cache习题
- 【2009-21】假设某计算机的存储系统由Cache和主存组成。某程序执行过程中访存1000次,其中访问Cache缺失(未命中)50次,则Cache的命中率是( )。
A. 5%
B. 9.5%
C. 50%
D. 95%
解析
答案:D
Cache命中率公式为:
总访存1000次,缺失50次,命中次数=1000-50=950次,因此命中率=950/1000=95%。
- 【2014-16】采用指令Cache与数据Cache分离的主要目的是( )。
A. 降低Cache的缺失损失
B. 提高Cache的命中率
C. 降低CPU平均访存时间
D. 减少指令流水线资源冲突
解析
答案:D
在指令流水线中,IF(取指)阶段访问指令 Cache,MEM(访存)阶段访问数据 Cache。若两者共用同一个 Cache,IF 和 MEM 阶段将产生结构冒险(资源冲突),无法并行执行。分离后,IF 和 MEM 可在同一时钟周期内同时访问各自的 Cache,消除结构冲突。
选项 A/B/C 不是主要目的,命中率和平均访存时间不一定因分离而明显改善。
- 【2009-14】某计算机的Cache共有16块,采用2路组相联映射方式(即每组2块)。每个主存块大小为32字节,按字节编址。主存129号单元所在主存块应装入到的Cache组号是( )。
A. 0
B. 2
C. 4
D. 6
解析
答案:C
组相联映射核心公式:
- 计算主存块号:主存块大小32字节,按字节编址,129号单元所在主存块号=⌊129/32⌋=4;
- 计算Cache组数:Cache共16块,2路组相联,每组2行,组数=16/2=8组;
- 计算组号:4 mod 8=4。
或者这样,
- Cache 共 16 块,2 路组相联 → 组数 = 16 / 2 = 8 组
- 块大小 = 32 字节 → 块内偏移位数 = log₂(32) = 5 位
- 组索引位数 = log₂(8) = 3 位 因此可知
主存地址 129 转为二进制为 100 00001,其中 00001 为块内地址,100 为组号,因此组号为 4.
- 【2012-17】假设某计算机按字编址,Cache有4个行,Cache和主存之间交换的块大小为1个字。若Cache的内容初始为空,采用2路组相联映射方式和LRU替换策略。访问的主存地址依次为 0,4,8,2,0,6,8,6,4,8 时,命中Cache的次数是( )。
A. 1
B. 2
C. 3
D. 4
解析
本题与 408 现在的映射规则不同,因此跳过不做
- 【2015-15】假定主存地址位数为32位,按字节编址,主存和Cache之间采用直接映射方式,主存块大小为4个字,每字32位,写操作时采用回写 (Write Back) 方式,则能存放4K字数据的Cache的总容量的位数至少是( )。
A. 146K
B. 147K
C. 148K
D. 158K
解析
答案:C
- 数据容量 = 4K 字 × 32 位/字 = 4K × 4B = 16KB
- 主存块大小 = 4 字 × 4B = 16B
- Cache 行数 = 16KB / 16B = 1024 行
- 地址位分配(32位,直接映射):
- 块内偏移 = log₂(16) = 4 位
- 行索引 = log₂(1024) = 10 位
- 标记(Tag)= 32 − 4 − 10 = 18 位
- 每行位数 = 标记(18) + 有效位(1) + 脏位(1,回写需要) + 数据(16B×8=128) = 148 位
- Cache 总容量 = 1024 × 148 = 148K 位
- 【2016-15】有如下 C 语言程序段:
若数组 a 以及变量 k 均为 int 型,int 型数据占 4B,数据 Cache 采用直接映射方式,数据区大小是 1KB,块大小是 16B,该程序段执行前 Cache 为空,则该程序段执行过程中,访问数组 a 的 Cache 的缺失率是( )。
A. 1.25%
B. 2.5%
C. 12.5%
D. 25%
解析
答案:C
- int = 4B,块大小 = 16B → 每块含 16B / 4B = 4 个 int
- 每次迭代对 a[k] 进行 1 次读 + 1 次写 = 2 次访问
- 总访问次数 = 2 × 1000 = 2000 次
- 每 4 个元素(一个块)的第 1 次读为冷缺失,随后的读/写均命中:
- 缺失次数 = 1000 / 4 = 250 次
- 缺失率 = 250 / 2000 = 12.5%
- 【2021-16】若计算机主存地址为32位,按字节编址,Cache数据区大小为32KB,主存块大小为32B,采用直接映射方式和回写(Write Back)策略,则Cache行的位数至少是( )。
A. 275
B. 274
C. 258
D. 257
解析
答案:A
解析:
- 数据区 = 32KB,块大小 = 32B,直接映射
- Cache 行数 = 32KB / 32B = 1024 行
- 地址分配(32 位):
- 块内偏移 = log₂(32) = 5 位
- 行索引 = log₂(1024) = 10 位
- 标记 = 32 − 5 − 10 = 17 位
- 每行位数 = 有效位(1) + 脏位(1,回写) + 标记(17) + 数据(32B×8=256) = 1 + 1 + 17 + 256 = 275 位
- 【2022-16】某计算机主存地址为32位,按字节编址,某Cache的数据区容量为32KB,主存块大小为64B,采用8路组相联映射方式,该Cache中比较器的个数和位数分别为( )。
A. 8,20
B. 8,23
C. 64,20
D. 64,23
解析
答案:A
- 数据区 = 32KB,块大小 = 64B,8 路组相联
- 组数 = (32KB / 64B) / 8 = 512 / 8 = 64 组
- 地址分配(32 位):
- 块内偏移 = log₂(64) = 6 位
- 组索引 = log₂(64) = 6 位
- 标记 = 32 − 6 − 6 = 20 位
- 访问时,用组索引选定一组,将输入标记与该组 8 路的标记同时比较:
- 比较器个数 = 8 个(每路一个,并行比较)
- 每个比较器宽度 = 标记位数 = 20 位
- (袁书习题)在主存和 CPU 之间增加 cache 的目的是( )。
A. 增加内存容量
B. 提高内存可靠性
C. 加快信息访问速度
D. 增加内存容量,同时加快访问速度
解析
答案:C
解析: “Cache(高速缓冲存储器)是CPU与主存之间的小容量高速缓冲存储层级,是现代计算机存储体系中弥补CPU与主存速度鸿沟的核心组件”。Cache 的主要目的是利用局部性原理,让 CPU 尽可能从高速的 Cache 中获取数据,从而大幅降低 CPU 的平均访存延迟(即加快信息访问速度),而不是为了增加容量(容量由主存决定)或提高可靠性。
- (袁书习题)以下( )情况能很好地发挥 cache 的作用。
A. 程序中不含有过多的 I/O 操作
B. 程序的大小不超过实际的内存容量
C. 程序具有较好的访问局部性
D. 程序的指令间相关度不高
解析
答案:C
解析: “Cache的高效工作完全依赖程序访问的局部性特征”,包括时间局部性和空间局部性。只有当程序具有较好的访问局部性时,Cache 才能保持高命中率,从而发挥加速作用。
- (袁书习题)假定主存地址位数为 32 位,按字节编址,主存和 cache 之间采用直接映射方式,主存块大小为 1 个字,每字 32 位,写操作时采用直写(write through)方式,则能存放 32K 字数据的 cache 的总容量至少应有( )位。
A. 1504K
B. 1536K
C. 1568K
D. 1600K
解析
答案:B
解析:
- 计算 Cache 行数: 数据区容量为 32K 字,块大小为 1 字,所以 Cache 行数 =
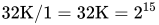 行。因此 Index(行索引)占 15 位。
- 计算地址划分: 主存地址 32 位,按字节编址。块大小 1 字 = 4 字节(32位),所以 Offset(块内偏移)占
 位。
- 计算 Tag 位数: Tag = 总地址位 - Index位 - Offset位 =
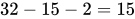 位。
- 确定控制位:
- Valid位(有效位):1 位(必须)。
- Dirty位(脏位):题目采用直写方式,无需脏位(dirty bit),因为数据同时写入主存,Cache与主存实时一致。
- 计算总容量:
- 每行位数 = 数据位 + Tag位 + Valid位 =
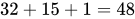 位。
- 总容量 = 行数 × 每行位数 =
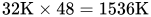 位。
- (袁书习题)假定主存地址位数为 32 位,按字节编址,主存和 cache 之间采用直接映射方式,主存块大小为 1 个字,每字 32 位,写操作时采用回写(write back)方式,则能存放 32K 字数据的 cache 的总容量至少应有( )位。
A. 1504K
B. 1536K
C. 1568K
D. 1600K
解析
答案:C
解析:
- 参数同上: 行数 32K,Tag 15 位,数据 32 位。
- 确定控制位: 题目采用回写方式,必须为每个 Cache行设置 1位脏位(Dirty Bit)。
- 计算总容量:
- 每行位数 = 数据位 + Tag位 + Valid位 + Dirty位 =
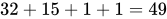 位。
- 总容量 =
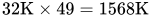 位。
- (袁书习题)假定主存地址位数为 32 位,按字节编址,主存和 cache 之间采用全相联映射方式,主存块大小为 1 个字,每字 32 位,采用回写(write Back)方式和随机替换策略,则能存放 32K 字数据的 cache 的总容量至少应有( )位。
A. 1536K
B. 1568K
C. 2016K
D. 2048K
解析
答案:D
解析:
- 计算 Cache 行数: 数据区 32K 字,块大小 1 字,行数 = 32K。
- 计算地址划分(全相联): 全相联映射没有 Index(组/行索引),主存块可以放在任意行。
- Offset = 2 位(块大小 4B)。
- Tag = 总地址位 - Offset位 =
 位。
- 确定控制位:
- Valid位:1 位。
- Dirty位:1 位(回写方式)。
- 替换策略位:题目采用随机替换,无需替换策略位
- 计算总容量:
- 每行位数 = 数据位 + Tag位 + Valid位 + Dirty位 =
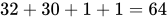 位。
- 总容量 =
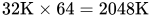 位。
- (袁书习题)假定主存按字节编址,cache 共有 64 行,采用直接映射方式,主存块大小为 32B,所有编号都从 0 开始。问主存第 2593 号单元所在主存块对应的 cache 行号是( )。
A. 1
B. 17
C. 34
D. 81
解析
答案:B
解析:
- 计算主存块号: 主存地址 2593,块大小 32B。
- 主存块号 =
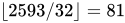 。
- 计算 Cache 行号(直接映射):
- 公式:Cache行号 = 主存块号 mod Cache行数。
- Cache行数 = 64。
- 行号 =
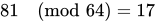 。
- (袁书习题)假定主存按字节编址,cache 共有 64 行,采用 4 路组相联映射方式,主存块大小为 32B,所有编号都从 0 开始。问主存第 2593 号单元所在主存块对应的 cache 组号是( )。
A. 1
B. 17
C. 34
D. 81
解析
答案:A
解析:
- 计算主存块号: 同上,主存块号 = 81。
- 计算 Cache 组数(组相联):
- Cache 总行数 = 64,路数 = 4。
- 组数 = 总行数 / 路数 =
 组。
- 计算 Cache 组号:
- 公式:Cache组号 = 主存块号 mod Cache组数。
- 组号 =
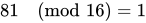 。
- 【2010-44】(12分)某计算机的主存地址空间大小为256MB,按字节编址,指令Cache和数据Cache分离,均有8个Cache行,每个Cache行大小为64B,数据Cache采用直接映射方式。现有两个功能相同的程序A和B,其伪代码如下所示:
int a[256][256]
...
int sum_array1()
{
    int i, j, sum=0;
    for (i=0; i<256; i++)
        for (j=0; j<256; j++)
            sum += a[i][j]
    return sum;
}
int a[256][256]
...
int sum_array1()
{
    int i, j, sum=0;
    for (j=0; j<256; j++)
        for (i=0; i<256; i++)
            sum += a[i][j]
    return sum;
}
假定int类型数据用32位补码表示,程序编译时i、j、sum均分配在寄存器中,数组a按行优先方式存放,首地址320(十进制数)。请回答下列问题,要求说明理由或给出计算过程。
(1) 若不考虑用于Cache一致性维护和替换算法的控制位,则数据Cache的总容量为多少?
(2) 数组数据a[0][31]和a[1][1]各自所在的主存块对应的Cache行号分别是多少(Cache行号从0开始)?
(3) 程序A和B的数据访问命中率各是多少?哪个程序的执行时间更短?
解析
基本参数
- 主存地址空间 = 256MB = 2²⁸ 字节 → 28 位地址
- 数据 Cache:8 行,每行 64B,直接映射
- int 型 = 4B,int a[256][256],行优先存放,首地址 = 320(十进制)
(1) 地址分配:
- 块内偏移 = log₂(64) = 6 位
- 行索引 = log₂(8) = 3 位
- 标记 = 28 − 6 − 3 = 19 位
不考虑一致性维护和替换算法控制位(包括脏位、LRU 位),但计入有效位:
- 每行 = 有效位(1) + 标记(19) + 数据(64×8=512) = 532 位
- 总容量 = 8 × 532 = 4256 位(即 532B 数据区 + 标记区)
(2) a[0][31]:
- 距首地址偏移 = (0×256 + 31) × 4 = 124 字节
- 绝对地址 = 320 + 124 = 444
- 主存块号 = ⌊444 / 64⌋ = 6
- Cache 行号 = 6 mod 8 = 6
或者 ,行号为110B=6。
a[1][1]:
- 距首地址偏移 = (1×256 + 1) × 4 = 257 × 4 = 1028 字节
- 绝对地址 = 320 + 1028 = 1348
- 主存块号 = ⌊1348 / 64⌋ = 21
- Cache 行号 = 21 mod 8 = 5
或者 ,行号为101B=5
(3)程序 A(按行访问,i 为外循环,j 为内循环):
- C 语言数组按行优先存储,程序 A 访问顺序:a[0][0], a[0][1], ..., a[0][255], a[1][0], ... → 顺序访问,空间局部性好
- 每块 64B / 4B = 16 个 int
- 每 16 次访问,第 1 次缺失,后 15 次命中
- 总访问次数 = 256 × 256 = 65536
- 缺失次数 = 65536 / 16 = 4096
- 程序 A 命中率 = (65536 − 4096) / 65536 = 61440 / 65536 ≈ 93.75%
程序 B(按列访问,j 为外循环,i 为内循环):
- 访问顺序:a[0][0], a[1][0], a[2][0], ... → 相邻两次访问之间跨度 = 256×4 = 1024 字节 = 16 块
- 8 行 Cache:16 mod 8 = 0 → a[i][j] 与 a[i+1][j] 映射到同一 Cache 行,产生冲突缺失
- 每次访问都会将上一次加载的块淘汰
- 程序 B 命中率 ≈ 0%
结论:程序 A 命中率远高于程序 B(93.75% vs 0%),程序 A 执行时间更短。
- 【2014-45】(12分)假设对于计算机M和程序段P的机器代码,M采用页式虚拟存储管理;P开始执行时,(R1)=(R2)=0,(R6)=1000,其机器代码已调入主存但不在Cache中;数组A未调入主存,且所有数组元素在同一页,并存储在磁盘同一个扇区。请回答下列问题并说明理由。
\(\begin{array}{cccccc} \text{编号}&\text{地址}&\text{机器代码}&\text{汇编代码}&\text{注释}\\\hline 1&\text{08048100H}&\text{00022080H}&\text{loop: sll R4, R2, 2}&\text{(R2)<<2→R4}\\ 2&\text{08048104H}&\text{00083020H}&\text{add R4, R4, R3}&\text{(R4)+(R3)→R4}\\ 3&\text{08048108H}&\text{8C850000H}&\text{load R5, 0(R4)}&\text{((R4)+0)→R5}\\ 4&\text{0804810CH}&\text{00250820H}&\text{add R1, R1, R5}&\text{(R1)+(R5)→R1}\\ 5&\text{08048110H}&\text{20420001H}&\text{add R2, R2, 1}&\text{(R2)+1→R2}\\ 6&\text{08048114H}&\text{1446FFFAH}&\text{bne R2, R6, loop}&\text{if (R2)!=(R6) goto loop}\\ \end{array}\)
(1) P执行结束时,R2的内容是多少?
(2) M的指令Cache和数据Cache分离。若指令Cache共有16行,Cache和主存交换的块大小为32字节,则其数据区的容量是多少?若仅考虑程序段P的执行,则指令Cache的命中率为多少?
(3) P在执行过程中,哪条指令的执行可能发生溢出异常?哪条指令的执行可能产生缺页异常?对于数组A的访问,需要读磁盘和TLB至少各多少次?
- 【2020-44】(10分)假定主存地址为32位,按字节编址,指令Cache和数据Cache与主存之间均采用8路组相联映射方式,直写(WriteThrough)写策略和LRU替换算法,主存块大小为64B,数据区容量各为32KB。开始时Cache均为空。请回答下列问题。
(1) Cache每一行中标记(Tag)、LRU位各占几位?是否有修改位?
(2) 有如下C语言程序段:
若数组s及其变量k均为int型,int型数据占4B,变量k分配在寄存器中,数组s在主存中的起始地址为008000C0H,则该程序段执行过程中,访问数组s的数据Cache缺失次数为多少?
(3) 若CPU最先开始的访问操作是读取主存单元00010003H中的指令,简要说明从Cache中访问该指令的过程,包括Cache缺失处理过程。
解析
基本参数
- 主存地址 = 32 位,按字节编址
- 指令/数据 Cache:8 路组相联,直写,LRU 替换
- 块大小 = 64B,数据区各 32KB,初始为空
(1) Cache采用8路组相联映射方式,组相联映射格式为 。
- 组数 = (32KB / 64B) / 8 = 64 组
- 块内偏移 = log₂(64) = 6 位
- 组索引 = log₂(64) = 6 位
- Tag = 32 − 6 − 6 = 20 位
LRU 位:
- 8 路 LRU 需对每路维护访问顺序计数,每路需 log₂(8) = 3 位
- 每个 Cache 行的 LRU 位 = 3 位
修改位(脏位):
- 采用直写策略,写操作同时写 Cache 和主存,Cache 内容始终与主存一致
- 无需修改位(没有脏位)
(2)int = 4B,数组 s 起始地址 = 008000C0H=  ,块内地址为000000B=0,所以s位于一个主存块开始处;
- 需要访问1024个数组元素,1024 × 4B = 4096B,共 4096/64 = 64 块;
每次循环:读 s[k](可能缺失) → 写 s[k](直写,缺失已加载则命中)
- 每块 64B / 4B = 16 个元素,第 1 次读缺失(冷缺失),随后 15 次读 + 16 次写均命中
- 总缺失次数 = 64 次(每块冷缺失一次)
(3) 访问 00010003H 指令的过程(包括缺失处理)
- 地址:00010003H =
- 块内偏移([5:0])=
000011= 3 - 组索引([11:6])=
000000= 组 0 - 标记([31:12])=
00000000000000010000= 0x10
访问过程:
- CPU 发出地址 00010003H,分解得 Tag=0x10,Set=0,Offset=3。
- 访问指令 Cache 第 0 组:Cache 初始为空,8 路均无效(Valid=0)→ Cache 缺失。
- 缺失处理:
- 该地址所在主存块起始地址00010000H,向主存发请求,读取 00010000H ~ 0001003FH 共 64 字节的数据块。
- 将该数据块填入指令 Cache 组 0 的某一路,置 Valid=1,Tag=0x10,同时更新 LRU 信息。
- 从填入的 Cache 行中,取偏移 3 处的字节(00010003H 处)开始读取 4 字节作为指令,送至 CPU。