3.2半导体存储器
Note
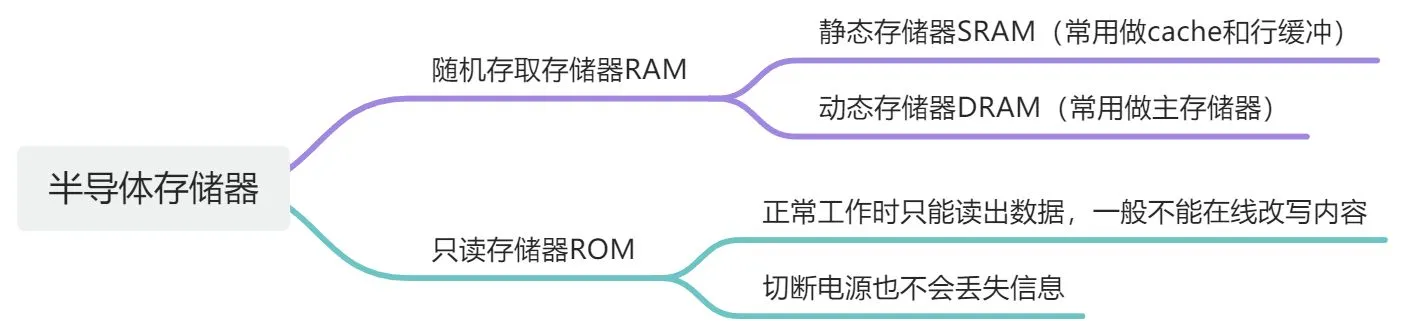
2022 年大纲调整将只读存储器 ROM 删除,新增固态硬盘 SSD, 不过 flash 存储器也属于只读存储器 ROM;
只读存储器 ROM
ROM 的核心概念与特征
- 基本定义: 只能读出、不能(或不能随意)写入的存储器。常用于存放不需要频繁修改的程序(如微程序、子程序、BIOS、系统软件等)。
- 非易失性 (Non-volatile): 断电后信息不会丢失,信息被可靠地固定在其中。
Tip
注意:“只读存储器”这个名称是历史遗留,现在多指“非易失性存储器”。除了 MROM 和一次性编程的 PROM,现代 ROM(如 EEPROM、Flash)都支持多次擦写,只是写入速度较慢或操作方式与RAM不同。同时注意是不能随意写!!而不是不能写!!!
- ⭐ 核心易错点:访问方式
- 尽管 ROM 的写入受限,但 ROM 同 RAM 一样,都采取“随机存取(Random Access)”的访问方式。这就意味着读取 ROM 中任何一个存储单元的时间都是相同的,与物理位置无关。
为什么 ROM 也支持随机访问
ROM 能做到随机访问,归功于其内部的物理结构设计。ROM 的存储单元并不是排成一条直线的单行道,而是排列成一个二维矩阵(网格)。
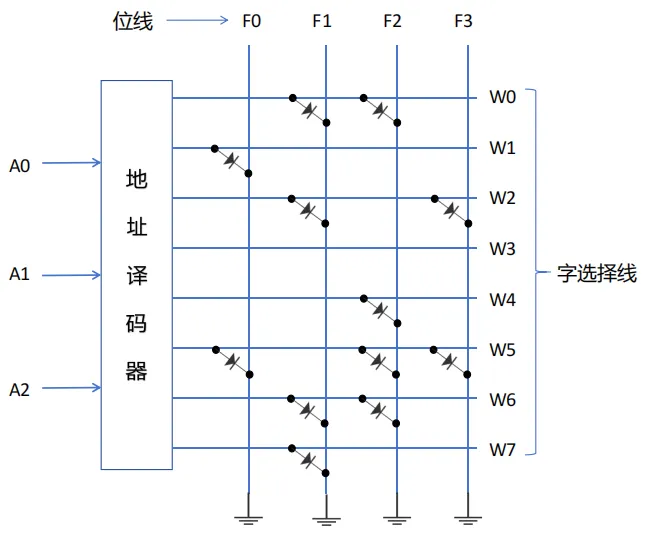
当 CPU 想要读取 ROM 中的某段数据时,整个过程是这样的:
- 地址总线传达目标:CPU 通过主板上的“地址总线”发送一个特定的物理地址给 ROM。
- 解码器精确定位:ROM 内部有“行解码器(Row Decoder)”和“列解码器(Column Decoder)”。它们就像电子地图的经纬度系统,瞬间将 CPU 发来的地址翻译成网格上的一个具体坐标(交点)。
- 数据直接输出:在这个交点上的晶体管状态(通电或断电,代表 1 或 0)会立刻被读取,并通过“数据总线”直接送回给 CPU。
因为这种基于坐标的硬件解码机制,定位第 1 个地址和定位第 10000 个地址所消耗的物理时间是完全一样的,这就是典型的“随机访问”。即每个单元的访问时间是一个常数,与地址无关。
ROM 的分类与演进(按制造工艺)
ROM 的发展历程是一部“灵活性不断增加”的历史。按读写特性可划分为以下几种:
| 类型缩写 | 全称及中文名 | 写入/编程机制 | 擦除方式 | 特点与应用 |
|---|---|---|---|---|
| MROM | Mask ROM 掩膜式只读存储器 | 厂家在制造过程中写入(固定掩膜)。 | 不可擦除 | 内容出厂即固定,不可修改。灵活性最差,但可靠性高,适合定型产品的批量生产。 |
| PROM | Programmable ROM 可编程只读存储器 | 用户通过专用编程器写入。采用熔丝或反向二极管击穿技术。 | 不可擦除 | 只能“一次性编程”(写1后不能再变为0)。克服了MROM需厂家定制的缺点,但写错即报废。 |
| EPROM | Erasable Programmable ROM 可擦除可编程只读存储器 | 用户通过编程器写入。采用浮置栅MOS管。 | 紫外线照射 (约8~20分钟) | 可多次修改。但擦除时不灵活,必须一次性擦除芯片上的所有信息。 |
| EEPROM (E²PROM) | Electrically Erasable Programmable ROM 电可擦除可编程只读存储器 | 加电写入。 | 电擦除 | 修改极为灵活,可以精准删除/重写个别字(字节),无需全部抹除。写操作时间比读操作长得多。 |
| Flash Memory | Flash Memory 闪速存储器(闪存) | 在线擦除和重写(写命令到命令寄存器)。 | 电擦除 | 结合了EEPROM的非易失性和RAM的读写特性。读写速度快,通常以“块(Block)”为基本单位进行擦除(不过写的速度远小于读的速度)。 常见于BIOS、U盘。 |
| SSD | Solid State Drive 固态硬盘 | 基于闪存芯片阵列制作。 | 电擦除 | 可修改、速度快、直接读取。广义上属于ROM,但已经没有“只读”的限制,相当于硬盘。 |
闪存 flash 和固态硬盘 SSD 均属于广义上的 ROM,但又没有保留 ROM 只读的特性。
FLASH存储器 
Flash存储也称为闪存,是高密度非易失性读写存储器,它兼有RAM和ROM的优点, 而且功耗低、集成度高,不需后备电源。这种器件沿用了EPROM的简单结果和浮栅/热电子注入的编程写入方式,又兼备了E2PROM的可擦除特点,可在计算机内进行擦除和编程写入,因此又称为快擦型电可擦除重编程ROM。目前被广泛使用的U盘和存储卡等都属于Flash存储器,也用于存放BIOS。
Flash具有整片擦除和高速编程的特点,需要注意的是Flash存储器的读操作速度与写操作速度相差很大,其读取速度与半导体RAM相当,而写数据(需要先整片擦除再写入)的速度则与硬磁盘存储器相当。
闪存的工作方式有读工作方式、编程工作方式、擦除工作方式和功耗下降方式。它的编程和擦除方式采用写命令到命令寄存器的方法来管理编程和擦除。闪存芯片主要应用于微机主板上的 BIOS 和移动存储器中。常见的 U 盘、SSD 均采用这种存储单元。
考点
- 名字带“E”的均可改写: ROM 名字中带有字母 E 的种类均可再次写入,因为 E 代表 “Erasable”(可擦除的)。有两个 E (EEPROM) 说明是用最方便的“电 (Electrical)”来擦除的。
- 擦除单位的区分:
- EPROM: 全片擦除(紫外线全照)。
- EEPROM: 字/字节级别擦除(精准打击)。
- Flash 闪存: 块(Block)级别擦除(介于两者之间,速度更快)。
- ROM 与 RAM 的区别与联系:
- 区别: RAM 断电丢数据(易失),ROM 断电不丢数据(非易失)。
- 联系: 主存(内存)实际上是由 RAM 和 ROM 共同组成的。系统加电后,CPU 首先从 ROM(BIOS)中读取引导指令来启动系统。
半导体随机存取存储器 RAM
半导体存储芯片的内部基本结构
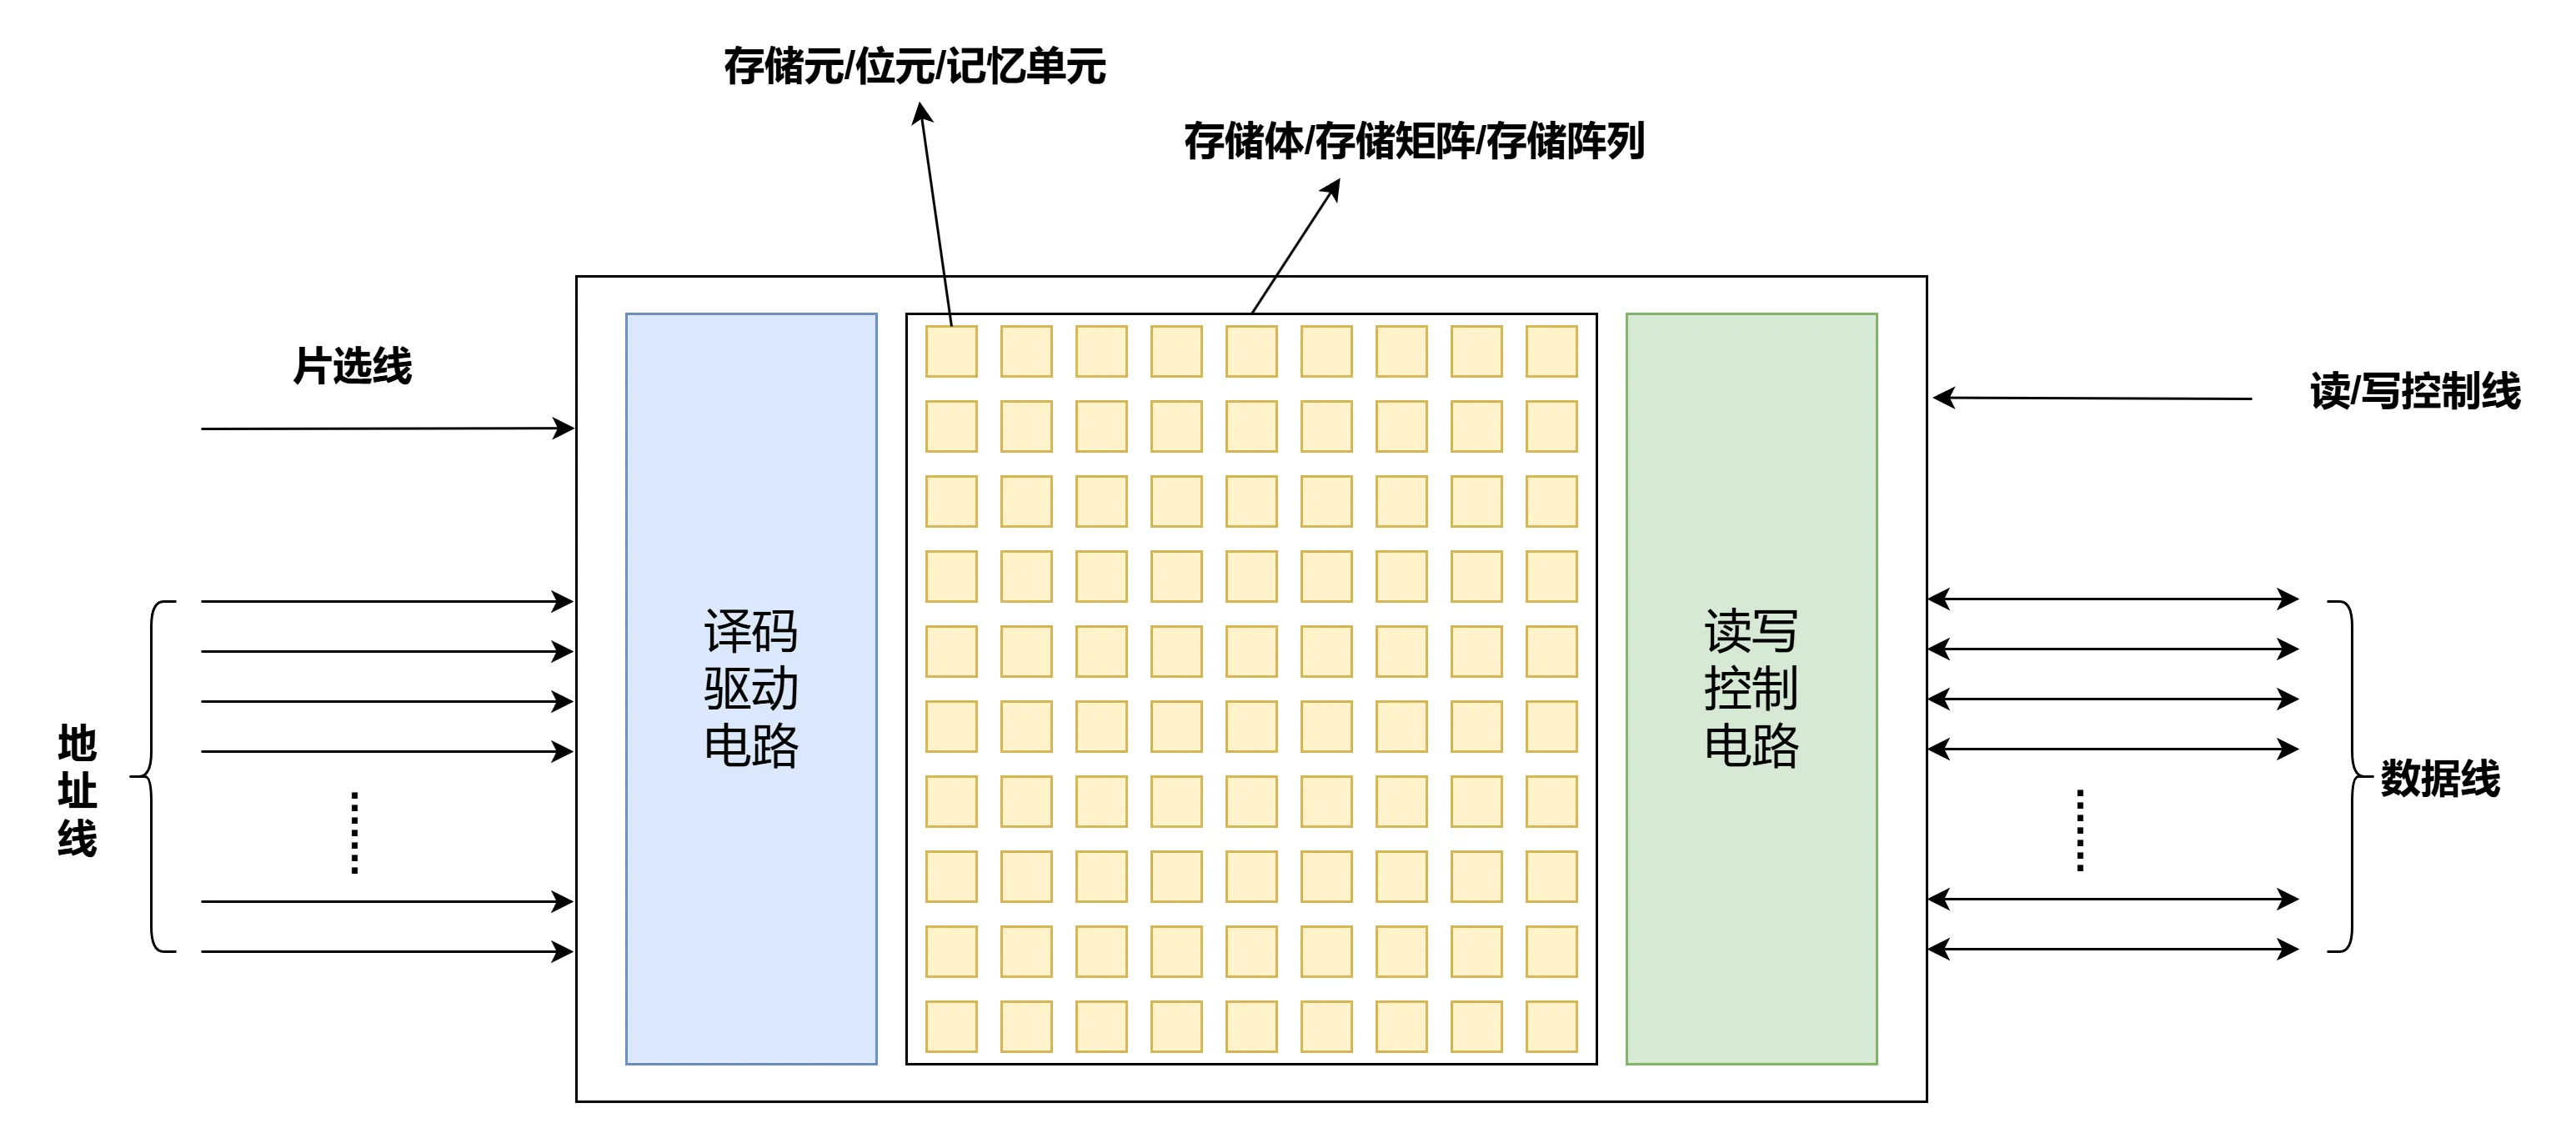
如图所示,一个半导体存储器的基本结构包括存储矩阵、译码驱动电路、和读写控制电路,此外半导体存储器还与地址线、数据线、片选线和读写控制线相连接。
- 记忆单元(存储基元 / 存储元 / 位元):具有两种稳态的能够表示二进制数码0和1的物理器件
- 存储单元 / 编址单位(Addressing Unit):主存中具有相同地址的位构成一个存储单元,也称为一个编址单位
- 存储体/ 存储矩阵 / 存储阵列(Bank):所有存储单元构成一个存储阵列,负责存储数据,是半导体存储器的核心部分。
- 译码驱动电路与地址线相接,负责将 CPU 传来的地址信号翻译成对特定存储单元的选择信号,选定待访问的特定存储单元。
- 读写电路与数据线相接,负责将待写入的数据写入存储矩阵,或者从存储矩阵读出数据。
- 控制电路负责控制存储器进行读操作或者写操作。
- 数据线是双向的,负责传输待读出的数据或者待写入的数据。地址线是单向的,负责将待访问的存储器地址传入译码器中。读写控制线是单向的,负责传输 CPU 向存储器下达的读/写命令。片选线是单向的,负责选定需要访问的存储器芯片。
用于地址译码的两种译码结构
先介绍一下译码器
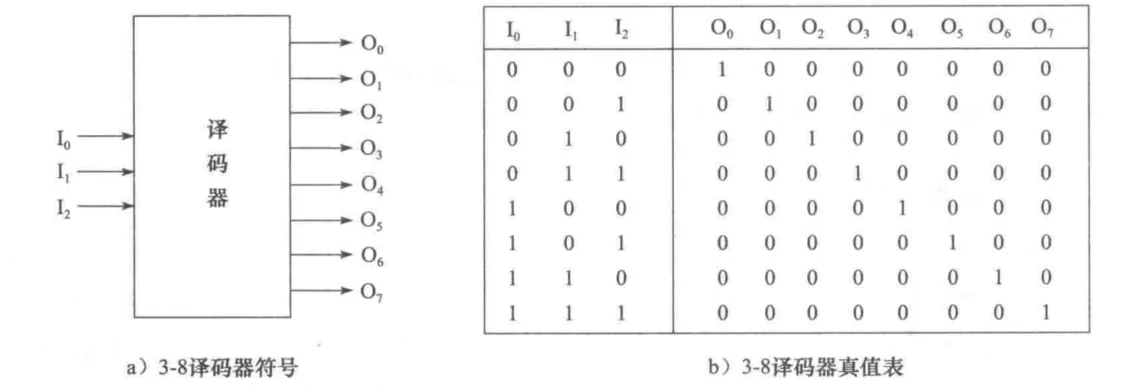
通常,若译码器的输人端有\(n\)位,则其输出端有\(2^n\)位。假定输入端分别为\(I_0,I_1,\dots I_{n-1}\) 输出端分别为\(O_0,O_1,\dots ,O_{2^n-1}\)。如果将输入的n位看成一个二进制数,则n位输入的可能取值 为0,1,2,…,,\(2^n-1\)。若输入对应的二进制值为 \(i\),则输出端中只有\(O_i\)为1,其他输出端全为0。 如,当n=3时,有3个输入端\(I_0,I_1,I_2\),8个输出端\(O_0,O_1,\dots ,O_7\),对应的译码器称为3- 8译码器,其符号和真值表如图所示。
单译码结构(线选法)
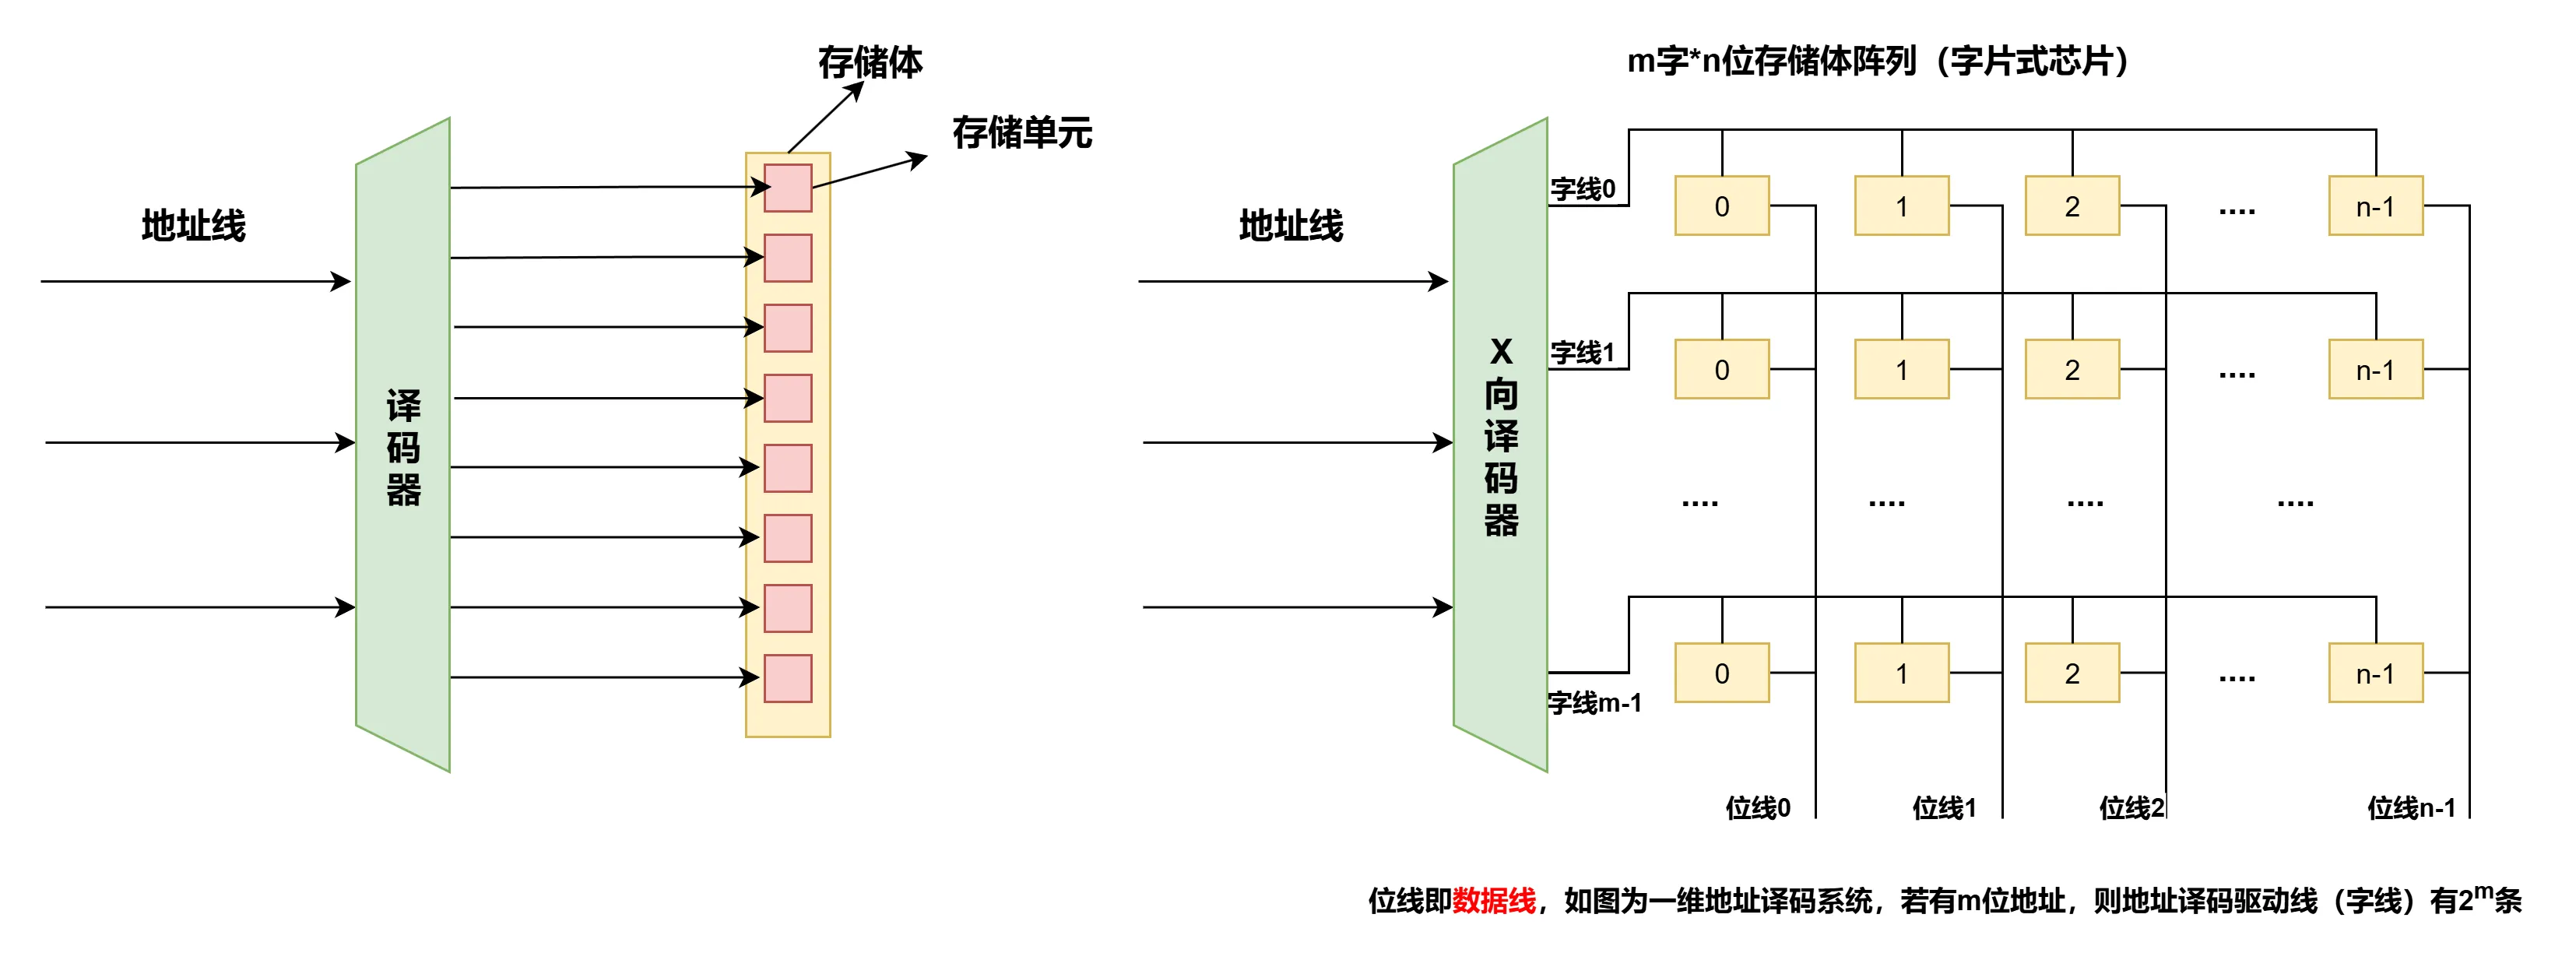
图示即为典型的单译码结构,左图中,假设存储体中包含 8 个存储单元,每个存储单元只存储一个二进制位,那么一个 3-8 译码器就能完成这 8 个存储单元的寻址,对应地址线只需要 3 根,译码器的 8 个输出端分别连接不同的存储单元;
右图为一个字片式芯片,其原理为将全部 N 位地址线直接输入一个 \(N-2^N\) 译码器,译码器的每一根输出线直接作为存储矩阵的一根字线(Word Line)。被选中的字线激活整行存储单元,通过位线(Bit Line)完成一个“字”的读写。(这种结构的存储器芯片中只有一个行译码器,同一行中所有存储单元的字线连在一起,接到地址译码器的输出端,这样选中一行中的各单元构成一个字,被同时读出或写入,这种结构的存储器芯片被称为字片式芯片)
这种结构中,当地址位数较多时,地址译码器输出太多。比如 n=16 时,需 16-65536 译码器,输出 65536 根字线。在硅片上布线密集、寄生电容极大、良率骤降,物理上不可实现。因此,大容量的存储器芯片一般不采用一维单译码方式。
双译码结构(重合法)
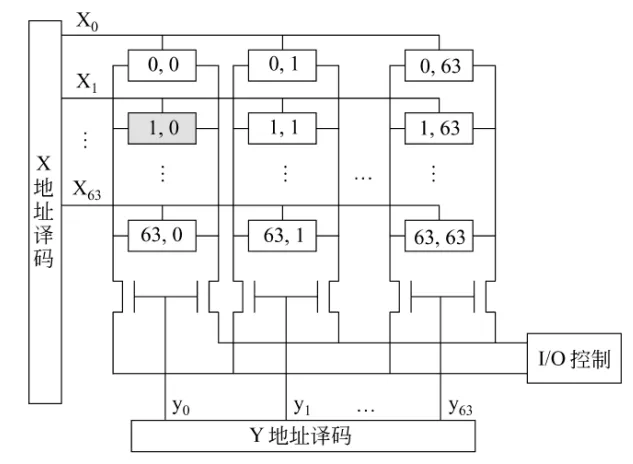
目前,动态存储芯片大多采用双译码结构。地址译码器分为 X 和 Y 方向两个译码器。如图,存储阵列有 4096 个单元,需要 12 根地址线:A₀~A₁₁,其中 A₀~A₅ 送至 X译码器,有 64 条译码输出线,各选择一行单元;A₆~A₁₁ 送至 Y 译码器,它也有 64 条译码输出线,分别控制一列单元的位线控制门。假如输入的 12 位地址为 A₁₁A₁₀…A₀ =000000000001 时,则 X 译码器的第 2 根译码输出线 (x₁) 为高电平,于是与它相连的 64 个存储单元的字选择 W 线为高电平。Y 译码器的第 1 根译码输出线 (y₀) 为高电平,打开第一列的位线控制门。在 X、Y 译码的联合作用下,存储矩阵中 (1,0) 单元被选中。
在选中的 行和列交叉点上的单元只有一位 ,因此,采用二维双译码结构的存储器芯片被称为位片式芯片。有些芯片的存储阵列采用三维结构,用多个位平面构成存储阵列(即后面提到的 位扩展 ),不同位平面在同一行和列交叉点上的多位构成一个存储字,被同时读出或写入。
若采用如图所示的双译码结构,存储器中译码器输出线的总数为行地址线数+列地址线数。
基本存储元件
存储单元是存储器中的最小存储单位,也称为存储元,其作用是存储一 位二进制信息。作为存储单元电路,需具备以下基本功能。
- 具有两种稳定状态。
- 两种稳定状态经外部信号控制可以相互转换。
- 经控制后能读出其中的信息。
- 无外部原因,其中的信息能长期保存。
六管静态 MOS 管存储元件(双稳态触发器,SRAM)
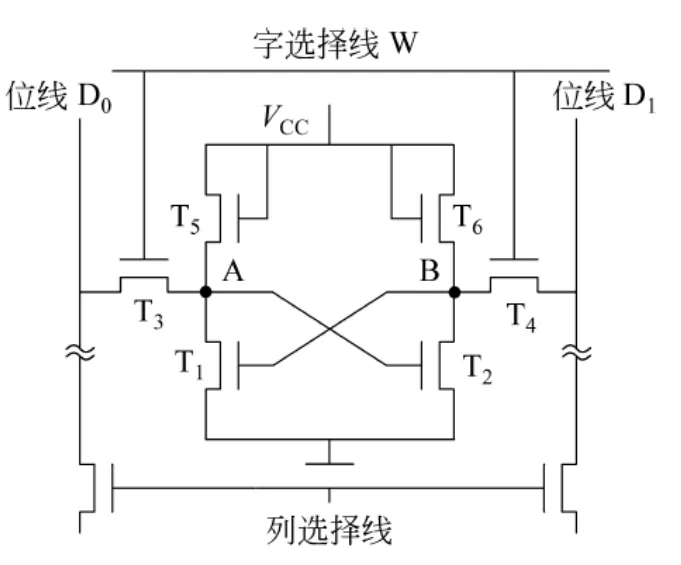
工作原理
- 结构:如图共6个MOS管,其中 4 个 MOS 管组成一对正负反馈门电路 → 即形成双稳态触发器, 另外 2 个MOS管就像是守门员,负责控制数据的进出(读和写)。
- 什么是双稳态?:你可以把它想象成两个面对面站着的人,互相紧紧抓着对方的手臂。如果左边的人向后倒(代表 0),他就会把右边的人往前拉(代表 1);右边的人的状态又反过来稳固了左边的人。
- 静态的含义: 只要接通着电源,这种“互相拉扯”的平衡状态就能永远保持下去。数据写进去是什么样,它就一直是什么样,不需要额外的动作去维持它(所以叫“静态”)。
优点
- 速度快(直接读触发器状态)
- 不用刷新(通电就稳,不是破环性读出,也无需重写)
- 读写简单,控制逻辑少
缺点
- 面积大(6个管子占地方);成本高,功耗相对大;集成度低(同样芯片面积,存的位少)
应用
- 主要用于构造 SRAM,CPU 高速缓存(L1/L2 Cache),DRAM 存储器的行缓冲等对速度要求极高的场景
单管动态 MOS 存储单元(DRAM)
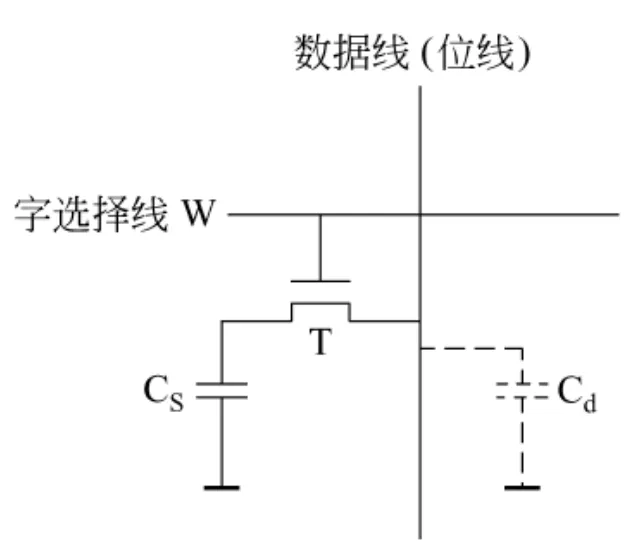
仅1个MOS管(T) + 1个电容(Cs) → 用电容Cs有无电荷表示 0/1
工作原理(比喻:带小孔的水杯)
- 写"1":给电容充电(杯子装满水)
- 写"0":电容放电(杯子倒空)
- 读数据:检测电容是否有电荷(看杯子有没有水),因为读出时Cs 上电荷放电,电位下降,所以是破坏性读出,读后应该有重写操作,称为“再生”。
- 动态与刷新:电容会漏电(杯子有小孔),几毫秒后电荷就漏光了 → 必须定期刷新(续杯!),即为了保住数据,系统必须定期(比如每 64 毫秒)把所有数据读出来,趁它还没漏光,再重新充满电。
优点
- 面积极小(1管1容,结构简单);成本低,功耗小(静态时几乎不耗电);集成度高(同样面积能存更多数据)
缺点
- 速度慢(读写要先充放电);必须刷新(增加控制复杂度);断电/不刷新就丢数据(易失性更强)
应用
- 计算机主内存(DDR 内存条)
核心区别对比表
| 特性 | 6管静态(SRAM) | 1管动态(DRAM) |
|---|---|---|
| 存储原理 | 双稳态触发器(电路自锁互保) | 电容器充放电(保存电荷) |
| 核心元件 | 6个MOS管 | 1个MOS管 + 电容 |
| 读出后是否需要重写 | 不需要(功耗管和工作管负责保持存储状态) | 需要(电容的电荷会泄露) |
| 是否需要刷新 | 不需要 | 必须定期刷新 |
| 读写速度 | 快(纳秒级) | 较慢(需充放电) |
| 集成度 | 低(面积大) | 高(面积小) |
| 成本 | 高 | 低 |
| 典型应用 | CPU 内部的高速缓存(L1/L2/L3 Cache) | 内存、显存 |
Tip
-
为什么叫"静态/动态"?
-
静态(Static):状态稳定,不需外部干预维持
-
动态(Dynamic):状态会衰减,需动态刷新维持
-
"易失性"两者都有:断电后数据都会丢,只是 DRAM 连不断电都会丢(不刷新的话)
SRAM 芯片的结构
又称静态随机存取存储器(Static Random Access Memory),它的每一个存储元都由六管静态 MOS 管存储元件(双稳态触发器)构成。下图为一个 SRAM 存储器的结构示意图
Note
注意:SRAM 既可以采用一维译码,也可以采用下图中的三维结构
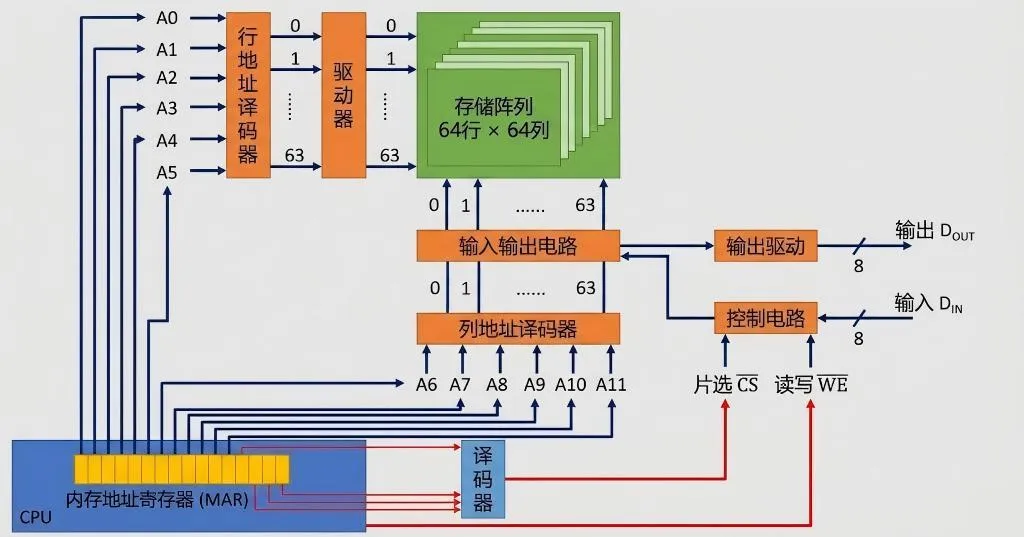
(1) 存储体(存储矩阵)。存储体是存储单元的集合。如图所示,4096 个存储单元被排成 64×64 的存储阵列,称为位平面,这样 8 个位平面构成 4096 字节的存储体。由 X 选择线(行选择线)和 Y 选择线(列选择线)来选择所需单元,不同位平面的相同行、列上的位同时被读出或写入。\ (2) 地址译码器。用来将地址转换为译码输出线上的高电平,以便驱动相应的读写电路。这里采用三维结构,用多个位平面构成存储阵列,不同位平面在同一行和列交叉点上的多位构成一个存储字,被同时读出或写入(其实就是位扩展)。\ (3) 驱动器:在双译码结构中,一条 X 方向的选择线要控制在其上的各个存储单元的字选择线,所以负载较大,因此需要在译码器输出后加驱动器。\ (4) I/O 控制电路。用以控制被选中的单元的读出或写入,具有放大信息的作用。\ (5) 片选控制信号。单个芯片容量太小,往往满足不了计算机对存储器容量的要求,因此需将一定数量的芯片按特定方式连接成一个完整的存储器。在访问某个字时,必须“选中”该字所在芯片,而其他芯片不被“选中”(即字扩展)。因而芯片上除了地址线和数据线外,还应有片选控制信号。在地址选择时,由芯片外的地址译码器的输入信号以及控制信号(如“访存控制”信号)来产生片选控制信号,选中要访问的存储字所在的芯片。\ (6) 读/写控制信号。根据 CPU 给出的是读命令还是写命令,控制被选中的存储单元进行读或写。
DRAM 芯片的结构、读写操作、刷新操作流程解析
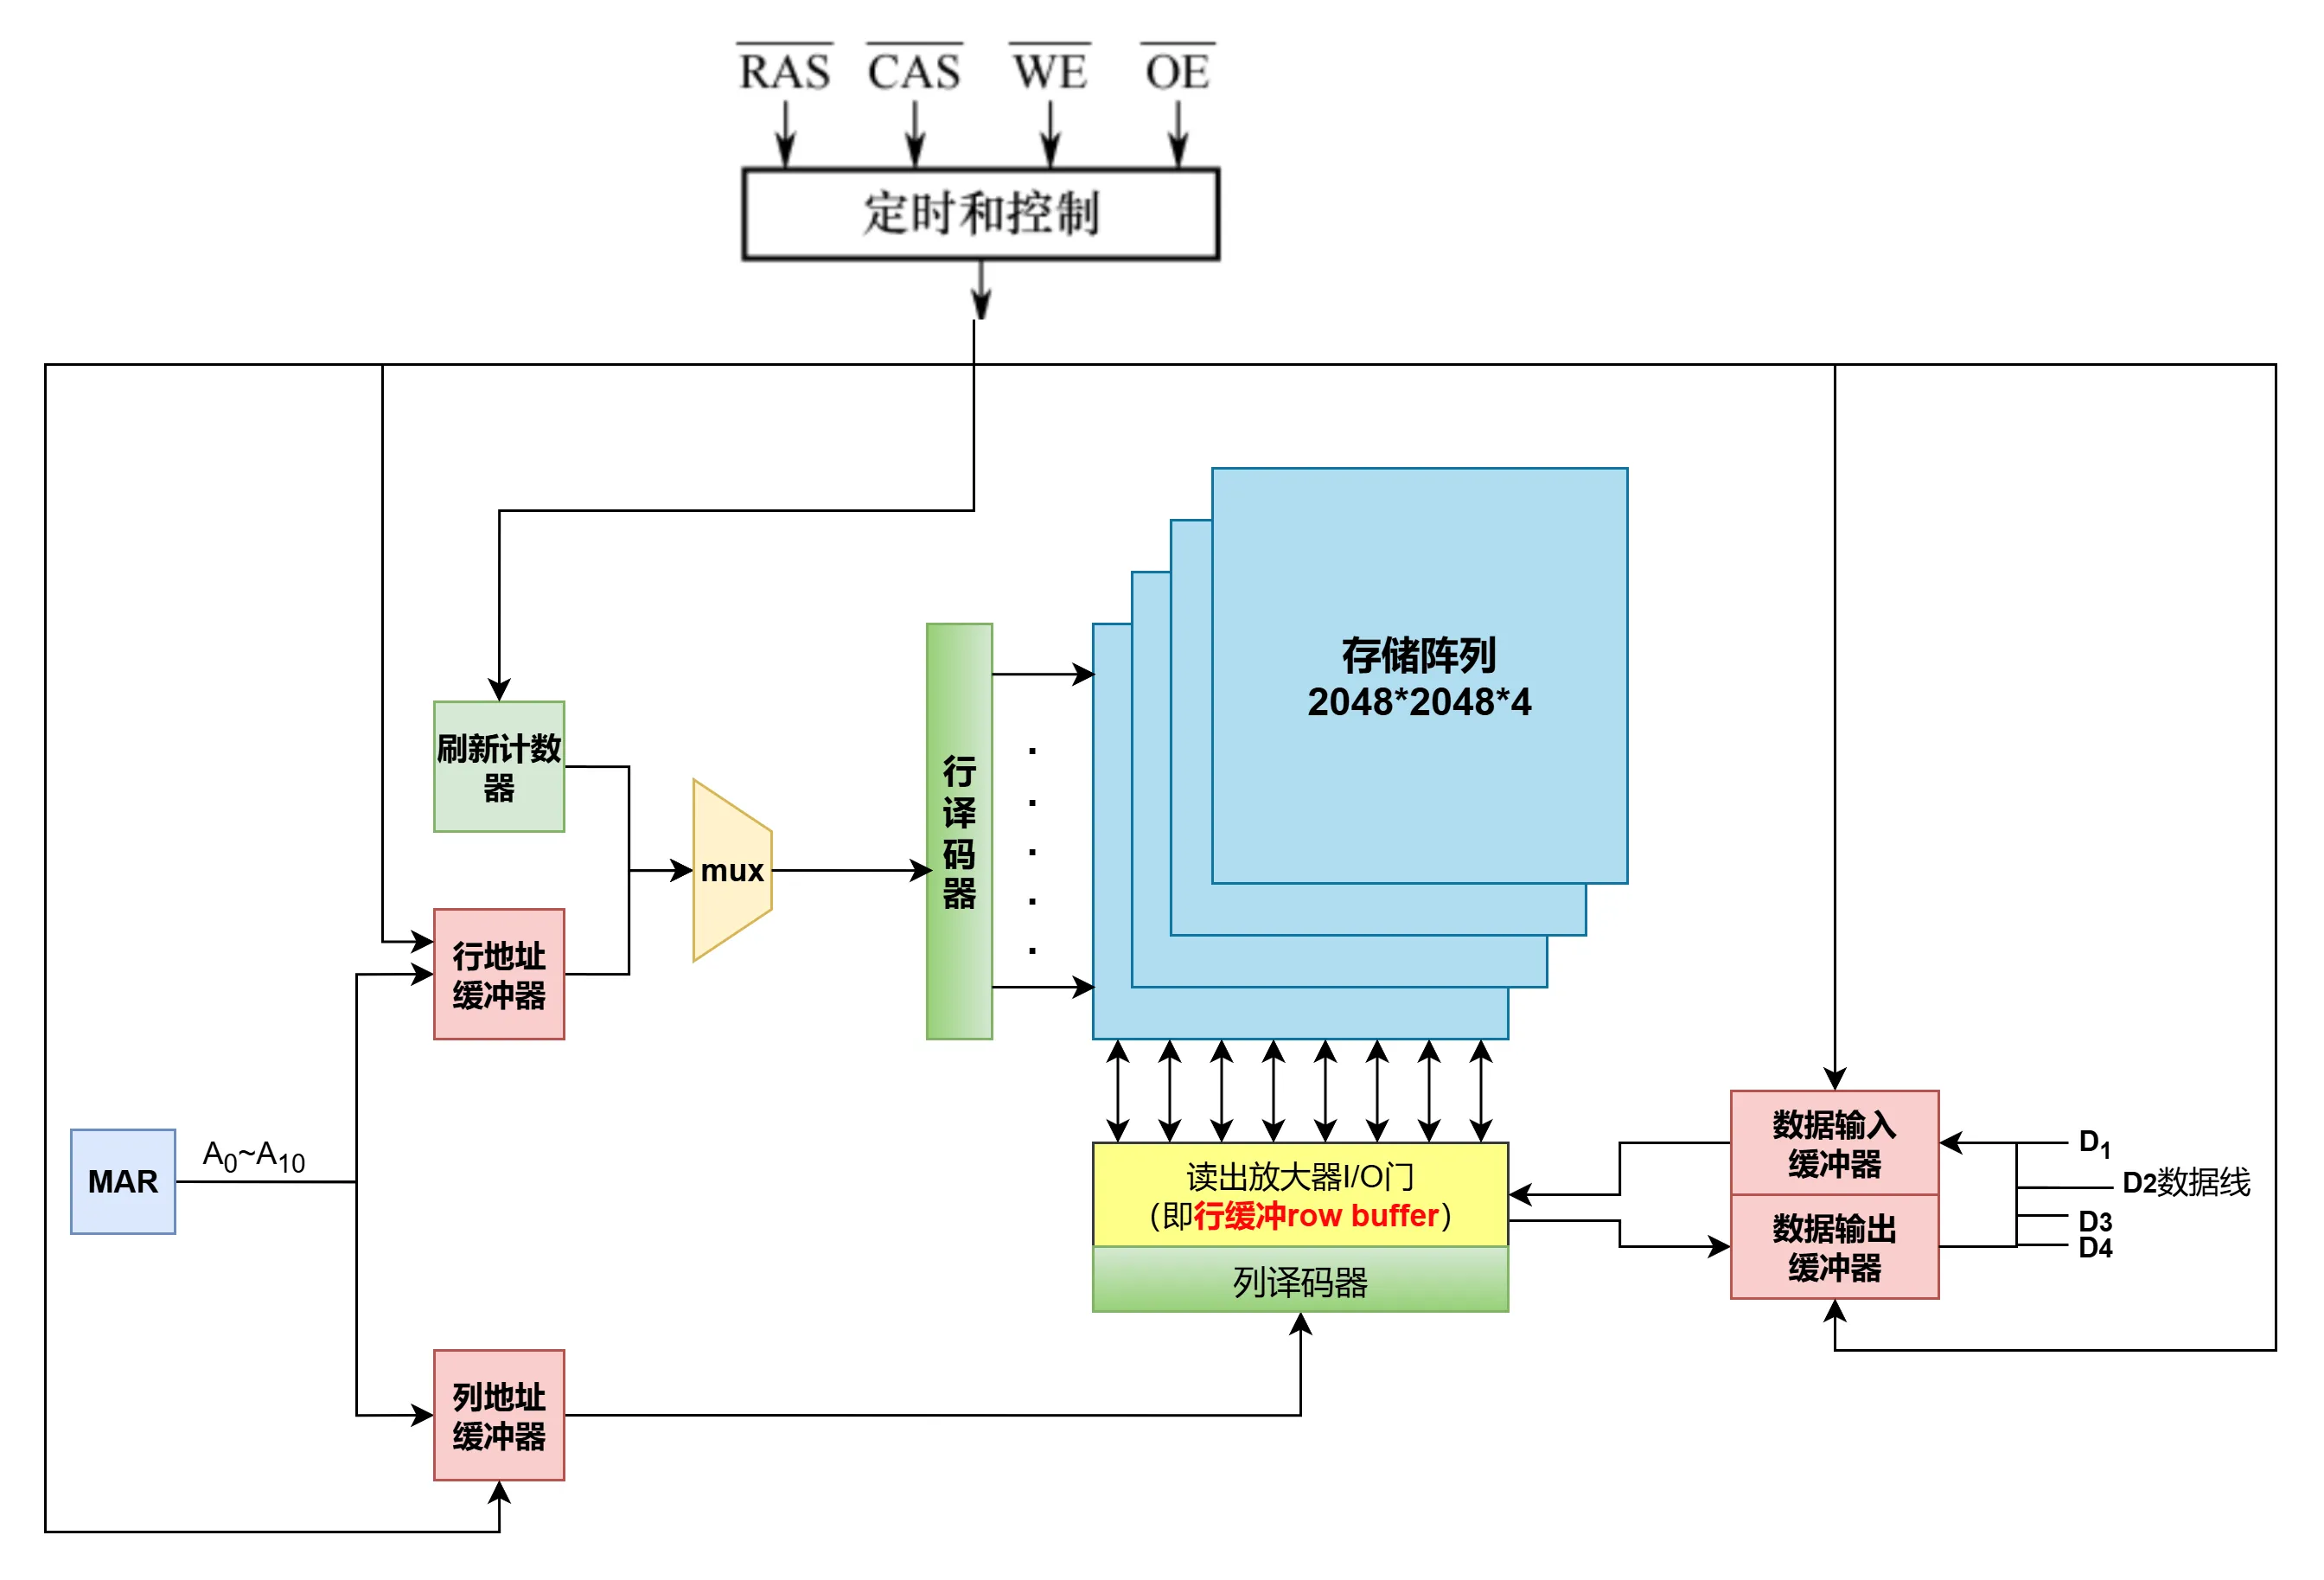
首先介绍一下图中的各组件
- 存储阵列:这是 DRAM 的核心区域,里面密密麻麻排列着存储单元。图中 \(2048 \times 2048 \times 4\)意味着这个 DRAM 芯片有 2048 行(Row)、2048 列(Column)。每次你在某个特定的行列交叉点存取数据时,会同时读写 4 位 (4-bit) 的数据(三维结构,相当于位扩展)。
- 行/列地址缓冲器 :图中左侧只有 11 根地址线(\(A_0 \sim A_{10}\)),但存储阵列有 2048 行和 2048 列,按理说需要 11 根行地址线 + 11 根列地址线 = 22 根线。为了节省芯片引脚,DRAM 采用了“地址复用”技术。同一组引脚(\(A_0 \sim A_{10}\)),先分发行地址,再分发列地址。
- 译码器 (Decoders):
- 行译码器: 它负责把 11 位的行地址翻译成 2048 条物理线(字线)中的唯一一条。被选中的那一整行(包含 2048 列)的存储单元全都会被激活,数据会被导出到下方的“读出放大器”(也就是行缓冲)中。
- 列译码器: 当一整行的数据被激活后,列译码器根据 11 位的列地址,控制 I/O 门(开关),从这 2048 列的庞大数据中,精准挑出你需要的那一列(在这个芯片里是挑出 4 个 bit),然后送到数据输出缓冲器。
- 刷新计数器 :由于 DRAM必须定期把每一行读出来再重新写回去,即刷新必须一行一行地遍历整个存储阵列。刷新操作是不需要 CPU 提供地址的(CPU 也没空管这事)。刷新计数器在芯片内部自动生成行地址(从第 0 行数到第 2047 行,然后循环)。每当需要刷新时,它就吐出一个行地址去告诉阵列:“现在该刷新这一行了”。
- MUX (多路复用器 ):可以看到行译码器的前面有一个 MUX,它有两个输入端:一个是行地址缓冲器,另一个是刷新计数器。
- 在正常读写时: MUX 切换到“行地址缓冲器”通道,听从 CPU 传来的外部地址,去指定的地方存取数据。
- 在执行刷新周期时: MUX 切换到“刷新计数器”通道,无视外部输入的地址,专门把计数器自动生成的地址送给行译码器,依次进行逐行刷新。
区分 DRAM 芯片的读操作与刷新操作
DRAM 的核心特性在于“破坏性读出”和“电容漏电”,这两个物理特性直接决定了它极其特殊的读操作和刷新机制。
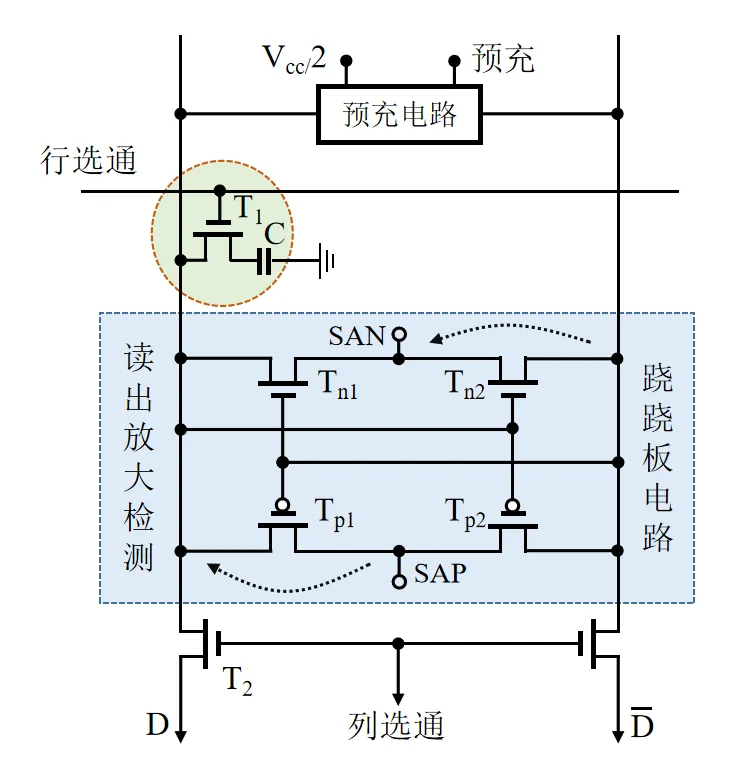
DRAM 的读操作流程
当 CPU 想要从 DRAM 读取数据时,芯片内部实际上经历了一个精密的 5 步动态过程。
1.预充操作 :准备阶段
- 微观动作: 在读取开始前,内部电路会把位线(数据通道,即 \(D\) 和 \(\overline{D}\))的电压预先充电到一半,也就是 \(V_{cc}/2\)。
- 目的: 就像把跷跷板人为地端平到水平位置。这样一来,后续无论电容里是微弱的高电平还是低电平,都能最快地打破平衡,加速读取。
2. 访问操作 :\(\overline{RAS}\)发挥作用( 行激活 )
- 宏观触发: 外部给出行地址,控制中心拉低 \(\overline{RAS}\) 信号(低位有效)。行地址缓冲器接收地址,交由行译码器翻译,选中存储阵列中的特定一行。
- 微观动作: 被选中的那一行,其控制晶体管(\(T_1\))导通。此时,存储电容(存储着真实数据)和位线(寄生电容巨大)连通,发生电荷分配。
- 如果电容里存的是“1”(有电荷),位线 \(D\) 的电压会被极其微弱地拉高一点点(略大于 \(V_{cc}/2\))。
- 如果存的是“0”(无电荷),位线 \(D\) 的电压会被微弱地拉低一点点。
- 注意: 这一步就是所谓的“破坏性读出”。因为电容极小,一旦连通位线,它里面原本的电荷就被稀释放电了,数据状态遭到了破坏。
3. 信号检测 (Sense): 读出放大器 登场(可以理解为将这一行数据读到行缓冲)
- 宏观触发: 这时,结构图中的读出放大器正式开始工作。
- 微观动作: 读出放大器就是一个极度灵敏的比较器(跷跷板的支点)。它捕捉到位线上那一点点微弱的电压变化,利用正反馈电路迅速将其放大极化。
- 略大于 \(V_{cc}/2\) 的电压会被瞬间拉高到稳定的逻辑“1”(满电平 \(V_{cc}\))。
- 略小于 \(V_{cc}/2\) 的电压会被瞬间拉低到稳定的逻辑“0”(0V 低电平)。
- 此时,放大器里锁存的就是清晰明了的数据了,这就是为什么放大器也被称为行缓冲。
4. 数据恢复 (Restore):内部的 自动 “回写”
- 微观动作: 既然第 2 步破坏了存储电容里的原始数据,就必须补救。因为此时位线上已经被读出放大器稳定在了满电平或零电平,这个强劲的电压会顺着导通的晶体管,反向给刚才那个电容充电或放电。
- 结果: 电容里的电荷恢复到了被读取之前的状态。这个过程不需要外部指令,是硬件电路自动完成的。
5. 数据输出 (Output):\(\overline{CAS}\)发挥作用( 列选择 )
- 宏观触发: 当一整行的数据都在读出放大器(行缓冲)中准备好后,外部给出列地址,控制中心拉低 \(\overline{CAS}\) 信号。列译码器根据地址,打开对应的 I/O 门。完成数据的读操作后,撤销行选通信号,关闭读出放大检测电路(传统 DRAM 效率低下的原因之一)。
- 动作: 需要的那几位数据(比如 \(D_1 \sim D_4\))通过数据输出缓冲器,正式送出芯片外部。读取完成。
写入过程也有和读操作类似的前4步,所以写入过程也可以进行行刷新。 最后一步数据变成输入,将逻辑0,和1直接写入存储电容即可。
Note
由于 DRAM 芯片容量较大,因此需要的地址位数也比较多,通过上面的读操作我们可以看出,DRAM 的行选通信号和列选通信号并不是同时给出的,因此可以行列地址复用,即行地址和列地址通过相同的引脚分两次先后输入,从而使得地址引脚数量减半。
DRAM 芯片的读写周期时序图解析
根据上面 DRAM 芯片的读操作流程我们再对 DRAM 芯片的读写周期时序图进行解析
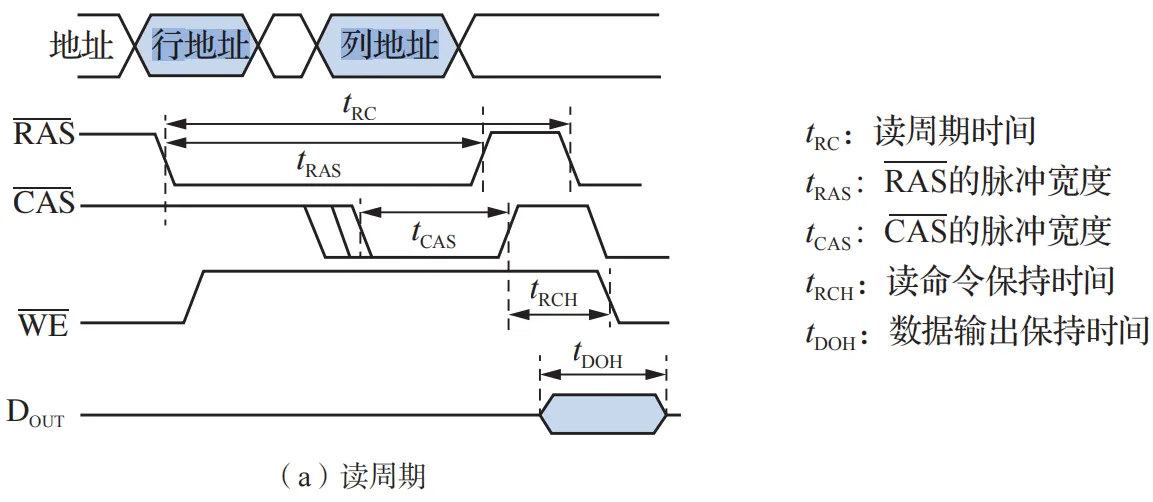
一、 读周期 (Read Cycle)
读周期的总时长记为 \(t_{RC}\)。在这个周期内,要完成“送行地址 \(\rightarrow\) 送列地址 \(\rightarrow\) 读出数据 \(\rightarrow\) 内部破坏性恢复”的完整流程。
核心动作顺序:
- 送行地址: 首先,外部控制器将行地址放在地址线上。
- 行地址选通 (\(\overline{RAS}\)下降): 行地址稳定后,\(\overline{RAS}\) 信号由高变低(有效)。芯片内部的行地址缓冲器锁存地址,并激活对应的这一整行。(行地址必须在 *\(\overline{RAS}\) 下降之前准备好)。*
- 确定读状态 (\(\overline{WE}\)保持高电平): \(\overline{WE}\)(写使能)信号必须保持在高电平,告诉芯片:“这次是读操作,别把数据写进去了”。( \(\overline{WE}\)高电平必须在下一步 *\(\overline{CAS}\) 下降之前就稳定下来)。*
- 送列地址: 外部控制器将地址线上的信号切换为列地址。
- 列地址选通 (\(\overline{CAS}\)下降): 列地址稳定后,\(\overline{CAS}\) 信号由高变低(有效)。芯片锁存列地址,去刚才激活的那一行里挑出具体的数据。(\(\overline{CAS}\)_ 必须滞后于 \(\overline{RAS}\),得给内部行激活留出时间)。_
- 数据有效 (\(D_{out}\)输出): 经过一段内部延迟后,被选中的数据会出现在数据输出引脚 \(D_{out}\) 上。
- 数据再生: 因为 DRAM 读出电容信号是破坏性的,所以在 \(\overline{RAS}\) 变回高电平结束周期之前,芯片内部的读出放大器会自动把读出来的数据重新写回电容里。
- 周期结束: \(\overline{RAS}\) 和 \(\overline{CAS}\) 重新拉高,数据线撤销信号,准备迎接下一个周期。
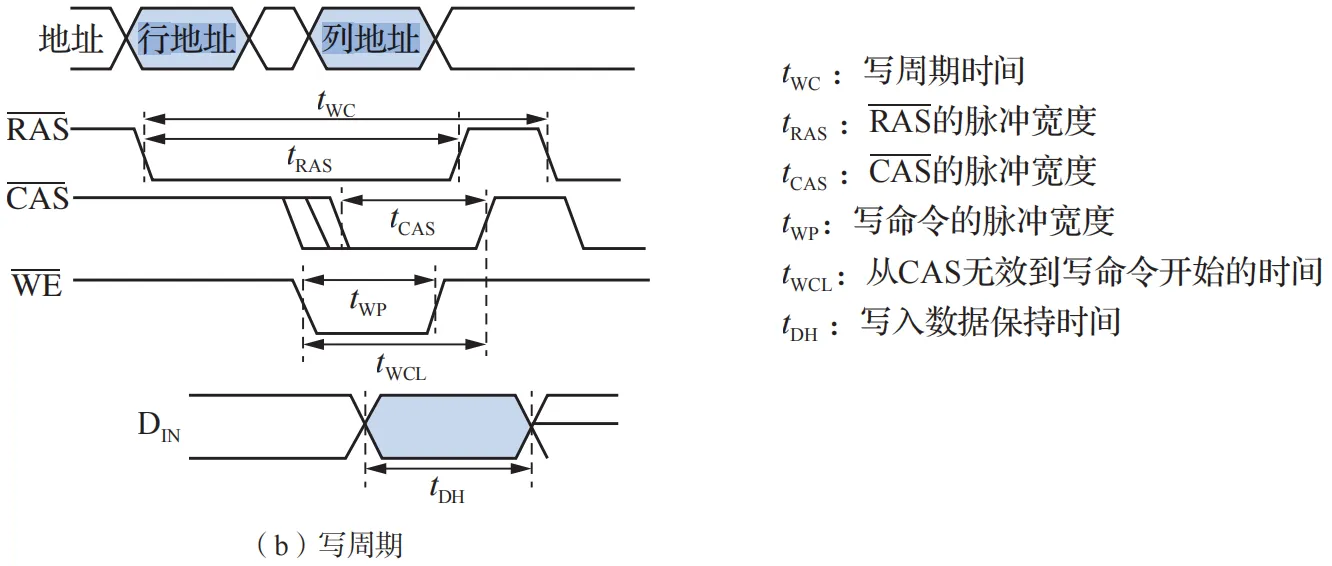
二、 写周期 (Write Cycle)
写周期的总时长记为 \(t_{WC}\)。写周期的前半段(寻址部分)与读周期几乎一模一样,唯一的区别在于\(\overline{WE}\)信号的状态以及数据出现的时间。
核心动作顺序:
- 送行地址: 外部控制器将行地址放在地址线上。
- 行地址选通 (\(\overline{RAS}\)下降): 芯片锁存行地址并激活该行。
- 确定写状态 (\(\overline{WE}\)拉低): 这是与读操作最大的区别。 \(\overline{WE}\) 信号被拉低,明确宣告:“这次是写操作,准备接收外部数据!”
- 准备写入的数据: 外部控制器将要写入的数据提前放在数据输入引脚 \(D_{in}\) 上。(写数据必须在 *\(\overline{CAS}\) 下降之前就出现在 \(D*{in}\) 端。不能等门开了再找数据,得先把数据放在门口)。_
- 送列地址与列选通 (\(\overline{CAS}\)下降): 外部切换列地址,随后拉低 \(\overline{CAS}\)。此时,芯片同时锁存列地址,并将 \(D_{in}\) 上的数据通过打开的内部通道,强制写入(充放电)到指定的电容单元中。
- 周期结束: 经过一段必须的写入保持时间(确保电容充满电或完全放电)后,\(\overline{RAS}\)、\(\overline{CAS}\) 和 \(\overline{WE}\) 依次恢复高电平,完成写入
DRAM 的刷新操作
了解了完整的读取流程,理解刷新就变得非常简单了。
为什么需要刷新?\ 即使不去读它,DRAM 里的电容也会随着时间慢慢漏电。如果存的是“1”,漏电久了电压下降,再读的时候电路就会误判为“0”。因此必须定期“打气”。
刷新到底在干什么?\ 刷新,本质上就是执行了一次没有“第 5 步(数据输出)”的读操作。
- 执行步骤: 仅仅执行前 4 步(预充 \(\rightarrow\) 访问 \(\rightarrow\) 检测放大 \(\rightarrow\) 恢复)。
- 宏观调度:
- 当到了需要刷新的时间,上图中的定时和控制模块接管指挥权。
- 它控制 MUX (多路复用器) 切换通道,屏蔽掉外部的地址输入,改为接收刷新计数器提供的内部地址。
- 行译码器选中计数器指定的这一行。
- 该行所有的电容与位线连通(破坏性读出)。
- 读出放大器检测并放大电平。
- 放大后的满额电压反向给该行所有电容重新充满电(数据恢复)。
- 不打开 列译码器,不输出数据。
- 刷新计数器加 1,准备下一次刷新下一行。
正是因为第 4 步(数据恢复)的存在,DRAM 巧妙地利用了自身的读取机制,顺手完成了给电容补充电荷的续命任务。
Note
重要考点:
- 行缓冲的作用,构成元件(非 DRAM,特定条件下等效于 SRAM),每个 DRAM 芯片都有一个行缓冲,因此需要会根据题目条件计算行缓冲的容量(注意问法):
- 芯片中行缓冲的大小(指单个DRAM中的行缓冲大小)
- 内存条中行缓冲的大小(整个内存条全部行缓冲的大小)
Info
行缓冲是由 SRAM 元件构成的这个说法其实不准确, 因为它和通用SRAM的设计目标不同。它的首要任务是能灵敏地感知和放大DRAM电容的微弱信号,其次才是锁存。而通用的SRAM芯片则专注于高速的读写和存储。这个放大器达到稳定的状态时,就和 SRAM 元件一样了,因此我们可以说该阵列通过其锁存功能,在功能上等效于一个高速SRAM缓存 。
行缓冲的物理实体是“读出放大器”。但因为读出放大器在完成信号放大后,利用了与 SRAM 极其相同的“交叉耦合正反馈”电路来锁存数据,使得它在保持打开状态时,具备了和 SRAM 一模一样的静态存储特性和极高的读取速度。
DRAM 的发展
DRAM的发展主要围绕着提高数据传输效率和解决系统性能瓶颈展开。其发展历程从早期的异步DRAM演进到同步DRAM,主要经历了以下几个关键阶段:
传统异步DRAM及其缺点
早期的DRAM属于异步DRAM。
- 工作原理: 芯片本身没有时钟信号,其时序控制、地址寻址和数据访问完全由带有时钟信号的内存控制器异步控制。
- 主要缺点(效率低下):
- 重复劳动: 每一次数据访问都需要经历完整的“行地址”和“列地址”阶段。
- 无法利用局部性: 即使连续两次访问的数据位于同一行(Page),系统也必须重复发送行地址、锁存行地址的整个过程。这导致访问效率非常低。
异步DRAM的优化阶段 (FPM -> EDO -> BEDO)
为了克服传统DRAM的效率瓶颈,后续出现了几种改进型的异步DRAM:
- FPM-DRAM (Fast Page Mode DRAM - 快页模式):工程师发现,CPU 读数据通常是连续读取相邻地址的(空间局部性)。既然都在同一行,为什么每次都要重新发一遍行地址?FPM 允许在 \(\overline{RAS}\) 保持低电平(行一直处于激活状态)的情况下,连续多次改变列地址并发射 \(\overline{CAS}\)。这省去了很多重复的行激活时间。
- EDO-DRAM (Extend Data Out DRAM - 扩展数据输出):
- 改进点: 在 FPM 的基础上,修改了内部的数据锁存器。使得上一笔数据还在数据线上向外传输时,下一笔数据的列地址(\(\overline{CAS}\))就可以提前送进来了,实现了某种程度的“时间重叠”。
- BEDO-DRAM (Burst Extend Data Out DRAM - 突发式EDO): EDO的进一步优化。内置了列地址计数器,连续访问的列地址由内部自动给出,无需外部总线传输,节省了总线时间。同时采用流水线方式。
同步DRAM (SDRAM) 的诞生
虽然 EDO 和 BEDO 拼命优化,但“没有时钟”的异步本质,让它们始终无法跟上 CPU 频率的发展速度。于是,内存界迎来了大一统的终极形态——SDRAM(Synchronous DRAM,同步动态随机存取存储器)。我们现在用的 DDR4、DDR5,全称都叫 DDR SDRAM,它们都是 SDRAM 的后代。
SDRAM 的革命性改变:
- 引入系统时钟 (CLK): 这是最根本的区别!SDRAM 的所有输入信号(地址、控制信号)和输出数据,全部都严格踩着时钟节拍(通常是时钟的上升沿)进行。读写受系统时钟(即前端总线时钟CLK)控制, 因此与 CPU 之间采用同步方式交换数据。
- 消灭了“安全冗余”: 因为有了统一的节拍,内存控制器再也不用盲目等待了。它确切地知道发一个命令后,经过几个时钟周期(这叫 CAS 延迟或 CL 值),数据一定会准时出现在引脚上。
- 完美的流水线与突发传输: 结合统一的时钟,SDRAM 可以将内部操作高度流水线化。外部只需要发送一次激活命令(\(\overline{RAS}\))和一次读命令(包含首个列地址的 \(\overline{CAS}\)),在度过初始的几个周期延迟后,数据就会像机枪子弹一样,每个时钟周期准时喷射出一个,这就是真正的无缝突发传输。
SDRAM 内部的工作方式寄存器(也称模式寄存器)可用来设置传送数据的长度以及从收到读命令(与CAS信号同时发出)到开始传送数据的延迟时间等,前者称为突发长度(burst lengths,BL),后者称为CAS时延(CAS latency,CL)。根据所设定的 BL和CL,CPU可以确定何时开始从总线上取数以及连续取多少个数据。在第一个数据读出后,同一行的所有数据都被送到行缓冲器中,因此,以后每个时钟可从 SDRAM读取一个数据,并在下一个时钟内通过总线传送到CPU。
DDR SDRAM
DDR 技术的出现,本质上是为了解决一个极其现实的物理瓶颈:DRAM 芯片内部存储阵列的物理充放电速度(核心频率)已经很难再大幅提升了。 为了满足 CPU 的数据吞吐需求,工程师们玩了一个非常聪明的“障眼法”——内部宽车道并行,外部窄车道狂奔。
-
DDR 的基本盘:双沿传输 (Double Data Rate)
-
传统 SDRAM: 只能在时钟信号的上升沿传输一次数据。
- DDR SDRAM: 利用时钟信号的上升沿和下降沿各传输一次数据。
-
结果: 在总线时钟频率不变的情况下,DDR 直接让数据传输率翻倍。
-
DDR 的核心魔法:预取机制 (Prefetch)
既然内部核心阵列跑不快(比如只能跑 200MHz),怎么让外部接口跑出 800MHz 甚至 3200MHz 的速度呢?靠的就是预取(Prefetch)加上芯片内部的 I/O 缓冲(I/O Buffer)。
-
原理: 每次读取时,芯片内部不是只读 1 位数据,而是一次性并行读出多位数据(2位、4位、8位等),把它们暂存在高速的 I/O 缓冲里。然后,利用外部高速跳变的时钟沿,把这些缓存好的数据像机枪子弹一样快速“打”到外部数据总线上。
-
DDR 家族的演进:预取位数的翻倍
DDR 每一代的升级,核心都在于预取位数的翻倍。我们可以以内部核心频率恒定为 200MHz 为例(前提: 数据位宽 w = 8 字节),来看看各代的差别:
| 内存代数 | 预取机制 (Prefetch) | 内部核心频率 | 外部总线频率 | 等效传输率 (数据频率) | 最大带宽 (64位宽) |
|---|---|---|---|---|---|
| DDR | 2位 (2n) | 200MHz | 200MHz | 400 MT/s | 3.2 GB/s |
| DDR2 | 4位 (4n) | 200MHz | 400MHz | 800 MT/s | 6.4 GB/s |
| DDR3 | 8位 (8n) | 200MHz | 800MHz | 1600 MT/s | 12.8 GB/s |
| DDR4 | 16位 (16n) | 200MHz | 1600MHz | 3200 MT/s | 25.6 GB/s |
仔细看表格最右侧和最左侧,无论外面的 DDR4-3200 标称得多吓人,它内部那颗老旧的存储核心,依然在以 200MHz 的慢速慢条斯理地工作着。 速度的狂飙,全靠内部一次性吞吐 16 倍的数据量(16n 预取)和外部总线频率的拉升来实现。
- 已知某 DDR4 SDRAM 芯片的内部核心频率为 200MHz,与之相连的存储器总线数据位宽为 64 位(即 8B),则下列有关该内存的叙述中,错误的是( )。
A. 该 DDR4 芯片内部采用了 16 位(16n)数据预取技术\ B. 存储器总线每个时钟周期可传送两次数据,其总线时钟频率为 1600MHz\ C. 存储器总线上的等效数据传输率为 6400 MT/s(兆次/秒)\ D. 该存储器总线的最大理论带宽为 25.6 GB/s
【解析】
答案:C
- 选项 A:因为是 DDR4 SDRAM 芯片,根据标准规范,其芯片内部 I/O 缓冲采用了 16 位 (16n) 预取技术。A 正确。
- 选项 C:存储器总线每秒传送数据的次数(即等效传输率)等于
内部核心频率 × 预取倍数,即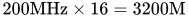 次/秒(3200 MT/s)。选项 C 宣称是 6400,故 C 错误。
- 选项 B:因为 DDR 技术利用时钟信号的上升沿和下降沿各传输一次数据(每周期传 2 次),所以实际的总线时钟频率等于
等效传输率 / 2,即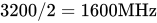 。B 正确。
- 选项 D:该存储器的理论带宽等于
等效传输率 × 数据位宽,即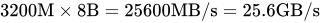 。D 正确。
综上所述,答案为选项 C。
- 已知某 DDR2 SDRAM 内存条的数据总线位宽为 64 位(8B),其标称的最大理论数据带宽为 6.4 GB/s,则下列关于该内存条参数的推断中,错误的是( )。
A. 该内存条存储器总线上的等效数据传输率(传送次数)为 800M 次/秒\ B. 芯片内部存储阵列的实际工作频率(核心频率)为 400MHz\ C. 存储器总线的实际时钟频率为 400MHz\ D. 芯片内部 I/O 缓冲采用了 4 位(4n)数据预取技术
【解析】
答案:B
- 选项 A:根据公式
带宽 = 等效传输率 × 数据位宽,可反推出等效传输率 =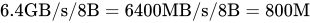 次/秒。A 正确。
- 选项 D:因为是 DDR2 SDRAM 芯片,其内部标准采用的是 4 位 (4n) 预取技术。D 正确。
- 选项 B:根据公式
等效传输率 = 核心频率 × 预取倍数,可反推出核心频率 =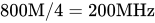 。选项 B 宣称是 400MHz,故 B 错误。
- 选项 C:由于双沿传输特性,总线时钟频率 =
等效传输率 / 2,即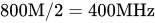 。C 正确。
综上所述,答案为选项 B。
DRAM 的动态刷新
DRAM 的刷新机制是妥协于其物理特性的产物(电容漏电),为了保证数据不丢失,必须在规定的时间(最大刷新周期,通常为 2ms)内,把所有的存储单元重新读写一遍。
一、 刷新的基本特性与规则
- 按行进行: 刷新操作是以“行”为单位的。每次刷新操作会选中一行,该行的所有列同时进行“破坏性读出 + 内部重新充电恢复”。因此,刷新操作只需要给出外部行地址,不需要列地址。
- 占用一个存取周期: 刷新一行所花费的时间,严格等于进行一次正常读写操作的时间(通常记为存取周期 \(t_c\),例如 0.5μs)。
- 内部控制: 刷新行地址不是由 CPU 提供的,而是由 DRAM 芯片内部(或内存控制器)的刷新地址计数器自动生成的。计数器每发出一行地址,刷新完毕后自动加 1。
- 优化方向: 为了减少总的刷新时间,芯片设计时通常会减少行数,增加列数(例如采用 128行 × 2048列,而不是对称的矩阵),这样需要刷新的总行数就变少了。
二、 三种刷新方式对比
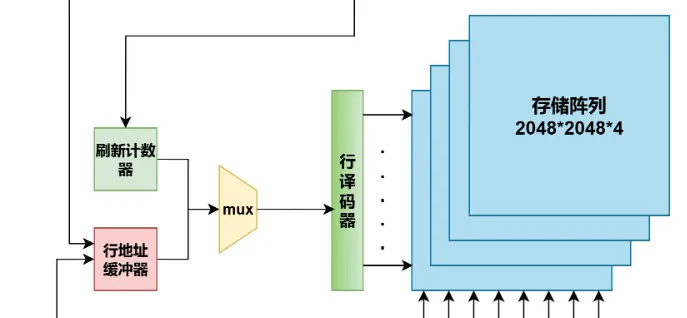
结合这个图可以看出,DRAM 在执行刷新操作时不能响应 CPU 的读写请求,因此CPU 正常读写与内存必须刷新之间 存在“内存争用”问题,为解决该问题,共有三种经典的策略:(结合下面的例子进行讲解)
假设 DRAM 芯片为 128 行 ×128 列结构,存储器的读写周期\(t_c\)= 0.5μs,刷新间隔为 2ms
因此 2ms 内应完成所有 128 行的刷新,刷新一行所花费的时间等于\(t_c\)= 0.5μs,可将这 2ms 划分为 4000 个 0.5μs 的时隙,在这些时隙中选出 128 个时隙,每个时隙刷新一行即可完成该 DRAM 的刷新任务。
1. 集中刷新方式
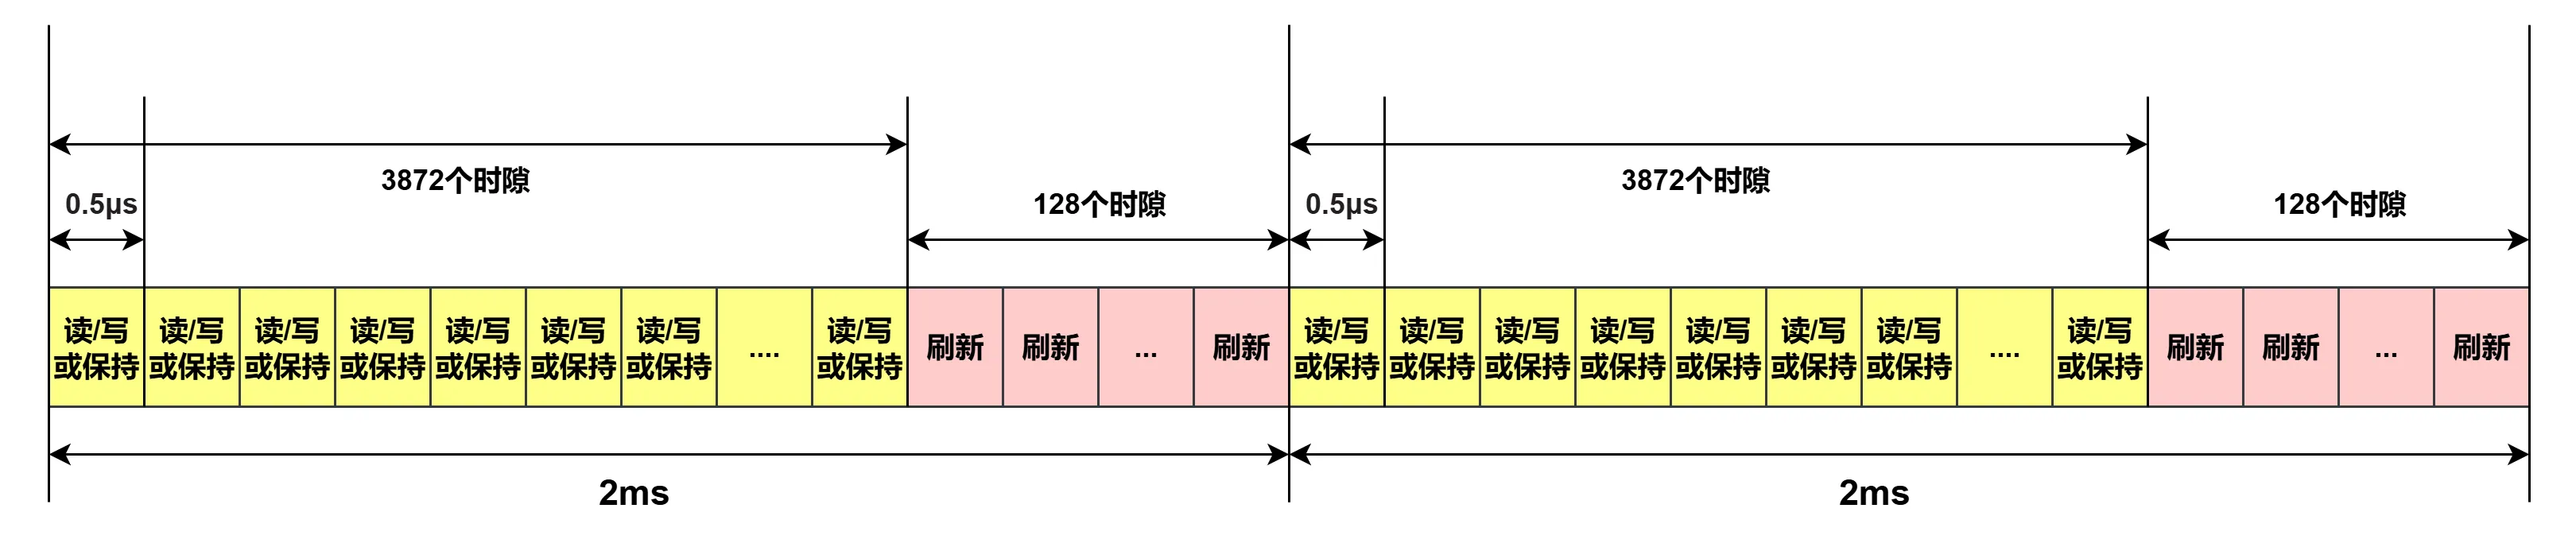
- 原理: 在允许的最大刷新周期( 2ms)内,前面绝大部分时间全部用来给 CPU 进行正常的读/写操作,把所有的刷新任务全部集中堆积在最后一段时间内一口气完成。(本例中2ms 内的前 3872 个读写周期都用来 进行读写或保持,2ms 内的最后 128 个读写周期集中用于刷新)
- 优点:读写操作期间不受刷新操作的影响,因此存储器的速度比较快;
- 缺点: 存在较长时间的“死区”,即在集中刷新的 128 个读写周期内,CPU 长时间不能访问存储器。 显然,存储器芯片内部的行数越多,“死区”时间就越长。
2. 分散刷新方式
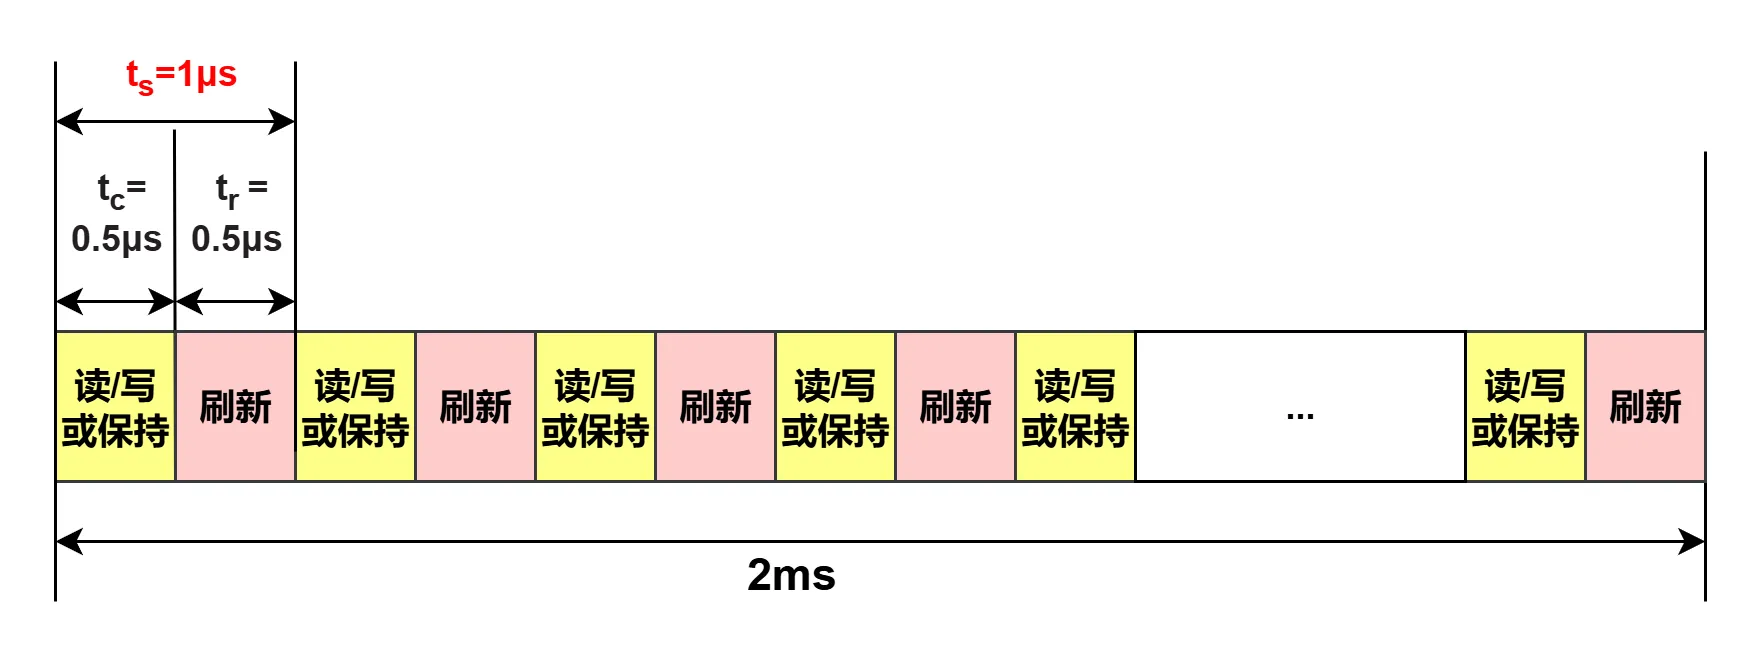
- 原理: 走向另一个极端。把正常的存取周期强行拉长一倍,变成前半段用于正常读/写或保持,后半段立刻强制刷新一行。(在本例中把存储周期 ts *分为 *tc *和 *tr *两个部分,前半段用来进行读写或保持操作,后半段用作刷新时间,因此 *ts *= 1μs。每过 128 个 *ts,整个存储器就被刷新一次。显然,在 2ms 内可进行约 15 次刷新。)
- 特点: 如果原本存取周期是 0.5μs,现在变成了 1μs(0.5μs 读写 + 0.5μs 刷新)。
- 缺点: 虽然彻底消灭了集中的“死区”,但因为刷新过于频繁,严重拖慢了系统速度。
3. 异步刷新方式
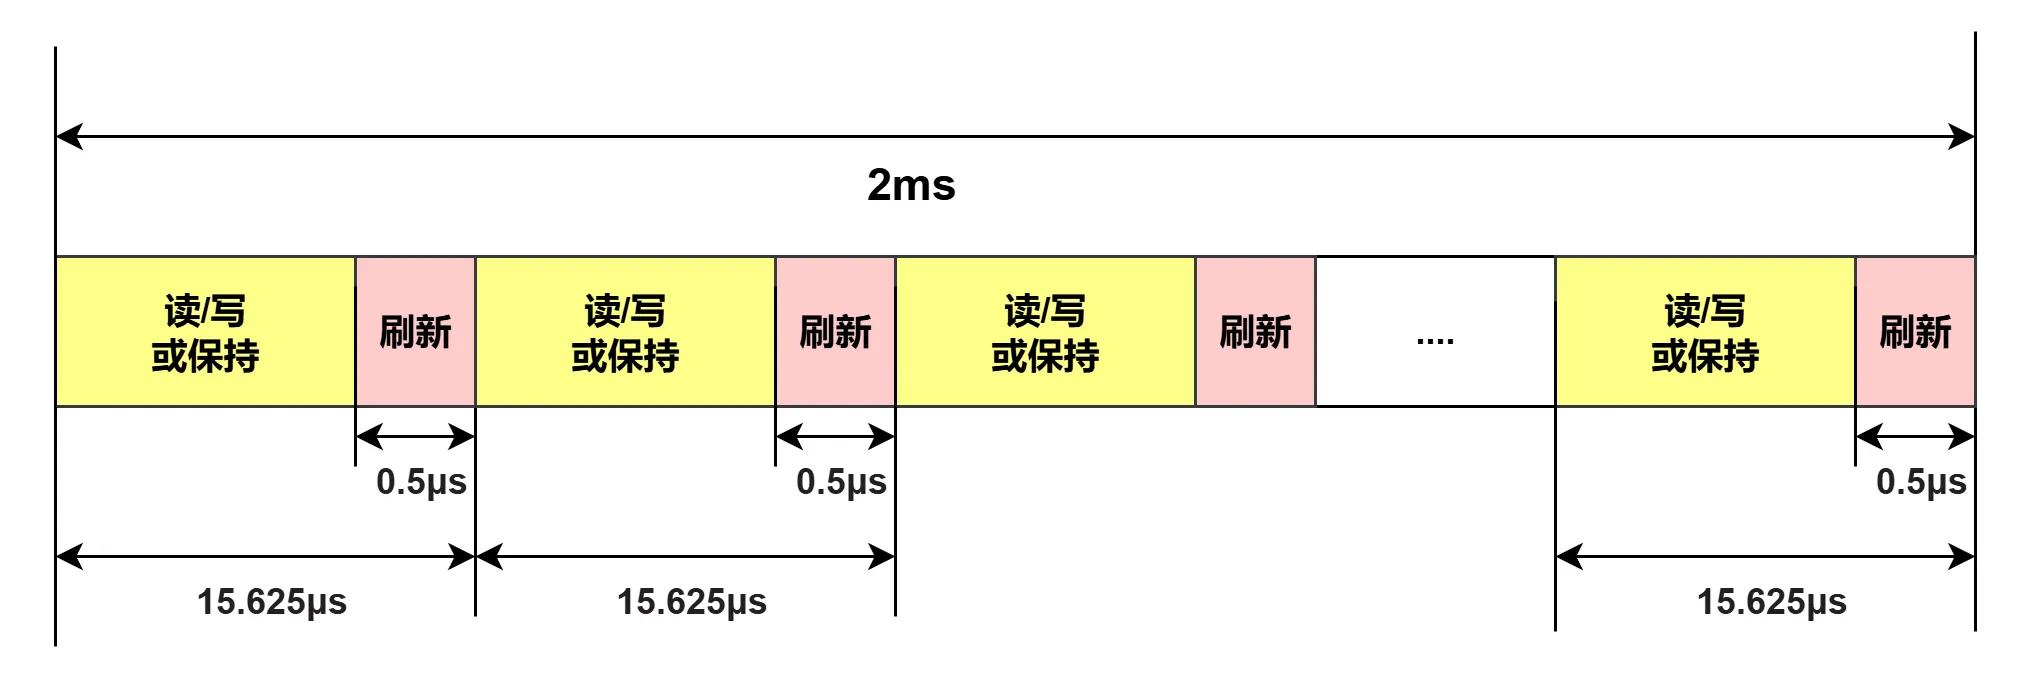
- 原理: 前两种方式的完美结合。它将需要刷新的总行数,均匀地平摊到整个最大刷新周期中。
- 计算方式: 相邻两行刷新的时间间隔 = 最大刷新周期 / 总行数。例如 2ms 内要刷新 128 行,那就每隔 15.625μs (2ms / 128) 抽空刷新一行(耗时 0.5μs)。
- 优点: 完美利用了 2ms 的时限,既保证了每一行在 2ms 内刚好被刷新一次,又把“死区”彻底打散了。CPU 只会偶尔遇到 0.5μs 的微小停顿,几乎感觉不到延迟。这是现代内存最常用、最高效的刷新方式。