index
Note
考纲:
- 虚拟存储器的基本概念
- 页式虚拟存储器:基本原理,页表,地址转换,TLB(快表)
- 段式虚拟存储器的基本原理
- 段页式虚拟存储器的基本原理
虚拟存储器的基本概念
虚拟存储器的相关概念和工作原理
虚拟存储器并非独立的物理存储硬件,而是一套由硬件与操作系统协同实现的内存管理技术,是计算机层次化存储体系中的核心设计,其核心定位是解决以下痛点:
- 突破物理主存的容量限制:计算机物理主存的容量远小于外存,且不同设备的主存配置存在显著差异。虚拟存储器为程序员提供了远超物理主存大小的连续、统一编程地址空间,让程序开发彻底摆脱物理内存大小对程序设计的约束。
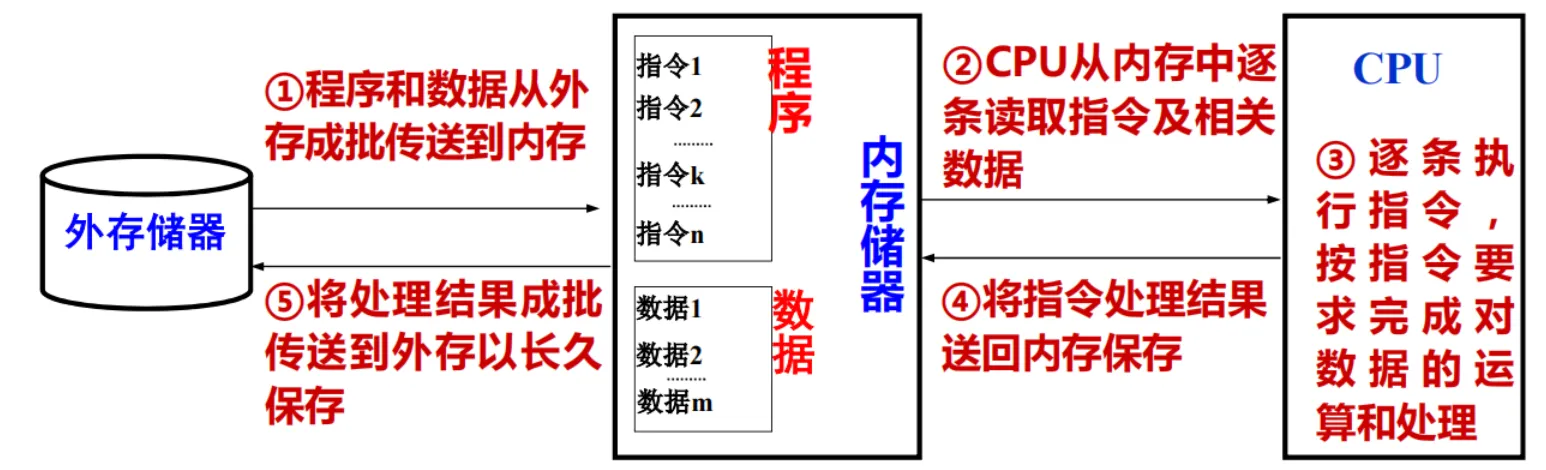
- 弥合CPU与外存的访问效率鸿沟:CPU无法直接对磁盘、固态硬盘等外存进行寻址访问,所有外存中的程序代码与数据,必须先载入主存才能被CPU读取和执行。虚拟存储器基于程序的局部性原理,通过主存缓存高频访问的外存数据,减少CPU对低速外存的直接依赖,大幅提升程序的整体执行效率。
- 支撑多进程的安全高效并发:现代通用操作系统需要同时运行多个用户进程,每个进程都需要独立、不受干扰的地址空间。虚拟存储器为每个进程提供了私有的、完全隔离的虚拟地址空间,从底层保障进程间互不干扰;即使多个进程的总代码与数据容量超过物理主存大小,也能在有限的主存资源中稳定、安全地并发运行。
从存储体系架构来看,虚拟存储器以物理主存(DRAM)为核心缓存、以联机工作的磁盘/固态硬盘等外存为后备存储载体,二者通过统一的地址编址体系整合为一个有机整体。对应用程序员而言,这套体系就像一个单一的、可被CPU直接访问的超大容量主存,开发过程中只需面向这套虚拟地址空间编写程序,使用统一的虚拟地址(VA, Virtual Address) 完成指令与数据的寻址,无需关注数据实际存储在主存还是外存中。
虚拟存储器的落地实现,必须依靠操作系统(OS)软件与内存管理单元(MMU, Memory Management Unit)硬件的深度协同,核心工作流程分为两大核心环节:
- 虚拟地址到物理地址的转换
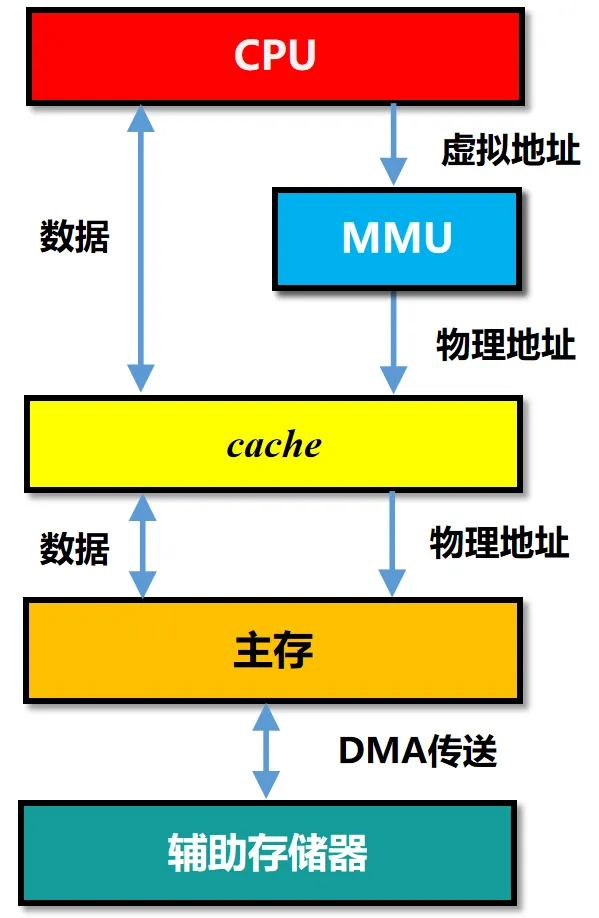
CPU执行程序时发出的是虚拟地址,首先会交由CPU芯片内部集成的MMU硬件处理。MMU会通过操作系统预设的页表/段表映射规则,将程序使用的虚拟地址(VA)转换为可被主存识别的物理地址(PA, Physical Address),完成寻址的核心转换。
- 异常检测与闭环处理
在地址转换的全过程中,MMU会同步完成地址合法性与数据可用性校验,识别两类核心异常场景并触发对应处理:- 若目标数据未载入主存(数据缺失):MMU会触发缺页异常,CPU随即从用户态陷入操作系统内核,由内核的缺页异常处理程序完成目标数据从外存到主存的载入,同时更新地址映射关系,处理完成后返回用户态,重新执行触发异常的原指令;
- 若出现地址越界、访问权限不符等存储保护违规:MMU会触发内存保护异常,由操作系统对违规行为进行对应处理(如终止违规进程、抛出内存访问错误等),从底层保障内存访问的安全性与进程间的地址隔离。
虚拟地址到物理地址的转换是硬件还是软件完成的?
这个问题,关键在于区分两件事:"谁建立映射规则" 和 "谁执行翻译动作"。
结论:地址翻译本身是硬件(MMU)完成的。 OS 负责建立和维护页表,但"查表翻译"这个动作每次都由 MMU 硬件执行。
用一个比喻理解:把页表想象成一本字典:
- OS(软件) = 编写字典的人,负责写入每一条词条(建立 VPN→PPN 的映射),在缺页时增加新词条,在进程切换时换一本新字典;
- MMU(硬件) = 使用字典查词的人,每次 CPU 发出虚拟地址,MMU 自动翻字典、找到物理地址,整个过程在硬件电路里完成,速度极快。
字典是软件写的,但"查字典"这个动作是硬件做的。
两者的精确分工

如果 TLB 没命中,现代架构的 MMU 内部有一个叫 硬件页表漫游器 (Hardware Page Table Walker) 的部件。它会自动根据页表基址寄存器的地址,去主存中逐级读取页表项。这个过程不需要任何一条操作系统指令的干预,纯靠硬件状态机完成。
OS 写好页表之后就"退场"了。CPU 执行用户程序时,每一次内存访问都是 MMU 硬件在自动查表,OS 完全不介入——除非出现异常(缺页、越权)才被硬件打断、通知 OS 处理。
| 事情 | 执行者 | 时机 |
|---|---|---|
| 创建页表、写入映射关系 | OS 软件 | 进程创建/缺页时 |
| 修改 PTBR 寄存器(切换页表) | OS 软件 | 进程切换时 |
| 处理缺页异常(分配页、加载磁盘) | OS 软件 | 缺页发生后 |
| 查 TLB,翻译地址,权限检查 | MMU 硬件 | 每次访存 |
| TLB 缺失时遍历页表 | MMU 硬件 | TLB 缺失时 |
Cache-主存层次与主存-辅存层次
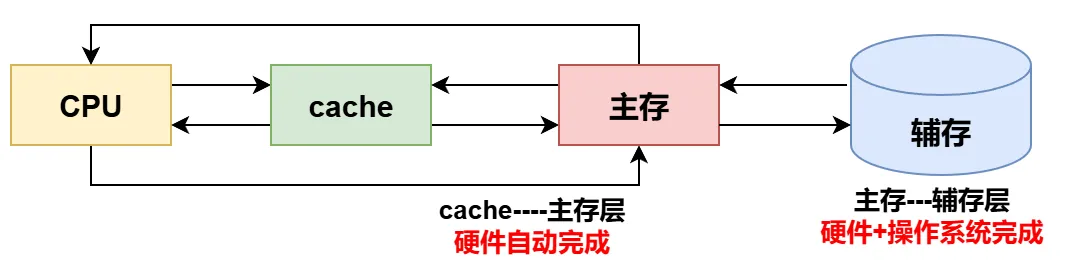
现代计算机主要通过构建两个层次来全面优化存储系统:
① Cache - 主存层次
- 主要目的: 缓解 CPU 与主存速度不匹配的问题。
- 实现方式: 数据调度完全由硬件自动完成。
- 透明性: 对所有程序员(包括系统程序员和应用程序员)都是透明的(即程序员无需关心其内部数据调度逻辑)。
② 主存 - 辅存层次
- 主要目的: 解决存储系统的容量不足问题(逐渐发展形成了虚拟存储系统,让程序员可以使用远大于实际主存的虚拟地址空间进行编程)。
- 实现方式: 由硬件和操作系统共同完成。
- 透明性: 对应用程序员透明,但对系统程序员不透明(系统程序员需要编写调度等底层逻辑)。
⭐Cache-主存层次与主存-辅存层次的异同点
一、 两个层次的相同点
这两个层次在工作原理和管理机制上有以下核心共性:
- 理论基础: 都是基于程序访问的局部性特点,将相邻的局部信息从慢速存储器复制到快速存储器中。
- 需要解决映射问题: 都必须考虑慢速存储器和快速存储器之间的地址映射关系。
- 需要解决替换问题: 当快速存储器已满,且需要装入新块时,都需要考虑替换策略(把哪一块替换出去)。
- 缺失时的调入机制: 当在快速存储器中找不到所需信息(缺失)时,都需要从慢速存储器中将包含该信息的块调入到快速存储器中。
二、 两个层次的不同点
由于所处位置和引入目的不同,两者在具体实现上存在显著差异:
| 对比维度 | Cache - 主存层次 | 主存 - 辅存层次 |
|---|---|---|
| 位置与访问权限 | 最靠近 CPU。CPU 可直接访问 Cache 和主存。 | 远离 CPU。CPU 不能直接访问辅存,辅存需与主存直接交换数据。 |
| 引入目的 | 解决速度问题:加快 CPU 访问信息的速度。 | 解决容量问题:采用虚拟存储器机制,扩大系统的存储容量,使编程不受内存大小限制。 |
| 交换的数据单位 | 称为主存块 (Block),通常较小,一般为 8 ~ 128B。 | 称为页 (Page),通常较大,一般为 4KB ~ 64KB(因缺页损失远大于 Cache 缺失,页太小会降低效率)。 |
| 缺失处理 | 由处理器(硬件)直接实现。 | 由操作系统(软件)实现。 |
| 映射方式 | 可灵活选择直接映射、全相联映射或组相联映射。 | 均采用全相联映射方式。 |
| 映射的实现介质 | 映射关系完全由硬件实现,使用 Cache 行中的标志 (Tag) 字段描述。 | 映射关系由操作系统实现,使用页表来描述。 |
| 写策略 | 可以采用直写 (Write-through) 和 回写 (Write-back) 两种策略。 | 都采用回写 (Write-back) 策略(因为直接写磁盘的开销过大,无法容忍直写策略)。 |
Note
cache与主存之间的数据交换单位是数据块,而页式虚拟存储器中,主存与辅存的数据交换单位是页面。cache由SRAM,主存由DRAM、辅存由磁盘等外设组成,容量关系为cache容量 << 主存容量 << 辅存容量,访问速度关系为cache访问速度 >> 主存访问速度 >> 辅存访问速度(主存比cache慢10~100倍,辅存比主存慢约10000倍)。
因此,页式虚拟存储器的缺页处理代价远大于cache未命中的处理代价,所以页面大小通常设置得更大,主流为4KB,也支持更大容量的页面;而cache与主存之间的数据块大小通常为16B、32B、64B等,远小于虚拟页面大小。
由于缺页处理代价极高,主存与辅存之间采用全相联映射方式以提升命中率;同时因辅存访问速度远低于主存,写操作默认采用写回法,而非直写法。
虚拟地址空间 vs 物理地址空间
- 虚地址VA(Virtual Address):应用程序视角中的连续逻辑地址,构成统一的虚拟内存空间,也叫逻辑地址;
- 物理地址PA(Physical Address):硬件实际使用的内存单元地址;
通过内存管理单元MMU和页表的动态转换,连续的虚拟地址可被映射到分散的物理地址上。
页式虚拟存储器
页式虚拟存储器概述(更详细的内容见 OS 第三章)
在页式虚拟存储器中,主存和虚拟地址空间被划分为大小完全相等的页面(简称页),外存与主存之间以页为单位交换信息:
- 虚拟页VP(Virtual Page):虚拟地址空间中的页,简称虚页,也叫逻辑页;
- 物理页PP(Physical Page):主存空间中的页,简称实页,也叫页框、页帧。
页式虚拟存储器采用请求分页的核心思想:
- 仅将进程中活跃的页面(包含当前访问的指令/数据)从辅存调入主存,非活跃页面保留在辅存中;
- 当访问的指令/数据所在页面不在主存时,触发缺页异常,由操作系统从辅存将缺失页面调入主存。
虚拟页式存储器采用全相联映射,即每个虚拟页可存放到主存中任意一个空闲物理页。
页表
对于每个进程,都需要建立虚拟页与主存物理页/磁盘存储位置的映射关系,该关系通过页表PT(Page Table) 记录。程序被加载到主存运行时成为进程,进程是程序的执行实例,是操作系统资源分配和调度的基本单位。
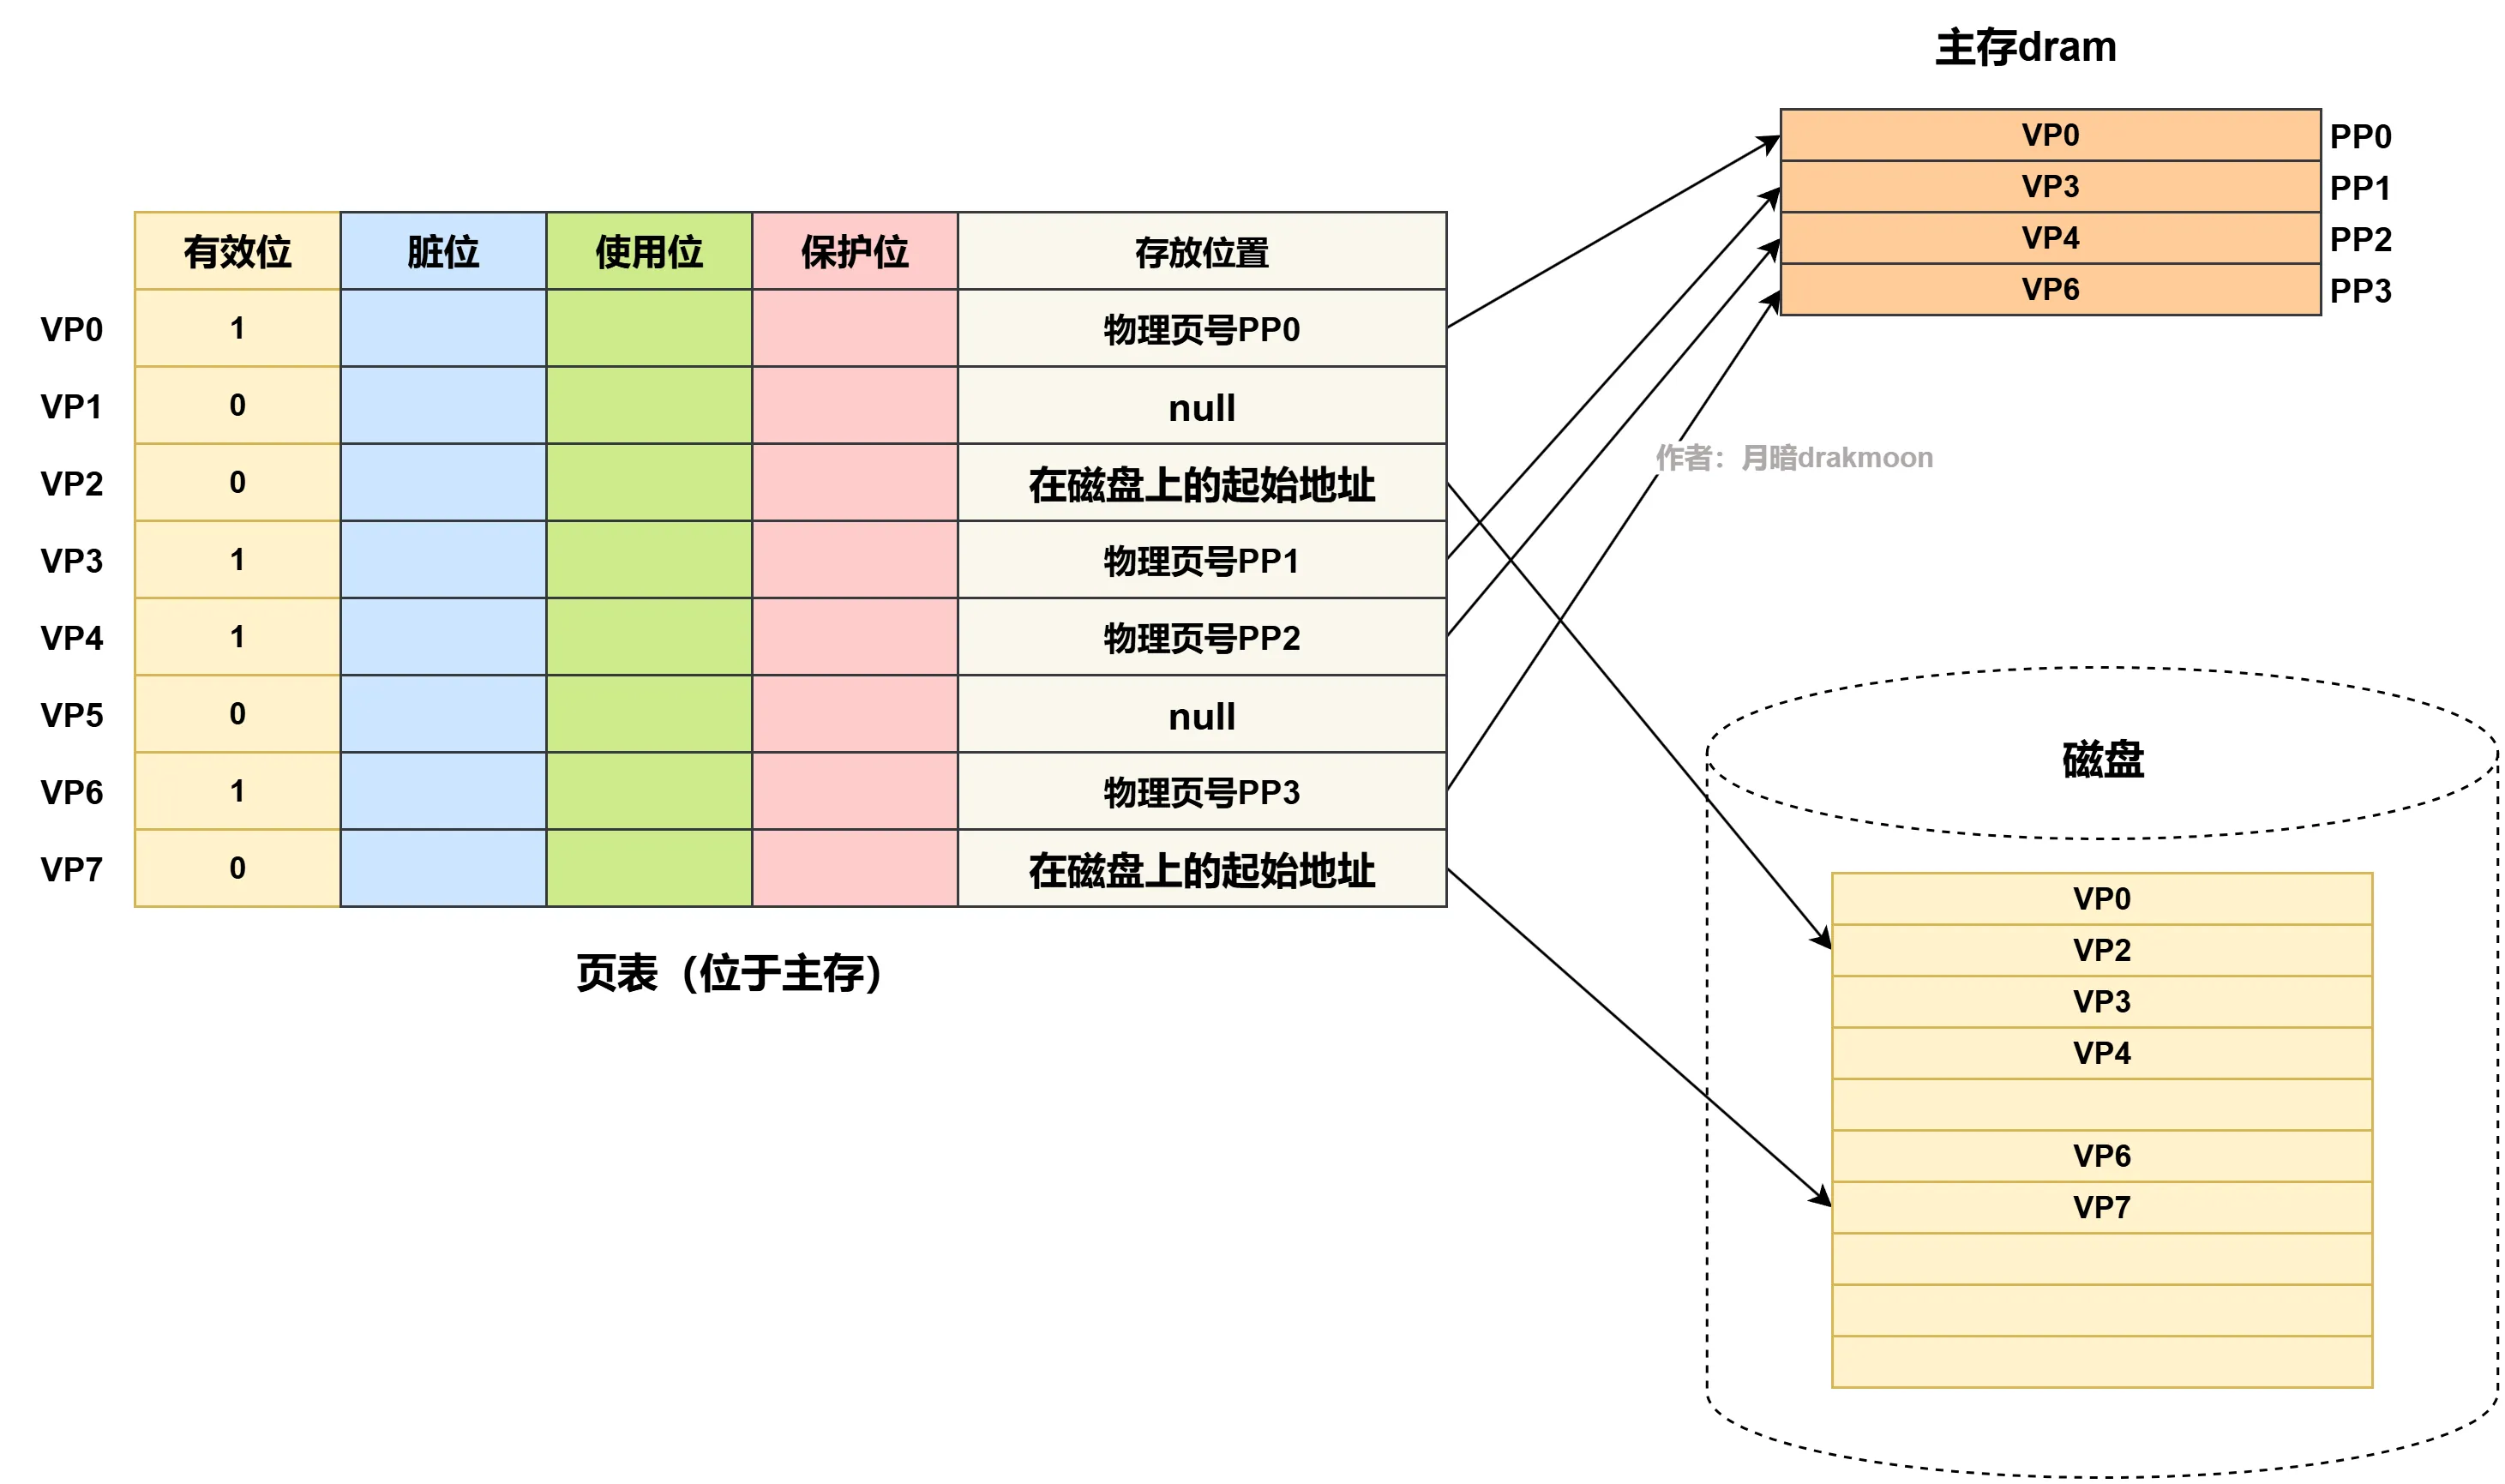
采用虚拟存储器的系统中,操作系统会为每个进程创建独立的页表,实现虚拟地址空间到物理地址空间的映射。页表中的每一行称为一个页表项,核心字段及说明如下:
| 字段名称 | 别名 | 核心作用与取值规则 |
|---|---|---|
| 有效位 | 装入位 | + 有效位=1:虚拟页已从辅存调入主存,存放位置字段存储物理页号; + 有效位=0:虚拟页未调入主存,若存放位置为NULL表示未分配物理内存,不为NULL 时记录该页在磁盘上的起始地址 |
| 脏位 | 修改位 | 标记虚拟页是否被修改,配合写回法使用: + 脏位=1:页面已被修改,替换时需写回辅存; + 脏位=0:页面未被修改,可直接替换无需写回 |
| 引用位 | 替换控制位/使用位 | 记录页面的访问情况,配合替换策略使用: LRU算法中作为LRU位 |
| 访问权限位 | 保护位 | 定义页面的访问权限,实现存储保护,可选权限:可读可写、只读、只可执行 |
PTBR 页表基址寄存器
PTBR 是一个硬件寄存器,存储当前进程页表在物理内存中的起始地址(根地址)。
MMU 每次翻译虚拟地址时,都以 PTBR 中的值为起点,去内存中找页表、完成地址翻译。它是 MMU 与页表之间的"入口指针"。(CPU 给出虚拟地址 VA,可划分为虚拟页号VPN + 页内偏移offset,页表项地址 = PTBR + VPN × 页表项大小 ,访问主存中的页表得到页表项,将里面的物理页号和页内偏移拼接在一起得到物理地址。)
进程切换时 PTBR 的变化:每个进程都有自己独立的页表,存在内存的不同位置。操作系统在进程切换时,只需修改 PTBR 的值,MMU 就能立刻切换到新进程的地址空间。这是虚拟存储器实现进程地址空间隔离的核心机制,进程 A 和进程 B 可以使用完全相同的虚拟地址,但因为 PTBR 不同,翻译出的物理地址完全不同,互不干扰。
PTBR 存储的是物理地址,这一点很关键:PTBR 中存放的必须是物理地址,而不是虚拟地址。
原因很简单:MMU 翻译地址时,需要先找到页表,如果页表的地址本身也是虚拟地址,就形成了"先有鸡还是先有蛋"的死循环——翻译虚拟地址需要页表,找页表又需要先翻译虚拟地址。
PTBR 与 TLB 的关系:每次通过 PTBR 查页表都要访问内存,代价很高(数十~数百周期)。TLB 正是为了减少这种开销而存在的:
有 TLB 时:                          无 TLB(或TLB缺失)时:

CPU发出VA                            CPU发出VA
    │                                   │
    ▼                                   ▼
查 TLB(快,1~4周期)              PTBR + VPN → 页表项地址
    │                                   │
  命中                               访问内存取页表项(慢,~100周期)
    │                                   │
    ▼                                   ▼
直接得到PA                          得到PA
(完全不需要 PTBR 和内存)
TLB 命中时,PTBR 完全用不上;只有 TLB 缺失时,MMU 才通过 PTBR 去内存查页表。TLB 的本质是对"PTBR + 页表查询"这个慢操作的缓存。
多级页表下 PTBR 的含义:如果系统使用多级页表,PTBR 存储的是最顶层页表(页目录)的物理基址。
Note
一句话总结: PTBR 是 MMU 访问页表的入口指针,存储当前进程页表根的物理地址。进程切换时 OS 修改 PTBR,即完成地址空间切换;TLB 命中时 PTBR 被绕过,TLB 缺失时 MMU 从 PTBR 出发遍历页表完成翻译。
地址映射及转换
对于采用虚存机制的系统,指令中给出的地址是虚拟地址,所以,CPU执行指令时,首先要将虚拟地址转换为主存物理地址,才能到主存取指令和数据。地址转换(address
translation)工作由 CPU 中的存储器管理部件(MMU)来完成。
由于页式虚拟存储器中,物理页与虚拟页大小完全一致,因此二者的页内偏移位数完全相同,简称页内偏移字段。
- 物理地址 = 物理页号 + 物理页内偏移
- 虚拟地址 = 虚拟页号 + 虚拟页内偏移
虚拟存储器容量大于主存容量,因此虚拟页号的位数大于物理页号的位数。
分页式虚拟存储管理方式下,地址变换过程如下图所示。首先 MMU根据页表基址寄存器的内容,找到主存中对应的页表起始位置(即页表基地址),然后将虚拟地址高位字段中的虚页号作为索引,找到对应的页表项,若装入位(有效位)为1,则取出物理页号,和虚拟地址中的页内地址拼接,形成访问主存时实际的物理地址;若装入位为0,则说明缺页,需要操作系统进行缺页处理。
页表属于进程控制信息,存放在进程地址空间的内核区,每个进程的页表常驻主存。页表基址寄存器PTBR 记录页表在主存中的首地址,进程切换时仅需修改PTBR的值,即可完成页表的快速切换。
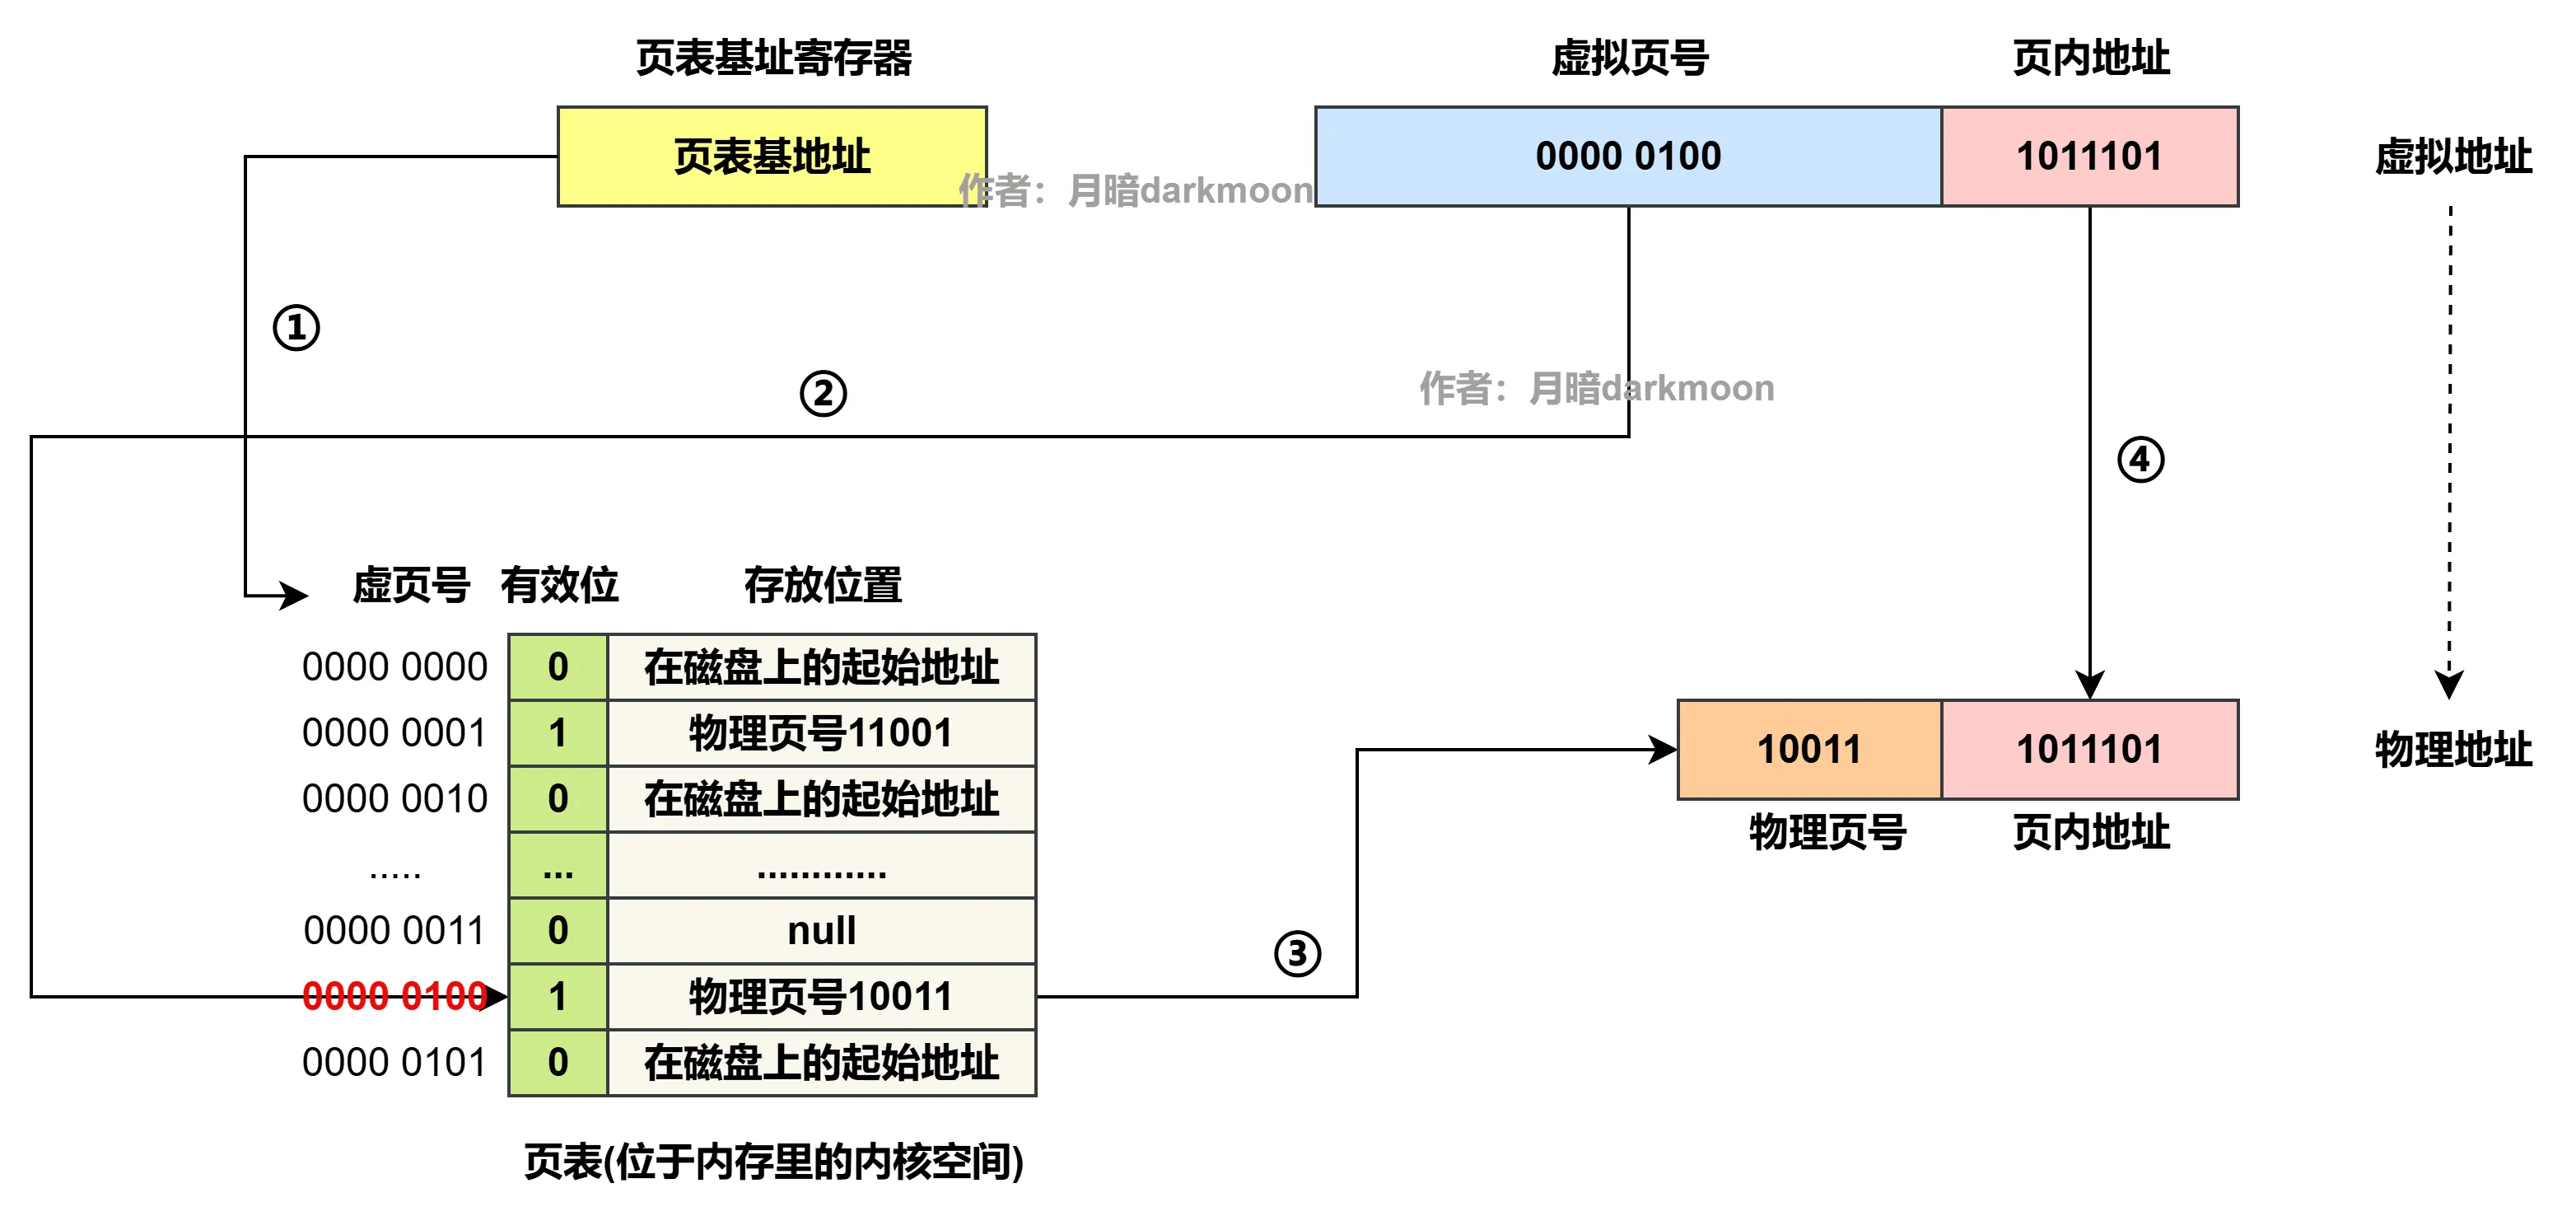
最基础的访存流程
页面命中时的访问流程
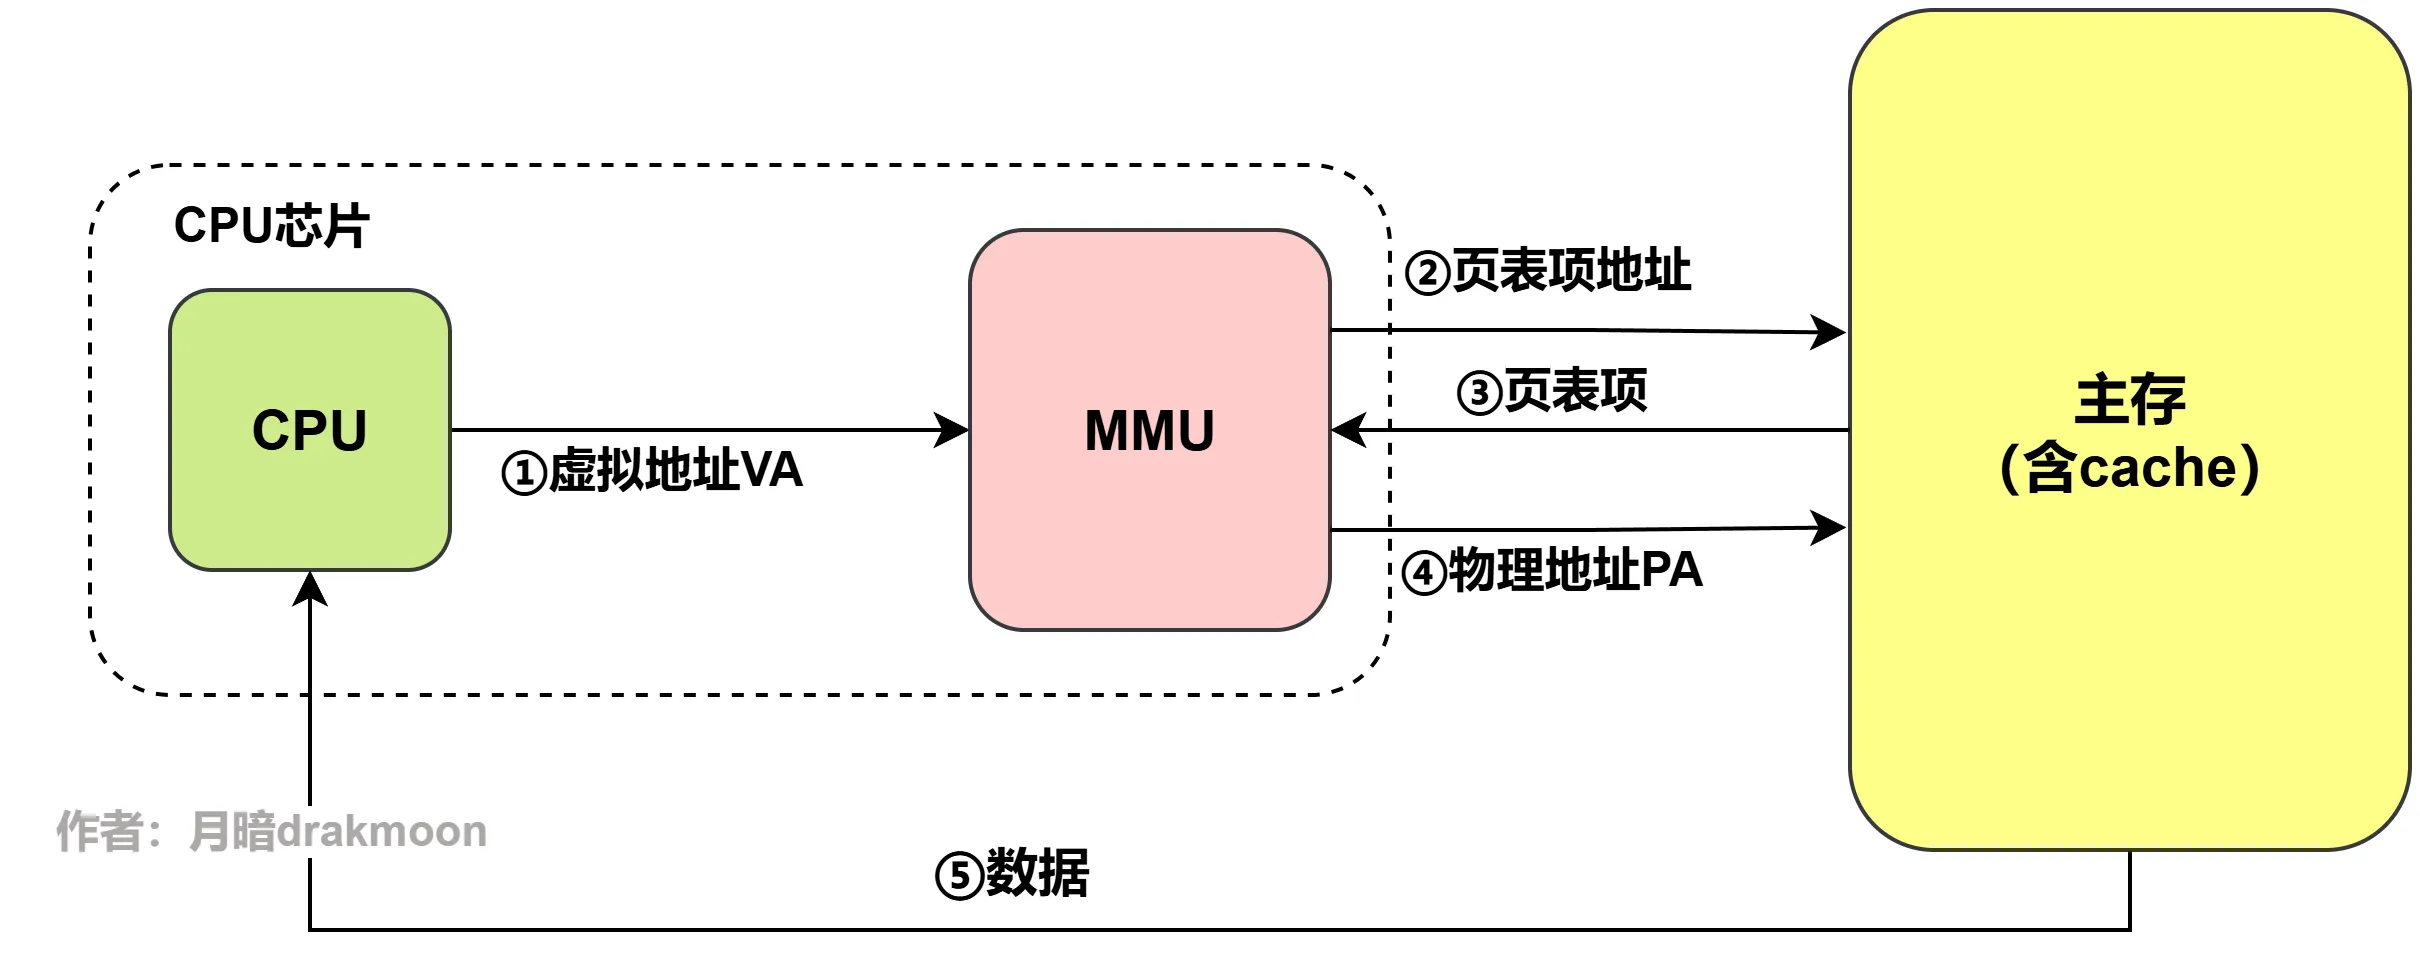
- CPU送出指令中的虚拟地址,交由MMU进行地址转换;
- MMU通过PTBR和虚拟地址中的虚拟页号,生成页表项地址,访问主存中的对应页表项;
- 主存向MMU返回页表项;
- 页表项有效位=1,确认页面已调入主存,通过物理页号+页内偏移拼接物理地址,访问主存对应数据;
- 主存向CPU返回目标数据。
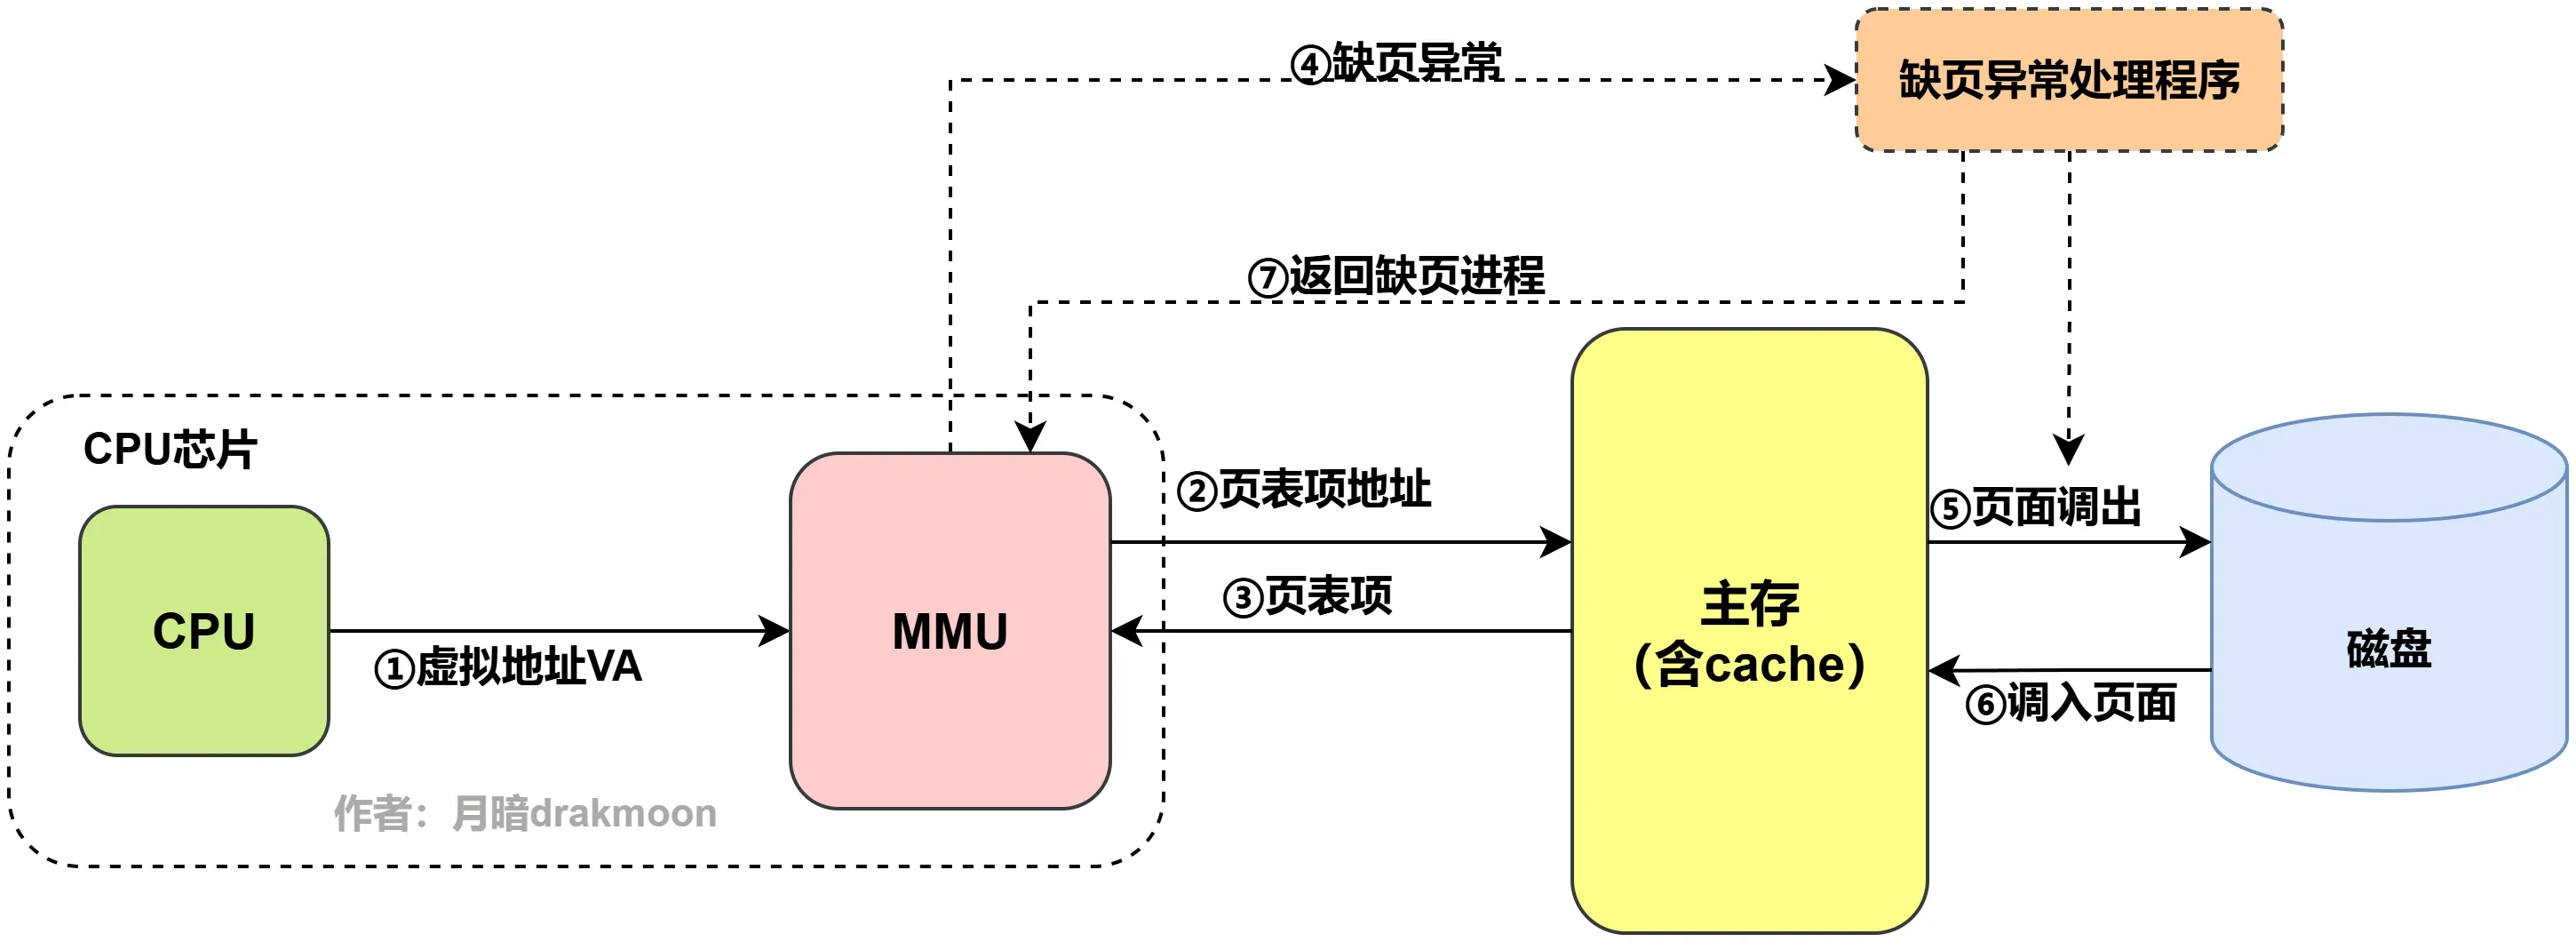
页面缺失(缺页)时的访问流程
步骤1~3与页面命中流程完全一致;
4. 页表项有效位=0,MMU触发缺页异常,调用操作系统内核的缺页异常处理程序;
5. 若主存已满,通过替换算法选定待淘汰页面;若该页面脏位=1,需先将页面写回磁盘,否则直接丢弃;
6. 缺页处理程序(由硬件和操作系统协作完成)从磁盘调入目标页面到主存,更新页表对应表项;
7. 缺页处理完成后,返回原进程,重新执行触发缺页的指令,此次执行将命中页面,按命中流程的步骤 2-5 完成访存。
【2022-15】某计算机主存地址为24位,采用分页虚拟存储管理方式,虚拟地址空间大小为4GB,页大小为4KB,按字节编址。某进程的页表部分内容如下表所示。当CPU访问虚拟地址00082840H,虚-实地址转换的结果是( )。
\(\begin{array} {|c|c|c|}\hline \text{虚页号}&\text{实页号(页框号)}&\text{存在位}\\\hline \text{82}&\text{024H}&0\\\hline \dots&\dots&\dots\\\hline \text{129}&\text{180H}&1\\\hline \text{130}&\text{018H}&1\\\hline \end{array}\)
A. 得到主存地址02 4840H
B. 得到主存地址18 0840H
C. 得到主存地址01 8840H
D. 检测到缺页异常
解析
采用分页虚拟存储管理方式,虚拟地址格式为 。
虚拟地址空间大小为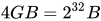 ,页大小为
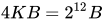 ,按字节编址,页内地址占低12位,虚拟地址占32位,虚页号占高32-12=20位。
虚拟地址  ,虚页号为00082H=8×16+2=130,查该进程页表得,虚页号130对应的存在位为1,实页号为018H,主存地址为24位,实页号占高24-12=12位,查表得到的实页号正好12位,高位不需要去0或者补0,拼接得到主存地址
 。
本题选C。
【2019-14】下列关于缺页处理的叙述中,错误的是()。
A.缺页是在地址转换时CPU检测到的一种异常
B.缺页处理由操作系统提供的缺页处理程序来完成
C.缺页处理程序根据页故障地址从外存读入所缺失的页
D.缺页处理完成后回到发生缺页的指令的下一条指令执行
解析
答案:D。
缺页处理完成后,会重新执行触发缺页的指令,而非跳转到下一条指令。
结合cache的访存流程
主存中的数据可分为两类:存储页表内容的页表块、存储程序数据的数据块。cache会缓存主存中的高频访问数据,因此常用的页表块也会被载入cache。
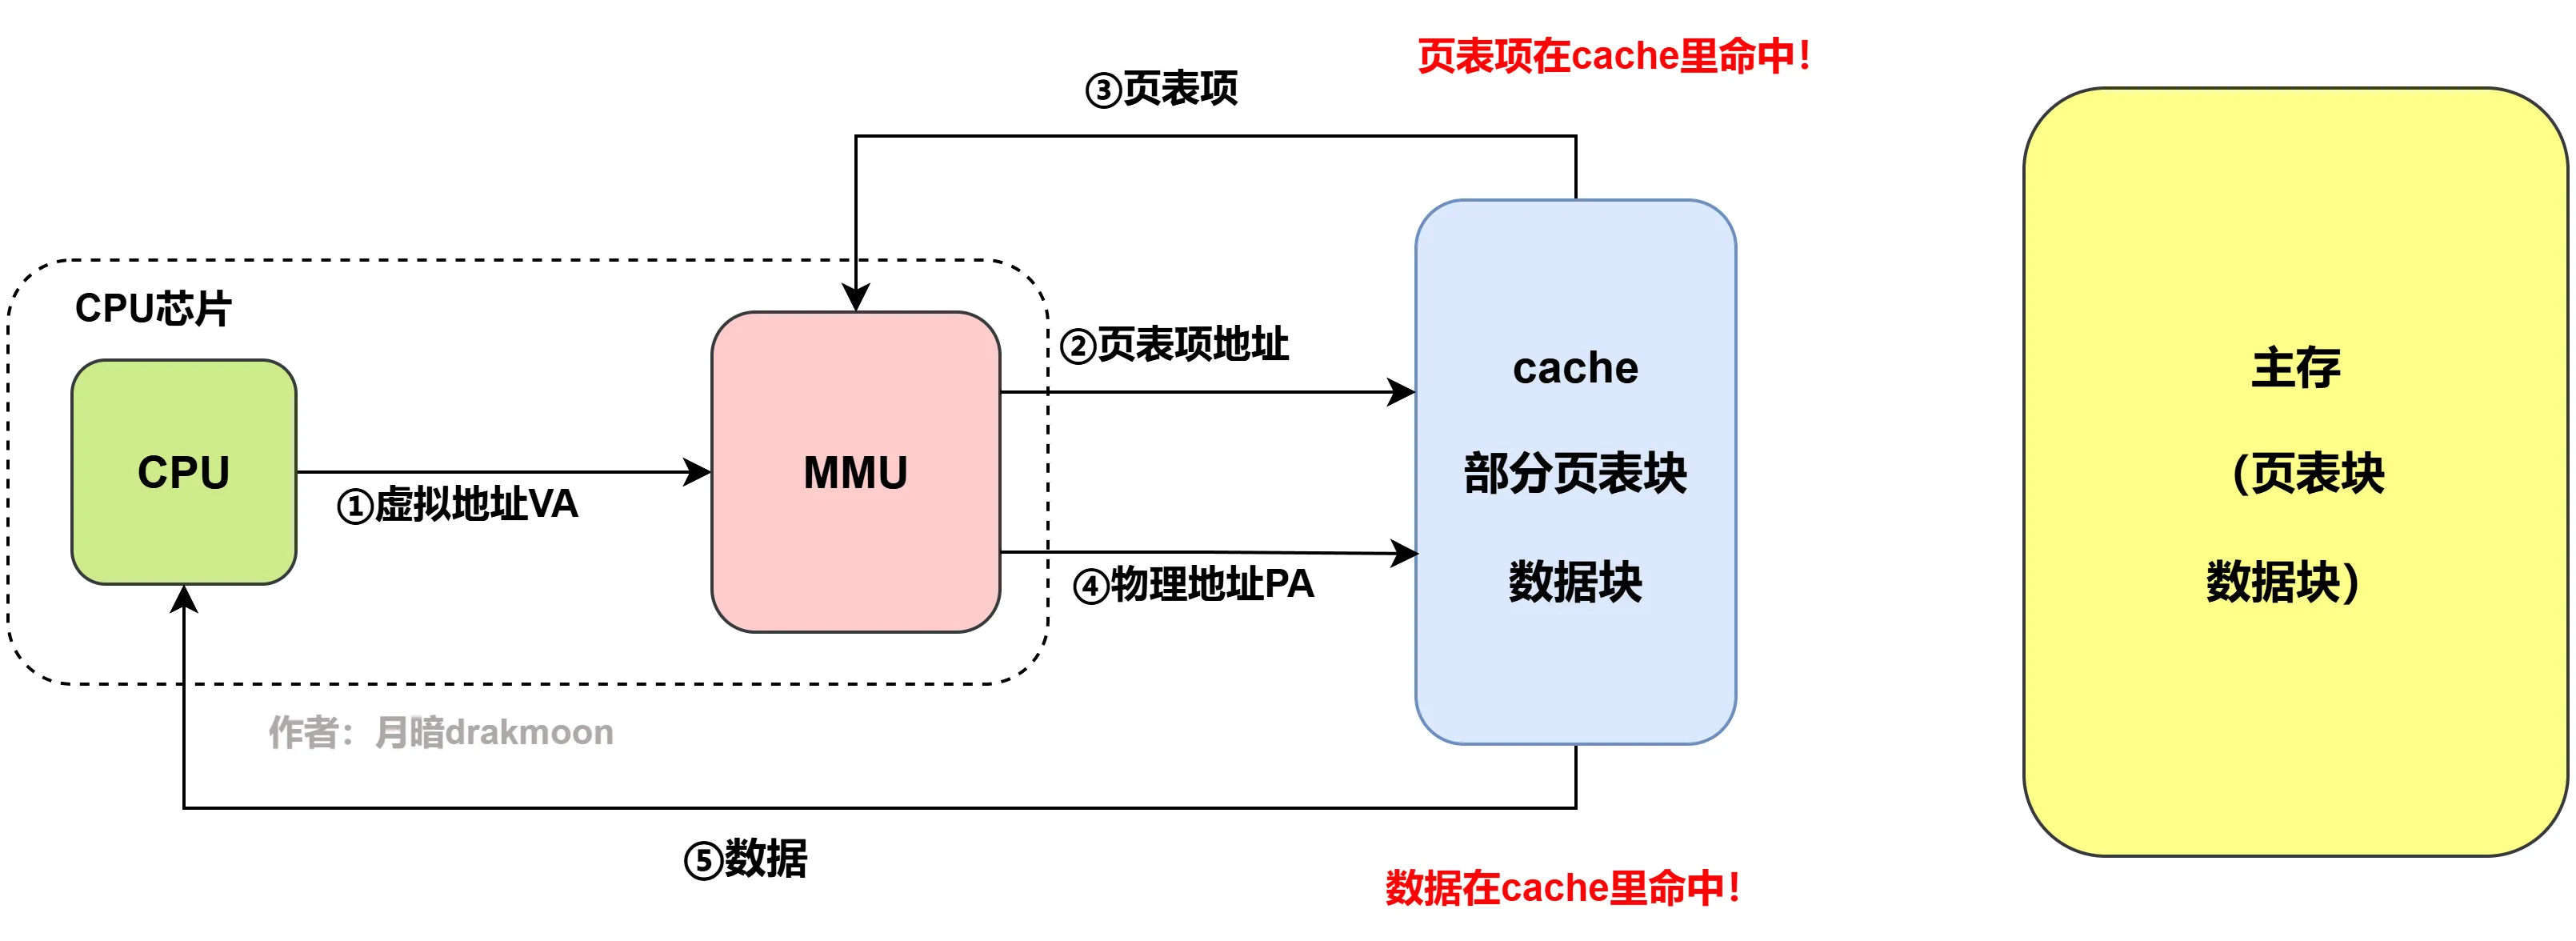
最理想情况
页表项在cache中命中、数据也在cache中命中,仅需2次cache访问即可获取数据。
- CPU发出虚拟地址,交由MMU转换;
- MMU通过PTBR和虚拟页号生成页表项地址,在cache中查找对应页表项;
- 页表项命中,cache向MMU返回页表项;
- 页表项有效位=1,拼接得到物理地址,通过物理地址在cache中查找目标数据块;
- 数据块命中,向CPU返回目标数据。
较糟糕情况
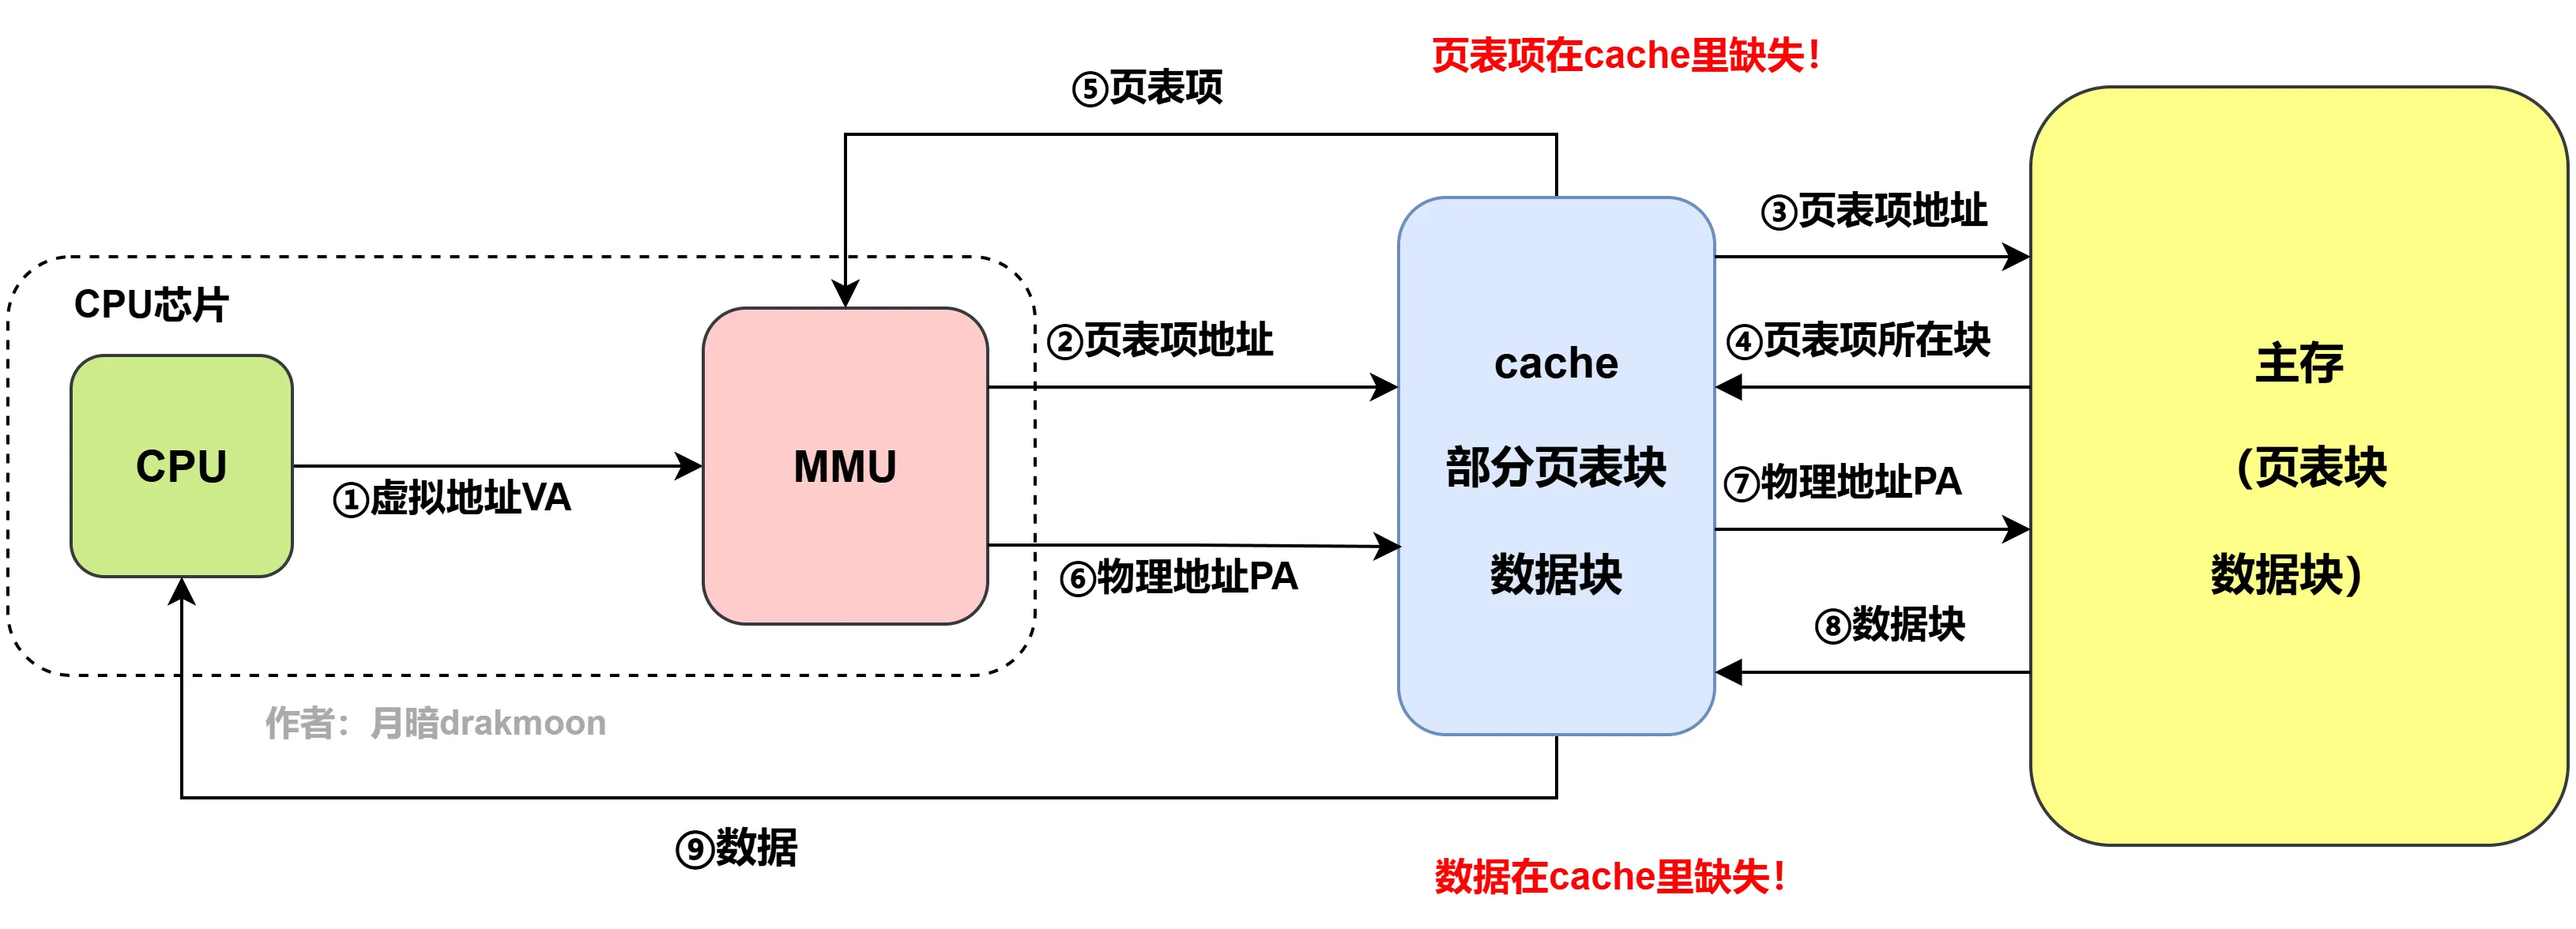
无缺页(页面在主存中),但页表项在cache中缺失、数据也在cache中缺失,需2次主存访问获取数据。
- CPU发出虚拟地址,交由MMU转换;
- MMU通过PTBR和虚拟页号生成页表项地址,在cache中查找对应页表项;
- 页表项在cache中缺失,通过页表项地址访问主存获取页表项;
- 将页表项所在数据块载入cache
- 向MMU返回页表项;
- 页表项有效位=1(页表项所在页面已载入主存),该页表项中的存放位置字段里记录了物理页号,再结合虚拟页号末尾的页内偏移字段,拼接得到物理地址,在cache中查找目标数据块;
- 数据块在cache中缺失,通过物理地址访问主存获取数据块;
- 将目标数据所在数据块载入cache
- 向CPU返回目标数据。
最糟糕情况
在较糟糕情况的基础上,访问目标数据块触发缺页异常,需访问磁盘获取数据,访存性能损耗最大。(前面 6 步与较糟糕情况一样,但是后面访问主存也缺失,因此得从磁盘将对应页面调入内存和 cache)
综上,虚拟存储技术会对存储器的访问性能产生影响。
使用快表TLB加速地址转换
cache虽然可以缓存部分经常访问的页表块,但这种数据块的粒度较大,并不能充分利用虚拟存储器访问的局部性。为了进一步降低虚拟存储器地址转换的硬件开销,现代处理器都维护着一个转换旁路缓冲区(Translation Look-aside Buffer,TLB),用于缓冲经常访问的页表项。
TLB本质上就是一个容量较小的cache,为提高查找速度,大多采用全相联或组相联方式,且采用随机替换算法。TLB离CPU更近,访问速度更快,所以通常将TLB表称为快表,而将主存中的页表称为慢表。
全相联方式的TLB工作逻辑
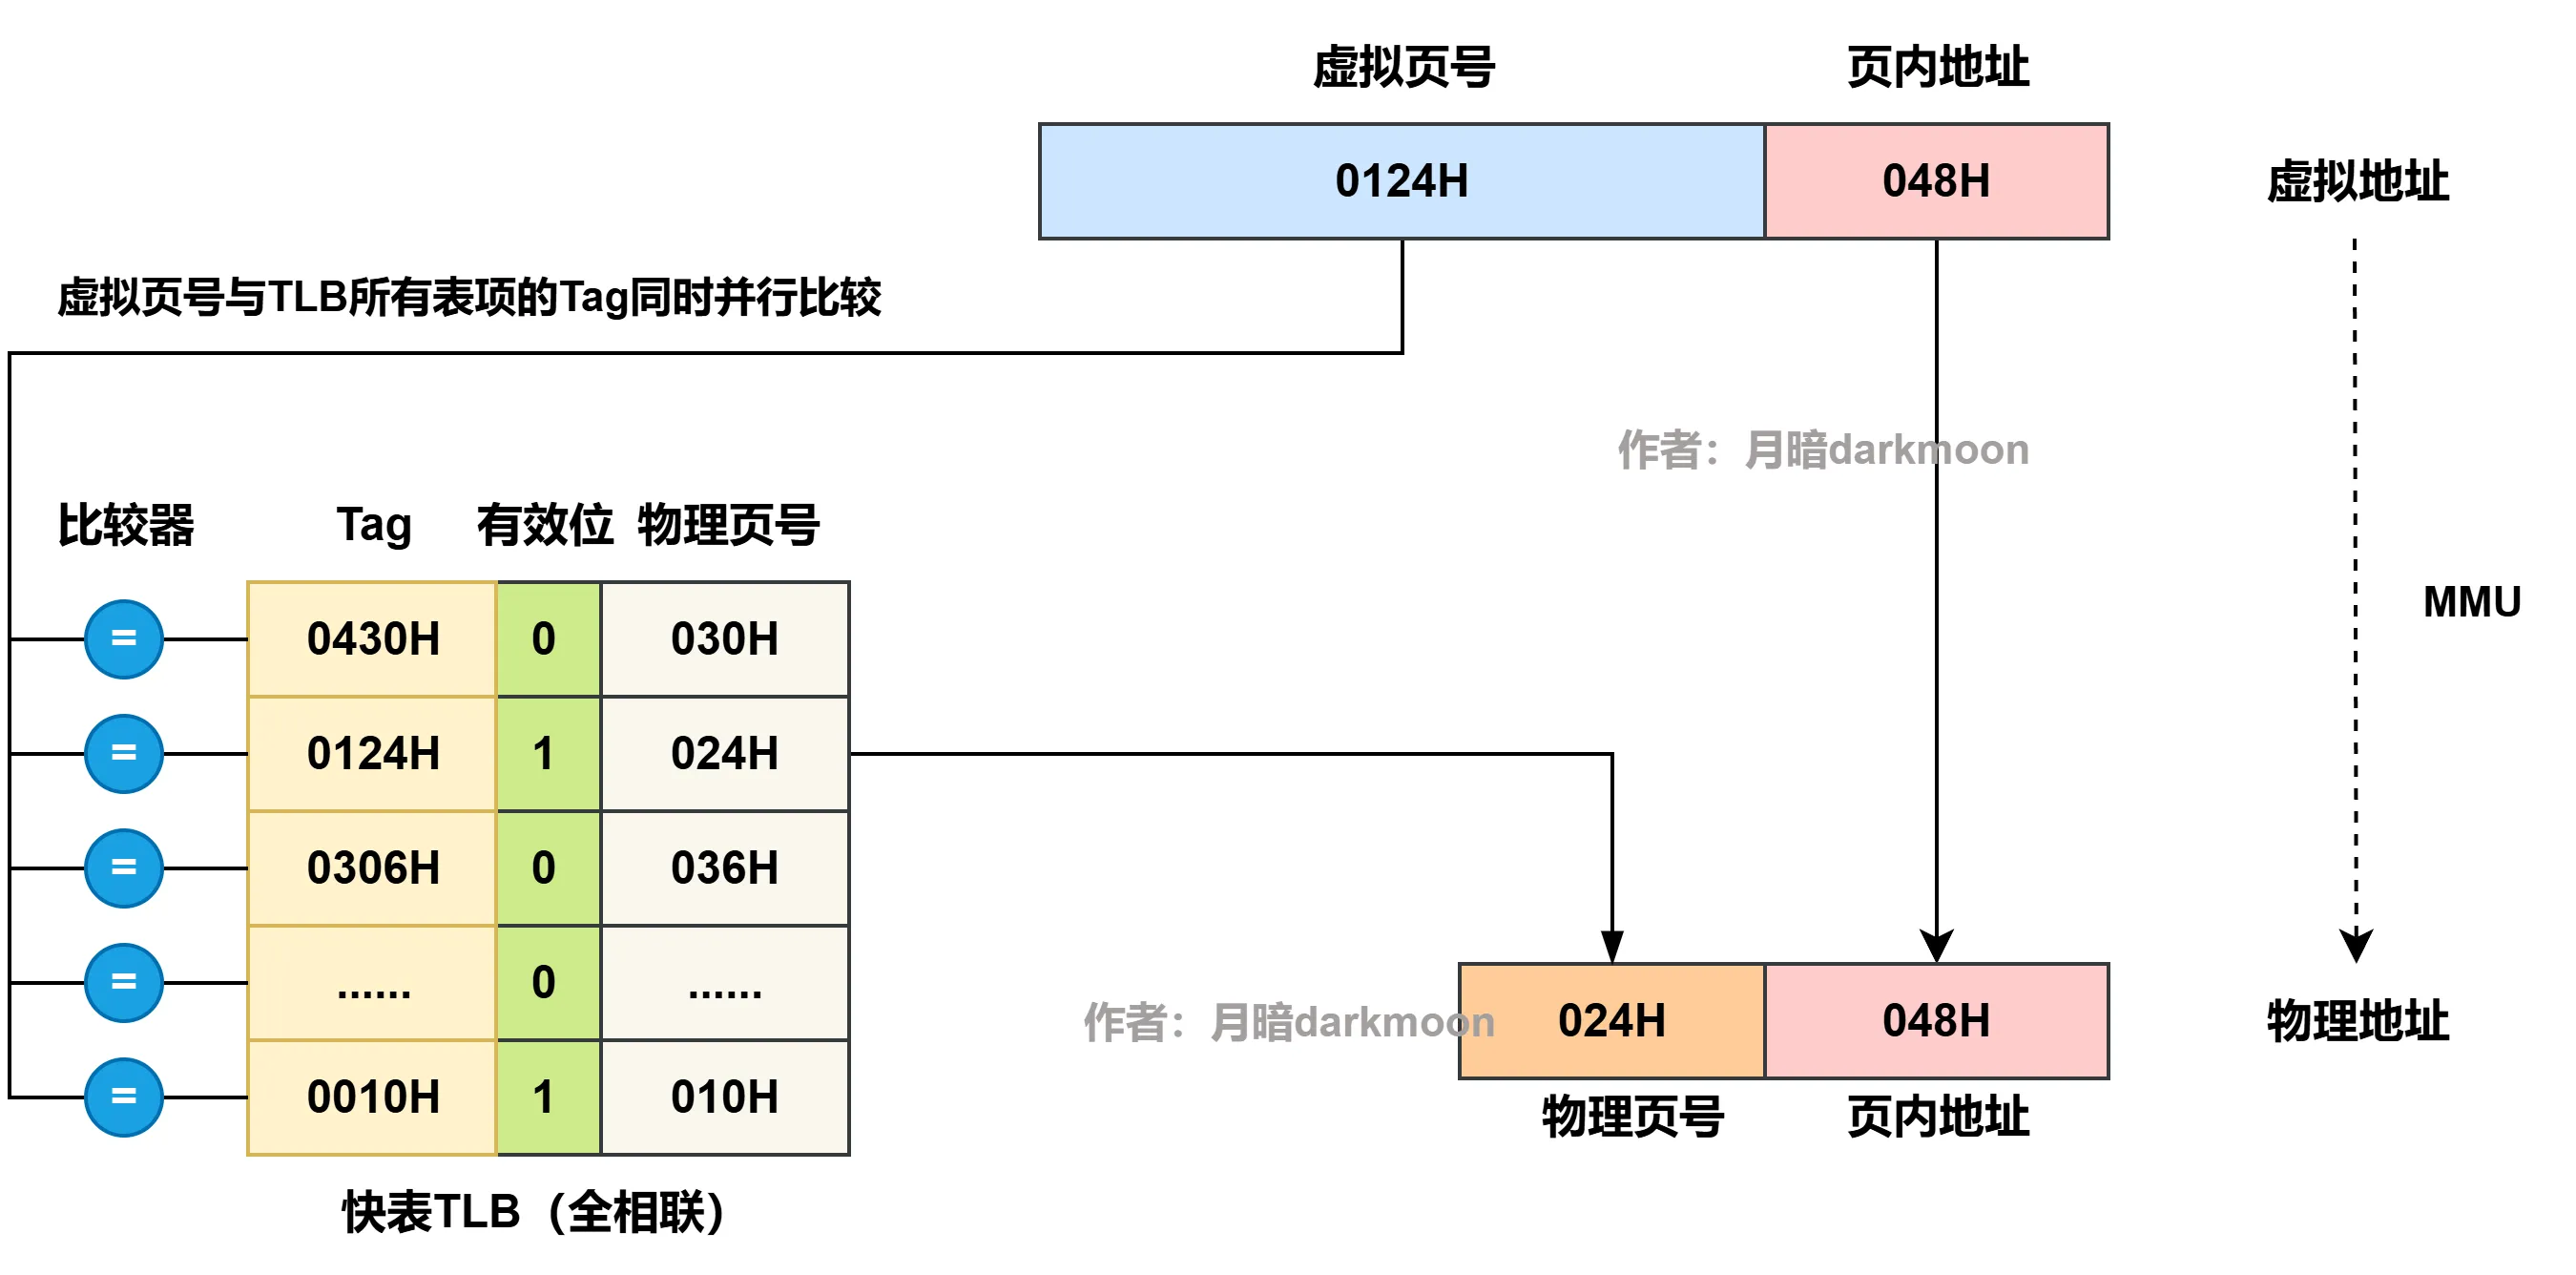
全相联模式下,虚拟地址划分为:虚拟页号 + 虚拟页内偏移。MMU将虚拟页号与TLB内所有页表项的tag标记进行并行比较,若tag匹配且有效位=1,则TLB命中,直接获取物理页号,与页内偏移拼接得到物理地址。
组相联方式的TLB工作逻辑
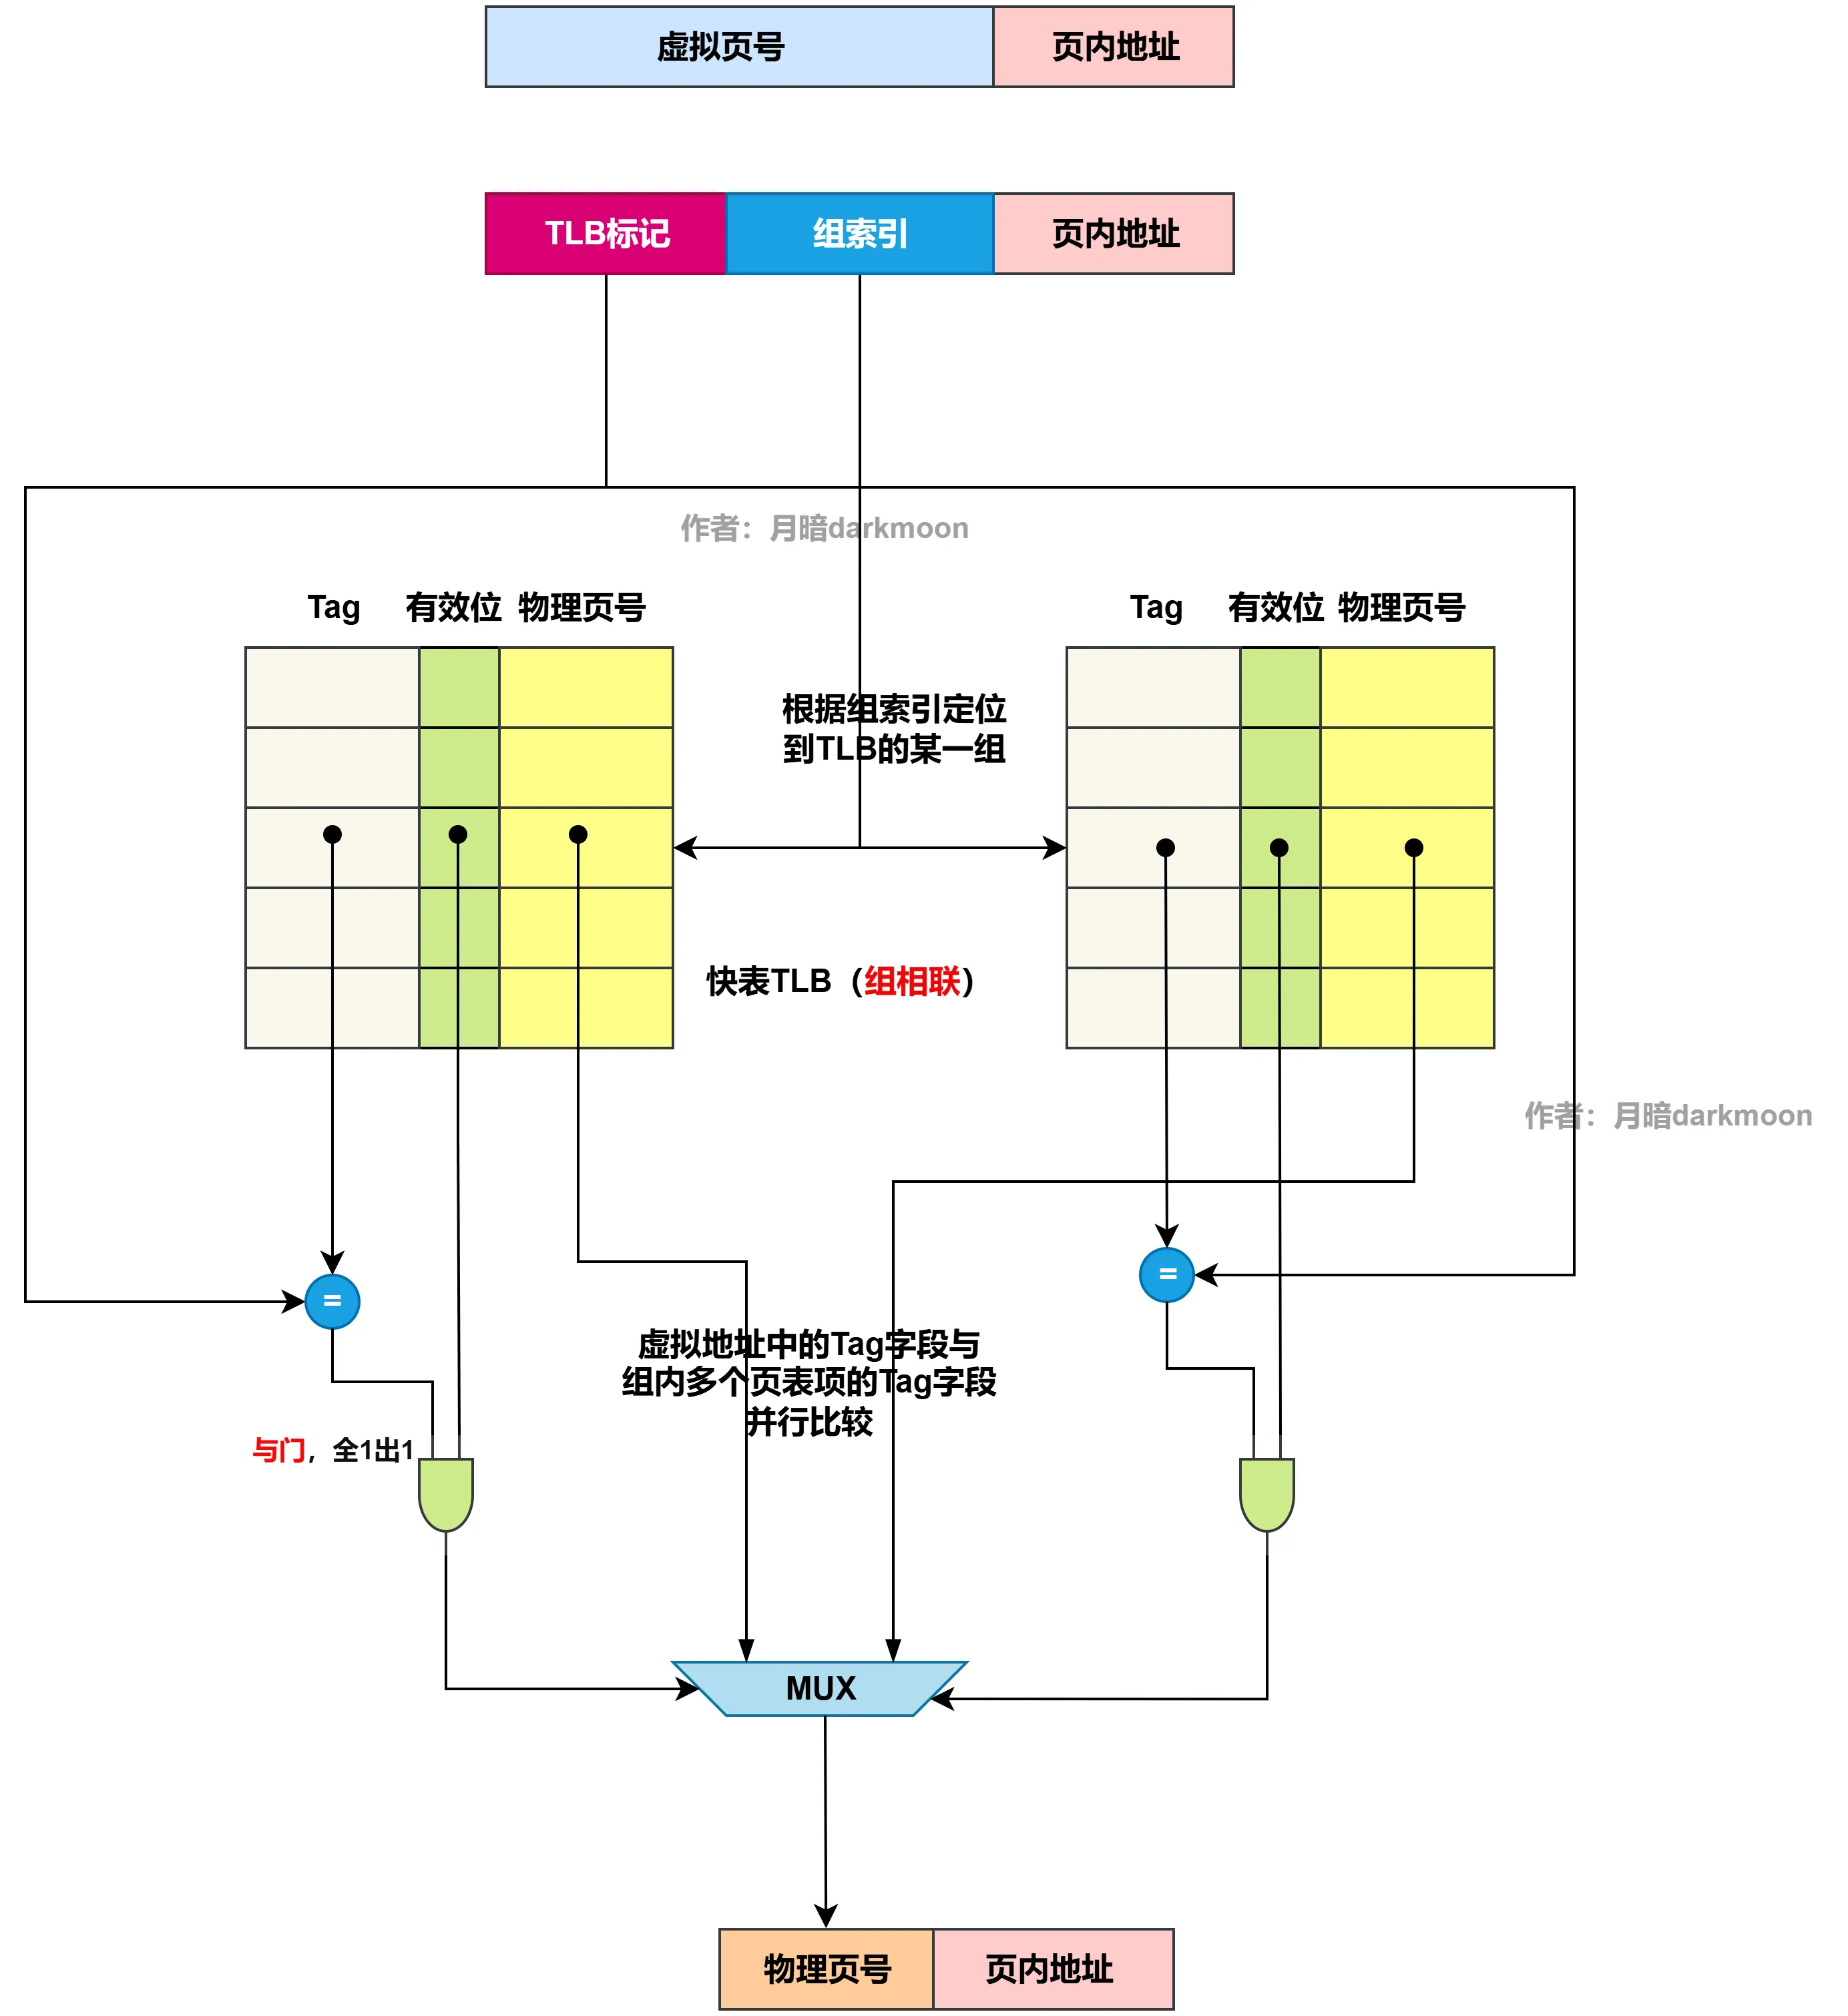
组相联模式下,虚拟地址划分为:TLB标记 + TLB组索引 + 虚拟页内偏移。
以2路组相联为例:
- MMU通过TLB组索引定位到对应的TLB组(每组包含2个页表项);
- 将TLB标记与组内2个表项的标记并行比较,结果与有效位做逻辑与运算,生成选择信号;
- 选中的物理页号与页内偏移拼接,得到最终物理地址。
基于TLB、cache的完整访存流程
采用虚拟存储器技术的计算机,需要硬件(MMU、TLB等)与操作系统协同工作:
- 操作系统引导完成前,CPU使用物理地址访问主存,处于实地址模式(实模式);
- 操作系统引导完成后,CPU进入保护模式(虚地址模式),使用虚拟地址访问主存。
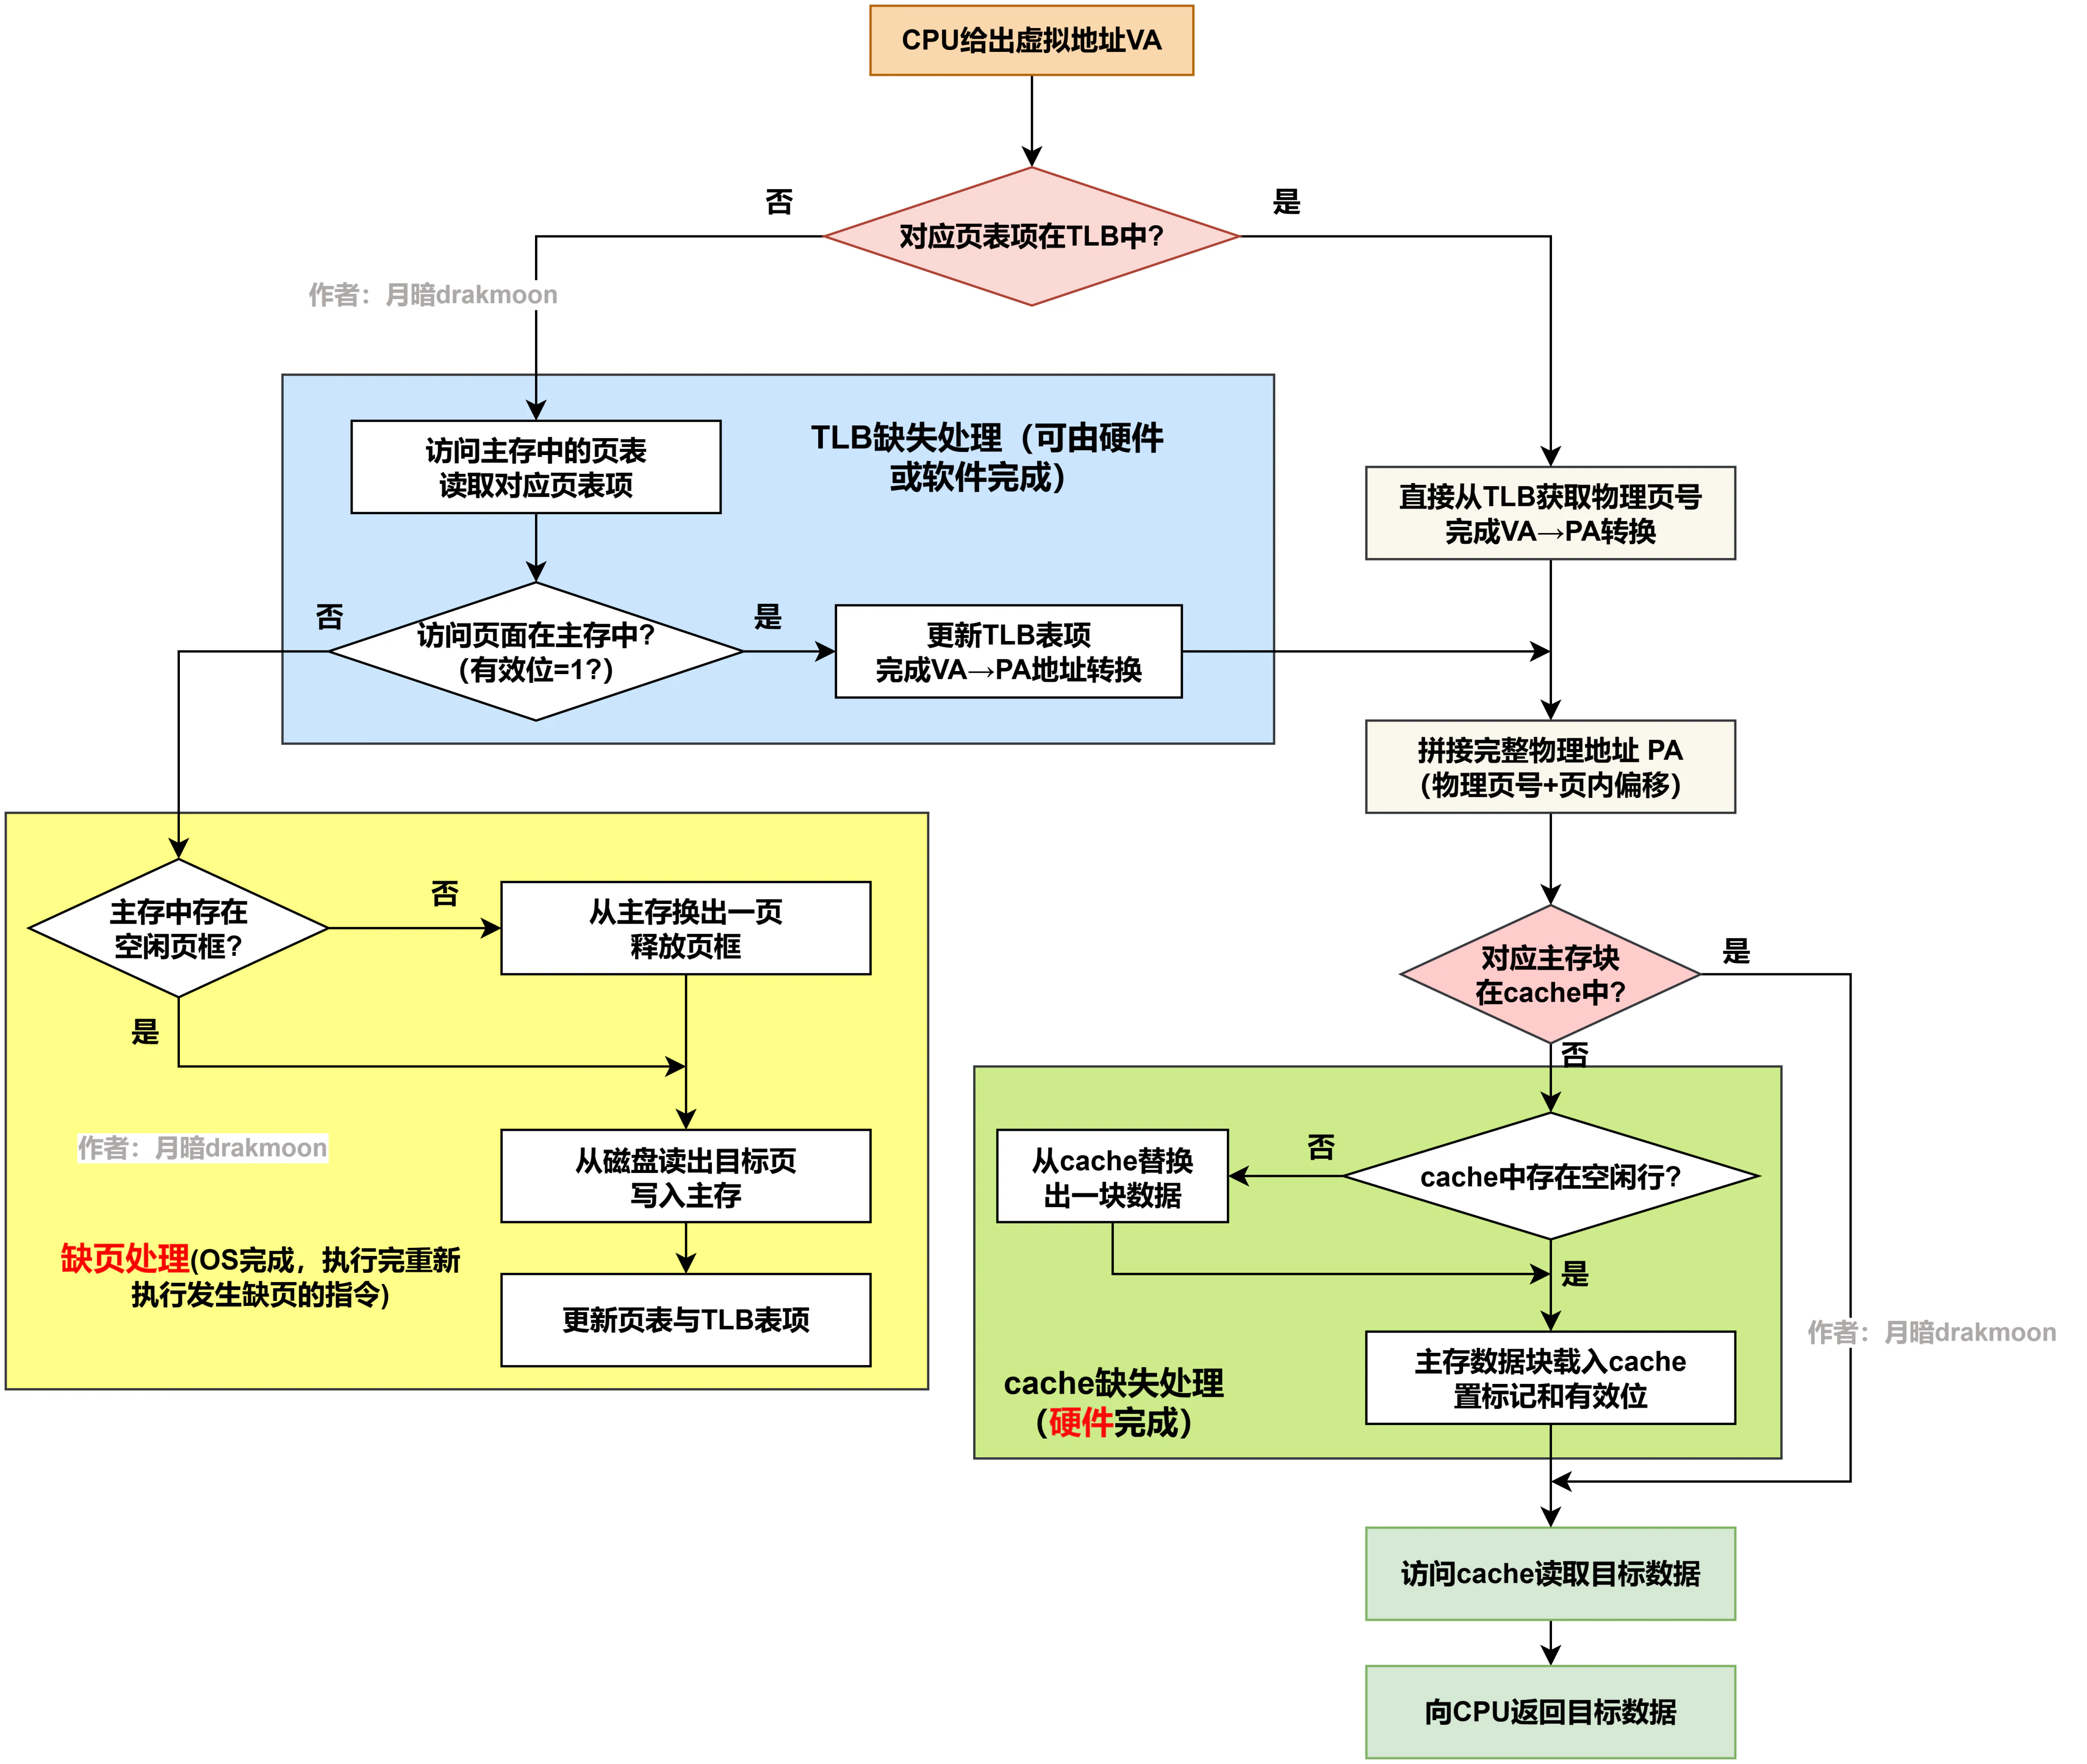
关键说明:cache缺失处理由硬件完成;缺页处理由操作系统(软件)完成;TLB缺失处理可由硬件完成,也可由操作系统通过TLB缺失异常处理程序(软件)完成。
下面该流程图为假设 TLB 采用全相联 随机替换策略, cache 采取组相联 LRU 替换策略时的访存流程

TLB、页表、cache命中/缺失的组合情况
| 场景分类 | TLB | 页 | cache | 可能性 | 核心说明 |
|---|---|---|---|---|---|
| 最好情况: 不访问主存 |
命中 | 命中 | 命中 | 可能 | TLB命中则页一定命中,数据在主存,就可能在cache中 |
访问主存1次 |
命中 | 命中 | 缺失 | 可能 | TLB命中则页一定命中,数据在主存,但可能不在cache中 |
| 缺失 | 命中 | 命中 | 可能 | TLB缺失但页可能命中,数据在主存,就可能在cache中 | |
| 访问主存2次 | 缺失 | 命中 | 缺失 | 可能 | TLB缺失但页可能命中,数据在主存,但可能不在cache中 |
| 最糟情况: 访问磁盘+至少2次主存访问 |
缺失 | 缺失 | 缺失 | 可能 | TLB缺失、页缺失,数据不在主存,必然不在cache中 |
不可能出现的情况 |
命中 | 缺失 | 缺失 | 不可能 | 页缺失,说明信息不在主存,TLB 中一定没有该表项 |
| 命中 | 缺失 | 命中 | 不可能 | ||
| 缺失 | 缺失 | 命中 | 不可能 | 页缺失则数据不在主存,必然不在cache中 |
Cache 与 TLB 对比
| 对比维度 | Cache | TLB |
|---|---|---|
| 缓存对象 | 主存中的数据/指令块 | 内存页表中的页表项 |
| 查询 key | 物理地址(块号部分) | 虚拟页号 VPN |
| 输出结果 | 数据内容 | 物理页号 PPN + 权限 |
| 解决问题 | CPU与主存速度差 | 每次地址翻译都要访问主存页表的开销 |
| 位置 | CPU 芯片内(L1/L2/L3) | MMU 内部 |
| 典型容量 | 32KB ~ 32MB(多级) | 32 ~ 1024 项(1~2级) |
| 映射方式 | 直接/组相联/全相联 | 全相联或组相联 |
| 缺失处理 | 硬件自动完成 | 硬件或OS(视架构) |
| 进程切换 | 无需刷新 | 需刷新 |
一句话区分:Cache 加速"取数据",TLB 加速"找地址"。
在访存流程中的位置
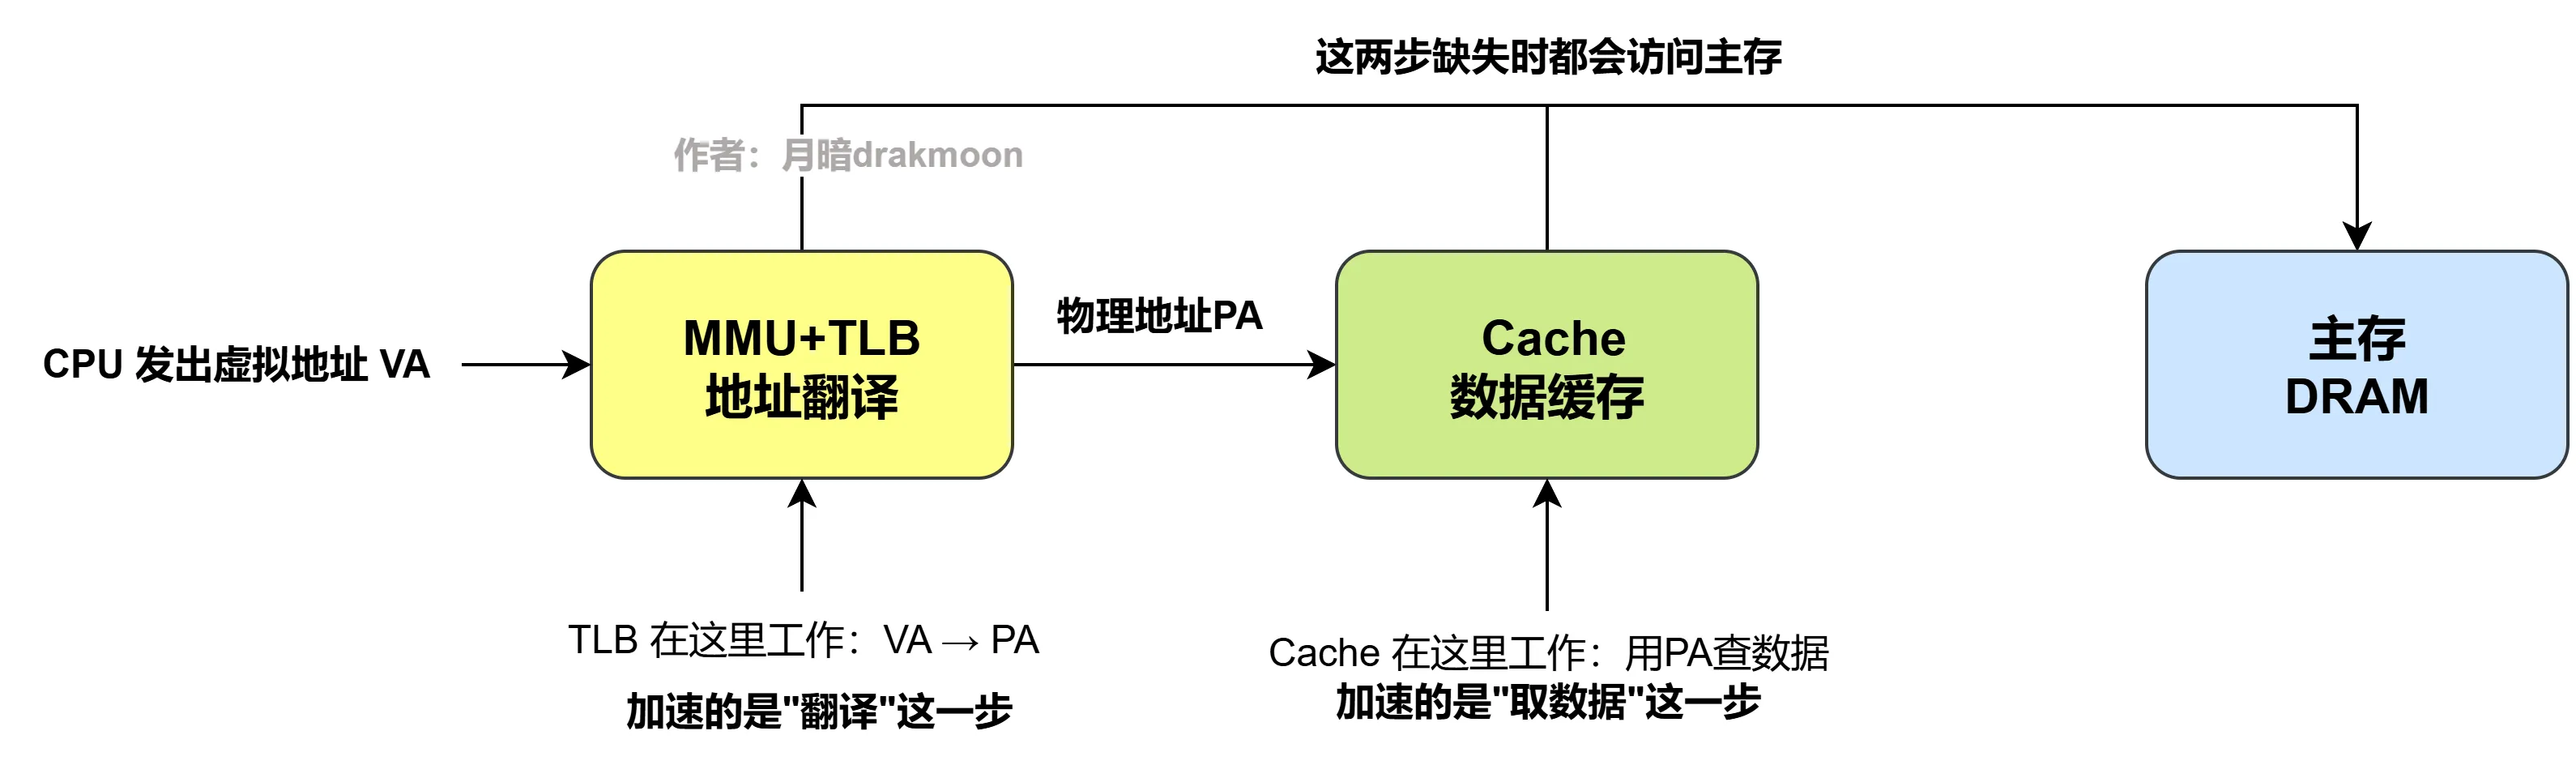
二者缺失后的处理方式
这是两者最显著的差异:

关键区别:Cache 缺失永远由硬件处理;TLB 缺失在某些架构下需要 OS 介入,缺页时必须 OS 介入。
进程切换时的行为不同
| 事件 | Cache | TLB |
|---|---|---|
| 进程切换 | 不需要刷新,物理地址是全局唯一的,不同进程的 Cache 内容可以共存 | 需要刷新,否则新进程会用到旧进程的翻译结果 |
| 原因 | Cache 的 key 是物理地址,物理地址全局唯一 | TLB 的 key 是虚拟地址,不同进程的相同虚拟地址映射到不同物理地址 |