第四章文件管理
【考纲】
Tip
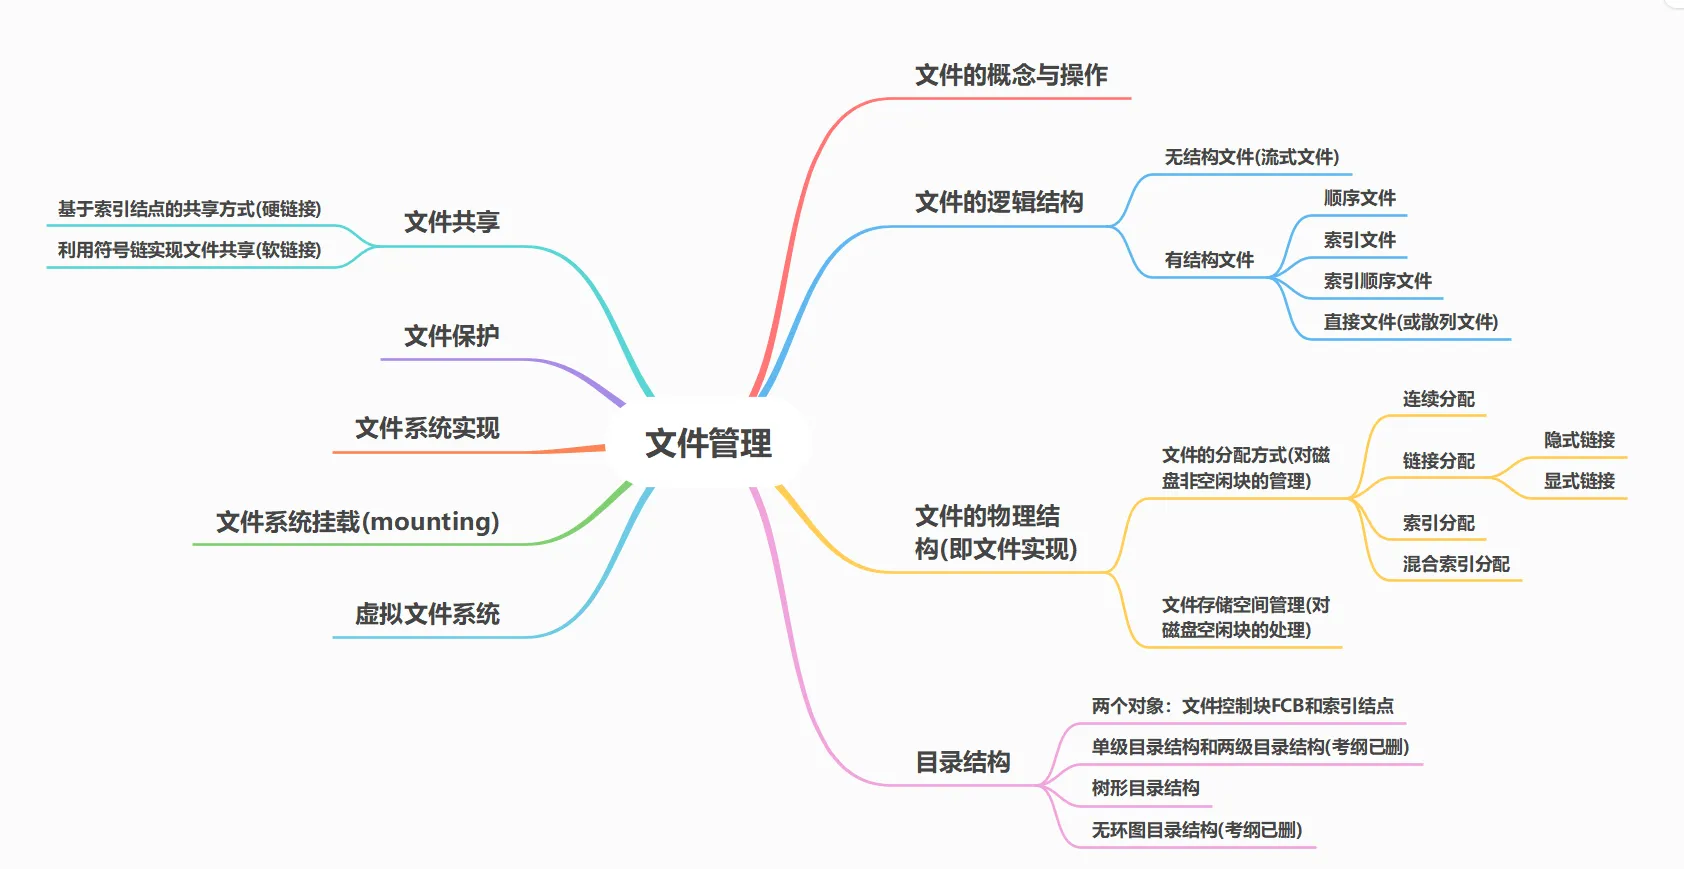
- 文件:
- 文件的基本概念;
- 文件元数据和索引节点(inode);
- 文件的操作:建立;删除;打开;关闭;读;写;
- 文件的保护;
- 文件的逻辑结构;
- 文件的物理结构
- 目录:
- 目录的基本概念;
- 树形目录;
- 目录的操作;
- 硬链接与软链接
- 文件系统:
- 文件系统的全局结构(layout);文件系统在外存中的结构;文件系统在内存中的结构;
- 外存空闲空间管理方法;
- 虚拟文件系统;
- 文件系统挂载(mounting)
【考频统计】
| 年份 | 考点 | 分值 |
|---|---|---|
| 2009 | 文件控制块\(FCB\)、文件共享(硬链接、符号链接)、文件物理结构之文件的分配方式 | 3*2=\(6\)分 |
| 2010 | 文件的物理结构(多级索引分配)、目录 | 2*2=\(4\)分 |
| 2011 | 文件的物理结构(文件分配方式)、\(FCB\) | \(7\)分 |
| 2012 | 文件操作(\(read\)系统调用)、文件的物理结构(索引分配) | 2+8=\(10\)分 |
| 2013 | 文件操作(删除)、文件的物理结构、索引结点 | 3*2=\(6\)分 |
| 2014 | 空闲区管理(位图法)、文件操作(打开文件)、文件物理结构之文件的分配方式(大题) | 4+6=\(10\)分 |
| 2015 | 文件的物理结构(索引分配)、空闲区管理(位图法) | 2*2=\(4\)分 |
| 2016 | 文件物理结构之链接分配大题\(FAT\) | \(9\)分 |
| 2017 | 文件控制块、文件保护、文件共享(硬链接)、文件操作(打开文件)、索引结点、 | 2*2=\(4\)分 |
| 2018 | 文件访问速度、文件的物理结构(索引分配) | 2+7=\(9\)分 |
| 2019 | 空闲区管理、索引结点、\(FAT\) | \(2\)分 |
| 2020 | 文件共享、文件操作(打开文件)、文件物理结构之文件的分配方式、目录 | 3*2=\(6\)分 |
| 2021 | 文件操作(删除文件) | \(2\)分 |
| 2022 | 大题:文件的物理结构(索引分配)、目录、目录项、打开文件 | \(7\)分 |
| 2023 | 空闲区管理(位图法)、文件操作(打开文件、关闭文件)、目录、目录项 | \(4\)分 |
文件
1.1 文件的基本概念
1.2 文件元数据和索引节点(inode)
1.3 文件的操作
1.3.1 open系统调用
磁盘索引结点与内存索引结点
Note
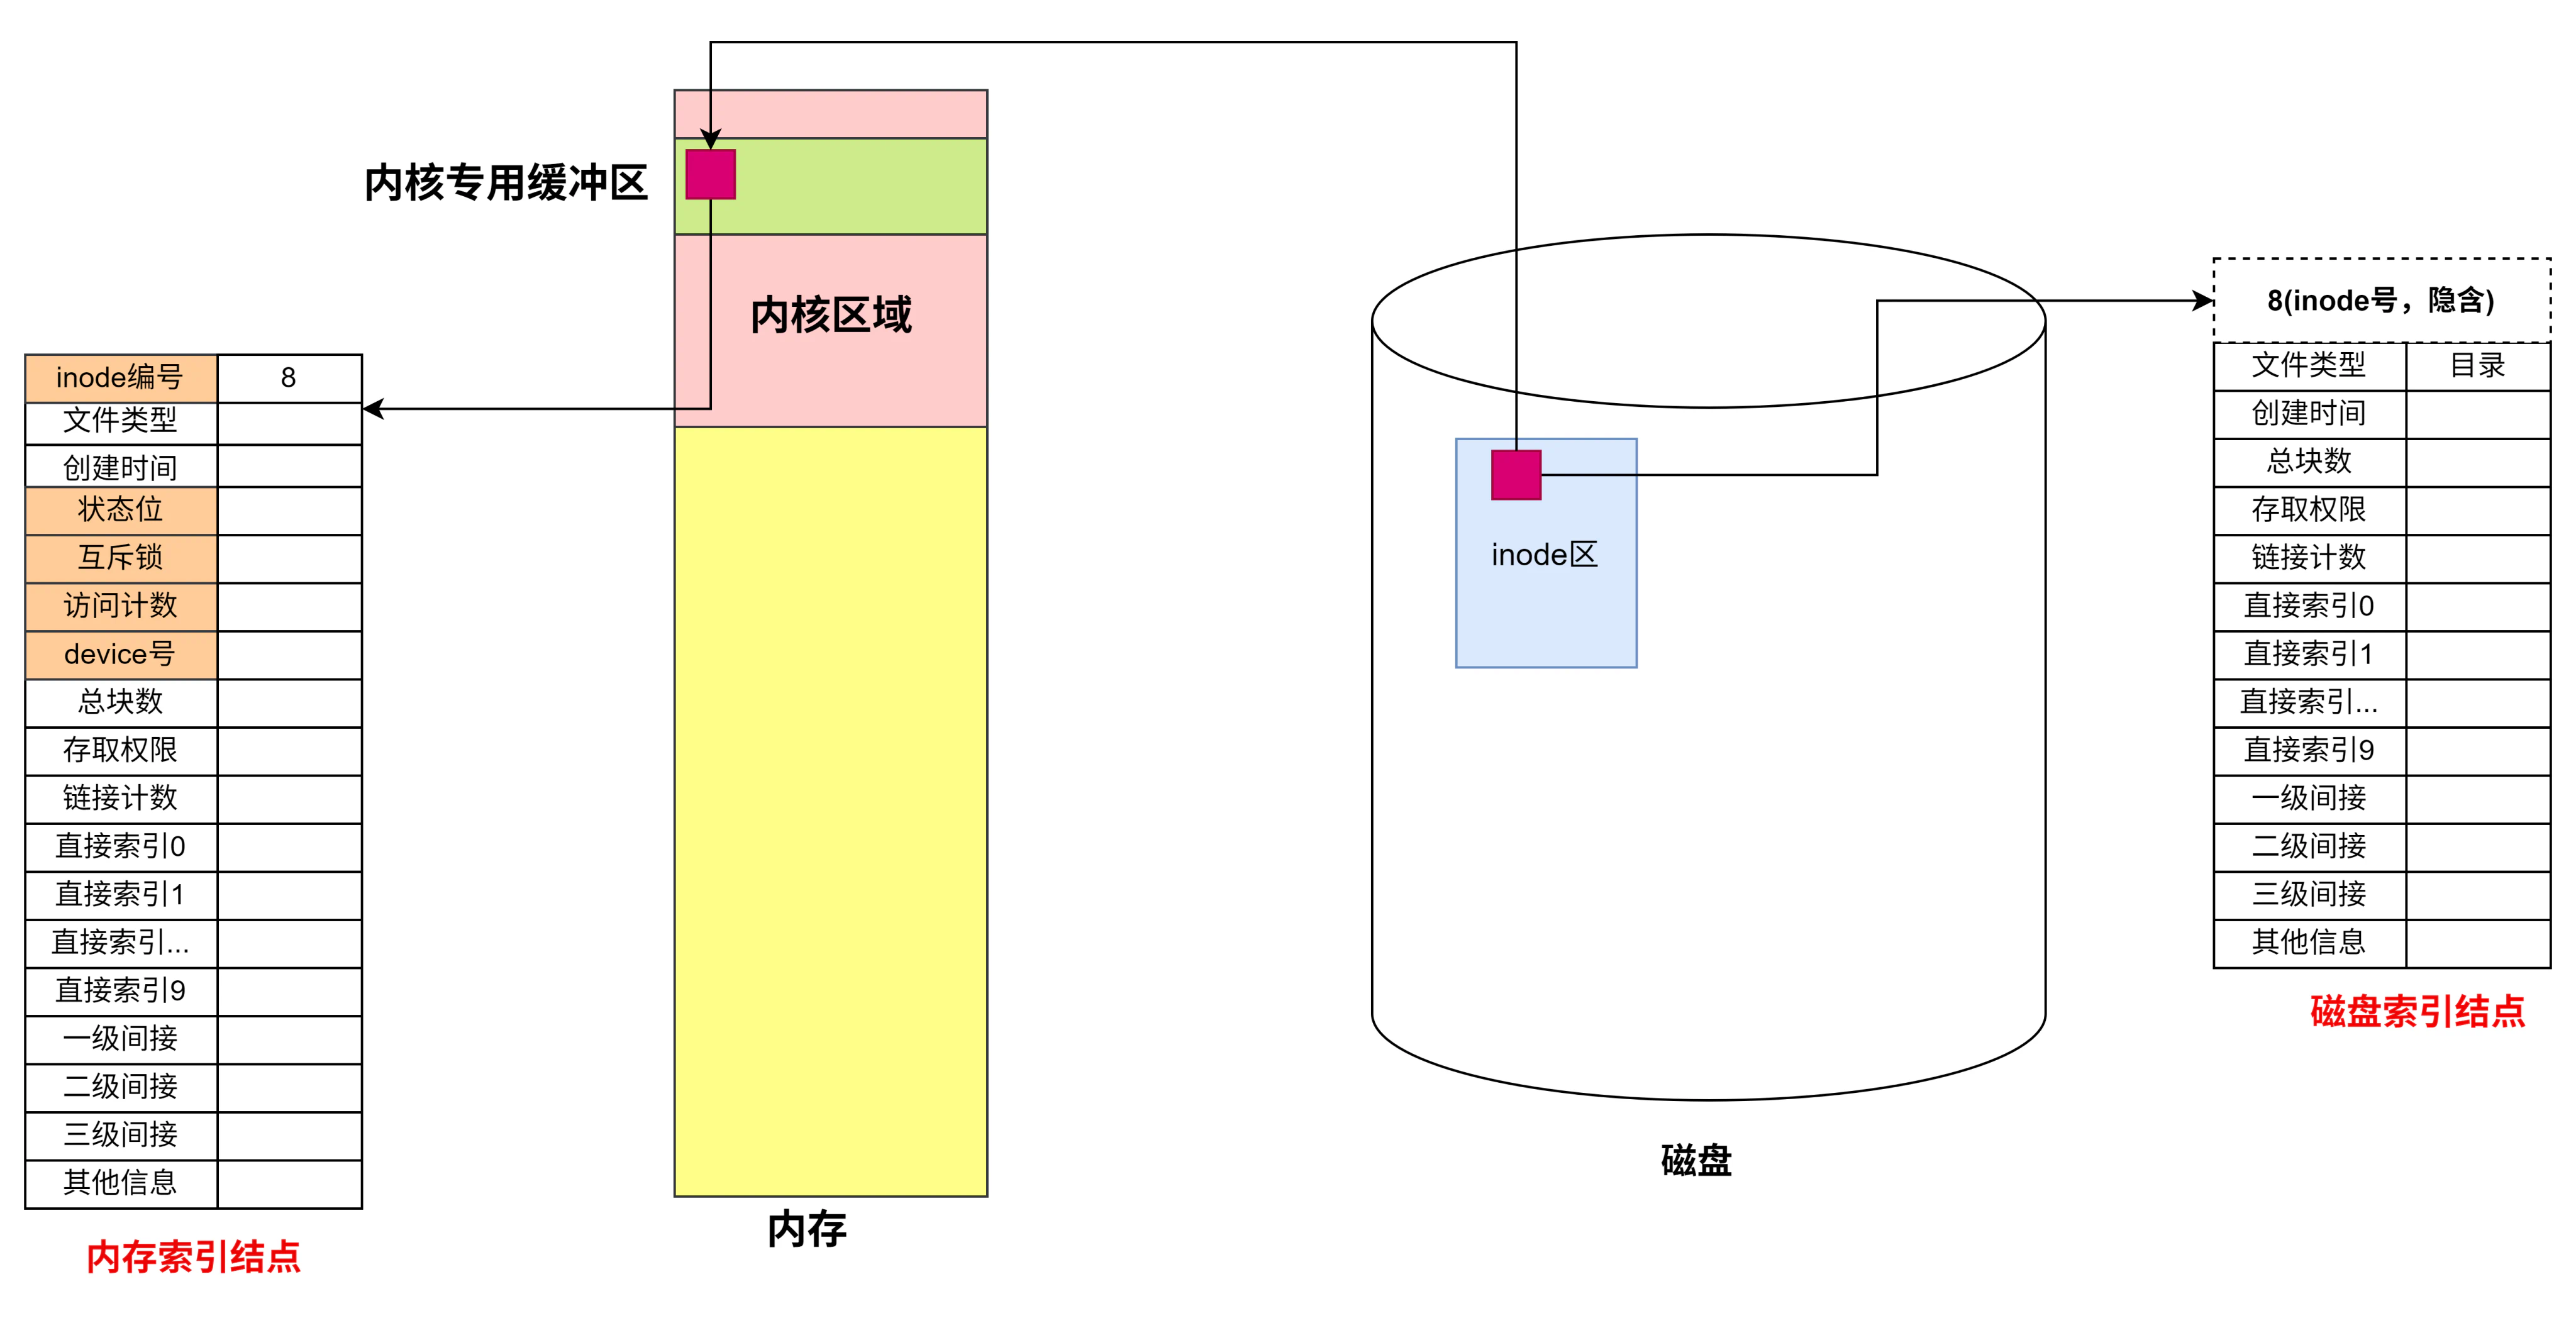
- 磁盘索引结点存放在磁盘的inode区中,进程通过检索目录获取文件名对应的目录项,并根据里面的inode号将对应的索引结点载入内存,索引节点里面存放着文件的元数据,里面有着文件类型、存取权限、创建时间、物理地址(直接索引、间接索引)、链接计数/文件大小(总块数)等信息;
- 文件类型:标识该文件是目录/普通文件/软链接等
- 存取权限:控制文件的访问权限
- 物理地址(直接索引、间接索引等):实现逻辑地址到磁盘物理地址的映射
- 链接计数:记录文件被硬链接的次数
- 其他信息:如文件大小、创建时间等辅助信息
- 当磁盘索引结点调入内存(内核专用缓冲区)以后,可以供多个进程共享使用,因此需要增加一些内存属性以便操作系统使用,如
- inode编号:标识对应外存inode的编号
- 状态位:包含修改位(决定是否需要写回外存)
- 互斥锁:保证多进程共享访问时的互斥
- 访问计数:记录文件被打开的次数
- device号:标识inode所在的逻辑设备号
在某些系统的设计中,为了不在内存inode中加入太多信息使其冗余,便建立一张系统级打开文件表,每个表项对应一个已经打开的文件(即inode已经载入内存),表项中保存了inode在内存中的位置信息以及其他附属信息。
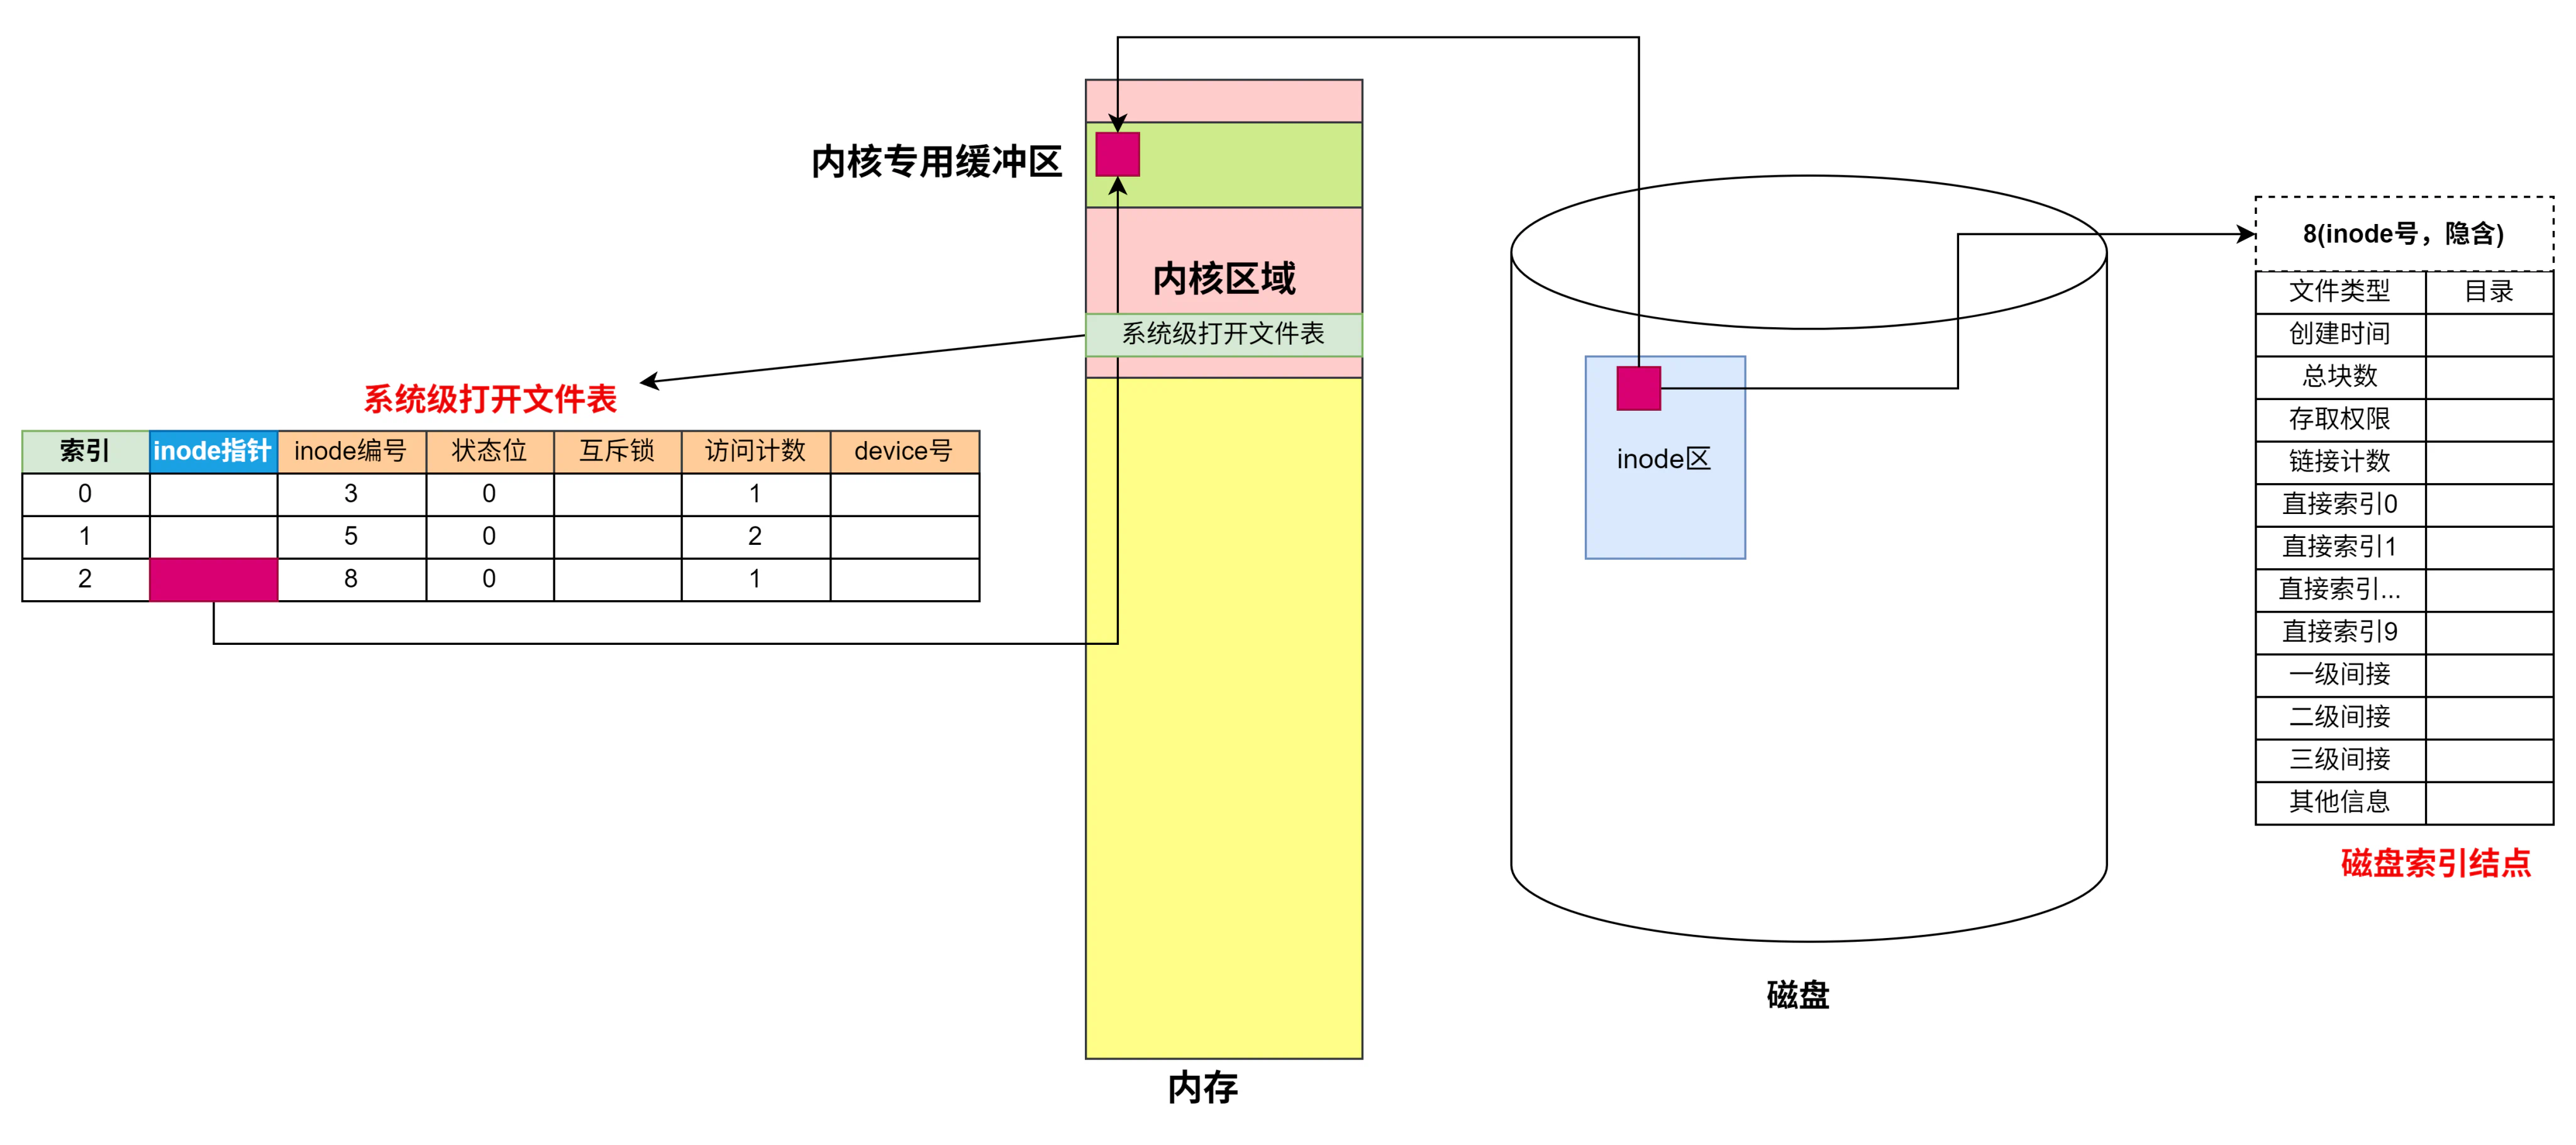
各进程虽然可以共享已经装入内存的inode(系统级打开文件表中的表项),但是每个进程对于文件的访问可能有模式/访问速度等各方面的差异,为了记录不同进程对于文件的不同访问情况,操作系统为每个进程创建了一张进程级打开文件表(或文件描述符表/用户级打开文件表),该表的物理地址被记录在进程PCB中,这个表也是在内存中的内核区域(不能在用户态下访问)
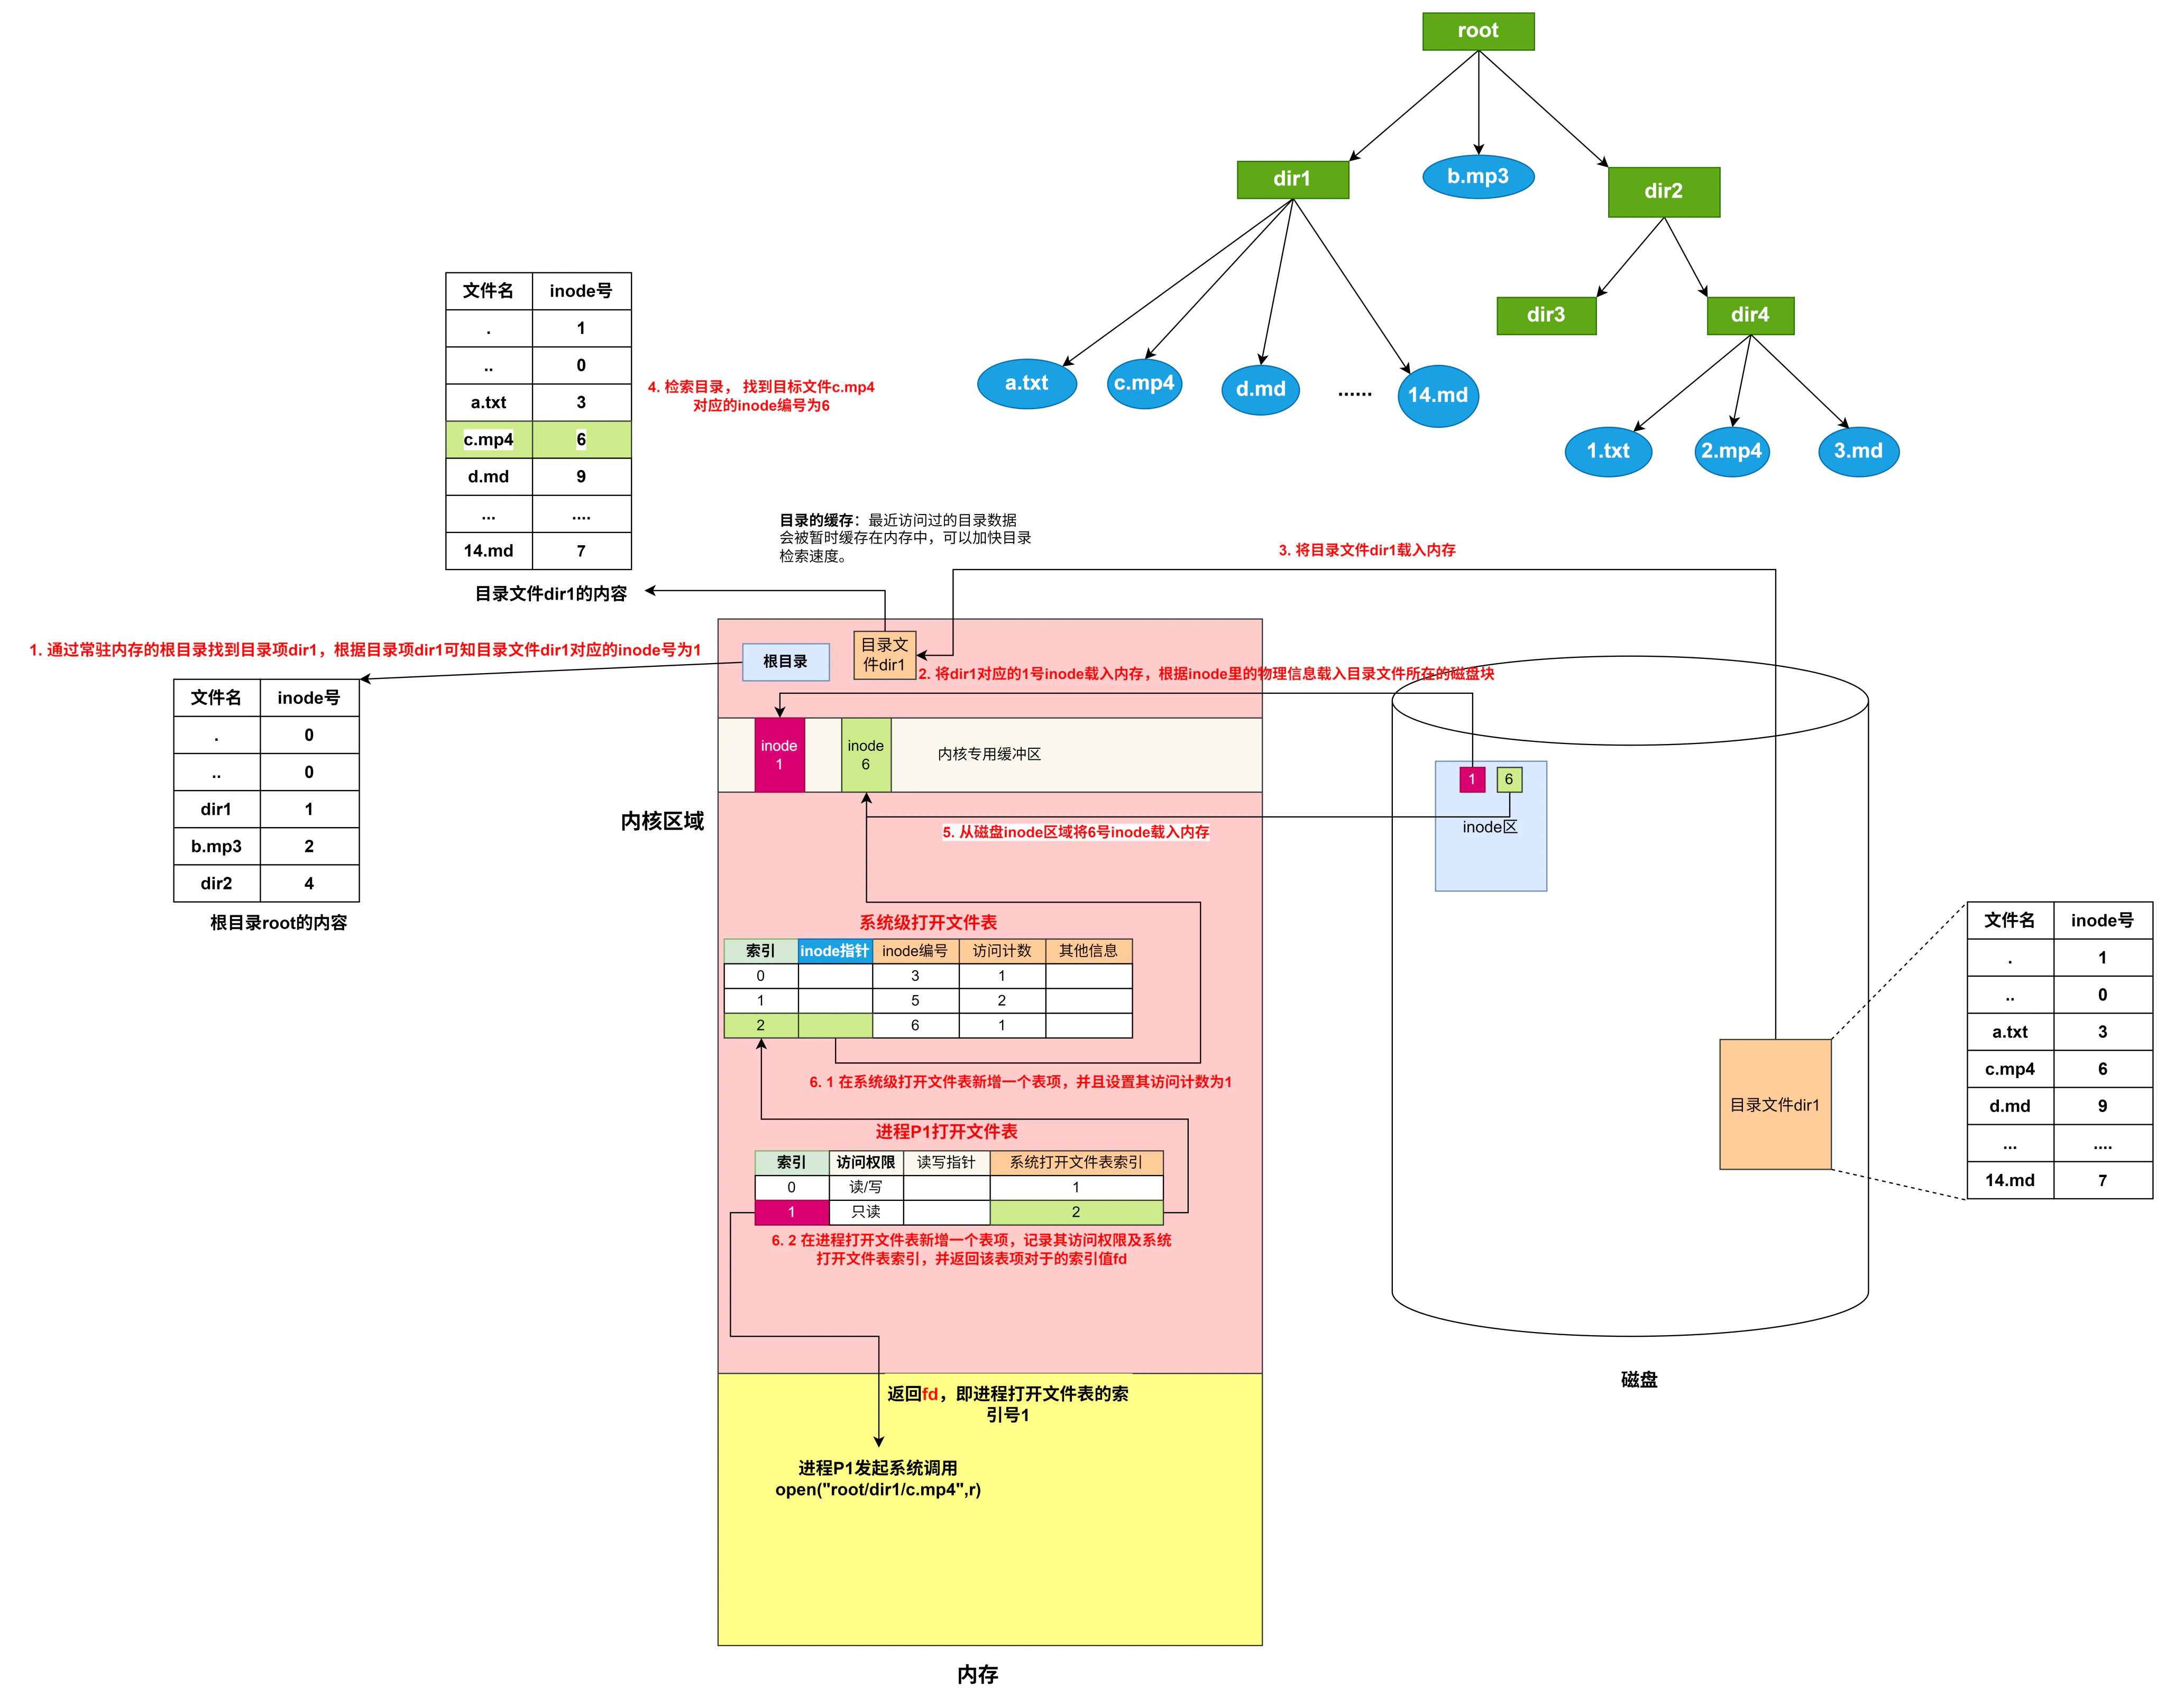
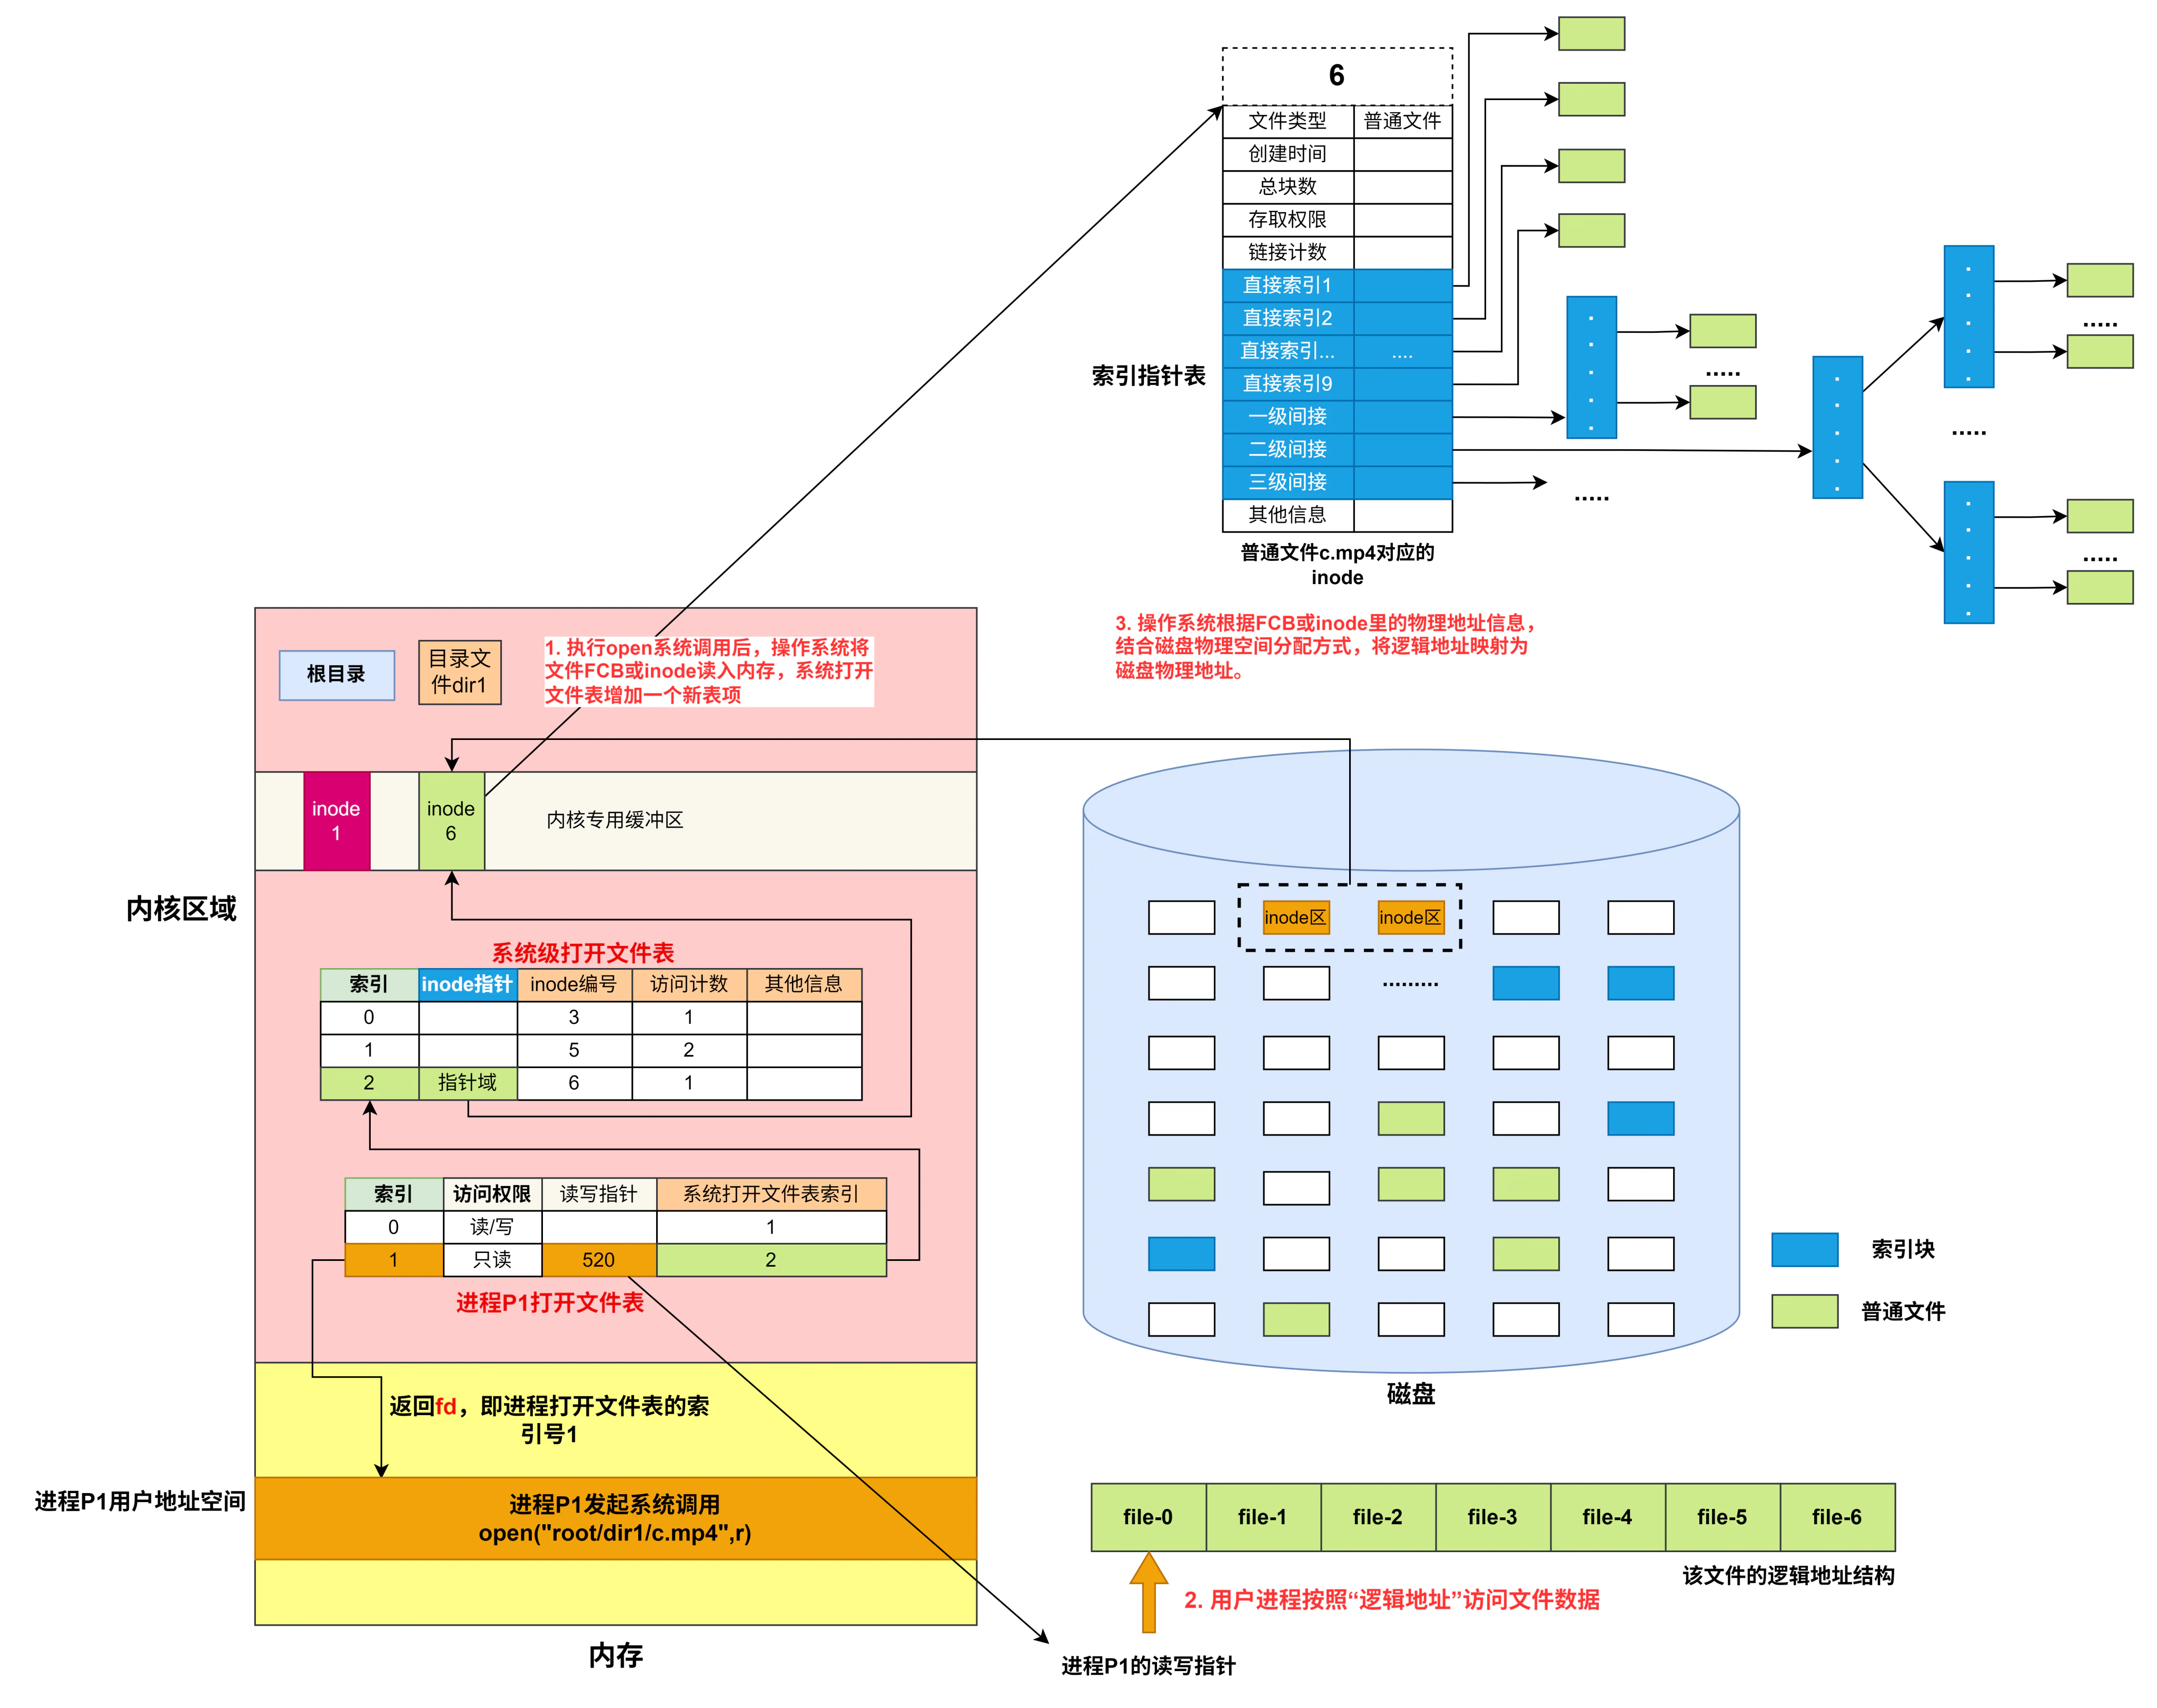
假设进程P1首次打开使用fd = open("root/dir1/c.mp4",r),并且该文件之前从未有人打开过,下面便是这个打开文件背后所做的事
Tip
open系统调用必要参数:文件路径,访问权限(如只读、读&写)。打开文件后,文件的读写和关闭都不再以文件路径为参数,而是以打开文件返回的文件标识符fd为参数,即必须打开文件后,才可以进行文件读写和关闭操作。
因此,我们可以总结一下open系统调用的处理过程
- 根据路径查找各级目录,如果在目录缓存中没有命中,就去磁盘中将目录文件读入内存,逐层检索直到找到目标文件的目录项
- 根据目录项,得到inode编号,然后根据该编号,去系统打开文件表中检索
- 如果未命中,需要从磁盘中将该inode结点载入内核专用缓冲区,检查是否逾越访问权限,如果没有,在系统级打开文件表中新增一个表项,访问计数记为1,并将inode在内存中的位置信息记录在inode指针里;如果访问非法,则此次打开失败;
- 如果命中,且没有访问越权,则将访问计数值+1;
- 在进程打开文件表中,新建一个表项,并记录其对应的系统打开文件表索引;
- 将该表项的索引值作为fd返回给用户进程
【2014-29】在一个文件被用户进程首次打开的过程中,操作系统需要做的是( )。
A. 将文件内容读到内存中
B. 将文件控制块读到内存中
C. 修改文件控制块中的读写权限
D. 将文件的数据缓冲区首指针返回给用户进程
各进程读取打开文件的起始位置被记录在(C)
A、外存索引节点中
B、系统级打开文件表中
C、用户级打开文件表中
D、文件对应的目录项中
解析:文件指针用来记录各进程对文件的读写位置被记录在用户级打开文件表的表项中,选 C(linux 里面是放在系统打开文件表的表项)
open系统调用执行成功之后
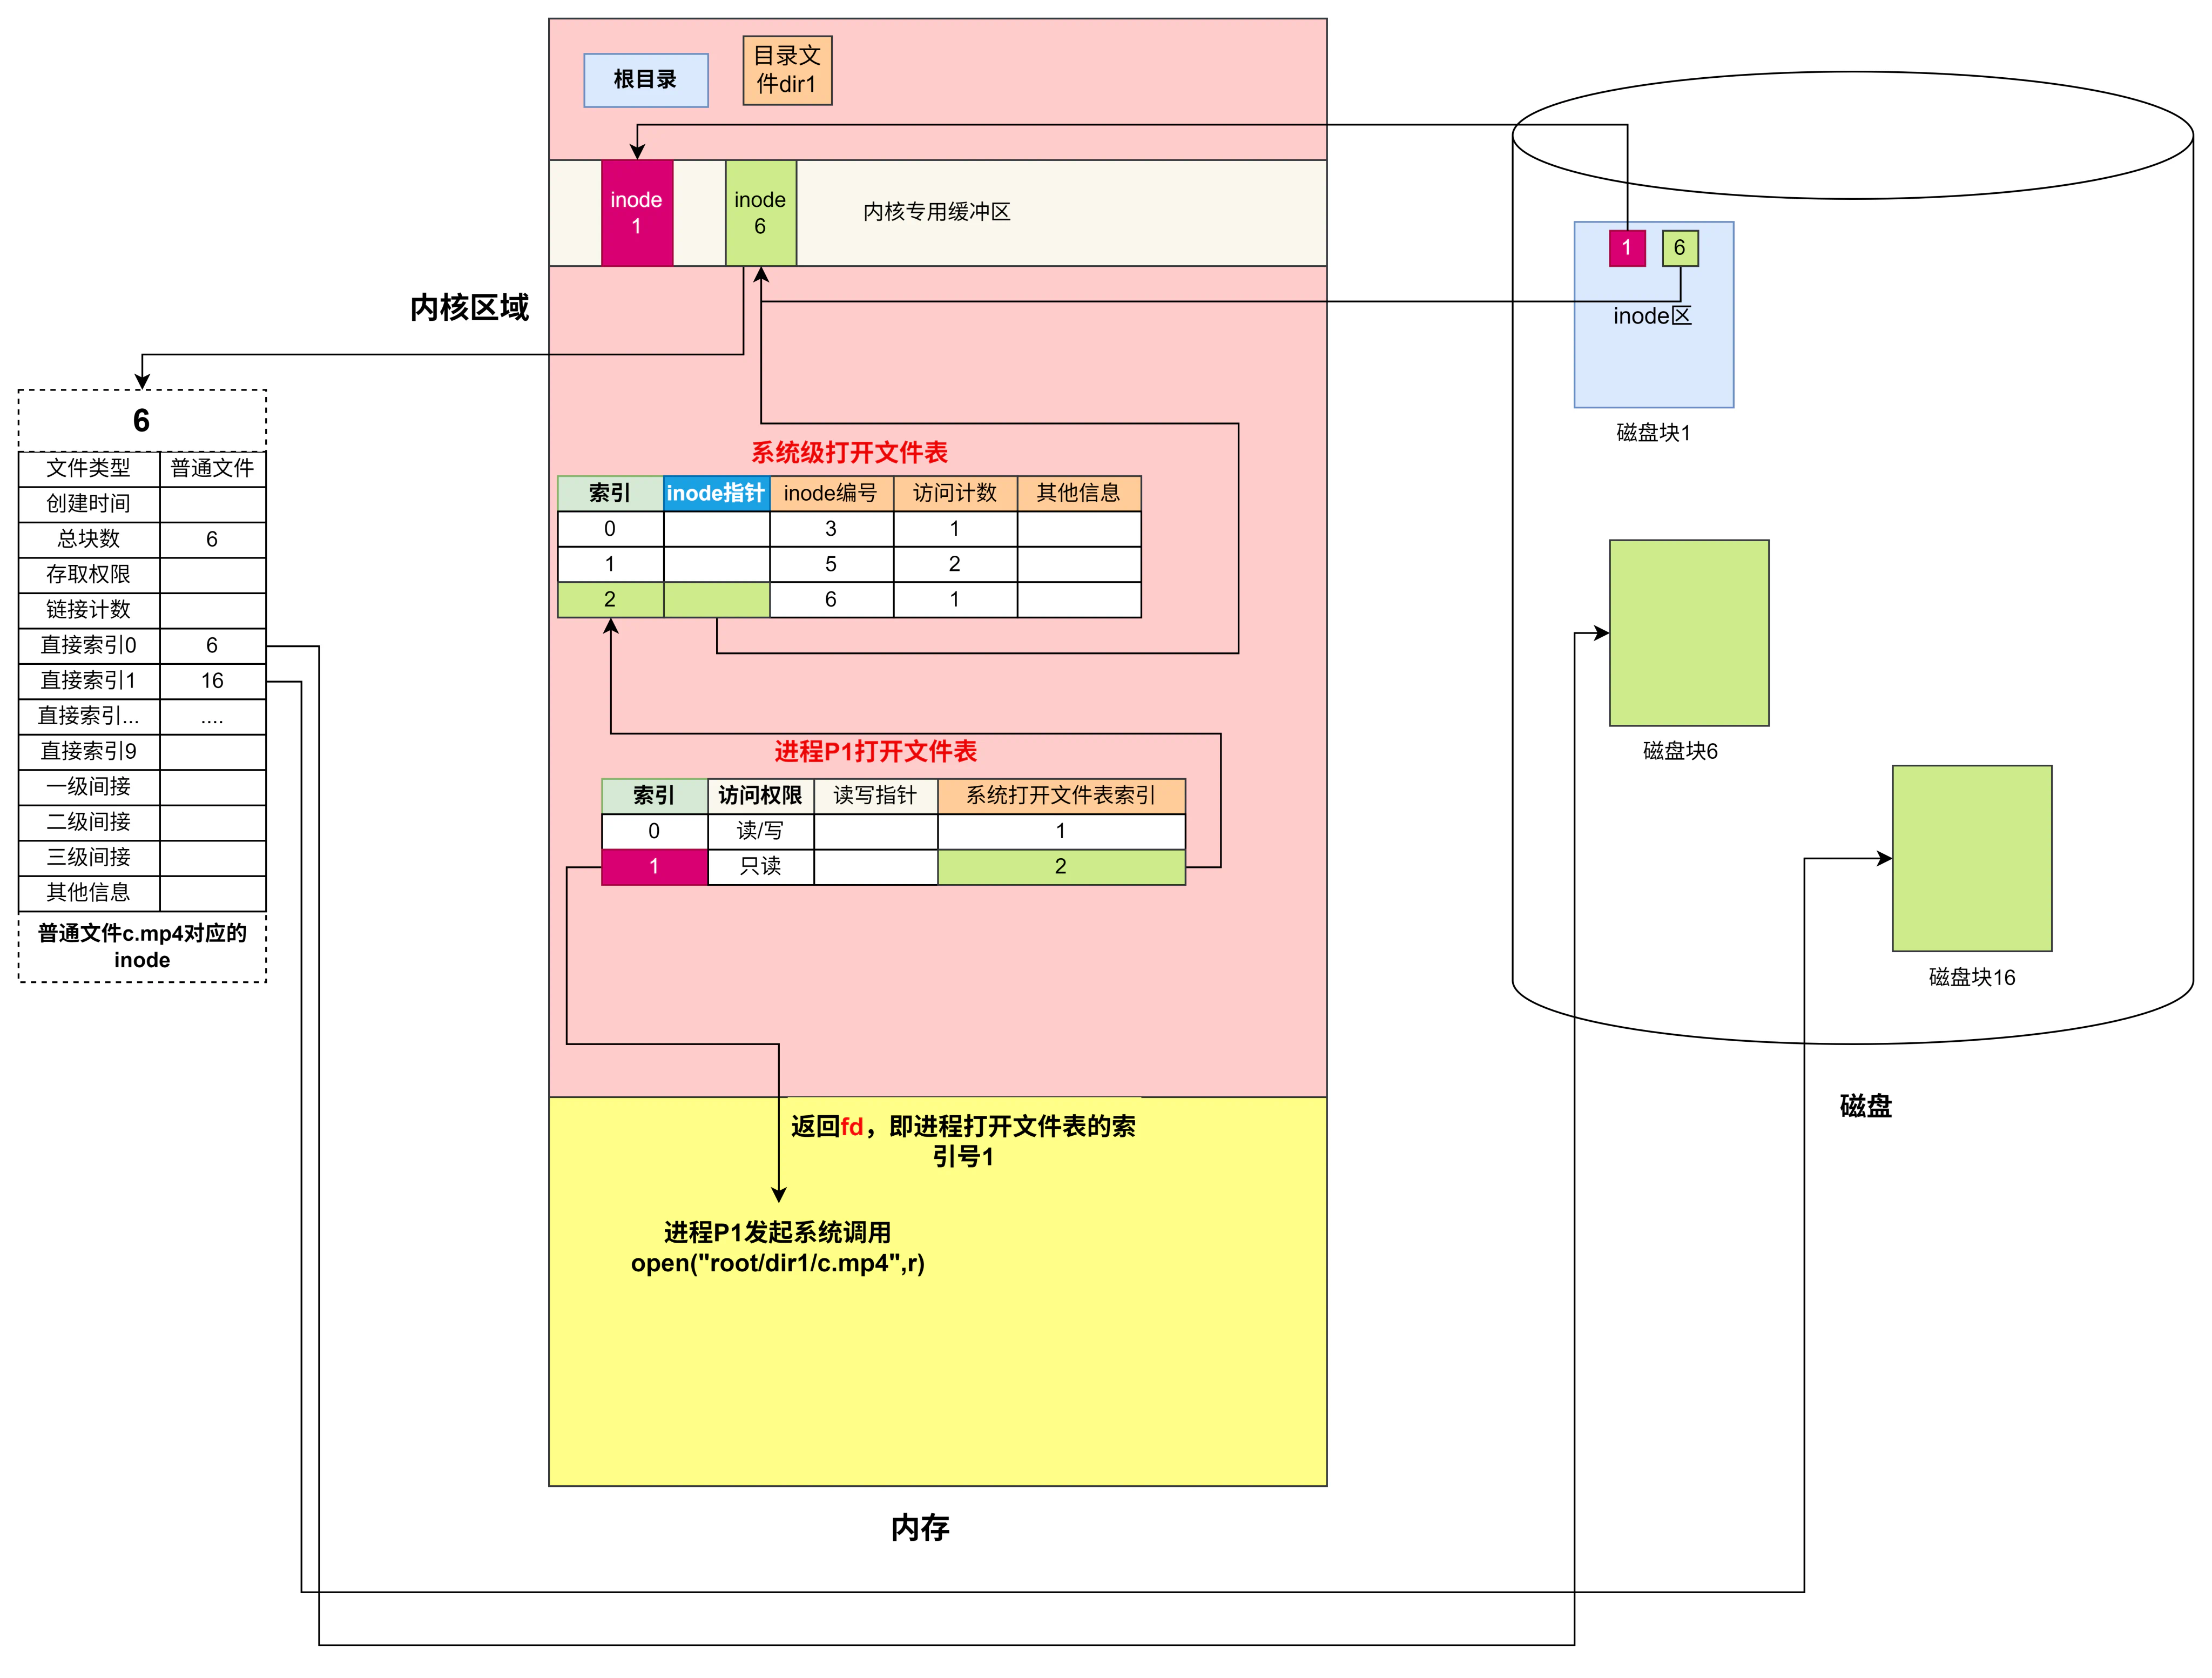
- 第一次open文件成功之后,会将该文件的inode结点调入内存,并且修改系统打开文件表和进程打开文件表,并且会返回给进程一个fd;
- 之后进程需要访问该文件,只需要根据fd去查找自己的进程打开文件表(该表的起始地址在进程PCB里面),找到对应表项,再去查对应的系统打开文件表的表项,找到目标文件inode结点的物理位置信息,便能够访问该inode结点;
- inode结点里面记录了该文件的磁盘物理地址信息(例如本例,从文件c.mp4的inode我们可以知道,该文件的第一个磁盘块号为6号,第二个磁盘块为16号)
多个进程打开同一个文件
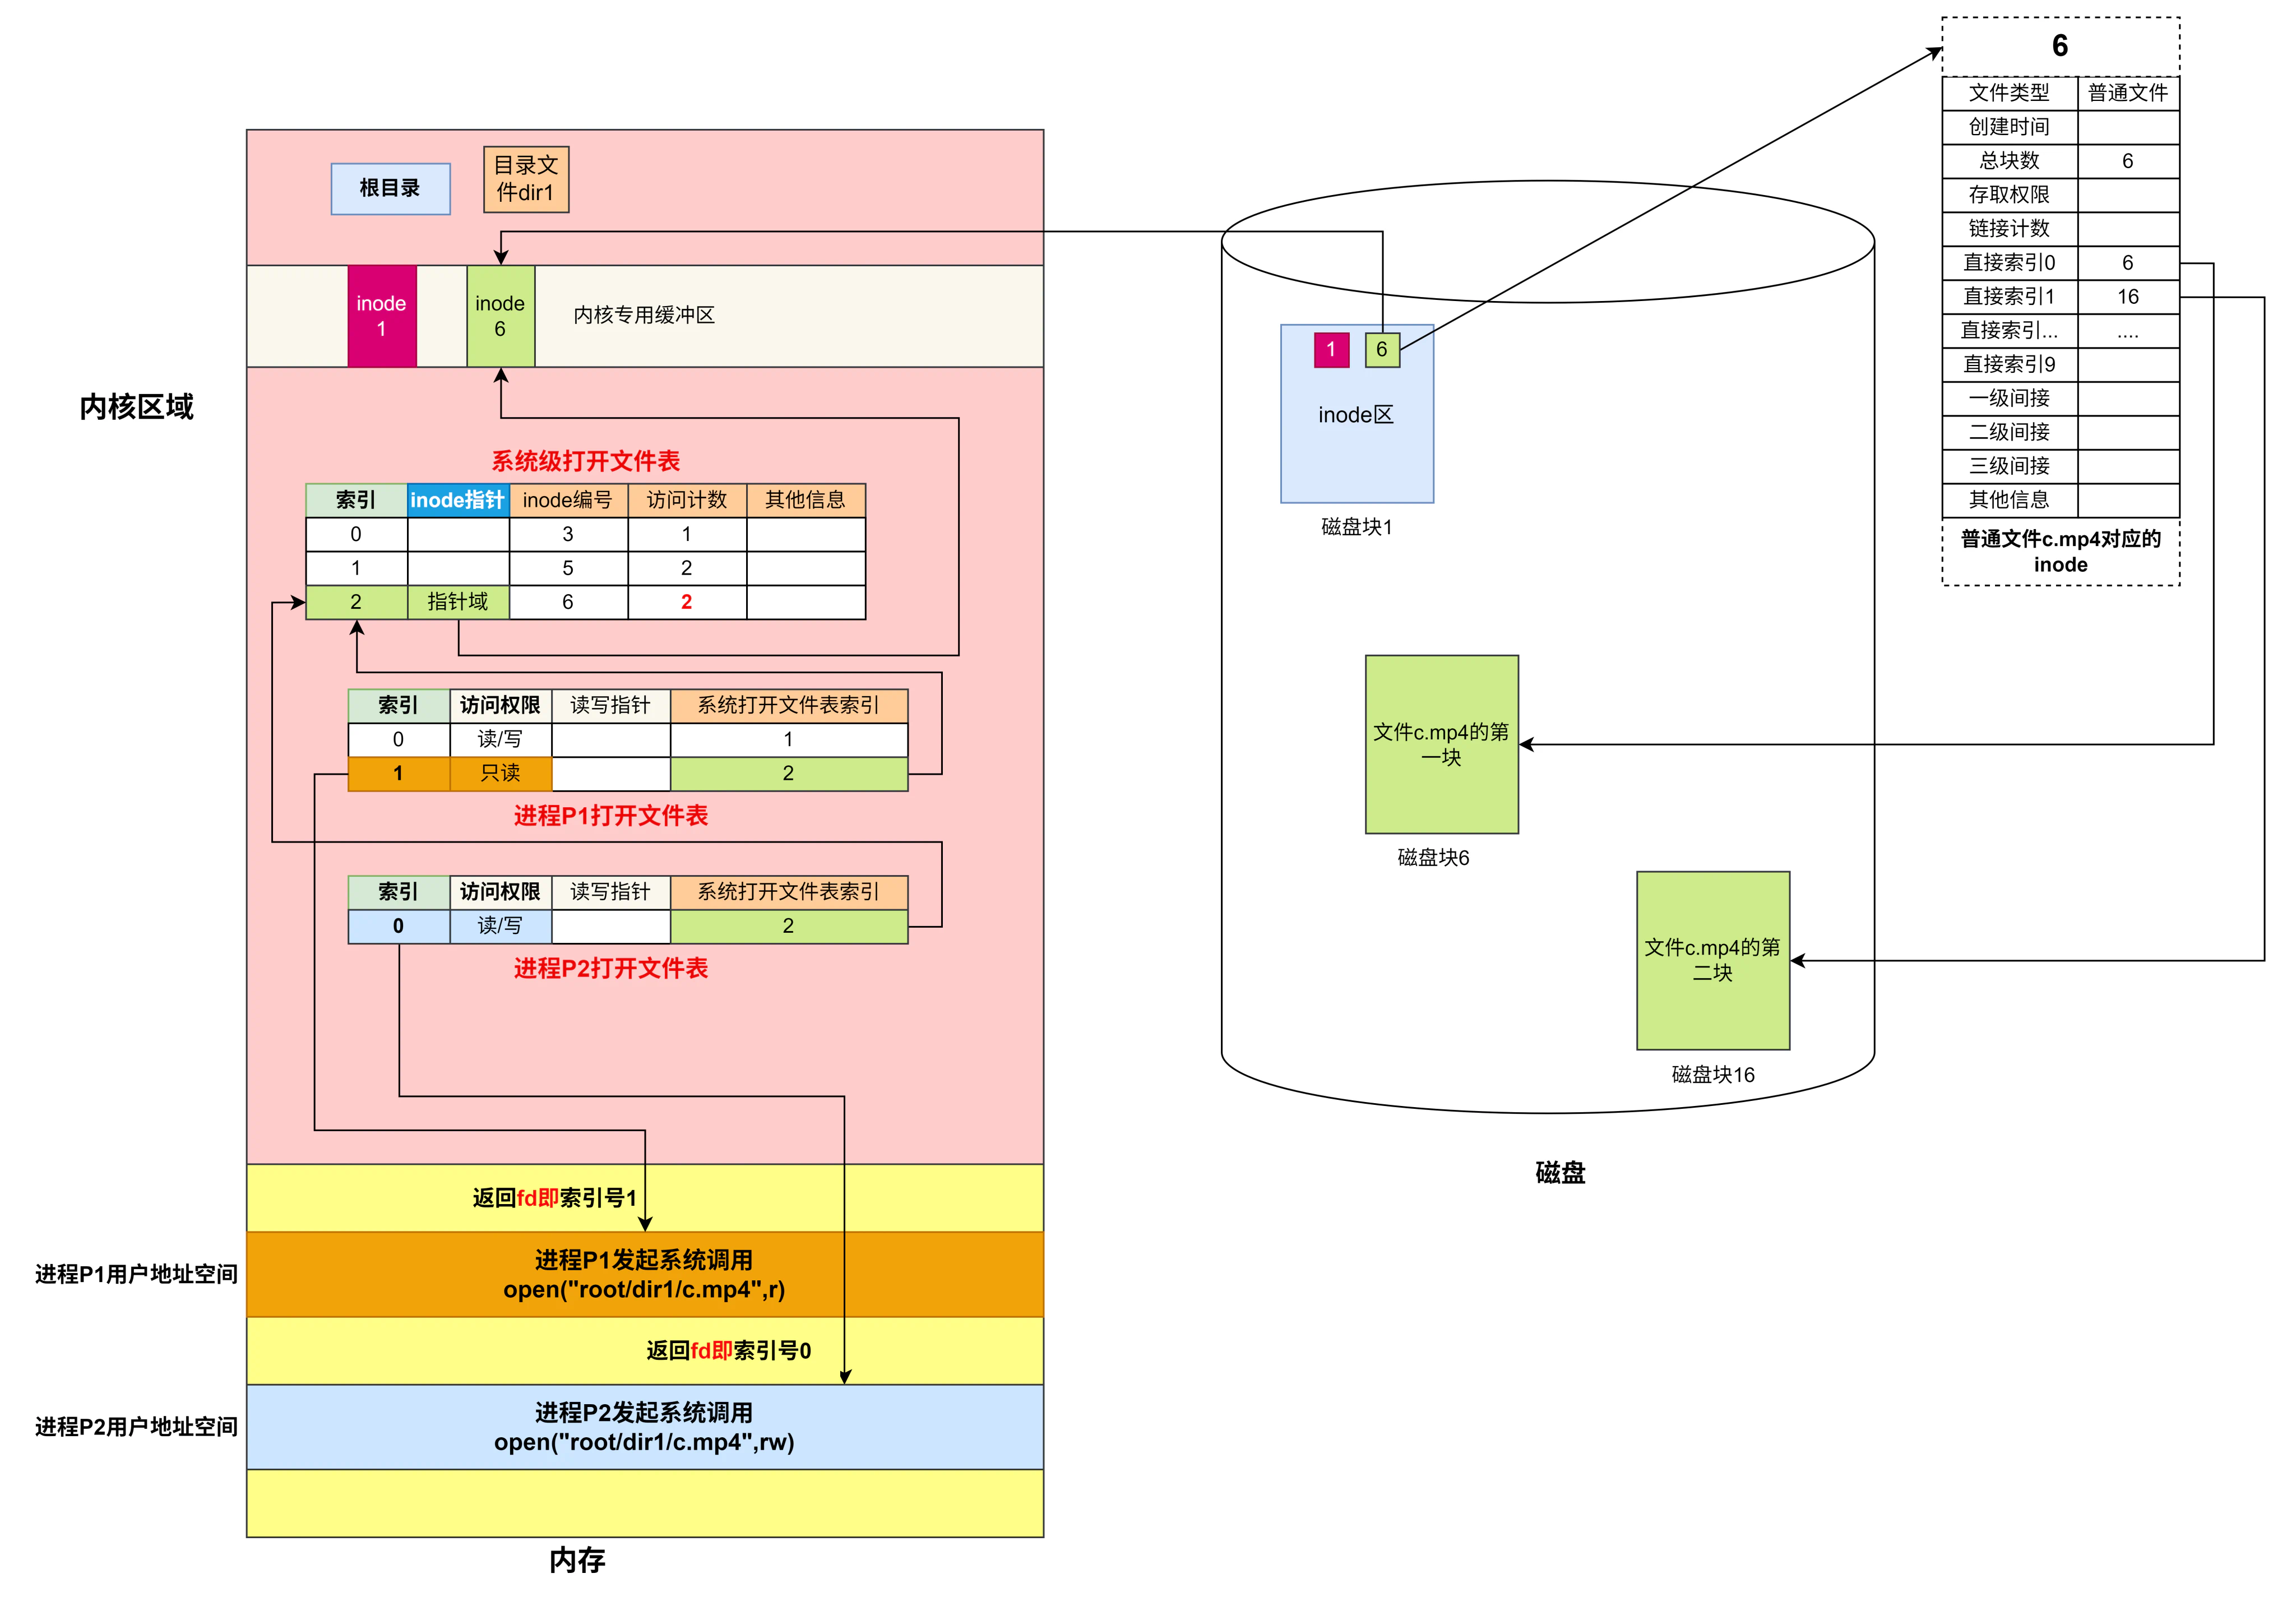
多个进程同时打开同一个文件的情况:假设现在有另外一个进程P2,同样的想要打开文件c.mp4。
由于进程P1之前已经打开了文件c.mp4,同时文件c.mp4的inode已经被加载到内存当中,且在系统打开文件表中注册了表项,所以当进程P2打开文件c.mp4的时候,操作系统做的事情就是在进程P2的进程打开文件表当中,新建一个表项。在这个表项当中,会用一个指针指向系统打开文件表。同时,系统打开文件表当中这个文件的访问计数+1。现在c.mp4的访问计数为2,表示此时有两个进程打开了文件。
值得注意的是,不同的进程在打开文件的时候,它的打开方式可以各不相同。比如在这个例子当中,进程P1是以只读的方式打开文件c.mp4的。而进程P2是以读和写的方式打开这个文件的。打开文件的方式不同,那么接下来这两个进程可以对文件进行的操作就不同。对于进程P1来说,接下来只能去读这个文件。而对于进程Q来说,可以读也可以写这个文件。
总之,在系统打开文件表当中,一个文件只会对应一个表项。如果这个文件被多个进程同时打开,那么会让这些进程的打开文件表去指向系统打开文件表相应的位置。
Tip
多个进程同时打开一个文件时,可以任意对文件进行读写操作,操作系统并不保证写的互斥性,进程可以通过系统调用对文件进行上锁,从而实现对文件内容的保护。
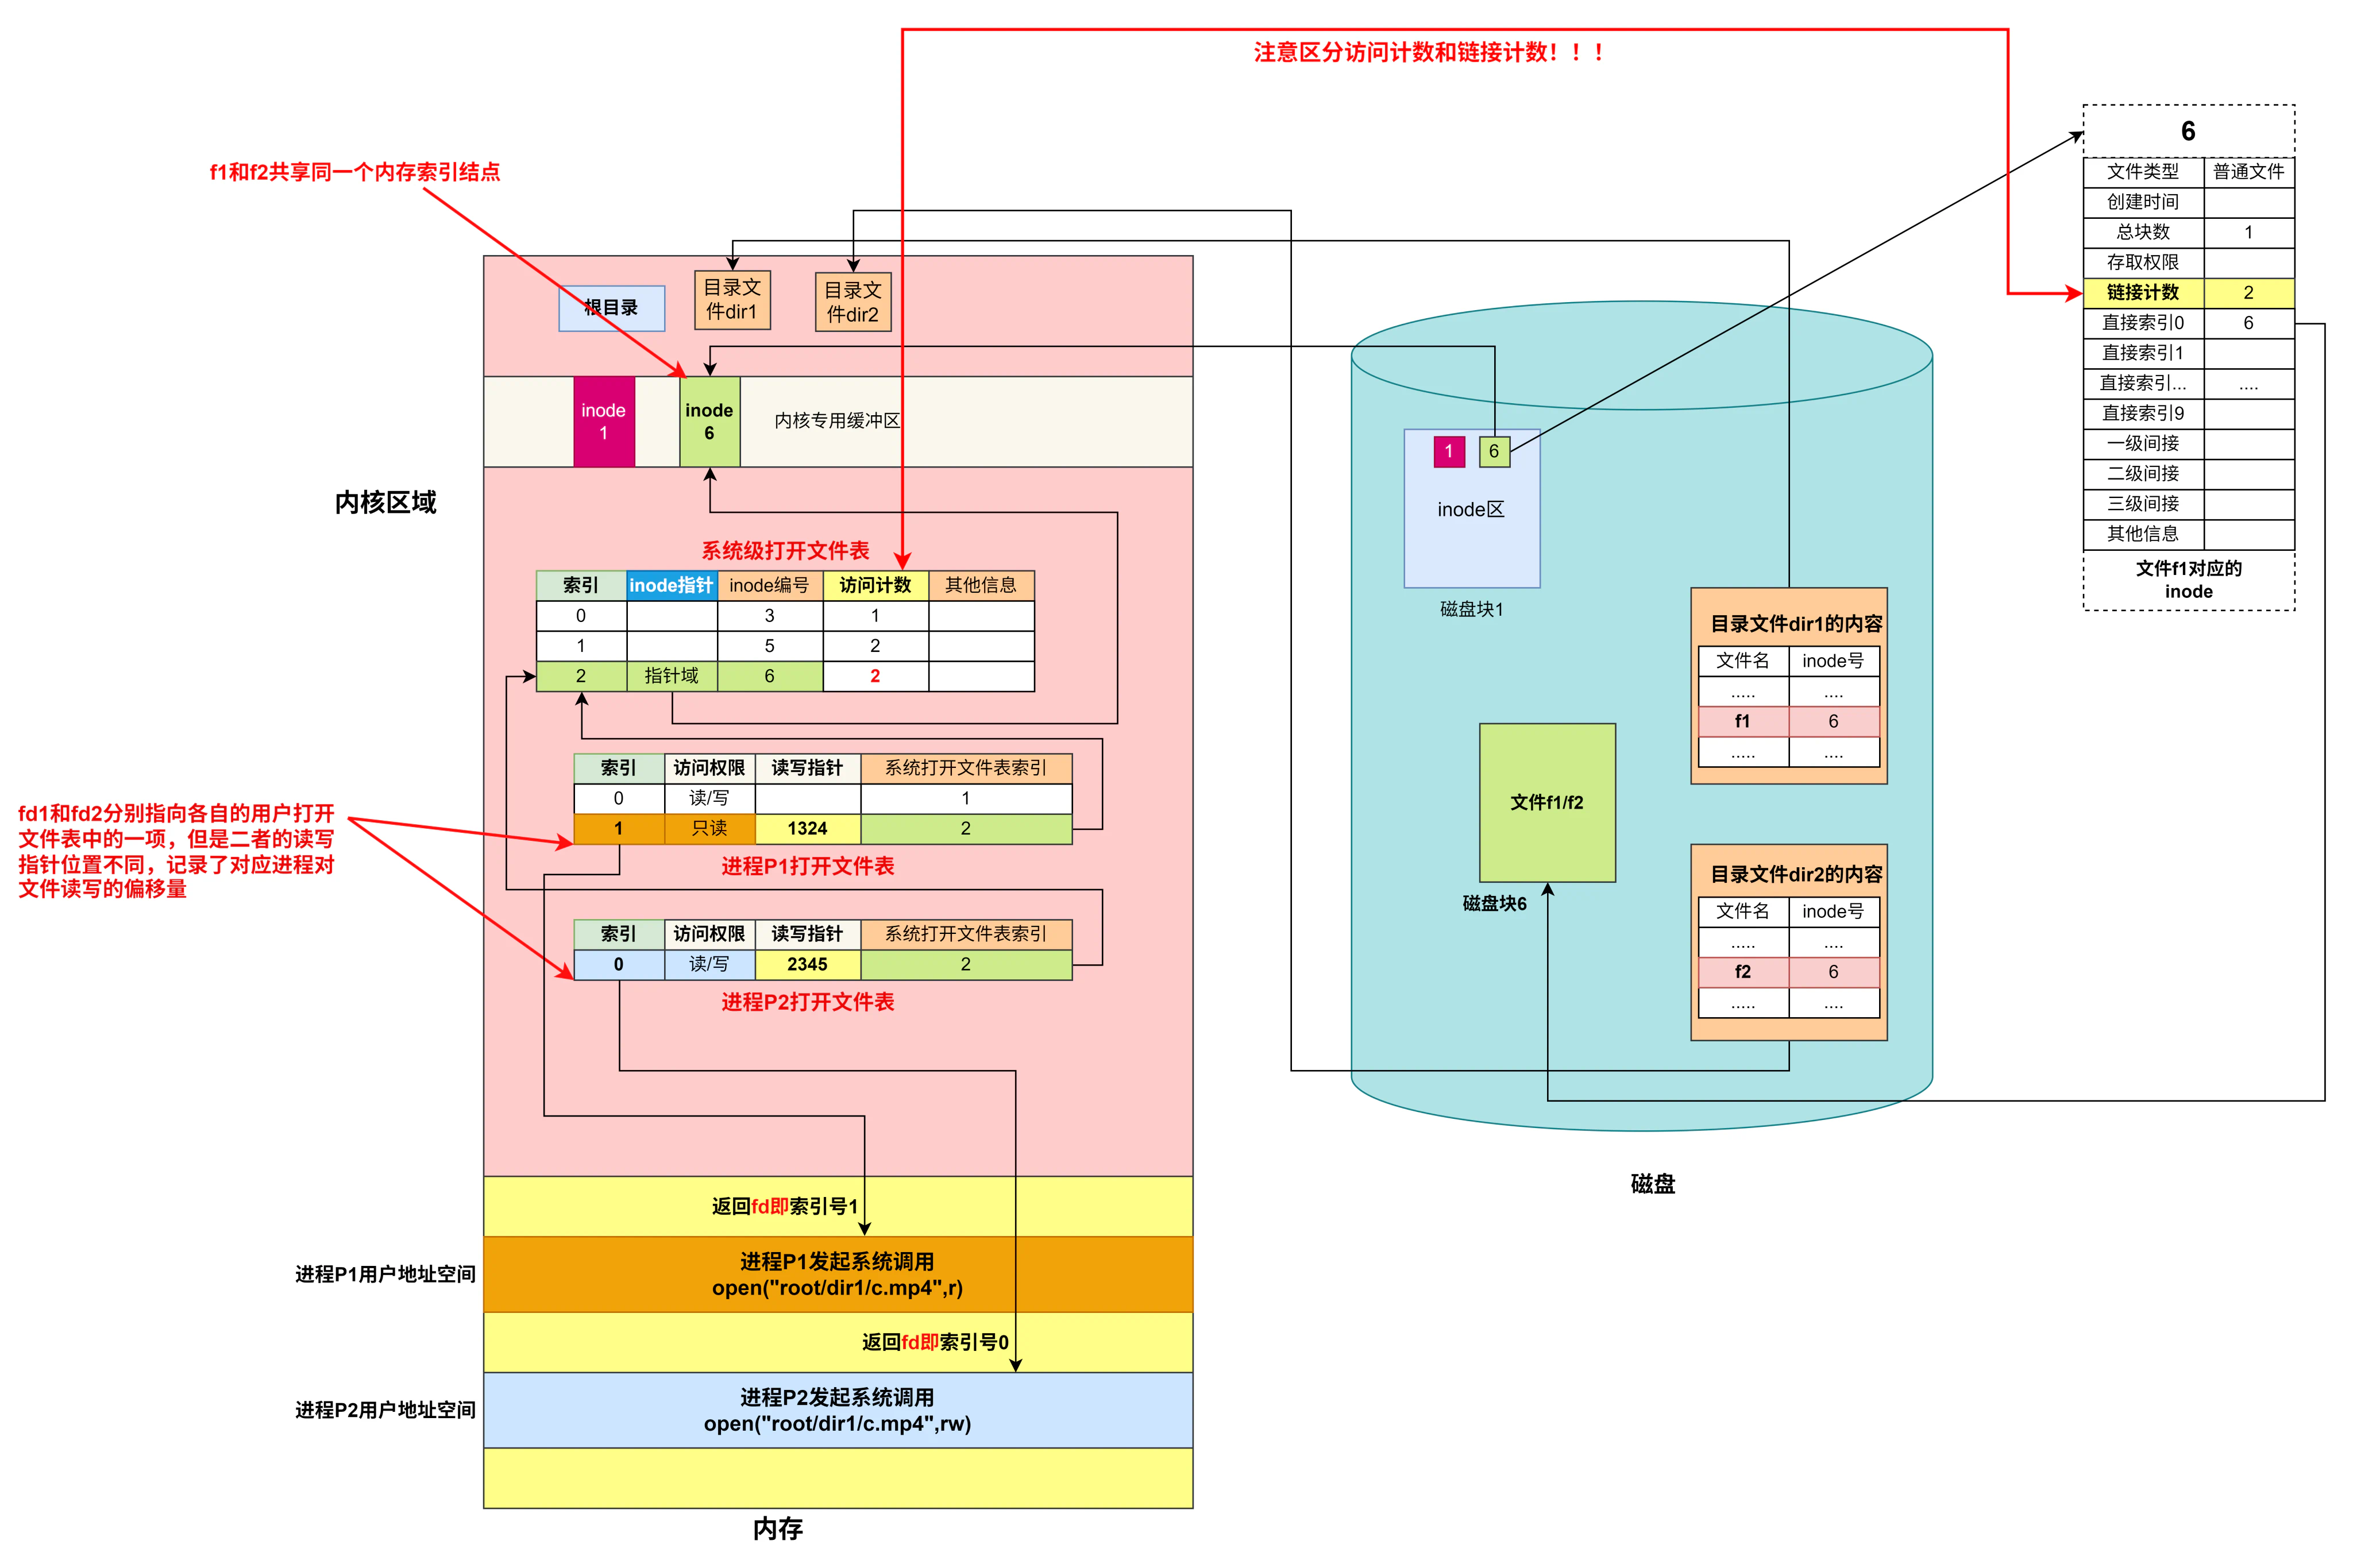
【2017-31】若文件f1的硬链接为f2,两个进程分别打开f1和f2,获得对应的文件描述符为fd1和fd2,则下列叙述中,正确的是( )。
Ⅰ. f1和f2的读写指针位置保持相同
Ⅱ. f1和f2共享同一个内存索引结点
Ⅲ. fd1和fd2分别指向各自的用户打开文件表中的一项
A. 仅Ⅲ
B. 仅Ⅱ、Ⅲ
C. 仅Ⅰ、Ⅱ
D. Ⅰ、Ⅱ和Ⅲ
1.3.2 close系统调用
关闭文件的系统调用格式为close(fd),调用成功返回0,失败则返回-1,具体操作如下:
- 根据文件描述符fd找到“进程打开文件表”中对应表项并删除;
- 系统级打开文件表中的对应表项的访问计数(打开计数)-1
- 若-1后不为0,说明还有其他进程正在使用该文件,直接返回即可;
- 若-1后为0,则需要删除该表项,如果对应的内存索引节点没有修改,直接释放即可,若修改可以根据OS的策略决定是否将该inode写回外存;
【2020-23】若多个进程共享同一个文件F,则下列叙述中,正确的是( )。
A. 各进程只能用“读”方式打开文件F
B. 在系统打开文件表中仅有一个表项包含F的属性
C. 各进程的用户打开文件表中关于F的表项内容相同
D. 进程关闭F时,系统删除F在系统打开文件表中的表项
1.3.3 create系统调用
目的:在指定路径path下创建一个空文件,可以指定该文件的类型和访问权限等;
步骤:
- 查询磁盘里的inode表,为该文件分配一个空闲的inode,在里面登记文件类型 访问权限 创建时间等信息;
- 打开path所对应的新创建文件所在目录,在该目录中加入一个新的目录项,目录项的文件名从path中截取,inode编号关联到给它新分配的inode上。
1.3.4 delete系统调用
目的:删除指定路径path下的目录项,若该目录项对应的inode链接计数为1,则还需要删除该文件的文件实体;
具体步骤:
- 根据路径找到目标文件的目录项,然后找到inode;
- 根据inode里的访问权限判断“删除”操作是否允许(文件保护),若允许则获取其链接计数;
- 若该链接计数为1,则释放该文件所占有的所有磁盘块,同时释放该磁盘inode;
- 若不为1,则将其减1;
- 在目标文件所在目录中,删除其对应的目录项;
1.3.5 进程打开文件表(文件描述符表)的共享与继承
在进程那一章节的学习我们说,打开文件作为进程的一种资源,那学习了文件操作之后我们知道这是因为进程拥有进程级打开文件表(文件描述符表),拥有对文件的操作能力;
同一个进程的不同线程共享进程打开文件表,因此每一个线程都可以用相同的文件描述符fd访问相同的文件。
父进程通过fork()系统调用创建子进程时,子进程会继承(复制)父进程的文件描述符表,这意味着子进程也可以访问父进程可以访问的文件,这也是管道通信的基础,父进程通过pipe()系统调用创建管道文件,然后fork()创建子进程,子进程继承该文件描述符,至此,父子进程都可以访问到这个管道文件,借助该管道文件实现进程间通信。
1.3.6 lseek系统调用
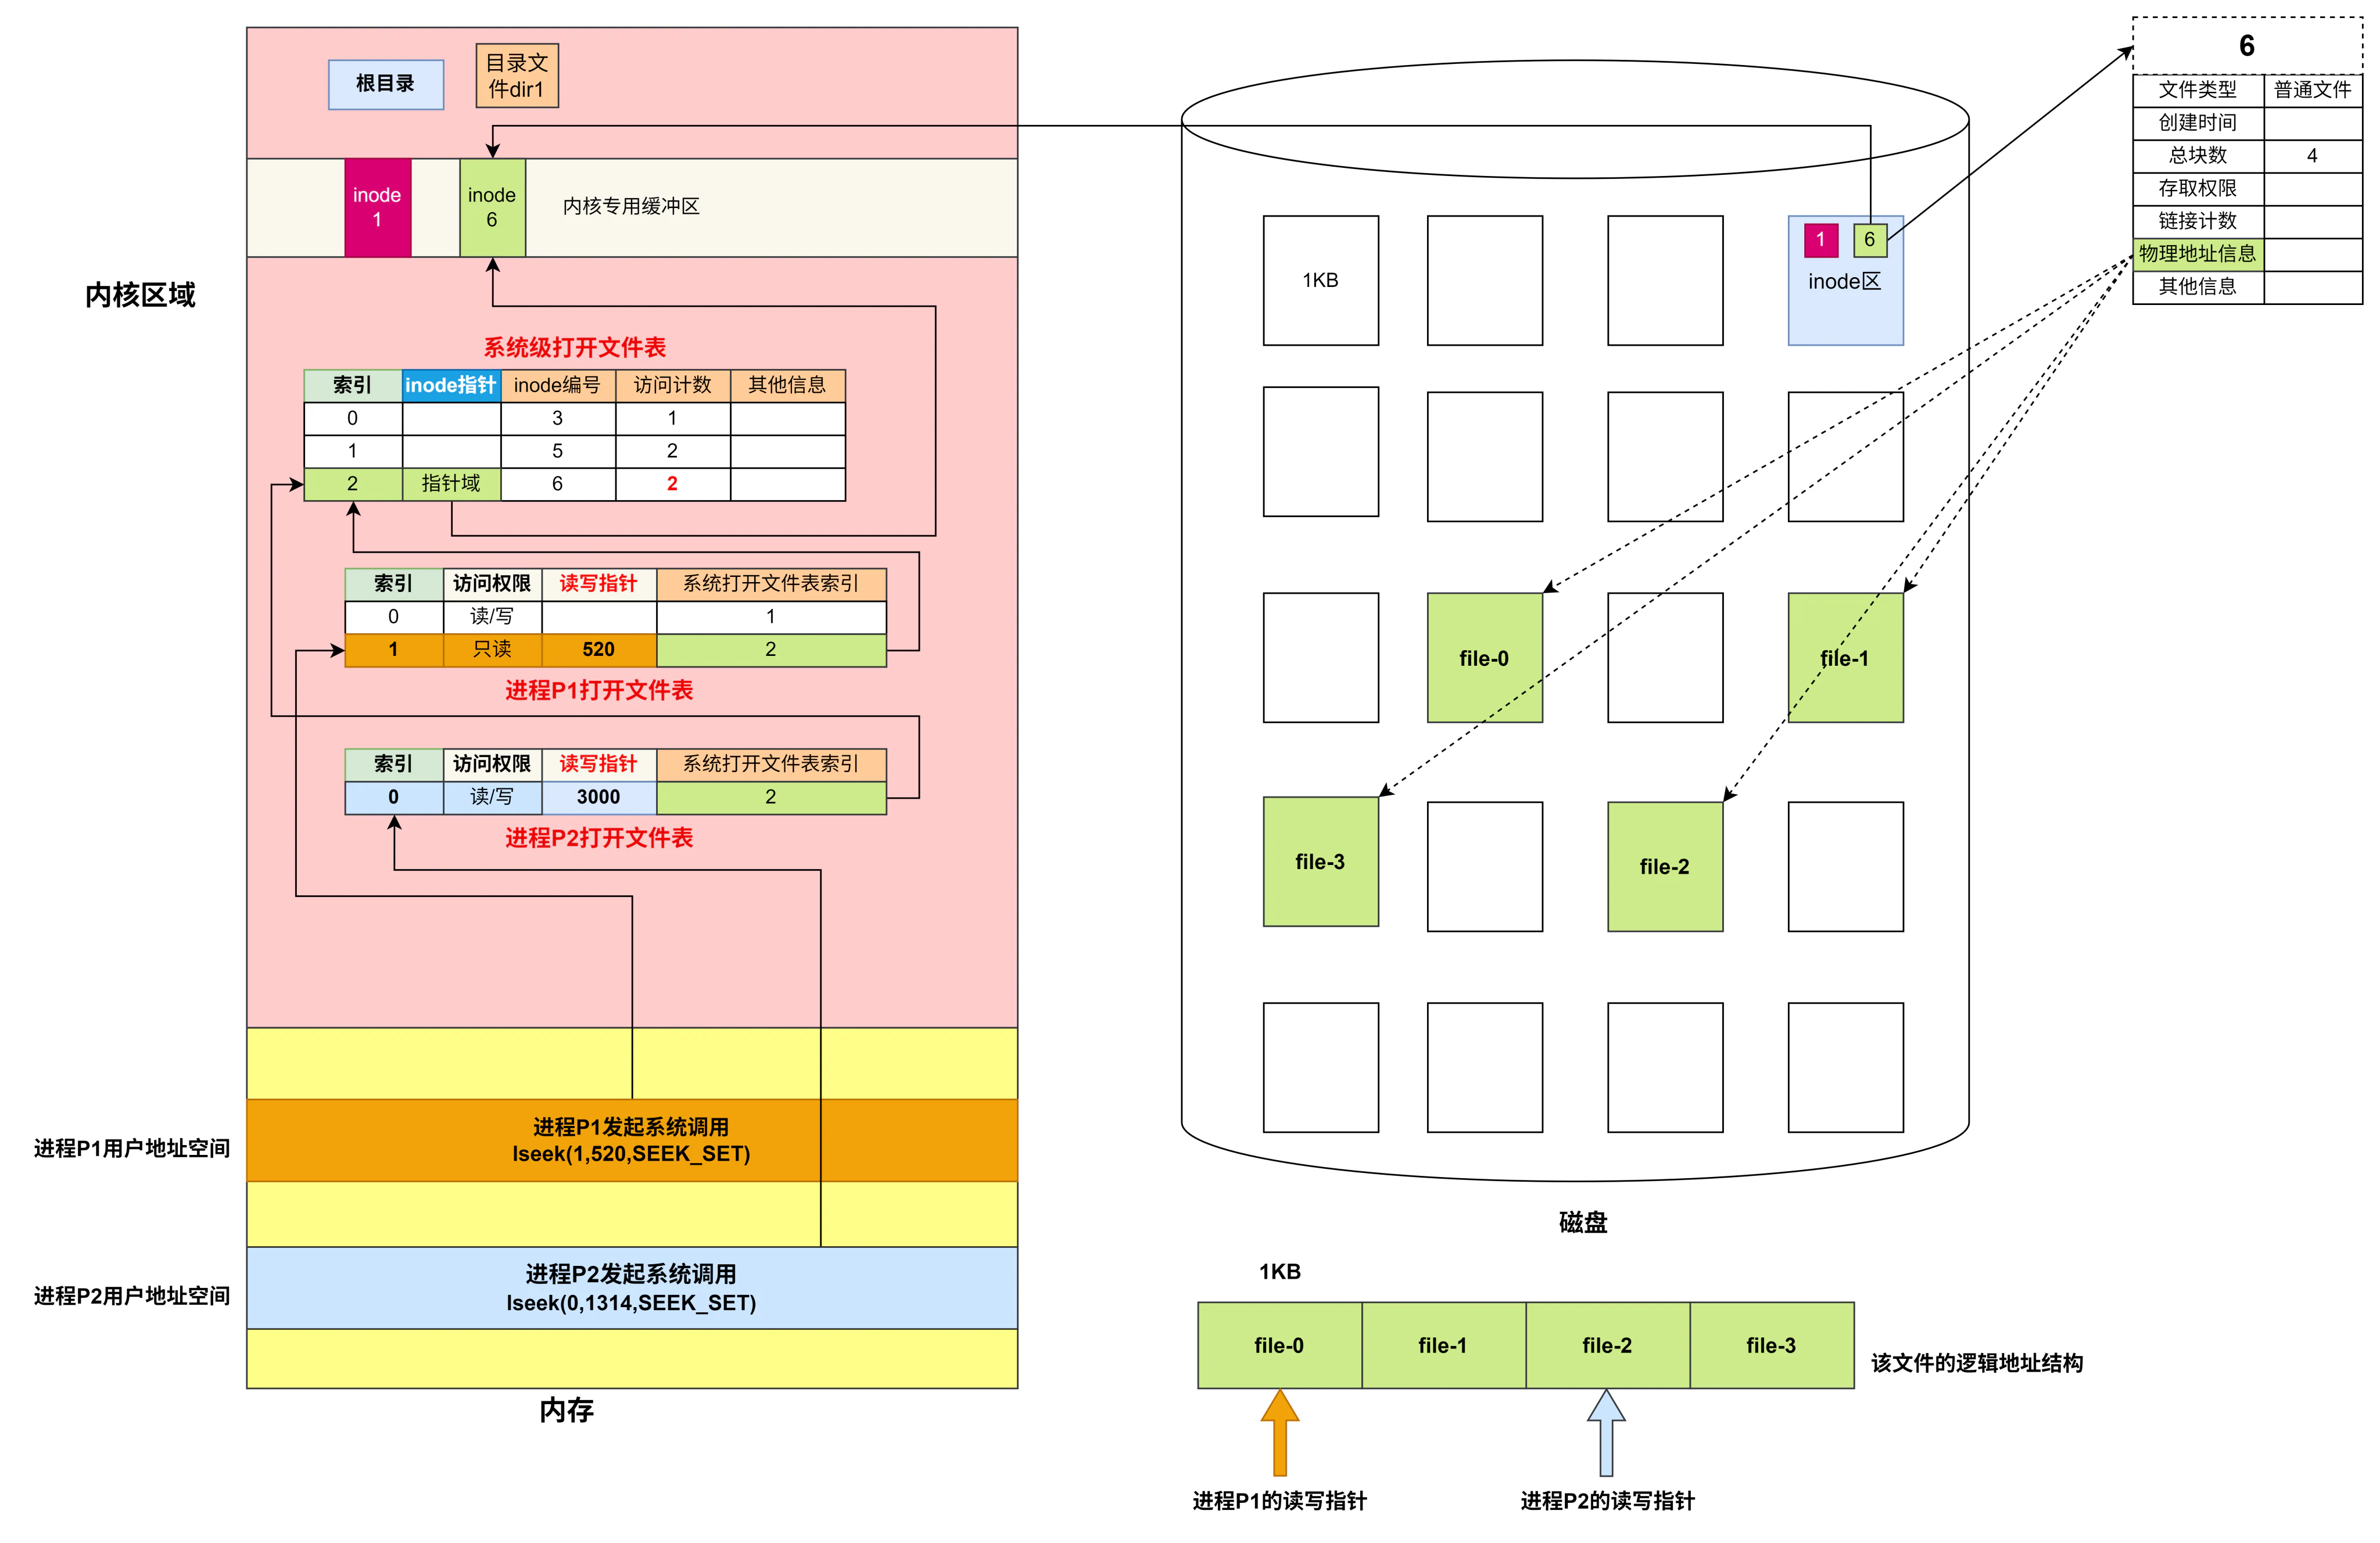
lseek() 是 Linux/Unix 系统中用于调整文件读写指针(文件偏移量)的系统调用,允许对文件进行随机访问。
- 参数说明:
fd:文件描述符(通过open()或creat()获得)。offset:偏移量(字节数),其意义由whence决定。whence:基准位置,可选值如下:SEEK_SET:文件开头(偏移量直接指定位置)。SEEK_CUR:当前读写位置(偏移量为相对值)。SEEK_END:文件末尾(偏移量为相对末尾的偏移)。
- 返回值:
- 成功时返回新的文件读写指针(文件偏移量(以字节为单位))。
- 失败时返回
-1
使用示例
- 移动文件指针到文件开头
- 移动文件指针到文件末尾
- 相对当前位置移动
- 获取文件大小
- 在文件中间插入数据
1.3.7 read系统调用
read 系统调用用于从指定的文件描述符所对应的文件读取数据到用户空间缓冲区。文件描述符可以指向普通文件、设备文件、管道、套接字等支持读取操作的对象。
fd:文件描述符,通常通过open()、pipe()等系统调用获得buf:用户空间缓冲区的指针,用于存储(读/写)读取的数据。count:期望读取的最大字节数- 返回值:若执行成功,返回值代表实际读取的字节数,若失败返回-1.
读/写文件的逻辑区域为以文件读写指针指向位置为起点,长度为count的字节流。
具体处理过程:
- 用户程序 在用户态下调用
read(fd, *buf, count),陷入内核态; - 根据fd找到进程打开文件表(文件描述符表)的对应表项,根据访问权限位判断是否支持读取操作;
- 若支持读操作,再去系统打开文件表,然后找到文件对应的inode,根据读写指针位置,再根据inode里的文件位置信息,去将读区域所在的磁盘块读入内存中的内核缓冲区;
- 将需要读取的数据从内核缓冲区读入用户空间的buf中;
- 返回实际读取的字节数。
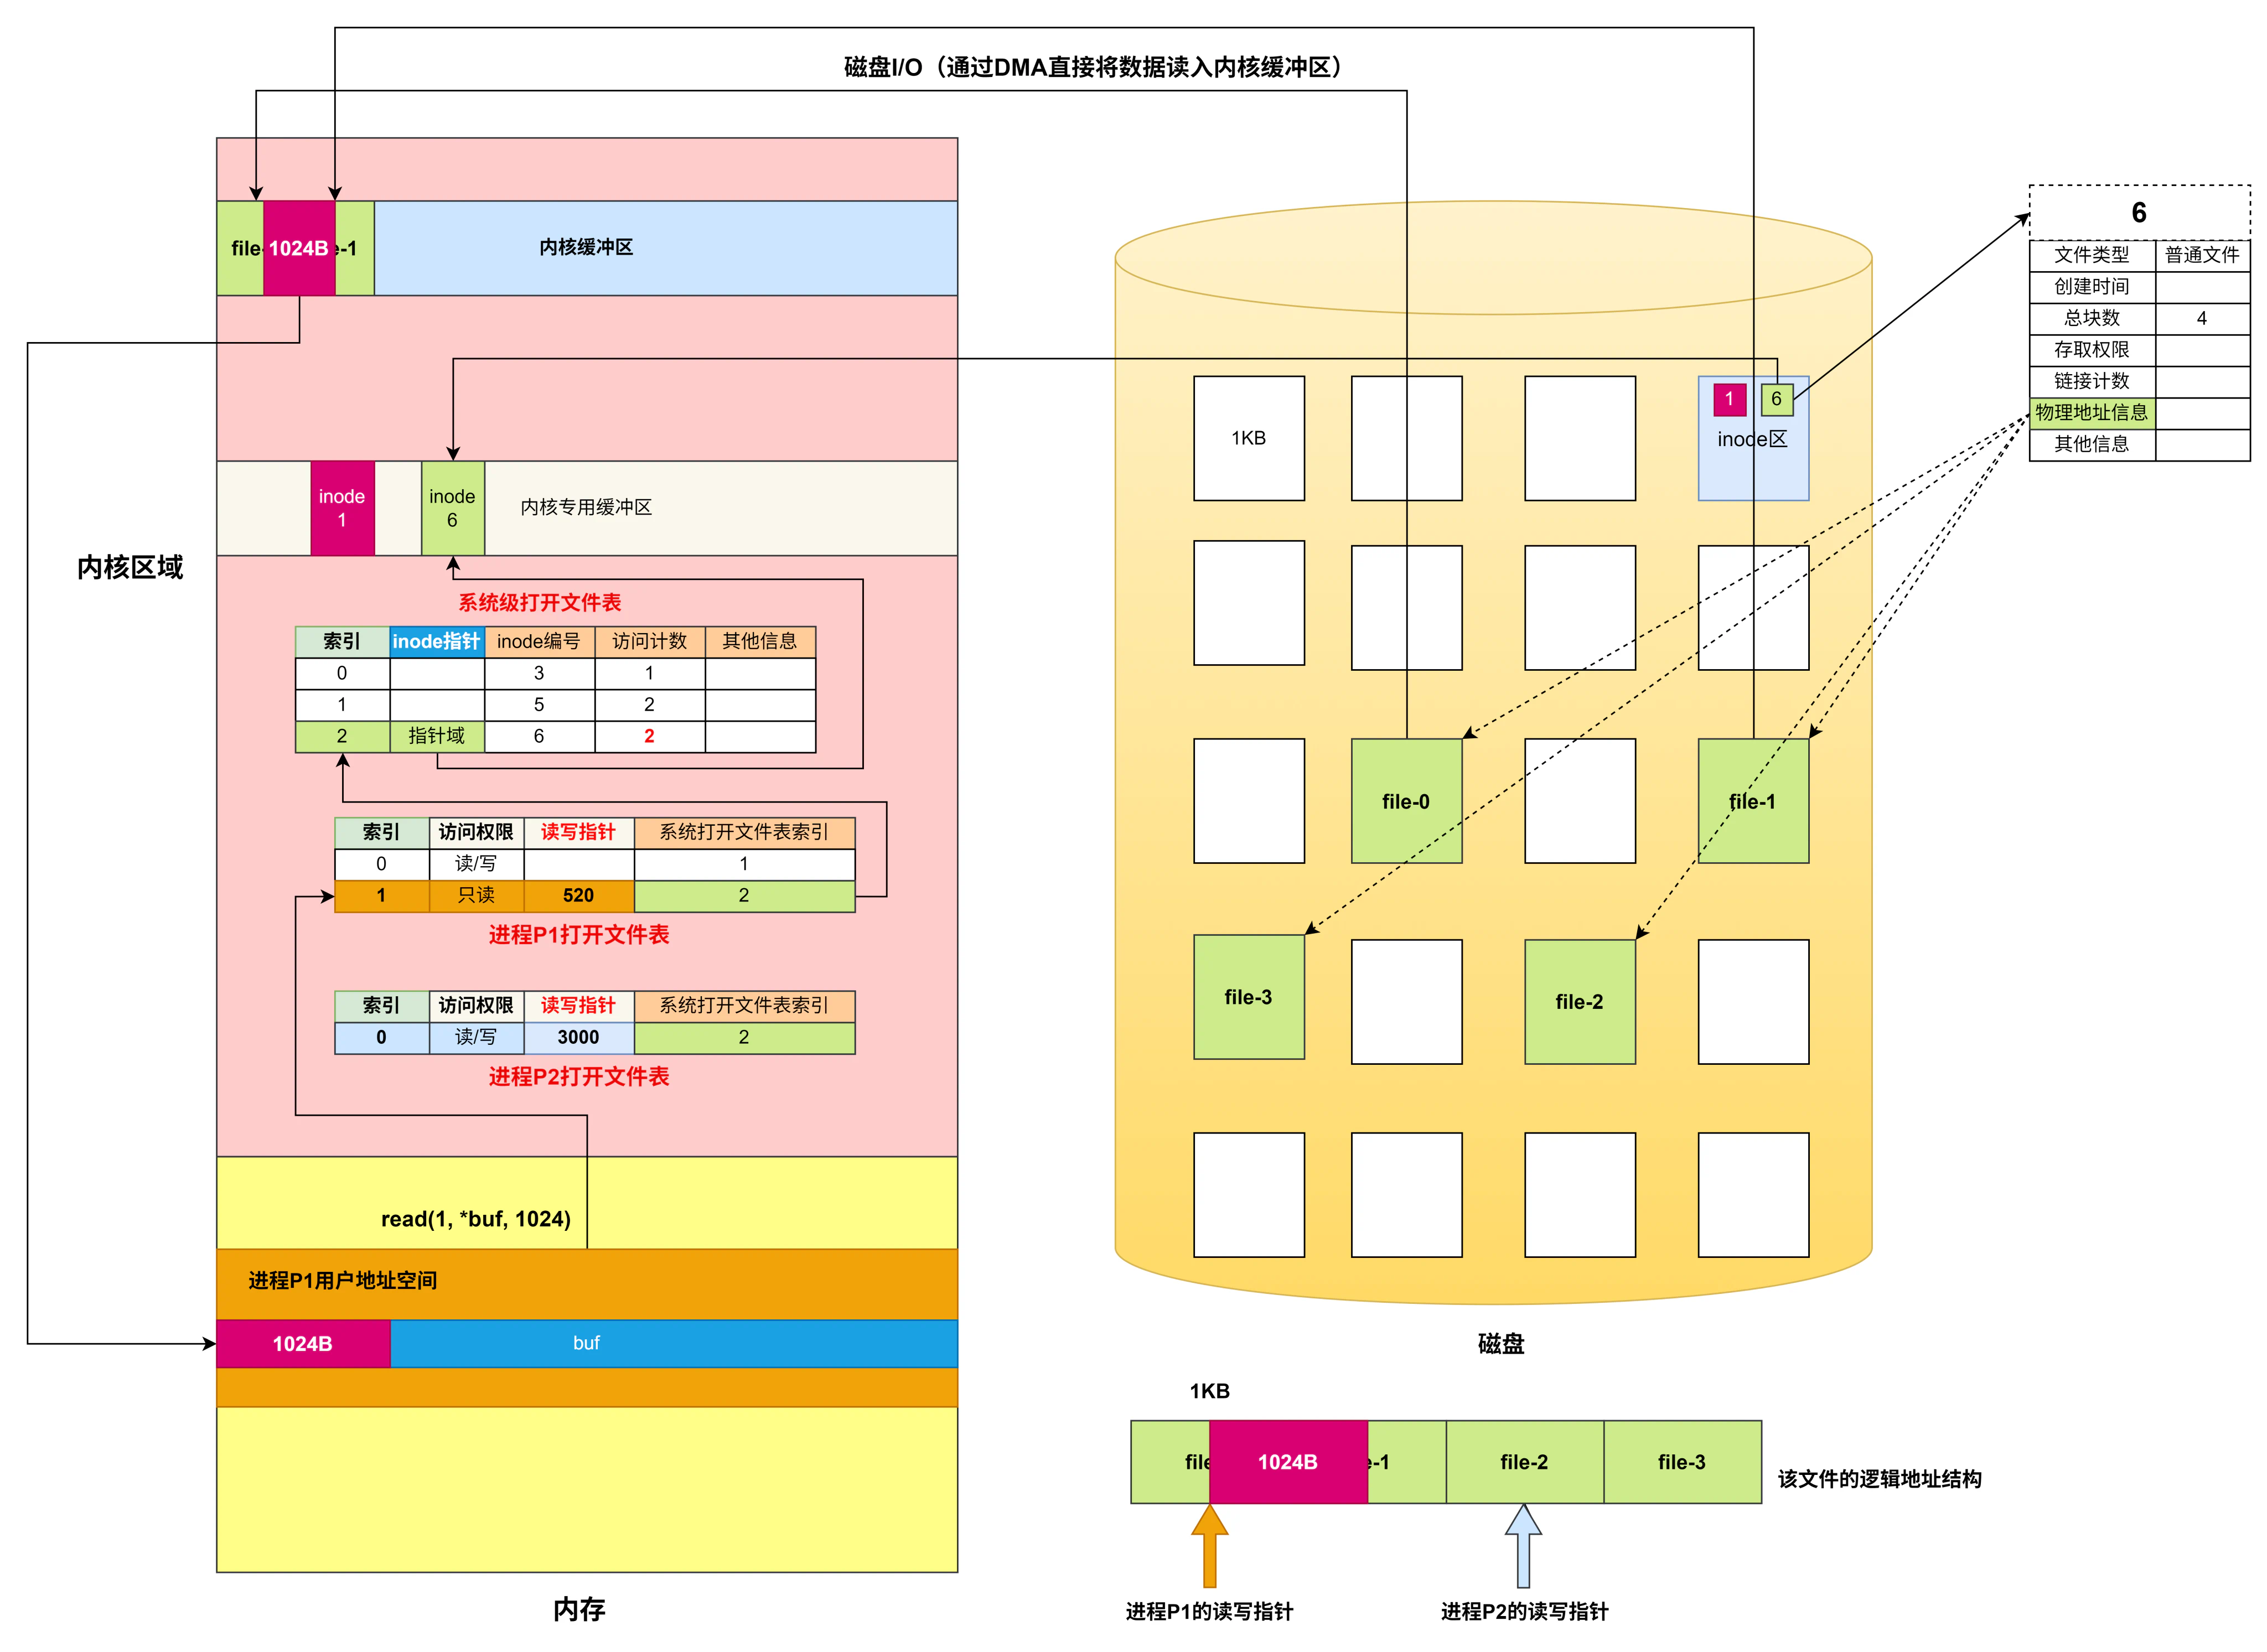
Tip
读操作是从当前进程的读写指针所指明的位置开始往后偏移的,比如此时进程P1要读1024个字节。首先根据读写指针的位置和此次要读的数据量,操作系统就可以知道,这一次读的数据一定是被包舍在0号块和1号块当中,根据文件的inode就可以找到这个文件的各个块存放在磁盘的什么位置,接下来,操作系统会把这两个磁盘块都读入到内存,并且是读入到内存的内核缓冲区。然后再把0号块的末尾504字节复制到用户区,接下来再把1号块头部的520字节也复制到用户区。这样就完成了read系统调用。
因为磁盘、硬盘、U盘等存储设备基本都是Flash块设备,因为块设备硬件本身有读写限制等特征,块设备是以一块一块为单位进行读写的(一个块包含多个扇区,而一个扇区包含多个字节), 一个字节的改动也需要将该字节所在的block全部读取出来进行修改,修改完成之后再写入块设备中,所以导致对块设备的读写操作非常不灵活 ;而内存可以按字节为单位来操作,而且可以随机操作任意地址数据,非常地很灵活 ,所以对于操作系统来说,会先将磁盘中的静态文件读取到内存中进行缓存,读写操作都是针对这份动态文件,而不是直接去操作磁盘中的静态文件,不但操作不灵活,效率也会下降很多,因为内存的读写速率远比磁盘读写快得多。
若再让进程P2执行read(0,*buf,1024)
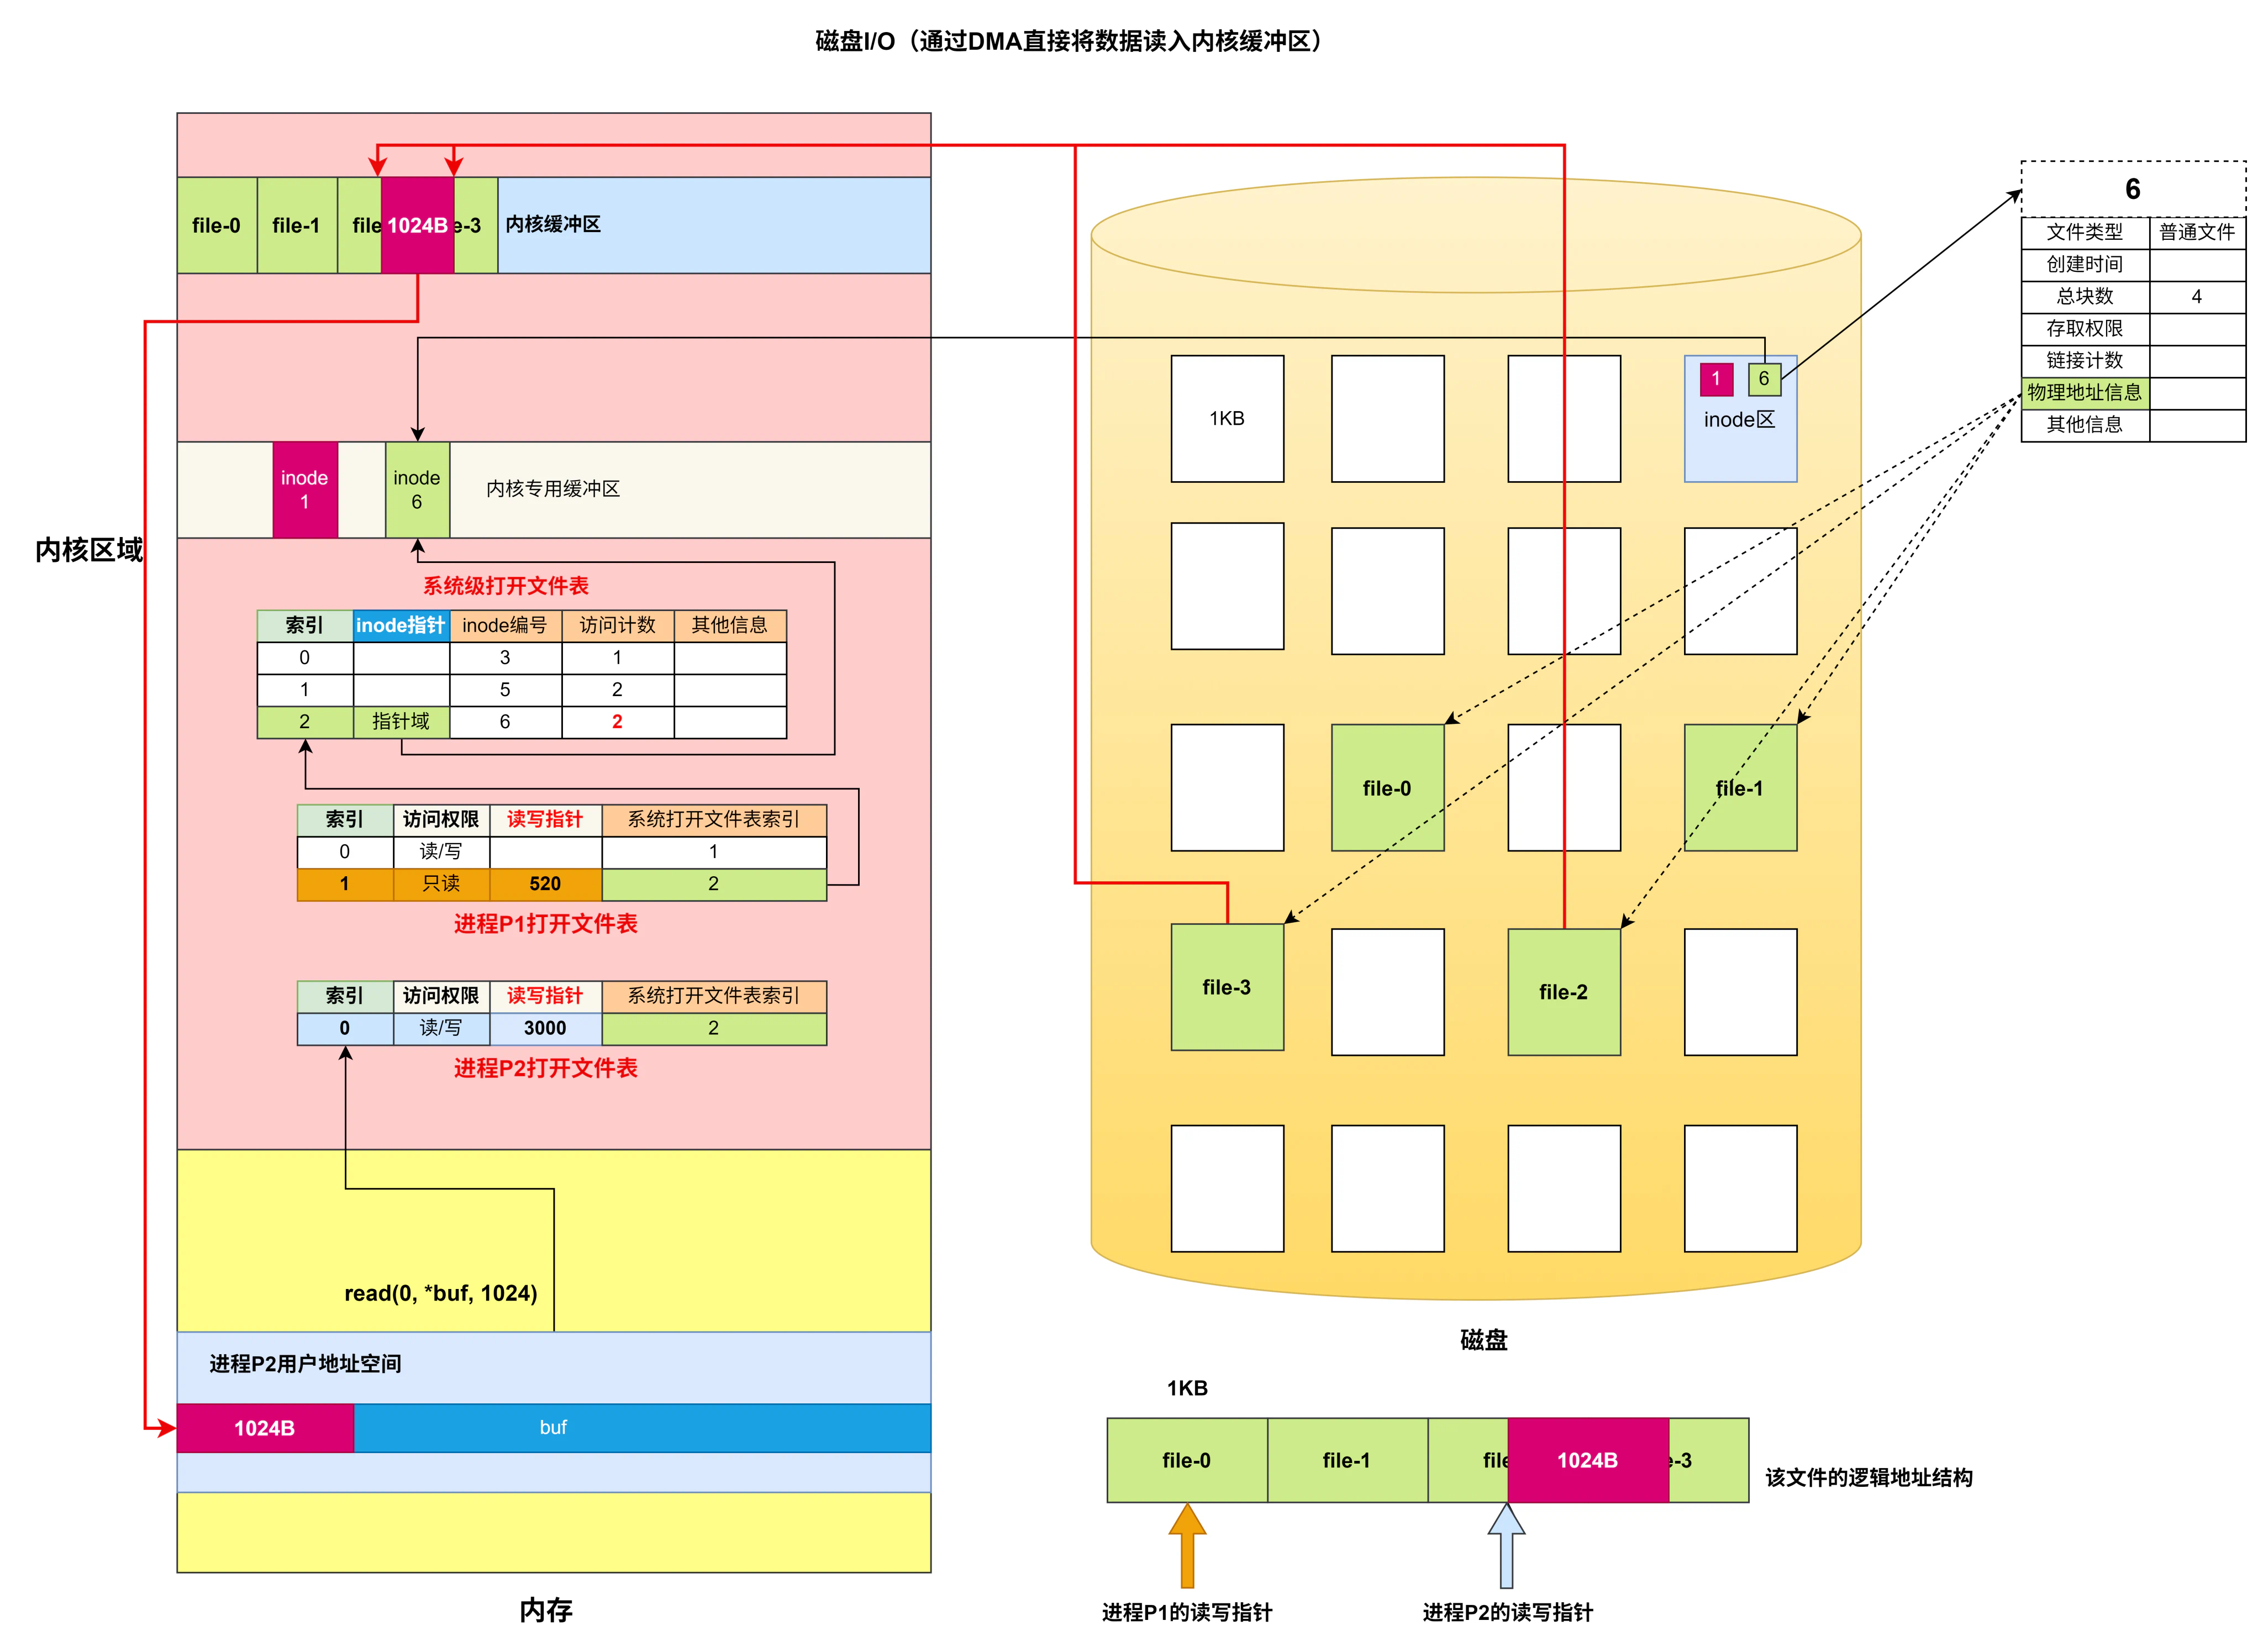
对于进程P2的read系统调用,同样进程P2也要读入1024个字节,根据进程P2的读写指针和此次读的数据量,操作系统可以知道这一次读的数据一定是被包舍在2号块和3号块当中,然后根据inode找到该文件所在的2号和3号块存储在磁盘的位置,再把这两个块读入内存的内核缓冲区,之后复制到用户区。这样也就处理完了进程P2的read系统调用。
可以看到不同的进程,它的读写指针不一样,那这个读写指针指明了要从文件的哪个逻辑地址开始往后读或者写,之后操作系统会根据inode当中记录的信息,把文件的逻辑地址映射为物理地址。最终在磁盘里边找到相应的数据。
1.3.8 write系统调用
write 系统调用用于将用户空间缓冲区中的数据写入到指定的文件描述符。文件描述符可以指向普通文件、设备文件、管道、套接字等支持写入操作的对象。
fd:文件描述符,通常通过open()、pipe()等系统调用获得buf:用户空间缓冲区的指针,包含要写入的数据。count:期望写入的字节数- 返回值:若执行成功,返回值代表实际写入的字节数,若失败返回-1.
具体处理过程:
- 用户程序 在用户态下调用
write(fd, *buf, count),陷入内核态; - 根据fd找到进程打开文件表(文件描述符表)的对应表项,根据访问权限位判断是否支持写操作;若进程打开文件时是以只读的方式打开,那么执行write操作是不被允许的;
- 若支持写操作,得先去系统打开文件表,然后找到文件对应的inode,根据读写指针位置和inode里的文件位置信息,将读区域所在的磁盘块读入内存中的内核缓冲区,然后再将用户空间buf里待写入的数据覆盖掉读入内存的磁盘块中指定区域的内容,之后将磁盘块再写回磁盘对应位置;
Note
注意:文件系统的I/O以磁盘块为单位,因此不支持直接将用户空间buf里的数据写到内核缓冲区,再通过磁盘I/O写到指定的磁盘块里面这种操作。
- 返回实际写入的字节数。
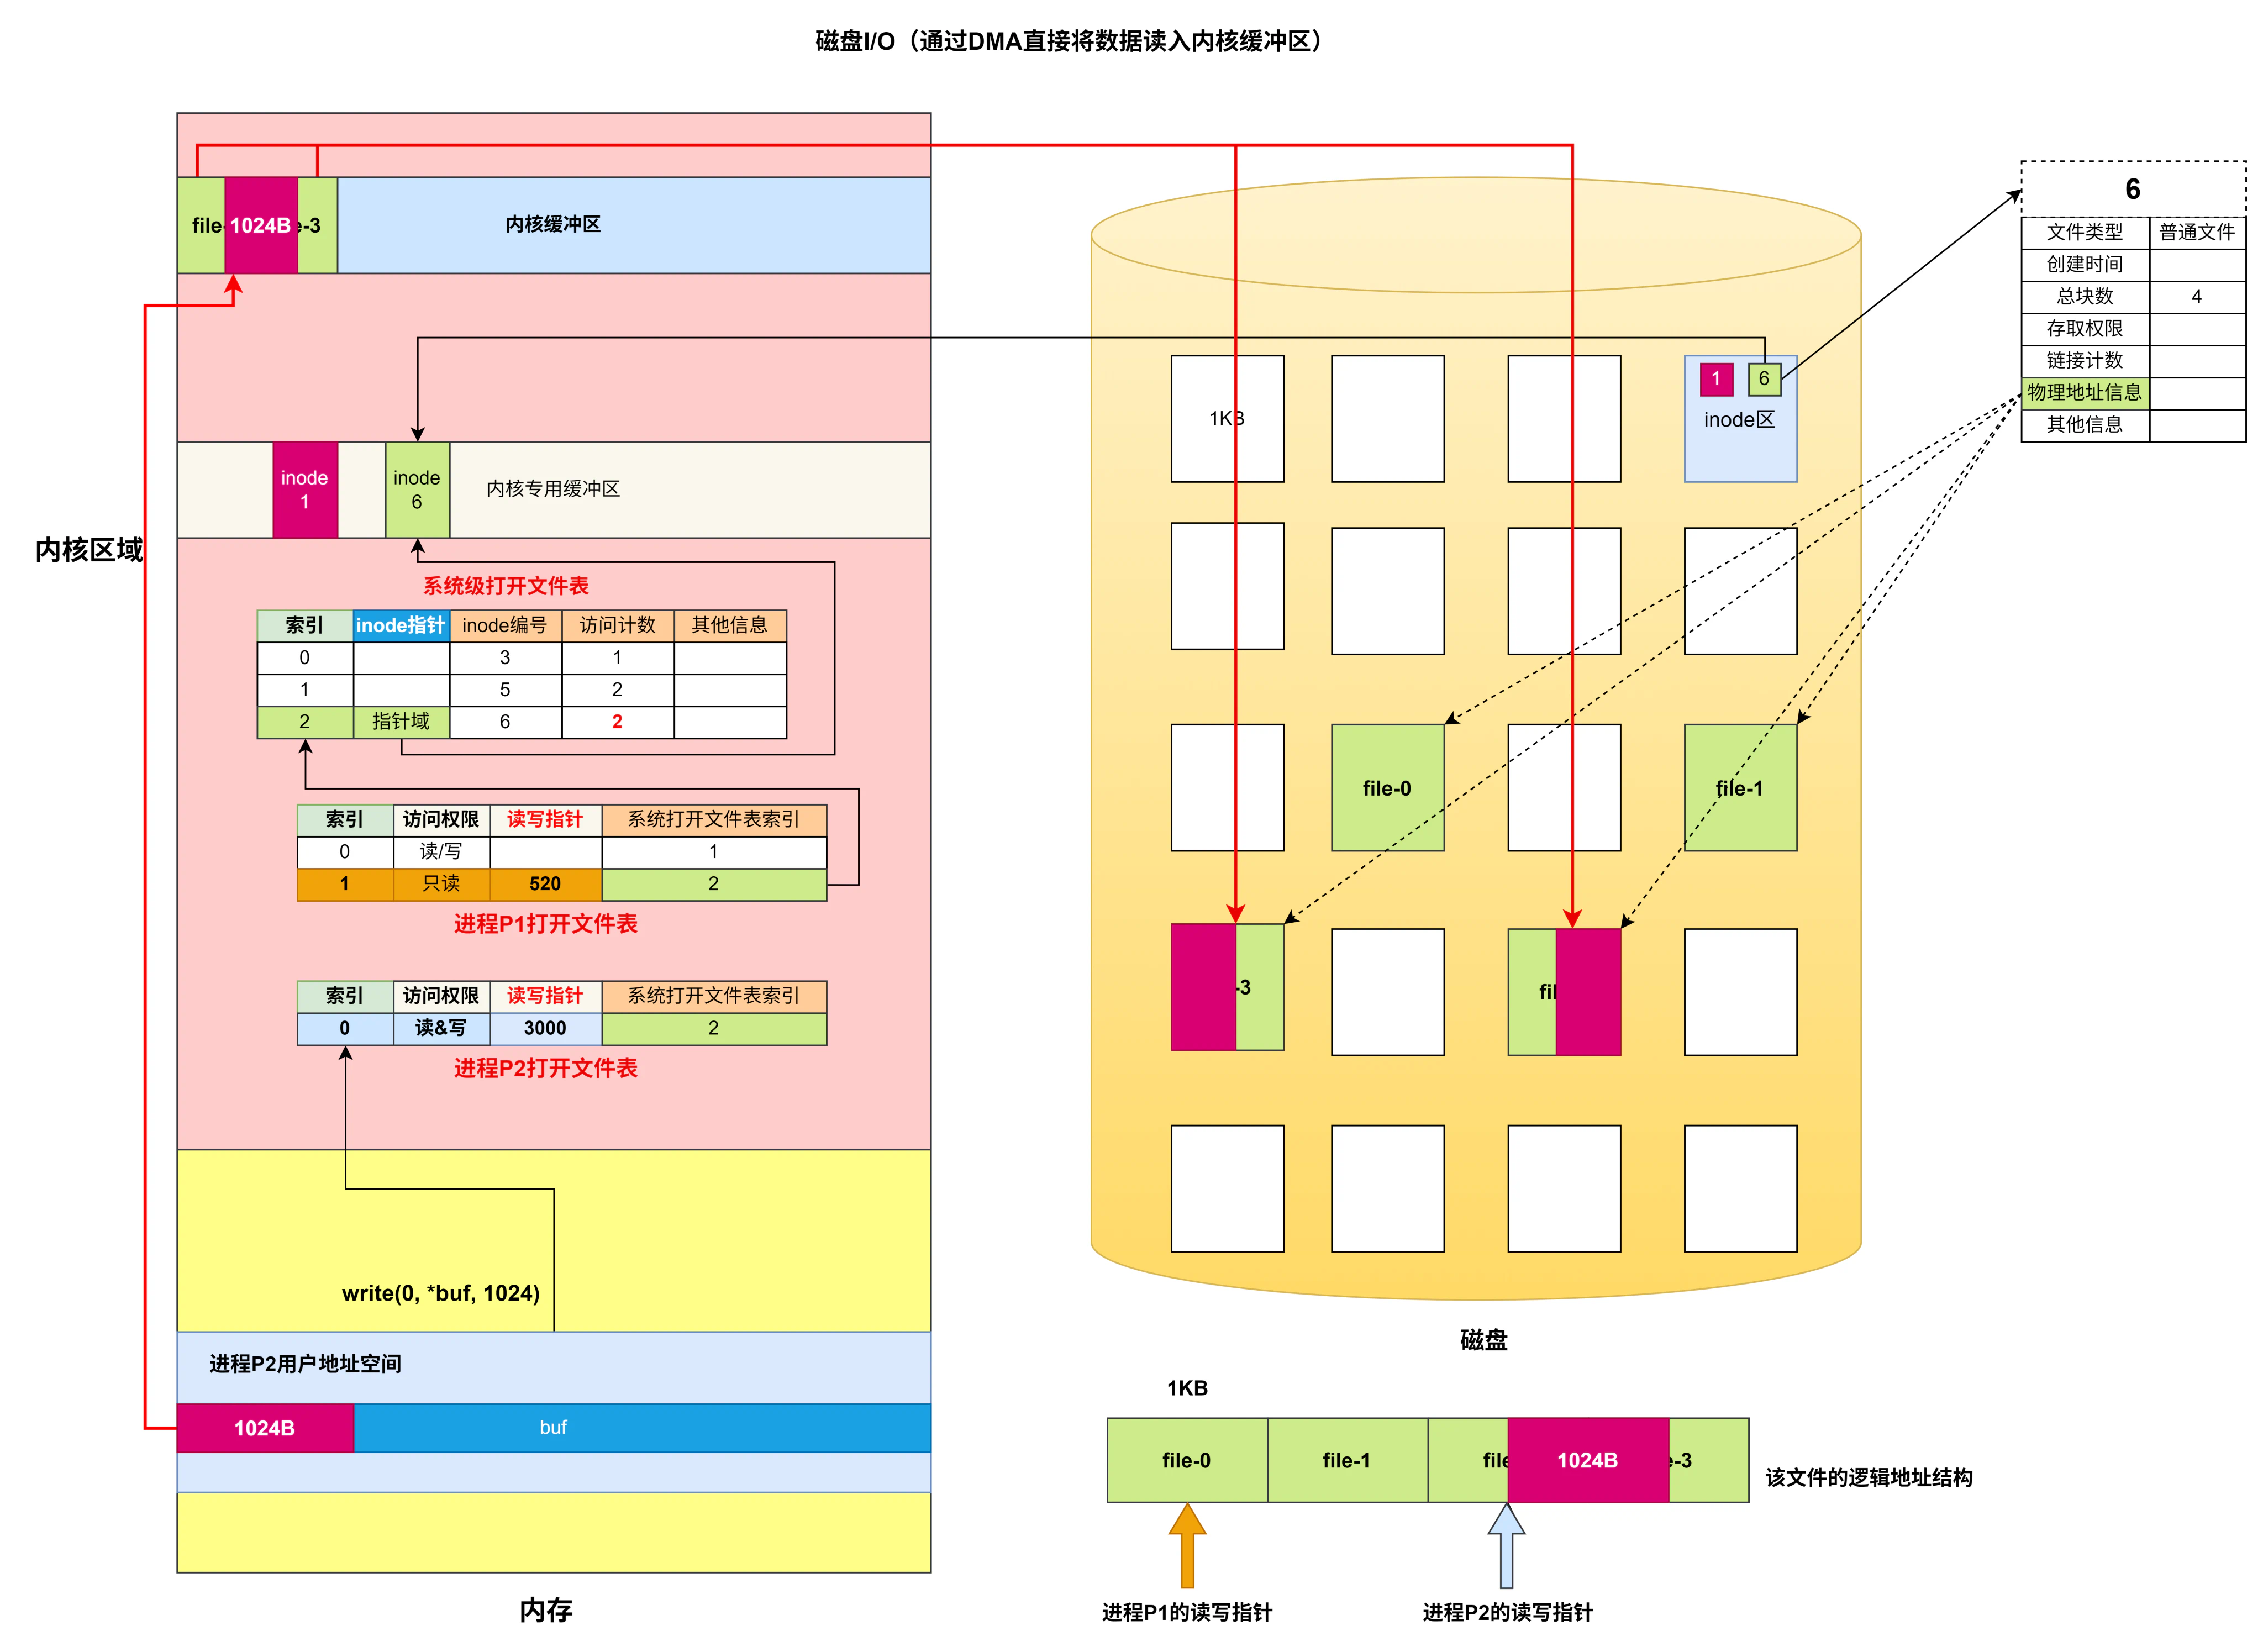
提问:为什么发起read系统调用后,磁盘I/O不能直接将数据从磁盘读入用户空间,而是先读入内核缓冲区再读入用户空间的buf?
镜像问题:为什么发起write系统调用后,需要先将buf里待写入的数据复制到内核缓冲区,然后再通过磁盘I/O写入读写指针所指位置?而不是直接从用户空间写入磁盘?
read:假设进程P1通过read( fd, *buf, count)系统调用请求读入磁盘指定区域数据,那么首先P1会通过trap指令陷入内核态,在read系统调用服务例程中,内核会做这些事:将*buf数组里的数据复制到内核缓冲区,然后开中断(允许设备控制器发出中断请求),查询磁盘状态,若为就绪,发送磁盘读入命令,之后主动阻塞进程P1;
调度器根据调度策略选择进程P2上处理机,P2在cpu上运行的时候,DMA控制器也在同步运行,负责把数据从磁盘读入内核缓冲区,当读入一批数据后,DMA控制器发出中断请求,P2进程响应中断陷入内核态,执行该中断对应的中断服务程序,也就是先判断需要的数据是否全部读入?若没有,则对DMA接口重新初始化,继续启动一轮传送;若已经全部读入,将进程P1唤醒,将其从阻塞态修改为就绪态,之后中断返回;若P1优先级不比P2大,那么P2回到用户态继续运行;
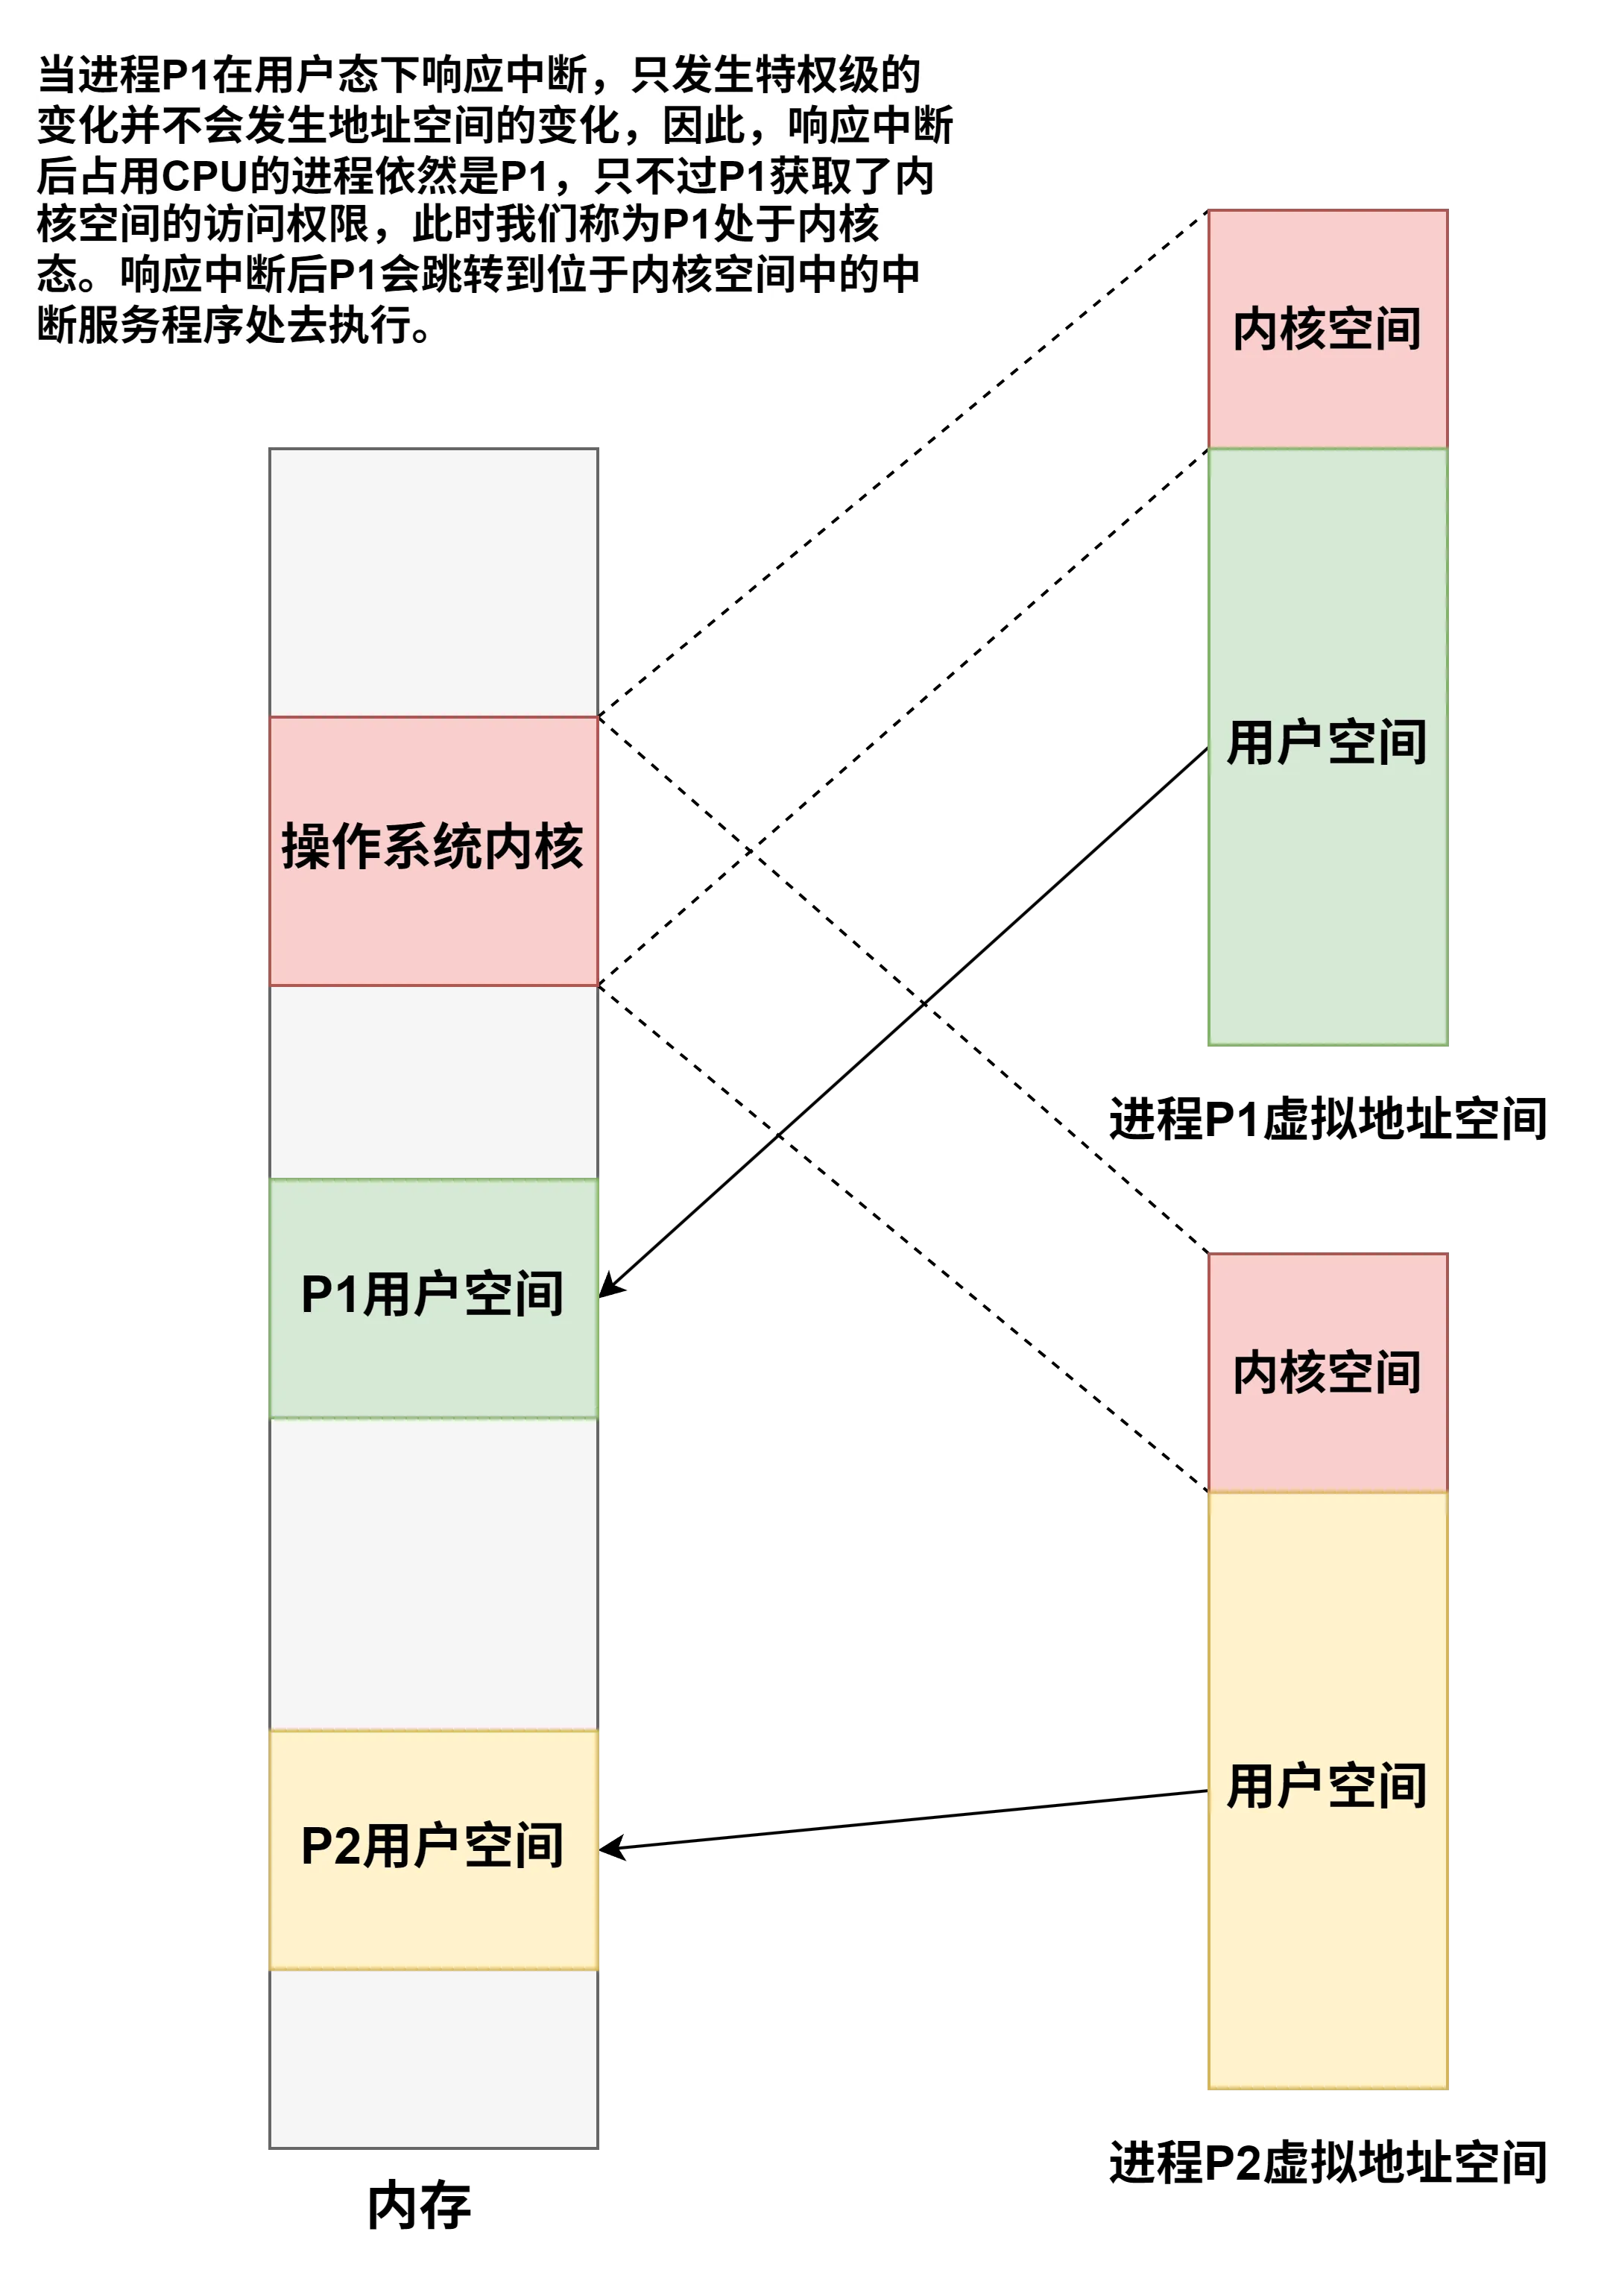
从上面描述的过程我们可以看到,执行中断服务程序的时候,是处于进程P2的地址空间之中,此时是无法将数据直接读入进程P1的用户空间,而内核区域由于被映射到每一个进程的内核空间,因此便可以作为一个通信中介先缓存这部分数据;
等到进程P1被调度上处理机的时候,便可以继续执行read系统调用剩下的事情,也就是把数据从内核缓冲区读入用户空间的buf中了,至此read系统调用执行完毕,返回用户态继续执行。
write系统调用的过程与之类似,不再过多介绍,可以自行推导或者看强化专题IO那边;
真题考察的键盘中断服务大部分过程与此类似,差异点就是键盘输入是程序IO中断方式,而这里介绍的是DMA方式;
相关例题:
【例 1】若一个用户进程通过 read 系统调用读取一个磁盘文件中的数据,则下列关于此过程的叙述中,正确的是( )
Ⅰ. 若该文件的数据不在内存,则该进程进入睡眠等待状态
Ⅱ. 请求 read 系统调用会导致 CPU 从用户态切换到核心态
Ⅲ. read 系统调用的参数应包含文件的名称
A. Ⅰ、Ⅱ
B. Ⅰ、Ⅲ
C. Ⅱ、Ⅲ
D. Ⅰ、Ⅱ、Ⅲ
【解】若该文件的数据不在内存,则系统需要对磁盘进行 I/O 操作,先入核心态,进程进入阻塞态,I、II 正确。
read 系统调用的参数应包含文件描述符,即打开文件表中的索引号,III 错误。
【例 2】若多个进程共享同一个文件 F,则下列叙述中正确的是( )
A、各进程只能用“读”方式打开文件 F
B、在系统打开文件表中仅有一个表项包含 F 的属性
C、各进程的用户打开文件表中关于 F 的表项内容相同
D、进程关闭 F 时系统删除 F 在系统打开文件表中的表项
【解】A 项显然不对。
B 项,整个系统只有一张系统打开文件表,显然正确。
C 项,不同进程的打开文件表的文件描述符都是不一样的,除此之外访问权限也不一样。
D 项,当有多个进程时,其中某一个进程关闭文件,并不会使系统删除打开文件表中的对应表项。
1.4 文件的保护
Tip
- 用户打开文件时申请的权限不能超过文件允许的权限;
- 用户对文件的操作不能超过自身打开文件时申请的权限;
为了防止文件共享可能会导致文件被破坏或未经核准的用户修改文件,文件系统必须控制用户对文件的存取,即解决对文件的读、写、执行的许可问题。为此必须在文件系统中建立相应的文件保护机制。
文件保护我们这里仅介绍口令保护、加密保护、访问控制这三种方式。口令和加密是为了防止用户文件被他人存取或窃取,而访问控制是用于控制用户对文件的访问方式。
-
访问类型,对文件的保护可以从限制对文件的访问类型出发,可加以控制的访问类型主要有这几种:
-
读:从文件中读数据;
- 写:向文件中写数据;
- 执行:将文件装入内存并执行;
- 添加:将新信息添加到文件结尾部分;
- 删除:删除文件,释放空间;
- 列表清单:列出文件名和文件属性;
此外对文件的重命名、复制、编辑等高层的功能可以通过系统程序调用低层系统调用来实现,保护可以只在低层提供。例如复制文件可以利用一系列的读请求来完成,这样,具有读访问权限的用户同时也就具有了复制和打印权限。
-
保护方式
-
口令保护:为文件建立
FCB的同时附上口令,并告诉允许共享的所有其他用户,用户请求访问时需要提供相应的口令。(OS会将用户提供的口令与FCB中存储的口令进行对比,如正确就允许访问) - 优点:保存口令的空间开销不多,验证口令的时间开销也很小。
- 缺点:正确的“口令”存放在系统内部,不够安全。
- 加密保护:使用某个“密码”对文件进行加密,在访问文件时需要提供正确的“密码”才能对文件进行正确的解密。
- 优点:保密性强,不需要在系统中存储“密码”
- 缺点:编码/译码,或者说加密/解密要花费一定时间。 加密由外部实现,虽然很牛,但是对文件的控制肯定不如自家人系统实现的访问控制灵活。
- 访问控制:在每个文件和目录的
FCB(或索引结点)中增加一个访问控制列表/矩阵(Access-Control List, ACL),该表中记录了各个用户可以对该文件执行哪些操作。(多用户之间的存取权限保护) - 优点:灵活,可使用复杂的访问方式; 缺点:ACL的大小无法预计,可能导致复杂的空间管理;
- 由该缺点引入精简的访问列表:以“组”为单位,标记各“组”用户可以对文件执行哪些操作。为此,控制用户对文件的访问方式(对文件的访问由用户访问权限和文件属性共同控制),由系统实现。
- 示意:
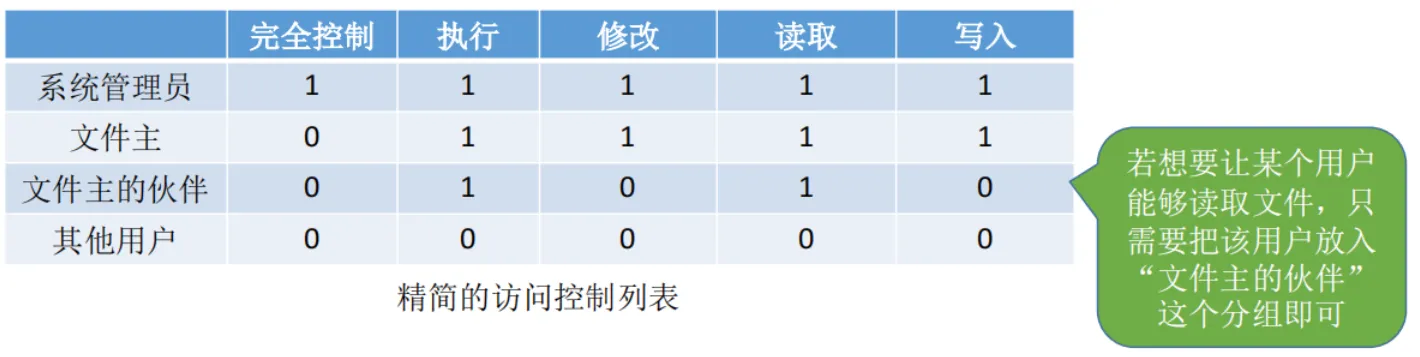
- 例如精简的访问列表利用采用拥有者、组和其他三种用户类型,当某用户想要访问文件时,系统会检查该用户所属的分组是否有相应的访问权限。(系统需要管理分组的信息,文件的文件主名、所属组名存放在该文件的
FCB中) - 引入精简的访问列表后该方法的优点是灵活,缺点是安全性差,相对于加密保护,访问控制机制的安全性较差。
对于多级目录结构来说,不仅需要保护单个文件,而且需要保护子目录内的文件,即需要提供目录保护机制。目录操作与文件操作并不相同,因此需要不同的保护机制。
1.5 文件的逻辑结构(最后更新,不重要)
文件的逻辑结构是从用户观点出发看到的文件的组织形式,即文件是由一系列的逻辑记录组成的,是用户可以直接处理的数据及其结构,它独立于文件的物理特性,实际上是指在文件的内部,这些逻辑记录是如何被组织起来构成逻辑文件的。
对文件逻辑结构提出的要求有:
- 有助于提高对文件的检索速度;
- 方便对文件进行增删改查;
- 降低文件存放在外存上的存储费用,即尽量减少文件所占用的存储空间,不要求大片的连续存储空间;
文件的逻辑结构按是否有结构来分,分为两大类;
1.5.1 无结构文件
- 数据的组织方式:将数据以字节为单位按顺序组织成记录并积累保存;
文件内部的数据就是一系列二进制流或字符流组成,又称“流式文件”,如windows操作系统中的.txt文件。
- 访问方式:由于没有结构,因此对记录的访问只能通过穷举搜索,利用读写指针指出下一个要访问的字符。
- 适用场合:适用于对基本信息单位操作不多的文件,如源程序、可执行文件、库函数、目标代码等
1.5.2 有结构文件
由一组相似的记录组成,又称“记录式文件”。每条记录又若干个数据项组成。如:数据库表文件。一般来说,每条记录有一个数据项可作为关键字。根据各条记录的长度(占用的存储空间)是否相等,又可分为定长记录和可变长记录两种。
- 定长记录:
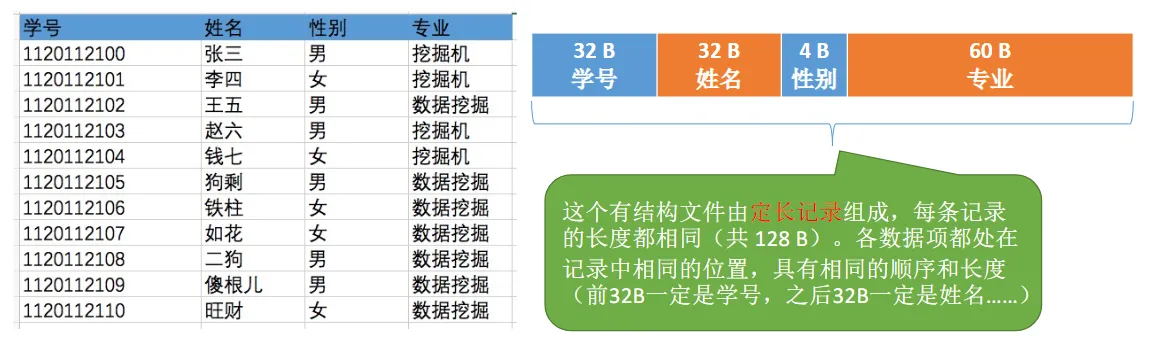
优点:能有效地提高检索记录的速度和效率,能方便地对文件进行处理和修改,被广泛用于数据处理;
- 可变长记录:
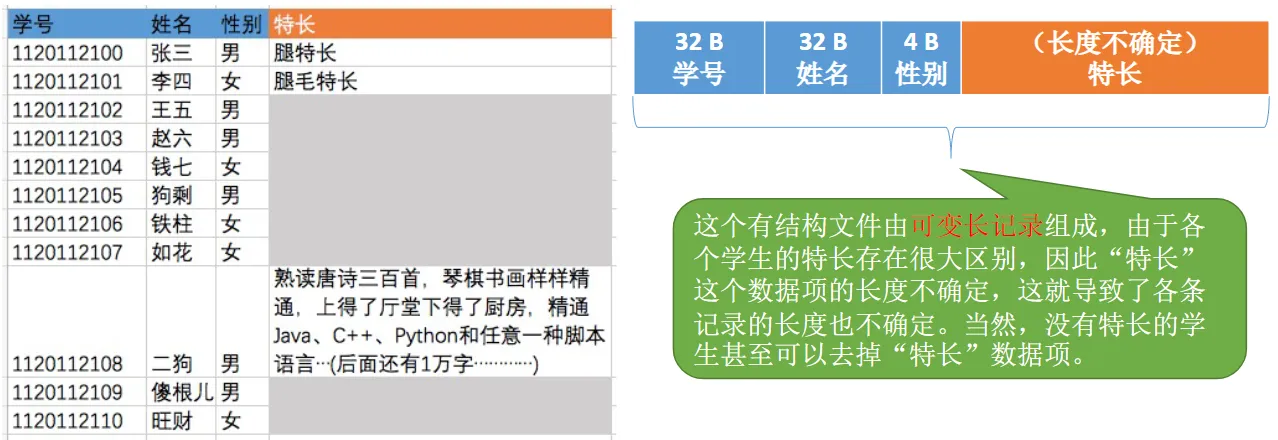
分析:对可变长记录的检索速度慢,也不便于对文件进行处理和修改。
根据文件的组织方式,可以分为以下四类:
1.5.2.1 顺序文件
文件中的记录一个接一个地顺序排列(逻辑上),记录可以是定长的或可变长的。各个记录在物理上可以顺序存储或链式存储。
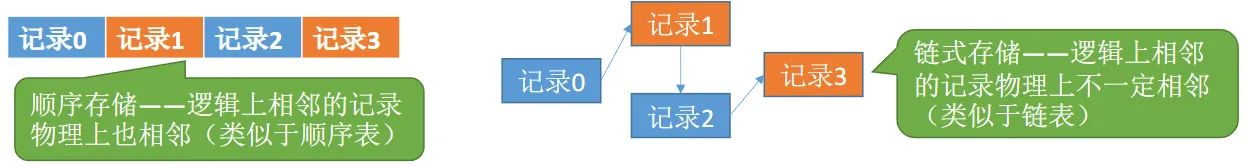
链式存储的顺序文件在逻辑地址空间的情况:
| 地址 | 0 | 1 | 2 | 3 | 4 | … |
|---|---|---|---|---|---|---|
| 记录 | 记录 1(指针:4) | 记录 0(指针:0) | (空) | (空) | 记录 2(指针:…) | … |
顺序文件有两种结构:
- 串结构:记录之间的顺序与关键字无关,通常按照记录存入的时间决定记录的顺序;对该结构文件进行检索(查找某记录)必须从头开始顺序依次查找,较费时;
- 顺序结构:记录按关键字顺序排列;可通过折半查找等算法提高检索效率;
当顺序文件在物理上采取链式存储,那么无论是变长/可变长记录,都无法实现随机存取,每次都只能从第一个记录开始依次往后查找;
当顺序文件在物理上采取顺序存储,根据记录长度分为以下两类:
- 若是可变长记录,依旧无法实现随机存取,只能顺序查找,第 i 个记录的首地址如下,需要遍历每个记录计算长度;
- 若是定长记录,可实现随机存取,第 i 个记录的地址:
address = i * length;若采用串结构,无法快速找到某关键字对应的记录;若采用顺序结构,可以快速找到某关键字对应的记录(如采用折半查找)。
- 可变长记录需要显式地给出记录长度,定长记录不需要。
- 定长记录的顺序文件,若物理上再采用顺序存储,则可以实现随机存取,若能再保证记录的顺序结构,则可以实现快速检索(如折半查找);
- 一般来说,考试题目中所说的“顺序文件”指的是物理上顺序存储的顺序文件。之后的讲解中提到的顺序文件也默认如此。
- 适用场合:对增删改查单个记录的操作困难,性能也较差;因此适合对数据批量操作,例如顺序存储设备磁带等,在这种每次读或写一大批数据时,所有逻辑文件中顺序文件的存取效率是最高的。
1.5.2.2 索引文件
对于可变长记录文件,要找到第 i 个记录,必须先顺序查找前 i-1 个记录,但是很多应用场景中又必须使用可变长记录。如何解决这个问题?
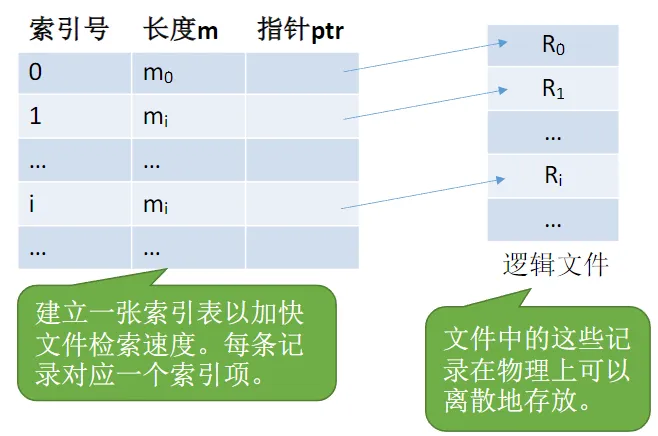
为主文件的每个记录在索引表中分别设置一个表项,包含指向变长记录的指针(即逻辑起始地址)和记录长度。
索引表本身是定长记录的顺序文件。因此可以快速找到第i个记录对应的索引项。可将关键字作为索引号内容,若按关键字顺序排列,则还可以支持按照关键字折半查找(快速检索)。每当要增加/删除一个记录时,需要对索引表进行修改。由于索引文件有很快的检索速度,因此主要用于对信息处理的及时性要求比较高的场合。
另外,可以用不同的数据项建立多个索引表。如:学生信息表中,可用关键字“学号”建立一张索引表。也可用“姓名”建立一张索引表。这样就可以根据“姓名”快速地检索文件了.(Eg:SQL 就支持根据某个数据项建立索引的功能)
1.5.2.3 索引顺序文件
思考索引文件的缺点:每个记录对应一个索引表项,因此索引表可能会很大。\ 比如:文件的每个记录平均只占 8B ,而每个索引表项占32个字节,那么索引表都要比文件内容本身大4倍,这样对存储空间的利用率就太低了。
为了缩减索引表的表项长度,提出了索引顺序文件的方案。索引顺序文件是索引文件和顺序文件思想的结合,索引顺序文件中,同样会为文件建立一张索引表,但不同的是:并不是每个记录对应一个索引表项,而是一组记录对应一个索引表项。每个分组就是一个顺序文件,分组内的记录不必按关键字排序。索引表和各分组顺序文件(主文件)组成一个索引顺序文件。先在索引表内顺序找组的索引,再在组内顺序找记录。
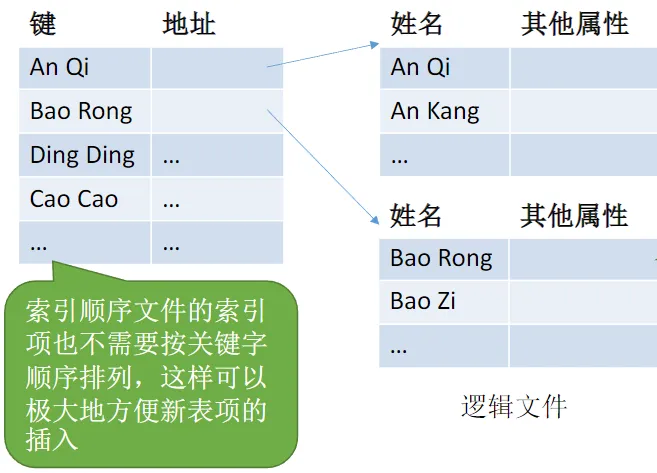
n个记录
- 顺序查找,平均n/2次查找;
- 索引顺序查找,分成平均i组,每组n/i个,则平均查找i/2 + (n/i)/2次,最优情况是n个记录分成sqrt(n)组,则总查找次数为根号n次;
为了进一步提高检索效率,可以为顺序文件建立多级索引表。例如,对于一个含 106个记录的文件,可先为该文件建立一张低级索引表,每 100 个记录为一组,故低级索引表中共有 10000个表项(即10000个定长记录),再把这 10000个定长记录分组,每组100个,为其建立顶级索引表,故顶级索引表中共有100个表项。
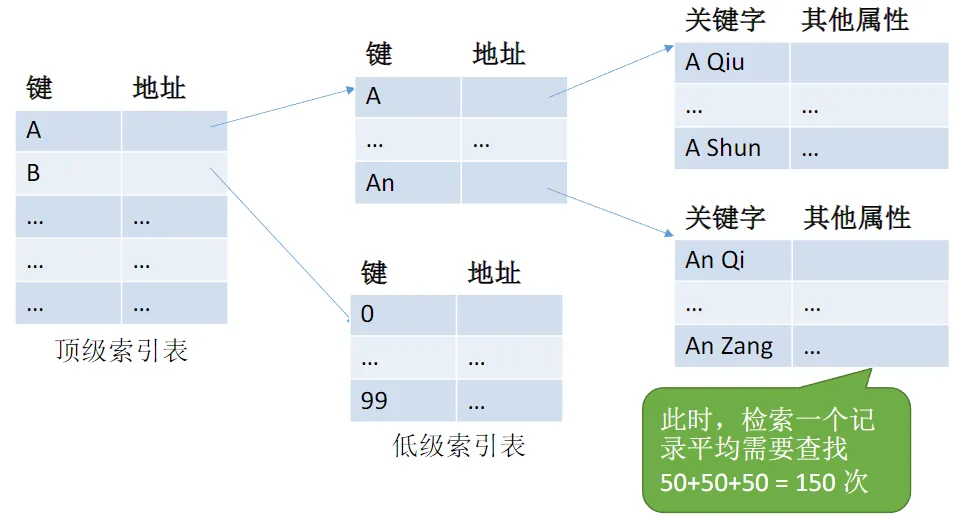
Tips: 技巧:要为 N 个记录的文件建立 K 级索引,则最优的分组是每组 N1/(K+1) 个记录。检索一个记录的平均查找次数是\(\left(N^{1/(K+1)}/2\right)\times(K+1)\),如:本例中,建立2级索引,则最优分组为每组\(1000000^{1/3}=100\) 个记录,平均查找次数是\((100/2)\times 3=150\) 次.
1.5.2.4 直接文件或散列文件
给定记录的键值或通过Hash函数转换的键值直接决定记录的物理地址;
散列文件有很高的存取速度,但是会引起冲突,即不同关键字的散列函数值相同;
1.6 文件的物理结构(文件的分配方式)
文件的物理结构,又称为文件的存储结构。这是指系统将文件存储在外存上所形成的一种存储组织形式,是用户不能看见的。文件的物理结构不仅与存储介质的存储性能有关,而且与所采用的外存分配方式有关。文件的物理结构就是研究文件的实现,即文件数据在物理存储设备上是如何分布和组织的。这里有两方面的回答:一是文件的分配方式,讲的是对磁盘非空闲块的管理;二是文件存储空间管理,讲的是对磁盘空闲块的管理(文件系统那边介绍,在后面)。
【注】随机存取/随机访问:
- 文件的某种逻辑结构支持随机存取/随机访问:采用这种逻辑结构的文件,可以根据记录号直接算出该记录对应的逻辑地址 (逻辑块号,块内地址)。
- 文件的某种物理结构支持随机存取/随机访问:采用这种物理结构的文件,可以根据逻辑地址(逻辑块号,块内地址)直接算出该记录对应的物理地址。
- 磁盘块:磁盘中的存储单元也会被分为一个个“块/磁盘块/物理块”,磁盘块的大小与内存块、页面的大小相同。内存与磁盘之间的数据交换(即读/写操作、磁盘 I/O)都是以“块”为单位进行的。即每次读入一块,或每次写出一块。
- 文件块:在外存管理中,为了方便对文件数据的管理,文件的逻辑地址空间也被分为了一个一个的文件“块”。
【注 1】在 Windows 系统中称为“磁盘簇”“文件簇”,在 UNIX 系统中称为“磁盘块”“文件块”。
【注 2】簇是文件的分配单位,簇是操作系统使用的逻辑概念,扇区是磁盘上最小的物理单元。
so文件的逻辑地址也可以表示为(逻辑块号,块内地址)的形式。
1.6.1 连续分配
- 概念:连续分配方式要求每个文件在磁盘上占有一组连续的块,逻辑上相邻的块物理上也相邻。
- 如何实现从逻辑地址到物理地址的映射:用户给出要访问的逻辑块号,操作系统找到该文件对应的目录项(FCB),(逻辑块号,块内地址)→(物理块号,块内地址). 只需转换块号就行,块内地址保持不变.
- 访问方式:支持顺序访问和随机(直接)访问。
- 最佳应用场景: 文件长度基本不会改变,对随机读写的速度要求高
- 优点:顺序存取速度快(访问磁盘时寻道数与寻道时间最小),实现简单;
- 缺点:
- 文件长度不宜动态增加(不方便拓展),因为一个文件末尾的盘块可能已分配给其他文件,一旦需要增加,就要大量移动盘块;
- 存储空间利用率低,反复增删文件后会产生外部碎片;
- 记录插入和删除操作效率低下
- 示意图:
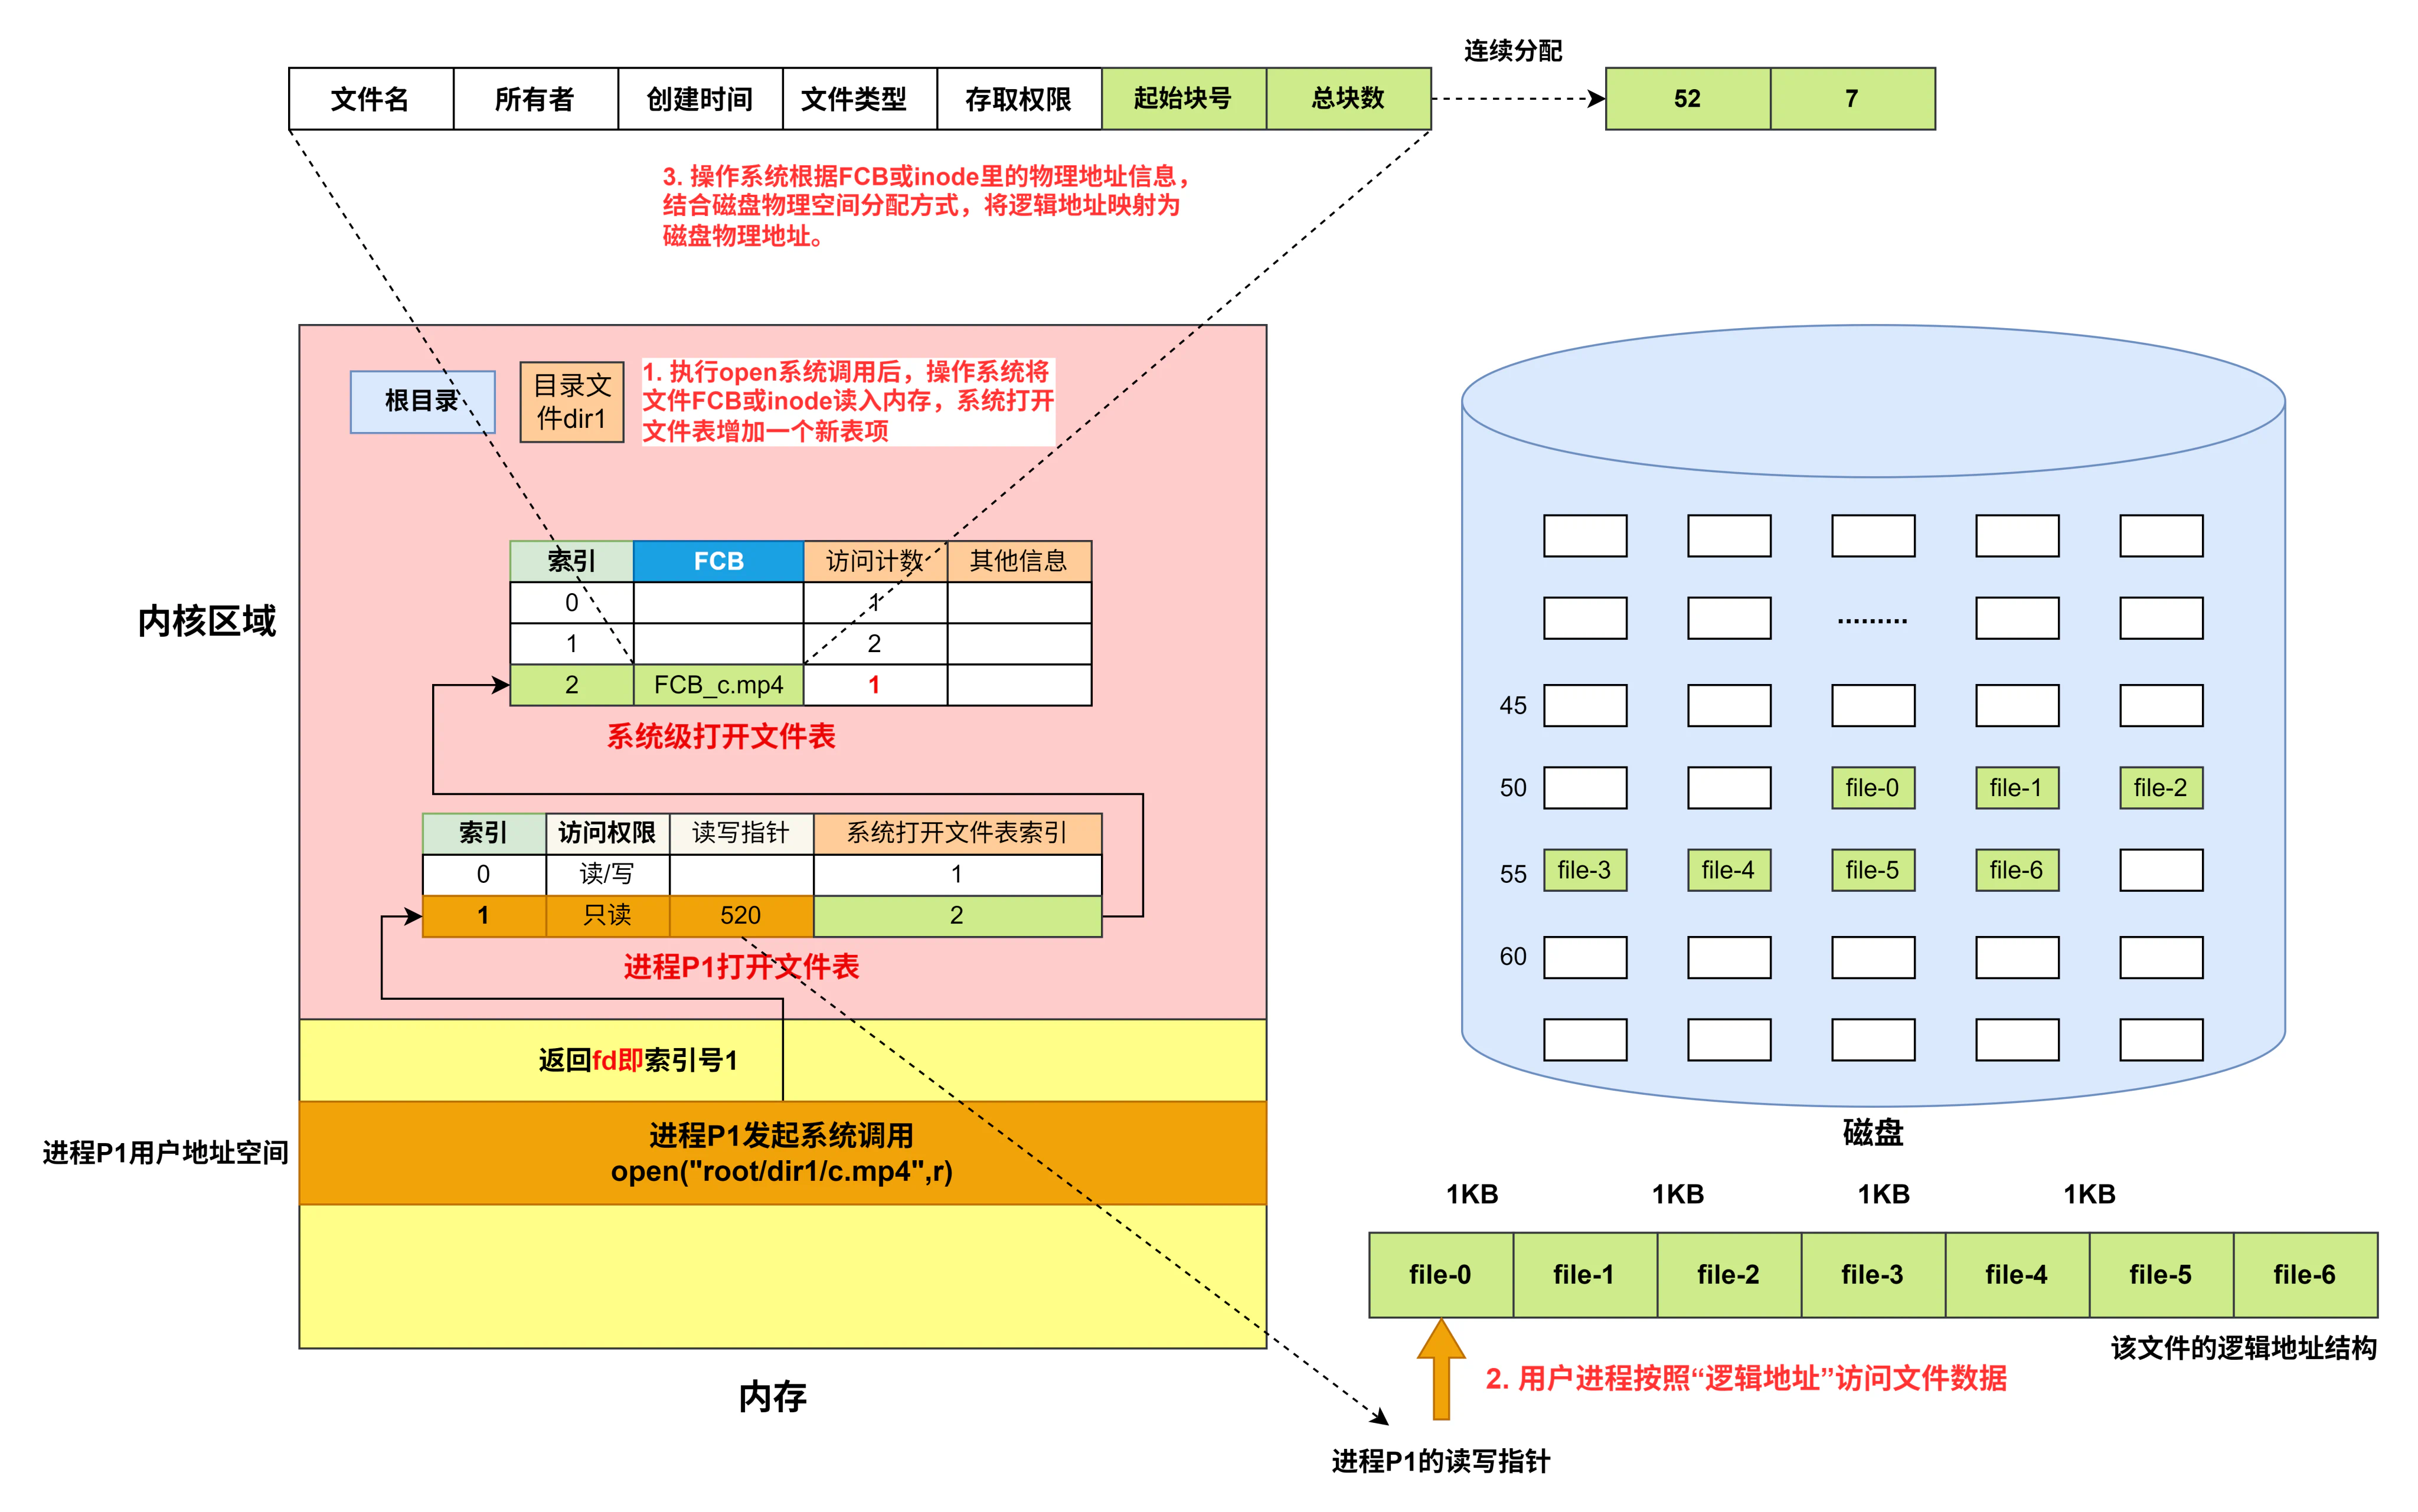
参考上图,回答以下问题(连续分配的前提):
Note
- 是否支持随机读写?是否方便文件扩展?
- 该种文件分配方式下,FCB或inode中的文件物理地址字段中需要保存什么内容?(为定位文件数据块,需要在FCB/inode中设计哪些相关描述字段?)
- 单个文件的最大大小取决于什么因素?
- 假设c.mp4的FCB已经读入内存,想要访问第3个逻辑块(块号从1开始)需要多少次读磁盘操作?
- 假设c.mp4的FCB已经读入内存,修改file-3文件块中的内容需要几次磁盘I/O?
- 假设c.mp4的FCB已经读入内存,删除file-2文件块,最少需要几次磁盘I/O?该文件的FCB内容会发生哪些改变?(不考虑回收空闲磁盘块需要的磁盘I/O次数)
- 假设该文件由7条记录组成,记录从1开始编号,用户打开文件后,想要把内存中的一条记录插入该文件,作为该文件的第4条记录;该文件采用连续分配方式,且该文件存储区域前后均有足够的空闲磁盘空间,则完成上述插入操作最少需要访问多少次磁盘块?该文件的FCB内容会发生哪些改变?
答案
- 是;否
- 起始块号和总块数(文件块数)
- 取决于以下两种因素:FCB中用多少个bit表示总块数;每个磁盘块的大小;单个文件最大大小 = 最大块数 * 磁盘块大小;
- 1次即可,直接读入(起始块号+3-1=52+2=)54号磁盘块即可;
- 2次,一次读入内存中修改,还有一次写回磁盘;
- 如果想要删除file-2文件块,有两种方案,将file0-1 依次后移一个位置;或者将file3-6依次前移一个位置,因为本题要求磁盘IO次数最少,因此可以选择将file0-1依次后移一位,这样的话需要将file1读入内存再写入原来file2的位置,file0同理,因此需要4次磁盘I/O;需要修改起始块号为53,总块数为6;
- 将前三条记录依次前移一个位置,需要读入内存和写回磁盘共3*2 = 6次,然后将这条记录写入磁盘作为第四条记录,需要一次写磁盘,因此一共要7次磁盘I/O;需要修改起始块号为51,总块数为8;
1.6.2 链接分配
链接分配是一种采取离散分配的方式,可以为文件分配离散的磁盘块。分为隐式链接和显式链接两种。
隐式链接分配(默认)
- 实现方式:每个盘块(除最后一个)尾部都有指向下一个盘块的指针。
- 访问方式:只能顺序访问
- 最佳应用场景: 文件长度经常改变,只要求对文件进行顺序访问
- 如何实现从逻辑地址到物理地址的转变:用户给出要访问的逻辑块号,操作系统找到该文件对应的目录项(FCB),从目录项中找到起始块号(即0号块),将0号逻辑块读入内存,由此知道1号逻辑块存放的物理块号,于是读入1号逻辑块,再找到2号逻辑块的存放位置......以此类推。因此,读入i号逻辑块,总共需要 i+1次磁盘I/O。
- 优点:消除了外部碎片,提高了磁盘利用率,适合文件长度的动态增长(动态分配块)
- 缺点:只支持顺序查找,不支持随机访问,查找效率低(各盘块的指针都在磁盘的各盘块中,访问磁盘的次数高,速度慢。无法直接访问盘块,只能通过指针顺序访问文件);指向下一个盘块的指针也需要耗费少量的存储空间。
- 示意图:
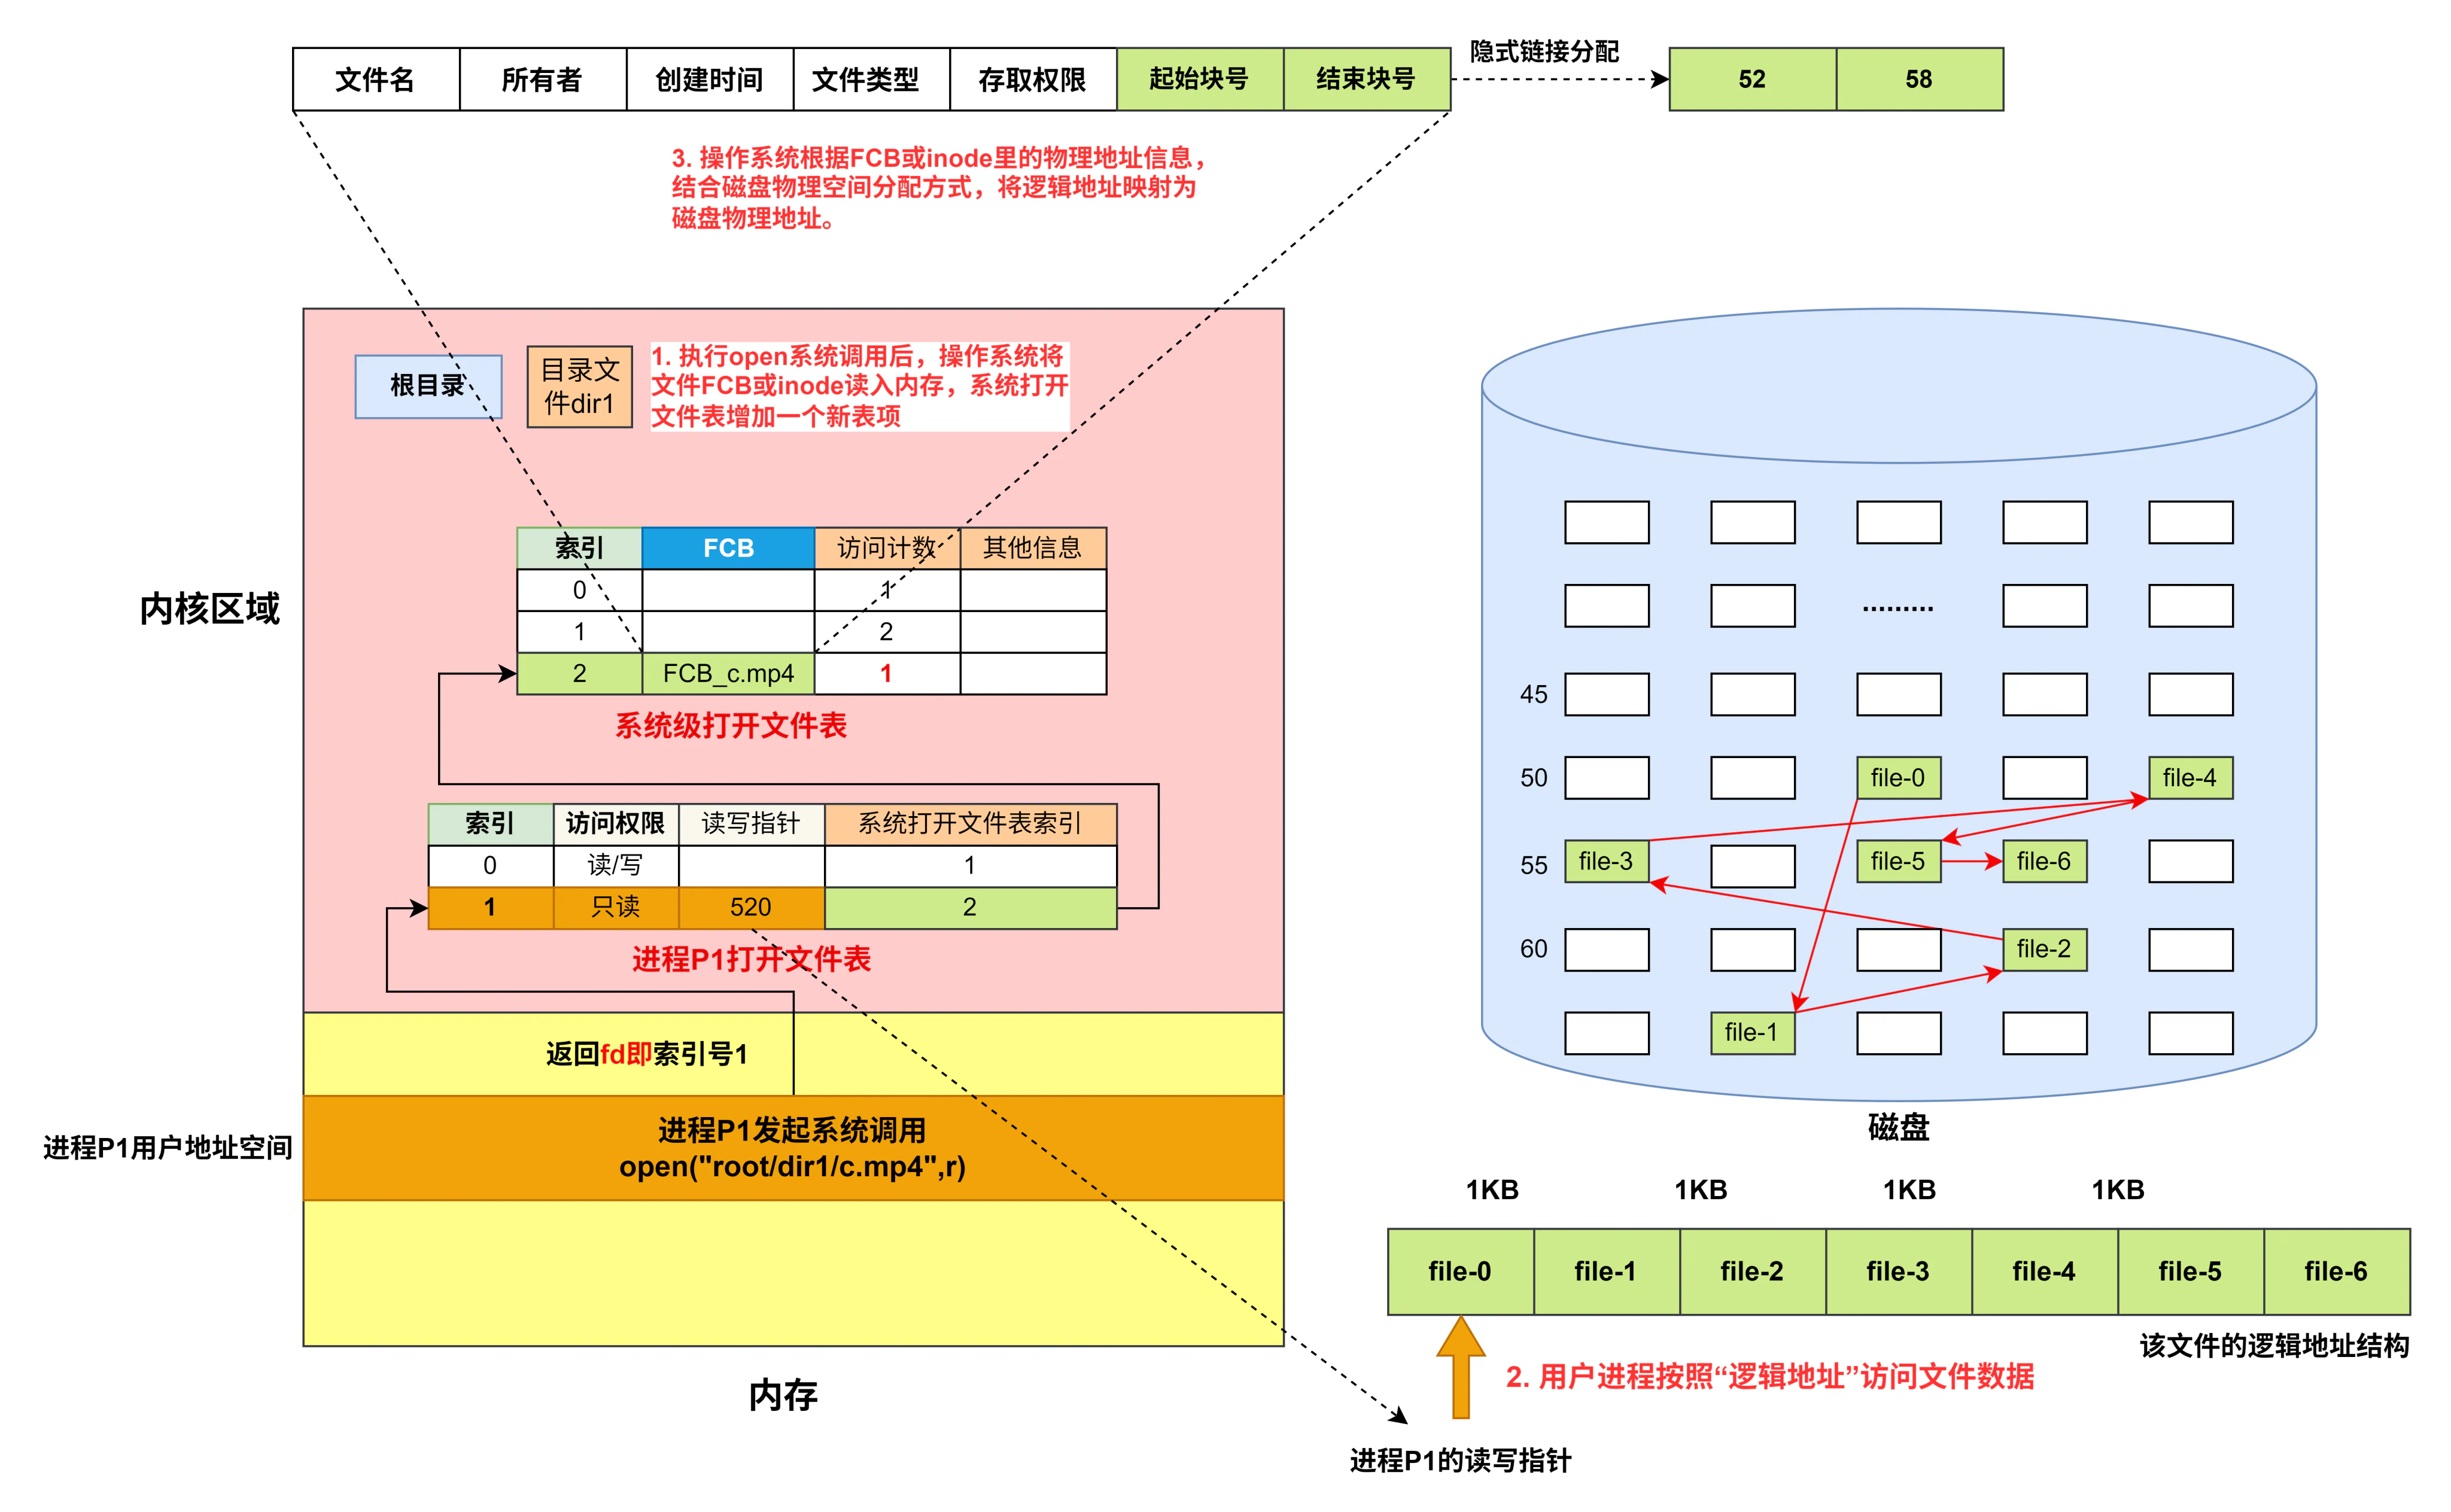
参考上图,回答以下问题(隐式链接分配的前提):
Note
- 是否支持随机读写?是否方便文件扩展?
- 该种文件分配方式下,FCB或inode中的文件物理地址字段中需要保存什么内容?(为定位文件数据块,需要在FCB/inode中设计哪些相关描述字段?)
- 单个文件的最大大小取决于什么因素?
- 假设c.mp4的FCB已经读入内存,想要访问第3个逻辑块(块号从1开始)需要多少次读磁盘操作?
- 假设c.mp4的FCB已经读入内存,修改file-3文件块中的内容需要几次磁盘I/O?
- 假设c.mp4的FCB已经读入内存,删除file-2文件块,最少需要几次磁盘I/O?(不考虑回收空闲磁盘块需要的磁盘I/O次数)
- 假设该文件由7条记录组成,记录从1开始编号,用户打开文件后,想要把内存中的一条记录插入该文件,作为该文件的第4条记录;该文件采用隐式链接分配方式,假设获取空闲磁盘块不需要磁盘I/O操作(实际系统中获取空闲磁盘块可能也需要一定的磁盘访问次数,但本题暂不考虑这部分额外开销),则完成上述插入操作最少需要访问多少次磁盘块?
答案
- 否;是
- 起始块号和结束块号
- 取决于以下两种因素:①一个磁盘块中,用多少bit表示下一块的链接指针②磁盘块大小;假设磁盘块大小为1KB,用2B存放链接指针,那么文件系统支持的最大文件长度是:
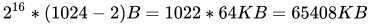
- 需要3次;因为需要获取第1块和第二块磁盘块中的下一个盘块的链接指针,因此前两块也需要读入;
- 5次,需要先将file0-2依次读入内存,然后找到file-3,读入内存后修改,再写回磁盘,因此一共需要5次磁盘I/O;
- 需要依次读入file-0-2,获取到file-2的链接指针知道了file-3的位置信息,再修改file-1的链接指针,将file-1写回磁盘即可,因此一共4次磁盘I/O;
- 可分为以下三步:
- 首先需要依次将前三条记录所在的磁盘块读到内存中,然后根据第三条记录所在的磁盘块的链接指针知道原来第四条记录所在的磁盘块号,此过程需要写磁盘3次;
- 将新记录写入一个空闲磁盘块,链接指针区域写入原来第四条记录所在的磁盘块号,让其指向原来第四条记录所在磁盘块,此过程需要写磁盘1次;
- 修改第3条记录所在磁盘块的链接指针,将其指向新插入的记录所在的磁盘块,此过程需要写磁盘1次;
因此一共需要5次磁盘I/O;
显式链接分配
- 实现方式:把所有链接盘块的指针从各盘块尾部抽离出来,存放在内存的一张链接表(
文件分配表FAT,File Allocation Table)中,每条表项存放对应磁盘块的下一链接的指针,每条链的首指针(文件的第一块)作为文件的首地址写入FCB中,即记录在目录项“物理地址”字段.后续的盘块可以通过查FAT找到。
注意:一个文件系统仅设置一张FAT。开机时,将FAT读入内存,并常驻内存。FAT的各个表项在物理上连续存储,且每一个表项长度相同,因此“物理块号”字段可以是隐含的。
- 最佳应用场景: 文件长度经常改变,且要求随机读写
- 如何实现从逻辑地址到物理地址的转变:用户给出要访问的逻辑块号,操作系统找到该文件对应的目录项(FCB), 从目录项中找到起始块号,若i>0,则查询内存中的文件分配表FAT,往后找到i号逻辑块对应的物理块号。逻辑块号转换成物理块号的过程不需要读磁盘操作,因此访问某记录时只需要1次访盘操作取出记录即可。
- 访问方式:随机(直接)访问
- 优点:采用链式分配(显式链接)方式的文件,支持顺序访问,也支持随机访问(想访问 i号逻辑块时,并不需要依次访问之前的 0 ~ i号逻辑块),由于块号转换的过程不需要访问磁盘,因此相比于隐式链接来说,访问速度快很多。\ 显然,显式链接也不会产生外部碎片,也可以很方便地对文件进行拓展。
这里说支持随机访问欠妥,这里的意思是进行随机查找的时候,不用进行那么多次磁盘访问,只需要访问内存中的FAT就可以。
- 缺点:文件分配表FAT需要占用一定的存储空间
- 示意图:
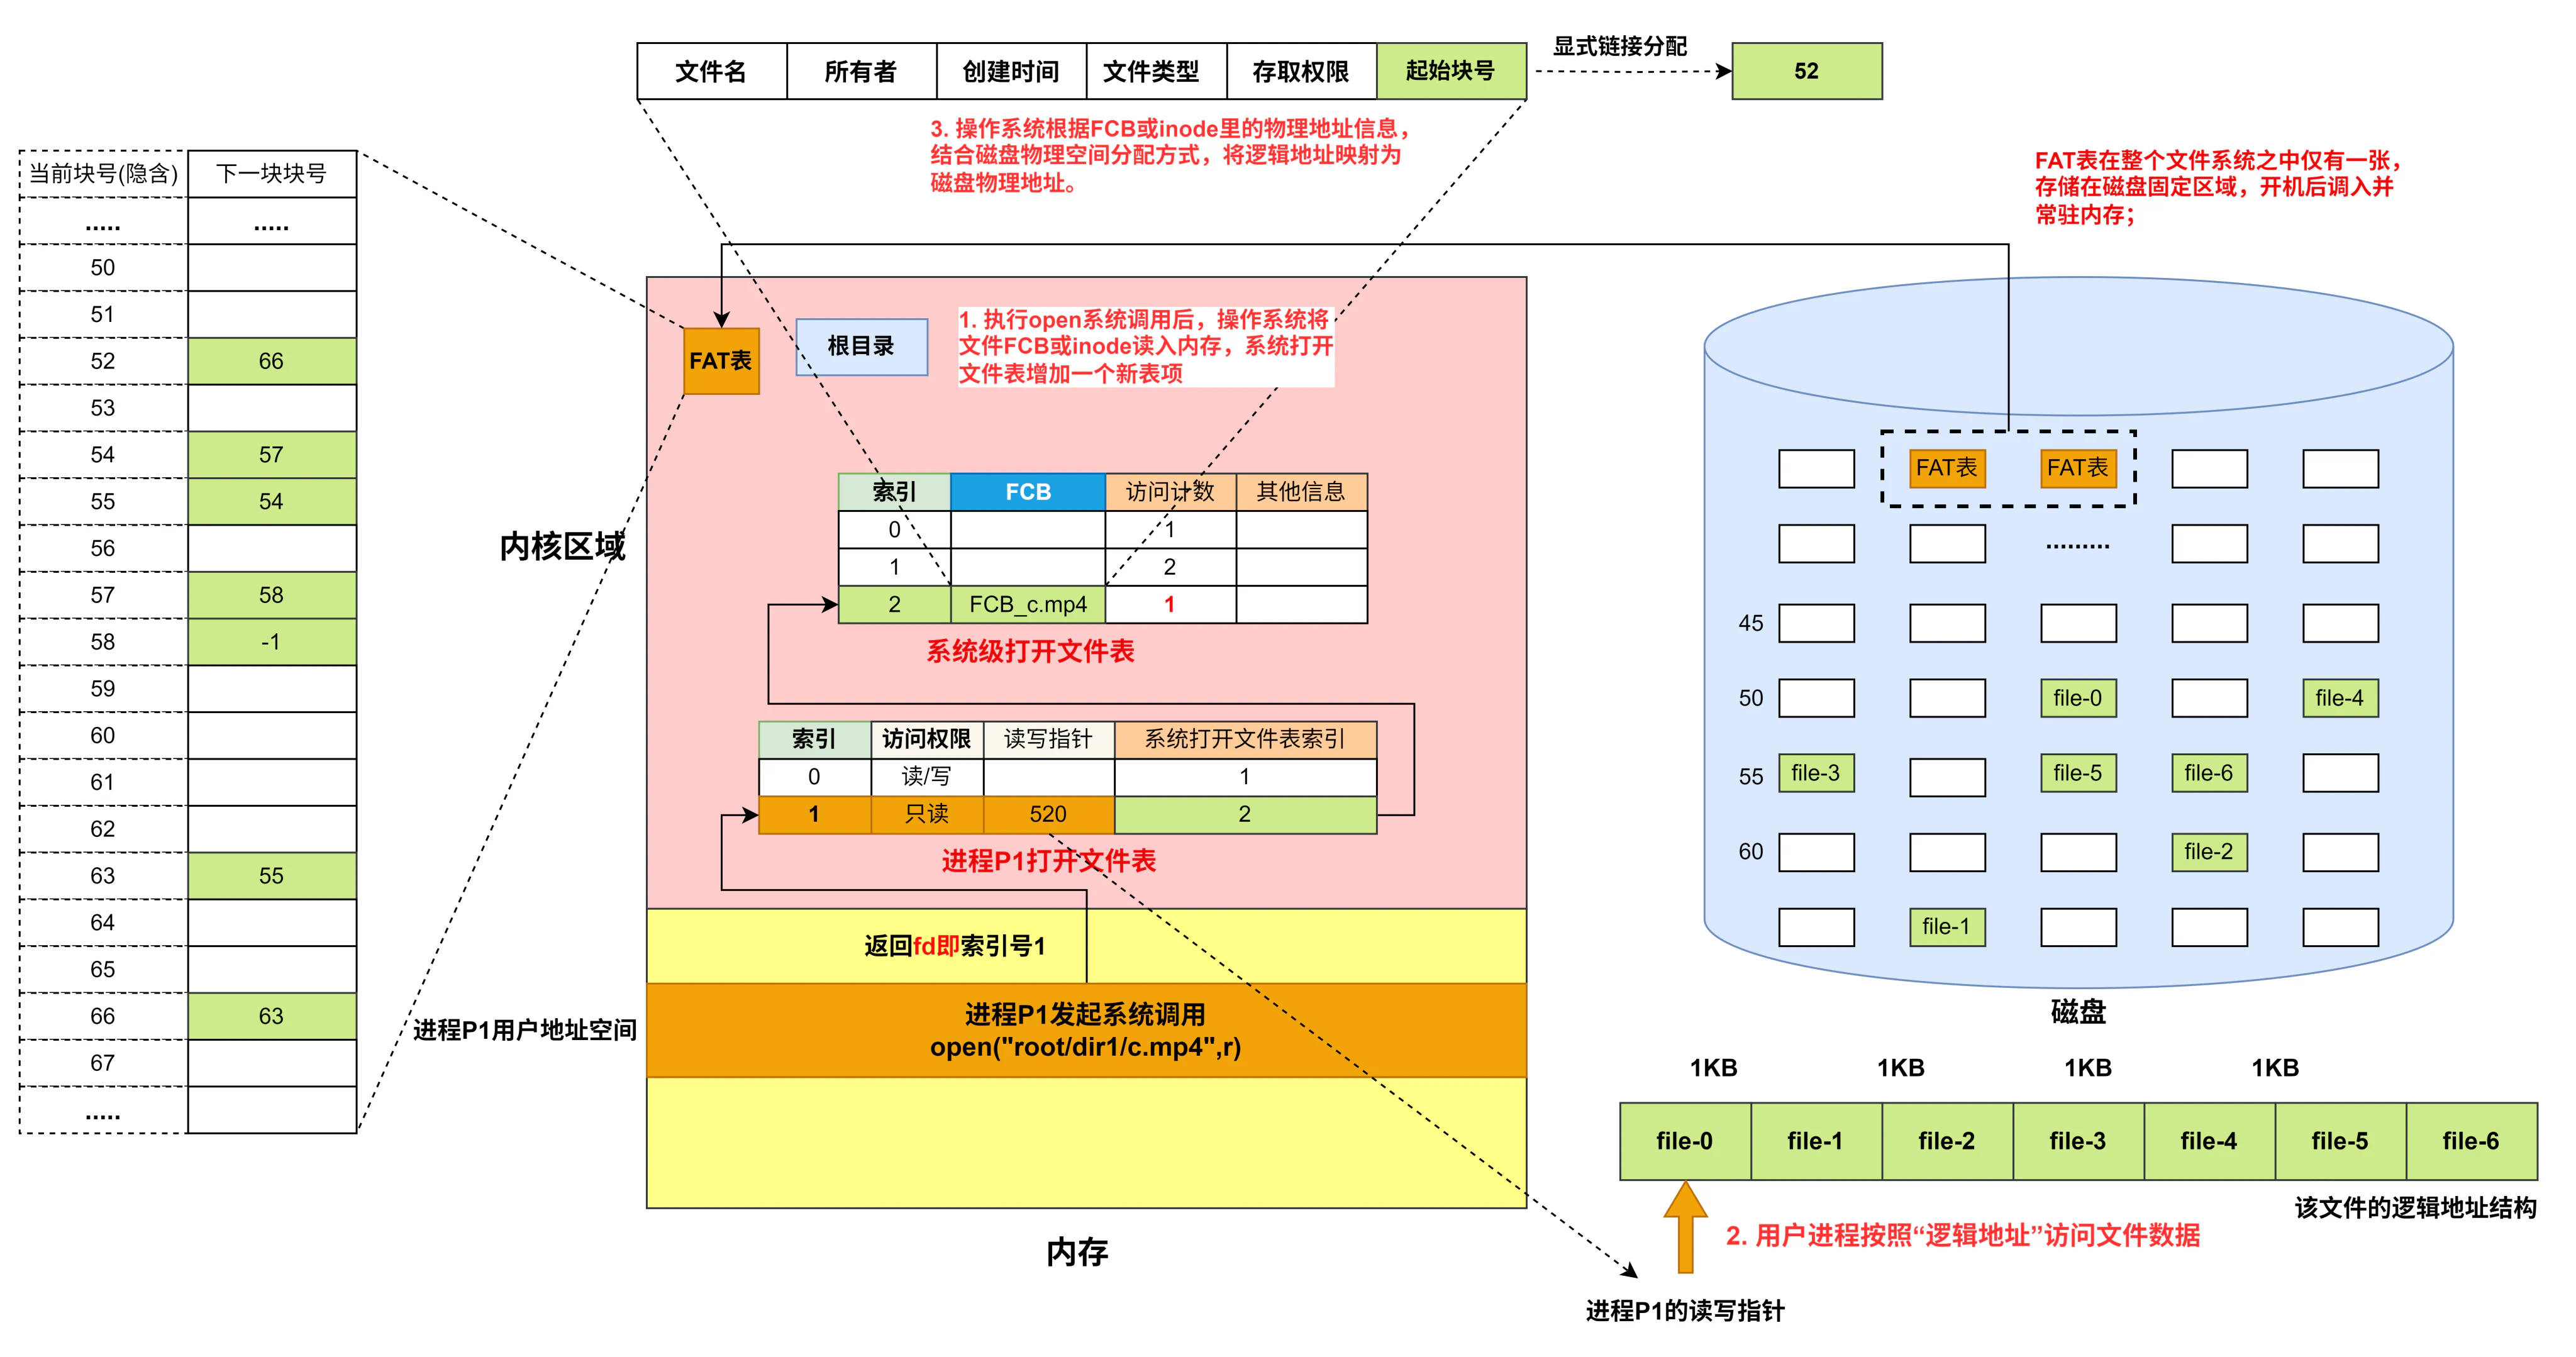
参考上图,回答以下问题(基于显式链接分配的前提,FAT已读入内存):
Note
- 是否支持随机读写?是否方便文件扩展?
- 该种文件分配方式下,FCB或inode中的文件物理地址字段中需要保存什么内容?(为定位文件数据块,需要在FCB/inode中设计哪些相关描述字段?)
- 单个文件的最大大小取决于什么因素?
- FAT用到了哪种数据结构?可以用来管理空闲磁盘空间吗?可以的话,如何管理?
- 简述操作系统是如何使用FAT表的?
- 假设c.mp4的FCB已经读入内存,想要访问第3个逻辑块(块号从1开始)需要多少次读磁盘操作?
- 假设c.mp4的FCB已经读入内存,修改file-3文件块中的内容需要几次磁盘I/O?
- 假设c.mp4的FCB已经读入内存,删除file-2文件块,最少需要几次磁盘I/O?
- 假设该文件由7条记录组成,记录从1开始编号,用户打开文件后,想要把内存中的一条记录插入该文件,作为该文件的第4条记录;该文件采用显式链接分配方式,则完成上述插入操作最少需要访问多少次磁盘块?
答案
- 是;是
- 起始块号
- 取决于以下两种因素:①FAT表中每个表项有多少个bit(每个表项仅存放下一块块号),②磁盘块大小;
假设磁盘块大小为2KB,FAT表中每个表项大小为2B,那么文件系统支持的最大文件长度是: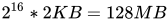
- 静态链表;可以;如上图,我们可以用-1表示一个文件的最后一块,用-2表示空闲的磁盘块,当需要为文件分配磁盘块时,遍历查找一个表项值为-2的磁盘块分配给它即可;回收磁盘块时,将表项值置为-2;
- 开机后,就会把整个FAT表读入内存,系统运行过程中,FAT表会一直常驻内存,也就是说,查FAT表不需要读磁盘,若进程需要访问某个文件,则需要找到这个文件对应的目录项,从目录项中找到该文件的起始块号,再根据起始块号查FAT表就可以确定后续块号在磁盘中的存放位置了。
- 需要1次;通过FCB可以知道文件的起始块号,再去查FAT表便可以直接确定文件的第三个逻辑块在磁盘的存储位置,因此仅需1次磁盘I/O;
- 2次,根据FCB和FAT找到file-3所在磁盘块后读入内存修改再写回磁盘即可;
- 0次,仅需修改FAT表中关于该文件的链接关系即可,至于file-2在FAT中的表项,直接将表项值置为-2当成空闲磁盘块即可;
- 1次即可,查找FAT表找到一个空闲磁盘块所在块号,将该记录写入磁盘对应位置,然后修改FAT表中关于该文件的链接关系即可;
1.6.3 索引分配(重点)
- 实现思想: 事实上,在打开某个文件时,只需要把该文件占用的盘块的编号调入内存即可,完全没有必要将整个FAT调入内存。为此,可以将每个文件所对应的盘块号集中放在一起,在访问到某个文件时,将该文件所对应的盘块号一起调入内存,索引分配就是基于这个思想。
- 实现方式:索引分配允许文件离散地分配在各个磁盘块中,系统会为每个文件建立一张索引表,第i个条目指向文件的第i个块,索引表中记录了文件的各个逻辑块对应的物理块。索引表存放的磁盘块称为索引块,文件数据存放的磁盘块称为数据块.
Note
在inode(或FCB)中存放一个索引指针的数组,利用这些索引指针来指示文件所占据的物理磁盘块;
- 优点:支持随机访问(可以直接从索引块中读取想要的盘块号),且没有外部碎片问题;
- 缺点:由于索引块的分配,增加了系统存储空间的开销。索引块的大小是一个重要问题,每个文件必须有一个索引块,因此索引块应尽可能小,但是索引块太小就无法支持大文件,比如一个文件很大,一个磁盘块无法装下文件的整张索引表。此外由于索引块的存在,访问文件可能需要多次磁盘I/O;
- 最佳应用场景: 文件长度经常改变,且要求随机读写
索引分配有以下实现方案:
- 直接索引(直接地址)
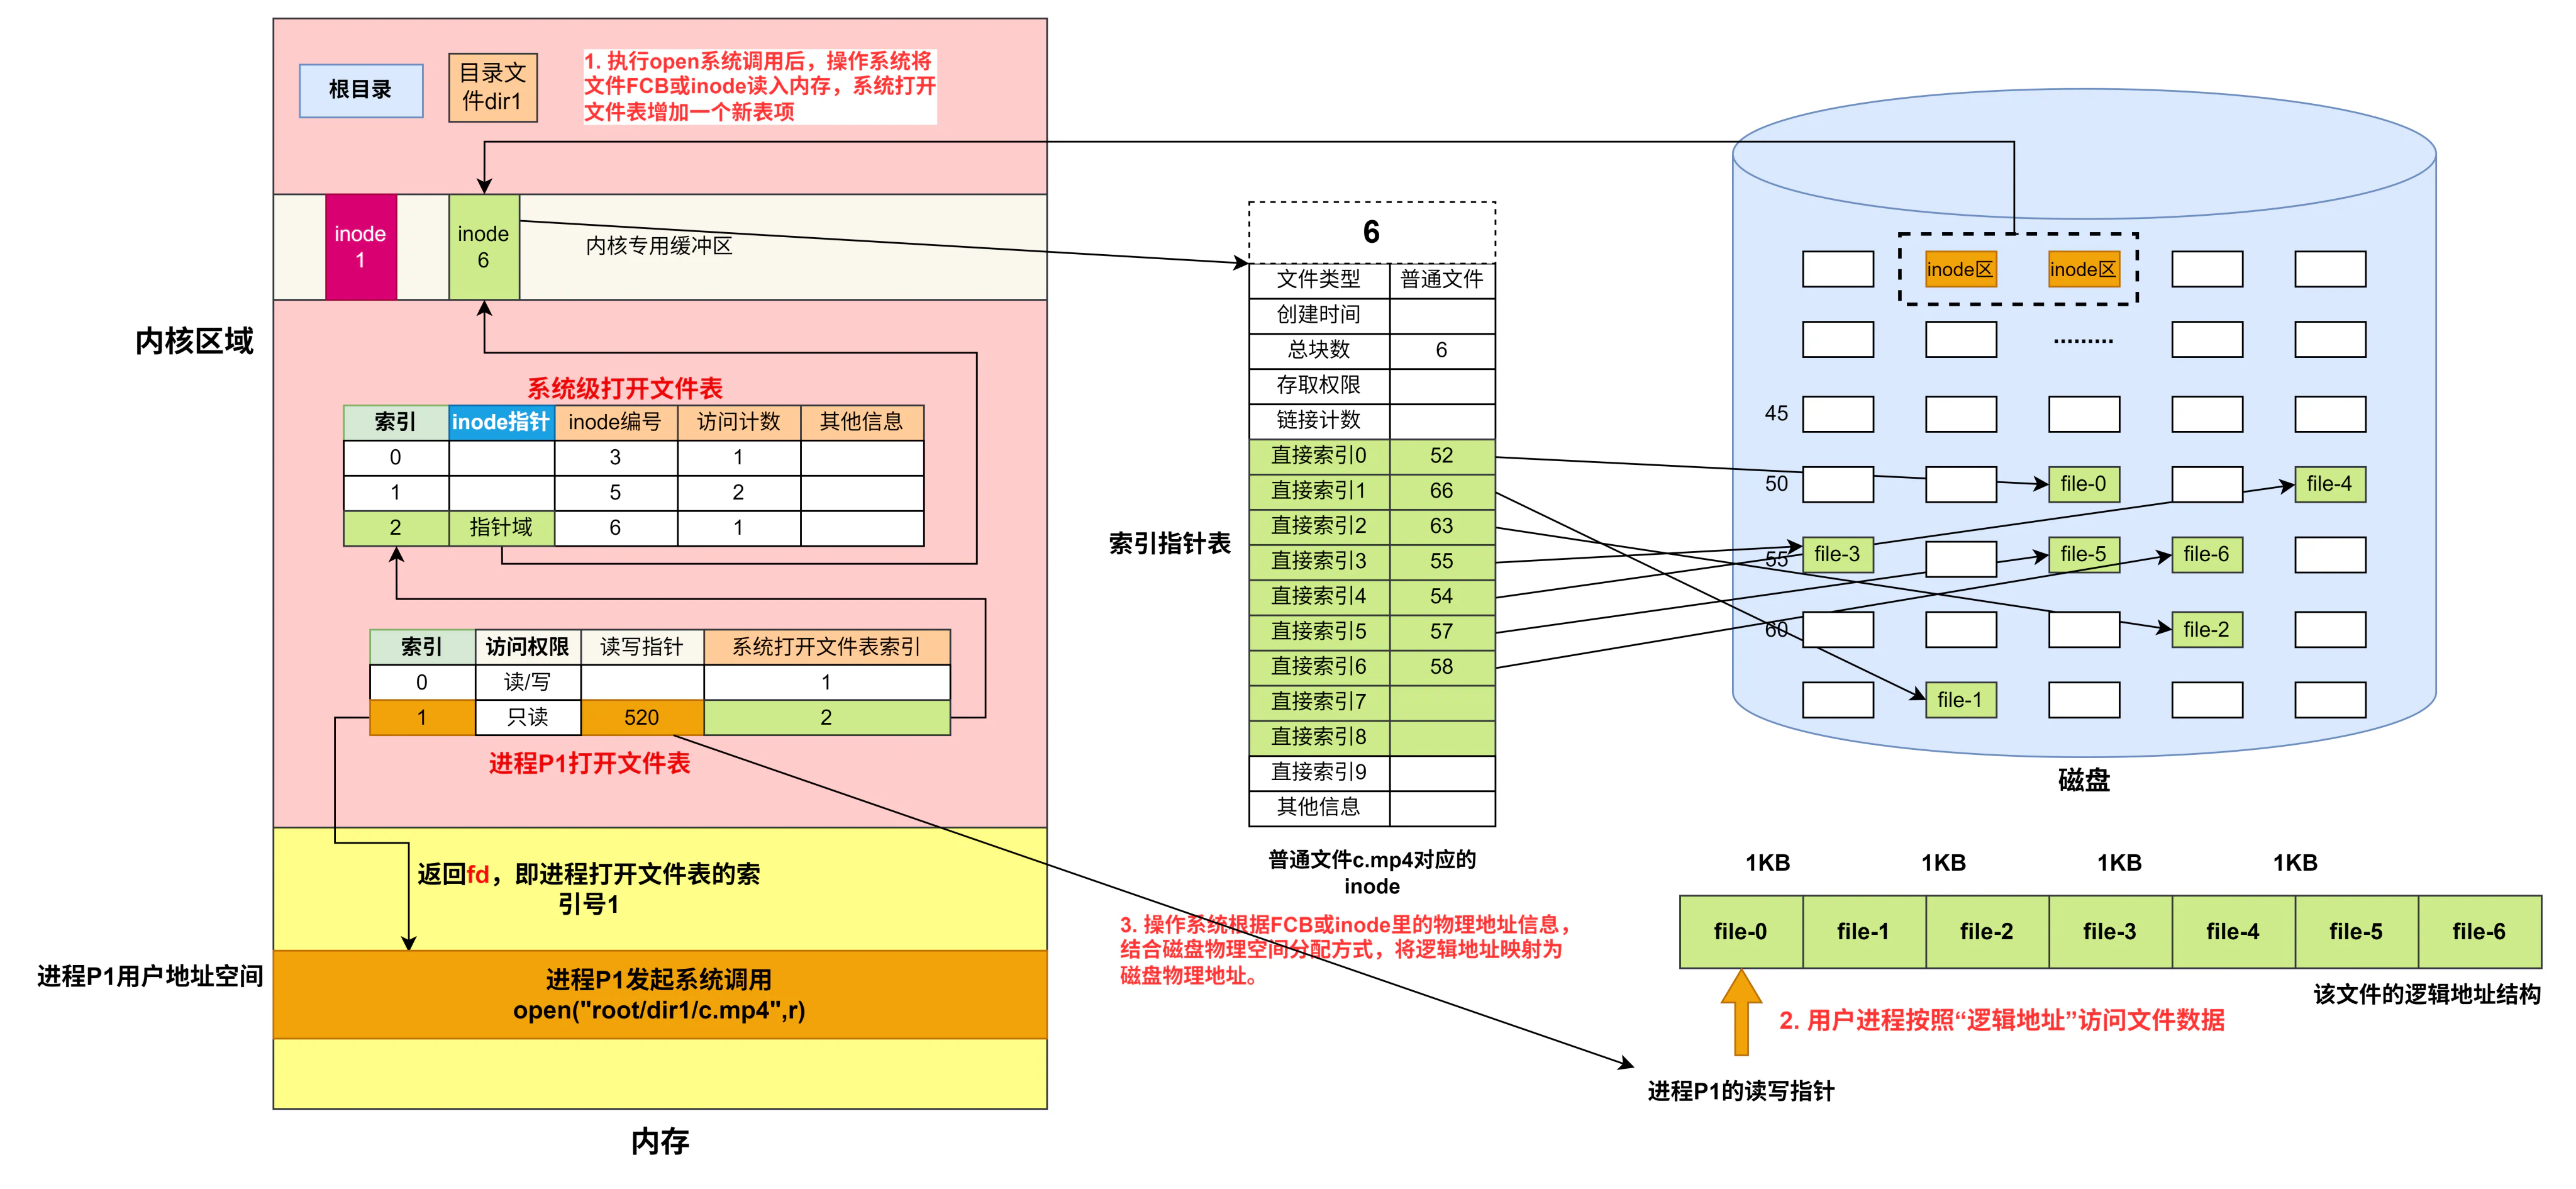
由于inode结点大小有限,不可能无节制增加直接索引项,因此可以采取多级页表的思想,将直接索引表放在磁盘块里,这个磁盘块即索引块,inode里面只需要保存一级索引所在盘块号即可,如下图所示;
- 一级索引
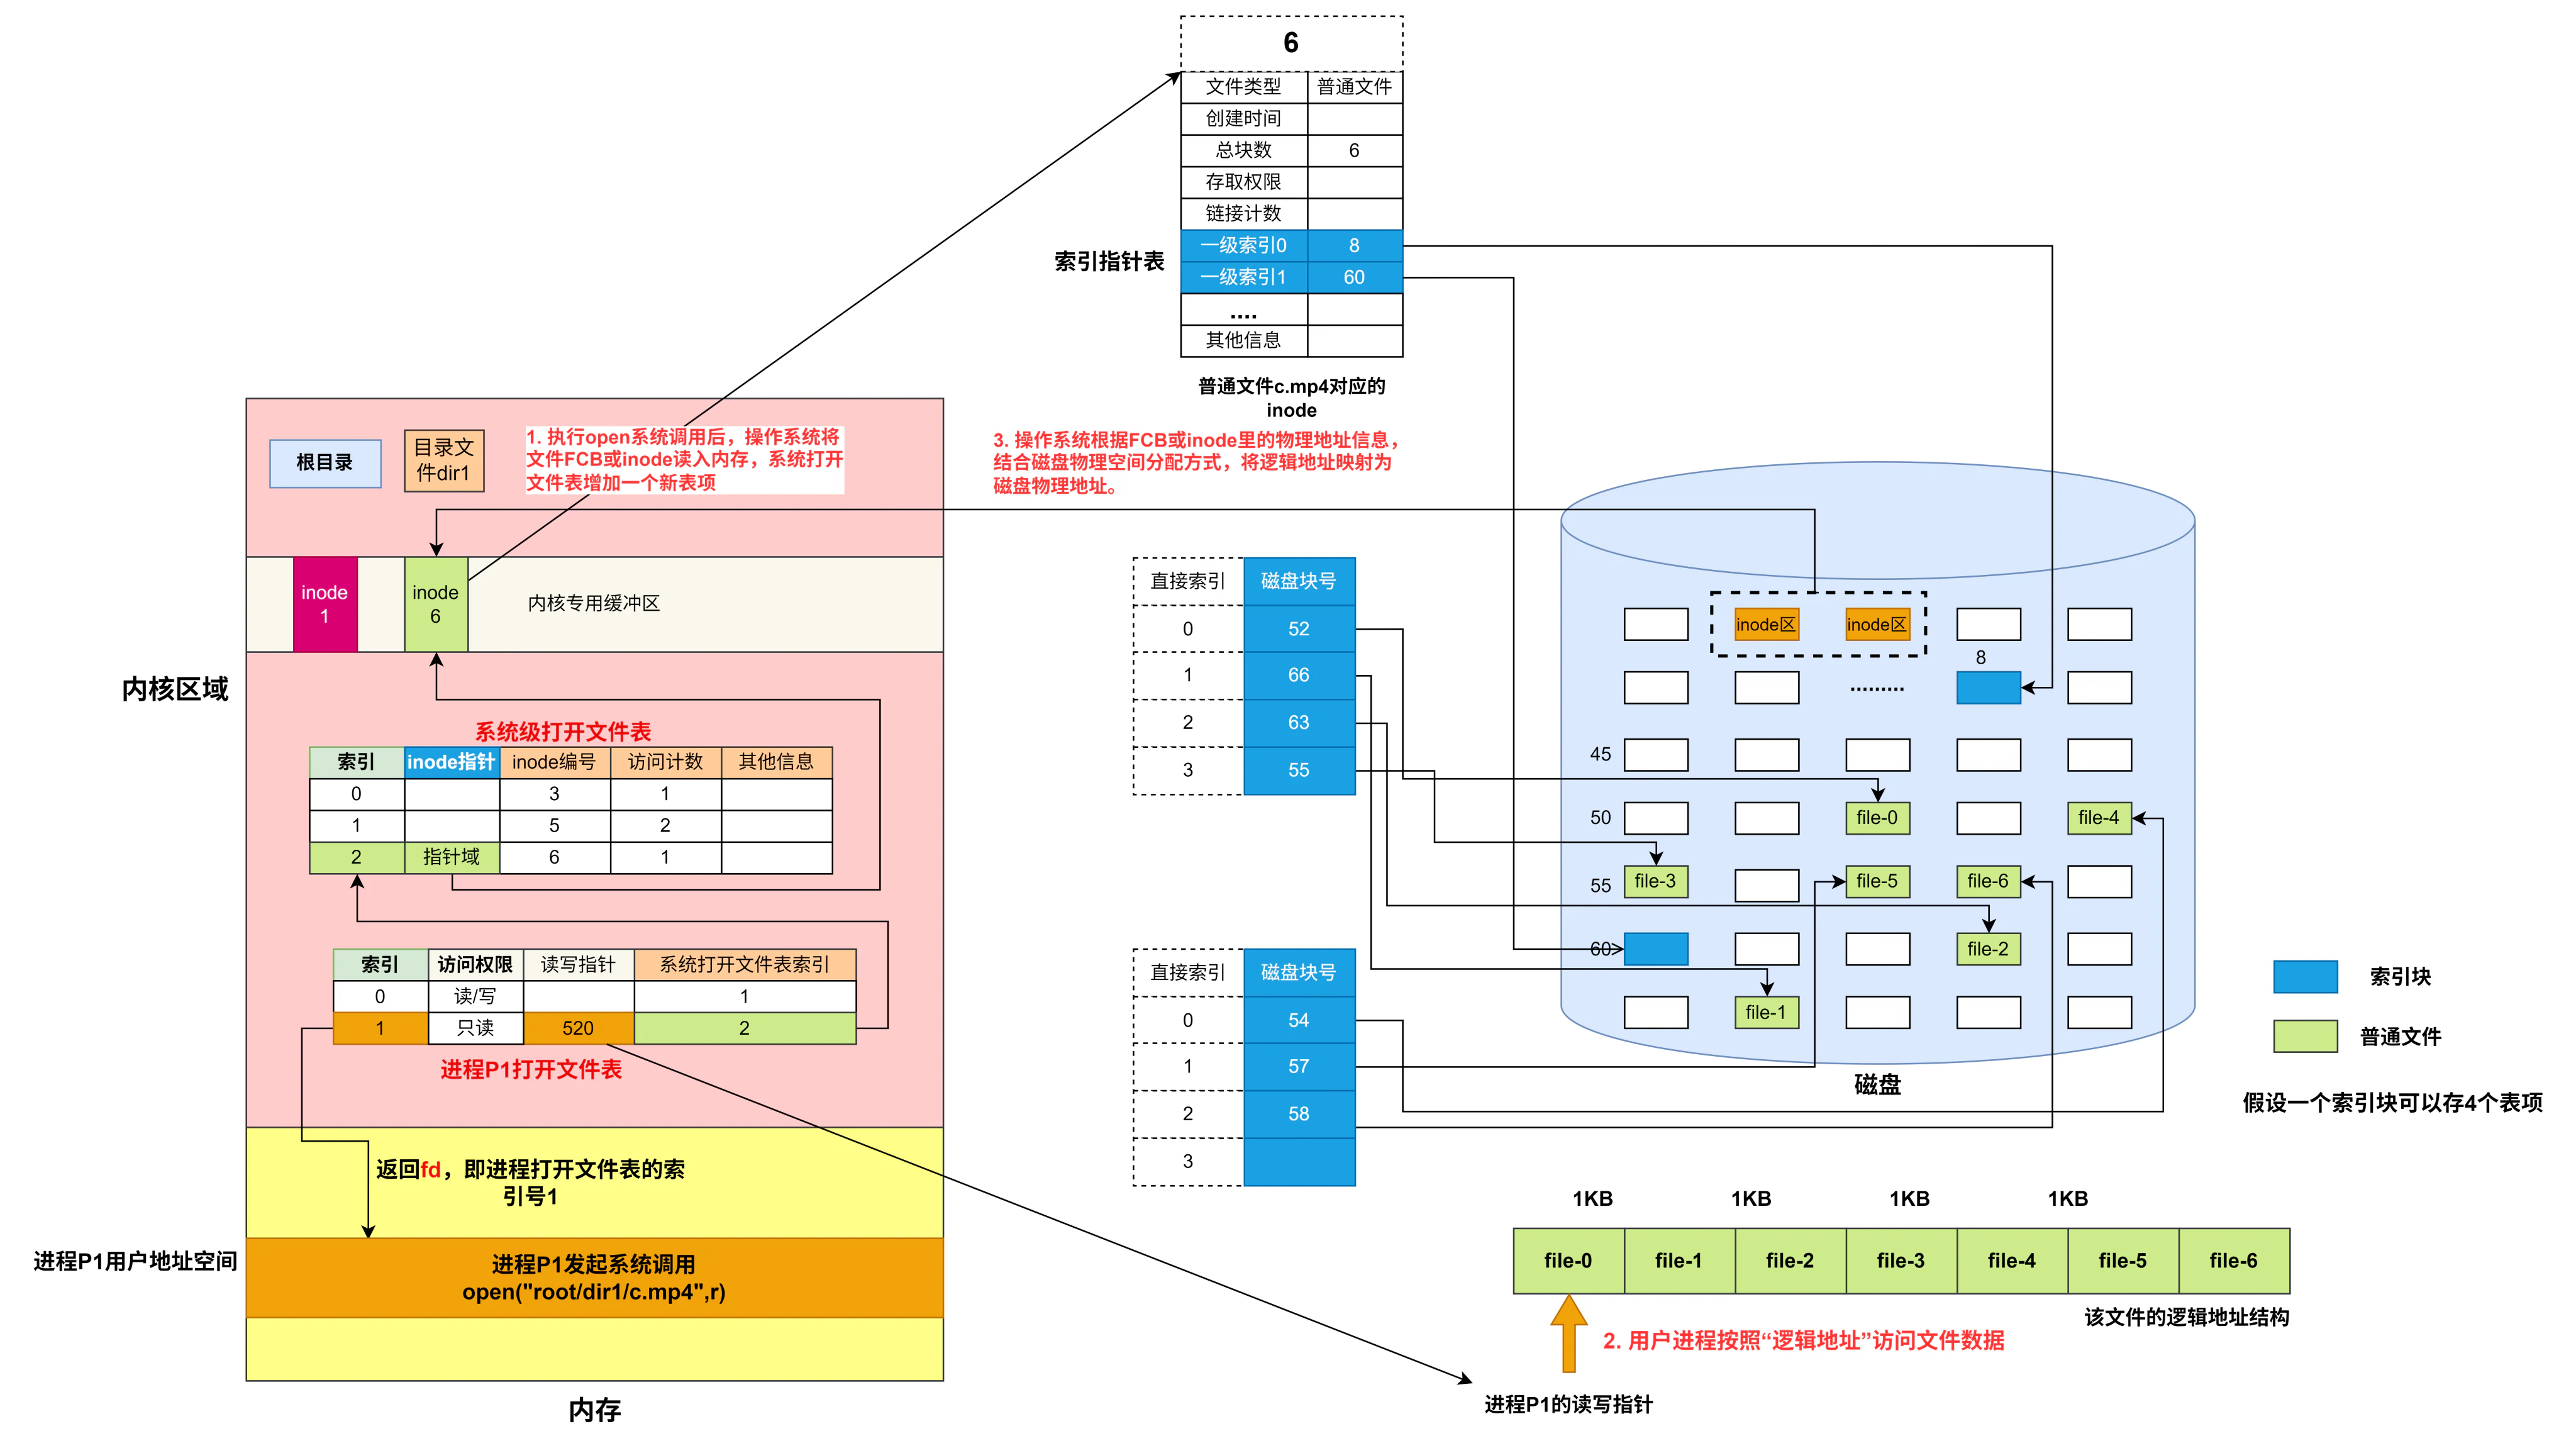
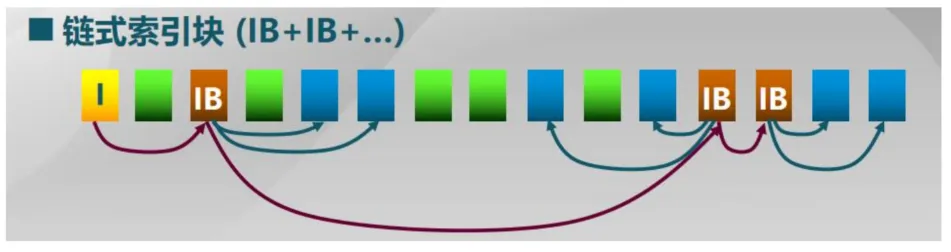
除了图中的这种方式,也可以采取下图中的链接索引分配方式:将多个索引块链接起来,每个索引块包括指向下一个索引块的指针。
同理,inode里面一级索引所能支持的文件大小也是有限的,假设最多有10个一级索引项,磁盘块大小1KB,每个索引表项占4B,则一个磁盘块只能放256个索引,即一个文件最大为102561KB=2560KB,若文件超出2560KB,那怎么办?
答案是:套娃,继续引入二级(多级)页表,如下图所示
- 二级索引(多级索引)
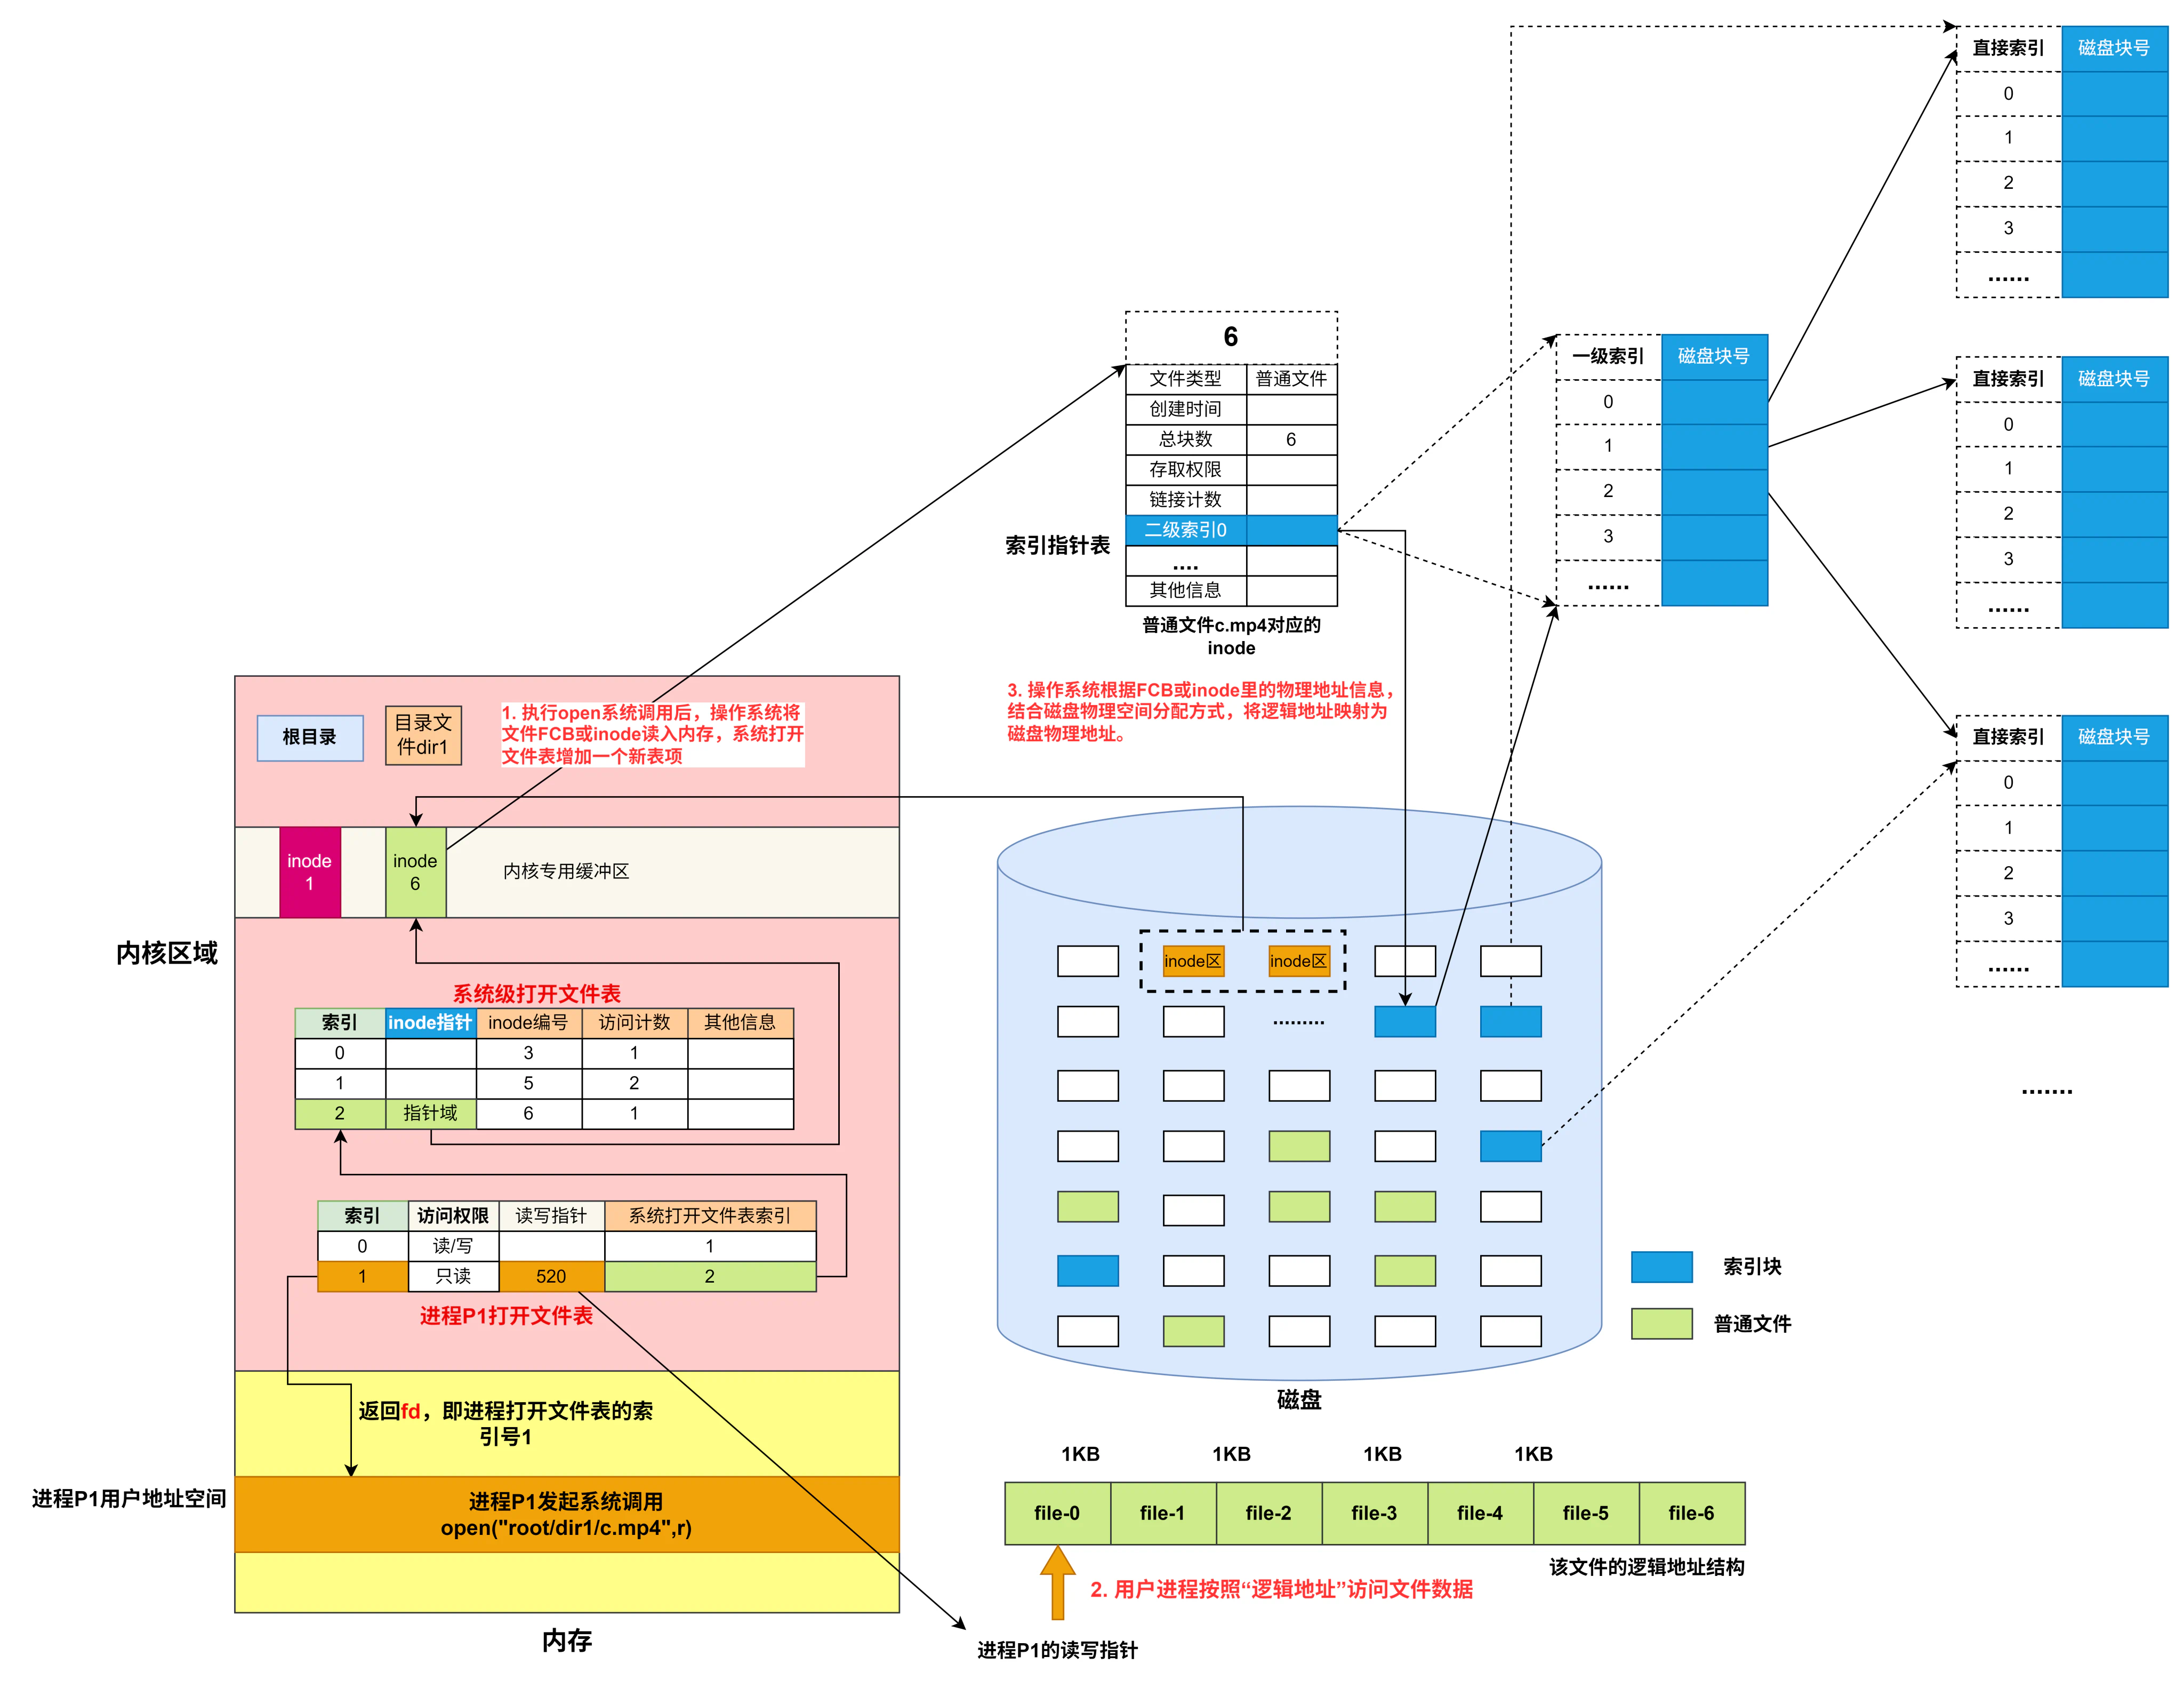
Note
优点:可以支持更大的文件;加快了对大型文件的查找速度;
缺点:随着索引级数的增加,访问磁盘的次数也在变多;
- 混合索引分配
这种分配方式可以全面照顾各种大小的文件,UNIX文件系统就是采取的这种分配方式:
- 对于小文件,inode里的若干直接索引项就可以满足,这样可以直接从inode里获取该文件的盘块地址;
- 对于中型文件,可以用到单级索引分配,需要先从inode里面获取一级间接索引块的块号,然后将索引块载入内存获取该文件的盘块地址;
- 对于大型或超大型文件,便可以采用两级和三级索引分配;
参考上图,回答以下问题(基于混合索引分配前提,且文件inode已读入内存):
Note
假设该文件系统中,每个inode里面有10个直接索引项,一个一级间址索引项,一个二级间址索引项,一个三级索引项,一个磁盘块大小为1KB,一个索引表表项大小为4B;
- 是否支持随机读写?是否方便文件扩展?
- 一个一级索引项和一个二级索引项分别可以管理多少个数据块?
- 单个文件允许的最大长度是多少?
- 假设该文件系统中各参数未知,单个文件的最大长度取决于哪些因素?
- 假设c.mp4大小为276KB,该文件一共占用几个索引块?几个数据块?
- 假设c.mp4大小为276KB,访问它的第8号(从1开始)文件块、第250号文件块、第270号文件块,分别需要多少次磁盘I/O?
答案
- 是;是
- 1KB/4B=256 因此一个一级索引项可以管理256个数据块,一个二级索引项可以管理
 个数据块
- 一个磁盘索引块可以存储 256个索引表表项。
- 10 个地址项是直接地址索引:可以表示的长度为 10 * 1KB = 10KB;
- 1 个地址项是一级间接地址索引:可以表示的长度为 256KB;
- 1 个地址项是二级间接索引:可以表示的长度为 1 * 256 * 256KB = 64MB;
- 1 个地址项是三级间接索引:可以表示的长度为 1 * 256 * 256 * 256KB = 16GB
- 所以可表示的单个文件最大长度是 16GB+64MB + 266KB
- 取决于以下因素:
- inode里面,索引项的数量,以及每个索引项是哪种类型(直接索引/一级/二级/三级间接)?
- 每个索引项占的bit数(通常来说要能够表示磁盘块总数);
- 结合以上因素计算出每个磁盘块(索引块)可以存储多少个索引项;
- 该文件用了276个磁盘块(数据块),276>10+256,so,用到了一个一级索引对应的索引块,一个二级索引对应的索引块(里面用到了一个一级索引表项,因此这里又用到了一个一级索引对应的索引块),总结,用到了3个索引块,276个数据块;
- 访问它的第8号文件块需要根据inode里的直接索引找到对应磁盘号把该磁盘块读入内存,因此需要1次磁盘IO;
访问第250号磁盘块首先需要根据inode里的一级索引项把对应索引块载入内存,然后查询该索引表,找到第240个表项对应的磁盘块号,把该磁盘块读入内存,因此需要2次磁盘IO;
访问它的270号文件块,首先需要根据inode里的二级索引项把对应的索引块读入内存,然后查询该索引块,找到第一个表项,将其对应的索引块读入内存,然后找到该索引块的第四个表项,将对应的磁盘块读入内存,因此一共需要3次磁盘I/O;
1.6.4 真题赏析
【2010-30】设文件索引节点中有7个地址项,其中4个地址项是直接地址索引,2个地址项是一级间接地址索引,1个地址项是二级间接地址索引,每个地址项大小为4B,若磁盘索引块和磁盘数据块大小均为256B,则可表示的单个文件最大长度是( )。
A. 33KB
B. 519KB
C. 1057KB
D. 16516KB
解析
本题选C。
磁盘索引块和磁盘数据块大小均为256B,每个地址项大小为4B,一个磁盘块能存放256B/4B=64个地址项。因为文件索引节点中有7个地址项,其中4个地址项是直接地址索引,2个地址项是一级间接地址索引,1个地址项是二级间接地址索引,所以单个文件最大长度=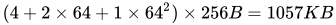 。
总结
设磁盘块大小  ,每个地址项大小为
 ,文件采用混合索引,地址索引最大为
 级,
 级地址索引数量为
 ,直接地址索引视为
 级索引,则文件最大长度为
 。
【2013-26】若某文件系统索引结点 (inode) 中有直接地址项和间接地址项,则下列选项中,与单个文件长度无关的因素是( )。
A. 索引结点的总数
B. 间接地址索引的级数
C. 地址项的个数
D. 文件块大小
解析
本题选A。
索引结点的总数只会影响文件系统支持的文件数量。
设磁盘块大小 ,每个地址项大小为 ,文件采用混合索引,地址索引最大为 级, 级地址索引数量为 ,直接地址索引视为级索引,则文件最大长度为 。
【2015-29】在文件的索引节点中存放直接索引指针10个,一级和二级索引指针各1个。磁盘块大小为1KB,每个索引指针占4个字节。若某文件的索引节点已在内存中,则把该文件偏移量(按字节编址)为1234和307400处所在的磁盘块读入内存,需访问的磁盘块个数分别是( )。
A. 1、2
B. 1、3
C. 2、3
D. 2、4
解析
本题选B。
磁盘块大小为1KB,每个索引指针占4B,一个磁盘块可以装载1KB/4B=256个索引指针。
直接索引视为0级索引。
 个 i 级索引指向数据块大小为
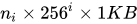 。
访问 i 级索引指向数据块需要读 i 次索引,1次数据块,总计 i+1 次磁盘。
10个直接索引指向数据块大小为10×1KB=10240B。首地址偏移量为0,按字节编址,直接索引指向数据块偏移量范围为[0, 10239]。
1个一级索引指向数据块大小为1×256×1KB=262144B。首地址偏移量为0,按字节编址,前面有直接索引指向数据块,一级索引指向数据块偏移量范围为[10240, 10240+262143],即[10240, 272383]。
1个二级索引指向数据块大小为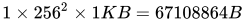 。首地址偏移量为0,按字节编址,前面有直接索引和一级索引指向数据块,二级索引指向数据块偏移量范围为[10240+262144, 10240+262144+67108863],即[272384, 67381247]。
因为偏移量为1234∈[0, 10239],所以该偏移量位于直接索引指向数据块范围内,访问该数据块需要读1次磁盘。
因为偏移量为307400∈[272384, 67381247],所以该偏移量位于二级索引指向数据块范围内,访问该数据块需要读3次磁盘。
举一反三
在文件的索引节点中存放直接索引指针10个,一级和二级索引指针各1个。磁盘块大小为1KB,每个索引指针占4个字节。若某文件的索引节点已在内存中,则把该文件偏移量(按字节编址)为10240和272384处所在的磁盘块读入内存,需访问的磁盘块个数分别是( )。
A. 1、2
B. 1、3
C. 2、3
D. 2、4
参考答案:C
【2009-28】下列文件物理结构中,适合随机访问且易于文件扩展的是( )。
A. 连续结构
B. 索引结构
C. 链式结构且磁盘块定长
D. 链式结构且磁盘块变长
解析
本题选B。
文件物理结构就是典型的数据结构的应用。
连续结构可以视为数组,因为数组适合随机访问但插入删除慢,所以连续结构适合随机访问但不易于文件扩展。A错误。
索引结构适合随机访问但插入删除较快,所以索引结构适合随机访问且易于文件扩展。B正确。
链式结构可以视为链表,因为链表只能顺序访问但插入删除块,所以链式结构不适合随机访问但易于文件扩展。C和D错误。
【2013-24】为支持 CD-ROM 中视频文件的快速随机播放,播放性能最好的文件数据块组织方式是( )。
A. 连续结构
B. 链式结构
C. 直接索引结构
D. 多级索引结构
解析
本题选A。
CD-ROM 是一种光盘存储介质,具有顺序读取的特点。在视频文件中,通常需要随机访问不同的数据块来实现快速播放和定位。因此,选择一种数据块组织方式能够最好地支持随机访问和快速定位是关键。
【2020-24】下列选项中,支持文件长度可变、随机访问的磁盘存储空间分配方式是( )。
A. 索引分配
B. 链接分配
C. 连续分配
D. 动态分区分配
解析
本题选A。
A正确。索引分配是一种磁盘存储空间分配的方式,它使用一个索引表来映射文件中每个数据块的物理位置。索引表通常存储在磁盘上,每个文件都有一个对应的索引表。在索引分配中,文件的长度可以是可变的,因为可以根据需要增加或删除索引表中的条目。这样,可以动态地增加或缩小文件的大小。由于索引表中存储了每个数据块的物理位置信息,因此通过索引表,可以快速定位到指定的数据块,实现对文件的随机访问。
B错误。链接分配将文件的数据块通过链表的方式连接起来,支持文件长度可变、不支持随机访问。
C错误。连续分配将文件占用的存储空间连续地分配给文件,不适合长度可变的文件,支持随机访问。
D错误。动态分区分配用于管理主存中的区域划分和分配,并不涉及磁盘文件的存储空间分配。
【2020-31】某文件系统的目录项由文件名和索引结点号构成。若每个目录项长度为64字节,其中4字节存放索引结点号,60字节存放文件名。文件名由小写英文字母构成,则该文件系统能创建的文件数量的上限为( )。
A. \(2^{26}\)
B. \(2^{32}\)
C. \(2^{60}\)
D. \(2^{64}\)
解析
本题选B。
因为索引结点号占4B=32bit,最多可以表示  个索引结点号,所以该文件系统能创建的文件数量的上限为 。
【2018-31】下列优化方法中,可以提高文件访问速度的是( )。
Ⅰ. 提前读
Ⅱ. 为文件分配连续的簇
Ⅲ. 延迟写
Ⅳ. 采用磁盘高速缓存
A. 仅Ⅰ、Ⅱ
B. 仅Ⅱ、Ⅲ
C. 仅Ⅰ、Ⅲ、Ⅳ
D. Ⅰ、Ⅱ、Ⅲ、Ⅳ
解析
本题选D。
Ⅰ正确。提前读是指在文件被请求访问之前,预先将文件的内容加载到内存或高速缓存中。通过提前读取文件的数据,可以减少后续对磁盘的实际读取次数,从而提高文件的访问速度。
Ⅱ正确。文件系统通常将文件划分为簇(cluster)或块(block)进行存储。如果文件的簇是连续的,就可以实现更高效的顺序读取,从而提高文件的访问速度。因为连续簇的读取可以最小化磁头的移动,并允许连续的数据传输。
Ⅲ正确。延迟写是一种延迟文件写入操作的策略,主要用于提高系统性能和响应速度。在延迟写策略中,当应用程序执行写操作时,操作系统并不立即将数据写入存储设备(如磁盘),而是将数据缓存在内存中或者延迟到后续合适的时机再进行写入。延迟写的优点在于可以将多个写操作合并为一个较大的写操作,从而减少了磁盘写入的次数。这样可以提高磁盘的效率和整体系统的性能,特别是当有大量小型写操作发生时。通过延迟写,可以积极利用系统内存进行缓存,并减少对磁盘的频繁访问,从而降低了写操作的延迟和系统负载。
Ⅳ正确。磁盘高速缓存是一种位于内存中的缓存区域,用于存储最常访问的数据块或文件。当文件被访问时,先检查缓存中是否有对应的数据,如果存在,就可以直接从缓存中获取,避免了访问慢速的磁盘。磁盘高速缓存可以显著加快对常用文件的访问速度。
综上,Ⅰ、Ⅱ、Ⅲ、Ⅳ正确。
【2011-46】(7分)某文件系统为一级目录结构,文件的数据一次性写入磁盘,已写入的文件不可修改,但可多次创建新文件。请回答如下问题∶
(1) 在连续、链式、索引二种文件的数据块组织方式中。哪种更合适?要求说明理由。为定位文件数据块,需要在FCB中设计哪些相关描述字段?
(2) 为快速找到文件,对于FCB,是集中存储好,还是与对应的文件数据块连续存储好?要求说明理由。
解析
(1)
第一问。连续更合适,因为一次写入不存在扩展问题,连续的数据块组织方式完全可以满足一次性写入磁盘。同时连续文件组织方式减少了其他不必要的空间开销,而连续的组织方式顺序查找时磁盘寻道时间最短,读取速度是最快的。
第二问。为定位文件数据块,需要在FCB中设计的相关描述字段为起始块号和块数,或者起始块号和结束块号。类比数组在内存中的分布,需要知道起始元素地址和元素个数,或者起始元素地址和结束元素地址。
(2) 第一问FCB集中存储好。
第二问。FCB是存在磁盘上的。所以检索FCB的时候需要访问磁盘。所以访问磁盘次数越少越好,将FCB集中存储,最大化减少了存储FCB需要的磁盘块数量,这样在随机查找文件时,只需要访问FCB对应的磁盘块,最大化减少了磁头移动和磁盘I/O次数。
【2012-46】(8分)某文件系统空间的最大容量为4TB( \(1TB= 2^{40} B\)),以磁盘块为基本分配单位。磁盘块大小为1KB。文件控制块 (FCB) 包含一个512B的索引表区。请回答下列问题。
(1) 假设索引表区仅采用直接索引结构,索引表区存放文件占用的磁盘块号,索引表项中块号最少占多少字节?可支持的单个文件最大长度是多少字节?
(2) 假设索引表区采用如下结构:第0~7字节采用<起始块号,块数>格式表示文件创建时预分配的连续存储空间,其中起始块号占6B,块数占2B;剩余504字节采用直接索引结构,一个索引项占6B,那么可支持的单个文件最大长度是多少字节?为了使单个文件的长度达到最大,请指出起始块号和块数分别所占字节数的合理值并说明理由。
解析
(1) 第一问。因为该文件系统空间的最大容量为4TB,磁盘块大小为1KB,所以该文件系统中所能容纳的磁盘块总数为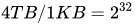 。要完全表示所有磁盘块,索引项中的块号最少要占32bit=4B。
第二问。因为文件控制块 (FCB) 包含一个512B的索引表区,根据第一问结果,索引表项中块号最少占4字节,索引表区仅采用直接索引结构,所以索引表区最多能容纳512B/4B=128个索引项。又因为每个索引项对应一个磁盘块,磁盘块大小为1KB,所以该系统可支持的单个文件最大长度是128×1KB=128KB。
(2) 第一问。因为块数占2B=16bit,共可以表示  个磁盘块,磁盘块大小为1KB,所以预分配的连续存储空间大小为
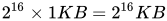 。又因为块号占6B,剩余504字节采用直接索引结构,直接索引区共504B/6B=84个索引项,磁盘块大小为1KB,所以直接索引区存储空间大小为84×1KB=84KB。综上,该系统可支持的单个文件最大长度=预分配的连续存储空间大小+直接索引区存储空间大小=
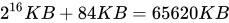 。
第二问。根据(1)中第一问的结果,块数最少要占4B,才可表示4TB大小的文件长度,此时达到文件系统的空间上限,第0~7字节采用<起始块号,块数>格式表示文件创建时预分配的连续存储空间,总共8B,所以合理的起始块号和块数所占字节数分别为4、4,或3、5,或2、6,或1、7。
【这个答案有点小争议,因为2B表示总块数的话,0是用不了的,因此共可以表示  个磁盘块;如果把<起始块号,块数>改成<起始块号,偏移量>,那么该答案才正确】
【2014-46】文件F由200条记录组成,记录从1开始编号。用户打开文件后,欲将内存中的一条记录插入文件F中,作为其第30条记录。请回答下列问题,并说明理由。
(1) 若文件系统采用连续分配方式,每个磁盘块存放一条记录,文件F存储区域前后均有足够的空闲磁盘空间,则完成上述插入操作最少需要访问多少次磁盘块?F的文件控制块内容会发生哪些改变?
(2) 若文件系统采用链接分配方式,每个磁盘块存放一条记录和一个链接指针,则完成上述插入操作需要访问多少次磁盘块?若每个存储块大小为1KB,其中4B存放链接指针,则该文件系统支持的文件最大长度是多少?
解析
文件物理结构就是典型的数据结构的应用。
(1) 第一问。若文件系统采用连续分配方式,则插入记录可能需要移动其他的记录块。文件F共有200条记录,要插入新记录作为第30条,而存储区前后均有足够的磁盘空间,且题目要求最少的访问磁盘块数(原因是访问磁盘块非常耗时),若移动第30条记录后面的记录,则需要移动170条记录,若移动第30条记录前面的记录,则需要移动29条记录,显然后一种策略是最优策略。第一步,将文件前29条记录依次前移一个位置,移动一条记录读取和写回磁盘各需访问一次磁盘块,这步操作需要访问磁盘块29×(1+1)=58次。第二步,插入新记录作为第30条,写入磁盘需要访问一次磁盘块,这步操作需要访问磁盘块1次。综上,完成上述插入操作最少需要访问58+1=59次磁盘块。
第二问。文件控制块一般应包括下列的文件属性信息:
- 文件标志和控制信息:包括指示标识一个文件的符号名(操作系统可以进行按名存取)、文件状态标志、文件引用计数等等。
- 文件逻辑结构信息:指示文件是流式文件还是记录式文件,是定长记录还是变长记录,记录数等。
- 文件物理结构信息:指示文件在外存上的存储位置,包括存放文件的设备名、文件在外存的起始盘块号、指示文件所占用的盘块数或字节数的文件长度。
- 文件使用信息:包括文件创建时间、上次一修改时间、当前使用信息等。
- 文件管理信息:包括文件的访问权限和保护级别等。
因为文件F的首个磁盘块发生移动,所以F的文件控制区的起始块号发生改变。因为文件F增加了一个磁盘块,所以F的文件控制区的文件长度发生改变。
(2) 第一问。若文件系统采用链接分配方式,每个磁盘块存放一条记录和一个链接指针,插入记录并不用移动其他记录,模仿链表的插入操作,只需要找到插入记录的直接前驱并修改该磁盘块的链接指针即可。
- 第一步,找到第 30 条记录的直接前驱磁盘块,即第 29 条记录所在的磁盘块,需要读文件的前 29 块的链接指针,每个磁盘块存放一条记录和一个链接指针,从文件开头开始顺着链接指针逐个查找磁盘块,直到找到第 29 条记录所在的磁盘块,此过程需要读取磁盘块 29 次。此时读取到第 29 条记录所在的磁盘块的首地址及链接指针(即原来第 30 条记录所在的磁盘块的首地址)。
- 第二步,将新记录写入一个空闲磁盘块(假设获取空闲磁盘块的操作不需要额外访问磁盘块,实际系统中获取空闲磁盘块可能也需要一定的磁盘访问次数,但本题暂不考虑这部分额外开销),修改新插入记录所在磁盘块的链接指针为原来第 30 条记录所在的磁盘块的首地址,使其指向原来第 30 条记录所在的磁盘块(在插入操作前它是第 30 条记录,现在变成第 31 条记录了),此过程需要写入磁盘 1 次。
- 第三步,修改第 29 条记录所在磁盘块的链接指针为新插入记录所在的磁盘块的首地址,使其指向新插入的记录所在的磁盘块,此过程需要写入磁盘 1 次。
综上,完成上述插入操作需要查找第 29 条记录的 29 次 + 修改第 29 条记录所在磁盘块链接指针的 1 次 + 写入记录及修改新插入记录所在磁盘块链接指针的 1 次 = 31 次。
第二问。若每个存储块大小为1KB,其中链接指针占4B=32bit,则最多可以表示 232 个磁盘块位置,每个存储块除链接指针外可存放数据1KB-4B=1024B-4B=1020B,推出该文件系统支持的文件最大长度是1020B× 232 =4080GB。
【2018-46】(7分)某文件系统采用索引节点存放文件的属性和地址信息,簇大小为4KB。每个文件索引节点占64B,有11个地址项,其中直接地址项8个,一级、二级和三级间接地址项各1个,每个地址项长度为4B。请回答下列问题。
(1) 该文件系统能支持的最大文件长度是多少?(给出计算表达式即可)
(2) 文件系统用1M(\(1M= 2^{20}\)) )个簇存放文件索引节点,用512M个簇存放文件数据。若一个图像文件的大小为5600B,则该文件系统最多能存放多少个这样的图像文件?
(3) 若文件F1的大小为6KB,文件F2的大小为40KB,则该文件系统获取F1和F2最后一个簇的簇号需要的时间是否相同?为什么?
解析
(1) 因为簇大小为4KB,每个地址项长度为4B,所以每簇有4KB/4B=1024个地址项。又因为有11个地址项,其中直接地址项8个,一级、二级和三级间接地址项各1个,所以最大文件长度为 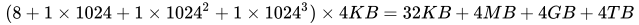 。
(2) 文件系统用1M(1M= 220 )个簇存放文件索引节点,每个簇大小为4KB,每个文件索引节点占64B,文件索引节点总个数为1M×4KB/64B=64M。
文件系统通常将文件划分为簇进行存储,5600B的图像文件占 ⌈5600B/4KB⌉=2 个簇,用512M个簇存放文件数据,该文件系统最多能存放512M/2=256M个这样的图像文件。
综上,因为可表示的文件总个数受限于文件索引节点总个数,所以该文件系统最多能存放min{64M, 256M}=64M个大小为5600B的图像文件。
(3) 直接地址项最大能表示的文件大小为4KB×8= 32KB,文件F1大小为6KB,6KB≤32KB,所以获取文件F1的最后一个簇的簇号只需要访问索引节点的直接地址项。
直接地址项和一级地址项最大能表示的文件大小为 (8+1×1024)×4KB=32KB+4MB ,文件F2大小为40KB,32KB<40KB≤32KB+4MB,所以获取F2的最后一个簇的簇号需要读一级索引表。
访问一级索引表比访问直接地址项需要多一次访问磁盘,所以该文件系统获取F1和F2最后一个簇的簇号需要的时间不相同。
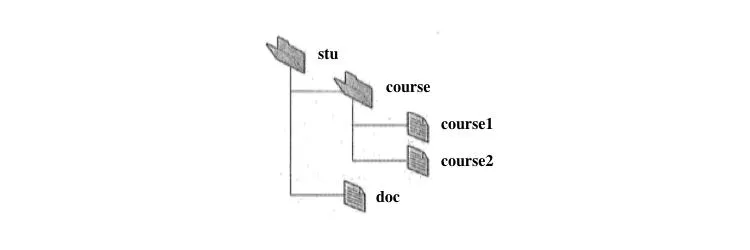
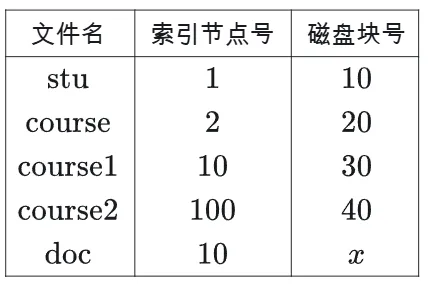
【2022-45】(7分)某文件系统的磁盘块大小为4KB,目录项由文件名和索引节点号构成,每个索引节点占256字节,其中包含直接地址项10个,一级、二级和三级间接地址项各1个,每个地址项占4字节。该文件系统中子目录stu的结构如题45(a)图所示,stu包含子目录course和文件doc,course子目录包含文件course1和course2。各文件的文件名、索引节点号、占用磁盘块的块号如题45(b)图所示。
请回答下列问题。
(1) 目录文件stu中每个目录项的内容是什么?
(2) 文件doc占用的磁盘块的块号 x 的值是多少?
(3) 若目录文件course的内容已在内存,则打开文件course1并将其读入内存,需要读几个磁盘块?说明理由。
(4) 若文件course2的大小增长到6MB,为了存取course2需要使用该文件索引节点的哪几级间接地址项?说明理由。
解析
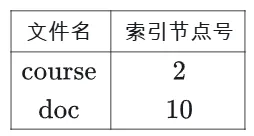
(1) 由题45(a)图可知,stu目录下有course和doc两个文件,查题45(b)图中的表可知,course的索引节点号为2,doc的索引节点号为10。因为目录项由文件名和索引节点号构成,所以目录文件stu中两个目录项的内容是:
(2) 查题45(b)图中的表可知,文件doc和文件course1的索引节点号都是10,说明两者共享同一个索引节点,指向同一个文件,所以两者的磁盘块号相同。文件course1占用的磁盘块的块号为30,所以文件doc占用的磁盘块的块号 x 的值为30。
(3) 需要读2个磁盘块。先读course1的索引节点所在的磁盘块,再读course1的内容所在的磁盘块。若目录文件course的内容已在内存,course1的目录项在文件course的目录中,根据course1的目录项可知其索引节点号为10,首先读取10号索引节点所在的磁盘块,索引节点中包含文件的地址项,然后读取30号磁盘块的内容。
(4) 存取course2需要使用索引节点的一级和二级间接地址项。文件course2的大小增长到6MB,磁盘块大小为4KB,文件course2需占用6MB/4KB=1536个磁盘块。每个地址项占4B,一个磁盘块可容纳4KB/4B=1024个地址项。每个索引节点包含直接地址项10个,一级、二级和三级间接地址项各1个。所以直接地址项可记录10×1=10个磁盘块,直接地址项和一级间接地址可记录10×1+1×1024=1034,直接地址项、一级间接地址和二级间接地址可记录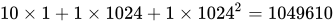 。文件course2中的地指项位于100号索引节点,即对应一个索引节点,占用1536个磁盘块,1034<1536≤1049610。所以存取course2需要使用到索引节点的的间接地址项包括一级和二级间接地址项。
目录
文件目录是一种数据结构,用于标识系统中的文件及其物理地址,供检索时使用。对目录管理的要求如下:
- 实现“按名存取”;
- 提高对目录的检索速度;
- 允许文件重名;
- 文件共享,在多用户系统中,应允许多个用户共享一个文件;
文件控制块FCB和索引结点
-
文件控制块
FCB -
为了能对一个文件进行正确的存取,必须为文件设置用于描述和控制文件的数据结构,称之为“文件控制块”。文件管理程序可借助于文件控制块中的信息对文件施以各种操作。
- 文件与文件控制块一一对应,而人们把
FCB的有序集合称为文件目录,即一个FCB就是一个文件目录项。通常,一个文件目录也被看作是一个文件,称为目录文件。
所以
文件目录大小 = FCB大小 * 文件目录项个数
- 每创建一个新文件,就为之创建一个FCB并加入到文件目录中,成为目录项
FCB包含的信息: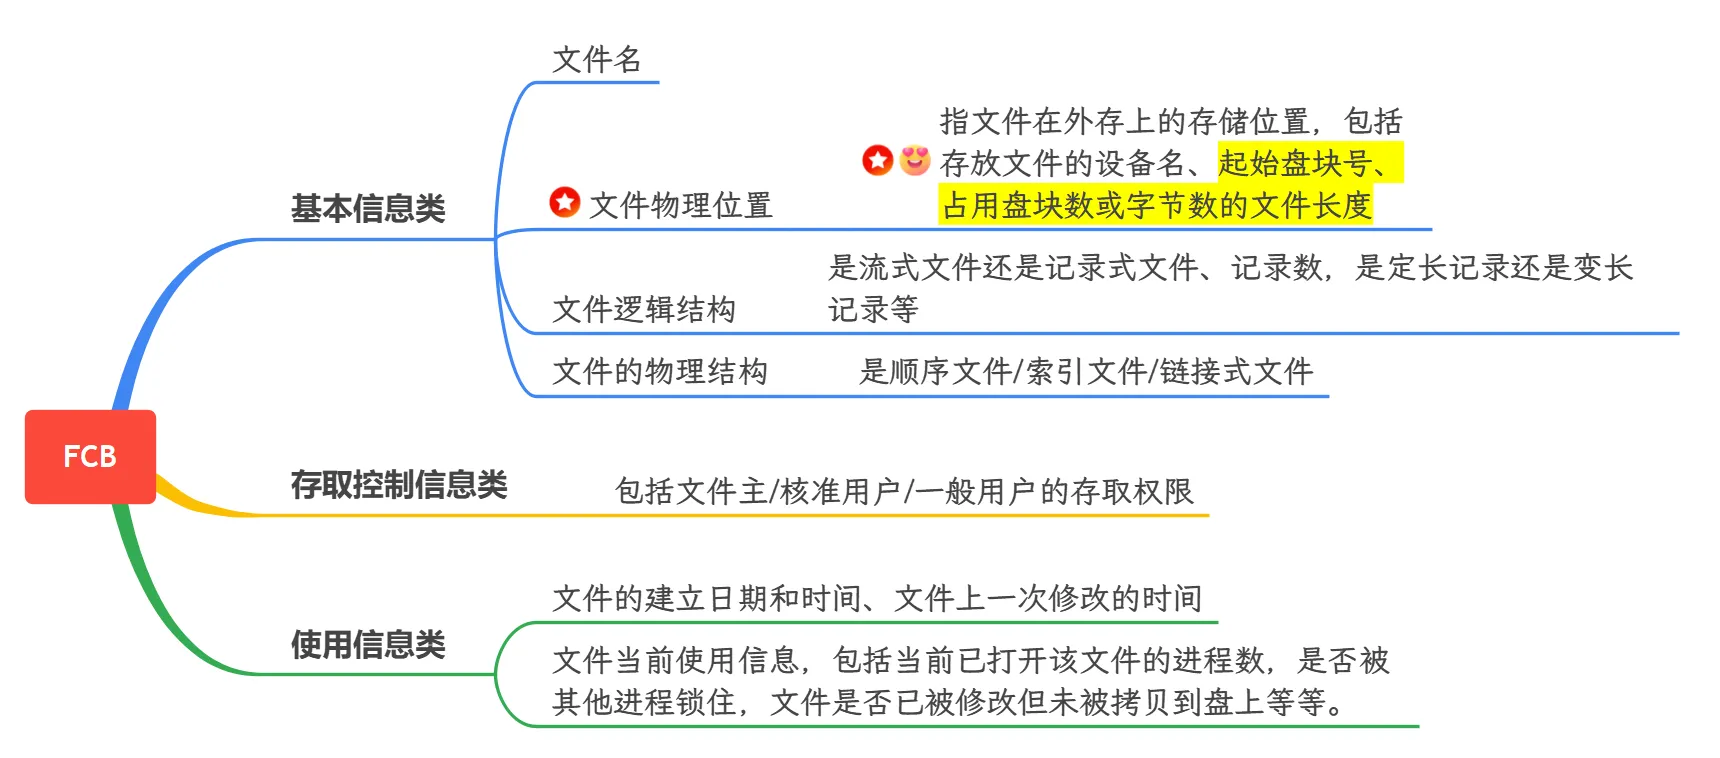
- FCB实现了文件名和文件之间的映射。使得用户(用户程序)可以实现“按名存取”
- 文件中目录的形式示意图:
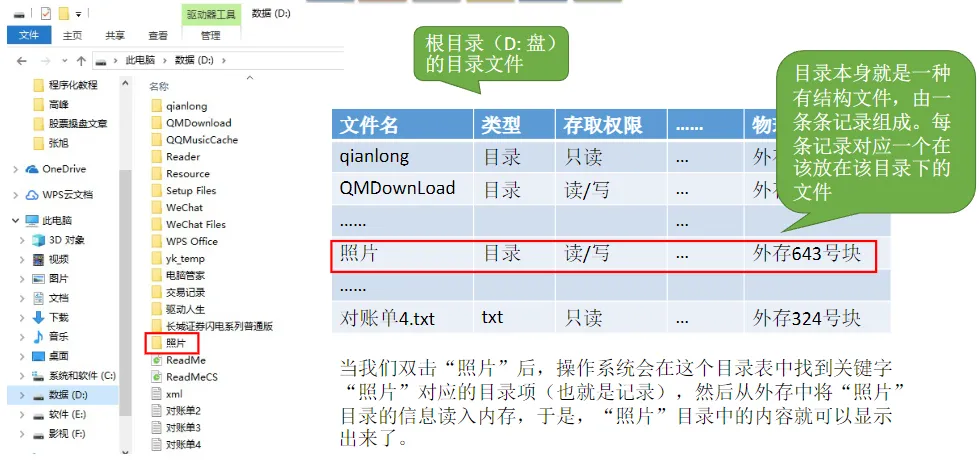
-
索引结点(
i结点、inode) -
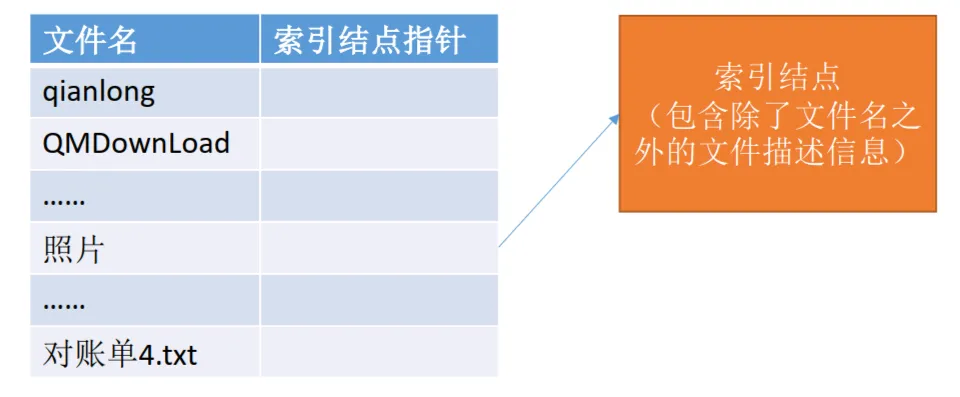
引入原因:文件目录通常是存放在磁盘上的,当文件很多时,文件目录要占用大量的盘块。在查找目录的过程中,必须先将存放目录文件的第一个盘块的目录调入内存,然后将用户给定的文件名,与目录项中的文件名逐一比较。若未找到指定文件,还需要将下一盘块的目录调入内存。这样开销很大,其实在查找各级目录的过程中只需要用到“文件名”这个信息,只有文件名匹配时,才需要读出文件的其他信息。因此可以考虑让目录表“瘦身”来提升效率。为此引入索引节点。
- 概念:将
FCB中除了文件名的所有信息抽离出来形成索引结点,在文件目录中的每个目录项仅由文件名和指向该文件所对应的索引节点的指针(或索引结点编号)构成。
节省开销的示例:假设一个
FCB是64B,磁盘块的大小为1KB,则每个盘块中只能存放16个FCB。若一个文件目录中共有640个目录项,则共需要占用640/16 = 40个盘块。因此按照某文件名检索该目录,平均需要查询320个目录项,平均需要启动磁盘20次(每次磁盘I/O读入一块)。若使用索引结点机制,文件名占14B,索引结点指针占2B,则每个盘块可存放64个目录项,那么按文件名检索目录平均只需要读入320/64 =5个磁盘块。显然,这将大大提升文件检索速度。
- 当找到文件名对应的目录项时,才需要将索引结点调入内存,便于以后使用,索引结点中记录了文件的各种信息,包括文件在外存中的存放位置,根据“存放位置”即可找到文件。
- 存放在外存中的索引结点称为“磁盘索引结点”,当索引结点放入内存后称为“内存索引结点”。相比之下内存索引结点中需要增加一些信息,比如:文件是否被修改、此时有几个进程正在访问该文件等。
- 磁盘索引结点的主要内容:文件主标识符、文件类型、文件存取权限、文件物理地址、文件长度、文件链接计数
count、文件存取时间等 - 内存索引结点主要内容:相比于磁盘索引结点增加了索引结点编号(用于标识内存索引结点)、状态(是否被上锁或修改)、访问计数、逻辑设备号、链接指针(设置分别指向空闲链表和散列队列的指针)
- 示意图:
目录结构
-
单级目录结构(考纲已删)
-
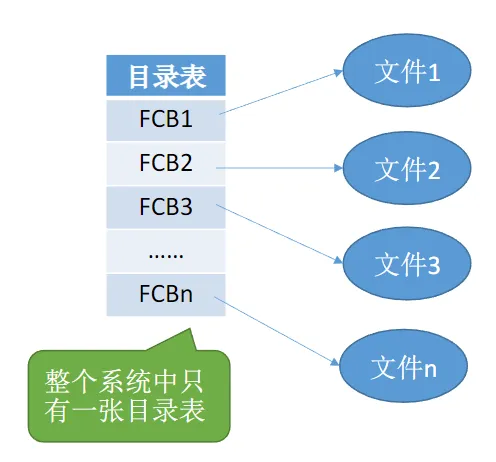
早期操作系统并不支持多级目录,整个系统中只建立一张目录表,每个文件占一个目录项。
- 单级目录实现了“按名存取”,但是不允许文件重名。在创建一个文件时,需要先检查目录表中有没有重名文件,确定不重名后才能允许建立文件,并将新文件对应的目录项插入目录表中。显然,单级目录结构不适用于多用户操作系统。
- 示意图:
- 两级目录结构(考纲已删)
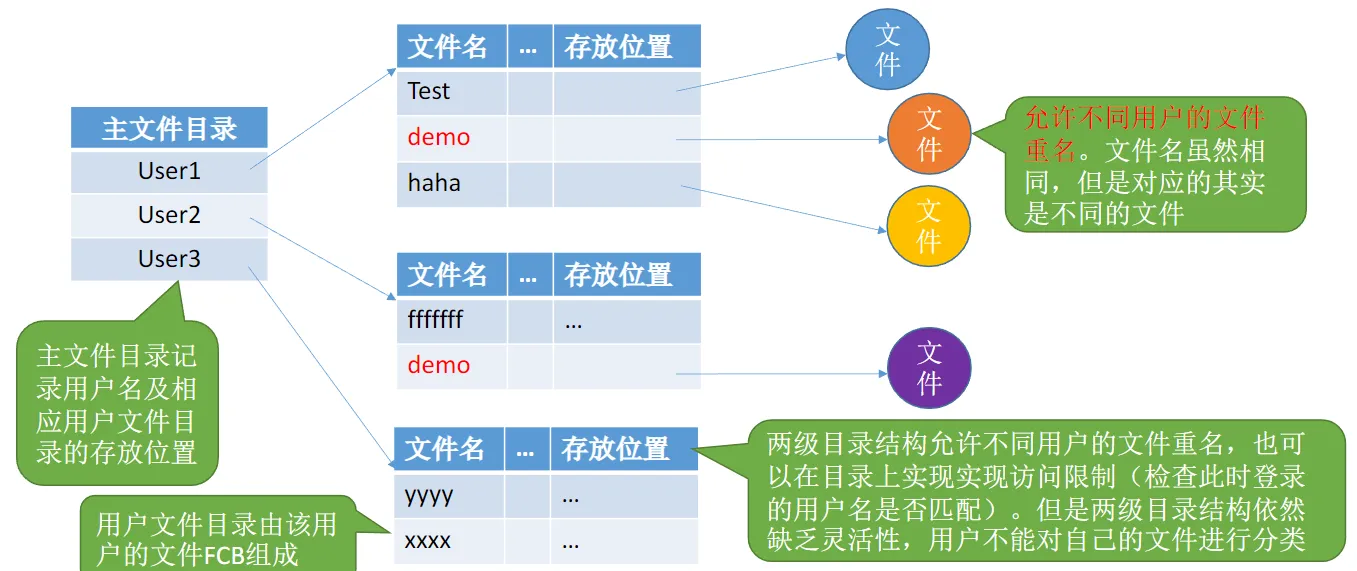
早期的多用户操作系统,采用两级目录结构。分为主文件目录(MFD,Master File Directory)和用户文件目录(UFD,User Flie Directory)。
- 一个文件系统一张主文件目录表;一个文件主目录表项对应一个用户(用户文件目录表);一个用户一张用户文件目录表
- 缺点:不能对文件分类(没有文件夹系统)
- 优点:解决了不同用户文件不能重名的问题;一定程度上保证了文件的安全;可实现访问限制;
- 示意图:
-
多级(树形)目录结构
-
示意图:
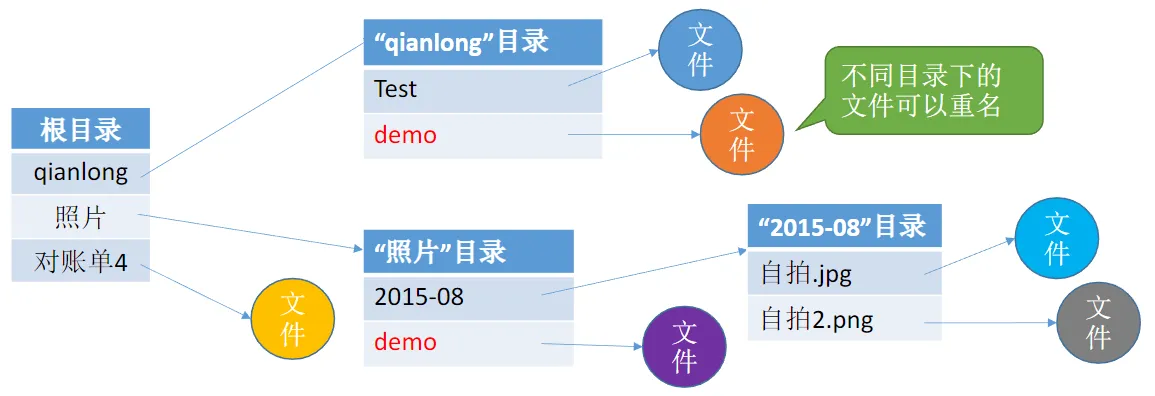
用户(或用户进程)要访问某个文件时要用文件路径名标识文件,文件路径名是个字符串。各级目录之间用“/”隔开。从根目录出发的路径称为绝对路径。
例如:自拍
.jpg的绝对路径是“/照片/2015-08/自拍.jpg”
系统根据绝对路径一层一层地找到下一级目录。刚开始从外存读入根目录的目录表;找到“照片”目录的存放位置后,从外存读入对应的目录表;再找到“2015-08”目录的存放位置,再从外存读入对应目录表;最后才找到文件“自拍.jpg”的存放位置。整个过程需要3次读磁盘I/O操作。很多时候,用户会连续访问同一目录内的多个文件(比如:接连查看“2015-08”目录内的多个照片文件),显然,每次都从根目录开始查找,是很低效的。因此可以设置一个“当前目录”。
例如,此时已经打开了“照片”的目录文件,也就是说,这张目录表已调入内存,那么可以把它设置为“当前目录”。当用户想要访问某个文件时,可以使用从当前目录出发的“相对路径” 。在Linux 中,“.”表示当前目录,因此如果“照片”是当前目录,则”自拍.jpg”的相对路径为:“./2015-08/自拍.jpg”。从当前路径出发,只需要查询内存中的“照片”目录表,即可知道“2015-08”目录表的存放位置,从外存调入该目录,即可知道“自拍.jpg”存放的位置了。
可见,引入“当前目录”和“相对路径”后,磁盘I/O的次数减少了。这就提升了访问文件的效率.
- 优点:方便对文件进行分类,层次清晰,可有效对文件进行管理和保护;
- 缺点:需要按路径逐级访问中间结点,增加了磁盘开销,影响查询速度;
- 无环图目录结构
由于树形目录结构不方便实现文件共享,为此在树形目录结构的基础上增加了一些指向同一结点的有向边,使整个目录成为一个有向无环图。
- 示意图:
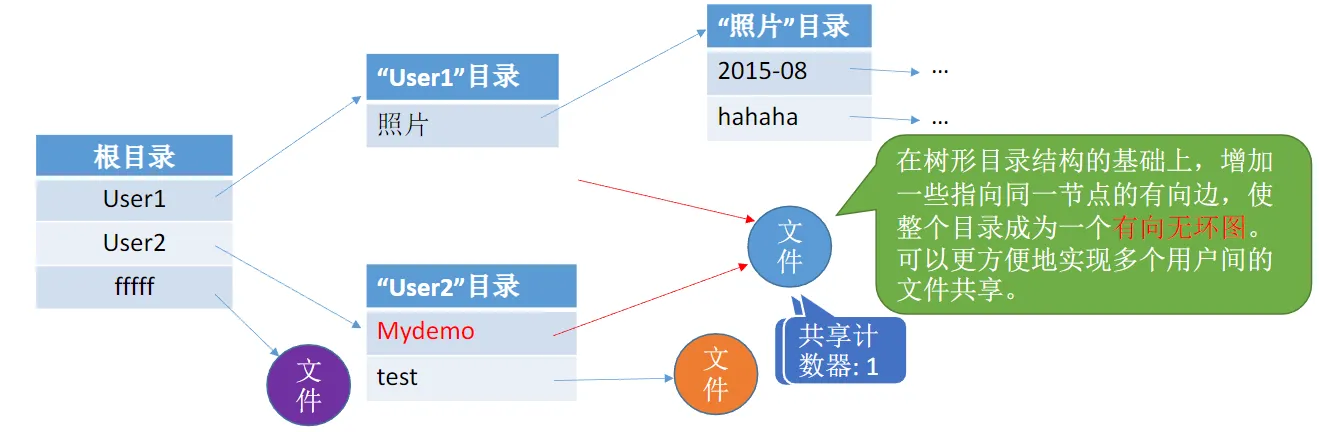
可以用不同的文件名指向同一个文件,甚至可以指向同一个目录(共享同一目录下的所有内容)。需要为每个共享结点设置一个共享计数器count,用于记录此时有多少个地方在共享该结点。用户提出删除结点的请求时,只是删除该用户的FCB、并使共享计数器减1,并不会直接删除共享结点。只有共享计数器减为0时,才删除结点。
注意:共享文件不同于复制文件。在共享文件中,由于各用户指向的是同一个文件,因此只要其中一个用户修改了文件数据,那么所有用户都可以看到文件数据的变化。
- 优缺点:方便地实现了文件的共享,但使得系统的管理变得更加复杂。
目录的操作
- 搜索:当用户要使用一个文件时,系统要根据文件名搜索目录,找到该文件对应的目录项
- 创建文件:创建一个新文件时,需要在其所属的目录中增加一个目录项
- 创建目录:在树形目录结构中,用户可创建自己的用户文件目录,并可再创建子目录。
- 删除文件:当删除一个文件时,需要在目录中删除相应的目录项
- 删除目录:有两种方式:1. 不删除非空目录,删除时要先删除目录中的所有文件,并递归地删除子目录 2. 可删除非空目录,目录中的文件和子目录同时被删除。
- 显示目录:用户可以请求显示目录的内容,如显示该目录中的所有文件及相应属性
- 修改目录:某些文件属性保存在目录中,因此这些属性变化时需要修改相应的目录项(如:文件重命名)
- 移动目录:需要修改相应的路径名
- 链接目录:对于树形结构目录,每个文件和每个目录都只允许有一个父目录,这样不适合文件共享,但可以通过链接操作让指定文件具有多个父目录,从而方便了文件共享
目录实现
线性列表(采用文件名和数据块指针的线性列表)
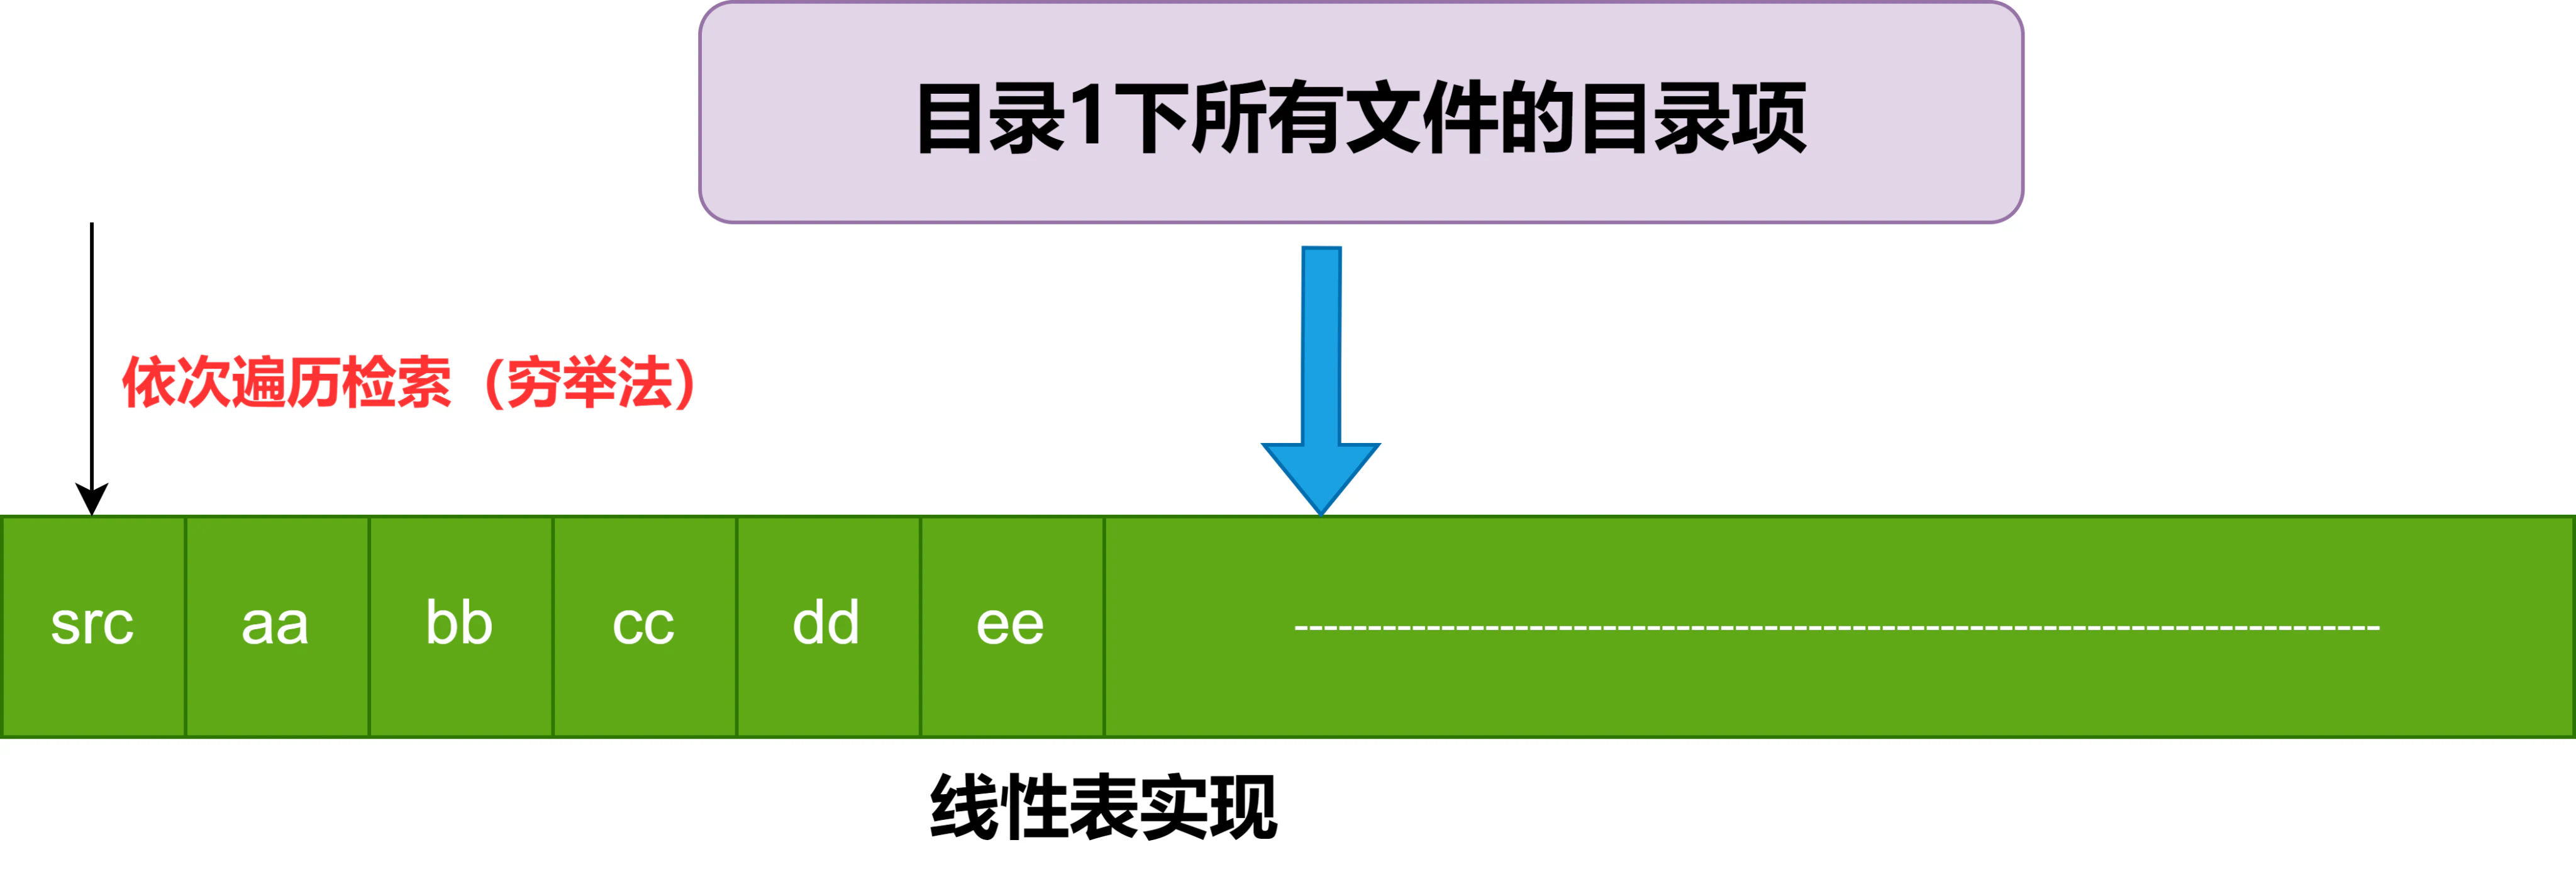
- 实现:使用数组或链表作为底层数据结构来存储目录项。数组适合静态目录,其中目录项的增加和删除较少;链表则适合动态目录,便于频繁的插入和删除操作。
- 优缺点:实现简单,但是效率比较低
- 创建新文件:必须首先搜索目录以确定没有同名的文件存在,然后在目录中增加一个新的目录项
- 删除文件:根据给定的文件名搜索目录,然后释放分配给它的空间
- 处理不再使用的目录项方法(重用目录项)
1. 将目录项标记为不再使用:
- 操作:这种方法涉及到在目录项中设置一个标志位或状态,表示该目录项已经不再被使用。例如,可以在目录项的状态字段中添加“已删除”或“空闲”标记。
- 优点:实现简单,能迅速将目录项标记为不可用,不需要移动其它目录项。
- 缺点:搜索有效目录项时可能需要跳过这些标记为不再使用的目录项,可能会稍微影响查找性能。
2. 将目录项加到空闲目录项的列表上:
- 操作:创建一个专门的列表(或使用链表、栈等数据结构)来管理所有的空闲目录项。当删除目录项时,将其添加到这个空闲列表中。新的目录项需要时,可以从空闲列表中取出复用。
- 优点:可以快速地重用空闲的目录项,管理集中,易于监控和调优。
- 缺点:需要额外的数据结构来维护空闲列表,可能会增加系统的复杂度和维护成本。
3. 将目录的最后一个目录项复制到空闲位置,并减少目录的长度:
- 操作:当某个目录项变为空闲时,可以将目录中的最后一个目录项移动到这个空闲位置,并更新目录长度,使得目录中不出现空洞。
- 优点:通过这种方式,目录始终保持连续,不会有空洞,可以优化目录的存储和访问速度。
- 缺点:此操作涉及到数据的移动,如果目录项较大或者目录项数量很多时,这种移动操作可能会比较耗时。
哈希表实现目录

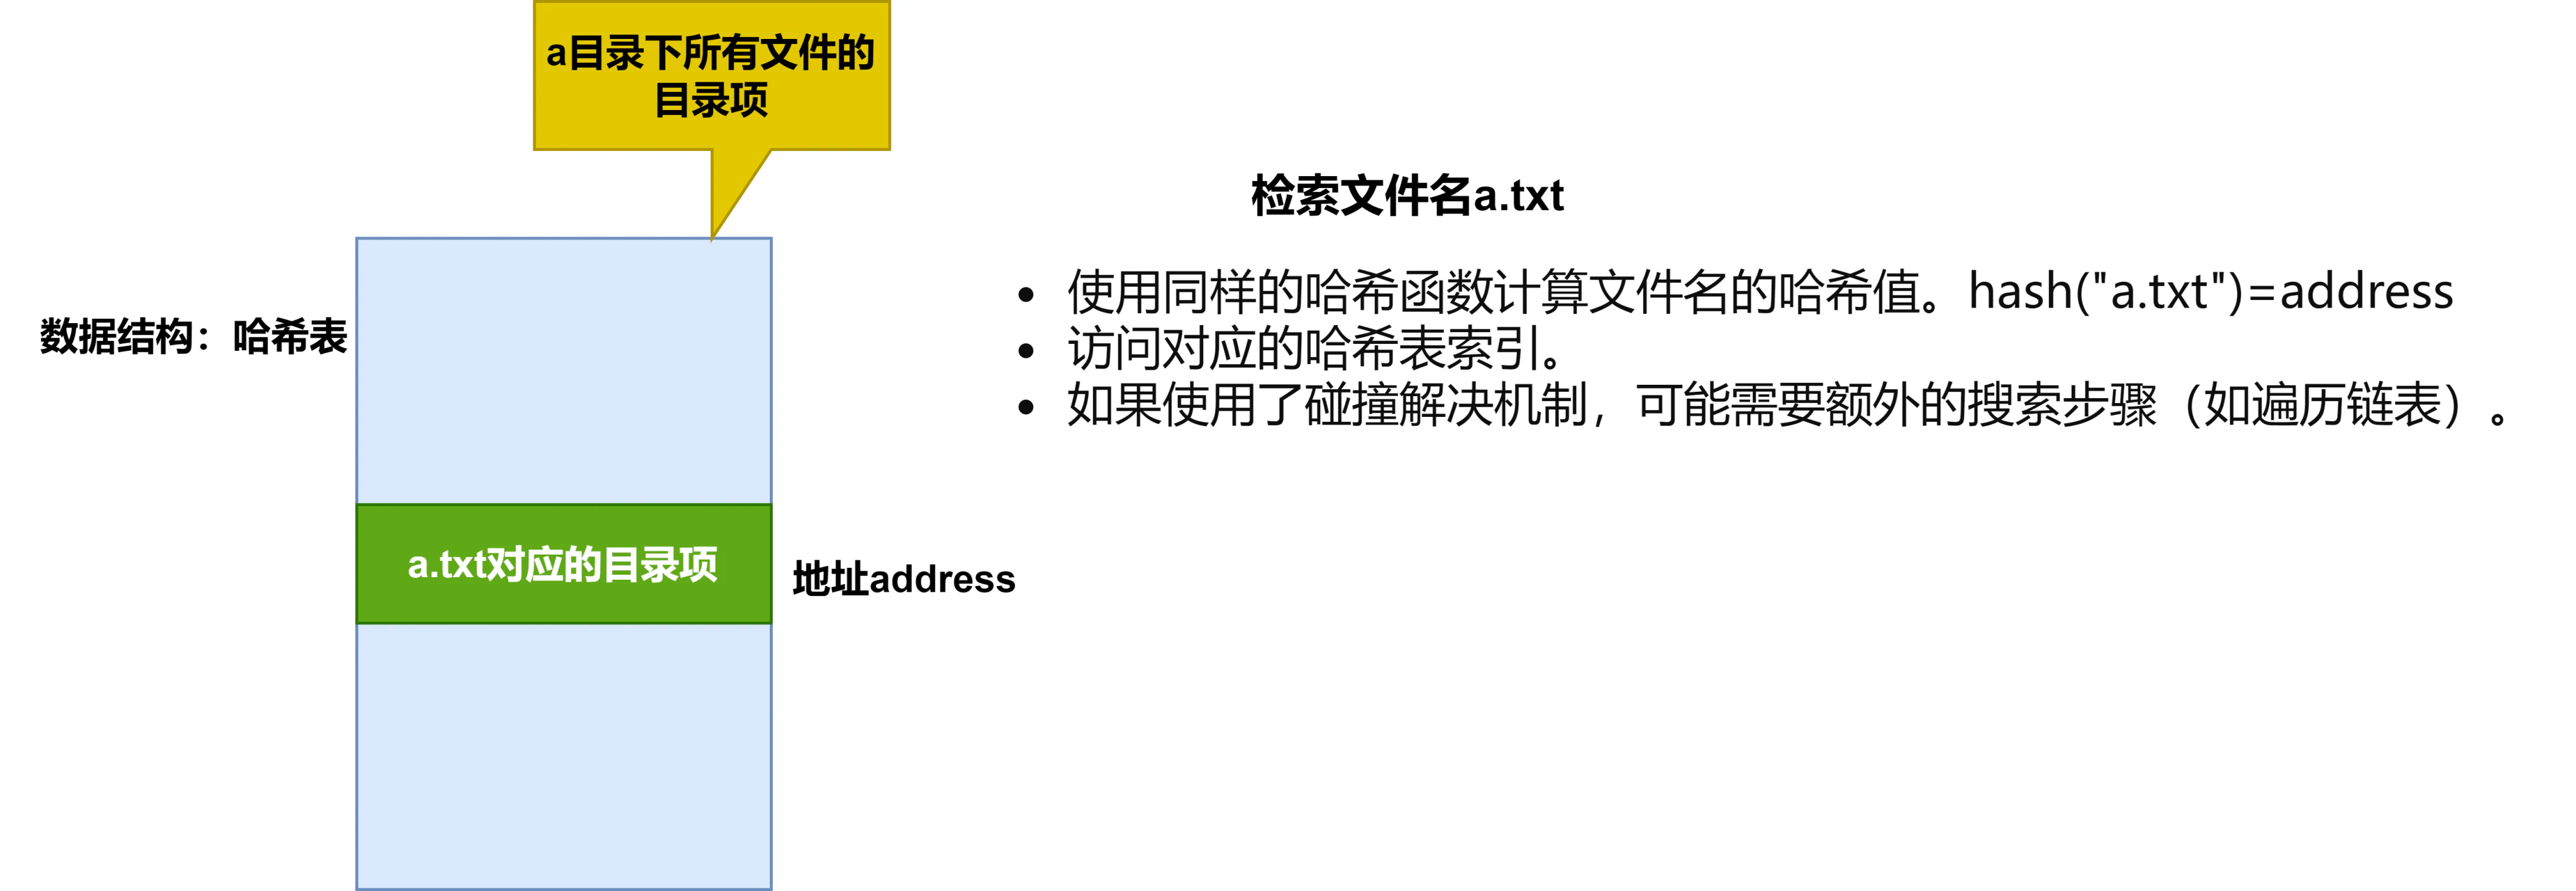 、
- 基本原理:哈希法通过使用哈希函数将目录项的键值(通常是文件名或路径)映射到一个较小的索引范围内,这个索引用来定位存储目录项的位置。哈希函数的设计尽量保证键值均匀分布,以减少碰撞(不同的键值映射到同一位置)的发生。
- 存储结构:
- 哈希表:通常使用一个数组或者链表数组(拉链法)来作为哈希表的底层存储结构。
- 目录项:每个目录项包括键(如文件名)和值(如文件属性、位置等信息)。
- 优点:
- 提供了快速的数据访问速度,尤其是在直接通过键值访问时。
- 哈希表动态扩展相对容易,适合处理大量动态变化的目录项。
- 缺点:
- 容易造成空间浪费
- 哈希表的大小通常固定,如果哈希函数设计不合理,可能导致较高的碰撞率和存储效率下降。
- 删除和添加操作可能相对复杂,尤其是在处理大量碰撞时。
键树实现目录

键树(Key Tree),也常被称为前缀树或Trie树,在文件系统或数据库中实现目录结构时提供了一种高效的搜索和存储方式。键树的核心优势在于它可以快速地通过键(如文件路径或名称的前缀)进行查找,特别适合处理有大量共享前缀的字符串集合,如文件名、路径等。
- 基本结构和原理
键树是一种树形结构,每个节点代表一个字符或字符串的一部分。从根节点到某一节点的路径代表了目录中的一个文件或文件夹的名称。键树常用于实现具有以下特点的目录:
- 节点存储:每个节点通常存储一个字符,并有多个子节点,每个子节点也代表一个字符。
- 路径表示:从根节点到任意节点的路径表示一个字符串(如文件或目录名)。
- 结束标记:节点通常包含一个标记,用以表示该节点是否是一个字符串(即文件或目录名)的结束。
- 操作步骤
添加文件或目录
- 从根节点开始,对文件名或目录名中的每一个字符进行操作。
- 检查当前字符是否已经作为子节点存在。
- 如果存在,移动到该子节点;如果不存在,创建一个新的子节点。
- 重复上述步骤,直到文件名的所有字符都被处理完。
- 设置最后一个节点的结束标记,表示一个完整的文件名或目录名结束。
查找文件或目录
- 从根节点开始,对目标字符串的每一个字符进行查找。
- 按顺序访问每个字符对应的子节点。
- 如果中途某个字符的子节点不存在,则查找失败,说明目录中没有该文件或目录。
- 如果所有字符都成功匹配,并且最后一个节点标记为结束,则查找成功。
删除文件或目录
- 找到文件或目录名对应的节点。
- 如果该节点是其父节点的唯一子节点且没有其他子节点,可以递归删除该节点及其父节点(直到遇到有多个子节点的节点或根节点)。
- 如果节点有多个子节点或不是结束节点,仅移除结束标记。
优点:
- 搜索速度快,特别是在有大量共享前缀的数据集中。
- 占用空间更小(平均比 O(n)还小)
- 插入和查询的时间复杂度通常与字符串长度成线性关系。
缺点:
- 算法比较复杂
- 空间优化需要额外的设计,如压缩键树等。
文件共享
现代操作系统必须提供文件共享手段,即指系统应允许多个用户(进程)共享同一份文件,这样在系统中只需保留该共享文件的一份副本。如果系统不能提供该功能,就意味着凡是需要该文件的用户,都须各自备有此文件的副本,显然会造成对存储空间的极大浪费。
注意:多个用户共享同一个文件,意味着系统中只有“一份”文件数据。并且只要某个用户修改了该文件的数据,其他用户也可以看到文件数据的变化。如果是多个用户都“复制”了同一个文件,那么系统中会有“好几份”文件数据。其中一个用户修改了自己的那份文件数据,对其他用户的文件数据并没有影响。
这里我们仅介绍考研用到的两种文件共享方式:
基于索引结点的共享方式(硬链接Hard Link)
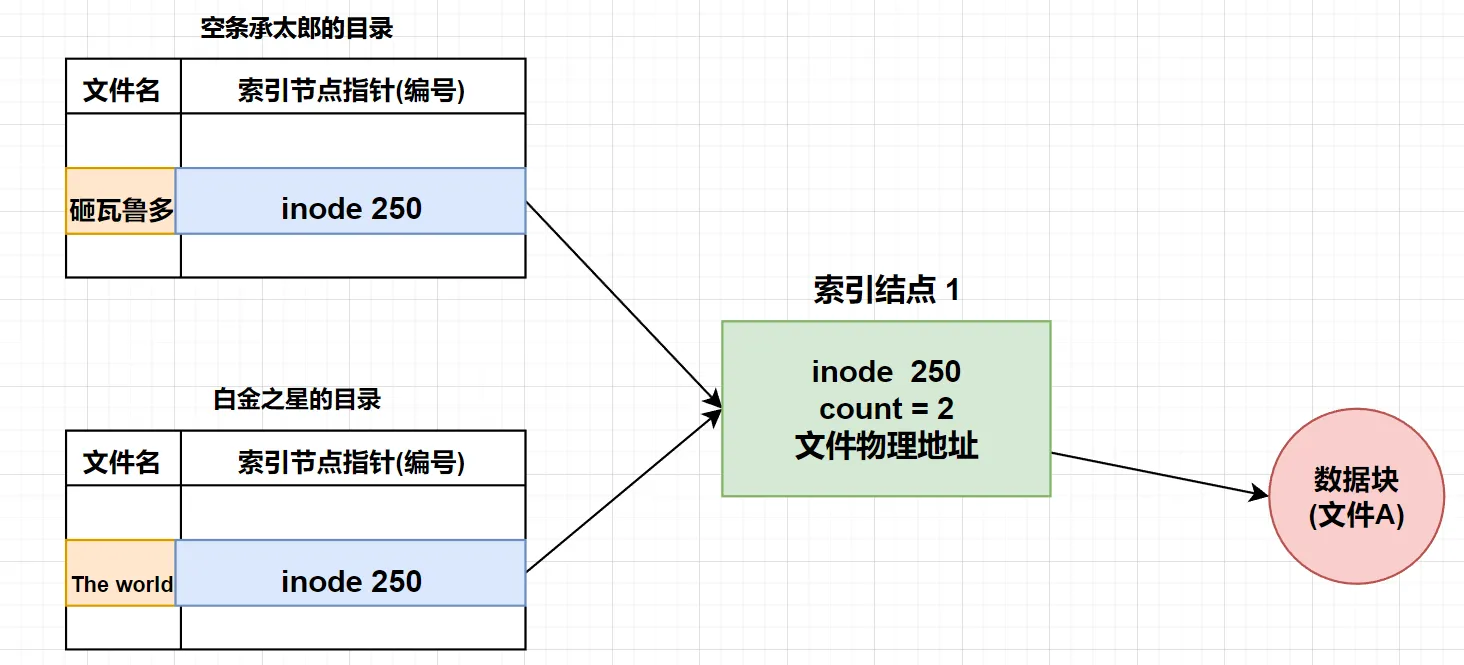
- 引入原因:在有向无环图的目录结构中实现文件共享,必须将共享文件或子目录链接到多个用户的父目录中,才能方便地找到该文件,如果父目录中包含的是共享文件的物理地址,即起始盘块号和盘块数这些信息,那么如果以后某个父目录还要对该文件添加新内容,也必然要增加新的盘块,而这些新加入的信息只有操作它的目录才能看到,可见这种变化对其他目录不可见,因此不能共享;而索引结点就可以完美解决这个问题!
- 采用目录结构中的索引结点的方式,通过文件目录中索引结点编号来定位到索引结点,进而找到相应的文件地址;
- 共享文件的索引结点编号同时存在于多个用户的文件目录中,通过共享同一个索引结点来实现文件共享;
注意:虽然这些目录项指向同一个
inode,但是inode是不可能跨越文件系统的,每个文件系统都有各自的inode数据结构和列表,所以硬链接是不可用于跨文件系统的。
count记录相应文件被共享的用户数,只有当count=0时系统才能将文件删除,count>0时若删除文件数据会导致指针悬空;因此当某用户删除共享文件时不影响其他用户对文件的访问,并不是真的删除,只是count--(UNIX采用了这种方法)
因此,在硬链接中各用户都可对文件进行删除操作,只要当前用户执行完
count--后count == 0时即可真正删除该文件;
- 示意图:
基于符号链接的共享方式(软链接symbolic Link)
- 基本思想:允许一个文件或子目录有多个父目录,但其中仅有一个作为主(属主)父目录,其他的几个父目录都是通过符号链接方式与之相链接的(简称链接父目录)。
- 实现方式:为了使用户
Dio能共享用户空条承太郎的一个文件A,由系统创建一个LINK类型的新文件(只包含共享文件的路径名),并将该文件写入Dio的目录中,以实现Dio与文件A的链接。这样的链接方式被称为符号链接,新创建文件中的路径名则只被看作是符号链。当用户Dio想要访问LINK新文件时,此要求被OS截获,OS根据新文件中的路径名去找到了文件A,然后对它进行读(写),这样就实现了文件共享。
软链接相当于重新创建一个文件,这个文件有独立的 inode,但是这个文件的内容是另外一个文件的路径,所以访问软链接的时候,实际上相当于访问到了另外一个文件,所以软链接是可以跨文件系统的。
- 符号链接 (Symbolic Link) (也称软链接 (Soft Link) )是一个指向另一个文件的特殊文件。它类似于Windows系统中的快捷方式。符号链接文件具有自己的索引结点 (inode) 和数据块,并保存指向目标文件的路径或文件名。删除软链接文件不会影响目标文件的引用计数,但如果删除目标文件,则符号链接将成为无效链接。建立符号链接时,引用计数值为1。删除符号链接后,由于符号链接不持有目标文件,因此目标文件不受影响。
硬链接共享原文件的计数,软链接为全新文件,拥有自己的计数,创建时初值为1,当对软链接进行硬链接时,遵循普通文件的链接规则,即该软链接与硬链接计数均+1,王道说法时错误的
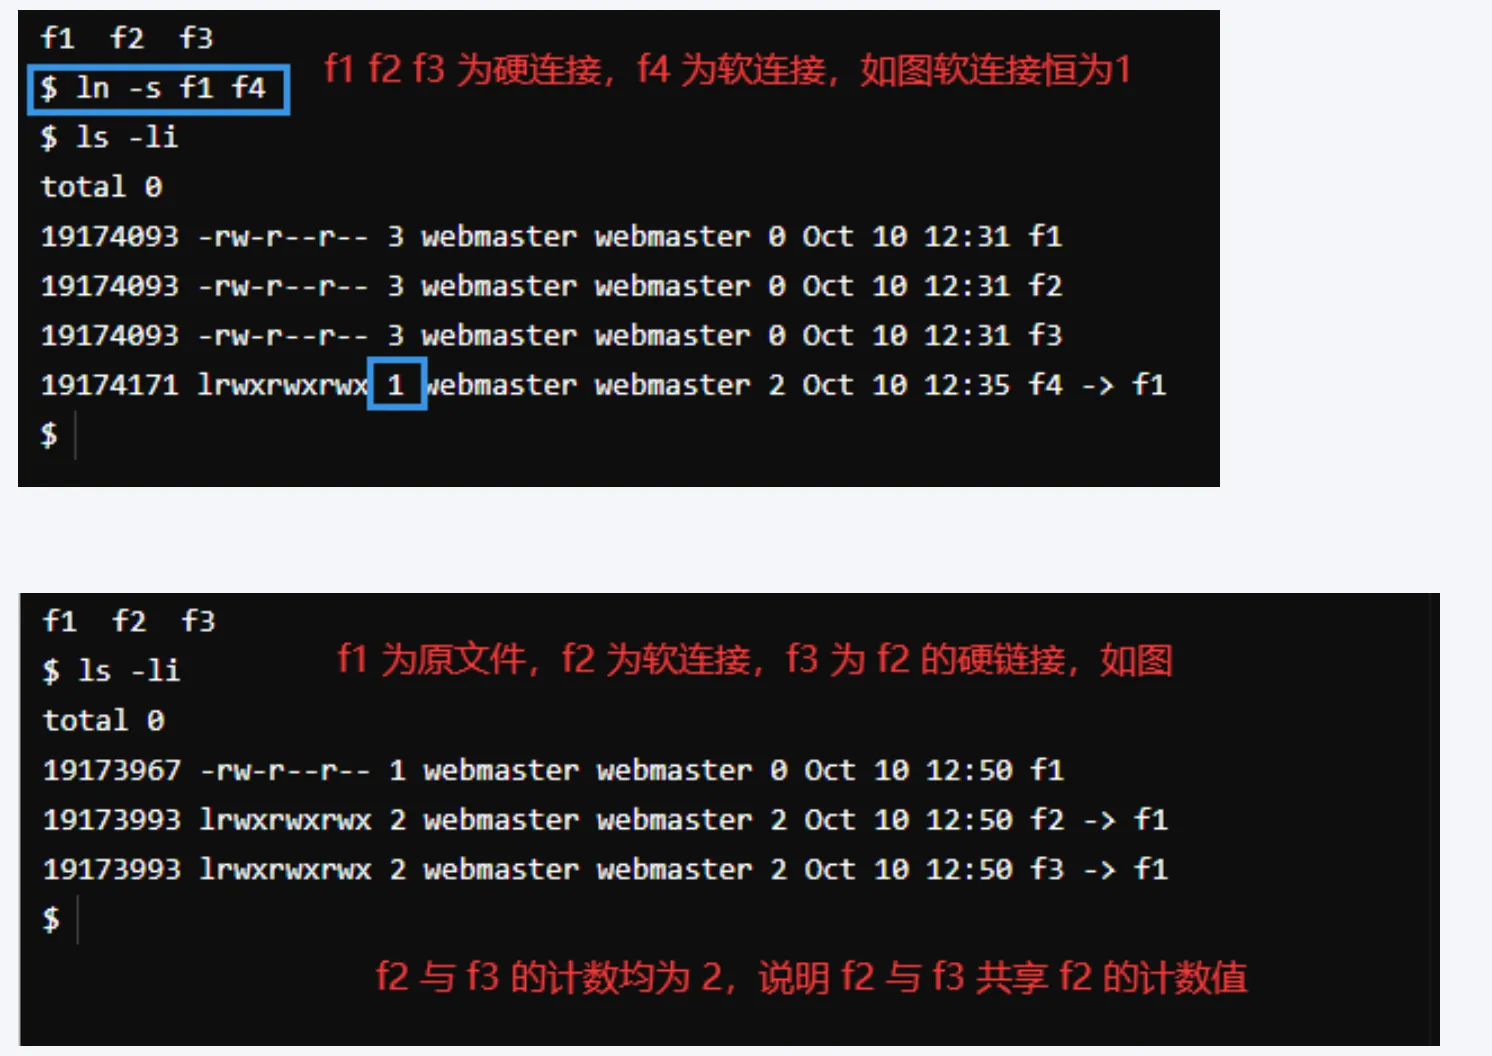
- 优点:
- 在该共享方式中,只有文件主才拥有指向其索引结点的指针,而共享该文件的其他用户则只拥有路径名;这样就不会出现文件主删除共享文件后留下悬空指针的情况;所以只有文件主才能对共享文件进行删除操作,其余用户只能删除LINK类型的新文件,并不能删除共享文件。
- 当文件的拥有者将共享文件删除后,它的符号链接仍继续保留,直到如果有其他用户试图通过符号链去访问该文件,则会访问失败,于是将符号链删除,此时不会有任何影响;
若文件主删除共享文件的同时,同时另一用户创建同名路径的另一文件,LINK文件仍然有效,但访问已不是同一文件了。
- 缺点:
- 当其他用户去读共享文件时,系统是根据路径名逐个去查找目录,直到找到该文件的索引结点,因此,在每次访问共享文件时,都可能要多次地读盘,这使得每次访问共享文件的开销很大,且增加了启动磁盘的频率;所以硬链接比软链接快!
- 要为每一个用户建立一条符号链,虽然链本身是一条很简单的文件,但却要为它配置一个索引结点,这也要耗费一定的磁盘空间。
- 示意图:
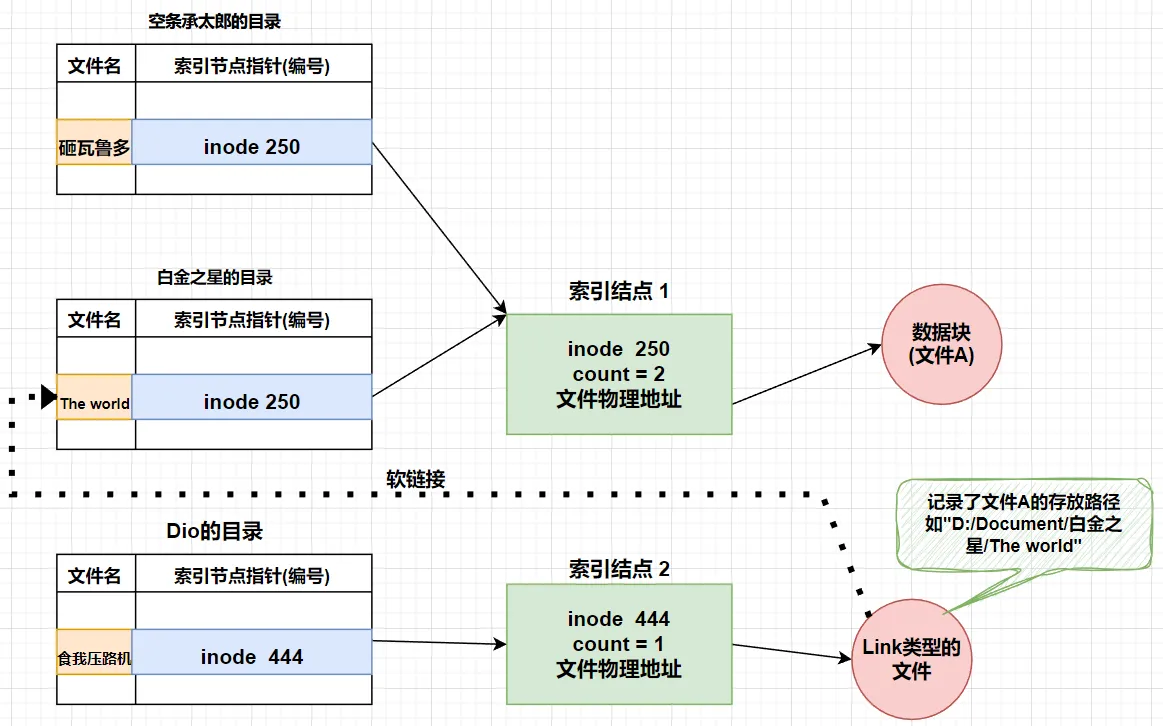
- windows实例:
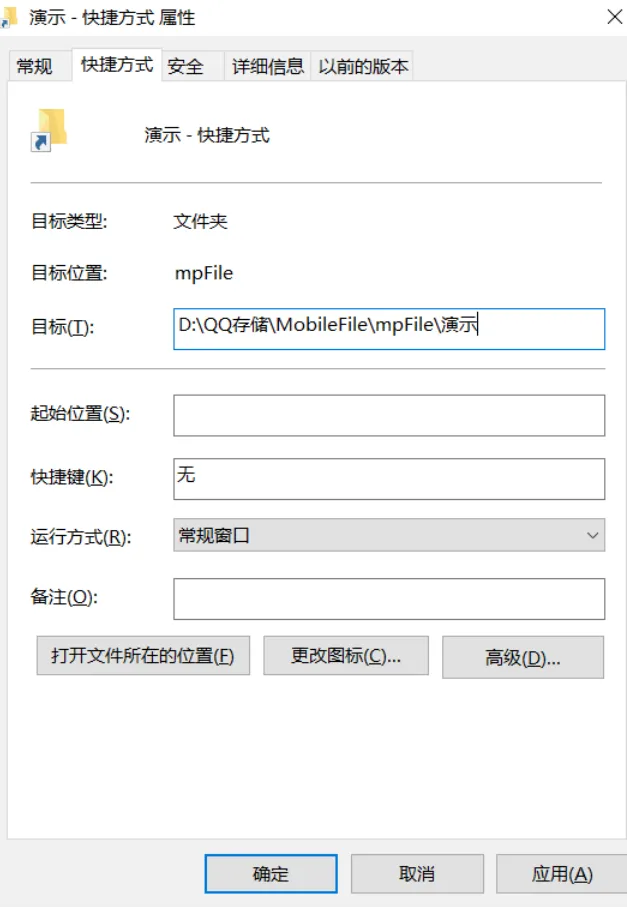
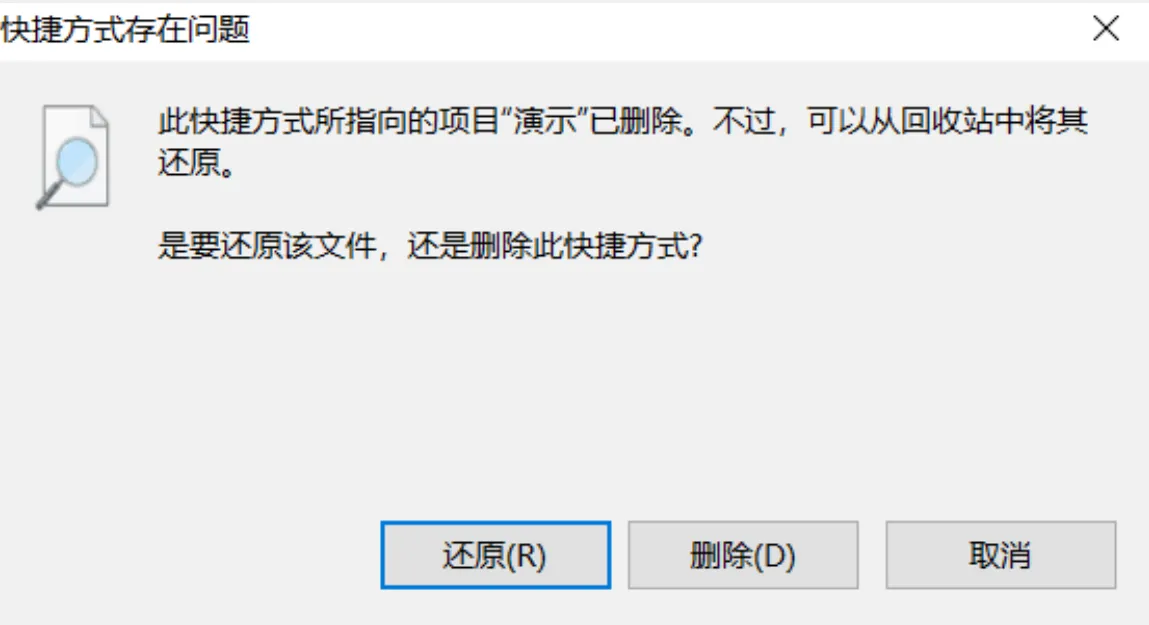
以上两种链接方式也是给文件取别名的常用方法,当采用这两种方法后,每一个共享文件都有几个文件名。也就是说,每增加一条链接,就增加一个文件名。实质上就是每个用户用自己的路径名去访问共享文件。这就带来一个问题,当我们试图去遍历整个文件系统时,将会多次遍历到该共享文件。
硬链接和软链接都是文件系统中的静态共享方法,在文件系统中还存在着另外的共享需求,即两个进程同时对一个文件进行操作,这样的共享称为“动态共享”。
文件系统
引言:对于一般用户来说,直接驱动磁盘存取数据位置是极其困难的。操作系统为磁盘外面包裹一层易于使用的抽象,即为文件系统。用户直接与文件系统打交道,无需了解磁盘的技术细节。
什么是文件系统?(这段解释来自博客《我所认识的EXT2》)
人们在认识一件陌生事物时一开始总是从事物的定义、作用和结构入手的。那么首先文件系统的定义是什么呢?简单地说文件系统就是在磁盘上组织文件的方法。可是为什么需要用文件系统呢?也许朋友们会这么认为:磁盘是自己的,想怎么放文件就怎么放,还要弄个文件系统来管多麻烦啊!那让我们来打个比方好了,比如你花了100万买了一套100平米的房子,如果没有一个预先规划,今天在厨房放个洗衣机,明天在阳台放个双人床,后天你就会发现新买的冲水马桶只能放在卧室了。。。当然这种局面是我们不希望看到了,为了避免这种情况的出现,我们在放东西之前就找一个能帮我们放东西的“管家”,一来这个“管家”知道东西怎么放可以在100万的房子里放尽量多的“东西”,二来“管家”可以帮我们快速地找“东西”,不会发生在卧室找到冲水马桶的尴尬。甚至这个有些“管家”还能在我们不小心“丢掉东西”以后还能帮我们找回来。而我们在放东西或取东西的时候只需要委托“管家”,让她帮我们实现放和找。
将这个例子推演到文件系统中就可以得知文件系统(“管家”)的主要作用:
- 优化磁盘空间利用率;
- 提高磁盘查找数据的效率;
- 能够提供N多“增值”服务,如:磁盘恢复、压缩、访问许可、磁盘配额等等,当然要视不同的文件系统而言;
- 由于我们是委托“管家”帮我们操作的,只要接口统一,“管家”是可以更换的,这样一来系统的耦合性就降低了。
当然,我们要请到这个超有能力的“管家”是要付出代价的
- 首先,“管家”是需要住在你的“家里的”,因此需要空间上的代价;
- 然后,你要利用“管家”帮你“放东西”,当然需要去了解“管家”,因此需要时间上的代价;
- 最后,还需要承担“管家”做错事的风险,因为如果文件系统一旦出错,有可能损失的将是整个磁盘的宝贵数据。
文件系统的层次结构(体系结构)
本节非大纲内容,了解即可
文件系统提供高效和便捷的磁盘访问,以便允许存储、定位、提取数据。文件系统中有两个不同的设计问题:
- 定义文件的用户接口:涉及定义文件及其属性、所允许的文件操作、如何组织文件的目录结构;
- 创建算法和数据结构:以便映射逻辑文件系统到物理外存设备;
现代操作系统有多种文件系统类型,因此文件系统的层次结构也不尽相同;我们这里介绍两种,一种是王道课里咸鱼介绍的,一种是《操作系统概念》里介绍的。
- 王道课程介绍的层次结构
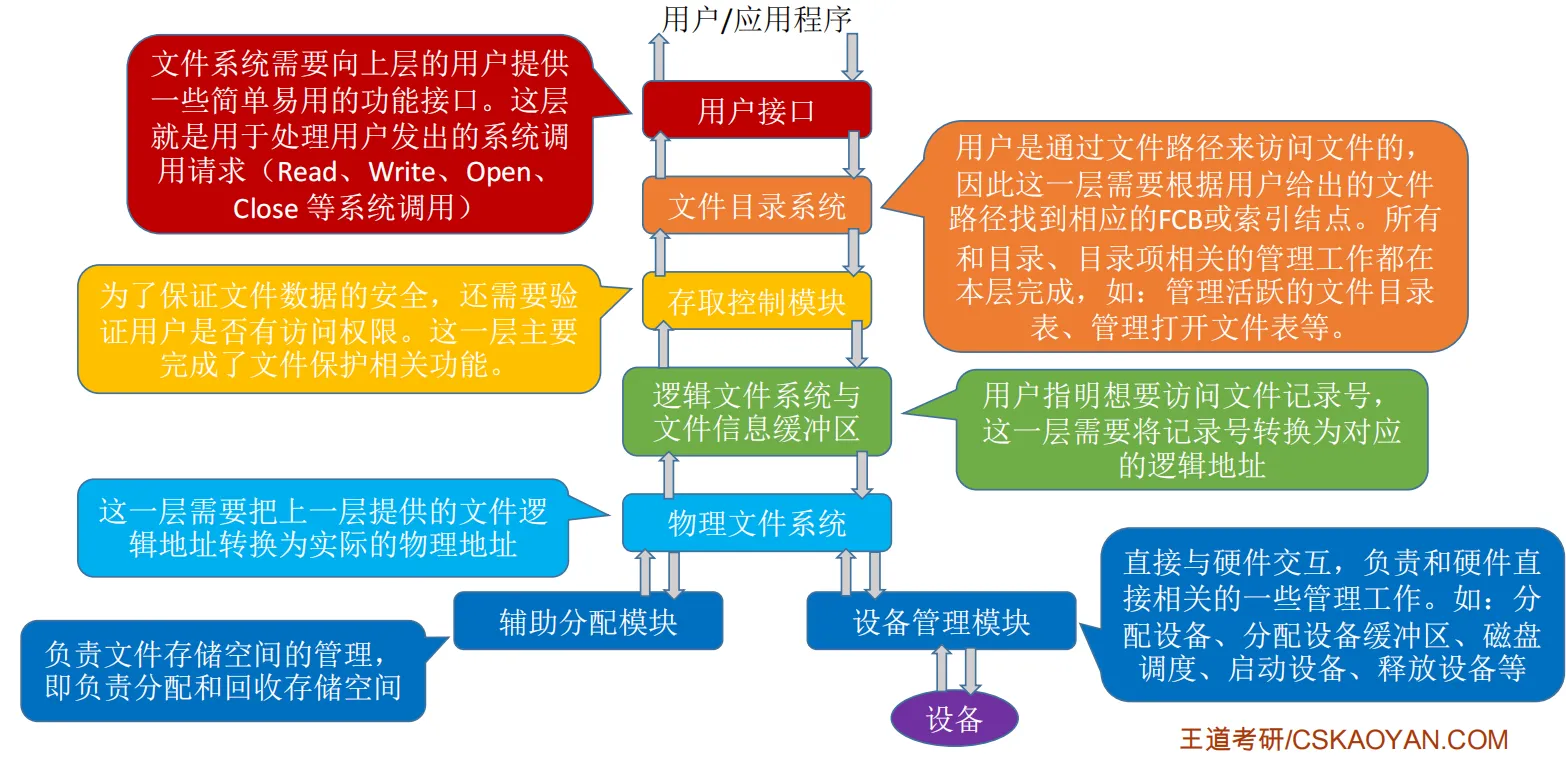
用一个例子来辅助理解文件系统的层次结构:假设某用户请求删除文件 “D:/工作目录/学生信息.xlsx” 的最后100条记录。
- 用户需要通过操作系统提供的接口发出上述请求——用户接口
- 由于用户提供的是文件的存放路径,因此需要操作系统一层一层地查找目录,找到对应的目录项——文件目录系统
- 不同的用户对文件有不同的操作权限,因此为了保证安全,需要检查用户是否有访问权限——存取控制模块(存取控制验证层)
- 验证了用户的访问权限之后,需要把用户提供的“记录号”转变为对应的逻辑地址——逻辑文件系统与文件信息缓冲区
- 知道了目标记录对应的逻辑地址后,还需要转换成实际的物理地址——物理文件系统
- 要删除这条记录,必定要对磁盘设备发出请求——设备管理程序模块
- 删除这些记录后,会有一些盘块空闲,因此要将这些空闲盘块回收——辅助分配模块
- 另一种分层结构:
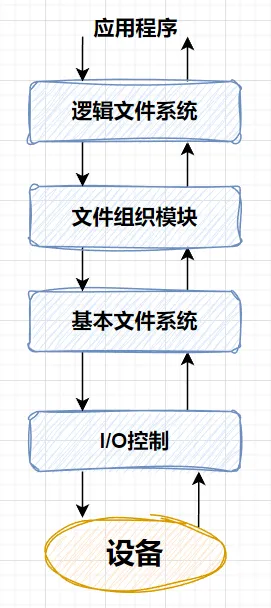
具体层次做什么事情可以参考王道书4.3.1或者《操作系统概念》P337.
文件系统布局
文件系统在磁盘中的结构
文件系统存放在磁盘上,多数磁盘划分为一个或多个分区,每个分区可以有一个独立的文件系统。文件系统可能包含以下信息:启动存储在该分区的操作系统的方式、总的块数、空闲块的数量和位置、目录结构以及各个具体文件等。
如图为一个可能的文件系统布局:
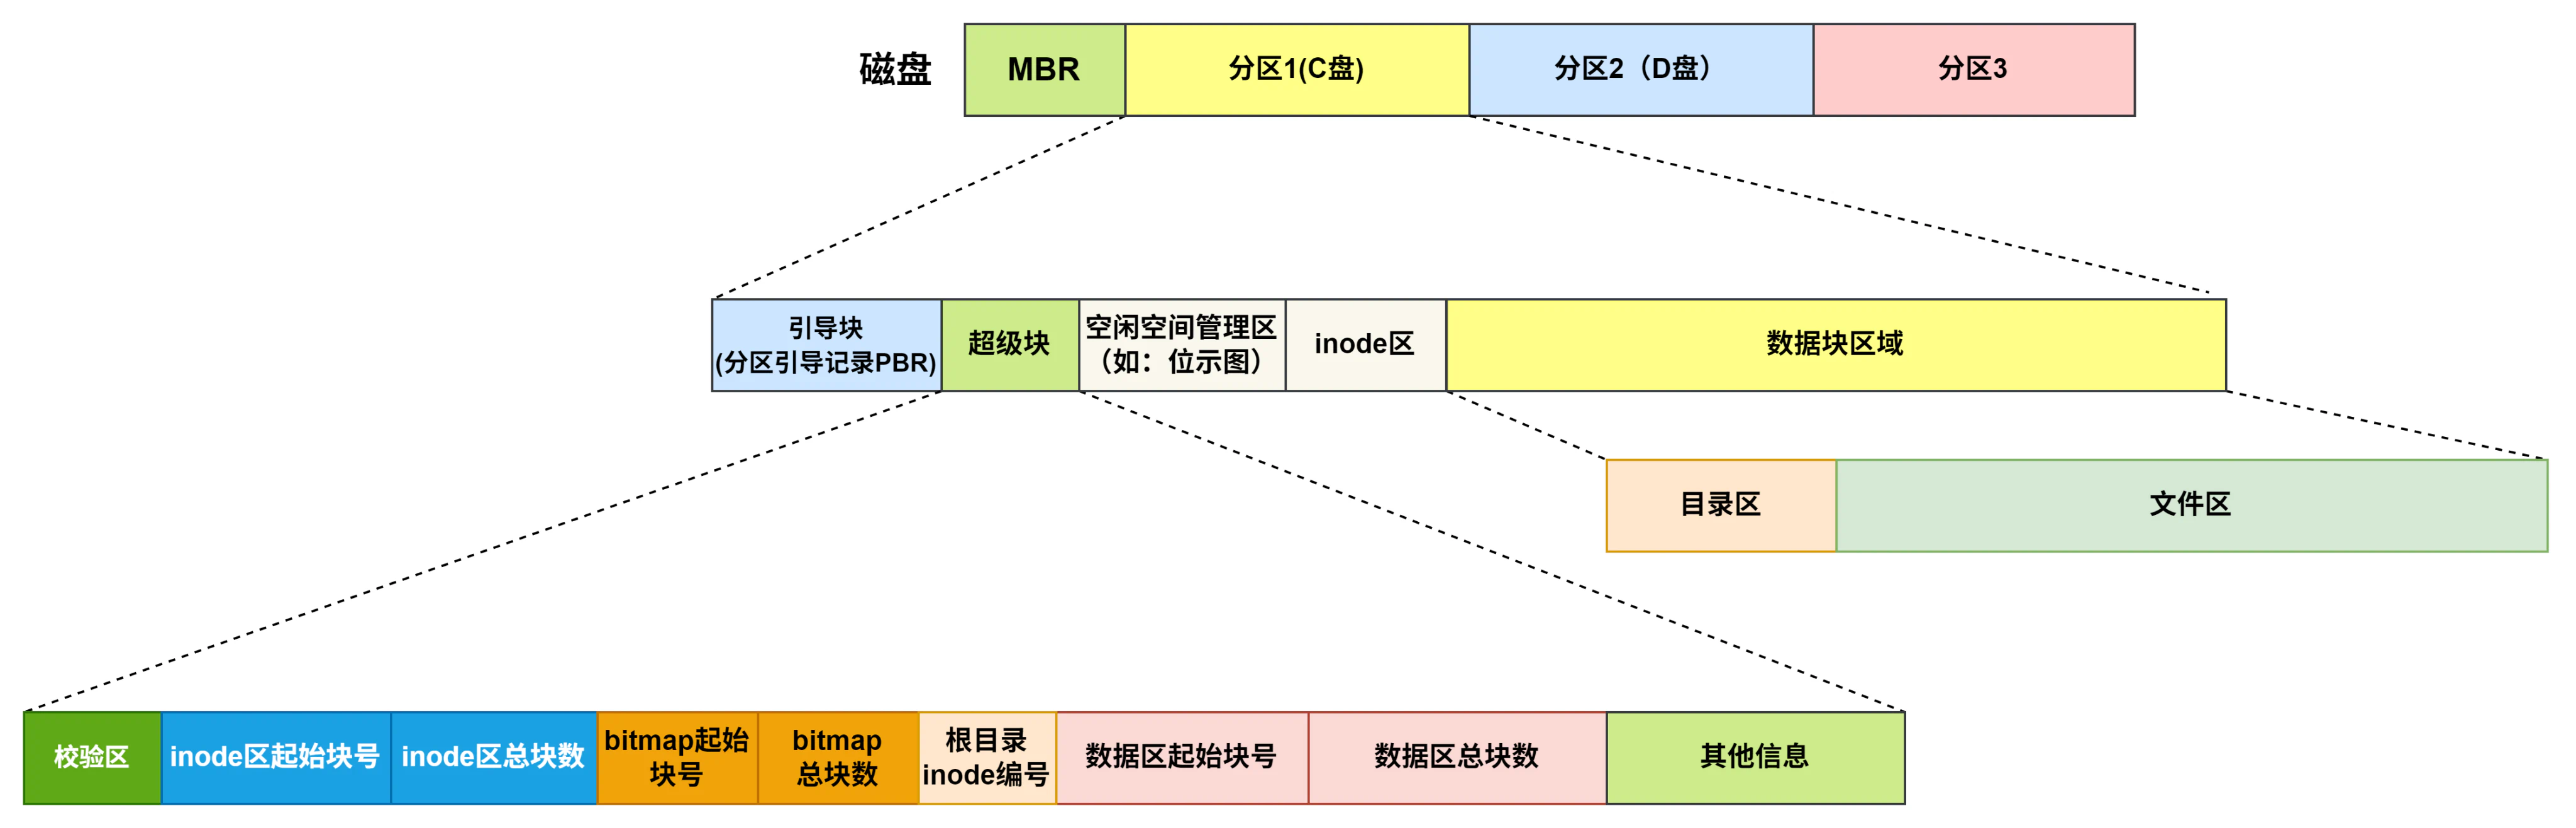
Super Block(超级块) 是文件系统的核心元数据结构,存储了文件系统的关键信息(如图所示),用于管理磁盘空间、文件和目录。不同文件系统的 Super Block 结构可能有所不同,上面是一种可能的结构,主要用于介绍其作用;
- 在系统启动时,内核需要读取根文件系统的超级块,以确认文件系统类型(如 ext2/ext4)、块大小、inode布局等关键信息。
- 超级块通常在挂载时被读取并缓存到内存中,后续操作(如读写文件)会直接使用缓存的超级块信息,无需重复读取磁盘。
- 超级块通常存储在磁盘的固定偏移位置(例如,ext2/ext4 文件系统中,超级块位于磁盘的第 1 个块,但实际可能有多个备份)。
Note
一般来说,超级块有如下字段:
- 校验区:进行文件系统校验的字段,用于区分文件系统类型,检测文件系统合法性;
- inode区起始块号:索引节点表占用的第一个物理磁盘块块号;
- inode区总块数:索引节点表占用的磁盘块数;
- bitmap起始块号:位示图占用的第一个物理磁盘块;
- bitmap总块数:位示图占用的磁盘块数;
- 数据区起始块:文件数据占用的第一个物理磁盘块块号;
- 数据区总块数:文件数据总共占用的磁盘块数;
- 其他信息:
- 磁盘块大小;
- inode大小;
- 根目录的inode编号等;
Note
假设上图所示的文件系统中,磁盘块大小为4KB,一个inode的大小为16B,inode区起始块号为6,inode区总块数为16,bitmap起始块号为22,bitmap总块数为16,请回答以下问题:
- superblock中的信息是什么时候写入的?(提示:磁盘管理)
- 该文件系统中最多可以存在多少个文件?
- 若不考虑磁盘容量, 数据区最多可以存在多少个磁盘块?
- 若文件darkmoon.png的inode编号为1314(inode编号从0开始),则该文件对应的inode位于几号磁盘块?它是该盘块中的几号inode?如果该文件是第一次打开,是仅将该inode读入内存,还是将该inode所在磁盘块一起读入内存?为什么?
参考答案
- 逻辑格式化;
- 一个磁盘块可以装入4KB/16B=256个inode,inode区总块数为16,一个文件对应一个inode,因此该文件系统中最多存在256*16=4096个文件;
- 数据区磁盘块由bitmap管理,1bit对应一个磁盘块,由于bitmap一共有16*4096*8=5524288bit,因此数据区最多有5524288个磁盘块;
- 1314/256=5,1314%256=34,所以darkmoon.png存放在6+5=11号磁盘块,是本磁盘中的34号inode;将该inode所在磁盘块一起读入内存,因为磁盘读取操作以“块(block)”为单位,而不是以“inode”为单位。即使你只需要一个 inode,系统也必须读取整个块,因为磁盘硬件无法直接读取块内的某一部分。
- 磁盘 I/O 无法按字节粒度读取:磁盘硬件只能以块为单位读取或写入数据,无法直接读取块内的某个字节范围。
- 虽然读取整个块会多读一些数据,但现代文件系统通过 缓存机制(如 inode 缓存)避免重复读取。例如:如果后续访问同一磁盘块中的其他 inode,可以直接从内存缓存中获取,无需再次读取磁盘。
文件系统在内存的结构
内存中的信息用于管理文件系统并通过缓存来提高性能。这些数据在安装文件系统时被加载,在文件系统操作期间被更新,在卸载时被丢弃,这些结构的类型可能包括:
- 内存中的安装表(mount table),包含每个已安装文件系统分区的有关信息。
- 内存中的目录结构的缓存包含最近访问目录的信息。对安装分区的目录,它可以包括一个指向分区表的指针;
- 整个系统的打开文件表,包含每个打开文件的
FCB副本及其他信息; - 每个进程的打开文件表,包含一个指向整个系统的打开文件表中的适当条目的指针,以及其它信息。
示意图: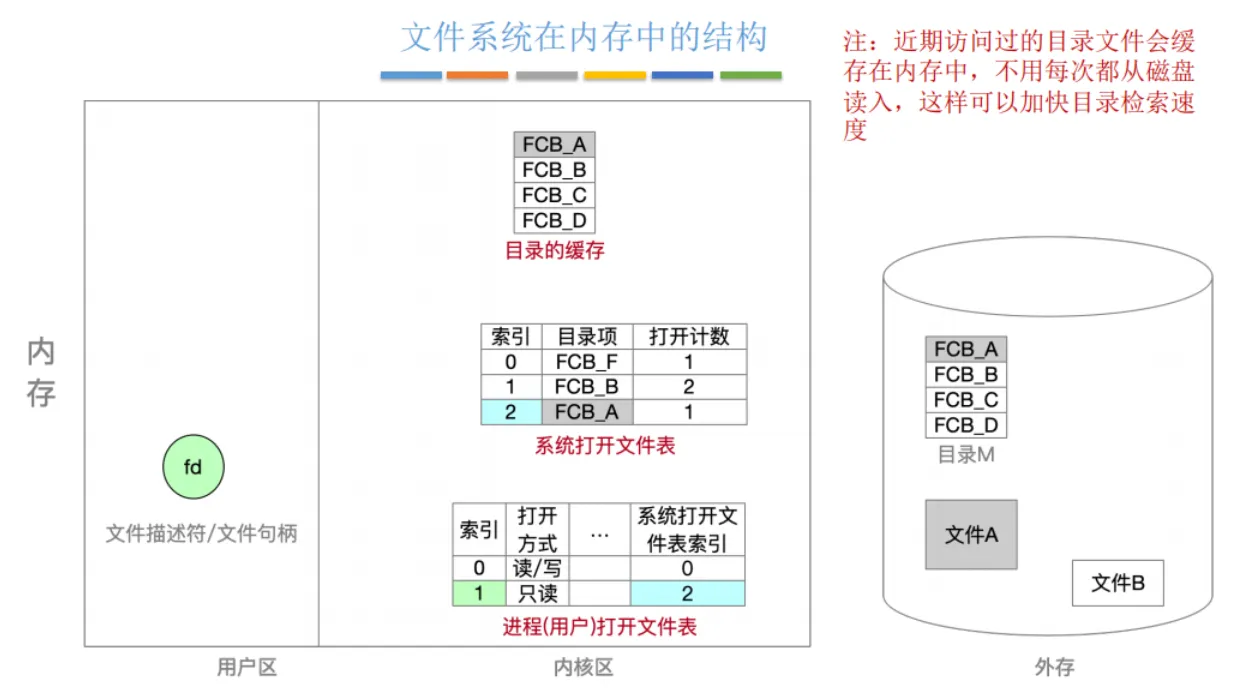
外存空闲空间管理方法
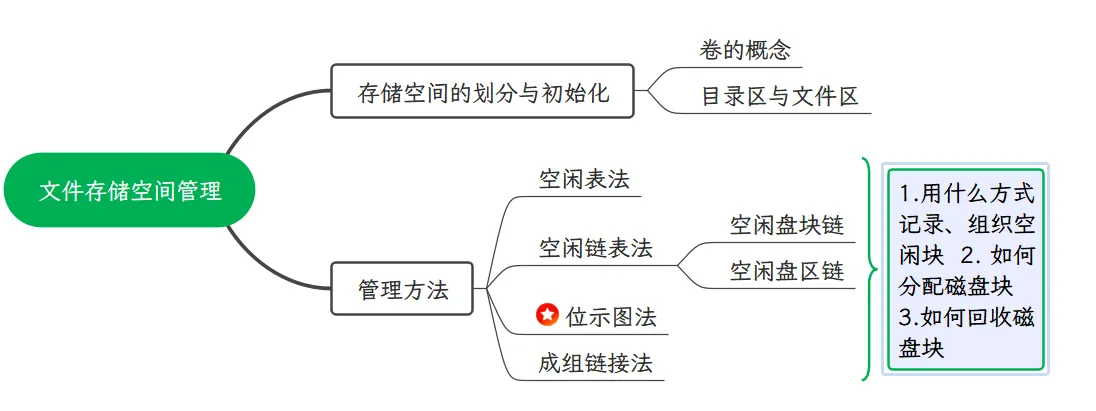
存储空间的划分与初始化
存储空间的划分:将物理磁盘划分为一个个文件卷存储空间的初始化:将各个文件卷划分目录区、文件区卷的概念:一组在辅存上可寻址的扇区的集合,操作系统或应用程序用卷来存储数据。卷中的扇区在物理存储设备上不需要连续,只需要对操作系统或应用程序来说连续即可。卷可能由更小的卷合并或组合而成。因此从本质上来讲,卷是逻辑磁盘,可作为物理磁盘的一部分(将一个物理磁盘划分为一个个文件卷即逻辑卷);也可跨物理盘,由多个物理磁盘组成RAID集。卷的组成:目录区+文件区,目录区主要存放文件目录信息(FCB),用于磁盘存储空间管理的信息;文件区用于存放文件数据.对逻辑卷格式化(初始化)的实质就是对卷内的目录区进行初始化(空闲空间管理表格、超级块的建立等)超级块:位于目录区内一小块,存放:空闲空间的“位向量表”或第一个成组链块;目录区、文件区的划分信息注意:在对卷中文件操作时需要先将超级块读入内存,且需要时刻保持内存、外存的超级块一致性。
示意图: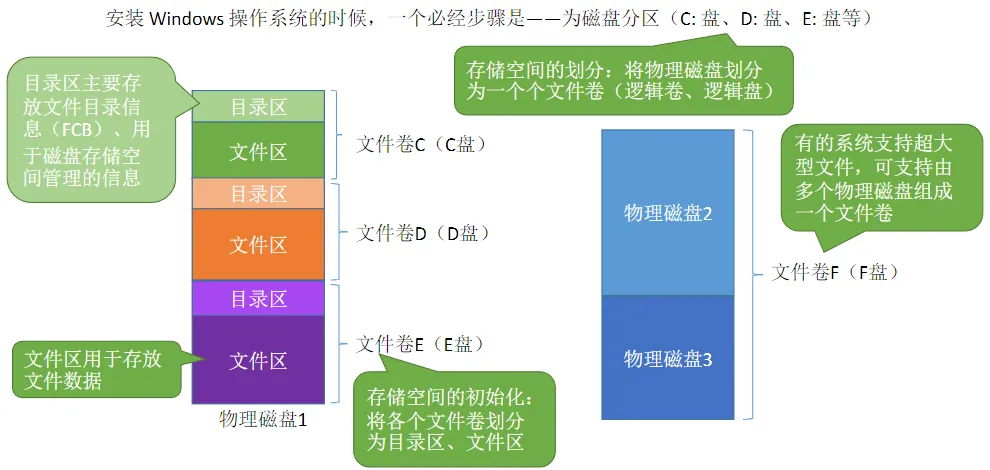
空闲区管理方法
空闲表法
空闲表法就是为所有空闲空间建立一张表,表内容包括空闲区的第一个块号和该空闲区的块个数,注意,这个方式是连续分配的。如下图:
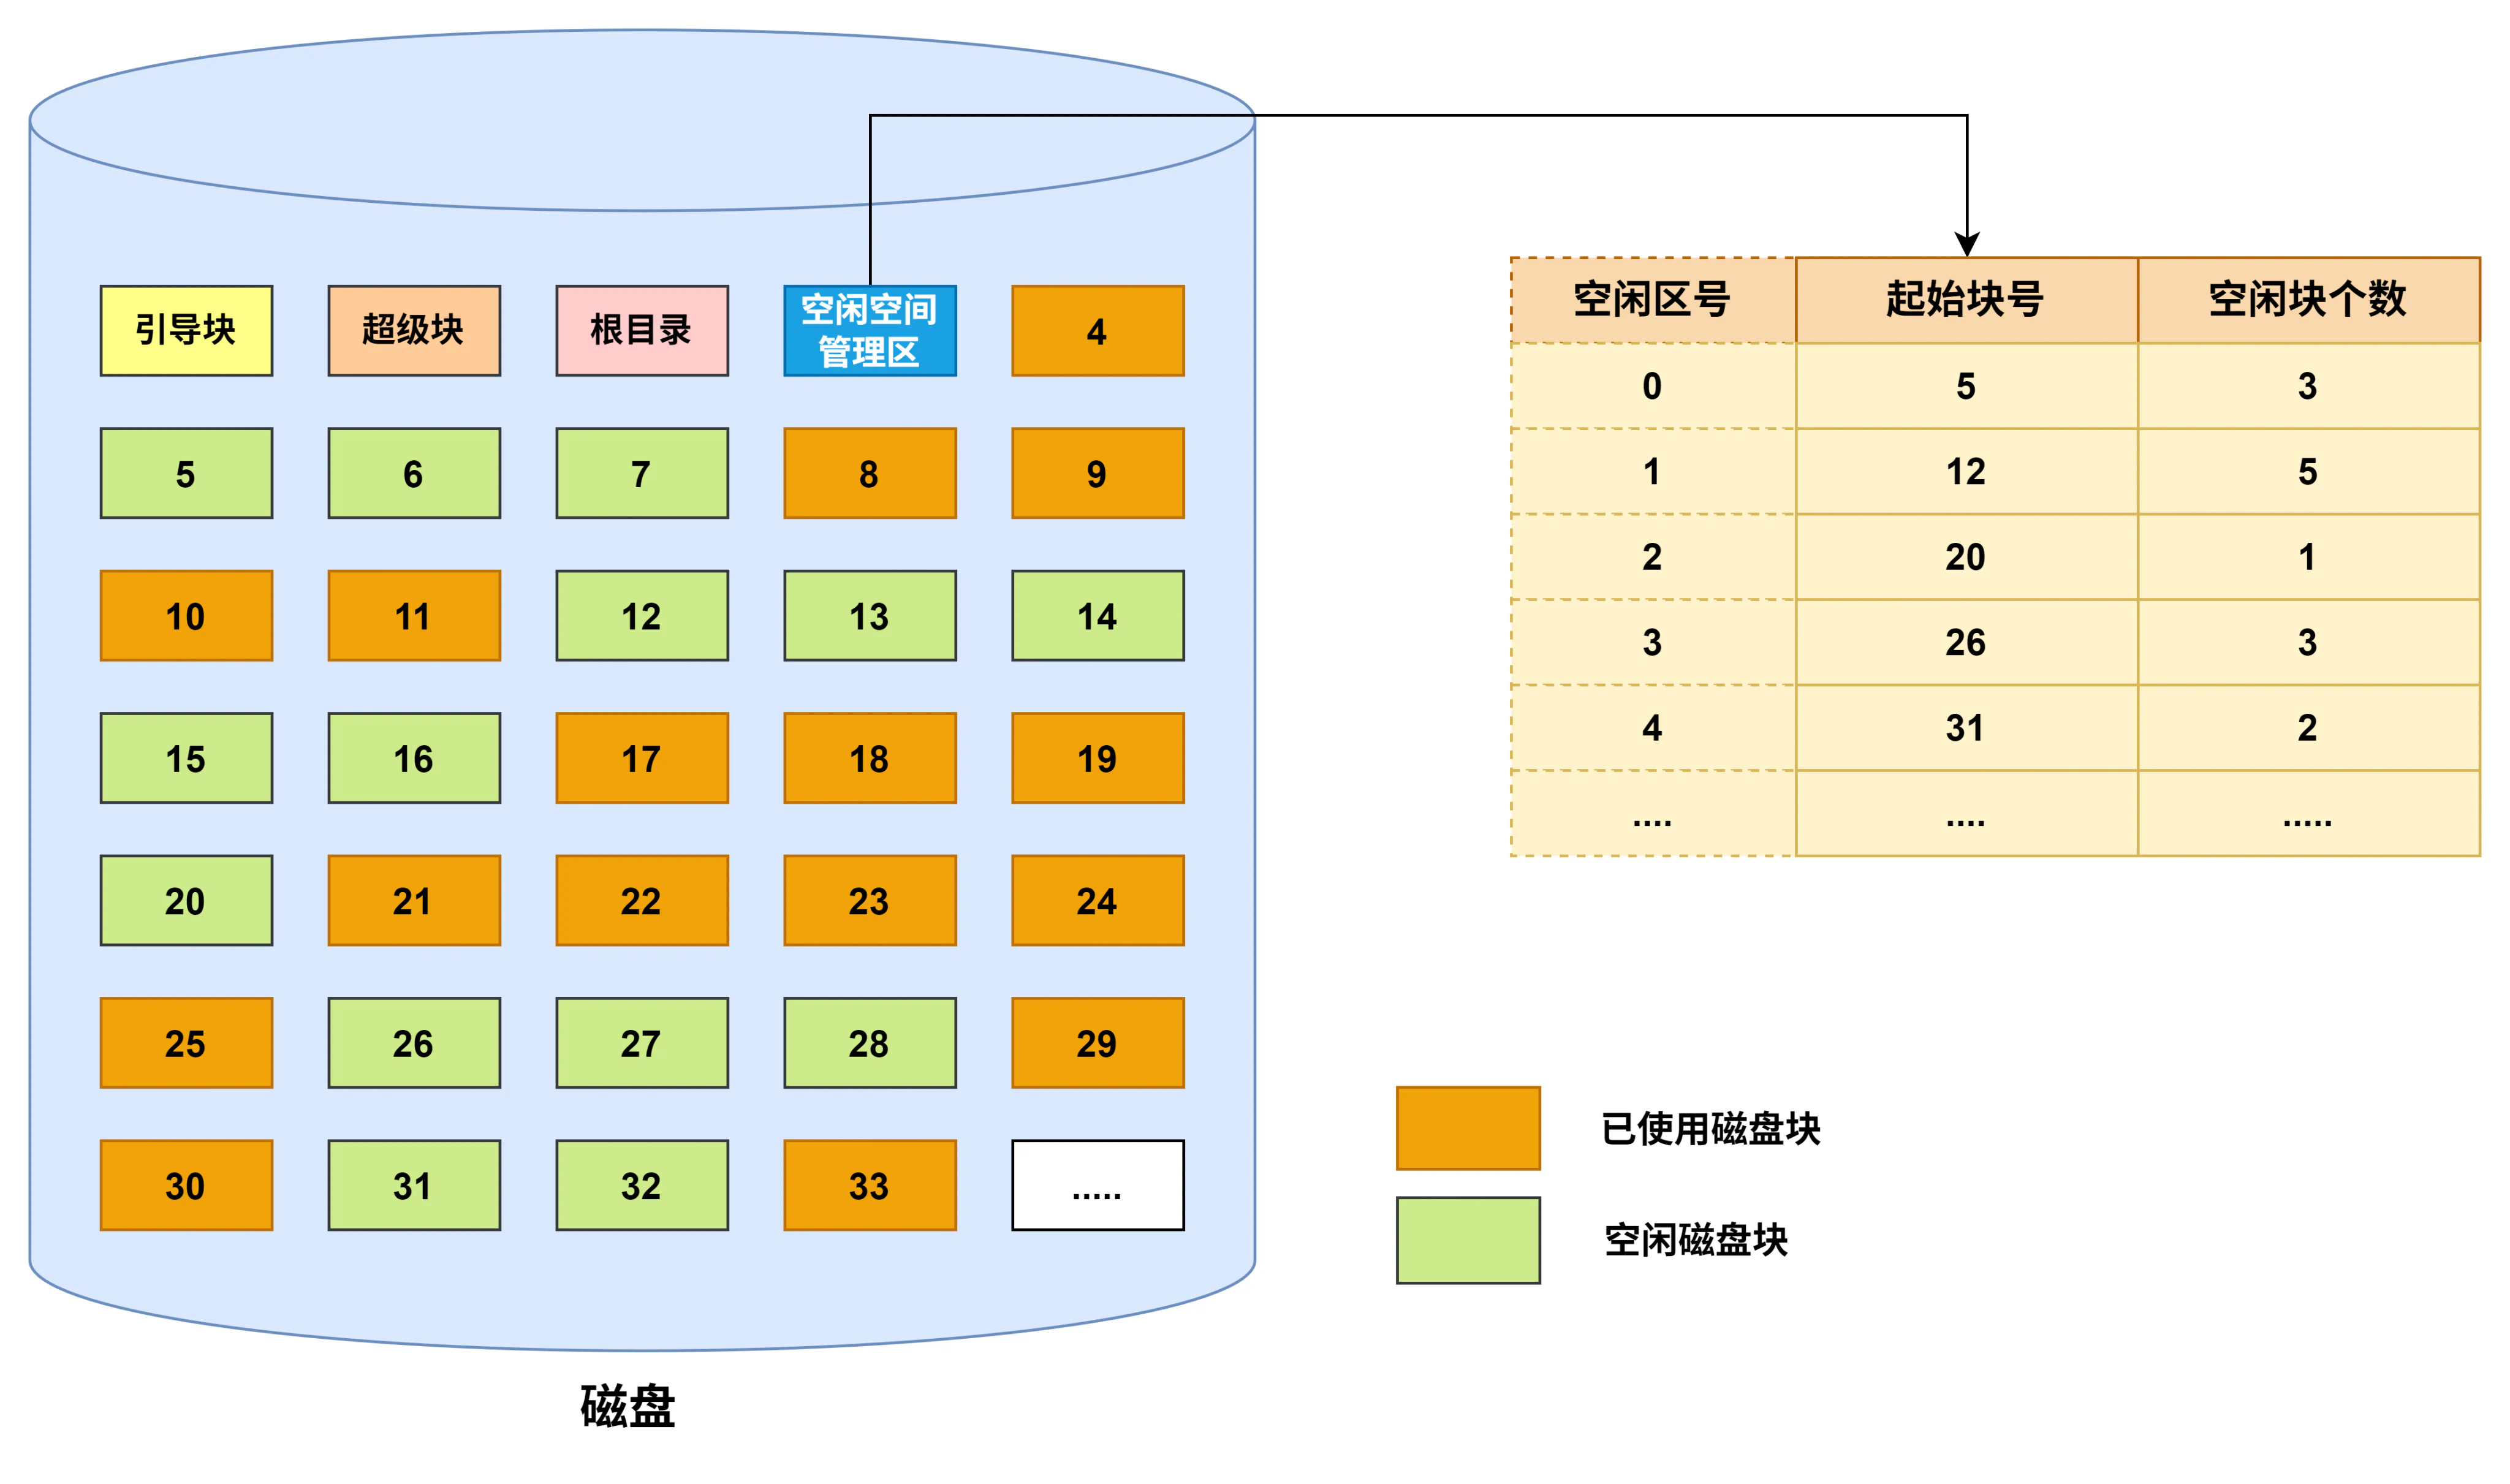
- 如何分配:与内存管理中的动态分区分配很类似,为一个文件分配连续的存储空间。同样可采用首次适应、最佳适应、最坏适应等算法来决定要为文件分配哪个区间。 例如,在系统为某个新创建的文件分配空闲磁盘块时,先顺序检索空闲表的各表项,直至找到第一个大小可以满足要求的空闲区,然后将该空闲区分配给该文件,同时修改空闲盘块表;
- 如何回收:与内存管理中的动态分区分配很类似,当回收某个存储区时需要有四种情况——①回收区的前后都没有相邻空闲区;②回收区的前后都是空闲区;③回收区前面是空闲区;④回收区后面是空闲区,总之记得将相邻接的空闲块合并;
- 适用场合:这种方法仅当有少量的空闲区时才有较好的效果。因为,如果存储空间中有着大量的小的空闲区,则空闲表变得很大,这样查询效率会很低,因此不适合大型文件系统。另外,这种分配技术适用于建立连续文件。
Note
在内存管理那节我们了解到,内存分配很少采用连续分配,更多采用的是离散分配,但在外存分配的特殊场景中,连续分配具有较高的分配速度,还可以减少磁盘的I/O频率,磁头的寻道时间;例如以下场景:
- 磁盘的对换区,为了追求换入换出速度,采用连续分配;
- 对于文件系统,当文件较小时,采用连续组织方式为文件分配相邻的若干盘块;当文件较大时,便采用离散组织方式;
- 对于多媒体文件,例如MP3/MP4文件,为了减少磁头的寻道时间,采用连续组织方式;
空闲链表法
将所有空闲盘区拉成一条空闲链,根据构成链所用基本元素的不同,分为俩种形式:
空闲盘块链
以盘块为单位组成一条空闲链,每个空闲盘块(除最后一个)中存储着下一个空闲盘块的指针(物理地址)。
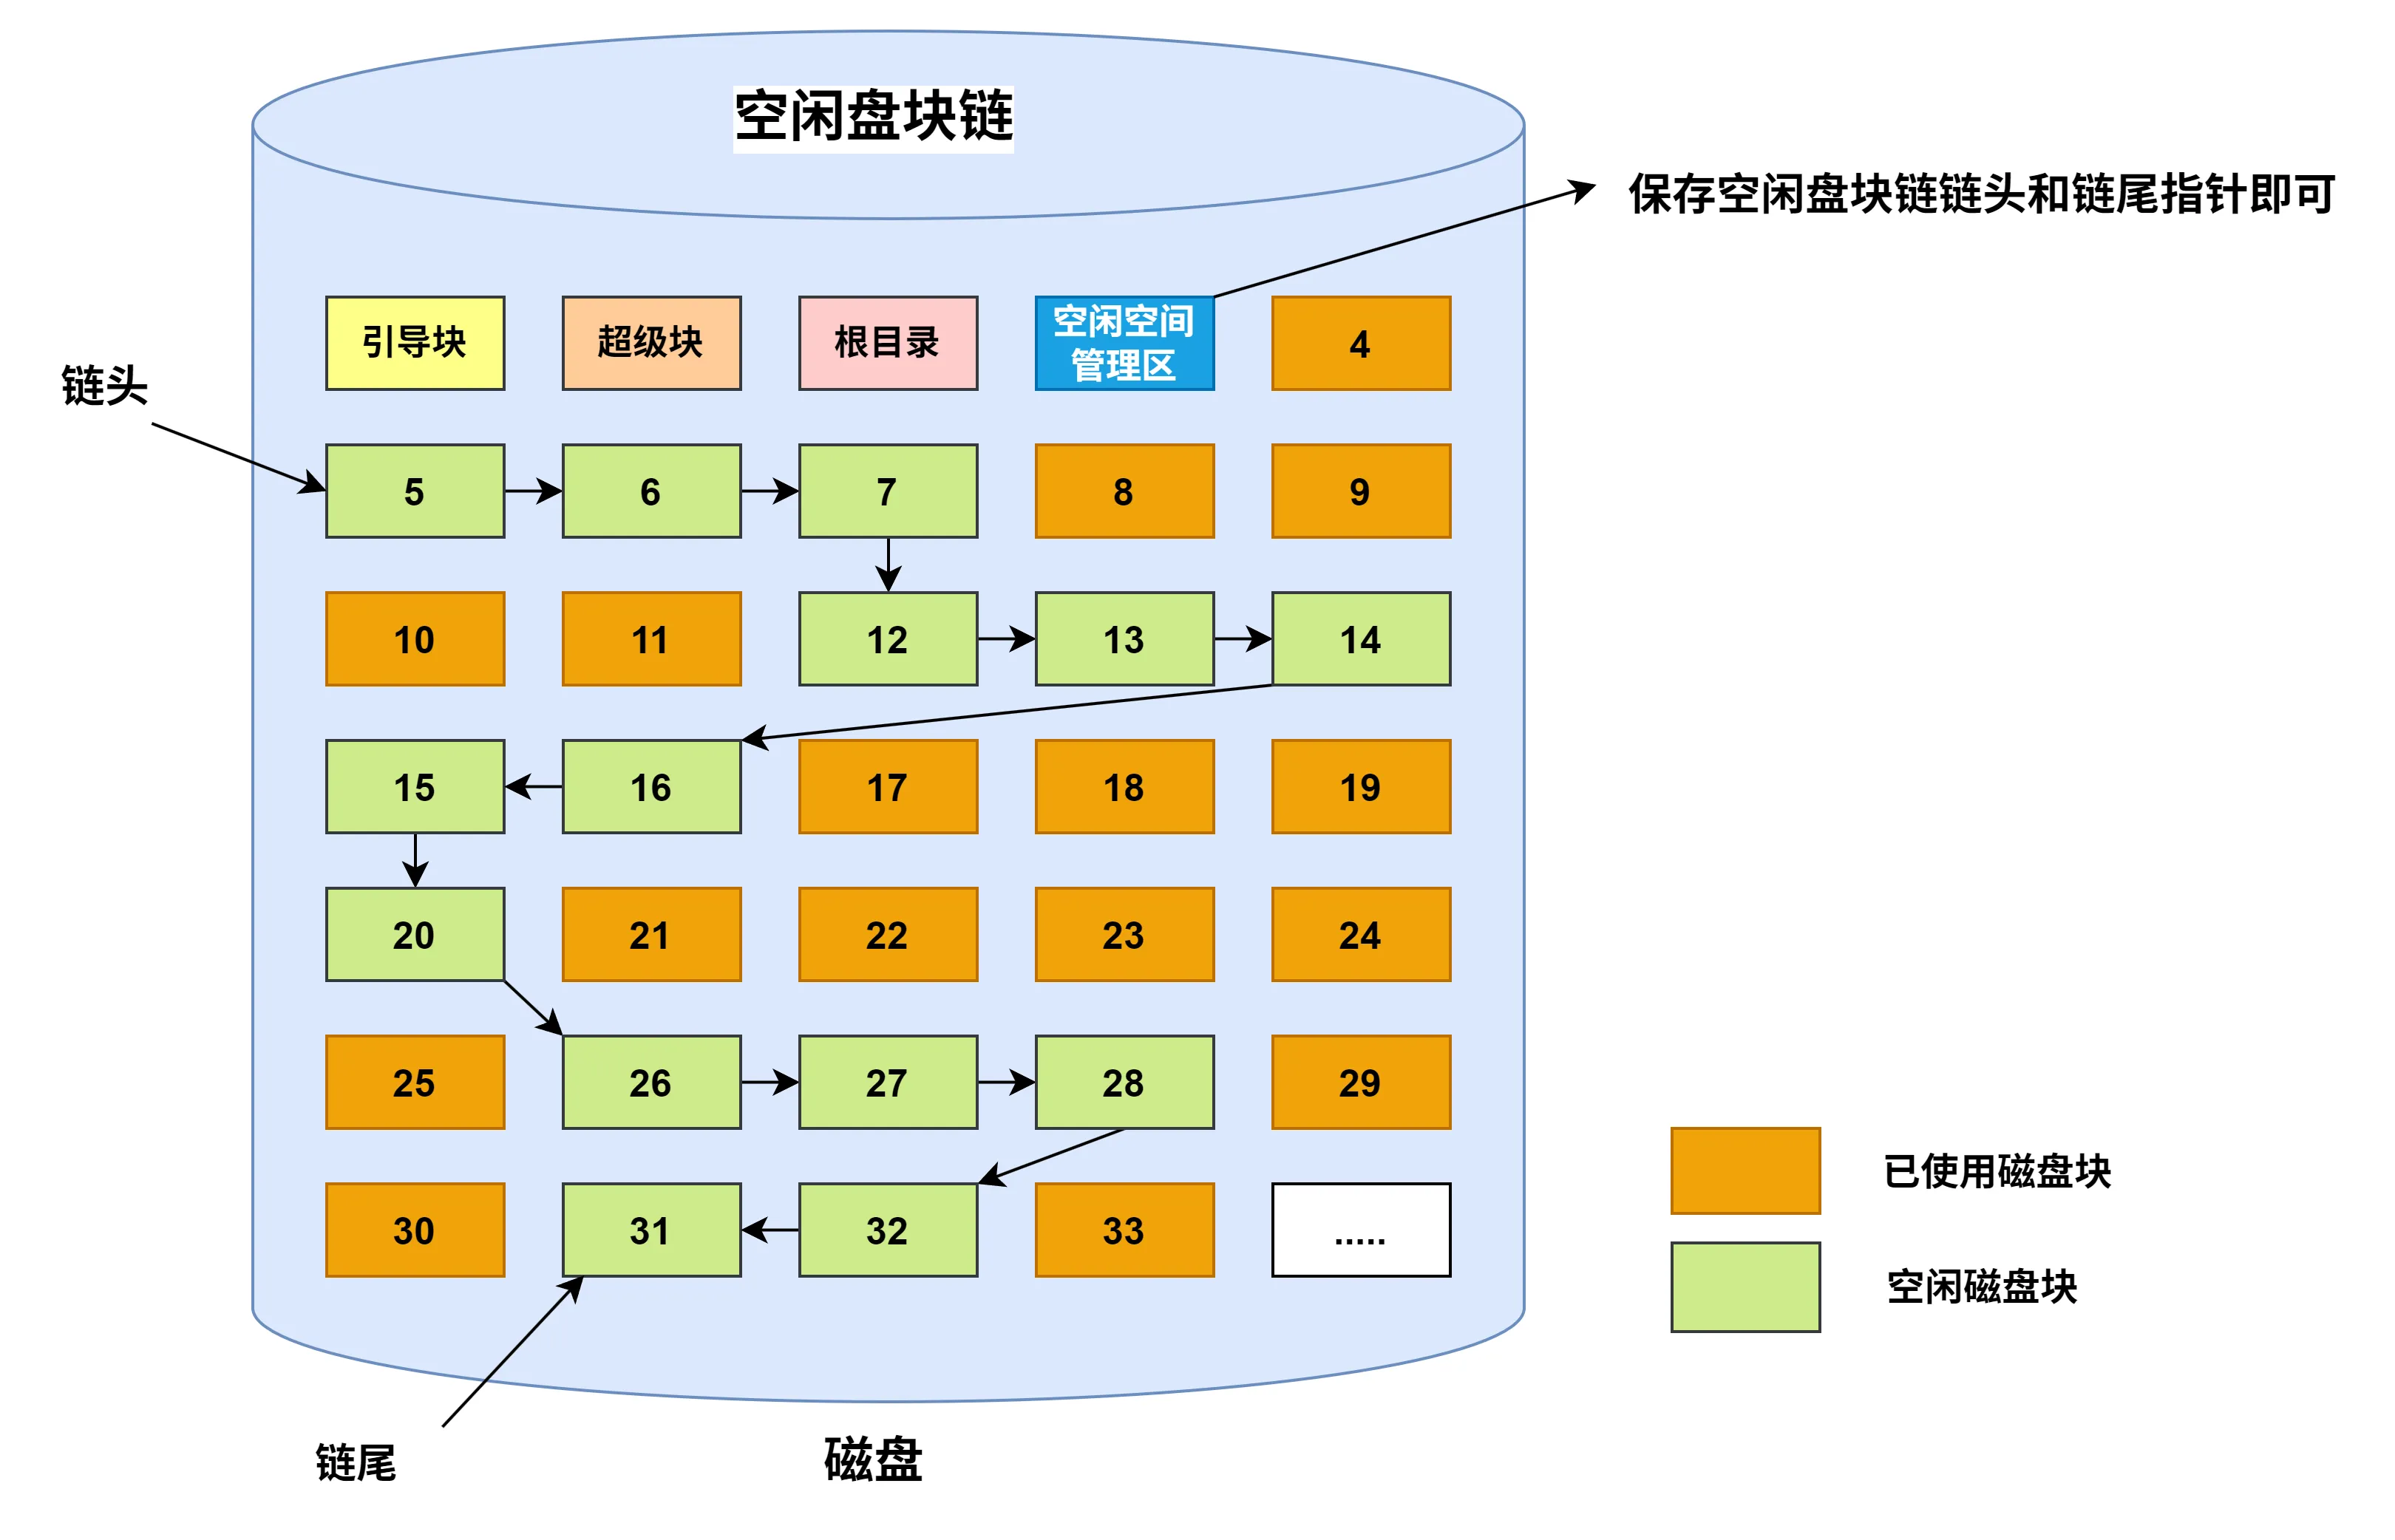
- 文件系统中需保存着链头链尾指针,这与其分配、回收方式有关;
- 如何分配:若某文件申请K个盘块,则从链头开始依次摘下K个盘块分配,并修改空闲链的链头指针。
- 如何回收:回收的盘块依次挂到链尾,并修改空闲链的链尾指针。(回收的每一个磁盘块都得先读入内存修改指针后再写回磁盘,因此磁盘I/O开销很大)
- 适用场合:适用于离散分配的物理结构。
空闲盘区链
连续的空闲盘块组成一个空闲盘区,以盘区为单位链接,每个盘区要携带自己含有的盘块数和指向下一盘区的指针。
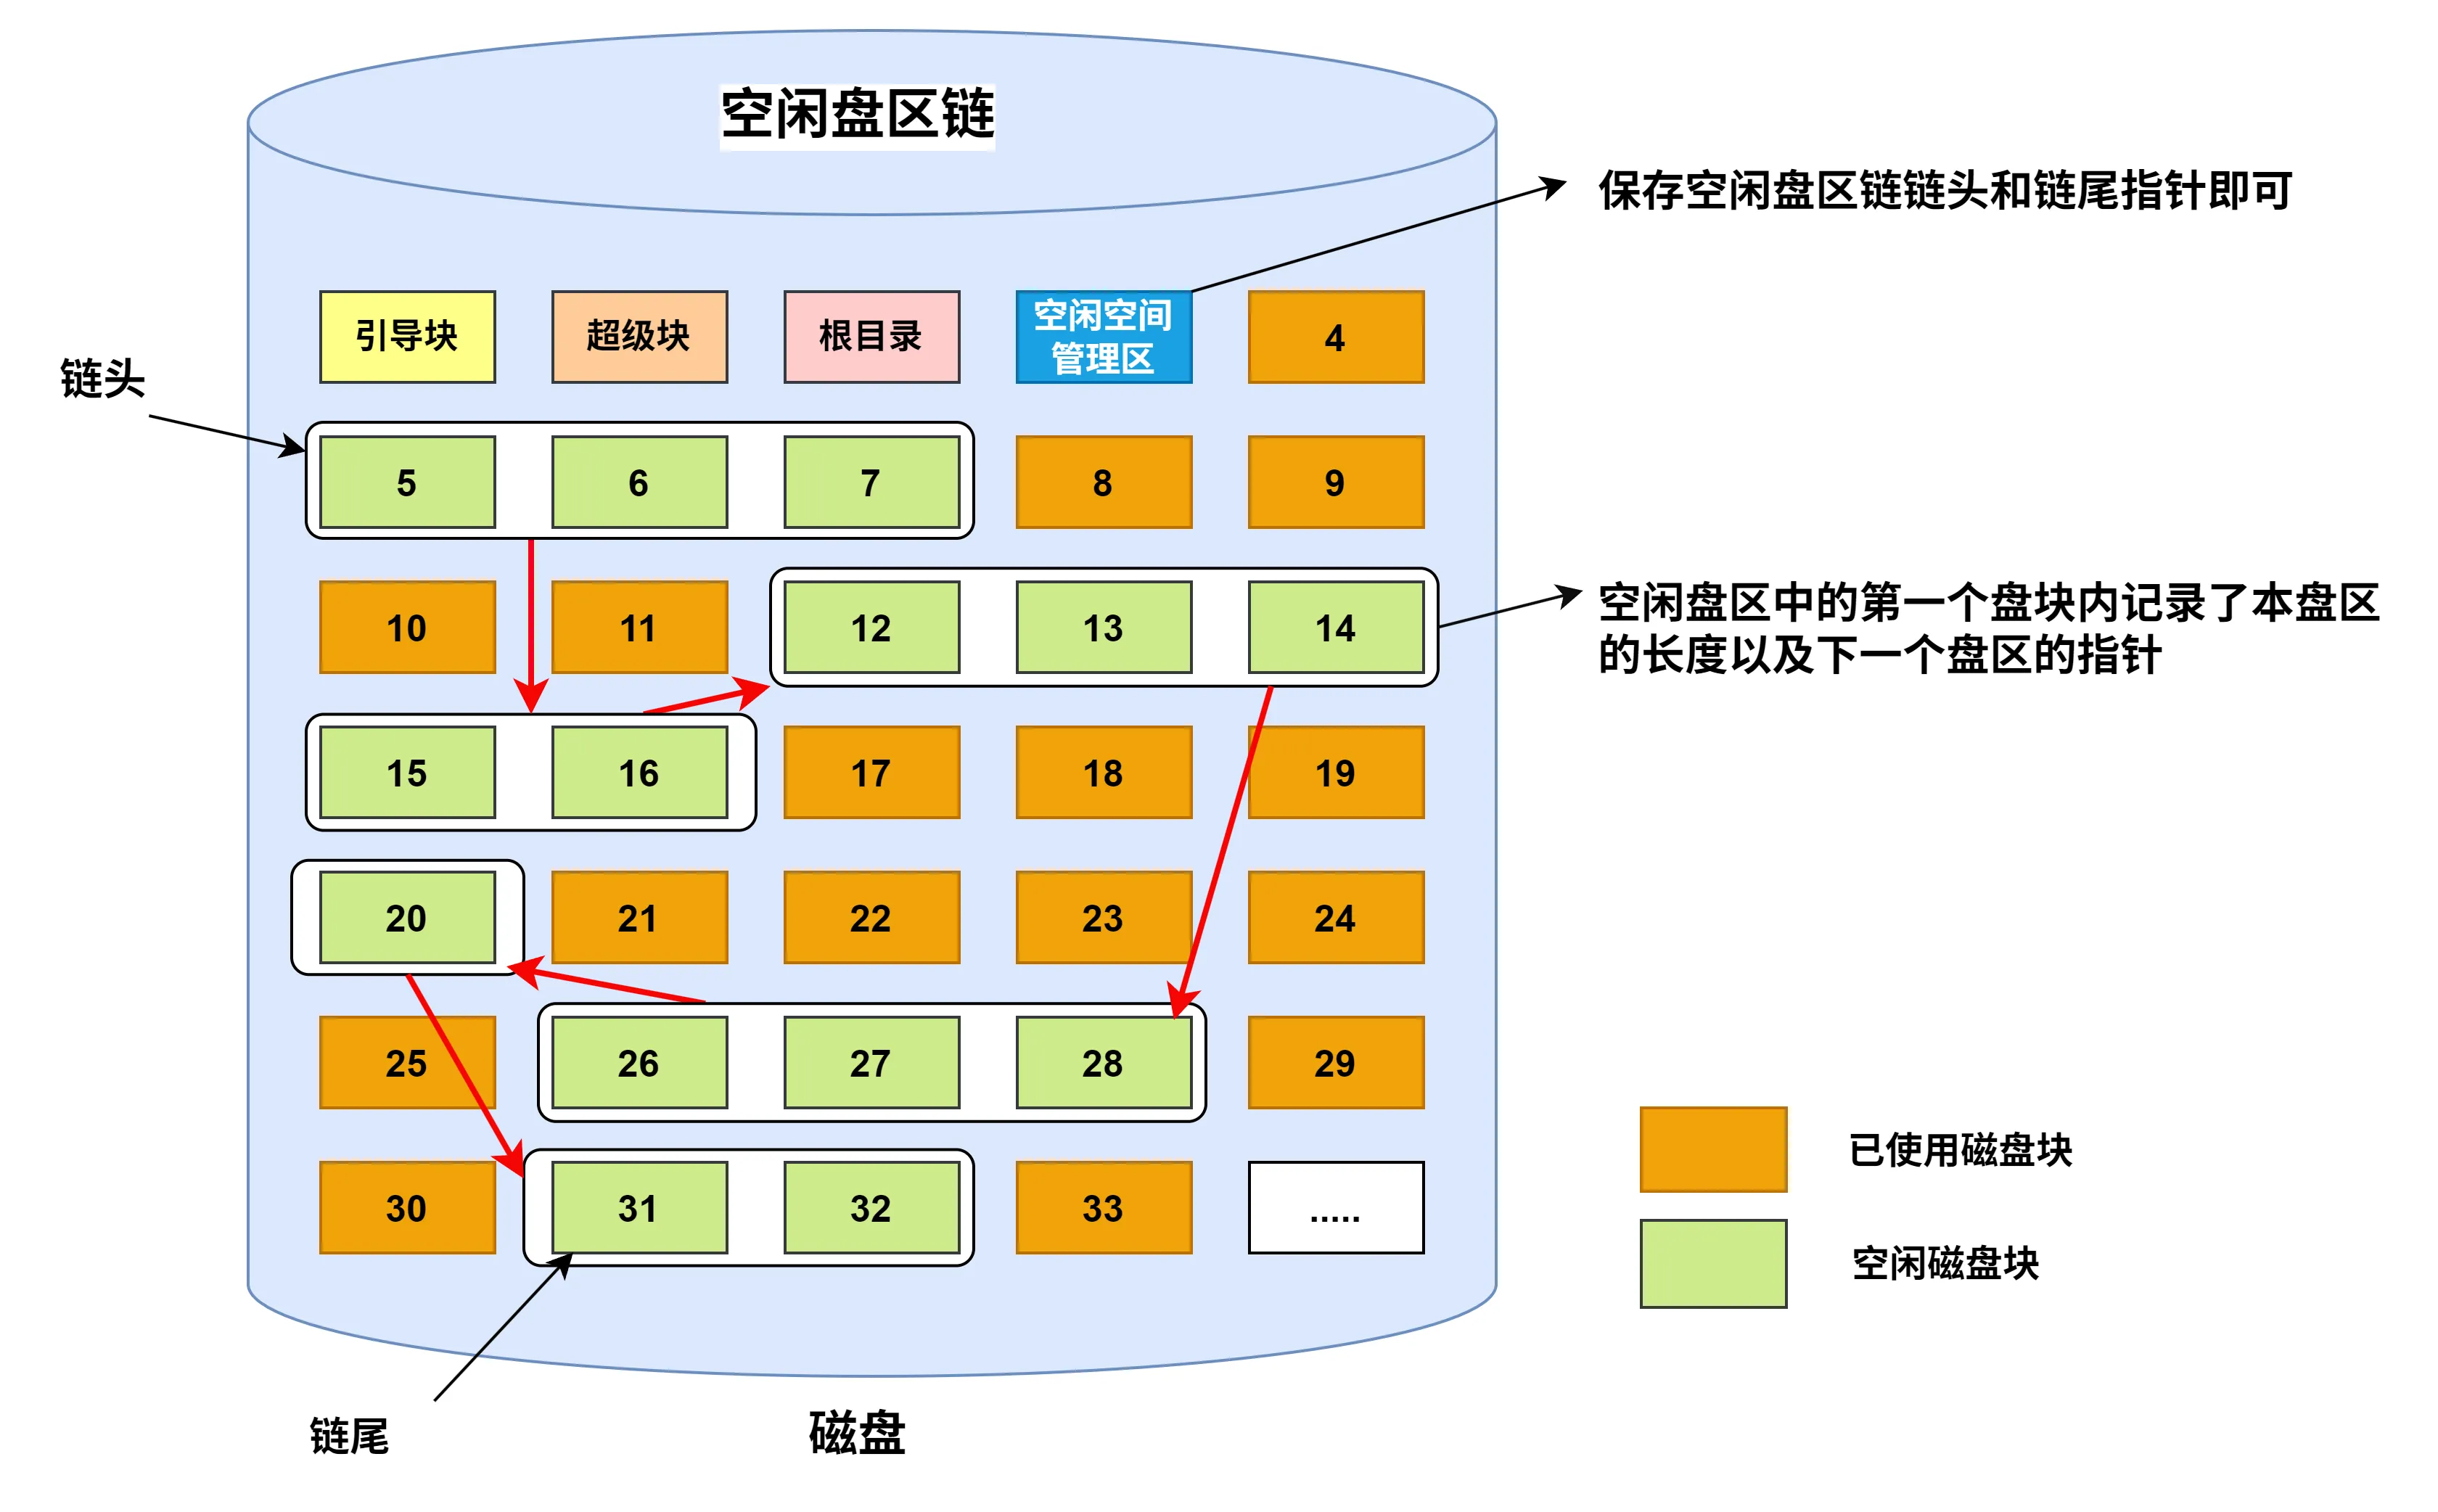
- 如何分配:若某文件申请
K个盘块,则可以采用首次适应、最佳适应等算法,从链头开始检索,按照算法规则找到一个大小符合要求的空闲盘区,分配给文件。若没有合适的连续空闲块,也可以将不同盘区的盘块同时分配给一个文件,注意分配后可能要修改相应的链指针、盘区大小等数据。 - 如何回收:若回收区和某个空闲盘区相邻,则需要将回收区合并到空闲盘区中。若回收区没有和任何空闲区相邻,将回收区作为单独的一个空闲盘区挂到链尾。
- 适用场合:适用于离散分配、连续分配,为一个文件分配多个盘块时效率更高。
位示图法
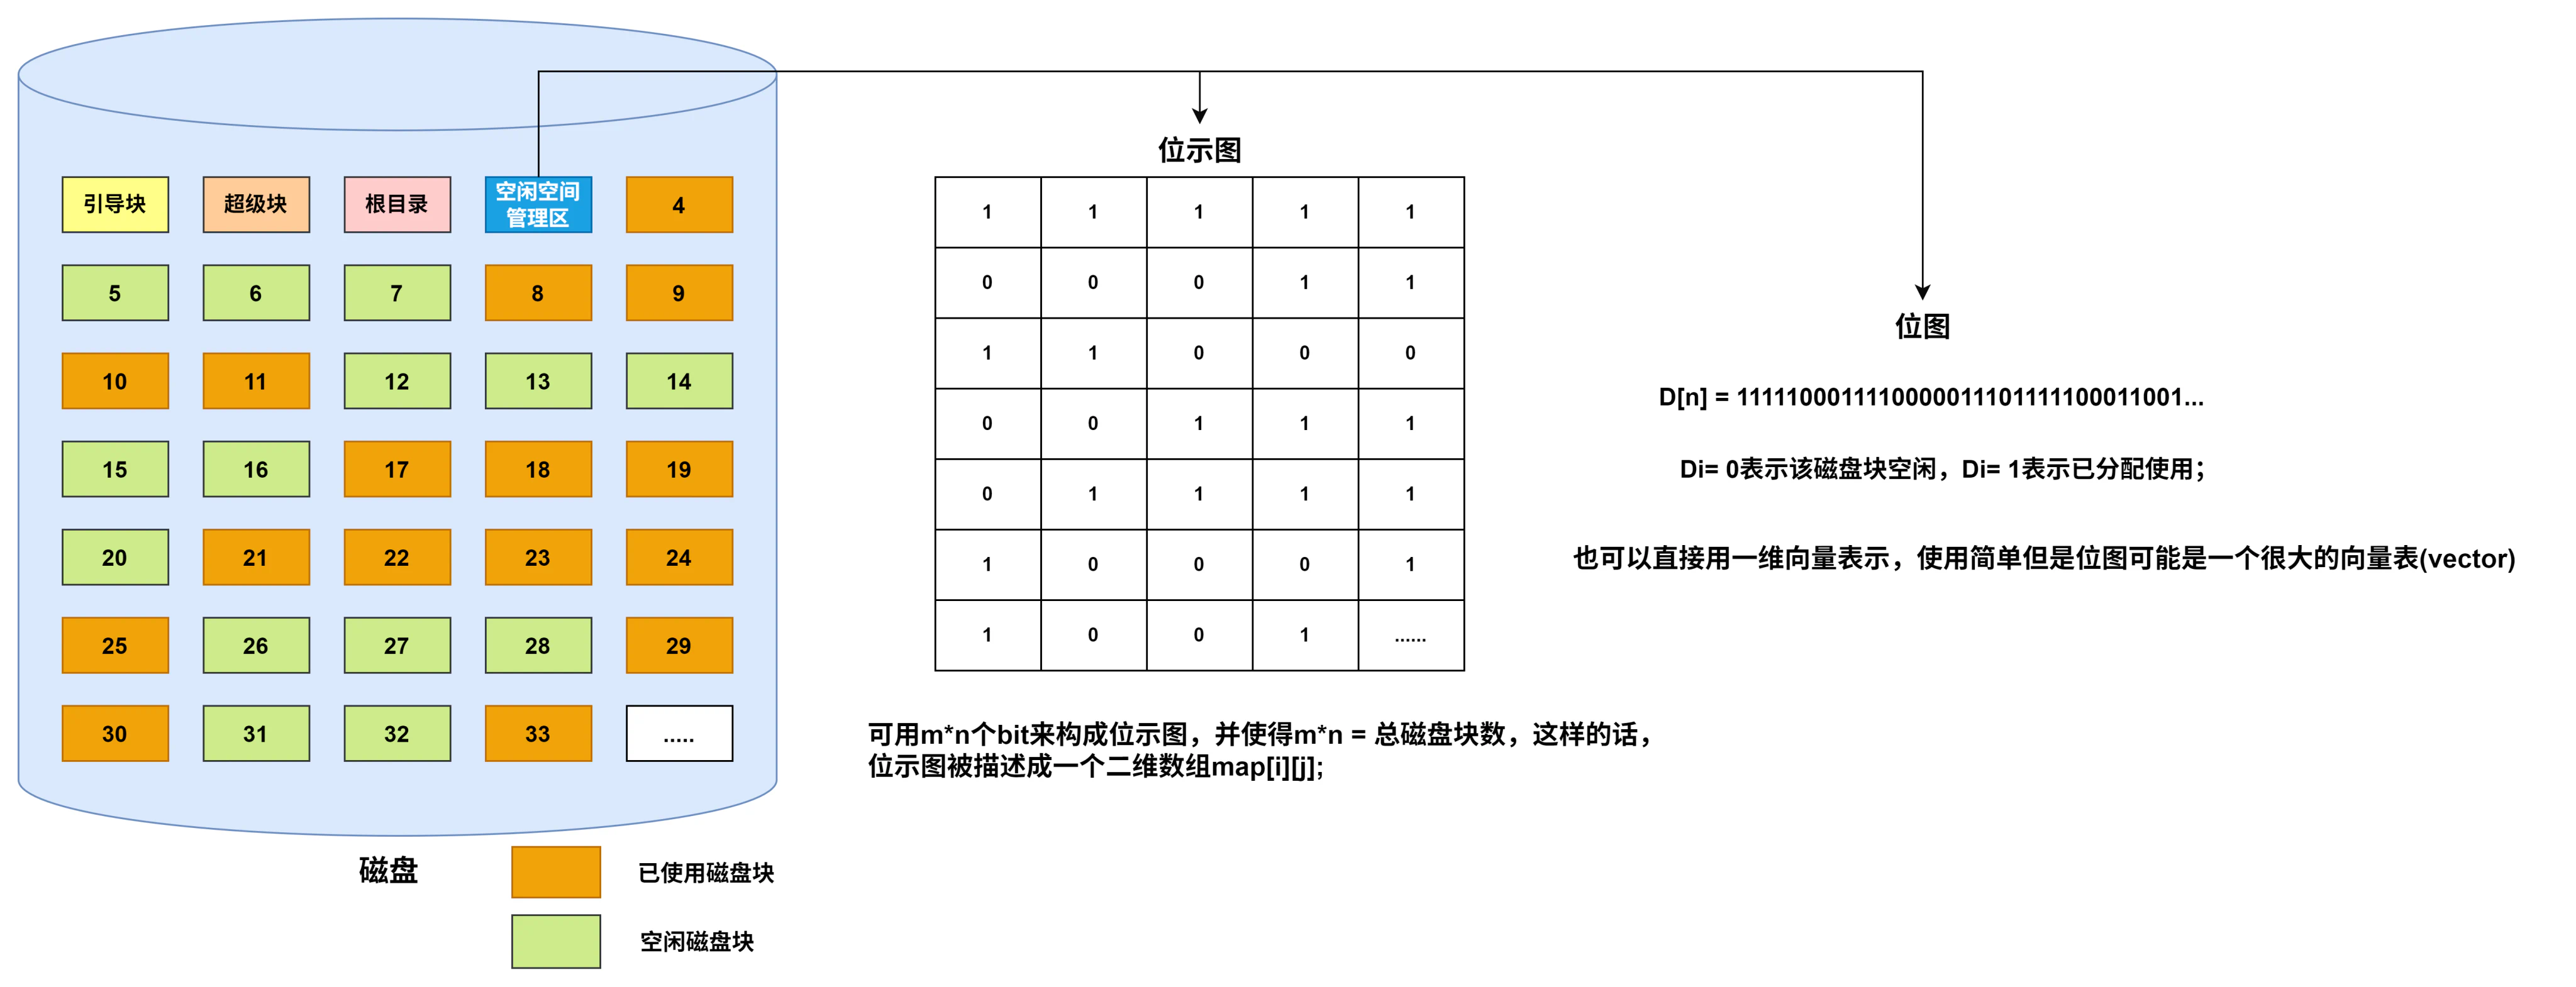
Note
位示图中,每个bit 代表一个磁盘块,“0”代表盘块空闲, “1”代表盘块已分配。因此若磁盘块共有n 个,则位示图也至少要有 n bit;
如图,这里只用一个磁盘块表示位示图,假设一个磁盘块大小为4 KB, 即32 K bit,因此这个位示图能支持管理的磁盘块数量上限为 32K 个块。如果需要支持管理更多磁盘块,则需要扩充位示图的大小;
注意:在磁盘块的分配与回收过程中,需要将位示图所在的磁盘块读入内存(不需要都读入,根据需要读入指定位所在磁盘块即可),依据具体需要进行修改,在适当时机写回磁盘;由于位图占用磁盘空间小,因此在磁盘分配与回收时磁盘I/O次数也会很少。
- 如何分配:若文件需要K个块,顺序扫描位示图,找到K个相邻或不相邻的“0”将相应盘块分配给文件,将相应位设置为“1”。
- 如何回收:根据回收的盘块号将位示图相应二进制位设为“0”即可,不像前面介绍的几种方法,因为需要修改指针等可能需要磁盘I/O多次;
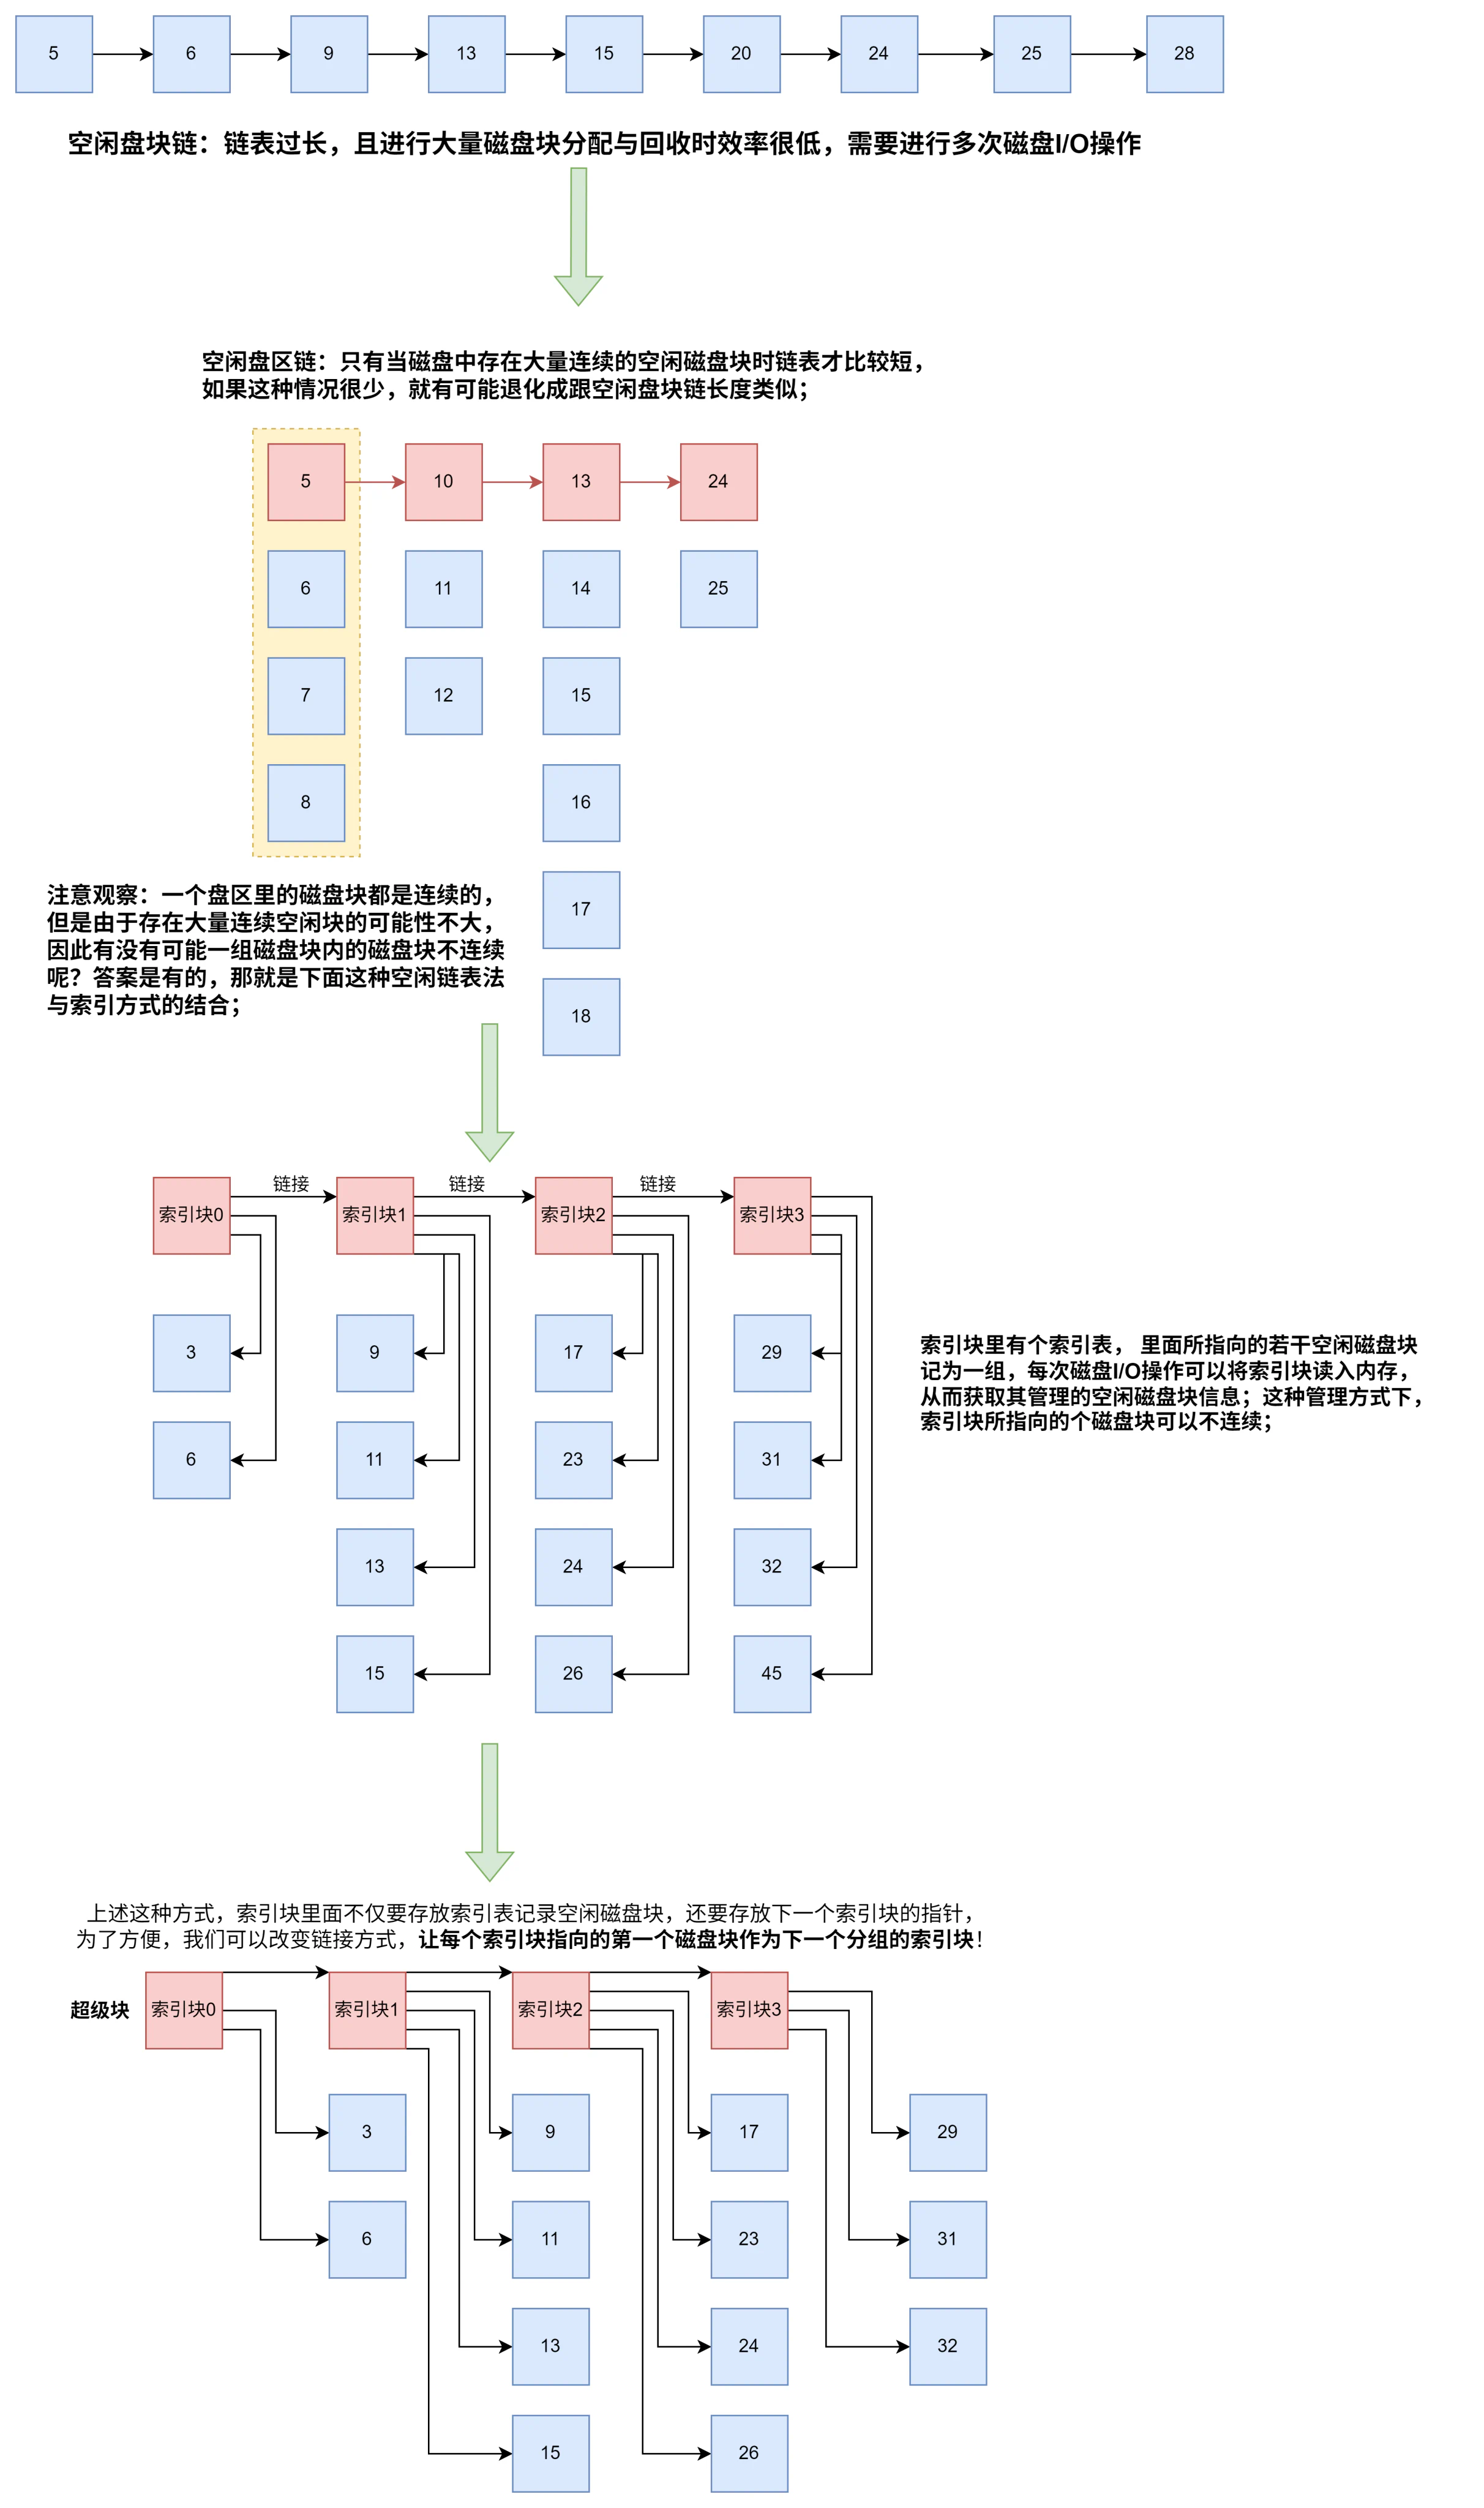
成组链接法
Note
推荐视频:【天勤考研】成组链接法
- 空闲磁盘块分配的演化过程:
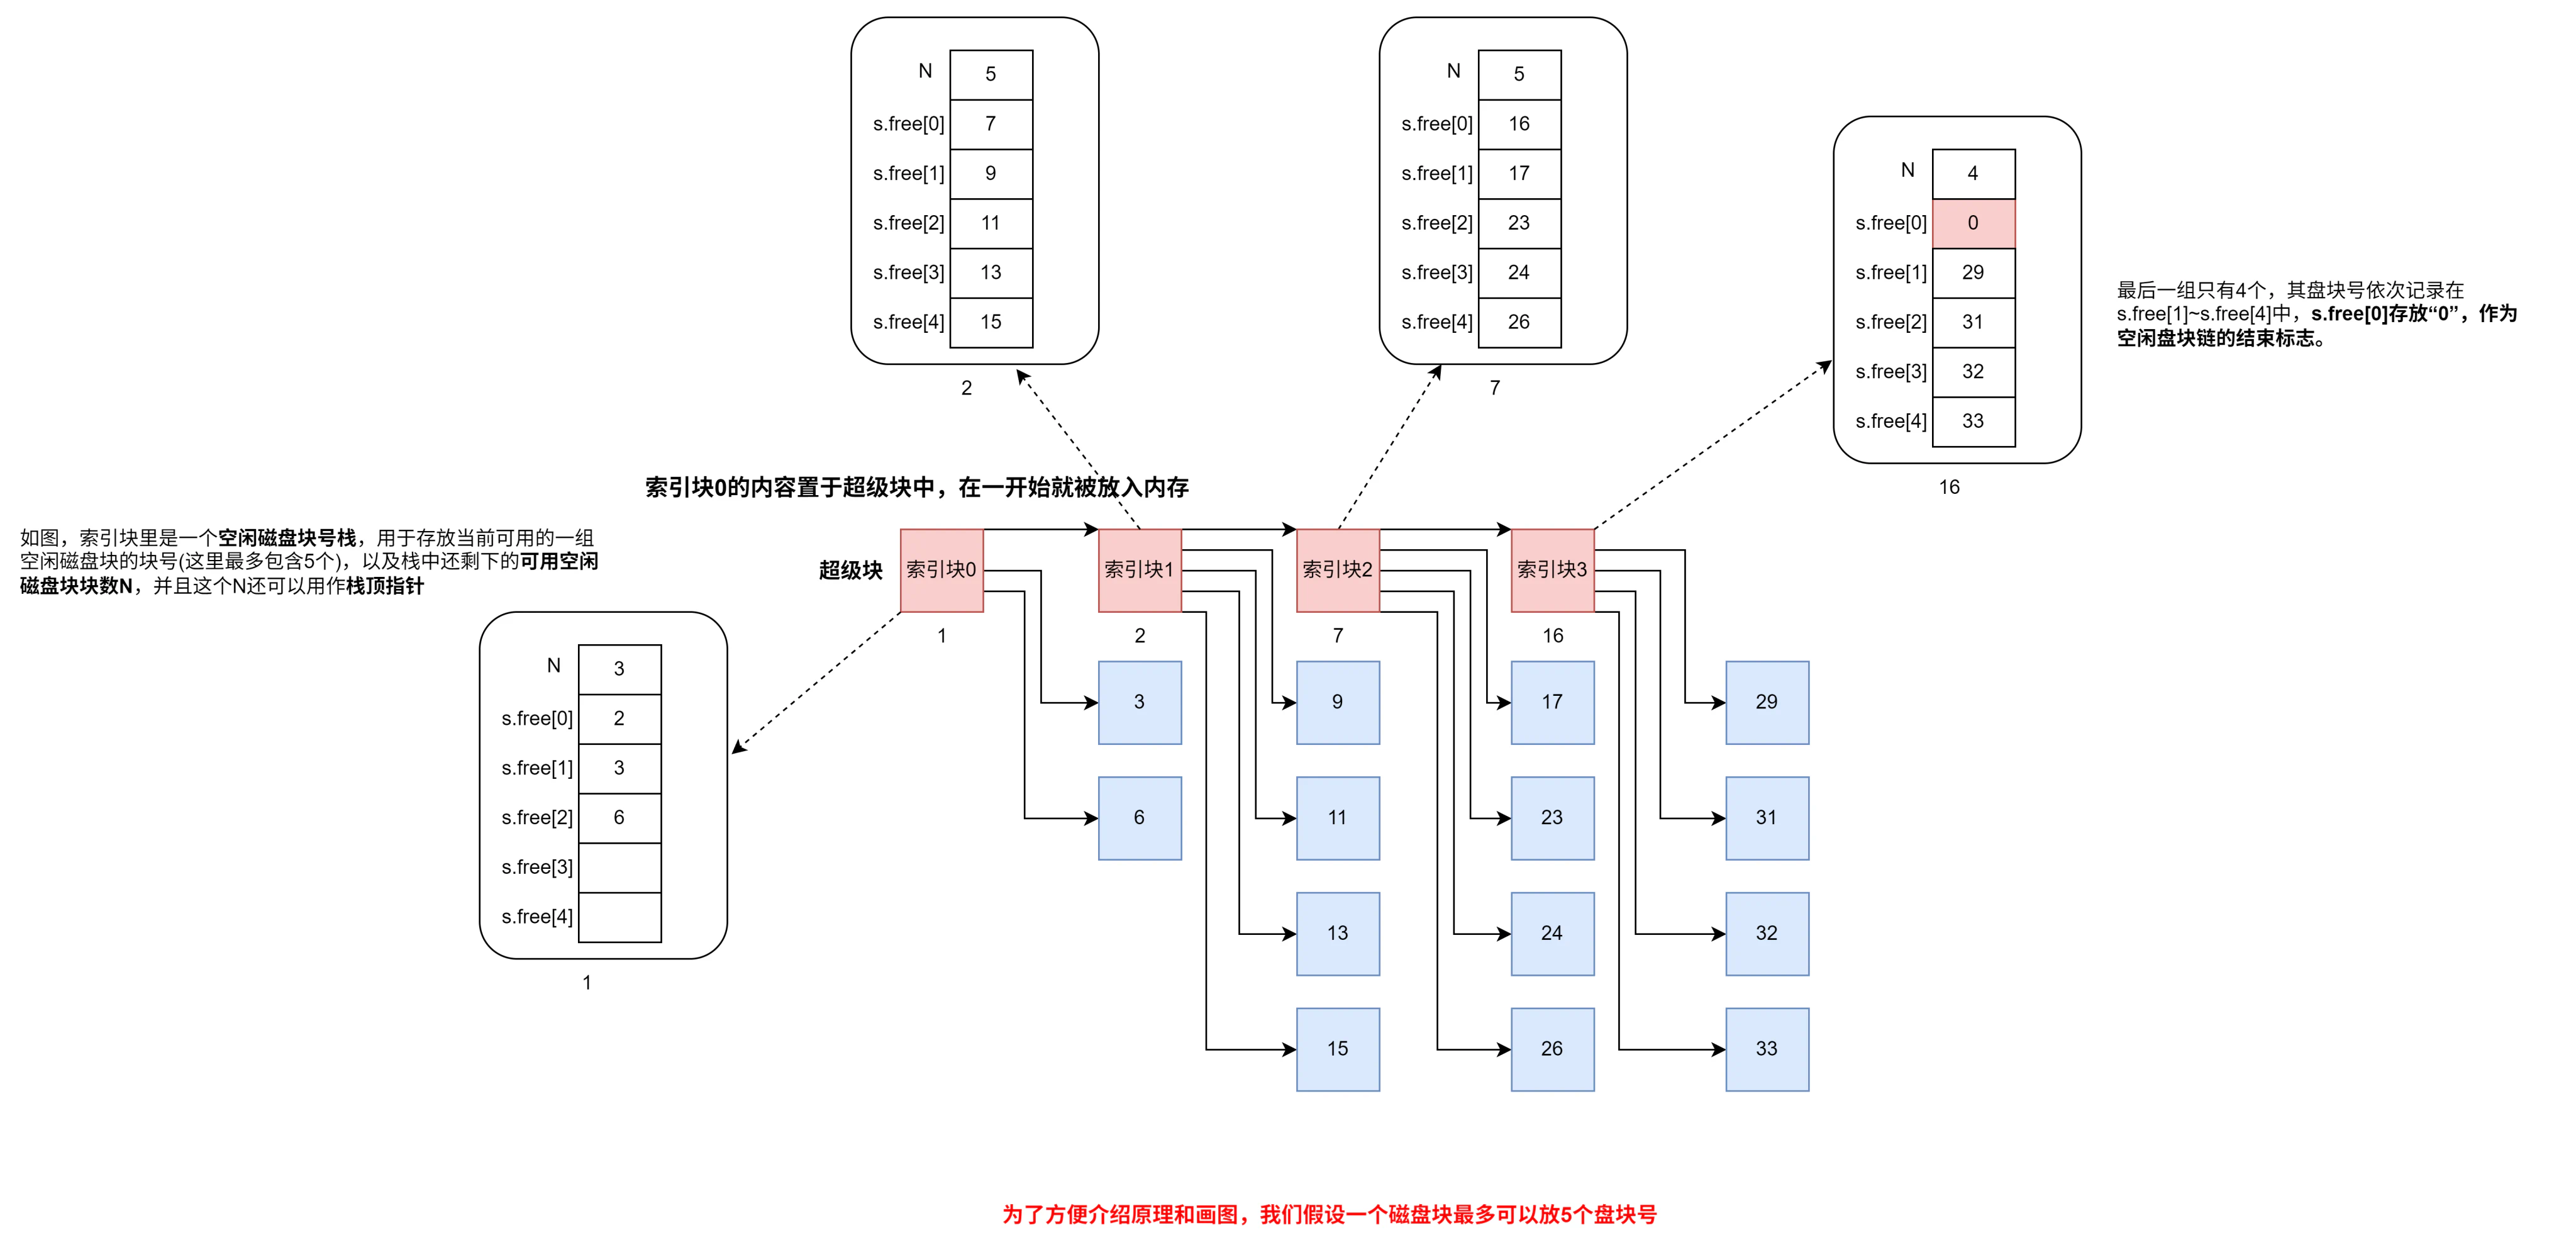
- 索引块具体内容:
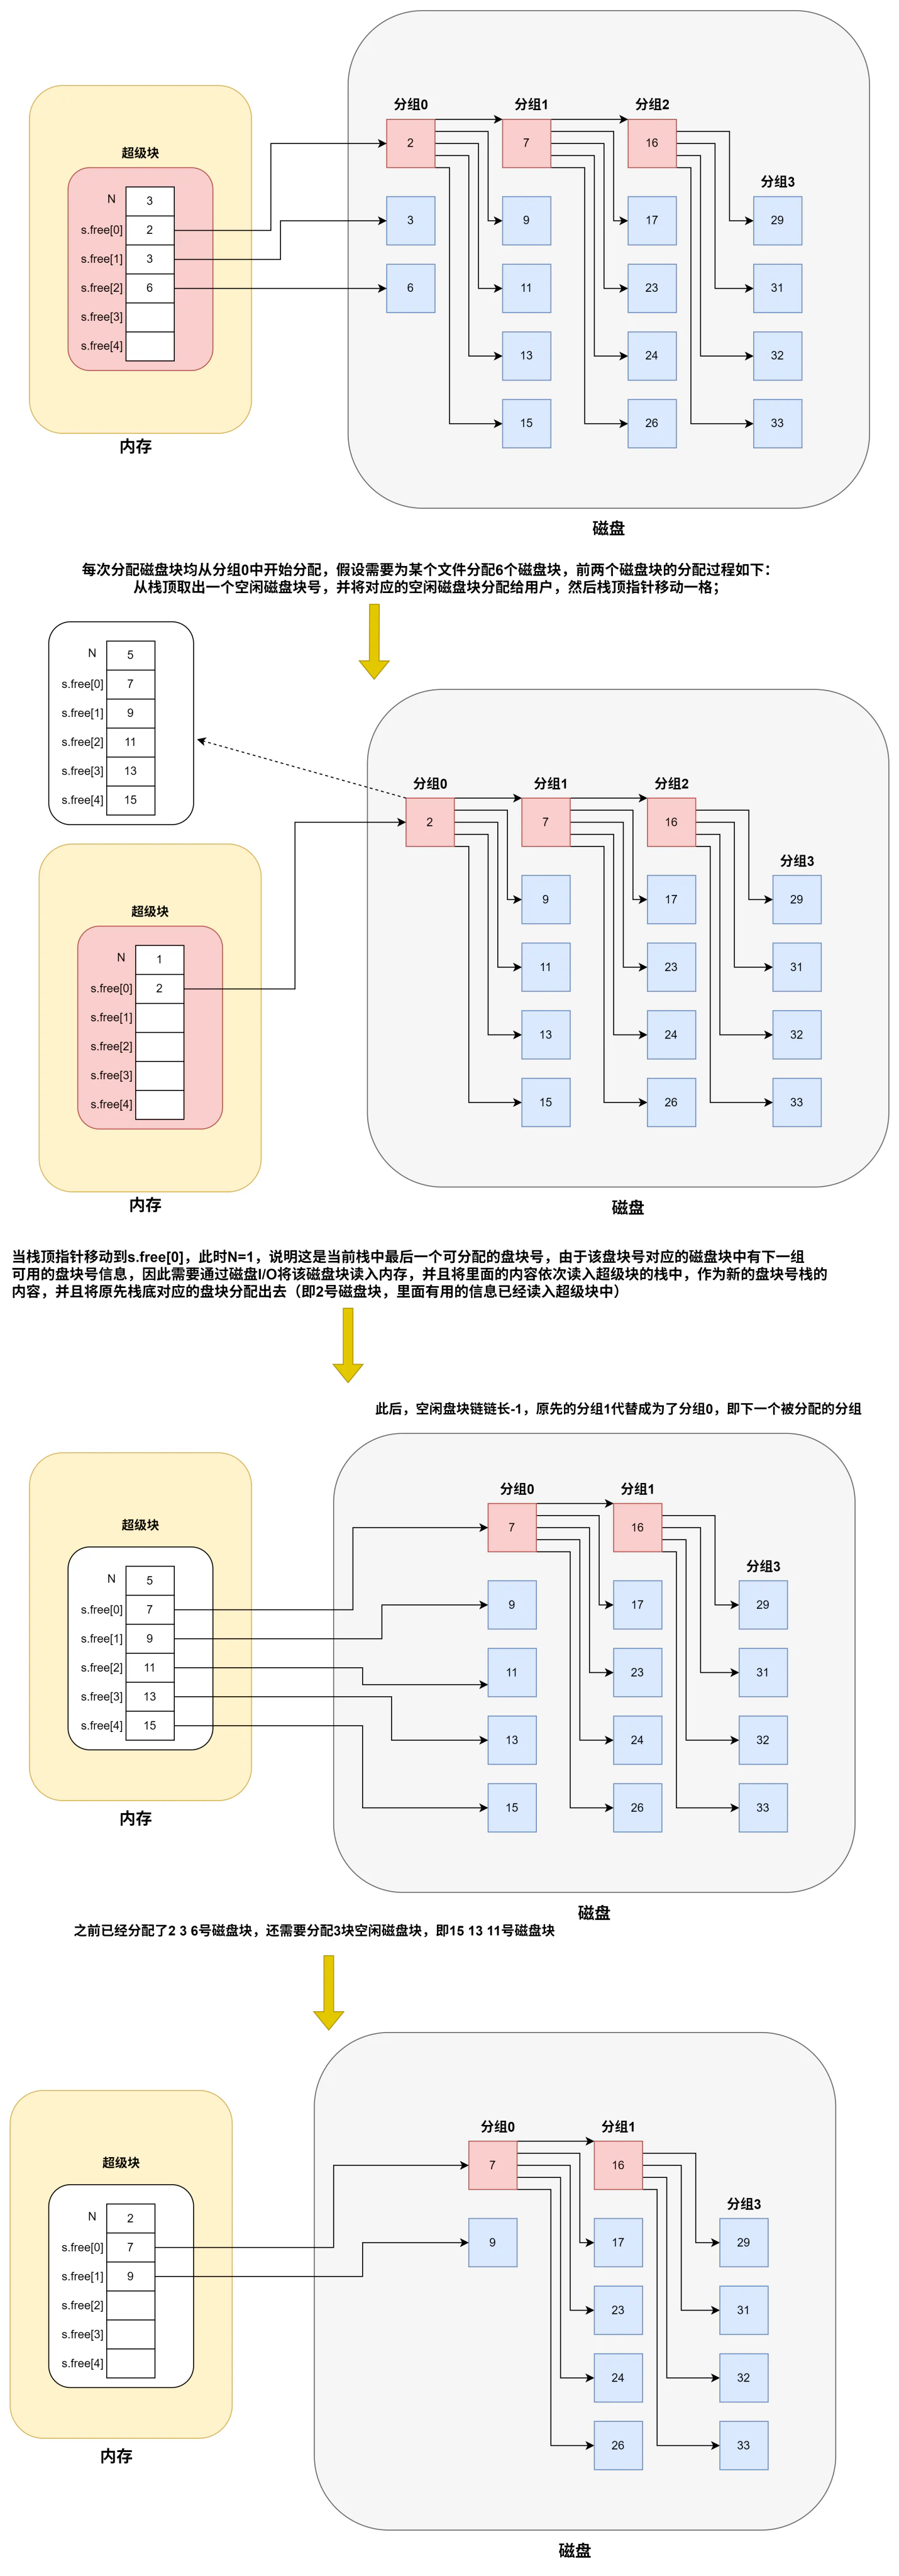
- 空闲磁盘块的分配:
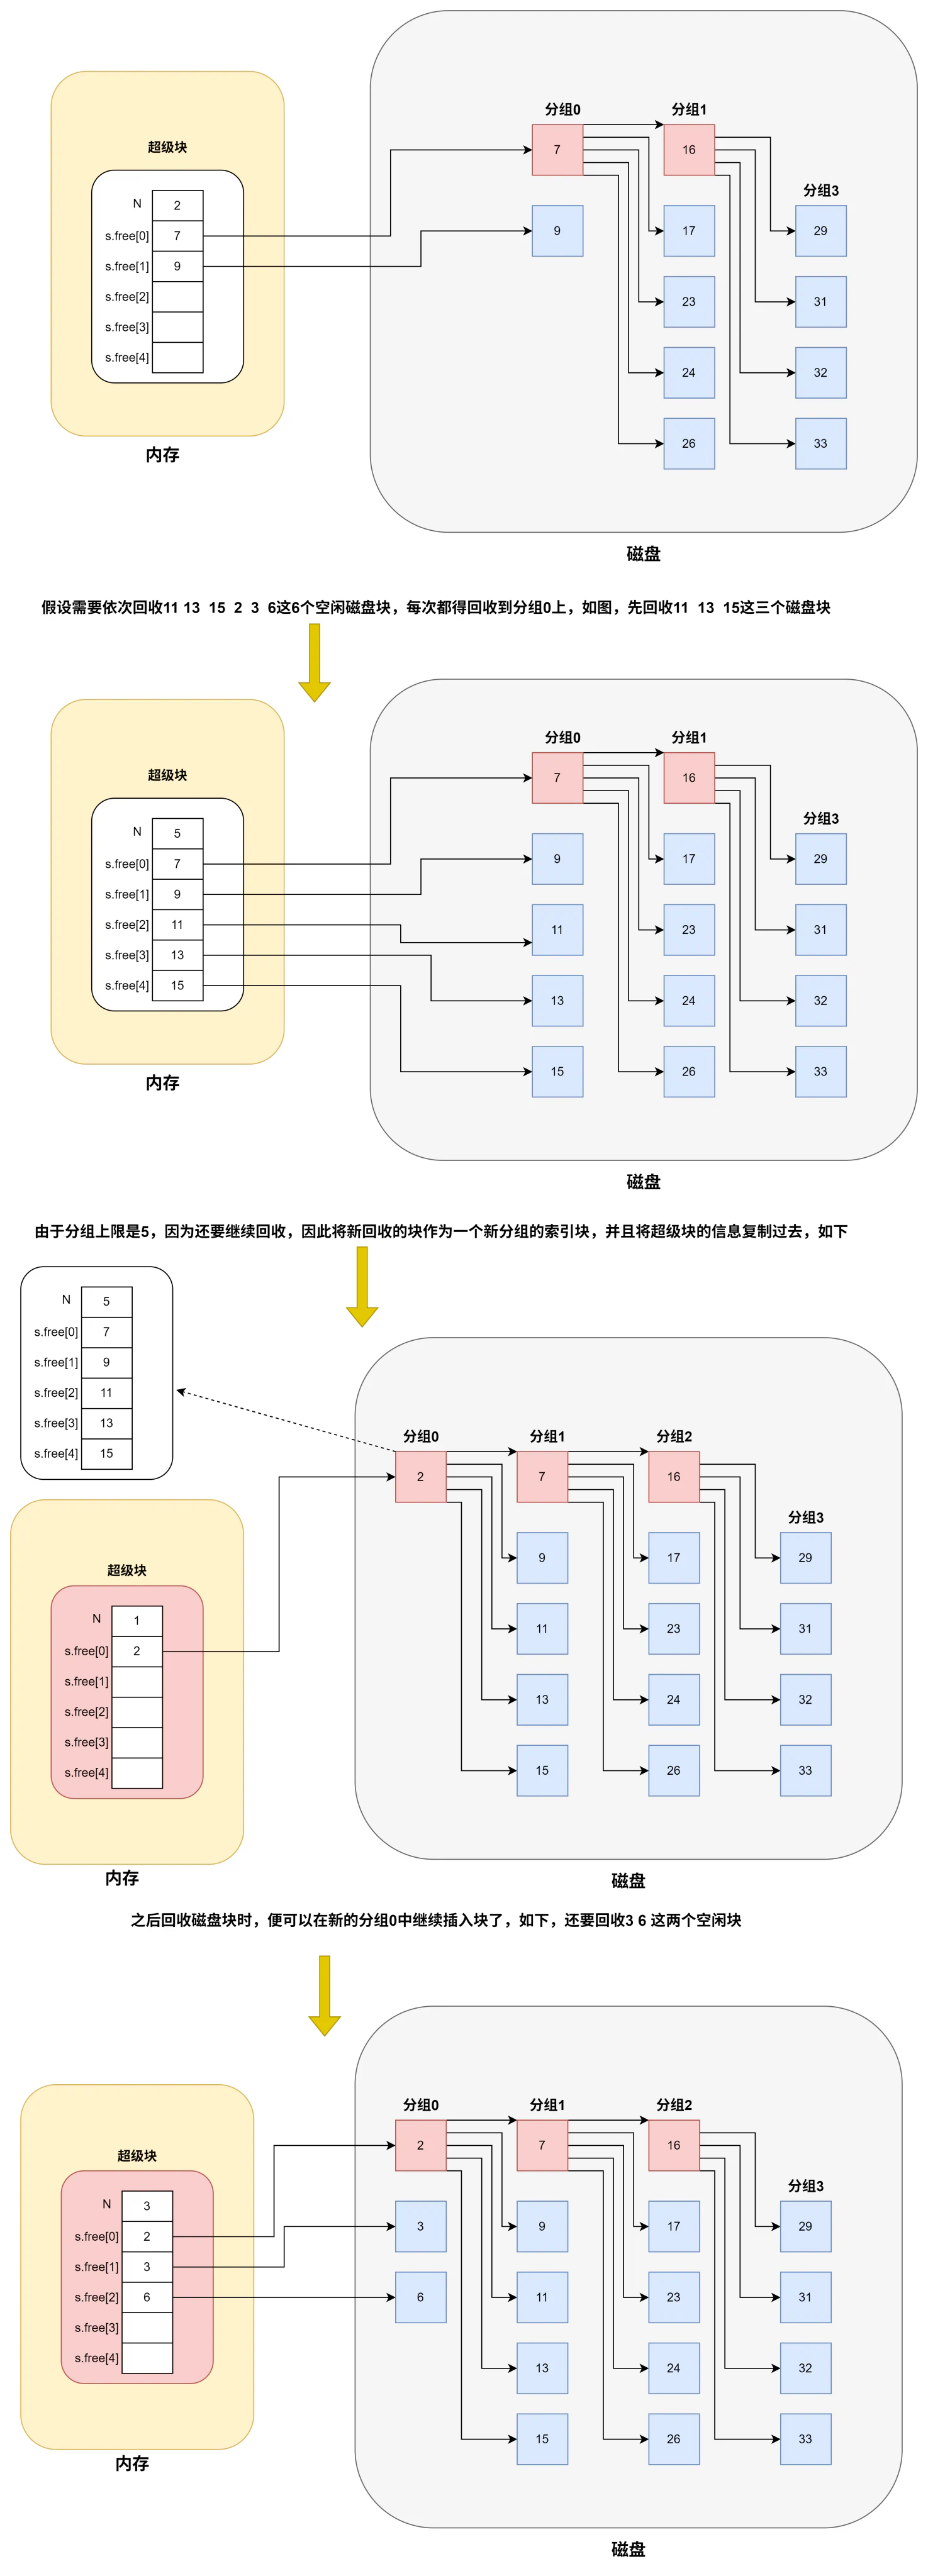
- 空闲磁盘块的回收
- 成组链接法的优势:
- 分配时:只有当分组0的空闲盘块均分配完,才需要进行I/O操作;
-
回收时:只有当分组0中的空闲盘块超出上限时,才需要进行I/O操作;
-
空闲表法、空闲链表法不适用于大型文件系统,因为空闲表或空闲链表可能过大。UNIX系统中采用了成组链接法对磁盘空闲块进行管理。文件卷的目录区中专门用一个磁盘块作为“超级块”,当系统启动时需要将超级块读入内存。并且要保证内存与外存中的“超级块”数据一致。
- 概念:用来存放一组空闲盘块号的盘块称为成组链块,把顺序的
n个空闲盘块号保存在第一个成组链块中,其最后一个空闲盘块(作为成组链块)又保存另一组空闲盘块号,如此继续,直到所有空闲盘块均予以链接,系统只需要保存指向第一个成组链块的指针即可。 - 其中索引块0的内容放在超级块中,常驻内存,每一组磁盘块的第一个盘块作为下一组盘块的索引结点。
- 若管理空闲磁盘块的方法是成组链接法, 且 0 号分组(即首个分组) 中仅剩唯一一个索引块, 则进行一次空闲盘块分配后, 各分组和内存中的索引块会发生哪些变化?\ 分组0中的索引块内容将被复制到超级块中,并将该索引块分配给文件使用。
- 若管理空闲磁盘块的方法是成组链接法, 且 0 号分组的盘块数量达到上限, 则回收磁盘块后, 各分组和内存中的索引块会发生哪些变化?\ 将新回收的块作为一个新分组的索引,并将索引块0的信息复制过去。
虚拟文件系统vfs
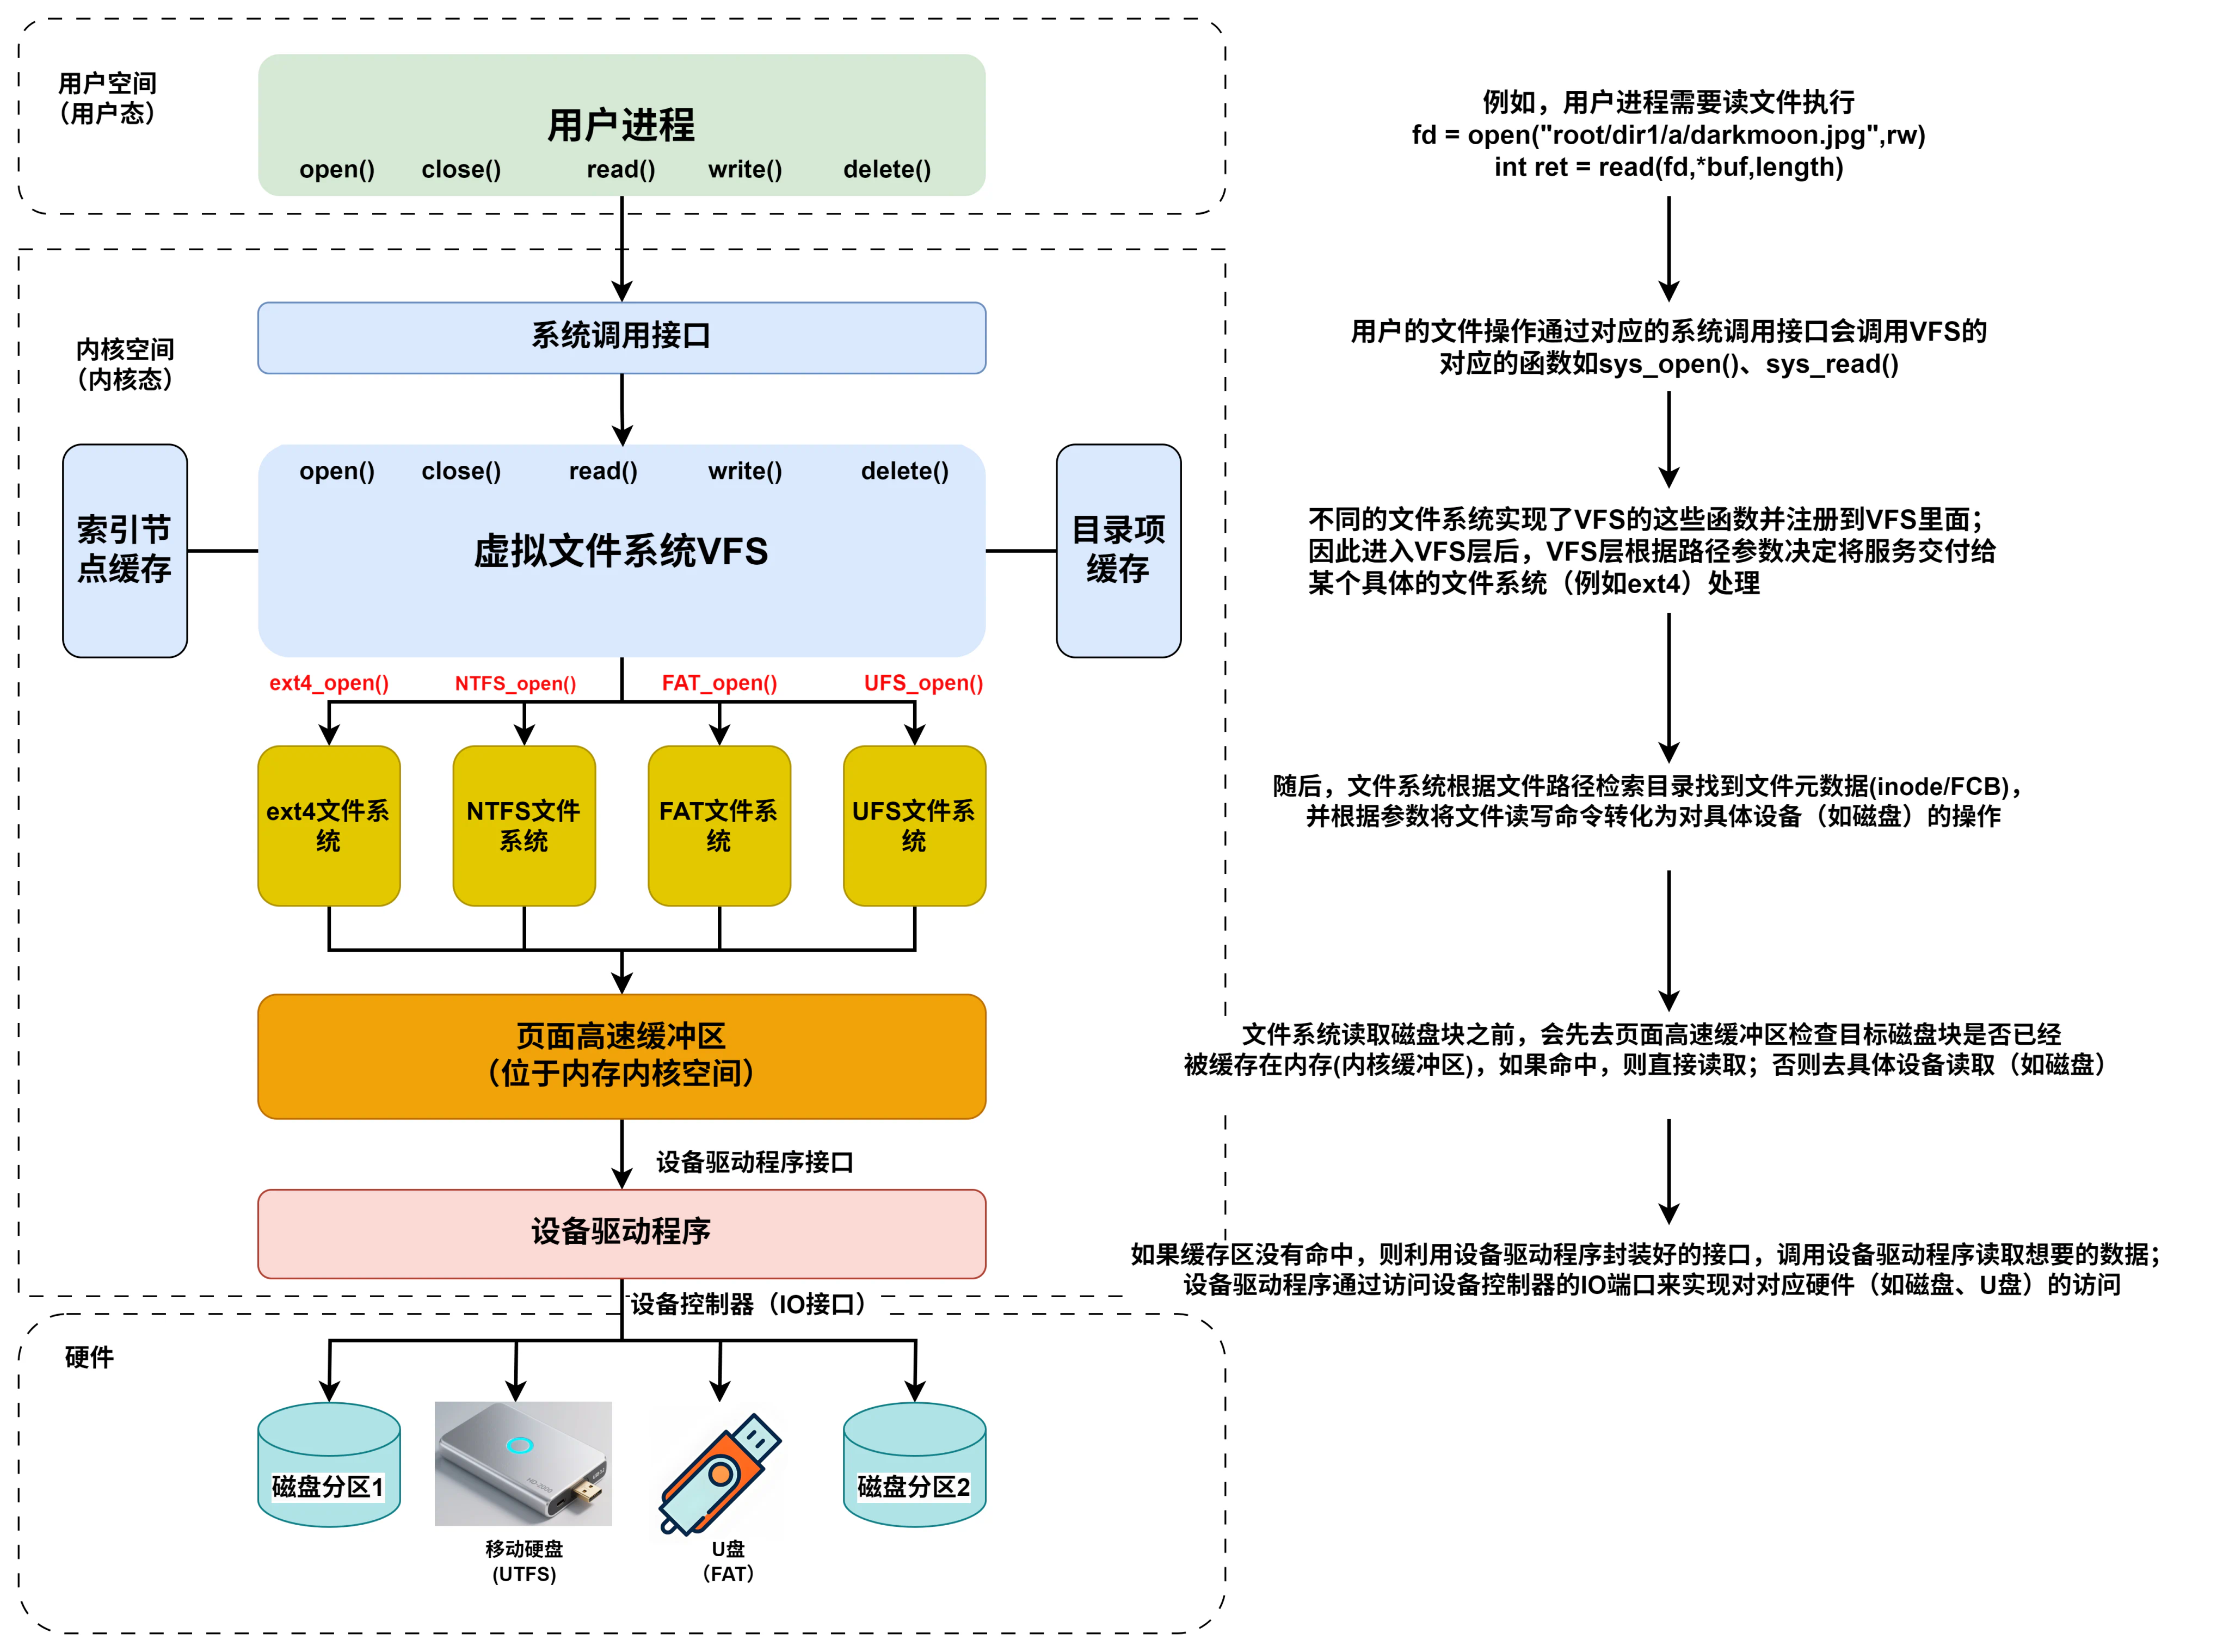
【补充】:
- 默认情况下,写操作会先写入Page Cache(这时应用就认为写入成功了),这被称为延迟写入(Write-back)。内核会在之后的某个时刻(比如系统空闲、内存紧张或定时)才将“脏”的缓存页面(Dirty Page)同步回磁盘。这个机制极大地提高了写入性能。
- 在“页面高速缓冲区”和“设备驱动程序”之间,其实还有一个重要的层次叫做块设备I/O层 (Block I/O Layer),其中包含了I/O调度器 (I/O Scheduler)。调度器的作用是对发往磁盘的请求进行合并、排序(例如电梯算法),以减少磁头寻道时间,优化磁盘性能。图中为了简洁,将这一层省略了。
- VFS使用三个缓存来提升性能:
- 索引节点缓存:每个目录和文件都由一个 vnode 表示,访问目录或文件会访问其索引节点,因此索引节点高速缓存中存储最近访问过的索引节点,可加快访问速度。
- 目录缓存:目录缓存中存储完整的目录名称和其索引节点号之间的映射,可加快列出目录的过程。
- 页面高速缓存区:缓冲区高速缓存中存放文件的具体数据,当需要相同的数据时,可从高速缓存中读取,而不是磁盘。
Tip
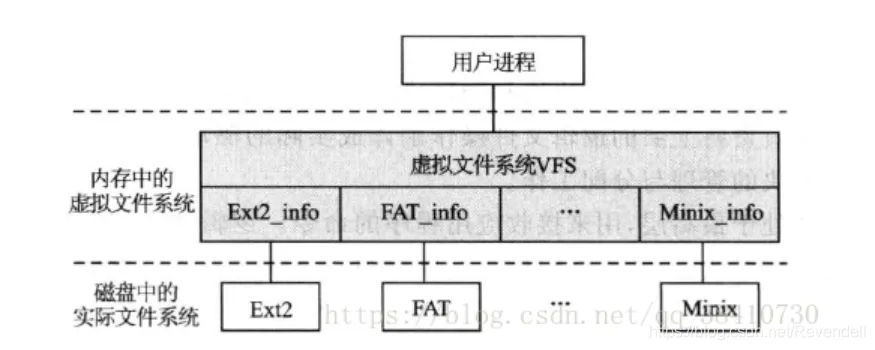
VFS,Virtual File System的定义:VFS是一个抽象层,其向上提供了统一的文件访问接口,而向下则兼容了各种不同类型的文件系统。(将接口暴露给用户,屏蔽底层文件系统的差异性,它是对所有不同文件系统的抽象)VFS采用标准的Linux系统调用读写位于不同物理介质上的不同文件系统,即为各类文件系统提供了一个统一的操作界面和应用编程接口, VFS是一个内核软件层 。VFS是一个可以让open()、read()、write()等系统调用不用关心底层的存储介质和文件系统类型就可以工作的抽象层VFS抽象层之所以能衔接各种文件系统,是因为它定义了所有文件系统都支持的、基本的、概念上的接口和数据结构。对于任何特定文件系统,需要一个映射模块来转换实际文件系统的特征到虚拟文件系统所期望的特征。(例如VFS要求下层的文件系统必须实现某些规定的函数功能,如:open/read/write。一个新的文件系统想要在某操作系统上被使用,就必须满足该操作系统VFS的要求
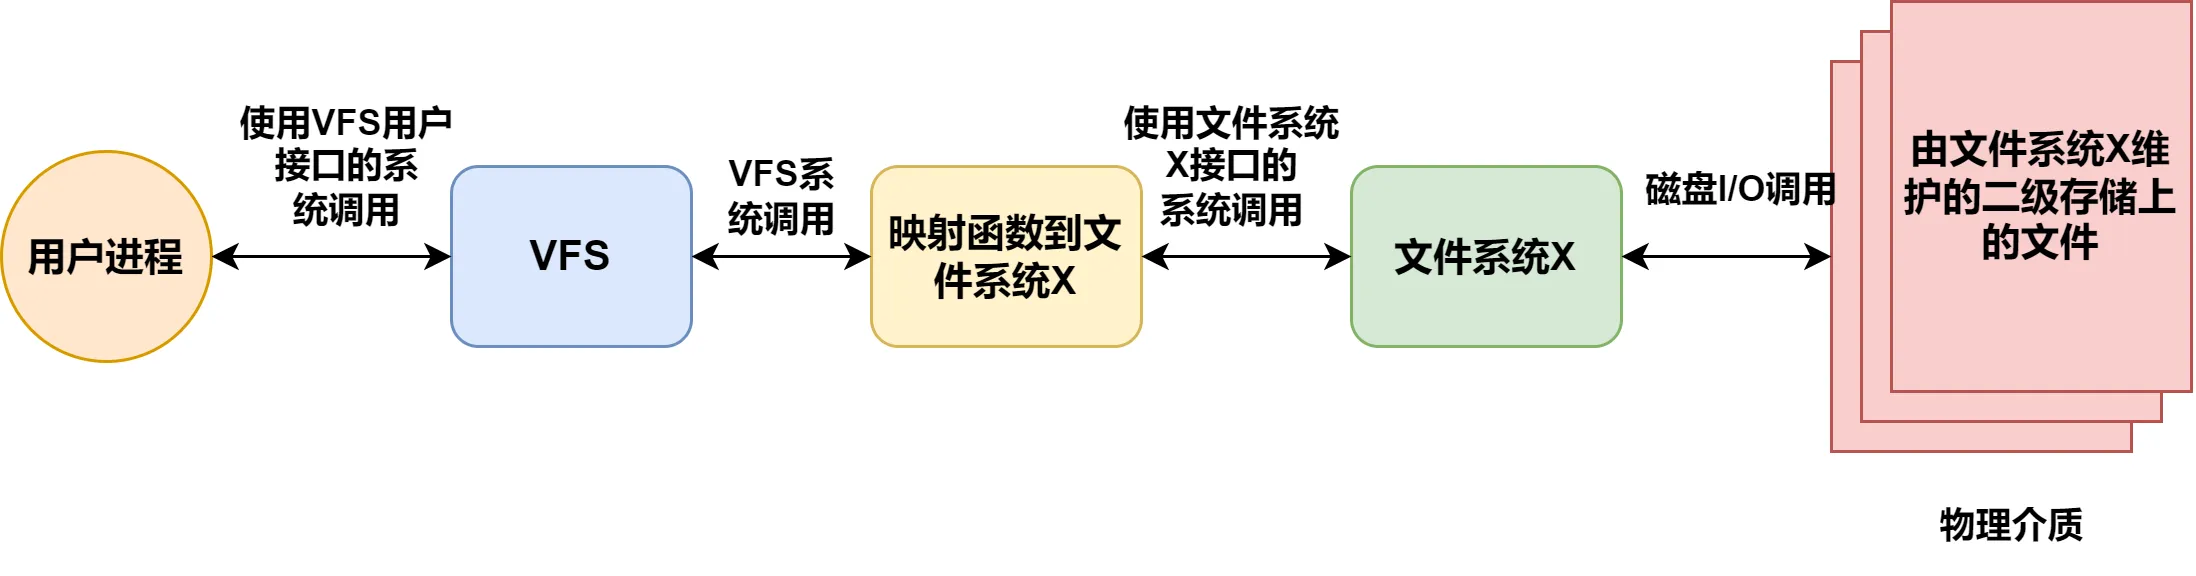
VFS在内核中起到的作用如下图所示:当进程发起一个面向文件的系统调用时,内核调用VFS中的一个函数。该函数处理完与具体文件系统无关的操作后,调用目标文件系统中的相应函数。这个调用通过一个转换VFS的调用到目标文件系统调用的映射函数来实现。VFS独立于任何具体文件系统。因此映射函数的实现是文件系统在Linux上的实现的一部分。目标文件系统转换文件系统请求到面向设备的指令。
由于不同的文件系统,表示文件的数据结构各不相同,打开文件后,其在内核中的表示就不同。如图所示:
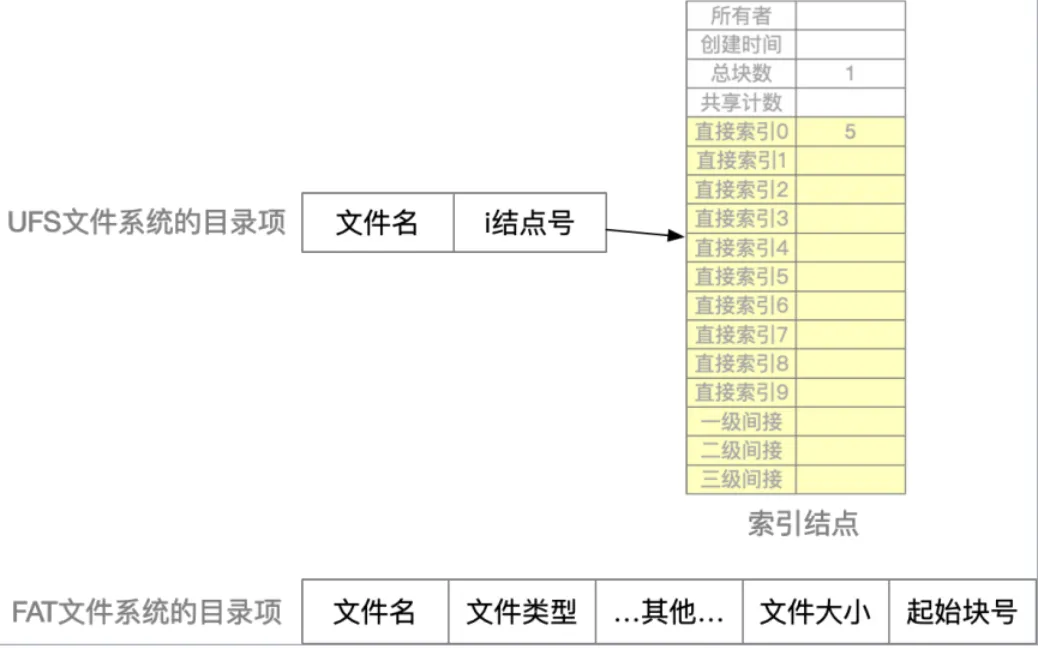
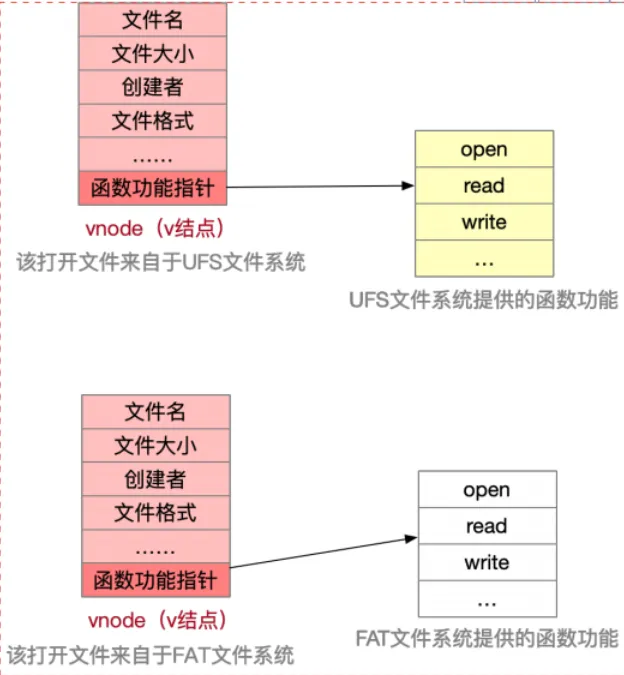
因此,每打开一个文件VFS就在主存中新建一个vnode,用统一的数据结构表示文件,无论该文件存储在哪个文件系统。
Tip
注意:vnode只存在于主存中,而inode既会被调入主存,也会在外存中存储
打开文件后,创建vnode,并将文件信息复制到vnode中,vnode的功能指针指向具体文件系统的函数功能。
虚拟文件系统VFS对象及其数据结构:
超级块是对一个文件系统的描述 ; 索引节点是对一个 文件物理属性的描述 ;而目录项是对一个文件逻辑属性的描述;文件file是对当前进程打开的文件的描述。
文件系统是特殊的数据分层存储结构,它包含文件、目录和相关的控制信息。为了描述这个结构, VFS采用面向对象的设计思路。因为VFS不是用支持面向对象的语言(如C++和 Java)来实现的,而是使用C语言来实现的,因此VFS的对象可以简单地实现为C语言的结构。每一个对象包含数据和函数指针。这些函数指针指向操作这些数据的文件系统的实现函数。VFS主要的四个对象如下:
1. 超级块(superblock)对象:代表一个特定的已挂载的文件系统。
超级块用来描述整个文件系统的信息。超级块占用1号物理块,就是文件系统的控制块 ,要使用一个分区来进行数据访问,那么第一个要访问的就是超级块 。所以,超级块坏了,那磁盘也就基本没救了。
- 内容包括:文件系统类型、文件系统的大小、 文件系统所挂载的设备 、操作方法(函数)指针、空闲块数目、空闲块索引表、空闲i节点数目、空闲i节点索引表、封锁标记等。其中操作方法(函数)指针指向该超级块的操作方法表,包含一系列可在超级块对象上调用的操作函数等,主要有分配inode、销毁inode、读inode、写inode、文件同步等。
- 当内核在对一个文件系统进行初始化和注册时在内存为其分配一个超级块 。此时的超级块为
VFS超级块 。也就是说,VFS 超级块是各种具体文件系统在安装时建立的,并在这些文件系统卸载时被自动删除。 VFS超级块只存放在内存中 。对于每个具体的文件系统来说,都有各自的超级块,如Ext2超级块和Ext3超级块,它存放在磁盘上。- 超级块是系统为文件分配存储空间、回收存储空间的依据。
2.索引节点(inode)对象:代表一个特定的文件。 (文件系统处理文件所需要的所有信息都存放在索引节点中。 在同一个文件系统中,每个索引节点号都是唯一的 。 )
- 具体文件系统的索引节点是存放在磁盘上,是一种静态结构,要使用它,必须调入内存,填写
VFS的索引节点( vnode ),因此,也称VFS索引节点是动态节点 。 - 我们的磁盘在进行分区、格式化的时候会分为两个区域,一个是 数据区 ,用于存储文件中的数据 ;另一个是
inode区 ,用于存放inode表 ,inode table中存放的是一个一个的inode,不同的inode就可以表示不同的文件,每一个文件都必须对应一个inode,inode实质上是一个结构体,这个结构体中有很多的元素,不同的元素记录了文件了不同信息,譬如:文件字节大小、文件所有者、文件对应的读/写/执行权限、文件时间戳(创建时间、更新时间等)、文件类型、文件数据存储的block(块)位置。
3.目录项(dentry)对象:代表一个特定的目录项。 (目录项对象是一个路径的组成部分,它要么是目录名,要么是文件名)
每个文件除了有一个索引节点inode数据结构外,还有一个目录项dentry数据结构。 目录项反应了文件系统的树状结构,目前主流的操作系统基本都是用树状结构来组织文件的。linux也不例外。dentry表示一个目录项,目录项下面又有子目录。目录在文件系统中的存储方式与常规文件类似,常规文件包括了 inode节点 以及 文件内容数据存储块(block) ;但对于目录来说,其存储形式则是由 inode节点 和目录块所构成,目录块当中记录了有哪些文件组织在这个目录下,记录它们的 文件名 以及对应的inode编号 。所以对此总结如下:
- 普通文件由
inode节点和数据块构成- 目录文件 由
inode节点和目录块构成
- 目录文件 由
4.文件(file)对象:代表一个与进程相关的打开的文件。
文件对象是进程打开的文件在内存中的实例。Linux用户程序可以通过open()系统调用来打开一个文件,通过close()系统调用来关闭一个文件。文件对象和物理文件的关系类似于进程与程序的关系。由于多个进程可以同时打开和操作同一个文件, 所以同一个文件,在内存中也存在多个对应的文件对象,但对应的索引节点和目录项是唯一的 。文件对象仅在进程观点上代表已经打开的文件,它反过来指向其索引结点。文件对象包含与该文件相关联的目录项对象,包含该文件的文件系统、文件指针等,还包括在该文件对象上调用的一系列操作函数。
进程与文件进行交互的简单示例:
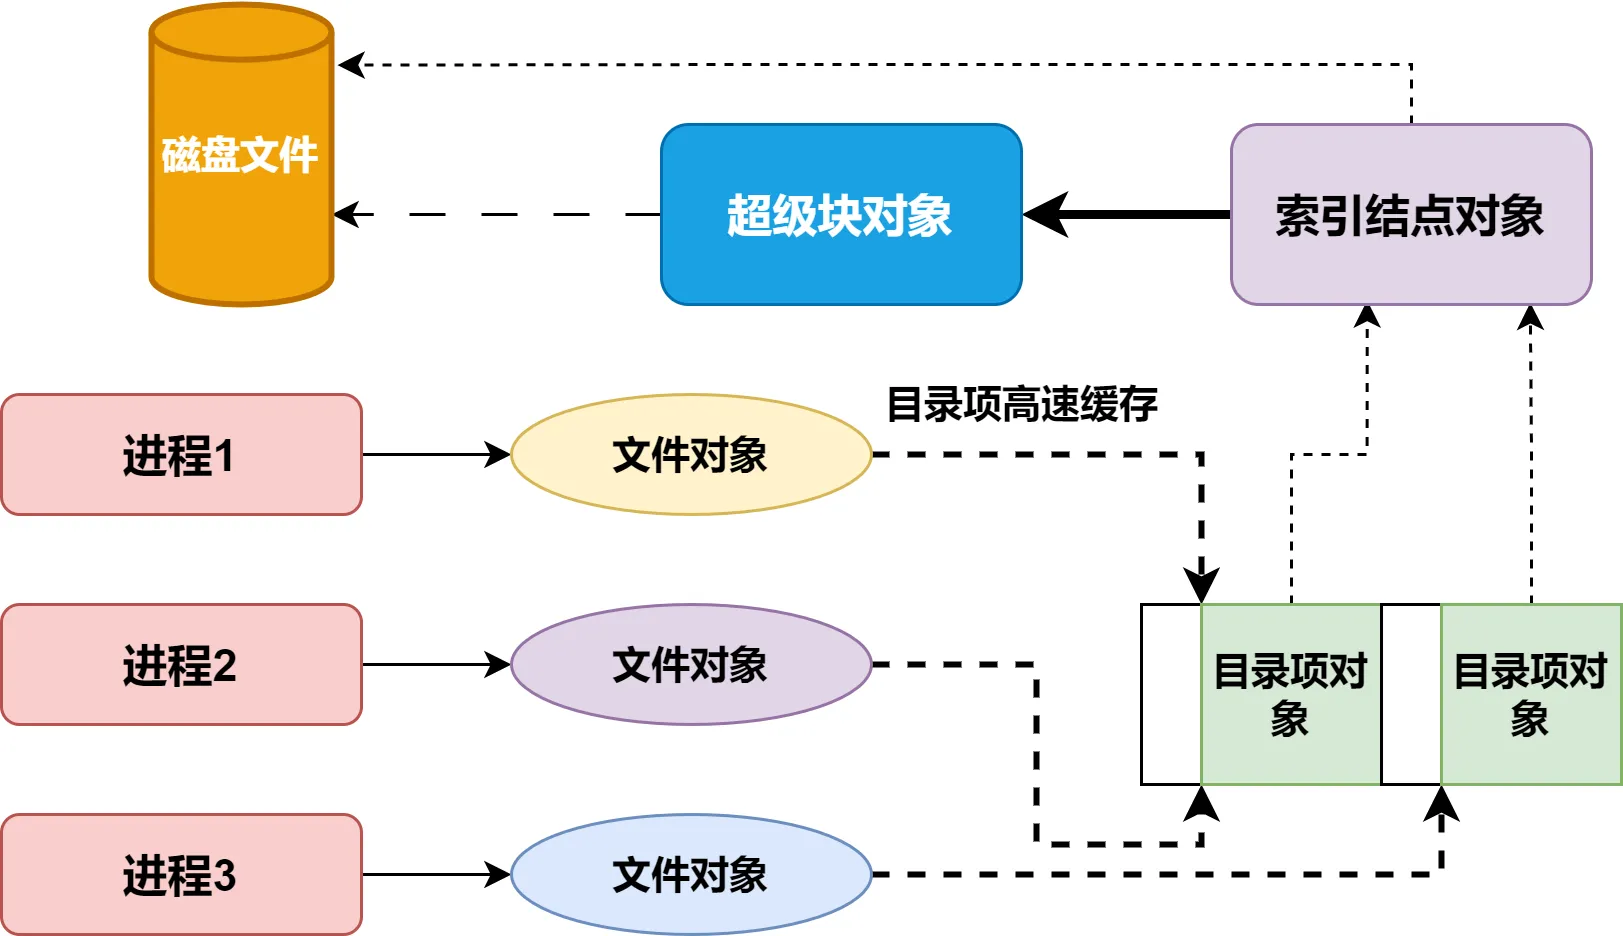
三个不同的进程已打开了同一个文件,其中两个进程使用同一个硬链接。在这种情况下,每个进程都使用自己的文件对象,但只需要两个目录项对象,每个硬链接对应一个目录项对象。这两个目录项对象指向同一个索引结点对象,这个索引结点对象标识的是超级块对象及随后的普通磁盘文件。
文件系统挂载(mounting)
挂载(Mount) 是指:将一个存储设备(或其分区)上的文件系 统,“连接”到操作系统的目录树中的某个目录上,使其内容可以被访问。
核心要点:
- Linux/Unix 系统中,所有文件和设备都组织在一个统一的“目录树”中,根目录是
/。 - 但硬盘、U盘、网络存储等设备上的数据,默认不会自动出现在这个目录树里。
- 必须通过 “挂载”操作,把设备上的文件系统“嫁接”到目录树的某个“挂载点”(通常是空目录),才能访问其中的文件。
类比:就像给一棵树(目录树)接上一个新的树枝(设备),接上后你才能摘到这个树枝上的果子(文件)。
挂载的本质 :挂载操作包含以下关键动作
- 识别设备:如
/dev/sdb1(U盘第一个分区)、/dev/nvme0n1p2(SSD 分区)等。 - 识别文件系统类型:如 ext4、FAT32、NTFS、XFS、Btrfs 等。
- 选择挂载点:一个已存在的空目录,如
/mnt/usb、/media/disk。 - 执行挂载命令:如
mount /dev/sdb1 /mnt/usb - 内核注册:VFS 将该设备的文件系统纳入统一管理,用户可通过挂载点访问文件。
🚫 未挂载的设备 = “存在但不可见/不可用”
选择挂载点的注意事项
- 并不是根目录下任何一个目录都可以作为挂载点,由于挂载操作会使得原有目录中文件被隐藏,因此根目录以及系统原有目录都不要作为挂载点,会造成系统异常甚至崩溃,挂载点最好是新建的空目录。
- 当一个文件系统被挂载到一个目录上时,该目录就成为了该文件系统的挂载点。在该目录下创建的文件和目录都会被存储在该文件系统中,而不是存储在原来的文件系统中。如果该文件系统中已经存在同名的文件或目录,则会覆盖原来的文件或目录。
- 挂载后,访问该目录 = 访问设备上的文件系统。
- 挂载后,原挂载点目录的内容会被“遮盖”,但不会被删除! 原目录内容在卸载(umount)后会重新出现。
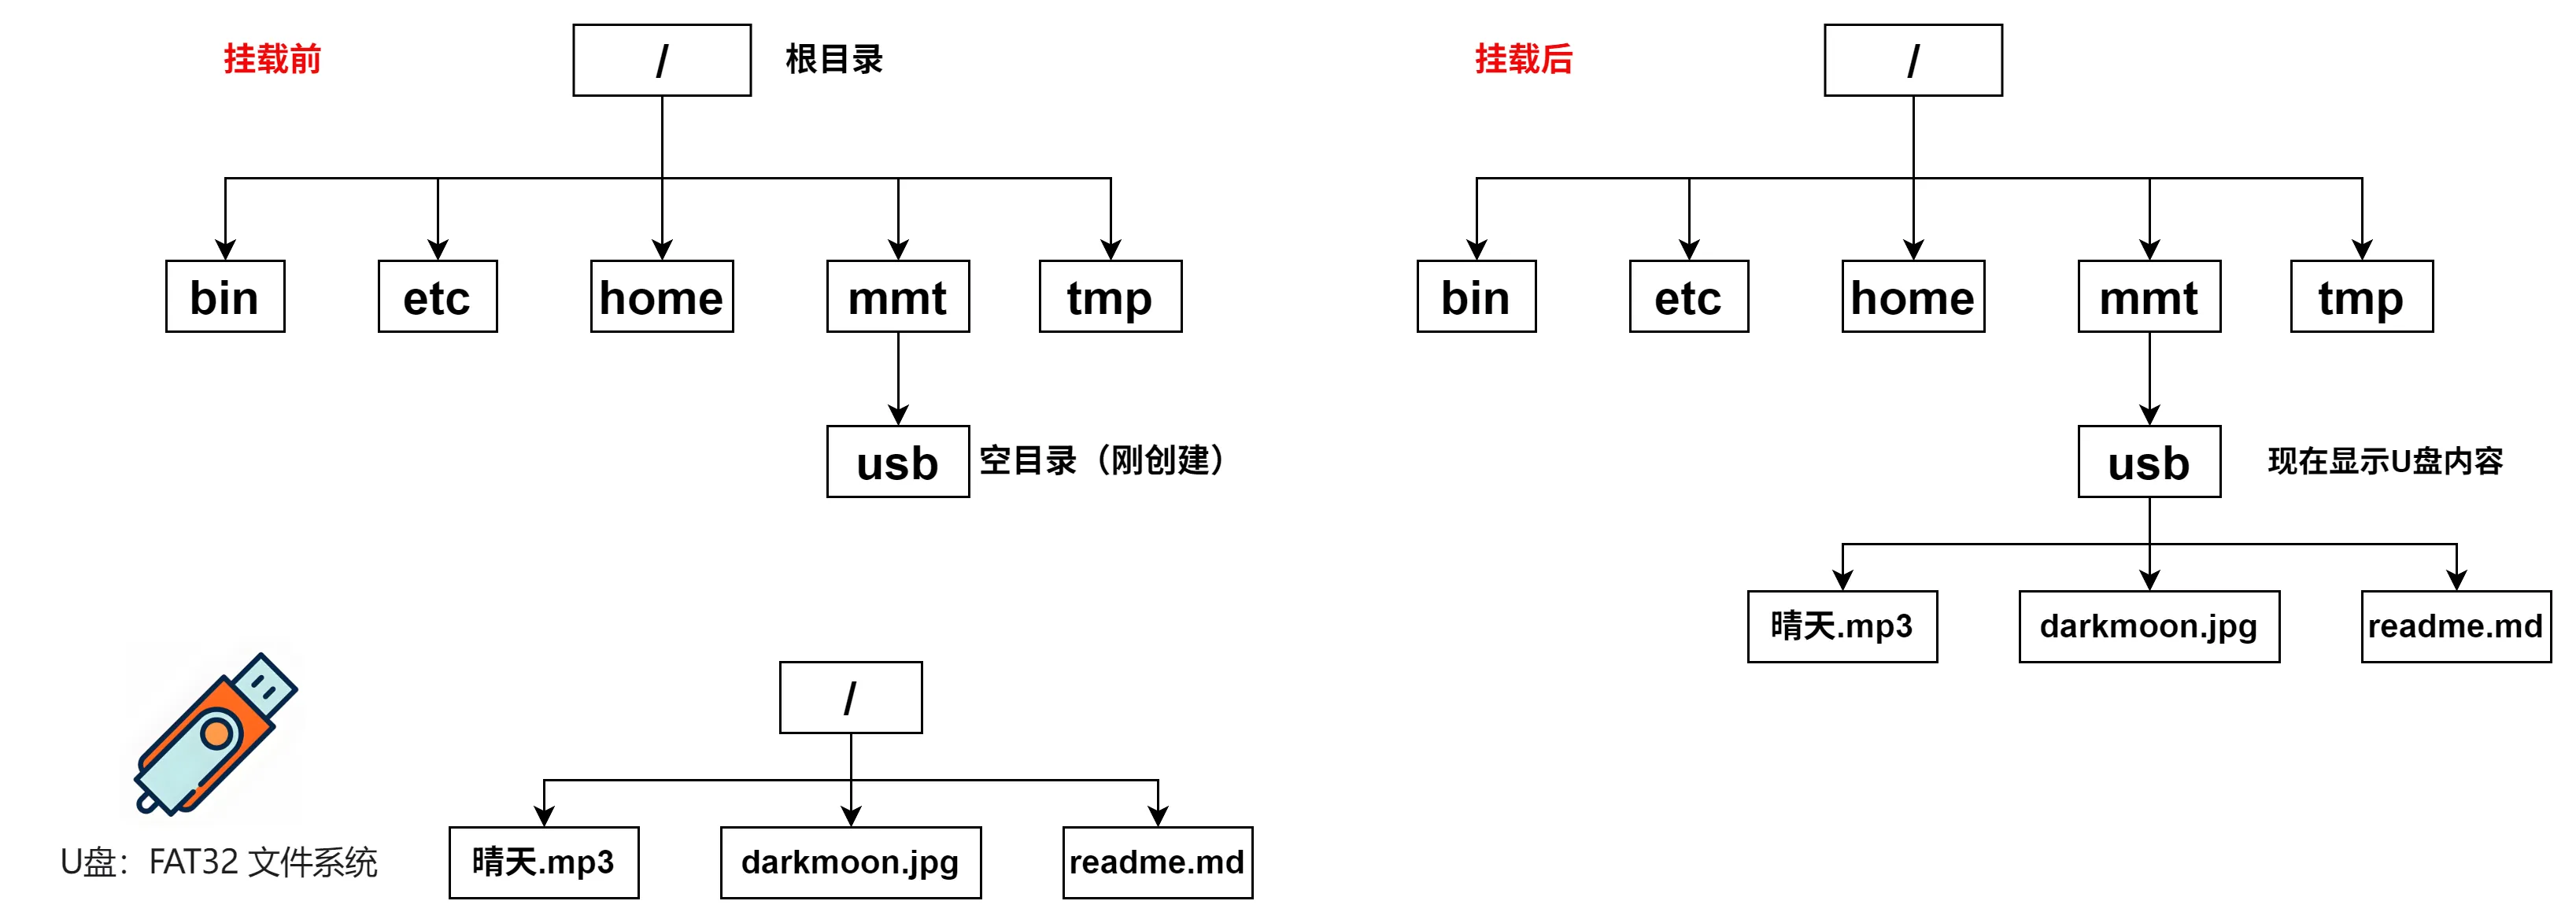
例子 1:插入 U 盘并挂载
# 插入 U 盘后,系统识别为 /dev/sdb1(FAT32 格式)
sudo mkdir /mnt/usb          # 创建挂载点
sudo mount /dev/sdb1 /mnt/usb # 挂载

# 现在就可以访问 U 盘内容了
ls /mnt/usb                  # 查看 U 盘里的文件
cp /mnt/usb/photo.jpg ./     # 复制照片到当前目录
📌 挂载前:U盘插上了,但你看不到内容。
📌 挂载后:通过 /mnt/usb 就像访问普通文件夹一样访问 U 盘。
例子 2:挂载第二块硬盘分区
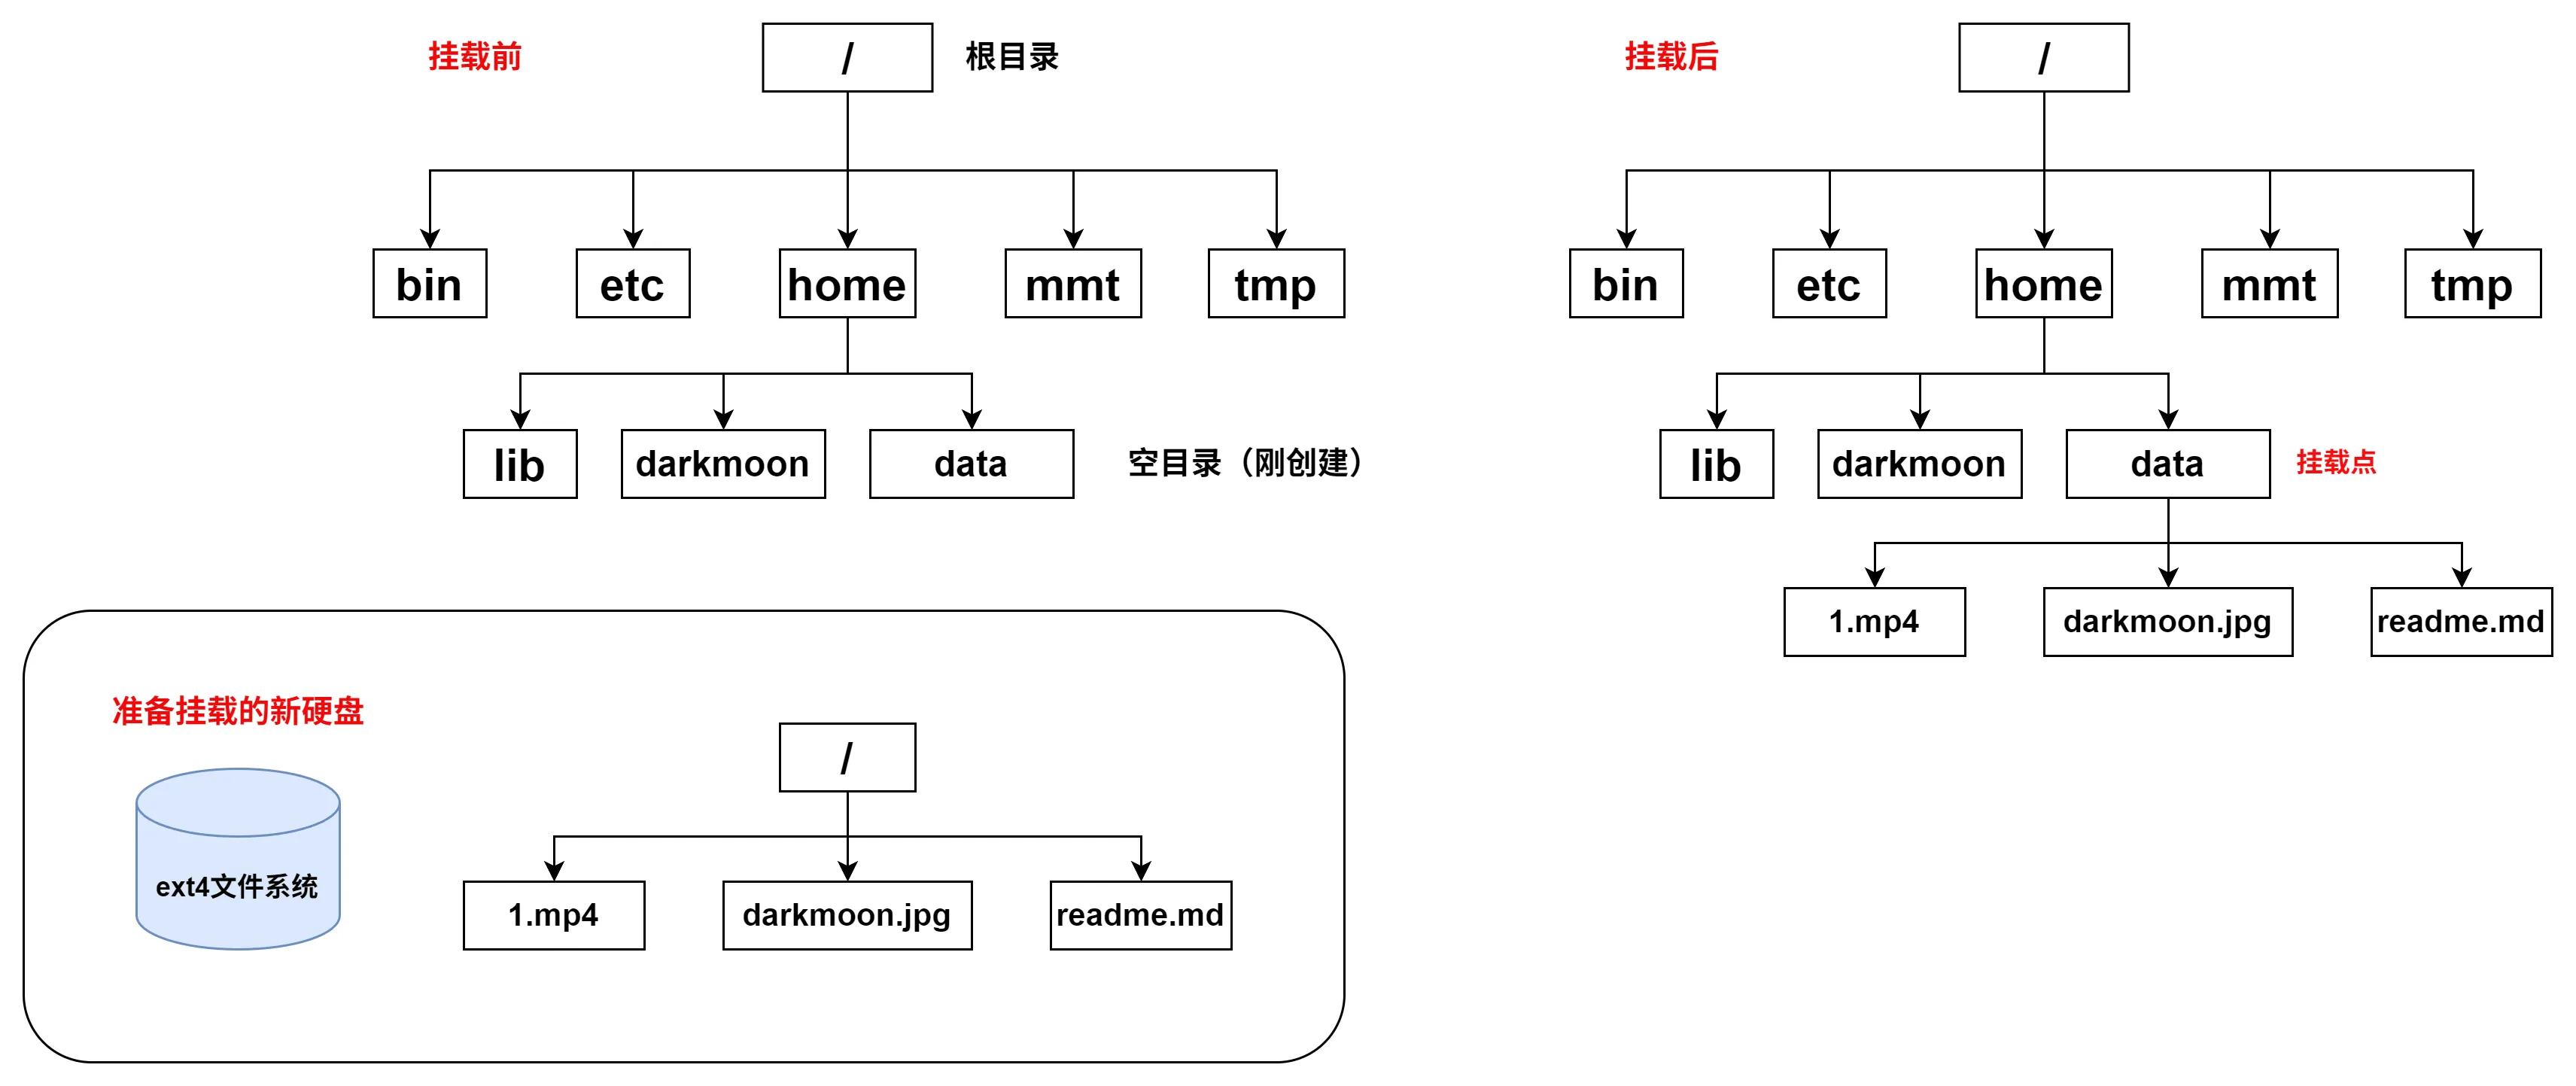
假设你加装了一块新硬盘,分区为 /dev/sda2,格式是 ext4,你想把它作为 /home 的扩展:
sudo mkdir /home/data
sudo mount /dev/sda2 /home/data

# 现在 /home/data 下就是新硬盘的内容
df -h  # 可看到 /dev/sda2 挂载在 /home/data
挂载 FAT 分区时,内核都做了什么?
- 读取引导扇区:位于分区开头(偏移 0),包含:每扇区字节数(通常 512)、每簇扇区数、保留扇区数、FAT 表个数、根目录项数(FAT12/16)或根目录起始簇(FAT32)、总扇区数、FAT 表大小等(文件系统的元数据)
Tip
这一步是必须的,用于计算 FAT 表位置、根目录位置、数据区起始位置;可以看出其作用和内容与 unix 文件系统中的超级块类似
- 读入整个文件分配表 (FAT): 在获取了 FAT 表的位置和大小信息后,操作系统会执行关键的一步:将第一份 FAT 表从磁盘完整地读取到 RAM(内存)中。
为什么这么做? FAT 表的核心作用是记录文件数据块(簇)之间的链接关系,它像一个巨大的链表。读取文件时需要频繁查询这个表来找到下一个数据块在哪。磁盘 I/O 非常慢,如果每次查询都去读硬盘,性能会 (灾难性地) 低下。所以,一次性把它全部加载到内存里,后续操作就快得多了。
- 读取根目录: 操作系统会找到根目录的位置,读取一些初始的目录项,为文件访问做好准备。
挂载时会读取根目录内容,用于填充 dentry 缓存,加速后续路径查找。
-
完成挂载: 此时,文件系统已经准备就绪,可以在操作系统的目录树中看到并访问它了(比如在 Windows 中出现一个新的盘符 G:,或在 Linux 中挂载到
/mnt/usb目录下)。 -
文件访问时,根据路径找到目录项 → 获取起始簇号 → 通过 FAT 表查找后续簇 → 读取数据。
挂载 ext4 分区时,内核做了什么?
Ext4 的设计要比 FAT 复杂和高效得多,它的挂载过程也不同:
- 读取超级块 (Superblock): 操作系统首先读取超级块。超级块包含了整个文件系统的元数据(上面有介绍,这里跳过)
- 读取块组描述符 (Group Descriptors): Ext4 将磁盘空间划分为多个“块组”。每个块组都有自己的数据块位图、inode 位图和 inode 表。操作系统会读取这些块组的描述符信息,从而了解整个文件系统的布局。
- 读取根目录的 inode: 这是关键区别!Ext4 不会把所有文件的元数据(所有的 inode)都读入内存。它只会读取根目录 (
/) 的 inode。通过根目录的 inode,它能找到根目录的数据块,从而列出根目录下的文件和文件夹。其他文件或目录的 inode 会在被实际访问到时才按需从磁盘读入内存。 -
完成挂载: 文件系统准备就绪。
-
文件访问:路径 → dentry → inode → 通过 inode 中的块指针(直接/间接/extent)定位数据块 → 读取。
- 删除文件:释放 inode 和数据块(标记位图为可用),并写入日志。
- 支持硬链接、权限、扩展属性、ACL、加密等高级特性。
操作系统引导再回顾(加上挂载文件系统的内容)这部分可不看,有兴趣的可以了解一下
总结:开机时,系统通过 bootloader(如 GRUB)从分区1加载内核和 initramfs 到内存;内核启动后,借助 initramfs 临时挂载真正的根文件系统(可能在另一个分区);最后,系统根据
/etc/fstab自动挂载其他分区。
阶段 1:BIOS + Bootloader(GRUB)
🔹 硬件加电 → BIOS启动
- BIOS 读取硬盘的 MBR(主引导记录)找到活动分区,然后读取该分区的第一个扇区即PBR(分区引导记录)
- 找到并执行 bootloader(如 GRUB)。
🔹 GRUB 启动 → 加载 OS 内核
- GRUB 读取自己的配置文件(如
/boot/grub/grub.cfg)。 - 该配置文件指定了:内核镜像位置、initramfs 位置、根文件系统设备(如
root=/dev/sda2)
📌 关键点:
Tip
- 内核和 initramfs 存放在 分区1(如 /dev/sda1 ),通常是
/boot分区(格式可能是 ext4、FAT32 等)。 - 但 真正的根文件系统(/) 可能在 分区2(如 /dev/sda2 ),格式可能是 ext4、XFS、Btrfs 等。
- GRUB 能读取多种文件系统(ext2/3/4, FAT, XFS 等),所以它能从分区1读取内核。
阶段 2:内核启动 + initramfs 临时根文件系统
🔹 内核被加载到内存并执行:内核初始化硬件、内存、CPU、设备驱动等。
内核发现启动参数中有 root=/dev/sda2,但它此时还不能直接挂载 /dev/sda2!为什么?
❗ 因为:内核刚启动时,没有文件系统驱动、没有设备管理、甚至没有 /dev 目录结构!
🔹 initramfs 登场 —— 临时根文件系统
initramfs 是一个 压缩的、内存中的临时根文件系统,由 GRUB 一同加载。
- 它包含:设备管理工具(
udev或mdev)、文件系统驱动模块(ext4.ko, xfs.ko, ntfs.ko...)等
🔹 initramfs 的任务:
- 探测并创建设备节点(如
/dev/sda1,/dev/sda2) - 加载必要的内核模块(如
ext4模块,用于挂载根分区) - 执行
/init脚本 —— 核心流程控制 - 挂载真正的根文件系统(如
mount /dev/sda2 /mnt/root) - 切换根(switch_root) 到真正的根文件系统
示例 init 脚本关键步骤:
mount -t ext4 /dev/sda2 /mnt/root   # 挂载真正的根分区
exec switch_root /mnt/root /sbin/init # 切换根并启动真正的 init 进程
关键点:initramfs 是“桥梁”,让内核有能力挂载真正的根文件系统。挂载真正的根文件系统后,initramfs 会被丢弃,内存释放。
阶段 3:真正的根文件系统启动 + systemd/init
🔹 内核执行/sbin/init(现在通常是 systemd)
- systemd 读取配置,启动系统服务。读取
/etc/fstab文件,自动挂载其他分区。
示例
/etc/fstab:
# <设备>          <挂载点>   <文件系统>  <选项>       <dump> <pass>
/dev/sda1         /boot      ext4       defaults     0      2
/dev/sda3         /home      ext4       defaults     0      2
/dev/sda4         /data      xfs        defaults     0      2
UUID=1234-5678    /mnt/ntfs  ntfs-3g    defaults     0      0
关键点:
/boot(分区1)通常也会在 fstab 中再次挂载,因为 initramfs 用完就丢了,真正的系统需要它。/home、/data、NTFS 分区等都在此时挂载。- 所有挂载点成为 Linux 统一目录树的一部分。
阶段 4:用户登录 + 系统就绪
- 所有服务启动完成(网络、SSH、GUI 等)。
- 用户登录,看到完整的文件系统结构。
- 此时你可以访问:
/boot→ 分区1(内核存放处)/→ 分区2(根文件系统)/home→ 分区3/data→ 分区4(XFS)/mnt/ntfs→ 可能是 Windows 分区(NTFS)
结构图示意
硬盘 /dev/sda
├── 分区1: /dev/sda1 → 文件系统: ext4 → 挂载点: /boot → 存放 vmlinuz, initrd
├── 分区2: /dev/sda2 → 文件系统: ext4 → 挂载点: /     → 根文件系统,含 /bin, /etc, /usr...
├── 分区3: /dev/sda3 → 文件系统: ext4 → 挂载点: /home → 用户数据
├── 分区4: /dev/sda4 → 文件系统: xfs  → 挂载点: /data → 应用数据
└── 分区5: /dev/sda5 → 文件系统: NTFS → 挂载点: /mnt/windows → Windows 共享数据
开机后,这些分区通过
/etc/fstab自动挂载,形成统一树状结构。