index
【考频统计】
| 年份 | 考点 | 分值 |
|---|---|---|
| 2009 | 双指针问题(前后指针):查找单链表中倒数第\(k\)个结点 | \(15\)分 |
| 2010 | 数组循环左移(数组逆置问题) | \(13\)分 |
| 2011 | 寻找两个数组的中位数 | \(15\)分 |
| 2012 | 相交链表找交点 | \(15\)分 |
| 2013 | 将两个升序链表合并为一条降序链表(选择)、数组主元素(摩尔投票法) 应用题线性表的顺序存储结构与链式存储结构的ASL问题 |
\(25\)分 |
| 2014 | 未考察 | |
| 2015 | 删除链表重复结点 | \(15\)分 |
| 2016 | 单链表插入及其物理存储结构、双向循环链表删除结点操作、快排思想划分数组问题 | \(19\)分 |
| 2017 | 未考察 | |
| 2018 | 数组中未出现的最小正整数 | \(13\)分 |
| 2019 | 重排链表(快慢指针求中间结点、链表逆置、交叉合并链表) | \(13\)分 |
| 2020 | 三元组的最短距离(多指针) | \(13\)分 |
| 2021 | 单循环链表删除节点 | 2分 |
| 2022 | 未考察 | |
| 2023 | 顺序表的基本操作、非空双向链表删除结点 | 4分 |
【考点分析】:本章考察算法题的可能性极大,历年来该章节的算法题考了10次,其中链表考察了5次,数组5次;重点掌握后面提到的技巧及思想,没时间就暴力解!
2.1 顺序表的基本操作
-
顺序表的定义
-
静态分配
#define MaxSize 1024      //定义顺序表的最大长度;
#define ElemType int      //数组类型为ElemType,定义为int;

typedef struct{
    ElemType data[MaxSize];   //定义一个最多存放MaxSize个元素的数组,MaxSize代表数组的容量;
    int length;    //代表数组长度,即当前的元素个数;
}SeqList;
- 动态分配
#define ElemType int      //数组类型为ElemType,定义为int;

typedef struct{
    ElemType *Array;  //指示动态分配数组的指针
    int MaxSize;   //记录数组的最大容量
    int length;  //记录当前实际存放元素的个数,即表长
}SeqList;
C语言中使用malloc和free进行空间的申请和释放(C++则使用new和delete)。
- 初始化
- 插入操作\ 在顺序表的第i个位置(位序,非下标)插入元素x;
bool Insert(SeqList &L, int i, int x) {
    if(i > L.length + 1 || i < 1 || L.length == MaxSize) {
        //如果位序不在有效范围内或者顺序表已满,则插入失败;
        return false;
    }
    for(int j = L.length; j >= i; --j) {
        //将待插入元素后面的元素通通后移一位;
        L.data[j] = L.data[j-1];
    }
    L.data[i-1] = x;   //在位序为i的位置放入元素x;
    L.length ++;    //数组长度+1;
    return true;
}
设\(Pi\)是在第i个位置插入一个节点的概率,则在长度n的顺序表中插入一个元素,所需移动元素的平均次数为
\( \sum_{i=1}^{n+1}P_i(n-i+1)= \sum_{i=1}^{n+1}\frac{1}{n+1}(n-i+1)=\frac{1}{n+1}\sum_{i=1}^{n+1}(n-i+1)=\frac{1}{n+1}[n+(n-1)+(n-2)+\cdots+2+1)] = \frac{1}{n+1}\*\frac{n(n+1)}{2}=\frac{n}{2}=O(n) \)
所以插入操作的时间复杂度为\(O(n)\);
- 删除操作\ 删除顺序表L中的第i个元素;
bool ListDelete(SeqList &L, int i ) {
    if(i < 1 || i > L.length)    //如果删除元素的位置不在有效范围内,则删除失败;
        return false;
    int a = L.data[i-1];    //用变量a接收删除的元素;
    for(int j = i - 1; j < L.length - 1; ++j) {    //将待删除元素的后面位置的元素通通前移一位;
        L.data[j] = L.data[j+1];
    }
    L.length --;   //长度减1;
    return true;
}
设\(Pi\)是删除第i个位置元素的概率,则在长度n的顺序表中删除一个元素,所需移动元素的平均次数为
\( \sum_{i=1}^{n}P_i(n-i)= \sum_{i=1}^{n}\frac{1}{n}(n-i)=\frac{1}{n}\sum_{i=1}^{n}(n-i)=\frac{1}{n}[(n-1)+(n-2)+\cdots+2+1)] = \frac{1}{n}*\frac{n*(n-1)}{2}=\frac{n-1}{2}=O(n) \)由于删除元素涉及到遍历操作,因此时间复杂度为\( O(n) \);
- 按值查找\ 在顺序表中查找第一个值为x的元素,并返回其位序;
int LocateElem(SeqList &L, int x) {
    for(int i = 0; i < L.length; ++i ) {
        if(L.data[i] == x)
            return i+1;
    }
    return -1;  //查找失败
}
设\(Pi\)是查找的元素在第i个(1<=i<=L.length)位置上的的概率,则在长度n的顺序表中查找值为x的第一个元素,所需比较的平均次数为
\( \sum_{i=1}^{n}P_i*i= \sum_{i=1}^{n}\frac{1}{n}*i=\frac{1}{n}\sum_{i=1}^{n}i=\frac{1}{n}[1+2+\cdots+(n-1)+n)] = \frac{1}{n}*\frac{n*(n+1)}{2}=\frac{n+1}{2}=O(n) \)
因此时间复杂度也为\(O(n)\);
由上面的几个操作可以看出,只要该操作涉及到遍历操作,那么其时间复杂度就为\(O(n)\)
- 遍历输出
2.2 顺序表的相关算法题及模板
2.2.1 无序数组的排序
- 快速排序(优先使用)
- 快排思路:
- 有数组 \(q\), 左端点 \(l\), 右端点\(r\)
- 确定划分边界 \(x\)
- 将 \(q\) 分为 \(<=x\) 和 \(>=x\) 的两个小数组
- \(i\)的含义: \(i\)之前的元素都 \(≤x\), 即 \( q[l..i−1] ≤x \)
- \(j\)的含义: \(j\)之后的元素都 \(≥x\), 即 \(q[j+1..r] ≧x\)
- 递归处理两个小数组
y总快排模板 详细分析步骤见AcWing 785. 快速排序算法的证明与边界分析
void quickSort(int q[], int l, int r ) {
    if(l >= r)  return;   //递归终止条件;

    //第一步,分解子问题;
    int i = l - 1, j = r + 1, x = q[l + r >> 1];   //选取中间元素作为分界点
    while(i < j) {
        do i ++; while(q[i] < x);
        do j  -- ; while(q[j] > x);
        if(i < j) swap(q[i],q[j]);
    }
    //第二步,递归处理子问题;
    quickSort(q,l,j),quickSort(q,j+1,r);
}
-
归并排序
-
归并思路
- 有数组 \(q\), 左端点 \(l\), 右端点\(r\)
- 确定划分边界\(mid\)
- 递归处理子问题 \(q[l..mid], q[mid+1..r]\)
- 合并子问题
- 主体合并:至少有一个小数组添加到tmp数组中
- 收尾:可能存在的剩下的一个小数组的尾部直接添加到tmp数组中
- 复制回来,tmp数组覆盖原数组
- y总归并模板
void merge_sort(int q[], int l, int r)
{
    //递归的终止情况
    if(l >= r) return;

    //第一步:分成子问题
    int mid = l + r >> 1;

    //第二步:递归处理子问题
    merge_sort(q, l, mid ), merge_sort(q, mid + 1, r);

    //第三步:合并子问题
    int k = 0, i = l, j = mid + 1, tmp[r - l + 1];
    while(i <= mid && j <= r)
        if(q[i] <= q[j]) tmp[k++] = q[i++];
        else tmp[k++] = q[j++];
    while(i <= mid) tmp[k++] = q[i++];
    while(j <= r) tmp[k++] = q[j++];   //分别对应着其中一个数组的元素已经遍历结束;

    for(k = 0, i = l; i <= r; k++, i++) q[i] = tmp[k];
}
如果在做题时题目给的数组是无序数组,且无法想到最优解可以考虑先用快排将数组按升序或者降序先处理一下,再暴力求解;
408考试中不能使用
sort等库函数,如果需要排序先直接默写一个快排下来再调用即可;以下是几个需要先排序再处理的例题:
2.2.2 有序数组的查找——–折半查找(二分查找)
- 左闭右闭写法:
// A:数组,low 和 high:数组区间左端点及右端点下标/索引,x:数组元素
int Search(int A[], int low, int high, int x){
    int mid;
    while (low <= high){ // 左闭右闭
        mid = low + (high - low) / 2;
        if (A[mid] > x) // 若中间值大于 x,说明 x 在左半段
            high = mid - 1;
        else if (A[mid] < x) // 若中间值小于 x,说明 x 在右半段
            low = mid + 1;
        else // 若中间值就是 x
            return mid;
    }
    return -1; // 查找失败
}
- 划分红绿部分算法模板,利用这个模板,只需要修改
isGreen函数,就能实现绝大部分的二分枚举问题
/************** 二分查找 数组 模板 **************/
/*

  1)传参的数组满足:红红红红红红红红绿绿绿绿绿绿绿;
  2)返回值:绿色区段的左边界;
*/

int isGreen(int val, int x);

int binarySearch(int *arr, int arrSize, int x) {
    int l = -1, r = arrSize;
    int mid;
    while(l + 1 < r) {
        mid = l + (r - l) / 2;
        if( isGreen(arr[mid], x) )
            r = mid;
        else
            l = mid;
    }
    return r;
}
/************** 二分查找 数组 模板 **************/
其中,条件函数int isGreen(int val, int x)函数的实现需要根据具体问题具体分析。
int isGreen(int val, int x) {
    return val >= x;                   // (1)
}

int search(int* nums, int n, int x){
    int r = binarySearch(nums, n, x);  // (2)
    if(r == n || nums[r] != x)         // (3)
        return -1;
    return r;                          // (4)
}
对于查找 target 是否存在,我们把数组中 "大于等于 target" 的划分为 绿色,其它为红色,利用模板得到返回值,返回值返回的是 r,也就是绿色箭头指向位置。需要分三种情况讨论:\
1)r=n,所有数都小于 target,返回-1;\
2)nums[r] ≠ target,代表这个值不存在,返回-1;\
3)nums[r]=target,直接返回 r;\
时间复杂度为\(O(logn)\)。
2.2.3 有序数组的合并问题———归并思想
bool merge(vector<int>& nums1, vector <int>& nums2, vector<int>& ret) {
    int i = 0, j = 0, k = 0;
    while(i < nums1.size() && j < nums2.size()) {
        if(nums1[i] < nums2[j]) {
            ret[k++] = nums1[i++];
        }else{
            ret[k++] = nums2[j++];
        }
    }
    while(i < nums1.size())    ret[k++] = nums1[i++];
    while(j < nums2.size())    ret[k++] = nums2[j++];
    return true;
}

/*从后往前双指针*/
class Solution {
public:
    void merge(vector<int>& nums1, int m, vector<int>& nums2, int n) {
        int i = m + n -1;
        int j = m - 1, k = n - 1;
        while(j >= 0 && k >= 0) {
            if(nums1[j] > nums2[k]){
                nums1[i--] = nums1[j--];
            }else{
                nums1[i--] = nums2[k--];
            }
        }
        while(j >= 0) nums1[i--] = nums1[j--];
        while(k >= 0) nums1[i--] = nums2[k--];
    }
};
升序与降序思路一致,代码稍加变动即可;
- 将一个升序和一个降序数组合并为一个升序数组
bool merge(vector<int>& nums1, vector <int>& nums2, vector<int>& ret) {    //nums1为升序数组,nums2为降序数组
    int i = 0, j = nums2.size()-1, k = 0;
    while(i < nums1.size() && j >= 0) {
        if(nums1[i] < nums2[j]) {
            ret[k++] = nums1[i++];
        }else{
            ret[k++] = nums2[j--];
        }
    }
    while(i < nums1.size())    ret[k++] = nums1[i++];
    while(j >=0)               ret[k++] = nums2[j--];
    return true;
}

void merge(vector<int>& nums1, int n, const vector<int>& nums2, int m) {
    // nums1 必须已经有 n+m 个位置,前 n 个元素升序,nums2 的 m 个元素降序。
    int i = n - 1;
    int j = 0;
    int k = n + m - 1;
    while(i >= 0 && j < m) {
        if(nums1[i] > nums2[j]) {
            nums1[k--] = nums1[i--];
        }else{
            nums1[k--] = nums2[j++];
        }
    }
    while(i >= 0) nums1[k--] = nums1[i--];
    while(j < m) nums1[k--] = nums2[j++];
}
同样地,也可以将一个升序和一个降序合并为一个降序,思路与上面的一致,具体代码不再赘述。
2.2.4 数组元素的删除
2.2.4.1 删除特定元素
-
从无序顺序表中删除所有值为x的元素,要求时间复杂度为\(O(n)\),空间复杂度为\(O(1)\)
-
法一:
void delete_x(vector<int>&nums, int x ) {
    int i;       //快指针,正常遍历数组
    int j = 0;  // 慢指针,只有当i当前所指元素不为x时才会移动,实现了遇到多少个值为 x 的元素就滞后于快指针多少个位置的效果,即需要保存的元素个数
    for(i = 0; i < nums.size(); ++i) {
        if(nums[i] != x) {
            nums[j] = nums[i];
            j++;
        }
        // 如果是值为 x 的元素,则慢指针 j 不加 1,这样就和快指针 i 多滞后了一个位置
        // 此时 j 指向值为 x 的元素
    }
    nums.resize(j);   真正缩短 vector 的长度
}
因为是在数组原地操作,所以空间复杂度为\(O(1)\)
- 从有序表中删除所有值为x的元素;
void delete_x(vector<int>& nums, int x) {
    int n = nums.size(); // 获取数组的大小
    int i = 0, j = 0;  // 初始化两个指针,i用于存储结果位置,j用于遍历数组

    // 遍历数组
    while (j < n) {
        if (nums[j] != x) { // 如果当前元素不等于x
            nums[i++] = nums[j]; // 将其移动到位置i,并递增i
        }
        j++; // 无论是否相等,j都递增,继续扫描下一个元素
    }

    // 调整数组大小
    while (i < n) { // 从位置i开始到数组末尾
        nums.pop_back(); // 移除数组末尾元素
        i++; // 继续前进直到调整完毕
    }
}
2.2.4.2 删除值为s到t之间的所有元素
- 无序表中删除值为
s到t之间的所有元素
法一:(好用点)
void delete_s_t(SeqList& L, int s,  int t ) {
    int i;          // 快指针,正常遍历数组元素
    int j = 0;      // 慢指针,遇到多少个值为 s 到 t 之间的元素就滞后于快指针多少个位置,即需要保存的元素个数
    for(i = 0; i < L.length; ++i) {
        if(L.data[i] < s || L.data[i] > t){
            L.data[j++] = L.data[i];
        }
    }
    L.length = j;    //更新顺序表长度;
}
法二:
void delete_s_t(SeqList& L, int s,  int t ) {
    int i;          // 快指针,正常遍历数组元素
    int j = 0;      // 慢指针,遇到多少个值不为 s 到 t 之间的元素就滞后于快指针多少个位置
    for(i = 0; i < L.length; ++i) {
        if(L.data[i] >= s &&  L.data[i] <= t){
            j++;
        }else{
            L.data[i-j] = L.data[i];      // 当前元素往前移到下标为 i-j 的位置
        }
    }
    L.length =L.length - j;    //更新顺序表长度;
}
- 有序表中删除值为
s到t之间的所有元素\ 思路是找到第一个和最后一个值处于该区间的元素下标,然后将该区间的后面的元素依次前移即可;
void Delete_s_t (SeqList& L, int s, int t){
    if (s > t || L.length == 0) return;
    int i = 0; // 头指针
    int j = L.length - 1; // 尾指针

    while (i < L.length && L.data[i] < s)
        i++;
    while (j >= 0 && L.data[j] > t)
        j--;
    if(i <= j){
       int d = j - i + 1;
       while(j < L.length - 1) {
              L.data[i++]  = L.data[j+1] ;   //从最后一个值为x的元素开始,将数组前移
              j++;
        }
        L.length -= d;  //顺序表长度变化
    }else{
        return;    //不存在值为x的元素;
    }
}
2.2.4.3 删除重复元素
从有序表中删除所有其值重复的元素,使表中所有元素的值均不相同,返回处理完的顺序表元素个数
Tip
思路:当顺序表长度不为0时,顺序表中至少有一个元素,在删除完重复元素后也剩下一个元素,因此L.data[0]保持原状即可,从下标为1处开始删除重复元素;设置两个指针,快指针fast用来遍历数组,慢指针slow用来表示下一个不同元素要填入的下标位置,初始时两个指针都指向下标为1处。
由于该顺序表有序,所以如果L.data[fast] != L.data[fast-1],那么就说明此时fast指针指向的元素是之前未出现的元素,因此将``slow指针处元素赋值为当前fast下标出的值然后让slow++即可。
int remove_duplicates(SeqList& L) {
    if(L.length == 0) return 0;
    int fast = 1, slow = 1;
    while(fast < L.length) {
        if(L.data[fast] != L.data[fast-1]) {
            L.data[slow] = L.data[fast];
            ++ slow;
        }
        ++fast;
    }
    L.length = slow;
    return L.length;
}
2.2.5 其他数组问题
- 数组逆置
void reverse(vector<int>& nums) {
    int i = 0, j = static_cast<int>(nums.size()) - 1, tmp;
    while(i < j) {
        tmp = nums[i];
        nums[i] = nums[j];
        nums[j] = tmp;
        ++i,--j;
    }
}
2.3 链表的定义和基本操作
- 单链表结点的数据结构描述
typedef struct LNode{
    int data;    //数据域
    struct LNode *next;    //代表指针域,指向直接后继元素;
}LNode,*LinkList;    //结构体别名
单链表是由表头指针唯一确定,因此单链表可以用头指针的名字来命名。若头指针名是L,则简称该链表为表L。
- 单链表的初始化
//有头结点的单链表的初始化
LNode* InitList_with_head() {
    LNode *head = (LNode*) malloc(sizeof(LNode));    //创建头结点;
    head->next = NULL;      //初始化为空链表
    head->data = 0;
    return head;
}

//无头结点的单链表的初始化
LNode* InitList_without_head(){
    LNode *head = NULL;    //直接指向NULL,初始为空链表
    return head;
}
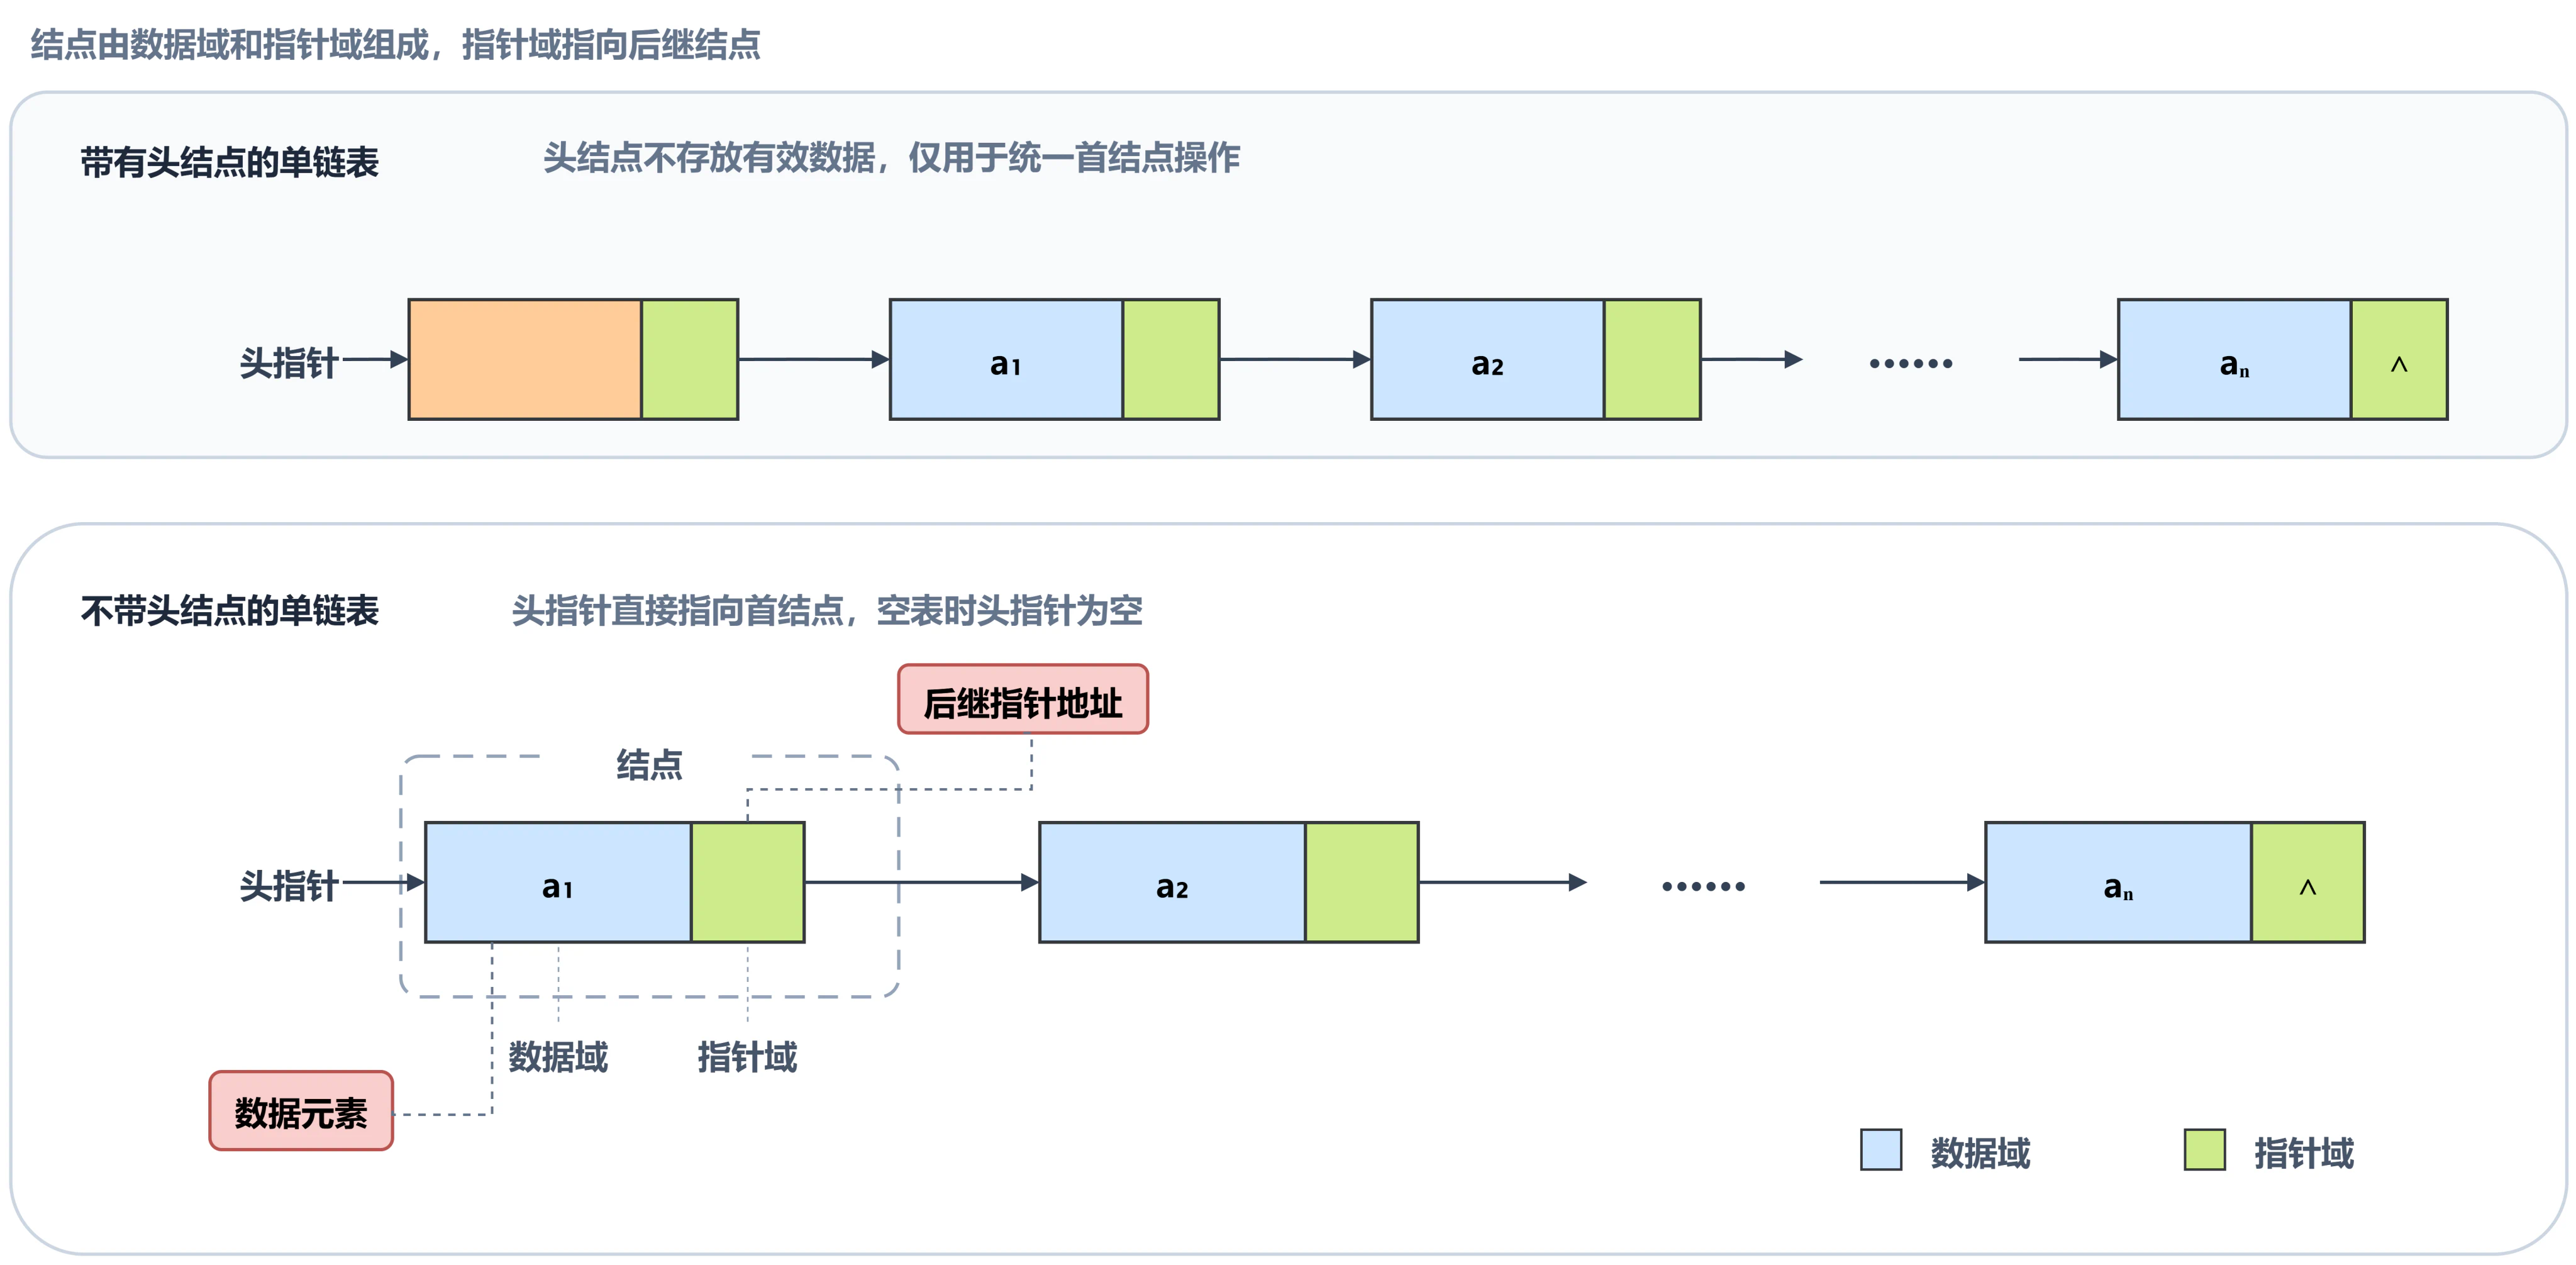
由于带有头结点的链表更容易操作,因此如果题目中给的链表无头结点,可以自己申请一个dummy结点指向第一个结点,然后dummy就是新的头节点,之后就可以按照有头结点的链表进行操作
- 单链表求表长(不含头结点)
int ListLength(LNode *L) {
    LNode *p = L->next;    //带有头结点的情况;
    //LNode *p = L;     // 无头结点的情况
    int length = 0;
    while(p != NULL) {
        ++length;
        p = p -> next;
    }
    return length;
}
该操作遍历了整个链表,因此时间复杂度为\(O(n)\)
- 单链表按位查找\ 由于单链表不支持随机存取,所以只能从头结点开始遍历,直到找到目标结点,所以时间复杂度为\(O(n)\)
LinkList getElem(LNode *L, int i) {      // 当函数需要返回某个结点时,用LinkList作文件名
    LNode *p = L;    //带有头结点的情况;
    //LNode *p = L;     // 无头结点的情况
    if(i == 0)  return L;    //若i=0,返回头结点;
    else if(i < 0) return NULL;
    else{
        while(p != NULL && i != 0) {
            p = p -> next;
            i--;
        }
        return p;   //退出循环时要么找到,返回p结点;要么i超过了链表的长度,则返回NULL;
    }
}
- 单链表的按值查找
LinkList LocateElem(LNode *L, int target) {      // 当函数需要返回某个结点时,用LinkList作文件名
    LNode *p = L->next;    //带有头结点的情况;
    //LNode *p = L;     // 无头结点的情况
    while(p != NULL && p -> data != target) {
        p = p-> next;
    }
    return p;
}
- 头插法建立单链表
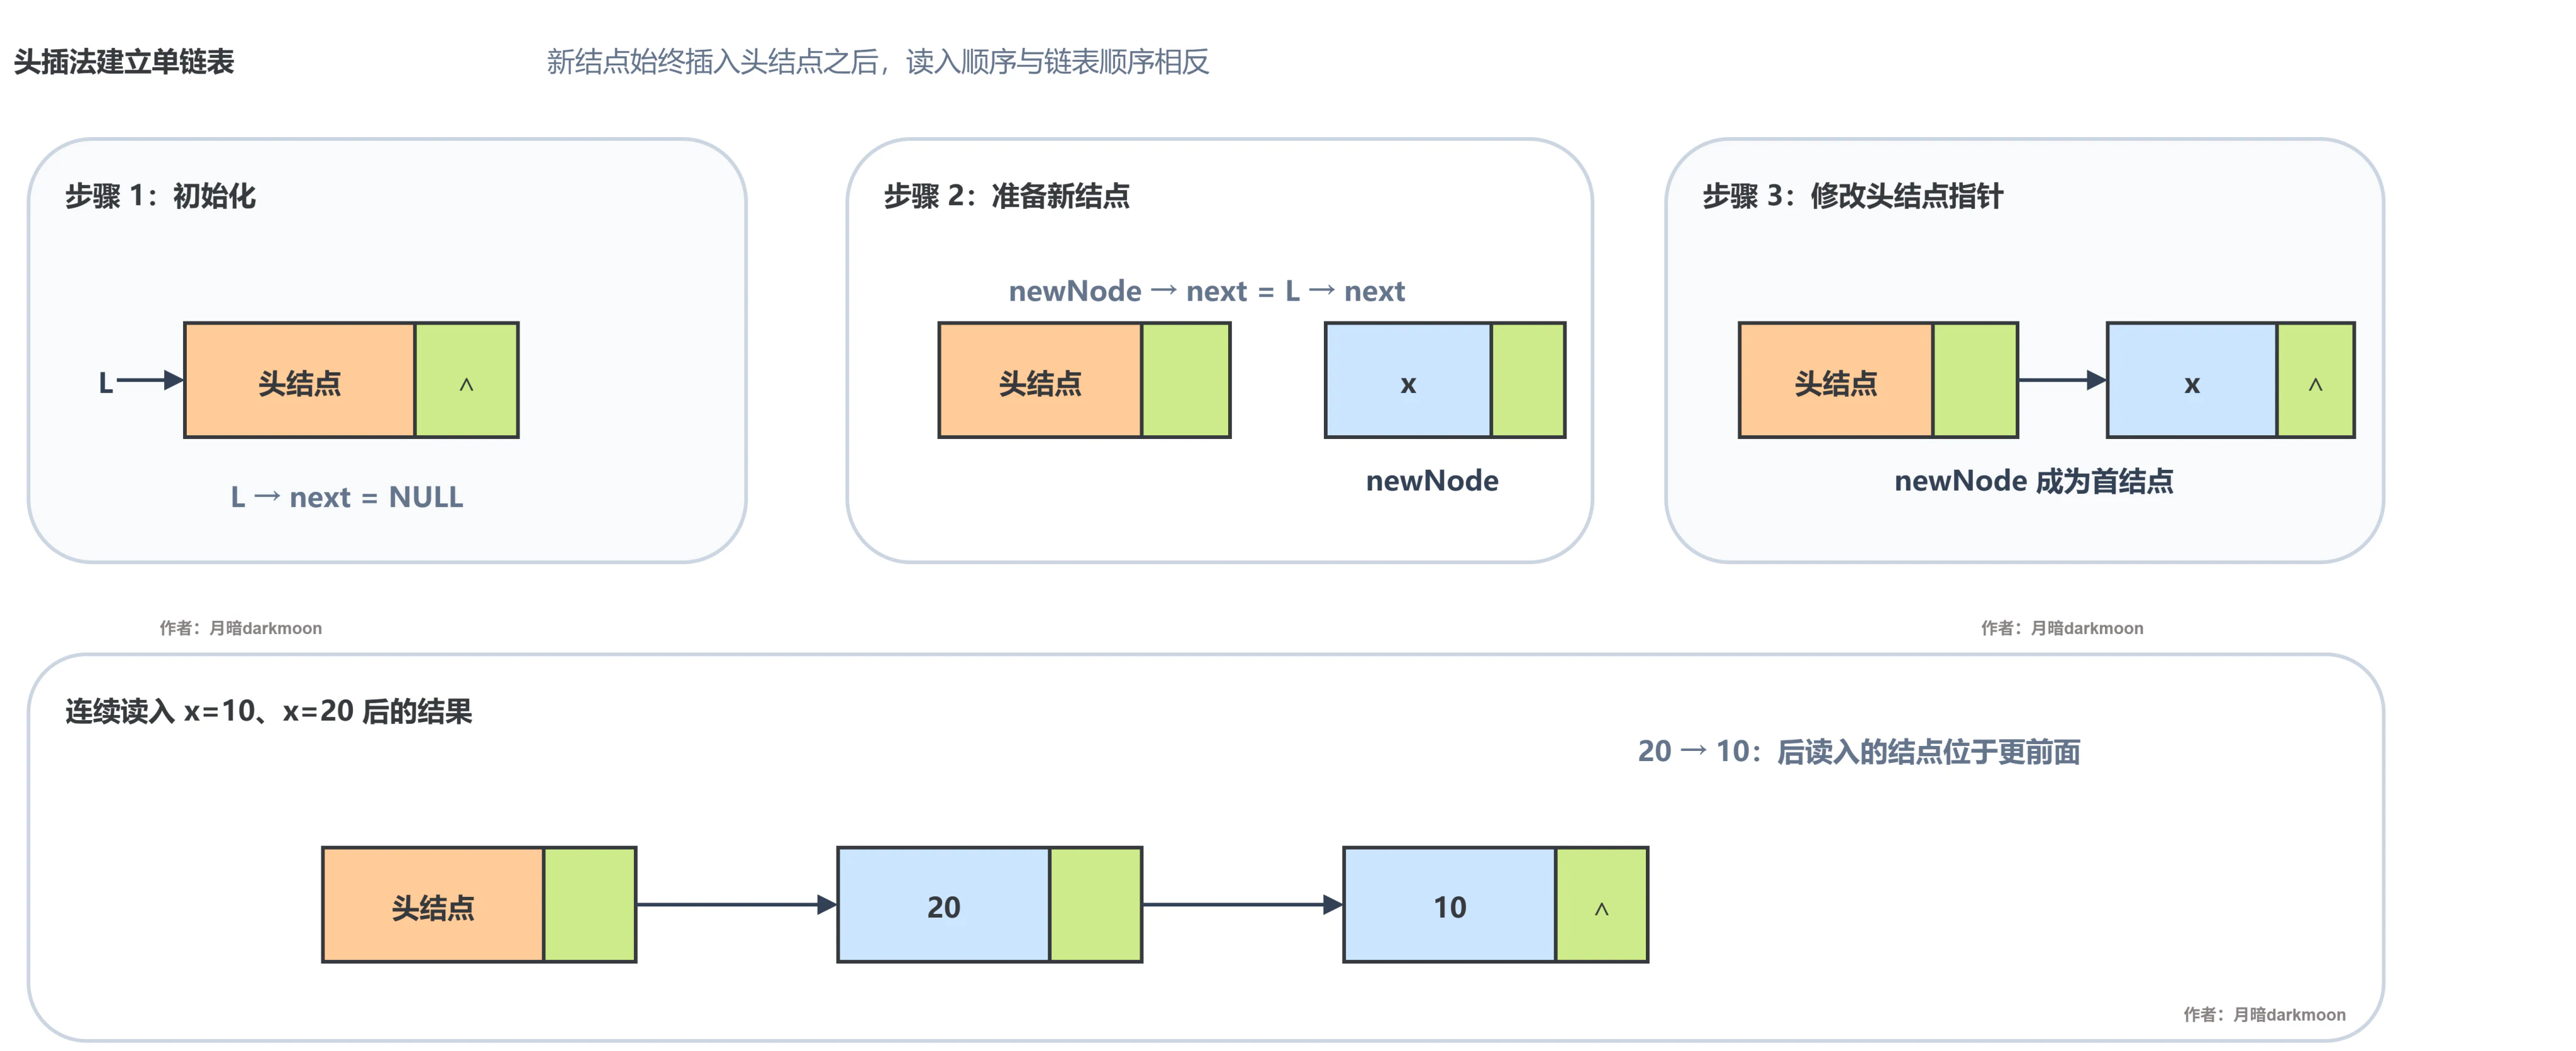
LinkList  List_head_insert(LNode *&L) {    //若链表要改变的话注意带上&
    LNode *newNode;
    int x;      //假设输入x = -1 代表输入结束
    L = (LinkList)malloc(sizeof(LNode));   // 创立头结点;
    L ->next = NULL;   //初始化为空链表;
    scanf("%d",&x);    //输入结点的值;
    while(x != -1) {
        newNode = (LNode*) malloc(sizeof(LNode));
        newNode -> data = x;
        newNode -> next = L-> next;
        L -> next = newNode;
        scanf("%d", &x);
    }
    return L;
}
采用头插法建立链表时,读入数据的顺序与生成链表中的元素的顺序是相反的,该重要特性常应用与链表的逆置。
由于插入每个结点的时间复杂度为\(O(1)\),设单链表表长为\(n\),则总的时间复杂度为\(O(n)\).
- 尾插法建立单链表
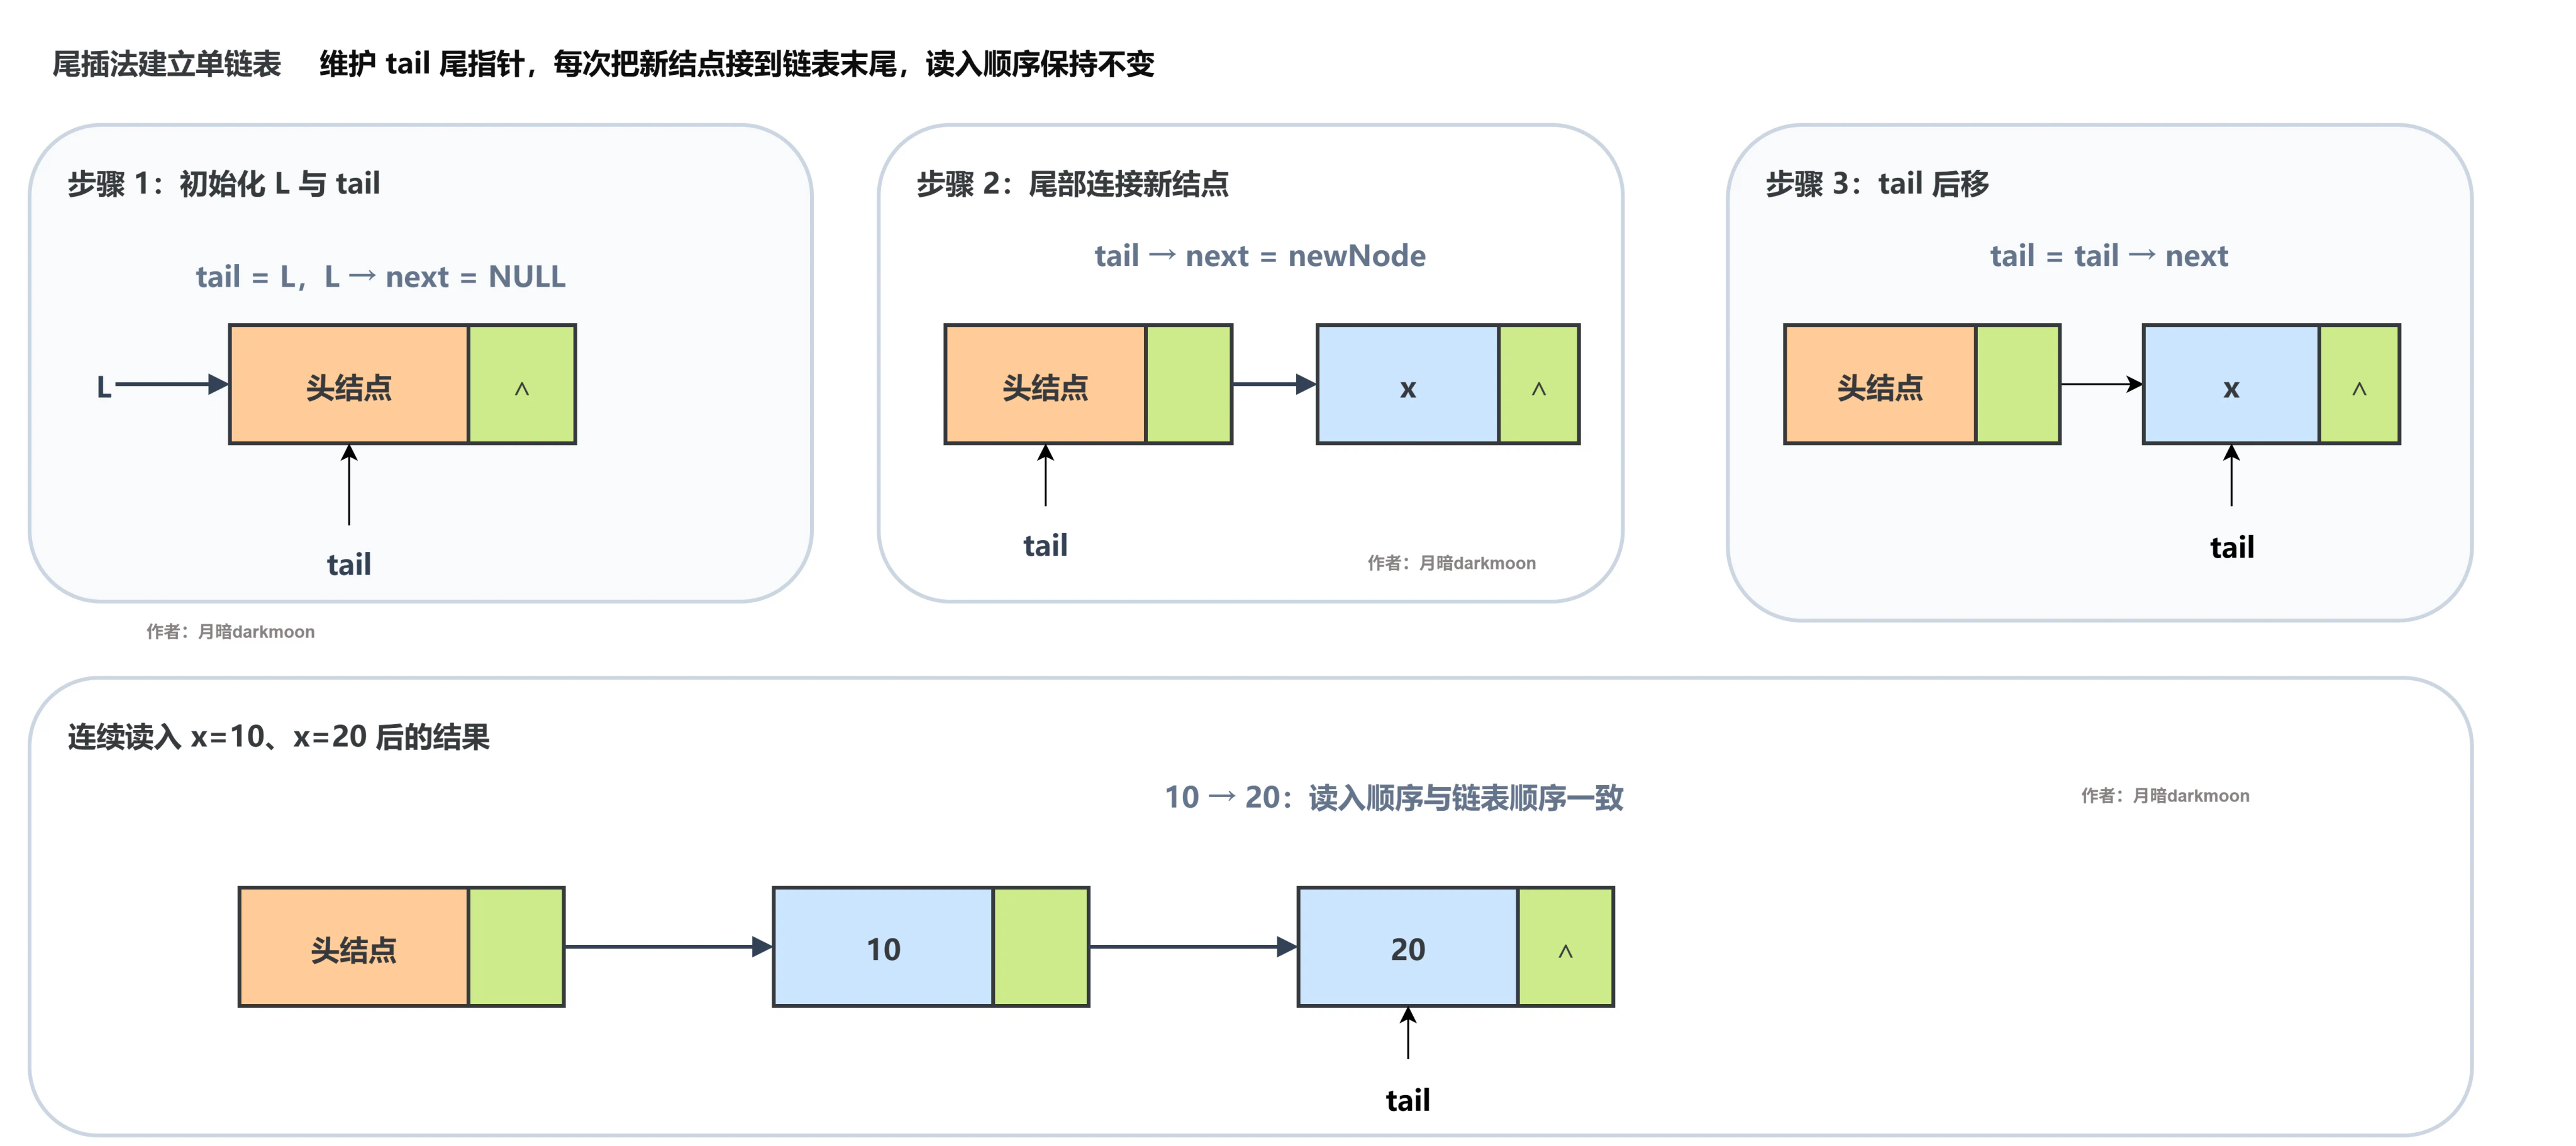
LinkList List_tail_insert(LNode *&L) {        //LNode *&L == LinkList &L
    LNode *newNode, *tail;     //tail为指向链表的表尾指针;
    int x;
    L = (LinkList) malloc(sizeof(LNode));
    L -> next = NULL;
    tail = L;
    scanf("%d",&x);
    while(x!=-1) {
        newNode = (LNode*)malloc(sizeof(LNode));
        newNode -> data = x;
        newNode -> next = NULL;
        tail  -> next = newNode;
        tail  = tail  -> next;     //尾指针始终指向链表表尾位置,每次插入让表尾指针指向新插入节点,然后表尾指针后移;
        scanf("%d", &x);
    }
    return L;
}
尾插法关键点在于建立一个始终指向表尾的指针Lnode *r,因此插入的总体时间复杂度为\(O(n)\)
- 插入结点操作
将值为x的新结点插入单链表的第i个位置;
- 后插法,找到第i-1个元素将新结点插入其后面
bool InsertNode (LNode *&L, int i, int x) {
    LNode *newNode, *preNode,*curNode;   //新插入结点,第i-1个结点,原来第i个结点;
    if( i <= 0) return false;
    preNode = getElem(L, i-1);   //调用上面的按位查找函数,先找到第i-1个结点;
    if(preNode == NULL )    return false;
    curNode = preNode -> next;

    newNode = (LNode*)malloc(sizeof(LNode));
    newNode -> data = x;
    newNode -> next = curNode;
    preNode -> next = newNode;
    return true;
}
该算法由于在查找第i-1个位置时涉及到了遍历操作,因此时间复杂度为\(O(n)\);
- 扩展:由上面的操作可知,对某个结点的前插操作可以转化为后插操作,前提是要找到第
i-1个结点,如果题目已经给出了当前结点,我们可以将待插入结点插入当前结点的后面,然后交换这两个结点的值,那么就可以实现\(O(1)\)时间复杂度的算法\ 例如:将值为x的结点插入P结点的后面
void  insertnode(LNode *p,int x ){
    LNode *newNode;
    newNode = (LNode*)malloc(sizeof(LNode));
    newNode -> data = p-> data;      //交换数据域
    newNode -> next = p -> next;    //修改指针域,注意不能颠倒顺序;
    p -> next = newNode;
    p -> data = x;    //交换数据域
}
- 删除结点操作
- 如果仅仅给出了要删除结点的位置
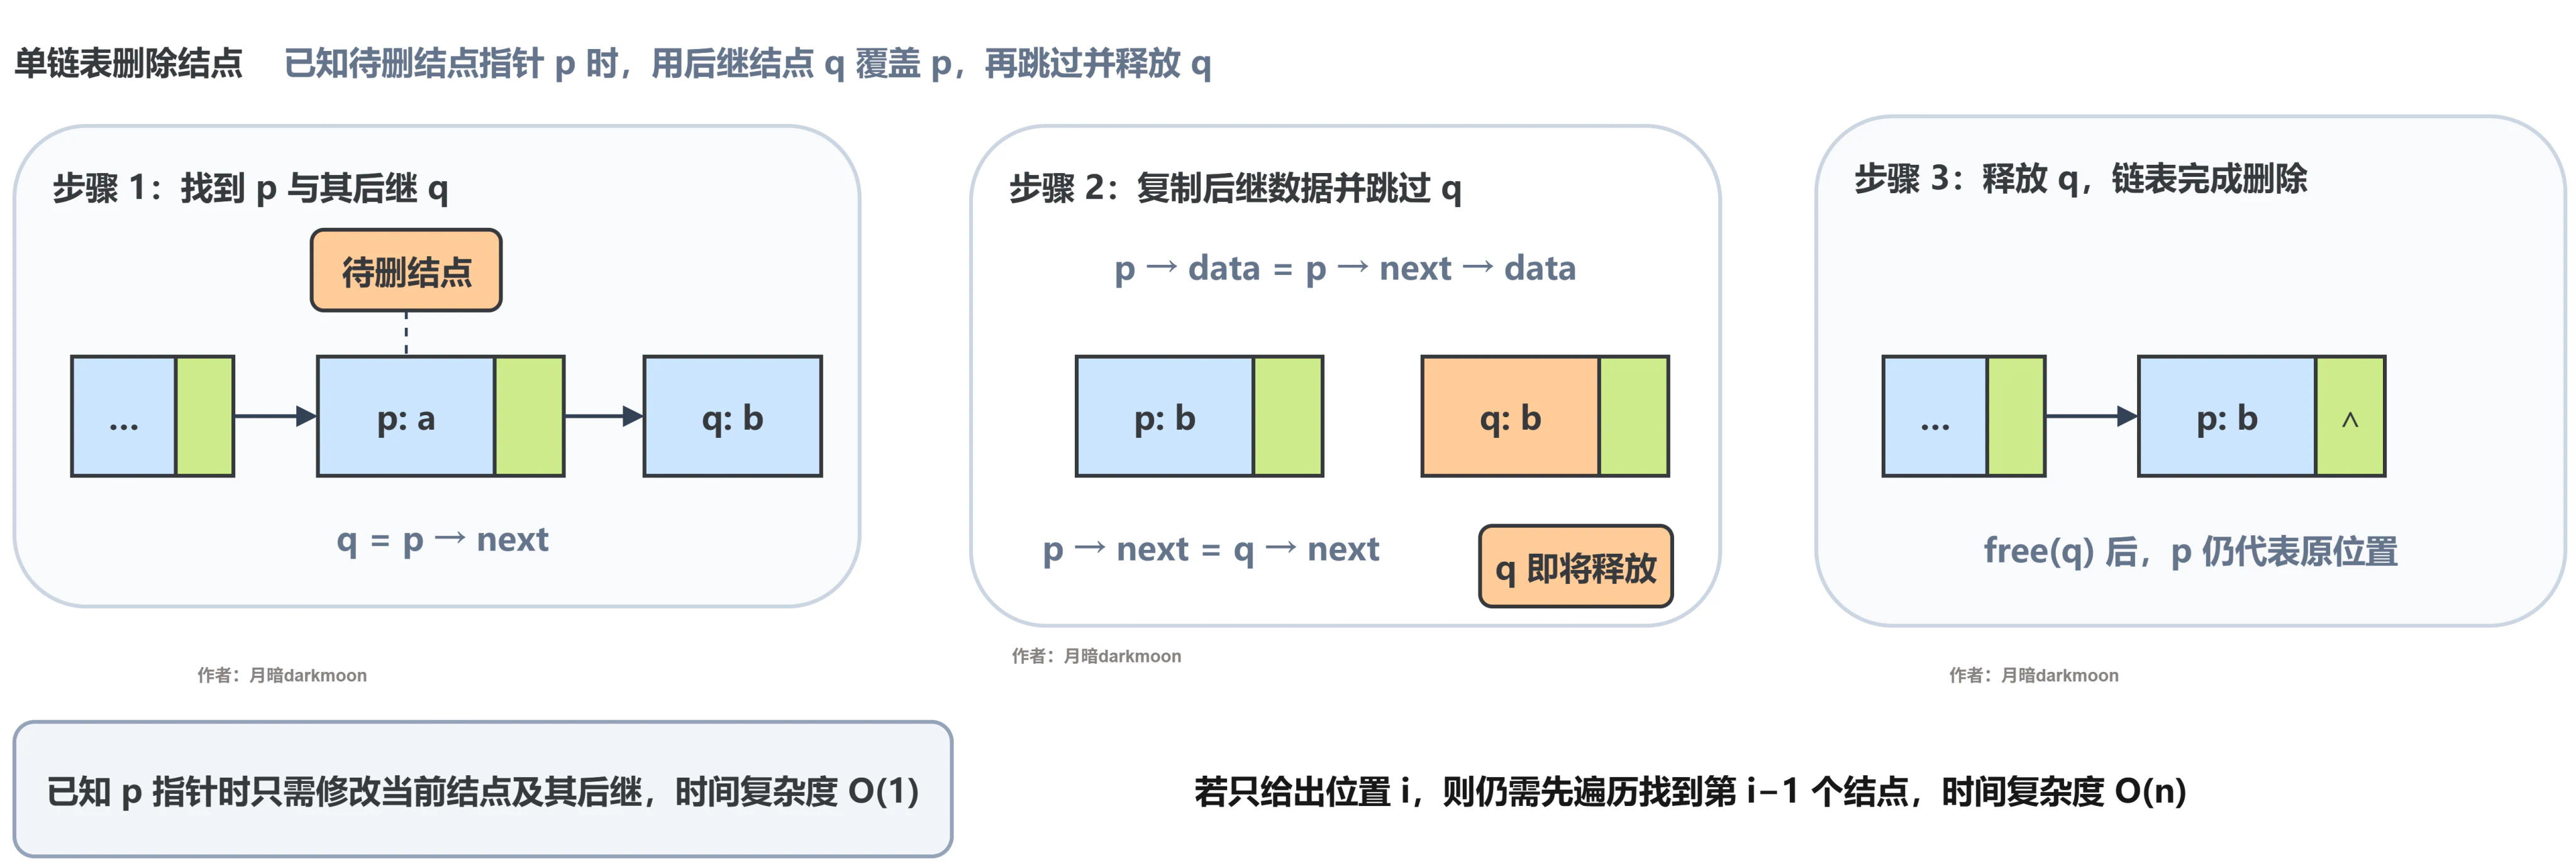
i,那么需要调用getElem来找到第i-1个结点p,然后p->next = p -> next -> next,再将该结点释放掉即可,由于查找i-1个结点需要遍历,因此该程序的时间复杂度为\(O(n)\); - 如果给出了当前结点的指针,那么要删除该结点的话就可以用下面的方法:
既然不能干掉自己,那就变成儿子,在干掉儿子\ 237. 删除链表中的节点
void deleteNode(LNode *p) {
    if (p == NULL || p->next == NULL) return;
    p -> data = p -> next -> data;
    LNode *q = p -> next;
    p-> next = q -> next;
    free(q);       //释放空间
}
2.4 双向链表的定义和基本操作
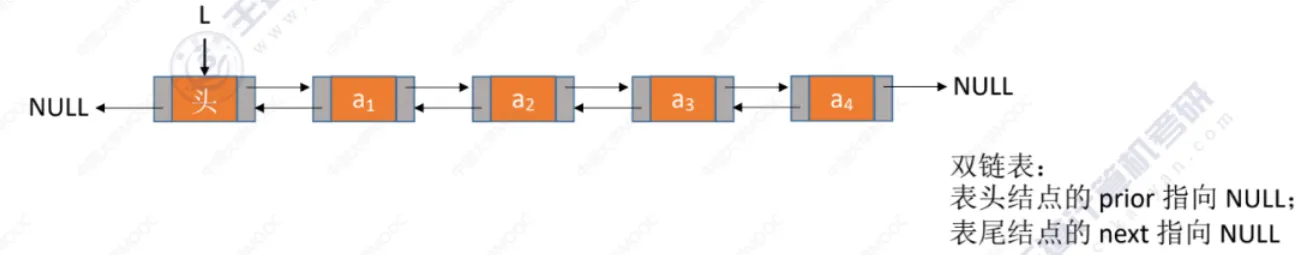
- 双向链表的数据结构定义
- 双向链表的插入操作\
在
p结点的后面插入结点q,双向链表的操作画图注意顺序即可;
- 双向链表的删除操作\ 删除p结点后面的q结点
2.5 其他链表
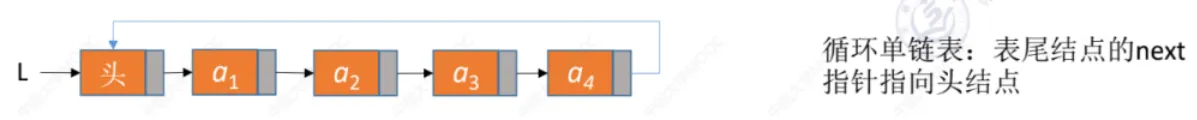
- 循环单链表:与普通单链表的区别在于,表中最后一个结点的指针不是NULL,而改为指向头结点,从而使整个链表形成一个环。所以其判空条件为“
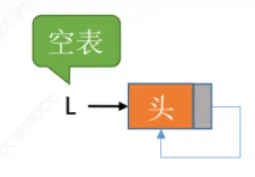
tail == head”或head->next==head,对于普通单链表,访问最后一个结点的时间复杂度为\(O(n)\),而如果在循环单链表的表尾设置了一个表尾指针tail,那么就能以\(O(1)\)的时间复杂度访问头、尾结点了。\ 由于其具有的循环特性,循环单链表可以从表中的任意一个结点开始遍历整个链表,而普通的单链表从一个结点出发只能找到后续的各个结点。循环链表的插入、删除操作与普通链表区别不大,但是在头尾处进行插入、删除操作需要注意维护循环特性。如果有尾指针,在删除尾指针指向的结点时,要注意维护尾指针,即将其重新指向表尾结点。\ 初始化操作:
bool InitList(LNode*& Head)
{
    Head=(LNode*)malloc(sizeof(LNode));
    if(Head==NULL)
        return false;
    Head->next=Head;//代表这是一个空表
    return true;
}
【2021-1】已知头指针h指向一个带头结点的非空单循环链表,结点结构为data next ,其中next是指向直接后继结点的指针,p是尾指针,q是临时指针。现要删除该链表的第一个元素,正确的语句序列是( )。
A. h->next = h->next->next; q = h->next; free(q);
B. q = h->next; h->next = h->next->next; free(q);
C. q = h->next; h->next = q->next; if (p != q) p = h; free(q);
D. q = h->next; h->next = q->next; if (p == q) p = h; free(q);
答案
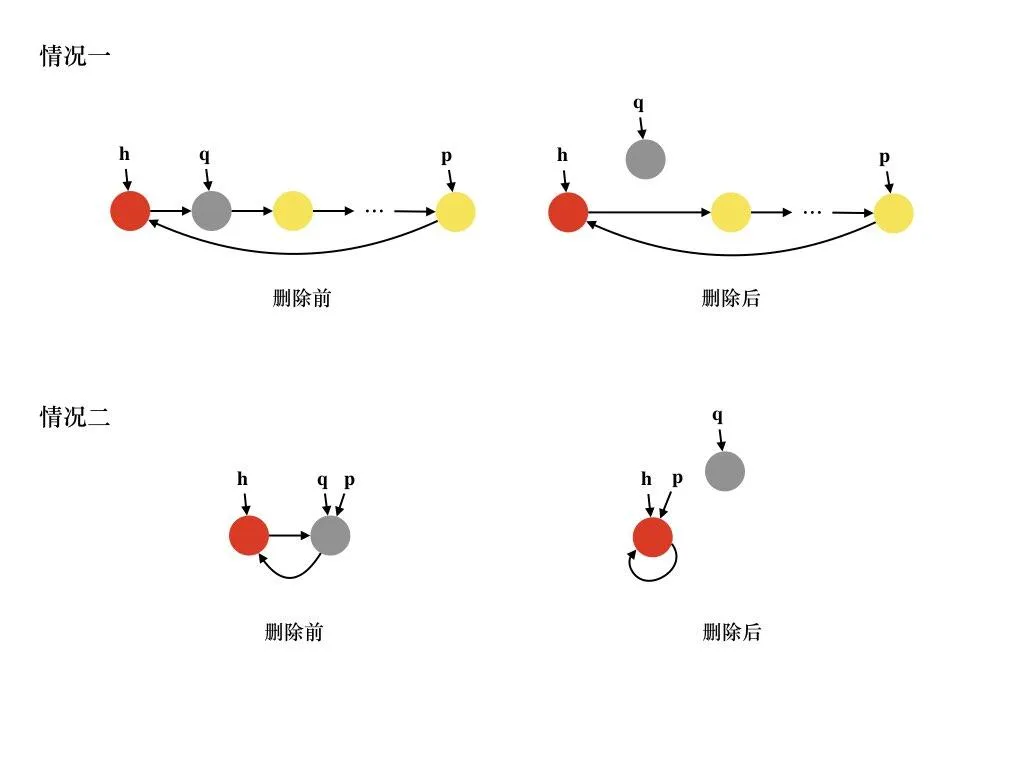
如上图所示,为了生动形象,图中删除后没有释放被删除结点。
情况一:链表元素个数大于 1 。
此时p != q,有
q = h->next; h->next = q->next; free(q);
情况二:链表元素个数等于 1 。
此时p == q,有
q = h->next; h->next = q->next; p = h; free(q);
综上,
q = h->next; h->next = q->next; if (p == q) p = h; free(q);
本题选D。
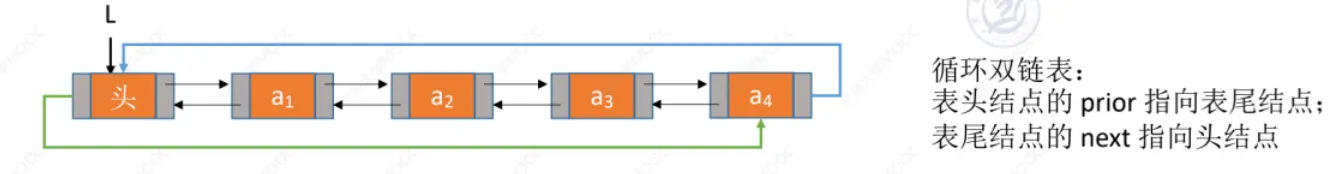
- 循环双链表:每个结点都有两个指针,一个
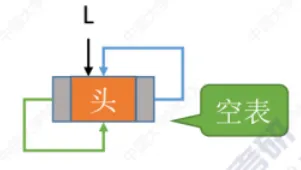
next指针,一个prior指针,头结点的prior指向表尾结点,表尾的next指向头结点;对于带有头结点的循环双链表,其判空条件有head -> next == head和head -> prior = head.
//初始化
bool InitDlinkList(DNode*& Head)
{
    Head=(DNode*)malloc(sizeof(DNode));
    if(Head==NULL)
        return false;
    Head->prior=Head;//注意
    Head->next=Head;//注意
    return true;
}
- 静态链表:借助数组来描述线性表的链式存储结构,结点还有指针域和数据域,指针域存放的是数组下标,文件分配表
FAT采用的就是这种数据结构;静态链表一般以next == -1作为其结束的标志,其插入删除操作与动态链表相同,只需要修改指针,而不需要移动元素。缺点和FAT一样,不能随机存取,只能从头结点开始依次往后查找;容量固定不可变。
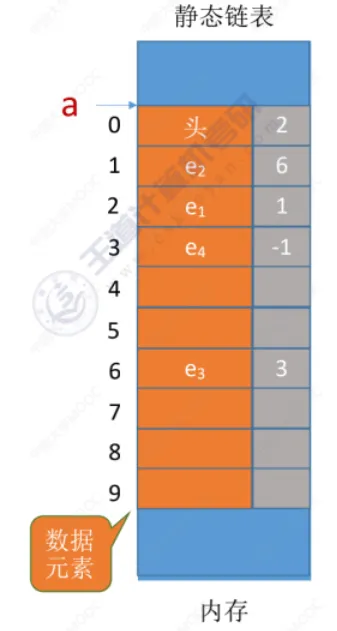
数据结构描述如下:
#define MaxSize 50    //静态数组的最大长度
typedef  struct {
    int data;     //存储数据元素;
    int next;    //下一个元素的数组下标
}SLinkList[MaxSize];
【2016-01】已知表头元素为c的单链表在内存中的存储状态如下表所示。
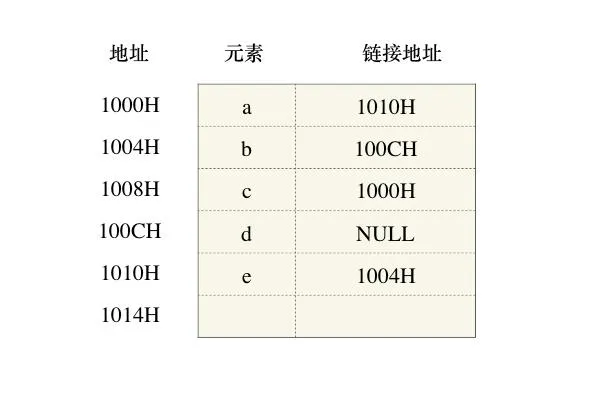
现将f存放于1014H处并插入到单链表中,若f在逻辑上位于a和e之间,则a, e, f的“链接地址”依次是( )。
A. 1010H, 1014H, 1004H
B. 1010H, 1004H, 1014H
C. 1014H, 1010H, 1004H
D. 1014H, 1004H, 1010H
答案
首先要构造出这条链表,题目已经降低难度告诉你表头元素为c,正向构造单链表为:
c(1008H)→a(1000H)→e(1010H)→b(1004H)→d(100CH)→NULL
当然命题组可以加大难度,不告诉你表头元素为c这个条件,那么就需要从d的链接地址为NULL从表尾到表头逆向构造链表。如果进一步加大难度,可以添加一些不在链表中的干扰元素。
按照题意,插入f(1014H)到a和e之间,单链表变为:
c(1008H)→a(1000H)→f(1014H)→e(1010H)→b(1004H)→d(100CH)→NULL
a指向f,链接地址为1014H;e指向b,链接地址为1004H;f指向e,链接地址为1010H。
本题选D。
注意:如果没有按照题目要求a, e, f的顺序输出链接顺序,而是按照链表a, f, e的顺序输出链接顺序,会误选C,所以审题一定要仔细。
【relax每日一题】已知表头元素为c的单链表在内存中的存储状态如下表所示:
| 下标 | 元素 | 链接地址 |
|---|---|---|
| 0 | a | 4 |
| 1 | b | 3 |
| 2 | c | 0 |
| 3 | d | -1 |
| 4 | e | 1 |
删除元素a后,数组下标为0,2的表项中地址内容为()
A. 2,4
B. -1,4
C. -1,3
D. -2, 4
答案
答案:D。【解析】原链表为c->a->e->b->d->NULL,现在删除a,那么变为c->e->b->d->NULL,-1表示指向NULL,-2表示空表项,所以应该把a所在的表项0中的地址改为-2,把c所在的表项2中的地址改为4(指向e)。
2.6 链表的典型应用
- 单向链表通常用于实现栈、队列、散列表和图等数据结构。
- 栈与队列:当插入和删除操作都在链表的一端进行时,它表现出先进后出的的特性,对应栈;当插入操作在链表的一端进行,删除操作在链表的另一端进行,它表现出先进先出的特性,对应队列。
- 散列表:链地址法是解决哈希冲突的主流方案之一,在该方案中,所有冲突的元素都会被放到一个链表中。
- 图:邻接表是表示图的一种常用方式,在其中,图的每个顶点都与一个链表相关联,链表中的每个元素都代表与该顶点相连的其他顶点。
- 多级反馈队列调度算法:多级反馈队列调度算法中,任务被分成多个优先级队列,并按照一定规则进行调度。每个队列可以使用单向链表来管理任务,实现按优先级进行任务调度。
- 资源管理:单向链表可以用来管理资源,例如内存分配中的空闲块链表,通过将空闲的内存块连接成一个链表,可以方便地进行分配和释放。
- 双向链表常被用于需要快速查找前一个和下一个元素的场景。
- 高级数据结构:比如在红黑树、B 树中,我们需要知道一个节点的父节点,这可以通过在节点中保存一个指向父节点的指针来实现,类似于双向链表。
- 浏览器历史:在网页浏览器中,当用户点击前进或后退按钮时,浏览器需要知道用户访问过的前一个和后一个网页。双向链表的特性使得这种操作变得简单。
浏览器的前进后退功能本质上是“栈”的体现。当用户访问一个新页面时,该页面会被添加到栈顶;当用户点击后退按钮时,该页面会从栈顶弹出。使用双向队列可以方便实现一些额外操作。
- LRU 算法:在缓存淘汰算法(LRU)中,我们需要快速找到最近最少使用的数据,以及支持快速地添加和删除节点。这时候使用双向链表就非常合适。每次访问数据时,将其移到链表的头部,这样尾部的节点就是最近最少使用的数据,可以方便地淘汰。
- 双向队列(Deque):双向队列是一种具有队列和栈的特性的数据结构,可以在队列的头部和尾部进行插入和删除操作。双向链表可以用来实现双向队列,提供高效的插入和删除操作。
- 图的表示:在图的表示中,每个顶点通常包含一个指向其邻居顶点的链表。双向链表可以用于表示有向图或无向图中顶点的邻居关系,每个顶点可以同时保存指向前一个邻居和后一个邻居的指针。
- 文本编辑器的撤销和重做操作:在文本编辑器中,双向链表可以用来实现撤销和重做操作。每次编辑操作都可以将编辑内容添加到链表的尾部,可以通过向前或向后遍历链表来实现撤销和重做操作。
- 音乐播放器的播放列表:在音乐播放器中,双向链表可以用来实现播放列表,每个节点表示一个音乐文件,可以方便地在当前歌曲的前后插入或删除歌曲。
3. 循环链表常被用于需要周期性操作的场景,比如操作系统的资源调度。 - 时间片轮转调度算法:在操作系统中,时间片轮转调度算法是一种常见的 CPU 调度算法,它需要对一组进程进行循环。每个进程被赋予一个时间片,当时间片用完时,CPU 将切换到下一个进程。这种循环的操作就可以通过循环链表来实现。 - 环形缓冲区(Circular Buffer):环形缓冲区是一种常见的数据结构,用于在固定大小的缓冲区中循环存储数据。环形链表可以用来实现环形缓冲区,实现高效的数据读写操作。 - 数据缓冲区:在某些数据缓冲区的实现中,也可能会使用到循环链表。比如在音频、视频播放器中,数据流可能会被分成多个缓冲块并放入一个循环链表,以便实现无缝播放。 - 循环队列(Circular Queue):循环队列是一种特殊的队列数据结构,当队列的尾部达到数组的末尾时,可以绕回数组的开头,形成一个循环。环形链表可以用来实现循环队列,提供高效的队列操作。