第三讲栈、队列和数组
【考频统计】:
| 年份 | 考点 | 分值 |
|---|---|---|
| 2009 | 队列的应用、栈和队列的出入操作 | 单选 * 2 = 4分 |
| 2010 | 栈的出入操作、受限双端队列的出入操作 | 单选 * 2 = 4分 |
| 2011 | 栈的出入操作、循环队列的判空 | 单选 * 2 = 4分 |
| 2012 | 栈的应用:中缀转后缀 | 单选 2分 |
| 2013 | 栈的出入操作 | 单选 2分 |
| 2014 | 栈的应用:中缀转后缀、循环队列的判空判满 | 单选 * 2 = 4分 |
| 2015 | 栈的应用:递归 | 单选 2分 |
| 2016 | 队列的出入操作、三对角矩阵的压缩存储 | 单选 * 2 = 4分 |
| 2017 | 栈的综合考察、稀疏矩阵的压缩存储 | 单选 * 2 = 4分 |
| 2018 | 栈在表达式求值中的应用、栈与队列的出入操作、对称矩阵的压缩存储 | 单选 * 3 = 6分 |
| 2019 | 队列的设计(判空、判满等) | 应用题 10分 |
| 2020 | 三角矩阵的压缩存储、栈的出入操作 | 单选 * 2 = 4分 |
| 2021 | 受限双端队列的出入操作、二维数组的存储 | 单选 * 2 = 4分 |
| 2022 | 栈的出入序列 | 单选 2分 |
| 2023 | 稀疏矩阵的存储之三元组 | 单选 2分 |
【考情分析】:本章每年都会出2个选择题左右,重点掌握栈与队列的出入操作、循环队列的判空判满、栈在表达式求值中的应用、矩阵压缩存储的下标计算等知识点;
【考点预测及重点指出】:
- 掌握用顺序表和链表实现的队列和栈的判空判满条件;
- 对于数组实现的栈注意区分
top==0和top == -1入栈时是先进栈再自增还是先自增再进栈。- 栈在括号匹配中的作用;
- 初始化两个栈,操作数栈和运算符栈,实现中缀表达式直接计算(包含了中缀转后缀以及用栈实现后缀表达式的计算)
- 循环队列的判空判满的三种实现方法:牺牲一个空位、设置计数器
count、设置bool型变量flag(回忆具体实现方法,记不清就去看);- 谨记入队时
front指针不会变,变化的是rear指针;出队时,rear指针不会变,变化的是front指针- 记得看一下预测的应用题;
3.1 栈
3.1.1 出栈元素的不同排列与卡特兰数
栈对线性表的插入和删除是在位置上进行了限制,但是并没有对进出时机进行限制。也就说,刚进去的元素也可以立即出栈,也可以等待一会儿再在合适的时机出栈,只要保证当前位置是栈顶即可。
\(n\)个不同元素进栈,出栈元素不同排列的个数\(N\)可由卡特兰(\(Catalan\))数确定:\(N=\frac{1}{n+1}C^n_{2n}=\frac{(2n)!}{n!(n+1)!}\)
比如5个元素进栈的话出栈不同排列的个数为\(\frac{1}{5+1}C^5_{10}=\frac{1}{6}(\frac{10*9*8*7*6}{5*4*3*2*1}) = 42\)
栈混洗(\(stack\ permutation\)):将栈 \(A\) 的栈顶元素弹出并压入栈 \(S\) ,或将栈 \(S\) 的栈顶元素弹出并压入栈\(B\) ,经过一系列的操作后, \(A\)中的元素全部转入 \(B\) 中,则称之为 \(A\) 的一个栈混洗。由于栈 \(A\) 和栈 \(S\) 的弹出与压入次序不一样,由此产生了在栈 \(B\) 中的不同排列方式。若栈A中元素个数为n,其栈混洗种类个数为卡特兰数。具体原理见邓俊辉的栈那一节。
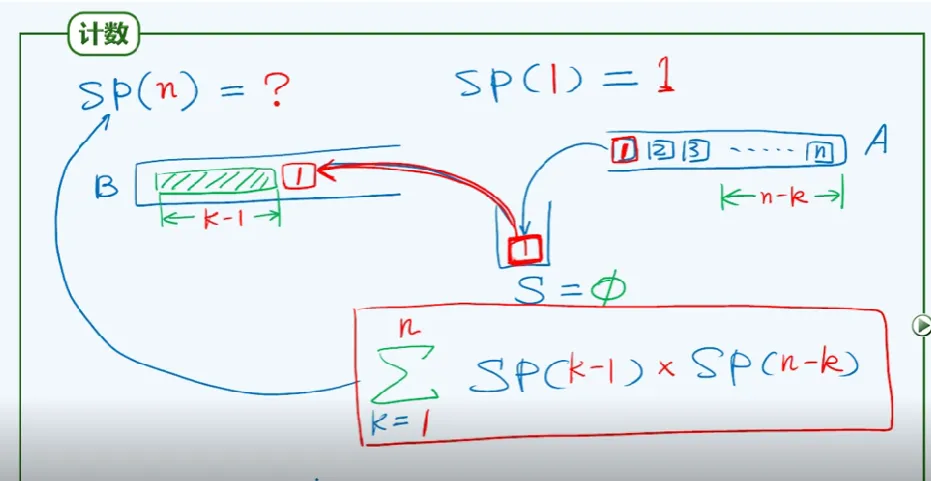
卡特兰数还有另外一个重要用途,即计算二叉树的形态数
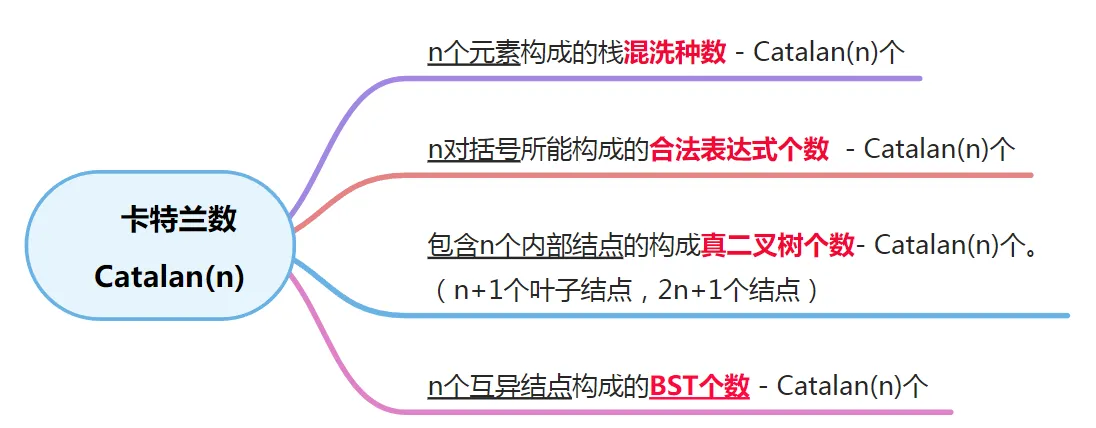
先序序列(前序序列)为 a, b, c, d 的不同二叉树的个数是?
【解】先序序列为入栈次序,中序序列为出栈序列,因为前序序列和中序序列可以唯一确定一棵二叉树,所以相当于“以序列 a, b, c, d为入栈次序,则出栈序列的个数是?”
\(N =\frac{1}{5}C^4_8=\frac{70}{5}=14\)
进栈出栈操作与二叉树中序遍历的关系(这也就是二叉树的中序遍历非递归(迭代)的操作方式):
- 一个结点进栈后有两种处理方式:要么立即出栈(此时该入栈结点没有左孩子),要么下一个结点进栈(有左孩子);
- 一个结点出栈后也有两种处理方式:要么继续出栈(该结点无右孩子),要么下一个结点进栈(有右孩子)
class Solution {
public:
    vector<int> inorderTraversal(TreeNode* root) {
        vector<int> result;
        stack<TreeNode*> st;
        TreeNode* cur = root;
        while (cur != NULL || !st.empty()) {
            if (cur != NULL) { // 指针来访问节点,访问到最底层
                st.push(cur); // 将访问的节点放进栈
                cur = cur->left;                // 左
            } else {
                cur = st.top(); // 从栈里弹出的数据,就是要处理的数据(放进result数组里的数据)
                st.pop();
                result.push_back(cur->val);     // 中
                cur = cur->right;               // 右
            }
        }
        return result;
    }
};
3.1.2 栈的顺序表实现
注意题目中top指针指向的是栈顶元素,还是说指向栈顶元素的下一个位置,条件不同,相应的基本操作也会发生变化,下面给出的源码top指针指向的就是下一个位置。
#define DataType int   //用DataType这个宏定义来统一代表栈中数据的类型,这里将它定义为整型,根据需要可以定义成其它类型,例如浮点型、字符型、结构体 等等;
#define bool int
#define maxn 100010     //maxn代表我们定义的栈的最大元素个数;

struct Stack {                 //定义栈的结构体
    DataType data[maxn];       //DataType data[maxn]作为栈元素的存储方式,数据类型为DataType,可以自行定制;
    int top;        // top即栈顶指针,data[top-1]表示栈顶元素,top == 0代表空栈;
};

void StackClear(struct Stack* stk) {
    //初始化,清空栈,在这里我们规定top指向栈顶元素的下一个存储单元,当然也可以将top设置为指向当前栈顶元素的存储单元,那样的话需要修改为stk -> top = -1;
    stk->top = 0;
}
bool PushStack(struct Stack *stk, DataType dt) {
    //入栈操作,stk是一个指向栈对象的指针,由于这个接口会修改栈对象的成员变量,所以这里必须传指针,否则,就会导致函数执行完毕,传参对象没有任何改变;
    if(stk-> top == maxn){
        return false;         //栈满,报错
    }else{
        stk->data[ stk->top++ ] = dt;       // 将传参的元素放入栈中, 然后将栈顶指针自增 1
        return true;
    }
}

bool PopStack(struct Stack* stk) {      //这里的出栈操作仅仅将栈顶元素弹出,如果需要用这个元素做什么的话弹出时可以用一个临时变量来接收它;
    if(stk->top == 0){
        return false;    //栈空,报错;
    }else{
        --stk->top;          //出栈 操作,只需要简单改变将 栈顶 减一 即可
        return true;
    }
}

//下面为只读接口

DataType StackGetTop(struct Stack* stk) {     //获取栈顶元素:数组中栈元素从 0 开始计数,所以实际获取元素时,下标为 栈顶元素下标 减一;
    return stk->data[ stk->top - 1 ];
}
int StackGetSize(struct Stack* stk) {          //获取栈大小,因为只有在入栈的时候,栈顶指针才会加一,所以它 正好代表了 栈元素个数;
    return stk->top;
}
bool StackIsEmpty(struct Stack* stk) {
    return !StackGetSize(stk);      //当 栈元素 个数为 零 时,栈为空
}
3.1.3共享栈
利用栈底位置相对不变的特性,可以让两个顺序栈共享一个一维数组空间,将两个栈的栈底分别设置在共享空间的两端,两个栈顶向共享空间的中间延伸,如图所示,如果栈顶指针指向当前元素的话,仅当两个栈顶指针相邻时,判断为栈满。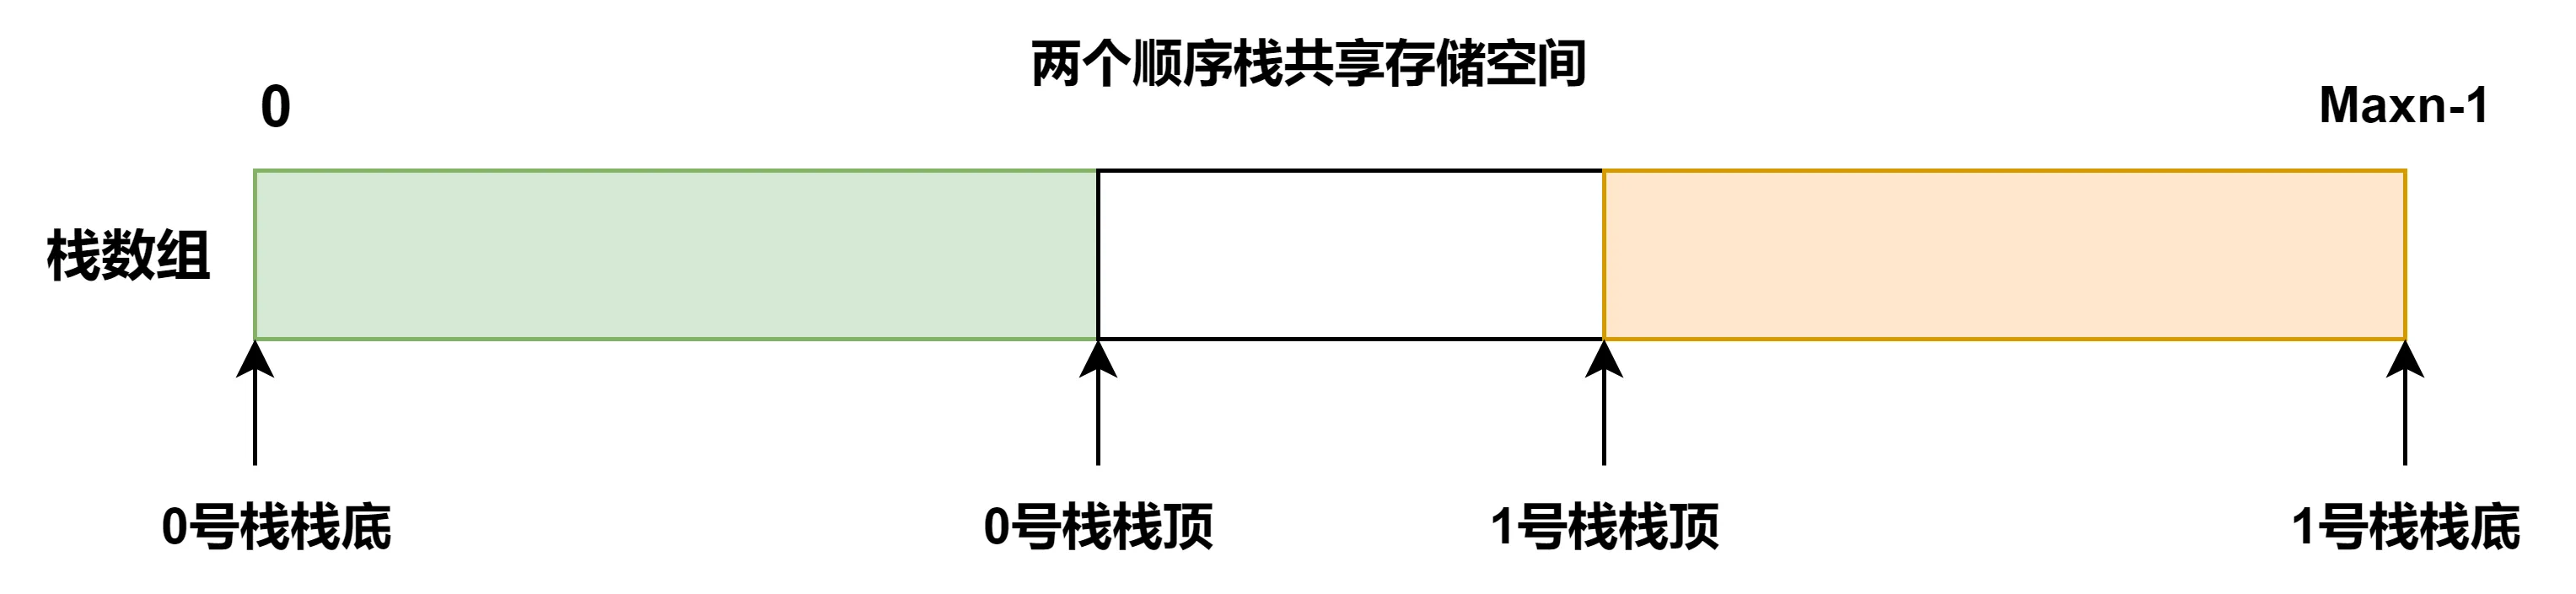
共享栈是为了更有效地利用存储空间,两个栈的空间相互调节,只有在整个存储空间被占满时才发生上溢。其存取数据的时间复杂度均为\(O(1)\),所以对存取效率没有什么影响。
栈的上溢就是缓冲区满还往里写,栈的下溢就是缓冲区空还往外读,为了解决上溢,可以给栈分配很大的空间,而这样又会造成空间的浪费,共享栈的提出就是在解决上溢的基础上节省存储空间,将两个栈放在同一段更大的空间内。
3.1.4 栈的链表实现
不需要掌握,只要知道链栈的操作都是在表头进行的就够了;
采用链式存储的栈称为链栈,其优点是便于多个栈共享存储空间和提高其效率,且不存在栈满上溢的情况。为了方便操作,通常采用不带头结点的单链表实现,并规定所有操作都是在单链表的表头进行的。
尾结点就相当于栈底。
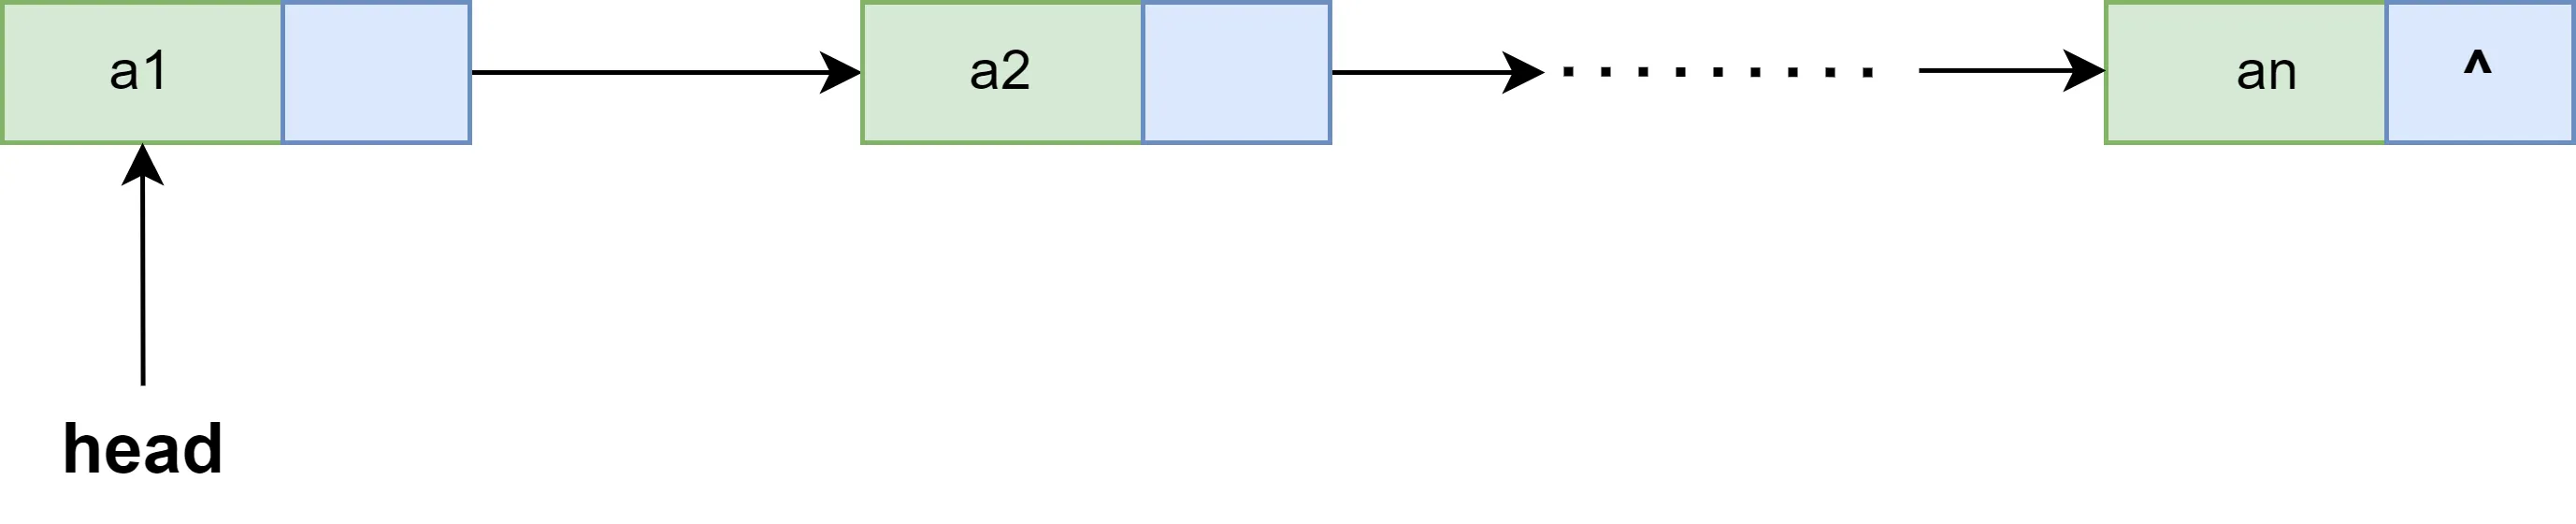
- 定义链栈,并实现基本操作(要求单链表实现,栈顶在链头)带有头结点
//有头节点版本,栈为空时,栈中仅有一个头结点。
//定义栈结点
typedef struct SNode{           //定义单链表结点类型
    int data;                       //每个节点存放一个数据元素
    struct SNode *next;         //指针指向下一个节点
}SNode, *LiStack;

//初始化一个链栈(单链表实现,栈顶在链头)
bool InitStack(LiStack &S) {
    S = (SNode *) malloc(sizeof(SNode)); //分配一个头结点
    S->next = NULL;         //头结点之后暂时还没有节点
    return true;
}

//判断栈是否为空
bool StackEmpty(LiStack S){
    if(S->next==NULL)   //头结点后面没有结点
        return true;    //返回true,表示栈为空
    else
        return false;
}

//入栈(本质上是单链表的“头插法”)
bool Push (LiStack &S, int x){
    SNode * p = (SNode *) malloc(sizeof(SNode));    //新分配一个结点
    p->data = x;     //存入新元素
    p->next = S->next;
    S->next = p;     //新结点插入到头结点后面
    return true;
}

//出栈(本质上是单链表的“头删法”)
bool Pop (LiStack &S, int &x){
    if (StackEmpty(S))      //栈空,出栈操作失败
        return false;
    SNode * p = S->next;     //栈不空,链头结点出栈
    x = p->data;             //x返回栈顶元素
    S->next = p->next;       //头删法,栈顶元素"断链"
    free(p);
    return true;
}
- 用c语言实现链栈的结构体定义与基本操作,不带头节点
//没有头结点的版本,栈为空时,top==NULL;
typedef struct StackNode {                // 定义链栈结点;
    int data;      //每个结点存放一个数据元素;
    struct StackNode *next;   //指针指向下一个节点;
}StackNode;

struct Stack {     //定义链栈;
    StackNode *top;        // top作为 栈顶指针,当栈为空的时候,top == NULL;否则,永远指向栈顶;
    int size;
    // 由于 求链表长度 的算法时间复杂度是 O(n) 的, 所以我们需要记录一个size来代表现在栈中有多少元素。每次入栈时size自增,出栈时size自减。这样在询问栈的大小的时候,就可以通过 O(1)的时间复杂度。
};

//入栈操作,其实就是类似 头插法,往链表头部插入一个新的结点;
void PushStack(struct Stack *stk, int dt) {
    StackNode *insertNode = (StackNode *) malloc(sizeof(StackNode)); // 利用malloc生成一个链表结点insertNode;
    insertNode->next = stk->top;     // 将 当前栈顶 作为insertNode的 直接后继结点;
    insertNode->data = dt;           // 将 insertNode的 数据域 设置为传参 dt;
    stk->top = insertNode;           // 将insertNode作为 新的栈顶;
    ++ stk->size;                    //栈元素 加一;
}

int StackIsEmpty(struct Stack* stk);

//出栈操作,由于链表头结点就是栈顶,其实就是删除这个链表的头结点的过程。
void PopStack(struct Stack* stk) {
    if(stk->top == NULL) {
        return;
    }
    StackNode *temp = stk->top;  // 将 栈顶指针 保存到temp中;
    stk->top = temp->next;              //将 栈顶指针 的 后继结点 作为新的 栈顶;
    free(temp);                         // 释放之前 栈顶指针 对应的内存;
    --stk->size;                        // 栈元素减一;
}

//清空栈,即栈的初始化,可以理解为,不断的出栈,直到栈元素个数为零。
void StackClear(struct Stack* stk) {
    while(!StackIsEmpty(stk)) {       //判断当前栈是否为空
        PopStack(stk);           // 每次操作其实就是一个 出栈 的过程,如果 栈 不为空;则进行 出栈 操作,直到 栈 为空;
    }
    stk->top = NULL;                  //  然后将 栈顶指针 置为空,代表这是一个空栈了;
    stk->size = 0;
}

//只读接口
int StackGetTop(struct Stack* stk) {
    if(stk->top == NULL) return 0;
    return stk->top->data;                 // stk->top作为 栈顶指针,它的 数据域 data就是 栈顶元素的值,返回即可;
}
int StackGetSize(struct Stack* stk) {
    return stk->size;                      //  size记录的是 栈元素个数;
}

int StackIsEmpty(struct Stack* stk) {
    return !StackGetSize(stk);      //当 栈元素 个数为 零 时,栈为空。
}
- 定义链栈,并实现基本操作(要求双链表实现,栈顶在链尾)
//定义栈结点
typedef struct DbSNode{             //定义双链表结点类型
    int data;                       //每个节点存放一个数据元素
    struct DbSNode *last,*next;     //指向前后两个结点
}DbSNode;

typedef struct DbLiStack{           //双链表实现的栈(栈顶在链尾)
    struct DbSNode *head, *rear;    //两个指针,分别指向链头、链尾
}DbLiStack, *DbStack;

//初始化一个链栈(单链表实现,栈顶在链头)
bool InitDbStack(DbStack &S) {
    S = (DbLiStack *) malloc(sizeof(DbLiStack));    //初始化一个链栈(双链表实现,栈顶在链尾)
    DbSNode * p = (DbSNode *) malloc(sizeof(DbSNode)); //新建一个头结点
    p->next = NULL;         //头结点之后暂时还没有节点
    p->last = NULL;         //头结点之前没有节点

    S->head = p;
    S->rear = p;

    return true;
}

//判断栈是否为空
bool DbStackEmpty(DbStack S){
    if(S->head == S->rear)   //头指针和尾指针指向同一个结点
        return true;    //返回true,表示栈为空
    else
        return false;
}

//入栈(在双链表链尾插入)
bool DbPush (DbStack &S, int x){
    DbSNode * p = (DbSNode *) malloc(sizeof(DbSNode));     //新分配一个结点
    p->data = x;     //存入新元素
    p->next = NULL;
    p->last = S->rear;  //新结点插入链尾
    S->rear->next = p;
    S->rear = p;
    return true;
}

//出栈(删除双链表链尾元素)
bool DbPop (DbStack &S, int &x){
    if (DbStackEmpty(S))     //栈空,出栈操作失败
        return false;

    DbSNode * p = S->rear;    //栈不空,链尾结点出栈
    x = p->data;             //x返回栈顶元素
    S->rear = p->last;       //更新链尾指针
    S->rear->next = NULL;
    free(p);                 //释放结点
    return true;
}
3.1.5 栈的两种实现的优缺点
- 顺序表实现:在利用顺序表实现栈时,入栈和出栈的常数时间复杂度低,且清空栈操作相比链表实现可以做到\(O(1)\),唯一的不足之处是:需要预先申请好空间,而且当空间不足时,需要进行扩容;
- 链表实现:在利用链表实现栈时,入栈 和 出栈 的常数时间复杂度略高,主要是每插入一个栈元素都需要申请空间,(不过,如果入栈元素本身就是节点对象,那么可以省去初始化步骤,从而提高效率);每删除一个栈元素都需要释放空间,且 清空栈 操作是\(O(n)\)的,直接将 栈顶指针 置空会导致内存泄漏。好处就是:不需要预先分配空间,且在内存允许范围内,可以一直 入栈,没有顺序表的限制。
3.1.6 c++中的栈(\(stack\))容器适配器
如果在算法题中想要用栈这个数据结构解决问题的话,自己实现的话有点不切实际,由于408考试允许用c++,因此我们可以用stack这个stl容器来做题;
常用的基本操作如下:
stack<int> stk;    //定义一个栈,数据类型可以看情况定义,可以定义为int,链表结点,二叉树结点等等,根据情况自行选择;
stk.push(1);   //元素入栈;
stk.pop();    //元素出栈,无返回值;
int top = stk.top();     //访问栈顶元素;
int size = stk.size();   //获取栈的长度;
bool empty = stk.empty();    //判读栈是否为空
3.1.7 栈的应用 
Note
消除递归必须使用栈这个说法是错误的,迭代也可以用来消除递归,只需要简单的循环就可以完成。
表达式求值有很多方法,使用栈解决只是其中的一种。
3.1.7.1 栈在括号匹配中的应用
题目描述
给定一个只包括 '(',')','{','}','[',']' 的字符串 s ,
判断字符串是否有效。有效字符串需满足:左括号必须用相同类型的右括号闭合。\ 左括号必须以正确的顺序闭合。\ 每个右括号都有一个对应的相同类型的左括号。
样例输入:
s = "()[]{}"样例输出:
true
Note
解题原理:我们遍历给定的字符串\(s\)。当我们遇到一个左括号时,我们会期望在后续的遍历中,有一个相同类型的右括号将其闭合。由于后遇到的左括号要先闭合,因此我们可以将这个左括号放入栈顶。\
当我们遇到一个右括号时,我们需要将一个相同类型的左括号闭合。此时,我们可以取出栈顶的左括号并判断它们是否是相同类型的括号。如果不是相同的类型,或者栈中并没有左括号,那么字符串\(s\)无效,返回False。\
在遍历结束后,如果栈空,说明我们将字符串\(s\)中的所有左括号闭合,返回True,否则返回False。\
注意到有效字符串的长度一定为偶数,因此如果字符串的长度为奇数,我们可以直接返回False,省去后续的遍历判断过程。
我们可以发现,左右括号和入栈出栈(\(push/pop\))其实是对应的关系,当栈为空时再想弹出就会失败,其实这和括号序列中多了一个右括号没有与之相匹配的左括号是一样的效果。
- 代码:
class Solution {
public:
    bool isMatch(char a,char b){
        if((a == '(' && b == ')')|| (a == '[' && b == ']') || (a == '{' && b == '}')){
            return true;
        }
        return false;
    }
    bool isValid(string s) {
        stack<char> stk;      //定义一个栈,用来存放左括号
        if(s.size() % 2 == 1)  return false;     //如果字符串长度为奇数则不可能有效,直接返回false;
        for(int i = 0; i < s.size(); i++){
            if(s[i] == '(' || s[i] == '[' || s[i] == '{')  stk.push(s[i]);     //遇到左括号入栈;
            else if(stk.empty()) return false;       //如果遇到了右括号但是栈已经空了,说明不是有效的括号,直接返回false;
            else if(! isMatch(stk.top(),s[i])) return false;     //如果遇到右括号且栈不为空,但是栈顶不是相匹配的左括号,返回false;
            else stk.pop();      //当前遍历到的右括号与栈顶左括号相匹配,弹出栈顶元素继续遍历;
        }
        return stk.empty();     //遍历结束后,栈为空则为有效,否则无效;
    }
};
- 进阶版,32. 最长有效括号
Note
题目描述: 给你一个只包含 '(' 和 ')' 的字符串,找出最长有效(格式正确且连续)括号子串的长度。
示例1:
示例2:
Info
- 解题思路:
- 分析合法的括号序列,一定是以下两种中的一种:
- \((1)(\cdots)\)
- \((2)(\cdots)\cdots(\cdots)\)
- 我们可以选准备好一个栈,并且塞入一个元素-1。
- 然后,遍历这个字符串,遇到左括号,无脑入栈;遇到右括号,无脑出栈;
- 这时候,如果栈为空,表明右括号多出来一个,说明断层了,这时候把当前的位置下标入栈;否则,当前位置减去栈顶的位置就是一个合法的长度,计算后更新最大值。
- 最后得到的最大值就是我们要求的字符串最大长度。
- 解题代码
class Solution {
public:
    int longestValidParentheses(string s) {
        int maxans = 0;
        stack<int> stk;
        stk.push(-1);
        for(int i = 0; i < s.size(); i++){
            if(s[i] == '('){
                stk.push(i);    // 如果是左括号直接入栈即可
            }else{
                 // 如果是右括号,存在两种情况
                // 1.如果前面可以有左括号和它进行匹配,那么就存在一个由左括号、右括号组成的子串
                // 2.如果前面没有左括号和它进行匹配,那么这个右括号就形成了新的边界。新的子串匹配时,起点必须在该边界右边
                stk.pop();
                if(stk.empty()){   //如果这时候栈为空,表示断层了,将当前右括号位置入栈;
                    stk.push(i);
                }else{
                    maxans = max(maxans,i - stk.top());    //否则,取栈顶元素和当前位置相减,必然是一个合法序列,更新最大长度;
                }
            }
        }
        return maxans;
    }
};
3.1.7.2 栈在表达式求值中的应用
-
前缀、中缀、后缀表达式的互相转换
-
前缀表达式:也称波兰式,指运算符处于两个操作数的前面
- 中缀表达式:指运算符在两个操作数之间的位置
- 后缀表达式:也称逆波兰式,指运算符处于两操作数后面
【例 1】已知中缀表达式:a+b-c*d
- 先确定运算顺序:
(a+b)-(c*d) - 前缀表达式:
-+ab *cd - 后缀表达式:
ab+ cd*-
【例 2】已知中缀表达式:a/b+(c*d-e*f)/g
- 先确定运算顺序:
(a/b)+(((c*d)-(e*f))/g) - 前缀表达式:
+ /ab / -*cd *ef g -
后缀表达式:
ab/ cd* ef*- g/ + -
后缀表达式求值问题
我们转换表达式的目的就在于让计算机实现表达式的求值,并且去掉括号后表达式无歧义,或者说,计算机是不认识也不清楚中缀式的含义的,只有人能读懂,但是我们转换为前缀或者后缀后却可以借助栈的性质来完成计算
力扣有该算法的对应习题150. 逆波兰表达式求值
题目:
Info
给你一个字符串数组 tokens ,表示一个根据 逆波兰表示法 表示的算术表达式。
请你计算该表达式。返回一个表示表达式值的整数。
注意:
有效的算符为 '+'、'-'、'*' 和 '/' 。\ 每个操作数(运算对象)都可以是一个整数或者另一个表达式。\ 两个整数之间的除法总是 向零截断 。\ 表达式中不含除零运算。\ 输入是一个根据逆波兰表示法表示的算术表达式。\ 答案及所有中间计算结果可以用 32 位 整数表示。
- 示例:
输入:tokens = ["10","6","9","3","+","-11","*","/","*","17","+","5","+"]
输出:22
解释:该算式转化为常见的中缀算术表达式为:
  ((10 * (6 / ((9 + 3) * -11))) + 17) + 5
= ((10 * (6 / (12 * -11))) + 17) + 5
= ((10 * (6 / -132)) + 17) + 5
= ((10 * 0) + 17) + 5
= (0 + 17) + 5
= 17 + 5
= 22
Note
解题步骤:逆波兰表达式严格遵循「从左到右」的运算。计算逆波兰表达式的值时,使用一个栈存储操作数,从左到右遍历逆波兰表达式,进行如下操作:
- 如果遇到操作数,则将操作数入栈;
- 如果遇到运算符,则将两个操作数出栈,其中先出栈的是右操作数,后出栈的是左操作数,使用运算符对两个操作数进行运算,将运算得到的新操作数入栈。
- 整个逆波兰表达式遍历完毕之后,栈内只有一个元素,该元素即为逆波兰表达式的值。
- 参考代码:
class Solution {
public:
    int evalRPN(vector<string>& tokens) {
        stack<int> st;
        for (string s : tokens) {
            if (s == "+") {
                int a = st.top(); st.pop();
                int b = st.top(); st.pop();
                st.push(b+a);
            }
            else if (s == "-") {
                int a = st.top(); st.pop();
                int b = st.top(); st.pop();
                st.push(b-a);
            }
            else if (s == "*") {
                int a = st.top(); st.pop();
                int b = st.top(); st.pop();
                st.push(b*a);
            }
            else if (s == "/") {
                int a = st.top(); st.pop();
                int b = st.top(); st.pop();
                st.push(b/a);
            }
            else {
                st.push(stoi(s));    //将字符串转化为int型数字放入栈中;
            }
        }
        return st.top();    //栈内只有一个元素,该元素即为逆波兰表达式的值。
    }
};
如果想要优雅一点的话,可以这样写
class Solution {
public:
    int evalRPN(vector<string>& tokens) {
        stack<long long> s;
        for(auto x : tokens){
            if(x == "+" || x == "-" || x == "*" || x == "/"){
                long long nums1 = s.top();     //先弹出的为右操作数
                s.pop();
                long long nums2 = s.top();     //后弹出的为左操作数
                s.pop();
                if(x == "+") s.push(nums2 + nums1);
                else if(x == "-") s.push(nums2-nums1);
                else if(x =="*") s.push(nums2 * nums1);
                else s.push(nums2/nums1);
            }else s.push(stoi(x));       //遇到数字则入栈
            //stoi和atoi都是将字符串转成int类型,但是stoi的参数是const string*类型,
            //而atoi的参数是const char*类型;
        }
        long long ans = s.top();
        return ans;
    }
};
- 中缀表达式转后缀表达式的算法(选择题重要考点)
初始化一个栈,用来保存暂时还不能确定运算顺序的运算符。从左到右处理各个元素,直到末尾。可能遇到三种情况:
- 扫描到操作数:直接加入后缀表达式;
- 扫描到界限符:遇到“(”直接入栈;遇到“)”则依次弹出栈内运算符并加入后缀表达式,直到弹出“(”为止,注意“(”不加入后缀表达式。
- 扫描到运算符:
- 如果当前运算符优先级大于栈顶运算符,当前运算符直接入栈;
- 如果当前运算符优先级小于等于栈顶运算符,需要弹出当前运算符优先级小于等于栈顶的运算符,直到栈空或遇到栈顶为左括号,最后当前运算符入栈。
以
1+2+3*4*5举例,看是如何利用上述两个关键点实施计算的。首先,这个例子只有+和*两个运算符,所以它的运算符表是:
这里的含义是:
(1)如果栈顶是+,即将入栈的是+,栈顶优先级高,需要先计算,再入栈;
(2)如果栈顶是+,即将入栈的是*,栈顶优先级低,直接入栈;
(3)如果栈顶是*,即将入栈的是+,栈顶优先级高,需要先计算,再入栈;
(4)如果栈顶是_ ,即将入栈的是_,栈顶优先级高,需要先计算,再入栈;
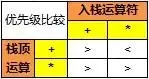
算法实现:
#include <iostream>
#include <stack>
#include <string>
using namespace std;

int getpriority(char c)//优先级判断
{
    if (c == '+' || c == '-')
    {
        return -1;//加减优先级小
    }
    else
    {
        return 1;//乘除优先级大
    }
}

string convert(string& express)
{
    int i = 0;
        string ans;     //后缀表达式
        stack<char> s;    //初始化一个栈用于存放还没有确定运算顺序的运算符;
    while (express[i] != '\0')//扫描中缀表达式
    {
        if ('0' <= express[i] && express[i] <= '9')
        {
            ans += express[i];
            i++; //处理完数字后必须后移,否则会重复处理同一字符
        }
        else if (express[i] == '(')//如果扫描到了左括号,直接入栈
        {
            s.push(express[i++]);
        }
        else if (express[i] == '+' || express[i] == '-' || express[i] == '*' || express[i] == '/')//扫描到运算符进行优先级判断
        {
            if (s.empty() || s.top() == '(' || getpriority(express[i]) > getpriority(s.top()))
                        //如果此时栈为空或者栈顶元素为左括号,或者扫描到的运算符优先级大于栈顶运算符优先级,则将当前运算符入栈;
            {
                s.push(express[i++]);
            }
            else//反之优先级如果是小于等于的话,那么就要把运算符出栈然后加入后缀表达式;
            {
                char temp = s.top();
                s.pop();
                ans += temp;
            }
        }
        else if (express[i] == ')')//最后一种情况就是扫描到了右括号,那么就把从栈顶到左括号的元素依次出栈加入后缀表达式;
        {
            while (!s.empty() && s.top() != '(') //先判断非空,避免右括号不匹配时访问空栈
            {
                char temp = s.top();
                s.pop();
                ans += temp;
            }
            //注意最后停止循环的时候栈顶元素是左括号,但是不要把左括号入栈,所以直接丢掉左括号
            if (!s.empty()) s.pop(); //仅在确实找到左括号时弹出
            i++;//不要忘记后移
        }
    }
    while (!(s.empty()))//如果栈没有空,那么依次出栈,加入后缀表达式;
    {
        char temp = s.top();
        s.pop();
        ans += temp;
    }
    return ans;
}
- 结合上面的后缀表达式计算和中缀转后缀的算法实现,我们可以用栈实现中缀表达式的计算 ;
- 初始化两个栈,操作数栈和运算符栈;
- 若扫描到操作数,则直接压入操作数栈;
- 若扫描到运算符或界限符,则按照“中缀转后缀”相同的逻辑压入运算符栈(期间也会弹出运算符,每当弹出一个运算符时,就需要再弹出两个操作数栈的栈顶元素并执行相应运算,运算结果再压回操作数栈)
代码部分,要么重新按照这个逻辑写一下,要么直接将中缀表达式传入,然后分别调用上面两个函数就可以得到运算结果了;\ acwing 3302. 表达式求值,解题:https://www.acwing.com/solution/content/40978/
#include <iostream>
#include <stack>
#include <string>
#include <unordered_map>
using namespace std;

stack<int> num;
stack<char> op;

//优先级表
unordered_map<char, int> h{ {'+', 1}, {'-', 1}, {'*',2}, {'/', 2} };

void eval()//求值
{
    int a = num.top();//第二个操作数
    num.pop();

    int b = num.top();//第一个操作数
    num.pop();

    char p = op.top();//运算符
    op.pop();

    int r = 0;//结果

    //计算结果
    if (p == '+') r = b + a;
    if (p == '-') r = b - a;
    if (p == '*') r = b * a;
    if (p == '/') r = b / a;

    num.push(r);//结果入栈
}

int main()
{
    string s;//读入表达式
    cin >> s;

    for (int i = 0; i < s.size(); i++)
    {
        if (isdigit(s[i]))//数字入栈
        {
            int x = 0, j = i;//计算数字
            while (j < s.size() && isdigit(s[j]))
            {
                x = x * 10 + s[j] - '0';
                j++;
            }
            num.push(x);//数字入栈
            i = j - 1;
        }
        //左括号无优先级,直接入栈
        else if (s[i] == '(')//左括号入栈
        {
            op.push(s[i]);
        }
        //括号特殊,遇到左括号直接入栈,遇到右括号计算括号里面的
        else if (s[i] == ')')//右括号
        {
            while(op.top() != '(')//一直计算到左括号
                eval();
            op.pop();//左括号出栈
        }
        else
        {
            while (op.size() && h[op.top()] >= h[s[i]])//待入栈运算符优先级低,则先计算
                eval();
            op.push(s[i]);//操作符入栈
        }
    }
    while (op.size()) eval();//剩余的进行计算
    cout << num.top() << endl;//输出结果
    return 0;
}
3.1.7.3 栈的应用—–递归
函数调用的特点:最后调用的函数最先被执行(\(LIFO\))
函数调用时,需要用一个“函数调用栈”存储:调用返回值、实参、局部变量
递归调用时,函数调用栈可称为“递归工作栈”
每进入一层递归,就将递归调用所需信息压入栈顶;
每退出一层递归,就从栈顶弹出相应信息;
缺点:效率低,太多层递归可能会导致栈溢出,因为可能会包含很多重复计算;
后续在二叉树的遍历一节,我们可以看到如何用栈来讲递归算法改成迭代算法!
3.1.7.4 栈的其他典型应用
- 浏览器中的后退与前进、软件中的撤销与反撤销。每当我们打开新的网页,浏览器就会将上一个网页执行入栈,这样我们就可以通过「后退」操作回到上一页面。后退操作实际上是在执行出栈。如果要同时支持后退和前进,那么需要两个栈来配合实现。
- 程序内存管理。每次调用函数时,系统都会在栈顶添加一个栈帧,用于记录函数的上下文信息。在递归函数中,向下递推阶段会不断执行入栈操作,而向上回溯阶段则会执行出栈操作。
3.1.8 栈的相关算法题
- 20. 有效的括号
- 32. 最长有效括号
- 150. 逆波兰表达式求值
- 二叉树的各种遍历的非递归版本
- 225. 用队列实现栈
- 232. 用栈实现队列
- 206. 反转链表
- LeetCode 234. 回文链表
3.2 队列
3.2.1 用顺序表实现队列
- 队列的定义:是一种只允许在一端插入,在另一端删除的线性表。我们把允许插入的一端称之为队尾(
rear),把允许删除的一端称之为队头(front)。不含任何数据元素的队列称之为空队列。队列遵循先进先出(FIFO)原则 - 基于数组的实现:由于数组删除首元素的时间复杂度为\(O(n)\)(要移动大量的元素),这会导致出队操作效率较低。然而,我们可以采用以下巧妙方法来避免这个问题。我们可以使用一个变量
front指向队首元素的索引,并维护一个变量queSize用于记录队列长度。定义rear = front + queSize,这个公式计算出的rear指向队尾元素之后的下一个位置(不同教材定义不同,rear也可以指向队尾元素自己)。 - 基于此设计,数组中包含元素的有效区间为 [front, rear - 1],进而:
- 对于入队操作,将输入元素赋值给
rear索引处,,并将rear和queSize增加 1 。 - 对于出队操作,只需将
front增加 1 ,并将queSize减少 1 。
可以看到,入队和出队操作都只需进行一次操作,时间复杂度均为\(O(1)\)。
- 我们发现一个问题:在不断进行入队和出队的过程中,
front和rear都在向右移动,当它们到达数组尾部时就无法继续移动了,即使此时数组内仍然有可以存放元素的空位置。为解决此问题,我们可以将数组视为首尾相接的「环形数组」。对于环形数组,我们需要让front或rear在越过数组尾部时,直接回到数组头部继续遍历。这种周期性规律可以通过“取余操作”来实现。
Info
百度百科:循环队列:循环队列就是将队列存储空间的最后一个位置绕到第一个位置,形成逻辑上的环状空间,供队列循环使用。在循环队列结构中,当存储空间的最后一个位置已被使用而再要进入队运算时,只需要存储空间的第一个位置空闲,便可将元素加入到第一个位置,即将存储空间的第一个位置作为队尾。循环队列可以更简单防止伪溢出的发生,但队列大小是固定的。
在循环队列中,当队列为空时,有front=rear,而当所有队列空间全占满时,也有front=rear。为了区别这两种情况,规定循环队列最多只能有MaxSize-1个队列元素,当循环队列中只剩下一个空存储单元时,队列就已经满了。因此,队列判空的条件是front=rear,而队列判满的条件是front=(rear+1)%MaxSize。
对于一个固定大小的数组,只要知道队尾rear与队首front,即可计算出队列当前的长度:\( (
rear
−
front
\+
capacity
) \)mod\( capacity \)
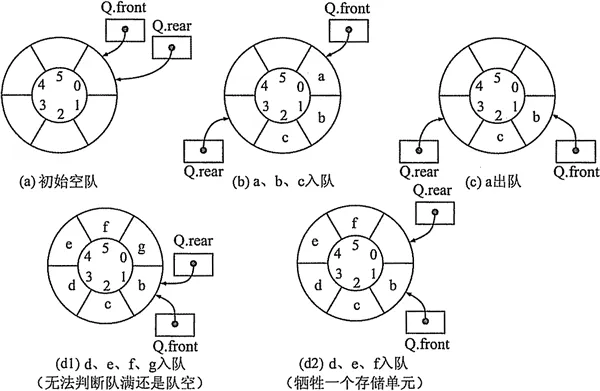
- 循环队列的实现(做题时一定要注意
rear指针指向的是下一个待插入元素的位置还是当前队尾元素,条件不同判空判满的方式也有所不同)\ 622. 设计循环队列
//注意该实现方式rear指向的是队尾元素的下一个位置;
#define MaxSize 6
typedef struct{
    int front, rear;    //队头和队尾指针;
    bool flag;          //用于不牺牲存储单元时区分队空和队满
    int  data[MaxSize]   ;//队列元素的存储方式,即数组;
}sqQueue;      //队列结构体;

void InitQueue(sqQueue &Q){     //初始化队头、队尾指针;
    Q.front = Q.rear = 0;
    Q.flag = false;           //初始化 flag
}

void testQueue(){
    //声明一个队列;
    sqQueue Q;
    InitQueue(Q);
    //.....执行下列操作。
}

bool isEmpty(sqQueue Q) {     //判队空;
    if(Q.rear == Q.front)   return true;
    else  return false;
}

bool isFull(sqQueue Q) {       //判队满;
    if((Q.rear + 1) % MaxSize == Q.front){       //如果队头指针在队尾指针的下一个位置,说明队满;
        return true;
    }else return false;
}

bool EnQueue(sqQueue &Q, int value) {    //从队尾入队;
    if((Q.rear + 1) % MaxSize == Q.front){     //队满报错;
        return false;
    }
    Q.data[Q.rear] = value;              //将待加入队列的值放入队尾;
    Q.rear = (Q.rear + 1) % MaxSize;     //队尾指针加1取模;
    return true;
}

bool DeQueue(sqQueue &Q) {         //从队头出队;
    if(Q.rear == Q.front) {
        return false;        //队空则出队失败;
    }
    Q.front = (Q.front + 1) % MaxSize;       //队头元素出队,然后队头指针加1取模;
    return true;
}

int  GetFrontQueue(sqQueue Q) {    //队列是操作受限的线性表,一般来说只允许读取队头元素,不允许随便读取队列中间的某个元素;
    if(Q.rear == Q.front) {
        return -1;                 //队列空,读取队头元素失败;
    }
    return Q.data[Q.front];          //读取队头元素;
}
- 时间复杂度:初始化和每项操作的时间复杂度均为\(O(1)\)。
- 空间复杂度:\(O(k)\),其中\(k\)为给定的队列元素数目。
- 以上实现的队列仍然具有局限性,即其长度不可变。然而,这个问题不难解决,我们可以将数组替换为动态数组,从而引入扩容机制。
- 区分队空和队满有三种处理方式,上述的属于牺牲一个单元来区分队空和队满,这是最普遍的做法,还有两种处理方式,不需要牺牲队列的空间,这里来介绍一下
- 设置一个计数器
count,有元素入队时,count++,有元素出队时count--,队空count == 0,队满count == MAXsize,在这种情况下,如果rear指针指向的仍然是下一个位置,那么队空还是队满都是rear == front;该种实现方式可以见下面用链表实现的循环队列; - 类型中增设一个
flag数据成员,以区分队空还是队满;具体操作方式为:
Note
队列初始化时,bool flag == false;
入队操作:除了赋值给队尾指针所处位置并将rear后移以外,还多了一个flag == true;
出队操作:除了front后移,还多了一个flag == false;
队空条件:Q -> rear == Q -> front && flag == false (如果出队次数与入队次数刚好相等,则互相抵消,flag最终仍热为false);
队满条件:Q -> rear == Q -> front && flag == true (如果两指针相等且标记为真,说明此时一定队满)
bool  EnQueue(sqQueue &Q, int value) {      //设flag方式的循环队列入队操作;
 if(Q.rear == Q.front && Q.flag == true) {
     return false;      //如果队满,则入队失败
 }else{
      Q.flag = true;                         //更新队列成员 flag
      Q.data[Q.rear] = value;                //将待加入队列的值放入队尾;
      Q.rear = (Q.rear + 1) % MaxSize;       //队尾指针加1取模;
     return true;
 }
}

bool DeQueue(sqQueue &Q) {         //设flag方式的循环队列出队操作;
 if(Q.rear == Q.front && Q.flag == false) {
     return false;        //队空则出队失败;
 }
 Q.front = (Q.front + 1) % MaxSize;         //队头元素出队,然后队头指针加1取模;
 Q.flag = false;
 return true;
}
3.2.2 用链表实现队列
用链表实现的队列实际上是一个带有队头指针和队尾指针的单链表;有带头结点和不带头结点两种方式;
- 用不带头结点的单链表实现的队列:
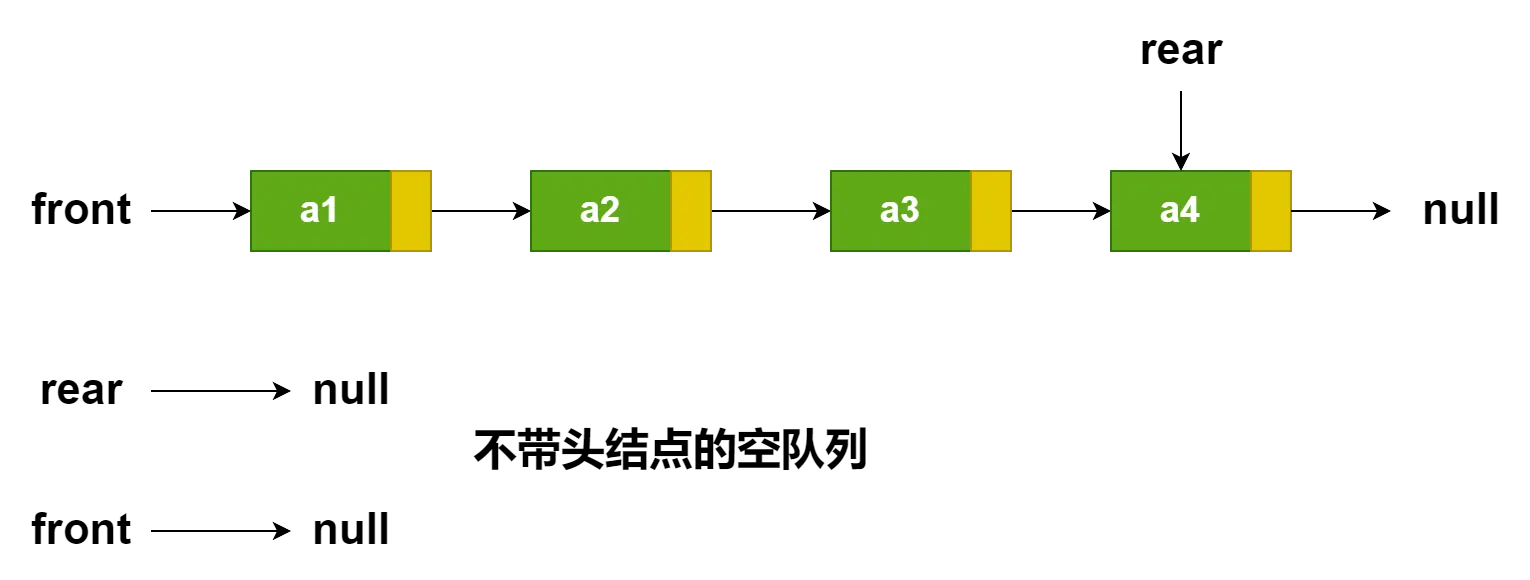
- 该实现方式中,头指针指向队头结点,尾指针指向队尾结点,规定队尾仅可添加结点,而队首仅可删除结点;
- 判空方式:
Q->front == NULL && Q -> rear == NULL.(其实Q->front == NULL就足够确定该队列为空了) - 出队操作:首先判断队是否为空,若不为空,则取出队头元素,将其从链表中摘除,并让
Q->front指向下一个结点,如果该出队结点就是最后一个结点,则置Q->front == NULL && Q -> rear == NULL - 入队操作:首先建立一个新结点,将该结点插入到队列链表的尾部。并且让
Q->rear指向这个新插入的结点,如果原链表为空的话,则让Q->front也指向该结点;
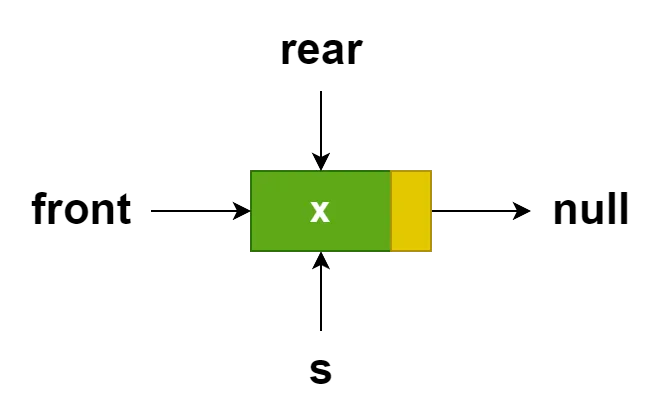
//用不带头结点的单链表实现的队列
//链式队列结构体定义:
typedef struct Qnode{    //链式队列结点
    int data;      //数据域
    struct Qnode* next;    //指针域
}Qnode;

typedef struct  LinkQueue{
    Qnode *front, *rear;    // 队列的队头和队尾指针;
}LinkQueue;

void InitQueue(LinkQueue &Q) {   //初始化,队头队尾指针都指向空;
    Q.front = NULL;
    Q.rear = NULL;
}

bool IsEmpty(LinkQueue Q) {      //判队空;
    if(Q.front == NULL)   return true;
    else return false;
}

void EnQueue(LinkQueue &Q, int value) {      //入队操作
    Qnode *s = (Qnode *) malloc(sizeof(Qnode));       //利用malloc生成一个链表结点Qnode,并且填充 数据域 和 指针域;
    s -> data = value;
    s -> next = NULL;
    if(Q.front == NULL){       //;如果当前队列为空,则让头尾指针都指向这个新节点;
        Q.front = Q.rear = s;
    }else{        //如果不为空的话则将其插入队尾;
        Q.rear->next = s;
        Q.rear = s;
    }
}

bool  DeQueue(LinkQueue &Q) {
    if(Q.front == NULL)   return false;    //;如果队空,则出队失败;
    Qnode *temp = Q.front;                 //temp为出队结点;
    if(temp -> next == NULL){
        Q.front = Q.rear = NULL;           //如果出队元素是最后一个元素,出队后都指向空;
    } else{
        Q.front = temp->next;              //将队头指针后移,并释放掉该结点空间;
    }
    free(temp);
    return true;
}

int QueueGetFront(LinkQueue Q){      //获取队首元素值;
    if(Q.front == NULL) return -1;   //空队列不能解引用 front
    return Q.front->data;
}
- 用带头结点的单链表实现的队列:
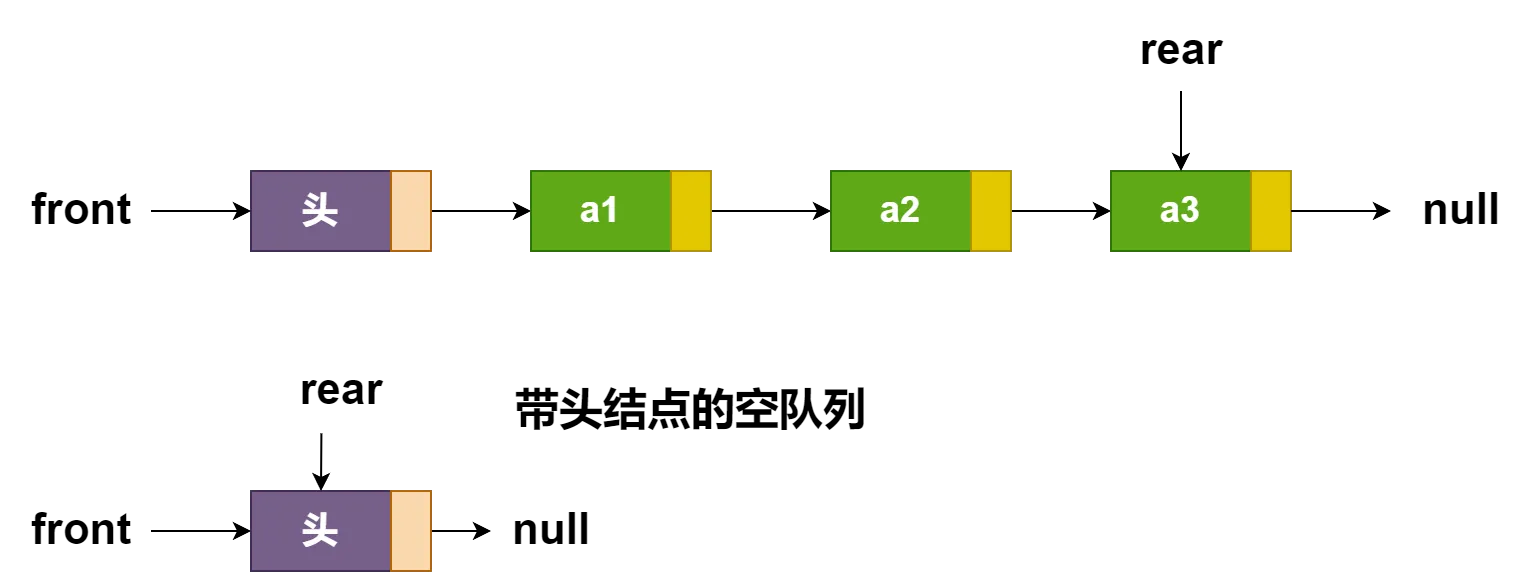
- 该实现方式中,头指针指向链表头结点,尾指针指向队尾结点,规定队尾仅可添加结点,而队首仅可删除结点;
- 判空方式:
Q->front == Q -> rear. - 出队操作:首先判断队是否为空,若不为空,则取出队头元素,将其从链表中摘除,并让
Q->front->next指向下一个结点,如果该出队结点就是最后一个结点,则让Q->rear == Q -> front,让他们都指向头结点;
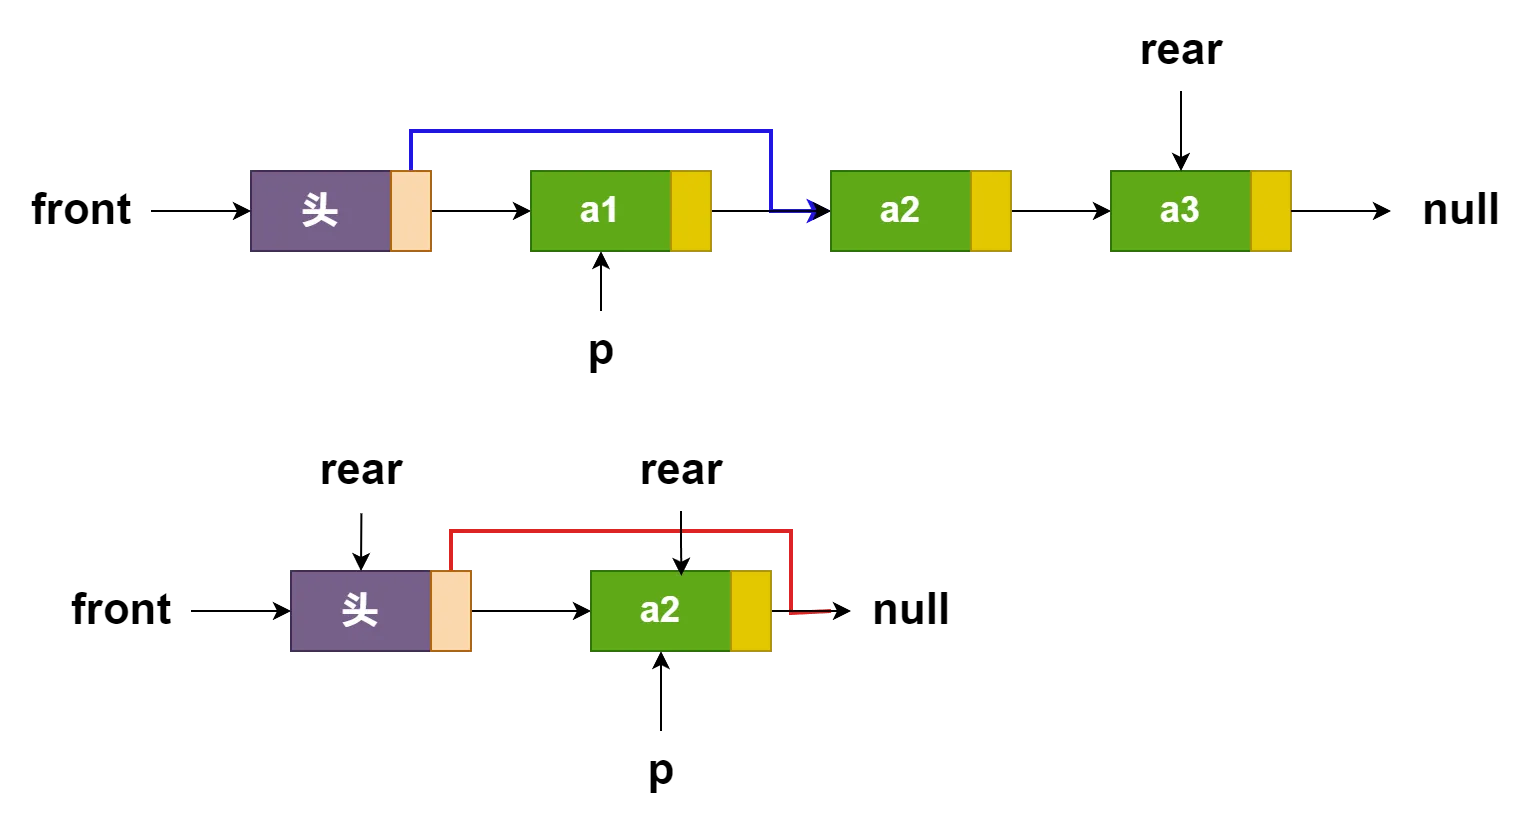
- 入队操作:首先建立一个新结点,将该结点插入到队列链表的尾部,然后让
Q->rear指向这个新插入的结点即可;
//用带头结点的单链表实现队列
//结构体同上;

//初始化队列;
void InitQueue(LinkQueue &Q) {
    Q.front = Q.rear = (Qnode*)malloc(sizeof(Qnode));         //;建立头结点
    Q.front->next = NULL;                                     //;初始为空;
}
//判队空;
bool IsEmpty(LinkQueue Q) {
    if(Q.front == Q.rear)  return true;                       //
    else return false;
}

//入队操作
void EnQueue(LinkQueue &Q, int value) {
    Qnode *s = (Qnode*) malloc(sizeof(Qnode));
    s -> data = value;
    s -> next = NULL;
    Q.rear->next = s;
    Q.rear = s;              //;更新队尾指针;
}

//出队操作
bool  DeQueue(LinkQueue &Q) {
    if(Q.front == Q.rear)   return false;                     //;如果队空则出队失败;
    Qnode *temp = Q.front->next;
    Q.front->next = temp->next;                               //更新头节点的 next 指针;
    if(Q.rear == temp) {                                      //
        Q.rear = Q.front;
    }
    free(temp);      //释放出队元素空间;
    return true;
}
- 用链表实现的循环队列(不过意义不大,因为链表实现的队列本来就可以动态删除和增加元素,与19年应用题有一丢丢相似)
//为了区别队空与队满,该方法采用了设置一个size变量而不是以牺牲一个结点空间为代价实现的,因此初始时首尾指针均指向空;
//循环队列结构体
typedef struct ListNode {
    int val;
    struct ListNode *next;
} ListNode;

typedef struct {
    ListNode *front ;           //队列的头指针
    ListNode *rear;             //队列的尾指针
    int capacity;
    int size;       //队列当前的元素的数量
} MyCircularQueue;

MyCircularQueue* myCircularQueueCreate(int k) {
    MyCircularQueue *Q = (MyCircularQueue *)malloc(sizeof(MyCircularQueue));
    Q->capacity = k;     //循环队列长度为k;
    Q->size = 0;
    Q->front = Q->rear = NULL;    //不带头结点的链表,头尾指针初始化为指向空
    return Q;
}

//入队操作
bool myCircularQueueEnQueue(MyCircularQueue* Q, int value) {
    if (Q->size == Q->capacity) {   //队满报错
        return false;
    }
    ListNode *node = (ListNode *)malloc(sizeof(ListNode));
    node->val = value;
    node->next = NULL;
    if (!Q->front) {   //如果初始队空,则入队后首尾指针都指向该结点;
        Q->front = Q->rear = node;
    } else {       //如果队未满且非空;
        Q->rear->next = node;   //将新节点插入链尾;
        Q->rear= node;      //更新链尾指针;
    }
    Q->size++;     //当前队列元素加1;
    return true;
}

//出队操作;
bool myCircularQueueDeQueue(MyCircularQueue* Q) {
    if (Q->size == 0) {
        return false;   //队空出队失败;
    }
    struct ListNode *node = Q->front;   //用node指向待出队队首元素;
    Q->front = Q->front->next;     //队首指针后移
    if (Q->front == NULL) Q->rear = NULL; //删除最后一个结点后同步清空 rear
    Q->size--;       //队内元素-1
    free(node);     //释放该元素;
    return true;
}

//获取队首元素值
int myCircularQueueFront(MyCircularQueue* Q) {
    if (Q->size == 0) {
        return -1;
    }
    return Q->front->val;
}
//判空操作
bool myCircularQueueIsEmpty(MyCircularQueue* Q) {
    return Q->size == 0;
}
//判满操作;
bool myCircularQueueIsFull(MyCircularQueue* Q) {
    return Q->size == Q->capacity;
}
- 真题解析:【2019】请设计一个队列,要求满足:①初始时队列为空;②入队时,允许增加队列占用空间;\ ③出队后,出队元素所占用的空间可重复使用,即整个队列所占用的空间只增不减;④入队操作和出队操作的时间复杂度始终保持为\(O(1)\)。请回答下列问题:\ (1)该队列应该选择链式存储结构,还是顺序存储结构;\ (2)画出队列的初始状态,并给出判断队空和队满的条件;\ (3)画出第一个元素入队后的队列状态;\ (4)给出入队操作和出队操作的基本过程。
解析:推荐看千葉原2019年408真题数据结构篇这里的解析。
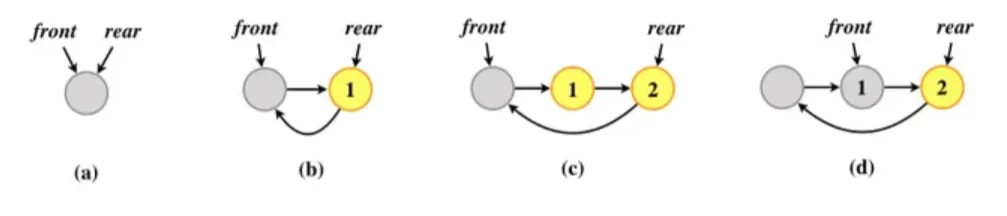
- 由要求2可知顺序存储结构无法满足其要求,因此应该选择链式存储结构;由要求3可知,这与普通的单链表实现链栈有很大的不同,普通的链栈占用的空间可增可减,而该题要求只增不减,因此又与上面的用链表实现的循环队列有些许区别,本题采用的数据结构应该是一种没有队列空间上限
MaxSize的循环链表;与普通的链栈不同的是,出队后的结点不用真正释放,只要将队头指针指向新的队头结点即可;新元素入队时,如果有空闲的结点,则无需开辟新空间,将值赋给队尾后的第一个空闲结点即可,然后让队尾指针指向它即可;如果入队时队满,则申请一个新的结点然后赋值并加入链尾即可- 参考用一维数组实现的循环队列,为了区分队满还是队空,可以牺牲一个单元来判断;初始时,创建只有一个空闲结点的循环单链表,头尾指针
rear和front均指向它,如图所示,加入新元素以后,队尾指针指向队尾元素的下一个位置:\ 因此,队列判空的条件为:
front == rear;\ 判满的条件为rear -> next == front;- 插入第一个元素后的状态为:
4.
//入队操作
void EnQueue(LinkQueue &Q, int value) {
    if(Q.rear->next == Q.front){   //队满时申请新结点
        Qnode *s = (Qnode*) malloc(sizeof(Qnode));
        s->next = Q.front;       //;申请的空闲结点指向队头
        Q.rear->data = value;    //将值赋给队尾指针所指的空闲结点;
        Q.rear->next = s;        //将申请的空闲结点插入 rear 后面;
        Q.rear = s;              //更新 rear 指针指向新的空闲结点;
    }else{
        Q.rear->data = value;    //;
        Q.rear = Q.rear->next;   //如果队未满,则更新队尾指针即可;
    }
}

//出队操作;
int  DeQueue(LinkQueue &Q) {
    if(Q.front == Q.rear)   return -1;                 //;队空则出队失败
    int res = Q.front->data;
    Q.front = Q.front->next;                           //更新队头指针,不释放结点空间;
    return res;
}
上面的是其中一种解题方法,是让队首指针指向队列中第一个带有关键字的结点,然后让队尾指针指向队尾元素的下一个位置,如图,亮黄色的代表队列中的元素,灰色但是有关键字的代表已经出队但是结点空间不释放,仅仅只是移动指针;
\ 另一种方法是让队首指针指向队首元素的前一个空结点,让队尾指针指向队尾元素自身,如图:
入队出队操作与上面那种有细微差别;
3.2.3 双端队列
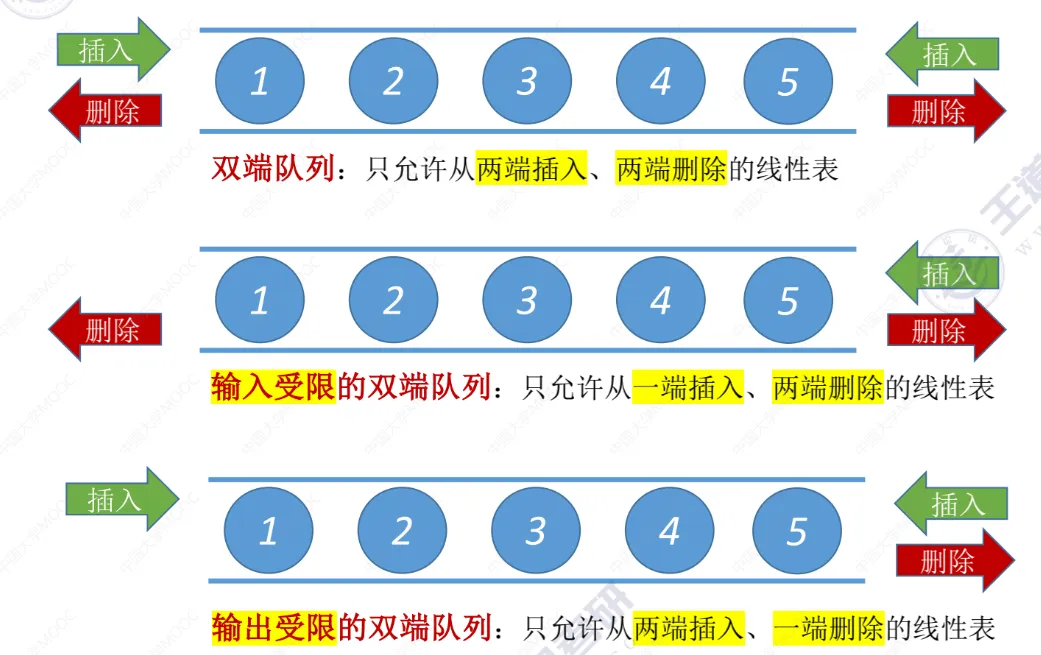
选择题考点:对输出序列合法性的判断
3.2.4 循环队列选择题解题技巧
-
循环队列首尾指针的相关问题:
-
先根据题意画出循环队列的示意图,最好画两个同心圆,然后分割成六七份的样子;
- 一般来说,在选择题中为了区别队满和队空,不会采用设置变量
count或者布尔型变量flag的方法,都是采用牺牲一个队列元素空间的方法; - 因此,有以下两种队尾、队首指针的不同指向;
- 头指针
front指向队首元素,尾指针rear指向队尾元素的后一个位置;此时判空条件为rear = front,判满的条件是\(front=(rear+1)\%MaxSize\),当前队列中的元素个数为\((rear-front+MaxSize)\%MaxSize\). - 头指针
front指向队首元素的前一个位置,尾指针rear指向队尾元素;判空判满与上面的一样,只是两个指针都向前移动了一位. - 注意,不管是在队头删除元素还是在队尾加入新元素,都是
(rear或front + 1) % MaxSize,还有如果仅仅只是加入新元素,一般只有表尾指针rear会变化,front一般不动。 - 如果题目问当前队列有多少个元素或者问你
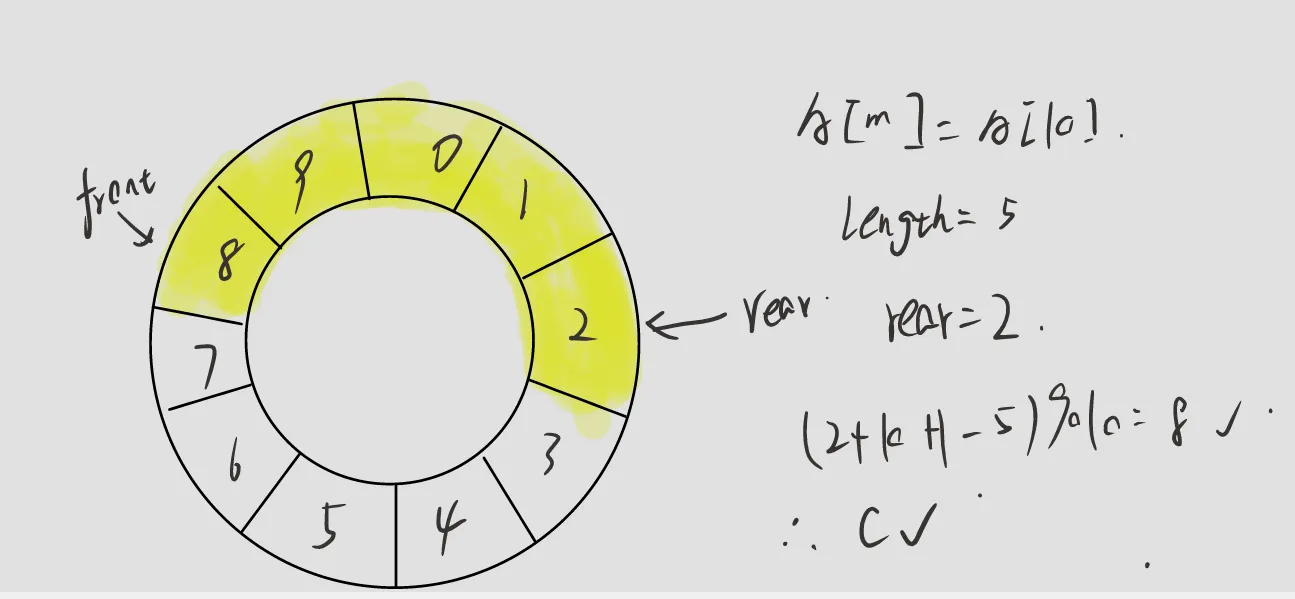
rear指针和front指针的位置,而你把上面的公式都忘记了,没关系,画完图举特例就可以了,注意,举特例时最好举那种rear比front小的例子,比如让rear = 1,front = 5这种,这样的话容易判断含有mod的式子哪个正确; - 示例:

2.
- 链队列用各种各样链表实现的相关问题:
Note
- 最适合用作链队的链表就是带有队首指针和队尾指针的非循环单链表;
- 对于带有队首指针和队尾指针的循环单链表,入队和出队在修改首尾指针之余,还要修改指针保持链表的循环特性,显然有点画蛇添足;
- 对于只带队首指针的非循环单链表或循环单链表,由于其入队操作需要找到队尾元素,因此插入元素的时间复杂度是\(O(n)\),因此不合适;
- 只带队尾指针的循环单链表、只带队尾指针的循环双链表、只带队尾指针的循环双链表这些寻找队头和队尾结点的时间复杂度都可以控制在\(O(1)\),也可以用作链栈,只不过需要多维护一些该链表专有属性;
- 像是只带队头指针的非循环双链表,其查找队尾元素的时间复杂度为\(O(n)\),从队尾加入新节点极其不方便,还需要维护无用的
prior指针,因此也是很不适合用作链栈。
3.2.5 队列的应用(了解即可)
- 任务调度:队列可用于任务调度系统,其中任务按照提交的顺序进行处理。每当一个任务完成时,下一个任务就会从队列中取出并执行,即
FCFS。 - 消息传递:队列在消息传递系统中起着重要的作用。消息可以按照顺序发送到队列中,并按照相同的顺序接收和处理。这在异步通信和事件驱动系统中非常有用。
- 缓冲区管理:队列可用于管理缓冲区,特别是在生产者和消费者之间的数据传输中。生产者将数据放入队列,而消费者从队列中取出数据进行处理。这种方式可以平衡生产者和消费者之间的速度差异。
- 广度优先搜索:在图论和算法中,队列常用于广度优先搜索(
BFS)算法中。BFS通过遍历图的层级结构来搜索最短路径或解决其他问题。队列用于存储待处理的节点,并按照它们的距离从起始节点进行处理。 - 线程管理:在并发编程中,队列可用于线程管理。线程可以将任务放入队列中,而其他线程可以从队列中获取任务并执行。这种方式可以避免线程之间的竞争条件,并提高并发性能。
- 打印队列:在打印机管理系统中,队列用于存储待打印的文档。每当一个文档完成打印时,下一个文档就会从队列中取出并发送到打印机
- 树的层次遍历
- 淘宝订单。购物者下单后,订单将加入队列中,系统随后会根据顺序依次处理队列中的订单。在双十一期间,短时间内会产生海量订单,高并发成为工程师们需要重点攻克的问题。
- 各类待办事项。任何需要实现“先来后到”功能的场景,例如打印机的任务队列、餐厅的出餐队列等。队列在这些场景中可以有效地维护处理顺序。
3.2.6 c++中的队列(\(queue\))容器适配器
#include <queue>
头文件queue主要包括循环队列queue和优先队列priority_queue两个容器。
queue<int> q;    //定义一个空队列q;
q.push(i);   //将i的值从队尾插入队列;
q.pop();   //无返回值,将队首元素弹出;
int a = q.front() ;//返回队首元素;
int b = q.back();  //返回队尾元素;
int n = q.size();  //n为队列中元素的个数;
//优先队列也就是堆,后面在堆排序那里介绍;
#include <deque>  双端队列,是一个在两端都可以插入和删除元素的数据结构;
3.2.7 队列的相关算法题
3.3 栈和队列的相关应用题
Note
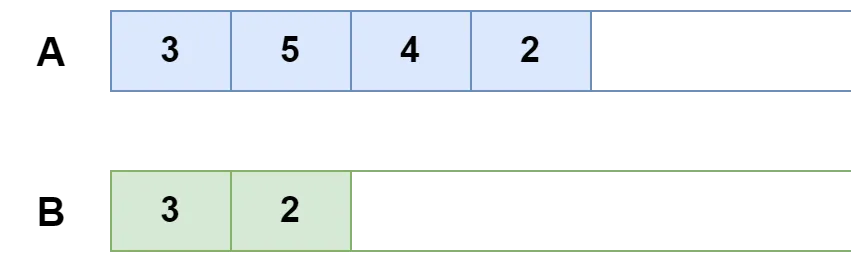
- 请设计一个最小栈数据结构,要求满足:\ (1)最小栈具有栈的基本功能,包括入栈,查看栈顶元素,出栈,查看栈内元素个数,且这些操作的时间复杂度均为\(O(1)\)。\ (2)可以查看最小栈中最小元素,时间上尽可能高效。\ (3)最小栈中元素个数不会超过10000个。\ 请回答以下问题:\ (1)请使用顺序存储结构,完成最小栈的设计。用C/C++代码实现,仅需要写出结构,不需要实现具体功能,并简要说明。\ (2)请给出查看最小栈中最小元素的基本过程,并说明该操作的时间复杂度。\ (3)请画出向最小栈依次添加3,5,4,2之后的结构状态。\ (4)请描述问题(3)操作完毕后,最小栈出栈,请给出出栈过程和出栈后查看最小栈的最小元素的过程。
解析
- 代码如下
#define MAX_SIZE 10000
typedef struct{
    int A[MAX_SIZE];   //数据栈
    int B[MAX_SIZE];   //辅助栈
    int aTop;  //数据栈顶
    int bTop;  //辅助栈顶
}minStack;最小栈的结构中包括数据栈和辅助栈。数据栈完成所有栈的基本功能,另外维护一个辅助栈。最小栈入栈时,如果数据栈入栈元素小于等于当前最小栈的最小元素,则同时压入辅助栈。最小栈出栈时,如果数据栈出栈元素等于辅助栈的栈顶元素,则辅助栈出栈。如此可以保证,在栈非空时,辅助栈栈顶永远保存着数据栈的最小元素。
- 如果辅助栈为空,则最小栈为空,无最小元素;如果辅助栈不为空,则辅助栈顶为最小元素。该操作的时间复杂度为0(1)。
- 如图所示
- 出栈时,数据栈出栈元素为2,与辅助栈顶元素相同,说明该元素出栈会改变栈的最小值。辅助栈同样出栈。最小栈元素变为3。
评分说明:该题有多种解法,只要设计的数据结构和方法能保证每个操作的时间复杂度都是O(1),即视为正确答案。
Note
2. 请设计一个队列,要求:
- 该队列具有入队(\(push(x)\)),出队(\(pop\)),查看队列中的元素个数三个函数,且这些操作在时间上尽可能高效。
- 使用两个栈实现该结构。\ 请回答以下问题:
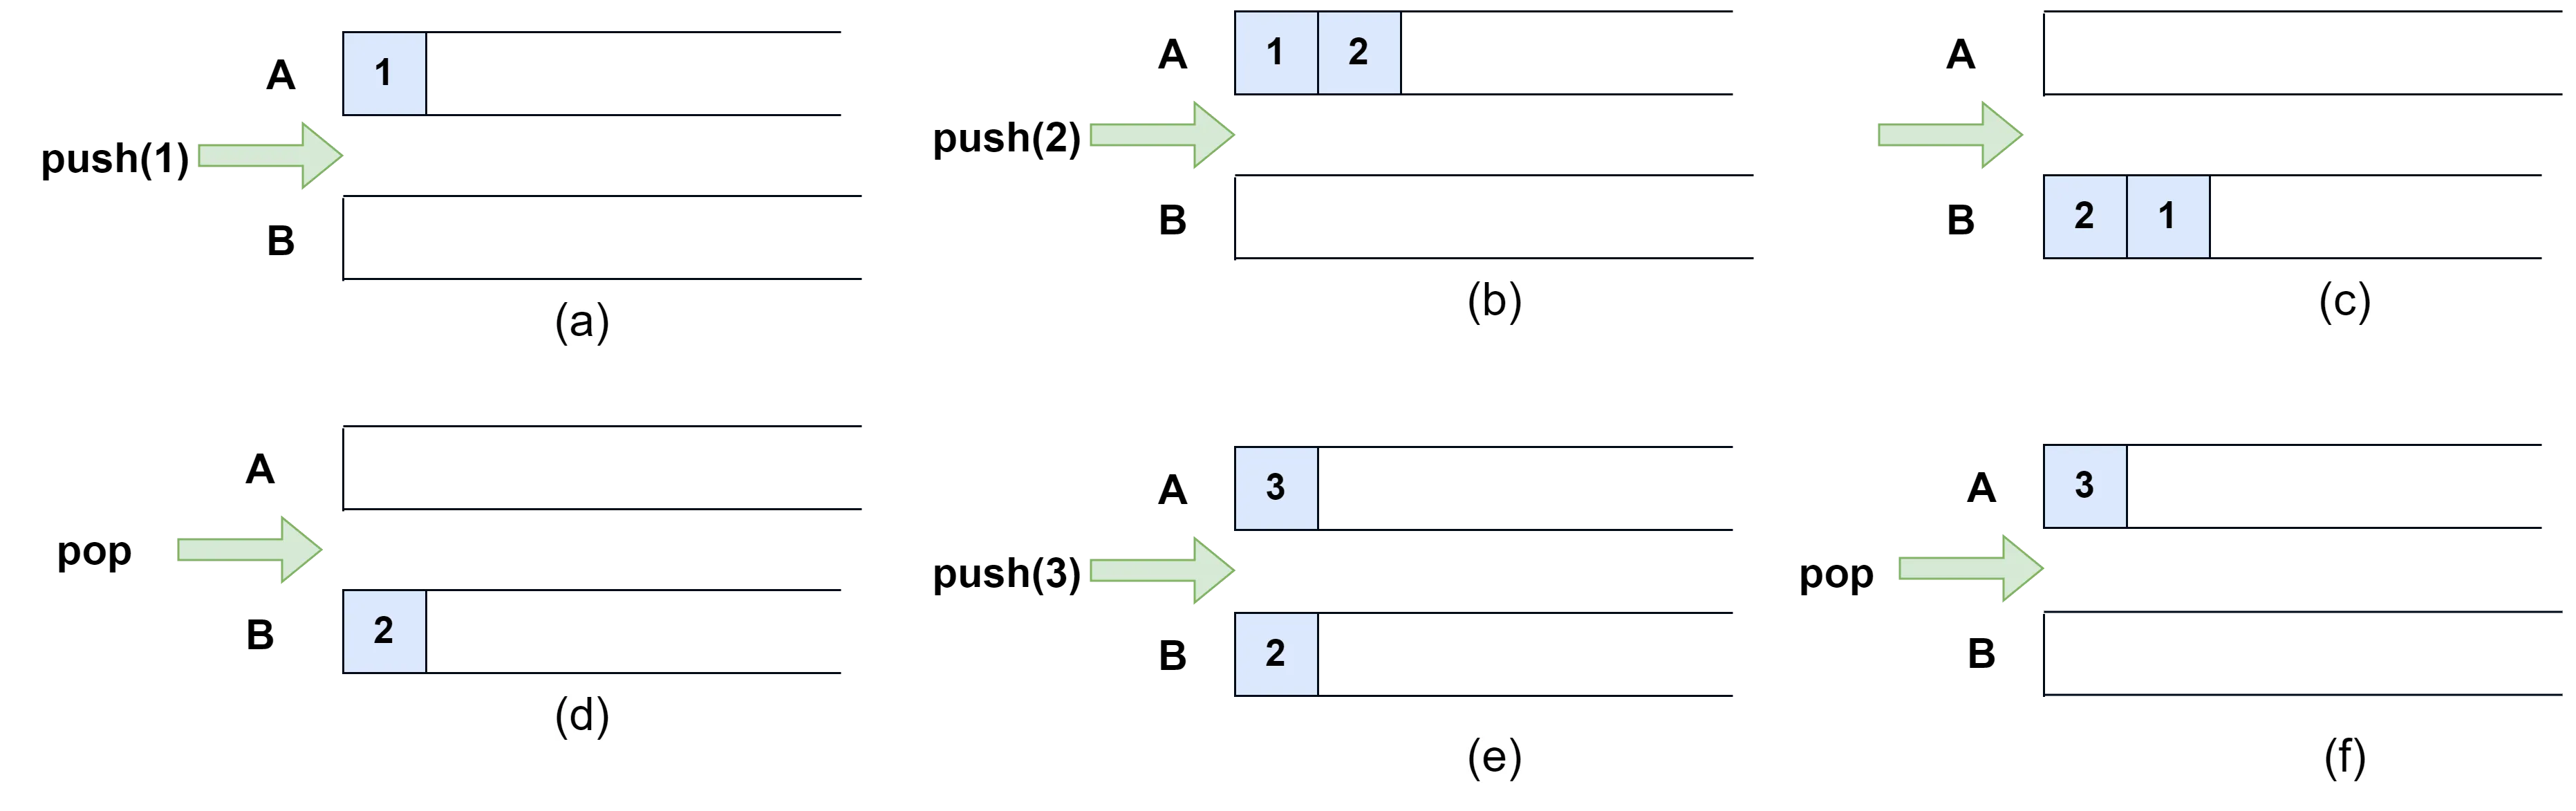
(1):请完成该队列的设计,并简要说明。\ (2)请给出入队和出队的基本过程。\ (3)请画出在空队列完成以下操作的过程:\(push(1),push(2),pop,push(3),pop\)。\ (4)现有\(n\)个元素和一个空队列,元素以任意顺序入队和出队,最后队列为空。请给出使用该结构完成上述任务的总时间复杂度。
解析
- 代码如下
const int MAX_SIZE = 10000;
typedef struct{
    int A[MAX_SIZE];   //入队栈
    int B[MAX_SIZE];   //出队栈
    int aTop;  //入队栈顶
    int bTop;  //出队栈顶
}Queue;- 入队时,元素直接加入入队栈。出队时,出队栈出栈。如果出队栈为空,则将入队栈的元素依次出栈并加入出队栈。
- 如图所示
- 每个元素都会经历两次入栈和两次出栈,所以栈操作的总时间复杂度为O(n)。入队和出队时,除了出入栈以外的时间复杂度为0(1)。综上所述,上述任务时间复杂度为O(n)。
评分说明: (1) 亦可选用链式存储栈。若使用了效率较低的算法,即在(4)中时间复杂度为 的算法,酌情扣分。
3.4 数组和特殊矩阵
3.4.1 数组
- 数组:是由\(n(n>=1)\)个相同类型的数据元素构成的有限序列。每个数据元素称之为一个数组元素,每个元素在\(n\)个线性关系中的序号称之为该元素的下标,下标的取值范围称之为数组的维界.
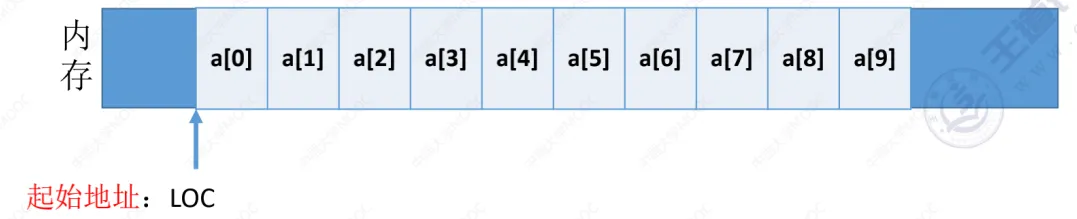
其中数组元素\(a[i]\)的存放地址=LOC+\(i\)×sizeof(DataType)
一般来说下标默认从0开始,但是特别注意如果从1开始则是\(i-1\).
- 二维数组:对于多维数组,以二维数组为例,有以下两种映射方式
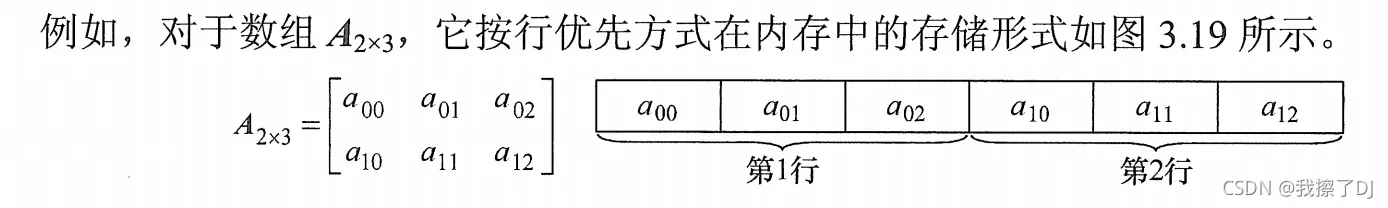
- 行优先:先行后列,先存储行号较小的元素,行号相等时先存储列号较小的元素。假设二维数组的行列下标范围分别为\([0,h_1][0,h_2]\),则存储结构关系为:\(LOC(a_{i,j}) =LOC(a_{0,0})+[i\*(h_2+1)+j]\*L\)
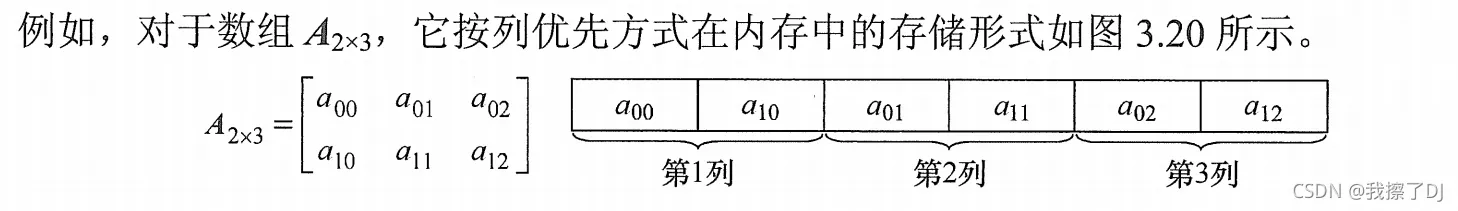
- 列优先:先列后行,先存储列号较小的元素,列号相等时先存储行号较小的元素。假设二维数组的行列下标范围分别为\([0,h_1][0,h_2]\),则存储结构关系为:\(LOC(a_{i,j}) =LOC(a_{0,0})+[j\*(h_1+1)+i]\*L\)
3.4.2 特殊矩阵
- 矩阵的压缩存储:对于普通二维数组,存储时自然使用普通矩阵,但是对于一些特殊的情况,使用特殊的矩阵进行存储可以压缩空间
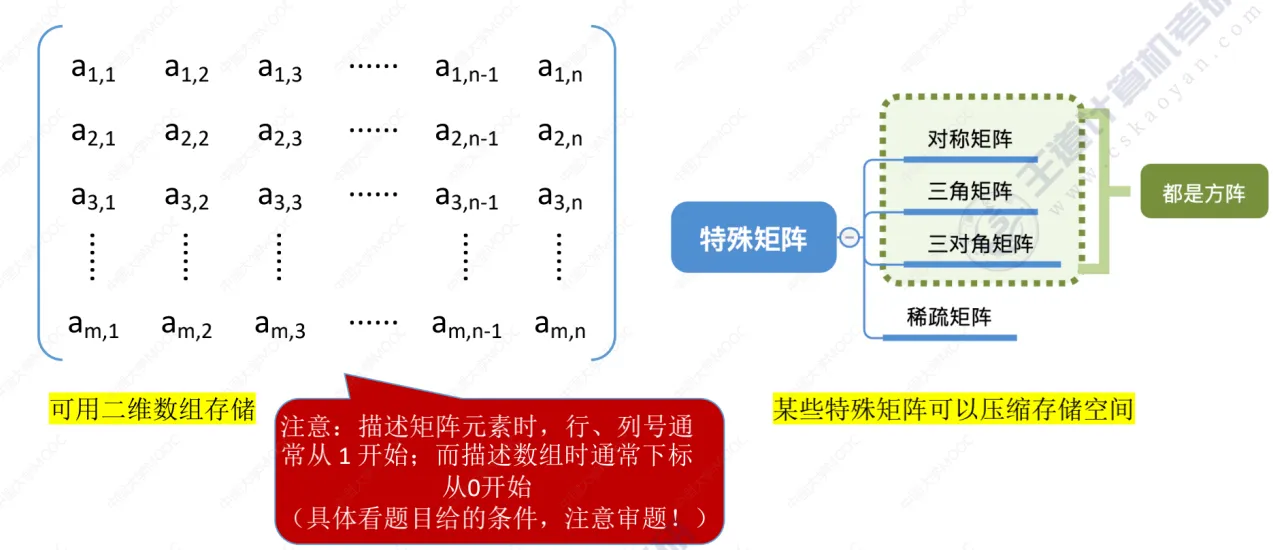
-
对称矩阵:对于一个\(n\)阶方阵\(A [ n ] [ n ]\) ,其任意一个元素 \(a_{i,j}*\) 都有 \(*a*{i,j}=a*{j,i}\),则称为对角矩阵
-
如下一个\(n\)阶对角矩阵,可以分为上三角区、主对角线和下三角区三个部分,压缩存储策略:只存储主对角线+下三角区或主对角线上三角区
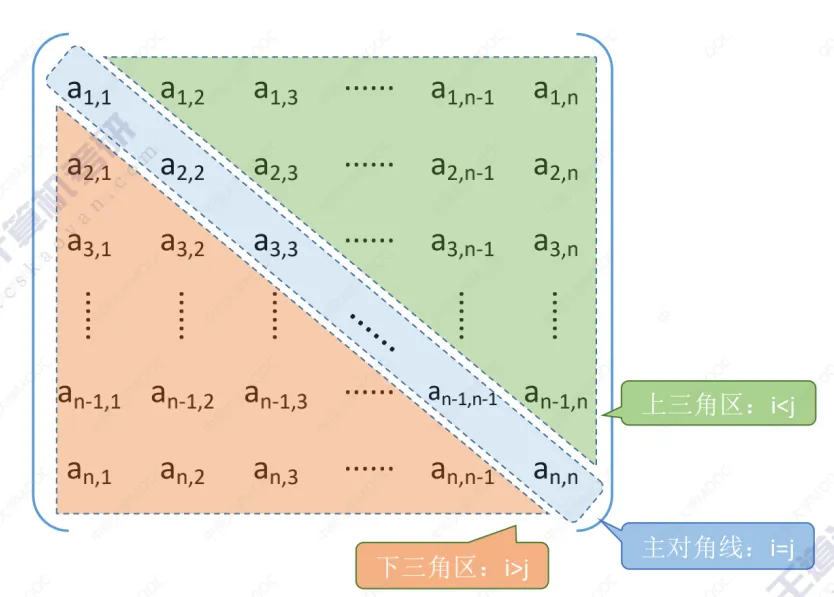
具体细节(以主对角线+下三角区为例)
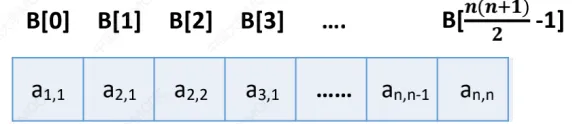
1:首先按照行优先原则将各元素存储在一维数组中
- 数组大小由等差数列确定\(S=\frac{n(n+1)}{2}\)
- 数组最后一个元素下标即为:\(\frac{n(n+1)}{2}-1\)
- 存储的目的是为了访问,因此需要把矩阵下标\(a_{i,j}\)映射为一维数组下标\(B[k]\)
- 按照行优先原则\(a_{i,j}\)(因为是下三角区所以\(i ≥ j\) )前共有\(1+2+…+(i-1)+j-1\)个元素,即\(a_{i,j}\)是第\(\frac{i(i-1)}{2}+j\)个元素,即\(k=\frac{i(i-1)}{2}+j-1\)
- 需要注意如果是上三角区的\(a[i][j]\)那么\(i≤j\),则\(k =\frac{j(j-1)}{2}+i-1\)
- 三角矩阵
- 下三角矩阵:除了主对角线元素和下三角区,其余的元素都相同
- 上三角矩阵:除了主对角线元素和上三角区,其余的元素都相同
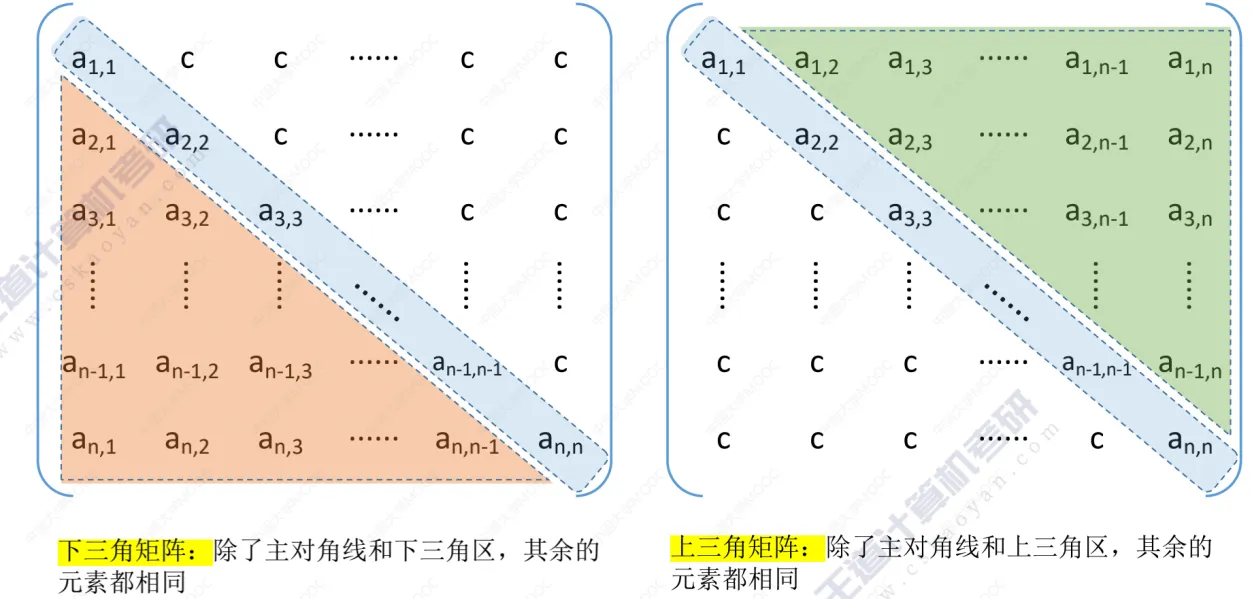
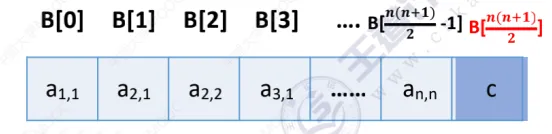
压缩存储策略(以下三角为例) :按照行优先或列优先原则将主对角线和非常量区存储在一维数组中,并在此一维数组最后一个位置存储一个常量
首先按照行优先原则将各元素存储在一维数组中
数组大小由等差数列确定\(S=\frac{n(n+1)}{2}+1\)
- 数组最后一个元素下标即为:\(\frac{n(n+1)}{2}\)
- 存储的目的是为了访问,因此需要把矩阵下标\(a_{i,j}\)映射为一维数组下标\(B[k]\)
- 按照行优先原则\(a_{i,j}\)(因为是下三角区所以\(i ≥ j\))前共有\(1+2+…+(i-1)+j\)个元素,即\(a_{i,j}\)是第\(\frac{i(i-1)}{2}+j\)个元素,即\(k=\frac{i(i-1)}{2}+j-1\)
- 需要注意如果是上三角区的\(a[i][j]\)那么\(i≤j\),则\(k =\frac{n(n+1)}{2}\)常量,即一维数组最后一个位置;
- 三对角矩阵
三对角矩阵定义:又称为带状矩阵。对于\(n\)阶方阵\(A\)中的任一元素\(a_{i,j}\),当\(∣ i − j ∣ > 1\) 时,有 \(a_{i,j}=0\),则称为三对角矩阵
- 在三对角矩阵中,所有非零元素都集中在主对角为中心的3条对角线的区域,其他区域的元素都为0
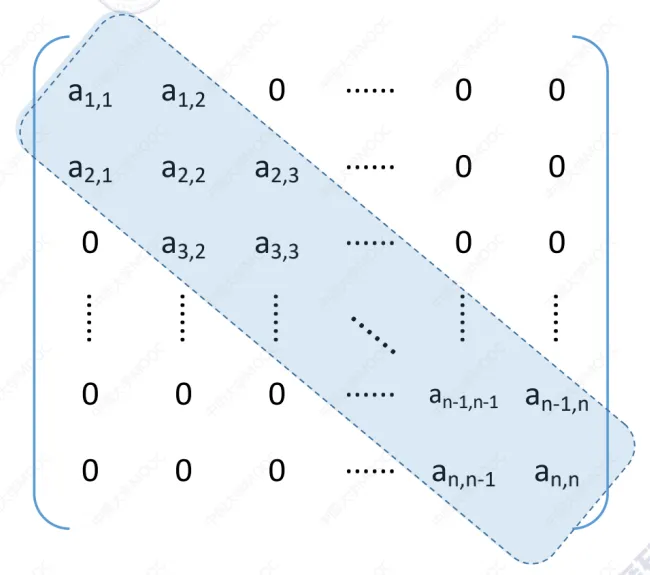
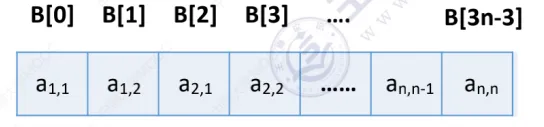
压缩存储策略:按照行优先或列优先原则,只存储带状部分到一个一维数组即可
- 首先按照行优先原则将各元素存储在一维数组中
- 按照行优先原则,每一行共有3个元素,第一行和最后一行各自少一个元素,因此总的元素个数为\(3n-2\),故一维数组最后一个元素下标为\(3n-3\)
- 存储的目的是为了访问,因此需要把矩阵下标\(a_{i,j}\)映射为一维数组下标\(B[k]\)
- 按照行优先原则\(a_{i,j}\)其前\(i-1\)行共有\(3(i-1)-1\)个元素,\(a_{i,j}\)是第\(i\)行第\(j-i+2\)个元素,故\(a_{i,j}\)是第\(2i+j-2\)个元素,因此\(k=2i+j-3\)
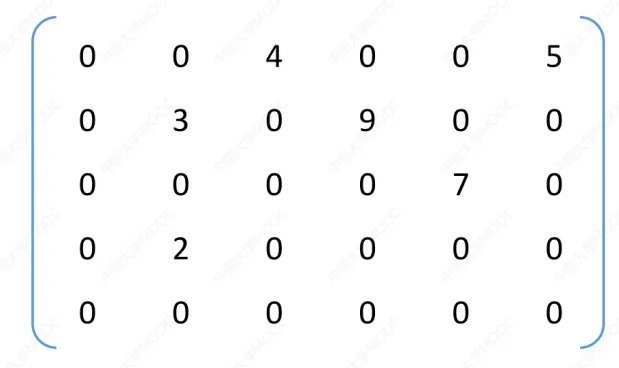
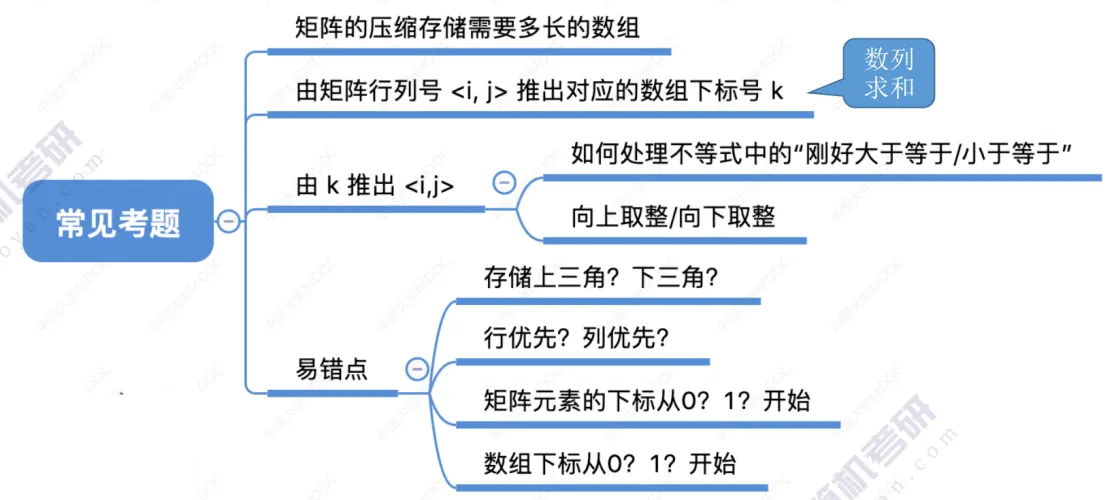
- 稀疏矩阵:矩阵中非零元素的个数\(t\)相对于矩阵元素的个数\(s\)非常少,也即\(s>>t\)的矩阵称之为稀疏矩阵
 \
压缩存储策略:
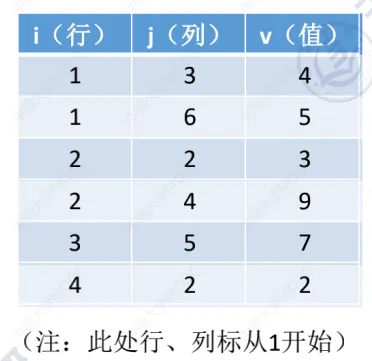
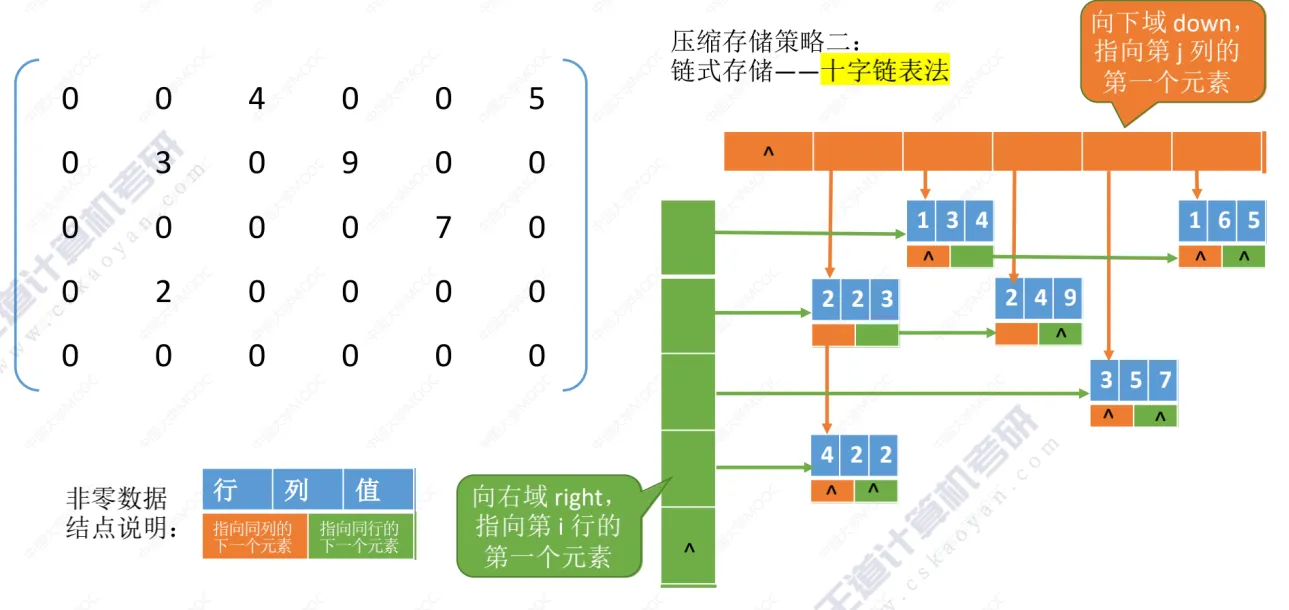
- 三元组法:这是顺序存储,存储稀疏矩阵的非零元素,一个三元组就是<行,列,值>\
- 十字链表法 :这是链式存储,将在图那一章详细介绍
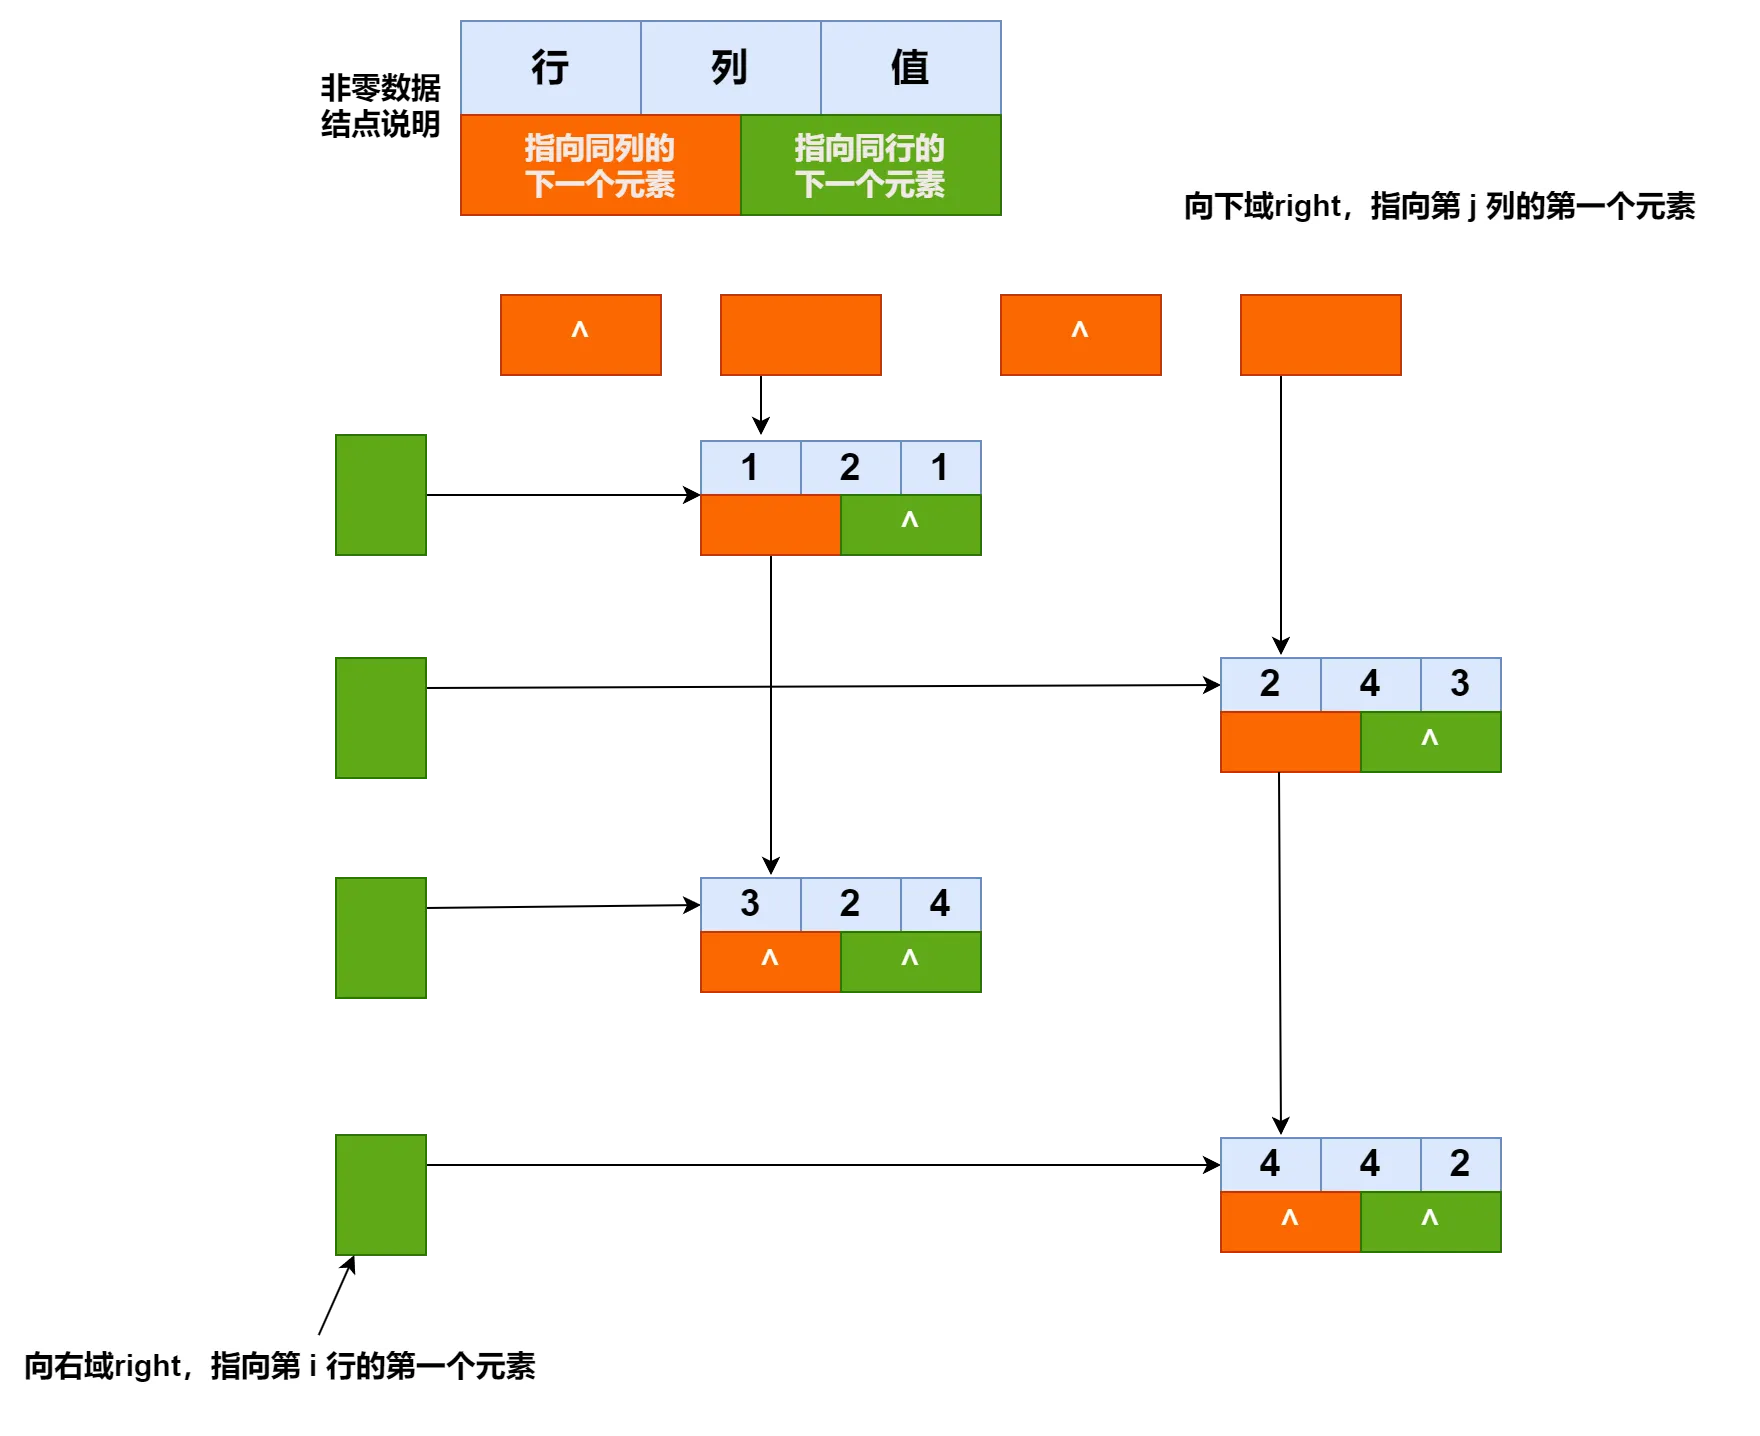
用十字链表法存储一个稀疏矩阵(5分)
\(A=\begin{Bmatrix} 0& 1& 0& 0\ 0& 0& 0& 3\ 0& 4& 0& 0\ 0& 0& 0& 2 \end{Bmatrix}\)
十字链表法是一种有效存储稀疏矩阵的链表结构,适合行列非零元素稀疏的矩阵。每个节点包含一个非零元素的位置、值,以及指向其同一行和同一列中下一个非零元素的指针。这样可以通过行和列同时遍历稀疏矩阵中的非零元素.
根据A的邻接矩阵我们可以画出其对应的有向图为: