第五讲图
【考频统计】
| 年份 | 考点 | 分值 |
|---|---|---|
| 2009 | 无向连通图的特性、最短路径问题(应用题) | 单选2分+应用题10分=\(12\)分 |
| 2010 | 无向连通图的特性、拓扑排序 | 单选*2 =\(4\)分 |
| 2011 | 图的基本概念、图的存储、拓扑序列(选择) 图的邻接矩阵、关键路径 | 单选2分+应用8分=\(10\)分 |
| 2012 | 图的邻接矩阵与邻接表存储、图的广度优先遍历、拓扑序列 最短路径(Dijkstra算法)最小生成树(性质、prim和kruskal) |
单选*4 = \(8\)分 |
| 2013 | 图的邻接矩阵表示、图的广度优先遍历、关键路径 | 单选*3 =6分 |
| 2014 | 拓扑序列、图的基本概念及存储方式、最短路径(Dijkstra算法) |
单选2分+应用题10分=\(12\)分 |
| 2015 | 深度优先遍历、最小生成树(prim和kruskal)、图的邻接矩阵表示应用题 |
单选 * 2+应用题 8 分=\(12\)分 |
| 2016 | 图的深度优先搜索序列、邻接表存储、拓扑排序、最短路径(Dijkstra算法) |
单选*3 = \(6\)分 |
| 2017 | 无向图顶点与度数的关系、最小生成树(prim) |
单选2分+应用8分=\(10\)分 |
| 2018 | 拓扑序列、最小生成树(prim或kruskal) |
单选2分+应用12分=\(14\)分 |
| 2019 | 有向无环图描述表达式、关键路径 | 单选*2 =\(4\)分 |
| 2020 | 图的深度优先遍历、拓扑排序、最小生成树(kruskal)、关键路径 |
单选*3 = \(6\)分 |
| 2021 | 拓扑排序、最短路径(Dijkstra算法)、邻接矩阵表示的图的简单算法题 |
单选*2+算法题15分=\(19\)分 |
| 2022 | 无向图的连通性、AOE网的时间余量问题 | 单选*2 =\(4\)分 |
| 2023 | 单源最短路径问题、邻接矩阵表示的图的简单算法题 | 单选2分+算法题13分=15分 |
本章是应用题重点出题章节,分值大于10分的有8年以上,因此对各应用题考点必须掌握充分!!!
【考点分析】:图的邻接矩阵与邻接表存储考察过8次,最小生成树考察过5次左右、拓扑排序考察过8次、最短路径考察过5次、关键路径问题考察过4次、
BFS和DFS也考察过好几次,这些都是很重要的考点;【冷门考点及考点预测】:
- 通过调用
BFS或者DFS的次数判断无向图中的连通分量个数,当然该问题也可用并查集来解决;- 最短路径问题的单源最短路径问题已考察过多次,但是带权全源最短路径的
Floyd算法至今未考查过,该算法主要思想是依次允许通过\(v_0、v_1、v_2\cdots、v_n\)中转,如果有新的两点间更短距离的话,则要更新这两个矩阵对应元素的值。注意掌握画十字法快速求解Floyd的方法;Dijkstra算法无法求解带有负权值的有向图,Floyd算法可以解决带有带有负权值但是不带有负权值回路的带权有向图;- 有向无环图描述表达式的方法注意回顾;
- 结合【DAG图(
AOV网)中各顶点的地位平等,每个顶点编号是人为的,因此可以按照拓扑排序的结果重新编号,从而生成的新的邻接矩阵可以是三角矩阵;】这个知识点将拓扑排序和数据的压缩存储一起考察;- 拓扑排序的DFS和BFS实现以及用来判断图中是否有环结合考察;
- 无向图判环以及有向图判环的几种方式需要掌握;
- 图的十字链表法和邻接多重表;
【图的应用算法总结】
| 算法名称 | 最小生成树 \(Prim\) | 最小生成树 \(Kruskal\) | 最短路径 \(Dijkstra\) | 最短路径 \(Floyd\) | 拓扑排序 | 关键路径 |
|---|---|---|---|---|---|---|
| 算法思想 | 顶点为主、排序多次、 贪心思想 | 边为主、排序一次、 贪心思想 | 贪心思想、分成两个集合、 两个记录数组\(dist[\ ]\)和\(path[\ ]\)一个标记数组\(final[\ ]\) | 动态规划、中转顶点 | 找入度为0结点入队、 出队更新邻接结点度数 | 四个关键数组 \(ve、vl、ee、el;ee=el\)的活动为关键活动 |
| 算法特点 | 适合于边稠密图 | 适用于边稀疏而顶点较多的图 | 求解某一顶点到其余所有顶点的最短路径 | 可以求解图中所有顶 点对之间的最短路径 | 拓扑排序可能有多个 ,它也是求关键路径的基础 | 关键路径可能有多条,需修改所有 关键路径上的活动才能提升效率; |
| 空间复杂度 | $O( | V | )$ | $O( | V | )$ |
| 时间复杂度 | 1. 常规方法:两种实现都是$O( | V | ^2)\(<br/>2. 采用堆优化\)O( | E | log | V |
| 应用 | 求解将所有顶点连接起来的最低花销和连接方案 | 同左 | 求解顶点对之间的最短距离 | 同左 | 用于有前后发生顺序约束的实际场景,如大学课程排序、项目编译顺序、判断图中是否有环 | 求工程的最短工期;加快工程进度的解决方案 |
5.1 图的基本定义及常见术语
5.1.1 基本概念
| 名称 | 含义或概念 | 示意图 |
|---|---|---|
图G(Graph) |
图\(G\)由顶点集V(Vertex)和边集 E(Edge)组成,记为\(G=(V,E)\),其中\(V(G)\)表示图\(G\)中顶点的有限非空集;\(E(G)\)表示图\(G\)中顶点之间的关系(边)集合。若\(V=\left\{ V_1,V_2,\cdots,V_n \right\}\),则用 |
V |
| 无向图\(undirected \ graph\) | 若\(E\)是无向边(简称边)的有限集合时,则图\(G\)为无向图。边是顶点的无序对, 记为\((v,w)\)或\((w,v)\),因为\((v,w)=(w,v)\),其中\(v,w\)是顶点。 | 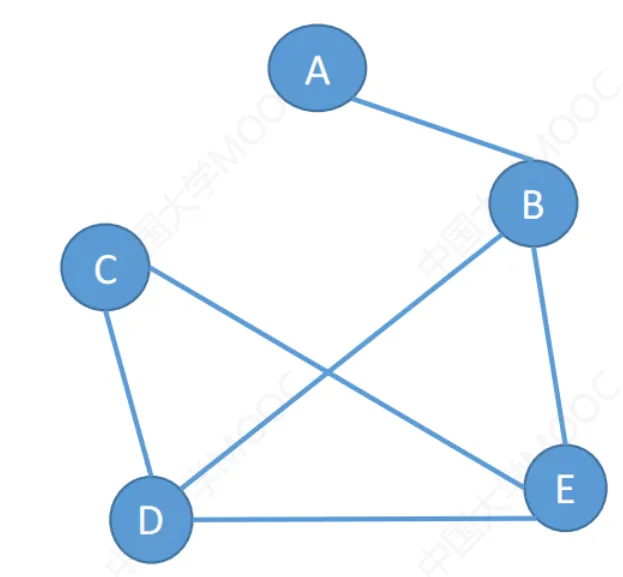 |
| 有向图\(directed\ graph/digraph\) | 若\(E\)是有向边(也称弧)的有限集合时,则图\(G\)为有向图。 弧是顶点的有序对,记为\(\<v, w>\)其中\(v\)、\(w\)是顶点,\(v\)称为弧尾,\(w\)称为弧头,\(\<v, w>\)称为从顶点\(v\)到顶点\(w\)的弧, \(\<v, w> ≠ \<w, v>\) | 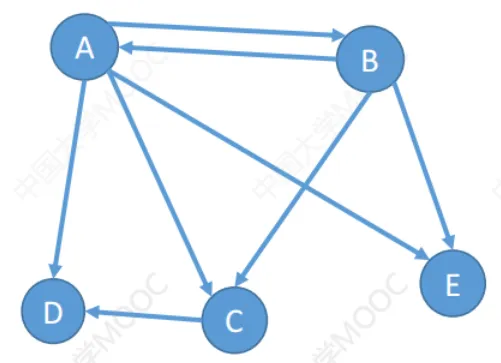 |
| 简单图 | 1. 不存在重复边 2. 不存在顶点到自身的边 3. 【注】:数据结构中只探讨“简单图” |
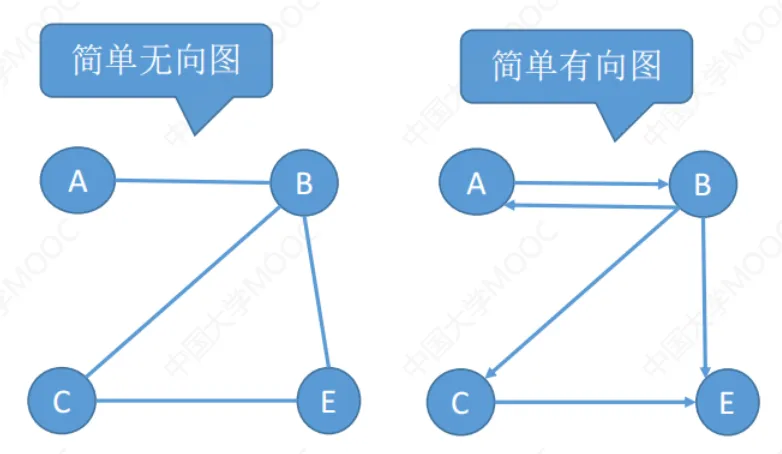 |
| 多重图 | 图_G_中某两个结点之间的边数多于一条,又允许顶点通过同一条边和自己关联,则_G_为多重图 | 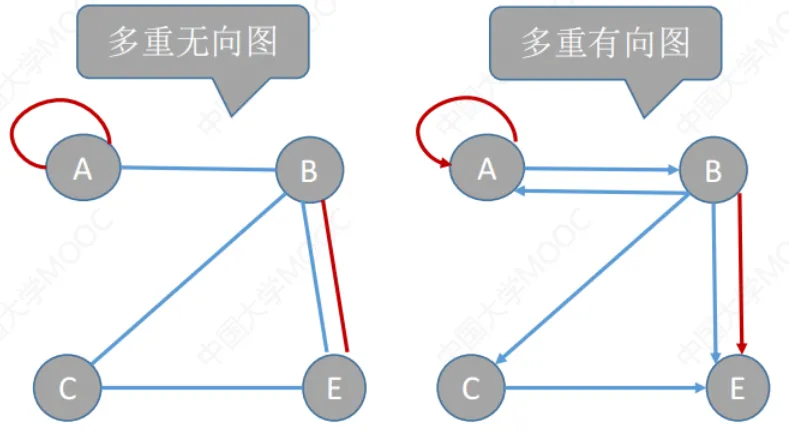 |
| 无向图的度\(degree\) | 1. 顶点\(v\)的度是指依附于该顶点的边的条数,记为\(TD(v)\)。 2. 在具有\(n\)个顶点、\(e\)条边的无向图中,\(\sum_{i=1}^{n} TD(v_i)=2e\)即无向图的全部顶点的度的和等于边数的2倍 |
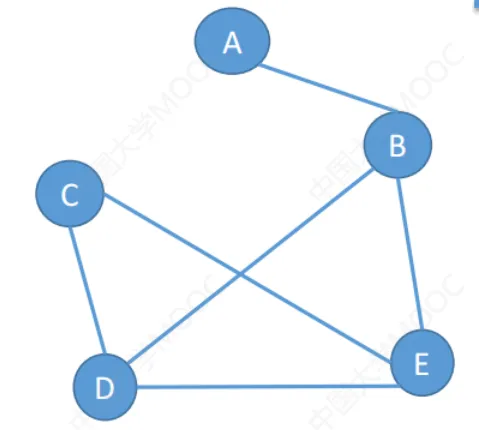 |
| 有向图的度 | 入度\(indegree\)是以顶点_v_为终点的有向边的数目,记为ID(v); 出度\(outdegree\)是以顶点_v_为起点的有向边的数目,记为OD(v)。 顶点\(v\)的度等于其入度和出度之和,即TD(v) = ID(v) + OD(v)。 在具有 \(n\) 个顶点、\(e\) 条边的有向图中,\(\sum_{i=1}^{n}ID(v_i)=\sum_{i=1}^{n}OD(v_i)=e\) | 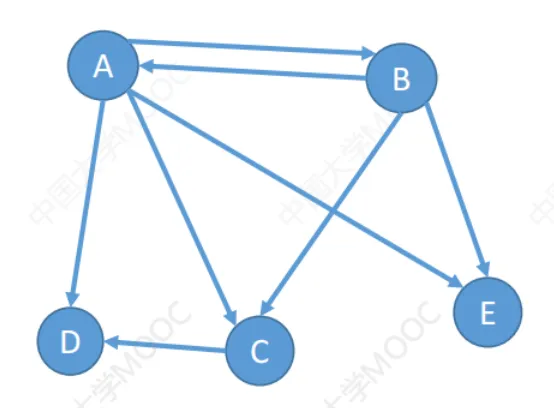 |
| 边的权/值\(weight/cost\) | 在一个图中,每条边都可以标上具有某种含义的数值,该数值称为该边的权值; | 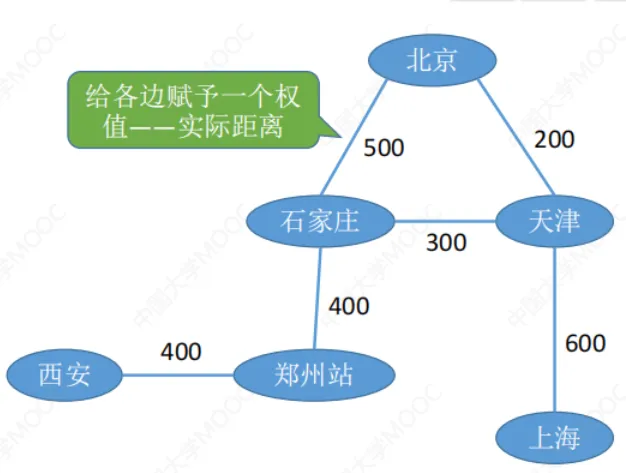 |
| 带权图/网 | 边上带有权值的图称为带权图,也称网 | |
| 带权路径长度 | 当图是带权图时,一条路径上所有边的权值之和,称为该路径的带权路径长度。 |
5.1.2 点到点的关系
| 路径\(path\) | 顶点 \(v_p\) 到顶点 \(v_q\) 之间的一条路径是指顶点序列 ,\(v_p,v_{i1},v_{i2},\cdots,v_{im},v_q\)有向图中的路径也是有向的 | 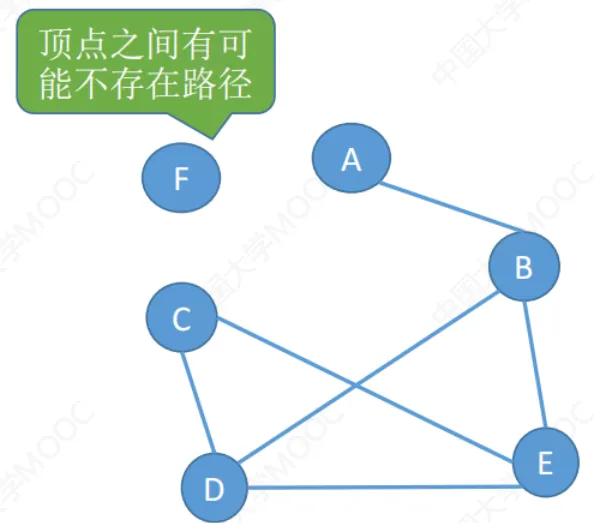 |
|---|---|---|
| 邻接 \(adjacent\) | 当两顶点之间存在边相连时,称这两顶点“邻接”,比如上图中的顶点B的邻接顶点为A、D、E | |
| 回路 | 第一个顶点和最后一个顶点相同的路径称为回路或环 | |
| 简单路径\(simple\ path\) | 在路径序列中,顶点不重复出现的路径称为简单路径。 | |
| 简单回路 | 除第一个顶点和最后一个顶点外,其余顶点不重复出现的回路称为简单回路。 | |
| 路径长度\(path \ length\) | 路径上边的数目 | |
| 点到点的距离 | 从顶点 \(u\) 出发到顶点 \(v\) 的最短路径若存在,则此路径的长度称为从 \(u\) 到 \(v\) 的距离, 若从\(u\)到 \(v\) 根本不存在路径,则记该距离为无穷\((\infty )\)。 | |
| 连通 | 无向图中,若从顶点 \(v\) 顶点 \(w\)有路径存在,则称 \(v\) 和 \(w\) 是连通的 | |
| 强连通\(strongly \ connected\) | 在有向图中,若从顶点 \(v\) 顶点 \(w\) 和从顶点 \(w\) 顶点 \(v\) 之间都有路径,则称这两个顶点是强连通的 | |
| 连通图\(connected\ graph\) | 若无向图中任意两个顶点都是连通的,则称该图是连通图,否则称为非连通图对于\(n\)个顶点的无向图\(G\),若\(G\)是连通图,则最少有\(n-1\) 条边; 若\(G\) 是非连通图, 则最多可能有\(C_{n-1}^2\) 条边(\(C_n^m=\frac{n(n-1)\cdots(n-m+1)}{m!}=\frac{n!}{m!(n-m)!}\)) | 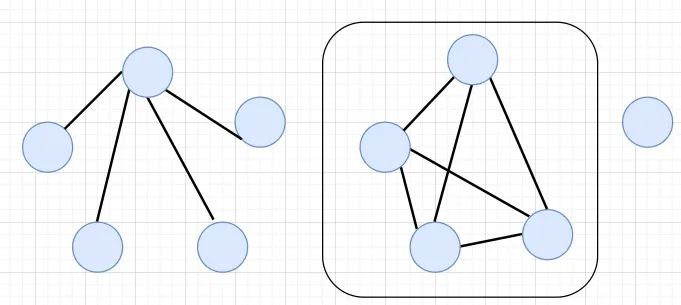 |
| 强连通图 | 如果有向图中任何一对顶点都是强连通的,则称此图为强连通图; 对于\(n\)个顶点的有向图\(G\), 若\(G\) 是强连通图, 则最少有 \(n\) 条边(形成回路) | 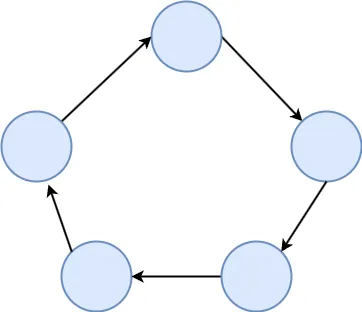 |
5.1.3 图的局部
| 子图 | 设有两个图\(G = (V,E)\)和\(G'=(V',E')\),若\(V’\)是\(V\)的子集,且\(E'\)是\(E\)的子集,则称\(G’\)是\(G\)的子图 | 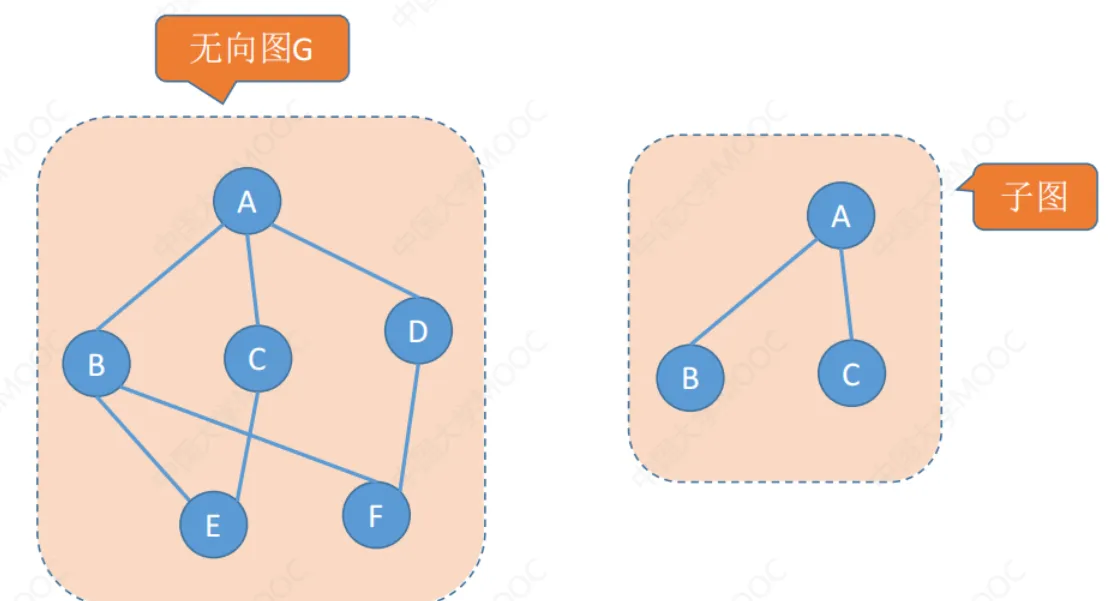 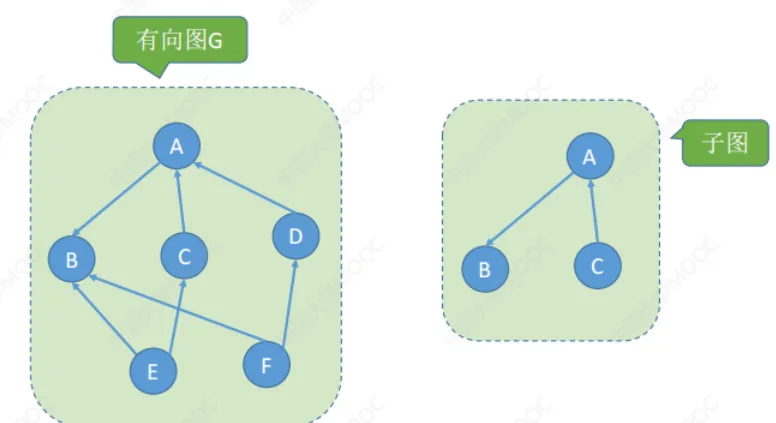 |
|---|---|---|
| 生成子图 | 若有满足\(V(G’)=V(G)\) 的子图\(G’\), 则称其为\(G\) 的生成子图 | 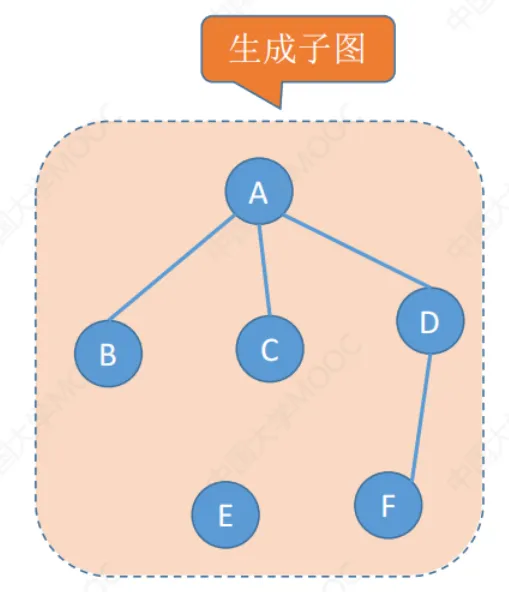 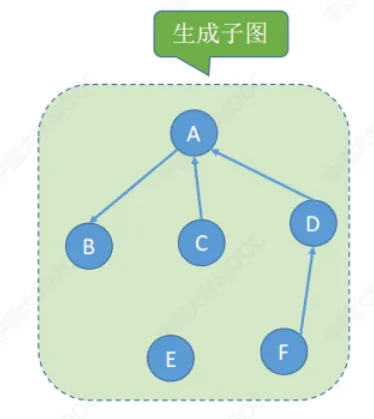 |
| 连通分量\(connected \ component\) | 无向图中的极大连通子图(子图必须连通,且包含尽可能多的顶点和边)称为连通分量。 | 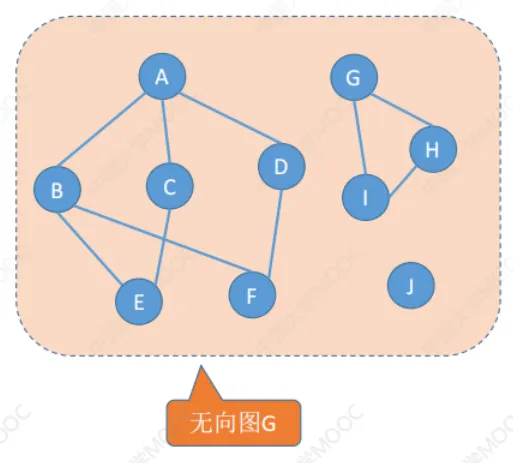 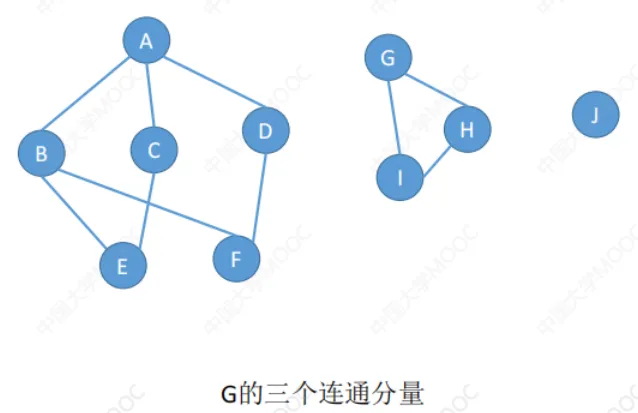 |
| 强连通分量 | 有向图中的极大强连通子图称为有向图的强连通分量 极大强连通子图:子图必须强连通,保留尽可能多的边 |
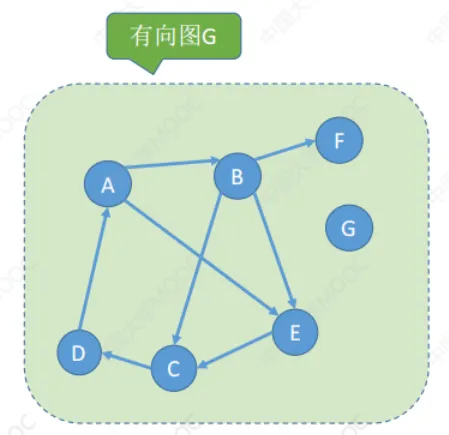 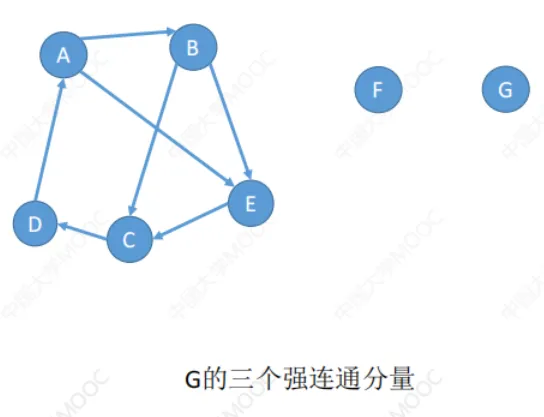 |
| 生成树 | 连通图(无向图)的生成树是包含图中全部顶点的一个极小连通子图; 极小连通子图:边尽可能地少,但是要保持连通若图中顶点数为\(n\), 则它的生成树含有 \(n-1\) 条边。 对生成树而言, 如果砍去它的一条边,则会变成非连通图,若加上一条边,则会形成一个回路; | 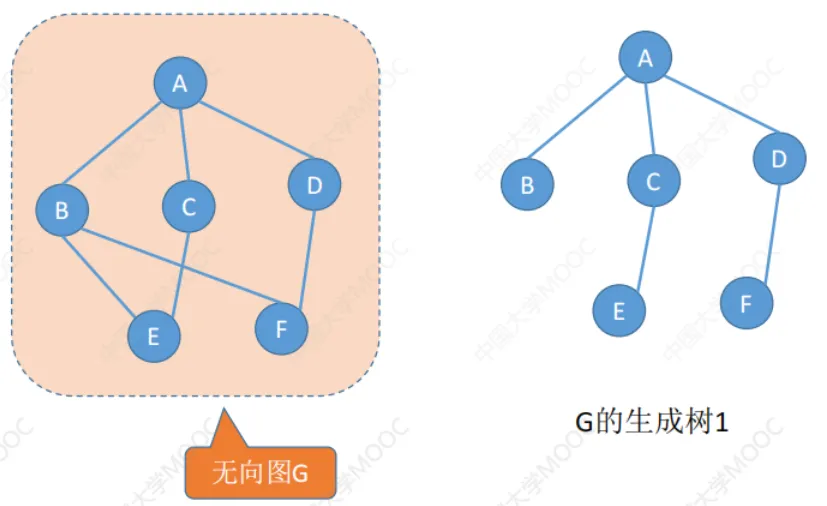 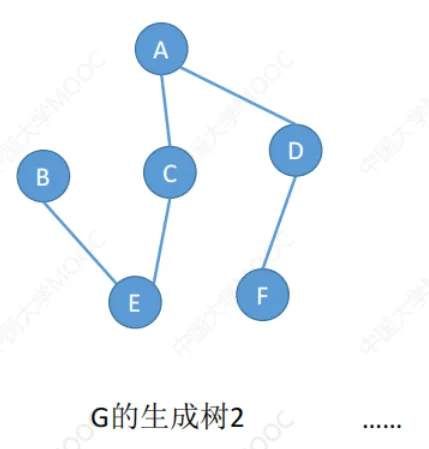 |
| 生成森林 | 在非连通图中,连通分量的生成树构成了非连通图的生成森林 | 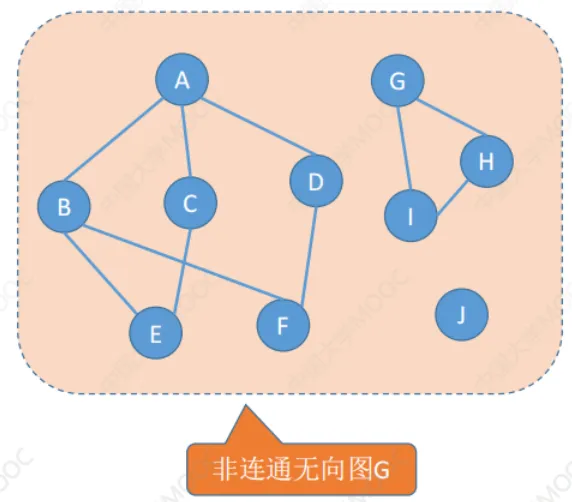 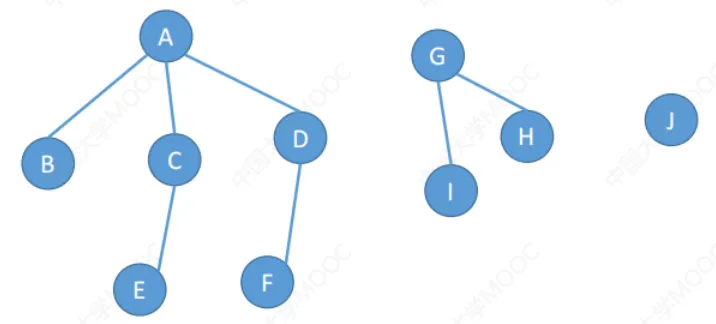 |
5.1.4 特殊形态的图
| 无向完全图 | 无向图中任意两个顶点之间都存在边,边数为\(\frac{n(n-1)}{2}\) 普通的无向图的顶点数\(|V|=n\), 则\(|E|\in[0,C_n^2]=[0,n(n-1)/2]\) | 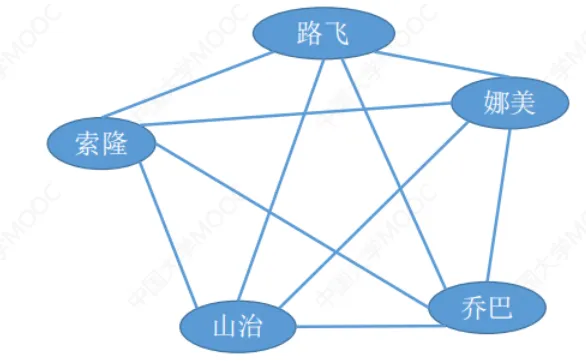 |
| --- | --- | --- |
| 有向完全图 | 有向图中任意两个顶点之间都存在方向相反的两条弧 普通的有向图的顶点数\(|V|=n\),则\(|E|\in[0,2C_n^2]=[0,n(n-1)]\) |
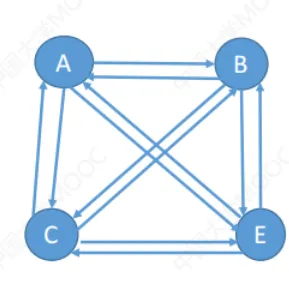 |
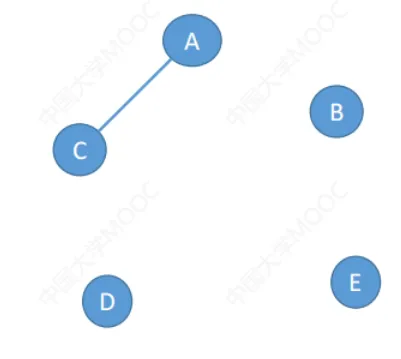
| 稀疏图 | 边数很少的图称为稀疏图 没有绝对的界限,一般来说\(|E|<|V|log|V|\)时,可以将其视为稀疏图 |
 |
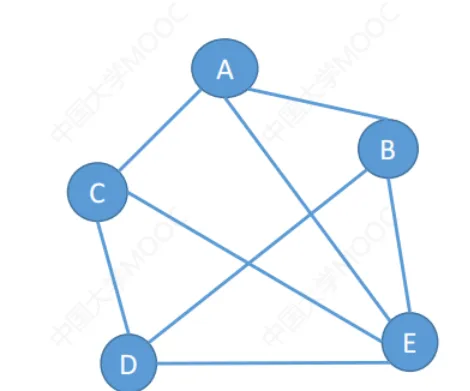
| 稠密图 | 边数很多的图 |
 |
| 树 | 不存在回路,且连通的无向图 因此\(n\) 个顶点的树, 必定有\(n-1\) 条边 考点:\(n\)个顶点的图,如果边数大于\(n-1\),则一定有回路 | |
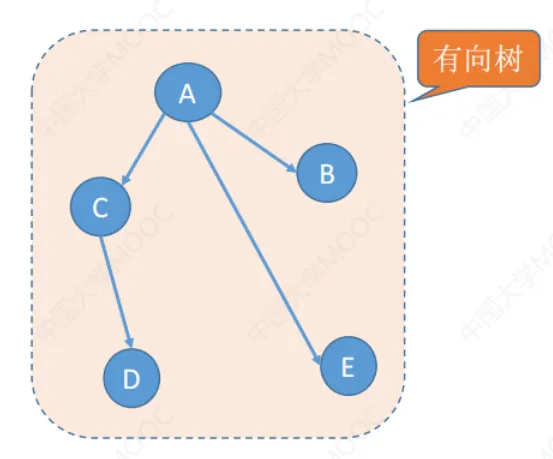
| 有向树 | 一个顶点入度为0,其余顶点的入度均为1的有向图,称为有向树 |
 |
5.2 图的存储
5.2.1 邻接矩阵法
设图的顶点数量为 \(n\) ,邻接矩阵 使用一个 \(n \times n\) 大小的矩阵来表示图,每一行(列)代表一个顶点,矩阵元素代表边,用 \(1\) 或 \(0\) 表示两个顶点之间是否存在边。
#define MAXV 100     // 顶点数目的最大值

typedef struct {
    int numVertices;       // 图中实际的顶点数
    int numEdges;          // 图中实际的边数
    char vertexList[MAXV]; // 顶点表
    int edges[MAXV][MAXV];  // 邻接矩阵
} MGraph;
如下图所示,设邻接矩阵为 \(M\) 、顶点列表为 \(V\) ,那么矩阵元素 \(M[i][j] = 1\) 表示顶点 \(V[i]\) 到顶点 \(V[j]\) 之间存在边,反之 \(M[i][j] = 0\) 表示两顶点之间无边。
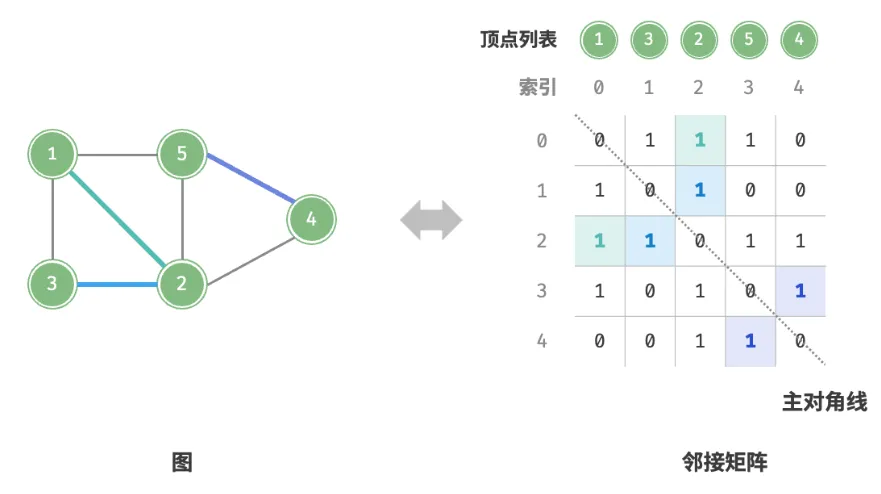
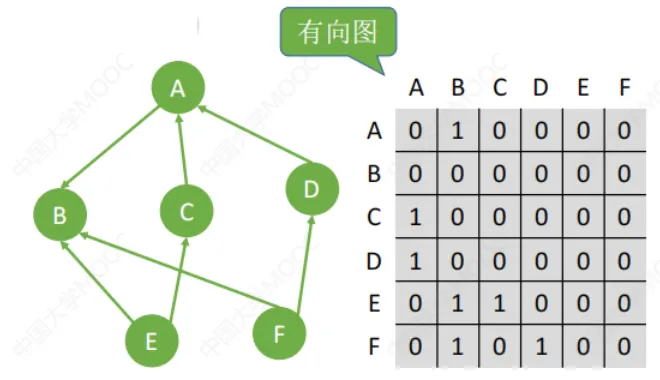
如上左图,在无向图的邻接矩阵中,第\(i\) 个结点的度 = 第\(i\) 行(或第\(i\) 列) 的非零元素个数。
如上右图,在有向图的邻接矩阵中(行出列入)
- 第\(i\) 个结点的出度 = 第\(i\)行 的非零元素个数;
- 第\(i\) 个结点的入度 = 第\(i\)列 的非零元素个数;
- 第\(i\) 个结点的度 = 第\(i\)行 + 第\(i\)列 的非零元素个数
因此 ,邻接矩阵法求顶点的度/出度/入度的时间复杂度为\(O(|V|)\)
#define MAXV 100     // 顶点数目的最大值

typedef struct {
    int numVertices;       // 图中实际的顶点数
    int numEdges;          // 图中实际的边数
    char vertexList[MAXV]; // 顶点表
    int edges[MAXV][MAXV];  // 邻接矩阵
} MGraph;

// 计算某个顶点的入度
int InDegree(MGraph graph, char V) {
    int index = -1;
    int count = 0;

    // 查找顶点 V 在顶点表中的索引
    for (int i = 0; i < graph.numVertices; i++) {
        if (graph.vertexList[i] == V) {
            index = i;
            break;
        }
    }

    // 如果没有找到顶点 V,返回 -1 表示错误
    if (index == -1) {
        return -1;
    }

    // 遍历邻接矩阵的每一行,检查是否有指向该顶点的边
    for (int i = 0; i < graph.numVertices; i++) {
        if (graph.edges[i][index] != 0) {
            count++;
        }
    }

    return count;  // 返回顶点 V 的入度
}

// 计算某个顶点的出度
int OutDegree(MGraph graph, char V) {
    int index = -1;
    int count = 0;

    // 查找顶点 V 在顶点表中的索引
    for (int i = 0; i < graph.numVertices; i++) {
        if (graph.vertexList[i] == V) {
            index = i;
            break;
        }
    }

    // 如果没有找到顶点 V,返回 -1 表示错误
    if (index == -1) {
        return -1;
    }

    // 遍历邻接矩阵的该顶点对应的行,检查是否有从该顶点出发的边
    for (int j = 0; j < graph.numVertices; j++) {
        if (graph.edges[index][j] != 0) {
            count++;
        }
    }

    return count;  // 返回顶点 V 的出度
}
邻接矩阵也可以用来存储带权图(网) 对角线元素可以设置为\(0\)或\(\infty\)
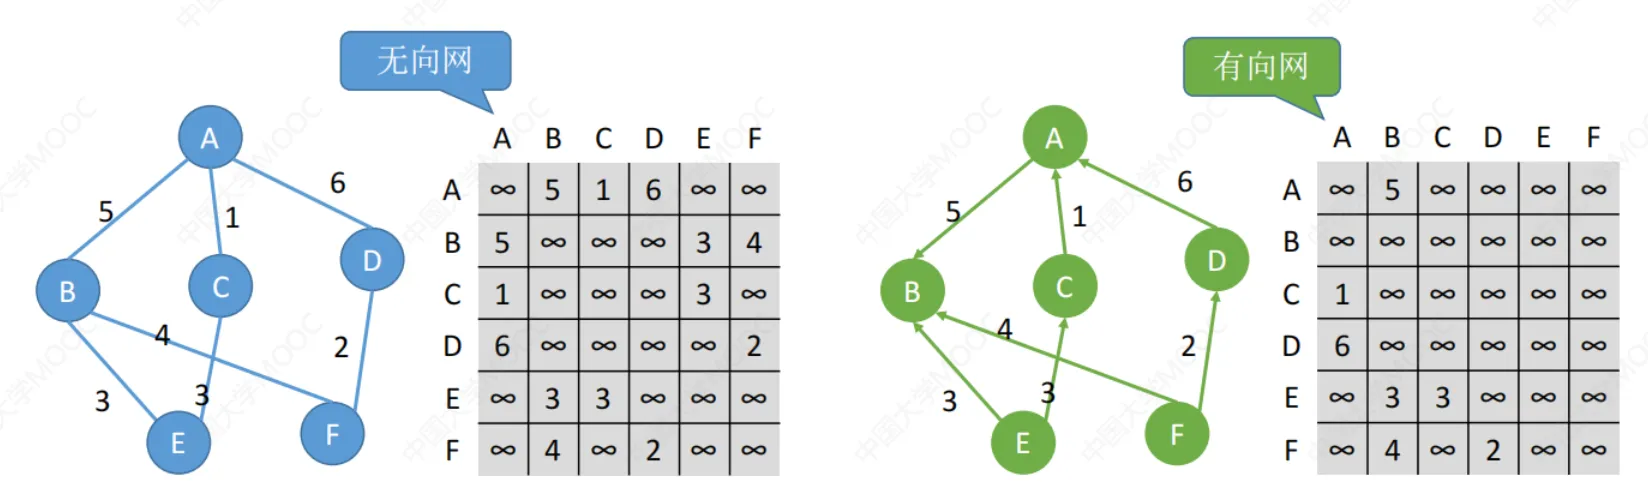
如图所示,设邻接矩阵为 \(M\) 、顶点列表为 \(V\) ,那么矩阵元素 \(M[i][j] = k\) 表示顶点 \(V[i]\) 到顶点 \(V[j]\) 之间存在边且权值为\(k\),反之 \(M[i][j] = \infty\) 即Edge[i][j] == INT_MAX表示两顶点之间无边。
邻接矩阵具有以下特性:
Note
- 顶点不能与自身相连,因此邻接矩阵主对角线元素没有意义。
- 对于无向图,两个方向的边等价,此时邻接矩阵关于主对角线对称。(可以压缩存储,即只存储上三角区或下三角区)
- 将邻接矩阵的元素从 \(1\) , \(0\) 替换为权重,则可表示有权图。
使用邻接矩阵表示图时,我们可以直接访问矩阵元素以获取边,因此增删查操作的效率很高,时间复杂度均为\(O(1)\)。然而,矩阵的空间复杂度为\(O(|V|^2)\),内存占用较多,因此适合用于存储 稠密图
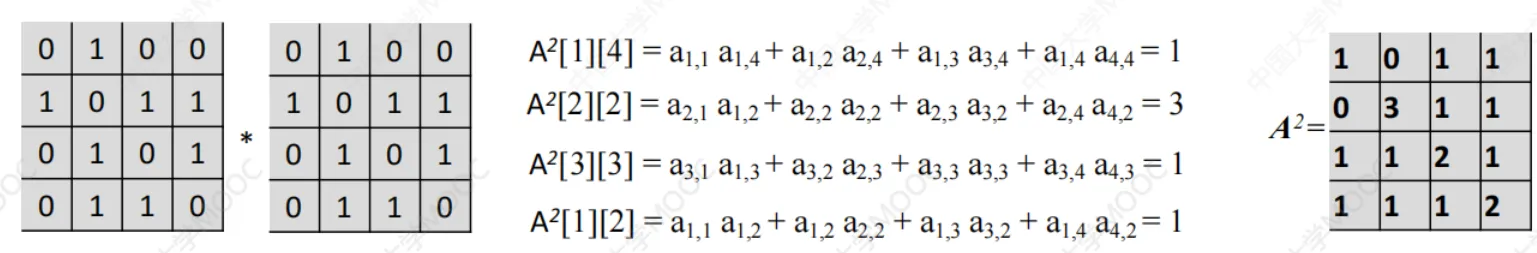
邻接矩阵还有一个重要性质:
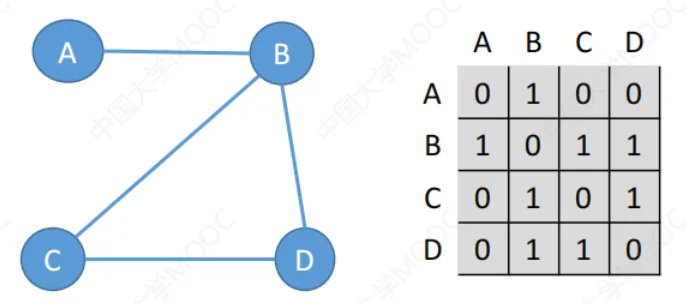
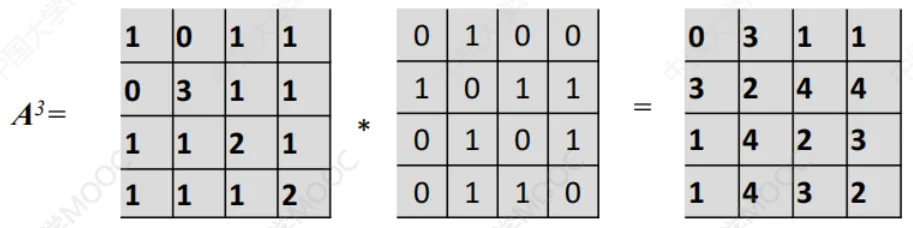
设图 \(G\) 的邻接矩阵为\(A\)(矩阵元素为\(0/1\)),则\(A^n\)的元素\(A^n[i][j]\)等于由顶点\(i\)到顶点\(j\)的长度为\(n\)的路径的数目
这个“图”对于有向图与无向图都成立,《算法导论》中给出了平方图的定义:有向图 \(𝐺=(𝑉,𝐸)\) 的平方图 \(𝐺^2=(𝑉,𝐸^2)\) ,其中,\((𝑢,𝑣)∈𝐸^2\)当且仅当 𝐺 包含一条最多由两条边构成的从𝑢 到 𝑣 的路径。
5.2.2 邻接表法(顺序+链式存储)
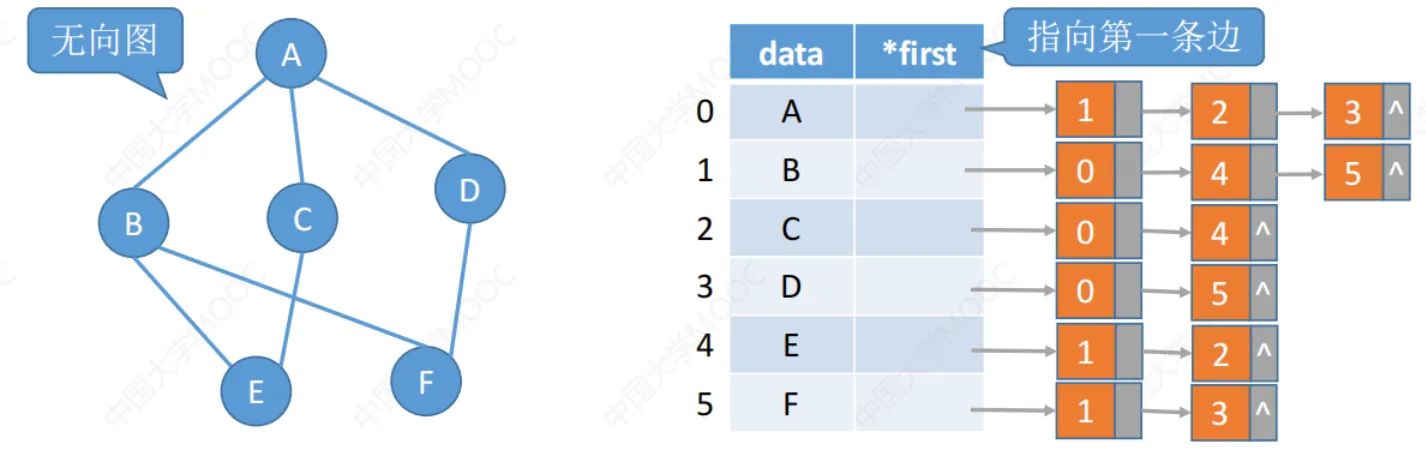
「邻接表Adjacency List」是指对图\(G\)的每个顶点\(v_i\) 建立一个单链表, 第 \(i\) 个单链表的结点表示依附于顶点 \(v_i\) 的边 (对于有向图则是以\(v_i\)为尾的弧),这个单链表就称为顶点\(v_i\) 的边表(对于有向图则称为出边表)。
边表的头指针和顶点的数据信息采用顺序存储(称为顶点表), 所以在邻接表中存在两种结点:顶点表结点和边表结点。(可与树的孩子表示法对比记忆)
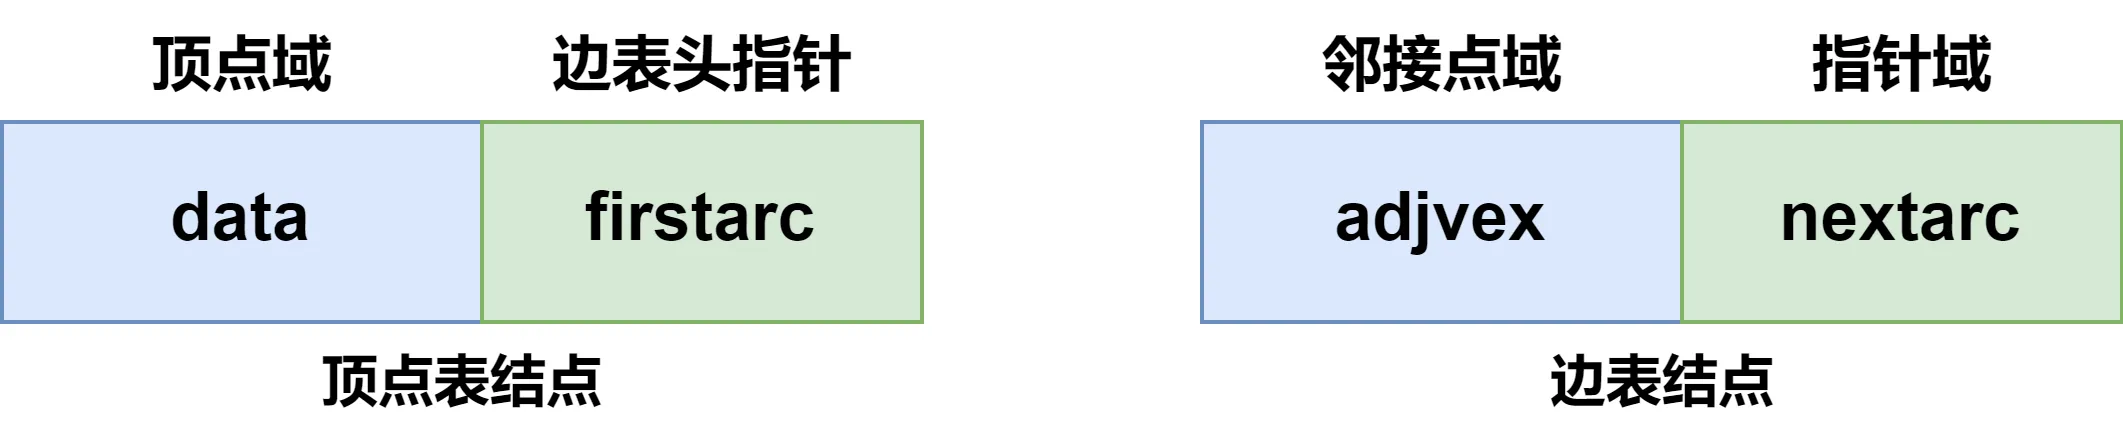
图的邻接表存储结构定义如下:
#define MAXV 1000    //顶点数目的最大值

typedef struct ArcNode {  //边表结点
    int adjvex;            //该弧所指向的结点在顶点表中的位置(索引)
    struct ArcNode* next;  //指向下一条弧的指针
    // InfoType info;      // 如果用来表示网,可以加上一个边权值
} ArcNode;

typedef struct VNode {     //顶点表结点
    char data;             //顶点信息
    ArcNode* firstarc;     //指向第一条依附于该顶点的弧的指针
} VNode, AdjList[MAXV];

typedef struct {
    int numVertices, numEdges;  //图中实际的顶点数和边数
    AdjList vertices;           //顶点表
} ALGraph;  //以邻接表存储的图
邻接矩阵表示的图求出度、入度的已经考了两次,因此邻接表求出入度也一定要掌握!!!
在有向图(网)中,顶点的入度指的是以当前顶点一端为弧头的弧的数量;顶点的出度指的是以当前顶点一端为弧尾的弧的数量。
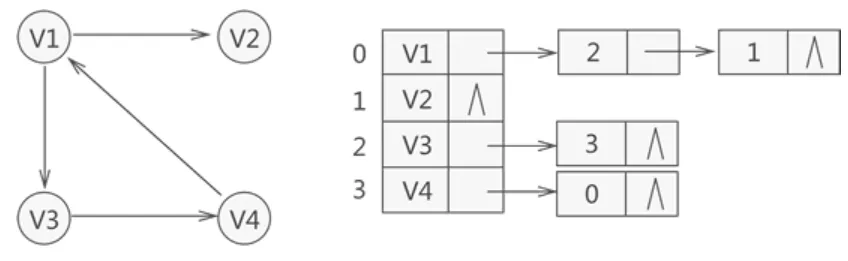
例如,上图中顶点 V1 的入度为 1,出度为 2。
在邻接表中计算某个顶点的出度是非常简单的,只需要在顺序表中找到该顶点,然后计算该顶点所在链表中其它结点的数量,即为该顶点的出度。例如,图中为V1构建的链表中有 2 个结点,因此 \(V1\) 的出度就是 2。
在邻接表中计算某个顶点的入度,有两种实现方案:
 遍历顺序表,找到该顶点,获取该顶点所在顺序表中的下标(假设为 K)。然后遍历所有单链表中的结点,统计数据域为 K 的结点数量,即为该顶点的入度。
- 建立一个逆邻接表,表中各个顶点的链表中记录的是以当前顶点一端为弧头的弧的信息。比如说,上图对应的逆邻接表如下图所示:
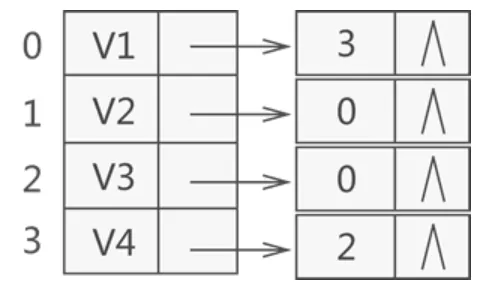
在一个有n个结点,e条边的图G,用逆邻接表存储时,将图中某个顶点的所有出边删除需要\(O(n+e)\)的时间复杂度。
#define MAXV 1000    //顶点数目的最大值

typedef struct ArcNode {  //边表结点
    int adjvex;            //该弧所指向的结点在顶点表中的位置(索引)
    struct ArcNode* next;  //指向下一条弧的指针
    // InfoType info;      // 如果用来表示网,可以加上一个边权值
} ArcNode;

typedef struct VNode {     //顶点表结点
    char data;             //顶点信息
    ArcNode* firstarc;     //指向第一条依附于该顶点的弧的指针
} VNode, AdjList[MAXV];

typedef struct {
    int numVertices, numEdges;  //图中实际的顶点数和边数
    AdjList vertices;           //顶点表
} ALGraph;  //以邻接表存储的图

//计算某个顶点的入度
int InDegree(ALGraph graph, char V) {
    int index = -1;
    int count = 0;
    //找到 V 在顺序表中的下标
    for (int j = 0; j < graph.numVertices; j++) {
        if (graph.vertices[j].data == V) {
            index = j;
            break;
        }
    }
    //如果未找到顶点 V,返回 -1 表示错误
    if (index == -1) {
        return -1;
    }
    //遍历每个单链表,找到指向 V 的边,并计数
    for (int j = 0; j < graph.numVertices; j++) {
        ArcNode* p = graph.vertices[j].firstarc;
        while (p) {
            if (p->adjvex == index) {
                count++;
            }
            p = p->next;
        }
    }
    return count;
}

//计算某个顶点的出度
int OutDegree(ALGraph graph, char V) {
    //查找顶点 V 对应的出度
    for (int j = 0; j < graph.numVertices; j++) {
        if (graph.vertices[j].data == V) {
            int count = 0;
            ArcNode* p = graph.vertices[j].firstarc;
            while (p) {
                count++;
                p = p->next;
            }
            return count;
        }
    }
    //如果查找失败,返回 -1 表示计算失败
    return -1;
}
- 邻接表仅存储实际存在的边,而边的总数通常远小于 \(|V|^2\) ,因此它更加节省空间,适合用于存储稀疏图。然而,在邻接表中需要通过遍历链表来查找边,因此其时间效率不如邻接矩阵。
- 无向图中边结点的数量是\(2|E|\), 整体的空间复杂度为\(O(|V|+2|E|)\)
- 有向图中,只记录顶点的出边,因此边结点的数量是\(|E|\), 整体的空间复杂度为\(O(|V|+|E|)\),因此计算有向图的入度需要遍历所有的链表,很不方便。
- 注意,用邻接矩阵存储图,其表示方法是唯一的,但是用邻接表存储矩阵的话,其表示方法不唯一。
观察上图可发现,邻接表结构与哈希表中的「链地址法」非常相似,因此我们也可以采用类似方法来优化效率。例如,当链表较长时,可以将链表转化为
AVL树或红黑树,从而将时间效率从 \(O(n)\) 优化至 \(O(\log n)\) ,还可以通过中序遍历获取有序序列;此外,还可以将链表转换为哈希表,将时间复杂度降低至 \(O(1)\) 。
5.2.3 十字链表法(用于有向图)
存储有向图(网),可以使用邻接表或者逆邻接表结构,也可以使用十字链表结构。
用邻接表存储有向图(网),可以快速计算出某个顶点的出度,但计算入度的效率不高。反之,用逆邻接表存储有向图(网),可以快速计算出某个顶点的入度,但计算出度的效率不高。
那么有没有一种存储结构,可以快速计算出有向图(网)中某个顶点的入度和出度呢?答案是肯定的,十字链表就是这样的一种存储结构。
十字链表(Orthogonal List)是一种专门存储有向图(网)的结构,它的核心思想是:将图中的所有顶点存储到顺序表(也可以是链表)中,同时为每个顶点配备两个链表,一个链表记录以当前顶点为弧头的弧,另一个链表记录以当前顶点为弧尾的弧。
- 特别提醒:\(< A , B >\)中
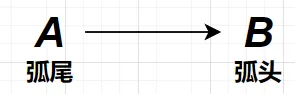 A是弧尾,B 是弧头
顶点表结构:其中firstin表示以该顶点作为弧头(指向我)的第一条弧;firstout表示以该顶点作为弧尾(我发出)的第一条弧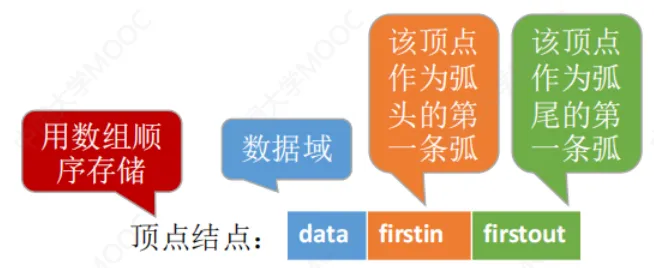
边表结点: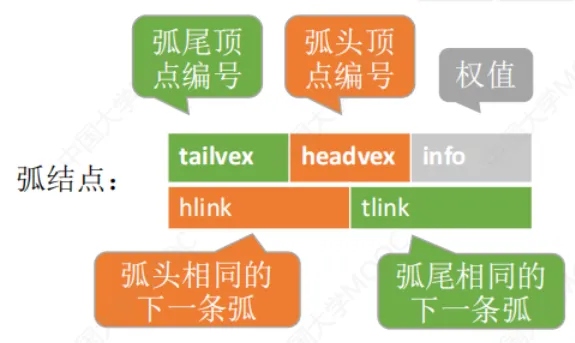
tailvex数据域:存储弧尾一端顶点在顺序表中的位置下标;headvex数据域:存储弧头一端顶点在顺序表中的位置下标;hlink指针域:指向下一个以当前顶点作为弧头的弧;tlink指针域:指向下一个以当前顶点作为弧尾的弧;info指针:存储弧的其它信息,例如有向网中弧的权值。如果不需要存储其它信息,可以省略。
数据结构实现:
#define MAXV 1000    //顶点数目的最大值
typedef struct Arcnode{  //边表结点;
    int tailvex,headvex;   //该弧的弧尾和弧头顶点在顶点表中的下标;
    struct Arcnode*hlink, *tlink;   //分别指向弧头和弧尾相同的下一条弧;
    //InfoType info;  //如果用来表示网,可以加上一个边权值
}ArcNode;

typedef struct VNode{   //顶点表头结点
    char data;    //顶点信息;
    ArcNode* firstin,*firstout;
}VNode,xjList[MAXV];

typedef struct{
    int numVertices,numEdges;   //图中实际的顶点数和边数;
    xjList vertices;
}OLgraph;     //十字链表
十字链表关系稍微有点复杂,我们可以用下面的例子理解一遍:\(A、B、C、D\)的编号分别为0 1 2 3
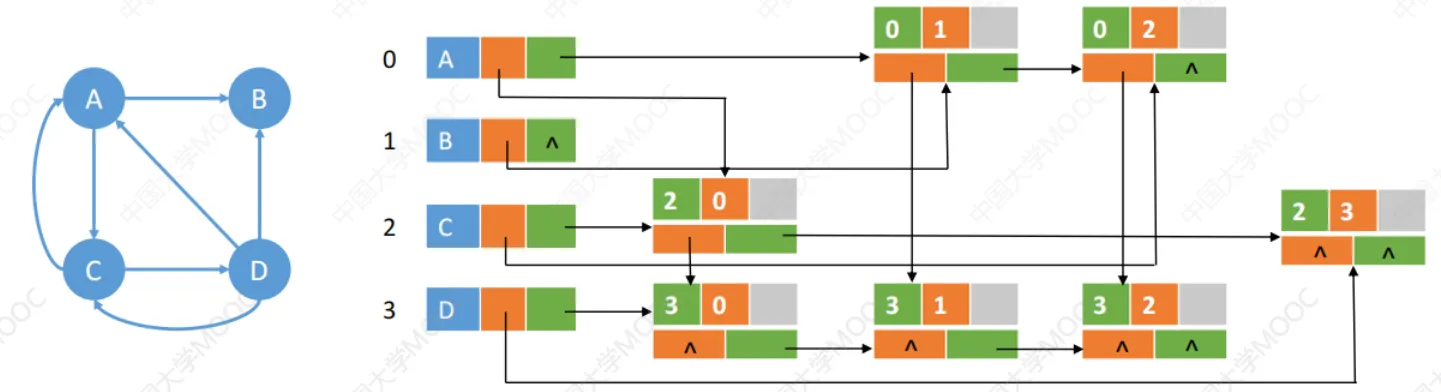
- 对于\(\<A,B>\)和\(\<A,C>\),\(A\)是弧尾,\(B\)是弧头,\(C\)也是弧头。所以顶点表A的
fistout指向以\(A\)作为弧尾的第一条弧,也即边表顶点\(B\),然后边表顶点\(B\)的tlink指向弧尾相同的下一条弧,也即边表顶点\(C\)。由于再没有以\(A\)为弧尾的弧了,所以边表顶点C的tlink为空 - 对于\(\<C,A>\)和\(\<D,A>\),\(A\)是弧头,\(C\)是弧尾,\(D\)也是弧尾。所以顶点表\(A\)的
firstin指向以\(A\)作为弧头的第一条弧,也即边表顶点\(C\),然后边表顶点\(C\)的hlink指向弧头相同的下一条弧,也即边表顶点\(D\)。由于再没有以\(A\)为弧头的弧了,所以边表顶点\(D\)的hlink为空
所以对于十字链表:
- 只需按照
tlink遍历可以找到指定顶点的所有出边,即顺着绿色路线找 - 只需按照
hlink遍历可以找到指定顶点的所有入边,即顺着橙色路线找
在十字链表结构中,如果想计算某个顶点的出度,就统计
firstout所指链表中的结点数量,每找到一个结点,再根据它的tlink指针域寻找下一个结点,直到最后一个结点。同样的道理,如果想计算某个顶点的入度,就统计
firstin所指链表中的结点数量,每找到一个结点,再根据它的hlink指针域寻找下一个结点,直到最后一个结点。
5.2.4 邻接多重表(优化无向图的表示)
存储无向图(网),既可以使用邻接表结构,也可以使用本节讲解的邻接多重表结构。
在无向图里,\((Vi, Vj)\) 和 \((Vj, Vi)\) 表示的其实是同一条边,比如 \((V_1, V_2)\) 和 \((V_2, V_1)\) 就是同一条边。无向图的邻接表存储结构中,每条边都会存储两份,比如我们可以在 \(V_1\) 顶点的链表中找到\((V_1, V_2)\)这条边,也可以在\(V_2\)的链表中找到\((V_2, V_1)\) 这条边。
实际场景中,如果需要对无向图中的边做大量的插入或删除操作,不推荐使用邻接表存储结构,因为每条边在邻接表都存有两份,同样的操作需要处理两次。这种情况下,可以优先考虑邻接多重表存储结构。
邻接多重表(Adjacency Multilist)是一种专门存储无向图(网)的结构。
邻接多重表存储无向图的方式,可以看作是邻接表和十字链表的结合体,具体来讲就是:将图中的所有顶点存储到顺序表(也可以用链表)中,同时为每个顶点配备一个链表,链表的各个结点中存储的都是和当前顶点有直接关联的边。
重新定义顶点结点:其中data数据域用来存储顶点的数据;firstedge指针域用来指向为当前顶点配备的链表。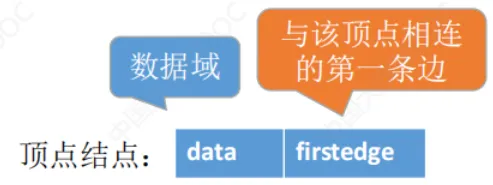
重新定义边结点: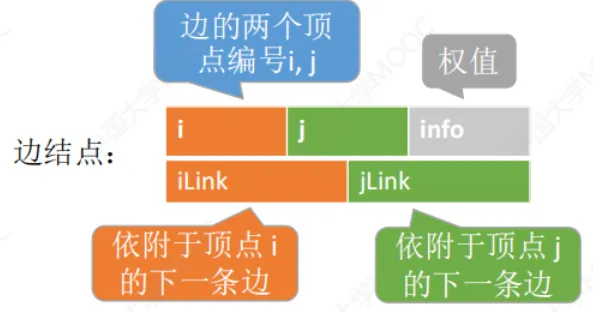
i和j:都是数据域,分别存储边两端顶点所在顺序表中的位置下标;ilink指针域:指向下一个与i顶点有直接关联的边结点;jlink指针域:指向下一个与j顶点有直接关联的边节点;info指针域:存储当前边的其它信息,比如存储无向网时,可以用info指针域存储边的权值。
数据结构实现:
#define MAXV 1000    //顶点数目的最大值
typedef struct Arcnode{  //边结点;
    int i,j;   //边的两个顶点在顶点表(数组)中的下标;
    struct Arcnode*ilink, *jlink;   //分别指向依附于顶点i和j的下一条边;
    //InfoType info;  //如果用来表示网,可以加上一个边权值
}Arcnode;

typedef struct VNode{   //顶点表头结点
    char data;    //顶点信息;
    Arcnode* firstedge;  //指向与该顶点相连的第一条边;
}vNode,adjMuList[MAXV];

typedef struct{
    int numVertices,numEdges;   //图中实际的顶点数和边数;
    adjMuList vertices;  //顶点表
}AMLgraph;     //邻接多重表;
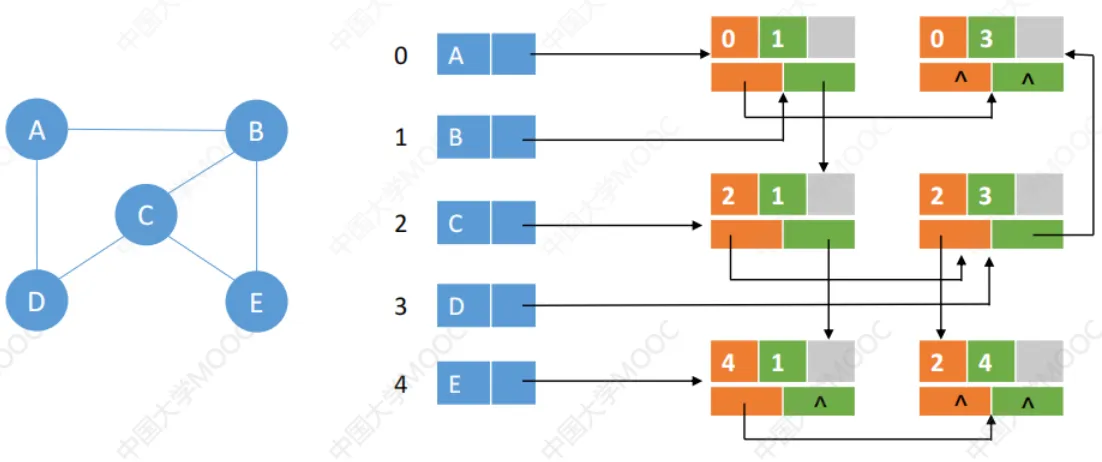
在邻接多重表中,很容易可以找到和目标顶点有直接关联的所有边。以图 中的\(A\) 顶点为例,在邻接多重表中查找和它直接关联的边,具体过程是:
- 根据\(A\) 顶点的
firstedge指针域,找到第一个和 \(A\) 有直接关联的边结点 \((A, B)\); - 在 \((A, B)\) 边结点中,
i数据域存储着 \(A\)顶点对应的顺序表下标,因此继续根据ilink指针域找到下一个边结点 \((A, D)\); - 在 \((A, D)\) 边结点中,
i数据域存储着 \(A\) 顶点对应的顺序表下标,但ilink指针域为NULL,因此查找结束;
邻接多重表和邻接表最大的不同是:对于无向图中的每个边,邻接表需要存储两份数据,而邻接多重表只需要存储一份。因此,当需要在无向图中做大量的插入或删除边的操作时,选用邻接多重表存储无向图,可以提高程序的执行效率。
空间复杂度:\(O(|V|+|E|)\), 每条边只对应一份数据;
删除边、删除结点等操作很方便,只需要根本更改指针即可。
四种存储方式的对比
| 邻接矩阵 | 邻接表 | 十字链表法 | 邻接多重表 | |
|---|---|---|---|---|
| 空间复杂度 | $O( | V | ^2)$ | 无向图:$O( |
| 找相邻边 | 遍历对应行或列 时间复杂度$O( | V | )$ | 找有向图的入边需要遍历整个邻接表,统计出度 只需要遍历该顶点的边表 |
| 删除边或顶点 | 删除边很方便\(O(1)\),删除顶点需要移动大量数据,时间复杂度达到$O( | V | ^2)$ | 无向图中删除边或顶点都不方便 |
| 适用于 | 稠密图 | 稀疏图 | 有向图 | 无向图 |
| 表示方式 | 唯一 | 不唯一 | 不唯一 | 不唯一 |
在十字链表法和邻接多重表中,一个顶点可能会被两个指针所指向,在删除结点时,我们可以轻易定位到一个结点关联的边,但是我们并不知道(可能存在)的另一个指向它的边在哪,还是需要做遍历,最坏情况下的时间复杂度达到了\(O(|V|+|E|)\)
5.3 图的基本操作
5.3.1 基于邻接矩阵的实现
#define MAXV 100     // 顶点数目的最大值

typedef struct {
    int numVertices;       // 图中实际的顶点数
    int numEdges;          // 图中实际的边数
    char vertexList[MAXV]; // 顶点表
    int edges[MAXV][MAXV];  // 邻接矩阵
} MGraph;
给定一个顶点数量为 \(|V|\) 的图,则有
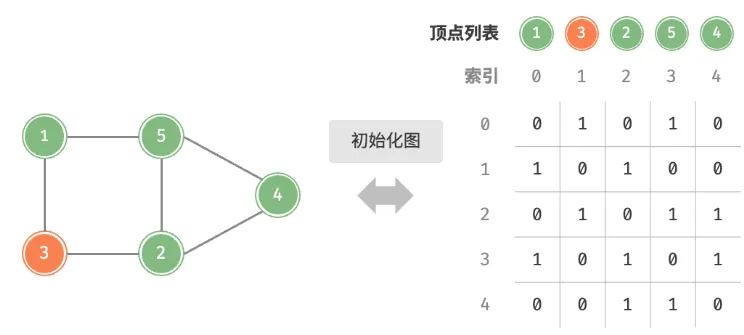
- 添加或删除边:直接在邻接矩阵修改指定的边就可以,时间复杂度为\(O(1)\), 有向图的话只要更新一个边即可,无向图的话则需要同时更新两个方向的边。\
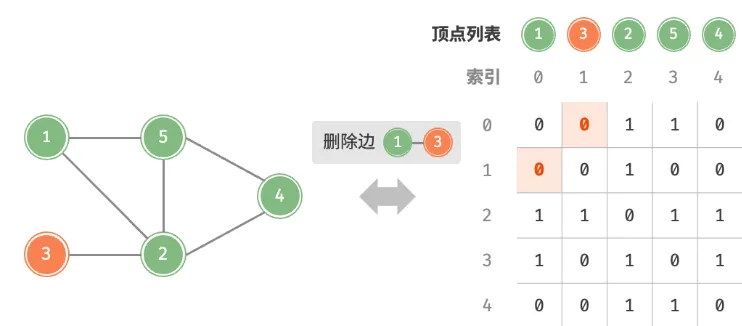
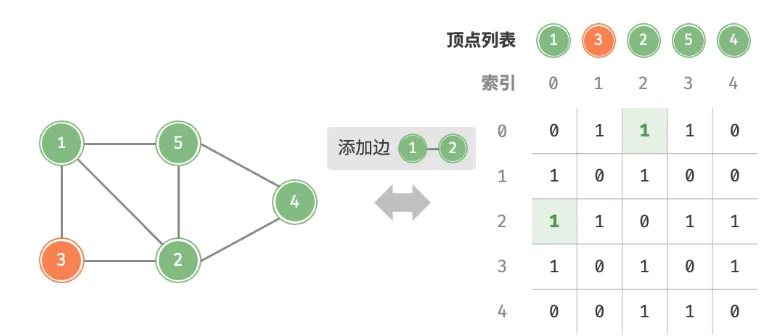 \
下面的示例代码是无向图的:
/* 添加边 */
// 参数 i, j 对应 vertexList 中的顶点索引
void addEdge(MGraph *G, int i, int j) {
    if (i < 0 || j < 0 || i >= G->numVertices || j >= G->numVertices) {  // 越界检查
        printf("错误: 顶点索引越界\n");
        return;
    }
    // 添加无向边,邻接矩阵中对称位置置1
    if (G->edges[i][j] == 0) {
        G->edges[i][j] = 1;
        G->edges[j][i] = 1;
        G->numEdges++;
    }

}

/* 删除边 */
void removeEdge(MGraph *G, int i, int j) {
    if (i < 0 || j < 0 || i >= G->numVertices || j >= G->numVertices) {  // 越界检查
        printf("错误: 顶点索引越界\n");
        return;
    }
    // 删除无向边,邻接矩阵中对称位置置0
    if (G->edges[i][j] != 0) {
        G->edges[i][j] = 0;
        G->edges[j][i] = 0;
        G->numEdges--;
    }
}
- 添加顶点:在邻接矩阵的尾部添加一行一列,并全部填0即可, 时间复杂度为\(0(|V|)\)
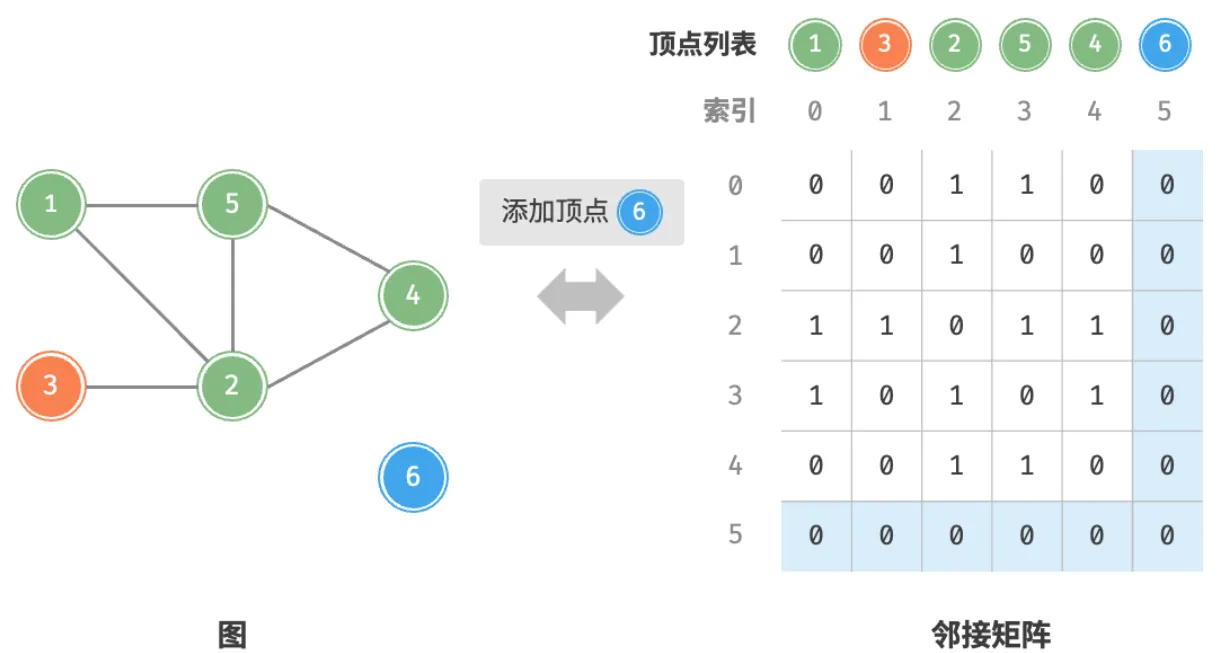
/* 添加顶点 */
void addVertex(MGraph *G, char val) {
    if (G->numVertices < MAXV) {
        G->vertexList[G->numVertices] = val;  // 向顶点列表中添加新顶点的值
        for (int i = 0; i <= G->numVertices; ++i) {
            G->edges[i][G->numVertices] = 0;  // 在邻接矩阵中添加一列
            G->edges[G->numVertices][i] = 0;  // 在邻接矩阵中添加一行
        }
        G->numVertices++;  // 顶点数+1
    } else {
        printf("错误: 无法添加顶点, 达到顶点数目的最大值\n");
    }
}
- 删除顶点:在邻接矩阵中删除一行一列。当删除首行首列时达到最差情况,需要将 \((n-1)^2\) 个元素“向左上移动”,从而使用 \(O(n^2)\) 时间。
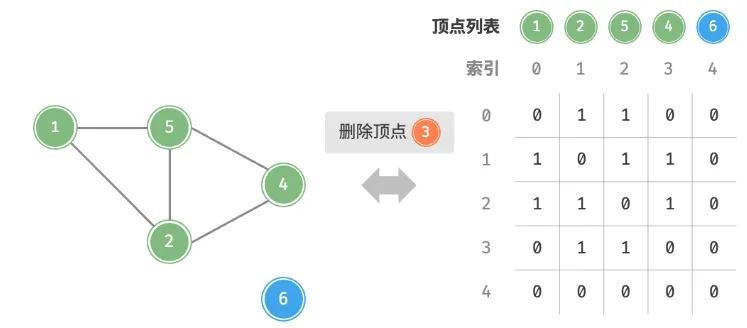
/* 删除顶点 */
void removeVertex(MGraph *G, int index) {
    // 1. 边界检查
    if (G == NULL || index < 0 || index >= G->numVertices) {
        printf("错误:顶点索引越界或图为空\n");
        return;
    }

    // 2. 统计被删除顶点关联的边数
    // 对于无向图,第 index 行的非零元素个数即为该顶点的度(即被删除的边数)
    int removedEdges = 0;
    for (int i = 0; i < G->numVertices; ++i) {
        if (G->edges[index][i] != 0) {
            ++removedEdges;
        }
    }

    // 3. 从顶点表中移除该顶点(后续元素前移)
    for (int i = index; i < G->numVertices - 1; ++i) {
        G->vertexList[i] = G->vertexList[i + 1];
    }

    // 4. 从邻接矩阵中删除对应列(所有行的 index 列之后的元素前移)
    for (int i = 0; i < G->numVertices; ++i) {
        for (int j = index; j < G->numVertices - 1; ++j) {
            G->edges[i][j] = G->edges[i][j + 1];
        }
    }

    // 5. 从邻接矩阵中删除对应行(index 行之后的元素上移)
    // 注意:此时矩阵的有效列宽已经变成了 G->numVertices - 1
    for (int i = index; i < G->numVertices - 1; ++i) {
        for (int j = 0; j < G->numVertices - 1; ++j) {
            G->edges[i][j] = G->edges[i + 1][j];
        }
    }

    // 6. 更新图的顶点数和边数
    G->numVertices--;
    G->numEdges -= removedEdges;
}
- 初始化:传入 \(|V|\)个顶点,初始化长度为 \(|V|\)的顶点列表
vertices,使用 \(O(|V|)\) 时间;初始化 \(|V|^2\)大小的邻接矩阵MGraph,使用 \(O(|V|)^2\)时间。
5.3.2 基于邻接表的实现
#define MAXV 1000  // 顶点数目的最大值

typedef struct ArcNode {
    int adjvex;           // 该弧所指向的顶点在顶点表中的位置(索引)
    struct ArcNode *next; // 指向下一条弧的指针
    // InfoType info;      // 如果用来表示网,可以加上一个边权值
} ArcNode;

typedef struct VNode {
    char data;          // 顶点信息
    ArcNode *firstArc;  // 指向第一条依附于该顶点的弧的指针
} VNode, AdjList[MAXV];

typedef struct {
    int numVertices;    // 图中实际的顶点数
    int numEdges;       // 图中实际的边数
    AdjList vertices;   // 顶点表
} ALGraph;  // 以邻接表存储的图
设无向图的顶点总数为 \(|V|\) 、边总数为 \(|E|\) ,则有:
- 添加边:在顶点对应链表的末尾添加边即可,使用 \(O(1)\) 时间。因为是无向图,所以需要同时添加两个方向的边。
- 删除边:在顶点对应链表中查找并删除指定边,使用 \(O(|E|)\) 时间。在无向图中,需要同时删除两个方向的边。
- 添加顶点:在邻接表中添加一个链表,并将新增顶点作为链表头节点,使用 \(O(1)\) 时间。
- 删除顶点:需遍历整个邻接表,删除包含指定顶点的所有边,使用 \(O(|V|+ |E|)\) 时间。
- 初始化:在邻接表中创建 \(|V|\) 个顶点和 \(2|E|\) 条边,使用 \(O(|V|+ |E|)\) 时间。
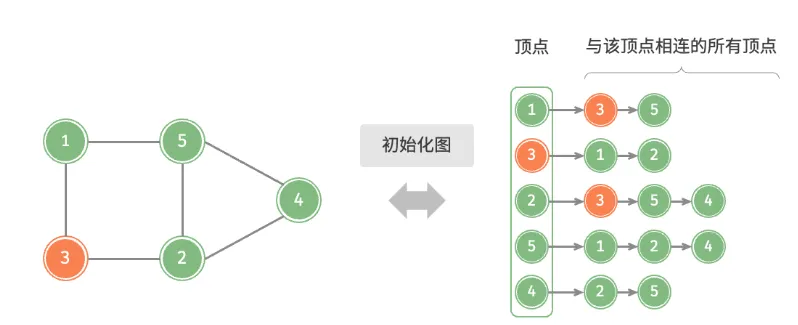
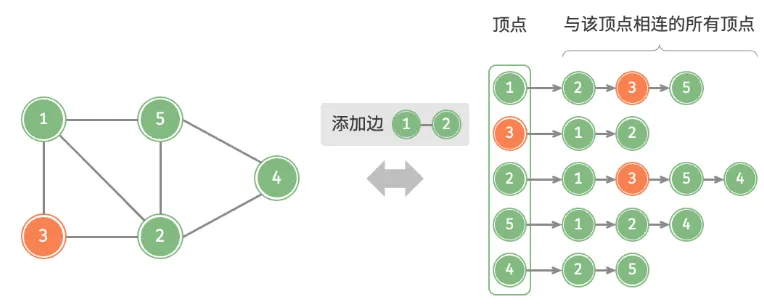
//向图中添加新边,并更新顶点的边表;如果是无向图,需要添加双向边。
void addEdge(ALGraph *G, int i, int j) {
    if (i < 0 || j < 0 || i >= G->numVertices || j >= G->numVertices) {  // 越界检查
        printf("错误: 顶点索引越界\n");
        return;
    }

    ArcNode *newArc = (ArcNode *)malloc(sizeof(ArcNode));
    newArc->adjvex = j;
    newArc->next = G->vertices[i].firstArc;
    G->vertices[i].firstArc = newArc;

    // 若为无向图,则添加另一条相反方向的边
    newArc = (ArcNode *)malloc(sizeof(ArcNode));
    newArc->adjvex = i;
    newArc->next = G->vertices[j].firstArc;
    G->vertices[j].firstArc = newArc;

    G->numEdges++;  // 边数+1
}
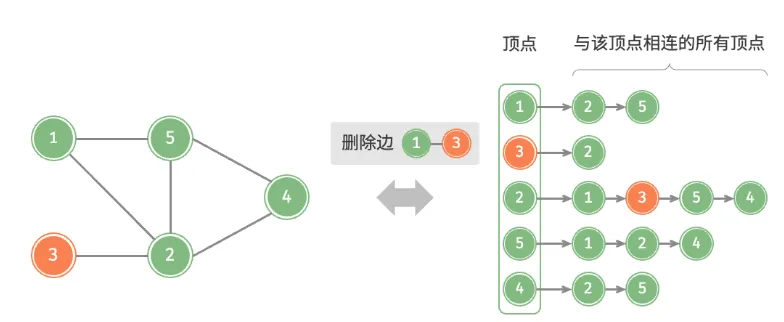
//删除指定的边,更新边表;对于无向图,同样需要删除相反方向的边。
void removeEdge(ALGraph *G, int i, int j) {
    if (i < 0 || j < 0 || i >= G->numVertices || j >= G->numVertices) {  // 越界检查
        printf("错误: 顶点索引越界\n");
        return;
    }

    bool removed = false;
    ArcNode *prev = NULL, *curr = G->vertices[i].firstArc;
    while (curr != NULL && curr->adjvex != j) {
        prev = curr;
        curr = curr->next;
    }
    if (curr != NULL) {
        if (prev != NULL) {
            prev->next = curr->next;
        } else {
            G->vertices[i].firstArc = curr->next;
        }
        free(curr);
        removed = true; //(此处修改)确认正向边已删除
    }

    // 若为无向图,则删除另一条相反方向的边
    prev = NULL, curr = G->vertices[j].firstArc;
    while (curr != NULL && curr->adjvex != i) {
        prev = curr;
        curr = curr->next;
    }
    if (curr != NULL) {
        if (prev != NULL) {
            prev->next = curr->next;
        } else {
            G->vertices[j].firstArc = curr->next;
        }
        free(curr);
    }

    if (removed) G->numEdges--;
}
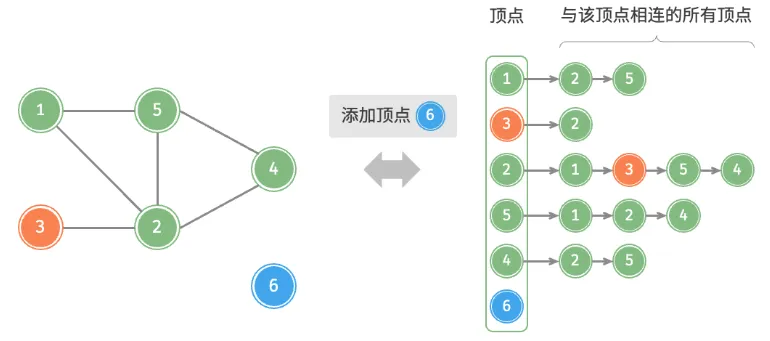
//向图中添加新顶点,如果图的顶点数已经达到最大限制,打印错误信息。
void addVertex(ALGraph *G, char val) {
    if (G->numVertices < MAXV) {
        G->vertices[G->numVertices].data = val;  // 向顶点表中添加新顶点的值
        G->vertices[G->numVertices].firstArc = NULL;  // 初始化新顶点的边表
        G->numVertices++;  // 顶点数+1
    } else {
        printf("错误: 无法添加顶点, 达到顶点数目的最大值\n");
    }
}
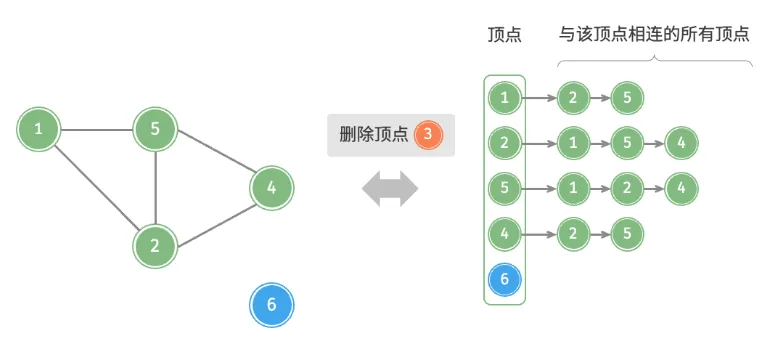
//删除指定的顶点,首先删除与该顶点相关的所有边,然后将顶点表中的顶点前移,更新顶点数量。
void removeVertex(ALGraph *G, int index) {
    if (index < 0 || index >= G->numVertices) {
        printf("错误: 顶点索引越界\n");
        return;
    }

    // 删除与该顶点相关的所有边
    ArcNode *curr = G->vertices[index].firstArc;
    while (curr != NULL) {
        ArcNode *temp = curr;
        curr = curr->next;
        removeEdge(G, index, temp->adjvex);
    }

    // 将顶点表中该顶点后的顶点前移
    for (int i = index; i < G->numVertices - 1; ++i) {
        G->vertices[i] = G->vertices[i + 1];
    }

    // 顶点前移后,所有大于被删下标的邻接点下标都要减一
    for (int i = 0; i < G->numVertices - 1; ++i) {
        for (ArcNode *p = G->vertices[i].firstArc; p != NULL; p = p->next) {
            if (p->adjvex > index) --p->adjvex;
        }
    }

    G->numVertices--;  // 顶点数-1
}
设图中共有 \(|V|\) 个顶点和 \(|E|\) 条边,下表为邻接矩阵和邻接表的时间和空间效率对比。
| 邻接矩阵 | 邻接表(链表) | |
|---|---|---|
| 判断是否邻接 | \(O(1)\) | $O( |
| 添加边 | \(O(1)\) | \(O(1)\) |
| 删除边 | \(O(1)\) | $O( |
| 添加顶点 | $O( | V |
| 删除顶点 | $O( | V |
| 内存空间占用 | $O( | V |
观察上表,似乎邻接表(哈希表)的时间与空间效率最优。但实际上,在邻接矩阵中操作边的效率更高,只需要一次数组访问或赋值操作即可。综合来看,邻接矩阵体现了“以空间换时间”的原则,而邻接表体现了“以时间换空间”的原则。
其他基本操作:
Adjacent(G,x,y):判断图G是否存在边\
Neighbors(G,x):列出图G中与结点x邻接的边。
InsertVertex(G,x):在图G中插入顶点x。
DeleteVertex(G,x):从图G中删除顶点x。
AddEdge(G,x,y):若无向边(x,y)或有向边\
RemoveEdge(6,x,y):若无向边(x,y)或有向边\
FirstNeighbor(G,x):求图G中顶点x的第一个邻接点,若有则返回顶点号。若x没有邻接点或图中不存在x,则返回-1。
NextNeighbor(G,x,y):假设图G中顶点y是顶点x的一个邻接点,返回除v之外顶点x的下个邻接点的顶点号,若y是x的最后一个邻接点,则返回-1。
Get_edge_value(G,x,y):获取图G中边(x,y)或\
Set_edge_value(G,x,y,v):设置图G中边(x,y)或\
此外,还有图的遍历算法,包括深度优先遍历和广度优先遍历。
5.3 图的遍历
5.3.1 广度优先搜索
广度优先搜索(Breadth First Search)简称广搜或者 BFS,是遍历图存储结构的一种算法,既适用于无向图(网),也适用于有向图(网)。
所谓图的遍历,简单理解就是逐个访问图中的顶点,确保每个顶点都只访问一次。
对于连通图来说,广度优先搜索算法从一个顶点出发就能访问图中所有的顶点。但是对于非连通图来说,广度优先搜索算法必须从各个连通分量中选择一个顶点出发,才能访问到所有的顶点。
广度优先遍历是一种由近及远的遍历方式,从距离最近的顶点开始访问,并一层层向外扩张。具体来说,从某个顶点出发,先遍历该顶点的所有邻接顶点,然后遍历下一个顶点的所有邻接顶点,以此类推,直至所有顶点访问完毕。
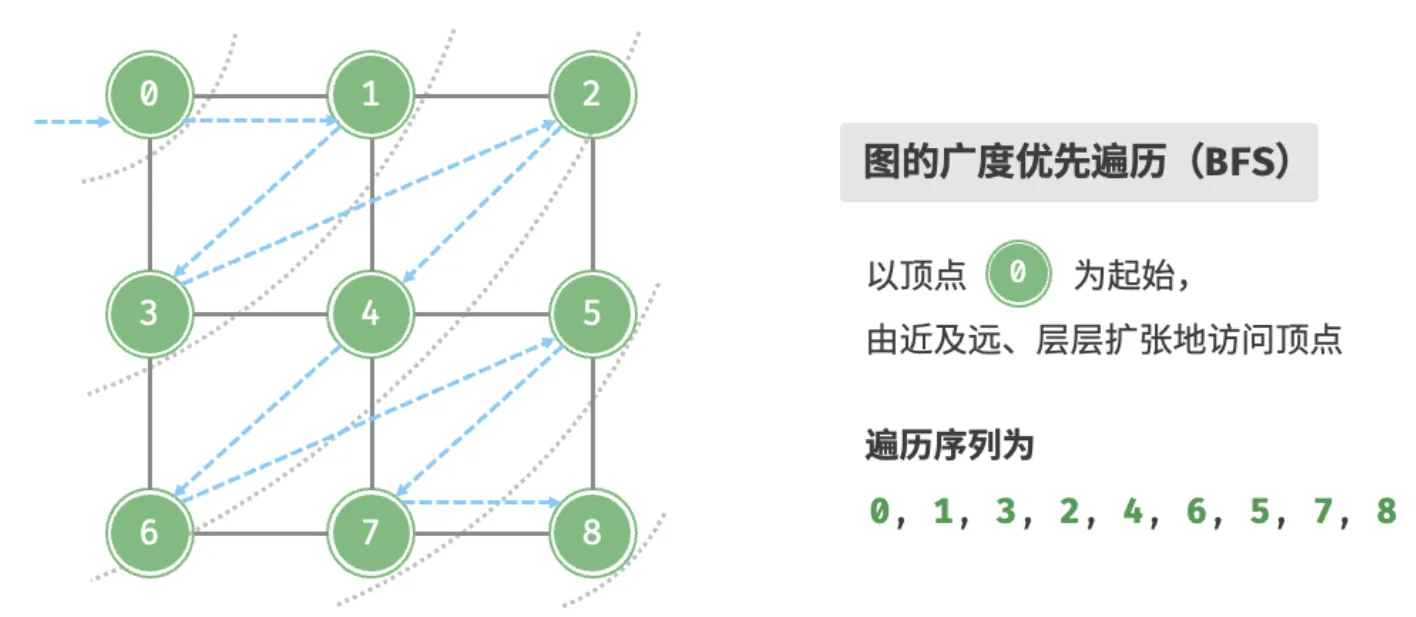
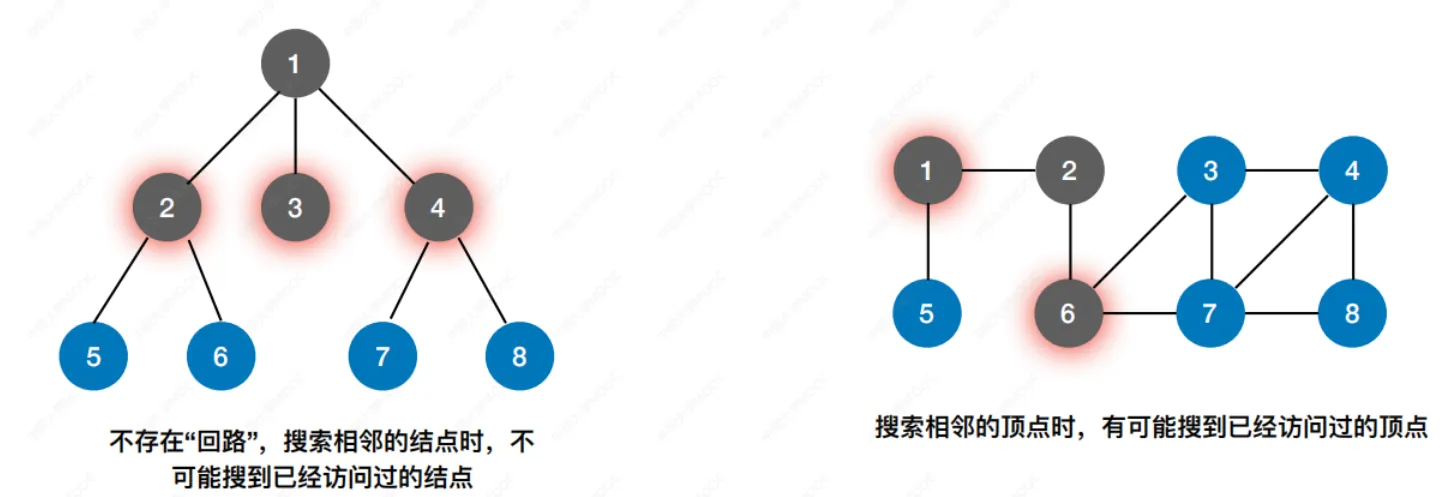
为什么要设置visit数组标记顶点是否被访问过?
算法实现
BFS通常借助「队列」来实现。队列具有“先入先出”的性质,这与 BFS 的“由近及远”的思想异曲同工。
#include <queue>
#include <cstdio>

#define MAXV 100  // 顶点数目的最大值

typedef struct {
    int numVertices;       // 图中实际的顶点数
    int numEdges;          // 图中实际的边数
    char vertexList[MAXV]; // 顶点表
    int edges[MAXV][MAXV]; // 邻接矩阵
} MGraph;

bool visited[MAXV];   // 访问标记数组

void BFS(MGraph G, int v);       //先声明 BFS,供 BFSTraverse 调用
void visit(char vertex);         //先声明访问函数

// 对于数组下标为v的顶点,找到第一个和它相邻的顶点,并返回该顶点的数组下标
int FirstNeighbor(MGraph *G, int v) {
    for(int i = 0; i < G->numVertices; ++i) {
        if(G->edges[v][i])  // 如果存在边
            return i;
    }
    return -1;  // 如果没有邻接顶点,返回-1
}

// 对于数组下标为v的顶点,从位置w开始查找和它相邻的顶点,并返回该顶点的数组下标
int NextNeighbor(MGraph *G, int v, int w) {
    for(int i = w + 1; i < G->numVertices; ++i) {
        if(G->edges[v][i])  // 如果存在边
            return i;
    }
    return -1;  // 如果没有邻接顶点,返回-1
}

// 广度优先遍历
void BFSTraverse(MGraph G) {
    for(int i = 0; i < G.numVertices; ++i) {
        visited[i] = false;  // 将访问标记数组初始化
    }
    for(int i = 0; i < G.numVertices; ++i) {
        if(!visited[i])  // 对每个未访问过的顶点调用一次BFS
            BFS(G, i);
    }
}

// 从顶点v出发,广度优先遍历图G
void BFS(MGraph G, int v) {
    queue<int> que;  // 设置一个队列,用来存储顶点的索引
    visit(G.vertexList[v]);  // 访问初始顶点v
    visited[v] = true;  // 对v做访问标记
    que.push(v);  // 初始顶点入队
    while(!que.empty()) {
        int cur = que.front();  // 用cur来接收队头弹出的顶点索引
        que.pop();  // 队头元素出队
        // 检测当前顶点cur的所有邻接点
        for(int w = FirstNeighbor(&G, cur); w >= 0; w = NextNeighbor(&G, cur, w)) {
            if(!visited[w]) {  // w为当前顶点cur的尚未访问过的邻接顶点
                visit(G.vertexList[w]);  // 访问w顶点
                visited[w] = true;  // 标记w已访问
                que.push(w);  // 访问完将其入队
            }
        }
    }
}

// 示例的visit函数,可以根据需要修改
void visit(char vertex) {
    // 根据需求实现具体的访问操作,如打印或存储顶点信息
    printf("%c ", vertex);
}
上面的是邻接矩阵实现,下面来介绍一下邻接表实现
Note
- 将遍历起始顶点
v加入队列,并开启循环。 - 在循环的每轮迭代中,弹出队首顶点并记录访问,然后将该顶点的所有邻接顶点加入到队列尾部。
- 循环步骤
2.,直到所有顶点被访问完成后结束。
为了防止重复遍历顶点,我们需要借助一个哈希表 visited 来记录哪些节点已被访问。
#include <queue>
#include <cstdio>

#define MAXV 1000  // 顶点数目的最大值

// 边表结点结构定义
typedef struct ArcNode {
    int adjvex;            // 该弧所指向的结点在顶点表中的位置(索引)
    struct ArcNode* next;  // 指向下一条弧的指针
} ArcNode;

// 顶点表结点结构定义
typedef struct VNode {
    char data;            // 顶点信息
    ArcNode* firstarc;    // 指向第一条依附于该顶点的弧的指针
} VNode, AdjList[MAXV];

// 图的邻接表结构定义
typedef struct {
    int numVertices, numEdges;  // 图中实际的顶点数和边数
    AdjList vertices;           // 顶点表
} ALGraph;

bool visited[MAXV];  // 访问标记数组

void BFS(ALGraph G, int v);      //(此处修改)先声明 BFS,供 BFSTraverse 调用
void visit(char vertex);         //(此处修改)先声明访问函数

// BFS 遍历整个图的函数
void BFSTraverse(ALGraph G) {
    // 初始化访问标记数组
    for(int i = 0; i < G.numVertices; ++i) {
        visited[i] = false;
    }
    // 从第一个顶点开始遍历,如果图是非连通图,确保遍历所有顶点
    for(int i = 0; i < G.numVertices; ++i) {
        if(!visited[i])
            BFS(G, i);  // 对每个未访问过的顶点调用一次 BFS
    }
}

// BFS 从顶点 v 出发,广度优先遍历图 G
void BFS(ALGraph G, int v) {
    queue<int> que;  // 设置一个队列,用来存储顶点的索引
    visit(G.vertices[v].data);  // 访问初始顶点 v
    visited[v] = true;  // 对 v 做访问标记
    que.push(v);  // 初始顶点入队

    while(!que.empty()) {
        int cur = que.front();  // 获取队头元素
        que.pop();  // 队头元素出队
        ArcNode *p = G.vertices[cur].firstarc;  // 获取当前顶点的第一个邻接点

        // 遍历当前顶点 cur 的所有邻接点
        while(p != NULL) {
            int adjIndex = p->adjvex;  // 获取邻接顶点的索引
            if(!visited[adjIndex]) {  // 如果邻接顶点未被访问
                visit(G.vertices[adjIndex].data);  // 访问邻接顶点
                visited[adjIndex] = true;  // 标记邻接顶点已访问
                que.push(adjIndex);  // 将邻接顶点入队
            }
            p = p->next;  // 继续访问下一个邻接点
        }
    }
}

// 示例的 visit 函数,可以根据需要修改
void visit(char vertex) {
    // 根据需求实现具体的访问操作,如打印或存储顶点信息
    printf("%c ", vertex);
}
性能分析:
空间复杂度:两种存储结构的遍历均需要一个辅助队列,最坏情况下,辅助队列的大小为\(O(|V|)\)
时间复杂度:
- 邻接矩阵:\(O(|V|+|V|^2) = O(|V|^2)\)
- 邻接表:\(O(|V|)+O(|2E|)=O(|V|+|E|)\)
BFS还可用于求无权图的单源最短路径问题,这个后面在最短路径问题介绍;
广度优先生成树:在广度遍历的时候,我们会得到一棵遍历树,称为“广度优先生成树”,注意,由于给定图的邻接矩阵存储是唯一的,因此从某个点开始遍历所生成的广度优先生成树是唯一的,但是由于给定图的邻接表表示不唯一,故其广度优先生成树也是不唯一的。
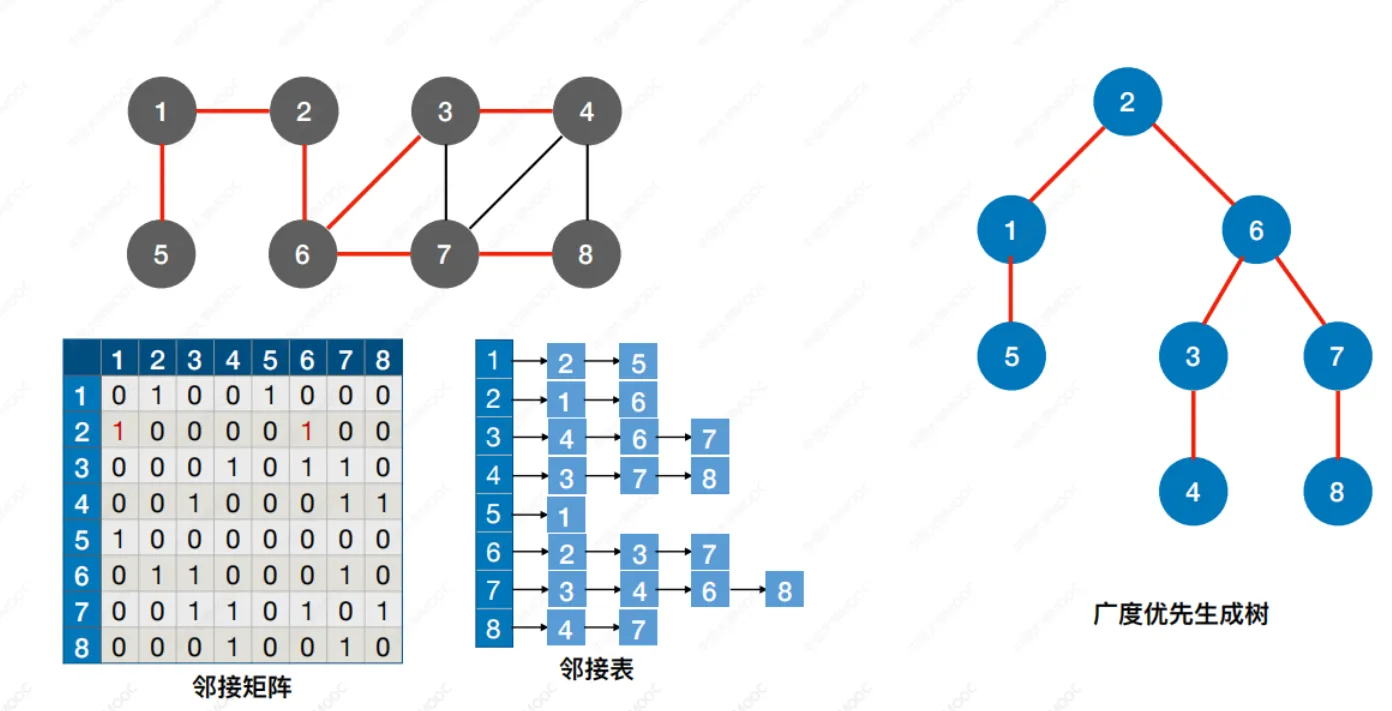
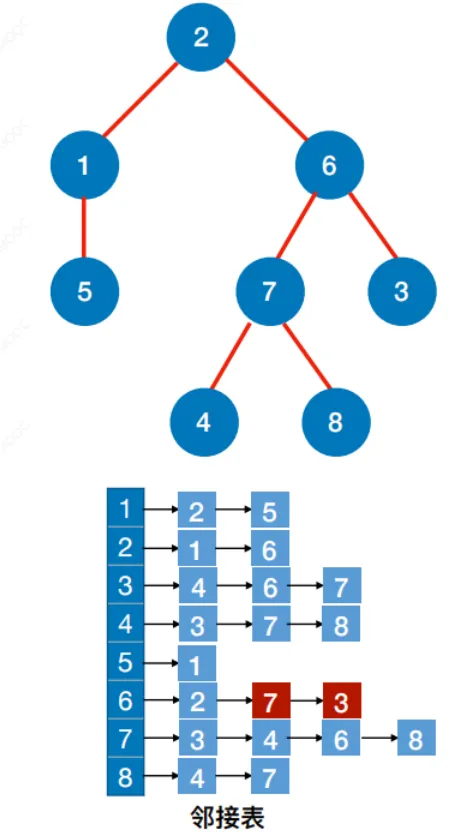
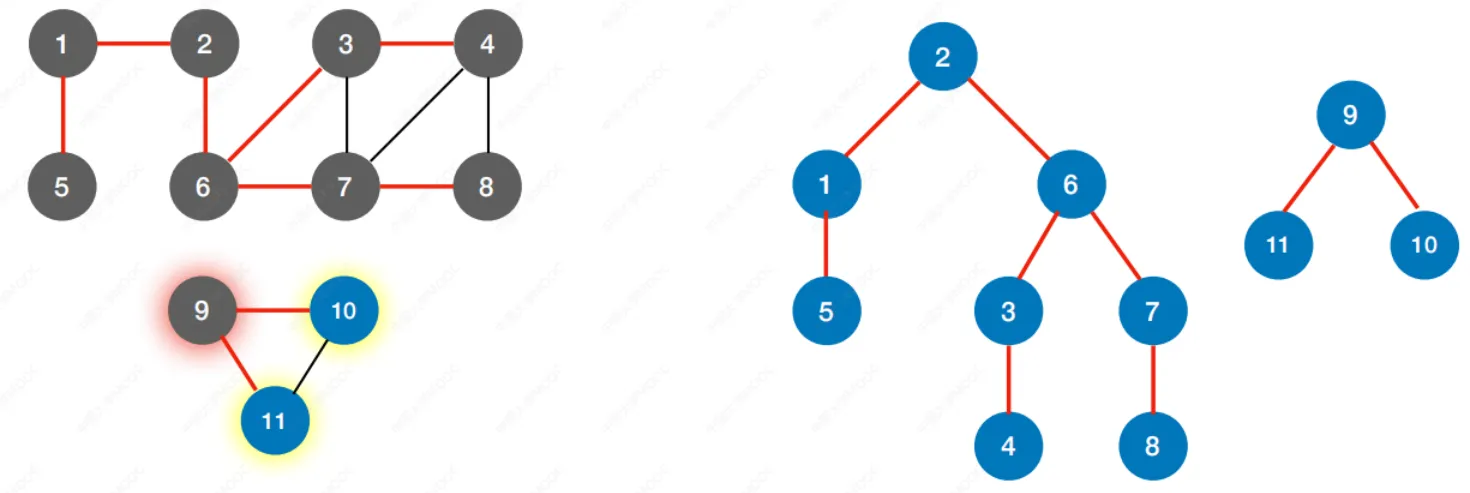
对非连通图的广度优先遍历,可得到广度优先生成森林。
5.3.2 深度优先遍历
深度优先搜索(Depth First Search)简称深搜或者 DFS,是遍历图存储结构的一种算法,既适用于无向图(网),也适用于有向图(网)。
它是一种优先走到底、无路可走再回头的遍历方式。具体地,从某个顶点出发,访问当前顶点的某个邻接顶点,直到走到尽头时返回,再继续走到尽头并返回,以此类推,直至所有顶点遍历完成。
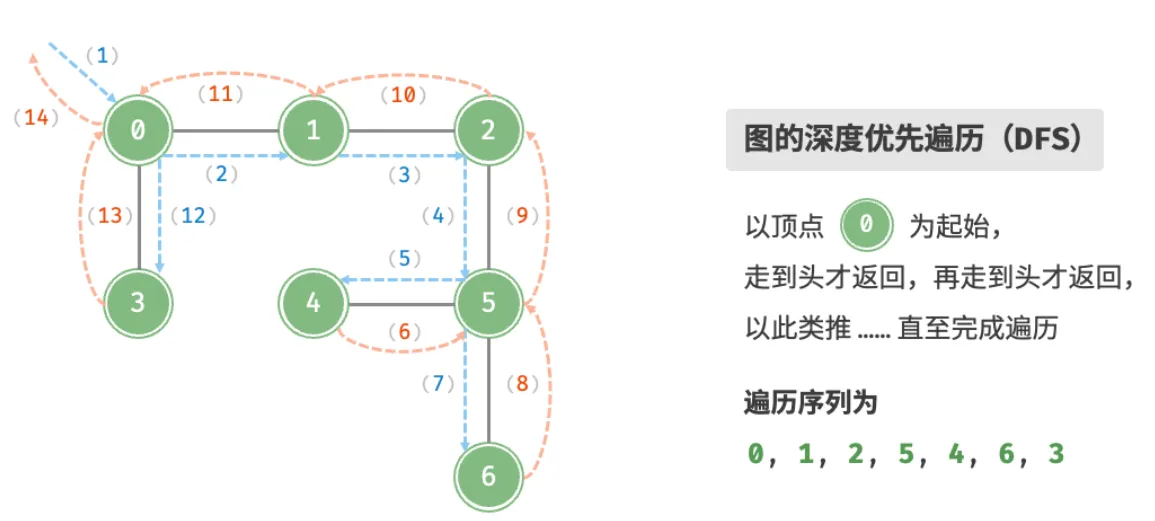
这种“走到尽头 + 回溯”的算法形式通常基于递归来实现。与 BFS 类似,在 DFS 中我们也需要借助一个 visited 数组来记录已被访问的顶点,以避免重复访问顶点。
- 邻接矩阵实现的
DFS
#include <cstdio>

#define MAXV 100  // 顶点数目的最大值

// 图的邻接矩阵存储结构定义
typedef struct {
    int numVertices;        // 图中实际的顶点数
    int numEdges;           // 图中实际的边数
    char vertexList[MAXV];  // 顶点表
    int edges[MAXV][MAXV];  // 邻接矩阵
} MGraph;

bool visited[MAXV];  // 访问标记数组

void DFS(MGraph G, int v);       //(此处修改)先声明 DFS,供 DFSTraverse 调用
void visit(char vertex);         //(此处修改)先声明访问函数

// 找到顶点 v 的第一个邻接顶点,并返回其下标
int FirstNeighbor(MGraph *G, int v) {
    for(int i = 0; i < G->numVertices; ++i) {
        if(G->edges[v][i])  // 如果存在边,则返回该顶点的下标
            return i;
    }
    return -1;  // 如果没有邻接顶点,返回 -1
}

// 从顶点 v 的位置 w 开始查找下一个邻接顶点,并返回其下标
int NextNeighbor(MGraph *G, int v, int w) {
    for(int i = w + 1; i < G->numVertices; ++i) {
        if(G->edges[v][i])  // 如果存在边,则返回该顶点的下标
            return i;
    }
    return -1;  // 如果没有下一个邻接顶点,返回 -1
}

// 图的深度优先遍历(DFS)入口函数
void DFSTraverse(MGraph G) {
    // 初始化访问标记数组
    for(int i = 0; i < G.numVertices; ++i) {
        visited[i] = false;
    }
    // 对每个顶点进行 DFS,防止非连通图未遍历完全
    for(int i = 0; i < G.numVertices; ++i) {
        if(!visited[i])
            DFS(G, i);
    }
}

// 从顶点 v 出发进行深度优先遍历
void DFS(MGraph G, int v) {
    visit(G.vertexList[v]);  // 访问顶点 v
    visited[v] = true;  // 将顶点 v 标记为已访问

    // 对顶点 v 的每个邻接顶点进行递归 DFS
    for(int w = FirstNeighbor(&G, v); w >= 0; w = NextNeighbor(&G, v, w)) {
        if(!visited[w]) {
            DFS(G, w);
        }
    }
}

// 示例的 visit 函数,可以根据需要修改
void visit(char vertex) {
    // 根据需求实现具体的访问操作,如打印或存储顶点信息
    printf("%c ", vertex);
}
- 基于邻接表实现的
DFS
#include <cstdio>

#define MAXV 1000  // 顶点数目的最大值

// 定义边表结点结构
typedef struct ArcNode {
    int adjvex;            // 该弧所指向的顶点在顶点表中的位置(索引)
    struct ArcNode* next;  // 指向下一条弧的指针
    // 如果需要,可以在这里添加边权信息
} ArcNode;

// 定义顶点表结点结构
typedef struct VNode {
    char data;            // 顶点信息
    ArcNode* firstarc;    // 指向第一条依附于该顶点的弧的指针
} VNode, AdjList[MAXV];

// 定义图的邻接表存储结构
typedef struct {
    int numVertices, numEdges;  // 图中实际的顶点数和边数
    AdjList vertices;           // 顶点表
} ALGraph;

bool visited[MAXV];  // 访问标记数组

void DFS(ALGraph G, int v);      //(此处修改)先声明 DFS,供 DFSTraverse 调用
void visit(char vertex);         //(此处修改)先声明访问函数

// 图的深度优先遍历(DFS)入口函数
void DFSTraverse(ALGraph G) {
    // 初始化访问标记数组
    for(int i = 0; i < G.numVertices; ++i) {
        visited[i] = false;
    }
    // 对每个顶点进行 DFS,防止非连通图未遍历完全
    for(int i = 0; i < G.numVertices; ++i) {
        if(!visited[i])
            DFS(G, i);
    }
}

// 从顶点 v 出发进行深度优先遍历
void DFS(ALGraph G, int v) {
    visit(G.vertices[v].data);  // 访问顶点 v
    visited[v] = true;  // 标记顶点 v 为已访问

    // 遍历顶点 v 的所有邻接顶点
    ArcNode* p = G.vertices[v].firstarc;
    while(p != NULL) {
        if(!visited[p->adjvex]) {  // 如果邻接顶点未访问过
            DFS(G, p->adjvex);  // 递归调用 DFS
        }
        p = p->next;  // 移动到下一条边
    }
}

// 示例的 visit 函数,可以根据需要修改
void visit(char vertex) {
    // 根据需求实现具体的访问操作,如打印或存储顶点信息
    printf("%c ", vertex);
}
性能分析:
时间复杂度:= 访问各结点所需时间 + 探索各条边所需时间
- 邻接矩阵存储的图:访问顶点\(O(|V|)\)+访问各个顶点的边总共\(O(|V|^2)\),因此总的时间复杂度为\(O(|V|^2)\);
- 邻接表存储的图:所有顶点都会被访问 \(1\) 次,使用 \(O(|V|)\) 时间;所有边都会被访问 \(2\) 次,使用 \(O(2|E|)\) 时间;总体使用 \(O(|V| + |E|)\) 时间。
空间复杂度:
- 邻接矩阵:递归深度最大为 \(O(|V|)\)
- 邻接表:
visited数组,顶点数量最多为 \(|V|\) ,递归深度(函数调用栈)最大为 \(|V|\) ,因此使用 \(O(|V|)\) 空间。
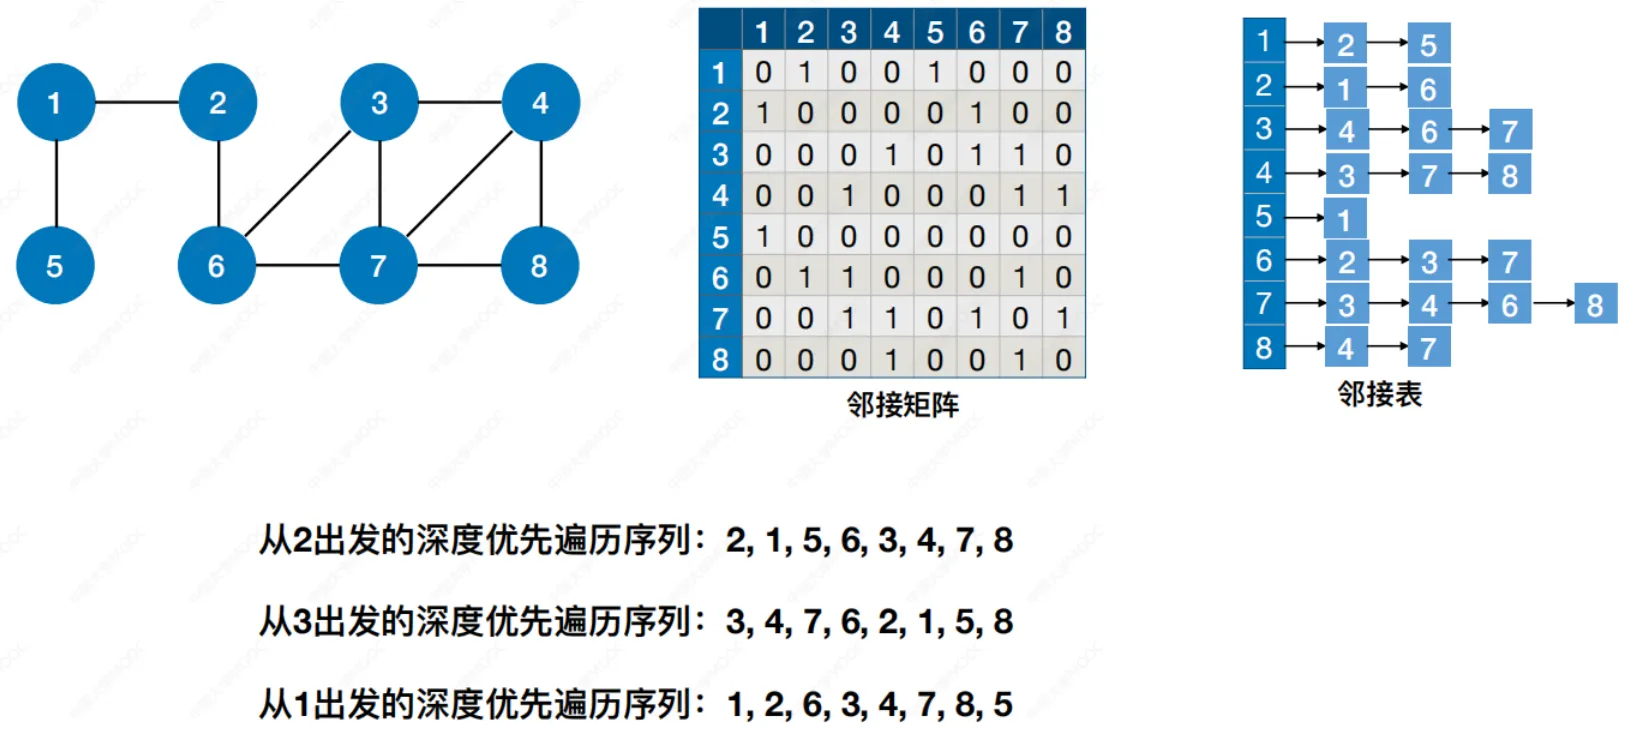
Note
同⼀个图的邻接矩阵表示⽅式唯⼀,因此深度优先遍历序列唯⼀,深度优先生成树也唯一
同⼀个图邻接表表示⽅式不唯⼀,因此深度优先遍历序列不唯⼀,深度优先生成树也不唯一
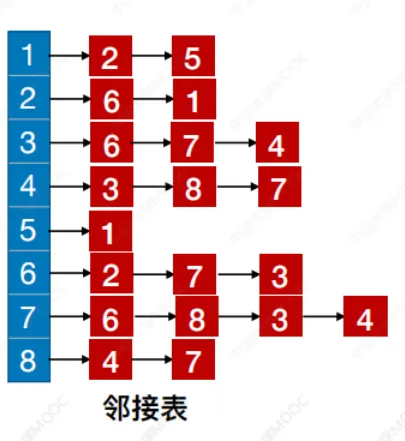
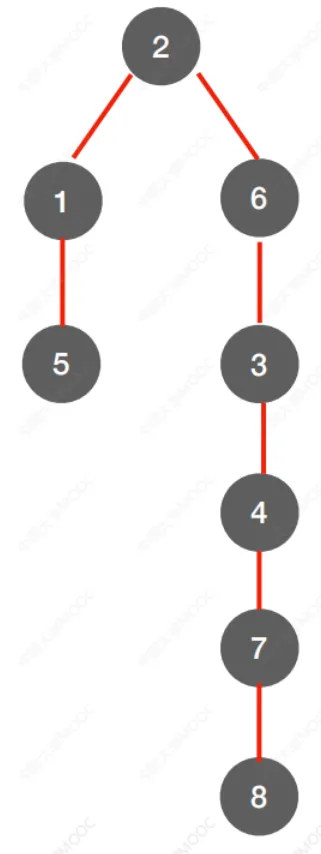
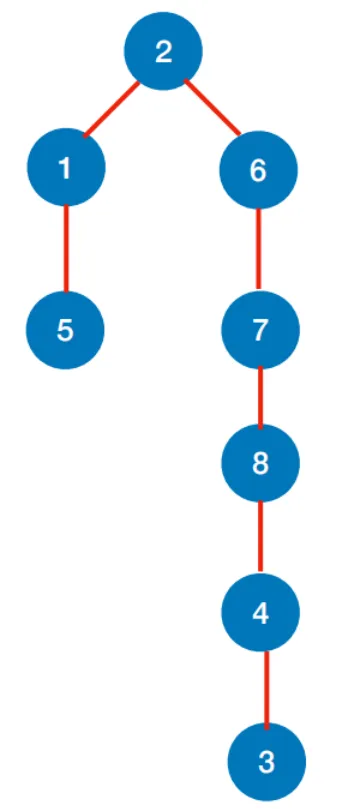
深度优先生成森林
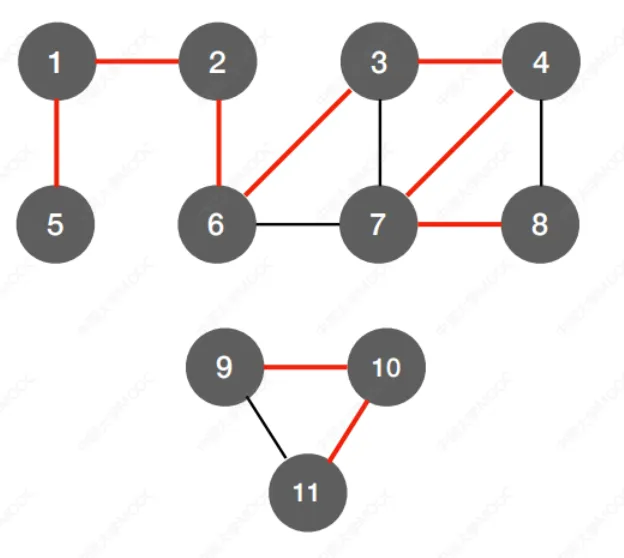
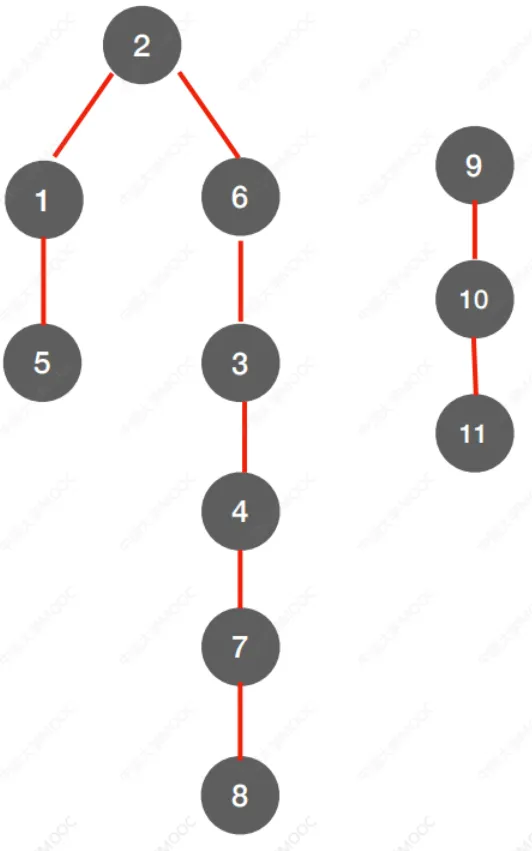
5.3.3 图的遍历与连通性
对无向图进行BFS/DFS遍历,调用BFS/DFS函数的次数 = 连通分量数
对于连通图,只需要调用一次BFS/DFS
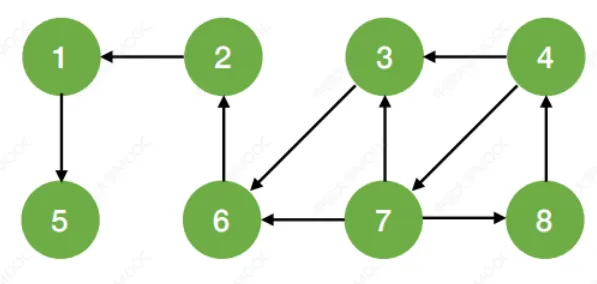
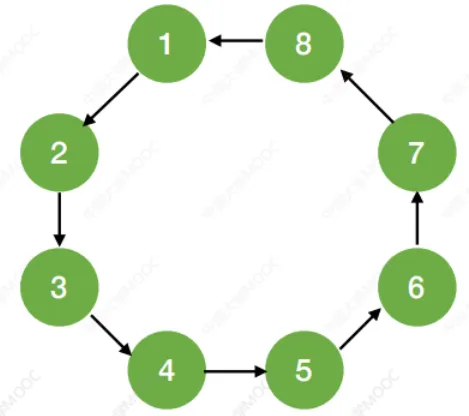
对有向图进行BFS/DFS遍历,调用BFS/DFS函数的次数要具体情况具体分析
- 如果起始顶点到其他各顶点都有路径,则只需要调用1次
BFS/DFS - 对于强连通图,从任一结点出发都只需要调用一次
BFS/DFS
【重要应用】:无向图中连通分量的数目
思路:
- 依次访问所有顶点,对于当前顶点 \(u\),先检查它是否已经被访问过,若未被访问,以它为起始点进行「搜索」,在开始搜索后立即将 \(u\) 标记为已访问。
- 搜索过程中,跳过那些「已访问」的顶点,对于「未访问」的顶点,显然它们与 \(u\) 同属一个连通分量。
- 因为从 \(u\) 开始的「搜索」一定能够找到所有与 \(u\) 在同一连通分量的顶点,因此能够以多少个顶点为「起点」开始搜索,就有多少个连通分量。
上述过程的实现需要设置一个 \(bool\)型 \(visited\) 数组,大小为顶点数,表示在此后的搜索中是否访问过。「搜索」可以采用 \(bfs\) 或 \(dfs\)。
※ 通过 \(bfs / dfs\) 来 逐渐标记整张图 (的所有顶点) 的做法,也被形象地称之为 flood fill (泛洪) 或 seed fill(播种),本质上是 「记忆化搜索」 的应用。
※ 若采用 \(bfs\) 时,不只是对单个顶点按层搜索,而是对整张图按层搜索,也即初始时找到最外层的所有顶点 (对无向图来说度为 1,对有向图来说入度为 0 的顶点),然后将这些顶点的邻接顶点作为下一层顶点,以此类推,按层操作。那么这种处理方式也被形象地称为「涟漪法」、「波纹法」、「涨潮法」等。 后续在「拓扑排序」、「无权单源最短路」中都能看到此方法的应用。
代码与普通的\(dfs\)和\(bfs\)区别不大,只需要添加一个\(count\)变量用来统计即可;
时间复杂度:无论是\(bfs\)实现还是\(dfs\)实现,遍历顶点 \(v\) 并从 \(v\) 开始泛洪。考虑图所有顶点构成 完全图 (任意两个顶点间都有边连接),那么对第一个顶点 \(v\) 执行搜索后,每个顶点都会询问所有他的 \(|V| - 1\) 个邻接顶点是否已被访问。最坏和平均时间复杂度为\(O(|V|^2)\)。
当然,这种问题也是并查集的拿手好戏!
Note
如果该无向图是用邻接矩阵存储,遍历它的上三角区域,如果G.Edge[i][j]!=0,并且i,j的祖先结点不同,也就是说二者不在一个集合,那么就将这两个点加入并查集集合中,遍历结束后,再遍历一下父节点数组查看值为\(-1\)的元素个数,这就是集合的个数,也就是连通分量的个数;
#define MAXV 100  // 顶点数目的最大值

typedef struct {
    int numVertices;       // 图中实际的顶点数
    int numEdges;          // 图中实际的边数
    char vertexList[MAXV]; // 顶点表
    int edges[MAXV][MAXV];  // 邻接矩阵
} MGraph;

int s[MAXV];  // 集合元素数组,用于双亲表示法的数据结构

// 初始化并查集
void Initial(int Size) {
    for(int i = 0; i < Size; ++i) {
        s[i] = -1;  // -1 表示每个元素都为根节点
    }
}

// 查操作,找 x 所属集合(返回 x 所属树的根节点)
int Find(int x) {
    while(s[x] >= 0) {  // 只要数组中该元素值 >= 0,说明还未找到其所属集合根节点,继续循环寻找
        x = s[x];  // 更新 x 为其父节点的下标
    }
    return x;  // 返回根节点的下标
}

// 将 v->u 这条边加入并查集
void join(int u, int v) {
    u = Find(u);  // 查找顶点 u 的根节点
    v = Find(v);  // 查找顶点 v 的根节点
    if(u == v) return;  // 如果二者本来就属于同一个集合,则直接返回
    s[v] = u;  // 将顶点 v 的根节点设置为 u,合并两个集合
}

// 计算图的连通分量的个数
int countComponents(MGraph G) {
    Initial(G.numVertices);  // 初始化并查集

    // 遍历邻接矩阵的上三角区域
    for(int i = 0; i < G.numVertices; ++i) {
        for(int j = i + 1; j < G.numVertices; ++j) {
            if(G.edges[i][j] != 0) {  // 如果 i 和 j 之间有边
                if(Find(i) != Find(j))  join(i, j);  // 如果二者不在同一个集合中,将 j 并入 i 所在的集合
            }
        }
    }

    // 计算集合的个数
    int count = 0;
    for(int i = 0; i < G.numVertices; ++i) {
        if(s[i] == -1) {  // 如果在父节点数组中值为 -1,说明它是某个集合的根节点
            count++;
        }
    }
    return count;  // 返回连通分量的个数
}
5.4 图的应用
5.4.1 最小生成树
- 概念回顾:\ 连通图:若无向图中任意两个顶点都是连通的,则称该图是连通图,否则称为非连通图;对于\(n\)个顶点的无向图\(G\),若\(G\)是连通图,则最少有\(n-1\) 条边;\ 生成树:对连通图进行遍历,过程中所经过的边和顶点的组合可看做是一棵普通树,通常称为生成树(上面提到的广度优先生成树、深度优先生成树)。连通图的生成树包含图中所有顶点,并且只含尽可能少的边(又叫极小连通子图,任意两顶点之间有且仅有一条通路)
对于生成树而言,若图中顶点数是\(n\),则它的生成树含有\(n-1\)条边,对生成树而言,若砍去它的一条边,则会变成非连通图,如果加上一条边,则会形成一个回路。
一个连通图的生成树往往有很多种,例如
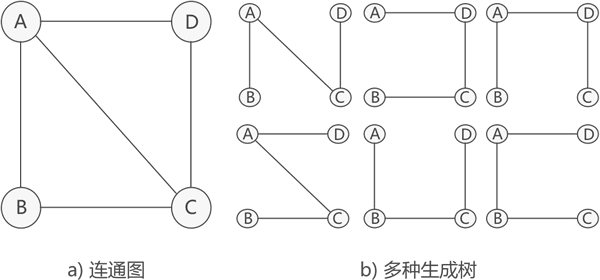
如果为连通图中的每条边赋予一个权值(可以理解为一个整数),这样的连通图又称为连通网。
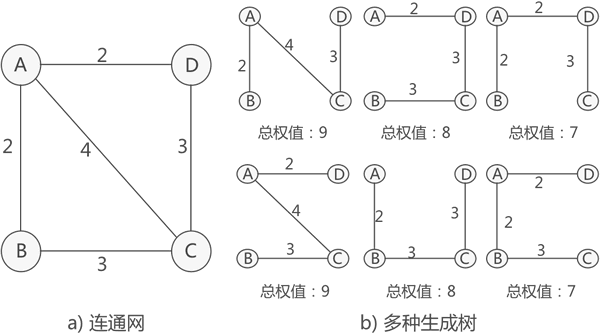
各个生成树包含的边不相同,因此它们的总权值(所有边的权值之和)也不相等。所谓最小生成树(Minimum-Spanning-Tree,MST),指的就是总权值最小的生成树。
- 注意,一个连通网对应的最小生成树可能有多个,上图就是一个很好的范例,上图连通网对应的最小生成树有两个,但是边的权值之和总是唯一且最小的。
- 当图G中各顶点的权值互不相等时,G的最小生成树是唯一的; 若无向连通图的边数比顶点数少1时,则G的最小生成树就是它自己。
- 只有连通图才有⽣成树,⾮连通图只有⽣成森林
设\(G\)是无向连通带权图,\(T\)是\(G\)的一个最小生成树。T是G的唯一最小生成树当且仅当对于不在\(T\)中的每一条边\(e\),\(e\)的权重大于\(T+e\)所产生的圈中其它每条边的权重。(即充要条件)
证明:
- 环的生成:\ 如果我们向最小生成树\(T\)中添加一条不在\(T\)中的边\(e\),这会在\(T\)中产生一个环(因为\(T\)已经包含了所有顶点且是一个树,添加任何一条边都会产生环)。
- 替代路径的比较:\ 在这个环中,边\(e\)与环中其他边进行比较。
- 如果\(e\)的权重小于或等于环中任何一条边的权重,那么我们可以通过用e替换那条边来得到一个新的生成树,其权重和不会比\(T\)大,甚至可能更小。这就意味着原来的\(T\)不是唯一的最小生成树,因为存在另一个同样权重的最小生成树(或者权重更小)。
- 如果对于不在\(T\)中的每一条边 \(e\),\(w(e)\) 总是大于环中其他边的权重,那么替换环中的任何一条边都会导致权重和增加,从而保证 \(T\)是唯一的最小生成树。
因此,唯一性条件就是通过确保不在最小生成树中的每一条边的权重都大于加入该边后形成的环中的其他任何一条边的权重来保证的。这样就避免了通过替换边形成新的最小生成树,确保了最小生成树的唯一性。
最小生成树可以用来解决一些实际问题。仍以上图为例,假设 A、B、C、D 这 4 个顶点各自代表一座城市,各个边表示两座城市之间可以铺设网线,边的权值表示铺设网线需要耗费的经费。如果想为这 4 座城市建立通信联络网,最节省经费的方案就是按照总权值为 7 的生成树铺设网线。
对于给定的连通图,求最小生成树常用的算法有两个,分别叫做普里姆(Prim)算法和克鲁斯卡尔(Kruskal)算法。
5.4.1.1 prim算法
算法思想:从某一个顶点开始构建生成树,每次将代价最小的新顶点(与当前T中顶点集合距离最近的顶点)纳入生成树,直到所有顶点都纳入为止;
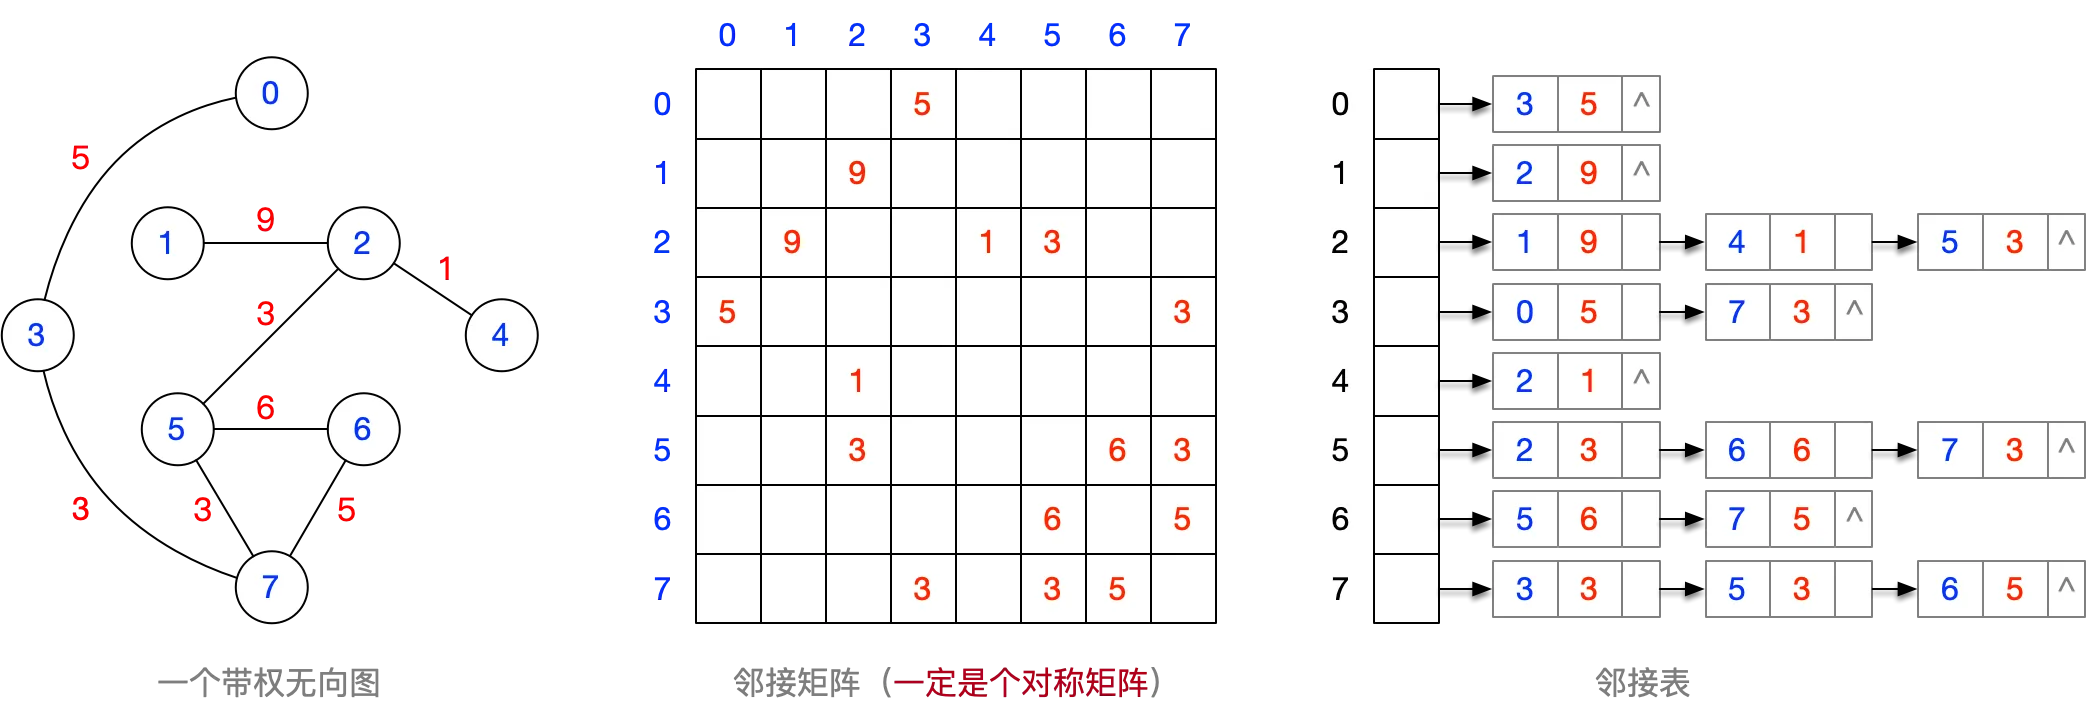
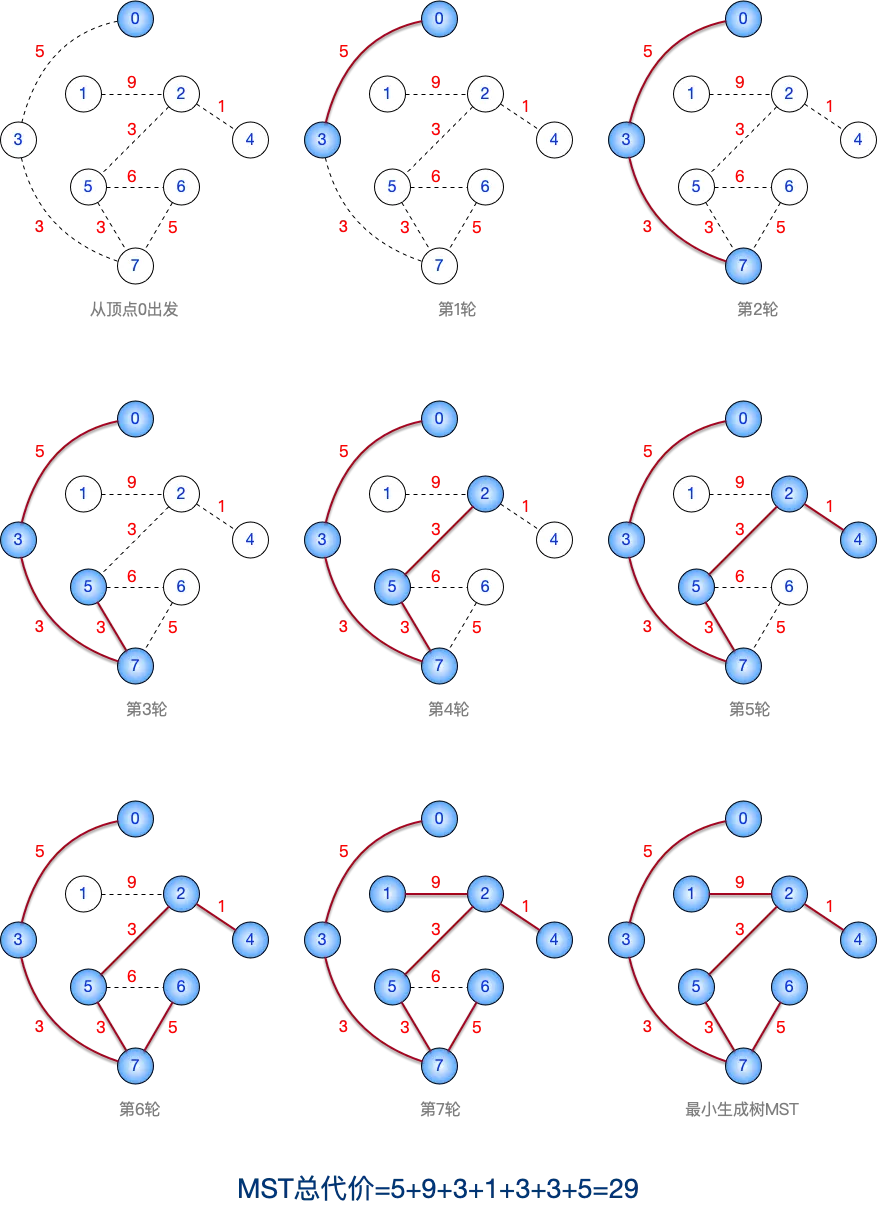
示例:下面是一个带权无向连通图,使用Prim算法生成MST,画出算法执行过程的示意图,并计算MST的总代价
注:普利姆算法是选代价最小的“点”,克鲁斯卡尔算法是选代价最小的“边”,别记混了。
可以这么联想记忆,“Prim”是字母 P 开头的,“点”的英文是Point,也是 P 开头的,因此Prim算法是选“点”。
| 从顶点\(0\)开始,运行\(Prim\)算法 | 从顶点\(7\)开始,运行\(Prim\)算法 |
|---|---|
 |
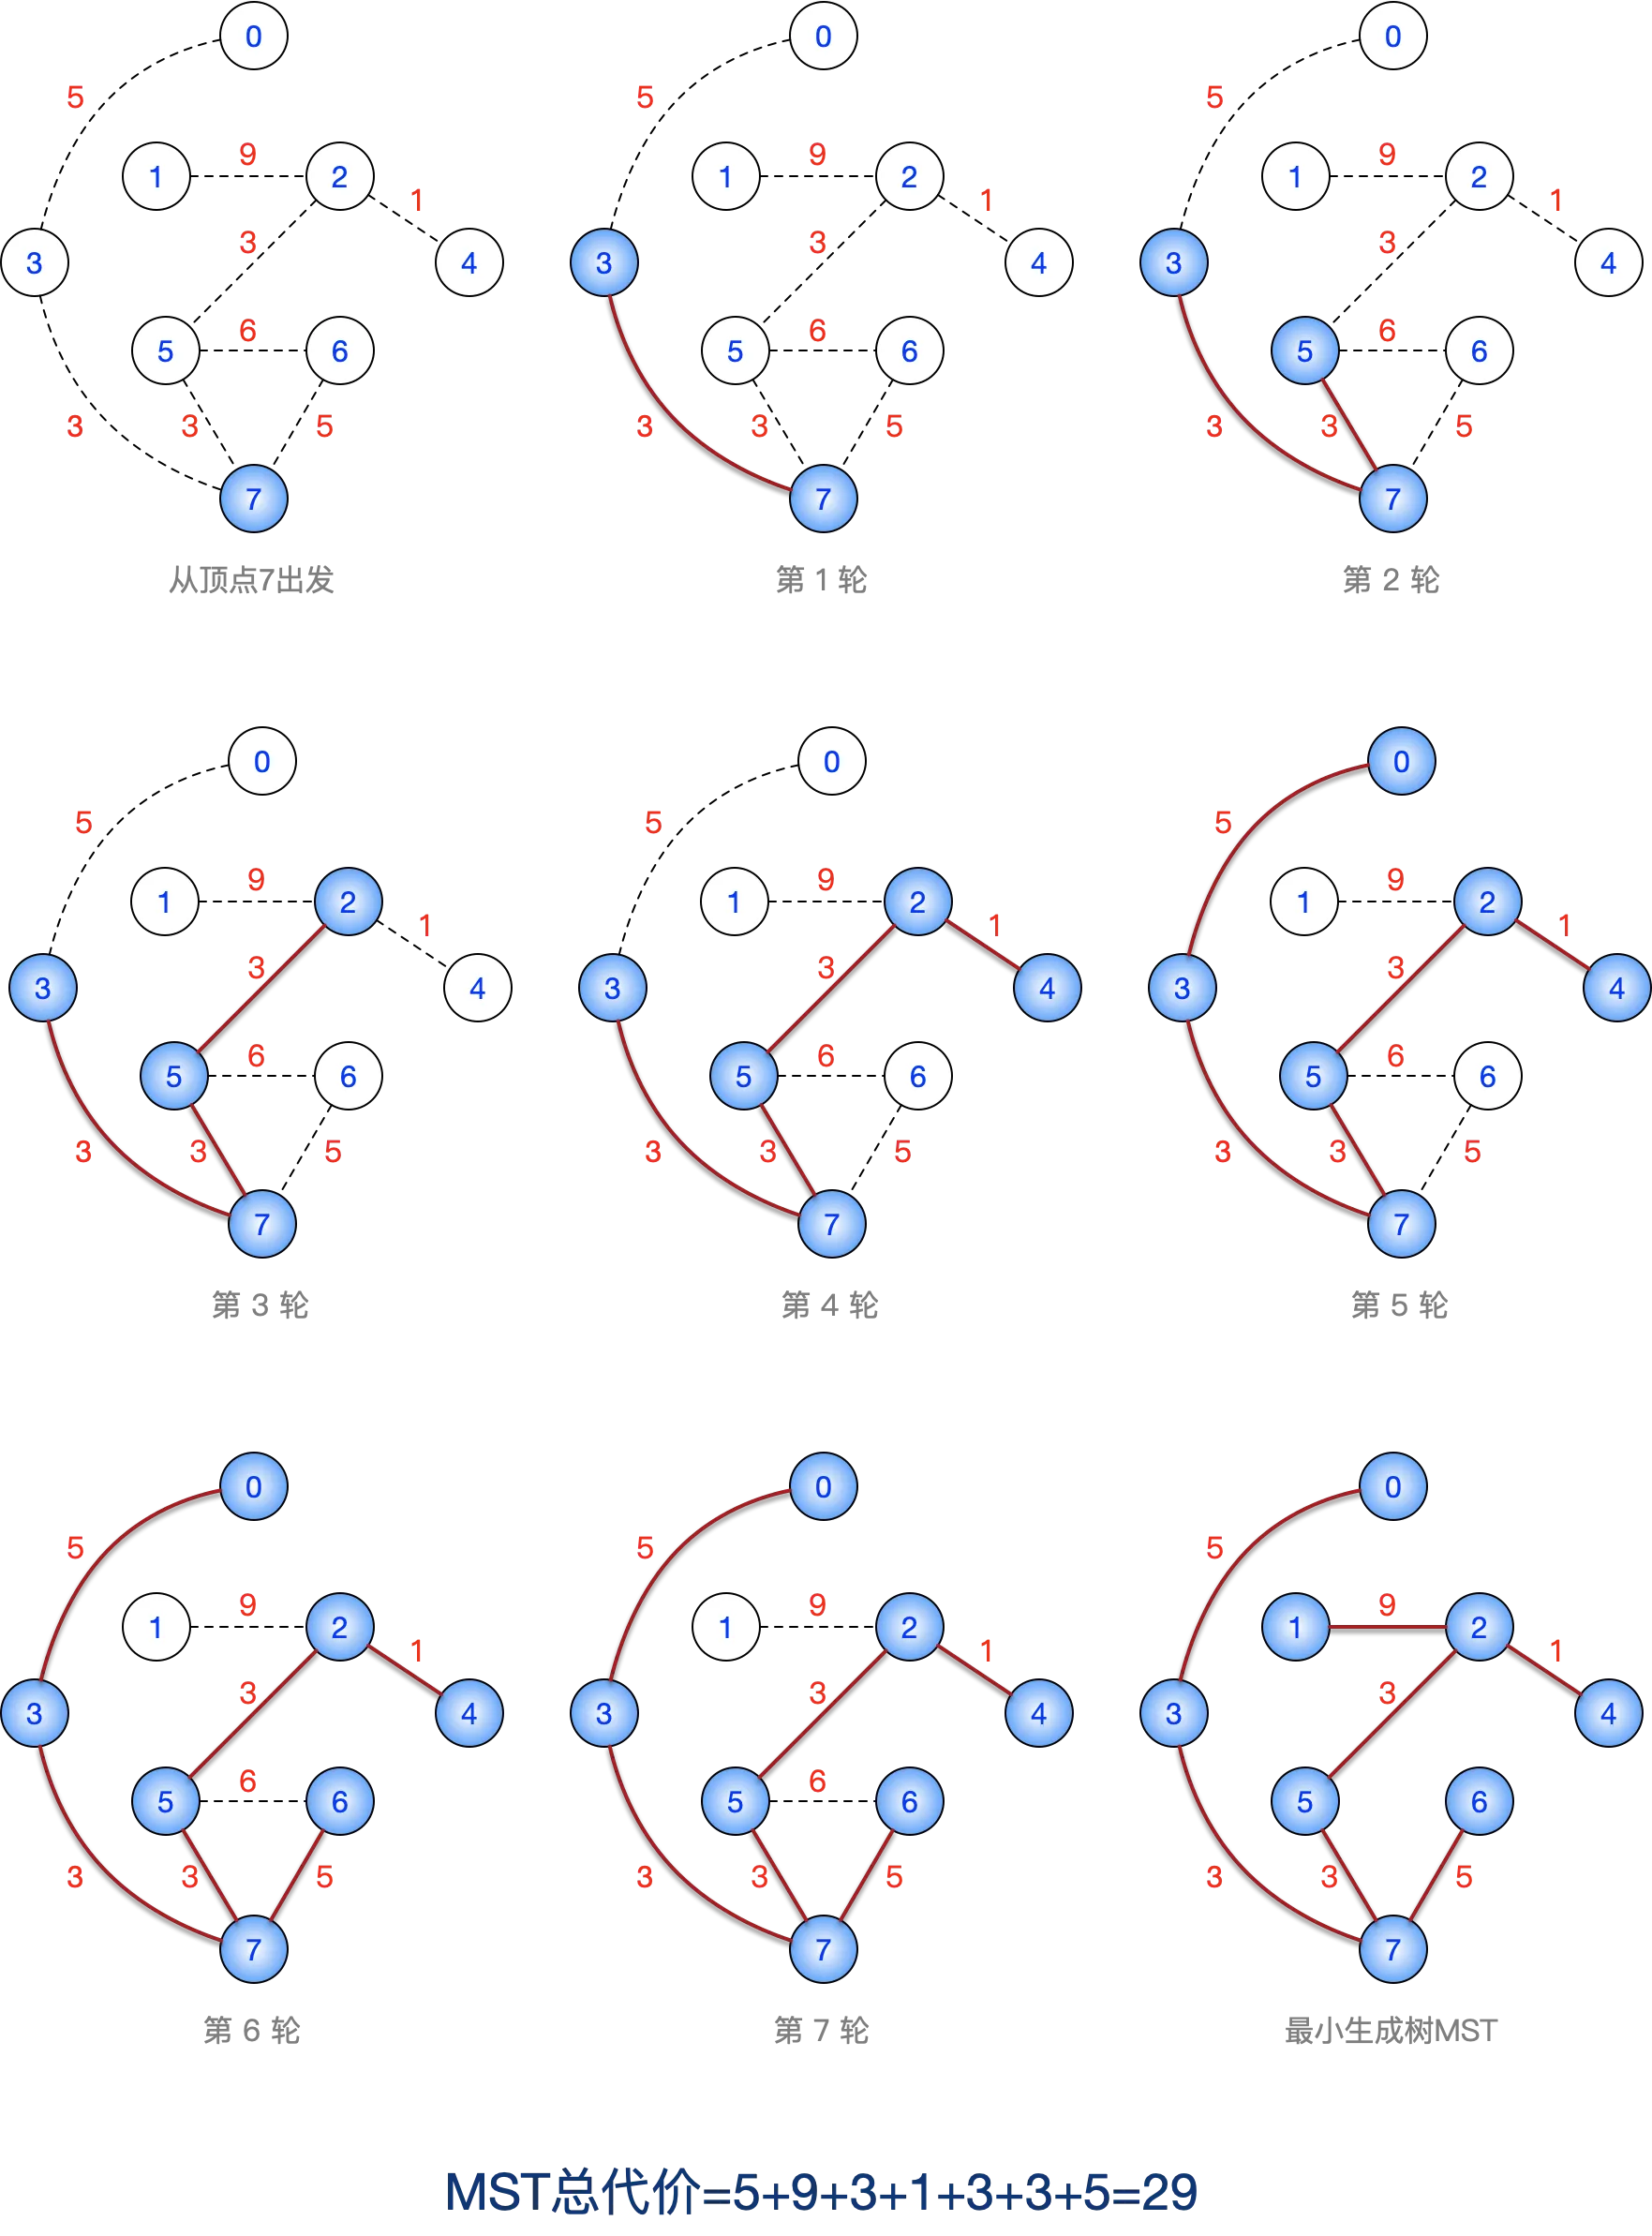 |
这里想强调的是:当同时有两个代价相同的顶点时,优先将编号小的顶点加入MST。 如:第 1 轮从顶点7出发,与其相连的顶点3、顶点5代价都是最小的, 优先选择编号更小的顶点3。 |
Info
算法思想:
从顶点\(v\)出发,按照\(prim\)算法构建图G的最小生成树\(T\)
- 初始时,最小生成树集合\(U\)中只有一个起始顶点,即\(U=\left\{ v \right\}\)
- 从剩余未确定顶点集合中选取一个距离已确定顶点距离最短的一个顶点,将其加入集合\(U\),将这条边加入最小生成树\(T_E\)中;
- 重复步骤2 \(n-1\)次,使得所有顶点都加入集合\(U\)中。此时\(T_E\)就是最小生成树。
算法具体实现步骤:
- 初始化
- 设置一个大小为 \(|V|\) 的用于标记顶点距离是否「已确定」的 \(bool\) 数组 \(visited[]\) ,下标表示顶点。
- 设置一个大小为 \(|V|\) 的距离数组 \(dist[]\) ,下标表示顶点。
- 任意选取 一个顶点作为起始顶点,置距离为 0,通常我们将第一个顶点的距离置为 0 ,并将其加入最小生成树集合。
- 更新其他剩余顶点到起始顶点的距离,并设置\(visited[i] = false\);
- 以一个循环寻找 当前距离未确定顶点中距离最小者 \(u\) ,立即置 \(u\) 的距离为「已确定」,即将其加入最小生成树。
- 距离更新。尝试更新 \(u\) 的所有 距离未确定的 邻接顶点 \(v\) 的距离 \(dv\)。即 \(dv = min{dv, |(u,v)|}\)
- 循环结束时,所有顶点距离被求出,也就是
MST所有边权被求出。
示例代码:
#include <climits>
#include <cstdio>

#define MAXV 100     // 顶点数目的最大值

typedef struct {
    int numVertices;       // 图中实际的顶点数
    int numEdges;          // 图中实际的边数
    char vertexList[MAXV]; // 顶点表
    int edges[MAXV][MAXV];  // 邻接矩阵
} MGraph;

void miniSpanTreePrim(MGraph G, int v) {
    int dist[MAXV];
    int sum = 0;  // 表示当前最小生成树的权值之和
    bool visited[MAXV];

    // 初始化,将当前顶点 v 加入集合 U,并更新其它顶点到 v 的距离
    for(int i = 0; i < G.numVertices; ++i) {
        dist[i] = (i == v || G.edges[v][i] != 0) ? G.edges[v][i] : INT_MAX;
        //无边初始化为无穷大
        visited[i] = false;
    }
    visited[v] = true;  // 将起始顶点 v 加入集合 U
    dist[v] = 0;  // 生成树起始点距离置 0

    // 外循环,执行 n-1 次,每次挑出一个符合条件的顶点加入 U
    for(int i = 1; i < G.numVertices; ++i) {
        int min = INT_MAX, u = -1;

        // 找出满足条件的权值最小的边对应的顶点
        for(int j = 0; j < G.numVertices; ++j) {
            if(!visited[j] && dist[j] < min) {
                min = dist[j];
                u = j;
            }
        }

        if(u == -1) break;  // 如果未找到合适的顶点,结束循环

        visited[u] = true;  // 将找到的符合条件的顶点加入集合 U 中
        sum += min;  // 更新最小生成树的权值之和

        // 对于 u 的邻接顶点 k,更新 k 到集合 U 中顶点的最短距离
        for(int k = 0; k < G.numVertices; ++k) {
            if(!visited[k] && G.edges[u][k] != 0 && G.edges[u][k] < dist[k]) {
                //只用真实存在的边更新
                dist[k] = G.edges[u][k];  // 更新最短距离
            }
        }
    }

    // 结果
    printf("Minimum spanning tree weight: %d\n", sum);
}
Note
时间复杂度:\(O(|V|^2)\),外层循环执行\(O(|V|-1)\)次,内层有两个同级的非嵌套\(for\)循环,若采用邻接矩阵是\(2O(|V|)\),采用邻接表则是\(O(|V|)+O|E|\),都等价于\(O(|V|)\),因此总的时间复杂度为\(O(|V|^2)\).。另外根据代码可以看出其时间复杂度和Dijkstra算法相同.
由于其时间复杂度与\(|E|\)(边)无关,因此,prim适合用于求解边稠密的图的最小生成树。如果图中所含的边稠密度不高的话,推荐使用克鲁斯卡尔求最小生成树。
5.4.1.2 Kruskal算法
算法思想:每次选择一条权值最小的边,使这条边的两头连通(原本已经连通的就不选),直到所有结点都已连通。
Info
Prim 算法从一个顶点出发,逐渐「长出」一棵 MST,而本节的 Kruskal 算法在「生成」MST 的过程上与 Prim 颇有相对之感,该方法令 MST的各部分各自生长,最终合并成一棵完整的 MST。它是一种基于贪心思想的求解无向图上 MST 的算法, 是并查集的典型应用,该算法首先将所有边按边权排序,接着应用「并查集」的「查询-合并」过程来决定将哪些边加入到MST 中。算法内容的简要描述为: 对排序后的边权,依序 (按边权从小到大) 取边\((u,v)\),若顶点\(u, v\)还未连通,则将\((u,v)\)加入 MST ,直到加入的边数等于\(|V| - 1\)
示例:基于上面的带权无向连通图,使用Kruskal算法生成MST,画出算法执行过程的示意图,并计算MST`的总代价
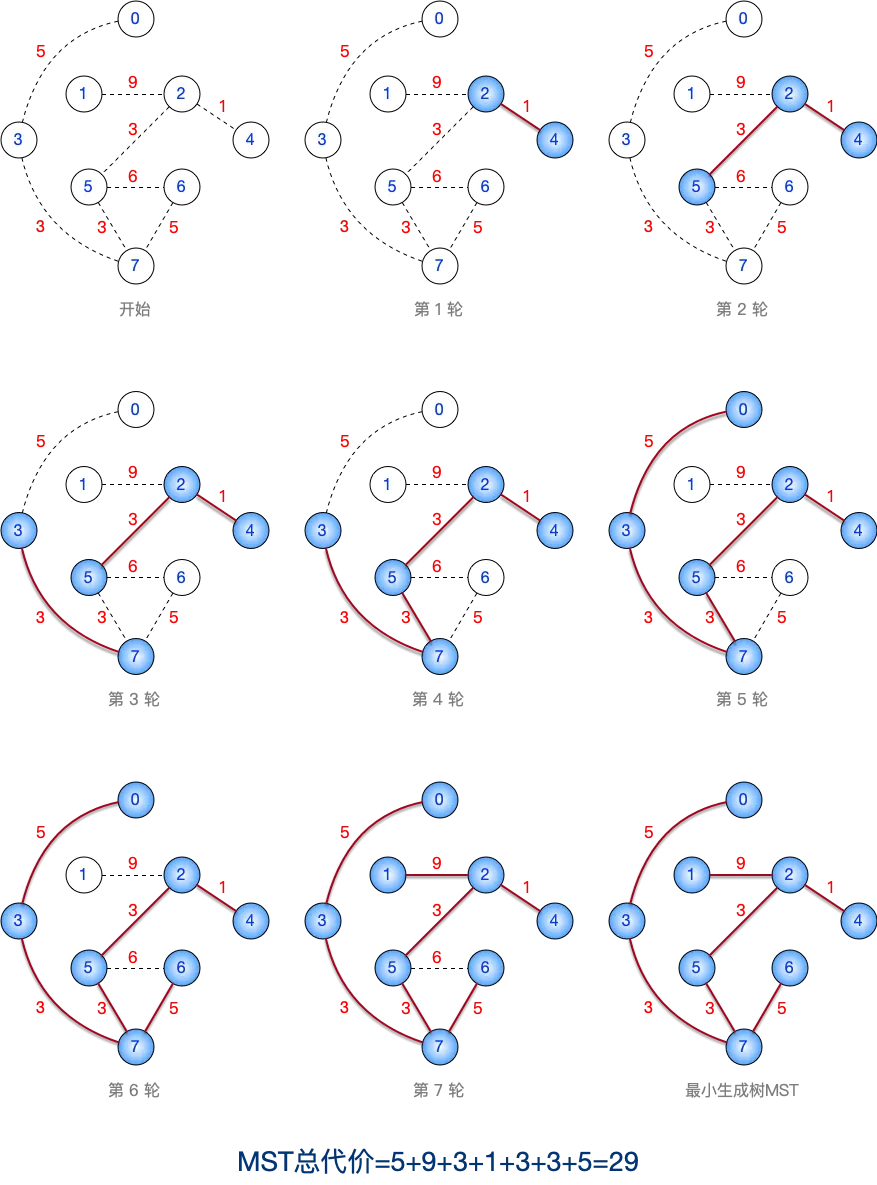
Kruskal算法的执行过程是:先将各条边按照权值递减的排序,再按顺序依次检查是否将这些边加入MST。各条边排序结果如下:( 2 ,4 ) ——权值 1
( 2, 5 ) ——权值 3
( 3, 7 ) ——权值 3
( 5, 7 ) ——权值 3
( 0, 3 ) ——权值 5
( 6, 7 ) ——权值 5
( 5, 6 ) ——权值 6
( 1, 2 ) ——权值 9
可见,当多条边的权值相同时,“起点”编号更小的边排在前面。因此,在
Kruskal算法的第2轮中,虽然有3条边 (2,5) (3,7) (5,7) 的权值都是最小的,但算法会优先选择将排序靠前的 (2,5) 加入MST。
Tip
算法过程:
- 构建无向带权图。
- 按边权从小到大排序所有边。
- 实现以顶点的并查集。
- 从排序后的边中依序 (按边权从小到大) 选取边 \((u, v)\) ,查询该边的两个顶点是否已在
MST中 (即是否已连通) ,是则跳过,否则合并,也即将此边加入MST中。 - 当加入的边数等于 \(|V| - 1\) 时,表明所有在一个连通分量中的顶点构成了
MST,算法结束。 - 若依序取完所有的边后,加入
MST的边数仍达不到 \(|V| - 1\),说明此图不存在MST,也即图中存在不连通的顶点。
#include <stdio.h>
#include <stdlib.h>

#define MAXV 100     // 顶点数目的最大值

typedef struct {
    int u, v;  // 边的两个顶点
    int weight;  // 边的权重
} Edge;

typedef struct {
    int numVertices;       // 图中实际的顶点数
    int numEdges;          // 图中实际的边数
    char vertexList[MAXV]; // 顶点表
    int edges[MAXV][MAXV];  // 邻接矩阵
    Edge edgeList[MAXV * (MAXV - 1) / 2];  // 存储图中的所有边
} MGraph;

int parent[MAXV];  // 并查集的父节点数组
int rank[MAXV];    // 并查集的秩数组,用于优化合并操作

// 初始化并查集
void initUnionFind(int n) {
    for (int i = 0; i < n; i++) {
        parent[i] = i;  // 每个顶点的父节点初始为自己
        rank[i] = 0;    // 每个顶点的秩初始为 0
    }
}

// 查找操作 (Find),路径压缩
int find(int x) {
    if (parent[x] != x) {
        parent[x] = find(parent[x]);  // 路径压缩
    }
    return parent[x];
}

// 合并操作 (Union),按秩合并
void unionSets(int x, int y) {
    int rootX = find(x);
    int rootY = find(y);

    if (rootX != rootY) {
        if (rank[rootX] > rank[rootY]) {
            parent[rootY] = rootX;
        } else if (rank[rootX] < rank[rootY]) {
            parent[rootX] = rootY;
        } else {
            parent[rootY] = rootX;
            rank[rootX]++;
        }
    }
}

// 边的比较函数,用于按权重排序边
int compareEdges(const void *a, const void *b) {
    const int wa = ((const Edge *)a)->weight;
    const int wb = ((const Edge *)b)->weight;
    return (wa > wb) - (wa < wb); //避免权值相减时整数溢出
}

// Kruskal算法求最小生成树
void kruskalMST(MGraph *G) {
    int edgeCount = 0;  // 记录已加入 MST 的边数
    int mstWeight = 0;  // MST 的总权值

    // 初始化并查集
    initUnionFind(G->numVertices);

    // 对边按权重从小到大排序
    qsort(G->edgeList, G->numEdges, sizeof(Edge), compareEdges);

    // 遍历排序后的所有边
    for (int i = 0; i < G->numEdges; i++) {
        Edge currentEdge = G->edgeList[i];

        int rootU = find(currentEdge.u);
        int rootV = find(currentEdge.v);

        // 如果当前边的两个顶点不在同一个集合中,合并它们
        if (rootU != rootV) {
            unionSets(currentEdge.u, currentEdge.v);
            mstWeight += currentEdge.weight;  // 累加权值
            edgeCount++;

            // 当加入的边数达到 |V| - 1 时,MST 构建完成
            if (edgeCount == G->numVertices - 1) {
                break;
            }
        }
    }

    // 检查是否所有顶点已连通
    if (edgeCount == G->numVertices - 1) {
        printf("Minimum spanning tree weight: %d\n", mstWeight);
    } else {
        printf("The graph does not have a spanning tree.\n");
    }
}

// 主函数,用于测试
int main() {
    MGraph graph;
    graph.numVertices = 4;
    graph.numEdges = 5;

    // 添加顶点
    graph.vertexList[0] = 'A';
    graph.vertexList[1] = 'B';
    graph.vertexList[2] = 'C';
    graph.vertexList[3] = 'D';

    // 添加边及其权重
    graph.edgeList[0] = (Edge){0, 1, 10};
    graph.edgeList[1] = (Edge){0, 2, 6};
    graph.edgeList[2] = (Edge){0, 3, 5};
    graph.edgeList[3] = (Edge){1, 3, 15};
    graph.edgeList[4] = (Edge){2, 3, 4};

    // 调用 Kruskal 算法计算最小生成树
    kruskalMST(&graph);

    return 0;
}
时空复杂度:边权排序的时间复杂度为\(O(|E|log|E|)\), 单次查询或合并均为\(O(\alpha(n))\),近似\(O(1)\),至多\(|V|-1\)次查询或合并,综合为\( O(|E|log|E|+|V|)=O(|E|log|E |) \)
由于其时间复杂度和图的顶点数\(|V|\)无关,因此,Kruskal算法更适合于边稀疏而顶点较多的图。
Info
【Tips】:prim是选择符合要求的点加入集合,所以其时间复杂度与点的数量有关,因此其适合点比较少,边比较多的图,即适用于求解边稠密的图的最小生成树;
而Kruskal是选择符合要求的边加入集合,所以其时间复杂度与边的数量有关,因此其适合边数比较少,点比较多的图,即适用于求解边稀疏而顶点较多的图的最小生成树;
5.4.2 最短路径
5.4.2.1 无权单源最短路径–BFS
无权单源最短路: (Single Source Shortest Path, SSSP) 给定一张无权图 \(G\) 和一个顶点 \(s\) ,找出从 \(s\) 到 \(G\) 中每一个顶点的最短路径。
无权图可以看作是一种特殊的带权图,只是每条边的权值都为1;
算法描述:从源点 \(s\) 开始执行 \(bfs\) ,一开始将 \(s\) 放入队列中。每次处理一层顶点,在一个 \(for\) 循环内依次将该层顶点出队,对每一个当前层的顶点 \(u\) ,遍历它的邻接顶点 \(v\) ,只要它未被标记为「已访问」,则它是下一层顶点,此时即可赋予其当前距离,此距离每处理一层增加 1,将 \(v\) 入队并置 \(v\) 为「已访问」。当 \(q\) 中顶点全都出队时,我们就得到了 \(s\) 到所有顶点的最短路径距离。
Info
算法过程:
- 设置一个队列 \(q\) ,一个用于记录访问状态的 \(visited\) 数组,一个记录所有顶点距离的 \(dists\) 数组。
- 首先将源点 \(s\) 入队,并立即置其访问状态为「已访问」。
- 执行 \(while(!q.isEmpty())\) ,开始 \(bfs\) 泛洪。每次以一个 \(for\) 循环处理 一层 顶点,\(dist++\) ,表示当前层的距离。
- 对每一个当前层的顶点 \(u\) ,以一个 \(for\) 循环遍历它的邻接顶点 \(v\) ,只要它未被标记为「已访问」,则它是下一层顶点,此时即可赋予其当前距离,将 \(v\) 入队 并置 \(v\) 为「已访问」。
- 当 \(q\) 中顶点全都出队时,我们就得到了 \(s\) 到所有顶点的最短路径距离。
#include <stdio.h>
#include <limits.h>
#include <queue>

#define MAXN 100     // 假设顶点数目的最大值

typedef struct {
    int numVertices;       // 图中实际的顶点数
    int numEdges;          // 图中实际的边数
    char vertexList[MAXN]; // 顶点表
    int edges[MAXN][MAXN];  // 邻接矩阵
} Graph;

// 边的邻接查询函数
int FirstNeighbor(Graph *G, int v) {
    for (int i = 0; i < G->numVertices; ++i) {
        if (G->edges[v][i] != 0) {  // 这里假设非零表示有边
            return i;
        }
    }
    return -1;  // 没有邻接顶点
}

int NextNeighbor(Graph *G, int v, int w) {
    for (int i = w + 1; i < G->numVertices; ++i) {
        if (G->edges[v][i] != 0) {
            return i;
        }
    }
    return -1;  // 没有更多邻接顶点
}

// 最短路径计算,使用宽度优先搜索(BFS)
void shortestPath(Graph *G, int u) {
    int n = G->numVertices;  // 顶点总数
    int d[MAXN];  // d[i] 表示从顶点 u 到顶点 i 的最短路径长度
    int path[MAXN];  // path[i] 表示从顶点 i 到顶点 u 的最短路径前驱节点
    bool visited[MAXN];  // 访问标记数组

    // 初始化
    for (int i = 0; i < n; ++i) {
        d[i] = INT_MAX;  // 初始时,所有顶点距离 u 的距离为无穷大
        path[i] = -1;    // 初始时,前驱节点未知
        visited[i] = false;  // 初始时,所有顶点均未访问
    }
    d[u] = 0;  // 从 u 到 u 的距离为 0
    visited[u] = true;  // 将起点 u 标记为已访问

    queue<int> que;  // BFS 队列
    que.push(u);  // 将起点 u 入队

    while (!que.empty()) {
        int cur = que.front();  // 获取队头元素
        que.pop();  // 出队

        // 遍历当前顶点 cur 的所有邻接顶点
        for (int w = FirstNeighbor(G, cur); w >= 0; w = NextNeighbor(G, cur, w)) {
            if (!visited[w]) {  // 如果顶点 w 未被访问
                visited[w] = true;  // 标记为已访问
                d[w] = d[cur] + 1;  // 更新从 u 到 w 的最短路径长度
                path[w] = cur;  // 更新顶点 w 的前驱节点
                que.push(w);  // 将顶点 w 入队
            }
        }
    }

    // 输出结果
    for (int i = 0; i < n; ++i) {
        if (d[i] == INT_MAX) {
            printf("Vertex %d is not reachable from vertex %d\n", i, u);
        } else {
            printf("Shortest path from vertex %d to vertex %d is %d\n", u, i, d[i]);
        }
    }
}
时间复杂度: 时间复杂度:
- 邻接矩阵:\(O(|V|+|V|^2) = O(|V|^2)\)
- 邻接表:\(O(|V|)+O(|2E|)=O(|V|+|E|)\)
5.4.2.2 带权单源最短路径—Dijkstra算法()
BFS算法求单元最短路径有很大的局限性,只能用于无权图或者所有边权值都相等的图;
当图为有权图时,我们将无法简单地通过层数增加来确定每一层顶点的距离,因为从源点若有多条路径可到达顶点 \(v\),更深的路径完全可以比更浅的路径具有更短的路径长 (路径上的边的权之和) 。再次强调,图「有向」或「无向」,对于这些算法,区别仅在于建图时为双向边还是单向边,最短路算法不区分有向图或是无向图 。
迪杰斯特拉(dijkstra)算法不便于用语言完整描述,可以跟随下面的例子体会一下这个过程。其中会涉及三个数组
dist[]数组:存储了当前起点到其余顶点最短路径的长度path[]数组:存储了起点到其余顶点的最短路径(通过查询该数组,可获得路径信息)final[]数组:如果标记为\(true\)则表示该顶点被选入最短路径
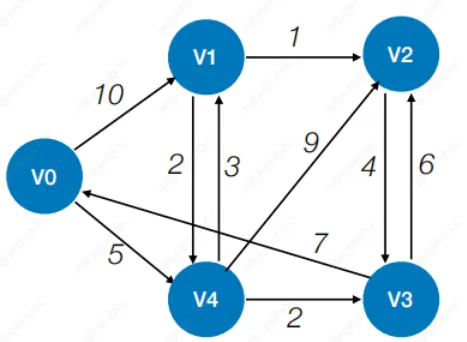
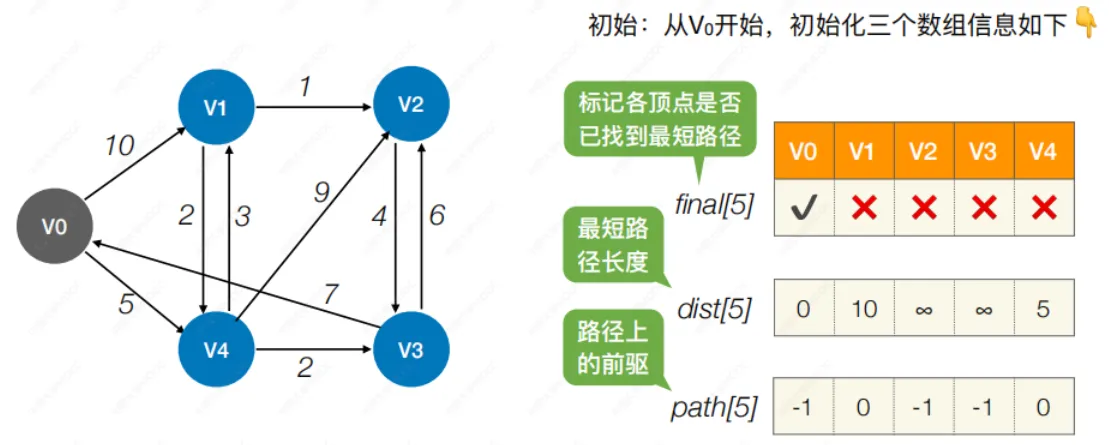
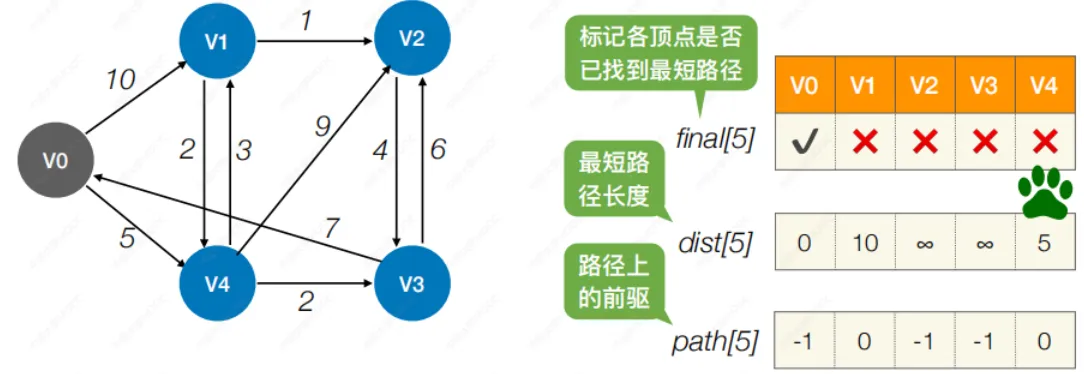
开始时,初始化各数组。其中\(v_0\) 到 \(v_1\)有直接路径为10、\(v_0\) 到\(v_4\) 有直接路径为5
- 因此,
path[1]=0,表示\(v_0\) 有到\(v_1\) 直接路径,其路径长度为dist[1]=10 - 因此,
path[4]=0,表示\(v_0\) 有到\(v_4\) 直接路径,其路径长度为dist[4]=5 final[0]=true表示此时\(v_0\) 已经被选入最短路径了- 由于目前\(v_0\) 到\(v_2\) 没有路径,因此\(dist[2]= \infin\),\(path[2]=-1\)
接着循环遍历,从dist[]数组中找到一个值最小且对应final数组为false的顶点\(v_i\)、使final[i]=true
因此选择了\(v_4\)
在没有加入\(v_4\)时,\(v_0\)无法到达其中的某些顶点,但是当\(v_4\)加入之后情况有所改变
- 比如之前\(v_0\)到\(v_3\)是没有路径的,但是\(v_4\)加入后,就存在了一个路径:\(v_{0} ->v_{4}->v_{3}\)
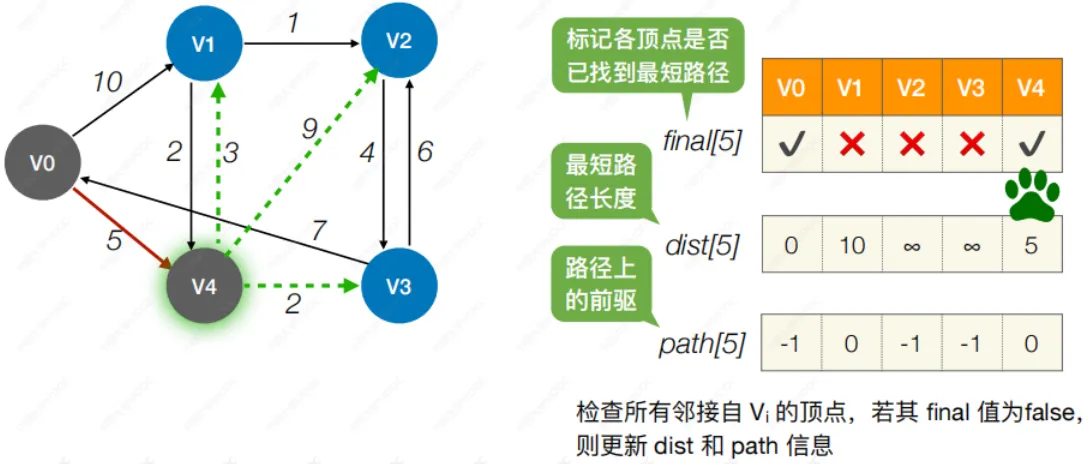 \
因此将\(v_4\)纳入路径后,所有数组信息可能会发生改变。所以我们需要进行对比,若
final值为false,则按如下规则更新对应的dist和path信息\ 对于\(v_1\):之前\(v_{0}\)->\(v_{1}\)为10,但是现在\(v_0\)->\(v_4\)->\(v_1\)路径之和为8,这是一条更短的路径,因此将dist[1]改为8,将path[1]改为4\ 对于\(v_2\):之前\(v_0\)->\(v_2\)为\(\infin\),但是现在\(v_0\)->\(v_4\)->\(v_2\)路径之和为14,这是一条更短的路径,因此将dist[2]改为14,将path[2]改为4\ 对于\(v_3\)之前\(v_0\)->\(v_3\)为 \(\infin\),但是现在\(v_0\)->\(v_4\)->\(v_3\)路径之和为7,这是一条更短的路径,因此将dist[3]改为7,将path[3]改为4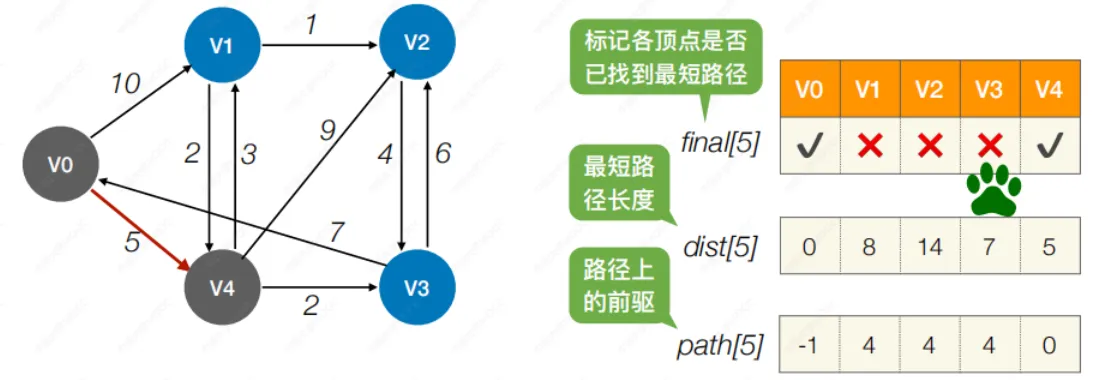 \
第一轮结束,迪杰斯特拉算法会进行多轮,每一轮都会涉及如下两个环节:\
先在
dist数组中找到一个最小的值,通往这个顶点的路径在通往其它顶点路径中长度是最短的。换句话说如果你不能保证它是最小的,那就更别提后面的了\ 接着由于该顶点的加入,使得前后情况有所变化。之前A到C没有路径,但是B加入之后,存在了一个路径A->B->C,所以我们要判断刚并入路径中的顶点是否会导致产生一些潜在的更短的路径,如果有,那么更新数组信息
| 第二轮 | 第三轮 |
|---|---|
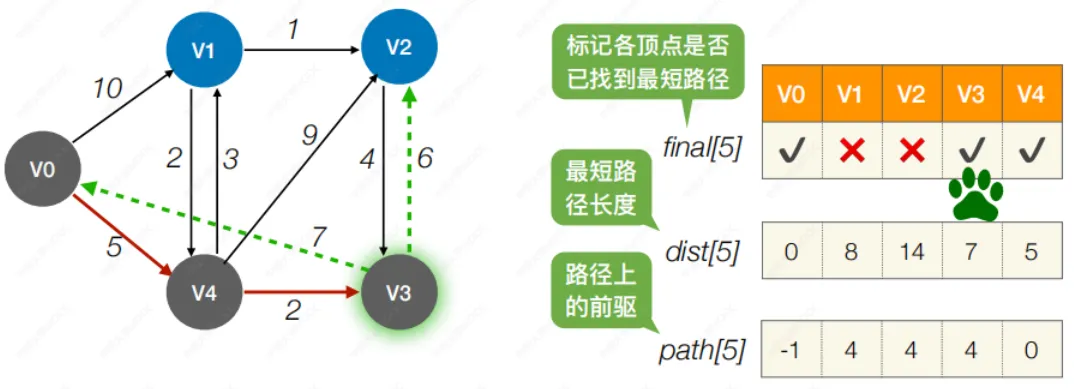 |
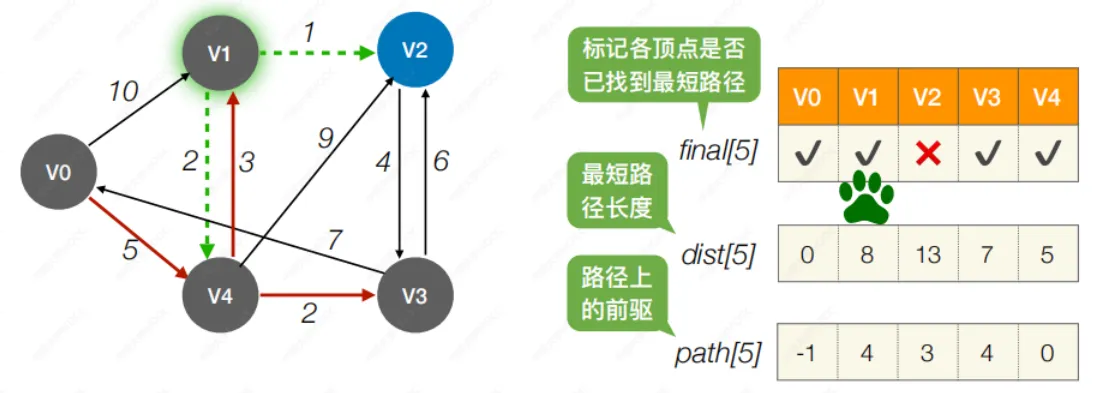 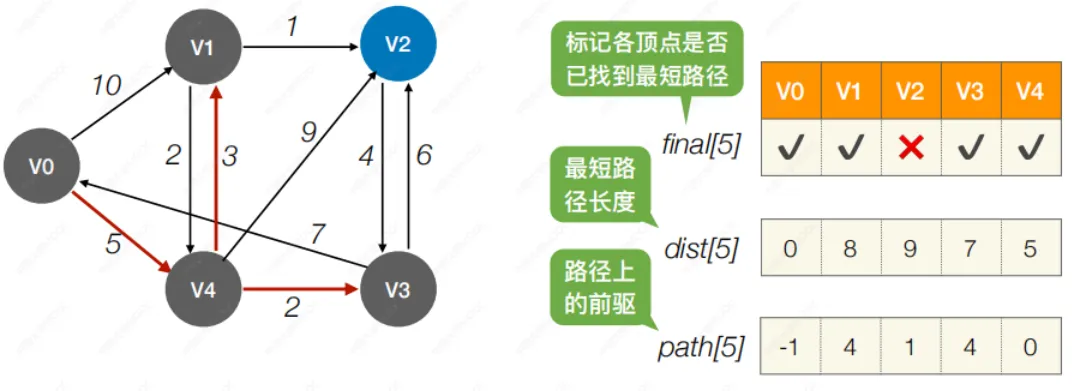 |
*
第四轮:算法结束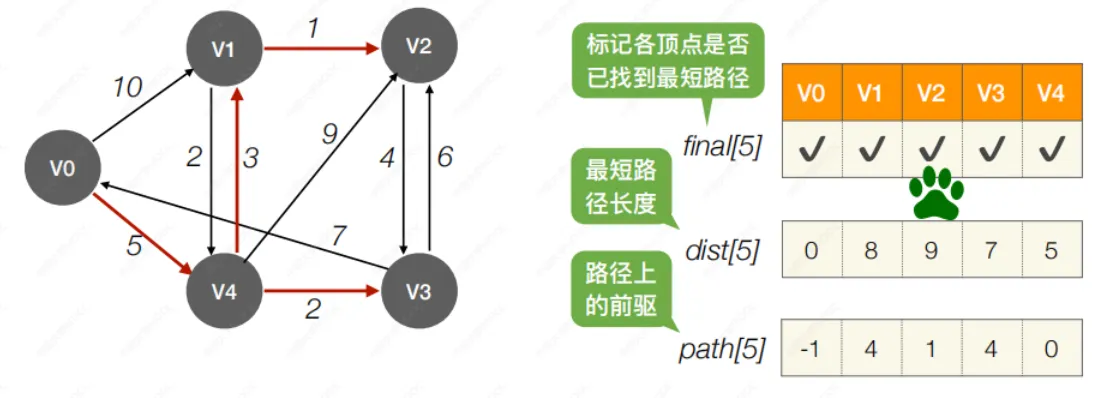
算法实现:
- 初始:若从 \(v_i\) 开始,令\(final[i]=true\),\(dist[i] =0,path[i]=-1\)\ 其余顶点\(final[k]=false,dist[k]=Edge[i][k],path[k]=(Edge[i][k]==\infin) ? -1 : 0\)
- 然后进行\(n-1\)轮处理:循环遍历所有顶点,找到还没确定最短路径,且\(dist\)最小的顶点\(v_j\),令\(final[j] = true\),并检查所有邻接自\(v_j\)的顶点,对于邻接自\(v_j\)的顶点\(v_s\),若\(final[s]=false 且dist[j]+Edge[j][s]\<dist[s]\),则令\(dist[s]=dist[j]+Edge[j][s],path[s]=j\),这里的\(Edge[j][s]\)表示的是从顶点\(v_j\)到\(v_s\)的弧的权值。
具体代码:
#include <stdio.h>
#include <limits.h>
#include <stdbool.h>

#define MAXV 100     // 顶点数目的最大值

typedef struct {
    int numVertices;       // 图中实际的顶点数
    int numEdges;          // 图中实际的边数
    char vertexList[MAXV]; // 顶点表
    int edges[MAXV][MAXV];  // 邻接矩阵
} MGraph;

// Dijkstra 算法,v 表示起始顶点在顶点表中的数组下标
void Dijkstra(MGraph G, int v, int dist[], int path[]) {
    bool final[MAXV];  // 用于标记顶点是否已经确定最短路径
    int n = G.numVertices;  // 图中顶点的数量

    // 初始化
    for (int i = 0; i < n; ++i) {
        final[i] = false;    // 初始化,所有顶点均未确定最短路径
        bool hasEdge = G.edges[v][i] != 0 && G.edges[v][i] < INT_MAX; //(此处修改)同时排除无边标记 0 和 INT_MAX
        dist[i] = hasEdge ? G.edges[v][i] : INT_MAX; //(此处修改)无直接边时距离应为无穷大
        path[i] = hasEdge ? v : -1;  //(此处修改)无直接边时不设置前驱
    }

    // 起始顶点的初始化
    final[v] = true;   // 起点顶点 v 已经确定了
    dist[v] = 0;       // 起点到自身的距离为 0
    path[v] = -1;      // 起点的前驱节点为 -1

    // 执行 n-1 次循环
    for (int i = 1; i < n; ++i) {
        int cur = -1;   // 当前顶点
        int tmpmin = INT_MAX;  // 临时最小距离

        // 在未确定最短路径的顶点中找到距离最小的顶点
        for (int j = 0; j < n; ++j) {
            if (!final[j] && dist[j] < tmpmin) {
                cur = j;
                tmpmin = dist[j];
            }
        }

        if (cur == -1) break;  // 如果没有找到可用的顶点,说明剩余顶点不可达

        final[cur] = true;  // 将当前顶点加入已确定的集合

        // 更新与当前顶点连接的所有顶点的最短路径
        for (int j = 0; j < n; ++j) {
            if (!final[j] && G.edges[cur][j] != 0 && G.edges[cur][j] < INT_MAX && dist[cur] != INT_MAX) { //(此处修改)仅处理有效边并避免无穷大相加
                if (dist[cur] + G.edges[cur][j] < dist[j]) {
                    dist[j] = dist[cur] + G.edges[cur][j];  // 更新距离
                    path[j] = cur;  // 更新前驱节点
                }
            }
        }
    }
}

// 辅助函数:打印最短路径和距离
void printShortestPaths(int dist[], int path[], int n, int start) {
    printf("Shortest paths from vertex %d:\n", start);
    for (int i = 0; i < n; ++i) {
        if (dist[i] == INT_MAX) {
            printf("Vertex %d is unreachable\n", i);
        } else {
            printf("Distance to vertex %d is %d\n", i, dist[i]);
            printf("Path: ");
            int p = i;
            while (p != -1) {
                printf("%d ", p);
                p = path[p];
            }
            printf("\n");
        }
    }
}
时间复杂度:无论是邻接矩阵还是邻接表存储,外层循环的复杂度是\(O(|V|)\)级别的,内层有两个同级的\(for\)循环,邻接矩阵中是\(2O(|V|)\),邻接表中是\(O(|V|)+O|E|\),都等价于\(O(|V|)\),因此总的时间复杂度为\(O(|V|^2)\).
代码逻辑与
prim类似,因此二者时间复杂度相同。人们可能只想找到从源点到某个特定顶点的最短路径,但这个问题和求解源点到其他所有顶点的最短路径一样复杂,时间复杂度也是\(|V|^2\)
【注意】:Dijkstra 算法无法处理负权值带权图;
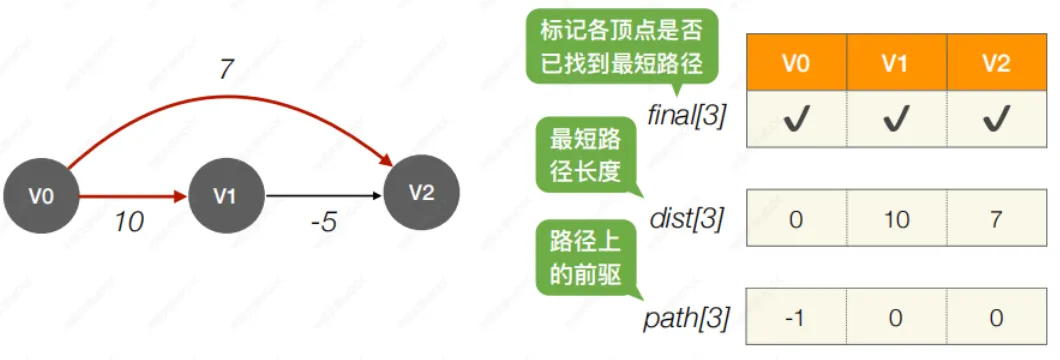
按照Dijkstra 算法算出的\(v_0\)到\(v_2\)的最短路径是7,然而事实上\(v_0\)到\(v_2\)的最短路径是5;
由此我们也可以看到,
Dijkstra「贪心」能够成立的一个隐含前提是路径边数的增长 必须 使得路径长 (边权和) 是 「非递减」 的。存在负边则导致路径边数增长后边权和递减,使得「贪心」成立的前提不成立。
对比:Prim 算法与 Dijkstra 算法无论是从思想还是实际代码表现上都非常类似,后续我们以一个表格逐行比较二者的内容,读者将发现 二者最根本的差别只在于顶点距离的更新方法 。
| Dijkstra | Prim |
|---|---|
| 贪心算法 | 贪心算法 |
| 顶点分为 距离已确定 和 距离未确定 顶点 | 顶点分为 距离已确定 (已加入生成树) 和 距离未确定 (未加入生成树) 顶点 |
| 所有顶点距离初始化为 \(Infinity\) | 所有顶点距离初始化为 \(Infinity\) |
| 源点 \(s\) 的距离初始化为 0 | 生成树起始点 \(s\) 的距离初始化为 0 |
| 以一个循环寻找 当前距离未确定顶点中距离最小者\(u\) , 立即置 \(u\) 的距离为「已确定」。 | 以一个循环寻找 当前距离未确定顶点中距离最小者\(u\) , 立即置 \(u\) 的距离为「已确定」。 |
| 尝试以如下方式更新 (松弛) \(u\) 的邻接顶点的距离 \(dv = min(dv, du + d(u, v))\) | 尝试以如下方式更新 \(u\) 的邻接顶点的距离 \(dv = min(dv, d(u,v))\) |
| \(while\) 结束时所有顶点最短路径及其距离被求出 | \(while\) 结束时 MST 及其所有边权被求出 |
我们看到这两个算法的每一步都几乎相同,不同点主要有三处,最主要的是第 3 点。
Info
Prim用于在「无向图」中求MST,因此建图时要「双向建边」。Dijkstra应用于有向图时单向建边,应用于无向图时双向建边。Dijkstra中的「距离」指的是顶点到源点的距离。Prim中的「距离」指的是顶点到其已在生成树上的邻接顶点 (父顶点) 的距离。- 顶点距离更新方式不同 。
【真题讲解】
使用迪杰斯特拉(Djkstra)算法求下图中从顶点 1 到其他各顶点的最短路径,依次得到的各最短路径的目标顶点是( )。
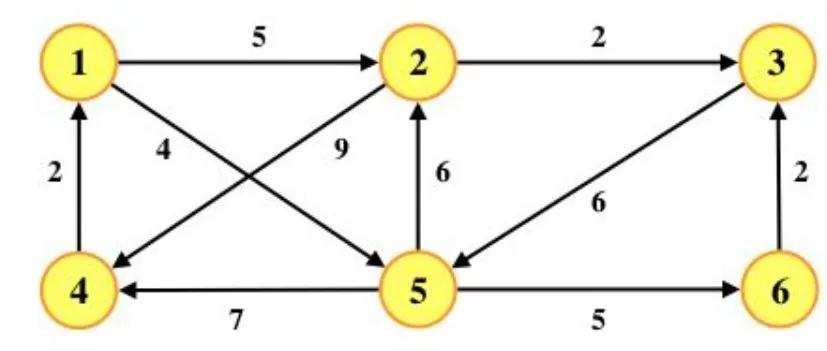
A. 5, 2, 3, 4, 6
B. 5, 2, 3, 6, 4
C. 5, 2, 4, 3, 6
D. 5, 2, 6, 3, 4
解:考试时手算模拟可以画一个这样的表格
| 顶点 | 第1轮 | 第2轮 | 第3轮 | 第4轮 | 第5轮 |
|---|---|---|---|---|---|
| 2 | 5 \(v_1\)->\(v_2\) | 5\(v_1\)->\(v_2\) |
|||
| 3 | \(\infin\) | \(\infin\) | 7\(v_1\)->\(v_2\)->\(v_3\) |
||
| 4 | \(\infin\) | 11 \(v_1\)->\(v_5\)->\(v_4\) | 11 \(v_1\)->\(v_5\)->\(v_4\) | 11 \(v_1\)->\(v_5\)->\(v_4\) | 11\(v_1\)->\(v_5\)->\(v_4\) |
| 5 | 4\(v_1\)->\(v_5\) |
||||
| 6 | \(\infin\) | 9 \(v_1\)->\(v_5\)->\(v_6\) | 9 \(v_1\)->\(v_5\)->\(v_6\) | 9\(v_1\)->\(v_5\)->\(v_6\) |
|
| 已确定集合 | {1,5} | {1,5,2} | {1,5,2,3} | {1,5,2,3,6} | {1,5,2,3,6,4} |
5.4.2.3 带权全源最短路径—Floyd算法
注意该知识点,尚未考察过!!!
该算法用于一次求解所有顶点对 (all pairs) 的最短路径
简而言之,设置一个
dist[]矩阵和一个path[]矩阵,dist[i][j]中的值代表这两个顶点的距离,path[i][j]的值代表这两个顶点为了达到最短距离上一次路过的顶点。依次允许通过\(v_0、v_1、v_2\cdots、v_n\)中转,如果有新的两点间更短距离的话,则要更新这两个矩阵对应元素的值。
相关习题:1334. 阈值距离内邻居最少的城市
1.算法思想:使⽤动态规划思想,将问题的求解分为多个阶段
对于\(n\)个顶点的图\(G\),求任意⼀对顶点\(Vi\) —> \(Vj\)之间的最短路径可分为如下⼏个阶段:
#初始:不允许在其他顶点中转,最短路径是?
#0:若允许在\(v_0\)中转,最短路径是?
#1:若允许在\(v_0、v_1\)中转,最短路径是?
#0:若允许在\(v_0、v_1、v_2\)中转,最短路径是?
\(\cdots\)
#\(n-1\):若允许在\(v_0、v_1、v_2、\cdots、v_{n-1}\)中转,最短路径是?
算法以 3 重循环考察任意顶点 \(i\) 到任意顶点 \(j\) 是否有经过任意顶点 \(k\) 的可松弛路径,即对每一个顶点 \(k\) (外层循环),考察是否有 \(d(i, k) + d(k, j) < d(i, j)\) ,若有则更新 \(d(i, j) = d(i, k) + d(k, j)\) 。
可以这样理解其工作过程。已知确定的任意两点 \(i, j\) 间有确定的最短路径 \(p(i, j)\) (只要无负圈,必有最短路径,不连通时最短路径长度为 \(Infinity\) ),\(p(i, j)\) 由多次松弛操作得到, 在 \(p(i, j)\) 的最后一次松弛后 (通过顶点 \(y\) 松弛),得到 \(p(i, j) = p(i, y) + p(y, j)\) 。同理,\(p(i, y)\) 和 \(p(y, j)\) 是 \(p(i, j)\) 的两个部分,它们由之前的松弛操作得到。例如松弛顶点 \(x\) 后得到 \(p(i, y)\) ,可知 \(p(i, y) = p(i, x) + p(x, y)\) ,松弛顶点 \(z\) 后得到 \(p(y, j)\) ,可知 \(p(y, j) = p(y, z) + p(z, j)\) 。路径 \(p(i, j)\) 的构建过程可以一直拆分溯源到某三个相邻顶点的连接。例如在 \(p(i, j)\) 上有三个相邻顶点为 \(i > a > b\) ,那么在外层循环处理 \(a\) ,中层循环处理 \(i\) ,内层循环处理 \(b\) 时,松弛操作将 \(i > a > b\) 「连接起来」(因为 最短路径上的任意子路径都是最短的 ,必松弛)顺着算法执行过程不难看出,算法通过外循环的 \(k\) 来连接边,通过不断连接短路径产生长路径,最终增长为完整的最短路径。
- 算法执行图例:
| 初始状态 | 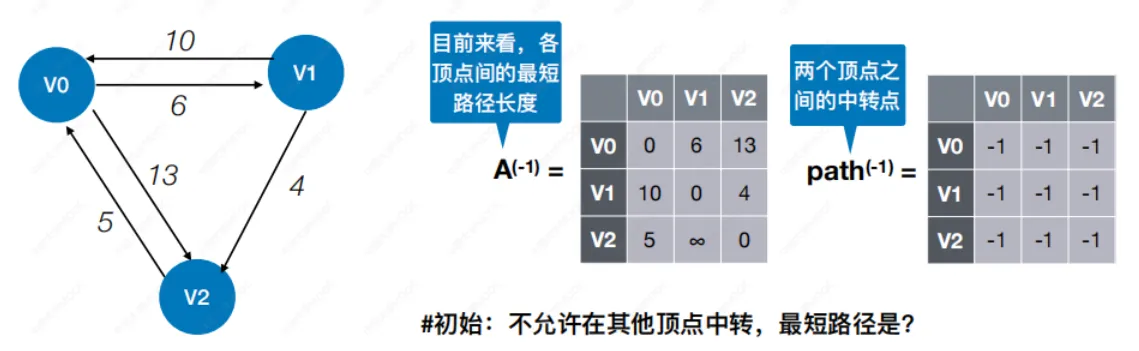 |
|---|---|
| #0,若允许在\(v_0\)中转 | 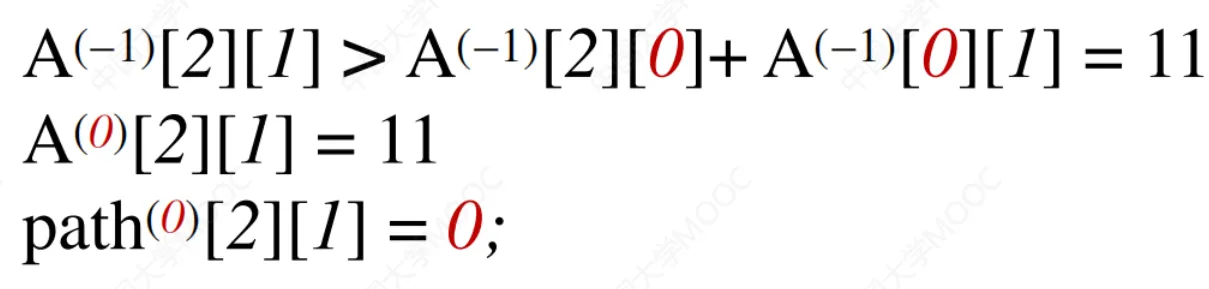 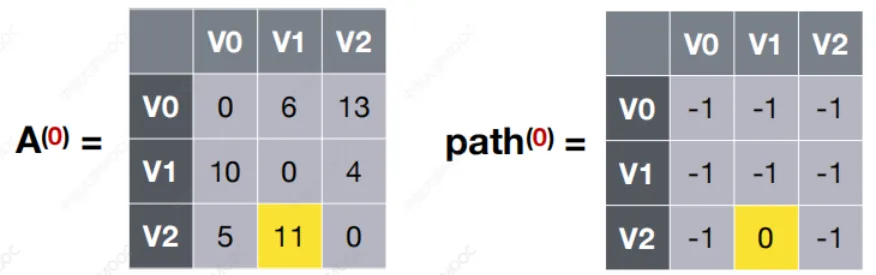 |
| #1:若允许在\(v_0、v_1\)中转 | 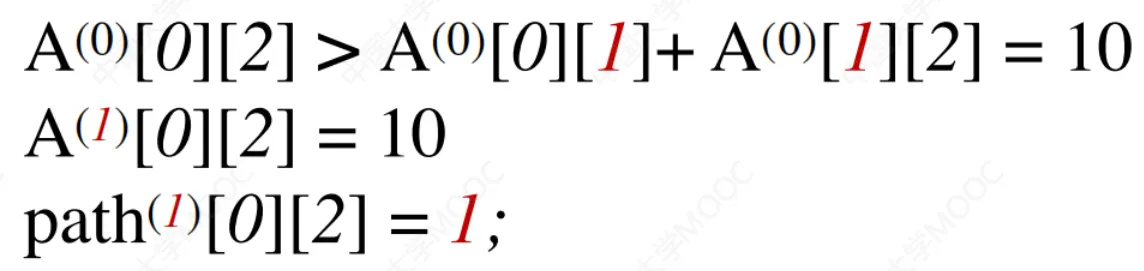 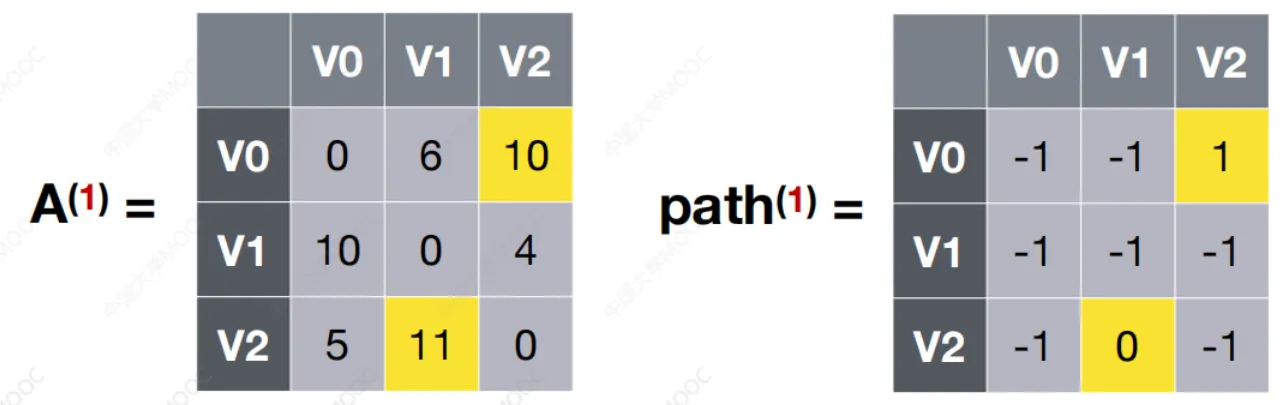 |
| #2:若允许在\(v_0、v_1、v_2\)中转 | 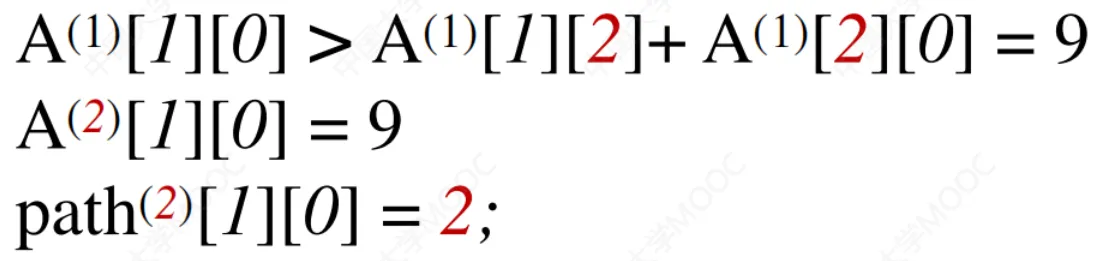 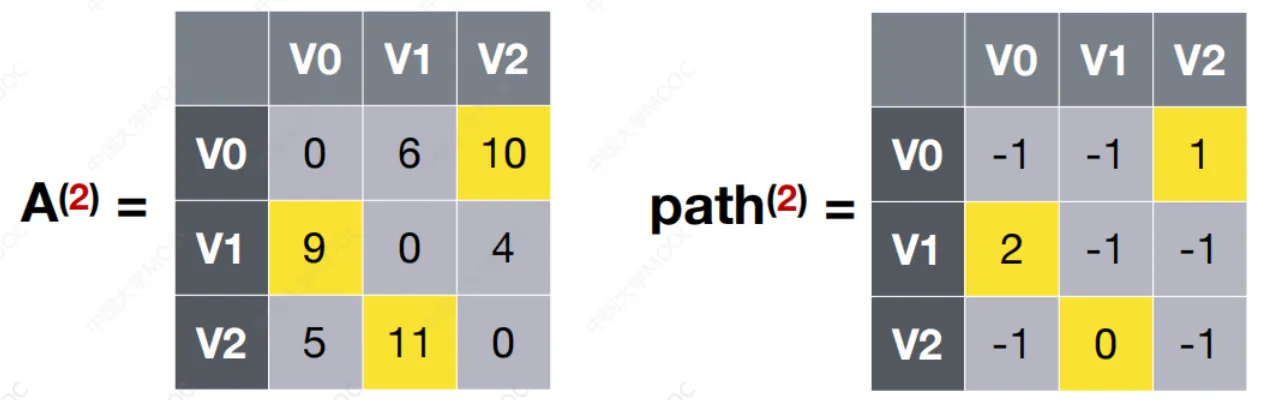 |
| 结束 |  |
算法过程:
Info
- 初始化
- 首先建立带权图,一般在该算法中采用邻接矩阵更方便;
- 定义两个与图G相关的辅助数组,一个是二维数组\(dist[][]\):表示顶点\(i\)和顶点\(j\) 之间的最短路径长度\(dist[i][j]\),初始时,\(dist\)数组等于图的邻接矩阵;\ 还有一个是二维数组\(path\), 表示顶点 \(i\) 和顶点\(j\) 之间的最短路径要经过\(path[i][j]\).初始时\(path\)数组值都为\(-1\);
- 外层循环执行 \(|V|\) 次, 每次固定顶点 \(k\)。
- 中层循环执行 \(|V|\) 次,每次固定顶点 \(i\) 。
- 内层循环执行 \(|V|\) 次,每次固定顶点 \(j\) 。\ 考察是否有 \(dist[i, k] + dist[k, j] < dist[i, j]\) ,若有,松弛之,即令 \(dist[i, k] + dist[k, j] = dist[i, j]\) 。并更新路径信息矩阵。
- 外层循环结束时,(若无负圈) 所有顶点对的最短路径距离被求出。
代码实现:
#include <stdio.h>
#include <limits.h>

#define MAXV 100     // 顶点数目的最大值

typedef struct {
    int numVertices;       // 图中实际的顶点数
    int numEdges;          // 图中实际的边数
    char vertexList[MAXV]; // 顶点表
    int edges[MAXV][MAXV];  // 邻接矩阵
} MGraph;

// Floyd-Warshall 算法计算所有顶点对之间的最短路径
void Floyd(MGraph G, int dist[MAXV][MAXV], int path[MAXV][MAXV]) {
    int n = G.numVertices;  // 图中的顶点数量

    // 初始化 dist 和 path
    for (int i = 0; i < n; ++i) {
        for (int j = 0; j < n; ++j) {
            if (i == j) {
                dist[i][j] = 0;  // 顶点到自身的距离为0
            } else if (G.edges[i][j] == 0) {
                dist[i][j] = INT_MAX;  // 如果没有边,则设置为无穷大
            } else {
                dist[i][j] = G.edges[i][j];  // 初始化距离为边的权值
            }
            path[i][j] = (dist[i][j] != INT_MAX && i != j) ? i : -1; //(此处修改)根据已初始化的 dist 判断是否存在路径
        }
    }

    // Floyd 算法核心循环
    for (int k = 0; k < n; ++k) {    // 外层循环,固定中转顶点k
        for (int i = 0; i < n; ++i) {   // 中层循环,固定起点i
            for (int j = 0; j < n; ++j) {   // 内层循环,固定终点j
                if (dist[i][k] < INT_MAX && dist[k][j] < INT_MAX && dist[i][k] + dist[k][j] < dist[i][j]) {
                    // 如果从i到k的路径和从k到j的路径更短,则更新距离
                    dist[i][j] = dist[i][k] + dist[k][j];
                    path[i][j] = k;  // 更新路径
                }
            }
        }
    }
}

void printPath(int path[MAXV][MAXV], int start, int end); //先声明路径打印函数

// 辅助函数:打印最短路径和距离
void printShortestPaths(int dist[MAXV][MAXV], int path[MAXV][MAXV], int n) {
    printf("Shortest paths and distances:\n");
    for (int i = 0; i < n; ++i) {
        for (int j = 0; j < n; ++j) {
            if (dist[i][j] == INT_MAX) {
                printf("From %d to %d: No path\n", i, j);
            } else {
                printf("From %d to %d: Distance = %d\n", i, j, dist[i][j]);
                printf("Path: ");
                printPath(path, i, j);
                printf("\n");
            }
        }
    }
}

// 辅助函数:打印路径
void printPath(int path[MAXV][MAXV], int start, int end) {
    if (path[start][end] == -1) {
        printf("%d ", end);
    } else {
        printPath(path, start, path[start][end]);
        printf("%d ", end);
    }
}
时间复杂度: 3 重循环,\(O(|V|^3)\) 。
空间复杂度: 邻接矩阵、距离矩阵、路径信息矩阵 (若有的话) 均为 \(O(|V|^2)\) 。总的空间复杂度为 \(O(|V|^2)\) 。
【注】:floyd算法可以解决带有负权值的图,因为算法会处理所有顶点的 所有入边的松弛 。但是不能解决带有“负权回路”的图(即有负权值的边组成回路),这种图有可能没有最短路径,如图所示
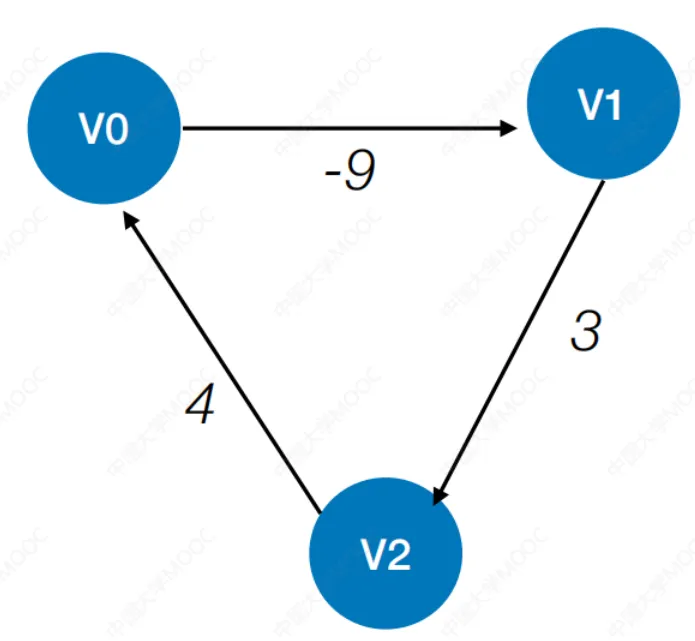
当图存在负圈时,\(s\) 到圈上任意顶点的距离都可以通过不断绕圈趋于无限小。因此若不能保证输入的图无负圈,可以在 3 重循环后再执行一次全量松弛,若仍有边可被松弛,说明存在负圈。
解题技巧:快速手算方法:
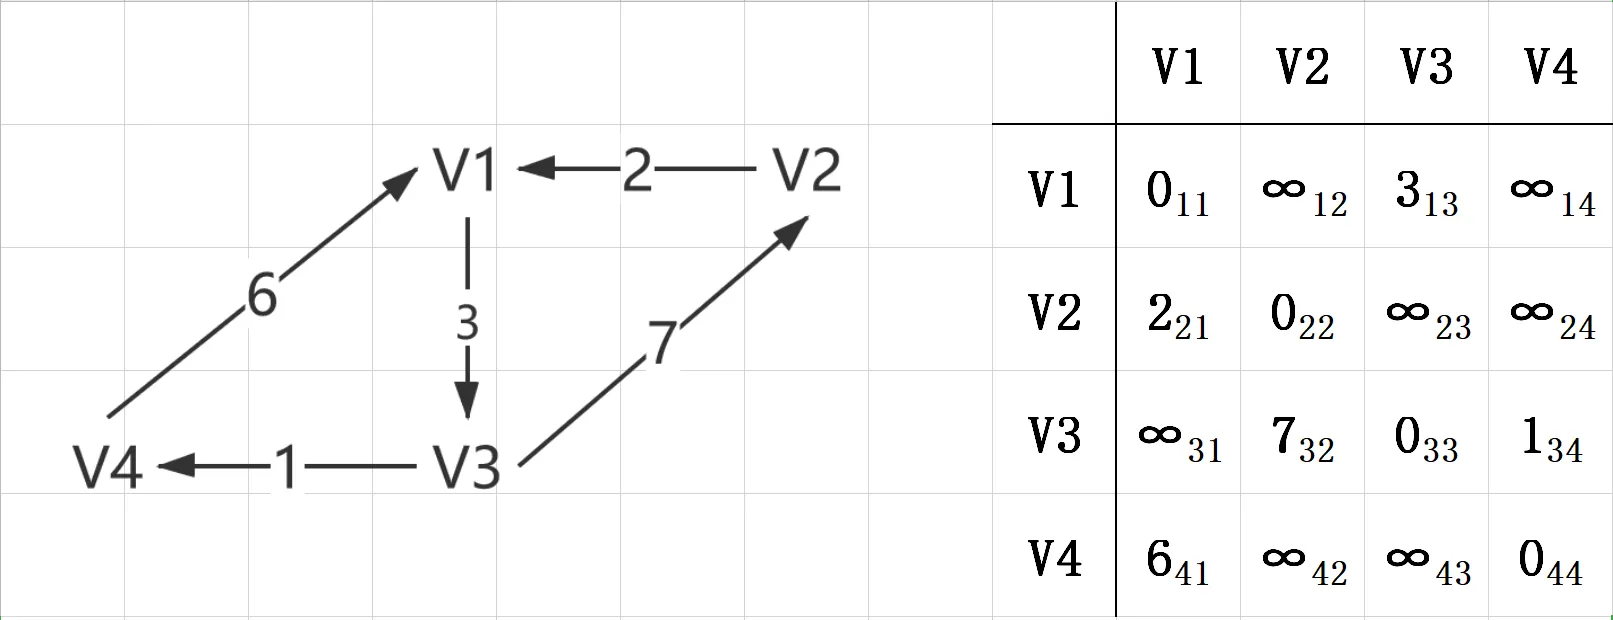
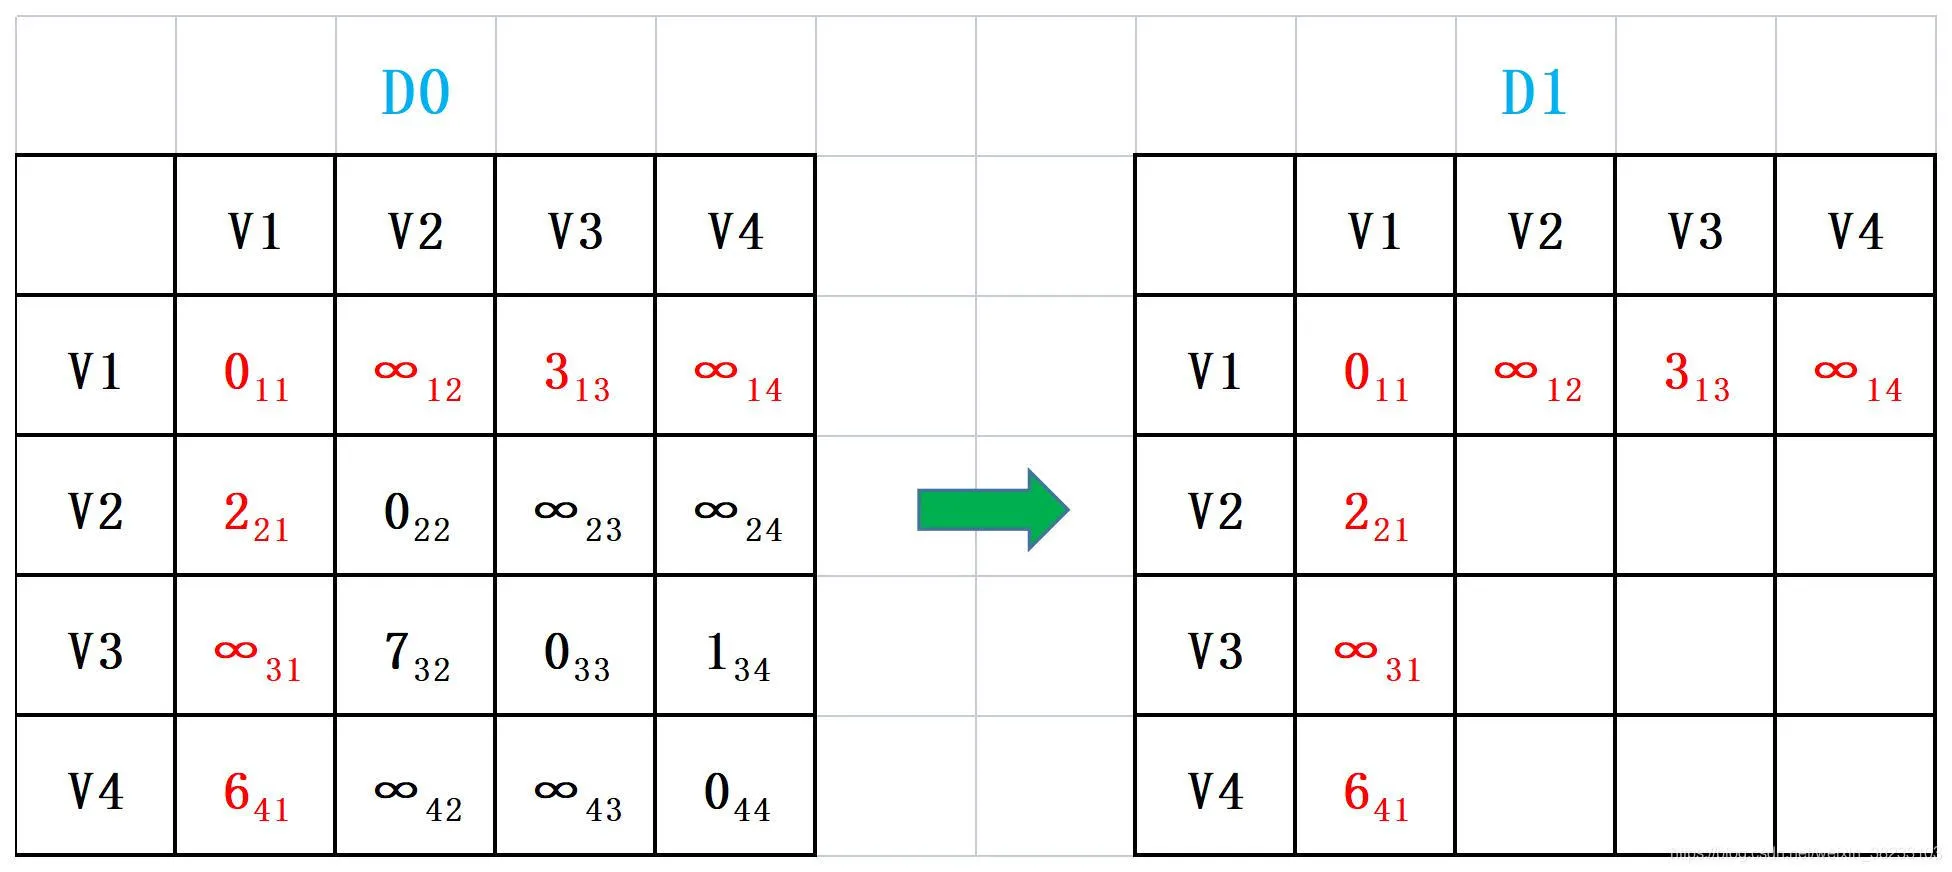
在弗洛伊德算法中,需要通过迭代填写矩阵的思路计算最短路径。在填写过程中有一些规律,以D0到D1为例。
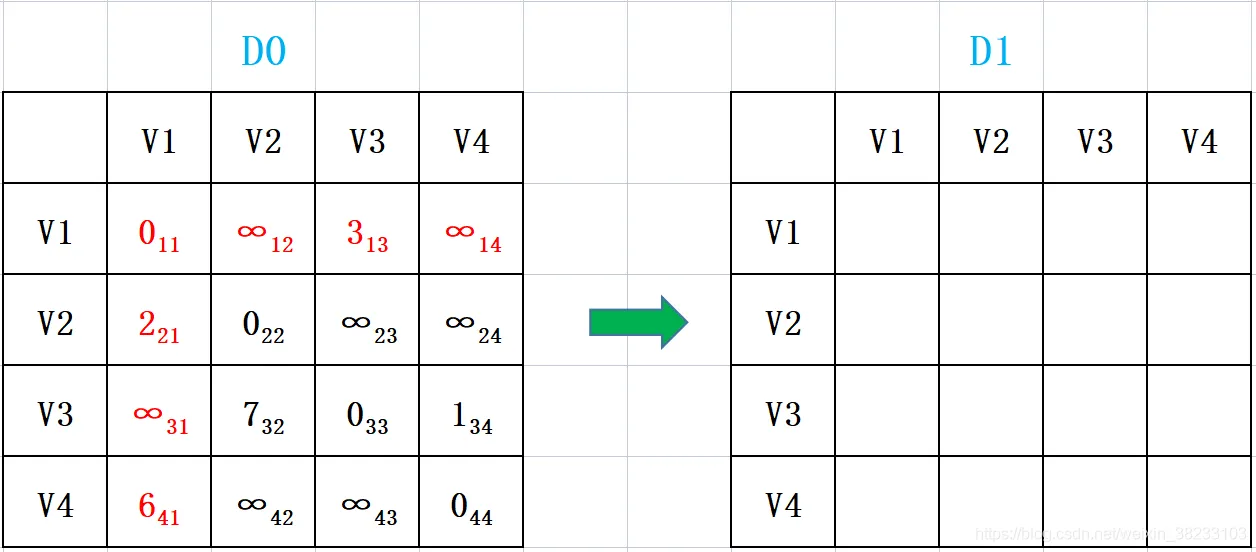
在\(D_1\)中填写的时候,有以下规律。
- 红色部分直接复制,即每轮选取第k号对角线元素,在对角线元素上不断地画“十字”(该元素所在的行或列)的元素值不变;
- 如果红色区域有元素的值是无穷,那么该元素所对应的列和行都填入原来的值(蓝色部分,深色的是有重叠)。
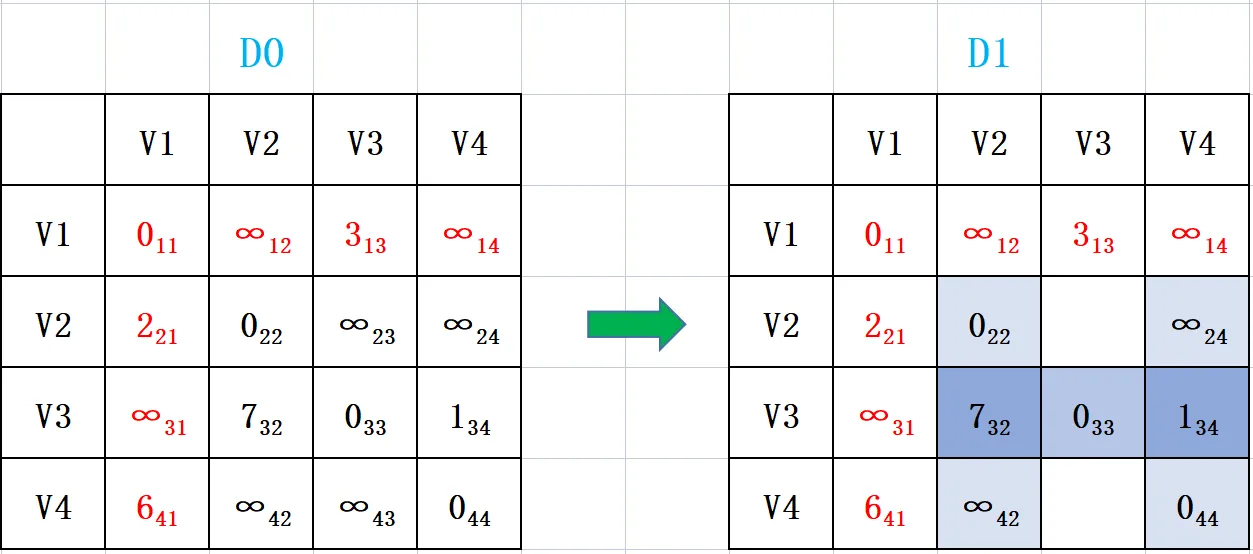
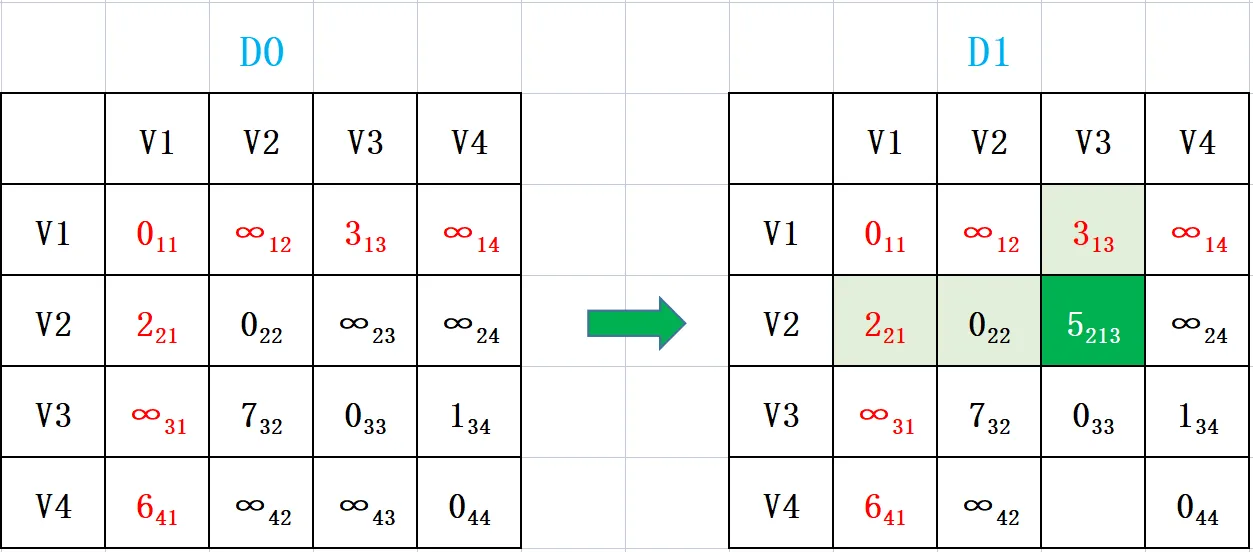
剩余的空白格
- 对角线 直接填原来的(默认顶点到自身的路径长度为0)
- 非对角线,以
(V2,V3)这个格为例,如果红色与浅绿色的交点处的值相加比草绿色处的值小,就将(V2,V3)的值替换为交点值得和。此处,\(2+3<∞\)。\ 填入值后修改值的下标,下标为交点的下标连起来,重复的只写一个。下标的意义是从V2点到V3点当前最短路径是V2 -> V1 -> V3,路径长度为5;按照上述规则填入(V4,V3)
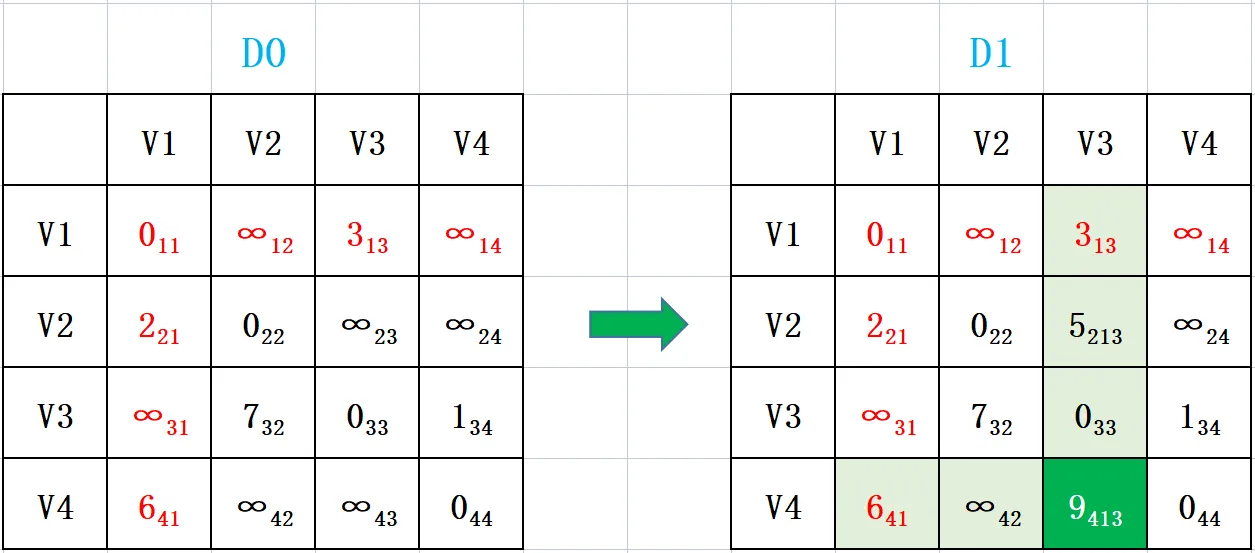
其他部分同理:
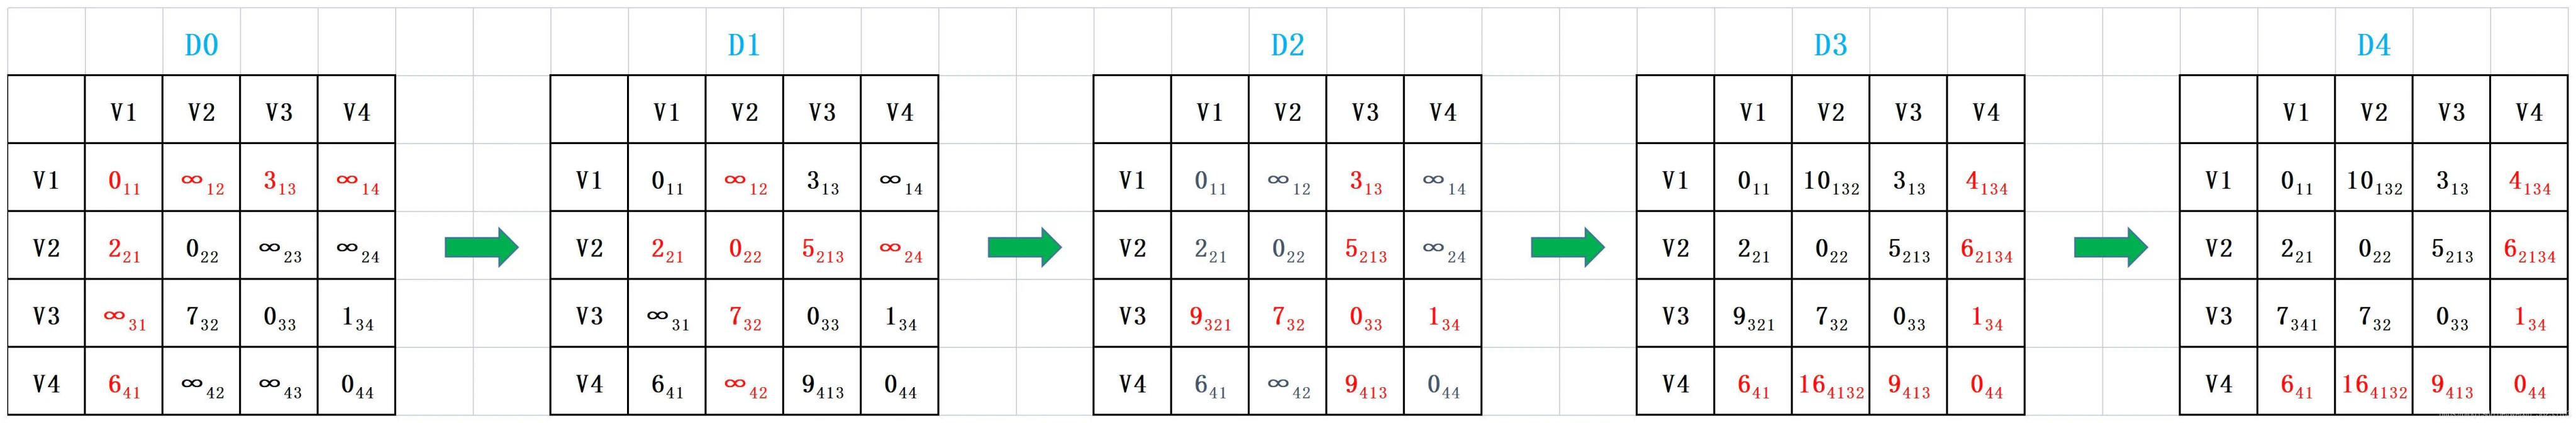
规律总结:
- 每轮开始选取第k号对角线元素,然后画“十字”(所在行和列);
- “十字”上的元素、对角线上的元素以及十字上值为\(∞\)的元素所在的行和列上的元素的值都不变;
- 更新剩余未确定最短路径的元素值,经过新加入结点后距离变小才更新;
- 继续重复下一轮,直到所有对角线都执行完该操作,算法结束;
5.4.3 有向无环图DAG的应用
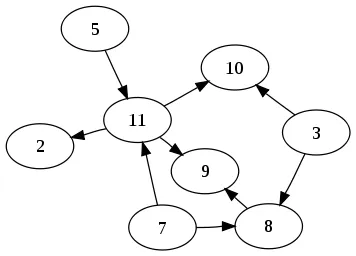
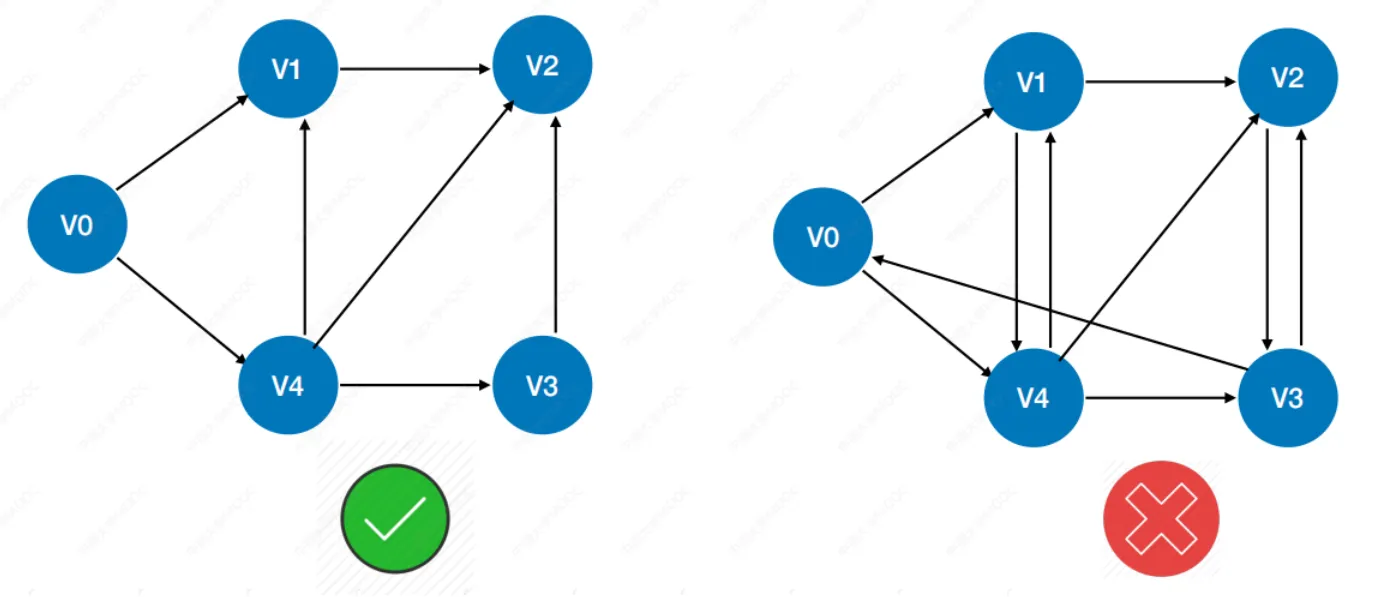
有向无环图:在图论中,如果一个有向图从任意顶点出发无法经过若干条边回到该点,则这个图是一个有向无环图(DAG,Directed Acyclic Graph)。
Info
有向图中的道路为一系列的边,系列中每条边的终点都是下一条边的起点。如果一条路径的起点是这条路径的终点,那么这条路径就是一个环。有向无环图即为没有环出现的有向图。
因为有向无环图中从一个点到另一个点有可能存在两种路线,因此有向无环图未必能转化成树,但任何有向树均为有向无环图。
5.4.3.1 有向无环图描述表达式
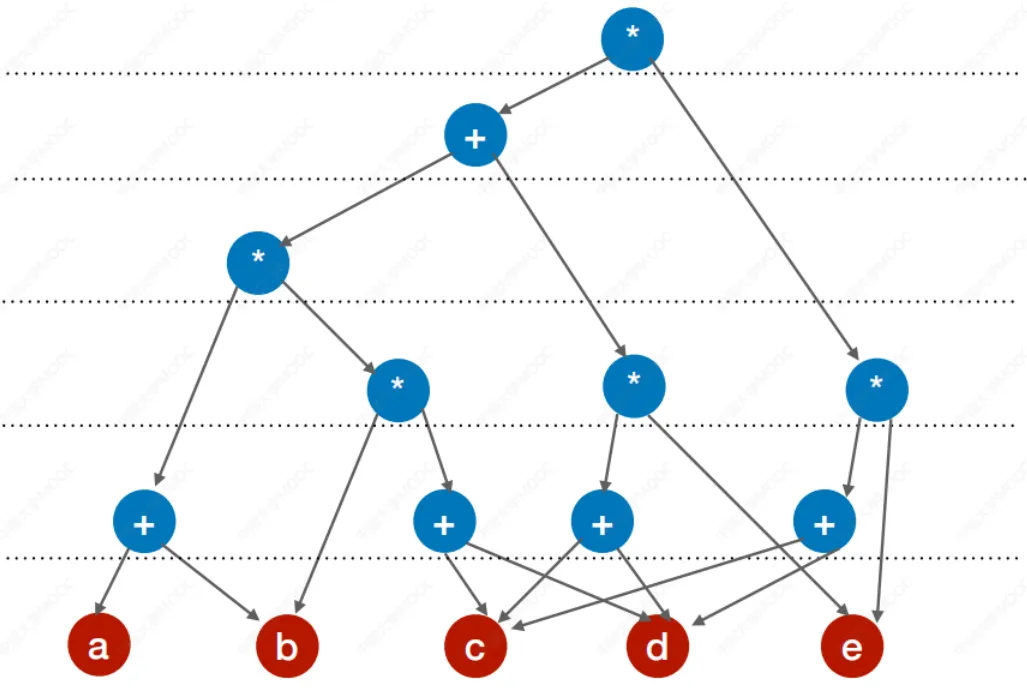
有向无环图是描述含有公共子式的表达式的有效工具。表达式可以由二叉树来描述,但是有许多相同的子式会重复出现,若利用DAG即可对其实现子式的共享,从而节省存储空间,如下图所示
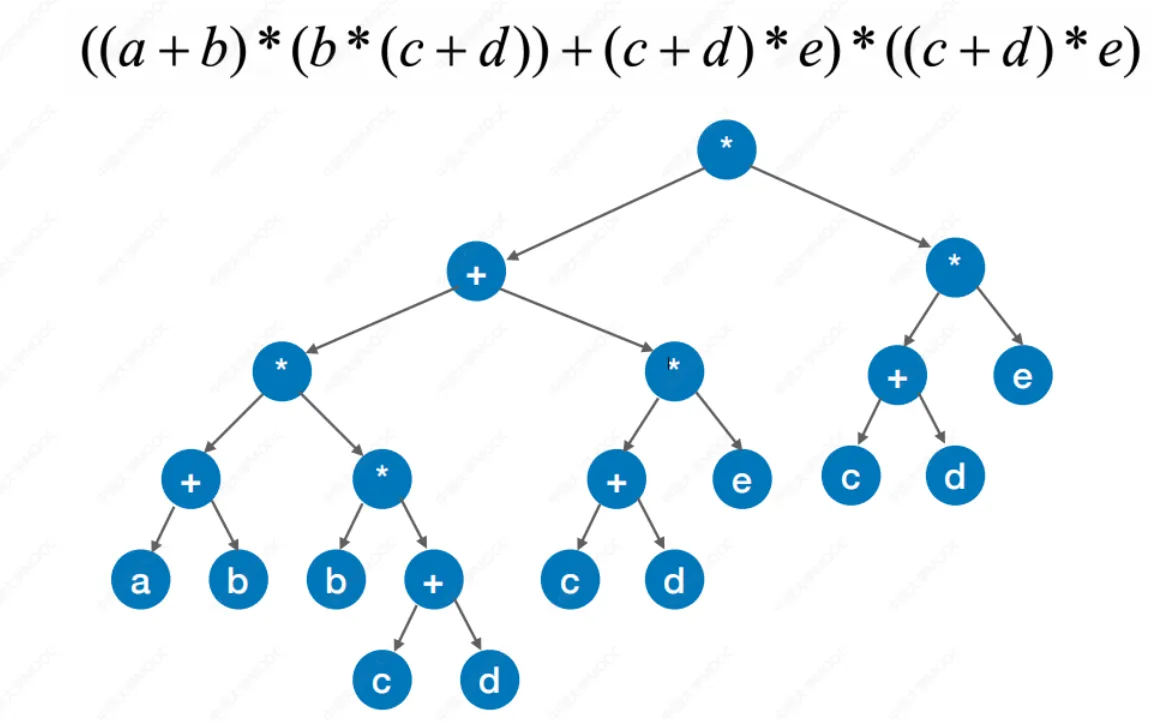
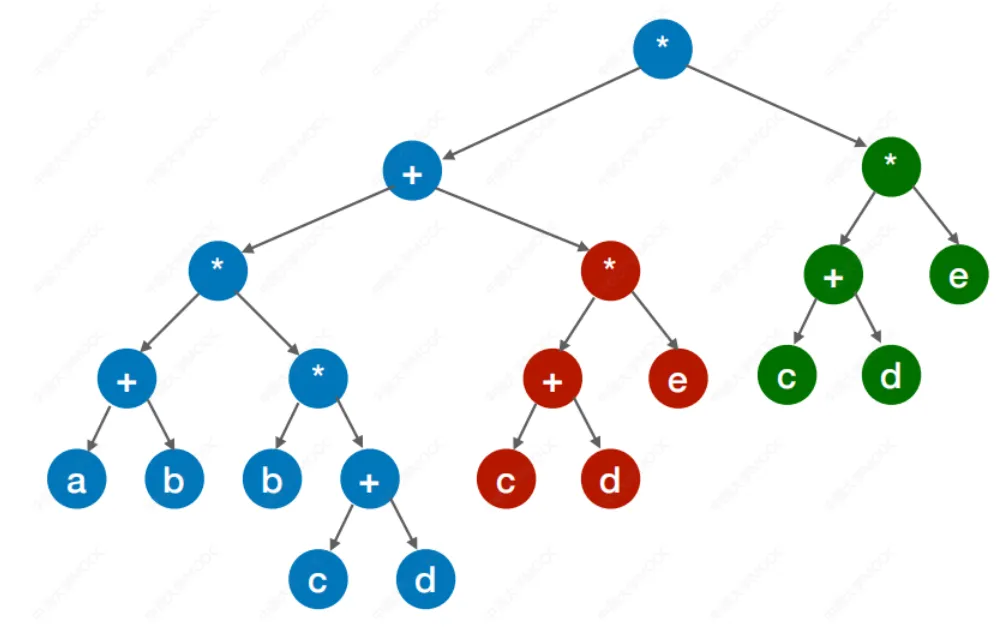
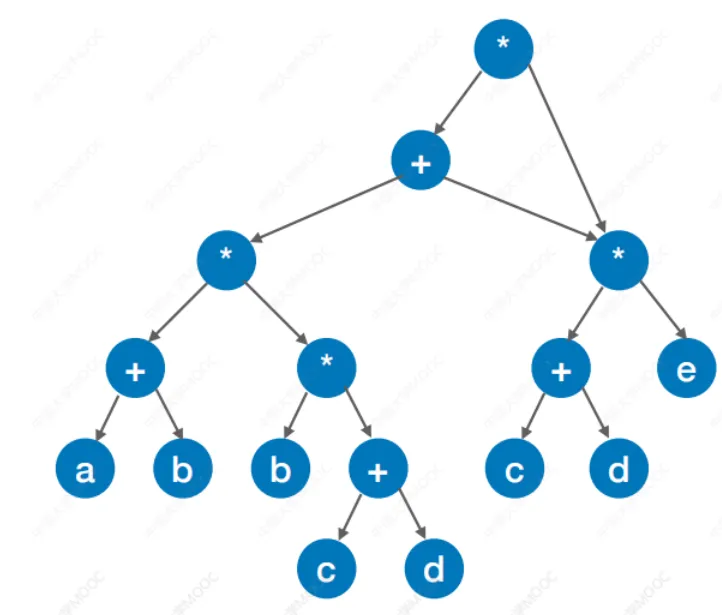
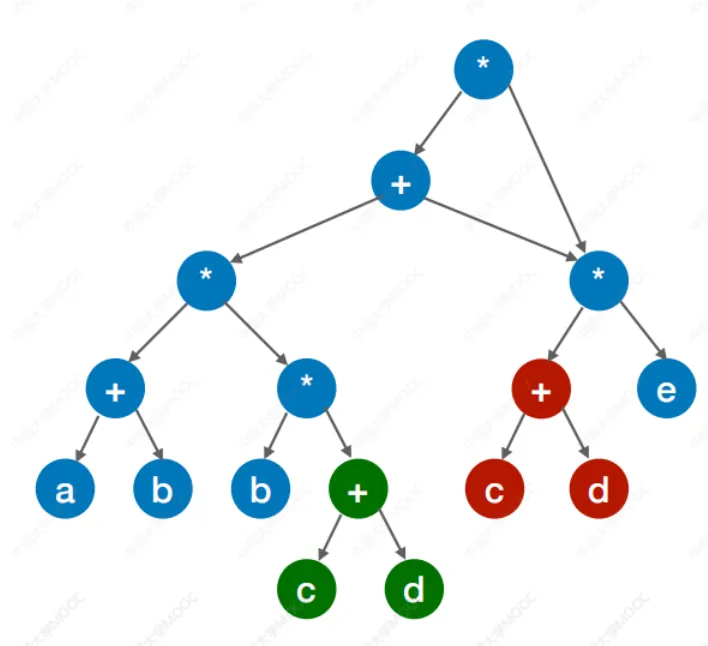
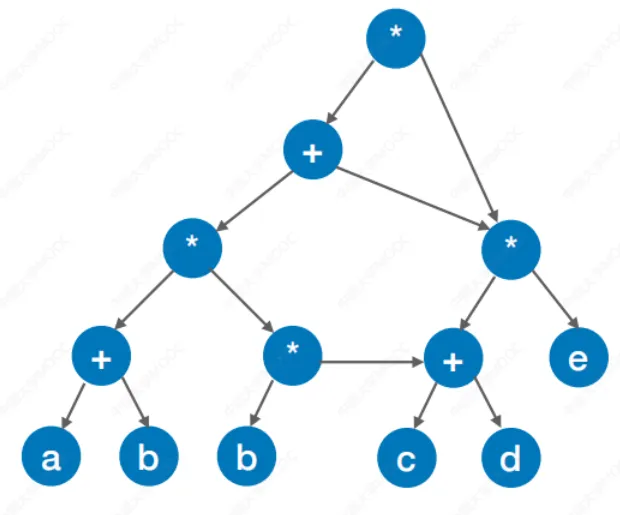
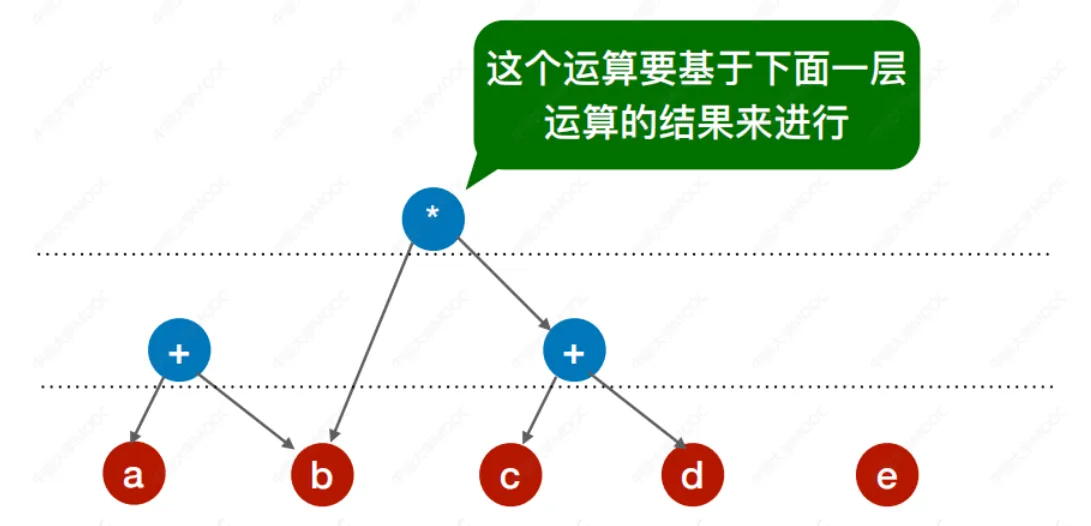
将一个表达式转换为 DAG 的解题方法:
- 把各个操作数不重复地排成一排;
- 标出表达式中各个运算符的运算顺序;
- 按顺序往图中加入运算符,
注意“分层”;- 从 DAG 的最底层开始,向上逐层检查同层的运算符是否可以合并。只要发现某几个运算符的出边指向的目标都相同,那么这几个运算符就可以合并。
示例:\(((a+b)*(b*(c+d))+(c+d)*e)*((c+d)\*e)\)
 |
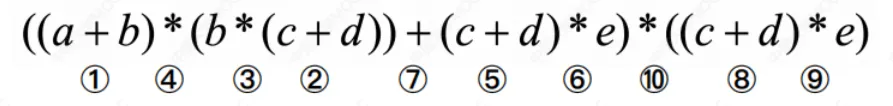 |
 |
|---|---|---|
 |
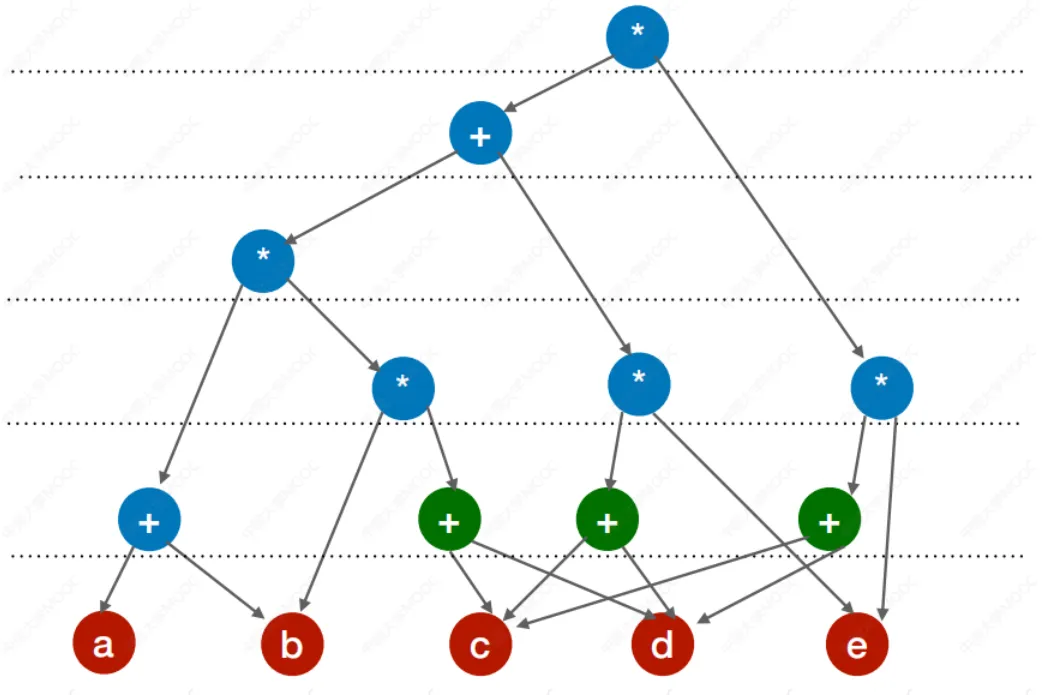 |
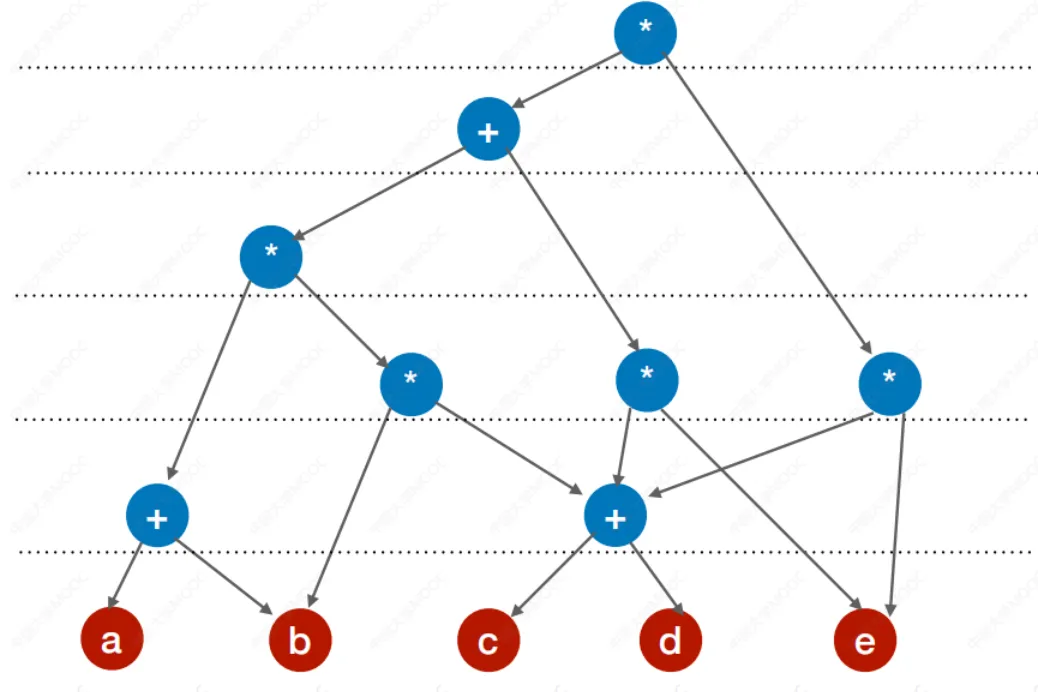 |
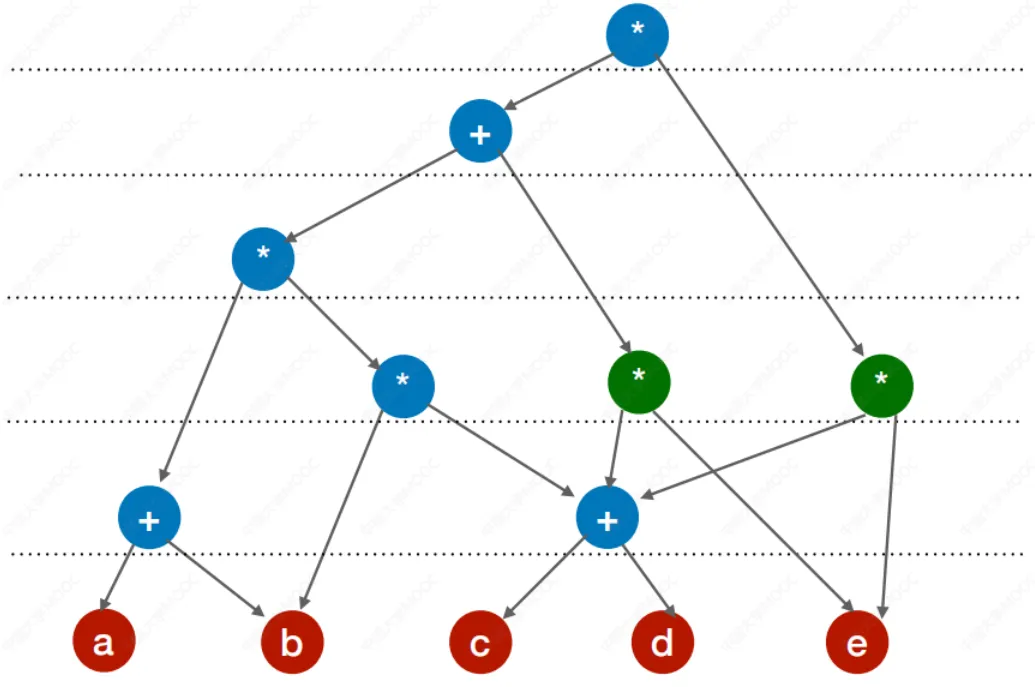 |
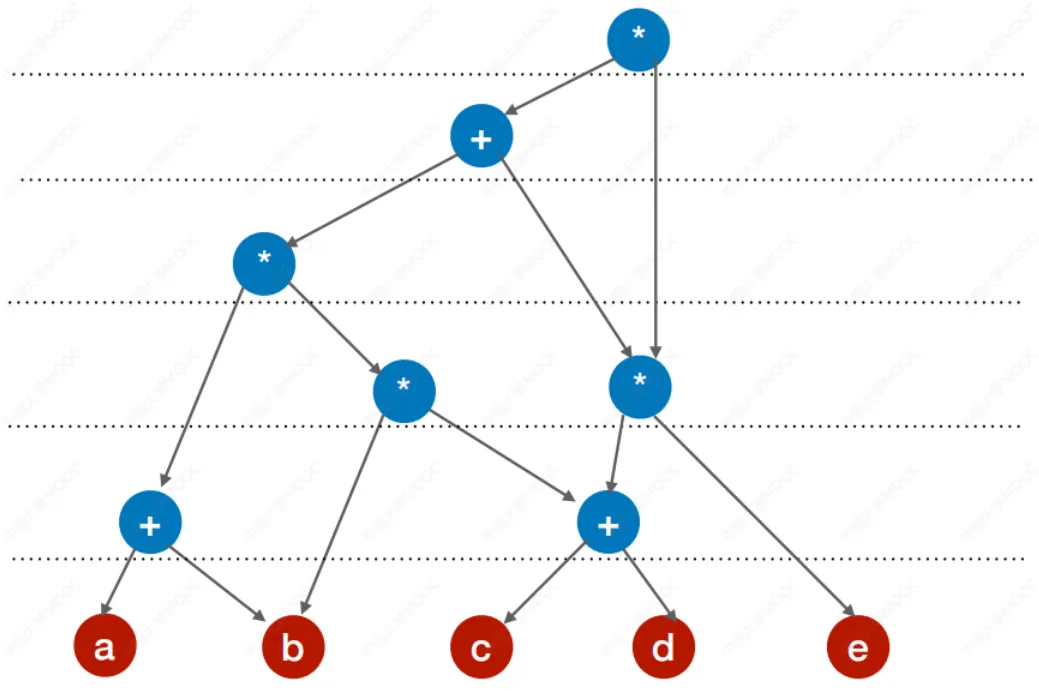 |
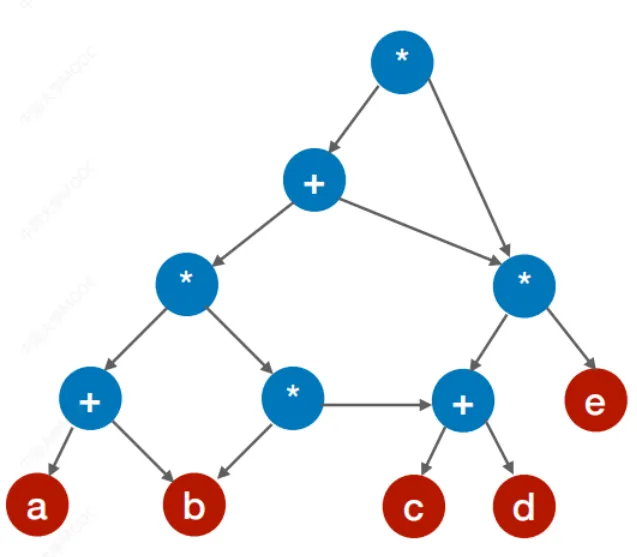 |
练习:
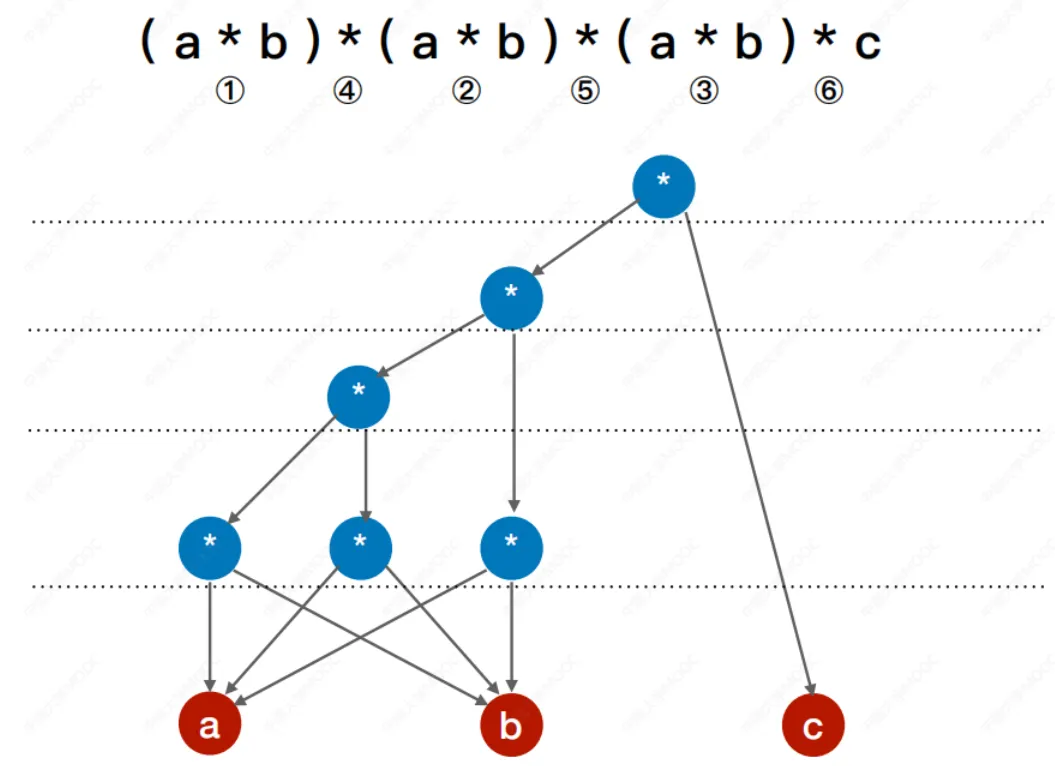
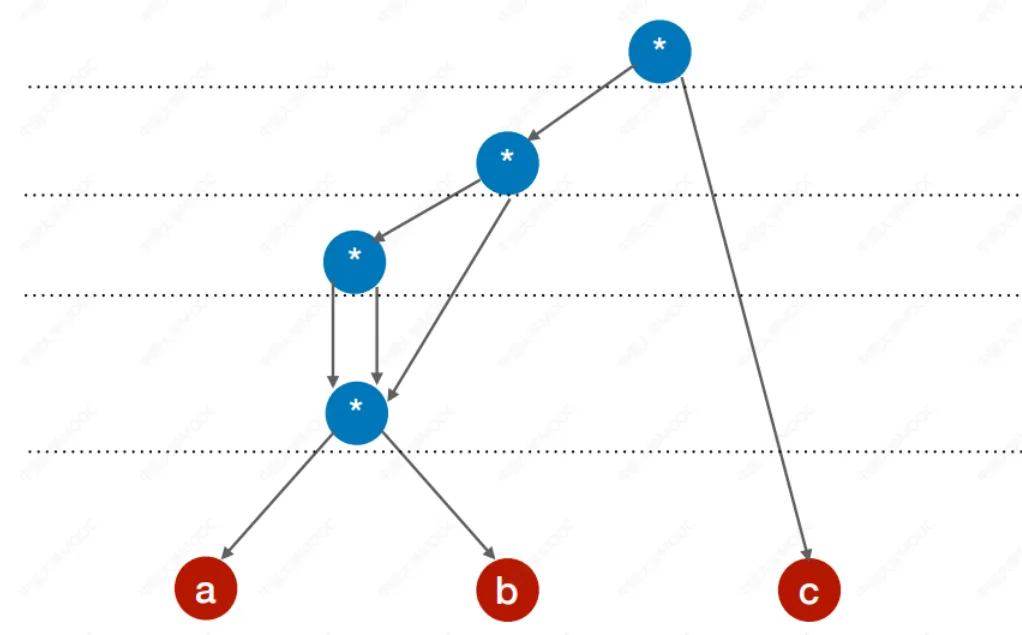
5.4.3.2 拓扑排序
\(wiki\):有向无环图的拓扑排序为所有边的起点都出现在其终点之前的排序。能构成拓扑排序的图一定没有环,因为环中的一条边必定从排序较后的顶点指向比其排序更前的顶点。基于此,拓扑排序可以被用来定义有向无环图:当且仅当一个有向图有拓扑排序,它是有向无环图。一般情况下,拓扑排序并非唯一。
AOV⽹(Activity On Vertex NetWork,⽤顶点表示活动的⽹):
⽤DAG图(有向⽆环图)表示⼀个⼯程。顶点表示活动,有向边\(\<v_i,v_j>\)表示活动 \(v_i\) 必须先于活动 \(v_j\) 进⾏
Info
拓扑排序(Topological Sorting):在图论中,由⼀个有向⽆环图的顶点组成的序列,当且仅当满⾜下列条件时,称为该图的⼀个拓扑排序:
① 每个顶点出现且只出现⼀次。\ ② 若顶点A在序列中排在顶点B的前⾯,则在图中不存在从顶点B到顶点A的路径。
Precisely, a topological sort is a graph traversal in which each node \(v\) is visited only after all its dependencies are visited.
更准确地,拓扑排序是对图的一种遍历,在这种遍历中,对一个顶点 \(v\) 的访问只发生在它所依赖的顶点被访问之后。
【注】:
- 只要图为 \(DAG\) ( 有向无环图),则该图 至少存在一种拓扑排序结果(每个
AOV网都有⼀个或多个拓扑排序序列) - 有向无环图仅仅在
存在一条路径可以包含其所有顶点的情况下,有唯一的拓扑排序方式,这时,拓扑排序与它们在这条路径中出现的顺序相同 - 若一个顶点有多个直接后继,则拓扑排序的结果通常不唯一;但若各个顶点已经排在一个线性有序的序列中,每个顶点有唯一的前驱后继关系,则拓扑排序的结果是唯一的;
- 拓扑排序存在的前提是 有向图无环 。此外,是否存在拓扑排序与图是否存在不连通的分量无关,这是显然的,因为互不连通的分量互不依赖,在拓扑排序中这些分量的顺序是任意的。
【选择题考点】:
- 如果一个有向图不能构成拓扑排序,那么该图一定有环,也就是说在该图中一定含有顶点数目大于1的强连通分量,注意该图不一定是强连通图,强连通图的定义是如果有向图中任何一对顶点都是强连通的,则称此图为强连通图,这个显然是充分不必要条件;
- 由于DAG图(
AOV网)中各顶点的地位平等,每个顶点编号是人为的,因此可以按照拓扑排序的结果重新编号,从而生成的新的邻接矩阵可以是三角矩阵;但是对于一般的图而言,若其邻接矩阵是三角矩阵,则必定存在可能不唯一的拓扑序列,但是反之则不一定成立。- 用邻接矩阵存储有向图,矩阵中主对角线以下的元素均为零,若对顶点按照矩阵下标进行编号,也就是只有从编号小的顶点往编号大的顶点的有向边,没有从编号大的顶点往编号小的顶点的有向边,也就是该有向图不可能存在环,既然没有环,也就是一定存在拓扑序列。由于没有具体的有向图,无法判断其拓扑序列是否唯一。
【应用题考点】:结合数组的压缩存储来考察,另外注意其与操作系统死锁部分的资源分配图的联系。
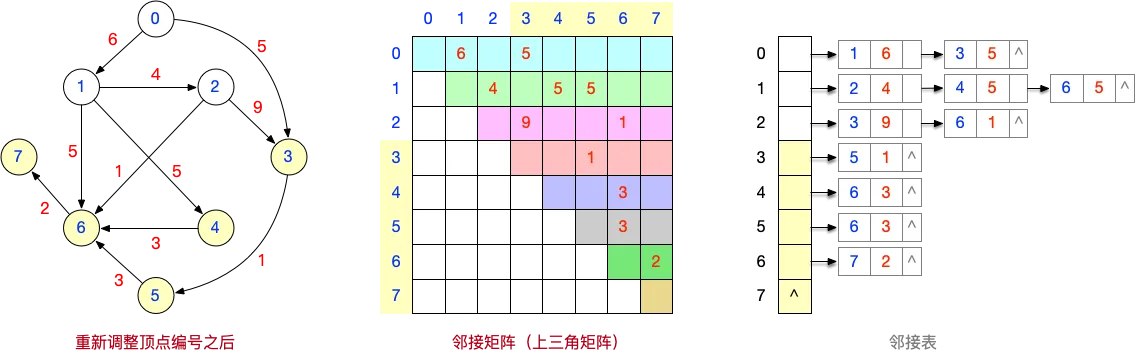
- 先设计一个不少于6个结点的带权有向无环图,并画出其邻接矩阵
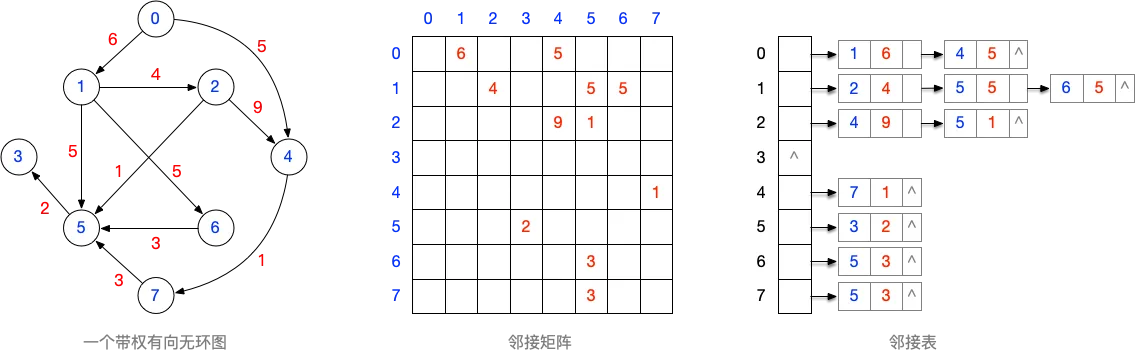
- 用一维数组将该邻接矩阵进行压缩存储
注:有向无环图,一定可以转化为一个上三角或下三角矩阵。但是需要调整顶点的编号。
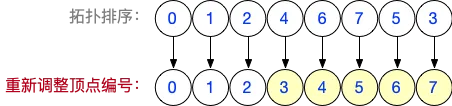
如果要用上三角矩阵表示有向无环图的邻接矩阵,可以对图进行拓扑排序,按照拓扑排序序列,重新调整各个顶点的编号。这样可以确保,所有的弧都是从小编号顶点指向大编号顶点,从而也就保证了邻接矩阵可以转化为“上三角矩阵”

- 基于你压缩存储的数组,如何判断结点 i、j 之间是否有边?
行优先压缩存储上三角矩阵,元素\((i, j)\) 和一维数组间的对应关系为:\(k=n\cdot i-\frac{i\times(i-1)}{2} +(j-i),i≤j\)(上三角区和主对角线元素)
只需用上述公式将\( i、j \)\( 转化为 \)\( k \),再检查一维数组中下标为\( k \) 的元素即可
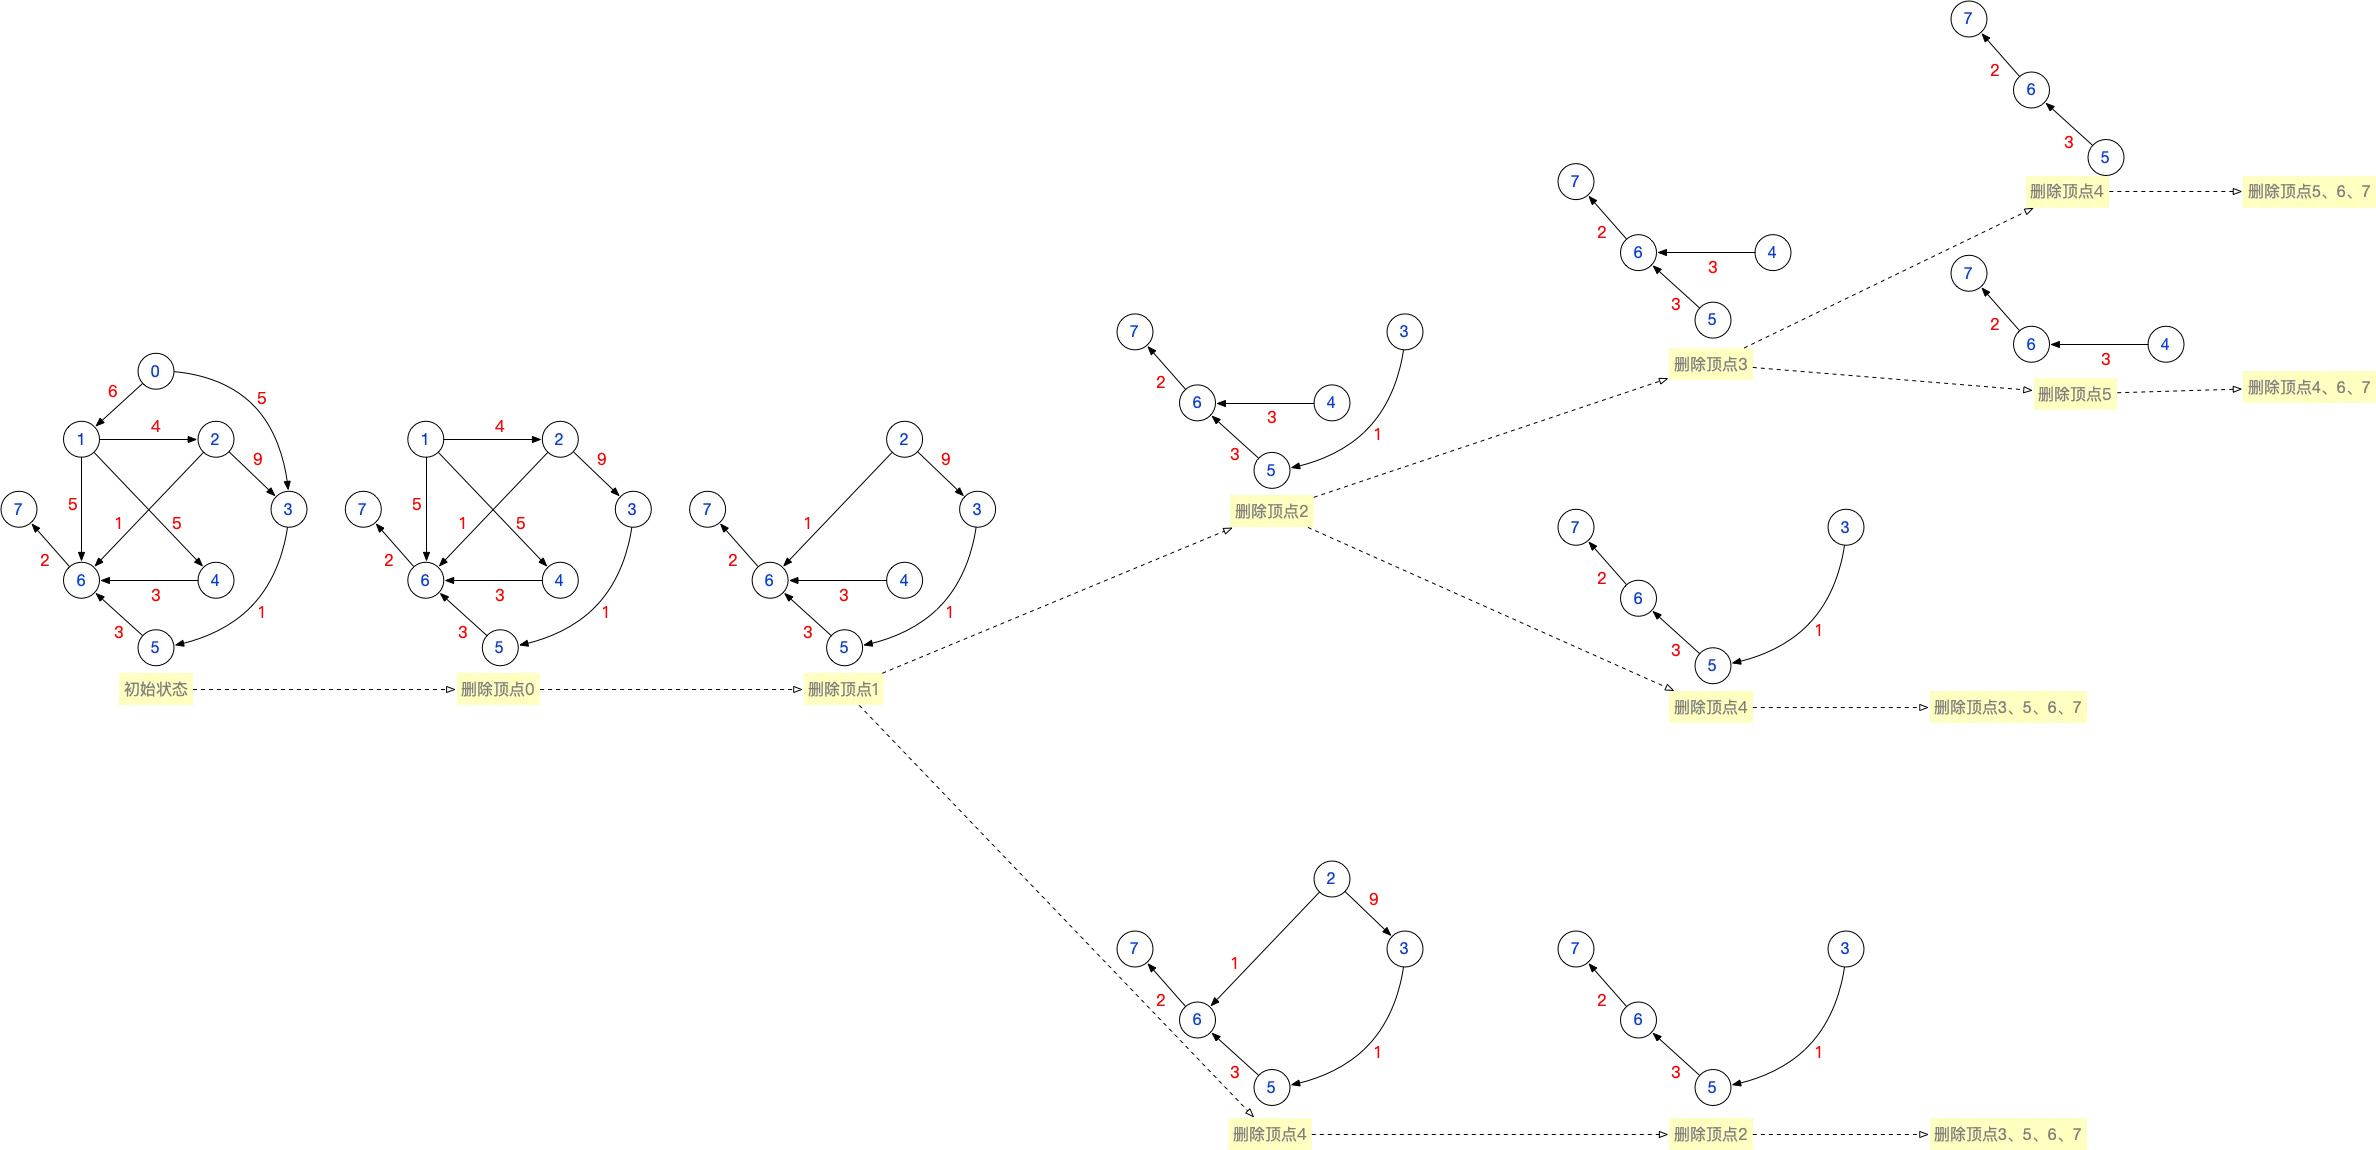
- 基于你设计的带权有向无环图,写出所有合法的拓扑排序序列
拓扑排序序列1:\(0,1,2,3,4,5,6,7\)
拓扑排序序列2:\(0,1,2,3,5,4,6,7\)
拓扑排序序列3:\(0,1,2,4,3,5,6,7\)
拓扑排序序列4:\(0,1,4,2,3,5,6,7\)
- 文字描述拓扑排序的过程
Info
拓扑排序:
- 从
AOV网中选择一个没有前驱的顶点并输出; - 从网中删除该顶点和所有以它为起点的有向边;
- 重复上面两步,直到当前的
AOV网为空或当前网中不存在无前驱的顶点为止。后面这种情况说明有向图中必定存在环。
逆拓扑排序:
- 从
AOV网中选择一个没有后继(出度为0)的顶点并输出; - 从网中删除该顶点和所有以它为终点的有向边;
- 重复上面两步直到当前
AOV网为空。
【具体原理与实现】:
拓扑排序的主要实现为基于 \(BFS\) 的 「Kahn算法」 以及基于 \(DFS\) 的 「Tarjan拓扑排序算法」 。接下来我们将看到,这两种算法实现的拓扑排序在求解过程上是 「互逆」 的。
基于 BFS的 「Kahn算法」
练习题:210. 课程表 II
算法描述:
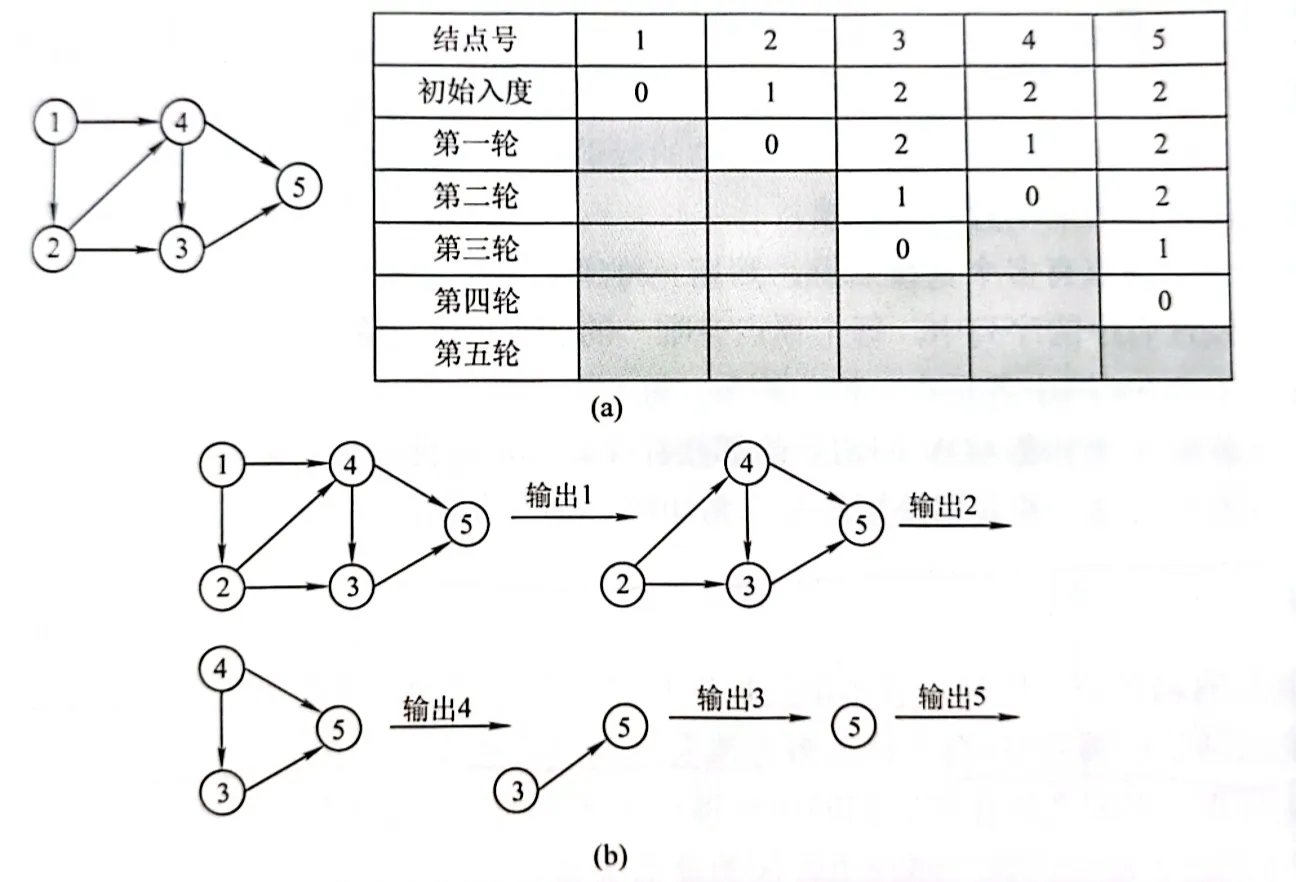
Kahn算法:基于 \(BFS\) 的拓扑排序算法,当访问一个顶点 \(v\) ,若其 「入度」 为 0 ,即说明它所依赖的所有顶点一定已经被访问过了,此时即可将其输出 (将其排序)。具体来说,先计算所有顶点的入度,然后将入度为 0 的顶点放入队列中,从队列输出队首顶点并依次将其所有 邻接顶点入度减 1 ,每一个邻接顶点入度减 1 后,判断其入度是否减至 0 ,若为 0 将其入队。重复上述过程,直到队列为空 (所有顶点均已入队又出队) 。容易看出,一个顶点入度减至 0 ,当前仅当 它所依赖的顶点的入度在此之前已减至 0。算法结束时,顶点出队的顺序即为拓扑排序,这是一个 「顺序」 拓扑排序过程。
Info
有向图判圈: 某个节点出队时对其存在的邻边入度减 1 后,若这些邻边入度均未减至 0,则说明该图 有圈 。可以通过在循环结束后考察 出队顶点数与总顶点数是否相等 来判圈。
这就是课本上介绍的方法,在手算模拟时对一个AOV网进行拓扑排序可以按照下面的步骤:
- 从
AOV网中选择一个没有前驱的顶点并输出;- 从网中删除该顶点和所有以它为起点的有向边;
- 重复上面两步,直到当前的
AOV网为空或当前网中不存在无前驱的顶点为止。后面这种情况说明有向图中必定存在环。
算法过程:
- 根据图的邻接表计算出每个顶点的入度,用数组\(indegree[|V|]\)表示;
- 设置一个队列\(q\) 、一个用于保存拓扑排序结果的列表\(res\),、一个用于后续判断图中是否有环的计数变量\(count\);
- 遍历数组\(indegree[|V|]\),将入度为0的顶点入队(若已知该图为有向无环连通图,则有且只有一个顶点入度为0,可在找到后立即跳出遍历);
- 以一个 \(while\) 检查当前队列是否为空,不空则队首顶点 \(u\) 出队,放入输出结果 \(res\) 中。同时
count++,表明 \(u\) 已被排序。 - 遍历 \(u\) 的邻接顶点 \(v\) ,使 \(v\) 的入度减 1,并检查减 1 后是否为 0 ,为 0 则 \(v\) 入队。
- 当 \(while\) 结束后,在返回前判环。 图有环则存在入度不可能减至 0 的顶点 ,则已拓扑排序 (已出队) 的顶点个数 \(count\) 必小于顶点总数。若满足 \(count == n\) 则返回拓扑排序结果,否则无结果。
代码实现:
#include <stdio.h>
#include <vector>
#include <queue>

#define MAXV 1000    // 顶点数目的最大值

typedef struct ArcNode {  // 边表结点
    int adjvex;            // 该弧所指向的结点在顶点表中的位置(索引)
    struct ArcNode* next;  // 指向下一条弧的指针
    // InfoType info;      // 如果用来表示网,可以加上一个边权值
} ArcNode;

typedef struct VNode {     // 顶点表结点
    char data;             // 顶点信息
    ArcNode* firstarc;     // 指向第一条依附于该顶点的弧的指针
} VNode, AdjList[MAXV];

typedef struct {
    int numVertices, numEdges;  // 图中实际的顶点数和边数
    AdjList vertices;           // 顶点表
} ALGraph;  // 以邻接表存储的图

// 计算每个顶点的入度
vector<int> InDegree(ALGraph G) {
    vector<int> indegree(G.numVertices, 0);  // 初始化每个顶点的入度为0
    for (int i = 0; i < G.numVertices; ++i) {     // 计算每个顶点的入度
        ArcNode* p = G.vertices[i].firstarc;
        while (p != NULL) {
            indegree[p->adjvex]++;  // 每遇到一个指向顶点p->adjvex的弧,增加该顶点的入度
            p = p->next;
        }
    }
    return indegree;
}

// 拓扑排序函数
bool TopologicalSort(ALGraph G, vector<int>& res) {
    vector<int> indegree = InDegree(G);  // 获取每个顶点的入度
    queue<int> q;  // 初始化队列,存储入度为0的顶点序号
    int count = 0;  // 记录已经排序的顶点数量

    // 遍历入度数组,将入度为0的顶点入队
    for (int i = 0; i < G.numVertices; ++i) {
        if (indegree[i] == 0) {
            q.push(i);
        }
    }

    // 利用队列完成拓扑排序
    while (!q.empty()) {
        int u = q.front();
        q.pop();
        count++;
        res.push_back(u);  // 将该入度为0的顶点出队并加入到拓扑排序序列

        // 遍历出队顶点的出边,将出边上的所有顶点的入度-1
        ArcNode* p = G.vertices[u].firstarc;
        while (p != NULL) {
            indegree[p->adjvex]--;  // 将顶点u的邻接顶点的入度都-1
            if (indegree[p->adjvex] == 0) {  // 如果入度-1后为0,则将其加入队列q
                q.push(p->adjvex);
            }
            p = p->next;
        }
    }

    // 判断是否所有顶点都已被排序
    return count == G.numVertices;
}

// 测试主函数
int main() {
    ALGraph G;
    // 初始化图G
    // 添加顶点和边
    // 调用 TopologicalSort() 函数

    vector<int> result;
    if (TopologicalSort(G, result)) {
        printf("拓扑排序成功!\n");
        for (int v : result) {
            printf("%d ", v);
        }
        printf("\n");
    } else {
        printf("图中存在环,拓扑排序失败!\n");
    }

    return 0;
}
Info
时空复杂度:
- 建图及计算所有顶点入度需遍历所有边,邻接表时间复杂度为 \(O(|V||+|E|)\).。
- 队列中每个顶点均入队一次,出队一次,\(O(|V|)\) 。
- 更新并检查邻接顶点的 \(for\) 中,更新和检查的总次数邻接表中等于边数 \(O(|E|)\)。
故总的时间复杂度邻接表为 \(O(|V|+|E|)\) 。此时间复杂度体现了图的规模,因此也称之为图的 线性时间复杂度 。 若图是连通的 ,由于 \(|E| ≥ |V|\) (仅在图为链状有向图时 \(|E| = |V| - 1\)),因此通常也可以粗略地记做 \(O(|E|)\) 。
空间复杂度: 存图空间 \(O(|V|+|E|)\) , \(res / indegree\) 空间 \(O(|V|)\),队列空间 \(O(|V|)\)。总体为线性空间复杂度 \(O(|V|+|E|)\) 。
#include <iostream>
#include <vector>
#include <queue>
#include <climits>

#define MAXV 100     // 顶点数目的最大值

typedef struct {
    int numVertices;       // 图中实际的顶点数
    int numEdges;          // 图中实际的边数
    char vertexList[MAXV]; // 顶点表
    int edges[MAXV][MAXV];  // 邻接矩阵
} MGraph;

using namespace std;

bool TopologicalSort(MGraph G, vector<int>& res) { //通过引用返回拓扑序列,供调用方输出
    queue<int> q;  // 初始化队列,存储入度为0的顶点序号
    int count = 0;  // 用于后续判断图中是否有环的计数变量

    // 计算每个顶点的入度
    vector<int> indegree(G.numVertices, 0);  // 初始化每个顶点的入度为0
    for(int j = 0; j < G.numVertices; ++j) {  // 计算每个顶点的入度
        for(int i = 0; i < G.numVertices; ++i) {  // 遍历该顶点所在列
            if(G.edges[i][j] != 0 && G.edges[i][j] < INT_MAX) { //带权图中排除 INT_MAX 表示的无边
                indegree[j]++;
            }
        }
    }

    // 遍历入度数组,将入度为0的顶点入队
    for(int i = 0; i < G.numVertices; ++i) {
        if(indegree[i] == 0)
            q.push(i);
    }

    // 利用队列完成拓扑排序
    while(!q.empty()) {
        int u = q.front();
        q.pop();
        count++;
        res.push_back(u);  // 将该入度为0的顶点出队并加入到拓扑排序序列

        // 遍历出队顶点的出边,将出边上的所有顶点的入度-1
        for(int i = 0; i < G.numVertices; ++i) {
            if(G.edges[u][i] != 0 && G.edges[u][i] < INT_MAX) { //带权图中排除 INT_MAX 表示的无边
                indegree[i]--;
                if(indegree[i] == 0) q.push(i);
            }
        }
    }

    // 检查是否所有顶点都已被排序
    if(count < G.numVertices) {
        return false;  // 出队顶点数小于顶点总数,说明图中有环,拓扑排序失败
    } else {
        return true;  // 拓扑排序成功
    }
}

// 测试主函数
int main() {
    MGraph G;
    // 初始化图G
    // 添加顶点和边
    // 调用 TopologicalSort() 函数

    vector<int> result;
    if (TopologicalSort(G, result)) { //传入 result 接收实际的拓扑序列
        cout << "拓扑排序成功!" << endl;
        for (int v : result) {
            cout << v << " ";  // 打印拓扑排序序列
        }
        cout << endl;
    } else {
        cout << "图中存在环,拓扑排序失败!" << endl;
    }

    return 0;
}
Info
采用邻接矩阵,时间复杂度为\(O(|V|^2)\)
基于 DFS 的「Tarjan」拓扑排序算法
【2020】年选择题考察过
该算法和课本上的求逆拓扑排序的方法思想类似,其提到的步骤如下:
- 从
AOV网中选择一个没有后继(出度为0)的顶点并输出; - 从网中删除该顶点和所有以它为终点的有向边;
- 重复上面两步直到当前
AOV网为空。
【算法描述】:
Tarjan拓扑排序算法:基于 \(DFS\) 的拓扑排序算法。回顾之前提到的「拓扑排序准确表述」中的「对一个顶点 \(v\) 的访问只发生在它所依赖的顶点被访问之后」,我们从中可以嗅到「层层深入」的味道,即对于 \(v\) ,「层层深入」它所依赖的顶点后访问到它,这是一个 \(dfs\) 的过程,「表述」中要求,完成 \(v\) 的访问的前提是完成它所依赖的顶点的访问,那么我们可以在 \(dfs\) 到 \(v\) 的过程中,「缓存」 路径上 \(v\) 所依赖的顶点的状态 (即暂不处理),当我们要处理 \(v\) 的时候,已经保证了它所依赖的顶点会在此后「回溯」的过程中处理,因为它们此刻都在 递归栈的更靠顶部的空间中 (也就是在返回路径上) 缓存着。换句话说,我们只需要将 \(v\) 放在当前用于存放拓扑排序结果的空间的最后侧 (这是栈的特点,我在这里称其为「排序结果栈」),此后的回溯一定会将它所依赖的顶点放在它的前面。那么我们什么时候处理 \(v\) 呢?自然是无法从它再深入到任何顶点的时候,可以是其无 (依赖关系的) 后继顶点时,也可以是其后继顶点均已被排序 (被放入结果栈中) 时。理解了这一点,我们即可给出如下 Tarjan 拓扑排序的主要过程。建图过程无需多言。
顶点在算法过程中有三个状态, 未搜索,搜索中、已完成 (访问) 。算法从遍历顶点开始,每遇到一个「未搜索」的顶点 \(u\) ,就以其为起点开始 \(dfs\) 。进入 \(dfs\) 方法时我们首先将 \(u\) 标记为「搜索中」,然后以 \(for\) 循环依次考察 \(u\) 的邻接顶点 \(v\) 。
- 若其状态为「未搜索」,对其递归调用 \(dfs\) ,重复前述过程。
- 若其状态为「搜索中」,表明我们此前进入过 \(v\) 的 \(dfs\) 过程,而此时又遇到了 \(v\) ,显然 \(v\) 是通过一个圈回到了 \(v\)。于是将 \(hasCycle\) 标记为 \(true\) 并返回。
- 注意我们不必处理「已完成」的 \(v\) ,无判断分支会直接跳过。
如前一段所说,当 \(u\) 无法再深入到任何顶点时,我们标记其状态为「已完成」。每以一个「未搜索」的顶点为起点完成 \(dfs\) 后,检测一次 \(hasCycle\) 是否为 \(true\),是则结束,否则当程序终止时,顺序输出结果栈即为正确的拓扑排序。
【算法过程】
算法的详细过程如下,也即该算法求解拓扑排序问题时的编程范式。
- 根据输入建图及准备 \(visited\) 数组、 \(hasCycle\) 布尔值、拓扑排序结果栈 \(res\) 以及栈底下标 \(idx\) (初始时为 \(|V| - 1\))。(从后往前放得到的就是拓扑序列,若直接顺序放入则是逆拓扑序列)
- \(visited\) 数组下标为顶点,有三种取值,表示顶点在拓扑排序过程中的三种状态。0: 未搜索 1: 搜索中 2: 已完成 (搜索)。初始时 \(hasCycle = false\) 。
- 拓扑排序。遍历所有顶点,对「未搜索」状态的顶点 \(u\) 执行 \(dfs\) 。
- 进入 \(dfs\) 后,首先置 \(visited[u] = 1\),表示 \(u\) 处于搜索中状态。
- 以 \(for\) 循环依次考察 \(u\) 的邻接顶点 \(v\) 。
- 若 \(visited[v] == 0\) ,状态为「未搜索」。对其递归调用 \(dfs\) ,也就是看它是否是其他顶点的「依赖」,使其置于「缓存」之中。
- 若\(visited[v] == 1\),状态为「搜索中」。表明我们此前进入过\(v\)的\(dfs\)过程,而此时又遇到了\(v\),显然\(v\)是通过一个圈回到了\(v\)。于是将\(hasCycle\)标记为\(true\)并返回。
- 若 \(visited[v] == 2\) ,状态为「已完成」。跳过。
- 对于 \(u\),若其完成了 \(for\),表明要么其无 (依赖关系中的) 后继顶点,要么其后继顶点均已被排序 (被放入结果栈中)。也就是 \(u\) 是当前所有未完成排序的顶点中位于依赖关系最后面的顶点,于是将其放入当前结果栈中的的底部。
- 若能完成所有顶点的遍历而无圈,说明所有顶点已被拓扑排序,返回 \(res\)。
【邻接矩阵实现】
#include <iostream>
#include <vector>
#include <queue>

#define MAXV 100     // 顶点数目的最大值

typedef struct {
    int numVertices;       // 图中实际的顶点数
    int numEdges;          // 图中实际的边数
    char vertexList[MAXV]; // 顶点表
    int edges[MAXV][MAXV];  // 邻接矩阵
} MGraph;

using namespace std;

void dfs(int u, MGraph &G, vector<int> &visited, vector<int> &res, int &idx, bool &hasCycle) {
    if (hasCycle) return;  // 只要发现有环,立刻停止搜索

    visited[u] = 1;  // 进入 dfs 后,首先置 visited[u] = 1, 表示 u 处于搜索中状态
    for (int i = 0; i < G.numVertices; ++i) {
        if (G.edges[u][i] != 0) {  // 如果是 u 的邻接顶点
            if (visited[i] == 0) {
                dfs(i, G, visited, res, idx, hasCycle);  // 邻接顶点为「未搜索」状态,dfs 之
                if (hasCycle) return;  // 如果在递归中检测到环,立即返回
            } else if (visited[i] == 1) {
                hasCycle = true;   // 若邻接顶点为「搜索中」状态,说明有圈
                return;
            }
        }
    }
    visited[u] = 2;  // 完成搜索,表明在对 u 进行 dfs 的过程中未遇到正在搜索中的其他顶点
    res[idx--] = u;  // 此时 u 所依赖的顶点都在栈中「缓存」等待后续处理
}

vector<int> TopologicalSort(MGraph G) {
    vector<int> visited(G.numVertices, 0);  // 初始化 visited 数组, 都设为 0
    bool hasCycle = false;
    vector<int> res(G.numVertices);  // 用列表模拟的用来存储拓扑排序结果的栈
    int idx = G.numVertices - 1;  // 模拟栈的栈底下标

    // 遍历所有顶点,对「未搜索」状态的顶点 u 执行 dfs
    for (int u = 0; u < G.numVertices; ++u) {
        if (visited[u] == 0) {
            dfs(u, G, visited, res, idx, hasCycle);
            if (hasCycle) return {};  // 每次搜索后,若检测出环,返回空数组
        }
    }
    return res;  // 返回拓扑排序结果
}

// 测试主函数
int main() {
    MGraph G;
    // 初始化图 G
    // 添加顶点和边

    vector<int> result = TopologicalSort(G);
    if (result.empty()) {
        cout << "图中存在环,拓扑排序失败!" << endl;
    } else {
        cout << "拓扑排序成功!" << endl;
        for (int v : result) {
            cout << v << " ";  // 打印拓扑排序序列
        }
        cout << endl;
    }

    return 0;
}
由于该算法是找某顶点的邻接点,用邻接表找出边更方便,时空复杂度也更低一点;
【邻接表】实现:大部分代码一样,只不过这里找邻接顶点更方便;
#include <iostream>
#include <vector>
#include <queue>

using namespace std;

#define MAXV 1000     // 顶点数目的最大值

typedef struct ArcNode {  // 边表结点
    int adjvex;            // 该弧所指向的结点在顶点表中的位置(索引)
    struct ArcNode* next;  // 指向下一条弧的指针
    // InfoType info;      // 如果用来表示网,可以加上一个边权值
} ArcNode;

typedef struct VNode {     // 顶点表结点
    char data;             // 顶点信息
    ArcNode* firstarc;     // 指向第一条依附于该顶点的弧的指针
} VNode, AdjList[MAXV];

typedef struct {
    int numVertices, numEdges;  // 图中实际的顶点数和边数
    AdjList vertices;           // 顶点表
} ALGraph;  // 以邻接表存储的图

void dfs(int u, ALGraph &G, std::vector<int> &visited, vector<int> &res, int &idx, bool &hasCycle) {
    if (hasCycle) return;  // 只要发现有环,立刻停止搜索
    visited[u] = 1;  // 进入 dfs 后,首先置 visited[u] = 1, 表示 u 处于搜索中状态
    ArcNode* p = G.vertices[u].firstarc;
    while (p != NULL) {   // 遍历邻接表
        if (visited[p->adjvex] == 0) {
            dfs(p->adjvex, G, visited, res, idx, hasCycle);
            if (hasCycle) return;  // 如果在递归中检测到环,立即返回
        } else if (visited[p->adjvex] == 1) {
            hasCycle = true;  // 若邻接顶点为「搜索中」状态,说明有圈
            return;
        }
        p = p->next;
    }
    visited[u] = 2;  // 完成搜索,表明在对 u 进行 dfs 的过程中未遇到正在搜索中的其他顶点
    res[idx--] = u;  // 此时 u 所依赖的顶点都在栈中「缓存」等待后续处理
}

vector<int> TopologicalSort(ALGraph &G) {
    vector<int> visited(G.numVertices, 0);  // 初始化 visited 数组, 都设为 0
    bool hasCycle = false;
    vector<int> res(G.numVertices);  // 用列表模拟的用来存储拓扑排序结果的栈
    int idx = G.numVertices - 1;  // 模拟栈的栈底下标

    // 遍历所有顶点,对「未搜索」状态的顶点 u 执行 dfs
    for (int u = 0; u < G.numVertices; ++u) {
        if (visited[u] == 0) {
            dfs(u, G, visited, res, idx, hasCycle);
            if (hasCycle) return {};  // 每次搜索后,若检测出环,返回空数组
        }
    }
    return res;  // 返回拓扑排序结果
}

// 测试主函数
int main() {
    ALGraph G;
    // 初始化图 G
    // 添加顶点和边

    vector<int> result = TopologicalSort(G);
    if (result.empty()) {
        cout << "图中存在环,拓扑排序失败!" << endl;
    } else {
        cout << "拓扑排序成功!" << endl;
        for (int v : result) {
            cout << v << " ";  // 打印拓扑排序序列
        }
        cout << endl;
    }

    return 0;
}
5.4.3.3 关键路径
5.4.3.3.1 相关概念
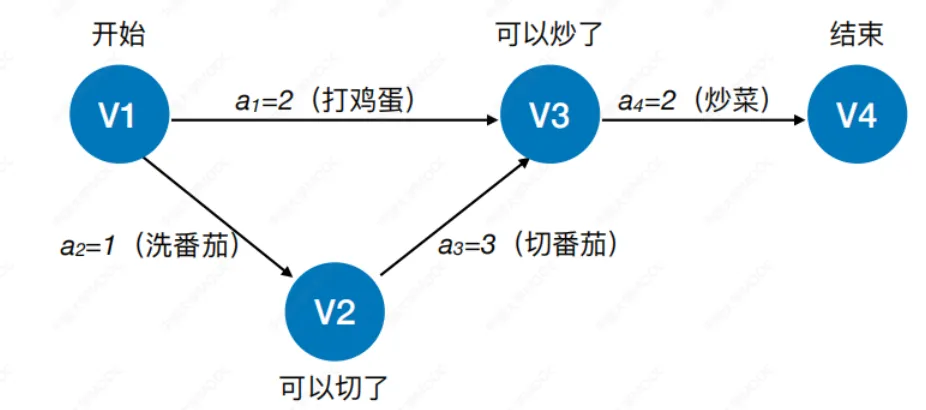
- AOE网(
Activity On Edge Network):在一个表示工程的带权有向图中,用顶点表示事件,用有向边表示和活动,用边上的权值表示活动的持续时间。其中没有入边的顶点称之为源点,没有出边的点称之为终点(汇点); 如下图所示
AOE网的性质:
- 只有在某顶点所代表的事件发⽣后,从该顶点出发的各有向边所代表的活动才能开始;
- 只有在进⼊某顶点的各有向边所代表的活动都已结束时,该顶点所代表的事件才能发⽣。另外,有些活动是可以并⾏进⾏的
- AOV网和AOE网的对比
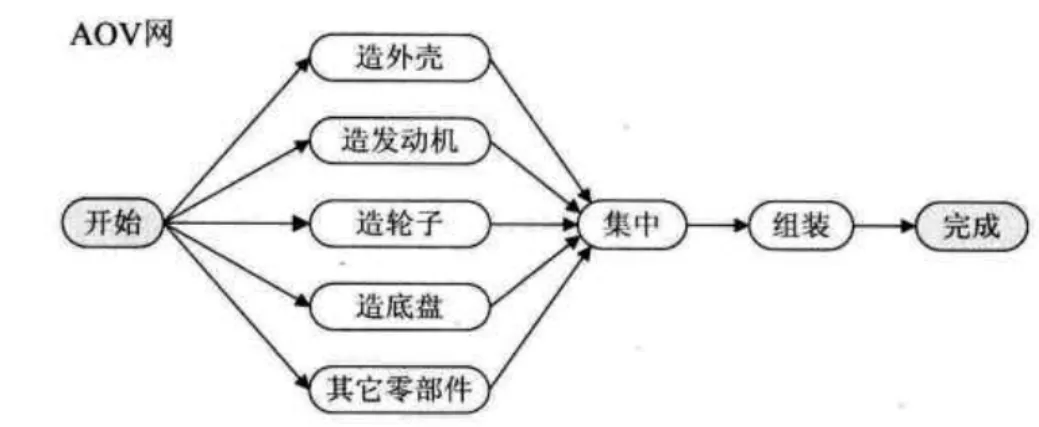
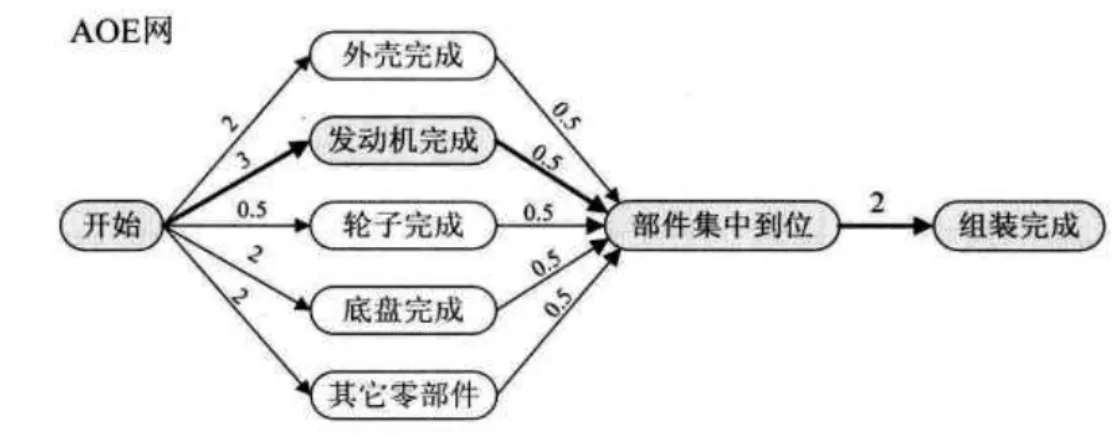
| AOV网 | AOE网 |
|---|---|
| 顶点表示活动 | 顶点表示事件 |
| 边无权值,仅代表活动的先后顺序 | 边有权值,代表活动的持续时间 |
- 关键路径:我们把路径上各个活动的持续时间之和称之为路径长度。从源点到终点具有最大长度的路径叫做
关键路径,在关键路径上的活动叫做关键活动。关键路径直接决定了整个工程的时间长短,只有缩短关键路径上的关键活动时间才能减少整个工程时间
Info
- 可通过加快关键活动来缩短工期,但不可任意缩短关键活动,因为一旦缩短到一定程度,该关键活动就可能变成非关键活动
- 关键路径可能不唯一,但所有的关键路径的长度是相同的;
- 若增大某个关键活动,则一定会使关键路径的长度变大;但是,若减小某个关键活动的权值,不一定会使关键长度变小,只有加快
所有关键路径上的关键活动才能缩短工期。
- 事件 \(v_k\) 的最早发生时间 \(ve(k)\) —指从源点到顶点 \(v_k\) 的最长路径长度。 同时它也决定了所有从 \(v_k\) 开始的活动能够开工的最早时间;
\(ve(起点) = 0\) \( ve(\text{顶点 } k) = \max \left\{ ve(\text{前驱顶点 } j) + \text{边权值} \right\} \)
- 事件 \(v_k\) 的最迟发生时间 \(vl(k)\) —指在不推迟整个工程完成的前提下,该事件最迟必须发生的时间;
\(vl(终点) = ve(终点)=关键路径长度\)
\(vl(顶点k) = min\left\{vl(后继顶点j) - 边权值\right\}\)
注意:最后一个顶点的最迟和最早发生时间是相同的,因此求得最后一个顶点的最早发生时间后让该时间继续作为它的最迟发生时间,然后向前推算其余事件的最迟发生时间
- 活动 \(a_i\)的最早开始时间\(e(i)\) —–指该活动弧的起点所表⽰的事件的最早发⽣时间
- 活动 \(a_i\)的最迟开始时间\(l(i)\) —–它是指该活动弧的终点所表示事件的最迟发⽣时间与该活动所需时间之差
- 活动 \(a_i\)的时间余量 \(d(i) = l(i)-e(i)\) ,表⽰在不增加完成整个⼯程所需总时间的情况下,活动 \(a_i\) 可 以拖延的时间\ 若⼀个活动的时间余量为零,则说明该活动必须要如期完成,\(d(i)=0\)即\(l(i)=e(i)\)的活动 \(a_i\) 是关键活动;
5.4.3.3.2 关键路径的标准解法
- 求所有时间的最早发生时间\(ve()\)
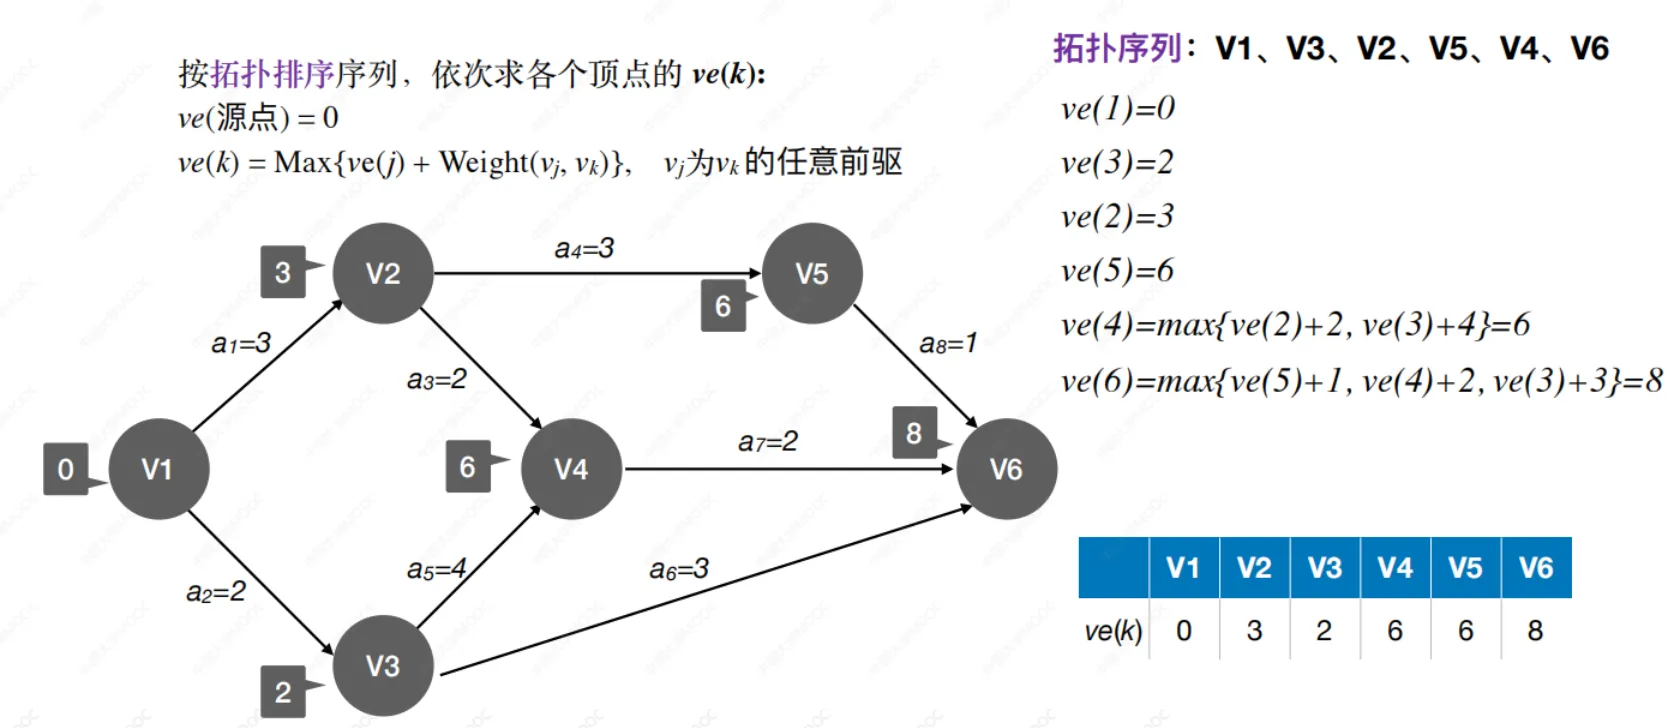
- 求所有事件的最迟发⽣时间\(vl()\)
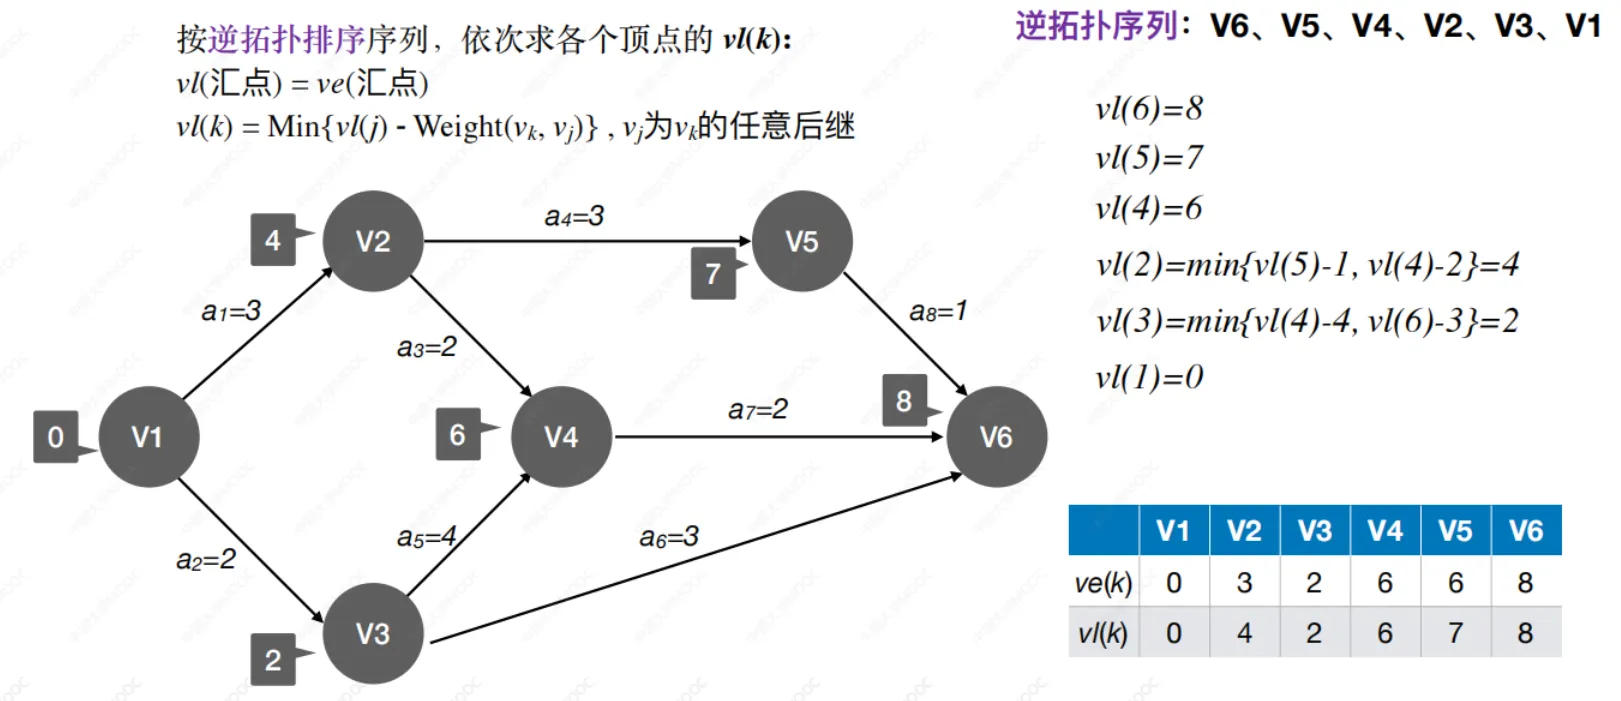
注意:勘误\(vl(2)=min\){\({vl(5)-3,vl(4)-2}=4\)}
-
求所有活动的最早发生时间\(e()\) :\(若边\<v_k, v_j>表⽰活动a_i,则有e(i) = ve(k)\)
-
求所有活动的最迟发⽣时间\(l()\): \(若边\<v_k, v_j>表⽰活动a_i,则有l(i) = vl(j) - Weight(v_k, v_j)\)
-
求所有活动的时间余量 \(d_i=l(i)-e(i)\)
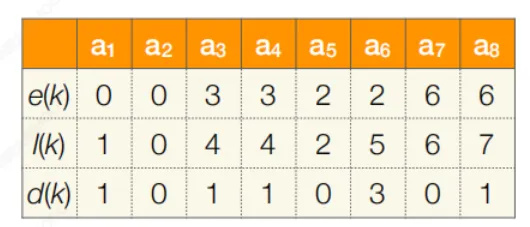
\(d(k) =0\)的活动就是关键活动, 由关键活动可得关键路径;
关键活动:\(a_2、a_5、a_7\) 关键路径:\(v_1->v_3->v_4->v_6\)
5.4.3.3.3 一种快速求解关键路径的手算方法
只需要求出事件的最早发生时间 \(ve(k)\) :按照上面介绍的求\(ve\)的方法,从前往后计算\(ve\)的值,将其余从源点到 顶点\(k\)的所有路径中,路径长度比\(ve\)小的且终点为 顶点\(k\) 的边从图中删除(和\(ve\)值\ 相等的路径上的边不用删除),即删除一定是非关键的边。当 \(ve(k)\) 求解完毕时,剩余能连通源(起点)点和汇点(终点)的路径都是关键路径。\ 举一个直观的例子:对下图进行\(ve(k)\)的求解:
- \(ve(1)= 0\)
- \(ve(2)= ve(1)+5=5\)
- \(ve(3)= ve(1) +6=6\)
- \(ve(4)= ve(3)+ 3=9\)
- \(ve(5) = max\left\{ ve(2) + 3, ve(3) +6, ve(4)+3\right\} = max\left\{ 8,12,12 \right\} =12\)
此时以\(2\)为起点的边\(<2,5>\)生成\(ve\)值较小,从图中删除该边,如图所示。另两条边生成的\(ve\)值一样都是最大的,都保留。
- \(ve(6)= ve(5) +4= 16\)
- \(ve(7)=max\left\{ ve(5)+ 2, ve(4)+ 1 \right\} = max\left\{ 14,10\right\} = 14\)
以\(4\)为起点的边\(<4,7>\)生成\(ve\)值较小,从图中删除该边,如图所示。
- \(ve(8)= ve(4) +4= 13\)
- \(ve(9) = max\left\{ ve(7)+5, ve(8) +2 \right\} =max\left\{ 19,15 \right\} =19\)
以\(8\)为起点的边\(<8,9>\)生成\(ve\)值较小,从图中删除该边,如图所示。
- \(ve(10) = max\left\{ ve(6) +4, ve(9)+ 2 \right\} =max\left\{ 20,21 \right\} =21\)
以\(6\)为起点的权值是\(4\)的边生成\(ve\)值较小,从图中删除该边,如图所示。此时可在剩余的边中容易地画出\(2\)条能连通源点和汇点的路径: \(1->3->5->7->9->10\)和\(1->3->4->5->7->9->10\)。 此时关键路径求解完毕。
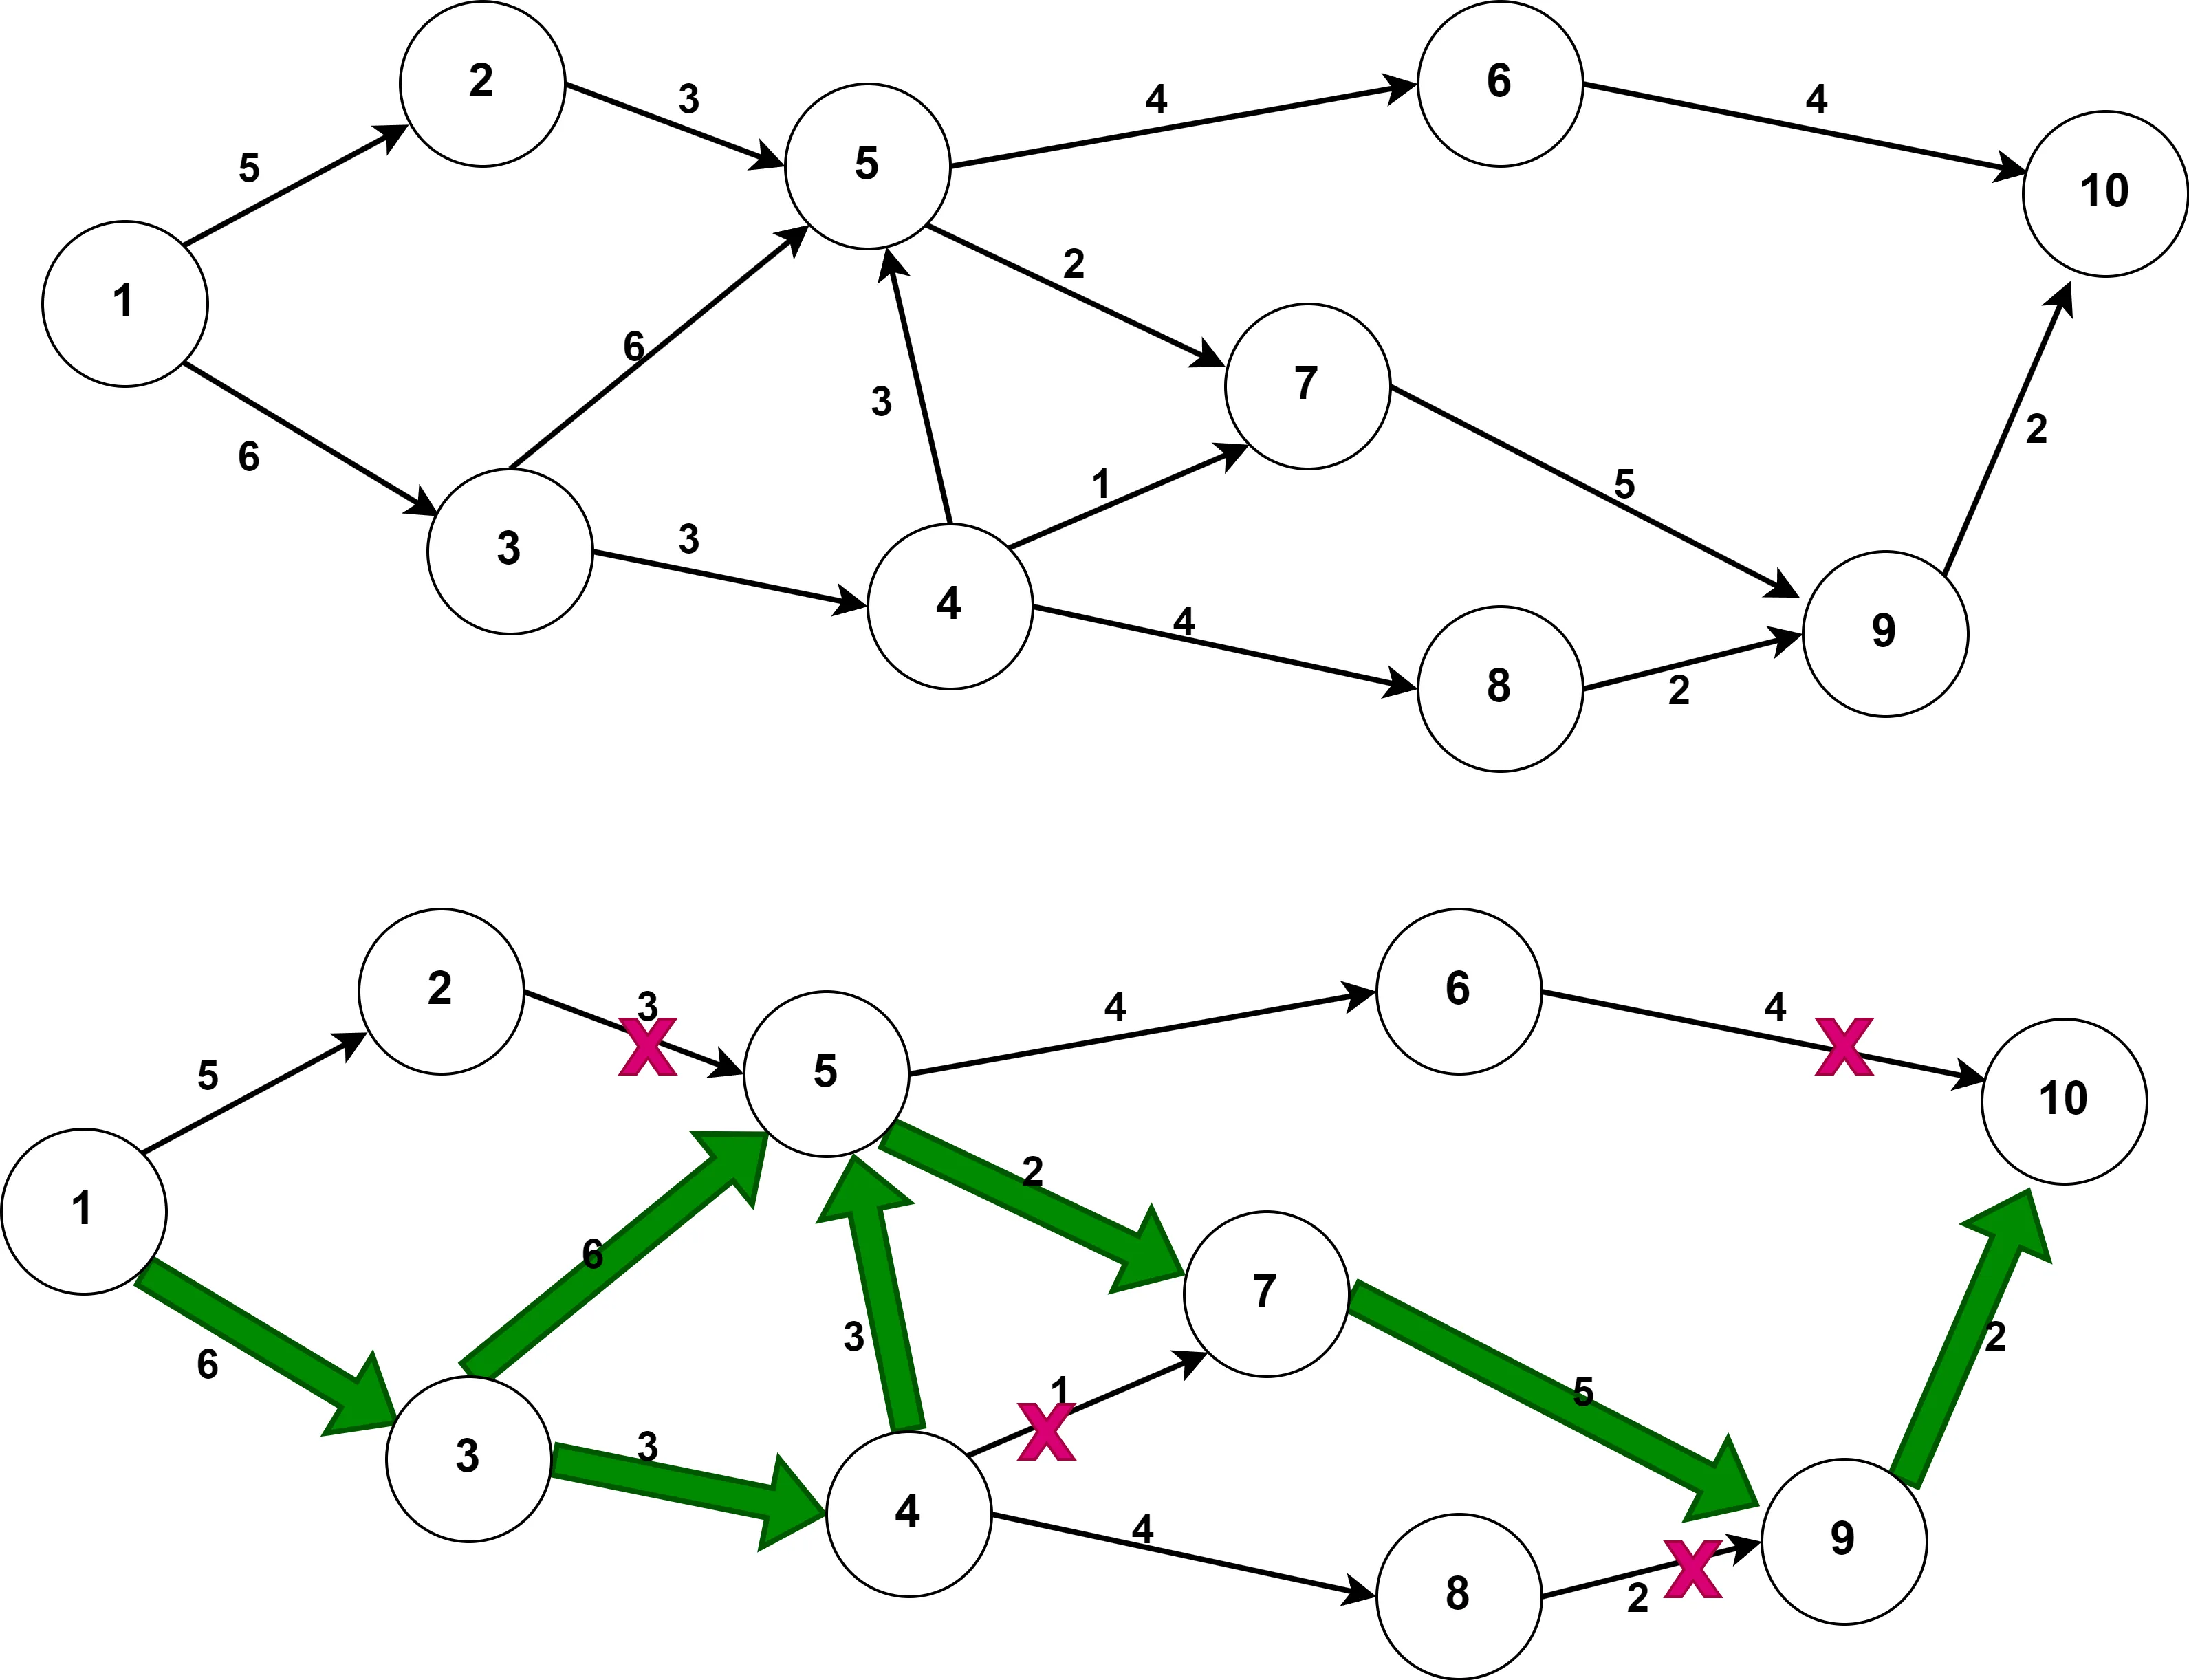
该方法还可以进一步地优化: 当确定删除一条边时,可以向源点方向继续进行删除直至遇到一个出度大于1的交叉点。例如:确定删除边\(<2, 5>\)时,可以继续删除\(<1, 2>\),遇到交叉点\(V_1\)(其出度是\(2> 1\)),停止删除操作;确定删除边\(<8, 9>\) 时,可以继续删除\(<4, 8>\) ,此时遇到一个交叉点\(V_4\)(其出度是\(3> 1\)),停止删除操作;确定删除边\(<6,10>\) 时,可以继续删除\(<5, 6>\),此时遇到一个交叉点\(V_5\)(其出度是\(2> 1\)),停止删除操作。此时就可以更容易地找出连通源点和汇点的关键路径了。
5.4.4 补充:判断图是否有环[圈]
5.4.4.1 无向图判环(圈)
法一:从某顶点 \(v\) 出发,对其执行 \(bfs\)或\(dfs\) ,若能在此过程中找到 \(v\) ,则我们确定该图有环(圈),并且 \(v\) 是该圈上的一个顶点。如果要找到圈上的所有顶点,只要我们对所有的顶点,都执行同样的搜索,就可以确定。
法二:拓扑排序判环:注意,应用 基于 BFS的Kahn 拓扑排序时,对于「无向图」上的顶点,考虑的是无关方向的 「度」 ,开始排序时要将 度为 1 的顶点入队;对于「有向图」上的顶点,考虑的是 「入度」 ,开始排序时要将 入度为 0 的顶点入队。如果在找不到度为1的顶点随后跳出循环遍历之后,count的值小于顶点数,说明该无向图有环;
通常,拓扑排序是针对有向图设计的,用来检测有向图中是否有环。对于无向图,通常不会使用拓扑排序的方法。下面这段代码其实是基于剥洋葱的思想,从外围开始逐步剥离度为1的节点,这是一个常见的方法来检测无向图中的环。
#include <vector>
#include <queue>
#include <iostream>
#include <cstdio>

using namespace std;

#define MAXV 100     // 顶点数目的最大值

typedef struct {
    int numVertices;       // 图中实际的顶点数
    int numEdges;          // 图中实际的边数
    char vertexList[MAXV]; // 顶点表
    int edges[MAXV][MAXV];  // 邻接矩阵
} MGraph;

bool hascycle(MGraph G) {
    vector<int> degree(G.numVertices, 0);   // 初始化每个顶点的度为0
    // 首先统计所有顶点的度
    for (int i = 0; i < G.numVertices; ++i) {
        for (int j = 0; j < G.numVertices; ++j) {
            if (G.edges[i][j] == 1) {
                degree[i]++;  //每个邻接点只为当前顶点贡献一次度数
            }
        }
    }

    queue<int> q;  // 创建一个队列用于存储度为1的顶点
    int count = 0; // 统计出队的元素个数,用于后续判环

    // 将所有度不超过1的顶点入队(孤立顶点也不属于环)
    for (int i = 0; i < G.numVertices; ++i) {
        if (degree[i] <= 1) q.push(i); //(此处修改)同时处理度为0的孤立顶点
    }

    while (!q.empty()) {
        int u = q.front();
        q.pop();
        count++;
        // 减少与u相连的顶点的度
        for (int i = 0; i < G.numVertices; ++i) {
            if (G.edges[u][i] == 1) {
                degree[i]--;
                if (degree[i] == 1) q.push(i);
            }
        }
    }

    if (count < G.numVertices) return true;  // 如果出队的顶点数少于顶点总数,说明图中有环
    else return false;
}
法三:并查集,如下图所示,如果该无向图是用邻接矩阵存储,遍历它的上三角区域,如果G.Edge[i][j]!=0,并且i,j的祖先结点不同,也就是说二者不在一个集合,那么就将这两个点加入并查集集合中,如果在遍历过程中发现i,j顶点已经在集合中了,说明这两个顶点已经连通了,如果再加入这条边就会出现环了;
#define MAXV 100     // 顶点数目的最大值

typedef struct {
    int numVertices;       // 图中实际的顶点数
    int numEdges;          // 图中实际的边数
    char vertexList[MAXV]; // 顶点表
    int edges[MAXV][MAXV];  // 邻接矩阵
} MGraph;

const int Size = 100;  //(此处修改)数组长度必须是编译期常量
int s[Size];   //集合元素数组,即用于双亲表示法的数据结构;
//初始化并查集;
void Initial() {
    for(int i = 0; i < Size; ++i) {
        s[i] = -1;
    }
}
//查操作,找x所属集合(返回x所属树的根节点)
int Find(int x) {  //x是该元素在数组中存储的值,即其父节点的数组下标;
    while(s[x] >= 0) {  //只要数组中该元素值>0,说明还未找到其所属集合根节点,继续循环寻找;
        x = s[x];   //因为数组中存放的是当前节点父节点的数组下标,未找到即更新x;
    }
    return x;   //找到所属集合根节点,此时x值为根节点下标;
}
//将v->u这条边加入并查集;
void join(int u,int v) {
    u = Find(u);  //查找顶点u的根节点,也就是其所属集合;
    v = Find(v);
    if(u == v) return; //如果二者本来就属于同一个集合则直接返回;
    s[v] = u;  //将顶点v加入集合;
}

bool hascycle(MGraph G) {
    Initial();   //初始化并查集;
    for(int i = 0; i < G.numVertices; ++i) {
        for(int j = i+1; j < G.numVertices; ++j) {  //遍历邻接矩阵的上三角区域;
            if(G.edges[i][j] == 1) { //(此处修改)成员名为 edges,而不是未定义的 Edge
                if(Find(i) != Find(j)) {
                    join(i,j);  //如果这两个顶点不在同一个集合中,则将j并入i所在的集合中;
                }else{
                    return true;  //如果在遍历过程中,遇到的边的顶点已经在一个集合中了,说明遇到环了,直接返回true;
                }
            }
        }
    }
    return false;  //如果遍历结束,都没有发现环,返回false;
}
当然也可以采用路径压缩和让小树合并到大树优化,优化后的代码如下
#include <iostream>
#include <vector>

using namespace std;

#define MAXV 100     // 顶点数目的最大值

// 图的邻接矩阵表示
typedef struct {
    int numVertices;       // 图中实际的顶点数
    int numEdges;          // 图中实际的边数
    char vertexList[MAXV]; // 顶点表,存储每个顶点的标识
    int edges[MAXV][MAXV]; // 邻接矩阵,存储图的边
} MGraph;

// 并查集类,用于处理图的连通性问题
class UnionFind {
public:
    // 构造函数,初始化并查集
    UnionFind(int size) {
        parent.resize(size); // 初始化 parent 数组
        rank.resize(size, 0); // 初始化 rank 数组
        // 每个节点的父节点指向自身
        for (int i = 0; i < size; ++i) {
            parent[i] = i;
        }
    }

    // 查操作,带路径压缩
    int Find(int x) {
        if (parent[x] != x) {
            parent[x] = Find(parent[x]); // 递归查找并压缩路径
        }
        return parent[x]; // 返回根节点
    }

    // 并操作,按秩合并
    void Union(int x, int y) {
        int rootX = Find(x); // 查找 x 的根节点
        int rootY = Find(y); // 查找 y 的根节点

        if (rootX != rootY) { // 如果 x 和 y 不在同一个集合中
            // 按秩合并,保持树的平衡
            if (rank[rootX] > rank[rootY]) {
                parent[rootY] = rootX; // 将 rootY 的根设置为 rootX
            } else if (rank[rootX] < rank[rootY]) {
                parent[rootX] = rootY; // 将 rootX 的根设置为 rootY
            } else {
                parent[rootY] = rootX; // 将 rootY 的根设置为 rootX
                rank[rootX] += 1;     // 如果秩相等,增加 rootX 的秩
            }
        }
    }

private:
    vector<int> parent; // 存储每个节点的父节点
    vector<int> rank;   // 存储每棵树的秩
};

// 检测图中是否存在环的函数
bool hasCycle(MGraph &G) {
    UnionFind uf(G.numVertices); // 创建并查集对象

    // 遍历邻接矩阵,处理每一条边
    for (int i = 0; i < G.numVertices; ++i) {
        for (int j = i + 1; j < G.numVertices; ++j) {
            if (G.edges[i][j] == 1) { // 如果存在边 (i, j)
                if (uf.Find(i) == uf.Find(j)) {
                    return true; // 如果 i 和 j 已经在同一个集合中,说明存在环
                }
                uf.Union(i, j); // 将 i 和 j 合并到同一个集合中
            }
        }
    }
    return false; // 如果遍历完所有边,没有发现环,则返回 false
}

// 测试主函数
int main() {
    MGraph G;
    // 初始化图 G 的相关属性,如顶点、边等
    // ...

    if (hasCycle(G)) {
        cout << "图中存在环。" << endl;
    } else {
        cout << "图中不存在环。" << endl;
    }

    return 0;
}
5.4.4.2 有向图判环(圈)
- 深度优先搜索(DFS):
- 使用深度优先搜索遍历图,同时用一个栈(或标记)来记录当前遍历的路径。
- 在DFS过程中,如果遇到一个已经在当前路径栈中的节点,则表示找到了一个环。
- 使用颜色标记(例如:未访问、正在访问、已完成访问)也可以帮助检测环。如果从一个正在访问的节点(灰色标记)遇到另一个正在访问的节点,那么存在环。
- 拓扑排序:\
采用基于
BFS的kahn拓扑排序算法,思想为首先算出所有顶点的入度,然后采用一个队列将入度为0的顶点入队,随后依次出队,每次出队将当前顶点的邻接顶点的入度-1,并判断其邻接顶点减1后的度数是否为0,是的话将其入队,此外用count变量记录遍历到的结点数量,遍历结束后比较count和顶点数量便可知道是否有环; - Tarjan算法(或其他基于强连通分量的方法):
- Tarjan算法可以用来找到有向图中的所有强连通分量。
- 如果任何一个强连通分量包含多于一个节点,或者有自环的单节点,那么这个图中存在环。
- 使用并查集:
- 并查集通常用于无向图中判断环,但通过一些扩展和额外的数据结构(比如记录每个节点的父节点),也可以适用于有向图。
- 每次添加一条边时,检查这条边的起点和终点是否属于同一集合,如果是,则表示添加这条边会形成环。
【总结】这些方法各有优缺点,适用于不同的情景和需求。例如,如果你只是想检测环的存在,使用DFS或拓扑排序可能更直接;如果你需要更多的图结构信息,如强连通分量,可以选择使用Tarjan算法。
关于BFS能否用于有向图判环
广度优先搜索(BFS)原则上可以用于有向图来检测环,但其实现和无向图中的使用有所不同,并且通常不如深度优先搜索(DFS)或拓扑排序那样直接有效。在有向图中使用BFS检测环涉及更多的注意事项和额外的数据结构支持。下面是如何使用BFS在有向图中检测环的基本思路:
【基本思路】
- 记录入度:在开始
BFS之前,计算图中每个节点的入度(指向该节点的边的数量)。 - 使用队列:与
DFS使用栈或递归不同,BFS使用队列来实现。初始时,将所有入度为0的节点加入队列。 - 遍历节点:
- 从队列中取出一个节点,然后访问该节点的所有邻接节点。
- 对于每个邻接节点,将其入度减1(表示移除从当前节点指向邻接节点的边)。
- 如果任何邻接节点的入度变为0,将其加入队列。
- 检测环:
- 如果在处理过程中所有节点都被加入并从队列中移除过,且图中没有剩余的节点,则图中没有环。
- 如果存在未被处理的节点(即队列空了但仍有节点的入度不为0),这意味着这些节点形成了循环依赖,即图中存在环。
注意点
BFS本身不直接检测环,它依赖于节点的入度信息。如果没有节点的入度降为0,则表明这部分节点在一个闭环中。- 这种方法实际上是一种拓扑排序的变种,用于检测是否所有节点都可以排序。如果不能,说明存在环。
总的来说,虽然BFS可以用于有向图检测环,但通常它不是首选方法,特别是在需要直接和有效检测环的场景。深度优先搜索或拓扑排序通常更适用于这种情况,因为它们可以更直接地处理节点访问和依赖关系。