寻址方式
指令寻址方式
操作数寻址方式
在计算机的微观世界里,程序运行的核心本质就是 CPU 不断地从存储器中取出指令,并对特定的数据(操作数)进行加工处理。一条完整的指令不仅需要告诉计算机“做什么”(由操作码 OP 决定),更需要指明“对谁做”以及“去哪里找它”。寻找操作数真实物理位置的方法,就是操作数寻址方式(也称数据寻址)。
为了满足高级语言中复杂的程序设计需求(如指针操作、数组遍历、函数调用等),操作数的存放位置十分灵活。概括而言,操作数的来源基本分为三种情况:
- 直接藏身于 指令内部(立即数);
- 栖身于 CPU 内部的 寄存器 中(寄存器操作数);
- 存放在广阔的 主存空间 里(存储器操作数)。
面对如此多样的存放地,如果仅仅用一个固定的地址码去硬性指定,不仅会极大地浪费指令字长,也会让程序的浮动和重定位变得寸步难行。因此,现代计算机系统的指令格式通常将地址码字段巧妙地一分为二:
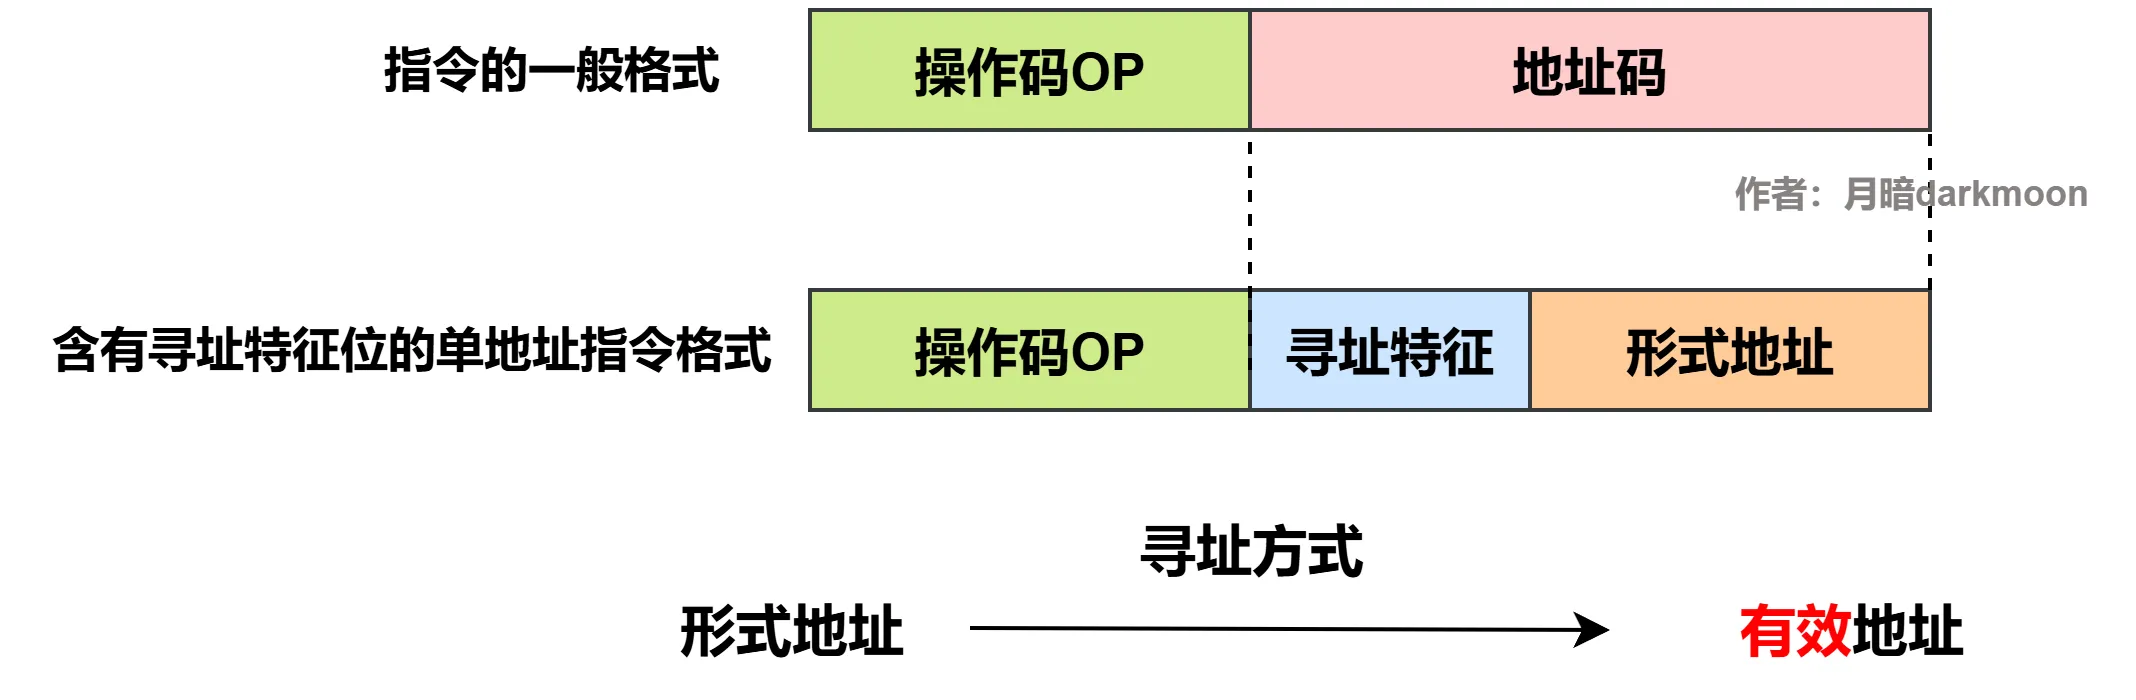
- 寻址特征字段: 用于向 CPU 声明当前采用的是哪一种寻址“规则”。该字段的位数决定了 CPU 硬件能支持的最多寻址方式种类(例如,支持 8 种寻址方式至少需要 3 位寻址特征码)。
- 形式地址:它是指令字中给出的地址信息,但请务必牢记:形式地址往往并非操作数的真实地址。
寻址的过程,本质上就是一个“解密”的过程。 CPU 根据寻址特征的指引,运用特定的硬件逻辑电路,对形式地址进行相应的算术或逻辑加工,最终计算出操作数在寄存器或主存中的真正物理位置——即有效地址(EA, Effective Address)。
我们可以用一个简单的表达式来概括这个核心思想:操作数\(S = (EA)\)(注:括号表示访问该有效地址所指向的主存单元或寄存器里的内容)
不同的计算机指令系统拥有各自的一套寻址“武功秘籍”。理解并熟记从形式地址到有效地址的映射规则(如立即寻址、直接寻址、间接寻址、寄存器间接寻址等),不仅是掌握指令系统运作原理的钥匙,更是后续理解 CPU 控制器设计、流水线数据冒险等高级概念的坚实基石。接下来,我们将逐一揭开这些常用基本寻址方式的面纱。
立即(数)寻址

如何找操作数: 形式地址字段 \(A\) 就是操作数本身。
优点: 速度最快。在执行指令阶段,CPU 不需要再去访问主存取操作数,省去了访存时间。
缺点: 数值范围极受限。因为操作数的大小被硬塞进了指令格式里,如果指令中地址码字段只有 8 位,那立即数最多只能表示 0~255(无符号)或 -128~127(带符号)。它通常只能用于给寄存器赋初值等简单的常数操作。
该寻址方式在 x86 和 MIPS 中的具体实例
Intel x86 示例:
MOV EAX, 2026H
- 功能: 将十六进制立即数
2026H直接赋值给 32 位寄存器EAX。- 说明: 在机器码中,
2026H这几个字节就紧跟在MOV操作码之后,CPU 取指令时顺便就把数据取进来了。MIPS 示例:
addi $t0, $t1, 100
- 功能: 将寄存器
$t1中的值与十进制立即数100相加,结果存入寄存器$t0。- 说明: MIPS 的 I 型指令专门留了 16 位来存放立即数。
直接寻址
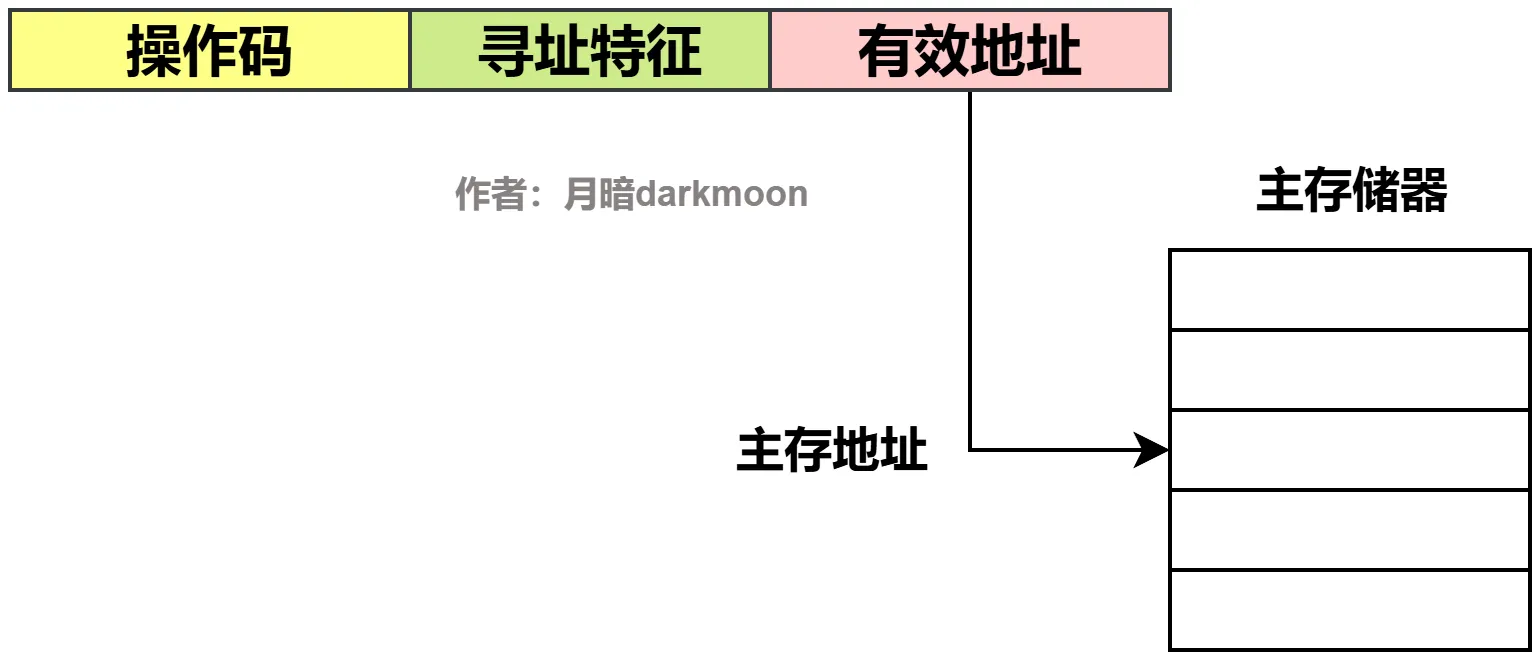
如何找操作数: 指令中的形式地址 \(A\) 就是操作数在主存中的真实物理地址。即 \(EA = A\)。
优点: 简单直接,不需要专门的算术逻辑单元(ALU)进行地址的加减计算。
缺点:
- 寻址范围受限: 取决于形式地址 \(A\) 的位数。如果 \(A\) 是 16 位,那就只能寻址 \(2^{16}\)(即 64KB)的主存空间。
- 不够灵活: 物理地址被硬编码写死在了程序里,如果程序在内存中被移动了位置,这条指令就找不到正确的数据了(不方便程序的浮动运行)。
该寻址方式在 x86 和 MIPS 中的具体实例
Intel x86 示例:
MOV EAX, [00401000H]
- 功能: 将主存绝对物理地址(或虚拟地址)为
00401000H的内存单元中的 32 位数据,读取到EAX寄存器中。- 说明: x86 作为 CISC 架构,指令长度可变,因此可以轻松地把一个 32 位的长地址直接塞进指令的后缀里。
MIPS 无纯粹的数据直接寻址
- 架构差异科普: MIPS 作为 RISC 架构,所有指令严格定长为 32 位。如果你用掉 6 位做操作码,剩下的位数根本不够塞下一个完整的 32 位内存地址。因此,MIPS 不支持访问数据的直接寻址。MIPS 访问内存必须依赖寄存器(即基址寻址)。
(注:MIPS 中的 *
j target无条件跳转指令使用了“伪直接寻址”,但那是针对指令跳转的,不用于取数据)*。
隐含寻址
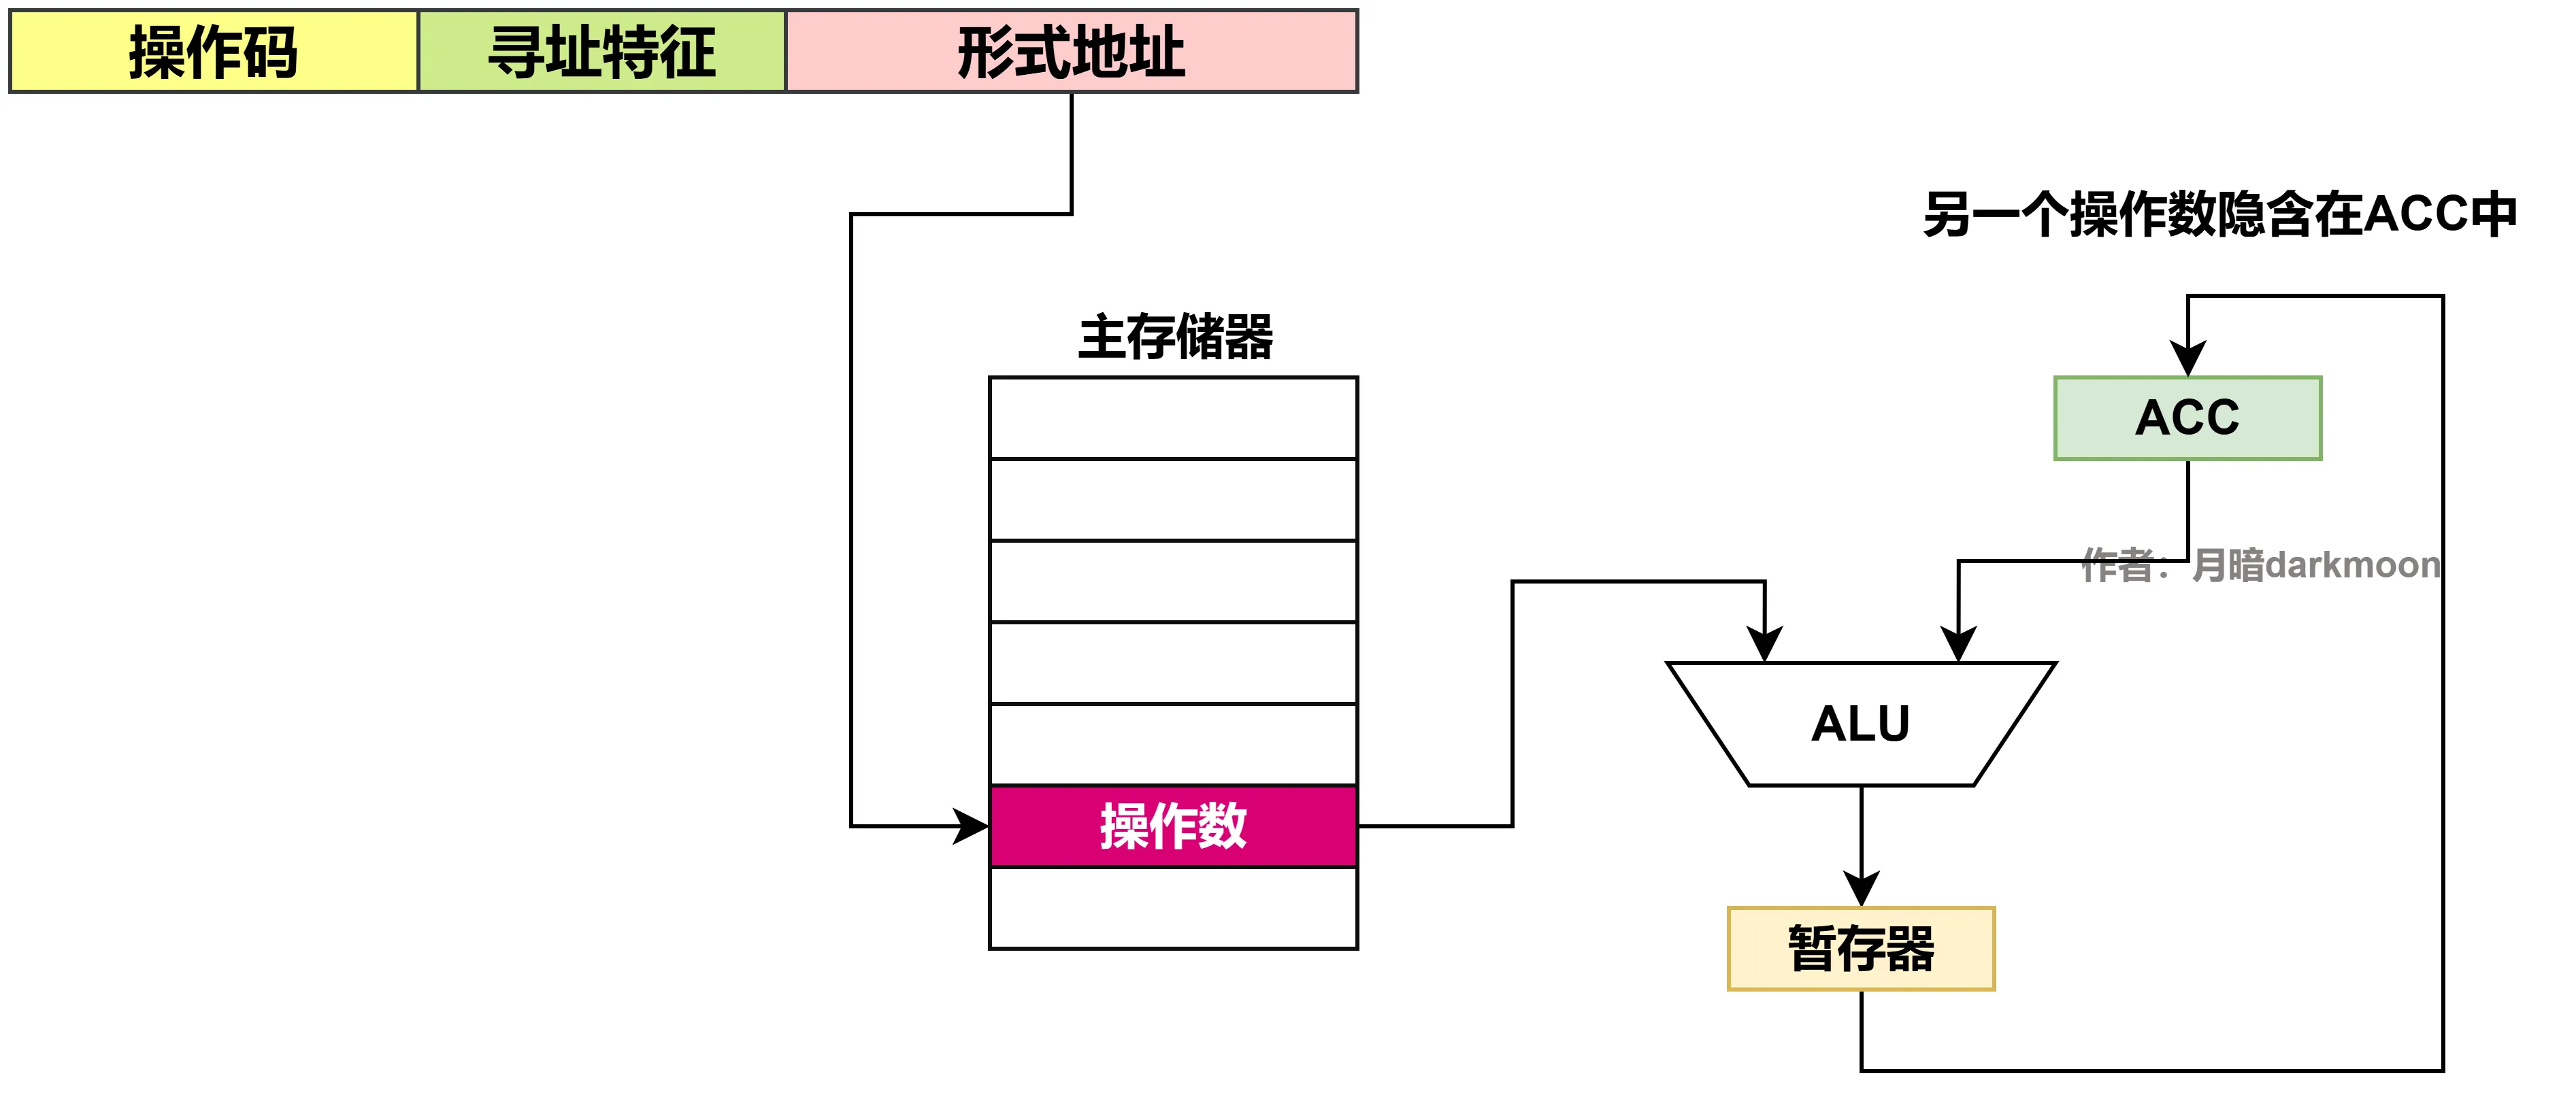
这种类型的指令不明显地给出操作数的地址,而在指令中隐含操作数的地址。例如,单地址的指令格式就不明显地在地址字段中指出第二操作数的地址,而规定累加器(ACC)作为第二操作数地址,指令格式明显指出的仅是第一操作数的地址。 因此,累加器(ACC) 对单地址指令格式来说是隐含寻址。
寄存器寻址
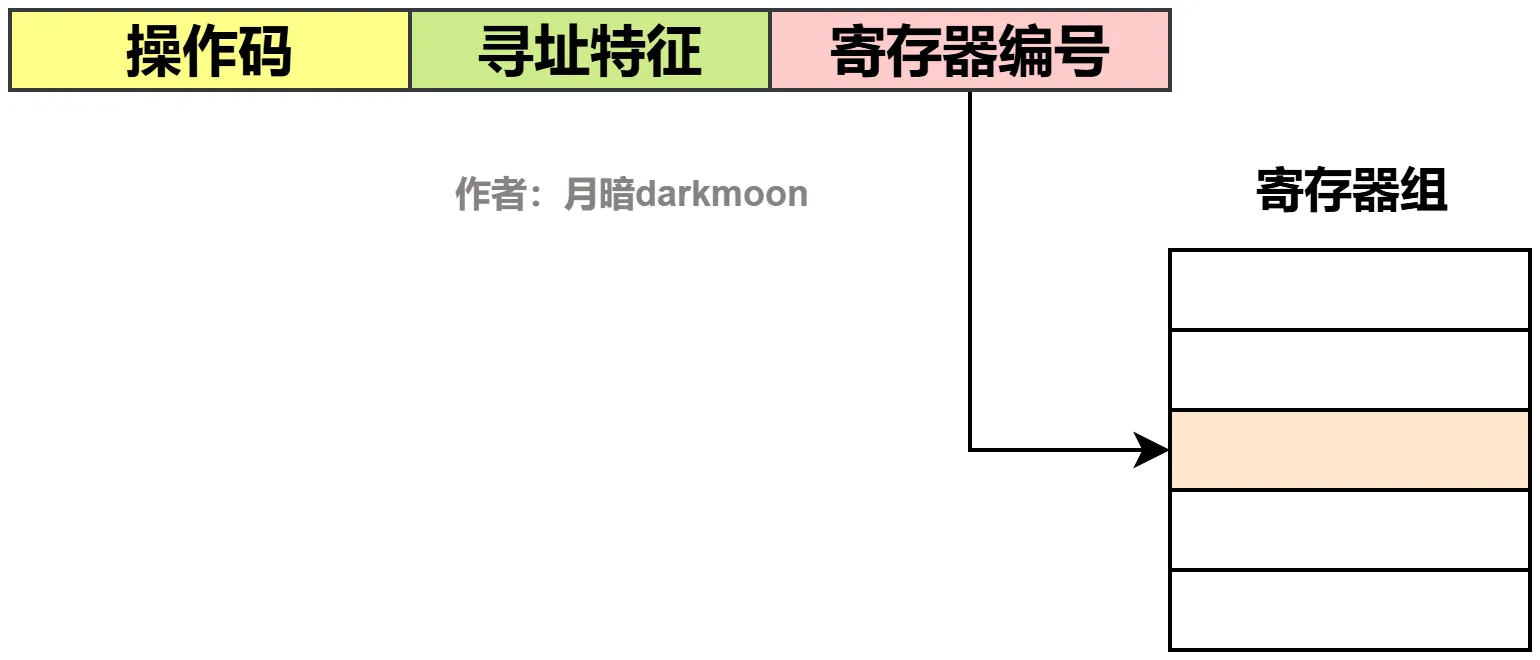
如何找操作数: 形式地址给出的是 CPU 内部通用寄存器的编号(记为 \(R_i\)),操作数就存放在这个寄存器中。即 \(EA = R_i\),操作数 \(= (R_i)\)。
优点:
- 速度极快: 访问 CPU 内部寄存器的速度远高于访问外部主存。
- 指令字长较短: 计算机内部的寄存器通常很少(比如 8 个或 16 个),只需要 3 到 4 个二进制位就能表示寄存器编号,大大节省了指令空间。
缺点: 寄存器是非常昂贵且稀缺的硬件资源,数量有限,不能把所有数据都放在里面。
该寻址方式在 x86 和 MIPS 中的具体实例
Intel x86 示例:
ADD EAX, EBX
- 功能: 将
EAX寄存器的值与EBX寄存器的值相加,结果写回EAX。- 说明: 两个操作数都来自寄存器,执行速度极快,不需要访问主存。
MIPS 示例:
add $t0, $t1, $t2
- 功能: 将寄存器
$t1和$t2的值相加,结果存入$t0。- 说明: 这是 MIPS 最典型的 R 型指令格式,完全在 CPU 内部的 ALU 完成运算。
间接寻址
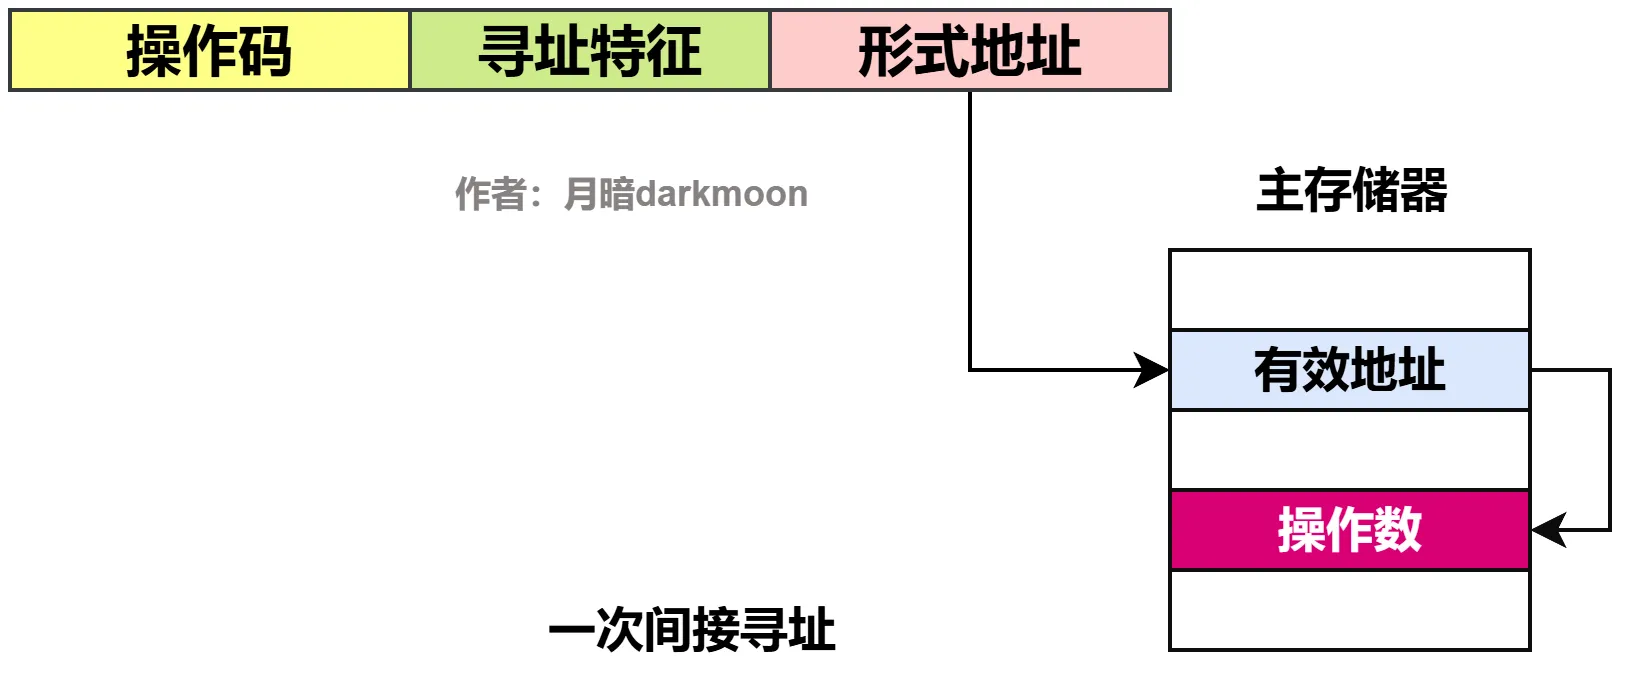
如何找操作数: 指令中的形式地址 \(A\) 是一个主存地址,但这个地址单元里装的不是真正的数据,而是操作数的有效地址。即 \(EA = (A)\),操作数 \(= ((A))\)。
优点:
- 极大扩大寻址范围: 虽然指令里的 \(A\) 位数可能很少,但 A 地址单元的字长可以很长,从而能访问庞大的物理内存。
- 便于实现指针操作、子程序返回参数等高级编程技巧。
缺点: 速度最慢。执行这一条指令,取操作数阶段至少需要两次访存(第一次去主存拿真实地址,第二次去主存拿真正的数据)。
如果是多次间址的话,每个主存单元还得拿 1bit 作为间址标记位标记当前是有效地址还是间接地址,不过由于一次间接寻址已经够慢了,多次间址几乎不可能使用,稍微有个映像即可。
指令中给出的地址指向内存中的一个“指针变量”,这个指针变量里存的才是真实数据的地址。
现代 x86 和 MIPS 都没有原生的单条指令级别的数据间接寻址!
原因: 纯粹的间接寻址需要 CPU 自动执行两次主存访问(先读地址,再读数据)。这极其拖慢流水线的速度,完全违背了现代 CPU 的设计原则。
寄存器间接寻址
如何找操作数: 形式地址给出的是寄存器编号 \(R_i\),但该寄存器里装的不是数据本身,而是操作数在主存中的真实地址。即 \(EA = (R_i)\),操作数 \(= ((R_i))\)。
优点:
- 兼顾了速度与寻址范围: 比起纯粹的主存间接寻址,它少了一次访存操作(因为找地址的第一步是在 CPU 内部极速完成的),只需要一次访存去拿真正的数据。
- 极度灵活: 在高级语言中,这就是指针的最底层实现。它极其适合用来遍历数组、处理字符串和控制循环(只要对寄存器 \(R_i\) 里的内容不断加 1,就能顺藤摸瓜遍历一片连续的内存)。
缺点: 相比直接寻址,它仍然需要多经过一次寄存器跳转;且需要提前把地址基准值计算好并放进寄存器中。
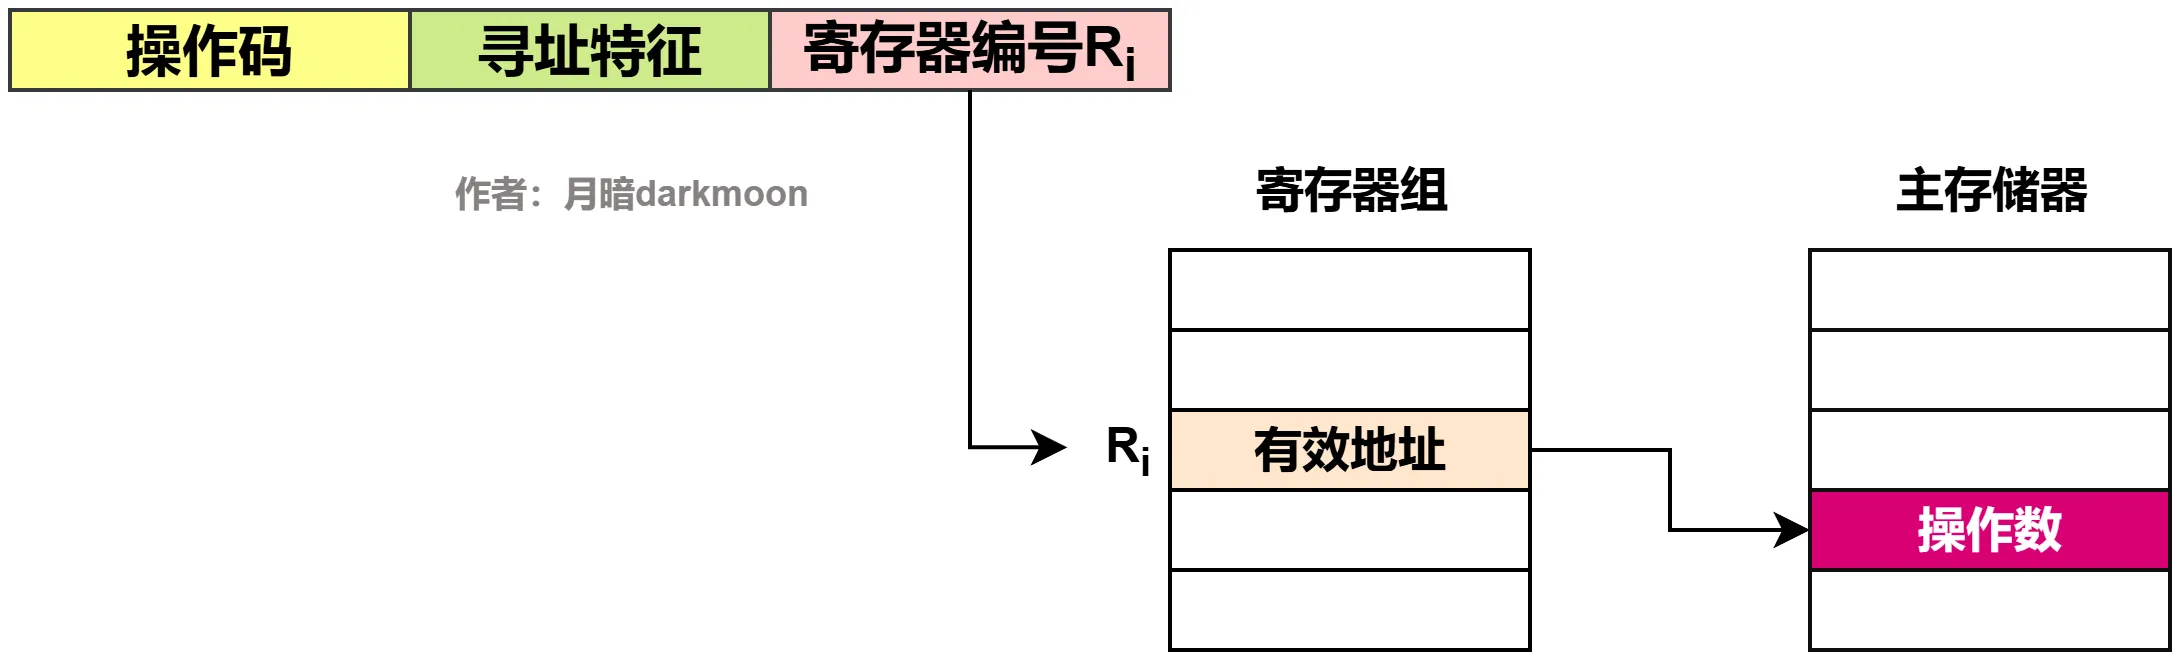
这是高级语言中指针(Pointer)在汇编层面的真面目,该寻址方式在 x86 和 MIPS 中的具体实例
Intel x86 示例:
MOV EAX, [EBX]
- 功能:
EBX寄存器里存着一个地址值。CPU 会去访问这个地址指向的主存单元,把里面的数据取出来放到EAX中。- 说明: 方括号
[]在 x86 汇编中就代表“解引用”(类似于 C 语言的*p)。MIPS 示例:
lw $t0, 0($t1)
- 功能:
$t1寄存器里存着内存基地址,加上偏移量0,作为有效地址,从该内存取出一个字(Word)放入$t0。- 说明: MIPS 原生支持的是“基址寻址”,即
寄存器值 + 立即数偏移量。当这个偏移量写为0时,它在逻辑上就等价于纯粹的“寄存器间接寻址”。这也是遍历数组时最常用的指令形式。
Note
下面三种寻址方式(相对寻址、基址寻址、变址寻址)在计组中被统称为偏移寻址,它们的底层数学逻辑完全一致,核心公式都是:有效地址\(EA = \text{某个寄存器的内容} + \text{指令中的形式地址 A(或 D)}\)
既然算式一样,为什么还要分三种?
核心区别在于: 参与相加的寄存器是谁?这个寄存器由谁来控制?以及它们被设计出来的主要应用场景是什么?
相对寻址 (Relative Addressing)
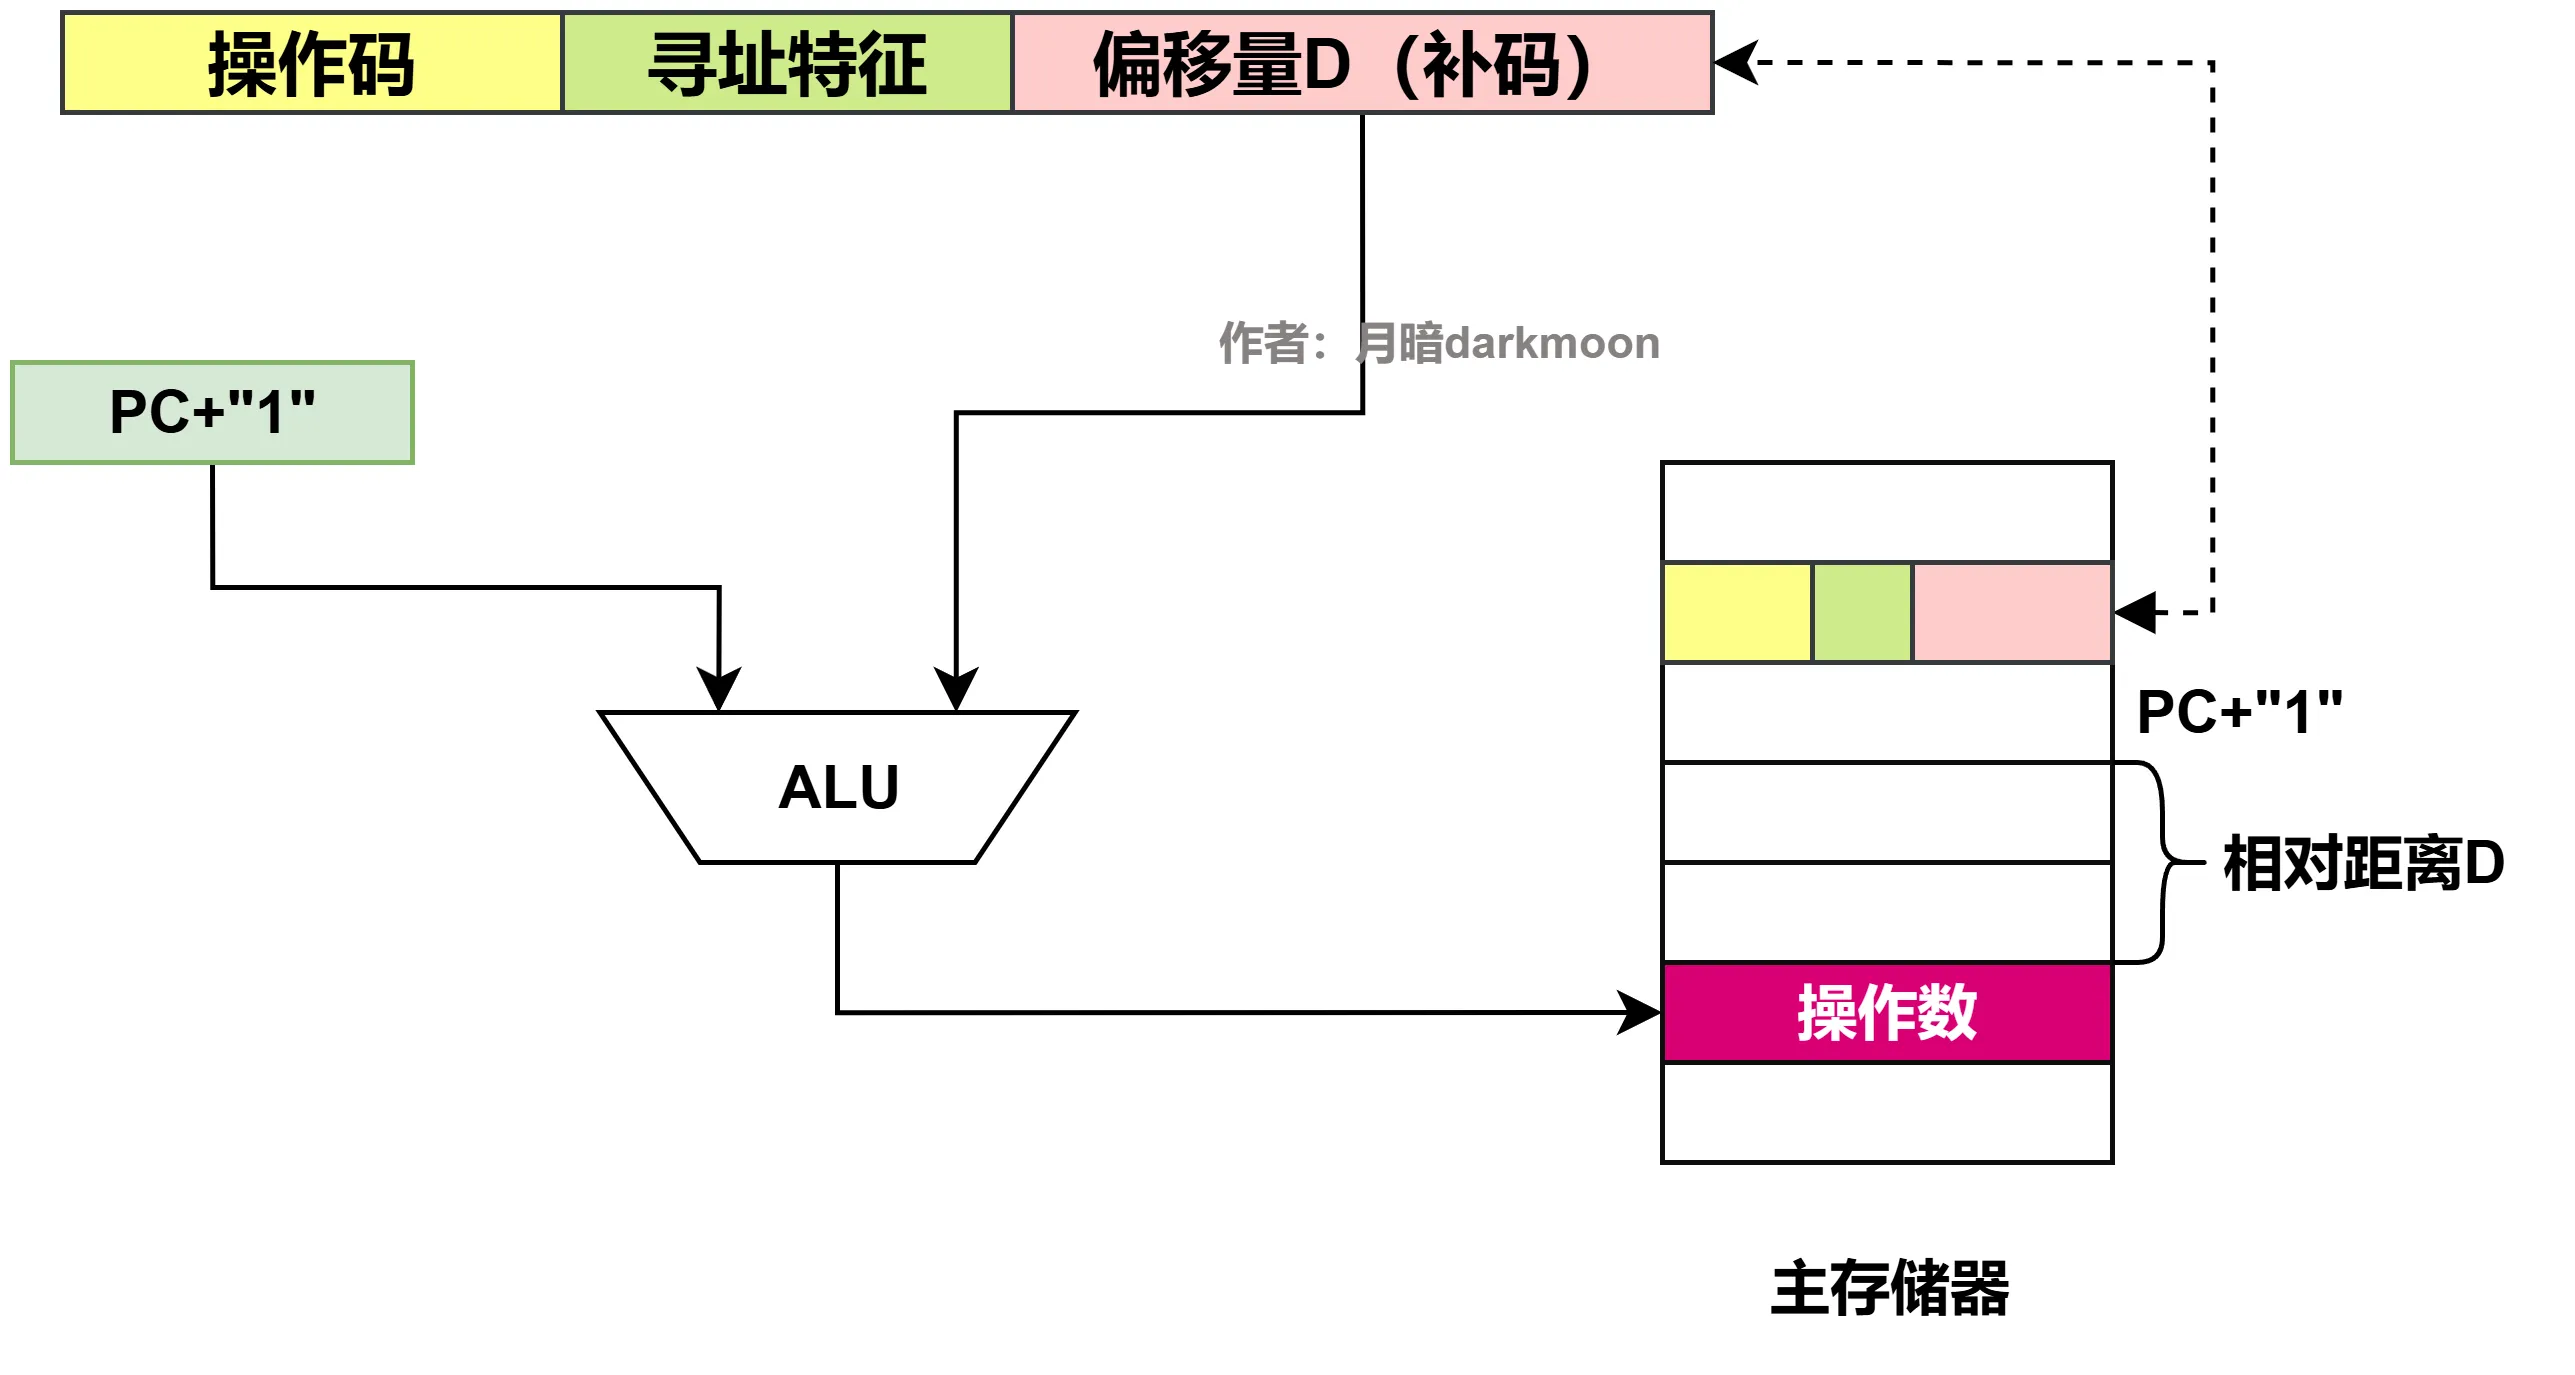
有效地址计算式: \(EA = (PC) + D\)
\(D\) 为指令中给出的位移量/形式地址,注意由于指令中的位移量位数有限,因此在计算有效地址时需要位数扩展,位移量为补码表示,因此这里需要进行符号扩展。
该寻址方式即可用于 寻找操作数 ,也可以用于分支转移类指令中确定指令的 转移目标地址 ,因此有效地址可以是操作数的地址或者是指令的地址。
⚠️ 核心考点(坑点): 计算有效地址时,\((PC)\)的值是当前指令的下一条指令的地址。因为 CPU 在“取指令”阶段结束时,\(PC\) 就会自动加上当前指令的字长。
应用场合:
- 公共子程序的浮动:因为公共子程序可能被许多用户程序调用,因而会随着用户程序装入内存不同的地方运行。为了让公共子程序能在不同的内存区正确运行,一般在公共子程序内部采用相对寻址方式,以保证指令的操作数总在相对于指令距离一定的单元内。这样,不管子程序浮动到哪里,指令和数据的相对位置不变。例如,现行指令的地址为2000H,指令中给出的形式地址为05H,说明操作数在当前指令后面第05H个单元处,即2005H处。当程序向后浮动了1000H,使当前指令的地址为3000H时,此时公共子程序中的指令、数据以及相对位置都不变,指令中给出的相对地址还是05H,操作数还是应该在当前指令后面的第05H个单元处,所以应该在3005H处,因此,指令取到的还是同一个数据。
- 跳转目标地址的寻址:当需要转到当前指令的前面或后面第n条指令执行时,可以用相对寻址方式。此时,得到的跳转地址是一个相对地址。
这种寻址方式在以下两种架构中都专门用于控制流的跳转(比如循环、条件判断),而不用于取数据。
Intel x86 示例:
JNE target_label
- 功能: 这是一个“不相等则跳转”(Jump if Not Equal)的条件分支指令。如果标志寄存器显示上次比较不相等,程序就跳转到
target_label执行。- 原理解析: 汇编代码中写的是标签名,但在被编译成机器码时,指令中存放的是一个有符号的相对偏移量(\(D\),补码)。CPU 执行时,会将当前的 \(EIP\)(x86 的 PC 寄存器)加上这个偏移量,计算出目标物理地址。
MIPS 示例:
bne $t0, $t1, target_label
- 功能: 如果寄存器
$t0和$t1的值不相等,则跳转到target_label。- 原理解析: MIPS 的 I 型指令中有 16 位用于存放立即数。在这条指令中,这 16 位存放的就是相对偏移量。MIPS 计算有效地址的底层动作是:\(EA = (PC + 4) + (D \times 4)\)。(注:因为 MIPS 是定长 32 位指令,按字对齐,所以偏移量 \(D\) 代表的是“跳过几条指令”,需要乘以 4 转换成字节地址)。
基址寻址 (Base Addressing)
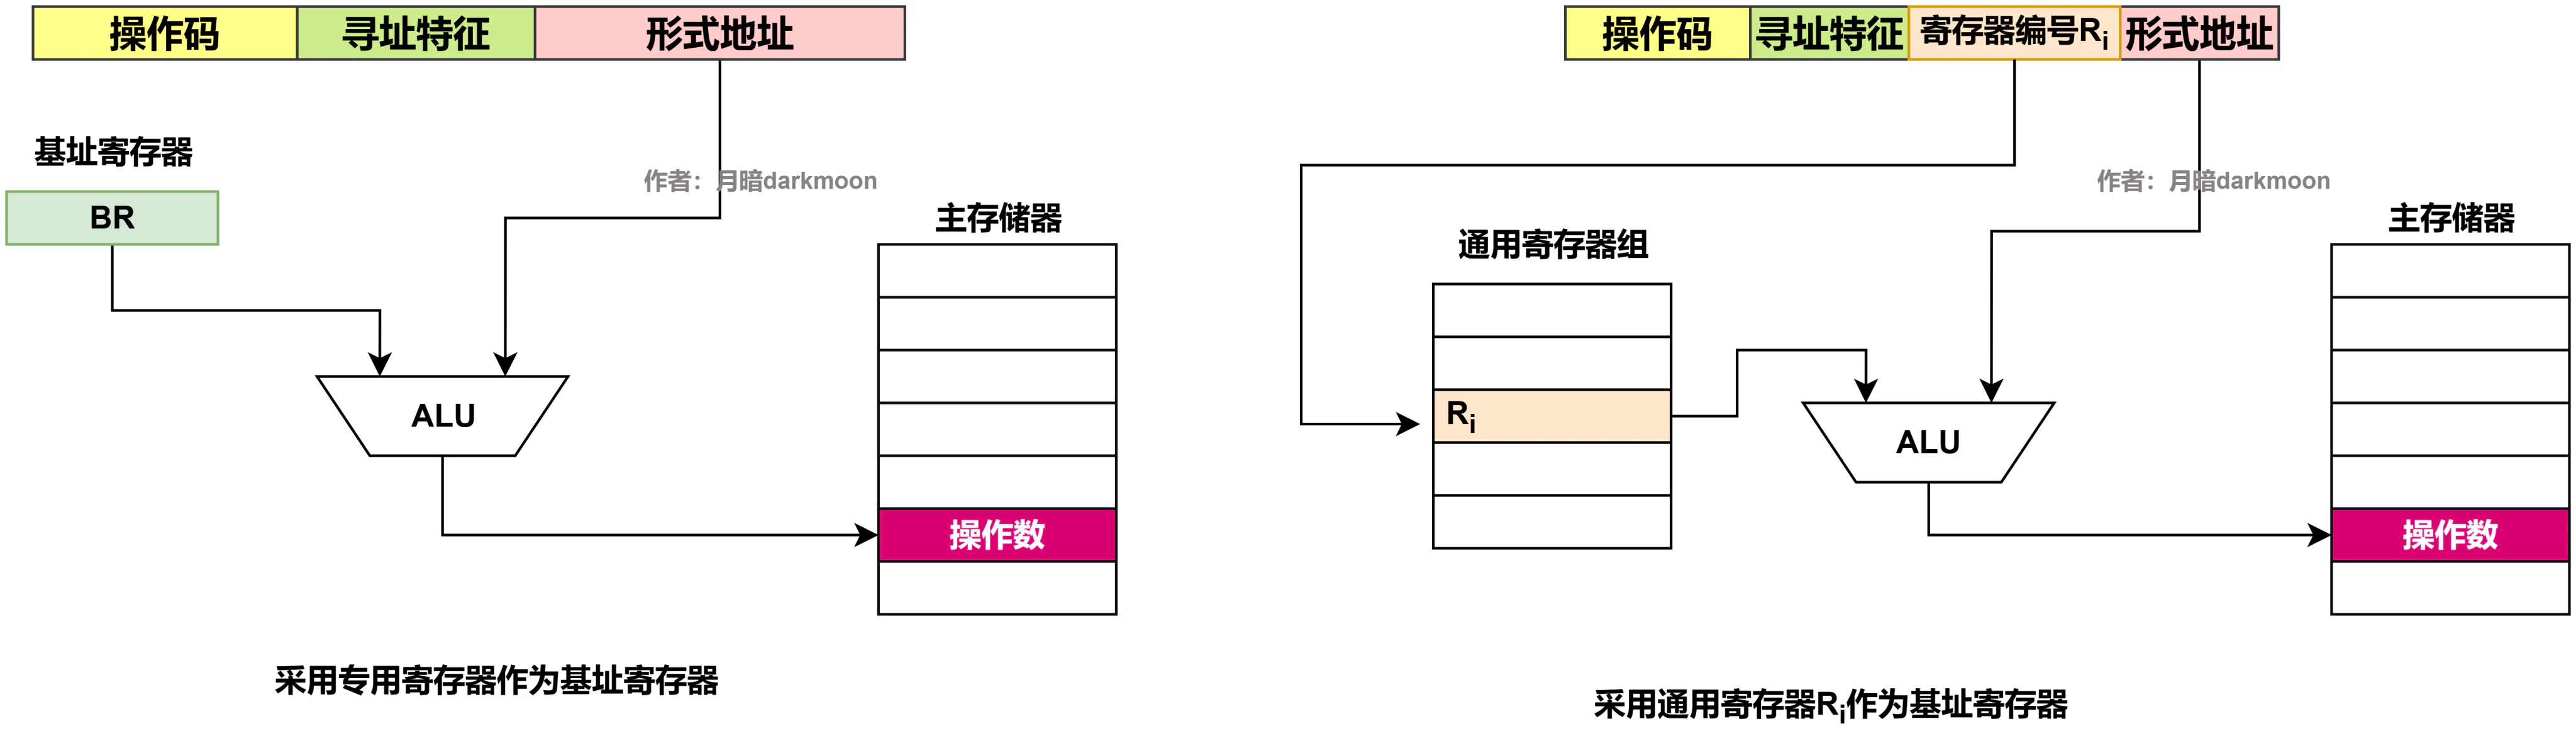
有效地址计算式: \(EA = (B) + A\) (\(B\) 为基址寄存器,可以是专用寄存器或通用寄存器)
应用场景(来自袁书习题解答):
- 程序重定位:在多道程序运行的系统中,每个用户程序在一个逻辑地址空间里编写程序。装入运行时,由操作系统给用户程序分配主存空间,每个用户程序有一个基地址,存放在基址寄存器中,在程序执行时,通过基址寄存器的值加上指令中的形式地址就可以形成实际的主存单元地址。(操作系统存储管理里程序的装入用到的重定位寄存器、页表基址寄存器等即为基址寄存器)
- 扩展有限长度指令的寻址空间:在运行时将某个存储区的首地址或程序段的首地址装入基址寄存器,而形式地址给出要访问的单元相对于该首地址的距离(即偏移量),因此指令中只要用较短的地址码来表示偏移量。访问操作数时,用基址寄存器的值和偏移量相加,得到操作数所在的存储单元地址。只要基址寄存器的内容更改到另外的一个存储地址,则操作数的地址空间就移到另一个存储区间。因而,可以访问到整个地址空间,以实现短地址访问大空间的目的。
关于基址寄存器用户能不能修改的问题
场景一:用于“程序重定位”(不可修改)
- 硬件载体:CPU 内部专门设置的专用基址寄存器,例如重定位寄存器或者页表基址寄存器 PTBR
- 谁来控制:操作系统(OS)。
- 解析:当程序被装入内存时,OS 决定它存放在哪里,并把起始物理地址强行写入这个专用寄存器。这个过程对用户是完全透明的。如果你在用户态程序里尝试用指令去修改这个专用寄存器,CPU 会直接报特权级异常(Segment Fault)。在这种语境下,用户绝对不能改。
场景二:用于“扩展寻址空间”(用户必须改)
- 硬件载体:由通用寄存器(如 x86 的 EBP、EBX)或专门的段寄存器(Segment Register,如 x86 的 DS、CS)来充当基址寄存器。
- 谁来控制:用户/程序员。
- 深度解析:为什么这里用户能改了?
假设一台计算机的指令里,形式地址(偏移量)只有 16 位,这意味着它一条指令最多只能“够得着” 的数据。但如果物理内存有 1GB 怎么办?
这时候,系统允许用户把一个通用寄存器指定为“基址寄存器”。
- 第一步:程序员通过指令,把内存中某个 64KB 大数据块的首地址,手动
MOV进这个通用/段寄存器里。 - 第二步:在这个数据块内部,使用 16 位的短偏移量进行愉快的访问。
- 第三步:(关键点来了)当这个 64KB 块访问完了,要访问下一个数据块时,程序员要在代码里写一条指令,把新的首地址重新赋值给这个寄存器(这就是场景二中“只要基址寄存器的内容更改到另外的一个存储地址...空间的移到另一个存储区间”的意思)。
现实案例:Intel 8086 的段寻址(实模式)
8086 CPU 是 16 位的,但地址总线有 20 位(能寻址 1MB)。为了用 16 位寄存器访问 1MB 空间,Intel 发明了段寄存器(如 DS 数据段寄存器,本质就是基址寄存器)。程序员在写汇编时,必须亲自写下这样的代码来修改基址:
MOV AX, 2000H  ; 把段基址 2000H 放入 AX
MOV DS, AX     ; 把 AX 的值写入数据段基址寄存器 DS (用户主动修改基址!)
MOV AL, [15H]  ; 此时有效地址 EA = (DS)*16 + 15H
总结:考试/做题时怎么看?
- 如果题目讨论的是多道程序并发、虚拟存储器、程序浮动装入,那么提到的“基址寄存器”是指操作系统管理的专用硬件,用户不可修改,内容执行中不变。
- 如果题目讨论的是扩大寻址范围、或者明确说是“通用寄存器作基址寄存器”,那么这个基址就变成了高级语言里大数组或对象的“首地址指针”,用户当然可以且必须修改它。
这种寻址方式主要应用于确定数据块的起始位置(如栈帧、数据段),偏移量用于访问块内的具体元素。
Intel x86 示例:
MOV EAX, [EBP + 8]
- 功能: 将栈帧基址指针
EBP的内容加上偏移量8,作为物理地址,从该内存单元取出一个 32 位数据放入EAX寄存器。- 原理解析: 这里
EBP就是典型的基址寄存器(Base Pointer),在函数调用过程中,操作系统或调用者设定好EBP的值(指向当前函数栈的底部),函数内部的代码通过硬编码的偏移量(如 \(+8\)、\(+12\))来访问传入的参数。MIPS 示例:
lw $s0, 100($sp)
- 功能: 将栈指针寄存器
$sp的内容加上偏移量100,从该内存取出一个字(Word)存入$s0。- 原理解析: 这是 MIPS 架构中唯一原生的访存寻址方式! MIPS 极度精简,把所有的数据访问都归结为“基址 + 偏移”的形式。这里的
$sp(栈指针)充当基址寄存器,100就是形式地址 \(A\)。上面两个示例中, 基址寄存器借用了通用寄存器(如 EBP、EBX、$sp),由用户程序通过正常指令自行调度,用户必须自己修改它,否则函数就没法正常运行!
只有当基址寄存器用在宏观的“内存管理/多道程序重定位”时 , 由操作系统在内核态修改,用户绝对不能碰,碰了就报错。
变址寻址 (Indexed Addressing)
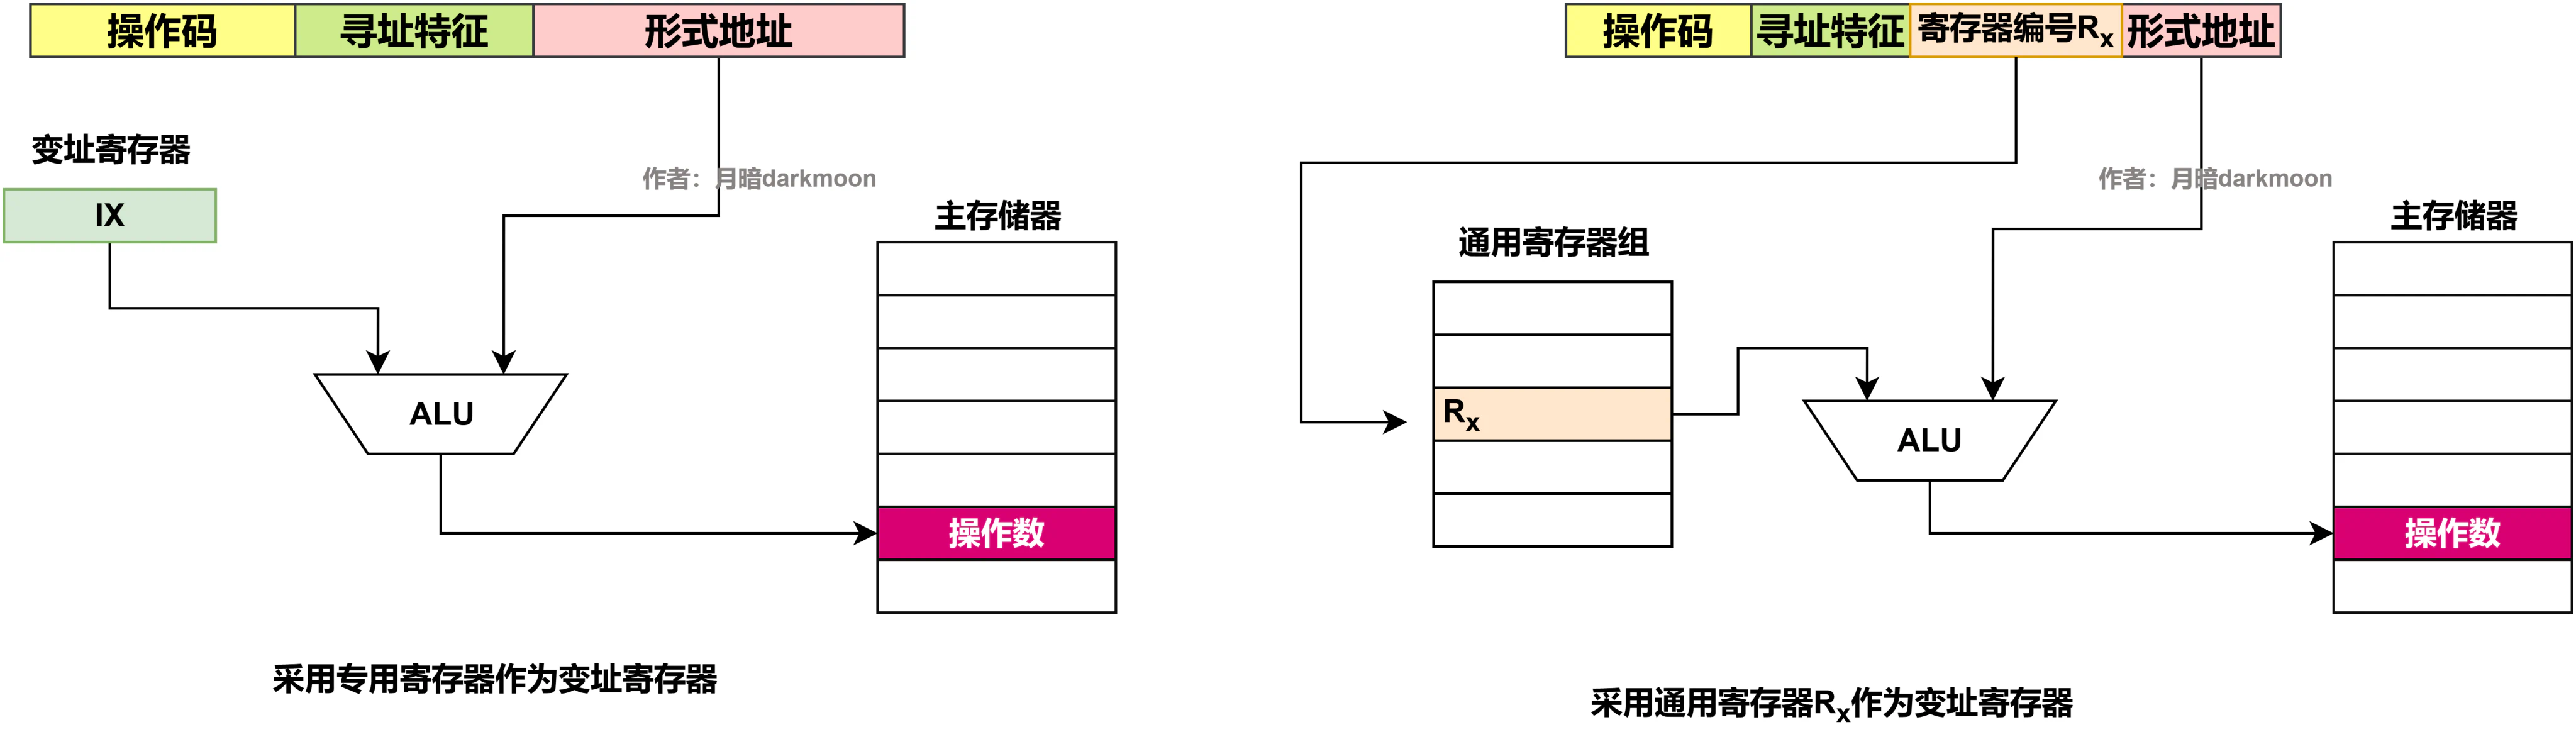
有效地址计算式: \(EA = (I) + A\) (\(I\) 或 \(X\) 为变址寄存器)
形式地址\(A\): 充当基准地址(例如:数组 a 在内存中的首地址,在编译时就固定了)。
变址寄存器\((I)\): 充当偏移量/下标(例如:数组的索引 i)。
如果任何一个通用寄存器都可作为变址寄存器,则必须在指令中明确地给出一个通用寄存器的编号,并标明作为变址寄存器使用;若处理器中有一个专门的变址寄存器,则无须在指令中明确给出。
控制权归属: 变址寄存器面向的是用户/程序员。在程序执行过程中,形式地址 \(A\) 保持不变,而变址寄存器的内容可以由用户通过指令不断修改(例如在 for 循环中让 \(I\) 不断 \(+1\) 或 \(+4\))。
应用场景:专门用于处理线性表、数组等具有规律性连续存储的数据结构。
该寻址方式在 x86 和 MIPS 中的具体实例 `
Intel x86 示例:
MOV AL, [ESI + 1000H]
- 功能: 将源变址寄存器
ESI的内容加上1000H,作为物理地址,从内存中取出一个字节(8 位)放入AL寄存器。- 原理解析: x86 作为 CISC 架构,专门设计了变址寄存器(如
ESISource Index )。在这个例子中,1000H是数组在内存中的首地址(形式地址 \(A\) 保持不变),在循环体中,程序员只需不断执行INC ESI(让 \(ESI\) 加 1),这条MOV指令就能依次取出数组的第 0、1、2... 个元素。(如果数组元素占4字节,则每次变址寄存器I的内容就应该加4。)MIPS 示例: MIPS 没有原生的变址寻址指令!
- MIPS 是 RISC 架构,追求指令格式简单和极速解码。如果允许像 x86 那样把一个 32 位的数组基地址(\(A\))和寄存器编号都塞进一条指令里,32 位的指令长度根本不够用。
变址寻址和基址寻址的区别是什么?
变址寻址方式和基址寻址方式的有效地址形成过程类似。但是,基址寻址方式与变址寻址方式在两方面不同:
①具体应用的场合不同。变址寻址面向用户,可用于访问字符串、数组、表格等成批数据或其中的某些元素;基址寻址面向系统,用于解决程序的重定位问题和短地址访问大空间的问题。
②使用方式不同。变址寻址时,指令中提供的形式地址是一个基准地址,位移量由变址寄存器给出;基址寻址时,指令中给出的形式地址为位移量,而基址寄存器中存放的是基准地址。不过,这里所讲的使用方式并不是绝对的,实际中可能会有不同的应用场合和使用方式。
| 特性 | 基址寻址 (Base) | 变址寻址 (Indexed) |
|---|---|---|
| 公式 | \(EA = (B) + A\) | \(EA = (I) + A\) |
| \((B)\)或\((I)\)存什么? | 存基准地址 (程序起点) | 存偏移量 (数组下标) |
| \(A\)存什么? | 存偏移量 | 存基准地址 (数组首地址) |
| 谁来修改寄存器? | 操作系统 (OS) | 用户/程序员 |
| 执行过程中寄存器内容 | 保持不变 | 不断变化 |
| 主要应用场景 | 多道程序定位、解决内存分配 | 遍历数组、循环控制 |
堆栈寻址
堆栈以先进后出的方式存储数据。寻找存放在堆栈中操作数地址的方法称为堆栈寻址。堆栈有存储器堆栈和寄存器堆栈两种,前者在内存空间中开辟堆栈区,后者将寄存器作为堆栈区无论是哪种类型的堆栈,数据的存取都通过栈顶进行。堆栈操作有进栈和出栈两种,进栈是将指定数据传送到堆栈中;出栈是将栈顶的数据传送给指定的寄存器。
- 存储器堆栈
为满足用户对堆栈容量的要求,目前计算机普遍采用存储器堆栈。由于内存基于地址访问, 因此,需要设置一个堆栈指针寄存器(SP)指向栈顶单元。若主存按字节编址,以字节为单位进出栈,则进栈时 SP 向低地址方向变化。存储器堆栈进出栈的操作过程如图所示。
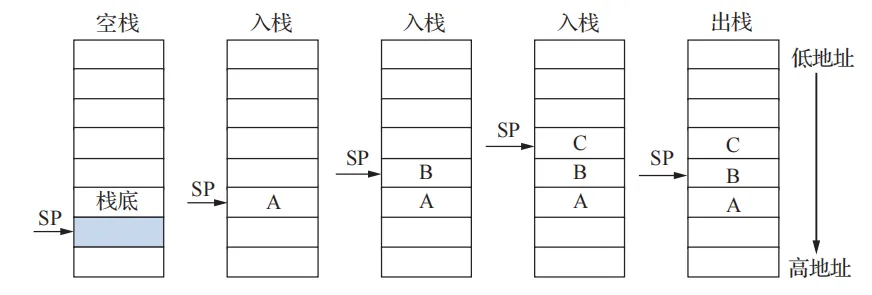
可用下列表达式描述如图所示的存储器堆栈操作。
- 入栈操作:SP=SP-1,M[SP]=R。
- 出栈操作:R=M[SP],SP=SP+1。
注意,如果进出栈时的数据单位不同,SP 每次自减或自增的值会有所不同,如以 32 位字为单位进出栈,上式中 -1 和 +1 应该换成 -4 和 +4。
- 寄存器堆栈
为满足用户对堆栈速度的要求,一些计算机采用了寄存器堆栈。由于寄存器不基于地址访问,因此,与存储器堆栈不同,寄存器堆栈中不需要设置堆栈指示器。寄存器堆栈的操作过程与内存堆栈的操作过程及特征均不同,其进出栈的操作过程如图 5.12 所示。
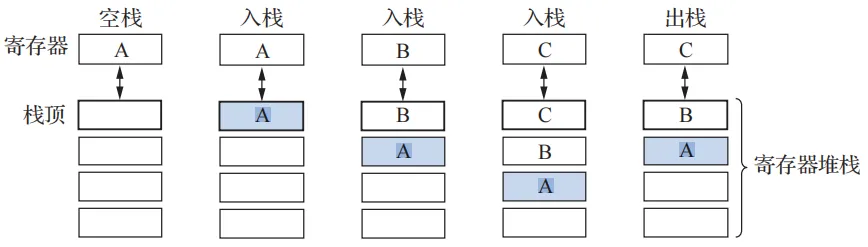
比较图 5.11 和图 5.12 不难发现寄存器堆栈与存储器堆栈存在下列不同。
- 寄存器堆栈栈顶固定不动,而存储器堆栈栈顶随着堆栈操作而移动。
- 进行堆栈操作时,寄存器堆栈中的数据移动,而存储器堆栈中的数据不动。
寄存器堆栈速度快,但容量有限;存储器堆栈速度较慢,但容量很大。 寄存器堆栈必须采用专用堆栈指令进行控制,存储器堆栈则不一定。

【2009-16】某机器字长16位,主存按字节编址,转移指令采用相对寻址,由两个字节组成,第一字节为操作码字段,第二字节为相对位移量字段。假定取指令时,每取一个字节PC自动加1。若某转移指令所在主存地址为2000H,相对位移量字段的内容为06H,则该转移指令成功转移后的目标地址是( )。
A. 2006H
B. 2007H
C. 2008H
D. 2009H
解析
答案:C
- 题目中“每取一个字节PC自动加1”,该转移指令由两个字节组成。
- 当取出并执行这条指令时,PC已经取完了这2个字节。指令所在初始地址为 2000H,取2个字节后,PC的值为
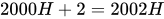 (此时PC指向下一条指令的地址)。
- 相对寻址的目标地址计算公式为:目标地址 = (PC) + 相对位移量。
- 目标地址 = 2002H + 06H = 2008H。
【2011-16】偏移寻址将某个寄存器内容与一个形式地址相加而生成有效地址。下列寻址方式中,不属于偏移寻址方式的是( )。
A.间接寻址
B.基址寻址
C.相对寻址
D.变址寻址
解析
答案:A. 间接寻址
偏移寻址是指将某个寄存器的内容(作为基准)与指令字中的形式地址(作为偏移量)相加来形成有效地址的寻址方式。包括:
- 基址寻址:(基址寄存器) + 形式地址
- 变址寻址:(变址寄存器) + 形式地址
- 相对寻址:(PC) + 形式地址
而间接寻址是指令字中给出的是操作数有效地址所在的存储单元的地址,即去内存里找地址,不涉及加法偏移,因此不属于偏移寻址。
【2013-17】假设变址寄存器R的内容为1000H,指令中的形式地址为2000H;地址1000H中的内容为2000H,地址2000H中的内容为3000H,地址,3000H的内容为4000H,则变址寻址方式下访问到的操作数是()。
A. 1000H
B. 2000H
C. 3000H
D. 4000H
解析
答案:D
- 变址寻址的有效地址计算公式:
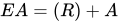 。
- 已知变址寄存器 R 的内容为 1000H,形式地址 A 为 2000H,所以有效地址
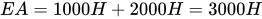 。
- 题目要求的是“访问到的操作数”,即内存地址为 3000H 里的内容。根据题意,“地址3000H的内容为4000H”。
- 因此访问到的操作数是 4000H。
【2014-17】某计算机有16个通用寄存器,采用32位定长指令字,操作码字段(含寻址方式位)为8位,Store指令的源操作数和目的操作数分别采用寄存器直接寻址和基址寻址方式。若基址寄存器可使用任一通用寄存器,且偏移量用补码表示,则Store指令中偏移量的取值范围是( )。
A. -32768~+32767
B. -32767+~32768
C. -65536~+65535
D. -155535~+65536
解析
答案:A
- 指令字长共 32 位。
- 操作码占 8 位。
- 源操作数(寄存器直接寻址):指出是哪个通用寄存器。共有16个通用寄存器,因此需要
 位。
- 目的操作数(基址寻址):需要指出一个基址寄存器(也是从16个通用寄存器中选),占用 4 位。
- 剩下的位数为偏移量:
 位。
- 题目说明偏移量用补码表示。16位补码的表示范围是
 到
 ,即 -32768 ~ +32767。
【2016-17】某指令格式如下所示。
\(\begin{array}{|c|c|c|c|}\hline\text{OP}&\text{M}&\text{I}&\text{D}\\\hline\end{array}\)
其中M为寻址方式,I为变址寄存器编号,D为形式地址。若采用先变址后间址的寻址方式,则操作数的有效地址是( )。
A. I+D
B. (I)+D
C. ((I)+D)
D. ((I))+D
解析
答案:C
- 括号
()在计算机体系结构中表示“取内容”(访存或取寄存器内容)。 - 先变址:变址寄存器 I 的内容加上形式地址 D,得到一个中间地址,即
(I) + D。 - 后间址:以上一步算出的中间地址作为指针,去内存中取真正的有效地址。即取
(I) + D这个地址单元里的内容,表示为((I) + D)。
【2017-15】下列寻址方式中,最适合按下标顺序访问一维数组元素的是( )。
A. 相对寻址
B. 寄存器寻址
C. 直接寻址
D. 变址寻址
解析
答案:D
变址寻址(Index Addressing)的特点是将指令中的形式地址作为基准地址(如数组的首地址),将变址寄存器的内容作为修改量(如数组的下标)。在循环执行时,形式地址不变,只需按规律改变变址寄存器(下标)的内容,便能十分方便地依次访问数组中的元素。这是变址寻址最典型、最重要的应用场景。
【2018-18】按字节编址的计算机中,某double型数组A的首地址为2000H,使用变址寻址和循环结构访问数组A,保存数组下标的变址寄存器初值为0,每次循环取一个数组元素,其偏移地址为变址值乘以sizeof(double),取完后变址寄存器内容自动加1。若某次循环所取元素的地址为2100H,则进入该次循环时变址寄存器的内容是( )。
A. 25
B. 32
C. 64
D. 100
解析
答案:B
- 数组A为 double 型,每个元素占
sizeof(double) = 8个字节。 - 变址寻址的有效地址公式在此处为:
 。
- 已知本次循环访问的元素地址
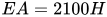 ,首地址 = 2000H。
- 偏移量 =
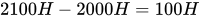 。100H 转为十进制是
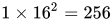 。
- 变址寄存器的值(即下标) = 偏移字节数 / 单个元素字节数 =
 。
【2019-15】某计算机采用大端方式,按字节编址。某指令中操作数的机器数为1234 FF00H,该操作数采用基址寻址方式,形式地址(用补码表示)为FF12H,基址寄存器的内容为F000 0000H,则该操作数的LSB(最低有效字节)所在的地址是( )。
A. F000 FF12H
B. F000 FF15H
C. EFFF FF12H
D. EFFF FF15H
解析
答案:D
这是一个易错题,结合了地址计算和大端模式。
- 求有效地址:基址寻址
 。形式地址 FF12H 是补码,作为负数在与32位的基址寄存器相加时,需要符号扩展为 32 位,即 FFFF FF12H。
计算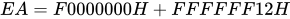 。相加后丢弃最高位的进位,得到
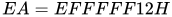 。这是该32位操作数(占用4个字节)的首地址。
- 大小端存放机制:操作数机器数为 12 34 FF 00H。
- 大端方式:最高有效字节(MSB,即 12H)存放在最低地址。
- 地址分布如下:
- EFFF FF12H 存放:12H (MSB)
- EFFF FF13H 存放:34H
- EFFF FF14H 存放:FFH
- EFFF FF15H 存放:00H (LSB,最低有效字节)
- 题目求的是 LSB(00H)所在的地址,即 EFFF FF15H。
【2020-16】某计算机采用16位定长指令字格式,操作码位数和寻址方式位数固定,指令系统有48条指令,支持直接、间接、立即、相对4种寻址方式。单地址指令中,直接寻址方式的可寻址范围是( )。
A. 0~255
B. 0~1023
C. -128~127
D. -512~511
解析
答案:A
- 指令字长 16 位,操作码和寻址方式位数固定。
- 指令系统有 48 条指令,因此操作码固定占用
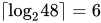 位。
- 有 4 种寻址方式,因此寻址方式字段占用
 位。
- 在单地址指令中,留给形式地址的位数为:
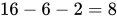 位。
- 直接寻址方式中,形式地址直接作为主存物理地址使用(无符号数表示物理地址单元),8位地址码可寻址的范围是
 到
 ,即 0~255。
【2023-17】某运算类型指令中有一个地址码为通用寄存器编号,对应通用寄存器中存放的是操作数或操作数地址,CPU 区分两者的依据是( )。
A. 操作数的寻址方式
B. 操作数的编码方式
C. 通用寄存器的编号
D. 通用寄存器的内容
解析
答案:A
在通用指令格式中,地址码字段指向了一个通用寄存器。这个寄存器里面装的到底是操作数本身(寄存器寻址)还是操作数所在的内存地址(寄存器间接寻址),完全由指令格式中的寻址方式字段(M位)来指明。CPU在译码阶段会读取寻址方式字段的值,以此决定后续的数据通路是如何走的。