第五章传输层
第五章 传输层
5.1 传输层的功能
传输层是面向通信部分的最高层,用户功能中最低层
- 端到端的通信,即提供了不同主机上的进程之间的逻辑通信。
“逻辑通信”的意思是:从应用层来看,只要把应用层报文交给下面的运输层,运输层就可以把这报文传送到对方的运输层(哪怕双方相距很远,例如几千公里),好像这种通信就是沿水平方向直接传送数据。但事实上这两个运输层之间并没有一条水平方向的物理连接。“逻辑通信”的意思是“好像是这样通信,但事实上并非真的这样通信”。网络层为主机之间提供逻辑通信。
- 复用和分用
注意:网络层也有复用和分用,复用指发送方不同协议的数据可以封装成IP数据报发送出去,分用是接收发在剥去首部后可以把数据交付给相应的协议。
SAP服务访问点是计算机网络中相邻层实体之间进行通信的逻辑接口
SAP服务访问点:各层 SAP 的表示形式是对应层第一个单词的第-个字母加上“SAP”
- 物理层服务访问点 PSAP (Physical layer Service Access Point):网络通信中设备的具体物理接口;
- 数据链路服层务访问点 DLSAP (Data Link Control layer Service Access Point):物理接口的 MAC 地址;
- 网络层服务访问点 NSAP (Network layer Service Access Point):各物理接口上配置的网络地址(如IP地址,但在OSI/RM 中网络地址不一定是 IP 地址,要视具体的网络层协议而定,如还可以是 IPX 地址);
- 传输层服务访问点 TSAP (Transport layer Service Access Point):具体网络应用进程通信所用的传输层端口;
- 会话层服务访问点 SLSAP (Session layer Service Access Point):具体网络应用会话进程;
- 表示层服务访问点 PLSAP (Presentation layer Service Access Point):具体网络应用进程中的用户标识。
- 复用:在发送方不同的应用进程都可以使用同一个运输层协议传(TCP/UDP)送数据(当然需要加上适当的首部)
- 分用:指接收方的运输层在剥去报文的首部后能够把这些数据正确交付目的应用进程
- 流量控制
- 差错控制
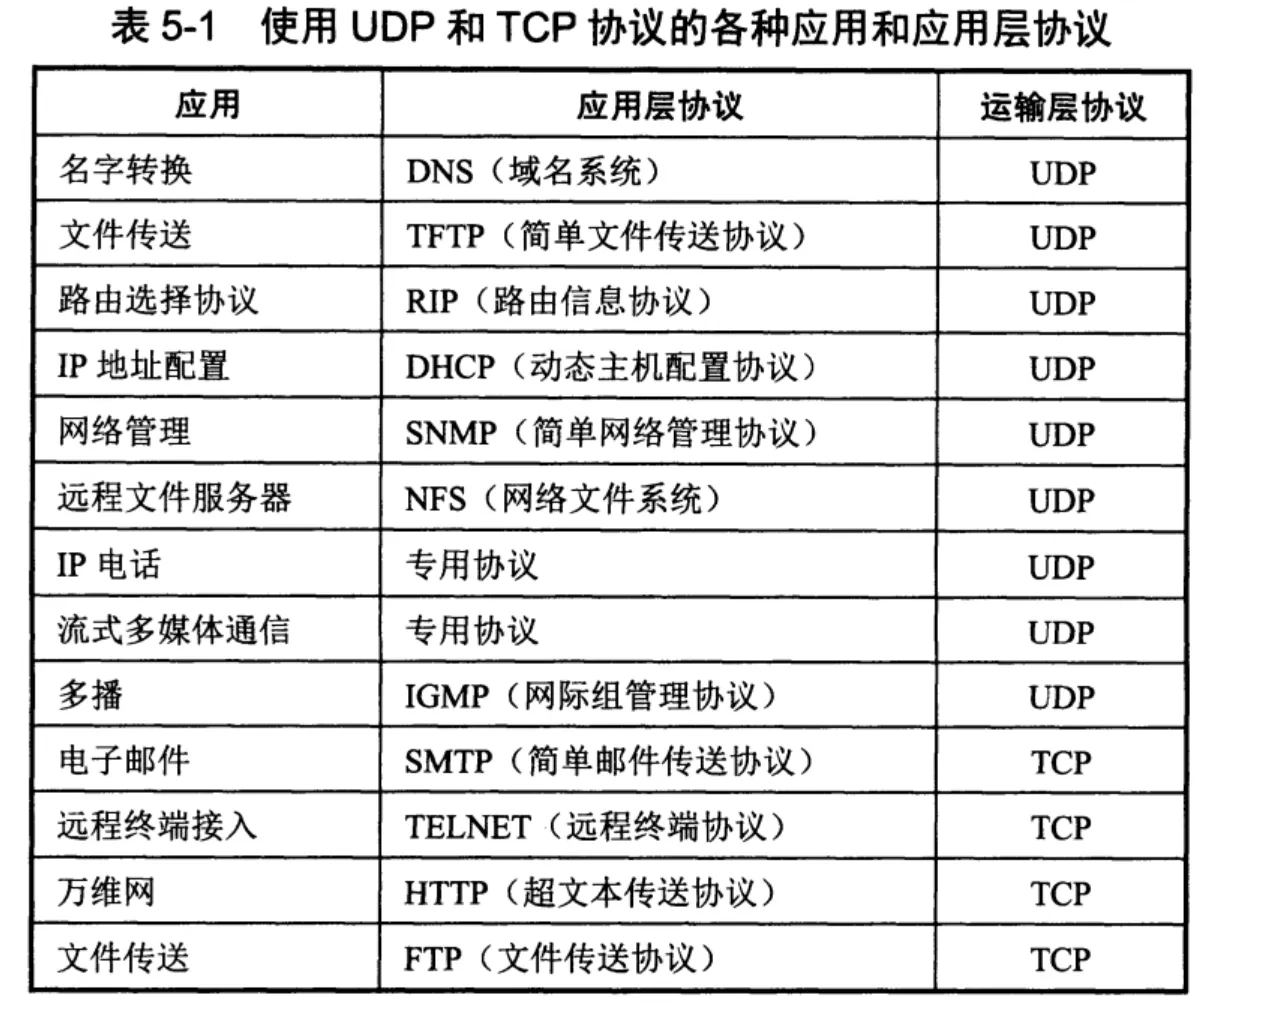
5.2 UDP
- UDP的特点(和TCP对比)
| 传输层功能 | UDP | TCP |
|---|---|---|
| 复用和分用 | √ | √ |
| 逻辑通信 | 不可靠无连接、支持一对一、一对多、多对一 | 可靠面向连接 |
| 发送长度 | 面向报文,应用层给多长的报文就发多长的报文,一次发送一个报文 | 面向字节流 |
| 校验和 | 可检测也可不检测,对伪首部+首部+数据进行校验、出错丢弃或向上层报告这是一个错误的报文段 | 必须检测,方法同UDP |
| 流量控制 | 无 | 有 |
| 拥塞控制 | 无 | 有 |
| 状态 | 无连接状态 | 需维护接收/发送缓存、拥塞控制参数和序号、确认号等参数 |
- UDP报文格式(首部8B+数据部分)
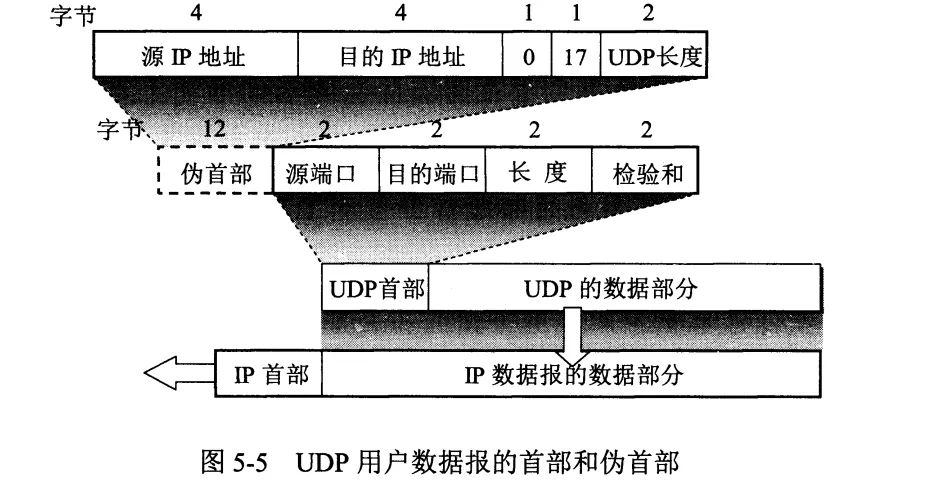
- 源端口(2B)
- 目的端口(2B)
- 长度(2B):首部+数据长度,单位字节。最小是8B
- 检验和(2B):
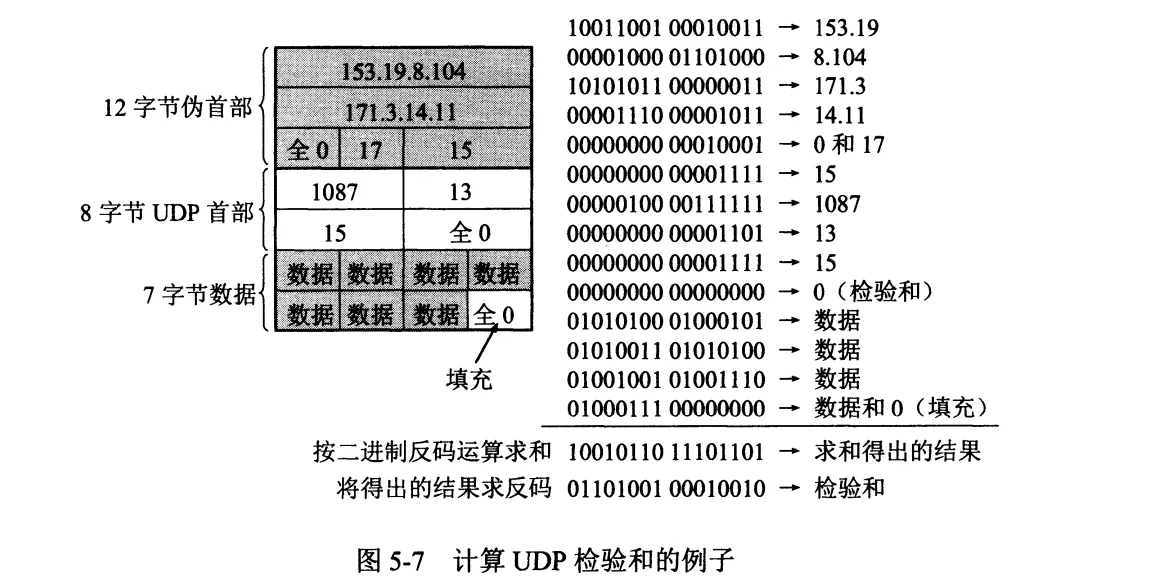
    * 校验和的校验范围:12B伪首部+8B首部+数据部分(+补充为偶数字节数的全0字节)
    * 发送方校验和计算步骤
        1. 每16bit(2B)为一个字进行16位求和
        2. 求和后最高位有进位,把进位的数在最低位再加上(回卷)
        3. 对求得的结果取反
    * 接收方校验:将伪首部和UDP报文按16bit进行二进制加法,所得为全1,传输无误。
    * 注意:全0校验和表示不进行UDP校验。伪首部和全0字节不发送。
5.3 TCP
- TCP的特点
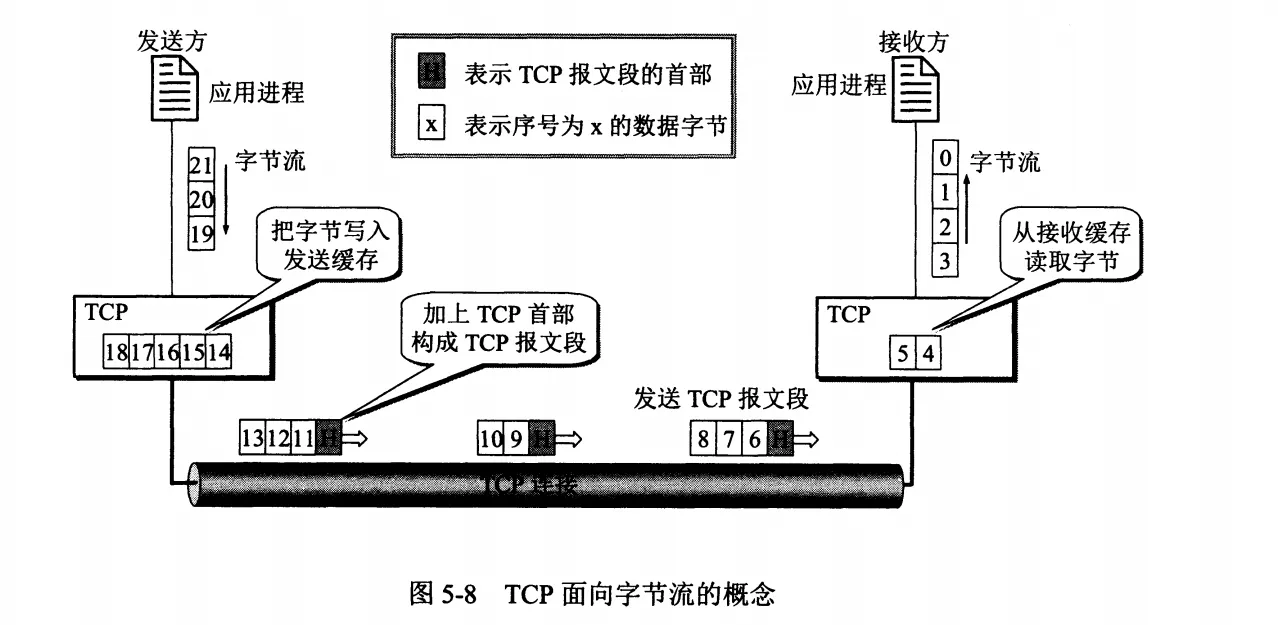
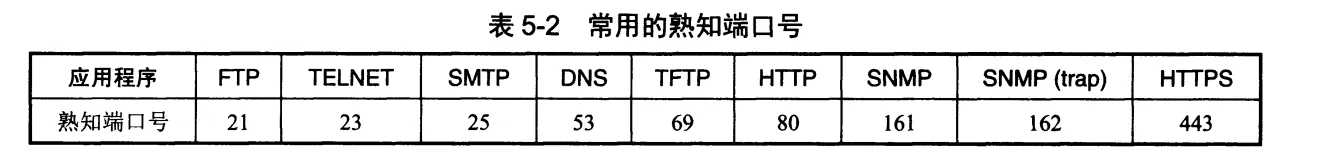 \(套接字socket =(IP地址:端口号)\) 每一条 TCP 连接唯一地被通信两端的两个端点(即两个套接字)所确定。即:\(TCP连接::=\) {\(socket1,socket2\)} = {\((IP1:port1;),(IP2:port2)\)}
- TCP报文段的首部格式(首部前20B固定,最长60B)
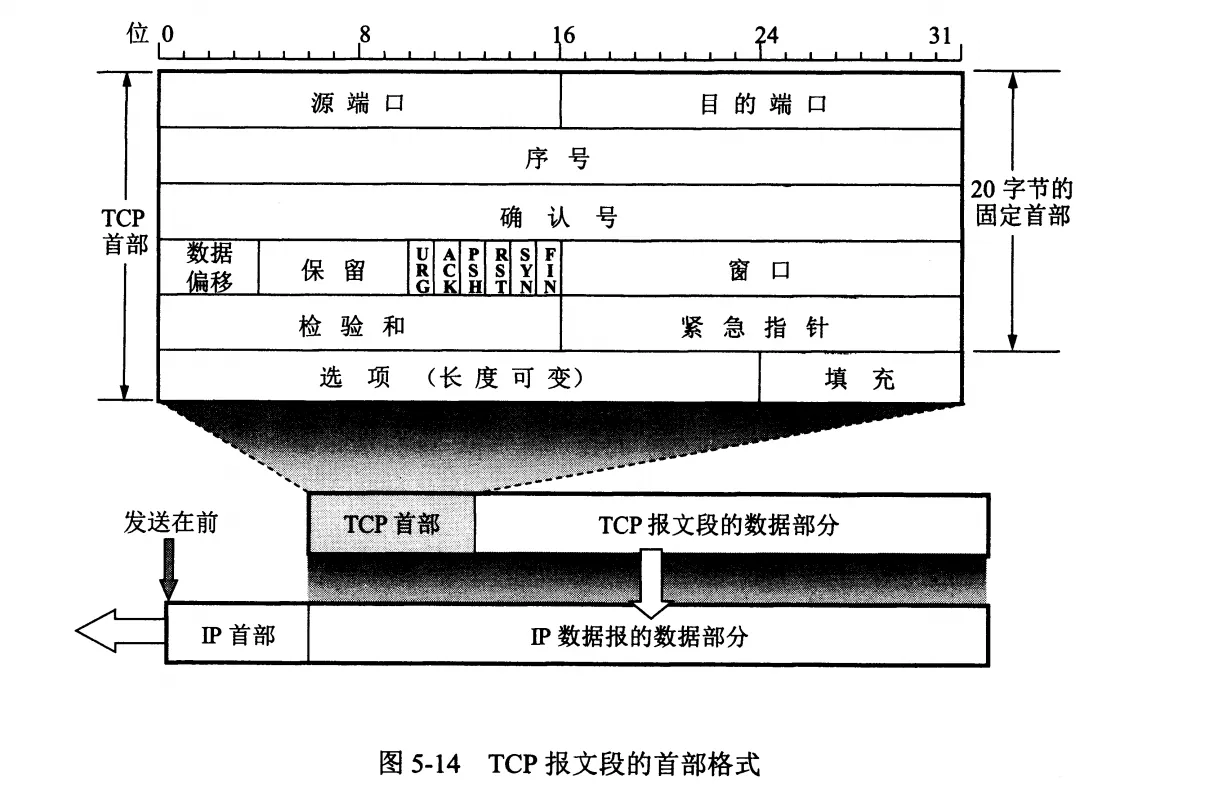
- 源端口/目的端口 (各2B)
- 序号(4B),表示本报文段数据的第一个字节的序号,最大序号是2<sup>32</sup>-1,下一个序号又回到0。
- 确认号ack(4B):当确认位ACK为1,确认号ack才有意义。表示期待接收到的下一个报文段的第一个数据字节的数据。
若确认号为N,则表明:到序号N-1为止的所有数据都已正确收到。
- 数据偏移(4bit):与IP数据报偏移量不同,这里是指<strong>数据部分第一个字节距离首部起始位置的距离,也即TCP报文首部的长度</strong>。以4B为单位,占4bit,最大值15,所以首部最长60B。
- 保留(6bit):日后使用。
- 6bit控制位
    * 紧急位(“<strong>插队位</strong>”)URG ,配合紧急指针使用,URG为1时紧急指针有效;
    * 确认位ACK,<strong>连接后始终为1</strong>。
    * 推送位PSH:置1表示不必等接收缓存满了再交付,而是尽快交付。(很少使用)
    * 复位位RST:置1表示连接出现重大错误,需要重连。也可以用来拒绝非法报文段。
    * 同步位SYN:连接请求(<strong>ACK = 0</strong>,SYN = 1),连接请求确认报文(ACK = 1,SYN = 1)。
    * 终止位 FIN:置1时表示发送数据完毕,要释放连接。
- 窗口(2B):(我自己)接收窗口大小,以字节为单节
- 检验和字段(2B):伪首部和UDP几乎一样,17改为6,UDP长度改为TCP长度。计算步骤一致
- 紧急指针(2B):URG=1才有意义,表示<strong>有多少字节的紧急数据</strong>(紧急数据在报文数据部分最前面),即使窗口为0紧急数据也能发送。
- 选项:最大40B,比如MSS的长度选项:每一个TCP报文段中的数据段的<strong>数据字段</strong>的最大长度,不包括TCP首部。MSS和窗口值无关。
正常情况下,TCP发送报文的长度规则:
①缓存中存放的数据到达MSS字节时,就组装成一个TCP报文发送出去。
②由应用进程指明要求发送报文段,即TCP支持的PUSH(推送)操作
③发送方的一个计时器期限到了,即使没达到MSS也发送出去。
④若接收窗口没有MSS大小,应等待接收窗口达到MSS一半或者MSS,两者任一时机再发送。
Nagle算法:对于一个TCP连接,第一个字节立马发送出去,然后继续缓存要发送的数据,收到上一个字节的确认再发送已缓存的数据。每轮等到上一个报文段的数据全部确认后再发送已缓存好的下一个报文段。
- 填充:为了确保整个首部是4B的整数倍
- TCP的连接/释放
- TCP三次握手
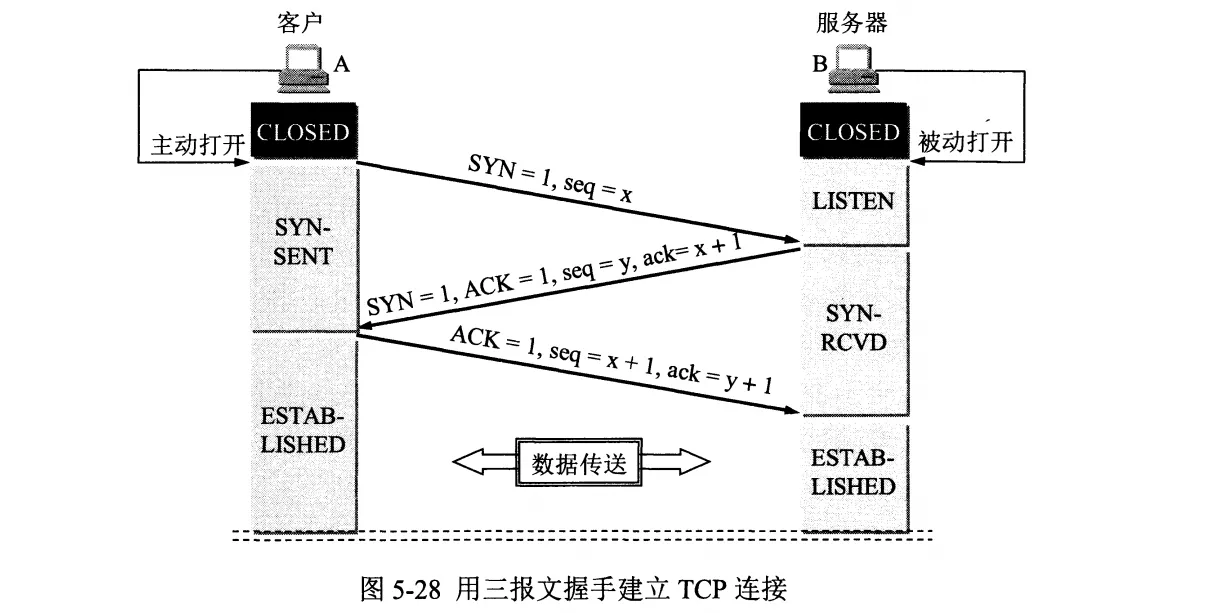
- 客户进程A向服务器B发送一个连接请求报文段:SYN=1,seq=x,ACK=0。SYN报文不能携带数据,并且要消耗一个序号,客户进程进入SYN-SENT状态。
- 服务器B收到请求连接后,如同意建立连接,则向A发送确认:SYN=1,ACK=1,ack=x+1,seq=y。也消耗一个序号。服务器B进入SYN_RCVD状态。
- 客户进程A收到B的确认后,还需要给B确认:ACK=1,ack=y+1,自己序号seq=x+1。第三次握手可以携带数据,携带数据则消耗序号,不携带则不消耗,在不携带情况下,下一个数据报文段的序号仍是seq=x+1。此时连接已建立,A进入ESTABLISHED状态
- TCP四次挥手
- TCP三次握手
最长报文段寿命MSL(Maximum Segment Lifetime):指一个报文段在网络中最长的生存时间,由操作系统决定,在几十秒到几分钟之间。
作用:
①确保A发送的最后一个确认报文段(第四次挥手)能成功到达B。如果A立马释放连接进入CLOSED关闭状态,那么确认报文段可能丢失,服务器B会超时重传FIN+ACK报文段(第三次握手),A此时已经关闭,B无法正常释放。正确做法是,进行2MSL计时,若A重复收到B的FIN+ACK释放报文,那么A的确认报文一定丢失了,需要重发确认报文段并且2MSL重新计时。
②由于各个TCP报文段到达主机的时间长短不一,那么客户进程A在收到FIN+ACK释放报文后,可能还有携带数据的报文段未接收到,如果此时进行第四次挥手,然后又立马建立下一次TCP连接,那么上一次结束的TCP连接中未收到的报文段的数据序号会对新的TCP连接产生影响,而经过2MSL可以确保旧的报文段在网络中完全消失,此时进入CLOSED可以完全避免这一情况
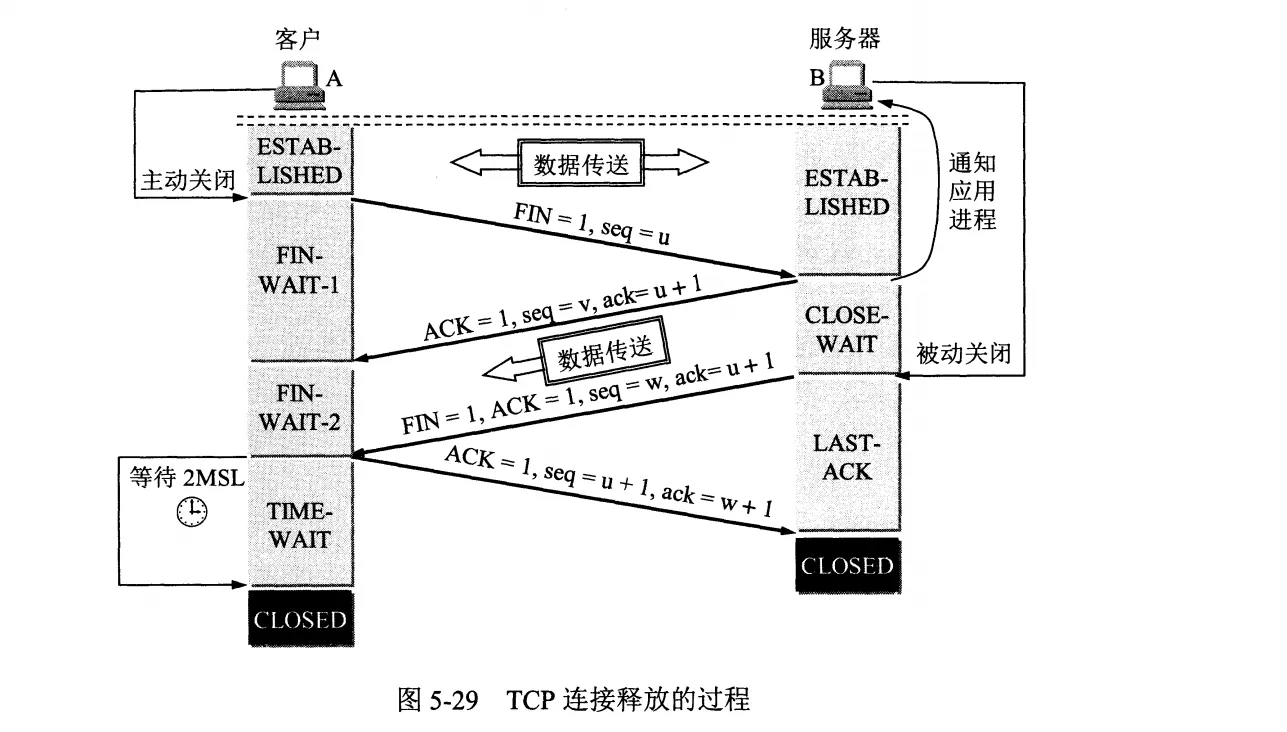
    1. 通信双方都可释放连接,假设客户进程A释放连接。A发出连接释放报文段,并停止发送数据:FIN=1,seq=u。<strong>FIN报文段不携带数据,但是消耗一个序号。</strong>客户进程A进入FIN-WAIT-1状态。
    2. 服务器B收到连接释放报文段后发出确认,ack=u+1,seq=v,ACK=1。B进入CLOSE-WAIT状态,客户进程收到此报文后进入FIN-WAIT-2状态。
    3. 服务器B传送完剩余要发送的数据后,发出连接释放报文段:FIN=1,ack=u+1,seq=w,ACK=1。服务器进入LAST-ACK状态。
若服务器没有数据要传送,那么第二次和第三次挥手可以合并成一次。所以从客户机发出FIN开始到通信双方进入CLOSED关闭状态,客户机最短1RTT+2MSL,服务器最短为1.5RTT
4. 客户进程A对B的连接释放报文段进行确认:ACK=1,seq=u+1,ack=w+1,然后进入TIME-WAIT阶段,必须经过时间等待计时器(TIME-WAIT timer)设置的时间2MSL后,A才进入CLOSED状态。
- TCP可靠性的工作原理
- 超时重传:每发送完一个分组时设置一个超时计时器。如果在超时之前收到了确认就撤销计时。否则就认为分组丢失了,因而要重传前面发送过的分组。
- 发送方在发送完一个分组后,必须暂时保留自己已发送的副本(在发送超时重传时使用),收到相应的确认后清除暂时保留的副本。
- 分组和确认都应该进行编号,这样才能收到确认的是哪个分组。若收到两个重复的分组,那么一定是发生了超时,丢弃较晚接收的分组并回送确认。
- 超时重传:每发送完一个分组时设置一个超时计时器。如果在超时之前收到了确认就撤销计时。否则就认为分组丢失了,因而要重传前面发送过的分组。
超时重传时间如何确定?
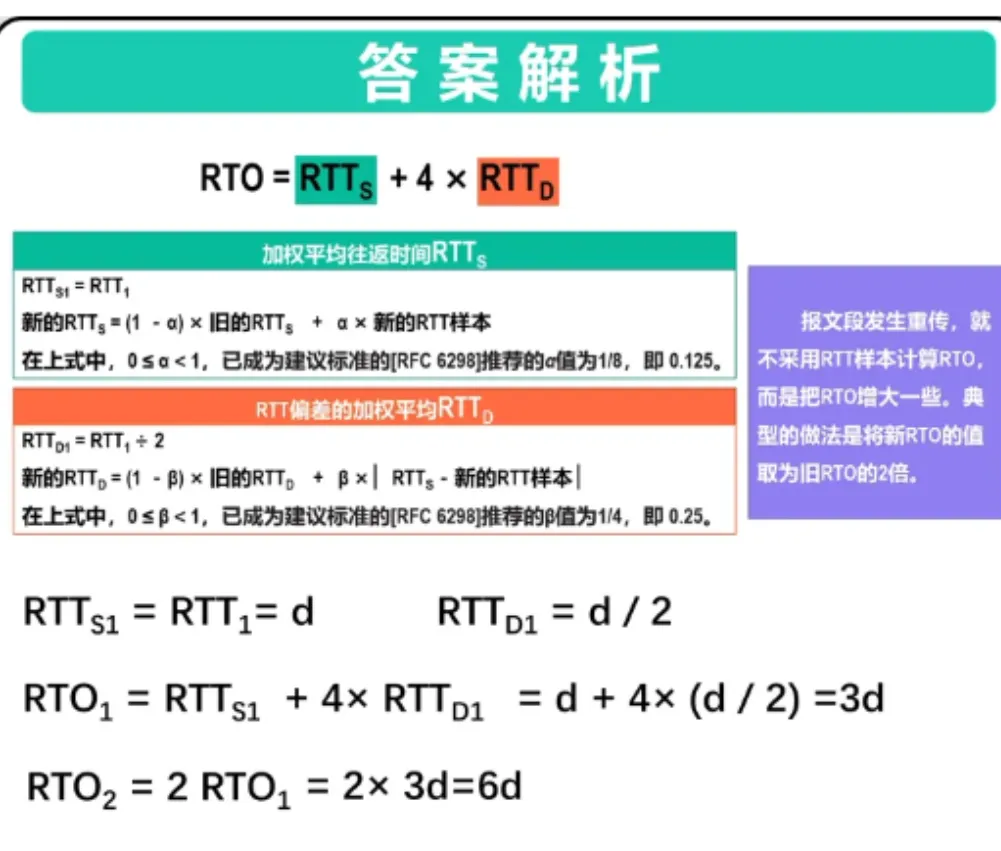
- 往返时间 RTT:自适应地记录一个报文段发出的时间,以及收到相应的确认的时间。
- 加权平均往返时间\(RTT_s\)。第一次测量到地RTT样本时,\(RTT_s\)就取这个RTT样本值。后续计算如下:\(\text{新的 RTT}_\mathrm{S}=(1-\alpha)\times(\text{旧的 RTT}_\mathrm{S})+\alpha\times(\text{新的 RTT 样本}),0≤\alpha<1,推荐的\alpha是1/8\)
超时重传时间RTO,应稍大于加权平均往返时间\( RTT_s \)\( \mathrm{RTO}=\mathrm{RTT_S}+4\times\mathrm{RTT_D} \)\( \text{新的 RTT}_{\mathrm{D}}=(1-\beta)\times(\text{旧的 RTT}_{\mathrm{D}})+\beta\times|\text{RTT}_{\mathrm{S}}-\text{ 新的 RTT 样本}|,\beta 推荐值1/4 \)
按推荐值推算可总结为以下:①第一次测量,直接把样本测量rtt1设为当前rtts1。②第二次测量的样本rtt2,则把当前rtts2设为rtt1×0.875+rtt2×0.125,以此类推。③rto始终是rtts的3倍,在超时情况下,简单的令为前一轮次rto的2倍.
答案:D。
- 自动重传(ARQ)
TCP采用累计确认(稍待确认),有时也采用SACK对非按序到达的报文段进行确认,可以看作GBN和SR的结合。确认号字段不变,此外需要在可选字段添加“允许SACK”的选项(具体实现无需了解)
    * 停止等待协议
    * 连续ARQ协议
- TCP的流量控制:让发送方发送速率不要太快,接收发来得及接收,由滑动窗口实现。
- 滑动窗口
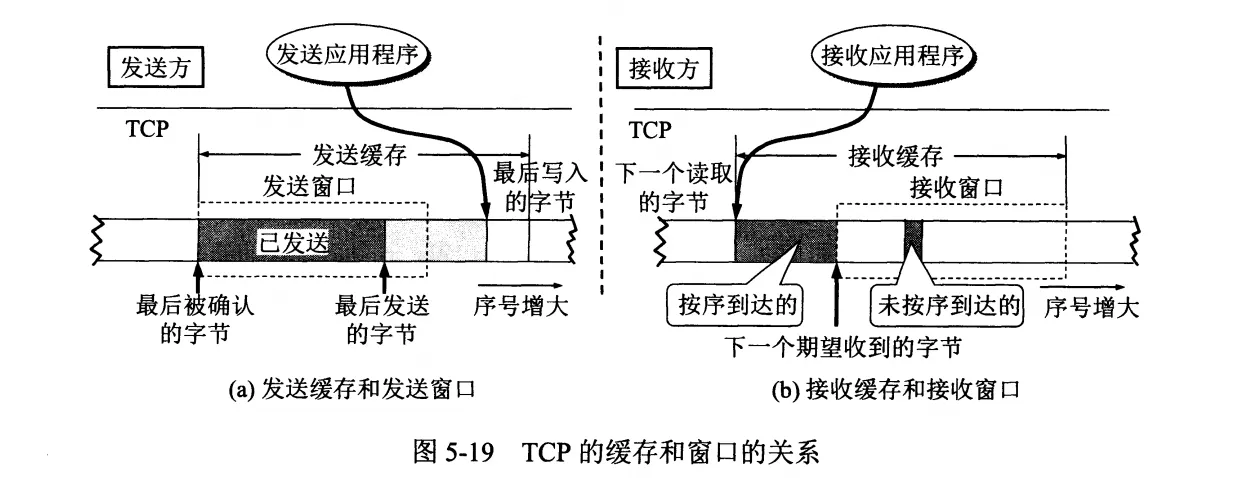
- 发送缓存:应用层想要发送的数据。缓存空间有限并且循环使用,逻辑上是一个圆。其中包含两个部分:①发送方的应用程序传送给发送方TCP准备发送的数据。②TCP已发送出但未收到确认的数据。
-
发送窗口:发送窗口里的序号表示允许发送的序号。包含:①已经发送了的但是还未收到确认的②允许发送但是还未发送的。
- 发送窗口左端点在收到新的确认后往右移动,没收到确认则不动。
- 发送窗口右端点通常是不断往右移动,因为收到了新的确认。但是也可能不动,因为接收发的接收窗口变小了,导致不动。但是TCP标准不赞成往左移动,因为窗口里的数据大部分已经发送出去,现在又要收缩窗口,不让发送这些数据,这样就会产生一些错误。 * 接收缓存:即将交给应用层的数据。包含:①按序到达的、但尚未交付应用进程的数据②未按序到达的 * 接收窗口:用来接收即将到达的数据,按序达到的数据,发送确认后接收窗口往右移动,但是不能超过接收缓存的范围。
- 滑动窗口
发送窗口的序号集是发送缓存序号集的子集。
接收窗口的序号集是接收缓存序号集的子集。
- TCP的拥塞控制
研究前提:
①数据是单方向传送,接收方只传送确认报文
②接收发总是有足够大接收缓存,因而发送窗口大小由网络的拥塞程度(拥塞窗口)来决定。
拥塞窗口(cwnd):取决于网络的拥塞程度,动态变化。所有的拥塞控制算法本质上都是控制每对TCP传输中发送方的cwnd。
实际的发送窗口=min{rwnd,cwnd};rwnd为接收方的接收窗口。
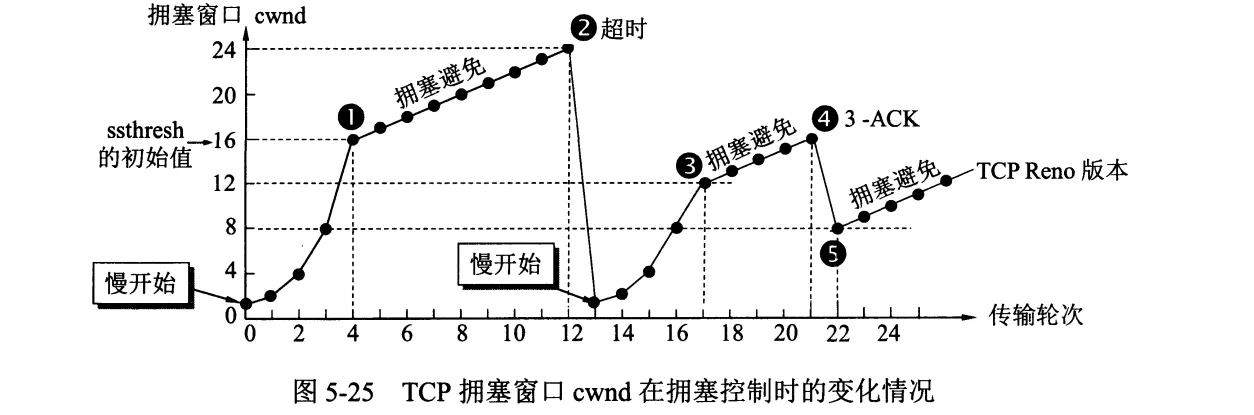
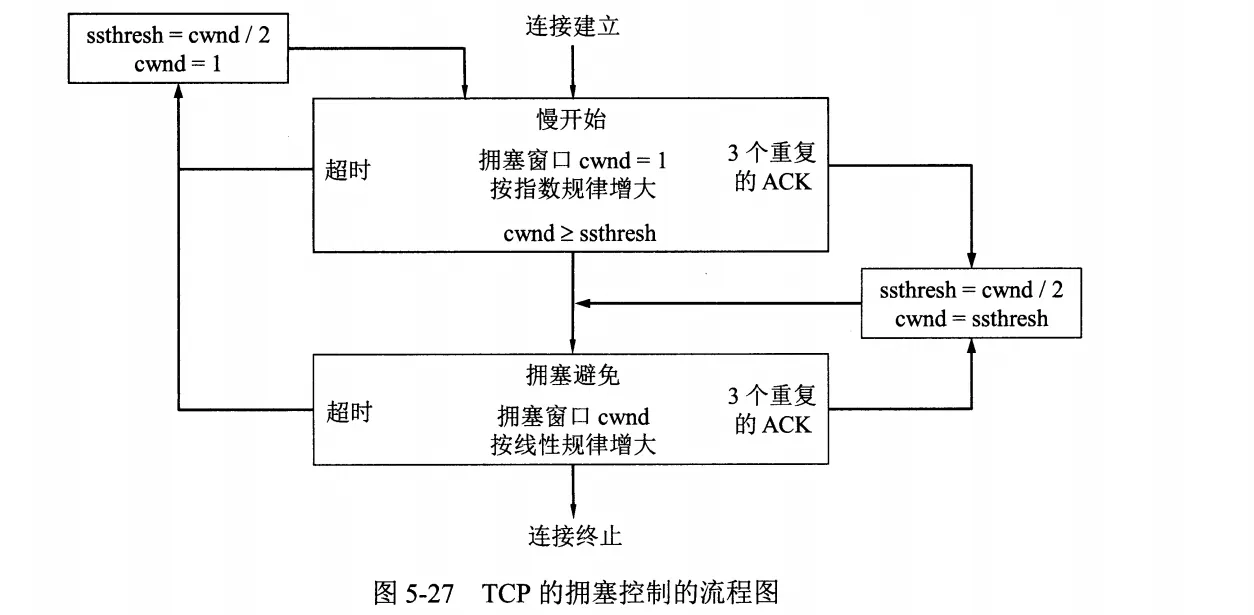
- 慢开始算法:<strong>每收到1(MSS)的报文段的确认后,拥塞窗口大小增加1(MSS)</strong>。这样每经过一个传输轮次(也即1个RTT),拥塞窗口cwnd就翻倍(指数增长)。慢开始的“慢”并不是指cwnd增长速率慢,而是指刚开始cwnd设为1,比一上来就向网络注入大量报文段“慢”得多。
- 拥塞避免算法:<strong>每收到1(MSS)的报文段的确认后,拥塞窗口大小增加</strong>$\frac{1}{cwnd}$<strong>(MSS)</strong>。这样每经过一个传输轮次(也即1个RTT),拥塞窗口cwnd就+1。(加法增大)
为了防止拥塞窗口 cwnd 增长过大引起网络拥塞,还需要设置一个慢开始门限 ssthresh状态变量。慢开始门限ssthresh 的用法如下:
当 cwnd<ssthresh 时,使用慢开始算法。
当cwnd>ssthresh 时,停止使用慢开始算法而改用拥塞避免算法
当cwnd=ssthresh 时,既可使用慢开始算法,也可使用拥塞避免算法
- 出现超时:发送方判断为网络拥塞,门限值 ssthresh=cwnd/2,同时设置拥塞窗口cwnd=1,进入慢开始阶段。
- 快重传:发送方一连收到 3个对同一个报文段的重复确认(即一共收到4个对一个报文段的确认报文),这是个别报文段丢失而不是网络拥塞,所以应立即重传。
- 快恢复:快重传后不启动慢开始,而是快恢复。发送方调整门限值ssthresh=cwnd/2,同时设置拥塞窗口cwnd=ssthresh,并开始执行拥塞避免算法。
- 流量控制和拥塞控制的区别
拥塞控制与流量控制的关系密切,它们之间也存在着一些差别。
拥塞控制就是防止过多的数据注入到网络中,这样可以使网络中的路由器或链路不致过载。拥塞控制是一个全局性的过程,涉及到所有的主机、所有的路由器,以及与降低网络传输性能有关的所有因素。
流量控制往往是指点对点通信量的控制,是个端到端的问题(接收端控制发送端)。流量控制所要做的就是抑制发送端发送数据的速率,以便使接收端来得及接收。