程序访问的局部性原理
一、 核心概念与本质
在较短时间间隔内,程序产生的地址往往集中在存储空间的一个很小范围,这种现象称为程序访问的局部性 。掌握局部性,核心在于区分时间和空间两个维度:
- 时间局部性 : 强调“重复访问”。被访问的某个存储单元在一个较短的时间间隔内很可能又被访问 。
- 空间局部性 : 强调“按序访问”。被访问的某个存储单元的邻近单元在一个较短的时间间隔内很可能也被访问 。
为什么会出现局部性?
- 指令层面: 程序由指令组成,指令在主存中按顺序连续存放;此外,循环程序段或子程序段通常会被重复执行 。
- 数据层面: 数据(尤其是数组等结构)在主存中一般也是连续存放的,常常被按序重复访问 。
步长 k:访问一个连续数组时,每隔 k 个元素访问一次。
- 步长为 1 = 顺序引用模式,是空间局部性最重要的来源
- 步长越大,空间局部性越差
二、 评判局部性的重要原则
在分析任何一段代码时,可以直接套用以下三条原则来快速定性:
- 变量重复原则: 对相同变量有重复访问的程序有良好的时间局部性 。
- 步长最小原则: 步长越小,空间局部性越好 。步长为1的引用模式(顺序引用)空间局部性极佳,而在内存中大步长跳跃会极大破坏空间局部性 。
- 循环体原则: 循环体一般具有良好的时间局部性和空间局部性;循环体越小、迭代次数越多,局部性越好 。(循环体指令连续存放 → 空间好;反复执行 → 时间好)
三、 经典代码场景分析
场景一:一维数组的遍历
代码特征: 简单的 for(i=0; i<N; i++) sum += v[i]; 结构 。
- 对于标量变量 (
sum,i): 在每次迭代中都被频繁引用,因此时间局部性极好。因为是单个变量(通常分配在寄存器中),探讨其空间局部性没有意义 。 - 对于数组元素 (
v[i]): 按照内存存储顺序被一个接一个读取,属于完美的步长为1的引用模式,因此空间局部性极好。但每个元素只被访问一次,所以时间局部性很差 。
场景二:行优先 vs 列优先遍历二维数组
前提:数组元素按行优先方式存放在主存,M = N = 2048,每元素4字节。
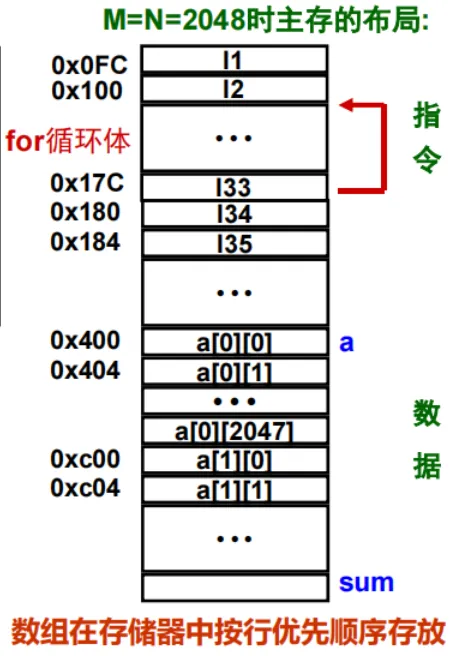
// 程序段 P1:按行遍历(行优先访问)
int sum_array_rows(int a[M][N]) {
    int i, j, sum = 0;
    for (i = 0; i < M; i++)
        for (j = 0; j < N; j++)
            sum += a[i][j];
    // 访问顺序:a[0][0], a[0][1], ..., a[0][2047], a[1][0]...
    return sum;
}

// 程序段 P2:按列遍历(列优先访问)
int sum_array_cols(int a[M][N]) {
    int i, j, sum = 0;
    for (j = 0; j < N; j++)
        for (i = 0; i < M; i++)
            sum += a[i][j];
    // 访问顺序:a[0][0], a[1][0], ..., a[2047][0], a[0][1]...
    return sum;
}
分析对比:
| 分析对象 | P1(行遍历) | P2(列遍历) |
|---|---|---|
| 数组a 空间局部性 | 好(步长1,与存放顺序一致) | 差(步长N=2048,每次跨行跳8KB) |
| 数组a 时间局部性 | 差(每个元素只访问一次) | 差(每个元素只访问一次) |
| 变量 sum 时间局部性 | 好(每次循环都访问) | 好(每次循环都访问) |
| 变量 sum 空间局部性 | 无意义(标量,通常存寄存器) | 无意义 |
| for循环体 空间局部性 | 好(指令连续存放) | 好(指令连续存放) |
| for循环体 时间局部性 | 好(内循环执行2048×2048次) | 好(内循环执行2048×2048次) |
结论:P1 和 P2 功能相同,但因内外循环顺序不同,P1 的空间局部性远优于 P2,实际执行时间差异显著(底层直接原因: Cache命中率不同)。
场景三:结构体数组的空间局部性比较
// clear1:先遍历vel,再遍历acc(两个分离的循环)
for (i = 0; i < n; i++) {
    for (j = 0; j < 3; j++) p[i].vel[j] = 0;
    for (j = 0; j < 3; j++) p[i].acc[j] = 0;
}

// clear2:在同一循环中同时清零vel和acc(合并)
for (i = 0; i < n; i++)
    for (j = 0; j < 3; j++) {
        p[i].vel[j] = 0;
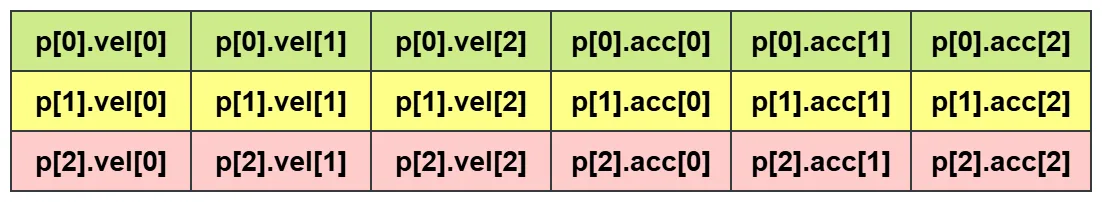
        p[i].acc[j] = 0;   // vel[j] 与 acc[j] 不相邻,最大间隔 3×4=12B
    }

// clear3:外层按字段(j),内层按元素(i)
for (j = 0; j < 3; j++)
    for (i = 0; i < n; i++) p[i].vel[j] = 0;// 相邻两次访问跨越整个结构体,间隔 6×4=24B
    for (i = 0; i < n; i++) p[i].acc[j] = 0;
    }
分析:
- 对于函数
clear1,其数组访问顺序与在内存的存放顺序完全一致,因此,空间局部性最好 - 对于函数
clear2,其数组访问顺序在每个数组元素内跳越式访问,相邻两次访问的单元最大相差3个int型变量(相当于12B),因此空间局部性比clear1差。若主存块大小比12B小,则大大影响命中率。 - 对于函数
clear3,其数组访问顺序与在内存的存放顺序不一致,相邻两次访问的单元都相差6个int型变量(相当于24B)因此,空间局部性比clear2还差。若主存块大小比24B小,则大大影响命中率。
关键洞察:结构体数组中,字段在结构体内是连续存放的,但不同结构体的同名字段之间有跨度。按结构体(行)遍历比按字段(列)遍历的空间局部性好,道理与二维数组行列遍历完全相同。
实战例题
- 【2017-14】 某C语言程序段如下:
下列关于数组a的访问局部性的描述中,正确的是( )。
A. 时间局部性和空间局部性皆有
B. 无时间局部性,有空间局部性
C. 有时间局部性,无空间局部性
D. 时间局部性和空间局部性皆无
解析
本题选A。
分析数组 a 的访问:
- 空间局部性:内层循环顺序访问
a[0], a[1], ..., a[i],步长为1,与存放顺序一致 → 空间局部性好 - 时间局部性:
a[0]在每次外层循环都被访问(共10次),a[1]被访问9次……靠前的元素被反复重复访问 → 时间局部性好
- 假设二维数组
A、B、C的大小均为 \(N \times N\),且在主存中均按行优先方式存放。考虑以下计算矩阵乘法的代码段:
int i, j, k;
for(i = 0; i < N; i++) {
    for(j = 0; j < N; j++) {
        for(k = 0; k < N; k++) {
            C[i][j] += A[i][k] * B[k][j];
        }
    }
}
关于该代码段在最内层循环(k 循环)执行时,数组 A、B、C 的空间局部性,以下说法正确的是( )。
A. 数组 A 和 C 具有良好的空间局部性,数组 B 的空间局部性较差
B. 数组 A 具有良好的空间局部性,数组 B 的空间局部性较差,探讨 C 的空间局部性无意义
C. 数组 A 具有良好的空间局部性,数组 B 和 C 的空间局部性都较差
D. 数组 A、B、C 均具有较差的空间局部性
解析
答案:B
根据题目要求把目光聚焦在最内层循环(这里是 k 变化,而 i 和 j 是常量)。
- 对于
A[i][k]:i固定,k连续变化。访问顺序是A[i][0], A[i][1], A[i][2]...。这与行优先存储完全一致,步长为 1,空间局部性好。 - 对于
B[k][j]:j固定,k连续变化。访问顺序是B[0][j], B[1][j], B[2][j]...。这是在按列访问!每次跳过一整行(N 个元素),步长极大,空间局部性极差。 - 对于
C[i][j]: 注意,在最内层循环中,i和j都是不发生变化的!这意味着在整个k循环(执行 N 次)的过程中,程序始终在对同一个内存单元进行累加。既然它被当作一个类似于标量的单一变量来高频使用(编译器甚至会把它放进寄存器),探讨它在一个循环内的空间局部性是没有意义的(它根本没有向邻近单元移动)。所以选 B。
- 给定两个长度为 \(N\) 的一维数组
a和b(\(N\)极大,远远超过 Cache 容量),针对以下两种代码写法,哪种写法对 Cache 的利用率更高(局部性更好)?( )
// 写法 1:
for(int i = 0; i < N; i++) {
    a[i] = a[i] * 2;
}
for(int i = 0; i < N; i++) {
    b[i] = a[i] + 10;
}

// 写法 2:
for(int i = 0; i < N; i++) {
    a[i] = a[i] * 2;
    b[i] = a[i] + 10;
}
A. 写法 1 更好,因为它把不同的操作分开了,指令的时间局部性更好\
B. 写法 1 更好,因为它对数组 a 的访问具有更好的空间局部性\
C. 写法 2 更好,因为它显著提升了数组 a 的时间局部性\
D. 写法 2 更好,因为它显著提升了数组 b 的空间局部性
解析
答案:C
数组长度  极大,超过 Cache 容量,这意味着数组会被不断挤出 Cache。
- 写法 1: 第一个循环遍历了整个数组
a,第二个循环又重新从头遍历数组a去算b。当第二个循环要用a[0]时,a[0]早就因为 Cache 容量不够被后面的a[99999]替换出去了,必须重新从主存读! - 写法 2: 在一个循环体内,刚刚算完
a[i](此时a[i]还在 Cache 里,热乎着呢),紧接着下一句就立刻使用a[i]去算b[i]。
结论: 对同一个元素 a[i] 的两次访问在时间上被拉到了最近。这是非常典型地通过修改代码逻辑来提升时间局部性的操作,所以选 C。
- 阅读以下程序
int val[N];       // 数组,顺序存放
int idx[N];       // 索引数组,存放0~N-1的随机排列

// 程序M
int sum = 0;
for(i = 0; i < N; i++)
    sum += val[i];

// 程序K
int sum = 0;
for(i = 0; i < N; i++)
    sum += val[idx[i]];
以下说法正确的是( )。
A. M和K对 val 的空间局部性相同,因为都访问了所有元素\
B. K对 idx 有良好的空间局部性,对 val 的空间局部性取决于 idx 中值的分布\
C. K对 val 的时间局部性一定比M好,因为某些元素可能被多次访问\
D. M 和 K 对 val 的时间局部性相同,且均表现出良好的时间局部性,因为两段程序都完整遍历了 val 的所有元素
解析
答案:B
- A 错:M 顺序访问 val(步长1,空间局部性好);K 按 idx 的随机顺序访问 val,若 idx 是随机排列,则 val 的访问是乱序的 → 空间局部性差
- B 正确:K 顺序访问 idx(步长1,空间局部性好);而对 val 的访问顺序由 idx 的值决定——若 idx 恰好是 {0,1,2,...,N-1},则空间局部性好;若 idx 是随机排列,则空间局部性差
- C 错:题目明确 idx 是 0~N-1 的排列(每个值恰好出现一次),所以 val 的每个元素被访问恰好一次,时间局部性与 M 相同(均差)
- D 错:混淆了"访问了所有元素"与"时间局部性好"——后者要求同一元素在短时间内被重复访问,而非访问元素的覆盖度。