并查集(Union-Find)笔记
并查集概述
定义
并查集(Disjoint Set Union,简称 DSU) 是一种处理不相交集合的合并与查询问题的数据结构。
"并"指合并(Union),"查"指查找(Find),"集"指集合这个数学概念。
并查集支持三种基本操作:
| 操作 | 功能描述 |
|---|---|
| Initial(S) | 将集合 S 中的每个元素都初始化为一个独立的单元素集合 |
| Union(S, Root1, Root2) | 将集合 S 中的子集合 Root2 并入子集合 Root1。要求 Root1 和 Root2 分别属于不同的集合,否则不执行合并 |
| Find(S, x) | 查找集合 S 中单元素 x 所在的子集合,返回该子集合的根结点 |
核心思想
用一棵树表示一个集合,树中每个结点代表集合中的一个元素。
- 根结点作为集合的代表
- 查找元素属于哪个集合 → 找该元素所属树的根结点
- 合并两个集合 → 将两个集合对应树的根结点合并即可
并查集的存储结构
双亲表示法
并查集通常采用树的双亲表示法实现,即用一个数组来存储:
- 数组的下标代表某个元素(结点编号)
- 数组元素的值代表该元素的父结点在数组中的下标
根结点的特殊表示:
- 根结点没有父结点,其值为负数
- 负数的绝对值表示该集合中包含的元素个数(集合大小)
这样设计的好处:根结点既可以标识集合,又能记录集合的大小,一举两得。
结构示意图
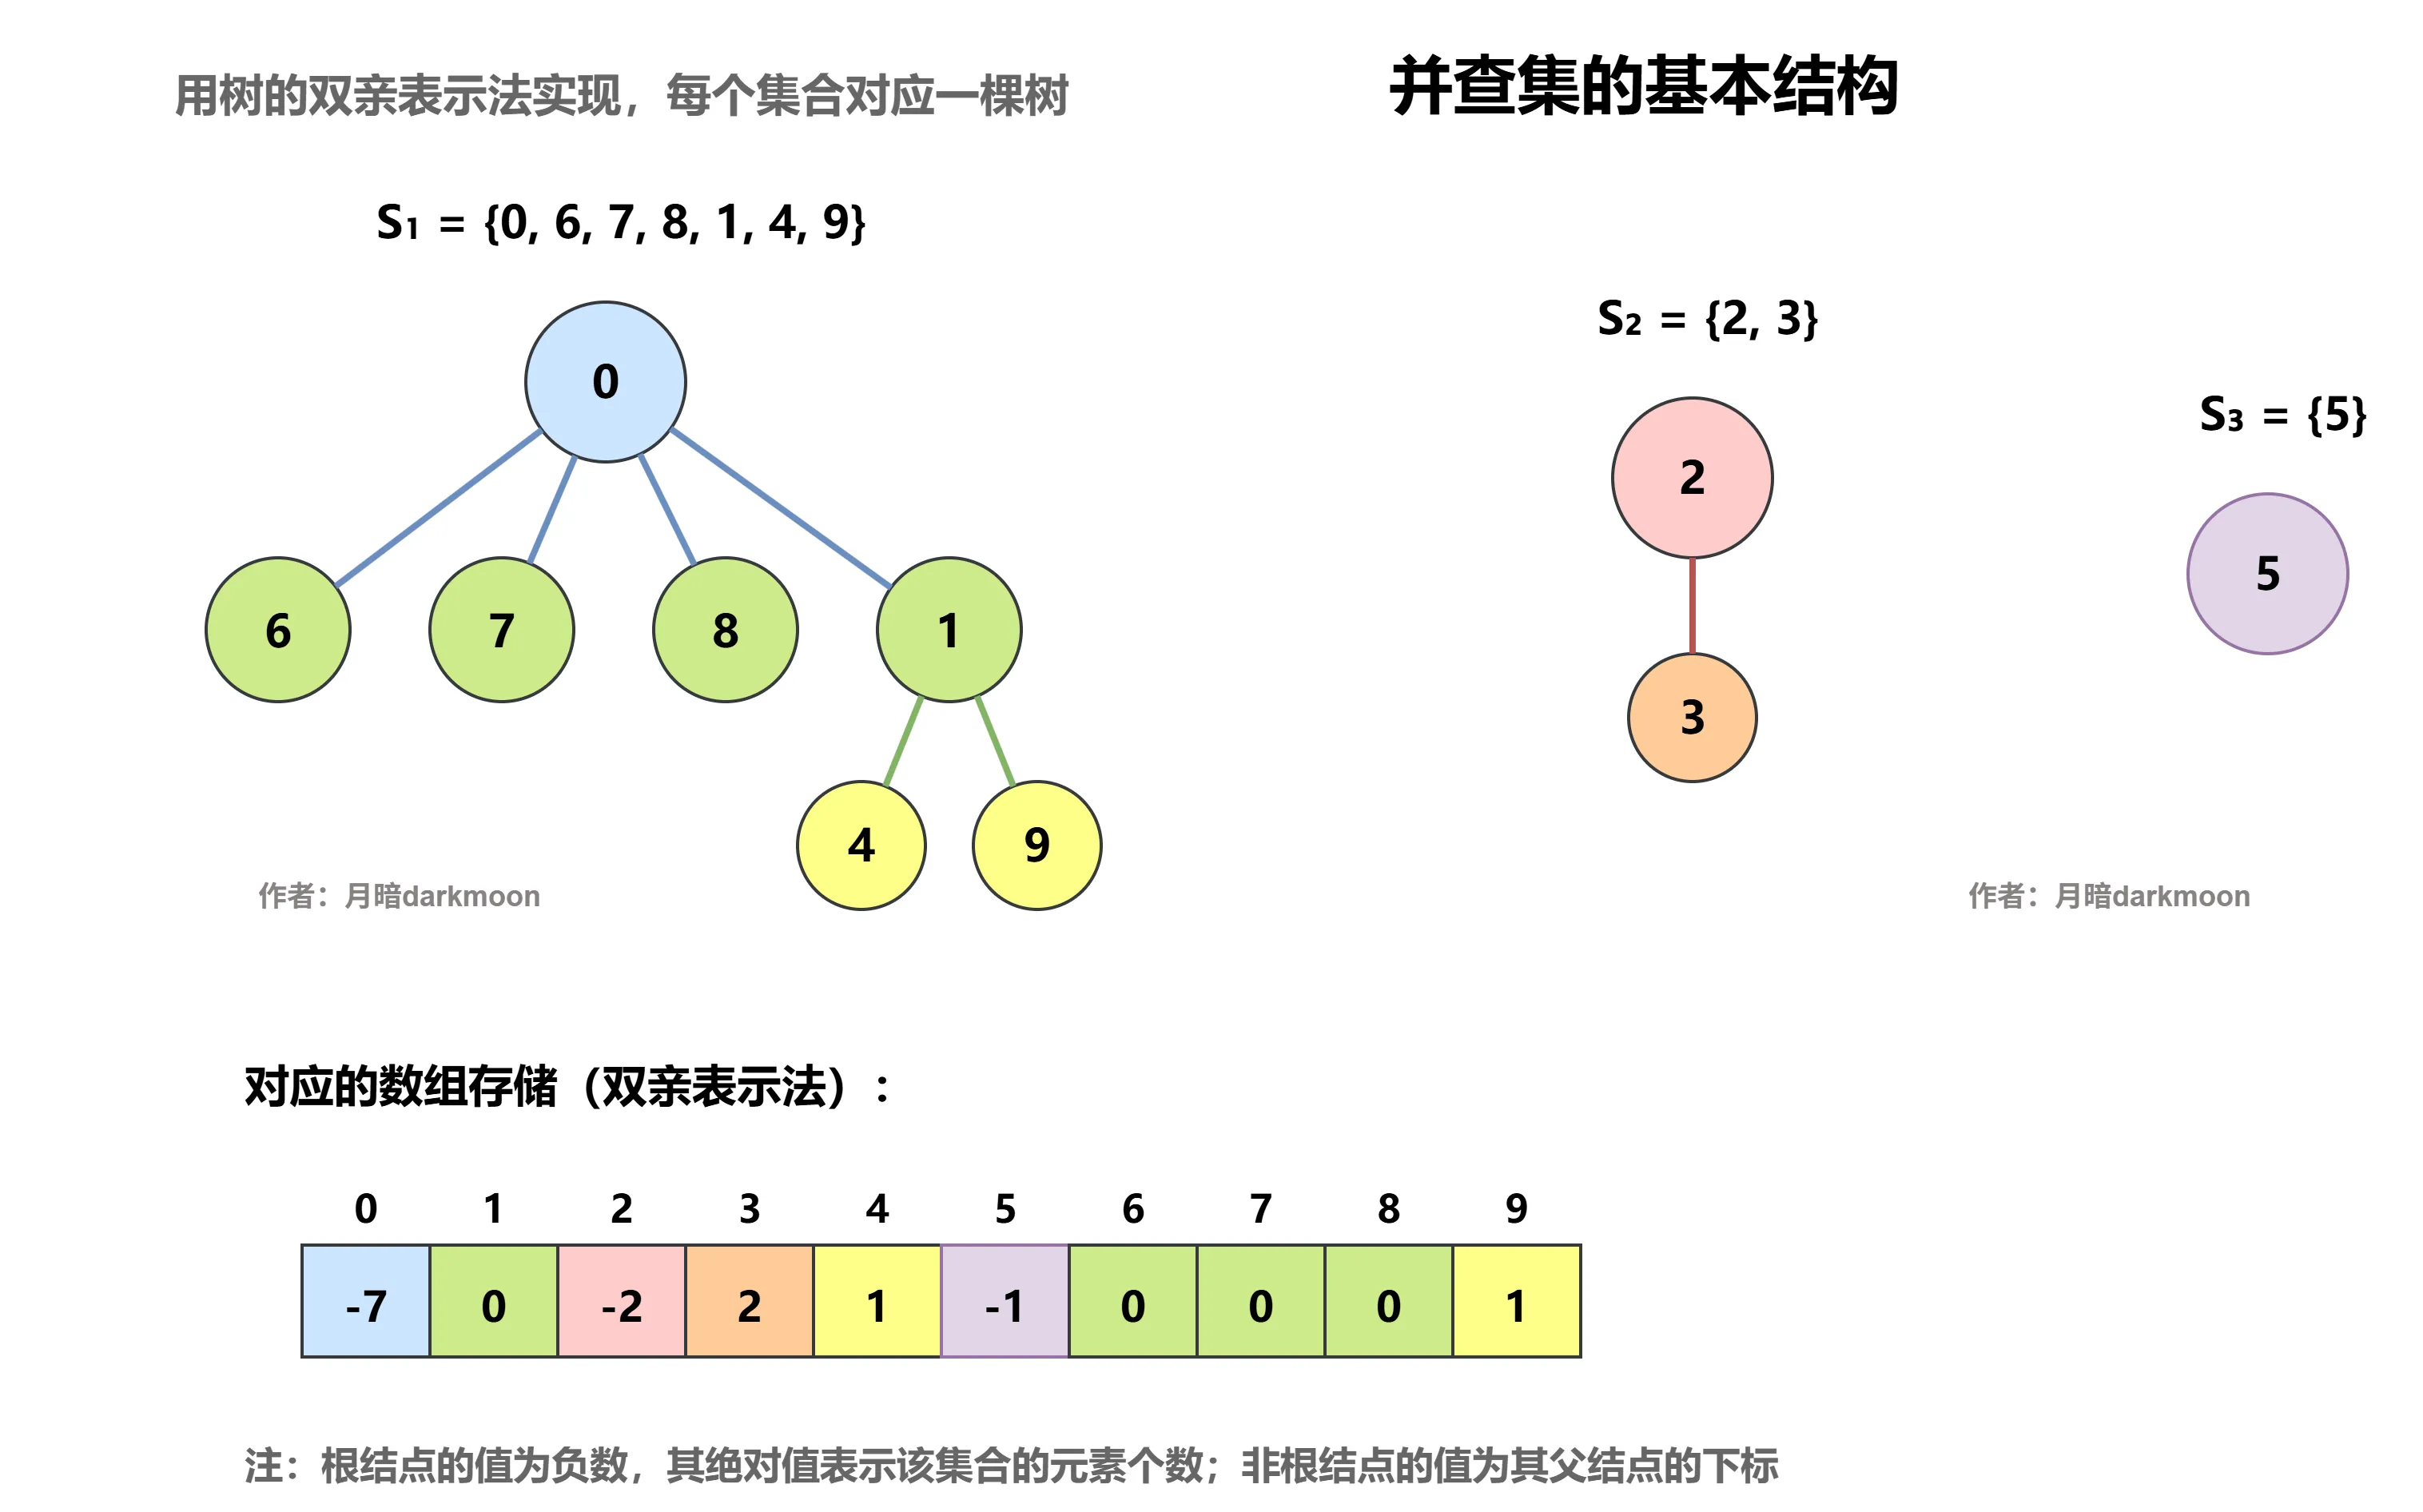
如上图所示:
- S₁ = {0, 6, 7, 8, 1, 4, 9},根结点为 0,
S[0] = -7(集合大小为7) - S₂ = {2, 3},根结点为 2,
S[2] = -2(集合大小为2) - S₃ = {5},根结点为 5,
S[5] = -1(集合大小为1)
C 语言定义
#define SIZE 100  // 集合元素的最大数量

typedef struct {
    int data;           // 元素的数据值
    int parent;         // 父结点在数组中的下标(双亲指针数组)
} UFSType;             // 集合元素的类型定义

typedef struct {
    UFSType *elements;  // 集合元素数组(双亲指针数组)
    int n;              // 集合中元素的个数
} UnionFindSet;        // 并查集类型
注意:当集合内的编号是从 1 ~ n 时,需要申请长度为 n+1 的数组,此时第 0 号元素空缺,其对应的 parent 值默认为 -1。
并查集的基本操作
初始化(Initial)
初始时,每个元素自成一个集合,即每个元素都是根结点。\
因此每个元素的 parent 值都设为 -1(表示集合大小为1)。
代码实现
// 初始化并查集(S 为并查集,n 为元素个数)
void Initial(int S[], int n) {
    for (int i = 0; i < n; i++)
        S[i] = -1;   // 每个元素自成一个集合
}
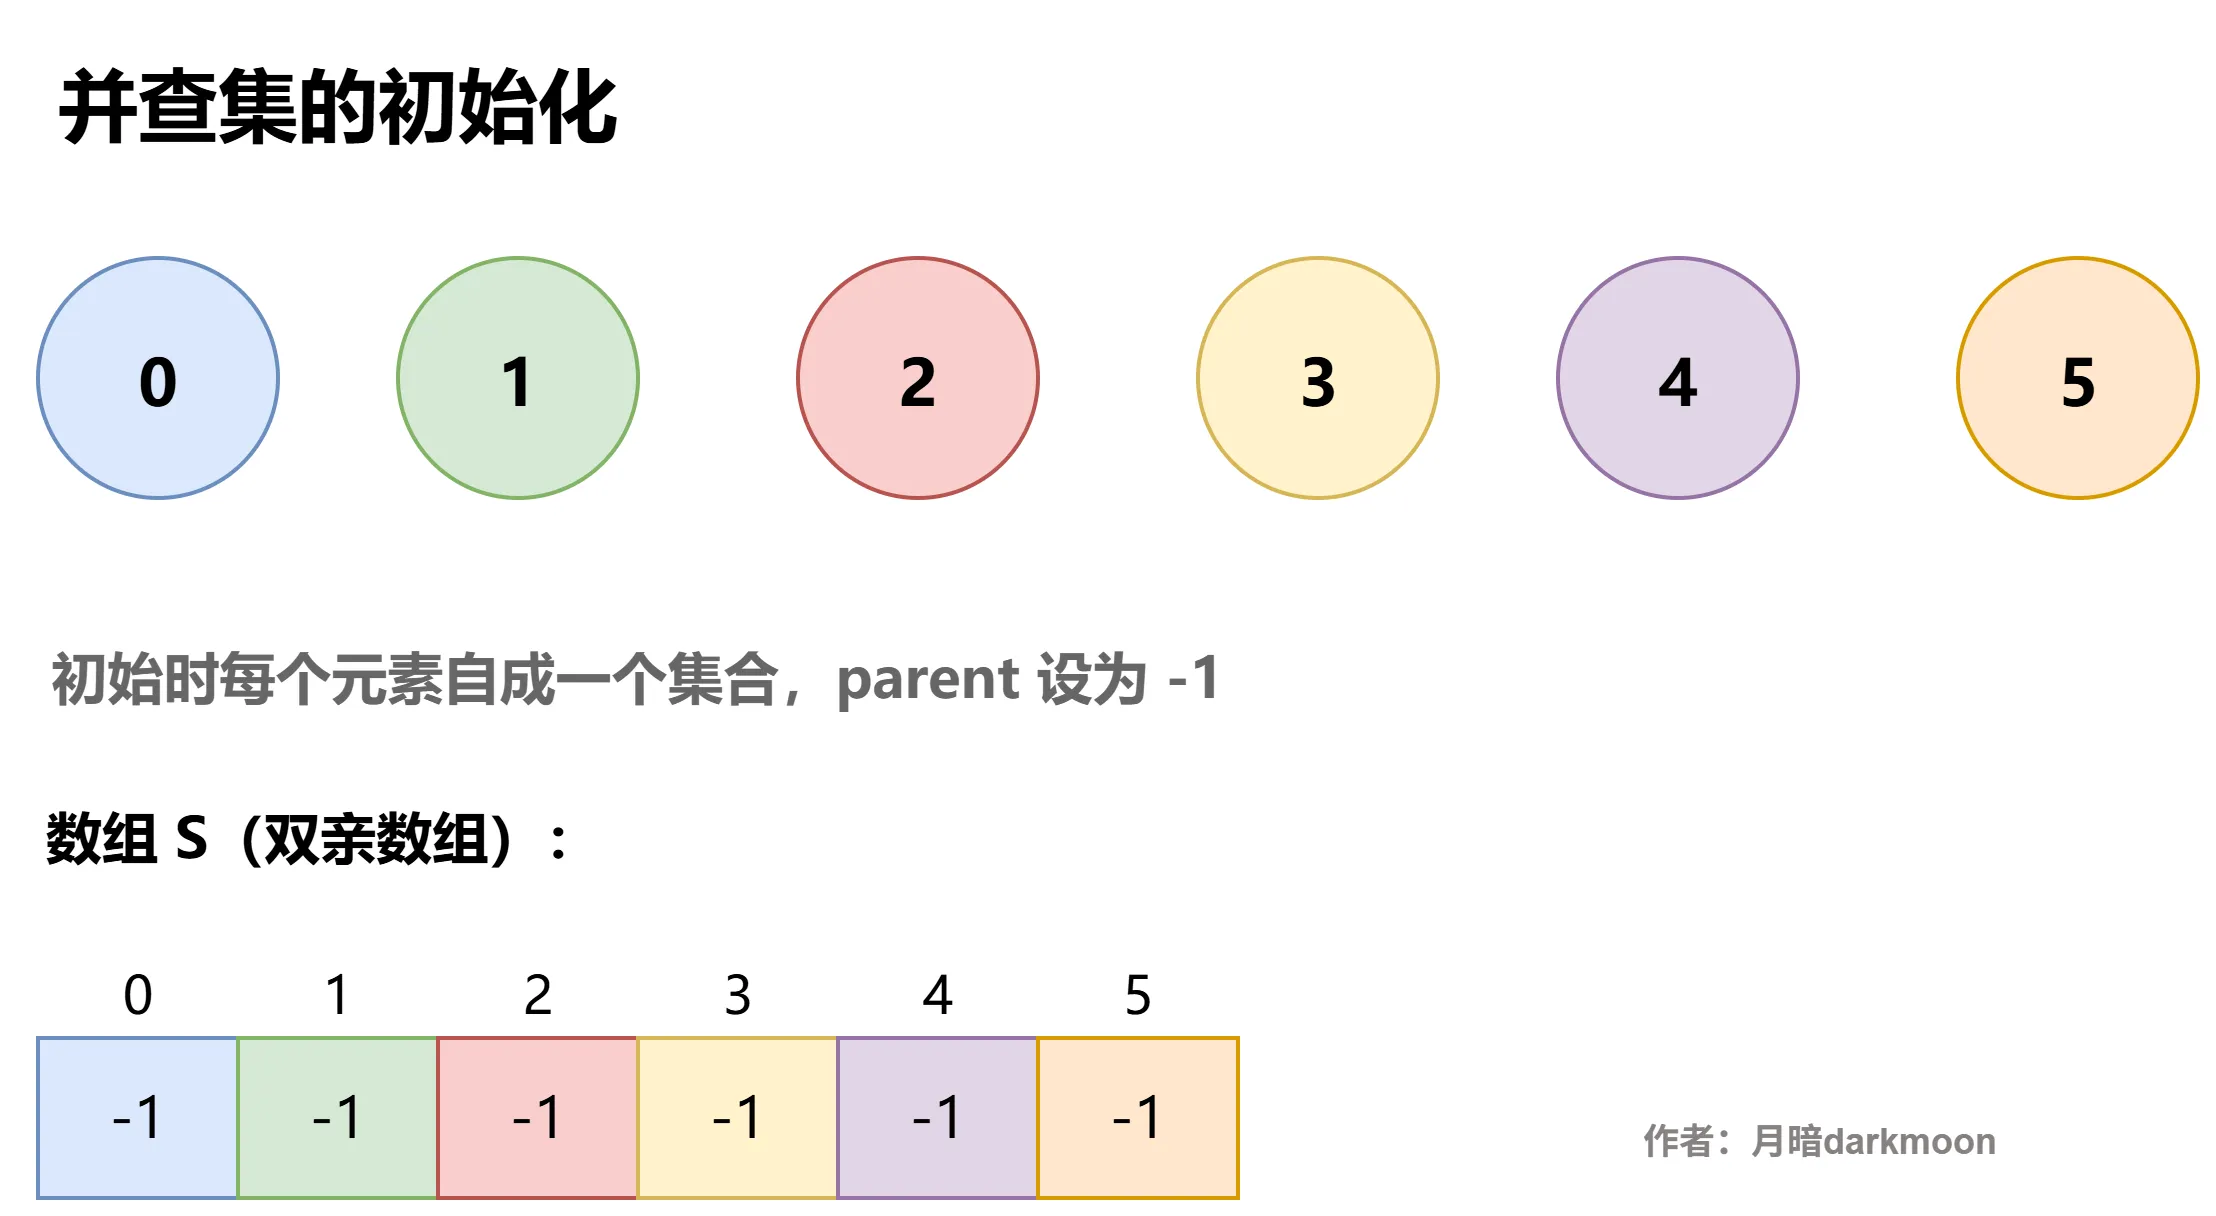
每个结点都是独立的树(根结点),共有 n 棵树。
查找操作(Find)
查找元素x所属的集合,即找到该元素所在树的根结点。
查找过程:
- 从
x开始,沿着parent指针向上走 - 直到遇到一个
parent值为负数的结点 - 该结点就是根结点,返回其下标
代码实现(迭代版)
// 查找元素 x 所属集合的根结点
int Find(int S[], int x) {
    while (S[x] >= 0)    // 循环向上找根,parent >= 0 表示非根结点
        x = S[x];
    return x;             // 返回根结点的数组下标
}
查找过程示意
以查找 Find(9) 为例:
时间复杂度
朴素 Find 操作的时间复杂度为 O(d),其中 d 为树的深度。\ 最坏情况下(树退化为链表),时间复杂度为 O(n)。
Note
这就是为什么需要优化——如果不优化,Find 操作可能很慢!
合并操作(Union)
将两个元素所属的集合合并为一个集合。
合并步骤:
- 先用
Find找到两个元素各自的根结点 - 如果根结点相同(同一集合),直接返回
- 否则,将其中一个根结点的
parent设为另一个根结点的下标
代码实现
// 合并两个集合(Root1 和 Root2 为两个集合的根)
void Union(int S[], int Root1, int Root2) {
    if (Root1 == Root2) return;   // 属于同一集合,无需合并
    S[Root1] += S[Root2];         //更新集合大小
    S[Root2] = Root1;             // 将 Root2 挂到 Root1 下
}
合并过程示意
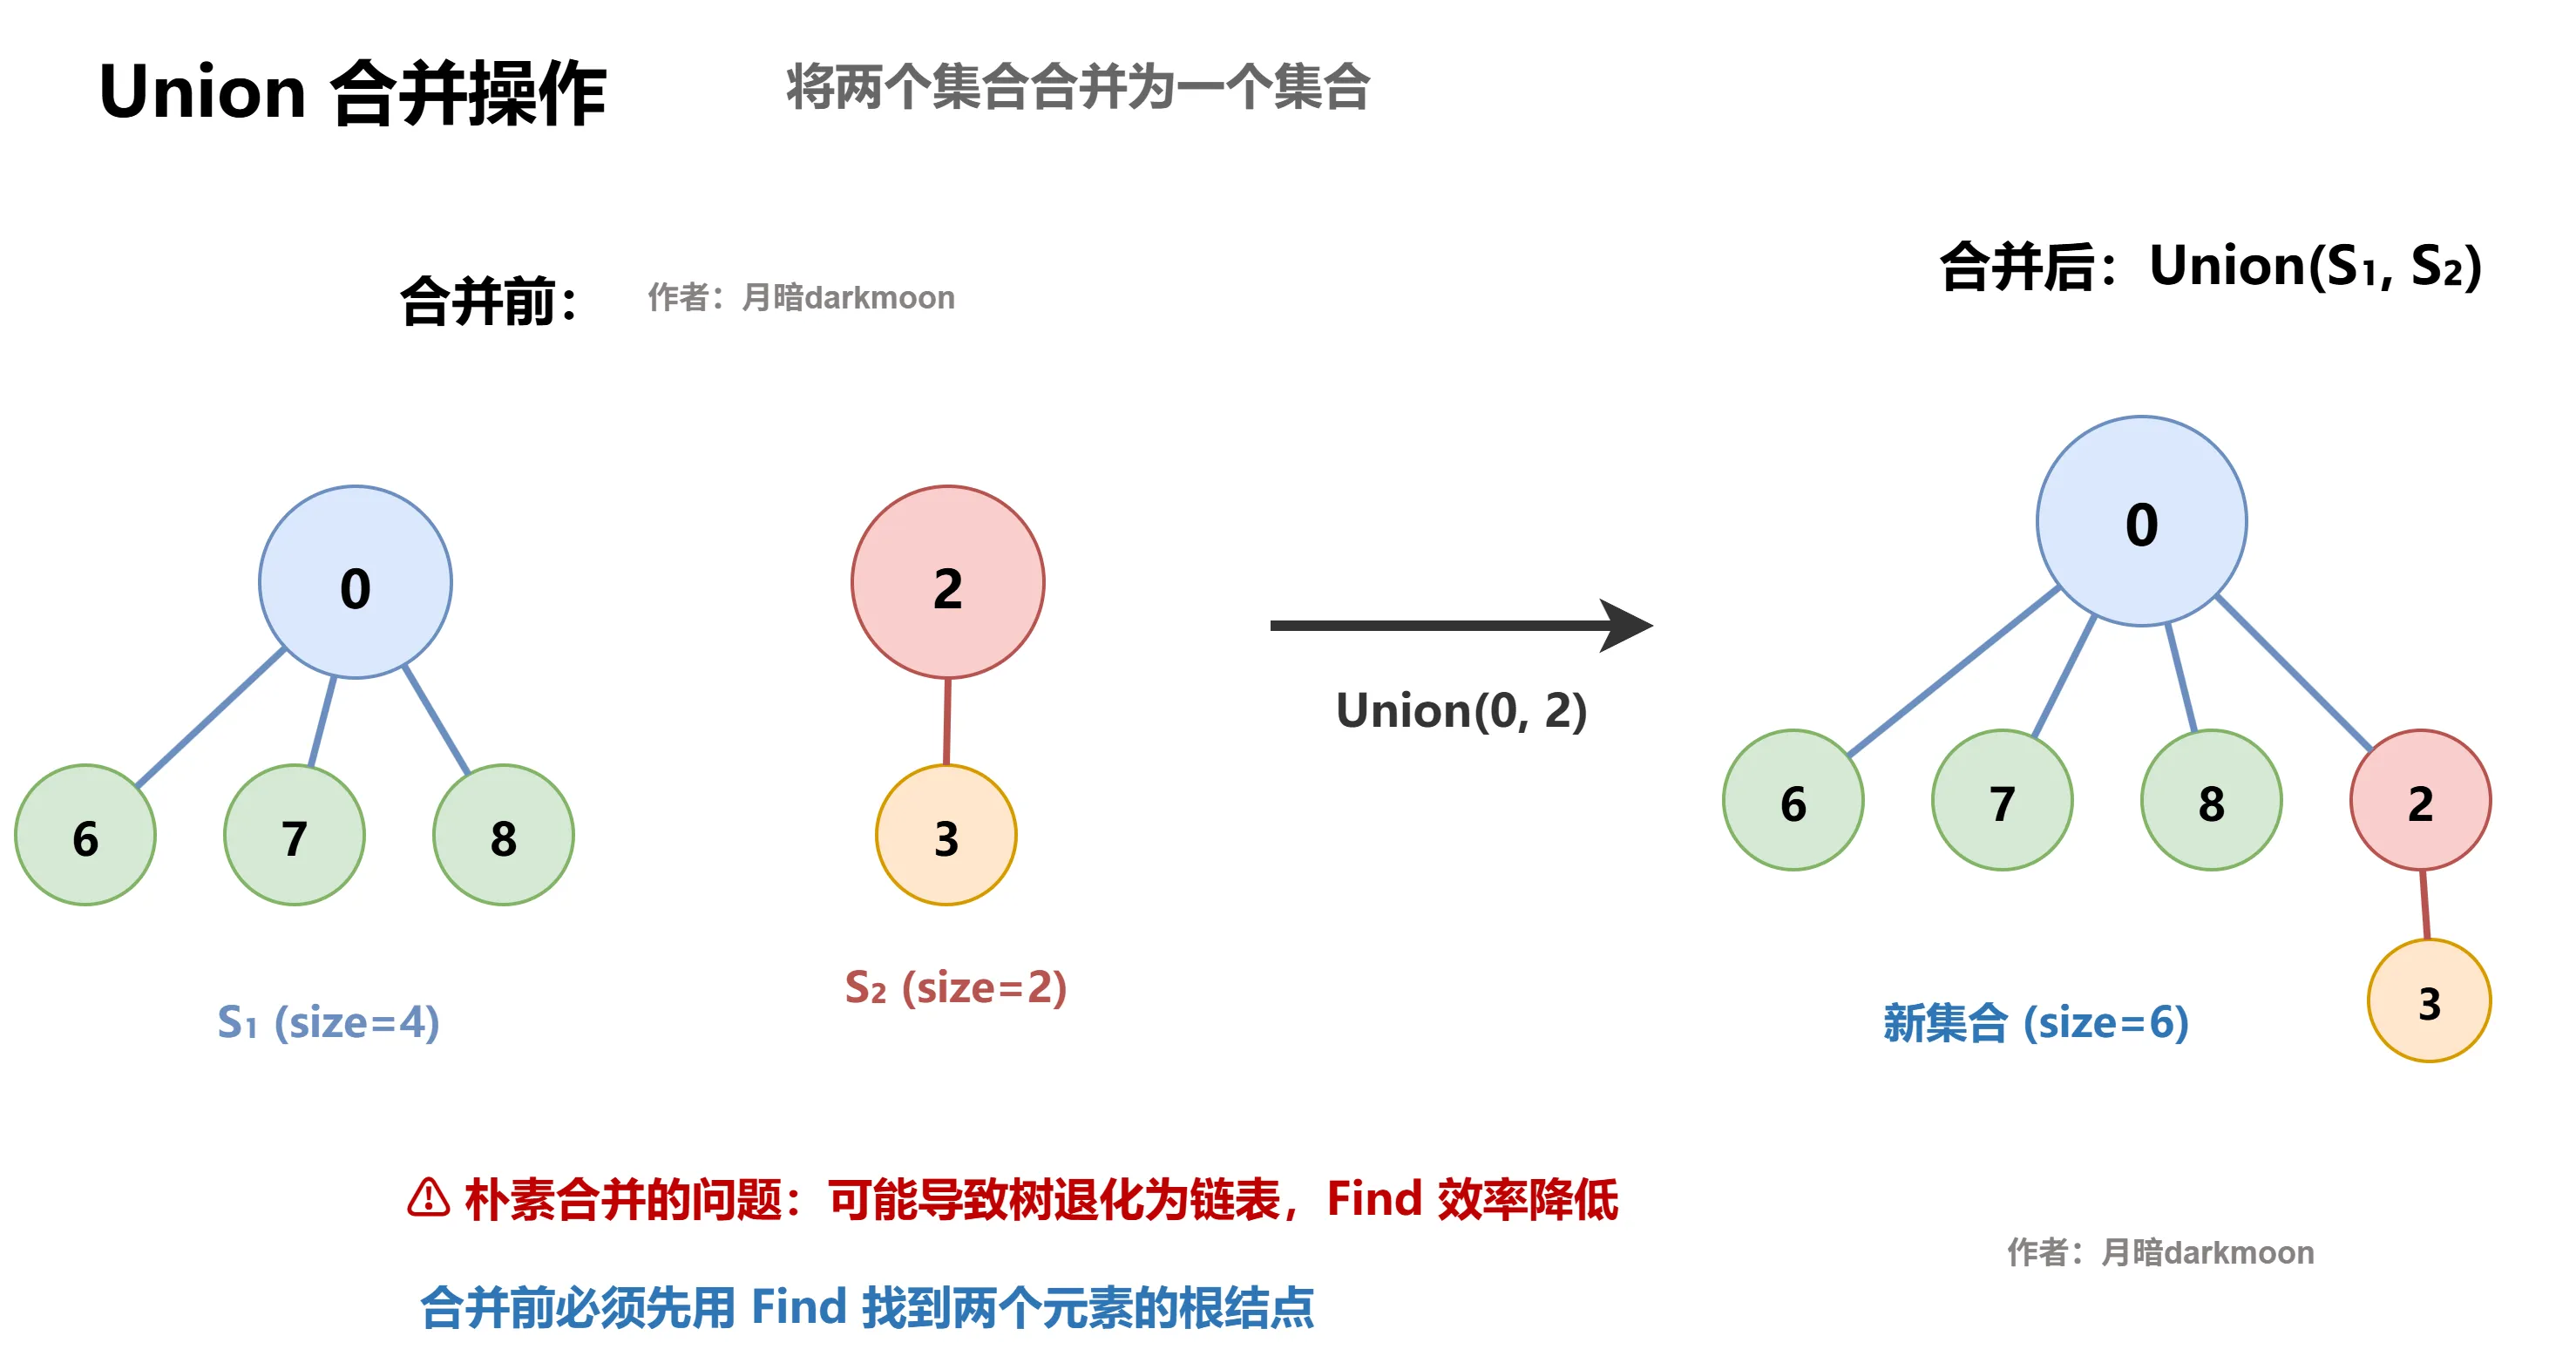
朴素合并的问题:朴素的 Union 操作不考虑两棵树的大小,可能导致树的高度越来越大,甚至退化为链表。
并查集的优化
路径压缩
在 Find 查找的过程中,顺便将查找路径上的所有结点直接指向根结点,从而压缩树的高度。
这样下次再查找这些结点时,就能直接一步到达根结点,大大提高查找效率。
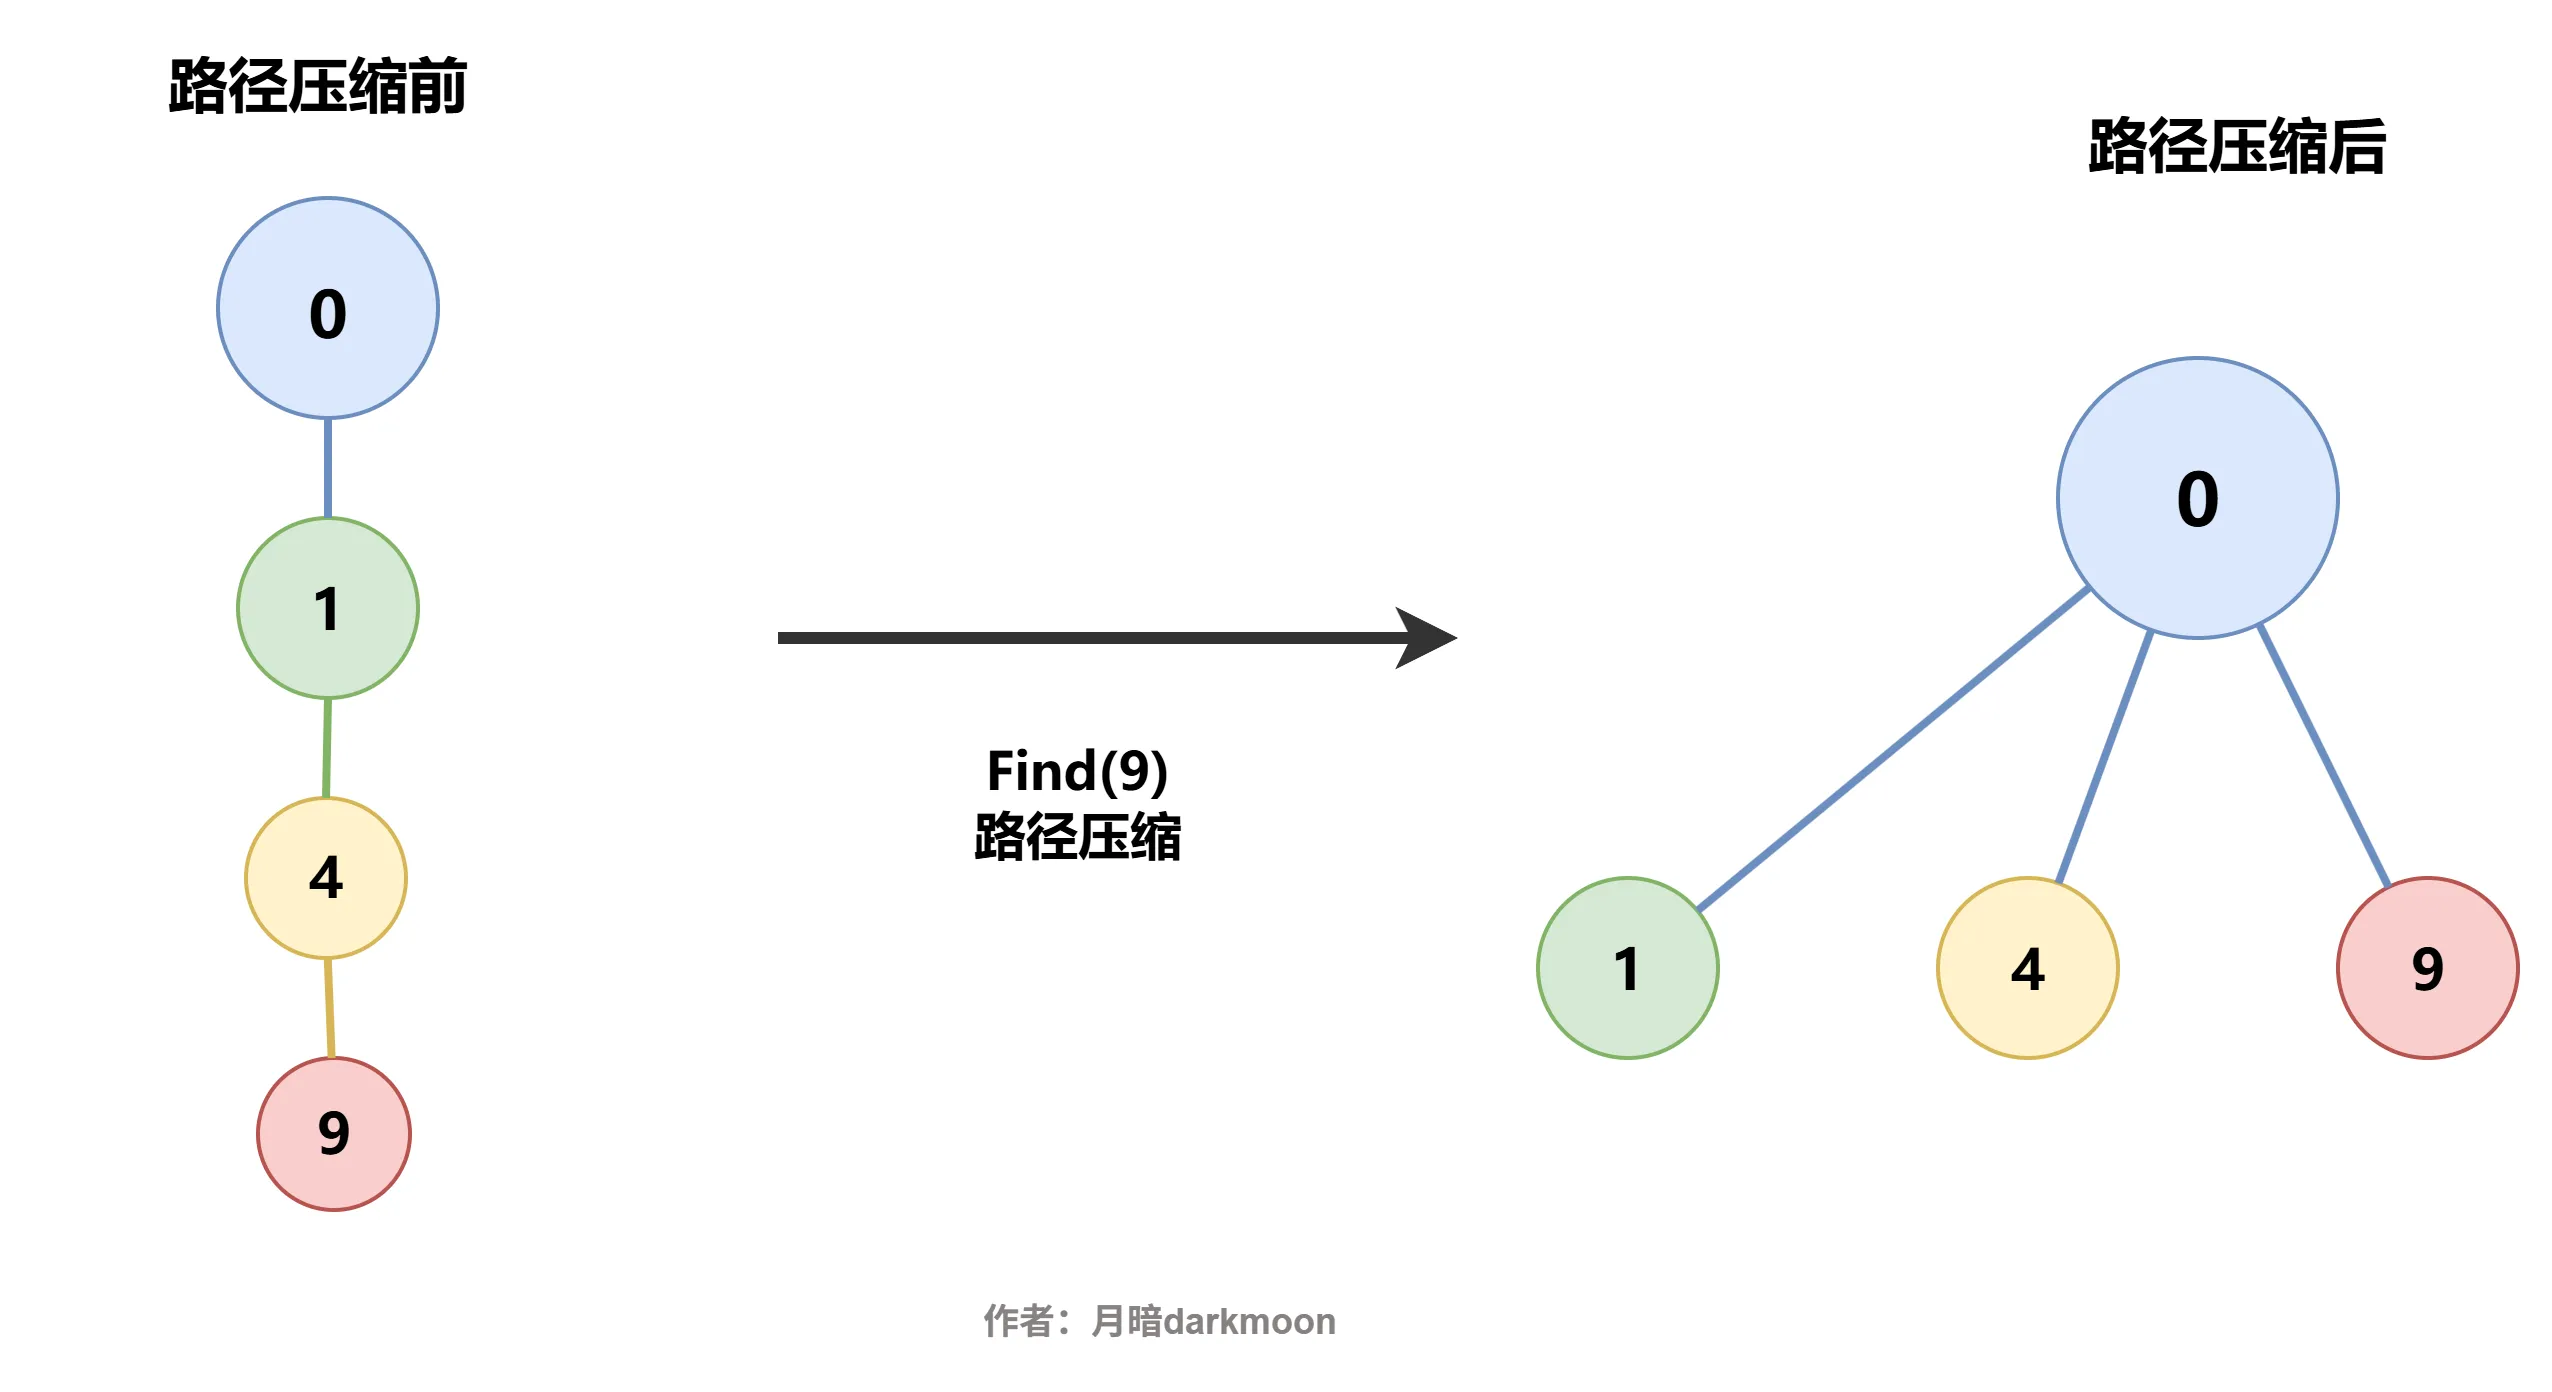
代码实现(递归版)
// 路径压缩的 Find 操作(递归版)
int Find(int S[], int x) {
    if (S[x] >= 0)
        S[x] = Find(S, S[x]);  // 递归找根,同时将 x 的 parent 设为根
    else
        return x;              // 找到根,返回
    return S[x];
}
代码实现(迭代版)
// 路径压缩的 Find 操作(迭代版)
int Find(int S[], int x) {
    int root = x;

    // 第一步:先找到根结点
    while (S[root] >= 0)
        root = S[root];

    // 第二步:路径压缩,将路径上所有结点直接指向根
    while (x != root) {
        int temp = S[x];   // 保存 x 的父结点
        S[x] = root;       // 将 x 直接挂到根结点下
        x = temp;          // 继续处理 x 原来的父结点
    }

    return root;
}
Note
路径压缩是"事后优化"——第一次查找可能还是慢,但后续查找会非常快。
4.2 按秩合并(小树挂大树)
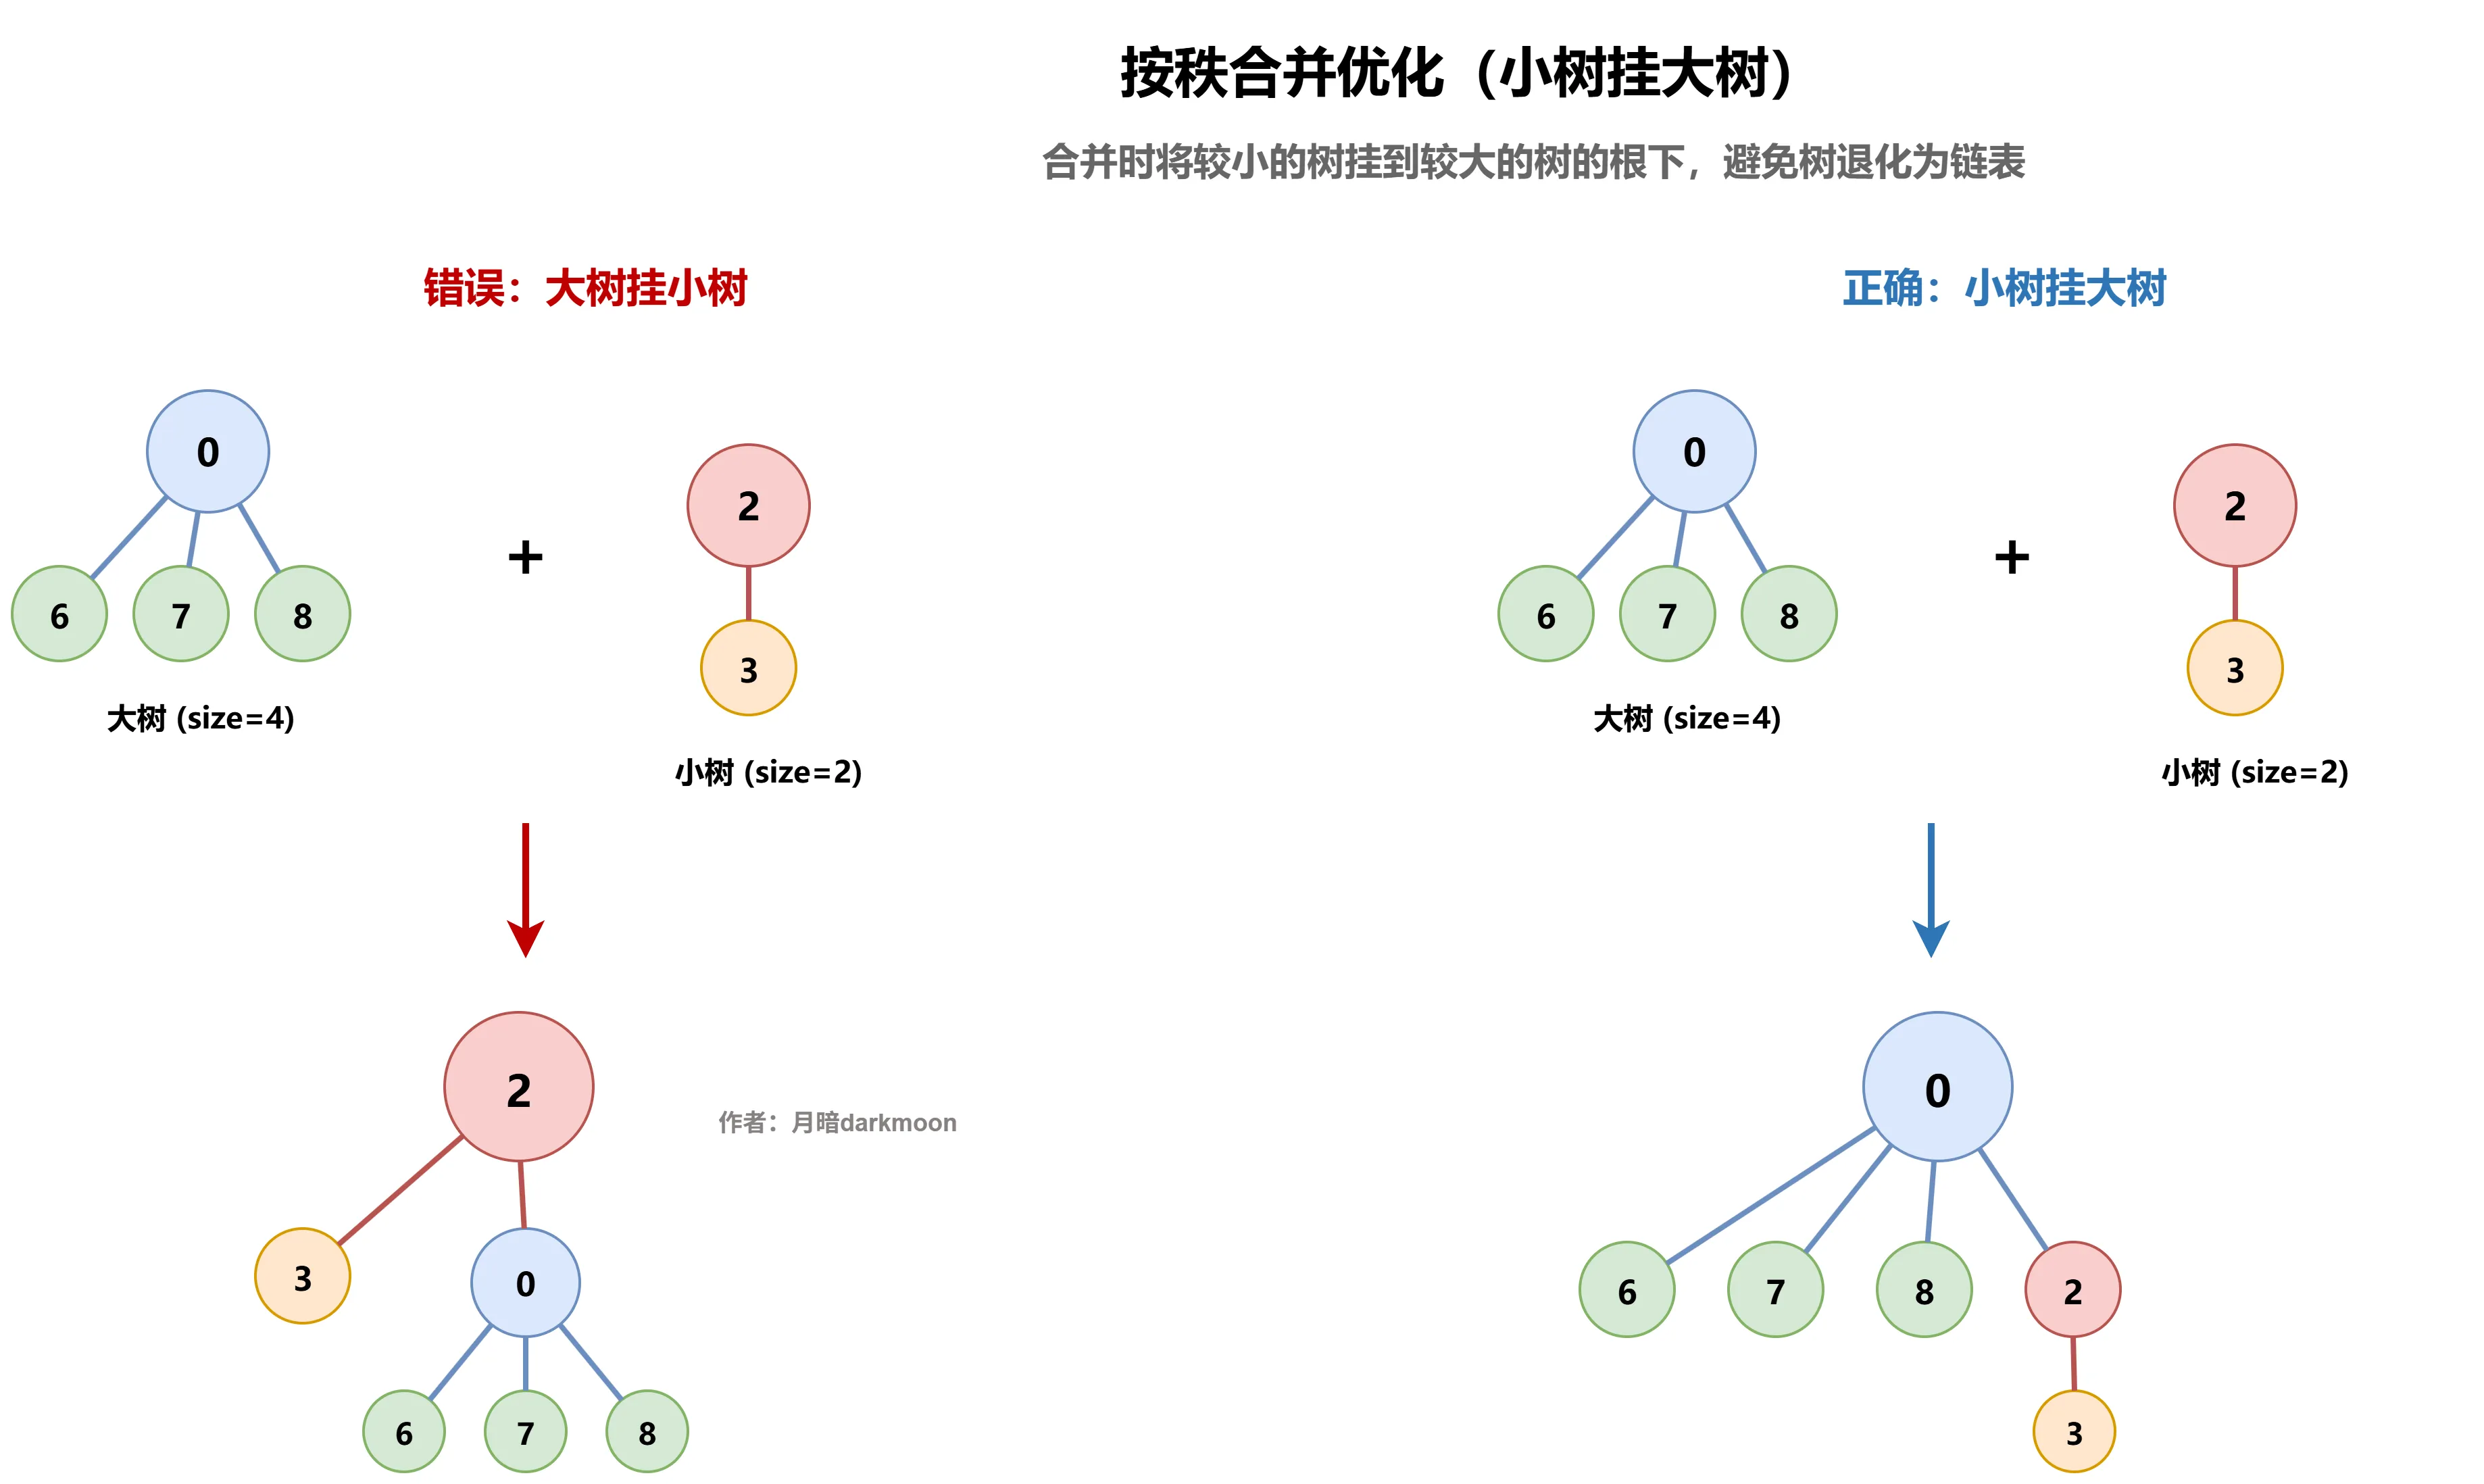
在 Union 合并时,比较两棵树的大小,将较小的树挂到较大的树的根下。
这样可以避免树的高度增长过快,保持树的平衡。
也叫按大小合并(Union by Size)或按秩合并(Union by Rank)。
代码实现
// 按秩合并的 Union 操作(小树挂大树)
void Union(int S[], int Root1, int Root2) {
    if (Root1 == Root2) return;   // 同一集合,直接返回

    // 比较两个集合的大小(取绝对值)
    if (abs(S[Root2]) > abs(S[Root1])) {
        // Root2 所在集合更大,将 Root1 挂到 Root2 下
        S[Root2] += S[Root1];    // 累加集合大小
        S[Root1] = Root2;
    } else {
        // Root1 所在集合更大(或相等),将 Root2 挂到 Root1 下
        S[Root1] += S[Root2];    // 累加集合大小
        S[Root2] = Root1;
    }
}
合并效果对比
| 合并方式 | 树高变化 | 最坏树高 |
|---|---|---|
| 朴素合并 | 可能增加很多 | O(n) |
| 按大小合并 | 尽量不增加 | O(log n) |
Note
采用按大小合并策略后,所构造的集合树深度不超过 ⌊log₂n⌋ + 1。
时间复杂度分析
记法约定:n = 元素个数;m = 操作总次数(Find + Union 混合序列);α(n) 为 Ackermann 函数的反函数,增长极慢(\(n ≤ 10^{80} 时 α(n) ≤ 4\)),可视为常数。
| 操作 | 朴素实现(无序合并) | 仅按秩合并(小树并大树) | 仅路径压缩 | 路径压缩 + 按秩合并 |
|---|---|---|---|---|
| 单次 Find | O(n)(最坏树高) | O(logn)(最坏) | 单次最坏仍可为 O(n),标准均摊界为 O(log n) |
均摊复杂度 O(α(n)) |
| 单次 Union | O(1)(已找到根时) | O(1) | O(1) | O(1) |
| n 个元素合并为 1 个集合 | O(n²) | O(n logn) | O(n logn) | O(n·α(n)) |
Note
注意:Union 本身只是"把一棵树的根挂到另一棵树的根上",O(1);实际使用中 Union(x, y) 前要各做一次 Find,所以"一次逻辑上的合并"代价由 Find 主导。
- 朴素实现:Union(直接让一棵树的整体挂到另一棵树下,树可能退化为链),Find( 沿父指针一直走到根,代价 = 树的深度)。最坏:反复 Union 形成一条 n 个节点的链,Find(最深节点) = O(n)。把 n 个独立元素合并为一个集合,总代价 O(n²)。
-
按秩合并(小树并到大树)
-
关键结论:秩为 k 的树至少有 2ᵏ 个节点(数学归纳法:秩首次变为 k 时,必是两棵秩 k-1 的树合并,节点数 ≥ 2ᵏ⁻¹ + 2ᵏ⁻¹ = 2ᵏ)。
- 推论:n 个节点的树,秩(树高上界)≤ ⌊log₂ n⌋,故 Find 最坏 O(logn)。
- 该界是单次最坏界,无需均摊分析。
-
n 个元素合并为一个集合总代价 O(n logn)。
-
路径压缩
-
规则:Find(x) 找到根后,把查找路径上的所有节点直接挂到根下面。
- 单次 Find 第一次走原路径(仍可能较长),但之后同一路径上的节点到根的距离变为 1,越查越平。
-
效果:m ≥ n 次操作总代价 O(m·log n),均摊每次 O(log n)
-
路径压缩 + 按秩合并
-
两者结合是最强形态:任意 m 次 Find/Union 混合序列的总代价为 O(m·α(m, n)),均摊每次 O(α(n))
- α(n) 是均摊界,不是单次最坏界——单次 Find 最坏仍可能是 O(log n) ,只是摊到整个操作序列上平均接近常数。这就是并查集"近乎常数时间"的来源。
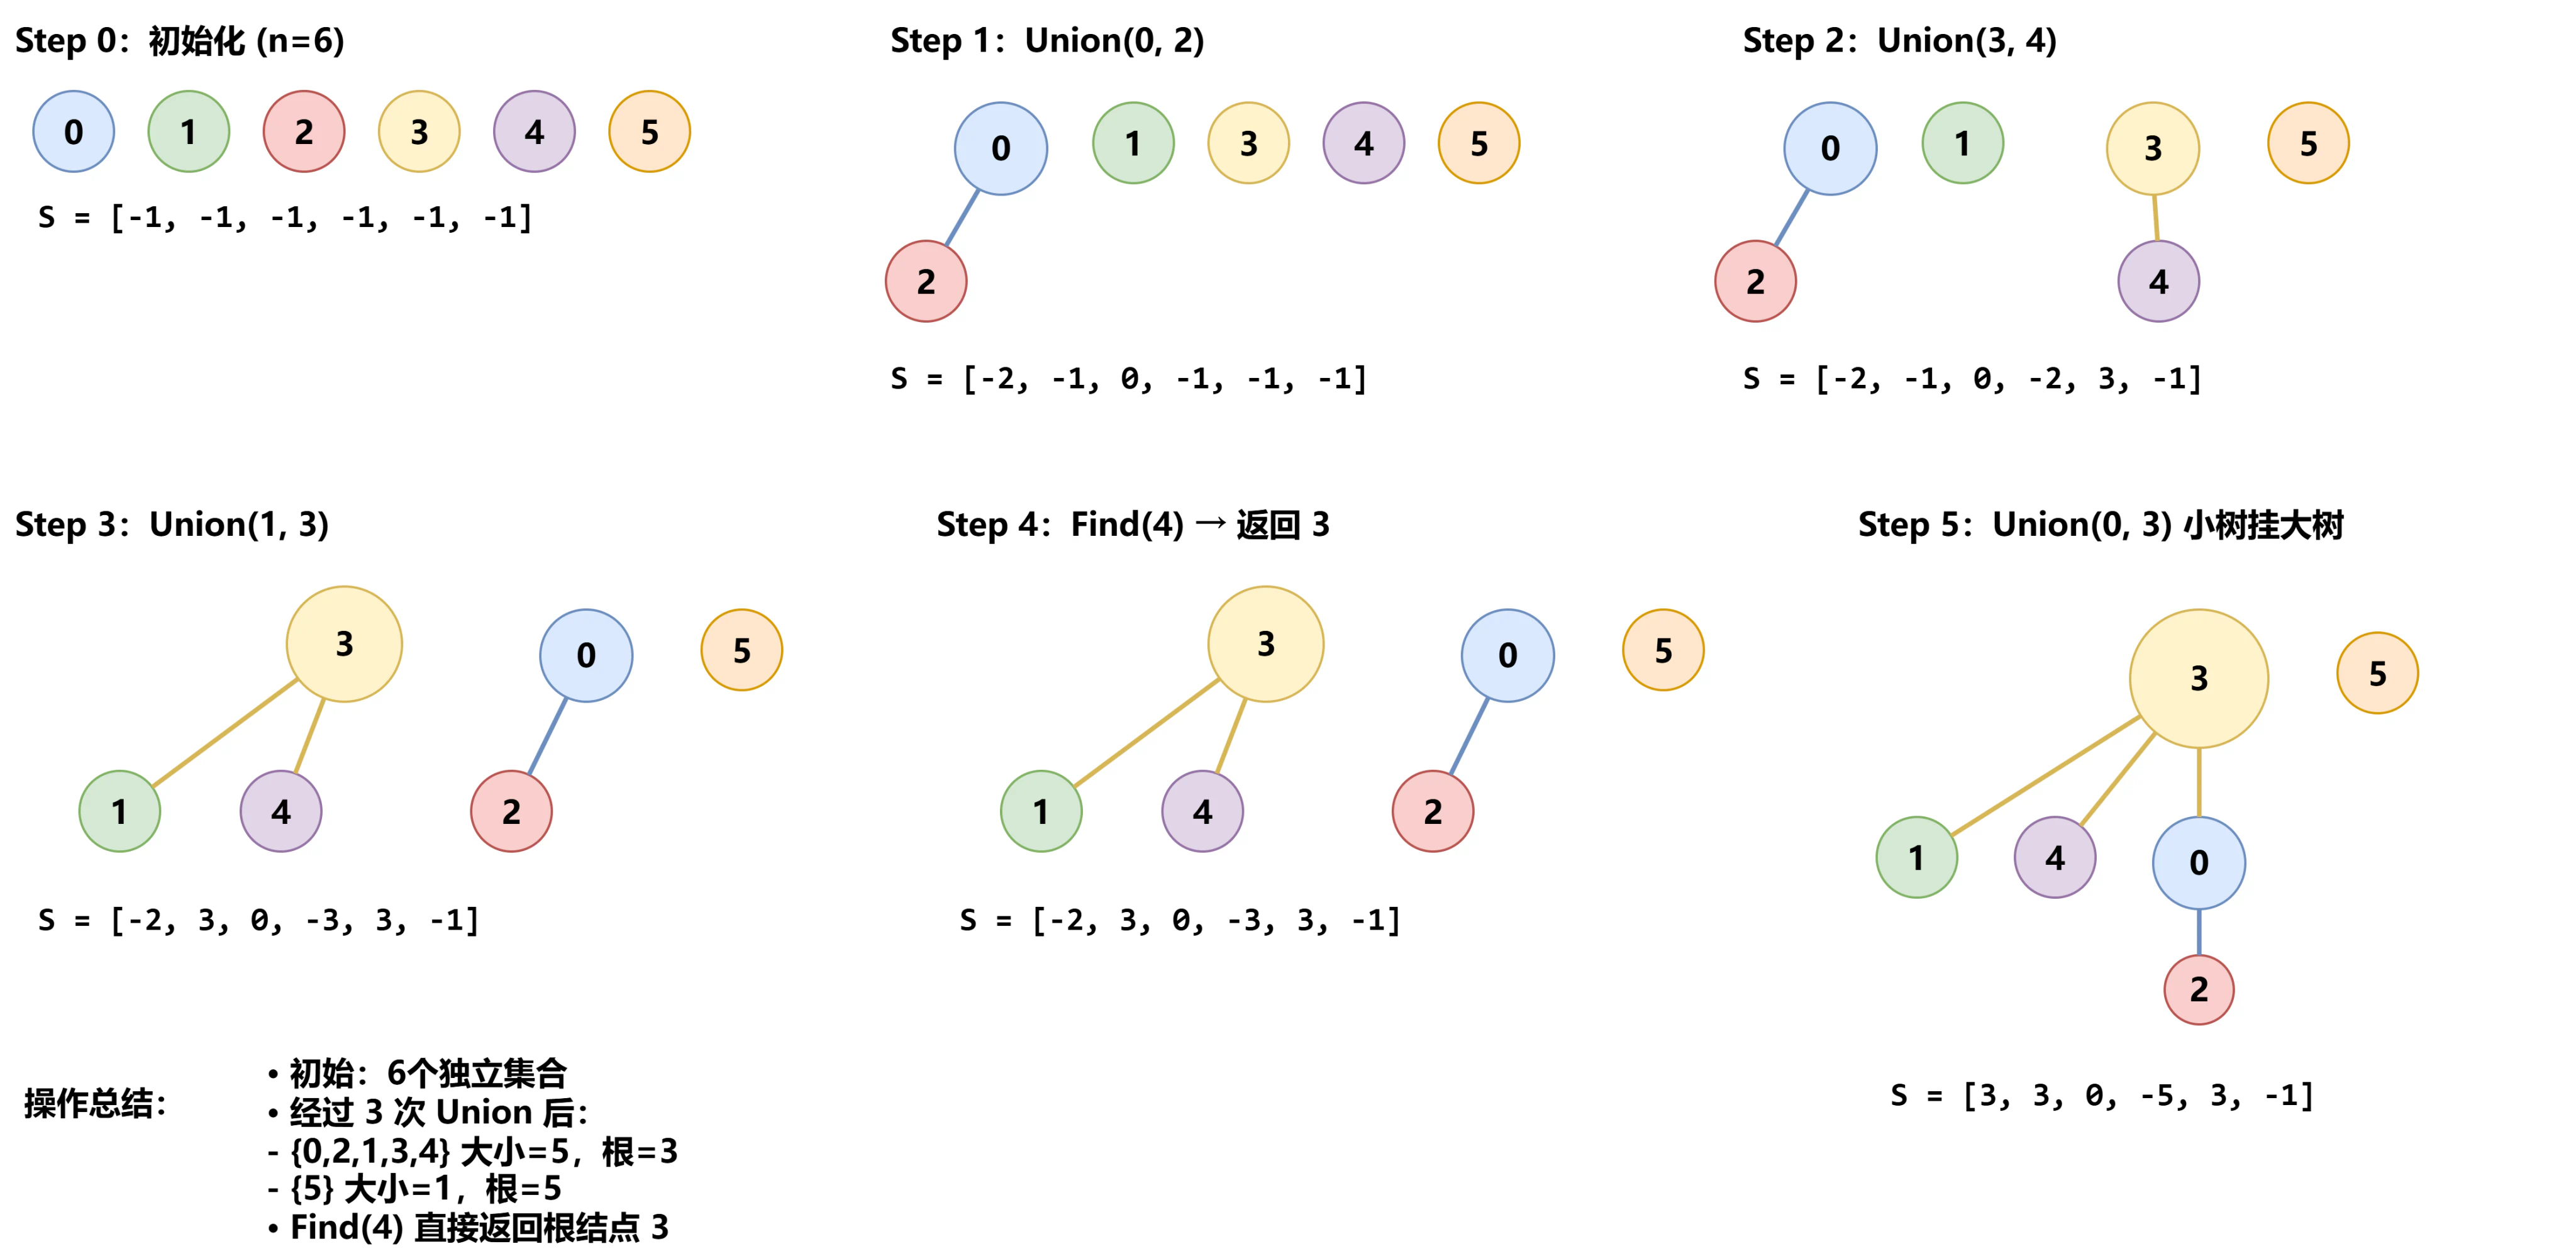
完整操作示例
典型应用场景
图的连通性问题
判断无向图中两个顶点是否连通。
- 每个顶点初始为一个集合
- 每条边对应一次 Union 操作
- 判断连通性 → Find(u) == Find(v) ?
Kruskal 最小生成树算法
Kruskal 算法的核心就是用并查集来判断加入边是否会形成环:
- 将所有边按权值从小到大排序
- 依次选边,如果边的两个端点不在同一集合(不形成环),就加入生成树
- 用并查集的 Union 操作合并两个集合
图不连通时,Kruskal 得到的是最小生成森林,而不是最小生成树。
练习题
- 下列关于并查集的叙述中,错误的是( )。
A. 并查集中的每个集合可表示为一棵有根树
B. Find(x)可用于确定元素 x 所属集合的代表元
C. 路径压缩可能改变元素所属的集合
D. 常规并查集不适合直接处理集合的拆分操作
解析
答案:C
路径压缩只改变同一棵集合树内部的父子关系,不会改变集合的划分。压缩前后,元素的根结点不变。并查集擅长合并和查询,但不支持高效地把一个集合拆开。
- 下列关于并查集的叙述中,错误的是( )。
A. 并查集通常采用树的双亲表示法存储\ B. 根结点的数组值可用负数表示,其绝对值等于该集合中的元素个数\ C. 只要采用路径压缩优化,任意时刻树高都不超过 ⌊log₂n⌋+1\ D. Find 操作返回元素所在集合的根结点在数组中的下标
解析
答案:C
A 正确。并查集的标准实现就是树的双亲表示法:数组下标表示元素,数组值表示父结点下标。
B 正确。根结点没有父结点,用负数标识;负数的绝对值记录集合大小,一举两得。
D 正确。Find(S, x) 沿 parent 指针向上走到值为负数的结点,返回其下标。
C 错误。树高不超过 ⌊log₂n⌋+1 是按大小(按秩)合并带来的保证;路径压缩只是"事后"压低被访问路径的高度,并不保证整棵树的高度上界。仅使用路径压缩时,树高仍可能为 O(n)
- 已知并查集采用双亲表示法存储,数组 S = [-4, 0, 0, 1, -4, 4, 5, 6],共 8 个元素(下标 0~7)。下列叙述中,正确的是( )。
A. 元素 3 和元素 7 属于同一集合\ B. 该并查集中共有 3 个集合\ C. 执行 Find(7)(带路径压缩)后,S[7] 的值变为 4\ D. 将两个集合按大小合并后,根结点的值为 -7
解析
先还原树结构:
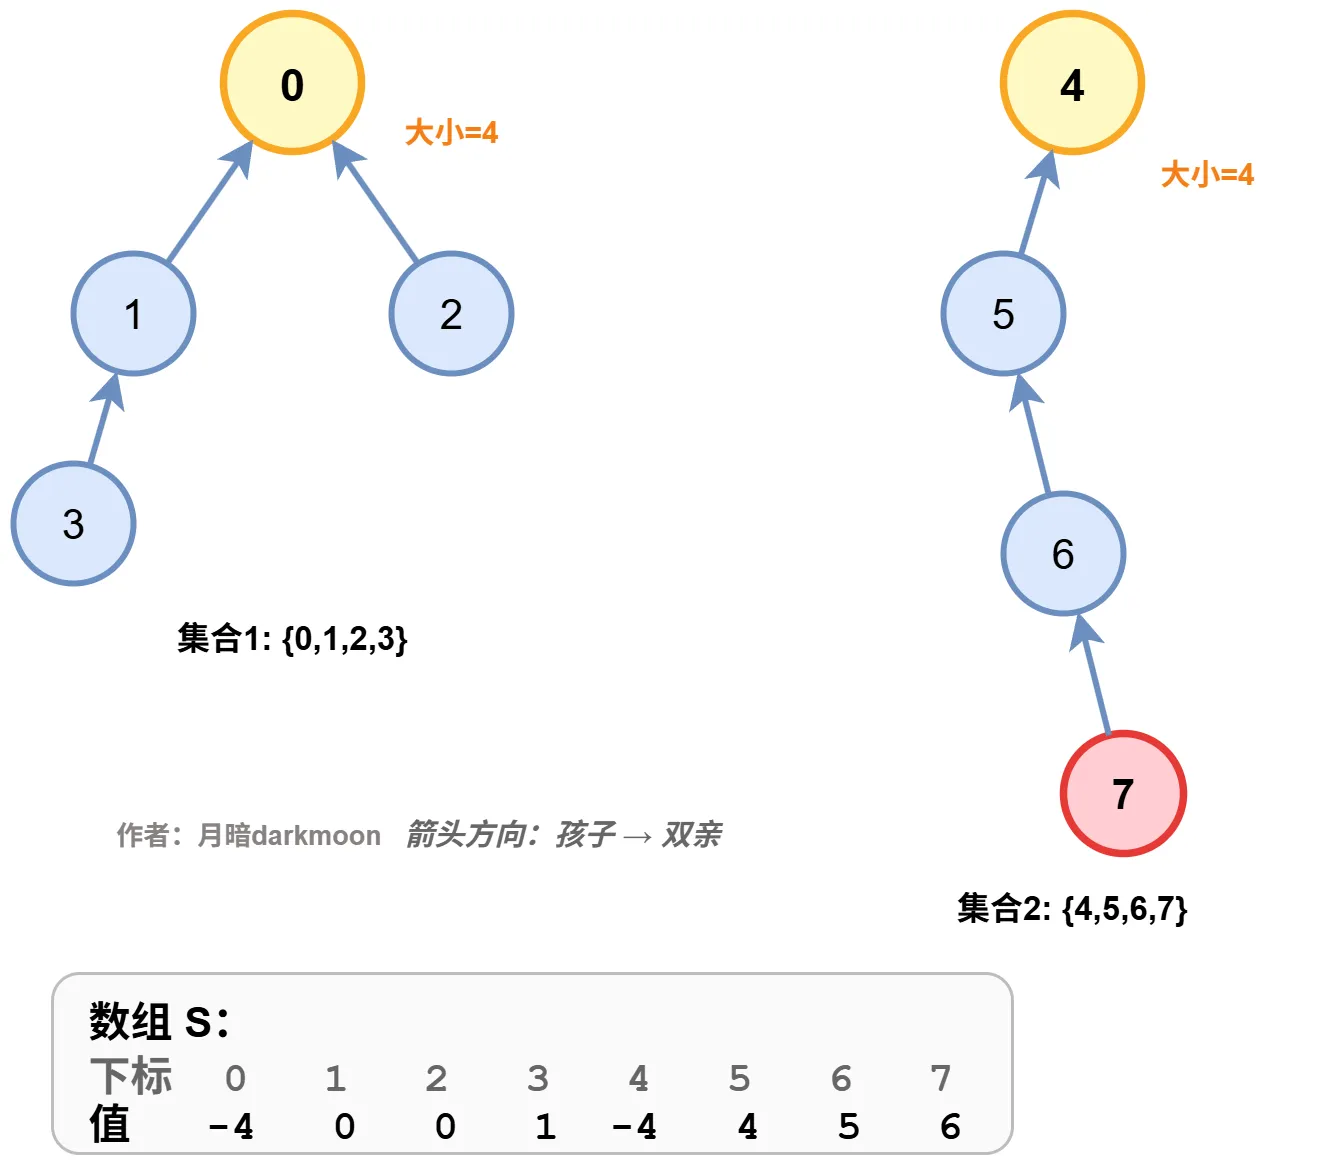
- 集合一:根为 0(S[0]=-4),1、2 是 0 的孩子,3 是 1 的孩子,即 {0, 1, 2, 3};
- 集合二:根为 4(S[4]=-4),5 是 4 的孩子,6 是 5 的孩子,7 是 6 的孩子,即 {4, 5, 6, 7}。
A 错误。3 属于根为 0 的集合,7 属于根为 4 的集合。
B 错误。数组中只有 2 个负数(S[0] 和 S[4]),即只有 2 个集合。
C 正确。Find(7) 的查找路径为 7→6→5→4,路径压缩将路径上的结点直接挂到根下,S[7] 由 6 变为 4(同时 S[6] 也变为 4)。
D 错误。两个集合大小均为 4,合并后根结点的值为 -4 + -4 = -8,不是 -7。
答案:C
- 初始时并查集中 5 个元素各自独立,即 S[i] = -1(0 ≤ i ≤ 4)。依次执行 Union(0,1)、Union(2,3)、Union(0,2)(Union 先对两元素 Find 求根,再按大小合并,大小相同时将第二个根挂到第一个根下),然后执行 Find(3)(带路径压缩)。全部操作完成后,数组 S 为( )。
A. [-4, 0, 0, 0, -1]\ B. [-4, 0, 0, 2, -1]\ C. [-3, 0, 0, 0, -1]\ D. [-4, 0, 2, 0, -1]
解析
答案:A
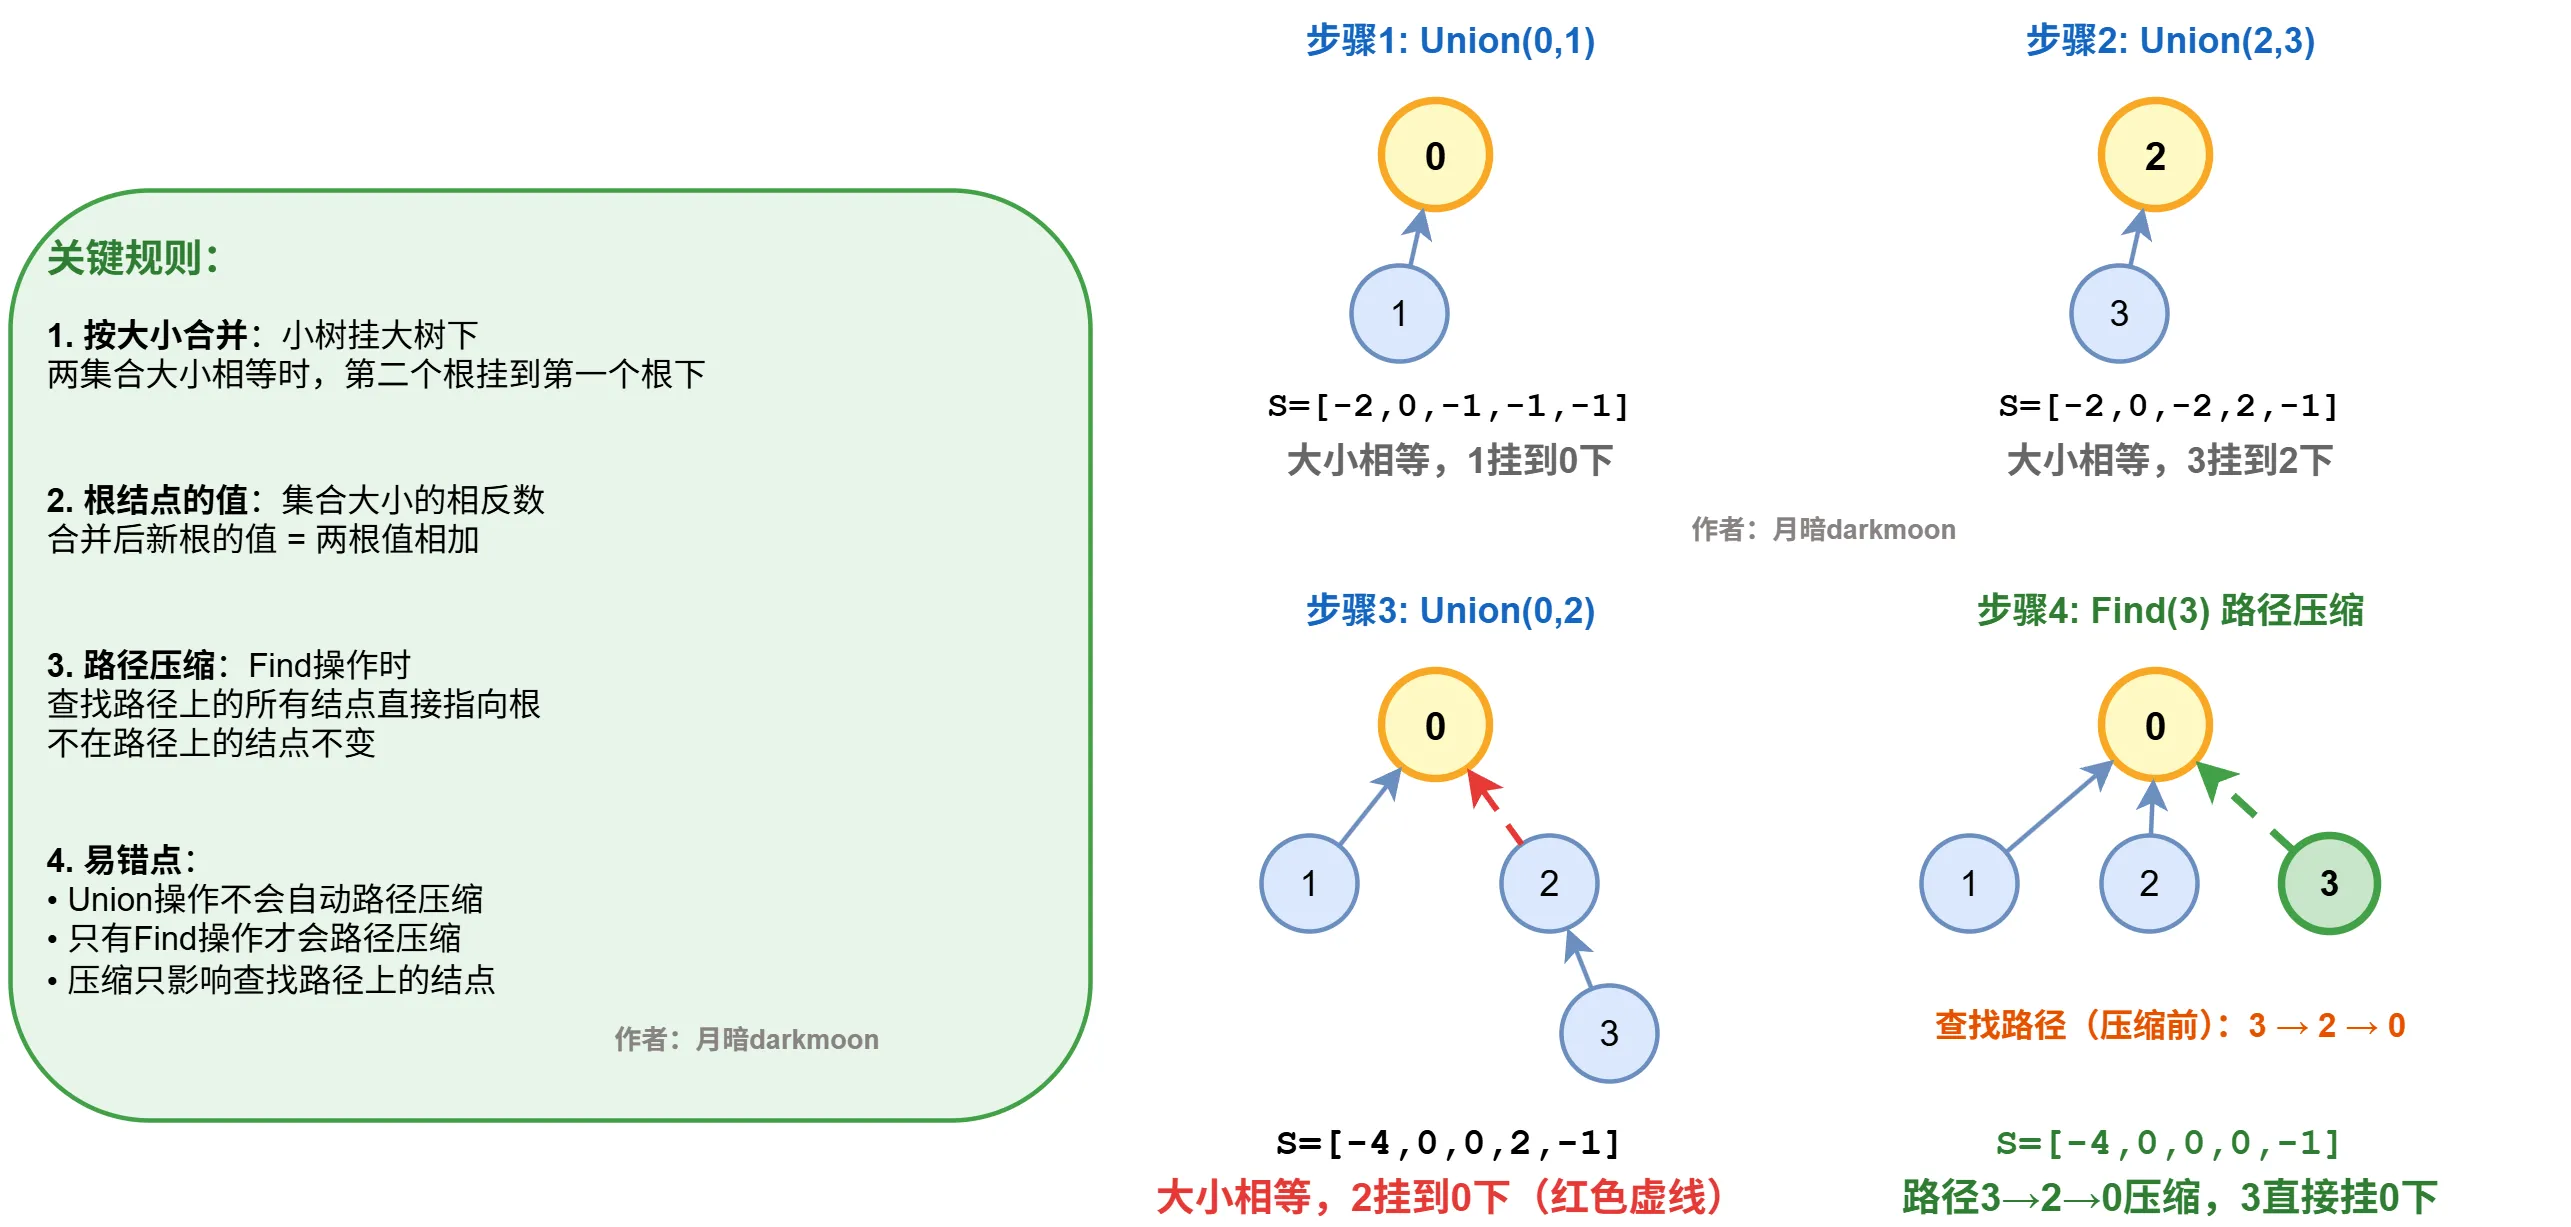
逐步模拟:
- Union(0,1):两根大小相等(均为 1),1 挂到 0 下,S[0]=-2,S[1]=0;
- Union(2,3):同理,S[2]=-2,S[3]=2;
- Union(0,2):两根大小均为 2,相等时第二个根挂到第一个根下,S[0]=-4,S[2]=0。此时 S = [-4, 0, 0, 2, -1];
- Find(3):查找路径 3→2→0,路径压缩使 S[3]=0(S[2] 本来就等于 0,不变)。
最终 S = [-4, 0, 0, 0, -1]。
B 是忘了路径压缩的结果;C 错在集合大小;D 错在合并方向(把 0 挂到了 2 下)
- 用 Kruskal 算法求无向连通图的最小生成树时,使用并查集的主要目的是( )。
A. 存储各顶点到源点的最短路径\ B. 判断新加入的边是否会与已选边构成环\ C. 对所有边按权值从小到大排序\ D. 统计每个顶点的度数
解析
答案:B
Kruskal 算法按权值从小到大依次考察每条边:若边的两个端点分属不同集合(Find(u) ≠ Find(v)),加入该边不会成环,予以选中并执行 Union;若两端点已在同一集合,加入会构成环,舍弃。
A 是 Dijkstra 等最短路径算法的工作;C 由排序完成,与并查集无关;D 与选边判环无关。
- 已知并查集数组为
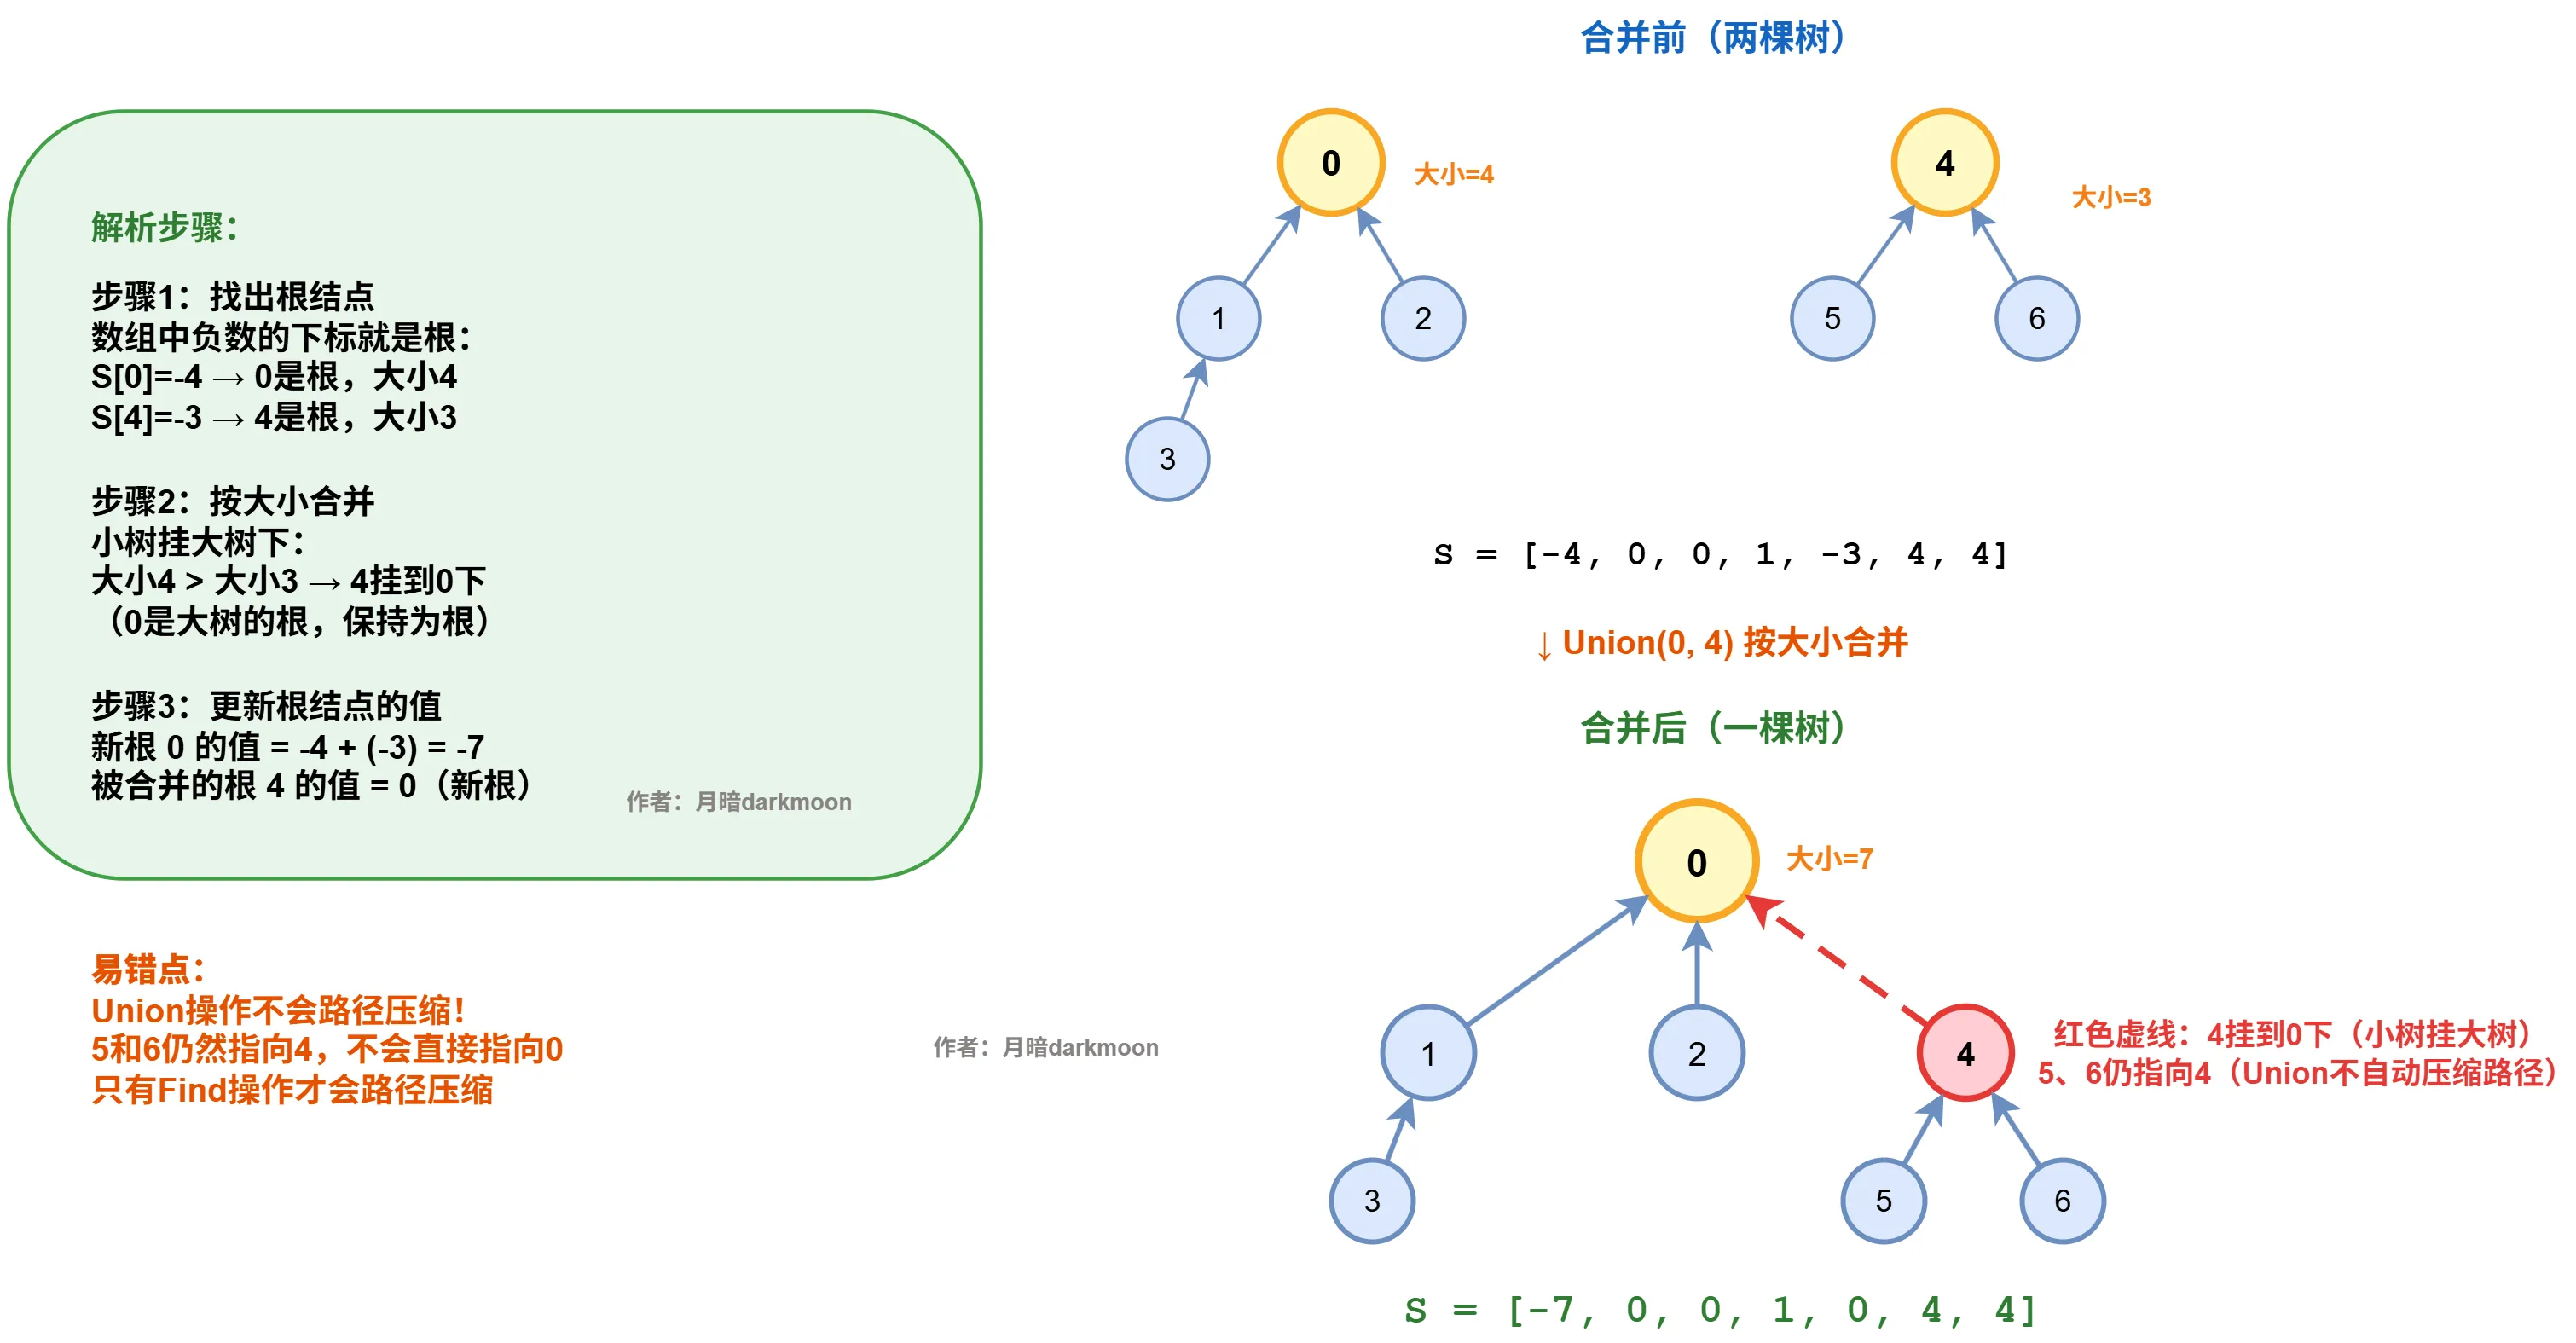
S = [-4, 0, 0, 1, -3, 4, 4],其中0和4均为根结点。执行按大小合并的Union(S, 0, 4)后,数组S为( )。
A. [-7, 0, 0, 1, 0, 4, 4]\
B. [-4, 0, 0, 1, -3, 4, 4]\
C. [-7, 0, 0, 1, 0, 0, 0]\
D. [4, 0, 0, 1, -7, 4, 4]
解析
答案:A
根 0 所在集合大小为 4,根 4 所在集合大小为 3,因此将根 4 挂到根 0 下:
S[0] = -4 + (-3) = -7
S[4] = 0
合并不会自动压缩结点 5 和 6 的路径,所以二者仍指向 4。
- 【模拟】设并查集采用树的双亲表示法,用数组 S 存储,根结点的值为该集合元素个数的相反数。初始时有 8 个元素(编号 0~7),各自独立成集合,即 S[i] = -1。现依次执行以下操作:
Union(0,1),Union(2,3),Union(4,5),Union(6,7),Union(0,2),Union(4,6),Find(3),Union(0,4),Find(7)
约定:Union 操作先对两个元素分别执行 Find 求根,再按大小合并(小树挂大树),两集合大小相等时将第二个根挂到第一个根下;所有 Find 均带路径压缩。
请回答下列问题:
⑴ 给出执行完前 6 个 Union 操作后的数组 S,并画出对应的树结构。
⑵ 给出全部 9 个操作执行完后的数组 S。
⑶ 指出本题全部操作结束后树的实际高度。
解析
⑴ 前 6 次合并的过程:
- Union(0,1):大小相等,1 挂到 0 下,S[0]=-2,S[1]=0;
- Union(2,3):同理,S[2]=-2,S[3]=2;
- Union(4,5):同理,S[4]=-2,S[5]=4;
- Union(6,7):同理,S[6]=-2,S[7]=6;
- Union(0,2):两根大小均为 2,相等时第二个根 2 挂到 0 下,S[0]=-4,S[2]=0;
- Union(4,6):同理,S[4]=-4,S[6]=4。
此时数组为 S = [-4, 0, 0, 2, -4, 4, 4, 6]。
对应的树结构(两棵均为 3 层的树):
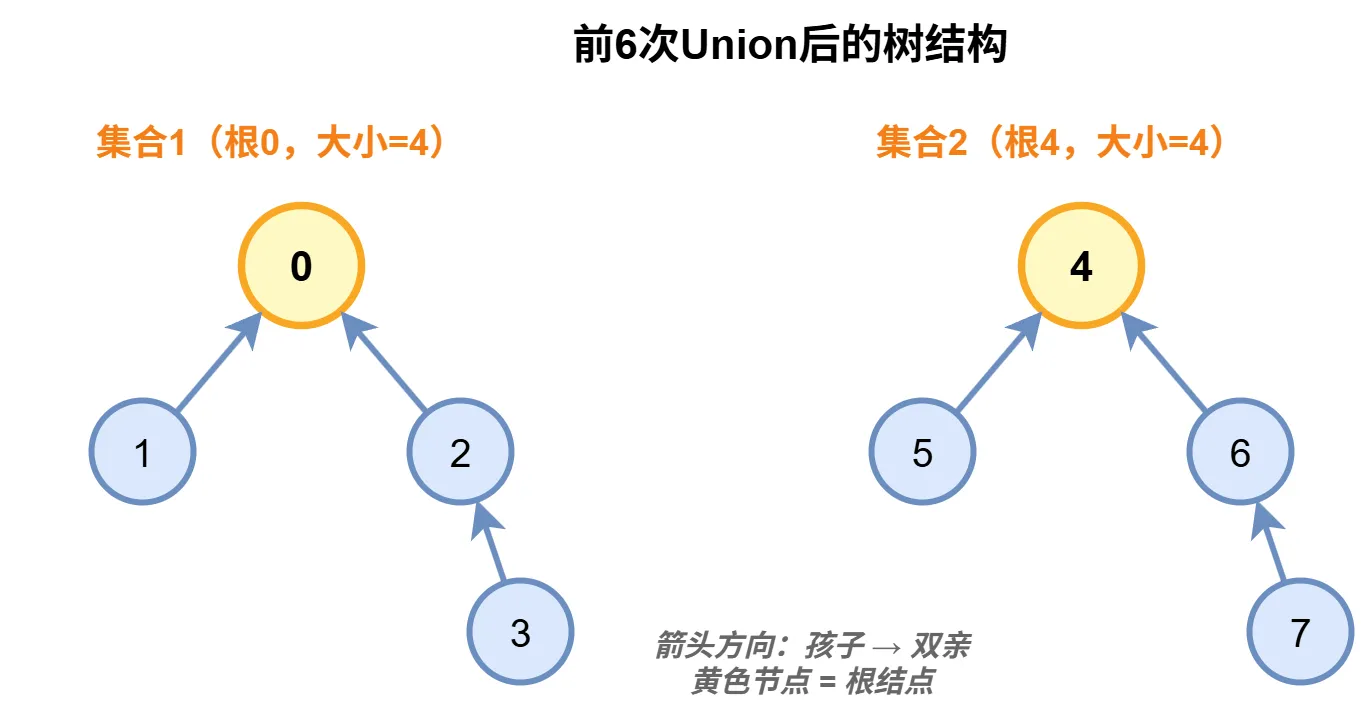
即:0 的孩子为 1、2,2 的孩子为 3;4 的孩子为 5、6,6 的孩子为 7。
⑵ 继续执行剩余操作:
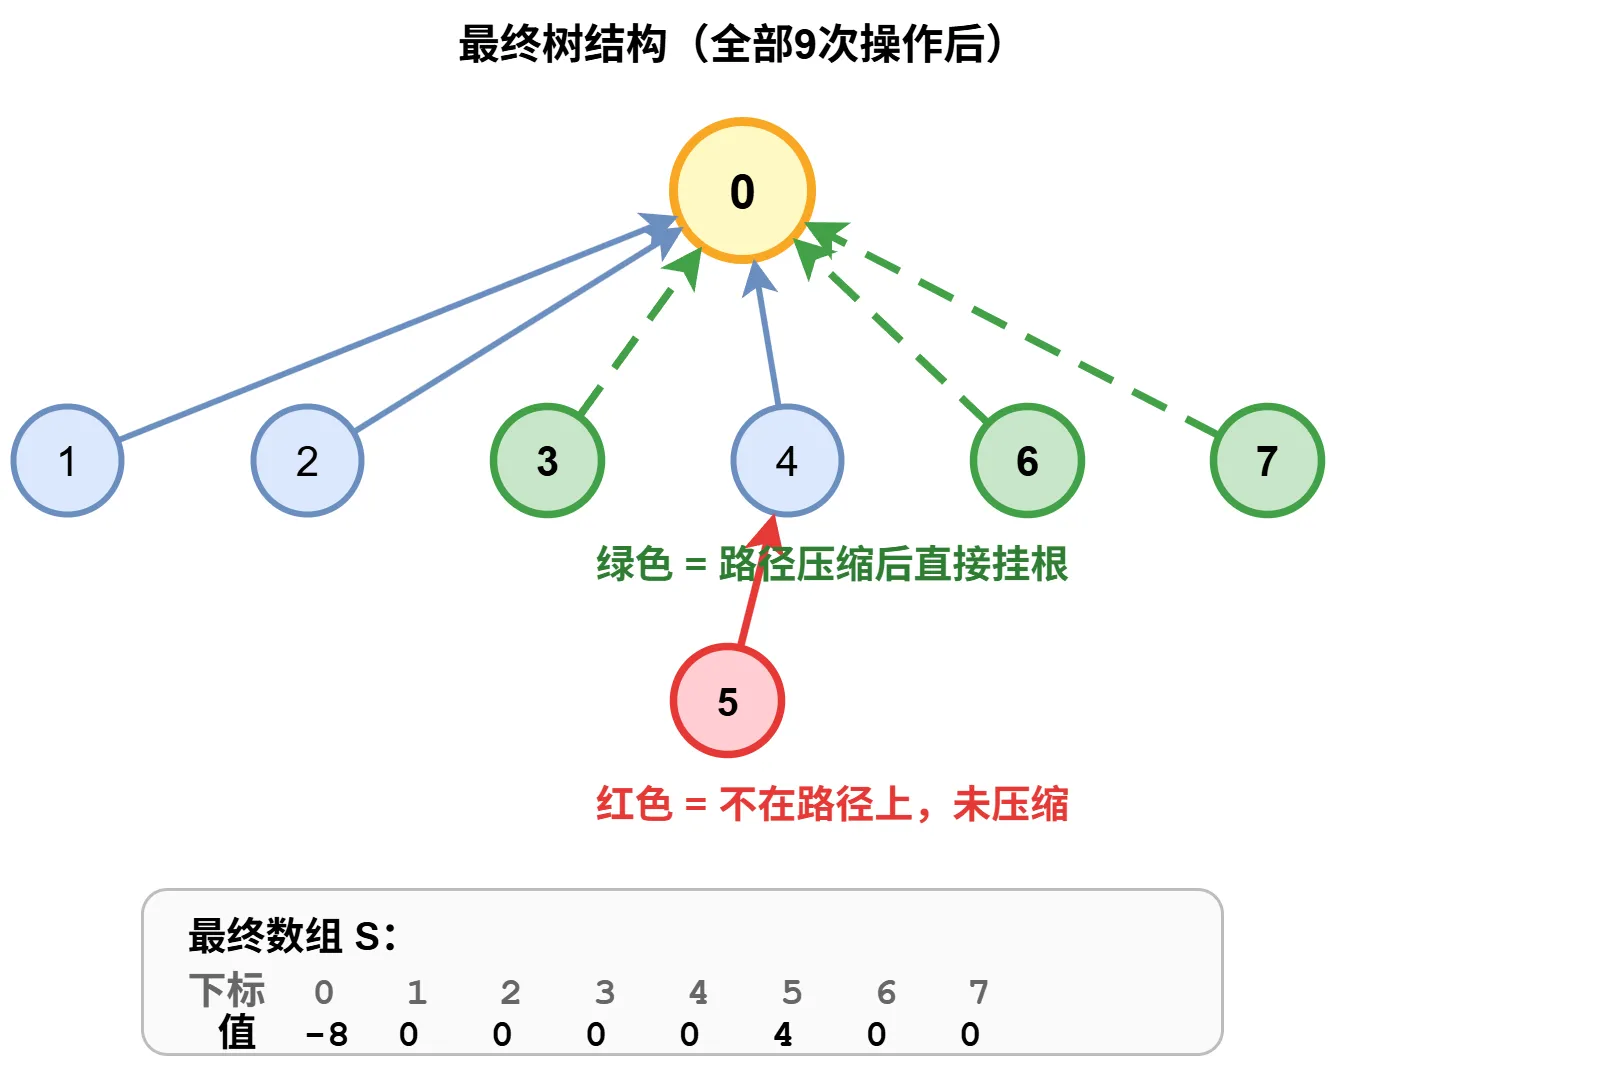
- Find(3):查找路径 3→2→0,路径压缩使 S[3]=0,得 S = [-4, 0, 0, 0, -4, 4, 4, 6];
- Union(0,4):Find(0)=0,Find(4)=4,两集合大小均为 4,相等时第二个根 4 挂到 0 下,S[0]=-8,S[4]=0,得 S = [-8, 0, 0, 0, 0, 4, 4, 6];
- Find(7):查找路径 7→6→4→0,路径压缩使 S[7]=0、S[6]=0(S[4] 已是 0,S[5]=4 不在路径上,保持不变)。
最终数组为 S = [-8, 0, 0, 0, 0, 4, 0, 0]。
⑶ 全部操作结束后,0 的直接孩子为 1、2、3、4、6、7,5 挂在 4 下,树的实际高度为 3 层(根 0 为第 1 层)
- 设无向连通图的顶点集为
V = {0,1,2,3,4,5,6},边已按权值递增排列:
e1 = (0,1,1)    e2 = (1,2,2)
e3 = (3,4,3)    e4 = (0,2,4)
e5 = (4,5,5)    e6 = (2,3,6)
e7 = (1,5,7)    e8 = (5,6,8)
三元组的前两个分量是端点,第三个分量是边权。使用 Kruskal 算法和并查集求最小生成树,请回答:
- 依次说明每条边被选中还是被舍弃。
- 写出最小生成树包含的边及其总权值。
- 处理完
e7后,图中共有几个连通分量?
解析:
Kruskal 算法的处理过程如下:
| 边 | 处理结果 | 原因 |
|---|---|---|
e1=(0,1,1) |
选中 | 0、1 原本不连通 |
e2=(1,2,2) |
选中 | 1、2 原本不连通 |
e3=(3,4,3) |
选中 | 3、4 原本不连通 |
e4=(0,2,4) |
舍弃 | 0、2 已连通,加入会形成环 |
e5=(4,5,5) |
选中 | 4、5 原本不连通 |
e6=(2,3,6) |
选中 | 合并 {0,1,2} 与 {3,4,5} |
e7=(1,5,7) |
舍弃 | 1、5 已连通,加入会形成环 |
e8=(5,6,8) |
选中 | 将顶点 6 接入生成树 |
最小生成树包含:
总权值为:
处理完 e7 后,{0,1,2,3,4,5} 已连通,顶点 6 单独构成一个连通分量,因此共有 2 个连通分量。