二叉树的遍历与构造
二叉树的遍历
二叉树遍历:从根节点出发,按照某种次序依次访问二叉树中的所有结点,使得每个结点被访问一次且仅被访问一次。
简单说就是:把树里所有节点都走一遍,每个只走一次。
两种遍历思想
二叉树主要有两大类遍历方式,它们也是图论中最基本的两种遍历思想:
| 遍历方式 | 核心思想 | 典型实现 |
|---|---|---|
| 深度优先遍历 (DFS) | 先往深走,走到头再往回走 | 递归 / 栈 |
| 广度优先遍历 (BFS) | 一层一层横着走 | 队列 |

前中后序是什么意思?
前、中、后,指的是「中间节点(根)」在遍历中的位置。记住这一句话就够了:
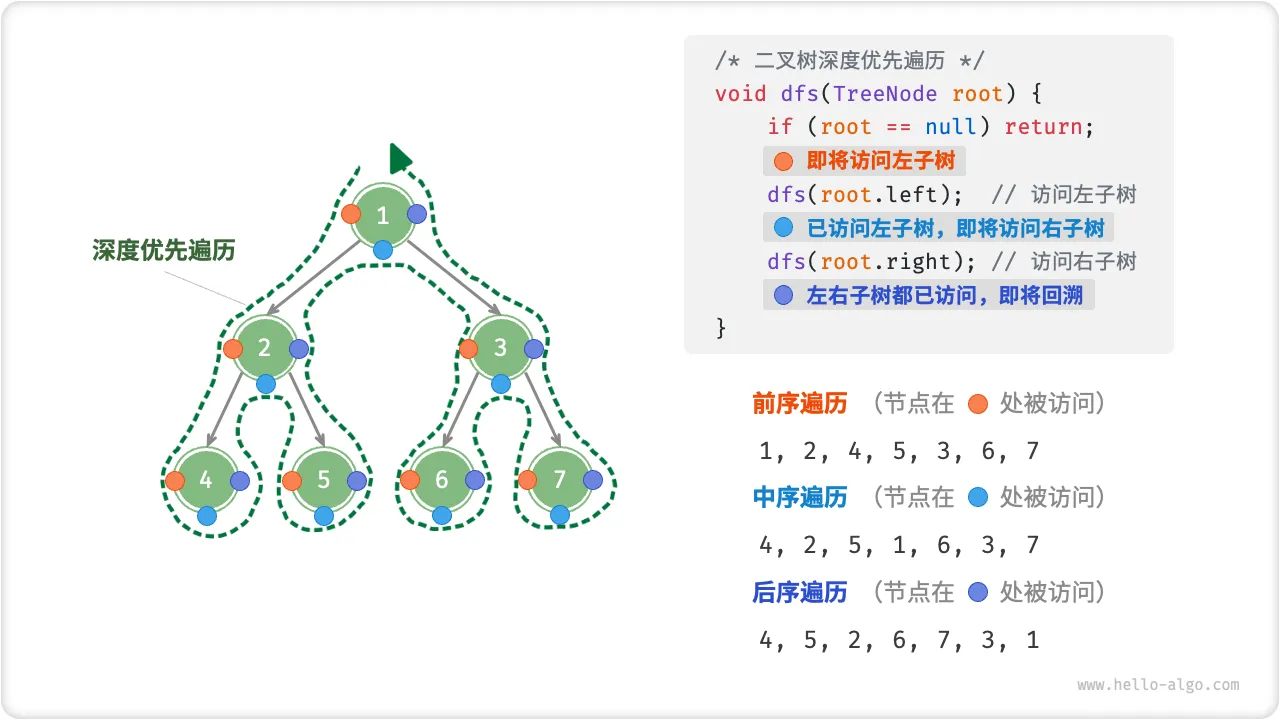
- 前序:根 → 左 → 右(根在最前面)
- 中序:左 → 根 → 右(根在中间)
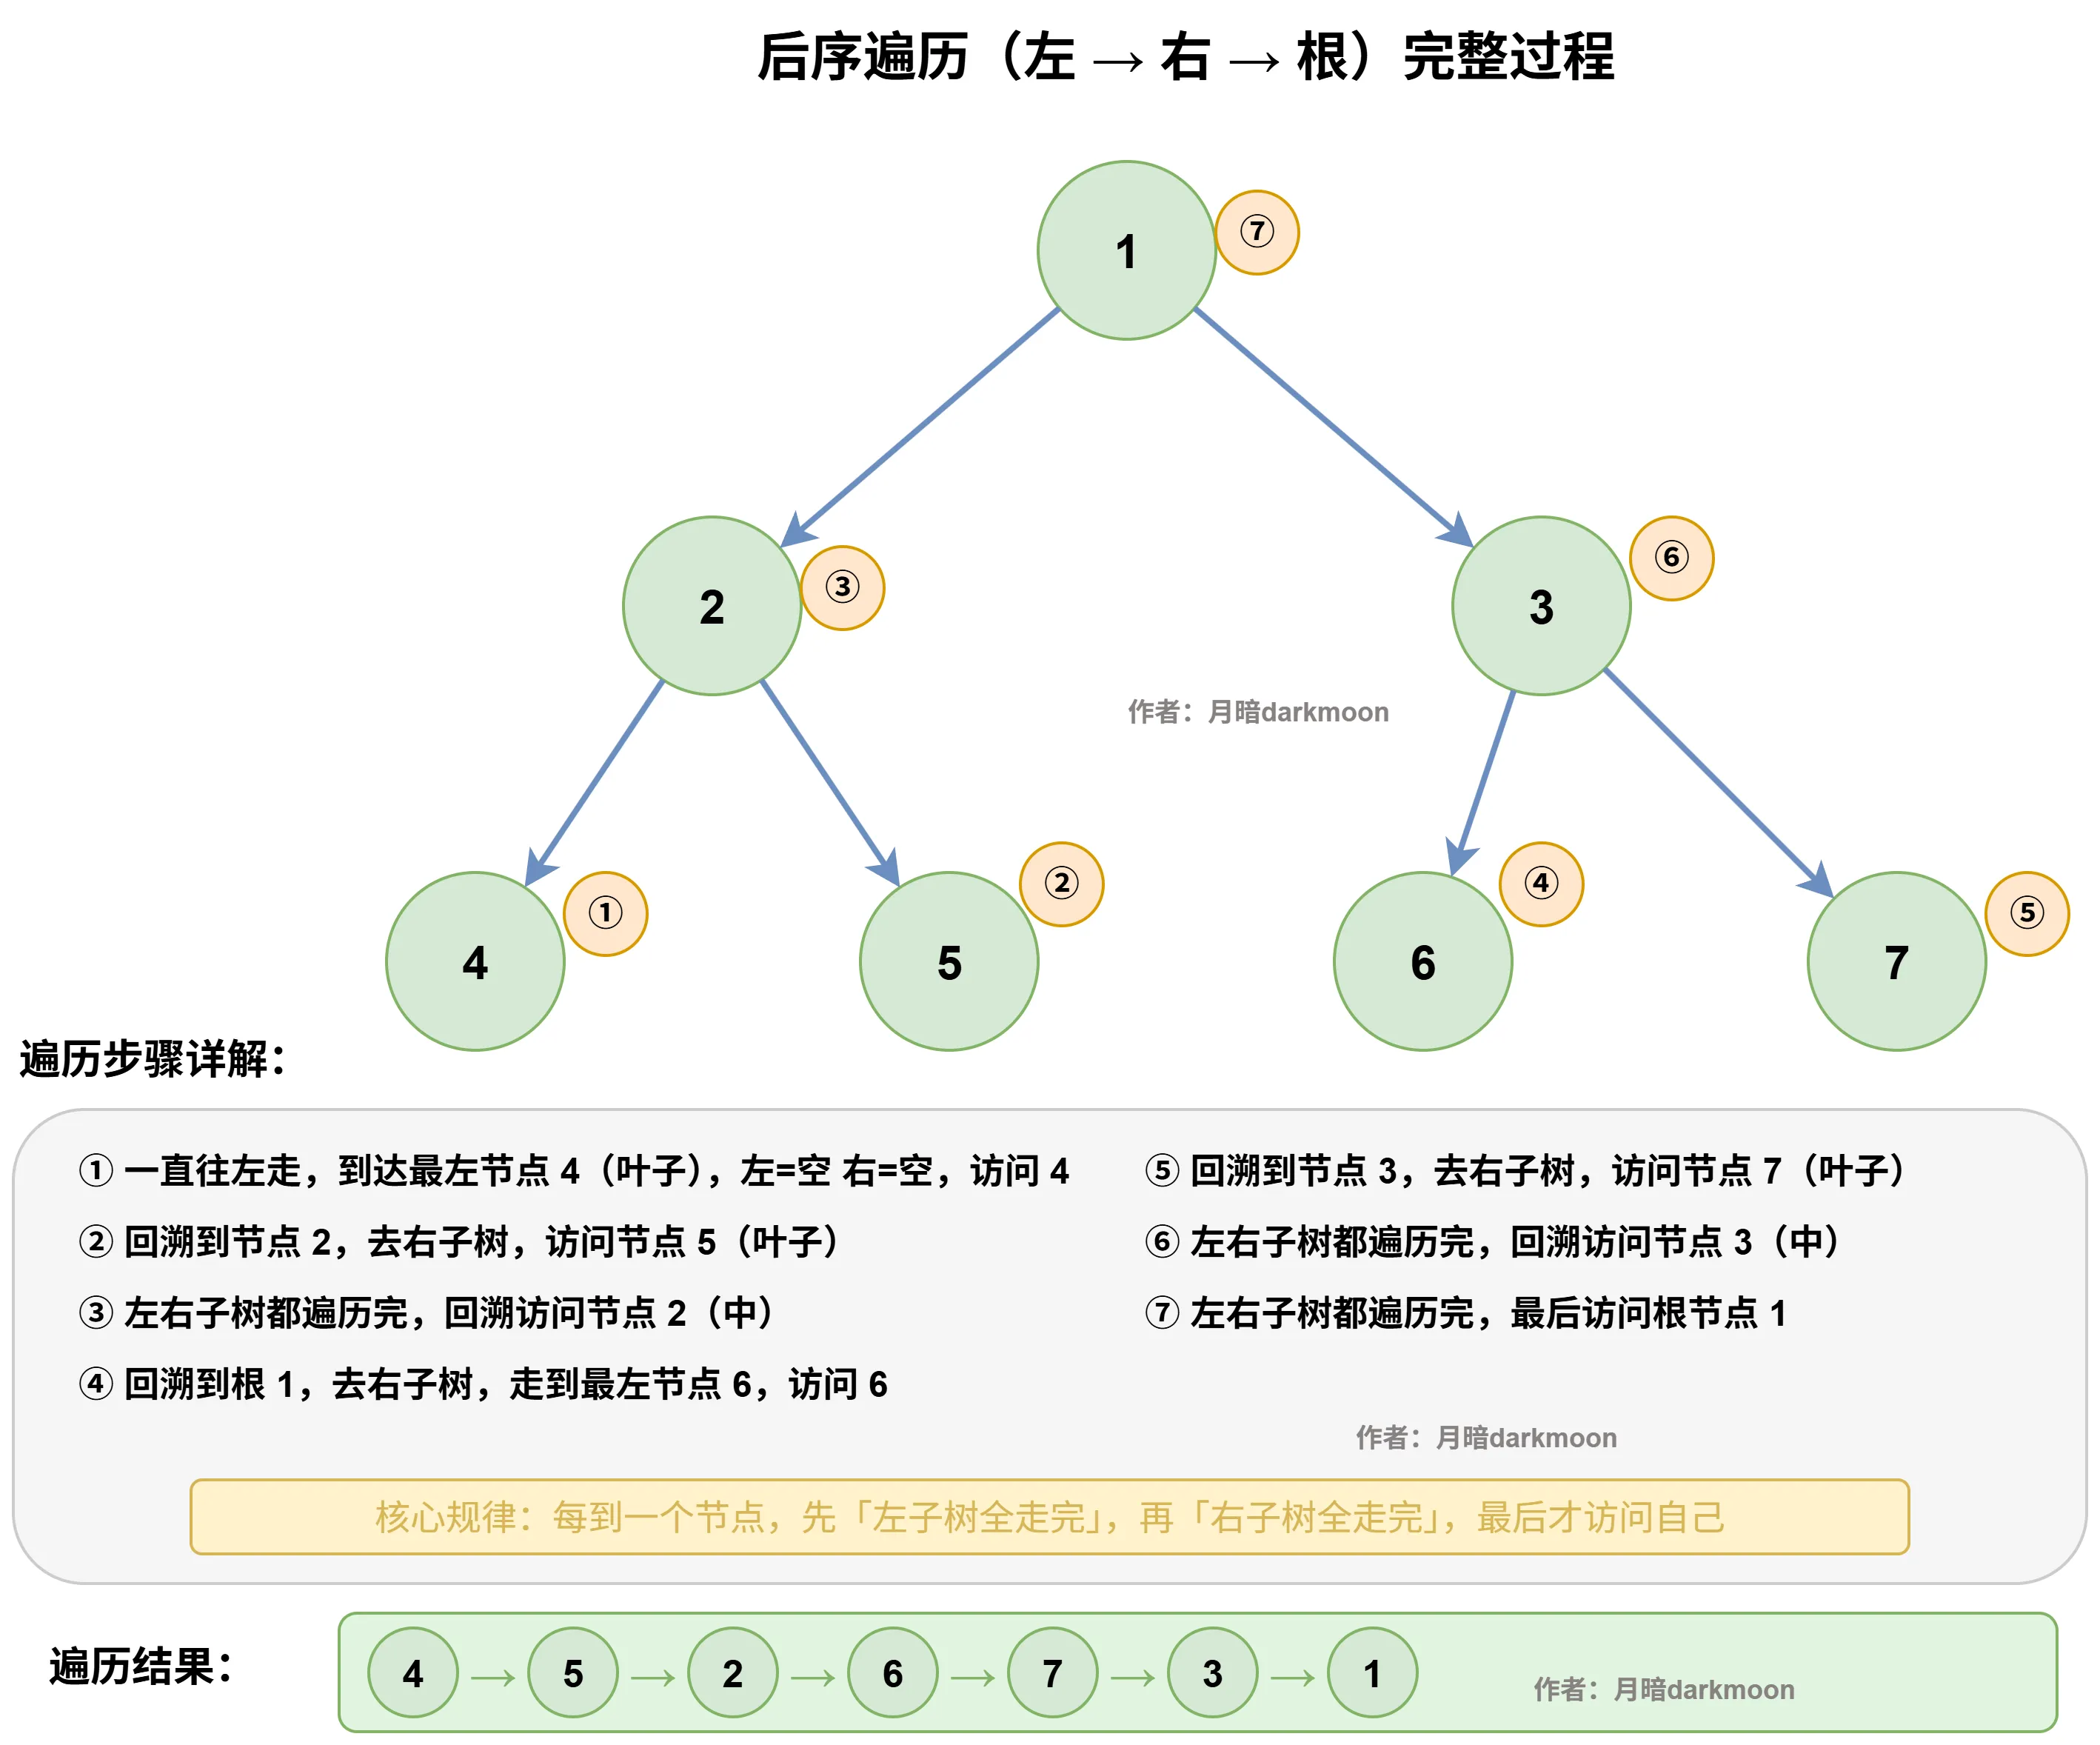
- 后序:左 → 右 → 根(根在最后面)
大家可以对着如下图,看看自己理解的前后中序有没有问题。
二叉树的递归遍历
在介绍三种深度优先遍历之前,先介绍一下递归算法的三要素:
- 确定递归函数的 参数和返回值 :确定哪些参数是递归的过程中需要处理的,那么就在递归函数里加上这个参数, 并且还要明确每次递归的返回值是什么进而确定递归函数的返回类型。
- 确定 终止条件 : 写完了递归算法, 运行的时候,经常会遇到栈溢出的错误,就是没写终止条件或者终止条件写的不对,操作系统也是用一个栈的结构来保存每一层递归的信息,如果递归没有终止,操作系统的内存栈必然就会溢出。
- 确定 单层递归的逻辑 : 确定每一层递归需要处理的信息。在这里也就会重复调用自己来实现递归的过程。
以下以前(先)序遍历为例:
- 确定递归函数的参数和返回值:因为要打印出前序遍历节点的数值,所以参数里需要传入
vector来放节点的数值,除了这一点就不需要再处理什么数据了也不需要有返回值,所以递归函数返回类型就是void,代码如下:
- 确定终止条件:在递归的过程中,如何算是递归结束了呢,当然是当前遍历的节点是空了,那么本层递归就要结束了,所以如果当前遍历的这个节点是空,就直接return,代码如下:
- 确定单层递归的逻辑:前序遍历是中左右的循序,所以在单层递归的逻辑,是要先取中节点的数值,代码如下:
单层递归的逻辑就是按照中左右的顺序来处理的,这样二叉树的前序遍历,基本就写完了,再看一下完整代码:
//C++实现代码
class Solution {
public:
void traversal(TreeNode* cur, vector<int>& vec) {
if (cur == NULL) return;
vec.push_back(cur->val);    // 中
traversal(cur->left, vec);  // 左
traversal(cur->right, vec); // 右
}
vector<int> preorderTraversal(TreeNode* root) {
vector<int> result;
traversal(root, result);
return result;
}
};
//C实现代码
/**
* struct TreeNode {
* int val;
* struct TreeNode *left;
* struct TreeNode *right;
* };
*/
void traversal(struct TreeNode* cur, int* vec, int* idx) {
if (cur == NULL) return;
vec[(*idx)++] = cur->val; // 中
traversal(cur->left, vec, idx); // 左
traversal(cur->right, vec, idx);// 右
}
int* preorderTraversal(struct TreeNode* root, int* returnSize) {
*returnSize = 0;
int* result = (int*)malloc(sizeof(int) * 1000);
traversal(root, result, returnSize);
return result;
}
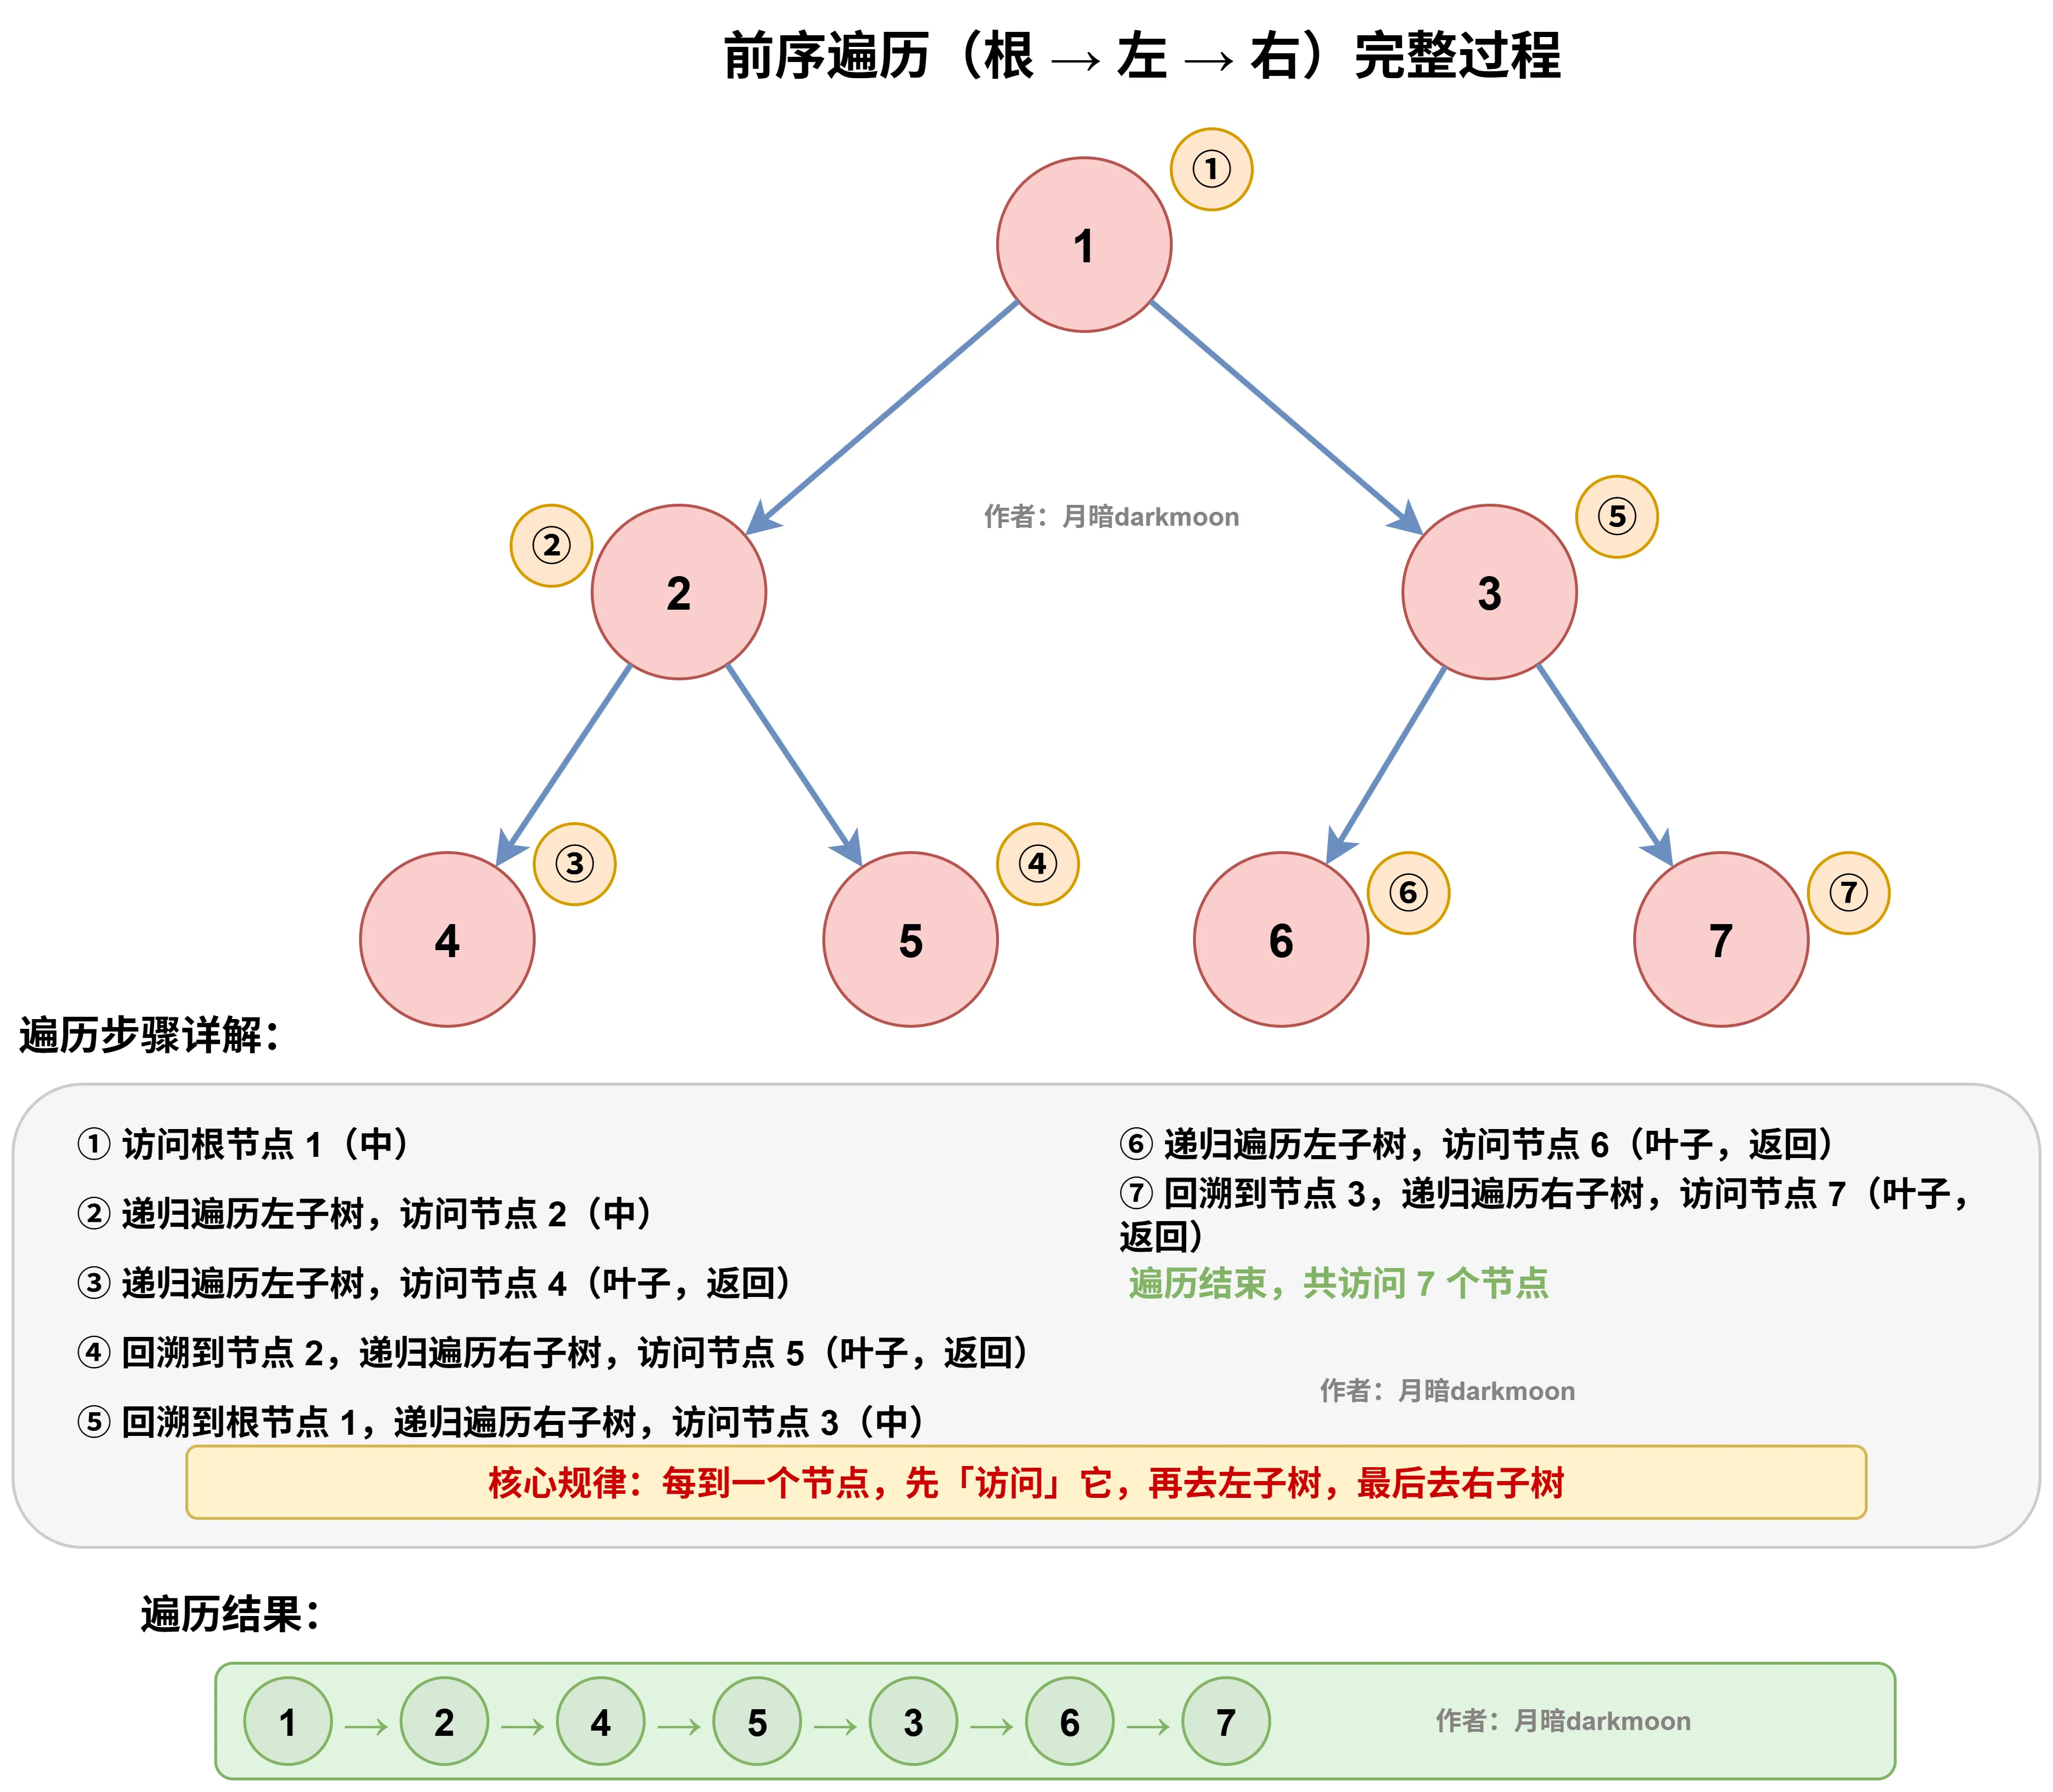
那么前序遍历写出来之后,中序和后序遍历就不难理解了,代码如下:
//C++实现代码
void traversal(TreeNode* cur, vector<int>& vec) {
    if (cur == NULL) return;
    traversal(cur->left, vec);  // 左
    vec.push_back(cur->val);    // 中
    traversal(cur->right, vec); // 右
}

//C实现代码
void traversal(struct TreeNode* cur, int* vec, int* idx) {
    if (cur == NULL) return;
    traversal(cur->left, vec, idx); // 左
    vec[(*idx)++] = cur->val;       // 中
    traversal(cur->right, vec, idx);// 右
}

int* inorderTraversal(struct TreeNode* root, int* returnSize) {
    *returnSize = 0;
    int* result = (int*)malloc(sizeof(int) * 1000);
    traversal(root, result, returnSize);
    return result;
}
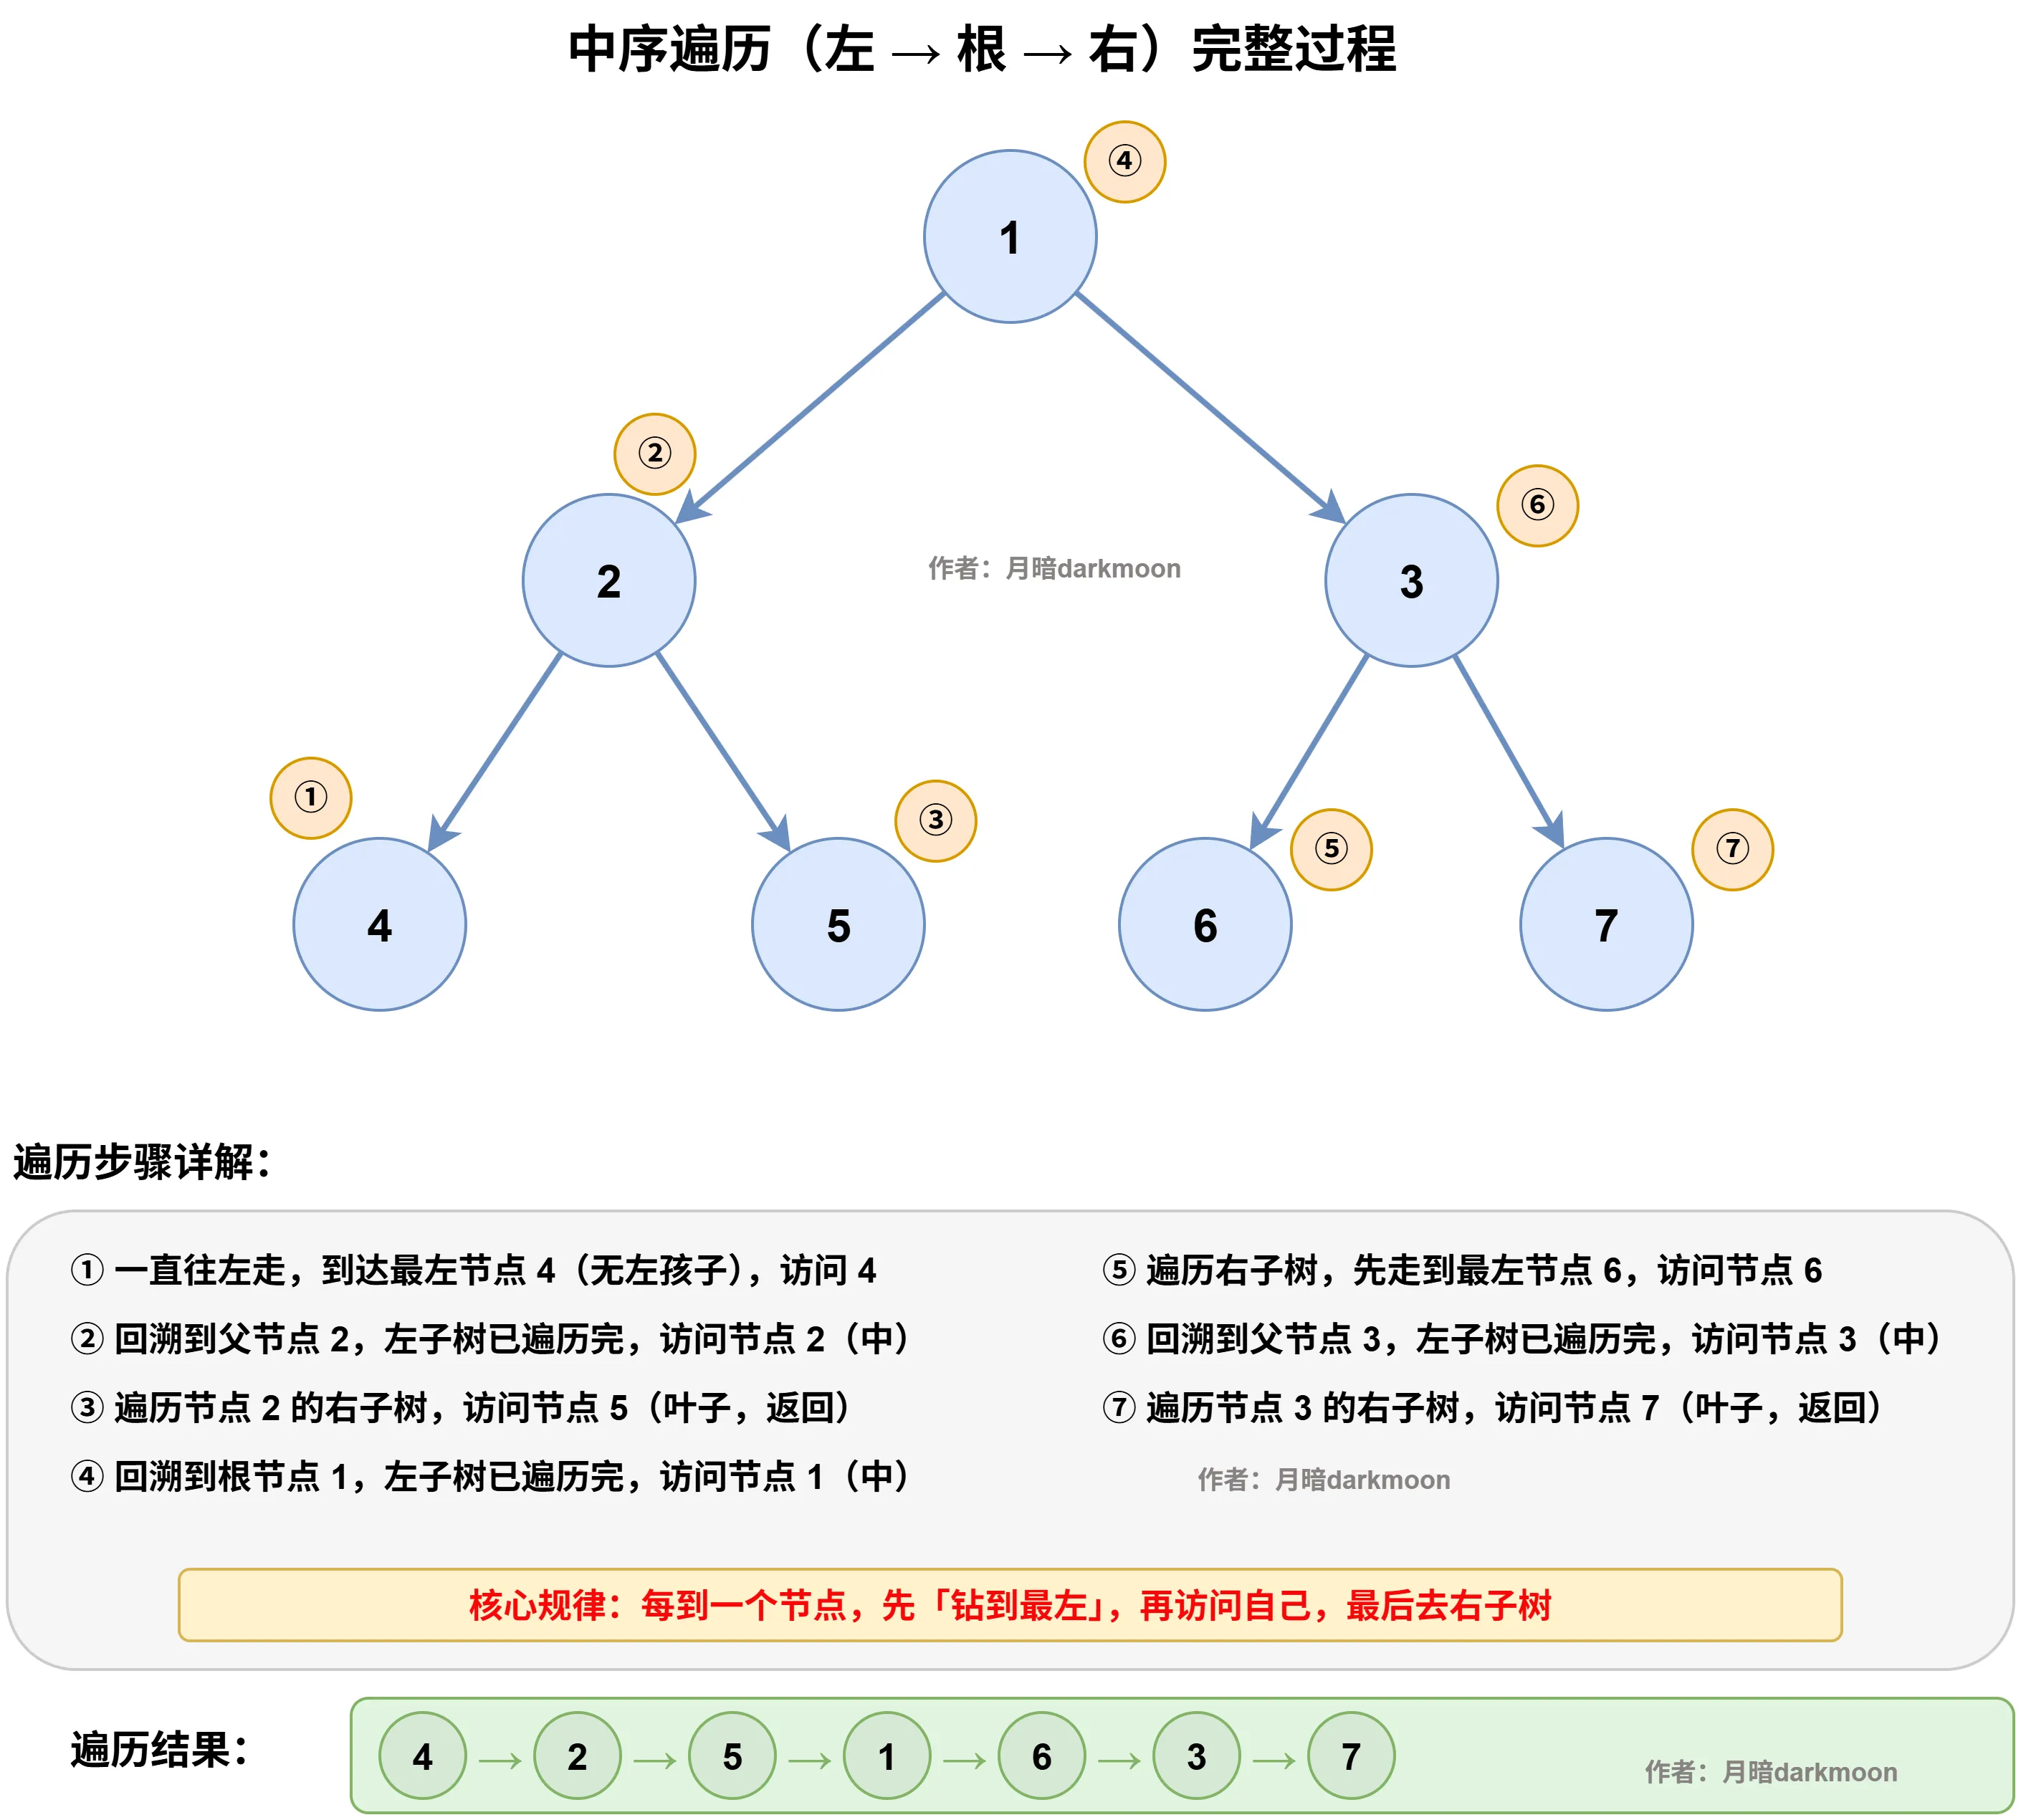
//C++实现代码
void traversal(TreeNode* cur, vector<int>& vec) {
    if (cur == NULL) return;
    traversal(cur->left, vec);  // 左
    traversal(cur->right, vec); // 右
    vec.push_back(cur->val);    // 中
}
//C实现代码
void traversal(struct TreeNode* cur, int* vec, int* idx) {
    if (cur == NULL) return;
    traversal(cur->left, vec, idx); // 左
    traversal(cur->right, vec, idx);// 右
    vec[(*idx)++] = cur->val;       // 中
}

int* postorderTraversal(struct TreeNode* root, int* returnSize) {
    *returnSize = 0;
    int* result = (int*)malloc(sizeof(int) * 1000);
    traversal(root, result, returnSize);
    return result;
}
对以上三种遍历的时空复杂度分析:
时间复杂度:\(O(n)\),其中\(n\)是二叉树的节点数。每一个节点恰好被遍历一次。
空间复杂度:\(O(n)\),为递归过程中栈的开销,平均情况下为 \(O(logn)\),最坏情况下树呈现链状,为\(O(n)\)
由于递归遍历过于简单,不足以应对考试或者面试官,因此,我们有必要掌握非递归遍历
二叉树的迭代遍历
为什么可以用迭代法(非递归的方式)来实现二叉树的前后中序遍历呢?
递归的实现就是:每一次递归调用都会把函数的局部变量、参数值和返回地址等压入调用栈中,然后递归返回的时候,从栈顶弹出上一次递归的各项参数,所以这就是递归为什么可以返回上一层位置的原因。
因此我们用栈也可以实现二叉树的前后中序遍历,两种方式是等价的,区别在于递归的时候隐式地维护了一个栈,而我们在迭代的时候需要显式地将这个栈模拟出来,其余的实现与细节都相同.
前序遍历(迭代法)
我们先看一下前序遍历。
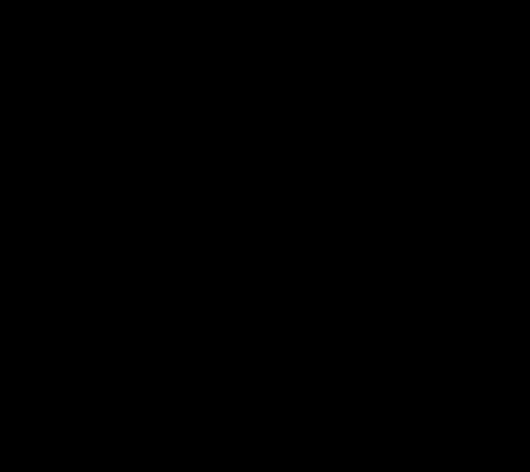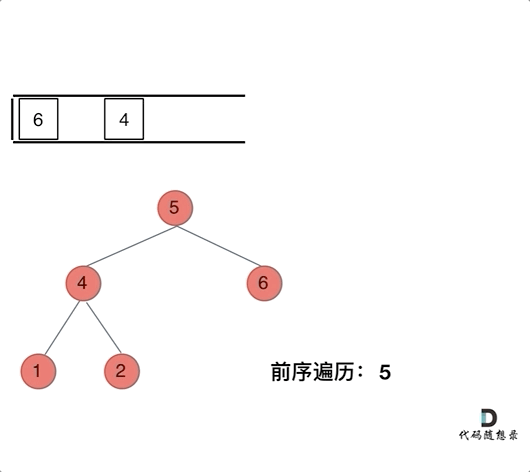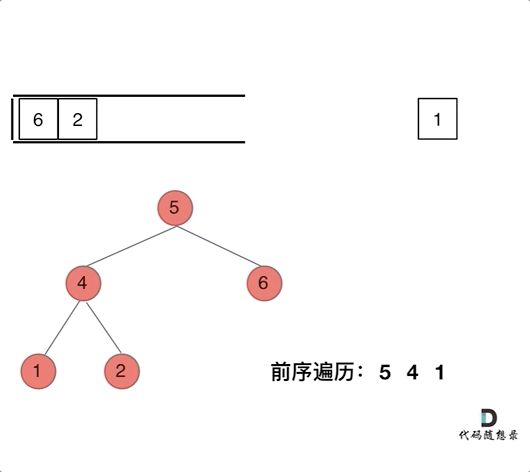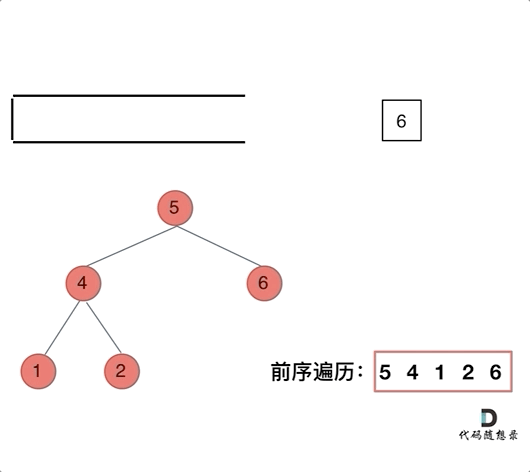
前序遍历是中左右,每次先处理的是中间节点,那么先将根节点放入栈中,然后将右孩子加入栈,再加入左孩子。
为什么要先加入 右孩子,再加入左孩子呢? 因为这样出栈的时候才是中左右的顺序。
动画如图:
不难写出如下代码: (注意代码中空节点不入栈)
class Solution {
    public:
    vector<int> preorderTraversal(TreeNode* root) {
        stack<TreeNode*> st;
        vector<int> result;       //用于返回遍历序列
        if (root == NULL) return result;
        st.push(root);
        while (!st.empty()) {
            TreeNode* node = st.top();                       // 中
            st.pop();
            result.push_back(node->val);    //访问并处理当前结点, <==> 本层递归处理
            if (node->right) st.push(node->right);           // 右孩子入栈(空节点不入栈) <==> 后递归处理右子树
            if (node->left) st.push(node->left);             // 左孩子入栈(空节点不入栈)<==> 先递归处理左子树
        }
        return result;
    }
};
由上面可以看出,前序遍历的非递归处理与递归处理实现对比:每一层的出栈都相当于进入一层递归函数。因为后入栈的元素先被处理,那么每次出栈顶元素都先将右孩子结点入栈,后入栈其左孩子,这就相当于先递归处理左子树,后递归处理右子树。即入栈顺序是递归顺序的逆置。
补充:根据此代码可以轻松写出统计二叉树中有且仅有一个孩子结点的结点个数,设置一个变量
count用于统计个数,每次访问栈顶元素然后出栈的时候,判断其是否仅有一个孩子结点(if((!node->left && node -> right) || (node->left && !node -> right))),是的话count++,否则count--.
此时会发现貌似使用迭代法写出前序遍历并不难,确实不难。
此时是不是想改一点前序遍历代码顺序就把中序遍历搞出来了?
其实还真不行!
但接下来,再用迭代法写中序遍历的时候,会发现套路又不一样了,目前的前序遍历的逻辑无法直接应用到中序遍历上。
中序遍历(迭代法)
为了解释清楚,我说明一下 刚刚在迭代的过程中,其实我们有两个操作:
- 处理:将元素放进result数组中
- 访问:遍历节点
分析一下为什么刚刚写的前序遍历的代码,不能和中序遍历通用呢,因为前序遍历的顺序是中左右,先访问的元素是中间节点,要处理的元素也是中间节点,所以刚刚才能写出相对简洁的代码,因为要访问的元素和要处理的元素顺序是一致的,都是中间节点。
那么再看看中序遍历,中序遍历是左中右,先访问的是二叉树顶部的节点,然后一层一层向下访问,直到到达树左面的最底部,再开始处理节点(也就是在把节点的数值放进result数组中),这就造成了处理顺序和访问顺序是不一致的。
那么在使用迭代法写中序遍历,就需要借用指针的遍历来帮助访问节点,栈则用来处理节点上的元素。
动画如下:
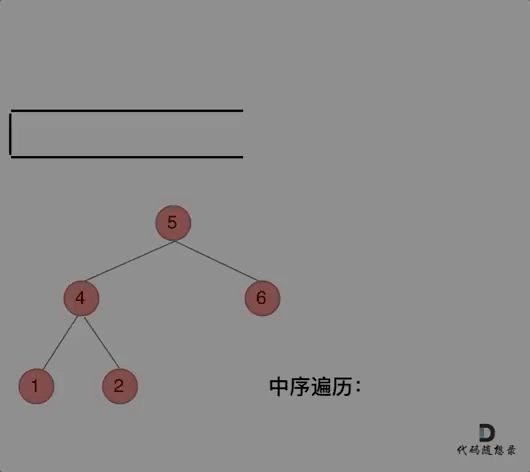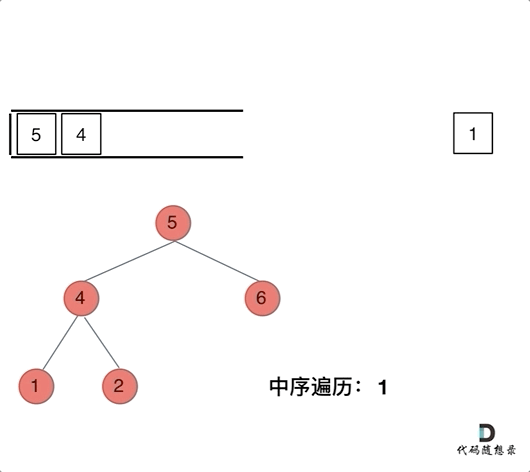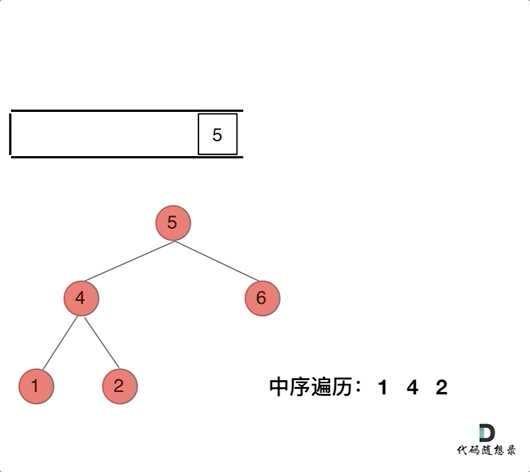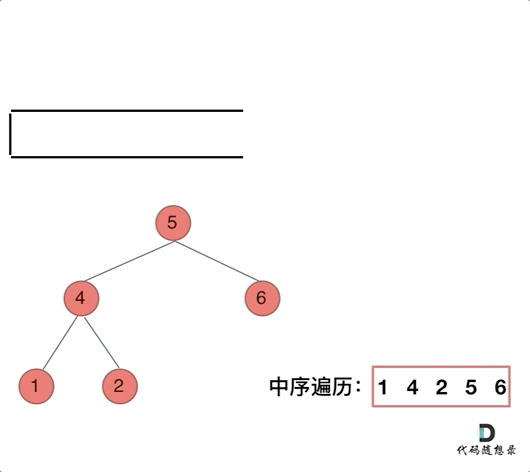
中序遍历,可以写出如下代码:
class Solution {
    public:
    vector<int> inorderTraversal(TreeNode* root) {
        vector<int> result;     //定义一个结果数组用于存放中序遍历序列;
        stack<TreeNode*> st;
        TreeNode* cur = root;      //cur为遍历指针
        while (cur != NULL || !st.empty()) {
            if (cur != NULL) { // 指针来访问节点,访问到最底层
                st.push(cur); // 将访问的节点放进栈
                cur = cur->left;                // 左
            } else {
                cur = st.top(); // 从栈里弹出的数据,就是要处理的数据(放进result数组里的数据)
                st.pop();
                result.push_back(cur->val);     // 中
                cur = cur->right;               // 右
            }
        }
        return result;
    }
};
其实,我们也可以套用这个中序遍历的模式来实现先序遍历,只需要将访问结点操作放在入栈操作的前面即可,即先将当前结点的值加入先序遍历序列,再将当前结点和它的所有左节点入栈即可,代码如下:
class Solution {
public:
    vector<int> preorderTraversal(TreeNode* root) {
        vector<int> result;     //定义一个结果数组用于存放中序遍历序列;
        stack<TreeNode*> st;
        TreeNode* cur = root;      //cur为遍历指针
        while (cur != NULL || !st.empty()) {
            if (cur != NULL) { // 指针来访问节点,访问到最底层
                result.push_back(cur->val);     // 中
                st.push(cur); // 将访问的节点放进栈
                cur = cur->left;                // 左
            } else {
                cur = st.top();
                st.pop();
                cur = cur->right;               // 右
            }
        }
        return result;
    }
};

//也可以修改为
vector<int> preorderTraversal(TreeNode* root) {
    vector<int> result;
    stack<TreeNode*> st;
    TreeNode* cur = root;
    while (!st.empty() || cur != NULL) {
        while (cur != NULL) {
            result.push_back(cur->val);
            st.push(cur);
            cur = cur->left;
        }
        cur = st.top();
        st.pop();
        cur = cur->right;
    }
    return result;
}
后序遍历(迭代法)
再来看后序遍历,先序遍历是中左右,后续遍历是左右中,那么我们只需要调整一下先序遍历的代码顺序,就变成中右左的遍历顺序,然后在反转result数组,输出的结果顺序就是左右中了,如下图:
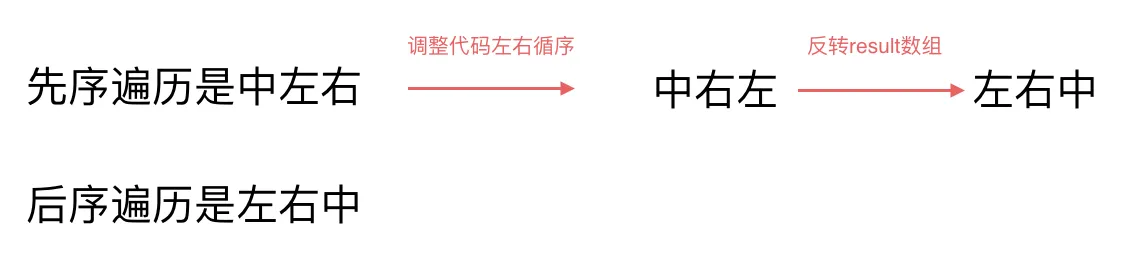
所以后序遍历只需要前序遍历的代码稍作修改就可以了,代码如下:
class Solution {
    public:
    vector<int> postorderTraversal(TreeNode* root) {
        stack<TreeNode*> st;
        vector<int> result;
        if (root == NULL) return result;
        st.push(root);
        while (!st.empty()) {
            TreeNode* node = st.top();
            st.pop();
            result.push_back(node->val);
            if (node->left) st.push(node->left); // 相对于前序遍历,这更改一下入栈顺序 (空节点不入栈)
            if (node->right) st.push(node->right); // 空节点不入栈
        }
        reverse(result.begin(), result.end()); // 将结果反转之后就是左右中的顺序了
        return result;
    }
};
在考试时,如果不敢直接用
reverse函数,可以再设置一个辅助栈,每次访问结点的时候,直接将该结点加入辅助栈,遍历结束以后,再从辅助栈出栈得到的就是后序遍历序列;
这种方法属于讨巧的解法,其实后序遍历的非递归遍历难度最大,接下来我们来看一种正经的迭代解法,摘自该题解。
与中序的不同之处在于:
- 中序遍历中,从栈中弹出的节点,其左子树是访问完了,可以直接访问该节点,然后接下来访问右子树。
- 后序遍历中,从栈中弹出的节点,我们只能确定其左子树肯定访问完了,但是无法确定右子树是否访问过。
因此,我们在后序遍历中,引入了一个pre来记录历史访问记录。
- 当访问完一棵子树的时候,我们用
pre指向该节点。 - 这样,在回溯到父节点的时候,我们可以依据
pre是指向左子节点,还是右子节点,来判断父节点的访问情况。
class Solution {
public:
    vector<int> postorderTraversal(TreeNode* root) {
        vector<int> res;
        stack<TreeNode*> stk;
        TreeNode* cur = root, *pre = NULL;
        //主要思想:
        //由于在某颗子树访问完成以后,接着就要回溯到其父节点去
        //因此可以用prev来记录访问历史,在回溯到父节点时,可以由此来判断,上一个访问的节点是否为右子树;
        while(cur != NULL || !stk.empty()){
            while(cur!=NULL) {     //步骤1:沿着根的左孩子依次入栈,直到左孩子为空;
                stk.push(cur);
                cur = cur ->left;
            }
            cur = stk.top();
            stk.pop();  //步骤2:此时从栈中弹出的元素,左子树一定是访问完了的;
            //现在需要确定的是是否有右子树,或者右子树是否访问过
            //如果没有右子树,或者右子树访问完了,也就是上一个访问的节点是右子节点时
            //说明可以访问当前节点
            if(cur->right == NULL || pre == cur->right) {
                res.push_back(cur->val);
                pre = cur;//更新历史访问记录,这样回溯的时候父节点可以由此判断右子树是否访问完成;
                cur = NULL;  //结点访问完,重置cur指针,以免跳到步骤1;
            }else{
                stk.push(cur);//如果右子树没有被访问,那么将当前节点压栈,访问右子树
                cur = cur -> right;  //将其右子树转去执行步骤2.
            }
        }
        return res;
    }
};
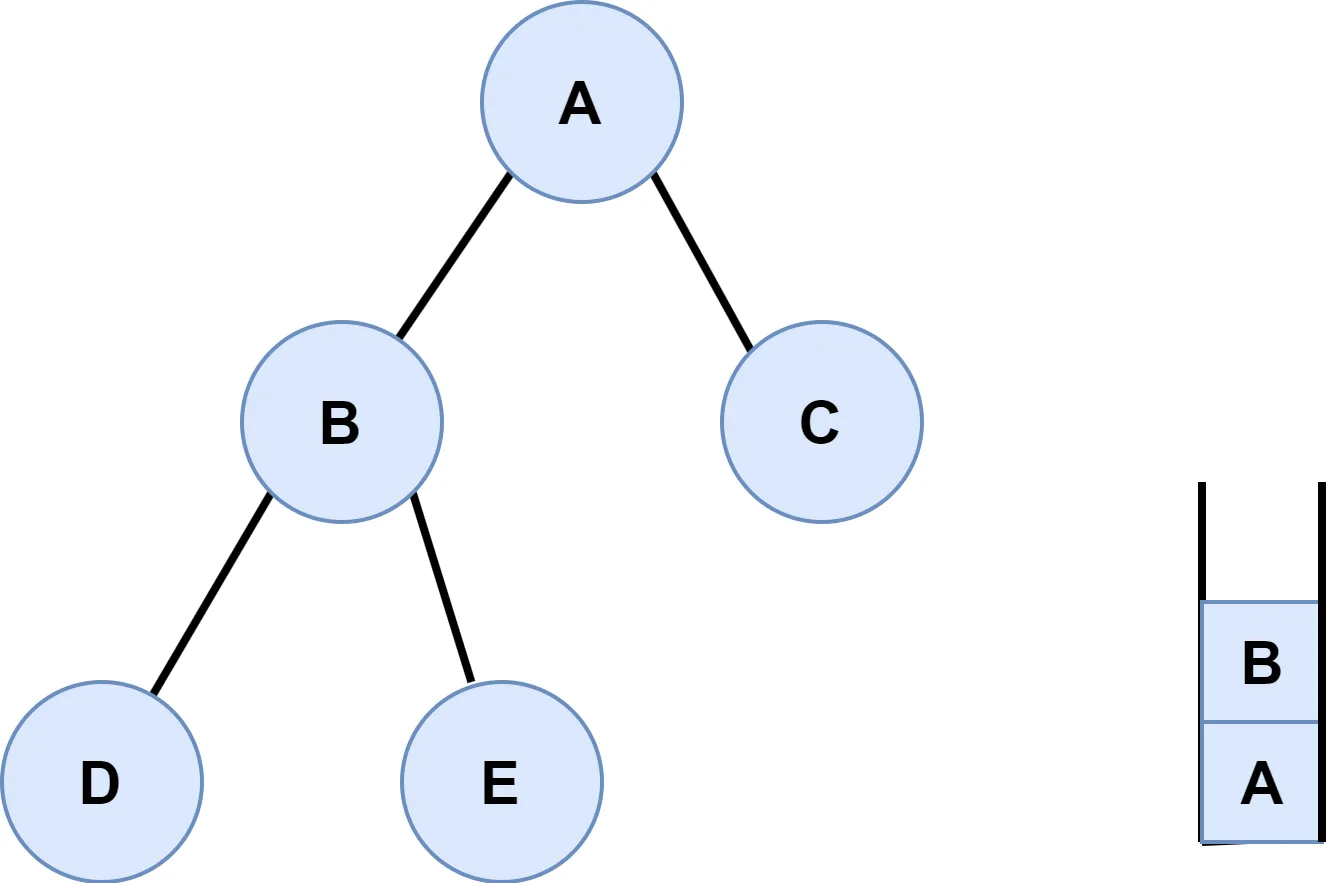
按照上述介绍的后序非递归遍历访问如图的二叉树,当访问到结点E时,A、B、E都已入过栈,其中D结点由于无右子树已经出栈,因此此时栈中还剩A、B结点,事实上,这也是E结点的全部祖先。不难得出一个结论:在该种遍历方式下,访问到一个结点p时,栈中结点恰好是p的所有祖先结点,并且从栈底到栈顶结点再加上当前访问结点p,刚好构成从根结点到p结点的一条路径。
该结论可以用来解决如下问题:
- 求根到某结点的路径
- 236. 二叉树的最近公共祖先
- 129. 求根节点到叶节点数字之和
总结:
Note
上面三种非递归遍历的开销与递归遍历的开销一样,同样是\(O(n)/O(n)\)
二叉树的层序遍历
层序遍历一个二叉树。就是从左到右一层一层的去遍历二叉树。这种遍历的方式和我们之前讲过的都不太一样。
需要借用一个辅助数据结构即队列来实现,队列先进先出,符合一层一层遍历的逻辑,而用栈先进后出适合模拟深度优先遍历也就是递归的逻辑。
而这种层序遍历方式就是图论中的广度优先遍历,只不过我们应用在二叉树上。
使用队列实现二叉树广度优先遍历,动画如下:

这样就实现了层序从左到右遍历二叉树。
代码如下:这份代码也可以作为二叉树层序遍历的模板。
//用二维数组保存写法:
class Solution {
public:
    vector<vector<int>> levelOrder(TreeNode* root) {
        queue<TreeNode*> que;
        if (root != NULL) que.push(root);
        vector<vector<int>> result;
        while (!que.empty()) {
            int size = que.size();
            vector<int> vec;
            // 这里一定要使用固定大小size,不要使用que.size(),因为que.size是不断变化的
            for (int i = 0; i < size; i++) {
                TreeNode* node = que.front();
                que.pop();
                vec.push_back(node->val);
                if (node->left) que.push(node->left);
                if (node->right) que.push(node->right);
            }
            result.push_back(vec);
        }
        return result;
    }
};

//简化为用一维数组保存
vector<int> levelOrder(TreeNode *root) {
    vector<int> res;
    queue<TreeNode*> que;
    if(root == NULL) return res;
    que.push(root);
    while(!que.empty()){
        TreeNode *cur = que.front();
        que.pop();
        res.push_back(cur->val);
        if(cur->left!=NULL) que.push(cur->left);
        if(cur->right!=NULL) que.push(cur->right);
    }
    return res;
}
//递归法
class Solution {
public:
    void order(TreeNode* cur, vector<vector<int>>& result, int depth)
    {
        if (cur == nullptr) return;
        if (result.size() == depth) result.push_back(vector<int>());
        result[depth].push_back(cur->val);
        order(cur->left, result, depth + 1);
        order(cur->right, result, depth + 1);
    }
    vector<vector<int>> levelOrder(TreeNode* root) {
        vector<vector<int>> result;
        int depth = 0;
        order(root, result, depth);
        return result;
    }
};
由遍历序列构造二叉树
Tip
给定一棵二叉树,其对应的先中后、层序遍历的序列也就确定了,但是只给四种序列的其中一种,往往无法确定一棵二叉树。若已知中序遍历序列,再给定其他三种序列中的任何一种,即可唯一确定一棵二叉树。
注意:若无中序遍历序列,单凭其他任意两个遍历序列,是无法唯一确定一棵二叉树的!!!解释在下面
根据先序和中序遍历序列还原二叉树
给定一棵二叉树的先序遍历序列和中序遍历序列,在结点值互不相同的前提下,可以唯一还原这棵二叉树。
Note
- 先序遍历:
根 -> 左 -> 右 - 中序遍历:
左 -> 根 -> 右 - 先序序列的第一个元素一定是当前子树的根。
- 在中序序列中定位根,根左边全部属于左子树,根右边全部属于右子树。
- 左子树的结点数决定先序序列如何切分;这一步是该还原算法的关键。
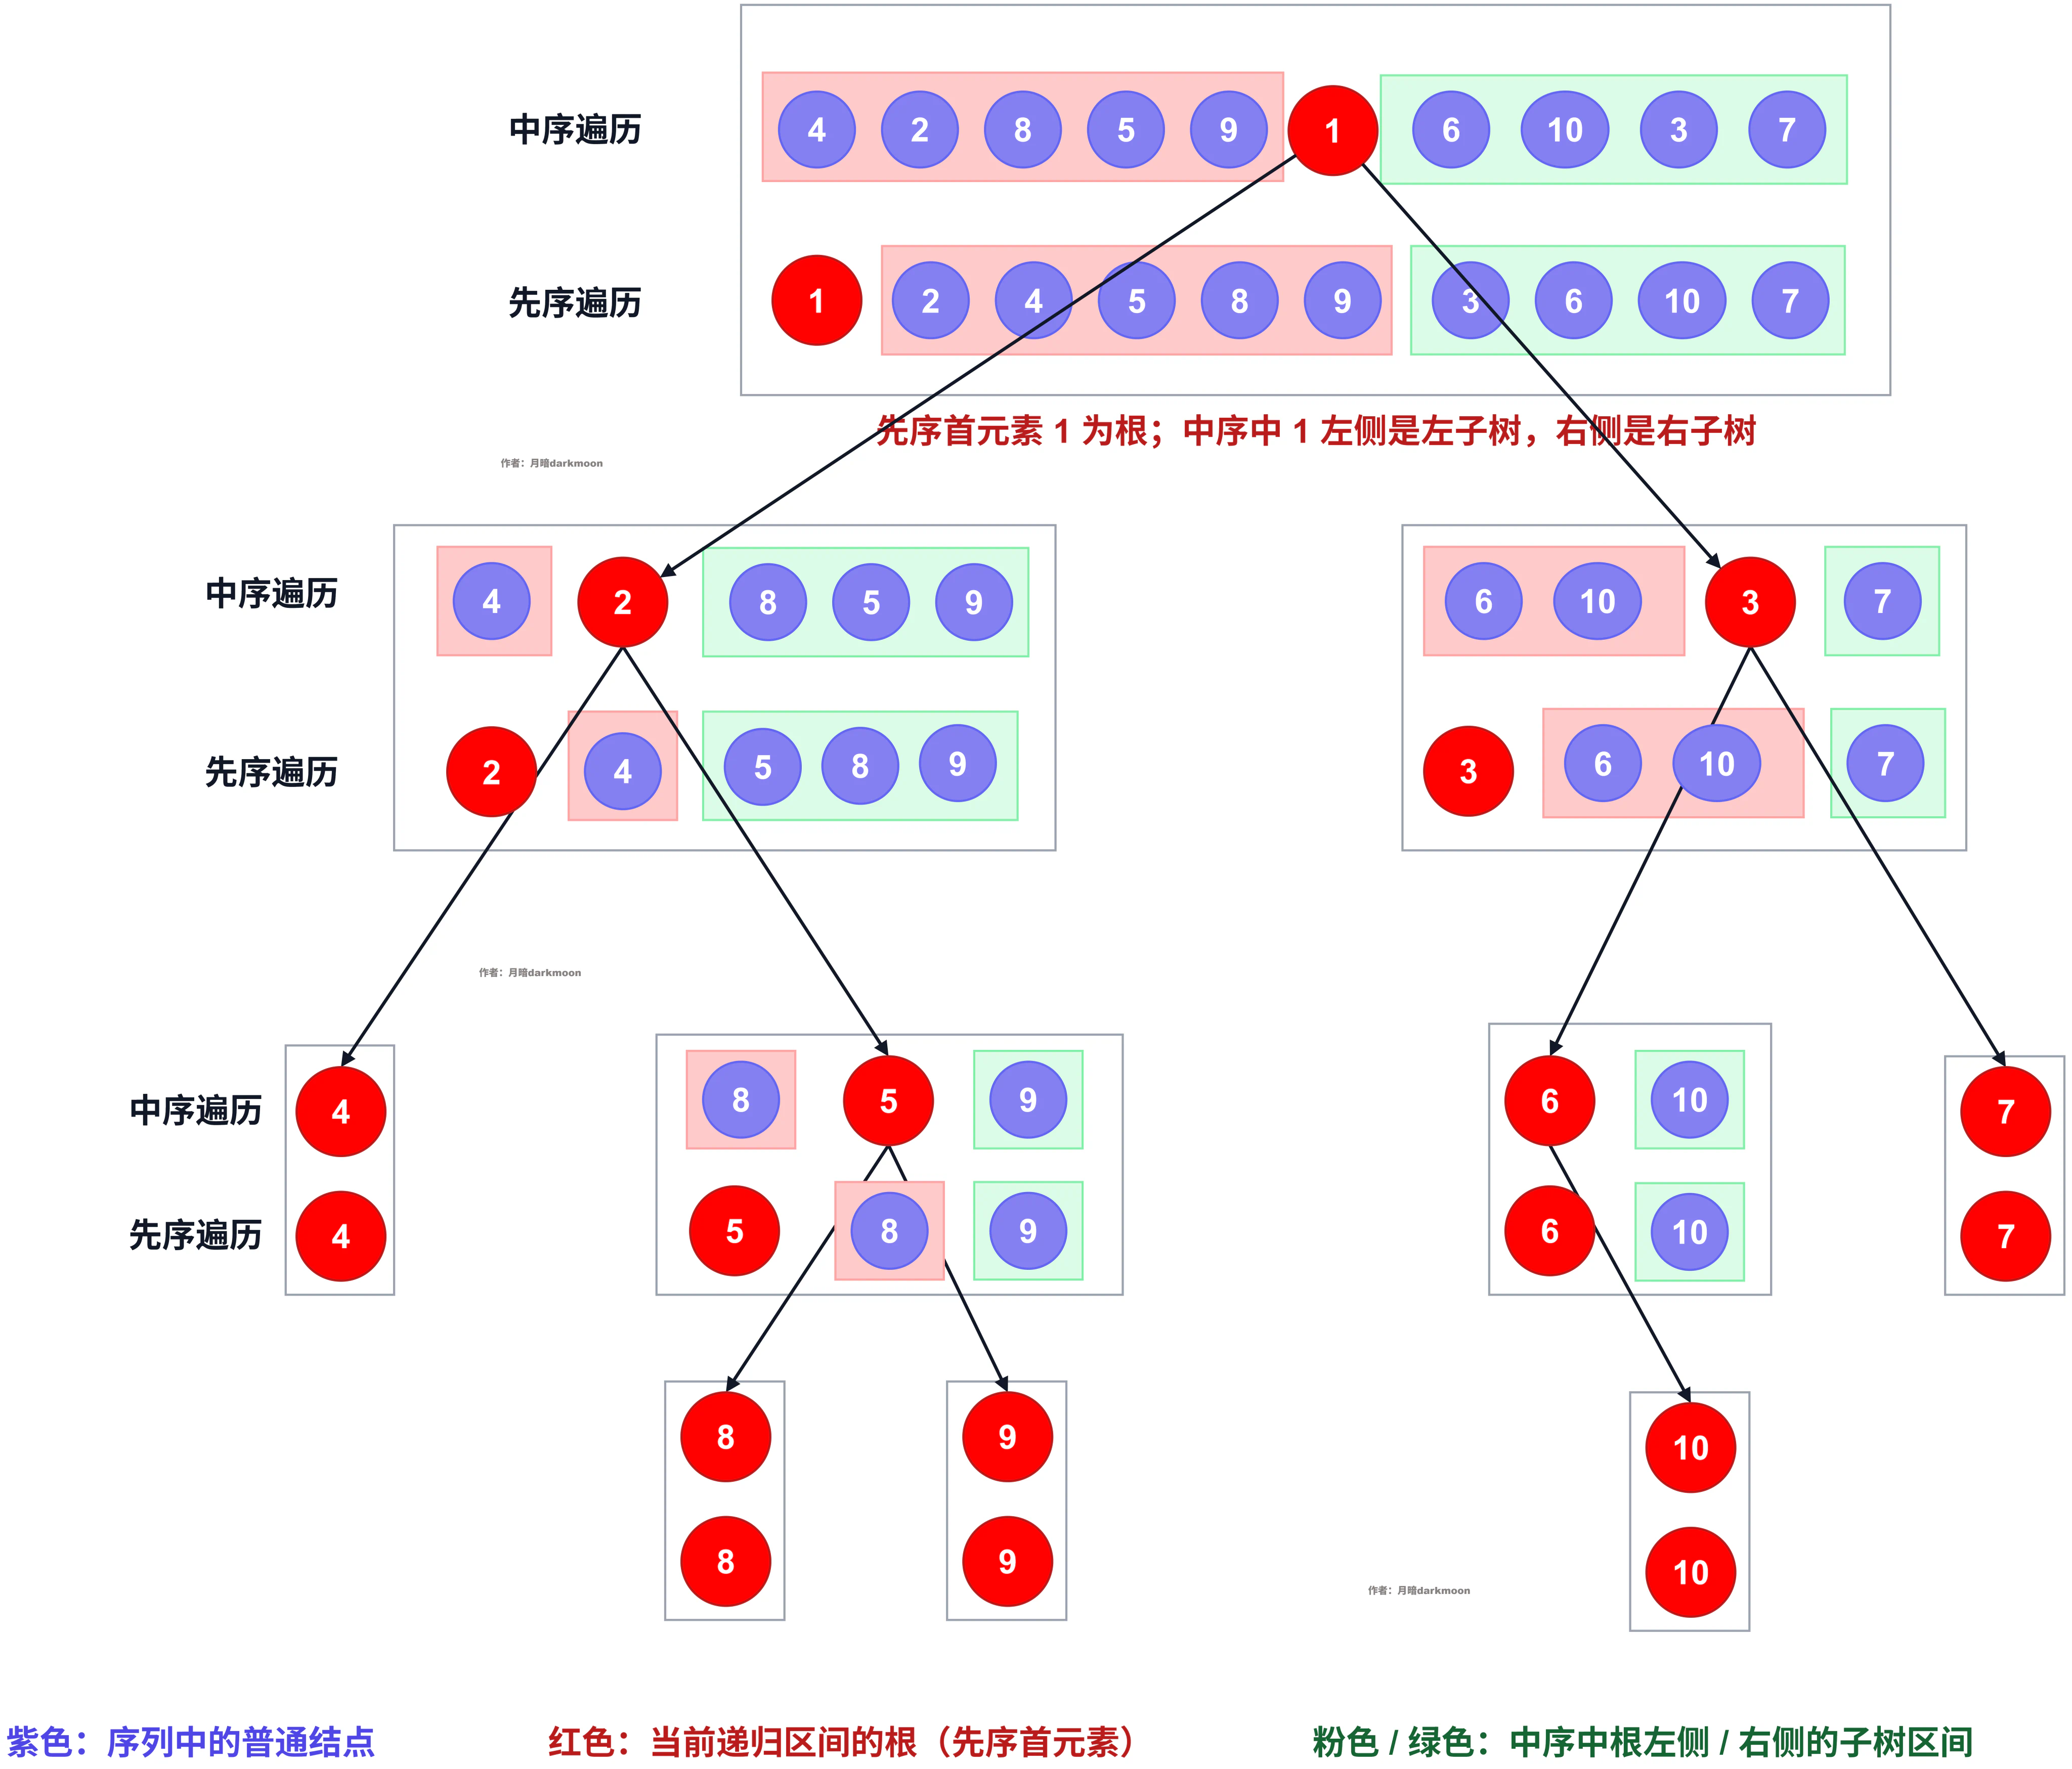
会手动模拟过程即可,不要求会写代码,若有兴趣用代码实现的话可以去下面链接里面测试,或者看里面的题解也不错
105. 从前序与中序遍历序列构造二叉树 - 力扣(LeetCode)
class Solution {
public:
    TreeNode* buildTree(vector<int>& preorder, vector<int>& inorder) {
        if (preorder.empty() || inorder.empty()) return NULL;
        return build(preorder,0,(int)preorder.size()-1,inorder,0,(int)inorder.size()-1);
    }
    TreeNode* build(vector<int>&preorder,int preStart,int preEnd,vector<int>&inorder,int inStart,int inEnd) {
        //最后写递归出口,很简单,就是两个数组之一越界就是出口(其实写1个也行,因为两个数组长度肯定相同的)
        if(preStart > preEnd || inStart > inEnd) return NULL;

         /*先序遍历框架-根、左、右*/
        //1.先构造根节点的值,做根节点
        //2.递归构造左子树
        //3.递归构造右子树

        int rootval = preorder[preStart];//1.很明显根节点的值由先序遍历数组的第一个值确定
        TreeNode* root = new TreeNode(rootval);
        //2.递归构造左子树
        // root->left = bulid(preorder, ?, ?, inorder, ?, ?);
        //?需要我们画图去求的,也就是左右子树的索引
        // root->right = bulid(preorder, ?, ?, inorder, ?, ?);
        //?需要我们画图去求的,也就是左右子树的索引
        //首先通过rootVal在inorder中的索引(index),然后就能够知道inorder中左子树和右子树的边界
        //可以改进的,一开始用hashMap把inorder的值和索引存好,到时候直接查就行。
        int index = -1;
        for(int i = inStart; i <= inEnd; ++i) {
            if(inorder[i] == rootval) {
                index = i;
                break;
            }
        }
        //找到了index,确定inorder中左右子树的边界
        // root.left = bulid(preorder, ?, ?, inorder, inStart, index - 1);//确定inorder中左子树的边界
        // root.right = bulid(preorder, ?, ?, inorder, index + 1, inEnd);//确定inorder中右子树的边界
        //通过inorder中左子树节点的数目来确定preorder中左右子树的边界
        int nums_of_left_tree = index - inStart;
        root -> left = build(preorder,preStart+1,preStart+nums_of_left_tree,inorder,inStart,index-1);
        root -> right = build(preorder,preStart+nums_of_left_tree+1,preEnd,inorder,index+1,inEnd);
        return root;
    }
};
根据后序和中序遍历序列还原二叉树
基本思想:后序遍历可以确定一个子树的根节点,而中序遍历可以在此基础上,依据该结点再次划分为左右子树
原理跟上面那个类似, 不再赘述
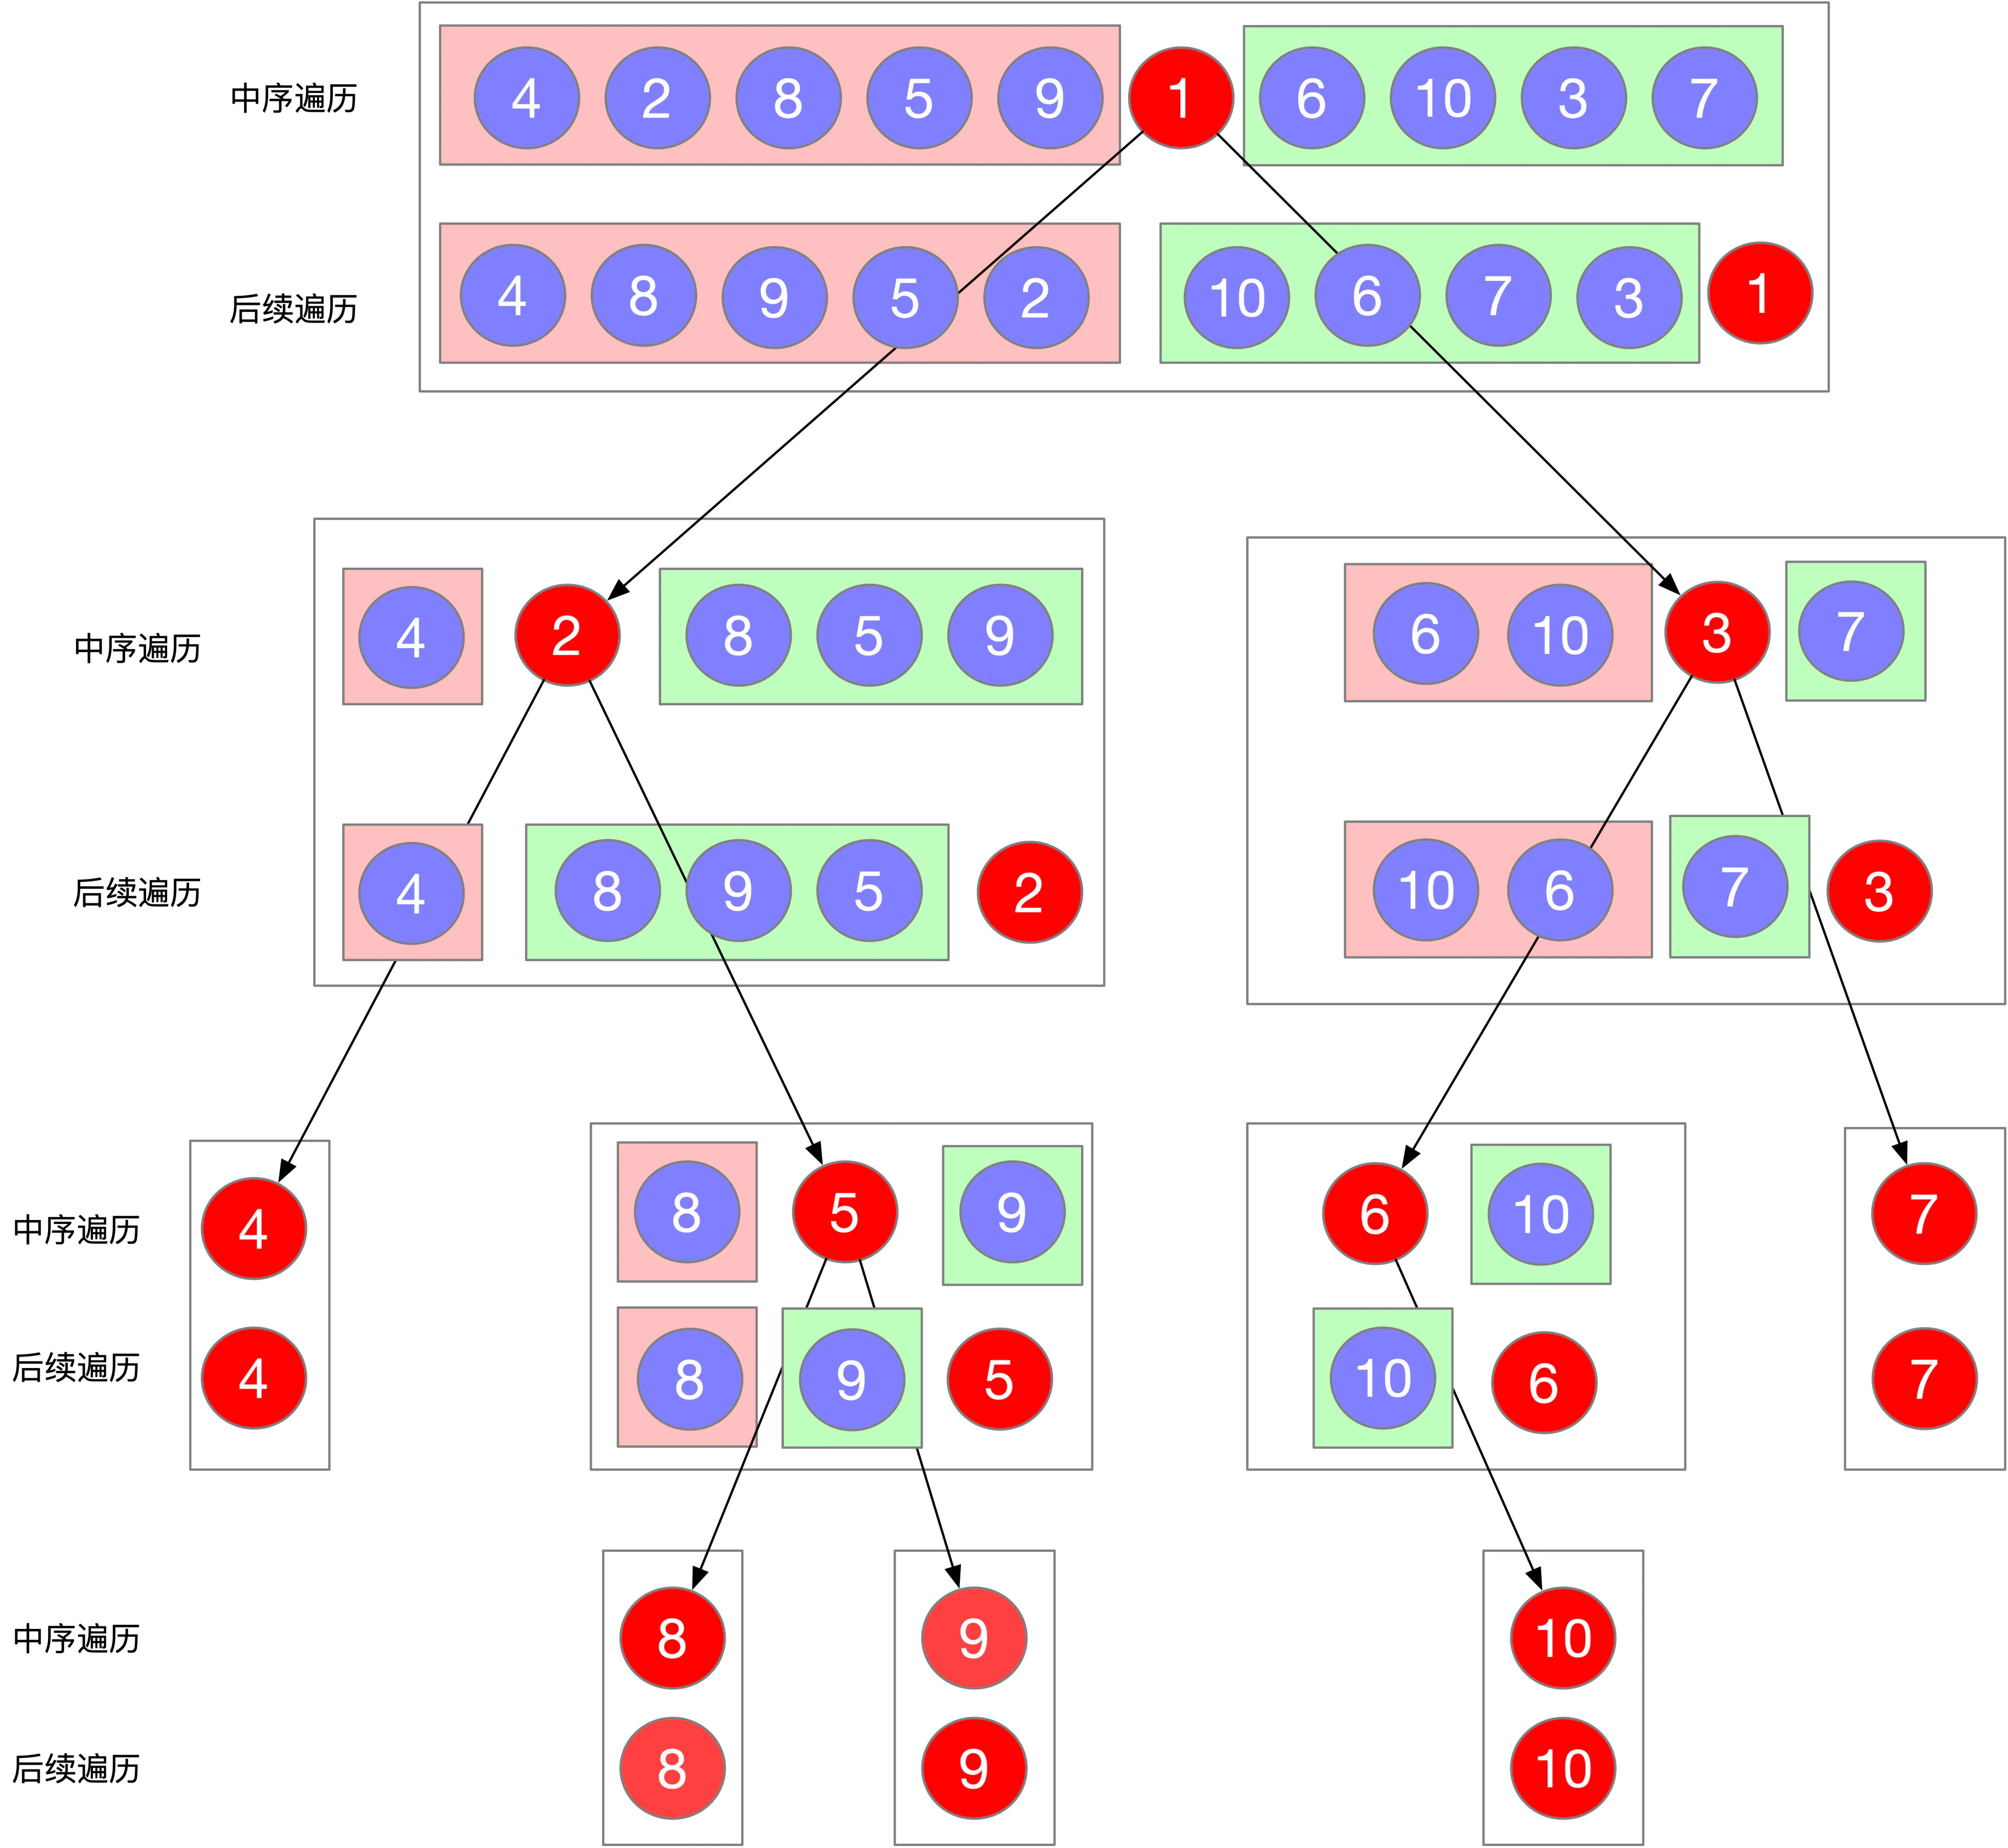
106. 从中序与后序遍历序列构造二叉树 - 力扣(LeetCode)
//代码思路同上,这里不再介绍
class Solution {
public:
    TreeNode* buildTree(vector<int>& inorder, vector<int>& postorder) {
        return build(inorder,0,inorder.size()-1,postorder,0,postorder.size()-1);
    }
    TreeNode* build(vector<int>& inorder,int inStart,int inEnd,vector<int>postorder,int postStart,int postEnd) {
        if(inStart > inEnd || postStart > postEnd) {
            return NULL;
        }
        int rootval = postorder[postEnd];
        TreeNode* root = new TreeNode(rootval);
        int index = -1;
        for(int i = inStart; i <= inEnd; ++i) {
            if(inorder[i] == rootval) {
                index = i;
                break;
            }
        }
        //根据后序遍历逻辑,递归创建右子树 和左子树。注意这里有需要先创建右子树,再创建左子树的依赖关系。
        //可以理解为在后序遍历的数组中整个数组是先存储左子树的节点,再存储右子树的节点,最后存储根节点,
        //如果按每次选择「后序遍历的最后一个节点」为根节点,则先被构造出来的应该为右子树。
        int nums_of_left_tree = index-inStart;
        root -> right = build(inorder,index+1,inEnd,postorder,postStart+nums_of_left_tree,postEnd-1);
        root -> left = build(inorder,inStart,index-1,postorder,postStart,postStart+nums_of_left_tree-1);
        // int nums_of_right_tree = postEnd-postStart - nums_of_left_tree;
        // root -> left = build(inorder,inStart,index-1,postorder,postStart,postStart+nums_of_left_tree-1);
        // root-> right = build(inorder,index+1,inEnd,postorder,postStart+nums_of_left_tree,postStart+nums_of_left_tree-1+nums_of_right_tree);
        return root;
    }
};
根据层序和中序序列还原二叉树
层序遍历的关键性质:
- 第 1 个元素是根节点
- 节点按层次出现,同一层的节点在序列中连续(或基本连续)
- 父节点一定出现在其子节点之前
根据层序和中序序列还原二叉树的原理:
Note
层序序列告诉我们"谁是根",中序序列告诉我们"根的左右各有谁"。
具体来说:
- 层序序列的第一个元素就是整棵树的根节点
- 在中序序列中找到根节点的位置,根节点左边是左子树的所有节点,右边是右子树的所有节点
- 从层序序列中筛选出左子树的节点(保持原有顺序),得到左子树的层序序列
- 从层序序列中筛选出右子树的节点(保持原有顺序),得到右子树的层序序列
- 对左右子树递归执行上述过程
Note
为什么需要"重新筛选层序序列"?
层序序列是整棵树的层序,当我们确定了根节点后,左子树的节点和右子树的节点在原层序序列中是交错排列的。我们需要从中分别"挑出"属于左子树和右子树的节点,各自组成新的层序序列,才能继续递归。
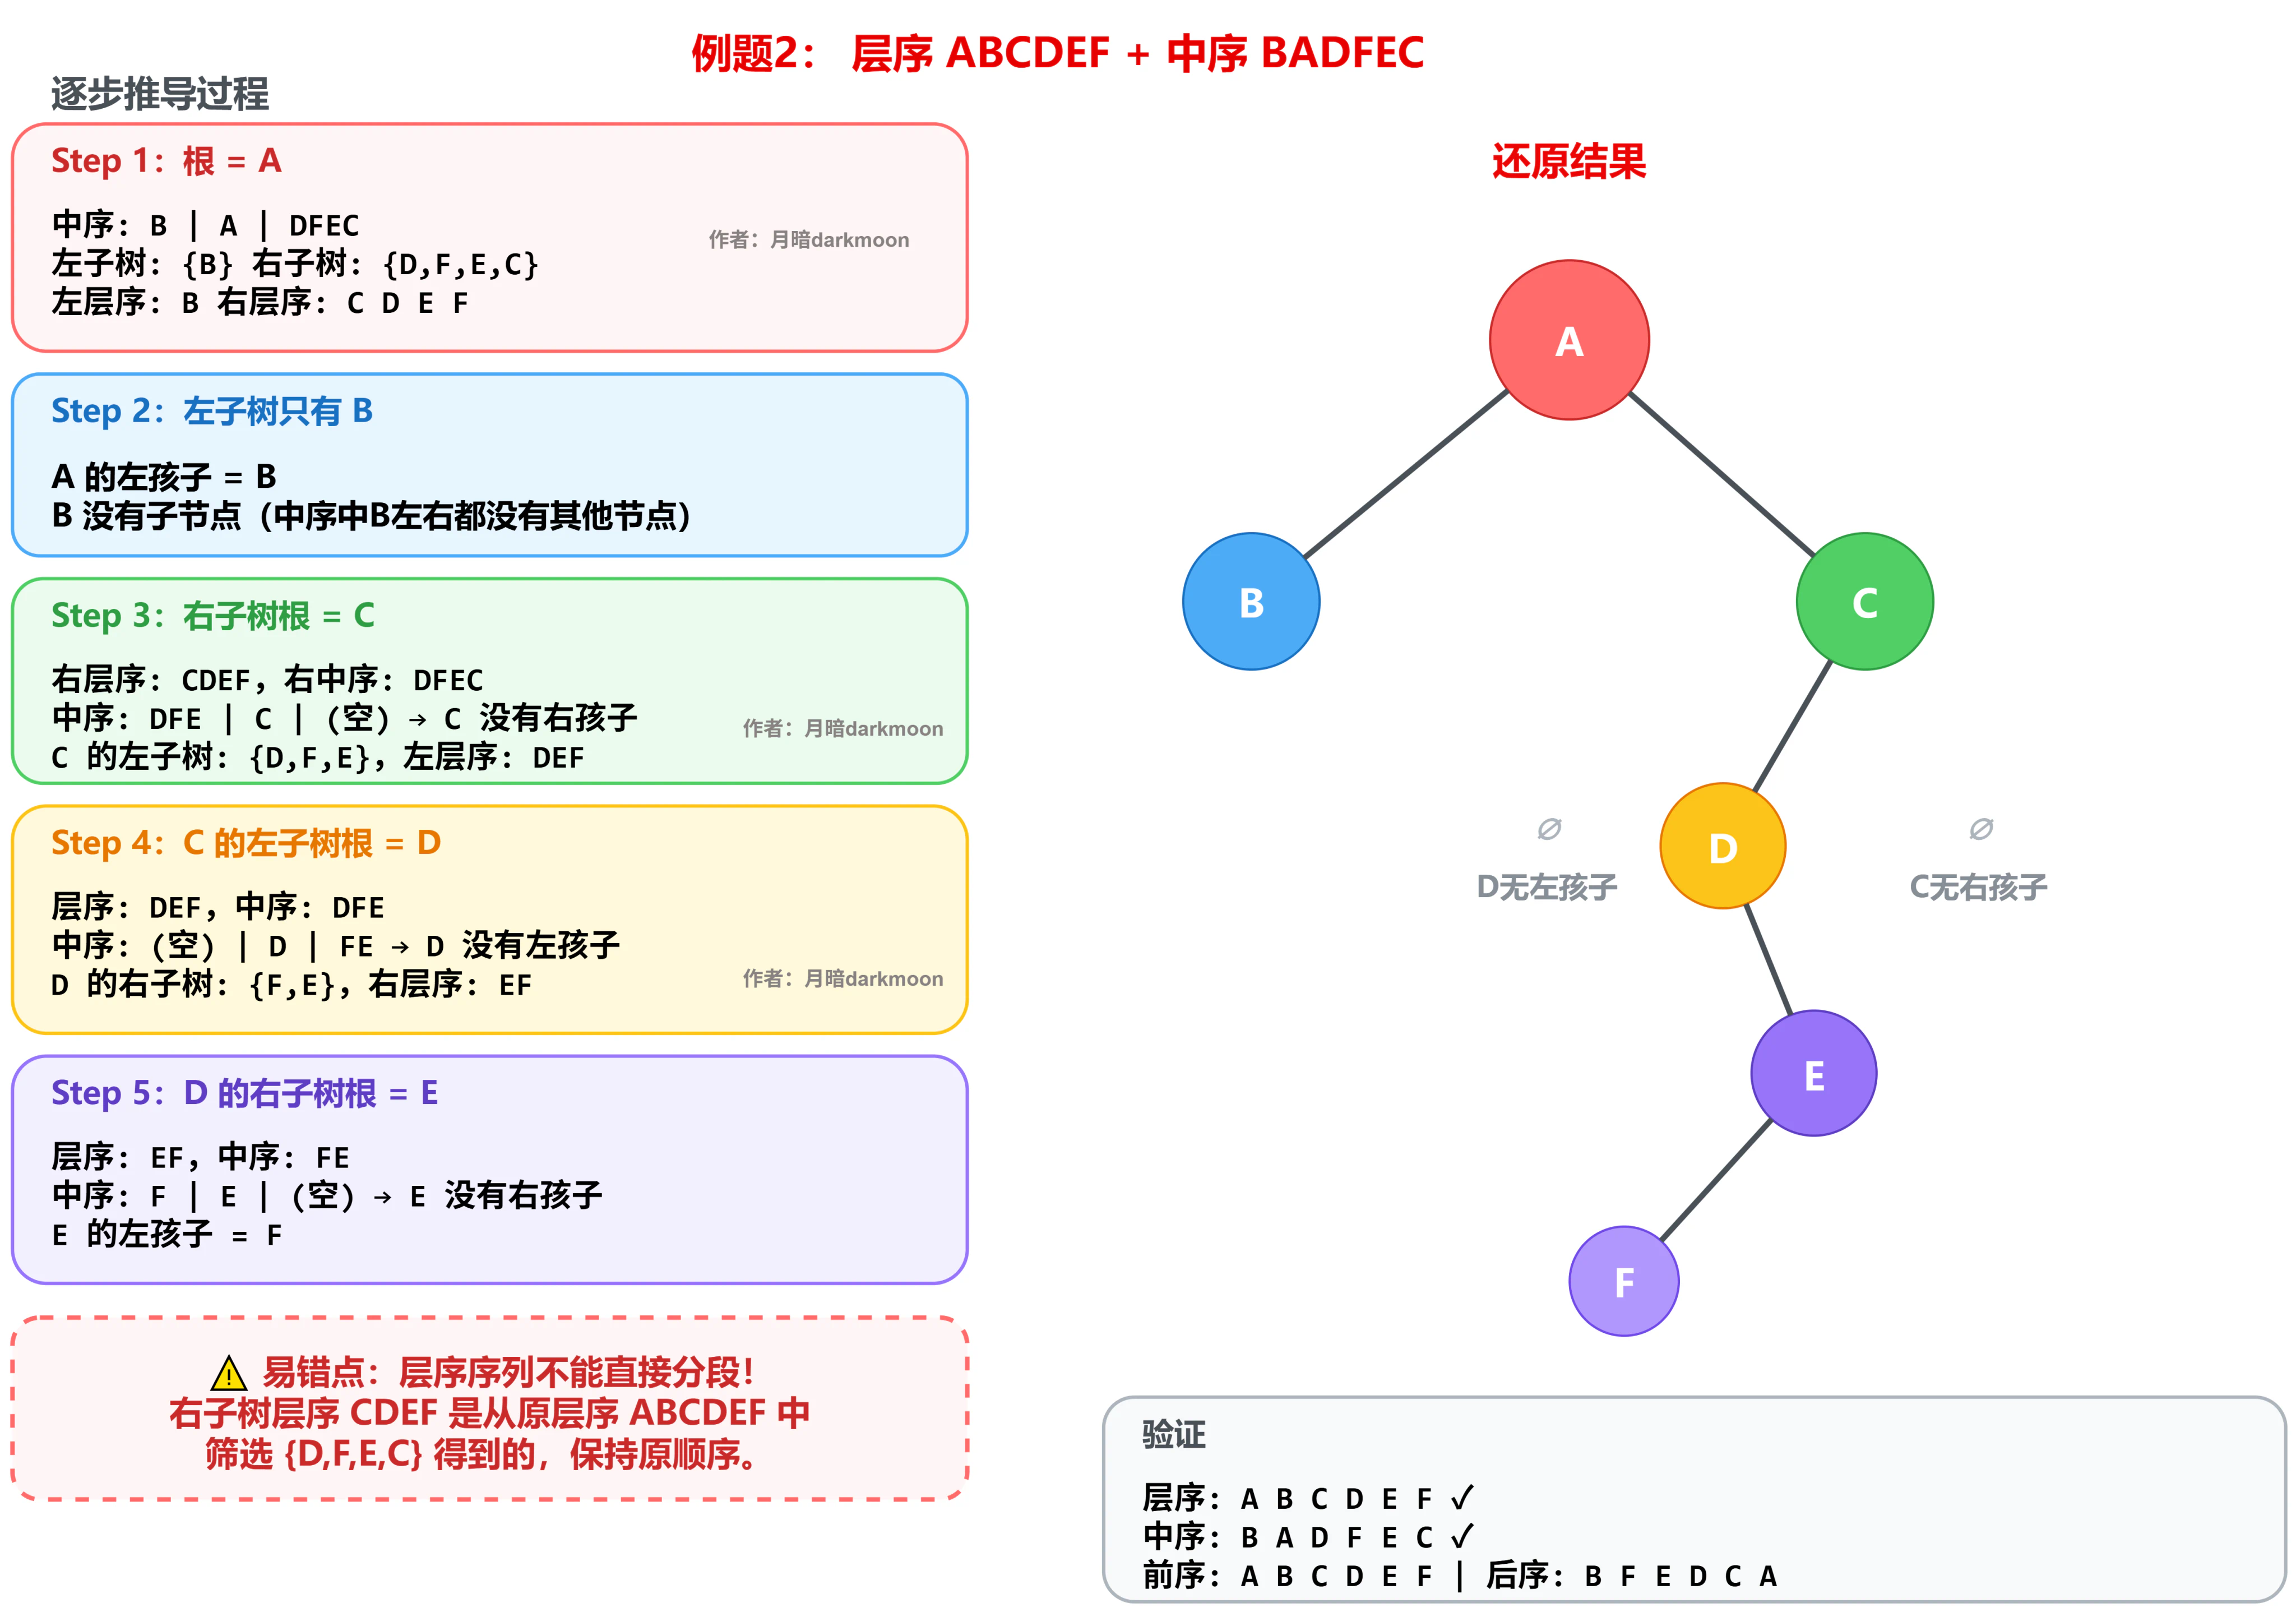
示例:
- 层序:
A B C D E F - 中序:
D B E A F C - 根是
A,左子树中序:D B E,右子树中序:F C - 左子树层序:从原层序中挑出
{D, B, E}中的元素,保持顺序 →B D E - 右子树层序:从原层序中挑出
{F, C}中的元素,保持顺序 →C F
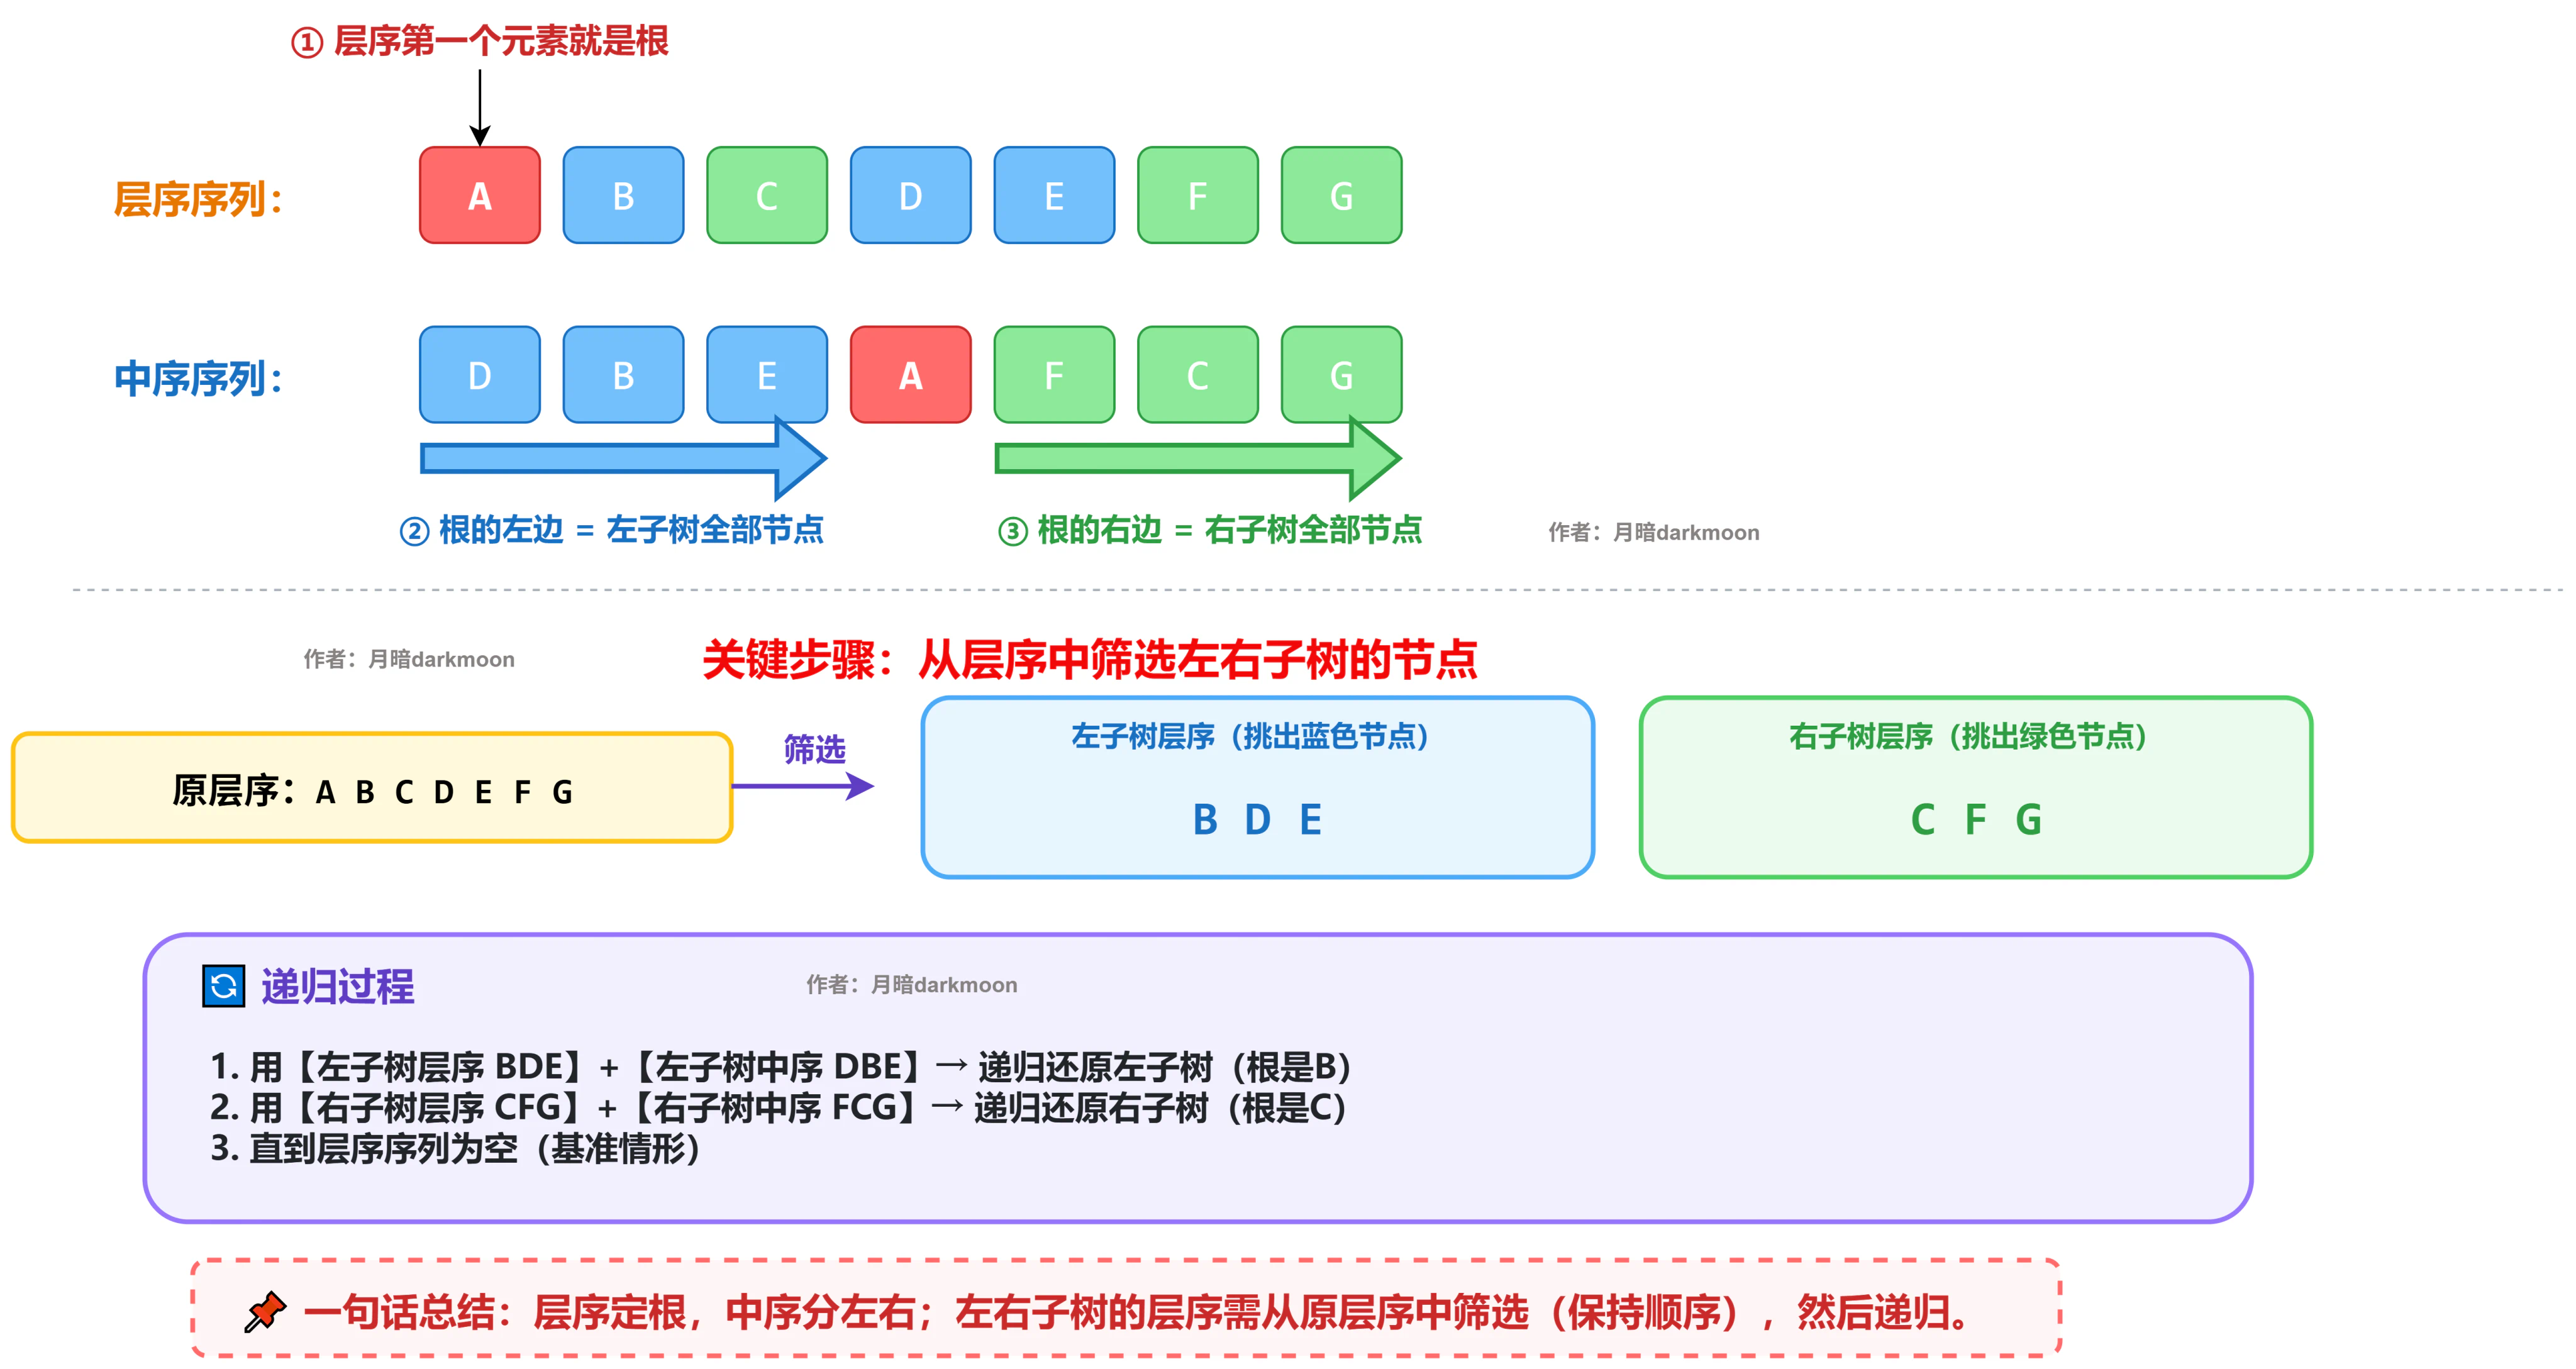
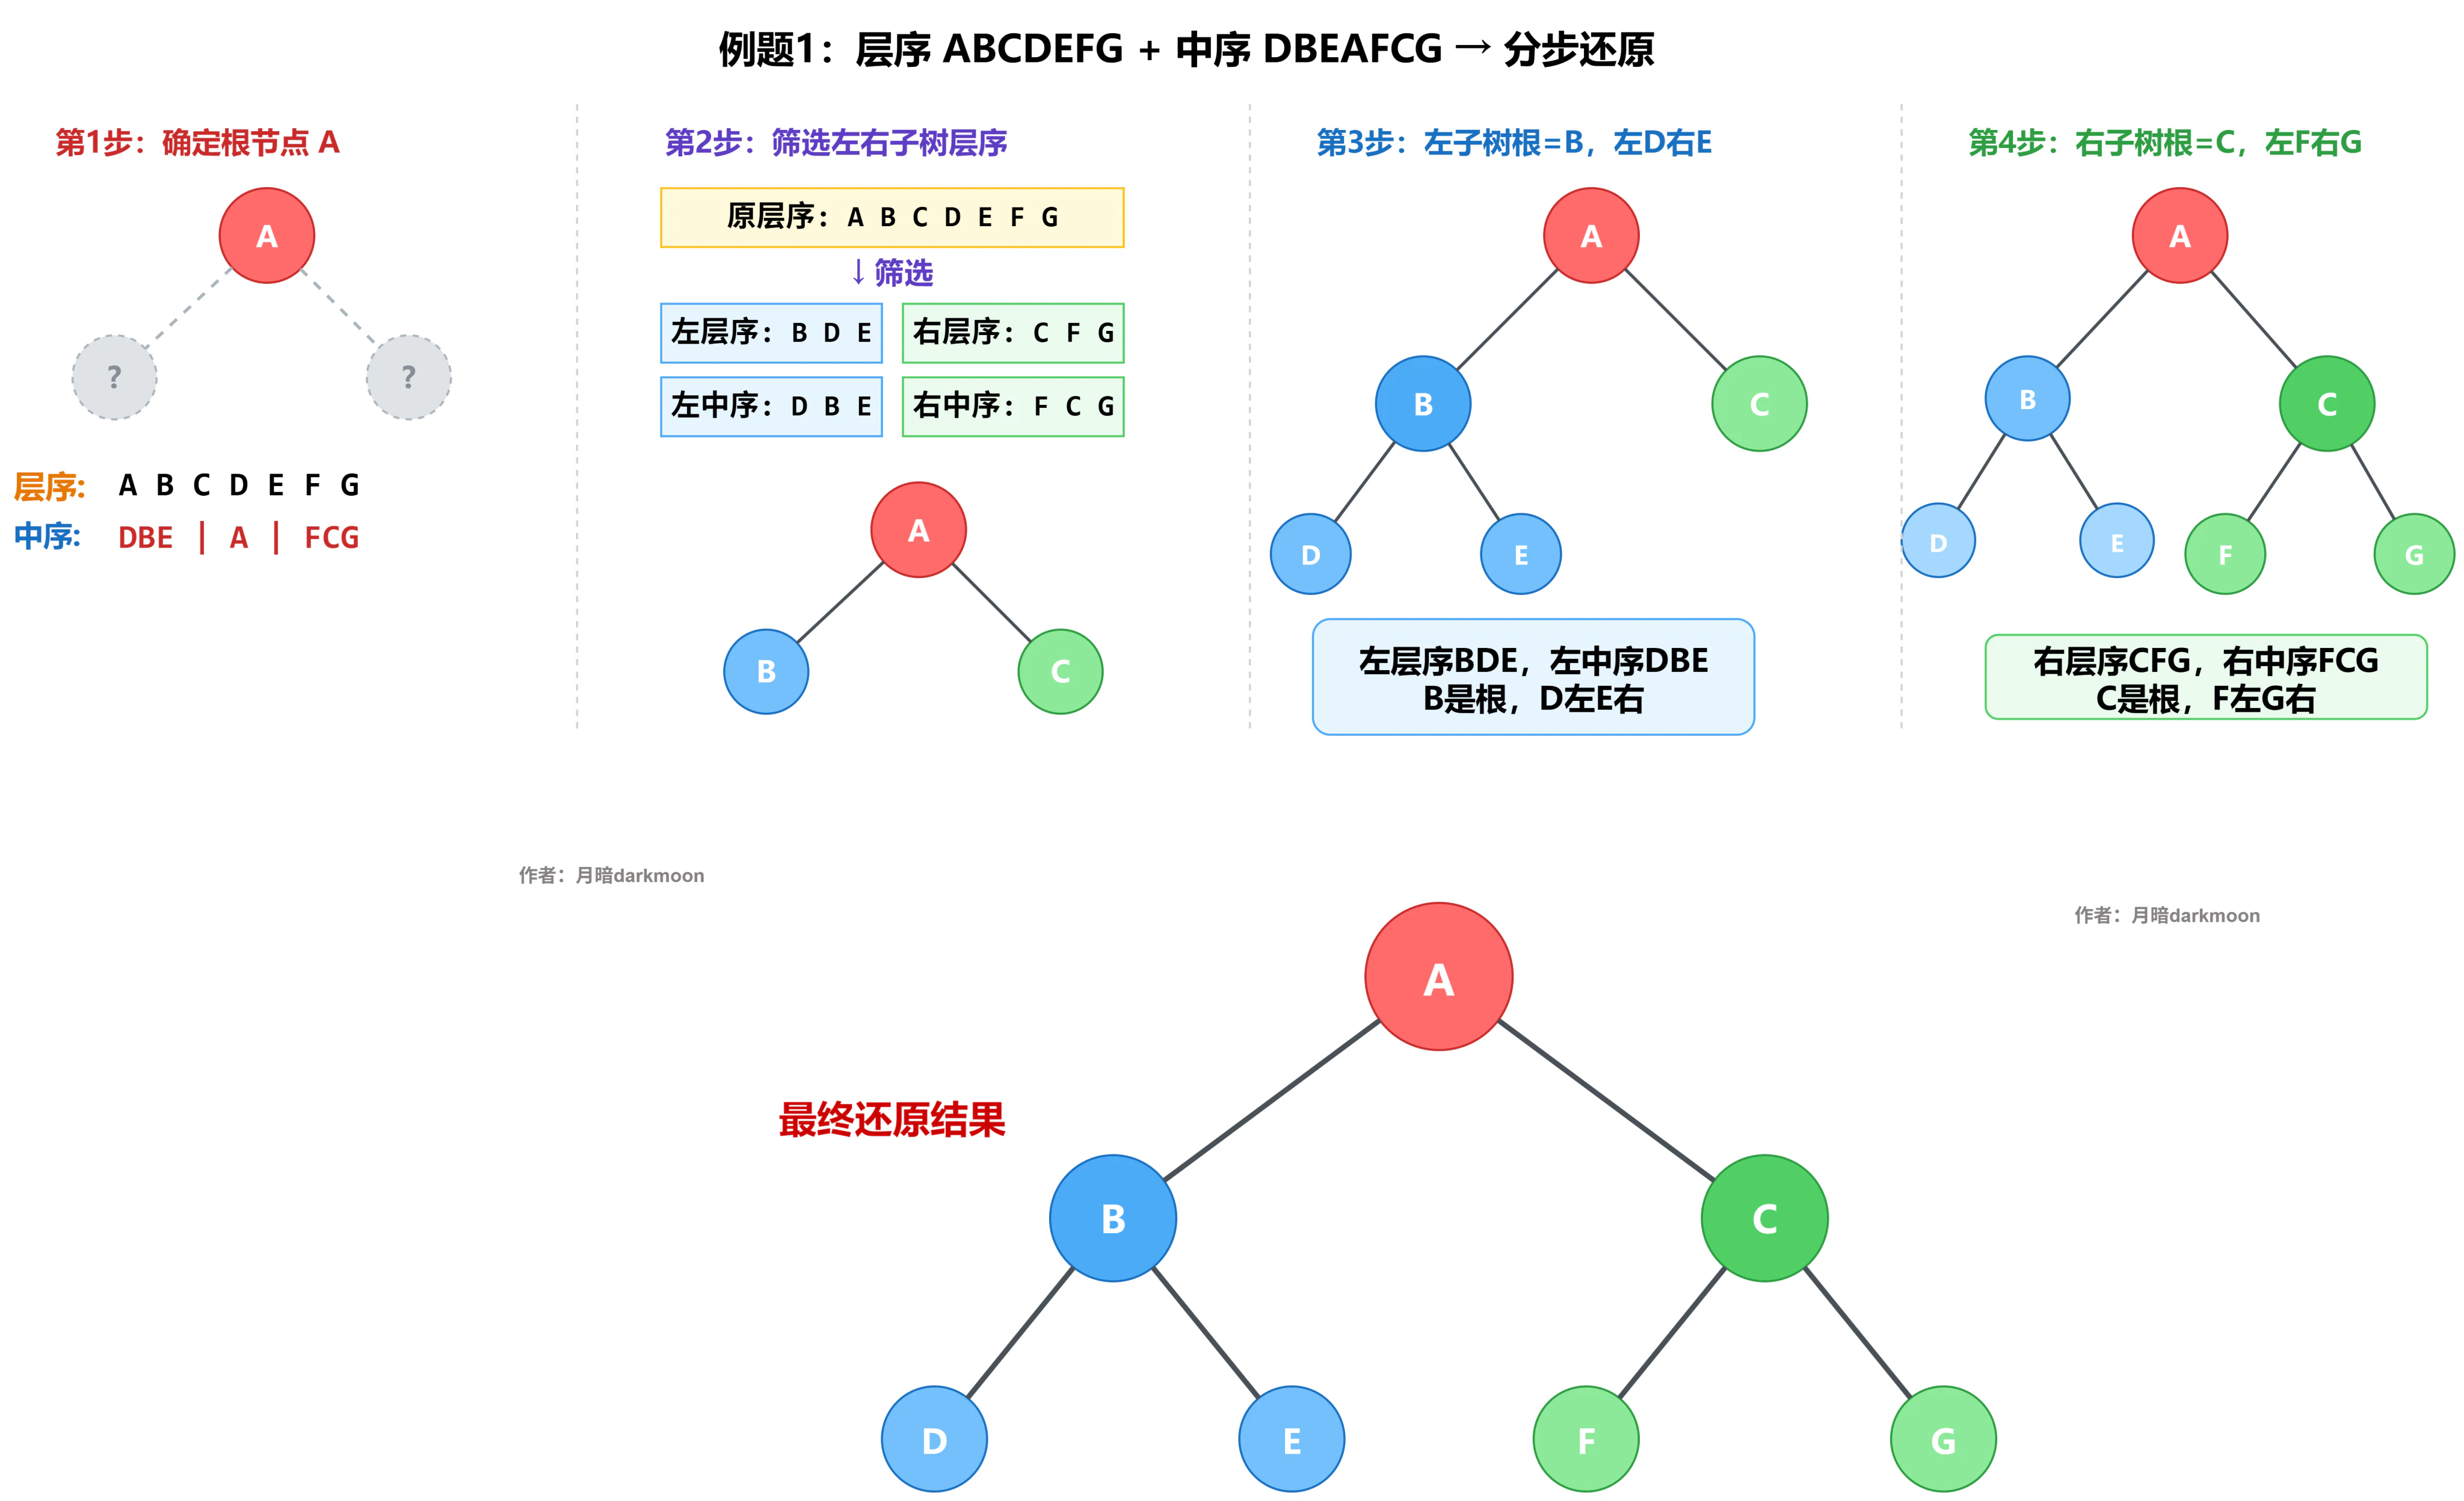
其他不能唯一确定一棵二叉树的组合
已知先序和后序序列
已知先序和后序序列为什么不能确定唯一的一棵二叉树,
核心原因:单分支子树无法区分左右
先序(根 - 左 - 右)和后序(左 - 右 - 根)虽然都能确定根节点,但当某个节点只有一个子节点时,无法判断这个子节点是左孩子还是右孩子—— 两种情况产生的先序和后序序列完全相同。
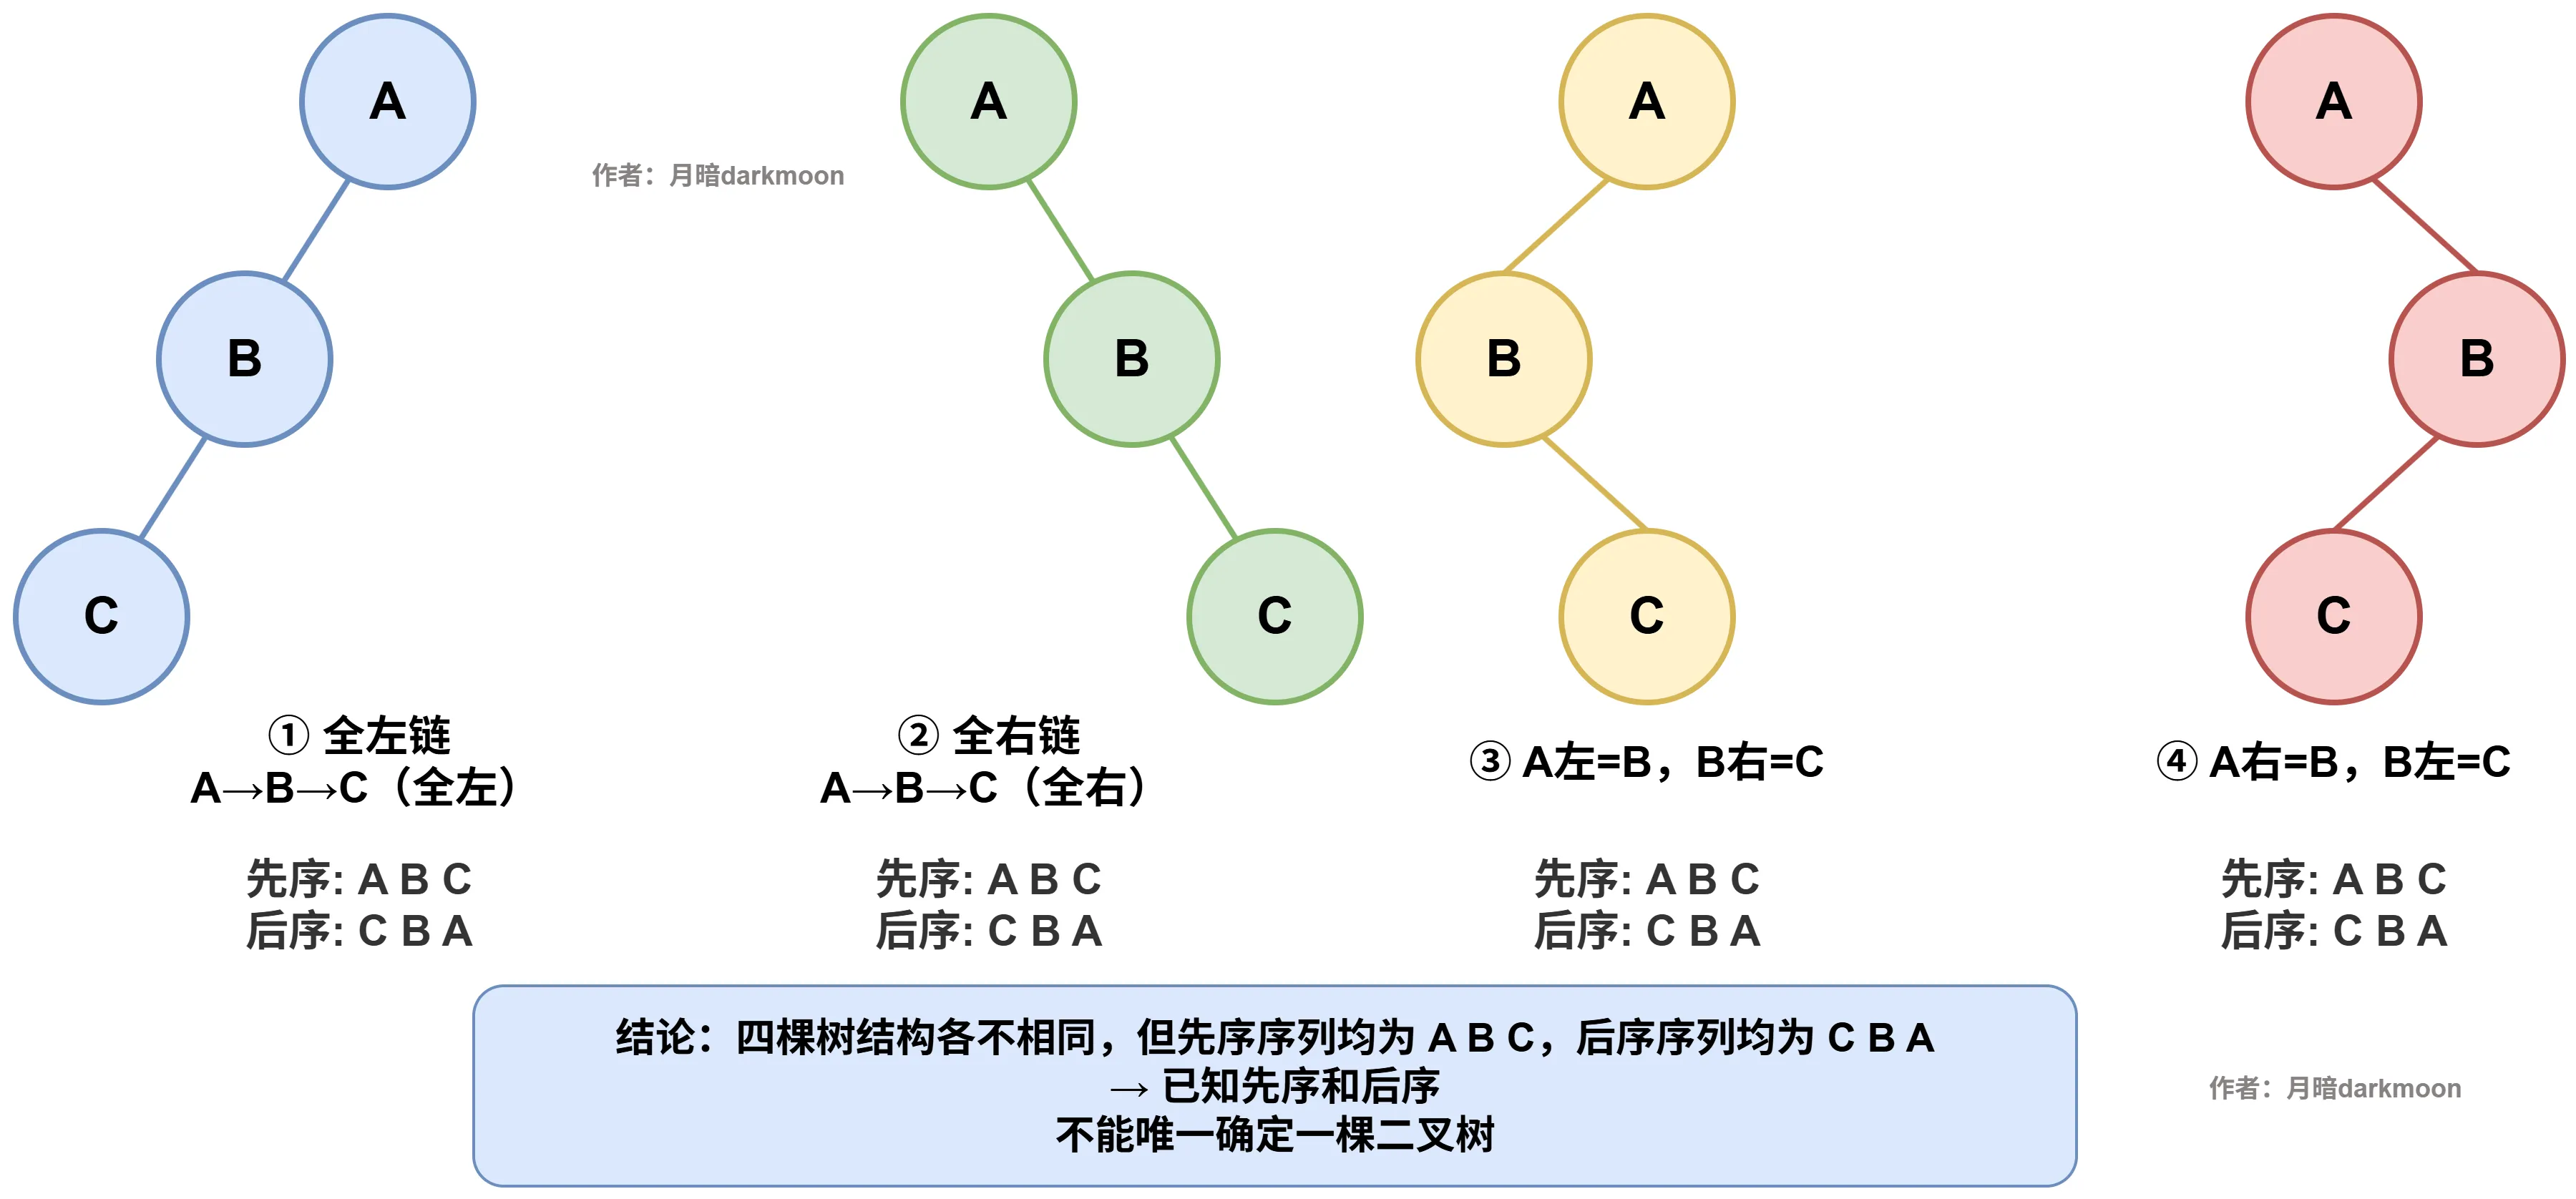
先序和后序都遵循"根 → 子树"和"子树 → 根"的模式:
- 先序去掉根后,剩下的是「左子树先序 + 右子树先序」
- 后序去掉根后,剩下的是「左子树后序 + 右子树后序」
但问题是:你不知道左子树有几个节点、右子树有几个节点。
只有当某个节点同时有左右两个孩子时,才能通过先序的第二个元素(左子树的根)和后序的倒数第二个元素(右子树的根)来确定分界。一旦某个节点只有一个孩子,这个孩子在左在右都不影响先序和后序的结果,歧义就产生了。
什么样的二叉树能被先序 + 后序唯一确定
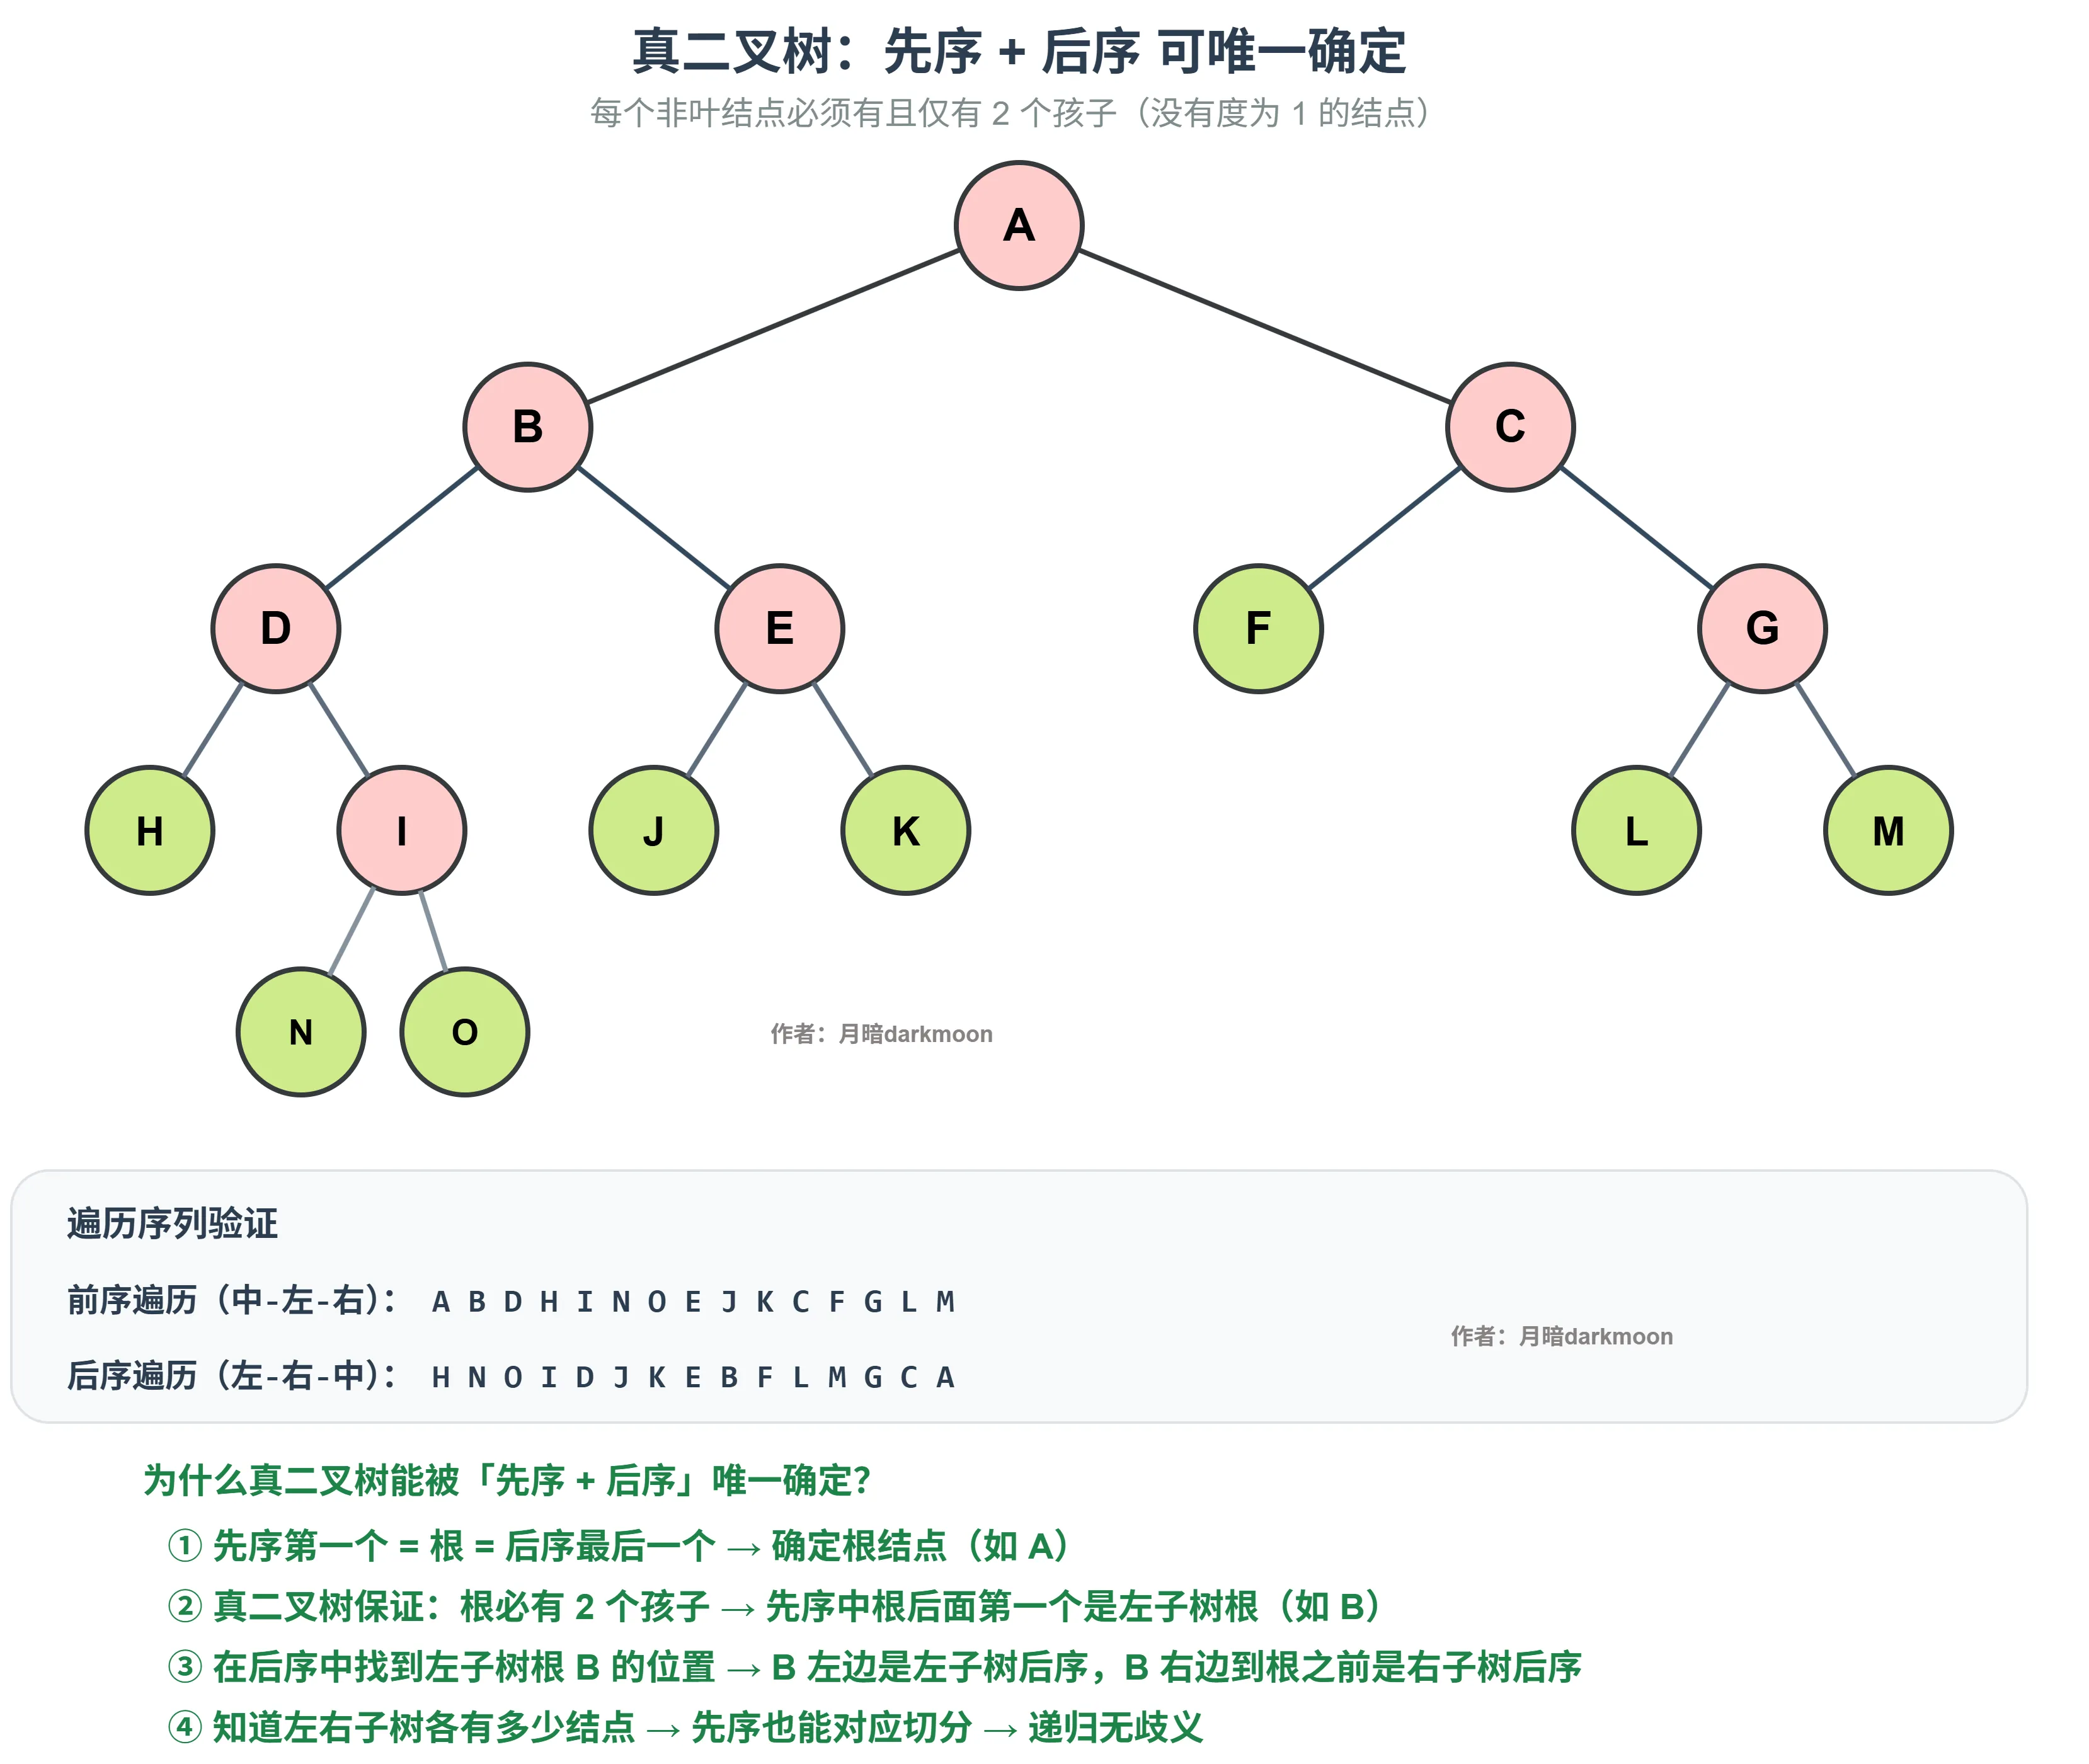
在结点值互不相同、且区分左右孩子的前提下:只有 严格二叉树 (也叫真二叉树、正则二叉树)才能由“先序 + 后序”唯一确定。
其结构条件是:
- 每个结点要么没有孩子;
- 要么同时有左、右两个孩子;
- 不能出现只有一个孩子的结点。
Note
注意:这里的“严格二叉树”不等同于“完美二叉树”。它不要求所有叶子在同一层,只要求非叶结点必须恰好有两个孩子。
表达式树就是一棵典型的真二叉树,如果给出该表达式树的先序序列(前缀表达式)和后序序列(后缀表达式),就可以唯一确定一棵表达式树。
已知层序+前序或层序+后序
已知二叉树的层序遍历和前序遍历,一般不能唯一确定二叉树;已知层序遍历和后序遍历,同样不能唯一确定二叉树。
根本原因是:当某个结点只有一个孩子时,遍历序列可以确定这个孩子的结点内容和所在层次,但不能判断它是左孩子还是右孩子。
最小反例
考虑两棵不同的二叉树:
它们的结构不同:树 1 中 B 是 A 的左孩子,树 2 中 B 是 A 的右孩子。
但两棵树的遍历结果分别是:
| 遍历方式 | 树 1 | 树 2 |
|---|---|---|
| 层序 | A B C |
A B C |
| 前序 | A B C |
A B C |
| 后序 | C B A |
C B A |
因此:
- 层序 + 前序都是
A B C,却对应两棵不同的树; - 层序 + 后序分别都是
A B C和C B A,也仍对应两棵不同的树。
为什么中序遍历可以帮助确定,而这里不行
前序和后序主要确定“访问顺序”:
- 前序先访问根,再访问孩子;
- 后序最后访问根,先访问孩子。
但是,如果只有一个孩子,访问顺序不会暴露它位于左边还是右边。层序遍历只记录从上到下、从左到右的层次访问顺序;在只有一个结点的下一层中,也没有另一个同层结点可用于比较左右位置。
中序遍历则把根放在左右子树之间。配合前序或后序时,可以用根在中序序列中的位置切分左右子树,所以通常能够递归地唯一确定二叉树(假设结点值互不相同)。
什么时候层序+前序或层序+后序可以唯一确定一棵二叉树
Note
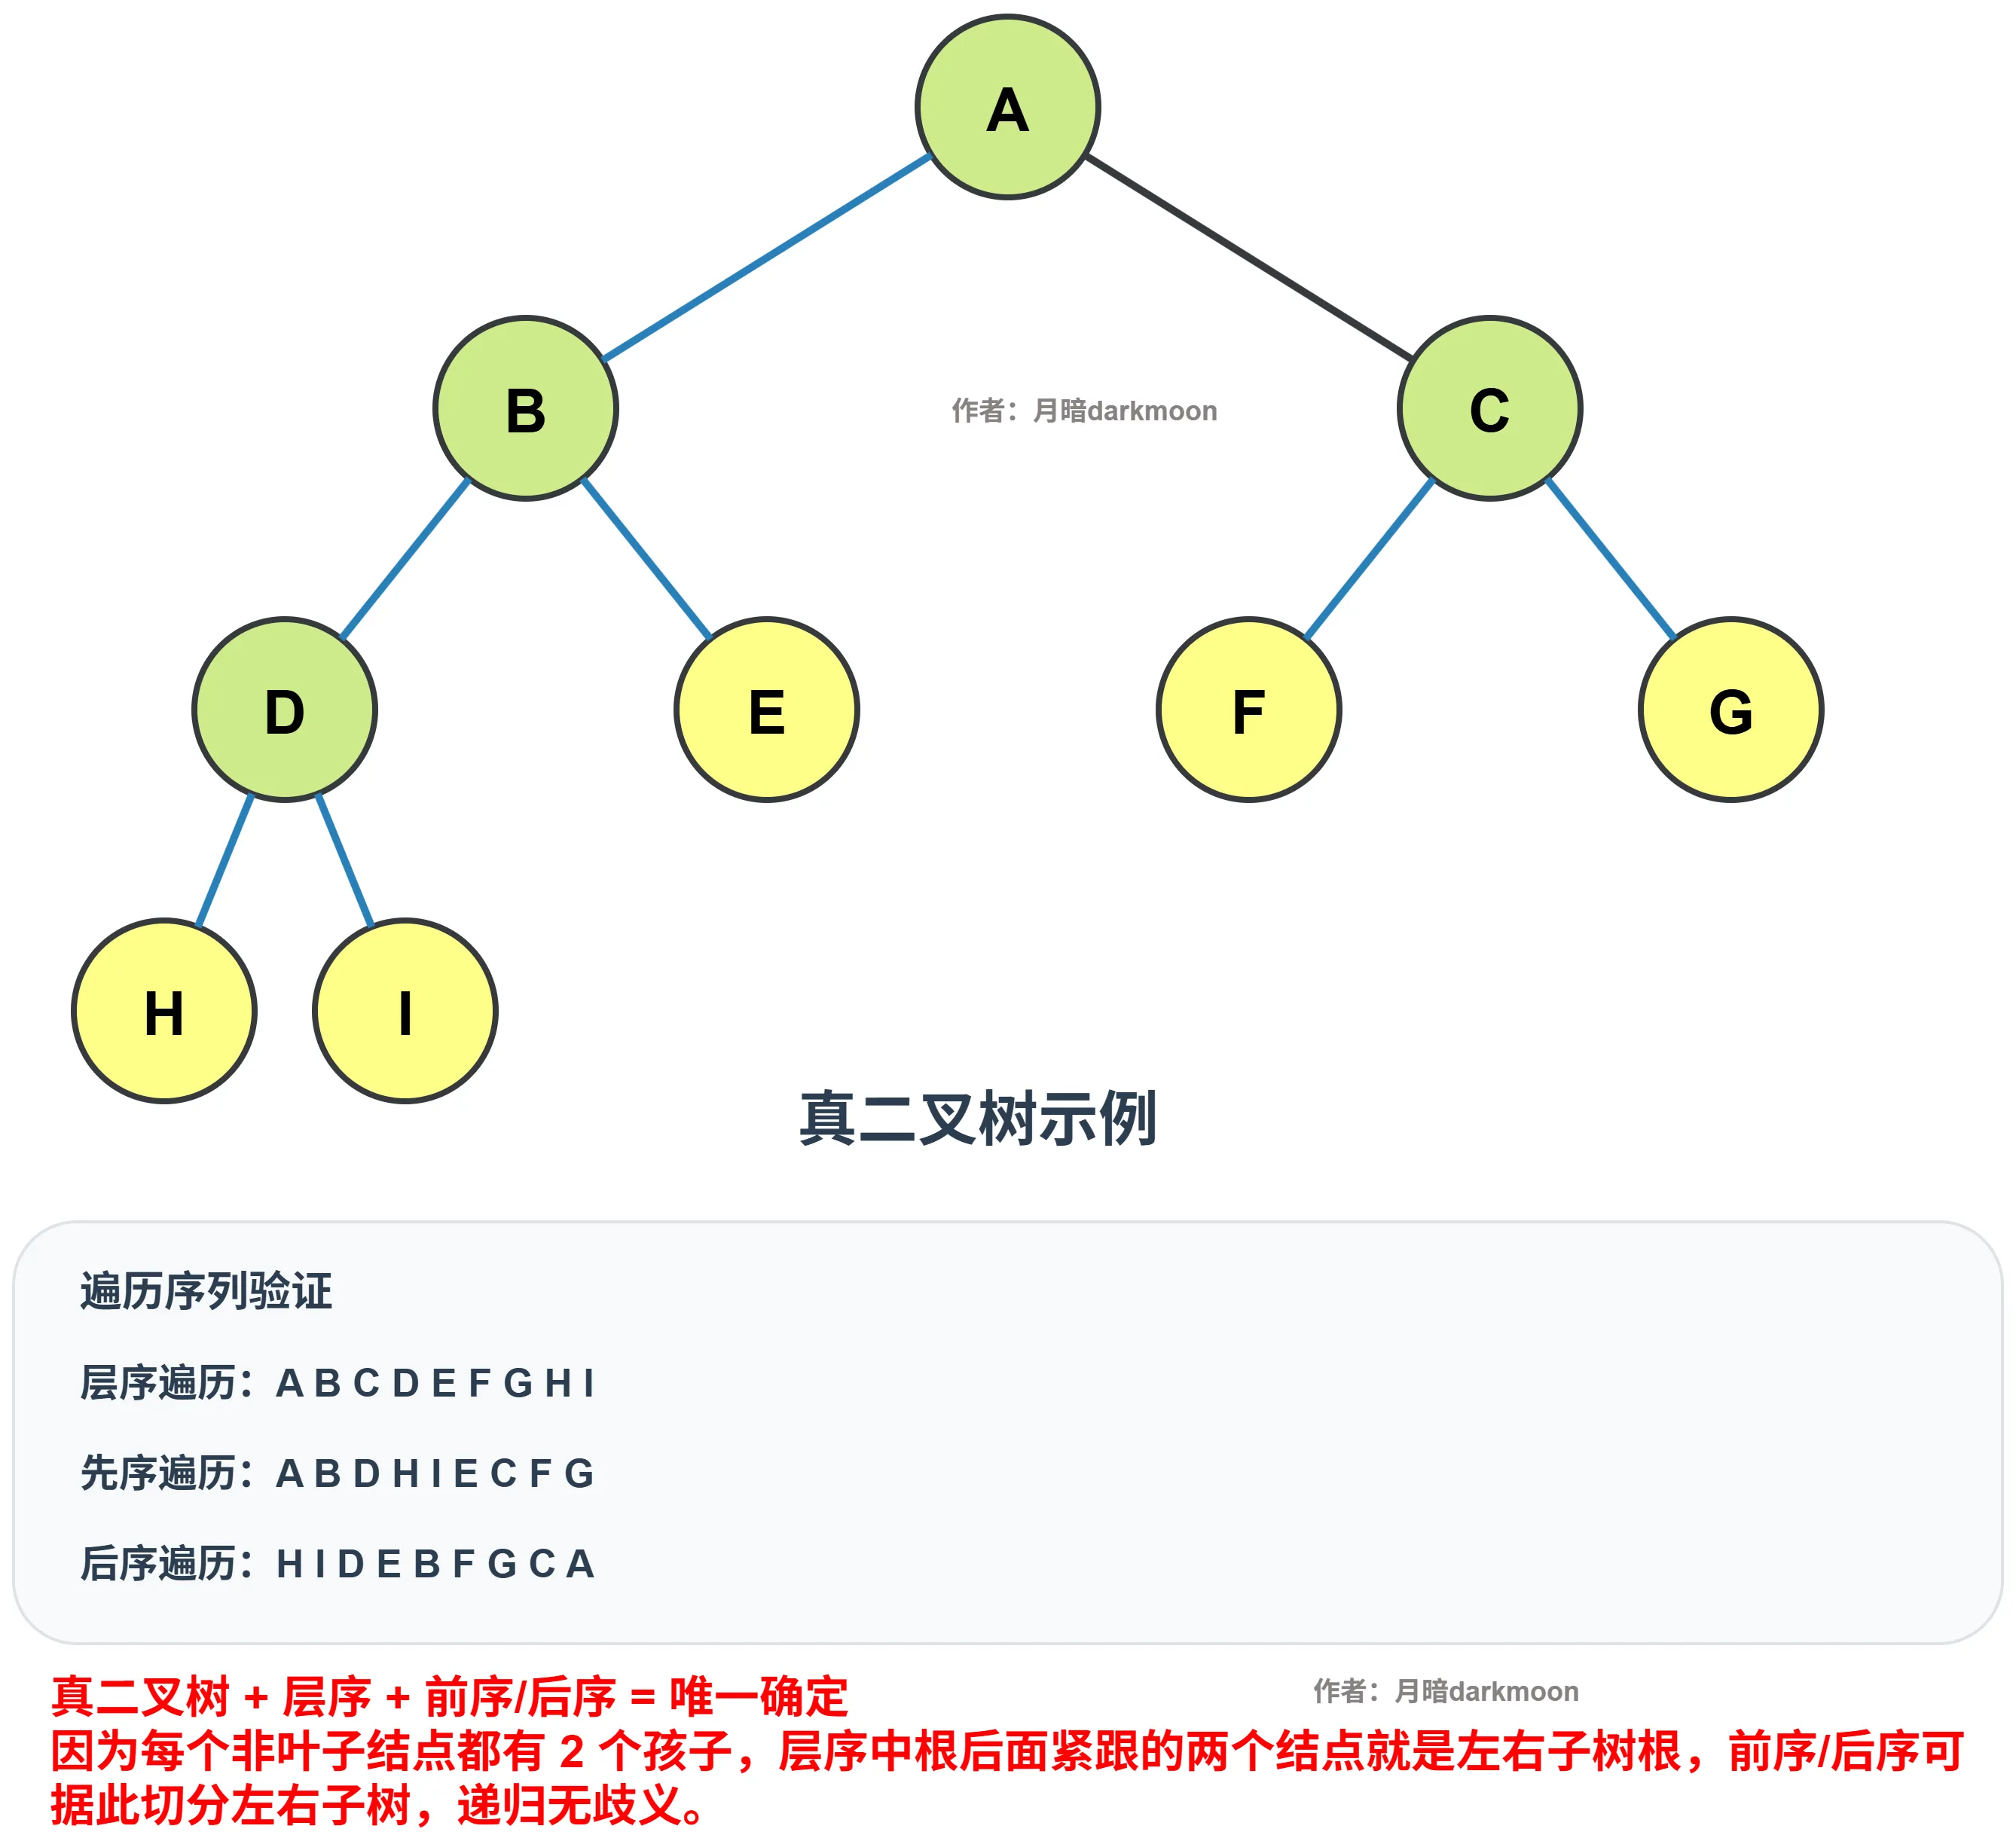
在结点值互不相同、对于不附加任何形状限制的二叉树:当且仅当该树是 严格二叉树 (每个结点要么有 0 个孩子,要么有 2 个孩子)层序 + 前序或层序 + 后序才能够唯一确定二叉树。
也就是不能存在“只有一个孩子”的结点。
以“层序 + 前序”为例:
- 层序第一个结点是根;
- 严格二叉树保证根有左右两个孩子;
- 层序中根后面的两个结点分别是左、右子树根;
- 在前序中找到右子树根,即可把前序划分为:
- 对左右子树递归处理。
“层序 + 后序”同理,只是利用后序的结构:
注意:如果有额外形状约束,条件可以更宽
例如 完全二叉树 中,即使某个结点只有一个孩子,也规定它只能是左孩子;而且层序遍历本身结合完全二叉树的形状就能确定位置。
所以更准确地说:
- 对一般二叉树:必须是 严格二叉树 ;
- 对带有额外形状约束的树:只要这些约束能确定单孩子的位置,也可能唯一确定,例如 完全二叉树 。
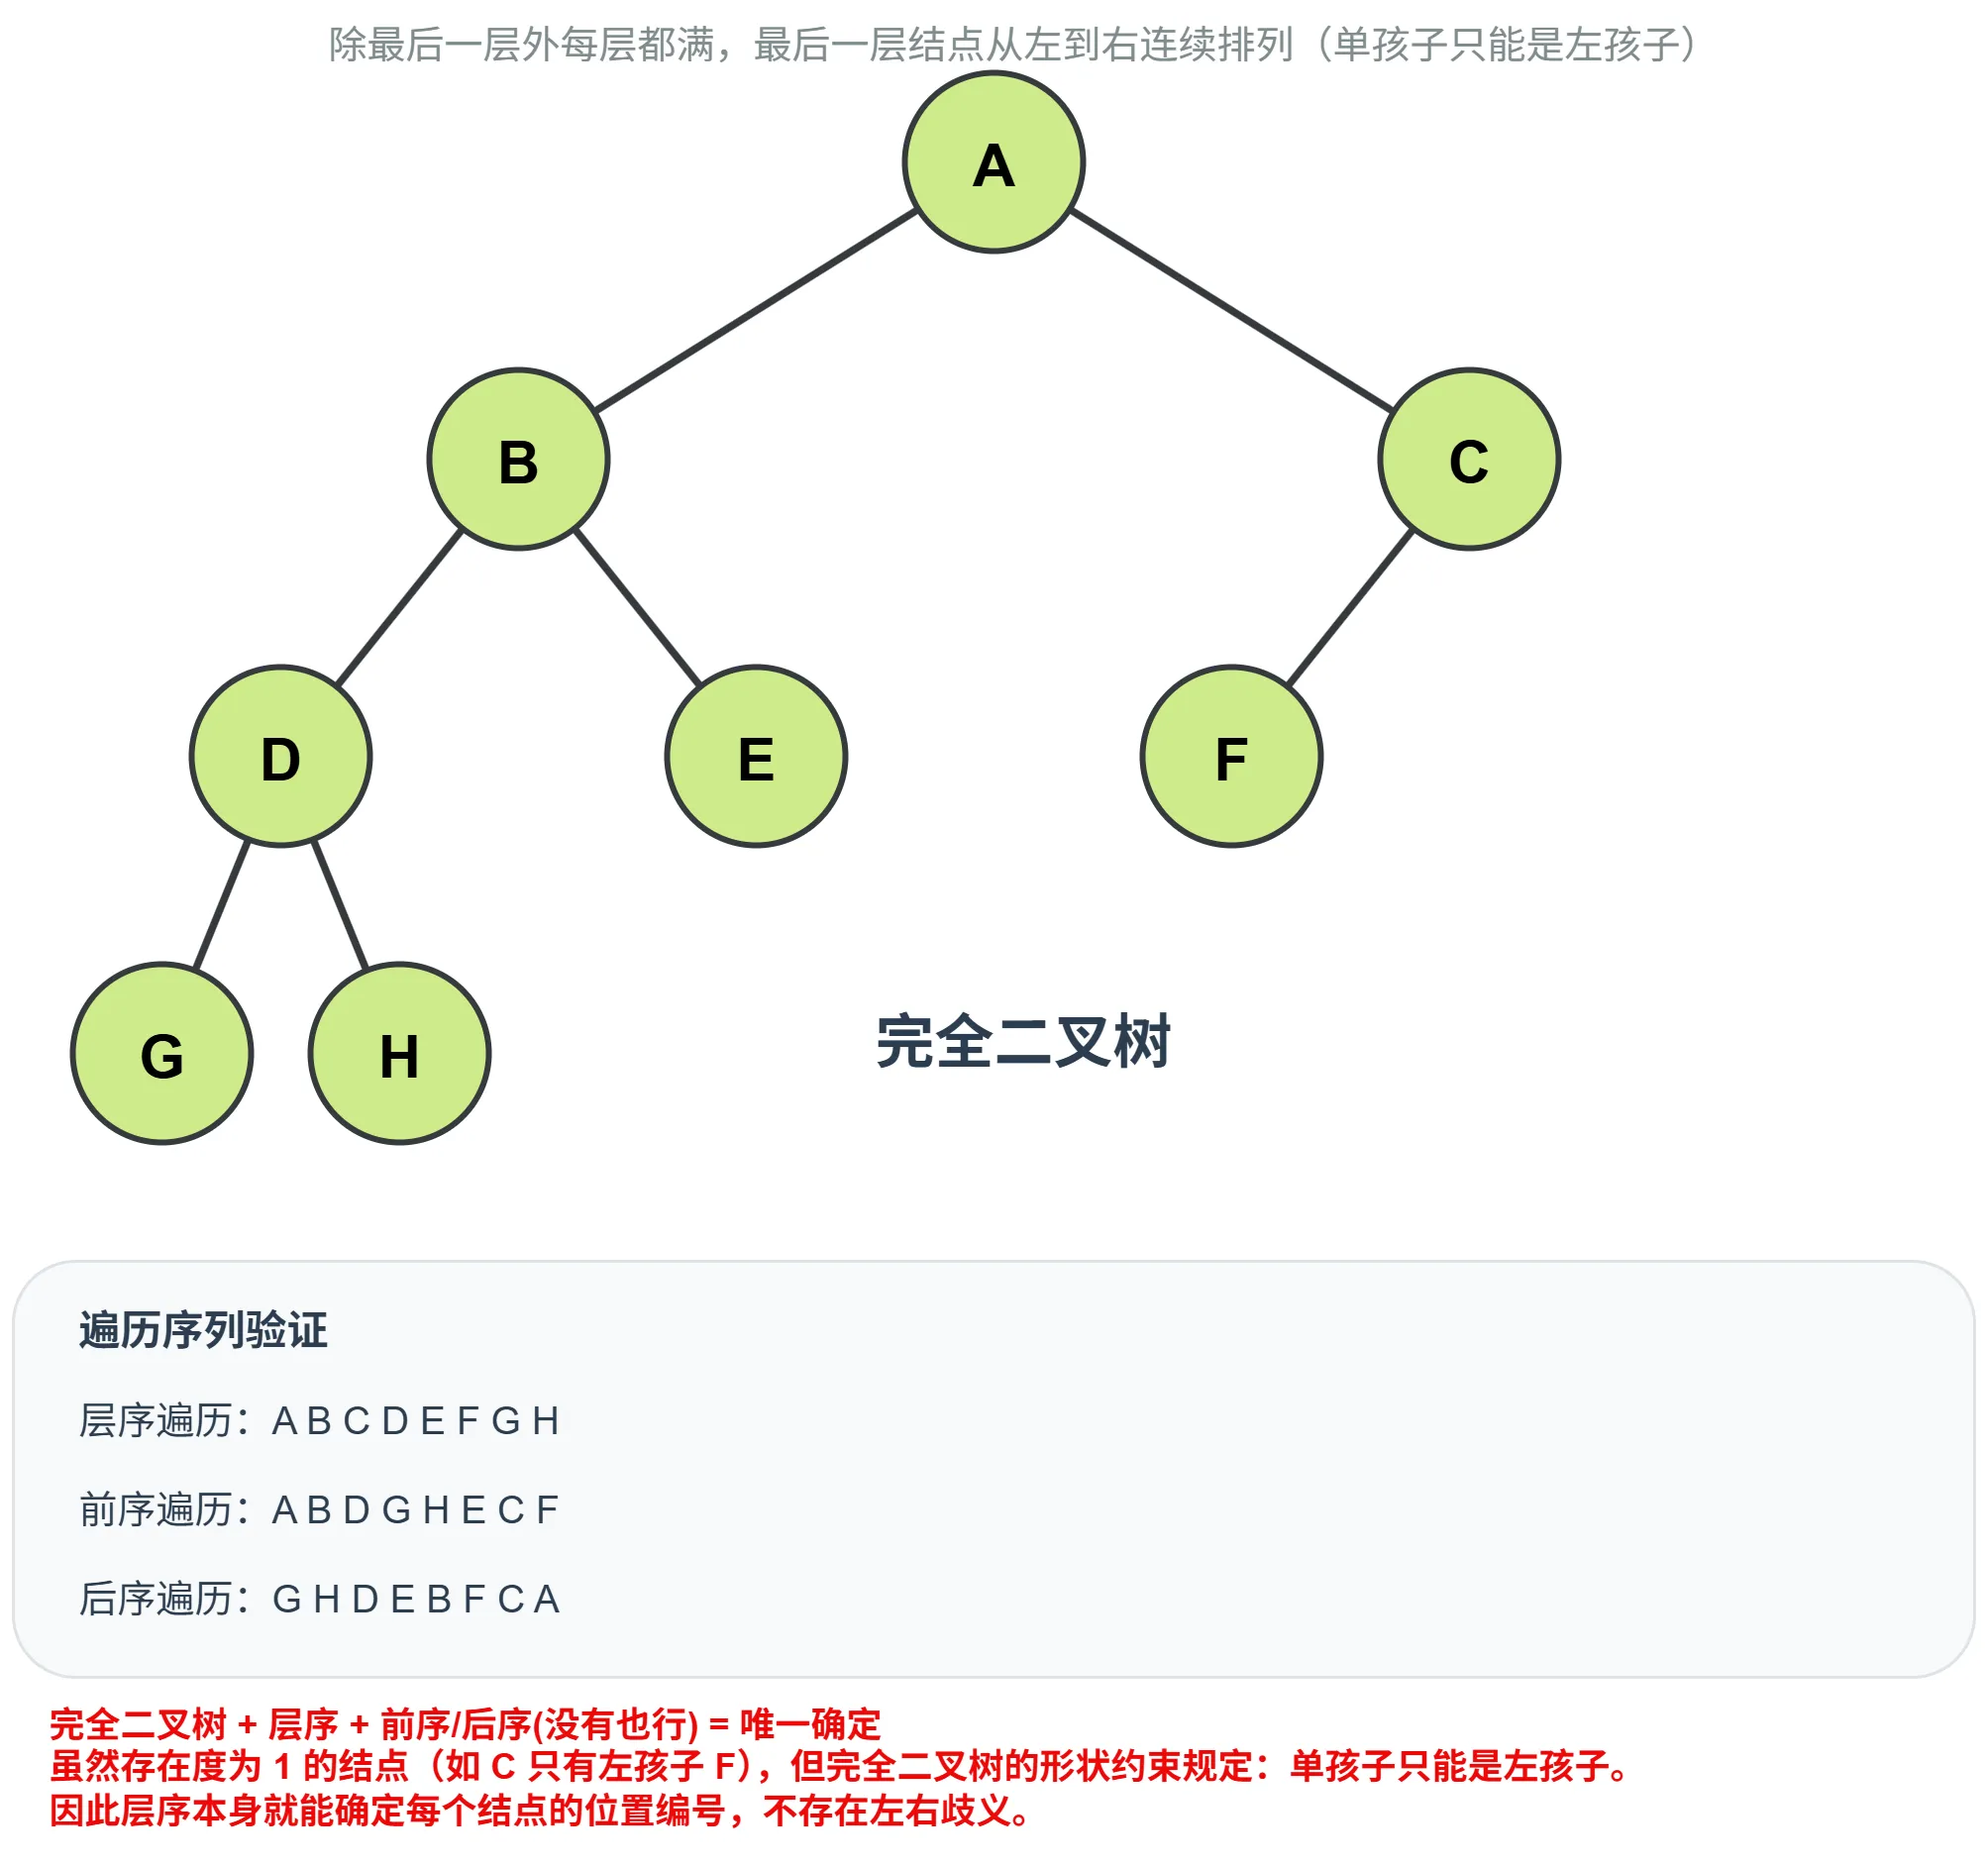
根据改进的层序遍历序列还原二叉树(可以作为应用题设计存储方法)
297. 二叉树的序列化与反序列化 - 力扣(LeetCode)
仅由之前提到的层序遍历得到的遍历序列,无法唯一确定一棵树。若层序遍历在输出时,做如下改进:在遍历时,若遇到某个结点的左或右孩子指针为空,则输出NULL作为在输出序列中的占位符。这样对于二叉树中的任意结点,其左、右孩子结点在输出序列中的位置都是唯一确定的,则可以通过此序列还原二叉树。这些冗余的NULL结点相当于提供了二叉树的结构信息。
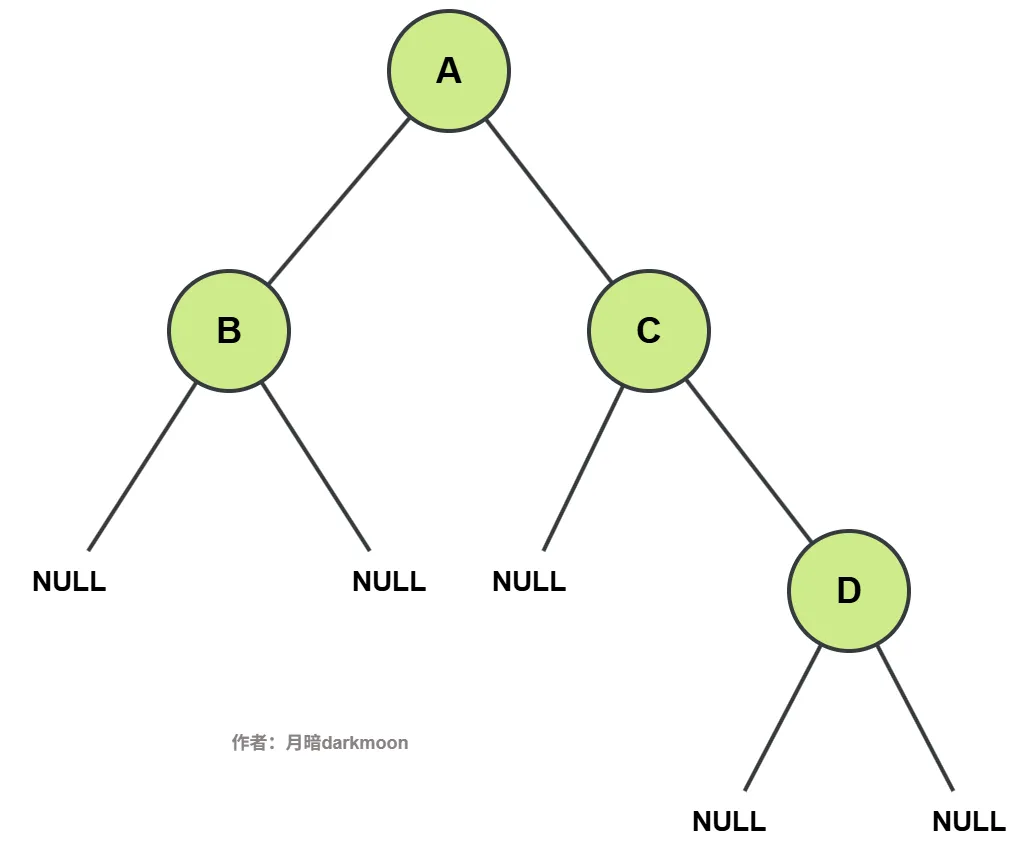
例如:对如图所示二叉树,应用做上述改进后的层序遍历算法,用数组S[]存放输出的遍历序列,i表示数组S的下标,S[i]的值如下表所示。
| i | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
|---|---|---|---|---|---|---|---|---|---|
| s[i] | A | B | C | NULL | NULL | NULL | D | NULL | NULL |
类似地,先序遍历序列也可以仅通过此记法就能还原二叉树;
根据先序+后序得到层序序列
给定一棵二叉树的先序和后序序列(节点互不相同),可以得到这棵二叉树的层序序列
相关证明
(递归生成法)
- 设其先序遍历为:
V,L,R - 后序遍历为:
L,R,V - 当遍历到某一节点 v
- ① v无孩子,显然无歧义
- ② v既有左孩子lc,也有右孩子rc
- 局部先序为 v,lc,rc ;后序为 lc,rc ,v
- 分离根节点v之后,左右子树先后顺序明确,确定层次遍历 v,lc,rc
- 递归左子树
L和右子树R
- ③ v只有左孩子lc,没有右孩子
- 局部先序为 v,lc;后序为 lc,v
- 确定层次遍历 v,lc
- 递归左子树
L
- ④ v只有右孩子rc,没有左孩子
- 局部先序为 v,rc;后序为 rc,v
- 确定层次遍历 v,rc
- 递归右子树
R
综上,因为可以递归生成唯一的层次遍历序列,显然就确定了层次遍历序列。
相关练习题
真题
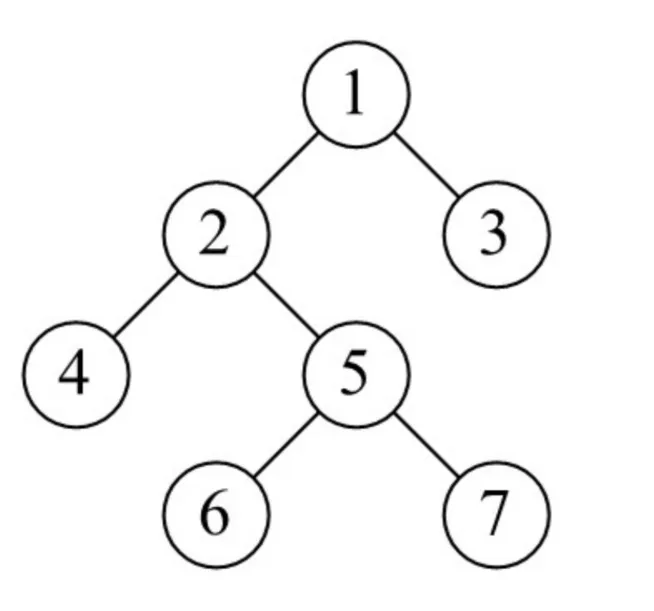
- 【2009-03】给定二叉树如右图所示。设 N 代表二叉树的根, L 代表根结点的左子树, R 代表根结点的右子树。若遍历后的结点序列为3, 1, 7, 5, 6, 2, 4,则其遍历方式是( )。
A. LRN
B. NRL
C. RLN
D. RNL
解析
题目序列从 3 开始,而 3 是根结点 1 的右子树,所以第一步是 R。
访问完右子树 3 后,序列立即出现根结点 1,所以第二步是 N。
最后处理左子树。对以 2 为根的左子树也采用 RNL:
- 先遍历 2 的右子树 5;
- 在以 5 为根的子树中,先访问右孩子 7,再访问根 5,再访问左孩子 6;
- 然后访问根 2;
- 最后访问左孩子 4。
于是完整序列为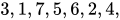
与题目完全一致。
答案:D
- 【2011-05】若一棵二叉树的前序遍历序列和后序遍历序列分别为1, 2, 3, 4和4, 3, 2, 1,则该二叉树的中序遍历序列不会是( )。
A. 1, 2, 3, 4
B. 2, 3, 4, 1
C. 3, 2, 4, 1
D. 4, 3, 2, 1
解析
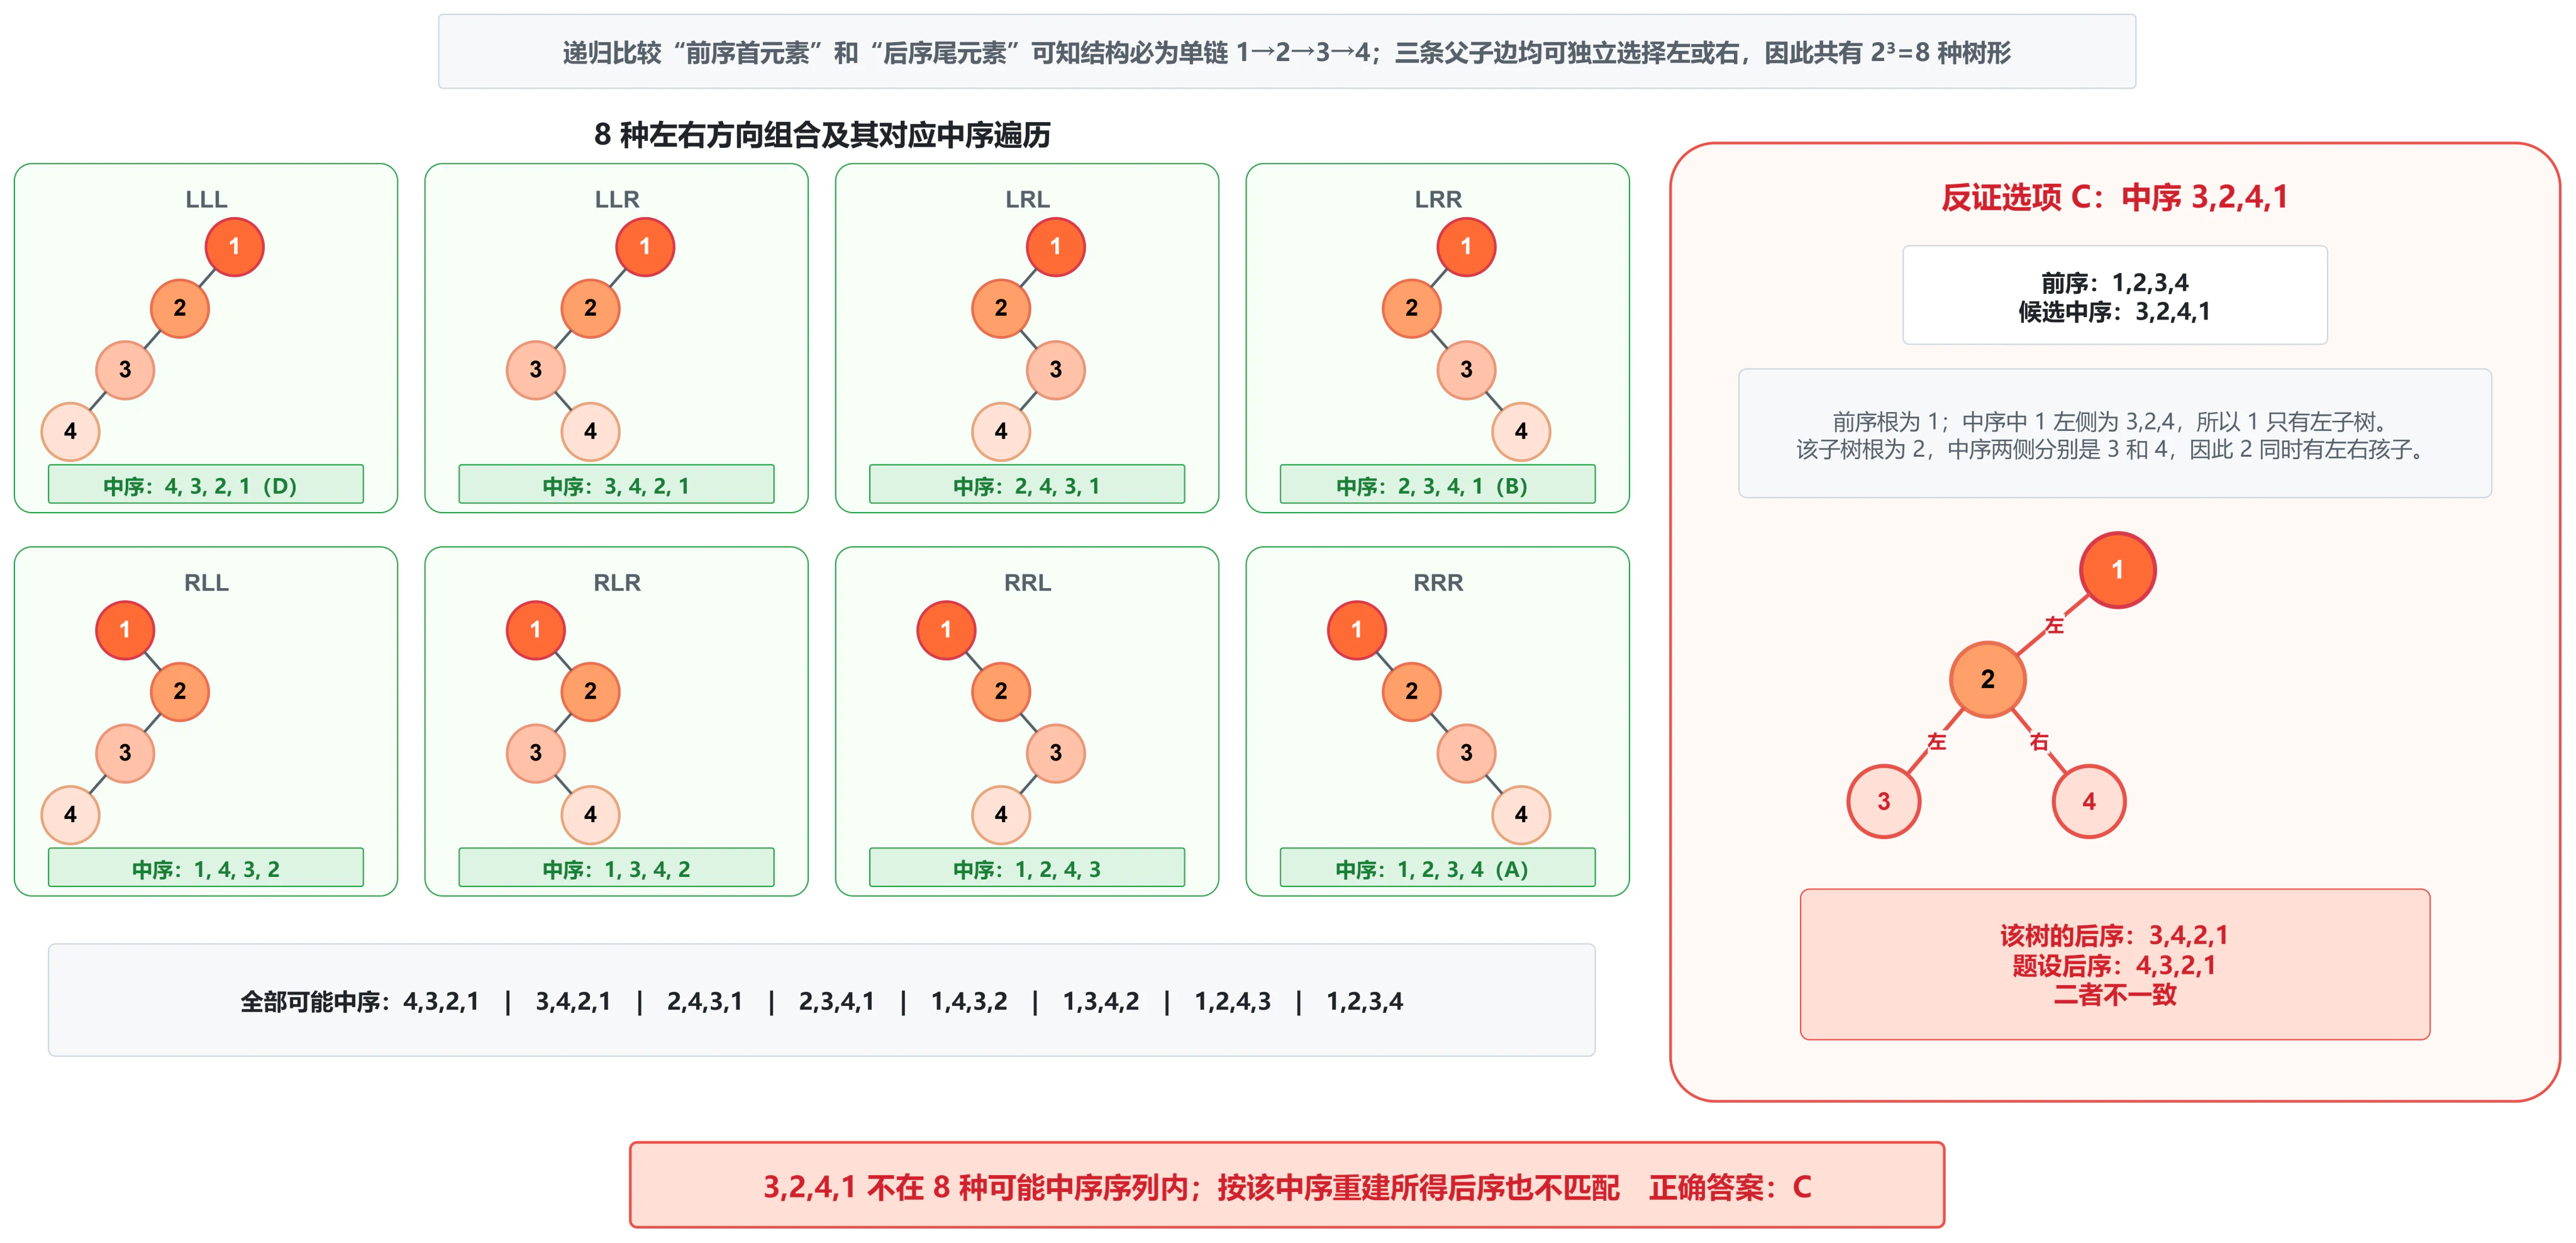
前序为 1、2、3、4,后序为 4、3、2、1,说明结点关系只能是一条单支链: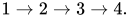
每个父结点都只有一个孩子,但这个孩子可以是左孩子,也可以是右孩子。
- 若每个孩子都是右孩子,中序为 1、2、3、4,所以 A 可能。
- 若 1 的孩子 2 是左孩子,而 2、3、4 构成右链,中序为 2、3、4、1,所以 B 可能。
- 若每个孩子都是左孩子,中序为 4、3、2、1,所以 D 可能。
检查 C:要使 1 最后访问,2 必须位于 1 的左子树。对于以 2 为根的单支链:
- 若 2 的唯一孩子在右边,中序必须先出现 2;
- 若唯一孩子在左边,中序必须先完整访问孩子子树,再出现 2,2 后面不可能再出现同一子树中的 4。
因此 3、2、4、1 无法产生。
答案:C
- 【2012-03】若一棵二叉树的前序遍历序列为a, e, b, d, c,后序遍历序列为b, c, d, e, a,则根结点的孩子结点( )。
A. 只有e
B. 有e、b
C. 有e、c
D. 无法确定
解析
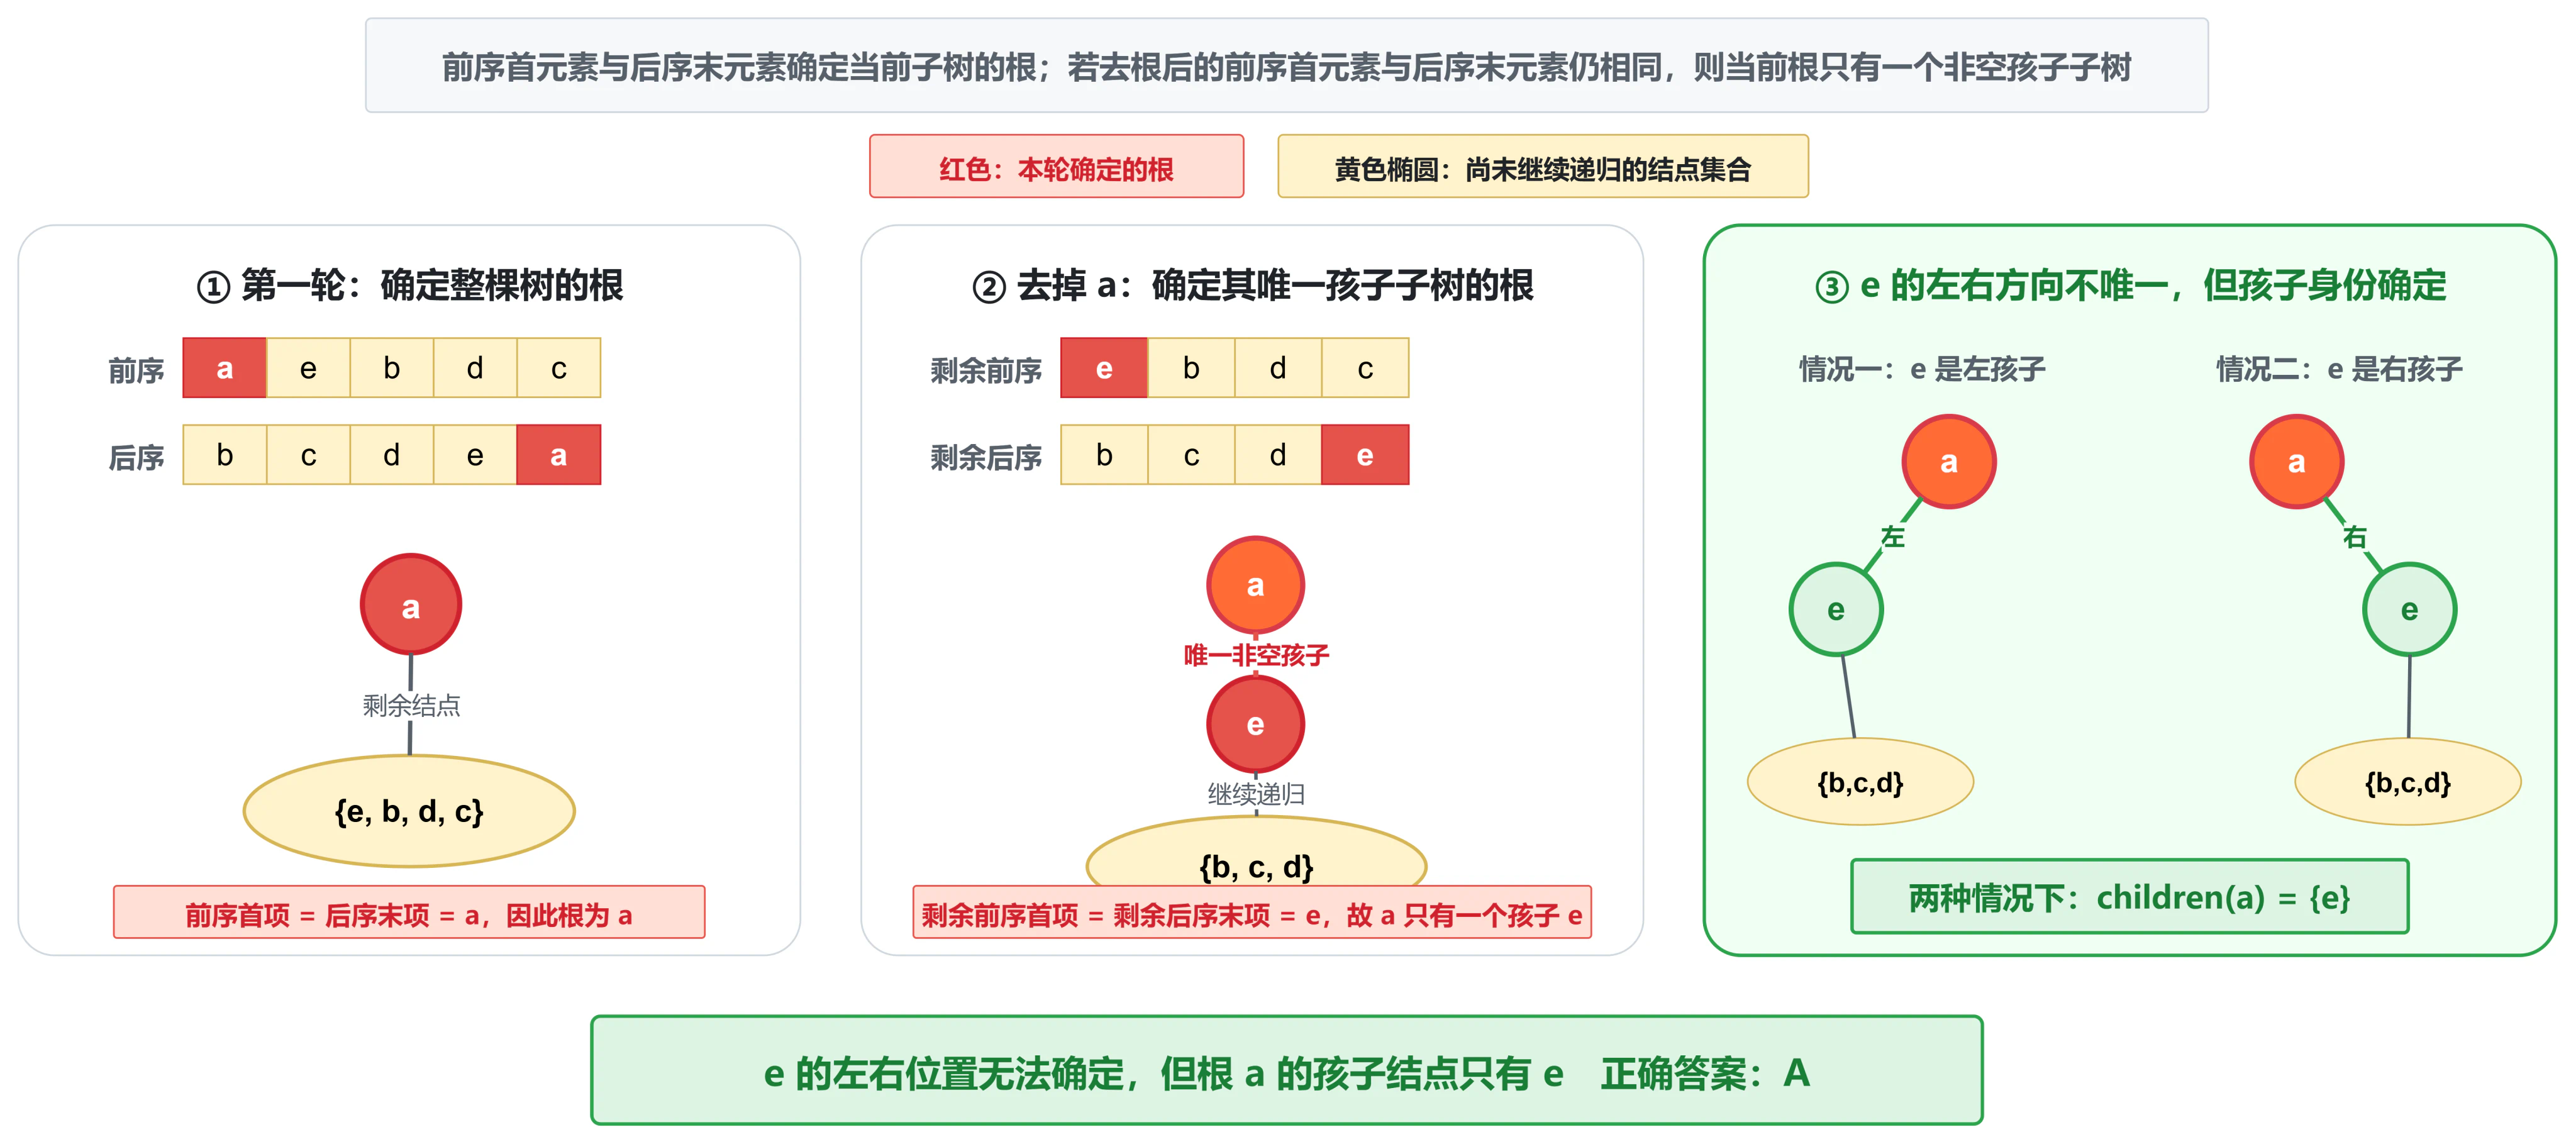
前序遍历的第一个结点和后序遍历的最后一个结点都是根,因此根为 a。
前序中 a 后面的第一个结点 e 一定是 a 的某个孩子,并且是 a 唯一子树或左子树的根。
后序序列中,e 位于 a 之前的最后一个位置:
这说明除 a 外的所有结点 b、c、d、e 都属于以 e 为根的同一棵子树。
如果 a 还有第二个孩子,那么第二棵子树的根应在后序遍历中位于 e 与 a 之间,但这里没有任何结点。因此 a 只有一个孩子 e。
至于 e 是左孩子还是右孩子,仅凭前序和后序不能确定,但题目只问孩子结点是谁。
答案:A
- 【2015-02】先序序列为a, b, c, d的不同二叉树的个数是( )。
A. 13
B. 14
C. 15
D. 16
解析
给定 4 个互不相同的结点和固定先序序列后,每一种不同的二叉树形状都唯一对应一种结点安排:按照先序顺序依次把 a、b、c、d 填入该形状即可。
含 n 个结点的不同二叉树形状数为第 n 个卡特兰数: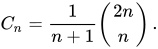
当  时:
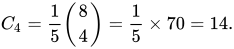
答案:B
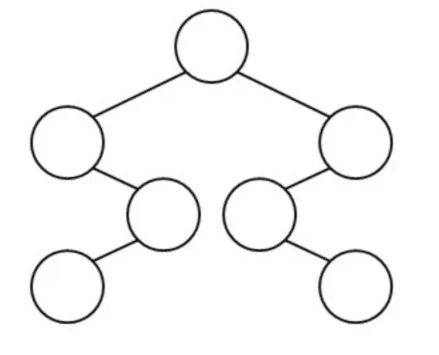
- 【2017-05】已知一棵二叉树的树形如下图所示,其后序序列为e, a, c, b, d, g, f,树中与结点a同层的结点是( )。
A. c
B. d
C. f
D. g
解析
根据题图形状和后序遍历“左子树—右子树—根”依次回填结点,可得到:
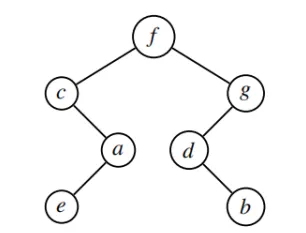
验证后序:
- 左子树后序为 e、a、c;
- 右子树后序为 b、d、g;
- 最后访问根 f。
合并后正是 e、a、c、b、d、g、f。
从层次看:
- 第 1 层:f;
- 第 2 层:c、g;
- 第 3 层:a、d;
- 第 4 层:e、b。
所以与 a 同层的是 d。
答案:B
- 【2017-04】要使一棵非空二叉树的先序序列与中序序列相同,其所有非叶结点须满足的条件是( )。
A. 只有左子树
B. 只有右子树
C. 结点的度均为1
D. 结点的度均为2
解析
先序遍历次序是
中序遍历次序是
两者唯一的差异是根与左子树的先后顺序。
如果任一非叶结点存在左子树:
- 先序会先访问该结点,再访问左子树;
- 中序会先访问左子树,再访问该结点。
两种序列必然不同。
因此所有非叶结点都不能有左子树,只能有右子树。这样先序和中序都会先访问当前根,再沿右子树继续。
“度均为 1”还可能包含只有左孩子的结点,条件不够充分。
答案:B
- 【2023-05】已知一棵二叉树的树形如下图所示,若其后序遍历为 f, d, b, e, c, a,则其先(前)序遍历序列是( )。
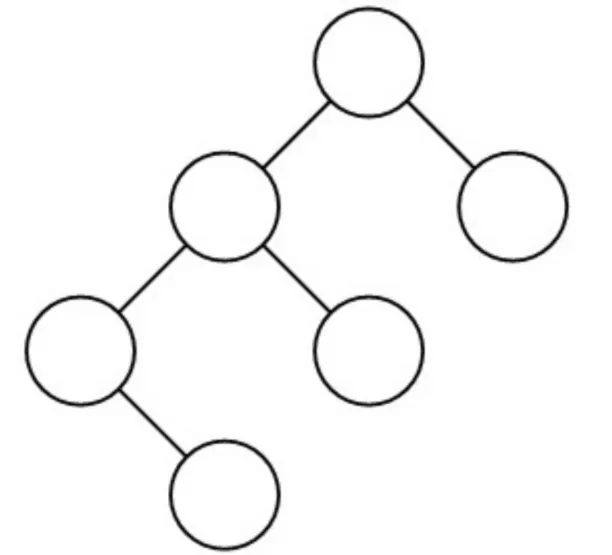
A. a, e, d, f, b, c
B. a, c, e, b, d, f
C. c, a, b, e, f, d
D. d, f, e, b, a, c
解析
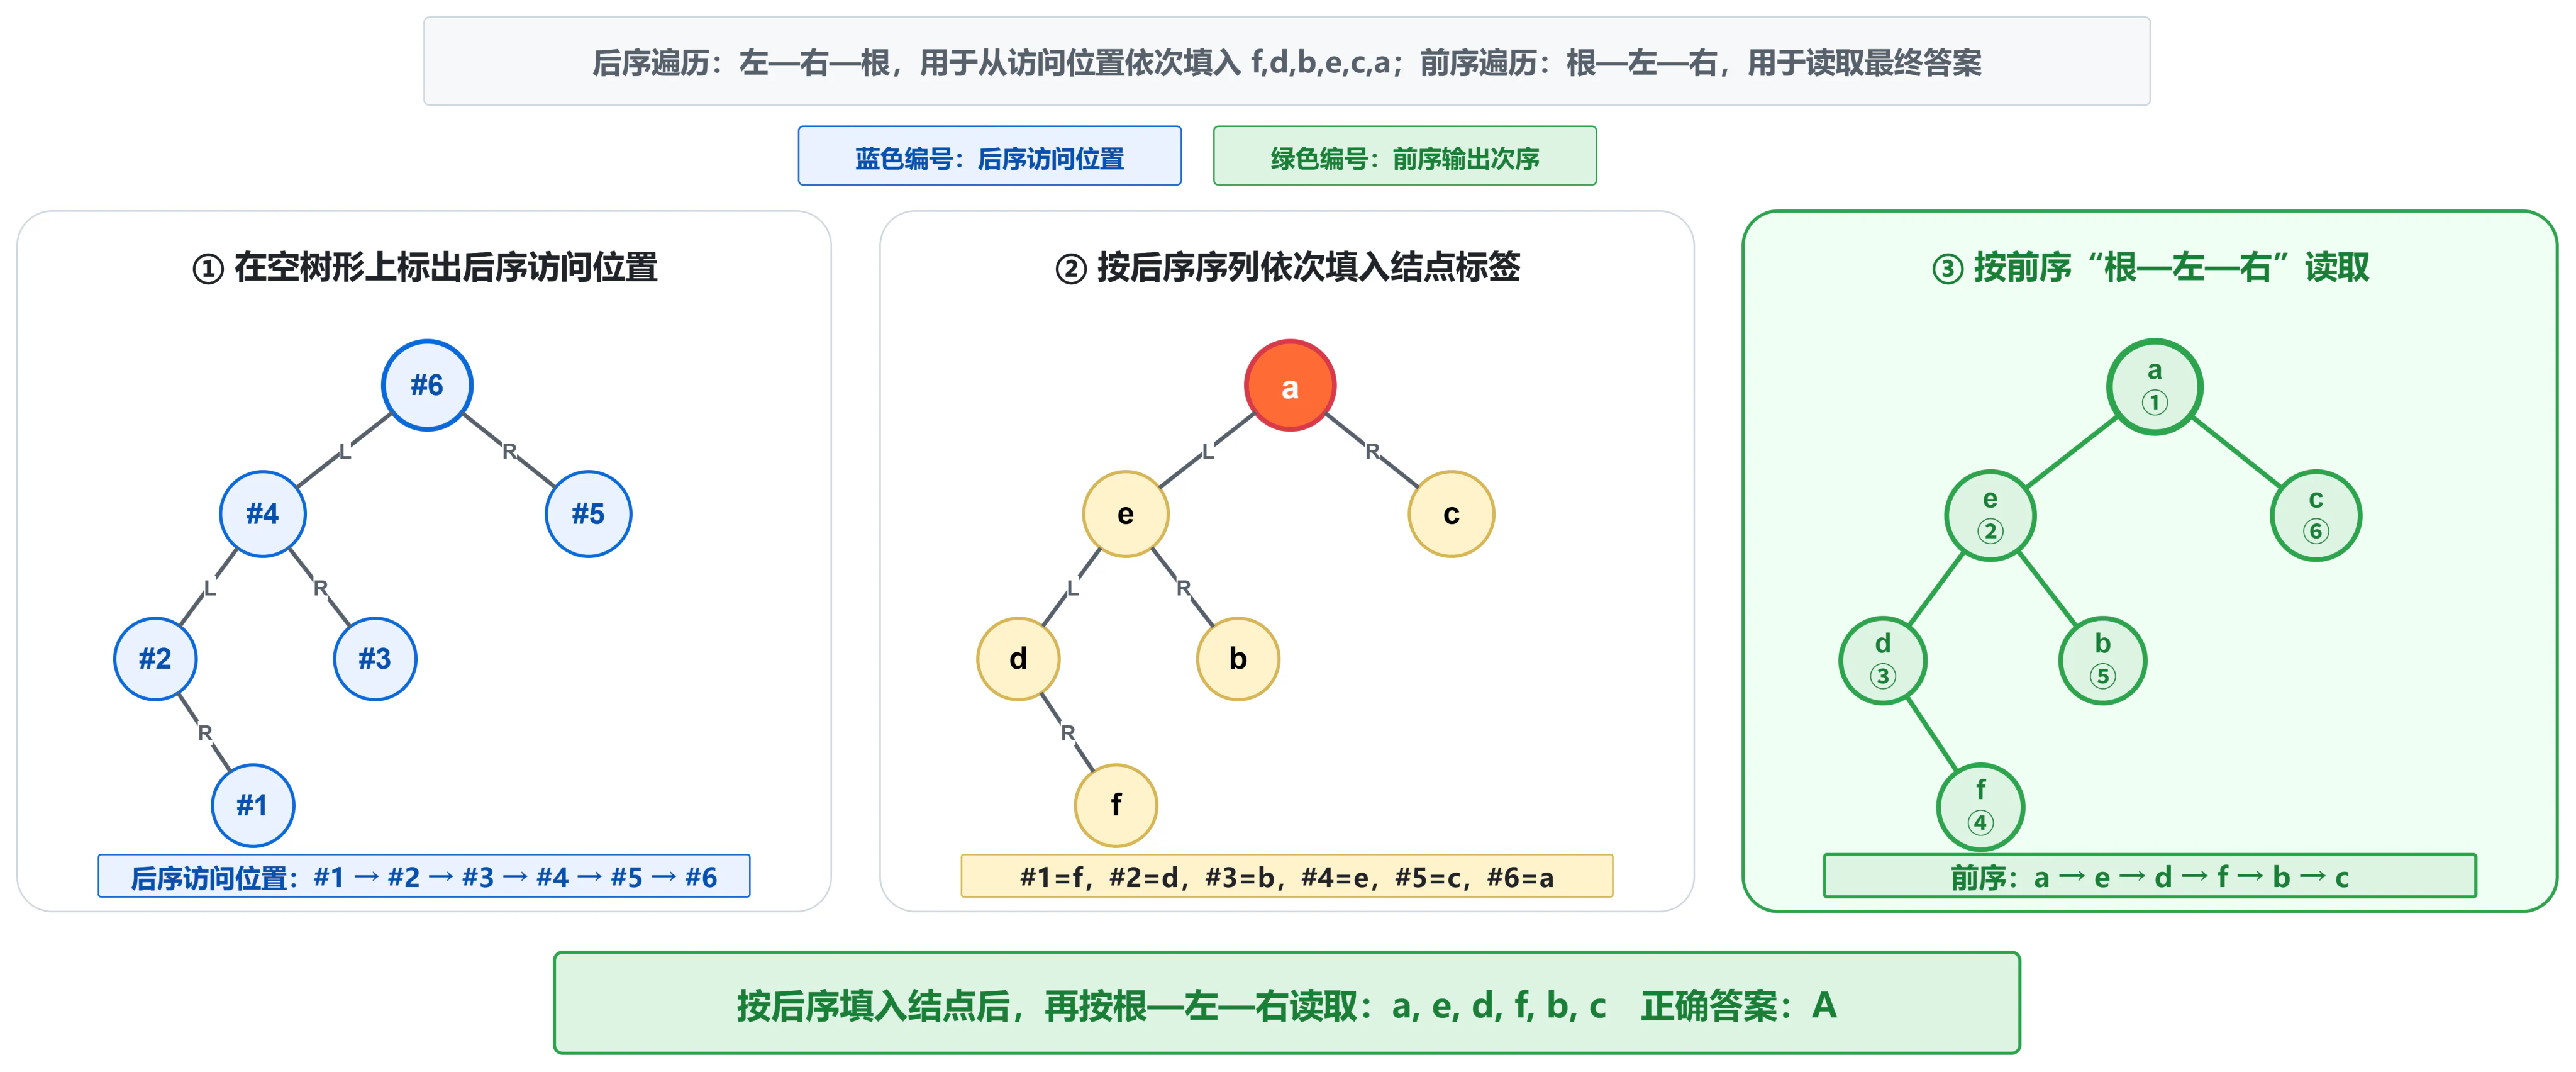
答案:A
- 【2024-03】若 p、q 和 v 均为二叉树 T 中的结点,v 有两个孩子结点,T 的中序遍历序列形如“ …,p,v,q,… ”,则下列叙述中,正确的是
A. p没有右孩子,q没有左孩子
B. p没有右孩子,q有左孩子
C. p有右孩子,q没有左孩子
D. p有右孩子,q有左孩子
解析
因为 v 有左子树,中序遍历中 v 的直接前驱 p 是 v 左子树中最靠右的结点。
如果 p 还有右孩子,那么中序遍历在访问 p 后还必须访问其右子树,p 就不可能紧邻 v。因此 p 没有右孩子。
同理,v 的直接后继 q 是 v 右子树中最靠左的结点。
如果 q 还有左孩子,中序遍历必须先访问该左子树,再访问 q,q 就不可能紧邻 v。因此 q 没有左孩子。
答案:A
- 【2026-03】已知二叉树 T 的中序遍历为 b, e, d, f, c, a, g。层序遍历为 a, b, g, c, d, e, f。则其后序遍历序列为多少?
A.c, e, d, f, b, g, a
B.c, e, f, d, b, g, a
C.e, f, d, c, b, g, a
D.e, g, f, d, b, c, a
解析
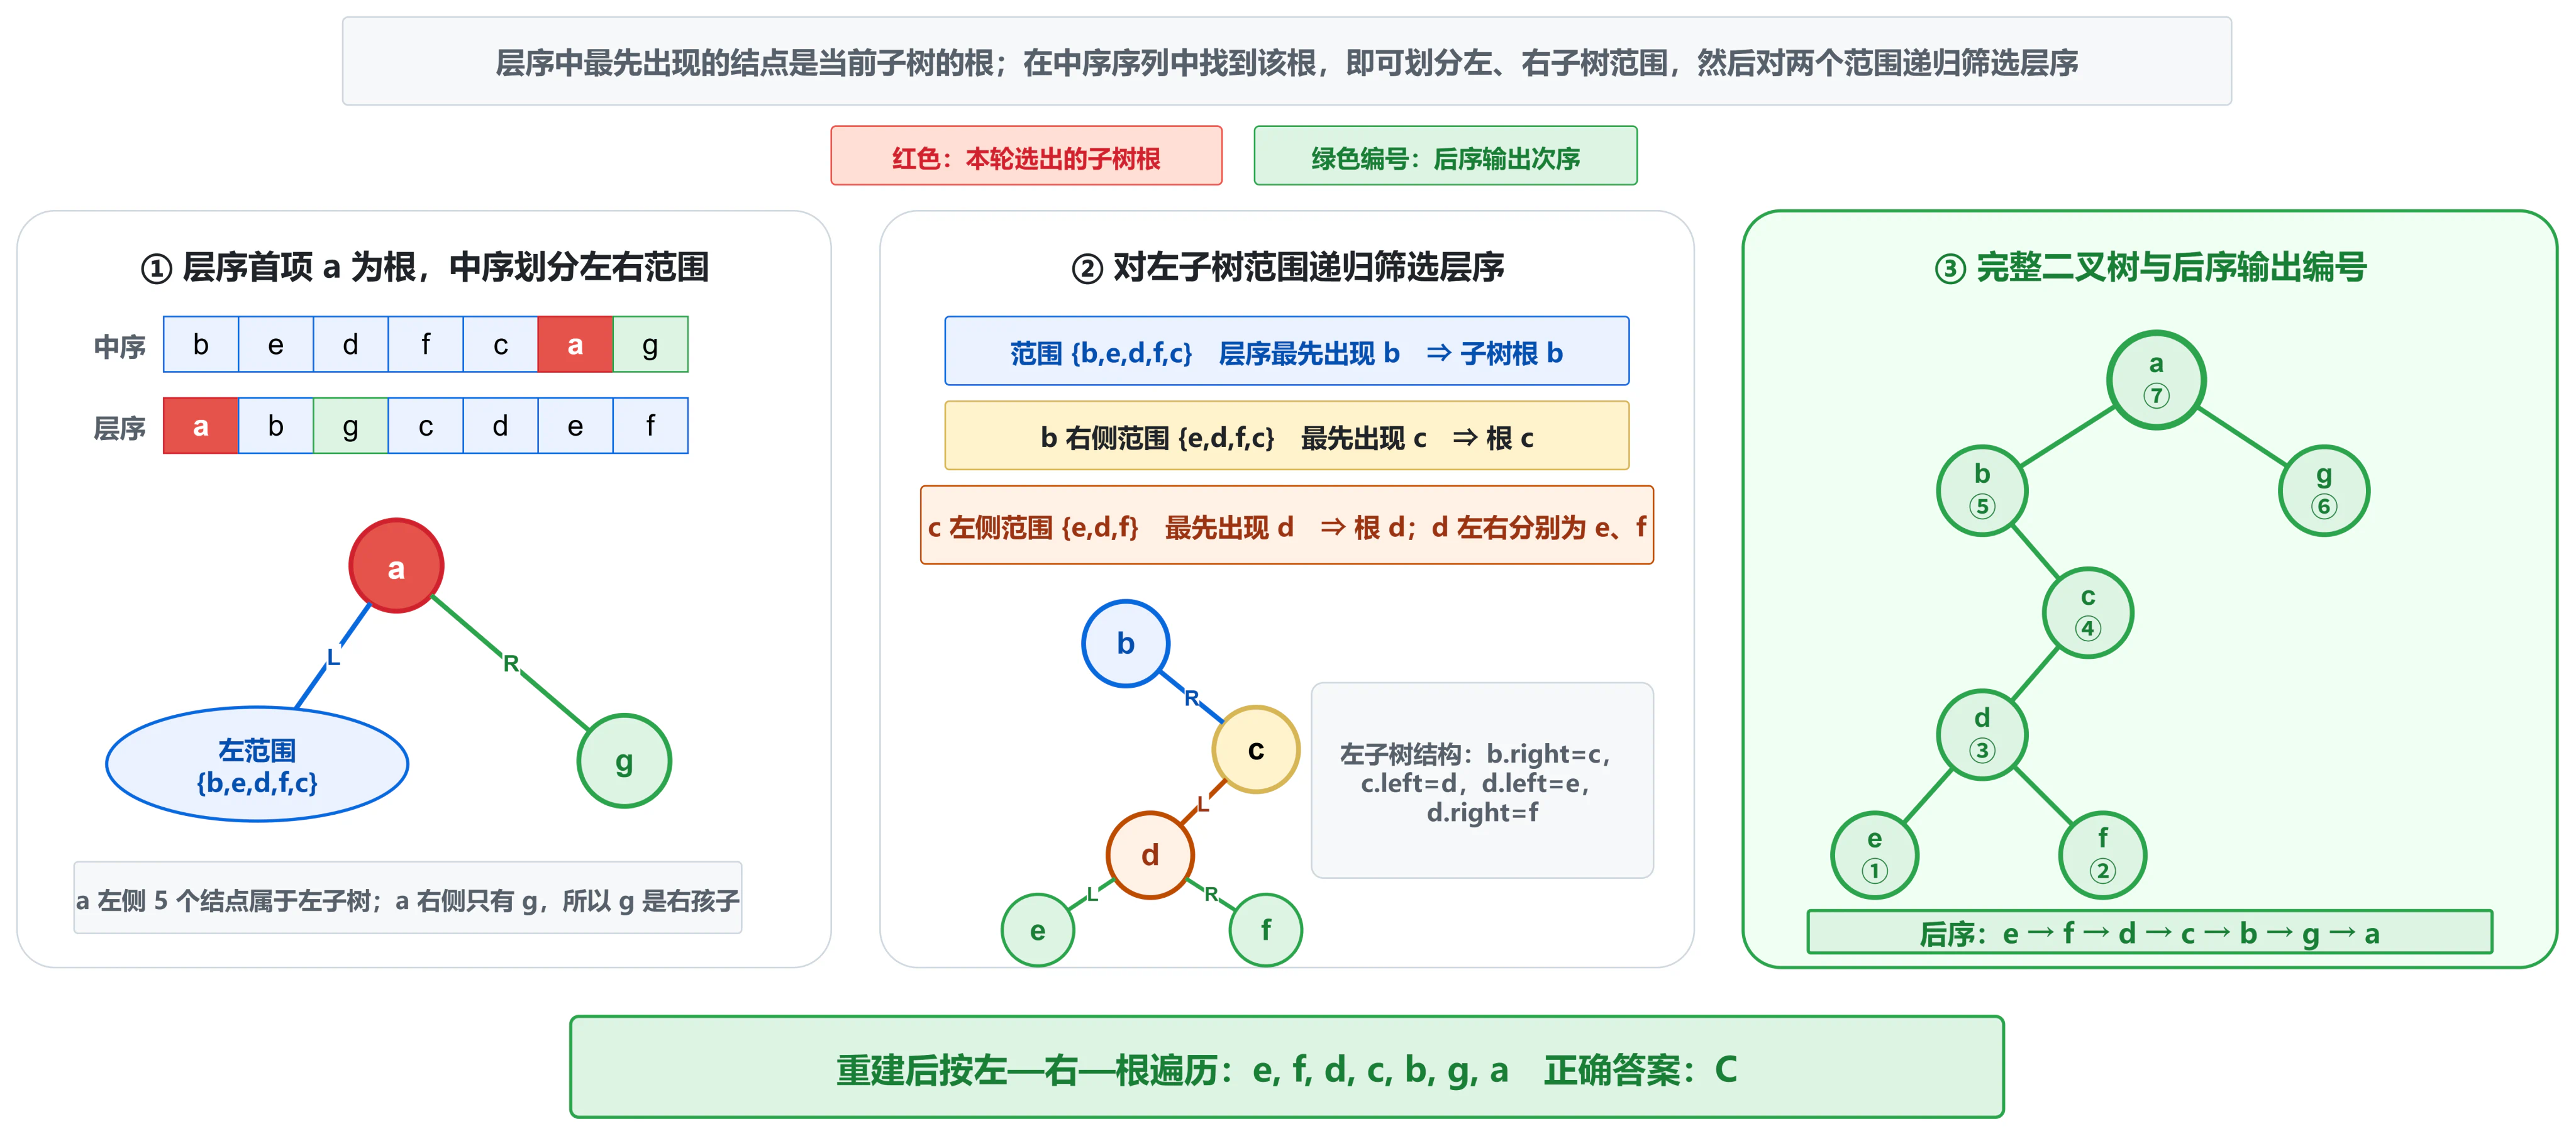
层序遍历的第一个结点 a 是根。a 在中序序列中把树分成:
- 左子树:b、e、d、f、c;
- 右子树:g。
在层序序列中筛选左子树结点,最先出现的是 b,所以 b 是左子树根。b 在对应中序片段的最左端,因此 b 没有左子树,右子树包含 e、d、f、c。
继续筛选,c 最先出现,所以 c 是 b 的右孩子。c 在中序片段末尾,因此 c 只有左子树 e、d、f。
该左子树根为 d,中序中 d 左边是 e、右边是 f,所以 d 的左右孩子分别是 e、f。
后序遍历为:
- a 的左子树:e、f、d、c、b;
- a 的右子树:g;
- 根:a。
所以结果是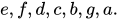
答案:C
预测题
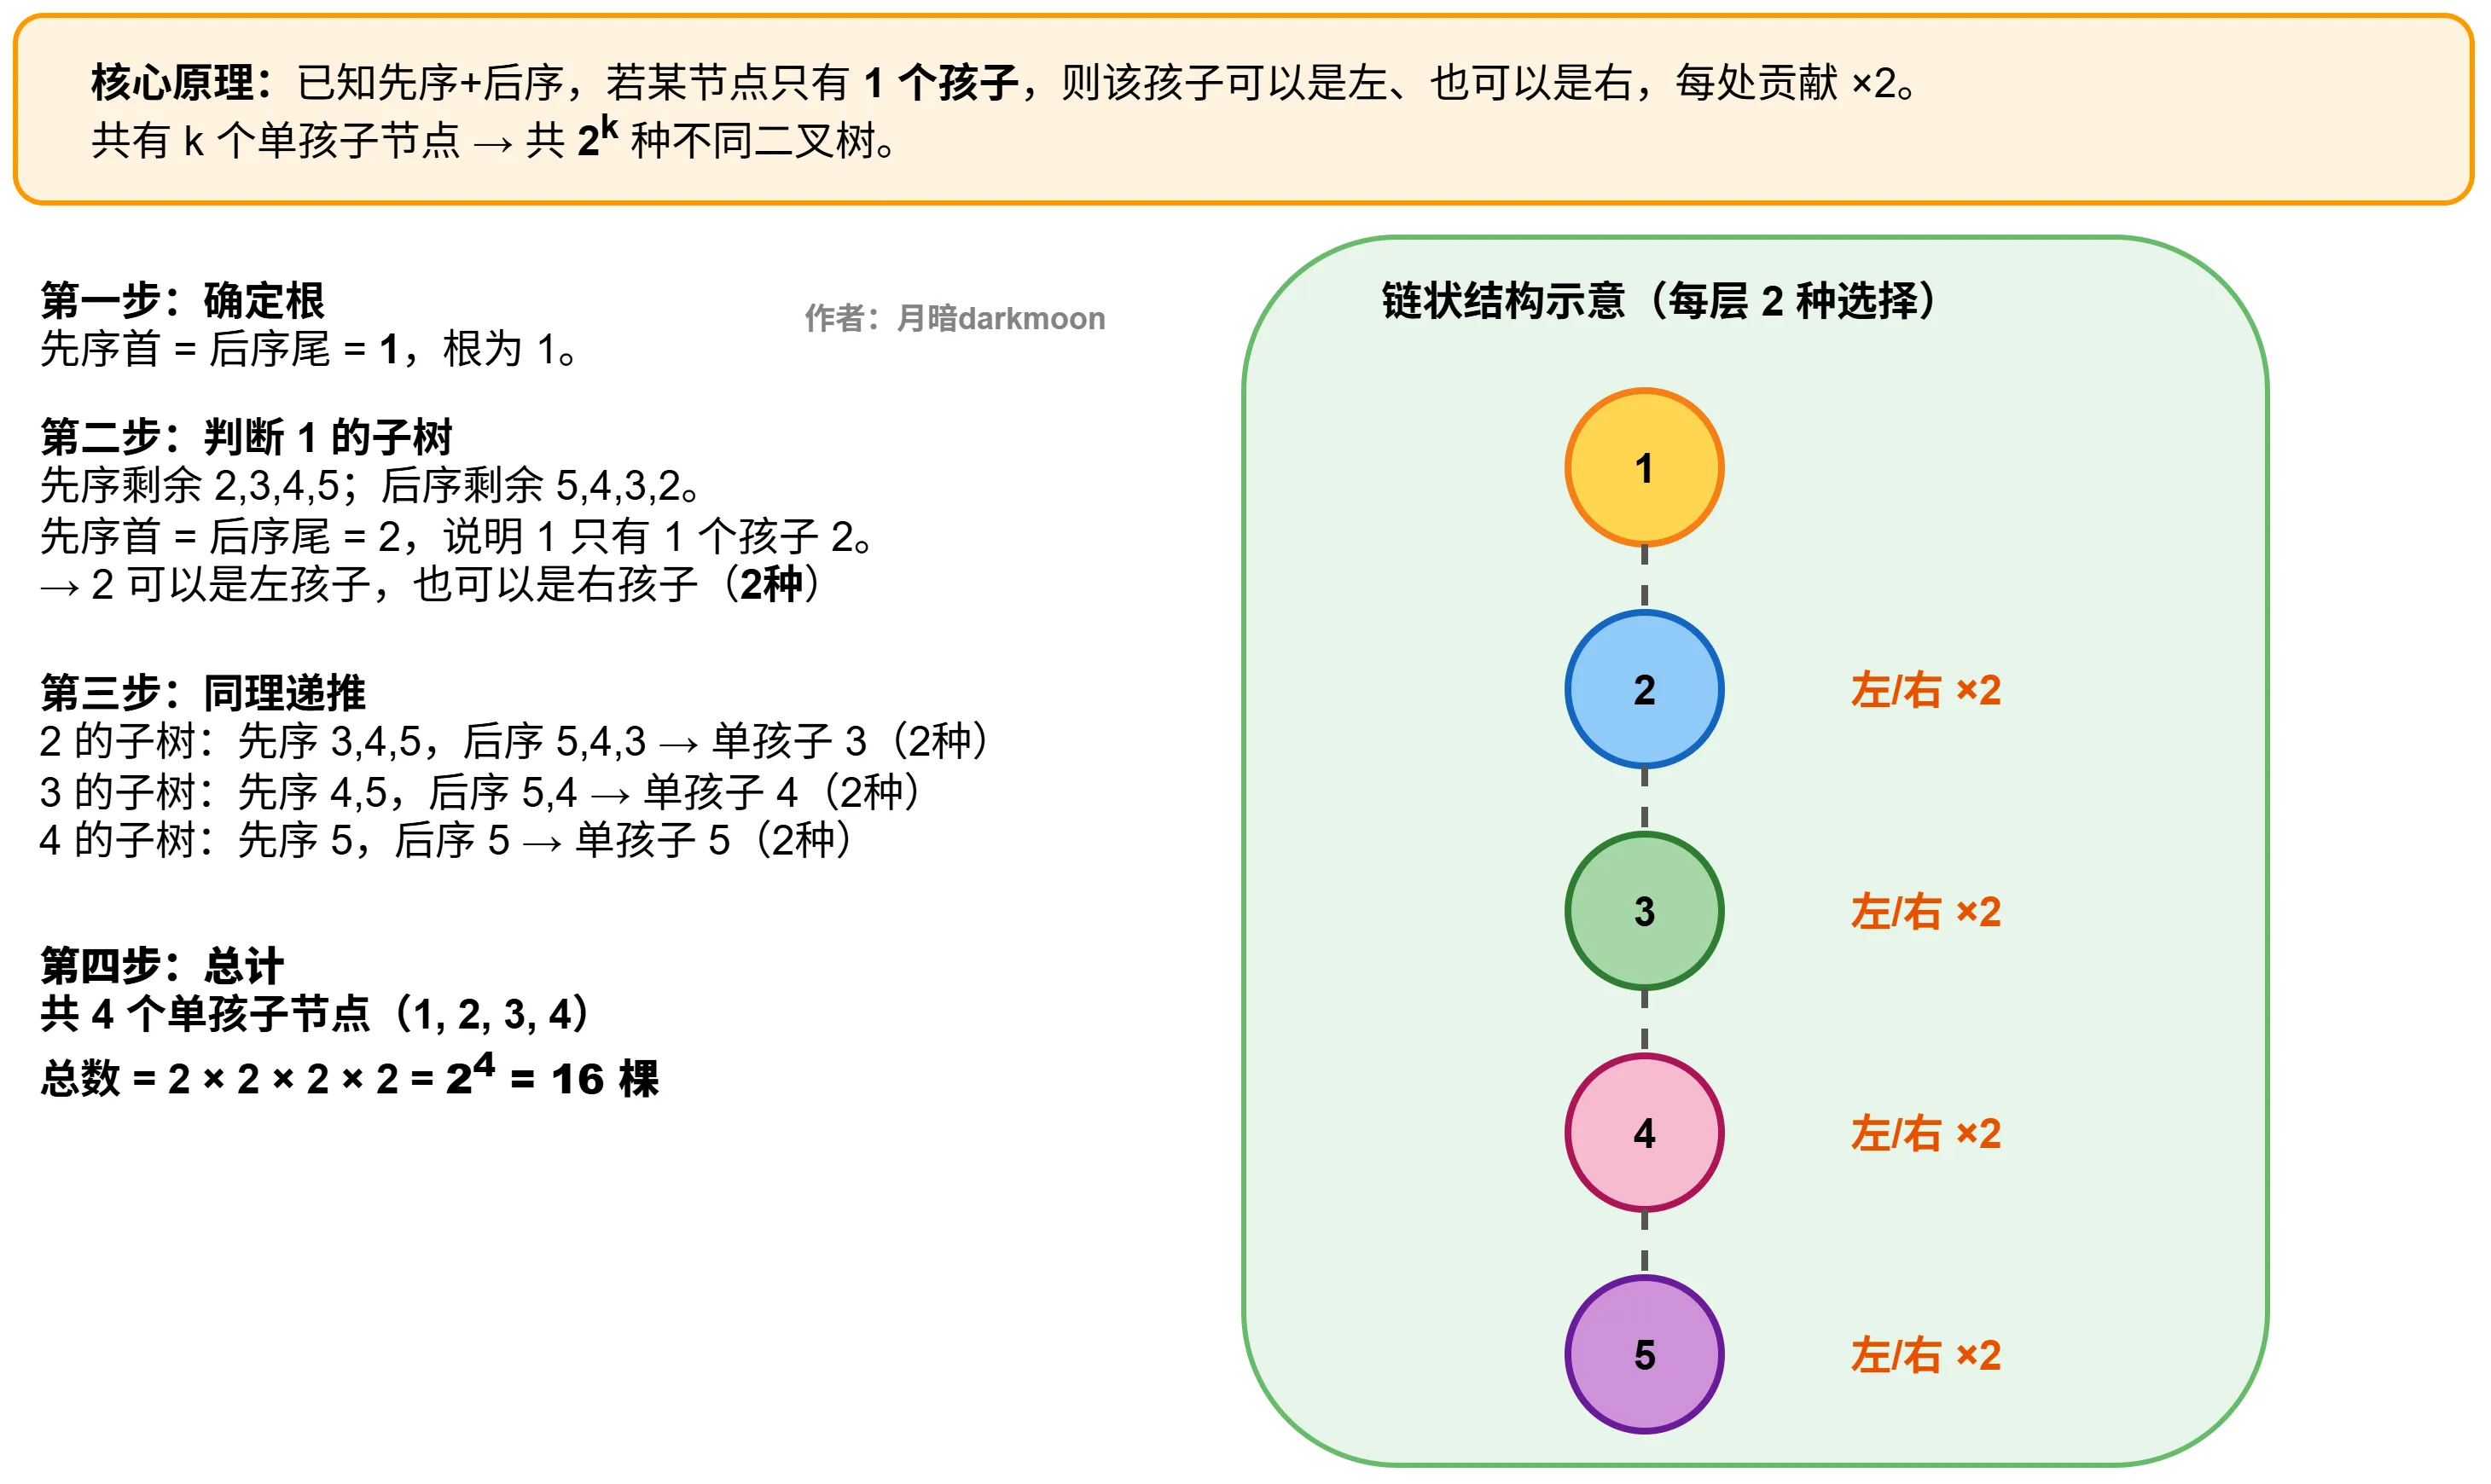
- 已知先序遍历为
1,2,3,4,5,后序遍历为5,4,3,2,1,满足这两个序列的不同二叉树共有( )。
A. 8 棵\ B. 12 棵\ C. 16 棵\ D. 32 棵
解析
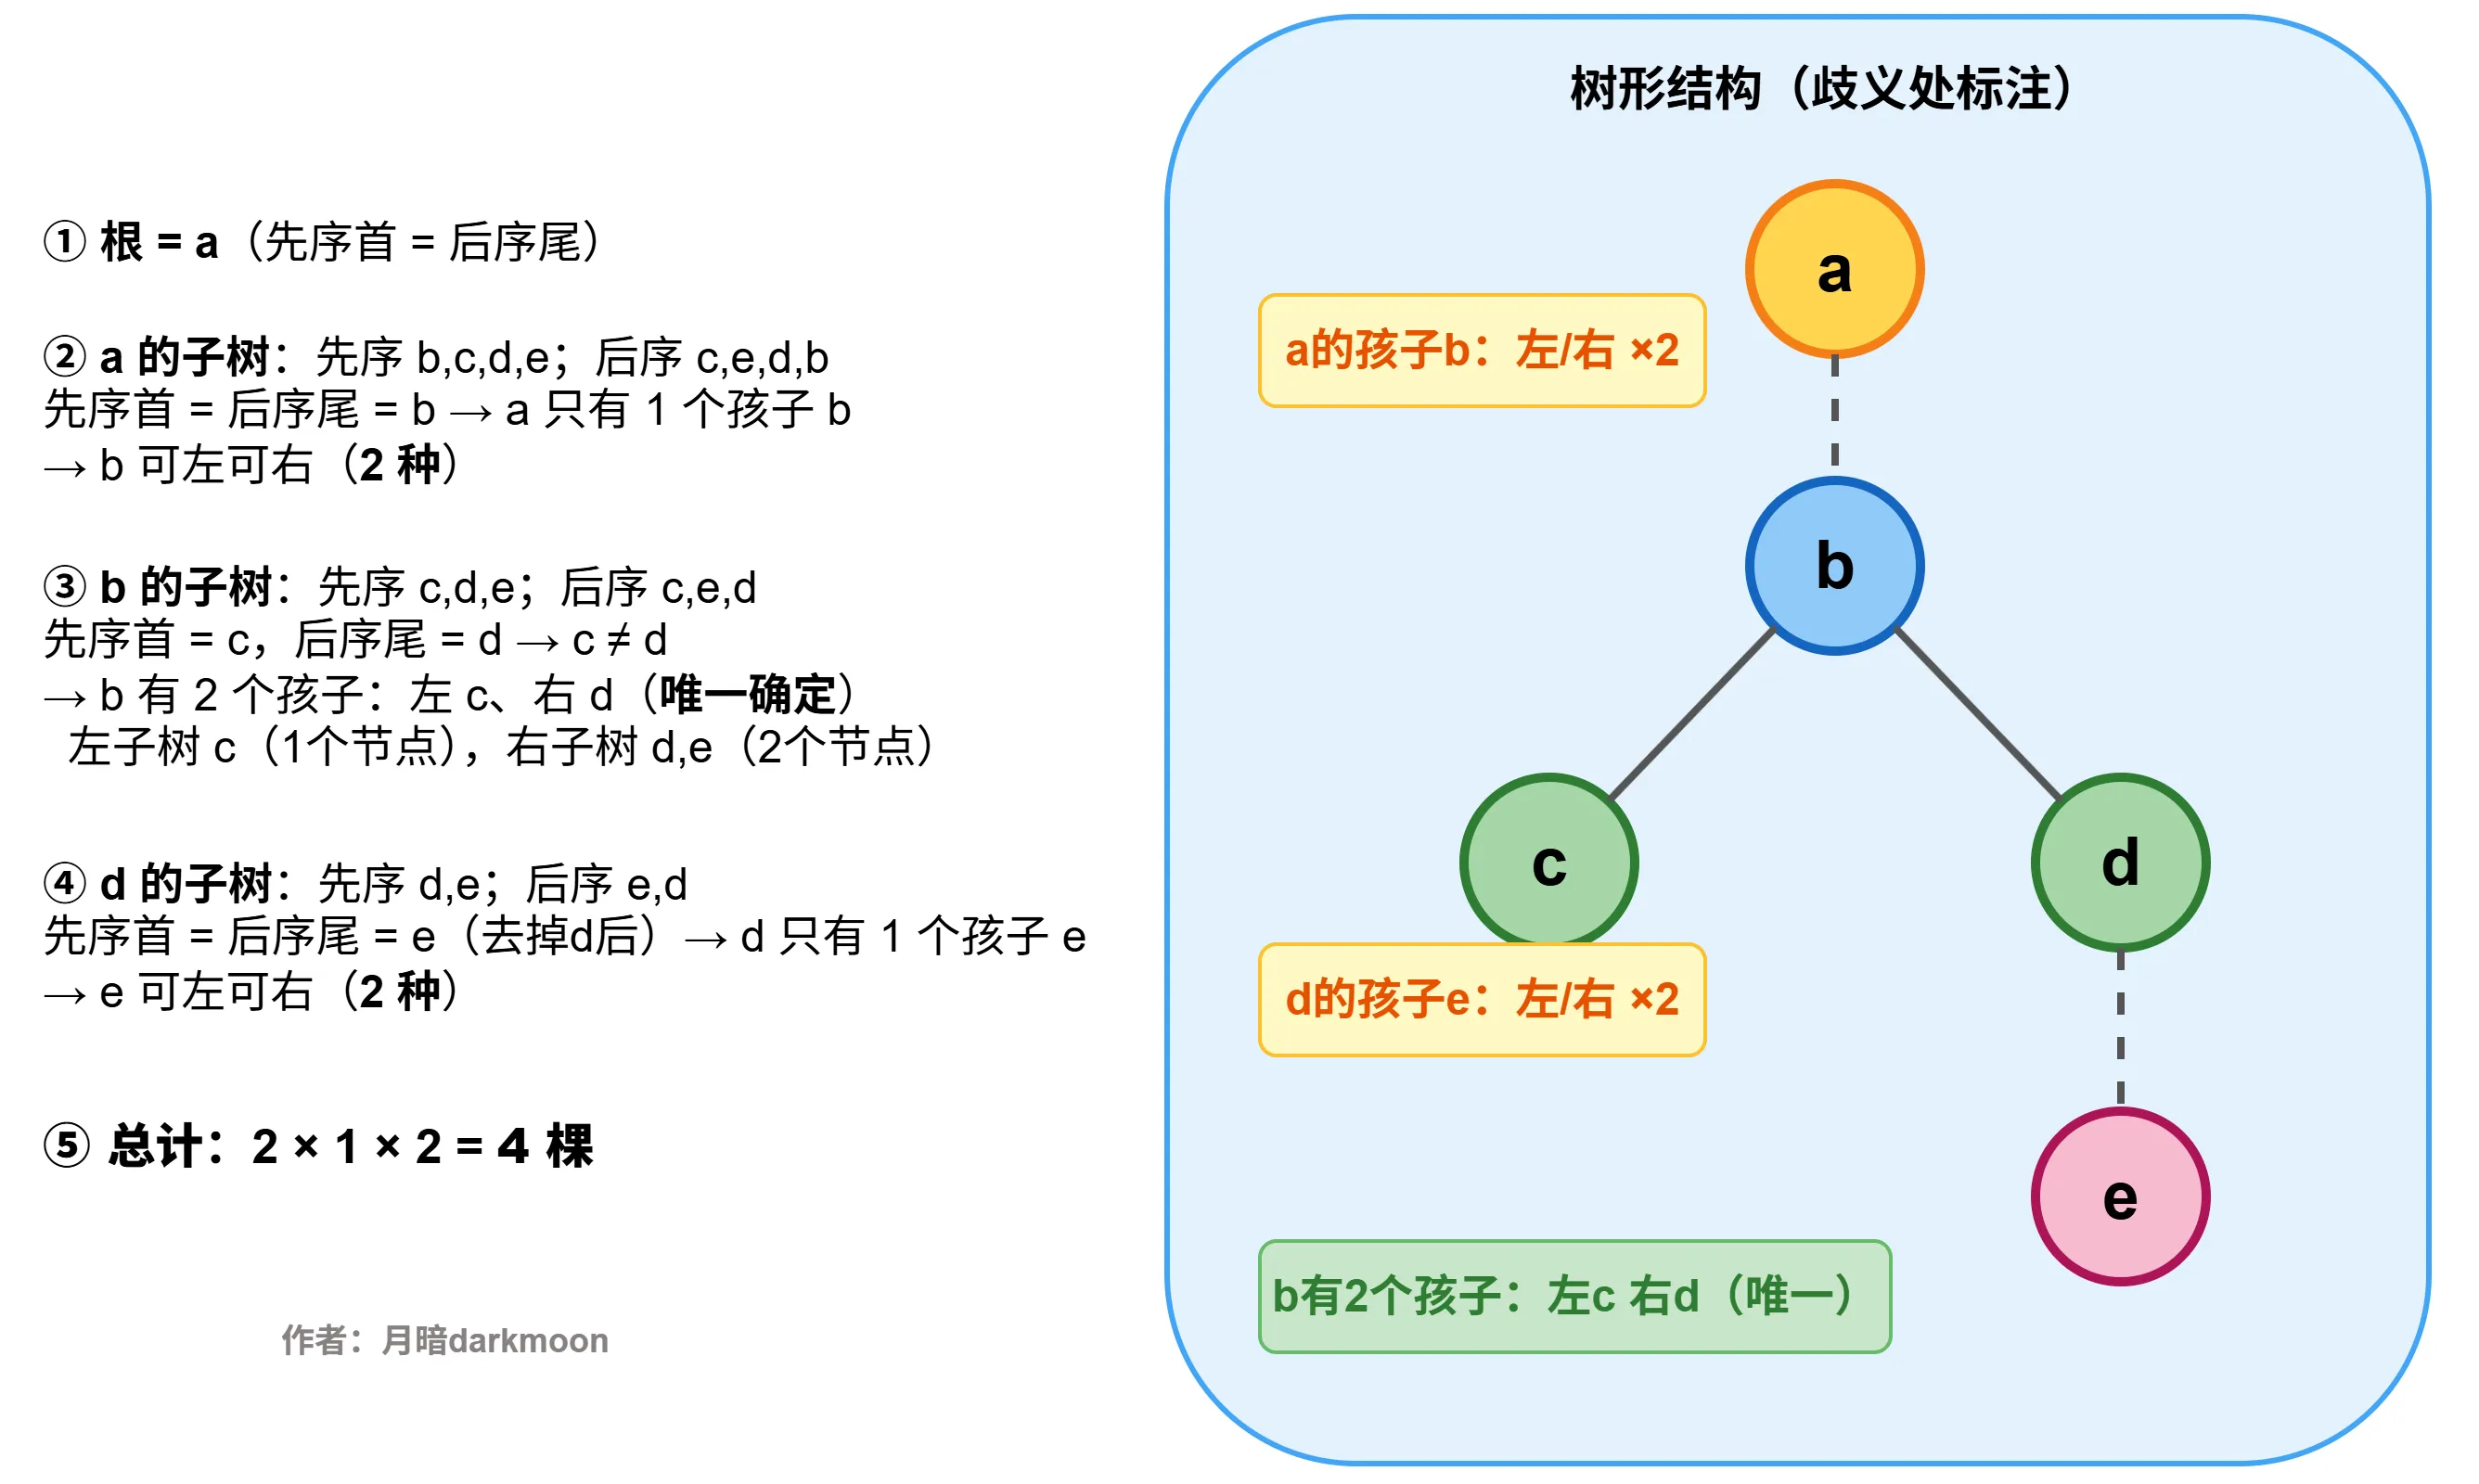
- 一棵二叉树的先序遍历为
a,b,c,d,e,后序遍历为c,e,d,b,a,则满足这两个序列的不同二叉树共有( )。
A. 2 棵\ B. 4 棵\ C. 6 棵\ D. 8 棵
解析
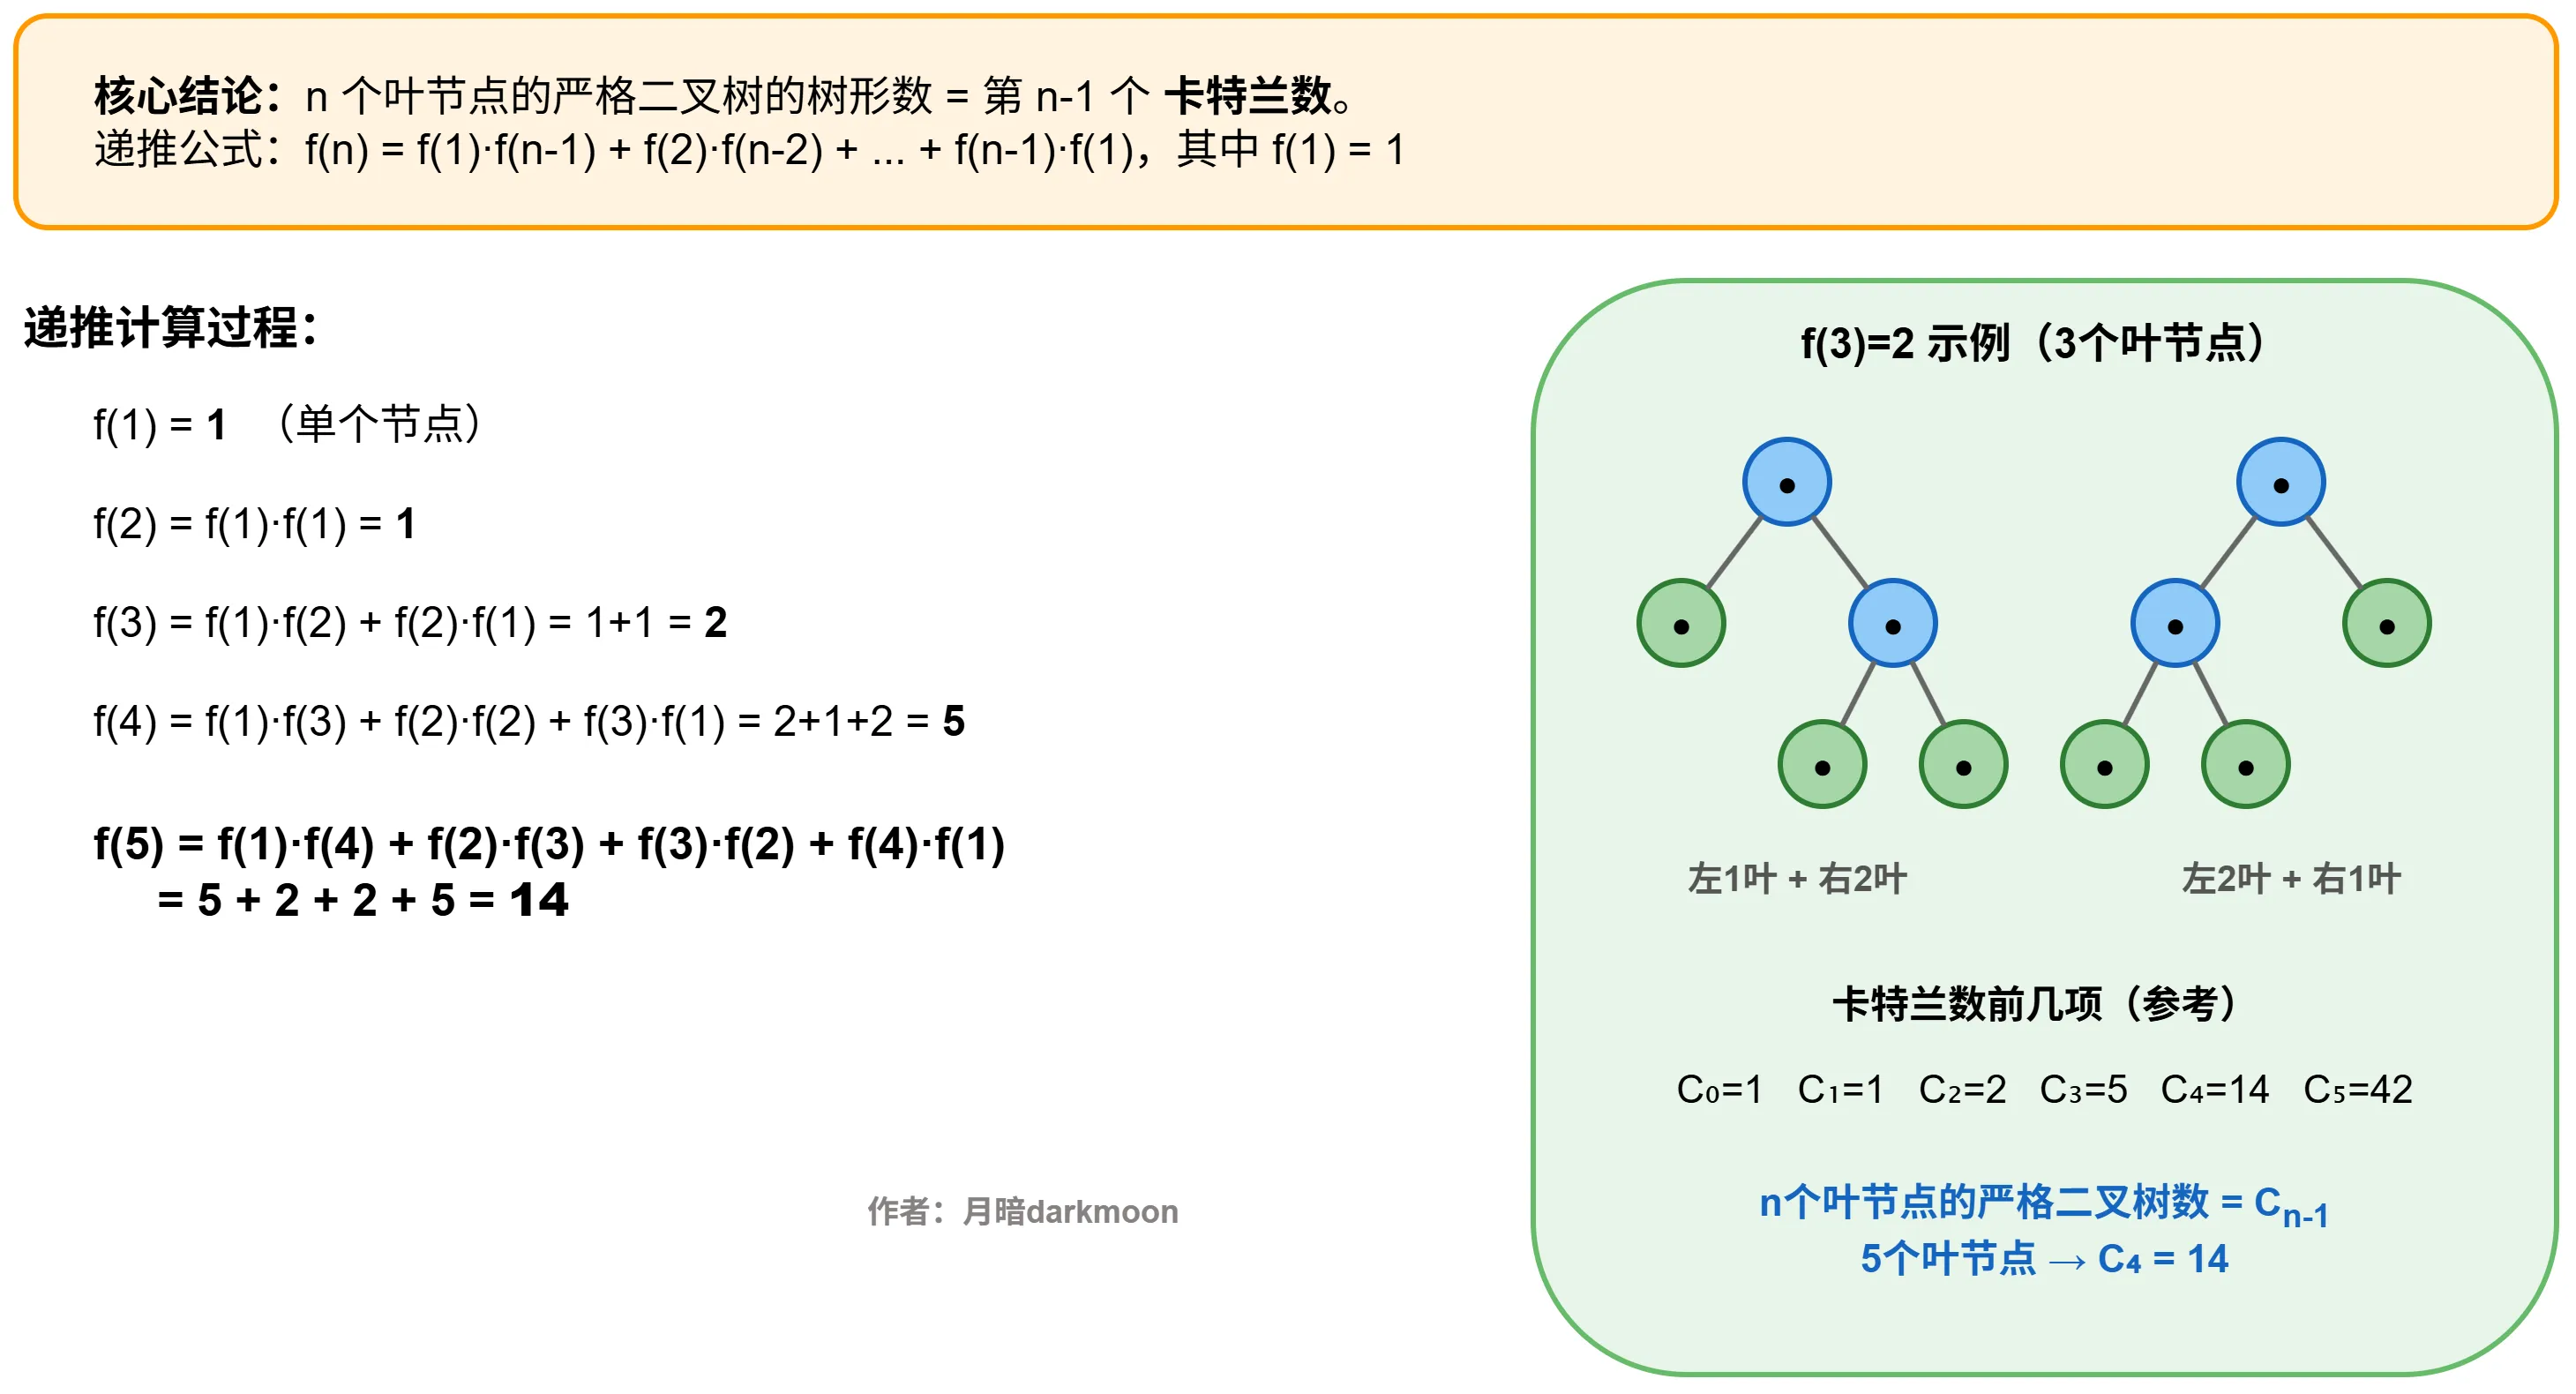
- 含有 5 个叶结点的严格二叉树(每个结点要么有 0 个孩子,要么有 2 个孩子),其不同树形的数量为( )。
A. 5\ B. 14\ C. 42\ D. 132
解析
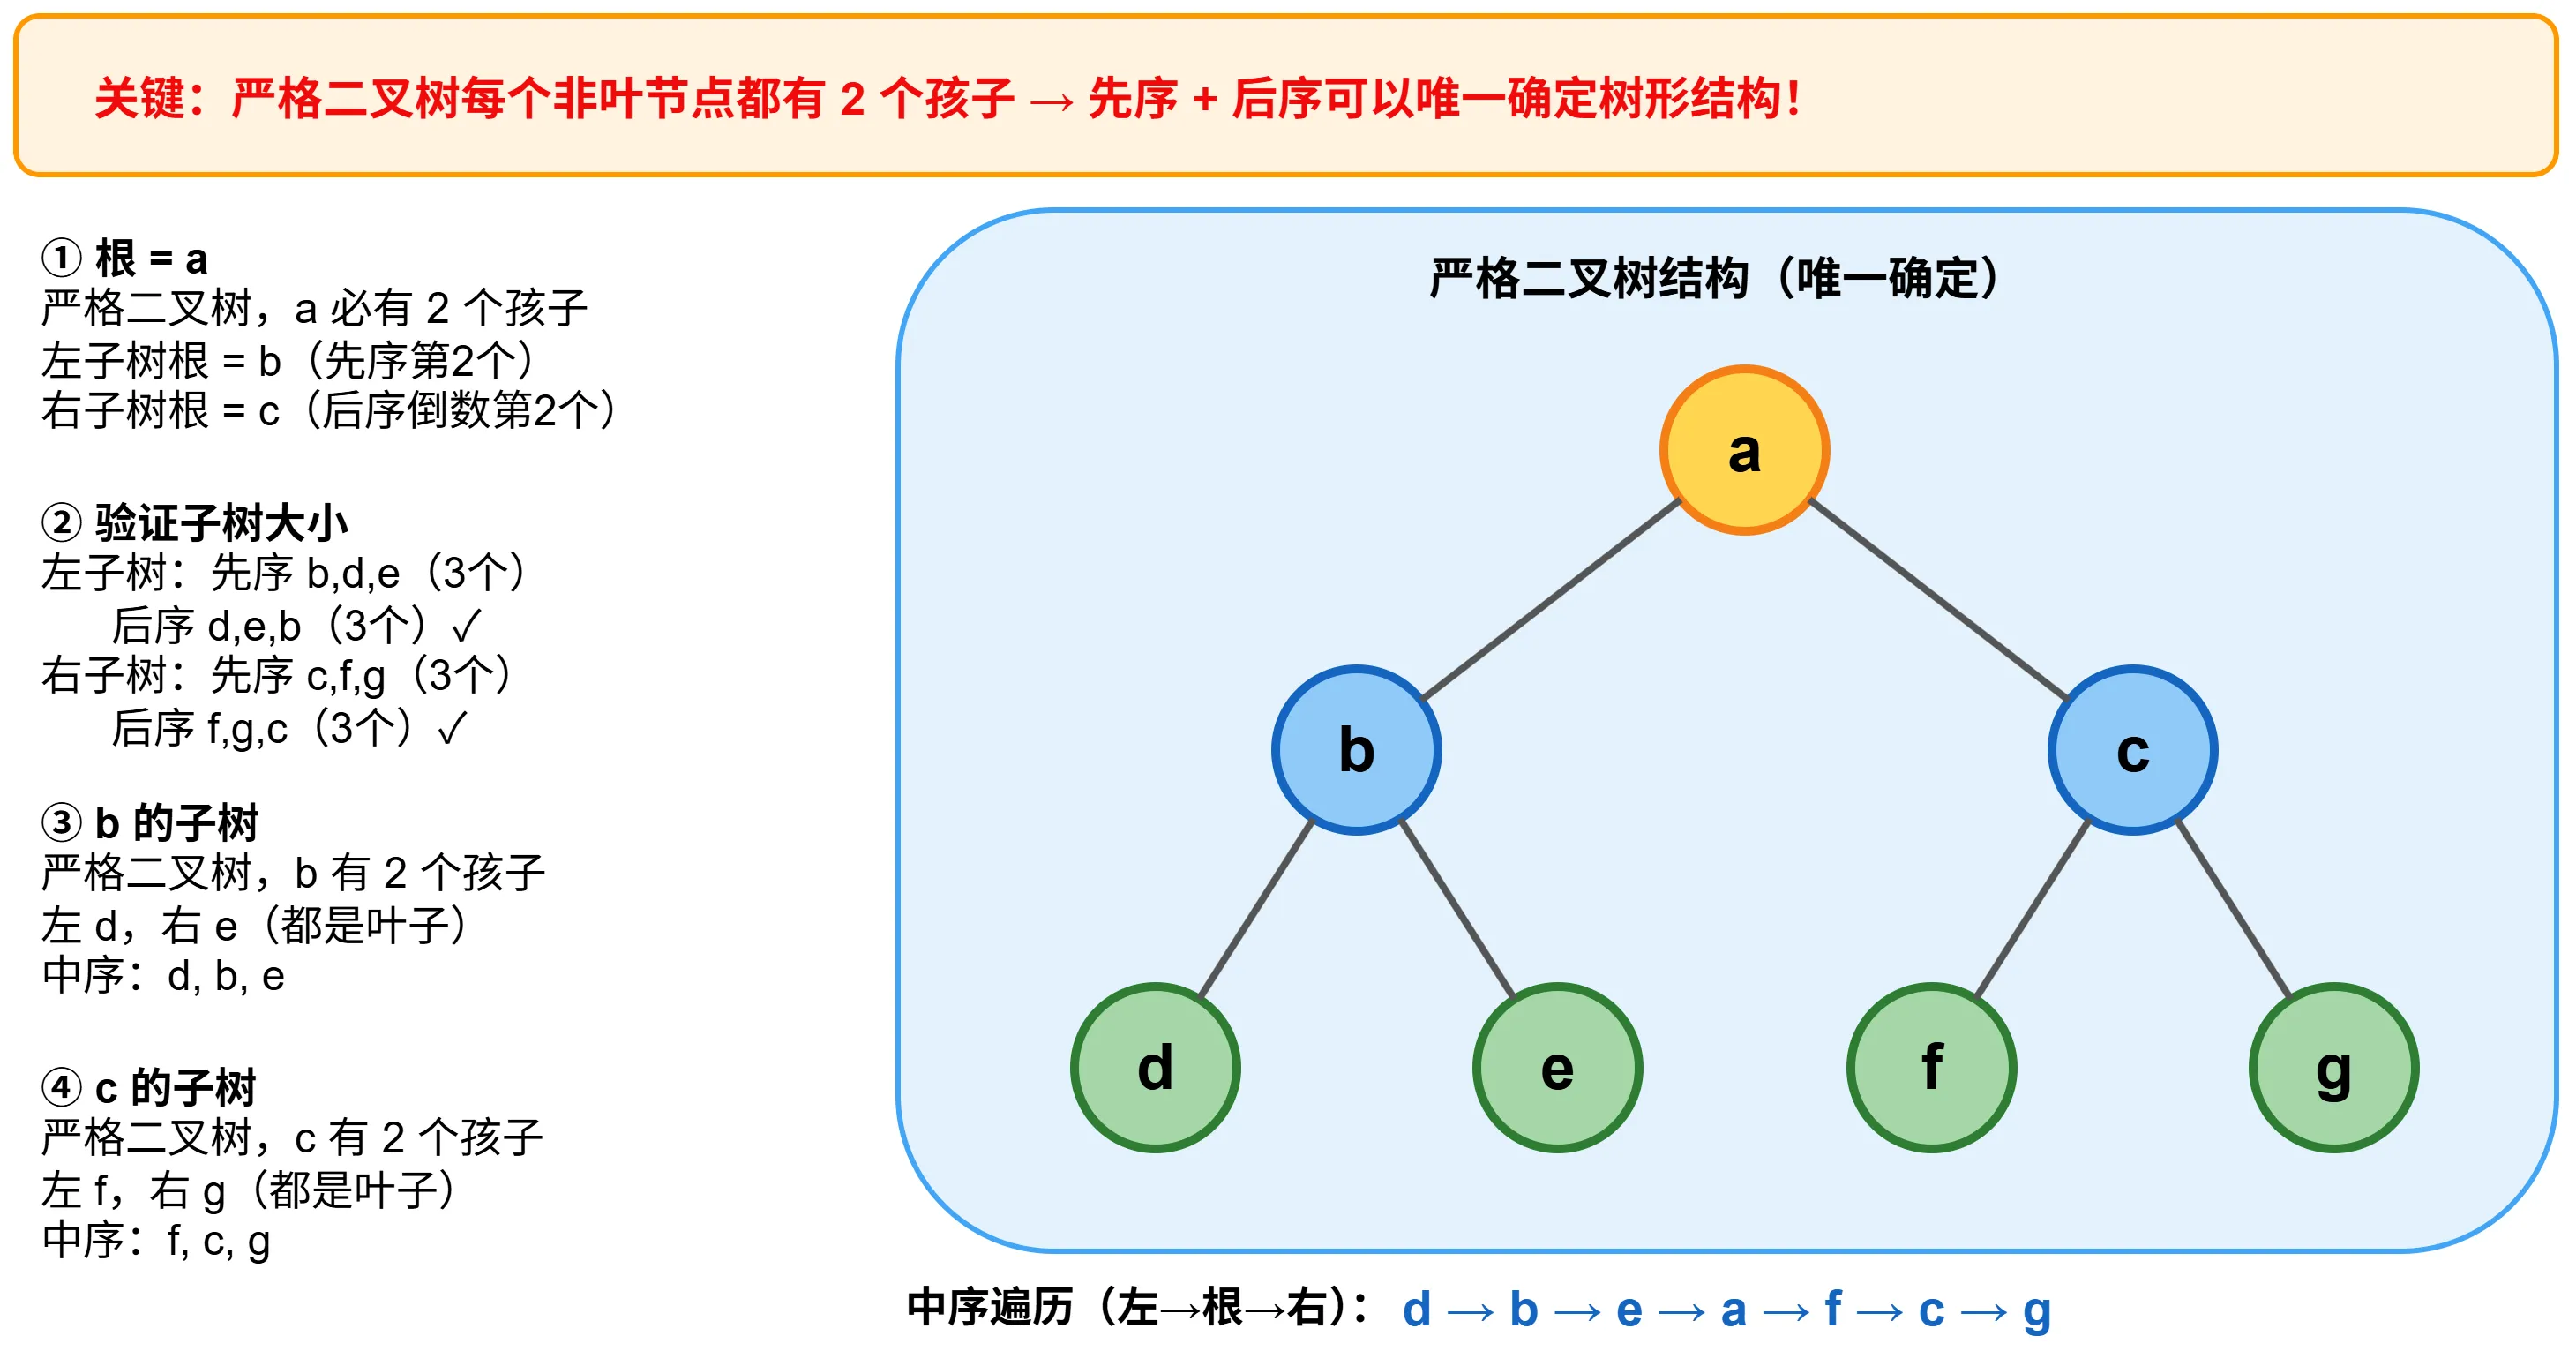
- 一棵严格二叉树的先序遍历为
a,b,d,e,c,f,g,后序遍历为d,e,b,f,g,c,a,其中序遍历为( )。
A. d,b,e,a,f,c,g\
B. b,d,e,a,c,f,g\
C. d,e,b,a,f,g,c\
D. b,d,a,e,c,f,g
解析
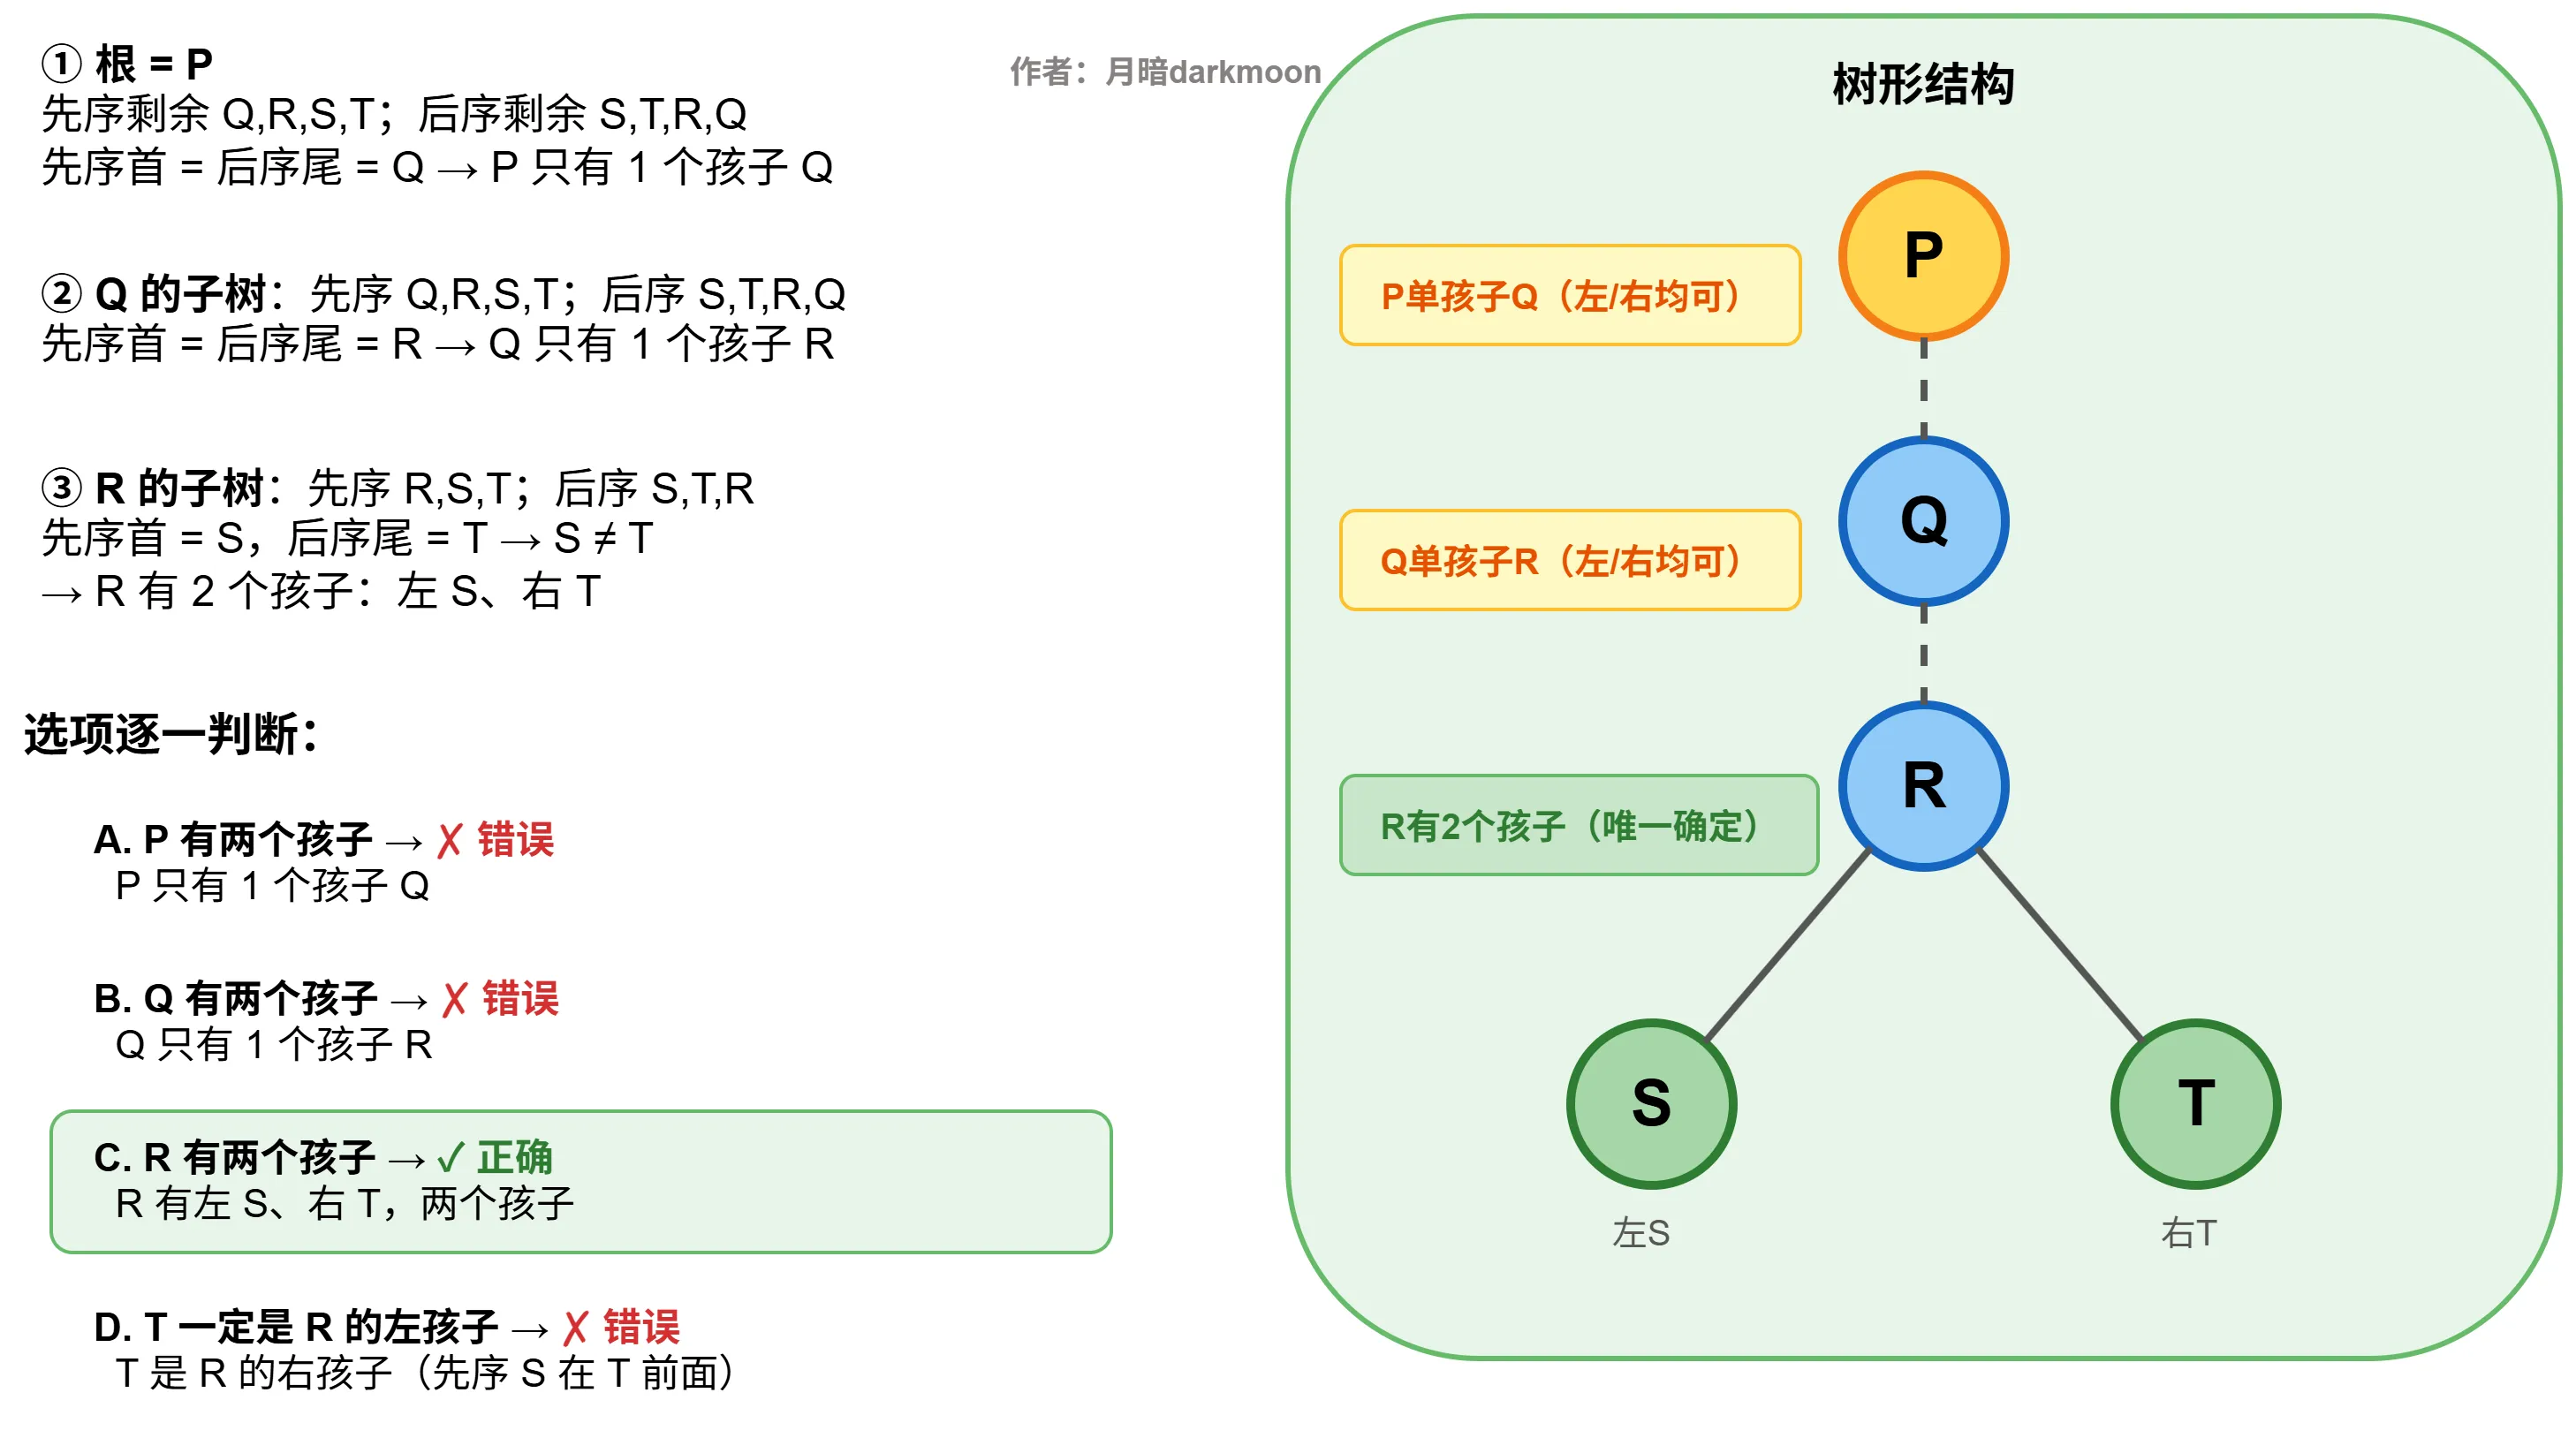
- 已知某二叉树的前序遍历序列为:P, Q, R, S, T ,后序遍历序列为:S, T, R, Q, P,则下列叙述正确的是:
A. P 有两个孩子\
B. Q 有两个孩子\
C. R 有两个孩子\
D. T 一定是 R 的左孩子
解析
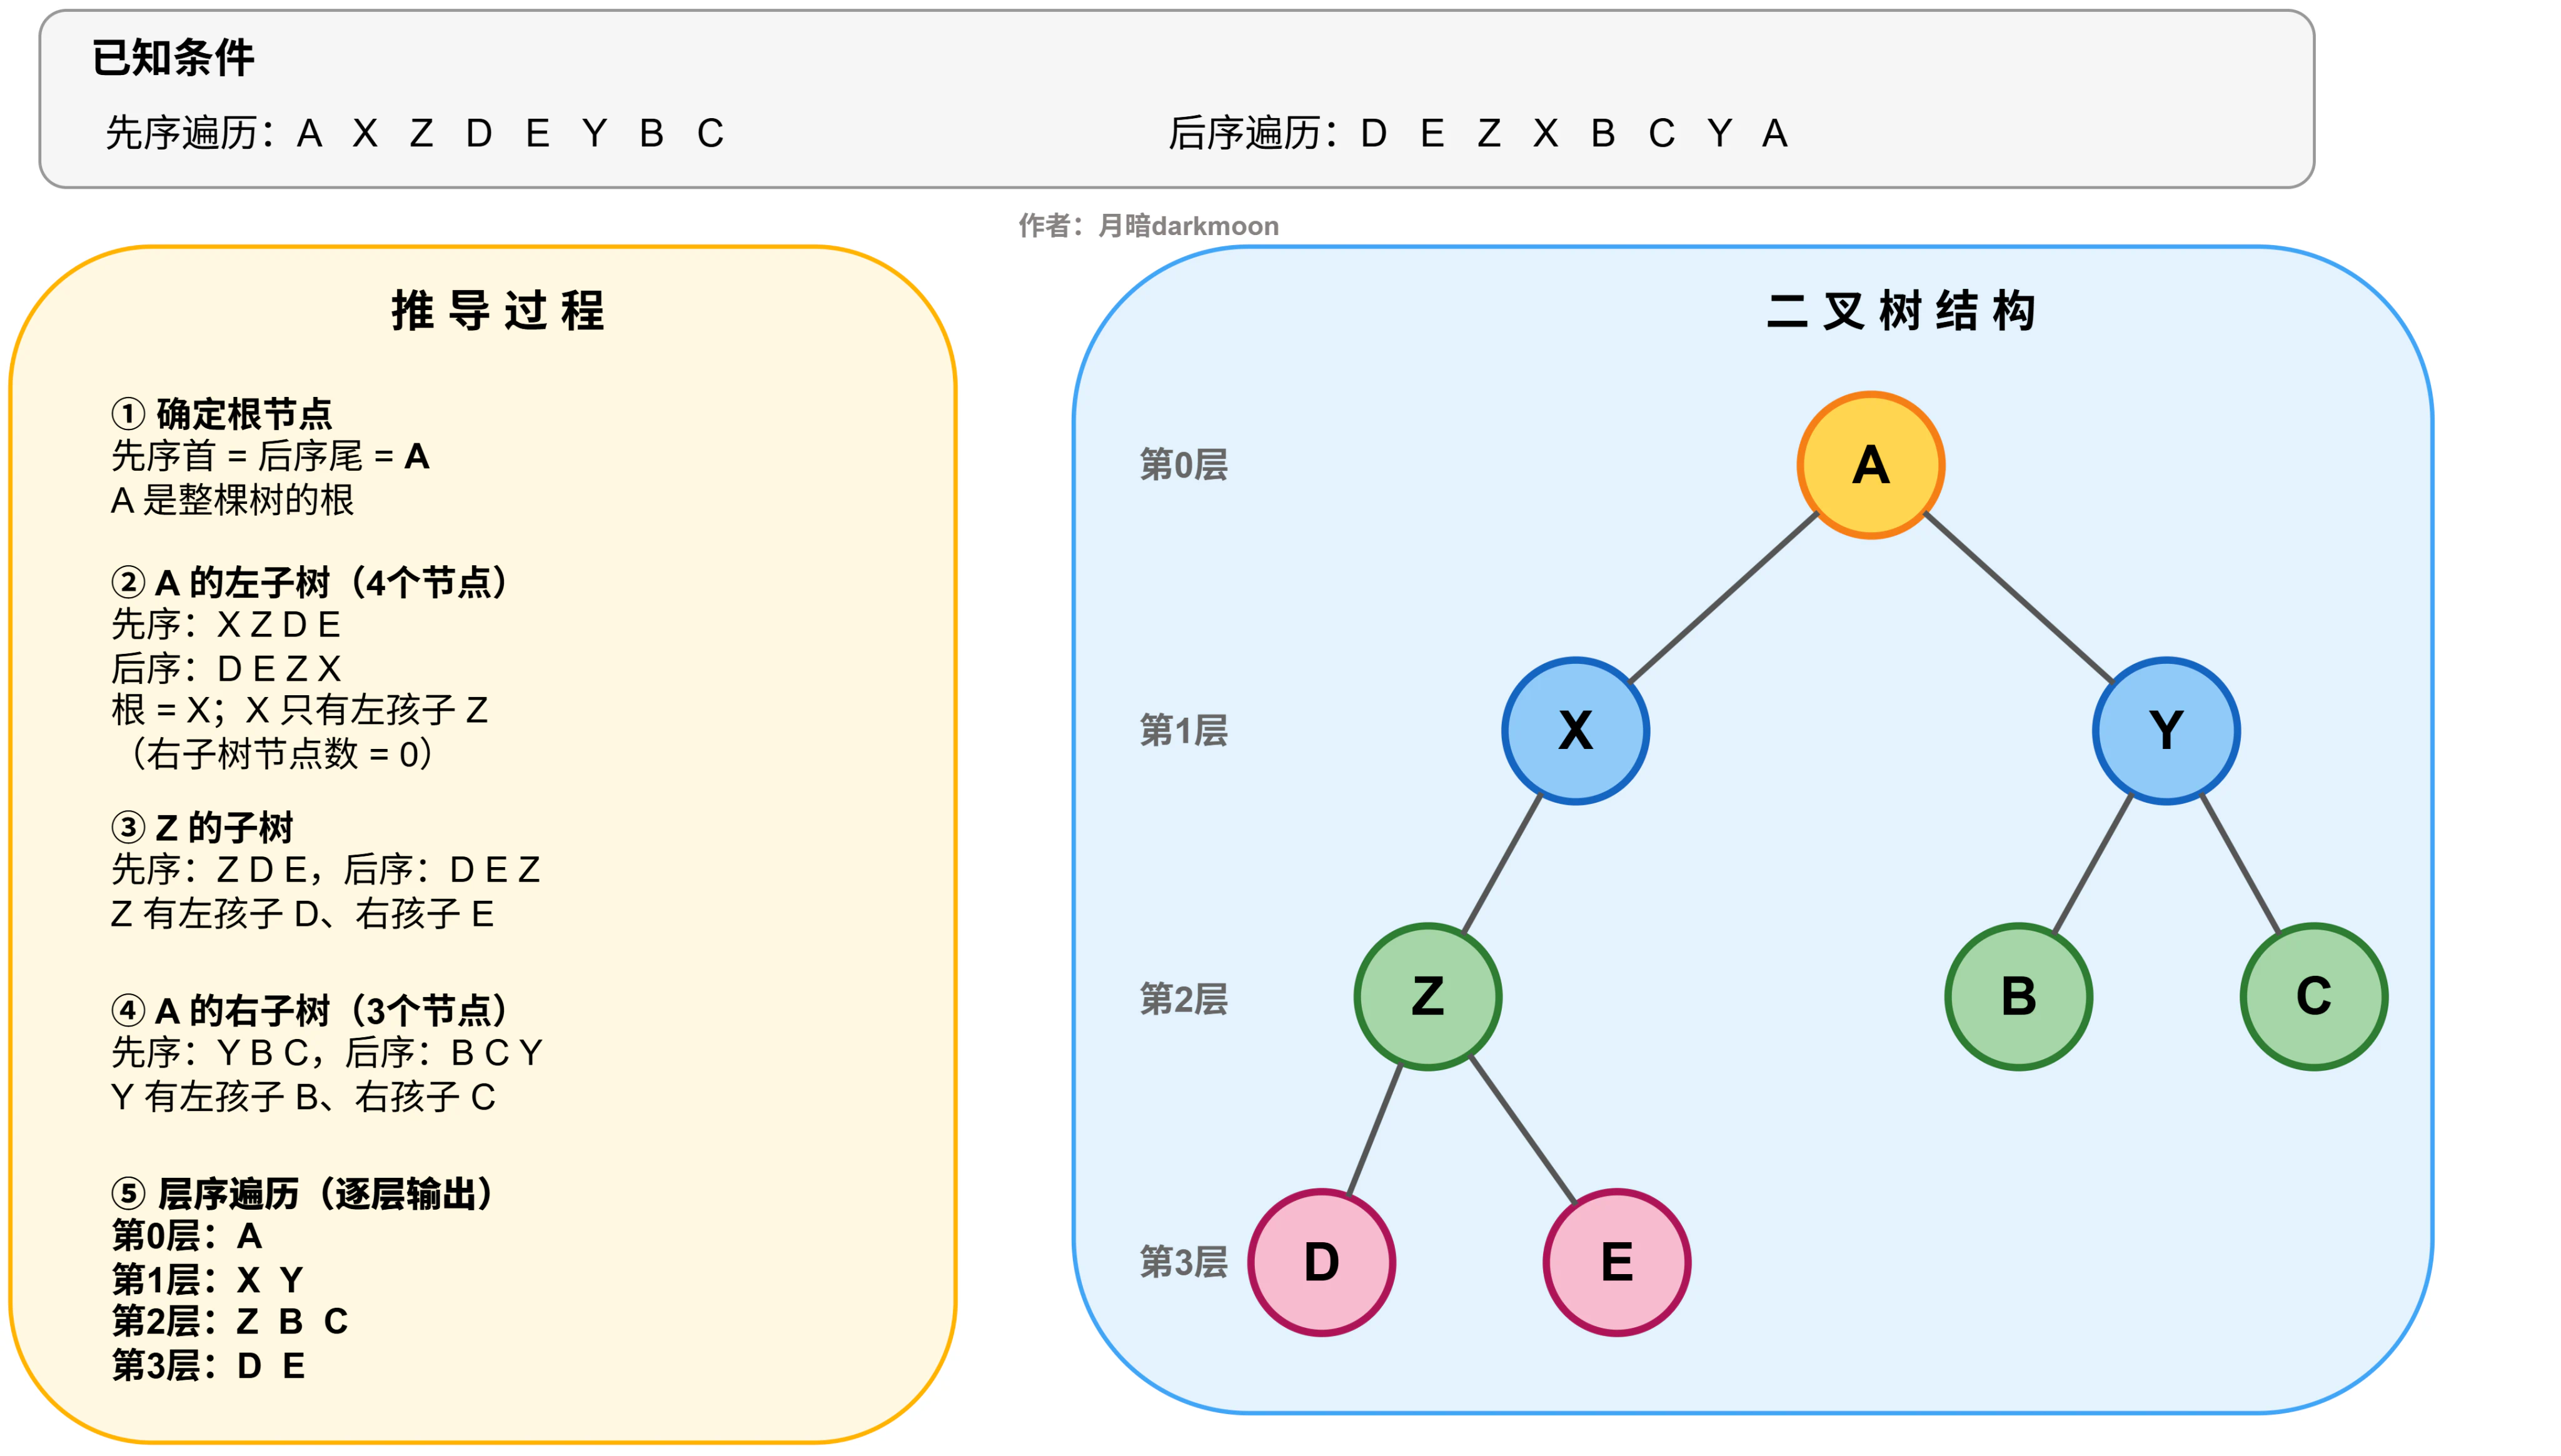
- 已知一棵二叉树的结点值互不相同,其先序遍历序列为: A X Z D E Y B C ,后序遍历序列为: D E Z X B C Y A ,则该二叉树的层序遍历序列是:
A. A X Y Z B C D E
B. A X Y Z D E B C
C. A X Z Y B C D E
D. A X Y B C Z D E
解析
答案:A
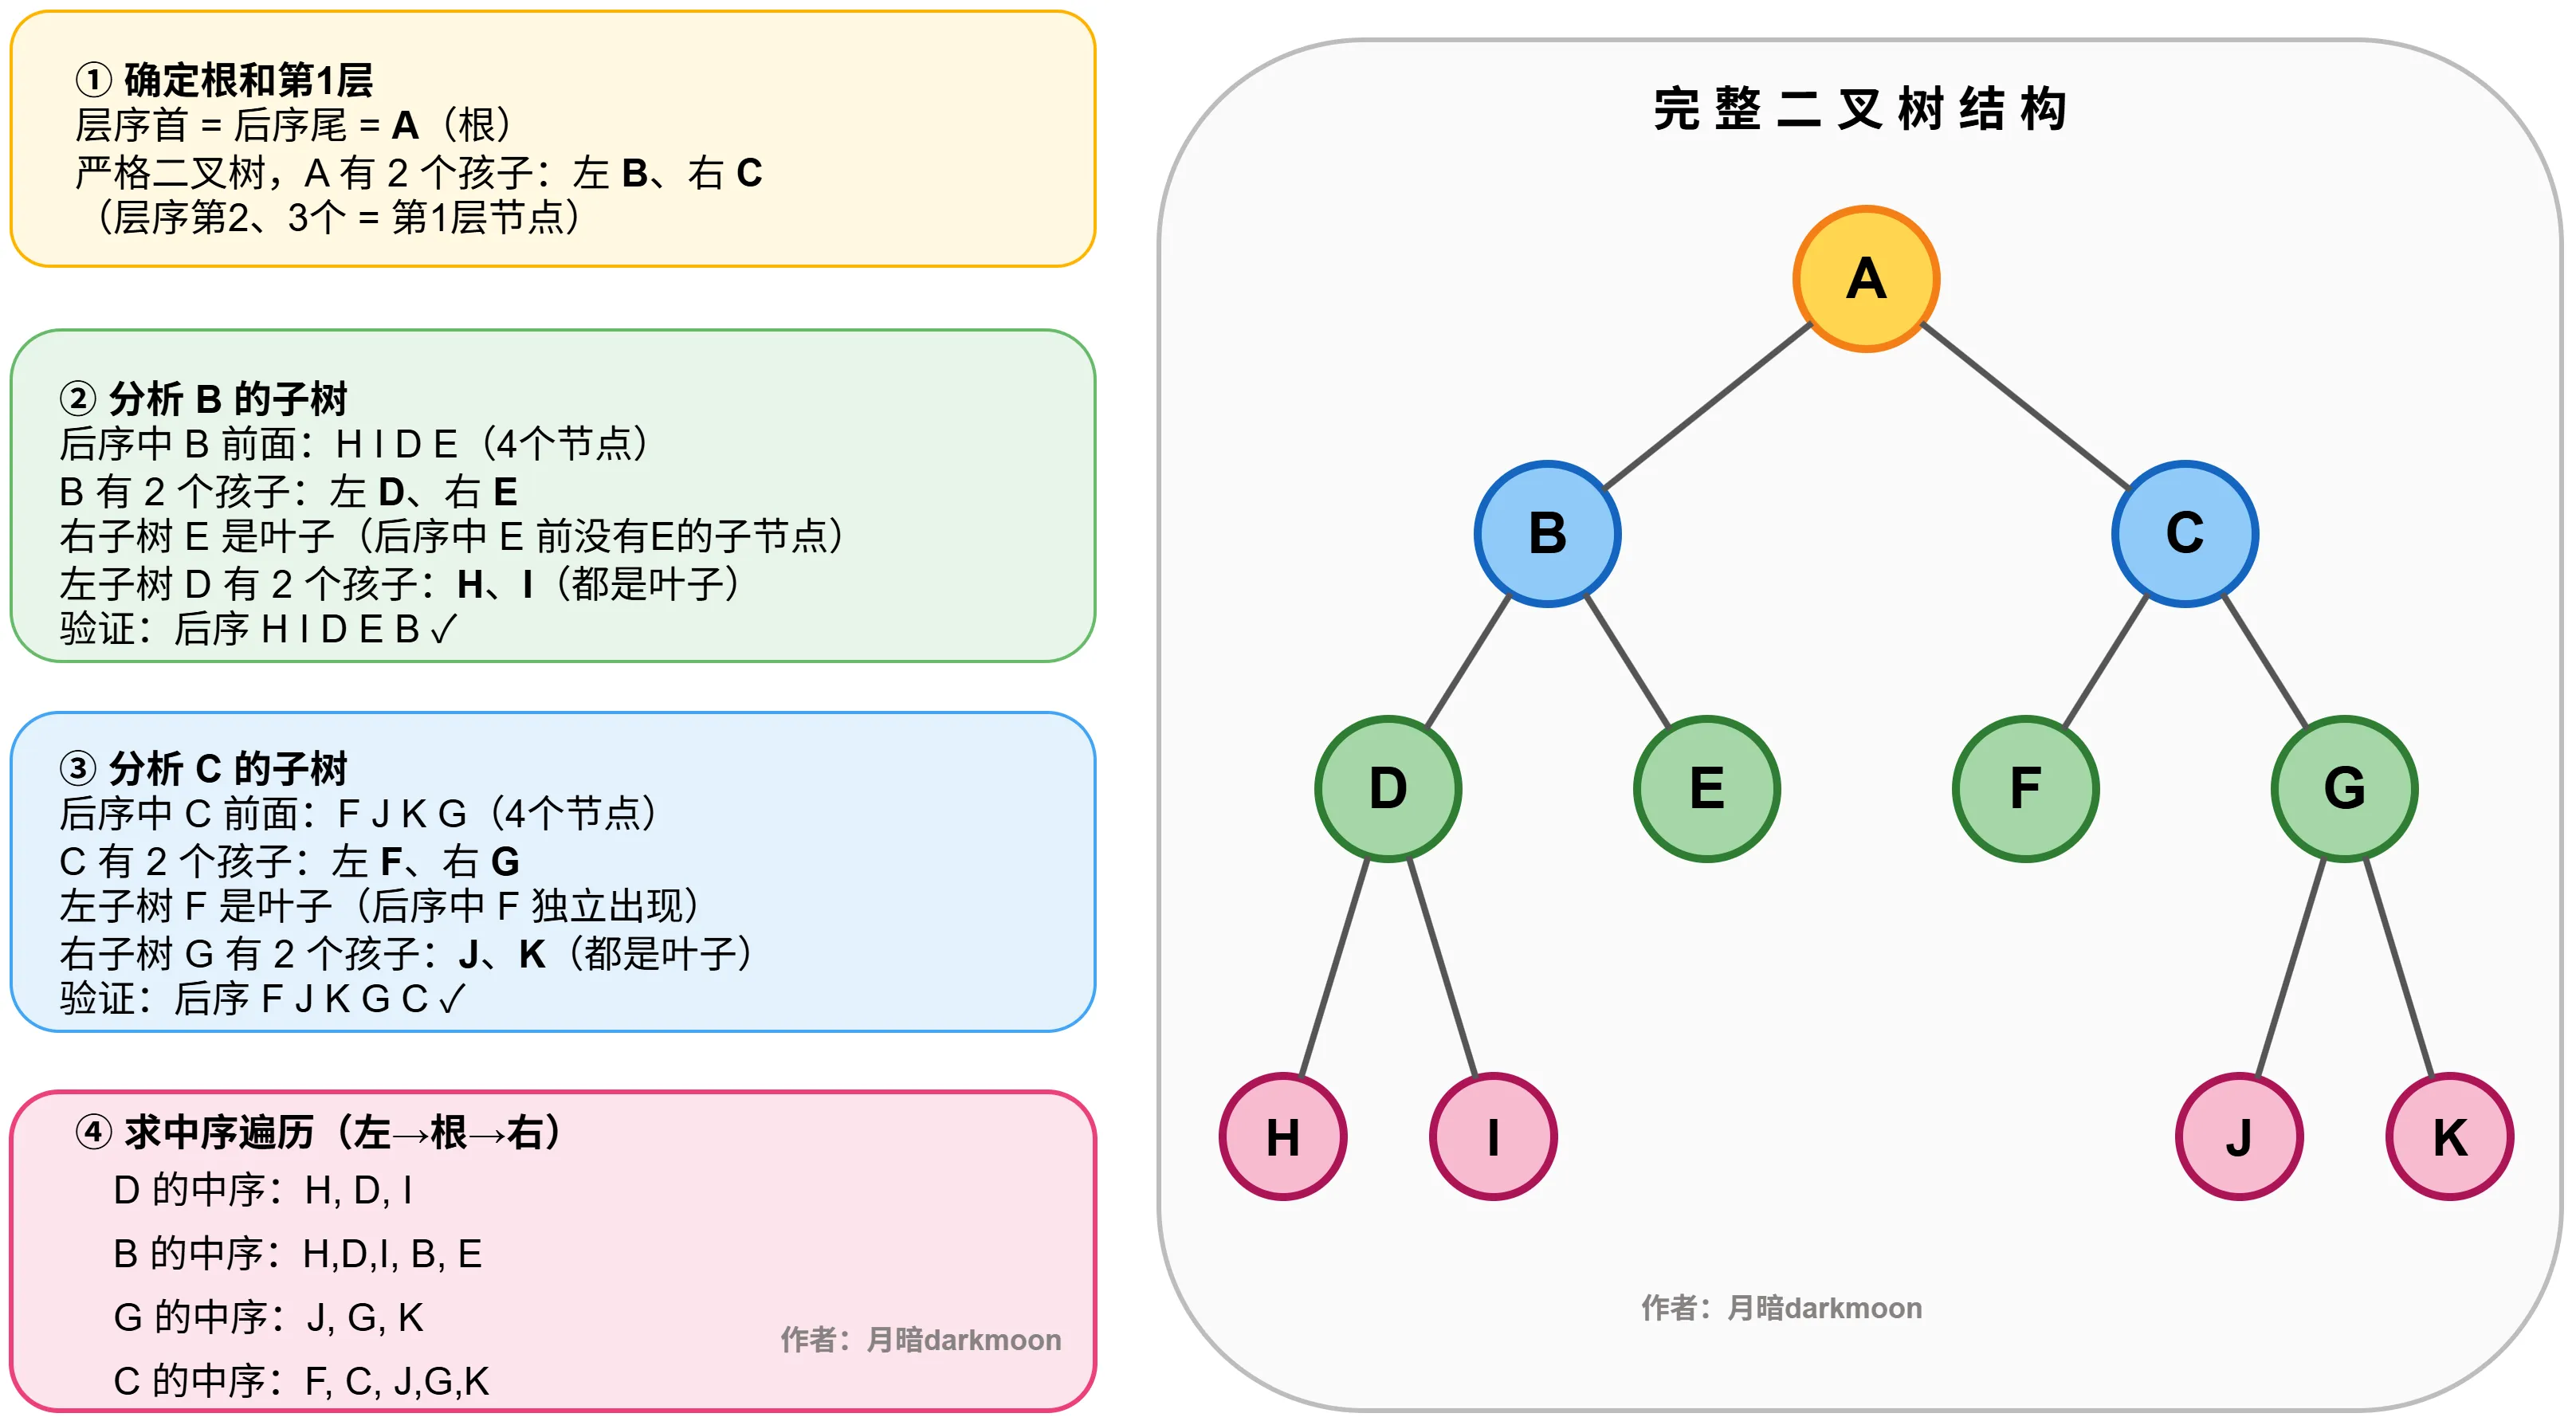
- 已知一棵结点值互不相同的严格二叉树中:
- 层序遍历:
A,B,C,D,E,F,G,H,I,J,K - 后序遍历:
H,I,D,E,B,F,J,K,G,C,A
则该二叉树的中序遍历序列是( )。
A. H,D,I,E,B,A,F,C,G,J,K\
B. H,D,I,B,E,A,F,C,G,J,K\
C. H,D,I,B,E,A,F,C,J,G,K\
D. H,I,D,B,E,A,F,C,J,G,K
解析
答案:C