哈夫曼树(HuffmanTree)
Warning
哈夫曼树又称最优二叉树,是一种带权路径长度最短的二叉树,广泛应用于数据压缩、编码等领域。
基本概念
在学习哈夫曼树之前,我们需要先掌握几个核心概念。
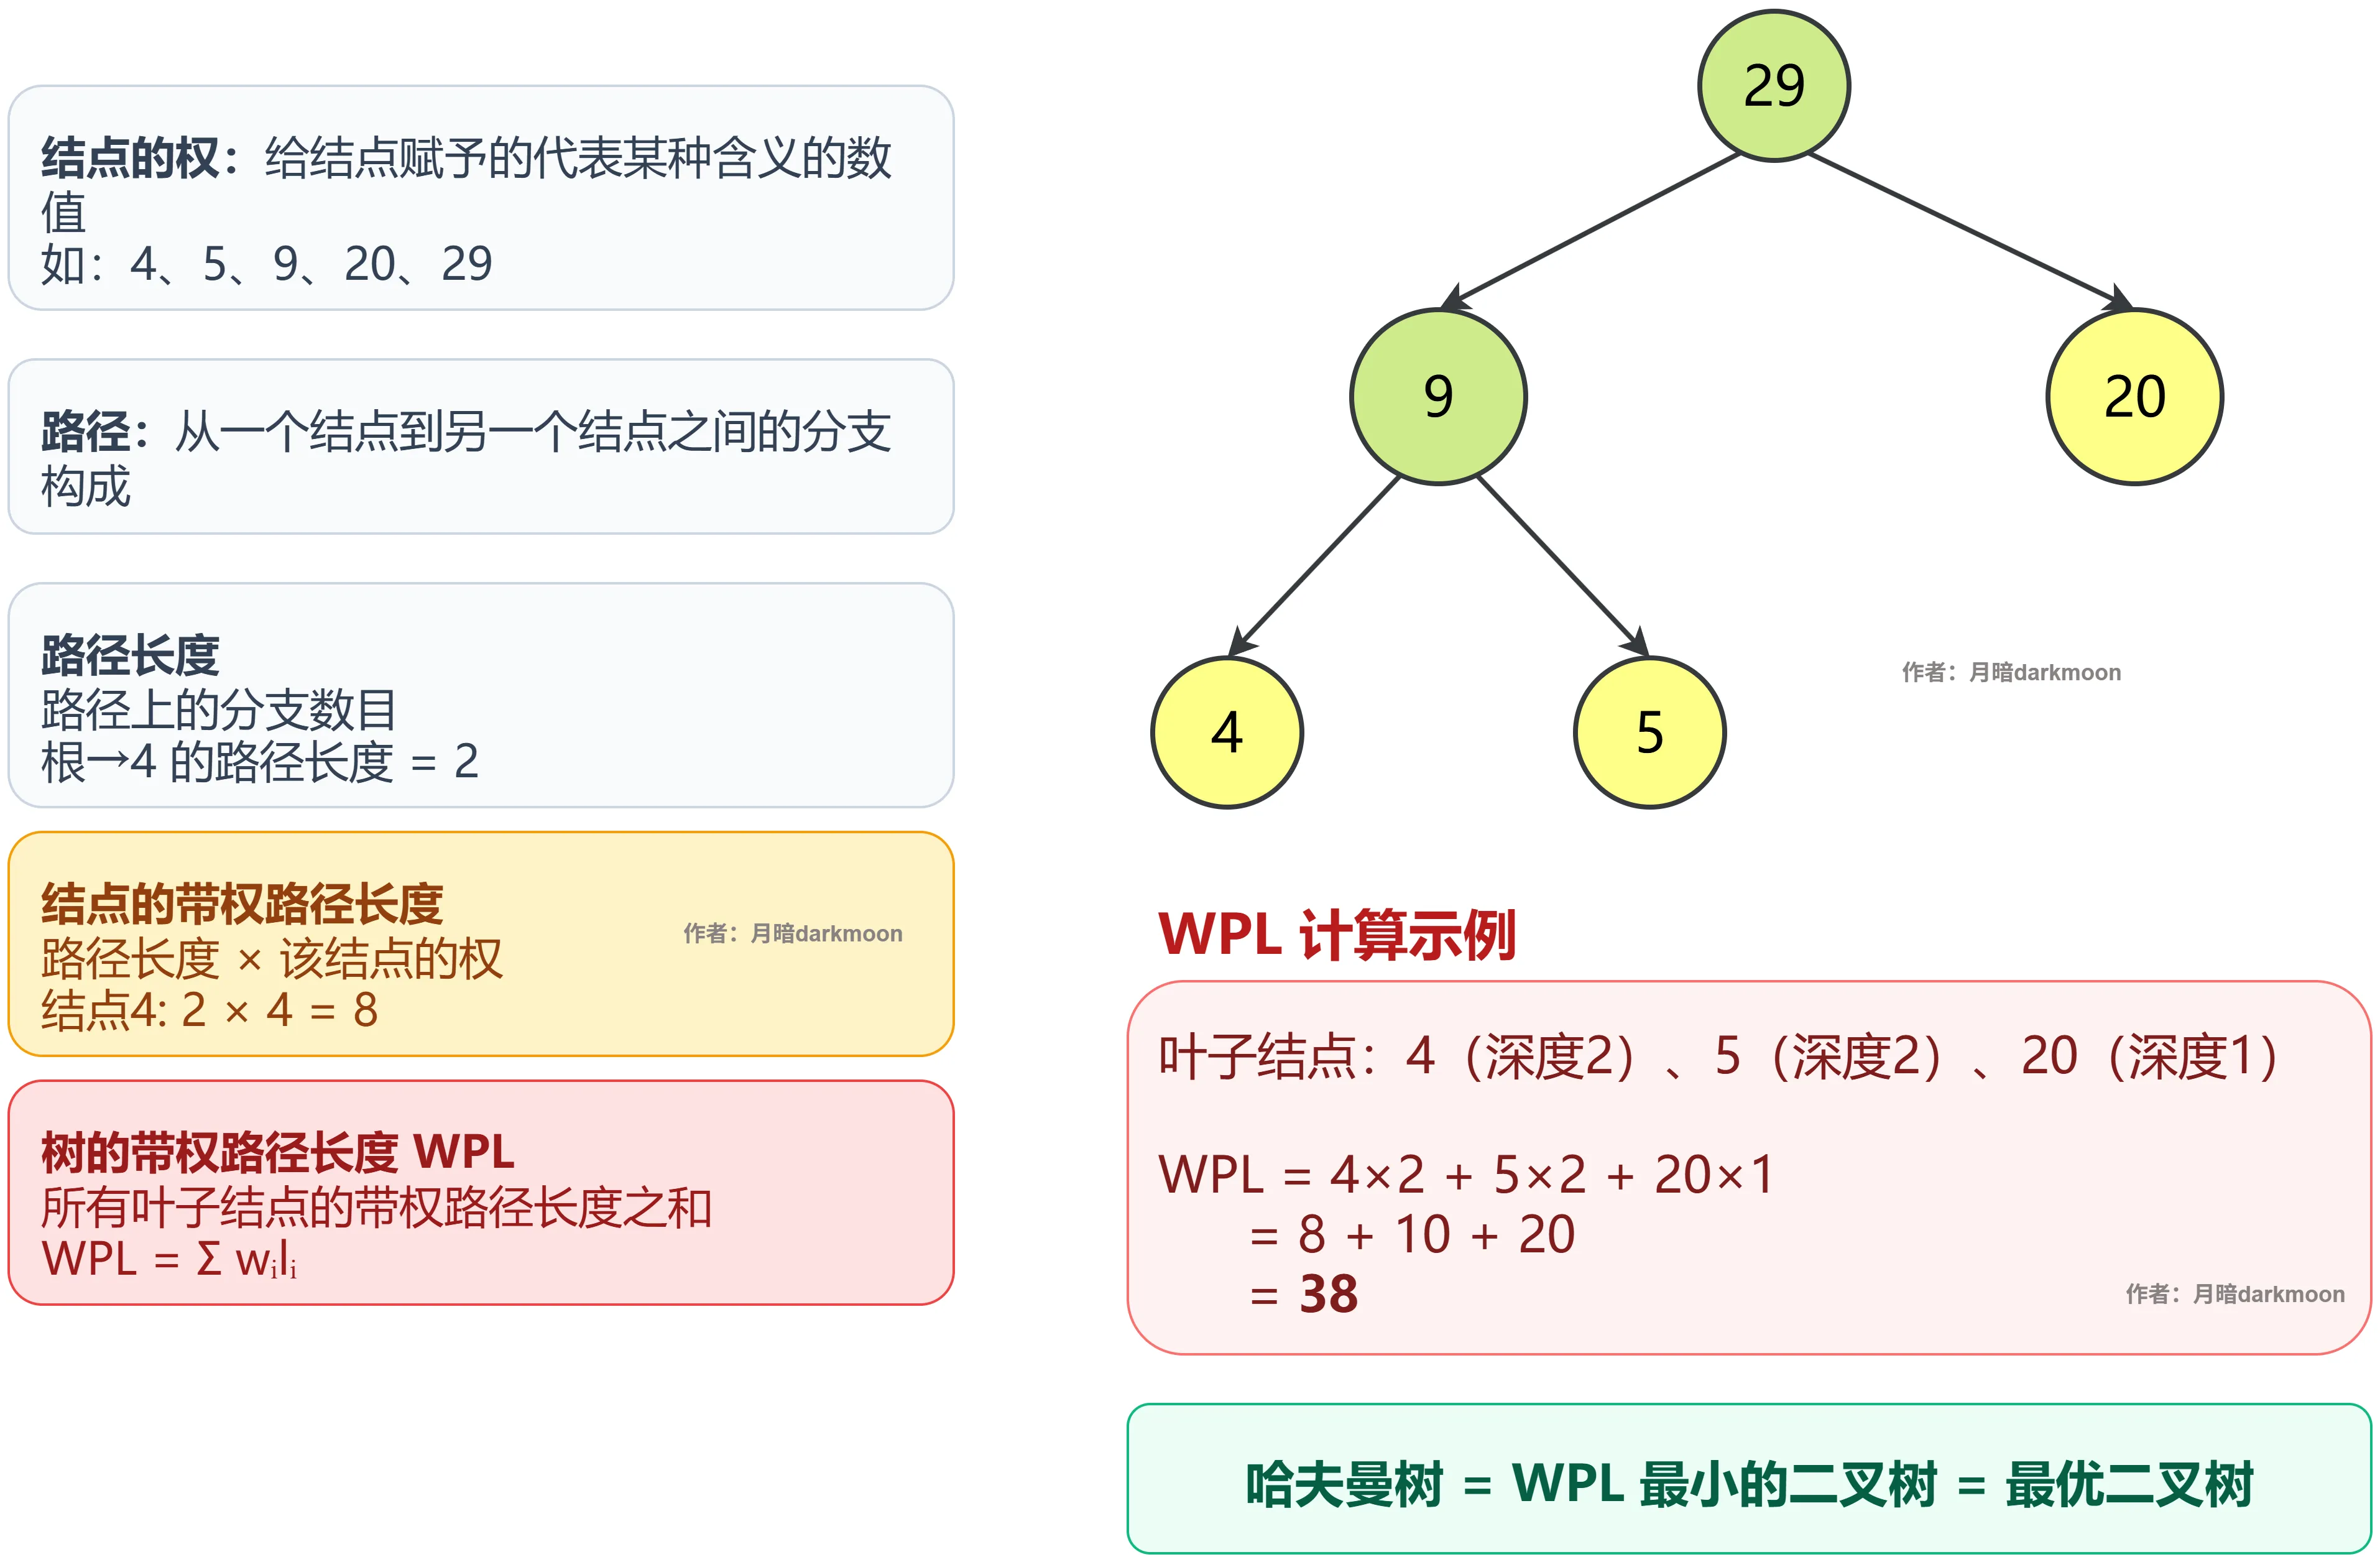
- 结点的权:在实际应用中,给树中的结点赋予代表某种含义的数值,将此数值称为该结点的权,有时也称权值。例如:
- 在文件压缩中,权可以表示字符出现的频率
- 在判定树中,权可以表示某个判断的概率
- 路径长度:路径上的分支数目称作路径长度。例如:从根结点到某叶子结点经过了 3 条边,则路径长度为 3。
- 结点的带权路径长度:从该结点到树根之间的路径长度与该结点的权的乘积\(\text{结点带权路径长度} = w_i \times l_i\),其中 \(w_i\) 是第 \(i\) 个结点的权值,\(l_i\) 是该结点到根的路径长度。
- 树的带权路径长度/加权外部路径长度(WPL):树中所有叶子结点的带权路径长度之和,记为:
\(WPL = \sum_{i=1}^{n_0} w_i l_i\),其中:\(n_0\) 指树中叶子结点的个数,\(w_i\) 指第 \(i\) 个叶子结点的权,\(l_i\) 指第 \(i\) 个叶子结点到根结点的路径长度
注意:WPL 只计算叶子结点,不计算内部结点!
哈夫曼树的定义
哈夫曼树(Huffman Tree) 也称为最优二叉树,指在 \(n_0\) 个带权叶子结点构成的所有二叉树中,带权路径长度(WPL)最小的二叉树。
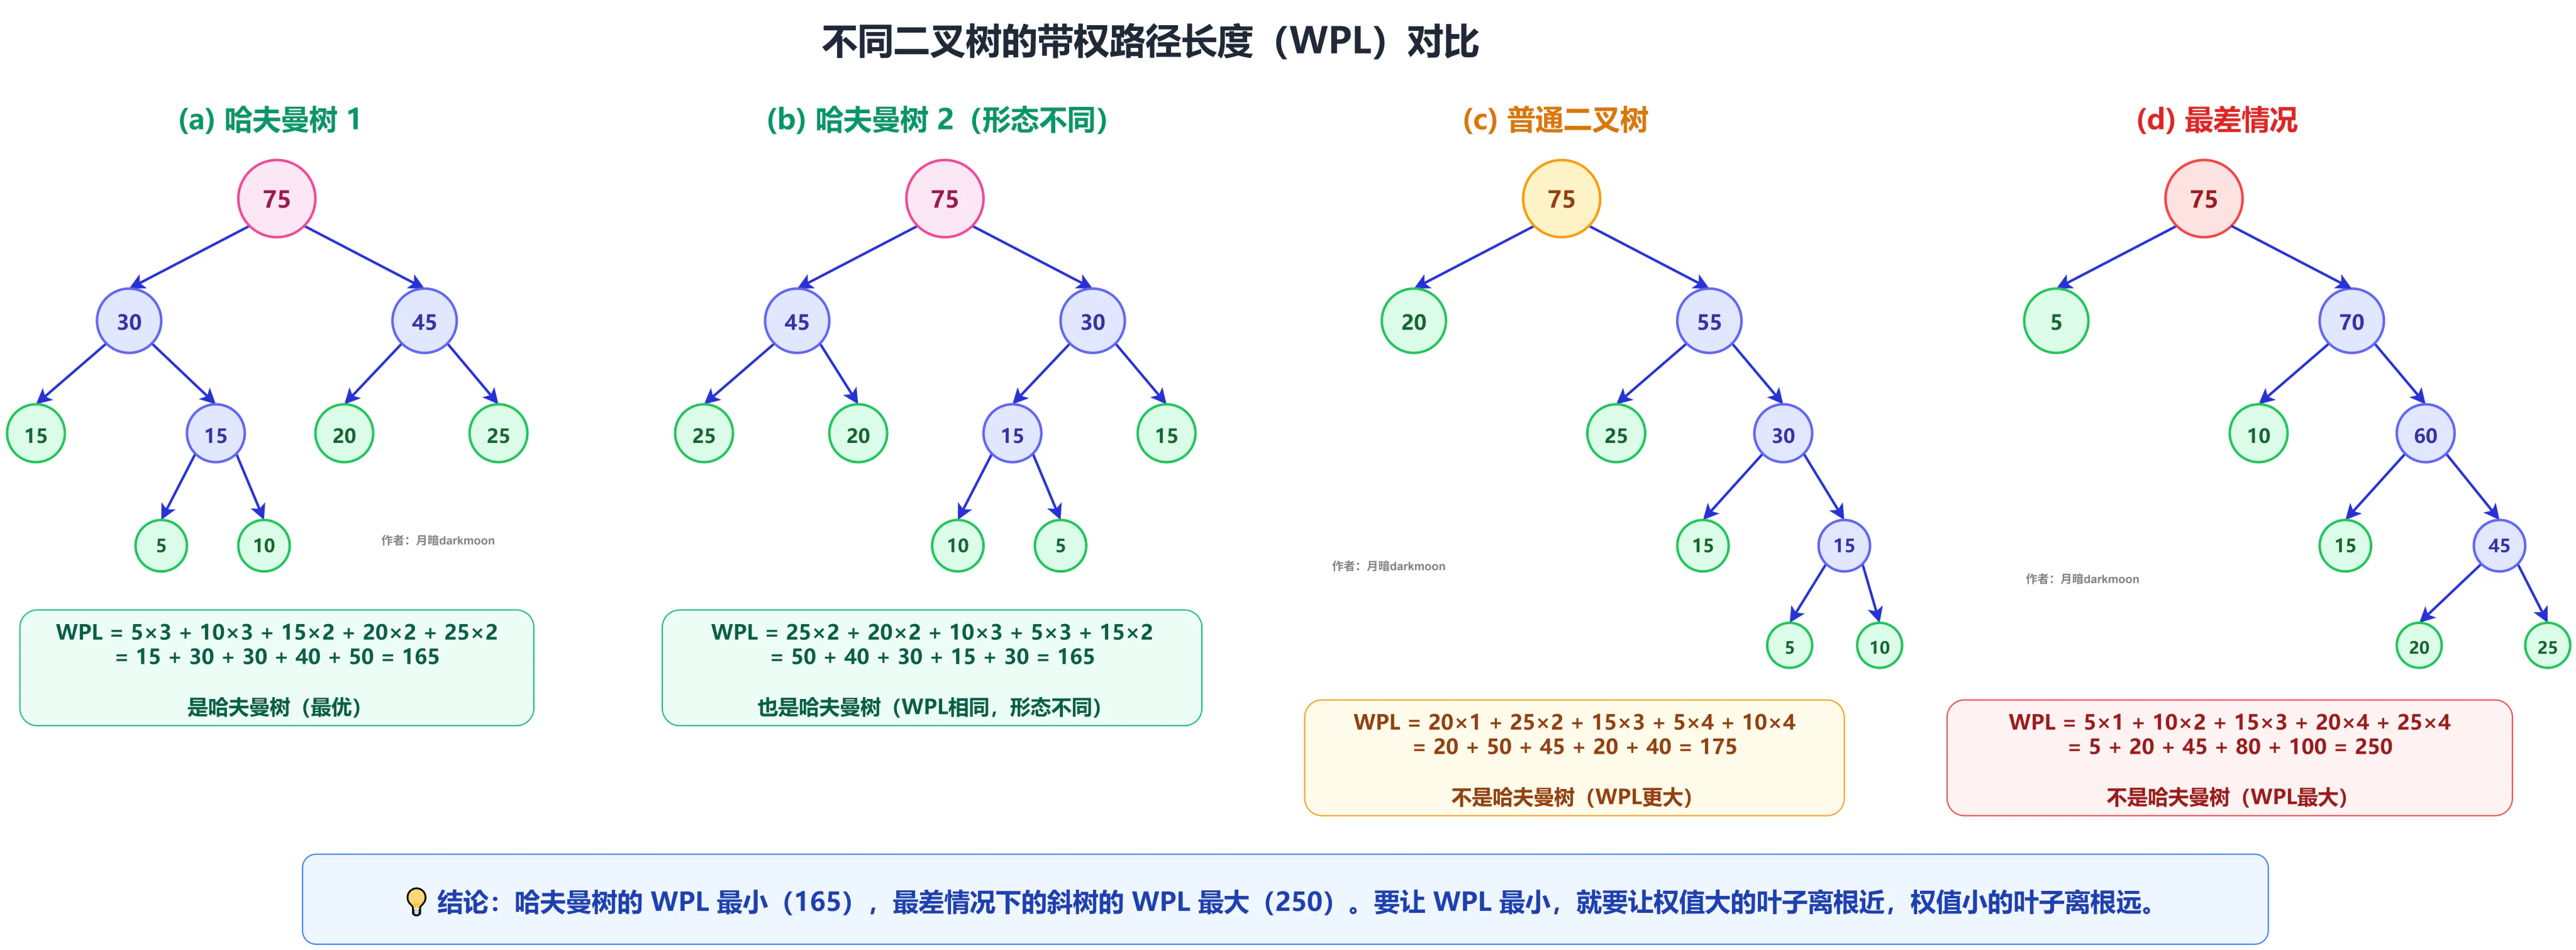
WPL 对比示例:假设有 5 个叶子结点,权值分别为 5、10、15、20、25,我们可以构造出多种不同形态的二叉树:
重要结论
- 哈夫曼树的形态不唯一:由 \(n_0\) 个叶子结点构成的二叉树中可以有多棵哈夫曼树,只要它们的 WPL 都是最小即可。
- 左右子树翻转仍是哈夫曼树:翻转哈夫曼树中所有结点的左右子树,就能得到新的二叉树,虽然它们有着同样的 WPL,故也是哈夫曼树。
- 权值大的叶子离根近:要让 WPL 小,就要让权值大的叶结点尽可能离根结点近(路径短),权值小的叶结点尽可能离根结点远(路径长)。
哈夫曼树的构造算法
构造步骤
由 \(n_0\) 个结点(权值分别为 \(w_1, w_2, \dots, w_{n0}\))构造哈夫曼树的算法描述如下:
- 初始时,构造一个含有 \(n_0\) 棵二叉树的森林 \(F = \{T_1, T_2, \dots, T_{n0}\}\),\(F\) 中每棵树 \(T_i\) 都只有一个结点且该结点权为 \(w_i\),即:二叉树 \(T_i\) 的根结点权值为 \(w_i\)。
- 从森林\(F\)中,按如下规则依次选取两棵根结点权值最小的树\(T_x\)和\(T_y\)(选 2 次,可利用小顶堆实现):
- 在 \(F\) 中选取一棵根结点权值最小的二叉树,赋给 \(T_x\)。从 \(F\) 中删除刚选出的二叉树 \(T_x\)。
- 再次从 \(F\) 中选取一棵根结点权值最小的二叉树,赋给 \(T_y\)。从 \(F\) 中删除刚选出的二叉树 \(T_y\)。
- 构造一个新结点\(T_j\),将 \(T_x\) 作为 \(T_j\) 的左子树,将 \(T_y\) 作为 \(T_j\) 的右子树。\(T_j\) 的权值等于 \(T_x\) 根结点权值加上 \(T_y\) 根结点权值。并将 \(T_j\) 加入森林 \(F\) 中。
- 重复步骤 2 和 3,直到 \(F\) 中仅剩下一棵树时停止。最后剩下的那棵树就是哈夫曼树。
构造过程示例
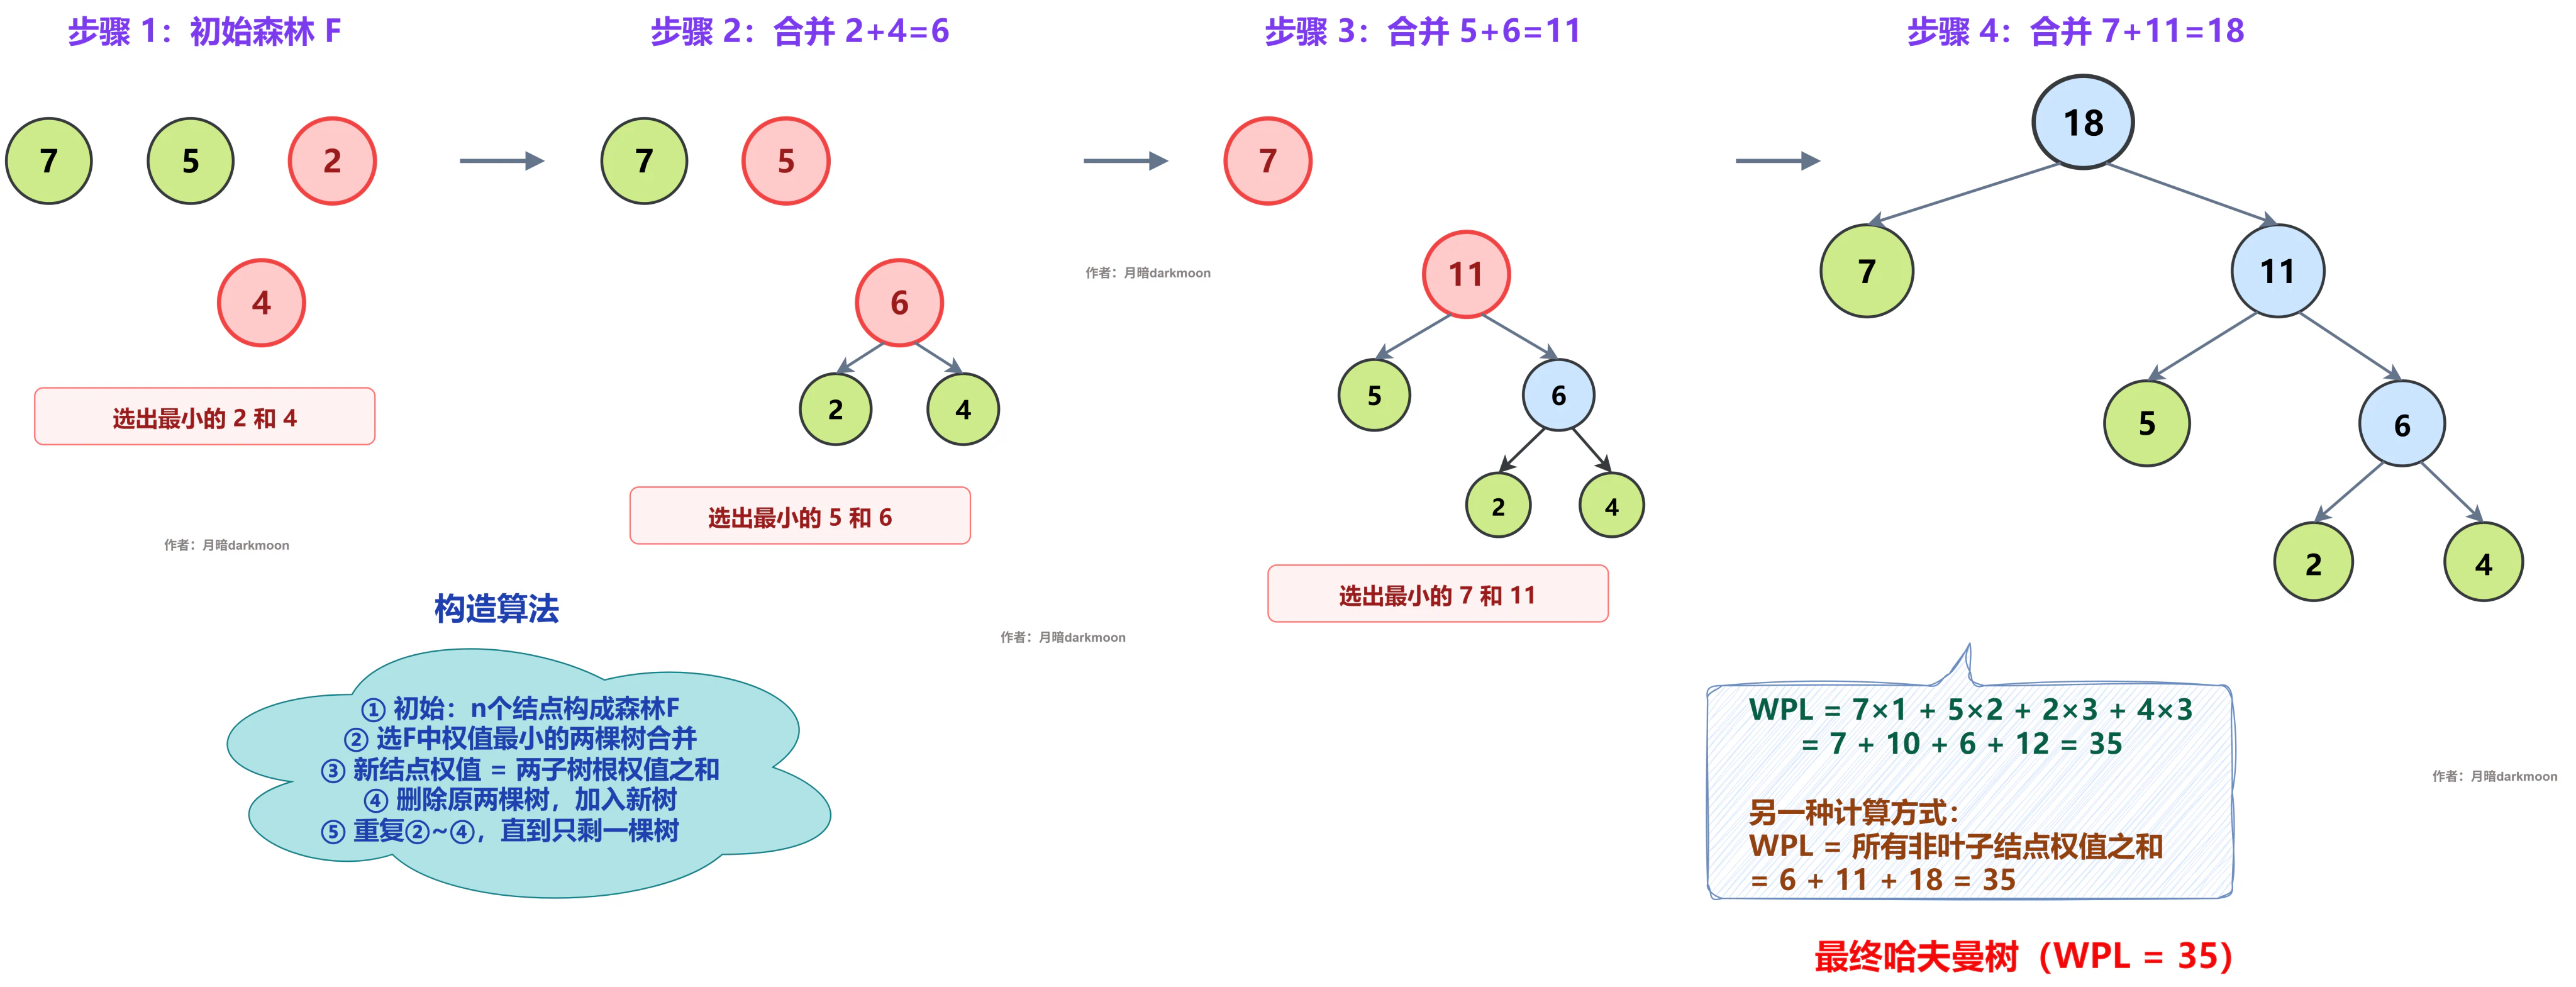
以权值 {7, 5, 2, 4} 为例,构造哈夫曼树的完整过程:
详细步骤:
| 步骤 | 森林 F | 操作 |
|---|---|---|
| 1 | {7, 5, 2, 4} | 初始森林,4棵树各一个结点 |
| 2 | {7, 5, 6} | 选最小的 2 和 4 合并,新结点权值 = 2+4 = 6 |
| 3 | {7, 11} | 选最小的 5 和 6 合并,新结点权值 = 5+6 = 11 |
| 4 | {18} | 选 7 和 11 合并,新结点权值 = 7+11 = 18 |
WPL 计算:\(WPL = 7 \times 1 + 5 \times 2 + 2 \times 3 + 4 \times 3 = 7 + 10 + 6 + 12 = 35\)
WPL 的另一种计算方式
哈夫曼树的带权路径长度也等于所有非叶子结点的权值之和:\(WPL = 6 + 11 + 18 = 35\)
原理:每次合并两个结点时,新结点的权值会被"累加"到所有子结点的路径长度中。实际上可以将分支结点的权重和不断拆分,最后就变成了所有叶子结点的带权路径长度之和。
哈夫曼树的性质
性质 1:结点总数公式:若哈夫曼树中有 \(n_0\) 个叶结点,则总共有 \(2 \times n_0 - 1\) 个结点,且度为 2(构造过程中新建立的)的结点数为 \(n_0 - 1\)。
推导:
- 二叉树的性质:\(n_0 = n_2 + 1\)(叶子结点数 = 度为2的结点数 + 1)
- 哈夫曼树没有度为 1 的结点
- 总结点数 \(n = n_0 + n_2 = n_0 + (n_0 - 1) = 2n_0 - 1\)
性质 2:严格二叉树:哈夫曼树也称为严格二叉树或正则二叉树,树中结点的度均为 0 或 2,没有度为 1 的结点
性质 3:权值单调性:在哈夫曼树中,上一层所有结点的权值均不小于下一层。哈夫曼树是由所有的叶子结点、按照哈夫曼树构造算法生成的。
换句话说:越靠近根的结点,权值越大。
补充:哈夫曼树的不唯一性
- 形态不唯一:左右子树可以互换,仍是哈夫曼树
- WPL 唯一:无论形态如何,最小 WPL 是确定的
- 高度不唯一:不同形态的哈夫曼树高度可能不同
- 合并顺序影响形态:权值相同时,选择顺序不同会导致不同的树
m叉哈夫曼树
可以将哈夫曼树扩展到 \(m\) 叉哈夫曼树,此时每个结点最多可以有 \(m\) 个子结点。
补充结点公式
由 \(n_0\) 个初始结点,构造 \(m\) 叉哈夫曼树的算法描述如下:
- 首先计算 \(t = (n_0 - 1) \bmod (m - 1)\)。若 \(t\) 不为 0,则补充 \(m - 1 - t\) 个权为 0 的结点到初始结点中;若 \(t\) 为 0,则无需添加结点。
- 每次构造 1 个新的结点,并从全部结点中取出 \(m\) 个权值最小的结点,作为新结点的孩子结点,新结点的权为各孩子结点的权之和。再将新结点加入总的结点中。这一过程移除了 \(m\) 个结点,新加 1 个结点,故结点减少 \(m - 1\) 个。
- 重复上一操作,直到只剩下一个结点,此时 \(m\) 叉哈夫曼树构造完毕。
为什么要补充结点?
补充权为 0 的结点是为了保证最后一次合并正好是\(m\)个结点,使得构造出的树是真正的 \(m\) 叉哈夫曼树(根结点恰好有 \(m\) 个孩子)。
三叉哈夫曼树示例
以权值 {4, 5, 6, 7} 构造三叉哈夫曼树:\(n_0 = 4, m = 3\),\(t = (4 - 1) \bmod (3 - 1) = 3 \bmod 2 = 1\), 需要补充:\(m - 1 - t = 2 - 1 = 1\) 个权为 0 的结点,补充后结点:{0, 4, 5, 6, 7}
构造过程:
- 选最小的 0, 4, 5 合并为 9,森林 {6, 7, 9}
- 选 6, 7, 9 合并为 22,得到三叉哈夫曼树
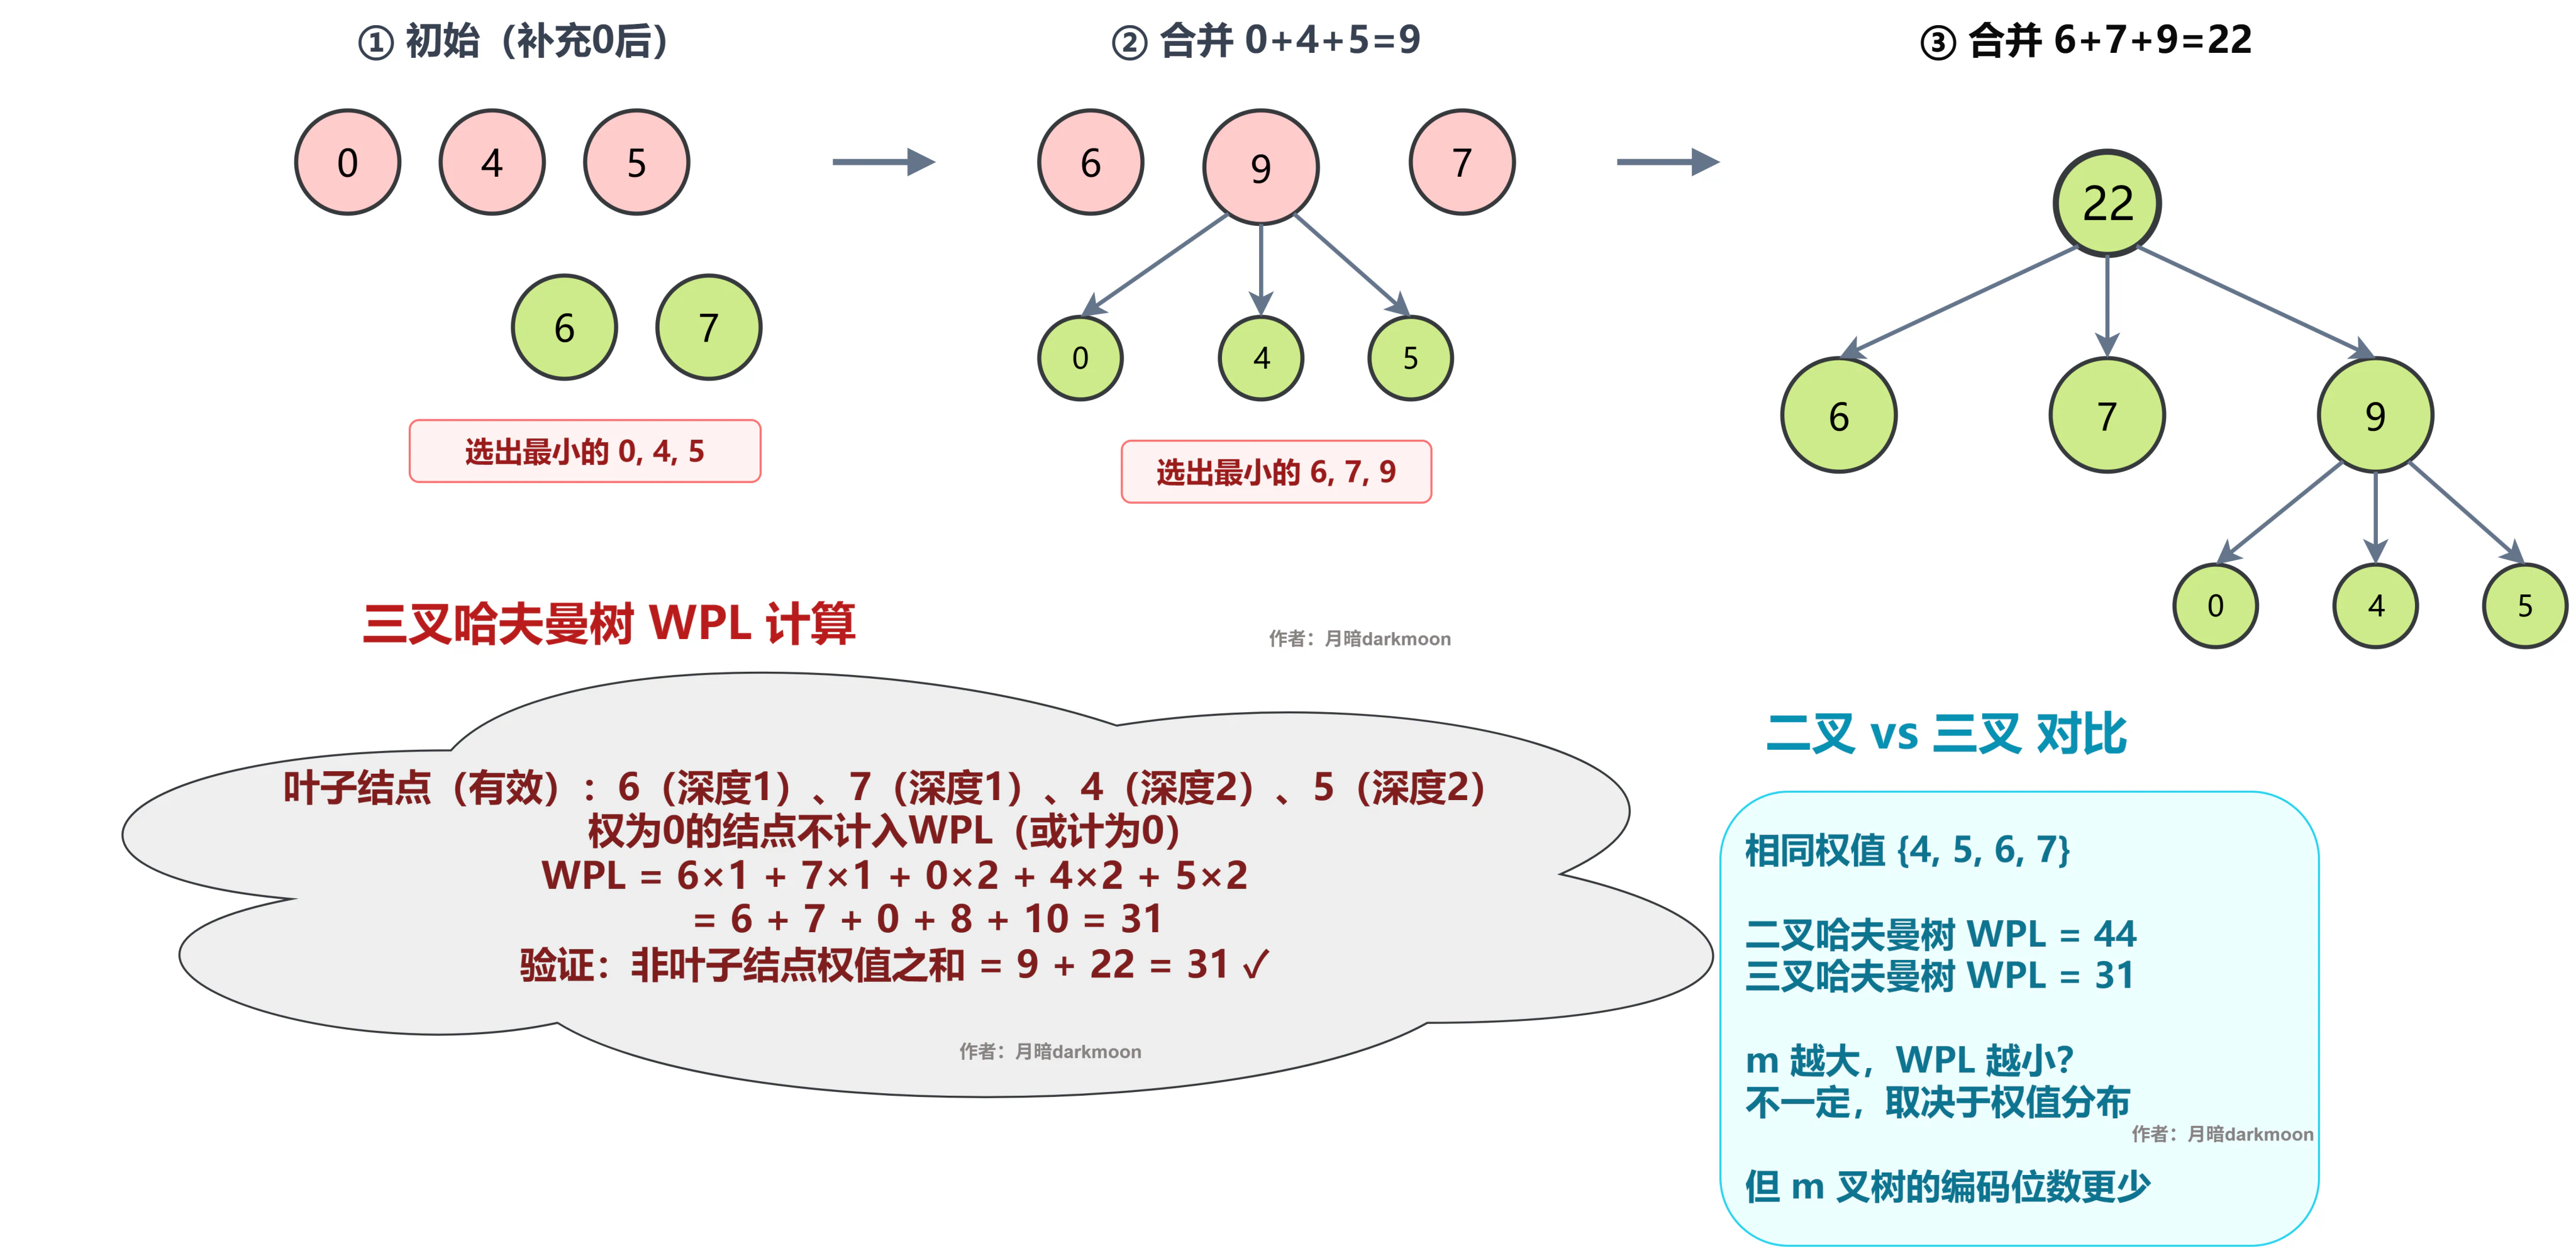
WPL 计算:\(WPL = 6 \times 1 + 7 \times 1 + 0 \times 2 + 4 \times 2 + 5 \times 2 = 6 + 7 + 0 + 8 + 10 = 31\)
注意:权为 0 的结点是为了凑数补充的,它们不影响实际 WPL(因为 0 乘以任何数都是 0)。
哈夫曼编码
编码相关概念
在介绍哈夫曼编码之前,先介绍一些相关概念:
编码
将数据转换成由 0 或 1 组成的二进制字符串的过程称为编码。
前缀编码
在对数据进行编码时,为了能根据编码准确还原出原来的数据(也就是解码),通常使用前缀编码方式。在前缀编码中,没有任何一个编码是其他某个编码的前缀。
例如,对字符集 {A, B, C},若其对应的编码方案为 {A=0, B=10, C=11},则该编码方案是前缀编码。
前缀编码的解码过程:从左到右读取,每遇到一个编码就将其解码,直至所有字符都被解码。
假设有编码:011100,则解码为 ABCBA。
口诀:前缀编码不是前缀!
哈夫曼编码的定义
哈夫曼编码(Huffman Coding):对一棵具有 \(n_0\) 个叶子的哈夫曼树,若对树中的每个左分支赋予 0,右分支赋予 1(也可以是左分支赋予 1,右分支赋予 0),则从根到每个叶子的路径上,各分支的赋值分别构成一个二进制串,该二进制串就称为哈夫曼编码。
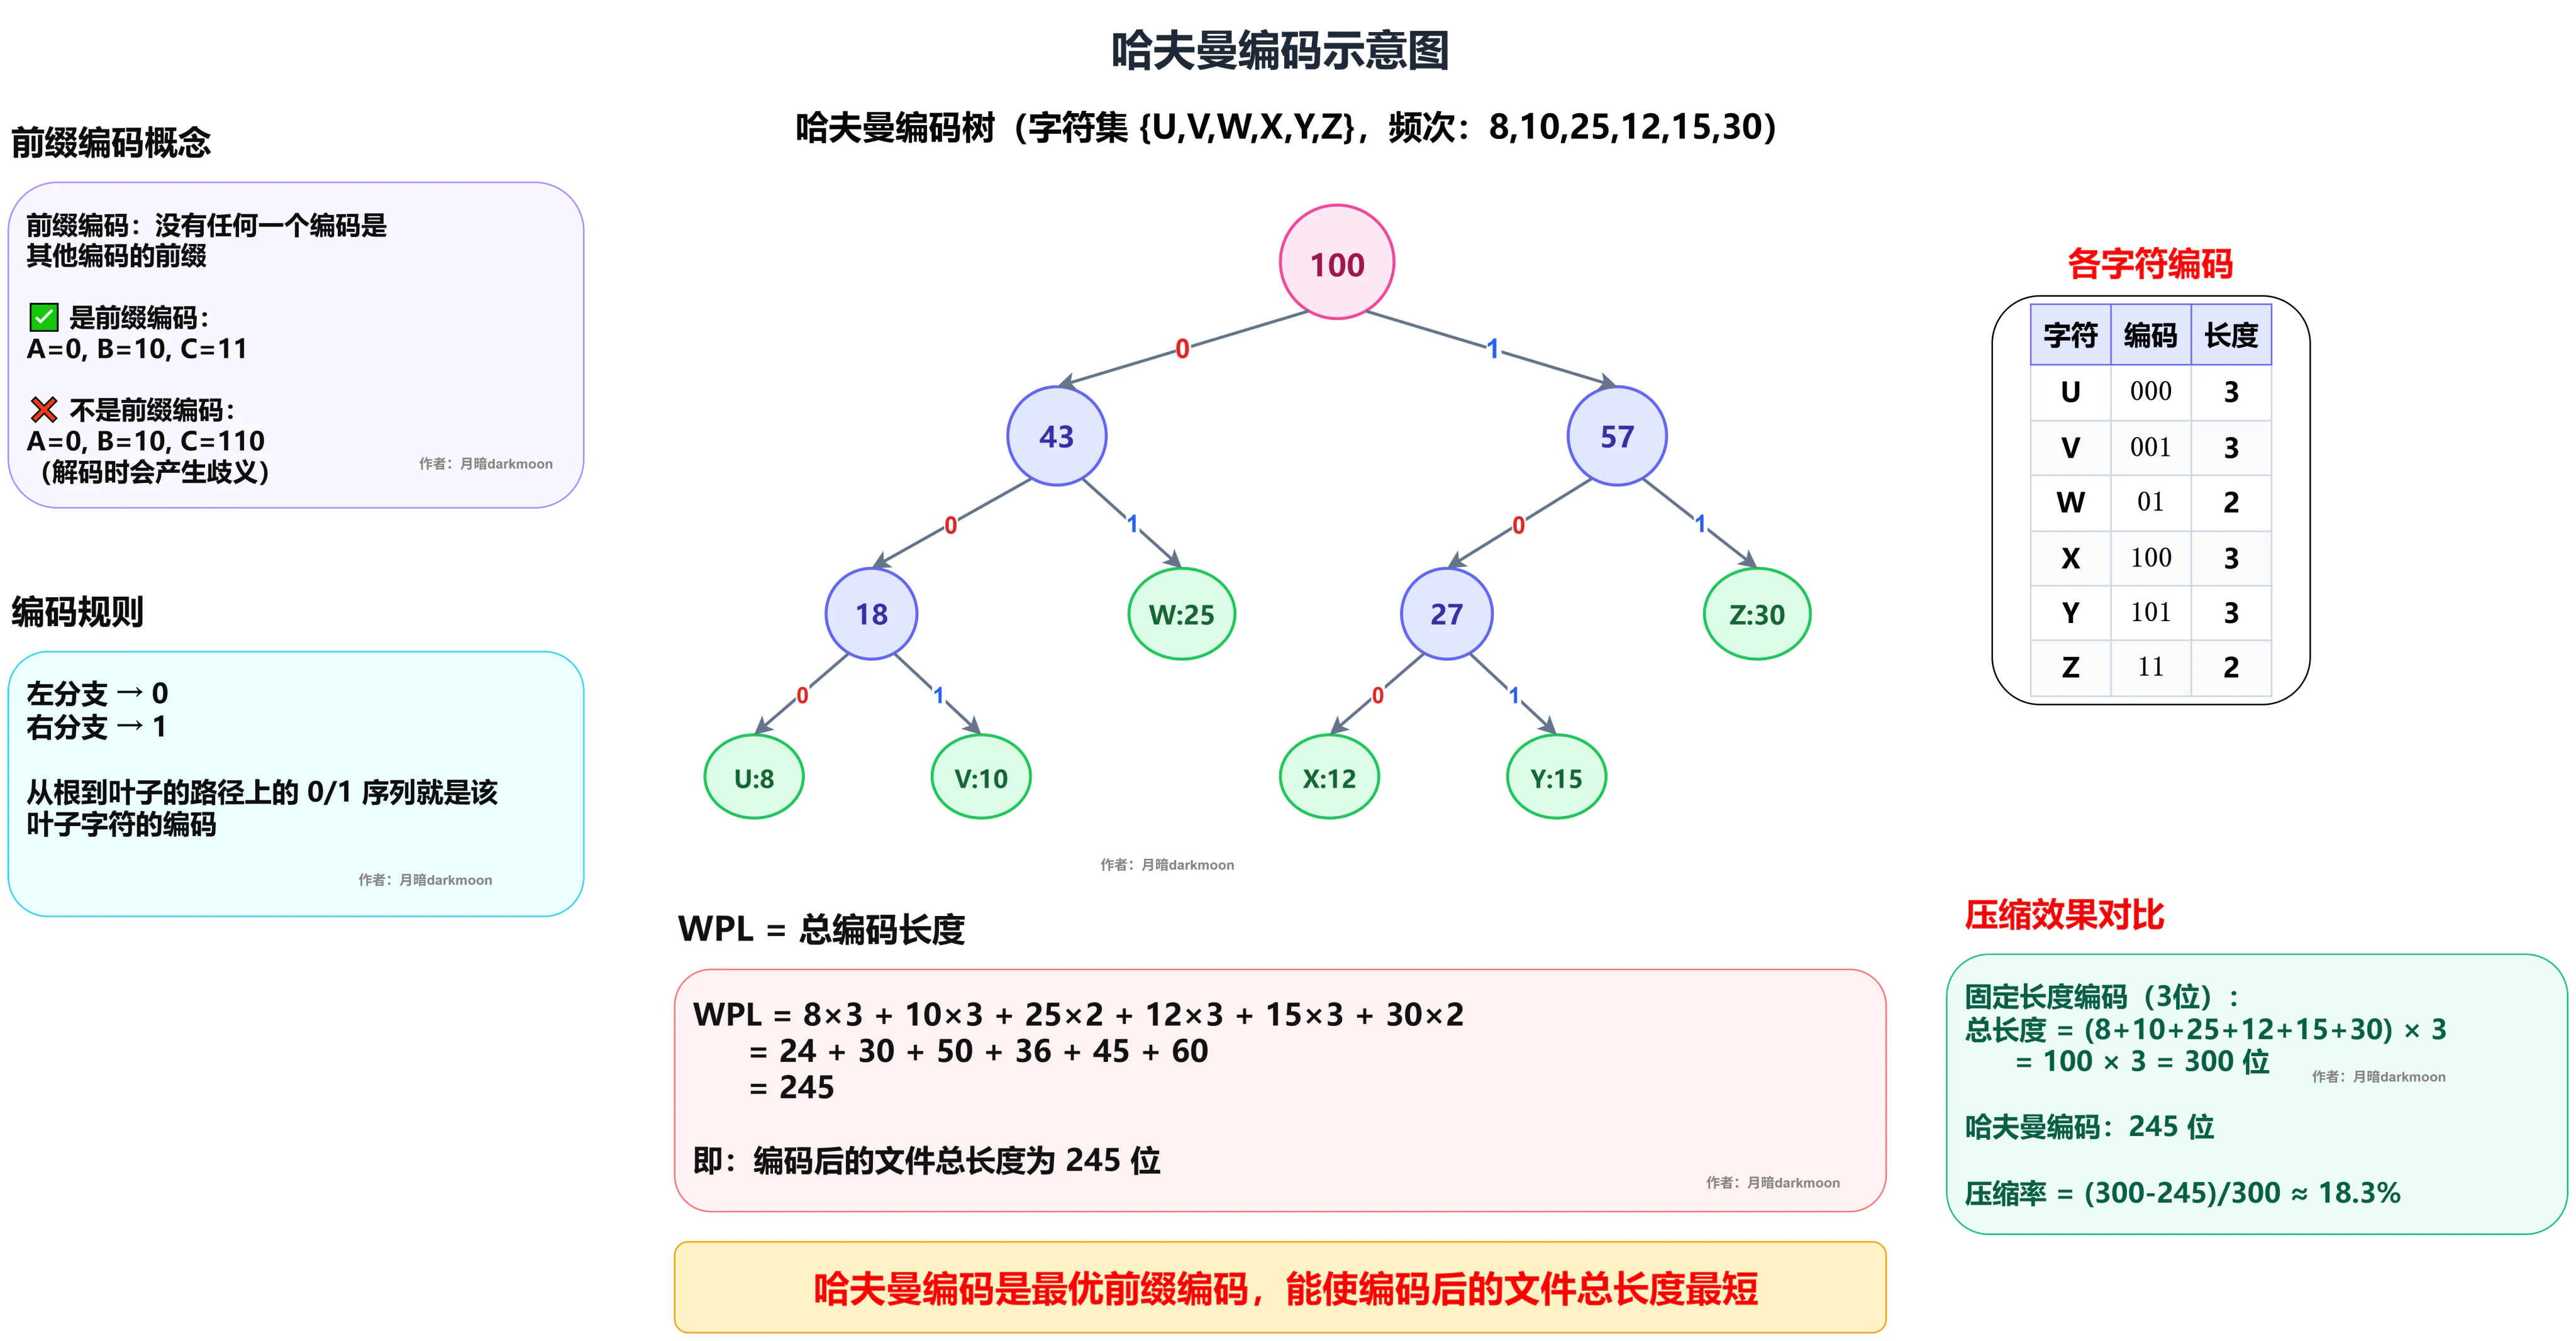
哈夫曼编码示例
若一个文件 \( f \) 由字符集 {U, V, W, X, Y, Z} 组成,每个字符在文件中出现的次数分别为:{8, 10, 25, 12, 15, 30}。
以每个字符出现的次数作为初始结点的权值,按照上面介绍的方法,构造出的哈夫曼树如上图所示。
构造过程:
- 初始权值排序:8, 10, 12, 15, 25, 30
- 合并最小的 8 和 10 → 新结点 18,剩余:12, 15, 18, 25, 30
- 合并最小的 12 和 15 → 新结点 27,剩余:18, 25, 27, 30
- 合并最小的 18 和 25 → 新结点 43,剩余:27, 30, 43
- 合并最小的 27 和 30 → 新结点 57,剩余:43, 57
- 合并 43 和 57 → 根结点 100,完成
各字符的编码(左0右1):
| 字符 | 出现次数 | 编码 | 编码长度 |
|---|---|---|---|
| U | 8 | 000 | 3 |
| V | 10 | 001 | 3 |
| W | 25 | 01 | 2 |
| X | 12 | 100 | 3 |
| Y | 15 | 101 | 3 |
| Z | 30 | 11 | 2 |
WPL = 总编码长度
哈夫曼树的带权路径长度(WPL)也就是文件的总编码长度:
\(WPL = 8 \times 3 + 10 \times 3 + 25 \times 2 + 12 \times 3 + 15 \times 3 + 30 \times 2\)
\(= 24 + 30 + 50 + 36 + 45 + 60 = 245\)
加权平均长度
加权平均长度(Average Code Length)是指在编码方案中,平均每个符号所占用的编码位数。它衡量的是单位符号的编码效率。
设共有 \(n\) 个符号,第 \(i\) 个符号的出现频次为 \(f_i\),编码长度为 \(l_i\),总频次为 \(F = \sum_{i=1}^{n} f_i\),则加权平均长度 \(L\) 为:\(L = \frac{\sum_{i=1}^{n} f_i \cdot l_i}{\sum_{i=1}^{n} f_i} = \frac{WPL}{F}\)
如果将频次标准化为概率 \(p_i = \frac{f_i}{F}\),也可以表示为:\(L = \sum_{i=1}^{n} p_i \cdot l_i\)
Note
加权平均长度越小,说明编码越高效。很多编码算法(如哈夫曼编码)的目标之一就是最小化加权平均长度。
示例:
| 符号 | 出现频次 \(f_i\) | 概率 \(p_i\) | 编码 | 编码长度 \(l_i\) |
|---|---|---|---|---|
| W | 40 | 0.4 | 0 | 1 |
| X | 30 | 0.3 | 10 | 2 |
| Y | 20 | 0.2 | 110 | 3 |
| Z | 10 | 0.1 | 111 | 3 |
计算一:加权路径长度(WPL)
\(WPL = 40 \times 1 + 30 \times 2 + 20 \times 3 + 10 \times 3 = 40 + 60 + 60 + 30 = 190 \text{ 位}\)
表示:整段编码文本总共用了 190 位。
计算二:加权平均长度
方法一(基于频次):\(L = \frac{WPL}{F} = \frac{190}{40 + 30 + 20 + 10} = \frac{190}{100} = 1.9 \text{ 位/符号}\)
方法二(基于概率):\(L = 0.4 \times 1 + 0.3 \times 2 + 0.2 \times 3 + 0.1 \times 3 = 0.4 + 0.6 + 0.6 + 0.3 = 1.9 \text{ 位/符号}\)
表示:平均每个符号的编码长度为 1.9 位。
对比总结
| 项目 | 值 | 单位 | 用途 |
|---|---|---|---|
| 加权路径长度(WPL) | 190 | 位(bit) | 衡量整体编码的总位数 |
| 加权平均长度(L) | 1.9 | 位/符号(bit/symbol) | 衡量单位符号的平均编码效率 |
💡 两者关系:加权路径长度和加权平均长度本质上描述的是相同的概念,只是表达形式不同——WPL 是总量,L 是平均值。两者可以通过总频次 \(F\) 相互换算:\(WPL = L \times F\)。
压缩效果对比
如果使用固定长度编码(每个字符用 3 位表示,因为有 6 个字符,\(2^3 = 8 \geq 6\)):\(\text{总长度} = (8 + 10 + 25 + 12 + 15 + 30) \times 3 = 100 \times 3 = 300 \text{ 位}\)
使用哈夫曼编码:245 位
压缩率:\(\text{压缩率} = \frac{300 - 245}{300} \approx 18.3\%\)
重要结论
- 哈夫曼编码是基于哈夫曼树的最优前缀编码。使用哈夫曼编码对文件进行编码,能使该文件压缩后,对应的二进制文件长度最短。
- 左右分支的 0/1 赋值无强制规定,因此构造出的哈夫曼树在形态上可能不唯一。此外,当存在多个权值相同的结点时,合并顺序的不同也可能导致结构不同的哈夫曼树。但无论其形态如何,其带权路径长度 WPL 始终相同且达到最小值,即最优性不受影响。
- 出现频率高的字符编码短,频率低的字符编码长——这正是哈夫曼编码高效的原因。
真题演练
- 【2010-06】对 n(n≥2) 个权值均不相同的字符构成哈夫曼树。下列关于该哈夫曼树的叙述中,错误的是( )。
A. 该树一定是一棵完全二叉树
B. 树中一定没有度为 1 的结点
C. 树中两个权值最小的结点一定是兄弟结点
D. 树中任一非叶结点的权值一定不小于下一层任一结点的权值
解析
哈夫曼树的构造过程是每次选取当前权值最小的两个结点合并。
B 正确。每次合并都会产生一个拥有两个孩子的新结点,所以哈夫曼树只有度为 0 和度为 2 的结点,没有度为 1 的结点。
C 正确。最初两个最小权值一定在第一次合并时成为同一新结点的两个孩子,之后它们的兄弟关系不会改变。
D 正确。内部结点的权值是其两个孩子权值之和,并且哈夫曼合并过程使越靠近根的合并权值越大,不会小于下一层结点的权值。
A 错误。哈夫曼树一定是严格二叉树,但不一定是完全二叉树。权值分布很不均匀时,较小权值会被多次合并,树形可能明显向一侧加深,不满足完全二叉树的层序连续性。
答案:A
- 【2013-04】已知三叉树 T 中 6 个叶结点的权分别是 2,3,4,5,6,7 , T 的带权(外部)路径长度最小是( )。
A. 27
B. 46
C. 54
D. 56
解析
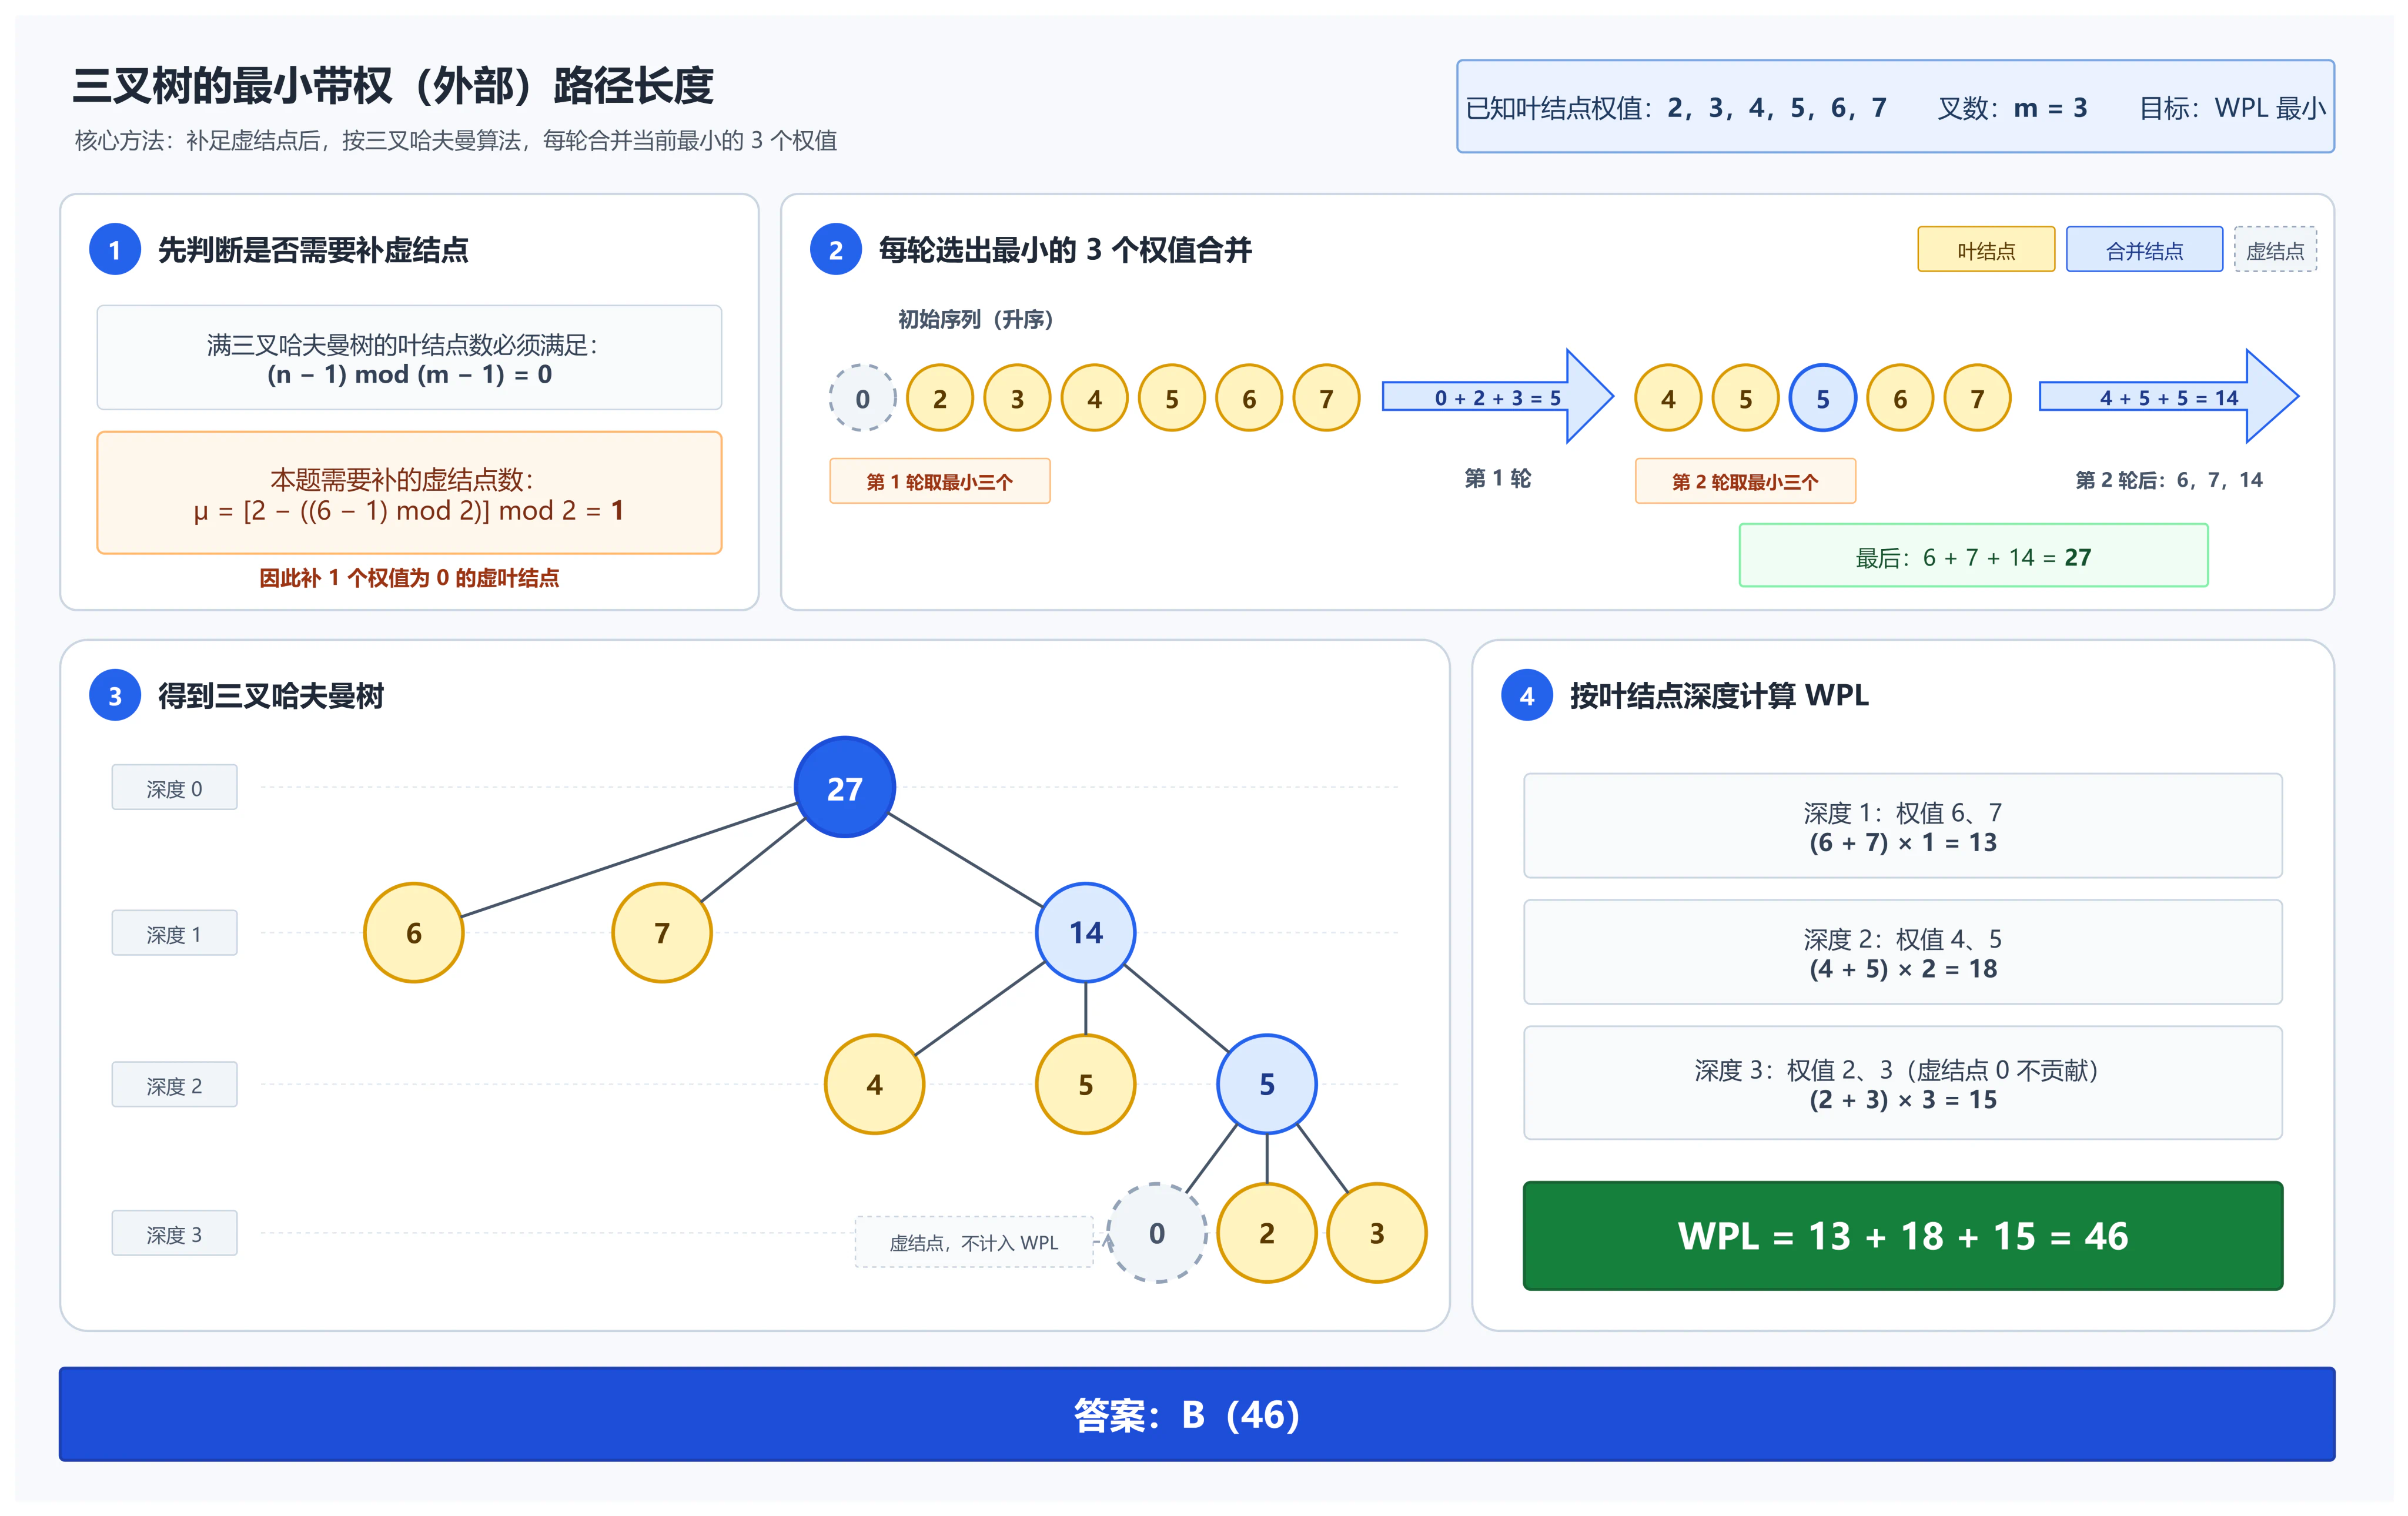
对于严格三叉哈夫曼树,叶结点数 n 应满足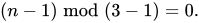
这里  ,不满足条件,所以补入一个权值为 0 的虚叶结点,使叶结点数变为 7。虚结点只用于构造,不增加 WPL。
每次合并三个最小权值:
- 合并
 ,得到新权值 5;
- 此时权值为
 ,合并
 ,得到 14;
- 合并
 ,得到根权值 27。
哈夫曼树的 WPL 等于所有合并权值之和: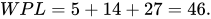
答案:B
- 【2014-06】5个字符有如下4种编码方案,不是前缀编码的是( )。
A. 01, 0000, 0001, 001, 1
B. 011, 000, 001, 010, 1
C. 000, 001, 010, 011, 100
D. 0, 100, 110, 1110, 1100
解析
前缀编码要求:任何一个字符的编码都不能是另一个字符编码的前缀。
A 中:
- 01 不会成为任何其他编码的开头;
- 001 与 0000、0001 在第三位已经不同;
- 1 也不是其他编码的前缀。
所以 A 是前缀编码。
B 中 4 个以 0 开头的编码长度都为 3,编码 1 与它们首位不同,因此也是前缀编码。
C 中所有编码等长,任一编码都不可能是另一个不同编码的前缀。
D 中存在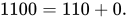
编码 110 是编码 1100 的前缀,因此无法进行唯一、即时译码。
答案:D
- 【2015-03】下列选项给出的是从根分别到达两个叶结点路径上的权值序列,能属于同一棵哈夫曼树的是( )。
A. 24, 10, 5 和 24, 10, 7
B. 24, 10, 5 和 24, 12, 7
C. 24, 10, 10 和 24, 14, 11
D. 24, 10, 5 和 24, 14, 6
解析
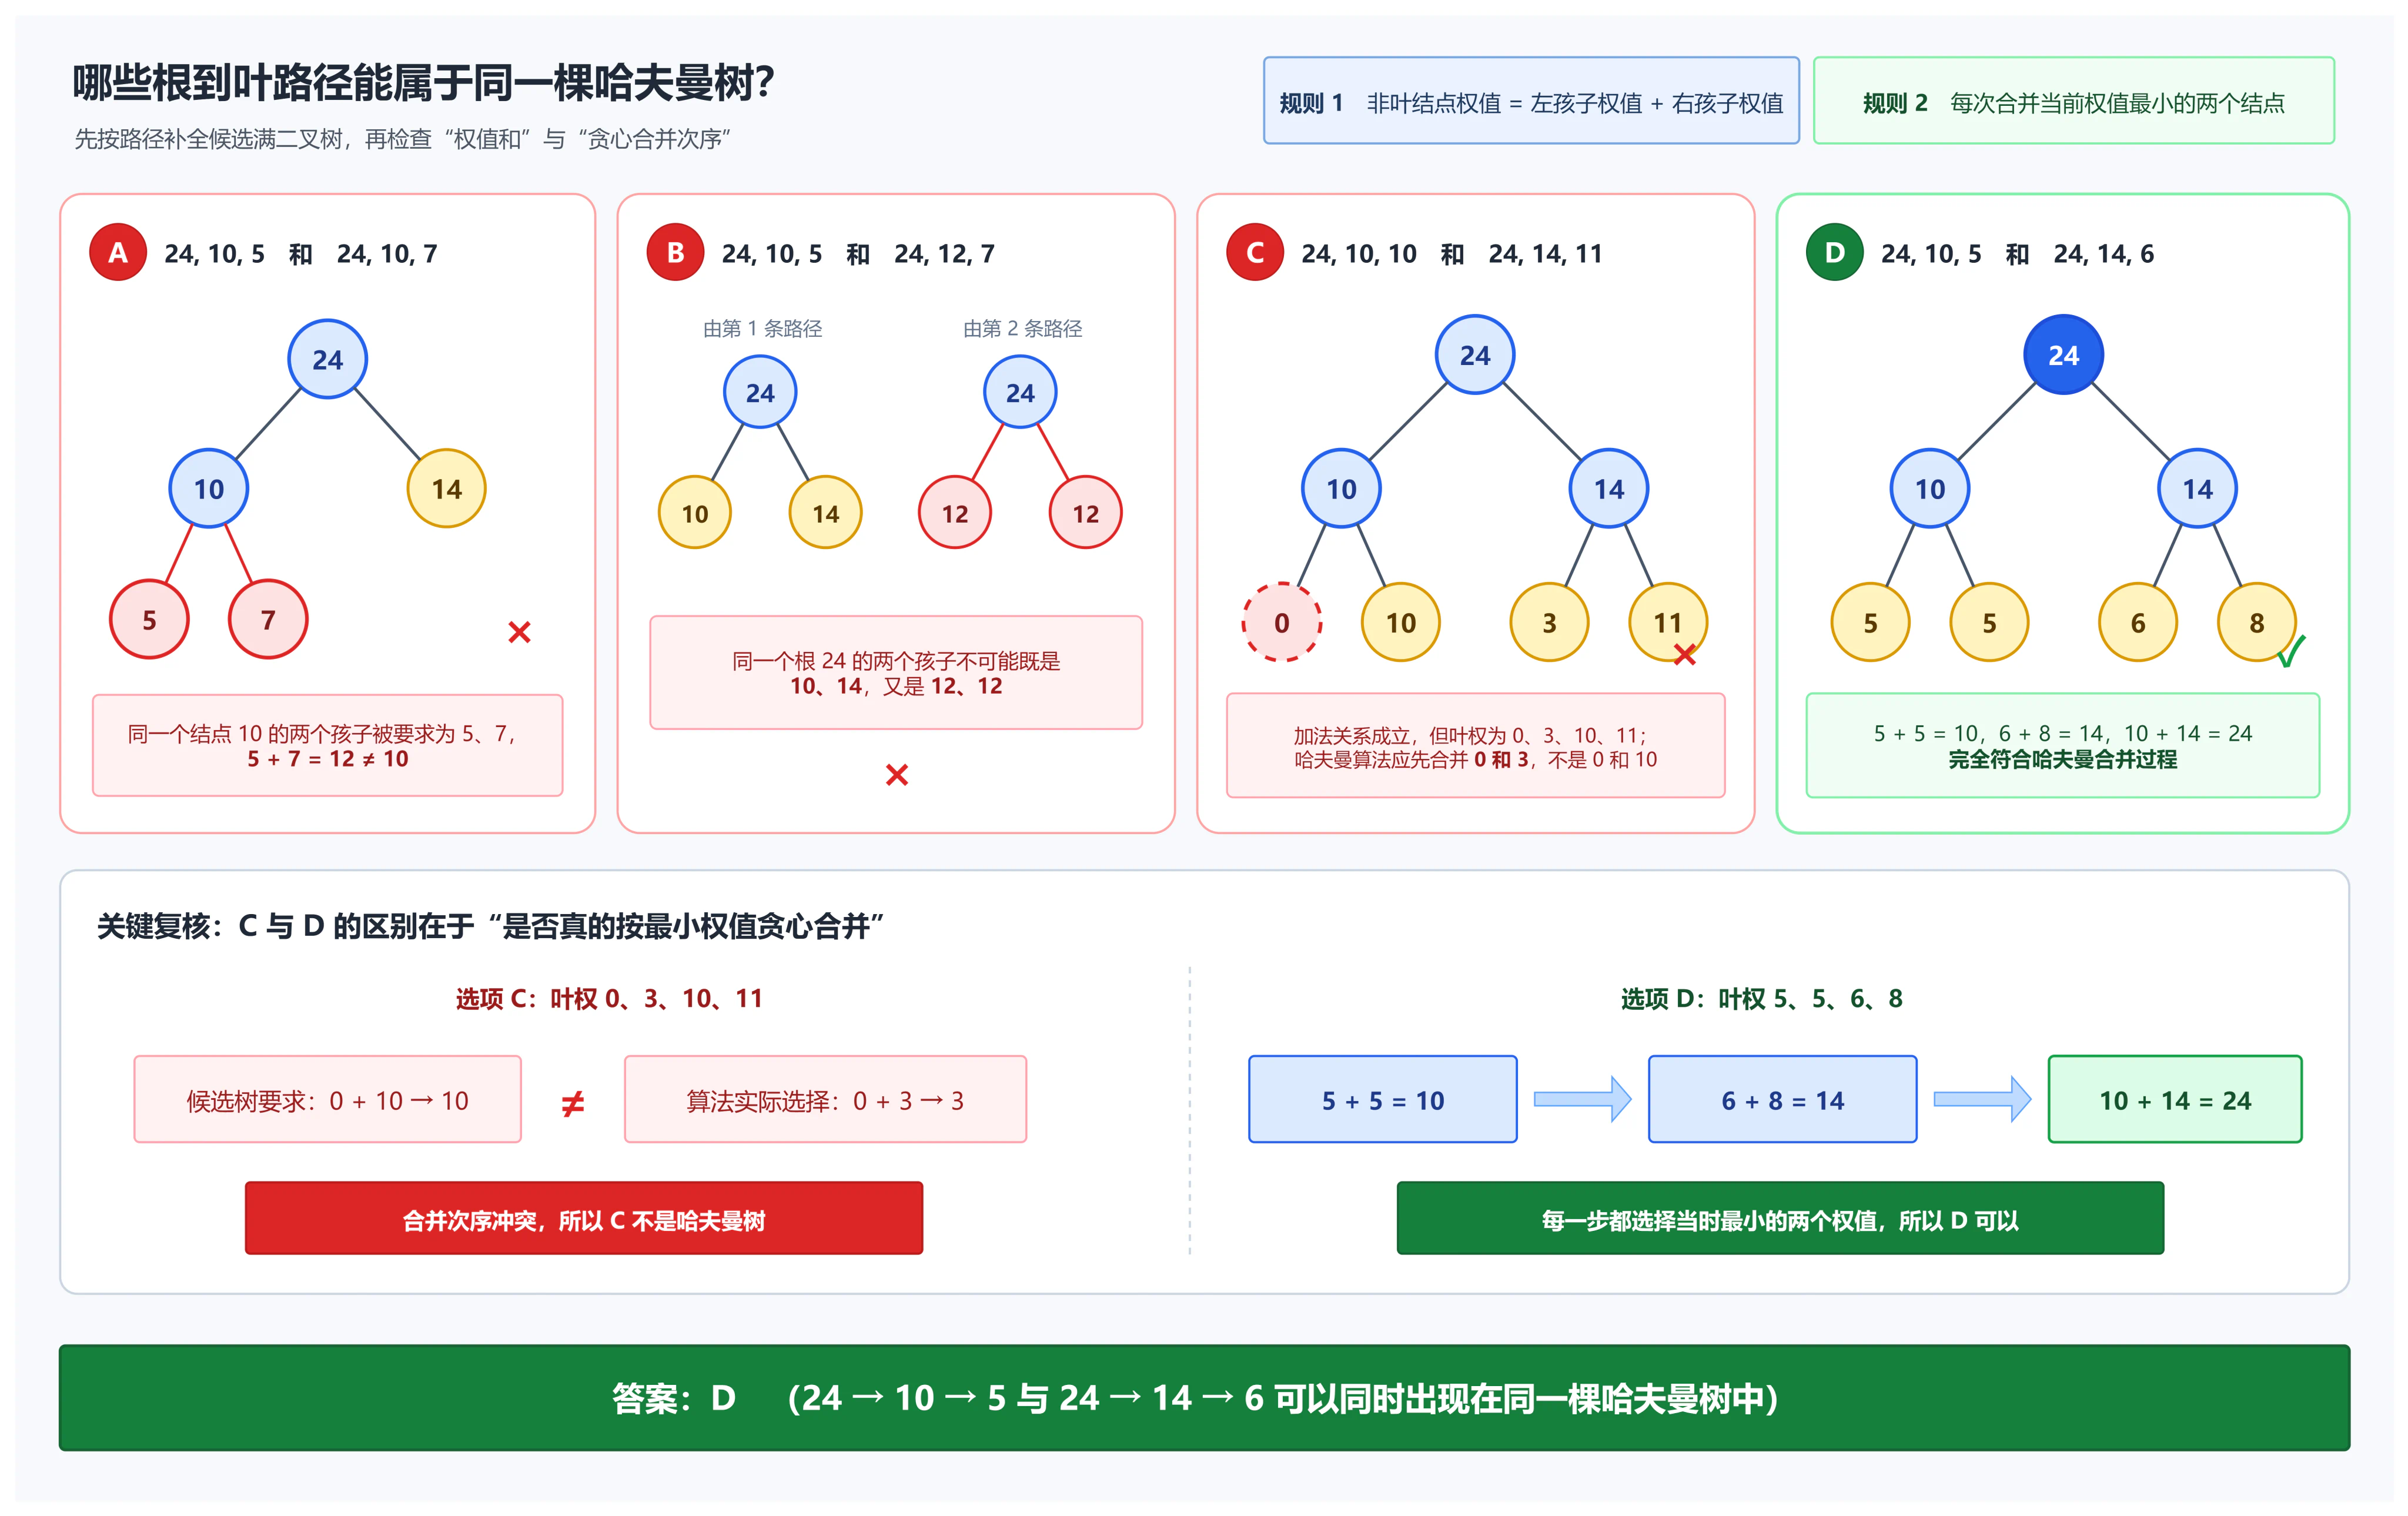
哈夫曼树中,每个非叶结点的权值等于两个孩子权值之和。
A 中两个叶结点 5、7 若同属于权值 10 的父结点,应满足  ,但实际为 12,不可能。
B 中根的两个孩子权值为 10、12,但 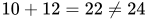 ,不可能。
C 中权值为 10 的非叶结点不可能有一个权值也为 10 的孩子,因为另一个孩子权值为正时,两个孩子之和必然大于 10。
D 中合并过程为  、
 、
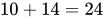 ,完全符合哈夫曼构造规则。两条路径可以分别是 24、10、5 和 24、14、6。
答案:D
- 【2017-06】已知字符集{a, b, c, d, e, f, g, h},若各字符的哈夫曼编码依次是0100, 10, 0000, 0101, 001, 011, 11, 0001,则编码序列0100011001001011110101的译码结果是( )。
A. a c g a b f h
B. a d b a g b b
C. a f b e a g d
D. a f e e f g d
解析
哈夫曼编码是前缀编码,所以从左向右扫描,每遇到一个完整编码就可立即确定字符。
对编码串分段: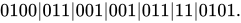
逐段查找:


所以译码结果为 a、f、e、e、f、g、d。
答案:D
- 【2018-05】已知字符集{a, b, c, d, e, f},若各字符出现的次数分别为6, 3, 8, 2, 10, 4,则对应字符集中各字符的哈夫曼编码可能是( )。
A. 00, 1011, 01, 1010, 11, 100
B. 00, 100, 110, 000, 0010, 01
C. 10, 1011, 11, 0011, 00, 010
D. 0011, 10, 11, 0010, 01, 000
解析
按哈夫曼算法合并权值:
 ;
 ;
- ;
 ;
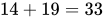 。
由此得到各字符的编码长度:
- a,频次 6:长度 2;
- b,频次 3:长度 4;
- c,频次 8:长度 2;
- d,频次 2:长度 4;
- e,频次 10:长度 2;
- f,频次 4:长度 3。
权值越小的字符通常越深,权值较大的字符更靠近根。
A 中各字符编码长度依次为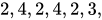
与哈夫曼树的深度完全一致,并且该组编码满足前缀编码条件。
其他选项的编码长度分配与上述深度不符,部分还不满足前缀条件。
答案:A
- 【2019-03】对 n 个互不相同的符号进行哈夫曼编码。若生成的哈夫曼树共有115个结点,则 n 的值是( )。
A. 56
B. 57
C. 58
D. 60
解析
二叉哈夫曼树没有度为 1 的结点,是严格二叉树。
设叶结点数为 n,度为 2 的内部结点数为  。严格二叉树满足
 所以

总结点数为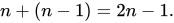
根据题意: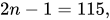


答案:C
- 【2021-05】若某二叉树有5个叶结点,其权值分别为10, 12, 16, 21, 30,则其最小的带权路径长度(WPL)是( )。
A. 89
B. 200
C. 208
D. 289
解析
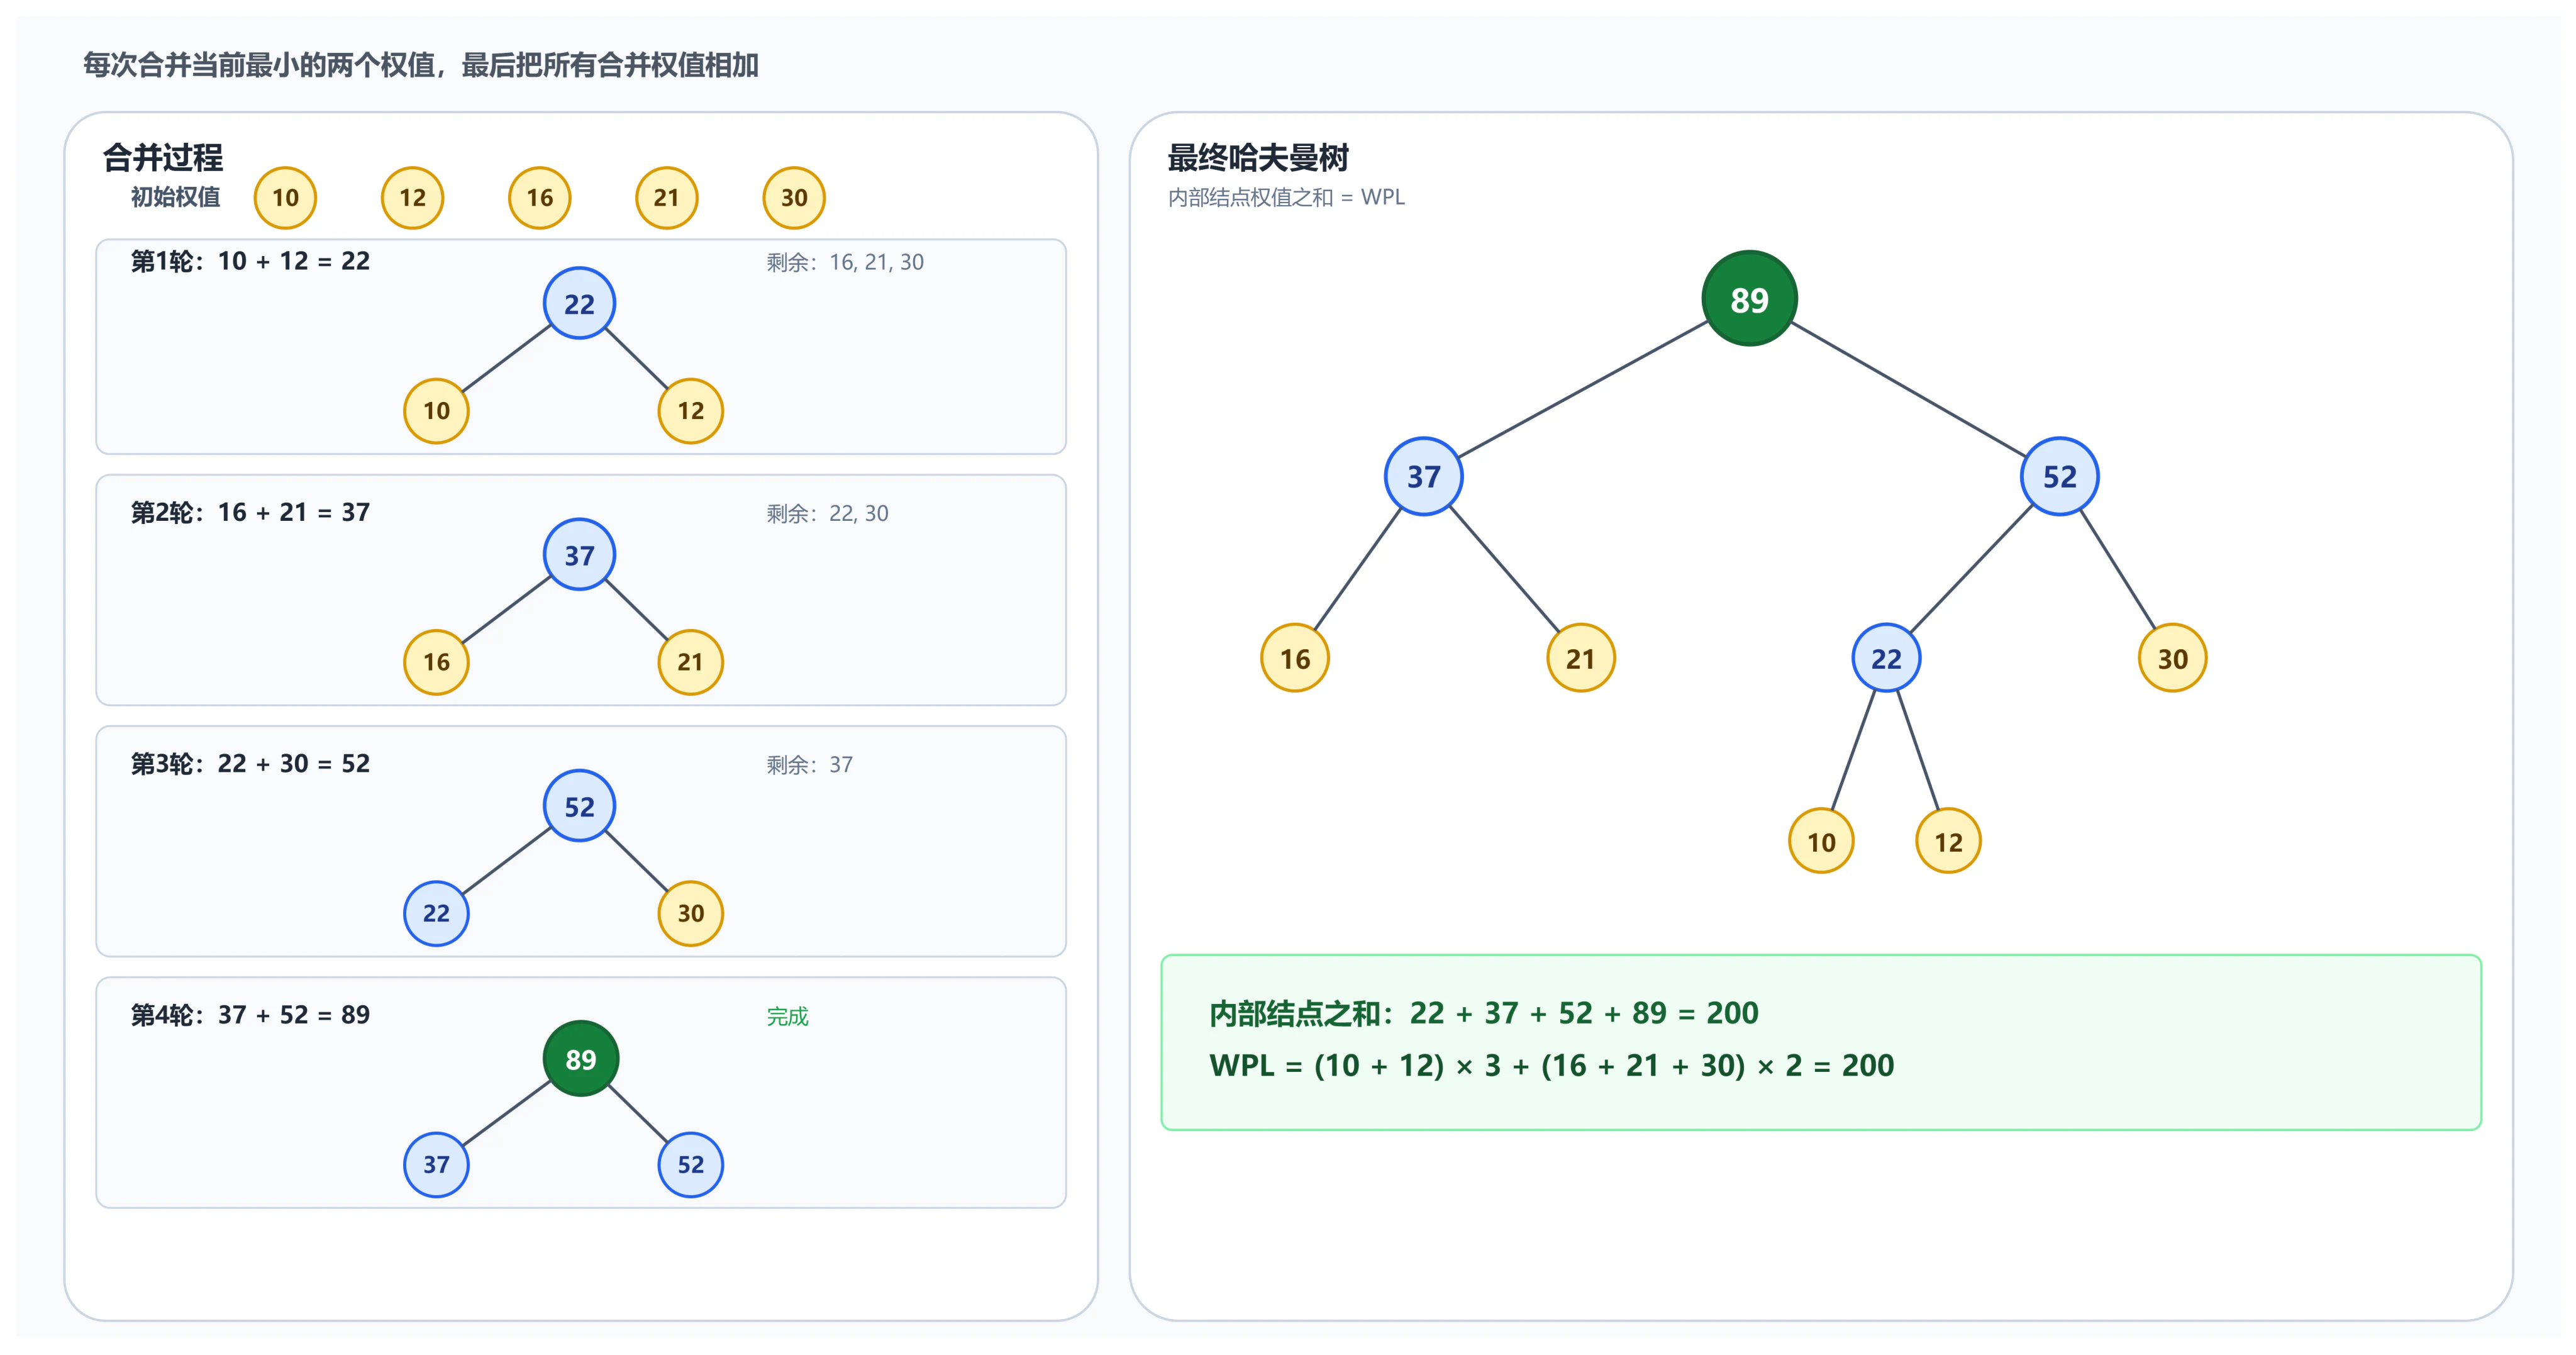
答案:B
- 【2022-05】对于任意给定的含 n(n>2) 个字符集的有限集 S ,用二叉树表示 S 的哈夫曼编码集和定长编码集,分别得到二叉树T1和T2。下列叙述中,正确的是( )。
A. T1和T2的结点数相同
B. T1的高度大于T2的高度
C. 出现频次不同的字符在T1中处于不同的层
D. 出现频次不同的字符在T2中处于相同的层
解析
定长编码的所有字符编码长度相同,所以表示这些字符的叶结点全部位于相同层。字符出现频次不会改变其编码长度,因此 D 正确。
A 错误。哈夫曼树和定长编码树的形状通常不同,内部结点和空缺分支情况也不同,结点数不保证相同。
B 错误。哈夫曼树可能比定长编码树高,但在频次相同或树形较平衡时也可能高度相同,不能对任意字符集都断言严格大于。
C 错误。频次不同的字符也可能得到相同长度的哈夫曼编码,即位于同一层。例如两个权值不同的叶结点可能恰好处于同一深度。
答案:D
- 【2023-04】在由 6 个字符组成的字符集 S 中,各字符出现的频次分别为 3, 4, 5, 6, 8, 10,为 S 构造的哈夫曼编码的加权平均长度为( )。
A. 2.4
B. 2.5
C. 2.67
D. 2.75
解析
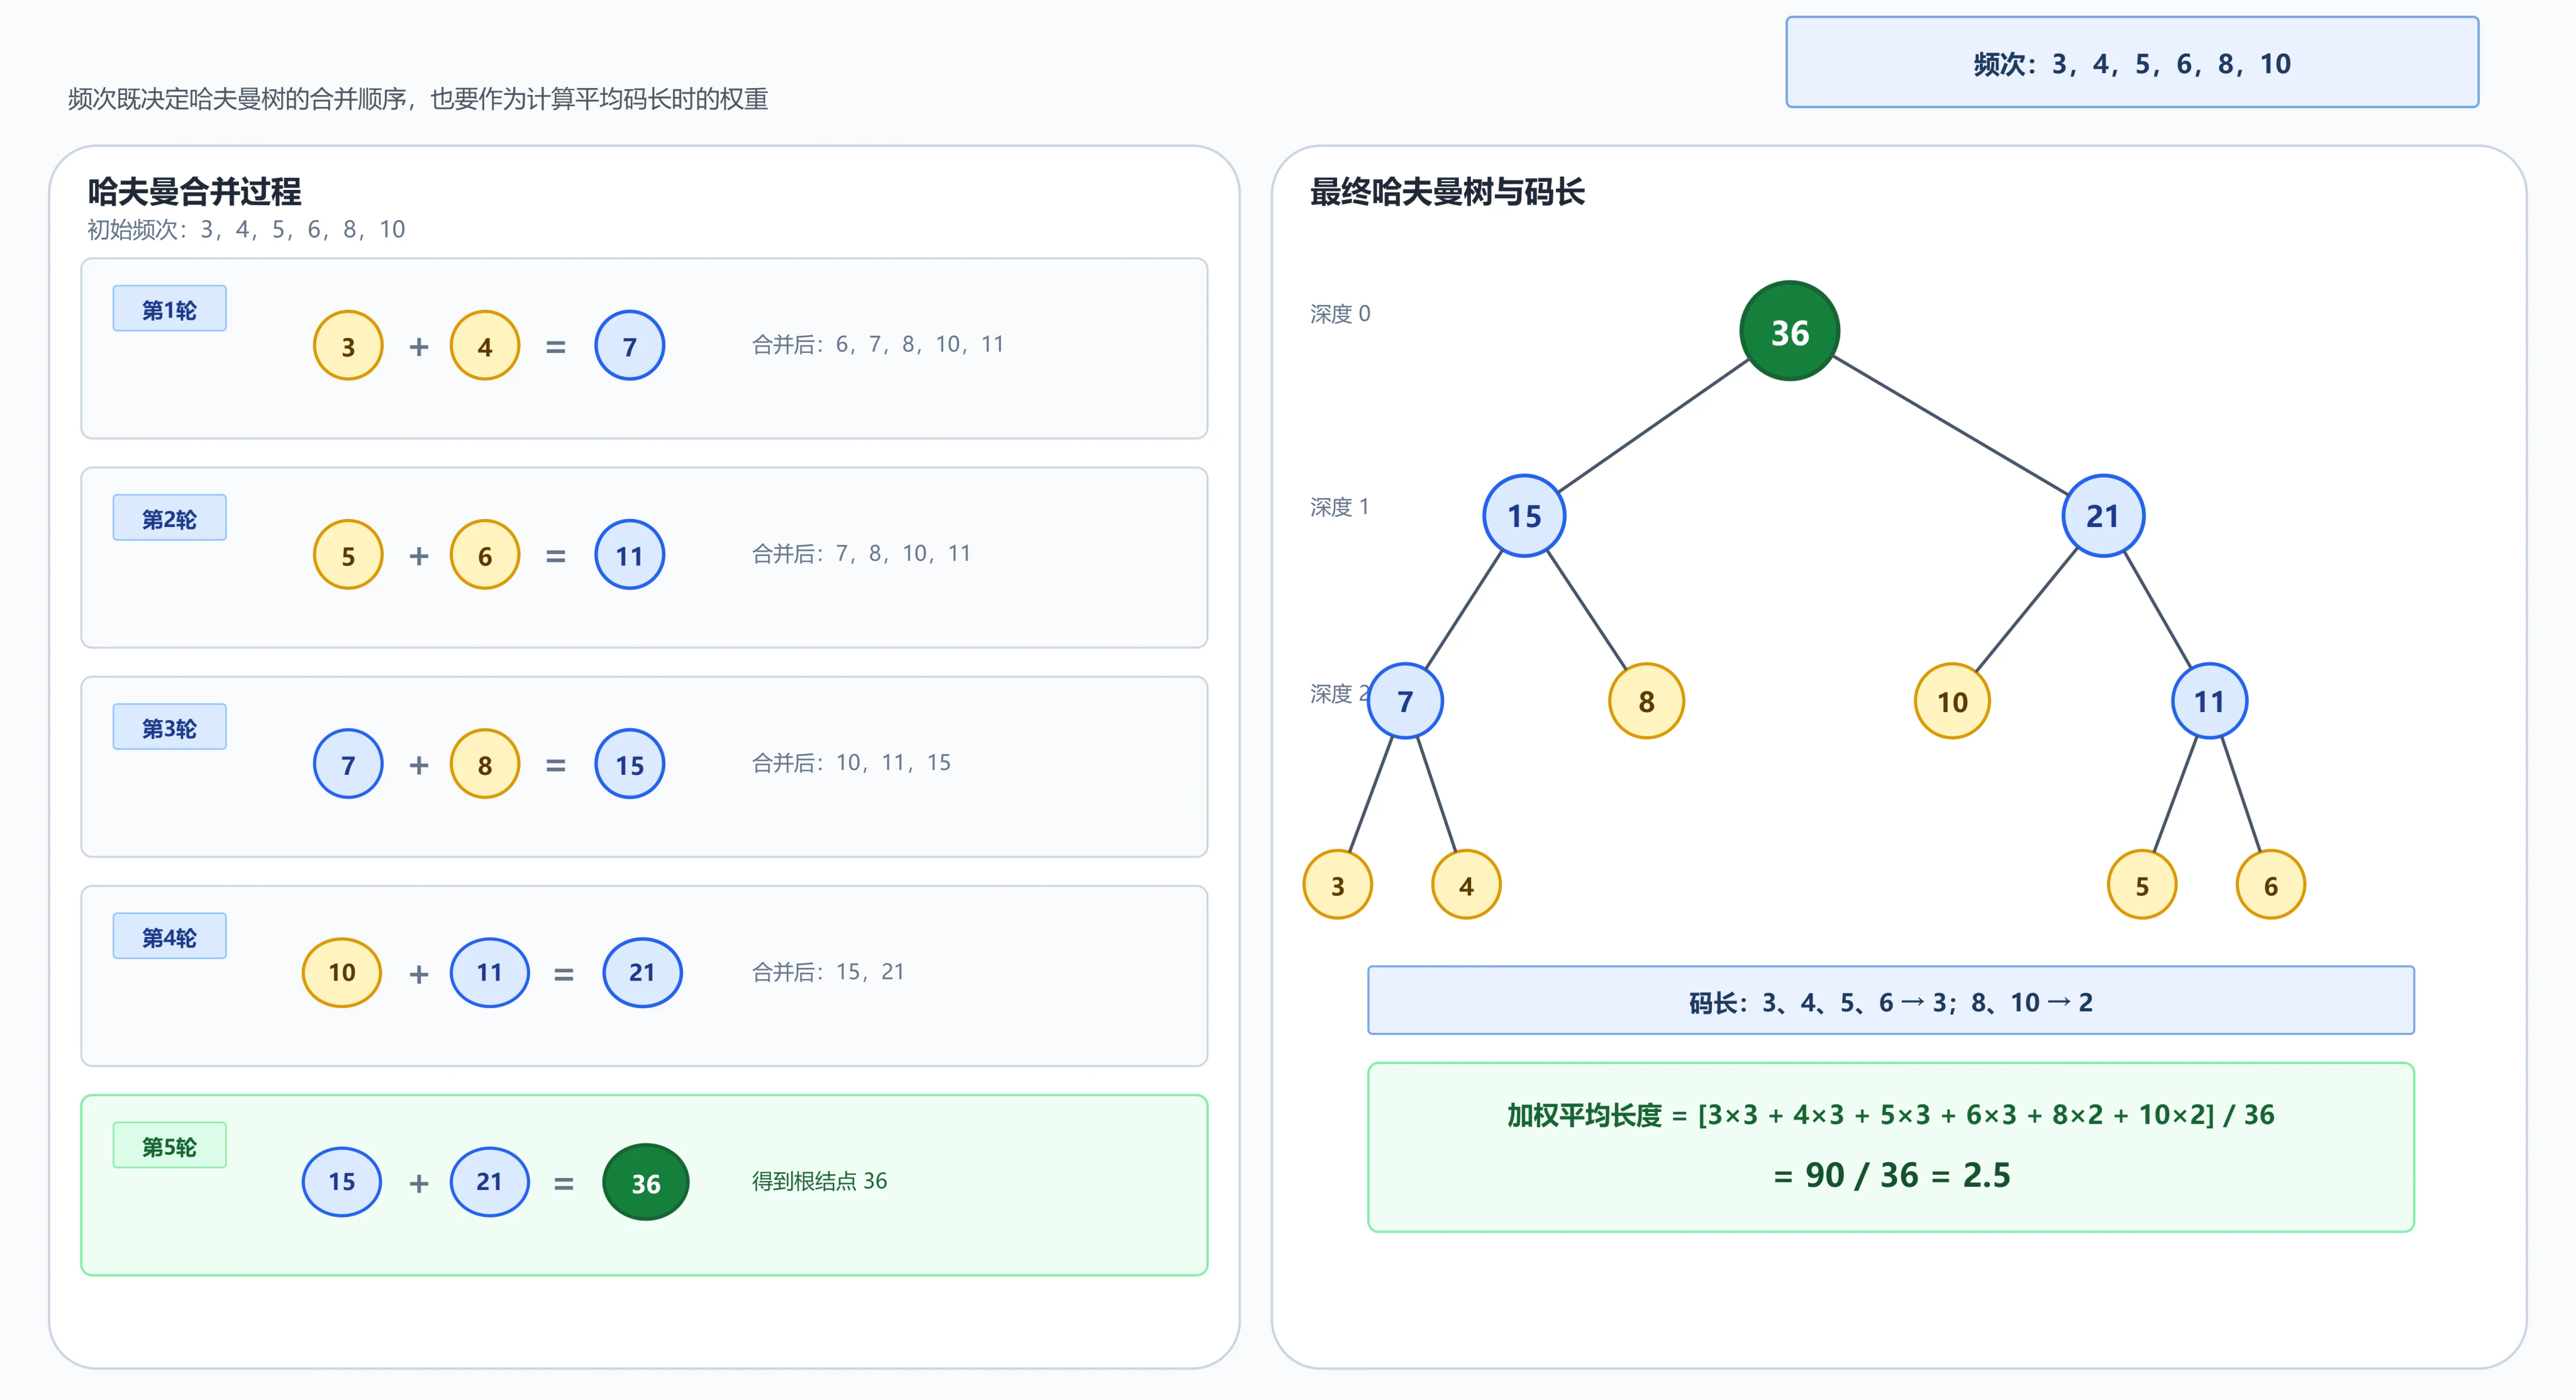
按哈夫曼算法合并:
 ;
 ;
 ;
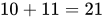 ;
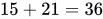 。
WPL 为所有合并权值之和: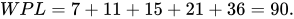
所有字符频次之和为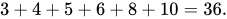
加权平均编码长度为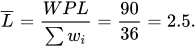
答案:B
- 【2026-05】假设二叉树中节点权值为 a=1 , b=2 , c=4 , d=5 , e=8 , f=10 , g=12 。当带权路径长度(WPL)最小时,与节点 e (权值 8)处于相同深度的节点是哪些?
A.d B.g C.d,f D.f,g
解析
按哈夫曼算法依次合并:
 ;
- ;
 ;
 ;
- 原权值 12 与新权值 12 合并为 24;
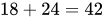 。
对应的一棵哈夫曼树为:
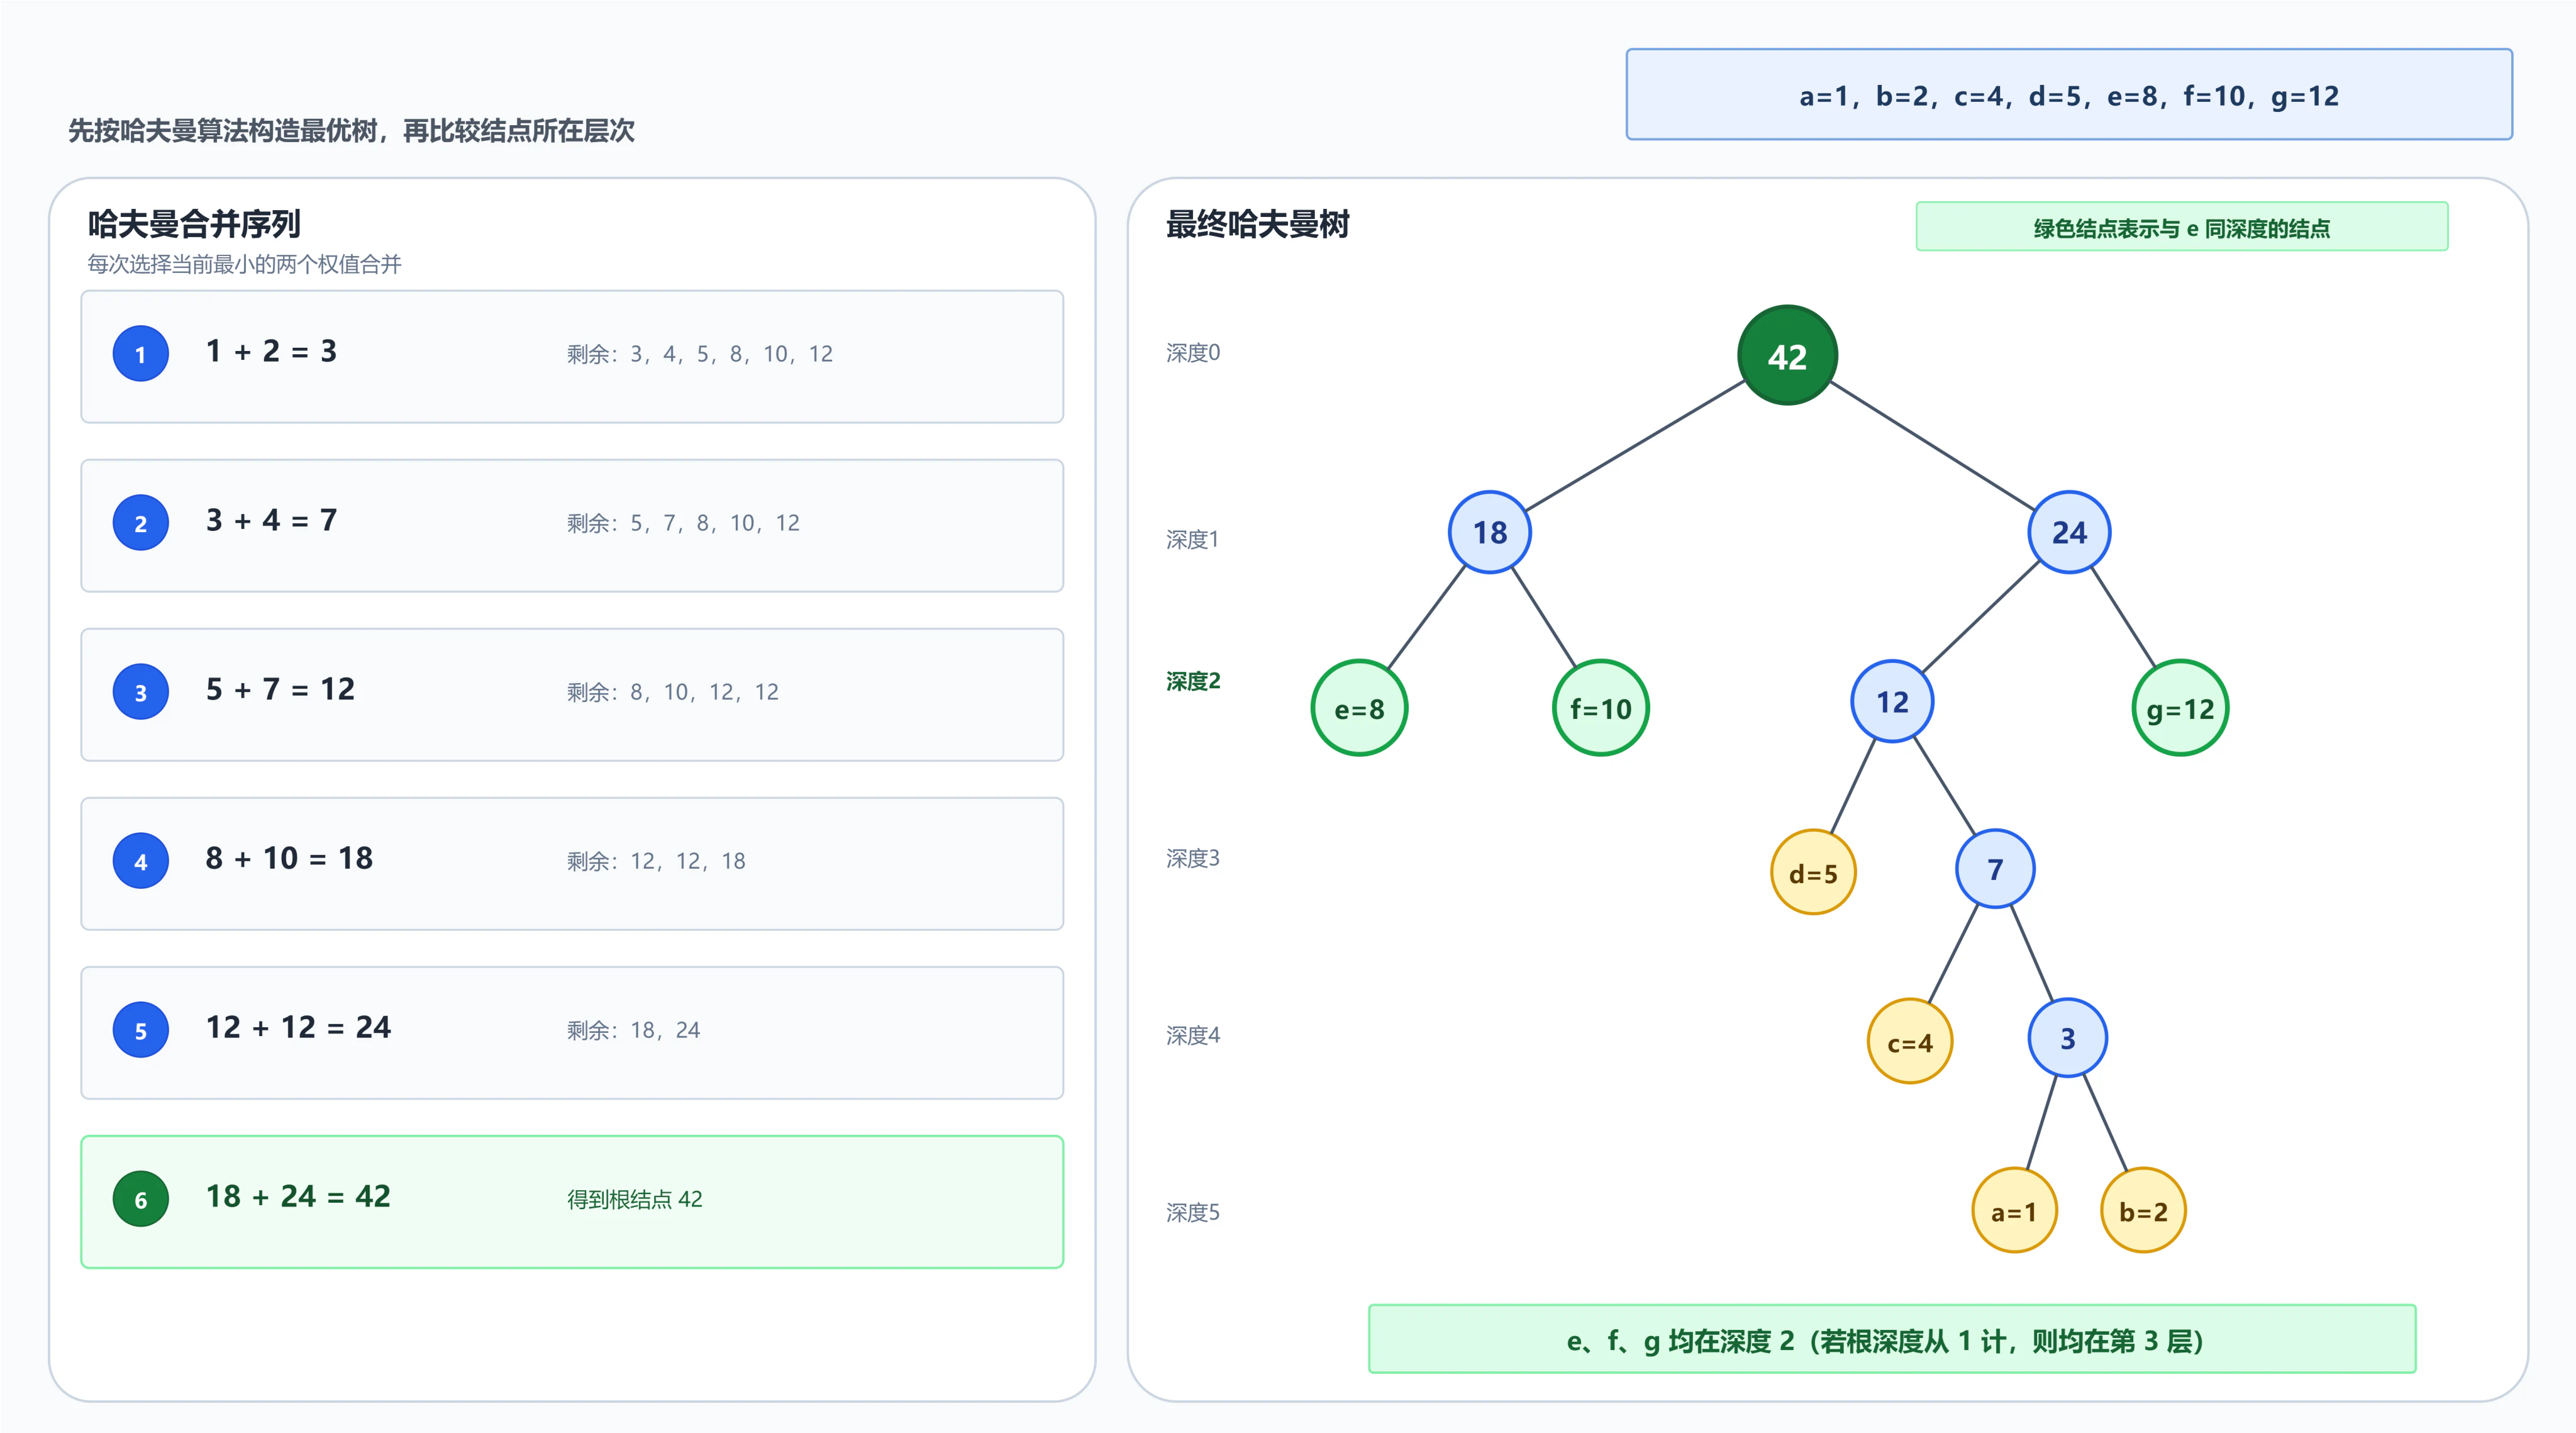
从根开始计算深度:
- e、f、g 都位于第 2 层深度;
- d 位于更深一层;
- c、a、b 更深。
因此与 e 同深度的是 f 和 g。
答案:D
- 【2012-41】(13分)设有 6 个有序表A、B、C、D、E,分别含有10、35、40、50、60和200个数据元素,各表中元素按升序排列.要求通过 5 次两两合并,将 5 个表最终合并成 1 个升序表,并在最坏情况下比较的总次数达到最小。请回答下列问题。
⑴ 给出完整的合并过程,并求出最坏情况下比较的总次数。
⑵ 根据你的合并过程,描述 N(N≥2) 个不等长升序表的合并策略,并说明理由。
解析
【官方答案】
(1) 6 个表的合并顺序如下图所示。
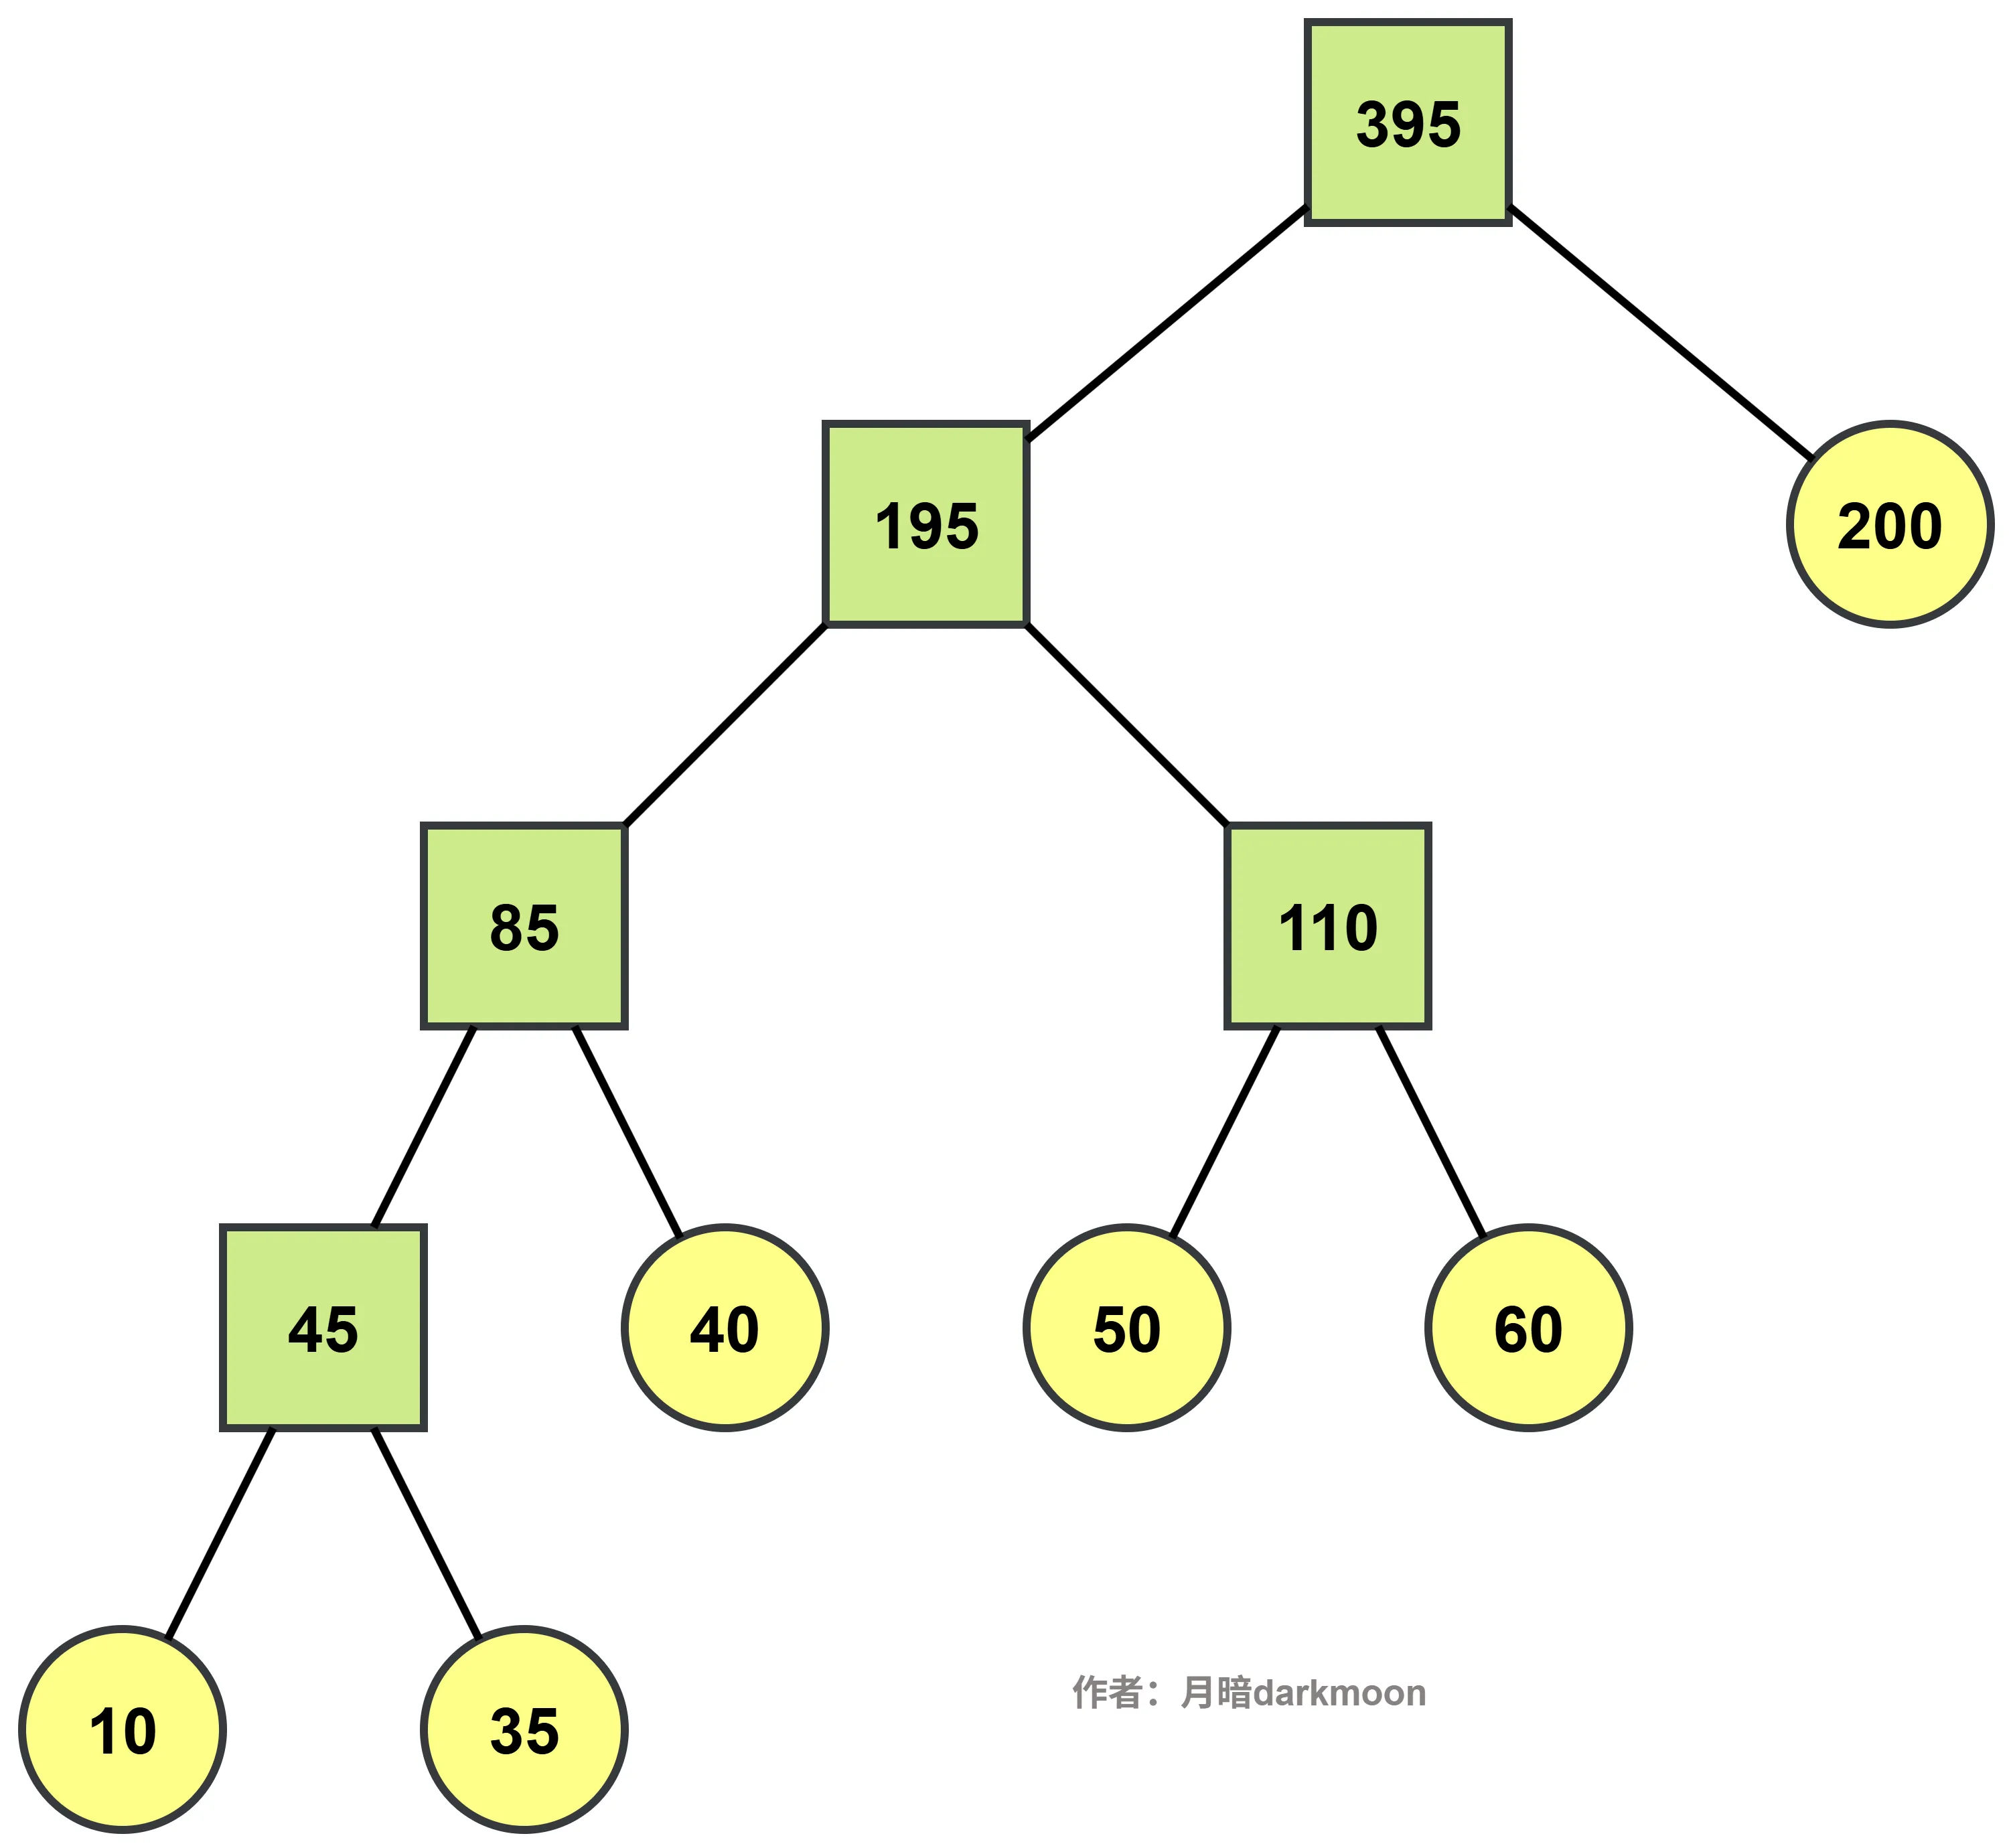
根据上图中的哈夫曼树,6 个序列的合并过程为:
第 1 次合并: 表 A 与表 B 合并, 生成含 45 个元素的表 AB;
第 2 次合并: 表 AB 与表 C 合并, 生成含 85 个元素的表 ABC;
第 3 次合并: 表 D 与表 E 合并, 生成含 110 个元素的表 DE;
第 4 次合并: 表 ABC 与表 DE 合并, 生成含 195 个元素的表 ABCDE;
第 5 次合并: 表 ABCDE 与表 F 合并, 生成含 395 个元素的最终表。(5 分)
由于合并两个长度分别为 m 和 n 的有序表, 最坏情况下需要比较 m+n-1 次, 故最坏情况下比较的总次数计算如下:
第 1 次合并: 最多比较次数=10+35-1=44
第 2 次合并: 最多比较次数=45+40-1=84
第 3 次合并: 最多比较次数=50+60-1=109
第 4 次合并: 最多比较次数=85+110-1=194
第 5 次合并: 最多比较次数=195+200-1=394
比较的总次数最多为: 44+84+109+194+394=825(2 分)
(2) 各表的合并策略是: 在对多个有序表进行两两合并时, 若表长不同, 则最坏情况下总的比较次数依赖于表的合并次序。可以借用哈夫曼树的构造思想, 依次选择最短的两个表进行合并, 可以获得最坏情况下最佳的合并效率。(3 分)
【评分说明】
(1)、(2)
① 对于用类似哈夫曼树(或最佳归并树)思想进行合并,过程描述正确,给 5 分。按其他策略进行合并,过程描述正确,给 3 分。
② 正确算出与合并过程一致的总比较次数,给 2 分。若计算过程正确,但结果错误,给 1 分。
③ 考生只要求说明采用的是类似哈夫曼树(或最佳归并树)的构造方法作为合并策略,即可给 3 分。如果采用其他策略,只要能够完成合并,给 2 分。
- 【2020-42】若任一个字符的编码都不是其它字符编码的前缀,则称这种编码具有前缀特性。现有某字符集(字符个数≥2)的不等长编码,每个字符的编码均为二进制的0、1序列,最长为L位,且具有前缀特性。请回答下列问题:
⑴ 哪种数据结构适宜保存上述具有前缀特性的不等长编码?
⑵ 基于你所设计的数据结构,简述从0/1串到字符串的译码过程。
⑶ 简述判定某字符集的不等长编码是否具有前缀特性的过程。
解析
【官方答案】
(1) 使用一棵二叉树保存字符集中各字符的编码,每个编码对应于从根开始到达某叶结点的一条路径,路径长度等于编码位数,路径到达的叶结点中保存该编码对应的字符。(2 分)
(2) 从左至右依次扫描 0/1 串中的各位。从根开始,根据串中当前位沿当前结点的左子指针或右子指针下移,直到移动到叶结点时为止。输出叶结点中保存的字符。然后再从根开始重复这个过程。直到扫描到 0/1 串结束,译码完成。(3 分)
(3) 二叉树既可用于保存各字符的编码,也可用于检测编码是否具有前缀特性。判定编码是否具有前缀特性的过程,同时也是构建二叉树的过程。初始时,二叉树中仅含有根结点,其左子指针和右子指针均为空。
依次读入每个编码 C,建立/寻找从根开始对应于该编码的一条路径,过程如下:
对每个编码,从左至右扫描 C 的各位,根据 C 当前位(0 或 1)沿结点的指针(左子指针或右子指针)向下移动。当遇到空指针时,创建新结点,让为空的指针指向该新结点并继续移动。
沿指针移动过程中,可能遇到三种情况:
① 若遇到了叶结点(非根),则表明不具有前缀特性,返回;
② 若在处理 C 的所有位的过程中,均没有创建新结点,则表明不具有前缀特性,返回;
③ 若处理 C 的最后一个编码位时创建了新结点,则继续验证下一个编码。
若所有编码均通过验证,则编码具有前缀特性。(5 分)