Relax1000 计算机组成原理 · 第3章 存储器层次结构 · 题目
第3章 存储器层次结构
本章 79 题;题目册印刷页 77–90。
Q1
按存储介质分类,下列存储器中属于半导体存储器的是( )。
- A.机械硬盘
- B.光盘
- C.SRAM
- D.磁带
Q2
关于各类存储器的介质特性、存取方式及功能的描述,下列说法正确的是( )。
- A.SSD 属于磁表面存储器,由于其容量极大且单位成本低,常被用作辅助存储器
- B.RAM 和 ROM 都采用随机存取方式,因此所有的半导体存储器都按地址随机访问
- C.CD-ROM 属于光存储器,存取方式兼有随机访问和顺序访问的特点,属于直接存取(DAM)
- D.SRAM 成本太高只能做 Cache,ROM 只能固化不能作主存。所以主存全部由 DRAM 构成
Q3
按访问方式分类,Cache 属于( )。
- A.随机存取存储器
- B.顺序存取存储器
- C.直接存取存储器
- D.只读存储器
Q4
关于存储器的分类与介质特性,下列说法正确的是( )。
- A.固态硬盘(SSD)与机械硬盘(HDD)虽然读写机制不同,但均属于磁表面存储器
- B.计算机的主存绝大部分由 DRAM 构成,相比于 SRAM,DRAM 的集成度更高且不需要定期刷新
- C.闪存(Flash Memory)属于半导体存储器,本质上是一种电可擦除的只读存储器(EEPROM)
- D.CPU 内通用寄存器组属于半导体存储器,主要用来存放运算的中间结果,且为了防止计算机突然断电导致数据丢失,它通常被设计为非易失性存储器
Q5
从工作原理角度,DRAM 属于( )。
- A.基于触发器存储信息的存储器
- B.基于电容存储信息的存储器
- C.基于磁性材料存储信息的存储器
- D.基于光反射原理存储信息的存储器
Q6
下列说法正确的是( )。
- A.半导体 RAM 信息可读可写,且断电后仍能保持记忆
- B.动态的 RAM 属非易失性存储器,而静态的 RAM 存储信息是易失性的
- C.静态 RAM、动态 RAM 都属易失性存储器,断电后存储的信息将消失
- D.ROM 不用刷新,且集成度比动态 RAM 高,断电后存储的信息将消失
Q7
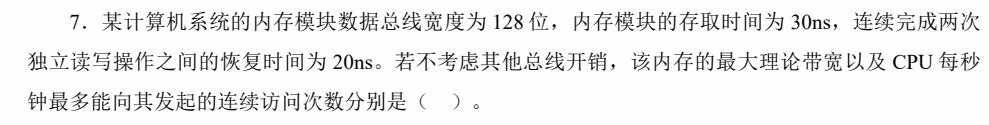
某计算机系统的内存模块数据总线宽度为 128 位,内存模块的存取时间为 30ns,连续完成两次独立读写操作之间的恢复时间为 20ns。若不考虑其他总线开销,该内存的最大理论带宽以及 CPU 每秒钟最多能向其发起的连续访问次数分别是( )。
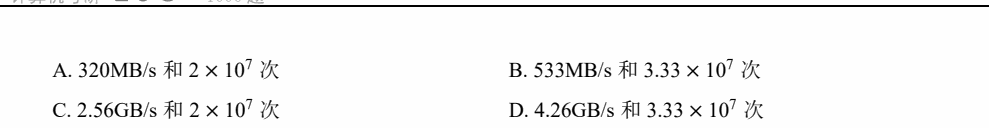
- A.320MB/s 和 2 × 10⁷次
- B.533MB/s 和 3.33 × 10⁷次
- C.2.56GB/s 和 2 × 10⁷次
- D.4.26GB/s 和 3.33 × 10⁷次
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q8
相联存储器是按( )进行寻址的存储器。
- A.地址指定方式
- B.堆栈指定方式
- C.寄存器指定方式
- D.内容指定方式
Q9
关于存储器的层次化存储器结构,下列说法正确的是( )。
- A.基于程序的局部性原理,上一层存储器的数据必然是下一层存储器数据的子集
- B.核心目的是为了彻底消除 CPU 与各类存储设备之间的速度差异
- C.系统在理想情况下的访问速度上接近主存
- D.系统在理想情况下的容量和单位成本接近外存(最下层)
Q10
在现代计算机层次化存储系统中,关于数据在不同层级间调度与管理,下列说法正确的是( )。
- A.Cache 与主存之间的数据交换由操作系统负责管理,对应用程序员透明
- B.主存与辅存之间的数据交换(如页面置换)完全由硬件自动完成,对系统程序员透明
- C.Cache 与主存之间的数据交换单位为“块”,主要为了解决 CPU 和主存速度不匹配的问题
- D.虚拟存储器的地址映射和缺页处理过程对所有程序员都是透明的
Q11
关于 Cache-主存层次与主存-辅存(外存)层次的异同,下列叙述中错误的是( )。
- A.引入 Cache-主存层次的主要目的是为了加快 CPU 访问信息的速度,而主存-辅存层次则是为了解决主存容量不足的问题
- B.CPU 可以直接访问 Cache 和主存中的数据,但不能直接访问辅存,辅存的数据必须先调入主存才能被 CPU 处理
- C.Cache-主存层次的地址映射关系完全由硬件实现并使用标志(Tag)描述,主存-辅存层次的映射关系则由操作系统通过页表来实现
- D.Cache-主存层次和主存-辅存层次的数据调度与交换过程,对所有的程序员都是完全透明的
Q12
在 Cache–主存–外存层次结构中,当 CPU 分别遭遇 Cache 缺失和缺页异常时,关于系统的处理过程及开销,下列说法错误的是( )。
- A.Cache 缺失通常直接由硬件逻辑完成数据的提取和块替换,开销较小
- B.缺页异常会触发处理器的内部异常,需要操作系统介入执行缺页处理程序,开销较大
- C.无论是 Cache 缺失还是缺页异常,CPU 都必须暂停当前正在执行的进程,进行线程切换
- D.Cache 缺失的开销远小于缺页异常,因为前者访问的是主存,后者需要进行磁盘 I/O 操作
Q13
SRAM 与 DRAM 相比,以下说法正确的是( )。
- A.SRAM 速度慢,成本低,集成度高
- B.SRAM 速度快,成本高,集成度低
- C.DRAM 速度快,成本高,集成度高
- D.DRAM 速度慢,成本低,集成度低
Q14
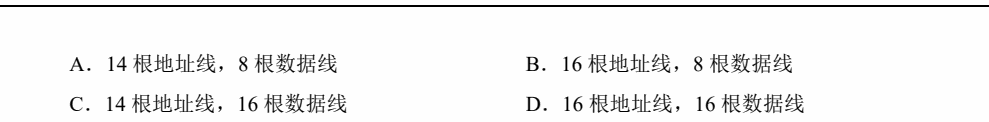
某 SRAM 芯片,存储容量为 16K×8 位,该芯片的地址线和数据线引脚数目分别为( )。
- A.14 根地址线,8 根数据线
- B.16 根地址线,8 根数据线
- C.14 根地址线,16 根数据线
- D.16 根地址线,16 根数据线
原页版面片段(公式/表图/电路/代码/数据通路以此为准)

Q15
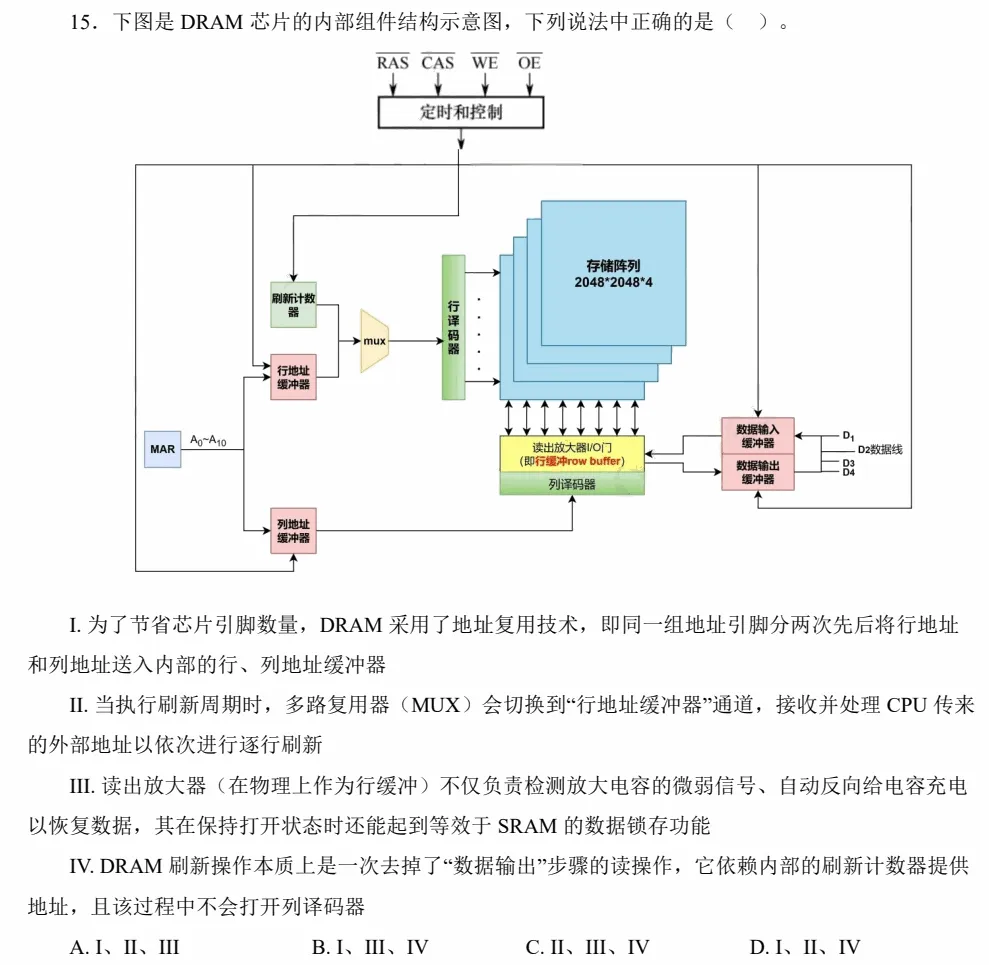
下图是 DRAM 芯片的内部组件结构示意图,下列说法中正确的是( )。
I. 为了节省芯片引脚数量,DRAM 采用了地址复用技术,即同一组地址引脚分两次先后将行地址和列地址送入内部的行、列地址缓冲器
II. 当执行刷新周期时,多路复用器(MUX)会切换到“行地址缓冲器”通道,接收并处理 CPU 传来的外部地址以依次进行逐行刷新
III. 读出放大器(在物理上作为行缓冲)不仅负责检测放大电容的微弱信号、自动反向给电容充电以恢复数据,其在保持打开状态时还能起到等效于 SRAM 的数据锁存功能
IV. DRAM 刷新操作本质上是一次去掉了“数据输出”步骤的读操作,它依赖内部的刷新计数器提供地址,且该过程中不会打开列译码器
- A.I、II、III
- B.I、III、IV
- C.II、III、IV
- D.I、II、IV
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q16
Flash 存储器的特点不包括( )。
- A.非易失性,断电后数据不丢失
- B.可电擦除和编程
- C.读操作速度接近半导体 RAM
- D.写操作速度快
Q17
用 16K×8 位的 DRAM 芯片构成 64K×32 位的存储器,需要芯片数量是( )。
- A.4
- B.8
- C.16
- D.32
原页版面片段(公式/表图/电路/代码/数据通路以此为准)

Q18
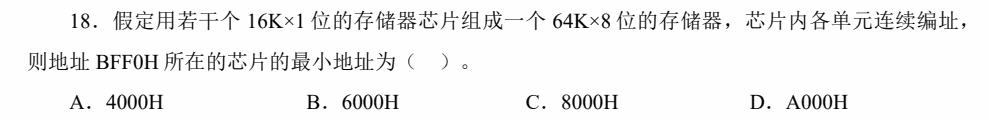
假定用若干个 16K×1 位的存储器芯片组成一个 64K×8 位的存储器,芯片内各单元连续编址,则地址 BFF0H 所在的芯片的最小地址为( )。
- A.4000H
- B.6000H
- C.8000H
- D.A000H
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q19
某 SRAM 芯片的存储容量为 32MB,若采用按字编址,1 字为 4 字节,则该芯片的地址线和数据线数目分别为( )。
- A.25 根地址线,8 根数据线
- B.24 根地址线,8 根数据线
- C.23 根地址线,32 根数据线
- D.20 根地址线,32 根数据线
Q20
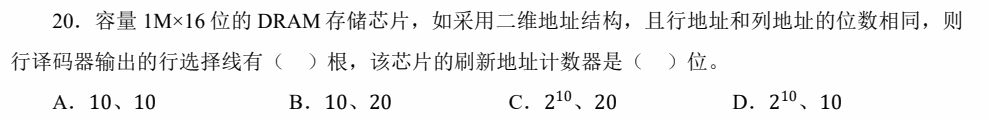
容量 1M×16 位的 DRAM 存储芯片,如采用二维地址结构,且行地址和列地址的位数相同,则行译码器输出的行选择线有( )根,该芯片的刷新地址计数器是( )位。
- A.10、10
- B.10、20
- C.210、20
- D.210、10
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q21
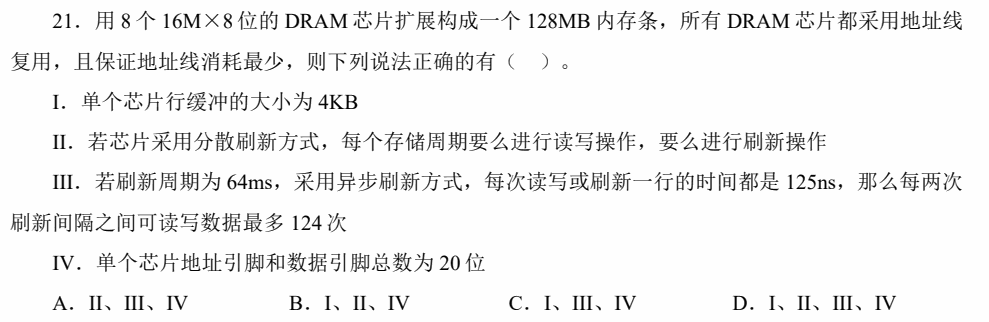
用 8 个 16M×8位的 DRAM芯片扩展构成一个 128MB内存条,所有 DRAM 芯片都采用地址线复用,且保证地址线消耗最少,则下列说法正确的有( )。
I.单个芯片行缓冲的大小为 4KB
II.若芯片采用分散刷新方式,每个存储周期要么进行读写操作,要么进行刷新操作
III.若刷新周期为 64ms,采用异步刷新方式,每次读写或刷新一行的时间都是 125ns,那么每两次刷新间隔之间可读写数据最多 124次
IV.单个芯片地址引脚和数据引脚总数为 20 位
- A.II、III、IV
- B.I、II、IV
- C.I、III、IV
- D.I、II、III、IV
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q22
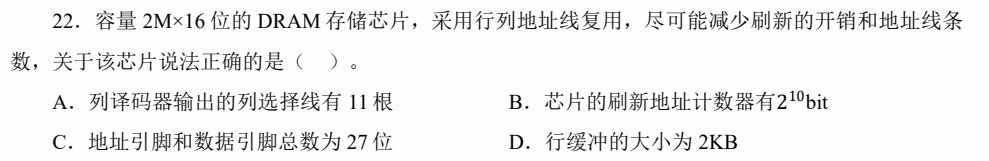
容量 2M×16 位的 DRAM 存储芯片,采用行列地址线复用,尽可能减少刷新的开销和地址线条数,关于该芯片说法正确的是( )。
- A.列译码器输出的列选择线有 11根
- B.芯片的刷新地址计数器有210 bit
- C.地址引脚和数据引脚总数为 27 位
- D.行缓冲的大小为 2KB
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q23
DRAM 芯片需要定期刷新的原因是( )。
- A.防止存储单元电路损坏
- B.避免数据被误读
- C.补充存储电容上泄漏的电荷,保持数据
- D.提高芯片的访问速度
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
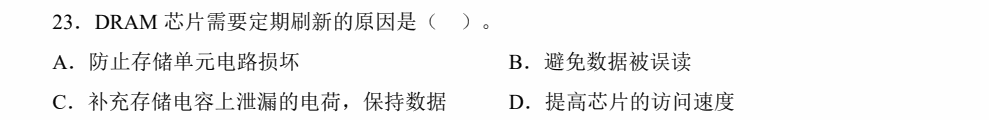
Q24
有一个 16K×16 的存储器,由 4K×4 的 DRAM 芯片(内部存储阵列为 64×64)构成,采用集中刷新,刷新间隔为 2ms,存储器的读写周期为 0.5us,死时间率为( )。
- A.0.6%
- B.1%
- C.1.6%
- D.2%
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
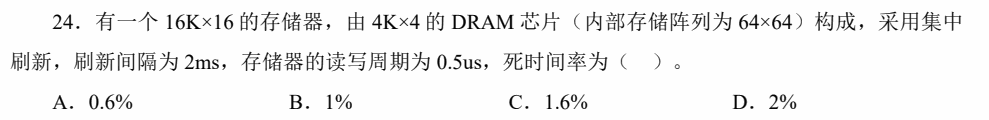
Q25
某机器主存储器为 32MB,由若干片 16KB(采用 128×128 存储阵列)的 DRAM 芯片字位同时扩展构成。若采用集中式刷新方式且刷新周期为 2ms,所有存储单元刷新一遍需要( )个存储周期。
- A.128
- B.256
- C.1024
- D.16384
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
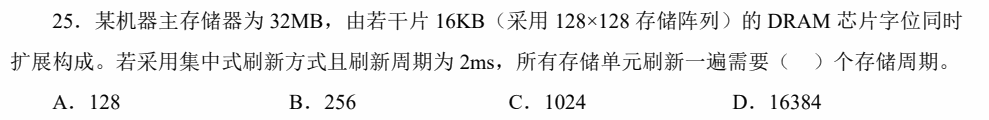
Q26
对于某存储芯片,假定动态刷新间隔为 2ms,读写周期和刷新周期均为 0.2μs,该芯片中包含128 行,每个刷新周期可以完成 1 行存储单元的刷新,如果该芯片采用异步刷新方式工作,那么其读写周期和刷新周期可以安排为( )。
- A.3999 次读写周期后,安排一次刷新操作
- B.2000次读写周期后,安排一次刷新操作
- C.128 次读写周期后,安排一次刷新操作
- D.64 次读写周期后,安排一次刷新操作
Q27
某计算机按字节编址,主存地址空间为 16MB 。现需用 512K4 位的 SRAM 芯片和 2M8 位的ROM 芯片构建主存。要求 RAM 区和 ROM 区容量之比为 3:1,且 ROM 区位于主存最高连续地址段。若 RAM 区采用连续编址,则地址 0A1234H 所在的 RAM 芯片的最小地址,以及构建该 RAM 区所需的SRAM 芯片总数分别是( )。
- A.080000H,48 片
- B.0A0000H,48 片
- C.080000H,24 片
- D.0A0000H,24 片
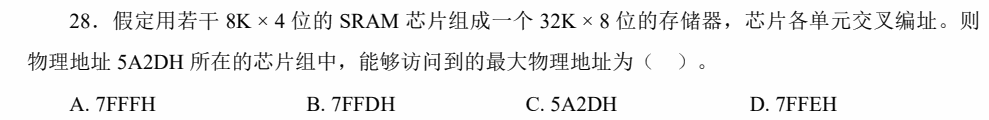
Q28
假定用若干 8K × 4 位的 SRAM 芯片组成一个 32K × 8 位的存储器,芯片各单元交叉编址。则物理地址 5A2DH 所在的芯片组中,能够访问到的最大物理地址为( )。
- A.7FFFH
- B.7FFDH
- C.5A2DH
- D.7FFEH
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q29
某存储器按字节编址,地址 0000~FFFFH 为 RAM 区,若采用 16K×2 位的 RAM 芯片进行设计,则在字方向和位方向上分别扩展了( )倍。
- A.4 和 2
- B.4 和 4
- C.2 和 4
- D.8 和 4
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q30
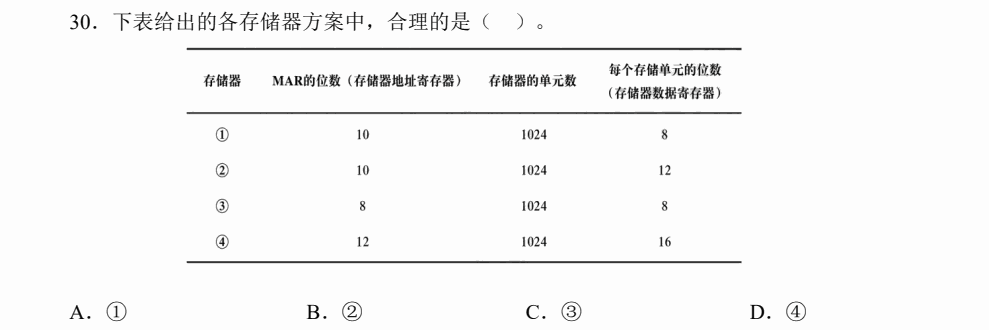
下表给出的各存储器方案中,合理的是( )。
- A.①
- B.②
- C.③
- D.④
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q31
已知某 DDR2 SDRAM 内存条的数据总线位宽为 64 位(8B),在每个存储器总线时钟的上升沿和下降沿各传一次,其标称的最大理论数据带宽为 6.4 GB/s,则下列关于该内存条参数的推断中,错误的是( )。
- A.该内存条存储器总线上的等效数据传输率(传送次数)为 800M 次/秒
- B.芯片内部存储阵列的实际工作频率(核心频率)为 400MHz
- C.存储器总线的实际时钟频率为 400MHz
- D.该芯片内部 I/O 缓冲采用了 4 位(4n)数据预取技术,那么内部存储阵列一次预取的量是 32B。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q32
假定 DDR3 SDRAM 芯片内部核心频率为 133.25MHz,在每个存储器总线时钟的上升沿和下降沿各传一次,采用 8 位预取技术,与之相连的存储器总线每次传输 8B,则下面有关叙述中,错误的是( )。
- A.芯片内部 I/O 缓冲 64B
- B.存储器总线每秒传 1066M 次数据
- C.存储器总线的时钟频率为 1066MHz
- D.存储器总线的带宽大约为 8.5GB/s
Q33
多模块存储器所以能高速进行读/写,是因为( )。
- A.采用了高速元器件
- B.各模块有独立的读写电路
- C.采用了信息预读技术
- D.模块内各单元地址连续
原页版面片段(公式/表图/电路/代码/数据通路以此为准)

Q34
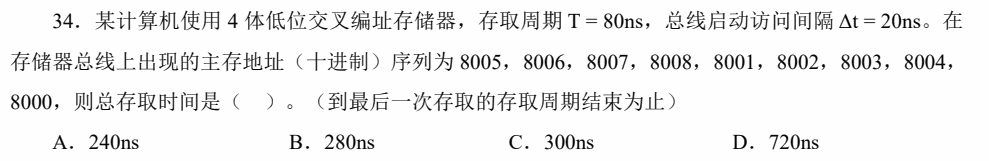
某计算机使用 4 体低位交叉编址存储器,存取周期 T = 80ns,总线启动访问间隔 Δt = 20ns。在存储器总线上出现的主存地址(十进制)序列为 8005,8006,8007,8008,8001,8002,8003,8004,8000,则总存取时间是( )。(到最后一次存取的存取周期结束为止)
- A.240ns
- B.280ns
- C.300ns
- D.720ns
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q35
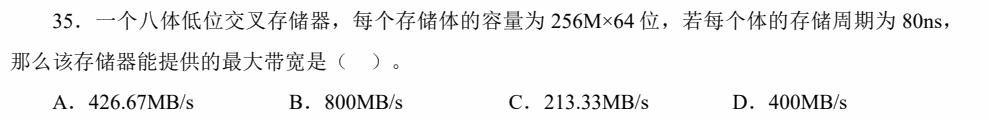
一个八体低位交叉存储器,每个存储体的容量为 256M×64 位,若每个体的存储周期为 80ns,那么该存储器能提供的最大带宽是( )。
- A.426.67MB/s
- B.800MB/s
- C.213.33MB/s
- D.400MB/s
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q36
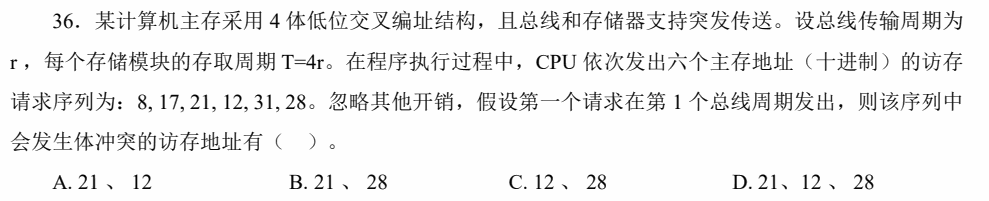
某计算机主存采用 4 体低位交叉编址结构,且总线和存储器支持突发传送。设总线传输周期为r ,每个存储模块的存取周期 T=4r。在程序执行过程中,CPU 依次发出六个主存地址(十进制)的访存请求序列为:8, 17, 21, 12, 31, 28。忽略其他开销,假设第一个请求在第 1 个总线周期发出,则该序列中会发生体冲突的访存地址有( )。
- A.21 、 12
- B.21 、 28
- C.12 、 28
- D.21、12 、 28
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q37
假定采用多模块交叉存储器组织方式,存储器芯片和总线支持突发传送,CPU通过存储器总线读取数据的过程为:发送首地址和读命令需 1 个时钟周期,存储器准备第一个数据需 8 个时钟周期,随后每个时钟周期总线上传送 1 个数据,可连续传送 8 个数据。若主存和 cache 之间交换的主存块大小为64B,存储宽度和总线宽度都为 8B,则 cache 的一次缺失损失(缺失开销)至少为( )个时钟周期。
- A.33
- B.20
- C.17
- D.65
Q38
磁盘的平均存取时间包括( )。
- A.寻道时间和旋转延迟时间
- B.寻道时间和数据传输时间
- C.旋转延迟时间和数据传输时间
- D.寻道时间、旋转延迟时间和数据传输时间
Q39
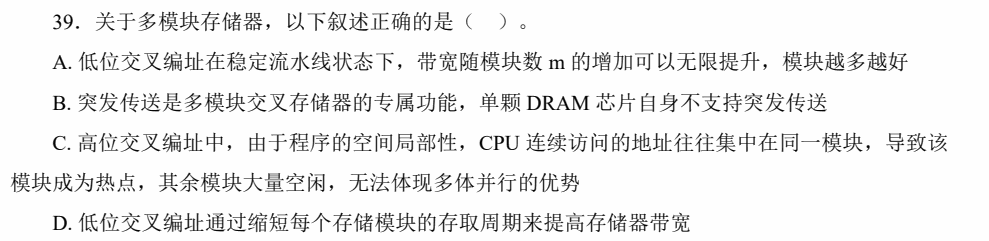
关于多模块存储器,以下叙述正确的是( )。
- A.低位交叉编址在稳定流水线状态下,带宽随模块数 m 的增加可以无限提升,模块越多越好
- B.突发传送是多模块交叉存储器的专属功能,单颗 DRAM 芯片自身不支持突发传送
- C.高位交叉编址中,由于程序的空间局部性,CPU 连续访问的地址往往集中在同一模块,导致该模块成为热点,其余模块大量空闲,无法体现多体并行的优势
- D.低位交叉编址通过缩短每个存储模块的存取周期来提高存储器带宽
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q40
固态硬盘采用的存储介质是( )。
- A.磁性材料
- B.半导体闪存芯片
- C.光盘片
- D.磁鼓
Q41
下列关于固态硬盘 SSD 的说法中,正确的是( )。
- A.固态硬盘属于磁表面存储器
- B.固态硬盘的闪存翻译层相当于磁盘中的磁盘控制器,起到地址转换的作用
- C.固态硬盘的随机读时延远低于常规硬盘,但随机写时延和常规硬盘的相差不大
- D.在对固态硬盘的某块写入信息时,不必按照块内页的顺序写入信息
Q42
下列关于固态硬盘(SSD)的说法中,错误的是( )。
- A.固态硬盘抗震性强、受机械震动影响较小,更适合移动设备使用。
- B.固态硬盘的磨损均衡技术中,动态磨损均衡比静态磨损均衡技术更先进、表现更优秀。
- C.固态硬盘的数据存储于 Flash 芯片之中。
- D.机械硬盘使用的硬盘调度算法不一定适用于固态硬盘。
Q43
下列关于固态硬盘 SSD 的说法中,正确的有( )。
I. 固态硬盘是基于闪存技术的存储技术
II. 固态硬盘在写入前必须进行擦除
III. 固态硬盘的读写性能、使用寿命均优于机械硬盘
IV. 固态硬盘写入时,总是要选择擦写次数少的存储块
- A.I、II
- B.I、II、III
- C.I、II、IV
- D.II、III、IV
Q44
下列关于固态硬盘(SSD)的叙述中,不正确的是( )。
- A.固态硬盘的读写是以页为单位的
- B.固态硬盘的擦除是以页为单位的
- C.固态硬盘的写入速度比读取速度慢很多
- D.固态硬盘的写入次数有限,引入磨损均衡可以延长使用寿命
Q45
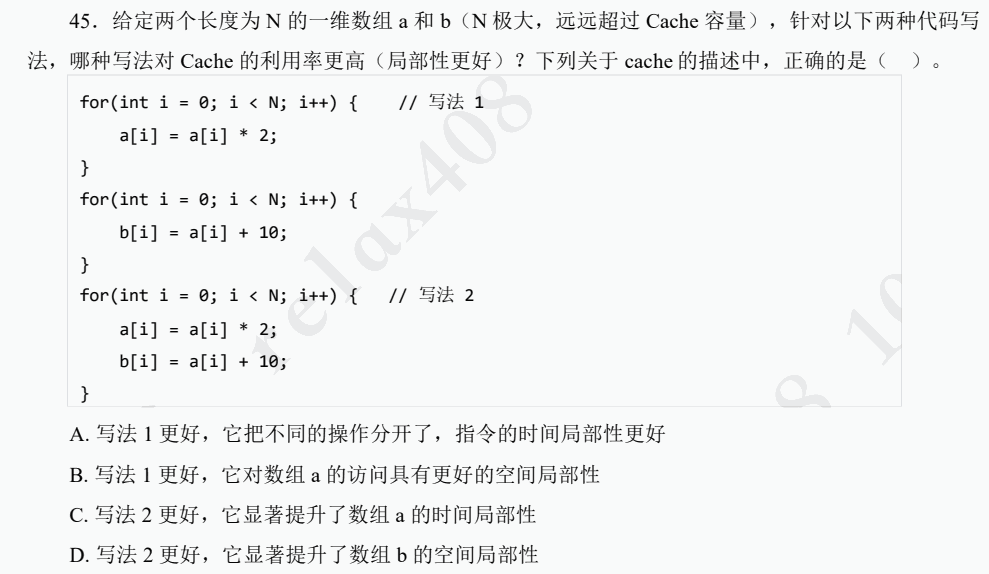
给定两个长度为 N 的一维数组 a 和 b(N 极大,远远超过 Cache 容量),针对以下两种代码写法,哪种写法对 Cache 的利用率更高(局部性更好)?下列关于 cache 的描述中,正确的是( )。for(int i = 0; i < N; i++) { // 写法 1 a[i] = a[i] * 2; } for(int i = 0; i < N; i++) { b[i] = a[i] + 10; } for(int i = 0; i < N; i++) { // 写法 2 a[i] = a[i] * 2; b[i] = a[i] + 10; }
- A.写法 1 更好,它把不同的操作分开了,指令的时间局部性更好
- B.写法 1 更好,它对数组 a 的访问具有更好的空间局部性
- C.写法 2 更好,它显著提升了数组 a 的时间局部性
- D.写法 2 更好,它显著提升了数组 b 的空间局部性
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q46
下列关于 cache 的描述中,正确的是( )。
- A.cache 行越大越好,这样可以提高 cache命中率
- B.直接映射方式无需考虑替换方式
- C.cache 可以看作内存的扩充
- D.在多级 cache 系统中,主存侧的 cache 通常将指令和数据分开,用两个 cache 存储
Q47
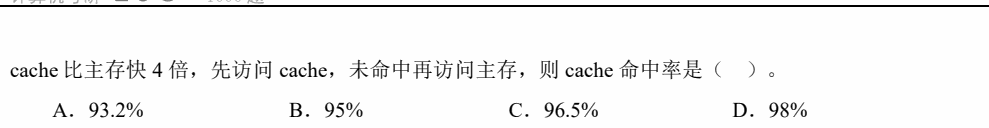
已知 cache-主存系统效率(cache命中访问时间/平均访问时间)为 85%,平均访问时间为 60ns,cache 比主存快 4 倍,先访问 cache,未命中再访问主存,则 cache 命中率是( )。
- A.93.2%
- B.95%
- C.96.5%
- D.98%
原页版面片段(公式/表图/电路/代码/数据通路以此为准)

王道核实旁注(非 Relax 原文):措辞歧义
“Cache 比主存快 4 倍”无唯一数学含义。原解析按 Tm=5Tc 得 C;若理解为主存时间是 Cache 的 4 倍,则 Tm=4Tc,结果约为 95.6%。必须明确“时间是几倍”后才能唯一作答。
[已降级 · 2026-09-01 逐题复核] “快 4 倍”措辞确有歧义,但按 Tm=4Tc 得 95.6% 并无对应选项,96.5% 精确命中 C,本题仍可唯一作答,不必视为废题。题旁改注“主存周期是 cache 的 5 倍”即可。
Q48
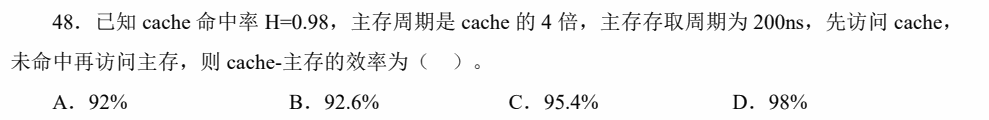
已知 cache 命中率 H=0.98,主存周期是 cache 的 4 倍,主存存取周期为 200ns,先访问 cache,未命中再访问主存,则 cache-主存的效率为( )。
- A.92%
- B.92.6%
- C.95.4%
- D.98%
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q49
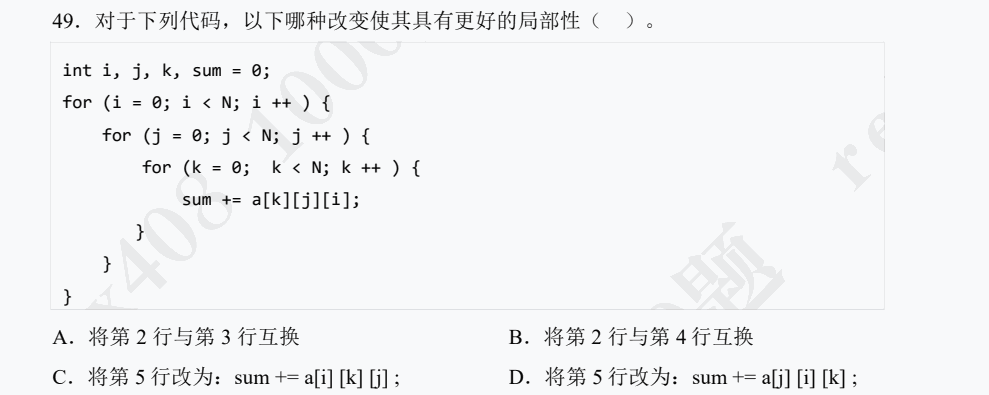
对于下列代码,以下哪种改变使其具有更好的局部性( )。int i, j, k, sum = 0; for (i = 0; i < N; i ++ ) { for (j = 0; j < N; j ++ ) { for (k = 0; k < N; k ++ ) { sum += a[k][j][i]; } } }
- A.将第 2 行与第 3 行互换
- B.将第 2 行与第 4 行互换
- C.将第 5 行改为:sum += a[i] [k] [j] ;
- D.将第 5 行改为:sum += a[j] [i] [k] ;
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q50
一个计算机有 cache、主存和用于虚拟存储的磁盘。若所访问的字在 cache 中,则存取它只需20ns。若字在主存而不在 cache 中,则需要 60ns 将它装入 cache,然后再从 cache 存取。若字不在主存中,则需要 12ns 将它由磁盘取来装入主存,再用 60ns 将它复制到 cache,最后从 cache 存取。cache 命中率是 0.9,主存命中率是 0.6。那么此系统访问一个字的平均存取时间是(以 ns 为单位)( )。
- A.18
- B.21.68
- C.22.8
- D.26.48
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
王道核实旁注(非 Relax 原文):单位异常
磁盘读取时间印为 12ns 明显异常;若字面按 12ns 计算,原答案 D 可复现;若原意为 12ms,则平均时间约为 0.480023ms,四个 ns 选项全部失效。本题不宜当作正常单选题背答案。
[已降级 · 2026-09-01 逐题复核] 12ns 经原页截图确认为印刷原文;按字面计算 D=26.48ns 自洽,本题仍可作答。只需知道该数值不合实际,不必当废题跳过。
Q51
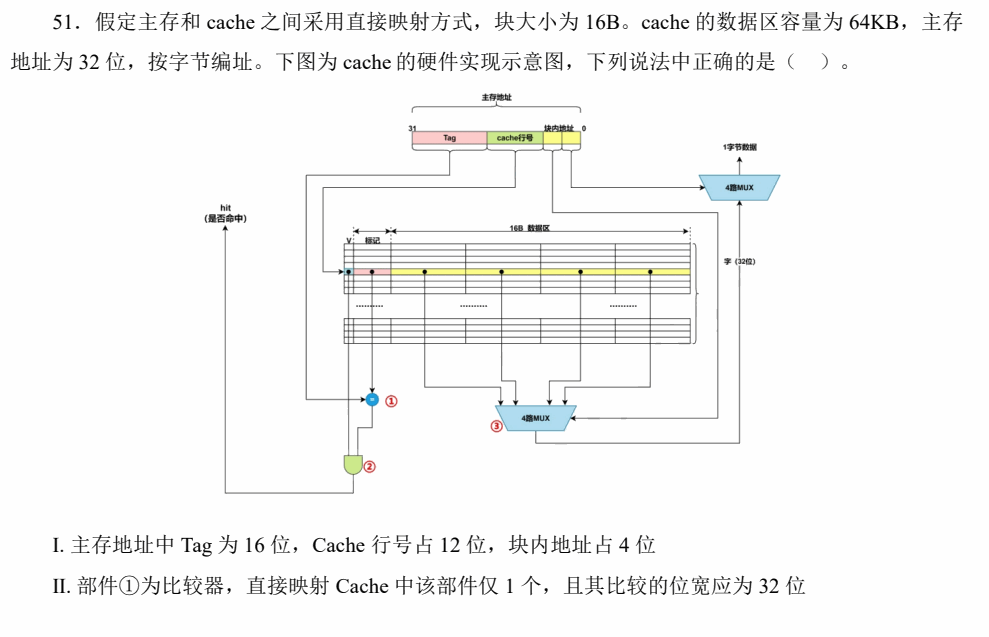
假定主存和 cache 之间采用直接映射方式,块大小为 16B。cache 的数据区容量为 64KB,主存地址为 32 位,按字节编址。下图为 cache 的硬件实现示意图,下列说法中正确的是( )。
Ⅰ. 主存地址中 Tag 为 16 位,Cache 行号占 12 位,块内地址占 4 位
Ⅱ. 部件①为比较器,直接映射 Cache 中该部件仅 1 个,且其比较的位宽应为 32 位
Ⅲ. 部件②为与门,如果比较器比较结果为相同,并且该 Cache 行的有效位为 1,则该与门输出为1,表示 Cache 命中
Ⅳ. 部件③为多路选择器(MUX),其控制信号来自于块内地址的低 2bit
Ⅴ. 假设写操作采用直写方式(Write-Through),则该 Cache 的总容量位数至少是 593920 位
Ⅵ.直接映射无需考虑替换算法,发生冲突直接替换冲突数据块即可
- A.Ⅰ、Ⅲ、Ⅴ 、Ⅵ
- B.Ⅰ、Ⅱ、Ⅲ
- C.Ⅱ、Ⅳ、Ⅴ 、Ⅵ
- D.Ⅰ、Ⅲ、Ⅳ、Ⅵ
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q52
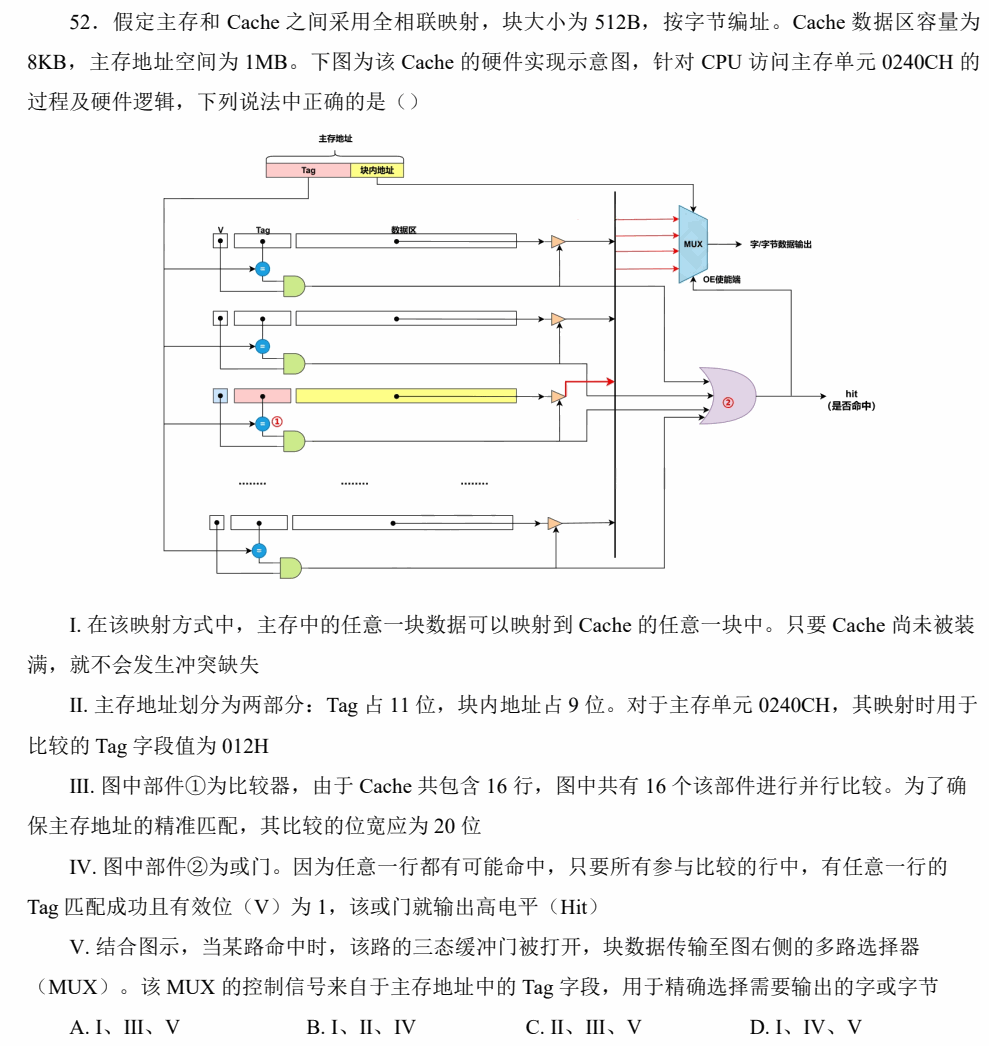
假定主存和 Cache 之间采用全相联映射,块大小为 512B,按字节编址。Cache 数据区容量为8KB,主存地址空间为 1MB。下图为该 Cache 的硬件实现示意图,针对 CPU 访问主存单元 0240CH 的过程及硬件逻辑,下列说法中正确的是()
Ⅰ. 在该映射方式中,主存中的任意一块数据可以映射到 Cache 的任意一块中。只要 Cache 尚未被装满,就不会发生冲突缺失
Ⅱ. 主存地址划分为两部分:Tag 占 11 位,块内地址占 9 位。对于主存单元 0240CH,其映射时用于比较的 Tag 字段值为 012H
Ⅲ. 图中部件①为比较器,由于 Cache 共包含 16 行,图中共有 16 个该部件进行并行比较。为了确保主存地址的精准匹配,其比较的位宽应为 20 位
Ⅳ. 图中部件②为或门。因为任意一行都有可能命中,只要所有参与比较的行中,有任意一行的Tag 匹配成功且有效位(V)为 1,该或门就输出高电平(Hit)
Ⅴ. 结合图示,当某路命中时,该路的三态缓冲门被打开,块数据传输至图右侧的多路选择器(MUX)。该 MUX 的控制信号来自于主存地址中的 Tag 字段,用于精确选择需要输出的字或字节
- A.Ⅰ、Ⅲ、Ⅴ
- B.Ⅰ、Ⅱ、Ⅳ
- C.Ⅱ、Ⅲ、Ⅴ
- D.Ⅰ、Ⅳ、Ⅴ
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q53
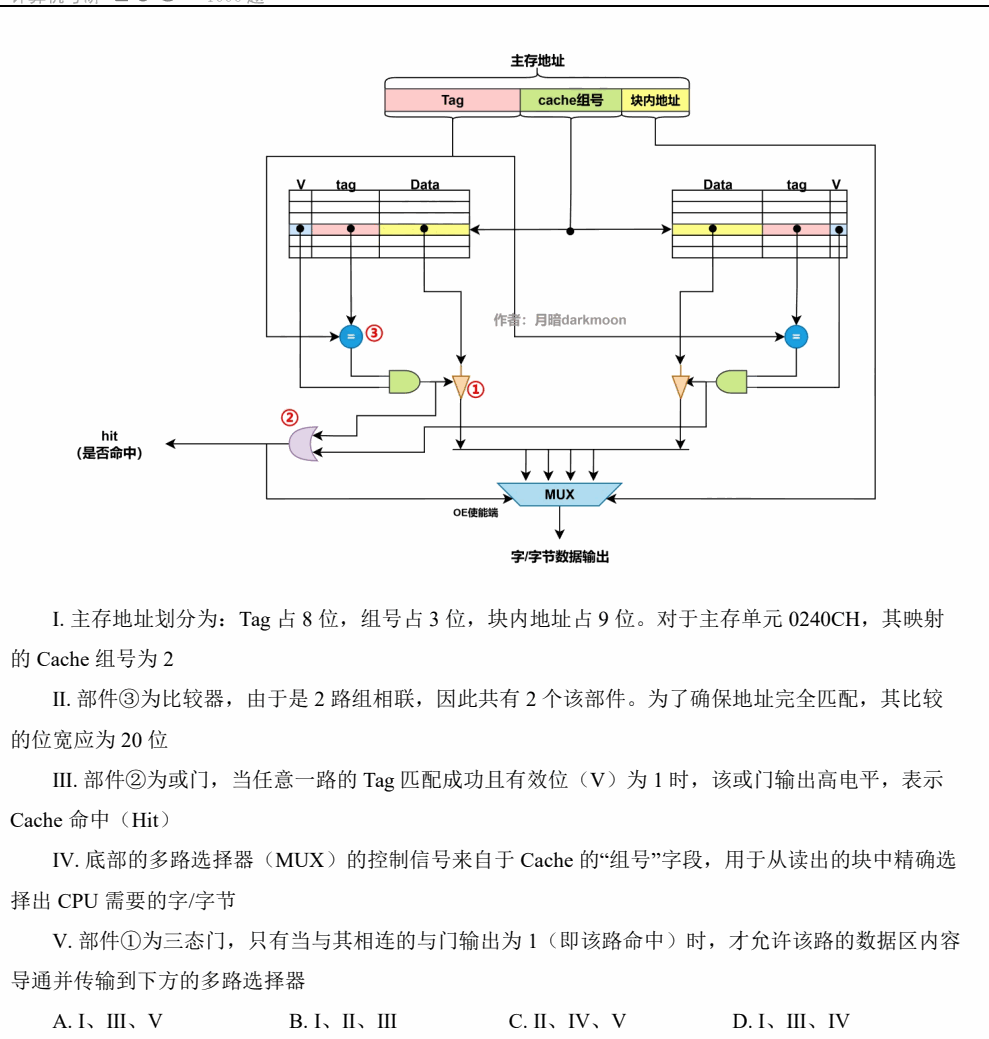
假定主存和 Cache 之间采用 2 路组相联映射,块大小为 512B,采用字节编址。Cache 数据区容量为 8KB,主存地址空间为 1MB。下图为该 Cache 的硬件实现示意图,针对 CPU 访问主存单元0240CH 的过程及底层硬件逻辑,下列说法中正确的是( )。
Ⅰ. 主存地址划分为:Tag 占 8 位,组号占 3 位,块内地址占 9 位。对于主存单元 0240CH,其映射的 Cache 组号为 2
Ⅱ. 部件③为比较器,由于是 2 路组相联,因此共有 2 个该部件。为了确保地址完全匹配,其比较的位宽应为 20 位
Ⅲ. 部件②为或门,当任意一路的 Tag 匹配成功且有效位(V)为 1 时,该或门输出高电平,表示Cache 命中(Hit)
Ⅳ. 底部的多路选择器(MUX)的控制信号来自于 Cache 的“组号”字段,用于从读出的块中精确选择出 CPU 需要的字/字节
Ⅴ. 部件①为三态门,只有当与其相连的与门输出为 1(即该路命中)时,才允许该路的数据区内容导通并传输到下方的多路选择器
- A.Ⅰ、Ⅲ、Ⅴ
- B.Ⅰ、Ⅱ、Ⅲ
- C.Ⅱ、Ⅳ、Ⅴ
- D.Ⅰ、Ⅲ、Ⅳ
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q54
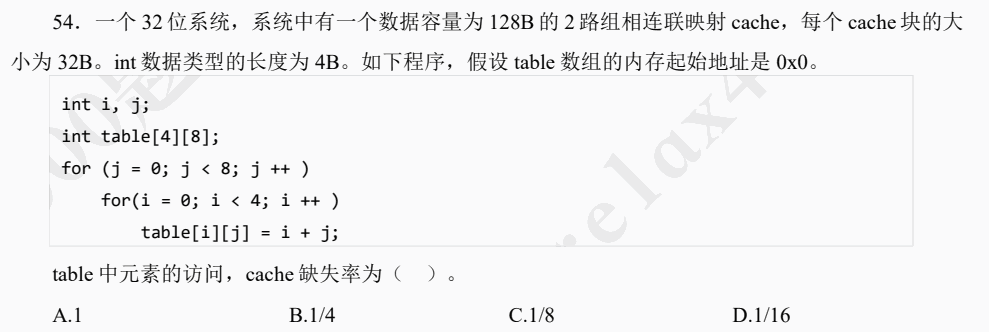
一个 32位系统,系统中有一个数据容量为 128B的 2路组相连联映射 cache,每个 cache块的大小为 32B。int 数据类型的长度为 4B。如下程序,假设 table 数组的内存起始地址是 0x0。int i, j; int table[4][8]; for (j = 0; j < 8; j ++ ) for(i = 0; i < 4; i ++ ) table[i][j] = i + j; table 中元素的访问,cache 缺失率为( )。
- A.1
- B.1/4
- C.1/8
- D.1/16
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q55
某计算机主存容量 4GB,按字节编址。Cache 采用二路组相联映射方式,共有 1024 行,若主存地址中标记位字段长度为 12,则 Cache 块大小是( )。
- A.512B
- B.1KB
- C.2KB
- D.4KB
Q56
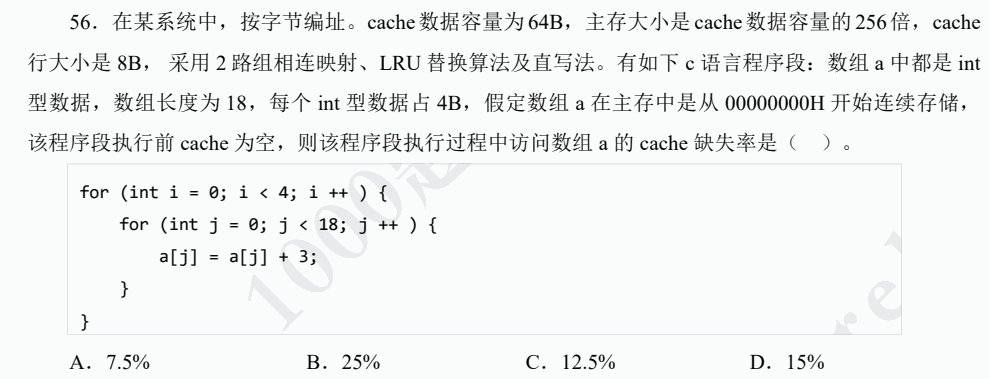
在某系统中,按字节编址。cache数据容量为64B,主存大小是cache数据容量的256倍,cache行大小是 8B, 采用 2 路组相连映射、LRU 替换算法及直写法。有如下 c 语言程序段:数组 a 中都是 int型数据,数组长度为 18,每个 int 型数据占 4B,假定数组 a 在主存中是从 00000000H 开始连续存储,该程序段执行前 cache 为空,则该程序段执行过程中访问数组 a 的 cache 缺失率是( )。for (int i = 0; i < 4; i ++ ) { for (int j = 0; j < 18; j ++ ) { a[j] = a[j] + 3; } }
- A.7.5%
- B.25%
- C.12.5%
- D.15%
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q57
假定主存地址位数为32位,按字节编址,主存和cache之间采用直接映射方式,主存块大小为1 个字,每字 32 位,写操作时采用回写方式,则能存放 32K字数据的 cache 总容量至少应有( )位。
- A.1504K
- B.1536K
- C.1568K
- D.1600K
Q58
假定某个计算机的内存地址空间为 64M,按字节编址,其数据 cache 有 8 个 cache 行,主存块块长 64B,采用回写(WriteBack)方式和随机替换策略,若 cache总容量为 532B,则 cache最可能采用的映射方式为( ),cache 中比较器的数量为( )。
- A.直接映射,1 个
- B.组相联映射,4 个
- C.组相连映射,2 个
- D.全相联映射,1 个
Q59
在指令存储器设置一个容量为 1KB 的 cache,采用 4 路组相联,每块 2 个字(字长 16bit),按字节编址。其 cache 中选出命中的行(如果存在)需要几个多路选择器以及每个多路选择器需要几位来控制( )。
- A.1 个多路选择器,每个多路选择器需要 4bit 用于控制
- B.4 个多路选择器,每个多路选择器需要 2bit 用于控制
- C.1 个多路选择器,每个多路选择器需要 2bit 用于控制
- D.4 个多路选择器,每个多路选择器需要 4bit 用于控制
Q60
某 32 位计算机的 cache 容量为 16KB,按字节编址,cache 行的大小为 16B,若主存与 cache 地址映像采用直接映像方式,则主存地址为 0x1234E8F8 的单元装入 cache 的地址是( )。
- A.00010001001101
- B.11010011101000
- C.01000100011010
- D.10100011111000
Q61
以下替换算法可能产生“Belady 异常”的是( )。
- A.先进先出算法(FIFO)
- B.最近最少使用算法(LRU)
- C.随机替换算法
- D.最不经常使用算法(LFU)
Q62
假设有一个块数为 4 的 Cache,采取全相联映射。起初 Cache 中内容为空,接下来 CPU 连续访问了以下主存块(均为十进制):1,2,3,4,5,4,2,3,5,1。当 Cache 采取 LRU 替换策略时,命中率为( )。
- A.20%
- B.30%
- C.40%
- D.50%
Q63
关于 Cache 写策略,若采用回写法,以下说法正确的是( )。
- A.数据写入 Cache 的同时也写入主存
- B.只有当 Cache 中的数据被替换时,才将其写回主存
- C.写操作速度较慢,因为需要等待主存写入完成
- D.不会出现 Cache 与主存数据不一致的情况
Q64
主存地址为 32位,按字节编址,主存和 cache 之间采用直接映射方式,主存块大小为 4 个字,每个字 32 位,采用回写(writeback)方式,则能存放 4K字数据的 Cache 的总容量的位数是( )。
- A.148K 位
- B.158K位
- C.146K 位
- D.147K 位
Q65
关于 Cache 的全写法(写直达法)和写回法这两种写策略,以下说法正确的是( )。
I.采用写回法时,只有在第一次写入 Cache 时需要写入主存
II.采用全写法时,写命中时则同时写 Cache 和辅存
III.采用写回法时,每块 Cache 都需要多加一位辅助位
- A.仅 I、III
- B.仅 II
- C.仅 III
- D.I、II 和 III
Q66
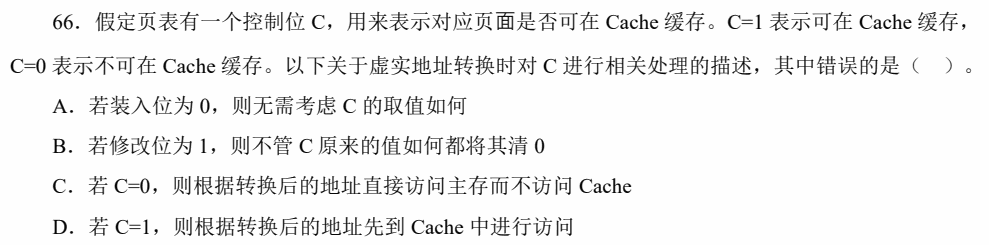
假定页表有一个控制位 C,用来表示对应页⾯是否可在 Cache 缓存。C=1 表示可在 Cache 缓存,C=0 表示不可在 Cache 缓存。以下关于虚实地址转换时对 C 进行相关处理的描述,其中错误的是( )。
- A.若装入位为 0,则无需考虑 C 的取值如何
- B.若修改位为 1,则不管 C 原来的值如何都将其清 0
- C.若 C=0,则根据转换后的地址直接访问主存而不访问 Cache
- D.若 C=1,则根据转换后的地址先到 Cache 中进行访问
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q67
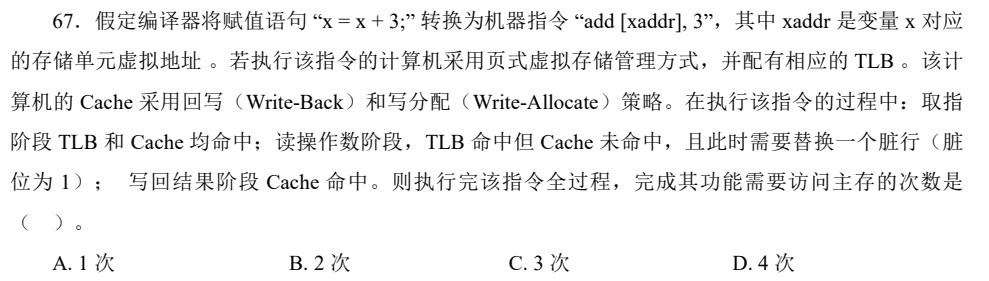
假定编译器将赋值语句 “x = x + 3;” 转换为机器指令 “add [xaddr], 3”,其中 xaddr 是变量 x 对应的存储单元虚拟地址 。若执行该指令的计算机采用页式虚拟存储管理方式,并配有相应的 TLB 。该计算机的 Cache 采用回写(Write-Back)和写分配(Write-Allocate)策略。在执行该指令的过程中:取指阶段 TLB 和 Cache 均命中;读操作数阶段,TLB 命中但 Cache 未命中,且此时需要替换一个脏行(脏位为 1); 写回结果阶段 Cache 命中。则执行完该指令全过程,完成其功能需要访问主存的次数是( )。
- A.1 次
- B.2 次
- C.3 次
- D.4 次
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q68
以下关于虚拟存储器的说法,错误的是( )。
- A.虚拟存储器技术需要硬件和软件的协同支持
- B.页式虚拟存储器中,页面置换可能会导致抖动现象
- C.段式虚拟存储器便于实现程序的动态链接和共享
- D.虚拟存储器的容量只受外存容量的限制
Q69
已知某计算机按字节编址,虚拟地址为 32 位,物理地址为 28 位,采用单级页式虚拟存储管理,页面大小为 4KB。其数据 Cache 采用 4 路组相联映射,总容量为 16KB,主存块大小为 32B。若某进程执行时,CPU 发出虚拟地址 0x00456ABC,查页表后得到的对应物理页框号为 0x012F。则该主存块被映射到的 Cache 组号(十进制)以及 Cache 标记(Tag,十六进制)分别是( )。
- A.组号 85,标记 0x012F
- B.组号 85,标记 0x0456
- C.组号 43,标记 0x012F
- D.组号 43,标记 0x0456
Q70
关于内存管理单元 (MMU) 的工作机制及异常处理,下列说法正确的是( )。
- A.缺页时,MMU 会直接从外存中读取目标页面并调入主存
- B.Cache 缺失和 TLB 缺失一样,都是在 MMU 进行地址转换的过程中被检测出来的
- C.若 TLB 命中,MMU 在完成虚拟地址到物理地址的转换时,完全不需要访问页表基址寄存器(PTBR)
- D.无论是哪种计算机架构,TLB 缺失后的表项填充操作都必须由操作系统内核中的异常处理程序(软件)来完成
Q71
某系统依次进行 4 次访存操作的情况如下:①TLB 命中,Cache 未命中 ②TLB 未命中,页表未命中,cache未命中③TLB 命中,Cache 命中 ④TLB 未命中,页表命中,Cache 未命中已知缺页处理时会更新 TLB 和页表,将缺页处理过程只视作一次访存,4 次访存操作之间操作数独立,则总访存次数是( )。
- A.6
- B.5
- C.8
- D.7
Q72
某个系统拥有 48 位的虚拟地址和 36 位的物理地址,按字节编址,并且主存储器的容量为128MB。如果系统中使用的页的大小为 4096 字节,该地址空间能够支持的虚页数为( )个,实页数为( )个。
- A.236,224
- B.248,236
- C.248,212
- D.236,212
Q73
已知某计算机采用单级页式虚拟存储管理,配有 TLB 和 Cache。CPU 执行一条读内存的取数指令(不考虑取指阶段)。假设不考虑 Cache 的写回操作(Write-Back)造成的额外开销,并且注意cache 也会缓存页表项。下列关于访存状态组合与主存访问次数的推断中,错误的是( )。
- A.若本次取数操作完全没有访问主存(即 0 次主存访问),则必定是因为:TLB 命中,且目标数据在 Cache 中命中
- B.若 TLB 未命中,但本次取数操作仅访问了 1 次主存,可能是因为:页表项在 Cache 中未命中,而目标数据在 Cache 中命中
- C.若 TLB 命中,但目标数据在 Cache 中未命中,硬件可能仅需访问 1 次主存可完成该取数指令
- D.无论 Cache 的命中率多高,只要在地址翻译阶段检测到了缺页异常,则本次访存的 TLB 必定是未命中的,且目标数据必定不在 Cache 中
Q74
以下是有关缺页处理的叙述,其中错误的是( )。
- A.若对应页表项中的有效位为 0,则发生缺页
- B.缺页是一种外部中断,需要调用操作系统提供的中断服务程序来处理
- C.缺页处理过程中需根据页表中给出的磁盘地址去读磁盘数据
- D.缺页处理完后要重新执行发生缺页的指令
Q75
为了缓解处理器与主存之间的速度差异,现代计算机系统同时引入了 TLB 和 Cache。下列关于TLB 与 Cache 工作机制及缺失行为的叙述中,错误的是( )。
- A.进程切换时,由于虚拟地址空间发生改变,TLB 必须进行刷新而 Cache 通常无需刷新,因为不同进程的 Cache 内容可以共存
- B.CPU 发出内存访问请求时,TLB 加速的是“地址翻译”,以虚拟页号作为查询依据;Cache 加速的是“数据读取”,通常以物理地址作为查询依据
- C.当 Cache 发生缺失时,必然由硬件自动完成数据块的替换与调入;而当 TLB 发生缺失时,必然会触发 TLB 缺失异常,引出操作系统内核中的异常处理程序来手动填充表项
- D.在一次取数操作中,完全可能出现“TLB 缺失,但由于页表项和目标数据均在 Cache 中命中,最终硬件访问主存的次数为 0 次”的理想情况
Q76
段式虚拟存储器的基本原理是( )。
- A.将程序按逻辑模块分段,每段分配连续的内存空间
- B.将内存划分为固定大小的页,程序按页存储
- C.结合页式和段式的优点,先分段再分页
- D.所有程序共享一个段表,通过段号访问
Q77
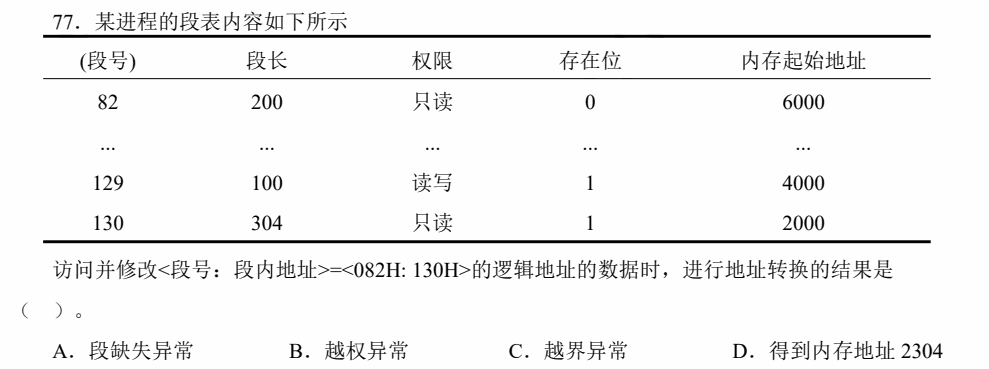
某进程的段表内容如下所示(段号) 段长 权限 存在位 内存起始地址82 200 只读 0 6000 ... ... ... ... ... 129 100 读写 1 4000 130 304 只读 1 2000访问并修改<段号:段内地址>=<082H: 130H>的逻辑地址的数据时,进行地址转换的结果是( )。
- A.段缺失异常
- B.越权异常
- C.越界异常
- D.得到内存地址 2304
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q78
以下是有关段式存储管理的叙述,其中错误的是( )。
- A.段是逻辑结构上相对独立的程序块,因此段是可变长的
- B.按程序中实际的段来分配主存,所以分配后的存储块是可变长的
- C.每个段表项必须记录对应段在主存的起始位置和段的长度
- D.分段方式对低级语言程序员和编译器来说是透明的
Q79
某段页式虚拟存储器系统中,段表项大小为 4 字节,页表项大小也为 4 字节。若某进程的段表中有 8 个段表项,平均每个段的页表有 32 个页表项,则该进程的段表和页表共占用内存空间大小是( )。
- A.512 字节
- B.1024 字节
- C.1056 字节
- D.2048 字节