Relax1000 计算机组成原理 · 第3章 存储器层次结构 · 解析
第3章 存储器层次结构
本章 79 题;解析册印刷页 103–118。
速对答案(原书): CCACB CADDC DCBAB DCCCD CCCCA DABBA BCBCB BCDCB BBABC BCBBD ABACC CCCCD ACBAC BBDAC AAABC ACDC
Q1
速对表原值: C
详细解析标注: C
SRAM(静态随机存取存储器)是利用半导体器件的双稳态电路来存储信息,属于半导体存储器,C 正确;机械硬盘是磁表面存储器,一般又称磁盘,A 错误;光盘是光存储器,B 错误;磁带也是磁表面存储器,D 错误。
注意:固态硬盘属于半导体存储器,其核心存储介质为闪存,不同于机械硬盘。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q2
速对表原值: C
详细解析标注: C
A 选项错误:固态硬盘(SSD)是基于闪存技术(Flash Memory),属于半导体介质 。传统的机械硬盘(HDD)才是磁表面存储器 。
B 选项错误:RAM 和 ROM 确实都采用随机存取方式 ,但并非所有半导体存储器都是按地址随机访问。例如快表(TLB)和全相联 Cache 的 Tag 是按内容访问(CAM)的半导体存储器。
C 选项正确:CD-ROM 属于光存储器,光头可以先定位区域(直接)再顺序查找(顺序),这种结合的模式属于直接存取(DAM)。
D 选项错误:通用计算机的主存由 RAM 和 ROM 共同组成,包含存放系统启动程序的 ROM 区(BIOS),所以“全部由 DRAM 构成”是错误的 。
Q3
速对表原值: A
详细解析标注: A
Cache(高速缓存)可以随机地对任何存储单元进行存取操作,属于随机存取存储器;顺序存取存储器如磁带,只能按顺序依次访问;直接存取存储器如磁盘,先直接定位到存储区域,再顺序访问;只读存储器只能读取数据。
Q4
速对表原值: C
详细解析标注: C
A 选项错误: 传统的机械硬盘(HDD)依靠磁盘盘片和读写磁头工作,属于磁表面存储器 ;而固态硬盘(SSD)是基于闪存技术(Flash Memory),属于半导体存储器 。两者介质完全不同。
B 选项错误: 这道题的陷阱在于后半句:DRAM 是以电容充电原理寄存信息的,电荷会逐渐泄漏,因此必须定期进行刷新;相反,SRAM 是以触发器原理寄存信息的,不需要定期刷新。
C 选项正确: 我们常用的固态硬盘或 U 盘所使用的闪存(Flash Memory),属于半导体存储器 。它在技术分类上属于电可擦除的 ROM,即 EEPROM ()。
D 选项错误: 前半句是正确的,CPU 内部的通用寄存器组(以及 Cache、主存等)都属于半导体存储器 ,用来存放地址、数据及运算的中间结果。但后半句错误:寄存器属于易失性存储器,一旦断电,内部存储的高低电平状态就会消失,无法永久保存数据。
Q5
速对表原值: B
详细解析标注: B
DRAM(动态随机存取存储器)利用电容存储电荷来表示信息,由于电容会漏电,需要定期刷新;基于触发器存储信息的是 SRAM;基于磁性材料存储信息的有硬盘、磁带等;基于光反射原理存储信息的是光盘,A、C、D 错误。
Q6
速对表原值: C
详细解析标注: C
A.半导体 RAM 信息可读可写,但断电后不能保持记忆,A 错误。B.动态的 RAM 和静态的 RAM 都是易失性存储器,B 错误。D.ROM 不用刷新,但集成度不比动态 RAM 高,且断电后存储的信息仍能保持,D 错误。
Q7
速对表原值: A
详细解析标注: A
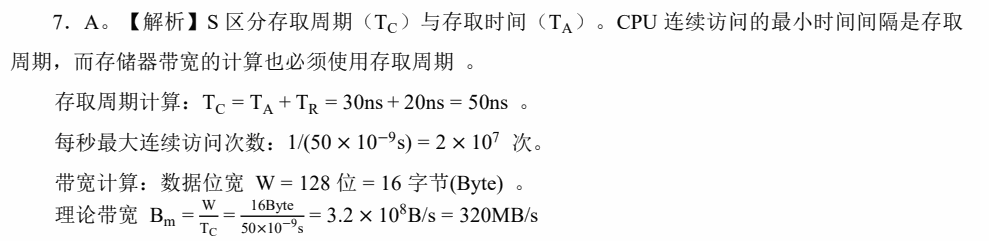
S 区分存取周期(TC)与存取时间(TA)。CPU 连续访问的最小时间间隔是存取周期,而存储器带宽的计算也必须使用存取周期 。存取周期计算:TC = TA + TR = 30ns + 20ns = 50ns 。每秒最大连续访问次数:1/(50 × 10−9s) = 2 × 10⁷次。带宽计算:数据位宽 W = 128 位 = 16 字节(Byte) 。理论带宽 Bm =W TC =16Byte 50×10−9s = 3.2 × 10⁸ B/s = 320MB/s
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q8
速对表原值: D
详细解析标注: D
相联存储器是指按照内容寻址的存储器,故 D 正确。
Q9
速对表原值: D
详细解析标注: D
A 错误,在某些特定的写策略(如 Write Back 写回法)下,Cache 中的最新数据在未被替换前,主存中的对应数据是旧的,两者并非严格的包含关系(主存和辅存之间也是这样,主存采用写回时,这两数据也有可能不一致);
B 错误,速度差异只能“缓解”或“掩盖”,无法“彻底消除”;
C 错误,系统的整体访问速度应接近最高层(Cache 或寄存器)而非主存;
D 正确,系统的容量和单位成本接近外存(最下层)。
Q10
速对表原值: C
详细解析标注: C
A 错误,Cache-主存完全由硬件管理;
B 错误,主存-辅存(虚拟存储器)是由操作系统和硬件结合管理的,且对系统程序员不透明(系统程序员需要编写缺页处理程序等);
D 错误,虚拟存储器对应用程序员透明,但对系统程序员是不透明的;C 准确描述了 Cache 层级的交换单位和目的。
Q11
速对表原值: D
详细解析标注: D
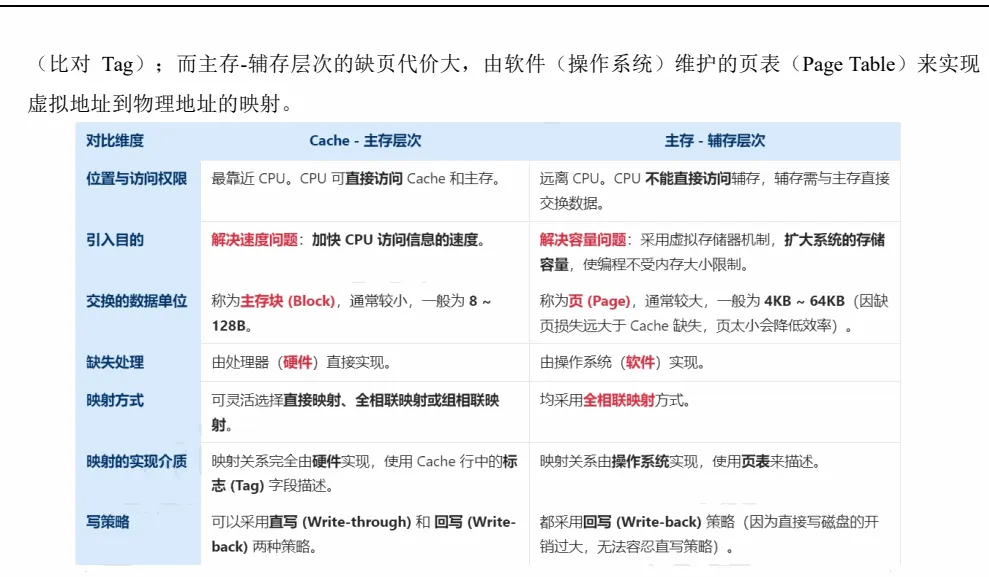
D 错误:两个层次在“透明性”上是不同的。Cache-主存层次的数据交换完全由硬件自动完成,对所有程序员(无论是应用程序员还是系统程序员)都是透明的;而主存-辅存层次(虚拟存储器)的数据交换由硬件和操作系统共同完成,它只对应用程序员透明,但对系统程序员是不透明的(因为系统程序员需要编写操作系统中的缺页中断处理、页面替换等底层硬件调度代码)。
A 正确: 准确描述了两者的引入目的。Cache 用于提速(填补 CPU 和主存间的速度鸿沟),虚拟存储器(主存-辅存)用于扩容。
B 正确: 准确描述了 CPU 的访问权限。Cache 和主存属于内部存储器,CPU 可直接寻址访问;辅存属于外部存储器,必须经过主存作为中转。
C 正确: 准确描述了映射关系的实现介质。Cache 为了极致的速度,映射和查找全靠纯硬件电路(比对 Tag);而主存-辅存层次的缺页代价大,由软件(操作系统)维护的页表(Page Table)来实现虚拟地址到物理地址的映射。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q12
速对表原值: C
详细解析标注: C
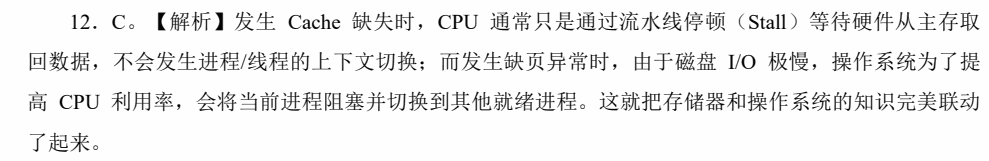
发生 Cache 缺失时,CPU 通常只是通过流水线停顿(Stall)等待硬件从主存取回数据,不会发生进程/线程的上下文切换;而发生缺页异常时,由于磁盘 I/O 极慢,操作系统为了提高 CPU 利用率,会将当前进程阻塞并切换到其他就绪进程。这就把存储器和操作系统的知识完美联动了起来。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q13
速对表原值: B
详细解析标注: B
SRAM 利用触发器存储信息,不需要刷新,速度快,但由于其存储单元结构复杂,成本高,集成度低;DRAM 利用电容存储信息,需要定期刷新,速度相对较慢,不过成本低,集成度高,B 正确,A、C、D 错误。
Q14
速对表原值: A
详细解析标注: A
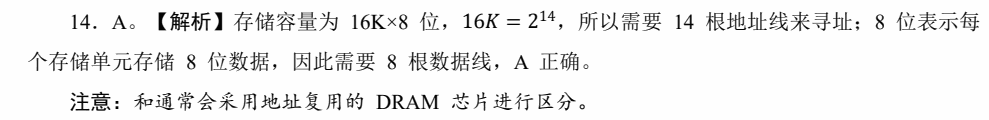
存储容量为 16K×8 位,16〔公式/符号见原页版面片段〕 = 214,所以需要 14 根地址线来寻址;8 位表示每个存储单元存储 8 位数据,因此需要 8 根数据线,A 正确。
注意:和通常会采用地址复用的 DRAM 芯片进行区分。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
PDF 字形回源提示(非原文)
原 PDF 的部分数学字体没有 Unicode 映射;可搜索文本保留了明确占位,公式和符号以本题的原页片段为准。
Q15
速对表原值: B
详细解析标注: B
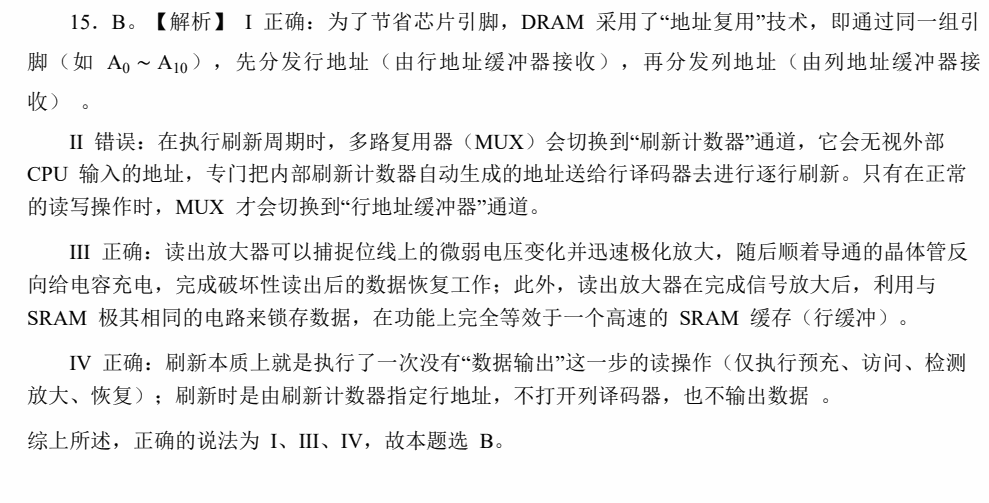
I 正确:为了节省芯片引脚,DRAM 采用了“地址复用”技术,即通过同一组引脚(如 A0 ∼ A10),先分发行地址(由行地址缓冲器接收),再分发列地址(由列地址缓冲器接收) 。II 错误:在执行刷新周期时,多路复用器(MUX)会切换到“刷新计数器”通道,它会无视外部CPU 输入的地址,专门把内部刷新计数器自动生成的地址送给行译码器去进行逐行刷新。只有在正常的读写操作时,MUX 才会切换到“行地址缓冲器”通道。III 正确:读出放大器可以捕捉位线上的微弱电压变化并迅速极化放大,随后顺着导通的晶体管反向给电容充电,完成破坏性读出后的数据恢复工作;此外,读出放大器在完成信号放大后,利用与SRAM 极其相同的电路来锁存数据,在功能上完全等效于一个高速的 SRAM 缓存(行缓冲)。IV 正确:刷新本质上就是执行了一次没有“数据输出”这一步的读操作(仅执行预充、访问、检测放大、恢复);刷新时是由刷新计数器指定行地址,不打开列译码器,也不输出数据 。综上所述,正确的说法为 I、III、IV,故本题选 B。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q16
速对表原值: D
详细解析标注: D
Flash 存储器(闪存)属于非易失性存储器,断电后数据不丢失,A 正确;它可以通过电信号进行擦除和编程操作,B 正确;Flash 的读取速度较快,与半导体 RAM 相当,C 正确;但 Flash 的写操作速度相对较慢,因为其写入前必须先进行整片或区块擦除,写入速度通常与硬磁盘存储器相当,D 错误 。本题选不包括的特点,故选 D。
Q17
速对表原值: C
详细解析标注: C
总容量 64K×32 位,需 (64K/16K) × (32 位/8 位) = 4×4 = 16 片,C 正确。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
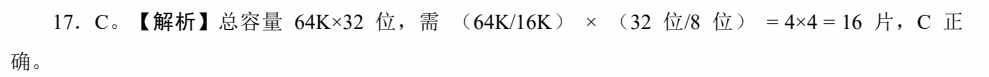
Q18
速对表原值: C
详细解析标注: C
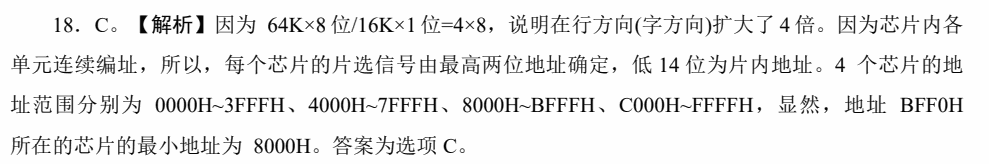
因为 64K×8位/16K×1位=4×8,说明在行方向(字方向)扩大了4 倍。因为芯片内各单元连续编址,所以,每个芯片的片选信号由最高两位地址确定,低 14 位为片内地址。4 个芯片的地址范围分别为 0000H~3FFFH、4000H~7FFFH、8000H~BFFFH、C000H~FFFFH,显然,地址 BFF0H所在的芯片的最小地址为 8000H。答案为选项 C。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q19
速对表原值: C
详细解析标注: C
由于按字编址,即每个存储单元为 4 字节,故只需要 23 根地址线来寻址,需要 32 根数据线,C 正确。
Q20
速对表原值: D
详细解析标注: D
地址个数为 1M,行列各 10 根地址线,行列地址分时复用地址线,分别送到行列译码器,行列译码器的输出线有210根。DRAM 按行刷新,所以刷新计数器即行地址线根数=10。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)

Q21
速对表原值: C
详细解析标注: C
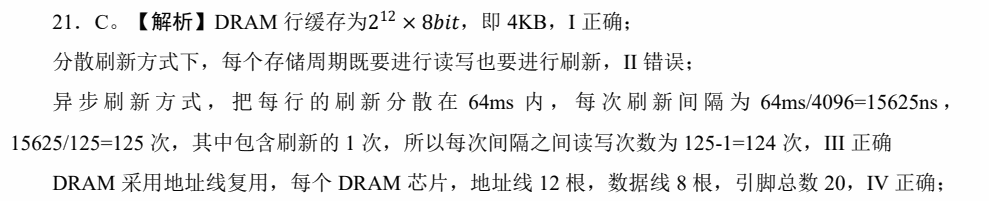
DRAM 行缓存为212 × 8〔公式/符号见原页版面片段〕,即 4KB,I 正确;分散刷新方式下,每个存储周期既要进行读写也要进行刷新,II 错误;异 步 刷 新 方 式 , 把 每 行 的 刷 新 分 散 在 64ms 内 , 每 次 刷 新 间 隔 为 64ms/4096=15625ns ,15625/125=125 次,其中包含刷新的 1 次,所以每次间隔之间读写次数为 125-1=124 次,III 正确DRAM 采用地址线复用,每个 DRAM 芯片,地址线 12 根,数据线 8 根,引脚总数 20,IV 正确;
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
PDF 字形回源提示(非原文)
原 PDF 的部分数学字体没有 Unicode 映射;可搜索文本保留了明确占位,公式和符号以本题的原页片段为准。
Q22
速对表原值: C
详细解析标注: C
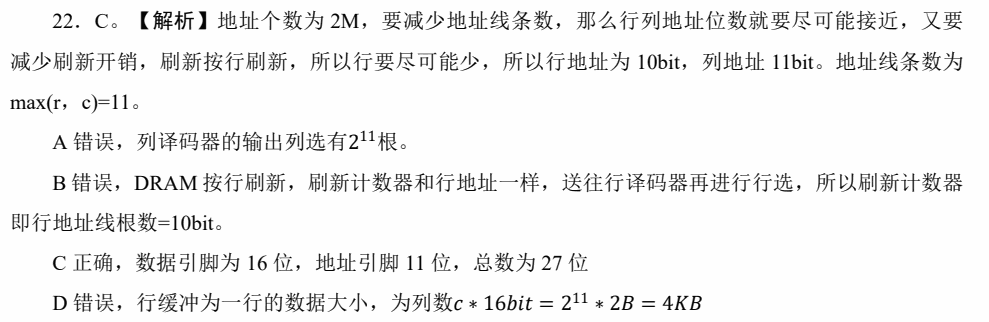
地址个数为 2M,要减少地址线条数,那么行列地址位数就要尽可能接近,又要减少刷新开销,刷新按行刷新,所以行要尽可能少,所以行地址为 10bit,列地址 11bit。地址线条数为max(r,c)=11。
A 错误,列译码器的输出列选有211根。
B 错误,DRAM 按行刷新,刷新计数器和行地址一样,送往行译码器再进行行选,所以刷新计数器即行地址线根数=10bit。
C 正确,数据引脚为 16 位,地址引脚 11 位,总数为 27 位D 错误,行缓冲为一行的数据大小,为列数〔公式/符号见原页版面片段〕 ∗ 16〔公式/符号见原页版面片段〕 = 211 ∗ 2〔公式/符号见原页版面片段〕 = 4〔公式/符号见原页版面片段〕
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
PDF 字形回源提示(非原文)
原 PDF 的部分数学字体没有 Unicode 映射;可搜索文本保留了明确占位,公式和符号以本题的原页片段为准。
Q23
速对表原值: C
详细解析标注: C
DRAM 依靠电容存储电荷来表示数据,由于电容存在漏电现象,一段时间后电荷会丢失,导致数据错误,因此需要定期刷新,补充存储电容上泄漏的电荷,保持数据,C 正确。
Q24
速对表原值: C
详细解析标注: C
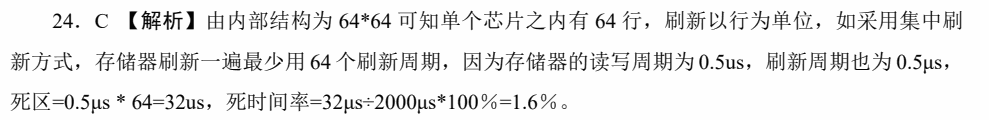
由内部结构为 6464 可知单个芯片之内有 64 行,刷新以行为单位,如采用集中刷新方式,存储器刷新一遍最少用64个刷新周期,因为存储器的读写周期为0.5us,刷新周期也为0.5μs,死区=0.5μs * 64=32us,死时间率=32μs÷2000μs100%=1.6%。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q25
速对表原值: A
详细解析标注: A
刷新以行为单位,一次刷新花费 1 个存储周期。该 DRAM 为 128 * 128 * 8bit,一共 128 行。
Q26
速对表原值: D
详细解析标注: D
2ms/128 行 =15.625μs/行,所以最大每隔 15.625us 就需要刷新一行,15.625/0.2=78.125 次读写操作,即最多 78 次读写操作就要一次刷新,本题符合的选项只有 D 选项。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
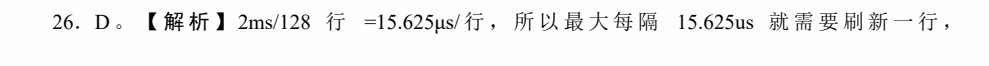

Q27
速对表原值: A
详细解析标注: A
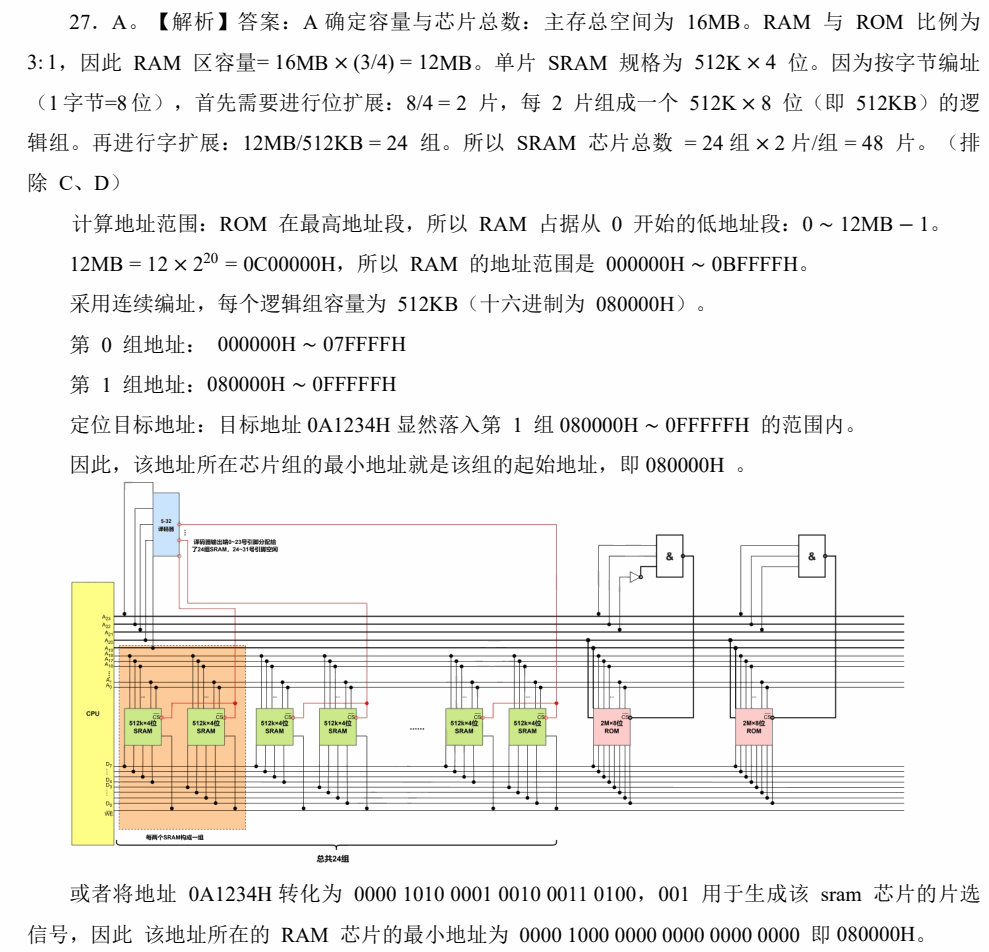
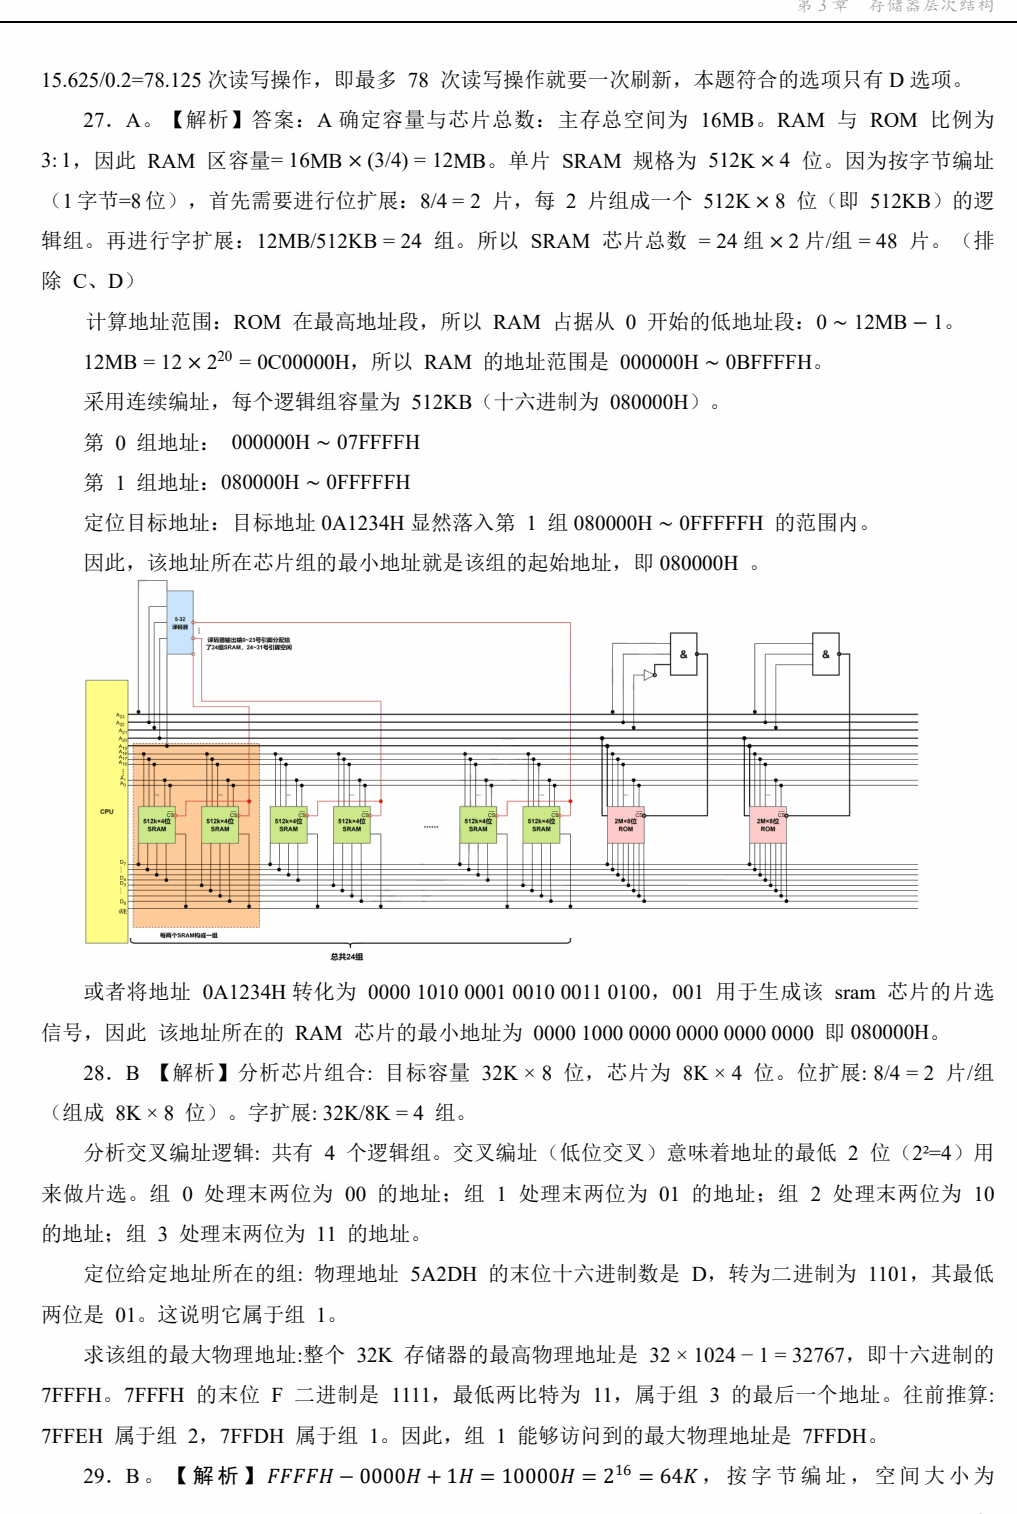
答案:A 确定容量与芯片总数:主存总空间为 16MB。RAM 与 ROM 比例为3:1,因此 RAM 区容量= 16MB × (3/4) = 12MB。单片 SRAM 规格为 512K × 4 位。因为按字节编址(1字节=8位),首先需要进行位扩展:8/4 = 2 片,每 2 片组成一个 512K × 8 位(即 512KB)的逻辑组。再进行字扩展:12MB/512KB = 24 组。所以 SRAM 芯片总数 = 24 组 × 2 片/组 = 48 片。(排除 C、D)计算地址范围:ROM 在最高地址段,所以 RAM 占据从 0 开始的低地址段:0 ∼ 12MB − 1。12MB = 12 × 220 = 0C00000H,所以 RAM 的地址范围是 000000H ∼ 0BFFFFH。采用连续编址,每个逻辑组容量为 512KB(十六进制为 080000H)。第 0 组地址: 000000H ∼ 07FFFFH第 1 组地址:080000H ∼ 0FFFFFH定位目标地址:目标地址 0A1234H 显然落入第 1 组 080000H ∼ 0FFFFFH 的范围内。因此,该地址所在芯片组的最小地址就是该组的起始地址,即 080000H 。或者将地址 0A1234H 转化为 0000 1010 0001 0010 0011 0100,001 用于生成该 sram 芯片的片选信号,因此 该地址所在的 RAM 芯片的最小地址为 0000 1000 0000 0000 0000 0000 即 080000H。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q28
速对表原值: B
详细解析标注: B
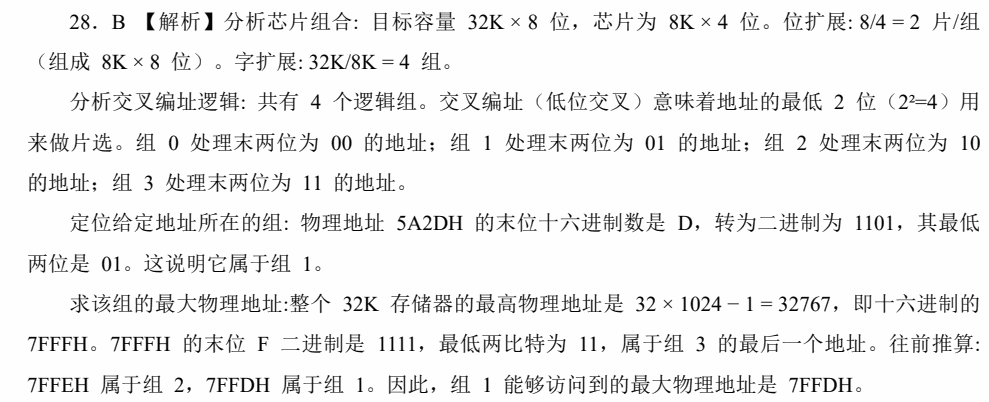
分析芯片组合: 目标容量 32K × 8 位,芯片为 8K × 4 位。位扩展: 8/4 = 2 片/组(组成 8K × 8 位)。字扩展: 32K/8K = 4 组。分析交叉编址逻辑: 共有 4 个逻辑组。交叉编址(低位交叉)意味着地址的最低 2 位(2²=4)用来做片选。组 0 处理末两位为 00 的地址;组 1 处理末两位为 01 的地址;组 2 处理末两位为 10的地址;组 3 处理末两位为 11 的地址。定位给定地址所在的组: 物理地址 5A2DH 的末位十六进制数是 D,转为二进制为 1101,其最低两位是 01。这说明它属于组 1。求该组的最大物理地址:整个 32K 存储器的最高物理地址是 32 × 1024 − 1 = 32767,即十六进制的7FFFH。7FFFH 的末位 F 二进制是 1111,最低两比特为 11,属于组 3 的最后一个地址。往前推算: 7FFEH 属于组 2,7FFDH 属于组 1。因此,组 1 能够访问到的最大物理地址是 7FFDH。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q29
速对表原值: B
详细解析标注: B
〔公式/符号见原页版面片段〕 − 0000〔公式/符号见原页版面片段〕 + 1〔公式/符号见原页版面片段〕 = 10000〔公式/符号见原页版面片段〕 = 216 = 64〔公式/符号见原页版面片段〕,按字节编址,空间大小为64K×1B。所以字方向扩展倍数为 64K/16K = 4,位方向扩展倍数为 1B/2b = 4,故正确答案为 B。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)

PDF 字形回源提示(非原文)
原 PDF 的部分数学字体没有 Unicode 映射;可搜索文本保留了明确占位,公式和符号以本题的原页片段为准。
Q30
速对表原值: A
详细解析标注: A
②不合理。因为存储单元的位数应为字节的整数倍。
③不合理。因为 MAR 的位数为 8,存储器的单元数最多为 256 个,不可能达到 1024 个。
④不合理。因为 MAR 的位数为 12,存储器的单元数应为 4K 个,不可能只有 1024 个。
Q31
速对表原值: B
详细解析标注: B
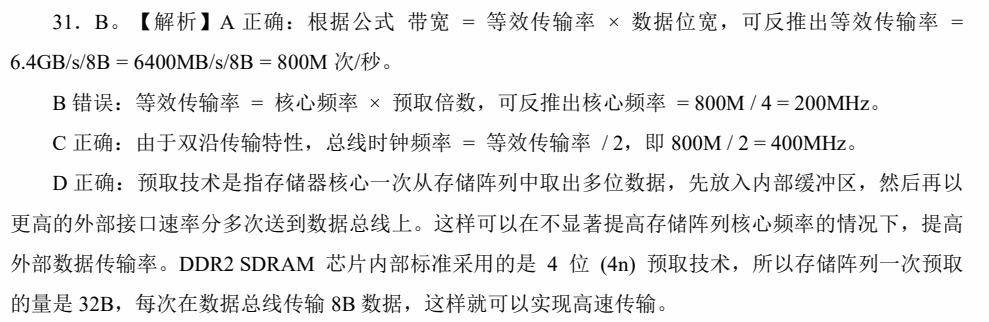
A 正确:根据公式 带宽 = 等效传输率 × 数据位宽,可反推出等效传输率 =6.4GB/s/8B = 6400MB/s/8B = 800M 次/秒。
B 错误:等效传输率 = 核心频率 × 预取倍数,可反推出核心频率 = 800M / 4 = 200MHz。
C 正确:由于双沿传输特性,总线时钟频率 = 等效传输率 / 2,即 800M / 2 = 400MHz。
D 正确:预取技术是指存储器核心一次从存储阵列中取出多位数据,先放入内部缓冲区,然后再以更高的外部接口速率分多次送到数据总线上。这样可以在不显著提高存储阵列核心频率的情况下,提高外部数据传输率。DDR2 SDRAM 芯片内部标准采用的是 4 位 (4n) 预取技术,所以存储阵列一次预取的量是 32B,每次在数据总线传输 8B 数据,这样就可以实现高速传输。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q32
速对表原值: C
详细解析标注: C
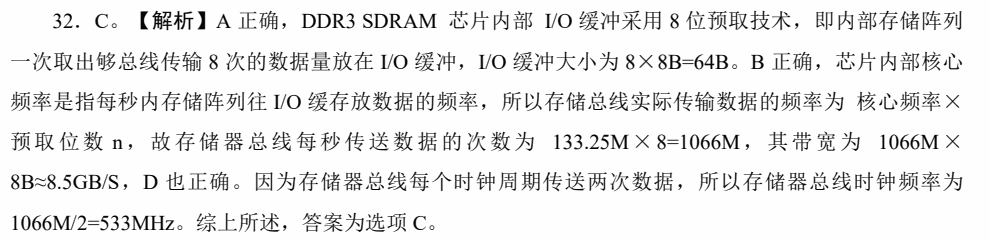
A 正确,DDR3 SDRAM 芯片内部 I/O 缓冲采用 8 位预取技术,即内部存储阵列一次取出够总线传输 8 次的数据量放在 I/O 缓冲,I/O 缓冲大小为 8×8B=64B。
B 正确,芯片内部核心频率是指每秒内存储阵列往 I/O 缓存放数据的频率,所以存储总线实际传输数据的频率为 核心频率×预取位数 n,故存储器总线每秒传送数据的次数为 133.25M×8=1066M,其带宽为 1066M× 8B≈8.5GB/S,D 也正确。因为存储器总线每个时钟周期传送两次数据,所以存储器总线时钟频率为1066M/2=533MHz。综上所述,答案为选项 C。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q33
速对表原值: B
详细解析标注: B
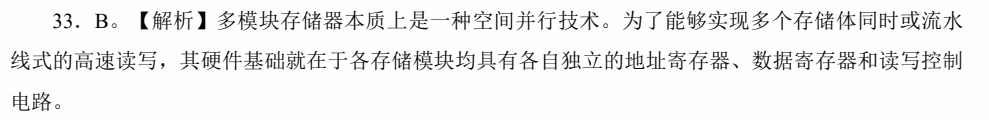
多模块存储器本质上是一种空间并行技术。为了能够实现多个存储体同时或流水线式的高速读写,其硬件基础就在于各存储模块均具有各自独立的地址寄存器、数据寄存器和读写控制电路。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q34
速对表原值: C
详细解析标注: C
根据访问地址求出访问存储体体号序列(地址 % 4):1,2,3,0,1,2,3,0,0。可发现只有最后访问 8004 和 8000 时发生了体冲突,即:体 1:0ns→80ns(首次启动)体 2:20ns→100ns(间隔 Δt)体 3:40ns→120ns(间隔 Δt)体 0:60ns→140ns(间隔 Δt)体 1:80ns→160ns(距首次启动 80ns,满足 T)体 2:100ns→180ns(距首次启动 80ns)体 3:120ns→200ns(距首次启动 80ns)体 0:140ns→220ns(距首次启动 80ns)体 0:220ns→300ns(距上一次体 0 启动 140ns→220ns,间隔 80ns)最后一个访问(第 9 个地址,体 0)的完成时间为 300 ns,C 正确。
Q35
速对表原值: B
详细解析标注: B
八体低位交叉存储器最大带宽时即完全流水线化,一个周期可访问 8 个存储体。每个存储体的容量为 256M×64 位,一个存储体一次传输 64 位数据即 8B,带宽为 8B×8/80ns =800MB/s。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)

Q36
速对表原值: B
详细解析标注: B
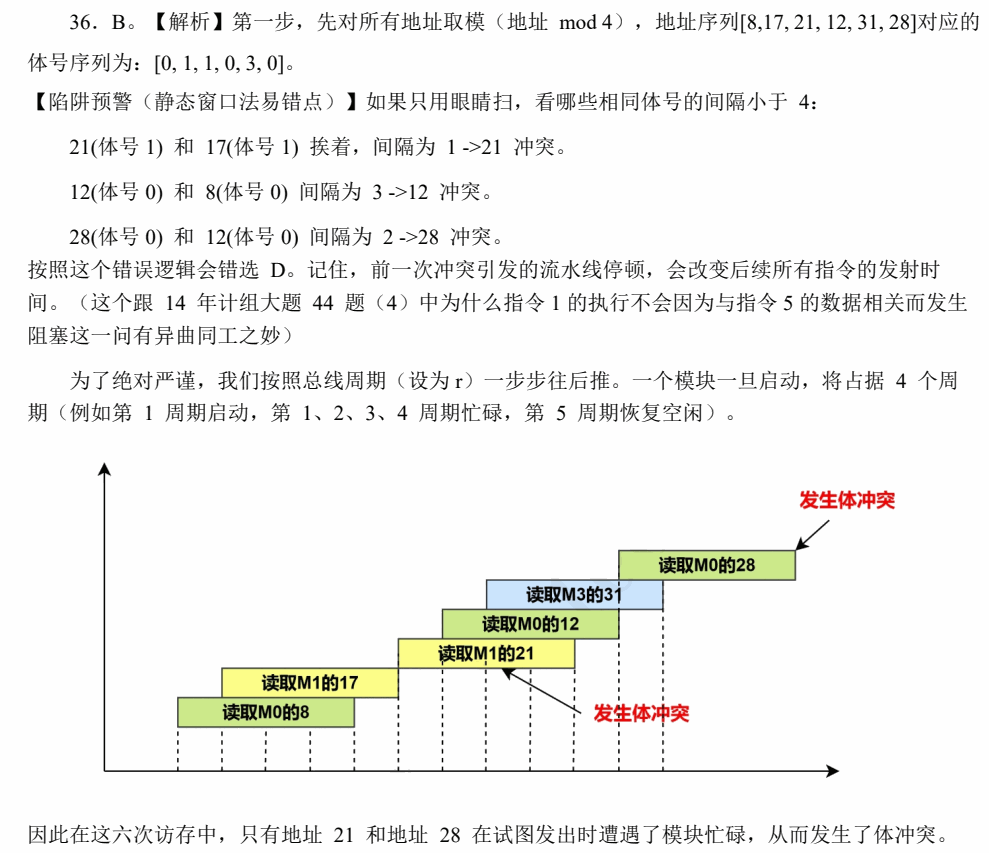
第一步,先对所有地址取模(地址 mod 4),地址序列[8,17, 21, 12, 31, 28]对应的体号序列为:[0, 1, 1, 0, 3, 0]。【陷阱预警(静态窗口法易错点)】如果只用眼睛扫,看哪些相同体号的间隔小于 4:21(体号 1) 和 17(体号 1) 挨着,间隔为 1 ->21 冲突。12(体号 0) 和 8(体号 0) 间隔为 3 ->12 冲突。28(体号 0) 和 12(体号 0) 间隔为 2 ->28 冲突。按照这个错误逻辑会错选 D。记住,前一次冲突引发的流水线停顿,会改变后续所有指令的发射时间。(这个跟 14 年计组大题 44 题(4)中为什么指令 1 的执行不会因为与指令 5 的数据相关而发生阻塞这一问有异曲同工之妙)为了绝对严谨,我们按照总线周期(设为 r)一步步往后推。一个模块一旦启动,将占据 4 个周期(例如第 1 周期启动,第 1、2、3、4 周期忙碌,第 5 周期恢复空闲)。因此在这六次访存中,只有地址 21 和地址 28 在试图发出时遭遇了模块忙碌,从而发生了体冲突。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q37
速对表原值: C
详细解析标注: C
一次缺失需要从主存读取一个主存块(64B),每个突发传送总线事务可以读取8B*8,因此需要一个突发传送总线事务。每个突发传送总线事务所用时间为 1+8+8=17 个时钟周期。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)

Q38
速对表原值: D
详细解析标注: D
磁盘的平均存取时间是指从发出读写请求到数据开始传输或传输结束所需要的平均时间,包括寻道时间(磁头移动到目标磁道的时间)、旋转延迟时间(盘片旋转使目标扇区移动到磁头下方的时间)和数据传输时间(数据在磁盘和内存之间传输的时间),D 正确。
Q39
速对表原值: C
详细解析标注: C
A 错:稳定流水线带宽上限 = 字长/r(总线传输周期),一旦 m ≥ T/r,继续增加 m 带宽不再提升,反而增加硬件成本和设计复杂度。B 错:单颗 SDRAM 芯片本身就支持突发传送,原因是芯片内部有行缓冲区——激活一行后,同一行内的数据可以在每个时钟周期连续读出,无需重复发送地址。突发传送与交叉编址无必然关系。
C 正确 :高位交叉编址(连续编址)中,相邻地址位于同一个模块,程序空间局部性恰好导致频繁访问集中于少数模块,其他模块闲置,完全失去多体并行优势。这是高位交叉仅适合容量扩展、不适合性能提升的根本原因。D 错:低位交叉编址不改变单个模块的存取时间 T,而是利用多体流水线并行工作(空间并行技术)来提高整体吞吐率。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q40
速对表原值: B
详细解析标注: B
固态硬盘(SSD)使用半导体闪存芯片作为存储介质,存储和读取数据;磁性材料用于传统的磁表面存储器如硬盘、磁带;光盘片是光盘的存储介质;磁鼓也是磁表面存储器,A、C、D 错误。
Q41
速对表原值: B
详细解析标注: B
固态硬盘基于闪存技术,不属于磁表面存储器,选项 A 错误。闪存翻译层可将 CPU 的逻辑磁盘块读/写请求转化为对底层 SSD 物理设备的读/写控制信号,选项 B 正确。(闪存翻译层是运行在 SSD 控制器内部的软件/固件,核心作用是地址转换(将逻辑块地址LBA 映射为物理页号 PPN)、垃圾回收和磨损均衡)固态硬盘无论是读还是写,速度都远快于常规硬盘。只不过对于 SSD,写比读要慢,因为涉及擦除和磨损均衡。选项 C 错误。固态硬盘块内的页必须按顺序写入信息,选项 D 错误。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q42
速对表原值: B
详细解析标注: B
静态磨损均衡技术比动态更先进、更优秀;SSD 损均衡技术大致分为两种:
-
动态磨损均衡。写入数据时,优先选择擦除次数少的新闪存块。老的闪存块先歇一歇。
-
静态磨损均衡。这种技术更为先进,就算没有数据写入,SSD 也会监测并自动进行数据分配,让老的闪存块承担以读为主的存储任务。同时让较新的闪存块腾出空间,以承担更多以写为主的存储任务。如此一来,各闪存块的寿命损耗就都差不多。
Q43
速对表原值: A
详细解析标注: A
Ⅰ正确,固态硬盘基于闪存技术。
Ⅱ正确,固态硬盘以页为读写单位,只有在一页所属的块整个被擦除后,才能对这一页进行写入。
Ⅲ错误,固态硬盘的读写性能优于机械硬盘,但是固态硬盘的 NAND 闪存中的块有擦写次数限制,其使用寿命一般短于机械硬盘。
Ⅳ错误,Ⅳ描述的是动态磨损均衡,而在静态磨损均衡中,会对数据块进行检测,尽可能保证各块写入和擦除均衡,并非是每次写入都选择长期存放数据而很少擦写的块。
Q44
速对表原值: B
详细解析标注: B
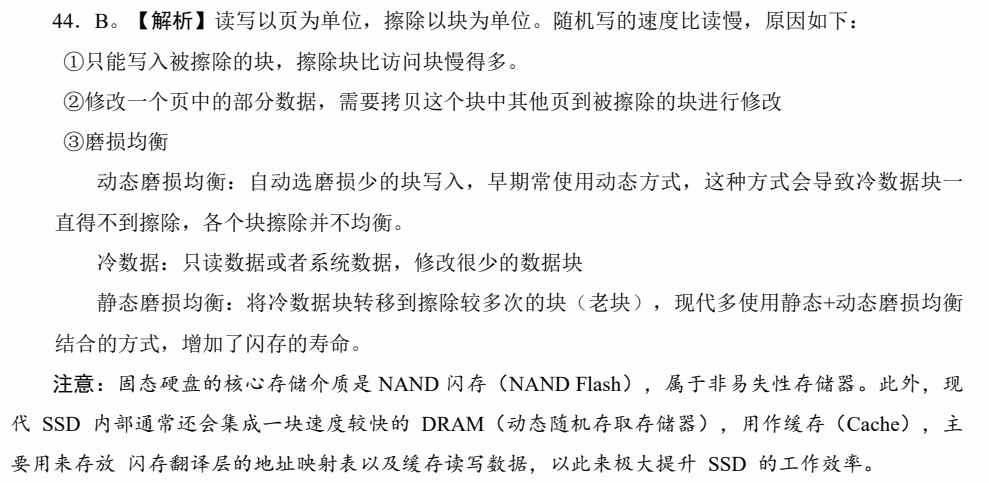
读写以页为单位,擦除以块为单位。随机写的速度比读慢,原因如下:
①只能写入被擦除的块,擦除块比访问块慢得多。
②修改一个页中的部分数据,需要拷贝这个块中其他页到被擦除的块进行修改
③磨损均衡动态磨损均衡:自动选磨损少的块写入,早期常使用动态方式,这种方式会导致冷数据块一直得不到擦除,各个块擦除并不均衡。冷数据:只读数据或者系统数据,修改很少的数据块静态磨损均衡:将冷数据块转移到擦除较多次的块(老块),现代多使用静态+动态磨损均衡结合的方式,增加了闪存的寿命。
注意:固态硬盘的核心存储介质是 NAND 闪存(NAND Flash),属于非易失性存储器。此外,现代 SSD 内部通常还会集成一块速度较快的 DRAM(动态随机存取存储器),用作缓存(Cache),主要用来存放 闪存翻译层的地址映射表以及缓存读写数据,以此来极大提升 SSD 的工作效率。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q45
速对表原值: C
详细解析标注: C
数组长度 N 极大,超过 Cache 容量,这意味着数组会被不断挤出 Cache。写法 1: 第一个循环遍历了整个数组 a,第二个循环又重新从头遍历数组 a 去算 b。当第二个循环要用 a[0] 时,a[0] 早就因为 Cache 容量不够被后面的 a[99999] 替换出去了,必须重新从主存读!写法 2: 在一个循环体内,刚刚算完 a[i](此时 a[i] 还在 Cache 里,热乎着呢),紧接着下一句就立刻使用 a[i] 去算 b[i]。结论: 对同一个元素 a[i] 的两次访问在时间上被拉到了最近。这是非常典型地通过修改代码逻辑来提升时间局部性的操作,所以选 C。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
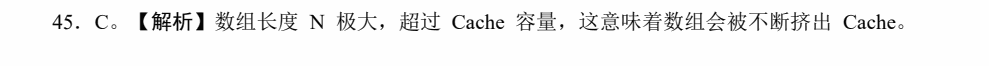
Q46
速对表原值: B
详细解析标注: B
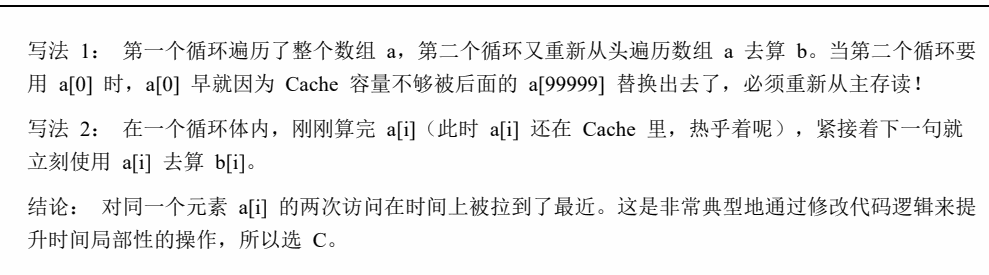
A 错误,cache 行并不是越大越好,因为缺失时,从主存读一个数据更大的块需要消耗更多时间,其次,虽然增大 cache 块可以更好利用空间局部性,但 cache 行变大,容量不变的情况下,行数变少,因而要替换的可能性增加,命中的可能性不一定增加。
B 正确,直接映射方式下,一个给定的主存地址映射到固定的 cache 行,若不命中,直接将该行数据替换,无需考虑替换算法。
C 错误,cache 仅仅是内存的拷贝,无法拓展不同的数据,所以无法扩充内存,扩充内存的方式一般指的是虚拟存储器。
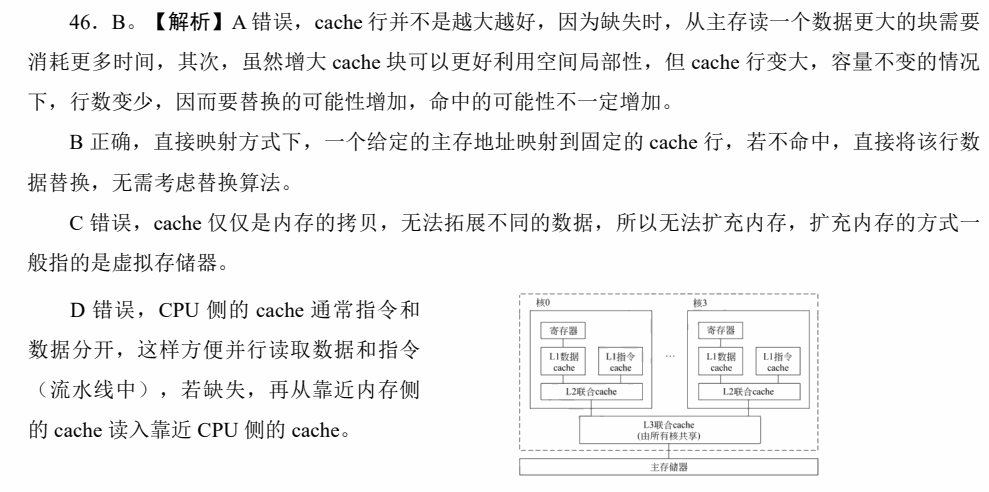
D 错误,CPU 侧的 cache 通常指令和数据分开,这样方便并行读取数据和指令(流水线中),若缺失,再从靠近内存侧的 cache 读入靠近 CPU 侧的 cache。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q47
速对表原值: C
详细解析标注: C
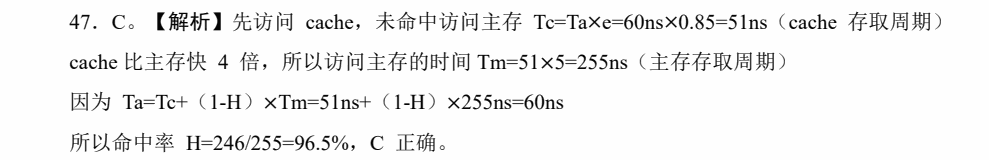
先访问 cache,未命中访问主存 Tc=Ta×e=60ns×0.85=51ns(cache 存取周期)cache 比主存快 4 倍,所以访问主存的时间 Tm=51×5=255ns(主存存取周期)因为 Ta=Tc+(1-H)×Tm=51ns+(1-H)×255ns=60ns所以命中率 H=246/255=96.5%,C 正确。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
王道核实旁注(非 Relax 原文):措辞歧义
“Cache 比主存快 4 倍”无唯一数学含义。原解析按 Tm=5Tc 得 C;若理解为主存时间是 Cache 的 4 倍,则 Tm=4Tc,结果约为 95.6%。必须明确“时间是几倍”后才能唯一作答。
Q48
速对表原值: B
详细解析标注: B
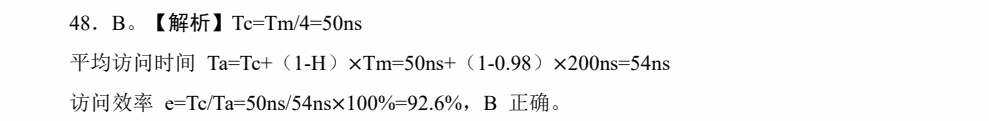
Tc=Tm/4=50ns平均访问时间 Ta=Tc+(1-H)×Tm=50ns+(1-0.98)×200ns=54ns访问效率 e=Tc/Ta=50ns/54ns×100%=92.6%,B 正确。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q49
速对表原值: B
详细解析标注: B
最好的局部性即完全按地址存放顺序访问数组。B 改完后对数组 a 的访问为顺序访问依次访问地址上连续的元素,故有更好的空间局部性。
Q50
速对表原值: D
详细解析标注: D
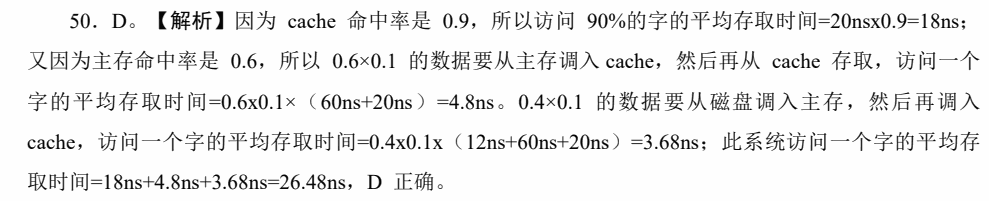
因为 cache 命中率是 0.9,所以访问 90%的字的平均存取时间=20nsx0.9=18ns;又因为主存命中率是 0.6,所以 0.6×0.1 的数据要从主存调入 cache,然后再从 cache 存取,访问一个字的平均存取时间=0.6x0.1×(60ns+20ns)=4.8ns。0.4×0.1 的数据要从磁盘调入主存,然后再调入cache,访问一个字的平均存取时间=0.4x0.1x(12ns+60ns+20ns)=3.68ns;此系统访问一个字的平均存取时间=18ns+4.8ns+3.68ns=26.48ns,D 正确。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
王道核实旁注(非 Relax 原文):单位异常
磁盘读取时间印为 12ns 明显异常;若字面按 12ns 计算,原答案 D 可复现;若原意为 12ms,则平均时间约为 0.480023ms,四个 ns 选项全部失效。本题不宜当作正常单选题背答案。
Q51
速对表原值: A
详细解析标注: A
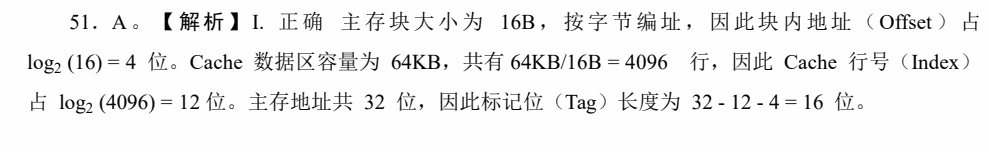
Ⅰ. 正确 主存块大小为 16B,按字节编址,因此块内地址(Offset)占log2 (16) = 4 位。Cache 数据区容量为 64KB,共有 64KB/16B = 4096 行,因此 Cache 行号(Index)占 log2 (4096) = 12 位。主存地址共 32 位,因此标记位(Tag)长度为 32 - 12 - 4 = 16 位。
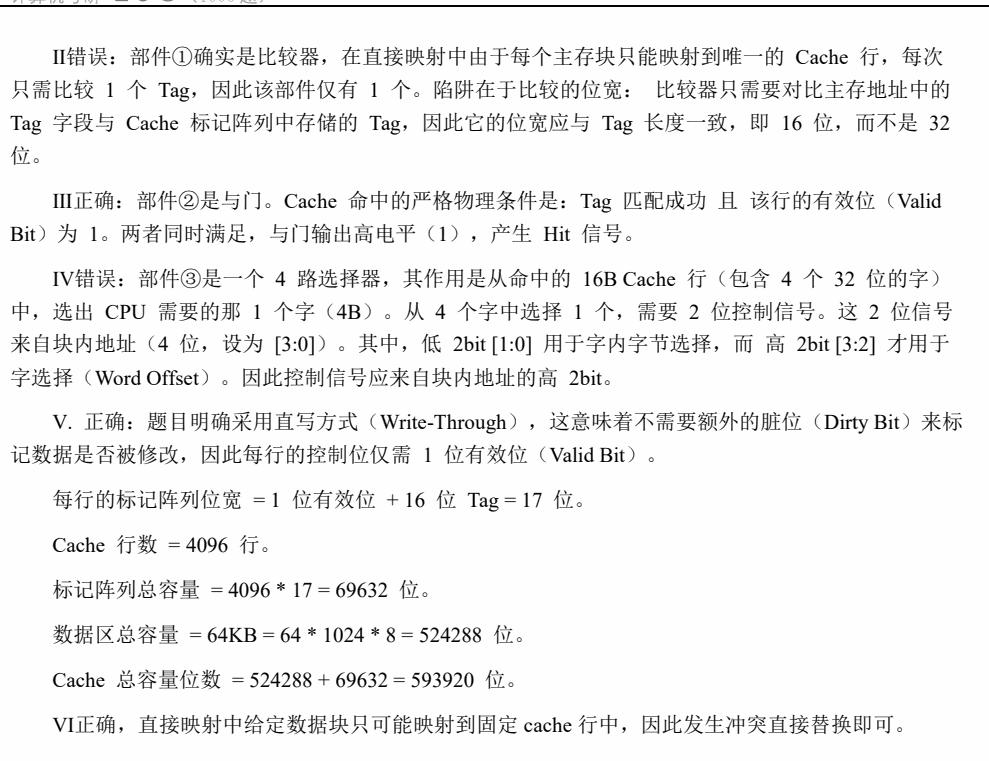
Ⅱ错误:部件
①确实是比较器,在直接映射中由于每个主存块只能映射到唯一的 Cache 行,每次只需比较 1 个 Tag,因此该部件仅有 1 个。陷阱在于比较的位宽: 比较器只需要对比主存地址中的Tag 字段与 Cache 标记阵列中存储的 Tag,因此它的位宽应与 Tag 长度一致,即 16 位,而不是 32位。
Ⅲ正确:部件
②是与门。Cache 命中的严格物理条件是:Tag 匹配成功 且 该行的有效位(Valid Bit)为 1。两者同时满足,与门输出高电平(1),产生 Hit 信号。
Ⅳ错误:部件
③是一个 4 路选择器,其作用是从命中的 16B Cache 行(包含 4 个 32 位的字)中,选出 CPU 需要的那 1 个字(4B)。从 4 个字中选择 1 个,需要 2 位控制信号。这 2 位信号来自块内地址(4 位,设为 [3:0])。其中,低 2bit [1:0] 用于字内字节选择,而 高 2bit [3:2] 才用于字选择(Word Offset)。因此控制信号应来自块内地址的高 2bit。
Ⅴ. 正确:题目明确采用直写方式(Write-Through),这意味着不需要额外的脏位(Dirty Bit)来标记数据是否被修改,因此每行的控制位仅需 1 位有效位(Valid Bit)。每行的标记阵列位宽 = 1 位有效位 + 16 位 Tag = 17 位。Cache 行数 = 4096 行。标记阵列总容量 = 4096 * 17 = 69632 位。数据区总容量 = 64KB = 64 * 1024 * 8 = 524288 位。Cache 总容量位数 = 524288 + 69632 = 593920 位。
Ⅵ正确,直接映射中给定数据块只可能映射到固定 cache 行中,因此发生冲突直接替换即可。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q52
速对表原值: B
详细解析标注: B
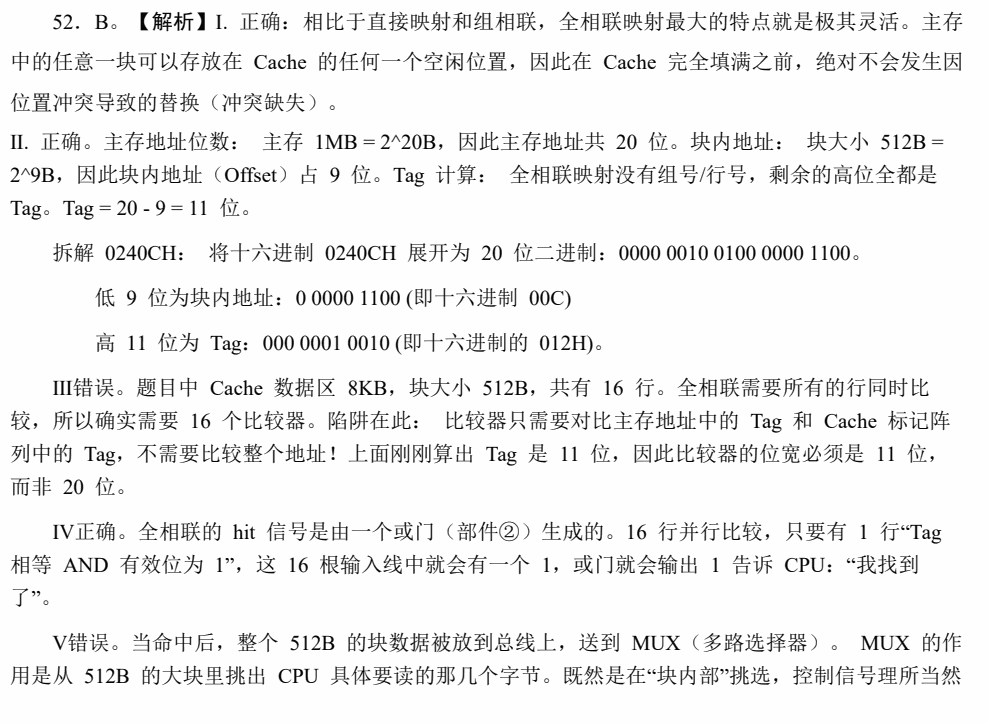
Ⅰ. 正确:相比于直接映射和组相联,全相联映射最大的特点就是极其灵活。主存中的任意一块可以存放在 Cache 的任何一个空闲位置,因此在 Cache 完全填满之前,绝对不会发生因位置冲突导致的替换(冲突缺失)。
Ⅱ. 正确。主存地址位数: 主存 1MB = 2^20B,因此主存地址共 20 位。块内地址: 块大小 512B =2^9B,因此块内地址(Offset)占 9 位。Tag 计算: 全相联映射没有组号/行号,剩余的高位全都是Tag。Tag = 20 - 9 = 11 位。拆解 0240CH: 将十六进制 0240CH 展开为 20 位二进制:0000 0010 0100 0000 1100。低 9 位为块内地址:0 0000 1100 (即十六进制 00C)高 11 位为 Tag:000 0001 0010 (即十六进制的 012H)。
Ⅲ错误。题目中 Cache 数据区 8KB,块大小 512B,共有 16 行。全相联需要所有的行同时比较,所以确实需要 16 个比较器。陷阱在此: 比较器只需要对比主存地址中的 Tag 和 Cache 标记阵列中的 Tag,不需要比较整个地址!上面刚刚算出 Tag 是 11 位,因此比较器的位宽必须是 11 位,而非 20 位。
Ⅳ正确。全相联的 hit 信号是由一个或门(部件
②)生成的。16 行并行比较,只要有 1 行“Tag相等 AND 有效位为 1”,这 16 根输入线中就会有一个 1,或门就会输出 1 告诉 CPU:“我找到了”。
Ⅴ错误。当命中后,整个 512B 的块数据被放到总线上,送到 MUX(多路选择器)。 MUX 的作用是从 512B 的大块里挑出 CPU 具体要读的那几个字节。既然是在“块内部”挑选,控制信号理所当然应该来自主存地址的块内地址(Block Offset),而绝不是 Tag 字段。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)

Q53
速对表原值: A
详细解析标注: A
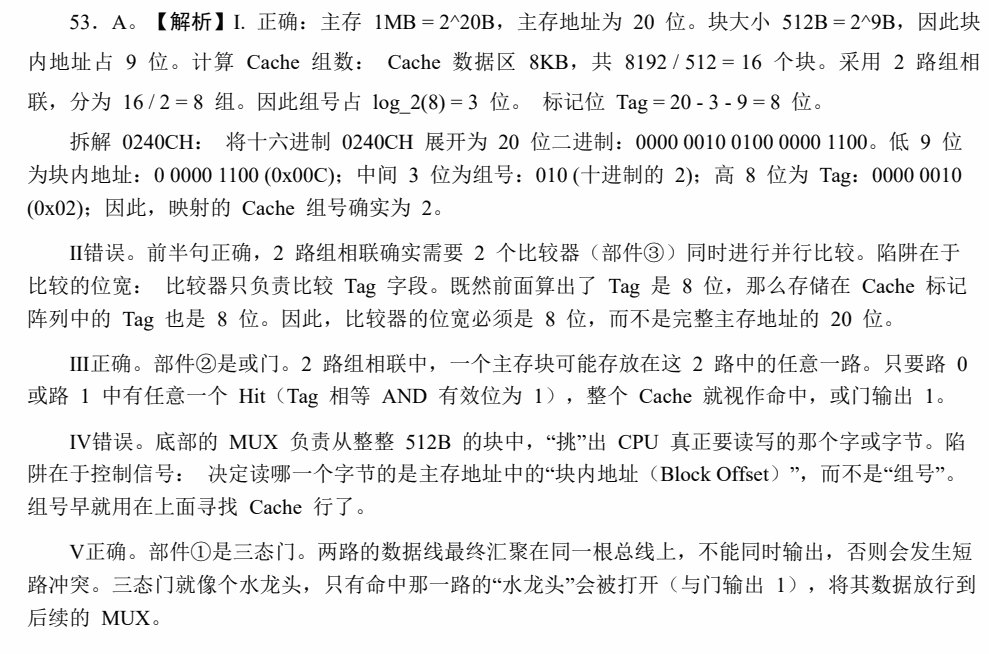
Ⅰ. 正确:主存 1MB = 2^20B,主存地址为 20 位。块大小 512B = 2^9B,因此块内地址占 9 位。计算 Cache 组数: Cache 数据区 8KB,共 8192 / 512 = 16 个块。采用 2 路组相联,分为 16 / 2 = 8 组。因此组号占 log_2(8) = 3 位。 标记位 Tag = 20 - 3 - 9 = 8 位。拆解 0240CH: 将十六进制 0240CH 展开为 20 位二进制:0000 0010 0100 0000 1100。低 9 位为块内地址:0 0000 1100 (0x00C);中间 3 位为组号:010 (十进制的 2);高 8 位为 Tag:0000 0010 (0x02);因此,映射的 Cache 组号确实为 2。
Ⅱ错误。前半句正确,2 路组相联确实需要 2 个比较器(部件
③)同时进行并行比较。陷阱在于比较的位宽: 比较器只负责比较 Tag 字段。既然前面算出了 Tag 是 8 位,那么存储在 Cache 标记阵列中的 Tag 也是 8 位。因此,比较器的位宽必须是 8 位,而不是完整主存地址的 20 位。
Ⅲ正确。部件
②是或门。2 路组相联中,一个主存块可能存放在这 2 路中的任意一路。只要路 0或路 1 中有任意一个 Hit(Tag 相等 AND 有效位为 1),整个 Cache 就视作命中,或门输出 1。
Ⅳ错误。底部的 MUX 负责从整整 512B 的块中,“挑”出 CPU 真正要读写的那个字或字节。陷阱在于控制信号: 决定读哪一个字节的是主存地址中的“块内地址(Block Offset)”,而不是“组号”。组号早就用在上面寻找 Cache 行了。
Ⅴ正确。部件
①是三态门。两路的数据线最终汇聚在同一根总线上,不能同时输出,否则会发生短路冲突。三态门就像个水龙头,只有命中那一路的“水龙头”会被打开(与门输出 1),将其数据放行到后续的 MUX。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q54
速对表原值: C
详细解析标注: C
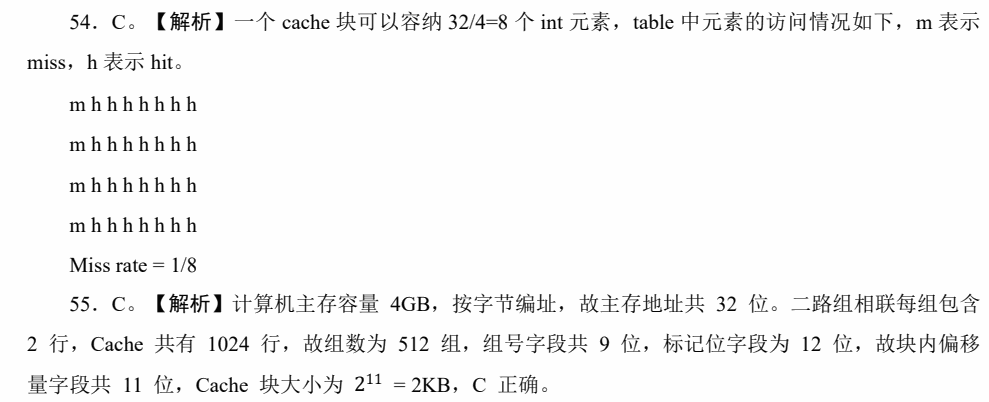
一个 cache 块可以容纳 32/4=8 个 int 元素,table 中元素的访问情况如下,m 表示miss,h 表示 hit。m h h h h h h h m h h h h h h h m h h h h h h h m h h h h h h h Miss rate = 1/8
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q55
速对表原值: C
详细解析标注: C
计算机主存容量 4GB,按字节编址,故主存地址共 32 位。二路组相联每组包含2 行,Cache 共有 1024 行,故组数为 512 组,组号字段共 9 位,标记位字段为 12 位,故块内偏移量字段共 11 位,Cache 块大小为 211 = 2KB,C 正确。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)

Q56
速对表原值: C
详细解析标注: C
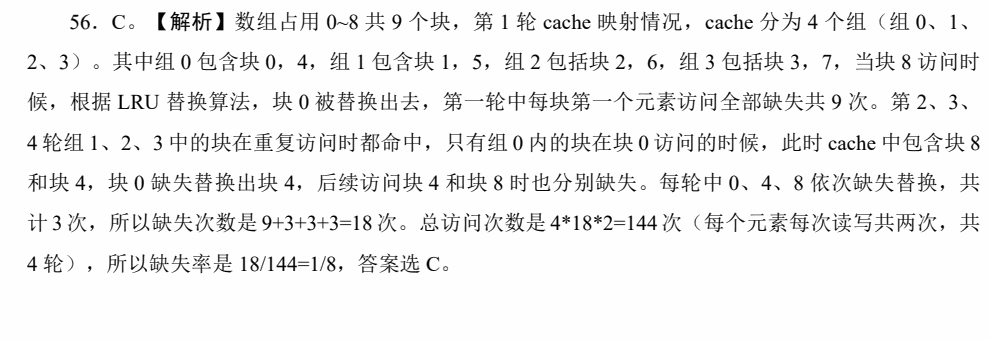
数组占用 0~8 共 9 个块,第 1 轮 cache 映射情况,cache 分为 4 个组(组 0、1、2、3)。其中组 0 包含块 0,4,组 1 包含块 1,5,组 2 包括块 2,6,组 3 包括块 3,7,当块 8 访问时候,根据 LRU 替换算法,块 0 被替换出去,第一轮中每块第一个元素访问全部缺失共 9 次。第 2、3、4 轮组 1、2、3 中的块在重复访问时都命中,只有组 0 内的块在块 0 访问的时候,此时 cache 中包含块 8和块 4,块 0 缺失替换出块 4,后续访问块 4 和块 8 时也分别缺失。每轮中 0、4、8 依次缺失替换,共计3次,所以缺失次数是9+3+3+3=18次。总访问次数是4182=144次(每个元素每次读写共两次,共4 轮),所以缺失率是 18/144=1/8,答案选 C。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q57
速对表原值: C
详细解析标注: C
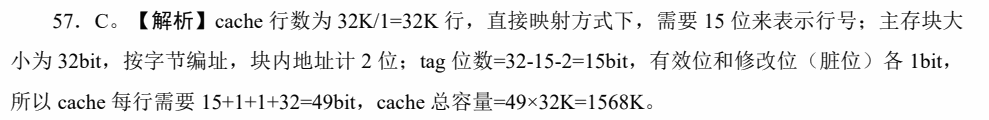
cache 行数为 32K/1=32K 行,直接映射方式下,需要 15 位来表示行号;主存块大小为 32bit,按字节编址,块内地址计 2 位;tag 位数=32-15-2=15bit,有效位和修改位(脏位)各 1bit,所以 cache 每行需要 15+1+1+32=49bit,cache 总容量=49×32K=1568K。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q58
速对表原值: C
详细解析标注: C
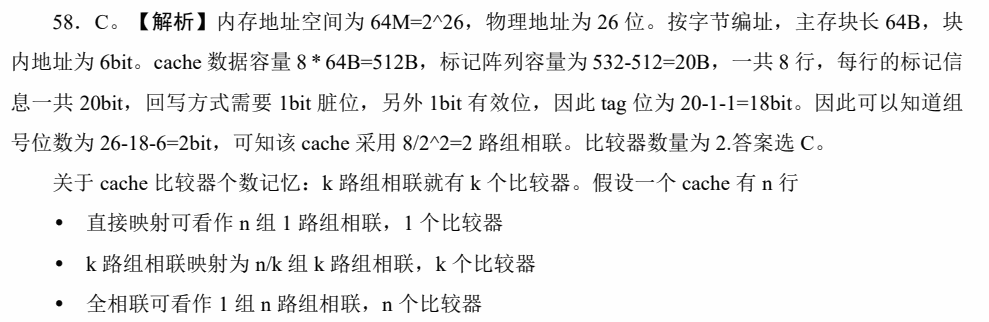
内存地址空间为 64M=2^26,物理地址为 26 位。按字节编址,主存块长 64B,块内地址为 6bit。cache 数据容量 8*64B=512B,标记阵列容量为 532-512=20B,一共 8 行,每行的标记信息一共 20bit,回写方式需要 1bit 脏位,另外 1bit 有效位,因此 tag 位为 20-1-1=18bit。因此可以知道组号位数为 26-18-6=2bit,可知该 cache 采用 8/2^2=2 路组相联。比较器数量为 2.答案选 C。关于 cache 比较器个数记忆:k 路组相联就有 k 个比较器。假设一个 cache 有 n 行
-
直接映射可看作 n 组 1 路组相联,1 个比较器
-
k 路组相联映射为 n/k 组 k 路组相联,k 个比较器
-
全相联可看作 1 组 n 路组相联,n 个比较器
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q59
速对表原值: C
详细解析标注: C
由于 cache 采用 4 路组相联,所以 cache 中有 4 个比较器,比较后通过一个多路选择器选择出一个块,每组有四个块,所以用 2bit 控制多路选择。实现一个四路组相联的 cache需要四个比较器和一个 4 选 1 的多路选择器来判断被选中的组中哪一个单元与标记匹配。
Q60
速对表原值: D
详细解析标注: D
cache 地址总共为 14 位,最后 4 位是块内偏移量,所以和主存地址的最后 4 位一样。由于采用直接映射,主存地址的最后 14 位,就是对应在 cache 的地址。
Q61
速对表原值: A
详细解析标注: A
FIFO 在特定访问序列下可能出现增加 Cache 容量反而命中率下降的现象,即“Belady 异常”,A 正确。补充:会发生“Belady 异常”的有 FIFO、CLOCK 和改进的 CLOCK。
Q62
速对表原值: C
详细解析标注: C
LRU 将最久未被访问的块替换,可以发现在第 6 次访问 4、第 7 次访问 2、第 8次访问 3 和第 9 次访问 5 时命中,命中四次,命中率为 4/10=40%。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)

Q63
速对表原值: B
详细解析标注: B
回写法中,数据写入 Cache 后不立即写入主存,只有当该数据所在的 Cache 块被替换时,才将其写回主存,写操作速度快,因为不需要每次都等待主存写入完成,但会存在 Cache与主存数据不一致的时间段;数据写入 Cache 同时写入主存的是全写法;C 描述的也是全写法的特点;写回法会出现数据不一致情况,A、C、D 错误。
Q64
速对表原值: A
详细解析标注: A
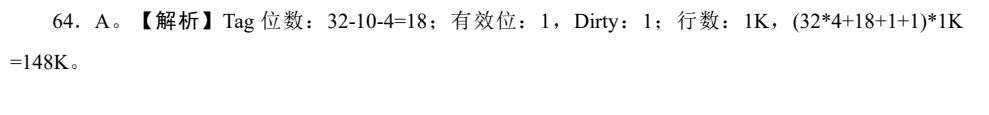
Tag 位数:32-10-4=18;有效位:1,Dirty:1;行数:1K,(324+18+1+1)1K =148K。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q65
速对表原值: C
详细解析标注: C
III 正确;II 写命中时不写辅存而是主存;I 写入主存不在第一次写入时,而在换出时,C 正确。
Q66
速对表原值: B
详细解析标注: B
装入位为 0 表示不在主存中,故也一定不在 Cache 中,无需考虑,A 正确。C=0 表示一定不在 Cache,故无需访问 Cache,C 正确。C=1 表示可能在 Cache 中,故要先在Cache 中查找,D 正确。B 选项一个页面被写入数据(修改位变 1),是非常正常的内存访问行为,这绝不会改变该页面的物理存储属性。普通的 RAM 页面被写了之后,依然是 RAM,依然允许被Cache 缓存,根本不存在“将其清 0(变成不可缓存)”的逻辑。
B 错误。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q67
速对表原值: B
详细解析标注: B
取指令阶段(0 次访存):题干明确指出取指阶段 TLB 和 Cache 均命中,直接从 Cache 中拿到指令,访问主存 0 次。读操作数阶段(2 次访存):指令 add [xaddr], 3 是典型的“读-改-写”指令,必须先将 x 从内存中读出来 。TLB 命中,MMU 直接将虚拟地址 xaddr 翻译为物理地址,不需要访问主存中的页表 。物理地址送往 Cache,此时 Cache 未命中。关键点(脏行写回),因为 Cache 采用回写策略,且未命中时触发了替换,而被替换的 Cache 行是“脏行”(脏位为 1,说明里面的数据被修改过且尚未同步到主存),此时硬件必须先将该脏行的数据写回主存(第 1 次访问主存)。 关键点(新块调入), 脏行腾空后,由于是读失效,需要将包含变量 x 的主存块读入 Cache(第 2 次访问主存) 。随后 CPU从 Cache 中读取 x 的值参与加法运算。写回结果阶段(0 次访存):运算完成后,新值需要写回 xaddr,此时包含 x 的数据块刚刚在读阶段被调入 Cache,因此写回时 Cache 必然命中。 在回写策略下,Cache 命中时仅修改 Cache 行中的内容,并将脏位置为 1,不需要同步写入主存 。因此这一阶段访问主存 0 次。总结: 0(取指) + 2(读操作数) + 0(写回) = 2 次。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q68
速对表原值: D
详细解析标注: D
虚拟存储器的容量受计算机的地址结构(决定逻辑地址空间大小)和外存容量的共同限制,并非只受外存容量限制;虚拟存储器需要硬件(如 MMU 内存管理单元)和操作系统软件协同实现地址映射等功能;在页式虚拟存储器中,若页面置换算法不当,可能导致频繁换页,出现抖动现象;段式虚拟存储器按逻辑模块分段,便于实现程序的动态链接和共享,A、B、C 正确,D 错误。
Q69
速对表原值: A
详细解析标注: A
第一步,明确地址划分: 主存物理地址共 28 位。Cache 块大小为 32B,因此块内偏移占 5 位 。Cache 总容量 16KB,4 路组相联,共有 16KB / (4 * 32B) = 128 组,因此组索引占 7 位 。物理地址高处的 28 - 5 - 7 = 16 位即为 Cache 标记 (Tag)。第二步,拼装物理地址: 页面大小为 4KB,因此虚拟地址和物理地址的低 12 位(页内偏移)完全相同 。虚拟地址 0x00456ABC 的低 12 位为 0xABC。物理地址由物理页号和页内偏移拼接而成,即物理地址 = 0x012FABC 。第三步,提取组号和标记:组索引位 (7 位) + 块内偏移位 (5 位) = 12 位 = 页内偏移位数。这意味着 Cache 的组号完全由页内偏移决定,不受虚拟/物理页号影响。将低 12 位的 0xABC 转为二进制:1010 1011 1100。抛弃最低的 5 位(1 1100),接下来的 7 位即为组索引:101 0101,转化为十进制为85。Cache 标记为物理地址去掉低 12 位后的高 16 位,即 0x012F
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q70
速对表原值: C
详细解析标注: C
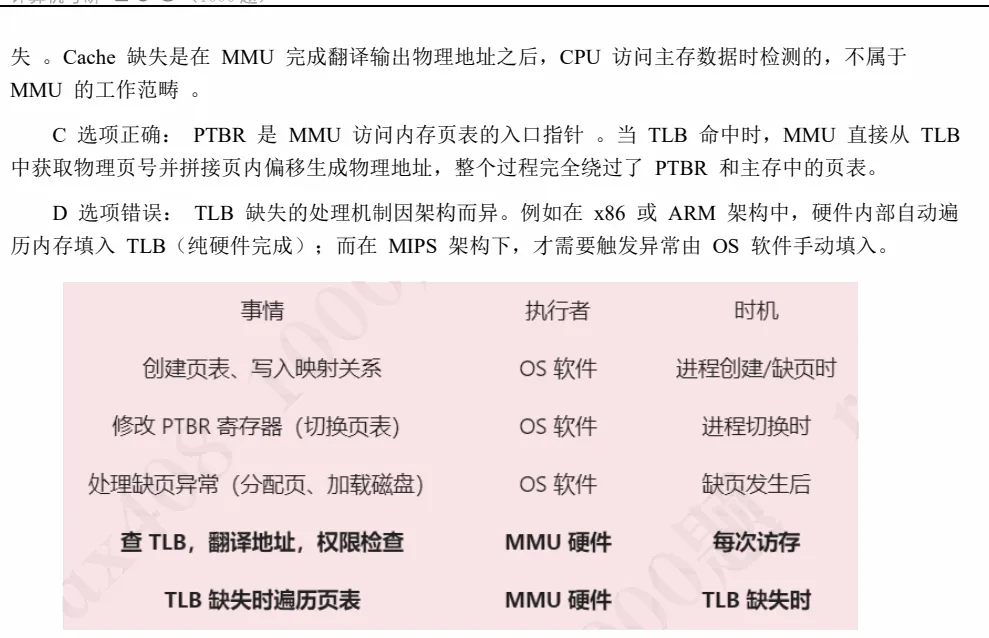
A 选项错误: MMU 只能检测缺页并触发缺页异常中断,真正的缺页处理程序是由操作系统(软件)在内核态接管并负责从外存读取页面调入主存的,并非硬件直接读取 。
B 选项错误: MMU 负责将虚拟地址转化为物理地址,在此过程中会检测越权、缺页和 TLB 缺失 。Cache 缺失是在 MMU 完成翻译输出物理地址之后,CPU 访问主存数据时检测的,不属于MMU 的工作范畴 。
C 选项正确: PTBR 是 MMU 访问内存页表的入口指针 。当 TLB 命中时,MMU 直接从 TLB中获取物理页号并拼接页内偏移生成物理地址,整个过程完全绕过了 PTBR 和主存中的页表。
D 选项错误: TLB 缺失的处理机制因架构而异。例如在 x86 或 ARM 架构中,硬件内部自动遍历内存填入 TLB(纯硬件完成);而在 MIPS 架构下,才需要触发异常由 OS 软件手动填入。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q71
速对表原值: A
详细解析标注: A
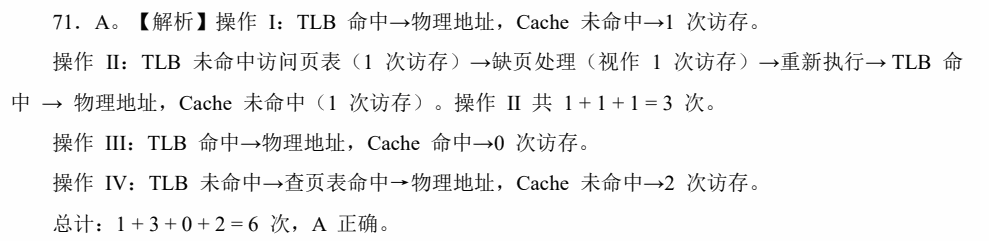
操作 I:TLB 命中→物理地址,Cache 未命中→1 次访存。操作 II:TLB 未命中访问页表(1 次访存)→缺页处理(视作 1 次访存)→重新执行→ TLB 命中 → 物理地址,Cache 未命中(1 次访存)。操作 II 共 1 + 1 + 1 = 3 次。操作 III:TLB 命中→物理地址,Cache 命中→0 次访存。操作 IV:TLB 未命中→查页表命中→物理地址,Cache 未命中→2 次访存。总计:1 + 3 + 0 + 2 = 6 次,A 正确。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q72
速对表原值: A
详细解析标注: A
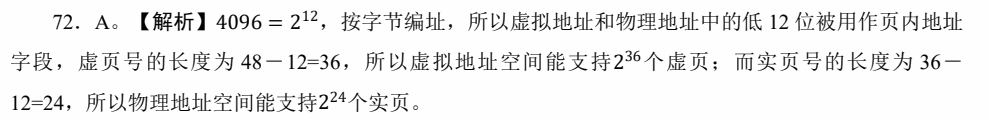
4096 = 212,按字节编址,所以虚拟地址和物理地址中的低 12 位被用作页内地址字段,虚页号的长度为 48-12=36,所以虚拟地址空间能支持236个虚页;而实页号的长度为 36- 12=24,所以物理地址空间能支持224个实页。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q73
速对表原值: A
详细解析标注: A
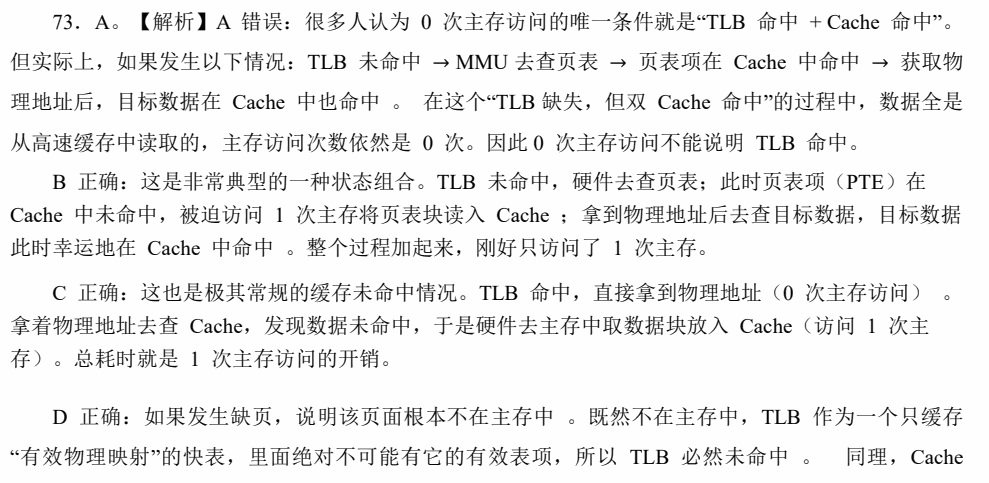
A 错误:很多人认为 0 次主存访问的唯一条件就是“TLB 命中 + Cache 命中”。但实际上,如果发生以下情况:TLB 未命中 → MMU 去查页表 → 页表项在 Cache 中命中 → 获取物理地址后,目标数据在 Cache 中也命中 。 在这个“TLB 缺失,但双 Cache 命中”的过程中,数据全是从高速缓存中读取的,主存访问次数依然是 0 次。因此 0 次主存访问不能说明 TLB 命中。
B 正确:这是非常典型的一种状态组合。TLB 未命中,硬件去查页表;此时页表项(PTE)在Cache 中未命中,被迫访问 1 次主存将页表块读入 Cache ;拿到物理地址后去查目标数据,目标数据此时幸运地在 Cache 中命中 。整个过程加起来,刚好只访问了 1 次主存。
C 正确:这也是极其常规的缓存未命中情况。TLB 命中,直接拿到物理地址(0 次主存访问) 。拿着物理地址去查 Cache,发现数据未命中,于是硬件去主存中取数据块放入 Cache(访问 1 次主存)。总耗时就是 1 次主存访问的开销。
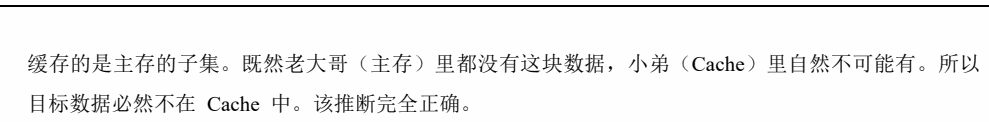
D 正确:如果发生缺页,说明该页面根本不在主存中 。既然不在主存中,TLB 作为一个只缓存“有效物理映射”的快表,里面绝对不可能有它的有效表项,所以 TLB 必然未命中 。 同理,Cache缓存的是主存的子集。既然老大哥(主存)里都没有这块数据,小弟(Cache)里自然不可能有。所以目标数据必然不在 Cache 中。该推断完全正确。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q74
速对表原值: B
详细解析标注: B
缺页是内部异常,需要调用缺页异常处理程序来处理,B 错误。
Q75
速对表原值: C
详细解析标注: C
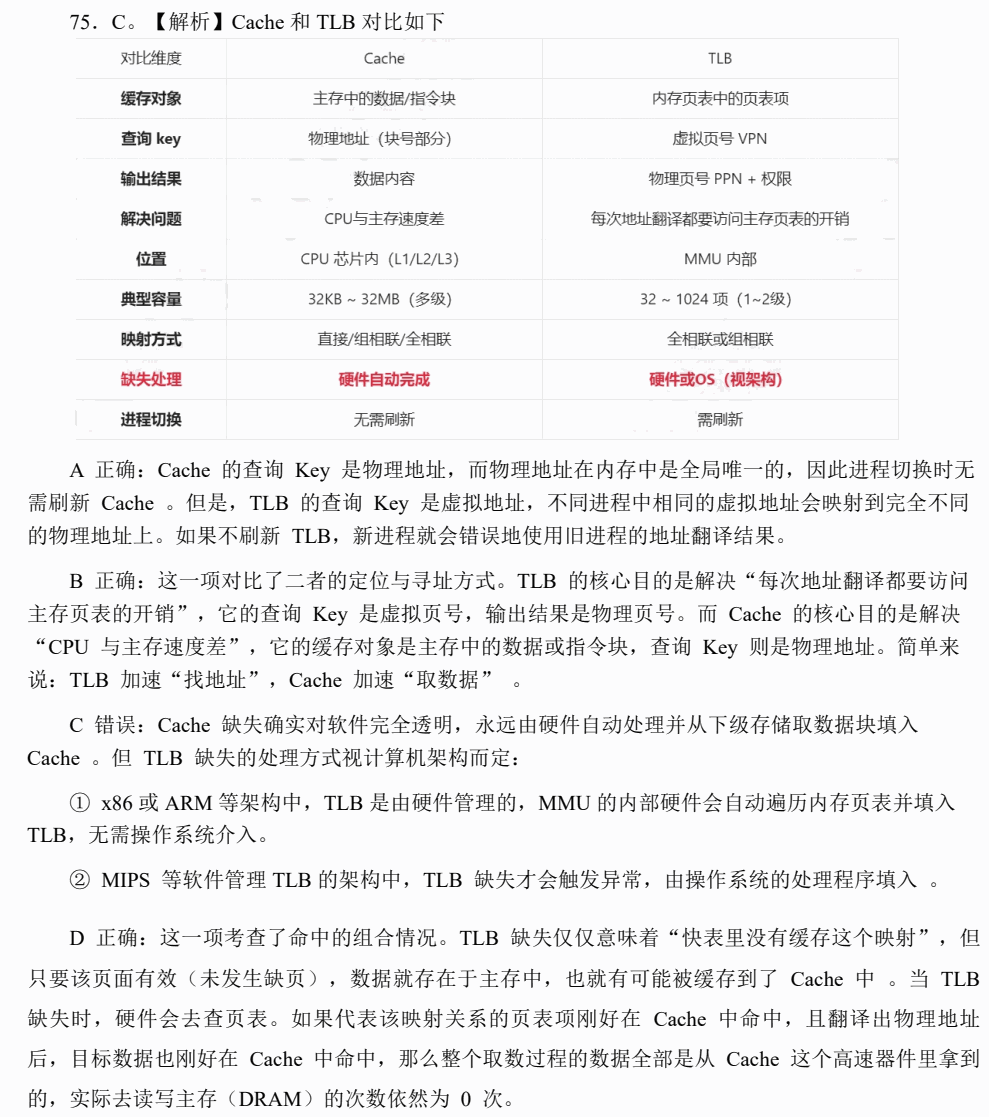
Cache 和 TLB 对比如下A 正确:Cache 的查询 Key 是物理地址,而物理地址在内存中是全局唯一的,因此进程切换时无需刷新 Cache 。但是,TLB 的查询 Key 是虚拟地址,不同进程中相同的虚拟地址会映射到完全不同的物理地址上。如果不刷新 TLB,新进程就会错误地使用旧进程的地址翻译结果。
B 正确:这一项对比了二者的定位与寻址方式。TLB 的核心目的是解决“每次地址翻译都要访问主存页表的开销”,它的查询 Key 是虚拟页号,输出结果是物理页号。而 Cache 的核心目的是解决“CPU 与主存速度差”,它的缓存对象是主存中的数据或指令块,查询 Key 则是物理地址。简单来说:TLB 加速“找地址”,Cache 加速“取数据” 。
C 错误:Cache 缺失确实对软件完全透明,永远由硬件自动处理并从下级存储取数据块填入Cache 。但 TLB 缺失的处理方式视计算机架构而定:
① x86 或 ARM 等架构中,TLB 是由硬件管理的,MMU 的内部硬件会自动遍历内存页表并填入TLB,无需操作系统介入。
② MIPS 等软件管理 TLB 的架构中,TLB 缺失才会触发异常,由操作系统的处理程序填入 。
D 正确:这一项考查了命中的组合情况。TLB 缺失仅仅意味着“快表里没有缓存这个映射”,但只要该页面有效(未发生缺页),数据就存在于主存中,也就有可能被缓存到了 Cache 中 。当 TLB缺失时,硬件会去查页表。如果代表该映射关系的页表项刚好在 Cache 中命中,且翻译出物理地址后,目标数据也刚好在 Cache 中命中,那么整个取数过程的数据全部是从 Cache 这个高速器件里拿到的,实际去读写主存(DRAM)的次数依然为 0 次。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q76
速对表原值: A
详细解析标注: A
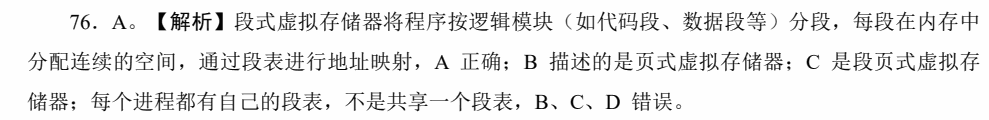
段式虚拟存储器将程序按逻辑模块(如代码段、数据段等)分段,每段在内存中分配连续的空间,通过段表进行地址映射,A 正确;B 描述的是页式虚拟存储器;C 是段页式虚拟存储器;每个进程都有自己的段表,不是共享一个段表,B、C、D 错误。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q77
速对表原值: C
详细解析标注: C
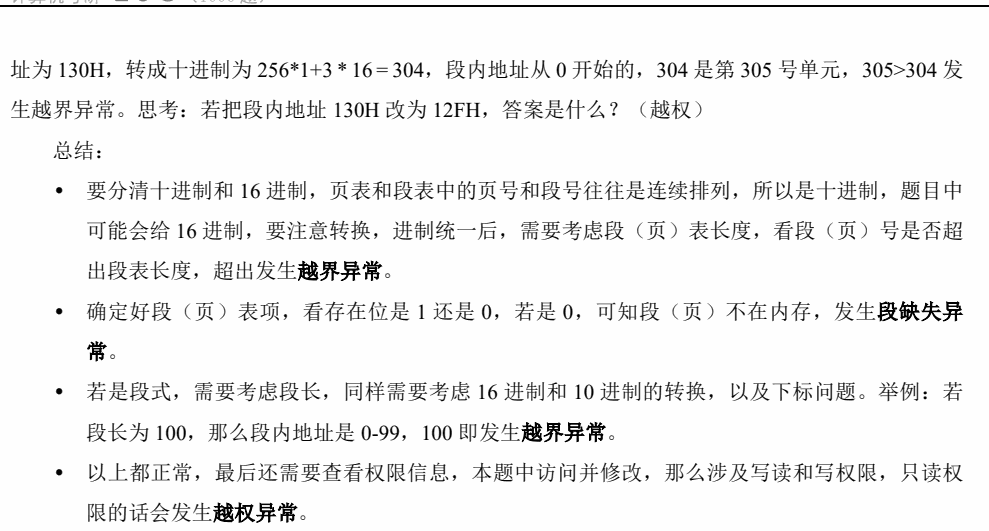
082H 转成 10 进制是 130,此时查段表,存在位是 1,段长是 304,而此时段内地址为 130H,转成十进制为 256*1+3 *16=304,段内地址从 0 开始的,304 是第 305 号单元,305>304 发生越界异常。思考:若把段内地址 130H 改为 12FH,答案是什么?(越权)总结:
-
要分清十进制和 16 进制,页表和段表中的页号和段号往往是连续排列,所以是十进制,题目中可能会给 16 进制,要注意转换,进制统一后,需要考虑段(页)表长度,看段(页)号是否超出段表长度,超出发生越界异常。
-
确定好段(页)表项,看存在位是 1 还是 0,若是 0,可知段(页)不在内存,发生段缺失异常。
-
若是段式,需要考虑段长,同样需要考虑 16 进制和 10 进制的转换,以及下标问题。举例:若段长为 100,那么段内地址是 0-99,100 即发生越界异常。
-
以上都正常,最后还需要查看权限信息,本题中访问并修改,那么涉及写读和写权限,只读权限的话会发生越权异常。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)

Q78
速对表原值: D
详细解析标注: D
低级语言程序员在编程时要指明段号,分段方式对其并不是透明的。
Q79
速对表原值: C
详细解析标注: C
段表占用空间 = 段表项数量 × 段表项大小 = 8×4 = 32 字节;页表占用空间 =段表项数量 × 平均每个段的页表项数量 × 页表项大小 = 8×32×4 = 1024 字节;段表和页表共占用空间= 32 + 1024 = 1056 字节,C 正确。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)