计组大题带答案版
第二章 数据的表示和运算
【2011-43】
(11分)假定在一个8位字长的计算机中运行如下C程序段:
unsigned int x=134;
unsigned int y=246;
int m=x;
int n=y;
unsigned int z1=x-y;
unsigned int z2=x+y;
int k1=m-n;
int k2=m+n;
若编译器编译时将8个8位寄存器R1~R8分别分配给变量x、y、m、n、z1、z2、k1和k2。请回答下列问题。(提示:带符号整数用补码表示)
(1) 执行上述程序段后,寄存器R1、R5和R6的内容分别是什么(用十六进制表示)?
(2) 执行上述程序段后,变量m和k1的值分别是多少(用十进制表示)?
(3) 上述程序段涉及带符号整数加/减、无符号整数加/减运算,这四种运算能否利用同一个加法器及辅助电路实现?简述理由。
(4) 计算机内部如何判断带符号整数加/减运算的结果是否发生溢出?上述程序段中,哪些带符号整数运算语句的执行结果会发生溢出?
解析
【官方答案】
(1) 134 = 128 + 6 = 1000 0110B,所以 x 的机器数为 1000 0110B,故 R1 的内容为 86H。(1 分)
246 = 255 - 9 = 1111 0110B,所以 y 的机器数为 11110110B。x-y: 1000 0110 + 0000 1010 = (0)1001 0000,括弧中为加法器的进位,故 R5 的内容为 90H。(1 分)
x+y: 1000 0110 + 1111 0110 = (1)0111 1100,括弧中为加法器的进位,故 R6 的内容为 7CH。(1 分)
(2) m 的机器数与 x 的机器数相同,皆为 86H = 1000 0110B,解释为带符号整数 m (用补码表示) 时,其值为 -111 1010B = -122。(1 分)
m-n 的机器数与 x-y 的机器数相同,皆为 90H = 1001 0000B,解释为带符号整数 k1 (用补码表示) 时,其值为 -111 0000B = -112。(1 分)
(3) 能。(1 分)
n 位加法器实现的是模 无符号整数加法运算。对于无符号整数 a 和 b,a+b 可以直接用加法器实现,而 a-b 可用 a 加 b 的补数实现,即 ,所以 n 位无符号整数加/减运算都可在 n 位加法器中实现。(1 分)
由于带符号整数用补码表示,补码加/减运算公式为: ,
 ,所以 n 位带符号整数加/减运算都可在 n 位加法器中实现。(1 分)
(4) 带符号整数加/减运算的溢出判断规则为:若加法器的两个输入端 (加数) 的符号相同,且不同于输出端 (和) 的符号,则结果溢出。(或加法器完成加法操作时,若次高位的进位和最高位的进位不同,则结果溢出)(2 分)
最后一条语句执行时会发生溢出。因为 1000 0110 + 1111 0110 = (1)01111100,括弧中为加法器的进位,根据上述溢出判断规则,可知结果溢出。(1 分)
【评分说明】
(1) “R1 的内容”也可以表示为“(R1)”。
(3) 理由部分基本正确,即可给分。
(4) ① 正确说明其中一种溢出判断规则给 2 分;若给出的说明是变形补码溢出判断规则且正确,可给 1 分。
② 只要说明最后一条语句溢出就给 1 分。
【2020-43】
(13分)有实现x×y的两个C语言函数如下:
假定某计算机M中ALU只能进行加减运算和逻辑运算。请回答下列问题。
(1) 若M的指令系统中没有乘法指令,但有加法、减法和移位等指令,则在M上也能实现上述两个函数中的乘法运算,为什么?
(2) 若M的指令系统中有乘法指令,则基于ALU、移位器、寄存器以及相应控制逻辑实现乘法指令时,控制逻辑的作用是什么?
(3) 针对以下三种情况:①没有乘法指令;②有使用ALU和移位器实现的乘法指令;③有使用阵列乘法器实现的乘法指令,函数umul()在哪种情况下执行时间最长?哪种情况下执行的时间最短?说明理由。
(4) n位整数乘法指令可保存2n位乘积,当仅取低n位作为乘积时,其结果可能会发生溢出。当\(n=32、x= 2^{31}−1 、y=2\)时,带符号整数乘法指令和无符号整数乘法指令得到的x×y的2n位乘积分别是什么(用十六进制表示)?此时函数umul()和imul()的返回结果是否溢出?对于无符号整数乘法运算,当仅取乘积的低位作为乘法结果时,如何用2n位乘积进行溢出判断?
解析
【2017-43】
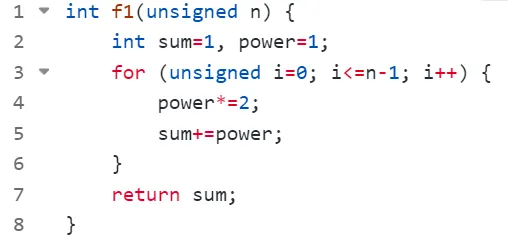
(13分)已知\(f(n)=\sum_{i=0}^{n}2^i =2^{n+1}-1=\overbrace{11...1}B\) ,计算f(n)的C语言函数f1如下:
int f1(unsigned n) {
    int sum=1, power=1;
    for (unsigned i=0; i<=n-1; i++) {
        power*=2;
        sum+=power;
    }
    return sum;
}
将f1中的int都改为float,可得到计算f(n)的另一个函数f2。假设unsigned和int型数据都占32位,float采用IEEE754单精度标准。请回答下列问题。
(1) 当n=0时,f1会出现死循环,为什么?若将f1中的变量i和n都定义为int型,则f1是否还会出现死循环?为什么?
(2) f1(23)和f2(23)的返回值是否相等?机器数各是什么(用十六进制表示)?
(3) f1(24)和f2(24)的返回值分别为33554431和33554432.0,为什么不相等?
(4) \(f(31)= 2^{32}−1\) ,而f1(31)的返回值却为-1,为什么?若使f1(n)的返回值与f(n)相等,则最大的n是多少?
(5) f2(127)的机器数为7F80 0000H,对应的值是什么?若使f2(n)的结果不溢出,则最大的n是多少?若使f2(n)的结果精确(无舍入),则最大的n是多少?
解析
【官方答案】
(1) 由于 i 和 n 是 unsigned 型,故“i <= n - 1”是无符号数比较,n = 0 时,n - 1 的机器数为全 1,值是 ,为 unsigned 型可表示的最大数,条件“i <= n - 1”永真,因此出现死循环。(2 分)
若 i 和 n 改为 int 类型,则不会出现死循环。(1 分)
因为“i <= n - 1”是带符号整数比较,n = 0 时,n - 1 的值是 -1,当 i = 0 时条件“i <= n - 1”不成立,此时退出 for 循环。(1 分)
(2) f1(23) 与 f2(23) 的返回值相等。(1 分)
f1(23) 的机器数是 00FFFFFFH,(1 分)
f2(23) 的机器数是 4B7FFFFFH。(1 分)
(3) 当 n = 24 时,f(24) = 1 1111 1111 1111 1111 1111 1111 B,而 float 型数只有 24 位有效位,舍入后数值增大,所以 f2(24) 比 f1(24) 大 1。(1 分)
(4) 显然 f(31) 已超出了 int 型数据的表示范围,用 f1(31) 实现时得到的机器数为 32 个 1,作为 int 型数解释时其值为 -1,即 f1(31) 的返回值为 -1。(1 分)
因为 int 型最大可表示数是 0 后面加 31 个 1,故使 f1(n) 的返回值与 f(n) 相等的最大 n 值是 30。(1 分)
(5) IEEE 754 标准用“阶码全 1、尾数全 0”表示无穷大。f2 返回值为 float 型,机器数 7F800000H 对应的值是+∞。(1 分)
当 n = 126 时,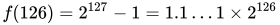 ,对应阶码为 127 + 126 = 253,尾数部分含人后阶码加 1,最终阶码为 254,是 IEEE 754 单精度格式表示的最大阶码。故使 f2 结果不溢出的最大 n 值为 126。(1 分)
当 n = 23 时,f(23) 为 24 位 1,float 型数有 24 位有效位,所以不需舍入,结果精确。故使 f2 获得精确结果的最大 n 值为 23。(1 分)
【评分说明】
(3) 只要说明 f2(24) 需舍入处理即可给分。
(4) 对于第二问,只要给出 n = 30 即可给分。
(5) 对于第二问,只要给出 n = 23,即可给分。对于第三问,只要给出 n = 126,即可给分。
第三章 存储器层次结构
【2010-44】
(12分)某计算机的主存地址空间大小为256MB,按字节编址,指令Cache和数据Cache分离,均有8个Cache行,每个Cache行大小为64B,数据Cache采用直接映射方式。现有两个功能相同的程序A和B,其伪代码如下所示:
int a[256][256]
...
int sum_array1()
{
    int i, j, sum=0;
    for (i=0; i<256; i++)
        for (j=0; j<256; j++)
            sum += a[i][j]
    return sum;
}
int a[256][256]
...
int sum_array1()
{
    int i, j, sum=0;
    for (j=0; j<256; j++)
        for (i=0; i<256; i++)
            sum += a[i][j]
    return sum;
}
假定int类型数据用32位补码表示,程序编译时i、j、sum均分配在寄存器中,数组a按行优先方式存放,首地址320(十进制数)。请回答下列问题,要求说明理由或给出计算过程。
(1) 若不考虑用于Cache一致性维护和替换算法的控制位,则数据Cache的总容量为多少?
(2) 数组数据a[0][31]和a[1][1]各自所在的主存块对应的Cache行号分别是多少(Cache行号从0开始)?
(3) 程序A和B的数据访问命中率各是多少?哪个程序的执行时间更短?
解析
【官方答案】
(1) 数据 Cache 的总容量为:4256 位 (532 字节)。(3 分)
(2) 数组 a 在主存的存放位置及其与 Cache 之间的映射关系如下图所示。a[0][31] 所在主存块映射到 Cache 第 6 行,(2 分)a[1][1] 所在主存块映射到 Cache 第 5 行。(2 分)
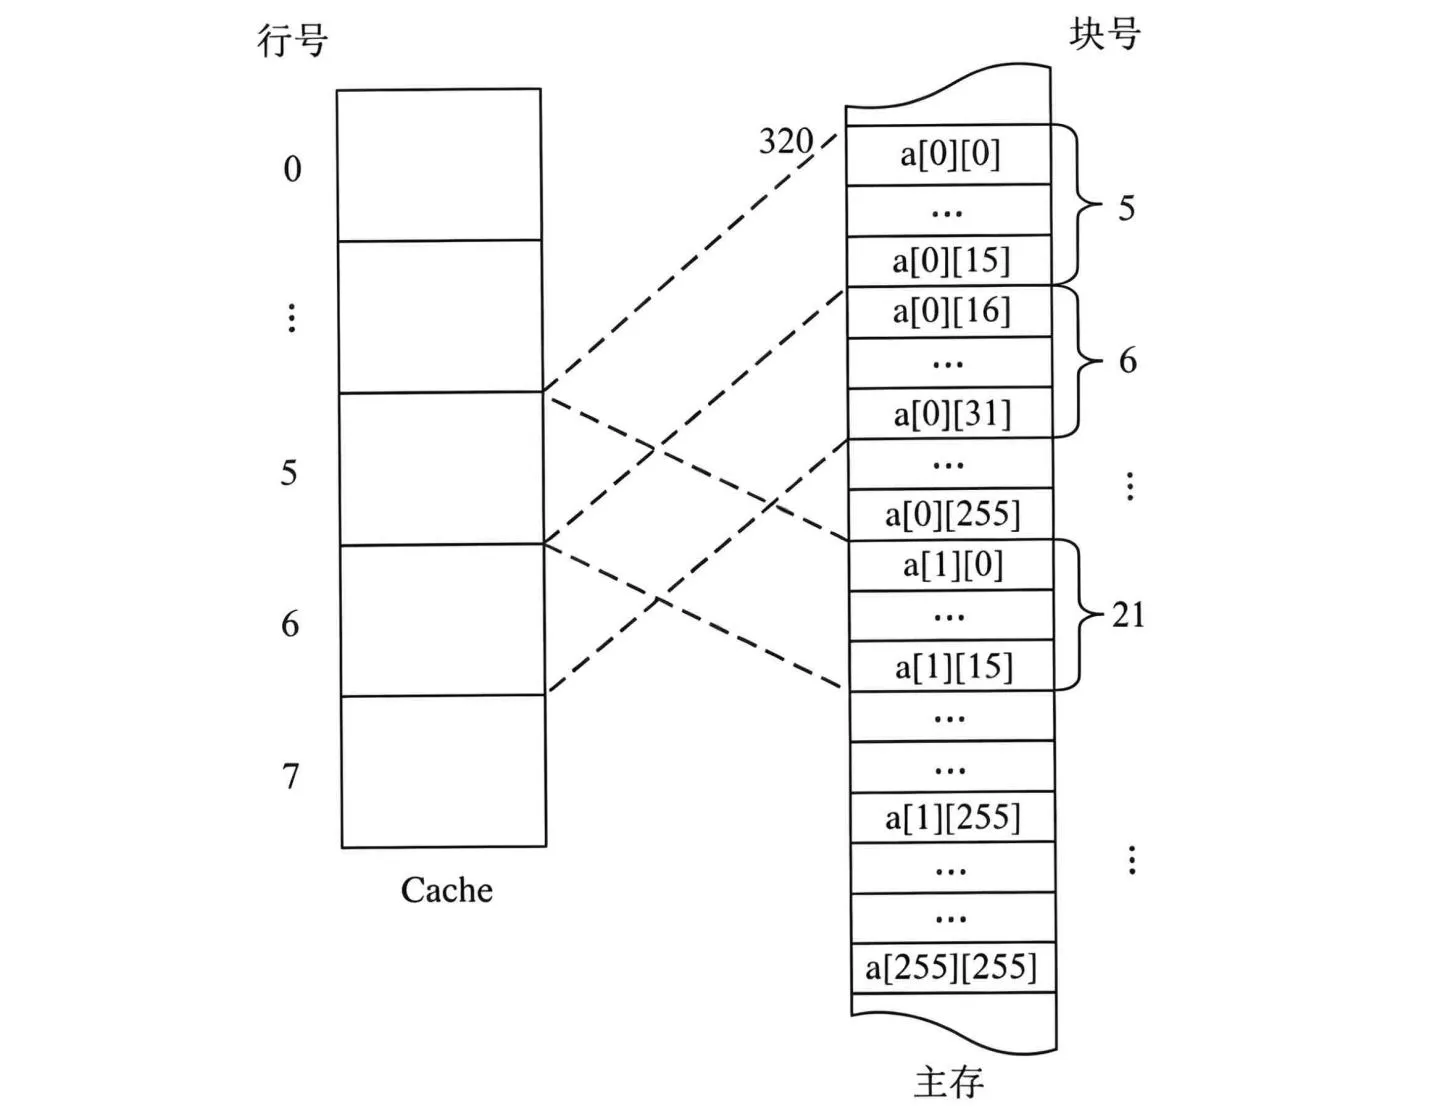
(3) 编译时 i, j, sum 均分配在寄存器中,故数据访问命中率仅考虑数组 a 的情况。
① 程序 A 的数据访问命中率为 93.75%;(2 分)② 程序 B 的数据访问命中率为 0。(2 分)
根据上述计算出的命中率,得知程序 B 每次取数都要访问主存,所以程序 A 的执行比程序 B 快得多。(1 分)
基本参数
- 主存地址空间 = 256MB = 2²⁸ 字节 → 28 位地址
- 数据 Cache:8 行,每行 64B,直接映射
- int 型 = 4B,int a[256][256],行优先存放,首地址 = 320(十进制)
(1) 地址分配:
- 块内偏移 = log₂(64) = 6 位
- 行索引 = log₂(8) = 3 位
- 标记 = 28 − 6 − 3 = 19 位
不考虑一致性维护和替换算法控制位(包括脏位、LRU 位),但计入有效位:
- 每行 = 有效位(1) + 标记(19) + 数据(64×8=512) = 532 位
- 总容量 = 8 × 532 = 4256 位(即 532B 数据区 + 标记区)
(2) a[0][31]:
- 距首地址偏移 = (0×256 + 31) × 4 = 124 字节
- 绝对地址 = 320 + 124 = 444
- 主存块号 = ⌊444 / 64⌋ = 6
- Cache 行号 = 6 mod 8 = 6
或者 ,行号为110B=6。
a[1][1]:
- 距首地址偏移 = (1×256 + 1) × 4 = 257 × 4 = 1028 字节
- 绝对地址 = 320 + 1028 = 1348
- 主存块号 = ⌊1348 / 64⌋ = 21
- Cache 行号 = 21 mod 8 = 5
或者 ,行号为101B=5
(3)程序 A(按行访问,i 为外循环,j 为内循环):
- C 语言数组按行优先存储,程序 A 访问顺序:a[0][0], a[0][1], ..., a[0][255], a[1][0], ... → 顺序访问,空间局部性好
- 每块 64B / 4B = 16 个 int
- 每 16 次访问,第 1 次缺失,后 15 次命中
- 总访问次数 = 256 × 256 = 65536
- 缺失次数 = 65536 / 16 = 4096
- 程序 A 命中率 = (65536 − 4096) / 65536 = 61440 / 65536 ≈ 93.75%
程序 B(按列访问,j 为外循环,i 为内循环):
- 访问顺序:a[0][0], a[1][0], a[2][0], ... → 相邻两次访问之间跨度 = 256×4 = 1024 字节 = 16 块
- 8 行 Cache:16 mod 8 = 0 → a[i][j] 与 a[i+1][j] 映射到同一 Cache 行,产生冲突缺失
- 每次访问都会将上一次加载的块淘汰
- 程序 B 命中率 ≈ 0%
结论:程序 A 命中率远高于程序 B(93.75% vs 0%),程序 A 执行时间更短。
【2014-45】
(12分)假设对于计算机M和程序段P的机器代码,M采用页式虚拟存储管理;P开始执行时,(R1)=(R2)=0,(R6)=1000,其机器代码已调入主存但不在Cache中;数组A未调入主存,且所有数组元素在同一页,并存储在磁盘同一个扇区。请回答下列问题并说明理由。\ \(\begin{array}{cccccc} \text{编号}&\text{地址}&\text{机器代码}&\text{汇编代码}&\text{注释}\\\hline 1&\text{08048100H}&\text{00022080H}&\text{loop: sll R4, R2, 2}&\text{(R2)<<2→R4}\ 2&\text{08048104H}&\text{00083020H}&\text{add R4, R4, R3}&\text{(R4)+(R3)→R4}\ 3&\text{08048108H}&\text{8C850000H}&\text{load R5, 0(R4)}&\text{((R4)+0)→R5}\ 4&\text{0804810CH}&\text{00250820H}&\text{add R1, R1, R5}&\text{(R1)+(R5)→R1}\ 5&\text{08048110H}&\text{20420001H}&\text{add R2, R2, 1}&\text{(R2)+1→R2}\ 6&\text{08048114H}&\text{1446FFFAH}&\text{bne R2, R6, loop}&\text{if (R2)!=(R6) goto loop}\ \end{array}\)
(1) P执行结束时,R2的内容是多少?
(2) M的指令Cache和数据Cache分离。若指令Cache共有16行,Cache和主存交换的块大小为32字节,则其数据区的容量是多少?若仅考虑程序段P的执行,则指令Cache的命中率为多少?
(3) P在执行过程中,哪条指令的执行可能发生溢出异常?哪条指令的执行可能产生缺页异常?对于数组A的访问,需要读磁盘和TLB至少各多少次?
解析
【官方答案】
(1) 由于(R6)=1000,故(R2)=1000。(1 分)
(2) 指令 Cache 数据区的容量:16 × 32 B = 512 B。(1 分)
P 共有 6 条指令,占 24 字节,小于主存块大小(32 B),其起始地址为 0804 8100H,因而所有指令都在同一个主存块中。读取第一条指令时,发生 Cache 缺失,故将 P 所在主存块调入 Cache 某一行,以后每次读取指令时,都能在指令 Cache 中命中。因此,P 在 1000 次循环执行过程中共发生 1 次指令访问缺失,故指令 Cache 的命中率为:(1000×6-1)/(1000×6)=99.98%。(2 分)
(3) P 执行过程中,指令 4(或 add R1, R1, R5)的执行可能发生溢出异常。(2 分)load 指令(或指令 3)的执行可能会产生缺页异常。因为 load 指令需要读取数组 A 的内容,当数组 A 不在主存时发生缺页异常。(1 分)
第一次执行 load 指令时,因为数组 A 未调入主存,故访问 TLB 缺失,并发生缺页,需要从磁盘上读取数组 A,因为数组 A 所在页在同一个磁盘扇区中,所以在不考虑页面置换的情况下,只要读取磁盘 1 次。(2 分)缺页异常处理结束后,重新执行 load 指令,load 指令的随后 1000 次执行中,每次都能在 TLB 中命中,因而无须访问内存页表项和磁盘,所以,P 在 1000 次循环执行过程中,对于数组 A,需要读取 TLB 共 1001 次。(2 分)
【评分说明】
(2) 若考生给出正确的命中率,而未说明原因和过程,给 1 分。 若命中率计算错误,但解题思路正确,可酌情给分。
(3) ① 对于第 1 问,若答案中除指令 4 外还包含其他运算类指令(即指令 1 、 2 、 5),则给 1 分,其他情况,则给 0 分。
② 对于第 2 问,只要回答“load 指令”,即可得分。
③ 对于第 3 问,若答案中给出的 读 TLB 的次数为 1002,同样给分。若直接给出正确的 TLB 及磁盘的访问次数,而未说明原因,给 3 分。若给出的 TLB 及磁盘访问次数不正确,但解题思路正确,可酌情给分。
【2020-44】
(10分)假定主存地址为32位,按字节编址,指令Cache和数据Cache与主存之间均采用8路组相联映射方式,直写(WriteThrough)写策略和LRU替换算法,主存块大小为64B,数据区容量各为32KB。开始时Cache均为空。请回答下列问题。
(1) Cache每一行中标记(Tag)、LRU位各占几位?是否有修改位?
(2) 有如下C语言程序段:
若数组s及其变量k均为int型,int型数据占4B,变量k分配在寄存器中,数组s在主存中的起始地址为008000C0H,则该程序段执行过程中,访问数组s的数据Cache缺失次数为多少?
(3) 若CPU最先开始的访问操作是读取主存单元00010003H中的指令,简要说明从Cache中访问该指令的过程,包括Cache缺失处理过程。
解析
基本参数
- 主存地址 = 32 位,按字节编址
- 指令/数据 Cache:8 路组相联,直写,LRU 替换
- 块大小 = 64B,数据区各 32KB,初始为空
(1) Cache采用8路组相联映射方式,组相联映射格式为 。
- 组数 = (32KB / 64B) / 8 = 64 组
- 块内偏移 = log₂(64) = 6 位
- 组索引 = log₂(64) = 6 位
- Tag = 32 − 6 − 6 = 20 位
LRU 位:
- 8 路 LRU 需对每路维护访问顺序计数,每路需 log₂(8) = 3 位
- 每个 Cache 行的 LRU 位 = 3 位
修改位(脏位):
- 采用直写策略,写操作同时写 Cache 和主存,Cache 内容始终与主存一致
- 无需修改位(没有脏位)
(2)int = 4B,数组 s 起始地址 = 008000C0H=  ,块内地址为000000B=0,所以s位于一个主存块开始处;
- 需要访问1024个数组元素,1024 × 4B = 4096B,共 4096/64 = 64 块;
每次循环:读 s[k](可能缺失) → 写 s[k](直写,缺失已加载则命中)
- 每块 64B / 4B = 16 个元素,第 1 次读缺失(冷缺失),随后 15 次读 + 16 次写均命中
- 总缺失次数 = 64 次(每块冷缺失一次)
(3) 访问 00010003H 指令的过程(包括缺失处理)
- 地址:00010003H =
- 块内偏移([5:0])=
000011= 3 - 组索引([11:6])=
000000= 组 0 - 标记([31:12])=
00000000000000010000= 0x10
访问过程:
- CPU 发出地址 00010003H,分解得 Tag=0x10,Set=0,Offset=3。
- 访问指令 Cache 第 0 组:Cache 初始为空,8 路均无效(Valid=0)→ Cache 缺失。
- 缺失处理:
- 该地址所在主存块起始地址00010000H,向主存发请求,读取 00010000H ~ 0001003FH 共 64 字节的数据块。
- 将该数据块填入指令 Cache 组 0 的某一路,置 Valid=1,Tag=0x10,同时更新 LRU 信息。
- 从填入的 Cache 行中,取偏移 3 处的字节(00010003H 处)开始读取 4 字节作为指令,送至 CPU。
【2011-44】
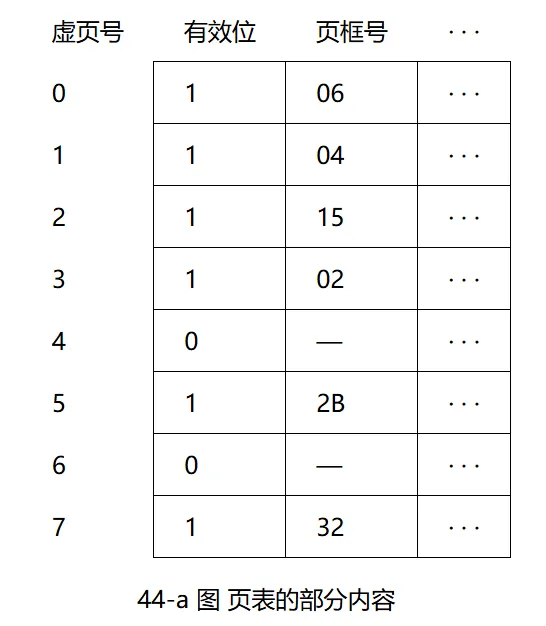
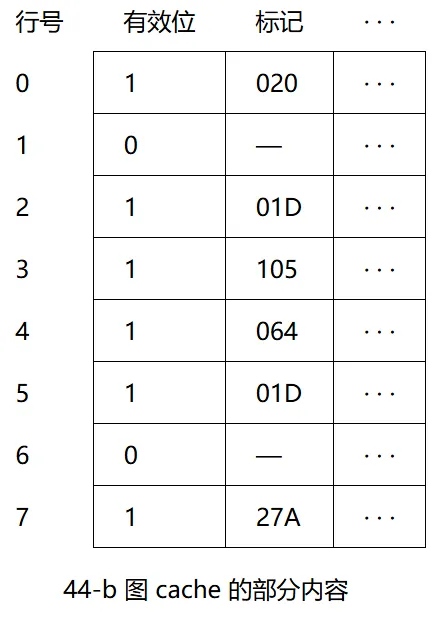
(12分)某计算机存储器按字节编址,虚拟(逻辑)地址空间大小为16MB,主存(物理)地址空间大小为1MB,页面大小为4KB:Cache采用直接映射方式,共8行:主存与Cache之间交换的块大小为32B。系统运行到某一时刻时,页表的部分内容和Cache的部分内容分别如题 44-a 图、题 44-b 图所示,图中页框号及标记字段的内容为十六进制形式。
请回答下列问题∶
(1) 虚拟地址共有几位,哪几位表示虚页号?物理地址共有几位,哪几位表示页框号(物理页号)?
(2) 使用物理地址访问Cache时,物理地址应划分成哪几个字段?要求说明每个字段的位数及在物理地址中的位置。
(3) 虚拟地址001C60H所在的页面是否在主存中?若在主存中,则该虚拟地址对应的物理地址是什么?访问该地址时是否Cache命中?要求说明理由。
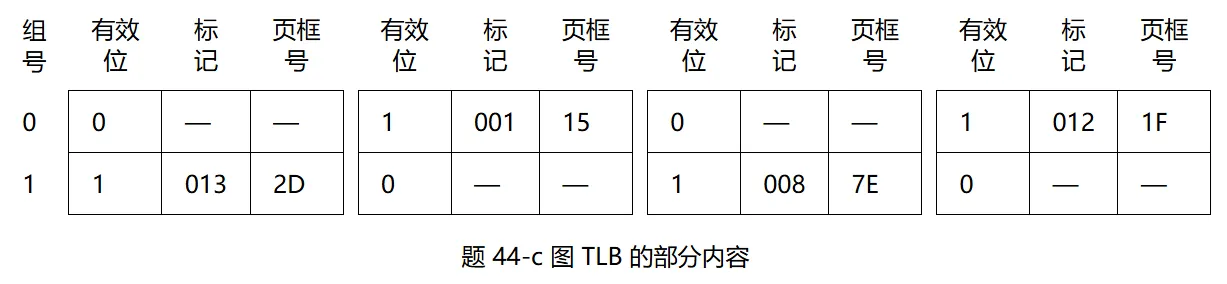
(4) 假定为该机配置一个4路组相连的TLB,该TLB共可存放8个页表项,若其当前内容(十六进制)如题 44-c 图所示,则此时虚拟地址024BACH所在的页面是否在主存中?要求说明理由。
解析
【官方答案】
(1) 虚拟地址为 24 位,其中高 12 位为虚页号;(1 分)
物理地址为 20 位,其中高 8 位为物理页号。(1 分)
(2) 20 位物理地址中,最低 5 位为块内地址,中间 3 位为 Cache 行号,高 12 位为标志。(3 分)
(3) 在主存中。(1 分)
虚拟地址 001C60H=0000 0000 0001 1100 0110 0000B,故虚页号为 0000 0000 0001B,查看 0000 0000 0001B = 001H 处的页表项,由于对应的有效位为 1 ,故虚拟地址 001C60H 所在的页面在主存中。(1 分)
页表 001H 处的页框号 (物理页号) 为 04H = 0000 0100B,与页内偏移 1100 0110 0000B 拼接成物理地址:0000 0100 1100 0110 0000B = 04C60H。(1 分)
对于物理地址 0000 0100 1100 0110 0000B,所在主存块只可能映射到 Cache 第 3 行 (即第 011B 行);由于该行的有效位 = 1、标记 (值为 105H) ≠ 04CH (物理地址高 12 位),故访问该地址时 Cache 不命中。(2 分)
(4) 虚拟地址 024BACH = 0000 0010 0100 1011 1010 1100B,故虚页号为 0000 0010 0100B;由于 TLB 只有 8/4=2 个组,故虚页号中高 11 位为 TLB 标记,最低 1 位为 TLB 组号,它们的值分别为 000 0001 0010B (即 012H) 和 0B,因此,该虚拟地址所对应物理页面只可能映射到 TLB 的第 0 组。(1 分)
由于组 0 中存在有效位 = 1、标记 = 012H 的项,所以访问 TLB 命中,即虚拟地址 024BACH 所在的页面在主存中。(1 分)
【评分说明】
(2) 每答对一个字段给 1 分。
(3) 仅指出正确的 Cache 行号给 1 分。
| 计算 | 结果 | |
|---|---|---|
| 虚拟地址位数 | 16MB = 2²⁴ | 24位 |
| 物理地址位数 | 1MB = 2²⁰ | 20位 |
| 页内偏移 | 4KB = 2¹² | 12位 |
| 虚页号位数 | 24 - 12 | 12位(bits 23~12) |
| 物理页框号位数 | 20 - 12 | 8位(bits 19~12) |
| Cache块内偏移 | 32B = 2⁵ | 5位(bits 4~0) |
| Cache行索引 | 8行 = 2³ | 3位(bits 7~5) |
| Cache标记 | 20 - 5 - 3 | 12位(bits 19~8) |
(1) 虚拟地址共24位(16MB = 2²⁴)
- 第23位~第12位(共12位)表示虚页号
- 第11位~第0位(共12位)表示页内偏移
物理地址共20位(1MB = 2²⁰)
- 第19位~第12位(共8位)表示页框号(物理页号)
- 第11位~第0位(共12位)表示页内偏移
(2)物理地址(20位)按以下方式划分:\(\begin{array}{|c|c|c|}\hline主存字块标记Tag& 行号& 块内地址\\\hline\end{array}\)
- 块内地址(5位,第4~0位):块大小32B = 2⁵,定位块内具体字节
- 行号(3位,第7~5位):直接映射共8行 = 2³,确定映射到哪一Cache行
- 标记位(12位,第19~8位):用于判断Cache行中的数据是否为所需数据
(3) 虚拟地址001C60H所在的页面是否在主存中?若在,对应物理地址是什么?是否Cache命中?
第一步:拆分虚拟地址 001C60H
001C60H = 0000 0000 0001 1100 0110 0000B(24位)
虚页号(bits 23~12)= 0x001 = 001H
页内偏移(bits 11~0)= 0xC60 = C60H
第二步:查页表
查页号001H对应的表项,有效位 = 1(在主存中),页框号 = 04H。
第三步:构造物理地址
页框号为04H,与页内地址拼接成物理地址为\(\rm \underbrace{04}*{\text{页框号}},\underbrace{C60}*{\text{页内地址}} H\) 。
第四步:判断Cache 是否命中。
\(\rm 04C60 H = \underbrace{0000 0100 1100}*{\text{主存字块标记}}, \underbrace{011}*{\text{行号}}, \underbrace{0 0000}_{\text{块内地址}}B\),映射到Cache的第011B=3行
查看44-b的表格,有效位为1,标记为105H不等于需要访问标记04CH,所以不命中。
(4) TLB(4路组相联,8项)中,虚拟地址024BACH所在的页面是否在主存中?
第一步:拆分虚拟地址 024BACH。
024BACH(24位)= 0000 0010 0100 1011 1010 1100B
虚页号(bits 23~12)= 0x024 = 024H = 0000 0010 0100B
页内偏移(bits 11~0)= BACH
第二步:TLB分组。
TLB共8个表项,4路组相联:
- 组数 = 8 ÷ 4 = 2组(组0和组1)
- 组索引位数 = log₂2 = 1位(取虚页号最低1位)
虚页号 024H = ...0010 0100B,最低位 = 0 → 映射到组0
TLB标记 = 虚页号高11位 = 0000 0010 010B = 0x012 = 012H
第三步:查TLB组0(题44-c图)。
在TLB组0的4个表项中查找标记 = 012H 的表项,发现组0中存在有效位为1、标记为012H的项,因此访问TLB命中,即虚拟地址024BACH所在的页面在主存中。
【2016-45】
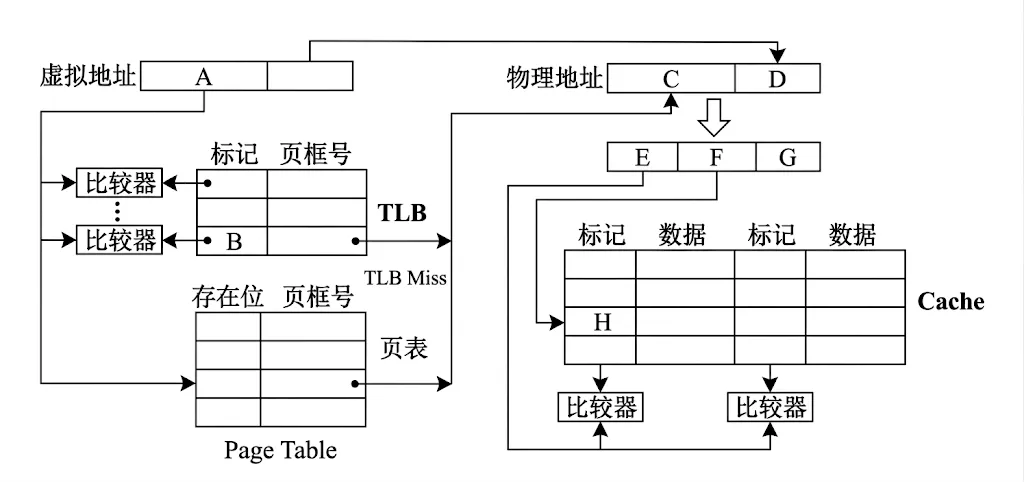
(14分)某计算机采用页式虚拟存储管理方式,按字节编址,虚拟地址为32位,物理地址为24位,页大小为8KB;TLB采用全相联映射;Cache数据区大小为64KB,按2路组相联方式组织,主存块大小为64B。存储访问过程的示意图如下。
请回答下列问题。
(1) 图中字段A~G的位数各是多少?TLB标记字段B中存放的是什么信息?
(2) 将块号为4099的主存块装入到Cache中时,所映射的Cache组号是多少?对应的H字段内容是什么?
(3) Cache缺失处理的时间开销大还是缺页处理的时间开销大?为什么?
(4) 为什么Cache可以采用直写 (Write Through) 策略,而修改页面内容时总是采用回写 (Write Back) 策略?
解析
【官方答案】
(1) 页大小为 8 KB,页内偏移地址为 13 位,故 A = B = 32 - 13 = 19;D = 13;C = 24 - 13 = 11;主存块大小为 64 B,故 G = 6。2 路组相联,每组数据区容量有 64 B × 2 = 128 B,共有 64 KB / 128 B = 512 组,故 F = 9;E = 24 - G - F = 24 - 6 - 9 = 9。
因而 A = 19, B = 19, C = 11, D = 13, E = 9, F = 9, G = 6。(各 1 分,共 7 分)
TLB 中标记字段 B 的内容是虚页号,表示该 TLB 项对应哪个虚页的页表项。(1 分)
(2) 块号 4099 = 00 0001 0000 0000 0011B,因此,所映射的 Cache 组号为 0 0000 0011B = 3,(1 分)对应的 H 字段内容为 0 0000 1000B。(1 分)
(3) Cache 缺失带来的开销小,而处理缺页的开销大。(1 分)因为缺页处理需要访问磁盘,而 Cache 缺失只要访问主存。(1 分)
(4) 因为采用直写策略时需要同时写快速存储器和慢速存储器,而写磁盘比写主存慢得多,所以,在 Cache-主存层次,Cache 可以采用直写策略,而在主存-外存(磁盘)层次,修改页面内容时总是采用回写策略。(2 分)
【评分说明】
(3) 对于 (3) 中第 2 问,若考生回答因为缺页需要软件实现而 Cache 缺失用硬件实现,则同样给分。
【预备计算】
| 参数 | 计算 | 结果 |
|---|---|---|
| 页内偏移 | 8KB = 2¹³ | 13位 |
| 虚页号位数(A) | 32 - 13 | 19位 |
| 物理页框号位数(C) | 24 - 13 | 11位 |
| Cache块内偏移(G) | 64B = 2⁶ | 6位 |
| Cache组数 | 64KB ÷ (2 × 64B) = 512 | 512组 |
| Cache组索引(F) | log₂512 | 9位 |
| Cache标记(E) | 24 - 6 - 9 | 9位 |
(1) 图中字段A~G的位数各是多少?TLB标记字段B中存放的是什么信息?
解:地址变换流程各字段:
虚拟地址(32位):\ ┌────────────────────┬───────────────────────┐\ │ 虚页号 A = 19位 │ 页内偏移 D = 13位 |\ └────────────────────┴───────────────────────┘\ ↓ TLB查找(全相联)\ ┌────────────────────┬───────────┐\ │ TLB标记 B = 19位 │ │\ └────────────────────┴───────────┘\ ↓ 命中则得到\ ┌─────────────────────┬──────────────────────┐\ │ 物理页框号 C = 11位 │ 页内偏移 D = 13位 |\ └─────────────────────┴──────────────────────┘\ ↓ 物理地址(24位)送Cache\ ┌──────────────┬─────────────┬───────────────┐\ │ Cache标记 │ Cache组索引 │块内偏移 │\ │ E = 9位 │ F = 9位 │ G = 6位 │\ └──────────────┴─────────────┴───────────────┘
TLB标记字段B中存放的是虚页号(19位)。 因为TLB采用全相联映射,没有组索引,TLB的整个标记字段就是完整的虚页号,用于与CPU给出的虚页号比较判断是否命中。
(2) 将块号为4099的主存块装入Cache时,所映射的Cache组号是多少?对应的H字段(Cache标记)内容是什么?
法一: Cache共512组,2路组相联,块大小64B:
Cache组号 = 主存块号 mod Cache组数
Cache标记H = 主存块号 ÷ Cache组数 = floor(4099 / 512)
H字段内容 = 8(十进制),即 000001000B(9位二进制)。
法二:对于任意Cache格式,主存地址均可划分为\(\begin{array}{|c|c|}\hline\text{块号}&\text{块内地址}\\\hline\end{array}\) ,本题Cache采用组相联格式, 地址可划分为\(\begin{array}{|c|c|}\hline\text{块号}&\text{块内地址}\\\hline\end{array} =\begin{array}{|c|c|c|}\hline\text{主存字块标记}&\text{组号}&\text{块内地址}\\\hline\end{array}\) ,所以 \(\begin{array}{|c|}\hline\text{块号}\\\hline\end{array} =\begin{array}{|c|c|}\hline\text{tag}&\text{组号}\\\hline\end{array}\) 。块号4099=4096+3=\(\underbrace{00 0001 000}*{\text{tag}}\underbrace{0 0000 0011}*{\text{组号}}\) B,因此,所映射的Cache组号为0 0000 0011B=3。标记H为主存字块标记,块号4099对应的H字段内容为0 0000 1000B。
(3) Cache缺失处理的时间开销大还是缺页处理的时间开销大?为什么?
缺页处理的时间开销远大于Cache缺失处理的时间开销。
Cache缺失时,直接从主存调块到Cache,全程硬件完成,速度快;缺页时必须从外存(磁盘)读取,磁盘I/O是机械运动或闪存擦写,延迟高出主存访问数个数量级。
(4) 为什么Cache可以采用直写策略,而修改页面内容时总是采用回写策略?
| 策略 | Cache(Cache-主存) | 虚拟内存(主存-外存) |
|---|---|---|
| 写策略 | 直写(Write Through)可行 | 必须采用回写(Write Back) |
| 原因 | 主存访问延迟约百纳秒,直写的性能损失可接受;且直写使Cache与主存保持一致,简化一致性管理 | 磁盘I/O延迟达毫秒级,若每次写页面都立即写磁盘,性能损失灾难性(写操作变慢10⁵倍);采用回写仅在页面被置换时才写磁盘,大幅减少磁盘I/O次数 |
本质区别:下层存储器的访问延迟差异决定了写策略的选择。主存速度相对较快,直写可接受;磁盘速度极慢,必须回写以避免频繁磁盘I/O造成的性能崩溃。
【2018-44】
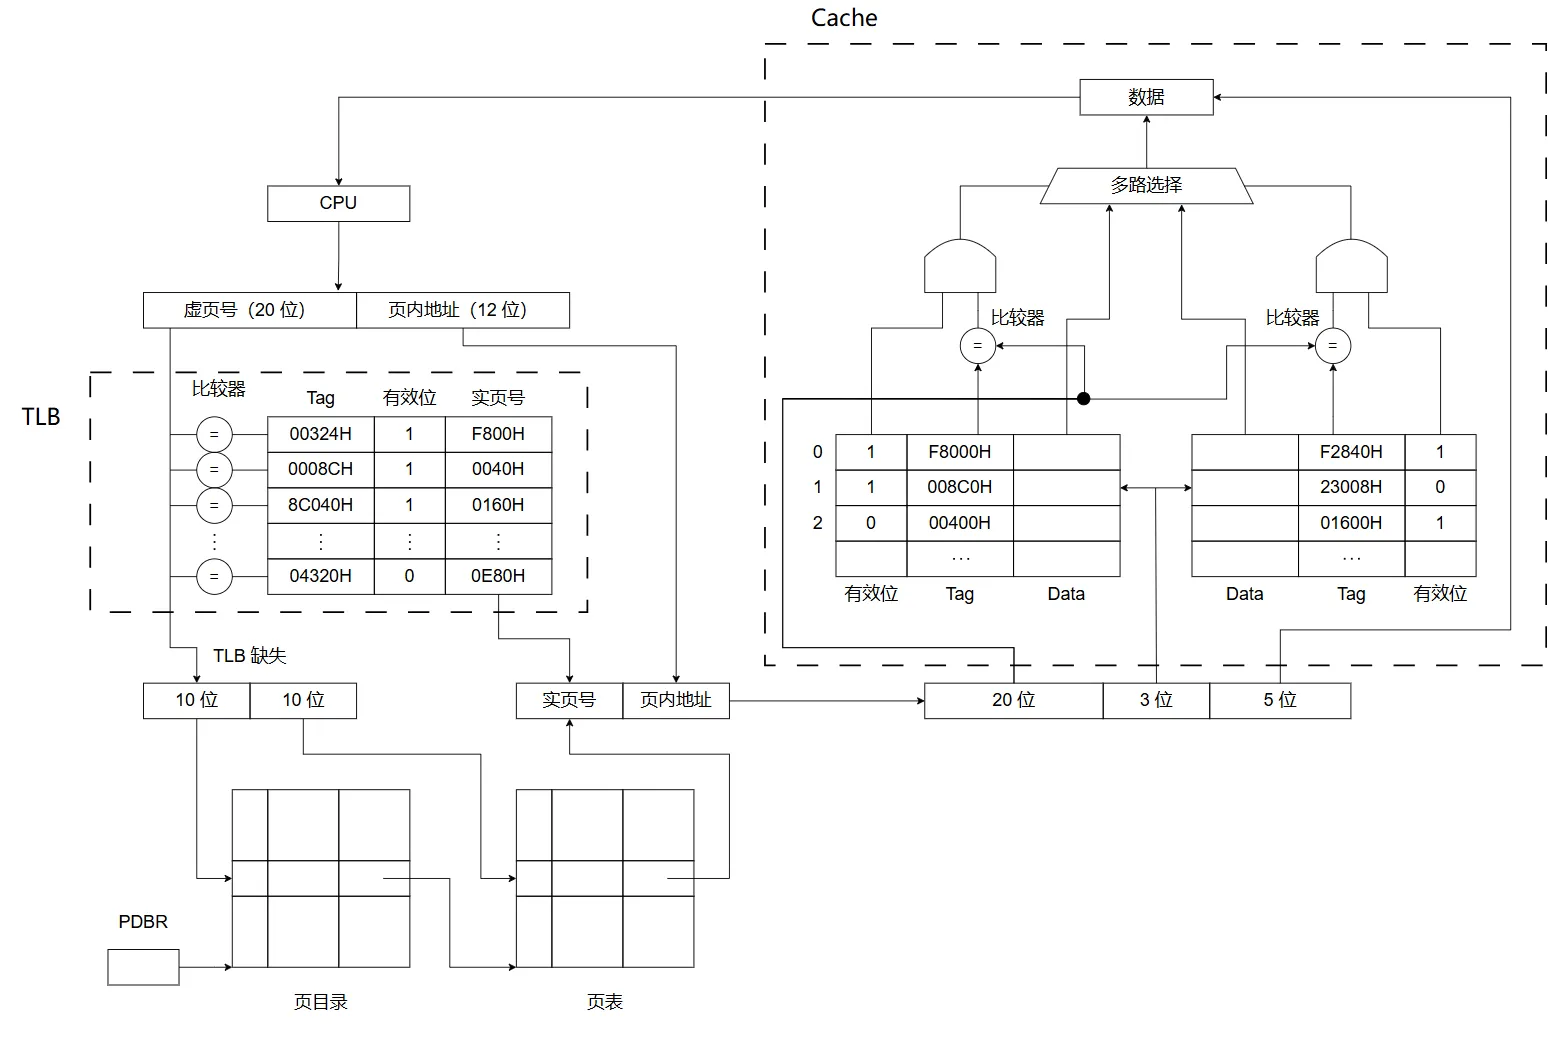
(15分)某计算机采用页式虚拟存储管理方式,按字节编址。CPU进行存储访问的过程如题44图所示。
根据题44图回答下列问题。
(1) 主存物理地址占多少位?
(2) TLB采用什么映射方式?TLB用SRAM还是DRAM实现?
(3) Cache采用什么映射方式?若Cache采用LRU替换算法和回写(Write Back)策略,则Cache每行中除数据(Data)、Tag和有效位外,还应有哪些附加位?Cache总容量是多少?Cache中有效位的作用是什么?
(4) 若CPU给出的虚拟地址为0008C040H,则对应的物理地址是多少?是否在Cache中命中?说明理由。若CPU给出的虚拟地址为0007C260H,则该地址所在主存块映射到的Cache组号是多少?
解析
【官方答案】
(1) 物理地址位数是 20+3+5=28 (或 16+12=28)。(1 分)
(2) TLB 中每项都有一个比较器,故 TLB 采用全相联映射方式。(1 分)
TLB 采用 SRAM 实现。(1 分)
(3) Cache 中每组有两行,故采用 2 路组相联映射方式。(1 分)
因为是 2 路组相联并采用 LRU 替换算法,所以每行(或每组)需要 1 位 LRU 位;(1 分)因为采用回写策略,所以每行有 1 位修改位(脏位)。(1 分)
28 位物理地址中 Tag 字段占 20 位,组索引字段占 3 位,块内偏移地址占 5 位,故 Cache 共有 2³ = 8 组,每组 2 行,每行有 2⁵ = 32 B;Cache 总容量为 8×2×(20+1+1+1+32×8) = 4464 位 = 558 字节。(或者 8×2×(20+1+1+32×8)+8 = 4456 位 = 557 字节)(4 分)
有效位用来指出所在 Cache 行中的信息是否有效。(1 分)
(4) 虚拟地址 0008 C040H 对应的物理地址是 004 0040H。(1 分)
访问 Cache 不命中。(1 分)
理由为:主存物理地址为 004 0040H,其中高 20 位 00400H 为标志字段,低 5 位 00000B 为块内偏移量,中间 3 位 010B 为组号 2,因此将 00400H 与 Cache 中第 2 组两行中的标志字段同时比较,可以看出,虽然有一个 Cache 行中的标志字段与 00400H 相等,但对应的有效位为 0,而另一 Cache 行的标志字段与 00400H 不相等,故访问 Cache 不命中。(1 分)
因为物理地址的低 12 位与虚拟地址低 12 位相同,即为 0010 0110 0000B,其中 011B 是组号(组索引),因此,该地址所在的主存块映射到的 Cache 组号为 3。(1 分)
(1) 主存物理地址占多少位?
物理地址映射到Cache后的地址位数不变,观察映射到Cache后的地址结构,可得物理地址占20+3+5=28位。
(2) TLB采用什么映射方式?TLB用SRAM还是DRAM实现?
- TLB采用全相联映射,可以把页表内容调入任一块空TLB项中,TLB中每项都有一个比较器,没有映射规则,只要空闲就行。
- TLB需要极高的访问速度(与CPU流水线匹配,通常1个时钟周期),必须使用SRAM实现。DRAM速度不够快,无法满足TLB的性能要求。
(3) Cache采用什么映射方式?附加位有哪些?Cache总容量是多少?有效位的作用?
- 根据题44图,Cache中每组有两行,采用2路组相联映射方式。
- 若Cache采用LRU替换算法和回写(Write Back)策略,则Cache每行中除数据(Data)、Tag和有效位外,还应有替换算法控制位和一致性维护位(脏位)。LRU需要的替换算法控制位数为
 ,本题为2路组相连,所以每行需要
 位替换算法控制位。每行有1位脏位,根据脏位判断数据是否被更新,如果脏位为1则需要写回内存。
- Cache组相联映射的地址结构中,主存字块标记占20位,组号占3位,Cache中有
 组,每组有两行,Cache中有8×2=16行,块内地址占5位,计算机按字节编址,Cache块大小为
 ×1B=32B。
Cache每行标记位数=主存字块标记位数+有效位位数+替换算法控制位位数+脏位位数=(20+1+1+1)bit=23bit。
Cache每行数据位数=32B=32×8bit=256bit。
Cache总容量=(Cache每行标记位数+Cache每行数据位数)×Cache行数=(23bit+256bit)×16=558B。
- 有效位的作用: 标记该Cache行是否包含有效数据。
- 系统初始化或Cache被清空时,所有有效位清0,表示所有Cache行均无有效内容。
- 当一个主存块调入Cache时,对应行的有效位置1。
- CPU访问Cache时,必须同时满足"有效位=1"且"Tag匹配",才算Cache命中。仅Tag匹配但有效位=0,仍视为Cache未命中(Miss)。
(4) 虚拟地址0008C040H和0007C260H的地址转换与Cache命中情况
① 虚拟地址 0008C040H
- 虚拟地址
 ,查找TLB表中Tag为0008CH的项,有效位为1,实页号为0040H,得到0008C040H所在的物理地址为
 。
- Cache组相联映射的地址格式为
 ,物理地址高20位对应主存字块标记,所以物理地址
 的主存字块标记为00400H,查Cache表表中Tag为00400H的项,左边一个存在Tag为00400H的项,但有效位为0,右边一个不存在Tag为00400H的项,所以访问Cache不命中。
② 虚拟地址 0007C260H(确定其主存块映射的Cache组号)
因为物理地址的低12位与虚拟地址低12位相同,对于虚拟地址为0007C260H,低12位为260H=0010 0110 0000B 。根据物理地址的结构,物理地址的后八位01100000B的前三位011B是组号,因此该地址所在的主存映射到Cache组号为011B=3。
【2019-46】
若计算机M的主存地址为32位,釆用分页存储管理方式,页大小为4KB,则第1行的push指令和第30行的ret指令是否在同一页中(说明理由)?若指令Cache有64行,采用4路组相联映射方式,主存块大小为64B,则32位主存地址中,哪几位表示块内地址?哪几位表示Cache组号?哪几位表示标记(tag)信息?读取第16行的call指令时,只可能在指令Cache的哪一组中命中(说明理由)?
int f1(int n){
1   00401000  55              push ebp
    ...       ...             ...
if(n>1)
11  00401018  83 7D 08 01     cmp dword ptr [ebp+8],1
12  0040101C  7E 17           jle f1+35h (00401035)
return n*f1(n-1);
13  0040101E  8B 45 08        mov eax, dword ptr [ebp+8]
14  00401021  83 E8 01        sub eax, 1
15  00401024  50              push eax
16  00401025  E8 D6 FF FF FF  call f1 (00401000)
    ...       ...             ...
19  00401030  0F AF C1        imul eax, ecx
20  00401033  EB 05           jmp f1+3Ah (0040103a)
else return 1;
21  00401035  B8 01 00 00 00  mov eax, 1
}
    ...       ...             ...
26  00401040  3B EC           cmp ebp, esp
    ...       ...             ...
30  0040104A  C3              ret
解析
【官方答案】
第 1 行指令和第 30 行指令的代码在同一页。(1 分)
因为页大小为 4 KB,所以虚拟地址的高 20 位为虚拟页号。第 1 行指令和第 30 行指令的虚拟地址高 20 位都是 00401H,因此两条指令在同一页中。(1 分)
Cache 组数为 64/4=16,因此,主存地址划分中,低 6 位为块内地址、(1 分)中间 4 位为组号(组索引)、(1 分)高 22 位为标记。(1 分)
读取第 16 行 call 指令时,只可能在指令 Cache 第 0 组中命中。(1 分)
因为页大小为 4 KB,所以虚拟地址和物理地址的最低 12 位完全相同,因而 call 指令虚拟地址 0040 1025H 中的 025H = 0000 0010 0101B = 00 0000 100101B 为物理地址的低 12 位,故对应 Cache 组号为 0。(1 分)
页大小4KB,因此页内偏移12位。
push地址 00401000H:虚页号 = 0x00401000 >> 12 = 0x00401
ret地址 0040104AH:虚页号 = 0x0040104A >> 12 = 0x00401
两条指令的虚页号相同,均为0x401页,因此在同一页中。
指令Cache字段划分(64行,4路组相联,块大小64B,32位地址):
Cache组数 = 64行 ÷ 4路 = 16组
块内偏移 = log₂(64B) = 6位(bits 5~0)
组索引 = log₂(16) = 4位(bits 9~6)
标记(Tag) = 32 - 6 - 4 = 22位(bits 31~10)
call指令(地址00401025H)所在的Cache组:
00401025H = 0000 0000 0100 0000 0001 0000 0010 0101B
块内偏移(bits 5~0) = 10 0101B = 0x25 = 37(在64B块内的第37字节)
块号 = 0x00401025 >> 6 = 0x10040(计算:0x401025 / 64 = 0x10040余0x25)
组号 = 0x10040 mod 16 = 0(因为0x10040 = 0x1004 × 16 + 0)
call指令只可能在指令Cache的第0组中命中。
理由:call指令的物理地址确定后,其所在主存块的块号为0x10040,0x10040 mod 16 = 0,固定映射到Cache第0组,无论该块是否在Cache中(命中或缺失),它都只可能在第0组。
【2021-44】
(8分)假设计算机M的主存地址为24位,按字节编址;采用分页存储管理方式,虚拟地址为30位,页大小为4KB;TLB采用2路组相联方式和LRU替换策略,共8组。请回答下列问题。
(1) 虚拟地址中哪几位表示虚页号?哪几位表示页内地址?
(2) 已知访问TLB时虚页号高位部分用作TLB标记,低位部分用作TLB组号,M的虚拟地址中哪几位是TLB标记?哪几位是TLB组号?
(3) 假设TLB初始时为空,访问的虚页号依次为10、12、16、7、26、4、12和20,在此过程中,哪一个虚页号对应的TLB表项被替换?说明理由。
(4) 若将M中的虚拟地址位数增加到32位,则TLB表项的位数增加几位?
解析
【官方答案】
(1) 因为按字节编址,页大小为 4 KB = 2¹² B,所以虚拟地址中高 30-12=18 位表示虚页号。(1 分)虚拟地址低 12 位表示页内地址。(1 分)
(2) 因为 TLB 采用 2 路组相联方式,共 8 = 2³ 组,所以虚拟地址(或虚页号)中高 18-3=15 位为 TLB 标记;(1 分)虚拟地址中随后 3 位(或虚页号中低 3 位)为 TLB 组号。(1 分)
(3) 虚页号 4 对应的 TLB 表项被替换。(1 分)因为虚页号与 TLB 组号的映射关系为 TLB 组号 = 虚页号 mod TLB 组数 = 虚页号 mod 8,因此,虚页号 10、12、16、7、26、4、12、20 映射到的 TLB 组号依次为 2、4、0、7、2、4、4、4。TLB 采用 2 路组相联方式,从上述映射到的 TLB 组号序列可以看出,只有映射到 4 号组的虚页号数量大于 2,相应虚页号依次是 12、4、12 和 20。根据 LRU 替换策略,当访问第 20 页时,虚页号 4 对应的 TLB 表项被替换出来。(2 分)
(4) 虚拟地址位数增加到 32 位时,虚页号增加了 32-30=2 位,使得每个 TLB 表项中的标记字段增加 2 位,因此,每个 TLB 表项的位数增加 2 位。(1 分)
(1) 虚拟地址中哪几位表示虚页号?哪几位表示页内地址?
虚拟地址格式为 \(\begin{array}{|c|c|}\hline \text{虚页号}&\text{页内地址}\\\hline \end{array}\)
- 按字节编址,且页大小 4KB = 2¹² → 页内地址:bits 11~0(低12位)
- 虚页号:bits 29~12(高18位)
(2) TLB中哪几位是标记?哪几位是组号?
TLB共8组 → 组号 = log₂8 = 3位
约定:虚页号高位作标记,低位作组号:\(\begin{array}{|c|}\hline \text{虚页号}\\\hline \end{array}=\begin{array}{|c|c|}\hline \text{标记}&\text{TLB组号}\\\hline \end{array}\)
- TLB组号:bits 14~12(虚页号的低3位,共3位)
- TLB标记:bits 29~15(虚页号的高15位,共15位)
(3) 访问序列:VPN = 10, 12, 16, 7, 26, 4, 12, 20。哪个VPN对应的TLB表项被替换?
首先计算每个VPN映射到的TLB组(组号 = VPN mod 8,即VPN低3位):因此,虚页号10、12、16、7、26、4、12、20映射到的 TLB 组号依次为 2、4、0、7、2、4、4、4。
只有第4组发生了3次以上访问(VPN 12、4、12、20),可能发生替换。追踪第4组状态:
初始状态:TLB第4组为空(2路)
访问VPN=12(第2次,组4):Miss → 装入,组4 = [12],LRU顺序:12最新
访问VPN=4(第6次,组4):Miss → 装入,组4 = [12, 4],LRU顺序:4最新,12最旧
访问VPN=12(第7次,组4):Hit → 更新LRU,组4 = [12, 4],LRU顺序:12最新,4最旧
访问VPN=20(第8次,组4):Miss,组4已满(2路),按LRU淘汰最旧的4 → 替换VPN=4
组4 = [12, 20]
被替换的TLB表项对应 VPN = 4。
理由:访问VPN=20时,第4组已存放VPN 12和VPN 4,组满需替换。按LRU策略,VPN 4是最近最少使用的(最后一次使用是第6次,而VPN 12在第7次被重新使用),故淘汰VPN 4。
(4) 若虚拟地址位数增加到32位,则TLB表项的位数增加几位?
| 参数 | 原(30位虚拟地址) | 新(32位虚拟地址) |
|---|---|---|
| 虚页号位数 | 30 - 12 = 18位 | 32 - 12 = 20位 |
| TLB组号位数 | log₂8 = 3位(不变) | 3位(不变) |
| TLB标记位数 | 18 - 3 = 15位 | 20 - 3 = 17位 |
| 增加位数 | — | 17 - 15 = 2位 |
TLB表项的标记字段增加 2位。(物理地址24位不变,物理页框号 = 24 - 12 = 12位不变,因此TLB表项中的页框号字段不增加位数。)
【2023-43】
(14 分)已知计算机M字长为32位,按字节编址,采用请求调页策略的虚拟存储管理方式,虚拟地址为32位,页面大小为4KB;数据Cache采用4路组相联映射,数据区大小为8KB,主存块大小为32B。现有C语言程序段如下:
已知二维数组a按行优先存放,在虚拟地址空间中分配的起始地址为0042 2000H,sizeof(int)=4,假定在M上执行上述程序段之前数组a不在主存,且在该程序段执行过程中不会发生页面置换。请回答下列问题。
(1) 数组a分为几个页面存储?对于数组a的访问,会发生几次缺页异常?页故障地址各是什么?
(2) 不考虑变量i和j,该程序段的数据访问是否具有时间局部性?为什么?
(3) 计算机M的虚拟地址(A31~A0)中哪几位用作块内地址?哪几位用作Cache组号?a[1][0]的虚拟地址是多少?其所在主存块对应的Cache组号是多少?
(4) 数组a占用多少主存块?假设上述程序段执行过程中数组a的访问不会和其他数据发生Cache访问冲突,则数组a的Cache命中率是多少?若将循环中i和j的次序按如下方式调换:
则数组a的Cache命中率又是多少?
解析
【官方答案】
(1) 数组 a 分布在 2 个页面中。(1 分)缺页异常次数为 2。(1 分)两个页故障地址分别是 0042 2000H、0042 3000H。(2 分)
(2) 该程序段的数据访问没有时间局部性。(1 分)因为每个数组元素仅访问 1 次。(1 分)
(3) 虚拟地址中低 5 位 (A4~A0) 用作块内地址;(1 分)低 11 位虚拟地址中高 6 位 (A10~A5) 用作 Cache 组号。(1 分)a[1][0]的虚拟地址为 00422000H+1×64×4+0×4=0042 2100H。(1 分)a[1][0] 所在主存块对应的 Cache 组号为 001000B=8。(1 分)
(4) 数组 a 占 24×64×4 B/32 B=192 个主存块。(1 分)每个主存块存放 32 B/4 B=8 个数组元素,访问数组 a 的 Cache 命中率为 (8-1)/8=87.5%。(1 分)8 行数组元素占 8×64×4 B/32 B=64 个主存块,分别映射到 64 个 Cache 组的某 Cache 行,数组 a 共有 24 行,因此每个 Cache 组中只有 24/8=3 个 Cache 行存放数组 a 中的数据,而每个 Cache 组有 4 行,因而不会发生替换,访问数组 a 的 Cache 命中率为 7/8=87.5%。(2 分)
(1) 数组a分为几个页面?会发生几次缺页异常?页故障地址各是什么?
数组a的大小:
元素个数 = 24 × 64 = 1536个
字节数 = 1536 × 4 = 6144字节 = 6KB页面占用分析:起始地址 0x00422000 恰好是页边界(页内偏移 = 0x000):
页0x422:0x422000 ~ 0x422FFF(4KB,存放a[0][0] ~ a[15][63])
页0x423:0x423000 ~ 0x4237FF(2KB,存放a[16][0] ~ a[23][63])
  a[16][0]的偏移 = 16×64×4 = 4096字节 → 地址0x423000(新页起始)
  a[23][63]的偏移 = (23×64+63)×4 = (1472+63)×4 = 1535×4 = 6140
  结束地址 = 0x422000 + 6140 = 0x4237FC
数组a共分为 2 个页面。
缺页次数:
执行中不发生页面置换,每个页面首次访问时产生1次缺页:
- 第1次缺页:访问 a[0][0](i=0, j=0),地址 0x00422000(页0x422首次访问)
- 第2次缺页:访问 a[16][0](i=16, j=0),地址 0x00423000(页0x423首次访问)
共发生 2次缺页异常,页故障地址分别为 0x0042 2000 和 0x0042 3000。
(2) 该程序段的数据访问是否具有时间局部性?为什么?
不具有时间局部性。
原因:程序段对数组a的每个元素执行"写操作"(a[i][j] = 10),每个元素在整个程序段执行过程中只被访问一次,写完之后不再被读取或写入。时间局部性要求同一数据在短时间内被多次访问,而这里每个数组元素仅访问一次,没有重复访问,因此不具备时间局部性。
注:空间局部性存在(按行顺序访问相邻元素),但时间局部性不存在。
(3) 虚拟地址各字段划分;a[1][0]的虚拟地址及对应Cache组号
虚拟地址格式为  ,物理地址格式为
 ,页大小和页框号大小相同,页面大小为4KB=
 B,按字节编址,页内地址占低12位。也就是虚拟地址和物理地址的低12位相同。
Cache结构参数:
块大小    = 32B = 2⁵  → 块内偏移:5位(A4~A0)
数据区    = 8KB
4路组相联 → 组数 = 8KB ÷ (4 × 32B) = 8192 ÷ 128 = 64组 = 2⁶
           → 组索引:6位(A10~A5)
物理地址组相联映射格式为  ,5+6=11<12,虚拟地址和物理地址的低11位一定相同。物理地址中低5位用作块内地址,低11位中高6位用作Cache组号。对应虚拟地址中低5位(A4~A0)用作块内地址,低11位中高6位(A10~A5)用作Cache组号。
a[1][0]的虚拟地址0042 2100H。因为a的起始地址为0042 2000H,一行有64个元素,一个元素占4个地址单元,所以a[1][0]的虚拟地址是0042 2000H+(64×1+0)×4H=0042 2100H。
a[1][0]所在主存块对应的Cache组号是8。因为a[1][0]的虚拟地址0042 2100H = ,组号001 000B=8。
(4) 数组a占多少主存块?两种循环顺序下的Cache命中率各是多少?
数组a占用的主存块数:
主存块数 = 6144B ÷ 32B = 192块分析Cache是否会发生冲突:
数组a的192个块分布在Cache的64组中,每组恰好 192÷64 = 3块。4路组相联每组可容纳4块,因此192块全部装入Cache不会发生组内冲突替换。
行优先循环(i外j内)的Cache命中率:
访问顺序:a[0][0], a[0][1], ..., a[0][63], a[1][0], ..., a[23][63]
每个主存块包含 32B/4B = 8个int元素:
- 访问块内第1个元素:缺失(Miss),块调入Cache
- 访问块内第2~8个元素:命中(Hit)
总访问次数 = 1536次
Miss次数   = 192次(每块首次访问)
Hit次数    = 1344次

Cache命中率 = 1344 / 1536 = 7/8 = 87.5%
列优先循环(j外i内)的Cache命中率:
访问顺序:a[0][0], a[1][0], ..., a[23][0], a[0][1], ..., a[23][63]
分析:
- 访问a[0][0]时,块(含a[0][0]~a[0][7])装入Cache(set 0)
- 访问a[1][0]时,其块装入不同的Cache组(set 8),不冲突
- ...访问完a[23][0]后,共加载24块,分布于8个不同的Cache组(每组3块,4路容纳)
- 访问a[0][1]:与a[0][0]在同一块(偏移差4B,同在32B块内)→ Hit
- 访问a[1][1]:与a[1][0]在同一块 → Hit
- ...
规律:每8列(j=0~7, j=8~15, ...)中,第1列(首次访问每行)产生24次Miss,其余7列产生Hit。
Miss轮次 = 64列 ÷ 8 = 8轮
每轮Miss = 24次(24行首次访问新块)
总Miss   = 8 × 24 = 192次
总Hit    = 1536 - 192 = 1344次

列优先Cache命中率 = 1344 / 1536 = 7/8 = 87.5%
结论: 本例中由于数组a(6KB)小于Cache数据区(8KB),且192块恰好分配在64组中每组3块(4路可全部容纳),无论行优先还是列优先,Cache命中率均为 7/8(87.5%)。
若Cache容量不足以容纳整个数组(如直接映射或容量更小),则列优先会因频繁冲突导致命中率大幅下降,甚至趋近于0。本题特殊之处在于4路组相联缓解了冲突。
【2024-44】
(本题10 分)对于题 43 中的计算机 M,C 语言程序 P 包含的语句 “sum += a[i];” 在 M 中对应的指令序列 S 如下。
slli r4, r2, 2  // R[r4]←R[r2]<<2
add r4, r3, r4  // R[r4]←R[r3]+R[r4]
lw r5, 0(r4)    // R[r5]←M[R[r4]+0]
add r1, r1, r5  // R[r1]←R[r1]+R[r5]
已知变量 i、sum 和数组 a 都为 int 型,通用寄存器 r1~r5 的编号为 01 H ~ 05 H。
请回答下列问题。
(1) 根据指令序列 S 中每条指令的功能,写出存放数组 a 的首地址、变量 i、变量 sum 的通用寄存器编号。(3 分)
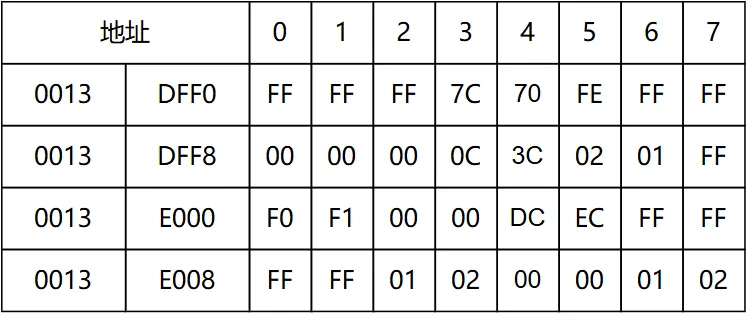
(2) 已知 M 为小端方式计算机,采用页式存储管理方式,页大小为 4 KB。若执行到指令序列 S 中第一条指令时,i=5,且 r1 和 r3 的内容分别为 0000 1332 H 和 0013 DFF0 H,从地址 0013 DFF0 H 开始的存储单元内容如题 44 图所示,则执行 “sum+=a[i];” 语句后,a[i] 的地址、a[i] 和 sum 的机器数分别是什么(用十六进制表示)?a[i] 所在页的页号是多少?此次执行中,数组 a 至少存放在几页中?(5 分)
(3) 指令 “slli r4, r2, 2” 的机器码是什么(用十六进制表示)?若数组 a 改为 short 类型,则指令序列 S 中 slli 指令的汇编形式应是什么?(2 分)
解析
【官方答案】
(1) a 的首地址存放在 r3;(1 分)i 存放在 r2;(1 分)sum 存放在 r1。(1 分)
(2) a[i] 的地址为 0013 E004H;(1 分)a[i] 的机器数为 FFFF ECDCH;(1 分)sum 的机器数为 0000 000EH。(1 分)a[i] 所在页的页号是 0013EH。(1 分)数组 a 至少存放在 2 页中。(1 分)
(3) 指令机器码为 0021 2213H。(1 分)汇编形式是 slli r4, r2, 1。(1 分)
(1) 写出存放数组a首地址、变量i、变量sum的通用寄存器编号。
add r4,r3,r4:这条指令将寄存器 r3 和 r4 的值相加,结果存储在寄存器 r4 中。这对应于计算数组元素的内存地址(即&a[i])。因此,我们可以推断出寄存器 r3 存储的是数组 a 的首地址,即 a 的寄存器编号为 03H。
slli r4,r2,2:这条指令将寄存器 r2 的值左移 2 位,2 结果存储在寄存器 r4 中。在 C 语言中,这对应于数组索引的计算(即 i*4,因为每个 int 类型占 4 字节)。因此,我们可以推断出寄存器 r2 存储的是变量 i 的值,即的寄存器编号位 02H。
add r1,rl,r5:这条指令将寄存器 r1 和 r5 的值相加,结果存储在寄存器 r1 中。这对应于累加操作(即 sum+=a[i])。因此,我们可以推断出寄存器 r1 存储的是变量 sum 的值,即 sum 的寄存器编号为 01H。
所以,数组 a 的首地址、变量 i 和 sum 的通用寄存器编号分别为 03H、02H 和 01H。
(2) 执行"sum+=a[i]"后,a[i]的地址、a[i]和sum的机器数;a[i]所在页的页号;数组a至少存放在几页中。
- a[i] 的地址:已知 i = 5,int 类型占 4 字节。偏移量为
 = 20 字节,即十六进制的
14 H。数组首地址为0013 DFF0 H,因此 a[5] 的地址 =0013 DFF0 H + 0014 H=0013 E004 H。 - a[i] 的机器数:查表可知,地址
0013 E004 H开始的连续 4 个字节内容分别为:DC、EC、FF、FF。由于该计算机采用小端方式(低字节存放在低地址),因此拼接后的机器数为:FFFF ECDC H。 - sum 的机器数:执行加法:
sum = sum + a[i]即0000 1332 H + FFFF ECDC H。按十六进制相加,忽略 32 位溢出产生的最高位进位,结果为:0000 000E H。 - a[i] 所在页的页号:页大小为 4KB(即 B),说明物理地址的低 12 位为页内偏移,高 20 位为页号。a[i] 的地址
0013 E004 H,截取高 20 位,其所在页的页号为:0013E H(或写为13E H)。 - 数组 a 至少存放在几页中:数组首地址在
0013 DFF0 H,它所在的页面(页号0013D H)结束地址为0013D FFF H。该页剩余可用空间为1000 H - FF0 H = 10 H字节(即 16 字节),刚好能存放 4 个 int 型元素(a[0]、a[1]、a[2]、a[3])。而本题中访问到了 a[5],说明 a[4] 和 a[5] 被存放在了下一个相邻的页面(页号0013E H)中。因此,数组 a 至少跨越了 2 页。
(3) "slli r4, r2, 2"的机器码;若数组a改为short类型,slli指令应如何修改?
指令的机器码: 根据图 43(a) 给出的 slli 指令格式: 000 0000(7位) | shamt(5位) | rs1(5位) | 010(3位) | rd(5位) | 001 0011(7位)
对于 slli r4, r2, 2:
rd= r4 = 04 H =00100rs1= r2 = 02 H =00010shamt= 2 =00010
拼接二进制:0000 000 | 0 0010 | 00010 | 010 | 00100 | 0010011 按 4 位一组转换为十六进制:0000_0000_0010_0001_0010_0010_0001_0011 机器码为:0021 2213 H。
改为 short 类型后的汇编形式: 若数组 a 为 short 类型,则每个元素占 2 个字节。计算偏移量时,应该将下标 i 乘以 2(即左移 1 位),而不是乘以 4。 因此,slli 指令的汇编形式应改为:slli r4, r2, 1。
第四章 指令系统
【2010-43】
(11 分)
某计算机字长为 16 位,主存地址空间大小为 128 KB,按字编址,采用单字长指令格式,指令各字段定义如下图所示。
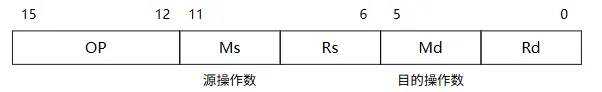
转移指令采用相对寻址,相对偏移量用补码表示,寻址方式定义如下:
注:(x) 表示有存储器地址 x 或寄存器 x 的内容。
请回答下列问题:
(1) 该指令系统最多可有多少条指令?该计算机最多有多少个通用寄存器?存储器地址寄存器 (MAR) 和存储器数据寄存器 (MDR) 至少各需要多少位?(4 分)
(2) 转移指令的目标地址范围是多少?(2 分)
(3) 若操作码 0010B 表示加法操作(助记符为 add),寄存器 R4 和 R5 的编号分别为 100B 和 101B,R4 的内容为 1234H,R5 的内容为 5678H,地址 1234H 中的内容为 5678H,地址 5678H 中的内容为 1234H,则汇编语句“add (R4),(R5)+”(逗号前为源操作数,逗号后为目的操作数)对应的机器码是什么(用十六进制表示)?该指令执行后,哪些寄存器和存储单元的内容会改变?改变后的内容是什么?(5 分)
【官方答案】
(1) 该指令系统最多可有 16 条指令;(1 分)该机最多有 8 个通用寄存器;(1 分)因为地址空间大小为 128 KB,按字编址,故共有 64 K 个存储单元,地址位数为 16 位,所以 MAR 至少为 16 位;(1 分)因为字长为 16 位,所以 MDR 至少为 16 位。(1 分)
(2) 转移指令的目标地址范围为 0000H~FFFFH。(2 分)
(3) 对于汇编语句“add(R4),(R5)+”,对应的机器码为:0010 001 100 010 101B,用十六进制表示为 2315H。(2 分)
“add(R4),(R5)+”指令执行后,R5 和存储单元 5678H 的内容会改变。(1 分)执行后,R5 的内容从 5678H 变为 5679H。(1 分)存储单元 5678H 中的内容从 1234H 变为 68ACH。(1 分)
【2013-44】
(14 分)某计算机采用 16 位定长指令字格式,其 CPU 中有一个标志寄存器,其中包含进位/借位标志 CF、零标志 ZF 和符号标志 NF。假定为该机设计了条件转移指令,其格式如下:
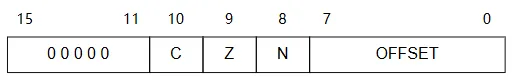
其中,00000 为操作码 OP;C、Z 和 N 分别为 CF、ZF 和 NF 的对应检测位,某检测位为 1 时表示需检测对应标志,需检测的标志位中只要有一个为 1 就转移,否则就不转移,例如,若 C = 1,Z = 0,N = 1,则需检测 CF 和 NF 的值,当 CF = 1 或 NF = 1 时发生转移;OFFSET 是相对偏移量,用补码表示。转移执行时,转移目标地址为 (PC)+2+2×OFFSET;顺序执行时,下条指令地址为 (PC)+2。请回答下列问题。
(1) 该计算机存储器按字节编址,还是按字编址?该条件转移指令向后(反向)最多可跳转多少条指令?(3 分)
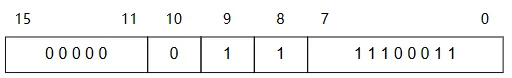
(2) 某条件转移指令的地址为 200CH,指令内容如下图所示,若该执行时 CF = 0,ZF = 0,NF = 1,则该指令执行后 PC 的值是多少?若该指令执行时 CF = 1,ZF = 0,NF = 0,则该指令执行后 PC 的值又是多少?请给出计算过程。(5 分)
(3) 实现“无符号数比较小于等时转移”功能的指令中,C、Z 和 N 应各是什么?(3 分)
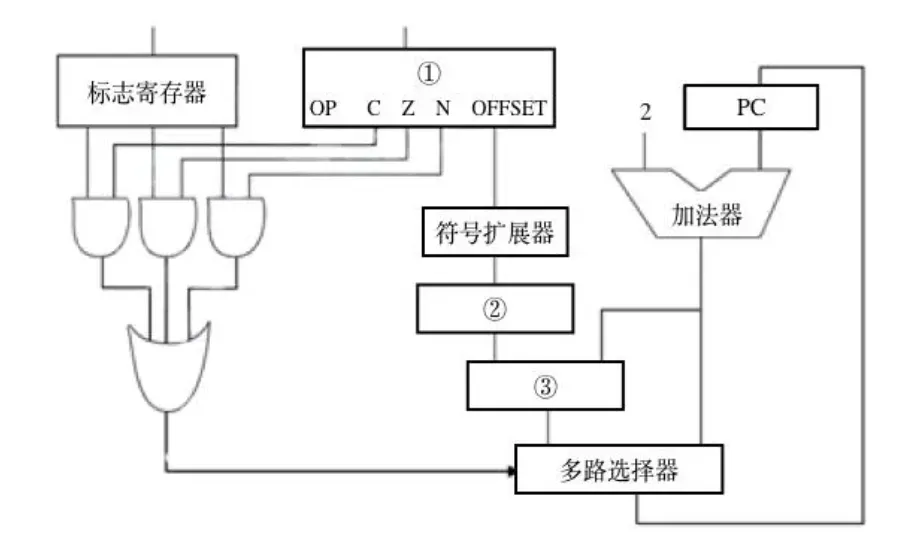
(4) 以下是该指令对应的数据通路示意图,要求给出中部件 ①~③ 的名称或功能说明。(3 分)
解析
【官方答案】
(1) 因为指令长度为 16 位,且下条指令地址为 (PC)+2,故编址单位是字节。(1 分)
偏移量 OFFSET 为 8 位补码,范围为 -128 ~ 127,故相对于当前条件转移指令,向后最多可跳转 127 条指令。(2 分)
(2) 指令中 C = 0, Z = 1, N = 1,故应根据 ZF 和 NF 的值来判断是否转移。当 CF = 0, ZF = 0, NF = 1 时,需转移。(1 分)已知指令中偏移量为 1110 0011B = E3H,符号扩展后为 FFE3H,左移一位(乘 2)后为 FFC6H,故 PC 的值(即转移目标地址)为 200CH+2+FFC6H = 1FD4H。(2 分)当 CF = 1, ZF = 0, NF = 0 时不转移。(1 分)PC 的值为:200CH+2 = 200EH。(1 分)
(3) 指令中的 C、Z 和 N 应分别设置为 C = Z = 1, N = 0。(3 分)
(4) 部件①:指令寄存器(用于存放当前指令);部件②:移位寄存器(用于左移一位);部件③:加法器(地址相加)。(3 分)
【评分说明】
(1) 若正确给出 OFFSET 的取值范围,则酌情给分。
(4) 合理给出部件名称或功能说明均给分。
【2014-44】
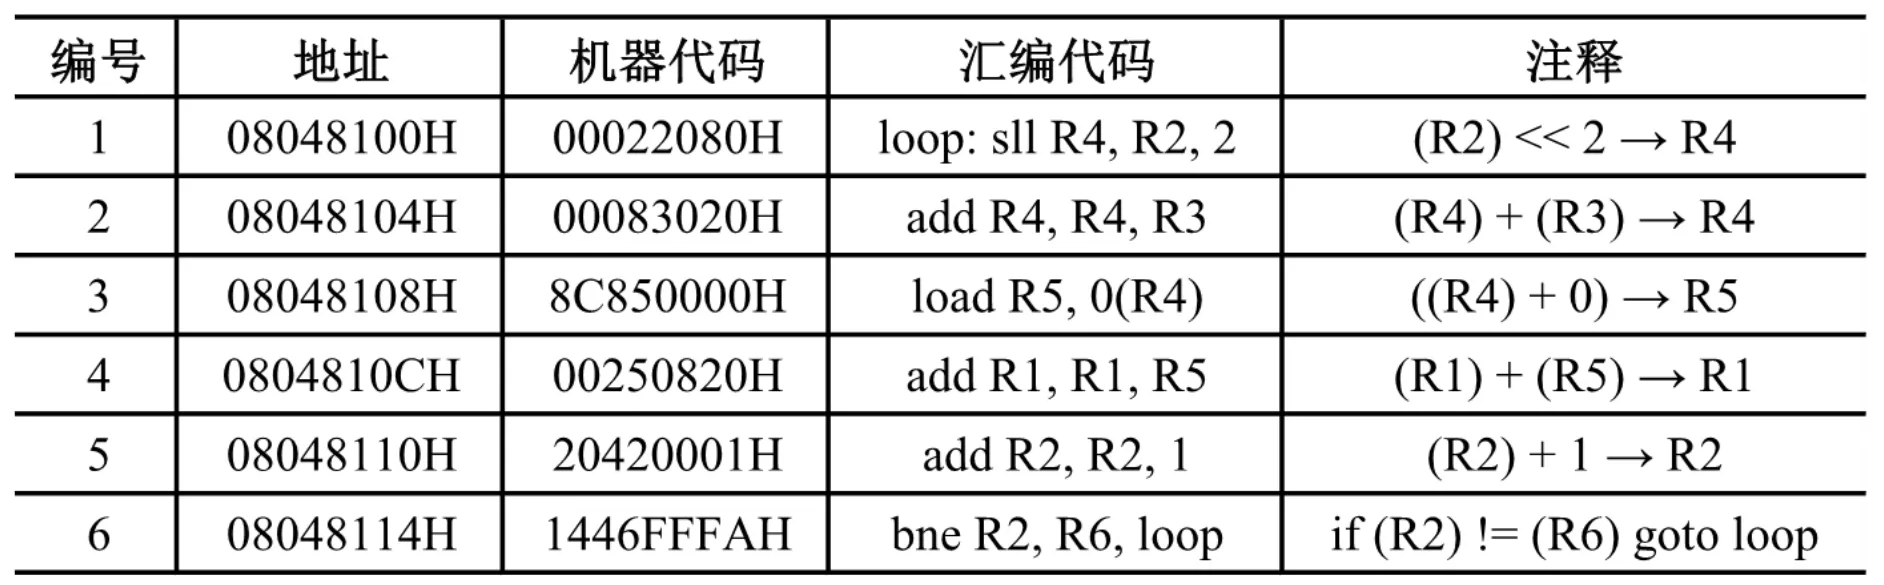
(12分)某程序中有如下循环代码段P:“for (int i=0; i<N; i++) sum += A[i];”。假设编译时变量sum和i分别分配在寄存器R1和R2中。常量N在寄存器R6中,数组A的首地址在寄存器R3中。程序段P起始地址为08048100H,对应的汇编代码和机器代码如下表所示。
执行上述代码的计算机M采用32位定长指令字,其中分支指令bne采用如下格式。
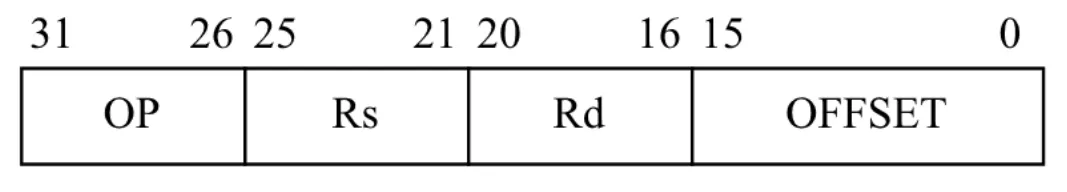
Op为操作码,Rs和Rd为寄存器编号,OFFSET为偏移量,用补码表示。请回答下列问题,并说明理由。
(1) M的存储器编址单位是什么?
(2) 已知sll指令实现左移功能,数组A中每个元素占多少位?
(3) 题44表中bne指令的OFFSET字段的值是多少?已知bne指令采用相对寻址方式,当前PC内容为bne指令地址,通过分析题44表中指令地址和bne指令内容,推断出bne指令的转移目标地址计算公式。
(4) 若M采用如下“按序发射、按序完成”的5级指令流水线:IF(取指)、ID(译码及取数)、EXE(执行)、MEM(访存)、WB(写回寄存器),且硬件不采取任何转发措施,分支指令的执行均引起3个时钟周期阻塞,则P中那些指令的执行会由于数据相关而发生流水线阻塞?哪条指令的执行会发生控制冒险?为什么指令1的执行不会因为与指令5的数据相关而发生阻塞?
解析
【官方答案】
(1) 因为每条指令长度为 32 位,占 4 个单元,所以存储器编址单位是字节。(2 分)
(2) 数组 A 中每个元素的地址通过下标左移两位(即乘 4)再加数组首地址得到,故每个数组元素占 4 个字节,即 32 位。 (2 分)
(3) OFFSET = FFFAH,值为 -6。(1 分)指令 bne 所在地址为 0804 8114H,转移目标地址为 0804 8100H,因为 0804 8100H = 0804 8114H+4+(-6)×4,(1 分)所以,指令 bne 的转移目标地址计算公式为:(PC)+4+OFFSET×4。(1 分)
(4) 由于数据相关而发生阻塞的指令为第 2、3、4、6 条, 因 为第 2、3、4、6 条指令都与各自前一条指令发生数据相关。(3 分) 第 6 条指令会发生控制冒险。(1 分) 当前循环的第 5 条指令与下次循环的第 1 条指令虽然有数据相关, 但由于第 6 条指令后有 3 个时钟周期的阻塞, 因而消除了该数据相关。(1 分)
【评分说明】
(4) 对于第 1 问,若考生回答:因为指令 1 和 2 、 2 和 3 、 3 和 4、 5 和 6 发生数据相关,因而发生阻塞的指令为第 2 、3 、4 、6 条,同样给 3 分。 答对 3 个以上给 3 分,部分正确酌情给分。
在分析具体问题前,我们先梳理已知条件和寄存器对应关系:
- 循环代码功能:对数组
 进行累加,
sum += A[i]。 - 寄存器分配:
sum R1,
i R2,A的首地址 R3,N R6。 - 机器特性:32位定长指令字,采用 5 级流水线(IF、ID、EXE、MEM、WB),按序发射、按序完成。
(1) 字节编址(或者说编址单位是字节/Byte)。
- 题目中明确指出:计算机M采用 32位定长指令字,也就是说每条指令占 32 位(即 4 个字节)。
- 观察表中连续指令的地址,例如:
- 指令 1 的地址为
08048100H - 指令 2 的地址为
08048104H
两个相邻指令的地址差为:08048104H - 08048100H = 4H(即十进制的 4)。
- 因为一条 4 字节的指令占用了 4 个地址单位,所以 1 个地址单位 = 1 个字节。因此,该存储器是按字节编址的。
(2) 数组A中每个元素占32位(或 4 字节)。
- 指令 1 为
sll R4, R2, 2,注释为(R2)<<2 -> R4。R2 中存放的是循环变量i,左移 2 位相当于乘以 。也就是说,
R4 = i * 4。 - 指令 2 为
add R4, R4, R3,将刚才计算的偏移量R4与数组首地址R3相加,得到A[i]的内存地址。 - 由于计算机是字节编址,下标
i每增加 1,地址就增加 4 个字节。这说明数组 中的每一个元素占 4 个字节。 - 换算成位数:
 32位。
(3) bne指令的OFFSET字段的值是FFFAH(或十进制的  )。bne指令的转移目标地址计算公式:
- 提取 OFFSET 字段:观察指令 6(
bne)的机器代码为1446FFFAH。根据题目给出的bne指令格式,高 16 位是OP、Rs、Rd,低 16 位(即最后 4 位十六进制数)是OFFSET。因此,OFFSET = FFFAH。 - 计算 OFFSET 的真值:
FFFAH用补码表示,首位为 1 是个负数。对其求源码(取反加 1):FFFAH取反得到0005H,再加 1 得到0006H。所以其十进制真值为。 - 推导目标地址公式:
- 当前
bne指令的地址(即当前 PC)=08048114H。 - 跳转的目标地址(
loop标签所在指令 1 的地址)=08048100H。 - 两者的实际地址差为:
08048100H - 08048114H = -14H(即十进制的 )。
- 已知
OFFSET = -6,如何通过-6和当前 PC 算出-20的地址偏移? - 因为指令是定长 4 字节,通常相对寻址会先将
PC + 4(指向下一条指令),再在此基础上加上OFFSET * 4。 - 验证:
- 结果完全吻合,因此公式为:
 。
(4) ① 指令 2、指令 3、指令 4、指令 6的执行会由于数据相关而发生流水线阻塞
题目说明“硬件不采取任何转发(旁路)措施”,这意味着后面指令如果需要用到前面指令写入的寄存器,必须等到前面指令执行到 WB(写回) 阶段将数据切实写入寄存器文件后,后面指令才能在 ID(译码/读寄存器) 阶段读出。
- 指令 2 依赖 指令 1 写入的
R4(第1条写,第2条读,产生RAW相关)。 - 指令 3 依赖 指令 2 写入的
R4(第2条写,第3条读,产生RAW相关)。 - 指令 4 依赖 指令 3 写入的
R5(第3条写,第4条读,产生RAW相关)。 - 指令 6 依赖 指令 5 写入的
R2(第5条写,第6条读,产生RAW相关)。
以上这些相邻指令均因为数据未及时写回而导致流水线阻塞。
② 指令 6(即 bne 指令)的执行会发生控制冒险
控制冒险通常由分支跳转指令引起。指令 6 是一条条件转移指令(bne),在它执行到确定是否跳转以及跳转到何处之前,流水线无法确定下一条应该取哪里的指令,从而导致控制冒险(题目也明确指出分支指令会引起 3 个时钟周期的阻塞)。
③ 因为 指令 6(分支指令)在执行时引入了 3 个时钟周期的控制冒险阻塞。
- 虽然指令 5 会修改
R2(add R2, R2, 1),而下一轮循环的指令 1 需要读取R2(sll R4, R2, 2),它们之间存在数据相关。 - 但是在指令 5 和下一轮的指令 1 之间,隔着一条指令 6(
bne)。 - 题目规定:“分支指令的执行均引起 3 个时钟周期阻塞”。在这 3 个时钟周期的等待时间内,指令 5 有足够的时间流向流水线的深处,并顺利完成它的 WB(写回寄存器) 阶段。
- 当 3 个周期的阻塞结束、下一轮的指令 1 开始进入 ID(读寄存器) 阶段时,
R2的新值已经稳稳地写回到寄存器中了。因此,指令 1 可以直接读到正确的数据,不需要再进行额外的因数据相关导致的阻塞。
【2021-43】
假定计算机M字长为16位,按字节编址,连接CPU和主存的系统总线中地址线为20位、数据线为8位,采用16位定长指令字,指令格式及其说明如下:
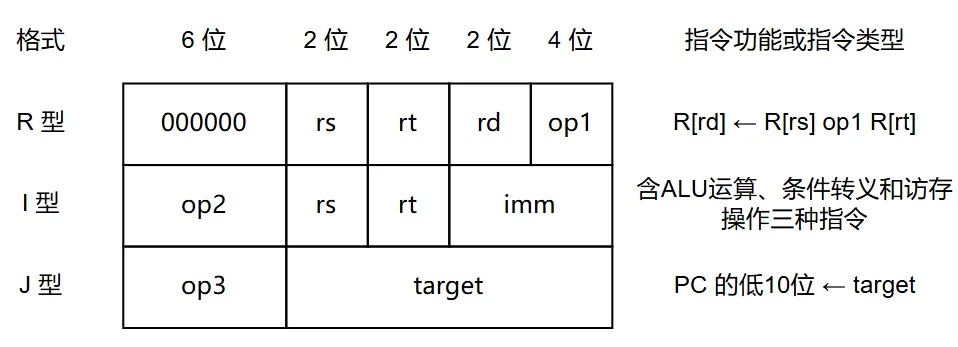
其中,op1~op3为操作码,rs、rt和rd为通用寄存器编号,R[r]表示寄存器r的内容,imm为立即数,target为转移目标的形式地址。请回答下列问题。
(1) ALU的宽度是多少位?可寻址主存空间大小为多少字节?指令寄存器、主存地址寄存器(MAR)和主存数据寄存器(MDR)分别应有多少位?
(2) R型格式最多可定义多少种操作?I型和J型格式总共最多可定义多少种操作?通用寄存器最多有多少个?
(3) 假定op1为0010和0011时,分别表示带符号整数减法和带符号整数乘法指令,则指令01B2H的功能是什么(参考上述指令功能说明的格式进行描述)?若1、2、3号通用寄存器当前内容分别为B052H、0008H、0020H,则分别执行指令01B2H和01B3H后,3号通用寄存器内容各是什么?各自结果是否溢出?
(4) 若采用I型格式的访存指令中imm(偏移量)为带符号整数,则地址计算时应对imm进行零扩展还是符号扩展?
(5) 无条件转移指令可以采用上述哪种指令格式?
解析
【官方答案】
(1) ALU 的宽度为 16 位。(1 分)可寻址主存空间大小为 2²⁰ 字节(或 1 MB)。(1 分)指令寄存器、MAR 和 MDR 各有 16 位、(1 分)20 位(1 分)和 8 位。 (1 分)
(2) R 型最多有 2⁴(或 16)种操作。(1 分)I 型和 J 型总共最多有 63 种操作。(1 分)通用寄存器最多有 4 个。 (1 分)
(3) 指令 01B2H = 000000 01 10 11 0010B,其功能为 R[3]←R[1]-R[2]。(1 分)执行指令 01B2H 后,R[3]=B052H-0008H=B04AH;(1 分)结果不溢出;(1 分)执行指令 01B3H 后,R[3]=R[1]× R[2]=B052H×0008H=8290H,(1 分)结果溢出。(1 分)
(4) 应对 imm 进行符号扩展。(1 分)
(5) 无条件转移指令可以采用 J 型格式。(1 分)
(1) 硬件参数计算
- ALU 的宽度:
ALU(算术逻辑单元)的宽度通常与计算机的字长一致。题目已知“计算机 M 字长为 16 位”,因此 ALU 的宽度是 16 位。 - 可寻址主存空间大小:
地址线决定了最大寻址空间。题目给出“地址线为 20 位”,且“按字节编址”,因此可寻址空间为 。
- 指令寄存器(IR)位数:
IR 存放当前正在执行的指令,其位数与指令字长一致。题目指明“采用 16 位定长指令字”,故 IR 为 16 位。 - 主存地址寄存器(MAR)位数:
MAR 的位数与主存地址线的根数一致。地址线为 20 位,故 MAR 为 20 位。 - 主存数据寄存器(MDR)位数:
MDR 用于缓冲 CPU 与主存之间的数据交换,其位数通常与数据线的根数一致。题目给出“数据线为 8 位”,故 MDR 为 8 位。 (注:虽然字长是 16 位,但由于外部数据总线瓶颈只有 8 位,CPU 每次访存只能取 8 位数据,需要分两次才能取完一个字,此时 MDR 与外部数据线等宽为 8 位。这也是 408 常考的“陷阱”之一)。
(2) 指令操作空间与寄存器数量
- R 型格式最多可定义的操作数:
观察 R 型指令格式,其操作码字段为op1,占 4 位。因此 R 型格式最多可定义 种操作。
- I 型和 J 型格式总共最多可定义的操作数:
最高 6 位是决定指令大类的主操作码。R 型指令独占了000000这一种状态。因此,剩余的 种状态可以全部分配给 I 型(
op2)和 J 型(op3)指令使用。 - 通用寄存器最多数量:
观察 R 型或 I 型指令格式,用于表示寄存器编号的字段rs、rt、rd均为 2 位。因此,最多只能寻址 个通用寄存器。
(3) 指令解析与执行推演
第一步:翻译指令 01B2H
将十六进制 01B2H 展开为 16 位二进制:0000 0001 1011 0010B
- 最高 6 位:
000000 这是一个 R 型指令。 - rs 字段(第 9~8 位):
01 源操作数寄存器 1。 - rt 字段(第 7~6 位):
10 源操作数寄存器 2。 - rd 字段(第 5~4 位):
11 目的操作数寄存器 3。 - op1 字段(第 3~0 位):
0010 题目已知表示带符号整数减法。
功能描述:
将 1 号寄存器的内容减去 2 号寄存器的内容,结果保存到 3 号寄存器中。即:R[3] <- R[1] - R[2]。
第二步:执行 01B2H(减法)
- 算式:
R[3] = B052H - 0008H - 由于是减去一个正数
 ,相当于
B052向下减,结果为 B04AH。 - 溢出判断:
B052H最高位为 1,是负数;0008H为正数。负数减正数,结果本就该是负数。结果B04AH(最高位1011...是 1)依然是负数,没有发生符号突变(即双符号位运算不会出现01或10),因此 未发生溢出。
第三步:执行 01B3H(乘法)
- 指令
01B3H(0000 0001 1011 0011B)中op1变为0011,即带符号整数乘法。 - 算式:
R[3] = B052H * 0008H - 乘以 (即
 )相当于在二进制下左移 3 位。
B052H二进制为1011 0000 0101 0010。左移 3 位后,低位补 0,舍弃高 3 位(101),截断保留 16 位结果为:1000 0010 1001 0000B,即8290H。- 溢出判断:
B052H作为 16 位带符号整数的真值是负数(约等于 ),乘以 8 后实际真值约为
 。而 16 位带符号整数能表示的最小负数是
 。实际结果远远超出了 16 位补码的表示范围,发生了截断(舍弃的高 3 位
101与剩下的最高位1并不全同),因此 发生溢出。
(4) 符号扩展的底层逻辑
在地址计算时,应对 imm 进行 符号扩展。
原因: imm 代表的是相对基址(如 R[rs])的偏移量。在访存指令中,偏移量既可以向后偏移(正数),也可以向前偏移(负数)。因此 imm 必须作为带符号整数处理,扩展到 16 位时要保持其数值和符号不变,就必须进行符号扩展(如果是负数,高位补 1;正数高位补 0)。
(5) 无条件转移指令的格式
无条件转移指令可以采用 J 型 格式。 观察表格中 J 型指令的说明 PC 的低10位 <- target,这就是典型的绝对转移,直接将目标地址硬编码在指令中。
【2017-44】
(10分)在按字节编址的计算机M上,题43中f1的部分源程序(阴影部分)与对应的机器级代码(包括指令的虚拟地址)如下图所示。
int f1(unsigned n)
 1   00401020 55         push ebp
     ...      ...        ...
         for (unsigned i = 0; i <= n-1; i++)
     ...      ...        ...
 20  0040105E 39 4D F4   cmp dword ptr [ebp-0Ch],ecx
     ...      ...        ...
         { power *= 2;
     ...      ...        ...
 23  00401066 D1 E2      shl edx,1
     ...      ...        ...
         return sum;
     ...      ...        ...
 35  0040107F C3         ret
其中,机器级代码行包括行号、虚拟地址、机器指令和汇编指令。
请回答下列问题。
(1) 计算机M是RISC还是CISC?为什么?
(2) f1的机器指令代码共占多少字节?要求给出计算过程。
(3) 第20条指令cmp通过i减n-1实现对i和n-1的比较。执行f1(0)过程中,当i=0时,cmp指令执行后,进/借位标志CF的内容是什么?要求给出计算过程。
(4) 第23条指令shl通过左移操作实现了power*2运算,在f2中能否也用shl指令实现power*2?为什么?
本题需结合前面一题题目条件来做:
已知\(f(n)=\sum_{i=0}^n2^i=2^{n+1}-1=\overbrace{11\cdots 1}^{n+1\text{位}}{\rm B}\) ,计算f(n)的C语言函数f1如下:
将f1中的int都改为float,可得到计算f(n)的另一个函数f2。假设unsigned和int型数据都占32位,float采用IEEE754单精度标准。
参考答案
【官方答案】
(1) M 为 CISC。(1 分)
M 的指令长短不一,不符合 RISC 指令系统特点。(1 分)
(2) f1 的机器代码占 96 B。(1 分)
因为 f1 的第一条指令“push ebp”所在的虚拟地址为 0040 1020H,最后一条指令“ret”所在的虚拟地址为 0040 107FH,所以,f1的机器指令代码长度为 0040 107FH - 0040 1020H + 1 = 90H = 96个字节。(1 分)
(3) CF = 1。(1 分)
cmp 指令实现 i 与 n - 1 的比较功能,进行的是减法运算。在执行 f1(0) 过程中,n = 0,当i = 0时,i = 0000 0000H,并且 n - 1 = FFFF FFFFH。因此,当执行第20条指令时,在补码加/减运算器中执行“0 减 FFFF FFFFH”的操作,即 0000 0000H + 0000 0000H + 1 = 0000 0001H,此时,进位输出 C = 0,减法运算时的借位标志 CF = C ⊕ 1 = 1。(2 分)
(4) f2 中不能用 shl 指令实现 power * 2。(1 分)
因为 shl 指令用来将一个整数的所有有效数位作为一个整体左移;而 f2 中的变量 power 是 float 型,其机器数中不包含最高有效数位,但包含了阶码部分,将其作为一个整体左移时并不能实现“乘2”的功能,因而 f2 中不能用 shl 指令实现 power*2。(2 分)
解析
(1) 计算机M是 CISC(复杂指令集计算机)。原因:
- 指令长度可变:从给出的机器级代码可以看出,不同指令占用的字节数不同。例如,
push(55)占 字节,
cmp(39 4D F4)占 字节,
shl(D1 E2)占 字节。而 RISC 架构通常采用定长指令。
- 寻址方式复杂(直接访存):第20条指令
cmp dword ptr [ebp-0Ch],ecx允许直接对内存地址([ebp-0Ch])中的操作数进行处理。在 RISC 架构中,通常只有专用的Load/Store指令才能访问内存,其他运算指令均在寄存器之间进行。
(2) f1的机器指令代码共占 96 字节(十六进制为 60H 字节)。
计算过程:函数 f1 的第一条指令 push ebp 的起始虚拟地址为 00401020H,函数 f1 的最后一条指令 ret 的起始虚拟地址为 0040107FH,根据代码片段中的机器指令,ret 对应的机器码为 C3,占用 个字节。代码占用的连续内存空间总长度 = 最后一条指令的地址 - 第一条指令的地址 + 最后一条指令占用的字节数 = 0040107FH - 00401020H + 1H = 60H = 96 字节。
(3) 标志位  。
- 题目已知
 为
unsigned(无符号)类型。在执行f1(0)时, 。
- 循环条件为
i <= n-1,由于 是无符号数, 会发生下溢出。在 32 位计算机中,
 的无符号数机器码表示为全 1,即
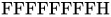 。
- 当
 时,
cmp指令通过做减法来比较 和
 ,即执行运算
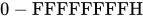 。
- 在无符号数减法运算中,当被减数(
 )小于减数()时,必须向高位借位,因此会产生借位标志。所以进/借位标志 。
(注:从底层加法器实现的角度来看,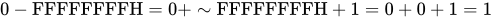 。加法运算的最高位进位
 。对于减法,
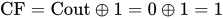 。)
(4) 不能。(1 分)f2中不能用shl指令实现power*2。因为shl指令用来将一个整数的所有有效数位作为一个整体左移,但f2中的变量power是float型,按照IEEE754标准,其机器数中不包含最高有效数位,但包含了阶码部分,将其作为一个整体左移时并不能实现乘以2的功能,所以f2中不能用shl指令实现 power*2。(2 分)浮点数运算比整型运算要复杂,耗时也较长。
【2019-45】
(16分)已知\(f(n)=n!=n×(n-1)×(n-2)×…×2×1\),计算f(n)的C语言函数f1的源程序(阴影部分)及其在32位计算机M上的部分机器级代码如下:
int f1(int n){
 1   00401000  55              push ebp
     ...       ...             ...
 if(n>1)
 11  00401018  83 7D 08 01     cmp dword ptr [ebp+8],1
 12  0040101C  7E 17           jle f1+35h (00401035)
 return n*f1(n-1);
 13  0040101E  8B 45 08        mov eax, dword ptr [ebp+8]
 14  00401021  83 E8 01        sub eax, 1
 15  00401024  50              push eax
 16  00401025  E8 D6 FF FF FF  call f1 (00401000)
     ...       ...             ...
 19  00401030  0F AF C1        imul eax, ecx
 20  00401033  EB 05           jmp f1+3Ah (0040103a)
 else return 1;
 21  00401035  B8 01 00 00 00  mov eax, 1
 }
     ...       ...             ...
 26  00401040  3B EC           cmp ebp, esp
     ...       ...             ...
 30  0040104A  C3              ret
其中,机器级代码行包括行号、虚拟地址、机器指令和汇编指令,计算机M按字节编址,int型数据占32位。请回答下列问题:
(1) 计算f(10)需要调用函数f1多少次?执行哪条指令会递归调用f1?
(2) 上述代码中,哪条指令是条件转移指令?哪几条指令一定会使程序跳转执行?
(3) 根据第16行的call指令,第17行指令的虚拟地址应是多少?已知第16行的call指令采用相对寻址方式,该指令中的偏移量应是多少(给出计算过程)?已知第16行的call指令的后4字节为偏移量,M是采用大端方式还是采用小端方式?
(4) f(13)=6227020800,但f1(13)的返回值为1932053504,为什么两者不相等?要使f1(13)能返回正确的结果,应如何修改f1的源程序?
(5) 第19行的imul指令(带符号整数乘)的功能是R[eax]←R[eax]×R[ecx],当乘法器输出的高、低32位乘积之间满足什么条件时,溢出标志OF=1?要使CPU在发生溢出时转异常处理,编译器应在imul指令后应加一条什么指令?
解析
【官方答案】
(1) 计算 f(10) 需要调用函数 f1 共 10 次。(1 分)执行第 16 行 call 指令会递归调用 f1。(1 分)
(2) 第 12 行 jle 指令是条件转移指令。(1 分)第 16 行 call 指令(1 分)、第 20 行 jmp 指令(1 分)、第 30 行 ret 指令(1 分)一定会使程序跳转执行。
(3) 第 16 行 call 指令的下一条指令的地址为 0040 1025H + 5 = 0040 102AH,故第 17 行指令的虚拟地址是 0040 102AH。(1 分)call 指令采用相对寻址方式,即目标地址 = (PC) + 偏移量,call 指令的目标地址为 0040 1000H,所以偏移量 = 目标地址 - (PC) = 0040 1000H - 0040 102AH = FFFF FFD6H。(2 分)根据第 16 行 call 指令的偏移量字段为 D6 FF FF FF,可确定 M 采用小端方式。(1 分)
(4) 因为 f(13) = 6 227 020 800,大于 32 位 int 型数据可表示的最大值,因而 f1(13) 的返回值是一个发生了溢出的结果。(1 分)为使 f1(13) 能返回正确结果,可将函数的返回值类型改为 double(或 long long 或 long double 或 float)。(2 分)
(5) 若乘积的高 33 位为非全 0 或非全 1,则 OF = 1。(2 分)
编译器应该在 imul 指令后加一条“溢出自陷指令”,使得 CPU 自动查询溢出标志 OF,当 OF = 1 时调出“溢出异常处理程序”。(1 分)
(1) 函数调用次数与递归指令
- 调用次数:计算 f(10) 需要调用函数 f1 共 10 次(分别在 n 为 10, 9, 8, 7, 6, 5, 4, 3, 2, 1 时被调用)。
- 递归指令:执行第 16 行的
call f1 (00401000)指令会进行递归调用。
(2) 转移指令分析
- 条件转移指令:第 12 行的
jle f1+35h (00401035)(小于或等于则跳转)是条件转移指令。 - 必然跳转的指令:以下三条指令一定会使程序跳转执行:
- 第 16 行的
call指令(无条件过程调用) - 第 20 行的
jmp指令(无条件直接跳转) - 第 30 行的
ret指令(无条件过程返回)
(3) 虚拟地址、偏移量与端序
- 第17行的虚拟地址:0040102A。
计算过程:第 16 行指令起始地址为 00401025H,该机器指令(E8 D6 FF FF FF)共占 5 个字节。因此下一条指令(即第 17 行指令)的地址为 00401025H + 5H = 0040102AH。
- 偏移量:FFFFFFD6H。
计算过程:在相对寻址中,转移目标地址 = 转移指令下一条指令的地址 (PC) + 偏移量。
已知目标地址为 00401000H,PC 为 0040102AH。
偏移量 = 目标地址 - PC = 00401000H - 0040102AH = FFFFFFD6H。
- 小端方式
分析:由机器码 E8 D6 FF FF FF 可知,E8 为操作码,偏移量 FFFFFFD6H 在内存中按从低地址到高地址存放的顺序为 D6 FF FF FF,即最低有效字节(D6)存放在了最低地址处,符合小端存储机制。
(4) 结果不相等的原因与修改方法
- 不相等的原因:发生了整数溢出。32 位带符号整数(
int)的最大表示范围是 (即 2147483647)。f(13) 的正确结果 6227020800 超过了此范围,导致乘法运算后高位发生截断,从而输出了错误的结果 1932053504。
- 修改方法:将 f1 函数的返回值类型由 32 位整数(
int)修改为能够容纳更大数值的类型,例如 64 位整型(long long)或双精度浮点型(double)。修改后的函数头示例:long long f1(int n)
(5) 溢出标志OF的判断与异常处理指令
- OF=1 的条件:当乘法器输出的 64 位乘积中,高 32 位不是低 32 位的符号扩展时(非全 0 或非全 1),溢出标志 OF=1。
对于带符号整数乘法,如果结果的高位部分仅仅是低位部分符号位的延伸(即低 32 位最高位为 0 时,高 32 位全为 0;最高位为 1 时,高 32 位全为 1),则表明未溢出;反之则溢出。
- 应加的指令:编译器应该在imul指令后加一条“溢出自陷指令”,使得CPU自动查询溢出标志OF,当OF=1时调出“溢出异常处理程序”。
溢出自陷指令 ( 例如 x86 架构中的 into 指令,即 Interrupt on Overflow ) 是一种处理整数运算溢出的机器指令。它通常由处理器提供,并用于捕捉和处理算术运算中发生的溢出错误。当执行一条溢出自陷指令时,处理器会检测当前的算术运算结果是否发生了溢出。如果发生了溢出,处理器会触发一个异常或中断,将控制权转移到相应的异常处理程序中。溢出自陷指令的目的是提供一种机制,用于检测和处理数值运算的溢出。当进行加法、减法、乘法等算术运算时,如果结果超过了数据类型能够表示的范围,就会发生溢出。溢出可能导致错误的计算结果和无效的程序行为,因此通过溢出自陷指令可以及时地进行检测和处理。
【2023-44】
(9 分)题43中C程序段在计算机M上的部分机器级代码如下,每个机器级代码行中依次包含指令序号、虚拟地址、机器指令和汇编指令。
for(i=0; i<24; i++)
 1   00401072  C7 45 F8 00 00 00 00              mov[ebp-8], 0
 2   00401079  EB 09                             jmp 00401084h
 3   0040107B  8B 55 F8                          mov eax, [ebp-8]
     ...       ...                               ...
 7   00401088  7D 32                             jge 004010bch
     for(j=0; j<64; j++)
 8   0040108A  C7 45 FC 00 00 00 00              mov[ebp-4], 0
     ...       ...                               ...
         a[i][j]=10;
     ...       ...                               ...
 19  004010AE  C7 84 82 00 20 42 00 0A 00 00 00  mov[ecx+edx*4+00422000h], 0Ah
 20  ...       ...                               ...
请回答下列问题。
(1) 第20条指令的虚拟地址是多少?
(2) 已知第2条jmp和第7条jge都是跳转指令,其操作码分别是EBH和7DH,跳转地址分别为0040 1084H、0040 10BCH,这两条指令都采用什么寻址方式?给出第2条指令jmp的跳转目标地址计算过程。
(3) 已知第19条mov指令的功能是“a[i][j]←10”,其中ecx和edx为寄存器名,0042 2000H是数组a的首地址,指令中源操作数采用什么寻址方式?已知edx中存放的是变量j,ecx中存放的是什么?根据该指令的机器码判断计算机M采用的是大端还是小端方式。
(4) 第一次执行第19条指令时,取指令过程中是否会发生缺页异常?为什么?
解析
【官方答案】
(1) 第 20 条指令的虚拟地址为 0040 10B9H。(1 分)
(2) 第 2 条 imp 和第 7 条 jge 指令都采用相对寻址方式。(1 分)第 2 条指令 jmp 的跳转目标地址=00401079H+2+09H=0040 1084H。(1 分)
(3) 第 19 条指令中源操作数采用立即(数)寻址方式。(1 分)根据汇编指令中给出的计算公式 ecx+edx*4+00422000h 可知,ecx 中存放的是 i×256。(1 分)M 采用小端方式。(1 分)
(4) 第一次执行第 19 条指令时,取指令过程中不会发生缺页异常。(1 分)因为第 19 条指令所在的程序段都在页号为 00401H 的同一个页面中,执行第 19 条指令时,该页已在主存,因而取指令过程中不会发生缺页异常。(2 分)
(1)第20条指令的虚拟地址是 0040 10B9H。
计算过程:第19条指令的起始地址为 0040 10AEH,通过数第19条指令的字节数可知,它共占用 11 个字节(十六进制为 0BH)。第20条指令紧跟在第19条之后,因此其起始地址 = 第19条指令起始地址 + 第19条指令占用的字节数 = 0040 10AEH + 0BH = 0040 10B9H。
(2) 这两条指令(jmp 和 jge)均采用 相对寻址。
第2条指令 jmp 的跳转目标地址计算过程:在相对寻址中,跳转目标地址 = 转移指令下一条指令的地址 (PC) + 偏移量。
- 第2条指令 jmp 所在的虚拟地址为
0040 1079H,指令占 2 个字节(机器码EB 09),因此下一条指令的地址(即 PC 值)为0040 107BH。 - 从机器码
EB 09中提取出偏移量为09H。 - 目标地址 =
0040 107BH + 09H = 0040 1084H。
(3) 源操作数寻址方式、ecx内容及大小端判断
- 源操作数寻址方式:立即寻址。
分析:指令 mov[ecx+edx*4+00422000h], 0Ah 中的源操作数是常数 0Ah(即十进制的 10),它直接包含在指令的机器码中。
- ecx 中存放的是什么:ecx 中存放的是
 (即数组第 行首地址相对于数组首地址的字节偏移量)。
分析:二维数组 a[i][j] 在内存中按行优先连续存放。要计算 a[i][j] 的地址,公式为:数组首地址 + (i * 列数 + j) * 元素大小。题目代码中有 for(j=0; j<64; j++),可知每行有 64 个元素;根据目标地址乘以 4(edx*4),可知每个 int 元素占 4 个字节。将公式展开为:数组首地址 + i * 64 * 4 + j * 4。指令中的地址表达式为 00422000h + ecx + edx * 4。已知 edx 存放的是 j,00422000h 是数组首地址,所以 ecx 对应 i * 64 * 4,即 。
- 计算机M采用的是 小端方式。
分析:观察第19条指令的机器码,数组首地址 0042 2000H 在机器码中表示为 00 20 42 00,立即数 0000 000AH 在机器码中表示为 0A 00 00 00。可以看出,数据的低有效字节存放在了低地址端,符合小端存储机制。
(4) 不会发生缺页异常。
原因分析:缺页异常发生在 CPU 访问的虚拟地址所在的页面不在物理内存中时。
- 第19条指令的虚拟地址为
0040 10AEH。 - 程序的执行是按顺序进行的(或者经过循环跳转)。在第一次执行第19条指令之前,CPU 已经取了同处于一个循环代码块中的前面几条指令(例如第1、2、3条指令,地址在
0040 1072H附近)。 - 无论系统采用多大的页面大小(通常至少为 4KB,即
1000H),地址0040 1072H和0040 10AEH都必然同属于同一个页面(它们的页号都是00401H)。 - 既然前面的指令已经成功取指并执行,说明该代码段所在的页面已经被装入主存,因此取第19条指令时,该页面必定在内存中,不会发生缺页异常。
第五章 中央处理器
【2009-44】
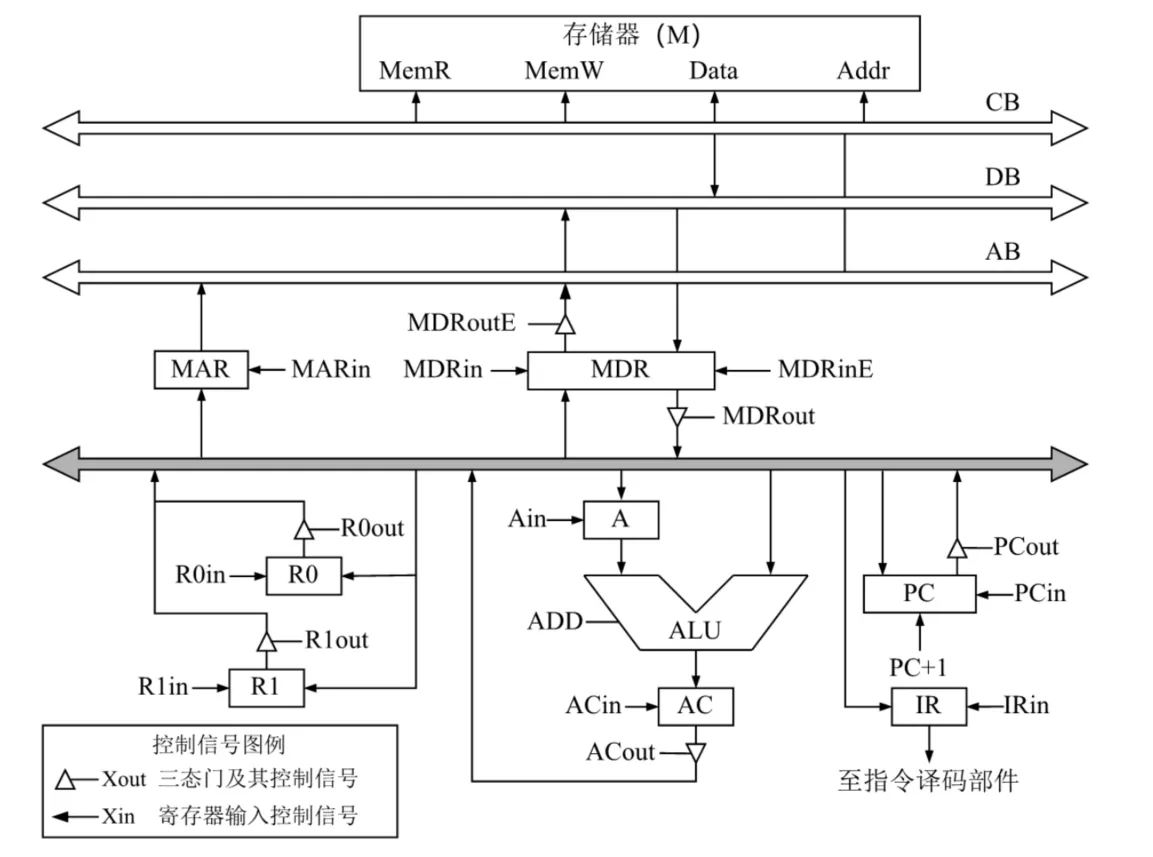
某计算机字长16位,采用16位定长指令字结构,部分数据通路结构如下图所示(见下页),图中所有控制信号为1时表示有效、为0时表示无效,例如控制信号MDRinE为1表示允许数据从DB打入MDR,MDRin为1表示允许数据从内总线打入MDR。假设MAR的输出一直处于使能状态。加法指令“ADD (R1),R0”的功能为(R0)+((R1))→(R1),即将R0中的数据与R1的内容所指主存单元的数据相加,并将结果送入R1的内容所指主存单元中保存。
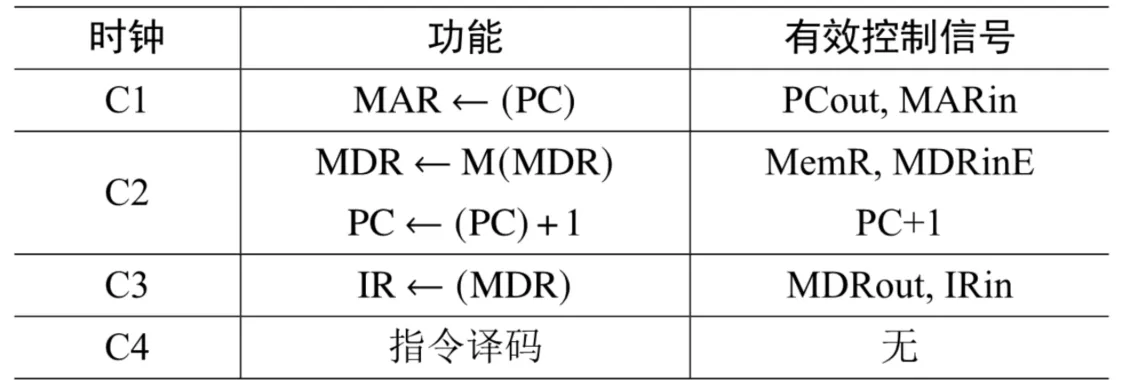
下表给出了上述指令取指和译码阶段每个节拍(时钟周期)的功能和有效控制信号,请按表中描述方式用表格列出指令执行阶段每个节拍的功能和有效控制信号。
解析
【官方答案】
参考答案一:
“A←(R0)” 也可在 C7:“AC←(MDR)+(A)” 之前单列的一个时钟周期内执行。
参考答案二:
【2015-43】
(13分)某16位计算机的主存按字节编址,存取单位为16位;采用16位定长指令字格式;CPU采用单总线结构,主要部分如下图所示。图中R0~R3为通用寄存器;T为暂存器;SR为移位寄存器,可实现直送(mov)、左移一位(left)和右移一位(right)3种操作,控制信号为SRop,SR的输出由信号SRout控制;ALU可实现直送A(mova)、A加B(add)、A减B(sub)、A与B(and)、A或B(or)、非A(not)、A加1(inc)这7种操作,控制信号为ALUop。
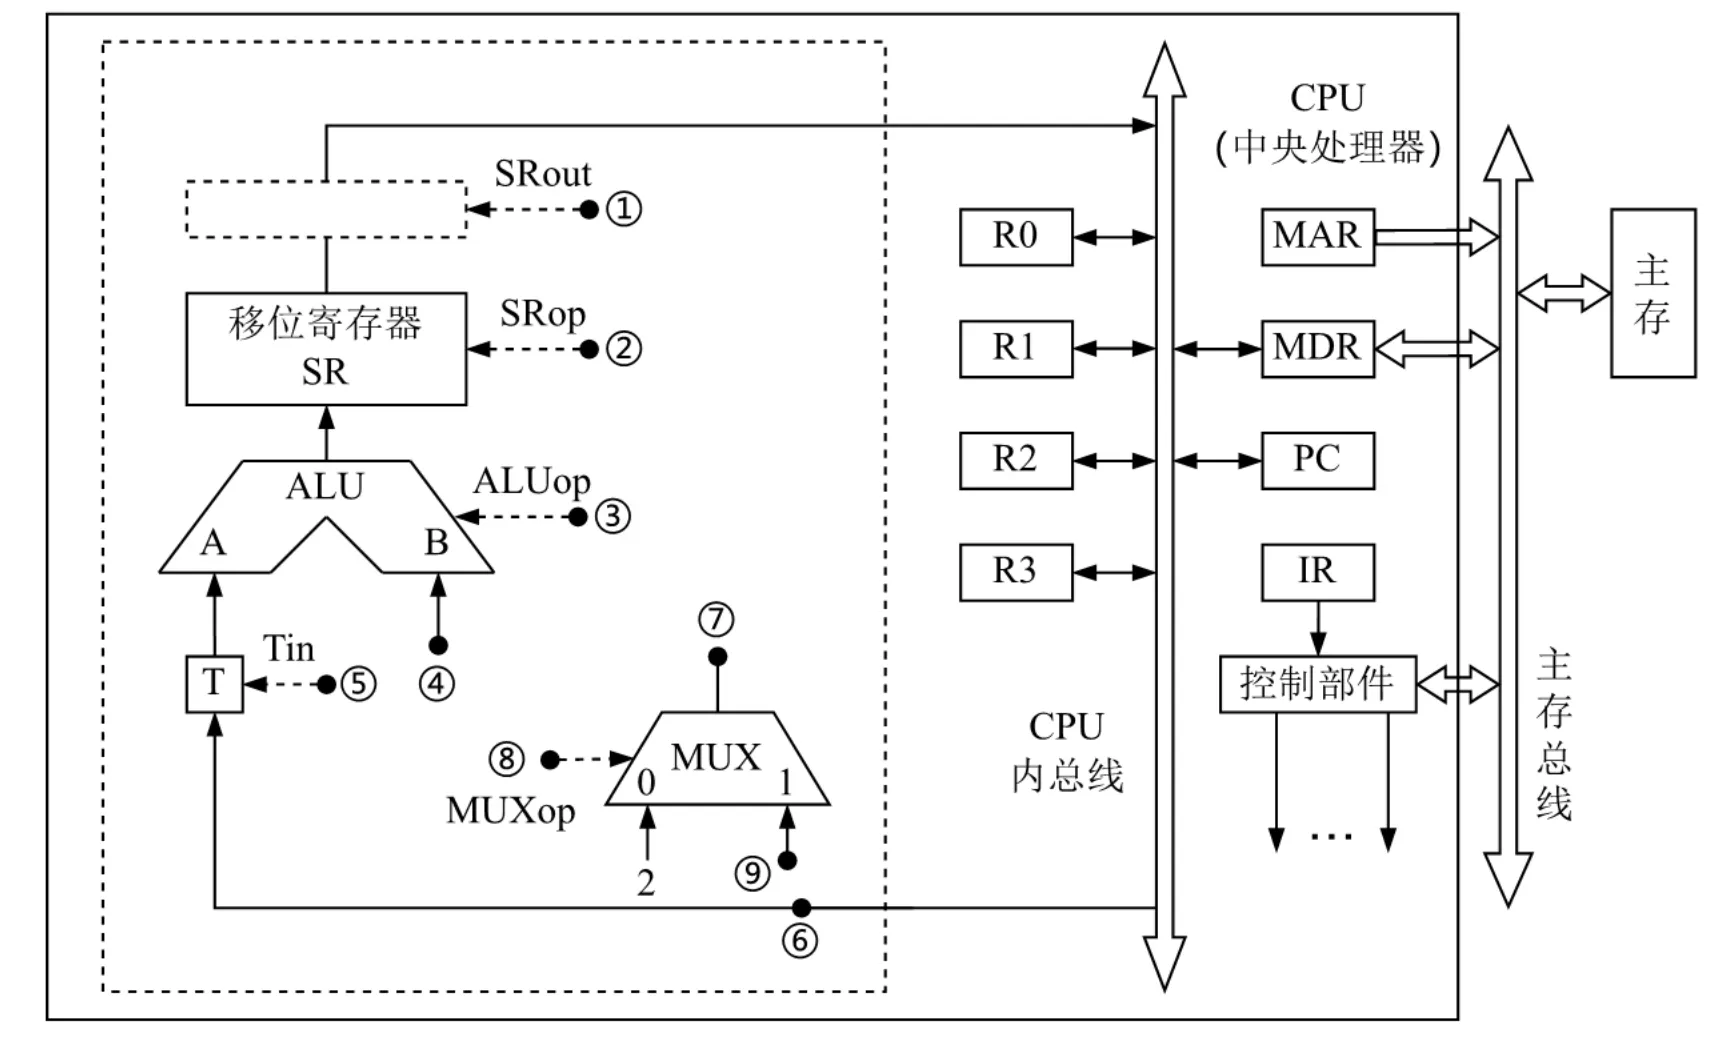
题43图
注:已补充内总线到MAR的箭头和内总线到IR的箭头。
请回答下列问题。
(1) 图中哪些寄存器是程序员可见的?为何要设置暂存器T?
(2) 控制信号ALUop和SRop的位数至少各是多少?
(3) 控制信号SRout所控制部件的名称或作用是什么?
(4) 端点①~⑨中,哪些端点须连接到控制部件的输出端?
(5) 为完善单总线数据通路,需要在端点①~⑨中相应的端点之间添加必要的连线。写出连线的起点和终点,以正确表示数据的流动方向。
(6) 为什么二路选择器MUX的一个输入端是2?
解析
【官方答案】
(1) 程序员可见寄存器为通用寄存器 (R0~R3) (2 分,每个 0.5 分,答全给 2 分)和 PC(1 分)。因为采用了单总线结构,因此,若无暂存器 T,则 ALU 的 A、B 端口会同时获得两个相同的数据,使数据通路不能正常工作。(1 分)
(2) ALU 共有 7 种操作,故其操作控制信号 ALUop 至少需要 3 位(1 分);移位寄存器有 3 种操作,其操作控制信号 SRop 至少需要 2 位(1 分)。
(3) 信号 SRout 所控制的部件是一个三态门,用于控制移位器与总线之间数据通路的连接与断开。(1 分)
(4) 端口①、②、③、⑤、⑧须连接到控制部件输出端。(3 分,每个 0.5 分,答全给 3 分)
(5) 连线 1,⑥→⑨;(1 分)连线 2,⑦→④。(1 分)
(6) 因为每条指令的长度为 16 位,按字节编址,所以每条指令占用 2 个内存单元,顺序执行时,下条指令地址为 (PC) + 2。MUX 的一个输入端为 2,可便于执行 (PC) + 2 操作。(1 分)
【评分说明】
(1) 回答通用寄存器 (R0~R3),给分;回答 PC 给分;部分正确,酌情给分。设置暂存器 T 的原因若回答用于暂时存放端口 A 的数据,则给分,其他答案,酌情给分。
(3) 只要回答出三态门或者控制连接/断开,即给分。
(4) 答案包含④、⑥、⑦、⑨中任意一个,不给分;答案不全酌情给分。
(5) 回答除上述连线以外的其他连线,酌情给分。
【2015-44】
(10分)题43中描述的计算机,其部分指令执行过程的控制信号如题44图a所示。
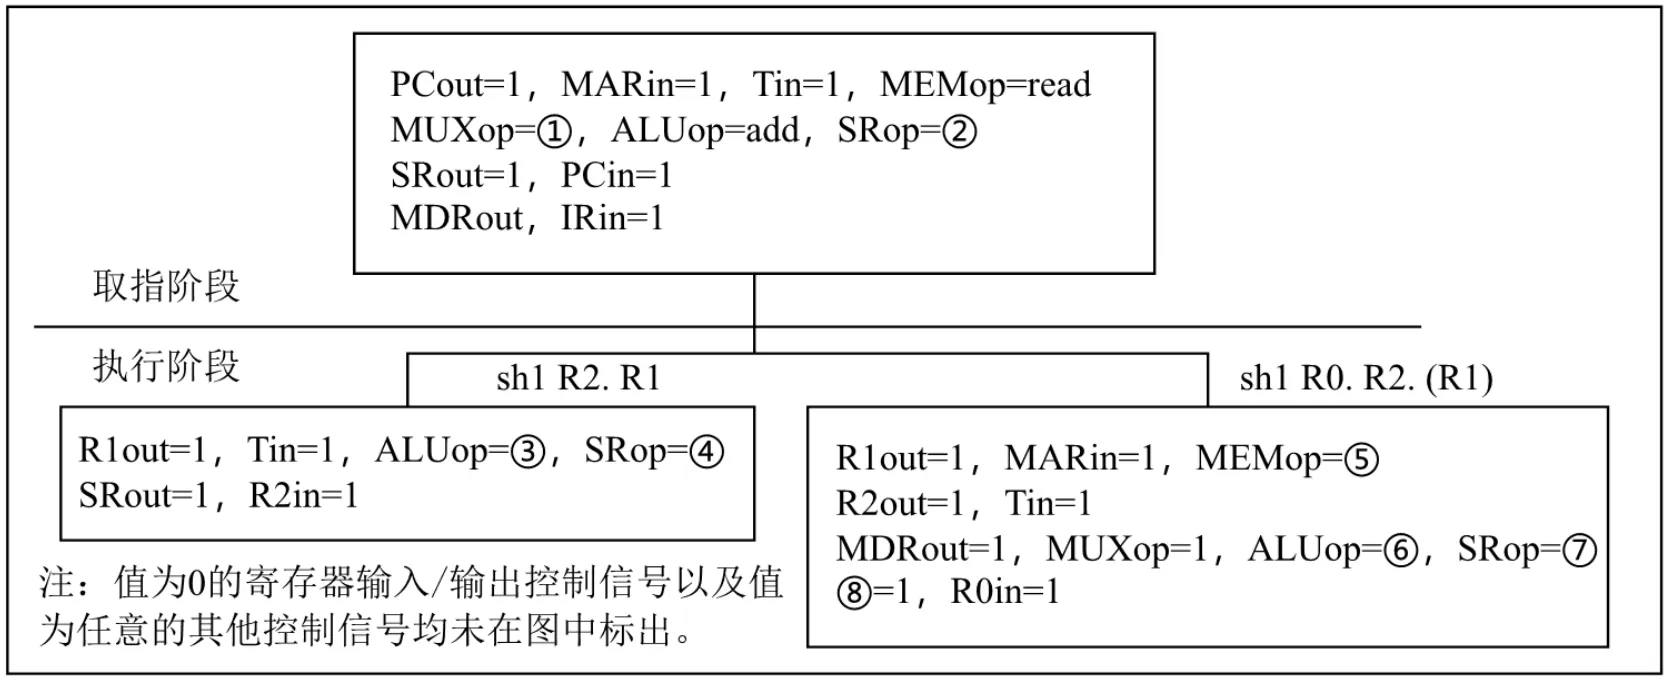
该机指令格式如题44图b所示,支持寄存器直接和寄存器间接两种寻址方式,寻址方式位分别为0和1,通用寄存器R0~R3的编号分别为0、1、2和3。
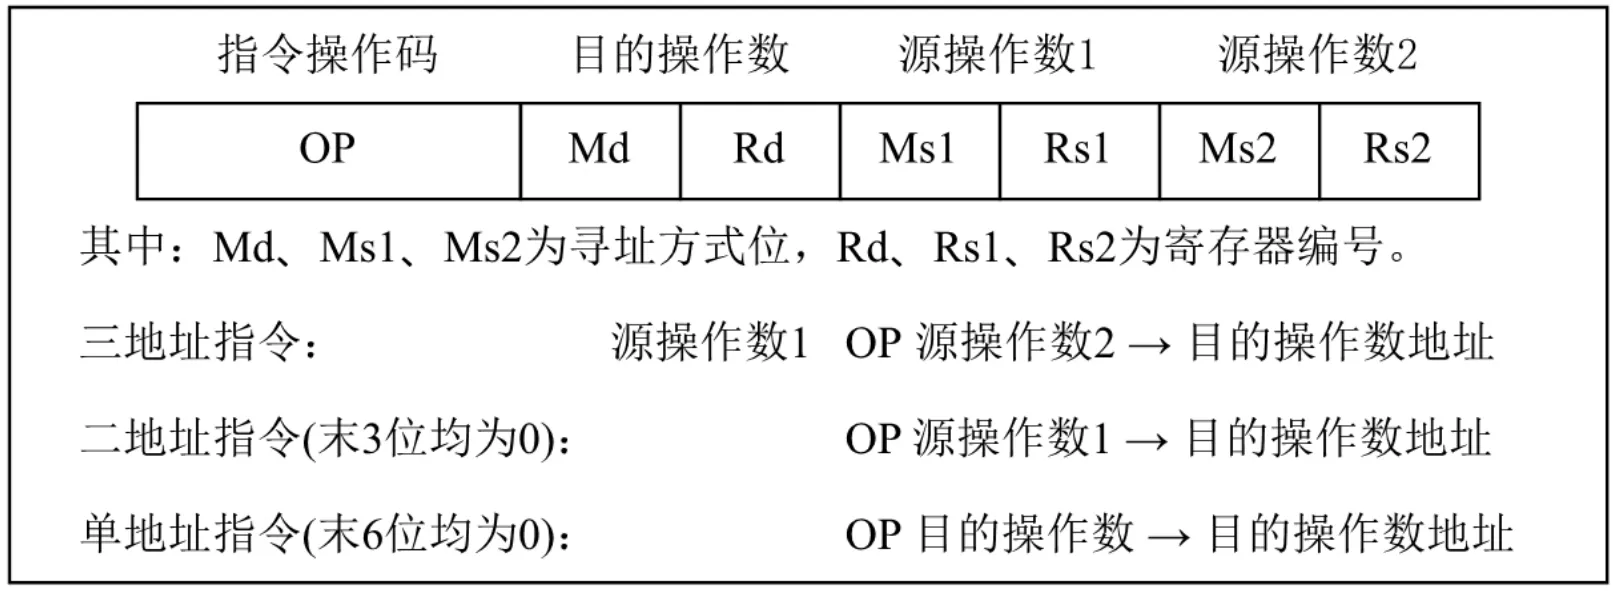
请回答下列问题。
(1) 该机的指令系统最多可定义多少条指令?
(2) 假定inc、shl和sub指令的操作码分别为01H、02H和03H,则以下指令对应的机器代码各是什么?
- inc R1 ; (R1)+1→R1
- shl R2, R1; (R1)<<1→R2
- sub R3, (R1), R2; ((R1))–(R2)→R3
(3) 假设寄存器X的输入和输出控制信号分别为Xin和Xout,其值为1表示有效,为0表示无效(例如,PCout=1表示PC内容送总线);存储器控制信号为MEMop,用于控制存储器的读(read)和写(write)操作。写出题44图a中标号①~⑧处的控制信号或控制信号的取值。
(4) 指令“sub R1,R3,(R2)”和“inc R1”的执行阶段至少各需要多少个时钟周期?
解析
【官方答案】
(1) 指令操作码有 7 位,因此最多可定义 = 128 条指令。(1 分)
(2) 各条指令的机器代码分别如下:
① “inc R1”的机器码为:0000001 0 01 0 00 0 00,即 0240H。(1 分)
② “shl R2, R1”的机器码为:0000010 0 10 0 01 0 00,即 0488H。(1 分)
③“sub R3, (R1), R2”的机器码为:0000011 0 11 1 01 0 10,即06EAH。(1 分)
(3) 各标号处的控制信号或控制信号取值如下:
①0;②mov;③mova;④left;⑤read;⑥sub;⑦mov;⑧SRout。(4 分,每个 0.5 分)
(4) 指令“sub R1, R3, (R2)”的执行阶段至少包含 4 个时钟周期;(1 分)指令“inc R1”的执行阶段至少包含 2 个时钟周期。(1 分)
【评分说明】
(3) 答对两个给分。
【2022-43】
(15分)某CPU中部分数据通路如图所示,其中,GPRs为通用寄存器组;FR为标志寄存器,用于存放ALU产生的标志信息;带箭头虚线表示控制信号,如控制信号Read、Write分别表示主存读、主存写,MDRin表示内部总线上数据写入MDR,MDRout表示MDR的内容送内部总线。
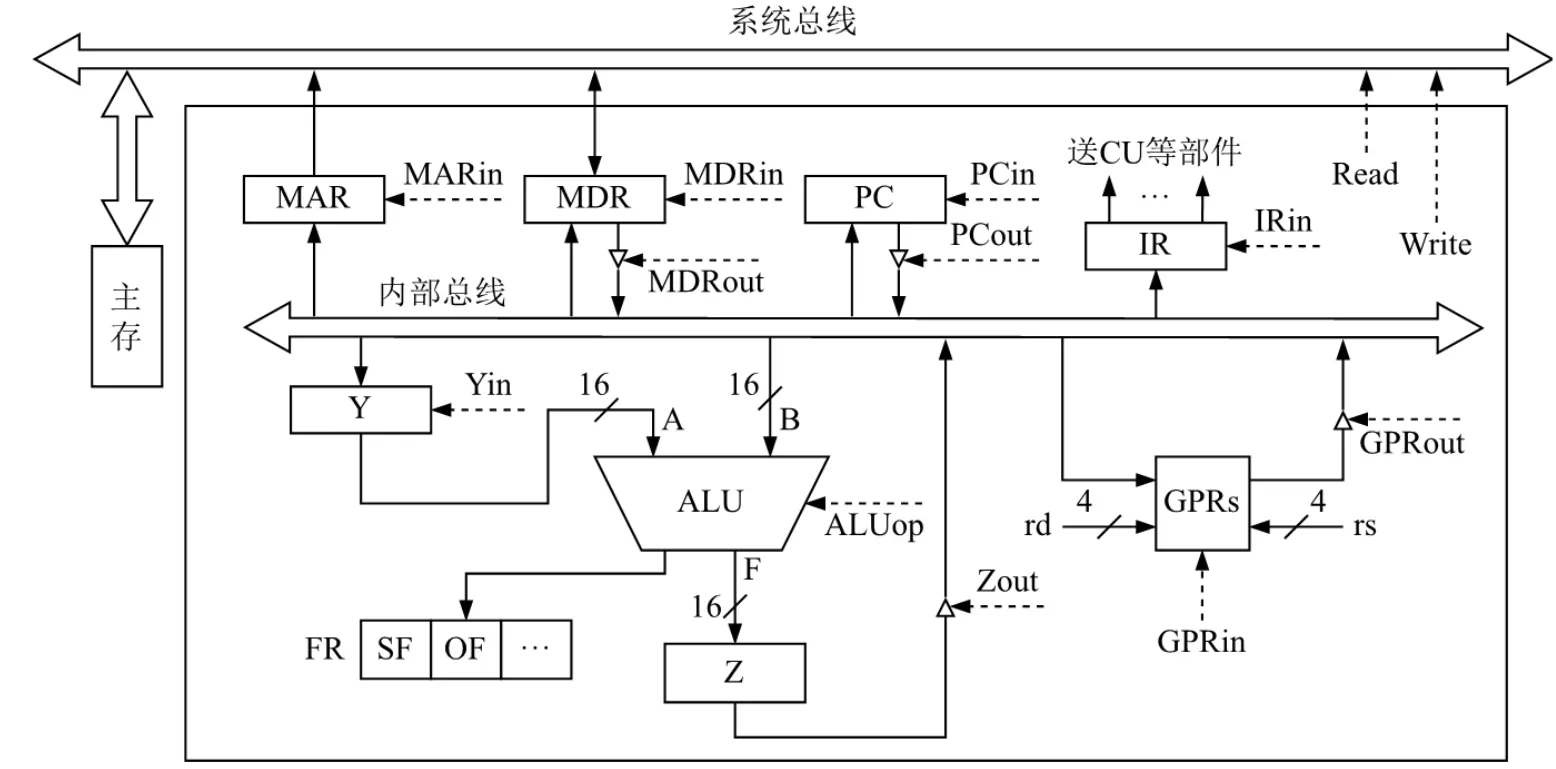
题43图
(1) ALU的输入端A、B及输出端F的最高位分别为 A_{15} 、 B_{15} 及 F_{15} ,FR中的符号标志和溢出标志分别为SF和OF,则SF的逻辑表达式是什么?A加B、A减B时OF的逻辑表达式分别是什么?要求逻辑表达式的输入变量为A_{15} 、 B_{15} 及 F_{15} 。
(2) 为什么要设置暂存器Y和Z?
(3) 若GPRs的输入端rs、rd分别为所读、写的通用寄存器的编号,则GPRs中最多有多少个通用寄存器?rs和rd来自图中的哪个寄存器?已知GPRs内部有一个地址译码器和一个多路选择器,rd应该连接地址译码器还是多路选择器?
(4) 取指令阶段(不考虑PC增量操作)的控制信号序列是什么?若从发出主存读命令到主存读出数据并传送到MDR共需5个时钟周期,则取指令阶段至少需要几个时钟周期?
(5) 图中控制信号由什么部件产生?图中哪些寄存器的输出信号会连到该部件的输入端?、
解析
【官方答案】
(1) ;(1 分)加运算时,
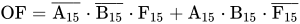 ;(1 分)
减运算时,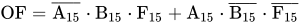 。(1 分)
(2) 因为单总线结构中每一时刻总线上只有一个数据有效,而 ALU 有两个输入端和一个输出端,因而需要设置 Y 和 Z 两个暂存器,以缓存 ALU 的一个输入端和输出端数据。(2 分)
(3) GPRs 中最多有 2⁴=16 个通用寄存器;(1 分)rs 和 rd 来自指令寄存器 IR;(1 分)rd 应连接地址译码器。(1 分)
(4) 取指阶段的控制信号序列为:①PCout, MARin ②Read ③MDRout, IRin。(3 分)取指令阶段至少需要 7 个时钟周期。(1 分)
(5) 图中控制信号由控制部件 (CU) 产生。(1 分)指令寄存器 IR 和标志寄存器 FR 的输出信号会连到控制部件的输入端。(2 分)
【2024-43】
(严格来说不属于 mips,是 RISC-V 指令系统)假定计算机M字长32位,按字节编址,采用32位定长指令字。指令 add、slli 和 lw 的格式、编码和功能说明如题 43 图 (a) 所示。
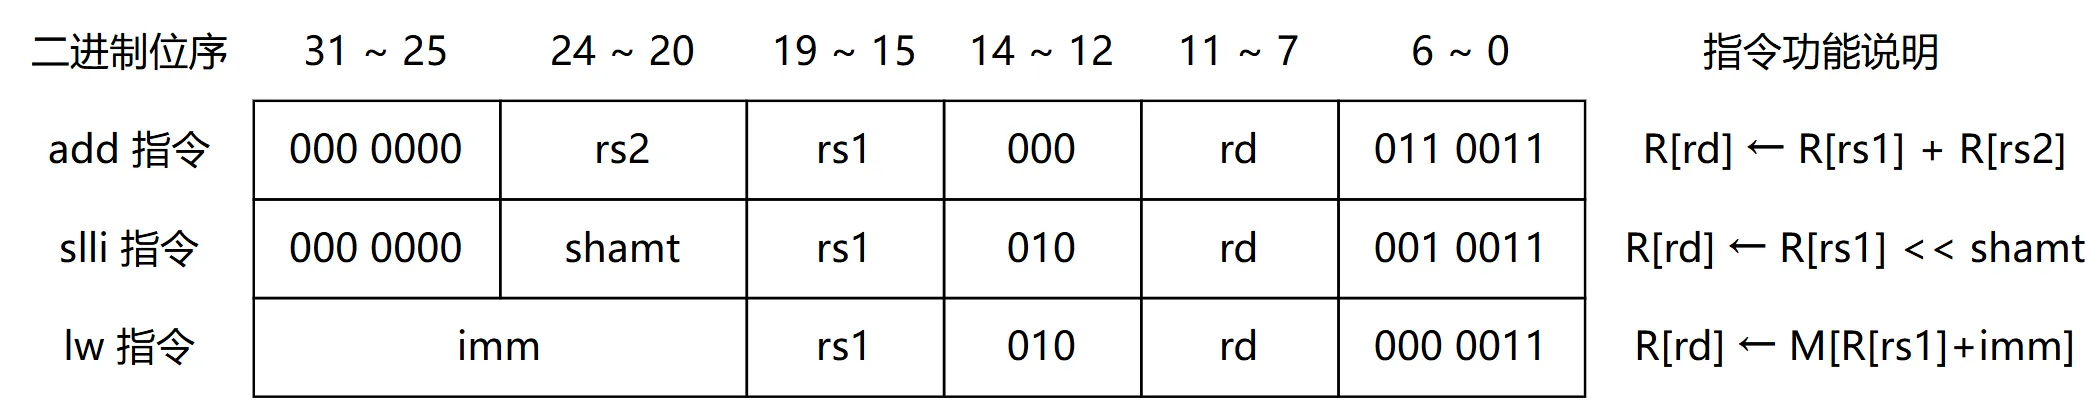
其中,R[x] 表示通用寄存器 x 的内容,M[x] 表示地址为 x 的存储单元内容,shamt 为移位位数,imm 为补码表示的偏移量。题 43 图 (b) 给出了计算机 M 的部分数据通路及控制信号(用带箭头虚线表示),其中,A 和 B 分别表示从通用寄存器 rs1 和 rs2 中读出的内容;IR[31:20] 表示指令寄存器中的高 12 位;控制信号 Ext 为 0、1 时扩展器分别实现零扩展、符号扩展,ALUctr 为 000、001、010 时 ALU 分别实现加、减、逻辑左移运算。
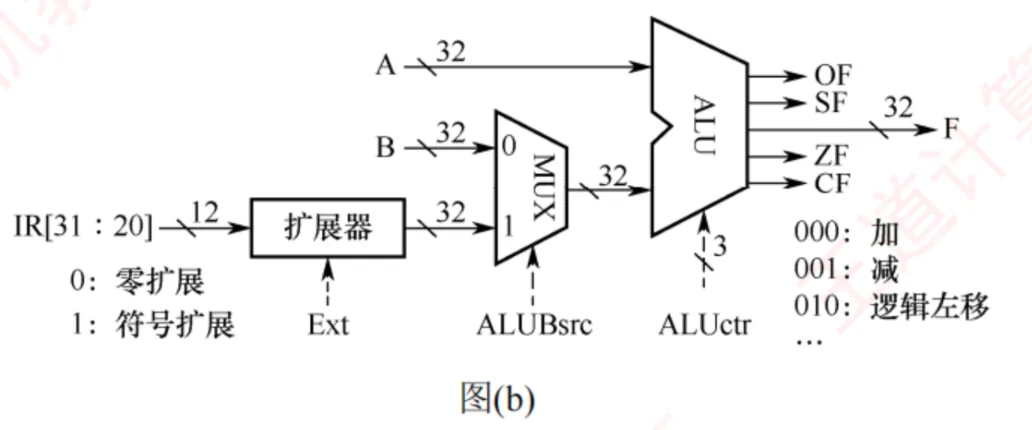
请回答下列问题。
(1) 计算机 M 最多有几个通用寄存器?为什么 shamt 占 5 位?(2 分)
(2) 执行 add 指令时,控制信号 ALUBsrc 的取值应是什么?若 rs1 和 rs2 寄存器内容分别是 8765 4321 H 和 9876 5432 H,则 add 指令执行后,ALU 输出端 F、OF 和 CF 的结果分别是什么?若该 add 指令处理的是无符号整数,则应该根据哪个标志位判断是否溢出?(5 分)
(3) 执行 slli 指令时,控制信号 Ext 的取值可以是 0 也可以是 1,为什么?(2 分)
(4) 执行 lw 指令时,控制信号 Ext、ALUctr 的取值分别是什么?(2 分)
(5) 若一条指令的机器码是 A040 A103 H,则该指令一定是 lw 指令,为什么?若执行该指令时,R[01H] = FFFF A2D0 H,则所读取数据的存储地址是什么?(2 分)
解析
【官方答案】
(1) 最多有 = 32 个通用寄存器。(1 分)M 字长为 32 位,故通用寄存器宽度为 32 位,因此 shamt 字段占  位。(1 分)
(2) 控制信号 ALUBsrc = 0。(1 分)F = 1FDB 9753H;(1 分)OF = 1;(1 分)CF = 1;(1 分)根据 CF 判断是否溢出。 (1 分)
(3) 因为 slli 指令的移位位数只使用 IR[31:20] 中的低 5 位,与高位 IR[31:25] 及扩展出来的位无关,故 Ext 取值可以是 0 也可以是 1。(2 分)
(4) Ext = 1;(1 分)ALUctr = 000。(1 分)
(5) 因为 A040 A103H = 1010 0000 0100 0000 1010 0001 0000 0011B,根据指令格式中 IR[6:0] = 0000011B,IR[14:12] = 010B,可以判定该指令是 lw 指令。(1 分)lw 指令所读取数据的存储地址为 FFFF 9CD4H。(1 分)
【2012-44】
(13分)某16位计算机中,带符号整数用补码表示,数据Cache和指令Cache分离。下表给出了指令系统中部分指令格式,其中Rs和Rd表示寄存器,mem表示存储单元地址,(x)表示寄存器x或存储单元x的内容。
指令系统中部分指令格式
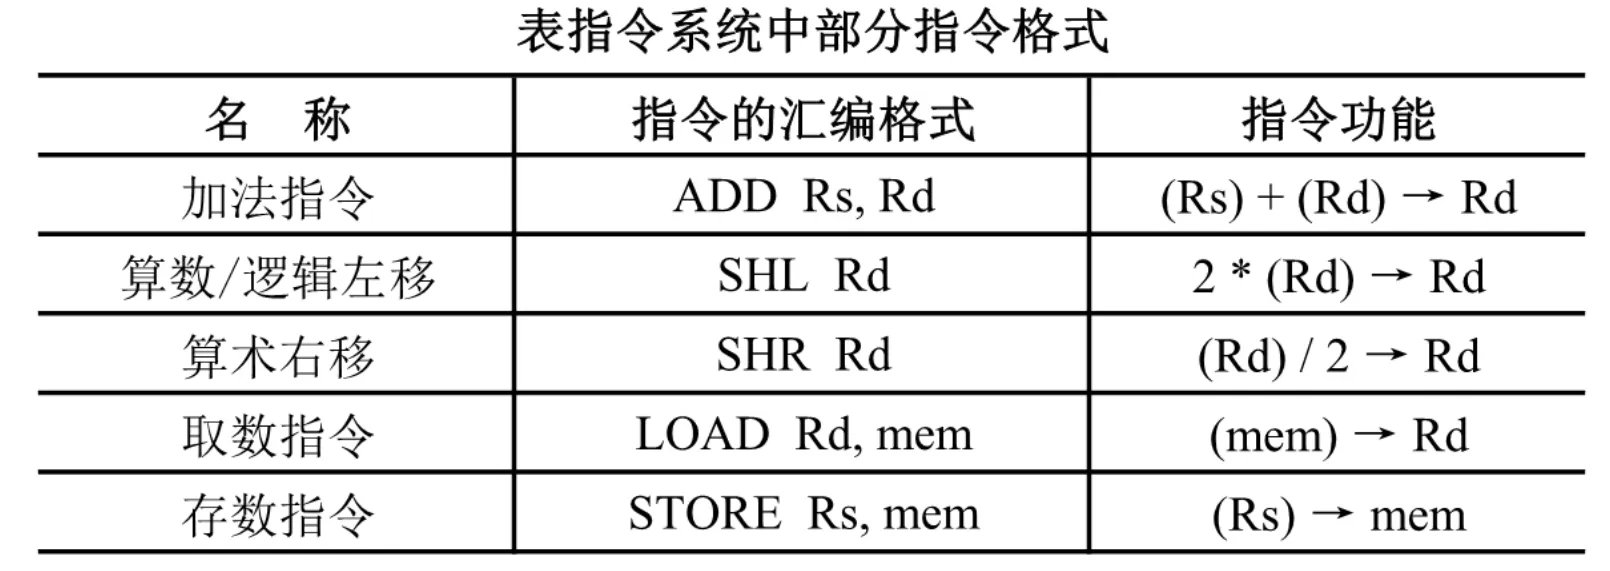
该计算机采用5段流水方式执行指令,各流水段分别是取指(IF)、译码/读寄存器(ID)、执行/计算有效地址(EX)、访问存储器(M)和结果写回寄存器(WB),流水线采用“按序发射,按序完成”方式,没有采用转发技术处理数据相关,并且同一个寄存器的读和写操作不能在同一个时钟周期内进行。请回答下列问题:
(1) 若int型变量x的值为-513,存放在寄存器R1中,则执行指令“SHR R1” 后,R1的内容是多少(用十六进制表示)?
(2) 若某个时间段中,有连续的4条指令进入流水线,在其执行过程中没有发生任何阻塞,则执行这4条指令所需的时钟周期数为多少?
(3) 若高级语言程序中某赋值语句为x=a+b,x、a和b均为int型变量,它们的存储单元地址分别表示为[x]、[a]和[b]。该语句对应的指令序列及其在指令流水线中的执行过程如下图所示。
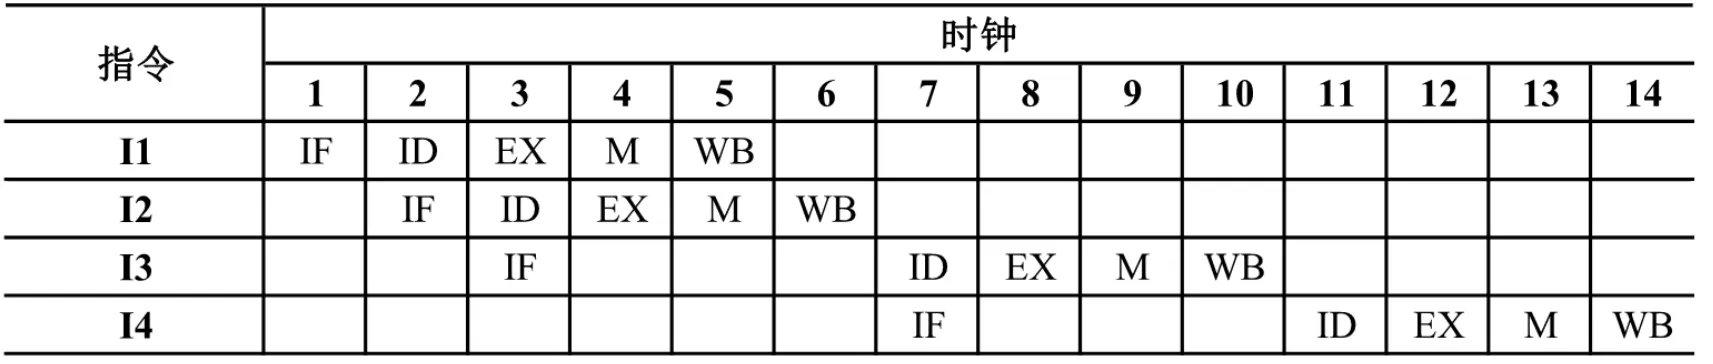
则这4条指令执行过程中,I3的ID段和I4的IF段被阻塞的原因各是什么?
(4) 若高级语言程序中某赋值语句为x=x*2+a,x和a均为unsigned int类型变量,它们的存储单元地址分别表示为[x]、[a],则执行这条语句至少需要多少个时钟周期?要求模仿题44图画出这条语句对应的指令序列及其在流水线中的执行过程示意图。
解析
【官方答案】
(1) x 的机器码为  ,即指令执行前 (R1) = FDFFH,右移一位后为 1111 1110 1111 1111B,即指令执行后 (R1) = FEFFH。(2 分)
(2) 至少需要 4+(5-1)=8 个时钟周期数。(2 分)
(3)  的 ID 段被阻塞的原因:因为 与
 和
 都存在数据相关,需等到 和 将结果写回寄存器后, 才能读寄存器内容,所以 的 ID 段被阻塞。(1 分)
 的 IF 段被阻塞的原因:因为 的前一条指令 在 ID 段被阻塞,所以 的 IF 段被阻塞。(1 分)
(4) 因 2 * x 操作有左移和加法两种实现方法,故 x = 2 * x + a 对应的指令序列为:(2 分)
这 5 条指令在流水线中的执行过程如下图所示。(3 分)
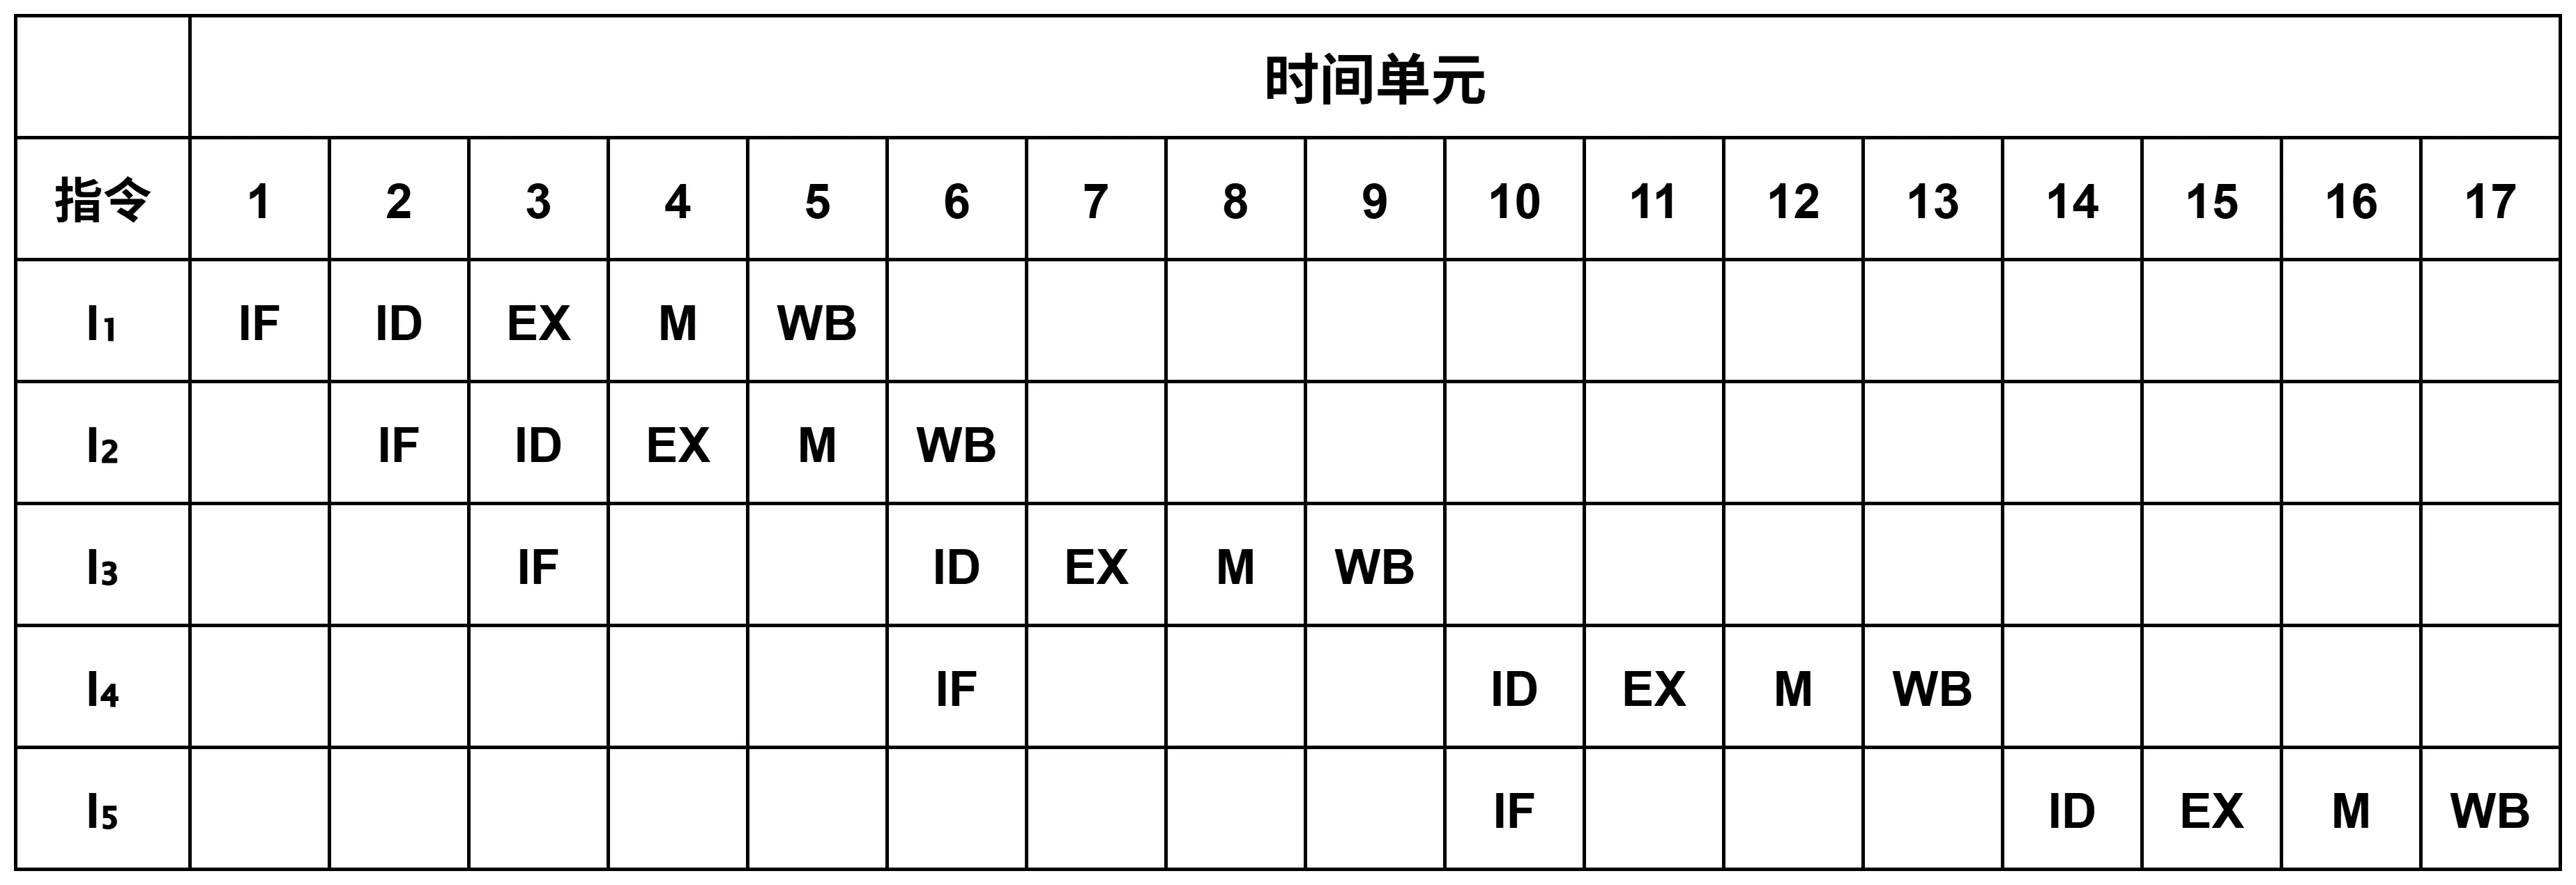
故执行语句为 x = x * 2 + a 最少需要 17 个时钟周期。(1 分)
【评分说明】
(1) 仅正确写出指令执行前的 (R1) 可给 1 分。
(4) 指令正确给 2 分;其他正确答案同样给分;部分正确,酌情给分。
第六章 总线和输入/输出系统
【2009-43】
某计算机的CPU主频为500MHz,CPI为5(即执行每条指令平均需5个时钟周期)。假定某外设的数据传输率为0.5MB/s,采用中断方式与主机进行数据传送,以32位为传输单位,对应的中断服务程序包含18条指令,中断服务的其他开销相当于2条指令的执行时间。请回答下列问题,要求给出计算过程。
(1) 在中断方式下,CPU用于该外设I/O的时间占整个CPU时间的百分比是多少?
(2) 当该外设的数据传输率达到5MB/s时,改用DMA方式传送数据。假定每次DMA传送块大小为5000B,且DMA预处理和后处理的总开销为500个时钟周期,则CPU用于该外设I/O的时间占整个CPU时间的百分比是多少(假设DMA与CPU之间没有访存冲突)?
解析
【官方答案】
(1) 中断方式下,CPU 每次用于数据传送的时钟周期数:5×18+5×2 = 100。
为达到外设 0.5 MB/s 的数据传输率,设每秒申请的中断次数:0.5 MB/4 B = 125000。
1 秒钟内用于中断的开销:100×125000 = 12500000 = 12.5 M 个时钟周期。
CPU 用于外设 I/O 的时间占整个 CPU 时间的百分比:12.5 M/500 M=2.5%。
(2) 外设数据传输率提高到 5 MB/s 时,1 秒钟内需产生的 DMA 次数:5 MB/5000 B = 1000。
CPU 用于 DMA 处理的总开销:1000×500 = 500000 = 0.5 M 个时钟周期。
CPU 用于外设 I/O 的时间占整个 CPU 时间的百分比:0.5 M/500 M = 0.1%。
【2012-43】
(11 分)假定某计算机的 CPU 主频为 80 MHz,CPI 为 4,平均每条指令访存 1.5 次,主存与 Cache 之间交换的块大小为 16 B,Cache 的命中率为 99%,存储器总线宽度为 32 位。请回答下列问题。
(1) 该计算机的 MIPS 数是多少?平均每秒 Cache 缺失的次数是多少?在不考虑 DMA 传送的情况下,主存带宽至少达到多少才能满足 CPU 的访存要求?(4 分)
(2) 假定在 Cache 缺失的情况下访问主存时,存在 0.0005% 的缺页率,则 CPU 平均每秒产生多少次缺页异常?若页面大小为 4 KB,每次缺页都需要访问磁盘,访问磁盘时 DMA 传送采用周期挪用方式,磁盘 I/O 接口的数据缓冲寄存器为 32 位,则磁盘 I/O 接口平均每秒发出的 DMA 请求次数至少是多少?(3 分)
(3) CPU 和 DMA 控制器同时要求使用存储器总线时,哪个优先级更高?为什么?(2 分)
(4) 为了提高性能,主存采用 4 体交叉存储模式,工作时每 1/4 个存储周期启动一个体。若每个体的存储周期为 50 ns,则该主存能提供的最大带宽是多少?(2 分)
解析
【官方答案】
(1) 平均每秒 CPU 执行的指令数为:80 M/4 = 20 M,故 MIPS 数为 20。(1 分)
平均每秒 Cache 缺失的次数为:20 M × 1.5 × (1-99% ) = 300000。(1 分)
当 Cache 缺失时,CPU 访问主存,主存与 Cache 之间以块为单位传送数据,此时,主存带宽为:16 B × 300000/s = 4.8 MB/s。在不考虑 DMA 传输的情况下,主存带宽至少达到 4.8 MB/s 才能满足 CPU 的访存要求。(2 分)
(2) 平均每秒钟“缺页”异常次数为:300000 × 0.0005% = 1.5 次。(1 分)
因为存储器总线宽度为 32 位,所以,每传送 32 位数据,磁盘控制器发出一次 DMA 请求,故平均每秒磁盘 DMA 请求的次数至少为:1.5 × 4 KB / 4 B = 1.5 K = 1536。(2 分)
(3) CPU 和 DMA 控制器同时要求使用存储器总线时,DMA 请求优先级更高。(1 分)
因为,若 DMA 请求得不到及时响应,I/O 传输数据可能会丢失。(1 分)
(4) 4 体交叉存储模式能提供的最大带宽为:4× 4 B / 50 ns = 320 MB/s。(2 分)
【2013-43】
(9 分)某 32 位计算机,CPU 主频为 800 MHz,Cache 命中时的 CPI 为 4,Cache 块大小为 32 字节;主存采用 8 体交叉存储方式,每个体的存储字长为 32 位、存储周期是 40 ns;存储器总线宽度为 32 位,总线时钟频率为 200 MHz,支持突发传送总线事务。每次读突发传送总线事务的过程包括:送首地址和命令、存储器准备数据、传送数据。每次突发传送 32 字节,传送地址或者 32 位数据均需要一个总线时钟周期。请回答下列问题,要求给出理由或者计算过程。
(1) CPU 和总线的时钟周期各是多少?总线的带宽(即最大数据传输率)为多少?(3 分)
(2) Cache 缺失时,需要用几个读突发传送总线事务来完成一个主存块的读取?(1 分)
(3) 存储器总线完成一次读突发传送总线事务所需的时间是多少?(2 分)
(4) 若程序 BP 执行过程中,共执行了 100 条指令,平均每条指令需要 1.2 次访存,Cache 缺失率是 5%,不考虑替换等开销,则 BP 的 CPU 执行时间是多少?(3 分)
解析
【官方答案】
(1) CPU 的时钟周期为: 1 / 800 MHz = 1.25 ns。(1 分)
总线的时钟周期为:1 / 200 MHz = 5 ns。(1 分)
总线带宽为: 4 B × 200 MHz = 800 MB/s 或 4 B / 5 ns = 800 MB/s。(1 分)
(2) Cache 块大小是 32 B,因此 Cache 缺失时需要一个读突发传送总线事务读取一个主存块。(1 分)
(3) 一次读突发传送总线事务包括一次地址传送和 32 B 数据传送:用 1 个总线时钟周期传输地址;每隔 40 ns / 8 = 5 ns 启动一个体工作(各进行 1 次存取),第一个体读数据花费 40 ns,之后数据存取与数据传输重叠;用 8 个总线时钟周期传输数据。读突发传送总线事务时间:5 ns + 40 ns + 8 × 5 ns = 85 ns。(2 分)
(4) BP 的 CPU 执行时间包括 Cache 命中时的指令执行时间和 Cache 缺失时带来的额外开销。命中时的指令执行时间:100 × 4 × 1.25 ns = 500 ns。(1 分)指令执行过程中 Cache 缺失时的额外开销:1.2 × 100 × 5% × 85 ns = 510 ns。BP 的 CPU 执行时间:500 ns + 510 ns = 1010 ns。(2 分)
【评分说明】
① 执行时间采用如下公式计算时,可酌情给分。
执行时间 = 指令条数 × CPI × 时钟周期 × 命中率 + 访存次数 × 缺失率 × 缺失损失
② 计算公式正确但运算结果不正确时,可酌情给分。
【2016-44】
(9分)假定CPU主频为50MHz,CPI为4。设备D采用异步串行通信方式向主机传送7位ASCII字符,通信规程中有1位奇校验位和1位停止位,从D接收启动命令到字符送入I/O端口需要0.5ms。请回答下列问题,要求说明理由。
(1) 每传送一个字符,在异步串行通信线上共需传输多少位?在设备D持续工作过程中,每秒钟最多可向I/O端口送入多少个字符?
(2) 设备D采用中断方式进行输入/输出,示意图如下∶
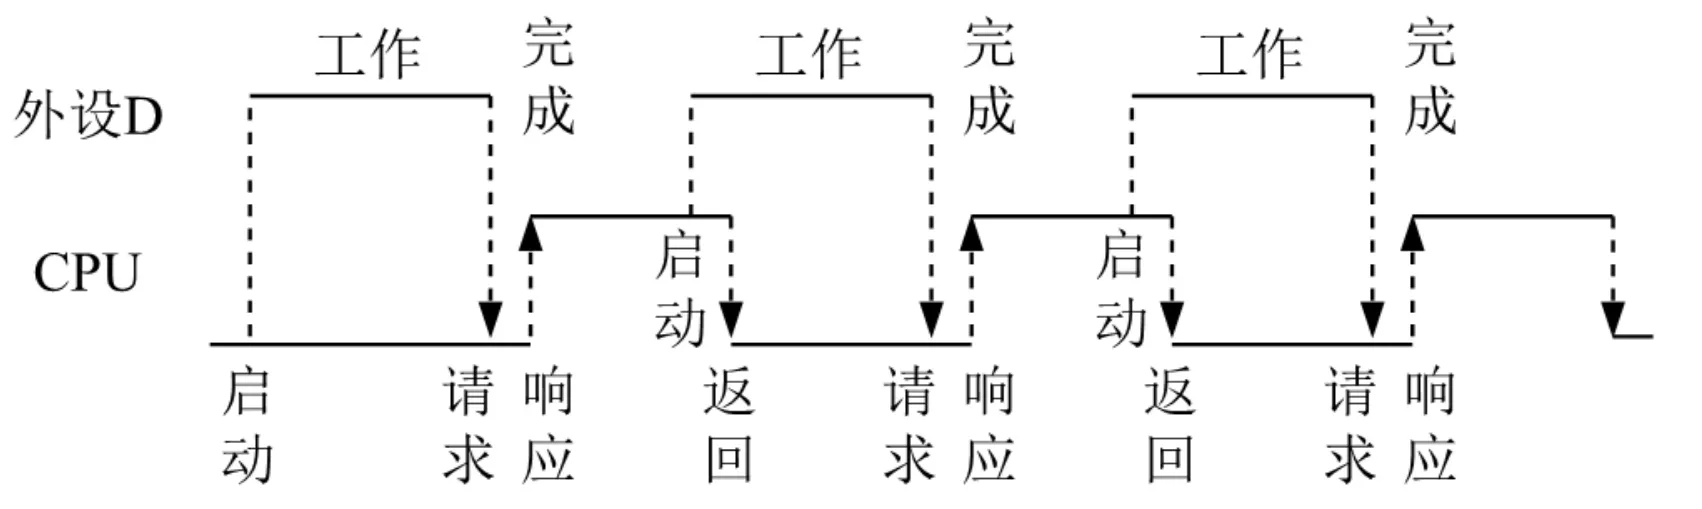
I/O端口每收到一个字符申请一次中断,中断响应需10个时钟周期,中断服务程序共有20条指令,其中第15条指令启动D工作。若CPU需从D读取1000个字符,则完成这一任务所需时间大约是多少个时钟周期?CPU用于完成这一任务的时间大约是多少个时钟周期?在中断响应阶段CPU进行了哪些操作?
解析
【官方答案】
(1) 每传送一个 ASCII 字符,需要传输的位数有 1 位起始位、7 位数据位(ASCII 字符占 7 位)、1 位奇校验位和 1 位停止位,故总位数为 1 + 7 + 1 + 1 = 10。(2 分)
I/O 端口每秒钟最多可接收 1000 / 0.5 = 2000 个字符。(1 分)
(2) 一个字符传送时间包括:设备 D 将字符送 I/O 端口的时间、中断响应时间和中断服务程序前 15 条指令的执行时间。时钟周期为 1 / (50 MHz) = 20 ns,设备 D 将字符送 I/O 端口的时间为 0.5 ms / 20 ns = 2.5 * 10^4 个时钟周期。一个字符的传送时间大约为 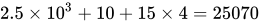 个时钟周期。完成 1000 个字符传送所需时间大约为 1000 × 25070 = 25070000 个时钟周期。(3 分)
CPU 用于该任务的时间大约为 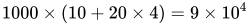 个时钟周期。(1 分)
在中断响应阶段,CPU 主要进行以下操作;关中断、保护断点和程序状态、识别中断源。(2 分)
【评分说明】
(1) 对于第一问,若考生回答总位数为 9,则给 1 分。
(2) ① 对于第一问,若答案是 25070020,则同样给分;若答案是 25000000 或 25000020,则给 2 分。如果没有给出分步计算步骤,但算式和结果正确,同样给分。
② 对于第三问,只要回答关中断和保护断点,就给 2 分,其他答案酌情给分。
【2018-43】
(8分)假定计算机的主频为500MHz,CPI为4。现有设备A和B,其数据传输率分别为2MBps和40MBps,对应I/O接口中各有一个32位数据缓冲寄存器。请回答下列问题,要求给出计算过程。
(1) 若设备A采用定时查询I/O方式,每次输入/输出都至少执行10条指令。设备A最多间隔多长时间查询一次才能不丢失数据?CPU用于设备A输入/输出的时间占CPU总时间的百分比至少是多少?
(2) 在中断I/O方式下,若每次中断响应和中断处理的总时钟周期数至少为400,则设备B能否采用中断I/O方式?为什么?
(3) 若设备B采用DMA方式,每次DMA传送的数据块大小1000B,CPU用于DMA预处理和后处理的总时钟周期数为500,则CPU用于设备B输入/输出的时间占CPU总时间的百分比最大是多少?
解析
【官方答案】
(1) 设备 A 准备 32 位数据所用时间为 4 B / 2 MB = 2 μs,所以,最多每隔 2μs 必须查询一次,才能不丢失数据。(1 分)
设备 A 每秒至少查询 10⁶ / 2 = 5 × 10⁵ 次,因此每秒钟内 CPU 用于设备 A 输入/输出的时间至少为 5 × 10⁵ × 10 × 4 = 2 × 10⁷ 个时钟周期,占整个 CPU 时间的百分比至少为 2 × 10⁷ / 500 M = 4%。(2 分)
(2) 设备 B 不适合采用中断 I/O 方式。(1 分)因为设备 B 准备 32 位数据所用时间为 4 B / 40 MB = 0.1 μs,而中断响应和中断处理时间为 400 × (1 / 500 M) = 0.8 μs,大于 0.1 μs,因而会造成数据丢失。(2 分)
(3) 设备 B 每秒钟内 DMA 次数最多为 40 MB / 1000 B = 40000,CPU 用于设备 B 输入/输出的时间最多为 40000 × 500 = 2 × 10⁷ 个时钟周期,占 CPU 总时间的百分比最多为 2 × 10⁷ / 500 M = 4%。(2 分)
注:评分分值为本人标注,仅供参考。
【2022-44】
(8分)假设某磁盘驱动器中有4个双面盘片,每个盘面有20000个磁道,每个磁道有500个扇区,每个扇区可记录512字节的数据,盘片转速为7200rpm(转/分),平均寻道时间为5ms,请回答下列问题。
(1) 每个扇区包含数据及地址信息,地址信息分为3个字段,这3个字段的名称格式什么?对于该磁盘,各字段至少占多少位?
(2) 一个扇区的平均访问时间约为多少?
(3) 若采用周期挪用DMA方式进行磁盘与主机之间的数据传送,磁盘控制器中的数据缓冲区大小为64位,则在一个扇区读写过程中,DMA控制器向CPU发送了多少次总线请求?若CPU检测到DMA控制器的总线请求信号时也需要访问主存,则DMA控制器是否可以获得总线使用权?为什么?
解析
【官方答案】
(1) 3 个字段的名称为柱面号(或磁道号)、(0.5 分)磁头号(或盘面号)、(0.5 分)扇区号;(0.5 分)该磁盘的柱面号、磁头号、扇区号字段至少分别占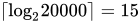 位、(0.5 分)
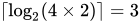 位、(0.5 分)
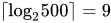 位。(0.5 分)
(2) 该磁盘转一圈的时间为 60 ×10^3 / 7200 = 8.33 ms,一个扇区的平均访问时间约为 5+8.33/2+8.33/500 ≈ 9.18 ms。(2 分)
(3) 在一个扇区读写过程中,DMA 控制器向 CPU 发送了 512 B / 64 b = 64 次总线请求。(1 分)DMA 控制器可以获得总线使用权。(1 分)因为一旦磁盘开始读写就必须按时完成数据传送,否则会发生数据丢失。(1 分)