数据结构真题大题带答案
线性表
【2010-42】
(13分)设将 \(n(n>1)\)个整数存放到一维数组 R中。试设计一个在时间和空间两方面都尽可能高效的算法。将 R中保存的序列循环左移p(0 个位置,即将 R 中的数据由 \(⟨X_0,X_1,…,X_{n−1}⟩\)变换为 \(⟨X_p,X_{p+1},…,X_{n−1},X_0,X_1,…,X_{p−1}⟩\) 。要求:
⑴ 给出算法的基本设计思想。
⑵ 根据设计思想,采用C或C++或Java语言描述,关键之处给出注释。
⑶ 说明你所设计算法的时间复杂度和空间复杂度。
解析
【官方答案】
(1) 给出算法的基本设计思想:
先将 n 个数据 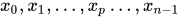 原地逆置,得到
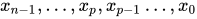 ,然后将前 n-p 和后 p 个元素分别原地逆置,得到最终结果:
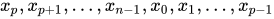 。
(2) 算法实现:
void reverse(int r[], int left, int right) {
int k = left, j = right, temp; // k等于左边界left, j等于右边界right
}
void leftShift(int r[], int n, int p) {
if (p > 0 && p < n) {
reverse(r, 0, n - 1); // 将全部数据逆置
reverse(r, 0, n - p - 1); // 将前 n-p 个元素逆置
reverse(r, n - p, n - 1); // 将后 p 个元素逆置
}
}(3) 说明算法复杂性:上述算法的时间复杂度为 O(n) ,空间复杂度为 O(1) 。
【2011-42】
一个长度为 \(L(L≥1)\)的升序序列 S ,处在第 \(⌈L/2⌉\)个位置的数称为 S 的中位数。例如,若序列\(S1=⟨11,13,15,17,19⟩\) ,则 S1 的中位数是 15 。两个序列的中位数是含它们所有元素的升序序列的中位数。例如,若序列 \(S2=⟨2,4,6,8,20⟩\) ,则 S1 和 S2 的中位数是 11 。现有两个等长的升序序列 A 和 B ,试设计一个在时间和空间两方面都尽可能高效的算法,找出两个序列 A 和 B 的中位数。要求:
⑴ 给出算法的基本设计思想。
⑵ 根据设计思想,采用C或C++或Java语言描述,关键之处给出注释。
⑶ 说明你所设计算法的时间复杂度和空间复杂度。
解析
【官方答案】
(1) 给出算法的基本设计思想:(5 分)
分别求两个升序序列 A、B 的中位数,设为 a 和 b。若 a=b,则 a 或 b 即为所求中位数;否则,舍弃 a、b 中较小者所在序列之较小的一半,同时舍弃较大者所在序列较大的一半,要求两次舍弃的元素个数相同。在保留的两个升序序列中,重复上述过程,直到两个序列中均只含一个元素时为止,则较小者即为所求中位数。
(2) 算法实现:(8 分)
int M_Search(int A[], int B[], int n) { // n 即为序列长度 L
    int s1 = 0, e1 = n - 1, mid1, s2 = 0, e2 = n - 1, mid2;
    while(s1 != e1 || s2 != e2) {
        mid1 = (s1 + e1) / 2;
        mid2 = (s2 + e2) / 2;
        if (A[mid1] == B[mid2]) {
             return A[mid1];
        } else if (A[mid1] < B[mid2]) {
            // 分别考虑奇数和偶数,保持两个子数组元素个数相等
            if ((s1 + e1) % 2 == 0) { // 若元素个数为奇数
                 s1 = mid1;  // 舍弃 A 中间点以前的部分
                 e2 = mid2;  // 舍弃 B 中间点以后的部分
            } else { // 若元素个数为偶数
                 s1 = mid1 + 1;  // 舍弃 A 中间点及中间点以前的部分
                 e2 = mid2;  // 舍弃 B 中间点以后的部分
            }
        } else {
            // 分别考虑奇数和偶数,保持两个子数组元素个数相等
            if ((s1 + e1) % 2 == 0) { // 若元素个数为奇数
                 e1 = mid1;  // 舍弃 A 中间点以后的部分
                 s2 = mid2;  // 舍弃 B 中间点以前的部分
            } else { // 若元素个数为偶数
                 e1 = mid1;  // 舍弃 A 中间点以后的部分
                 s2 = mid2 + 1;  // 舍弃 B 中间点及中间点以前的部分
            }
        }
    }
    return A[s1] < B[s2] ? A[s1] : B[s2];
}
(3) 上述所给算法的时间、空间复杂度分别是  和 O(1) 。(2 分)
【评分说明】
① 若考生设计的算法满足题目的功能要求且正确,则(1)、(2)根据所实现算法的效率给分,细则见下表:
// 采用 2 路归并的思想实现
int M_Search(int A[], int B[], int n) { // n 即为序列长度 L
    int i, j, k;
    i = j = k = 0;
    while (i < n && j < n) {
        k++;
        if (A[i] < B[j]) {
            i++;
            if (k == n) return A[i - 1];
        } else {
            j++;
            if (k == n) return B[j - 1];
        }
    }
}
② 若在算法的基本设计思想描述中因文字表达没有非常清晰反映出算法思路,但在算法实现中能够清晰看出算法思想且正确的,可参照 ① 的标准给分。
③ 若算法的基本设计思想描述或算法实现中部分正确,可参照 ① 的各种情况的相应给分标准酌情给分。
④ 若考生所估计的时间复杂度及空间复杂度与考生所实现的算法一致,各给 1 分。
⑤ 参考答案中值给出了使用 C 语言的版本,使用 C++/Java 语言的答案视同使用 C 语言。
【2013-41】
(13分)已知一个整数序列\(A=(a_0,a_1,…,a_{n−1})\) ,其中 \(0≤a_i\) 。若存在 \(a_{p1}=a_{p2}=⋯=a_{pm}=x 且 m>n/2(0≤p_k<n,1≤k≤m)\) ,则称 x 为 A 的主元素。例如 A=(0,5,5,3,5,7,5,5) ,则 5 为主元素;又如 A=(0,5,5,3,5,1,5,7) ,则 A 中没有主元素。假设 A 中的 n 个元素保存在一个一维数组中,请设计一个尽可能高效的算法,找出 A 的主元素。若存在主元素,则输出该元素;否则输出 −1 。要求:
⑴ 给出算法的基本设计思想。
⑵ 根据设计思想,采用C、C++或Java语言描述算法,关键之处给出注释。
⑶ 说明你所设计算法的时间复杂度和空间复杂度。
【官方答案】 (1) 算法的基本设计思想(4 分) 算法的策略是从前向后扫描数组元素,标记出一个可能成为主元素的元素 Num。然后重新计数,确认 Num 是否是主元素。 算法可分为以下两步: ① 选取候选的主元素:依次扫描所给数组中的每个整数,将第一个遇到的整数 Num 保存到 c 中,记录 Num 的出现次数为 1;若遇到的下一个整数仍等于 Num,则计数加 1,否则计数减 1;当计数减到 0 时,将遇到的下一个整数保存到 c 中,计数重新记为 1,开始新一轮计数,即从当前位置开始重复上述过程,直到扫描完全部数组元素。 ② 判断 c 中元素是否是真正的主元素:再次扫描该数组。统计 c 中元素出现的次数,若大于 (2) 算法实现(7 分) (3) 算法复杂度 参考答案中实现的程序的时间复杂度为 O(n) ,(1 分)空间复杂度为 O(1) 。(1 分) 【评分说明】 (1)、(2) ① 若考生设计的算法满足题目的功能要求且正确,则 (1)、(2) 根据所实现算法的效率给分,细则见下表: ② 若在算法的基本设计思想描述中因文字表达没有非常清晰反映出算法思路,但在算法实现中能够清晰看出算法思想且正确的,可参照①的标准给分。 ③ 若算法的基本设计思想描述或算法实现中部分正确,可参照①的各种情况的相应给分标准酌情给分。 ④ 参考答案中值给出了使用 C 语言的版本,使用 C++语言的答案视同使用 C 语言。 (3) 若考生所估计的时间复杂度及空间复杂度与考生所实现的算法一致,各给 1 分。解析
 ,则为主元素,否则,序列中不存在主元素。
int Majority(int A[], int n) {
    int i, c, count = 1; // c 用来保存候选主元素, count 用来计数
    c = A[0];  // 设置 A[0] 为候选主元素
    for (i = 1; i < n; i++) // 查找候选主元素
        if (A[i] == c)
            count++; // 对 A 中的候选主元素计数
        else
            if (count > 0)  // 处理不是候选主元素的情况
                count--;
            else  // 更换候选主元素, 重新计数
            {   c = A[i];
                count = 1;
            }
    if (count > 0)
        for (i = count = 0; i < n; i++) // 统计候选主元素的实际出现次数
            if (A[i] == c)
                count++;
    if(count > n / 2) return c; // 确认候选主元素
    else return -1; // 不存在主元素
}
// 采用计数排序思想,时间复杂度 O(n),空间复杂度 O(n)
int Majority1(int A[], int n) {
    int k, p, max;
    p = (int *)malloc(sizeof(int)n);    // 申请辅助计数数组
    for (k = 0; k < n; k++) {    // 计数数组清 0
        p[k] = 0;
    }
    max = 0;
    for (k = 0; k < n; k++) {
        p[A[k]]++;    // 计数器+1
        if (p[A[k]] > p[max]) {
            max = A[k];    // 记录出现次数最多的元素
        }
    }
    if (p[max] > n/2) {
        return max;
    } else {
        return -1;
    }
}
【2018-41】
(13分)给定一个含 n(n≥1) 个整数的数组,请设计一个在时间上尽可能高效的算法,找出数组中未出现的最小正整数。例如,数组{-5, 3, 2, 3}中未出现的最小正整数是1;数组{1, 2, 3}中未出现的最小正整数是4。要求:
⑴ 给出算法的基本设计思想。
⑵ 根据设计思想,采用C或C++语言描述算法,关键之处给出注释。
⑶ 说明你所设计算法的时间复杂度和空间复杂度。
解析
【官方答案】
(1) 算法的基本设计思想:
设要查找的数组中未出现的最小正整数为 K。K 取值范围只能是 [1, n + 1]。采用类似计数排序的思想,分配个数组 B[n],用来标记 A 中是否出现了 1~n 之间的正整数。
从左至右依次扫描数组元素 A[i] 并标记数组 B。若 A[i] 是负数、零或是大于 n,则忽略该值;否则,根据计数排序的思想将 B[A[i] - 1] 置为 1。标记完毕,遍历数组 B,查找第一个值为 0 的元素,其下标 +1 即为目标元素 K;找不到 0 时,K = n + 1。
(2) 算法实现:
int findMissMin(int A[], int n) {
    int i, *B;   // 标记数组
    B = (int *)malloc(sizeof(int) * n);   // 分配空间
    memset(B, 0, sizeof(int) * n);   // 赋初值为0
    for (i = 0; i < n; i++)
        if (A[i] > 0 && A[i] <= n)   // 若A[i]的值介于1~n,则标记数组B
            B[A[i] - 1] = 1;
    for (i = 0; i < n; i++)   // 扫描计数数组,找到目标值K
        if (B[i] == 0) break;
    return i + 1;   // 返回结果
}
(3) 以上算法的时空复杂度都是 O(n) 。
【2020-41】
(13分)定义三元组\((a,b,c)\)( a,b,c 均为正数)的距离 \(D=|a−b|+|b−c|+|c−a|\) 。给定 3 个非空整数集合 S1 、 S2 和 S3 ,按升序分别存储在 3 个数组中。请设计一个尽可能高效的算法,让算并输出所有可能的三元组 (a,b,c) (其中 a∈S1,b∈S2,c∈S3 )中的最小距离。例如 S1={−1,0,9} , S2={−25,−10,10,11} , S3={2,9,17,30,41} ,则最小距离为 2 ,相应的三元组为 (9,10,9) 。要求:
⑴ 给出算法的基本设计思想。
⑵ 根据设计思想,采用C或C++语言描述算法,关键之处给出注释。
⑶ 说明你所设计算法的时间复杂度和空间复杂度。
解析
【官方答案】
(1) 算法的基本设计思想(4 分)
① 使用 min 记录当前所有已处理过的三元组的最小距离,初值为 C 语言能表示的最大整数 INT_MAX;
② 若集合 S1、S2 和 S3 分别保存在数组 A、B、C 中。数组下标变量 i = j = k = 0,当 i < |S1| 且 j < |S2| 且 k < |S3| 时( |S| 表示集合 S中的元素个数),循环执行 (a)~(c):
(a) 计算(A[i], B[j], C[k]) 的距离 d;
(b) 若 d < min,则 min=d;
(c) 将 A[i]、B[j]、C[k] 中的最小值的下标 +1;
③ 输出 min,结束。
(2) 算法实现(7 分)
#include <limits.h> // 定义最大整数 INT_MAX 的头文件
#include <math.h> // abs() 函数所在的头文件
#define xIsMin(x,y,z) (((x) <= (y)) && ((x) <= (z)))  // 定义辅助计算的宏
int findMinOfTrip(int A[], int n, int B[], int m, int C[], int p) {
    int i = 0, j = 0, k = 0, min = INT_MAX, dist;
    // min 用于记录三元组最小距离, 初值赋为 INT_MAX
    while (i < n && j < m && k < p && min > 0) {
        dist = abs(A[i] - B[j]) + abs(B[j] - C[k]) + abs(C[k] - A[i]);
        if (dist < min) min = dist;
        if (xIsMin(A[i], B[j], C[k])) i++;
        else if (xIsMin(B[j], C[k], A[i])) j++;
        else k++;
    }
    return min;
}
(3) 时间复杂度为 O(n) ,(1 分)空间复杂度为O(1) 。(1 分)
【2009-42】
(15分)已知一个带有表头结点的单链表,结点结构为|data| link| ,假设该链表只给出了头指针 list 。在不改变链表的前提下,请设计一个尽可能高效的算法,查找链表中倒数第 k 个位置上的结点( k 为正整数)。若查找成功,算法输出该结点的 data 域的值,并返回 1 ;否则,只返回 0 。要求:
⑴ 描述算法的基本设计思想。
⑵ 描述算法的详细实现步骤。
⑶ 根据设计思想和实现步骤,采用程序设计语言描述算法(使用C或C++或Java语言实现),关键之处请给出简要注释。
解析
【官方答案】
(1) 算法的基本设计思想:
定义两个指针变量 p 和 q,初始时均指向头结点的下一个结点。p 指针沿链表移动;当 p 指针移动到第 k 个结点时,q 指针开始与 p 指针同步移动;当 p 指针移动到链表最后一个结点时,q 指针所指元素为倒数第 k 个结点。
以上过程对链表仅进行一遍扫描。
(2) 算法的详细实现步骤:
① count=0, p 和 q 指向链表表头结点的下一个结点;
② 若 p 为空, 转⑤;
③ 若 count 等于 k, 则 q 指向下一个结点; 否则, count=count+1;
④ p 指向下一个结点, 转步骤②;
⑤ 若 count 等于 k, 则查找成功, 输出该结点的 data 域的值, 返回 1; 否则, 查找失败, 返回 0;
⑥ 算法结束。
(3) 算法实现:
int SearchN (LinkList list, int k) {
    LinkList p, q;
    int count = 0; /* 计数器赋初值 */
    p = q = list-> link; /* p 和 q 指向链表表头结点的下一个结点 */
    while (p != NULL) {
        if (count < k)
            count++; /* 计数器+1 */
        else
            q = q->link; /* q 移到下一个结点 */
        p = p->link; /* p 移到下一个结点 */
    }
    if (count < k) /* 如果链表的长度小于 k */
        return 0; /* 查找失败 */
    else {
        printf("%d", q->data); /* 查找成功 */
        return 1;
    }
}【2012-42】
假定采用带头结点的单链表保存单词,当两个单词有相同的后缀时,则可共享相同的后缀存储空间,例如,’loading’和’being’的存储映像如下图所示。
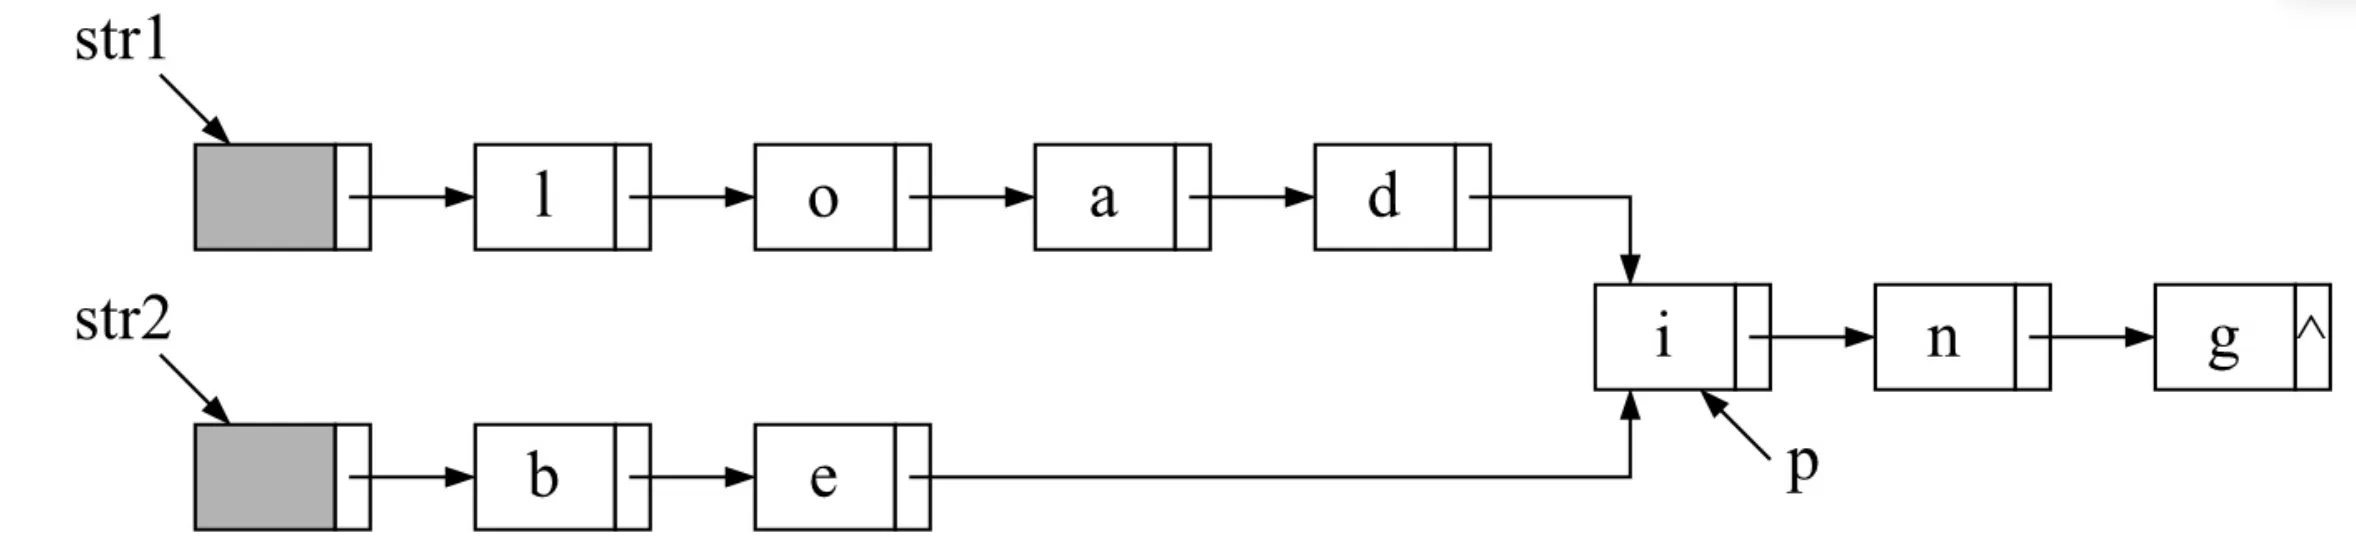
设str1和str2分别指向两个单词所在单链表的头结点,链表结点结构为 datanext ,请设计一个时间上尽可能高效的算法,找出由str1和str2所指向两个链表共同后缀的起始位置(如图中字符i所在的结点位置p)。要求:
⑴ 给出算法的基本设计思想。
⑵ 根据设计思想,采用C或C++或Java语言描述算法,关键之处给出注释。
⑶ 说明你所设计算法的时间复杂度。
解析
【2015-41】
(15分)用单链表保存 m 个整数,结点的结构为data link,且 |data|≤n ( n 为正整数)。现要求设计一个时间复杂度尽可能高效的算法,对于链表中 data 的绝对值相等的结点,仅保留第一次出现的结点而删除其余绝对值相等的结点。例如,若给定的单链表 head 如下:
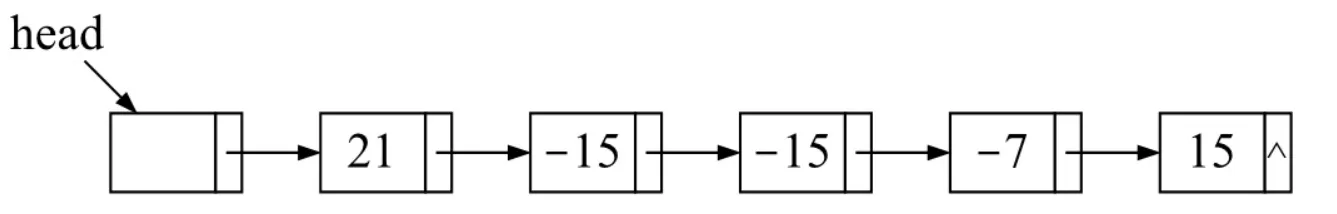
则删除结点后的 head 为:
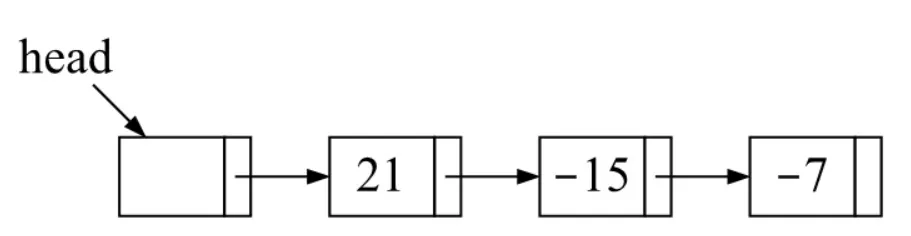
要求:
⑴ 给出算法的基本设计思想。
⑵ 使用C或C++语言,给出单链表结点的数据类型定义。
⑶ 根据设计思想,采用C或C++语言描述算法,关键之处给出注释。
⑷ 说明你所设计算法的时间复杂度和空间复杂度。
解析
【官方答案】
(1) 算法的基本设计思想
算法的核心思想是用空间换时间。使用辅助数组记录链表中已出现的数值,从而只需对链表进行一趟扫描。
因为 ,故辅助数组 q 的大小为 ,各元素的初值均为0。依次扫描链表中的各结点,同时检查 q[|data|] 的值,如果为 0,则保留该结点,并令 q[|data|]=1;否则,将该结点从链表中删除。
(2) 使用C语言描述的单链表结点的数据类型定义
typedef struct node {
    int data;
    struct node *link;
} NODE;
typedef NODE *PNODE;
(3) 算法实现
void func( PNODE h, int n) {
    PNODE p = h, r;
    int *q, m;
    q = (int *)malloc(sizeof(int)*(n + 1)); // 申请n+1个位置的辅助空间
    for (int i = 0; i < n+1; i++) // 数组元素初值置0
        *(q + i) = 0;
    while (p->link != NULL) {
        m = p->link->data > 0 ? p->link->data : -p->link->data;
        if (*(q + m) == 0) { // 判断该结点的data是否已出现过
            *(q + m) = 1; // 首次出现
            p = p->link; // 保留
        } else { // 重复出现
            r = p->link; // 删除
            p->link = r->link;
            free(r);
        }
    }
    free(q);
}
【评分说明】
(1)、(2)、(3) 评分说明
① 若考生设计的算法满足题目的功能要求且正确,则 (1)、(3) 根据所实现算法的时间复杂度给分,细则见下表:
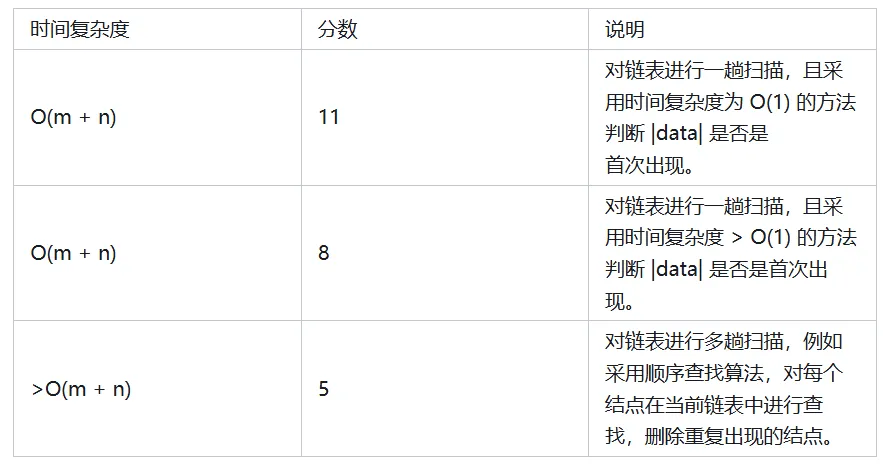
② 若在算法的基本设计思想描述中因文字表达没有清晰反映出算法思路,但在算法实现中能够表达出算法思想且正确的,可参照 ① 的标准给分。
③ 若算法的基本设计思想描述或算法实现中部分正确,可参照 ① 中各种情况的相应给分标准酌情给分。
④ 若考生给出的单链表结点的数据类型定义与题目中所给的结点形式不完全相同,酌情给分。
⑤ 参考答案中只给出了使用 C 语言的版本,使用 C++ 语言的答案视同使用 C 语言。
(4) 参考答案所给算法的时间复杂度为 O(m + n),空间复杂度为 O(n)。
若考生所估计的时间复杂度和空间复杂度与考生实现的算法一致,可给分。
【2019-41】
(13分)设线性表\(L=(a_1,a_2,a_3,…,a_{n−2},a_{n−1},a_n)\) 采用带头结点的单链表保存,链表中的结点定义如下:
请设计一个空间复杂度为 O(1)且时间上尽可能高效的算法,重新排列 L 中的各结点,得到线性表 \(L′=(a_1,a_n,a_2,a_{n−1},a_3,a_{n−2},…)\)。要求:
⑴ 给出算法的基本设计思想。
⑵ 根据设计思想,采用C或C++语言描述算法,关键之处给出注释。
⑶ 说明你所设计算法的时间复杂度。
解析
【官方答案】
(1) 算法的基本设计思想:(4 分)
算法分 3 步完成。
第 1 步,采用两个指针交替前行,找到单链表的中间结点;
第 2 步,将单链表的后半段结点原地逆置;
第 3 步,从单链表前后两段中依次各取出一个结点,按要求重排。
(2) 算法实现:(8 分)
void change_list(NODE* h) {
    NODE *p, *q, *r, *s;
    p = q = h;
    while (q->next != NULL) {  // 寻找中间结点
        p = p->next;  // p 走一步
        q = q->next;
        if (q->next != NULL) q = q->next;  // q 走两步
    }
    q = p->next;  // p 所指结点为中间结点,q 为后半段链表的首结点
    p->next = NULL;
    while (q != NULL) {  // 将链表后半段逆置
        r = q->next;
        q->next = p->next;
        p->next = q;
        q = r;
    }
    s = h->next;  // s 指向前半段的第一个数据结点
    q = p->next;  // q 指向后半段的第一个数据结点
    p->next = NULL;
    while (q != NULL) {  // 将链表后半段的结点插入到指定位置
        r = q->next;  // r 指向后半段的下一个结点
        q->next = s->next;  // 将 q 所指结点插入到 s 所指的结点之后
        s->next = q;
        s = q->next;  // s 指向前半段的下一个插入点
        q = r;
    }
}
(3) 算法的时间复杂度:
参考答案的时间复杂度为O(n) 。(1 分)
栈与队列
【2019-42】
(13分)请设计一个队列,要求满足:
① 初始时队列为空;
② 入队时,允许增加队列占用空间;
③ 出队后,出队元素所占用的空间可重复使用,即整个队列所占用的空间只增不减;
④ 入队操作和出队操作的时间复杂度始终保持为 O(1) 。
请回答下列问题:
⑴ 该队列是应选择链式存储结构,还是应选择顺序存储结构?
⑵ 画出队列的初始状态,并给出判断队空和队满的条件。
⑶ 画出第一个元素入队后的队列状态。
⑷ 给出入队操作和出队操作的基本过程。
解析
(1) 采用链式存储结构(两段式单向循环链表),队头指针为 front,队尾指针为 rear。
(2) 初始时,创建只有一个空闲结点的两段式单向循环链表,头指针 front 与尾指针 rear 均指向空闲结点。如下图所示。
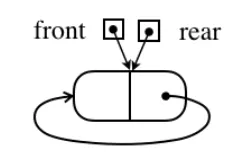
队空的判定条件:front == rear。
队满的判定条件:front == rear->next。
(3) 插入第一个元素后的队列状态:
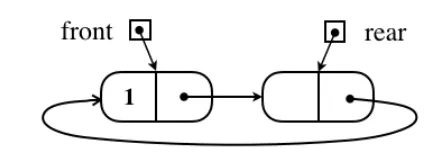
(4) 操作的基本过程:
入队操作:
若 (front == rear->next) // 队满
则在 rear 后面插入一个新的空闲结点;
入队元素保存到 rear 所指结点中; rear = rear->next; 返回。
出队操作:
若 (front == rear) // 队空
则出队失败, 返回;
取 front 所指结点中的元素 e; front = front->next; 返回 e。
树与二叉树
【2016-42】
(8分)如果一棵非空 k(k≥2) 叉树 T 中每个非叶结点都有 k 个孩子,则称 T 为正则 k 叉树。请回答下列问题并给出推导过程。
⑴ 若 T 有 m 个非叶结点,则 T 中的叶结点有多少个?
⑵ 若 T 的高度为 h (单结点的树 h=1 ),则 T 的结点数最多为多少个?最少为多少个?
解析
【官方答案】
(1) 根据定义,正则 k 叉树中仅含有两类结点:叶结点(个数记为  )和度为 k 的分支结点(个数记为
 )。树 T 中的结点总数
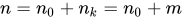 。树中所含的边数
 ,这些边均为
 个度为
 的结点发出的,即
 。整理得:
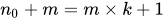 ,故
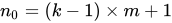 。(3 分)
(2) 高度为  的正则 k 叉树 中,含最多结点的树形为:除第 h 层外,第 1 到第 h-1 层的结点都是度为 k 的分支结点,而第 h 层均为叶结点,即树是“满”树。此时第
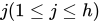 层结点数为
 ,结点总数
 为:
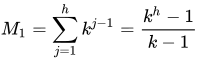
(3 分)
含最少结点的正则 k 叉树的树形为:第 1 层只有根结点,第 2 到第 h-1 层仅含 1 个分支结点和 k-1 个叶结点,第 h 层有 k 个叶结点。即除根外第 2 到第 h 层中每层的结点数均为 k ,故 T 中所含结点总数  为:
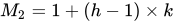
(2 分)
【评分说明】
① 参考答案仅给出一种推导过程,若考生采用其他推导方法且正确,同样给分。
② 若考生仅给出结果,但没有推导过程,则 (1)、(2) 的最高得分分别是 2 分和 3 分。若推导过程或答案不完全正确,酌情给分。
【2017-41】
(15分)请设计一个算法,将给定的表达式树(二叉树)转换为等价的中缀表达式(通过括号反映操作符的计算次序)并输出。例如,当下列两棵表达式树作为算法输入时:
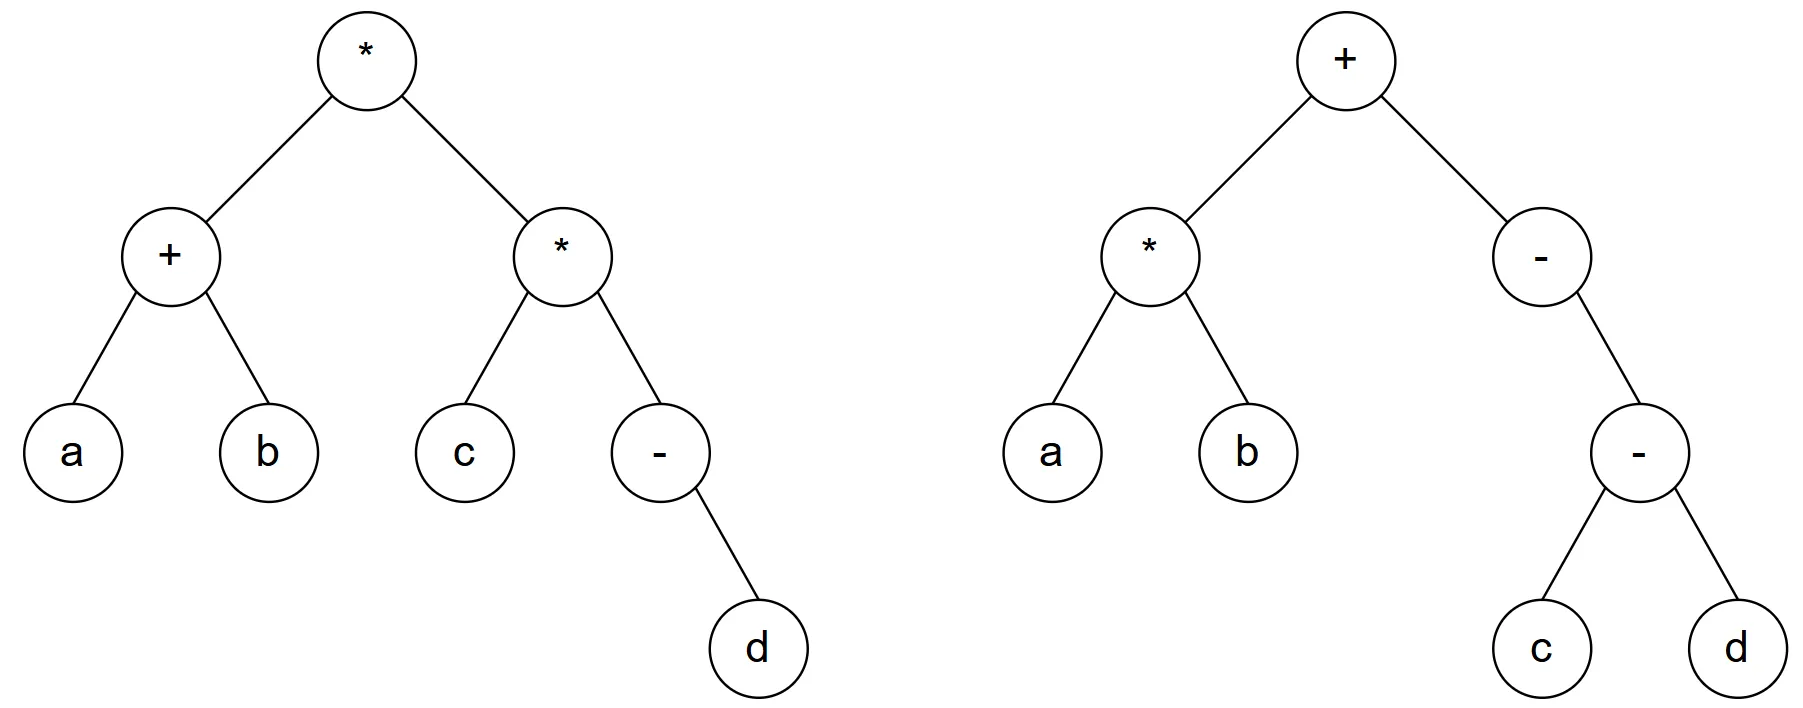
输出的中缀表达式分别为 (a+b)∗(c∗(−d)) 和 (a∗b)+(−(c−d)) 。
二叉树结点的定义如下:
要求:
⑴ 给出算法的基本设计思想。
⑵ 根据设计思想,采用C或C++语言描述算法,关键之处给出注释。
解析
【官方答案】
(1) 算法的基本设计思想
表达式树的中序序列加上必要的括号即为等价的中级表达式。可以基于二叉树的中序遍历策略得到所需的表达式。(3 分)
表达式树中分支结点所对应的子表达式的计算次序,由该分支结点所处的位置决定。为得到正确的中级表达式,需要在生成遍历序列的同时,在适当位置增加必要的括号。显然,表达式的最外层(对应根结点)及操作数(对应叶结点)不需要添加括号。(2 分)
(2) 算法实现(10 分)
void BtreeToExp(BTree *root, int deep) {
    if (root == NULL) {
        return;
    } else if (root->left == NULL && root->right == NULL) { // 若为叶结点
        printf("%s", root->data);    // 输出操作数
    } else {
        if (deep > 1) printf("(");    // 若有子表达式则加1层括号
        BtreeToExp(root->left, deep + 1);
        printf("%s", root->data);    // 输出操作符
        BtreeToExp(root->right, deep + 1);
        if (deep > 1) printf(")");    // 若有子表达式则加1层括号
    }
}

void BtreeToE(BTree \*root) {
BtreeToExp(root, 1);    // 根的高度为1
}
【评分说明】
① 若考生设计的算法满足题目的功能要求,则 (1)、(2) 根据所实现算法的策略及输出结果给分,细则见下表:
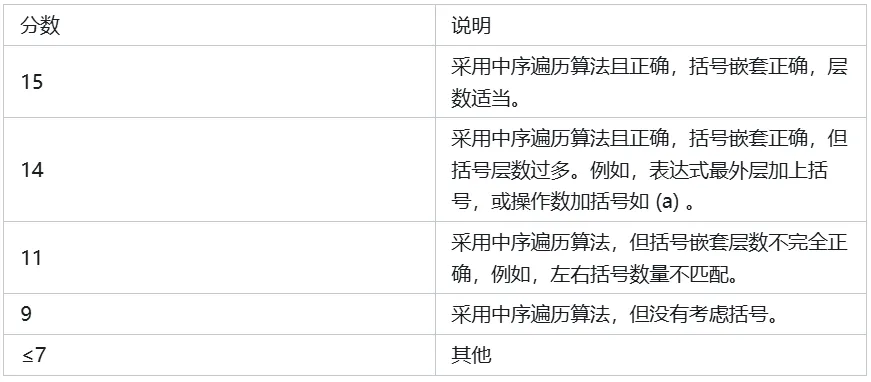
② 若考生采用其他方法得到正确结果,可参照①的评分标准给分。
③ 如果程序中使用了求结点深度等辅助函数,但没有给出相应的实现过程,只要考生进行了必要的说明,可不扣分。
④ 若在算法的基本设计思想描述中因文字表达没有清晰反映出算法思路,但在算法实现中能够表达出算法思想且正确的,可参照①的标准给分。
⑤ 若算法的基本设计思想描述或算法实现中部分正确,可参照①中各种情况的相应给分标准的情给分。
⑥ 参考答案中只给出了使用 C 语言的版本,使用 C++ 语言的答案参照以上评分标准。
【2012-41】
(13分)设有 6 个有序表A、B、C、D、E,分别含有10、35、40、50、60和200个数据元素,各表中元素按升序排列.要求通过 5 次两两合并,将 5 个表最终合并成 1 个升序表,并在最坏情况下比较的总次数达到最小。请回答下列问题。
⑴ 给出完整的合并过程,并求出最坏情况下比较的总次数。
⑵ 根据你的合并过程,描述 N(N≥2) 个不等长升序表的合并策略,并说明理由。
解析
【官方答案】
(1) 6 个表的合并顺序如下图所示。
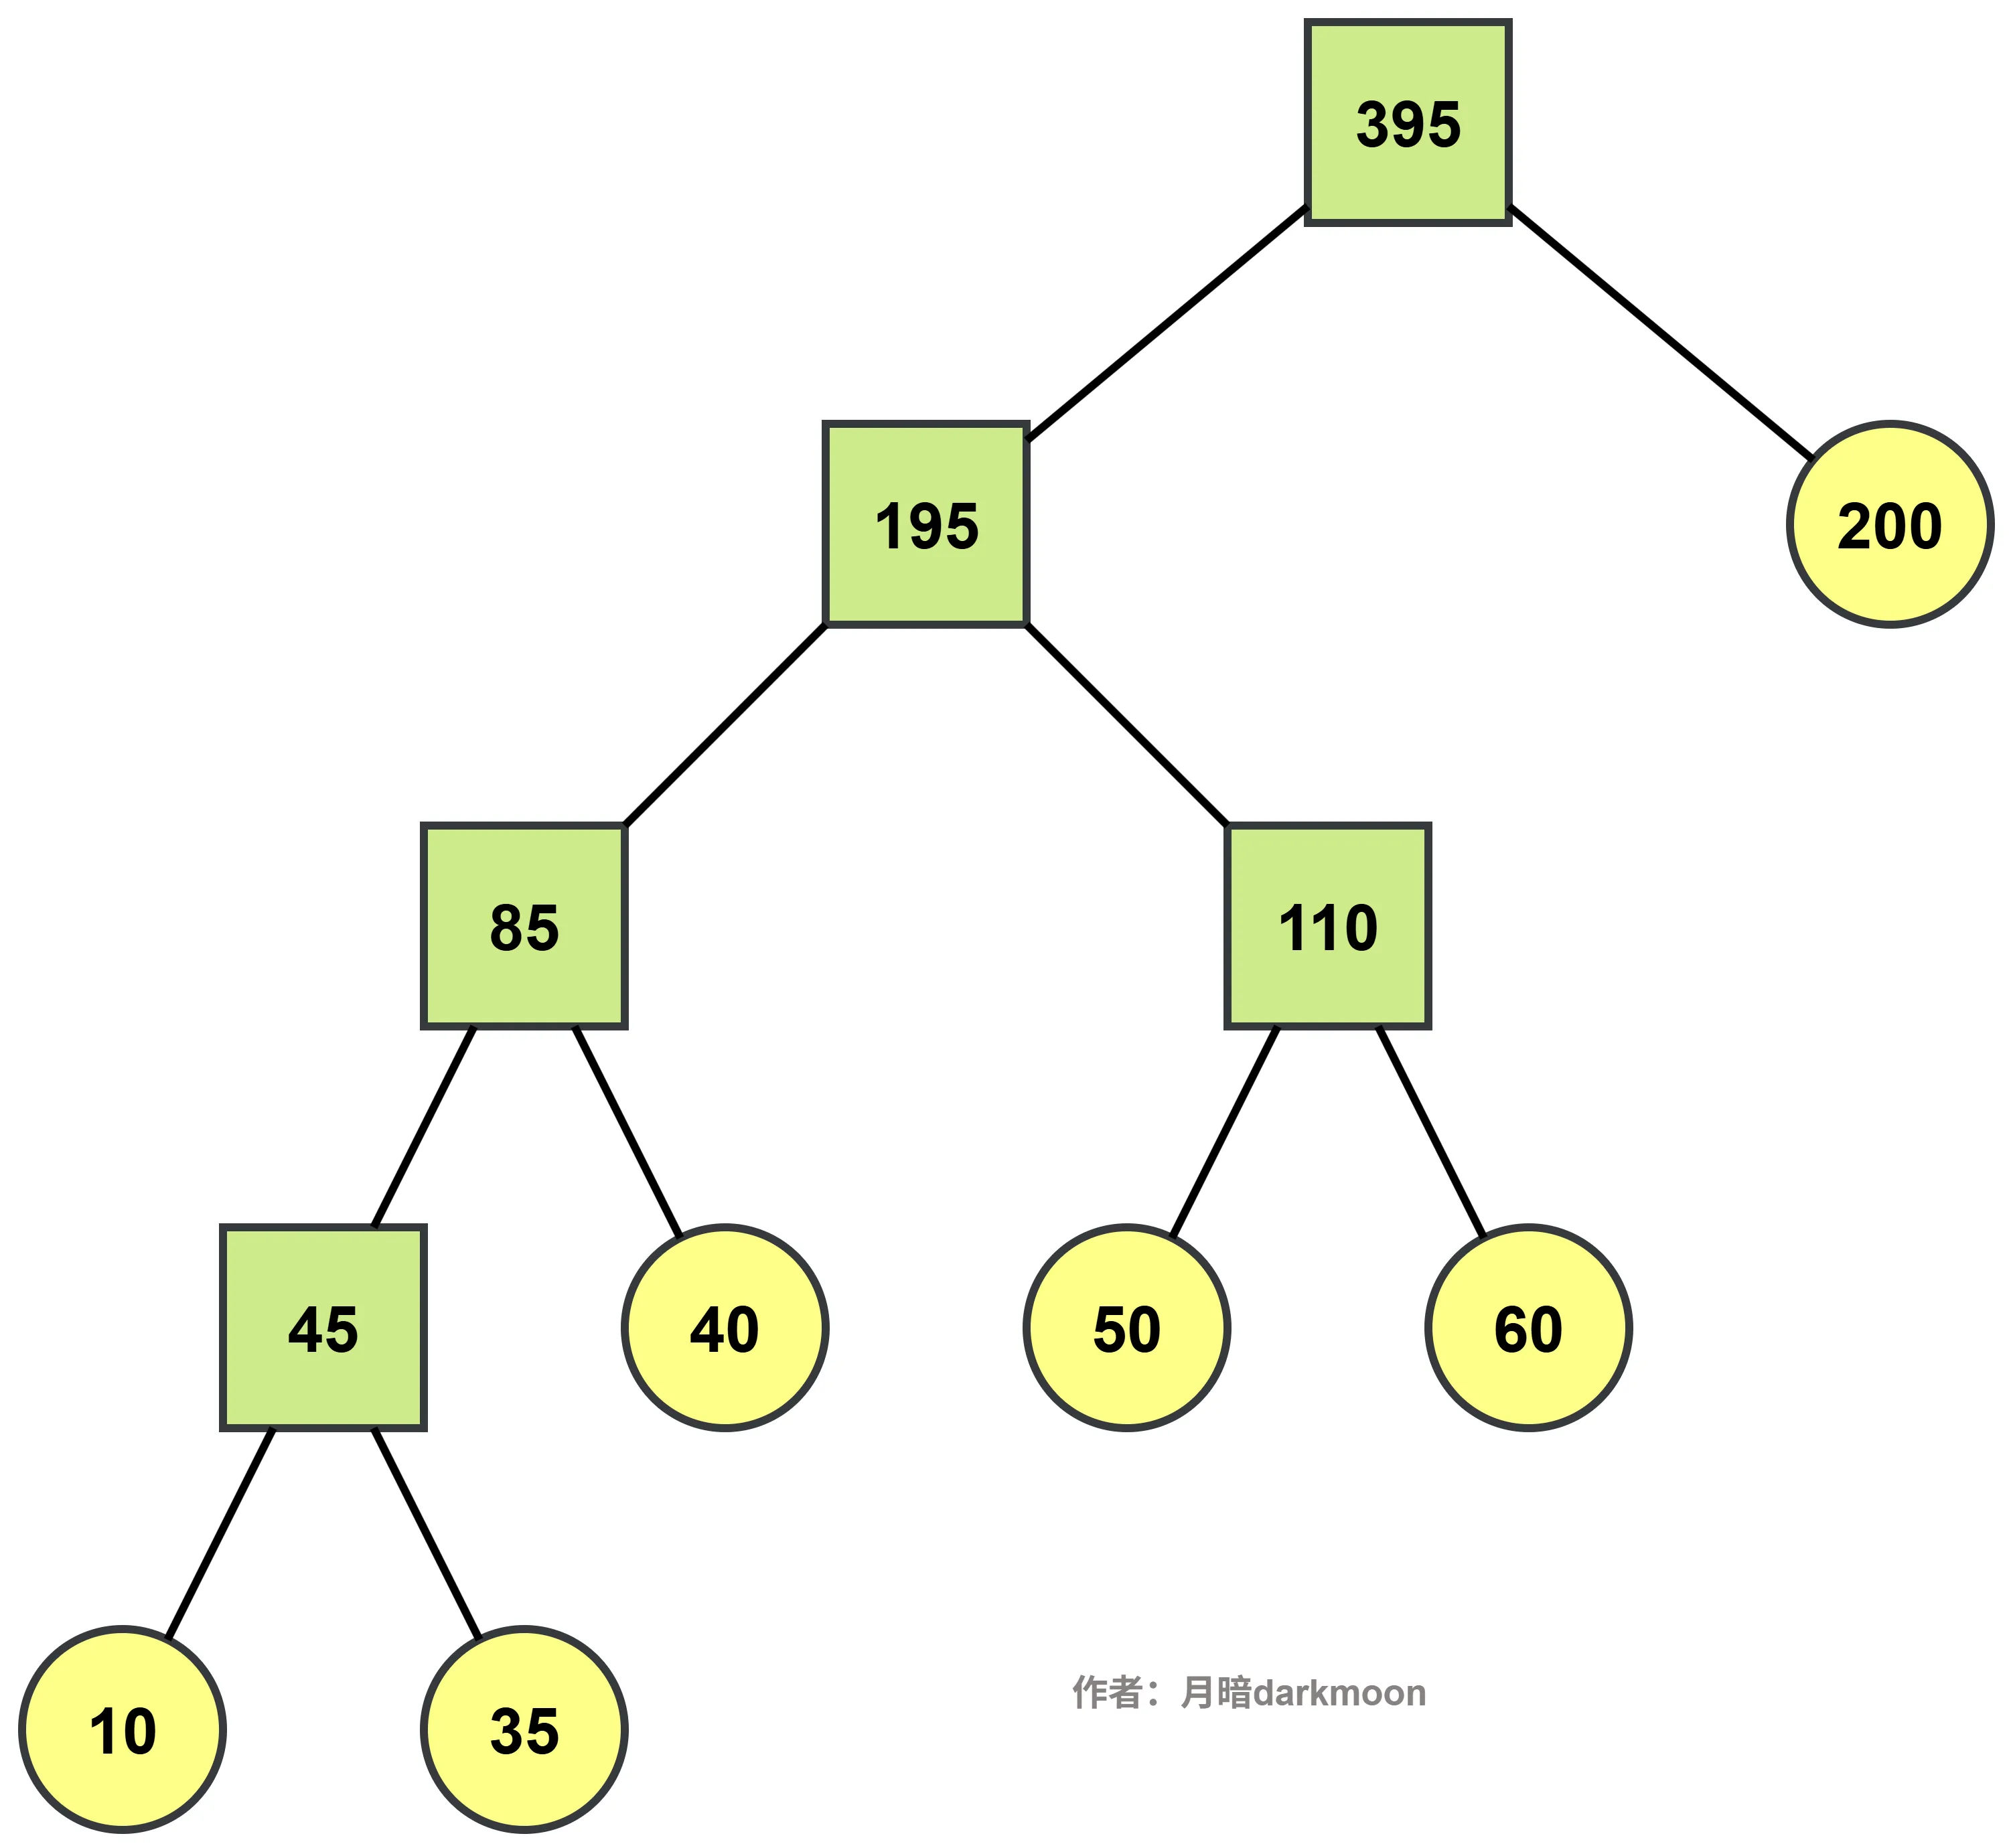
根据上图中的哈夫曼树,6 个序列的合并过程为:
第 1 次合并: 表 A 与表 B 合并, 生成含 45 个元素的表 AB;
第 2 次合并: 表 AB 与表 C 合并, 生成含 85 个元素的表 ABC;
第 3 次合并: 表 D 与表 E 合并, 生成含 110 个元素的表 DE;
第 4 次合并: 表 ABC 与表 DE 合并, 生成含 195 个元素的表 ABCDE;
第 5 次合并: 表 ABCDE 与表 F 合并, 生成含 395 个元素的最终表。(5 分)
由于合并两个长度分别为 m 和 n 的有序表, 最坏情况下需要比较 m+n-1 次, 故最坏情况下比较的总次数计算如下:
第 1 次合并: 最多比较次数=10+35-1=44
第 2 次合并: 最多比较次数=45+40-1=84
第 3 次合并: 最多比较次数=50+60-1=109
第 4 次合并: 最多比较次数=85+110-1=194
第 5 次合并: 最多比较次数=195+200-1=394
比较的总次数最多为: 44+84+109+194+394=825(2 分)
(2) 各表的合并策略是: 在对多个有序表进行两两合并时, 若表长不同, 则最坏情况下总的比较次数依赖于表的合并次序。可以借用哈夫曼树的构造思想, 依次选择最短的两个表进行合并, 可以获得最坏情况下最佳的合并效率。(3 分)
【评分说明】
(1)、(2)
① 对于用类似哈夫曼树(或最佳归并树)思想进行合并,过程描述正确,给 5 分。按其他策略进行合并,过程描述正确,给 3 分。
② 正确算出与合并过程一致的总比较次数,给 2 分。若计算过程正确,但结果错误,给 1 分。
③ 考生只要求说明采用的是类似哈夫曼树(或最佳归并树)的构造方法作为合并策略,即可给 3 分。如果采用其他策略,只要能够完成合并,给 2 分。
【2014-41】
(13分)二叉树的带权路径长度(WPL)是二叉树中所有叶结点的带权路径长度之和。给定一棵二叉树T,采用二叉链表存储,结点结构为:
$\begin{array}{|c|c|c|} \hline \text{left}& \text{weight}& \text{right} \ \hline \end{array}$
其中叶结点的weight域保存该结点的非负值。设root为指向T的根结点的指针,请设计求T的WPL的算法,要求:
⑴ 给出算法的基本设计思想;
⑵ 使用C或C++语言,给出二叉树结点的数据类型定义;
⑶ 根据设计思想,采用C或C++语言描述算法,关键之处给出注释。
解析
【官方答案】
【答案一】
(1) 算法的设计思想:(4 分)
本问题可采用递归算法实现。根据定义:
二叉树的 WPL 值 = 树中全部叶结点的带权路径长度之和 = 根结点左子树中全部叶结点的带权路径长度之和 + 根结点右子树中全部叶结点的带权路径长度之和
叶结点的带权路径长度 = 该结点的 weight 域的值 × 该结点的深度
设根结点的深度为 0,若某结点的深度为 d 时,则其孩子结点的深度为 d + 1。
(2) 算法中使用的二叉树结点的数据类型定义如下:(2 分)
typedef struct node {
    int weight;
    struct node * left, * right;
} BTree;
(3) 算法实现:(7 分)
int WPL(BTree * root) {  // 根据 WPL 的定义采用递归算法实现
    return WPL1 (root,0);
}

int WPL1(BTree \* root, int d) {  // d 为结点深度
if (root->left == NULL && root->right == NULL)
return(root->weight \* d);
else
return(WPL1(root->left, d + 1) + WPL1(root->right, d + 1));
}
【答案二】
(1) 算法的设计思想:(4 分)
若借用非叶结点的 weight 域保存其孩子结点中 weight 域值的和,则树的 WPL 等于树中所有非叶结点 weight 域值之和。
采用后序遍历策略,在遍历二叉树 T 时递归计算每个非叶结点的 weight 域的值,则树 T 的 WPL 等于根结点左子树的 WPL 加上右子树的 WPL,再加上根结点中 weight 域的值。
(2) 算法中使用的二叉树结点的数据类型定义同【答案一】。(2 分)
(3) 算法实现:(7 分)
int WPL(BTree\* root) {  // 基于递归的后序遍历算法实现
int w_l, w_r;
if (root->left == NULL && root->right == NULL)
return 0;
else {
w_l = WPL(root->left);  // 计算左子树的 WPL
w_r = WPL(root->right);  // 计算右子树的 WPL
root->weight = root->left->weight + root->right->weight;  // 填写非叶结点的 weight 域
return (w_l + w_r + root->weight);  // 返回 WPL 值
}
}
【评分说明】
① 若考生给出能够满足题目要求的其他算法且正确(包括用非递归的遍历方式实现的算法),可同样给分。
② 参考答案中只给出了使用 C 语言的版本,使用 C++ 语言正确实现的算法同样给分。
③ 若对算法的基本设计思想和主要数据结构描述不十分准确,但在算法实现中能够清晰反映出算法思想且正确,参照①的标准给分。
④ 若考生给出的二叉树结点的数据类型定义及算法实现中,使用的是除整型之外的其他数值类型,可视同使用整型类型。
⑤ 若考生给出的答案中算法主要设计思想或算法实现中部分正确,可酌情给分。
【2020-42】
若任一个字符的编码都不是其它字符编码的前缀,则称这种编码具有前缀特性。现有某字符集(字符个数≥2)的不等长编码,每个字符的编码均为二进制的0、1序列,最长为L位,且具有前缀特性。请回答下列问题:
⑴ 哪种数据结构适宜保存上述具有前缀特性的不等长编码?
⑵ 基于你所设计的数据结构,简述从0/1串到字符串的译码过程。
⑶ 简述判定某字符集的不等长编码是否具有前缀特性的过程。
解析
【官方答案】
(1) 使用一棵二叉树保存字符集中各字符的编码,每个编码对应于从根开始到达某叶结点的一条路径,路径长度等于编码位数,路径到达的叶结点中保存该编码对应的字符。(2 分)
(2) 从左至右依次扫描 0/1 串中的各位。从根开始,根据串中当前位沿当前结点的左子指针或右子指针下移,直到移动到叶结点时为止。输出叶结点中保存的字符。然后再从根开始重复这个过程。直到扫描到 0/1 串结束,译码完成。(3 分)
(3) 二叉树既可用于保存各字符的编码,也可用于检测编码是否具有前缀特性。判定编码是否具有前缀特性的过程,同时也是构建二叉树的过程。初始时,二叉树中仅含有根结点,其左子指针和右子指针均为空。
依次读入每个编码 C,建立/寻找从根开始对应于该编码的一条路径,过程如下:
对每个编码,从左至右扫描 C 的各位,根据 C 当前位(0 或 1)沿结点的指针(左子指针或右子指针)向下移动。当遇到空指针时,创建新结点,让为空的指针指向该新结点并继续移动。
沿指针移动过程中,可能遇到三种情况:
① 若遇到了叶结点(非根),则表明不具有前缀特性,返回;
② 若在处理 C 的所有位的过程中,均没有创建新结点,则表明不具有前缀特性,返回;
③ 若处理 C 的最后一个编码位时创建了新结点,则继续验证下一个编码。
若所有编码均通过验证,则编码具有前缀特性。(5 分)
图
【2015-42】
(8分)已知含有5个顶点的图G如下图所示。
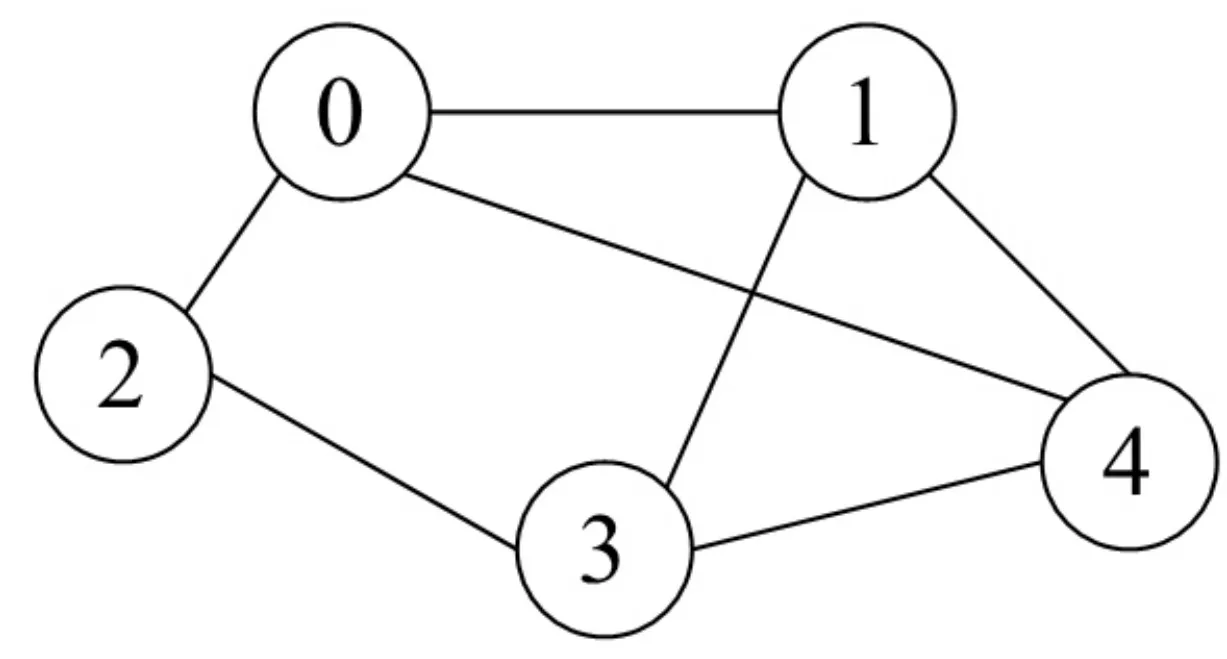
请回答下列问题:
⑴ 写出图G的邻接矩阵 A (行、列下标均从0开始)。
⑵ 求 \(A^2\),矩阵 \(A^2\) 中位于0行3列元素值的含义是什么?
⑶ 若已知具有 n(n≥2) 个顶点的图的邻接矩阵为 B ,则 \(B^m(2≤m≤n)\)中非零元素的含义是什么?
解析
【官方答案】
(1) 图 G 的邻接矩阵 A :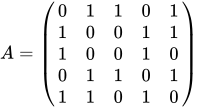
(2)  如下:
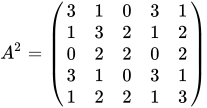
0 行 3 列的元素值 3 表示从顶点 0 到顶点 3 之间长度为 2 的路径共有3条。
(3)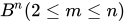 中位于 i 行 j 列
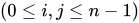 的非零元素的含义是:图中从顶点 i 到顶点 j 长度为 m 的路径条数。
【评分说明】
① 若考生给出的邻接矩阵 中,结点与行、列的对应次序与本参考答案不完全一致,只要正确,同样给分。问题 (2) 中,考生所给的答案中顶点编号要与其所给的邻接矩阵相对应。
② 若考生给出的矩阵 及 部分正确,酌情给分。
③ 若考生分别说明矩阵 中非零元素的含义,同样给分。
④ 若考生给出的 中非零元素的含义部分正确,酌情给分。
【2017-42】
(8 分)使用 Prim(普里姆)算法求带权连通图的最小(代价)生成树 (MST)。请回答下列问题。
(1) 对下列图 G ,从顶点 A 开始求 G 的 MST,依次给出按算法选出的边。
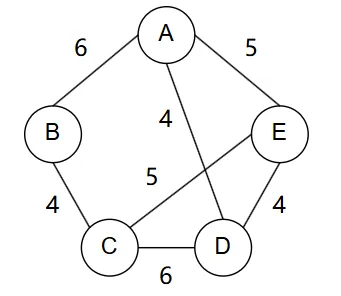
(2) 图 G 的 MST 是唯一的吗?
(3) 对任意的带权连通图,满足什么条件时,其 MST 是唯一的?
解析
【官方答案】
(1) 依次选出的边为:
(A,D), (D,E), (C,E), (B,C) (4 分)
(2) 图 G 的 MST 是唯一的。(2 分)
(3) 当带权连通图的任意一个环中所包含的边的权值均不相同时,其 MST 是唯一的。(2 分)
【评分说明】
(1) 每正确选对一条边且次序正确,给 1 分。若考生选择的边正确,但次序不完全正确,酌情给分。
(3) ① 若考生答案中给出的是其他充分条件,例如“带权连通图的所有边的权值均不相同”,同样给分。
② 若考生给出的充分条件对图的顶点数和边数做了某些限制,例如,限制了图中顶点的个数(顶点个数少于 3 个)、限制了图的形状(图中没有环)等,则最高给 1 分。
③ 答案部分正确,酌情给分。
【2018-42】
(12 分)拟建设一个光通信骨干网络连通 BJ、CS、XA、QD、JN、NJ、TL 和 WH 等 8 个城市,题 42 图中无向边上的权值表示两个城市间备选光缆的铺设费用。
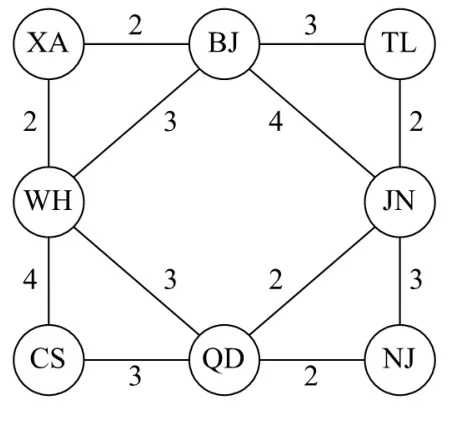
题 42 图
请回答下列问题。
(1) 仅从铺设费用角度出发,给出所有可能的最经济的光缆铺设方案(用带权图表示),并计算相应方案的总费用。(8 分)
(2) 题 42 图可采用图的哪一种存储结构?给出求解问题 (1) 所使用的算法名称。(2 分)
(3) 假设每个城市采用一个路由器按 (1) 中得到的最经济方案组网,主机 H1 直接连接在 TL 的路由器上,主机 H2 直接连接在 BJ 的路由器上。若 H1 向 H2 发送一个 TTL = 5 的 IP 分组,则 H2 是否可以收到该 IP 分组?(2 分)
解析
【官方答案】
(1) 最经济的光缆铺设方案可以抽象为求最小生成树的问题。根据题图可以求得两种最经济的光缆建设方案,如下所示。(7 分,每条边 0.5 分)
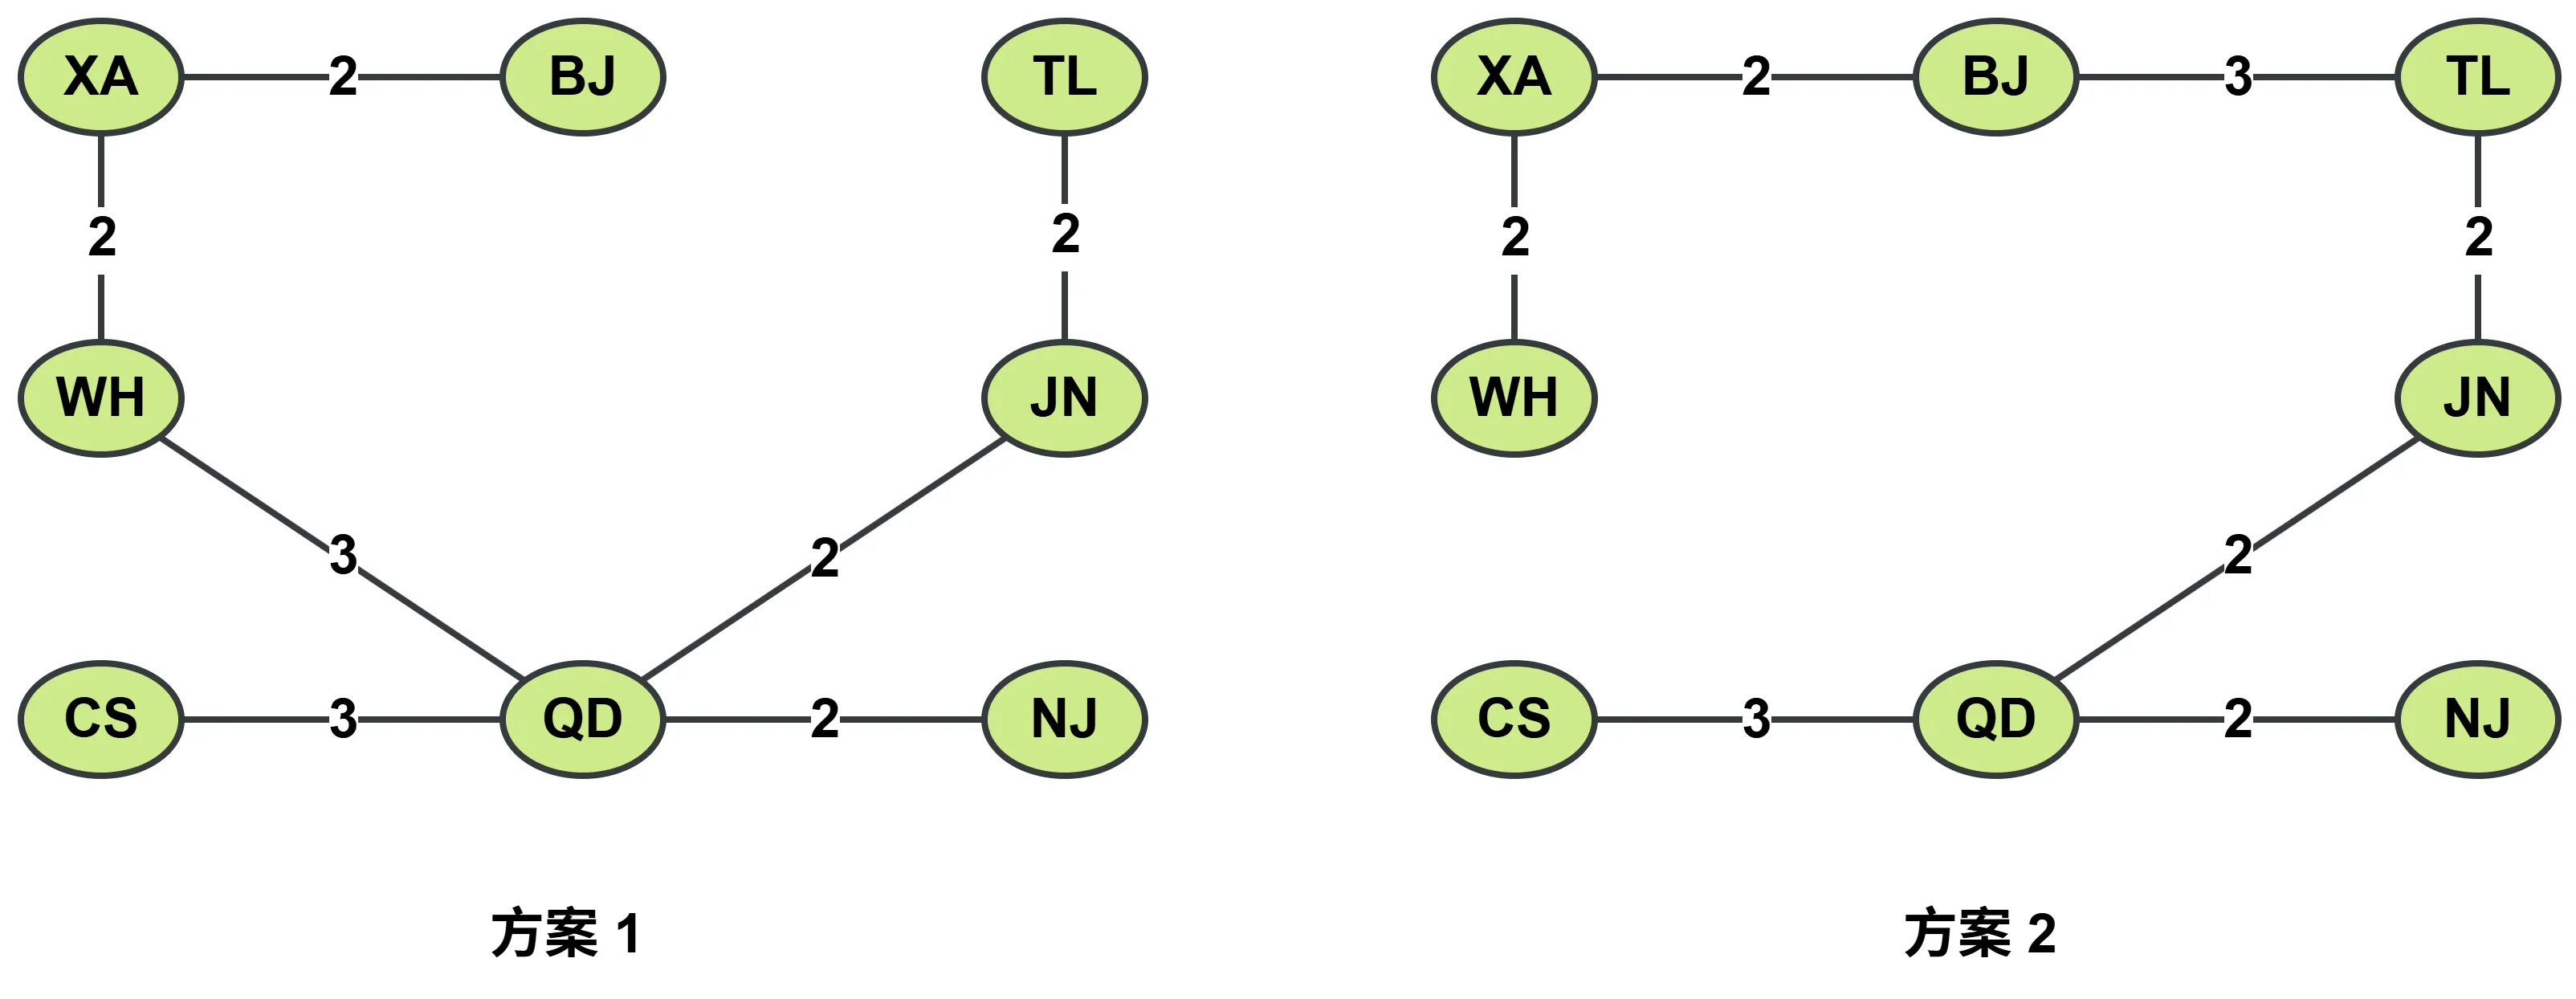
方案的总费用为 16。(1 分)
(2) 可采用邻接矩阵保存题 42 图。(1 分)可使用 Prim 算法求解。(1 分)
(3) 使用方案 1:H2 不能收到该 IP 分组;(1 分)使用方案 2:H2 可以收到该 IP 分组。(1 分)
【2021-41】
(15分)已知无向连通图G由顶点集V和边集E组成,|E| > 0,当G中度为奇数的顶点个数为不大于2的偶数时,G存在包含所有边且长度为|E|的路径(称为EL路径)。设图G采用邻接矩阵存储,类型定义如下:
typedef struct {                    // 图的定义
    int numVertices, numEdges;      // 图中实际的顶点数和边数
    char VerticesList[MAXV];        // 顶点表,MAXV为已定义常量
    int Edge[MAXV][MAXV];           // 邻接矩阵
}MGraph;
请设计算法int IsExistEL(MGraph G),判断G是否存在EL路径,若存在,则返回1 ,否则返回0。要求:
⑴ 给出算法的基本设计思想。
⑵ 根据设计思想,采用C或C++语言描述算法,关键之处给出注释。
⑶ 说明你所设计算法的时间复杂度和空间复杂度。
解析
【官方答案】
(1) 算法的基本设计思想(4 分)
对于采用邻接矩阵存储的无向图,邻接矩阵每一行(列)中非零元素的个数为本行(列)对应顶点的度。可以依次计算连通图 G 中各顶点的度,并记录度为奇数的顶点个数,若个数为 0 或 2,则返回 1,否则返回 0。
(2) 算法实现(9 分)
int IsExistEL(MGraph G) {  // 采用邻接矩阵存储,判断图是否存在 EL 路径
    int degree, i, j, count = 0;
    for (i = 0; i < G.numVertices; i++) {
        degree = 0;
        for (j = 0; j < G.numVertices; j++)  // 依次计算各个顶点的度
            degree += G.Edge[i][j];
            if (degree % 2 != 0)
                count++;   // 对度为奇数的顶点计数
    }
    if (count == 0 || count == 2)
        return 1;  // 存在 EL 路径,返回 1
    else
        return 0;  // 不存在 EL 路径,返回 0
}
(3) 算法的时间复杂度和空间复杂度
本参考答案给出的算法的时间复杂度是 ,(1 分)空间复杂度是 。(1 分)
【2023-41】
(13分)已知有向图 G 采用邻接矩阵存储,类型定义如下:
typedef struct {                    // 图的类型定义
     int numVertices, numEdges;      // 图中顶点数和有向边数
     char VerticesList[MAXV];        // 顶点表,MAXV为已定义常量
     int Edge[MAXV][MAXV];           // 邻接矩阵
 }MGraph;
将图中出度大于入度的顶点称为 K 顶点。例如在题41图中,顶点 a 和 b 都是 K 顶点。
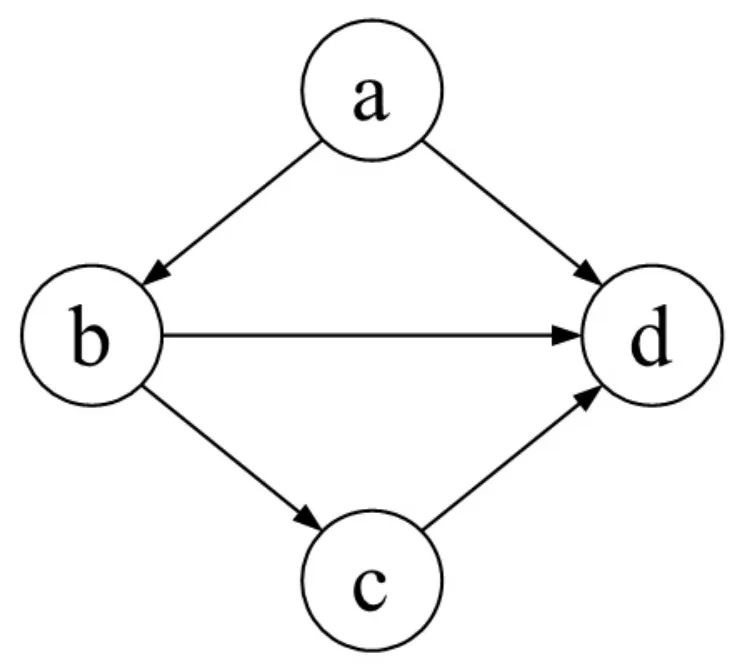
请设计算法: int printVertices(MGraph G),对给定的任意非空有向图 G,输出 G 中所有 K 顶点,并返回 K 顶点的个数。要求:
⑴ 给出算法的基本设计思想。
⑵ 根据设计思想,采用C或C++语言描述算法,关键之处给出注释。
解析
【官方答案】
(1) 算法的基本设计思想(4 分)
采用邻接矩阵表示有向图时,一行中 1 的个数为该行对应顶点的出度,一列中 1 的个数为该列对应顶点的入度。使用一个初值为 0 的计数器记录 K 顶点的个数。对图 G 的每个顶点,根据邻接矩阵计算其出度 outdegree 和入度 indegree。若 outdegree - indegree > 0,则输出该顶点且计数器加 1。最后返回计数器的值。
(2) 用 C 语言描述的算法(9 分)
int printVertices(MGraph G) {  // 采用邻接矩阵存储,输出K顶点,返回个数
    int indegree, outdegree, k, m, count = 0;
    for(k = 0; k < G.numVertices; k++) {
        indegree = outdegree = 0;
        for (m = 0; m < G.numVertices; m++)  // 计算顶点的出度
            outdegree += G.Edge[k][m];
        for (m = 0; m < G.numVertices; m++)  // 计算顶点的入度
            indegree += G.Edge[m][k];
        if (outdegree> indegree) {
            printf("%c", G.VerticesList[k]) ;
            count++;
        }
    }
    return count;   // 返回K顶点的个数
}【2009-41】
(10分)带权图(权值非负,表示边连接的两顶点间的距离)的最短路径问题是找出从初始顶点到目标顶点之间的一条最短路径。假定从初始顶点到目标顶点之间存在路径,现有一种解决该问题的方法:
① 设最短路径初始时仅包含初始顶点,令当前顶点 u 为初始顶点;
② 选择离 u 最近且尚未在最短路径中的一个顶点 v ,加入到最短路径中,修改当前顶点 u=v ;
③ 重复步骤②,直到 u 是目标顶点时为止。
请问上述方法能否求得最短路径?若该方法可行,请证明之;否则,请举例说明。
解析
【官方答案】
该方法不一定能(或不能)求得最短路径。
举例说明如下:
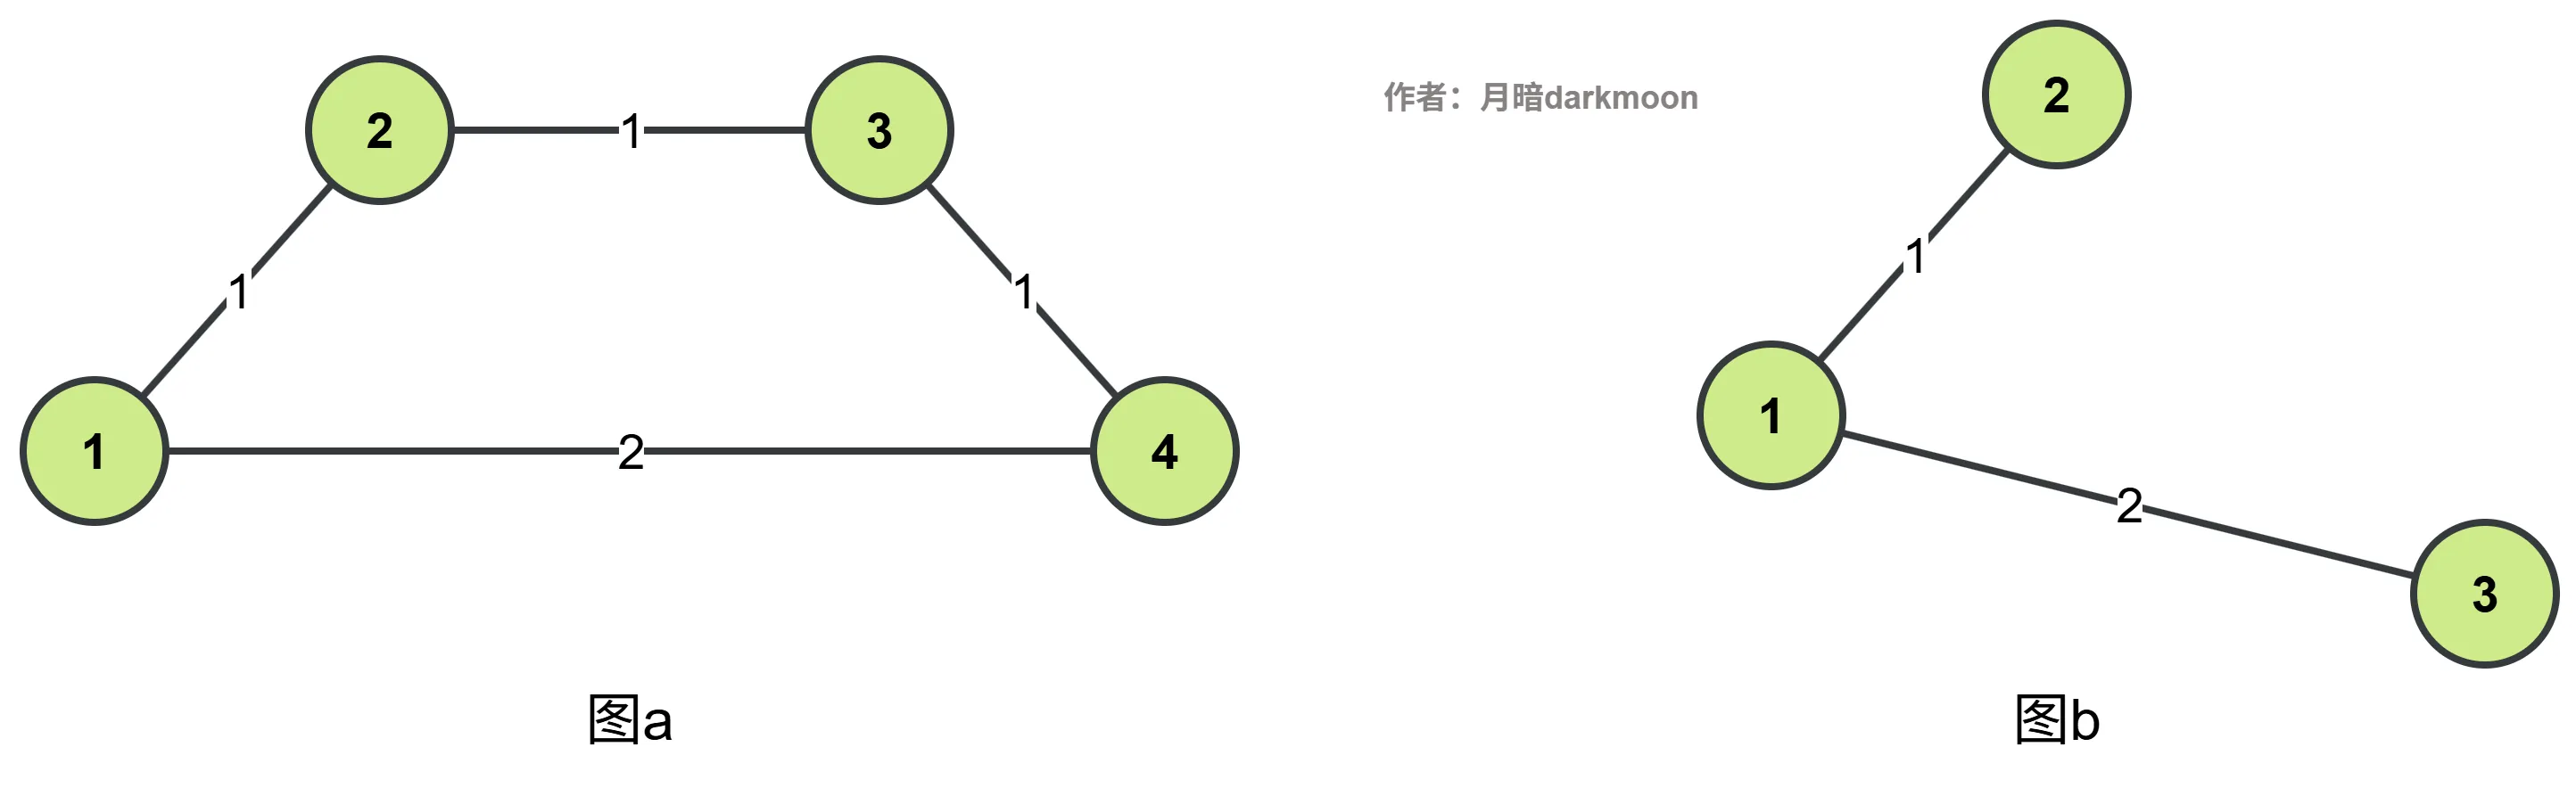
图 a 中,设初始顶点为 1,目标顶点为 4,欲求从顶点 1 到顶点 4 之间的最短路径。显然,这两点之间的最短路径长度为 2。但利用给定方法求得的路径长度为 3,因此这条路径并不是这两点之间的最短路径。
图 b 中,设初始顶点为 1,目标顶点为 3,欲求从顶点 1 到顶点 3 之间的最短路径。利用给定的方法,无法求出顶点 1 到顶点 3 的路径。
【2014-42】
(10分)某网络中的路由器运行OSPF路由协议,题42表是路由器R1维护的主要链路状态信息(LSI),题42图是根据题42表的接口名构造出来的网络拓扑。
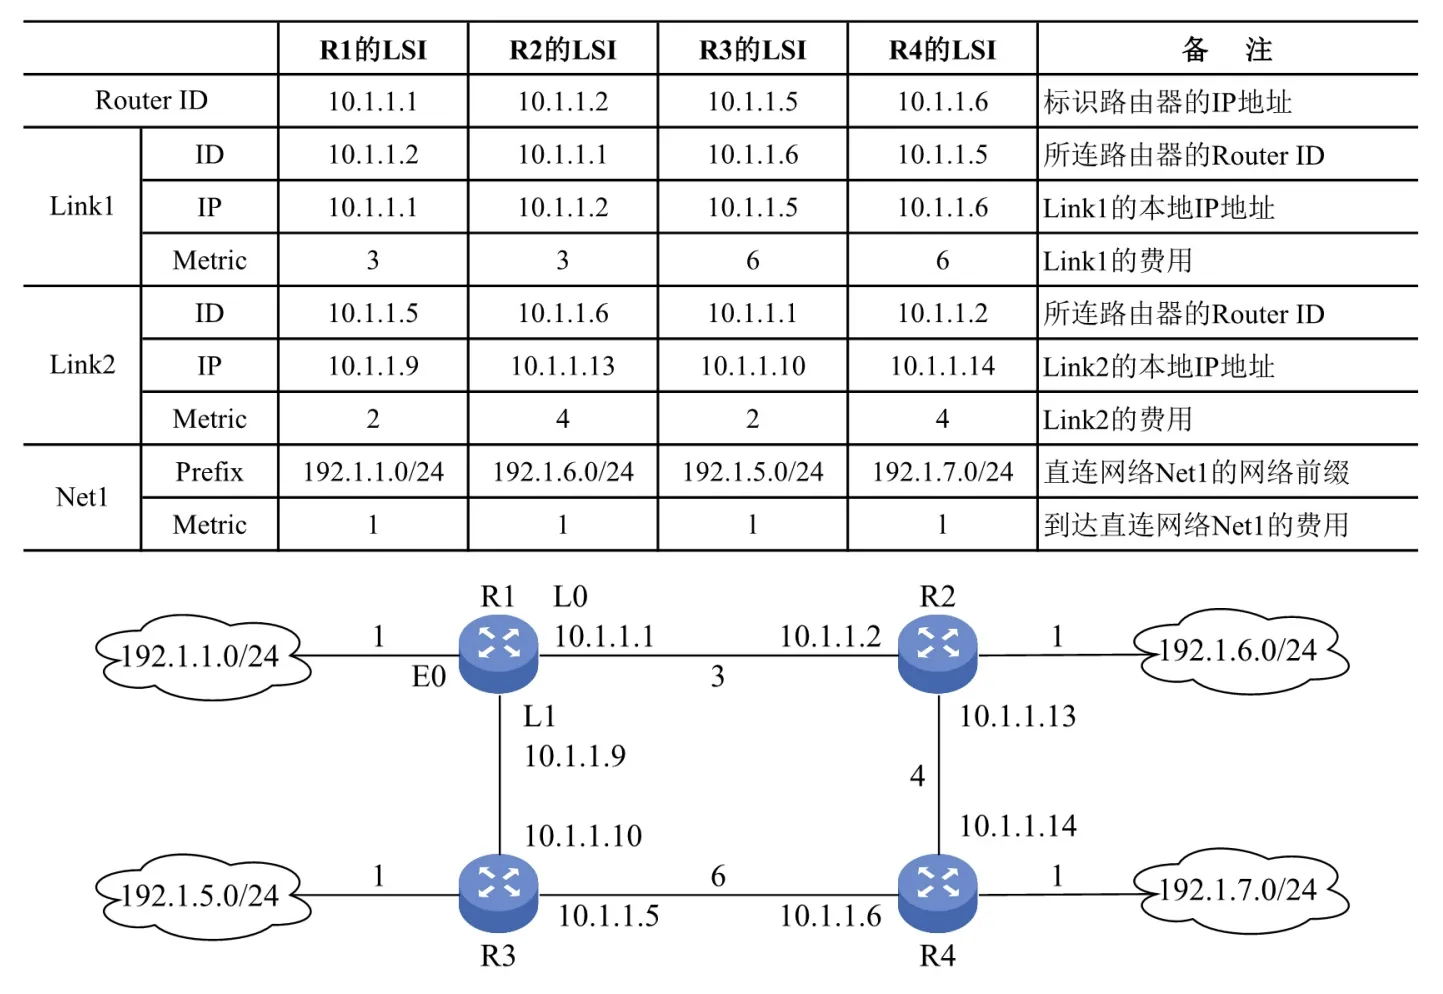
请回答下列问题。
⑴ 本题中的网络可抽象为数据结构中的哪种结构?
⑵ 针对题42表中的内容,设计合理的链式存储结构,以保存题42表中的链路状态信息(LSI)。要求给出链式存储结构的数据定义,并画出对应题42表的链式存储结构示意图(示意图中仅以ID标识结点)。
⑶ 按照迪杰斯特拉(Dijkstra)算法的策略,依次给出R1到达题42图中子网192.1.x.x的最短路径及费用。
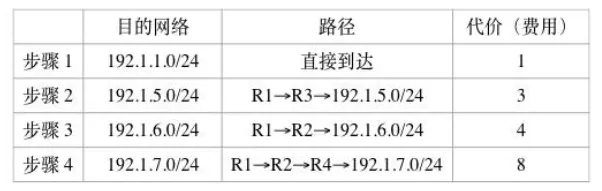
解析
1)图(1 分)
题中给出的是一个简单的网络拓扑图,可以抽象为无向图。
【评分说明】只要考生的答案中给出与图含义相似的描述,例如,“网状结构”“非线性结构”等,同样 给分。
2)链式存储结构的如下所示。
struct Arc {
  uint32_t id;
  uint32_t ip;
  int metric;
};

struct Net {
uint32_t prefix;
uint32_t mask;
int metric;
};

struct LNode {
LNode \*next;
// flag == 1:链路连接到路由器
// flag == 2:链路连接到子网
int flag;
union NetOrArc {
Net net;
Arc arc;
};
};

struct HNode {
uint32_t router_id;
LNode \*next;
HNode \*next_hnode;
};
【评分说明】
① 若考生给出的答案是将链表中的表头结点保存在一个一维数组中(即采用邻接表形 式),同样给分。
② 若考生给出的答案中,弧结点没有使用 union 定义,而是采用两种不同的结构分别表示 Link 和 Net,同时在表头结点中定义了两个指针,分别指向由这两种类型的结点构成的两个链 表,同样给分。
③考生所给答案的弧结点中,可以在单独定义的域中保存各直连网络 P 地址的前缀长度, 也可以与网络地址保存在同一个域中。
④数据类型定义中,只要采用了可行的链式存储结构,并保存了题目中所给的 LS 信息, 如将网络抽象为一类结点,写出含 8 个表头结点的链式存储结构,均可参照①③的标准给分。
⑤若考生给出的答案中,图示部分与其数据类型定义部分一致,图示只要能够体现链式 存储结构和网络连接关系(可以不给出结点内细节信息),即可给分。
⑥若解答不完全正确,酌情给分。
3)计算结果如下表所示:
【评分说明】
①若考生给出的各条最短路径的结果部分正确,可酌情给分。
②若考生给出的从 R1 到达子网 192.1.x.x 的最短路径及代价正确,但不完全符合代价不减 的次序,可酌情给分。
【2024-41】
(本题 13 分)2023 年 10 月 26 日,神舟十七号载人飞船发射取得圆满成功,再次彰显了中国航天事业的辉煌成就。载人航天工程是包含众多子工程的复杂系统工程,为了保证工程的有序展开,需要明确各子工程的前导子工程,以协调各子工程的实施。该问题可以简化、抽象为有向图的拓扑序列问题。已知有向图G采用邻接矩阵存储,类型定义如下:
typedef struct {                    // 图的类型定义
     int numVertices, numEdges;      // 图的顶点数和有向边数
     char VerticesList[MAXV];        // 顶点表,MAXV为已定义常量
     int Edge[MAXV][MAXV];           // 邻接矩阵
 } MGraph;
请设计算法:int uniquely(MGraph G),判定G是否存在唯一的拓扑序列。若是,则返回1,否则返回0。
要求如下。
(1) 给出算法的基本设计思想。(4 分)
(2) 根据设计思想,采用C或C++语言描述算法,关键之处给出注释。(9 分)
解析
【官方答案】
(1) 算法的基本设计思想(4 分)
建立图 G 各顶点的入度表 degree[]。选择入度为 0 的顶点 v,将 v 的所有邻接点的入度减 1,重复执行这个过程。若每次选中的入度为 0 的顶点有且仅有一个,且共进行了 G.numVertices 次,则意味着存在唯一的拓扑序列,返回 1,否则不存在拓扑序列,或存在多个拓扑序列,返回 0。
(2) 用 C 语言描述的算法(9 分)
int uniquely(MGraph G) {  // 判定有向图是否存在唯一的拓扑序列
    int *degree, i, j, count = 0, in0 = -1, prev_in0;
    degree = (int *)malloc(G.numVertices * sizeof(int));
    for (j = 0; j < G.numVertices; j++) { // 计算各顶点的入度
        degree[j] = 0;
        for (i = 0; i < G.numVertices; i++)
            degree[j] += G.Edge[i][j];
        if (degree[j] == 0) {
            if (in0 == -1) in0 = j; // 入度为0的顶点
            else in0 = -2;  // 有多个入度为0的顶点
        }
    }
    while (in0 >= 0) {
        count++;
        prev_in0 = in0;
        in0 = -1;
        for(j = 0; j < G.numVertices; j++)
            if (G.Edge[prev_in0][j] > 0) {
                if (--degree[j] == 0) { // 邻接点入度值减1
                    if (in0 == -1) in0 = j; // 入度为0的顶点
                    else in0 = -2;  // 有多个入度为0的顶点
                }
            }
    }
    free(degree);
    if (count == G.numVertices) return 1;
    else return 0;
}【2011-41】
(8分)已知有6个顶点(顶点编号为0~5)的有向带权图 G ,其邻接矩阵 A 为上三角矩阵,按行为主序(行优先)保存在如下的一维数组中。

要求:
⑴ 写出图 G 的邻接矩阵 A 。
⑵ 画出有向带权图 G 。
⑶ 求图 G 的关键路径,并计算该关键路径的长度。
解析
【官方答案】
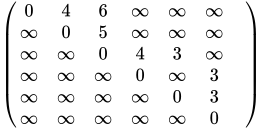
(1) 图G 的邻接矩阵 A 如下:(2 分)
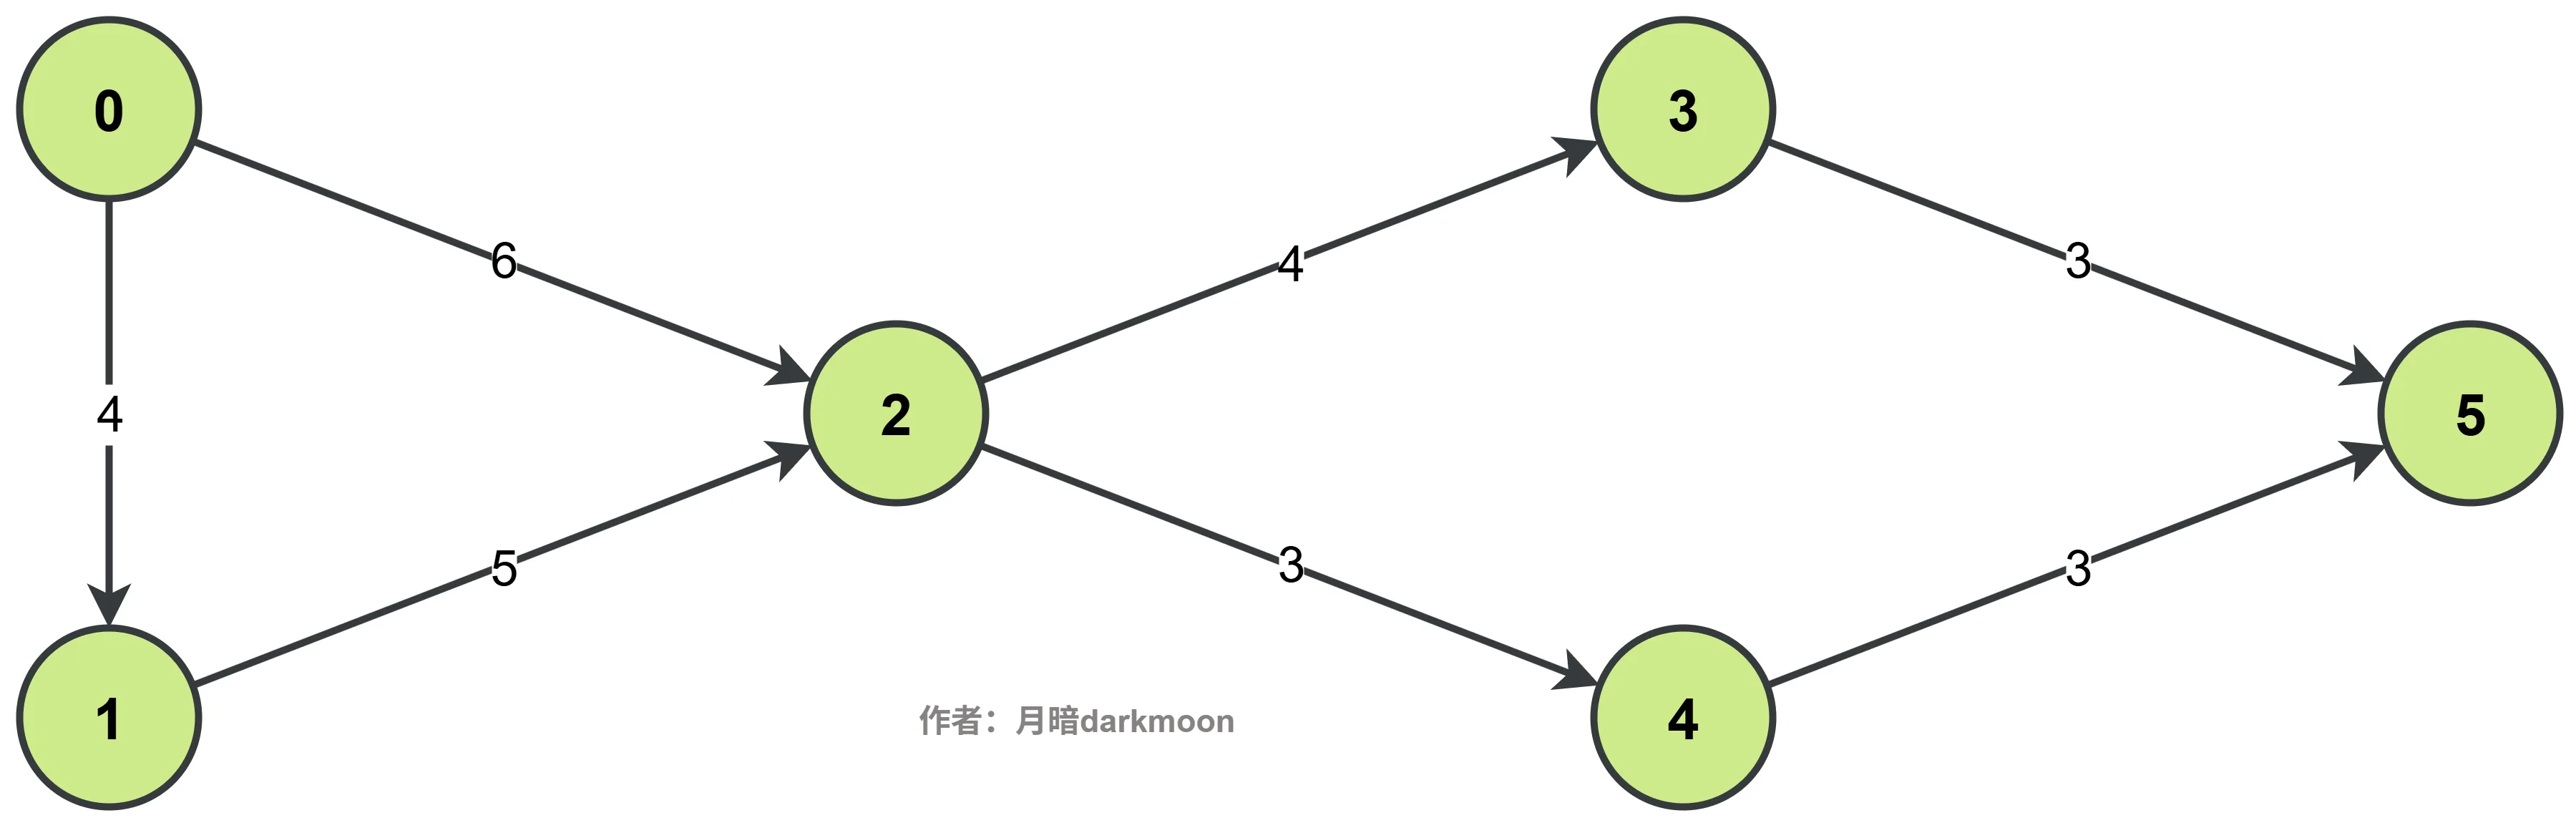
(2) 图 G 如下:(2 分)
(3) 下图粗线条所标识的 4 个活动组成 图 G 的关键路径。(3 分)
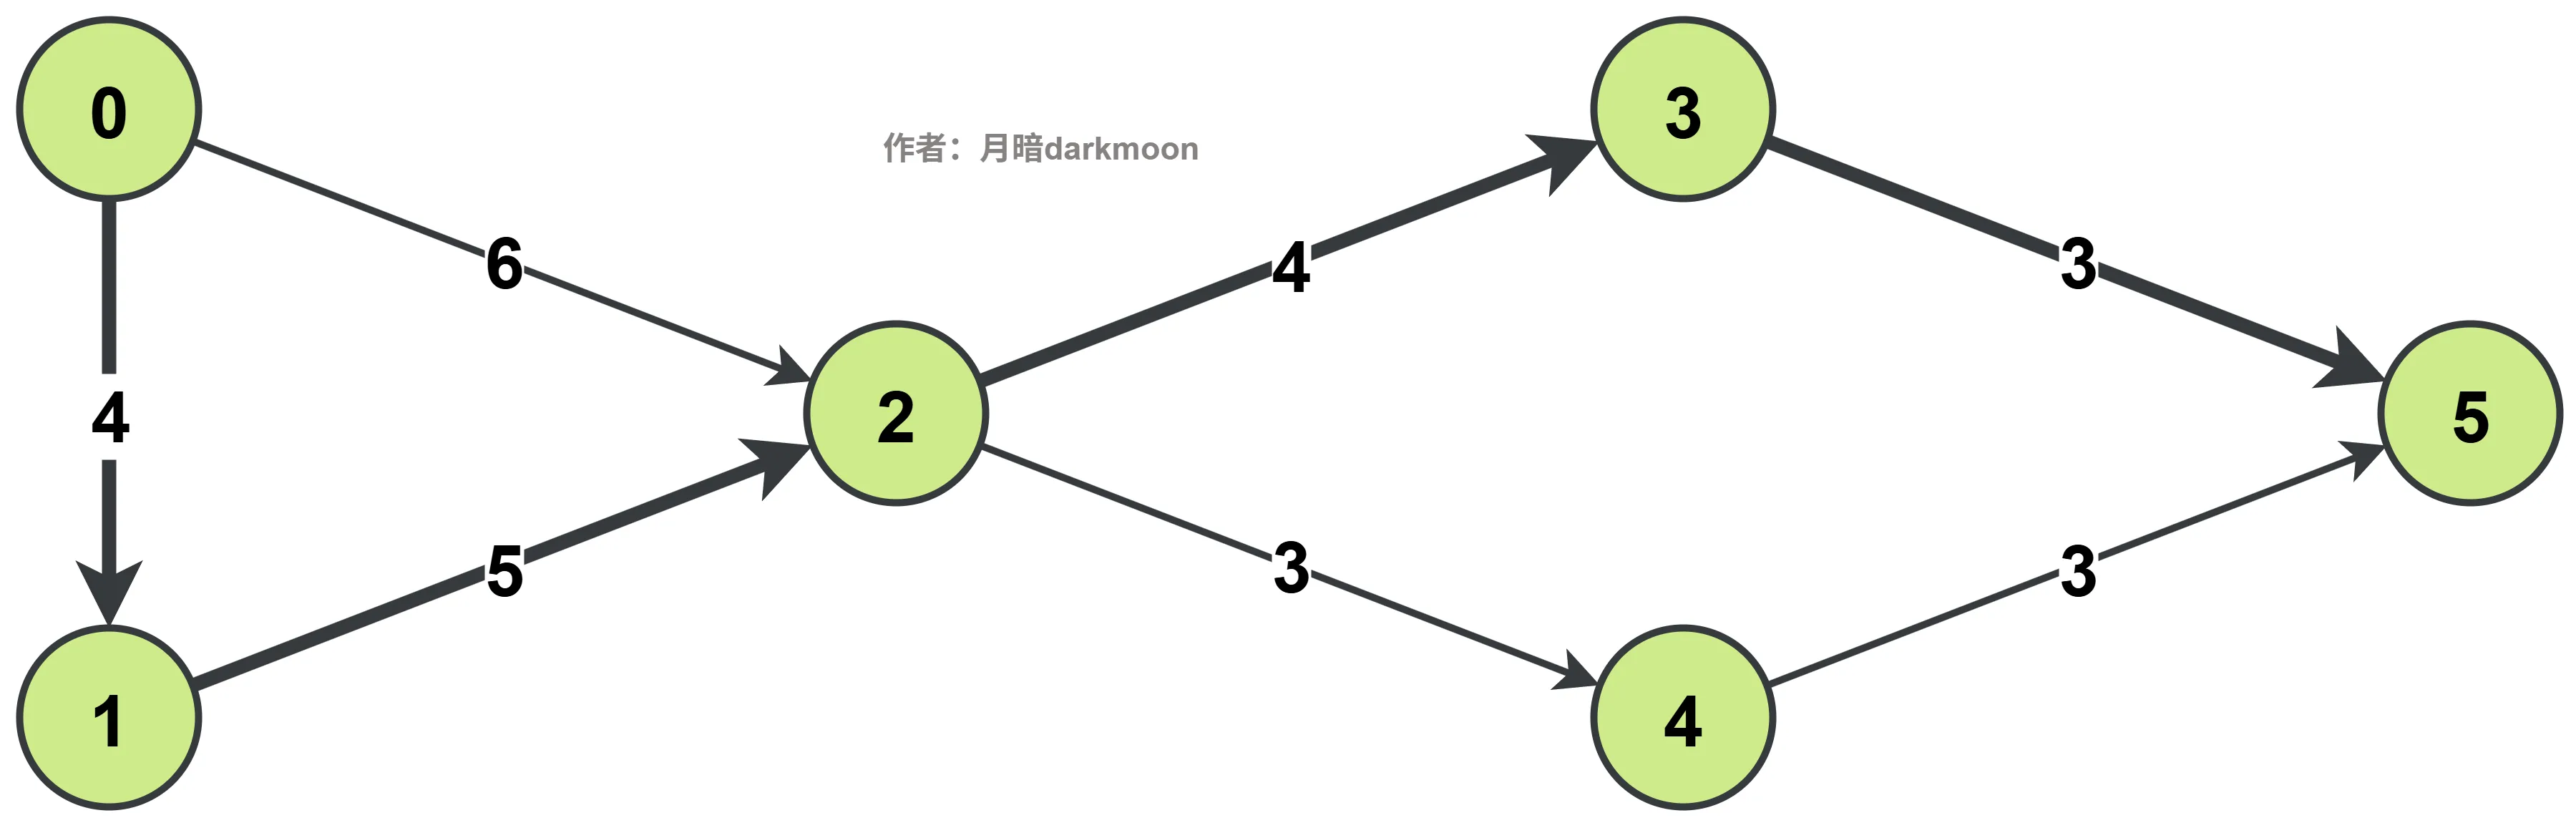
图 G 的关键路径长度为 16。(1 分)
查找
【2013-42】
(10分)设包含 4 个数据元素的集合 S={“do”, “for”, “repeat”, “while”},各元素的查找概率依次为: \(p_1=0.35,p_2=0.15,p_3=0.15,p_4=0.35\) 。将 S 保存在一个长度为 4 的顺序表中,采用折半查找法,查找成功时的平均查找长度为 2.2 。请回答:
⑴ 若采用顺序存储结构保存 S ,且要求平均查找长度更短,则元素应如何排列?应使用何种查找方法?查找成功时的平均查找长度是多少?
⑵ 若采用链式存储结构保存 S ,且要求平均查找长度更短,则元素应如何排列?应使用何种查找方法?查找成功时的平均查找长度是多少?
解析
【官方答案】
(1) 采用顺序存储结构,数据元素按照其查找概率降序排列。(2 分)
采用顺序查找方法。(1 分)
查找成功时的平均查找长度 = 0.35×1 + 0.35×2 + 0.15×3 + 0.15×4 = 2.1。(2 分)
(2) 【答案一】
采用链式存储结构,数据元素按其查找概率降序排列,构成单链表。(2 分)
采用顺序查找方法。(1 分)
查找成功时的平均查找长度 = 0.35×1 + 0.35×2 + 0.15×3 + 0.15×4 = 2.1。(2 分)
【答案二】
采用二叉链表的存储结构,构造二叉排序树,元素的存储方式见下图。(2 分)
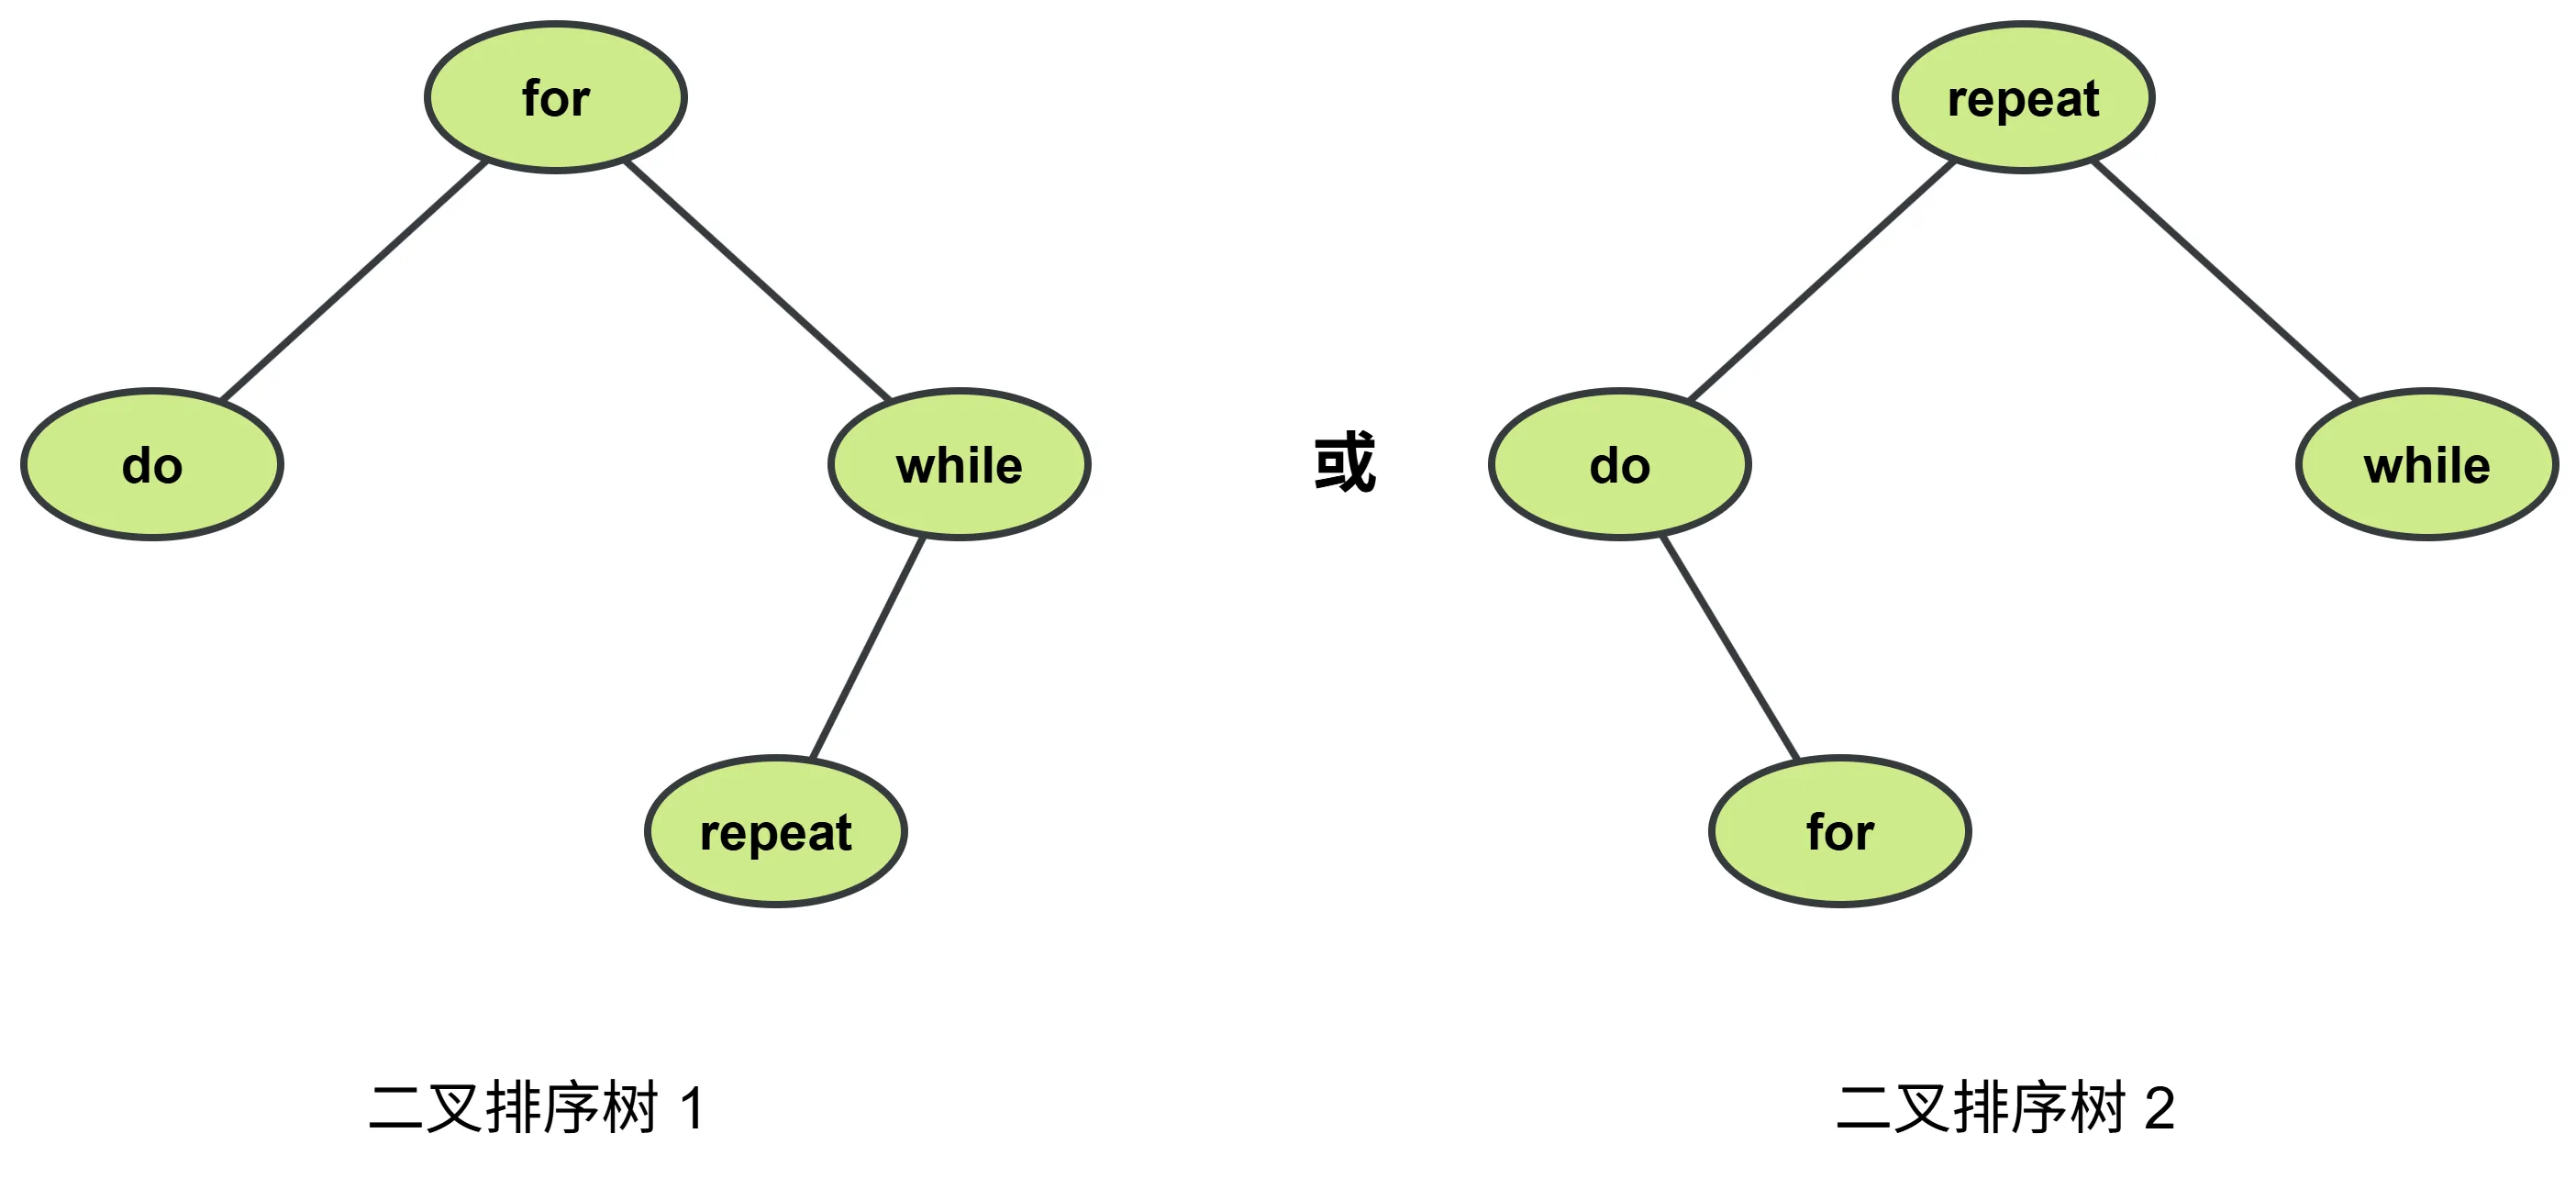
采用二叉排序树的查找方法。(1 分)
查找成功时的平均查找长度 = 0.15×1 + 0.35×2 + 0.35×2 + 0.15×3 = 2.0。(2 分)
【评分说明】
(1)、(2) ① 若考生以实际元素表示''降序排列'',同样给分。
② 若考生正确求出与其查找方法对应的查找成功时的平均查找长度,给 2 分;若计算过程正确,但结果错误,给 1 分。
③ 考生给出其他更高效的查找方法且正确,可参照评分标准给分。
【2022-41】
(13分)已知非空二叉树T的结点值均为正数,采用顺序存储方式保存,数据结构定义如下:
typedef struct {                    // MAX_SIZE为已定义常量
     Elemtype SqBiTNode[MAX_SIZE];   // 保存二叉树结点值的数组
     int ElemNum;                    // 实际占用的数组元素个数
 }SqBiTree;
T中不存在的结点在数组SqBiTNode中用-1表示。例如,对于下图所示的两棵非空二叉树T1和T2:
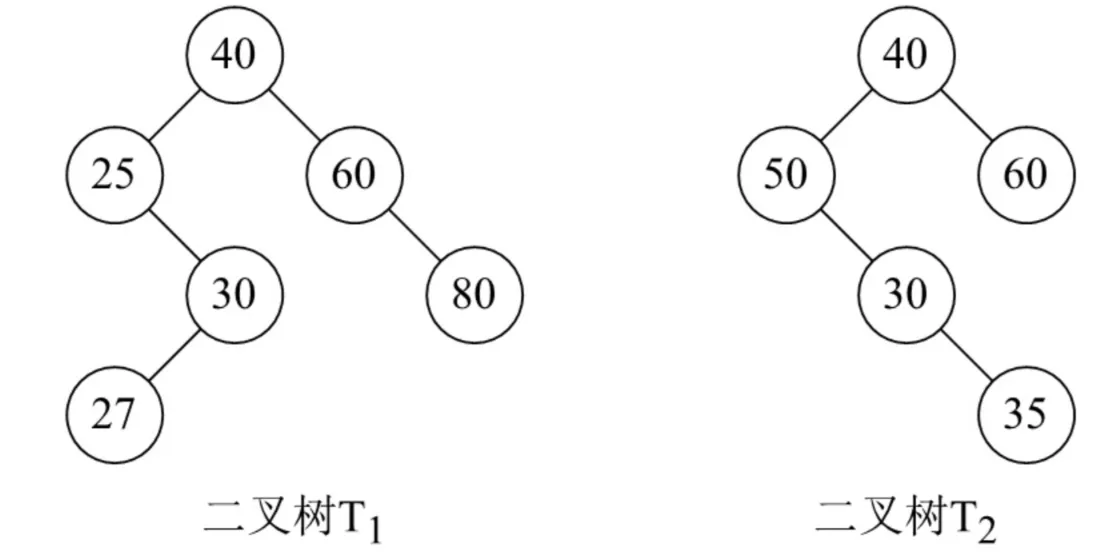
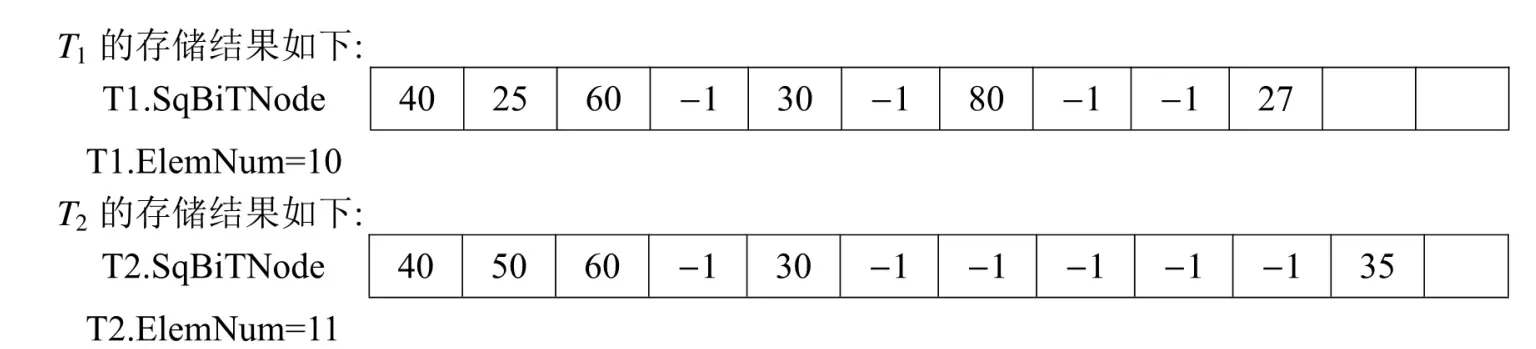
请设计一个尽可能高效的算法,判定一棵采用这种方式存储的二叉树是否为二叉搜索树,若是,则返回true,否则,返回false,要求:
⑴ 给出算法的基本设计思想。
⑵ 根据设计思想,采用C或C++语言描述算法,关键之处给出注释。
解析
【官方答案】
(1) 算法的基本设计思想
对于采用顺序存储方式保存的二叉树,根结点保存在 SqBiTNode[0] 中;当某结点保存在 SqBiTNode[i] 中时,若有左孩子,则其值保存在 SqBiTNode[2i+1] 中;若有右孩子,则其值保存在 SqBiTNode[2i+2] 中;若有双亲结点,则其值保存在 SqBiTNode[(i-1)/2] 中。
二叉搜索树需要满足的条件是:任一结点值大于其左子树中的全部结点值,小于其右子树中的全部结点值。中序遍历二叉搜索树得到一个升序序列。
使用整型变量 val 记录中序遍历过程中已遍历结点的最大值,初值为一个非正整数。若当前遍历的结点值小于等于 val,则算法返回 false,否则,将 val 的值更新为当前结点的值。
(2) 算法实现
#define false 0
#define true 1
typedef int bool;
bool judgeInOrderBST(SqBiTree bt, int k, int *val) {  // 初始调用时 k 的值是 0
    if (k < bt.ElemNum && bt.SqBiTNode[k] != -1) {
        if (!judgeInOrderBST(bt, 2 * k + 1, val)) return false;
        if (bt.SqBiTNode[k] <= *val) return false;
        *val = bt.SqBiTNode[k];
        if (!judgeInOrderBST(bt, 2 * k + 2, val)) return false;
    }
    return true;
}

bool judgeBST(SqBiTree bt) {
// 从根结点开始递归,初始调用时 k 的值是 0
int val = 0;
return judgeInOrderBST(bt, 0, \&val);
}【2024-42】
(本题 10 分)将关键字数列 20, 3, 11, 18, 9, 14, 7 依次存储到初始值为空、长度为11的散列表HT中,散列函数 H(key)=(key×3)%11 , H(key) 计算出的初始散列地址为 \(H_0\) ,发生冲突时探查地址序列是 \(H_1,H_2,H_3,…\) ,其中, \(H_k=(H_0+k^2)\%11\) , k=1,2,3,… 。
请回答下列问题。
(1) 画出所构造的HT,并计算HT的填装因子。(6 分)
(2) 给出在HT中查找关键字14的关键字比较序列。
(3) 在HT中查找关键字8,确认查找失败时散列地址是多少?
解析
【官方答案】
(1) HT 如下:(5 分)
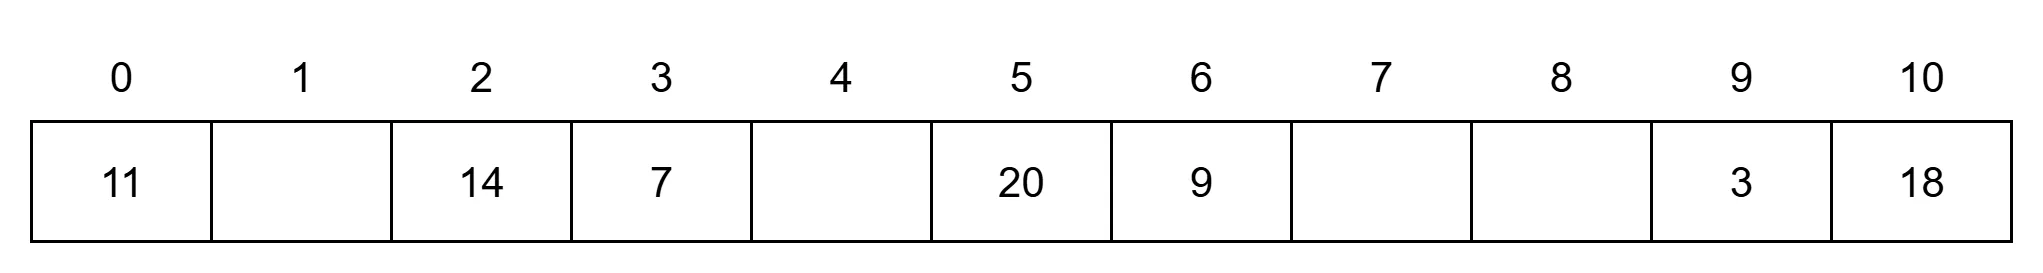
装填因子 。(1 分)
(2) 查找关键字 14 的关键字比较序列:3, 8, 14。 (2 分)
(3) 查找关键字 8,确认查找失败时散列地址是 7。(2 分)
【2010-41】
(10分)将关键字序列 \(⟨7,8,30,11,18,9,14⟩\)散列存储到散列表中。散列表的存储空间是一个下标从 0 开始的一维数组,散列函数为 \(H(key)=(key×3)\ mod\ 7\),处理冲突采用线性探测再散列法,要求装填(载)因子为 0.7 。
⑴ 请画出所构造的散列表。
⑵ 分别计算等概率情况下查找成功和查找不成功的平均查找长度。
解析
【官方答案】
(1) 构造的散列表如下:
(2) 查找成功的平均查找长度: 。
查找不成功的平均查找长度: 。
排序
【2016-43】
(15分)已知由 n(n≥2) 个正整数构成的集合 \(A={a_k|0≤k\<n}\),将其划分为两个不相交的子集 A1 和 A2 ,元素个数分别是 n1 和 n2 , A1 和 A2 中元素之和分别为 S1 和 S2 。设计一个尽可能高效的划分算法,满足 |n1−n2| 最小且 |S1−S2| 最大。要求:
⑴ 给出算法的基本设计思想。
⑵ 根据设计思想,采用C或C++语言描述算法,关键之处给出注释。
⑶ 说明你所设计算法的时间复杂度和空间复杂度。
【官方答案】 (1) 算法的基本设计思想(4 分) 由题意知,将最小的 ① 若 ② 若 ③ 若 基于该设计思想实现的算法,毋须对全部元素进行全排序,其平均时间复杂度是O(n) ,空间复杂度是O(1) 。 (2) 算法实现(9 分) (3) 算法的平均时间复杂度和空间复杂度(2 分) 本参考答案给出的算法平均时间复杂度是 【评分说明】 (1) (2) 本题目只需将最大的一半元素与最小的一半元素分组,不需要对所有元素进行全部排序。参考答案基于快速排序思想,采用非递归的方式实现。若考生设计的算法满足题目的功能要求且正确,则 (1)、(2) 根据所实现算法的平均时间复杂度给分,细则见下表。 ② 若在算法的基本设计思想描述中因文字表达没有清晰反映出算法思路,但在算法实现中能够表达出算法思想且正确的,可参照 ① 的标准给分。 ③ 若算法的基本设计思想描述或算法实现中部分正确,可参照 ① 中各种情况的相应给分标准酌情给分。 ④ 参考答案中只给出了使用 C 语言的版本,使用 C++ 语言的答案视同使用 C 语言。 (3) 若考生所估计的平均时间复杂度和空间复杂度与考生所实现的算法一致,可各给 1 分。解析
 个元素放在
 中,其余的元素放在
 中,分组结果即可满足题目要求。仿照快速排序的思想,基于枢轴将 个整数划分为两个子集。根据划分后枢轴所处的位置 i 分别处理:
 ,则分组完成,算法结束;
 ,则枢轴及之前的所有元素均属于 ,继续对 i 之后的元素进行划分;
 ,则枢轴及之后的所有元素均属于 ,继续对 i 之前的元素进行划分;
int setPartition(int a[], int n) {
    int pivotkey, low = 0, low0 = 0, high = n - 1, high0 = n - 1, flag = 1, k = n / 2, i;
    int s1 = 0, s2 = 0;
    while (flag) {
        pivotkey = a[low];  // 选择枢轴
        while (low < high) {  // 基于枢轴对数据进行划分
            while (low < high && a[high] >= pivotkey) --high;
            if (low != high) a[low] = a[high];
            while (low < high && a[low] <= pivotkey) ++low;
            if (low != high) a[high] = a[low];
        }  // end of while (low < high)
        a[low]=pivotkey;
        if (low == k - 1) {  // 如果枢轴是第 n/2 小元素,划分成功
            flag = 0;
        } else {  // 否则继续划分
            if (low < k - 1) {
                low0 = ++low;
                high = high0;
            } else {
                high0 = --high;
                low = low0;
            }
        }
    }
    for (i = 0; i < k; i++) s1 += a[i];
    for (i = k; i < n; i++) s2 += a[i];
    return s2 - s1;
} ,空间复杂度是
 。
【2022-42】
(10分)现有 n(n>100000) 个数保存在一维数组 M 中,需要查找 M 中最小的10个数,请回答下列问题。
⑴ 设计一个完成上述查找任务的算法,要求平均情况下的比较次数尽可能少,简单描述其算法思想,不需要程序实现。
⑵ 说明你所设计的算法平均情况下的时间复杂度和空间复杂度。
解析
【官方答案】
(1) 算法思想(6 分)
【答案一】
定义含 10 个元素的数组 A,元素值均为该数组类型能表示的最大数 MAX。
for  M 中的每个元素 s
     if (s < A[9])  丢弃 A[9] 并将 s 按升序插入 A 中;
当数据全部扫描完毕,数组 A 中保存的就是最小的 10 个数。
【答案二】
定义含 10 个元素的大根堆 H,元素值均为该堆元素类型能表示的最大数 MAX。
for  M 中的每个元素 s
     if (s < H 的堆顶元素)  删除堆顶元素并将 s 插入 H 中;
当数据全部扫描完毕,堆 H 中保存的就是最小的 10 个数。
(2) 算法平均情况下的时间复杂度是 O(n) ,(2 分)空间复杂度是O(1) 。(2 分)
【2023-42】
(10分)对含有 n(n>0) 个记录的文件进行外部排序,采用置换-选择排序生成初始归并段时需要使用一个工作区,工作区中能保存 m 个记录,请回答下列问题。
⑴ 若文件中含有 19 个记录,其关键字是 51, 94, 37, 92, 14, 63, 15, 99, 48, 56, 23, 60, 31, 17, 43, 8, 90, 166, 100;当 m=4 时,可以生成几个初始归并段?各是什么?
⑵ 对任意的 m(n≫m>0) ,生成的第一个初始归并段的长度最大值和最小值分别是多少?
解析
【官方答案】
(1) 可生成 3 个初始归并段,(1 分)分别是:
37, 51, 63, 92, 94, 99(2 分)
14, 15, 23, 31, 48, 56, 60, 90, 166(2 分)
8, 17, 43, 100(2 分)
(2) 最大值为 n ,(1 分)最小值为 m 。(1 分)
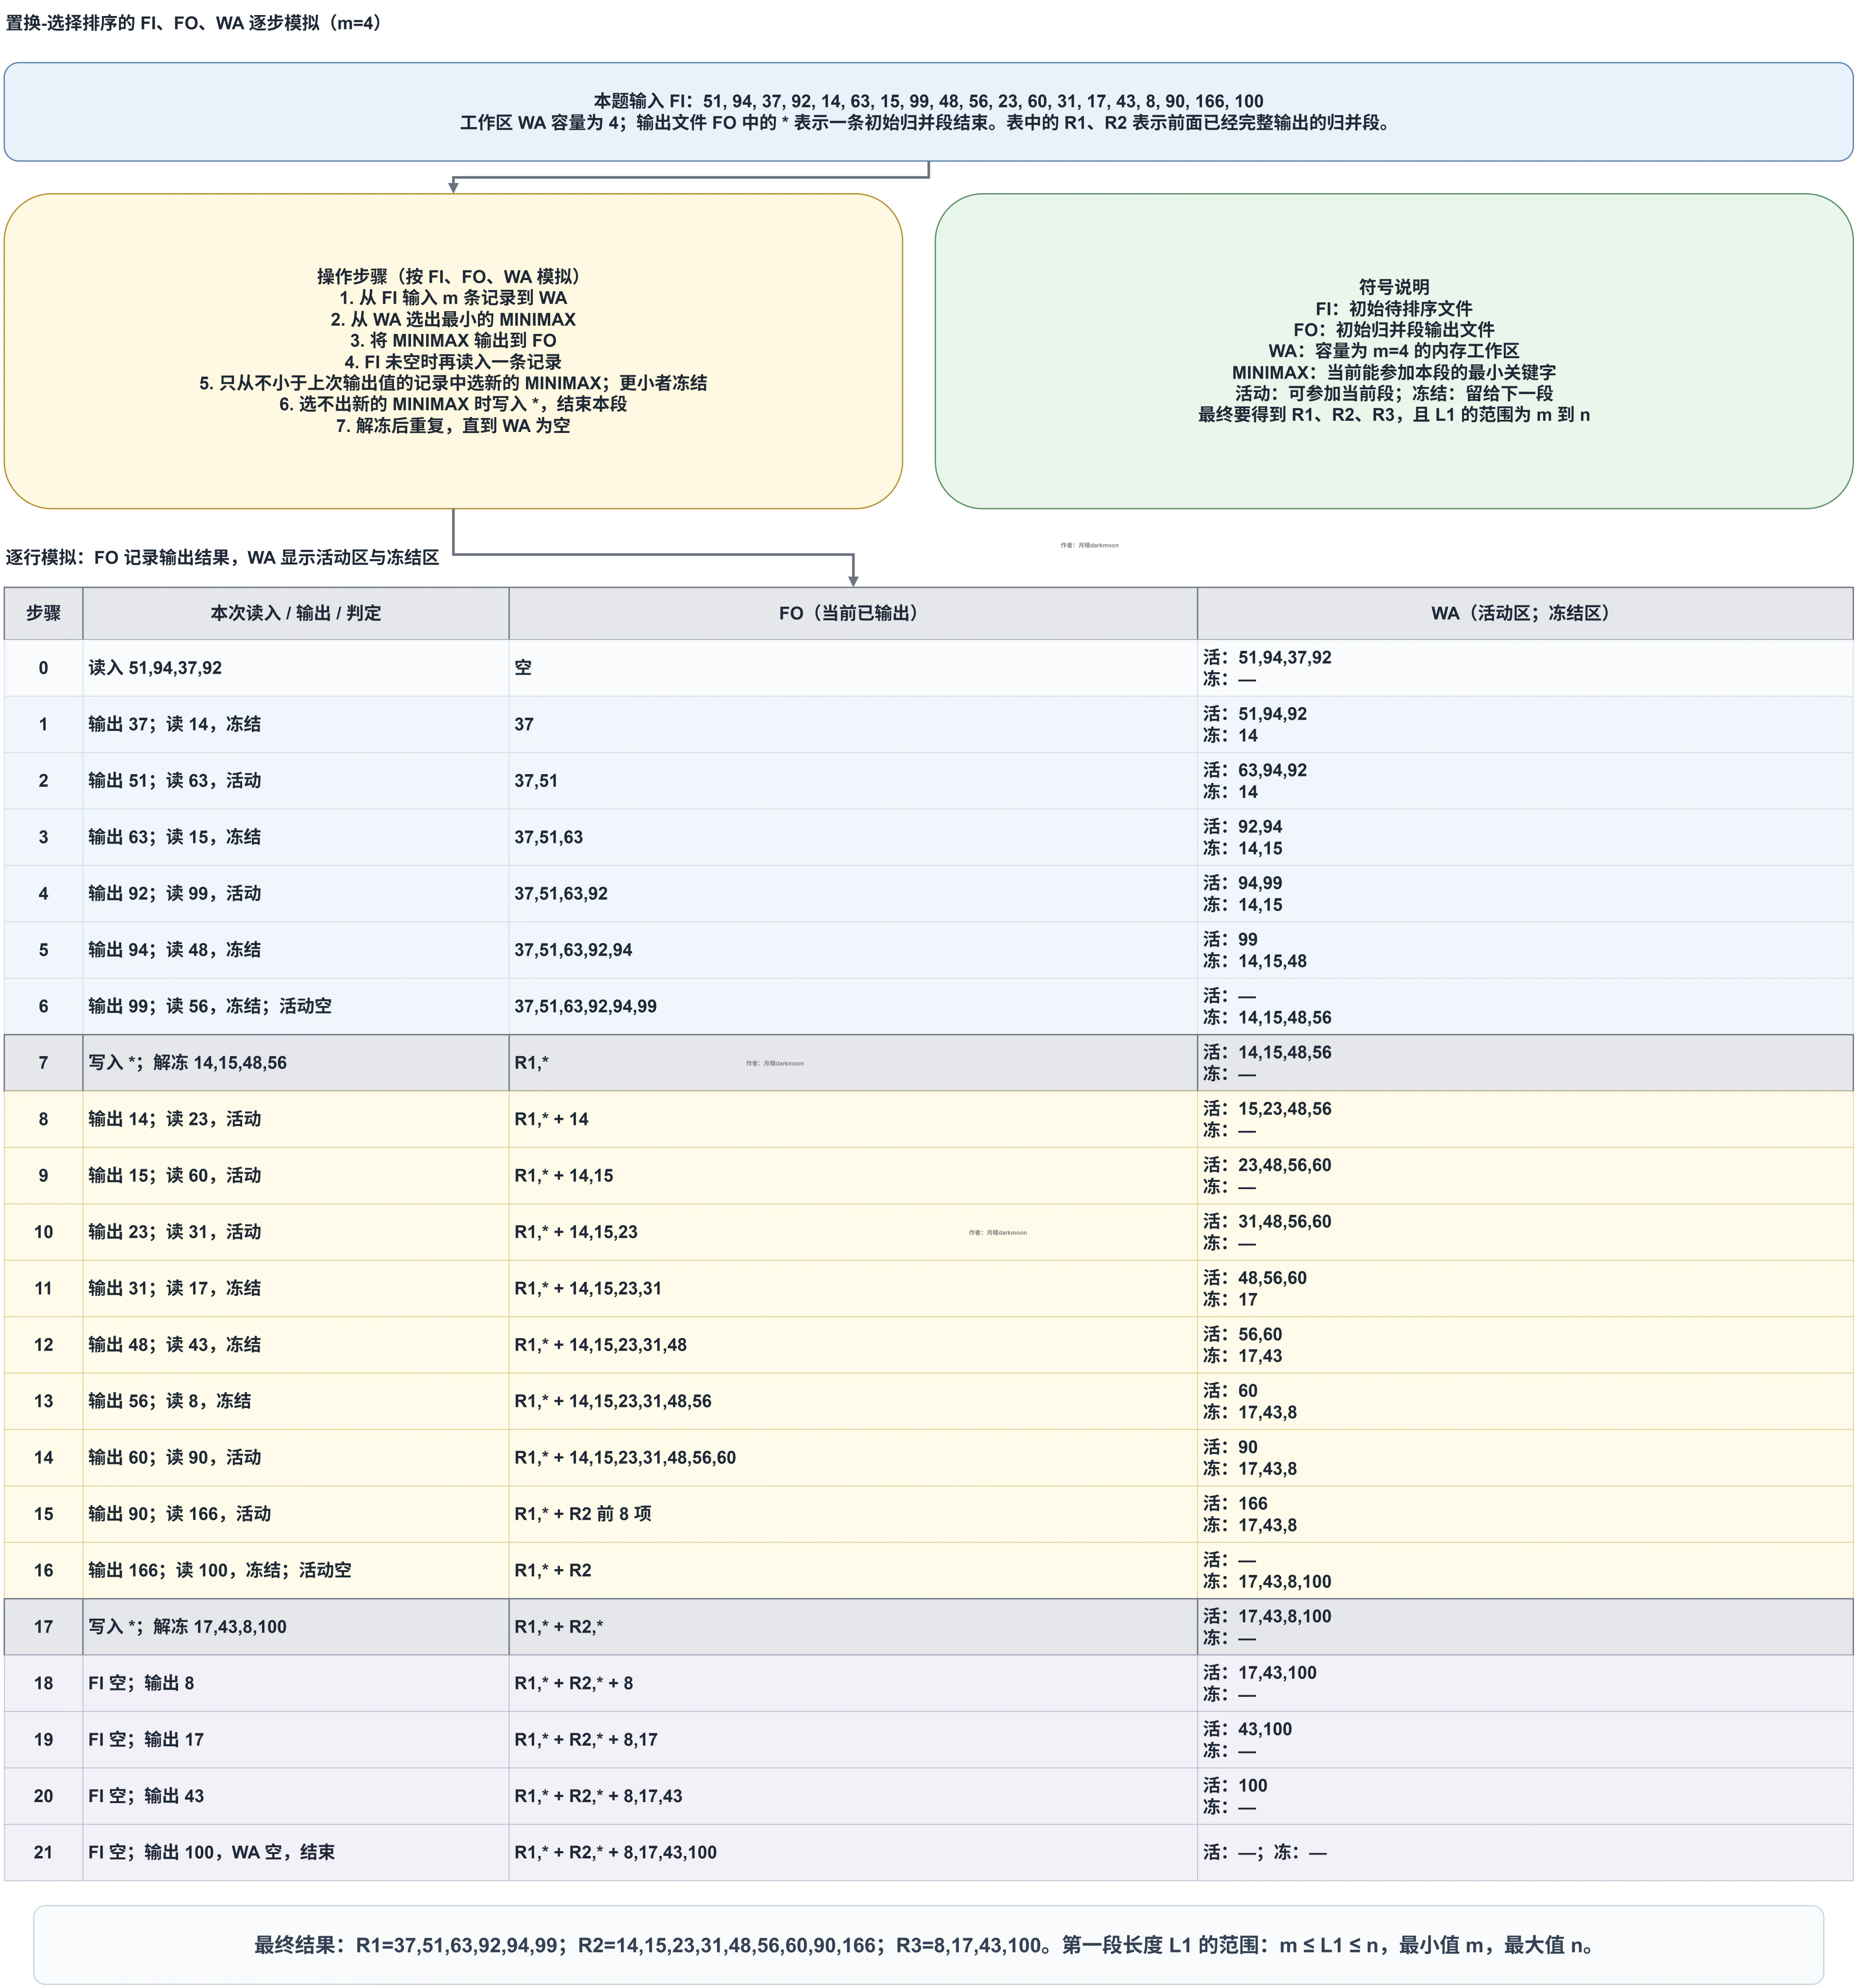
一、置换-选择排序的规则
工作区中的记录分成两种状态:
- 活动记录:可以参加当前归并段的输出;
- 冻结记录:关键字小于当前归并段最后输出值,不能放入当前段,只能留给下一段。
具体步骤如下:
- 先读入前
m个记录,全部标记为活动记录。 - 在活动记录中选择最小关键字输出,记这个值为
last。 - 从输入文件读入一个新记录
x: - 若
x ≥ last,把x放入活动区,它仍有机会进入当前归并段; - 若
x < last,把x冻结,留到下一段。 - 重复步骤 2~3,直到活动区为空。此时当前归并段结束,把冻结记录解冻,开始生成下一段。
因此,每一段的输出序列天然是递增的;段与段之间不要求有序关系,后续还要用多路归并把这些初始段合并成一个有序文件。
二、m=4时的完整计算
1. 第一个初始归并段
开始时工作区装入:51, 94, 37, 92,均为活动记录。下面的“读入”是输出一个记录后从文件补充进工作区的下一个记录。
| 步骤 | 输出活动区最小值 | 随后读入 | 比较结果 | 处理后的活动区 | 冻结区 |
|---|---|---|---|---|---|
| 0 | — | — | 初始化 | 51, 94, 37, 92 | — |
| 1 | 37 | 14 | 14 小于 37,冻结 14 | 51, 94, 92 | 14 |
| 2 | 51 | 63 | 63 不小于 51,加入活动区 | 63, 94, 92 | 14 |
| 3 | 63 | 15 | 15 小于 63,冻结 15 | 92, 94 | 14, 15 |
| 4 | 92 | 99 | 99 不小于 92,加入活动区 | 94, 99 | 14, 15 |
| 5 | 94 | 48 | 48 小于 94,冻结 48 | 99 | 14, 15, 48 |
| 6 | 99 | 56 | 56 小于 99,冻结 56 | 空 | 14, 15, 48, 56 |
活动区在第 6 步变空,所以第一段结束。其输出顺序为:
这里容易出错的地方是:14、15、48、56 并没有丢失,它们只是因为小于当前段的最后输出值而被冻结,转入下一段。
2. 第二个初始归并段
第一段结束时,将冻结区 14, 15, 48, 56 解冻为新的活动区;输入文件还未读完,下一条待读记录是 23。
| 步骤 | 输出 | 随后读入 | 比较结果 | 处理后的活动区 | 新冻结区 |
|---|---|---|---|---|---|
| 7 | 14 | 23 | 23 不小于 14,活动 | 15, 23, 48, 56 | — |
| 8 | 15 | 60 | 60 不小于 15,活动 | 23, 48, 56, 60 | — |
| 9 | 23 | 31 | 31 不小于 23,活动 | 31, 48, 56, 60 | — |
| 10 | 31 | 17 | 17 小于 31,冻结 17 | 48, 56, 60 | 17 |
| 11 | 48 | 43 | 43 小于 48,冻结 43 | 56, 60 | 17, 43 |
| 12 | 56 | 8 | 8 小于 56,冻结 8 | 60 | 17, 43, 8 |
| 13 | 60 | 90 | 90 不小于 60,活动 | 90 | 17, 43, 8 |
| 14 | 90 | 166 | 166 不小于 90,活动 | 166 | 17, 43, 8 |
| 15 | 166 | 100 | 100 小于 166,冻结 100 | 空 | 17, 43, 8, 100 |
活动区再次为空,第二段输出为:
3. 第三个初始归并段
最后把第二段产生的冻结记录 17, 43, 8, 100 解冻。文件已经没有新的记录可读,因此只需把这 4 个活动记录依次取最小值输出:
4. 结果检查
三个初始归并段合计包含 6+9+4=19 个记录,恰好覆盖原文件的全部关键字,且每一段内部均为递增序列。因此:
初始归并段共有 3 个:
R1 = 37, 51, 63, 92, 94, 99
R2 = 14, 15, 23, 31, 48, 56, 60, 90, 166
R3 = 8, 17, 43, 100
三、第一个初始归并段长度的范围
设第一个初始归并段长度为 L1。
最小值:m
开始时工作区中有 m 个活动记录。即使读入的后续记录全部小于当前输出值,它们也只是被依次冻结;原来工作区中的 m 个活动记录仍然必须先输出完,活动区才会为空。因此第一段不可能少于 m 个记录。
这个下界可以达到:如果每次补充进来的记录都小于当前段最后输出值,那么每补充一个就冻结一个,第一段恰好输出最初的 m 个记录,所以 L1=m。
最大值:n
如果输入文件的关键字整体呈不下降趋势,那么每次读入的新记录都满足“新记录不小于上次输出值”,不会有记录被冻结。工作区不断用新记录替换已经输出的记录,直到文件结束,全部 n 个记录都属于第一段,所以 L1=n。
综上:最小值 = m,最大值 = n
【2021-43】
(8分)已知某排序算法如下:
void cmpCountSort(int a[],int b[],int n) {
    int i, j, *count;
    count = (int *)malloc(sizeof(int) * n); //C++语言: count = new int[n];
    for (i = 0; i < n; i++) count[i] = 0;
    for (i = 0; i < n - 1; i++)
        for (j = i + 1; j < n; j++)
            if (a[i] < a[j]) count[j]++;
    else count[i]++;
    for (i = 0; i < n; i++) b[count[i]]= a[i];
    free(count); // C++语言: delete count;
}
请回答下列问题。
⑴ 若有int a[] = {25, -10, 25, 10, 11, 19}, b[6]; ,则调用cmpCountSort(a, b, 6)后数组b中的内容是什么?
⑵ 若a中含有n个元素,则算法执行过程中,元素之间的比较次数是多少?
⑶ 该算法是稳定的吗?若是,则阐述理由;否则,修改为稳定排序算法。