Relax1000 计算机组成原理 · 第1章 计算机系统概述 · 解析
第1章 计算机系统概述
本章 35 题;解析册印刷页 79–85。
速对答案(原书): CCADA DDBCB DBBBB DDCCB BABBD DDABB DCDCB
Q1
速对表原值: C
详细解析标注: C
指令集体系结构(Instruction Set Architecture,ISA)指令集体系结构是计算机硬件与系统软件之间的接口,高级语言程序经过编译后,最终会变成机器指令。CPU 要能执行这些机器指令,就必须有一套明确的规则,这套规则就是 ISA,ISA 关心的是程序员能看到什么、指令能使用什么、软件能依赖什么,不关心的是 CPU 等硬件 内部具体怎么实现。其核心部分是指令系统同时还包含数据类型和数据格式定义、寄存器组织、IO 空间的编址和数据传输方式、中断结构、计算机状态的定义和切换、存储保护等,A、B、D 正确,C 错误。
Q2
速对表原值: C
详细解析标注: C
ISA 规定了指令的功能与规范,不规定指令的内部实现细节,指令寻址方式、操作码个数、指令使用的通用寄存器的编号均属于指令格式内容,而乘法器实现方式不属于,C 正确。
注意:凡是程序员、编译器、汇编器必须知道才能正确写程序或生成机器码的内容,通常属于 ISA;只影响硬件内部如何执行、对软件不可见的内容,属于微体系结构或具体硬件实现,不属于 ISA。
Q3
速对表原值: A
详细解析标注: A
A 正确:冯·诺依曼结构的标志性思想是“程序与数据共存”。在物理实体上,指令和数据同样都表现为二进制代码位流(0 和 1),存储于同一主存中。两者的唯一区别在于 CPU在不同运行阶段对它们的解读方式不同:在取指阶段从主存流向指令寄存器(IR)的二进制串被解释为指令;在执行阶段流向通用寄存器或 ALU 的被解释为操作数(数据)。B 错:主存地址空间分配自由灵活,并不强制限定指令低、数据高的刚性区间。C 错:这是哈佛结构(Harvard Architecture)的特征,不是冯·诺依曼 结构。D 错:数据取出后可能作为控制信号、地址偏移量,甚至有时会被用于间接寻址等,不直接是操作数本身。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q4
速对表原值: D
详细解析标注: D
冯·诺依曼结构五大部件包括运算器、控制器、存储器、输入设备和输出设备,总线接口属于现代计算机的扩展结构,D 错误。
Q5
速对表原值: A
详细解析标注: A
最低层为微程序级(硬件直接执行),向上依次为机器语言级、操作系统级、汇编语言级、高级语言级,A 正确。
Q6
速对表原值: D
详细解析标注: D
编译或汇编后生成的目标程序通常是机器语言形式,但可能还包含未解决的外部引用不能直接运行,链接程序负责把一个或多个目标文件以及所需库函数组合起来,解决外部符号引用,最终生成可执行文件。因此选 D。预处理阶段主要处理宏定义、条件编译、头文件包含等内容。例如 C 语言中的 #include、#define 通常由预处理器处理;编译主要完成高级语言源程序到目标程序或汇编程序的翻译,并进行词法、语法、语义分析等;汇编是通过汇编程序将汇编语言程序转换为机器语言目标程序。
Q7
速对表原值: D
详细解析标注: D
I 错误,汇编语言本质是用助记符表示的机器语言,CPU 无法识别助记符,只有通过汇编程序转化为机器语言才可被 CPU 直接执行。II 错误,硬件描述语言主要用于描述硬件电路结构和行为,它不是 CPU 直接执行的机器语言,也不是普通意义上的软件程序语言。
III错误,汇编语言通常与具体机器的指令系统一一对应或密切相关,不同处理器的汇编语言差异较大。高级语言相对独立于具体机器。IV 错误,高级语言可以通过翻译程序直接转换成机器语言,无需通过汇编语言过渡,如解释型语言。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q8
速对表原值: B
详细解析标注: B
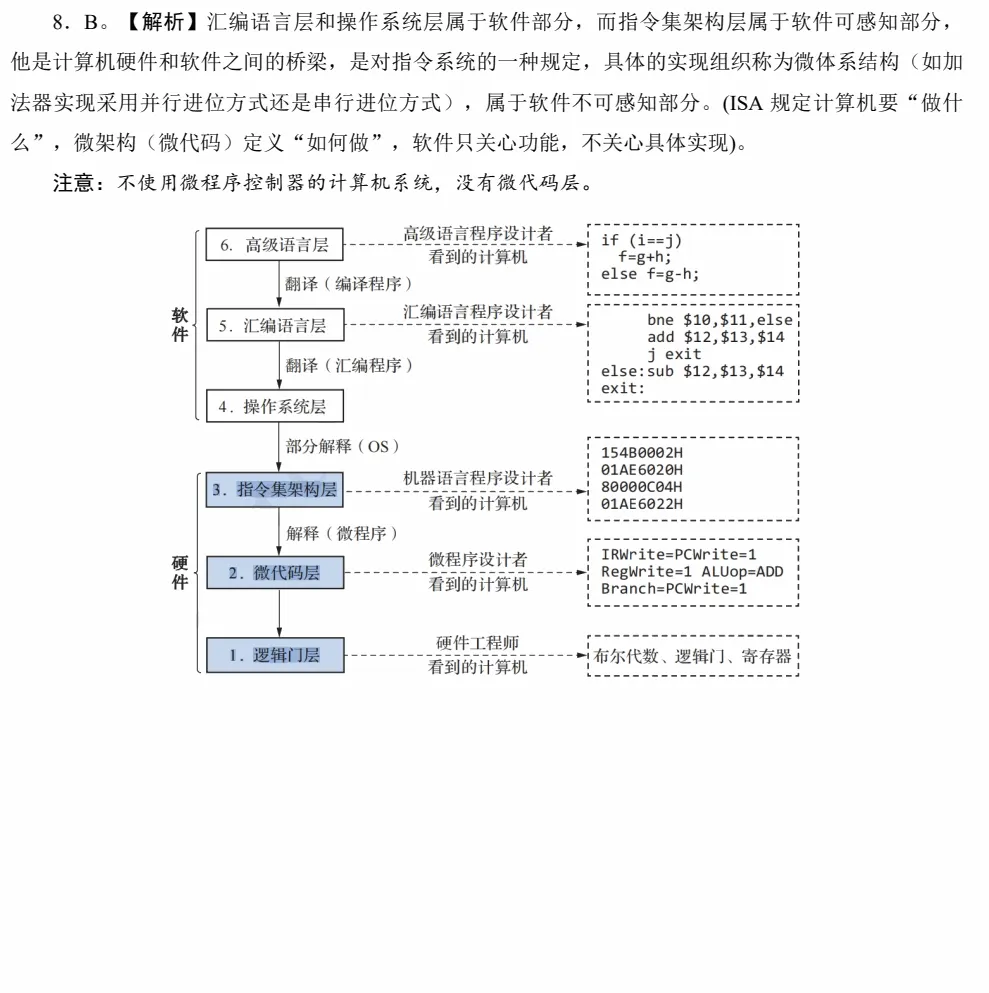
汇编语言层和操作系统层属于软件部分,而指令集架构层属于软件可感知部分,他是计算机硬件和软件之间的桥梁,是对指令系统的一种规定,具体的实现组织称为微体系结构(如加法器实现采用并行进位方式还是串行进位方式),属于软件不可感知部分。(ISA 规定计算机要“做什么”,微架构(微代码)定义“如何做”,软件只关心功能,不关心具体实现)。
注意:不使用微程序控制器的计算机系统,没有微代码层。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q9
速对表原值: C
详细解析标注: C
-
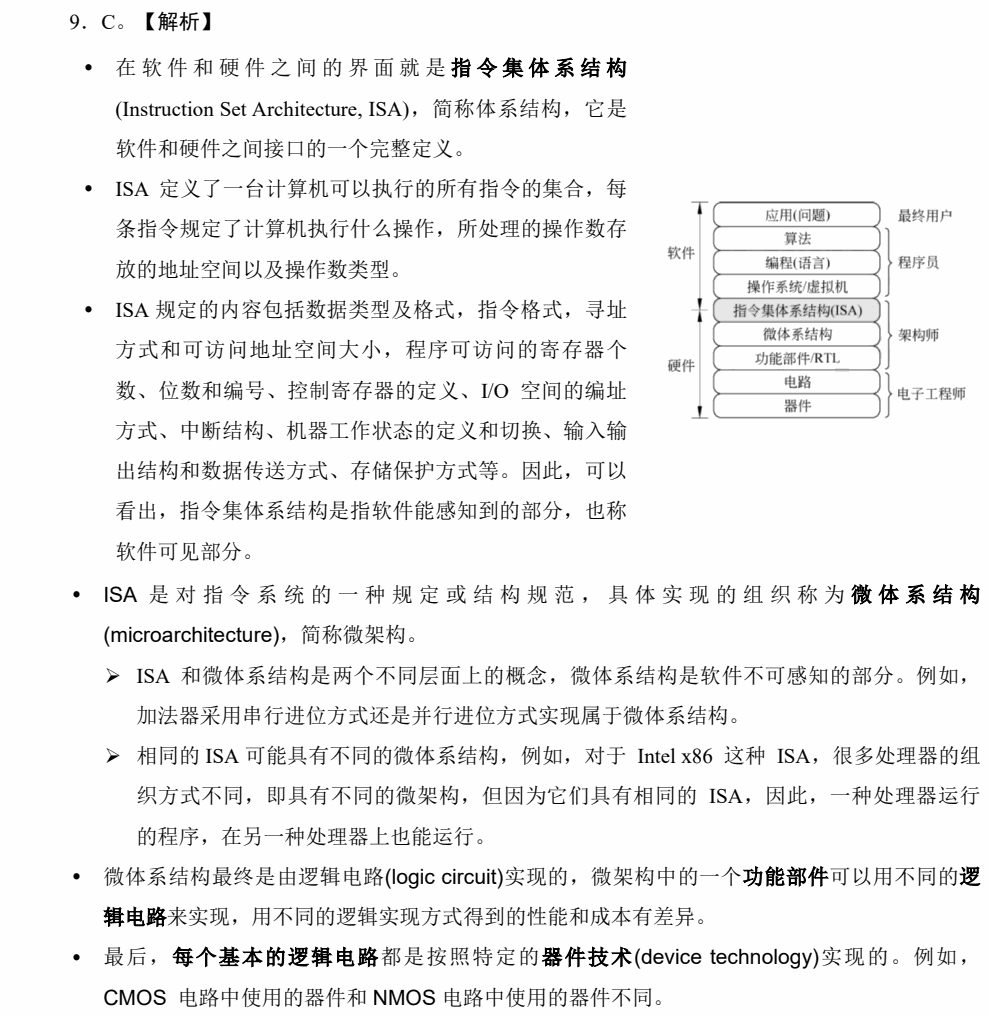
在 软 件 和 硬 件 之 间 的 界 面 就 是 指 令 集 体 系 结 构(Instruction Set Architecture, ISA),简称体系结构,它是软件和硬件之间接口的一个完整定义。
-
ISA 定义了一台计算机可以执行的所有指令的集合,每条指令规定了计算机执行什么操作,所处理的操作数存放的地址空间以及操作数类型。
-
ISA 规定的内容包括数据类型及格式,指令格式,寻址方式和可访问地址空间大小,程序可访问的寄存器个数、位数和编号、控制寄存器的定义、I/O 空间的编址方式、中断结构、机器工作状态的定义和切换、输入输出结构和数据传送方式、存储保护方式等。因此,可以看出,指令集体系结构是指软件能感知到的部分,也称软件可见部分。
-
ISA 是 对 指 令 系 统 的 一 种 规 定 或 结 构 规 范 , 具 体 实 现 的 组 织 称 为 微 体 系 结 构(microarchitecture),简称微架构。 ISA 和微体系结构是两个不同层面上的概念,微体系结构是软件不可感知的部分。例如,加法器采用串行进位方式还是并行进位方式实现属于微体系结构。 相同的 ISA 可能具有不同的微体系结构,例如,对于 Intel x86 这种 ISA,很多处理器的组织方式不同,即具有不同的微架构,但因为它们具有相同的 ISA,因此,一种处理器运行的程序,在另一种处理器上也能运行。
-
微体系结构最终是由逻辑电路(logic circuit)实现的,微架构中的一个功能部件可以用不同的逻辑电路来实现,用不同的逻辑实现方式得到的性能和成本有差异。
-
最后,每个基本的逻辑电路都是按照特定的器件技术(device technology)实现的。例如,CMOS 电路中使用的器件和 NMOS 电路中使用的器件不同。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q10
速对表原值: B
详细解析标注: B
主机包括 CPU 和主存;CPU 包括运算器、控制器、寄存器、磁盘、键盘、鼠标等是外部设备。所以磁盘不包括在主机内,B 错误。
Q11
速对表原值: D
详细解析标注: D
计算机的软件可以分为系统软件和应用软件两大类。其中,系统软件主要用来管理整个计算机系统、监视服务,使系统资源得到合理调度,高效运行,它包括标准程序库、语言处理程序、操作系统、服务程序、数据库管理系统、网络软件等;应用软件是根据任务需要所编制的各种程序,如科学计算程序、数据处理程序、过程控制程序、事务管理程序、文本处理程序等。操作系统是系统运行的必要条件,所以其属于系统软件,A 错误。编译程序和汇编程序均属于系统软件中的语言处理程序,B、C 错误。
Q12
速对表原值: B
详细解析标注: B
现代 CPU 普遍通过浮点运算部件(Float Point Unit, FPU)实现浮点运算,其他选项属于操作系统软件功能,B 正确。A 选项,进程调度主要由操作系统内核实现;C 选项,文件系统管理由操作系统完成,包括文件系统管理、文件创建、文件删除、目录管理、权限分配等;D 选项,中断响应是由硬件完成的,而中断处理程序由软件实现。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q13
速对表原值: B
详细解析标注: B
ISA 是软硬件的分界面,规定编程可见的寄存器、指令格式和寻址方式等,B 正确。
Q14
速对表原值: B
详细解析标注: B
在“存储程序”思想指的是程序和数据都以二进制形式存放在存储器中,CPU从存储器中取出指令并执行。程序在存储器中存放的是机器指令形式,而不是高级语言形式。
Q15
速对表原值: B
详细解析标注: B
在冯·诺依曼计算机中,指令和数据以同等地位存放于存储器中,都根据地址访存,这并不是 CPU 区分指令和数据的方法,A,C 错误。计算机中将时刻划分为不同的阶段,取指阶段从存储器中取出的是指令,执行阶段从存储器中取出的是数据,CPU 正是通过这种方式来区分指令和数据的,B 正确。无论是指令还是数据,在计算机中都使用二进制数表示,D 错误。
Q16
速对表原值: D
详细解析标注: D
编译程序一次性将整个源程序转换目标程序(通常为机器代码),然后由处理器执行目标程序。这样可以实现较高的执行效率,但目标代码通常是特定于某种处理器架构的,因此可移植性较差。解释程序则逐条解释并执行源程序,不会生成一个完整的目标程序,这样可以在不同的处理器架构上运行,具有较好的可移植性,但执行效率相对较低,D 正确,A、C 错误。编译程序和解释程序的适用场景并不是以执行时间和运行频率来区分的。实际上,编译程序和解释程序的主要区别在于执行效率和可移植性。编译程序适用于对执行效率要求较高的程序,解释程序则适用于对可移植性要求较高的程序,或者在开发过程中需要快速调试的场景,B 错误。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q17
速对表原值: D
详细解析标注: D
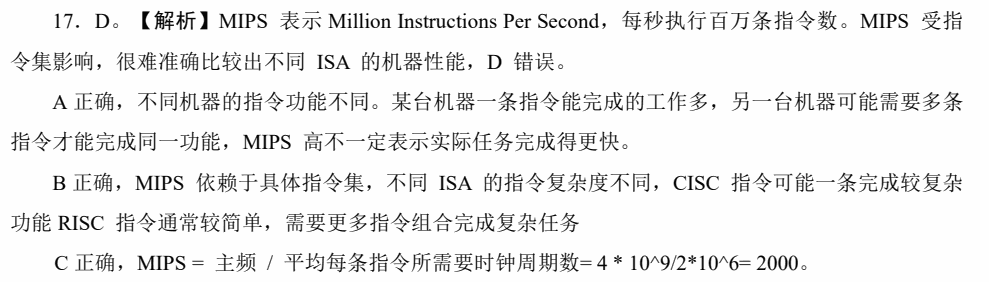
MIPS 表示 Million Instructions Per Second,每秒执行百万条指令数。MIPS 受指令集影响,很难准确比较出不同 ISA 的机器性能,D 错误。
A 正确,不同机器的指令功能不同。某台机器一条指令能完成的工作多,另一台机器可能需要多条指令才能完成同一功能,MIPS 高不一定表示实际任务完成得更快。
B 正确,MIPS 依赖于具体指令集,不同 ISA 的指令复杂度不同,CISC 指令可能一条完成较复杂功能 RISC 指令通常较简单,需要更多指令组合完成复杂任务C 正确,MIPS = 主频 / 平均每条指令所需要时钟周期数= 4 * 109/2*106= 2000。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q18
速对表原值: C
详细解析标注: C
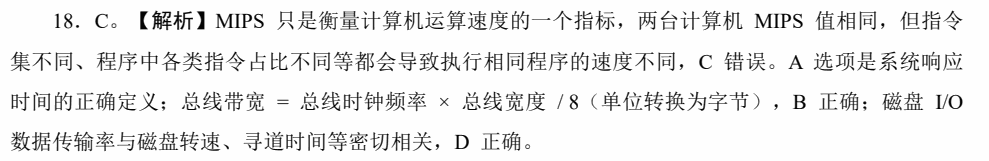
MIPS 只是衡量计算机运算速度的一个指标,两台计算机 MIPS 值相同,但指令集不同、程序中各类指令占比不同等都会导致执行相同程序的速度不同,C 错误。A 选项是系统响应时间的正确定义;总线带宽 = 总线时钟频率 × 总线宽度 / 8(单位转换为字节),B 正确;磁盘 I/O数据传输率与磁盘转速、寻道时间等密切相关,D 正确。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q19
速对表原值: C
详细解析标注: C
题目中可看出该基准测试程序主要侧重于整数处理性能的评估,第二台计算机测试结果更高,说明在整数处理上可能更优,但不能就此得出执行整数运算速度一定快 50%,因为测试存在局限性,A 错误,C 正确;该基准测试不能代表通用任务处理性能,B 错误;虽然基准测试程序单一,但能在一定程度上反映整数处理性能,D 错误。
Q20
速对表原值: B
详细解析标注: B
0.4×1 + 0.3×2 + 0.2×3 + 0.1×4 = 2.0,B 正确。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
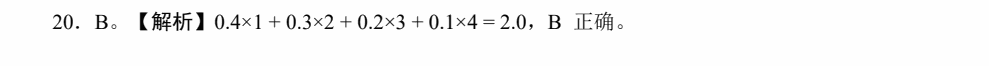
Q21
速对表原值: B
详细解析标注: B
A 执行时间 = 1 × 106 × 2 / 2 × 109 = 1 × 10⁻³ s。B 机时间 = 0.8 × 106 × 3 / 3 × 109 = 0.8 × 10⁻³ s。显然 B 执行时间更短,B 正确。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)

Q22
速对表原值: A
详细解析标注: A
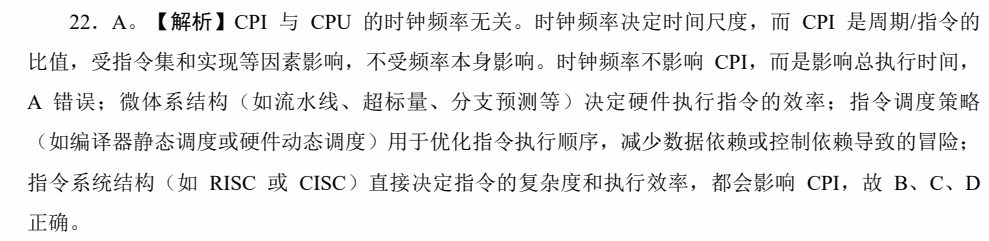
CPI 与 CPU 的时钟频率无关。时钟频率决定时间尺度,而 CPI 是周期/指令的比值,受指令集和实现等因素影响,不受频率本身影响。时钟频率不影响 CPI,而是影响总执行时间,A 错误;微体系结构(如流水线、超标量、分支预测等)决定硬件执行指令的效率;指令调度策略(如编译器静态调度或硬件动态调度)用于优化指令执行顺序,减少数据依赖或控制依赖导致的冒险;指令系统结构(如 RISC 或 CISC)直接决定指令的复杂度和执行效率,都会影响 CPI,故 B、C、D正确。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q23
速对表原值: B
详细解析标注: B
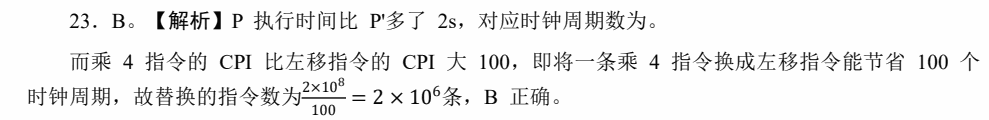
P 执行时间比 P'多了 2s,对应时钟周期数为。而乘 4 指令的 CPI 比左移指令的 CPI 大 100,即将一条乘 4 指令换成左移指令能节省 100 个时钟周期,故替换的指令数为2×10⁸ 100 = 2 × 10⁶条,B 正确。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q24
速对表原值: B
详细解析标注: B
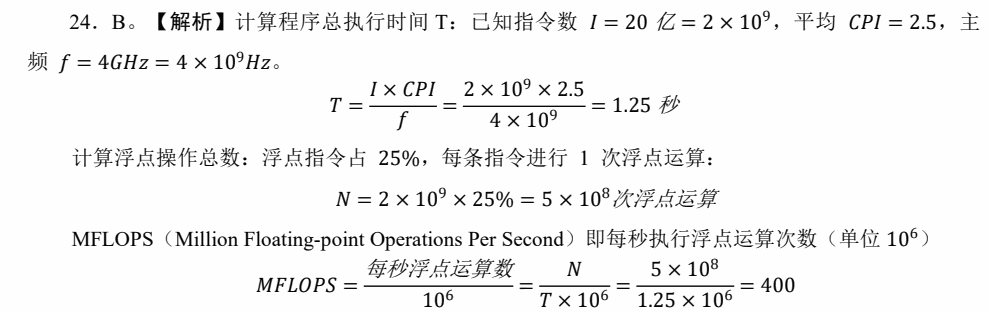
计算程序总执行时间 T:已知指令数 〔公式/符号见原页版面片段〕 = 20 亿 = 2 × 10⁹,平均 〔公式/符号见原页版面片段〕 = 2.5,主频 〔公式/符号见原页版面片段〕 = 4〔公式/符号见原页版面片段〕 = 4 × 10⁹〔公式/符号见原页版面片段〕。〔公式/符号见原页版面片段〕 =〔公式/符号见原页版面片段〕 × 〔公式/符号见原页版面片段〕 〔公式/符号见原页版面片段〕 =2 × 109 × 2.5 4 × 109 = 1.25 秒计算浮点操作总数:浮点指令占 25%,每条指令进行 1 次浮点运算:〔公式/符号见原页版面片段〕 = 2 × 109 × 25% = 5 × 10⁸次浮点运算MFLOPS(Million Floating-point Operations Per Second)即每秒执行浮点运算次数(单位 106)〔公式/符号见原页版面片段〕 =每秒浮点运算数106 =〔公式/符号见原页版面片段〕 〔公式/符号见原页版面片段〕 × 106 =5 × 10⁸ 1.25 × 106 = 400
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
PDF 字形回源提示(非原文)
原 PDF 的部分数学字体没有 Unicode 映射;可搜索文本保留了明确占位,公式和符号以本题的原页片段为准。
Q25
速对表原值: D
详细解析标注: D
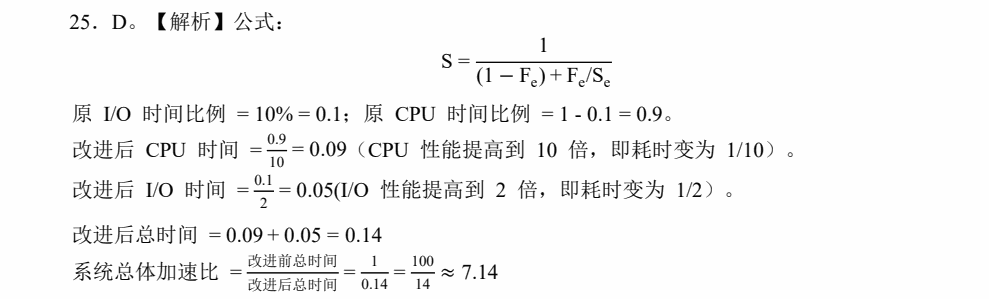
公式:S =1 (1 − Fe) + Fe/Se原 I/O 时间比例 = 10% = 0.1;原 CPU 时间比例 = 1 - 0.1 = 0.9。改进后 CPU 时间 =0.9 10 = 0.09(CPU 性能提高到 10 倍,即耗时变为 1/10)。改进后 I/O 时间 =0.1 2 = 0.05(I/O 性能提高到 2 倍,即耗时变为 1/2)。改进后总时间 = 0.09 + 0.05 = 0.14系统总体加速比 =改进前总时间改进后总时间=1 0.14 =100 14 ≈ 7.14
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q26
速对表原值: D
详细解析标注: D
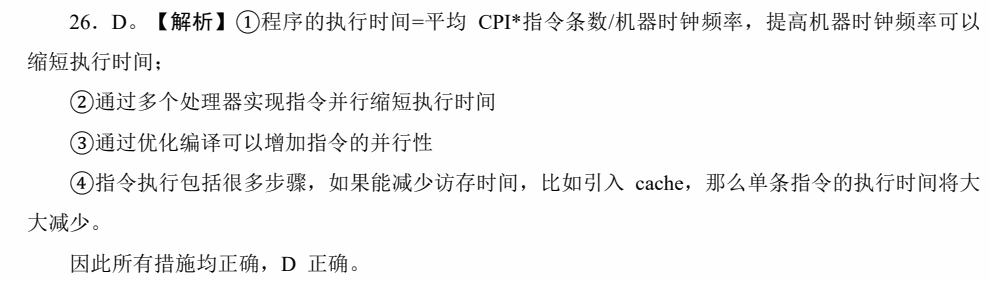
①程序的执行时间=平均 CPI*指令条数/机器时钟频率,提高机器时钟频率可以缩短执行时间;
②通过多个处理器实现指令并行缩短执行时间
③通过优化编译可以增加指令的并行性
④指令执行包括很多步骤,如果能减少访存时间,比如引入 cache,那么单条指令的执行时间将大大减少。因此所有措施均正确,D 正确。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
王道核实旁注(非 Relax 原文):缺并行前提
②增加处理器只有在该程序存在可并行部分、且软硬件能实际利用多处理器时才能缩短时间。原题没有这个前提,D 不能作为无条件结论。
Q27
速对表原值: D
详细解析标注: D
MIPS 表示每秒执行多少百万条指令,但不同计算机的指令系统不同,一条指令完成的功能和复杂度可能不同。同一任务在不同机器上所需指令条数也可能不同。因此,MIPS 较高并不一定表示程序执行时间更短,A、B、C 都是 MIPS 不能很好反映计算机性能的合理原因。D 表述错误,MIPS 主要与指令条数、执行时间、CPI、时钟频率、程序特征等因素有关,并不是由存储容量完全决定。
Q28
速对表原值: A
详细解析标注: A
CPI 是一条指令执行需要的时钟数,因此 MIPS=30/3=10,机器周期是干扰项,A 正确。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)

Q29
速对表原值: B
详细解析标注: B
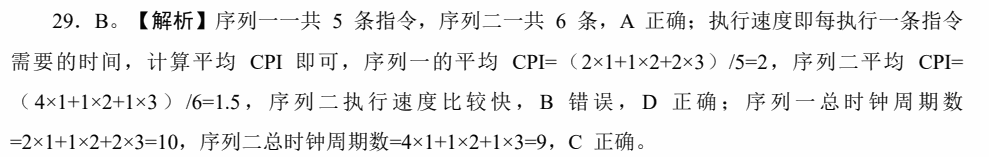
序列一一共 5 条指令,序列二一共 6 条,A 正确;执行速度即每执行一条指令需要的时间,计算平均 CPI 即可,序列一的平均 CPI=(2×1+1×2+2×3)/5=2,序列二平均 CPI=(4×1+1×2+1×3)/6=1.5,序列二执行速度比较快,B 错误,D 正确;序列一总时钟周期数=2×1+1×2+2×3=10,序列二总时钟周期数=4×1+1×2+1×3=9,C 正确。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q30
速对表原值: B
详细解析标注: B
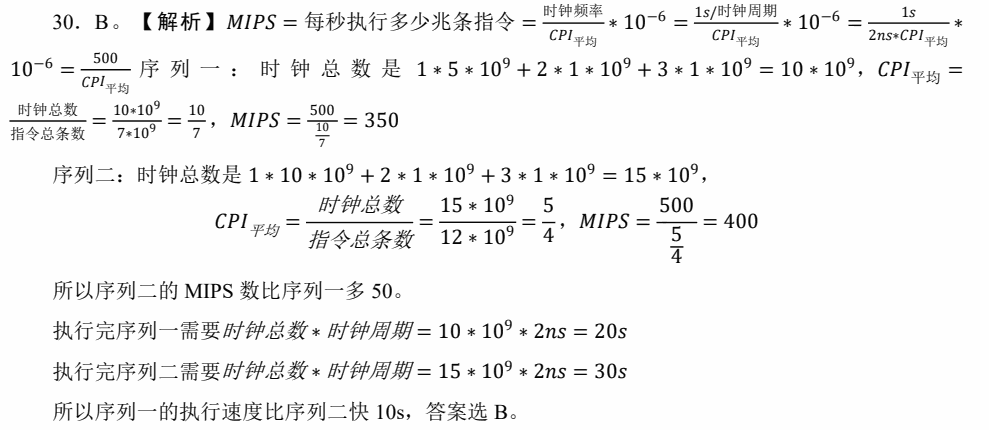
〔公式/符号见原页版面片段〕 = 每秒执行多少兆条指令 =时钟频率〔公式/符号见原页版面片段〕平均∗ 10−6 =1〔公式/符号见原页版面片段〕/时钟周期〔公式/符号见原页版面片段〕平均∗ 10−6 =1〔公式/符号见原页版面片段〕 2〔公式/符号见原页版面片段〕∗〔公式/符号见原页版面片段〕平均∗ 10−6 =500 〔公式/符号见原页版面片段〕平均序 列 一 : 时 钟 总 数 是 1 ∗ 5 ∗ 109 + 2 ∗ 1 ∗ 109 + 3 ∗ 1 ∗ 109 = 10 ∗ 109,〔公式/符号见原页版面片段〕平均 =时钟总数指令总条数=10∗109 7∗109 =10 7,〔公式/符号见原页版面片段〕 =500 10 7 = 350序列二:时钟总数是 1 ∗ 10 ∗ 109 + 2 ∗ 1 ∗ 109 + 3 ∗ 1 ∗ 109 = 15 ∗ 109,〔公式/符号见原页版面片段〕平均 =时钟总数指令总条数=15 ∗ 109 12 ∗ 109 =5 4,〔公式/符号见原页版面片段〕 =500 5 4 = 400所以序列二的 MIPS 数比序列一多 50。执行完序列一需要时钟总数 ∗ 时钟周期 = 10 ∗ 109 ∗ 2〔公式/符号见原页版面片段〕 = 20〔公式/符号见原页版面片段〕执行完序列二需要时钟总数 ∗ 时钟周期 = 15 ∗ 109 ∗ 2〔公式/符号见原页版面片段〕 = 30〔公式/符号见原页版面片段〕所以序列一的执行速度比序列二快 10s,答案选 B。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
PDF 字形回源提示(非原文)
原 PDF 的部分数学字体没有 Unicode 映射;可搜索文本保留了明确占位,公式和符号以本题的原页片段为准。
Q31
速对表原值: D
详细解析标注: D
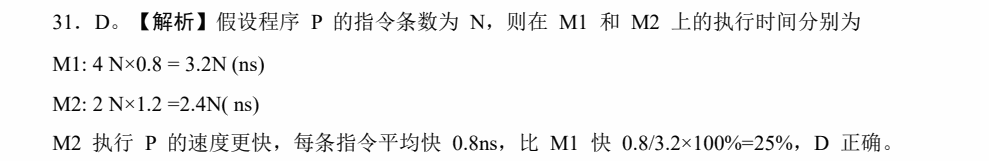
假设程序 P 的指令条数为 N,则在 M1 和 M2 上的执行时间分别为M1: 4 N×0.8 = 3.2N (ns) M2: 2 N×1.2 =2.4N( ns) M2 执行 P 的速度更快,每条指令平均快 0.8ns,比 M1 快 0.8/3.2×100%=25%,D 正确。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q32
速对表原值: C
详细解析标注: C
〔公式/符号见原页版面片段〕 = 1 × 60% + 2 × 18% + 4 × 12% + 8 × 10% = 2.24 MIPS=40/〔公式/符号见原页版面片段〕 = 40/2.24 = 17.9 T = 〔公式/符号见原页版面片段〕 × 1 〔公式/符号见原页版面片段〕 × 〔公式/符号见原页版面片段〕 = 2.24 × 1 40×106 × 5000 = 2.8 × 10⁻⁴秒,C 正确。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
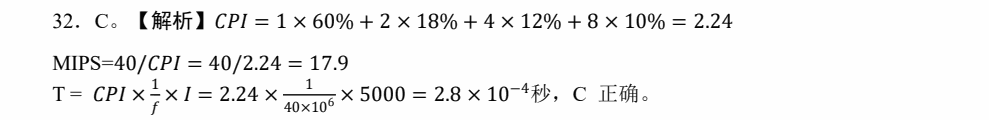
PDF 字形回源提示(非原文)
原 PDF 的部分数学字体没有 Unicode 映射;可搜索文本保留了明确占位,公式和符号以本题的原页片段为准。
Q33
速对表原值: D
详细解析标注: D
机器字长是计算机进行一次整数运算能够处理的二进制数据的位数。存储字长是一个存储单元中的二进制代码位数。指令字长是一个指令字中包含的二进制代码的位数。机器字长和存储字长没有必然的联系,但为了方便读取数据,通常规定机器字长等于整数倍的存储字长。故 I 错,II对。指令字长与存储字长间也没有必然联系,但为了方便取指,通常规定指令字长等于整数倍的存储字长,故 III 对,D 正确。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q34
速对表原值: C
详细解析标注: C
此处的字长为机器字长,即计算机进行一次整数运算所能处理的二进制数据的位数。一台计算机的字长为 4 字节,这表示该 CPU 进行一次整数运算(ALU)能够处理的二进制数据的位数是 32 位,C 正确。运算结果最大不一定为232,比如无符号数,最大为232 − 1
原页版面片段(公式/表图/电路/代码/数据通路以此为准)
Q35
速对表原值: B
详细解析标注: B
时钟周期也称为震荡周期,定义为时钟频率的倒数,它是最基本的、最小的时间单位。在一个时钟周期内,CPU 仅完成一个最基本的动作。机器周期也称 CPU 周期,在计算机中,为了便于管理,常把一条指令的执行过程划分为若干个阶段(如取指、译码、执行等),每一阶段完成一个基本操作。完成一个基本操作所需要的时间称为机器周期。一般情况下,一个机器周期由一个或若干个时钟周期组成。指令周期是取出一条指令并执行的时间,是从取指令、分析指令到执行完指令所需的全部时间,一般由一个或若干个机器周期组成。故这三者的大小关系应当是指令周期 ≥ 机器周期 ≥ 时钟周期,B 正确。
原页版面片段(公式/表图/电路/代码/数据通路以此为准)