时间复杂度:O(n²)
原始讲义 · 非增强校订版 · 原书检索 · 文字用于定位,公式与图表请回原页核验 · 本次导入快照
## 时间复杂度:O(n²)
Prim 算法和 Dijsktra 算法的比较:
• Prim 每次从未选顶点中选择距离已选集合最近的点(cost 最小),而 Dijsktra 算法每次从未选顶点中选择距离源点最近的顶点(dist最小)。
• Prim 的 cost 记录的是边的长度,Dijsktra 的 dist 记录的是路径的长度。
• Prim 中 cost[k] 的更新条件是 k 距离本次选择的顶点j 比距离已选集合中的其他顶点更近: cost[j] > w(k,j)。Dijsktra 中 dist[v] 的更新条件是借道 u 之后源点离 v 的距离比借道 u 之前更小:dist[u] + w(u, v) < dist[v]。
• Prim 和 Dijsktra都是贪心算法每次选择 xx 最小的,邻接表的写法都可以使用小根堆来优化选择的过程。
## Kruskal算法
核心思想:从边的角度出发,初始时已选边集合不包含任何边。每次将一条最小的、加入集合后不成环的边纳入已选边集合,重复 n-1 次。
## 步骤:
1. 题目给出从小到大排序的边数组或给出优先队列(堆)。
2. 初始化并查集,初始时所有顶点属于不同集合。
3. 循环,直到选出 n-1 条不成环的边:
a.对于还未处理的最小边,使用并查集判断该边的两个端点分别属于哪个集合。
b. 如果不属于同一个集合则选择该边、合并这两个集合。
## 邻接表
伪代码如下(忽略快速排序):
<!-- verified-by-hand -->
> [!success] 已结合原文第 151-152 页及 Markdown 上下文人工校对
> Find 被跨页截断;Kruskal 缺 edges/m 输入,根变量大小写错误并缺闭括号。
int parent[MAXV];
typedef struct { int u, v, weight; } Edge;
int Find(int x)
{
if (parent[x] != x) parent[x] = Find(parent[x]);
return parent[x];
}
void Union(int x, int y)
{
parent[Find(y)] = Find(x);
}
void Kruskal(ALGraph G, Edge edges[], int m)
{
int count = 0;
Qsort(edges, 0, m - 1);
for (int i = 0; i < G.numVertices; i++) parent[i] = i;
for (int i = 0; i < m && count < G.numVertices - 1; i++)
{
int rootU = Find(edges[i].u);
int rootV = Find(edges[i].v);
if (rootU != rootV)
{
Union(rootU, rootV);
// 输出或加入 edges[i]
count++;
}
}
}
return parent[x];
}
// 并查集:合并集合
void Union(int x, int y)
{
parent[Find(y)] = Find(x);
}
void Kruskal(ALGraph G)
{
Edge edges[MAXE]; //边集数组
int count = 0; //统计已纳入生成树中的边数
//1.题目给出从小到大排序的边数组或给出优先队列(堆)
不妨假设所有的边已经在数组 edges 中,边的数量为 m
void Qsort(edges[], 0, G.numEdges-1);
//2.初始化并查集,初始时所有顶点属于不同集合。
for (int i = 0; i < G.numvertices; i++)
parent[i] = i;
// 3.循环,直到选出 n-1 条不成环的边
for (int i = 0; i < m; i++)
{
//3-a. 对于还未处理的最小边,使用并查集判断该边的两个端点分别属于哪个集合
int rootU = Find(edges[i].u);
int rootV = Find(edges[i].v);
//3-b.如果不属于同一个集合则选择该边、合并这两个集合
if (rootu != rootv)
{ Union(rootU, rootV);
将该边加入到生成树中
count++;
if (count == G.numvertices-1) break; //已选择 n-1 条边
}
输出最小生成树
}
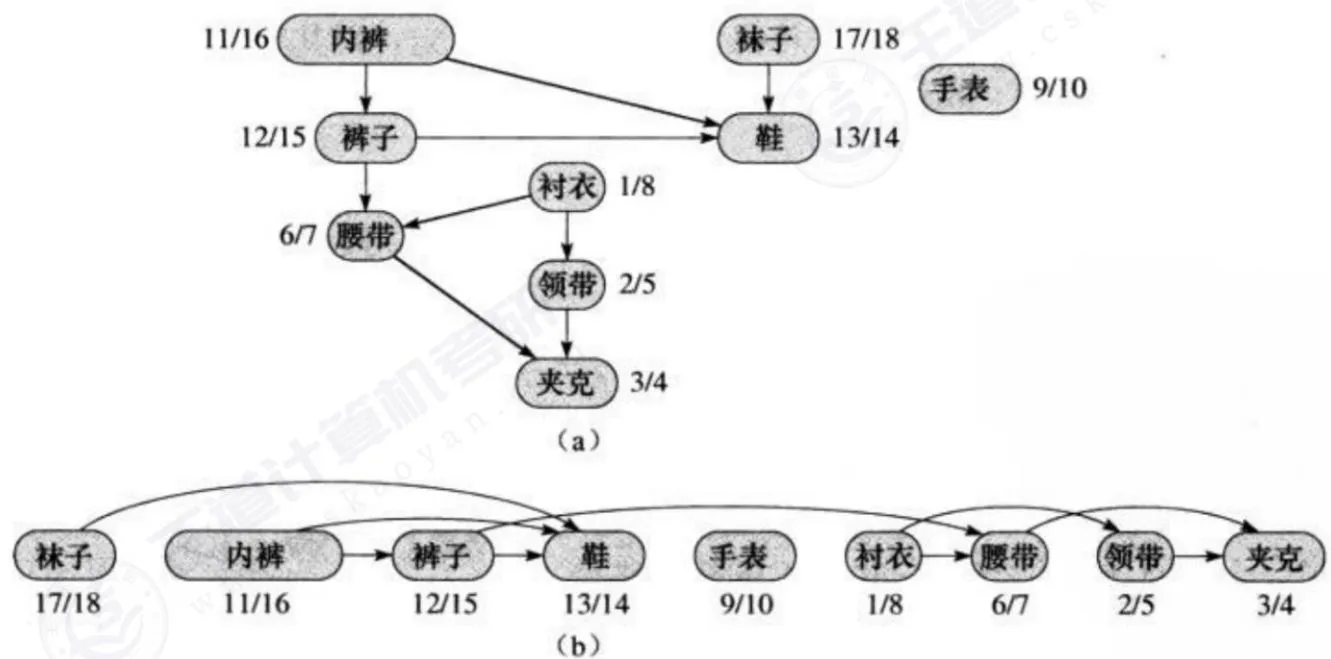 原资料配图 · 转写内容请回源核验
## 核心目的:
• 解决有向无环图(DAG)中顶点的先后顺序问题,得到拓扑序列。
• 如果顶点a到顶点b 存在有向边,则在拓扑序列中,顶点a 会在顶点b前面。
• 如果该有向图无环,则拓扑序列存在。如果该有向图有环,则拓扑序列不存在。
<table><tr><td rowspan=1 colspan=1>拓扑序列</td><td rowspan=1 colspan=1>条件</td></tr><tr><td rowspan=1 colspan=1>存在且唯一</td><td rowspan=1 colspan=1>每次选择结点时都只有一个结点可选</td></tr><tr><td rowspan=1 colspan=1>存在且不唯一</td><td rowspan=1 colspan=1>选择结点时不止一个结点可选</td></tr><tr><td rowspan=1 colspan=1>不存在</td><td rowspan=1 colspan=1>图中有环,环中的顶点未被访问 0 m</td></tr></table>
## 步骤:
1. 统计每个顶点的入度。
2. 将入度为0的顶点入队。
3. 队列出队一个顶点,访问它,并将它的出边所指向顶点的入度减1。
4. 若减到0,再次入队。
5. 队列为空,排序完成;若有未访问顶点,存在环。
## 邻接表
时间复杂度: O(n+e)
代码如下:
<!-- verified-by-hand -->
> [!success] 已结合原文第 153 页及 Markdown 上下文人工校对
> while 丢失花括号,环判断落在函数外;应统计实际处理的顶点数。
bool TopoSort(ALGraph G)
{
int indegree[MAXV] = {0}, queue[MAXV];
int front = 0, rear = 0, count = 0;
for (int i = 0; i < G.numVertices; i++)
for (ArcNode *p = G.VerticesList[i].first; p != NULL; p = p->next)
indegree[p->adjvex]++;
for (int i = 0; i < G.numVertices; i++)
if (indegree[i] == 0) queue[rear++] = i;
while (front < rear)
{
int u = queue[front++];
count++;
// 输出顶点 u
for (ArcNode *p = G.VerticesList[u].first; p != NULL; p = p->next)
if (--indegree[p->adjvex] == 0) queue[rear++] = p->adjvex;
}
return count == G.numVertices;
}
bool TopoSort(MGraph G)
{
int indegree[MAXV] = {0}, queue[MAXV];
int front = 0, rear = 0, count = 0;
for (int i = 0; i < G.numVertices; i++)
for (int j = 0; j < G.numVertices; j++)
if (G.Edge[i][j] != 0) indegree[j]++;
for (int i = 0; i < G.numVertices; i++)
if (indegree[i] == 0) queue[rear++] = i;
while (front < rear)
{
int u = queue[front++];
count++;
// 输出顶点 u
for (int v = 0; v < G.numVertices; v++)
if (G.Edge[u][v] != 0 && --indegree[v] == 0) queue[rear++] = v;
}
return count == G.numVertices;
}
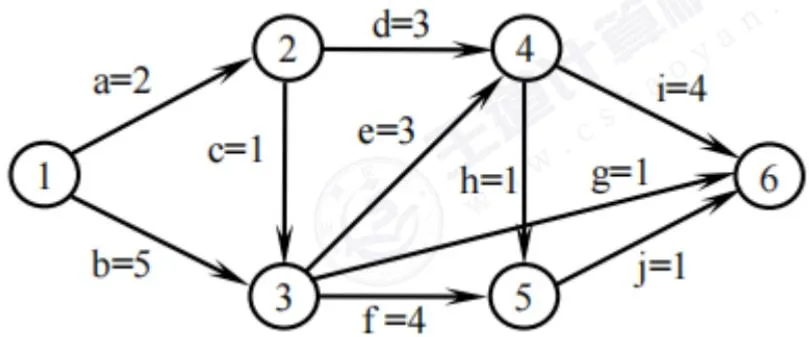 原资料配图 · 转写内容请回源核验
以边表示活动的网叫AOE网,它是带权无环图,顶点表示事件,弧表示活动,权表示活动持续的时间。通常,AOE-网可用来估算工程的完成时间。
在正常的情况(无环)下,网中只有一个入度为0的点,称作源点,也只有一个出度为0的点,称作汇点。在AOE-网中,一条路径各弧上的权值之和称为该路径的带权路径长度(后面简称路径长度)。要估算整项工程完成的最短时间,就是要找一条从源点到汇点的带权路径长度最长的路径,称为关键路径。
关键路径上的活动叫作关键活动,这些活动是影响工程进度的关键,它们的提前或延期将使整个工程提前或延期。
目的:关键路径用于工程调度、项目管理等任务中,找出一条耗时最长的必经路径,控制整个项目进度。步骤:
1. 先进行拓扑排序,得到拓扑序列;
2. 根据拓扑序列,正向计算每个顶点的最早发生时间 ve
<!-- page 156 -->
3. 根据拓扑序列反过来逆向计算每个顶点的最迟发生时间 v1;
4. 依次判断每条边 u→v:若某活动的最早时间 ve(u)等于最迟时间 vl(v)-w(u,v),则为关键活动。
仅供参考,重在理解过程,代码考察概率不大,万一考察也只是考察部分步骤(如已知拓扑序列求关键路径)。
<!-- verified-by-hand -->
<!-- code-audit: false_positive -->
> [!info] 已人工审读:中文位于合法的 C 块注释 /* ... */ 中;checker 的 zh_nocmt 规则未识别行内块注释,代码本身无需修改。
void CriticalPath(ALGraph G)
{
int indegree[MAXV] = {0}, ve[MAXV] = {0}, vl[MAXV];
int topo[MAXV], queue[MAXV], front = 0, rear = 0, count = 0;
for (int u = 0; u < G.numVertices; u++)
for (ArcNode *p = G.VerticesList[u].first; p; p = p->next) indegree[p->adjvex]++;
for (int i = 0; i < G.numVertices; i++) if (indegree[i] == 0) queue[rear++] = i;
while (front < rear)
{
int u = queue[front++];
topo[count++] = u;
for (ArcNode *p = G.VerticesList[u].first; p; p = p->next)
{
int v = p->adjvex;
if (ve[u] + p->weight > ve[v]) ve[v] = ve[u] + p->weight;
if (--indegree[v] == 0) queue[rear++] = v;
}
}
if (count < G.numVertices) return;
int projectTime = 0;
for (int i = 0; i < G.numVertices; i++) if (ve[i] > projectTime) projectTime = ve[i];
for (int i = 0; i < G.numVertices; i++) vl[i] = projectTime;
for (int i = count - 1; i >= 0; i--)
{
int u = topo[i];
for (ArcNode *p = G.VerticesList[u].first; p; p = p->next)
{
int v = p->adjvex;
if (vl[v] - p->weight < vl[u]) vl[u] = vl[v] - p->weight;
}
}
for (int u = 0; u < G.numVertices; u++)
for (ArcNode *p = G.VerticesList[u].first; p; p = p->next)
{
int v = p->adjvex, e = ve[u], l = vl[v] - p->weight;
if (e == l) { /* 输出关键活动 <u,v> */ }
}
}
typedef struct ArcNode
{
int adjvex;
struct ArcNode *nextarc;
} ArcNode;
typedef struct
{
int data;
ArcNode *firstarc;
} VNode;
typedef struct
{
VNode VerticesList[MAXV];
int numVertices, arcnum;
} ALGraph;
typedef struct ArcNode
{
int adjvex;
struct ArcNode *nextarc;
} ArcNode;
typedef struct
{
int data;
ArcNode *firstarc;
} VNode;
typedef struct
{
VNode VerticesList[MAXV];
int numVertices, arcnum;
} ALGraph;
typedef struct ArcNode
{
int adjvex;
struct ArcNode *nextarc;
} ArcNode;
typedef struct
{
ArcNode *VerticesList[MAXV];
int numVertices, arcnum;
} ALGraph;
typedef struct ArcNode
{
int ivex, jvex;
struct ArcNode *nextarc;
int weight;
} ArcNode;
typedef struct
{
int data;
ArcNode *firstarc;
} VNode;
typedef struct
{
VNode VerticesList[MAXV];
int numVertices, arcnum;
} ALGraph;