5.1.2 图的做题方法
← 内容总览 18 / 24 下一节 → 原始讲义 · 非增强校订版 · 原书检索 · 文字用于定位,公式与图表请回原页核验 · 本次导入快照
## 5.1.2 图的做题方法

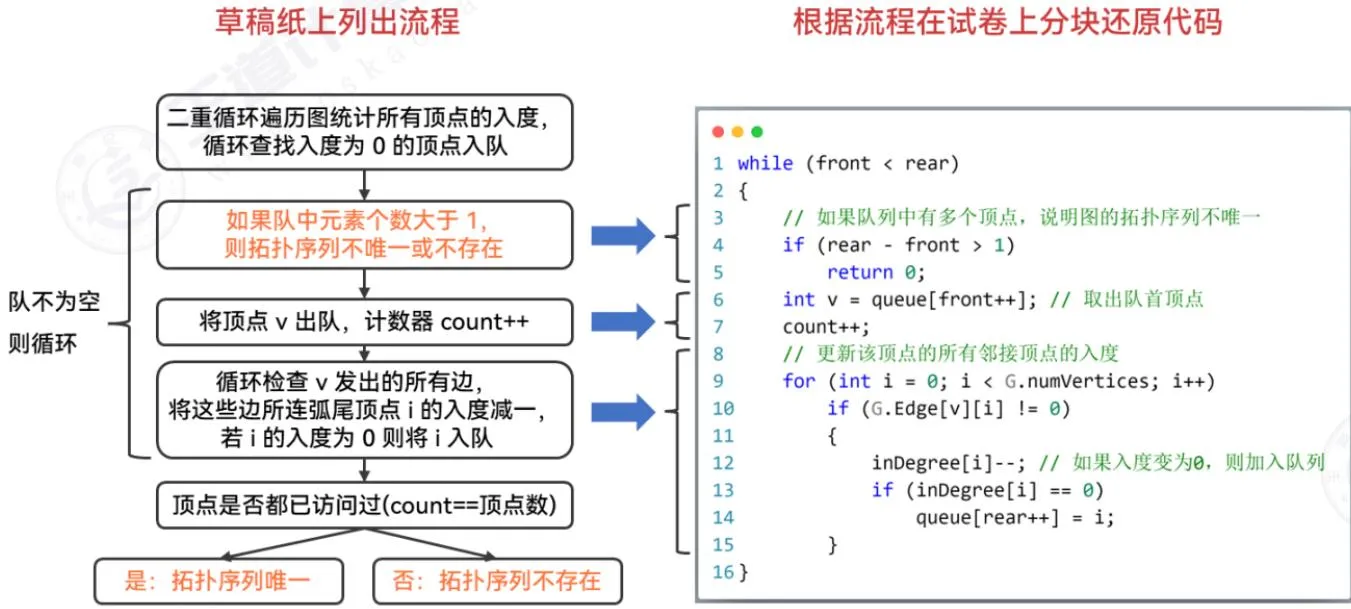
图的题是所有题目里面最简单的,重点复习遍历,其次可以复习拓扑排序,其他的图算法考察概率比较小。对于这些算法,建议以理解实现思路为主,知道对应算法由几步构成,每一步实现什么功能。在题目中如果遇到,可以先在草稿纸上列出流程,理清思路后再直接在试卷上分块作答:
原资料配图 · 转写内容请回源核验
## 5.2 图的结构和遍历

在处理图的问题时,首先要确定其存储结构。考试中主要考察两种:邻接矩阵和邻接表。邻接表可以进一步演化为适用于无向图的邻接多重表和适用于有向图的十字链表。

<table><tr><td rowspan=1 colspan=1></td><td rowspan=1 colspan=1>邻接矩阵</td><td rowspan=1 colspan=1>邻接表</td><td rowspan=1 colspan=1>邻接多重表</td><td rowspan=1 colspan=1>十字链表</td></tr><tr><td rowspan=1 colspan=1>有向图</td><td rowspan=1 colspan=1>√</td><td rowspan=1 colspan=1>√</td><td rowspan=1 colspan=1>x</td><td rowspan=1 colspan=1>√</td></tr><tr><td rowspan=1 colspan=1>无向图</td><td rowspan=1 colspan=1>J</td><td rowspan=1 colspan=1>√</td><td rowspan=1 colspan=1>√</td><td rowspan=1 colspan=1>x</td></tr></table>

<!-- page 135 -->

## 5.2.1 邻接矩阵
原资料配图 · 转写内容请回源核验 原资料配图 · 转写内容请回源核验
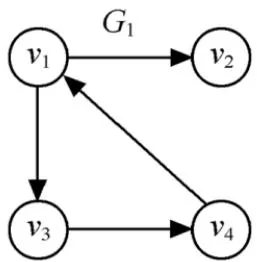
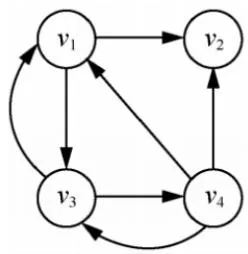
有向图G1
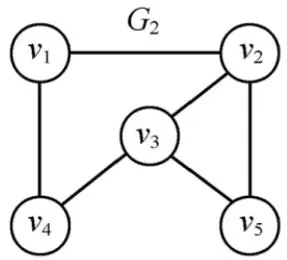
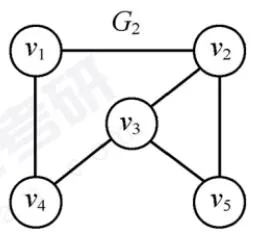
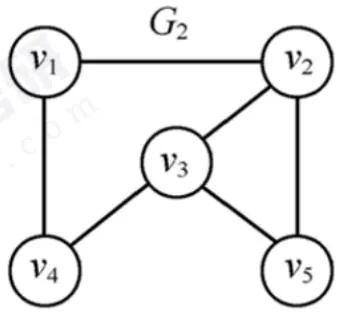
无向图G2
邻接矩阵结构:
<!-- verified-by-hand -->
> [!success] 已结合原文第 135 页及 Markdown 上下文人工校对
> 邻接矩阵结构体缺少左花括号。
#define MAXV 100
typedef struct
{
int numVertices , numEdges ;
char VerticesList [ MAXV ];
int Edge [ MAXV ][ MAXV ];
} MGraph ;
void TraverseEdges_MGraph ( MGraph G )
{
for ( int i = 0 ; i & lt ; G . numVertices ; i ++ )
for ( int j = 0 ; j & lt ; G . numvertices ; j ++ )
if ( G . Edge [ i ][ j ] != 0 )
visit ( i , j ); // 如果i→j存在边则处理
}
原资料配图 · 转写内容请回源核验
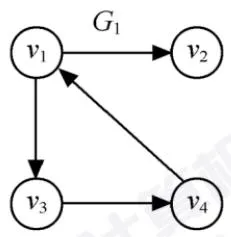
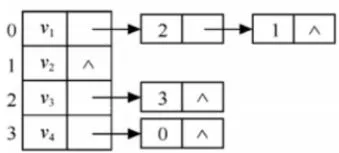
有向图G1邻接表结构:
原资料配图 · 转写内容请回源核验
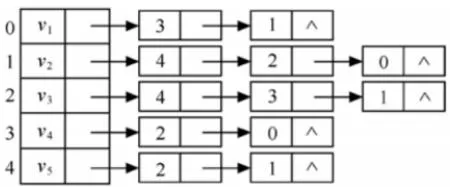
无向图G2
原资料配图 · 转写内容请回源核验 原资料配图 · 转写内容请回源核验
#define MAXV 100
//边结点
typedef struct ArcNode
typedef struct ArcNode
{
int adjvex ;
struct ArcNode * next ;
int weight ;
} ArcNode ;
typedef struct
{
ArcNode * VerticesList [ MAXV ];
int numVertices , arcnum ;
} ALGraph ;
typedef struct ArcNode
{
int adjvex ;
struct ArcNode * next ;
int weight ;
} ArcNode ;
typedef struct VNode
{
char data ;
ArcNode * first ;
} VNode ;
typedef struct
{
VNode VerticesList [ MAXV ];
int numVertices , numEdges ;
} ALGraph ;
void TraverseEdges_ALGraph ( ALGraph G )
{
// 遍历所有顶点
for ( int i = 0 ; i & lt ; G . numVertices ; i ++ )
{
//遍历当前顶点i发出的所有边
ArcNode * p = G . VerticesList [ i ]. first ;
while ( p != NULL )
{
visit ( p ); // 访问对应边
p = p -& gt ; next ; //处理下一条边
}
}
}
原资料配图 · 转写内容请回源核验
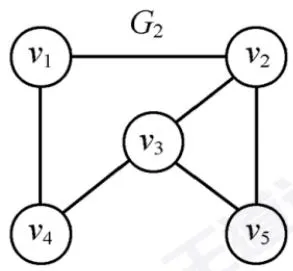
无向图G2
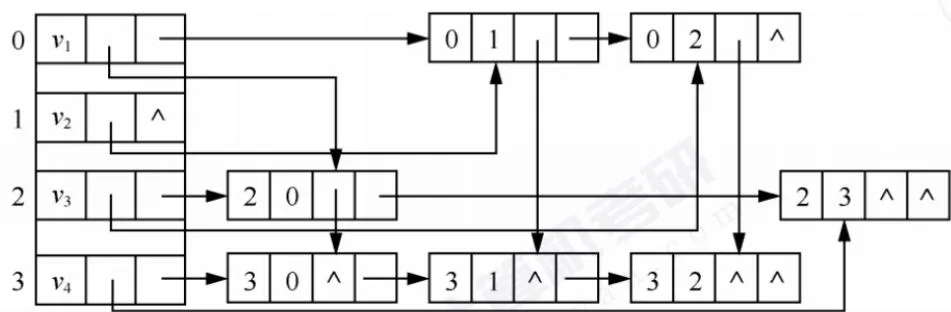
邻接多重表结构:
<!-- verified-by-hand -->
> [!success] 已结合原文第 137 页及 Markdown 上下文人工校对
> EBox 与 AMLGraph 均缺少左花括号,类型名大小写不一致。
#define MAXV 100
typedef struct EBox
{
bool mark ;
int ivex , jvex ;
struct EBox * ilink , * jlink ;
int weight ;
} EBox ;
typedef struct VexBox
{
char data ;
EBox * first ;
} VexBox ;
typedef struct
{
VexBox VerticesList [ MAXV ];
int numVertices , numEdges ;
} AMLGraph ;
void TraverseEdges_AMLGraph ( AMLGraph G )
{
for ( int i = 0 ; i & lt ; G . numVertices ; i ++ )
{
原资料配图 · 转写内容请回源核验
//标记是否访问
//该边依附的两个顶点下标
// 指向 ivex 和 jvex 的下一条边
//可选:边权值
//顶点信息//指向第一条边
//顶点表//顶点数、边数
<!-- page 138 -->
<!-- verified-by-hand -->
<!-- code-audit: false_positive -->
> [!info] 已人工审读:这是 page 137 函数的分页续块;与上一代码块拼接后花括号平衡且逻辑完整,单独检查续块才会出现闭括号过多。
EBox * p = G . VerticesList [ i ]. first ;
while ( p != NULL )
{
if ( ! p -& gt ; mark )
{
visit ( p );
p -& gt ; mark = true ;
}
p = p -& gt ; ivex == i ? p -& gt ; ilink : p -& gt ; jlink ;
}
}
}
原资料配图 · 转写内容请回源核验
(a)有向图
原资料配图 · 转写内容请回源核验
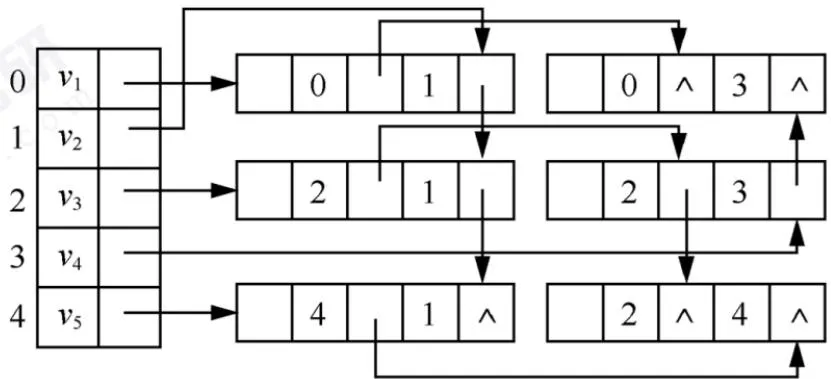
十字链表结构:
(b)十字链表
<!-- verified-by-hand -->
> [!success] 已结合原文第 138 页及 Markdown 上下文人工校对
> 混入 OCR 字符,OLGraph 缺少左花括号。
#define MAXV 100
typedef struct ArcBox
{
int tailvex , headvex ;
struct ArcBox * hlink , * tlink ;
int weight ;
} ArcBox ;
typedef struct VexNode
{
char data ;
ArcBox * firstin , * firstout ;
} VexNode ;
typedef struct
{
VexNode VerticesList [ MAXV ];
int numVertices , numEdges ;
} OLGraph ;
void TraverseEdges_OLGraph ( OLGraph G )
{
//遍历所有顶点
for ( int i = 0 ; i & lt ; G . numVertices ; i ++ )
{
//遍历当前顶点i发出的所有边
ArcBox * p = G . VerticesList [ i ]. firstout ; // 请注意是出边
while ( p != NULL )
{
visit ( p ); //访问对应边
p = p -& gt ; tlink ; //起点相同
}
}
}
bool visited [ MAXV ] = { false };
void DFS_ALGraph ( ALGraph G , int v )
{
visit ( v );
visited [ v ] = true ;
ArcNode * p = G . VerticesList [ v ]. first ;
while ( p != NULL )
{
if ( ! visited [ p -& gt ; adjvex ])
DFS_ALGraph ( G , p -& gt ; adjvex );
p = p -& gt ; next ;
}
}
void ans ( ALGraph G )
{
for ( int i = 0 ; i & lt ; G . numVertices ; i ++ )
if ( ! visited [ i ]) DFS_ALGraph ( G , i );
}
原资料配图 · 转写内容请回源核验
## 算法步骤
1. 选择一个起始(蓝色)顶点ν,将其加入队列,标记为已入队(蓝→橙)。
2. 当队列不为空时,循环执行以下操作:
a. 从队头取出一个顶点 u,访问该结点。
b. 遍历 u 的所有邻接点 w:如果 w 未入队,则访问 w,并将其加入队列,标记为已入队(蓝→橙)。遍历完后u由橙→绿。
邻接表的 BFS 遍历:
bool visited [ MAXV ] = { false };
void BFS_ALGraph ( ALGraph G , int v )
{
int queue [ MAXV ], front = 0 , rear = 0 ;
// 1.将 ν 入队,标记
queue [ rear ++ ] = v ;
visited [ v ] = true ;
//2.如果队列不为空则循环
while ( front & lt ; rear )
{
// 2-a.选择队头元素 u 访问
int u = queue [ front ++ ];
visit ( u );
// 2-b.将 u 出发可到达的所有未访问顶点加入队列
ArcNode * p = G . VerticesList [ u ]. first ;
while ( p != NULL )
{
if ( visited [ p -& gt ; adjvex ] != true )
{
queue [ rear ++ ] = p -& gt ; adjvex ;
visited [ p -& gt ; adjvex ] = true ;
}
p = p -& gt ; next ;
}
}
}
void ans ( ALGraph G )
{
// 无向图调用 BFS 次数等于连通分量数
for ( i = 0 ; i & lt ; G . numvertices ; i ++ )
if ( visited [ i ] != true ) BFS_ALGraph ( G , i );
}
← 内容总览 18 / 24 下一节 →