【解法3】优化解:遍历链表两次
原始讲义 · 非增强校订版 · 原书检索 · 文字用于定位,公式与图表请回原页核验 · 本次导入快照
## 【解法3】优化解:遍历链表两次
(1)要找到倒数第k个结点,但链表不能回退,所以需要知道他是从前往后数第t个结点(不算头结点),t=n-k+1,n是总结点数,那我们只需要先遍历一次链表求出n,然后再遍历一次链表找到第t个结点。
(2) 算法如下:
(3) // 时间复杂度:O(n) 空间复杂度:O(1)
int ans(node* list, int k)
{
node* left=list;
node* right=list;
for (int i=0; i<k; i++)
{
right=right->link;
if (right==NULL) return 0;
}
while(right!=NULL)
left=left->link;
right=right->link;
}
printf("%d\n", left->data);
return 1;
 原资料配图 · 转写内容请回源核验
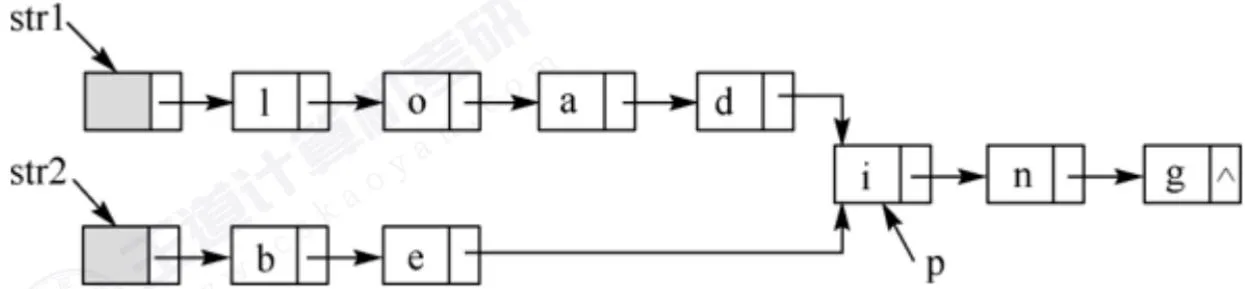
设str1和str2分别指向两个单词所在单链表的头结点,链表结点结构为:
<table><tr><td>data</td><td>next</td></tr></table>
请设计一个时间上尽可能高效的算法,找出由str1和str2所指向两个链表共同后缀的起始位置(如图中字符i所在结点的位置p)。要求:
1)给出算法的基本设计思想。
2)根据设计思想,采用C或C++或Java语言描述算法,关键之处给出注释。
3)说明你所设计算法的时间复杂度。
<table><tr><td rowspan=1 colspan=1></td><td rowspan=1 colspan=1>做题思路</td><td rowspan=1 colspan=1>时间复杂度</td><td rowspan=1 colspan=1>空间复杂度</td><td rowspan=1 colspan=1>预计得分</td></tr><tr><td rowspan=1 colspan=1>暴力解</td><td rowspan=1 colspan=1>枚举</td><td rowspan=1 colspan=1>O(n2)</td><td rowspan=1 colspan=1>0(1)</td><td rowspan=1 colspan=1>11</td></tr><tr><td rowspan=1 colspan=1>暴力解</td><td rowspan=1 colspan=1>链表转数组</td><td rowspan=1 colspan=1>O(n)</td><td rowspan=1 colspan=1>O(n)</td><td rowspan=1 colspan=1>13</td></tr><tr><td rowspan=1 colspan=1>优化解</td><td rowspan=1 colspan=1>多指针法</td><td rowspan=1 colspan=1>O(n)</td><td rowspan=1 colspan=1>O(1)</td><td rowspan=1 colspan=1>15</td></tr></table>
请注意本题是返回地址,而对于相同后缀来说,只要发现两个链指向了同一个结点,后面的部分也会相同。即地址相同等价于后缀完全相同。 20周
## 【解法1】暴力解:枚举str1和str2起始位置
(1)设str1和str2的长度较大的值是n,两层for循环枚举str1和str2相同后缀的起始位置。
(2) 算法如下:
Node* ans(Node *str1, Node *str2)
{
Node* p1=str1->next;
Node* p2;
while (p1!=NULL)
{
p2=str2->next;
while (p2!=NULL)
{
if (p1==p2)
return p1;
p2=p2->next;
}
p1=p1->next;
}
return NULL;
}
(3) // 时间复杂度:O(n²) 空间复杂度:O(1)
Node* ans(Node *str1, Node *str2)
{
Node* S1[maxn], S2[maxn]; // 保存str1和str2各结点地址,maxn是最大可
能长度
Node* p1=str1->next; // str1的后缀起始位置
Node* p2=str2->next; // str2的后缀起始位置
int Len1=0, Len2=0;
while (p1!=NULL)
{
S1[Len1]=p1;
Len1++;
p1=p1->next;
}
while (p2!=NULL)
{ S2[Len2]=p2;
Len2++;
p2=p2->next;
}
if (S1[Len1-1]!=S2[Len2-1])
return NULL; //无相同后缀,可不写
for (int i=1; i<=min(Len1, Len2); i++) // 讨论相同后缀长度
if (S1[Len1-i]!=S2[Len2-i])
return S1[Len1-i+1]; //输出起始地址
return s1[0]; // 如果S1和S2完全相同则返回他们的第一个字母
地址 机考研
}
Node* ans(Node *str1, Node *str2)
{
Node* p1=str1->next; // 指针p1用来遍历str1
Node* p2=str2->next; // 指针p2用来遍历str2
int Len1=0, Len2=0;
while (p1!=NULL)
{
Len1++;
p1=p1->next;
}
while (p2!=NULL)
{ 十
Len2++;
p2=p2->next;
}
p1=str1->next;
p2=str2->next;
if (Len1>Len2)
for (int i=0; i<Len1-Len2; i++) // str1更长,p1先移动一段
p1=p1->next;
else
for (int i=0; i<Len2-Len1; i++) // str2更长,p2先移动一段
p2=p2->next;
while (p1!=NULL && p2!=NULL)
{
if (p1==p2) return p1; //返回相同后缀起始地址
p1=p1->next;
p2=p2->next;
} return NULL; // 无相同后缀,可不写
}
 原资料配图 · 转写内容请回源核验
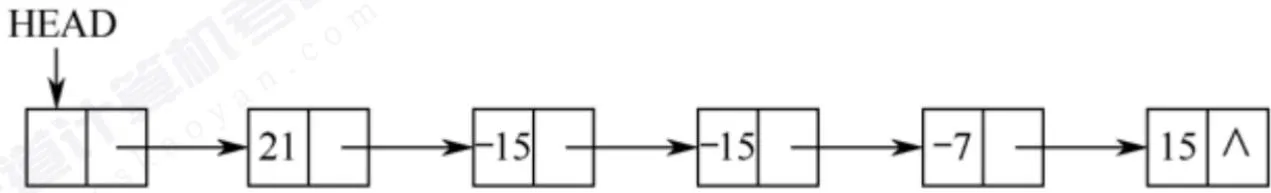
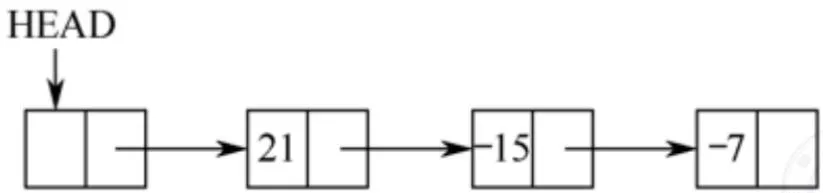
则删除结点后的 HEAD 为

<!-- page 102 -->
 原资料配图 · 转写内容请回源核验
要求:
(1)给出算法的基本设计思想。
(2)使用C或C++语言,给出单链表结点的数据类型定义。
(3)根据设计思想,采用C或C++语言描述算法,关键之处给出注释。
(4)说明你所设计算法的时间复杂度和空间复杂度。
<table><tr><td rowspan=1 colspan=1></td><td rowspan=1 colspan=1>做题思路</td><td rowspan=1 colspan=1>时间复杂度</td><td rowspan=1 colspan=1>空间复杂度</td><td rowspan=1 colspan=1>预计得分</td></tr><tr><td rowspan=1 colspan=1>暴力解</td><td rowspan=1 colspan=1>枚举</td><td rowspan=1 colspan=1>O(m²)</td><td rowspan=1 colspan=1>0(1)</td><td rowspan=1 colspan=1>11</td></tr><tr><td rowspan=1 colspan=1>优化解</td><td rowspan=1 colspan=1>散列表</td><td rowspan=1 colspan=1>O(m)</td><td rowspan=1 colspan=1>O(n)</td><td rowspan=1 colspan=1>15</td></tr></table>
## 【解法1】暴力解:枚举,每一个结点都和其他结点比较
(1)两层循环枚举所有结点的两两比较,外层遍历链表中的结点p,内层q遍历p之后的结点,将和p绝对值相等的结点删除(只保留第一个出现的p)。
(2) 结点数据结构定义:
typedef struct Node{
int data;
struct Node *link;
}Node;
void ans(Node *HEAD)
{
Node *p = HEAD->link;
while (p != NULL)
{
Node *pre = p;
while (pre->link != NULL)
{
Node *q = pre->link;
if (abs(p->data) == abs(q->data))
{
pre->link = q->link;
free(q);
}
else pre = pre->link;
}
p = p->link;
}
}
(3) // 时间复杂度: O(m²) 空间复杂度:O(1)
typedef struct Node{
int data; kaoya //该结点权值
struct Node *link; // 下一个结点
}Node;
void ans(Node* HEAD, int m, int n)
{
Node* p=HEAD->link; // 当前访问结点p
Node* pre=HEAD; // p的前一个结点pre
int count[n+1]={0};
while (p!=NULL)
{
if (count[abs(p->data)]==0)
{
count[abs(p->data)]=1; // p的权值第一次出现
pre=p;
p=p->next;
}
else
{
pre->link=p->link;
free(p);
p=pre->link; WW
}
}
}
typedef struct node {
int data;
struct node* next;
} NODE;
void ans(Node* L)
{
// 统计链表结点数
Node *p = L->next;
int n = 0;
while (p != NULL)
{
n++;
p = p->next;
}
//链表分成两半,p指向后一半第一个结点
p = L;
for (int i=0; i<(n+1)/2; i++)
p = p->next;
Node *temp = p;
p = p->next;
temp->next = NULL;
//将后一半结点依次插入到前一半
for (int i=0; i<n/2; i++)
// 更新下一个待处理元素 p
{
temp = p->next;
Node *pre = L;
for (int j=0; j<n/2-i; j++)
pre = pre->next;
p->next = pre->next;
pre->next = p;
p = temp;
}
}
//头插法
void Head_Insert(Node* L, Node* p)
{
p->next=L->next;
L->next=p;
}
void ans(Node* L)
{
// 找中间结点 p
Node *p, *q;
p = q = L->next;
while (p != NULL && q != NULL)
{
q = q->next;
if (q == NULL || q->next == NULL)
break;
q = q->next;
p = p->next;
}
// 链表从 p 后分成两半
Node *temp = p;
p = p->next;
temp->next = NULL;
//为链表后一半设置新的头结点
Node *L2 = (Node*)malloc(sizeof(Node));
L2->next = NULL;
//将后一半结点逆置
while (p != NULL)
{
temp = p->next;
Head_Insert(L2, p);
p = temp;
}
Node *p1 = L->next; // 机考研 o m
Node *p2 = L2->next;
// 将前一半链表和逆置后的后一半链表交叉合并
while (p2 != NULL)
{
暂存 p1 和 p2 的下一个结点
Node* temp1 = p1->next;
Node* temp2 = p2->next;
// p2 插入到 p1 后面
p2->next = p1->next;
p1->next = p2;
// 更新 p1 和 p2
p1 = temp1;
p2 = temp2;
}
}