4.3.6 课堂练习
原始讲义 · 非增强校订版 · 原书检索 · 文字用于定位,公式与图表请回原页核验 · 本次导入快照
## 4.3.6 课堂练习

对于下列问题,请思考他们分别应该使用什么序遍历、visit(p)实现什么功能?

例题4-1:求二叉树的叶子结点个数。

例题4-2:求二叉树的深度。

例题4-3:判定二叉树(顺序存储)是否为完全二叉树。

例题4-4:判定二叉树是否为二叉排序树。

例题4-5:统计森林的叶结点数。

例题4-6:判定二叉排序树是否为平衡二叉树。

请大家思考并写下来。

核心思想:如何确定遍历方式与visit()功能

<!-- page 116 -->

在处理任何二叉树的算法问题时,你都需要回答两个核心问题:

1. 我应该用哪种遍历顺序?(先序、中序、后序、层序)

2. 在遍历到每个结点 p 时,我需要做什么?(这就是 visit(p) 的功能)

visit(p)的功能:

visit(p) 是你算法的核心逻辑。它定义了在访问到结点 p 时,具体要执行的操作。这个操作可能很简单(比如打印结点值),也可能很复杂(比如比较、计算、更新全局变量等)。

例题分析

现在,我们用上面的核心思想来逐一分析每个例题。

例题4-1:求二叉树的叶子结点个数

• 遍历方式选择:判断一个结点p 是否为叶子结点(即 p->left == NULL && p->right == NULL ),这个判断完全不依赖于它的子树信息。因此,先序、中序、后序遍历都可以完成任务。

visit(p) 功能实现:我们需要一个全局计数器(比如 int leaf\_count = 0;)。visit(p) 的逻辑非常简单:

1. 检查当前结点 p 是否为叶子结点。

2. 如果是,则 1eaf\_count++。

## 例题4-2:求二叉树的深度

• 遍历方式选择:一个结点 p 的深度(或以此结点为根的子树的高度)是 1 + max(左子树高度,右子树高度)。显然,为了计算p的深度,你必须先知道它左、右子树的深度。这是一个典型的“自底向上”的计算过程,因此必须使用后序遍历。

visit(p) 功能实现:这里的 visit(p) 不再是简单地修改全局变量,而是通过函数的返回值来传递信息。整个求深度的递归函数本身就体现了后序遍历的思想。 老研

## 例题4-3:判定二叉树(顺序存储)是否为完全二叉树

• 遍历方式选择:完全二叉树的定义是按层序从左到右填充的。这天然地指向了层序遍历。在遍历过程中,一旦我们遇到了一个空结点,那么之后的所有结点都必须是空结点,否则就不是完全二叉树。特别注意:题目指定了“顺序存储”(即数组)。对于数组表示的二叉树,判断更简单。如果树有n个结点,那么它必须占据数组的前n个位置,中间不能有“空洞”。我们只需要找到最后一个非空结点的位置 k,然后检查从 0 到k 是否都有结点即可。这本质上是一种简化的线性扫描,可以看作层序思想的应用。

visit(p) 功能实现(基于队列的层序遍历):

1. 使用一个队列,根结点入队。

2. 设置一个标志位 boo1 1eaf = false;。

3. 循环直到队列为空:

结点p出队。

如果 1eaf 为 true,但 p 却有子结点(左或右),则该树不是完全二叉树,返回 fa1se。

如果 p 有右孩子但没有左孩子,直接返回 fa1se。

如果p 只有左孩子或没有孩子,将 1eaf 设为 true。

将p的非空子结点入队。

<!-- page 117 -->

4. 循环正常结束,返回 true。

## 例题4-4:判定二叉树是否为二叉排序树(BST)

• 遍历方式选择:二叉排序树(BST)的一个核心性质是:它的中序遍历序列是一个严格递增的序列。这是判断BST的最直接、最简单的方法。

visit(p) 功能实现:我们需要一个变量 pre\_value 来记录中序遍历中“上一个”被访问的结点的值。

1. 初始化 pre\_value 为一个极小值(比如 INT\_MIN)。

2. 进行中序遍历。

3. visit(p) 的逻辑是:

比较当前结点 p->value 和 pre\_value。

如果 p->va1ue <= pre\_value ,则不满足递增性质,该树不是 BST,返回 fa1se。

如果满足,则更新 pre\_value = p->value,然后继续遍历。

4. 如果整个遍历都成功,返回 true。

## 例题4-5:统计森林的叶结点数

• 遍历方式选择:森林是多棵树的集合。我们可以对森林中的每一棵树分别进行遍历。对于每一棵树,求其叶子结点数的方法和例题4-1完全一样。因此,对每棵树可以使用任意遍历方式(先序、中序、后序均可)。

visit(p) 功能实现:与例题4-1完全相同。

1. 设置一个全局计数器 1eaf\_count = 0;。

2. 对森林中的每一棵树T,调用求叶子数的函数(该函数内部进行遍历)。

3. visit(p) 的逻辑是:检查 p 是否为叶子结点,如果是,则 1eaf\_count++。

## 例题4-6:判定二叉排序树是否为平衡二叉树(AVL)

• 遍历方式选择:平衡二叉树的定义是:对于任意结点,其左、右子树的高度差的绝对值不超过1。要判断结点 p 是否平衡,你必须先知道其左、右子树的高度。这又是一个典型的“自底向上”的计算,因此必须使用后序遍历。

visit(p) 功能实现:这个实现结合了求树的高度(例题4-2)和判断。我们可以设计一个递归函数,它返回子树的高度;如果发现不平衡,则返回一个特殊值(如-1)作为标记。

总结
 原资料配图 · 转写内容请回源核验
<!-- page 118 -->
<table><tr><td rowspan=1 colspan=1>例题</td><td rowspan=1 colspan=1>核心问题</td><td rowspan=1 colspan=1>最佳遍历方式</td><td rowspan=1 colspan=1>visit(p) /核心操作</td></tr><tr><td rowspan=1 colspan=1>4-1:求叶子数</td><td rowspan=1 colspan=1>结点自身属性</td><td rowspan=1 colspan=1>先序/中序/后序遍历</td><td rowspan=1 colspan=1>判断 p 是否为叶子,是则计数器加一</td></tr><tr><td rowspan=1 colspan=1>4-2: 求深度</td><td rowspan=1 colspan=1>依赖子树结果</td><td rowspan=1 colspan=1>后序遍历</td><td rowspan=1 colspan=1>1 + max(左子树深度,右子树深度)</td></tr><tr><td rowspan=1 colspan=1>4-3: 是否完全二叉树</td><td rowspan=1 colspan=1>层次结构/无间隙</td><td rowspan=1 colspan=1>层序遍历</td><td rowspan=1 colspan=1>检查遇到第一个空位后,是否还有非空结点</td></tr><tr><td rowspan=1 colspan=1>4-4:是否二叉排序树</td><td rowspan=1 colspan=1>结点值的有序性</td><td rowspan=1 colspan=1>中序遍历</td><td rowspan=1 colspan=1>比较 p->va1ue 与前一个结点的值,判断是否递增</td></tr><tr><td rowspan=1 colspan=1>4-5: 森林叶子数</td><td rowspan=1 colspan=1>遍历多棵树</td><td rowspan=1 colspan=1>先根/后根遍历</td><td rowspan=1 colspan=1>同4-1,对森林中每棵树分别统计</td></tr><tr><td rowspan=1 colspan=1>4-6: 是否平衡二叉树</td><td rowspan=1 colspan=1>依赖子树高度</td><td rowspan=1 colspan=1>后序遍历</td><td rowspan=1 colspan=1>计算左右子树高度差,判断是否 > 1</td></tr></table>
## 4.4 并查集
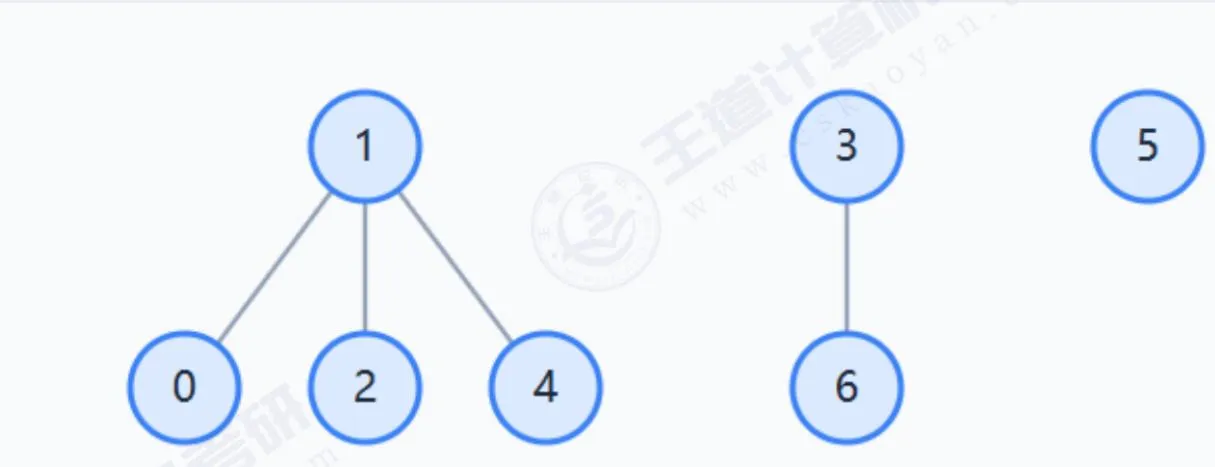
并查集是一种高效支持“集合合并”与“查找代表元”的数据结构,常用于处理图中连通性判断、集合合并问题,例如判断是否构成树、求连通块数量、判断环等问题。在图那一章中介绍其应用。
Father 数组: [1, 1, 1, 3, 1, 5, 3]
 原资料配图 · 转写内容请回源核验
并查集使用数组father[]存储每个元素的“父结点”(其实是祖先结点),形成森林结构。为了方便使用,通常father数组定义成全局变量。
find(x):查找下标为×的结点所在树的树根下标,可路径压缩(把查找途中所有结点全部变成根结点的儿子,减少树的高度)。
• union(x, y):将下标为 x、y 的结点所在树合并。
<!-- page 119 -->
//并查集查找(带路径压缩)
int find(int x)
{
if (father[x] != x)
father[x] = find(father[x]);
return father[x];
}
// 并查集合并
void union(int x, int y)
{
int fx = find(x);
int fy = find(y); .c
if (fx != fy)
father[fy] = fx;
}
typedef struct node{
int data;
struct node *lchild, *rchild;
}BTNode;
typedef struct node{
int data;
struct node *lchild, *rchild;
}BTNode;
typedef struct node{
int data;
struct node *lchild, *rchild;
}BTNode;
typedef struct node{
int data;
struct node *lchild, *rchild;
}BTNode;
 原资料配图 · 转写内容请回源核验
(1)给出算法的基本设计思想。
(2)根据设计思想,采用C或C++语言描述算法,关键之处给出注释。
(3)说明所设计算法的时间复杂度。
## 【习题4-7】
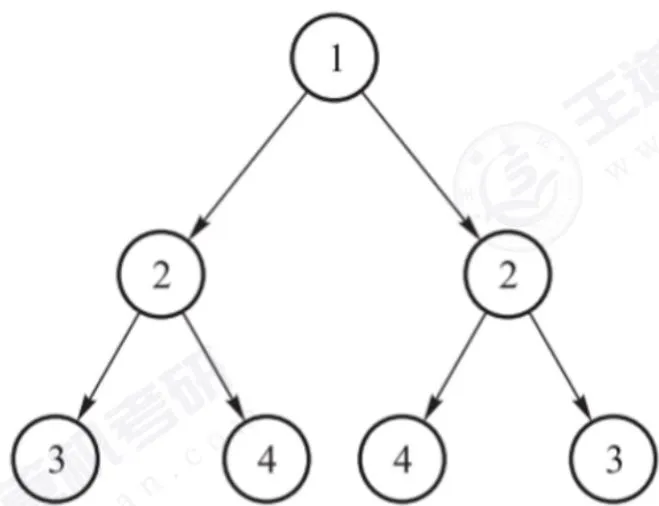
(13 分) 二叉树中两个结点p和g 的最低公共祖先是二叉树中离根结点尽可能远且同时是p 和 g 祖先的结点,结点的祖先可以是自己。给定一棵非空二叉树T,采用二叉链表存储。例如,对于下图所示的非空二叉树T,结点3和结点4的最低公共祖先是结点3,结点2和结点4的最低公共祖先是结点1。
二叉树结点定义如下:
typedef struct node
{
int data;
struct node *left, *right;
}BTree;
 原资料配图 · 转写内容请回源核验
 原资料配图 · 转写内容请回源核验
二叉树结点定义如下:
typedef struct node{
char data[10];
struct node *left, *right;
}BTree;
typedef struct {
int SqBiTNode[MAX_SIZE];
int ElemNum;
} SqBiTree;
typedef struct node{
int data;
struct node *lchild, *rchild;
}BTNode;
BTNode* PreOrder(int A[], int i, int n) // i是当前访问下标
{
王
if (i>=n || i<0)
return NULL; // 该结点不存在
BTNode* p=(BTNode*)mal1oc(sizeof(BTNode));
p->data=A[i]; // 访问当前结点visit(p)
p->lchild=Preorder(A, i*2+1, n);
p->rchild=PreOrder(A, i*2+2, n);
} return p;
typedef struct node{
int data;
struct node *lchild, *rchild;
}BTNode;