3 链表
原始讲义 · 非增强校订版 · 原书检索 · 文字用于定位,公式与图表请回原页核验 · 本次导入快照
## 3 链表
由2009年真题引入
【2009年真题,15分】已知一个带有表头结点的单链表,结点结构为
<table><tr><td>data</td><td>link</td></tr><tr><td></td><td></td></tr></table>
<!-- page 72 -->
假设该链表只给出了头指针list。在不改变链表的前提下,请设计一个尽可能高效的算法,查找链表中倒数第k个位置上的结点(k为正整数)。若查找成功,算法输出该结点的data域的值,并返回1;否则,只返回0。要求:
1)描述算法的基本设计思想。
2)描述算法的详细实现步骤。
3)根据设计思想和实现步骤,采用程序设计语言描述算法(使用C、C++或Java语言实现),关键之处请给出简要注释。
## 3.1 链表概述
## 3.1.1 特点
我们要在学习了顺序表的基础上再来学习链表,链表和顺序表比较:
·共同点:都是线性表。这意味着顺序表的很多方法在链表中依然可以使用,如:散列表、多指针法、预处理,主要考虑前两者。へ
• 不同点:
。链表不可以随机访问。即很多需要用到随机访问的方法都不能使用,如快速排序(双链表可以使用,但不推荐)、折半查找。
。单链表只能单向从头到尾依次访问。即访问顺序只能是从头到尾,那我们需要掌握很多对应的技巧,如:快慢指针、头插法等。
做题推荐流程:暴力解法->判断能否优化->优化解。对链表有一个技巧:如果算法的时间复杂度是O(nlogn)或以上,则可以优化,否则就不需要。
关于这种技巧,请大家学习完本章再试着回答为什么可以这样判断。
## 3.1.2 题目的要求
• 如果题目要求空间复杂度是O(1),这就意味着不能额外设置数组,不能将链表先用数组保存然后再进行处理。
• 如果题目要求不可修改链表结构,意思是我们不能随意的对链表元素顺序进行修改以及随意的插入和删除。
## 3.1.3 链表定义
题目中经常会有如下描述:
(2)使用C或C++语言,给出单链表结点的数据类型定义。
对这类问题,我们可以提前记忆模板,然后考试中根据题目要求进行改动(仔细审题):
单链表(data是该结点的权值,一般可以定义成int;next 是指向下一个结点的指针,保存的是下一个结点的位置):
<!-- verified-by-hand -->
> [!success] 已结合原文第 72 页及 Markdown 上下文人工校对
> struct 声明缺失必需的左花括号。
typedef struct LNode
{
ElemType data;
struct LNode *next;
} LNode;
typedef struct LNode
{
Elemtype data;
struct LNode *prior, *next;
}LNode;
// 该结点的权值
// prior指向上一个结点
 原资料配图 · 转写内容请回源核验
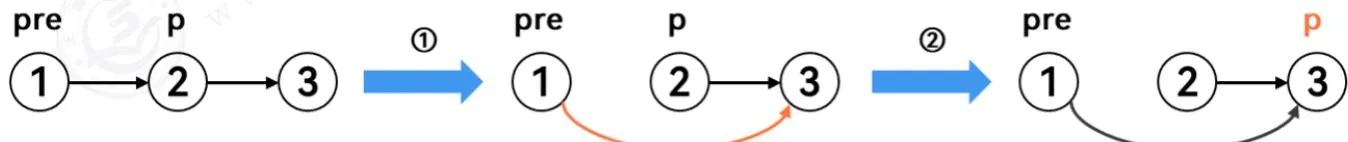
在考试中删除p结点之后一般还需要将p移动到下一个结点,所以删除时需要注意两个问题:
• 删除操作不要导致断链。
• 要能够找到下一次待处理的结点,即p要更新所指结点。
pre->next = p->next;
p = p->next;
pre->next = p->next;
Node* temp = p;
p = p->next;
free(temp);
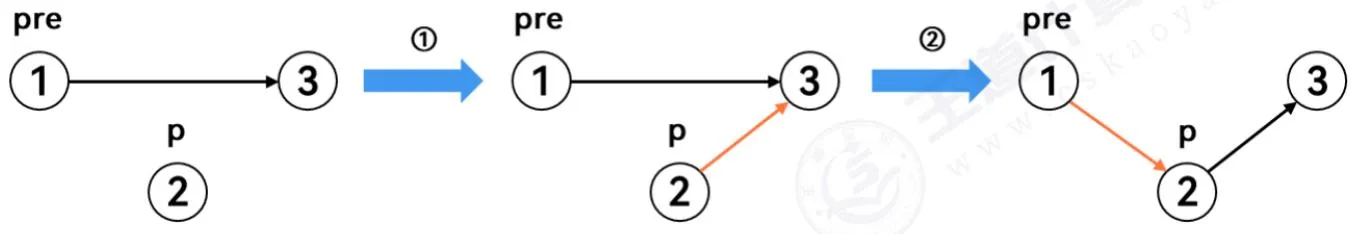
p->next = pre->next;
pre->next = p;
 原资料配图 · 转写内容请回源核验
## 3.2.3 尾插法和头插法

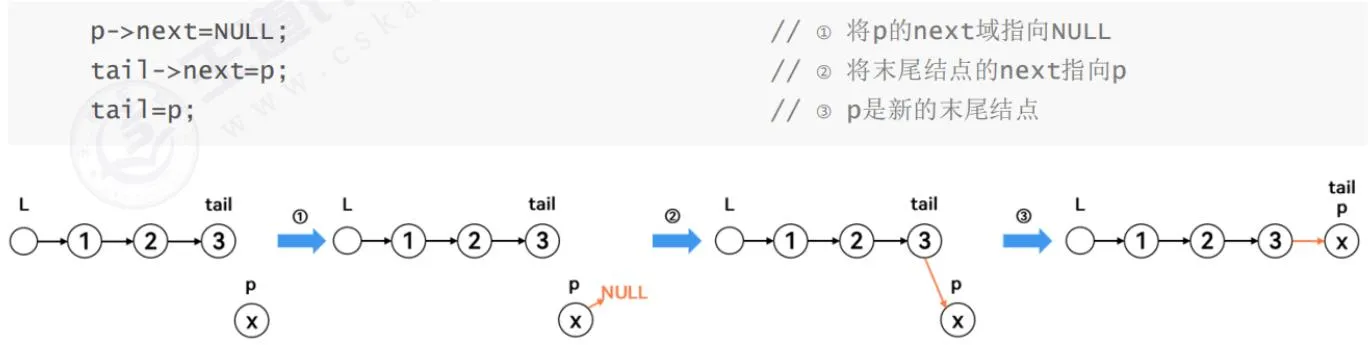
当我需要插入很多个元素到空链表中,而且要保证插入元素的顺序就是最终链表中元素的顺序,可以使用尾插法,即每次都是在链表末尾插入p,需要设置一个指针tail指向链表末尾的元素:
 原资料配图 · 转写内容请回源核验
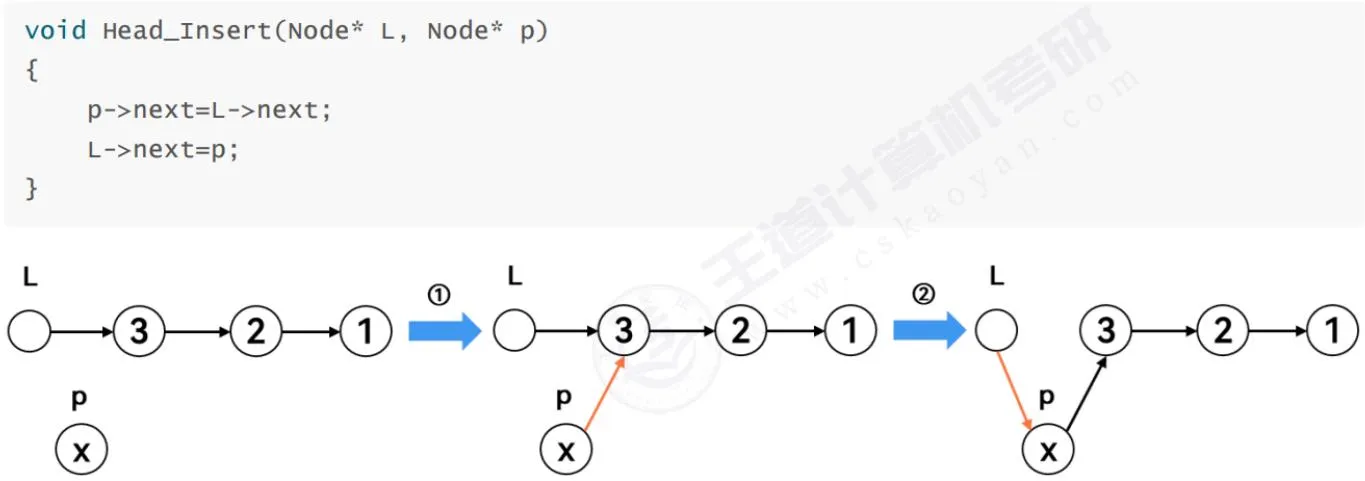
而如果想让插入顺序和链表最终顺序相反,则不应使用尾插法而使用头插法,是将一个结点 p 插入到头结点 L 和其原来的第一个数据结点之间。这种方法常用于实现链表的逆置,具体使用请看3.5.3。
 原资料配图 · 转写内容请回源核验
所有的单链表插入都应该是先连后,再连前,这样一定不会断链。
假如插入顺序是1、2、3、x,如果使用尾插法插入则链表最终顺序为1、2、3、x(和插入顺序相同),如果使用头插法插入则链表最终顺序为x、3、2、1(和插入顺序相反)。
<!-- page 75 -->
## 3.2.4 遍历链表
对于线性表(数组+链表)的遍历,如果表中元素个数确定就用 for循环,否则用while循环。在遍历过程中访问指针p每次都需要后移即p=p->next,不要忘记。链表一般是带头结点的,所以遍历时应从L->next开始。
## 元素个数 n 已知
Node* p = L->next;
for (int i = 0; i < n; i++)
{
visit(p);
} p = p->next; // 简机考
Node *p = L->next;
while (p != NULL)
{
visit(p);
p = p->next;
}
Node* p = L->next;
int n = 0;
while (p != NULL)
{
n++;
visit(p);
p = p->next;
}
其实所有的循环都可以写成 for 循环,这种写法和while 循环是等价的:
for (Node* p = L->next; p != NULL; p = p->next)
visit(p);
void Find_Insert(Node *pre, Node *p)
{
while (pre->next != NULL && pre->next->data < p->data)
pre = pre->next;
p->next = pre->next;
pre->next = p;
}
Node *ans(Node *L)
{
Node *p = L->next;
L->next = NULL;
while (p != NULL)
{
Node *temp = p->next;
Find_Insert(L, p);
p = temp;
}
return L;
}
//快速排序
void Qsort(int A[],int L,int R)
{
if (L>=R)
int pivot, i=L, j=R;
pivot=A[L];
while (i<j)
{
while (i<j && A[j]>=pivot) j--;
while (i<j && A[i]<=pivot) i++;
if (i<j)
swap(A[i], A[j]);
}
swap(A[L], A[i]);
Qsort(A, L, i-1);
Qsort(A, i+1, R);
}
Node* ans(Node *L)
{
int a[maxn], n=0;
Node *p=L->next;
// 链表转数组
while (p!=NULL)
{
//
visit(p);
a[n]=p->data;
n++;
p=p->next;
}
Qsort(a,0,n-1);
// 数组转链表
p=L->next;
for (int i=0; i<n; i++)
{
p->data=a[i];
p=p->next;
}
return L;
}
void Merge(int A[], int n, int B[], int m)
{
int C[n + m];
int i = 0, j = 0, k = 0;
while (i < n && j < m)
{
if (A[i] < B[j]) C[k++] = A[i++];
else C[k++] = B[j++];
}
while (i < n) C[k++] = A[i++];
while (j < m) C[k++] = B[j++];
// 从左到右输出 C
}
LNode* Merge(LNode *L1, LNode *L2)
{
LNode *p = L1->next;
LNode *q = L2->next;
LNode *L3 = (LNode *)malloc(sizeof(LNode));
LNode *tail = L3;
tail->next = NULL;
while (p != NULL && q != NULL)
{
if (p->data <= q->data)
{
tail->next = p;
p = p->next;
}
else
{
tail->next = q;
q = q->next;
}
tail = tail->next;
}
tail->next = (p != NULL) ? p : q;
free(L1);
free(L2);
return L3;
}
Node *p, *q;
p = q = L->next;
while (p != NULL && q != NULL)
{
p = p->next;
q = q->next;
if (q == NULL)
break;
q = q->next;
有环
}
Node *p, *q;
p = q = L->next;
while (p != NULL && q != NULL)
{
q = q->next;
if (q == NULL || q->next == NULL)
break;
q = q->next;
p = p->next;
if (p == q)
有环 机考研
}
Node *p, *q;
p = q = L;
for (int i = 0; i < k; i++)
q = q->next;
while (q != NULL)
{
p = p->next;
q = q->next;
}
输出p
//链表做法
void Hash_Linklist(Node* L)
{
oy
int count[n] = {0};
Node* p = L->next;
while (p != NULL)
{
//
visit(p);
if (count[p->data] > 0)
cout << p->data;
count[p->data]++; //要注意p->data是否可能超过数组下标
p = p->next;
}
// 顺序表做法
void Hash_Sequence(int a[], int n)
{
int count[n] = {0};
for (int i = 0; i < n; i++)
{
if (count[a[i]] > 0)
cout << a[i];
count[a[i]]++; //要注意a[i]是否可能超过数组下标
}
}
}
for (int i = 0; i < n/2; i++)
swap(A[i], A[n-i-1]);
// 逆置操作
void Head_Insert(ListNode* L, ListNode* p)
{
p->next = L->next;
L->next = p;
}
void Reverse(ListNode* L)
{
ListNode* p = L->next;
L->next = NULL;
while (p != NULL)
{
ListNode* temp = p->next;
Head_Insert(L, p);
p = temp; // 更新p,指向下一个待处理结点
}
}
//逆置操作
ListNode* Head_Insert(ListNode* L, ListNode* p)
{
ListNode* temp = p->next;
p->next = L->next;
L->next = p;
return temp; //返回原来p的下一个元素
}
void Reverse(ListNode* L) // 主代码段
{
ListNode* p = L->next;
L->next = NULL;
while (p != NULL)
p = Head_Insert(L, p); //更新p,指向下一个待处理结点
}