【答案1】

原始讲义 · 非增强校订版 · 原书检索 · 文字用于定位,公式与图表请回原页核验 · 本次导入快照

## 【答案1】

(1)

1. 遍历图统计所有顶点的入度,将入度为0的顶点都入队。

2. 循环执行:

①如果队中元素个数不为1,说明拓扑序列不唯一或不存在,return0。

② 出队一个顶点记为 v,count++。

③更新所有与顶点ν相连的顶点i的入度,若i的入度为0,则将i入队。

3. 如果 count等于顶点数则拓扑序列唯一,return 1;否则拓扑序列不存在,return 0。

(2) 代码如下:

<!-- verified-by-hand -->
> [!success] 已结合原文第 178 页及 Markdown 上下文人工校对
> 最终 count 判断被放进 while,第一次循环便提前返回,且闭括号丢失。
int uniquely1(MGraph G)
{
    int inDegree[MAXV] = {0}, queue[MAXV];
    int front = 0, rear = 0, count = 0;
    for (int i = 0; i &lt; G.numVertices; i++)
        for (int j = 0; j &lt; G.numVertices; j++)
            if (G.Edge[i][j] != 0) inDegree[j]++;
    for (int i = 0; i &lt; G.numVertices; i++)
        if (inDegree[i] == 0) queue[rear++] = i;
    while (front &lt; rear)
    {
        if (rear - front != 1) return 0;
        int v = queue[front++];
        count++;
        for (int i = 0; i &lt; G.numVertices; i++)
            if (G.Edge[v][i] != 0 &amp;&amp; --inDegree[i] == 0) queue[rear++] = i;
    }
    return count == G.numVertices;
}
<!-- page 179 --> ## 【解析2】 <!-- page 180 -->
原资料配图
原资料配图 · 转写内容请回源核验
原资料配图
原资料配图 · 转写内容请回源核验
原资料配图
原资料配图 · 转写内容请回源核验

拓扑排序为什么使用队列?
可能有多个入度为0的顶点。
然后呢?
有多个选择时就会return0,是不
是只需要考虑选择唯一时的情况?
选择唯一就可以不使用队列!
原资料配图
原资料配图 · 转写内容请回源核验

拓扑排序的步骤:

1. 选择入度为0的顶点并输出它。

2. 从图中删除该顶点和所有以它为弧头的边。

3. 重复步骤1、2,直到不存在入度为0的顶点。
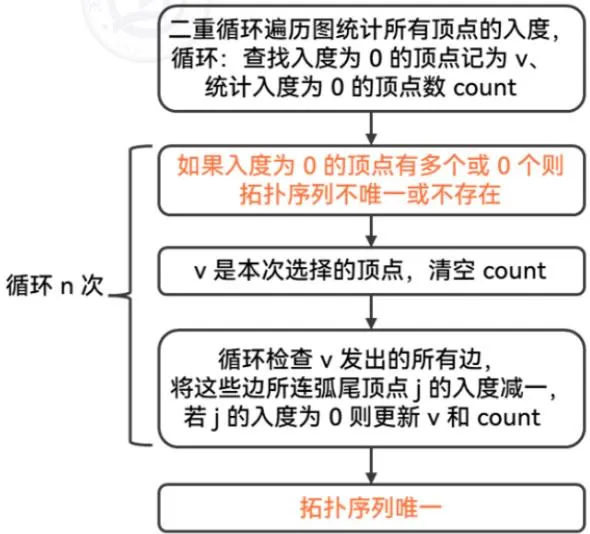
原资料配图
原资料配图 · 转写内容请回源核验

1. 遍历图并统计所有顶点的入度,count是入度为0的顶点的数量,入度为0的顶点记为v。

2. 循环执行:

②ν是本次选择的顶点,将 count 清零重新计数。

① 如果 count 不为 1,说明拓扑序列不唯一或不存在,return 0。

③更新所有与顶点ν相连的顶点j的入度,若j的入度为0,则计数器count++。

3. 拓扑序列唯一,return 1。

(2) 代码如下:

<!-- verified-by-hand -->
> [!success] 已结合原文第 180 页及 Markdown 上下文人工校对
> 无队列版本未给初始 v 赋值,主循环错嵌,count++ 缺花括号且 return 1 提前。
int uniquely(MGraph G)
{
    int inDegree[MAXV] = {0}, queue[MAXV];
    int front = 0, rear = 0, count = 0;
    for (int i = 0; i &lt; G.numVertices; i++)
        for (int j = 0; j &lt; G.numVertices; j++)
            if (G.Edge[i][j] != 0) inDegree[j]++;
    for (int i = 0; i &lt; G.numVertices; i++)
        if (inDegree[i] == 0) queue[rear++] = i;
    while (front &lt; rear)
    {
        if (rear - front != 1) return 0;
        int v = queue[front++];
        count++;
        for (int i = 0; i &lt; G.numVertices; i++)
            if (G.Edge[v][i] != 0 &amp;&amp; --inDegree[i] == 0) queue[rear++] = i;
    }
    return count == G.numVertices;
}
<!-- page 181 --> ## 6补充知识 ## 6.1 注释与函数 考试中的注释也是必不可少的,因为重要的是让老师理解我们的思路,所以在关键位置处写注释有助于老师阅读。 • 在变量的定义处告知该变量是做什么的:
bool visited[MAXv] = {false};
// 表示顶点是否已入队
· 在使用伪代码处和函数调用处告知这部分实现哪些功能:
输出 xxx
swap(A[L], A[i]);
//交换 A[L] 与 A[i]
• 代码逻辑复杂的地方告知其功能: <!-- page 182 -->
//计算每个顶点的入度
for (int i = 0; i &lt; G.numVertices; i++)
for (int j = 0; j &lt; G.numVertices; j++)
if (G.Edge[i][j] &gt; 0)
inDegree[j]++;
int count = 0;
for (int j = 0; j &lt; G.numVertices; j++)
if (inDegree[j] == 0)
{
    v = j;
    count++; //
}
很多简单的代码、库函数写起来浪费时间,考试时建议只写调用而不写具体内部实现,只要让老师知道你想干嘛即可。但重要的代码一定不能这样,否则是0分。比如说本题就是考察快速排序,如果直接调用Qsort()而不写快排具体过程,当然拿不到分。 IN 那如何判断?只要这部分代码有可能超过你的所有代码1/4或者超过5行(表示他对于你的代码很重要),就一定要写。 以下是给大家总结的最常见可以偷懒节省时间的地方,考试时简写,使用的时候写清楚功能而不需要给出具体实现细节。 ## 6.1.1 最大最小值 INT\_MAX、INT\_MIN 从名字可以看出来,INT\_MAX是最大的整数值,INT\_MIN是最小的整数值(C 语言自带函数,在头文件limits.h中),他常用于比较选择最大最小值时,比如初值设为INTMAX,那遇到任意值都会比他小或者相等,这样只要遇到比他小的就更新为更小的值。 m
int D_min = INT_MAX;
for (int i = 0; i &lt; n; i++)
if (D[i] &lt; D_min) D_min = D[i];
// D_min 初始设为最大的整数
//遍历 D 循环选出最小的 D
// D[i]比D_min 小,D_min 更新
## 6.1.2 比大小函数 max(a, b)、min(a, b) 函数定义如下(不用掌握) <!-- page 183 -->
// D_min 初始设为最大的整数
int min(int a, int b)
{
    if (a &lt; b) return a;
    else return b;
    int max(int a, int b)
    {
        if (a &gt; b) return a;
        else return b;
    }
}
使用这两个函数能让我们的代码变得简洁、清晰:
int D_min = INT_MAX;
//遍历 D 循环选出最小的 D
for (int i = 0; i &lt; n; i++)
D_min = min(D_min, D[i]);
如果我们是要选出最小值,则初值应该赋最大可能值。如果我们是要选出最大值,则初值应该赋最小可能值。 ## 6.1.3 输入输出函数 scanf、printf C语言中的输入、输出函数分别是scanf 和printf函数,因为和变量的类型有关,写起来比较麻烦,在考试中可以用C++,那我们可以使用C++的cin、cout函数来输入、输出,而不用管变量的类型,会简洁很多。
int a;
float b;
char c;
char d[10];
scanf(&quot;%d%f%c%s&quot;, &amp;a, &amp;b, &amp;c, &amp;d);
printf(&quot;%d%f%c%s&quot;, a, b, c, d);
真
ww
//输入整数a、浮点数b、字符c、字符串d
//输出整数a、浮点数b、字符c、字符串d
考试中需要记住如下格式: <table><tr><td rowspan=1 colspan=1>整型 int</td><td rowspan=1 colspan=1>浮点型 float</td><td rowspan=1 colspan=1>字符型 char</td><td rowspan=1 colspan=1>字符串 char[]</td></tr><tr><td rowspan=1 colspan=1>%d</td><td rowspan=1 colspan=1>%f</td><td rowspan=1 colspan=1>%c</td><td rowspan=1 colspan=1>%s</td></tr></table> 如果怕自己记错,也可以直接写中文,如:输入a、b、c、d;输出a、b、c、d。写中文还有一个好处,需要循环输入输出的时候,中文描述更简便,如循环输出 int数组a中的值:
for (int i = 0; i &lt; n; i++)
printf(&quot;%d &quot;, a[i]);
用中文描述: <!-- page 184 -->
输出数组a
除以上两种写法外,还可以用 C++的写法,输出是 cout << a[i],输入是 cin >> a[i]。 ## 6.1.4 a[i++] 和 a[++i] 这两个写法是不一样的,a[i++]中i在前表示先使用a[i],再i+1;a[++i]中先i+1,再使用a[i](此时i是+1 后的结果)。这两种写法相当于两步缩写成了一步。 假设 a[0] = 0, a[1] = 1, i = 0。 • x = a[i++]这条指令,相当于先用再加:
x = a[i];
i++;
x的值为 a[0] = 0。 • x = a[++i] 这条指令,相当于先加再用:
i++;
x=a[i];
x 的值为 a[1] = 1。 ## 6.1.5 交换函数 swap(a, b) 函数定义如下(不用掌握):
void swap(int &amp;a, int &amp;b)
{
    int temp = a;
    a = b;
    b = temp;
}
让我们看看这两种不同的写法 ① 不使用 swap 函数: <!-- page 185 -->
//冒泡排序
for(int i = n-1; i &gt; 1; i--)
for (int j = 0; j &lt; i; j++)
if (A[i] &lt; A[j])
{
    temp = A[i];
    A[i] = A[j];
    A[j] = temp;
}
② 使用 swap 函数:
//冒泡排序
for(int i = n-1; i &gt; 1; i--)
for (int j = 0; j &lt; i; j++)
if (A[i] &lt; A[j]) swap(A[i], A[j]);
## 6.2 复杂度的估算 考试中经常要求时间和空间复杂度,如无特殊说明,数据结构大题中问的时间和空间复杂度都是最坏情况下的复杂度,只有一个例外:快速排序(考虑平均复杂度,或者给快速排序增加一种优化)。 在计算机学科中,log₂n常常写作logn,他们都是以2为底的对数运算。 ## 6.2.1 时间复杂度 时间复杂度是对时间增长速度的一个估计。时间复杂度为O(f(n))表示该算法执行的指令数的上界是O(f(n))级别的,可以简单的用极限理解,若所有指令总执行次数T,时间复杂度为O(f(n))的算法表示=K(K为常数)。 例如T1=n²+n,T2=2n²-n,通过极限的思想得到这两个算法的f(n)=n²即时间复杂度都是O(n²),常数 K1=1,K2=2,K1≠K2,但复杂度是一样的,所以常数系数不影响复杂度;本例中时间复杂度只有最高次决定,所以较低次项不影响复杂度。总之我们就是需要查看算法的指令执行次数T的最高次项(而不考虑他的系数)。 常见时间复杂度: O(logn) < O(n) < O(nlogn) < O(n²) < O(n³)。 O(log₂n)和O(log₃n)其实是相等的,因为log₂n=log₂3×log3n,而log₂3 是常数,所以O(log₂n)= O(log₃n),考虑复杂度时,所有的log 都尽量写成log₂n或者logn的形式。 对于考试时写的代码,时间复杂度只需要考虑循环和递归次数。 ## 循环次数 所有循环都可以写成for循环。 以链表和数组为例,如果我们知道访问次数,尽量用for循环
for (i = 0; i &lt; n; i++)
cout&lt;&lt;A[i];
<!-- page 186 -->
// 对 p 结点的访问等
如果不知道访问次数而是满足某个条件时终止,用while循环
while (p != NULL)
{
    cout &lt;&lt; p-&gt;data;
    p = p-&gt;next;
}
①对于多层for循环,如果每一层的变量都是自增1,则直接把每层执行次数相乘
for (i = 0; i &lt; n; i++)
for (j = 0; j &lt; n; j++)
for (k = 0; k &lt; n; k++)
if (A[i][j] &gt; A[i][k] + A[k][j])
A[i][j] = A[i][k] + A[k][j];
他的每一层都是变量自增,且变量都是从 0\~n-1 共n 次,所以总次数是 n³,时间复杂度是 O(n³)。 ②对于多层for 循环,如果每一层的变量都是自增1,但第二三层变量取值范围和第一层变量有关
for (i = 0; i &lt; n; i++)
for (j = 0; j &lt; i; j++)
for (k = 0; k &lt; j; k++)
if (A[i][j] &gt; A[i][k] + A[k][j])
A[i][j] &gt; A[i][k] + A[k][j];
时间复杂度和第①种一样,但不用考虑具体次数,时间复杂度是O(n³)。 ③对于两层循环,变量不是自增1(这种情况主要针对小题)
// 22 考研真题
for (i = 1; i &lt; n; i*=2)
for (j = 0; j &lt; i; j++)
sum++;
需要讨论第一层变量i取不同值时,j的取值有x种,然后对x求和。比如本题,i =1,2,4,8...2k(2k< n ≤2k+1)时,第二层j有i个取值,所以总次数是对i求和,即 T= 1+2+4+2k=2k+1-1,n < T< 2n,时间复杂度就是O(n)。 ## 递归次数 递归总次数和时间复杂度有关,而最大递归层数和空间复杂度有关。 对于树中序遍历的递归写法,每个结点都会调用一次所以总共调用次数是O(n)级别的,时间复杂度是O(n)。
void Inorder(BTNode *p)
{
    if (p == NULL) return;
    Inorder(p-&gt;lchild);
    visit(p);
    Inorder(p-&gt;rchild);
}
<!-- page 187 --> ## 6.2.2 空间复杂度 只算额外空间开销,不考虑题目中已经给出的数据所占的空间,比如题目中给出了一个数组,这个数组是不计入空间复杂度的。 ## 定义的数组、链表 单个定义的变量都不需要考虑,但定义的数组中元素个数以及链表中结点个数都要计入空间复杂度中。
// 单个变量不考虑
int i, j, k;
//数组考虑元素个数,空间复杂度 0(n)
int a[n];
//链表考虑结点个数,空间复杂度 0(n)
Node* L = (Node*)malloc(sizeof(Node));
Node* p = L;
for (int i = 0; i &lt; n; i++)
{
    p-&gt;next = (Node*)malloc(sizeof(Node));
    p = p-&gt;next;
}
## 递归层数 是在递归栈中最多出现多少个过程函数,层数和总次数比较见时间复杂度的递归次数。 对于树中序遍历的递归写法,每个结点都会调用一次所以总共调用次数是O(n)级别的,时间复杂度是O(n),而递归使用的层数最多是树高h,空间复杂度是O(h),但h是不确定的,而我们又知道h≤n,最坏情况下高度h=n,因此空间复杂度为O(n)。
void InOrder(BTNode *p)
{
    if (p == NULL) return;
    Inorder(p-&gt;lchild);
    visit(p);
    Inorder(p-&gt;rchild);
}
// 对 p 结点的访问等
<!-- page 188 --> ## 6.3 书写 ## 6.3.1 题目要求 考试的代码题一般分为三小问: 第一小问:设计思想 主要介绍逻辑,告诉老师你用了什么,比如快速排序,重要的是让老师知道你用的方法是什么。 ## 第二小问:描述算法 注释要详实,用来介绍变量、过程的作用,提示老师。对于快速排序和折半查找(注意是否查找成功)可以直接默写,过程函数不需要改动,注意调用的参数即可。 第三小问:求时间和空间复杂度 直接写复杂度,不用过程,要检验是否符合代码。 ## 6.3.2 作答建议 本节不仅会教你如何解题,更重要的是:如果你不敢面对算法题、总想着数据结构还没学好,该方法旨在帮助你克服对代码题的心理恐惧和无力感。 1. 化解“无从下手”的绝望感:把一个大问题拆解成多个小任务,让你不再觉得面对的是一座无法翻越的高山,而是一级级可以攀登的阶梯。每完成一步,你都会获得一份正向反馈,这份小小的成就感会驱动你继续前进。 2. 降低“害怕犯错”的恐惧:先用草稿纸思考,再用文字描述,最后才动手写代码。这个过程允许你在低成本的环境中犯错和调整,很多时候你写不出来代码,不是你完全不会,可能只是某些模块没掌握。你可以准确定位问题,并针对性地学习和掌握,无需再害怕犯错。 这套方法不是让你立刻变得完美,而是让你变得比昨天更好,早晚有一天能够彻底拿下算法题。请今天开始,勇敢地面对它! 我建议同学们先思考清楚整个算法需要做哪些事情已经对应流程,分析完复杂度再开始写。 对于能想出思路但不会下笔的同学我有如下建议,可以练习模块化写法,分为如下步骤: 1. 想好思路之后在草稿纸上写简易流程图,把一道题分为不同的步骤,估算复杂度并确保方法和复杂度都正确。 2. 根据流程图在答题卡上回答第一小问设计思想,适当扩充描述。 3. 根据流程图在答题卡上回答第二小问描述算法,按照步骤尝试写出每一块的代码,这样可以减少代码的涂改。 4. 写上时间和空间复杂度。 在练习时使用此方法有助于找到自己的问题到底是理不清过程还是具体哪一块代码不会写(比如说折半查找),这有助于我们针对性练习对应模块。 以真题 2011.47 为例: (15 分)一个长度为L(L≥1)的升序序列S,处在第[L/2]个位置的数称为S的中位数。例如,若序列S1 =(11,13,15,17,19),则 S1 的中位数是15,两个序列的中位数是含它们所有元素的升序序列的中位数。例如,若S2 =(2,4,6,8,20),则 S1 和S2的中位数是11。现在有两个等长升序序列A和B,试设计一个在时间和空间两方面都尽可能高效的算法,找出两个序列A和 B的中位数。要求: (1)给出算法的基本设计思想。 (2)根据设计思想,采用C、C++或Java语言描述算法,关键之处给出注释。 (3)说明你所设计算法的时间复杂度和空间复杂度。 <!-- page 189 --> <table><tr><td rowspan=1 colspan=1></td><td rowspan=1 colspan=1>做题思路</td><td rowspan=1 colspan=1>时间复杂度</td><td rowspan=1 colspan=1>空间复杂度</td><td rowspan=1 colspan=1>预计得分</td></tr><tr><td rowspan=1 colspan=1>暴力解</td><td rowspan=1 colspan=1>快速排序</td><td rowspan=1 colspan=1>O(nlogn)</td><td rowspan=1 colspan=1>O(n)</td><td rowspan=1 colspan=1>11</td></tr><tr><td rowspan=1 colspan=1>优化解</td><td rowspan=1 colspan=1>多指针法+新数组</td><td rowspan=1 colspan=1>O(n)</td><td rowspan=1 colspan=1>O(n)</td><td rowspan=1 colspan=1>13</td></tr><tr><td rowspan=1 colspan=1>优化解</td><td rowspan=1 colspan=1>多指针法</td><td rowspan=1 colspan=1>O(n)</td><td rowspan=1 colspan=1>0(1)</td><td rowspan=1 colspan=1>14</td></tr><tr><td rowspan=1 colspan=1>优化解</td><td rowspan=1 colspan=1>折半查找</td><td rowspan=1 colspan=1>O(logn)</td><td rowspan=1 colspan=1>O(1)</td><td rowspan=1 colspan=1>15</td></tr></table>