index
- 增加考研用到的各种算法的时空复杂度表格
第一讲 时空复杂度
本文参考自
github《hello algo》 2.2 时间复杂度 2.3 空间复杂度- 知乎专栏 千葉原 408高频考点:时间复杂度
bilibili零壹考研 教你秒杀时间复杂度「计算机考研408 数据结构」- 邓俊辉《数据结构 C++语言版》
- 看不懂下面的定义法的话可以参考这个视频里的方法:bilibili 荣仔_最靓的仔数据结构——时间复杂度计算
- 「时间复杂度分析」统计的不是算法运行时间,而是算法运行时间随着数据量变大时的增长趋势。
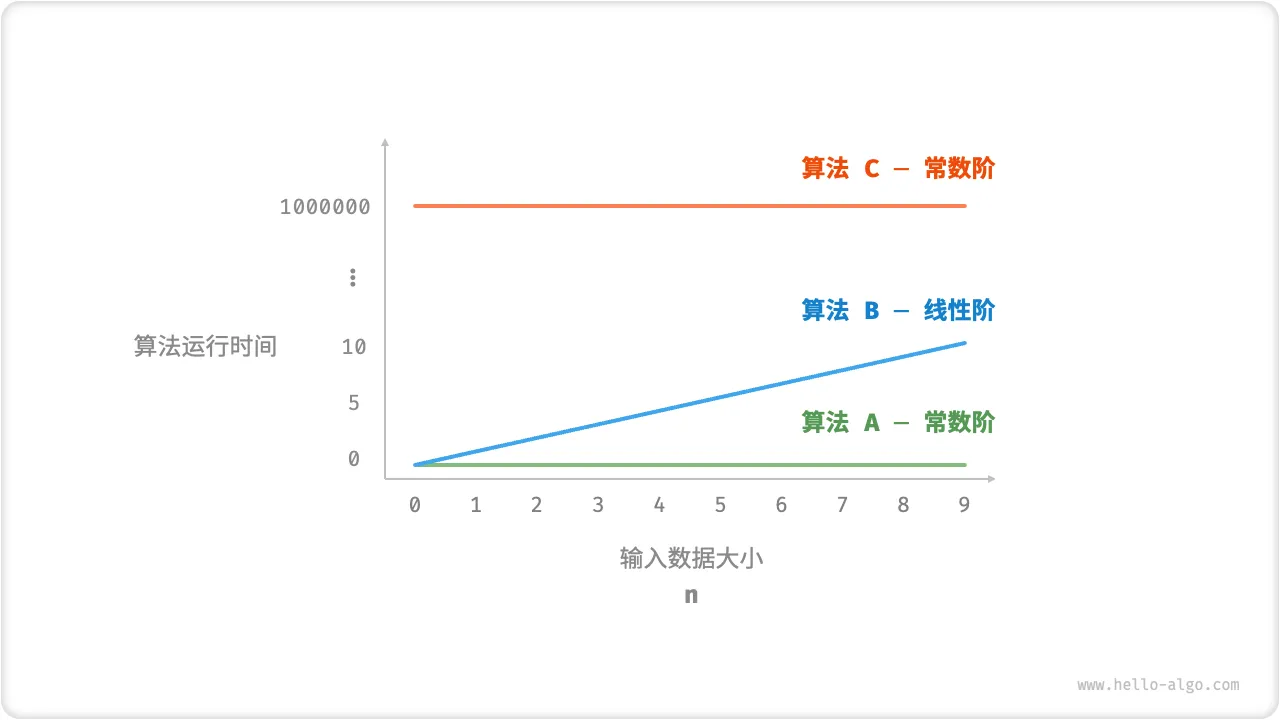
“时间增长趋势”这个概念较为抽象,我们通过一个例子来加以理解。假设输入数据大小为 n ,给定三个算法 A , B , C 。
- 算法
A只有 1 个打印操作,算法运行时间不随着 n 增大而增长。我们称此算法的时间复杂度为「常数阶」。 - 算法
B中的打印操作需要循环 n 次,算法运行时间随着 n 增大呈线性增长。此算法的时间复杂度被称为「线性阶」。 - 算法
C中的打印操作需要循环 1000000 次,但运行时间仍与输入数据大小 n 无关。因此C的时间复杂度和A相同,仍为「常数阶」。
// 算法 A 时间复杂度:常数阶
void algorithm_A(int n) {
    cout << 0 << endl;
}
// 算法 B 时间复杂度:线性阶
void algorithm_B(int n) {
    for (int i = 0; i < n; i++) {
        cout << 0 << endl;
    }
}
// 算法 C 时间复杂度:常数阶
void algorithm_C(int n) {
    for (int i = 0; i < 1000000; i++) {
        cout << 0 << endl;
    }
}
-
在统计时间复杂度的时候,有以下计数简化技巧:
-
忽略与n无关的操作;(顺序执行的代码只会影响常数项,可以忽略)
- 省略所有系数;
- 循环嵌套时使用乘法;(若有多层嵌套循环,只需要关注最深次循环循环了多少次)
【2011-01】设 n 是描述问题规模的非负整数,下面程序片段的时间复杂度是()
A.\( O(logn) \)\( B. \)\( O(n) \)\( C. \)\( O(nlogn) \)\( D. \)\( O(n^2 \)
【2012-01】求整数 n(n≥0) 阶乘的算法如下,其时间复杂度是( )。
A.\( O(logn) \)\( B. \)\( O(n) \)\( C. \)\( O(nlogn) \)\( D. \)\( O(n^2 \)
【2013-01】已知两个长度分别为 m 和 n 的升序链表,若将它们合并为长度为 m+n 的降序链表,则最坏情况下的时间复杂度是( )。
A. O(n)
B. O(mn)
C. O(min(m,n))
D. O(max(m,n))
【2014-01】下列程序段的时间复杂度是()
A.\( O(logn) \)\( B. \)\( O(n) \)\( C. \)\( O(nlogn) \)\( D. \)\( O(n^2 \)
【2017-01】下列函数的时间复杂度是()
A.\( O(logn) \)\( B. \)\( O(n^{1/2}) \)\( C. \)\( O(n) \)\( D. \)\( O(nlogn) \)
【2019-01】设 n 是描述问题规模的非负整数,下列程序段的时间复杂度是 ()
A.\( O(log_{10}n) \)\( B. \)\( O(n^{1/2}) \)\( C. \)\( O(n) \)\( D. \)\( O(n^2) \)
【2022-01】下列程序段的时间复杂度是 ()
A.\( O(logn) \)\( B. \)\( O(n) \)\( C. \)\( O(nlogn) \)\( D. \)\( O(n^2) \)
【2023-01】下列对顺序存储的有序表(长度为 n )实现给定操作的算法中,平均时间复杂度为 O(1) 的是( )。
A. 查找包含指定值的元素的位置
B. 插入包含指定值元素的算法
C. 删除第 i (1≤i≤n) 个元素的算法
D. 获取第 i (1≤i≤n) 个元素的算法
void algorithm(int n) {
    int a = 1;  // +0(技巧 1)
    a = a + n;  // +0(技巧 1)
    // +n(技巧 2)
    for (int i = 0; i < 5 * n + 1; i++) {
        cout << 0 << endl;
    }
    // +n*n(技巧 3)
    for (int i = 0; i < 2 * n; i++) {
        for (int j = 0; j < n + 1; j++) {
            cout << 0 << endl;
        }
    }
}
- 时间复杂度的常见类型
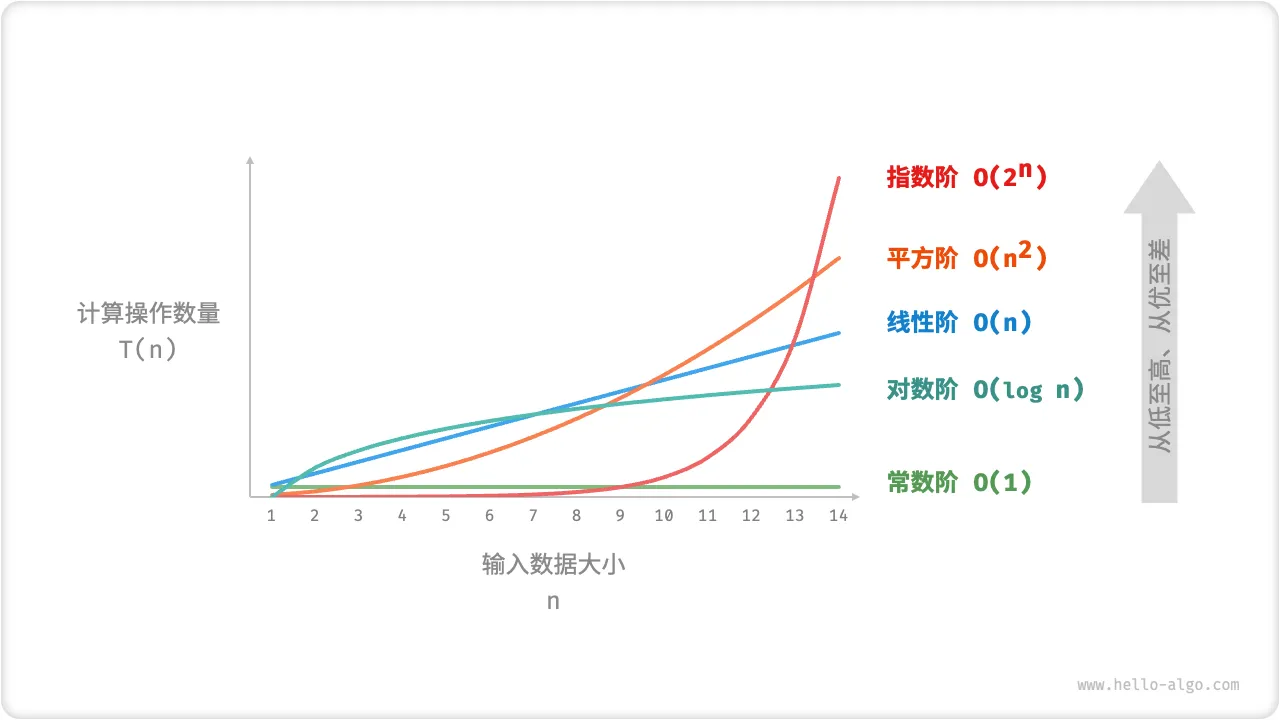
设输入数据大小为 n ,常见的时间复杂度类型包括(按照从低到高的顺序排列):(常对幂指阶)
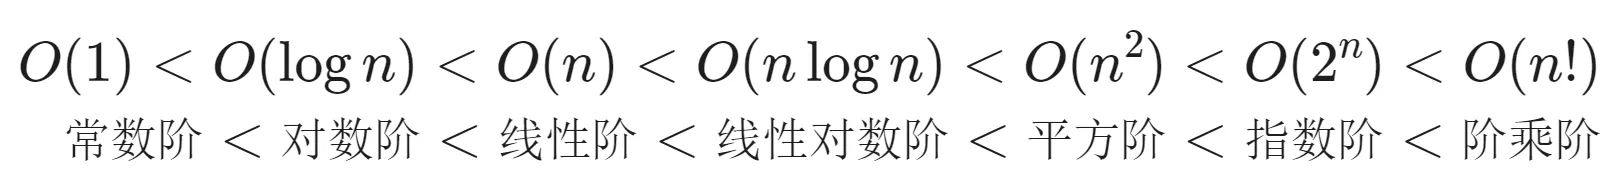
1.1 时间复杂度分析
1.1.1 常数阶 \(O(1)\)
常数阶的操作数量与输入数据大小 \(n\) 无关,即不随着 \(n\) 的变化而变化。
对于以下算法,尽管操作数量 size 可能很大,但由于其与数据大小 \(n\) 无关,因此时间复杂度仍为\(O(1)\)
int func(int n) {
    int count = 0;
    int size = 1000000;
    for(int i = 0; i < size; ++i)
        count ++;
    return count;
}
不难看出,除了输入数组等参数以外,该算法仅需常数规模的辅助空间。此类仅需\(O(1)\)辅助空间的算法,亦称作就地算法(in-place algorithm)
一般来说,仅含有一次或常数次基本操作的算法均属于此类。此类算法通常不含有循环、分支、子程序调用等,但是也不能仅凭语法结构一概而论。如下例 ,是一个包含循环、分支、子函数调用,甚至递归结构的算法,但是具有常数的总体时间复杂度.
void O1(unsigned int n) {
    for(unsigned int i = 0; i < n; i += 1 + n/2023;) {
  //虽然该函数有一个循环,但无论其输入参数n有多大,循环控制变量i总是以1+n/2023为步长,从0依次增至n,其迭代次数至多为2023,与n无关;
UNREACHABLE; //无法抵达的转向标志;
        if( 1 + 1 != 2) goto UNREACHABLE;    //分支:但是转向条件永远无法满足,转向无效;
        if(n * n < 0) doSomething(n);            //分支:条件永非,子函数调用无效;
        if((n + i) * (n + i) < 4 * n * i) doSomething(n);    //非负整数的算术平均不可能小与其几何平均,因此分支:条件永非,调用无效;
        if( 2 == (n * n) % 5)  O1(n  + 1);    //由基本数论知识不难验证,任何整数的平方关于5整除之后的余数不可能是2或3,所以条件永非,递归无效
        int f = fib(n); if(12 < n && (sqrt(f) * sqrt(f) == f)) O1(n - 1);   //条件永非
    }
}
1.1.2 线性阶\(O(n)\)
线性阶的操作数量相对于输入数据大小以线性级别增长。线性阶通常出现在单层循环中。
遍历数组和遍历链表等操作的时间复杂度均为\(O(n)\),其中n为数组或链表的长度。
输入数据大小n需根据输入数据的类型来具体确定,例如,在上述示例中,我们直接将n视为输入数据大小;在下面遍历数组的示例中,数据大小\(n\)为数据的长度;
int arrayTraversal(vector<int> &a) {   //遍历数组
    int count = 0;
    for(int i : a){    //循环次数与数组长度成正比
        count ++;
    }
    return count;
}
上面的是for循环,while循环也类似
1.1.3 对数阶\(O(logn)\)
与指数阶相反,对数阶反映了“每轮缩减到一半的情况”。对数阶仅次于常数阶,时间增长缓慢,是理想的时间复杂度。
对数阶常出现于「二分查找」和「分治算法」中,体现了“一分为多”和“化繁为简”的算法思想。
设输入数据大小为\(n\),由于每轮缩减到一半,因此循环次数是 \(O(log_2n)\),即 \(2^n\)的反函数。
- for循环:
定义法求时间复杂度:设自增\(r\)次退出循环,则\(2^r=n\),\(r=log_2n\)
count执行次数为
\( \sum_{r = 1}^{log_2n}1=\overbrace{(1+1+\cdots+1)}^{log_2n个} =log_2n=O(logn) \)
- while循环:
- 例3:
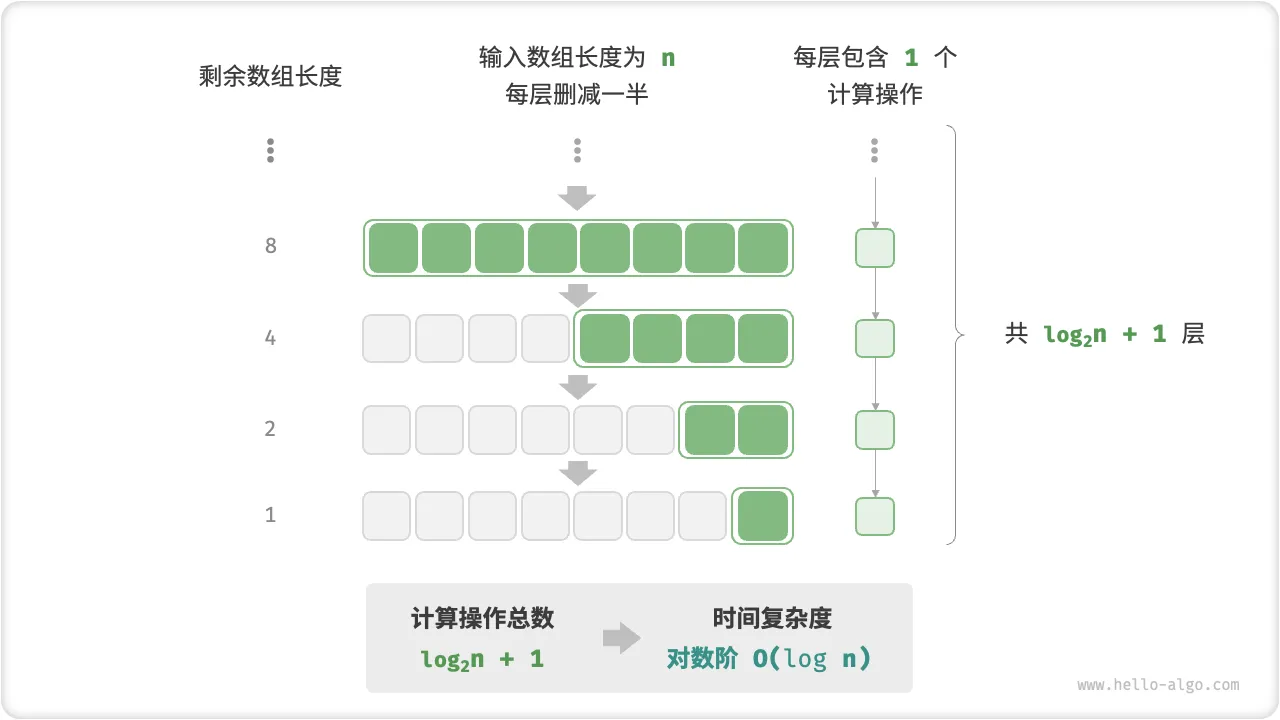
对数阶常出现递归函数,以下代码形成了一个高度为\(O(log_2n)\)的递归树
- 例5:对于任意非负整数,统计其二进制展开中数位1的个数
int countOnes (int n){
    int count = 0;
    while( n > 0){
        count += (n & 1);     //每次循环检查n的二进制展开的最低位,若该位为1则累计至count上,位与运算全1出1否则为0;
        n >>= 1;   //根据右移运算,每右移一位n都至少缩减一半,也就是说,至多经过1 + logn次循环,n必然缩减至0;
    }
    return count;
}
上述算法的时间复杂度为\(O(log_2n)\),事实上该算法还有改进空间
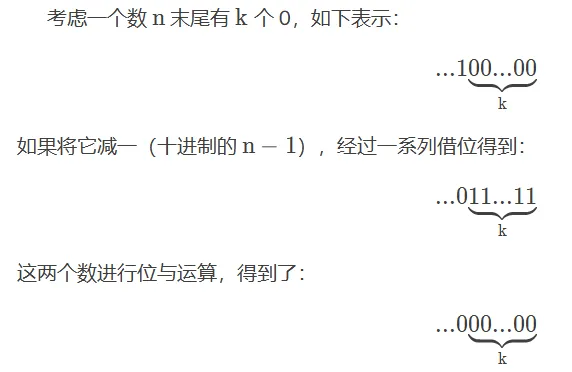
这就是n & (n-1)实现的效果,将n的二进制最低位的1给去掉,那么总共去掉多少次,就代表了二进制中有多少个1.
int countOnes(int n) {
    int count = 0;
    while(n) {
        n & (n - 1);   //去掉n二进制表示的最低位的1;
        ++ count;  //计数;
    }
    return count;
}
时间复杂度分析,该算法在将\(n\)二进制表示中的1全部去掉以后就跳出了循环,因此其时间复杂度为\(O(countOnes(n))\),线性正比于\(n\)中数位为1的实际数目。
1.1.4 平方阶\(O(n^2)\)
平方阶的操作数量相对于输入数据大小以平方级别增长。平方阶通常出现在嵌套循环中,外层循环和内层循环都为\(O(n)\),因此总体为\(O(n^2)\)
int  func(int n) {
    int count = 0;
    for(int i = 0; i < n; i++) {
        for(int j = 0; j < n; j++) {
            count ++;
        }
    }
    return count;
}
以冒泡排序为例,外层循环执行\(n - 1\)次,内层循环执行 \(n - 1, n - 2, n - 3……2,1\)次,平均为\(\frac{n}{2}\)次,因此时间复杂度为\(O((n-1)\*\frac{n}{2}) = O(n^2)\)
int bubbleSort(vector<int> & nums) {
    int count = 0;  //计数器,统计该程序执行次数
    for(int i = nums.size() - 1; i > 0;  i--) {   //外循环:未排序区间为【0,i】;
        for(int j = 0 ; j < i; j++) {   //内循环,将未排序区间的最大元素交换至该区间的最右端
            if(nums[ j ] > nums[j + 1]) {
                int tmp = nums[j];   //如果改位置元素比他右边的大,交换二者的值,以便将最大元素冒到右边界;
                nums[j] = nums[j + 1];
                nums[j+1] = tmp;
                count += 3;  //在内循环中吗,一次元素交换包含3个单元操作;
            }
        }
    }
    return count;
}
1.1.5 指数阶\(O(2^n)\)
指数阶增长非常迅速,在实际应用中通常是不可接受的。若一个问题使用「暴力枚举」求解的时间复杂度为\(O(2^n)\),那么通常需要使用「动态规划」或「贪心算法」等方法来解决。
/*指数阶(循环实现)*/
int func(int n) {
    int count = 0, base = 1;
    for(int i = 0; i < n; i++) {
        for(int j = 0; j < base; j++) {
            count ++;
        }
        base *= 2;
    }
    // count = 1 + 2 + 4 + 8 + .. + 2^(n-1) = 2^n - 1
    return count;
}
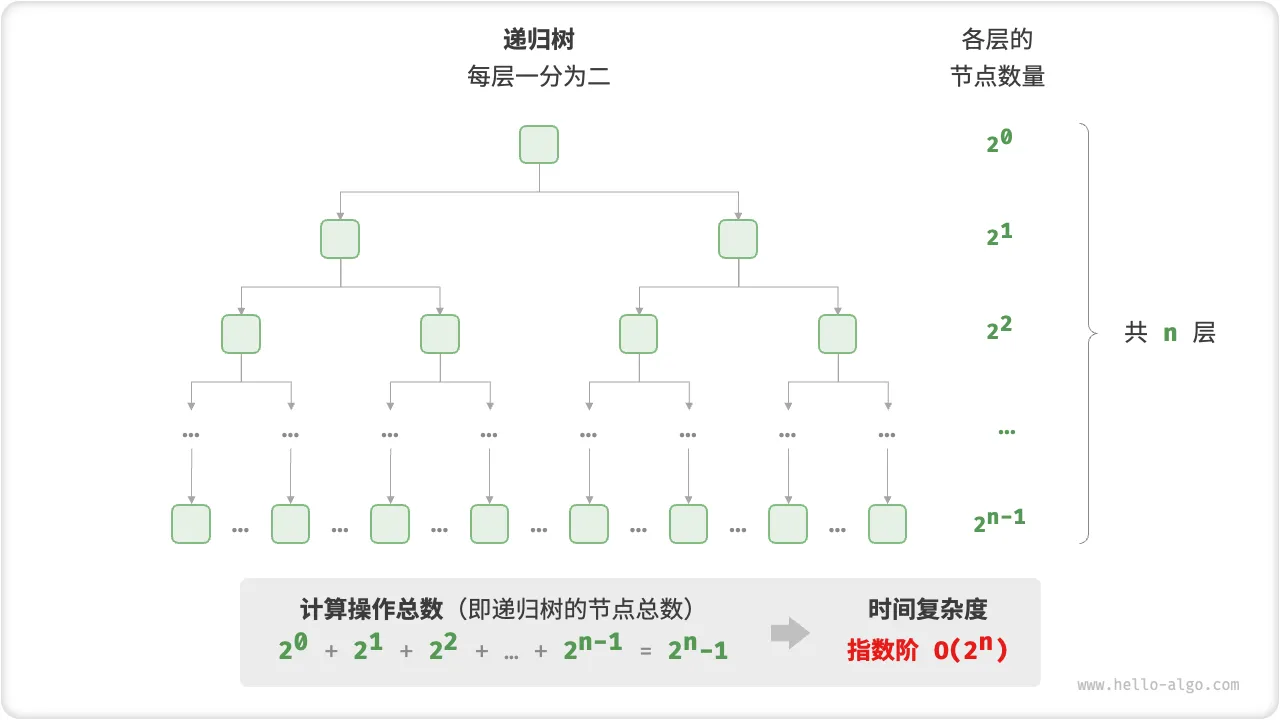
在实际算法中,指数阶常出现在递归函数。例如以下代码,不断地一分为2,经过n次分裂后停止。
/*指数阶(递归实现)*/
int func (int n) {
    if(n == 1)
        return 1;
    return func(n - 1) + func(n-1) + 1;   //与图中的递归树对应,代表着一分为2,例如细胞分裂。
这是一个递归函数,它在每个递归步骤中调用自身两次。因此,它的时间复杂度是指数级的。
更具体地说,我们可以通过递归树的方法来分析这个函数的时间复杂度。在每个递归级别,函数的调用次数都会翻倍。例如,对于输入n,第一级有1个函数调用,第二级有2个函数调用,第三级有4个函数调用,以此类推,直到第\(n\)级有\(2^{n-1}\)个函数调用。
因此,总的函数调用次数(即总的时间复杂度)是这个等比数列的和,即\(1 + 2 + 4 + ... + 2^{n-1}\)。这个等比数列的和可以用公式\(S = \frac{a \* (r^n - 1)} {(r - 1)}\)来计算,其中a是第一项(在这里是1),r是公比(在这里是2),\(n\)是项数(在这里是\(n\))。将这些值代入公式,我们得到\(S = \frac{1 \* (2^n - 1)} { 2 - 1} = 2^n - 1\)。
因此,这个函数的时间复杂度是\(O(2^n)\)。这意味着,随着输入n的增大,函数的运行时间将以指数速度增长。
1.1.6 线性对数阶\(O(nlogn)\)
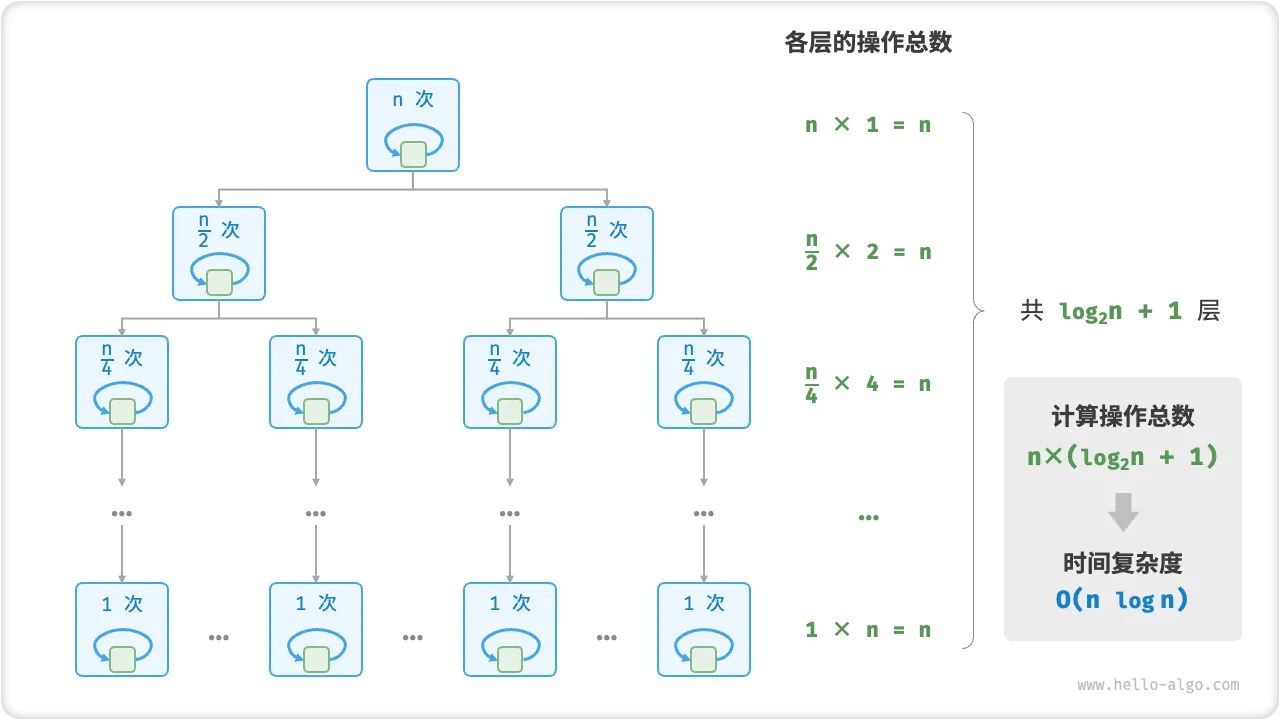
线性对数阶常出现在嵌套循环中,两层循环的时间复杂度分别为\(O(nlogn)\)和\(O(n)\).
主流排序算法的时间复杂度通常是\(O(nlogn)\),例如快速排序、归并排序、堆排序等。
/*线性对数阶*/
int linearLogRecur(float n) {
    if(n <= 1){
        return 1;
    }
    int count = linearLogRecur(n / 2) + linearLogRecur(n / 2);   //递归,时间复杂度为O(logn);
    for(int i = 0; i < n; i++) {   //内层循环条件与外层无关,内层循环为O(n);
        count ++;
    }
    return count;
}
真题
count = 0;
for(k = 1; k <= n; k *= 2){   //外层循环执行logn次
    for(j = 1; j < n; j++){  //内层循环条件与外存循环的变量无关,各自独立;外循环每执行一次,内层循环都会执行n次
        count ++;
    }
}
1.1.7 阶乘阶\(O(n!)\)
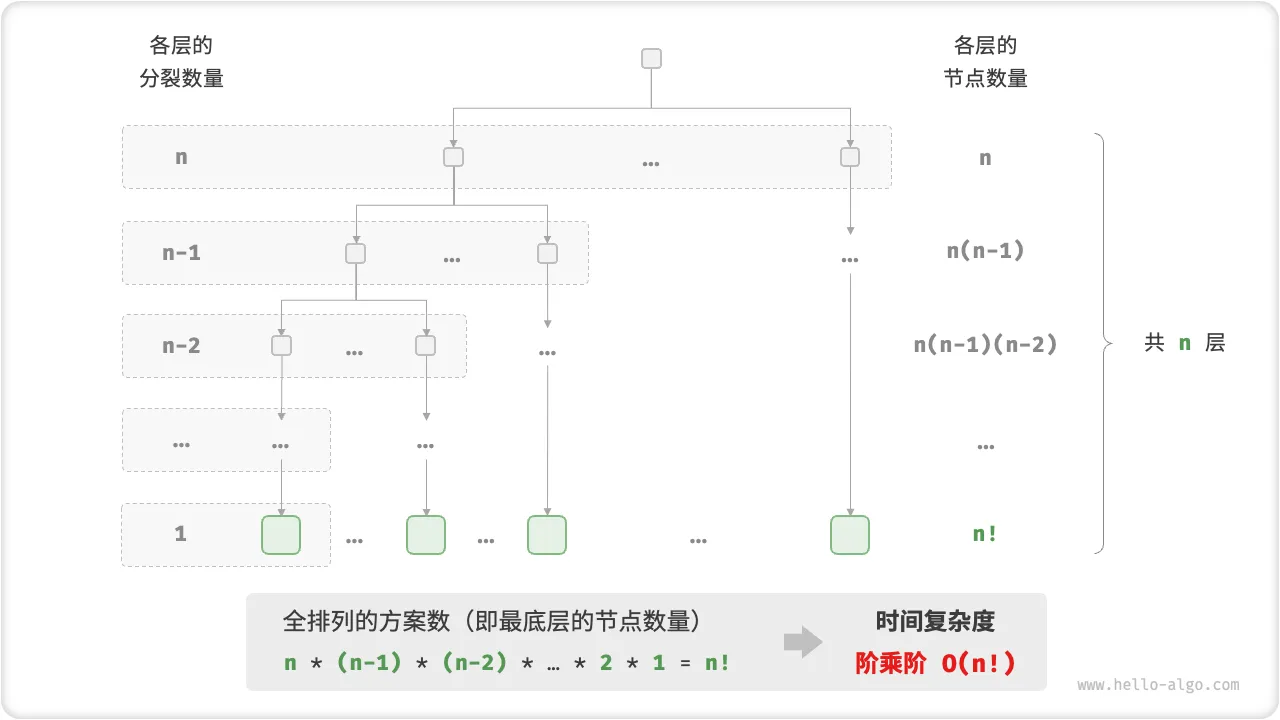
阶乘阶对应数学上的全排列问题,给定n个互不重复的元素,求其所有可能的排列方案,方案数量为:
\(n! = n \* (n-1) \* (n - 2) \* … \* 2 \* 1\)
阶乘通常使用递归实现。例如以下代码,第一层分裂出\(n\)个,第二层分裂出\(n - 1\)个,以此类推,直至第\(n\)层时终止分裂。
/*阶乘阶*/
int func(int n ) {
    if(n == 0)
        return 1;
    int count = 0;
    从1个分裂出n个;
    for(int i = 0; i < n; i++) {
        count += func(n - 1);
    }
    return count;
}
//当n大于等于1时,递归调用func函数,每次将n减1,直到n等于0。在每次递归调用中,func函数会计算从1到n-1的所有整数乘积,然后将结果累加到count变量中。因此,对于给定的n,func函数会计算从1到n-1的所有整数乘积,并将结果累加到count变量中。根据递归调用的特点,每次递归调用都会将n减1,因此递归调用层数与n-1成正比。因此,func函数的时间复杂度为O(2^n).
1.2 关于408中时间复杂度考察的补充
1.2.1 方根时间复杂度
for循环
while循环
时间复杂度为\(O(\sqrt{n})\)
1.2.2 多层嵌套循环的分析
1.2.2.1 嵌套循环指针无关
即i指针与j指针无关
【例1】:
时间复杂度为\(O(n \* n ) = O(n^2)\)
定义法:
\( \sum_{i = 1}^{n}\sum_{j=1}^{n}1 = \sum_{i=1}^{n}\overbrace{(1+1+\cdots+1)}^{n个} = \sum_{i=1}^{n}n=\overbrace{n+n+n+\cdots+n}^{n个}=n\*n = n^2=O(n^2) \)
【例2】:
时间复杂度\(O(logn) \* O(logn) = O(log^2n)\)
【例3】:
时间复杂度\(O(\sqrt{n}) \* O(\sqrt{n}) = O(n)\)
1.2.2.2 嵌套循环指针相关
即 j指针与i 指针相关:
【例1】:
时间复杂度为\(O(n) \* O(n) = O(n^2)\)
严格计算为:
\( \sum_{i = 0}^{n-1}\sum_{j=0}^{i-1}1 =\sum_{i=0}^{n-1}\overbrace{(1+1+\cdots+1)}^{i个} =\sum_{i=0}^{n-1}i = 0+1+2+\cdots+(n-1)= \frac{n(n-1)}{2} = O(n^2) \)
【例2】:
时间复杂度\(O(\sqrt{n}) \* O(\sqrt{n}) = O(n)\)
公式法严格计算如下:
\( \sum_{i = 1}^{\sqrt{n}}\sum_{j=1}^{i}1 = \sum_{i=1}^{\sqrt{n}}i = 1 + 2 + \cdots+\sqrt{n}= \frac{\sqrt{n}(\sqrt{n}+1)}{2} = O(n) \)
【例3】:
int count = 0;
for(int i = 1; pow(2,i) < n; ++i){   // 2的i次方 < n;
    for(int j = 1; pow(2,j) < i; ++j){
        count ++;
    }
}
时间复杂度为\(O(log_2n \* log_2log_2n) = O(log_2nlog_2log_2n)\).
公式法严格计算为
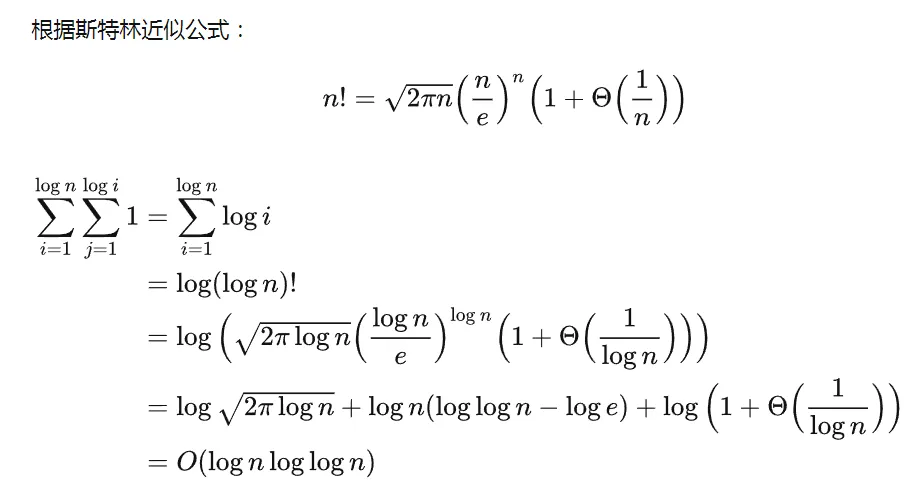
【例4】:
时间复杂度为\(O(\sqrt{n}\sqrt{\sqrt{n}}) = O(n^{\frac{3}{4}})\)
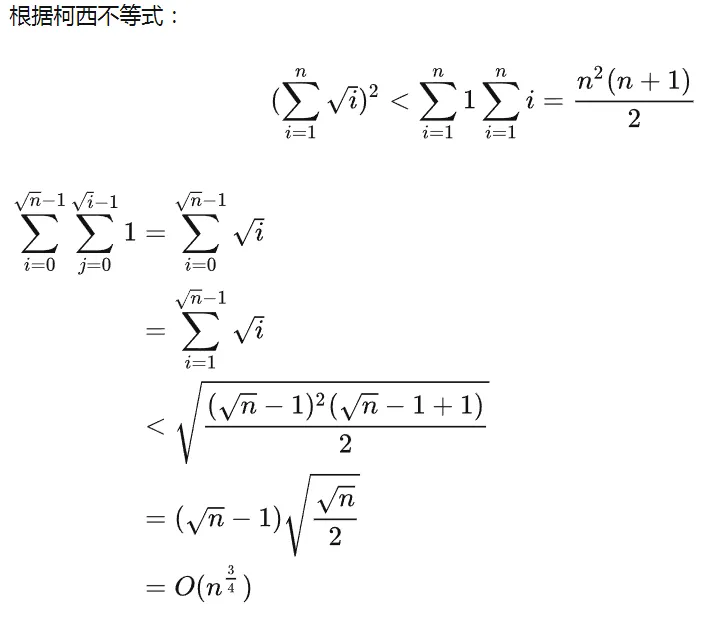
【例5】:
int count = 0;
for(int i =1 ; i <= n; ++i) {
    for(int j = 1; j <= n; ++j) {
        for(int k = 1; k <= n; ++k) {
            ++count;
        }
    }
}
三个指针都是线性变化,时间复杂度为\(O(n)\*O(n)\*O(n)=O(n^3)\)
定义法分析步骤:
\( \sum_{i = 1}^{n}\sum_{j=1}^{i}\sum_{k = 1}^{j}1 =\sum_{i=1}^{n}\sum_{j=1}^{i}j=\sum_{i=1}^{n}(1+2+\cdots+i)=\sum_{i=1}^{n}(\frac{i(i+1)}{2})=\frac{1}{2}\sum_{i=1}^{n}(i^2+i)\\=\frac{1}{2}[(1^2+2^2+3^2+\cdots+n^2)+(1+2+3+\cdots+n)]=\frac{1}{2}[\frac{n(n+1)(2n+1)}{6}+\frac{n(n+1)}{2}] \=\frac{n(n+1)(n+2)}{6}=O(n^3) \)
这里用到了公式
\( \sum_{i=1}^{n}i^2=1^2+2^2+3^2+\cdots+n^2=\frac{n(n+1)(2n+1)}{6} \)
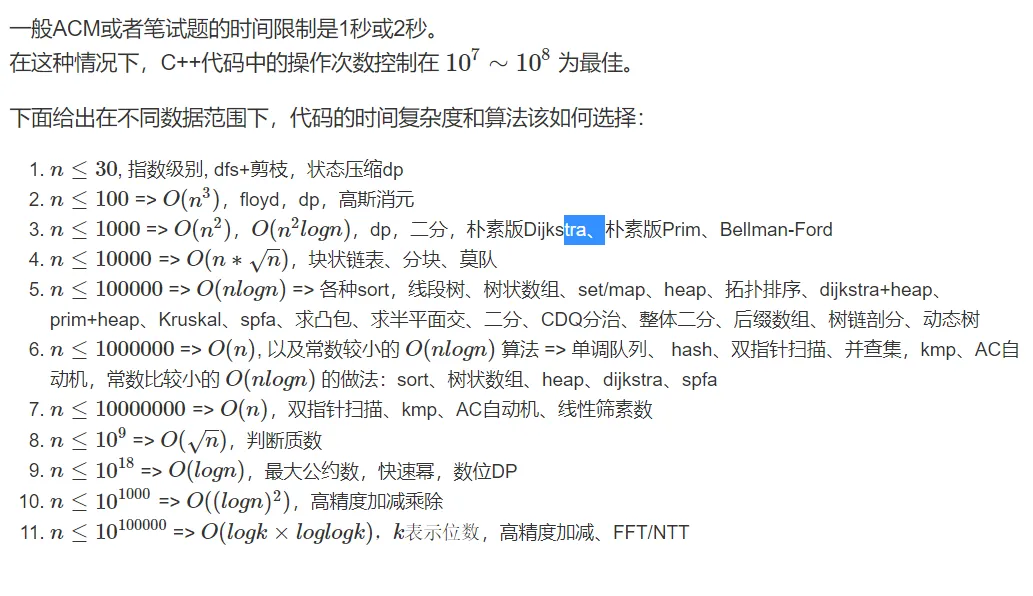
上面几个例子中指针的变化都是线性增加的,时间复杂度可以直接相乘,但是下面几题中的部分指针是指数变化的,必须要用定义法来求时间复杂度。
【例6】:非线性变化嵌套非线性变化
用定义法求解,用\(r\)表示执行的轮次,严格计算如下:
\( \sum_{r = 1}^{log_2n}\sum_{j=1}^{log_22^{r-1}}1 = \sum_{r = 1}^{log_2n}\sum_{j=1}^{r-1}1=\sum_{r=1}^{log_2n}(r-1) = 0 + 1 + 2 + \cdots+ (log_2n-1)= \frac{log_2n(log_2n-1)}{2} = O(log^2n) \)
因此该程序段的时间复杂度为\(O(log^2n)\)
【例7】:线性变化嵌套非线性变化
执行过程: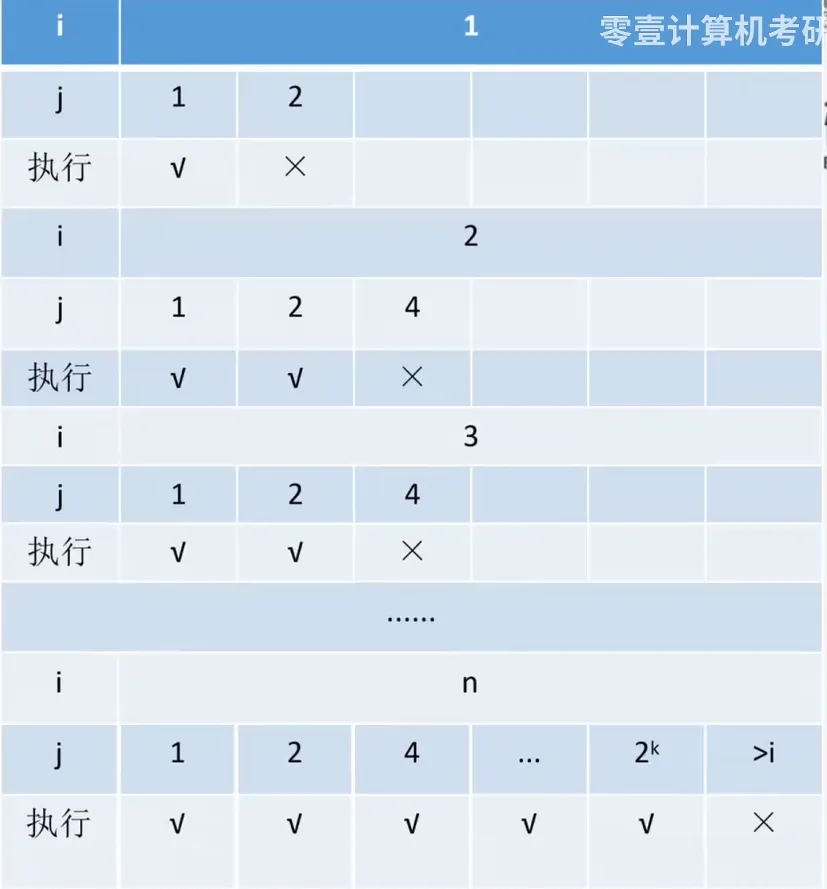
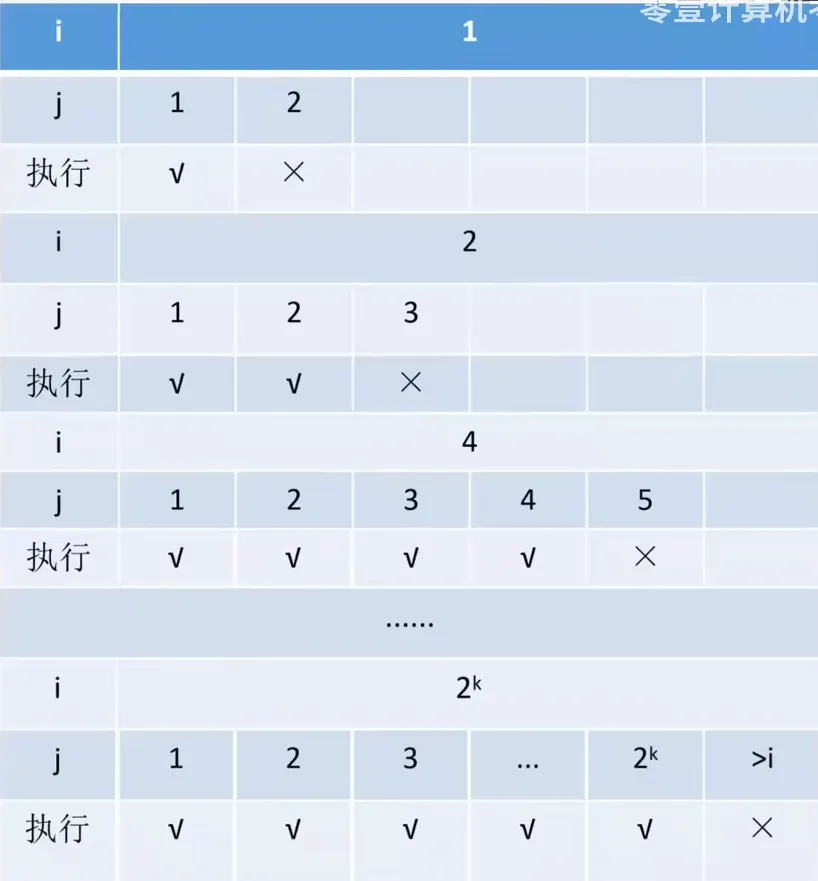
定义法求解:设\(j\)自增\(r\)次退出循环,则有\(2^r=i\),\(r=log_2i\),从上面的表格可以看出,\(j\)的执行次数始终比自增次数多1,所以
\( \sum_{i = 1}^{n}\sum_{r=1}^{log_2i+1}1 =\sum_{i=1}^{n}\overbrace{(1+1+\cdots+1)}^{(log_2i+1)个} =\sum_{i=1}^{n}(log_2i+1) = log1+log2+log3+\cdots+logn+n= log_2(n!)+n=O(nlogn) \)
时间复杂度\(O(log(n!))=O(nlogn)\)
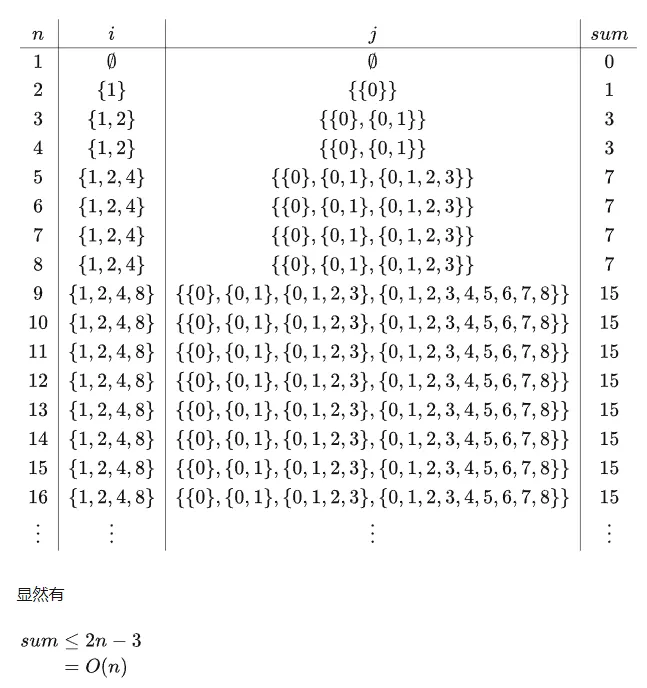
【2022年真题】:非线性变化嵌套线性变化,前面几种情况都可以用乘法估算,但是本例就不可以了!
下列程序段的时间复杂度是()
\(A. O(log_2 n)\)
\(B.O(n)\)
\(C.O(nlog_2n)\)
\(D.O(n^2)\)
这个代码段包含两个嵌套的循环。外层循环的变量
i从1开始,每次乘以2,直到达到n。内层循环的变量j从0开始,每次增加1,直到达到i。我们可以将这个代码段的运行时间看作是一个等比数列的和。在第一次外层循环的迭代中,内层循环会运行1次;在第二次外层循环的迭代中,内层循环会运行2次;在第三次外层循环的迭代中,内层循环会运行4次,以此类推,也就是说当外层循环的变量\(i\)取不同的值时,内层循环也就执行多少次。假设外层循环共执行\(k\)次,则总的运行次数为\(1 + 2 + 4 + 8 +\cdots+2^{k-1}(2^{k-1}\<n≤2^k,当i增加到了2^{k-1},再执行一次\*2操作就跳出循环)\)。该式子结果为\(2^k-1\),所以总运行次数跟\(n\)是同一数量级的,因此时间复杂度为\(O(n)\).这意味着,随着输入n的增大,代码段的运行时间将以线性的速度增长。
这个分析的关键在于理解,虽然外层循环的迭代次数近似为\(log_2n\),但是每次迭代的工作量(即内层循环的迭代次数)都在增加。因此,总的工作量是线性的,而不是对数的。
公式法:设\(i\)自增\(r\)次退出循环,此时\(2^r=n,r=log_2n\)
\( \sum_{i;in;(1,2,\cdots,2^r)}\sum_{j=0}^{i}1 =\sum_{i;in;(1,2,\cdots,2^r)}i=1+2+\cdots+2^r=2^{r+1}-1=2n-1=O(n) \)
枚举法:
1.2.2.3 嵌套循环指针总结
i指针与j指针无关时,时间复杂度直接相乘
形如
时间复杂度为\(T(n) = O(f^{-1}(n))\*O(g^{-1}(n)) = O(f^{-1}(n)g^{-1}(n))\)
i指针与j指针相关时,如果两个指针均为每次自增,j为i的复合函数,再相乘。
形如
时间复杂度为\(T(n) = O(f^{-1}(n))\*O(g^{-1}(n)) = O(f^{-1}(n)g^{-1}(n))\)
i指针与j指针相关时,如果两个指针变化非线性,用定义法计算
1.2 空间复杂度
「空间复杂度 Space Complexity」用于衡量算法使用内存空间随着数据量变大时的增长趋势。这个概念与时间复杂度非常类似。
1.2.1算法相关空间
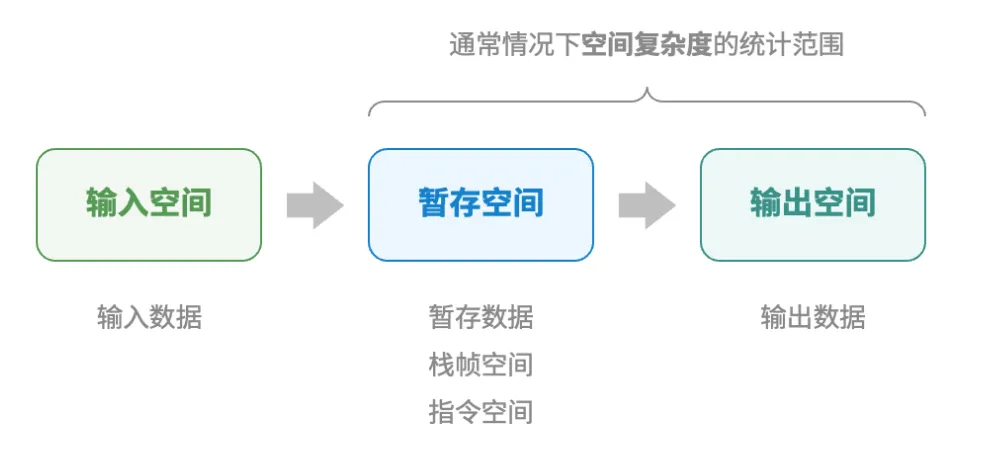
算法运行过程中使用的内存空间主要包括以下几种:
- 「输入空间」用于存储算法的输入数据;
- 「暂存空间」用于存储算法运行过程中的变量、对象、函数上下文等数据;
- 「输出空间」用于存储算法的输出数据;
通常情况下,空间复杂度统计范围是「暂存空间」+「输出空间」。
暂存空间可以进一步划分为三个部分:
- 「暂存数据」用于保存算法运行过程中的各种常量、变量、对象等。
- 「栈帧空间」用于保存调用函数的上下文数据。系统在每次调用函数时都会在栈顶部创建一个栈帧,函数返回后,栈帧空间会被释放。
- 「指令空间」用于保存编译后的程序指令,在实际统计中通常忽略不计。
因此,在分析一段程序的空间复杂度时,我们一般统计 暂存数据、输出数据、栈帧空间 三部分。
/* 结构体 */
struct Node {
    int val;
    Node *next;
    Node(int x) : val(x), next(nullptr) {}
};

/* 函数 */
int func() {
    // do something...
    return 0;
}

int algorithm(int n) {        // 输入数据
    const int a = 0;          // 暂存数据(常量)
    int b = 0;                // 暂存数据(变量)
    Node* node = new Node(0); // 暂存数据(对象)
    int c = func();           // 栈帧空间(调用函数)
    return a + b + c;         // 输出数据
}
1.2.2.推算方法
空间复杂度的推算方法与时间复杂度大致相同,只是将统计对象从“计算操作数量”转为“使用空间大小”。与时间复杂度不同的是,我们通常只关注「最差空间复杂度」,这是因为内存空间是一项硬性要求,我们必须确保在所有输入数据下都有足够的内存空间预留。
最差空间复杂度中的“最差”有两层含义,分别是输入数据的最差分布和算法运行过程中的最差时间点。
- 以最差输入数据为准。当 \(n\)<10 时,空间复杂度为 \(O(1)\);但当 \(n\)>10 时,初始化的数组
nums占用 \(O(n)\) 空间;因此最差空间复杂度为 \(O(n)\) ; - 以算法运行过程中的峰值内存为准。例如,程序在执行最后一行之前,占用\(O(1)\)空间;当初始化数组
nums时,程序占用 \(O(n)\)空间;因此最差空间复杂度为\(O(n)\);
void algorithm(int n) {
    int a = 0;               // O(1)
    vector<int> b(10000);    // O(1)
    if (n > 10)
        vector<int> nums(n); // O(n)
}
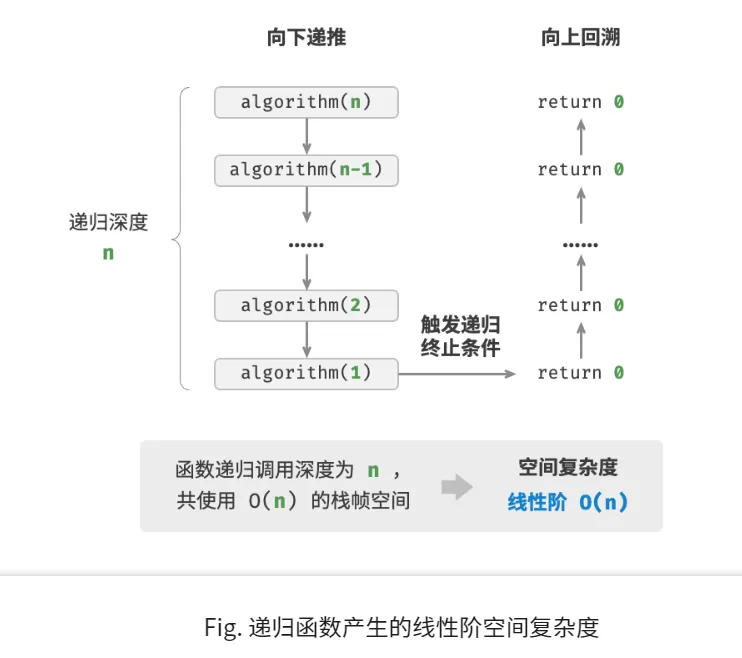
在递归函数中,需要注意统计栈帧空间。例如,函数 loop() 在循环中调用了 \(n\) 次 function() ,每轮中的 function() 都返回并释放了栈帧空间,因此空间复杂度仍为 \(O(1)\)。而递归函数 recur() 在运行过程中会同时存在 \(n\)个未返回的 recur() ,从而占用 \(O(n)\) 的栈帧空间。
int func() {
    // do something
    return 0;
}
/* 循环 O(1) */
void loop(int n) {
    for (int i = 0; i < n; i++) {
        func();
    }
}
/* 递归 O(n) */
void recur(int n) {
    if (n == 1) return;
    return recur(n - 1);
}
1.2.3 常见类型
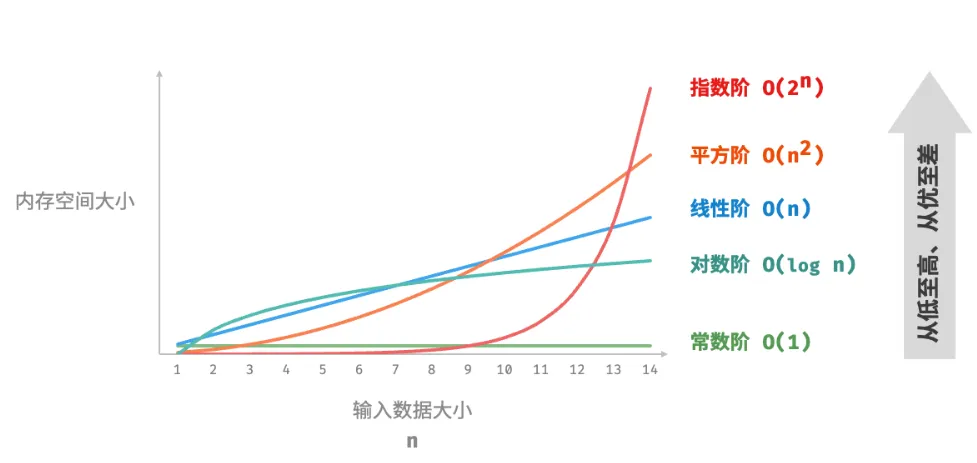
设输入数据大小为 \(n\) ,常见的空间复杂度类型有(从低到高排列)
\( O(1)\<O(logn)\<O(n)\<O(n^2)\<O(2^n)\常数阶<对数阶<线性阶<平方阶<指数阶 \)
- 常数阶\(O(1)\)
常数阶常见于数量与输入数据大小\(n\)无关的常量、变量、对象。
需要注意的是,在循环中初始化变量或调用函数而占用的内存,在进入下一循环后就会被释放,即不会累积占用空间,空间复杂度仍为\(O(1)\) 。
/* 常数阶 */
void constant(int n) {
    // 常量、变量、对象占用 O(1) 空间
    const int a = 0;
    int b = 0;
    vector<int> nums(10000);
    ListNode node(0);
    // 循环中的变量占用 O(1) 空间
    for (int i = 0; i < n; i++) {
        int c = 0;
    }
    // 循环中的函数占用 O(1) 空间
    for (int i = 0; i < n; i++) {
        func();
    }
}
- 线性阶\(O(n)\)
线性阶常见于元素数量与 \(n\) 成正比的数组、链表、栈、队列等。
/* 线性阶 */
void linear(int n) {
    // 长度为 n 的数组占用 O(n) 空间
    vector<int> nums(n);
    // 长度为 n 的列表占用 O(n) 空间
    vector<ListNode> nodes;
    for (int i = 0; i < n; i++) {
        nodes.push_back(ListNode(i));
    }
    // 长度为 n 的哈希表占用 O(n) 空间
    unordered_map<int, string> map;
    for (int i = 0; i < n; i++) {
        map[i] = to_string(i);
    }
}
以下递归函数会同时存在 \(n\) 个未返回的 algorithm() 函数,使用 \(O(n)\) 大小的栈帧空间。
/* 线性阶(递归实现) */
void linearRecur(int n) {
    cout << "递归 n = " << n << endl;
    if (n == 1)
        return;
    linearRecur(n - 1);
}
- 平方阶\(O(n^2)\)
平方阶常见于矩阵和图,元素数量与 \(n\) 成平方关系。
/* 平方阶 */
void quadratic(int n) {
    // 二维列表占用 O(n^2) 空间
    vector<vector<int>> numMatrix;
    for (int i = 0; i < n; i++) {
        vector<int> tmp;
        for (int j = 0; j < n; j++) {
            tmp.push_back(0);
        }
        numMatrix.push_back(tmp);
    }
}
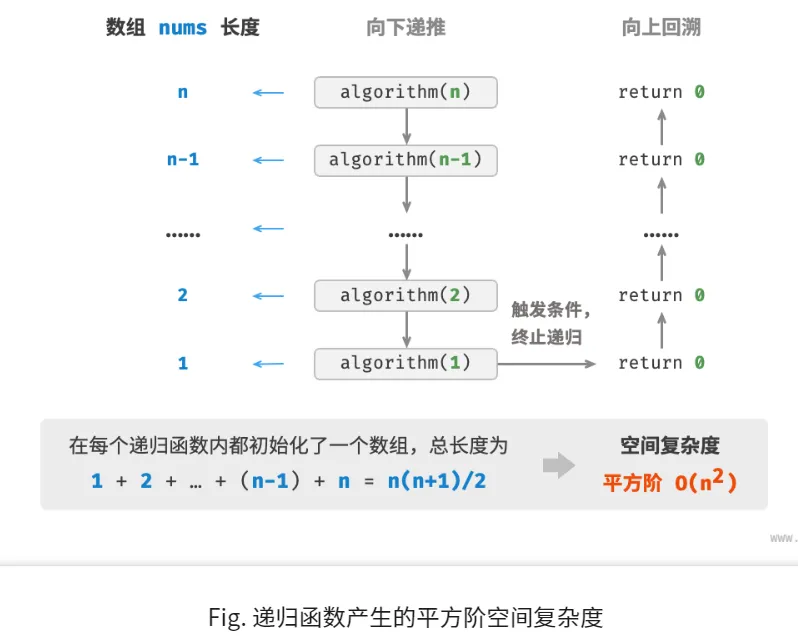
在以下递归函数中,同时存在 \(n\) 个未返回的 algorithm() ,并且每个函数中都初始化了一个数组,长度分别为\(n,n-1,n-2,\cdots,2,1\),平均长度为 \(\frac{n}{2}\) ,因此总体占用\(O(n^2)\)空间。
/* 平方阶(递归实现) */
int quadraticRecur(int n) {
    if (n <= 0)
        return 0;
    vector<int> nums(n);
    cout << "递归 n = " << n << " 中的 nums 长度 = " << nums.size() << endl;
    return quadraticRecur(n - 1);
}
- 指数阶\(O(2^n)\)
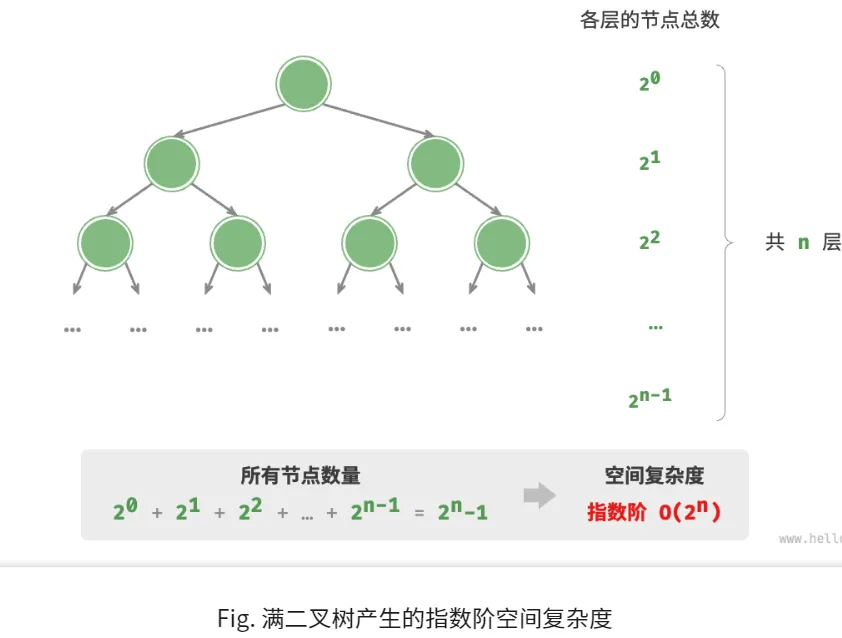
指数阶常见于二叉树。高度为 \(n\) 的「满二叉树」的节点数量为 \(2^n-1\) ,占用 \(O(2^n)\) 空间。
/* 指数阶(建立满二叉树) */
TreeNode *buildTree(int n) {
    if (n == 0)
        return nullptr;
    TreeNode *root = new TreeNode(0);
    root->left = buildTree(n - 1);
    root->right = buildTree(n - 1);
    return root;
}
- 对数阶\(O(logn)\)
对数阶常见于分治算法和数据类型转换等。
例如“归并排序”算法,输入长度为 \(n\) 的数组,每轮递归将数组从中点划分为两半,形成高度为 \(logn\)的递归树,使用 \(O(logn)\) 栈帧空间。
再例如“数字转化为字符串”,输入任意正整数 \(n\) ,它的位数为 \(log_{10}n\) ,即对应字符串长度为 \(log_{10}n\) ,因此空间复杂度为 \(O(log_{10}n)= O(logn)\)。
1.2.4 权衡时间与空间
理想情况下,我们希望算法的时间复杂度和空间复杂度都能达到最优。然而在实际情况中,同时优化时间复杂度和空间复杂度通常是非常困难的。
降低时间复杂度通常需要以提升空间复杂度为代价,反之亦然。我们将牺牲内存空间来提升算法运行速度的思路称为“以空间换时间”;反之,则称为“以时间换空间”。
选择哪种思路取决于我们更看重哪个方面。在大多数情况下,时间比空间更宝贵,因此以空间换时间通常是更常用的策略。当然,在数据量很大的情况下,控制空间复杂度也是非常重要的。