二叉搜索树BST
基本概念与定义
什么是二叉搜索树
二叉搜索树(Binary Search Tree,简称 BST),也常被称为二叉排序树、二叉查找树,是一种特殊的二叉树结构。它的核心设计思想是利用"左小右大"的性质,将数据组织成一棵便于快速查找的树。
递归定义:
- 空树是一棵二叉搜索树
- 若根节点的左子树非空,则左子树上所有节点的值都小于根节点的值
- 若根节点的右子树非空,则右子树上所有节点的值都大于根节点的值
- 根节点的左右子树本身也都必须是二叉搜索树
Note
注意:是左子树"所有节点"都小于根,而不仅仅是左孩子节点;右子树同理。这是 BST 最核心的不变式。
关键性质
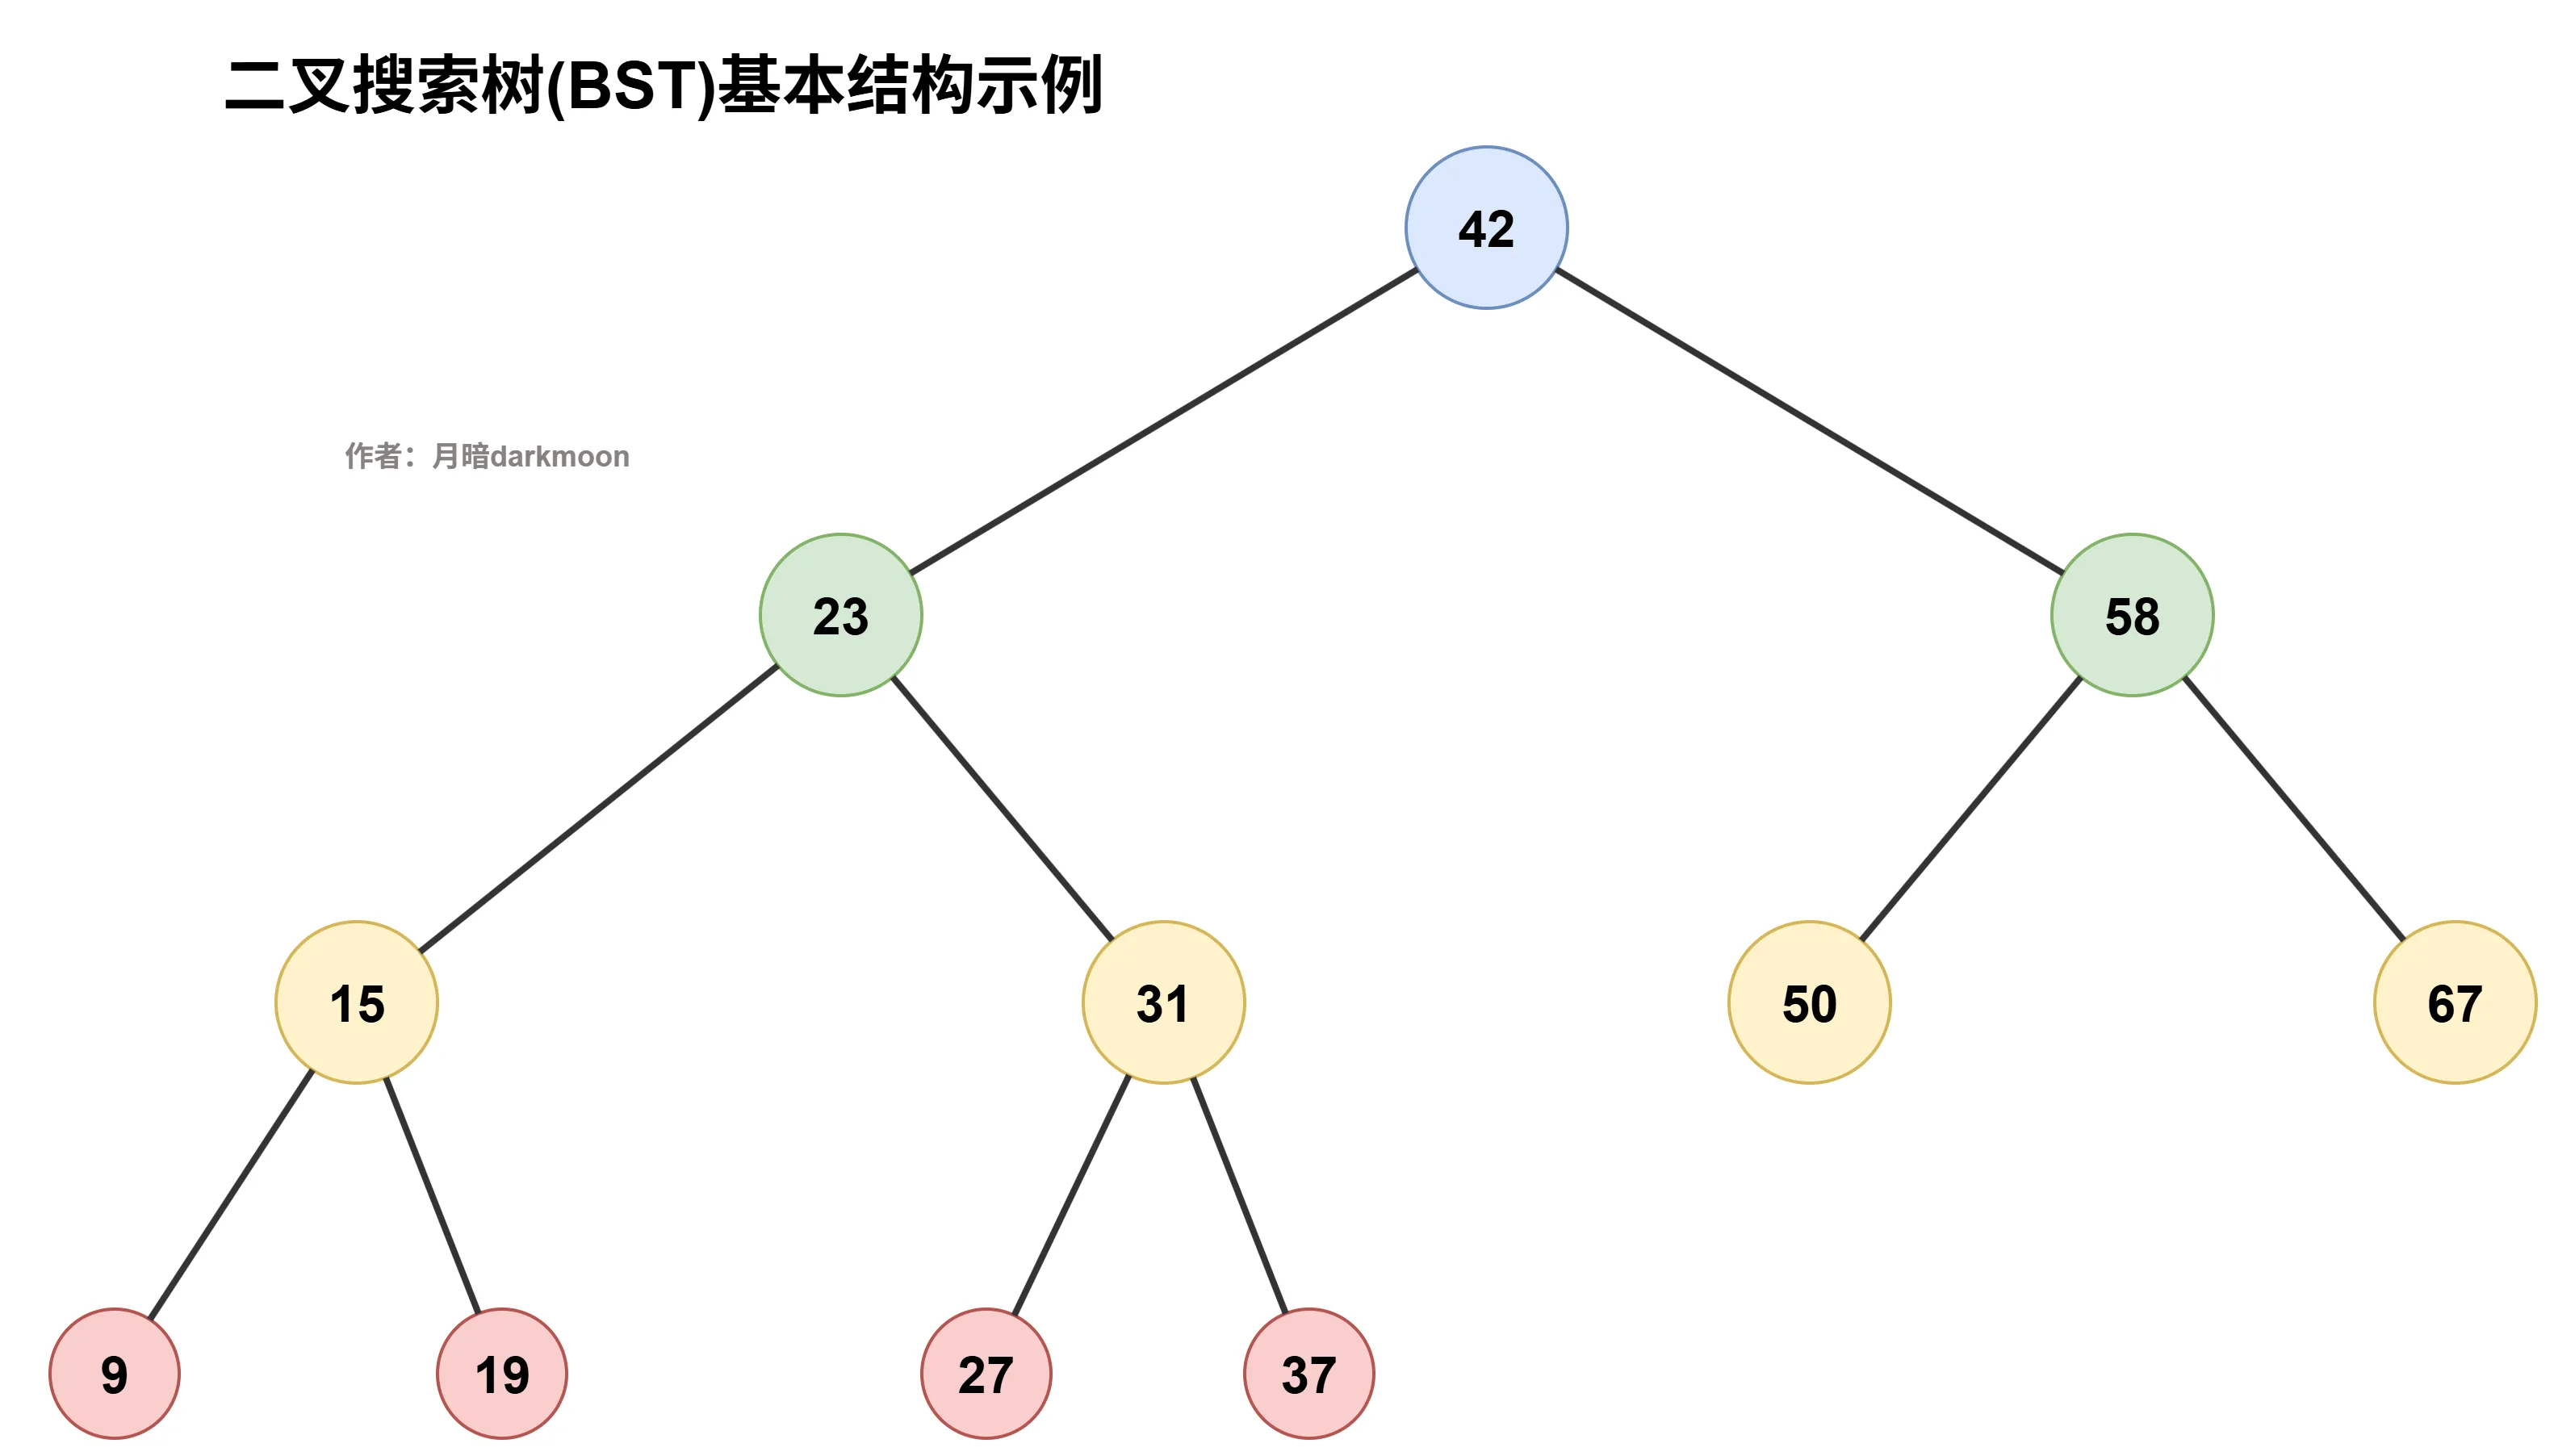
最重要的推论:对二叉搜索树进行中序遍历(左→根→右),得到的一定是一个严格递增的有序序列。
例如上图这棵树的中序遍历结果为:
这个性质非常重要,它是 BST 很多算法的基础,也是验证一棵树是否是合法 BST 的常用方法。
BST 与堆的区别
很多同学容易把 BST 和堆(Heap)搞混,这里做个对比:
| 特性 | 二叉搜索树 (BST) | 二叉堆 (Heap) |
|---|---|---|
| 大小关系 | 左子树全 < 根 < 右子树全 | 根节点 ≥ 或 ≤ 所有子节点(全局) |
| 左右子树 | 有严格的大小区分 | 左右子树没有大小区分 |
| 最顶层元素 | 中值(相对中间大小) | 最大值(大顶堆)或最小值(小顶堆) |
| 遍历有序性 | 中序遍历全局有序 | 层序遍历满足堆序,不是全局有序 |
| 主要用途 | 动态查找、有序遍历 | 优先队列、TopK 问题 |
存储结构
BST 通常采用二叉链表存储,每个节点包含数据域和两个指针域。C 语言描述如下:
typedef int ElemType;  // 关键字类型,这里以int为例
typedef struct BSTNode {
    ElemType data;              // 数据域(关键字)
    struct BSTNode *lchild;     // 左孩子指针
    struct BSTNode *rchild;     // 右孩子指针
} BSTNode, *BSTree;
查找操作
查找是 BST 最核心的操作,插入、删除等操作都建立在查找的基础上。
从根节点开始,逐层向下比较:
- 如果树为空,直接返回查找失败
- 将目标值与当前节点比较:
- 相等 → 查找成功,返回该节点
- 目标值 < 当前节点值 → 去左子树继续找
- 目标值 > 当前节点值 → 去右子树继续找
- 走到空指针还没找到 → 查找失败
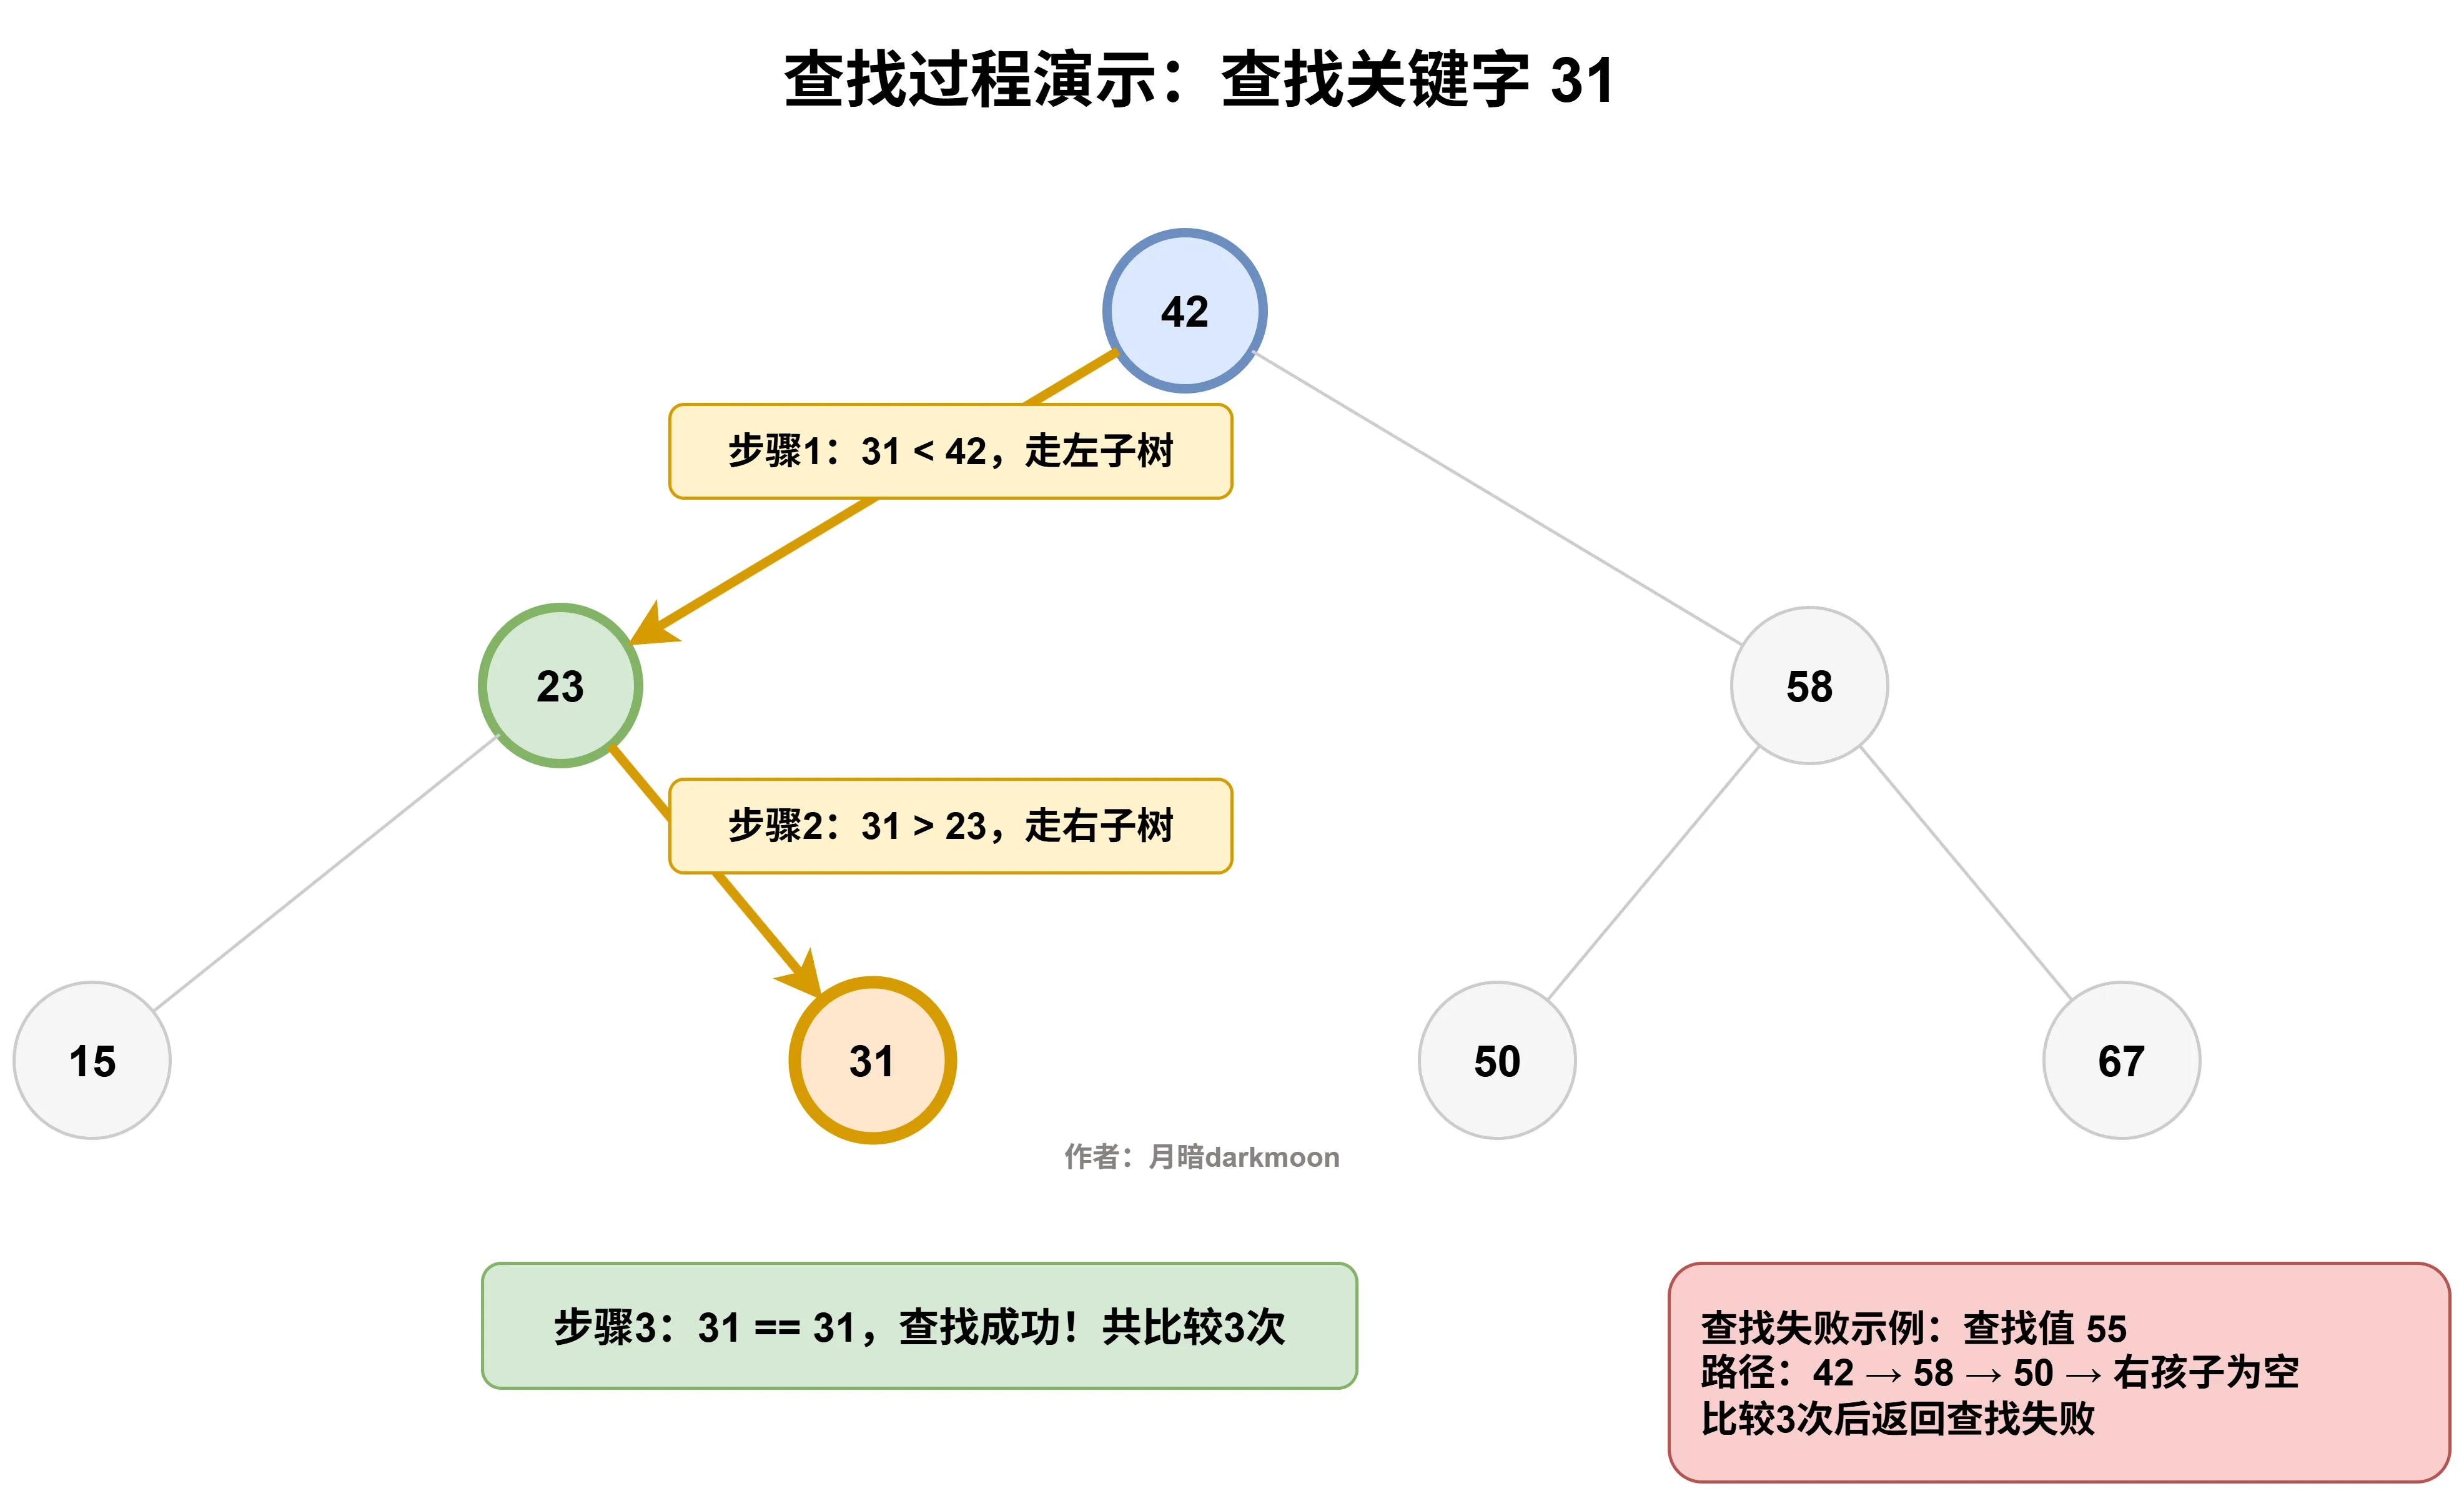
示例:在上图的树中查找值为 31 的节点
- 31 < 42 → 进入左子树(节点 23)
- 31 > 23 → 进入右子树(节点 31)
- 31 == 31 → 查找成功!总共比较了 3 次
查找失败示例:查找值为 55 的节点
- 55 > 42 → 右子树(58)
- 55 < 58 → 左子树(50)
- 55 > 50 → 右子树(空)→ 查找失败,共比较 3 次
// 在树T中查找key,成功返回节点指针,失败返回NULL
BSTNode* SearchBST(BSTree T, ElemType key) {
    if (T == NULL)
        return NULL;                // 空树,查找失败
    else if (key == T->data)
        return T;                   // 匹配成功
    else if (key < T->data)
        return SearchBST(T->lchild, key);  // 去左子树找
    else
        return SearchBST(T->rchild, key);  // 去右子树找
}
BSTNode* SearchBST_NonRecur(BSTree T, ElemType key) {
    BSTNode *p = T;
    while (p != NULL && p->data != key) {
        if (key < p->data)
            p = p->lchild;   // 关键字更小,走左边
        else
            p = p->rchild;   // 关键字更大,走右边
    }
    return p;  // 找到返回节点,找不到返回NULL
}
插入操作
BST 的插入非常巧妙:新插入的节点一定是叶子节点。
过程:
- 先按照查找逻辑从根往下走
- 如果树中已存在相同关键字 → 插入失败(BST 一般不允许重复关键字)
- 如果走到空指针(查找失败),这个位置就是插入点
- 创建新节点挂到这个空位置上
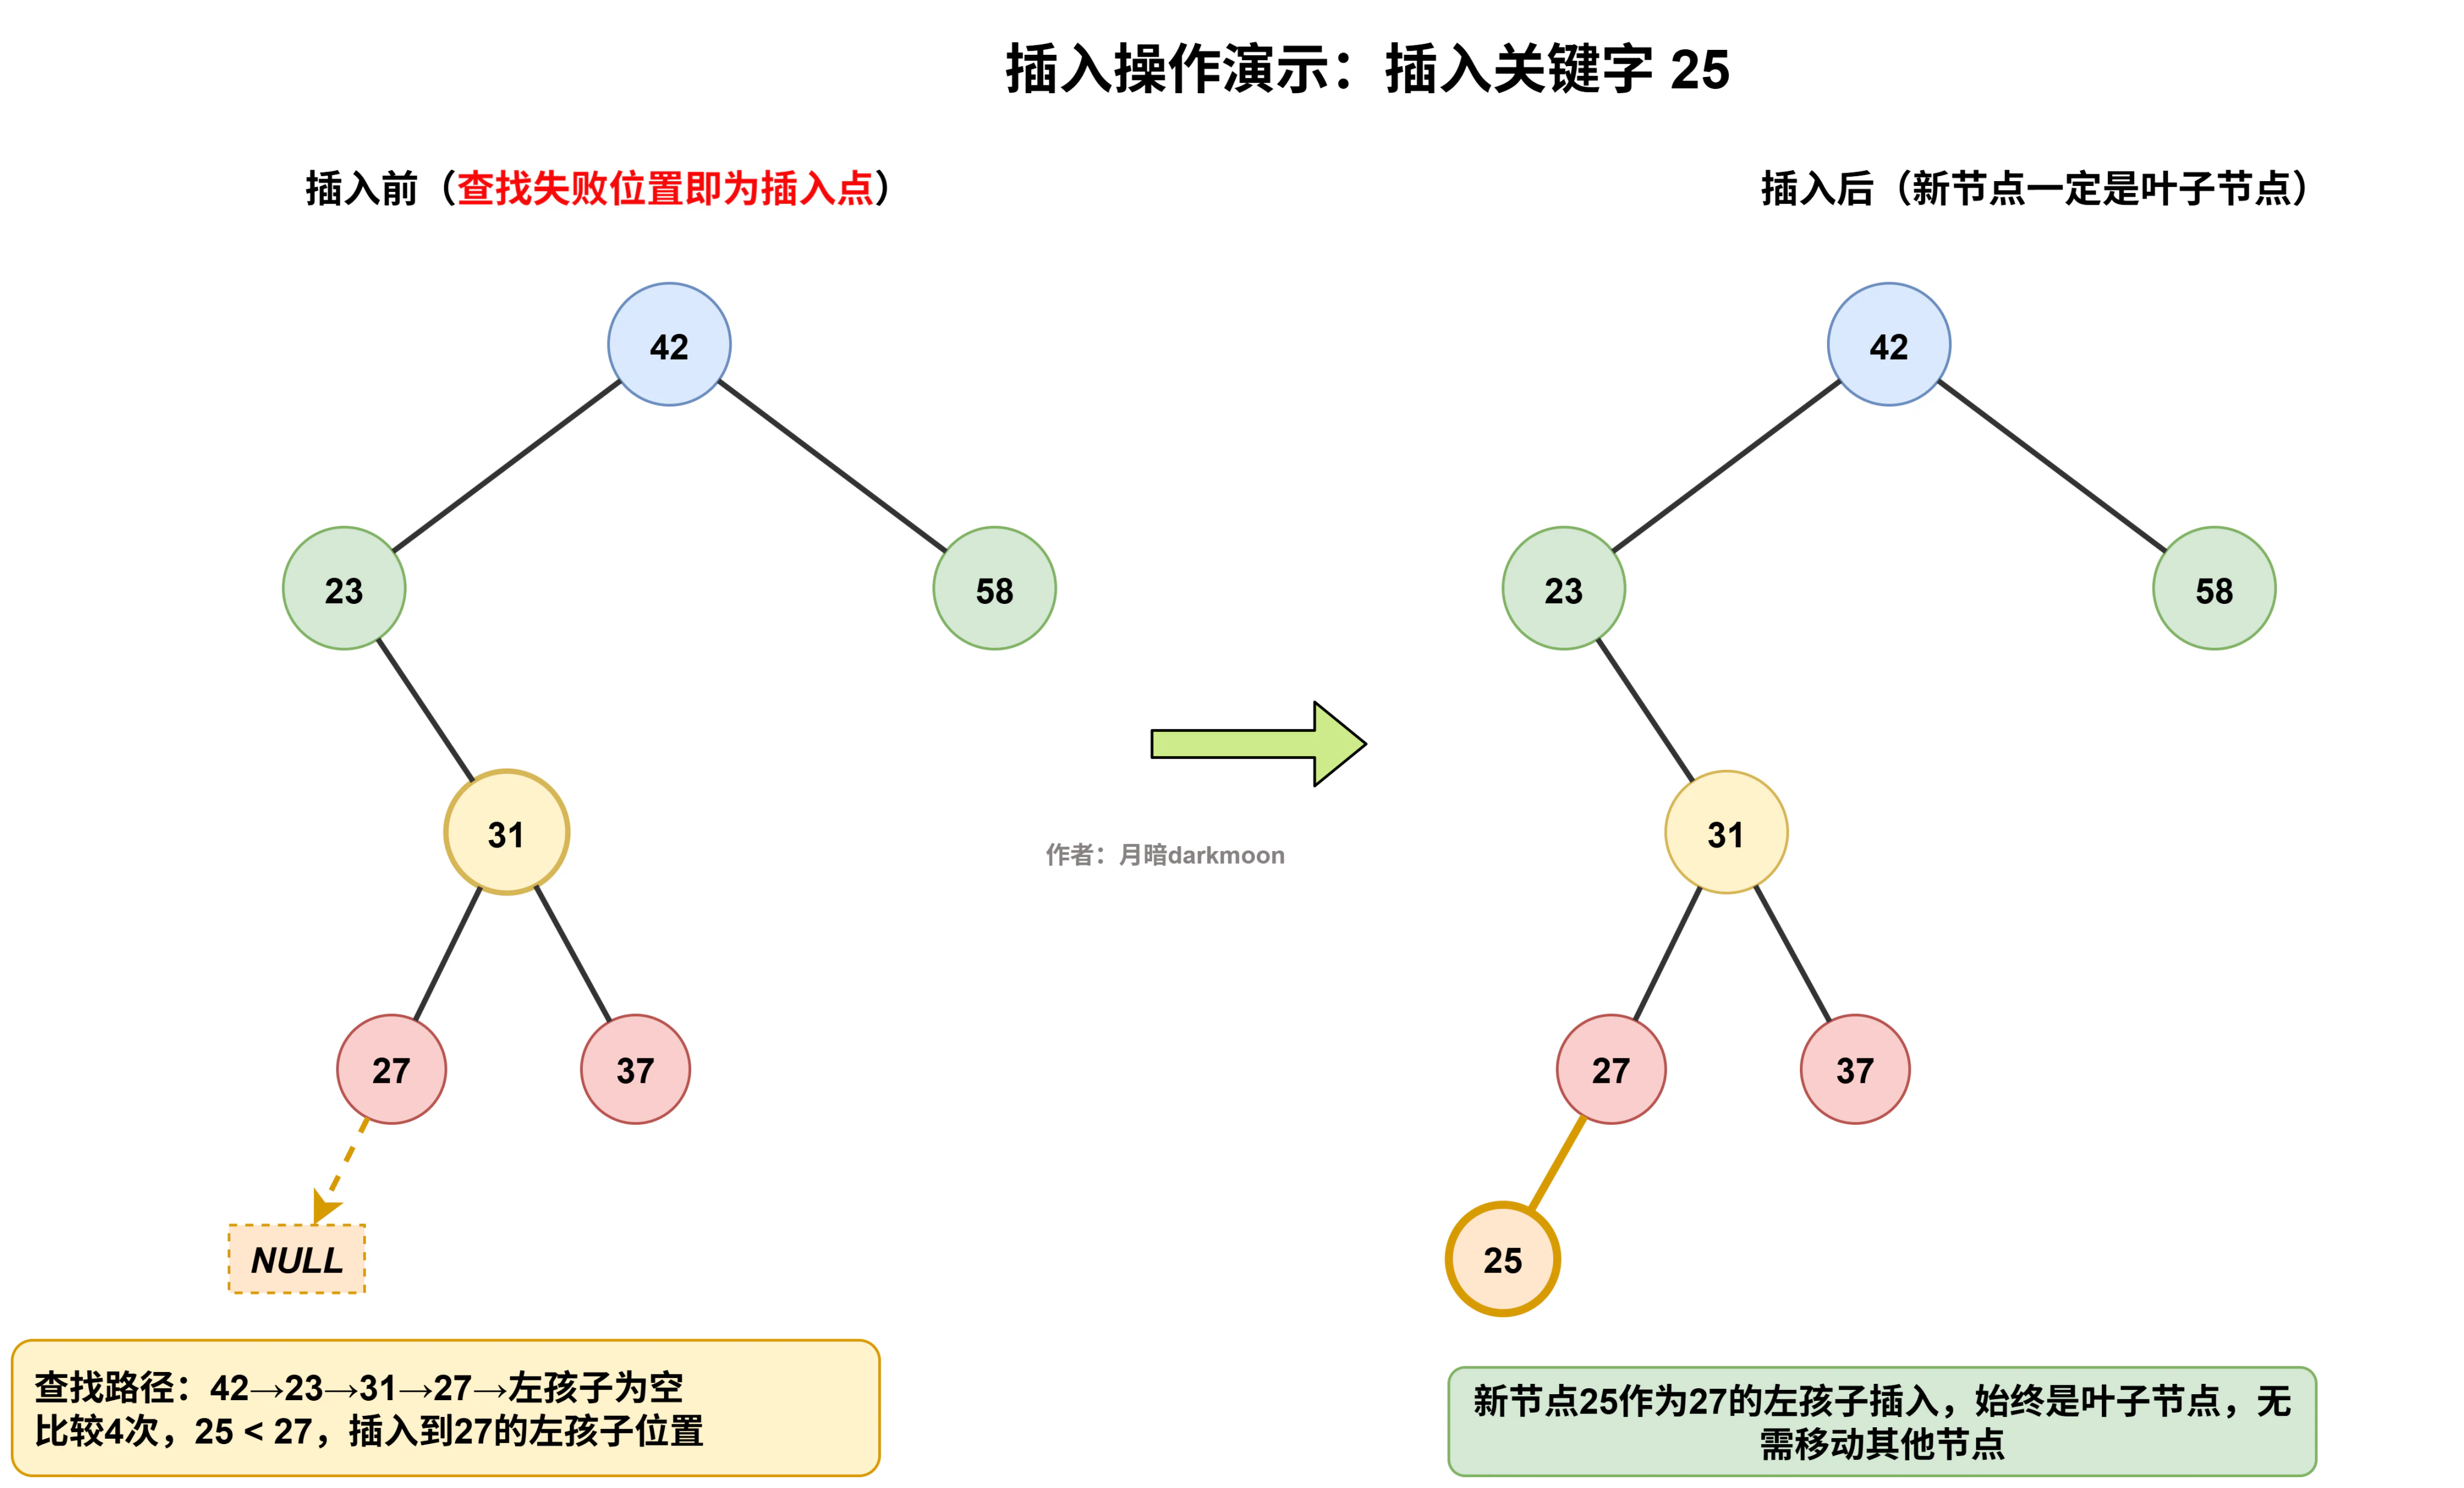
示例:在树中插入值 25
- 查找路径:42 → 23 → 31 → 27
- 25 < 27,而 27 的左孩子为空 → 插入到这里
- 新节点 25 成为 27 的左孩子,是叶子节点
代码实现:注意这里形参用了引用类型&T,因为当树为空或者走到空指针时,我们需要直接修改父节点的指针(或者修改根指针本身)。
// 插入成功返回1,失败(关键字已存在)返回0
int InsertBST(BSTree &T, ElemType key) {
    if (T == NULL) {
        // 走到空位置,创建新节点插入
        T = (BSTNode*)malloc(sizeof(BSTNode));
        T->data = key;
        T->lchild = T->rchild = NULL;
        return 1;
    }
    else if (key == T->data)
        return 0;  // 关键字已存在,不允许重复
    else if (key < T->data)
        return InsertBST(T->lchild, key);  // 插入到左子树
    else
        return InsertBST(T->rchild, key);  // 插入到右子树
}
为什么引用
&T就能把节点挂上?因为递归调用走到T == NULL时,这个 T 不是普通的局部变量,它就是父节点那个指针的别名。给 T 赋值就是直接修改了父节点的左/右孩子指针。
构造(创建)二叉搜索树
构造 BST 非常简单:从空树开始,按照给定序列,逐个调用插入函数即可。
void CreateBST(BSTree &T, ElemType arr[], int n) {
    T = NULL;  // 初始为空树
    for (int i = 0; i < n; i++) {
        InsertBST(T, arr[i]);  // 逐个元素插入
    }
}
同一组关键字,插入顺序不同,得到的 BST 形态可能完全不同!
例如用 7 个数字 {15, 23, 31, 42, 50, 58, 67}:
- 按
42, 23, 58, 15, 31, 50, 67插入 → 得到一棵矮胖的平衡树 - 按
15, 23, 31, 42, 50, 58, 67插入 → 得到一条右斜的单链 - 按
67, 58, 50, 42, 31, 23, 15插入 → 得到一条左斜的单链
这三种树的查找效率天差地别,我们在下一节详细分析。
删除操作
450. 删除二叉搜索树中的节点 - 力扣(LeetCode)
与插入节点类似,我们需要在删除操作后维持二叉搜索树的“左子树 < 根节点 < 右子树”的性质。首先,我们需要在二叉树中执行查找操作,获取待删除节点。接下来,根据待删除节点的子节点数量,删除操作需分为三种情况:
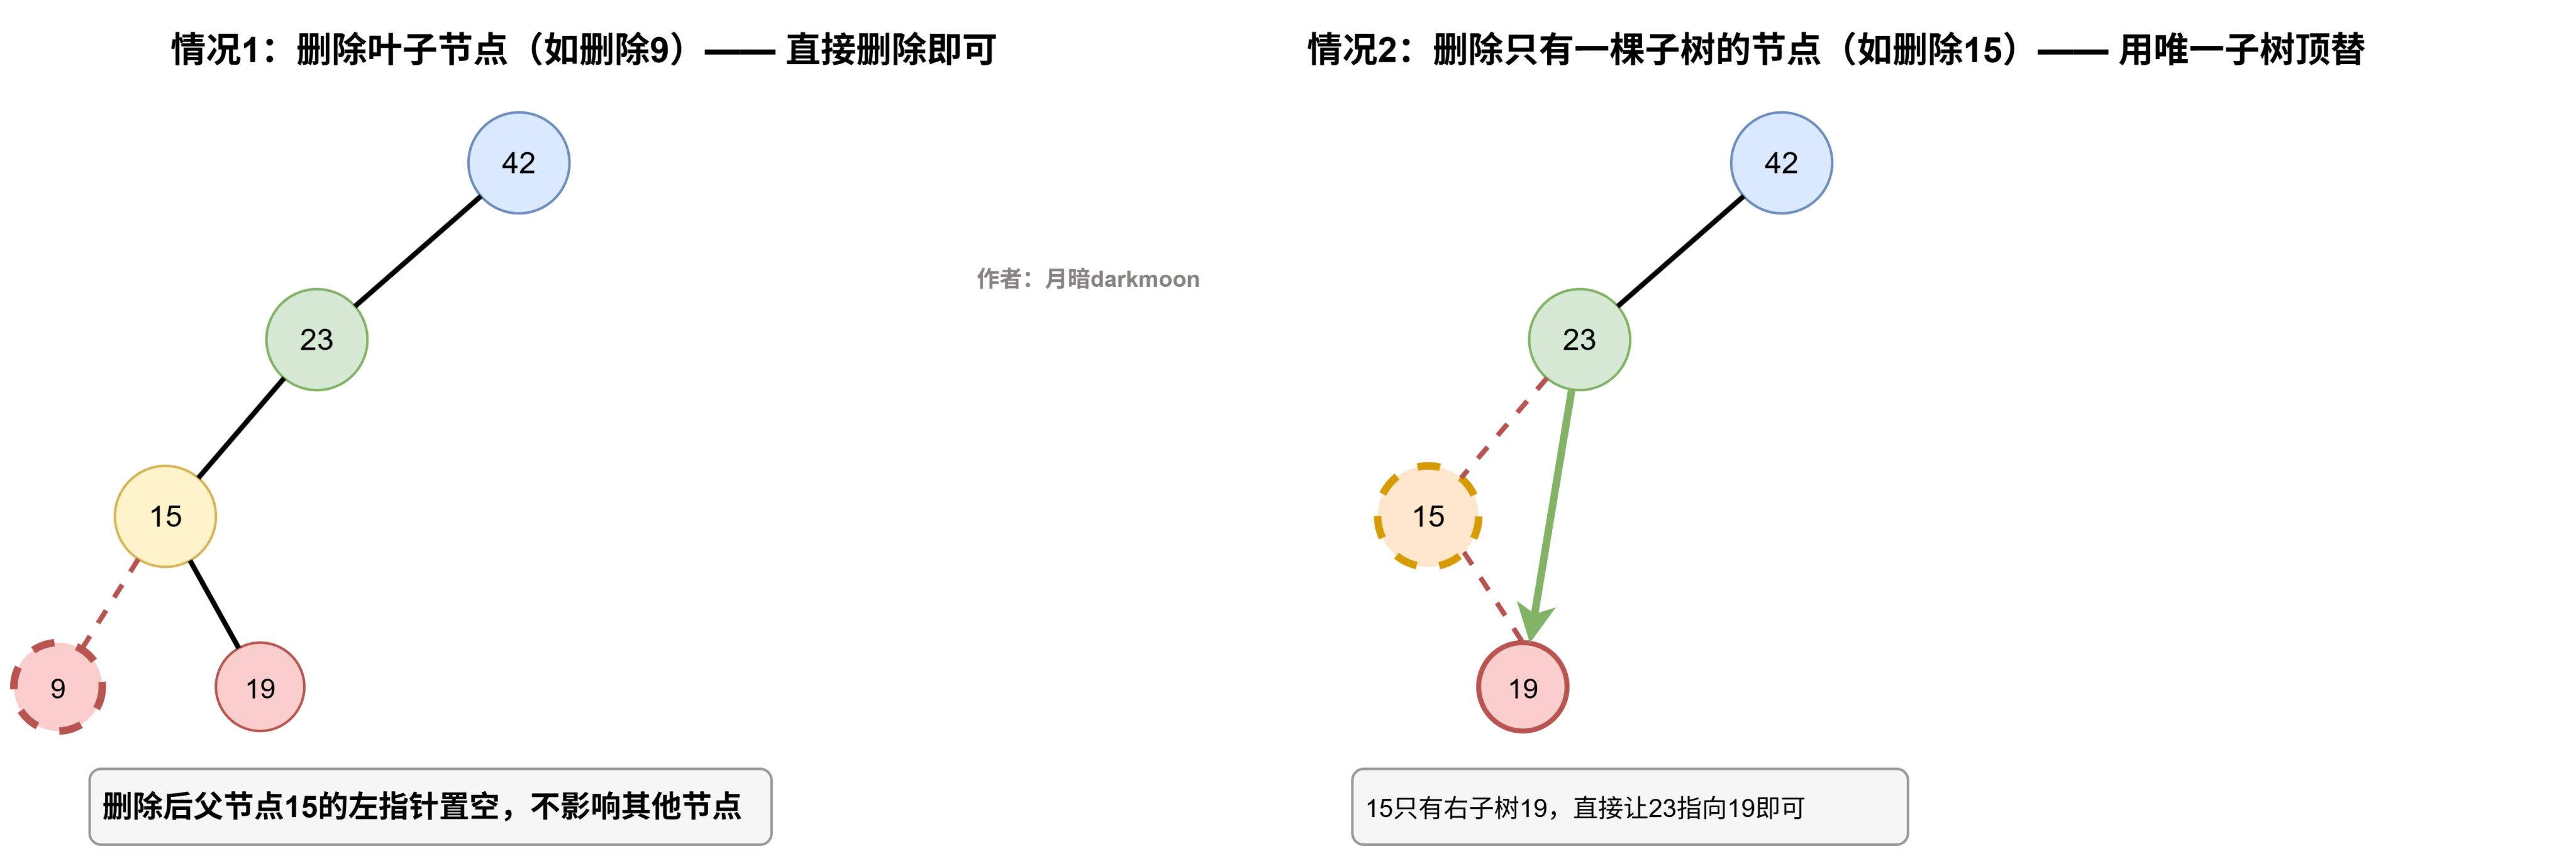
- 当待删除节点的度为 0 时,表示待删除节点是叶节点,可以直接删除。
- 当待删除节点的度为 1 即只有左子树或右子树时,将待删除节点替换为其子节点即可。
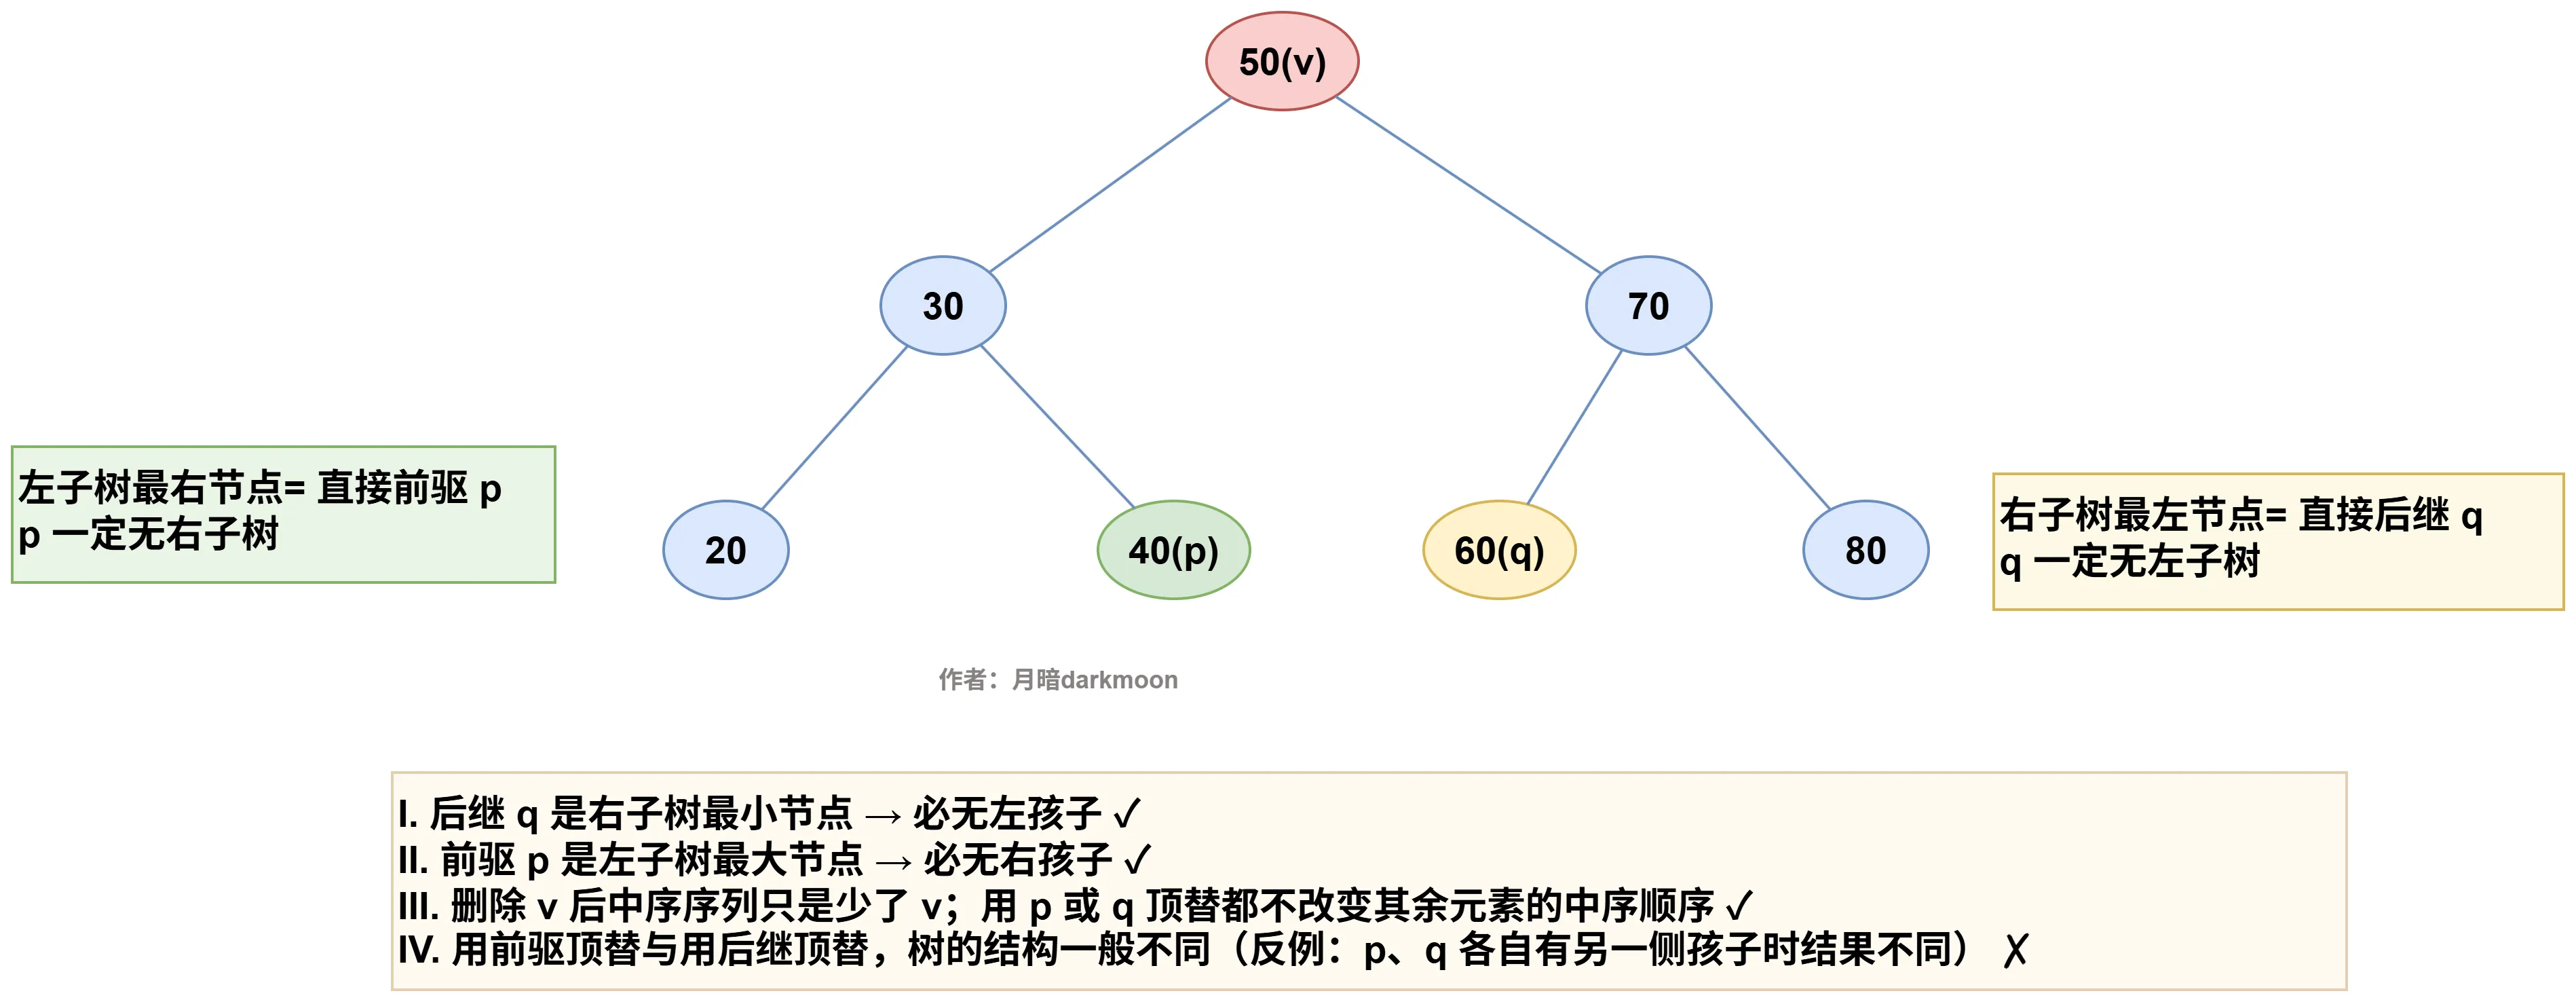
- 当待删除节点的度为 2 即左右子树都存在时,我们无法直接删除它,而需要使用一个节点替换该节点。由于要保持二叉搜索树“左 < 根 < 右”的性质,因此这个节点可以是右子树的最小节点(在右子树的最左下位置)或左子树的最大节点(左子树的最右下位置),也就是该节点的中序前驱(或中序后继)。
删除节点代码递归写法:\(root\)有左右子树,这时可以将 \(root\)的后继节点(比 \(root\) 大的最小节点,即它的右子树中的最小节点,记为\(successor\))作为新的根节点替代 \(root\),并将 \(successor\) 从\(root\) 的右子树中删除,使得在保持有序性的情况下合并左右子树。
TreeNode* deleteNode(TreeNode *root, int key) {
    if(root == NULL)  return NULL;
    if(root -> val < key){
        root -> right = deleteNode(root -> right,key);
        return root;
    }
    if(root -> val > key) {
        root -> left = deleteNode(root -> left,key);
        return root;
    }
    if(root -> val == key) {
        if(!root -> left && !root -> right) {   //情况1,被删除结点是叶节点,直接删除;
            delete root;  //释放被删除节点;
            return NULL;
        }
        if(!root -> left) {   //情况2:被删除结点没有左子树,则直接返回其右子树;
            TreeNode *child = root->right;  //保存子树后释放当前节点;
            delete root;
            return child;
        }
        if(!root->right) {    //情况3:被删除结点没有右子树,直接返回其左子树;
            TreeNode *child = root->left;  //保存子树后释放当前节点;
            delete root;
            return child;
        }
        TreeNode* successor = root -> right;   //用来寻找root的直接后继结点;
        while(successor -> left) {     //它的直接后继结点是它右子树的最左下结点;
            successor = successor -> left;
        }
        root -> val = successor -> val;  //复制后继值,避免直接移动节点造成指针错误;
        root -> right = deleteNode(root -> right, successor -> val);  //删除右子树中的重复后继节点;
        return root;
    }
    return root;
}
删除示意图(删除17):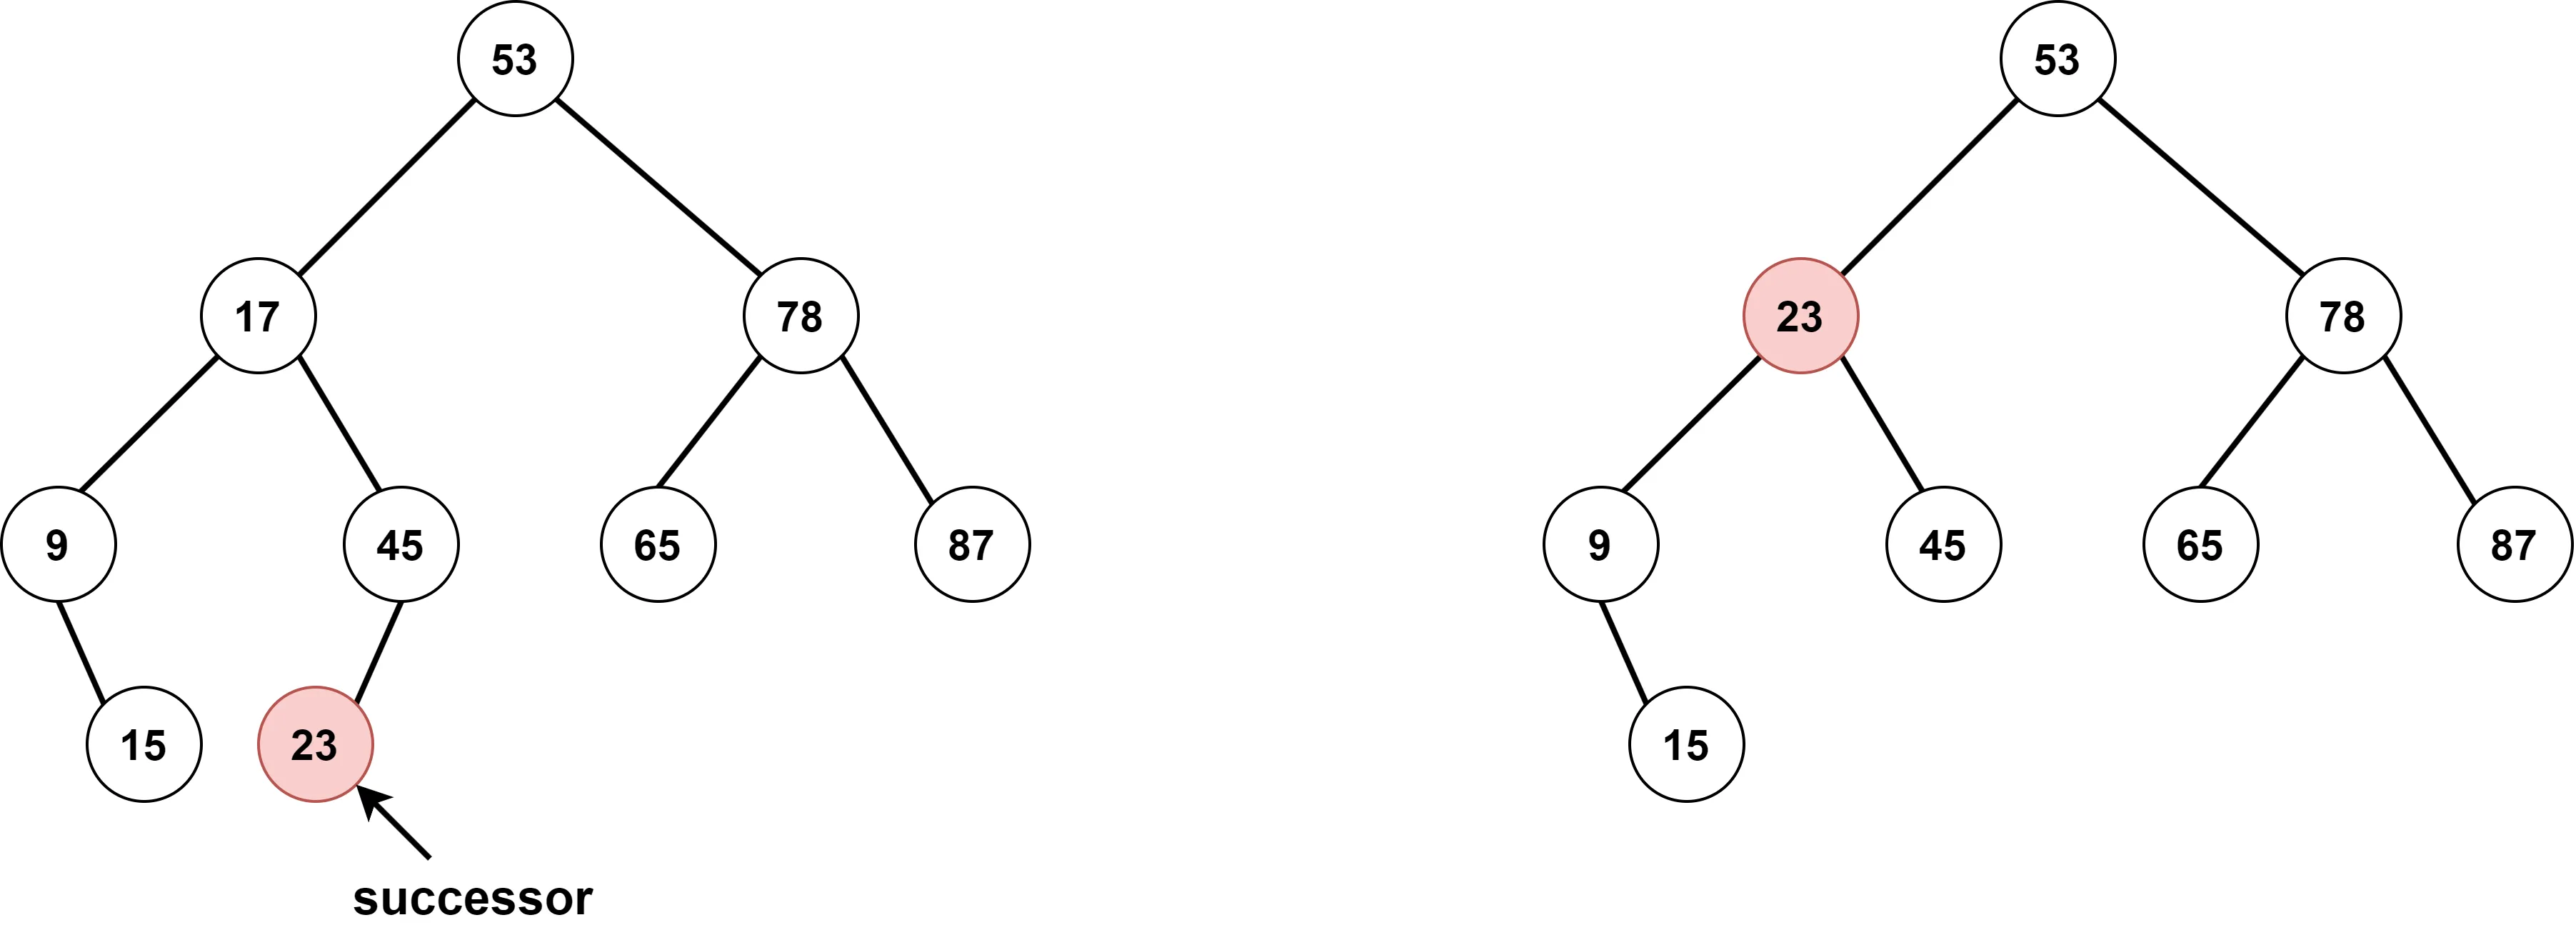
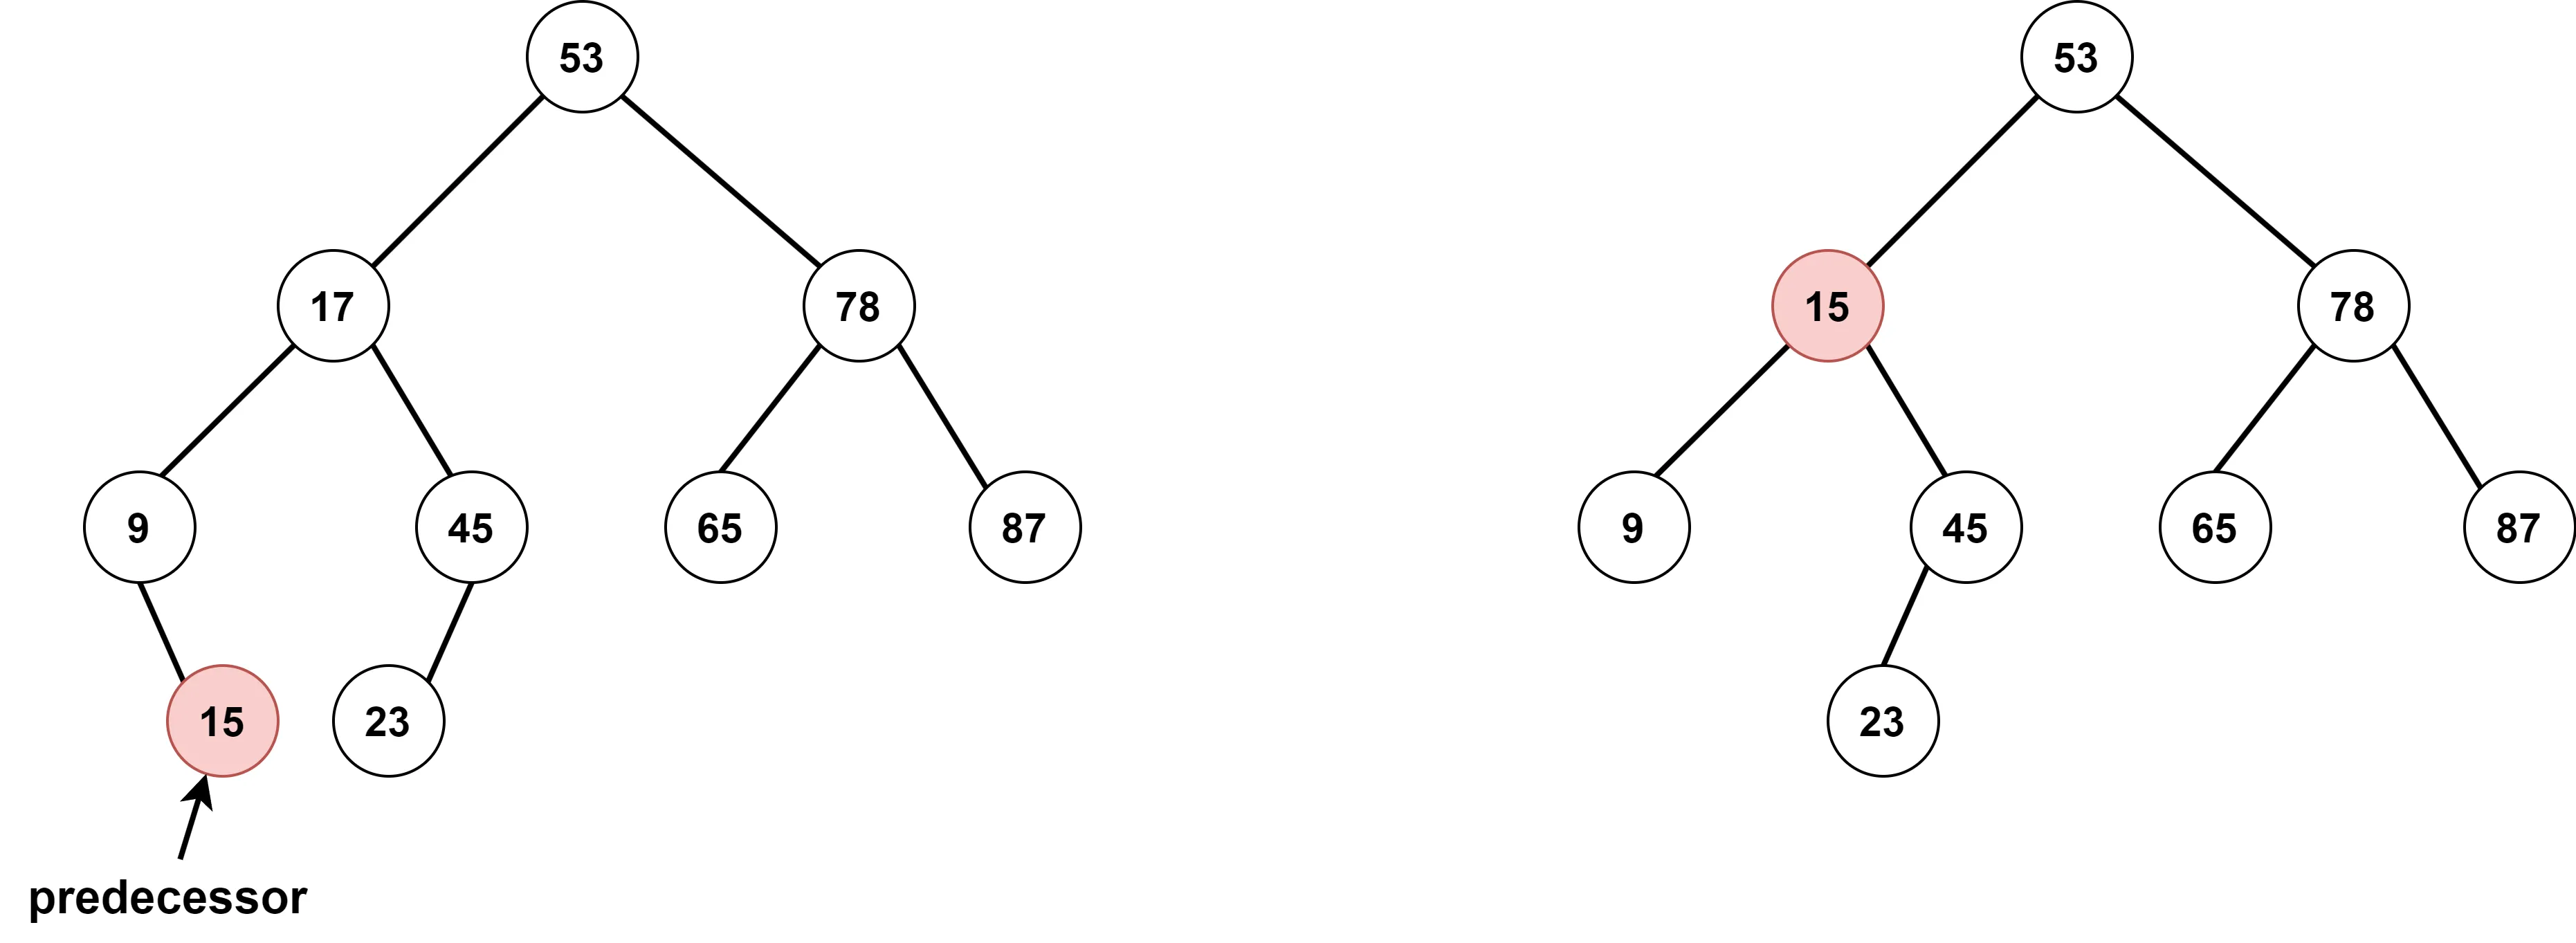
当然也可以用当前结点的直接前驱来代替它,即它的左子树的最右下的结点;下面为关键部分的修改:
TreeNode *predecessor = root->left;  //当前结点的直接前驱结点;
while (predecessor->right) {    //位于它的左子树最右下位置;
     predecessor= predecessor->right;
}
root->val = predecessor->val;  //复制前驱值,避免删除后继续访问已释放节点;
root->left = deleteNode(root->left, predecessor->val);  //删除左子树中的重复前驱节点;
return root;
这样的话删除结点17的示意图是这样的
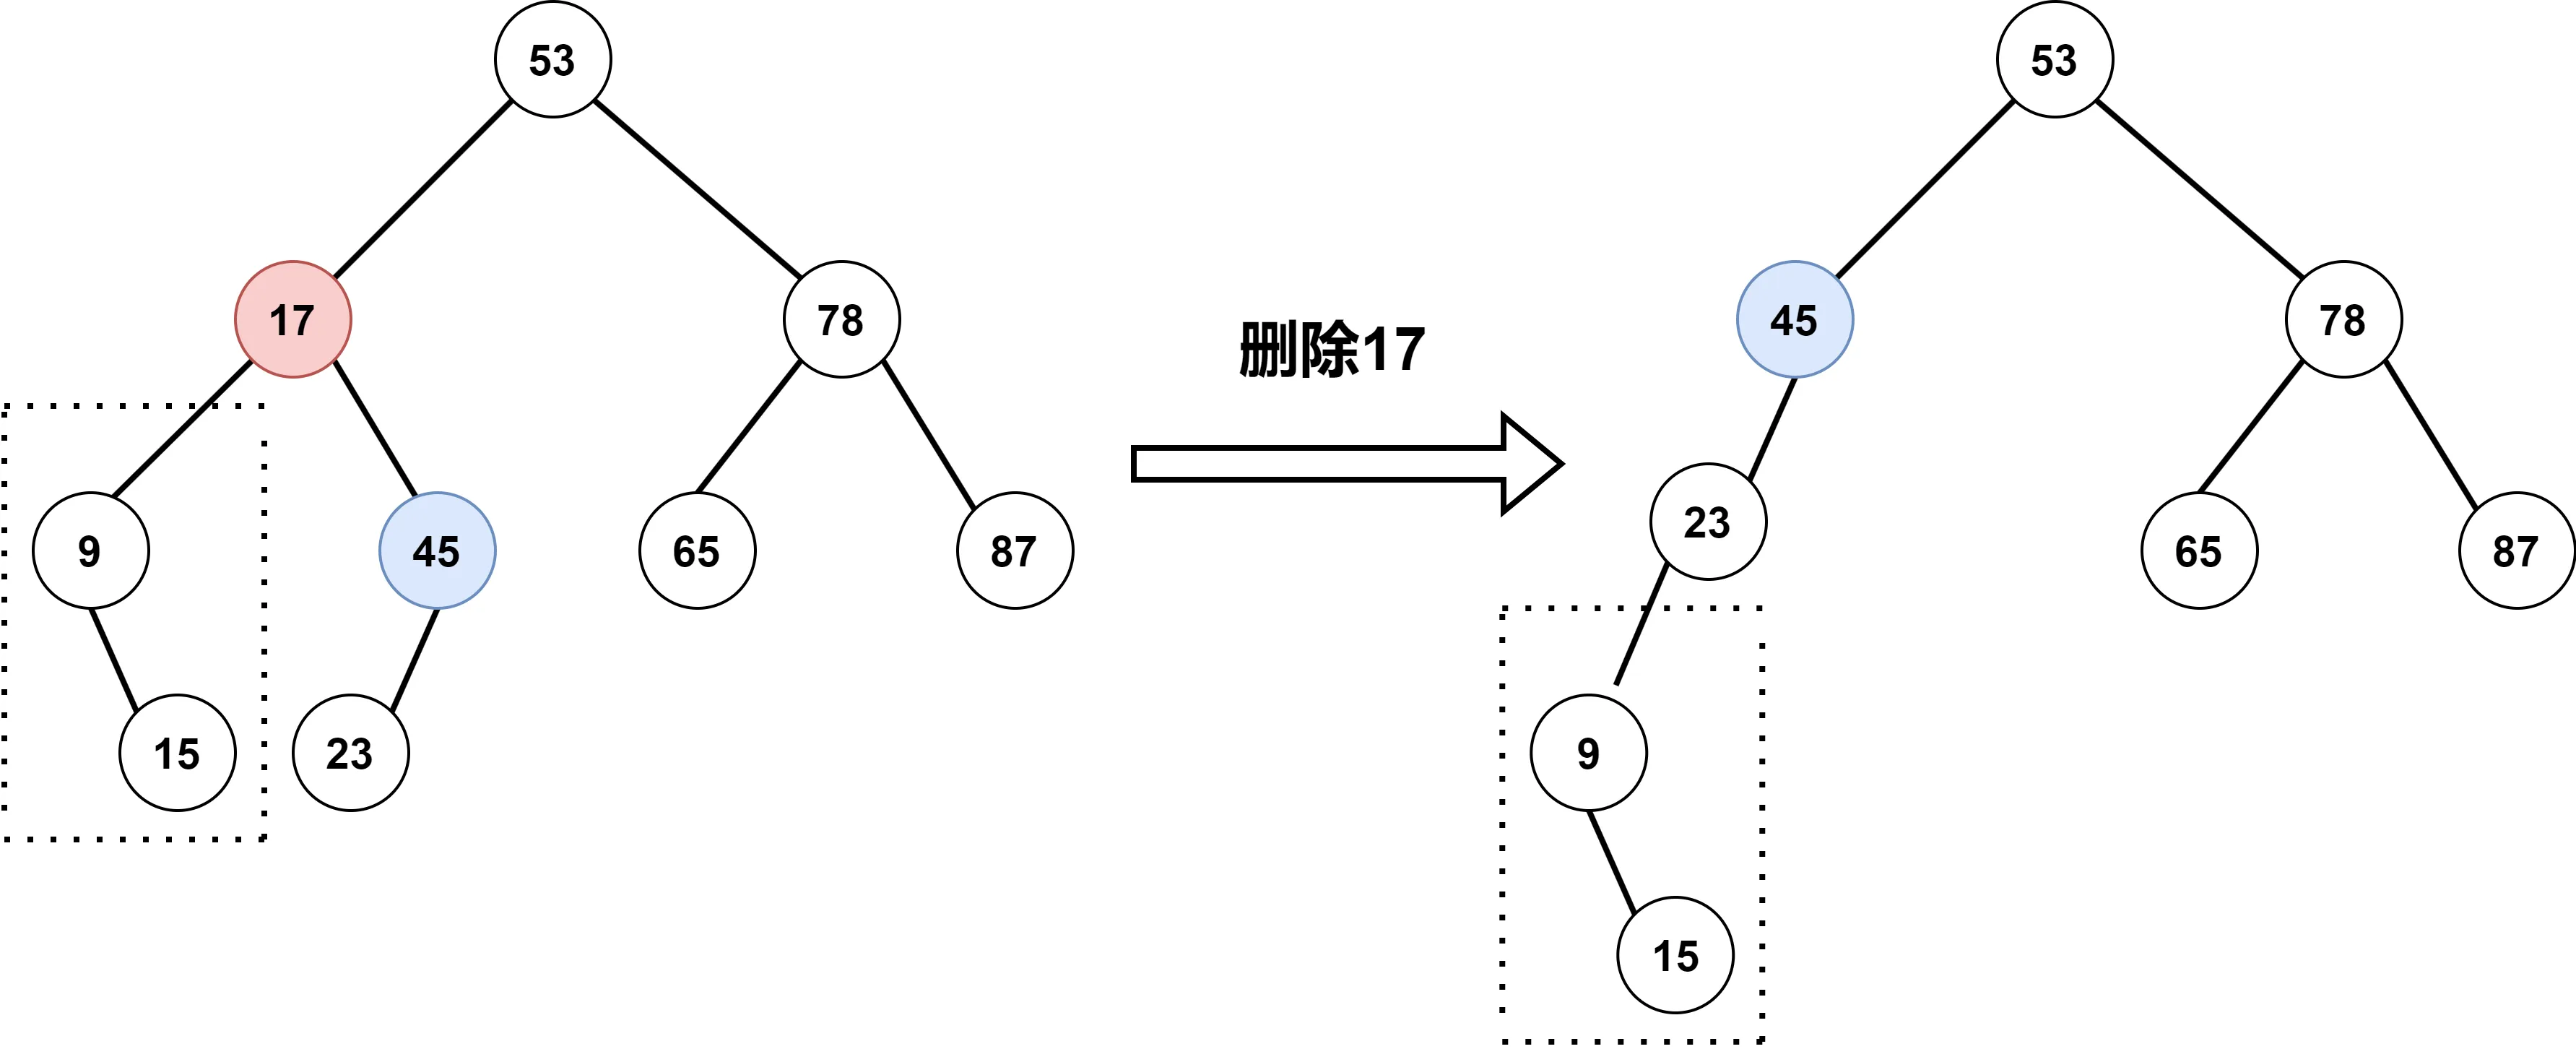
还有一种处理方式:若被删除节点有左右子树,将其左子树挂到其右子树的最左下结点的左子树位置,然后让该结点的右子树顶替他的位置,这样也可以删除该结点。
图例为下:由图可以看出,这样处理的话多次删除几个结点后,树就变成链表了,不推荐使用;
class Solution {
public:
    TreeNode* deleteNode(TreeNode* root, int key)
    {
        if (root == nullptr)    return nullptr;
        if (key > root->val)    root->right = deleteNode(root->right, key);     // 去右子树删除
        else if (key < root->val)    root->left = deleteNode(root->left, key);  // 去左子树删除
        else    // 当前节点就是要删除的节点
        {
            if (! root->left)   return root->right; // 情况1,欲删除节点无左子
            if (! root->right)  return root->left;  // 情况2,欲删除节点无右子
            TreeNode* node = root->right;           // 情况3,欲删除节点左右子都有
            while (node->left)          // 寻找欲删除节点右子树的最左节点
                node = node->left;
            node->left = root->left;    // 将欲删除节点的左子树成为其右子树的最左节点的左子树
            root = root->right;         // 欲删除节点的右子顶替其位置,节点被删除
        }
        return root;
    }
};
Note
【注】:如果删除的结点位于叶子节点处,那么将其删除后再插入,树的形态与原来保持不变,因为BST插入结点后该结点成为叶子节点处,这个位置是唯一的;
class Solution {
public:
    TreeNode* deleteNode(TreeNode* root, int key) {
        TreeNode *cur = root, *curParent = nullptr;
        while (cur && cur->val != key) {
            curParent = cur;
            if (cur->val > key) {
                cur = cur->left;
            } else {
                cur = cur->right;
            }
        }
        if (!cur) {
            return root;
        }
        if (!cur->left && !cur->right) {
            cur = nullptr;
        } else if (!cur->right) {
            cur = cur->left;
        } else if (!cur->left) {
            cur = cur->right;
        } else {
            TreeNode *successor = cur->right, *successorParent = cur;
            while (successor->left) {
                successorParent = successor;
                successor = successor->left;
            }
            if (successorParent->val == cur->val) {
                successorParent->right = successor->right;
            } else {
                successorParent->left = successor->right;
            }
            successor->right = cur->right;
            successor->left = cur->left;
            cur = successor;
        }
        if (!curParent) {
            return cur;
        } else {
            if (curParent->left && curParent->left->val == key) {
                curParent->left = cur;
            } else {
                curParent->right = cur;
            }
            return root;
        }
    }
};
查找效率分析
和二分查找类似,我们用平均查找长度 ASL 来衡量 BST 的查找效率。
在查找运算中,需要对比关键字的次数称为查找长度,反映了查找操作的时间复杂度
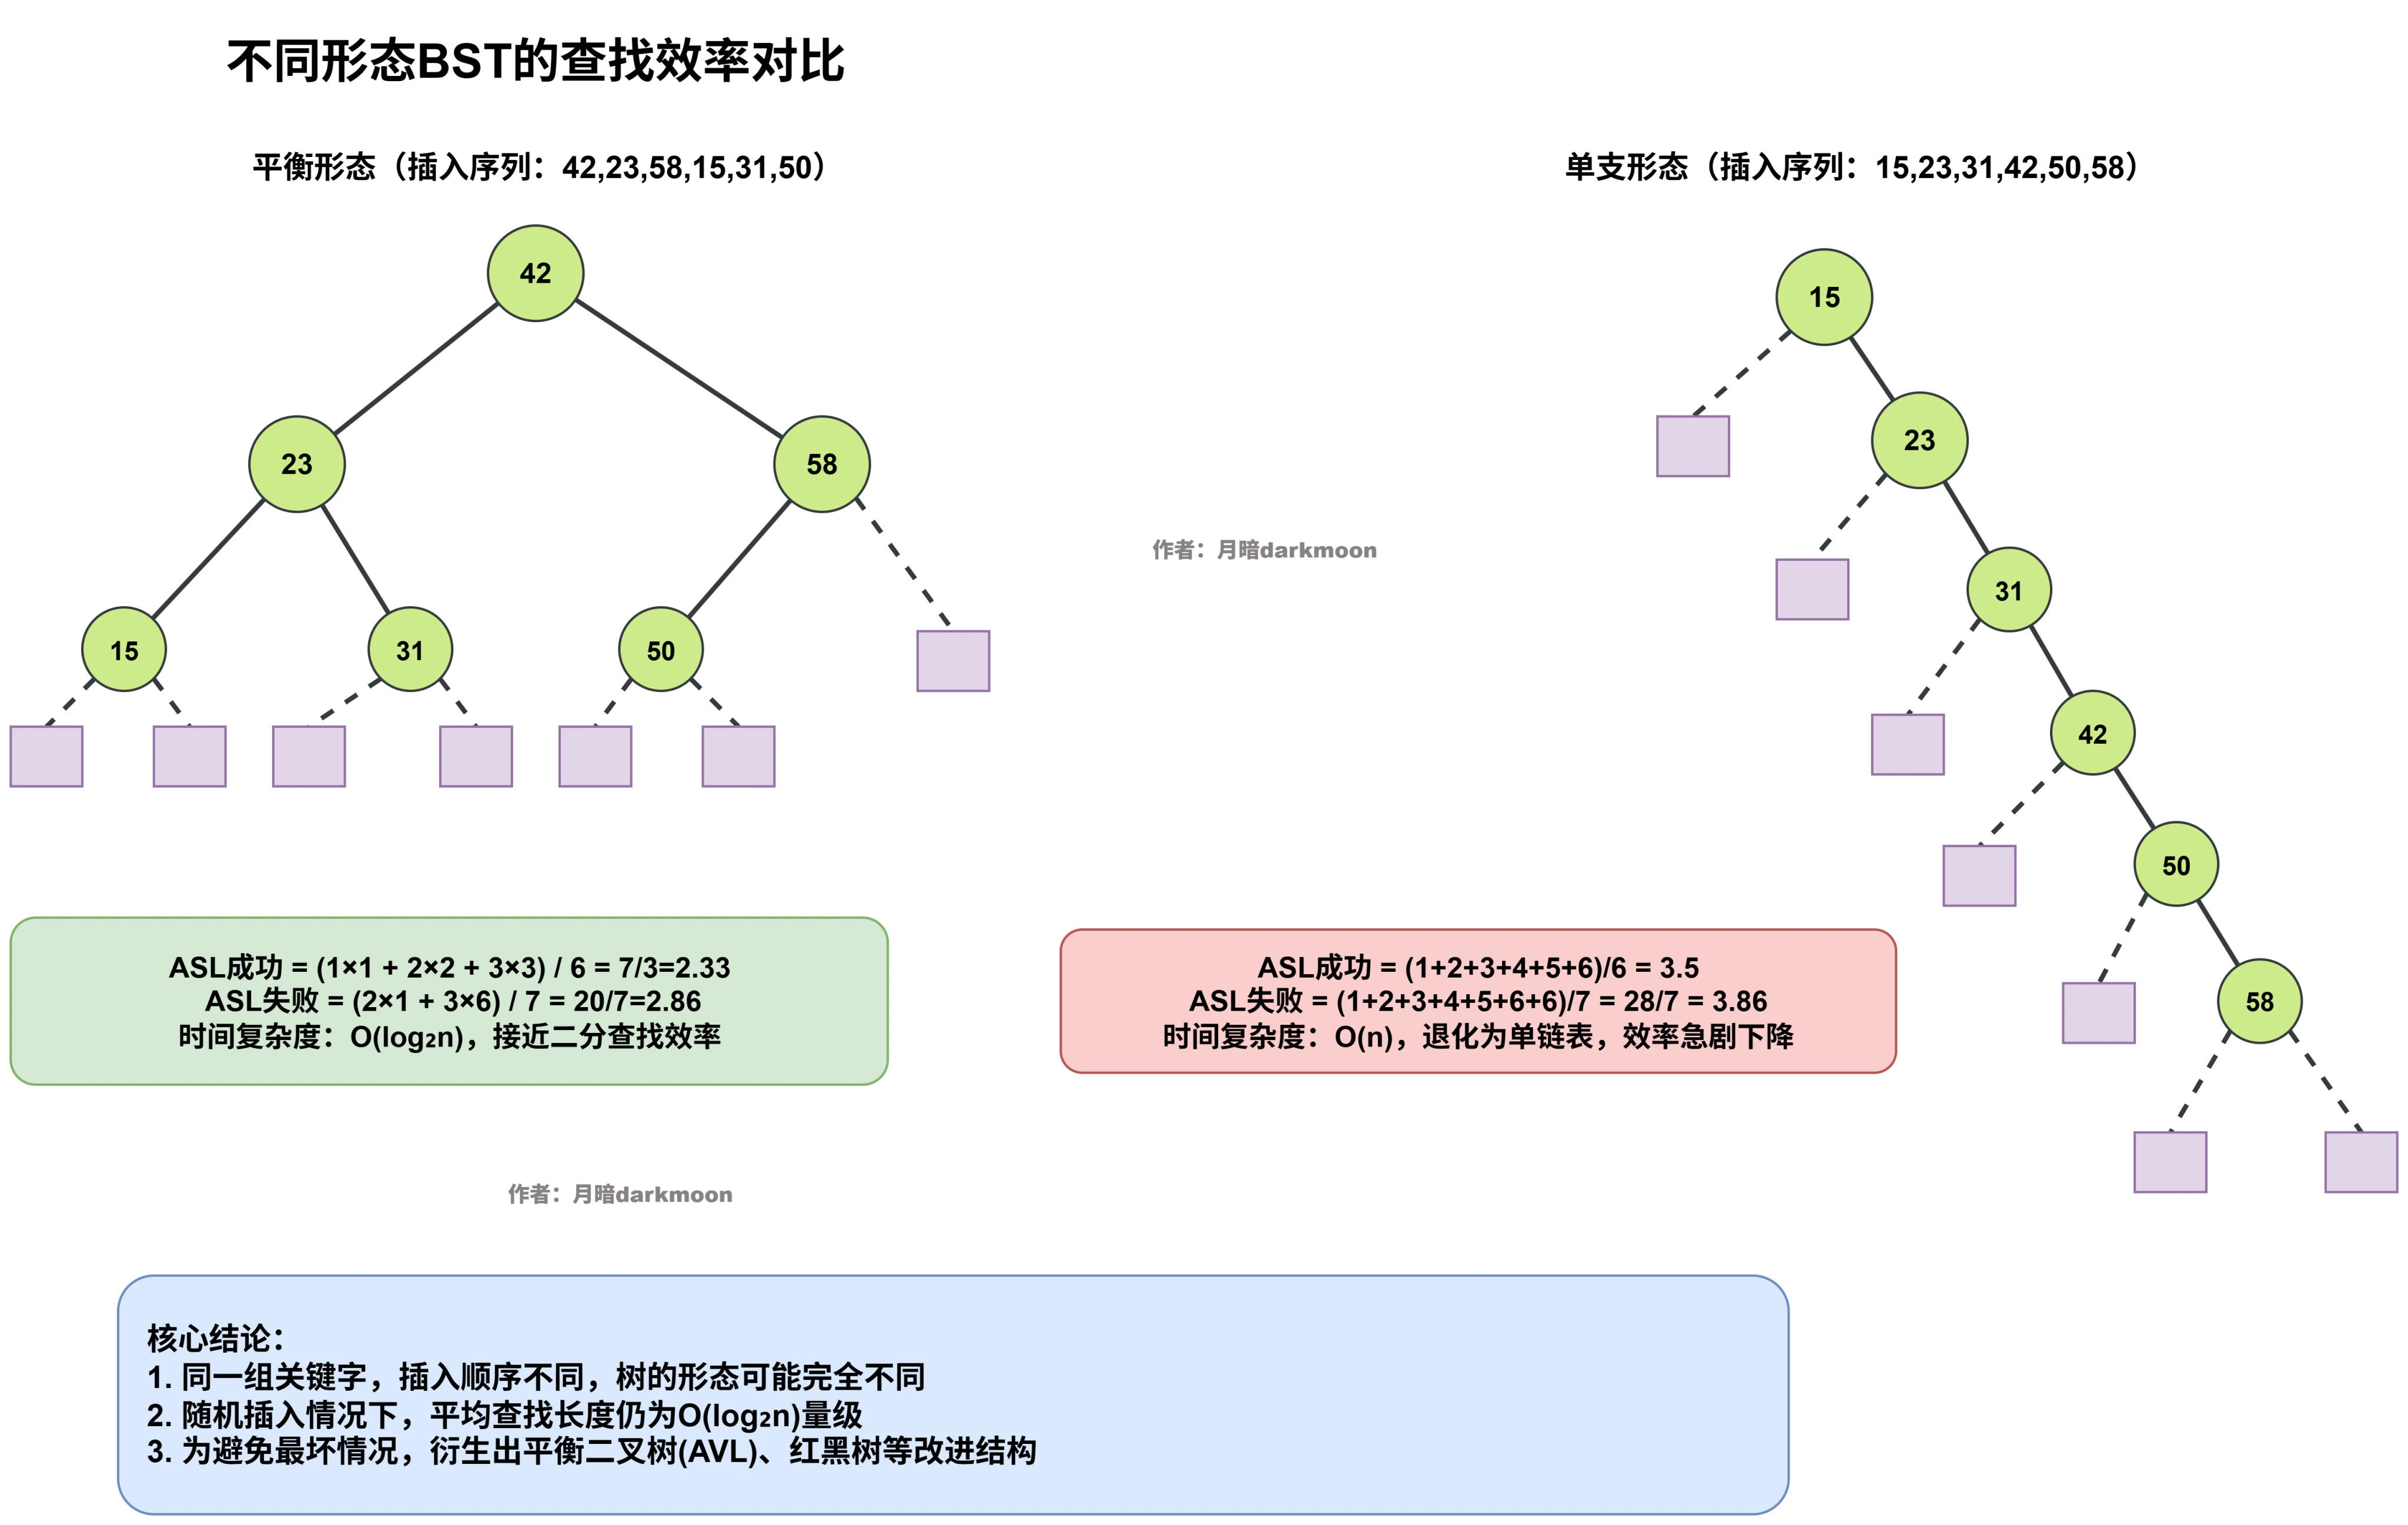
最好情况:平衡形态
当插入顺序比较随机,树的形态比较匀称,接近完全二叉树时:
- 树高约为
⌊log₂n⌋ + 1 - 成功 ASL ≈ O(log₂n)
- 查找效率和二分查找差不多
最坏情况:单支树
当插入序列本身有序(正序或逆序)时,BST 会退化成一条斜链:
- 树高 = n
- 成功 ASL = (n+1)/2 = O(n)
- 查找效率和顺序查找一样低,完全失去了 BST 的优势
虽然最坏情况很差,但数学上可以证明:随机构造的 BST,平均查找长度仍然是 O(log₂n) 量级的,只是常数比平衡树稍大一些。
也正因为 BST 存在最坏退化的问题,后来才衍生出了平衡二叉树(AVL树)、红黑树等改进结构,保证树高始终是 O(log₂n)。
BST 和二分查找的平均时间复杂度都是 O(log₂n),但二者适用场景不同:
| 对比维度 | 二分查找(有序顺序表) | 二叉搜索树(链式存储) |
|---|---|---|
| 存储结构 | 顺序存储(数组) | 链式存储 |
| 查找效率 | O(log₂n),稳定 | O(log₂n) ~ O(n),看树形 |
| 插入/删除 | O(n),需要移动大量元素 | O(log₂n),只需修改指针 |
| 适用场景 | 静态查找表,很少改动 | 动态查找表,频繁增删 |
| 判定树 | 唯一,形态固定 | 不唯一,随插入顺序变化 |
简单记忆:静态用二分,动态用 BST。
考点与常见坑点总结
- 中序遍历有序是 BST 的本质特征,给你一棵树问是不是 BST,直接中序遍历看是不是递增就行。
- 插入的新节点一定是叶子,这是 BST 插入的铁律。
- 删除有双子树的节点,用中序前驱(左子树最右)或中序后继(右子树最左)替换
- 插入顺序决定树形,同一个关键字集合可以对应多棵不同的 BST;但二分查找的判定树是唯一的。
- 删除后再插入,树形可能改变——这是很多同学想当然会错的点。
- BST 不允许重复关键字,插入相同值会失败。如果需要重复值,可以约定放在左子树或右子树,但标准实现中都是不重复的。
练习题
真题
- 【2011-07】对于下列关键字序列,不可能构成某二叉排序树中一条查找路径的序列是( )。
A. 95, 22, 91, 24, 94, 71
B. 92, 20, 91, 34, 88, 35
C. 21, 89, 77, 29, 36, 38
D. 12, 25, 71, 68, 33, 34
解析
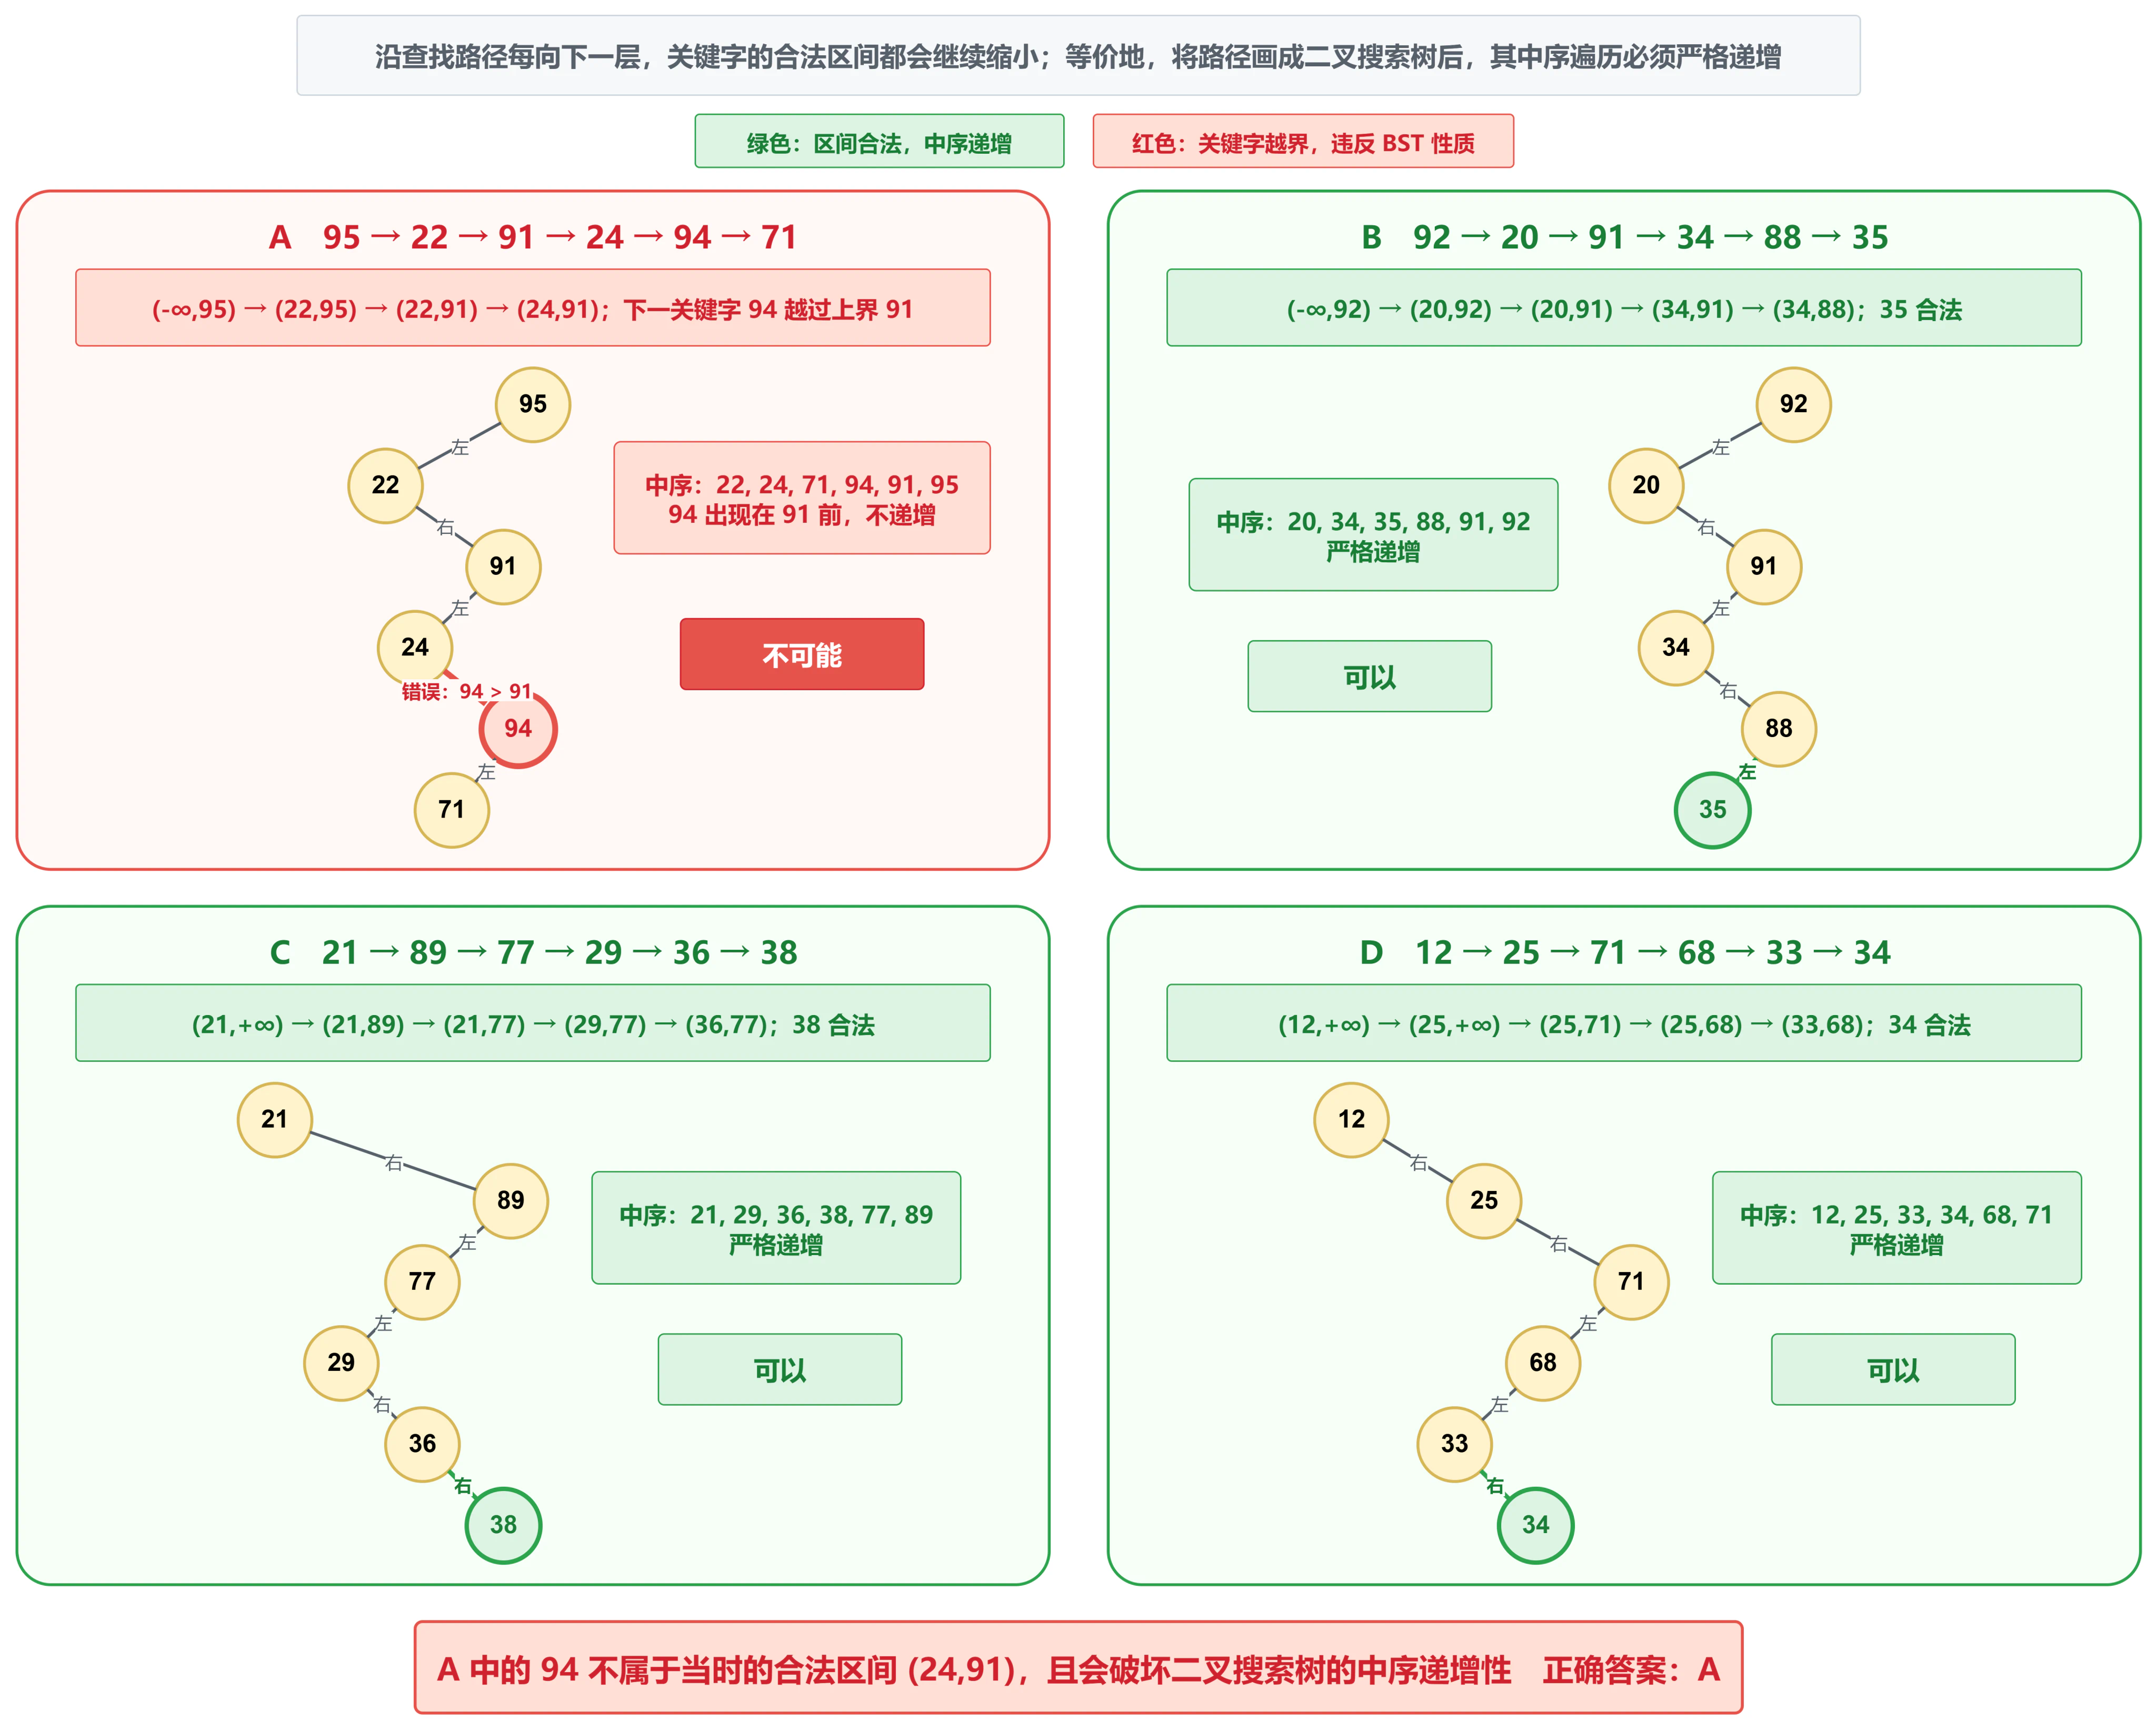
沿二叉搜索树查找时,每次向左或向右都会更新待查关键字的上下界。
检查 A:
 :说明待查关键字小于 95;
 :说明待查关键字大于 22,范围为
 ;
 :说明待查关键字小于 91,范围变为
 ;
 :虽然从 24 应向右,但右子树中的所有结点仍必须小于先前上界 91。
关键字 94 超过上界 91,因此 94 不可能出现在这条查找路径上。
B、C、D 中的每个后续关键字均位于此前形成的上下界内,可以构造相应二叉搜索树。
答案:A
- 【2013-06】在任意一棵非空二叉排序树 T1 中,删除某结点 v 之后形成二叉排序树 T2 ,再将 v 插入 T2 形成二叉排序树 T3 。下列关于 T1 与 T3 的叙述中,正确的是( )。
I. 若 v 是 T1 的叶结点,则 T1 与 T3 不同
II. 若 v 是 T1 的叶结点,则 T1 与 T3 相同
III. 若 v 不是 T1 的叶结点,则 T1 与 T3 不同
IV. 若 v 不是 T1 的叶结点,则 T1 与 T3 相同
A. 仅I、III
B. 仅I、IV
C. 仅II、III
D. 仅II、IV
解析
若 v 是叶结点,删除 v 不会改变其他结点之间的结构。再次查找 v 的插入位置时,会沿原来的路径到达原空位置,所以 v 回到原位置, 与
 相同。II 正确,I 错误。
若 v 不是叶结点,删除时需要用孩子、前驱或后继调整原结构。再次插入 v 时,普通 BST 插入总是把新结点放到某个空指针位置,因此 v 会成为叶结点。
原来 v 是非叶结点,重新插入后 v 是叶结点,树形不可能与原树完全相同。III 正确,IV 错误。
答案:C
- 【2018-06】已知二叉排序树如下图所示,元素之间应满足的大小关系是( )。
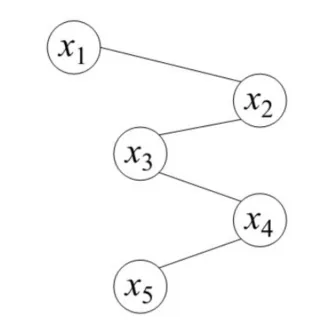
A. x1\<x2\<x3
B. x1\<x4\<x5
C. x3\<x5\<x4
D. x4\<x3\<x5
在二叉搜索树中: 合并得到 答案:C解析
 ;
 ;
 。
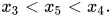
- 【2020-05】下列给定的关键字输入序列中,不能生成如下二叉排序树的是( )。
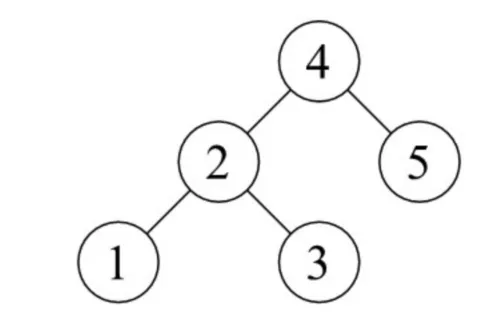
A. 4, 5, 2, 1, 3
B. 4, 5, 1, 2, 3
C. 4, 2, 5, 3, 1
D. 4, 2, 1, 3, 5
解析
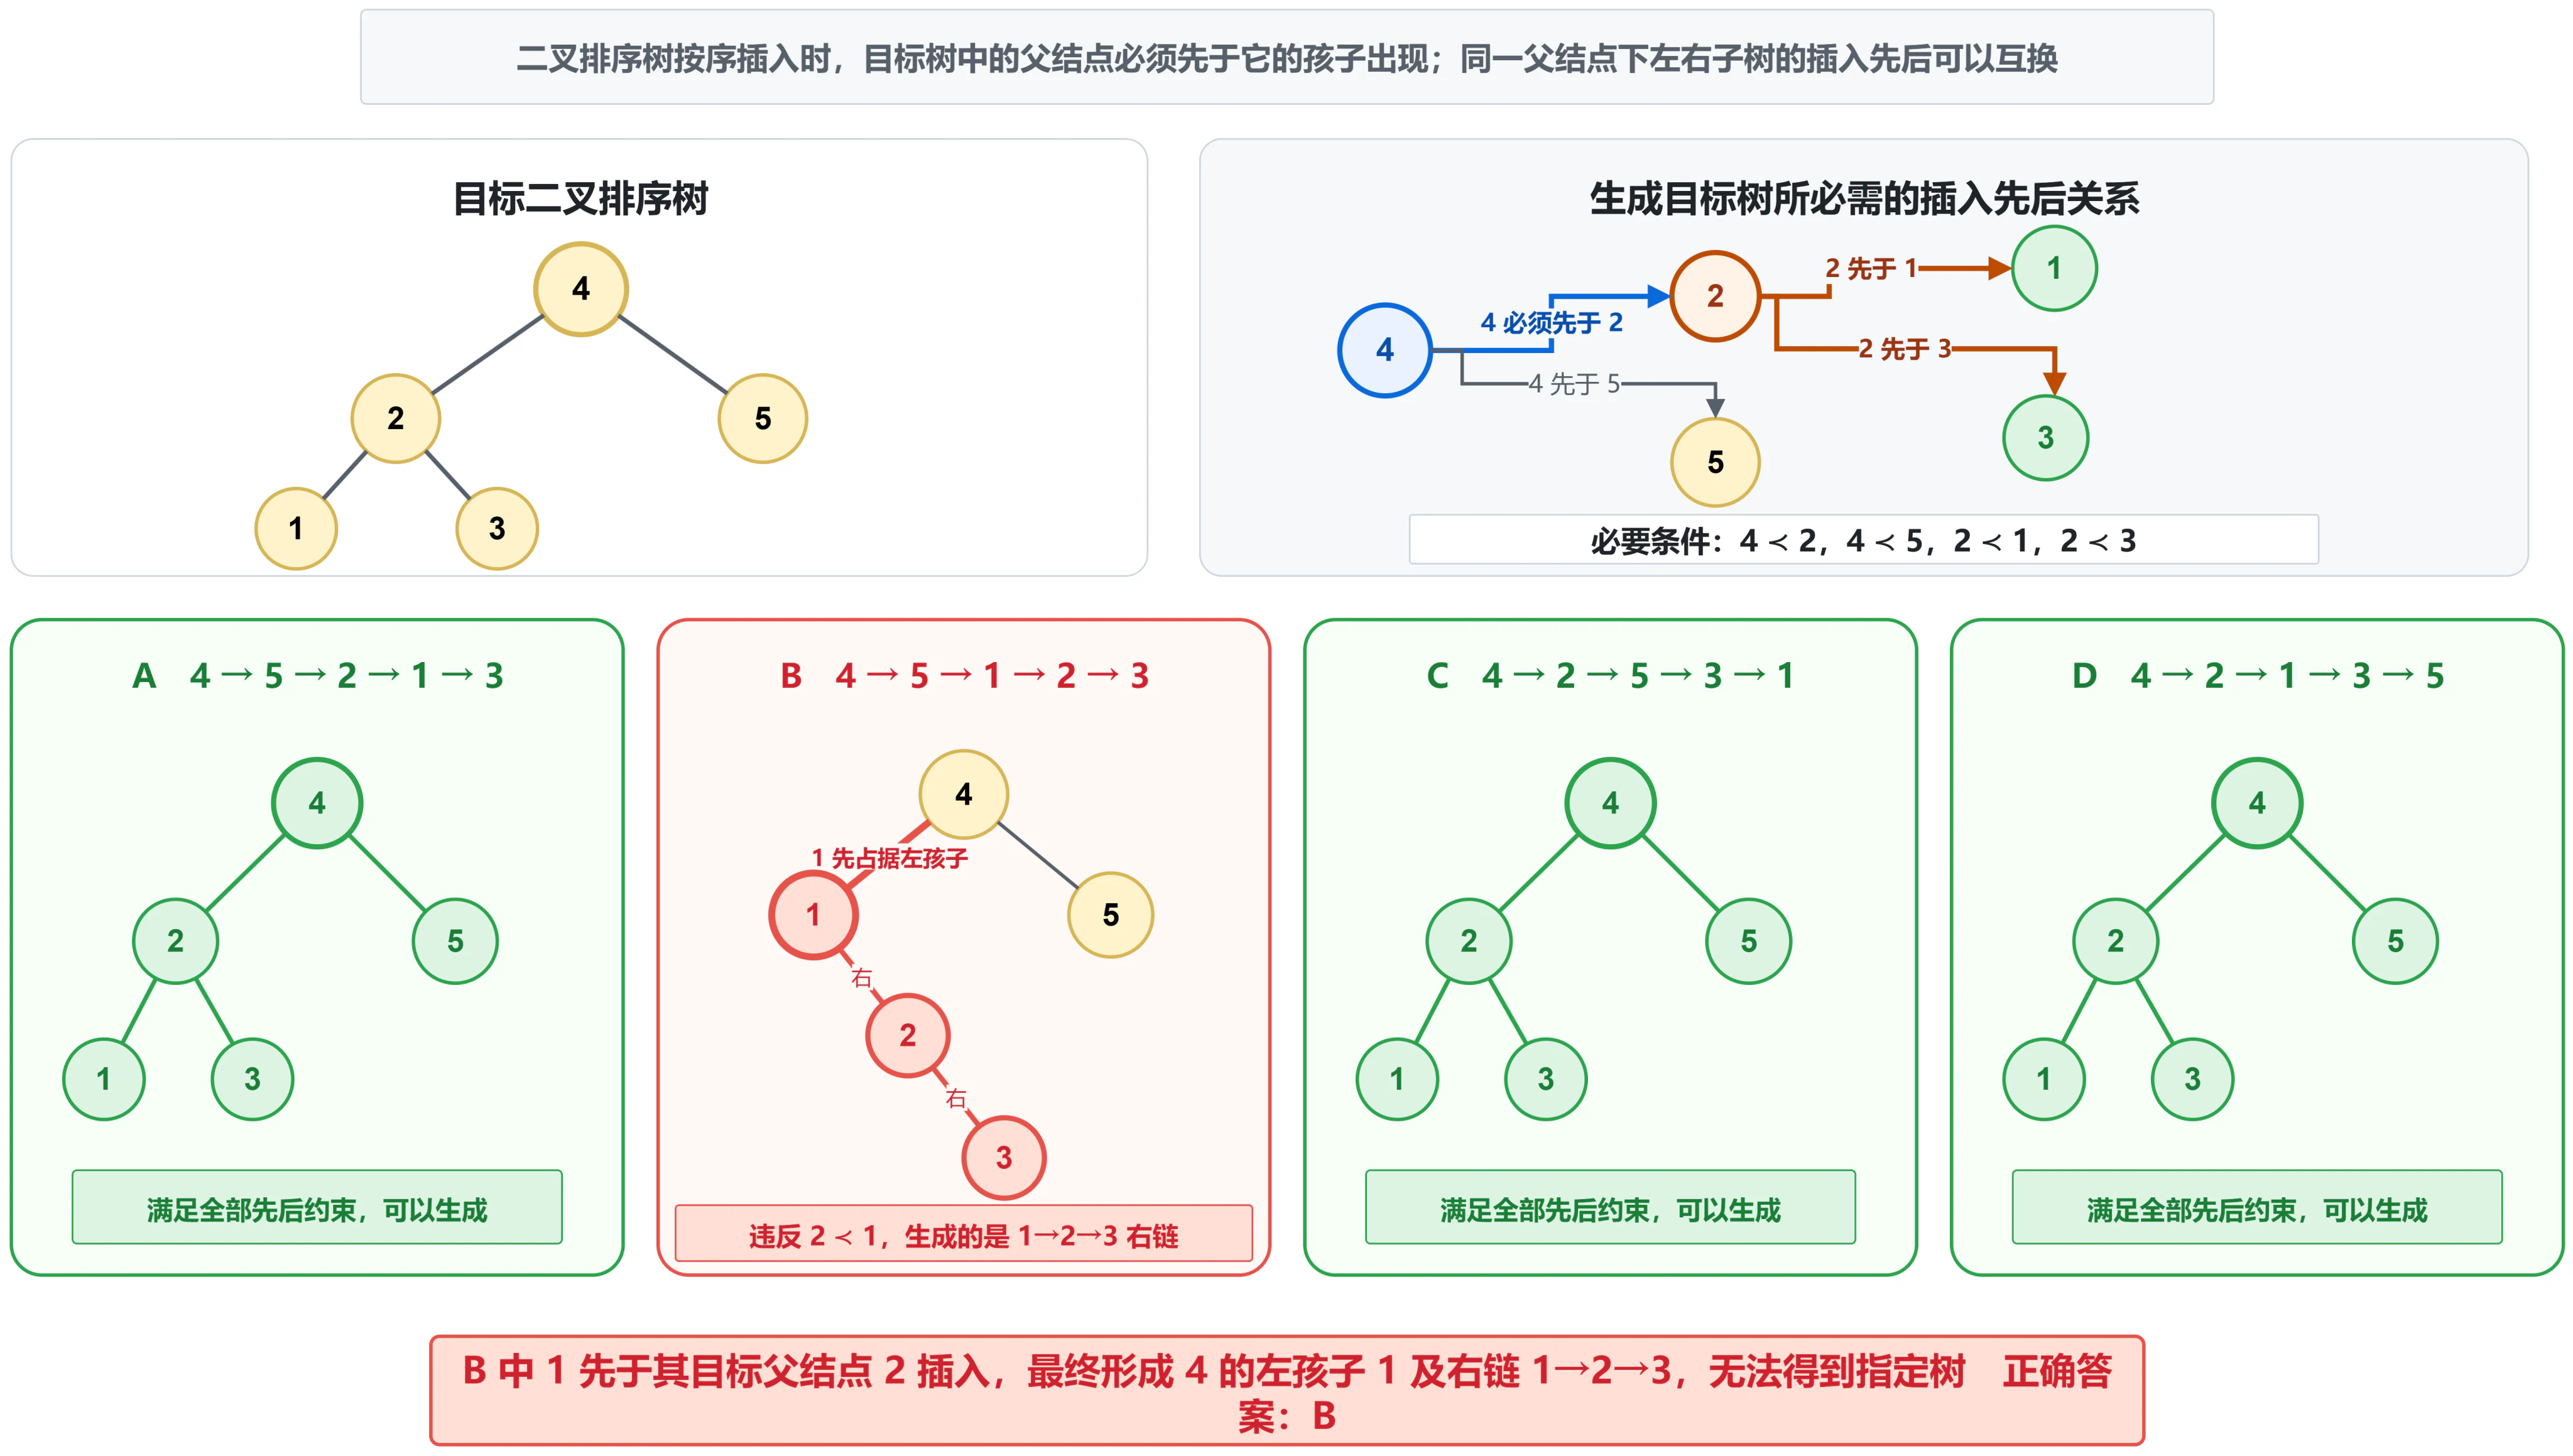
A:4 为根;5 成为右孩子;2 成为左孩子;1、3 分别成为 2 的左右孩子,可以生成目标树。
B:插入 4、5 后,再插入 1,1 成为 4 的左孩子。随后插入 2 时,路径为 所以 2 会成为 1 的右孩子。普通 BST 插入不会重新调整结点位置,因此无法让 2 变成 4 的左孩子、1 变成 2 的左孩子。
C、D 都在插入 1、3 前先插入了 2,可以生成目标树。
答案:B
- 【2022-03】若结点p与q在二叉搜索树T中的中序遍历中相邻,且p在q之前,则下列p与q的关系中,不可能的是( )。
I. q是p的双亲
II. q是p的右孩子
III. q是p的右兄弟
IV. q是p的双亲的双亲
A. 仅I
B. 仅III
C. 仅II、III
D. 仅II、IV
解析
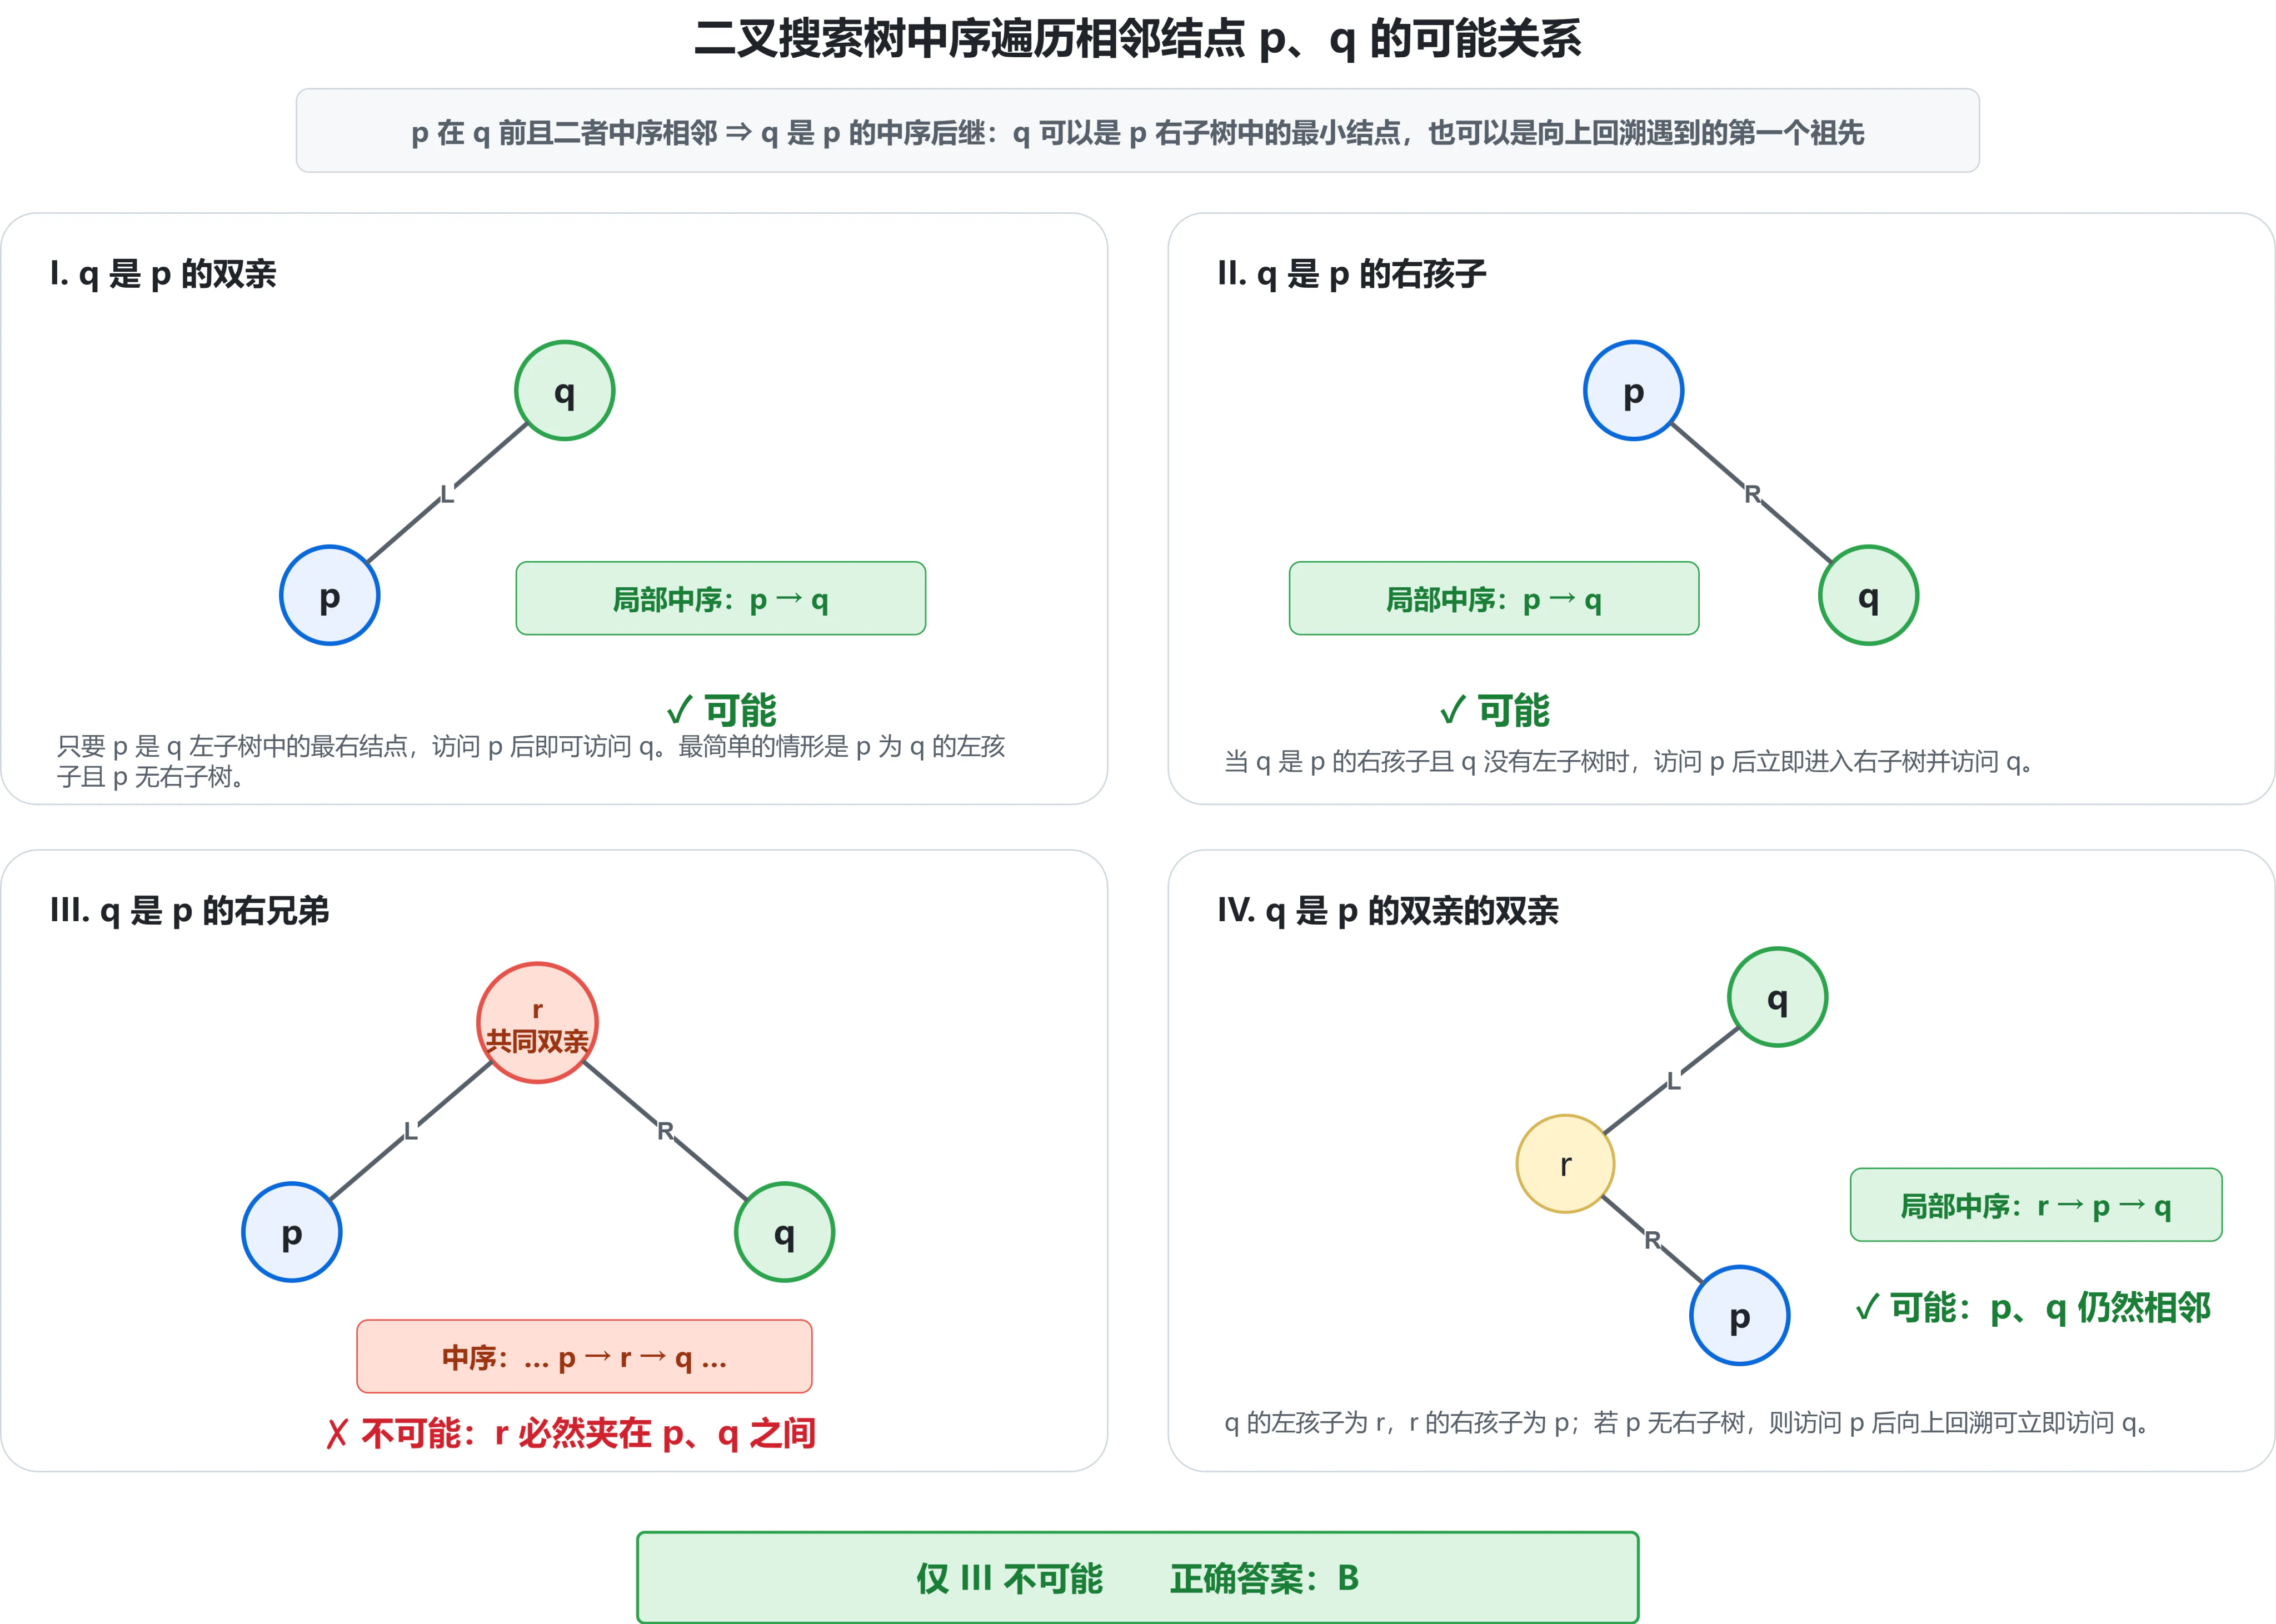
答案:B
- 【2024-07】一棵二叉搜索树如题 7 图所示,k1、k2、k3 分别是对应结点中保存的关键字。子树 T 的任一结点中保存的关键字 x 满足的是
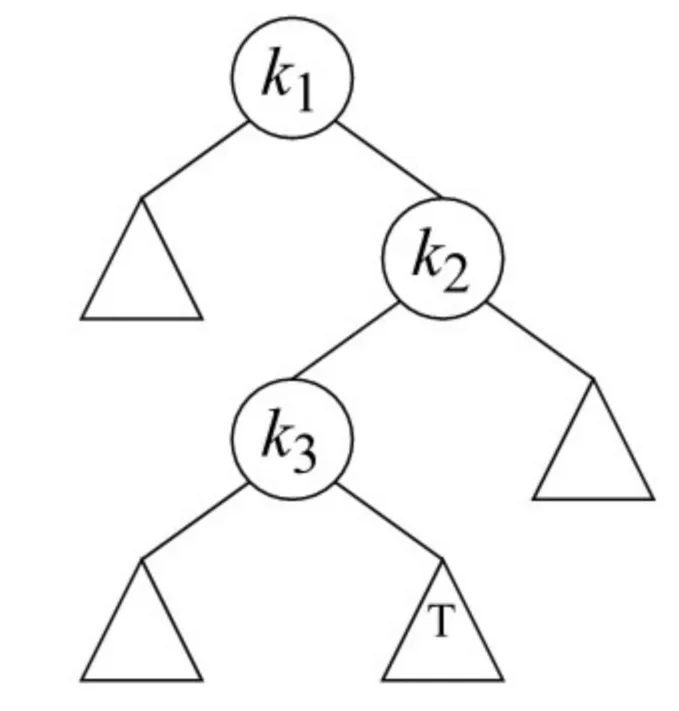
A. x\<k1
B. x>k2
C. k1\<x\<k3
D. k3\<x\<k2
T 位于 T 又位于 虽然整棵局部结构位于 答案:D解析
 的右子树,所以

 的左子树,所以

 的右子树,可得
 ,但更精确的上下界是
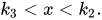
模拟练习题
- 查找关键字
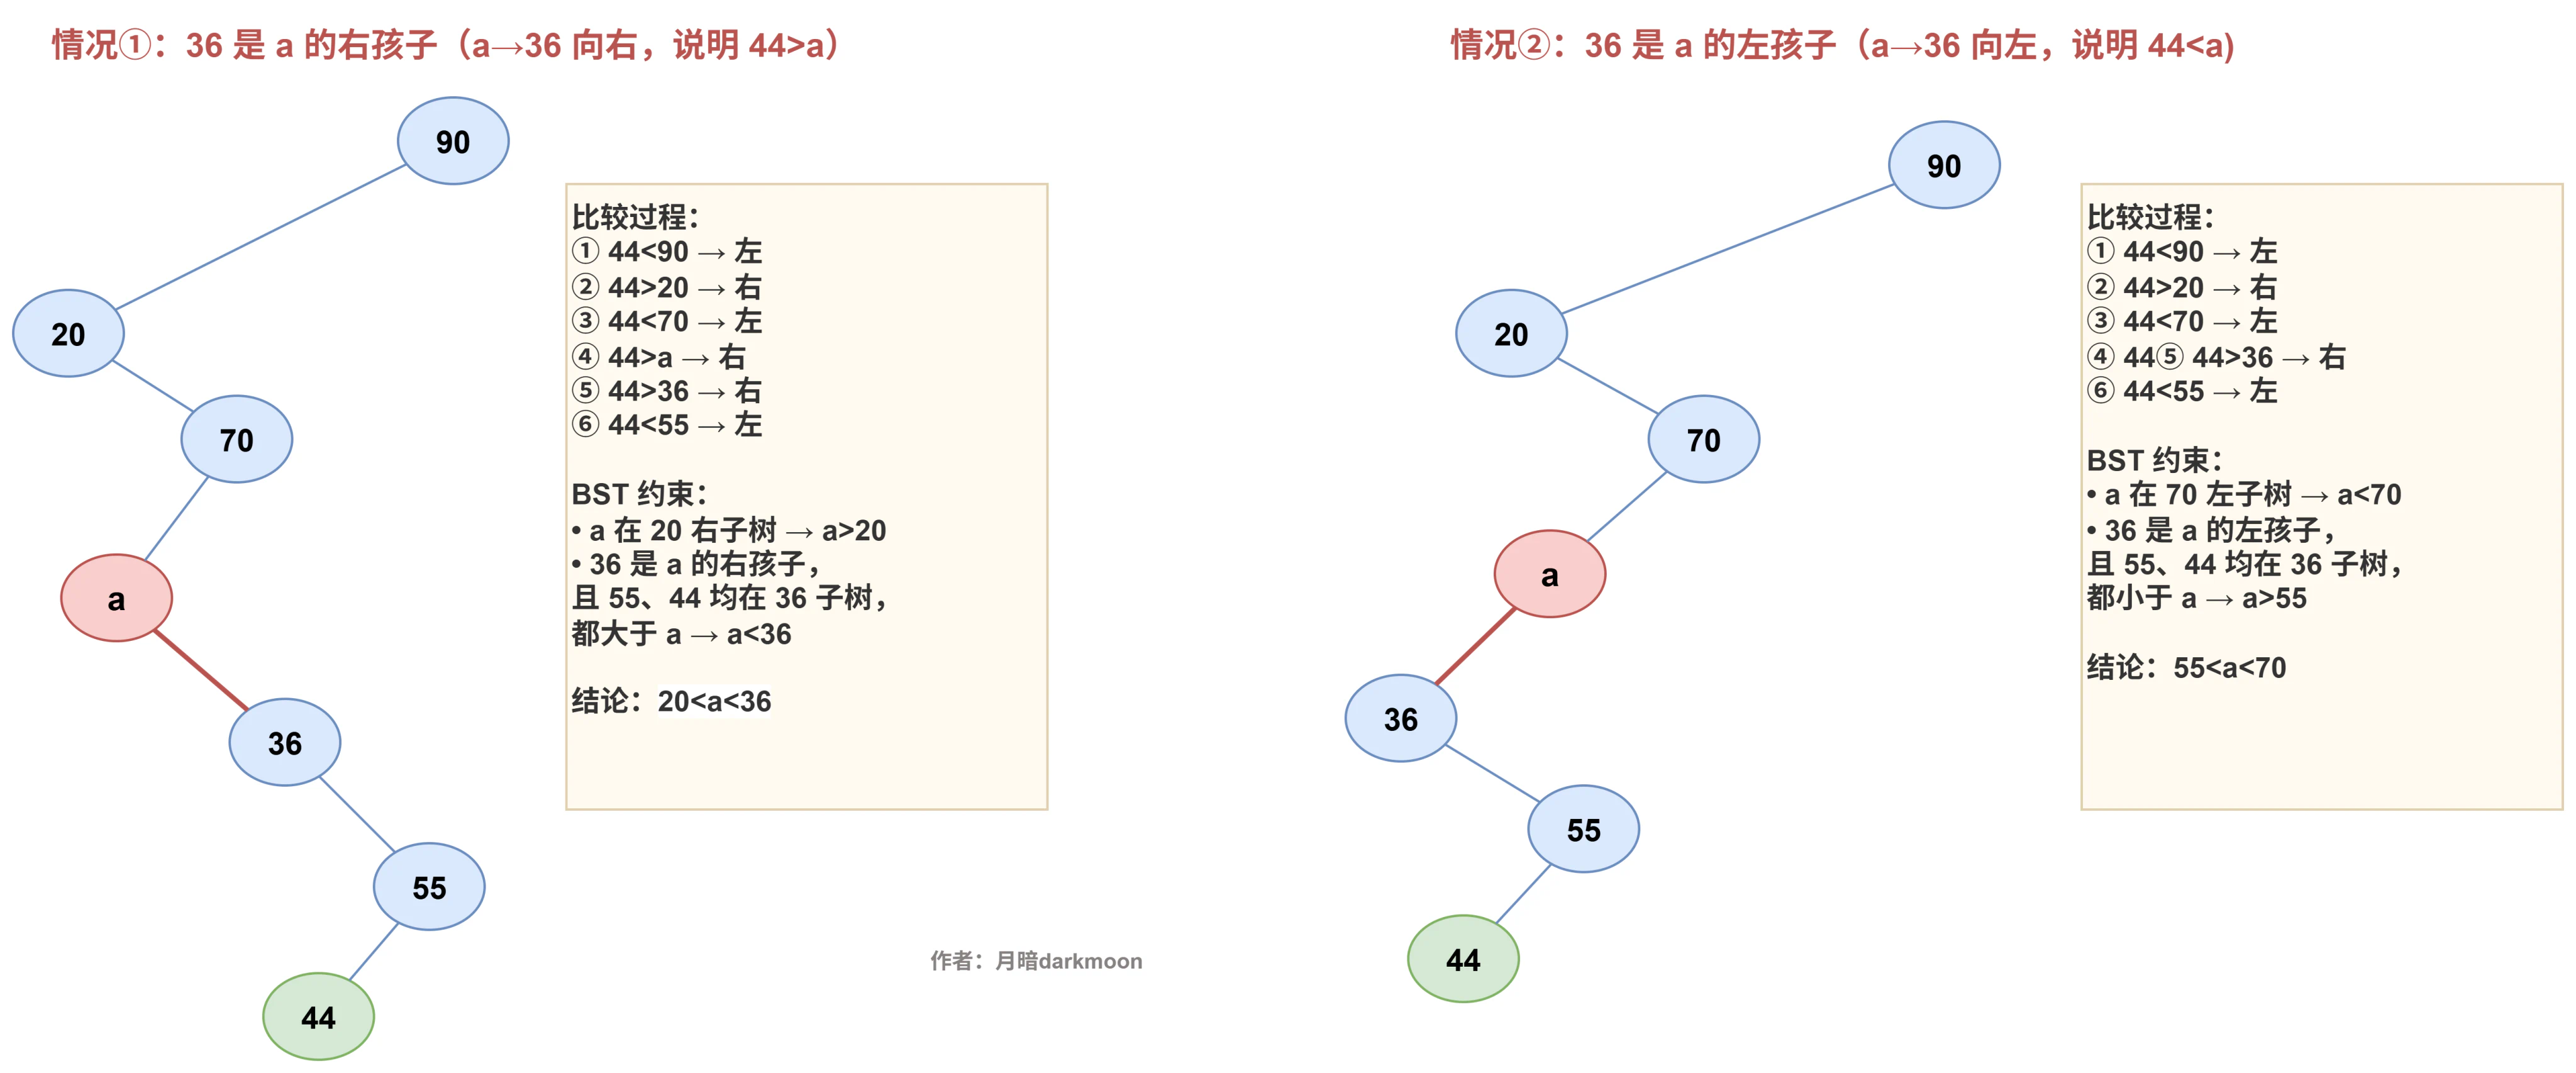
44成功时,依次访问:90, 20, 70, a, 36, 55, 44,a的全部可能范围是( )
A. 20<a<36\
B. 55<a<70\
C. 20<a<36 或 44<a<70\
D. 20<a<36 或 55<a<70
解析
答案:D
- 某 BST 的后序遍历为:
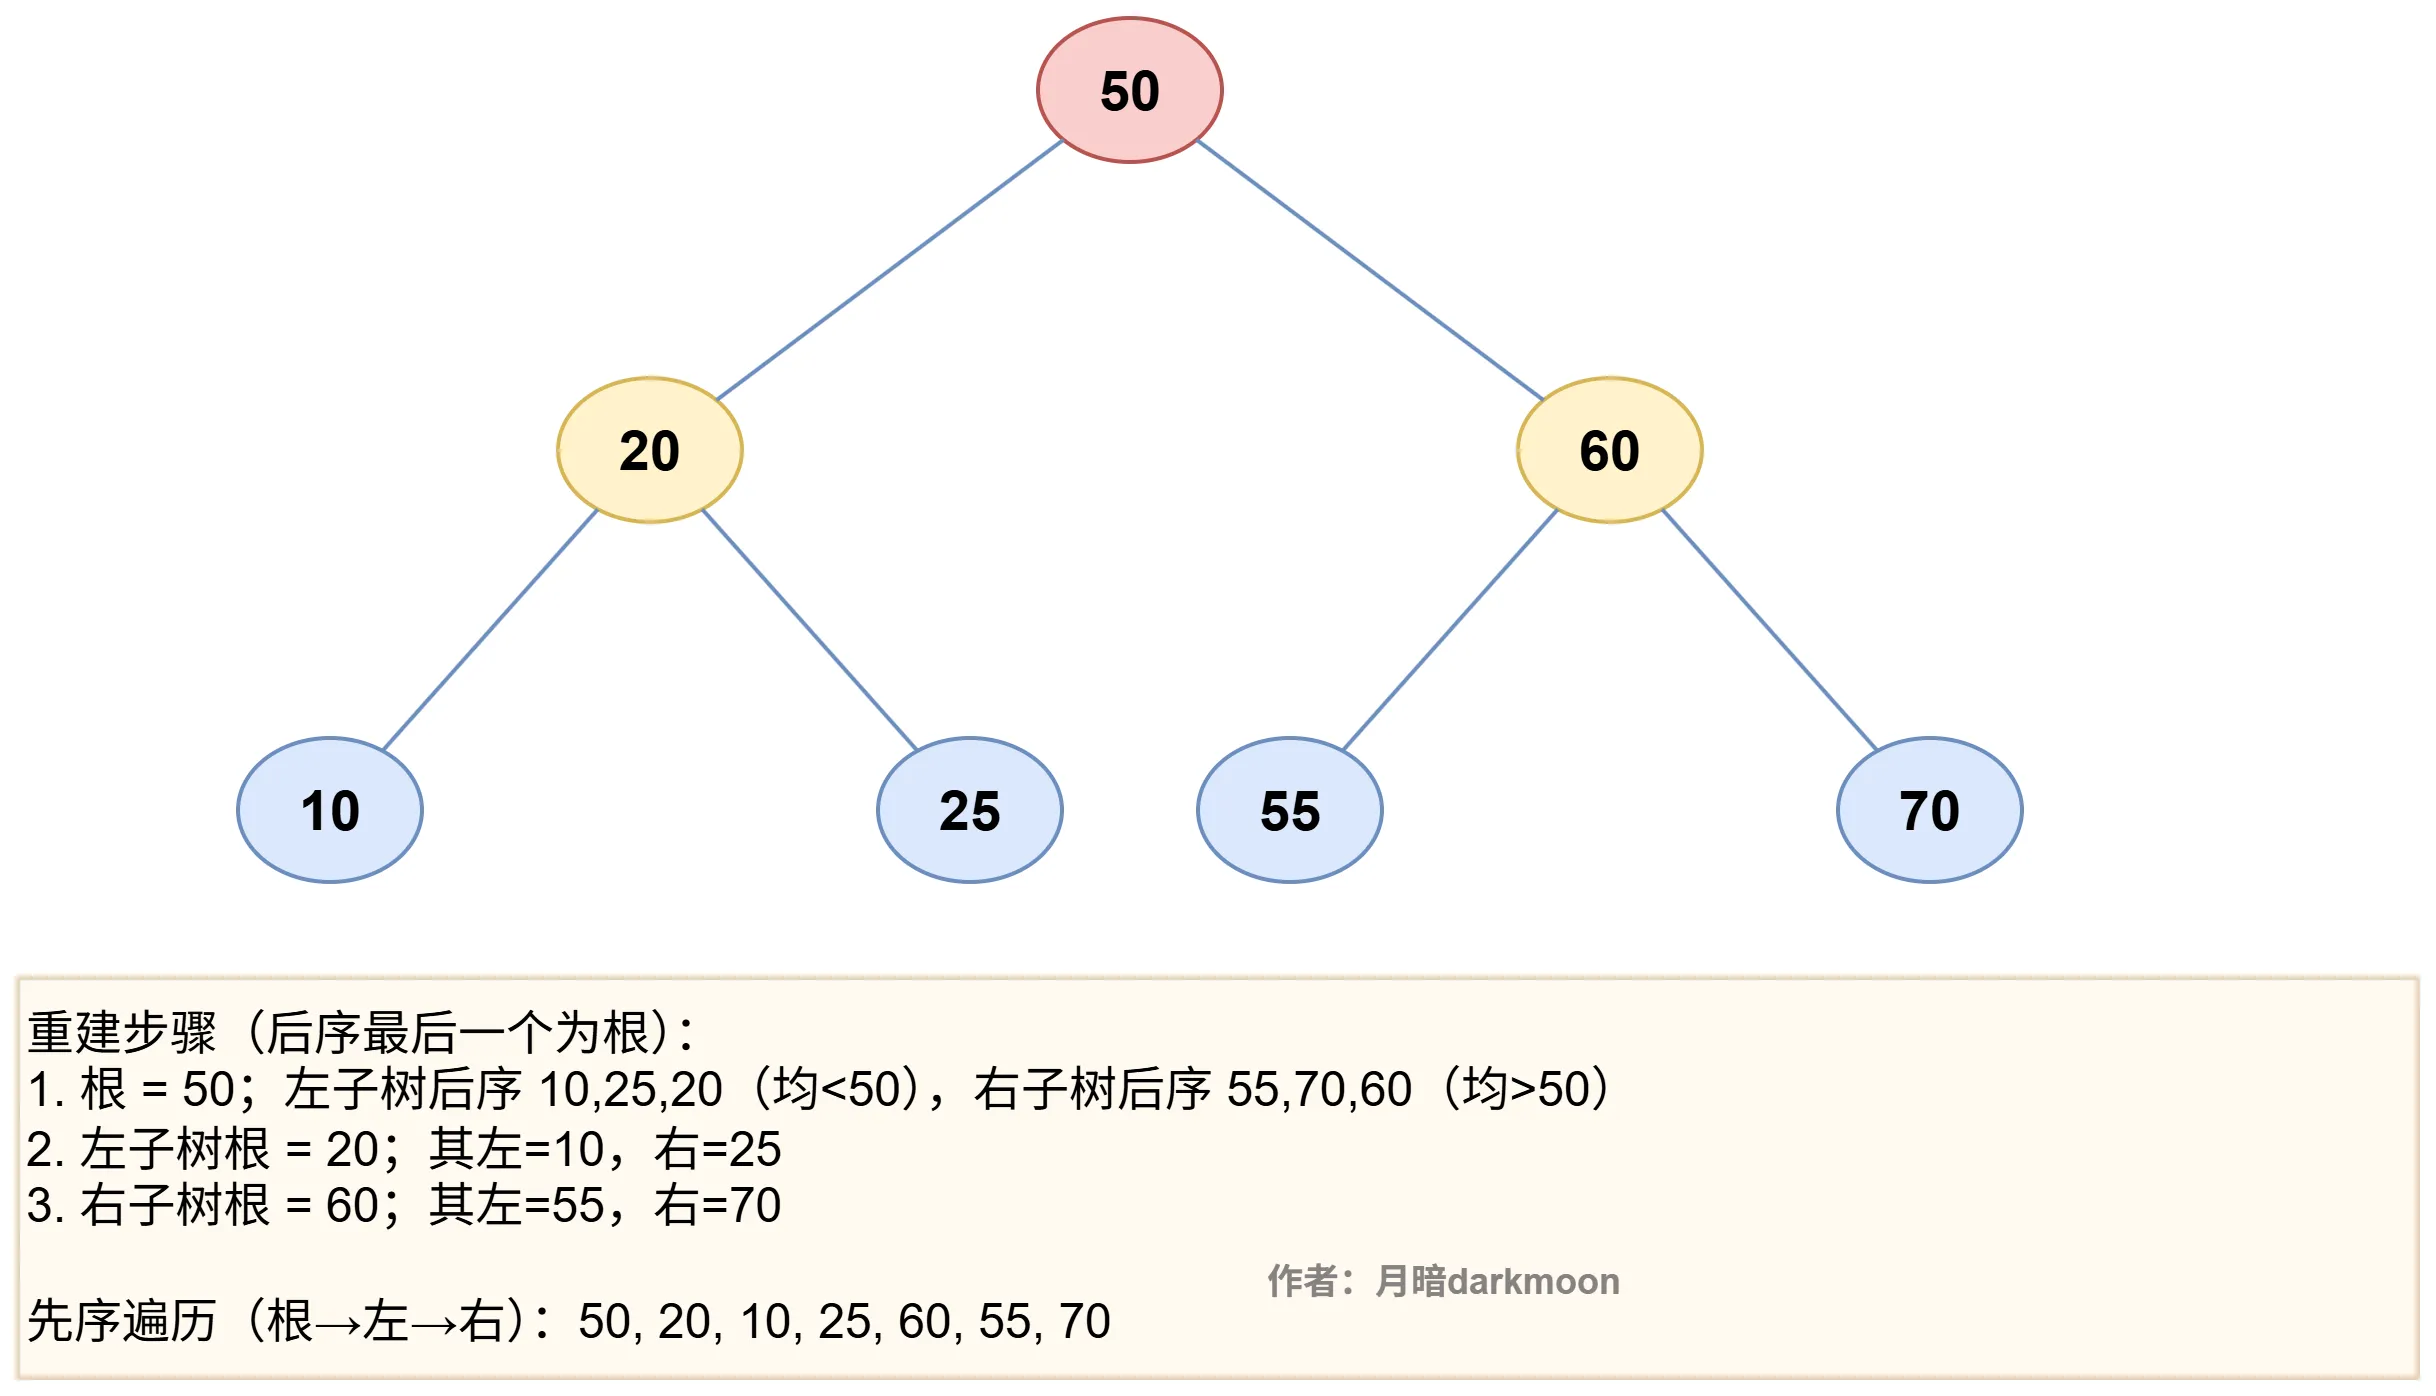
10, 25, 20, 55, 70, 60, 50,其先序遍历为()
A. 50, 20, 10, 25, 60, 55, 70\
B. 50, 20, 25, 10, 60, 55, 70\
C. 50, 20, 10, 25, 60, 70, 55\
D. 50, 60, 20, 10, 25, 55, 70
解析
答案:A
- 关键字集合为 \({1,2,3,4,5,6}\)。某 BST 的先序遍历为:\(4,\ 2,\ 1,\ 3,\ 6,\ 5\),将全部关键字各插入一次空 BST,能生成该树的不同输入序列数为( )。
A. 2 B. 10 C. 20 D. 40
解析
答案:C
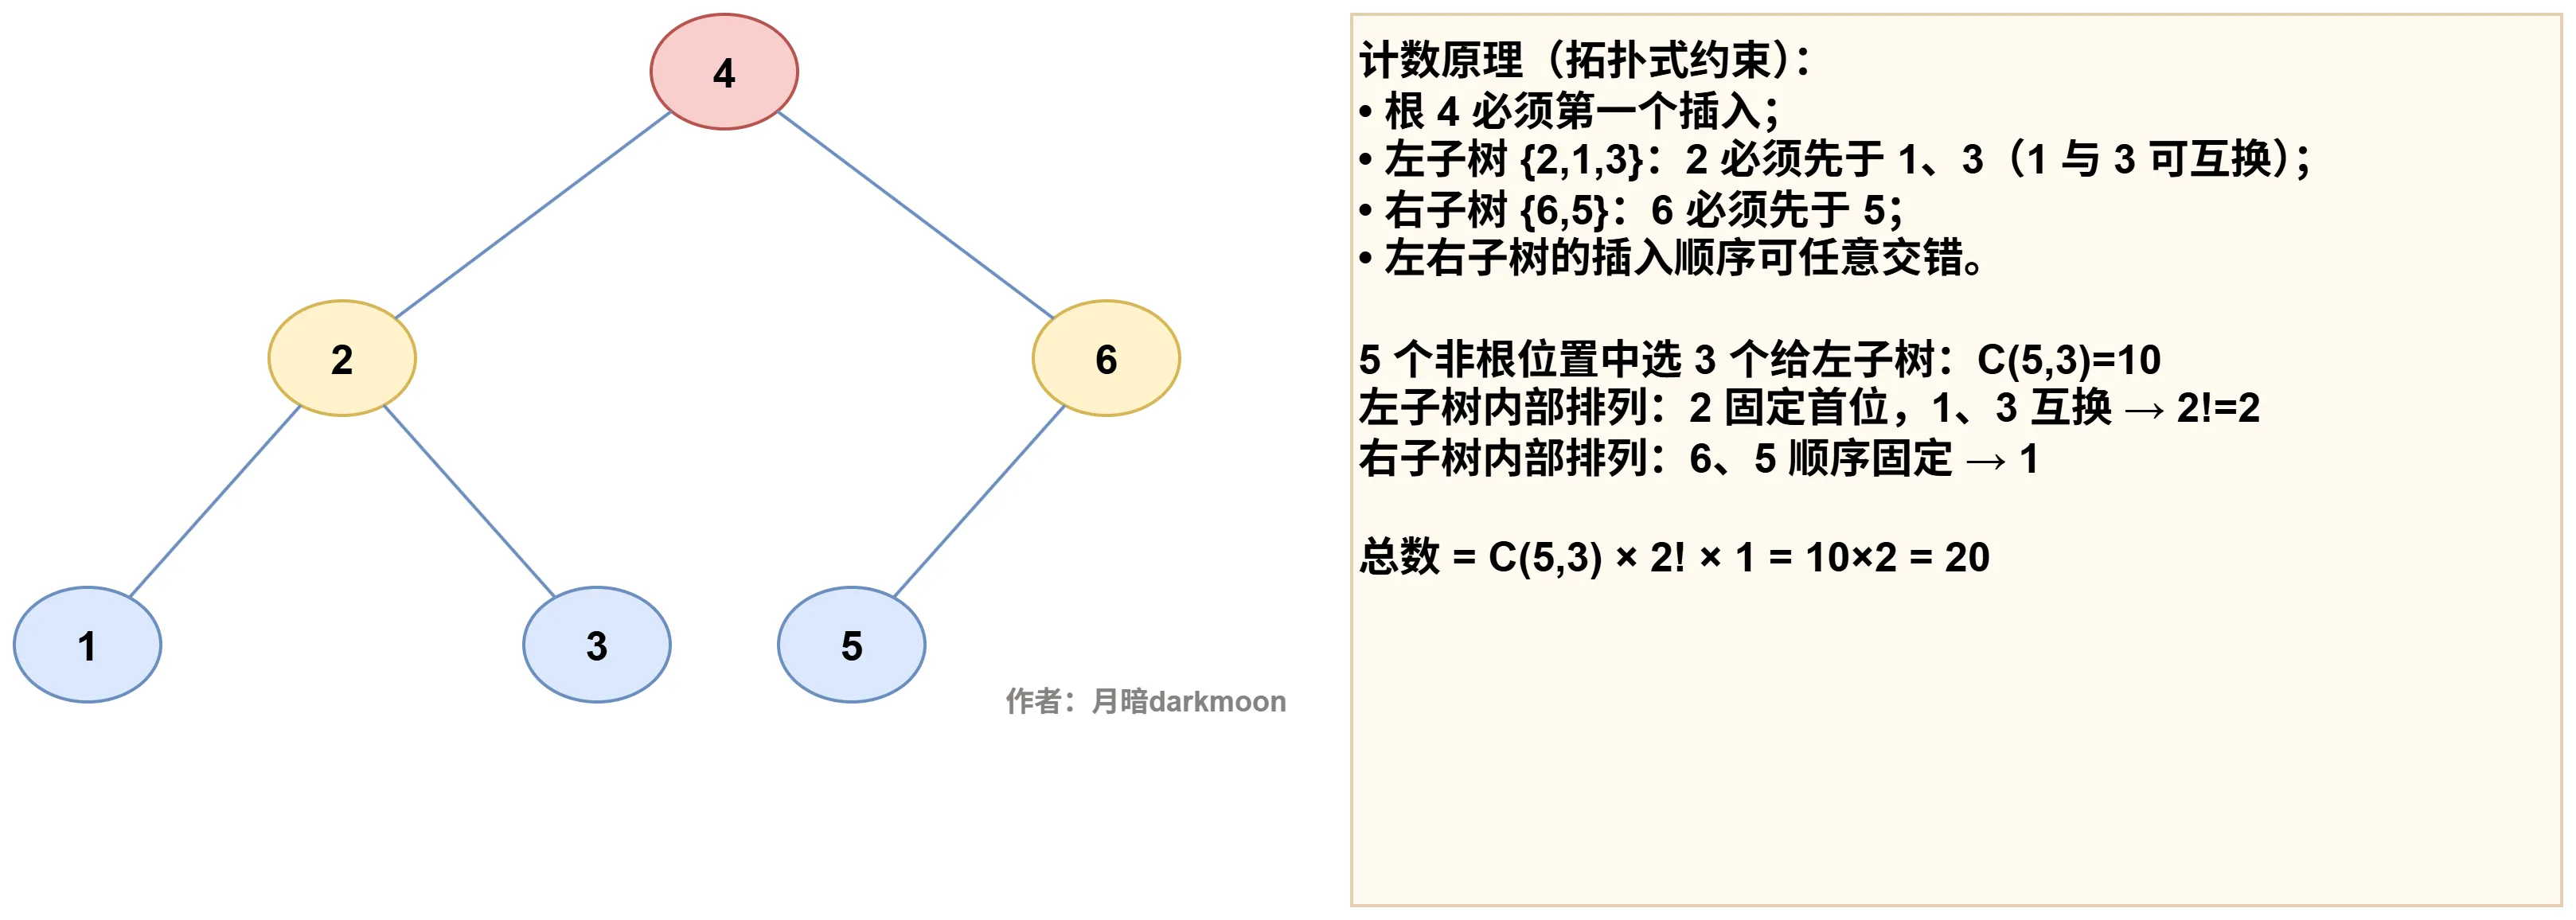
先根据先序遍历还原树结构(先序首元素为根,再按大小切分),一个插入序列能生成此树,当且仅当它满足"每个节点必须在它的后代之前插入"(因为后代节点插入时要靠祖先节点指路才能落到正确位置)。这等价于树上的一组拓扑序约束:
- 根 4 必须排第 1 位(它是所有节点的祖先)。
- 左子树 {2,1,3}:2 必须在 1、3 之前;1 与 3 之间无约束,可互换。
- 右子树 {6,5}:6 必须在 5 之前。
- 左、右两棵子树的插入可以任意交错(互不影响)。
计数分三步:
- 5 个非根位置中选 3 个位置放左子树节点:
 ;
- 左子树内部:2 必须占左子树的第 1 个位置,剩下 1、3 任意排:
 ;
- 右子树内部:6 在 5 前,只有 1 种排法。
总数 = 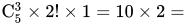 20,选 C。
推广公式:对节点数为 n 的树,合法插入序列数 =  (其中 size(u) 是以 u 为根的子树节点数)。本题
 ,子树规模依次为 6、3、1、1、2、1,
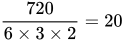 ,结果一致。
- BST 中,关键字为
v的结点左右子树均非空;其中序直接前驱、后继的关键字分别为p、q。删除v时,用直接后继q覆盖该结点,再删除q的原结点;随后重新插入关键字v。仅比较关键字结点的父子关系,必然成立的是( )
A. p 成为 v 的右孩子\
B. v 成为 p 的右孩子\
C. v 成为 q 的左孩子\
D. q 成为 v 的右孩子
解析
答案:B
先用一棵具体示例树把过程走一遍(取 v=50,p=40,q=60):
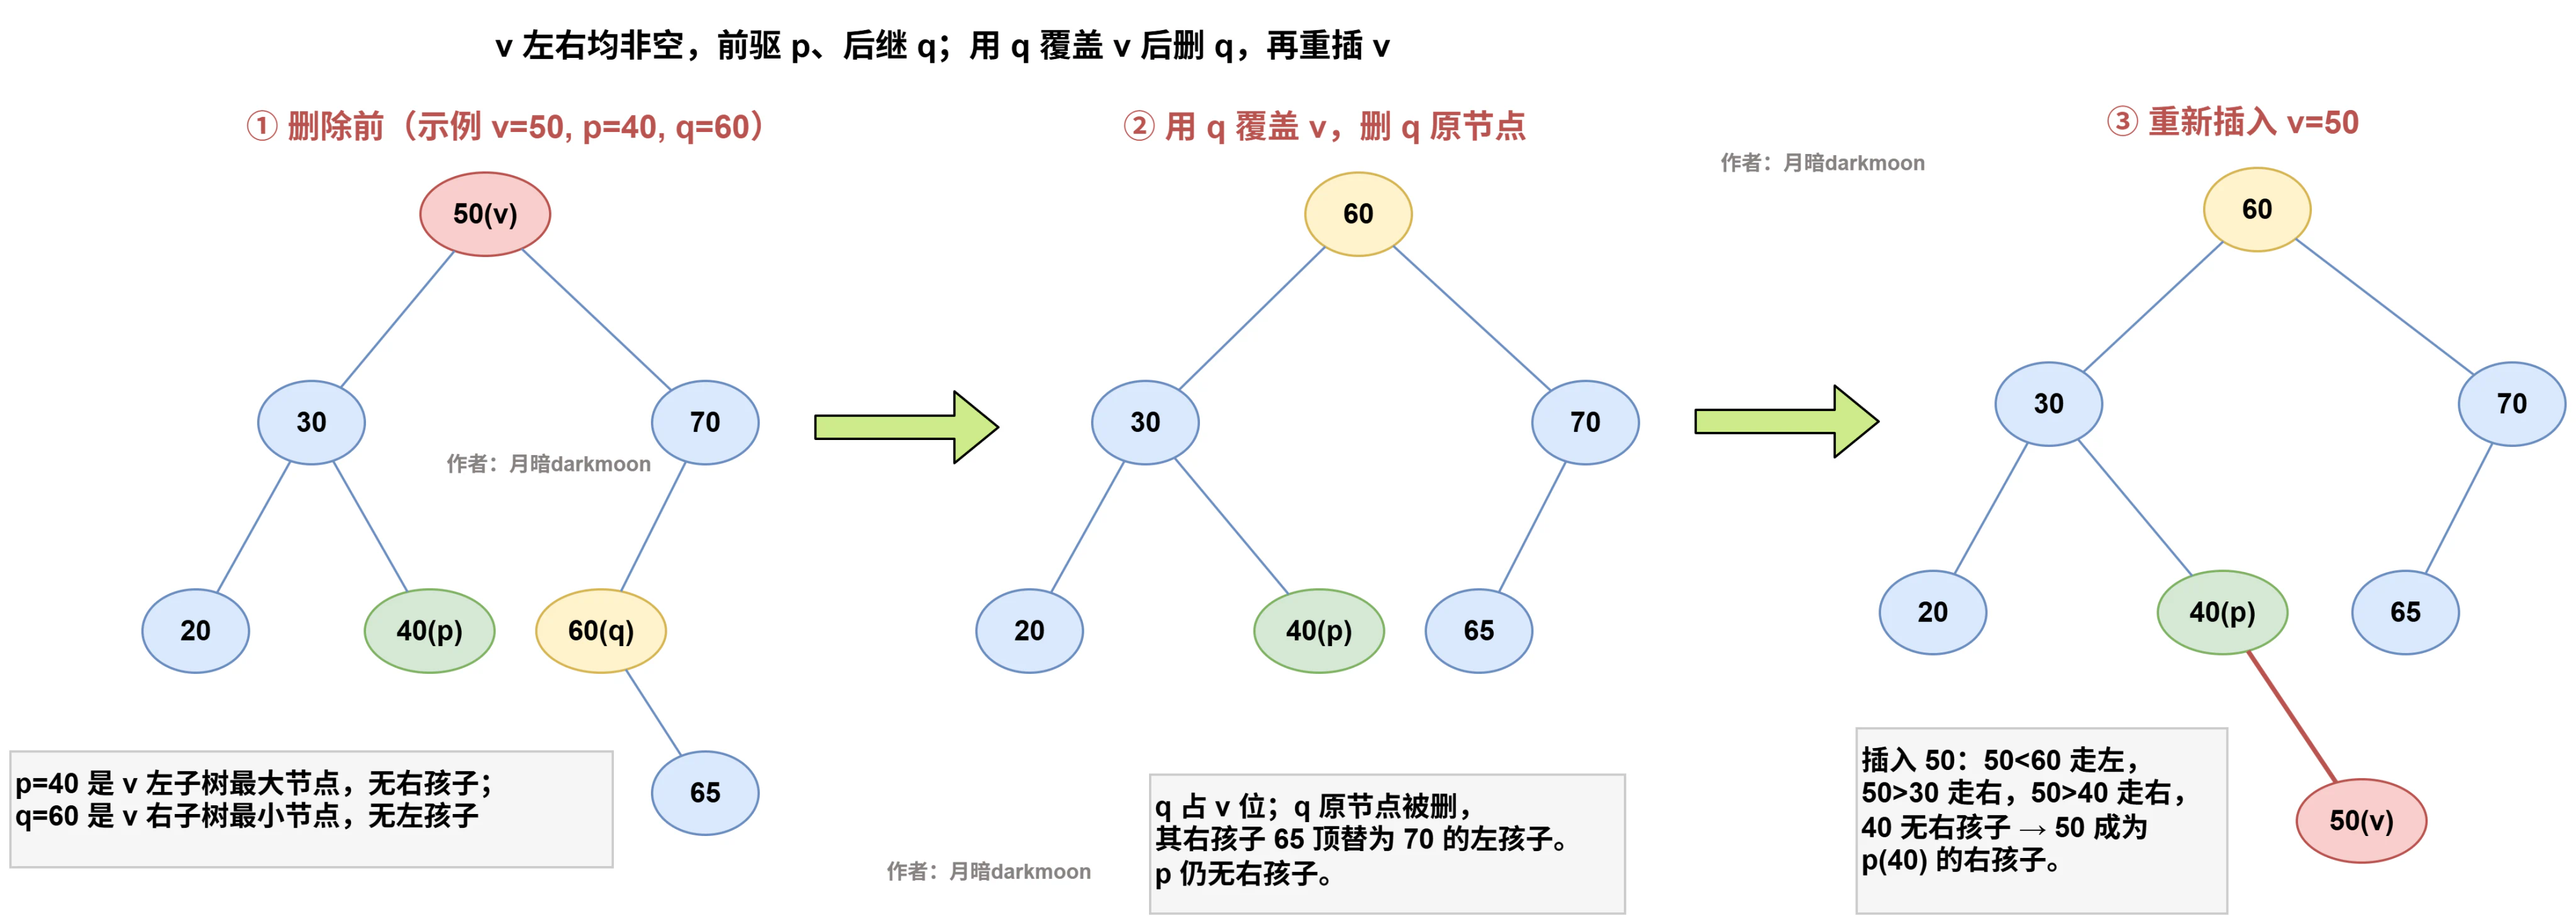
逐步分析:
- q 是 v 的中序直接后继,即 v 右子树中的最小节点,因此 q 一定没有左孩子(否则它左子树里会有更小的节点)。删除 q 原节点时,只需把 q 的右孩子(若有)顶替 q 即可。
- p 是 v 的中序直接前驱,即 v 左子树中的最大节点,因此 p 一定没有右孩子。删除 v 后,v 原来的整棵左子树原样挂在 q 下方,p 仍然没有右孩子。
- 重新插入 v:v<q(后继大于 v),进入 q 的左子树(即 v 原来的左子树);沿左子树下行,最终会到达左子树的最大节点 p。由于 p 没有右孩子,而 v>p,v 恰好作为 p 的右孩子插入。
因此必然成立的是 v 成为 p 的右孩子,选 B。
排除其他项:
- A:p<v,p 不可能是 v 的右孩子(右孩子必须大于父节点)。
- C:v 进入 q 的左子树,但 q 的左孩子是 v 原左子树的根,v 不一定直接挂在 q 下面。
- D:删除重插后 q 在 v 的上方而非下方。
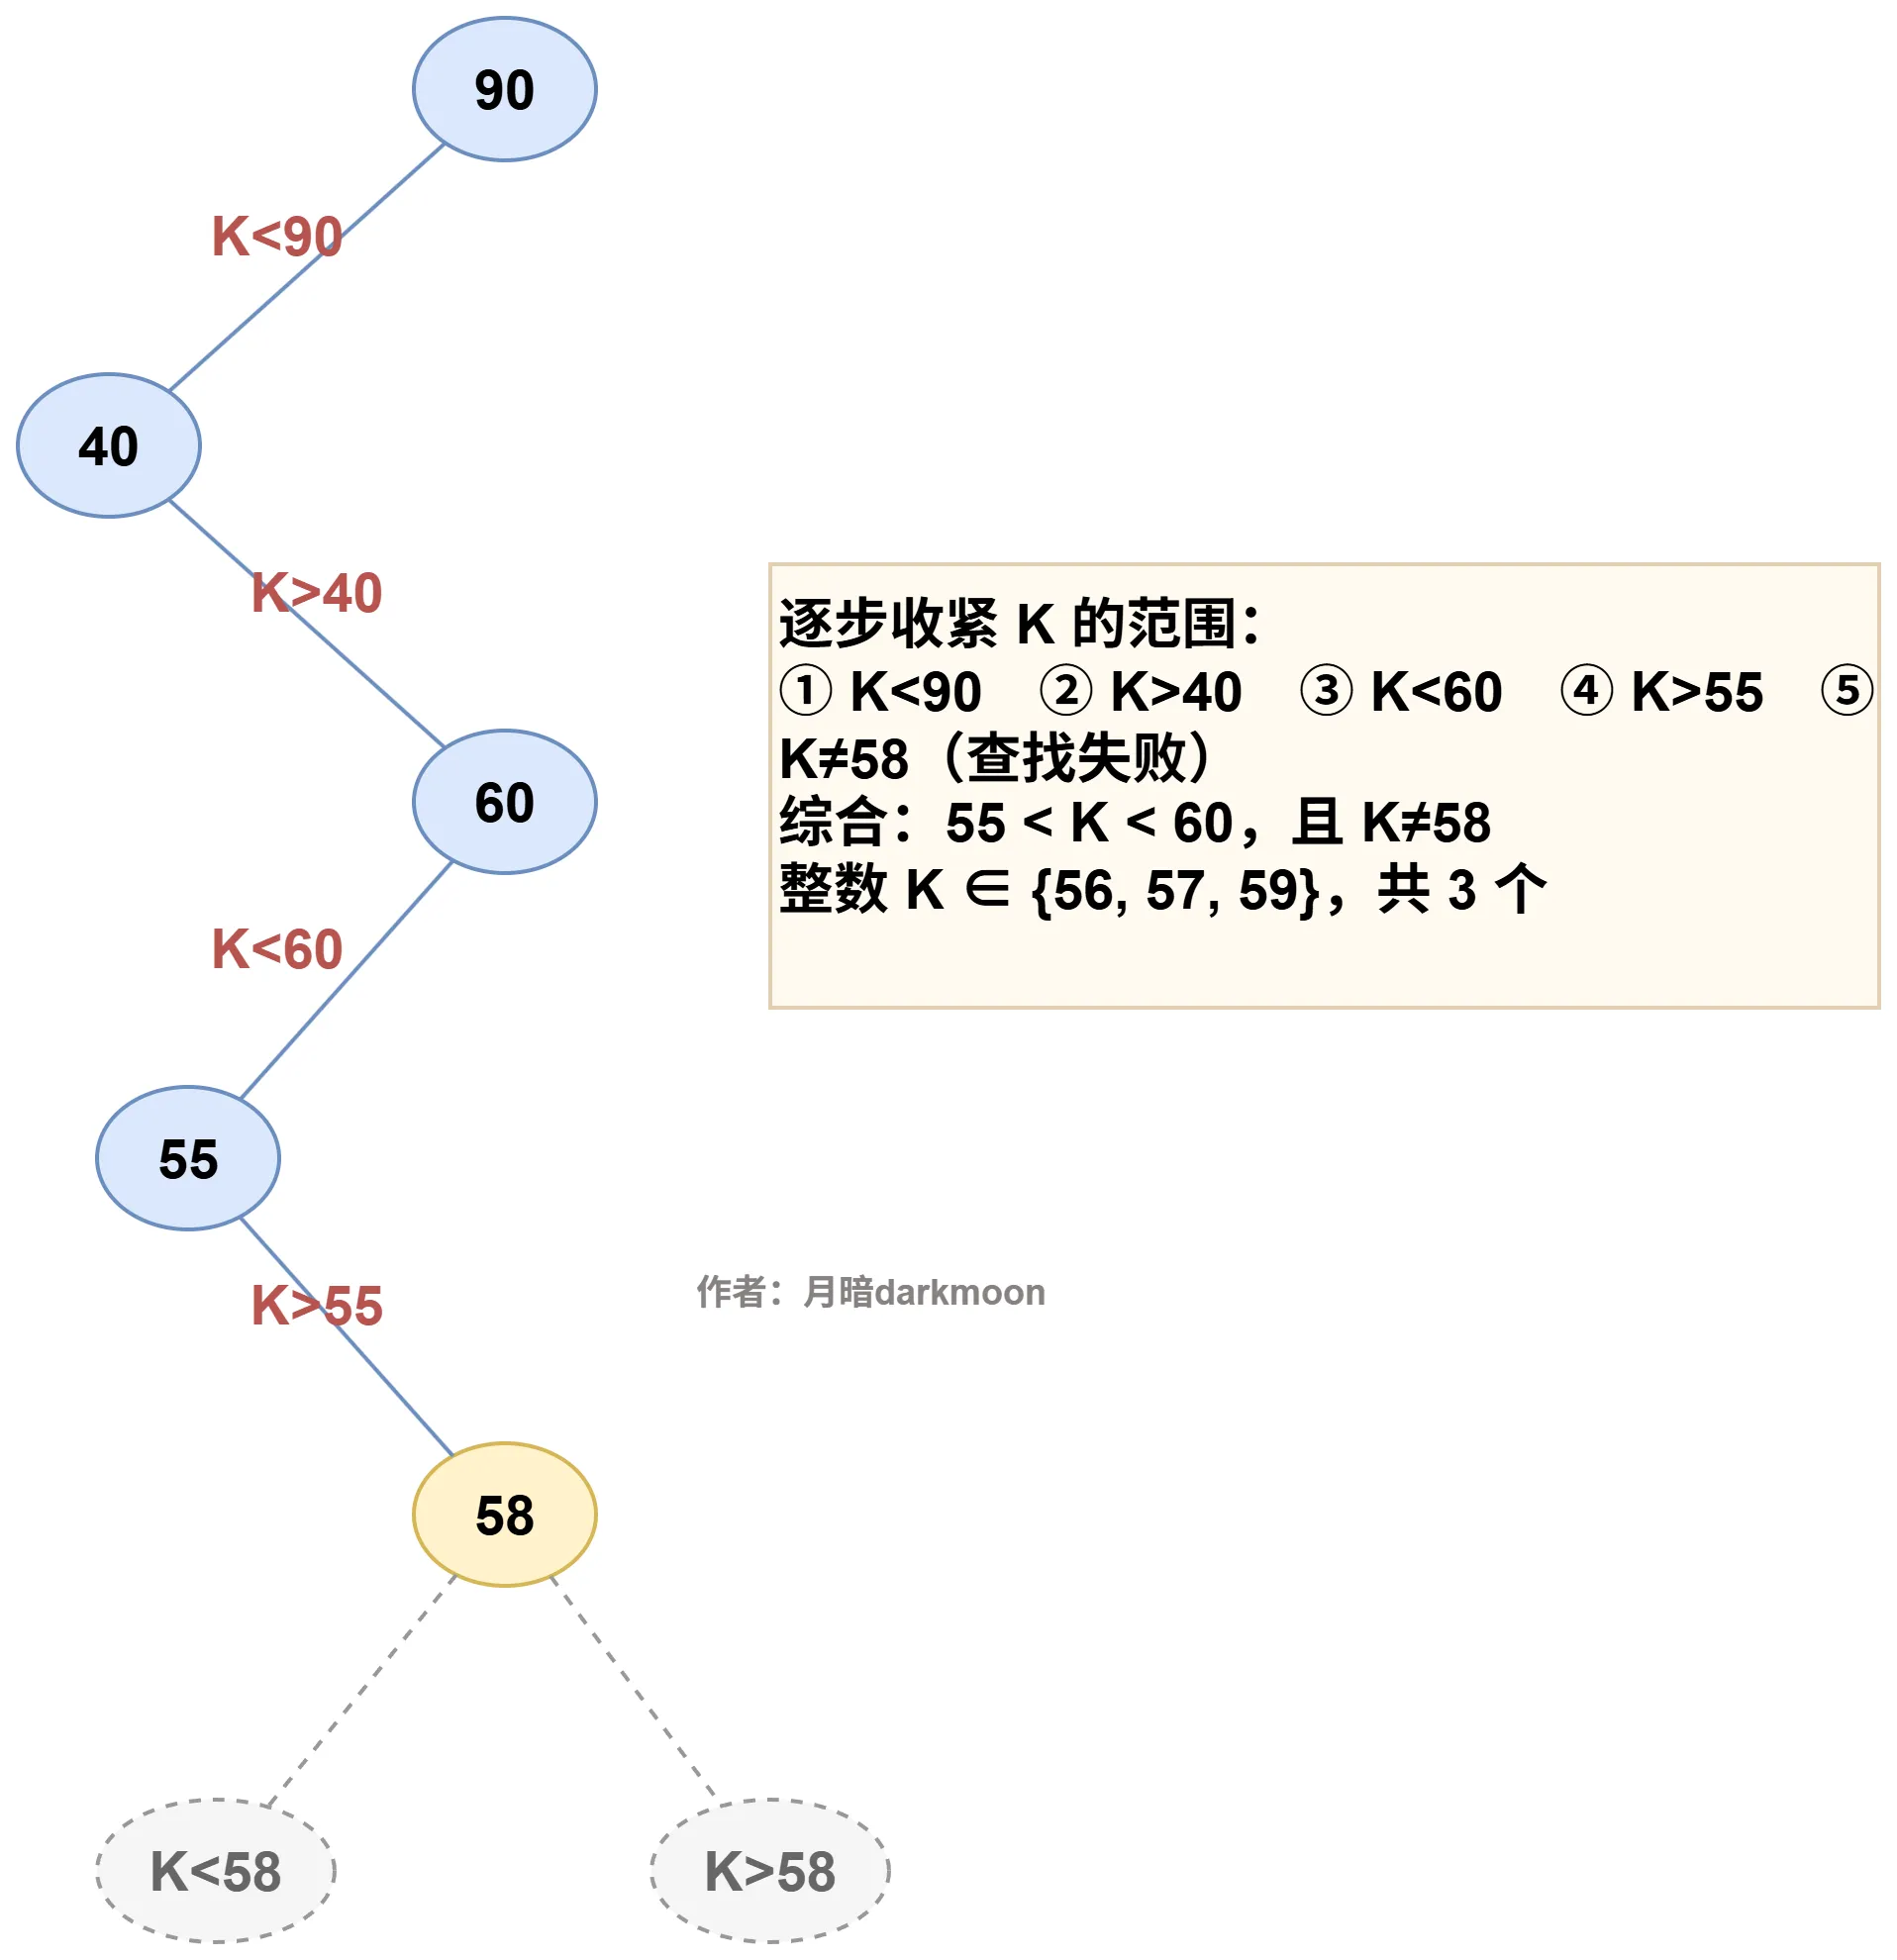
- 在一棵关键字均为整数的二叉排序树中查找关键字 K,查找路径为 90, 40, 60, 55, 58,且查找失败。则 K 可能的取值个数为( )。
A. 1 B. 2 C. 3 D. 4
解析
答案:C
- 在二叉排序树中,结点 q 是结点 p 的中序直接前驱。下列 q 与 p 的关系中,可能的是( )。
I. q 是 p 的左孩子\ II. q 是 p 的右孩子\ III. q 是 p 的双亲\ IV. q 是 p 的右兄弟
A. 仅 I、II B. 仅 I、III C. 仅 III、IV D. 仅 I、III、IV
解析
答案:B
中序遍历顺序为"左→根→右"。一个节点 p 的直接前驱,只有两种来源:
情形 A:p 有左子树 —— 前驱是 p 左子树中的最右节点(左子树最大值)。
- 该最右节点可能就是 p 的左孩子本身(当左孩子没有右子树时),此时 q 是 p 的左孩子,故 I 可能。
- q 不可能是 p 的右孩子(右孩子在 p 的右子树,中序在 p 之后),故 II 不可能。
情形 B:p 没有左子树 —— 前驱是"从 p 往上走,第一个把 p 放在其右子树中的祖先",即 p 是该祖先的右孩子。此时 q 是 p 的双亲(当 p 直接是 q 的右孩子时),故 III 可能。
再看 IV:若 q 是 p 的右兄弟,则中序顺序为"…p…双亲…q…",p 和 q 之间隔着双亲,不可能直接相邻,故 IV 不可能。
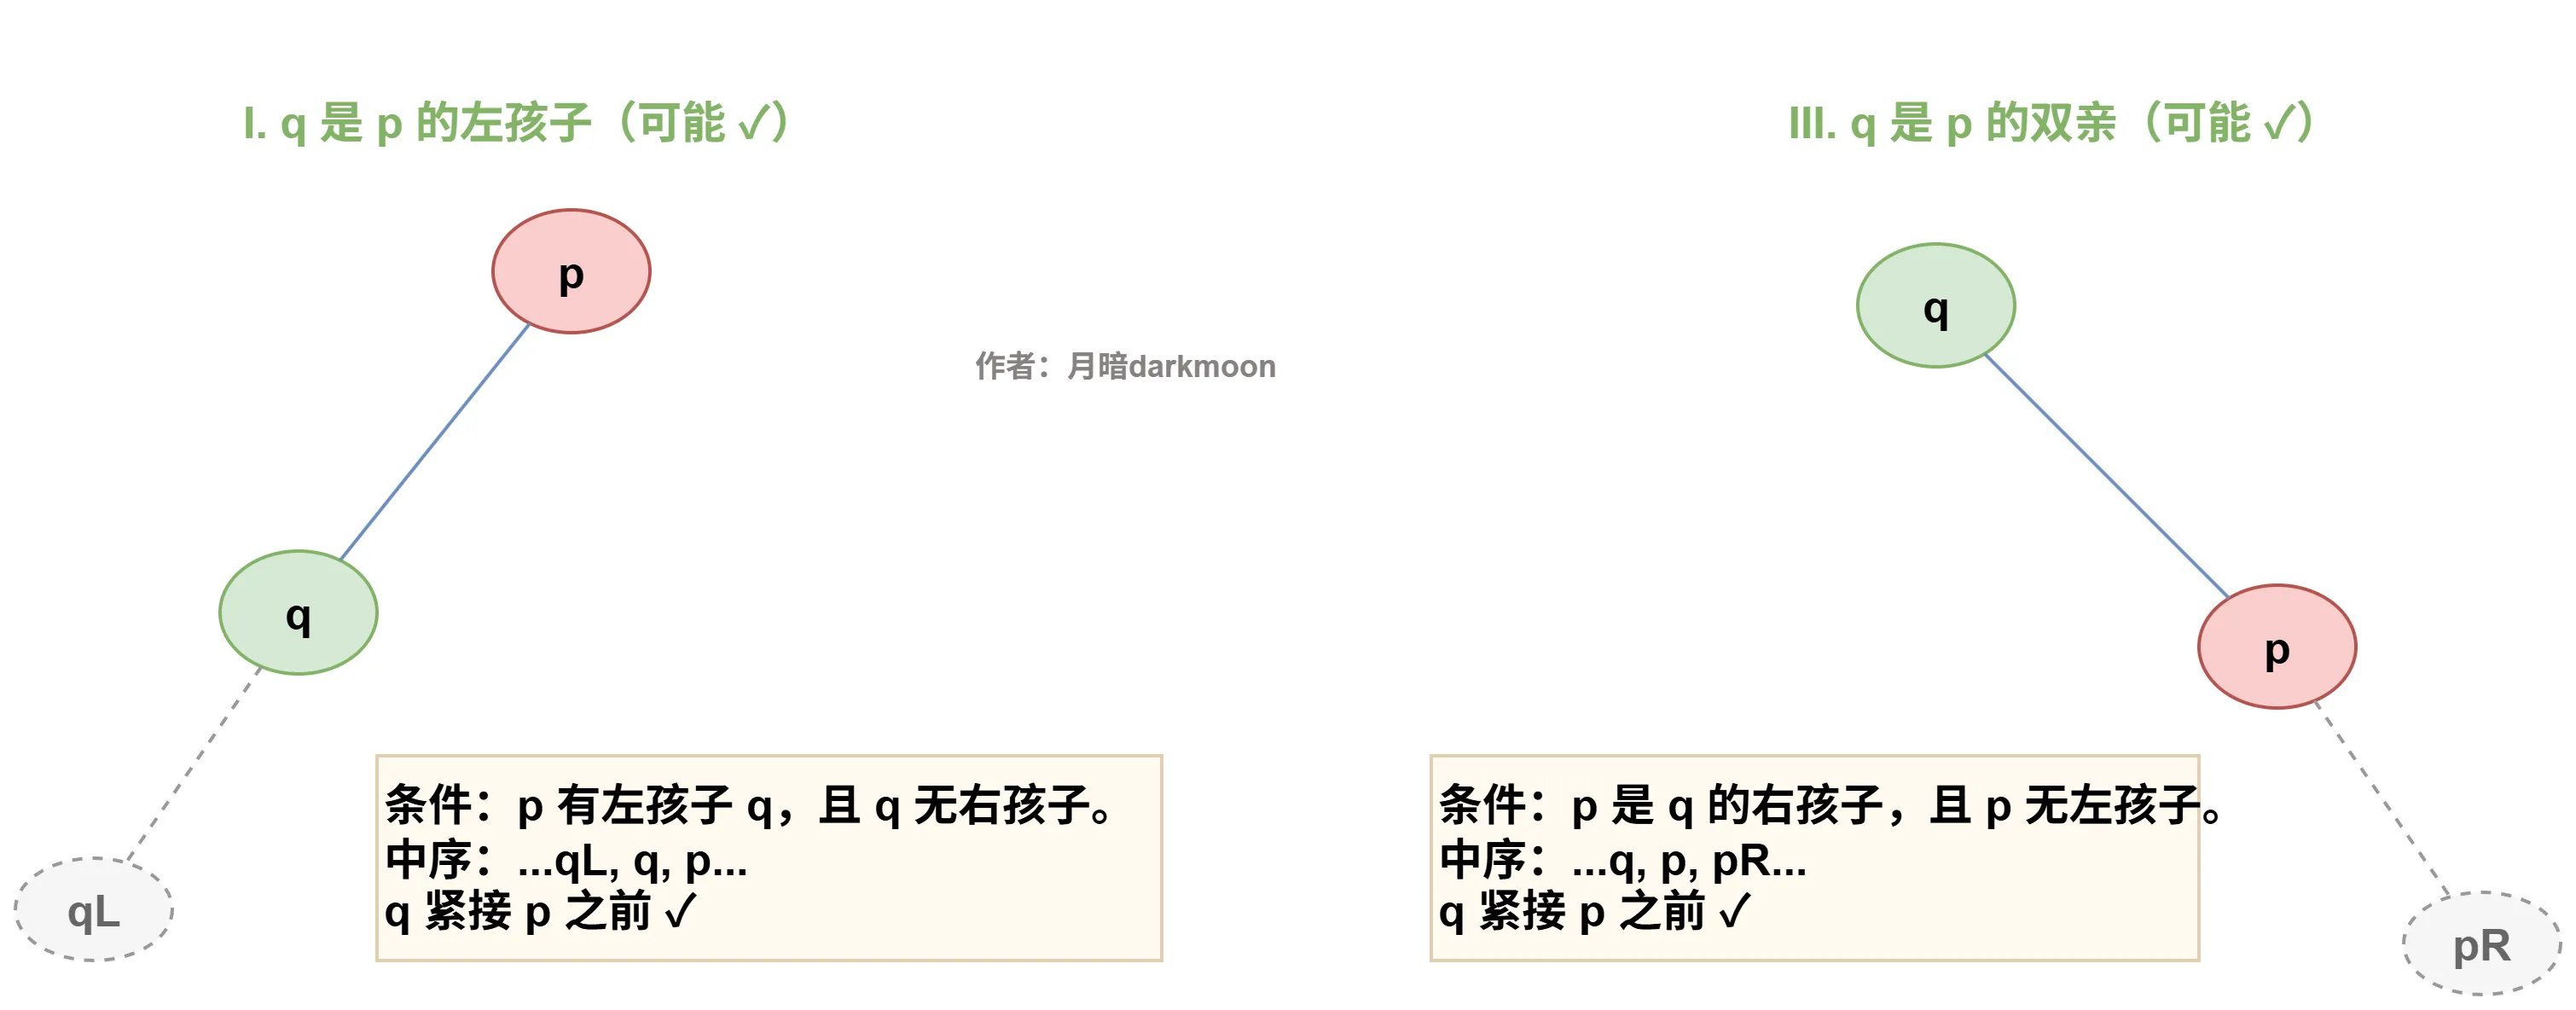
综上,只有 I、III 可能,选 B。
- 删除二叉排序树中一个既有左子树又有右子树的结点 v。下列叙述正确的是( )。
I. v 的中序直接后继一定没有左子树\ II. v 的中序直接前驱一定没有右子树\ III. 无论用前驱还是后继顶替,删除后树的中序序列相同\ IV. 用前驱顶替与用后继顶替得到的树一定相同
A. 仅 I、II B. 仅 III、IV C. 仅 I、II、III D. I、II、III、IV
解析
答案:C
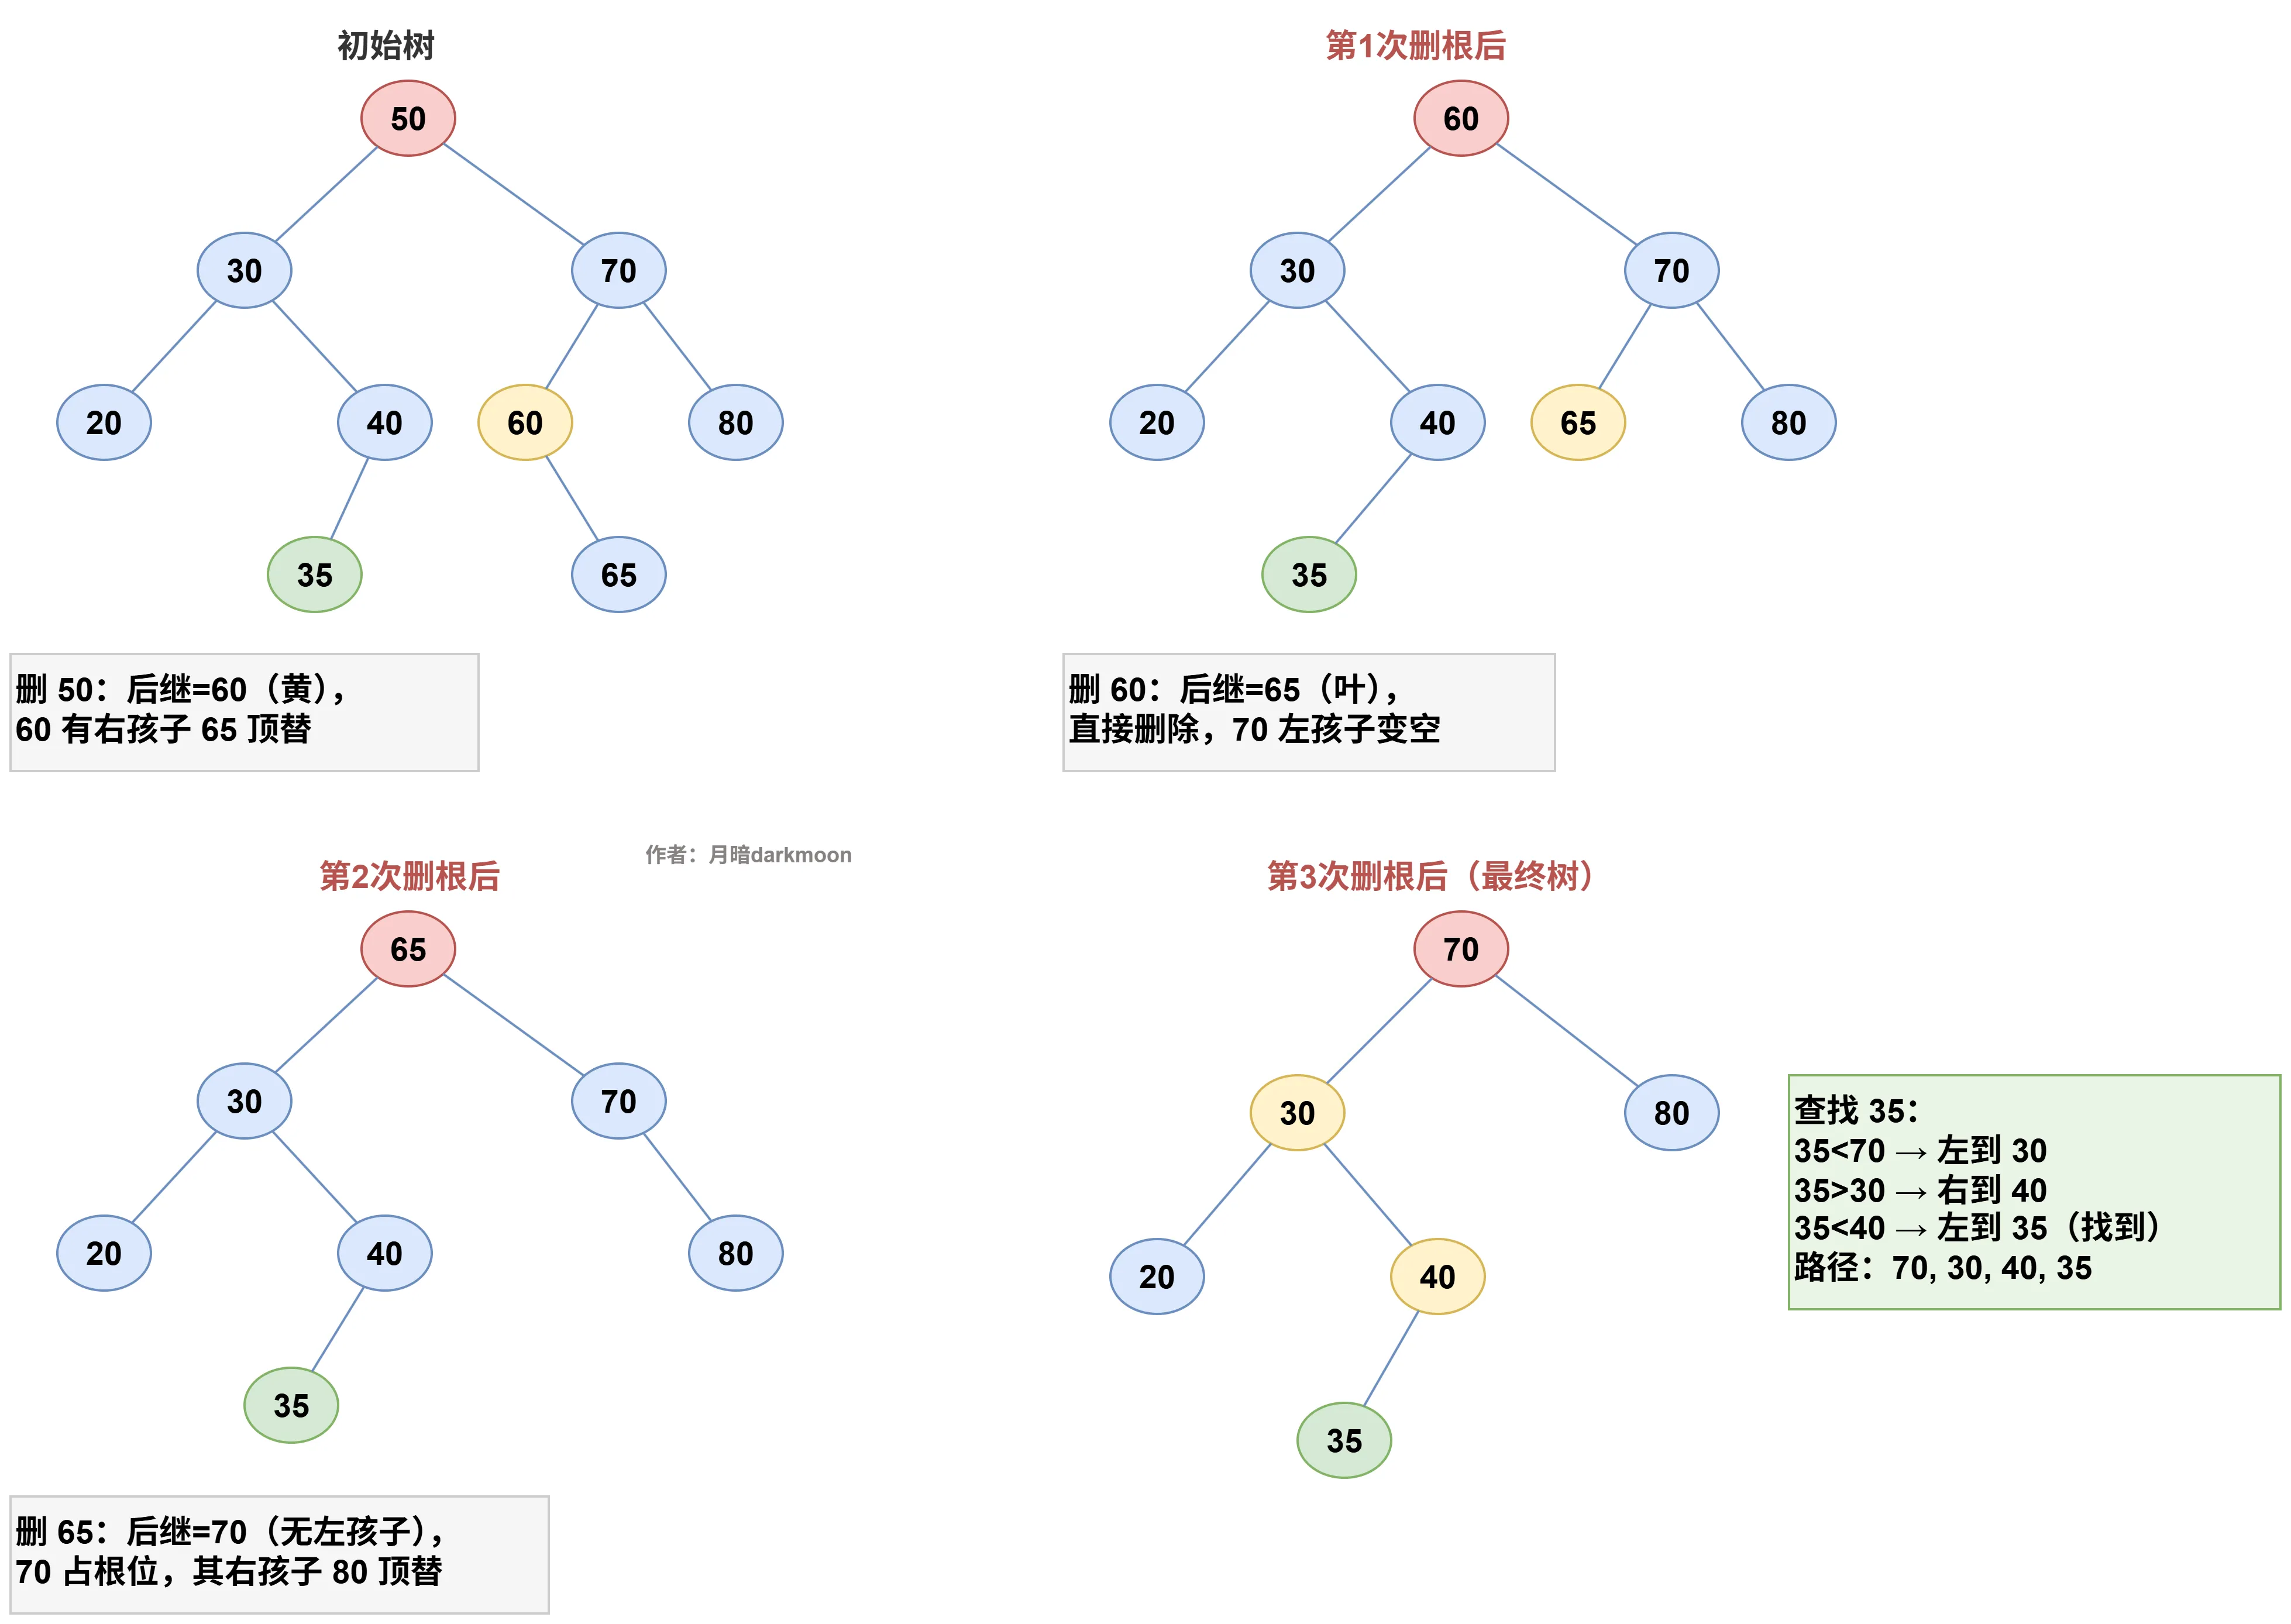
- 一棵二叉排序树如下图所示。现连续 3 次删除根结点(每次均用中序直接后继顶替),然后在得到的树中查找关键字 35。查找路径为( )。
A. 50, 30, 40, 35\ B. 60, 30, 40, 35\ C. 65, 30, 40, 35\ D. 70, 30, 40, 35
解析
答案:D
- 从空树开始依次插入 8, 3, 10, 1, 6, 14, 4, 7, 13 构造二叉排序树。约定:每次与一个结点的比较计 1 次,查找失败的比较次数等于失败前到达的最后一个结点的深度。则等概率下查找成功的 \(ASL_{成功}\) 与查找失败的 \(ASL_{失败}\) 分别为( )。
A. \(\dfrac{26}{9}\),\(\dfrac{7}{2}\) B. \(\dfrac{25}{9}\),\(\dfrac{7}{2}\) C. \(\dfrac{26}{9}\),\(\dfrac{18}{5}\) D. \(3\),\(\dfrac{7}{2}\)
解析
答案:A
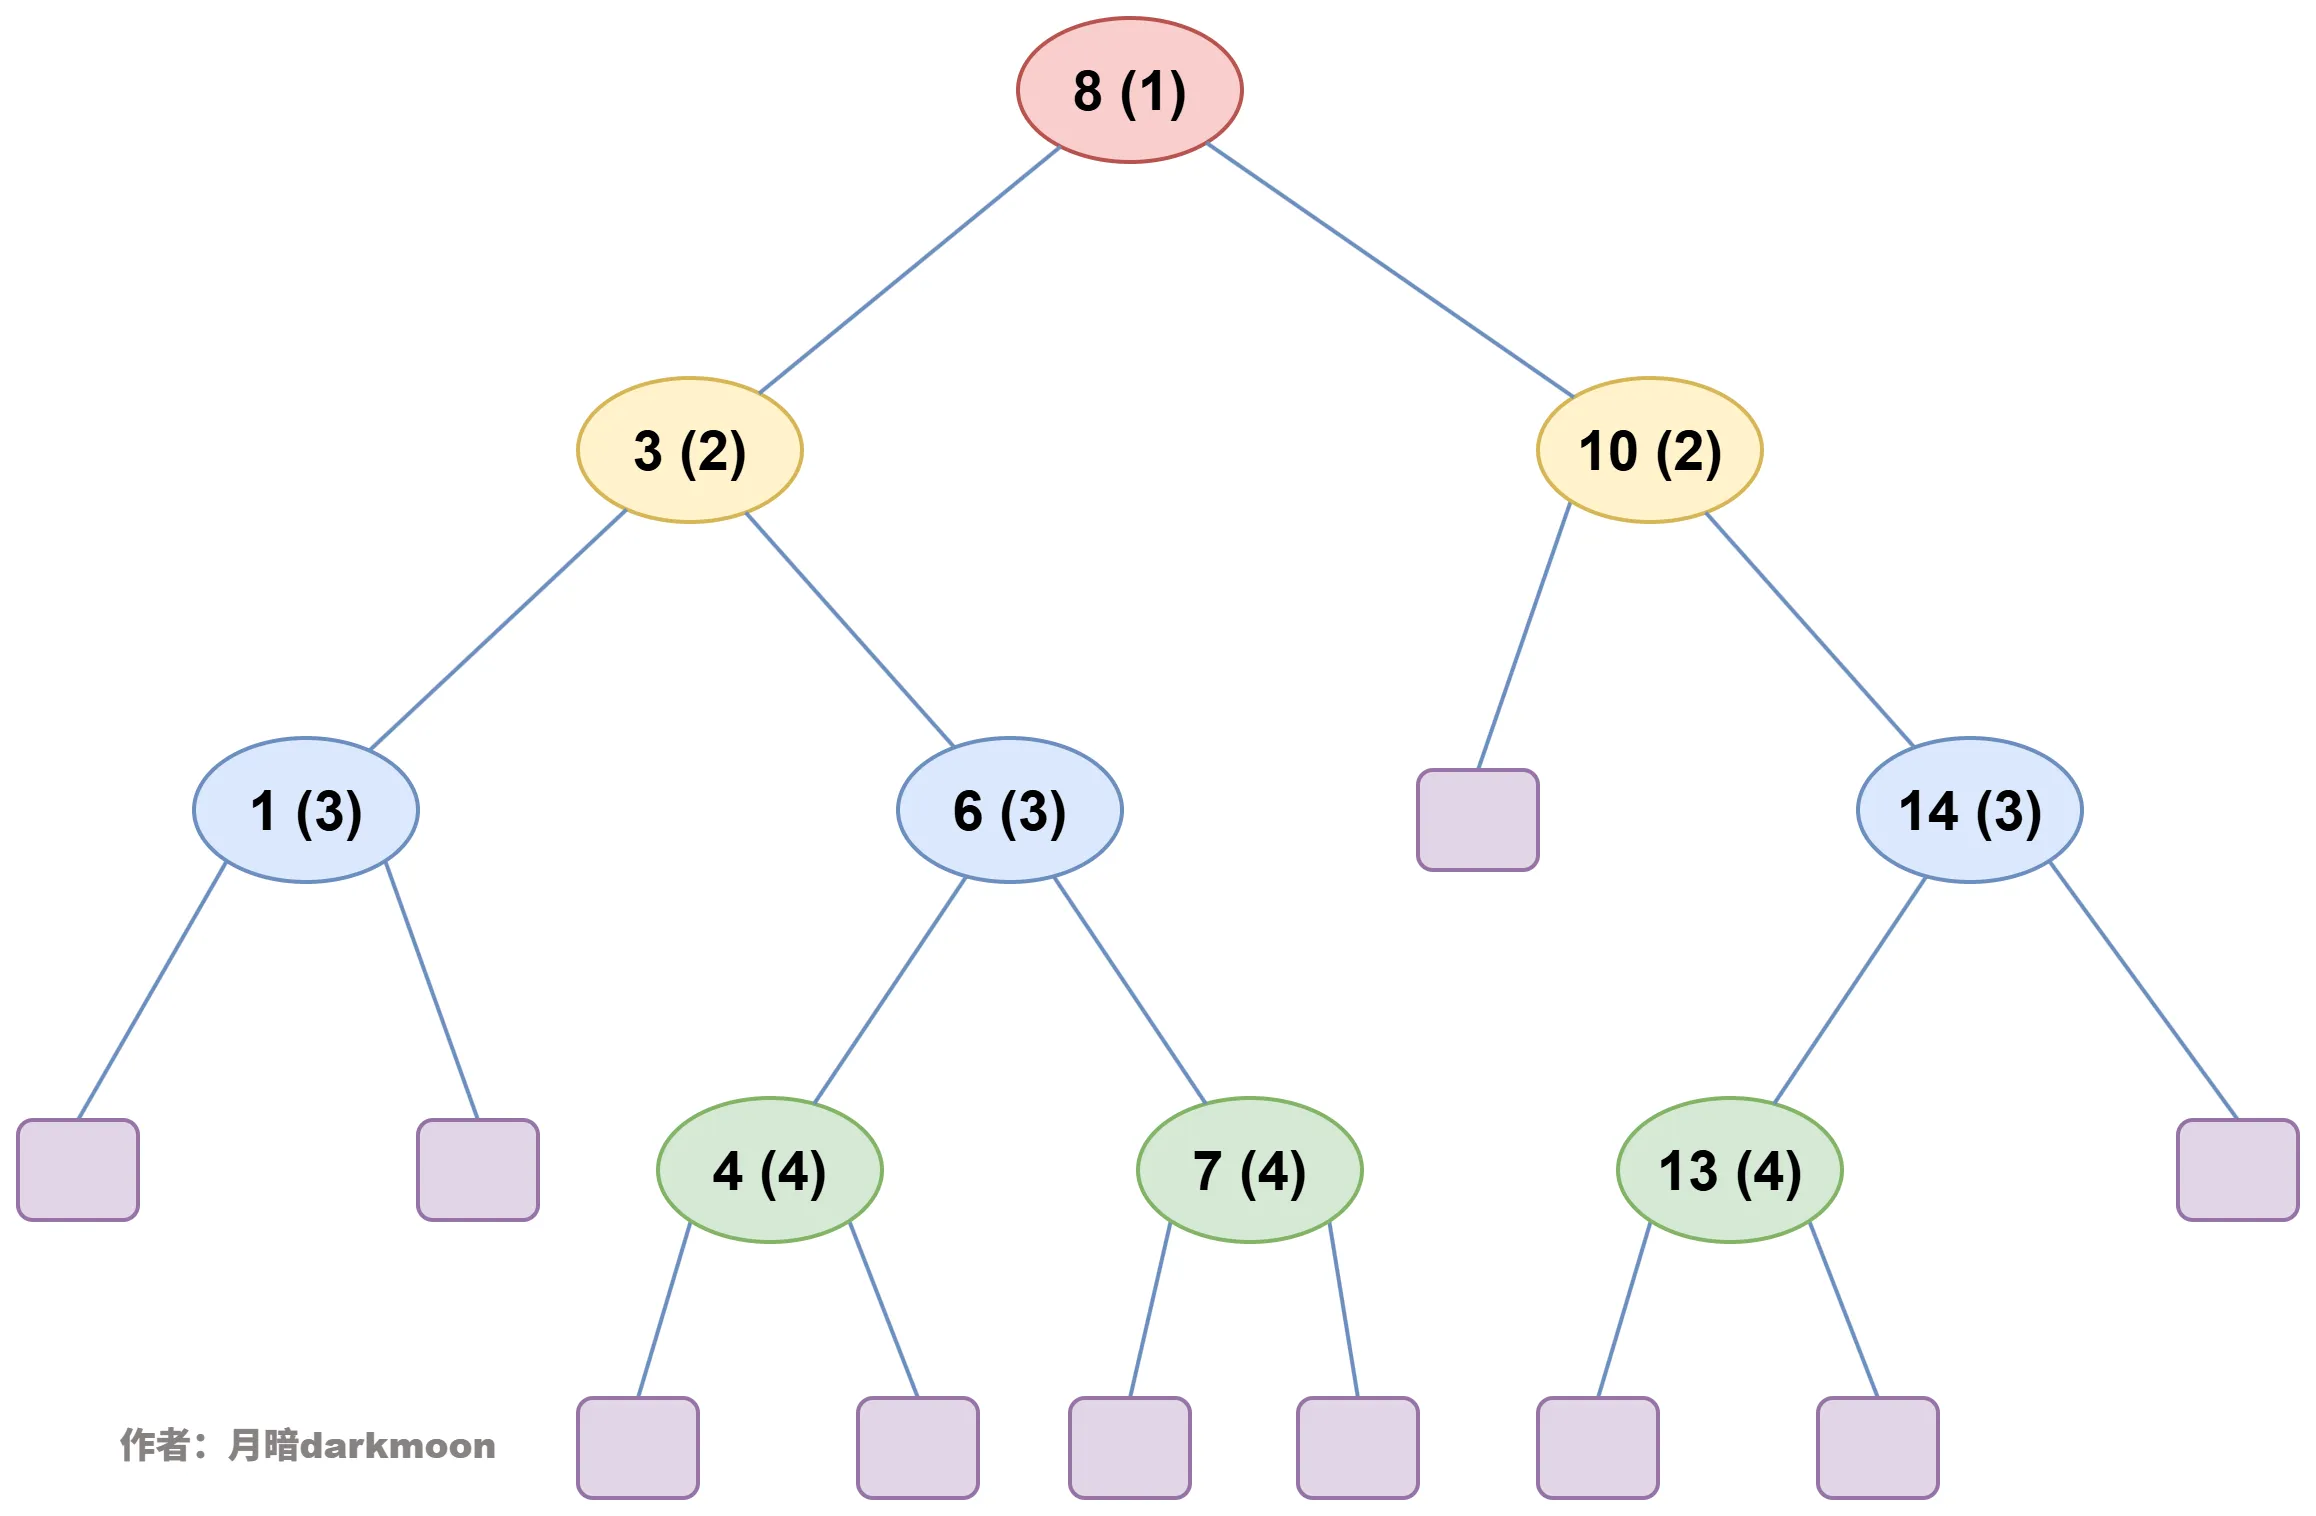
各结点深度:8(第 1 层);3、10(第 2 层);1、6、14(第 3 层);4、7、13(第 4 层)。
失败点(空指针)共  个,其比较次数 = 父结点深度:
- 10 的左空指针:2 次(1 个);
- 1 的两个空指针、14 的右空指针:各 3 次(共 3 个);
- 4、7、13 各自的两个空指针:各 4 次(共 6 个)。
陷阱:①失败点数应为  而不是
 ;②10 只有左空指针(深度浅),是最容易漏算/错算的一个;③失败比较次数按父结点深度计,而不是空指针自身的"层号"。