第六章查找
| 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 |
|---|---|---|---|---|---|---|---|---|---|
| B | A | B | A | B | D | A | C | C | B |
| 11 | 12 | 13 | 14 | 15 | 16 | 17 | 18 | 19 | 20 |
| B | D | B | C | B | D | D | A | D | D |
| 21 | 22 | 23 | 24 | 25 | 26 | 27 | 28 | 29 | 30 |
| D | A | D | A | B | B | B | A | D | B |
| 31 | 32 | 33 | 34 | 35 | 36 | 37 | 38 | 39 | |
| D | D | C | C | D | C | C | B | A |
(一)查找的基本概念
(二)顺序查找法
(三)分块查找法
(四)折半查找法
- 【2010-09】已知一个长度为 16 的顺序表 L ,其元素按关键字有序排列。若采用折半查找法查找一个 L 中不存在的元素,则关键字的比较次数最多是( )。
A. 4
B. 5
C. 6
D. 7
解析
折半查找每比较一次,就把待查区间缩小约一半。
长度为 16 时,查找路径的最大层数满足
但这不表示最多只比较 4 次。因为 16 个内部结点不能全部放在前 4 层: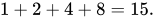
前 4 层最多容纳 15 个比较结点,第 16 个结点必须位于第 5 层。因此某些失败查找会沿路径比较 5 个关键字后,才进入空区间。
也可以使用公式: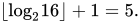
答案:B
- 【2015-07】下列选项中,不能构成折半查找中关键字比较序列的是( )。
A. 500, 200, 450, 180
B. 500, 450, 200, 180
C. 180, 500, 200, 450
D. 180, 200, 500, 450
解析
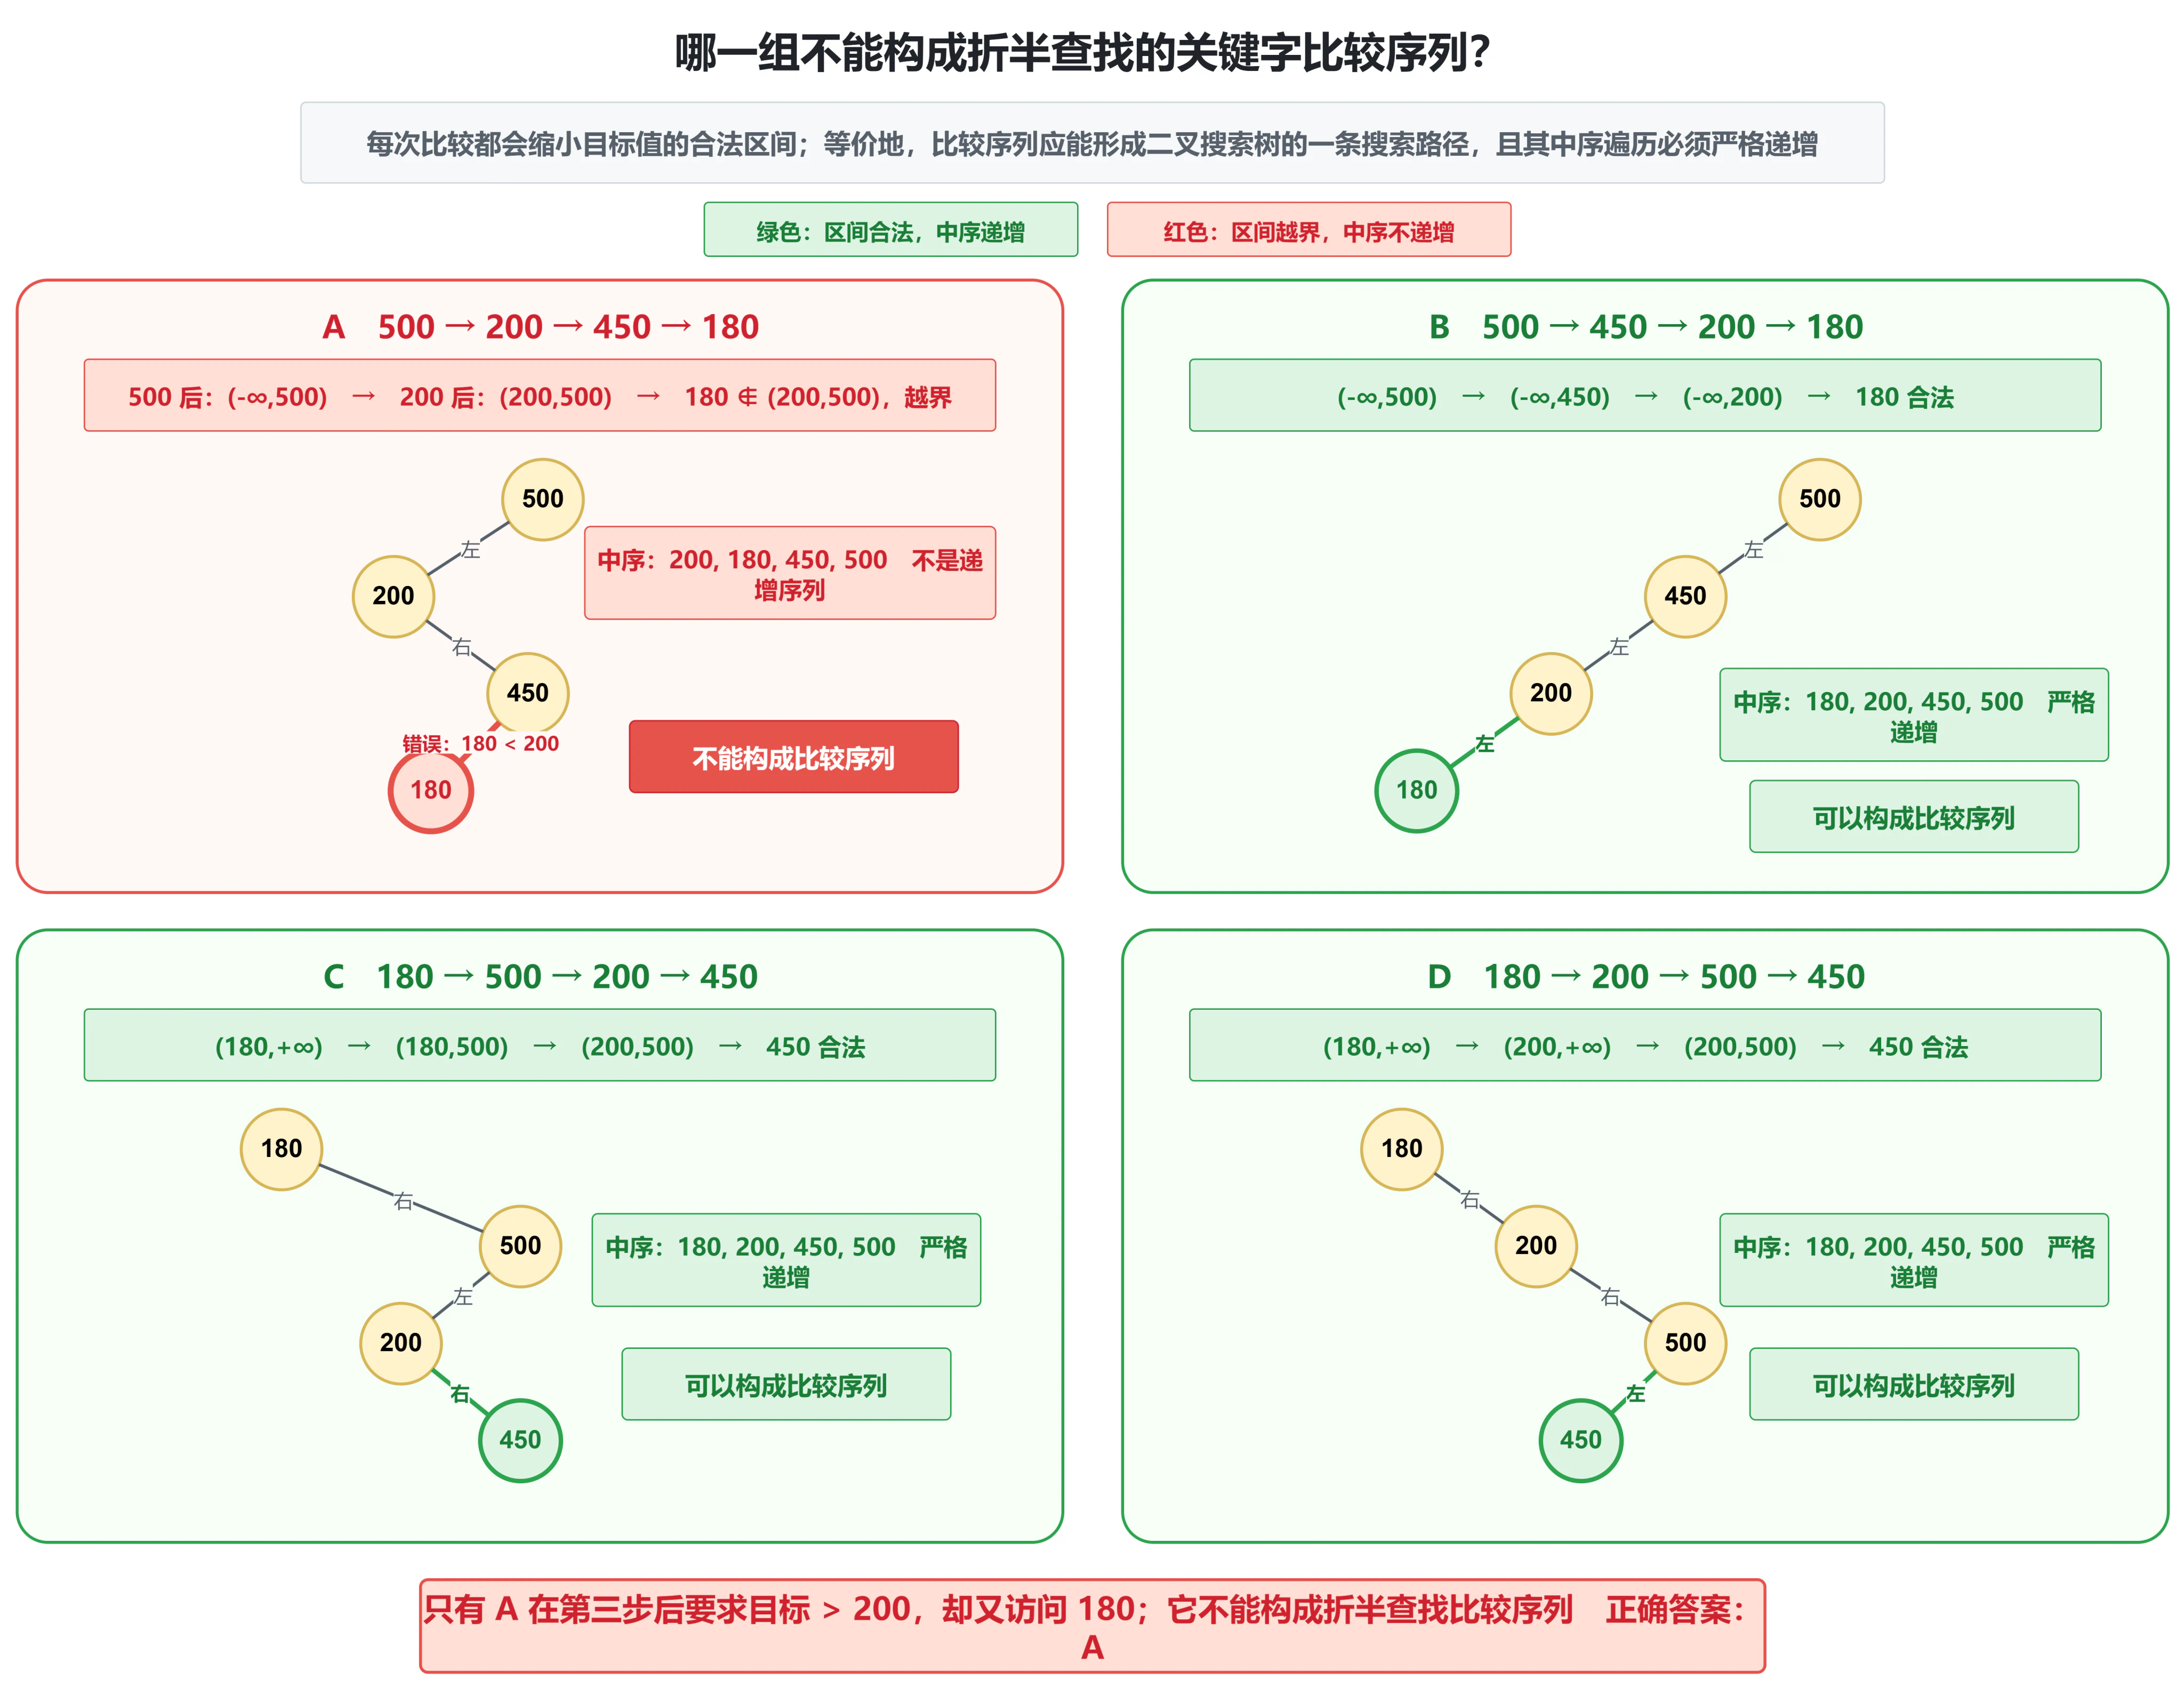
折半查找每比较一个关键字,都会确定待查关键字的上下界。后续比较值必须始终位于当前上下界之间。
检查 A:
- 先比较 500,下一次比较 200,说明待查关键字小于 500;
- 从 200 转到 450,说明待查关键字大于 200;
- 当前待查范围已经缩小为
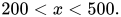
- 比较 450 后又转到 180,意味着继续向 450 的左侧查找,但新区间仍应满足
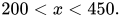
180 已经小于下界 200,不可能成为后续比较结点。
B、C、D 的每一步都能保持在此前形成的上下界范围内,因此可能出现。
答案:A
- 【2016-09】在有 n(n>1000) 个元素的升序数组 A 中查找关键字 x 。查找算法的伪代码如下所示。
k = 0;
while (k < n 且 A[k] < x) k = k + 3;
if (k < n 且 A[k] == x) 查找成功;
else if (k - 1 < n 且 A[k - 1] == x) 查找成功;
else if (k - 2 < n 且 A[k - 2] == x) 查找成功;
else 查找失败;
本算法与折半查找算法相比,有可能具有更少比较次数的情形是( )。
A. 当 x 不在数组中
B. 当 x 接近数组开头处
C. 当 x 接近数组结尾处
D. 当 x 位于数组中间位置
解析
该算法检查的位置依次为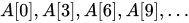
当越过 x 后,再检查该组中的前两个位置。
若 x 接近数组开头,只需很少几次跨步比较就能定位。例如 x 位于前几个元素中,算法可能只比较 1 至 3 次。
折半查找无论目标靠近开头还是结尾,通常仍需约 次比较。由于
 ,这个值约为 10。
若 x 位于中间、结尾或不存在,跨步算法可能需要扫描约  、
 级别的位置,远多于折半查找。
答案:B
- 【2017-08】下列二叉树中,可能成为折半查找判定树(不含外部结点)的是( )。
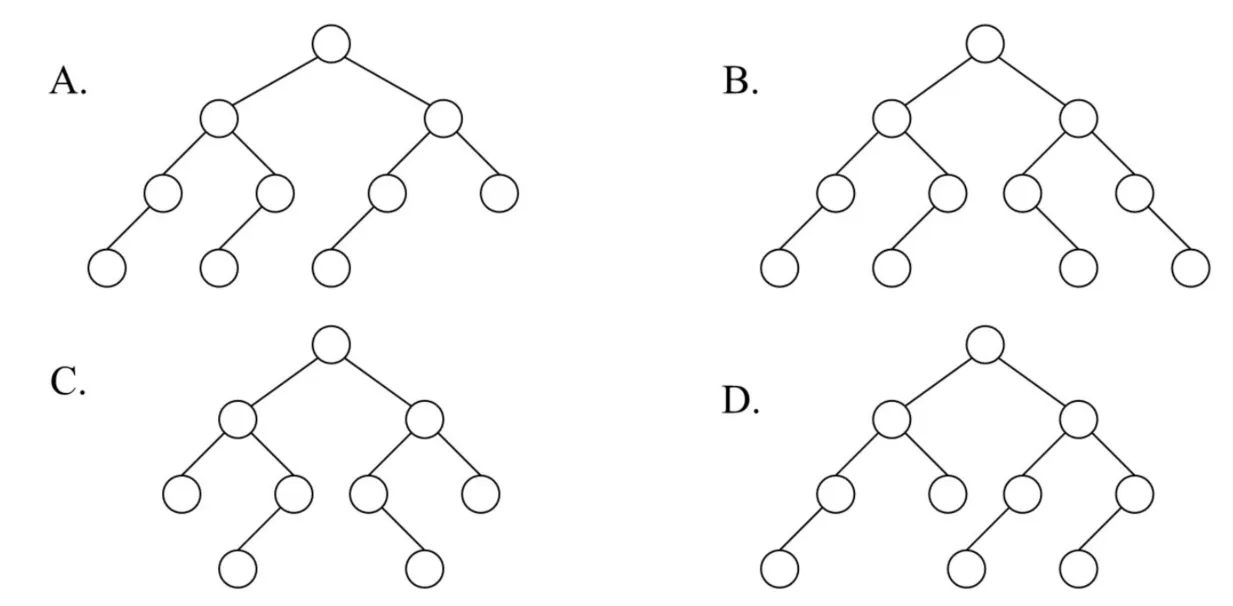
解析
折半查找判定树由“每次选择当前有序区间的中间元素”递归产生。对偶数长度区间,若采用上中位数,则左子区间比右子区间多 1 个元素;这一规则必须在每个子区间中保持一致。
图 A 可以按该规则递归划分。其结构可表示为:

图 A 中每个结点的左右子树规模都符合对相应有序区间折半后的规模关系。
其余选项在某个偶数长度子区间中把较大的半区放到了错误一侧,或者左右子树规模无法由连续有序区间取中点得到。
答案:A
- 【2023-08】对含 600 个元素的有序顺序表进行折半查找,关键字间的比较次数最多是( )。
A. 9
B. 10
C. 30
D. 300
解析
因为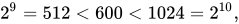 折半查找判定树需要 10 层才能容纳 600 个内部结点。
最大比较次数为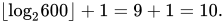
答案:B
- 【2024-05】下列数据结构中,不适合直接使用折半查找的是()。
I. 有序链表
II. 无序数组
III. 有序静态链表
IV. 无序静态链表
A. 仅I, III
B. 仅II, IV
C. 仅II, III, IV
D. I, II, III, IV
解析
折半查找需要同时满足两个条件:
- 元素按关键字有序;
- 能在
 时间内直接访问区间中点。
I 有序链表虽然有序,但不能按下标直接访问中间结点,必须从链头逐个移动,不适合直接折半。
II 无序数组可以随机访问,但元素无序,比较后无法排除一半区间。
III 有序静态链表的逻辑顺序由链接字段决定,逻辑上的中间结点不能根据数组下标直接得到,也不适合直接折半。
IV 同时缺少有序性和按逻辑位置随机访问能力。
所以四种结构都不适合直接使用折半查找。
答案:D
(五)树型查找
二叉搜索树
- 【2011-07】对于下列关键字序列,不可能构成某二叉排序树中一条查找路径的序列是( )。
A. 95, 22, 91, 24, 94, 71
B. 92, 20, 91, 34, 88, 35
C. 21, 89, 77, 29, 36, 38
D. 12, 25, 71, 68, 33, 34
解析
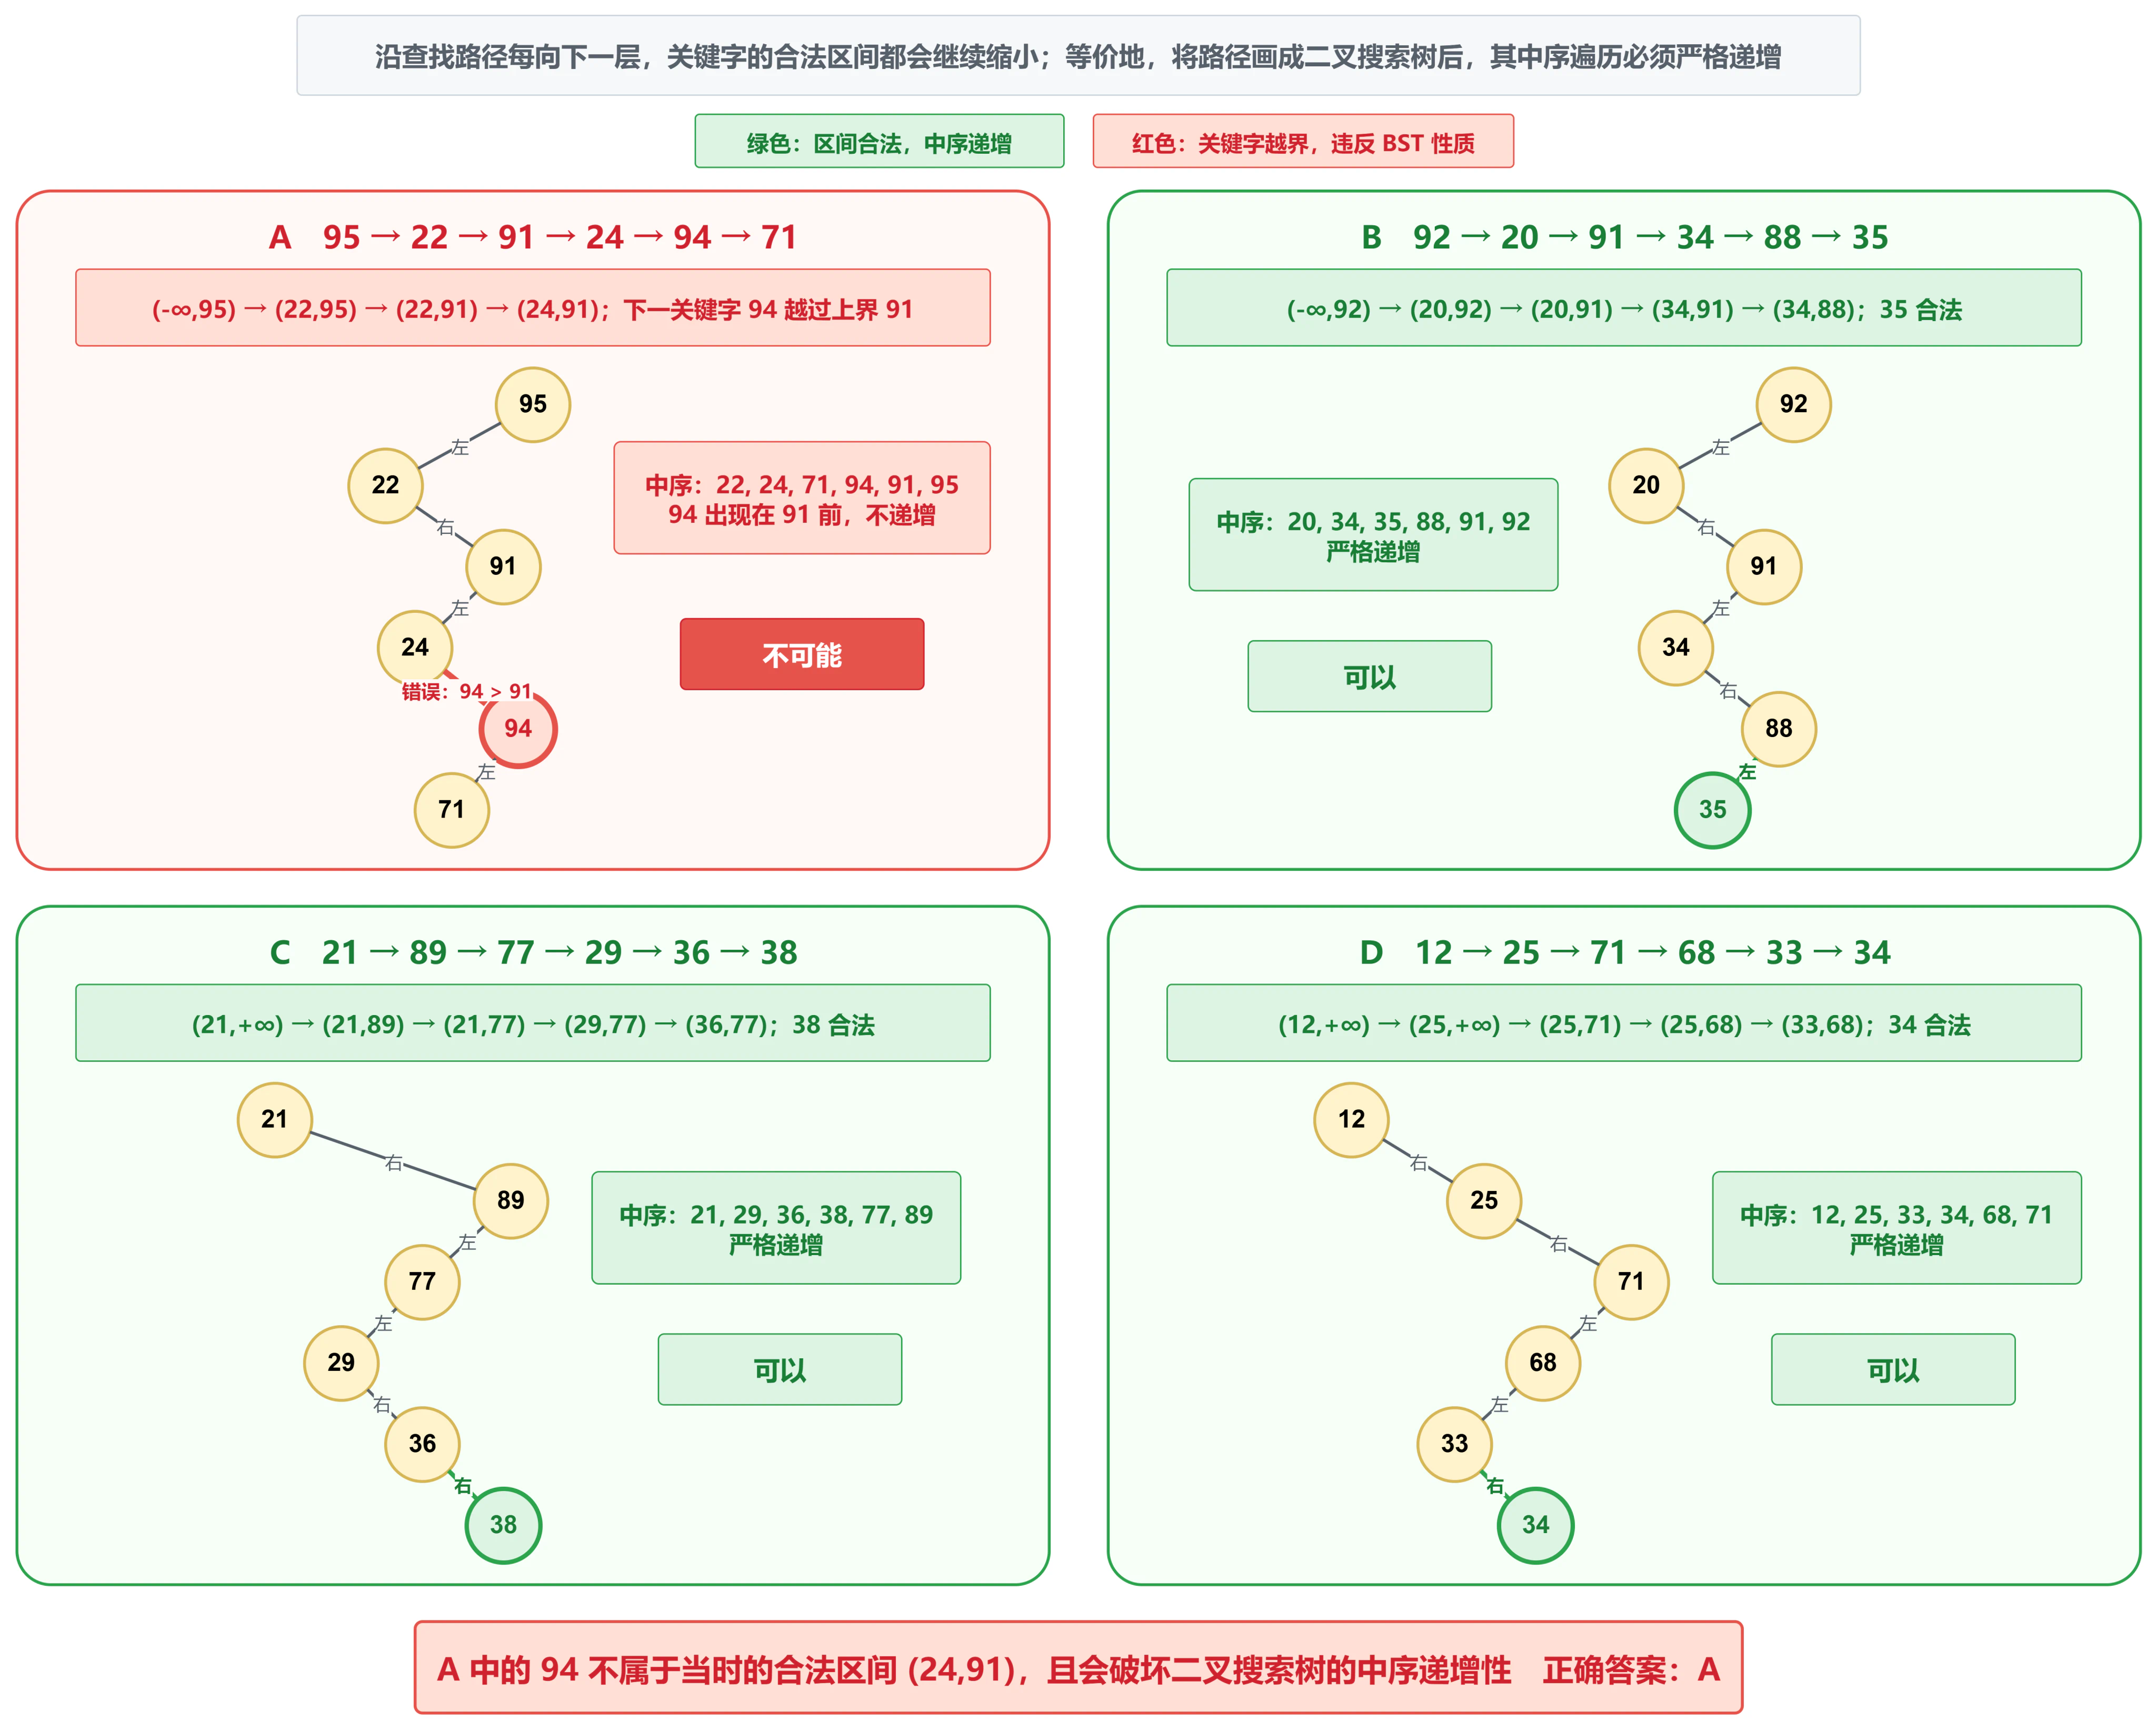
沿二叉搜索树查找时,每次向左或向右都会更新待查关键字的上下界。
检查 A:
 :说明待查关键字小于 95;
 :说明待查关键字大于 22,范围为
 ;
 :说明待查关键字小于 91,范围变为
 ;
 :虽然从 24 应向右,但右子树中的所有结点仍必须小于先前上界 91。
关键字 94 超过上界 91,因此 94 不可能出现在这条查找路径上。
B、C、D 中的每个后续关键字均位于此前形成的上下界内,可以构造相应二叉搜索树。
答案:A
- 【2013-06】在任意一棵非空二叉排序树 T1 中,删除某结点 v 之后形成二叉排序树 T2 ,再将 v 插入 T2 形成二叉排序树 T3 。下列关于 T1 与 T3 的叙述中,正确的是( )。
I. 若 v 是 T1 的叶结点,则 T1 与 T3 不同
II. 若 v 是 T1 的叶结点,则 T1 与 T3 相同
III. 若 v 不是 T1 的叶结点,则 T1 与 T3 不同
IV. 若 v 不是 T1 的叶结点,则 T1 与 T3 相同
A. 仅I、III
B. 仅I、IV
C. 仅II、III
D. 仅II、IV
解析
若 v 是叶结点,删除 v 不会改变其他结点之间的结构。再次查找 v 的插入位置时,会沿原来的路径到达原空位置,所以 v 回到原位置, 与
 相同。II 正确,I 错误。
若 v 不是叶结点,删除时需要用孩子、前驱或后继调整原结构。再次插入 v 时,普通 BST 插入总是把新结点放到某个空指针位置,因此 v 会成为叶结点。
原来 v 是非叶结点,重新插入后 v 是叶结点,树形不可能与原树完全相同。III 正确,IV 错误。
答案:C
- 【2018-06】已知二叉排序树如下图所示,元素之间应满足的大小关系是( )。
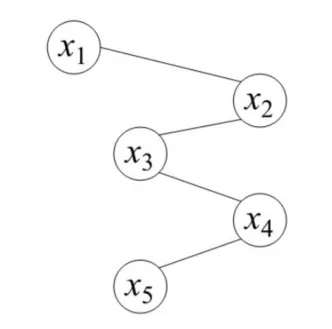
A. x1<x2<x3
B. x1<x4<x5
C. x3<x5<x4
D. x4<x3<x5
在二叉搜索树中: 合并得到 答案:C解析
 ;
 ;
 。
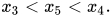
- 【2020-05】下列给定的关键字输入序列中,不能生成如下二叉排序树的是( )。
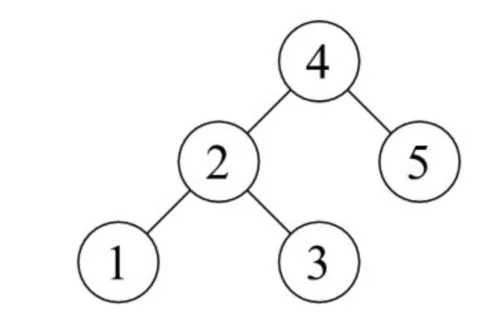
A. 4, 5, 2, 1, 3
B. 4, 5, 1, 2, 3
C. 4, 2, 5, 3, 1
D. 4, 2, 1, 3, 5
解析
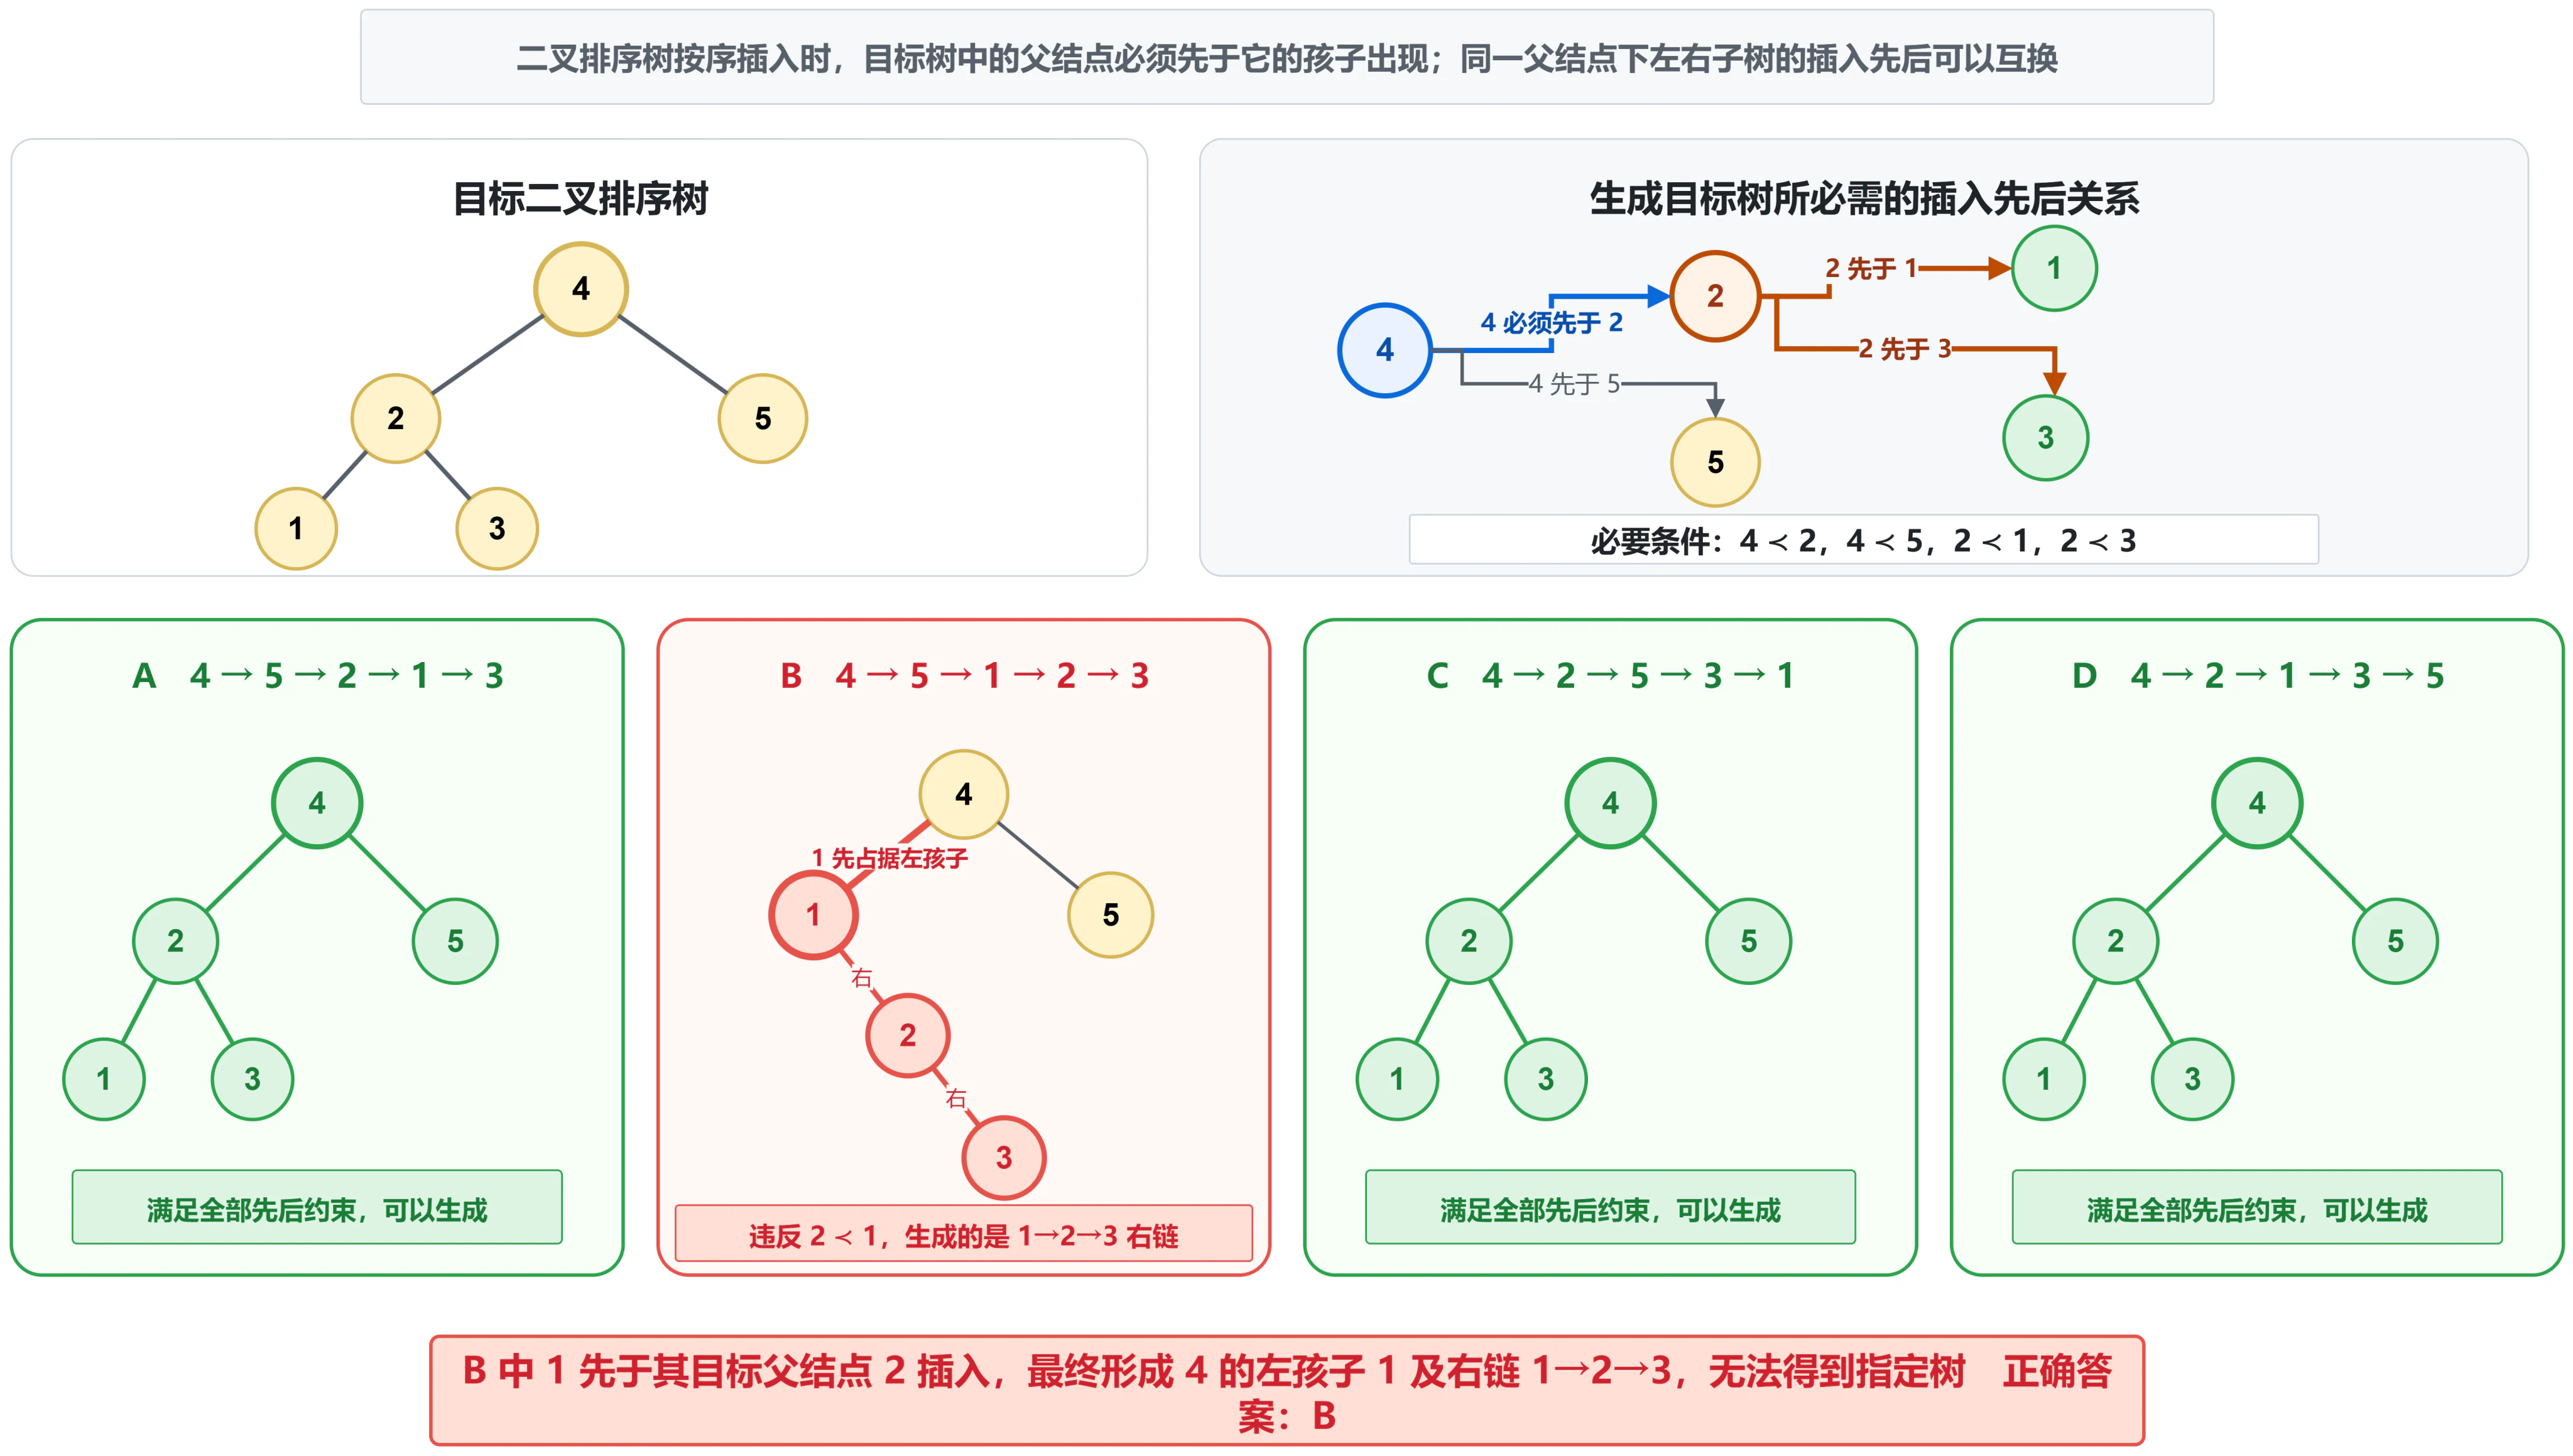
A:4 为根;5 成为右孩子;2 成为左孩子;1、3 分别成为 2 的左右孩子,可以生成目标树。
B:插入 4、5 后,再插入 1,1 成为 4 的左孩子。随后插入 2 时,路径为 所以 2 会成为 1 的右孩子。普通 BST 插入不会重新调整结点位置,因此无法让 2 变成 4 的左孩子、1 变成 2 的左孩子。
C、D 都在插入 1、3 前先插入了 2,可以生成目标树。
答案:B
- 【2022-03】若结点p与q在二叉搜索树T中的中序遍历中相邻,且p在q之前,则下列p与q的关系中,不可能的是( )。
I. q是p的双亲
II. q是p的右孩子
III. q是p的右兄弟
IV. q是p的双亲的双亲
A. 仅I
B. 仅III
C. 仅II、III
D. 仅II、IV
解析
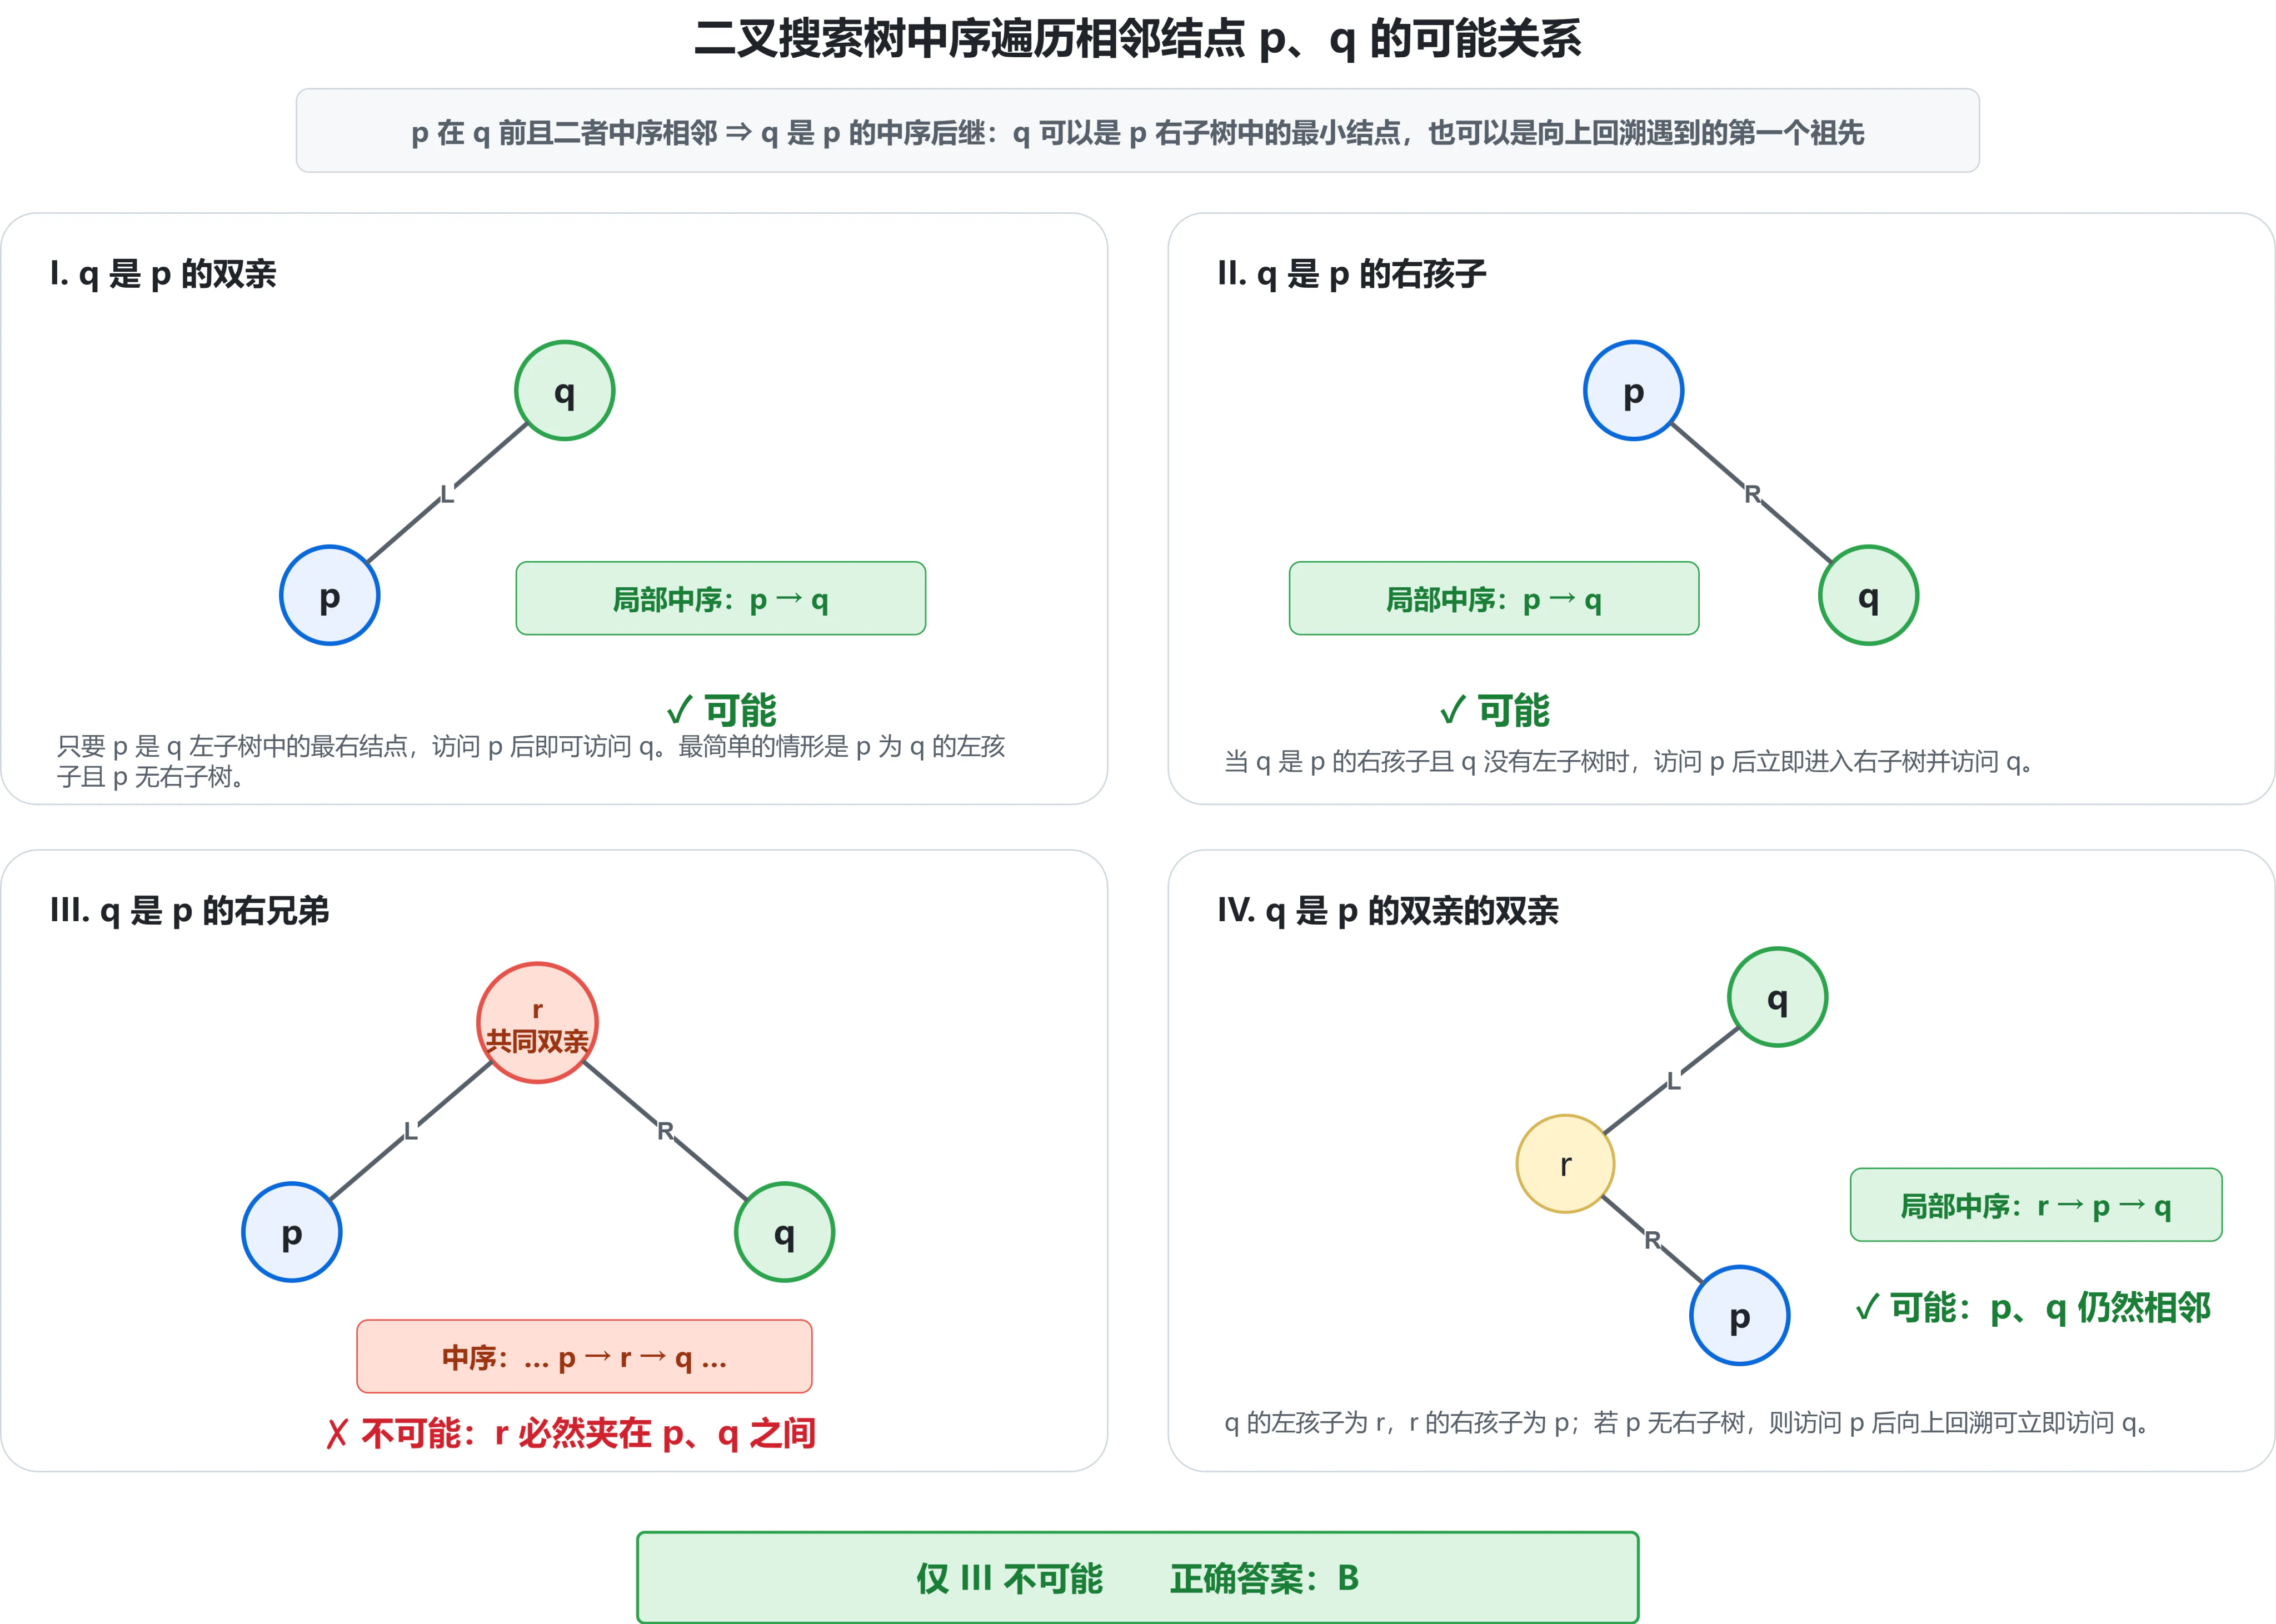
答案:B
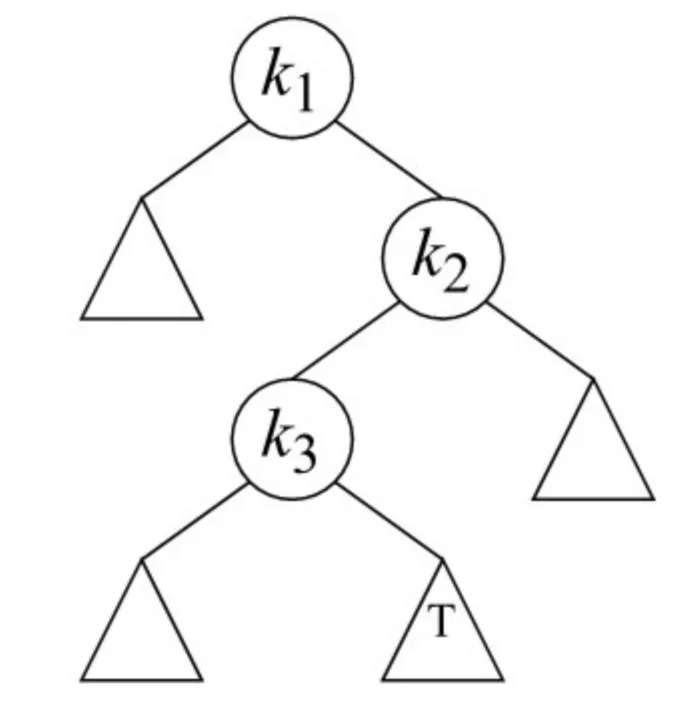
- 【2024-07】一棵二叉搜索树如题 7 图所示,k1、k2、k3 分别是对应结点中保存的关键字。子树 T 的任一结点中保存的关键字 x 满足的是
A. x<k1
B. x>k2
C. k1<x<k3
D. k3<x<k2
T 位于 T 又位于 虽然整棵局部结构位于 答案:D解析
 的右子树,所以

 的左子树,所以

 的右子树,可得
 ,但更精确的上下界是
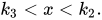
平衡二叉树
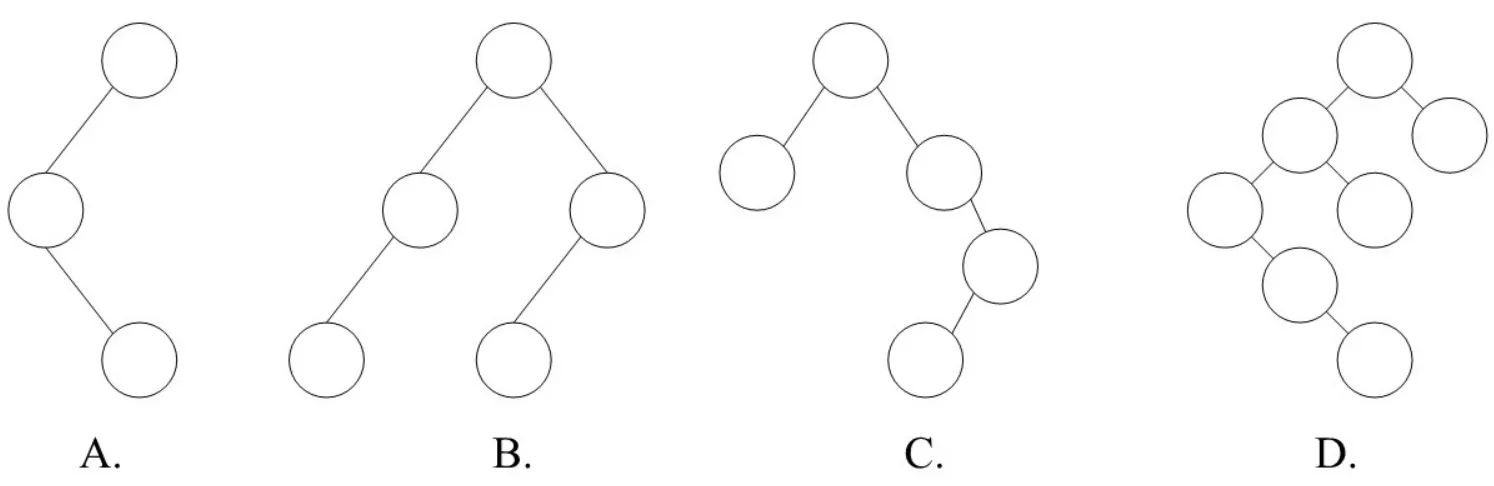
- 【2009-04】下列二叉排序树中,满足平衡二叉树定义的是( )。
解析
AVL 树要求任一结点的左右子树高度差绝对值不超过 1。
A 是 3 个结点的单支链,根结点一侧高度为 2、另一侧为 0,高度差为 2,不平衡。
B 的结构为:
flowchart TB
    r["根"] --> l["左子树根"]
    r --> q["右子树根"]
    l --> ll["叶结点"]
    q --> ql["叶结点"]
两个孩子结点的高度差均为 1,根的左右子树高度相同,所有结点都满足 AVL 条件。
C 的右子树形成较长单链,根的左右高度差超过 1。
D 的左下方存在较长链,相关祖先结点高度差超过 1。
答案:B
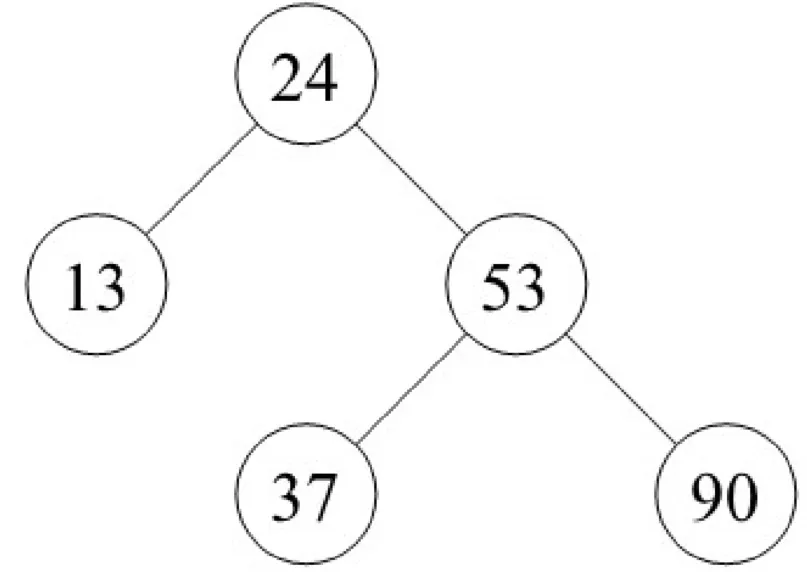
- 【2010-04】在下图所示的平衡二叉树中,插入关键字48后得到一棵新平衡二叉树。在新平衡二叉树中,关键字37所在结点的左、右子结点中保存的关键字分别是( )。
A. 13, 48
B. 24, 48
C. 24, 53
D. 24, 90
解析
48 的插入路径为
插入后,根 24 的右子树过高,而其右孩子 53 的左子树过高,属于 RL 型失衡。
处理 RL 型失衡:
- 先对 53 做右旋,使 37 上升;
- 再对 24 做左旋,使 37 成为新的根。
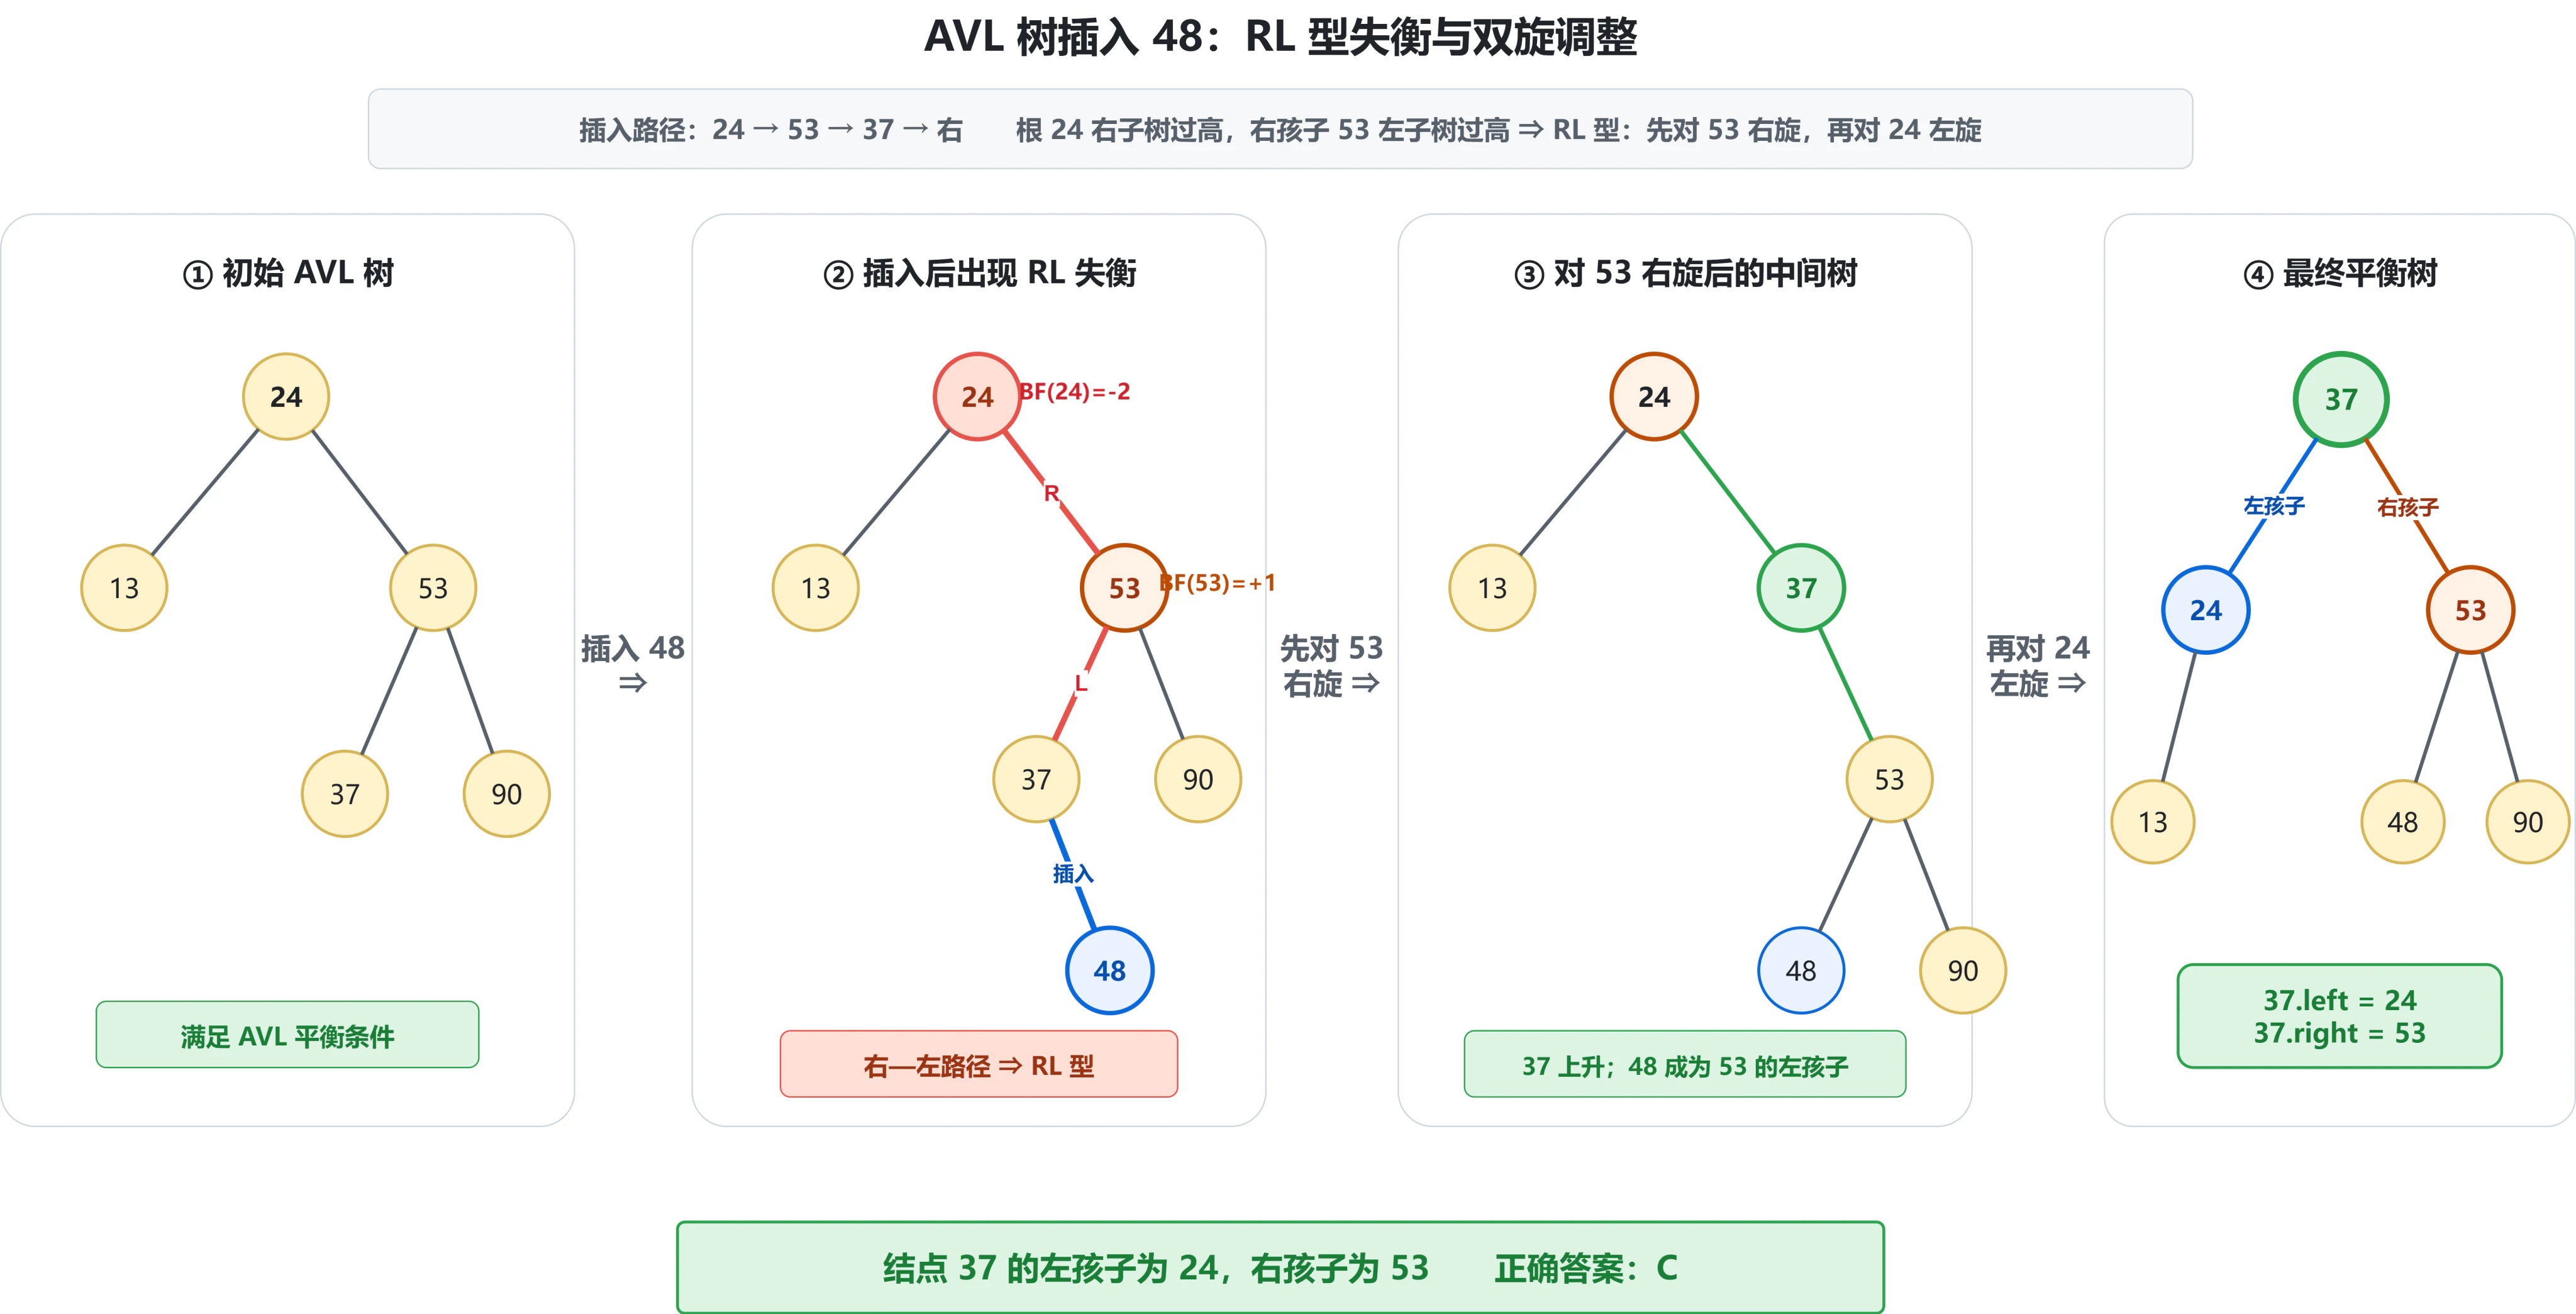
所以 37 的左孩子是 24,右孩子是 53。
答案:C
- 【2012-04】若平衡二叉树平的高度为 6 ,且所有非叶结点的平衡因子均为 1 ,则该平衡二叉树的结点总数为( )。
A. 10
B. 20
C. 32
D. 33
解析
平衡因子为 1 表示每个非叶结点的左子树比右子树高 1。
设满足条件且高度为 h 的树含  个结点,则根的两棵子树高度分别为
 和
 :
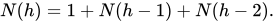
初值为
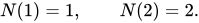
依次计算:
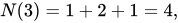
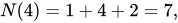
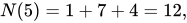
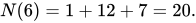
答案:B
- 【2013-03】若将关键字 1,2,3,4,5,6,7 依次插入到初始为空的平衡二叉树 T 中,则 T 中平衡因子为 0 的分支结点的个数是( )。
A. 0
B. 1
C. 2
D. 3
解析
连续递增插入会多次产生 RR 型失衡并进行左旋。
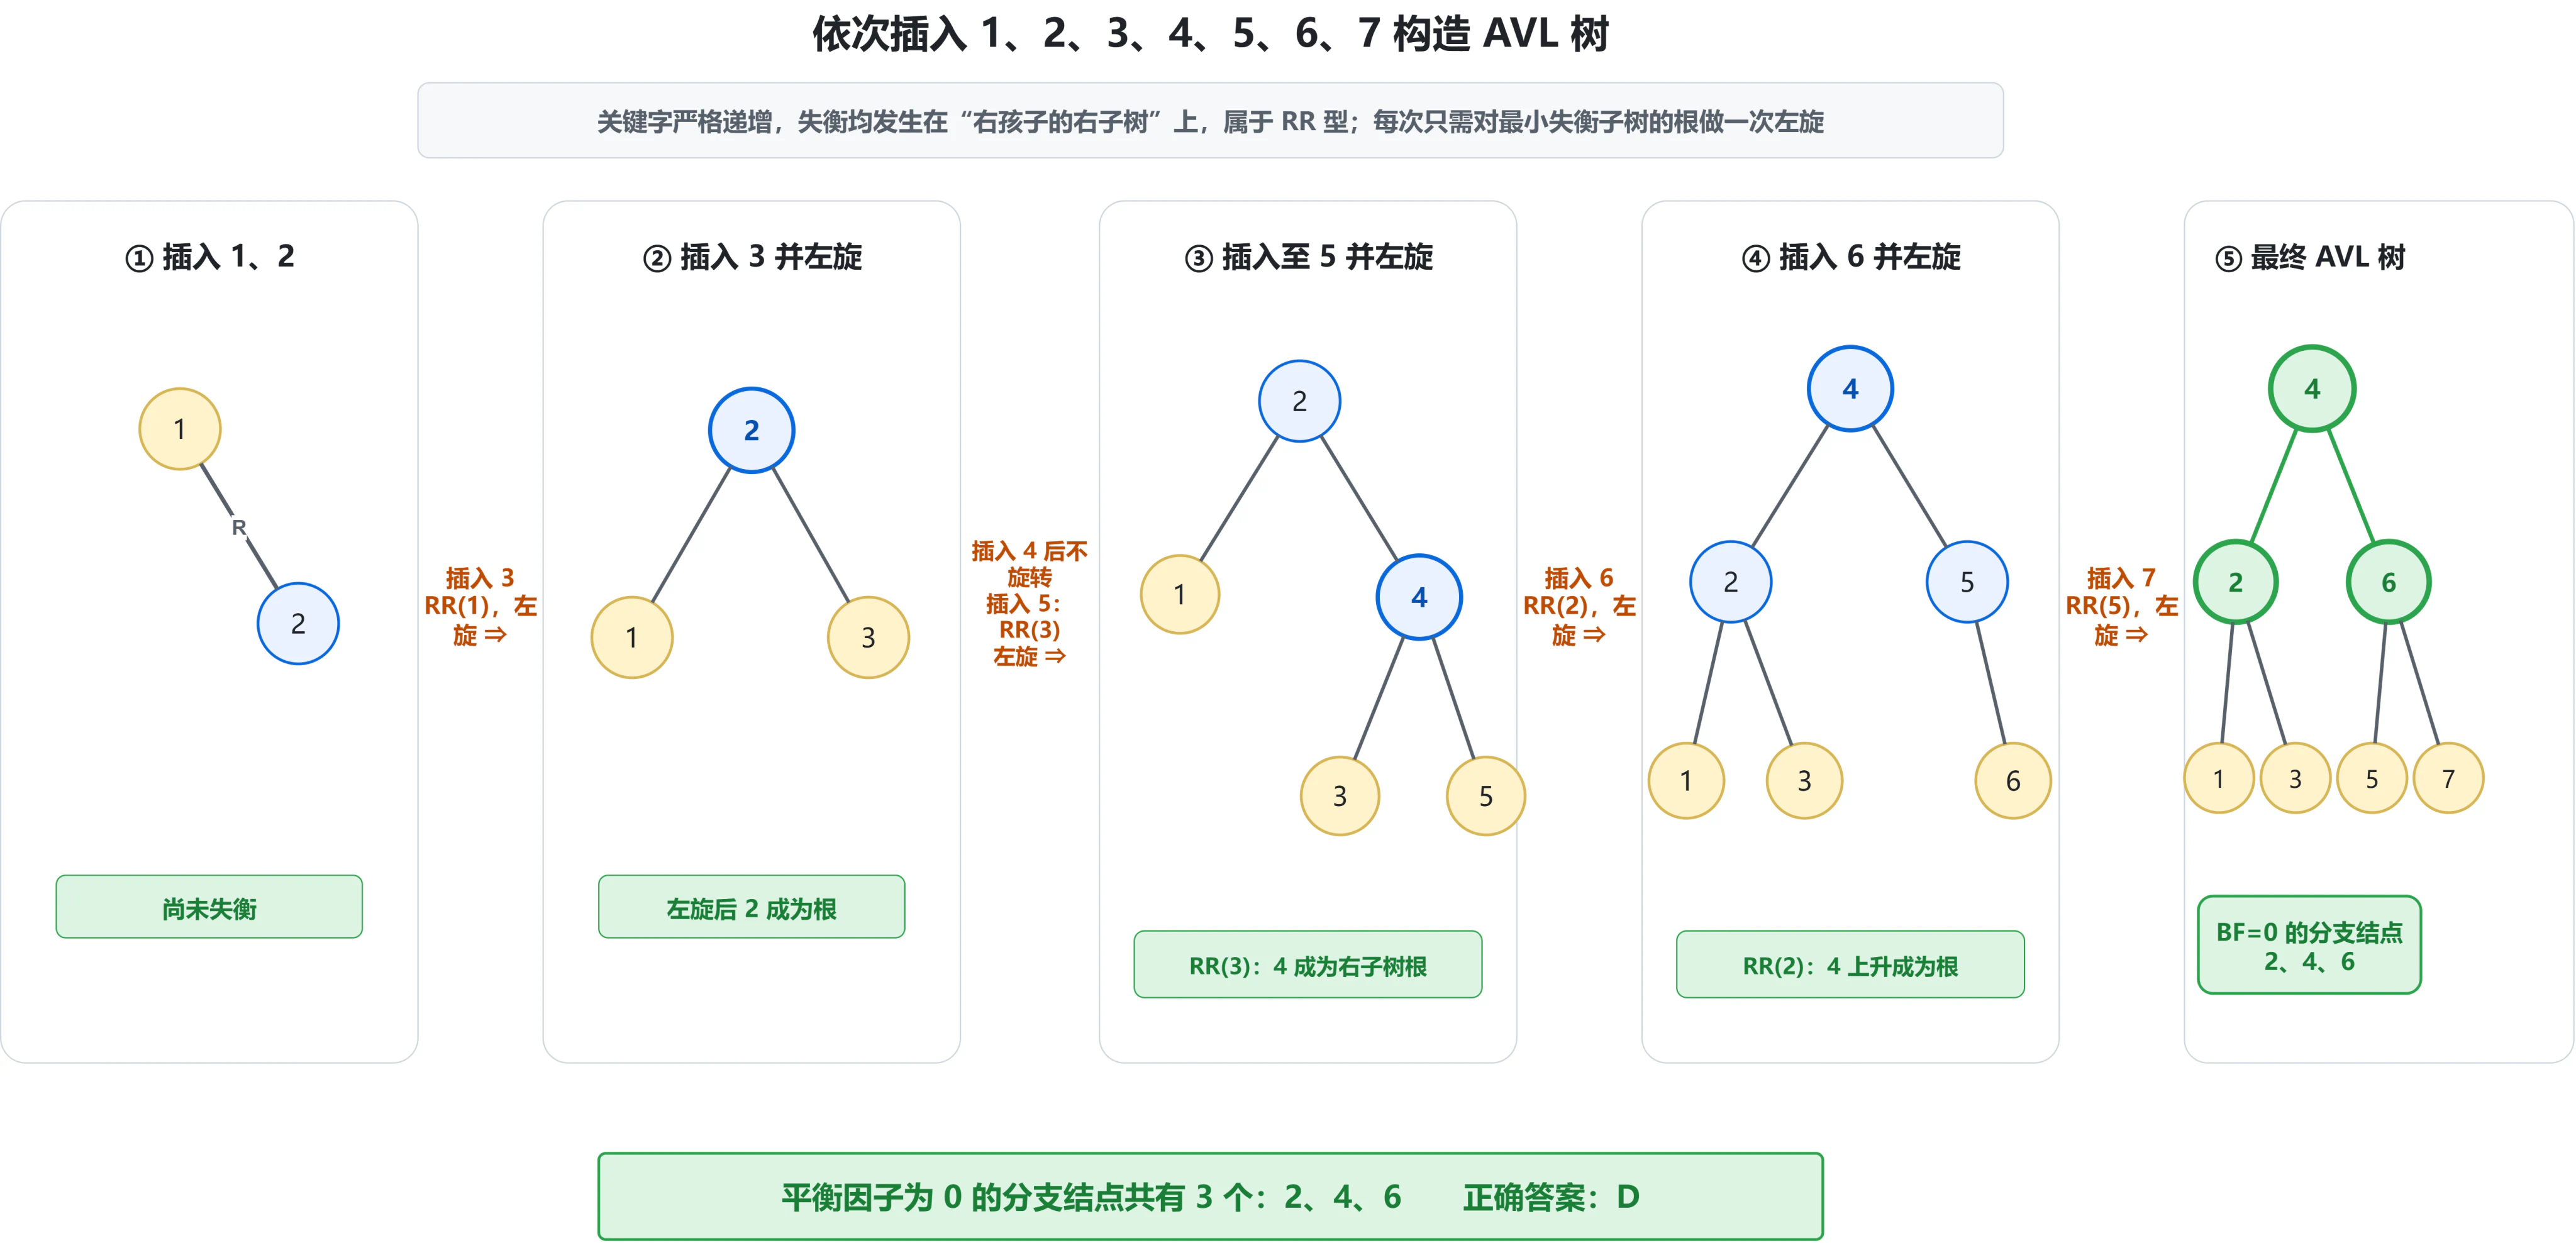
答案:D
- 【2015-04】现有一棵无重复关键字的平衡二叉树(AVL树),对其进行中序遍历可得到一个降序序列。下列关于该平衡二叉树的叙述中,正确的是( )。
A. 根结点的度一定为2
B. 树中最小元素一定是叶结点
C. 最后插入的元素一定是叶结点
D. 树中最大元素一定是无左子树
解析
普通二叉搜索树的中序是升序。本题中序为降序,说明比较方向相反:
- 左子树关键字大于根;
- 右子树关键字小于根。
最大元素位于不断沿左孩子到达的最左端位置。若最大元素还有左子树,其中应存在比最大值更大的关键字,产生矛盾。因此最大元素一定没有左子树,D 正确。
A 不成立,AVL 根可以只有一个孩子。
B 不成立。最小元素不能有右孩子,但可能有左孩子,所以不一定是叶结点。
C 不成立。AVL 插入后可能发生旋转,最后插入的结点可能上升为分支结点。
答案:D
- 【2019-04】在任意一棵非空平衡二叉树(AVL树) T1 中,删除某结点 v 之后形成平衡二叉树 T2 , 再将 v 插入 T2 形成平衡二叉树 T3 。下列关于 T1 与 T3 的叙述中,正确的是( )。
I.若 v 是 T1 的叶结点,则 T1 与 T3 可能不相同
II.若 v 不是 T1 的叶结点,则 T1 与 T3 一定不相同
III.若 v 不是 T1 的叶结点,则 T1 与 T3 一定相同
A. 仅I
B. 仅II
C. 仅I、II
D. 仅I、III
解析
I 正确。删除叶结点后可能导致祖先失衡并发生旋转;重新插入该关键字时,插入触发的旋转不一定把树恢复为原结构,所以可能不同。
II 错误。“一定不同”过强。例如原树为根 2、左右孩子 1 和 3。删除根 2 后再插入 2,经过 AVL 调整可以重新得到原来的平衡结构。
III 也错误。“一定相同”同样过强。例如原树只有根 2 和右孩子 3。删除非叶根 2 后得到根 3,再插入 2 得到根 3、左孩子 2,与原树不同。
因此只能确定 I。
答案:A
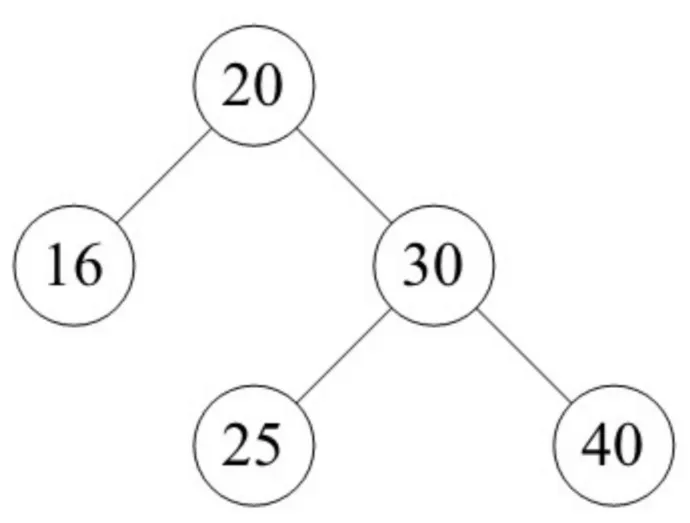
- 【2021-06】给定平衡二叉树如下图所示,插入关键字23后,根中的关键字是( )。
A. 16
B. 20
C. 23
D. 25
解析
23 的插入路径为
根 20 变成右重,而右孩子 30 的左子树增高,形成 RL 型失衡。
先对 30 右旋,再对 20 左旋:
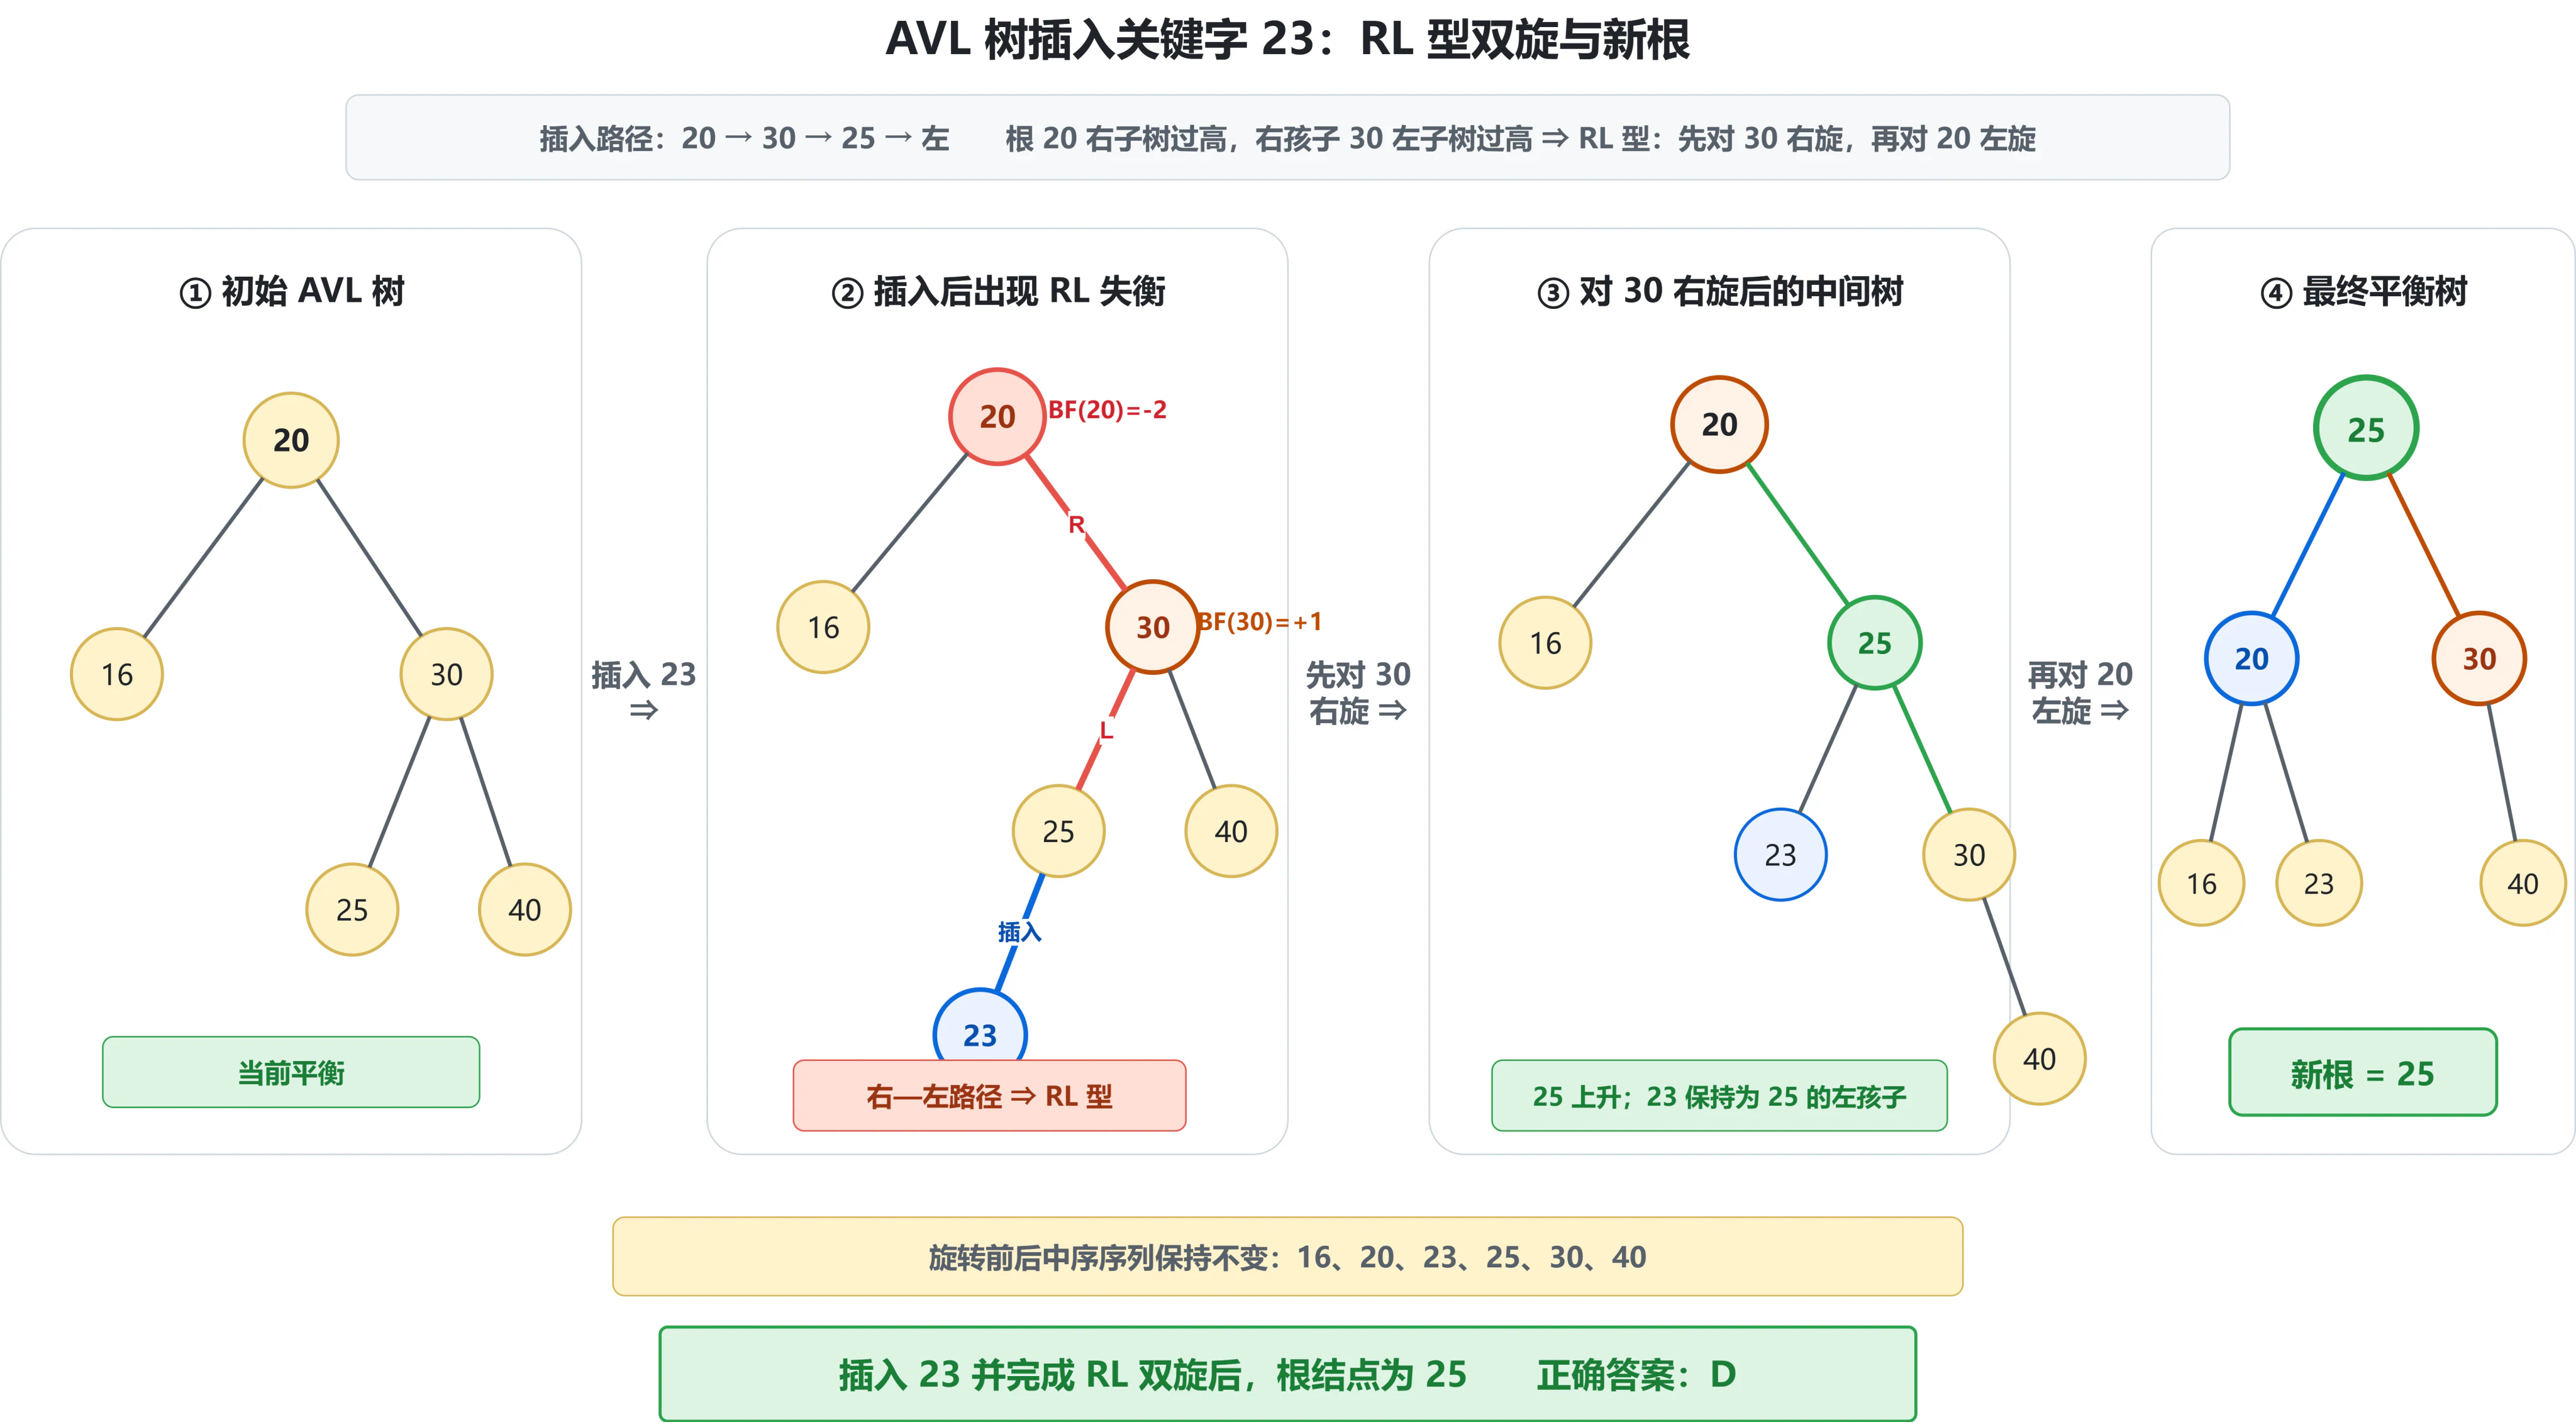
调整后的根为 25。
答案:D
红黑树
(六)B树及其基本操作、B+树的基本概念
- 【2009-08】下列叙述中,不符合 m 阶B树定义要求的是( )。
A. 根结点最多有 m 棵子树
B. 所有叶结点都在同一层上
C. 各结点内关键字均升序或降序排列
D. 叶结点之间通过指针链接
解析
m 阶 B 树中,每个结点最多有 m 棵子树,所以 A 符合定义。
B 树是一棵多路平衡查找树,所有叶结点都在同一层,所以 B 符合定义。
结点内的关键字必须有序,以便确定查找应进入哪棵子树,因此 C 符合定义。
叶结点通过指针依次链接是 B+ 树的典型特征,便于范围查询和顺序访问;普通 B 树没有这一强制要求。
答案:D
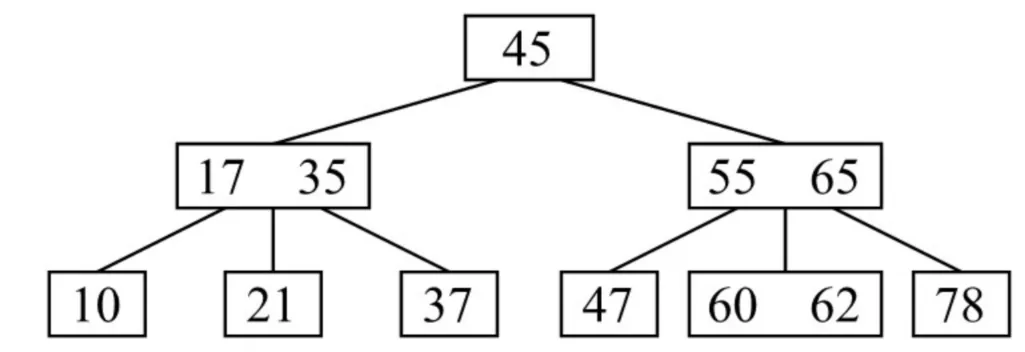
- 【2012-09】已知一棵3阶B树,如下图所示。删除关键字78得到一棵新B树,其最右叶结点中的关键字是( )。
A. 60
B. 60, 62
C. 62, 65
D. 65
解析
3 阶 B 树的非根结点至少含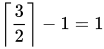 个关键字。
删除叶结点中的 78 后,该叶结点变空,发生下溢。
它的左兄弟为  ,含 2 个关键字,多于最少要求,可以借出一个关键字:
- 父结点中的分隔关键字 65 下移到最右叶结点;
- 左兄弟中的最大关键字 62 上移到父结点,替换原来的 65;
- 左兄弟剩余
 。
调整后:
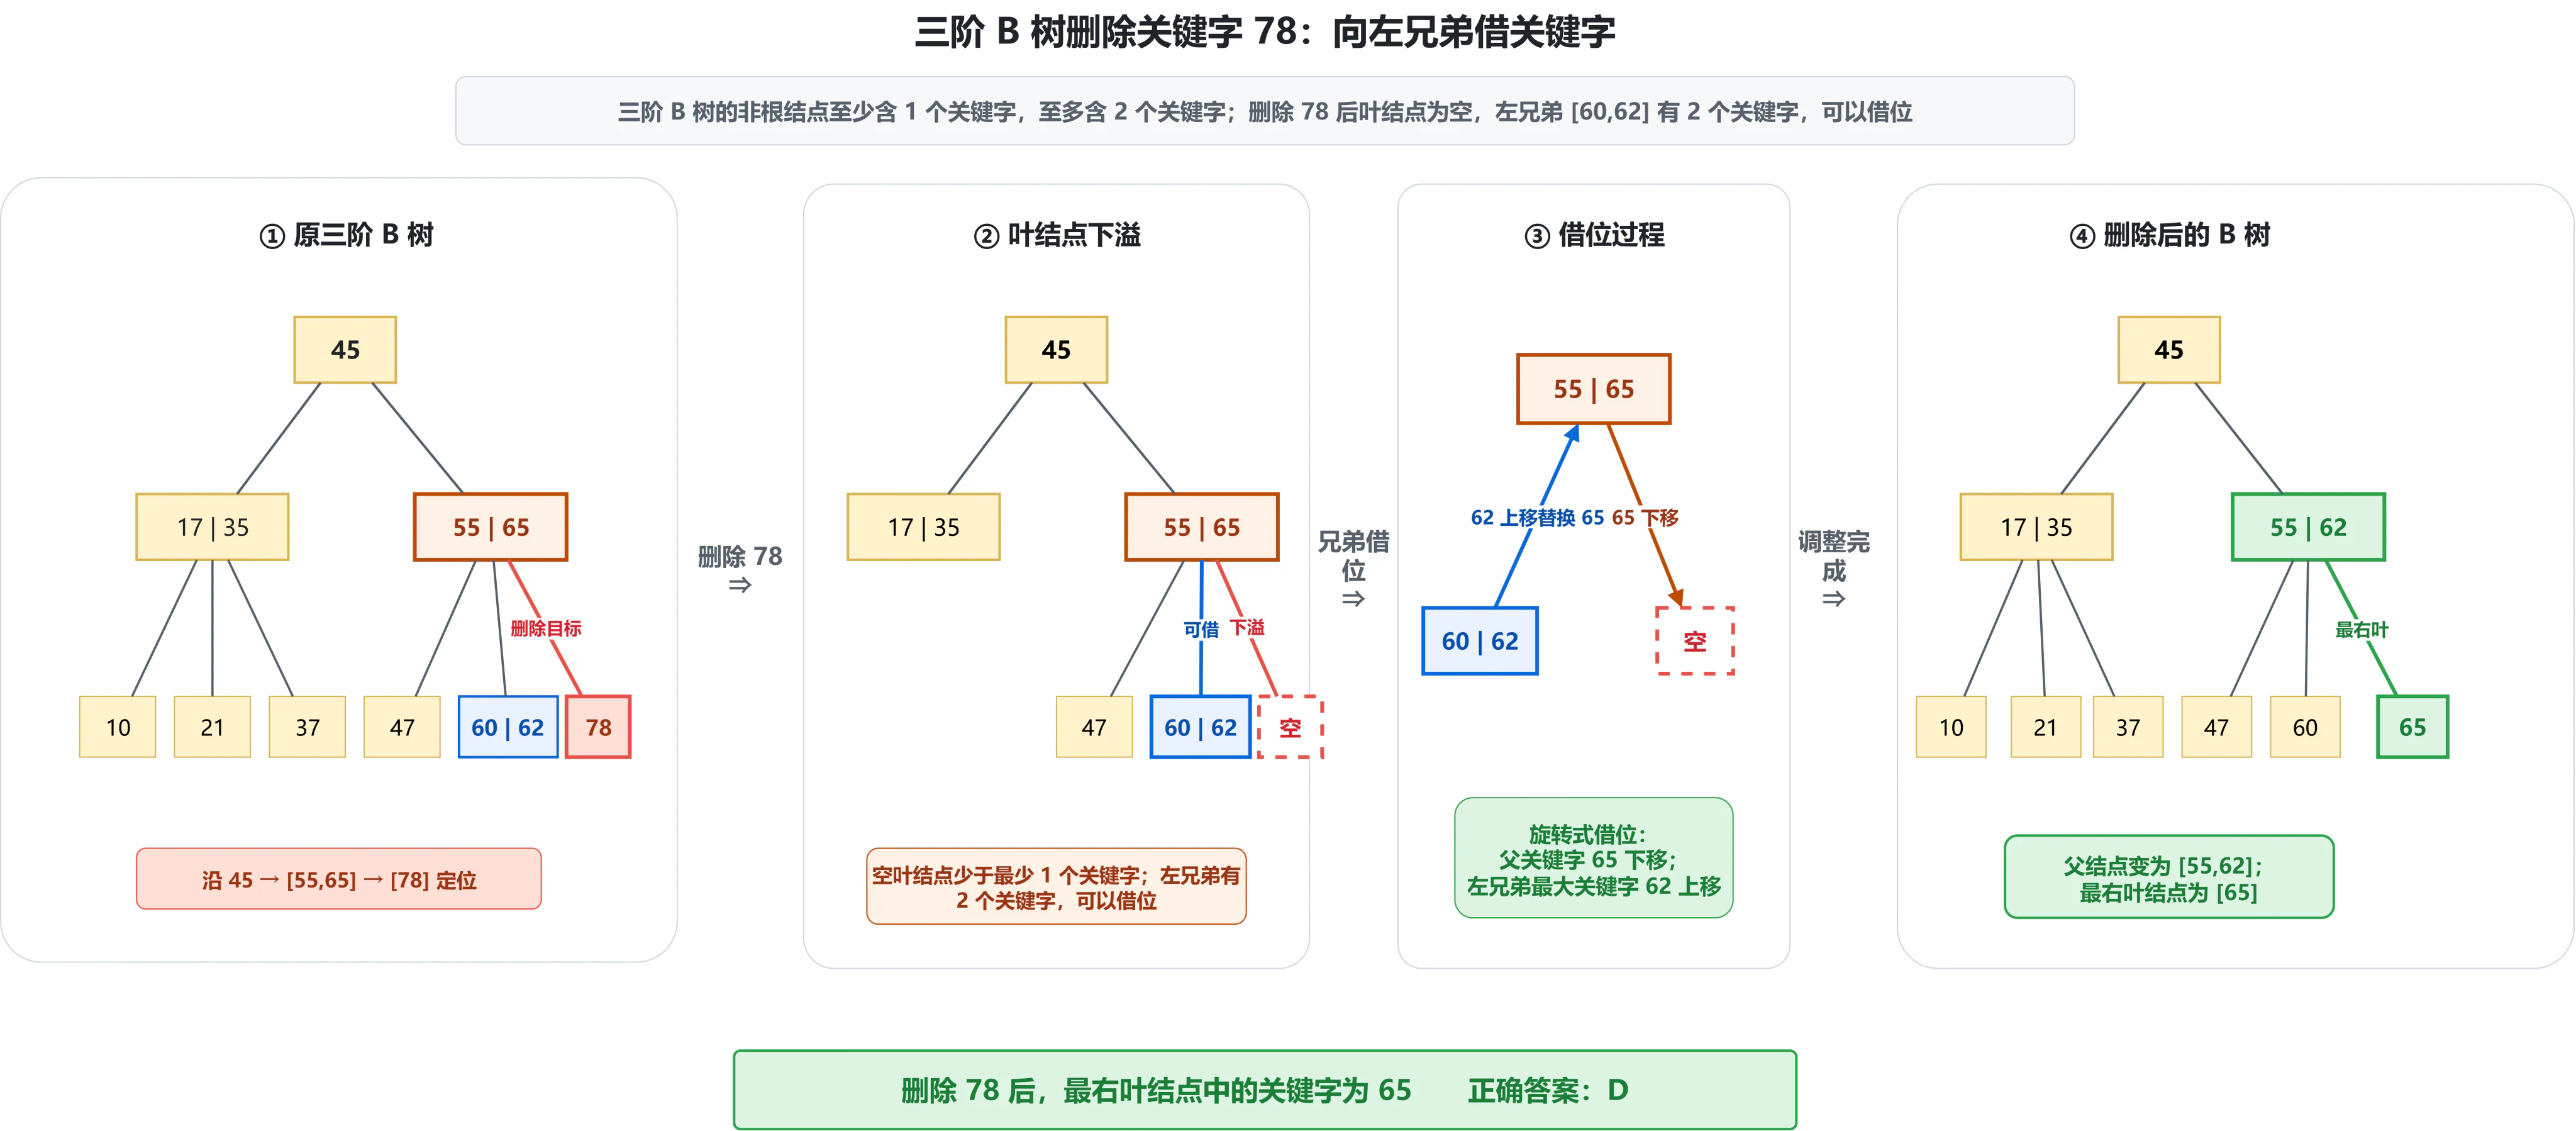
最右叶结点中的关键字为 65。
答案:D
- 【2013-10】在一棵高度为2的5阶B树中,所含关键字的个数最少是 ( )。
A. 5
B. 7
C. 8
D. 14
解析
高度为 2 表示根在第 1 层,叶结点在第 2 层。
非叶根结点至少有 2 棵子树,因此根至少有 1 个关键字。
5 阶 B 树的非根结点至少有
棵子树;对于叶结点,等价地要求至少含 个关键字。
根至少有 2 个叶孩子,每个叶孩子至少 2 个关键字,所以最少关键字总数为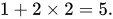
答案:A
- 【2014-09】在一颗具有15个关键字的4阶B树中,含关键字的结点个数最多的是( )。
A. 5
B. 6
C. 10
D. 15
解析
要让结点数最多,应让每个结点包含的关键字尽可能少。
4 阶 B 树的非根结点至少有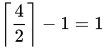 个关键字,根结点也至少有 1 个关键字。
因此每个含关键字的结点都只放 1 个关键字时,15 个关键字理论上可以分布到 15 个结点。
这个上界可以达到:让每个内部结点含 1 个关键字、拥有 2 个孩子,形成一棵所有叶结点同层的满二叉形 B 树。15 个结点可组成 7 个内部结点和 8 个叶结点,每个结点各含 1 个关键字。
答案:D
- 【2016-10】B+树不同于B树的特点之一是( )。
A. 能支持顺序查找
B. 结点中含有关键字
C. 根结点至少有两个分支
D. 所有叶结点都在同一层上
解析
B+ 树的所有数据记录或记录指针集中在叶结点,叶结点还通过链指针按关键字顺序连接,因此可以从某个叶结点开始连续扫描,直接支持高效顺序查找和范围查询。
B、C、D 都是 B 树和 B+ 树共有的基本特征:
- 两者的结点都含关键字;
- 非叶根通常至少有两个分支;
- 两者都保持所有叶结点位于同一层。
答案:A
- 【2017-09】下列应用中,适合使用 B+ 树的是( )。
A. 编译器中的词法分析
B. 关系数据库系统中的索引
C. 网络中的路由表快速查找
D. 操作系统的磁盘空闲块管理
解析
B+ 树的分支多、树高低,每访问一层通常只需一次磁盘页访问;同时叶结点有序链接,适合等值查询和范围查询。
关系数据库的索引正需要:
- 减少磁盘 I/O 次数;
- 支持按关键字定位;
- 支持范围查询和有序扫描。
因此数据库索引是 B+ 树最典型的应用。
答案:B
- 【2018-08】高度为5的3阶B树含有的关键字个数至少是( )。
A. 15
B. 31
C. 62
D. 242
解析
3 阶 B 树的非根结点至少有 个分支,即至少 1 个关键字。
为了使关键字总数最少:
- 根结点含 1 个关键字,有 2 个孩子;
- 此后每个非叶结点也只含 1 个关键字,有 2 个孩子;
- 每个叶结点含 1 个关键字。
高度为 5 时,各层结点数最少为
总结点数为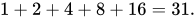
每个结点恰含 1 个关键字,所以最少关键字数也是 31。
答案:B
- 【2020-10】依次将关键字 5, 6, 9, 13, 8, 2, 12, 15 插入初始为空的 4 阶 B 树后,根结点中包含的关键字是( )。
A. 8
B. 6, 9
C. 8, 13
D. 9, 12
解析
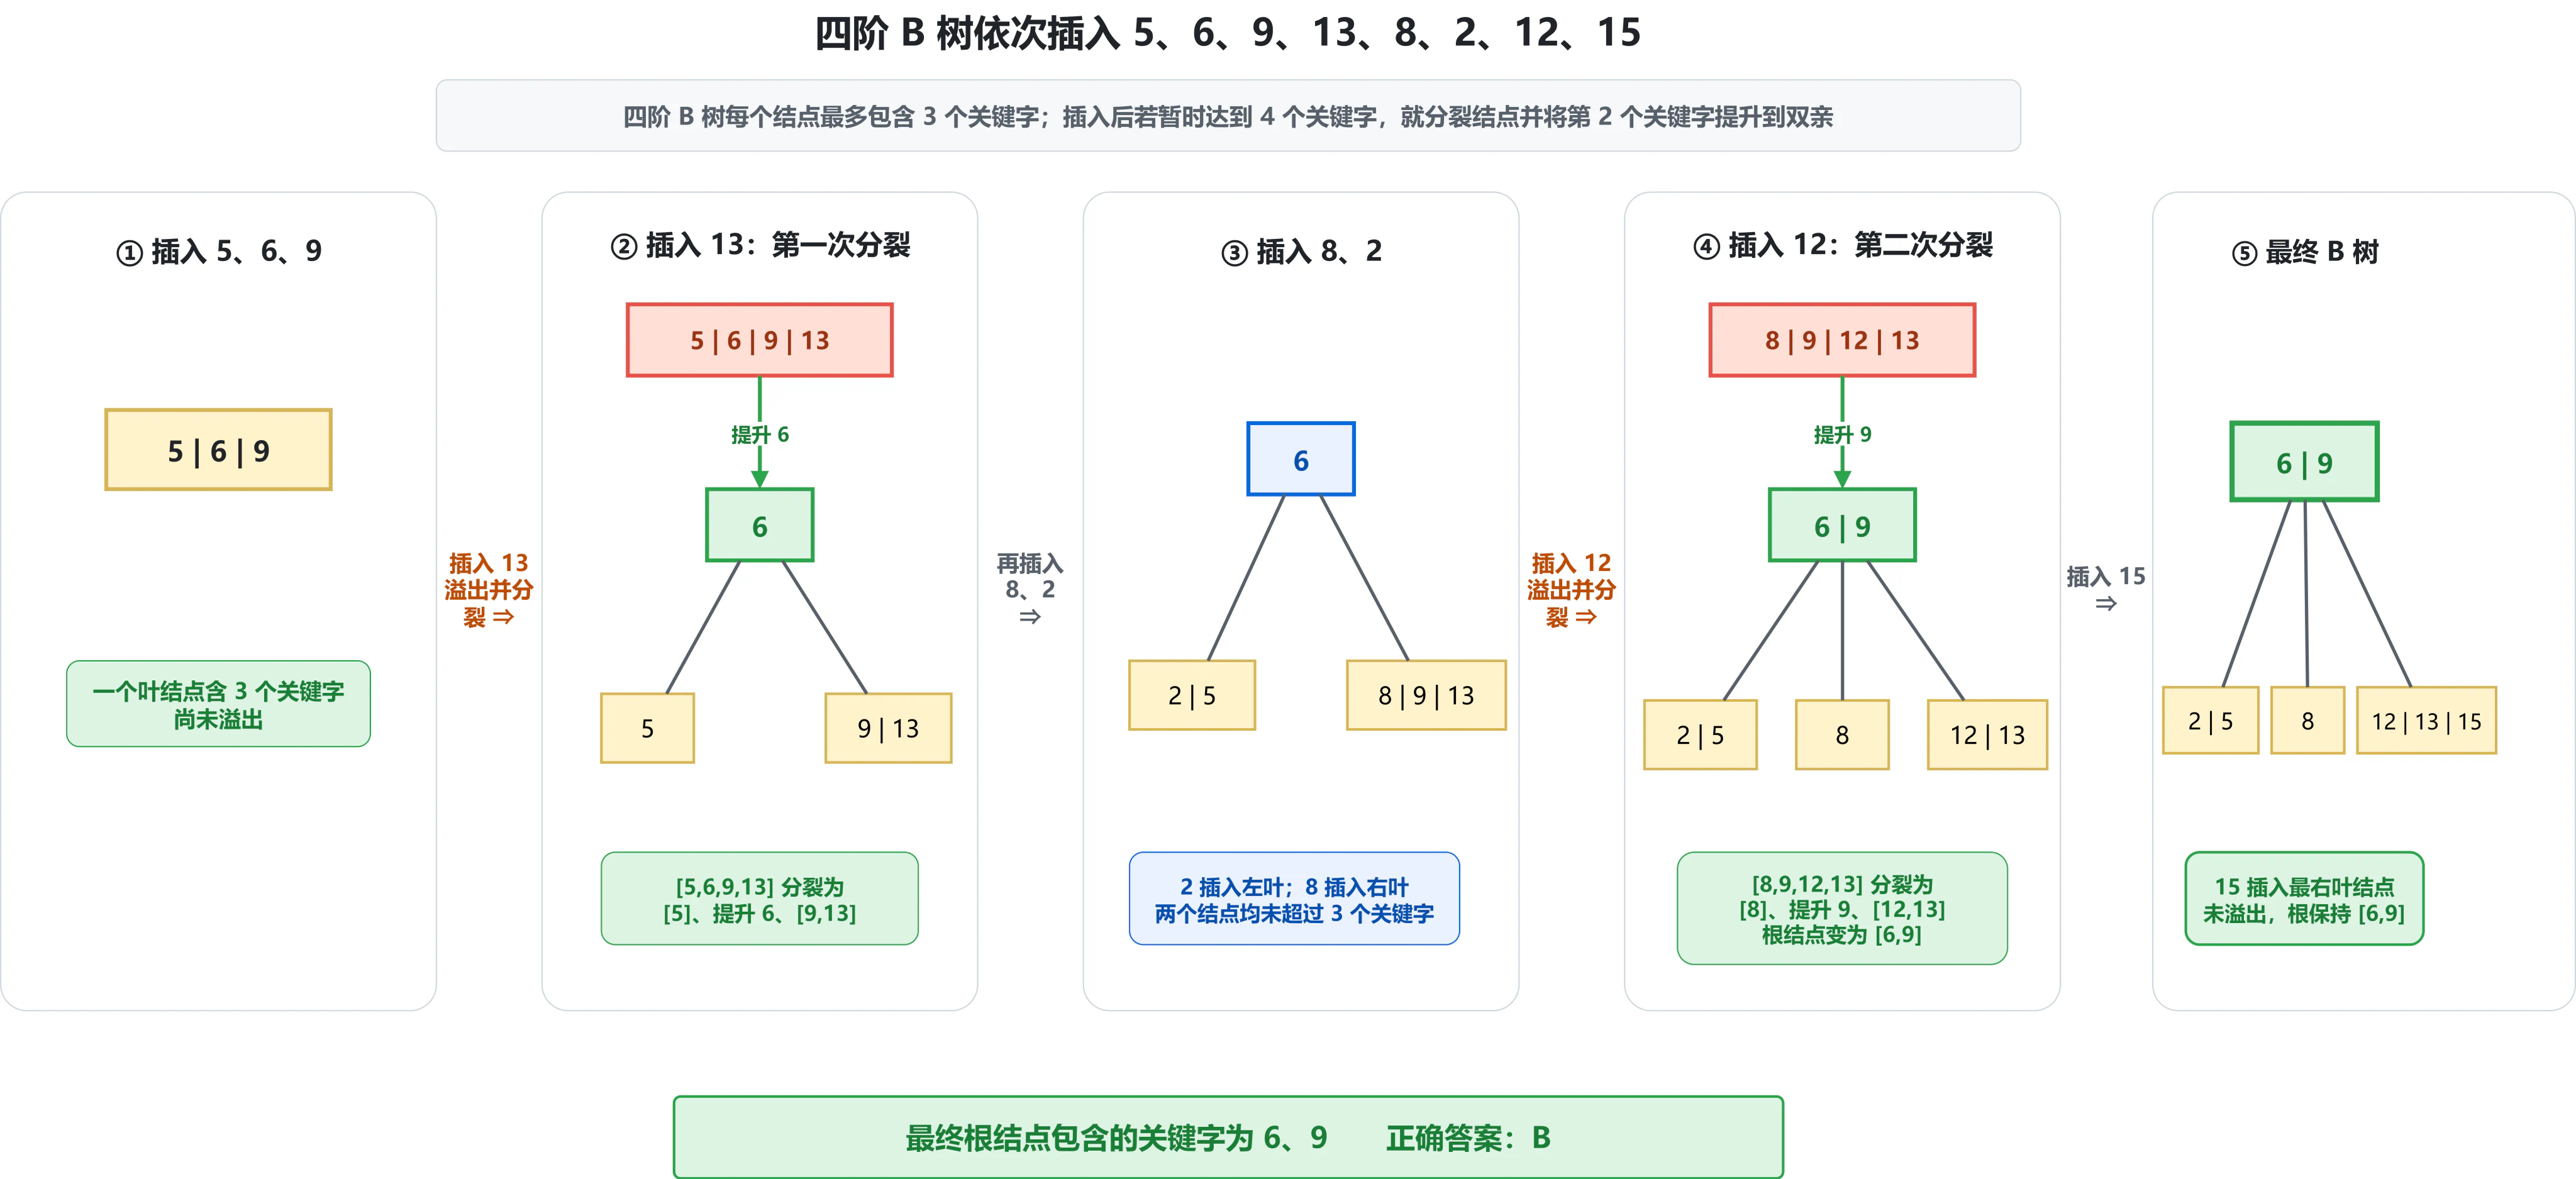
答案:B
- 【2021-09】在一棵高度为3的3阶B树中,根为第1层,若第2层中有4个关键字,则该树的结点个数最多( )。
A. 11
B. 10
C. 9
D. 8
解析
3 阶 B 树的一个结点最多含 2 个关键字、3 个孩子。
根最多有 3 个孩子,所以第 2 层最多有 3 个结点。
已知第 2 层共有 4 个关键字。每个第 2 层结点若含  个关键字,就有
 个第 3 层孩子。
要使总结点数最大,应让第 2 层结点数达到最大值 3。第 3 层结点数为
于是全树最多有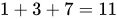 个结点。
答案:A
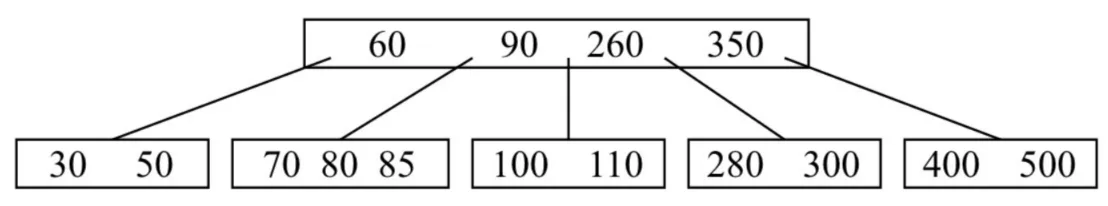
- 【2022-08】在下图所示的5阶B树 T 中,删除关键字 260 之后需要进行必要的调整,得到新的B树 T1 。下列选项中,不可能是 T1 根结点中的关键字序列的是( )。
A. 60,90,280
B. 60,90,350
C. 60,85,110,350
D. 60,90,110,350
解析
5 阶 B 树的非根结点至少含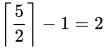 个关键字。260 位于内部根结点,可用前驱 110 或后继 280 替换。
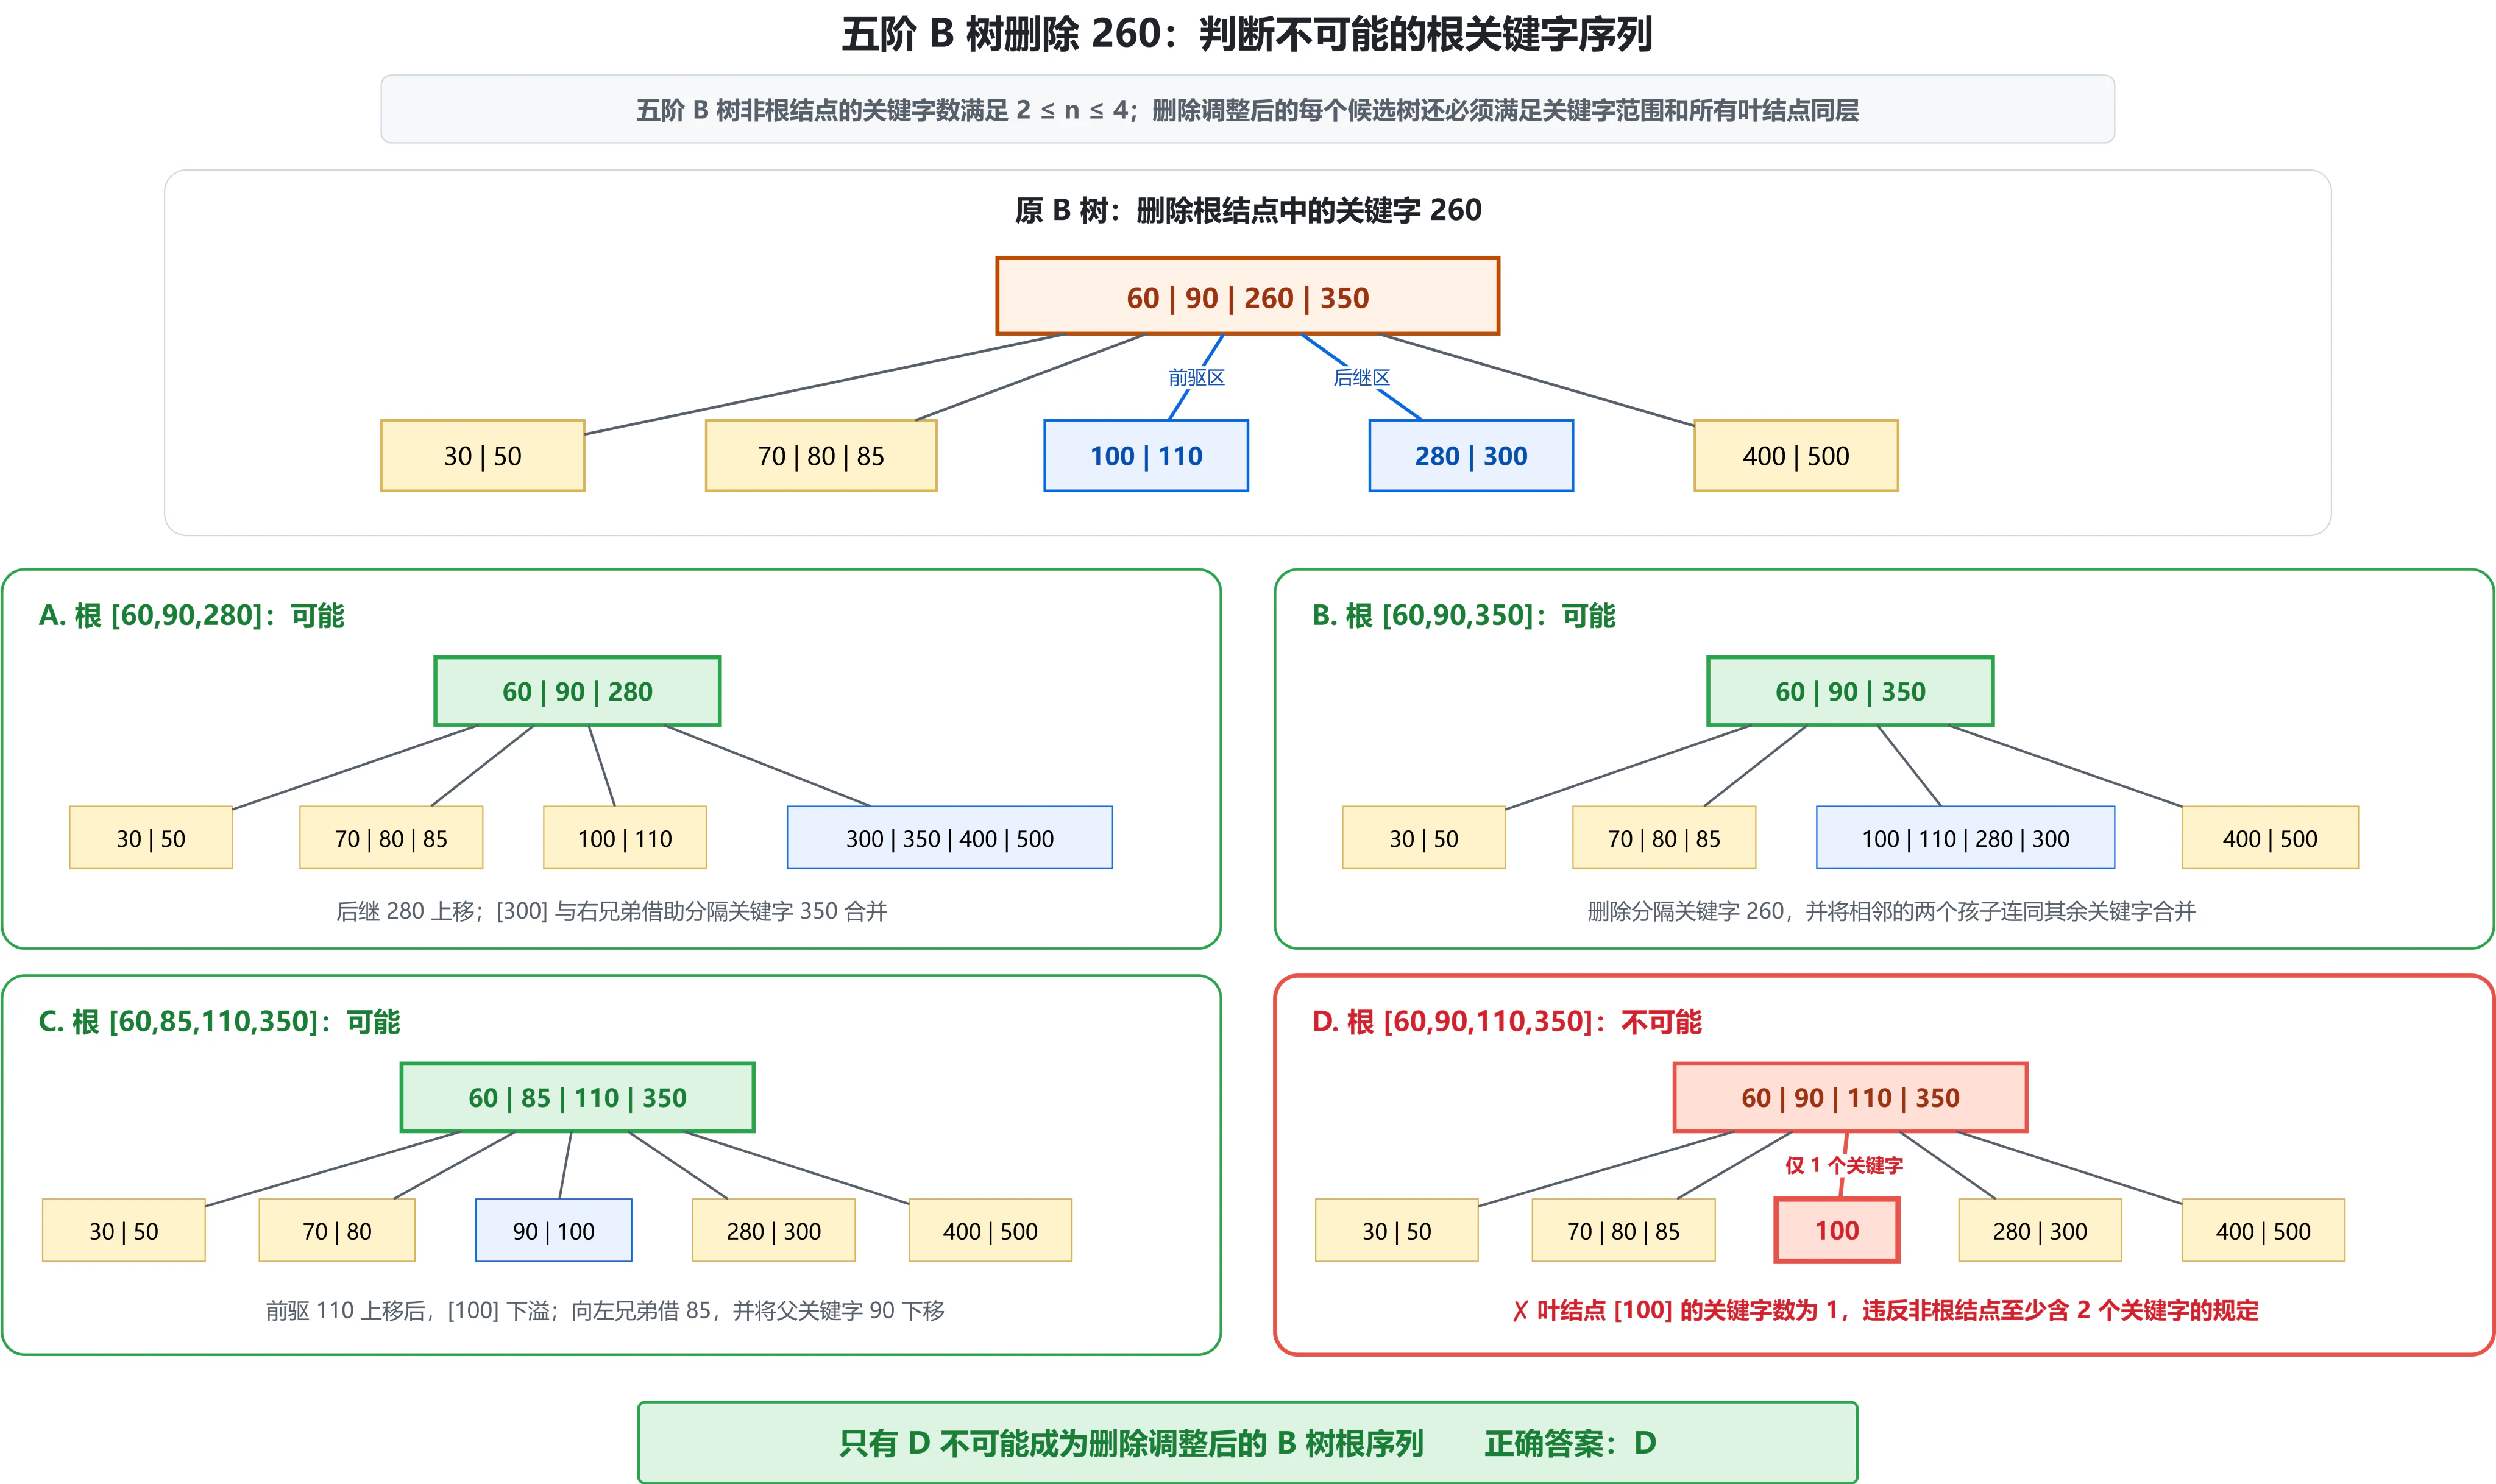
A 可能:用后继 280 替换 260,删除叶中的 280 后该叶下溢,再与右兄弟  及父关键字 350 合并。根删除 350,得到
 。
B 可能:删除替代关键字后,把中间两个相邻叶结点与父分隔关键字合并,根可变为  。
C 可能:用前驱 110 替换 260。删除叶中的 110 后,从左兄弟  借关键字:85 上移替换父中的 90,原 90 下移,根变为
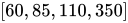 。
D 不可能。若用 110 替换 260,对含 110 的叶删除后会下溢:
- 向左兄弟借会使根中的 90 变为 85,得到 C;
- 合并会减少根关键字数,得到 B 类结果;
- 右兄弟只有最少的 2 个关键字,不能借出。
因此无法在保持 90 不变的同时得到 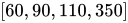 。
答案:D
- 【2023-07】下列关于非空 B 树的叙述中,正确的是( )。
I. 插入操作可能增加树的高度
II. 删除操作一定会导致叶结点的变化
III. 查找某关键字总是要查找到叶结点
IV. 插入的新关键字最终位于叶结点中
A. 仅 I
B. 仅 I 和 II
C. 仅 III 和 IV
D. 仅 I、II 和 IV
解析
I 正确。若根结点插入后溢出并分裂,会产生一个新根,树高增加 1。
II 正确。若删除的关键字本来就在叶结点中,叶结点内容会直接改变;若关键字位于内部结点,删除算法会用其前驱或后继替换,而前驱、后继最终取自叶结点,并继续在叶结点中完成实际删除。因此删除操作一定会使某个叶结点发生变化。
III 错误。B 树的内部结点也保存实际关键字,查找可能在内部结点就成功。
IV 错误。插入最初发生在叶结点,但叶结点分裂时,中间关键字可能被提升到父结点;若继续分裂,该关键字还可能位于更高层。
所以 I、II 正确。
答案:B
(七)散列(Hash)表
- 【2011-09】为提高散列(Hash)表的查找效率,可以采取的正确措施是( )。
Ⅰ. 增大装填(载)因子
Ⅱ. 设计冲突(碰撞)少的散列函数
Ⅲ. 处理冲突(碰撞)时避免产生聚集(堆积)现象
A. 仅Ⅰ
B. 仅Ⅱ
C. 仅Ⅰ、Ⅱ
D. 仅Ⅱ、Ⅲ
解析
装填因子为
增大装填因子意味着散列表更拥挤,冲突概率和探测次数通常都会增加,所以 I 错误。
设计分布均匀、冲突少的散列函数,可以减少冲突,提高查找效率,II 正确。
开放定址法中的聚集会让多个关键字形成连续占用区,导致成功和失败查找都需要更多探测。选择能减轻聚集的冲突处理方法可以提高效率,III 正确。
答案:D
- 【2014-08】用哈希(散列)方法处理冲突(碰撞)时可能出现堆积(聚焦)现象,下列选项中,会受堆积现象直接影响的是( )。
A. 存储效率
B. 散列函数
C. 装填(装载)因子
D. 平均查找长度
解析
聚集现象是指发生冲突的关键字经过探测后集中在一段连续区域内。
查找落入该区域时,需要连续比较多个位置才能找到目标或确认失败,所以探测次数增加,直接导致平均查找长度增大。
聚集不会改变已经选定的散列函数,也不会改变记录数和表长,因此不会直接改变装填因子。
答案:D
- 【2018-09】现有长度为7、初始为空的散列表HT,散列函数_H_(k) = k % 7,用线性探测再散列法解决冲突。将关键字22, 43, 15依次插入HT,查找成功的平均查找长度是( )。
A. 1.5
B. 1.6
C. 2
D. 3
解析
三个关键字的散列地址相同:
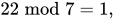
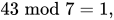
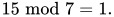
插入过程:
- 22 放在地址 1,成功查找需比较 1 次;
- 43 先比较地址 1,冲突后放在地址 2,成功查找需比较 2 次;
- 15 依次比较地址 1、2,最后放在地址 3,成功查找需比较 3 次。
成功平均查找长度为
答案:C
- 【2019-08】现有长度为11且初始为空的散列表HT,散列函数是_H_(key) = key % 7,采用线性探查 (线性探测再散列)法解决冲突。将关键字序列87, 40, 30, 6, 11, 22, 98, 20依次插入HT后,HT查找失败的平均查找长度是( )。
A. 4
B. 5.25
C. 6
D. 6.29
解析
依次插入:
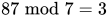 ,放入 3;
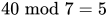 ,放入 5;
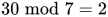 ,放入 2;
 ,放入 6;
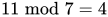 ,放入 4;
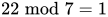 ,放入 1;
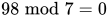 ,放入 0;
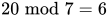 ,地址 6 冲突,向后探测并放入 7。
最终地址 0 至 7 连续被占用,地址 8 为空。
散列函数只会产生初始地址 0 至 6。失败查找必须探测到第一个空位置 8:
- 从 0 开始需探测 9 次;
- 从 1 开始需 8 次;
- 从 2 开始需 7 次;
- 从 3 开始需 6 次;
- 从 4 开始需 5 次;
- 从 5 开始需 4 次;
- 从 6 开始需 3 次。
所以
答案:C
- 【2022-09】影响散列(哈希)方法平均查找长度的是( )。
I. 装填因子
II. 散列函数
III. 冲突解决策略
A. 仅I、II
B. 仅I、III
C. 仅II、III
D. I、II、III
解析
装填因子越大,表越拥挤,冲突和探测次数通常越多,所以 I 有影响。
散列函数决定关键字在表中的初始分布。分布越均匀,冲突越少,所以 II 有影响。
发生冲突后,线性探测、二次探测、再散列和链地址法会产生不同的探测过程与聚集程度,所以 III 也有影响。
答案:D
- 【2023-09】现有长度为 5 ,初始为空的散列表 HT,散列函数 H(k)=(k+4) mod 5 ,用线性探查再散列法解决冲突。若将关键字序列 2022, 12, 25 依次插入 HT 中,然后删除关键字 25 ,则 HT 中查找失败的平均查找长度为( )。
A. 1
B. 1.6
C. 1.8
D. 2.2
解析
插入过程: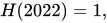 所以 2022 放在地址 1。
 地址 1 冲突,12 放在地址 2。
 25 放在地址 4。
开放定址散列表删除关键字时,不能简单把位置恢复为“从未使用”的空状态,否则可能截断其他关键字的探测链。通常把地址 4 标记为“已删除”,失败查找仍需越过该位置。
删除后:
- 地址 0 为空;
- 地址 1、2 有关键字;
- 地址 3 为空;
- 地址 4 为删除标记。
从 5 个可能初始地址开始,失败查找探测次数为:
- 从 0 开始:1 次;
- 从 1 开始:依次探测 1、2、3,共 3 次;
- 从 2 开始:探测 2、3,共 2 次;
- 从 3 开始:1 次;
- 从 4 开始:越过删除标记,再探测 0,共 2 次。
因此
答案:C
(八)字符串模式匹配
- 【2015-08】已知字符串S为“abaabaabacacaabaabcc”,模式串t为“abaabc”。采用KMP算法进行匹配,第一次出现“失配”(S[i] ≠ t[j])时,i = j = 5,则下次开始匹配时,i和j的值分别是( )。
A. i = 1, j = 0
B. i = 5, j = 0
C. i = 5, j = 2
D. i = 6, j = 2
解析
失配前已经成功匹配模式串的前 5 个字符:
这个已匹配部分的最长相等真前缀与真后缀是 长度为 2。
KMP 发生失配时,主串指针 i 不回退,仍停在原失配字符位置;模式串指针 j 回退到长度 2 的位置。
所以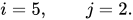
答案:C
- 【2019-09】设主串 T = "abaabaabcabaabc",模式串 S = "abaabc",采用 KMP 算法进行模式匹配,到匹配成功时为止,在匹配过程中进行的单个字符间的比较次数是( )。
A. 9
B. 10
C. 12
D. 15
解析
模式串 abaabc 的前缀函数在关键位置表明:匹配了前 5 个字符 abaab 后若失配,可以保留长度为 2 的公共前后缀 ab。
从主串开头比较:
- 前 5 次比较,
abaab与模式串前 5 个字符全部相等; - 第 6 次比较时,主串当前位置是 a,模式串第 6 个字符是 c,失配;
- 模式串回退到 j=2,主串指针不回退;
- 接下来 4 次比较分别匹配 a、a、b、c,模式串匹配成功。
总比较次数为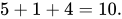
也可以逐次写为:5 次成功、1 次失败、4 次成功。
答案:B
- 【2024-06】KMP 算法使用修正后的 next 数组进行模式匹配,模式串 S=“aabaab”,当主串中某字符与 S 中某字符失匹时,S 向右滑动的最长距离是
A. 5
B. 4
C. 3
D. 2
解析
采用下标从 0 开始、首项为  的约定,模式串
 的修正 next 数组可以写为
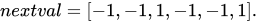
当模式串在位置 j 失配时,向右滑动距离为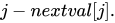
各位置可能滑动的距离依次为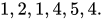
最大值为 5。它出现在  且
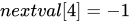 时。
答案:A