第七章排序
| 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 |
|---|---|---|---|---|---|---|---|---|---|
| D | D | B | A | D | D | A | C | D | D |
| 11 | 12 | 13 | 14 | 15 | 16 | 17 | 18 | 19 | 20 |
| D | A | A | B | C | A | C | B | B | B |
| 21 | 22 | 23 | 24 | 25 | 26 | 27 | 28 | 29 | 30 |
| A | C | C | C | D | B | D | B | A | A |
| 31 | 32 | 33 | 34 | 35 | 36 | ||||
| C | D | D | A | D | C |
(一)排序的基本概念
(二)直接插入排序
- 【2022-11】对数据进行排序时,若采用直接插入排序而不采用快速排序,则可能的原因是( )。
I. 大部分元素已有序
II. 待排序元素数量很少
III. 要求空间复杂度为 O(1)
IV. 要求排序算法是稳定的
A. 仅I、II
B. 仅III、IV
C. 仅I、II、IV
D. I、II、III、IV
解析
逐项判断:
- I 正确。直接插入排序具有很强的自适应性。若序列已经基本有序,每个元素向前寻找插入位置时只需进行很少的比较和移动,时间复杂度可接近
 。
- II 正确。当元素数量很少时,直接插入排序代码简单、常数开销小。快速排序的递归调用和划分操作反而可能带来更大的额外开销。
- III 正确。直接插入排序只需要一个临时变量,辅助空间复杂度为
 ;递归实现的快速排序需要递归栈,平均辅助空间为
 ,最坏可达到 。
- IV 正确。直接插入排序可以保持相同关键字元素的原有相对次序,是稳定排序;快速排序通常不稳定。
因此四项都可以成为选择直接插入排序的理由。
答案:D
(三)折半插入排序
- 【2012-11】对一待排序序列分别进行折半插入排序和直接插入排序,两者之间可能的不同之处是( )。
A. 排序的总趟数
B. 元素的移动次数
C. 使用辅助空间的数量
D. 元素之间的比较次数
解析
两种算法都把第  个元素插入到前面已经有序的子序列中,共需进行
 趟插入,因此总趟数相同。
折半插入排序只是把“顺序寻找插入位置”改成“折半寻找插入位置”。插入位置一旦确定,后面的元素仍要依次后移,所以对同一初始序列,两者的元素移动次数相同,辅助空间也都是 。
不同之处在于查找插入位置时的关键字比较次数:
- 直接插入排序顺序向前比较,基本有序时比较次数很少,最坏为
 ;
- 折半插入排序每趟用折半查找确定位置,查找阶段约需
 次比较,总比较次数为
 。
因此可能不同的是元素之间的比较次数。
答案:D
(四)起泡排序(bubble sort)
(五)简单选择排序
(六)希尔排序(shell sort)
- 【2014-10】用希尔排序方法对一个数据序列进行排序时,若第1趟排序结果为9, 1, 4, 13, 7, 8, 20, 23, 15,则该趟排序采用的增量(间隔)可能是( )。
A. 2
B. 3
C. 4
D. 5
解析
希尔排序完成增量为  的一趟排序后,下标相差 的元素属于同一组,并且每一组内部都应当有序。
检验  :
- 第 1 组:
 ,有序;
- 第 2 组:
 ,有序;
- 第 3 组:
 ,有序。
三组全部有序,因此增量可以是  。
其余增量均能找到组内逆序:
 时,
 不是升序;
 时,
 不是升序;
 时,
 不是升序。
答案:B
- 【2015-11】希尔排序的组内排序采用的是( )。
A. 直接插入排序
B. 折半插入排序
C. 快速排序
D. 归并排序
解析
希尔排序先按增量 把序列分成若干子序列,再分别对每个子序列进行直接插入排序。随着增量逐步减小,整个序列越来越接近有序;最后取  ,再进行一次直接插入排序。
因此,希尔排序也称“缩小增量排序”,其基本操作是分组直接插入排序。
答案:A
- 【2018-10】对初始数据序列(8, 3, 9, 11, 2, 1, 4, 7, 5, 10, 6)进行希尔排序。若第一趟排序结果为(1, 3, 7, 5, 2, 6, 4, 9, 11, 10, 8),第二趟排序结果为(1, 2, 6, 4, 3, 7, 5, 8, 11, 10, 9),则两趟排序采用的增量(间隔)依次是( )。
A. 3, 1
B. 3, 2
C. 5, 2
D. 5, 3
解析
先检验第一趟的增量 。按下标相差 5 分组:
- 下标
 :
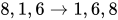 ;
- 下标
 :
 ;
- 下标
 :
 ;
- 下标
 :
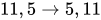 ;
- 下标
 :
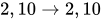 。
放回原位置后正好得到第一趟结果,因此第一趟增量为  。
再从第一趟结果出发检验 :
- 下标
 :
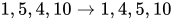 ;
- 下标
 :
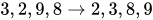 ;
- 下标
 :
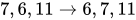 。
放回后得到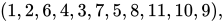
与题目一致,所以第二趟增量为 。
答案:D
(七)快速排序
- 【2010-10】采用递归方式对顺序表进行快速排序。下列关于递归次数的叙述中,正确的是( )。
A. 递归次数与初始数据的排列次序无关
B. 每次划分后,先处理较长的分区可以减少递归次数
C. 每次划分后,先处理较短的分区可以减少递归次数
D. 递归次数与每次划分后得到的分区的处理顺序无关
解析
快速排序每次划分后,对枢轴左、右两个分区继续递归。递归划分的结构取决于每次枢轴最终落在什么位置,而枢轴位置又会受到初始排列次序影响,所以 A 错误。
先递归处理左分区还是右分区,只会改变两个递归调用的先后顺序,不会改变需要处理的分区集合,也不会减少划分次数或递归调用总数。因此 B、C 均错误,D 正确。
注意:若专门把其中一侧改写为循环并进行尾递归优化,先处理短分区可以控制栈深度;但题目讨论的是普通递归实现的递归次数,并未引入这种优化。
答案:D
- 【2011-10】为实现快速排序算法,待排序序列宜采用的存储方式是( )。
A. 顺序存储
B. 散列存储
C. 链式存储
D. 索引存储
解析
快速排序的划分过程需要从区间两端向中间扫描,并频繁访问、交换指定位置的元素。顺序存储可以按下标在 时间内访问任意位置,最适合这种操作。
链式存储不能高效地从表尾向前移动,也不能按下标直接定位;散列存储不保持排序所需的线性次序;索引存储也不是实现快速排序的常规首选。
答案:A
- 【2014-11】下列选项中,不可能是快速排序第2趟排序结果的是( )。
A. 2, 3, 5, 4, 6, 7, 9
B. 2, 7, 5, 6, 4, 3, 9
C. 3, 2, 5, 4, 7, 6, 9
D. 4, 2, 3, 5, 7, 6, 9
解析
快速排序每完成一次划分,当前枢轴就到达最终位置。第二趟又会对第一趟产生的非空分区继续划分,因此第 2 趟结束后,至少应比第一趟多确定一个枢轴的最终位置。
全部元素的最终升序为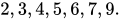
选项 C 为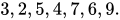
逐个对照最终位置,只有  已位于最终位置。也就是说,它至多体现了一个枢轴已经归位,不可能是完成两趟划分后的结果。
A、B、D 均能找到两个或更多已经归位的元素,并满足相应分区的大小关系。
答案:C
- 【2019-10】排序过程中,对尚未确定最终位置的所有元素进行一遍处理称为一“趟”。下列序列中,不可能是快速排序第二趟结果的是( )。
A. 5, 2, 16, 12, 28, 60, 32, 72
B. 2, 16, 5, 28, 12, 60, 32, 72
C. 2, 12, 16, 5, 28, 32, 72, 60
D. 5, 2, 12, 28, 16, 32, 72, 60
解析
全部元素的最终升序为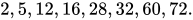
判断某个元素能否成为枢轴,不仅要看它是否处于最终位置,还要检查它左侧是否都比它小、右侧是否都比它大。
选项 D 中只有  和
 处于各自最终位置,所以第一趟枢轴只能在二者中选择:
- 若第一趟枢轴是 ,则第二趟必须继续处理左侧二元素分区
 。二元素分区经过一次划分后必然变为
 ,但选项中仍是 ,不成立。
- 若第一趟枢轴是 ,则第二趟必须继续处理右侧二元素分区
 。一次划分后必然变为
 ,但选项中仍是 ,也不成立。

其余选项可以分别选择合适的首枢轴和第二趟枢轴。例如 A 可先以  划分,再在其左分区中以
 划分;C 可先以
 划分,再在右分区中以 划分。
答案:D
- 【2022-11】对数据进行排序时,若采用直接插入排序而不采用快速排序,则可能的原因是( )。
I. 大部分元素已有序
II. 待排序元素数量很少
III. 要求空间复杂度为 O(1)
IV. 要求排序算法是稳定的
A. 仅I、II
B. 仅III、IV
C. 仅I、II、IV
D. I、II、III、IV
解析
本题与第 1 题相同。
- 序列基本有序时,直接插入排序的时间可接近 ;
- 数据规模很小时,直接插入排序常数开销小;
- 直接插入排序辅助空间为 ,递归快速排序需要递归栈;
- 直接插入排序稳定,而快速排序通常不稳定。
四项都可能成为选择直接插入排序的理由。
答案:D
- 【2023-11】使用快速排序算法对数据进行升序排序, 若经过一次划分后得到的数据序列是 68, 11, 70, 23, 80, 77, 48, 81, 93, 88,则该次划分的轴枢是( )。
A. 11
B. 70
C. 80
D. 81
解析
一次划分完成后,枢轴应满足:
- 左侧所有元素都小于或等于枢轴;
- 右侧所有元素都大于或等于枢轴。
逐项检查:
 左侧有
 ,不可能;
 右侧有
 ,不可能;
 右侧有
 ,不可能;
 左侧的
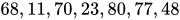 均小于 ,右侧的
 均大于 。
因此枢轴是 。
答案:D
- 【2024-08】使用快速排序对含 n(n≥3) 个元素的数组M进行排序,若第一趟排序将除M中枢轴外的 n-1 个元素划分为均不为空的 P 和 Q 两个块,则下列叙述中,正确的是
A. P 和 Q 块间有序
B. P 和 Q 均块内有序
C. P 和 Q 的元素个数大致相等
D. P 和 Q 中均不存在相等的元素
解析
一次升序划分只保证
因此任取  、
 ,都有
 ,即两个块之间已经具备整体的先后关系,称为块间有序。

但  、
 各自内部仍可能无序;两块大小也不一定接近,取决于枢轴的秩;存在重复关键字时,块内也可能出现相等元素。
答案:A
(八)堆排序
- 【2009-09】已知关键字序列5, 8, 12, 19, 28, 20, 15, 22是小根堆(最小堆),插入关键字3,调整后得到的小根堆是( )。
A. 3, 5, 12, 8, 28, 20, 15, 22, 19
B. 3, 5, 12, 19, 20, 15, 22, 8, 28
C. 3, 8, 12, 5, 20, 15, 22, 28, 19
D. 3, 12, 5, 8, 28, 20, 15, 22, 19
解析
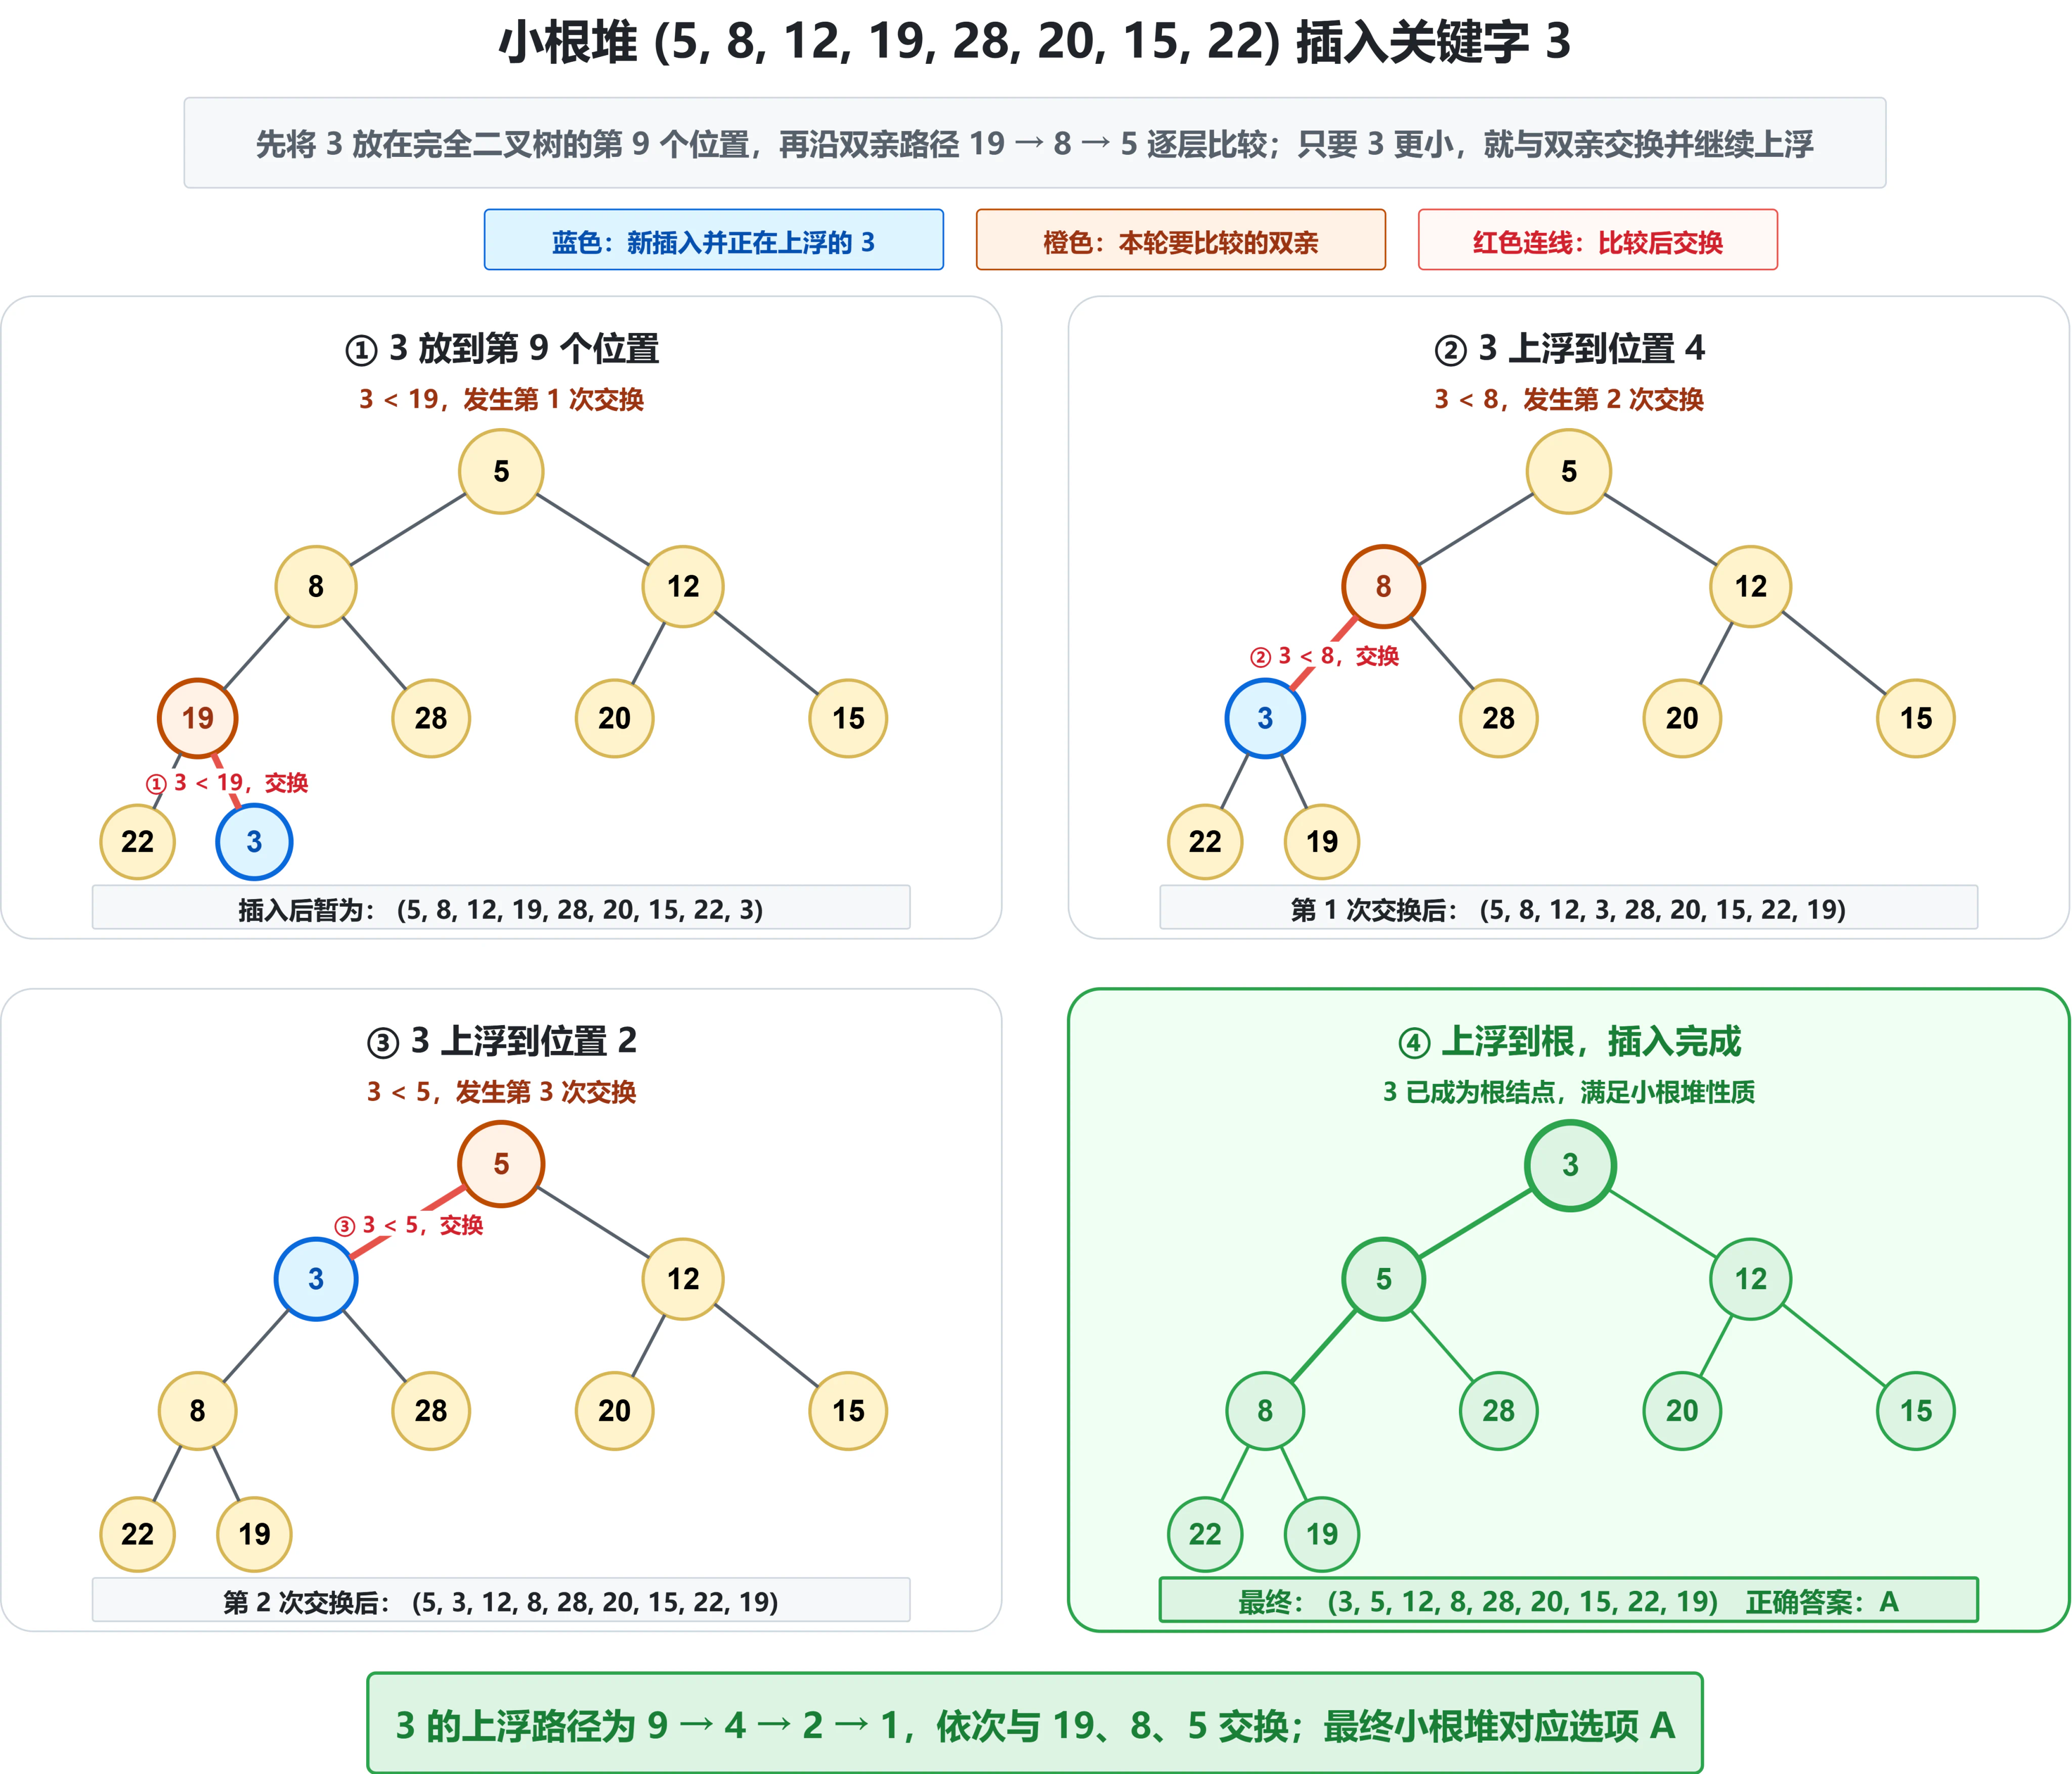
向堆中插入元素时,先把新元素放在完全二叉树的末尾,再沿父结点方向向上调整。
把 放到第 9 个位置后,其父结点为第  个元素
 :
 ,交换,序列变为
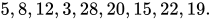
- 此时 位于第 4 个位置,其父结点为第 2 个元素
 。因为
 ,再次交换:
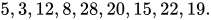
- 此时 的父结点为根结点 。因为
 ,继续交换:
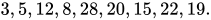
每个父结点均不大于其孩子,满足小根堆条件。
答案:A
- 【2011-11】已知序列25, 13, 10, 12, 9是大根堆,在序列尾部插入新元素18,将其再调整为大根堆,调整过程中元素之间进行的比较次数是( )。
A. 1
B. 2
C. 4
D. 5
解析
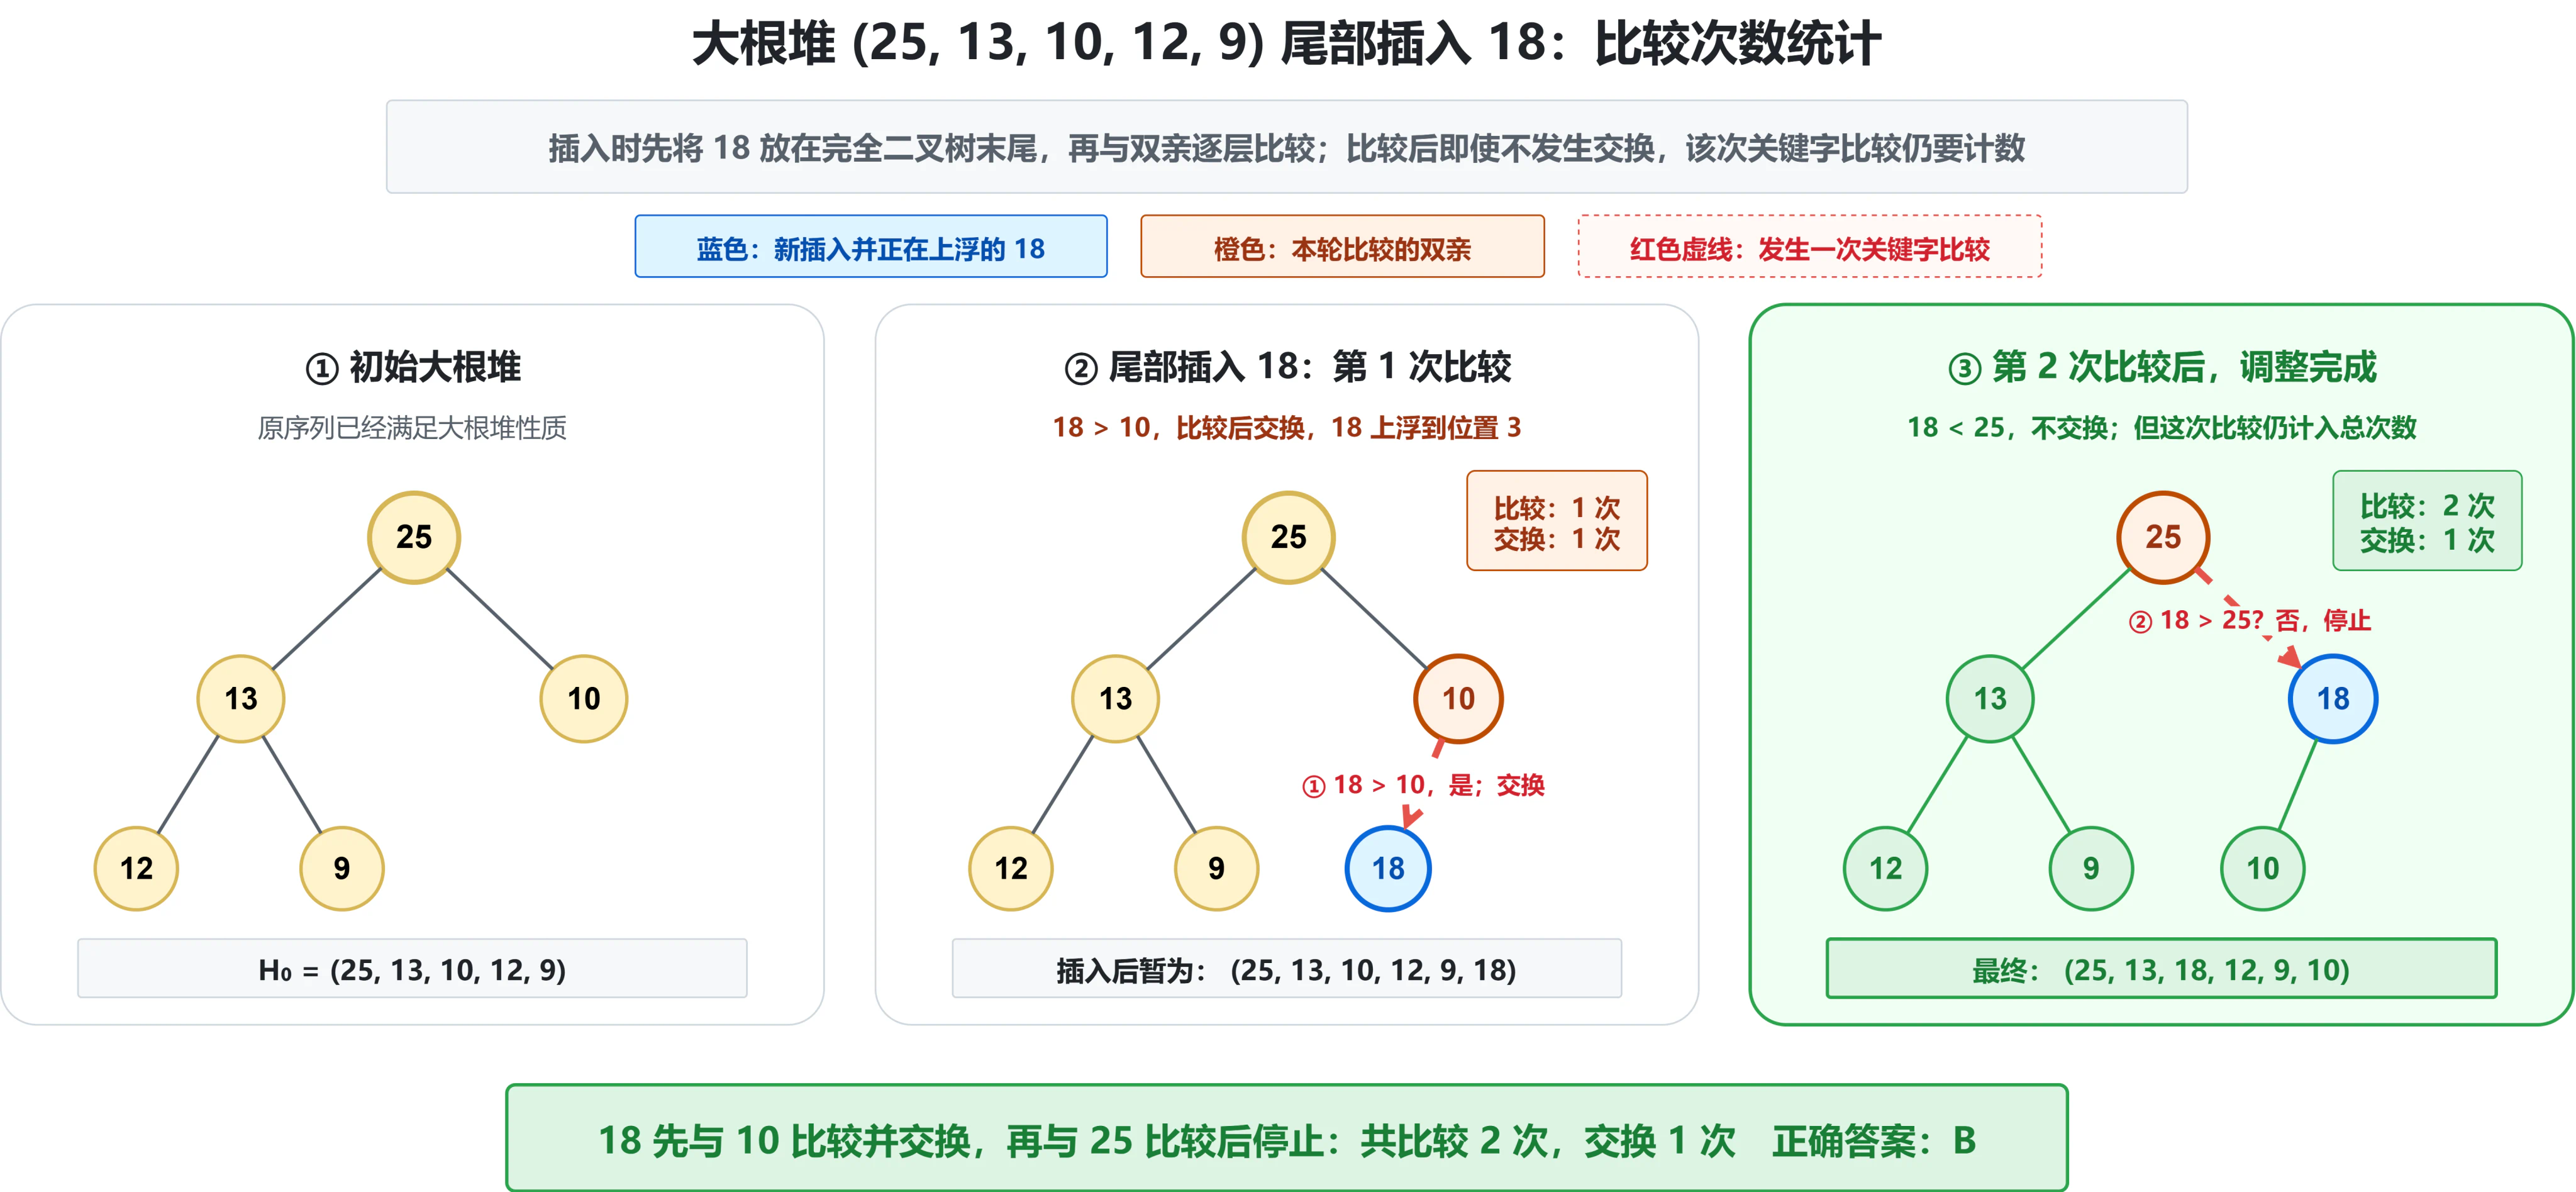
新元素  插入第 6 个位置,其父结点下标为

对应元素为  。
调整过程:
- 比较 与 :
 ,二者交换。第 1 次比较;
- 上移到第 3 个位置,其父结点为第 1 个元素
 。比较 与 :
 ,停止。第 2 次比较。
调整后的堆为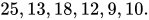 共进行了 次关键字比较。
答案:B
- 【2015-10】已知小根堆为8, 15, 10, 21, 34, 16, 12,删除关键字8之后需重建堆,在此过程中,关键字之间的比较次数是( )。
A. 1
B. 2
C. 3
D. 4
解析
删除堆顶后,用最后一个元素 补到根结点,再向下调整。此时有效序列为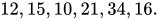
具体比较过程:
- 比较根的两个孩子
 与 ,选出较小的 ,第 1 次比较;
- 比较 与 ,因为
 ,交换,第 2 次比较;
- 下移到第 3 个位置,该位置只有孩子
 。比较 与 ,已有
 ,停止,第 3 次比较。
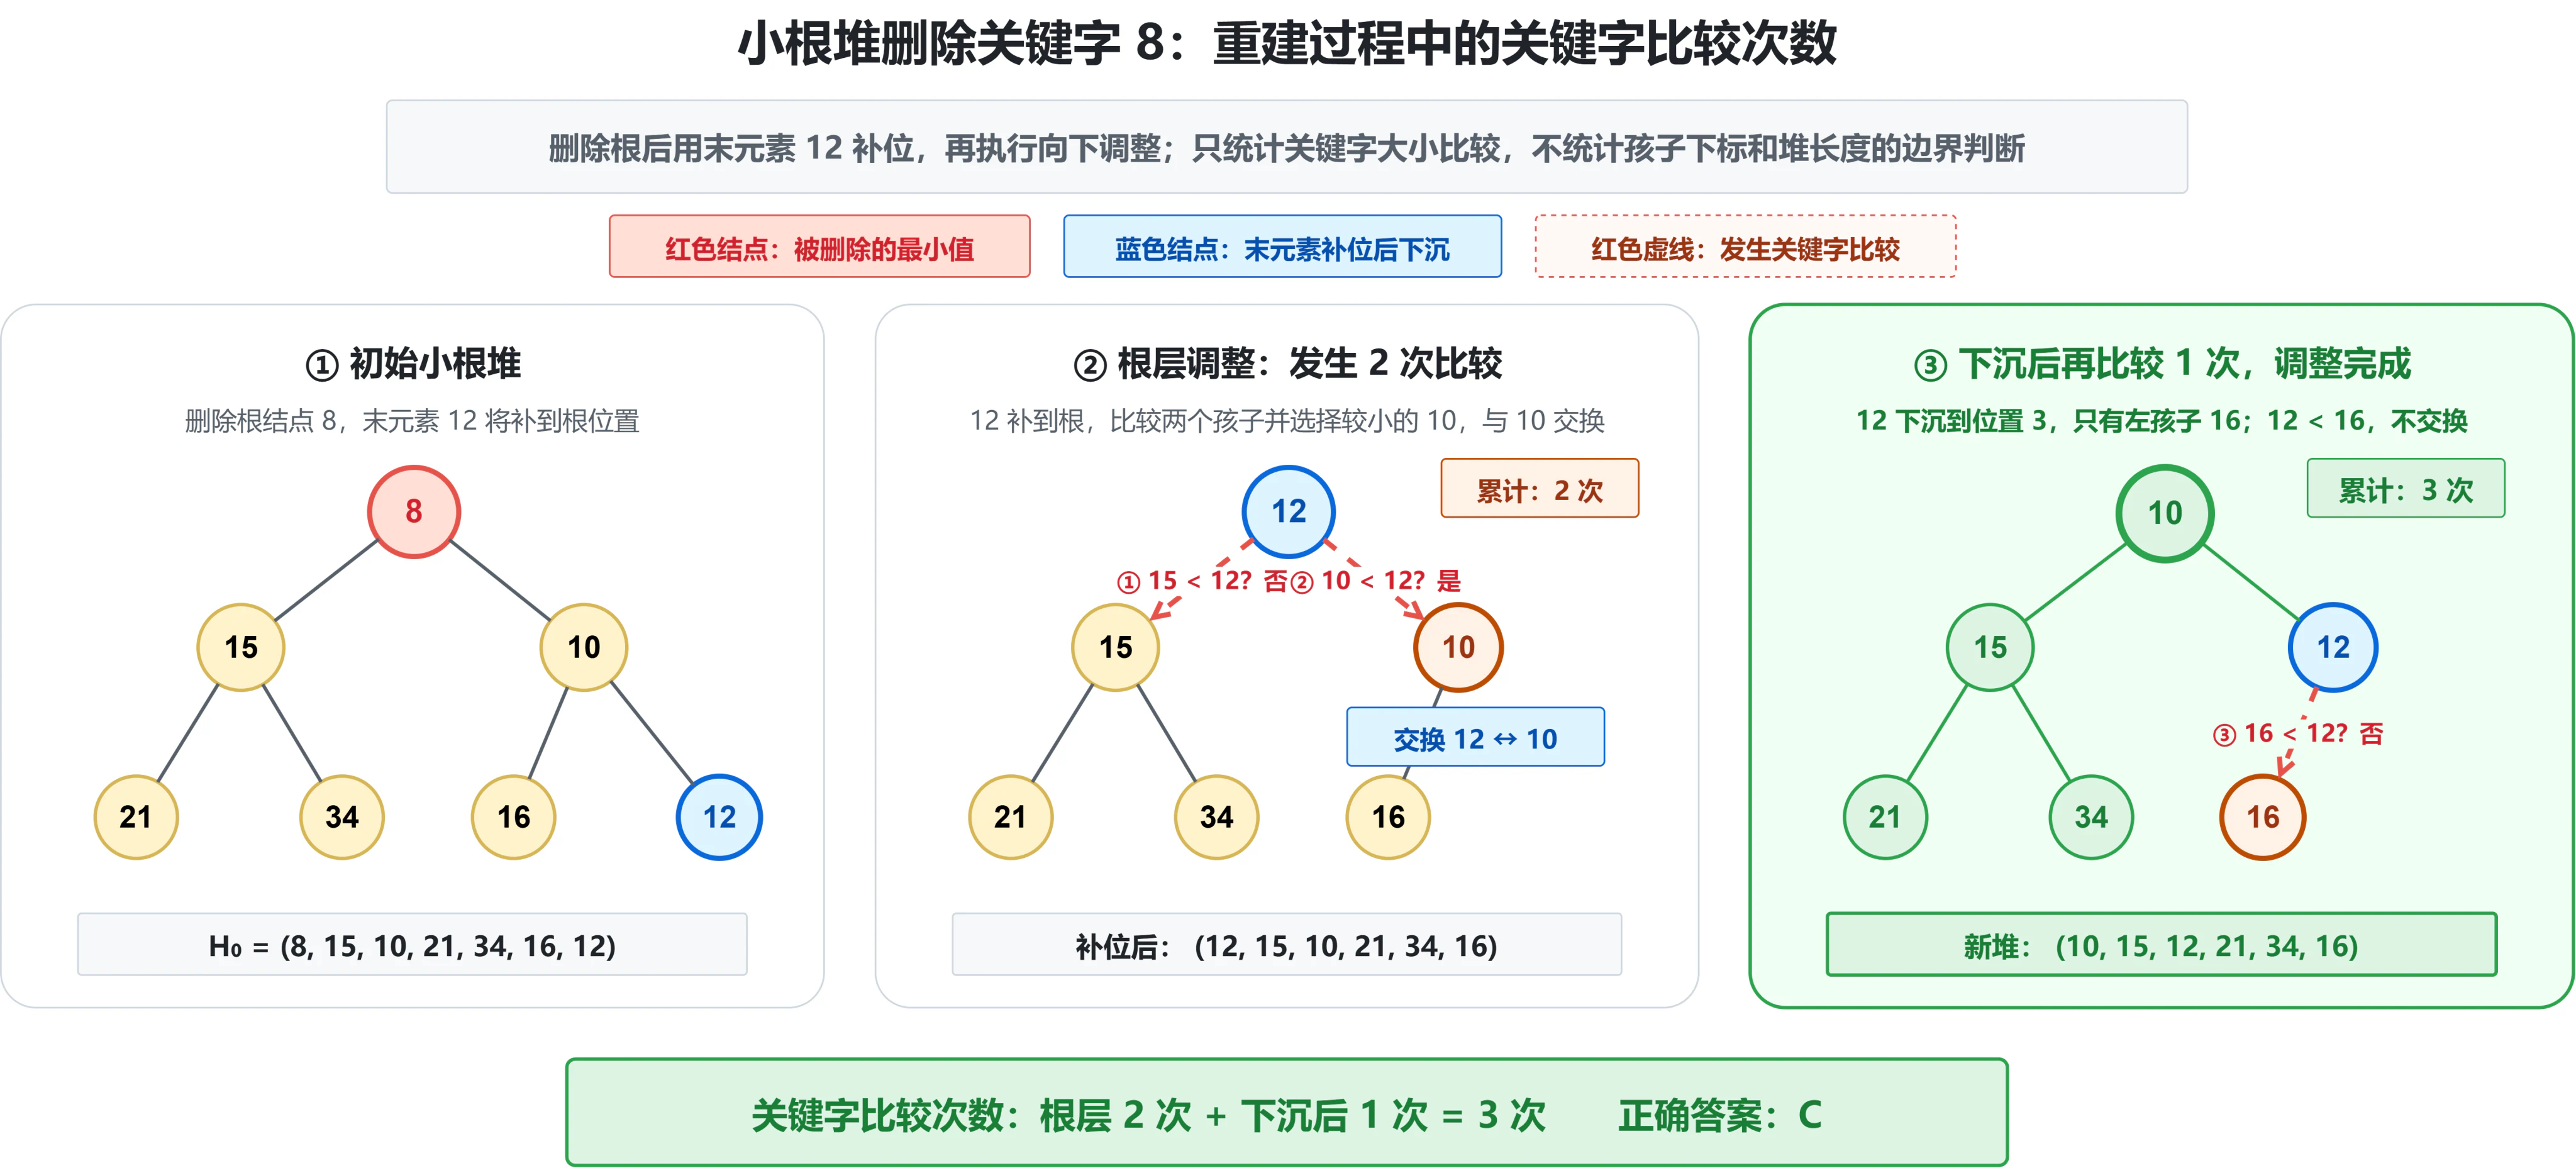
因此共比较 次。
答案:C
- 【2018-11】将数据序列 ⟨6,1,5,9,8,4,7⟩ 建成大根堆时,正确的序列变化过程
A. ⟨6,1,7,9,8,4,5⟩→⟨6,9,7,1,8,4,5⟩→⟨9,6,7,1,8,4,5⟩→⟨9,8,7,1,6,4,5⟩
B. ⟨6,9,5,1,8,4,7⟩→⟨6,9,7,1,8,4,5⟩→⟨9,6,7,1,8,4,5⟩→⟨9,8,7,1,6,4,5⟩
C. ⟨6,9,5,1,8,4,7⟩→⟨9,6,5,1,8,4,7⟩→⟨9,6,7,1,8,4,5⟩→⟨9,8,7,1,6,4,5⟩
D. ⟨6,1,7,9,8,4,5⟩→⟨7,1,6,9,8,4,5⟩→⟨7,9,6,1,8,4,5⟩→⟨9,7,6,1,8,4,5⟩→⟨9,8,7,1,6,4,5⟩
解析
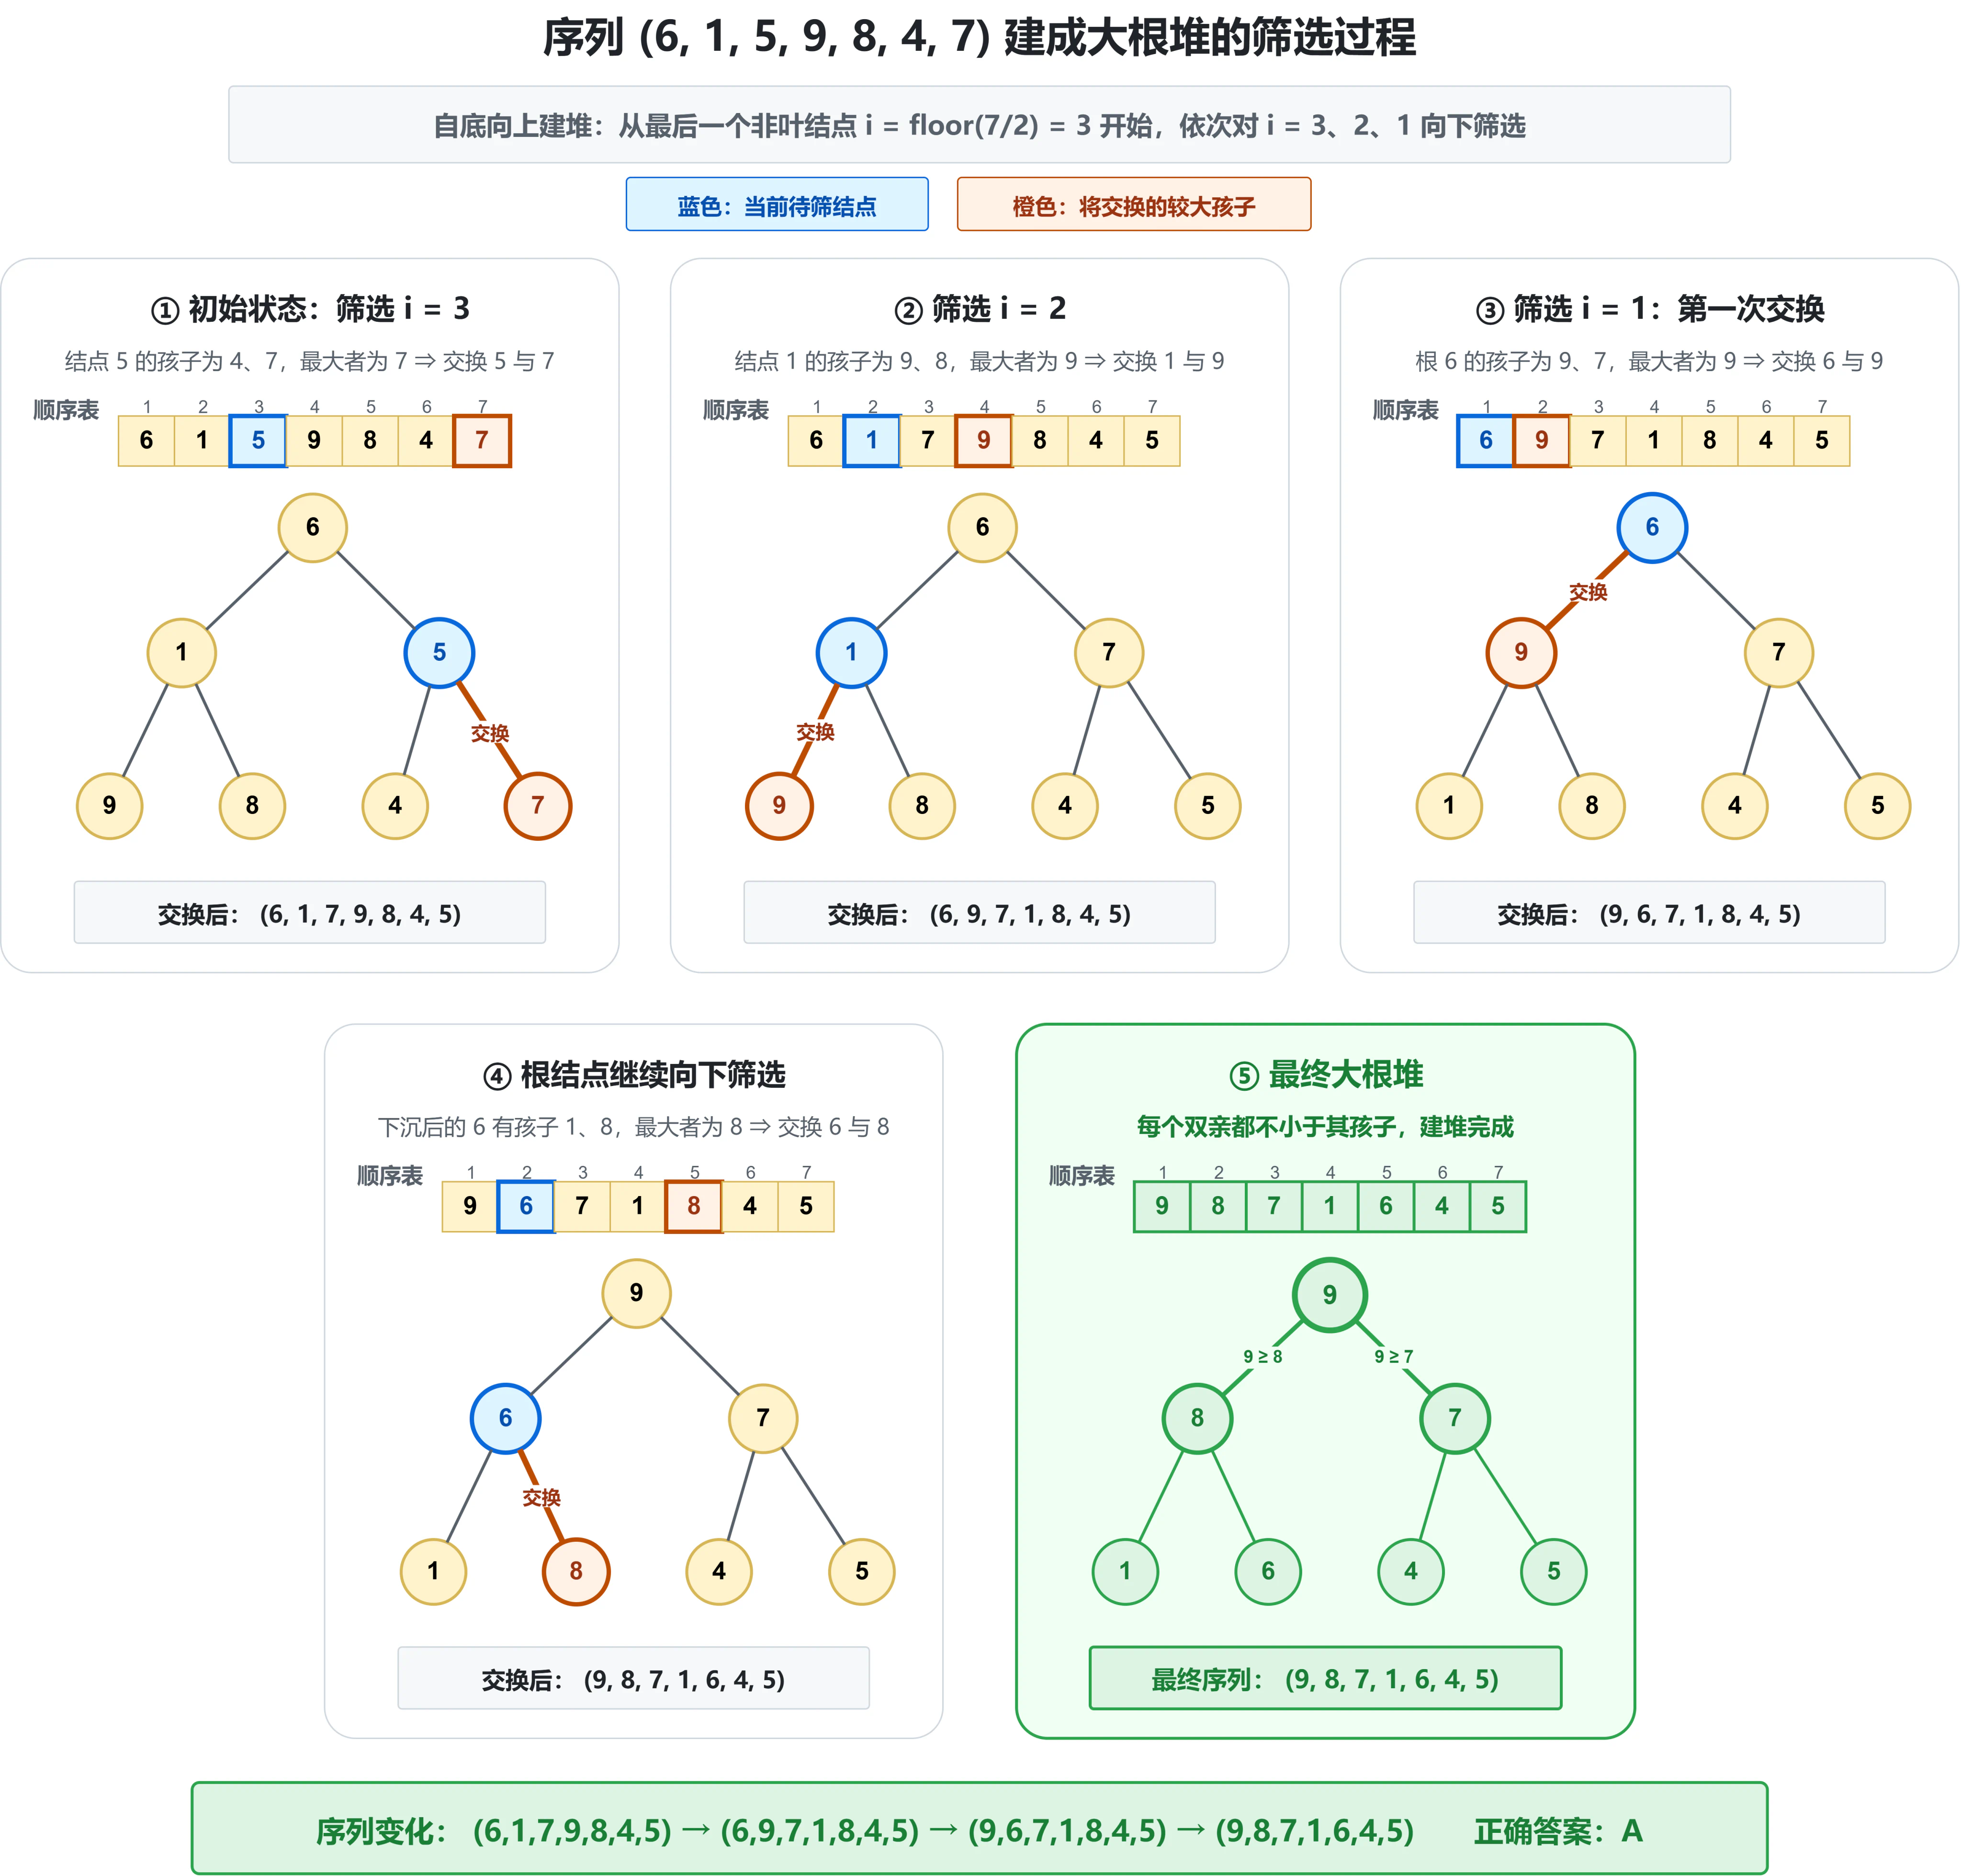
整个变化过程与 A 完全一致。
答案:A
- 【2020-09】下列关于大根堆(至少含2个元素)的叙述中,正确的是( )。
I. 可以将堆看成是一棵完全二叉树
II. 可以采用顺序存储方式保存堆
III. 可以将堆看成是一棵二叉排序树
IV. 堆中的次大值一定在根的下一层
A. 仅I、II
B. 仅II、III
C. 仅I、II和IV
D. 仅I、III和IV
解析
逐项判断:
- I 正确。堆在逻辑结构上是一棵完全二叉树。
- II 正确。完全二叉树适合顺序存储。若结点下标从
 开始,则下标为 的结点,其左右孩子下标分别为
 和
 。
- III 错误。大根堆只要求父结点不小于孩子,并不要求“左子树小于根、右子树大于根”,所以不是二叉排序树。
- IV 正确。最大值在根。任意更深层结点都不大于其父结点,因此除根外的最大值,也就是次大值,只可能是根的左孩子或右孩子。
故正确的是 I、II、IV。
答案:C
- 【2021-11】将关键字6, 9, 1, 5, 8, 4, 7依次插入到初始为空的大根堆H中,得到的H是( )。
A. 9, 8, 7 ,6, 5, 4, 1
B. 9, 8, 7, 5, 6, 1, 4
C. 9, 8, 7, 5, 6, 4, 1
D. 9, 6, 7, 5, 8, 4, 1
解析
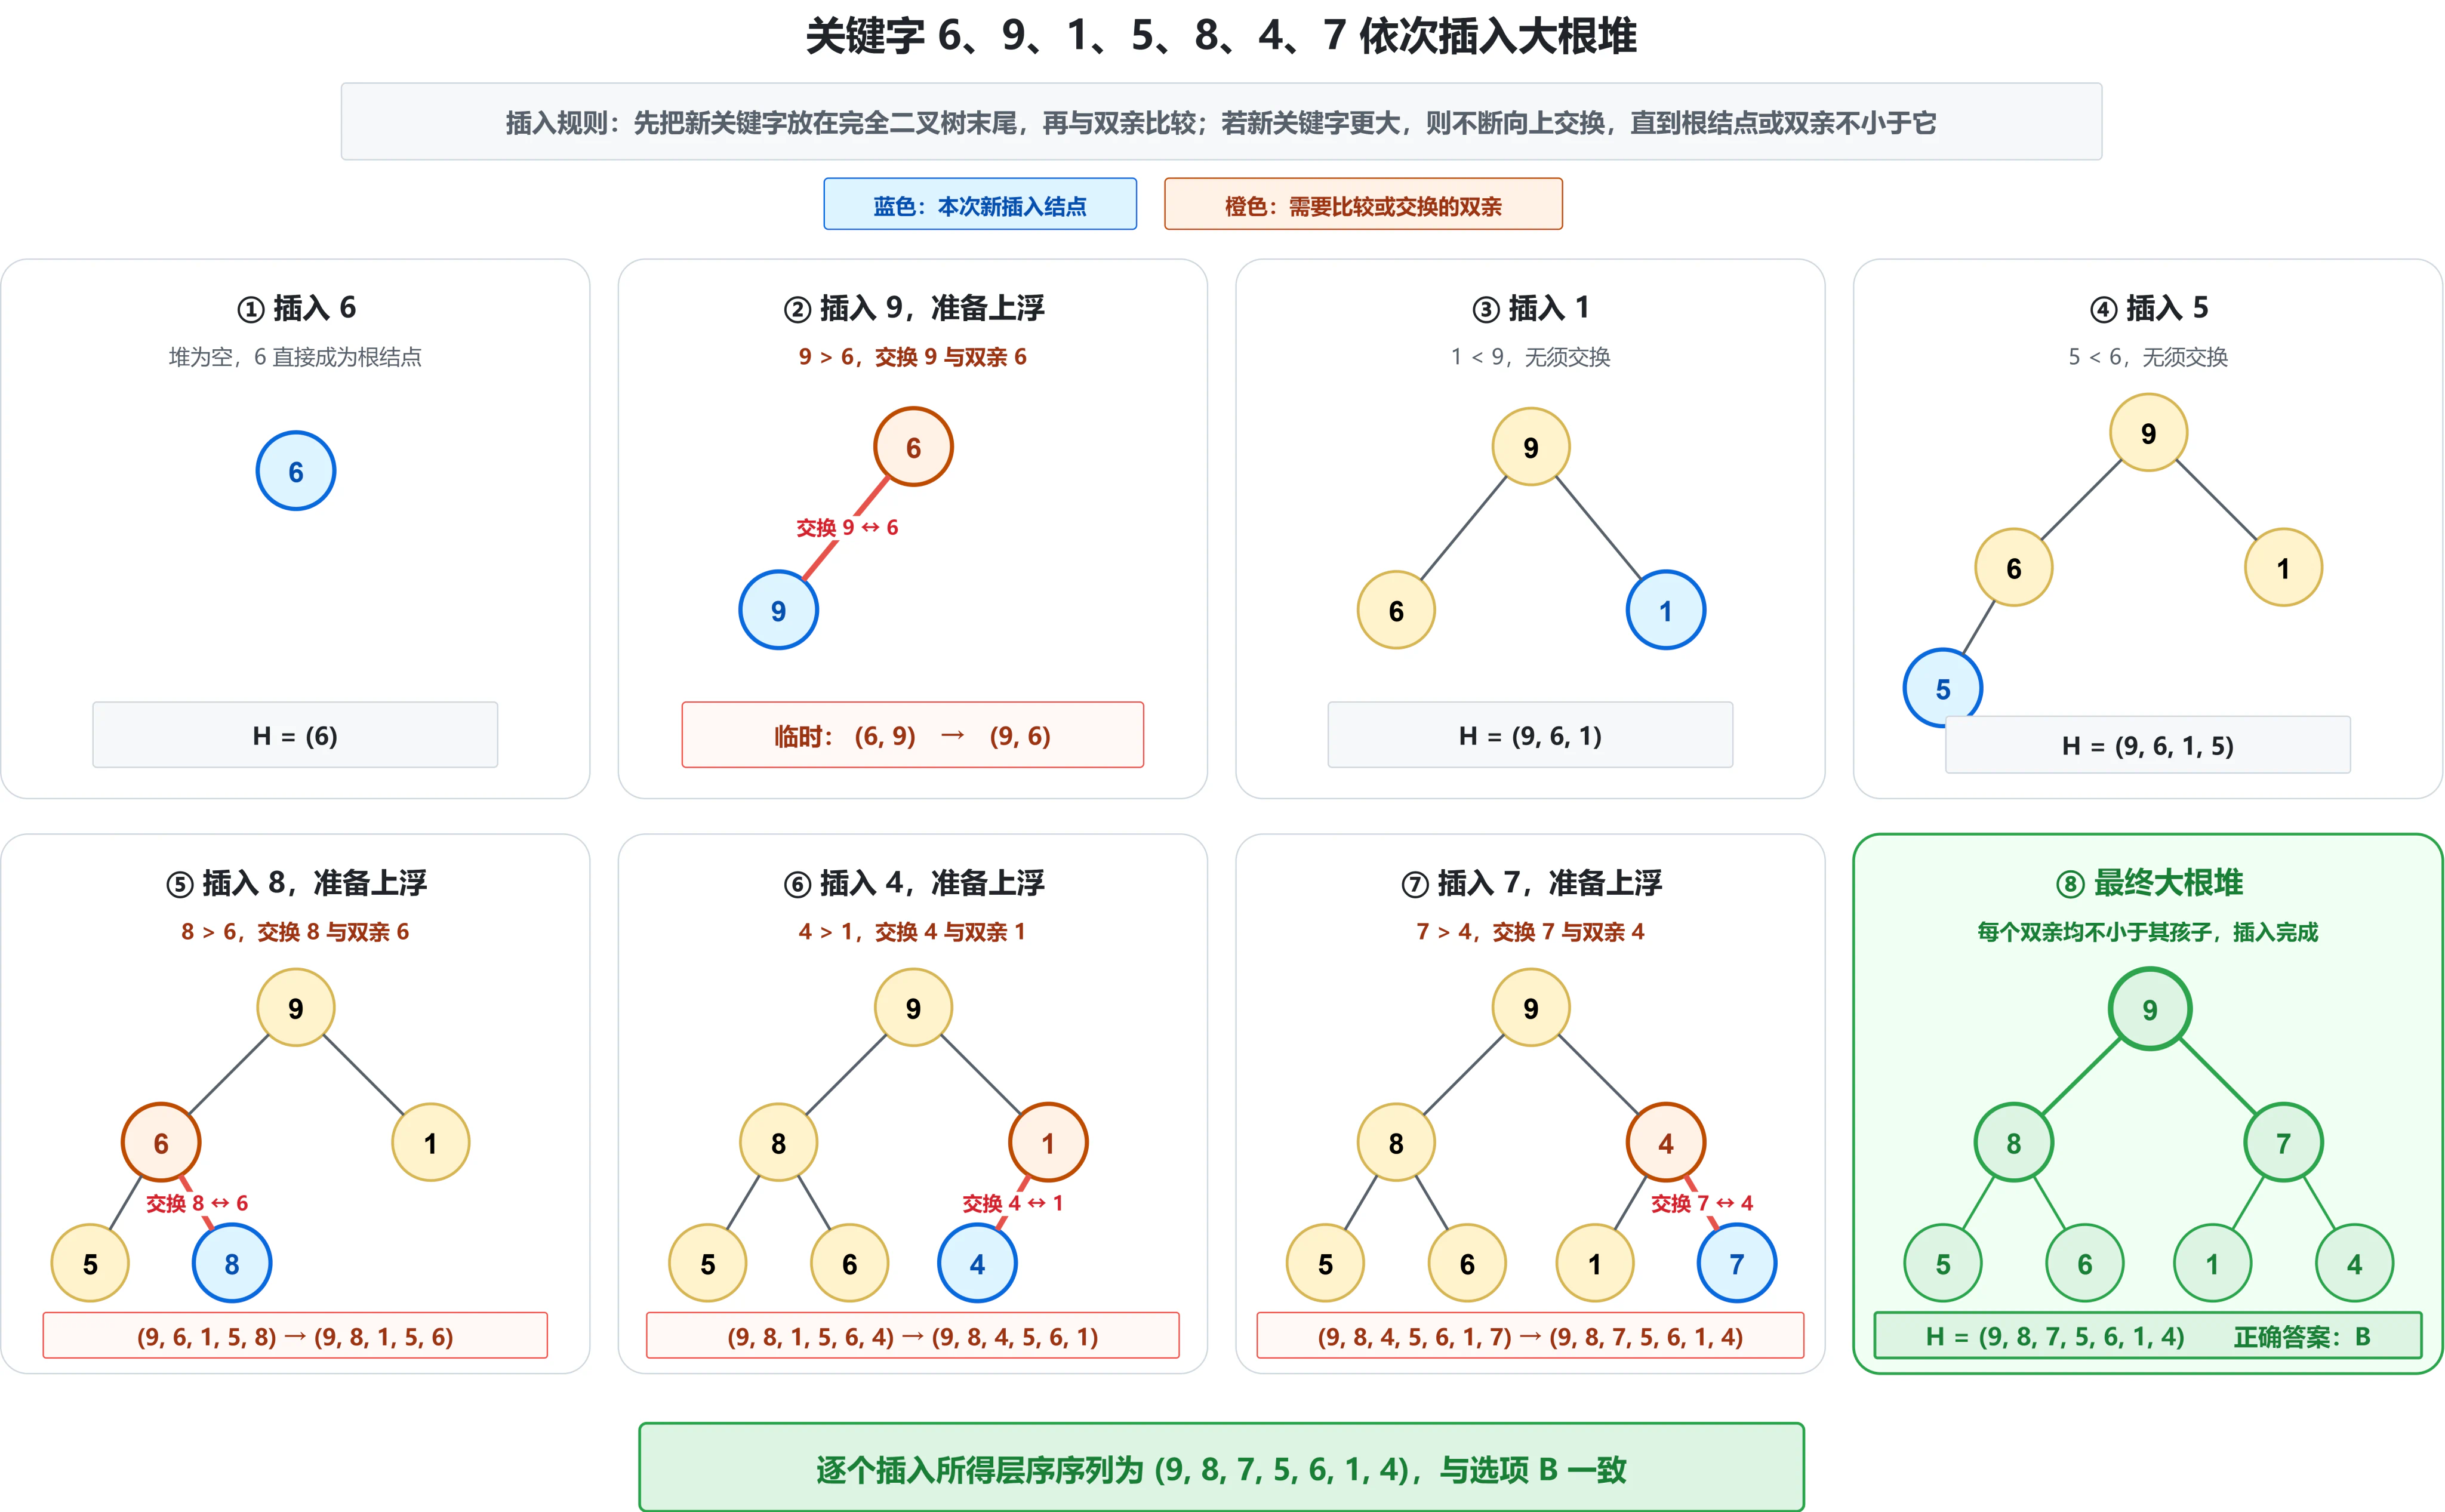
注意,本题是“依次插入建堆”,其结果不一定与对完整序列使用自底向上建堆完全相同。
答案:B
- 【2024-09】已知关键字序列 28, 22, 20, 19, 8, 12, 15, 5 是大根堆(最大堆),对该堆进行两次删除操作后,得到的新堆是
A. 20, 19, 15, 12, 8, 5
B. 20, 19, 15, 5, 8, 12
C. 20, 19, 12, 15, 8, 5
D. 20, 19, 8, 12, 15, 5
解析
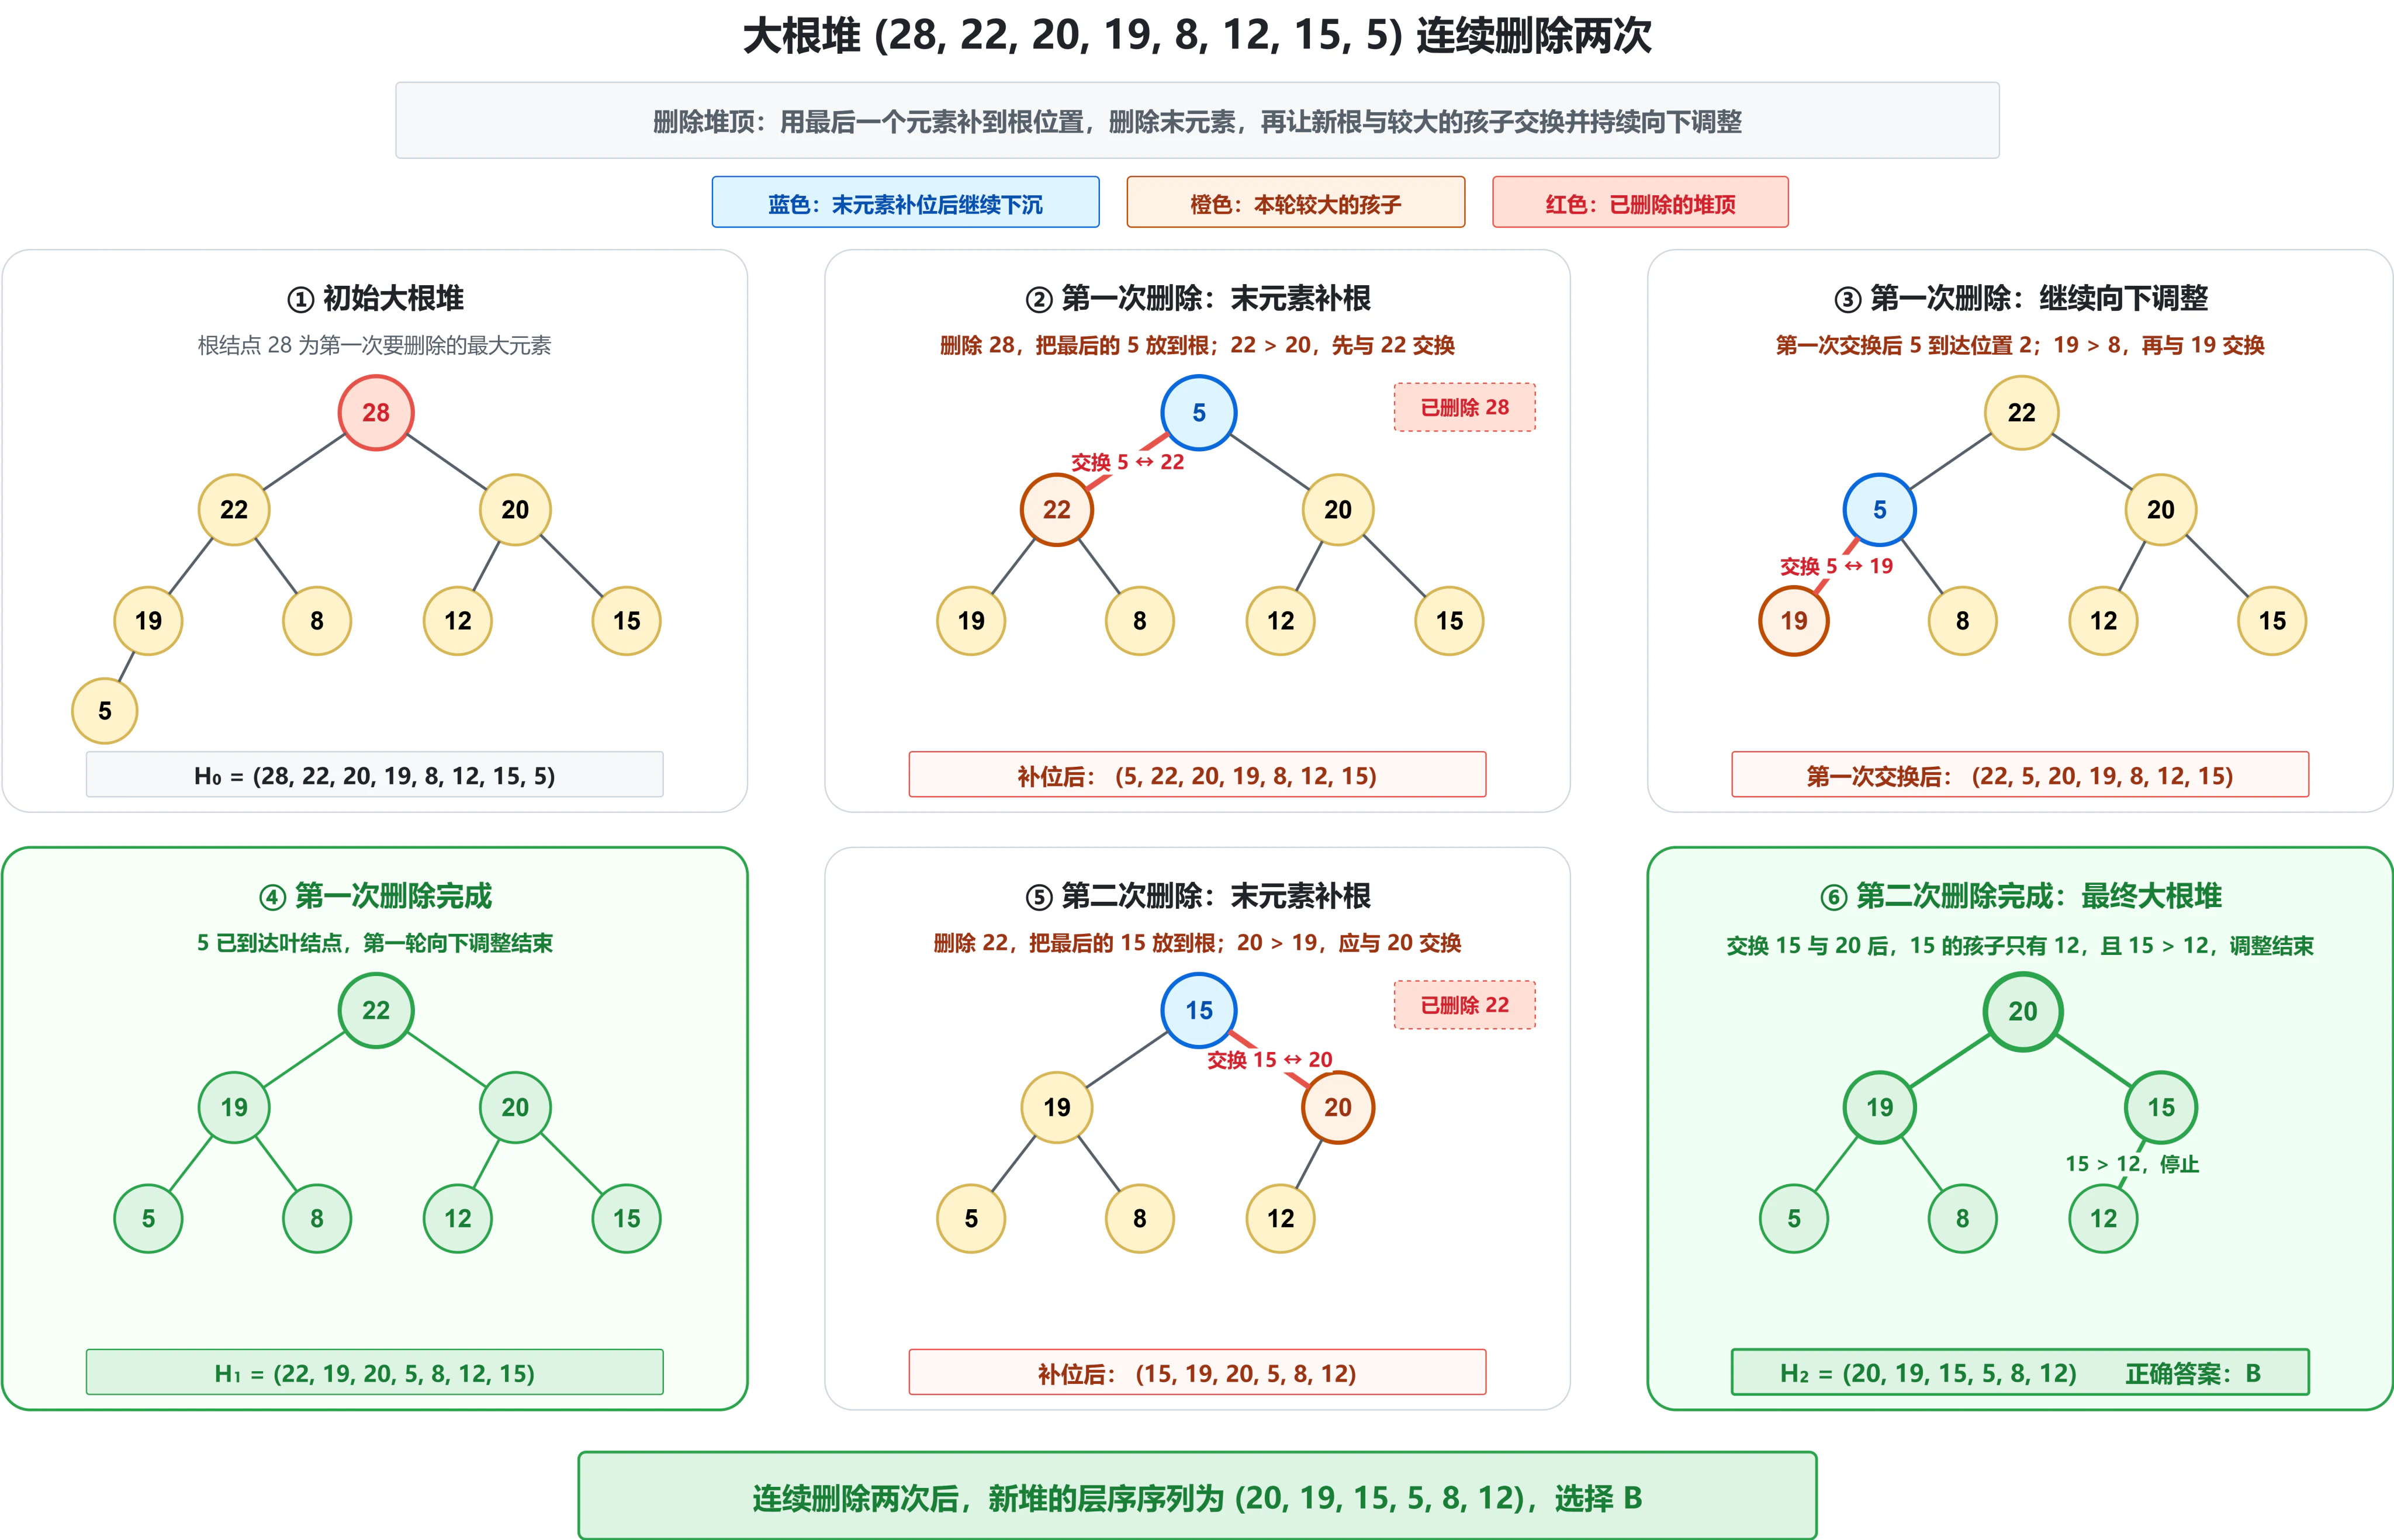
答案:B
(九)二路归并排序(merge sort)
- 【2017-10】在内部排序时,若选择了归并排序而没有选择插入排序,则可能的理由是( )。
Ⅰ.归并排序的程序代码更短
Ⅱ.归并排序的占用空间更少
Ⅲ.归并排序的运行效率更高
A. 仅Ⅱ
B. 仅Ⅲ
C. 仅Ⅰ、Ⅱ
D. 仅Ⅰ、Ⅲ
解析
逐项判断:
- I 错误。直接插入排序结构简单,通常比归并排序代码更短。
- II 错误。直接插入排序辅助空间为 ;数组上的二路归并排序通常需要 的辅助数组,因此归并排序占用空间更多。
- III 正确。归并排序的最好、平均和最坏时间复杂度均为 ;直接插入排序平均和最坏为 。当数据规模较大且没有接近有序等特殊条件时,归并排序通常运行效率更高。
所以只有 III 正确。
答案:B
- 【2022-10】使用二路归并排序对含 n 个元素的数组 M 进行排序时,二路归并排序操作的功能是( )。
A. 将两个有序表合并为一个新的有序表
B. 将 M 划分为两部分,两部分的元素个数大致相等
C. 将 M 分成 n 个部分,每个部分中仅含有一个元素
D. 将 M 划分为两部分,一部分元素的值均小于另一部分元素值
解析
“二路归并”这一基本操作的输入是两个已经有序的子表。每次比较两个子表的当前首元素,把较小者放入结果表,直到其中一个子表为空,再把另一个子表的剩余元素直接复制到结果表。
因此其功能是
B、C 描述的是递归归并排序中的分解过程,不是“归并操作”本身;D 更接近快速排序划分后的块间关系。
答案:A
- 【2024-10】现有由关键字组成的3个有序序列 (3,5), (7,9) 和 (6),若按从左至右的次序选择有序序列进行二路归并排序,则关键字之间的总比较次数是
A. 3
B. 4
C. 5
D. 6
解析
第一次归并前两个序列  和
 :
- 比较 与
 ,取 ;
- 比较 与 ,取 ;
- 左序列已空,直接接上
 。
第一次共比较 次,得到  。
第二次归并 与  :
- 比较 与
 ;
- 比较 与 ;
- 比较 与 ,取 ,第二个序列为空;
- 直接接上 。
第二次共比较 次。因此总比较次数为


答案:C
(十)基数排序
- 【2013-11】对给定的关键字序列 110, 119, 007, 911, 114, 120, 122 进行基数排序,则第2趟分配收集后得到的关键字序列是 ( )。
A. 007, 110, 119, 114, 911, 120, 122
B. 007, 110, 119, 114, 911, 122, 120
C. 007, 110, 911, 114, 119, 120, 122
D. 110, 120, 911, 122, 114, 007, 119
解析
最低位优先的基数排序先按个位分配,再按十位分配;每次收集都必须保持桶内原有的相对次序。
第 1 趟按个位分配并收集:
- 个位为
 :
 ;
- 个位为 :
 ;
- 个位为 :
 ;
- 个位为
 :
 ;
- 个位为 :
 ;
- 个位为 :
 。
得到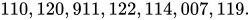
第 2 趟在上述顺序基础上按十位稳定分配:
- 十位为 :;
- 十位为 :
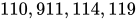 ;
- 十位为 :
 。
按桶号从小到大收集,得到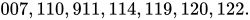
答案:C
- 【2021-10】设数组 S[] = {93, 946, 372, 9, 146, 151, 301, 485, 236, 327, 43, 892},采用最低位优先(LSD)基数排序将S排列成升序序列。第1趟分配、收集后,元素372之前、之后紧邻的元素分别是( )。
A. 43, 892
B. 236, 301
C. 301, 892
D. 485, 301
解析
第 1 趟只看个位,并在同一个桶中保持原序列的先后顺序:
- 个位为 :
 ;
- 个位为 :
 ;
- 个位为 :
 ;
- 个位为 :
 ;
- 个位为 :
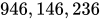 ;
- 个位为 :
 ;
- 个位为 :。
从 号桶到 号桶收集后得到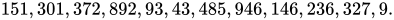
所以  的前一个元素是
 ,后一个元素是
 。
答案:C
(十一)外部排序
- 【2016-11】对 10 TB 的数据文件进行排序,应使用的方法是( )。
A. 希尔排序
B. 堆排序
C. 快速排序
D. 归并排序
解析
 数据通常无法一次全部装入内存,必须采用外部排序。外部排序的主要代价是磁盘读写次数,因此需要把数据分批读入内存,形成若干有序的初始归并段,再通过多路归并逐步合并。
归并排序具有两个适合外部存储的特点:
- 合并时主要按顺序读写文件,磁盘访问效率高;
- 不要求全部数据同时驻留内存,可以逐块处理。
希尔排序、堆排序和快速排序主要用于内存中的内部排序,并不适合直接处理如此巨大的外存文件。
答案:D
- 【2019-11】设外存上有120个初始归并段,进行12路归并时,为实现最佳归并,需要补充的虚段个数是( )。
A. 1
B. 2
C. 3
D. 4
解析
对严格的  路最佳归并树,若叶结点数为
 ,则应满足
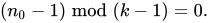
本题  ,所以
 。现有
 个初始归并段:
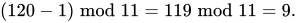
还需要补充 个虚段,使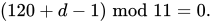
因为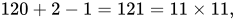 所以应补充 个虚段。
虚段不含实际记录,其作用只是补齐最佳归并树的结构,不增加实际文件读写量。
答案:B
- 【2024-11】在外部排序中,利用败者树对初始为升序的归并段进行多路归并,败者树中记录“冠军”的结点保存的是
A. 最大关键字
B. 最小关键字
C. 最大关键字所在归并段号
D. 最小关键字所在归并段号
解析
对升序归并段进行多路归并时,每次应该输出各归并段当前首元素中的最小者,因此比较中的“冠军”是当前最小关键字。
败者树的内部结点通常记录每次比较中的败者所对应的归并段号,另设结点记录最终冠军。为了输出冠军后能从对应归并段读取下一个记录,冠军结点保存的不是关键字本身,而是最小关键字所在的归并段号。

答案:D
(十二)排序算法的分析和应用
- 【2009-10】若数据元素序列11, 12, 13, 7, 8, 9, 23, 4, 5是采用下列排序方法之一得到的第二趟排序后的结果,则该排序算法只能是( )。
A. 起泡排序
B. 插入排序
C. 选择排序
D. 二路归并排序
解析
观察序列的前 3 个元素: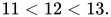
直接插入排序开始时把第 1 个元素视为有序子序列:
- 第 1 趟把第 2 个元素插入前缀,前 2 个元素有序;
- 第 2 趟把第 3 个元素插入前缀,前 3 个元素有序;
- 第 4 个及以后的元素尚未处理,可以保持任意状态。
这正符合题目序列的特征。
排除其他算法:
- 起泡排序两趟后,末尾应有两个最大元素到达最终位置,本序列末尾却是
 ;
- 简单选择排序两趟后,开头应有两个最小元素到达最终位置,应为 ;
- 自底向上的二路归并排序完成第二趟后,应形成长度为 左右的有序归并段,但开头的
 并非有序。
因此只能是直接插入排序。
答案:B
- 【2010-11】对一组数据 ⟨2,12,16,88,5,10⟩ 进行排序,若前三趟排序结果如下:
第一趟排序结果: ⟨2,12,16,5,10,88⟩
第二趟排序结果: ⟨2,12,5,10,16,88⟩
第三趟排序结果: ⟨2,5,10,12,16,88⟩
则采用的排序方法可能是( )。
A. 起泡排序
B. 希尔排序
C. 归并排序
D. 基数排序
解析
起泡排序从左到右比较相邻元素时,每一趟会把当前未排序区间中的最大元素移到区间末尾。
逐趟观察:
- 第 1 趟中最大值
 连续向右交换,最终到达最后一个位置;
- 第 2 趟中剩余元素的最大值 到达倒数第 2 个位置;
- 第 3 趟中剩余元素的最大值 到达倒数第 3 个位置。
已经确定的有序后缀依次为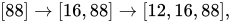
与起泡排序的特征完全吻合。
希尔排序按间隔分组,结果不会稳定地每趟确定一个最大后缀;二路归并排序产生的是若干有序段;基数排序按数位稳定分配,也不符合这些变化。
答案:A
- 【2012-10】在内部排序过程中,对尚未确定最终位置的所有元素进行一遍处理称为一趟排序。下列排序方法中,每一趟排序结束都至少能够确定一个元素最终位置的方法是( )。
I. 简单选择排序
II. 希尔排序
III. 快速排序
IV. 堆排序
V. 二路归并排序
A. 仅I、III、IV
B. 仅I、III、V
C. 仅II、III、IV
D. 仅III、IV、V
解析
逐项判断:
- 简单选择排序可以。每趟从未排序区间选出最小元素并放到前端最终位置。
- 希尔排序不一定。一趟只是让各个增量子序列有序,通常不能保证某个元素已经位于整个序列的最终位置。
- 快速排序可以。每次划分结束,枢轴到达最终位置。
- 堆排序可以。每趟把堆顶最大值与当前堆尾交换,该最大值到达最终位置。
- 二路归并排序不一定。中间各趟只形成越来越长的有序段,段内元素仍可能在后续归并时整体移动,不能保证已有元素到达全局最终位置。
因此符合条件的是 I、III、IV。
答案:A
- 【2015-09】下列排序算法中,元素的移动次数与关键字的初始排列次序无关的是( )。
A. 直接插入排序
B. 起泡排序
C. 基数排序
D. 快速排序
解析
最低位优先基数排序对每一位都进行一次分配和收集。若有  个元素、处理 个数位,则每一趟都要把全部 个元素分配到桶中并全部收集,元素移动次数主要由 和 决定,与初始排列次序无关。
另外三种算法的移动次数都会受到逆序程度或枢轴划分情况影响:
- 直接插入排序中,逆序对越多,后移次数通常越多;
- 起泡排序中,相邻逆序对越多,交换次数越多;
- 快速排序中,不同初始次序会产生不同划分和交换过程。
答案:C
- 【2017-11】下列排序方法中,若将顺序存储更换为链式存储,则算法的时间效率会降低的是( )。
Ⅰ. 插入排序
Ⅱ.选择排序
Ⅲ.起泡排序
Ⅳ.希尔排序
Ⅴ.堆排序
A. 仅Ⅰ、Ⅱ
B. 仅Ⅱ、Ⅲ
C. 仅Ⅲ、Ⅳ
D. 仅Ⅳ、Ⅴ
解析
链式存储可以顺序访问相邻结点,但不能在 时间内按下标访问任意位置。
- 插入排序、选择排序和起泡排序主要通过顺序扫描实现,改用链表后仍可保持 的时间复杂度;
- 希尔排序需要频繁访问下标相差增量 的元素。链表无法按下标直接跳转,定位这些元素需要额外遍历,效率降低;
- 堆排序依靠完全二叉树的数组下标关系 、、 快速访问父子结点。普通链式存储失去这种常数时间定位能力,效率也会降低。
因此是 IV、V。
答案:D
- 【2019-07】选择一个排序算法时,除算法的时空效率,下列因素中,还需要考虑的是( )。
I.数据的规模
II.数据的存储方式
III.算法的稳定性
IV.数据的初始状态
A.仅 III
B.仅 I、II
C.仅 II、III、IV
D. I、II、III、IV
解析
四项都会影响算法选择:
- 数据规模。小规模数据可优先考虑实现简单、常数开销低的直接插入排序;大规模数据更重视渐进时间复杂度。
- 存储方式。顺序表适合快速排序、堆排序和希尔排序等依赖随机访问的算法;链表更适合顺序扫描和链接操作。
- 稳定性。若相同关键字记录必须保持原有相对次序,应选直接插入、起泡、归并或基数排序等稳定算法。
- 初始状态。数据接近有序时,直接插入排序表现很好;快速排序若枢轴选择不当则可能退化。
因此 I、II、III、IV 都需要考虑。
答案:D
- 【2020-11】对大部分元素已有序的数组进行排序时,直接插入排序比简单选择排序效率更高,其原因是( )。
I. 直接插入排序过程中元素之间比较次数更少
II. 直接插入排序过程中所需要的辅助空间更少
III. 直接插入排序过程中元素的移动次数更少
A. 仅I
B. 仅III
C. 仅I、II
D. I、II和III
解析
逐项判断:
- I 正确。直接插入排序会在找到插入位置后立即停止向前比较。序列大部分已有序时,每个元素通常只比较很少几次,总比较次数可接近 。简单选择排序无论初始序列是否接近有序,都要在剩余区间中找最小值,比较次数固定为

- II 错误。两种算法都只需要常数个临时变量,辅助空间复杂度均为 。
- III 不能作为必然原因。简单选择排序本身的交换次数至多为 ,有些实现遇到元素已在正确位置时甚至不交换。直接插入排序的移动次数虽会因基本有序而减少,但不能笼统地断言一定少于简单选择排序。
所以确定成立的只有 I。
答案:A
- 【2022-11】对数据进行排序时,若采用直接插入排序而不采用快速排序,则可能的原因是( )。
I. 大部分元素已有序
II. 待排序元素数量很少
III. 要求空间复杂度为 O(1)
IV. 要求排序算法是稳定的
A. 仅I、II
B. 仅III、IV
C. 仅I、II、IV
D. I、II、III、IV
解析
本题与第 1 题、第 10 题相同:
- 基本有序时,直接插入排序可接近 ;
- 元素数量很少时,直接插入排序常数开销小;
- 直接插入排序辅助空间为 ,快速排序需要递归栈;
- 直接插入排序稳定,快速排序通常不稳定。
四项均正确。
答案:D
- 【2023-10】下列排序算法中,不稳定的是( )。
I. 希尔排序
II. 归并排序
III. 快速排序
IV. 堆排序
V. 基数排序
A. 仅 I 和 II
B. 仅 II 和 V
C. 仅 I、III 和 IV
D. 仅 III 、 IV 和 V
解析
稳定排序要求:关键字相等的两个元素,排序后仍保持原有相对次序。
逐项判断:
- 希尔排序不稳定。相同关键字可能处于不同增量组,并在跨越式移动后改变相对次序。
- 归并排序稳定。归并时若关键字相等,先取左侧有序段中的元素,就能保持相对次序。
- 快速排序不稳定。划分过程中远距离交换可能改变相等元素的相对次序。
- 堆排序不稳定。建堆和堆顶、堆尾交换可能使相等元素跨越移动。
- 基数排序稳定。每一趟分配和收集都必须保持同一桶内元素的原有相对次序。
所以不稳定的是 I、III、IV。
答案:C