第二章线性表
答案速对
- 2023-01:D
- 2013-01:D
- 2016-01:D
- 2016-02:D
- 2021-01:D
- 2023-02:C
- 2024-01:D
- 2026-01:A
- 2026-02:D
(一)线性表的基本概念
(二)线性表的实现
顺序存储
- 【2023-01】 下列对顺序存储的有序表(长度为 \(n\) )实现给定操作的算法中,平均时间复杂度为 \(O(1)\) 的是( )。
A. 查找包含指定值的元素的位置
B. 插入包含指定值元素的算法
C. 删除第 \(i(1 ≤ i ≤ n)\)个元素的算法
D. 获取第\(i(1 ≤ i ≤ n)\)个元素的算法
解析
答案:D
顺序表中的元素存放在一段连续的存储空间内。设第一个元素的地址为  ,每个元素占
 个存储单元,则第
 个元素的地址为
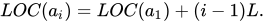
只要给出下标 ,就可以通过一次地址计算直接找到第 个元素,所需操作次数不随表长  改变,因此时间复杂度为
 。
逐项分析:
- A:有序顺序表可采用二分查找,每次将查找区间缩小一半,平均时间复杂度为
 。
- B:确定插入位置后,平均需要移动约一半元素,平均时间复杂度为
 。
- C:删除第 个元素后,平均需要将约一半后继元素前移,平均时间复杂度为 。
- D:根据下标直接计算地址并访问元素,时间复杂度为 。
顺序表具有“随机存取”特性,这里的“随机”表示可以在常数时间内访问任意给定下标的元素。
链式存储
- 【2013-01】已知两个长度分别为 m 和 n 的升序链表,若将它们合并为长度为 m+n 的降序链表,则最坏情况下的时间复杂度是( )。
A. O(n)
B. O(mn)
C. O(min(m,n))
D. O(max(m,n))
解析
案:D
可以同时设置两个指针,分别指向两个升序链表当前尚未处理的首结点。每次比较这两个结点:
- 取出关键字较小的结点;
- 将该结点用头插法插入结果链表;
- 对应链表的指针向后移动一次;
- 某一链表处理完后,再把另一链表的剩余结点依次头插到结果链表中。
被取出的结点按升序出现,而头插法会把次序反转,因此最终结果是降序链表。
在整个合并过程中,每个结点最多被访问和移动一次。两个链表共有  个结点,所以最坏情况下
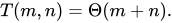
选项中没有直接给出  。注意:
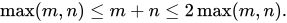
由于常数 2 在渐进复杂度中可以忽略,因此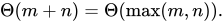
故应选择 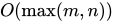 。不能选
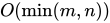 ,因为即使较短的链表已经处理完,较长链表中的剩余结点仍然需要接入结果链表。
- 【2016-01】已知表头元素为c的单链表在内存中的存储状态如下表所示。
\( \begin{array}{|c|c|c|} \hline \text{地址} & \text{元素} & \text{链接地址} \\ \hline 1000H & a & 1010H \\ 1004H & b & 100CH \\ 1008H & c & 1000H \\ 100CH & d & \text{NULL} \\ 1010H & e & 1004H \\ 1014H & & \\ \hline \end{array} \)
现将f存放于1014H处并插入到单链表中,若f在逻辑上位于a和e之间,则a, e, f的“链接地址”依次是( )。
A. 1010H, 1014H, 1004H
B. 1010H, 1004H, 1014H
C. 1014H, 1010H, 1004H
D. 1014H, 1004H, 1010H
解析
答案:D
单链表的逻辑顺序由“链接地址”决定,与各结点在内存中的物理地址是否连续无关。
表头元素 c 存放在 1008H。根据每个结点的链接地址依次追踪:
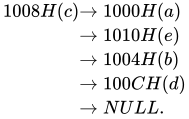
所以原链表的逻辑顺序是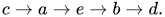
现在要把位于 1014H 的 f 插入 a 和 e 之间。插入前局部关系为
插入后应变为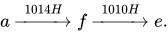
因此:
- a 的链接地址改为 1014H,因为 a 的直接后继变成 f;
- e 的链接地址仍为 1004H,因为 e 的直接后继仍是 b;
- f 的链接地址应为 1010H,因为 f 的直接后继是 e。
按题目要求的 a、e、f 顺序,三个链接地址依次为 1014H、1004H、1010H。
- 【2016-02】已知一个带有表头结点的双向循环链表L,结点结构为prev|data|next,prev和next分别是指向其直接前驱和直接后继结点的指针。现要删除指针p所指的结点,正确的语句序列是( )。
A. p->next->prev = p->prev; p->prev->next = p->prev; free(p);
B. p->next->prev = p->next; p->prev->next = p->next; free(p);
C. p->next->prev = p->next; p-> prev->next = p->prev; free(p);
D. p->next->prev = p->prev; p->prev->next = p->next; free(p);
解析
答案:D
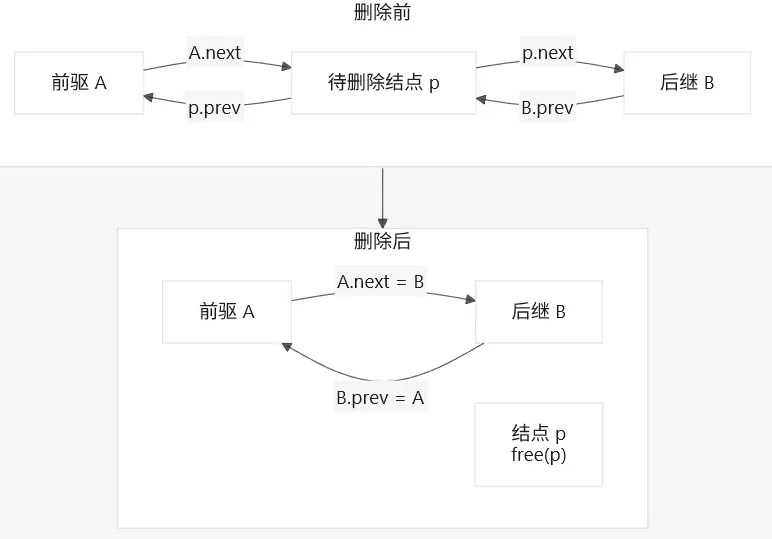
第一步,让后继结点的 prev 指向 p 的前驱:
p->next->prev = p->prev;第二步,让前驱结点的 next 指向 p 的后继:
p->prev->next = p->next;完成双向链接后,p 才与链表脱离,最后释放 p:
free(p);完整过程为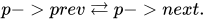
因为链表带头结点且为循环链表,头尾附近的结点仍然遵循同一组连接规则,不需要另设分支。
A 的第二条语句使前驱的 next 指向前驱自身;B、C 都把后继的 prev 错误地指向后继自身。
- 【2021-01】已知头指针h指向一个带头结点的非空单循环链表,结点结构为data next ,其中next是指向直接后继结点的指针,p是尾指针,q是临时指针。现要删除该链表的第一个元素,正确的语句序列是( )。
A. h->next = h->next->next; q = h->next; free(q);
B. q = h->next; h->next = h->next->next; free(q);
C. q = h->next; h->next = q->next; if (p != q) p = h; free(q);
D. q = h->next; h->next = q->next; if (p == q) p = h; free(q);
解析
答案:D
链表带有头结点,因此:
- h 指向头结点;
h->next指向第一个数据结点;- p 指向尾结点;
- 尾结点的 next 指回头结点 h。
删除第一个数据结点时,首先必须保存该结点的地址,否则修改 h->next 后就无法正确释放它:
q = h->next;接着让头结点跳过 q,直接指向 q 的后继:
h->next = q->next;还必须考虑链表原来只有一个数据结点的特殊情况。
删除前若 p == q,说明首结点同时也是尾结点。删除它以后,链表中只剩头结点,尾指针也应指向头结点:
if (p == q)
    p = h;
最后释放 q:
free(q);故完整语句是 D。
A 先修改 h->next,随后 q 保存的是新的首结点,最终会错误释放未被删除的结点。B 在数据结点数大于 1 时可完成删除,但没有处理“仅有一个数据结点”时尾指针 p 失效的问题。C 的条件恰好写反了。
- 【2023-02】现有非空双向链表 L ,其结点结构为:\(\begin{array}{|c|c|c|}\hline \rm prev&\rm data&\rm next\\ \hline \end{array}\) , prev 是指向直接前驱结点的指针, next 是指向直接后继结点的指针,若要在 L 中指针 p 所指向的结点(非尾结点)之后插入指针 s 指向的新结点,则在执行了语句 “
s->next = p->next; p->next = s;” 后,下列语句序列中还需要执行的是( )。
A. s->next->prev = p; s->prev = p;
B. p->next->prev = s; s->prev = p;
C. s->prev = s->next->prev; s->next->prev = s;
D. p->next->prev = s->prev; s->next->prev = p;
解析
答案:C
为了避免把“已经改变后的 p->next”仍当成原后继,应逐条观察指针状态。
设 p 原来的直接后继为 r。插入前的局部结构如下,其中 s 还是一个尚未接入链表的新结点:

执行第一条语句:
s->next = p->next;此时 s->next 指向 r。
执行第二条语句:
p->next = s;此时 p 的后继已经变成 s。把题目给出的两条语句合起来看,当前指针状态为:
p->next指向 s,已经正确;s->next指向 r,已经正确;s->prev尚未设置;r->prev仍然指向 p,尚未改为 s。
对应的示意图是:

可以看到,正向 next 链已经连接完成,但反向 prev 链还没有完成。还需要补上两条反向链接:
- s 的 prev 应指向 p;
- r 的 prev 应从 p 改为 s。
因为 r 原来是 p 的后继,所以 r 的 prev 原本就指向 p。执行完题目给出的两条语句后,s->next 是 r,因此
s->prev = s->next->prev;等价于把 s 的 prev 设为 p。然后执行
s->next->prev = s;把 r 的 prev 改为 s。最终结构为:

四个选项可按图快速判断:
- A:设置了
s->prev = p,但r->prev仍为 p,错误。 - B:此时
p->next已是 s,第一条语句操作的是s->prev,没有修改r->prev,错误。 - C:先利用原来的
r->prev = p得到s->prev = p,再令r->prev = s,正确。 - D:没有正确建立
s->prev = p,而且仍令r->prev = p,错误。
需要特别注意,执行 p->next = s 后,表达式 p->next 已经表示 s,不再表示原来的后继 r。这正是 B 不能完成插入的原因。
- 【2024-01】已知带头结点的非空链表 L 的头指针为 h,结点结构为 \(\begin{array}{|c|c|}\hline \rm data&\rm next\\\hline \end{array}\),其中 next 是指向直接后继结点的指针。现有指针 p 和 q,若 p 指向 L 中非首且非尾的任意一个结点,则执行语句序列
q = p->next; p->next = q->next; q->next = h->next; h->next = q;的结果是
A. 在 p 所指结点后插入 q 所指结点
B. 在 q 所指结点后插入 p 所指结点
C. 将 p 所指结点移动到 L 的头结点之后
D. 将 q 所指结点移动到 L 的头结点之后
解析
答案:D
设执行前局部链表为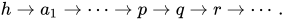
逐条执行:
q = p->next;q 指向 p 的直接后继。此时链表结构尚未改变。p->next = q->next;p 跳过 q,直接指向原来 q 的后继 r,相当于先把 q 从原位置摘下:
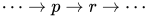
q->next = h->next;q 的后继改为原来的第一个数据结点 。
h->next = q;头结点 h 的后继改为 q,q 被插入表头:

因此,被移动的是 q 所指结点,而不是 p 所指结点;最终 q 位于头结点之后。
- 【2026-01】当存储空间有足够的空闲空间时,在保持表内元素顺序相对不变的情况下,下列哪些操作会必然导致产生移动次数( )。
I. 表头插入一个元素\ II. 表头删除一个元素\ III. 表尾插入一个元素\ IV. 表尾删除一个元素
A. I、II
B. I、III
C. II、IV
D. III、IV
解析
答案:A
结合“存储空间有足够的空闲空间”和“元素移动”可知,本题讨论的是顺序表。顺序表中的元素连续存放,且操作后需要保持原有元素的相对顺序。
设操作前元素为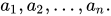
逐项分析:
- I,表头插入:必然移动。为了给首位置腾出空间, 至
 都要向后移动。
- II,表头删除:必然移动。删除 后,
 至 都要向前移动以保持连续。
- III,表尾插入:不必移动。空间充足时可直接写入原表尾之后的位置。
- IV,表尾删除:不必移动。只需将表长减 1,不需要移动其他元素。
因此,必然产生元素移动的是 I 和 II。
若讨论的是链表,插入、删除通常只修改指针而不移动元素;但该解释无法与题目给出的选项对应,所以本题的隐含对象是顺序表。
- 【2026-02】设有一个双向链表
L,结构为[p2, p1],头结点为head。初始时head = cu。现要将每个结点的p2指向p1指向结点的直接后继,应该进行的操作是( )。
A.while(cu!=NULL) {cu->p2=cu->p1->p1; cu=cu->p1;}
B.while(cu!=NULL && cu->p2!=NULL) {cu->p2 = cu->p1->p1; cu = cu->p1;}
C.while(cu!=NULL) {if(cu->p1!=NULL) {cu->p2=cu->p1->p1; cu=cu->p1;}}
D.while(cu!=NULL) {if(cu->p1!=NULL) {cu->p2=cu->p1->p1;} else {cu->p2=NULL;} cu=cu->p1;}
解析
答案:D
对当前结点 cu 而言:
cu->p1是 p1 所指的结点;cu->p1->p1是该结点沿 p1 方向的直接后继;- 因而在
cu->p1 != NULL时,应执行cu->p2 = cu->p1->p1。
算法还必须满足两个条件:
- 处理尾部时不能对 NULL 解引用;
- 无论当前结点是否有 p1 后继,cu 都必须向后移动,否则会出现死循环。
逐项判断:
- A:到达
cu->p1 == NULL的结点时仍访问cu->p1->p1,会对 NULL 解引用。 - B:循环条件检查的是尚未正确建立的 p2,不能保证遍历所有结点;同时也未直接保证 p1 非空。
- C:当
cu->p1 == NULL时不执行 if,cu 也不后移,循环永远无法结束。 - D:p1 非空时正确设置 p2;p1 为空时把 p2 设为 NULL;最后统一沿 p1 后移。
D 的执行逻辑可以整理为:
while (cu != NULL) {
if (cu->p1 != NULL)
cu->p2 = cu->p1->p1;
else
cu->p2 = NULL;
}它既完成了所有 p2 指针的设置,也正确处理了链尾并保证循环能够结束。