2026年41题(回忆版)
强化讲义 · 原始转写 · 原书检索 · 文字用于定位,公式与图表请回原页核验 · 本次导入快照
## 2026年41题(回忆版)
(13分)假定二叉搜索树使用二叉链表存储,存储结构如下:
typedef struct BSTNode{
int data;
struct BSTNode *left,*right;
}BSTNode;
typedef BSTNode BTNode;
int min_diff = INT_MAX;
void InOrder1(BSTNode *t, int k)
{
if (t == NULL) return;
InOrder1(t->left, k);
int diff = abs(t->data - k);
if (diff < min_diff) min_diff = diff;
InOrder1(t->right, k);
}
void InOrder2(BSTNode *t, int k)
{
if (t == NULL) return;
InOrder2(t->left, k);
if (abs(t->data - k) == min_diff) printf("%d ", t->data);
InOrder2(t->right, k);
}
void searchX(BSTNode *root, int k)
{
min_diff = INT_MAX;
InOrder1(root, k);
printf("最小差值为 %d,结点为:", min_diff);
InOrder2(root, k);
}
int min_diff = INT_MAX;
int round = 0;
void InOrder(BSTNode *t, int k)
{
if (t == NULL) return;
InOrder(t->left, k);
if (round == 1)
{
int diff = abs(t->data - k);
if (diff < min_diff) min_diff = diff;
}
else
{
if (abs(t->data - k) == min_diff) printf("%d ", t->data);
}
InOrder(t->right, k);
}
void searchX(BSTNode *root, int k)
{
min_diff = INT_MAX;
round = 1; InOrder(root, k);
printf("%d: ", min_diff);
round = 2; InOrder(root, k);
}
void searchX(BSTNode *root, int k)
{
BSTNode *small = NULL, *big = NULL;
// — 查找 small:比 k 小的最大值 —
BSTNode *p = root;
while (p != NULL)
{
if (p->data == k) H
{
printf("0: %d", p->data);
return;
}
if (p->data < k) // 当前值更小,向右
{
small = p; // 记录 small 候选
p = p->right;
}
if (p->data > k) // 当前值更大,向左走
p = p->left;
}
// — 查找 big:比 k 大的最小值 —
p = root;
while (p != NULL)
{
//命中
{
printf("0: %d", p->data);
return;
}X
if (p->data > k) //当前值更大,向左走
big = p; // 记录 big 候选
p = p->left;
}
if (p->data < k)
p = p->right;
}
// — 比较 small 和 big,输出结果
int d_small, d_big;
if (small != NULL)
d_small = k - small->data;
else
d_small = INT_MAX;
if (big != NULL)
else
d_big = INT_MAX;
if (d_small < d_big) //左边更接近
printf("%d: %d", d_small, small->data);
if (d_big < d_small) // 右边更接近
printf("%d: %d", d_big, big->data);
if (d_small == d_big) //两边一样近
printf("%d: %d %d", d_small, small->data, big->data);
25
void searchX(BSTNode *root, int k)
{
BSTNode *small = NULL, *big = NULL, *p = root;
// — 一次查找,同时维护 small 和 big
while (p != NULL)
{
if (p->data == k) //精确命中
{
printf("0, %d", k);
return;
}
// 当前值 < k,向右
{
small= p; // 更新 small
p = p->right;
}
if (p->data > k) //当前值 > k,向左
big = p; // 更新 big
p = p->left;
}
// — 比较 small 和 big,输出结果 —
int d_small, d_big;
if (small != NULL)
d_small = k - small->data;
else
d small = INT MAX;
if (big != NULL)
d_big = big->data - k;
else
d_big = INT_MAX;
if (d_small < d_big) // 左边更接近
printf("%d, %d", d_small, small->data);
if (d_big< d_small) //右边更接近
printf("%d, %d", d_big, big->data);
if (d_small == d_big) //两边一样近
printf("%d, %d %d", d_small, small->data, big->data);
}
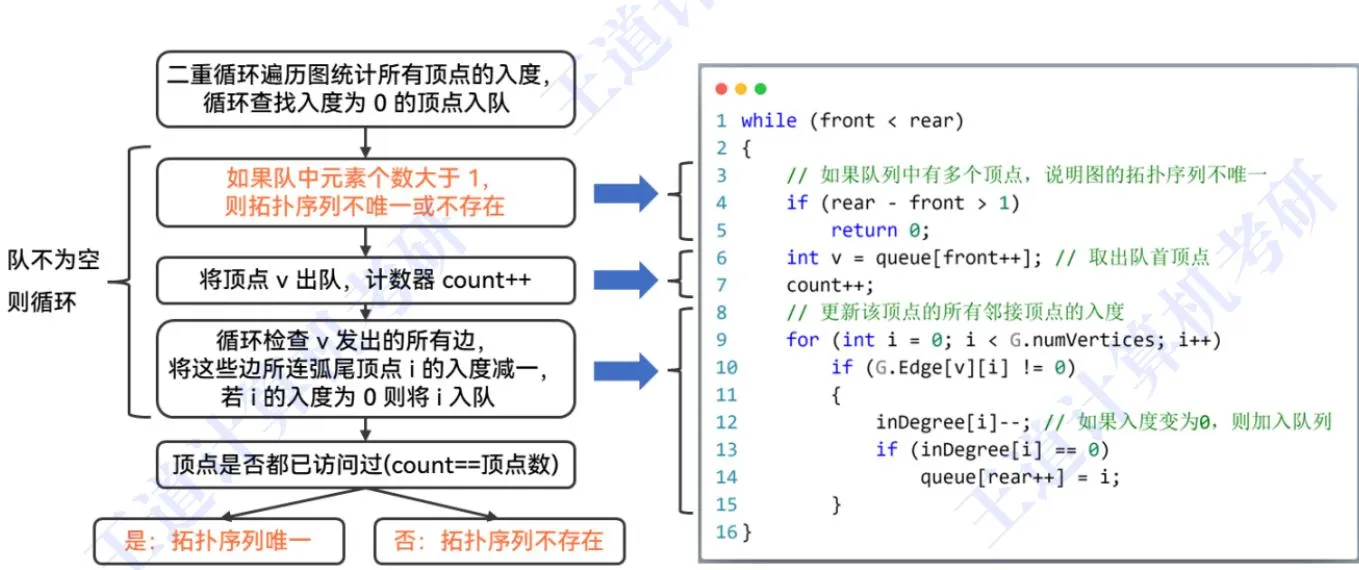 原资料配图 · 转写内容请回源核验
<!-- page 192 -->

## 5.2 图的结构和遍历

在处理图的问题时,首先要确定其存储结构。考试中主要考察两种:邻接矩阵和邻接表。邻接表可以进一步演化为适用于无向图的邻接多重表和适用于有向图的十字链表。

<table><tr><td rowspan=1 colspan=1></td><td rowspan=1 colspan=1>邻接矩阵</td><td rowspan=1 colspan=1>邻接表</td><td rowspan=1 colspan=1>邻接多重表</td><td rowspan=1 colspan=2>十字链表</td></tr><tr><td rowspan=1 colspan=1>有向图</td><td rowspan=1 colspan=1>V</td><td rowspan=1 colspan=1>√</td><td rowspan=1 colspan=1>×</td><td rowspan=1 colspan=2>マ</td></tr><tr><td rowspan=1 colspan=1>无向图</td><td rowspan=1 colspan=1>√</td><td rowspan=1 colspan=1>√</td><td rowspan=1 colspan=1>√</td><td rowspan=1 colspan=1>X</td><td rowspan=1 colspan=1></td></tr></table>

## 5.2.1 邻接矩阵
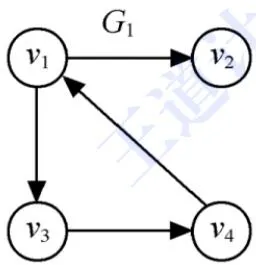 原资料配图 · 转写内容请回源核验
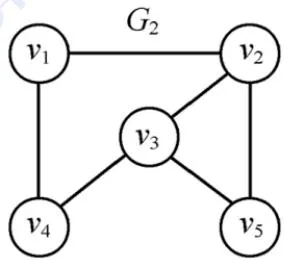 原资料配图 · 转写内容请回源核验
有向图G1
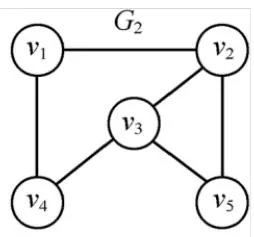
无向图G2
邻接矩阵结构:
#define MAXV 100 // 最大顶点数
typedef struct // 图的定义
{
int numVertices,numEdges; //图中实际的顶点数和边数
char VerticesList[MAXV]; // 可选:每个顶点名称
int Edge[MAXV] [MAXV]; //邻接矩阵
}MGraph;
void TraverseEdges_MGraph(MGraph G)
{
for (int i = 0; i < G.numVertices; i++)
for (int j = 0; j < G.numVertices; j++)
if (G.Edge[i][j] != 0)
visit(i, j); // 如果i→j存在边则处理
}
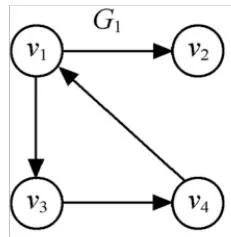 原资料配图 · 转写内容请回源核验
 原资料配图 · 转写内容请回源核验
 原资料配图 · 转写内容请回源核验
 原资料配图 · 转写内容请回源核验
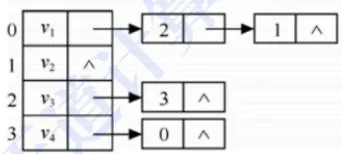
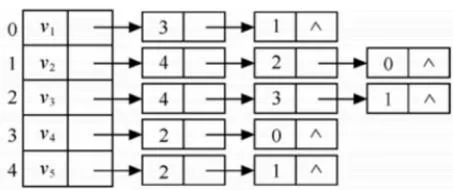
## 邻接表结构:
#define MAXV 100 机考 // 最大顶点数
//边结点
typedef struct ArcNode
{
int adjvex; //邻接点在顶点表中的下标
struct ArcNode *next; //指向下一条边
int weight; //有权图可选:边权值
} ArcNode;
// 顶点结点
typedef struct VNode
{
char data; // 可选:顶点信息
ArcNode *first; //指向第一条邻接边
} VNode;
//邻接表图定义
typedef struct
{
VNode VerticesList[MAXV];// 顶点表
int numVertices,numEdges; // 顶点数、边数
}ALGraph;
typedef struct ArcNode
{
int adjvex;
struct ArcNode *next; // 指向下一条弧的指针
int weight; //有权图可选:边权值
}ArcNode; 土考 //边结点
typedef struct
ArcNode *VerticesList[MAXV]; //顶点数组
typedef struct
{
VNode VerticesList[MAXV];
int numVertices, arcnum;
} ALGraph;
void TraverseEdges_ALGraph(ALGraph G)
{
//遍历所有顶点
for (int i = 0; i < G.numVertices; i++)
//遍历当前顶点i发出的所有边
ArcNode *p = G.VerticesList[i].first;
while (p != NULL)
{
visit(p); //访问对应边
p = p->next; //处理下一条边
}
}