3.1.2 题目的要求
← 内容总览 11 / 24 下一节 → 强化讲义 · 原始转写 · 原书检索 · 文字用于定位,公式与图表请回原页核验 · 本次导入快照
## 3.1.2 题目的要求
如果题目要求空间复杂度是O(1),这就意味着不能额外设置数组,不能将链表先用数组保存然后再进行处理。 人
如果题目要求不可修改链表结构,意思是我们不能随意的对链表元素顺序进行修改以及随意的插入和删除。 Y
<!-- page 101 -->
## 3.1.3 链表定义
题目中经常会有如下描述:
(2) 使用 C 或C++语言,给出单链表结点的数据类型定义。
对这类问题,我们可以提前记忆模板,然后考试中根据题目要求进行改动(仔细审题):
单链表(data 是该结点的权值,一般可以定义成int;next 是指向下一个结点的指针,保存的是下一个结点的位置): 1
<!-- verified-by-hand -->
> [!success] 已结合原文第 101 页及 Markdown 上下文人工校对
> 中文注释缺少注释符,next 字段后的说明同样混入代码。
typedef struct LNode
{
ElemType data ; // 该结点的权值
struct LNode * next ; // 指向下一个结点
} LNode ;
typedef struct LNode
{
ElemType data ;
struct LNode * prior , * next ;
} LNode ;
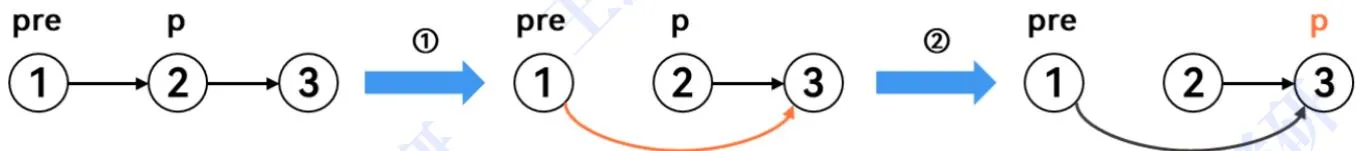
pre -& gt ; next = p -& gt ; next ; // ① 将pre的next域指向p的下一个结点
Node * temp = p ;
p = p -& gt ; next ; //②将p指向p的下一个结点
free ( temp );
原资料配图 · 转写内容请回源核验
在考试中删除p结点之后一般还需要将p移动到下一个结点,所以删除时需要注意两个问题: K 尊
删除操作不要导致断链。
要能够找到下一次待处理的结点,即p要更新所指结点。
pre -& gt ; next = p -& gt ; next ; //①将pre的next域指向p的下一个结点
p = p -& gt ; next ; //②将p指向p的下一个结点
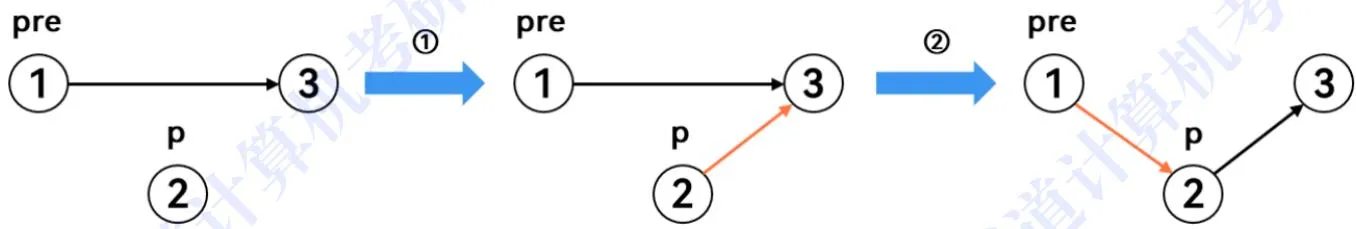
p -& gt ; next = pre -& gt ; next ; // ① 将p的next域指向pre的下一个结点
pre -& gt ; next = p ; // ②将pre的next域指向p对应结点
原资料配图 · 转写内容请回源核验
<!-- page 104 -->

## 3.2.3 尾插法和头插法

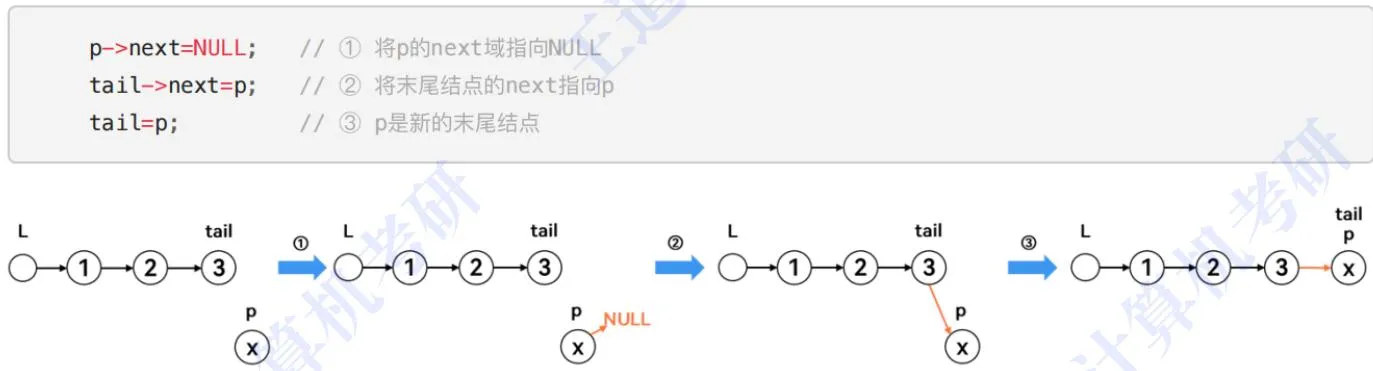
当我需要插入很多个元素到空链表中,而且要保证插入元素的顺序就是最终链表中元素的顺序,可以使用尾插法,即每次都是在链表末尾插入p,需要设置一个指针tail指向链表末尾的元素:
原资料配图 · 转写内容请回源核验
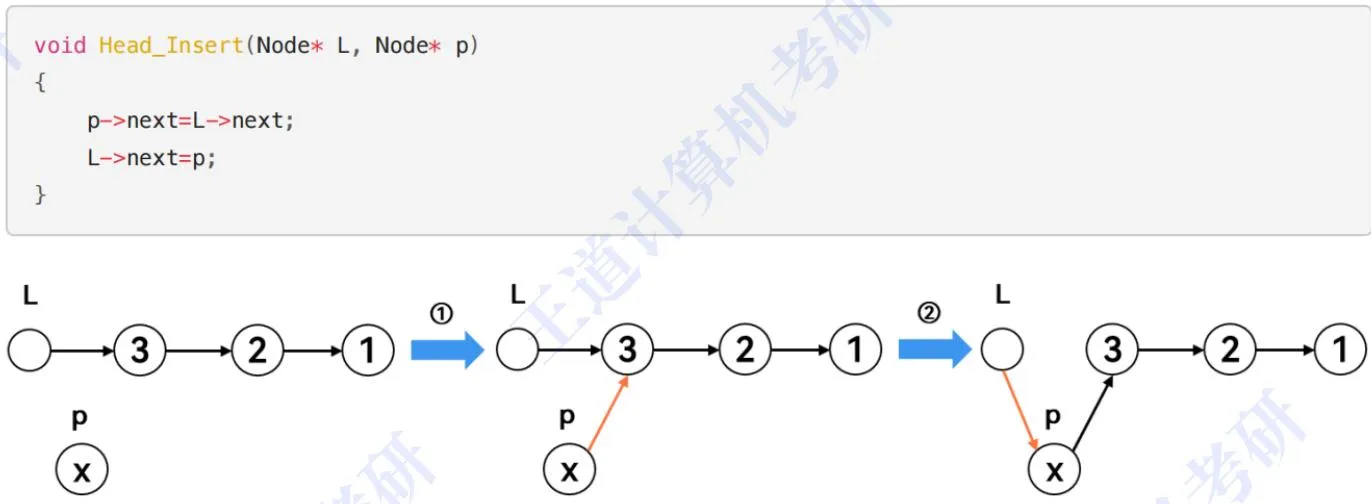
而如果想让插入顺序和链表最终顺序相反,则不应使用尾插法而使用头插法,是将一个结点p插入到头结点 和其原来的第一个数据结点之间。这种方法常用于实现链表的逆置,具体使用请看3.5.3。
原资料配图 · 转写内容请回源核验
所有的单链表插入都应该是先连后,再连前,这样一定不会断链。
假如插入顺序是1、2、3、x,如果使用尾插法插入则链表最终顺序为1、2、3、x(和插入顺序相同),如果使用头插法插入则链表最终顺序为x、3、2、1(和插入顺序相反)。
<!-- page 105 -->
## 3.2.4 遍历链表
对于线性表(数组+链表)的遍历,如果表中元素个数确定就用 for 循环,否则用 while 循环。在遍历过程中访问指针p每次都需要后移即p=p->next,不要忘记。链表一般是带头结点的,所以遍历时应从L->next 开始。
## 元素个数 n 已知
<!-- verified-by-hand -->
> [!success] 已结合原文第 105 页及 Markdown 上下文人工校对
> visit 后的中文说明缺少注释符;其余循环结构完整。
Node * p = L -& gt ; next ;
int n = 0 ;
while ( p != NULL )
{
n ++ ;
visit ( p ); // 访问 p 结点
p = p -& gt ; next ;
}
Node * p = L -& gt ; next ;
while ( p != NULL )
{
visit ( p ); // 访问p结点
p = p -& gt ; next ;
}
Node * p = L -& gt ; next ;
int n = 0 ;
while ( p != NULL )
{
n ++ ;
visit ( p ); 访问p结点
p = p -& gt ; next ;
}
for ( Node * p = L -& gt ; next ; p != NULL ; p = p -& gt ; next ) visit ( p );
// 查找并插入p
void Find_Insert ( ListNode * pre , ListNode * p )
{
while ( pre -& gt ; next != NULL & amp ; & amp ; pre -& gt ; next -& gt ; data & lt ; p -& gt ; data ) //查找插入位置
pre = pre -& gt ; next ;
p -& gt ; next = pre -& gt ; next ;
pre -& gt ; next = p ; //将p插入到pre之后
Node * ans ( Node * L )
{
Node * p = L -& gt ; next ;
L -& gt ; next = NULL ;
while ( p != NULL )
{
Find_Insert ( L , p );
p = temp ;
}
return L ; // 十算机
}
}
//快速排序
void Qsort ( int A [], int L , int R )
{
if ( L & gt ; = R )
return ;
int pivot , i = L , j = R ;
pivot = A [ L ];
while ( i & lt ; j )
{
while ( i & lt ; j & amp ; & amp ; A [ j ] & gt ; = pivot ) j -- ;
while ( i & lt ; j & amp ; & amp ; A [ i ] & lt ; = pivot ) i ++ ;
if ( i & lt ; j )
swap ( A [ i ], A [ j ]); // A[j]<pivot<A[i],交换
}
swap ( A [ L ], A [ i ]); //基准归位
Qsort ( A , L , i -1 );
Qsort ( A , i + 1 , R );
}
Node * ans ( Node * L )
{
Node * p = L -& gt ; next ;
// 链表转数组
while ( p != NULL )
{
//
visit ( p );
a [ n ] = p -& gt ; data ;
n ++ ;
p = p -& gt ; next ;
}
Qsort ( a , 0 , n -1 );
// 数组转链表
p = L -& gt ; next ;
for ( int i = 0 ; i & lt ; n ; i ++ )
{
p -& gt ; data = a [ i ];
p = p -& gt ; next ;
}
return L ;
}
void Merge ( int A [], int n , int B [], int m )
{
int C [ n + m ];
int i = 0 , j = 0 , k = 0 ;
//直到有一个数组遍历完退出循环
while ( i & lt ; n & amp ; & amp ; j & lt ; m )
if ( A [ i ] & lt ; B [ j ])
C [ k ++ ] = A [ i ++ ];
else
C [ k ++ ] = B [ j ++ ];
// 复制A 中剩余的元素
while ( i & lt ; n )
C [ k ++ ] = A [ i ++ ];
// 复制 B 中剩余的元素
while ( j & lt ; m )
C [ k ++ ] = B [ j ++ ];
从左到右输出数组C中的元素
}
//归并操作
void Merge ( LNode * L1 , LNode * L2 )
{
// p 和 q 分别指向两个链表的第一个数据结点
LNode * p = L1 -& gt ; next ;
LNode * q = L2 -& gt ; next ;
//创建一个新的头结点L3,并用tail指向它
LNode * tail = L3 ;
//遍历两个链表,直到其中一个为空
while ( p != NULL & amp ; & amp ; q != NULL )
{
if ( p -& gt ; data & lt ; = q -& gt ; data )
{
tail -& gt ; next = p ;
p = p -& gt ; next ;
else
tail -& gt ; next = q ;
q = q -& gt ; next ;
tail = tail -& gt ; next ; //移动 tail 指针到新链表的末尾
}
//将未处理完的链表剩余部分直接链接到tail 之后
if ( p != NULL ) tail -& gt ; next = p ;
else tail -& gt ; next = q ;
//释放原始链表的头结点,可以省略
free ( L1 );
free ( L2 );
return L3 ;
}
}
Node * p , * q ;
p = q = L -& gt ; next ;
while ( p != NULL & amp ; & amp ; q != NULL )
{
p = p -& gt ; next ;
q = q -& gt ; next ;
if ( q == NULL )
break ;
if ( p == q )
有环 √ / p和q相遇
}
Node * p , * q ;
p = q = L -& gt ; next ;
while ( p != NULL & amp ; & amp ; q != NULL )
{
q = q -& gt ; next ;
if ( q == NULL || q -& gt ; next == NULL )
break ;
q = q -& gt ; next ;
p = p -& gt ; next ;
if ( p == q )
有环 // p和q相遇
}
Node * p , * q ;
p = q = L ;
for ( int i = 0 ; i & lt ; k ; i ++ )
q = q -& gt ; next ; //假设链表长度>=k
while ( q != NULL )
{
p = p -& gt ; next ;
q = q -& gt ; next ;
}
输出p
//链表做法
{
Node * p = L -& gt ; next ;
while ( p != NULL )
{
//visit(p);
if ( count [ p -& gt ; data ] & gt ; 0 )
cout & lt ; & lt ; p -& gt ; data ;
count [ p -& gt ; data ] ++ ; // 要注意p->data是否可能超过数组下标
p = p -& gt ; next ;
}
}
//顺序表做法
void Hash_Sequence ( int a [], int n )
{
int count [ n ] = { 0 };
for ( int i = 0 ; i & lt ; n ; i ++ )
{
if ( count [ a [ i ]] & gt ; 0 )
cout & lt ; & lt ; a [ i ];
count [ a [ i ]] ++ ; // 要注意a[i]是否可能超过数组下标
}
}
for ( int i = 0 ; i & lt ; n / 2 ; i ++ )
swap ( A [ i ], A [ n - i -1 ]);
// 逆置操作
void Head_Insert ( ListNode * L , ListNode * p )
{
p -& gt ; next = L -& gt ; next ;
L -& gt ; next = p ;
}
void Reverse ( ListNode * L )
{
ListNode * p = L -& gt ; next ;
L -& gt ; next = NULL ;
while ( p != NULL )
{
ListNode * temp = p -& gt ; next ;
Head_Insert ( L , p );
p = temp ; // 更新p,指向下一个待处理结点
}
}
//逆置操作
ListNode * Head_Insert ( ListNode * L , ListNode * p )
{
ListNode * temp = p -& gt ; next ;
p -& gt ; next = L -& gt ; next ;
L -& gt ; next = p ;
return temp ; // 返回原来p的下一个元素
void Reverse ( ListNode * L ) //主代码段
{
ListNode * p = L -& gt ; next ;
L -& gt ; next = NULL ;
while ( p != NULL )
更新p , 指向下一个待处理结点
}
}
← 内容总览 11 / 24 下一节 →