步骤:
← 内容总览 20 / 24 下一节 → 强化讲义 · 原始转写 · 原书检索 · 文字用于定位,公式与图表请回原页核验 · 本次导入快照
## 步骤:
1. 初始化。初始化距离数组 dist,dist[s]= 0,所有其他顶点的距离为无穷大∞。同时,初始化路径数组 path 用于记录前驱结点。
<!-- page 207 -->
2. 循环直到所有顶点都已确定:a. 每次选择距离dist最小的、未选择过已确定顶点u。b.将顶点u视为已确定的顶点,之后不再考虑。c. 将u出发的所有邻接点ν做松弛:
if ( dist [ u ] + w ( u , v ) & lt ; dist [ v ])
dist [ v ] = dist [ u ] + w ( u , v );
int Dijkstra ( MGraph G , int start )
{
int dist [ MAXV ], path [ MAXV ];
// 1. 初始化
bool visited [ MAXV ] = { false }; // 记录顶点是否已确定
for ( int i = 0 ; i & lt ; G . numVertices ; i ++ )
{
dist [ i ] = INT_MAX ; path [ i ] = -1 ;
}
//将起点到自身的距离设为0
dist [ start ] = 0 ;
//2.循环G.numVertices 次,每次找到一个最短路径并更新其他顶点
for ( int i = 0 ; i & lt ; G . numVertices ; i ++ )
{
//a.在未访问的顶点中,找到距离起点最近的顶点u
// 在第一次循环中,由于 dist[start] = 0,u 会被自然地赋值为 start
int u = -1 ;
int min_dist = INT_MAX ;
{
if ( visited [ j ] == false & amp ; & amp ; dist [ j ] & lt ; min_dist )
{
min_dist = dist [ j ];
u = j ;
}
}
// 如果找不到下一个顶点说明是非连通图
// b标记 u 为已访问
visited [ u ] = true ;
// c. 松弛操作:更新从u出发能够到达的所有未访问顶点的距离
for ( int v = 0 ; v & lt ; G . numVertices ; v ++ )
{
//条件:V未被访问过,目存在从 u到V的边
// 并且通过u到达V的路径比当前记录的路径更短
if ( ! visited [ v ] & amp ; & amp ; G . Edge [ u ][ v ] != 0 & amp ; & amp ; dist [ u ] + G . Edge [ u ][ v ] & lt ; dist [ v ])
{
// 更新V 的最短距离和前驱结点
dist [ v ] = dist [ u ] + G . Edge [ u ][ v ];
path [ v ] = u ;
}
}
}
根据 dist 数组输出长度 , 根据 path 数组输出路径
return 0 ;
}
void Dijkstra_AL ( ALGraph G , int start )
{
int dist [ MAXV ], path [ MAXV ];
bool visited [ MAXV ] = { false };
for ( int i = 0 ; i & lt ; G . numVertices ; i ++ )
{
dist [ i ] = INT_MAX ;
path [ i ] = -1 ;
}
dist [ start ] = 0 ;
for ( int i = 0 ; i & lt ; G . numVertices ; i ++ )
{
int min_dist = INT_MAX , u = -1 ;
for ( int j = 0 ; j & lt ; G . numVertices ; j ++ )
if ( ! visited [ j ] & amp ; & amp ; dist [ j ] & lt ; min_dist )
{
min_dist = dist [ j ];
u = j ;
}
if ( u == -1 ) break ;
visited [ u ] = true ;
for ( ArcNode * p = G . VerticesList [ u ]. first ; p != NULL ; p = p -& gt ; next )
{
int v = p -& gt ; adjvex ;
if ( ! visited [ v ] & amp ; & amp ; dist [ u ] & lt ; = INT_MAX - p -& gt ; weight & amp ; & amp ; dist [ u ] + p -& gt ; weight & lt ; dist [ v ])
{
dist [ v ] = dist [ u ] + p -& gt ; weight ;
path [ v ] = u ;
}
}
}
}
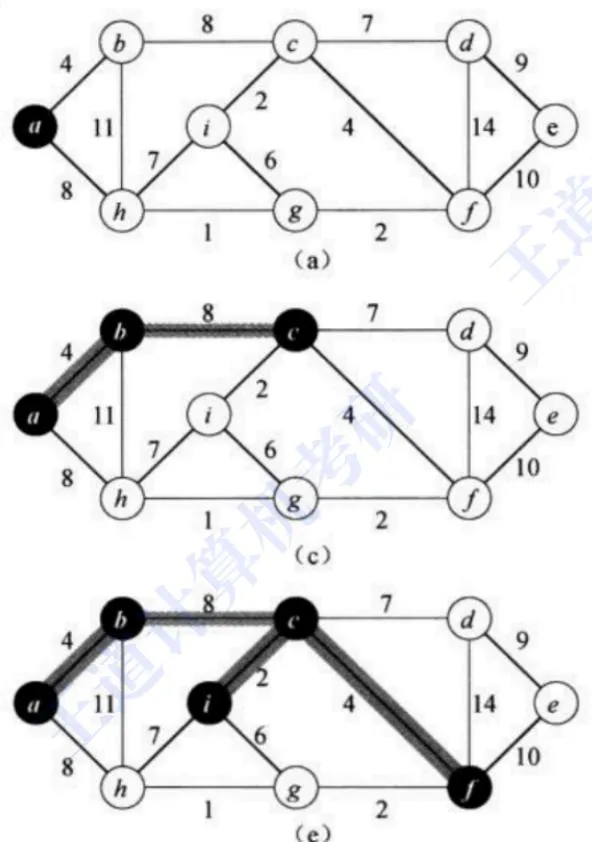
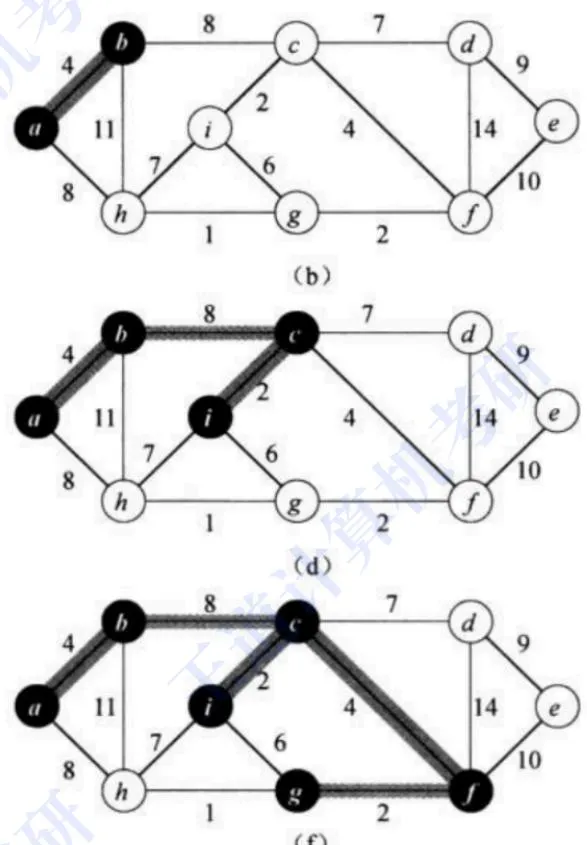
原资料配图 · 转写内容请回源核验 原资料配图 · 转写内容请回源核验
<!-- page 211 -->
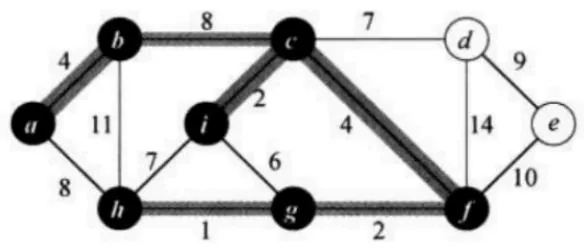
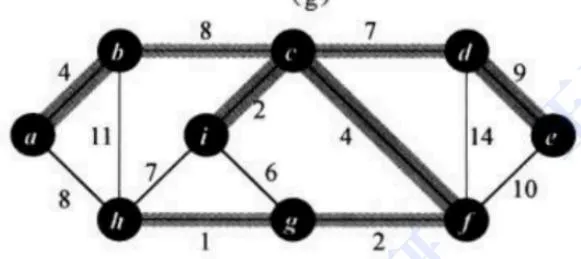
原资料配图 · 转写内容请回源核验 原资料配图 · 转写内容请回源核验 原资料配图 · 转写内容请回源核验
## 邻接矩阵
## 伪代码如下:
<!-- verified-by-hand -->
> [!success] 已结合原文第 211 页及 Markdown 上下文人工校对
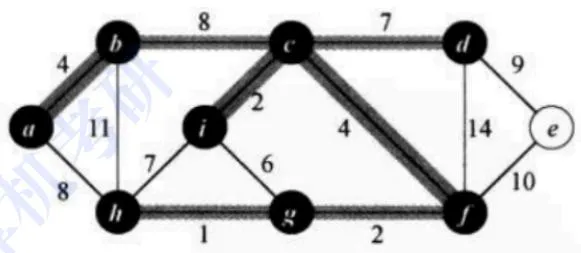
> 最小顶点选择时无条件覆盖 min 和 k,更新时没有排除用 0 表示的无边;作用域、赋值符和输出语句也被破坏。
void Prim ( MGraph G )
{
int cost [ MAXV ], parent [ MAXV ];
bool visited [ MAXV ] = { false };
int start = 0 ;
for ( int i = 0 ; i & lt ; G . numVertices ; i ++ )
{
if ( G . Edge [ start ][ i ] != 0 )
{
cost [ i ] = G . Edge [ start ][ i ];
parent [ i ] = start ;
}
else
{
cost [ i ] = INT_MAX ;
parent [ i ] = -1 ;
}
}
cost [ start ] = 0 ;
visited [ start ] = true ;
for ( int i = 1 ; i & lt ; G . numVertices ; i ++ )
{
int min_cost = INT_MAX , k = -1 ;
for ( int j = 0 ; j & lt ; G . numVertices ; j ++ )
if ( ! visited [ j ] & amp ; & amp ; cost [ j ] & lt ; min_cost )
{
min_cost = cost [ j ];
k = j ;
}
if ( k == -1 ) break ;
visited [ k ] = true ;
output_edge ( parent [ k ], k );
for ( int j = 0 ; j & lt ; G . numVertices ; j ++ )
if ( ! visited [ j ] & amp ; & amp ; G . Edge [ k ][ j ] != 0 & amp ; & amp ; G . Edge [ k ][ j ] & lt ; cost [ j ])
{
cost [ j ] = G . Edge [ k ][ j ];
parent [ j ] = k ;
}
}
}
int parent [ MAXV ];
//边结构体定义
typedef struct {
int u , v ; // 边的两个顶点
int weight ; //边的权值
} Edge ;
//查找根结点 int Find(int x)
if ( parent [ x ] != x )
parent [ x ] = Find ( parent [ x ]); //路径压缩
return parent [ x ];
}
//并查集:合并集合
{
parent [ Find ( y )] = Find ( x );
}
void Kruskal ( ALGraph G )
{
Edge edges [ MAXE ]; //边集数组
int count = 0 ; //统计已纳入生成树中的边数
//1.题目给出从小到大排序的边数组或给出优先队列(堆)
不妨假设所有的边已经在数组 edges 中 , 边的数量为m
Qsort ( edges [], 0 , G . numEdges -1 );
//2.初始化并查集,初始时所有顶点属于不同集合
parent [ i ] = i ;
for ( int i = 0 ; i & lt ; m ; i ++ )
{
//3-a.对于还未处理的最小边,使用并查集判断该边的两个端点分别属于哪个集合
int rootU = Find ( edges [ i ]. u );
int rootV = Find ( edges [ i ]. v );
if ( rootU != rootV )
{
Union ( rootU , rootV );
将该边加入到生成树中
count ++ ;
if ( count == G . numVertices -1 ) break ; // 已选择 n-1 条边
}
}
输出最小生成树 机考研
}
原资料配图 · 转写内容请回源核验
## 核心目的:
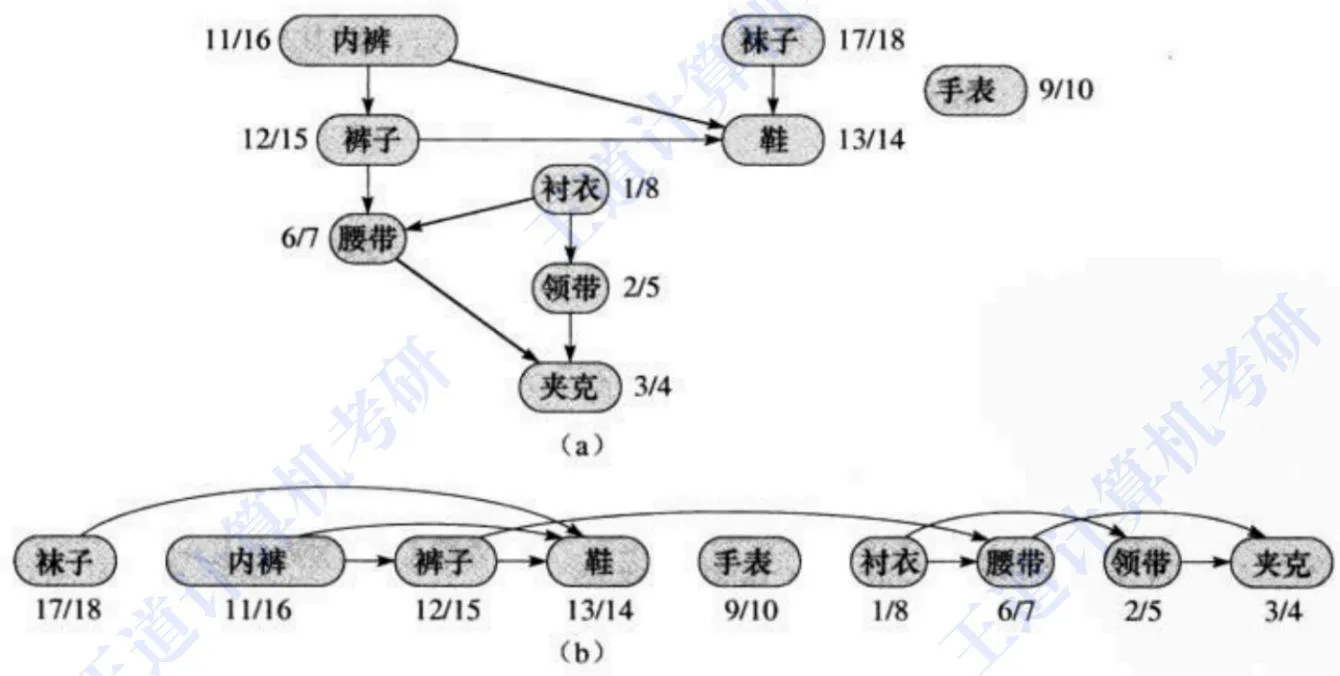
解决有向无环图(DAG)中顶点的先后顺序问题,得到拓扑序列。
如果顶点 a 到顶点 b 存在有向边,则在拓扑序列中,顶点 a 会在顶点b 前面。
如果该有向图无环,则拓扑序列存在。如果该有向图有环,则拓扑序列不存在。
<table><tr><td rowspan=1 colspan=1>拓扑序列</td><td rowspan=1 colspan=1>条件</td></tr><tr><td rowspan=1 colspan=1>存在且唯一</td><td rowspan=1 colspan=1>每次选择结点时都只有一个结点可选</td></tr><tr><td rowspan=1 colspan=1>存在且不唯一</td><td rowspan=1 colspan=1>选择结点时不止一个结点可选</td></tr><tr><td rowspan=1 colspan=1>不存在</td><td rowspan=1 colspan=1>图中有环,环中的顶点未被访问</td></tr></table>
## 步骤:
1. 统计每个顶点的入度。
2. 将入度为0 的顶点入队。
3. 队列出队一个顶点,访问它,并将它的出边所指向顶点的入度减1。
4. 若减到0,再次入队。
5. 队列为空,排序完成;若有未访问顶点,存在环。
## 邻接表
时间复杂度:O(n+e)
代码如下:
<!-- page 216 -->
void TopoSort ( ALGraph G )
{
int indegree [ MAXV ] = { 0 };
//计算每个顶点的入度
for ( int i = 0 ; i & lt ; G . numVertices ; i ++ )
{
while ( p != NULL )
{
indegree [ p -& gt ; adjvex ] ++ ;
p = p -& gt ; next ;
}
}
int queue [ MAXV ], front = 0 , rear = 0 ;
for ( int i = 0 ; i & lt ; G . numVertices ; i ++ )
if ( indegree [ i ] == 0 )
queue [ rear ++ ] = i ;
while ( front & lt ; rear )
{
int u = queue [ front ++ ];
输出顶点u
//此处可判断是否只有一个顶点可选,即front+1==rear
for ( ArcNode * p = G . VerticesList [ u ]. first ; p != NULL ; p = p -& gt ; next )
{
int v = p -& gt ; adjvex ;
if ( -- indegree [ v ] == 0 )
queue [ rear ++ ] = v ;
}
}
if ( rear & lt ; G . numVertices )
拓扑序列不存在 , 该有向图存在环
}
void TopoSort ( MGraph G )
{
int indegree [ MAXV ] = { 0 };
//计算每个顶点的入度
for ( int i = 0 ; i & lt ; G . numVertices ; i ++ )
for ( int j = 0 ; j & lt ; G . numVertices ; j ++ )
if ( G . Edge [ i ][ j ] != 0 ) //存在边 i→j
indegree [ j ] ++ ;
}
int queue [ MAXV ], front = 0 , rear = 0 ;
for ( int i = 0 ; i & lt ; G . numVertices ; i ++ )
if ( indegree [ i ] == 0 ) queue [ rear ++ ] = i ;
while ( front & lt ; rear )
{
int u = queue [ front ++ ];
output ( u );
for ( int v = 0 ; v & lt ; G . numVertices ; v ++ )
if ( G . Edge [ u ][ v ] != 0 & amp ; & amp ; -- indegree [ v ] == 0 )
queue [ rear ++ ] = v ;
}
if ( rear & lt ; G . numVertices ) report_cycle ();
原资料配图 · 转写内容请回源核验
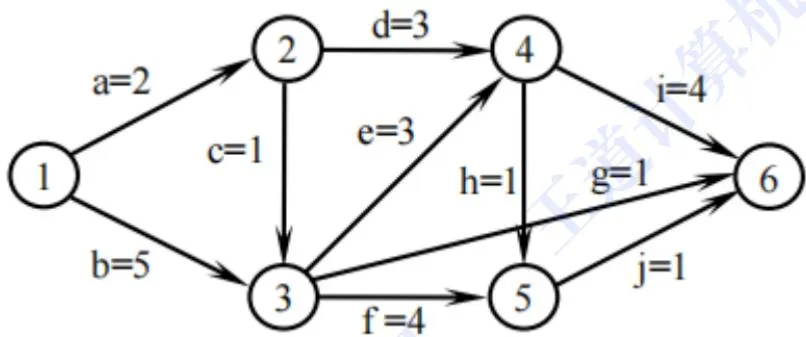
以边表示活动的网叫AOE网,它是带权无环图,顶点表示事件,弧表示活动,权表示活动持续的时间。通常,AOE-网可用来估算工程的完成时间。

在正常的情况(无环)下,网中只有一个入度为0的点,称作源点,也只有一个出度为0的点,称作汇点。在AOE-网中,一条路径各弧上的权值之和称为该路径的带权路径长度(后面简称路径长度)。要估算整项工程完成的最短时间,就是要找一条从源点到汇点的带权路径长度最长的路径,称为关键路径。

关键路径上的活动叫作关键活动,这些活动是影响工程进度的关键,它们的提前或延期将使整个工程提前或延期。

目的:关键路径用于工程调度、项目管理等任务中,找出一条耗时最长的必经路径,控制整个项目进度。
← 内容总览 20 / 24 下一节 →