4.1 树概述

强化讲义 · 原始转写 · 原书检索 · 文字用于定位,公式与图表请回原页核验 · 本次导入快照

## 4.1 树概述

## 4.1.1 思考流程

树和图的题目一般不会特别要求复杂度,如果没有特别要求的话,考试中只要做出来就可以直接写,不用考虑优化问题。一般都会考察树的遍历,除非特别说明,否则遍历就用递归写,不要写非递归。

<!-- page 148 -->

## 4.1.2 考察结构

树和森林

树和森林(孩子兄弟表示法)

firstchild 是指向该结点第一个儿子结点的指针,nextbro 是指向下一个兄弟结点的指针

<!-- verified-by-hand -->
> [!success] 已结合原文第 148 页及 Markdown 上下文人工校对
> 孩子兄弟表示法结构体左花括号丢失。
typedef struct TNode
{
    ElemType data;
    struct TNode *firstchild, *nextbro;
} TNode;
树和森林(结点用双亲表示法存储,常用于并查集) 一般采用数组表示,father数组保存每个结点的父亲结点在数组中的下标:
int father[MAX_SIZE]; //保存每个结点的父亲结点在数组中的下标
或者 <!-- verified-by-hand --> > [!success] 已结合原文第 148 页及 Markdown 上下文人工校对 > 双亲表示法结构体左花括号丢失。
typedef struct TNode
{
    ElemType data;
    struct TNode *father;
} TNode;
## 二叉树 二叉树 (二叉链表) <!-- verified-by-hand --> > [!success] 已结合原文第 148 页及 Markdown 上下文人工校对 > 二叉链表结构体左花括号丢失。
typedef struct BTNode
{
    ElemType data;
    struct BTNode *lchild, *rchild;
} BTNode;
## 二叉树(顺序) <!-- verified-by-hand --> > [!success] 已结合原文第 148 页及 Markdown 上下文人工校对 > 顺序二叉树结构体左花括号丢失。
typedef struct
{
    int SqBiTNode[MAX_SIZE];
    int ElemNum;
} SqBiTree;
<!-- page 149 --> 对于完全二叉树,只要从根起按层序存储即可,依次自上而下、自左至右存储结点元素,即将完全二叉树上编号为i的结点元素存储在如上定义的一维数组中下标为i-1的位置。可以用-1或者0表示对应结点不存在。 T1.SqBiTNode <table><tr><td rowspan=1 colspan=1>40</td><td rowspan=1 colspan=1>25</td><td rowspan=1 colspan=1>60</td><td rowspan=1 colspan=1>-1</td><td rowspan=1 colspan=1>30</td><td rowspan=1 colspan=1></td><td rowspan=1 colspan=1>80</td><td rowspan=1 colspan=1>-1</td><td rowspan=1 colspan=1>-1</td><td rowspan=1 colspan=1>27</td><td rowspan=1 colspan=1></td><td rowspan=1 colspan=1></td></tr></table> T1.ElemNum = 10 40 60 30 80 27 <!-- page 150 --> ## 4.2 树的递归遍历 树的遍历是408代码题的常考点,包括2014、2017、2022年,只要考察树必然需要用到遍历,一般是考察树的遍历+某种树的定义(如二叉搜索树),而二叉树的遍历包括先序中序后序遍历,他们又分为递归和非递归两种方式,每一种遍历的非递归逻辑都完全不一样,复习起来很痛苦也没有必要,而递归的代码逻辑非常简单,所以考试中除了特殊情况,树的遍历请一定使用递归(递归简单好用)。 XX ## 4.2.1 二叉树的递归遍历 递归,从本质上讲,是分治思想的一种完美体现。分治策略就是“分而治之”,它将一个复杂的大问题分解成若干个规模更小、但结构与原问题相同的子问题,然后逐个解决。 在二叉树的遍历中,分:将“遍历整棵树”这个大问题,分解为三个更小的问题: 访问根结点本身。 遍历左子树(一个规模更小的相同问题)。 遍历右子树(另一个规模更小的相同问题)。 因此,我们可以把递归想象成一个“任务分包”的过程。你作为“总指挥”,只需要应用分治思想,关注当前结点,并把子树的任务“外包”出去。 处理二叉树我们总共需要完成三个工作: 处理好你当前手头的工作(即访问结点p本身)。 把遍历左子树的整个任务,完全甩给你的“左下属”(处理左子树order(p->lchild))。 把遍历右子树的整个任务,完全甩给你的“右下属”(处理右子树order(p->rchild))。 核心信念:当你调用order(p->lchild)时,你不需要关心它内部是如何一步步执行的。你只需要完全信任这个调用,相信它一旦执行,就一定能帮你把整个左子树完美地遍历一遍。同理,order(p->rchild)也一样。 有了这个“信任”,你的工作就变得极其简单:你只需要考虑三件事(访问自己、调用左下属、调用右下属)的执行顺序即可。把复杂的大问题,分解成了在当前结点的一个极小问题。 ## 遍历 order 先序遍历 PreOrder: 1. 访问自己 visit(p); 2. 调用左 PreOrder(p->lchild); 3. 调用右 PreOrder(p->rchild); 中序遍历 InOrder: 1. 调用左 InOrder(p->Ichild); <!-- page 151 --> <!-- code-audit: false_positive --> > [!info] 已人工审读:这是分步讲解中的伪代码短句,不是独立 C 程序。
2. 访问自己 visit(p);
<!-- code-audit: false_positive --> > [!info] 已人工审读:这是分步讲解中的伪代码短句,不是独立 C 程序。
3. 调用右 InOrder(p-&gt;rchild);
后序遍历 PostOrder: 1. 调用左 PostOrder(p->lchild); 2. 调用右 PostOrder(p->rchild); 3. 访问自己 visit(p); 先访问自己是先序,在中间访问自己是中序,最后访问自己是后序 先中后序的递归遍历时间复杂度为 O(n),空间复杂度为 O(h),n 是总结点数,h 是树高,如果不确定树高则空间复杂度为O(n)。 <!-- verified-by-hand --> > [!success] 已结合原文第 151 页及 Markdown 上下文人工校对 > PreOrder/PostOrder 中 O 被识别成 0,后序函数头和左花括号整行丢失。
void PreOrder(BTNode *p)
{
    if (p == NULL) return;
    visit(p); PreOrder(p-&gt;lchild); PreOrder(p-&gt;rchild);
}
void InOrder(BTNode *p)
{
    if (p == NULL) return;
    InOrder(p-&gt;lchild); visit(p); InOrder(p-&gt;rchild);
}
void PostOrder(BTNode *p)
{
    if (p == NULL) return;
    PostOrder(p-&gt;lchild); PostOrder(p-&gt;rchild); visit(p);
}
<!-- page 152 --> ## 4.2.2 树和森林的递归遍历 树和森林的递归遍历本质上是对孩子兄弟表示法结构的递归操作,重点在于掌握: firstchild 表示第一个孩子(相当于“左子树”)。 nextbro 表示兄弟结点(相当于“右子树”)。 即“左孩子右兄弟”。 也就是说,这种结构可以转化为“二叉树”模型来理解递归逻辑。 树和森林的先根遍历等价于二叉树的先序遍历。 树和森林的后根遍历等价于二叉树的中序遍历。 先根遍历(等价于先序遍历):
void TreePre0rder(TNode *T)
{
    if (T == NULL) return;
    visit(T); // 访问当前结点
    TreePre0rder(T-&gt;firstchild); // 递归访问第一个孩子
    TreePre0rder(T-&gt;nextbro); //递归访问兄弟结点
}
后根遍历(孩子都访问完再访问根,等价于中序遍历):
void TreePost0rder(TNode *T) // 王進
{
    if (T == NULL) return;
    TreePostOrder(T-&gt;firstchild); //先访问所有孩子
    visit(T); // 最后访问根
    TreePost0rder(T-&gt;nextbro); //然后访问兄弟结点
}
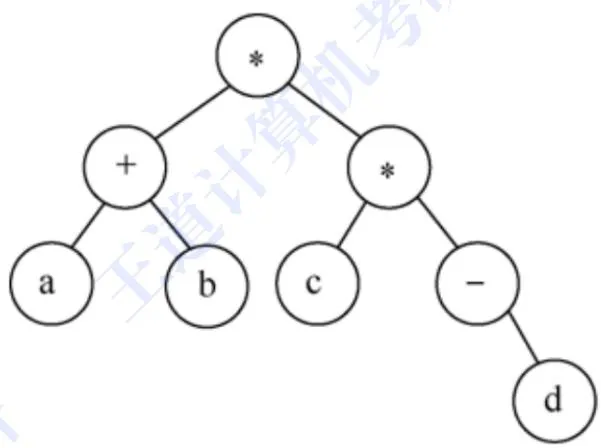
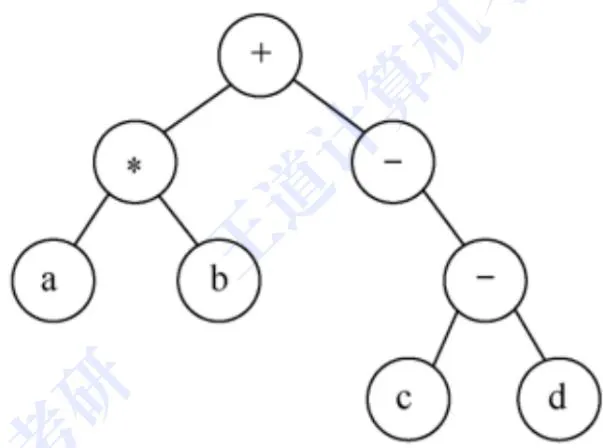
关键还是掌握二叉树的三种遍历,在二叉树遍历的基础上稍加修改就得到树和森林的遍历 <!-- page 153 --> ## 4.3 树的做题方法 408中树算法考察的核心是树的遍历,所以在做题应确定遍历,以对应遍历作为框架做题。建议分成四步:审题—写框架—填充——调整,其中第一步是最重要的。 请阅读2017 年41题 (15分)请设计一个算法,将给定的表达式树(二叉树)转换为等价的中缀表达式(通过括号反映操作符的计算次序)并输出。例如,当下列两棵表达式树作为算法的输入时,输出的等价中缀表达式分别为(a+b)×(c×(-d))和(a×b)+(-(c-d))。
原资料配图
原资料配图 · 转写内容请回源核验

二叉树结点定义如下:

原资料配图
原资料配图 · 转写内容请回源核验

typedef struct node{
    char data[10]; //存储操作数或操作符
    struct node *left, *right;
}BTree;
## 4.3.1 审题并分析 根据题目的要求,从根结点开始想一下按递归的方式需要当前结点做什么?然后根据访问顺序确定x序遍历。确定思路以后再回头看题检查是否满足了题目要求。 选择遍历方式的依据:处理p时需要子树的结果吗?不需要则先序;需要则后序;需要有序则中序;需要按层则层序。 先序(根→左→右):不依赖子树。如统计叶子、复制树、序列化、查找结点。 中序(左→根→右):利用有序性。如 BST 判合法、求第 k小、输出中缀表达式。 后序(左→右→根):依赖子树结果。如求深度、判平衡、删树、求直径。 层序(逐层扫描):需要层级信息。如最短路径、判完全二叉树、求宽度、按层输出。需队列。 X算 2017年41题分析:本题需要输出中缀表达式,因此考虑使用中序遍历。在访问每一个结点的时候需要输出该结点的data域。对于所有的不为原树也不为叶结点的子树,这种子树对应 <!-- page 154 --> 的式子两边都需要加括号。 ## 4.3.2 草稿纸上书写框架 写法1:只写递归过程部分(递归实现遍历,确定是什么序遍历),输出靠递归返回的参数。框架以中序为例: <!-- code-audit: false_positive --> > [!info] 已人工审读:这是用“返回值/xx”作占位符的教学模板,刻意不是可编译代码。
// 需要返回值
int In0rder(BTNode *p) //返回类型不—定是int
{
    if (p==NULL) return 返回值;
    In0rder(p-&gt;lchild); // 调用根据题目修改
    visit(p); //是最重要的部分,根据题目要求决定
    InOrder(p-&gt;rchild);
    return xx;
}
// 不需要返回值
void InOrder(BTNode *p)
{
    if (p==NULL) return;
    In0rder(p-&gt;lchild); // 调用根据题目修改
    visit(p); //是最重要的部分,根据题目要求决定
    InOrder(p-&gt;rchild);
}
如果递归过程即可完成所有功能则使用写法1,大部分问题都可以使用,建议优先使用。 写法2:程序分为两个部分:本题主过程部分ans(负责调用递归过程以及输入输出)、和对应的递归过程部分(递归实现遍历,确定是什么序遍历)。框架以中序为例: <!-- code-audit: false_positive --> > [!info] 已人工审读:这是展示递归框架的教学伪代码,中文是有意的占位说明。
int InOrder(BTNode *p)
{
    if(p==NULL) return  // 返回值;
    In0rder(p-&gt;lchild); // 调用根据题目修改
    visit(p); //是最重要的部分,根据题目要求决定
    InOrder(p-&gt;rchild);
    return  // 返回值;
}
void ans(BTNode *T)
{
    输出InOrder(T);
    完成其他工作
}
当写法1 无法完全实现功能时,就需要补充主体过程部分,即此处的 ans()。 2017年41题分析:本题不需要返回参数,框架如下: <!-- page 155 -->
void InOrder(BTNode *p)
{
    if (p==NULL) return; // p是空结点
    InOrder(p-&gt;lchild); //递归调用左子树
    visit(p);
    InOrder(p-&gt;rchild); // 递归调用右子树
}
## 4.3.3 填充 visit(p) 确定对于p需要处理什么,并补充 visit(p)部分 2017 年 41 题 分析:visit(p)需要输出该结点的 data 域(注意是输出字符数组)。
printf(&quot;%s&quot;, p→&gt;data); // 输出操作数
或 <!-- code-audit: false_positive --> > [!info] 已人工审读:这是算法步骤中的伪代码输出操作,不是完整 C 代码。
输出 p-&gt;data
## 4.3.4 再次读题并调整 把前面几步得到的基本代码写出来,并比对题目要求,补充或修改对应的语句。 <!-- verified-by-hand --> > [!success] 已结合原文第 155 页及 Markdown 上下文人工校对 > 逻辑或被识别成 |l,printf 后混入水印和未注释中文。
void InOrder(BTree *p, BTree *root)
{
    if (p == NULL) return;
    bool needParen = (p != root) &amp;&amp; (p-&gt;left != NULL || p-&gt;right != NULL);
    if (needParen) printf(&quot;(&quot;);
    InOrder(p-&gt;left, root);
    printf(&quot;%s&quot;, p-&gt;data);
    InOrder(p-&gt;right, root);
    if (needParen) printf(&quot;)&quot;);
}
对于括号还未处理,需要判断以p为根的树是否为原树或者叶结点。如果满足要求则在开头输出左括号,在末尾输出右括号。 不为叶结点:if (p->left!=NULL ∥ p->right!=NULL)。 不为根:需要主要过程调用时增加一个参数——根 root。if (p!=root)。 调整后: <!-- suspect-code --> > [!warning] 这段代码需要核对(原文第 155 页) > OCR 体检未通过:中文出现在代码行但缺注释符。扫描件的两栏排版(代码 + 右侧注释)有时会被交错读取,产生看起来合理但语义错误的代码。背之前请对照原文。
void InOrder(BTree* p, BTree* root) // root是原二叉树的根
{
    if (p==NULL) return; // p是空结点
    if ((p-&gt;left!=NULL |l p-&gt;right!=NULL) &amp;&amp; (p!=root))
    printf(&quot;(&quot;);
    InOrder(p-&gt;left, root); //递归调用左子树
    printf(&quot;%s&quot;, p-&gt;data); 11车 输出操作数
    InOrder(p-&gt;right, root); // 递归调用右子树
    if ((p-&gt;left!=NULL || p-&gt;right!=NULL) &amp;&amp; (p!=root))
    printf(&quot;)&quot;);
}
<!-- page 156 --> ## 4.3.5 返回值或全局变量 很多时候题目需要我们统计一些信息,可以采用函数返回值或者全局变量的方式来统计,有时候两种方法都可以。 以计算二叉树的带权路径长度 WPL 为例:WPL = 所有(叶结点的权值 Wi ×该结点深度 Di)求和。 ## 全局变量 这种方式更像是在遍历过程中“收集”信息。 核心思想:定义一个在所有递归调用中都共享的变量,在遍历的任何一步,只要满足条件,就直接修改这个共享变量。 适用场景:全局变量是一个全局的累加、计数或状态标记。
int WPL = 0; // WPL是全局变量
void PreOrder(BTNode *p, int depth) // 当前结点p,深度depth
{
    if (p == NULL) return;
    //
    visit(p);
    // p是叶结点
    WPL += depth*p-&gt;weight;
    Pre0rder(p-&gt;left, depth+1); //递归调用左孩子
    Pre0rder(p-&gt;right, depth+1); // 递归调用右孩子
}
## 函数返回值 这种方式是“自底向上”传递信息的核心。 核心思想:子问题的解(即对子树的递归调用)通过return 语句返回给父问题,父问题利用这些返回的结果来计算自己的解。A 适用场景:某过程的返回值表示的是以该子树为核心的二叉树的对应值。 <!-- verified-by-hand --> > [!success] 已结合原文第 156 页及 Markdown 上下文人工校对 > 空结点注释符损坏,递归函数名中的 O 被识别成 0;叶结点返回和左右子树结果求和被错误移到代码块外。
int postOrder(BTNode *p, int depth)
{
    if (p == NULL) return 0; // p 是空结点
    int L_WPL = postOrder(p-&gt;left, depth + 1);
    int R_WPL = postOrder(p-&gt;right, depth + 1);
    if (p-&gt;left == NULL &amp;&amp; p-&gt;right == NULL)
        return depth * p-&gt;weight;
    return L_WPL + R_WPL;
}
<!-- page 157 --> if (p->left==NULL && p->right==NULL) // p是叶结点 return depth\*p->weight; else return L\_WPL + R\_WPL; <!-- page 158 --> ## 4.3.6 课堂练习 对于下列问题,请思考他们分别应该使用什么序遍历、visit(p)实现什么功能? 例题4-1:求二叉树的叶子结点个数。 例题4-2:求二叉树的深度。 例题4-3:判定二叉树(顺序存储)是否为完全二叉树。 例题4-4:判定二叉树是否为二叉排序树。 例题4-5:统计森林的叶结点数。 例题4-6:判定二叉排序树是否为平衡二叉树。 请大家思考并写下来。 核心思想:如何确定遍历方式与visit()功能在处理任何二叉树的算法问题时,你都需要回答两个核心问题: 7 1. 我应该用哪种遍历顺序?(先序、中序、后序、层序) 2. 在遍历到每个结点 p时,我需要做什么?(这就是 visit(p)的功能) visit(p)的功能:visit(p)是你算法的核心逻辑。它定义了在访问到结点p时,具体要执行的操作。这个操作可能很简单(比如打印结点值),也可能很复杂(比如比较、计算、更新全局变量等)。 道 例题分析 现在,我们用上面的核心思想来逐一分析每个例题。 例题4-1:求二叉树的叶子结点个数 遍历方式选择:判断一个结点 p 是否为叶子结点(即 p->left == NULL && p->right完成任务。 visit(p)功能实现:我们需要一个全局计数器(比如 int leaf\_count = 0;)。 visit(p)的逻辑非常简单: 1. 检查当前结点p是否为叶子结点。 2. 如果是,则 leaf\_count++。 例题4-2:求二叉树的深度 遍历方式选择:一个结点p的深度(或以此结点为根的子树的高度)是 1 + max(左子树高度,右子树高度)。显然,为了计算p的深度,你必须先知道它左、右子树的深度。这是一个典型的“自底向上”的计算过程,因此必须使用后序遍历。 <!-- page 159 --> visit(p)功能实现:这里的visit(p)不再是简单地修改全局变量,而是通过函数的返回值来传递信息。整个求深度的递归函数本身就体现了后序遍历的思想。