5.2.3\*邻接多重表
← 内容总览 19 / 24 下一节 → 强化讲义 · 原始转写 · 原书检索 · 文字用于定位,公式与图表请回原页核验 · 本次导入快照
## 5.2.3\*邻接多重表
原资料配图 · 转写内容请回源核验
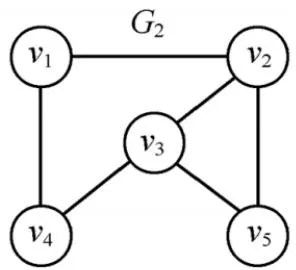
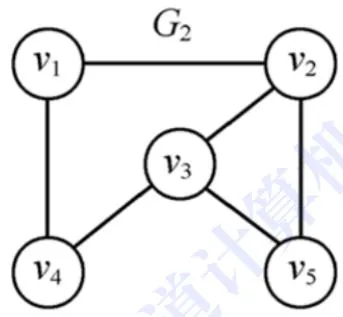
无向图G2
原资料配图 · 转写内容请回源核验
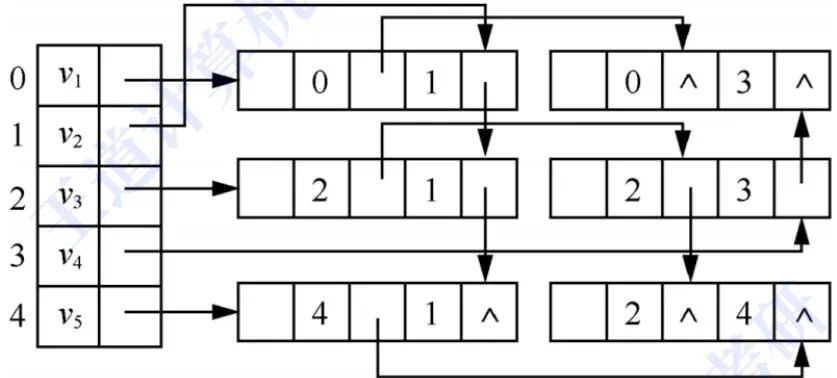
## 邻接多重表结构:
<!-- verified-by-hand -->
> [!success] 已结合原文第 195 页及 Markdown 上下文人工校对
> VexBox 和 AMLGraph 的左花括号丢失,int 与 numVertices 粘连。
#define MAXV 100
typedef struct EBox
{
bool mark ;
int ivex , jvex ;
struct EBox * ilink , * jlink ;
int weight ;
} EBox ;
typedef struct VexBox
{
char data ;
EBox * first ;
} VexBox ;
typedef struct
{
VexBox VerticesList [ MAXV ];
int numVertices , numEdges ;
} AMLGraph ;
void TraverseEdges_AMLGraph ( AMLGraph G )
{
for ( int i = 0 ; i & lt ; G . numVertices ; i ++ )
{
EBox * p = G . VerticesList [ i ]. first ;
while ( p != NULL )
{
if ( ! p -& gt ; mark )
{
visit ( p );
p -& gt ; mark = true ;
}
p = ( i == p -& gt ; ivex ) ? p -& gt ; ilink : p -& gt ; jlink ;
}
}
}
原资料配图 · 转写内容请回源核验
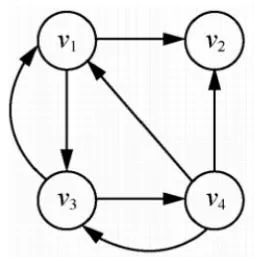
(a) 有向图
原资料配图 · 转写内容请回源核验
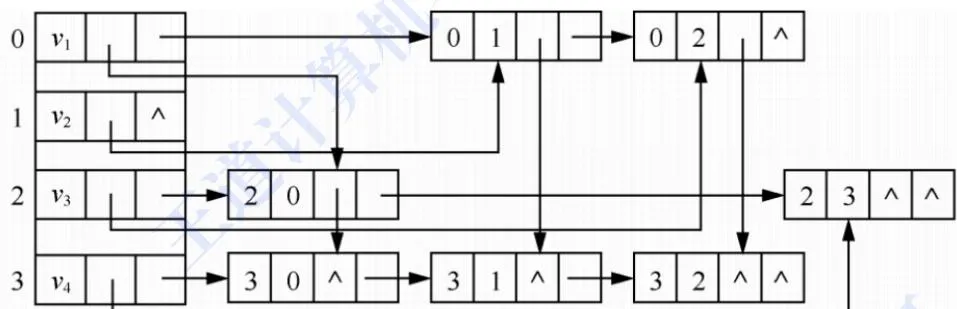
(b)十字链表
## 十字链表结构:
<!-- verified-by-hand -->
> [!success] 已结合原文第 197 页及 Markdown 上下文人工校对
> ArcBox、VexNode 和 OLGraph 三个结构体的左花括号全部丢失。
#define MAXV 100
typedef struct ArcBox
{
int tailvex , headvex ;
struct ArcBox * hlink , * tlink ;
int weight ;
} ArcBox ;
typedef struct VexNode
{
char data ;
ArcBox * firstin , * firstout ;
} VexNode ;
typedef struct
{
VexNode VerticesList [ MAXV ];
int numVertices , numEdges ;
} OLGraph ;
void TraverseEdges_OLGraph ( OLGraph G )
{
for ( int i = 0 ; i & lt ; G . numVertices ; i ++ )
{
ArcBox * p = G . VerticesList [ i ]. firstout ;
while ( p != NULL )
{
visit ( p );
p = p -& gt ; tlink ;
}
}
}
bool visited [ MAXV ] = { false };
void DFS_ALGraph ( ALGraph G , int v )
{
visit ( v );
visited [ v ] = true ;
for ( ArcNode * p = G . VerticesList [ v ]. first ; p != NULL ; p = p -& gt ; next )
if ( ! visited [ p -& gt ; adjvex ])
DFS_ALGraph ( G , p -& gt ; adjvex );
}
void ans ( ALGraph G )
{
for ( int i = 0 ; i & lt ; G . numVertices ; i ++ )
if ( ! visited [ i ]) DFS_ALGraph ( G , i );
}
原资料配图 · 转写内容请回源核验
## 算法步骤
1. 选择一个起始(蓝色)顶点v,将其加入队列,标记为已入队(蓝→橙)。
2. 当队列不为空时,循环执行以下操作:
a. 从队头取出一个顶点u,访问该结点。
b. 遍历 u的所有邻接点w:如果 w未入队,则访问w,并将其加入队列,标记为已入队(蓝→橙)。遍历完后u由橙→绿。
邻接表的 BFS 遍历:
bool visited [ MAXV ] = { false }; // 表示顶点是否已入队
void BFS_ALGraph ( ALGraph G , int v )
{
int queue [ MAXV ], front = 0 , rear = 0 ;
//1.将入队,标记
queue [ rear ++ ] = v ;
visited [ v ] = true ;
//2.如果队列不为空则循环
while ( front & lt ; rear )
{
// 2-a.选择队头元素 u 访问
int u = queue [ front ++ ];
visit ( u );
// 2-b.将u 出发可到达的所有未访问顶点加入队列
ArcNode * p = G . VerticesList [ u ]. first ;
while ( p != NULL )
{
if ( visited [ p -& gt ; adjvex ] != true )
{
queue [ rear ++ ] = p -& gt ; adjvex ;
visited [ p -& gt ; adjvex ] = true ;
}
p = p -& gt ; next ;
}
}
} void ans ( ALGraph G )
{
//无向图调用BFS 次数等于连通分量数
for ( i = 0 ; i & lt ; G . numVertices ; i ++ )
if ( visited [ i ] != true ) BFS_ALGraph ( G , i );
}
void BFS_ShortestPath ( MGraph G , int start )
{
int queue [ MAXV ], dist [ MAXV ], path [ MAXV ];
bool visited [ MAXV ] = { false };
int front = 0 , rear = 0 ;
for ( int i = 0 ; i & lt ; G . numVertices ; i ++ )
{
dist [ i ] = INT_MAX ;
path [ i ] = -1 ;
}
dist [ start ] = 0 ;
queue [ rear ++ ] = start ;
visited [ start ] = true ;
while ( front & lt ; rear )
{
int u = queue [ front ++ ];
for ( int v = 0 ; v & lt ; G . numVertices ; v ++ )
{
if ( ! visited [ v ] & amp ; & amp ; G . Edge [ u ][ v ] != 0 )
{
dist [ v ] = dist [ u ] + 1 ;
path [ v ] = u ;
visited [ v ] = true ;
queue [ rear ++ ] = v ;
}
}
}
}
//使用BFS计算无权图的单源最短路径
void BFS_ShortestPath_AL ( ALGraph G , int start )
{
int queue [ MAXV ];
int dist [ MAXV ], path [ MAXV ];
int front = 0 , rear = 0 ;
//1.初始化
for ( int i = 0 ; i & lt ; G . numVertices ; i ++ )
{
dist [ i ] = INT_MAX ;
path [ i ] = -1 ;
}
//2.将源点入队
dist [ start ] = 0 ;
queue [ rear ++ ] = start ; //源点入队
//3.当队列不为空时,循环执行
while ( front & lt ; rear ) //队列不为空
{
// 3-a 队头元素 u 出队
int u = queue [ front ++ ]; //队头元素出队
p = G . VerticesList [ u ]. first ;
while ( p != NULL )
{
int v = p -& gt ; adjvex ;
// 如果v尚未被访问过
if ( dist [ v ] == INT_MAX )
{
dist [ v ] = dist [ u ] + 1 ; // v的距离是u的距离+1
path [ v ] = u ; // v的前驱是u
queue [ rear ++ ] = v ; //将新访问的顶点v入队
}
p = p -& gt ; next ;
}
}
}
原资料配图 · 转写内容请回源核验 原资料配图 · 转写内容请回源核验 原资料配图 · 转写内容请回源核验 原资料配图 · 转写内容请回源核验 原资料配图 · 转写内容请回源核验 原资料配图 · 转写内容请回源核验 ← 内容总览 19 / 24 下一节 →