例题4-3:判定二叉树(顺序存储)是否为完全二叉树
← 内容总览 16 / 24 下一节 → 强化讲义 · 原始转写 · 原书检索 · 文字用于定位,公式与图表请回原页核验 · 本次导入快照
## 例题4-3:判定二叉树(顺序存储)是否为完全二叉树
遍历方式选择:完全二叉树的定义是按层序从左到右填充的。这天然地指向了层序遍历。在遍历过程中,一旦我们遇到了一个空结点,那么之后的所有结点都必须是空结点,否则就不是完全二叉树。特别注意:题目指定了“顺序存储”(即数组)。对于数组表示的二叉树,判断更简单。如果树有n个结点,那么它必须占据数组的前n个位置,中间不能有“空洞”。我们只需要找到最后一个非空结点的位置k,然后检查从0到k是否都有结点即可。这本质上是一种简化的线性扫描,可以看作层序思想的应用。
## visit(p)功能实现(基于队列的层序遍历):
1. 使用一个队列,根结点入队。
2. 设置一个标志位 bool leaf = false;。
3. 循环直到队列为空:
结点p出队。
如果 eaf 为 true,但p却有子结点(左或右),则该树不是完全二叉树,返回false。
如果 p有右孩子但没有左孩子,直接返回 false。
如果p只有左孩子或没有孩子,将 leaf设为 true。
将p的非空子结点入队。
4. 循环正常结束,返回 true
## 例题4-4:判定二叉树是否为二叉排序树 (BST)
遍历方式选择:二叉排序树(BST)的一个核心性质是:它的中序遍历序列是一个严格递增的序列。这是判断BST的最直接、最简单的方法。 X
visit(p)功能实现:我们需要一个变量pre\_value 来记录中序遍历中“上一个”被访问的结点的值。
1. 初始化 pre\_value 为一个极小值(比如 INT\_MIN)。
2. 进行中序遍历。
3. visit(p)的逻辑是:
比较当前结点 p->value 和 pre\_value。
如果 p->value <= pre\_value,则不满足递增性质,该树不是 BST,返回false。
如果满足,则更新 pre\_value = p->value,然后继续遍历。
4. 如果整个遍历都成功,返回 true
## 例题4-5:统计森林的叶结点数
遍历方式选择:森林是多棵树的集合。我们可以对森林中的每一棵树分别进行遍历。对于每一棵树,求其叶子结点数的方法和例题4-1完全一样。因此,对每棵树可以使用任意遍历方式(先序、中序、后序均可)。
<!-- page 160 -->
visit(p)功能实现:与例题4-1 完全相同。
1. 设置一个全局计数器 leaf\_count = 0;。
2. 对森林中的每一棵树,调用求叶子数的函数(该函数内部进行遍历)。
3. visit(p)的逻辑是:检查p是否为叶子结点,如果是,则 leaf\_count++。
## 例题4-6:判定二叉排序树是否为平衡二叉树 (AVL)
遍历方式选择:平衡二叉树的定义是:对于任意结点,其左、右子树的高度差的绝对值不超过1。要判断结点p是否平衡,你必须先知道其左、右子树的高度。这又是一个典型的“自底向上”的计算,因此必须使用后序遍历。
visit(p)功能实现:这个实现结合了求树的高度(例题4-2)和判断。我们可以设计一个递归函数,它返回子树的高度;如果发现不平衡,则返回一个特殊值(如-1)作为标记。 小
<table><tr><td rowspan=1 colspan=1>例题 </td><td rowspan=1 colspan=1>核心问题</td><td rowspan=1 colspan=1>最佳遍历方式</td><td rowspan=1 colspan=1>visit(p)/核心操作</td></tr><tr><td rowspan=1 colspan=1>4-1:求叶子数</td><td rowspan=1 colspan=1>结点自身属性</td><td rowspan=1 colspan=1>先序/中序/后序遍历</td><td rowspan=1 colspan=1>判断p是否为叶子,是则计数器加一</td></tr><tr><td rowspan=1 colspan=1>4-2: 求深度</td><td rowspan=1 colspan=1>依赖子树结果</td><td rowspan=1 colspan=1>后序遍历粥</td><td rowspan=1 colspan=1>1 + max(左子树深度,右子树深度)</td></tr><tr><td rowspan=1 colspan=1>4-3: 是否完全二叉树</td><td rowspan=1 colspan=1>层次结构/无间隙</td><td rowspan=1 colspan=1>层序遍历</td><td rowspan=1 colspan=1>检查遇到第一个空位后,是否还有非空结点</td></tr><tr><td rowspan=1 colspan=1>4-4: 是否二叉排序树</td><td rowspan=1 colspan=1>í</td><td rowspan=1 colspan=1>中序遍历</td><td rowspan=1 colspan=1>比较 p->value与前一个结点的值,判断是否递增</td></tr><tr><td rowspan=1 colspan=1>4-5: 森林叶子数</td><td rowspan=1 colspan=1>遍历多棵树</td><td rowspan=1 colspan=1>先根/后根遍历</td><td rowspan=1 colspan=1>同4-1,对森林中每棵树分别统计</td></tr><tr><td rowspan=1 colspan=1>4-6: 是否平衡二叉树</td><td rowspan=1 colspan=1>依赖子树高度</td><td rowspan=1 colspan=1>后序遍历</td><td rowspan=1 colspan=1>计算左右子树高度差,判断是否 > 1</td></tr></table>
<!-- page 161 -->
## 4.4 并查集
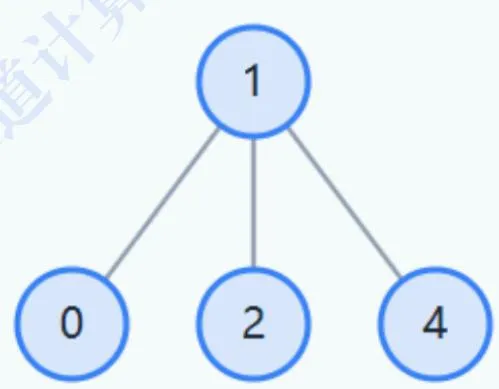
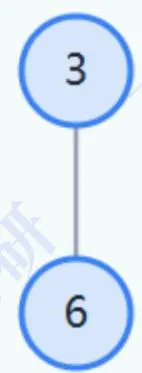
并查集是一种高效支持“集合合并”与“查找代表元”的数据结构,常用于处理图中连通性判断、集合合并问题,例如判断是否构成树、求连通块数量、判断环等问题。在图那一章中介绍其应用。
Father 数组: [1, 1, 1, 3, 1, 5, 3]
原资料配图 · 转写内容请回源核验 原资料配图 · 转写内容请回源核验
并查集使用数组 father[]存储每个元素的“父结点”(其实是祖先结点),形成森林结构。为了方便使用,通常 father数组定义成全局变量。
find(x):查找下标为x的结点所在树的树根下标,可路径压缩(把查找途中所有结点全部变成根结点的儿子,减少树的高度)。
Union(x, y):将下标为 x、y的结点所在树合并。
<!-- verified-by-hand -->
> [!success] 已结合原文第 161 页及 Markdown 上下文人工校对
> 注释缺少第二个斜杠,Union 函数丢失父结点赋值和闭合花括号。
int father [ MAXN ]; // father[i] 表示 i 所在集合的代表元(根)
int find ( int x )
{
if ( father [ x ] != x )
father [ x ] = find ( father [ x ]);
return father [ x ];
}
void Union ( int x , int y )
{
int fx = find ( x ), fy = find ( y );
if ( fx != fy )
father [ fy ] = fx ;
}
typedef struct BSTNode
{
ElemType data ;
struct BSTNode * lchild , * rchild ;
} BSTNode , * linklist ;
BTNode * BST_Search ( BSTNode * T , ElemType x )
{
BSTNode * p = T ;
while ( p != NULL )
{
if ( x == p -& gt ; data )
return p ;
if ( x & lt ; p -& gt ; data )
p = p -& gt ; lchild ;
else
p = p -& gt ; rchild ;
}
return NULL ;
}
typedef struct node {
int data ;
typedef struct node {
int data ;
struct node * lchild , * rchild ;
} BTNode ;
typedef struct node {
int data ;
struct node * lchild , * rchild ;
} BTNode ;
typedef struct node {
int data ;
struct node * lchild , * rchild ;
} BTNode ;
原资料配图 · 转写内容请回源核验
设计思想,采用C 或C++语言描述算法,关键之处给出注释。(3)说明所设计算法的时间复杂度。

(1)给出算法的基本设计思想。(2) 根据

<!-- page 170 -->

二叉树结点定义如下:

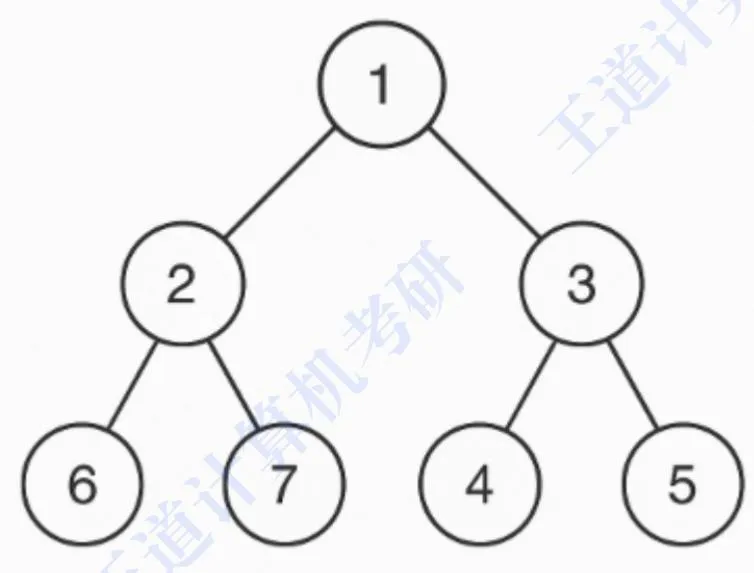
【习题4-7】(13 分)二叉树中两个结点p 和q的最低公共祖先是二叉树中离根结点尽可能远且同时是p和q祖先的结点,结点的祖先可以是自己。给定一棵非空二叉树T,采用二叉链表存储。例如,对于下图所示的非空二叉树T,结点3和结点4的最低公共祖先是结点3,结点2和结点4的最低公共祖先是结点1。 成村
原资料配图 · 转写内容请回源核验
typedef struct node
{
int data ;
struct node * left , * right ;
} BTree ;
原资料配图 · 转写内容请回源核验 原资料配图 · 转写内容请回源核验
二叉树结点定义如下:
typedef struct node {
char data [ 10 ]; // 存储操作数或操作符
struct node * left , * right ;
} BTree ;
typedef struct { //MAX_SIZE为已定义常量
int SqBiTNode [ MAX_SIZE ]; //保存二叉树结点值的数组
int ElemNum ; // 实际占用的数组元素个数
} SqBiTree ; // 首
typedef struct BSTNode {
int data ;
struct BSTNode * left , * right ;
} BSTNode ;
typedef BSTNode BTNode ;
typedef struct node {
int data ;
struct node * lchild , * rchild ;
} BTNode ;
BTNode * PreOrder ( int A [], int i , int n ) // i是当前访问下标
{
if ( i & gt ; = n || i & lt ; 0 )
return NULL ; // 该结点不存在
BTNode * p = ( BTNode * ) malloc ( sizeof ( BTNode ));
p -& gt ; data = A [ i ]; // 访问当前结点visit(p)
p -& gt ; lchild = Pre0rder ( A , i * 2 + 1 , n );
p -& gt ; rchild = Pre0rder ( A , i * 2 + 2 , n );
return p ;
}
← 内容总览 16 / 24 下一节 →