第二章数据的表示和运算
| 题号 | 年份-题号 | 正确答案 | 题号 | 年份-题号 | 正确答案 | 题号 | 年份-题号 | 正确答案 |
|---|---|---|---|---|---|---|---|---|
| 1 | 2018-12 | D | 13 | 2023-16 | B | 25 | 2009-13 | D |
| 2 | 2010-13 | B | 14 | 2024-15 | D | 26 | 2010-14 | B |
| 3 | 2011-17 | C | 15 | 2011-13 | A | 27 | 2015-14 | D |
| 4 | 2018-19 | A | 16 | 2012-14 | D | 28 | 2009-12 | D (同5) |
| 5 | 2009-12 | D | 17 | 2013-13 | A | 29 | 2010-14 | B (同26) |
| 6 | 2013-14 | A | 18 | 2014-14 | A | 30 | 2012-13 | B |
| 7 | 2014-13 | C | 19 | 2018-14 | A | 31 | 2016-13 | D |
| 8 | 2015-13 | B | 20 | 2020-13 | A | 32 | 2019-13 | A |
| 9 | 2018-13 | C | 21 | 2021-14 | A | 33 | 2023-13 | A |
| 10 | 2018-16 | B | 22 | 2022-14 | A | 34 | 2024-12 | B |
| 11 | 2021-13 | D | 23 | 2023-14 | A | |||
| 12 | 2022-13 | B | 24 | 2024-14 | C |
(一)数制与编码
Tip
- 进位计数制及其数据之间的相互转换
- 定点数的编码表示
- 【2018-12】冯·诺依曼结构计算机中数据采用二进制编码表示,其主要原因是( )。
Ⅰ. 二进制的运算规则简单
Ⅱ. 制造两个稳态的物理器件较容易
Ⅲ. 便于用逻辑门电路实现算术运算
A. 仅Ⅰ、Ⅱ
B. 仅Ⅰ、Ⅲ
C. 仅Ⅱ、Ⅲ
D. Ⅰ、Ⅱ和Ⅲ
解析
答案:D
- Ⅰ正确:二进制运算规则简单(仅
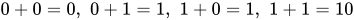 ),硬件实现成本低。
- Ⅱ正确:物理器件容易实现两个稳态(如高/低电平、有/无电流),可靠性高。
- Ⅲ正确:二进制的
 恰好对应逻辑代数中的
 ,便于用逻辑门电路实现算术运算。
三者均是采用二进制的核心原因,故选 D。
- 【2010-13】假定有4个整数用8位补码分别表示为r1=FEH,r2=F2H,r3=90H,r4=F8H。若将运算结果存放在一个8位寄存器中,则下列运算中会发生溢出的是( )。
A. \(r1×r2\)
B. \(r2×r3\)
C. \(r1×r4\)
D. \(r2×r4\)
解析
答案:B
先将各补码转为真值:
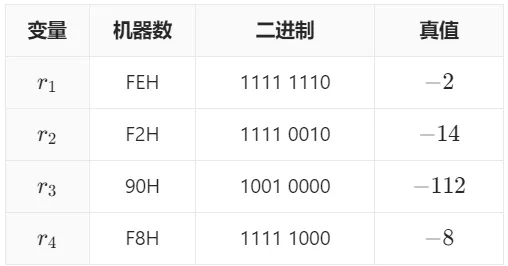
8位补码的表示范围为  ,逐项计算乘积:
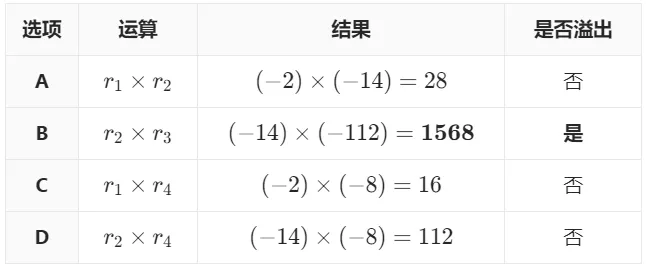
 远超
 ,必然溢出,故选 B。
- 【2011-17】某机器有一个标志寄存器,其中有进位/借位标志CF、零标志ZF、符号标志SF和溢出标志OF,条件转移指令bgt(无符号整数比较大于时转移)的转移条件是()。
A. \(CF+OF=1\)
B. \(\overline{SF} +ZF=1\)
C. \(\overline{CF+ZF}=1\)
D. \(\overline{CF+SF}=1\)
解析
答案:C
bgt(branch if greater than)用于无符号整数比较,当  时转移。
做  运算后:
 表示有借位(即
 )
 表示结果为零(即
 )
因此  的条件为
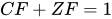 。
取反即得 的条件: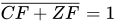
故选 C。
- 【2018-19】减法指令“sub R1,R2,R3”的功能为“(R1)-(R2)→R3",该指令执行后将生成进位/借位标志CF和溢出标志OF。若(R1)=FFFFFFFFH,(R2)=FFFFFFF0H,则该减法指令执行后,CF与OF分别为( )。
A. CF=0,OF=0
B. CF=1,OF=0
C. CF=0,OF=1
D. CF=1,OF=1
解析
答案:A
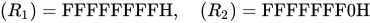
执行  :
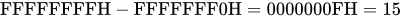
CF(进位/借位标志):按无符号数比较,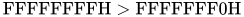 ,无需借位,
 。
OF(溢出标志):按有符号数计算: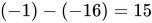
 在32位有符号整数范围
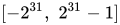 内,无溢出,
 。
故选 A(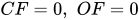 )。
(三)整数的表示和运算
Tip
- 无符号整数的表示和运算
- 带符号整数的表示和运算
- 【2009-12】一个C语言程序在一台32位机器上运行。程序中定义了三个变量x、y和z,其中x和z为int型,y为short型。当x = 127,y = -9时,执行赋值语句z = x+y后,x、y和z的值分别是( )。
A. x = 0000007FH,y = FFF9H,z = 00000076H
B. x = 0000007FH,y = FFF9H,z = FFFF0076H
C. x = 0000007FH,y = FFF7H,z = FFFF0076H
D. x = 0000007FH,y = FFF7H,z = 00000076H
解析
答案:D
x = 127(int,32位):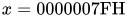
y = -9(short,16位): 的16位补码为

z = x + y: 符号扩展为32位
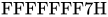
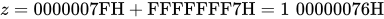
丢弃进位,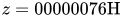 (即
 )。
故选 D。
- 【2013-14】某字长为 8 位的计算机中,已知整型变量x、y的机器数分别为\([x]_补=11110100\) , \([y]_补=10110000\) 。若整型变量\(z=2x+y/2\),则\(z\)的机器数为( )。
A. 11000000
B. 00100100
C. 10101010
D. 溢出
解析
答案:A
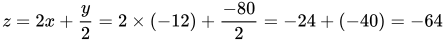
 的8位补码为
 。
用机器数直接验证:
 :算术左移1位 →
 (
 )
 :算术右移1位 →
 (
 )
无溢出,故选 A。
- 【2014-13】若x=103,y=-25,则下列表达式采用8位定点补码运算实现时,会发生溢出的是( )。
A. x+y
B. -x+y
C. x-y
D. -x-y
解析
答案:C
8位补码范围 。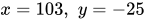 :
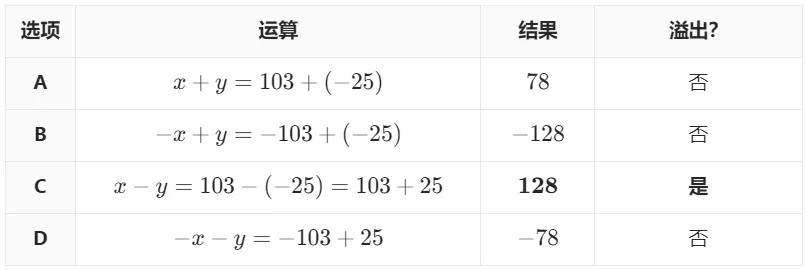
 ,上溢,故选 C。
- 【2015-13】由3个“1”和5个“0”组成的8位二进制补码,能表示的最小整数( )。
A. -126
B. -125
C. -32
D. -3
解析
答案:B
本题使用位权表示法
8位补码的值: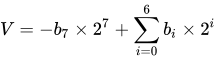
要求最小值,须  (负数),此时已用掉1个"1"。
剩余7位中需放2个"1"和5个"0"。
为使  最小,应使
 尽可能小:将2个"1"放在最低位:
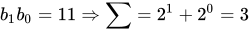
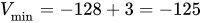
对应机器数  ,故选 B。
- 【2018-13】假定带符号整数采用补码表示,若int型变量x和y的机器数分别是FFFF FFDFH和0000 0041H,则x、y的值以及x-y的机器数分别是( )。
A. x=-65,y=41,x-y的机器数溢出
B. x=-33,y=65,x-y的机器数为FFFFFF9DH
C. x=-33,y=65,x-y 的机器数为FFFFFF9EH
D. x=-65,y=41,x-y的机器数为FFFFFF96H
解析
答案:C
求  :
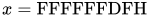
取反加一: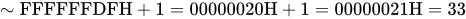
故  。
求 :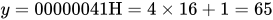
求  :
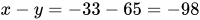
 的32位补码:
故选 C。
- 【2018-16】整数x的机器数为11011000,分别对x进行逻辑右移1位和算术右移1位操作,得到的机器数各是( )。
A. 1110 1100、1110 1100
B. 0110 1100、1110 1100
C. 1110 1100、0110 1100
D. 0110 1100、0110 1100
解析
答案:B
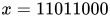
- 逻辑右移1位:高位补0 →

- 算术右移1位:高位补符号位1 →

故选 B。
- 【2021-13】已知带符号整数用补码表示,变量x,y,z的机器数分别为FFFDH,FFDFH,7FFCH,下列结论中,正确的是( )。
A. 若x、y和z为无符号整数,则z<x<y
B. 若x、y和z为无符号整数,则x<y<z
C. 若x、y和z为带符号整数,则x<y<z
D. 若x、y和z为带符号整数,则y<x<z
答案:D 先求各机器数的真值(16位): 故选 D。解析
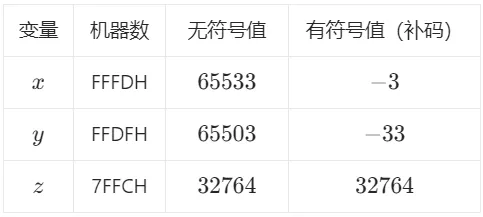
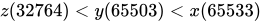 ,即
 ,A、B均不符。
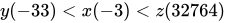 ,即
 ,与D吻合。
- 【2022-13】32位补码所能表示的整数范围是( )。
A. \(−2^{32}∼2^{31}−1\)
B. \(−2^{31}∼2^{31}−1\)
C. \(−2^{32}∼2^{32}−1\)
D. \(−2^{31}∼2^{32}−1\)
解析
答案:B
 位补码的表示范围为
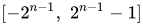 。32位补码范围:
故选 B。
- 【2023-16】已知 x 和 y 为 int 类型,当 x=100, y=200 时,执行“x减y”指令的到的溢出标志 OF 和借位标志 CF 分别为 0, 1,那么当 x=10, y=-20 时,执行该指令得到的 OF 和 CF 分别是( )。
A. OF=0, CF=0
B. OF=0, CF=1
C. OF=1, CF=0
D. OF=1, CF=1
解析
答案:B
已知条件验证: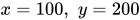
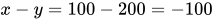 (在有符号范围内,
 )
- 无符号比较:
 ,需借位,
 ✓
第二组: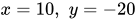
机器数: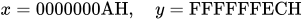 (
 的补码)
执行 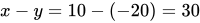 :
- OF:
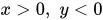 ,正减负有符号结果为正且远未越界,。
- CF:无符号比较 与 的机器数:
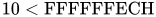 (无符号值为
 ),需借位,。
故选 B(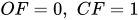 )。
- 【2024-15】下列关于整数乘法运算的叙述中,错误的是
A. 用阵列乘法器实现乘运算可以在一个时钟周期内完成
B. 用 ALU 和移位器实现的乘运算无法在一个时钟周期内完成
C. 变量与常数的乘运算可编译优化为若干条移位及加/减运算指令
D. 两个变量的乘运算无法编译为移位及加法等指令的循环实现
解析
答案:D
A.阵列乘法器是组合逻辑电路,可在一个时钟周期完成
B.ALU+移位器需多步迭代,无法一个周期完成
C.编译器"强度削弱":常数乘法优化为移位+加减
D.两变量乘法可以编译为移位加法的循环实现
D 选项说"无法"实现是错误的,实际上软件乘法就是用移位+加法循环实现的。
故选 D。
(四)浮点数的表示和运算
浮点数的表示:IEEE 754标准
- 【2011-13】float型数据通常用IEEE754单精度浮点数格式表示。若编译器将float型变量\( x \)\( 分配在一个32位浮点寄存器FR1中,且 \)\( x=-8.25 \),则FR1的内容是( )。
A. C1040000H
B. C2420000H
C. C1840000H
D. C1C20000H
解析
答案:A
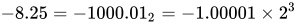
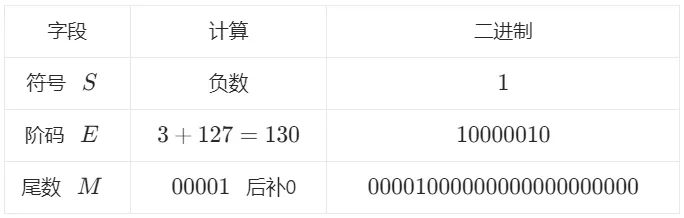
拼接: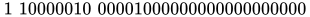
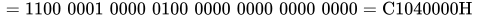
故选 A。
- 【2012-14】\(float\)类型(即IEEE754单精度浮点数格式)能表示的最大正整数是( )。
A. \(2^{126}−2^{103}\)
B.\(2^{127}−2^{104}\)
C. \(2^{127}−2^{103}\)
D. \(2^{128}−2^{104}\)
解析
答案:D
IEEE 754 单精度最大规格化数:
- 阶码
 (实际指数
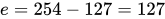 )
- 尾数
 全1:隐含
 (23个1)
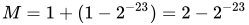
故选 D。
- 【2013-13】某数采用IEEE754单精度浮点数格式表示为C6400000H,则该数的值是( )。
A. \(−1.5×2^{13}\)
B. \(−1.5×2^{12}\)
C. \(−0.5×2^{13}\)
D. \(−0.5×2^{12}\)
解析
答案:A
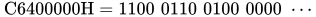
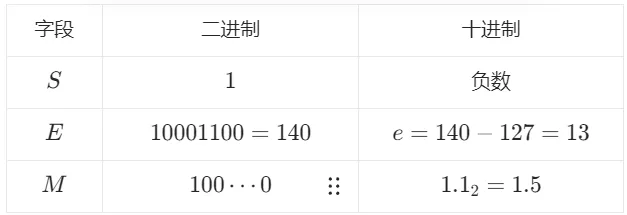
故选 A。
- 【2014-14】float型数据常用IEEE754单精度浮点格式表示。假设两个float型变量x和y分别存放在32位寄存器f1和f2中,若(f1)=CC90 0000H,(f2)=B0C0 0000H,则x和y之间的关系为( )。
A. x<y且符号相同
B. x<y且符号不同
C. x>y且符号相同
D. x>y且符号不同
解析
答案:A
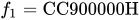 :
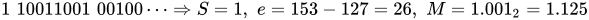
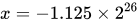
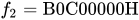 :
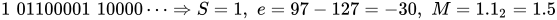
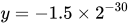
两者均为负数(符号相同),且  ,故
 。
故选 A( 且符号相同)。
- 【2018-14】IEEE754单精度浮点格式表示的数中,最小的规格化正数是( )。
A. \(1.0×2^{−126}\)
B. \(1.0×2^{−127}\)
C. \(1.0×2^{−128}\)
D. \(1.0×2^{−149}\)
解析
答案:A
规格化数要求阶码  ,故最小阶码
 :
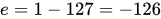
最小尾数 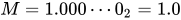
故选 A。
- 【2020-13】已知带符号整数用补码表示,float型数据用IEEE754标准表示,假定变量x的类型只可能是int或float,当x的机器数为C8000000H时,x的值可能是( )。
A. \(−7×2^{27}\)
B. \(−2^{16}\)
C. \(2^{17}\)
D. \(25×2^{27}\)
解析
答案:A
按 int(32位补码)解读:
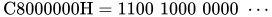
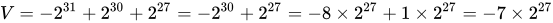
按 float 解读:
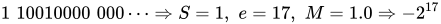
选项中  不存在,
 对应选项 A。
故选 A。
- 【2021-14】下列数值中,不能用IEEE754浮点格式精确表示的( )。
A. 1.2
B. 1.25
C. 2.0
D. 2.5
解析
答案:A
IEEE 754 能精确表示的数是  (
 、 为有限整数)。
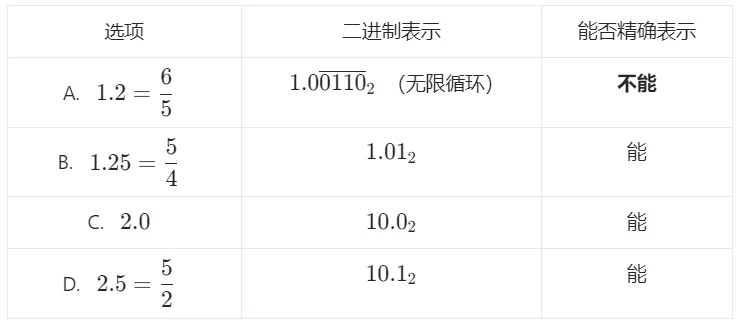
 在二进制中是无限循环小数,无法精确表示。
故选 A。
- 【2022-14】-0.4375的IEEE754单精度浮点数表示为( )。
A. BEE0 0000H
B. BF60 0000H
C. BF70 0000H
D. C0E0 0000H
解析
答案:A
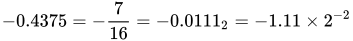
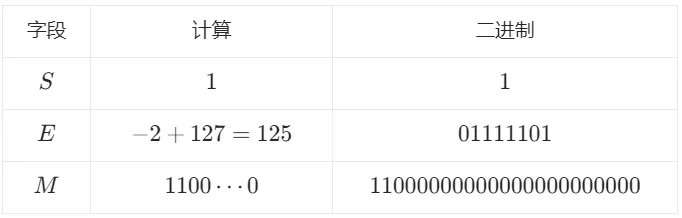
拼接: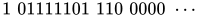
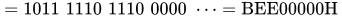
故选 A。
- 【2023-14】已知 float 型变量用 IEEE754 单精度浮点数格式表示。若 float 型变量 x 的机器数为80200000H,则 x 的值为( )。
A. \(−2^{−128}\)
B. \(−1.01×2^{−127}\)
C. \(−1.01×2^{−126}\)
D. 非数(NAN)
解析
答案:A
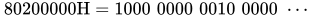
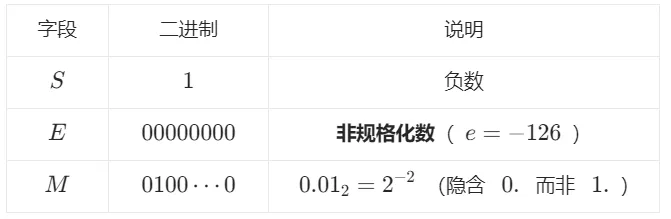
故选 A。
- 【2024-14】某科学实验中,需要使用大量的整型参数,为了在保证表数精度的基础上提高运算速度,需要选择合理的数据表示方法。若整型参数 α 、 β 的取值范围分别 \( −2^{20}∼2^{20} \)\( 、 \)\( −2^{40}∼2^{40} \) ,要求在保证数据精度的基础上提高运算速度, α 和 β 最适宜采用
A. 32位整数、32位整数
B. 单精度浮点数、单精度浮点数
C. 32位整数、双精度浮点数
D. 单精度浮点数、双精度浮点数
解析
答案:C
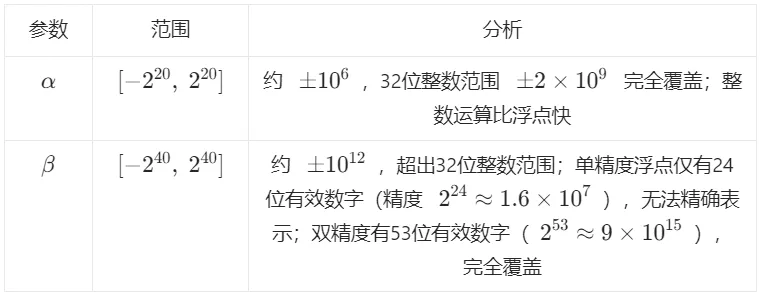
最佳方案: 用32位整数(快),
 用双精度浮点数(精确且范围够)。
故选 C。
浮点数的加/减运算
- 【2009-13】浮点数加、减运算过程一般包括对阶、尾数运算、规格化、舍入和判溢出等步骤。设浮点数的阶码和尾数均采用补码表示,且位数分别为5位和7位(均含2位符号位)。若有两个数 \(X=2^7×29/32\),\(Y=2^5×5/8\),则用浮点加法计算 \(X+Y\)的最终结果是( )。
A. 00111 1100010
B. 00111 0100010
C. 01000 0010001
D. 发生溢出
解析
答案:D
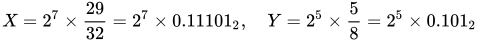
阶码5位(含2位符号位,变形补码),尾数7位(含2位符号位)
初始表示:
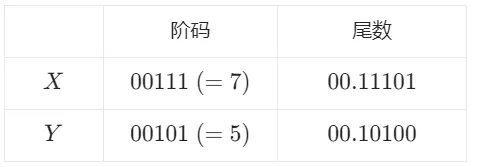
① 对阶: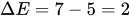 ,
 尾数右移2位:
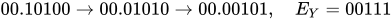
② 尾数相加:
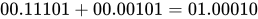
符号位为  ,表示尾数正溢出,需右规。
③ 右规:尾数右移1位 →  ,阶码加1:
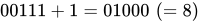
④ 判溢出:阶码  的双符号位为 (不一致),阶码上溢!
(2位符号位的5位阶码有效范围为  ,
 已溢出)
故选 D。
- 【2010-14】假定变量i、f和d的数据类型分别为 int、float、double(int 用补码表示,float和 double 分别用 IEEE754单精度和双精度浮点数据格式表示),已知i=785,f=1.5678e3,d=1.5e100,若在32位机器中执行下列关系表达式,则结果为真的是( )。
Ⅰ. i==(int)(float)i
Ⅱ. f==(float)(int)f
Ⅲ. f=(float)(double)f
Ⅳ.(d+f)-d==f
A. 仅Ⅰ和Ⅱ
B. 仅Ⅰ和Ⅲ
C. 仅Ⅱ和Ⅲ
D. 仅Ⅲ和Ⅳ
解析
答案:B
转换规则:
- int ↔ float:只有 |n| ≤ 2²⁴(= 16777216)的整数才能被 float 精确表示,往返转换才不丢精度;
- float → int:向零取整,小数部分直接丢弃;
- float ↔ double:double 的精度和表示范围完全覆盖 float,往返转换绝对不丢精度;
- 很大的数 + 很小的数:阶码对齐时,小数的尾数可能被完全挤出有效位,被"吞掉"。
Ⅰ. i == (int)(float)i —— 真 ✓
i = 785,远小于 2²⁴ = 16777216,785 可以被 float 精确表示为 785.0;再转回 int 仍是 785。等式成立。
注意陷阱:若 i 是超过 2²⁴ 的大整数(如 2²⁴+1),转 float 会丢最低位,往返后就不相等了。本题 785 很小,所以安全。
Ⅱ. f == (float)(int)f —— 假 ✗
f = 1.5678e3 = 1567.8。(int)f 向零取整得 1567,小数部分 0.8 被丢弃;再转回 float 是 1567.0 ≠ 1567.8。
Ⅲ. f == (float)(double)f —— 真 ✓
float → double:double 的 52 位尾数和更大阶码范围能精确装下任何 float 值;double → float:因为值本来就是 float 来的,尾数没有超出 23 位,转回时无需舍入。往返后值不变,等式成立。
Ⅳ. (d+f)-d == f —— 假 ✗
d = 1.5e100,f ≈ 1.57e3,两者相差约 97 个数量级。double 只有约 16 位十进制有效数字,计算 d+f 时 f 的尾数远在有效位之外,被完全舍去,即 d+f == d。于是 (d+f)−d = 0 ≠ f。
注意:不存在溢出(double 上限约 1.8e308),这里纯粹是精度不够导致小数被吞,而不是表示范围不够。
- 【2015-14】下列有关浮点数加减运算的叙述中,正确的是( )。
Ⅰ. 对阶操作不会引起阶码上溢或下溢
Ⅱ. 右规和尾数舍入都可能引起阶码上溢
Ⅲ. 左规时可能引起阶码下溢
Ⅳ. 尾数溢出时结果不一定溢出
A. 仅Ⅱ、Ⅲ
B. 仅Ⅰ、Ⅱ、Ⅳ
C. 仅Ⅰ、Ⅲ、Ⅳ
D. Ⅰ、Ⅱ、Ⅲ、Ⅳ
解析
答案:D
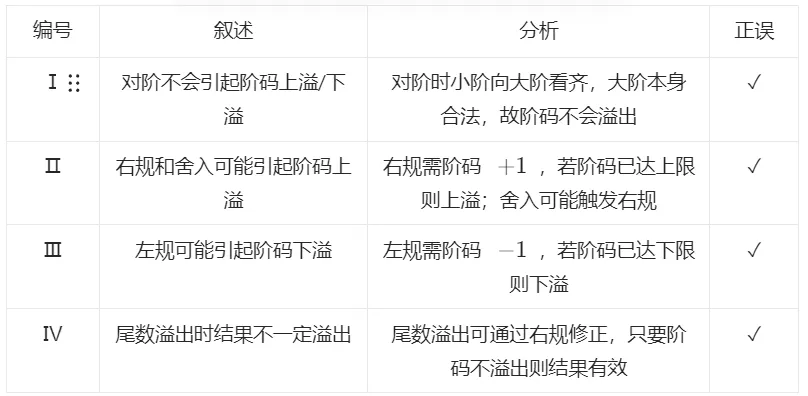
四项均正确,故选 D。
C语言中的类型转换
- 【2009-12】一个C语言程序在一台32位机器上运行。程序中定义了三个变量x、y和z,其中x和z为int型,y为short型。当x = 127,y = -9时,执行赋值语句z = x+y后,x、y和z的值分别是( )。
A. x = 0000007FH,y = FFF9H,z = 00000076H
B. x = 0000007FH,y = FFF9H,z = FFFF0076H
C. x = 0000007FH,y = FFF7H,z = FFFF0076H
D. x = 0000007FH,y = FFF7H,z = 00000076H
解析
答案:D
x = 127(int,32位):y = -9(short,16位): 的16位补码为 z = x + y: 符号扩展为32位
丢弃进位,(即 )。
故选 D。
- 【2010-14】假定变量i、f和d的数据类型分别为 int、float、double(int 用补码表示,float和 double 分别用 IEEE754单精度和双精度浮点数据格式表示),已知i=785,f=1.5678e3,d=1.5e100,若在32位机器中执行下列关系表达式,则结果为真的是( )。
Ⅰ. i==(int)(float)i
Ⅱ. f==(float)(int)f
Ⅲ. f==(float)(double)f
Ⅳ.(d+f)-d==f
A. 仅Ⅰ和Ⅱ
B. 仅Ⅰ和Ⅲ
C. 仅Ⅱ和Ⅲ
D. 仅Ⅲ和Ⅳ
解析
答案:B
转换规则:
- int ↔ float:只有 |n| ≤ 2²⁴(= 16777216)的整数才能被 float 精确表示,往返转换才不丢精度;
- float → int:向零取整,小数部分直接丢弃;
- float ↔ double:double 的精度和表示范围完全覆盖 float,往返转换绝对不丢精度;
- 很大的数 + 很小的数:阶码对齐时,小数的尾数可能被完全挤出有效位,被"吞掉"。
Ⅰ. i == (int)(float)i —— 真 ✓
i = 785,远小于 2²⁴ = 16777216,785 可以被 float 精确表示为 785.0;再转回 int 仍是 785。等式成立。
注意陷阱:若 i 是超过 2²⁴ 的大整数(如 2²⁴+1),转 float 会丢最低位,往返后就不相等了。本题 785 很小,所以安全。
Ⅱ. f == (float)(int)f —— 假 ✗
f = 1.5678e3 = 1567.8。(int)f 向零取整得 1567,小数部分 0.8 被丢弃;再转回 float 是 1567.0 ≠ 1567.8。
Ⅲ. f == (float)(double)f —— 真 ✓
float → double:double 的 52 位尾数和更大阶码范围能精确装下任何 float 值;double → float:因为值本来就是 float 来的,尾数没有超出 23 位,转回时无需舍入。往返后值不变,等式成立。
Ⅳ. (d+f)-d == f —— 假 ✗
d = 1.5e100,f ≈ 1.57e3,两者相差约 97 个数量级。double 只有约 16 位十进制有效数字,计算 d+f 时 f 的尾数远在有效位之外,被完全舍去,即 d+f == d。于是 (d+f)−d = 0 ≠ f。
注意:不存在溢出(double 上限约 1.8e308),这里纯粹是精度不够导致小数被吞,而不是表示范围不够。
- 【2012-13】假定编译器规定int和short型长度分别为32位和16位,执行下列C语言语句:
得到y的机器数为( )。
A. 0000 7FFAH
B. 0000 FFFAH
C. FFFF 7FFAH
D. FFFF FFFAH
解析
答案:B
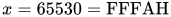 (16位)
unsigned short → unsigned int 采用零扩展: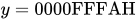
故选 B。
- 【2016-13】有如下C语言程序段
执行上述两条语句后,usi的值为( )。
A. -32767
B. 32767
C. 32768
D. 32769
解析
答案:D
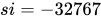 ,16位补码:
赋值给 unsigned short 时位模式不变,按无符号解读:
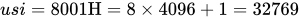
故选 D。
- 【2019-13】考虑以下C语言代码:
执行上述程序段后,si的值是( )。
A. -1
B. -32767
C. -32768
D. -65535
解析
答案:A
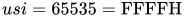
赋值给 short 时位模式不变,按有符号补码解读:
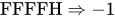
故选 A。
- 【2023-13】若short型变量x=-8190,则x的机器数为( )。
A E002H
B E001H
C 9FFFH
D 9FFEH
解析
答案:A
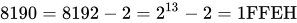
 的16位补码:
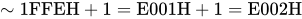
故选 A。
- 【2024-12】C语言代码如下:
执行上述代码后,j 的值是
A. -32777
B. -32759
C. 32759
D. 32777
解析
答案:B
① 
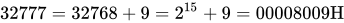
② short si = i(截断为16位):
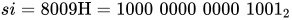
符号位为  (负数),求真值:
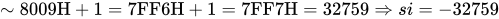
③ int j = si(符号扩展为32位):
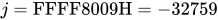
故选 B。