Relax1000 操作系统 · 第3章 内存管理 · 解析
第3章 内存管理
本章 79 题;解析册印刷页 203–223。
速对答案(原书): BDDCB DBBCD CCADC BACCB CADBB BCCCC DABAB BBBCD CCCBC BDDDC BBBDD BBDCD CBDCB DCBAA BDBCC CCCB
Q1
速对表原值: B
详细解析标注: B
Ⅰ错误,内存保护必须有硬件的支持才能有效实现。操作系统通过设置硬件机制(如基址寄存器、限长寄存器、内存管理单元 MMU 中的页表/段表机制以及相关的特权级别)来限制进程对内存的访问。软件(操作系统)负责管理这些硬件机制,但保护的执行和检查是由硬件在每次内存访问时进行的。如果完全依赖软件实现,效率会极低,且用户程序很容易绕过软件检查。
Ⅱ正确,内存保护可以采用两种方法:
-
在 CPU 中设置一对上、下限寄存器,存放用户进程在主存中的下限和上限地址,每当 CPU要访问一个地址时,分别和两个寄存器的值相比,判断有无越界。
-
采用重定位寄存器(也称基地址寄存器)和界地址寄存器(也称限长寄存器)进行越界检查。
Ⅲ错误,加载重定位寄存器和界地址寄存器时必须使用特权指令,只有操作系统内核才可以加载这两个存储器。这种方案允许操作系统内核修改这两个寄存器的值,而不允许用户程序修改。综上所述,选 B。
Q2
速对表原值: D
详细解析标注: D
形成逻辑地址的阶段是在完成链接步骤时。若源程序采用的装入方式为绝对装入或可重定位装入方式,则在装入阶段形成物理地址,若源程序采用的装入方式为动态运行时装入方式,则在程序运行时完成逻辑地址到物理地址的转换。综上,本题选择 D 选项。
Q3
速对表原值: D
详细解析标注: D
A正确,静态链接是在程序执行前,由链接器将编译后的目标模块与它们所需的库函数等链接成一个单一的可执行文件。这个可执行文件包含了所有需要运行的代码和数据,在运行时其内部结构不再改变B 正确,装入时动态链接是将链接过程推迟到程序装入内存时进行。 这种方式下,目标模块是分开存放的,因此当某个模块需要更新或修改时,只需替换该模块即可,无需重新链接整个程序。同时,多个应用程序可以共享内存中同一目标模块的单个副本。
C 正确,运行时动态链接是最灵活的链接方式,它只在程序运行过程中,当某个模块首次被调用时,才将其装入内存并进行链接。这种方式可以避免装入那些在本次执行中根本不会用到的模块,从而节省了内存开销,并且因为初始装入的模块较少,也加快了程序的启动速度。
D 错误,对于静态链接,链接完成后形成的是一个装入模块(可执行文件)。在这个模块中,对外部符号的引用会被解析为相对地址(相对于装入模块的起始地址)或者需要重定位的地址。最终的绝对物理地址是在程序被装入内存时,根据装入方式(如绝对装入、可重定位装入、动态运行时装入)才确定的。对于动态链接(包括装入时动态链接和运行时动态链接),链接本身就是在装入或运行时才进行的,其地址的解析和绑定同样会推迟,并且最终形成的地址也可能是逻辑地址(在动态运行时装入方式下),而不是立即转换为绝对物理地址。地址转换到物理地址是装入和运行时内存管理单元(MMU)的工作。综上所述,D 错误。链接过程主要是解决模块间的符号引用,并将它们组织成一个统一的逻辑地址空间,而不是直接解析为绝对物理地址。
Q4
速对表原值: C
详细解析标注: C
A、B、D 均正确。在动态运行时重定位系统中,编译链接形成的均是逻辑地址,且在运行过程中,即使页面被置换到不同的物理页框,CPU 执行的指令内部包含的依然是逻辑地址。
C 错误。动态重定位并不是在装载时由装载程序完成的,而是在程序真正执行到该条指令时,由硬件地址变换机构(MMU)利用重定位寄存器实时转换的。装载时一次性完成转换的是静态重定位
Q5
速对表原值: B
详细解析标注: B
还要修改 F2 分区的起始地址。
Q6
速对表原值: D
详细解析标注: D
只要是固定的分配就会产生内部碎片,其余的都会产生外部碎片。如果固定和不固定同时存在(如段页式),其物理本质还是固定的,解释如下:分段虚拟存储管理:每一段的长度都不一样(对应不固定),所以会产生外部碎片。分页虚拟存储管理:每一页的长度都一样(对应固定),所以会产生内部碎片。段页式分区管理:地址空间首先被分成若干个逻辑分段(这里的分段只是逻辑上的,而我们所说的碎片都是物理上真实存在的,所以是否有碎片还是要看每个段的存储方式,页才是物理单位),每段都有自己的段号,然后再将每个段分成若干个固定的页。所以其仍然是固定分配,会产生内部碎片。固定式分区管理:很明显是固定的,会产生内部碎片。综上分析,本题选 D 选项。
Q7
速对表原值: B
详细解析标注: B
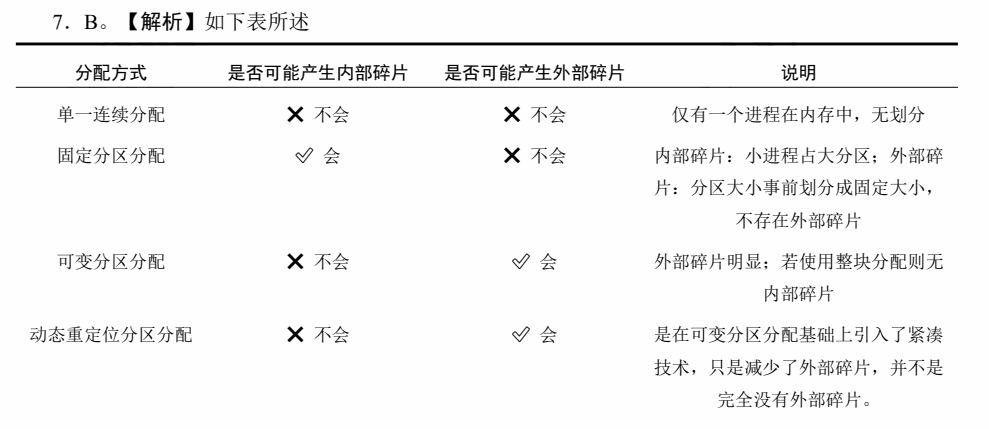
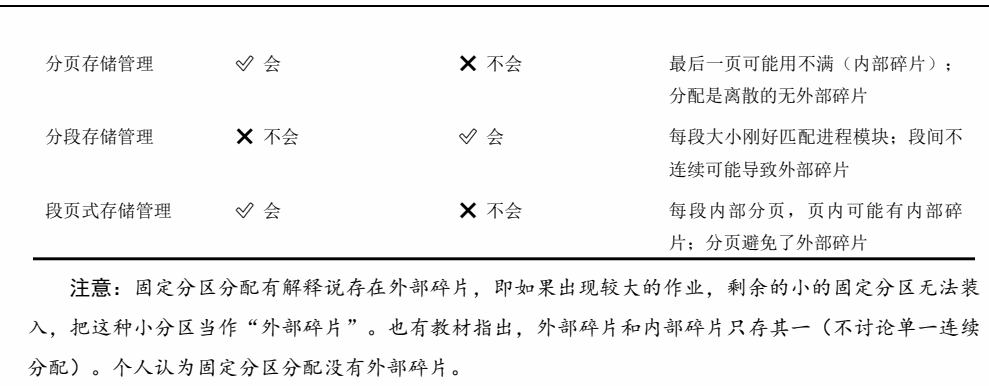
如下表所述分配方式 是否可能产生内部碎片 是否可能产生外部碎片 说明单一连续分配 ❌ 不会 ❌ 不会 仅有一个进程在内存中,无划分固定分区分配 ✅ 会 ❌ 不会 内部碎片:小进程占大分区;外部碎片:分区大小事前划分成固定大小,不存在外部碎片可变分区分配 ❌ 不会 ✅ 会 外部碎片明显;若使用整块分配则无内部碎片动态重定位分区分配 ❌ 不会 ✅ 会 是在可变分区分配基础上引入了紧凑技术,只是减少了外部碎片,并不是完全没有外部碎片。分页存储管理 ✅ 会 ❌ 不会 最后一页可能用不满(内部碎片);分配是离散的无外部碎片分段存储管理 ❌ 不会 ✅ 会 每段大小刚好匹配进程模块;段间不连续可能导致外部碎片段页式存储管理 ✅ 会 ❌ 不会 每段内部分页,页内可能有内部碎片;分页避免了外部碎片
注意:固定分区分配有解释说存在外部碎片,即如果出现较大的作业,剩余的小的固定分区无法装入,把这种小分区当作“外部碎片”。也有教材指出,外部碎片和内部碎片只存其一(不讨论单一连续分配)。个人认为固定分区分配没有外部碎片。
原页版面片段(用于核对图表、矩阵或代码)
Q8
速对表原值: B
详细解析标注: B
动态链接:程序在运行时才将所需的外部模块(如库函数)装入内存并建立链接。这就要求内存管理方式具有:模块化(每个模块可独立加载),地址空间支持逻辑分段、支持按需装载、独立保护、重定位等。而分段存储管理方式,程序划分为多个“段”(代码段、数据段、库段),每段可以独立加载、链接,最适合动态链接。分页存储管理方式通常是静态链接,将用户空间链接成一个统一的逻辑地址空间,通过页表可离散的映射到内存中的也框中。
Q9
速对表原值: C
详细解析标注: C
Ⅰ错误,首次适应算法中,空闲分区按地址递增的次序排序,系统每次分配第一个能满足大小的空闲分区。
Ⅱ正确,邻近适应算法(Next Fit)从上次查找结束的位置开始继续查找空闲分区。这种方式使得空闲分区的分布更加均匀,避免了首次适应算法中低地址部分被集中使用和切割,从而导致高地址部分保留大空闲区的情况。
Ⅲ正确,最坏适应算法(Worst Fit)总是选择最大的空闲分区进行分配。这样做的一个主要优点是,分配后剩余的空闲区通常也比较大,不容易产生过多难以利用的小碎片,这对于后续中、小作业的分配是有利的。
Ⅳ错误,最佳适应算法(BestFit)虽然听起来“最佳”,但它倾向于选择与请求大小最接近的空闲分区,这会导致系统中留下大量非常小的、难以再利用的外部碎片。而且,为了找到“最佳”分区,它通常需要扫描整个空闲分区列表或对空闲区按大小排序,查找开销较大,因此其整体性能(包括空间利用率和查找效率)并非最优。综上所述,正确的说法是ⅠI 和Ⅲ,选 C。
Q10
速对表原值: D
详细解析标注: D
A 正确,当需要分配一个较小的内存块而当前没有合适大小的空闲块时,系统会找到一个更大的空闲块,并将其分裂成两个大小相等的子块,这两个子块互为伙伴。
B 正确,伙伴系统在回收内存块时,会检查其伙伴块是否也空闲。只有当两个块大小相同、物理地址连续,并且它们的起始地址满足特定的对齐约束时,它们才被认为是伙伴,可以合并成一个更大的块。
C 正确,由于伙伴块是由一个父块等分成两部分得到的,并且它们的地址具有特定的对齐关系,因此对于任何一个块,其伙伴块的地址是唯一确定的,并且可以通过简单的位运算(通常是异或操作)根据其自身的起始地址和大小计算出来。
D 错误,伙伴关系的核心在于它们是由同一个父块直接分裂而来的,并且物理地址相邻。仅仅大小相同,或者都源自同一个更大的初始空闲块(但经过多次不同的分裂和合并),并不足以使它们成为伙伴。例如,一个 16KB 的块可以分裂成两个 8KB 的块(它们是伙伴);这两个 8KB 的块又可以各自独立分裂成 4KB 的块。其中一个 8KB 分裂出的两个 4KB 是伙伴,另一个 8KB 分裂出的两个 4KB 也是伙伴,但前一组的 4KB 块与后一组的 4KB 块(即使大小相同且都最终源自同一个 16KB 块)之间不是伙伴关系,因为它们不是由同一个直接父块分裂而来且不相邻。
Q11
速对表原值: C
详细解析标注: C
最佳适应(Best Fit)算法:空闲分区按容量递增的次序排列。每次分配内存时,顺序查找到第一个能满足大小的空闲分区,即最小的空闲分区,分配给作业。
Q12
速对表原值: C
详细解析标注: C
A 正确,快速适应算法的核心思想就是预先根据进程的常见需求大小将空闲分区分类管理,分配时直接从对应大小的链表中取用,查找效率高。但其缺点在于分区归还时,为了有效地合并可能产生的相邻小空闲块,算法会比较复杂。
B正确,伙伴系统的特点是内存块的大小固定为2的幂。分配时,如果找不到大小为2(i的空闲块,就会去查找大小为 2)(i+1)的空闲块,如果找到则将其分裂成两个大小为 2(i 的“伙伴”块,一个用于分配,另一个加入 2)i 的空闲链表。
C 错误,伙伴关系的核心在于它们是由同一个父块直接分裂而来的,并且物理地址相邻。仅仅大小相同并不足以使它们成为伙伴。
D 正确,哈希算法利用哈希函数将所需空闲分区的大小映射到哈希表的一个条目,该条目指向一个空闲分区链表,该链表中的空闲分区大小与所查找的大小相近,从而可以快速定位到合适的空闲分区。
Q13
速对表原值: A
详细解析标注: A
动态重定位分区分配可以在内存无足够大分区时移动内存中的程序使其互相连成一片,消除外部碎片以获得更大的内存分区,故 A 正确。
Q14
速对表原值: D
详细解析标注: D
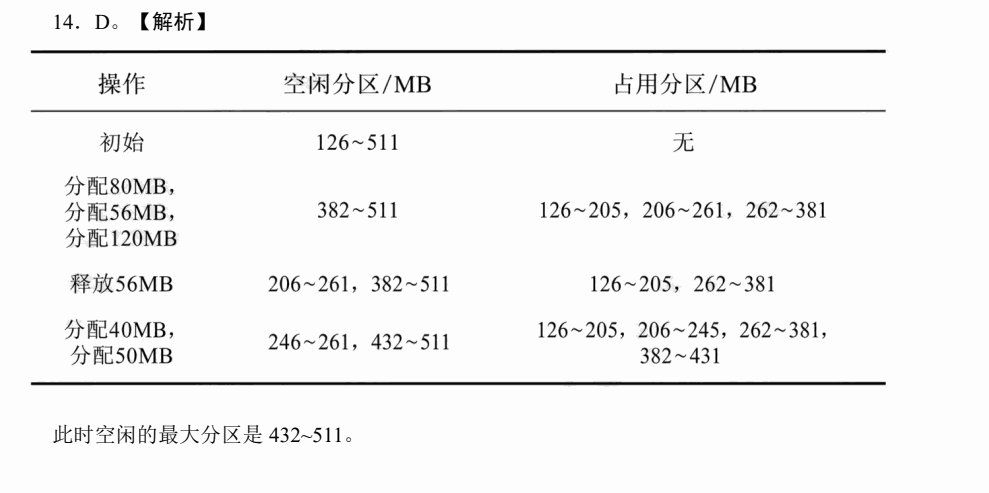
此时空闲的最大分区是 432~511。
原页版面片段(用于核对图表、矩阵或代码)
Q15
速对表原值: C
详细解析标注: C
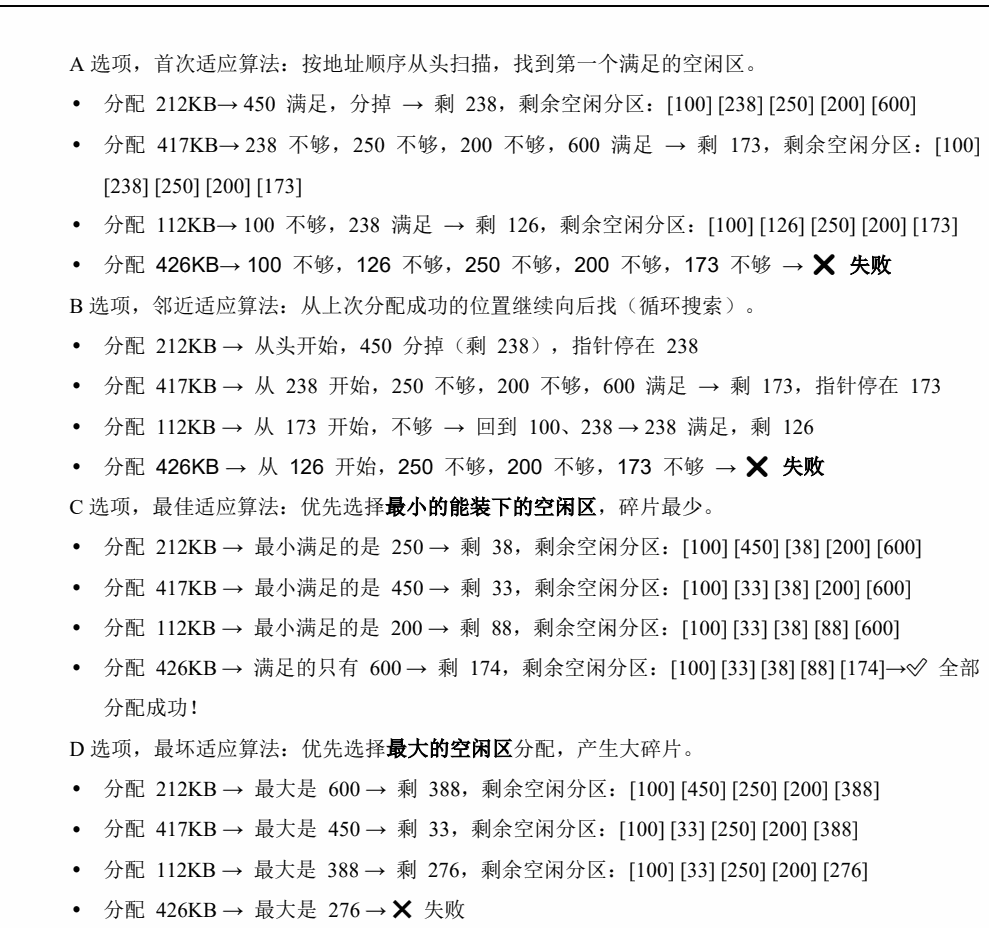
按照题中的各种分配算法,分配结果如下表所示。只有最佳适应算法能够完全完成分配任务。A 选项,首次适应算法:按地址顺序从头扫描,找到第一个满足的空闲区。
-
分配 212KB→ 450 满足,分掉 → 剩 238,剩余空闲分区:[100] [238] [250] [200] [600]
-
分配 417KB→ 238 不够,250 不够,200 不够,600 满足 → 剩 173,剩余空闲分区:[100] [238] [250] [200] [173]
-
分配 112KB→ 100 不够,238 满足 → 剩 126,剩余空闲分区:[100] [126] [250] [200] [173]
-
分配 426KB→ 100 不够,126 不够,250 不够,200 不够,173 不够 → ❌ 失败B 选项,邻近适应算法:从上次分配成功的位置继续向后找(循环搜索)。
-
分配 212KB → 从头开始,450 分掉(剩 238),指针停在 238
-
分配 417KB → 从 238 开始,250 不够,200 不够,600 满足 → 剩 173,指针停在 173
-
分配 112KB → 从 173 开始,不够 → 回到 100、238 → 238 满足,剩 126
-
分配 426KB → 从 126 开始,250 不够,200 不够,173 不够 → ❌ 失败C 选项,最佳适应算法:优先选择最小的能装下的空闲区,碎片最少。
-
分配 212KB → 最小满足的是 250 → 剩 38,剩余空闲分区:[100] [450] [38] [200] [600]
-
分配 417KB → 最小满足的是 450 → 剩 33,剩余空闲分区:[100] [33] [38] [200] [600]
-
分配 112KB → 最小满足的是 200 → 剩 88,剩余空闲分区:[100] [33] [38] [88] [600]
-
分配 426KB → 满足的只有 600 → 剩 174,剩余空闲分区:[100] [33] [38] [88] [174]→✅ 全部分配成功!D 选项,最坏适应算法:优先选择最大的空闲区分配,产生大碎片。
-
分配 212KB → 最大是 600 → 剩 388,剩余空闲分区:[100] [450] [250] [200] [388]
-
分配 417KB → 最大是 450 → 剩 33,剩余空闲分区:[100] [33] [250] [200] [388]
-
分配 112KB → 最大是 388 → 剩 276,剩余空闲分区:[100] [33] [250] [200] [276]
-
分配 426KB → 最大是 276 → ❌ 失败
原页版面片段(用于核对图表、矩阵或代码)

Q16
速对表原值: B
详细解析标注: B
A 正确,这是对“紧凑”技术的基本描述。通过移动内存中的作业,可以将原本分散的多个外部碎片合并成一个或少数几个较大的连续空闲区,以便分配给新的或等待的作业。
B 错误,这句话描述的是在静态重定位或可重定位装入方式下进行紧凑会面临的问题。在这些方式下,程序中的地址在装入时或之前就已经转换(或部分转换)为物理地址。如果内存中的物理位置改变,这些地址就需要修改。然而,紧凑技术通常与动态重定位配合使用。在动态重定位下,程序内部使用的是逻辑地址,物理地址是在每次访存时通过重定位寄存器动态计算的。
C 正确,这是动态重定位的基本原理。程序在内存中时,其内部地址仍为逻辑地址(通常是相对于程序起点的地址)。CPU执行时,硬件地址变换机构会自动将逻辑地址与重定位寄存器(存放程序在内存中的起始物理地址)中的内容相加,得到最终的物理地址。
D 正确,这是动态重定位配合紧凑技术的主要优点。由于程序内部使用的是逻辑地址,与物理位置无关,当作业因“紧凑”而在内存中移动后,操作系统只需要更新该作业在其进程控制块(PCB)中记录的内存起始地址,并将这个新的起始地址加载到重定位寄存器中即可。程序本身的指令和数据中包含的地址(逻辑地址)无需修改。
Q17
速对表原值: A
详细解析标注: A
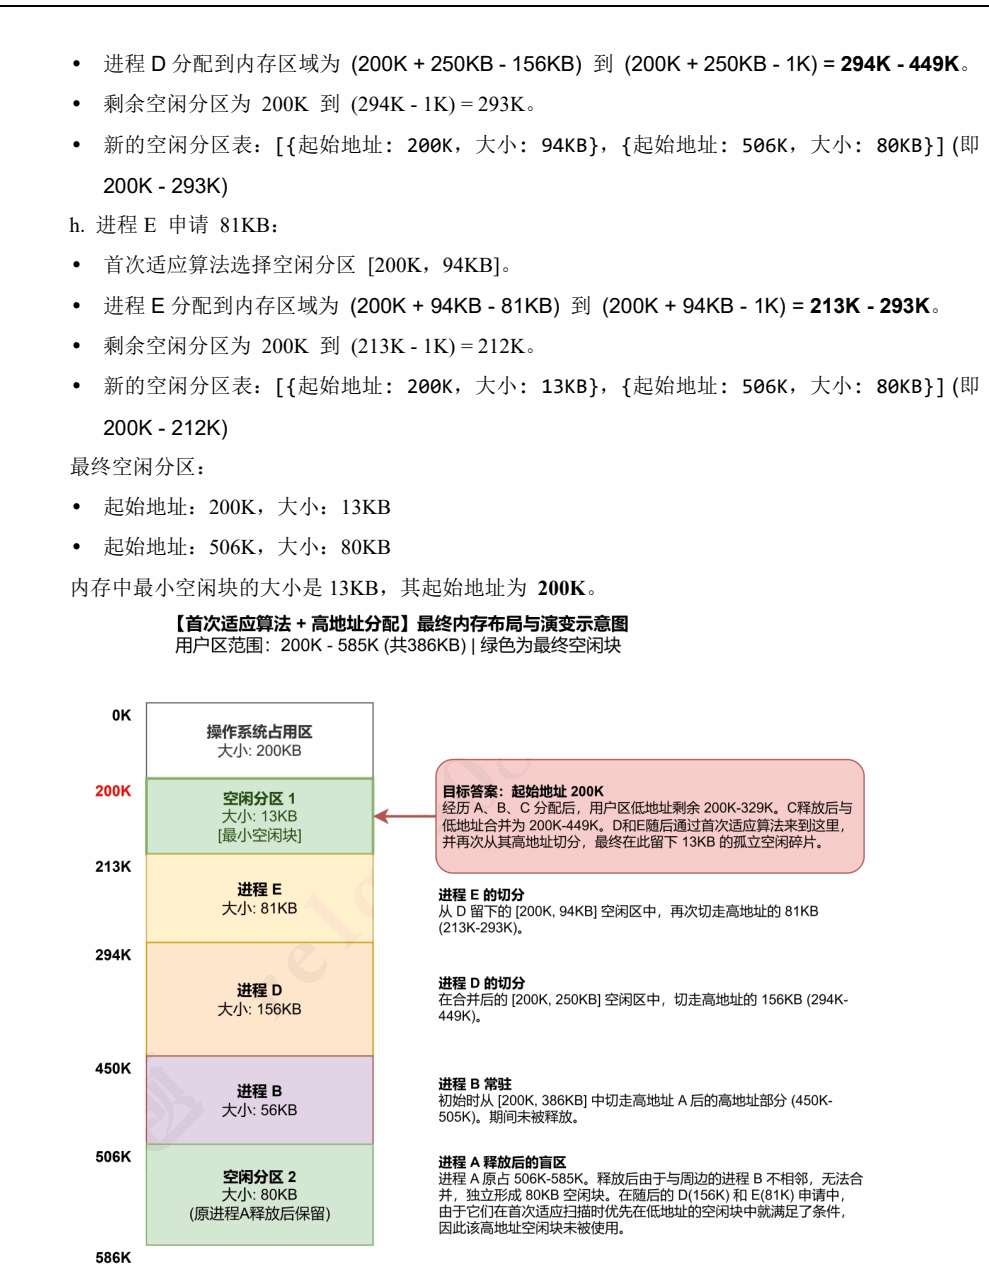
a. 初始状态:
-
操作系统占用:0K - 199K (200KB)
-
用户区空闲:200K - 585K (386KB)
-
空闲分区表:[{起始地址: 200K,大小: 386KB}] b. 进程 A 申请 80KB:
-
首次适应算法选择空闲分区 [200K,386KB]。
-
由于高地址部分分配出去,进程 A 分配到内存区域为 (586K - 80K) 到 585K,即 506K -585K。
-
剩余空闲分区为 200K 到 (506K - 1K) = 505K。
-
新的空闲分区表:[{起始地址: 200K,大小: 306KB}] (即 200K - 505K) c. 进程 B 申请 56KB:
-
首次适应算法选择空闲分区 [200K,306KB]。
-
进程 B 分配到内存区域为 (200K + 306KB - 56KB) 到 (200K + 306KB - 1K) = 450K - 505K。
-
剩余空闲分区为 200K 到 (450K - 1K) = 449K。
-
新的空闲分区表:[{起始地址: 200K,大小: 250KB}] (即 200K - 449K) d. 进程 C 申请 120KB:
-
首次适应算法选择空闲分区 [200K,250KB]。
-
进程 C 分配到内存区域为 (200K + 250KB - 120KB) 到 (200K + 250KB - 1K) = 330K - 449K。
-
剩余空闲分区为 200K 到 (330K - 1K) = 329K。
-
新的空闲分区表:[{起始地址: 200K,大小: 130KB}] (即 200K - 329K) e. 进程 A 释放 80KB (506K - 585K):
-
当前空闲分区表:[{起始地址: 200K,大小: 130KB}]
-
释放的区域 A (506K - 585K) 与当前空闲分区 (200K - 329K) 不相邻。
-
新的空闲分区表 (按地址排序):[{起始地址: 200K,大小: 130KB},{起始地址: 506K,大小: 80KB}] f. 进程 C 释放 120KB (330K - 449K):
-
当前空闲分区表:[{起始地址: 200K,大小: 130KB} (200K - 329K),{起始地址: 506K,大小: 80KB}]
-
释放的区域 C (330K - 449K) 的低地址端 330K 与第一个空闲分区 (200K - 329K) 的高地址端329K 相邻。
-
合并:新的空闲分区起始地址为 200K,大小为 130KB + 120KB = 250KB (范围 200K - 449K)。
-
新的空闲分区表:[{起始地址: 200K,大小: 250KB},{起始地址: 506K,大小: 80KB}] g. 进程 D 申请 156KB:
-
首次适应算法选择空闲分区 [200K,250KB]。
-
进程 D 分配到内存区域为 (200K + 250KB - 156KB) 到 (200K + 250KB - 1K) = 294K - 449K。
-
剩余空闲分区为 200K 到 (294K - 1K) = 293K。
-
新的空闲分区表:[{起始地址: 200K,大小: 94KB},{起始地址: 506K,大小: 80KB}] (即200K - 293K) h. 进程 E 申请 81KB:
-
首次适应算法选择空闲分区 [200K,94KB]。
-
进程 E 分配到内存区域为 (200K + 94KB - 81KB) 到 (200K + 94KB - 1K) = 213K - 293K。
-
剩余空闲分区为 200K 到 (213K - 1K) = 212K。
-
新的空闲分区表:[{起始地址: 200K,大小: 13KB},{起始地址: 506K,大小: 80KB}] (即200K - 212K)最终空闲分区:
-
起始地址:200K,大小:13KB
-
起始地址:506K,大小:80KB内存中最小空闲块的大小是 13KB,其起始地址为 200K。
原页版面片段(用于核对图表、矩阵或代码)
Q18
速对表原值: C
详细解析标注: C
按照最佳适应算法(选择能满足条件的最小空闲分区):初始:用户区 [{S:32MB,L:55MB}] A 分配 15MB: A 占用 [32MB,46MB]. 剩余 [{S:47MB,L:40MB}] B 分配 30MB: B 占用 [47MB,76MB]. 剩余 [{S:77MB,L:10MB}] A 释放 15MB (即 [32MB,46MB]): 空闲列表 (按地址排序) [{S:32MB,L:15MB},{S:77MB,L:10MB}] C 分配 8MB:
-
空闲块有 15MB 和 10MB。都能满足 8MB。
-
10MB 是能满足条件的最小空闲分区。
-
C 占用 [77MB,84MB]. 剩余 [85MB,86MB] (2MB)。
-
空闲列表:[{S:32MB,L:15MB},{S:85MB,L:2MB}] D 分配 6MB:
-
空闲块有 15MB 和 2MB。2MB 不够。
-
15MB 是能满足条件的最小(也是唯一)空闲分区。
-
D 占用 [32MB,37MB]. 剩余 [38MB,46MB] (9MB)。
-
空闲列表:[{S:38MB,L:9MB},{S:85MB,L:2MB}]最终空闲分区:
-
起始地址:38MB,大小:9MB
-
起始地址:85MB,大小:2MB此时内存中最大的空闲分区大小是 9MB。
Q19
速对表原值: C
详细解析标注: C
当逻辑地址空间很大时,单级页表可能非常庞大,需要一块巨大的连续内存空间来存放。多级页表通过将页表本身进行分页(外层页表指向页表的页面),使得这些页表的页面可以离散地存放在内存中,无需连续。只有当前需要的外层页表和部分内层页表页面需要驻留内存,从而解决了连续大空间分配的难题,故选 C。
Q20
速对表原值: B
详细解析标注: B
一级页表页表项的内容应当指向下一级页表的位置,然后在二级页表中根据页号找到目的程序文件的页框号,故一级页表页表项的内容为对应二级页表所在的页框号,本题选择 B 选项。
Q21
速对表原值: C
详细解析标注: C
A 错误,静态重定位是在程序装入内存时一次性完成的,由装入程序(软件)通过修改指令中的地址码来实现。在程序运行期间,CPU 直接访问物理地址,因此不需要硬件地址转换机构的支持。
B 错误,动态重定位确实是在程序执行时完成的,且支持程序在内存中移动。但它不依赖装入程序修改地址,而是依赖于 CPU 中的硬件地址转换机构(如重定位寄存器/基址寄存器或者MMU)在运行时动态计算物理地址。
C 项正确:分页和分段存储管理都属于动态重定位,在程序运行过程中,每一次访存(取指或读写数据)都需要进行地址转换,为了保证效率,这种高频的地址转换必须由硬件地址转换机构(MMU)自动完成。D 错在“由操作系统通过直接检索”这句话。操作系统负责的是页表的建立和维护(软件管理),而运行时根据逻辑地址去检索快表/慢表并拼接物理地址的过程,是 MMU 执行的。
Q22
速对表原值: A
详细解析标注: A
Ⅰ正确,不使用快表时,CPU 取指令需要先访问一次内存中的页表获得物理地址,之后再访问一次内存取相应指令。
Ⅱ正确,分页存储管理方式不存在外部碎片,但在进程最后一页会存在内部碎片。
Ⅲ错误,分页存储管理方式对用户透明,分段存储管理方式对用户不透明。
Ⅳ正确,分页存储管理方式下,进程装入内存后可能会改变位置,不能采用静态重定位。
Q23
速对表原值: D
详细解析标注: D
系统的平均访存时间 = 快表命中率 × 快表访问时间 + 快表未命中率 × (访问快表时间 + 访问页表时间) + 访问内存时间。设快表命中率为 F,则开启分页功能时访存时间为 F ×1ns + 100ns + (1 - F) ×100ns = 110ns,解得 F = 90.9%。因此选 D。
Q24
速对表原值: B
详细解析标注: B
由题中所给的条件,虚拟地址空间是 256TB(2^48B),即未完全使用 64 位地址。页面大小为 8KB(2^13B),则用于分页的地址线的位数为48-13=35。下面计算每级页表能容纳的最多数量。由题意每个页面为 8KB,每个页表项为 8B,则一页中能容纳的页表项为 8KB/8B=1K,即1024 个页表项,可占用 10 位地址线来寻址,剩余的 35 位地址线可分为 35/10=3.5,向上取整为 4,因此至少 4 级页表才能完成此虚拟存储的页面映射。
Q25
速对表原值: B
详细解析标注: B
页大小为 2KB,则页内偏移长 11 位,页号长 5 位;页框号长 7 位。0x1234 表示为 16 位二进制数即 0001001000110100,得到页号位 00010=2,对应页框号 36(二进制为 0100100),与页内偏移 01000110100 组合即得 010010001000110100,即 0x12234,因此选 B。
Q26
速对表原值: B
详细解析标注: B
本题采用两级页表,一个页面可放置页表项数 N=1KB/2B=512,逻辑地址空间页数 M=64MB/1KB=64K。所以页表大小为 64K/512=128 页。因此页目录表中应有 128 个表项。
Q27
速对表原值: C
详细解析标注: C
一个页面中能装入的页表项数 N=8KB/8B=1K=2^10。逻辑地址空间页面数 M=256TB/8KB=32G=2^35 个。最外层页表只能占一页,所以需要 35/10 取整=4 级页表。
C 正确。
Q28
速对表原值: C
详细解析标注: C
由题意可知,共有 7 位来表示页号,因此共有 2^7 个页面,页面大小为2^11B=2KB,主存最大容量为 27x2KB=256KB,在分页存储管理系统中,内存块数=页面数=27。由于该指令所在页的页号为 0,其分配的物理块号为 2,采用的是相对地址,所以该指令的物理地址=基地址 +相对地址 =2x2KB+1500=5596。该指令数据的存储地址为 12500,其所在页的页号为12500/2K=6。选项 C 正确。
审计旁注(非原文):作废
18 位逻辑地址和 2KB 页只能推出 128 个虚页,不能推出物理内存容量。
Q29
速对表原值: C
详细解析标注: C
当快表命中率为 85%时,系统的平均访存时间=快表命中率 x 快表访问时间+快表未命中率 x(访问快表时间+访问页表时间)+访问内存时间 =0.85x0.2+(1+0.2)x0.15+1=1.35。当快表命中率为 50% 时,系统的平均访存时间=快表命中率 x 快表访问时间+快表未命中率 x(访问快表时间+访问页表时间)+访问内存时间 =0.5x0.2+(1+0.2)x0.5+1=1.7。选 C。
注意:计算平均访存时间不要忘了访问页表后的访问内存时间。
Q30
速对表原值: C
详细解析标注: C
具体过程如下图所示:
原页版面片段(用于核对图表、矩阵或代码)
Q31
速对表原值: D
详细解析标注: D
A 正确,可重入代码(纯代码)的一个重要特性是其在执行期间自身不发生改变,任何可能改变的部分(如局部变量、返回地址)都存储在每个进程私有的栈空间或其他私有数据区。这使得多个进程可以同时执行同一份代码副本而不会相互干扰,是实现代码段共享的基础。
B 正确,如果多个进程共享一个可读写的数据段,那么它们对该数据段的并发访问可能会导致数据不一致的问题(例如,竞争条件)。因此,操作系统需要提供同步互斥机制(如信号量、互斥锁、管程等),让进程能够协调对共享数据的访问,以保证数据完整性和一致性。
C 正确,为了有效管理共享段,操作系统通常会维护一个系统级的共享段表。该表记录了每个共享段的物理信息(如在内存中的起始地址、段的长度)以及一个共享计数(或链接计数),用于表示当前有多少个进程正在共享该段。当共享计数为 0 时,该段所占用的内存才能被回收。
D 错误,在分段存储管理中,每个进程拥有自己独立的段表,段号是进程逻辑地址空间的一部分。当多个进程共享同一个物理段时,这个共享段在它们各自的段表中所对应的段号可以是不同的。例如,进程 A 可能将共享库段映射为其 3 号段,而进程 B 可能将其映射为其 5 号段。重要的是它们段表中的相应表项都指向物理内存中同一个共享段的起始地址和具有相同的段长。段内地址(偏移量)是相对于段起始而言的,对于同一个共享段内的同一逻辑位置,其段内地址是相同的。
Q32
速对表原值: A
详细解析标注: A
分页系统的核心是将虚拟内容空间和物理内存交国均划分为大小相同的页面,并以页面作为内存空间的最小分配单位,因此选项 A 正确。页是信息的物理单位,页长由系统决定,因此选项 B 错误。分段是为了方便用户编程以及方便共享,因此选项 C 请误。段是信息的逻单位,段长由用户决定,因此选项 D 错误。
Q33
速对表原值: B
详细解析标注: B
程序分段对用户和操作系统都可见,但其分段多在用户编程时决定。
Q34
速对表原值: A
详细解析标注: A
前者段基址为 0x00000,段内偏移为 0x1327,计算得到物理地址为 0x01327;后者段基址为 0xB8000,段内偏移为 0x1592,计算得物理地址为 0xB9592。因此选 A。
Q35
速对表原值: B
详细解析标注: B
段页式存储管理结合了页式管理和段式管理的优点,用分段的方法来分配和管理用户地址空间,用分页的方法来管理物理存储空间。故答案为选项 B。
Q36
速对表原值: B
详细解析标注: B
页式存储管理方式中页大小相同,页号和页内偏移量可直接通过逻辑地址计算得出,地址空间是一维的。而分段式和段页式中的段号和段内地址都要显式给出,地址空间是二维的。
Q37
速对表原值: B
详细解析标注: B
在段页式存储系统中,为了获取一条指令或数据,必须三次访问内存,第一次访问内存中的段表,从中取得页表地址;第二次访问内存中的页表,从中取得该页所在的物理块号并将该块号与页内地址一起形成指令或数据的物理地址;第三次访问是根据第二次访问所得的地址,真正取出指令或数据(但这是在访问地址正确的情况下)。为了防止越界,在段页式存储系统中配置了一个段表寄存器,用于存放段表始址和段表长度。在进行地址变换时,首先利用段号,将它与段长进行比较。若段号超出段表长度,则表示越界了。同样的段表中,页表大小这项也是为了预防地址越界的情况。一般情况下,段号、页号都是从 0 开始编址,这点从题目所给的图中也可得知。该用户访问的 3 个地址中,地址一,段号检查通过,页号越界,3 不在页号 0~2 范围内,所以只访问内存 1 次。地址二,段号检查未通过,8 不在段号 0~7 范围内,越界,所以访问内存 0 次。地址三,段号检查通过,且页号也无越界,成功访问到数据,所以访问内存 3 次。
Q38
速对表原值: B
详细解析标注: B
A 错误。在页式管理系统中,每个进程都有自己独立的页表。页表用于将进程的逻辑地址空间映射到物理内存地址空间。如果整个操作系统只有一张页表,那么不同进程的相同逻辑地址就会映射到相同的物理地址,无法实现进程地址空间的隔离。
B 正确。在段式管理系统中,每个进程的逻辑地址空间由若干个段组成,每个段都有其独立的属性(如基址、长度、权限等)。为了管理这些段并将段的逻辑地址映射到物理地址,操作系统会为每个进程建立一张段表。C、D 均错误。在段页式管理系统中,先将进程的逻辑地址空间分成若干个段,然后再将每个段分成若干个页。因此,每个进程会有一张段表,段表中的每个表项对应一个段,并指向该段的页表。这意味着每个进程的每个段都有一个对应的页表,所以一个进程可能会有多张页表,而不是整个进程只有一张页表,更不是整个操作系统只有一张页表。
Q39
速对表原值: C
详细解析标注: C
A 错误,虚拟存储器的核心思想之一是“对换性”或“部分驻留”,即只将程序当前需要运行的部分调入内存,暂时不用的部分则存放在外存(如磁盘)中。当需要时再调入,不需要或暂不使用的则可能被换出。这与“全部保留在内存中”相反。
B 错误,虚拟存储器的实现恰恰是建立在离散分配的内存管理方式之上的,如请求分页式或请求段式(或段页式)存储管理。 离散分配允许程序的不同部分存放在物理内存中不连续的位置,这为页面的换入换出提供了灵活性。连续分配方式难以支持虚拟存储器的有效实现,因为它要求为整个程序或其已知部分分配连续空间。
C 正确,虚拟存储器的“虚拟性”特征使得用户看到的逻辑地址空间可以远大于实际的物理内存容量。 这个逻辑地址空间的大小受限于 CPU 的寻址能力(如 32 位 CPU 理论上可寻址 4GB,64 位 CPU则大得多)。而这些逻辑地址空间中的内容,一部分在物理内存中,大部分则存放在外存(通常是磁盘的交换区或对换区)上。因此,虚拟存储的总容量可以理解为物理内存和可用外存空间之和,但实际上限更多地由 CPU 寻址范围和外存大小决定。
D 错误,这是传统存储管理方式的特征。 虚拟存储器的核心思想恰恰是打破了这两个限制,实现了“多次性”(程序不必一次全部调入,可以分多次调入)和“对换性”(程序不必一直常驻内存,可以换入换出)。
Q40
速对表原值: D
详细解析标注: D
A 正确,虚拟内存管理方式下,每个进程都认为自己拥有一个完整的、独立的地址空间,通常从 0 开始编址。即使不同进程使用了相同的虚拟地址,由于它们有各自独立的页表或段表,这些相同的虚拟地址会被映射到物理内存中不同的物理地址,从而实现了进程间的地址隔离。
B 正确,用户程序(包括 C 语言程序)在运行时,其所有地址引用(包括通过 malloc()等函数动态分配的内存地址)都是虚拟地址。这些虚拟地址由操作系统和硬件(MMU)转换为实际的物理内存地址。
C 正确,存保护是虚拟内存管理的重要功能。操作系统通过在页表项或段表项中设置保护位(如读、写、执行权限位),可以对进程虚拟地址空间中的不同逻辑段或页面施加不同的访问控制。例如,代码段通常设置为只读和可执行,数据段设置为可读写。
D 错误,一个进程的虚拟地址空间的总大小主要由 CPU 的寻址能力(即 CPU 地址线的位数,如 32位系统理论上最大虚拟地址空间为 232 字节,64 位系统则更大)决定,而不是直接由当前空闲物理内存或磁盘交换区的大小决定。物理内存和磁盘交换区的大小影响的是一个进程(或多个进程)实际可以使用的、能被有效映射到物理介质上的虚拟内存量,但不是虚拟地址空间本身理论上的最大范围。
Q41
速对表原值: C
详细解析标注: C
A 错误:MMU 只负责发现缺页并触发异常信号,陷入内核态是由 CPU 控制单元完成的,MMU 不执行中断处理程序。
B 错误:即使分配的页框再多,进程在首次访问某些虚拟页面时,依然会发生无法避免的“初次访问缺页”。
C 正确:OS 将页面调入内存并修改页表后,会执行异常返回指令(如 iret),CPU 会重新执行刚才被打断的指令。
D 错误:TLB 中不缓存存在位为 0 的表项。如果 TLB 命中,说明该页绝对在内存中且有效。发生缺页时,TLB 必定缺失。
Q42
速对表原值: C
详细解析标注: C
C 不会执行。引发缺页中断的进程当前正处于运行态(因为它正在执行指令并访问了不在内存的页面)。发生缺页中断后,该进程会从运行态直接进入阻塞态(等待态),以等待所需页面从外存调入内存。它不是从就绪队列移到阻塞队列。
Q43
速对表原值: C
详细解析标注: C
Ⅰ正确,交换区(也称为对换区或页面文件)的主要功能就是作为物理内存的后备存储,当物理内存不足时,操作系统可以将暂时不使用或不活跃的内存页面或整个进程的内容写入到交换区,以便释放物理内存供其他任务使用。
Ⅱ错误,交换区管理的主要目标是提高页面换入换出的速度和效率,而不是像文件系统那样追求灵活的空间利用或支持复杂的目录结构。为了追求速度,交换区的分配策略通常比文件系统简单得多,对对换区的管理应采取连续分配存储管理方式,很少需要考虑外存中的碎片问题,以最大限度地减少磁盘寻道时间和旋转延迟。文件系统通常采用更复杂的离散分配策略(如索引分配、链式分配)和数据结构来管理文件。
Ⅲ正确,这是交换区和虚拟内存机制的核心功能。通过页面换出(将内存页写入交换区)和页面换入(从交换区读回内存页),操作系统可以在有限的物理内存上运行比物理内存容量更大的程序,或者同时运行更多的程序。
Ⅳ错误,虚实地址的转换速度主要由硬件地址变换机构(如 MMU)、快表(TLB)的命中率以及页表(或段表)的结构和访问效率决定。 交换区的大小主要影响的是系统能够支持的虚拟内存的总量以及在物理内存极度紧张时系统的运行能力(即能换出多少页面)。增大交换区并不能直接加快单次地址转换的过程。相反,如果系统过于依赖交换区导致频繁的页面换入换出(抖动),反而会因为大量的磁盘 I/O 操作而降低整体性能,包括间接影响到与地址转换相关的操作(如因缺页中断而进行的页表操作)。
Q44
速对表原值: B
详细解析标注: B
页缓冲队列是将被淘汰的页面缓存下来,暂时不写回磁盘。发生缺页时,一定会修改页表和将对应物理页写入用户内存,也会重新执行缺页指令,但是由于页缓冲队列的存在,所以可能不必去磁盘获取页面,因此答案选 B。
审计旁注(非原文):作废
目标页已在缓冲区时,B、D 所述动作都可能不发生。
Q45
速对表原值: C
详细解析标注: C
页框大小 = 212 B = 4KB。每一级页表索引为 9 位,包含 29 = 512 个页表项。每个页表项 8B,则一页能完美容纳一个级别的完整页表(512 × 8B = 4KB),即每一张页表恰好占用 1个页框。将两个逻辑地址写成二进制,分析其各级索引:地址 1:0x0000 0000 0000 1000 -> 高位全为 0,其一级、二级、三级索引均为 0,四级索引为 1。地址 2:0x0000 0001 0000 2000 -> 拆分其中间 36 位(各 9 位)索引。一级索引:0二级索引:4 (因为 0x10000 溢出到了二级索引的低位)三级索引:0四级索引:2计算页表数:一级页表:全系统/进程共用 1 个(必不可少)。二级页表:地址 1 和地址 2 的一级索引都是 0,因此它们共用同一个二级页表 -> 1 个。三级页表:地址 1 通过二级页表项 0 指向一个三级页表;地址 2 通过二级页表项 4 指向另一个三级页表。由于二级索引不同,它们指向了不同的三级页表 -> 2 个。四级页表:这两个独立的三级页表中的相应表项(索引 0)又分别指向各自的四级页表 -> 2个。总计占用页框数 = 1 + 1 + 2 + 2 = 6 个。
Q46
速对表原值: B
详细解析标注: B
请求分页系统中的外存可分为两部分:用于存放文件的文件区和用于存放对换页面的对换区。通常,由于对换区采用连续分配方式,而文件区采用离散分配方式,因此对换区的数据存取(磁盘 IO)速度比文件区的高。这样,每当发生缺页请求时,系统应从何处将缺页调入内存,可分为以下 3 种情况。(1)系统拥有足够的对换区空间,这时可以从对换区调入全部所需页面,以提高调页速度。为此,在进程运行前,须将与该进程有关的文件从文件区复制到对换区。(2)系统缺少足够的对换区空间,这时,凡是不会被修改的文件都直接从文件区调入;而当换出这些页面时,由于它们未被修改,不必再将它们重写到磁盘(换出),以后再调入时仍从文件区直接调人。但对于那些可能已被修改的部分,在将它们换出时,须将它们调到对换区,以后需要时再从对换区调入。(3)UNIX 方式。由于与进程有关的文件都放在文件区,故凡是未运行过的页面,都应从文件区调入。而对于曾经运行过但又被换出的页面,由于被放在对换区,因此在下次调入时,应从对换区调入。由于 UNIX 系统允许页面共享,因此,某进程所请求的页面有可能已被其他进程调入内存,此时也就无须再从对换区调入。综上所述,已修改过的页面再次装入时应来自磁盘对换区。
Q47
速对表原值: D
详细解析标注: D
由题意知,每个页的大小为 1KB,即 1024B,所以页内地址有 10 位。把虚地址0A5CH 转换成二进制为 101001011100B,其中低 10 位 1001011100B 为页内地址,余下的高 2 位 10B.即2为页号,查虚页号和物理页号对照表可知,物理页号为4,即100B.所以物理地址为1001001011100B,即 125CH。用同样的方法,求得 1A5CH 的页号为 6,但此时的虚页号和物理页号对照表中没有虚页号6,所以会产生缺页中断。故答案为选项 D。
Q48
速对表原值: D
详细解析标注: D
页框大小为 512B,int 型数据 4B,则一个页框可以存放 512B/4B=128 个 int 型变量,又因数组按行存放,因此一个页框内刚好存放数组 a 的一行数据,由代码可知,每次访问数组 a 不同行的元素,导致访问均产生缺页,缺页的次数为 128x128 次=16384 次,故答案为选项 D。
Q49
速对表原值: D
详细解析标注: D
设缺页率为 P,则有效存取时间为 1μs(访问页表)+Px(0.6x10ms+0.4x1ms)(处理缺页)+1μs(访问内存),计算得 P=1/6400,选 D。
Q50
速对表原值: C
详细解析标注: C
A 项错误:既然共享同一个物理页框 F,两者的页表项中存储的物理页框号必然完全相同。B、C 项正确/错误分析:物理页框本身作为硬件内存是没有进程概念的,它不存储某个进程对其的访问权限。页面的访问权限(如只读、读写、执行)是存储在各个进程各自的页表项中的。因此,P1 的页表项里权限位写着“只读”,P2 的页表项里写着“读写”,它们互不干扰,故 C 正确,B 错误。
D 项错误:由于映射到同一个物理页框,P2 的修改是直接作用于物理内存的,P1 再次读取该物理内存时会立即看到更新。
Q51
速对表原值: B
详细解析标注: B
根据题意,忽略 TLB 访问时间。若快表命中则可直接获得物理地址,需要一次内存访问,若快表未命中,则需要访问页目录表、页表才能获得物理地址,共需要三次内存访问。所以,平均访存次数=0.25x3+0.75x1=1.5 次内存访问。
Q52
速对表原值: B
详细解析标注: B
A 错误: 多级页表确实节省了内存空间,但代价是增加了查表的层级。如果没有 TLB 命中,单级页表访存 1 次,二级页表需访存 2 次,因此它降低了单次地址转换的速度。
B 正确: 查表的起点(页表基址)必须是物理地址,供硬件 MMU 直接寻址。非运行态时,它安全地保存在内核空间的 PCB 中;运行态时,由 OS 填入 CPU 的页表基址寄存器。
C 错误: 32 位地址、4KB 页大小(偏移量 12 位),剩下的 20 位页号分为 10 位目录号和 10位页表号。页目录层只有 210 = 1024 个目录项,占用最大内存为 1024 × 4B = 4KB。(4MB 是所有二级页表全满时的总和)。
D 错误: 在多级页表架构下,除了顶级的页目录表必须常驻物理内存,其余下级页表是允许被换出到磁盘的。如果下级页表缺失,同样会触发缺页中断,这确实增加了额外的磁盘 I/O 开销。
Q53
速对表原值: B
详细解析标注: B
Ⅰ错误,内存分配策略和页面置换策略之间存在一定的关联性,不能随意搭配。例如,不存在固定分配全局替换策略。
Ⅱ正确,在固定分配局部置换策略中,系统需要为每个进程预先分配固定数量的物理页框。这个数量的是一个难点:如果分配得太少,进程会频繁发生缺页中断,降低系统吞吐量;如果分配得太多,会减少内存中可容纳的进程数量,可能导致 CPU 或其他资源空闲。
Ⅲ正确,可变分配局部置换策略允许根据进程的运行情况动态调整其分配到的物理页框数量。当一个进程频繁发生缺页中断(可能出现抖动的迹象)时,系统可以为其增加分配的物理页框数,直至其缺页率降低到适当程度。通过这种动态调整,可以在一定程度上缓解或降低抖动的发生。
Q54
速对表原值: D
详细解析标注: D
若采用 FIFO 算法,由于该算法存在 Belady 异常,所以缺页率可能升高、不变或降低。所以选 D。
Q55
速对表原值: D
详细解析标注: D
A 正确,这是一种实现 LRU 算法的硬件方法。每次访问页面时,对应页框的寄存器特定位(如最高位)被置 1。定时信号会周期性地将所有寄存器的内容右移。这样,长时间未被访问的页面,其寄存器中的 1 会逐渐右移出去,使得其数值变小。数值最小的寄存器对应的页面就是最近较长时间未使用的页面。
B 正确,硬件栈是实现 LRU 算法的一种有效方式。每当一个页面被访问时,就将其页面号从栈中取出(如果已存在)并压入栈顶。这样,栈顶总是最近被访问的页面,而栈底则是最近最久未被访问的页面。当需要淘汰页面时,选择栈底的页面即可。
C 正确,这描述的是 Clock(时钟)置换算法,它是 LRU 算法的一种常用近似实现。通过访问位来记录页面近期是否被访问,并通过循环扫描和清除访问位的方式来选择淘汰页面,其开销比精确 LRU 小。
D 错误,虽然为每个页表项设置时间戳并在每次访存时更新可以精确记录页面的最后访问时间,从而找到最近最久未使用的页面,但这种方法的开销非常大。硬件开销:为每个页表项增加一个足够宽的时间戳寄存器会增加硬件成本。时间开销:每次内存访问都需要更新对应页面的时间戳,这会增加内存访问的延迟。当需要淘汰页面时,还需要遍历所有页表项来比较时间戳,以找到最小(即最久未被访问)的那个,这个搜索过程本身也会有相当大的开销,尤其是在页表很大的情况下。
Q56
速对表原值: B
详细解析标注: B
本题考查各种页面替换算法。OPT(最佳替换)算法是理想中的最优算法(现实中不存在),而 LRU(最近最少使用)算法最接近 OPT 算法,FIFO(先进先出)算法一般是很差,缺页率最高。所以缺页率 FIFO>LRU>OPT,故答案为选项 B。
Q57
速对表原值: B
详细解析标注: B
LRU-2 维护两个队列,只有当当前访问的数据已经在历史访问队列中时,才会被加入缓存队列中。当访问到第 6 次时,历史访问队列为 5,6,7,8,3,此时访问 8,8 已在历史访问队列中,因此 8 加入缓存队列,此时历史访问队列为 5,6,7,3,缓存队列中为 8。接下来是第 7 次,访问 5,5 已在历史访问队列中,因此 5 加入缓存队列,此时历史访问队列为 6,7,3,缓存队列为 8,5。第 9 次,访问 6,6 已在历史访问队列中,因此 6 加入缓存队列,此时历史访问队列大 7,3,9,缓存队列为 8,5,6。访问到第 10 次时,访问 8,8 已在缓存队列中,将 8 重新放入队尾,此时历史访问队列为 7,3,9,缓存队列为 5,6,8。
Q58
速对表原值: D
详细解析标注: D
FIFO 算法中,1 号页面最先进入,故换出 1;LRU 算法中,3 号页面最久未访问,故换出 3;改进 CLOCK 算法中,选择访问位和修改位都为 0,代价最小的 3 被换出。因此选 D。
Q59
速对表原值: C
详细解析标注: C
CLOCK 算法的规则如下:
-
若页面命中,则简单把命中的页框访问位置 1,当前页框指针不变化。
-
若不命中,从当前页框出发,若当前页访问为 1,则把当前页访问位 置 0,继续往下找,直到找到访问位为 0 的页框,将旧页换出,新页换入,然后将此页框访问位置 1,当前页指针指向下一页框。回到本题:设页框号分别为 0,1,2。
①首先 7,0,1 三个页依次分配到 0,1,2 页框。状态:7 ¯ 0 1 , 01 1 , 12 1,下划线表示当前指针指向的页框,右下标是页框号,右上标是访问位。此时缺页 3 次。
②2 进入,指针依次转过 7,0,1,访问位依次置 0,然后回到 7,此时访问位为 0,换出 7,换入2。状态:20 1 , 0̄1 0 , 12 0,缺页 4 次。
③0 进入,命中,将访问位置 1,指针不动。状态:20 1 , 0̄1 1 , 12 0
④3 进入,1 换出,指针指向下一个页 2。状态:2 ¯ 0 1 , 01 0 , 32 1,缺页 5 次。
⑤0 进入,命中。状态:2 ¯ 0 1 , 01 1 , 32 1
⑥4 进入,2 换出,指针指向页 0。状态:40 1 , 0̄1 0 , 32 0,缺页 6 次。
Q60
速对表原值: D
详细解析标注: D
进程在内存中占 3 块(开始时为空)1、2、3 占满内存块,发生 3 次缺页;下一个 4 会发生缺页,4 置换 1,此时内存块有 2、3、4,下一个 1 会发生缺页,1 置换 2,此时内存块有 3、4、1;下一个 2 会发生缺页,2 置换 3,此时内存块有 4、1、2;下一个 5 会发生缺页,5 置换 4,此时内存块有 1、2、5;下一个 1、2 不会缺页;下一个 3、4、6 都会发生缺页;总共 10 次缺页。
Q61
速对表原值: C
详细解析标注: C
操作系统为进程 A 分配了 4 个页框,当第一次访问页面时会发生缺页中断,所以当第一次访问页面 1、8、7、2 都会发生缺页中断。采用的是 LRU 最近最久未使用置换算法访问 1(缺页)、8(缺页)、7(缺页)、8、2(缺页)、7、2、1、8、3(缺页)、8、2、1、3、1、7(缺页)、1、3、7。发生缺页中断的次数为 6 次,选 C。
Q62
速对表原值: B
详细解析标注: B
当为进程 A 分配页框数为 3 时,访问页面顺序 1(缺页),3(缺页),2(缺页),1,1,3,5(缺页),1,3,2(缺页),1,5(缺页)。缺页率=6/12=50%。当为进程 A 分配页框数为 4 时,访问页面顺序 1(缺页),3(缺页),2(缺页),1,1,3,5(缺页),1,3,2,1,5。缺页率=4/12=33%,选 B。
Q63
速对表原值: D
详细解析标注: D
根据 FIFO 策略,最先置换出去的页面是最早进入的,最早进入的页框号是 3,所以按照 FIFO 策略,会将页框号为 3 的页面置换出去。根据 LRU 策略,最先置换出去的是最近最久未使用的页面,由引用时间可知,最近最久未使用的页框为 1 号页框,所以会将 1 号页框置换出去。根据 CLOCK 策略,会将引用位为 0 的页面置换出去,所以会将 2 号页框置换出去。选项 D 正确。
Q64
速对表原值: C
详细解析标注: C
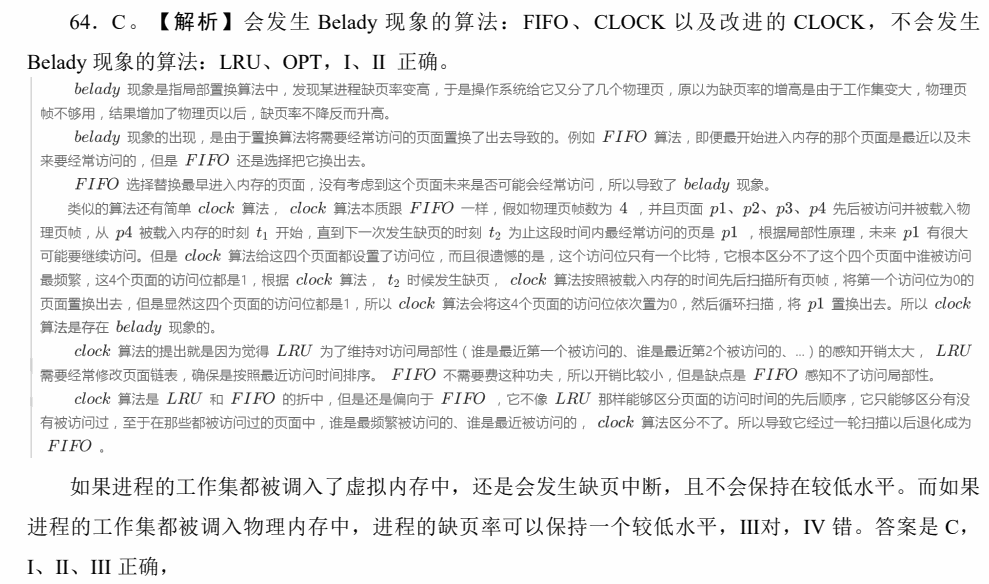
会发生 Belady 现象的算法:FIFO、CLOCK 以及改进的 CLOCK,不会发生Belady 现象的算法:LRU、OPT,I、Ⅱ 正确。如果进程的工作集都被调入了虚拟内存中,还是会发生缺页中断,且不会保持在较低水平。而如果进程的工作集都被调入物理内存中,进程的缺页率可以保持一个较低水平,Ⅲ对,IV 错。答案是 C,I、II、III 正确,
原页版面片段(用于核对图表、矩阵或代码)
Q65
速对表原值: B
详细解析标注: B
计算当前工作集 WS:刚刚访问完最后的页面 5,此时往前数 5 个访问记录(含页面 5 本身),涵盖的访问子序列为最后 5 位:{4, 1, 4, 2, 5}。 去除重复项后,去重集合为 {1, 2, 4, 5}。所以此时工作集 WS = {1, 2, 4, 5}。寻找历史最大驻留页面数:整个执行过程中,每个时刻的工作集就是当时的驻留集。我们滑动窗口看看哪个阶段去重后的不同页面最多:○ 访问到第 6 个元素 4 时,窗口为 {1, 2, 3, 2, 4}→页面有 {1, 2, 3, 4}(4 个)。○ 访问到第 7 个元素 1 时,窗口为 {2, 3, 2, 4, 1}→页面有 {1, 2, 3, 4}(4 个)。纵观全局,没有任何一个滑窗片段能够凑齐 5 个完全不同的页面(因为数字总共才活跃那么几个)。因此历史最多同时驻留页面的数量为 4 个。
Q66
速对表原值: D
详细解析标注: D
缺页中断的原因是当前访问的页不在主存,需将该页调入主存。此时不管主存是否已满(已满则先调出一页),都要发生一次缺页中断。即无论怎么安排,n 个不同的页号在首次进入主存时必须要发生一次缺页中断,总共发生 n 次,这就是缺页中断的下限。虽然不同页号数为 n,小于或等于总长度 p(访问串可能会有一些页重复出现),但驻留集 m<n,所以可能会有某些页进入主存后又被调出主存,当再次访问时又发生一次缺页中断的现象,即有些页可能会出现多次缺页中断。极端情况是每访问一个页号时,该页都不在主存,这样共发生了 p 次故障。所以无论对于 FIFO 或者 LRU 替换算法,其缺页中断的上限均为 p,下限均为 n。
Q67
速对表原值: C
详细解析标注: C
A 正确,一旦文件被映射到进程的虚拟地址空间,进程就可以像访问普通内存数组一样,通过指针和内存访问指令(如 MOV)来直接读写文件内容,而不需要调用传统的 read()或write()系统调用。
B 正确,内存映射文件是实现进程间共享数据(特别是大文件)的一种高效方式。多个进程可以将同一个文件映射到它们各自的地址空间。如果映射是共享的,那么一个进程对映射区域的修改对其他共享该映射的进程是可见的(取决于映射类型和同步机制)。
C 错误,当进程退出或关闭文件映射时,所有的被改动页面才会被写回磁盘文件,并非修改后立即写回。
D 正确,内存映射文件利用了操作系统的请求分页机制。当进程首次访问映射区域中的某个页面,而该页面尚未加载到物理内存时,会发生缺页中断。操作系统会响应该中断,从磁盘文件中读取相应的页面内容到物理内存,并更新页表,然后进程才能继续执行。这种按需调入的方式使得可以映射远大于物理内存的文件。
审计旁注(非原文):改解析
MAP_PRIVATE 的修改不会写回原文件;答案 C 可保留。
Q68
速对表原值: B
详细解析标注: B
B 错误,内存映射文件利用了操作系统的请求调页(Demand Paging)机制。当文件被映射时,并不会立即将其全部内容调入物理内存。只有当进程实际访问到映射区域中的某个特定页面,而该页面尚未在物理内存中时,才会触发缺页中断,操作系统再负责将对应的文件部分从磁盘调入物理内存。这种按需调页的方式使得可以映射远大于可用物理内存的文件。
A 正确,传统的 I/O 操作(如 read())会将文件数据从磁盘读入内核的页高速缓存,然后再从页高速缓存复制到用户进程的缓冲区。内存映射文件通过将文件内容直接映射到进程的虚拟地址空间,可以避免这次从内核空间到用户空间的额外数据复制,从而提高 I/O 效率。
C 正确,这是内存映射文件的核心概念。通过系统调用(如 mmap()),文件在磁盘上的内容被映射到进程虚拟地址空间的一个连续区域。之后,进程就可以像访问内存一样访问文件内容。
D 正确,当多个进程将同一个文件以共享模式映射到它们各自的虚拟地址空间时,它们实际上共享了物理内存中该文件的相同副本(通过页高速缓存)。一个进程对映射区域的修改可以被其他共享该映射的进程看到(取决于映射类型和同步)。这种直接的内存共享避免了传统 IPC 机制(如管道、消息队列)中数据需要通过内核进行多次复制的开销,因此可以提供一种高带宽的进程间通信方式,特别适合大量数据的共享。
Q69
速对表原值: A
详细解析标注: A
只有 IV 不会影响缺页率。
I. 页置换算法会影响缺页率,例如,LRU 算法的缺页率通常要比 FIFO 算法的缺页率低。
II. 工作集的大小决定了分配给进程的物理块数,分配给进程的物理块数越多,缺页率就越低。
III. 进程的数量越多,对内存资源的竞争越激烈,每个进程被分配的物理块数越少,缺页率也就越高。
IV. 页缓冲队列是将被淘汰的页面缓存下来,暂时不写回磁盘,缺页是指访问的页未分配页框,在页缓冲或在磁盘,都叫缺页。所以队列长度会影响页面置换的速度,但不会影响缺页率。V. 编写程序的局部化程度越高,执行时的缺页率就越低。若存储采用的是按行存储,则访问时就要尽量采用相同的访问方式,避免按列访问造成缺页率过高的现象。
Q70
速对表原值: A
详细解析标注: A
由题目可以得出,大部分时间消耗在磁盘交换区,也就是说,物理内存太小,导致数据需要频繁的换进换出,因此使用容量更大的内存可以改进 CPU 利用率。此外 CPU 和 I/O 利用率都很低,说明 CPU 一次读取了太多的程序放入内存中,因此减少系统多道程序度数,使每个进程可以分配到更多页框,也可以改进 CPU 利用率。选Ⅰ,Ⅱ。
Q71
速对表原值: B
详细解析标注: B
地址变换机构在拿到逻辑地址后,第一步必须用段内偏移量与段表项中的“段长”进行对比。如果 段内偏移 ≥ 段长,说明该地址请求已经超越了该段的合法边界,硬件立刻抛出越界异常,直接终止操作。只有在未越界的前提下,硬件才会去检查“有效位(存在位)”。如果有效位为 0,说明该合法段当前不在内存中,此时抛出缺段中断,由操作系统从外存调入该段。
Q72
速对表原值: D
详细解析标注: D
A、B、C 正确:大页的核心优势是减少页表层级/项数和提高 TLB 覆盖率(因为一个 TLB 表项代表的地址空间变大了)。缺点是内部碎片变大,且发生缺页时,从磁盘读入 2MB 数据的延迟远大于 4KB。
D 错误:无论页大小如何,页表的创建、分配、回收、权限设置以及缺页异常的处理,都必须由操作系统(软件)来管理。硬件 MMU 只负责“查表”和“转换”,绝不负责“建表”。
Q73
速对表原值: B
详细解析标注: B
由于磁盘 I/O(读盘)相对于 CPU 速度慢得令人发指(,操作系统不可能让CPU 在内核态死等。为了提高 CPU 利用率,内核在向磁盘发出 I/O 请求后,会立刻将当前缺页的进程 P 的状态由“运行态”改为“阻塞态”,将其挂入设备等待队列。随后,调度程序挑出另一个就绪进程Q 投入运行。当磁盘把页面读入内存后,磁盘控制器发出“I/O 中断”,操作系统响应中断,把进程 P的状态修改为“就绪态”,等待下一轮调度。故 B 项最符合标准。
Q74
速对表原值: C
详细解析标注: C
页面大小为 4KB(12 位页内偏移)。剩下 20 位由一级页目录号(10 位)和二级页号(10 位)平分。将 0040 8000H 展开为二进制:0000 0000 0100 0000 1000 0000 0000 0000;高 10位(页目录号)= 0000 0000 01 B = 1;中间 10 位(二级页号)= 00 0000 1000 B = 8定位二级页表基址:题目告知该地址对应的一级页目录项中存放的页框号为 00200H。因此,对应的二级页表在内存中的物理始址 = 00200H × 4KB = 0020 0000H。计算目标页表项(PTE)的物理地址:PTE 物理地址 = 二级页表基址+ 二级页号 *页表项大小=0020 0000H + 8 * 4 = 0020 0020H
Q75
速对表原值: C
详细解析标注: C
选项 A 错误,说法过于绝对(“仅”字),除了缺页异常(越界访问、页面不在内存),越权异常(例如试图修改一个只读的页面,或者用户态试图访问内核态的页面)也会在地址转换时被硬件检测出来,并触发操作系统执行相应的异常处理程序。此外在某些采用软件管理 TLB 的架构(如 MIPS 架构)中,TLB 未命中时硬件并不会自动去查页表,而是直接触发一个“TLB 缺失异常”,交由操作系统去内存中查找页表项并填入 TLB。因此,操作系统并非只在缺页时才参与。选项 B 错误,TLB 未命中时访问页表获取页框号后,不需要重新执行指令,而是继续当前的访问流程,因为这个过程并没有发生中断或异常,也就不会导致整个指令被打断后“重新执行”。选项 C 正确,MMU 在进行地址转换时,会检查页表项中的存在位(有效位)。如果发现该位为0,说明页面不在主存中,硬件会立即产生一个缺页异常信号,这是硬件的职责;CPU 响应异常,自动切换到内核态。OS 的缺页处理程序开始运行,它负责:查找空闲物理页框(分配页框) → 启动磁盘将页面读入(I/O 启动) → 在等待磁盘读取期间,将当前进程阻塞并切换其他进程运行(进程调度)→ 调页完成后更新页表,并唤醒原进程,这是操作系统的职责。选项 D 错误,权限检查是由 MMU(内存管理单元) 在进行地址转换的同时,根据 TLB 或页表项中的保护位/控制位完成的。如果发现越权(例如试图向只读的共享页面写入),MMU 会直接拦截该操作并触发异常,根本不会把物理地址发到总线去访问主存。
Q76
速对表原值: C
详细解析标注: C
A 正确,当页表项中的“存在位”为 0 时,说明页面不在主存中。此时对应页表项中的存放位置记录的是页面在磁盘中的存储位置,操作系统必须读取这个地址才能知道去哪里加载数据。
B 正确: 缺页处理的核心目标就是为缺失的页面找一个物理页框。操作系统必须管理并检索空闲页框链表,拿出一个空闲页框;如果没有空闲的,还需要调用页面置换算法(如 LRU)腾出一个页框。
C 错误,缺页中断属于异常中的故障类型。对于故障类型的异常,CPU 硬件在响应中断、切换到内核态时,会自动将引发故障的当前指令地址(而不是下一条指令的地址)即 PC 值压入内核栈或保存在特定的硬件寄存器中。因此,修改 PC 以便重新执行指令完全是硬件底层机制保障的,不属于操作系统的操作范畴。 操作系统完成物理页框的分配、磁盘读取和页表更新后,只需要执行一条“中断返回”指令。硬件会自动弹出之前保存的 PC 值。由于硬件当初保存的就是发生缺页的那条指令的地址,所以 CPU 自然会重新执行该指令。
审计旁注(非原文):作废
缺页处理动作取决于空闲页框、牺牲页是否为脏页等条件。
Q77
速对表原值: C
详细解析标注: C
I 正确,因为 P1 的工作集大于其可用页框数,必然导致频繁的页面置换和缺页,从而引发局部抖动 。II 错误,这是对局部置换策略的根本误解。局部置换意味着 P1 只能在自己的 2 个页框中进行替换,它不能去问 P2 借或抢页框。III 正确,由于是局部置换,P1 的行为不会直接影响 P2 的页框集合,因此 P2 的缺页率保持不变。
Q78
速对表原值: C
详细解析标注: C
【解析】A 错误:调用成功时,操作系统只是在进程的进程控制块(PCB)中记录了一块虚拟内存区域,并没有立刻在物理内存中分配空间,也没有读盘。
B 错误:页表项(PTE)只能映射“虚拟地址”到“物理物理页框”,绝不能直接映射到磁盘块号。
C 正确:当进程第一次尝试通过指针去访问这块虚拟地址时,硬件 MMU 查页表发现有效位为0,当即触发缺页异常。操作系统在缺页处理程序中才去分配物理页框,并读取对应的磁盘文件块进来。
D 错误:mmap 区域的页面管理完全复用了虚拟存储系统的页面高速缓存以及虚拟内存置换算法(如 LRU/CLOCK)等机制。
Q79
速对表原值: B
详细解析标注: B
选项Ⅰ错误,TLB 的主要作用是减少地址转换时间,不直接影响缺页率。选项Ⅱ正确,更好的置换算法可以降低系统缺页率。选项Ⅲ正确,增加页框可以容纳更多工作集。选项Ⅳ正确,操作系统介入,主动降低多道程序度(将部分低优先级或阻塞的进程挂起并换出到外存),可以腾出大量物理页框。把这些空出来的页框分给剩余的活跃进程,能显著降低系统的总体缺页率。答案为 B。