Relax1000 操作系统 · 第2章 进程管理 · 解析
第2章 进程管理
本章 131 题;解析册印刷页 166–202。
速对答案(原书): DCDCC BCCBB DADDC BCCCD DCDCD BABDC CBADB CBCCC DCACA BDCDA ADABB DBBCB CCDDC DBDBA BCCCC CADBA ABDDD CAABB BCCBA DCADA CACCC BCABD CDDBB BCCCD CABBC DCBDC B
Q1
速对表原值: D
详细解析标注: D
进程是程序的一次执行过程,因而是动态的;既然是一次执行,就需要使用 CPU且表明进程有生命周期,即具有 创建、运行、消亡 这样的一个过程。而程序是指令和数据的集合,是一个静态的概念,因此本题答案为 D。
Q2
速对表原值: C
详细解析标注: C
A 错误,进程由 3 部分组成:程序段、数据段、进程控制块 PCB;A 选项认为程序段就是进程是片面和错误的:进程运行确实需要将程序段装入内存,但内存中的程序段并不是进程。
B 错误,并行的进程之间,可以利用信号量等机制实现同步、互斥等关系,但是并不是所有并行(或并发)进程间都有相互依赖或制约的关系。
C 正确,当多个进程并发执行时,会使得进程具有不可再现性:并发执行的进程,在相同的初始环境和条件下,可能得到不同的结果。这是因为进程失去了封闭性。
D 错误,进程的四大特征为动态性、并发性、独立性和异步性。
Q3
速对表原值: D
详细解析标注: D
进程可以包含多个线程,A 错误;同一进程内的多个线程共享进程的用户地址空间,不必依赖内核实现线程间通信,B 错误;C 选项前半句正确后半句错误,内核级线程操作系统中线程是调度的最小单位。
Q4
速对表原值: C
详细解析标注: C
PCB 中不包含程序源代码,程序源代码属于程序段。
Q5
速对表原值: C
详细解析标注: C
Ⅰ. 当用户登录系统时,系统通常会为该用户创建一个初始进程,例如 shell 进程II. 在批处理系统中,作业调度程序负责将作业从外存调入内存,并为该作业创建进程III. 这里的“服务”通常指系统调用(如 exec、fork),或对用户请求的响应(如网络服务、打印服务等)。例如,当用户运行一个程序时,操作系统会通过 exec 调用创建新进程,此时会导致创建新进程;注意,这里的用词是可以,不是一定;
IV. 设备分配是资源管理的一部分,涉及为进程分配设备(如磁盘、打印机等),但不会直接导致进程的创建,具体来说是通过在操作系统中设置相应的数据结构实现的,不需要创建进程。V. 批处理作业初始化通常指的是将作业加载到内存并为其创建进程的过程,与作业调度密切相关;
VI. 文件创建是通过系统调用(如 open、create)实现的,通常由当前进程完成,不会创建新进程;I、II、III、V 共 4 个,可能导致创建新进程,因此本题选择 C。
审计旁注(非原文):改解析
exec 替换当前进程映像,不创建新进程。
Q6
速对表原值: B
详细解析标注: B
A、C、D 均可能且必须发生:进程从执行态变为阻塞态(例如主动请求 I/O、申请临界资源失败),这是一种内部异常(自陷)。系统会触发异常处理程序(D),保存当前 CPU 寄存器上下文(如 PC、PSW)到该进程的 PCB 中(A),随后调用进程调度程序让出 CPU(C)。
B 错误:该进程原本处于执行态(正在 CPU 上运行),其 PCB 并不在就绪队列中,因此不存在“从就绪队列移出”这一步。应该是将其 PCB 状态改为阻塞态,并直接插入到相应的阻塞/等待队列中。
Q7
速对表原值: C
详细解析标注: C
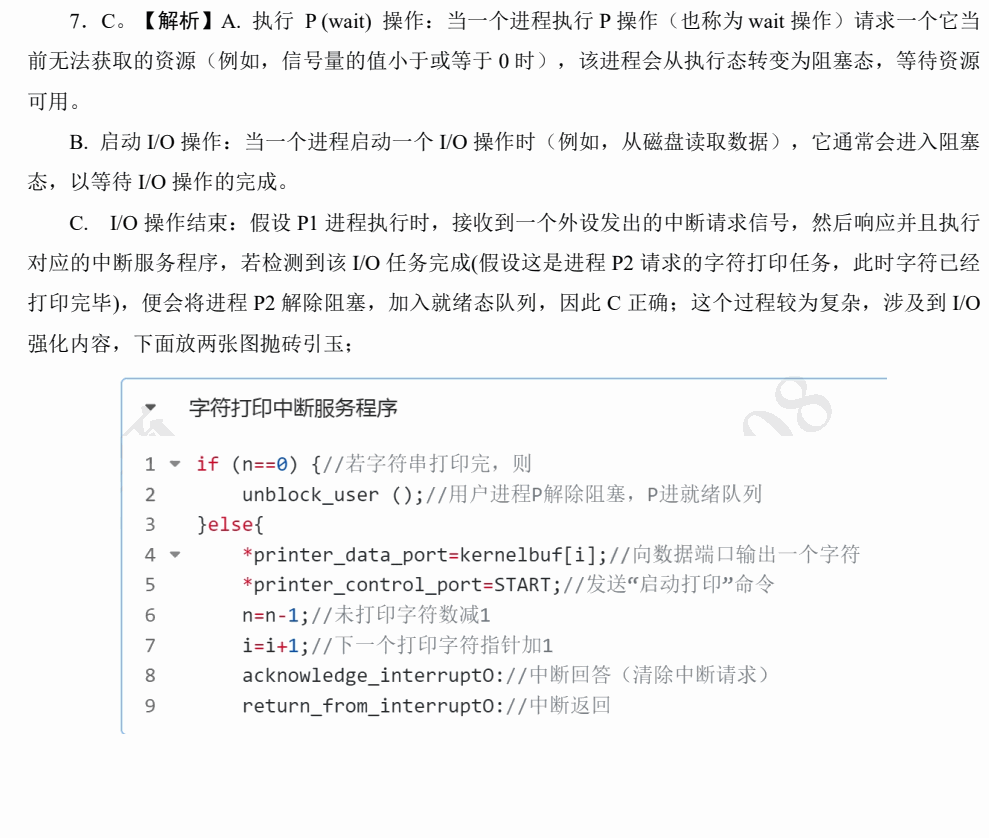
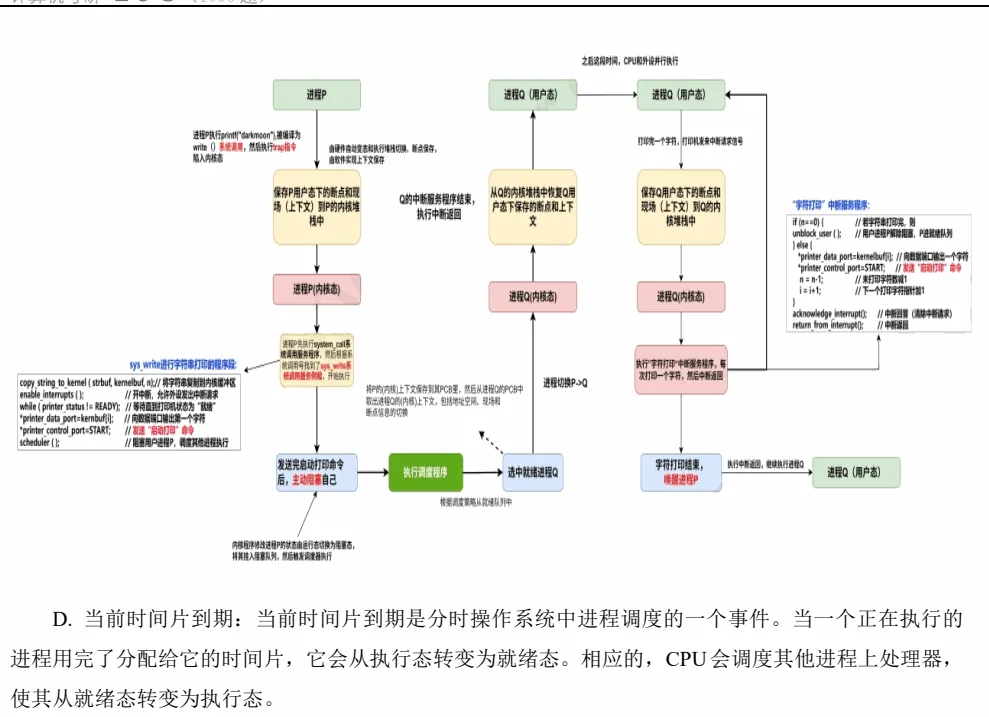
A. 执行 P (wait) 操作:当一个进程执行 P 操作(也称为 wait 操作)请求一个它当前无法获取的资源(例如,信号量的值小于或等于 0 时),该进程会从执行态转变为阻塞态,等待资源可用。B. 启动 I/O 操作:当一个进程启动一个 I/O 操作时(例如,从磁盘读取数据),它通常会进入阻塞态,以等待 I/O 操作的完成。C. I/O 操作结束:假设 P1 进程执行时,接收到一个外设发出的中断请求信号,然后响应并且执行对应的中断服务程序,若检测到该 I/O 任务完成(假设这是进程 P2 请求的字符打印任务,此时字符已经打印完毕),便会将进程 P2 解除阻塞,加入就绪态队列,因此 C 正确;这个过程较为复杂,涉及到 I/O强化内容,下面放两张图抛砖引玉;D. 当前时间片到期:当前时间片到期是分时操作系统中进程调度的一个事件。当一个正在执行的进程用完了分配给它的时间片,它会从执行态转变为就绪态。相应的,CPU会调度其他进程上处理器,使其从就绪态转变为执行态。
原页版面片段(用于核对图表、矩阵或代码)
Q8
速对表原值: C
详细解析标注: C
A正确:无论是进程切换还是线程切换,保存当前执行流的上下文(通用寄存器、PC 等)到其控制块(TCB/PCB)是必须的第一步。
B 正确:由于是从进程 P1 切换到进程 P2,虚拟地址空间发生了改变。如果不更新页表基址寄存器,CPU 会使用 P1 的页表去翻译 P2 的虚拟地址,必然导致严重的内存访问错误。因此这是跨进程切换必须执行的操作。(注:如果是同进程内的线程切换,则不需要此操作,这也是本题强调 P1 和P2 的原因)。
C 错误:关于 TLB(快表):TLB 缓存的是“虚拟地址 →→ 物理地址”的映射。因为 P1 和P2 的虚拟地址空间不同(相同的虚拟地址映射的物理页框不同),进程切换后 TLB 中的映射关系失效,必须刷新/清空 TLB。关于 Cache(高速缓存):Cache 缓存的是物理内存的数据副本。现代CPU 的 Cache 通常采用物理地址索引,进程切换并不会导致物理内存中的数据失效。更重要的是,Cache 对操作系统是完全透明的,由硬件自动管理,操作系统在进程切换时不需要、也无法直接去“清空” Cache。因此,“必须清空 Cache”是严重的错误表述。
D 正确:每个线程(无论属于哪个进程)在进入内核态时都需要使用独立的内核栈来保存内核局部变量和调用链路。因此,切换到 T2 时,必须将内核栈指针切换指向 T2 的内核栈。
Q9
速对表原值: B
详细解析标注: B
I 正确,执行 P (wait) 操作:S = S - 1,若 S ≤ 0,当前进程会被插入该信号量的等待队列,主动进入阻塞态。II 正确,进程主动申请 I/O 设备,设备当前忙时,进程需要等待 I/O 完成,会阻塞,属于典型的I/O 阻塞。III 错误,时间片用完,进程只是让出 CPU,从运行态→就绪态,依旧在就绪队列等待调度,并不会阻塞。
Q10
速对表原值: B
详细解析标注: B
B 符合题意:当发生“缺页异常”时,由于需要从磁盘(外存)将缺失的页面调入内存,这是一个耗时的磁盘 I/O 操作,当前进程必须放弃 CPU 并进入阻塞态。当磁盘 I/O 完成后,中断处理程序将该进程唤醒,进程进入就绪态。最后,进程被调度程序选中,再次进入执行态重新执行刚才失败的指令。整个过程完美契合循环。A、C 不符:时钟中断(时间片用完)或被高优先级抢占,进程的状态变化是“执行态 → 就绪态 → 执行态”,不经过阻塞态。D 不符:getpid() 属于非阻塞型的系统调用,进程切换到核心态执行完迅速返回用户态继续执行,状态始终是执行态(不发生状态转换,仅发生 CPU 模式切换)。
Q11
速对表原值: D
详细解析标注: D
进程处于就绪态的原因只有还没有分配到 CPU,但是进程处于阻塞态的原因可能是多种多样的,因此每一类原因造成阻塞的进程都会单独构建一个 PCB 等待队列。
Q12
速对表原值: A
详细解析标注: A
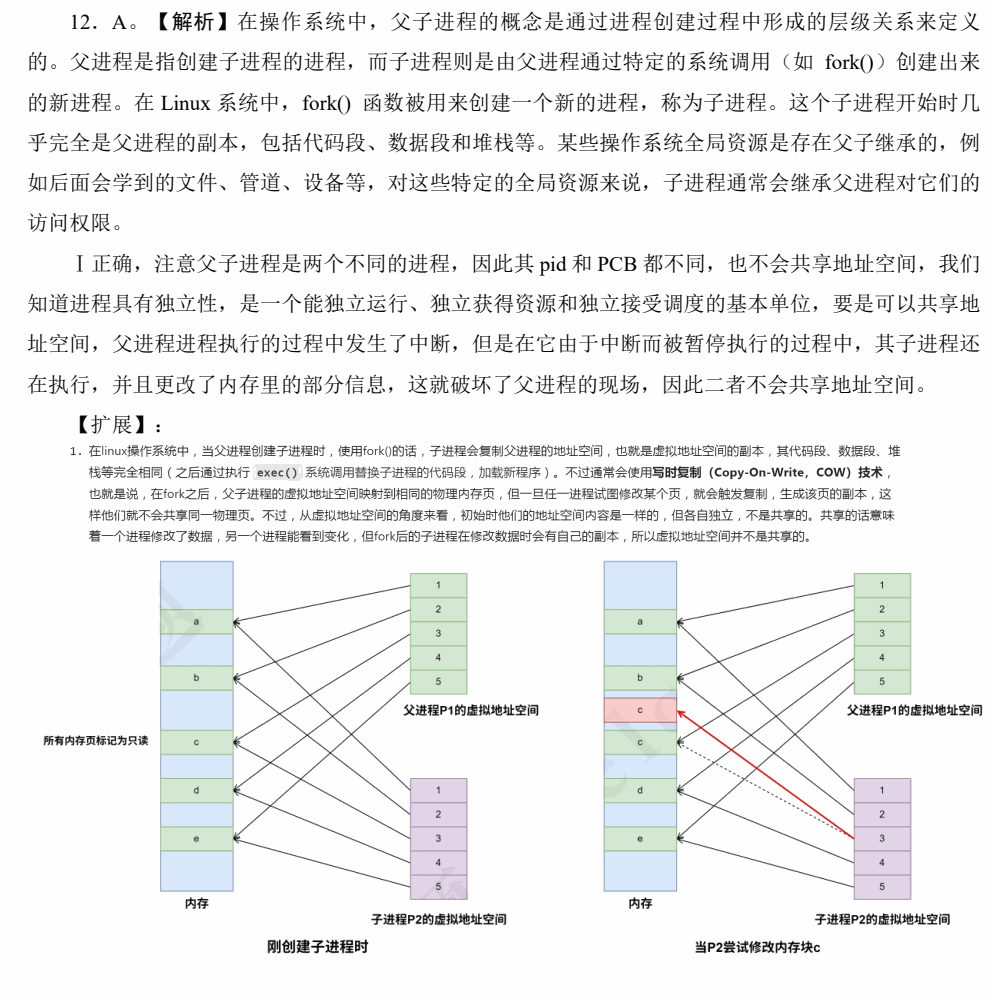
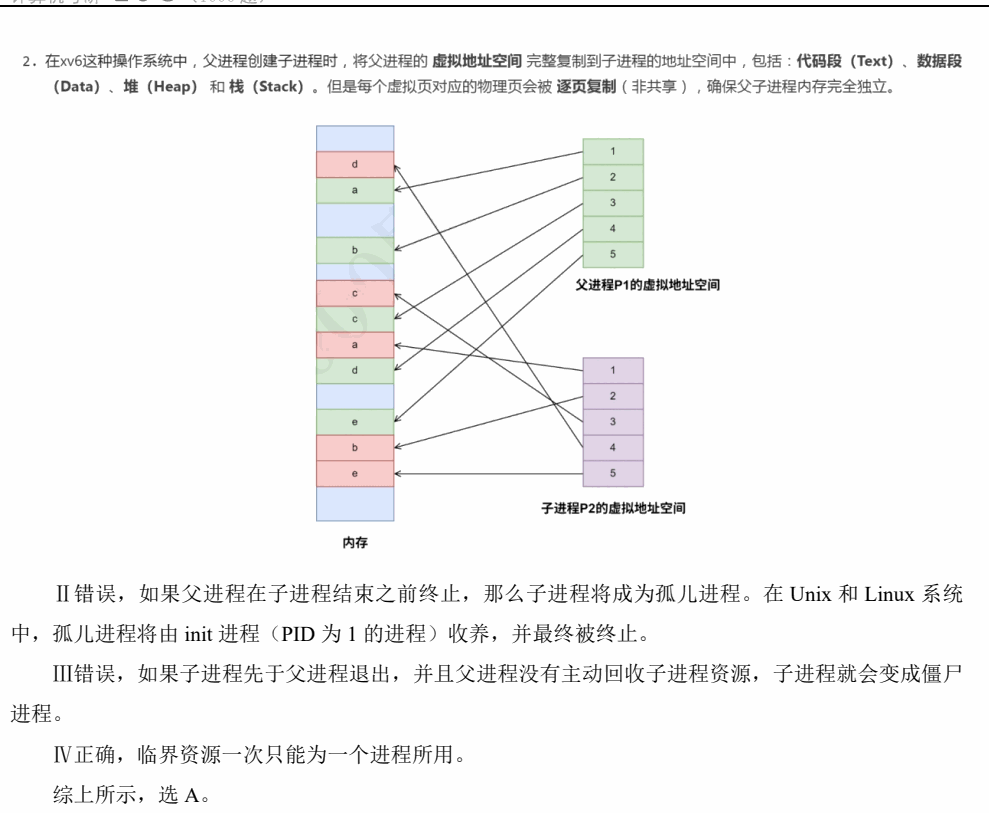
在操作系统中,父子进程的概念是通过进程创建过程中形成的层级关系来定义的。父进程是指创建子进程的进程,而子进程则是由父进程通过特定的系统调用(如 fork())创建出来的新进程。在 Linux 系统中,fork() 函数被用来创建一个新的进程,称为子进程。这个子进程开始时几乎完全是父进程的副本,包括代码段、数据段和堆栈等。某些操作系统全局资源是存在父子继承的,例如后面会学到的文件、管道、设备等,对这些特定的全局资源来说,子进程通常会继承父进程对它们的访问权限。
Ⅰ正确,注意父子进程是两个不同的进程,因此其 pid 和 PCB 都不同,也不会共享地址空间,我们知道进程具有独立性,是一个能独立运行、独立获得资源和独立接受调度的基本单位,要是可以共享地址空间,父进程进程执行的过程中发生了中断,但是在它由于中断而被暂停执行的过程中,其子进程还在执行,并且更改了内存里的部分信息,这就破坏了父进程的现场,因此二者不会共享地址空间。【扩展】:Ⅱ错误,如果父进程在子进程结束之前终止,那么子进程将成为孤儿进程。在 Unix 和 Linux 系统中,孤儿进程将由 init 进程(PID 为 1 的进程)收养,并最终被终止。
Ⅲ错误,如果子进程先于父进程退出,并且父进程没有主动回收子进程资源,子进程就会变成僵尸进程。
Ⅳ正确,临界资源一次只能为一个进程所用。综上所示,选 A。
原页版面片段(用于核对图表、矩阵或代码)
审计旁注(非原文):改解析
孤儿进程被收养后继续正常运行,不是被收养后最终终止。
Q13
速对表原值: D
详细解析标注: D
Ⅰ正确,在页式存储管理中,CPU 通过页表将逻辑地址转换为物理地址。每个进程都有其独立的页表。当进程切换时,操作系统必须更新 CPU 中指向当前活动页表基址的专用寄存器。这样,新调度的进程在执行时才能使用其自身的页表进行正确的地址映射,访问其独立的地址空间。
Ⅱ正确,通用数据寄存器(如累加器、数据寄存器等)保存了进程运行时的中间计算结果和数据。在进程切换时,这些寄存器的内容属于被切换出去进程的上下文,必须被保存到该进程的进程控制块(PCB)中,并加载新调度进程之前保存的通用寄存器内容到 CPU 中。否则,新进程会使用旧进程的寄存器数据,导致运行错误。
Ⅲ正确,程序计数器指示 CPU 下一条要执行的指令的地址。进程切换时,当前进程的 PC 值(即下一条要执行的指令地址)必须被保存到其 PCB 中。然后,将新调度进程在其上次被换下时保存的 PC 值加载到 CPU 的指令指针寄存器中,以便新进程能从正确的位置继续执行。
Ⅳ正确,每个进程都有自己的用户栈和内核栈,栈顶指针寄存器(如 ESP、SP)指向当前栈的栈顶。进程切换时,当前进程的栈顶指针必须被保存,并且新进程的栈顶指针必须被恢复。这确保了新进程在执行时能够正确使用其自身的栈空间进行函数调用、局部变量存储等操作。综上所述,选 D。
Q14
速对表原值: D
详细解析标注: D
中断响应维护的上下文可能是用户上下文(因为多重中断的存在),进程切换维护的一定是内核态下的上下文。
Q15
速对表原值: C
详细解析标注: C
当前进程的页表基址和栈基址不会因为进程的执行而改变,因此当发生进程切换时,不一定需要保存,但是一定要更新;至于其他的寄存器里的内容会随着进程的执行发生变化,因此需要先保存再更新。【扩展】:PSW 寄存器的内容在进程切换的过程中不需要保存或更新,在进程 P1 切换到进程P2,进程 P2 返回用户态时才会更新;PSW 的保存与回复可能因具体实现架构而异,此处仅做拓展。
Q16
速对表原值: B
详细解析标注: B
A 错误,进程切换全程发生在内核态,当进程从用户态切换到内核态(如通过系统调用、中断或异常),操作系统才会执行进程调度;切换过程中,CPU的控制权完全交给内核,因此切换操作必须在内核态完成。
B 正确,中断/异常是进程切换的前提条件,因为只有在内核态才能进行调度和切换。例如,当进程执行系统调用(如 fork、exec)或发生异常(如缺页中断),会从用户态进入内核态,此时操作系统可能触发进程调度,从而引发进程切换。
C 错误,进程除了寄存器以外的还有很多其他状态,它有变量,堆中的数据等等,但是所有的这些数据都在内存中,并且会保持不变。我们没有改变进程的任何栈或者堆数据。所以进程切换的过程中,cpu 中的寄存器是唯一的不稳定状态,且需要保存并恢复。而所有其他在内存中的数据会保存在内存中不被改变,所以不用特意保存并恢复。我们只是保存并恢复了cpu 中的寄存器,因为我们想在新的进程中也使用这组寄存器。至于页表基址本来就在进程 P0 的 pcb 中,因此进程切换时,只需要从进程P1 的 PCB 中取出 P1 的页表基址覆盖掉原页表基址寄存器中的内容(P1 的页表基址)即可;需要保存的信息有通用寄存器,PC,栈顶指针寄存器等,至于页表基址寄存器,栈基址寄存器等只需要更新,不需要保存;
D 错误,中断响应保存和恢复上下文是分开进行的,分别位于中断响应和中断返回的过程中;而进程切换的上下文保存与恢复是连续进行的(两个不同进程之间)。
Q17
速对表原值: C
详细解析标注: C
处于阻塞挂起状态的进程,它等待的事件在外存中完成。当 I/O 结束后,它的状态应当转换为就绪挂起态,而不是直接转换为就绪态。因为此时该进程的映像依然在外存中,需要经过中级调度(激活操作)将其调入内存后,才能变为就绪态。
Q18
速对表原值: C
详细解析标注: C
A 错误,进程因得不到资源(如等待 I/O 操作完成、等待信号量等)而进入的通常是阻塞态,而不是挂起态。挂起态通常是由于终端用户请求、父进程请求、系统负荷调节或操作系统自身需要等原因,将进程置于静止状态。
B 错误,新进程创建完成后,会进入就绪态并被放入就绪队列。此时是否立即引起进程调度取决于调度策略。在非抢占式调度中,当前运行的进程会继续执行直到主动放弃 CPU 或结束。在抢占式调度中,如果新创建的进程的优先级高于当前运行的进程,则可能会引起调度。因此,新进程的创建不必然引起进程调度。
D 错误,当正在执行的进程时间片用完后,它会从执行态转换为就绪态,并被放入就绪队列的末尾,等待下一次调度。它不会进入阻塞态,因为时间片用完并不意味着它在等待某个外部事件。
Q19
速对表原值: C
详细解析标注: C
CPU 状态变化中可能直接发生的有:
①就绪态→执行态,如进程获得时间片。
②阻塞态→就绪态,如进程获得一直等待的除 CPU 以外的资源。
③执行态→就绪态,如 CPU 时间片用完。
④执行态→阻塞态,如请求磁盘数据。而就绪态→阻塞态、阻塞态→执行态这两种情况不可能直接发生,因此答案为选项 C。
Q20
速对表原值: D
详细解析标注: D
进程除了寄存器以外的还有很多其他状态,它有变量,堆中的数据等等,但是所有的这些数据都在内存中,当该进程下处理机时这些信息会保持不变。我们没有改变进程的任何栈或者堆数据。所以进程切换的过程中,cpu 中的寄存器是唯一的不稳定状态,且需要保存并恢复。而所有其他在内存中的数据会保存在内存中不被改变,所以不用特意保存并恢复。我们只是保存并恢复了cpu 中的寄存器,因为我们想在新的进程中也使用这组寄存器。
Q21
速对表原值: D
详细解析标注: D
创建进程是一个很复杂的过程:首先由进程申请一个空白PCB,并向PCB 中填写用于控制和管理进程的信息;然后为该进程分配运行时所需的资源;最后,将该进程的状态转为就绪态并插入就绪队列的队尾。然而,如果进程所需的资源不能得到满足,例如系统尚无足够的内存装入进程,即创建工作尚未完成,进程不能被调度运行,那么此时进程所处的状态称为创建态。如果进程创建成功,那么进程状态就会转为就绪态,选项 D 错误。
Q22
速对表原值: C
详细解析标注: C
C 错误:一个进程在单核 CPU 上同一时刻只有一个线程处于执行态。时间片用完时,只有那个正在执行的线程会从执行态变为就绪态。该进程包含的其他线程本来就在就绪态、阻塞态或挂起态,不可能“均由执行态变为就绪态”。
A 正确:用户级线程对操作系统内核是不可见的。内核只看到进程,一旦某个用户级线程陷入内核并阻塞,内核会把整个进程阻塞,导致该进程内所有其他用户级线程“陪绑”阻塞。
B 正确:内核级线程对内核是可见的。一个线程缺页阻塞,内核可以调度同进程内的其他就绪线程继续执行。
D 正确:进程被挂起(通常意味着其地址空间被换出到外存),由于没有物理内存支持,其包含的所有线程都无法运行,调度器会直接忽略它们。
Q23
速对表原值: D
详细解析标注: D
A 正确,用户级线程上下文切换完全在用户空间完成,无需进入内核态,因此无需系统调用,代价较低。内核级线程切换需要保存和恢复更多寄存器状态,需进入内核态,代价更高。
B 正确,内核级线程的控制块(TCB)包含更多元数据(如线程状态、优先级、调度信息等),需要更多内存。用户级线程的控制块仅需存储少量信息(如栈指针、程序计数器等),因为其调度由用户空间库管理。
C 正确,内核级线程可被调度到不同 CPU 核心上运行,充分利用多核架构。用户级线程通常只能在一个进程中运行,无法直接利用多核优势。(操作系统内核无法感知到用户级线程的存在)D 错误,用户级线程是由用户程序或者线程库实现的,它们不依赖于操作系统内核,其调度和同步也需要消耗 CPU 资源,而且它们无法充分利用操作系统内核的调度器,可能会出现资源争用和不公平的问题。(用户级线程的调度依赖于用户空间的实现,若未设计公平的调度算法,可能不如内核级线程的调度公平。)例如,在采用时间片轮转调度算法时,各个进程轮流执行一个时间片,这对于各进程而言貌似是公平的,但假如在进程 A 中包含了 1 个 ULT(user level thread,用户级线程),而在进程 B 中包含了 100 个 ULT,那么,进程 A 中线程的运行时间将会是进程 B 中各线程运行时间的 100 倍;相应地,进程 A 的运行速度也要快上 100 倍,因此说实质上并不公平。因此 D 错误。
Q24
速对表原值: C
详细解析标注: C
I 正确。线程共享同一进程的地址空间和资源,切换时不需要像进程切换那样切换完整的进程资源环境,所以开销通常更小。II 正确。“内核级线程”的创建、调度、阻塞、切换等由操作系统内核管理,所以需要内核支持。III 错误。内核级线程由内核分别调度,一个线程阻塞,内核可以调度同一进程中的其他线程继续运行。IV 正确。内核级线程能被内核识别和独立调度,所以多个线程可以被分配到不同处理器上并行执行。
Q25
速对表原值: D
详细解析标注: D
A 正确: 用户级线程的切换完全由用户空间的线程库完成,对内核透明,因此不发生模式切换。
B 正确: 同一进程内的内核级线程切换只需要切换线程上下文(如寄存器、栈),而不需要切换进程上下文(如虚拟内存地址空间、页表等),因此开销小于进程间切换。
C 正确: 同一进程的线程共享同一个页表(地址空间),因此切换时不需要更换页表基地址寄存器,快表(TLB)中的进程页表项依然有效,不需要刷新。
D 错误: 无论是哪种线程,只要发生切换,就必须保存当前线程的寄存器上下文(如程序计数器PC、通用寄存器、栈指针 SP)。用户级线程的上下文由线程库保存在用户态的线程控制块(TCB)中,而不是不需要保存。
Q26
速对表原值: B
详细解析标注: B
I 正确,用户级线程是完全由进程管理的,操作系统无法感知到,因此调度的单位依旧是进程。II 正确,用户级线程的调度完全由用户空间的线程库实现,操作系统不参与线程的调度。III 正确,在用户级线程中,不同的应用程序自己决定如何调度线程。IV 错误,操作系统以进程为单位进行调度,因此这些线程每次只能执行一个,无法并行执行。
Q27
速对表原值: A
详细解析标注: A
在多线程映射模型中,操作系统内核调度的基本单位是内核级线程(KLT)。内核完全不知道用户级线程(ULT)的存在。当一个 ULT 执行了阻塞系统调用时,请求会通过内核处理,导致与其绑定的该内核级线程(KLT)陷入阻塞状态。题目中共有 3 个 KLT,其中 2 个 ULT 阻塞导致了 2 个 KLT 被阻塞。此时,该进程只剩下 1 个可运行的 KLT。操作系统只能将这唯一一个处于就绪态的 KLT 调度到某一个 CPU 核心上运行。尽管用户态还有 4 个处于就绪态的 ULT,但由于缺乏充当“载体”的 KLT,它们只能由这唯一一个可运行的 KLT 轮流轮转执行,无法在多个核心上真正并行。因此,最多只能有 1 个线程在核心上运行。
Q28
速对表原值: B
详细解析标注: B
KLT 的 TCB 由 OS 内核维护,存放调度信息、寄存器状态、内核栈指针等。A错:OS 不管理 ULT 的 TCB;C 错:ULT 的 TCB 由用户态线程库在堆/数据段中维护;D 错:PCB 通常包含进程级共享信息(如页表指针、打开文件表),并指向该进程的线程 TCB 链表。
Q29
速对表原值: D
详细解析标注: D
A 正确,一些 KST 对应多个 ULT,这是 ULT 通过时分多路复用 KST 来实现的,即将 ULT 对部分或全部 KST 进行多路复用,并且程序员可按应用需要和机器配置对 KST 的数目进行调整,以达到较好的效果。B,C 正确,由于 ULT 和 KST 的连接方式不同,从而形成了 3 种不同的多线程模型:多对一模型、一对一模型和多对多模型。多对一模型,将多个 ULT 映射到一个 KST 上。该模型的主要优点是:线程管理的开销小,效率高。其主要缺点是:如果一个线程在访问内核时发生阻塞,则整个进程都会被阻塞;此外,在任一时刻,只有一个线程能够访问内核,多个线程不能同时在多个处理机上运行。一对一模型,将每个 ULT 映射到一个 KST 上。该模型的主要优点是:当一个线程阻塞时,允许调度另一个线程运行,所以它提供了比多对一模型更好的并发性能。此外,在多处理机系统中,它允许多个线程并行地运行在多处理机系统上。该模型的唯一缺点是:每创建一个ULT,相应地就需要创建一个KST,开销较大。
D 错误,多对多模型,将许多 ULT 映射到同样数量或较少数量的 KST 上。KST 的数目可以根据应用进程和系统的不同而变化,其可以比 ULT 数少,也可以与之相等,但不会多于 ULT 的数目。
Q30
速对表原值: C
详细解析标注: C
A 正确: ULT 的管理依靠用户态的线程库(如利用函数调用),不需要陷入内核。
B 正确: KLT 的调度由内核直接负责,内核能感知到每一个 KLT。
C 错误: 对于 ULT(用户级线程),操作系统内核根本不知道它的存在,因此内核绝对不会为 ULT 分配内核栈。ULT 的 TCB和模拟栈空间都存放在用户空间(进程的堆区)。只有 KLT 才会由内核为其分配 TCB 和内核栈。
D正确: 线程的基本定义:共享进程的资源(代码段、数据段、全局变量、堆),独享执行资源(栈、程序计数器、寄存器)。
Q31
速对表原值: C
详细解析标注: C
线程使用的是所属进程的地址空间,并不单独占有地址空间,因此不需要分配页表。本题中的线程属于一对一线程模型,一个用户线程必须要有一个内核线程来对应,因此既需要为用户线程分配堆栈,也需要为对应的内核线程分配堆栈,另外,一对一线程模型下的线程是内核可以感知的,因此需要为其配备对应的线程控制块 TCB。
Q32
速对表原值: B
详细解析标注: B
Ⅰ正确,在引入线程的操作系统中,进程是操作系统进行资源分配(如内存、文件句柄等)的基本单位。线程作为进程内的一个执行实体,自身拥有非常少的资源(如程序计数器、寄存器组、栈),它必须依赖于其所属的进程而存在,无法脱离进程独立运行。
Ⅱ错误,线程不是简单的程序段的划分。一个进程可以包含多个线程,这些线程共享进程的代码段(程序段)和数据段。线程是进程中的一个执行流或执行单元。
Ⅲ错误,管道、共享存储、消息传递等机制通常是用于进程间通信(IPC)的。同一进程内的线程由于共享进程的地址空间(包括全局变量、堆内存等),它们之间的通信更为直接和高效,可以直接读写共享的内存数据,或者使用更为轻量级的同步机制(如互斥锁、条件变量)来协调。虽然理论上线程也可以使用某些 IPC 机制,但这通常不是它们主要的或最高效的通信方式。
Ⅳ正确,同一进程中的所有线程共享该进程的整个地址空间,包括代码段、数据段和堆。但是,每个线程为了能够独立执行函数调用和存储局部变量,都拥有自己私有的栈空间。一个线程不能直接访问另一个线程的栈空间。
Q33
速对表原值: A
详细解析标注: A
在多线程环境下,同一进程内的所有线程共享该进程的大部分资源,但也拥有各自独立的一些资源。
Ⅰ. 进程 P 的全局变量:可共享。全局变量属于进程 P 的地址空间的一部分。同一进程内的所有线程共享该进程的整个地址空间,因此线程 Ta 和 Tb 都可以访问和修改进程 P 的全局变量。
Ⅱ. 线程 T0 的局部变量存储区域:不可共享。线程的局部变量通常存储在该线程各自的栈空间中。每个线程拥有自己独立的栈。因此,线程 T0 的栈对于线程 Ta 和 Tb 来说是私有的,它们不能直接共享或访问 T0 的局部变量存储区域。
Ⅲ. 套接字描述符 sock_fd:可共享。文件描述符(包括套接字描述符)是操作系统内核为进程维护的资源。当一个线程(如 T0)打开一个文件或套接字并获得一个描述符时,这个描述符在进程 P 的级别是有效的。由于同一进程内的所有线程共享进程所拥有的资源,包括打开的文件表项和套接字,因此线程 Ta 和 Tb 可以共享并使用由线程 T0 打开的套接字描述符 sock_fd 来进行网络通信。
Ⅳ. 线程 Ta 和 Tb 各自独立的程序计数器:不可共享。程序计数器(PC)是 CPU 中用于指示下一条要执行指令地址的寄存器。每个线程都是一个独立的执行流,因此每个线程(包括 Ta 和 Tb)都必须拥有自己独立的程序计数器,以追踪各自的执行位置。这使得它们能够并发(或并行)执行不同的指令序列。如果共享 PC,它们就无法独立执行了。综上所述,选 A。
Q34
速对表原值: D
详细解析标注: D
IV 错误,PCB 只有文件描述符,并没有文件缓冲区。PCB 包含:进程标识符、处理器状态信息(通用寄存器、PC、PSW、栈指针等)、进程调度信息(进程状态、进程优先级、阻塞原因)、进程控制信息(程序和数据的地址、信号量、标志、资源、指向所在队列下一个进程 PCB的指针等)等。
原页版面片段(用于核对图表、矩阵或代码)
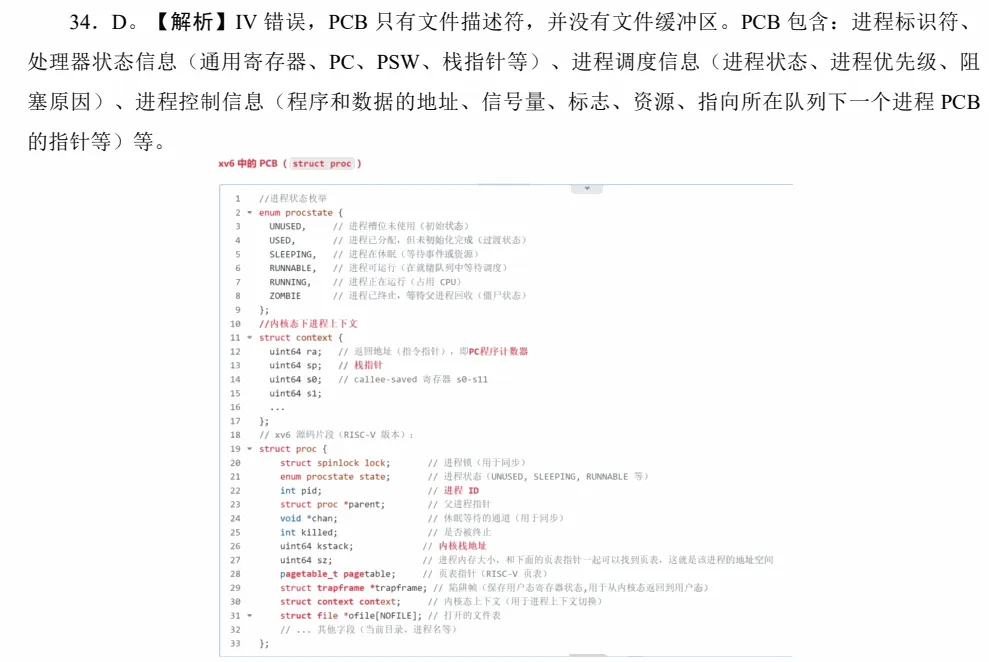
Q35
速对表原值: B
详细解析标注: B
Ⅳ. 互斥信号量(如 mutex)通常属于系统资源,由操作系统维护。例如,当进程请求一个互斥锁时,操作系统会检查该信号量的状态。PCB 中可能包含进程当前持有的信号量或等待的信号量的引用,但信号量本身的数据结构(比如它的值、等待队列等)并不在 PCB 中。
Ⅵ.进程执行的代码是代码段,和 PCB 一样是进程的组成部分,并不会被包含在 PCB 中。(进程的代码通常存储在内存或磁盘中,PCB 只保存代码段的起始地址,而非代码本身).其余均应包含在 PCB 中,故选 B。
Q36
速对表原值: C
详细解析标注: C
本题命制依据为汤小丹计算机操作系统慕课版 2.2.4 进程管理中的数据结构中4.PCB 的组织方式。
A 正确,线性方式(如数组)确实实现简单,可以通过下标直接访问。但如果要在中间插入或删除PCB,可能需要移动后续的 PCB,导致效率较低。
B 正确,链接方式使用指针连接 PCB,可以灵活地形成各种队列(如就绪队列、不同事件的阻塞队列)。当进程状态改变时,只需修改指针即可将其从一个队列移到另一个队列,非常适合进程状态频繁变化的场景。
C 错误,索引方式通常是为不同状态的进程分别建立索引表(如就绪索引表、阻塞索引表等),而不是一个统一的索引表让所有 PCB 都通过进程 ID 直接计算。
D正确,在链接方式中,插入或删除一个PCB通常只需要修改相邻节点的指针,时间复杂度较低。而在线性方式(如数组)中,如果在中间位置插入或删除,可能需要移动大量后续元素。
原页版面片段(用于核对图表、矩阵或代码)

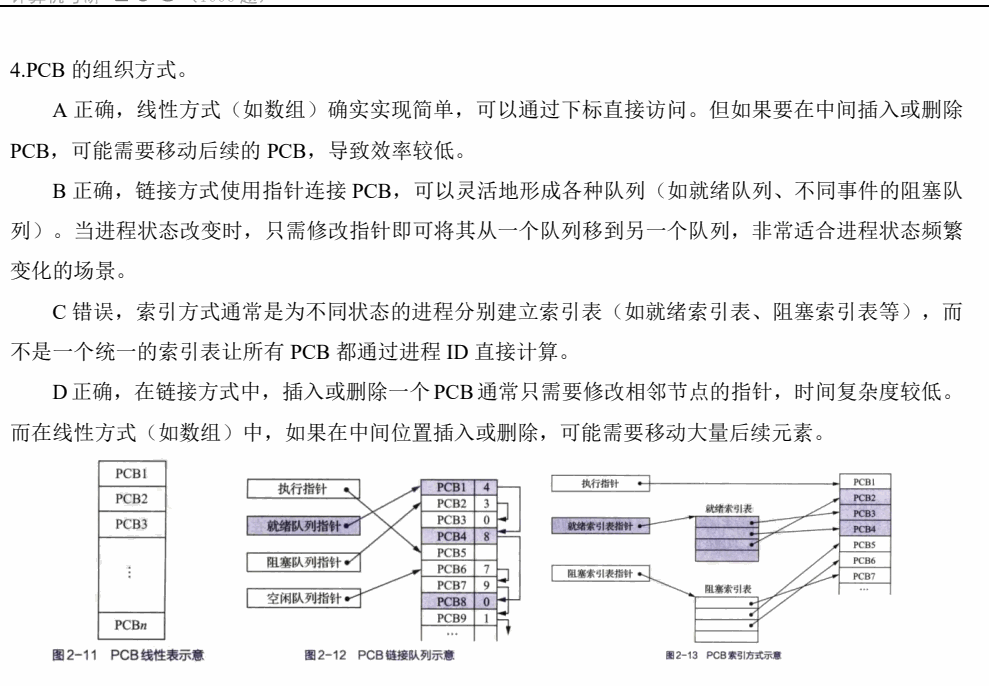
Q37
速对表原值: B
详细解析标注: B
A 正确,为了唯一地标识和管理线程,TCB 中必然会包含线程的唯一标识符。为了支持线程的独立调度和执行,每个线程必须有自己独立的程序计数器(PC)来记录下一条要执行的指令地址,以及一组寄存器(如通用寄存器、状态寄存器等)来保存其运行时的上下文。
B 错误,虽然同一进程中的线程共享进程的地址空间(如代码段、数据段、堆),但每个线程为了能够独立执行函数调用、存储局部变量和返回地址,必须拥有自己私有的栈空间。因此,TCB中需要包含一个指向该线程私有堆栈的指针(栈指针)。
C 正确,与进程类似,线程在其生命周期中也会经历不同的状态(如执行态、就绪态、阻塞态)。这些状态信息以及用于调度的优先级等,都是管理和调度线程所必需的,因此通常会记录在 TCB 中。
D 正确,内核级线程(KST)是由操作系统内核直接支持和管理的,因此其 TCB 也存放在内核空间,由内核负责维护。用户级线程(ULT)的管理完全在用户空间进行,由用户空间的线程库负责其TCB 的创建、调度和管理,内核对此是不可见的。
Q38
速对表原值: C
详细解析标注: C
创建共享内存需要通过系统调用实现,因为需要先进入内核态,内核在物理内存中分配一块连续区域,指定共享内存的访问权限(如读写权限)和大小;然后进程再通过系统调用将共享内存映射到自己的虚拟地址空间。(在虚拟页式内存管理的操作系统中,内核修改进程的页表,将指定的虚拟地址范围映射到共享内存的物理页框。多个进程的虚拟地址可以不同,但最终指向同一物理内存,如图所示)
原页版面片段(用于核对图表、矩阵或代码)
审计旁注(非原文):改解析
共享内存不要求物理连续;分页系统可映射同一组页框。
Q39
速对表原值: C
详细解析标注: C
如图
原页版面片段(用于核对图表、矩阵或代码)
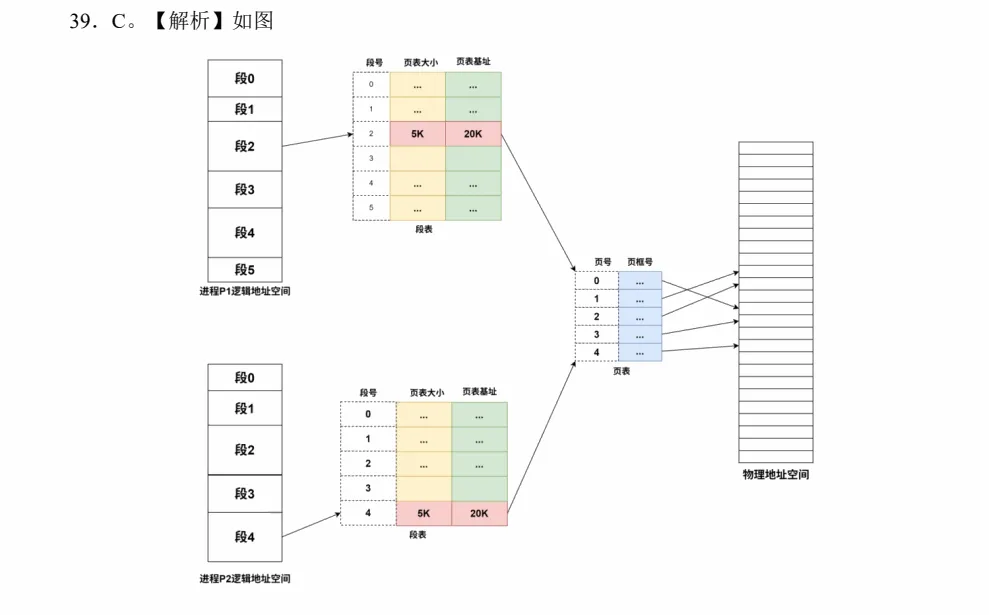
Q40
速对表原值: C
详细解析标注: C
B. 补充:无论哪个进程切换到内核态,访问的内核代码和全局数据(如中断向量表、系统调用表、设备驱动、内存管理结构等)都是同一份物理内存的映射;C:虽然说内核空间是共享的,但是每个进程在内核态执行时需要使用独立的内核栈,用于保存进程处于内核态时内核函数调用的返回地址、局部变量和中断上下文(进程响应中断/异常时,会把用户态下的断点/现场信息压入内核栈),每个进程的内核栈指针位于该进程的 PCB 中;
Q41
速对表原值: D
详细解析标注: D
下面给出管道(Pipe)通信的可能考察的所有考点:注意与 PV 信号量中的管程,I/O 方式中的通道做区分管道实际上是一种固定大小的缓冲区,管道对于管道两端的进程而言,就是一个文件,但它不是普通的文件,它不属于某种文件系统,而是自立门户,单独构成一种文件系统,并且只存在于内存中。普通管道只允许单向通信,数据只能往一个方向流动,要实现双向数据传输,就需要定义两个方向相反的管道。管道的容量大小通常为内存上的一页,它的大小不受磁盘容量大小的限制。可有多个读写进程对管道进行读写,但需要互斥访问,当管道满时,进程在写管道会被阻塞,而当管道空时,进程在读管道会被阻塞。管道一般用于亲缘关系的进程通信,匿名管道只能由创建它的进程(以及它的子进程)访问,而命名管道可以由任何可以访问对应文件的进程访问。管道允许两个进程按照生产者-消费者的方式进行通信。管道中的数据只能读一次,做一次读操作之后数据也就没有了(读数据相当于出队列)。
D 错误,管道文件位于内核区中,读写操作需要通过系统调用在内核态下读或写;
Q42
速对表原值: C
详细解析标注: C
A、B、D 均正确:硬件锁不关心有多少个核、多少个进程,直接在硬件电路层面原子化,但因为抢锁是随机的,可能导致某个进程一直抢不到而饥饿。C 错在:不管是 TSL 还是Swap,当进程拿不到锁时,执行的都是 while(TSL(&lock)); 这种死循环忙等,并没有主动放弃 CPU并进入阻塞态,因此违背了“让权等待”准则。
Q43
速对表原值: A
详细解析标注: A
进程的地址空间是相互隔离的,其他进程无法直接访问到该进程的全局变量。
Q44
速对表原值: C
详细解析标注: C
A. 错误,管道自身以及通过 mutx 互斥锁和两个等待队列实现了同步与互斥,但是共享内存自身没有同步互斥机制,一般需要和信号量一同使用;B. 错误,管道在内存之中,管道只能读 head(读指针)指向的数据,只能在 tail(写指针)指向的区域写入数据(队尾写入,队头读出),不支持 lseek 之类的文件定位操作。C. 正确,管道(Pipe)的同步与互斥机制就是通过 mutex 互斥锁,等待队列(rd_wait 和wr_wait)实现,读写操作需要用到读写指针(也可以理解为循环队列的队头、队尾指针);D. 错误,对管道的读写操作都需要互斥进行,同一时刻,管道只允许一个读进程对管道执行读操作或一个写进程对管道执行写操作;
Q45
速对表原值: A
详细解析标注: A
B 错误,当所有引用管道的文件描述符都被关闭后,内核直接回收管道的缓冲区资源;
C 错误,在此情景之下,持有管道读/写端文件描述符的进程数量都不为 0,只有当 readers 和writers 均为 0 时,内核才会销毁管道并释放其缓冲区内存D 错误,匿名管道只能用于具有血缘关系的进程同学滚毫无亲缘的两个独立进程,进程地址空间、文件描述符表完全隔离,没有任何天然的 fd 复制途径,无法互相拿到对方管道的 fd 自然没法访问同一个管道。
Q46
速对表原值: B
详细解析标注: B
管道是一种特殊的文件,读写进程以字符流形式进行读出和写入,因此 B 选项正确。
Q47
速对表原值: D
详细解析标注: D
A 错误,当写端引用计数为 0(所有写者关闭)且管道为空时,内核不会让读者阻塞,而是认为到了文件末尾,read() 系统调用会立即返回 0;如果管道内还有数据,读者可以继续读取,直到读空后下一次 read() 返回 0。
B 错误,管道底层是环形缓冲区(循环队列),数据遵循的是“先进先出”(FIFO)原则,队尾写入,队头读出。
C 错误,管道同一时刻只允许一个读进程或一个写进程操作,读操作也会修改缓冲区(移动head指针、减少data_size(即队列当前大小)),必须互斥。
D 正确,管道本质上是半双工通信,如果父子进程之间需要实现全双工(双向)通信,必须创建两个独立的管道:一个用于父进程写、子进程读;另一个用于子进程写、父进程读。
Q48
速对表原值: C
详细解析标注: C
A 正确,进程可以使用系统调用(如 kill())向其他有权限接收的进程发送信号,也可以给自身发信号。。同时,内核也会在某些事件发生时(如硬件错误、非法指令、定时器超时、子进程终止等)向特定进程发送信号。
B 正确,对于大多数信号,进程可以选择三种处理方式:
-
忽略信号:进程不响应该信号,如:Linux 中的 SIGWINGH 信号。
-
执行系统默认操作:每种信号都有一个系统预设的默认处理动作,如终止进程、忽略信号、暂停进程等。
-
执行用户自定义的处理函数:进程可以注册一个信号处理函数(signal handler),当接收到特定信号时,执行该用户定义的函数。
C 错误,信号是一种异步通知机制,它本身并不携带大量数据。它主要用于通知接收进程发生了某个事件。进程可以通过信号处理函数来响应这个通知,但信号本身不适合用来直接传递大量或复杂的数据结构。传递大量数据通常需要借助管道、共享内存、消息队列等其他 IPC 机制。
D 正确,操作系统定义了一些具有特殊用途的信号,它们的行为是固定的,不能被用户进程通过设置信号处理函数来改变(捕获)或忽略。如 SIGKILL,SIGSTOP。
Q49
速对表原值: D
详细解析标注: D
利用共享文件进行的进程通信机制称为管道。管道是一种文件,是服务于管道通信的特殊文件,而管道通信是一种通信方式,这种通信方式比较特殊,一般是半双工通信方式,数据只能单向流动,数据传递的方式是字符流形式。故答案为选项 D。考生要注意区分共享存储与管道通信的区别。
Q50
速对表原值: A
详细解析标注: A
管道是一种半双工的进程通信机制,适用于父子进程或具有亲缘关系的进程间通信。在这种情况下,P1 可以将数据写入管道,P2 从管道中读取数据,并将数据再次写入管道,最后P3 从管道中读取数据。消息队列适用于进程间传递消息的场景,但不适合多个进程之间的连续数据传递。共享内存允许多个进程访问同一块内存区域,但它需要额外的同步机制来确保数据的正确性,并且不适合这种连续的进程链式通信。信号量用于进程间同步和互斥,但不能直接用于进程间数据传递。因此,选项 A 是最适合这个需求的进程通信机制。
Q51
速对表原值: A
详细解析标注: A
A 项: 共享内存最核心的优势在于:一旦建立映射,多个进程可以直接读写同一块物理内存,不需要在用户态和内核态之间来回拷贝数据。因此,无论是面对“大容量”还是“高频次”的数据交换,它的效率都是绝对最高的。B 项:概念混淆。 消息传递(Message Passing)是必须经过内核的。发送方将消息复制到内核缓冲区,接收方再从内核缓冲区复制到自己的用户空间。选项中说“无需内核干预”是错误的(这恰恰是共享内存的特点)。C 项: 传统的管道(Pipe)是半双工(单向)的,而不是“双向并发”;且它严格遵循 FIFO(先进先出) 原则,属于典型的有序通信,而非“无序”。D 项: 这是最经典的考点。管道和消息传递是自带同步机制的(例如管道满了,写进程会阻塞;管道空了,读进程会阻塞)。而共享内存本身不提供任何同步机制,如果多个进程同时读写,会导致数据混乱,必须配合信号量(Semaphore)等互斥工具使用。
Q52
速对表原值: D
详细解析标注: D
Ⅰ正确,共享存储、信息传递、通道和信号都是高级通信方式,PV 操作(信号量)、管程也可用于进程通信,属于低级通信方式。II 正确,共享内存方式允许多个进程直接访问同一块内存区域。一旦共享内存区域映射到进程的地址空间,进程就可以像访问自己的私有内存一样读写这块区域,无需操作系统内核的介入来进行数据复制。因此,与其他需要内核参与数据拷贝的通信方式(如管道、消息队列)相比,共享内存通常是速度最快的进程间通信方式。III 正确,消息传递机制中,进程以格式化的消息为单位,通过操作系统提供的发送和接收原语进行数据交换。这种方式隐藏了通信实现的细节,使用方便,并且能够很好地支持分布式系统和计算机网络环境下的通信,因此成为当前应用最为广泛的一类进程通信机制。IV 正确,信号(Signal)是一种异步的通知机制,用于通知接收进程发生了某个事件。当一个进程接收到信号时,它的正常执行流程会被打断,转而去执行相应的信号处理程序(如果已注册),或者执行系统默认的操作。这种打断当前执行流并转去执行特定处理程序的过程,与中断(特别是软件中断或陷入)的机制非常相似。信号通信可以被视为一种软件层面的中断或异步事件通知。
Q53
速对表原值: A
详细解析标注: A
A 错误,虽然在基本的时间片轮转算法中,时间片大小通常是预设的,但在一些更高级的调度算法(如多级反馈队列调度)中,不同队列的进程可以拥有不同的时间片大小,并且系统也可能根据运行情况动态调整时间片的大小以优化性能。因此,时间片的大小并非绝对固定且不可调整。
B 正确,这是时间片轮转调度算法的基本工作方式。当进程用完其时间片后,如果它还需要继续执行,调度程序会将其置为就绪态,并将其移至就绪队列的尾部,等待下一轮调度。
C 正确,操作系统通过设置定时器(时钟部件)在每个时间片结束时产生一个时钟中断。CPU 响应这个中断后,会进入内核态,执行调度程序,从而剥夺当前进程的CPU,并分配给就绪队列中的下一个进程。
D 正确,如果时间片设置得非常长,以至于大多数进程都能在一个时间片内完成,那么进程调度的行为就近似于先来先服务(FCFS)算法。这会使得短作业和需要快速响应的交互式用户得不到及时的处理,降低了分时系统的交互性。
Q54
速对表原值: B
详细解析标注: B
在采用非抢占调度方式时,一旦把处理机分配给某进程,就会一直让它运行下去,而决不会因为时钟中断或其他原因去抢占该进程的处理机,直至该进程完成或发生某事件而被阻塞时,才会把分配给该进程的处理机分配给其他进程。在采用非抢占调度方式时,可能会引起进程调度的因素可归结为:
①正在执行的进程运行完毕,或执行 yield 系统调用主动释放处理机资源;
②正在执行的进程因提出 IO 请求而暂停执行;
③在进程通信或同步过程中执行了某种原语操作,如 Block 原语。非抢占调度方式的优点是实现简单、系统开销小,其适用于大多数批处理系统。但它不能用于分时系统和大多数实时系统。选项 A 会使该进程进入就绪态,选项 C、D 可能使某个进程从阻塞态进入就绪态,因此选项 A、C、D 不会引起进程调度。而选项 B 会使当前进程从运行态进入阻塞态,会引起调度。
Q55
速对表原值: B
详细解析标注: B
非抢占式调度方式下,运行态上的进程要么一口气完成,要么因为某些事件到阻塞态,不可能到就绪态。
Q56
速对表原值: D
详细解析标注: D
A 正确,批处理系统的设计初衷就是高效地完成大量计算任务,因此关注的是整个系统的效率(吞吐量、资源利用率)以及作业从提交到完成的整体时间(周转时间)。
B 正确,分时系统允许多个用户通过终端与计算机交互,因此快速响应用户输入、提供流畅的交互体验是其核心调度目标。同时,为保证每个用户都能获得合理的 CPU 时间,公平性也是一个重要因素。
C 正确,硬实时系统通常应用于工业控制、航空航天等对时间要求极为严格的领域。其调度算法的首要任务是保证所有硬实时任务在其规定的截止时间(deadline)内完成,系统的可预测性和高可靠性是关键,有时甚至可以牺牲部分资源利用率来确保这些目标的实现。
D 错误,不同类型操作系统的处理器调度目标确实存在差异,这些目标之间相互矛盾,需要在设计时进行权衡和折中。
Q57
速对表原值: B
详细解析标注: B
在设计处理机调度算法时,需要综合考虑多个目标,以期望获得良好的系统性能和用户体验,包括公平性,资源利用率,平均周转时间等。但不应包括互斥性。互斥性不属于调度算法直接考虑的性能指标。互斥性是指当多个进程访问共享资源(临界资源)时,确保在任意时刻只有一个进程能访问该资源。这是通过进程同步机制(如信号量、互斥锁、管程等)来实现的,而不是由处理器调度算法本身来直接保证或作为其设计目标。调度算法关注的是如何分配 CPU 时间,而互斥机制关注的是如何安全地共享其他资源。
Q58
速对表原值: B
详细解析标注: B
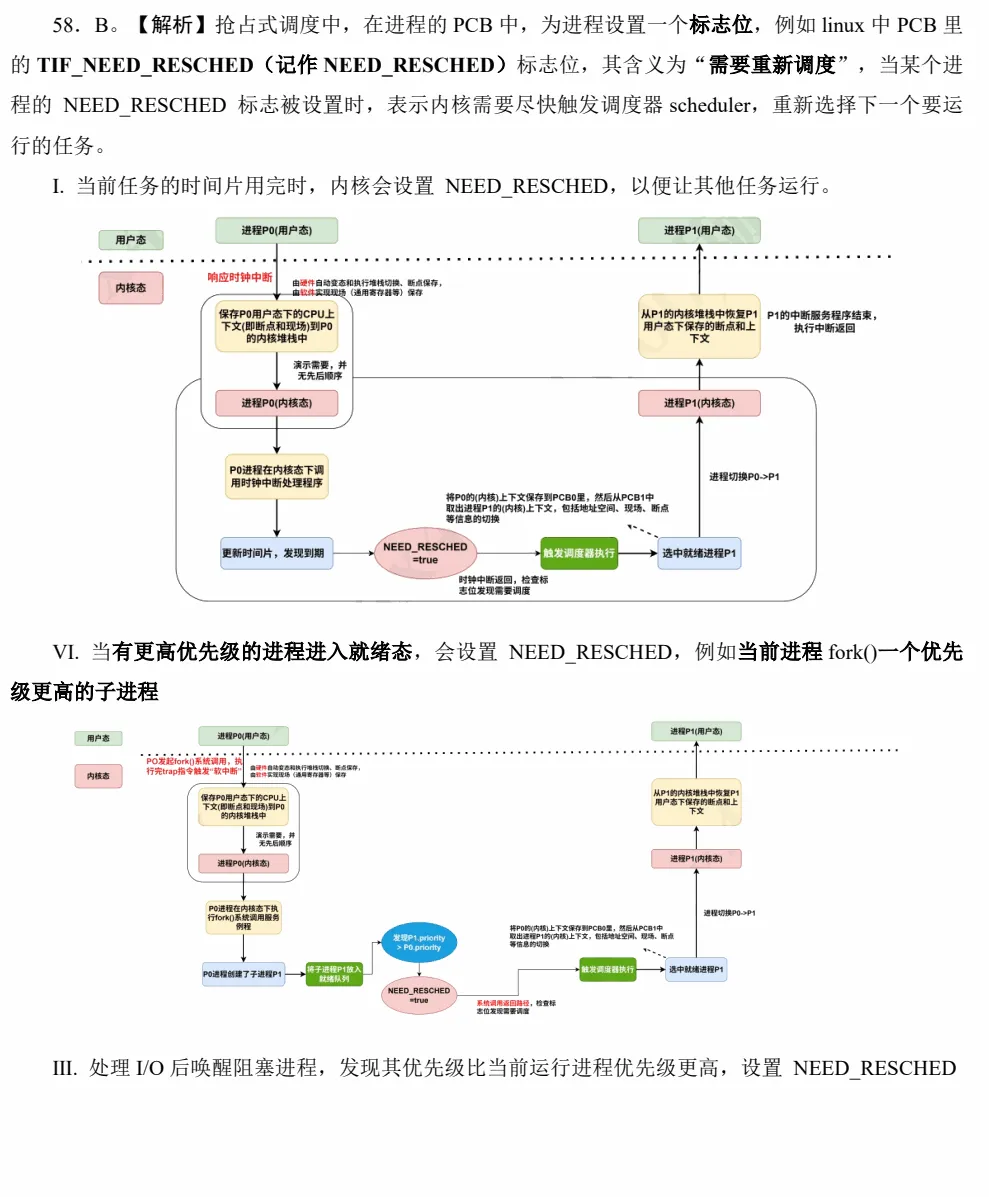
抢占式调度中,在进程的 PCB 中,为进程设置一个标志位,例如 linux 中 PCB 里的 TIF_NEED_RESCHED(记作 NEED_RESCHED)标志位,其含义为“需要重新调度”,当某个进程的 NEED_RESCHED 标志被设置时,表示内核需要尽快触发调度器 scheduler,重新选择下一个要运行的任务。
I. 当前任务的时间片用完时,内核会设置 NEED_RESCHED,以便让其他任务运行。
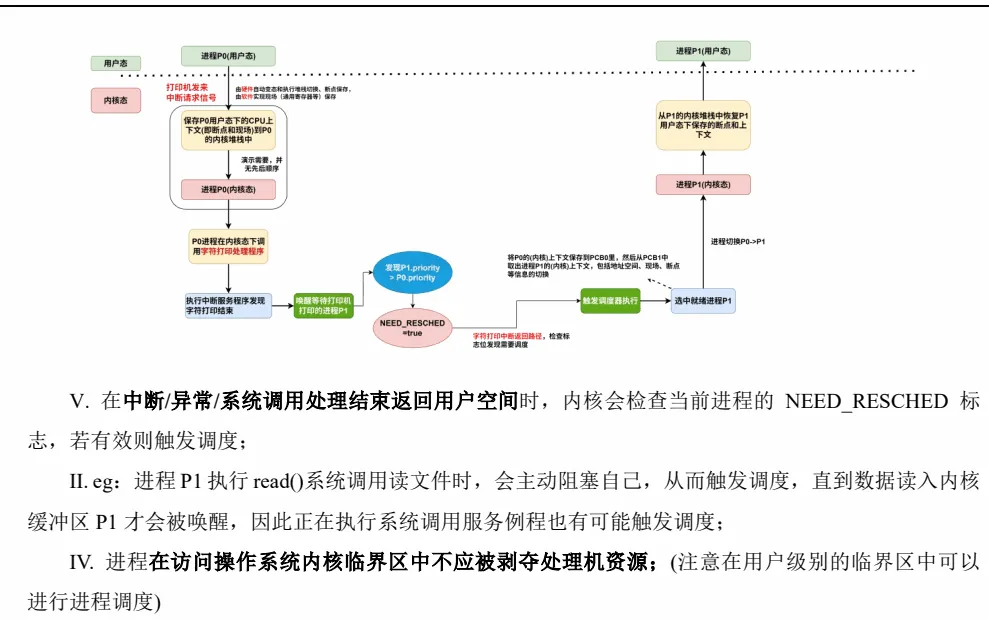
Ⅵ. 当有更高优先级的进程进入就绪态,会设置 NEED_RESCHED,例如当前进程 fork()一个优先级更高的子进程Ⅲ. 处理 I/O 后唤醒阻塞进程,发现其优先级比当前运行进程优先级更高,设置 NEED_RESCHED Ⅴ. 在中断/异常/系统调用处理结束返回用户空间时,内核会检查当前进程的 NEED_RESCHED 标志,若有效则触发调度;
II.eg:进程 P1 执行 read()系统调用读文件时,会主动阻塞自己,从而触发调度,直到数据读入内核缓冲区 P1 才会被唤醒,因此正在执行系统调用服务例程也有可能触发调度;
IV. 进程在访问操作系统内核临界区中不应被剥夺处理机资源;(注意在用户级别的临界区中可以进行进程调度)
原页版面片段(用于核对图表、矩阵或代码)
Q59
速对表原值: C
详细解析标注: C
闲逛进程不需要 CPU 以外的其他资源,且只运行在内核态下;
Q60
速对表原值: B
详细解析标注: B
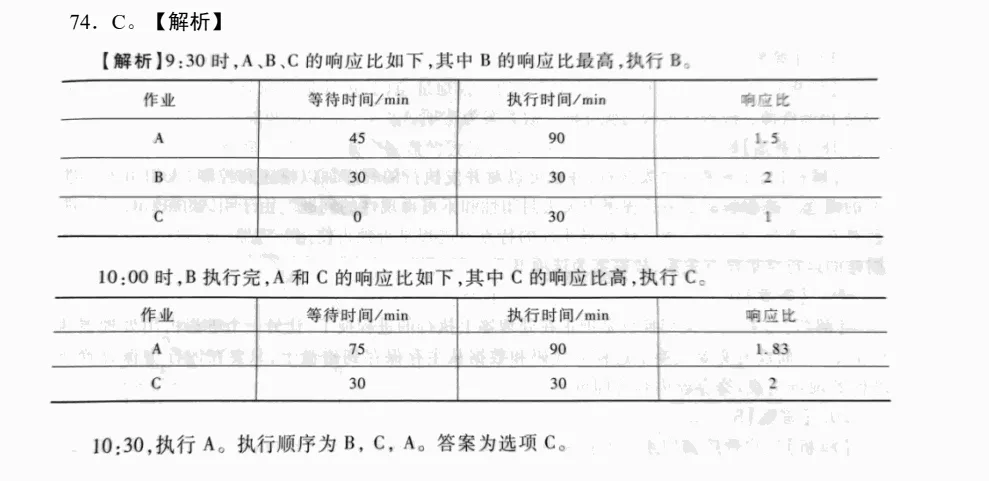
响应比=(等待时间+要求服务时间)/要求服务时间。其中,等待时间+要求服务时间=进程周转时间=作业完成时间-作业提交时间。
Q61
速对表原值: C
详细解析标注: C
A,D 描述的是一种情况。在多级反馈队列调度算法中,当一个进程在高优先级队列中用完了其(通常较短的)时间片但仍未完成时,它会被移至一个优先级较低、时间片较长的队列中。这本身就是一种降低优先级的体现,目的是照顾短作业和交互式进程,同时防止长作业饿死。B,进程“抖动”意味着它分配到的物理内存不足,导致频繁的页面换入换出,CPU 大部分时间用于处理缺页中断而非有效计算,这会严重降低系统性能。此时,降低该进程的优先级,甚至暂停该进程的运行,以释放资源给其他进程,是一种合理的系统调整策略。C, I/O 密集型进程的特点是 CPU 执行时间短,大部分时间在等待 I/O 完成。为了提高系统整体效率和 I/O 设备的利用率,操作系统通常会倾向于提高这类进程的优先级,以便它们在 I/O 完成后能尽快获得 CPU,再次发起新的 I/O 请求,从而保持 I/O 设备的繁忙。降低这类进程的优先级反而会延长其周转时间,降低系统对 I/O 操作的响应速度。
Q62
速对表原值: C
详细解析标注: C
MLFQ 的核心思想是“偏爱 I/O 密集型/交互式进程”。当一个进程发起 I/O 请求时,说明它很可能是交互式进程,为了让用户感觉系统响应迅速,当它 I/O 完成重新进入就绪态时,通常会返回它阻塞前所在的队列,甚至被提升到更高优先级的队列,而不是惩罚性地降到最低优先级。C选项描述的是对 CPU 密集型进程的惩罚机制,用在 I/O 完成后是错误的。
Q63
速对表原值: D
详细解析标注: D
Ⅰ正确,时间片轮转算法中,时间片大小的选择是一个关键问题。如果时间片设置得过短,CPU会在进程间频繁切换,而每次上下文切换都需要消耗系统资源(保存和恢复现场等),导致系统整体开销增大,有效工作时间减少。
Ⅱ正确,时间片轮转调度的核心机制是通过时钟中断来实现的。操作系统设置一个定时器,每当一个时间片结束时,定时器会产生一个时钟中断。CPU响应中断后,会转去执行时钟中断处理程序,该程序会剥夺当前运行进程的 CPU 使用权,并调用调度程序选择下一个就绪进程投入运行。
Ⅲ正确,在时间片轮转调度中,如果一个进程在其分配的时间片内没有执行完毕,当中断到来时,该进程会被剥夺 CPU,其状态从执行态转换为就绪态,并被重新放回就绪队列的末尾,等待下一轮调度。如果进程在时间片用完前就已经完成,则会进入终止态。
注意:有些同学可能考虑到时间片用完时,恰好进程执行完毕,因此此时是从运行态转变为退出态; 但是一般来说,时间片用完时,进程的状态会被直接转为就绪态,然后在下一次调度时被处理(检查到执行结束再退出)。
Ⅳ正确,时间片轮转调度算法需要将所有处于就绪态的进程组织在一个队列中,这个队列通常被称为就绪队列。当进行调度时,调度程序会按照先进先出(FCFS/FIFO)的原则从就绪队列的头部选择下一个进程分配 CPU。 进程控制块(PCB)、时钟中断处理程序和进程就绪队列是实现时间片轮转调度的关键数据结构或程序。
审计旁注(非原文):改解析
进程完成后进入终止态,不先回就绪队列等待再次调度。
Q64
速对表原值: D
详细解析标注: D
下面给出常考查的进程调度时机:
-
可以调度 创建新进程后 进程正常结束或异常终止(选项Ⅰ) 进程因 I/O 请求、信号量操作等原因阻塞(选项Ⅱ) I/O 完成后 出现高优先级紧急任务(选项Ⅲ) 进程处于普通临界区 进程从内核态返回用户态时(选项Ⅳ、【2012-30】选项 D)
-
不可调度 进程处理中断的过程中 进程执行原子操作中 进程处于内核程序临界区 关中断状态下综上所述,选 D。
Q65
速对表原值: C
详细解析标注: C
C 选项,高响应比优先调度算法通常是非抢占式的。它在选择下一个要执行的作业或进程时,会计算所有就绪作业/进程的响应比(响应比 = (等待时间 + 要求服务时间) / 要求服务时间),然后选择响应比最高的。一旦选定,该作业/进程会一直执行下去。将其设计成抢占式会比较复杂且不常见,因为响应比是动态变化的,频繁地重新计算和抢占会增加系统开销。
Q66
速对表原值: D
详细解析标注: D
进程发生饥饿时,应当增加其优先级,使其有机会使用处理器;当用户需要一个进程在规定时间完成时,也应该给予其高优先级以让该进程可以立即运行;/0 操作完成后,可以适当提高进程优先级,A、B、C 均是提高优先级的场合。当时间片耗尽后,显然不应该提高其优先级,否则该进程可能再次使用处理器,导致其他进程无法得到处理器资源。一般来说,D 选项的情况下应该降低优先级。
Q67
速对表原值: B
详细解析标注: B
A 正确,时间片轮转(RR)调度算法为每个就绪进程分配一个固定的时间片,进程在该时间片内运行。当时间片用完后,即使进程未完成,也会被剥夺 CPU,CPU 转给下一个就绪进程。这种机制保证了每个进程都能在较短的时间内得到响应,非常适合需要快速响应用户输入的人机交互环境,是分时操作系统的常用调度算法。
B 错误,抢占式调度算法允许高优先级进程抢占低优先级进程的 CPU。虽然这可以保证重要任务的及时执行,但如果系统中持续有高优先级进程到达,低优先级进程可能会长时间甚至永远得不到CPU,从而产生饥饿现象。例如,在抢占式优先级调度中,如果低优先级进程的优先级始终无法提升,就可能饿死。
C 正确,多级反馈队列调度算法通过设置多个不同优先级的就绪队列,并为每个队列分配不同的时间片大小,同时允许进程在不同队列间移动。这种机制能够较好地兼顾不同类型进程的需求:
-
对于交互型进程或短作业,它们可以在高优先级队列中获得较短的时间片并快速得到响应和完成。
-
对于处理器密集型或长作业,它们会逐渐从高优先级队列降到低优先级队列,获得较长的时间片,避免了因在高优先级队列中频繁切换而带来的开销,同时也保证了它们最终能够得到执行,避免了饥饿。
D 正确,先来先服务(FCFS)调度算法对所有类型的进程都是公平的,即按照它们到达的顺序进行服务。然而,如果一个长作业(通常是处理器密集型)先到达,它会长时间占用CPU,导致后续的短作业(包括 I/O 密集型进程,它们通常 CPU 执行时间短)长时间等待。因此,FCFS 算法通常不利于短作业和 I/O密集型进程,而相对有利于长作业(处理器密集型进程,一旦获得 CPU可以长时间使用)。
Q68
速对表原值: D
详细解析标注: D
分时系统的响应时间 T 可以表达为:T≈QxN,其中 Q 是时间片,而 N 是交互进程数量。因此,对进程响应时间的因素主要有:“时间片值的选取”和“交互进程的数量”。当时间片一定,交互进程的数越多(即 N 越大),T 就越大。所以选择 D。
Q69
速对表原值: B
详细解析标注: B
Ⅲ错误,多级反馈队列调度算法需要维护多个队列,并在进程执行过程中根据其行为在不同队列间移动进程,这会带来一定的调度开销。相比于简单的调度算法(如先来先服务),其系统开销通常要大一些。虽然它试图通过优化调度来提高整体性能,但算法本身的复杂性决定了其开销不会小的。
Ⅳ.通过多级队列和反馈机制,可以避免低优先级进程长时间得不到调度的问题。即使一个进程被降级到最低优先级的队列,它仍然有机会获得 CPU 资源,从而避免饥饿现象的发生。此外,在较低优先级队列中等待时间过长的进程会被移到更高优先级队列,这种形式的老化阻止饥饿的发生(极端情况下仍有可能发生饥饿)
Q70
速对表原值: A
详细解析标注: A
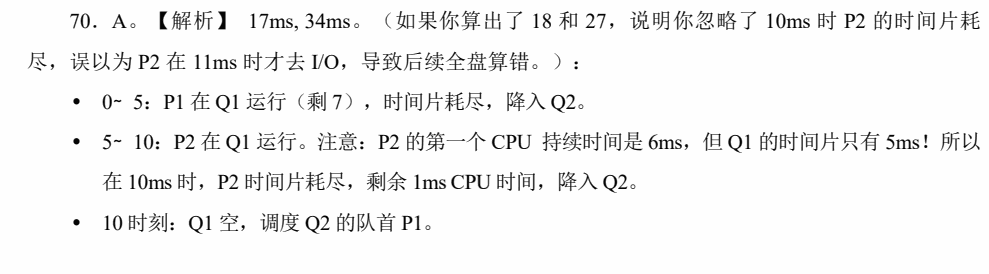
17ms, 34ms。(如果你算出了 18 和 27,说明你忽略了 10ms 时 P2 的时间片耗尽,误以为 P2 在 11ms 时才去 I/O,导致后续全盘算错。):
-
0∼ 5:P1 在 Q1 运行(剩 7),时间片耗尽,降入 Q2。
-
5∼ 10:P2 在 Q1 运行。
注意:P2 的第一个 CPU 持续时间是 6ms,但 Q1 的时间片只有 5ms!所以在 10ms 时,P2 时间片耗尽,剩余 1ms CPU 时间,降入 Q2。
-
10 时刻:Q1 空,调度 Q2 的队首 P1。
-
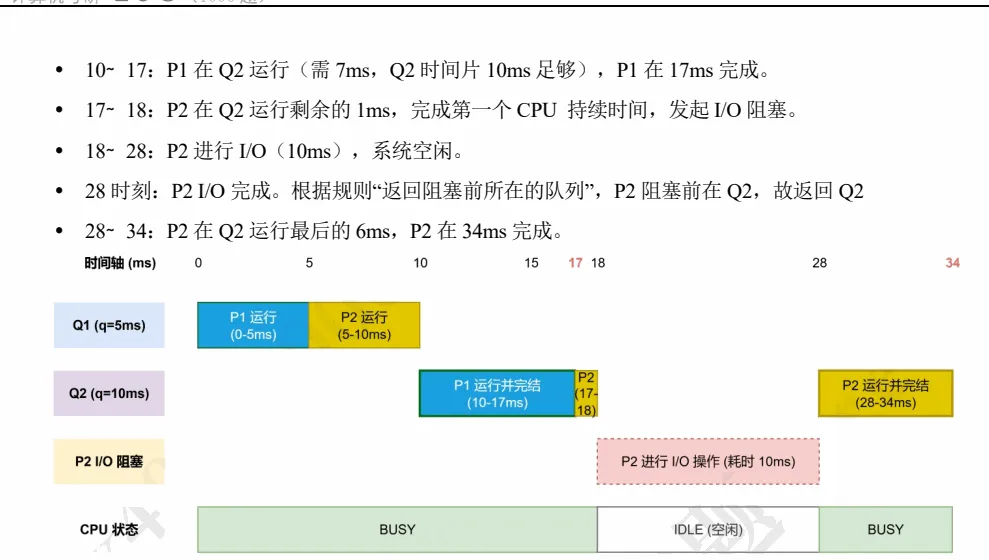
10∼ 17:P1 在 Q2 运行(需 7ms,Q2 时间片 10ms 足够),P1 在 17ms 完成。
-
17∼ 18:P2 在 Q2 运行剩余的 1ms,完成第一个 CPU 持续时间,发起 I/O 阻塞。
-
18∼ 28:P2 进行 I/O(10ms),系统空闲。
-
28 时刻:P2 I/O 完成。根据规则“返回阻塞前所在的队列”,P2 阻塞前在 Q2,故返回 Q2
-
28∼ 34:P2 在 Q2 运行最后的 6ms,P2 在 34ms 完成。
原页版面片段(用于核对图表、矩阵或代码)
审计旁注(非原文):作废
P1、P2 同时到达且未规定同优先级次序,A、D 都可能。
Q71
速对表原值: B
详细解析标注: B
A 错误。进程从运行状态变为阻塞状态是由于发生了某个等待事件。
B 正确。进程从运行态到就绪态或从就绪态 到运行态都是由进程调度程序决定的,从阻塞态到就绪态则取决于该进程所等待的外部事件是否完成。而从运行态到阻塞态是由运行进程自身决定的,即运行进程因某个等待事件发生而 将自己阻塞。
C 错误。运行进程的优先级一定高于就绪队列中所有进程的优先级,但不一定比阻塞队列中进程的优先级高。
D 错误。如果短作业总是在长作业已经投入运行后到达,那么作业的平均周转时间就不一定最小。
Q72
速对表原值: C
详细解析标注: C
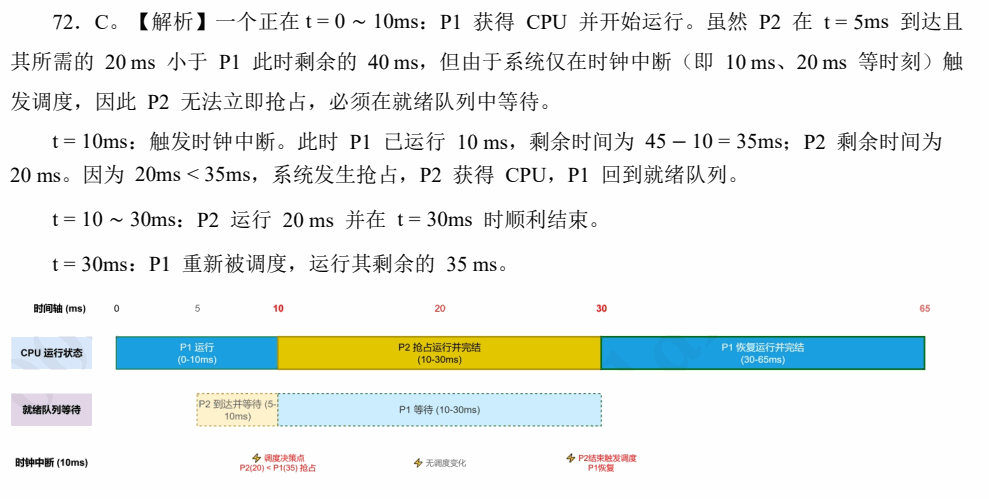
一个正在 t = 0 ∼ 10ms:P1 获得 CPU 并开始运行。虽然 P2 在 t = 5ms 到达且其所需的 20 ms 小于 P1 此时剩余的 40 ms,但由于系统仅在时钟中断(即 10 ms、20 ms 等时刻)触发调度,因此 P2 无法立即抢占,必须在就绪队列中等待。t = 10ms:触发时钟中断。此时 P1 已运行 10 ms,剩余时间为 45 − 10 = 35ms;P2 剩余时间为20 ms。因为 20ms < 35ms,系统发生抢占,P2 获得 CPU,P1 回到就绪队列。t = 10 ∼ 30ms:P2 运行 20 ms 并在 t = 30ms 时顺利结束。t = 30ms:P1 重新被调度,运行其剩余的 35 ms。
原页版面片段(用于核对图表、矩阵或代码)
Q73
速对表原值: C
详细解析标注: C
At = 12ms 时,高优先级的 P1 请求 Mutex,但此时该锁被低优先级的 P3 持有,因此 P1 无法获得锁,被迫进入阻塞队列。此时就绪队列中剩下 P2 和 P3。由于 P2 的优先级(中)高于 P3(低),系统会调度 P2 运行。只要 P2 不退出或不阻塞,P3 就无法获得 CPU 来执行临界区代码并释放 Mutex。导致的结果是:最高优先级的 P1 竟然在等待中优先级的 P2 执行完,这种现象就是优先级翻转。
Q74
速对表原值: C
详细解析标注: C
原页版面片段(用于核对图表、矩阵或代码)
Q75
速对表原值: C
详细解析标注: C
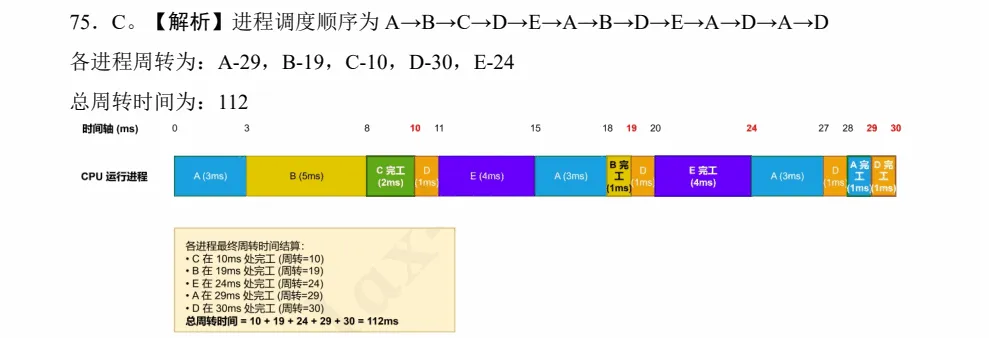
进程调度顺序为 A→B→C→D→E→A→B→D→E→A→D→A→D各进程周转为:A-29,B-19,C-10,D-30,E-24总周转时间为:112
原页版面片段(用于核对图表、矩阵或代码)
Q76
速对表原值: C
详细解析标注: C
带权周转时间是指作业周转时间与作业实际运行时间的比值:带权周转时间=作业周转时间/作业实际运行时间。平均带权周转时间是指多个作业带权周转时间的平均值。由优先权可知,进程的执行顺序为 P2→P3→P1。P2 的周转时间为 1+15+24=40us;P3 的周转时间为 18+1+24+1+36=80us;P1 的周转时间为 30+1+24+1+36+1+12=105us。三个进程的带权周转时间分别为 : P1 : 105/12=8.75us , P2 : 40/24≈1.67us , P3 : 80/36≈2.22us 。 平 均 带 权 周 转 时 间 为(8.75+1.67+2.22)/3≈4.21us
审计旁注(非原文):改单位
带权周转时间是无量纲比值,不是 μs。
Q77
速对表原值: A
详细解析标注: A
J1 进入内存时间为 10:00,运行结束时间为 11:10,周转时间 为 70 分钟。J2 进入内存时间为 10:20,运行结束时间为 10:50,周转时间为 30 分钟。J3 进入内存时间为 11:10,运行结束时间为 12:00,周转时间为 90 分钟。J4 进入内存时间为 10:50,运行结束时间为 12:20,周转时间为 90分钟。平均周转时间为:(70+30+90+90)/4=70 分钟。
Q78
速对表原值: D
详细解析标注: D
Ⅰ正确,在 0~10s 的时段内,只有 3~3.5s 间 CPU 未运行程序,因此 CPU 的利用率为 9.5/10 = 95%。
Ⅱ正确,进程 A 的周转时间为 3s-0s=3s,进程 D 的周转时间为 3.5s-0s=3.5s,进程 B 的周转时间为10s-4s=6s,进程 C 的周转时间为 8s-6s=2s,因此平均周转时间为(3s+3.5s+6s+2s)/4=3.625s。
Ⅲ正确,进程 D 的等待时间为 3s,进程 B 的等待时间为 2s,进程 A、C 的等待时间都是 0s,因此进程 D 的等待时间最长。
Ⅳ正确,进程 A 的带权周转时间为 3/3=1s,进程 B 的带权周转时间为 6/4=1.5s,进程 C 的带权周转时间为 2/2=1s,进程 D 的带权周转时间为 3.5/0.5=7s,因此,进程 A、B、C 和 D 的平均带权周转时间为(1s+1.5s+1s+7s)/4=2.625s。于是,选项Ⅰ~Ⅳ 都正确。
审计旁注(非原文):改单位
带权周转时间无量纲,不是 s;数值与答案 D 可保留。
Q79
速对表原值: B
详细解析标注: B
时钟中断处理程序发现当前进程时间片用完后,通常只是向当前进程发出抢占请求(例如设置一个“需要调度(need_resched)”的内核标志位)。真正的进程调度和切换程序,往往需要等待中断完成准备返回用户态的边界时刻才会被安全执行,而不是在中断处理程序的上半部分“就地、强行”切换,否则极易引发内核栈混乱或死锁。
Q80
速对表原值: A
详细解析标注: A
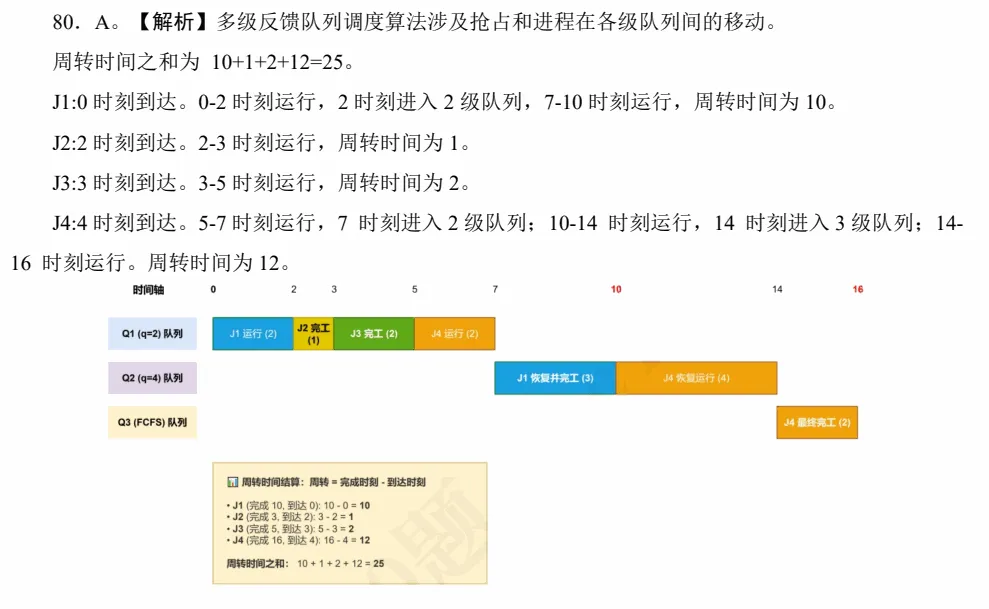
多级反馈队列调度算法涉及抢占和进程在各级队列间的移动。周转时间之和为 10+1+2+12=25。J1:0 时刻到达。0-2 时刻运行,2 时刻进入 2 级队列,7-10 时刻运行,周转时间为 10。J2:2 时刻到达。2-3 时刻运行,周转时间为 1。J3:3 时刻到达。3-5 时刻运行,周转时间为 2。J4:4 时刻到达。5-7 时刻运行,7 时刻进入 2 级队列;10-14 时刻运行,14 时刻进入 3 级队列;14-16 时刻运行。周转时间为 12。
原页版面片段(用于核对图表、矩阵或代码)
审计旁注(非原文):改题干
“单道程序”应改为“单处理器多道程序”,修正后 A=25。
Q81
速对表原值: A
详细解析标注: A
假设进程 M 先于进程 N 进入就绪队列。PM 和 PN 分别表示 M 和 N 的优先权数。在β>α>0 设定下,在就绪队列中,PM>PN,原因是α>0,则越早进入就绪队列,优先数就越大,所以是 FCFS(First Come First Service)。又因为β>α,所以在 M 运行时,PM 增长速度大于 PN 的增长速度,则 PM>PN,从而保证了 M 进程先于 N 进程完成,即 FIFO(First In First Out)。在α>β>0 设定下,还是 FCFS,原因跟β>α>0 一样。但由于α>β,所以在 M 运行时,无法保证PM 仍然大于 PN,即无法保证 FIFO。在β<α<0 设定下,在就绪队列中,PM<PN,原因是α<0,则越早进入就绪队列,优先数就越小,所以是 LCFS(Last Come First Service)。又因为β<α,所以在 N 运行时,PN 下降速度大于 PM 的下降速度,有可能出现 PM>PN 的情况,此时 CPU 有可能被 M 抢占,无法保证 LIFO(Last In First Out)。在α<β<0 设定下,还是 LCFS,原因跟β<α<0 一样。但由于α<β,在 N 运行时,PN 的下降速度变慢了,从而保证了 PN 始终大于 PM,导致 N 进程先于 M 进程完成,即 LIFO。所以本题的答案选 A。
Q82
速对表原值: B
详细解析标注: B
多处理机调度为 2025 年大纲新增考点。本题命制依据 2026 王道操作系统 2.2.6 多处理机调度。
B 错误,软亲和指由进程调度程序尽量保证“亲和性”,硬亲和指由用户进程通过系统调用,主动要求操作系统分配固定的 CPU,确保“亲和性”。
A 正确,公共就绪队列:所有处理器从同一个队列中获取任务,当一个处理器完成其任务变为空闲时,它会去公共队列中领取新的任务。这种机制使得任务能够自动地在空闲处理器间分配,从而天然地实现了负载均衡。私有就绪队列:每个处理器拥有自己的就绪队列。当一个进程或线程在某个处理器上运行时,它通常会被放回该处理器的私有就绪队列。这有助于该任务下次被调度时仍在同一个处理器上运行,从而可以利用该处理器高速缓存中可能存在的该任务的数据,这就是所谓的处理器“亲和性”(ProcessorAffinity)。
C 正确,公共就绪队列是所有 CPU 共享的数据结构。当多个 CPU 同时尝试访问(例如,添加或移除进程/线程)这个共享队列时,如果不进行同步控制,可能会导致数据结构损坏或不一致。因此,必须使用锁机制(如自旋锁、互斥锁)来确保在任何时刻只有一个 CPU 能够修改公共就绪队列,从而保证操作的互斥性和原子性。
D 正确,私有就绪队列中平衡负载的方法通常有两种:推迁移和拉迁移。对于推迁移,一个特定的系统程序周期性检査每个 CPU 的负载,若发现不平衡,则从超载 CPU 的就绪队列中“推”一些进程到空闲 CPU 的就绪队列,从而平均分配负载。若一个 CPU 负载很低,则从超载 CPU 的就绪队列中“拉”一些进程到自己的就绪队列,发生拉迁移。在系统中,推迁移和拉迁移常被并行实现。综上所述,选 B。
审计旁注(非原文):作废
题干问“正确”,解析却给错误项 B;原题不能按单选使用。
Q83
速对表原值: D
详细解析标注: D
多处理机调度为2025年大纲新增考点。本题命制依据汤小丹计算机操作系统慕课版 10.5.3 进程(线程)调度方式。
A 正确,自调度是最简单的一种多处理机调度方式,其核心思想是设置一个所有处理器共享的公共就绪队列。当一个处理器空闲时,它会访问这个公共队列,从中取出下一个就绪的进程或线程来执行。
B 正确,成组调度的核心思想是将一个应用程序中的多个线程(尤其是那些需要相互协作、频繁同步的线程)尽可能地同时分配到不同的处理器上并行运行。这样可以减少因等待协作线程而被阻塞的情况,从而提高应用程序的执行效率和并行度。
C 正确,动态分配允许一个进程或线程在不同次被调度时,或在其执行过程中,从一个处理器迁移到另一个处理器。这样做的好处是可以根据各个处理器的负载情况动态调整,实现更好的负载均衡。然而,如果一个线程频繁在不同处理器间切换,其先前在某个处理器高速缓存中的数据就会失效,导致缓存命中率下降,影响性能。
D 错误,专用处理器分配策略是指在一个应用程序执行期间,为该应用的每个线程都分配一个固定的处理器。这种方式确实可以避免线程切换的开销,提高单个应用程序的并行度。 但是,这会导致处理器的极大浪费,尤其是当线程因同步或 I/O 而阻塞时,其分配到的处理器会处于空闲状态。 同时,如果系统中就绪线程的总数超过了处理器的数量,那么为每个线程分配专用处理器是不现实的。此外,这种方式不一定能在所有情况下都获得最佳的系统整体性能,因为某些处理器可能会因为其分配的线程阻塞而空闲,而其他应用程序的线程可能在等待处理器。它更侧重于最大化单个高并行度应用的性能,而非系统整体的资源利用率或公平性。关于 2025 年大纲新增考点“多处理机调度”,王道和汤小丹老师的教材侧重点不同,考生在复习时应熟悉两本书的考点以应对考察。
Q84
速对表原值: D
详细解析标注: D
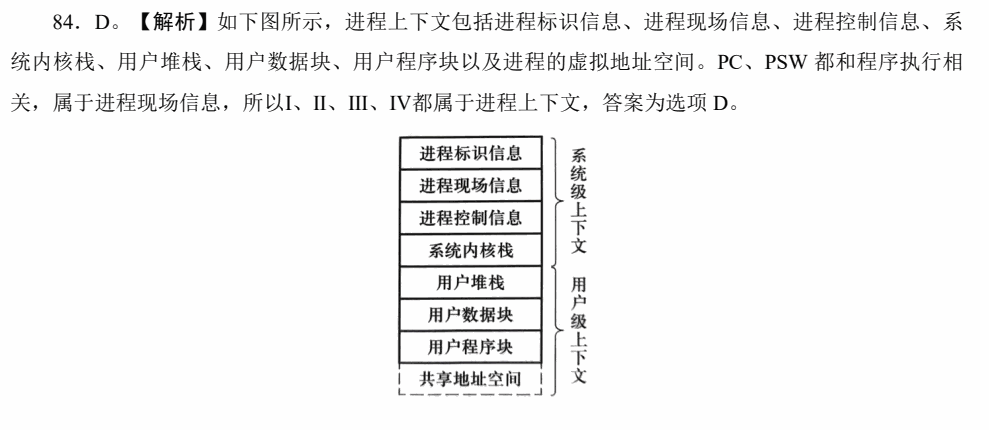
如下图所示,进程上下文包括进程标识信息、进程现场信息、进程控制信息、系统内核栈、用户堆栈、用户数据块、用户程序块以及进程的虚拟地址空间。PC、PSW 都和程序执行相关,属于进程现场信息,所以Ⅰ、Ⅱ、Ⅲ、Ⅳ都属于进程上下文,答案为选项 D。
原页版面片段(用于核对图表、矩阵或代码)
Q85
速对表原值: D
详细解析标注: D
A 正确,上下文切换的核心目的就是在处理器上停止一个进程(或线程)的执行,并开始执行另一个进程(或线程)。这必然涉及到 CPU 执行环境的转换,包括指令序列、数据、寄存器状态等的改变。
B 正确,调度程序负责决定下一个要运行的进程(或线程),分派程序负责实际执行上下文切换的操作(保存旧上下文,加载新上下文)。这些都是操作系统的核心功能,涉及到对硬件状态的直接操作和对进程/线程控制块的访问,因此必须在具有特权的内核态执行。
C 正确,进程控制块(PCB)是操作系统用于描述和管理进程的数据结构,其中包含了进程的完整上下文信息,如程序计数器、寄存器值、进程状态、内存管理信息等。 类似地,线程控制块(TCB)用于存储线程的独立执行上下文,如程序计数器、寄存器组、栈指针等。
D 错误,进程切换时,由于不同进程拥有独立的地址空间,因此确实需要保存和恢复包括程序计数器、程序状态字、所有通用寄存器以及与地址空间映射相关的信息(如页表基址寄存器等)。同一进程内的线程切换时,由于这些线程共享同一个进程的地址空间,因此不需要切换地址空间映射信息(如页表)。它们只需要保存和恢复各自独立的执行上下文,如程序计数器、寄存器组、栈指针和线程状态字等。线程切换的开销通常远小于进程切换,主要原因之一就是地址空间共享,无需切换内存管理信息。
Q86
速对表原值: C
详细解析标注: C
将 PA 和 PB 进程分解为以下 6 程序段,这 6 程序段具有相对的 完整性,都可以作为一个单独的执行过程存在。SA1:x:=1; x:=x+1; SA2:x:=x+y; SA3:z:=x+z; SB1:y:=1; y:=y+3; SB2:z:=y+1; SB3:y:=y+z;其中 SA1与SB1可以并发执行,SA2与SB2可以并发执行,SA3与 SB3不能并发执行。因此SA3与 SB3 的执行顺序 不同,可能会有不同的结果。如果先执行 SA3,则 y=15;如果先执行 SB3,则y=9。
Q87
速对表原值: A
详细解析标注: A
按照 1,2,3,4,5,6 的顺序执行,可以得到 z=0,c=9 的结果,按照 1,5,2,6,3,7,4 的顺序执行,可以得到 z=-3,c=9 的结果,按照 5,1,6,2,7,3,4 的顺序执行,可以得到 z=0,c=0 的结果。因此 z=0 或-3,c=9 或 0。故本题选 A。P1() { x=0; //(1) y =-1; //(2) z = xy; //(3) print z; //(4) } P2() { x= 3; //(5) C = xx; //(6) print c; //(7) }
Q88
速对表原值: A
详细解析标注: A
A 正确,访问不同临界区的两个进程,不要求必须互斥地进入临界区。B、D 错误,临界区是访问临界资源的那一段程序,不是包含临界资源的一段数据区。
C 错误,临界区不是用于进程同步的机制。
Q89
速对表原值: B
详细解析标注: B
当进程进入阻塞态,它就需要交出 CPU 的使用权,即允许其他进程竞争 CPU,C和 D 错误;但是它不会放弃其他已占有的资源,因为进程一旦占有一个资源(即一旦它的资源请求被批准),那么该资源就不能被夺走,直到该进程主动释放它,所以其他进程不能进入该进程的临界区,A错误,故本题选 B。
Q90
速对表原值: B
详细解析标注: B
Ⅰ打印机是临界资源。打印机在同一时刻只能为一个进程服务,如果多个进程同时向打印机输出内容,会导致输出结果混杂不堪。因此,打印机需要互斥访问。Ⅱ对于各进程的非共享数据,在正常情况下,它不应该被其他进程访问,操作系统会提供保护。因此对于多个进程之间的同步与互斥,各进程的非共享数据不是临界资源。Ⅲ磁盘不是典型的临界资源(指磁盘本身作为存储介质)。磁盘允许多个进程同时对其进行读写操作(宏观上),操作系统通过磁盘调度算法和文件系统来管理对磁盘的并发访问,确保数据读写的正确性和一致性。虽然对磁盘上某个特定文件或数据块的访问可能需要互斥(由文件系统或数据库管理系统保证),但磁盘设备本身作为整体是可共享的。Ⅳ共享缓冲区是临界资源。共享缓冲区是多个进程(如生产者和消费者)之间交换数据的公共区域。当一个进程正在向缓冲区写入数据或从中读取数据时,其他进程对该缓冲区的访问(特别是修改指针或数据本身的操作)必须受到限制,以防止数据覆盖、读取错误或指针混乱等问题。因此,共享缓冲区是典型的临界资源,需要互斥访问。
Q91
速对表原值: B
详细解析标注: B
为禁止两个进程同时进入临界区,同步机制应遵循以下准则:1)空闲让进。临界区空闲时,可以允许一个请求进入临界区的进程立即进入临界区。2)忙则等待。当已有进程进入临界区时,其他试图进入临界区的进程必须等待。3)有限等待。对请求访问的进程,应保证能在有限时间内进入临界区,防止进程无限等待4)让权等待(原则上应该遵循,但非必须)。当进程不能进入临界区时,应立即释放处理器防止进程忙等待。故选 B 不能进入临界区的执行态进程立即放弃 CPU(让权等待)。
Q92
速对表原值: C
详细解析标注: C
x 值为 2,就是加 1 成功,减 1 失败。因此只要在执行
③和
⑥之前,已经将数据x 的值取到 R1 和 R2 中,并且,
③操作在
⑥操作之后即可。II,III,Ⅳ都满足条件,答案选 C。
Q93
速对表原值: C
详细解析标注: C
本题考察单标志法的缺点,若 Thread1 没有将 turn 置为 2,则线程 2 会一直等待。因此选 C。
Q94
速对表原值: B
详细解析标注: B
假设 P0 执行完语句
①(turn = 1),此时发生进程切换;P1 接着执行语句
③(turn = 0)和语句
④(flag[1] = TRUE)。接着 P1 执行到 while(flag[0] && turn == 0)。由于此时 P0还没执行语句
②,flag[0] 依然是 FALSE!因此 P1 顺利跳出循环,进入临界区。此时若切换回 P0,P0 执行语句
②(flag[0] = TRUE),然后检查 while(flag[1] && turn == 1)。由于 turn 已经被 P1 改成了 0,turn == 1 为假,P0 也跳出循环,进入临界区。两个进程同时在临界区,违背“忙则等待” 。
Q95
速对表原值: A
详细解析标注: A
以上算法是双标志先检查法,该算法相比于单标志法,满足了空闲让进原则,但是由于进程 P0 可能会在判断 while 语句满足后切换到 P1,P1 也判断 while 满足后,两个进程就会同时访问临界区,因此该算法既不能保证进程互斥进入临界区,也违背了忙则等待原则,故本题选择A。
Q96
速对表原值: D
详细解析标注: D
A 正确,TestAndSet 指令的核心功能是原子地(不可中断地)读取一个内存字(通常是锁变量)的旧值,并同时设置该内存字为一个新的预定值(通常表示“已加锁”,如 TRUE或 1)。返回的是读取到的旧值。这个原子性保证了在多处理器环境下,即使多个处理器同时尝试对同一个锁变量执行 TSL,也只有一个能成功获取锁(即读取到锁变量为 FALSE 时的旧值)。
B 正确,Swap(或 XCHG)指令原子地交换一个 CPU 寄存器的内容和内存中锁变量的内容。进程通常会将一个表示“尝试加锁”的值(如 TRUE)放入寄存器,然后与锁变量进行交换。如果交换后寄存器中的值是表示“锁空闲”(如 FALSE)的值,则表示该进程成功获得了锁。
C 正确,当使用 TSL 指令实现自旋锁时,如果一个进程执行 TSL 指令后发现锁已被占用(例如,TSL 返回 TRUE),该进程会继续循环执行 TSL 指令,不断尝试获取锁,直到成功为止。这种在等待锁的过程中 CPU 持续执行测试指令而不放弃 CPU 的做法,被称为“忙等”(busy-waiting)。
D 错误,Swap 指令本身也是一种硬件原子操作,用于实现互斥的基础。像 TSL 指令一样,如果直接用 Swap 指令在一个循环中不断尝试获取锁(即“自旋”),那么当锁被占用时,进程同样会处于“忙等”状态,不断消耗 CPU 时间,而不释放 CPU。因此,单纯使用 Swap 指令实现的互斥锁并不能满足“让权等待”准则。
Q97
速对表原值: C
详细解析标注: C
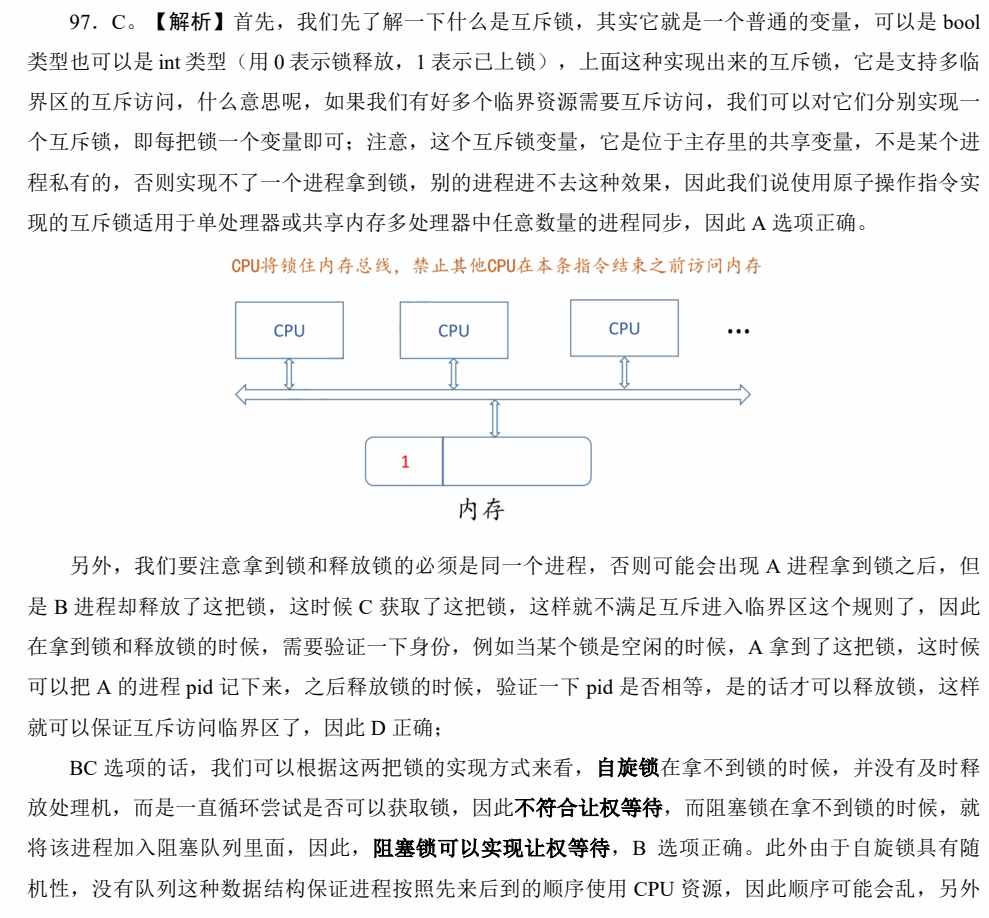
首先,我们先了解一下什么是互斥锁,其实它就是一个普通的变量,可以是 bool类型也可以是 int 类型(用 0 表示锁释放,1 表示已上锁),上面这种实现出来的互斥锁,它是支持多临界区的互斥访问,什么意思呢,如果我们有好多个临界资源需要互斥访问,我们可以对它们分别实现一个互斥锁,即每把锁一个变量即可;注意,这个互斥锁变量,它是位于主存里的共享变量,不是某个进程私有的,否则实现不了一个进程拿到锁,别的进程进不去这种效果,因此我们说使用原子操作指令实现的互斥锁适用于单处理器或共享内存多处理器中任意数量的进程同步,因此 A 选项正确。另外,我们要注意拿到锁和释放锁的必须是同一个进程,否则可能会出现 A 进程拿到锁之后,但是 B 进程却释放了这把锁,这时候 C 获取了这把锁,这样就不满足互斥进入临界区这个规则了,因此在拿到锁和释放锁的时候,需要验证一下身份,例如当某个锁是空闲的时候,A 拿到了这把锁,这时候可以把 A 的进程 pid 记下来,之后释放锁的时候,验证一下 pid 是否相等,是的话才可以释放锁,这样就可以保证互斥访问临界区了,因此 D 正确;BC 选项的话,我们可以根据这两把锁的实现方式来看,自旋锁在拿不到锁的时候,并没有及时释放处理机,而是一直循环尝试是否可以获取锁,因此不符合让权等待,而阻塞锁在拿不到锁的时候,就将该进程加入阻塞队列里面,因此,阻塞锁可以实现让权等待,B 选项正确。此外由于自旋锁具有随机性,没有队列这种数据结构保证进程按照先来后到的顺序使用 CPU 资源,因此顺序可能会乱,另外如果当某个进程离开临界区时有多个进程等待进入临界区,就有可能导致某些进程由于每次临界区空闲的时候没有上处理机,或者轮到上处理机的时候,临界区有锁,从而导致饥饿,因此 C 选项错误。扩展一下,以上这种使用原子操作实现的互斥锁还有可能导致死锁的发生,比如某个低优先级进程拿到了锁,在使用这把锁的时候,来了一个高优先级的进程获得处理机,并且它也想进入临界区,这时就发生了死锁。
原页版面片段(用于核对图表、矩阵或代码)
Q98
速对表原值: A
详细解析标注: A
允许 m 个进程同时进入互斥段,说明初始值为 m,当进入 m 后,剩下 n-m 个等待进入,因此下限是-(n-m)。因此范围是-(n+m,m)。
审计旁注(非原文):改公式
解析末式应为 [-(n-m), m];答案 A 不变。
Q99
速对表原值: D
详细解析标注: D
由下列代码,value--后,if 判断当前 value 的值为进程分配之后剩余的资源数,由这个逻辑,S.value<0 才会阻塞进程。P(s){ s.value--; if (s.value < 0) { add this process to list s.L;block;} }
Q100
速对表原值: A
详细解析标注: A
执行 36 次 P 操作和 20 次 V 操作后,信号量 S 的值为 0,说明信号量 S 的初始值为 16。对初始值为 16 的信号量 S 执行 19 次 P 操作和 1 次 V 操作后,计数信号量 S 的值为16-19+1=-2。如果信号量的值是负值,那么它的绝对值等于等待进入临界区的进程数,因此有 2 个进程在信号量 S 的等待队列中等待,故本题选 A。
Q101
速对表原值: C
详细解析标注: C
P、V 操作具体如下:P(){ S.value--; if(S.value<0){ add this process to S.L; block(S.L); } } V(){ S.value++; if(S.value<=0){ remove a process from S.L; wakeup(P); } }执行 P 操作时,当 S.value<0 时,阻塞当前进程;执行 V 操作时,当 S.value<=0 时,唤醒一个阻塞队列进程。选 C。
Q102
速对表原值: A
详细解析标注: A
Ⅰ正确,管程通过其互斥进入的机制,保证了同一时刻只有一个进程可以在管程内部执行其定义的过程。这意味着所有对管程内部共享数据结构的访问都是互斥的,程序员无需再显式地使用互斥锁等低级同步原语来实现对这些共享资源的互斥。II 正确,管程是一种程序设计语言级别的同步构造,它将共享数据以及对这些数据的操作封装起来,提供了比信号量更高层次的抽象。程序员使用管程时,不必关心底层的互斥和同步细节,使得并发程序的设计更为简单和不易出错。III 错误,当一个进程在管程中调用条件变量的 x.wait()操作时,该进程会被阻塞,并被放入与条件变量 x 关联的等待队列中。同时该进程会释放对管程的互斥访问权,以便其他进程可以进入管程执行。这避免了忙等待,并允许其他进程改变条件。IV 错误,条件变量的 x.signal()操作的作用是唤醒一个(通常是等待队列中的第一个)因条件 x 而阻塞的进程。如果没有进程正在等待条件 x,则 x.signal()操作通常不起任何作用(或被忽略),它不会像信号量的 V 操作那样改变某个内部计数器的值。 信号量是有状态的(其值会增减),而条件变量本身是无状态的,它仅作为进程排队和唤醒的机制。此处补充说明:在王道操作系统中,给出了条件变量的定义和使用:monitor Demo{共享数据结构 S; condition x; //定义一个条件变量 x init_code(){...} //此处不是对 x 进行初始化,而是对take_away(){ if(S<=0) x.wait(); //资源不够,在条件变量 x 上阻塞等待资源足够,分配资源,做一系列相应处理; } give_back(){归还资源,做一系列相应处理; if(有进程在等待) x.signal();//唤醒一个阻塞进程} }其中指出,当有进程在等待时才会执行 x.signal(),此时执行 x.signal()必定会唤醒阻塞进程,这与汤书中不同,汤书中对 x.signal 定义如下:且汤书后文 4.6.1 生产者—消费者问题中 3.利用管程解决生产者—消费者问题时给出的实例也未有任何判断是否有进程在等待才执行 x.signal()的语句。本题命制时,采用的汤书给出的说法。
原页版面片段(用于核对图表、矩阵或代码)

Q103
速对表原值: C
详细解析标注: C
A 错误: 条件变量没有值,它仅仅是一个等待队列的头部指针。而信号量内部包含一个表示资源数目的整型变量。
B 错误: 条件变量没有记忆功能(无状态)。如果当前没有进程在 x 上等待,执行 x.signal() 什么都不会发生(信号丢失)。而信号量的 signal()(V 操作)会使信号量的值加 1 并保留。
C 正确: 管程是由语言/编译器级别支持的进程同步机制。其最大的优点就是由编译器负责管理管程的互斥访问。程序员不需要像写 PV 操作那样手动加锁,编译器会确保任何时候只能有一个进程在管程内执行,实现了自动互斥。
D 错误: 当管程内的进程因为缺少某种资源而执行 x.wait() 进入阻塞状态时,它必须立即释放管程的互斥访问权。只有这样,其他进程才能进入管程去改变条件,并最终调用 x.signal() 唤醒它。如果它不释放互斥权,整个管程就会被它死死锁住,导致其他进程无法进入,从而引发死锁。
Q104
速对表原值: C
详细解析标注: C
C 错误,管程一次只允许一个进程进入,这是由管程的互斥性决定的。
A 正确,管程包含了面向对象的思想,将表达共享资源的数据结构和对其进行操作的进程封装在一个对象中,并封装了同步操作,从而对进程隐藏同步的细节,简化了调用同步功能的接口B 正确,管程机制可以便于集中管理分散于不同进程的临界区D 正确,管程是进程同步工具,避免了信号量机制中大量且分散的同步操作
Q105
速对表原值: C
详细解析标注: C
A 正确,如果多个进程运行在不同的 CPU 上,每个进程都试图进入一个临界区,即使禁止中断,其他进程依旧能够在其他处理器上进入临界区。
B 正确,软件方法与原子操作均属于忙等机制,无法实现让权等待C 错误,首先要明晰:自旋锁≠互斥锁,王道操作系统将两者混为一谈,汤书中明确指出(汤小丹计算机操作系统慕课版 4.7Linux 进程同步机制)两者的区别。自旋锁是一种忙等机制,无法实现让权等待,而互斥锁就是一个简化版的信号量,互斥锁加锁失败后,线程释放CPU,给其他线程,可以实现让权等待D正确,这是条件变量与信号量的重要区别。二者的区别有:
①条件变量是“没有值”的,仅实现了“排队等待”的功能;而信号量是有值的,信号量的值反映了剩余资源数,而在管程中,剩余资源数用共享数据结构记录。
②条件变量的 wait/signal 操作与信号量不同,如果在管程中的一个进程发信号,但没有在这个条件变量上等待的任务,则丢弃这个信号。
审计旁注(非原文):作废
题干未限定 Linux;按王道 A、B、C、D 全正确。
Q106
速对表原值: B
详细解析标注: B
M≥K×(N−1)+1(M 为资源总数,K 为进程数,N 为单进程最大需求)推导:12≥K×(3−1)+1⇒2K≤11⇒K≤5.5 取最大整数得 K=5。K=5,Maxi=3,∑Allocation=9,Available=3。系统安全 ⟺存在至少一个进程 Pi 满足 Needi≤Available。计算还需资源:Needi=Maxi−Allocationi=3−Allocationi。由于 Allocationi≥0,故 Needi≤3 恒成立。当前 Available=3,因此 所有进程的 Needi≤Available 均成立。任意一个进程都可被调度执行,执行后释放资源,Available 增大,后续进程依次可运行。结论:系统一定处于安全状态。由于多个进程同时满足运行条件,执行起点不唯一,故安全序列不唯一。选 B。
Q107
速对表原值: C
详细解析标注: C
A错误。当进程数大于资源数时,如果资源分配得当则进程竞争资源不会产生死锁。
B 错误。系统出现死锁是指系统内一些进程 被锁 而不 一定 是全部进程被锁,即这部分进程因相互等待对方资源而处于死锁状态。
C 正确。处于死锁状态的进程都在相互等待对方占用的资源,因此处于死锁状态的进程至少有两个。如果系统的全部进程都因相互等待对方的资源而处于死锁状态,就会使整个系统处于瘫痪状态。
D 错误。银行家算法是避免死锁的一种方法。
Q108
速对表原值: A
详细解析标注: A
极端法:求出每个进程都发生死锁需要的最大资源数,在此基础上,再增加一个资源,则死锁一定不会发生。当 n个进程共享 m 个互斥资源时,每个进程的最大需求是 w。则当m ≥n x ( w-1)+1 时,系统一定不发生死锁,显然 B、C、D 对,A 错。
Q109
速对表原值: B
详细解析标注: B
B 错误:死锁避免(银行家算法)对用户申请资源的限制确实比死锁预防(如顺序分配、静态分配)更少,因此它的资源利用率更高。但是,在系统运行时的时间开销上,死锁避免要大得多!因为死锁预防依靠的是静态的协议规则(编译或资源编号阶段就确定了),运行时操作系统不需要做额外算力推演;而死锁避免(银行家算法)在每一次进程发出资源请求时,操作系统都必须运行一次安全性检测算法。因此,死锁避免是以“高运行时开销”去换取“高资源利用率”。选项中“运行时时间开销更小”的表述完全颠倒了因果。
A 正确:静态分配要求进程运行前一次性申请全部资源,未满足时不投入运行,这完美破坏了“请求和保持”条件,但由于很多资源在运行后期才用得上,导致早期闲置,利用率极低。
C 正确:资源按序分配规定进程只能严格按照编号递增的顺序申请资源,这使得资源分配图中绝对不可能形成闭环,从而破坏了“循环等待”条件。
D 正确:必要性:如果系统发生了死锁,必然存在一组进程在循环等待资源,因此资源分配图中一定存在环路。充要性(单实例情况):如果每种资源类中只有 1 个实例(即图中的资源节点往外发射的箭头只有一根),那么一旦出现环路,环路上的每个进程都占有了 1 个资源且都在等待下一个资源,由于没有多余的实例可以打破僵局,此时有环必死锁。因此,在单实例资源图中,有环是死锁的充要条件。(注:若为多实例资源,有环不一定死锁)。
Q110
速对表原值: D
详细解析标注: D
A正确,死锁是多个进程(至少两个)之间形成循环等待资源的状态,导致这些进程都无法继续。饥饿则可能发生在单个进程上,例如一个低优先级进程由于不断有高优先级进程到达而长时间得不到 CPU。
B 正确,死锁是一种“僵持”状态,除非操作系统采取措施(如撤销进程、剥夺资源),否则死锁进程将永久等待。饥饿状态下,进程虽然长时间等待,但并非绝对没有机会,例如当高优先级进程执行完毕,或者调度策略发生变化(如动态优先级调整)时,饥饿的进程仍可能获得资源。
C 正确,死锁的产生需要满足互斥、请求和保持、不可剥夺、循环等待这四个必要条件,其中资源不足是前提,而进程推进顺序不当是形成循环等待的关键。饥饿则更多地与调度策略相关,如固定的低优先级可能导致进程持续得不到 CPU,或者某些资源分配算法可能使得某些进程的请求总是被忽略。
D 错误,发生饥饿的进程可能处于就绪态(长期得不到 CPU,如 SJF 算法的问题),也可能处于阻塞态(如长期得不到所需的 IO 设备,如上述举例);而发生死锁的进程必定处于阻塞态。
Q111
速对表原值: C
详细解析标注: C
A 正确,每个进程只能拥有一个资源,运行完毕后释放资源,不会产生死锁。
B 正确,死锁产生的必要条件之一是互斥条件,即资源在一段时间内只能被一个进程所占用。如果所有资源都可以被多个进程无冲突地共享访问,那么互斥条件就不成立,死锁也就不会发生。
C错误,仅仅有优先级并不能完全避免死锁。例如,一个高优先级进程 P_high 可能等待一个低优先级进程 P_low 持有的资源,而 P_low 又在等待另一个资源。如果这个等待链形成循环,即使有优先级,死锁依然可能发生。优先级调度可能会影响饥饿现象,但不能直接消除所有类型的死锁。
D 正确,循环等待条件是产生死锁的四个必要条件之一。如果能够破坏循环等待条件,例如通过资源有序分配法,确保进程请求资源时不会形成环路,那么死锁就不会发生。
Q112
速对表原值: D
详细解析标注: D
这破坏了循环等待条件。如果存在所有左边的哲学家等待右边哲学家放下筷子的循环等待,则每个哲学家肯定已获得左边的筷子,但还没有获得右边的筷子,这与存在右撇子的情况不符。同理,亦不存在相反的循环等待链,而且,因不相邻的哲学家之间不存在竟争资源关系,所以也不可能存在 5 个以下的哲学家的循环等待链。
Q113
速对表原值: D
详细解析标注: D
循环等待条件指系统发生死锁时,一定存在一条进程请求资源的循环等待链。题干中对所有资源进行编号,并要求进程只按严格增加(或减少)的顺序来请求资源,破坏了死锁产生的循环等待条件,选 D。
Q114
速对表原值: B
详细解析标注: B
请求和保持条件指进程已经占用至少一个资源,但又提出了新的资源请求,而该资源已被其他进程占用,此时进程请求阻塞,且不会释放已占用的资源。为所有进程一次性分配其所需的资源破坏了死锁产生的请求和保持条件,选 B。
Q115
速对表原值: B
详细解析标注: B
死锁预防是破坏死锁发生的必要条件,死锁避免是避免系统进入不安全状态从而防止死锁的发生,所以 B正确,A.C 错误。银行家算法不会规定进程申请资源的顺序,只会决定是否给进程分配其申请的资源,D 错误。
Q116
速对表原值: B
详细解析标注: B
Ⅲ、Ⅳ错误。
Ⅰ正确,安全状态的定义是,系统能按某种进程推进顺序(存在一个安全序列),为每个进程分配其所需的资源,直至满足每个进程对资源的最大需求,使每个进程都可顺利完成。如果系统处于安全状态,就一定可以找到至少一个这样的序列,从而避免了死锁的发生。
Ⅱ正确,如果系统发生了死锁,意味着存在一组进程循环等待资源,它们都无法继续执行,也无法释放资源。在这种情况下,不可能找到一个安全序列,使得所有进程都能顺利完成。因此,死锁状态一定是不安全状态。
Ⅲ错误,不安全状态是指系统不一定能找到一个安全序列。它意味着系统存在进入死锁状态的可能性,但并非一定会发生死锁。在不安全状态下,如果进程后续的资源请求和释放顺序恰当,仍然有可能避免死锁的发生。
Ⅲ错误,系统当前未发生死锁,并不意味着它一定处于安全状态。系统可能正处于一个不安全状态,只是尚未满足死锁发生的全部条件,或者进程的资源请求顺序尚未导致死锁。不安全状态是死锁的可能前兆,但当前不死锁不代表未来不会死锁,也不代表当前状态是安全的。
审计旁注(非原文):改标号
解析末段第二个“Ⅲ错误”应为“Ⅳ错误”。
Q117
速对表原值: C
详细解析标注: C
当前已分配资源总数为:(0,4,2)+(3,0,1)+(1,0,2)+(2,3,0)=(6,7,5),剩余可分配资源数为:(7,7,7)-(6,7,5)=(1,0,2)各进程对资源的需求量:P0:(2,4,3)-(0,4,2)=(2,0,1) P1:(5,1,2)-(3,0,1)=(2,1,1) P2:(2,0,3)-(1,0、2)=(1,0,1) P3:(5,3,5)-(2,3,0)=(3,0,5)因此初始时只有进程 P2 可满足需求,排除选项 A 和 B。给进程 P2 分配资源,则 P2 完成后剩余可分配资源:(1,0,2)+(1,0,2)=(2,0,4)。接下来只有进程 P0 可满足需求,只有选项 C 满足。给进程 P0 分配资源,则 P0 完成后剩余可分配资源:(2,0,4)+(0,4,2)=(2,4,6),然后依次分配进程 P1、P3,答案为选项 C。
Q118
速对表原值: C
详细解析标注: C
假设每个进程申请三种资源为随机的,申请的顺序可能性一样;此时,每个进程申请顺序种类为 3!,即 6 种。两者 结合则有 6×6=36 种可能的排列。不难看出,只要是两个进程第一次申请的资源相同,则不会发生死锁,即其中一个进程得到第一个资源,另外一个进程因为等待此记录而阻塞,不会申请其他资源,确保所有资源都可由第一个进程读完后再释放第二个进程。两个进程第一次同时申请资源 1 的排列有 4 种。A:1,2,3;B:1,2,3 A:1,2,3;B:1,3,2 A:1,3,2;B:1,2,3 A:1,3,2;B:1,3,2同理,两个进程第一次同时申请资源 2 的排列为 4 种,同时申请资源 3 的排列也为 4 种,也就是共有 12 种排列是不会发生死锁的,故系统保证不发生死锁的概率为 12/36=1/3。
Q119
速对表原值: C
详细解析标注: C
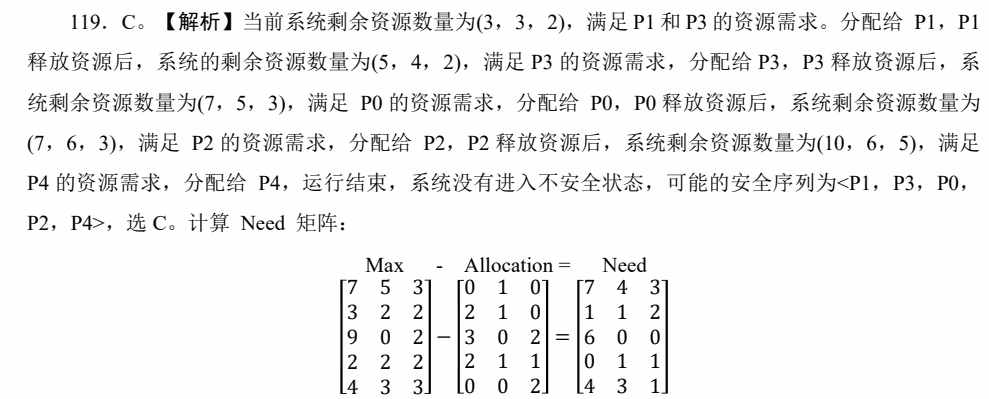
当前系统剩余资源数量为(3,3,2),满足 P1 和 P3 的资源需求。分配给 P1,P1释放资源后,系统的剩余资源数量为(5,4,2),满足 P3 的资源需求,分配给 P3,P3 释放资源后,系统剩余资源数量为(7,5,3),满足 P0 的资源需求,分配给 P0,P0 释放资源后,系统剩余资源数量为(7,6,3),满足 P2 的资源需求,分配给 P2,P2 释放资源后,系统剩余资源数量为(10,6,5),满足P4 的资源需求,分配给 P4,运行结束,系统没有进入不安全状态,可能的安全序列为
原页版面片段(用于核对图表、矩阵或代码)
Q120
速对表原值: D
详细解析标注: D
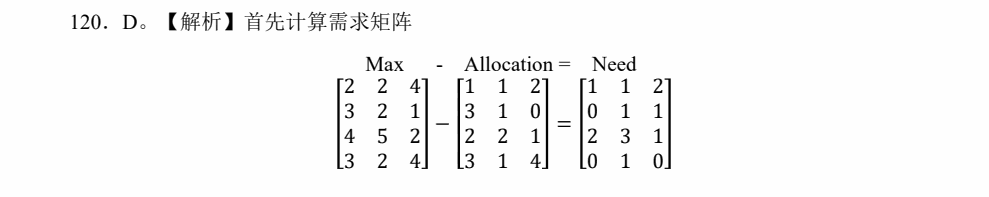
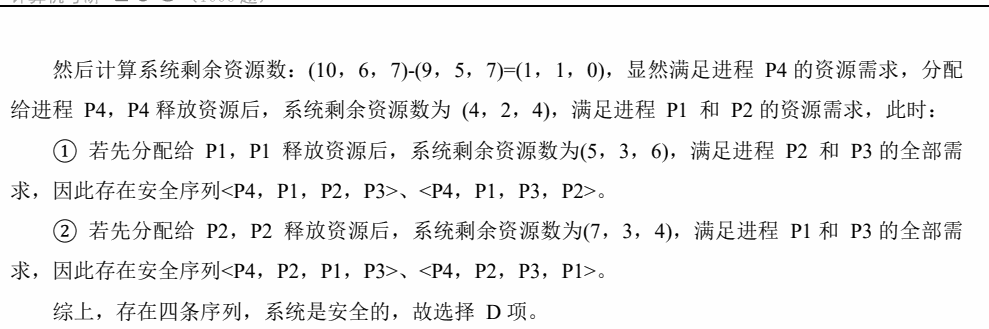
首先计算需求矩阵Max - Allocation = Need 2 2 4 3 2 1 4 5 2 3 2 4 − 1 1 2 3 1 0 2 2 1 3 1 4 =1 1 2 0 1 1 2 3 1 0 1 0然后计算系统剩余资源数:(10,6,7)-(9,5,7)=(1,1,0),显然满足进程 P4 的资源需求,分配给进程 P4,P4 释放资源后,系统剩余资源数为 (4,2,4),满足进程 P1 和 P2 的资源需求,此时:
① 若先分配给 P1,P1 释放资源后,系统剩余资源数为(5,3,6),满足进程 P2 和 P3 的全部需求,因此存在安全序列
② 若先分配给 P2,P2 释放资源后,系统剩余资源数为(7,3,4),满足进程 P1 和 P3 的全部需求,因此存在安全序列
原页版面片段(用于核对图表、矩阵或代码)
Q121
速对表原值: C
详细解析标注: C
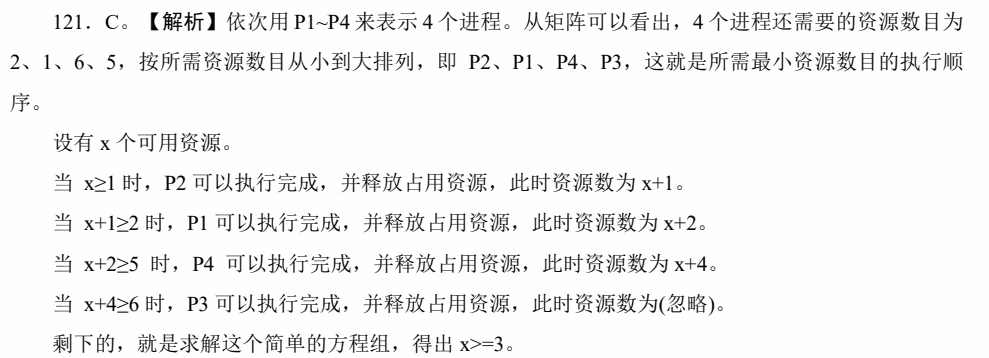
依次用 P1~P4 来表示 4 个进程。从矩阵可以看出,4 个进程还需要的资源数目为2、1、6、5,按所需资源数目从小到大排列,即 P2、P1、P4、P3,这就是所需最小资源数目的执行顺序。设有 x 个可用资源。当 x≥1 时,P2 可以执行完成,并释放占用资源,此时资源数为 x+1。当 x+1≥2 时,P1 可以执行完成,并释放占用资源,此时资源数为 x+2。当 x+2≥5 时,P4 可以执行完成,并释放占用资源,此时资源数为 x+4。当 x+4≥6 时,P3 可以执行完成,并释放占用资源,此时资源数为(忽略)。剩下的,就是求解这个简单的方程组,得出 x>=3。
原页版面片段(用于核对图表、矩阵或代码)
Q122
速对表原值: A
详细解析标注: A
同一时间请求所有资源破坏了死锁产生的请求和保持条件,属于死锁预防的策略,A 错误;死锁避免通过对资源分配的风险评估来决定是否为进程分配资源,需要收集进程运行所需资源总量信息,而死锁检测允许死锁的发生,会给可能导致死锁的进程分配资源,B、C、D 正确。
Q123
速对表原值: B
详细解析标注: B
资源状态:R1 实例全分配(给 P2, P4),空闲 0;R2 分配 1 给 P3,空闲1。找非阻塞进程:请求边对应资源空闲数 ≥ 请求量。P1 请求 R1(需 1,空闲 0)→ 阻塞P2 请求 R2(需 1,空闲 1)→ 非阻塞P3 请求 R1(需 1,空闲 0)→ 阻塞P4 请求 R2(需 1,空闲 1)→ 非阻塞图简化:选 P2 简化:移除 P₂→R₂ 和 R₁→P₂,P2 释放持有的 R1。R1 空闲变为 1。选 P4 简化:移除 P₄→R₂ 和 R₁→P₄,P4 释放持有的 R1。R1 空闲变为 2。此时 P1 请求 R1(需 1 ≤ 空闲 2)→ 可简化;P3 请求 R1(需 1 ≤ 空闲 2)→ 可简化。图可完全简化,无死锁。起点 P2/P4 均可。选 B。
Q124
速对表原值: B
详细解析标注: B
根据死锁定理,首先需要找出既不阻塞又非孤点的进程。对于图Ⅰ,由于资源R2已分配了 2个,还剩一个空闲的 R2,可以满足进程 P2的需求。P2运行结束后,释放一个资源 R1和两个资源 R2,可以满足P1进程的需求,从而系统的资源分配图可以完全简化,不处于死锁状态。对于图Ⅱ,P1 需要资源 R1,但是唯一一个资源 R1,已分配给 P2;同理,P2 需要资源 R4,而 R4 资源也只有一个且已经分配给了 P3;而 P3 还需要一个 R2 资源,但是两个 R2 资源都已经分配完毕了,所以 P1、P2、P3 都处于阻塞状态,系统中不存在既不阻塞又不是孤点的进程,所以系统工处于死锁状态。
注意:在进程资源图中,P->R 表示进程正在请求资源,R->P 表示资源已被分配给进程(资源只能是被动的)。
Q125
速对表原值: C
详细解析标注: C
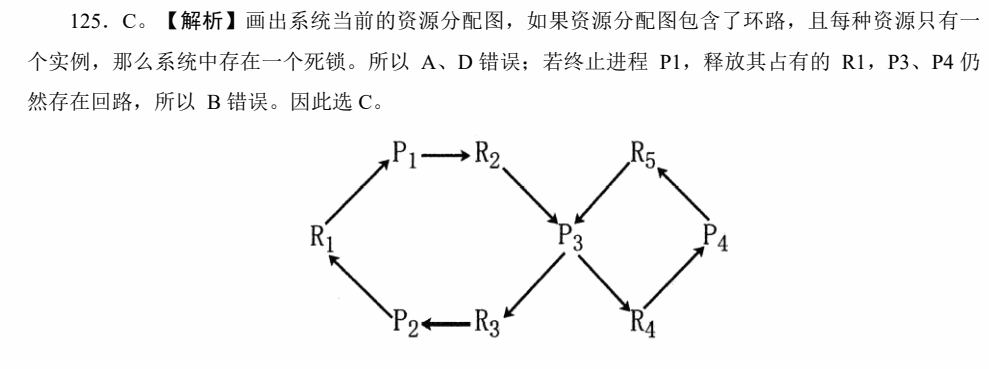
画出系统当前的资源分配图,如果资源分配图包含了环路,且每种资源只有一个实例,那么系统中存在一个死锁。所以 A、D 错误;若终止进程 P1,释放其占有的 R1,P3、P4 仍然存在回路,所以 B 错误。因此选 C。
原页版面片段(用于核对图表、矩阵或代码)
Q126
速对表原值: D
详细解析标注: D
A正确,终止所有死锁进程是一种简单粗暴但能有效解除死锁的方法。它的缺点是代价较大,因为所有死锁进程的工作都会丢失,包括那些可能已经运行了很长时间或接近完成的进程。
B 正确,进程回退是一种尝试恢复到死锁发生前某个安全状态的方法。系统需要周期性地为进程设置检查点,记录进程的状态和资源分配情况。当死锁发生时,可以将某些进程回退到最近的检查点,释放自该检查点以来获得的资源,从而可能打破死锁。这需要系统支持检查点机制。
C 正确,剥夺资源是指从某些死锁进程中强行收回其已分配的资源,并将这些资源分配给其他死锁进程,以打破循环等待。选择剥夺哪个进程的哪些资源以最小化代价是一个复杂的问题,需要考虑进程优先级、已执行时间、已占用资源类型和数量等因素。
D 错误,付出代价的衡量标准是多方面的,例如,该进程已运行的时间、已使用的资源、完成剩余工作所需的时间、进程的重要性(可能与优先级不完全一致)、该进程是交互式还是批处理式等。一个优先级最低的进程可能已经快要完成其任务,或者持有很多关键资源,终止它可能比终止一个优先级稍高但刚开始运行的进程代价更大。因此,选择代价最小的终止进程是一个复杂的决策过程,并非简单地看优先级。
Q127
速对表原值: C
详细解析标注: C
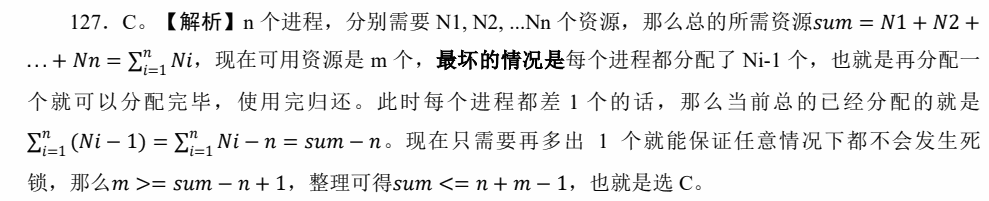
n 个进程,分别需要 \(N_1,N_2,\ldots,N_n\) 个资源,那么总的所需资源 \(sum=N_1+N_2+\cdots+N_n=\sum_{i=1}^{n}N_i\)。现在可用资源是 \(m\) 个,最坏的情况是每个进程都分配了 \(N_i-1\) 个,也就是再分配一个就可以分配完毕,使用完归还。此时每个进程都差 1 个的话,那么当前总的已经分配的就是 \(\sum_{i=1}^{n}(N_i-1)=\sum_{i=1}^{n}N_i-n=sum-n\)。现在只需要再多出 1 个就能保证任意情况下都不会发生死锁,那么 \(m\geq sum-n+1\),整理可得 \(sum\leq n+m-1\),也就是选 C。
原页版面片段(用于核对图表、矩阵或代码)
审计旁注(非原文):公式回源校正
原 PDF 数学字体缺少 Unicode 映射;求和公式已依据原页重新转写。
Q128
速对表原值: B
详细解析标注: B
Ⅲ、Ⅳ正确。
Ⅰ错误,资源的有序分配策略(即对资源类型进行线性排序,进程必须按序号递增的顺序申请资源)主要是为了破坏循环等待条件。 它并不直接作用于请求和保持条件。破坏请求和保持条件通常采用一次性申请所有资源或在得不到新资源时释放已持有资源等策略。
Ⅱ错误,银行家算法是一种死锁避免算法。它通过在每次资源分配前进行安全性检查,确保系统不会进入不安全状态,从而避免发生死锁。 它并不直接破坏死锁的四个必要条件中的任何一个,而是通过动态地控制资源分配来避免形成可能导致死锁的局面。
Ⅲ正确,死锁的发生首先是因为系统中的资源数量有限,不足以满足所有并发进程的需求(资源分配不足)。其次,即使资源不足,如果进程请求和释放资源的顺序得当,也未必会发生死锁。只有当多个进程对资源的请求和保持形成一种特定的循环等待关系,即进程推进顺序非法(导致了循环等待条件),才会最终导致死锁。
Ⅳ正确,进程回退是一种死锁解除策略。当检测到死锁后,系统选择一个或多个死锁进程,使其回退到足以避免死锁的某个先前状态(检查点或还原点)。这要求系统能够记录进程在不同时间点的状态信息(历史信息)并设置还原点,以便能够进行回退操作。
审计旁注(非原文):改措辞
死锁根因应记为不可剥夺资源竞争与非法推进顺序,不是资源少本身。
Q129
速对表原值: D
详细解析标注: D
A 选项正确:进程在某个核上运行久了,该核的 Cache 里存满了该进程的数据。频繁换核会导致 Cache 频繁失效,因此需要“处理器亲和性”。
B 选项正确:负载均衡要求把进程移到闲置的核上,而亲和性要求留在原核,二者在实际调度中需要进行折中权衡。
C 选项正确:多核同时去抢同一个全局队列的锁,会导致严重的互斥锁冲突,因此现代多核系统(如 Linux)通常为每个 CPU 核心配置独立的私有就绪队列。
D 选项错误:多核系统同样大量使用抢占式调度。死锁与抢占没有必然的因果关系,相反,允许强行剥夺资源(抢占)反而是解除死锁的有效手段之一。
Q130
速对表原值: C
详细解析标注: C
关中断”属于特权指令,必须在内核态下执行。如果允许用户态进程执行关中断,恶意进程就可以通过一直关中断来霸占 CPU,导致整个系统崩溃。因此 C 错误。
A 正确(单核关中断有效,多核关中断只能屏蔽当前核的中断,无法阻止其他核进入临界区);
B 正确(自旋锁就是忙等);
D 正确(极短临界区下,自旋锁避免了进程上下文切换的巨大开销,效率更高)。
Q131
速对表原值: B
详细解析标注: B
这是记录型信号量最核心的定理。当进程执行 wait(S) 时,S.value--。初值为K。当 V<0 时,说明 K 个资源已经全部分配完毕(消耗了 K 个 value),随后又有 m 个进程执行了 wait 并被阻塞(又消耗了 m 个 value)。所以总消耗量为 K+m。当前值 V=初值−总消耗量=K−(K+m)=−m。因此,只要有人阻塞(m>0),必定有 V<0 且 m=∣V∣=−V。这个结论与总进程数 n 完全无关(因为可能有进程还没申请资源)。D 选项后半句错误,只要有人阻塞,说明资源早就被占满了,正在使用的进程数必定是 K,而不是 K−m。