数据结构打卡表参考文档
Ch1 数组的应用
在应用题中,“数组”常结合“矩阵压缩存储”考察,此类题目需要注意以下条件:
✧ 行优先存储 or 列优先存储?
✧ 矩阵下标从 1 or 0 开始?——若题目未特别说明,矩阵下标默认从1开始
✧ 数组下标从 0 or 1 开始?——若题目未特别说明,数组下标默认从0开始
1.1 对称矩阵的压缩存储
若考察“对称矩阵的压缩存储”,除了关注 行优先 or 列优先,还需注意题目要求压缩存储的是 下三角区域 or 上三角区域:
1.1.1 自己动手创造,画一个5行5列的对称矩阵
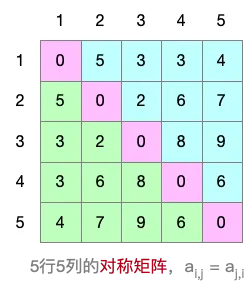
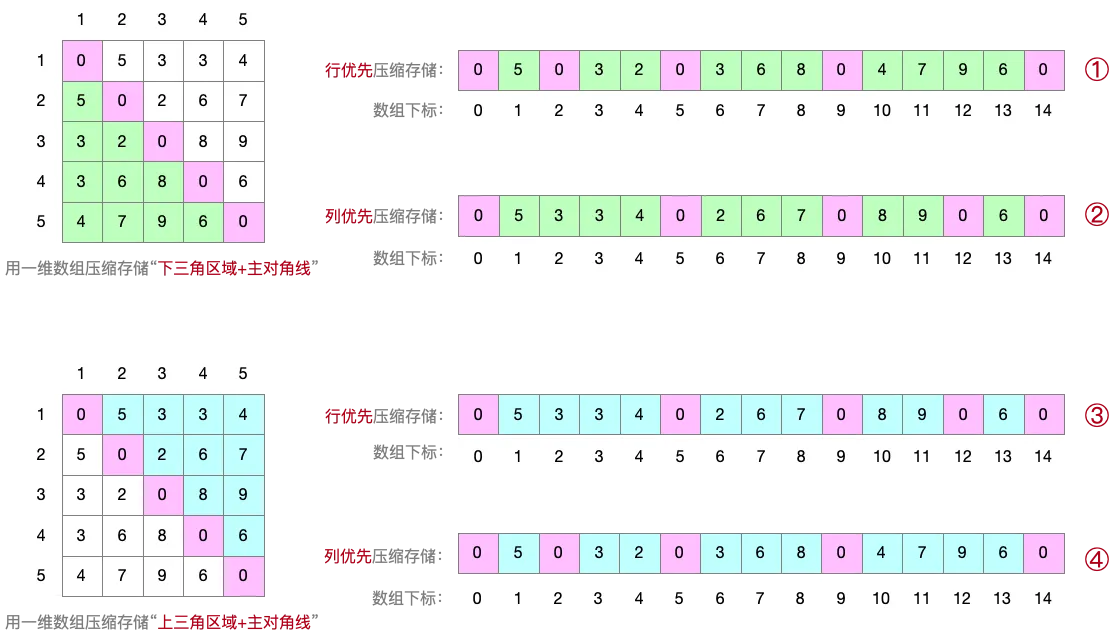
1.1.2 + 1.1.4 按“行优先/列优先”压缩存储上述矩阵,画出一维数组的样子
1.1.3 + 1.1.5 写出元素 i,j 与 数组下标之间的对应关系
设n行n列矩阵下标从1开始,数组下标从0开始。矩阵元素 i,j 和数组元素 k 的对应关系为:
①压缩存储下三角区域+主对角线,行优先存储
②压缩存储下三角区域+主对角线,列优先存储
③压缩存储上三角区域+主对角线,行优先存储
④压缩存储上三角区域+主对角线,列优先存储
Info
注:基于对称矩阵的特性可知,只需将式①的 i、j 互换即可得到④;只需将式②的 i、j 互换即可得到③;
1.1.6 假设你的对称矩阵表示一个无向图,画出无向图的样子
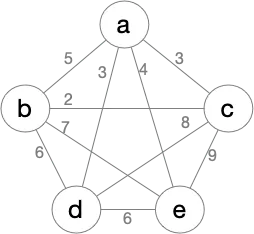
注:“无向图的邻接矩阵”刚好是一个“对称矩阵”,因此这两个考点很可能会结合考察
1.2 上/下三角矩阵的压缩存储
1.2.1 自己动手创造,画一个5行5列的下三角矩阵
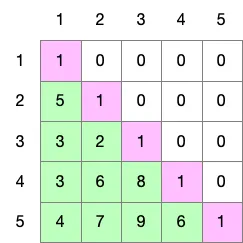
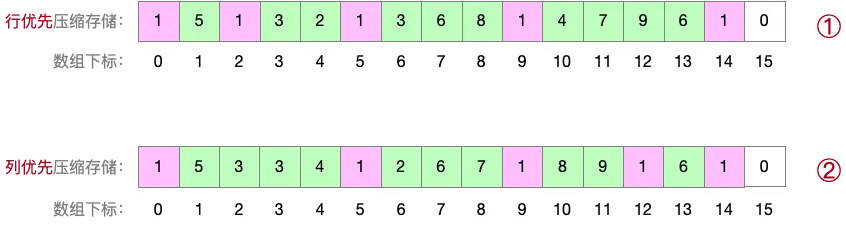
1.2.2 + 1.2.4 按“行优先/列优先”压缩存储上述矩阵,画出一维数组的样子
1.2.3 + 1.2.5 写出元素 i,j 与 数组下标之间的对应关系
设n行n列矩阵下标从1开始,数组下标从0开始。矩阵元素 i,j 和数组元素 k 的对应关系为:
①压缩存储下三角区域+主对角线,行优先存储
②压缩存储下三角区域+主对角线,列优先存储
1.2.6 假设你的对称矩阵表示一个有向图,画出有向图的样子
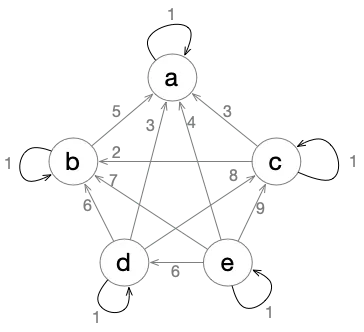
Info
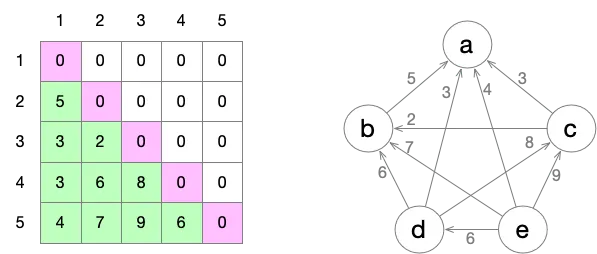
注:若一个有向图的邻接矩阵仅有下三角区域非空,主对角线和上三角区都为空(如下所示),则该有向图一定是有向无环图。因为所有的“有向边”都是大编号顶点指向小编号顶点,所以对于任意两个顶点 i、j (假设 i > j),则有可能存在 i 到 j 的路径,但一定不存在 j 到 i 的路径,因此不可能形成“环”。
1.3 三对角矩阵的压缩存储
Warning
注:任务 1.3.1~1.3.5 请参考王道书(或考点精讲课件)
“三对角矩阵(带状矩阵)”更有可能考选择题,不太可能在应用题考察。从出题人的视角猜测,三对角矩阵不太好和其他考点综合考察。
相比之下,“对称矩阵”可能和“无向图”综合考察;“三角矩阵”可能和“有向无环图”综合考察
Ch2 栈、队列的应用
2.1 栈的定义和基本操作实现
2.1.1 + 2.1.2 定义顺序栈,并实现基本操作
顺序栈的定义和实现,参考王道书 3.1.2
2.1.3 + 2.1.4 定义链栈,并实现基本操作(要求单链表实现,栈顶在链头)
//定义栈结点
typedef struct SNode{           //定义单链表结点类型
    int data;                       //每个节点存放一个数据元素
    struct SNode *next;         //指针指向下一个节点
}SNode, *LiStack;

//初始化一个链栈(单链表实现,栈顶在链头)
bool InitStack(LiStack &S) {
    S = (SNode *) malloc(sizeof(SNode)); //分配一个头结点
    S->next = NULL;         //头结点之后暂时还没有节点
    return true;
}

//判断栈是否为空
bool StackEmpty(LiStack S){
    if(S->next==NULL)   //头结点后面没有结点
        return true;    //返回true,表示栈为空
    else
        return false;
}

//入栈(本质上是单链表的“头插法”)
bool Push (LiStack &S, int x){
    SNode * p = (SNode *) malloc(sizeof(SNode));    //新分配一个结点
    p->data = x;     //存入新元素
    p->next = S->next;
    S->next = p;     //新结点插入到头结点后面
    return true;
}

//出栈(本质上是单链表的“头删法”)
bool Pop (LiStack &S, int &x){
    if (StackEmpty(S))      //栈空,出栈操作失败
        return false;

    SNode * p = S->next;     //栈不空,链头结点出栈
    x = p->data;             //x返回栈顶元素
    S->next = p->next;       //头删法,栈顶元素"断链"
    free(p);                 //释放结点
    return true;
}
2.1.5 + 2.1.6 定义链栈,并实现基本操作(要求双链表实现,栈顶在链尾)
//定义栈结点
typedef struct DbSNode{             //定义双链表结点类型
    int data;                       //每个节点存放一个数据元素
    struct DbSNode *last,*next;     //指向前后两个结点
}DbSNode;

typedef struct DbLiStack{           //双链表实现的栈(栈顶在链尾)
    struct DbSNode *head, *rear;    //两个指针,分别指向链头、链尾
}DbLiStack, *DbStack;

//初始化一个链栈(单链表实现,栈顶在链头)
bool InitDbStack(DbStack &S) {
    S = (DbLiStack *) malloc(sizeof(DbLiStack));    //初始化一个链栈(双链表实现,栈顶在链尾)
    DbSNode * p = (DbSNode *) malloc(sizeof(DbSNode)); //新建一个头结点
    p->next = NULL;         //头结点之后暂时还没有节点
    p->last = NULL;         //头结点之前没有节点

    S->head = p;
    S->rear = p;

    return true;
}

//判断栈是否为空
bool DbStackEmpty(DbStack S){
    if(S->head == S->rear)   //头指针和尾指针指向同一个结点
        return true;    //返回true,表示栈为空
    else
        return false;
}

//入栈(在双链表链尾插入)
bool DbPush (DbStack &S, int x){
    DbSNode * p = (DbSNode *) malloc(sizeof(DbSNode));     //新分配一个结点
    p->data = x;     //存入新元素
    p->next = NULL;
    p->last = S->rear;  //新结点插入链尾
    S->rear->next = p;
    S->rear = p;
    return true;
}

//出栈(删除双链表链尾元素)
bool DbPop (DbStack &S, int &x){
    if (DbStackEmpty(S))     //栈空,出栈操作失败
        return false;

    DbSNode * p = S->rear;    //栈不空,链尾结点出栈
    x = p->data;             //x返回栈顶元素
    S->rear = p->last;       //更新链尾指针
    S->rear->next = NULL;
    free(p);                 //释放结点
    return true;
}
2.2 队列的定义和基本操作实现
2.2.1 + 2.2.2 写代码:定义顺序存储的队列,并实现基本操作
参考王道书3.2.2
2.2.3 + 2.2.4 定义链式存储的队列,并实现基本操作
参考王道书 3.2.3
Ch3 树的应用
3.1 二叉树的性质、定义、画图
3.1.1 总结二叉树的度、树高、结点数等属性之间的关系
略
3.1.2 定义顺序存储的二叉树(从数组下标1开始存储)
Warning
二叉树顺序存储的数据结构定义,需要注意以下两点:
-
二叉树的结点用数组存储,每个结点需要标记“是否为空”
-
各结点的数组下标隐含结点关系,要能根据一个结点的数组下标 i,计算出其父节点、左孩子、右孩子的数组下标
typedef struct TreeNode {
    int data;       //结点中的数据元素
    bool isEmpty;   //结点是否为空
} TreeNode;

//初始化顺序存储的二叉树,所有结点标记为"空"
void InitSqBiTree (TreeNode t[], int length) {
    for (int i=0; i<length; i++){
        t[i].isEmpty=true;
    }
}

int main(){
    TreeNode t[100];        //定义一棵顺序存储的二叉树
    InitSqBiTree(t, 100);   //初始化为空树
    //...
}
3.1.3~3.1.5 实现函数,找到结点 i 的父结点、左孩子、右孩子
Warning
若顺序二叉树从数组下标1开始存储结点,则:
● 结点 i 的父结点编号为 i/2
● 结点 i 的左孩子编号为 i*2
● 结点 i 的右孩子编号为 i*2+1
若顺序二叉树从数组下标0开始存储结点,则:
● 结点 i 的父结点编号为 [(i+1)/2] - 1
● 结点 i 的左孩子编号为 [(i+1)2] - 1 = 2i + 1
● 结点 i 的右孩子编号为 [(i+1)2+1] - 1 = 2i + 2
//判断下标为 index 的结点是否为空
bool isEmpty(TreeNode t[], int length, int index){
    if (index >= length || index < 1) return true;   //下标超出合法范围
    return t[index].isEmpty;
}

//找到下标为 index 的结点的左孩子,并返回左孩子的下标,如果没有左孩子,则返回 -1
int getLchild(TreeNode t[], int length, int index){
    int lChild = index * 2;   //如果左孩子存在,则左孩子的下标一定是 index * 2
    if (isEmpty(t, length, lChild)) return -1;  //左孩子为空
    return lChild;
}

//找到下标为 index 的结点的右孩子,并返回右孩子的下标,如果没有右孩子,则返回 -1
int getRchild(TreeNode t[], int length, int index){
    int rChild = index * 2 + 1;                 //如果右孩子存在,则右孩子的下标一定是 index * 2 + 1
    if (isEmpty(t, length, rChild)) return -1;  //右孩子为空
    return rChild;
}

//找到下标为 index 的结点的父节点,并返回父节点的下标,如果没有父节点,则返回 -1
int getFather(TreeNode t[], int length, int index){
    if (index == 1) return -1;          //根节点没有父节点
    int father = index / 2;             //如果父节点存在,则父节点的下标一定是 index/2,整数除法会自动向下取整
    if (isEmpty(t, length, father)) return -1;
    return father;
}
3.1.6 利用上述三个函数,实现先/中/后序遍历
Warning
对于链式存储的二叉树,先序、中序、后序遍历的递归遍历代码实现很简单,大家都会
对于顺序存储的二叉树,利用上面👆封装的函数,也可以实现递归遍历
//从下标为 index 的结点开始先序遍历
void PreOrderSqTree (TreeNode *t, int length, int index){
    if (isEmpty(t, length, index))    //当前为空节点
        return;
    visitNode(t[index]);     //访问结点
    PreOrderSqTree(t, length, getLchild(t, length, index));       //先序遍历左子树
    PreOrderSqTree(t, length, getRchild(t, length, index));       //先序遍历右子树
}

//从下标为 index 的结点开始中序遍历
void InOrderSqTree (TreeNode *t, int length, int index){
    if (isEmpty(t, length, index))    //当前为空节点
        return;
    InOrderSqTree(t, length, getLchild(t, length, index));       //中序遍历左子树
    visitNode(t[index]);     //访问结点
    InOrderSqTree(t, length, getRchild(t, length, index));       //中序遍历右子树
}

//从下标为 index 的结点开始后序遍历
void PostOrderSqTree (TreeNode *t, int length, int index){
    if (isEmpty(t, length, index))    //当前为空节点
        return;
    PostOrderSqTree(t, length, getLchild(t, length, index));       //后序遍历左子树
    PostOrderSqTree(t, length, getRchild(t, length, index));       //后序遍历右子树
    visitNode(t[index]);     //访问结点
}

int main(){
    TreeNode t[100];        //定义一棵顺序存储的二叉树
    InitSqBiTree(t, 100);   //初始化为空树
    //...在空二叉树中插入数据
    //...略
    InOrderSqTree (t, 100, 1);    //从根节点1出发,进行中序遍历
}
3.1.7 定义顺序存储的二叉树(从数组下标0开始存储)
与 3.1.2 完全相同
3.1.8~3.1.10 实现函数,找到结点 i 的父结点、左孩子、右孩子(结点从下标0开始存储)
Warning
与 3.1.3~3.1.5 思路相同,只不过结点编号的计算有些区别而已
若顺序二叉树从数组下标0开始存储结点,则:
● 结点 i 的父结点编号为 [(i+1)/2] - 1
● 结点 i 的左孩子编号为 [(i+1)2] - 1 = 2i + 1
● 结点 i 的右孩子编号为 [(i+1)2+1] - 1 = 2i + 2
//判断下标为 index 的结点是否为空
bool isEmpty(TreeNode t[], int length, int index){
    if (index >= length || index < 0) return true;   //下标超出合法范围
    return t[index].isEmpty;
}

//找到下标为 index 的结点的左孩子,并返回左孩子的下标,如果没有左孩子,则返回 -1
int getLchild(TreeNode t[], int length, int index){
    int lChild = index * 2 + 1;   //如果左孩子存在,则左孩子的下标一定是 index * 2
    if (isEmpty(t, length, lChild)) return -1;  //左孩子为空
    return lChild;
}

//找到下标为 index 的结点的右孩子,并返回右孩子的下标,如果没有右孩子,则返回 -1
int getRchild(TreeNode t[], int length, int index){
    int rChild = index * 2 + 2;                 //如果右孩子存在,则右孩子的下标一定是 index * 2 + 1
    if (isEmpty(t, length, rChild)) return -1;  //右孩子为空
    return rChild;
}

//找到下标为 index 的结点的父节点,并返回父节点的下标,如果没有父节点,则返回 -1
int getFather(TreeNode t[], int length, int index){
    if (index == 1) return -1;          //根节点没有父节点
    int father = (index + 1) / 2 - 1;             //如果父节点存在,则父节点的下标一定是 index/2,整数除法会自动向下取整
    if (isEmpty(t, length, father)) return -1;
    return father;
}
3.1.11 利用上述三个函数,实现先/中/后序遍历
与 3.1.6 一模一样,不再赘述
3.2 树的性质
3.2.1 总结树的度、树高、结点数等属性之间的关系
注:通过“树、二叉树的性质”相关小题、大题积累解题思路
3.3 树的定义、画图
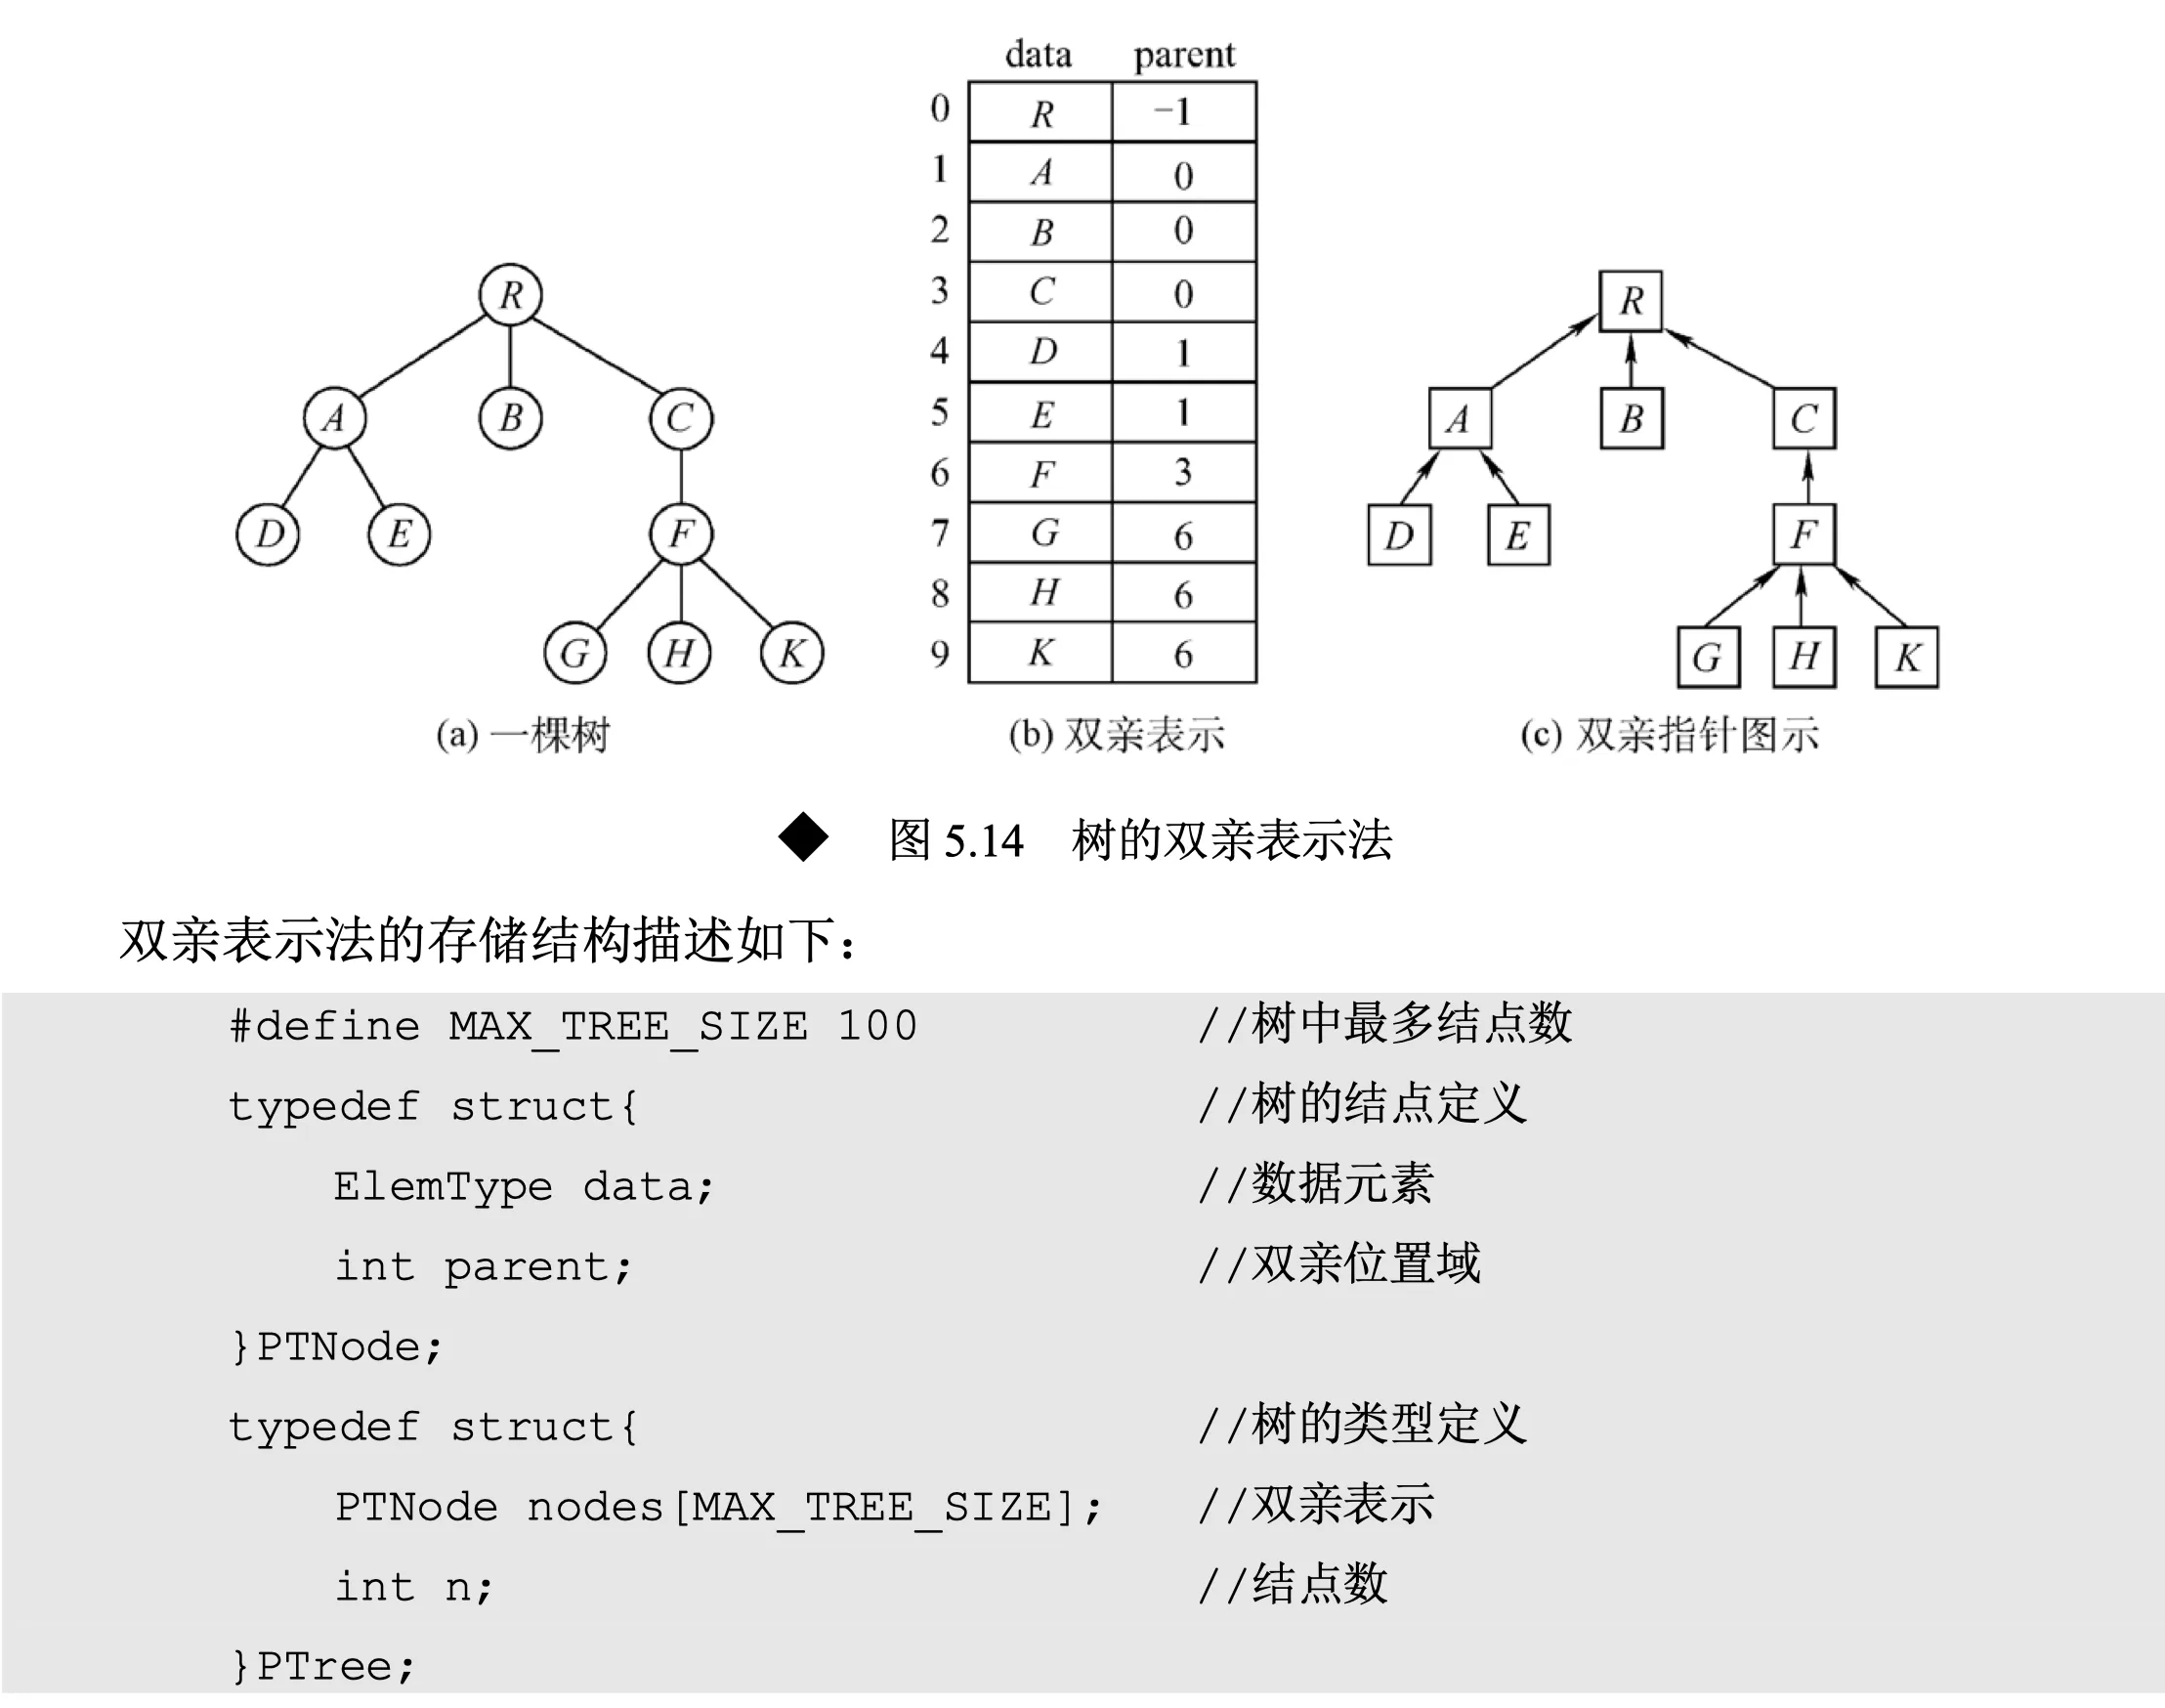
3.3.1 使用“双亲表示法”定义顺序存储的树(以及森林)
参考王道书 5.4.1 双亲表示法的代码描述
Warning
双亲表示法可以表示“多叉树”,如下所示:
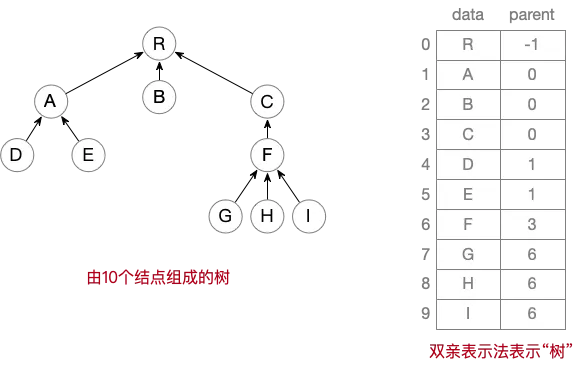
显然,双亲表示法也可以表示“森林”
只需令森林中的每棵树根结点的 parent 值为 -1 即可,如下所示:
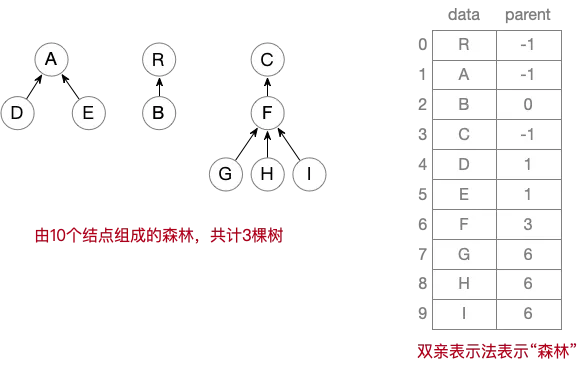
注意上面👆这个例子,如果未来考“森林”的应用题,很可能考双亲表示法的数据结构定义+画图
3.3.2 使用“孩子表示法”,定义链式存储的树(以及森林)
//Child表示下一个孩子的信息
typedef struct Child{
    int index;             //孩子编号
    struct Child * next;   //下一个孩子
} Child;

//TreeNode用于保存结点信息
typedef struct TreeNode {
    char data;             //结点信息
    Child * firstChild;    //指向第一个孩子
} TreeNode;

TreeNode tree[10];   //定义一棵拥有10个结点的树(孩子表示法)
Warning
孩子表示法可表示“多叉树”,如下所示:
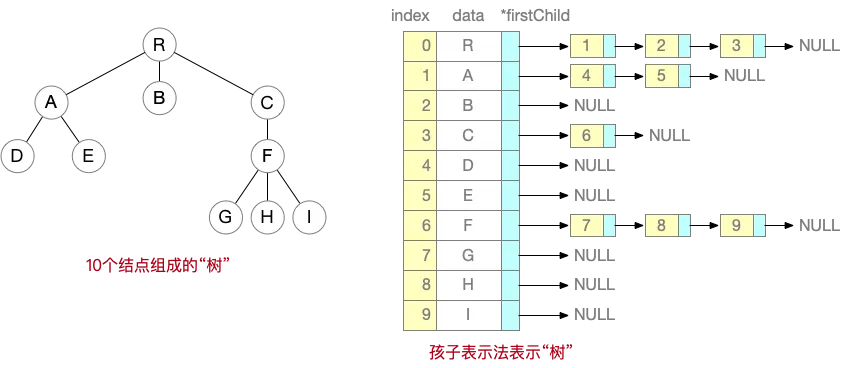
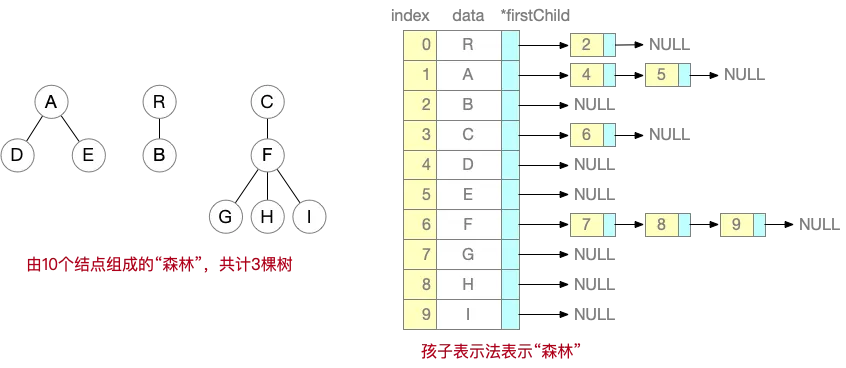
显然,孩子表示法也可以表示“森林”,如下所示:
3.3.3 对比:树的孩子表示法存储 v.s. 图的邻接表存储 v.s. 散列表的拉链法 v.s. 基数排序
①树的孩子表示法,请参考上面👆
②图的邻接表存储,请参考王道书6.2.1,数据结构示意图如下所示:
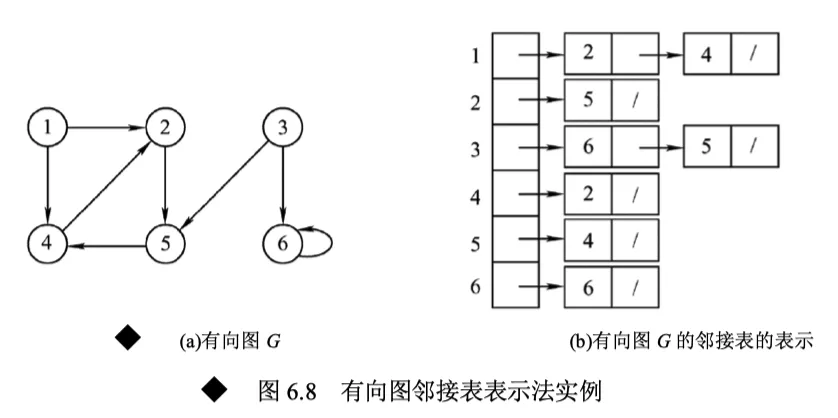
如果一个图拥有10个顶点,则可以这么定义其数据结构(请与本文档 3.3.2 “孩子表示法” 的数据结构定义对比):
typedef struct ArcNode{         //边表结点
    int adjvex;                 //该弧所指向的顶点的位置
    struct ArcNode *next;       //指向下一条弧的指针
    //InfoType info;            //网的边权值
}ArcNode;

typedef struct VNode{           //顶点表结点
    char data;                  //顶点信息
    ArcNode *first;             //指向第一条依附该顶点的弧的指针
}VNode;

VNode graph[10];               //定义一个拥有10个顶点的图(邻接表法)
③散列表的拉链法,请参考王道书 7.5.3,数据结构示意图如下所示: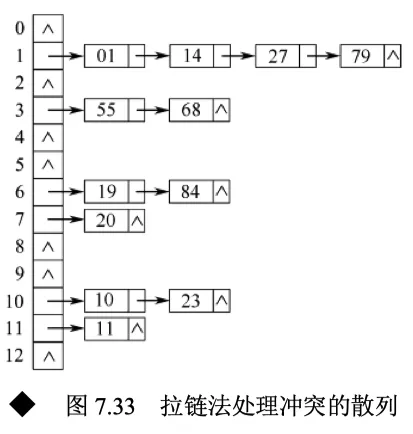 、
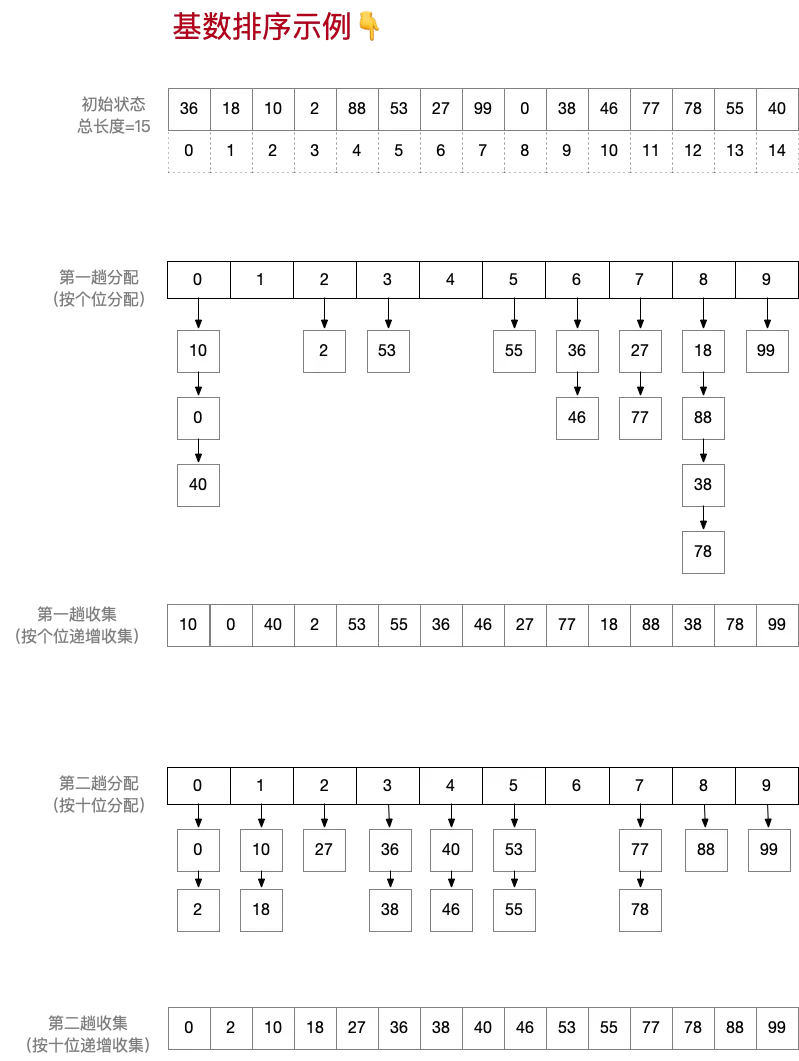
④基数排序,请参考王道书 8.5.2,算法示意图如下所示:
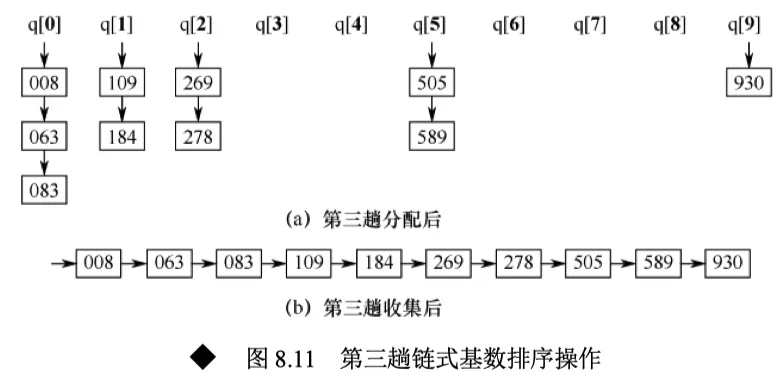
可见,上述四种数据结构/算法的示意图结构是类似的。相应地,对四种数据结构的定义也是类似的,可放在一起学习和记忆。
408重点掌握 ①树的孩子表示法、②图的邻接表 的数据结构定义代码,剩下的 ③散列表拉链法、④基数排序 可参考本文档 5.3.8、6.4.3。
3.3.4 使用“孩子兄弟表示法”,定义链式存储的树(以及森林)
可参考王道书 5.4.1
typedef struct CSNode{
    ElemType data;                              //数据域
    struct CSNode *firstchild,*nextsibling;    //第一个孩子和右兄弟指针
}CSNode,*CSTree;
Warning
孩子表示法可表示“多叉树”,如下所示:
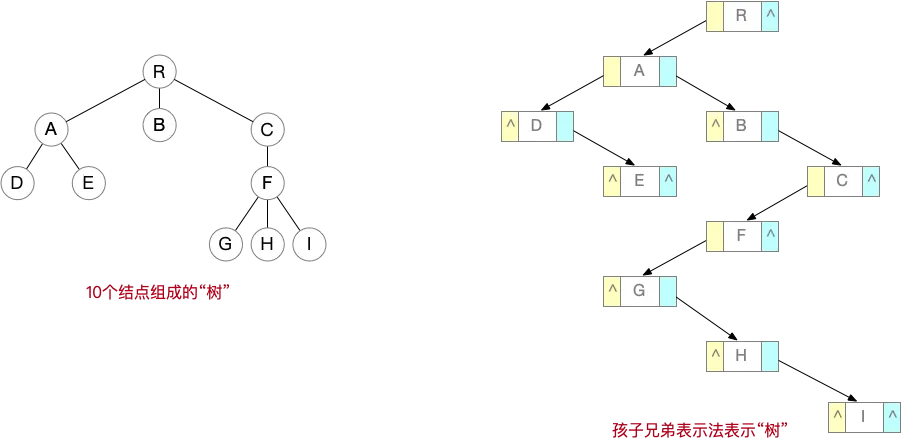
显然,孩子表示法可表示“森林”,如下所示: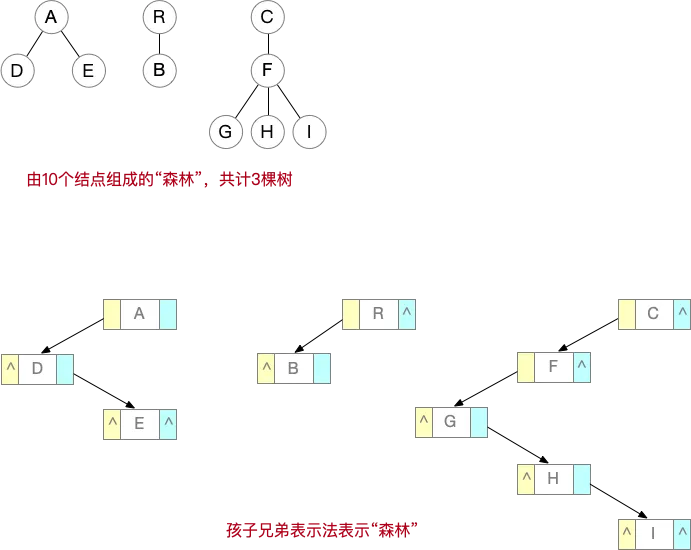
3.3.5 + 3.3.6 画出“树”和“森林”的数据结构示意图
请参考上面 👆 3.3.1、3.3.2、3.3.4
特别注意:应用题中很可能考双亲表示法、孩子表示法、孩子兄弟表示法的数据结构定义+画图
3.4 哈夫曼树的应用
该部分请参考王道书、考点精讲(基础课)课件自行完成
另外,请认真完成 2020年真题的应用题,即王道书 5.5.3 大题第3题
3.5 并查集的应用
3.5.1~3.5.3 实现并查集的数据结构定义,并实现 Union、Find 两个基本操作
#define SIZE 13
int UFSets[SIZE];       //用一个数组表示并查集

//初始化并查集
void Initial(int S[]){
    for(int i=0;i<SIZE;i++)
        S[i]=-1;
}

//Find “查”操作,找x所属集合(返回x所属根结点)
int Find(int S[],int x){
    while(S[x]>=0)          //循环寻找x的根
        x=S[x];
    return x;                       //根的S[]小于0
}

//Union “并”操作,将两个集合合并为一个
void Union(int S[],int Root1,int Root2){
    //要求Root1与Root2是不同的集合
    if(Root1==Root2)    return;
    //将根Root2连接到另一根Root1下面
    S[Root2]=Root1;
}
可采取“小树合并到大树”的策略优化 Union操作
//Union “并”操作,小树合并到大树
void Union(int S[],int Root1,int Root2){
    if(Root1==Root2)    return;
    if(S[Root2]>S[Root1]) { //Root2结点数更少
        S[Root1] += S[Root2];   //累加结点总数
        S[Root2]=Root1; //小树合并到大树
    } else {
        S[Root2] += S[Root1];   //累加结点总数
        S[Root1]=Root2; //小树合并到大树
    }
}
可采取“路径压缩”的策略优化 Find 操作
//Find “查”操作优化,先找到根节点,再进行“压缩路径”
int Find(int S[],int x){
    int root = x;
    while(S[root]>=0)  root=S[root]; //循环找到根
    while(x!=root){ //压缩路径
      int t=S[x];       //t指向x的父节点
      S[x]=root;        //x直接挂到根节点下
      x=t;
    }
    return root;                        //返回根节点编号
}
3.5.4 设计一个例子,对10个元素 Union
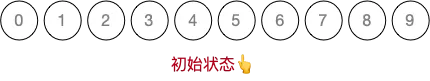
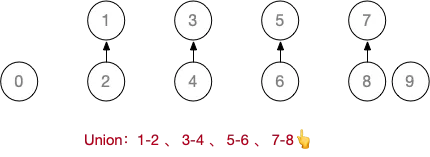
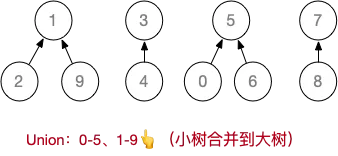
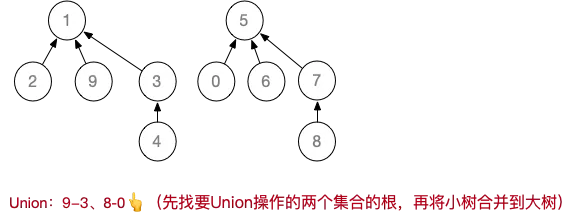
假设初始长度为 10 ( 0 ~ 9 )的并查集,按 1-2、3-4、5-6、7-8、 0-5 、1-9、9-3、8-0、4-6 的顺序进行Union操作
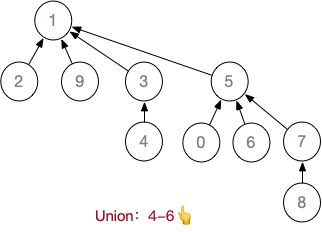
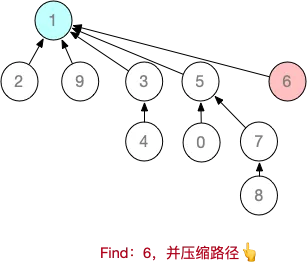
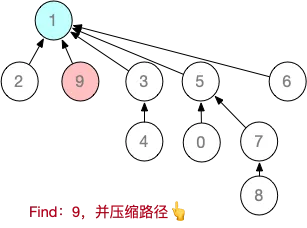
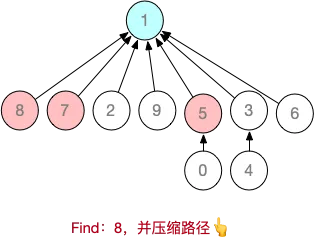
3.5.5 基于上述例子,进行若干次 Find,并完成“压缩路径”
依次对 6、9、8 执行 Find 操作,并完成压缩路径
3.6 二叉排序树、平衡二叉树的应用题潜在考法
3.6.1 自己设计一个例子,给出不少于10个关键字序列,按顺序插入一棵初始为空的二叉排序树,画出每一次插入后的样子
注:自己设计插入序列,并在“408快乐小网站”模拟执行
例:从一棵初始为空的BST开始,依次插入:50、26、10、3、5、60、90、40、55、100、59,最终结果如下
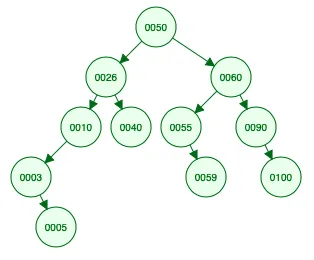
插入过程自己用网站模拟,可使用网站的“Pause、Step Forward”两个按钮单步执行。
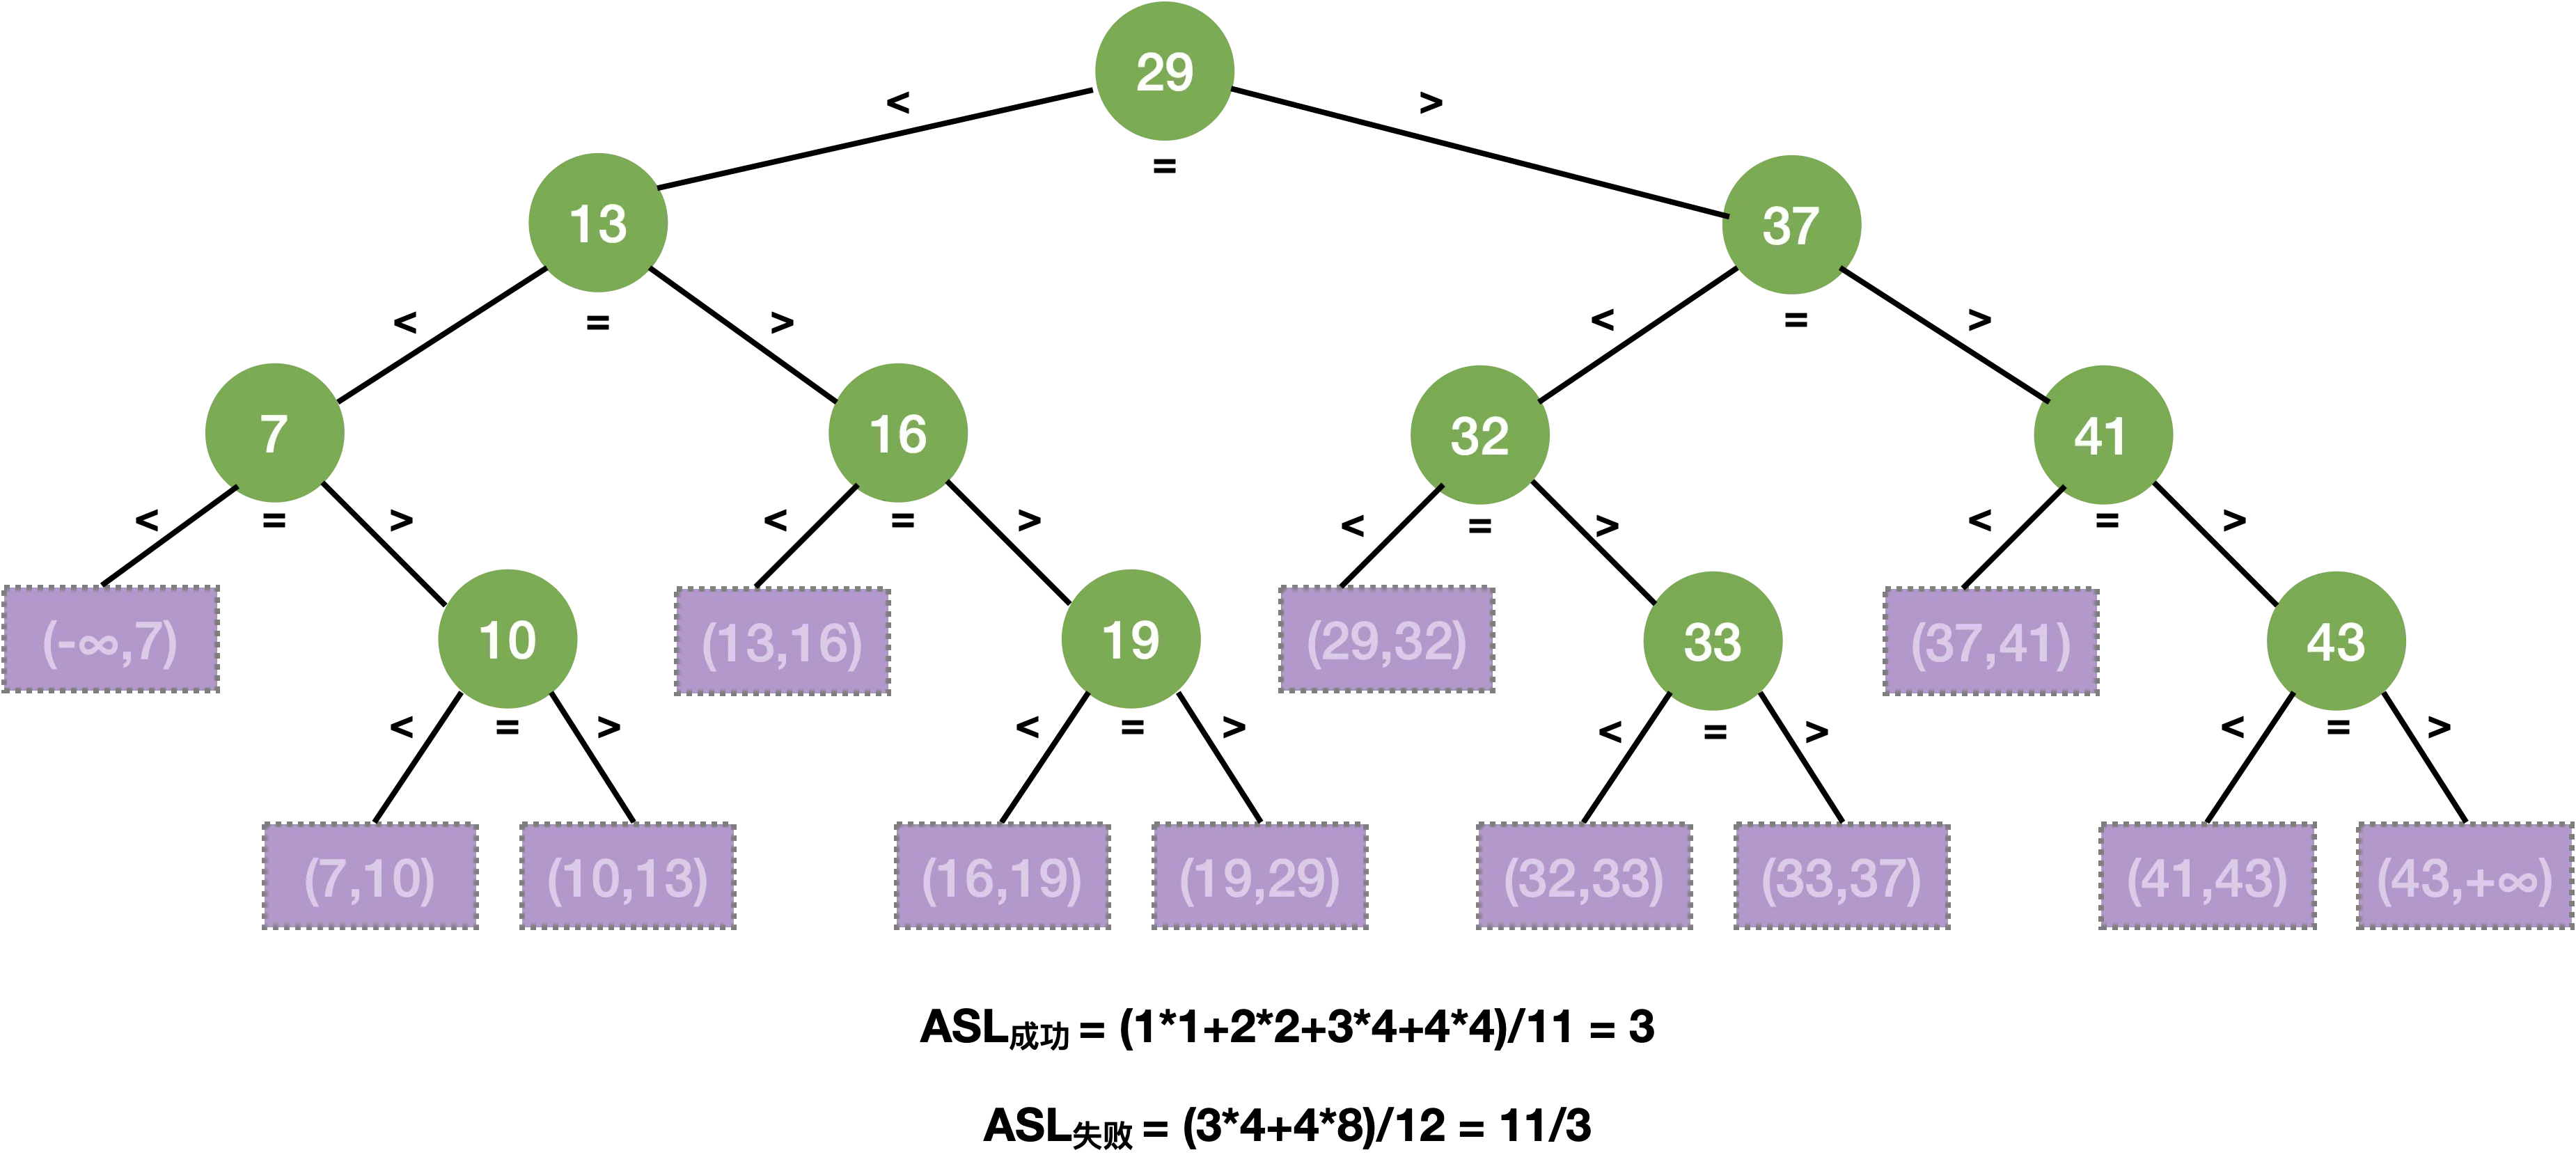
3.6.2 基于你设计的例子,计算二叉排序树在查找成功和查找失败时的 ASL
计算“树形查找”的ASL时,需要补充“失败结点”,再进行计算
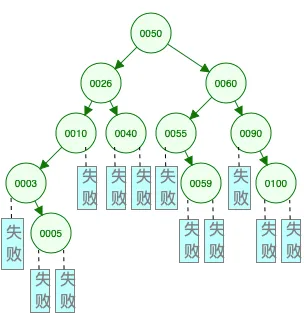
3.6.3 基于你设计的例子,依次删除不少于4个元素,画出每一次删除之后的样子(需要包含四种删除情况——删一个叶子结点、删一个只有左子树的结点、删一个只有右子树的结点、删一个既有左子树又有右子树的结点)
例:基于 3.6.1 的例子,依次删除:59(叶子)、10(仅有左子树)、90(仅有右子树)、50(拥有左右子树)。4次删除后,二叉排序树的状态分别如下:
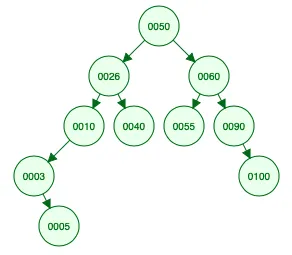
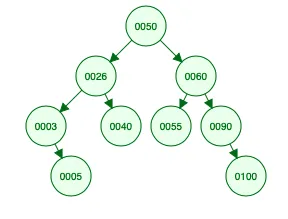
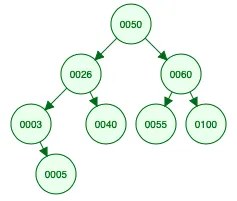
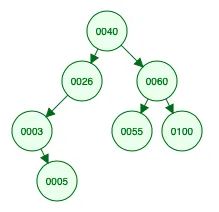
3.6.4 自己设计一个例子,给出不少于10个关键字序列,按顺序插入一棵初始为空的平衡二叉树,画出每一次插入后的样子(你设计的例子要涵盖LL、RR、LR、RL四种调整平衡的情况)
注:自己设计插入序列,并在“408快乐小网站”模拟执行
例:从一棵初始为空的AVL Trees 开始,依次插入:50、26、10(LL)、3、5(LR)、60、90(RR)、40、55、100、59(RL),最终结果如下
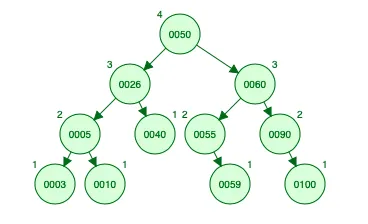
插入过程自己用网站模拟,可使用网站的“Pause、Step Forward”两个按钮单步执行。上述例子中,插入元素 10、5、90、59 时分别发生了 LL、LR、RR、RL 四种“调整平衡”的情况。
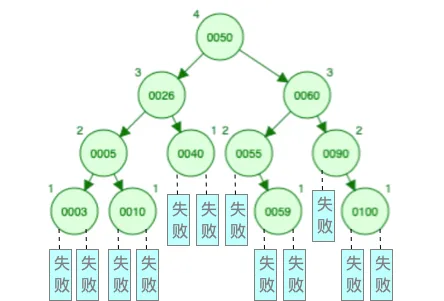
3.6.5 基于你设计的例子,计算平衡二叉树在查找成功和查找失败时的 ASL
计算“树形查找”的ASL时,需要补充“失败结点”,再进行计算
Ch4 图的应用
4.1 图的性质
注:通过“图的性质”相关小题、大题积累解题思路
4.2 图的数据结构定义
4.2.1 写代码:定义一个顺序存储的图(邻接矩阵实现)
#define N 8         //顶点数目的最大值,根据题目要求自己定义
typedef struct{
    char vex[N];    //N个顶点信息,每个顶点存储一个char字符,可根据题目要求将char改为其他类型
    int weight[N][N];   //N*N邻接矩阵,每条边的权值用int变量表示
    int vexnum,arcnum;  //图的当前顶点数和弧数
}MGraph;
4.2.2 写代码:定义一个链式存储的图(邻接表实现)
#define N 8     //图中顶点数目的最大值,根据题目要求自己定义
typedef struct ArcNode{         //弧结点
    int vexIndex;               //该弧所指向的顶点编号
    int weight;                //该弧的权值
    struct ArcNode *next;       //指向下一个弧结点
}ArcNode;

typedef struct VNode{   //顶点结点
    char data;          //顶点信息,每个顶点存储一个char字符,可根据题目要求将char改为其他类型
    ArcNode *first;     //指向第一条依附该顶点的弧的指针
}VNode;

typedef struct{
    VNode vex[N];           //N个顶点
    int vexnum,arcnum;      //图的顶点数和弧数
} ALGraph;                  //ALGraph是以邻接表存储的图类型
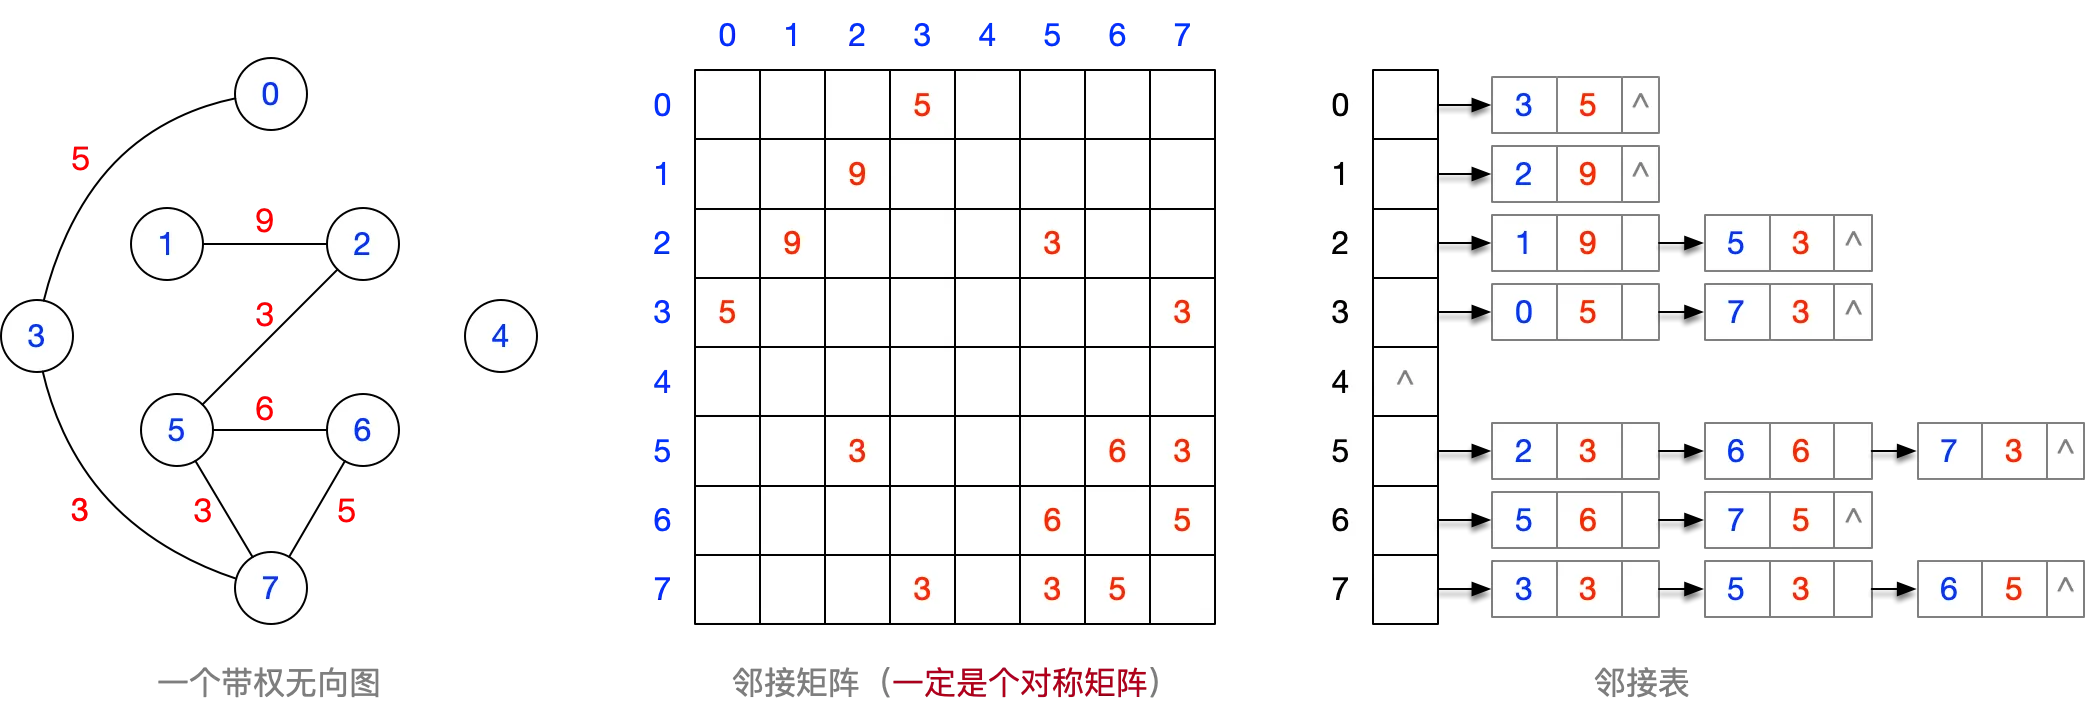
4.2.3 自己设计一个不少于6个结点的 带权无向图 ,并画出其邻接矩阵、邻接表的样子
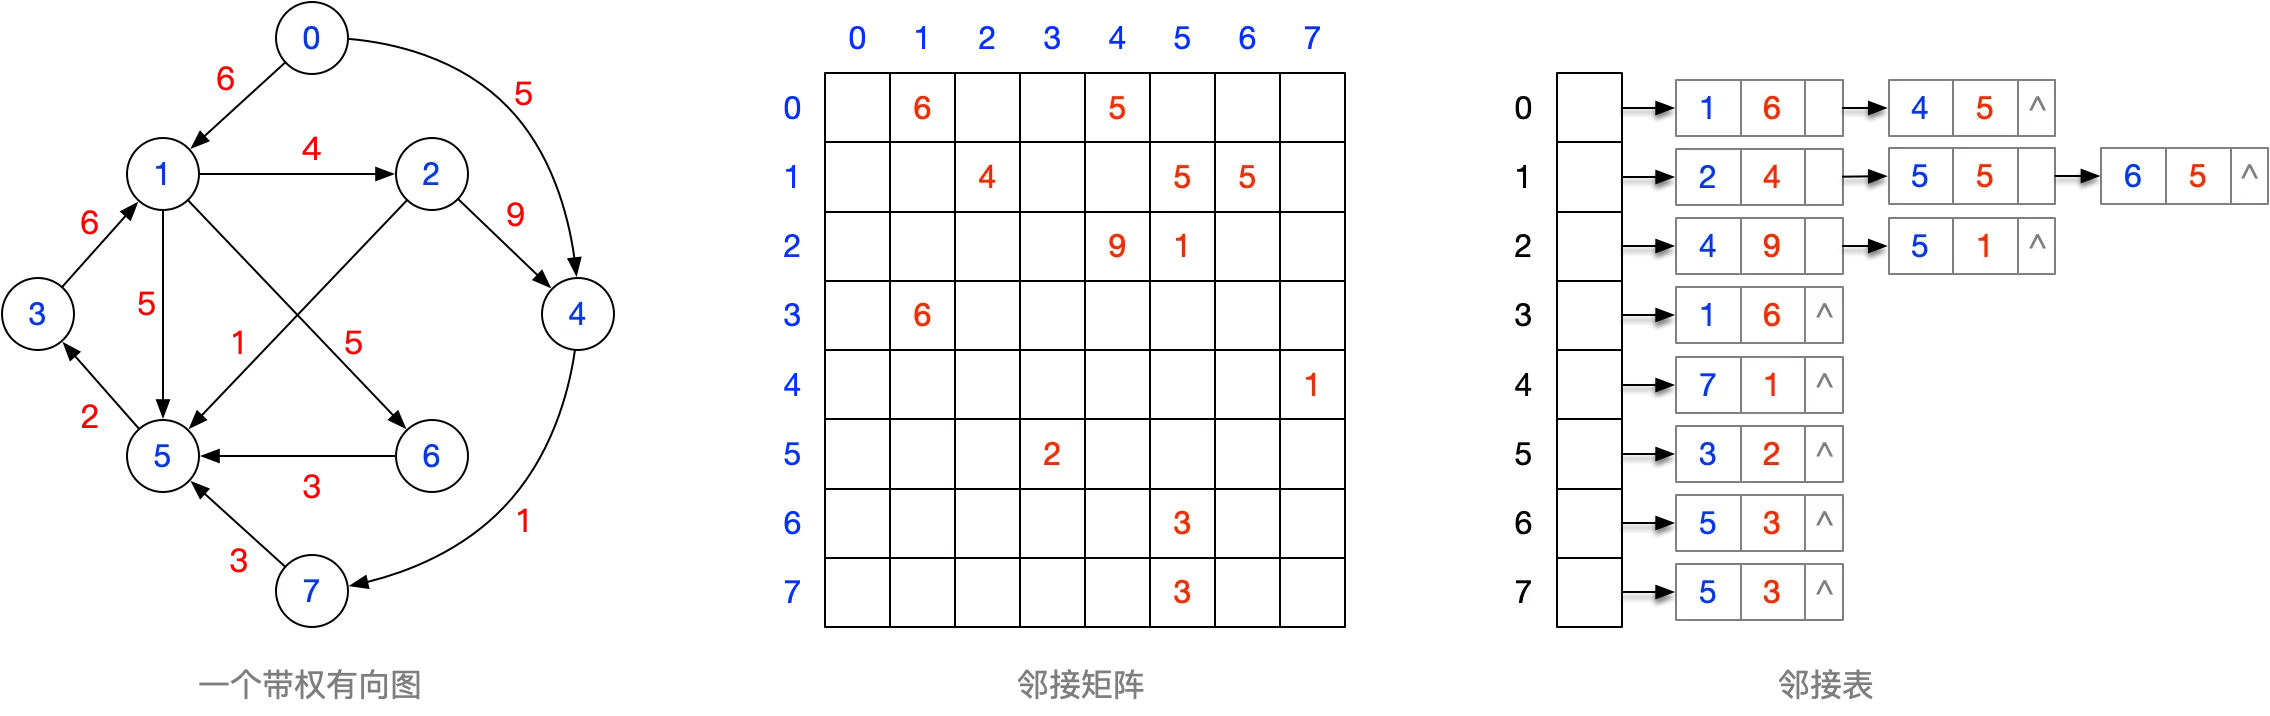
4.2.4 自己设计一个不少于6个结点的 带权有向图 ,并画出其邻接矩阵、邻接表的样子
4.3 图的应用:最小生成树
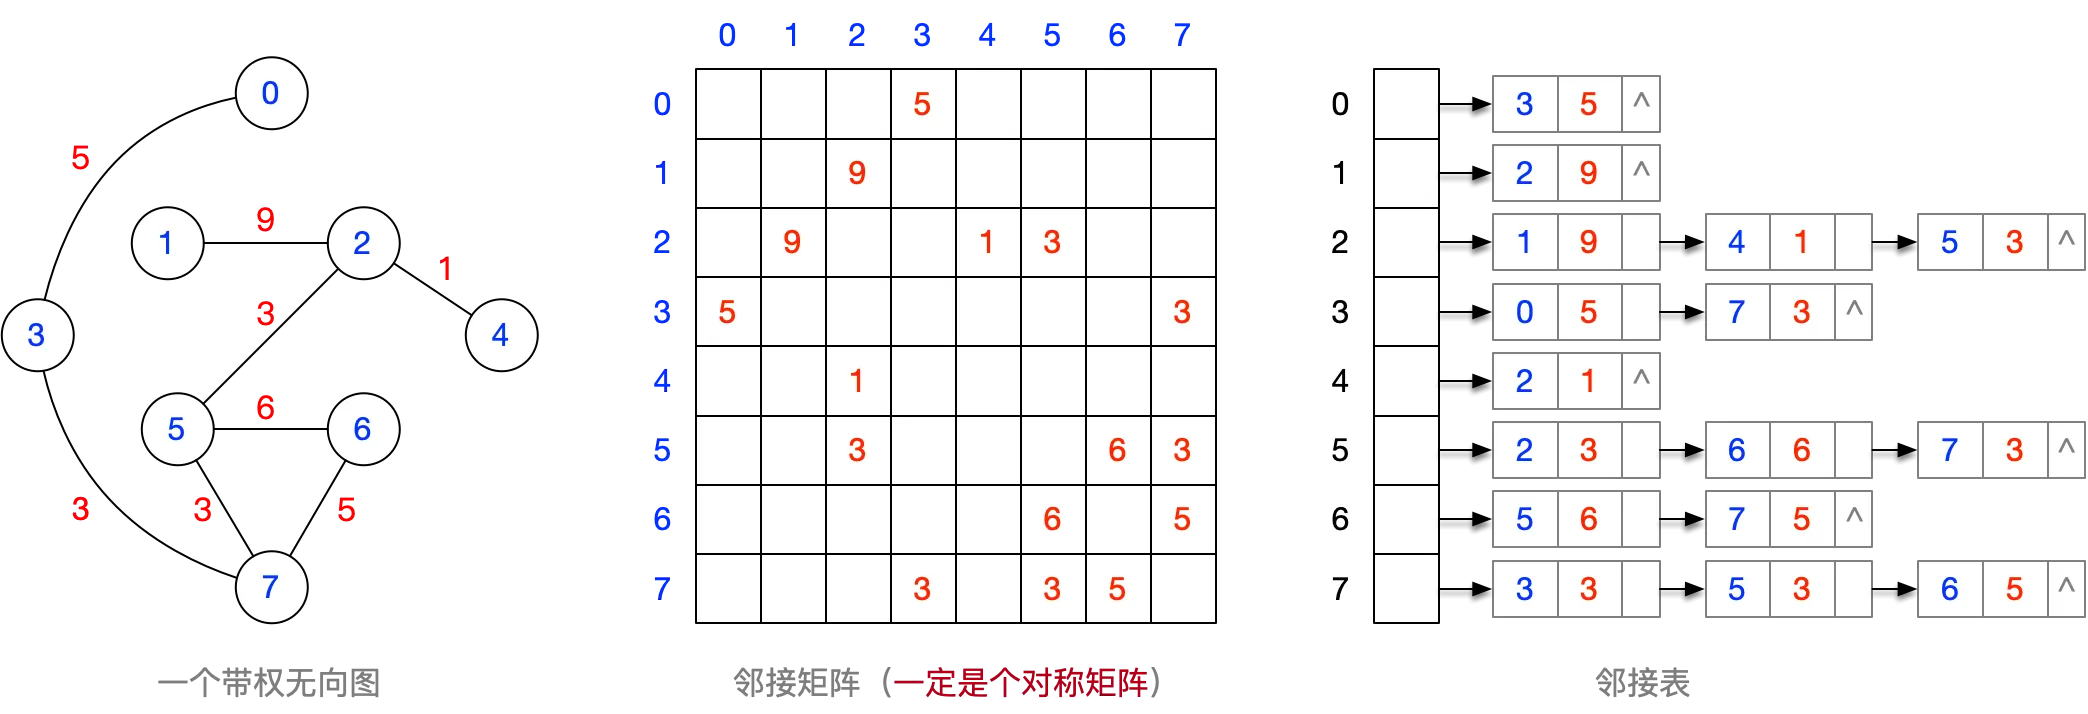
4.3.1 自己设计一个不少于6个结点的 带权无向连通图 ,并画出其邻接矩阵、邻接表的样子
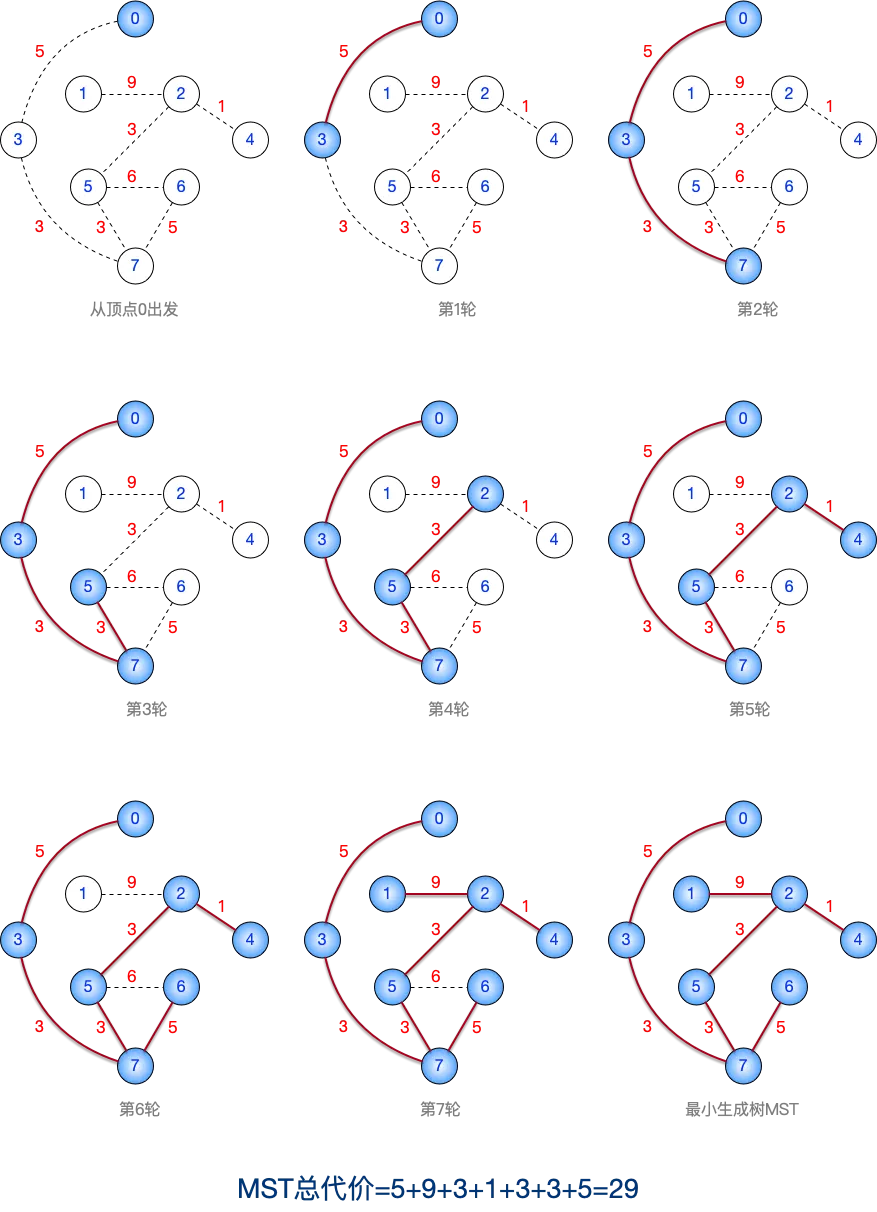
4.3.2 基于上述无向连通图,使用Prim算法生成MST,画出算法执行过程的示意图,并计算MST的总代价
注:普利姆算法是选代价最小的“点”,克鲁斯卡尔算法是选代价最小的“边”,别记混了。
可以这么联想记忆,“Prim”是字母 P 开头的,“点”的英文是Point,也是 P 开头的,因此Prim算法是选“点”。
Warning
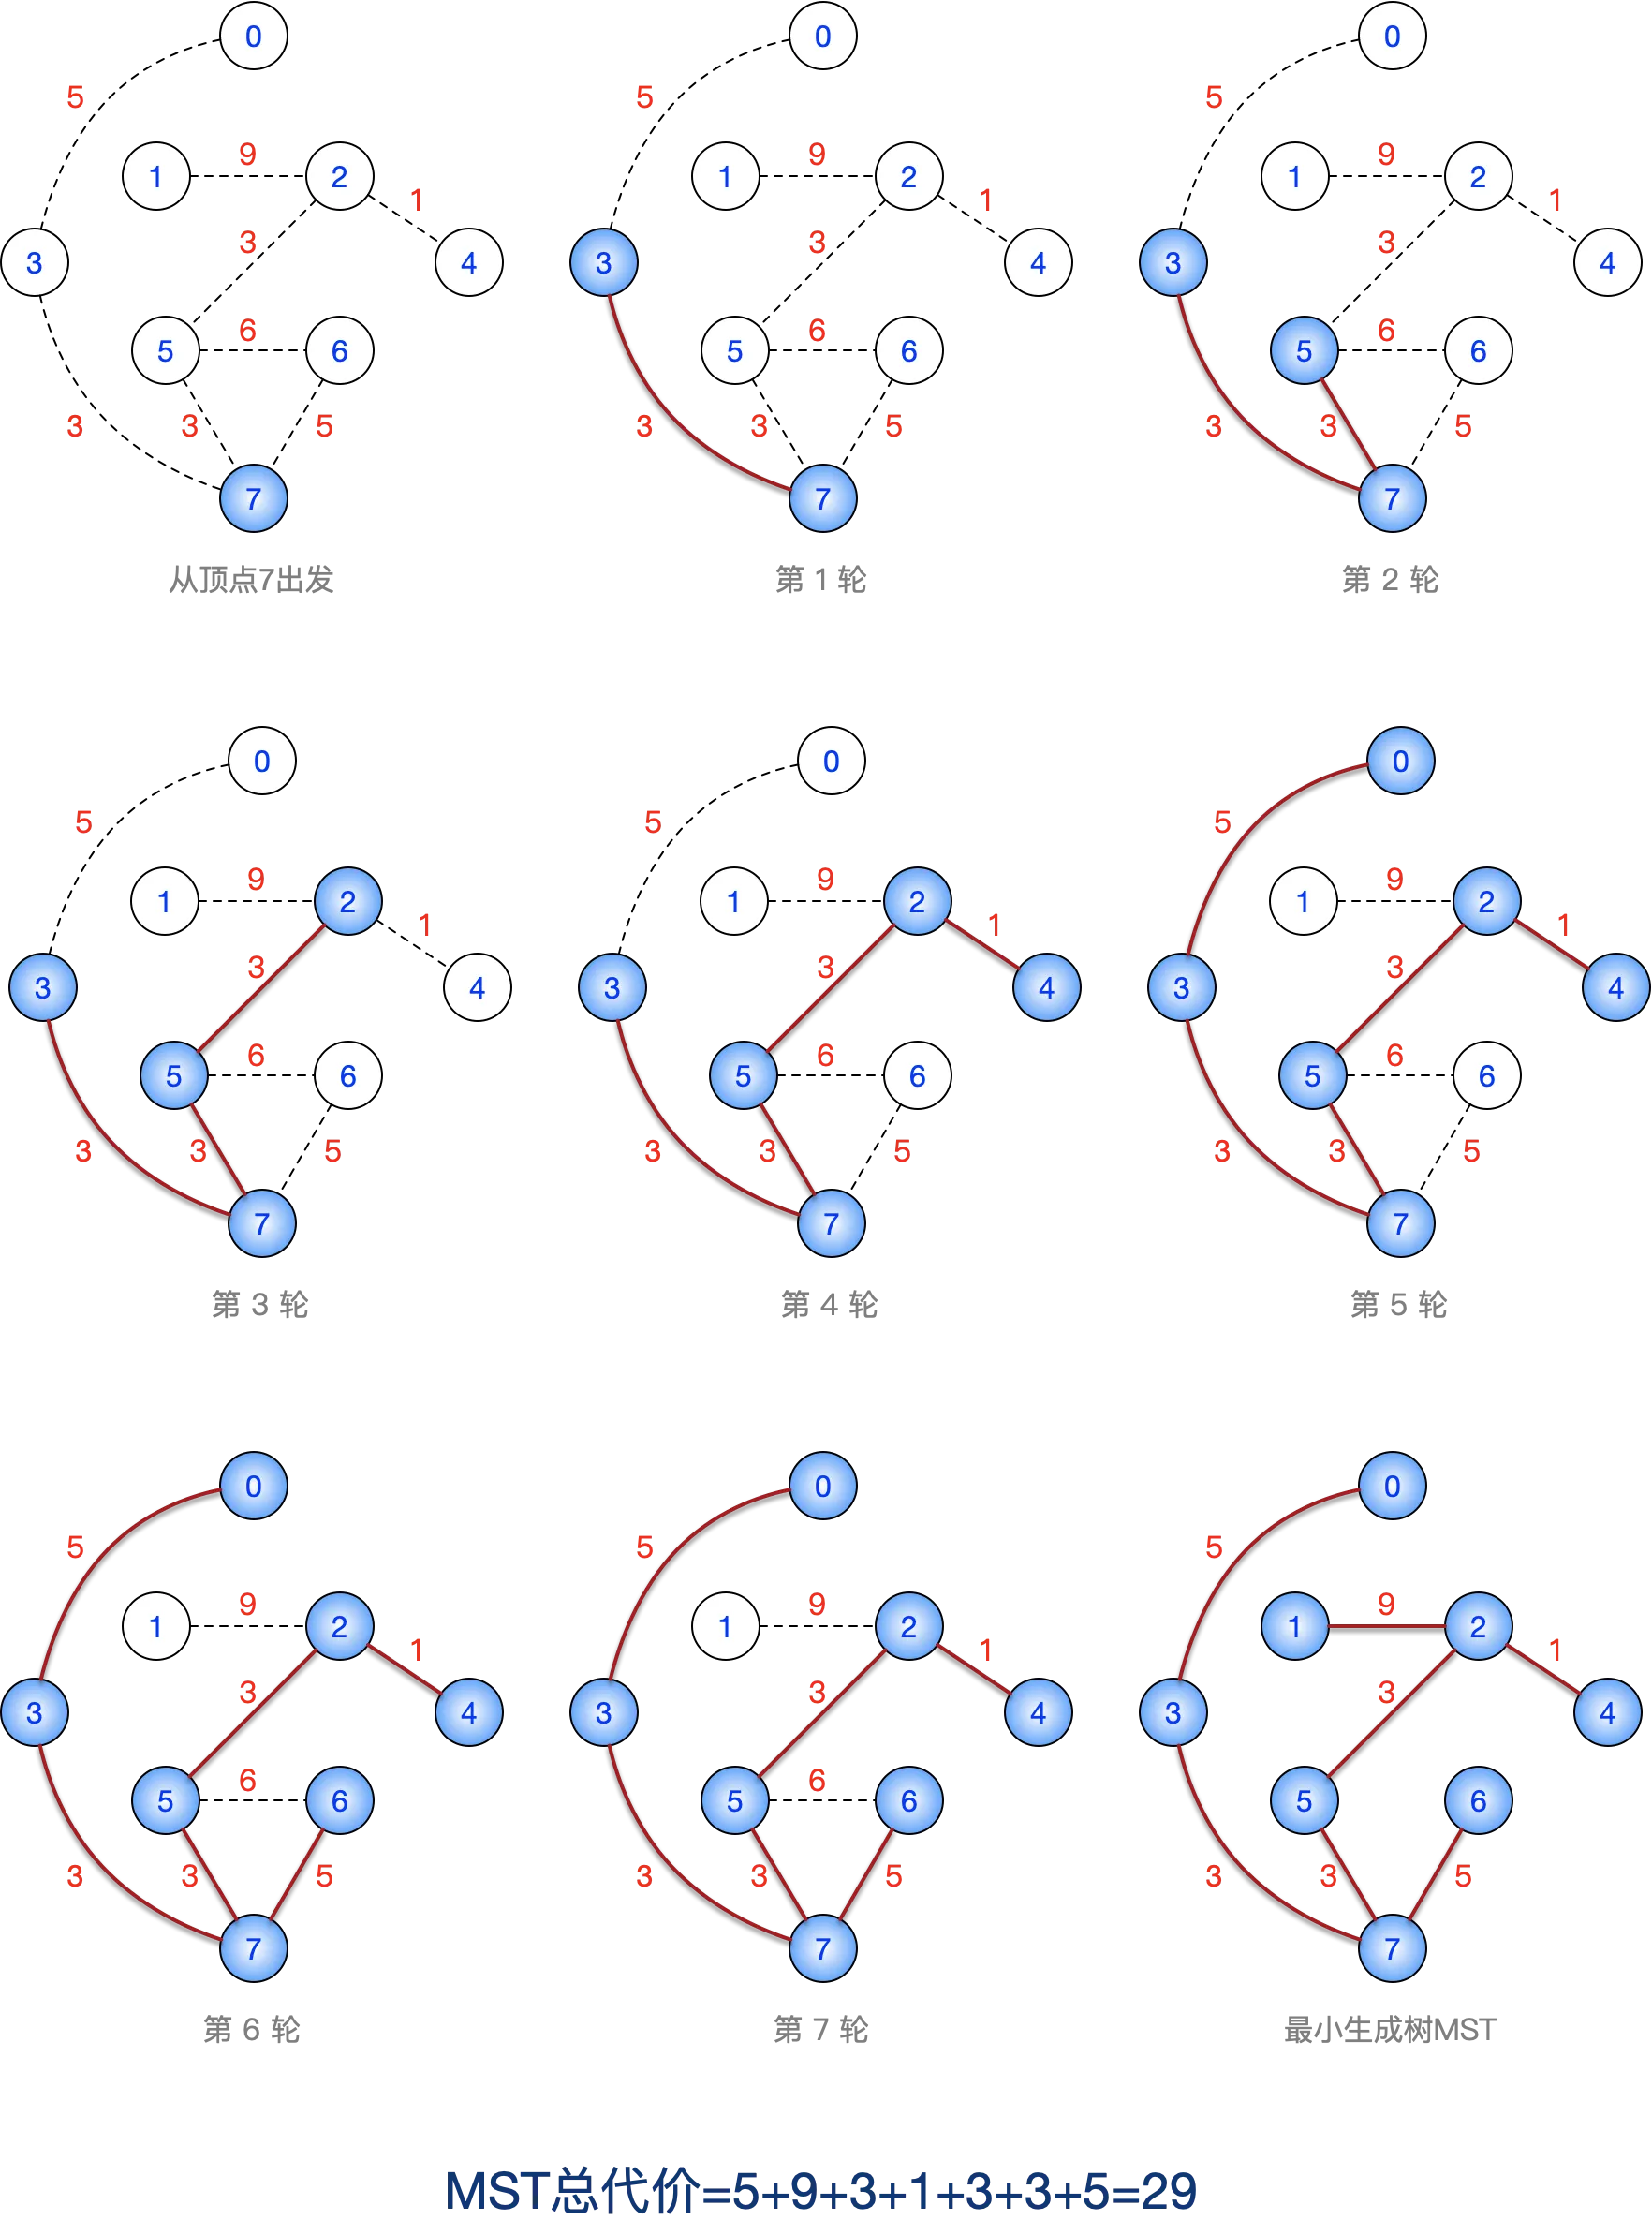
从顶点0开始,运行 Prim 算法的过程如下:
Warning
从顶点7开始,运行 Prim 算法的过程如下。这里想强调的是:当同时有两个代价相同的顶点时,优先将编号小的顶点加入MST。如:第 1 轮从顶点7出发,与其相连的顶点3、顶点5代价都是最小的,优先选择编号更小的顶点3。
4.3.3 基于上述无向连通图,使用Kruskal算法生成MST,画出算法执行过程的示意图,并计算MST的总代价
Warning
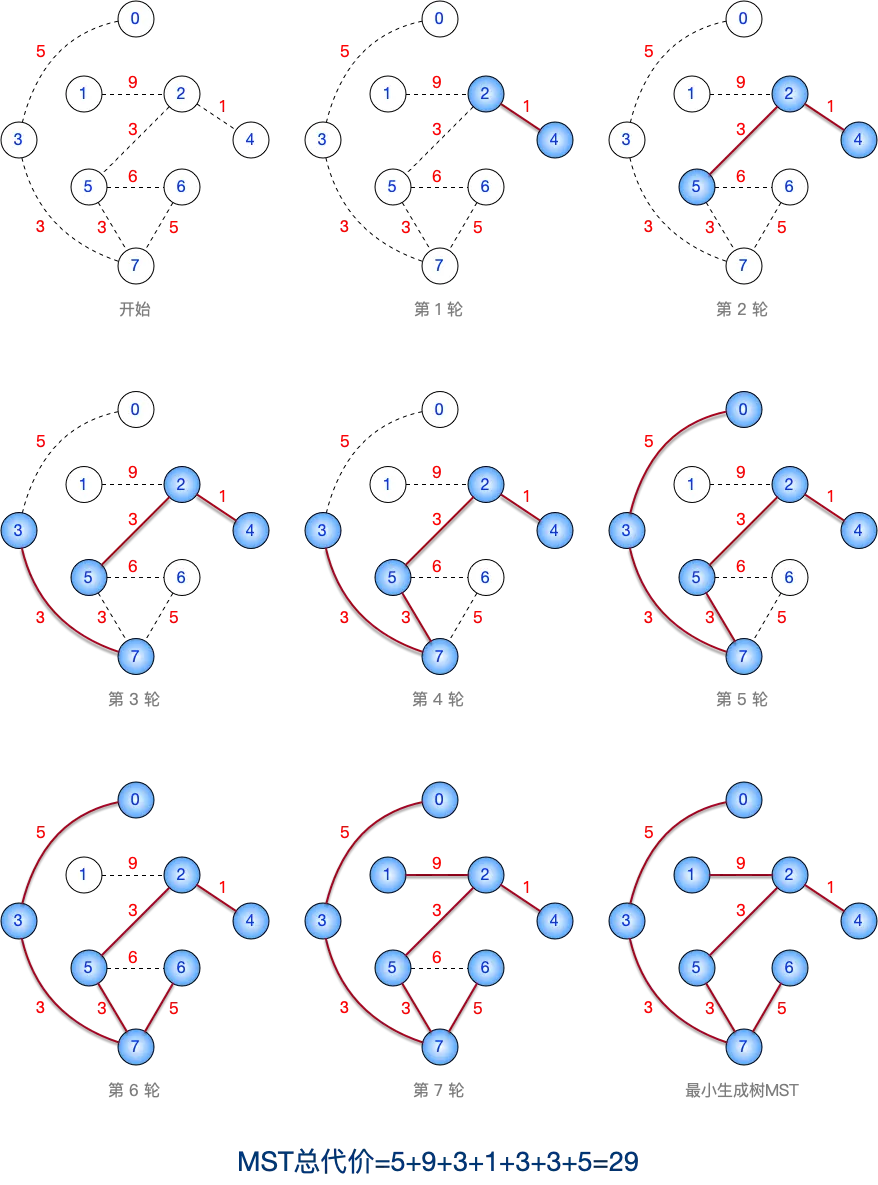
Kruskal 算法的执行过程是:先将各条边按照权值递减的排序,再按顺序依次检查是否将这些边加入MST。各条边排序结果如下:
( 2 ,4 ) ——权值 1
( 2, 5 ) ——权值 3
( 3, 7 ) ——权值 3
( 5, 7 ) ——权值 3
( 0, 3 ) ——权值 5
( 6, 7 ) ——权值 5
( 5, 6 ) ——权值 6
( 1, 2 ) ——权值 9
可见,当多条边的权值相同时,“起点”编号更小的边排在前面。因此,在Kruskal算法的第2轮中,虽然有3条边 (2,5) (3,7) (5,7) 的权值都是最小的,但算法会优先选择将排序靠前的 (2,5) 加入MST。
4.4 图的应用:最短路径
4.4.1 基于你设计的 带权有向图 ,从某一结点出发,执行Dijkstra算法求单源最短路径。用文字描述每一轮执行的过程
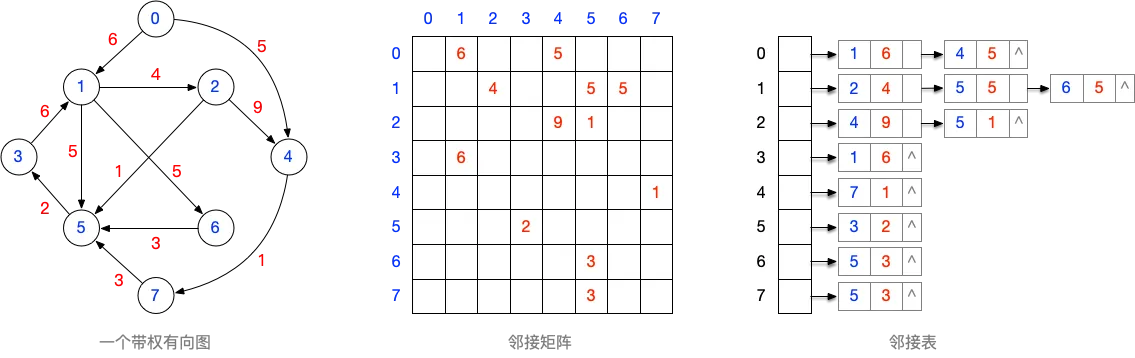
下面将从顶点1出发,执行 Dijkstra 算法
Warning
注1:如果题目让你描述迪杰斯特拉算法的执行过程,可以试着模仿王道书画一张表。如下所示👇。你会发现这个表画起来很崩溃,复杂的飞起。相信我,老师改卷也不愿意改这么复杂的答案。因此,考场上不太可能让你画这么复杂的表。
| 顶点(这一列不包含起点) | 第 1 轮 | 第 2 轮 | 第 3 轮 | 第 4 轮 | 第 5 轮 | 第 6 轮 | 第 7 轮 |
|---|---|---|---|---|---|---|---|
| 0 | ∞ | ∞ | ∞ | ∞ | ∞ | ∞ | ∞ |
| 2 | 4 1→2 |
已完成 | 已完成 | 已完成 | 已完成 | 已完成 | 已完成 |
| 3 | ∞ | ∞ | 7 1→5→3 |
7 1→5→3 |
已完成 | 已完成 | 已完成 |
| 4 | ∞ | 13 1→2→4 |
13 1→2→4 |
13 1→2→4 |
13 1→2→4 |
已完成 | 已完成 |
| 5 | 5 1→5 |
5 1→5 |
已完成 | 已完成 | 已完成 | 已完成 | 已完成 |
| 6 | 5 1→6 |
5 1→6 |
5 1→6 |
已完成 | 已完成 | 已完成 | 已完成 |
| 7 | ∞ | ∞ | ∞ | ∞ | ∞ | 14 1→2→4→7 |
已完成 |
| 集合S | {1, 2} | {1,2,5} | {1,2,5,6} | {1,2,5,6,3} | {1,2,5,6,3,4} | {1,2,5,6,3,4,7} | {1,2,5,6,3,4,7,0} |
注2:以下是一种更适合考试的“简洁答题方法”。自己打草稿,快速确定每一轮Dijkstra算法的运行结果,然后按下面这种方式答题到试卷上。
答:
从顶点1出发,运行迪杰斯特拉算法的过程如下:
第一轮:顶点1到2的最短路径为 1→2,距离为4
第二轮:顶点1到5的最短路径为 1→5,距离为5
第三轮:顶点1到6的最短路径为 1→6,距离为5
第四轮:顶点1到3的最短路径为 1→5→3,距离为7
第五轮:顶点1到4的最短路径为 1→2→4,距离为13
第六轮:顶点1到7的最短路径为 1→2→4→7,距离为14
第七轮:不存在顶点1到0的路径,距离为∞
4.4.2 文字描述:用BFS算法求单源最短路径的过程
注意:BFS算法只能对无权图求最短路径
4.5 图的应用:拓扑排序
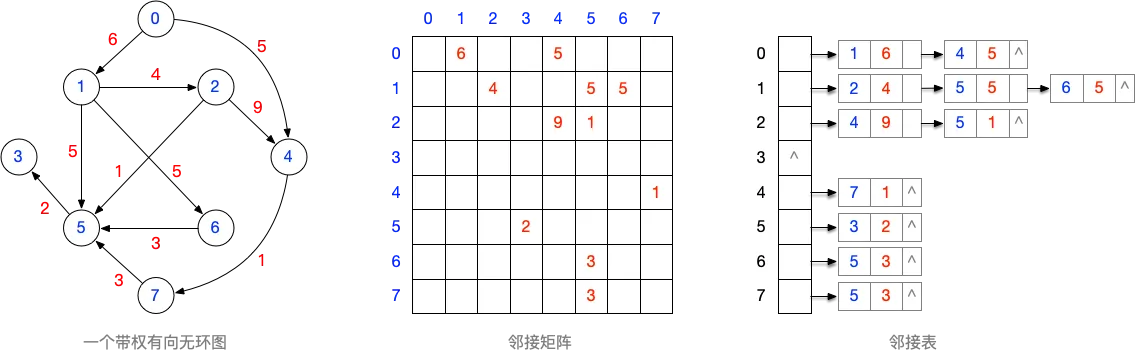
4.5.1 自己设计一个不少于6个结点的 带权有向无环图 ,并画出其邻接矩阵的样子
4.5.2 用一维数组将你设计的有向无环图的邻接矩阵进行 压缩存储
注:有向无环图,一定可以转化为一个上三角或下三角矩阵。但是需要调整顶点的编号。
如果要用上三角矩阵表示有向无环图的邻接矩阵,可以对图进行拓扑排序,按照拓扑排序序列,重新调整各个顶点的编号。这样可以确保,所有的弧都是从小编号顶点指向大编号顶点,从而也就保证了邻接矩阵可以转化为“上三角矩阵”
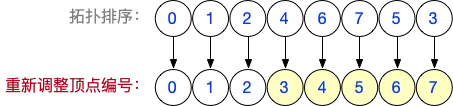
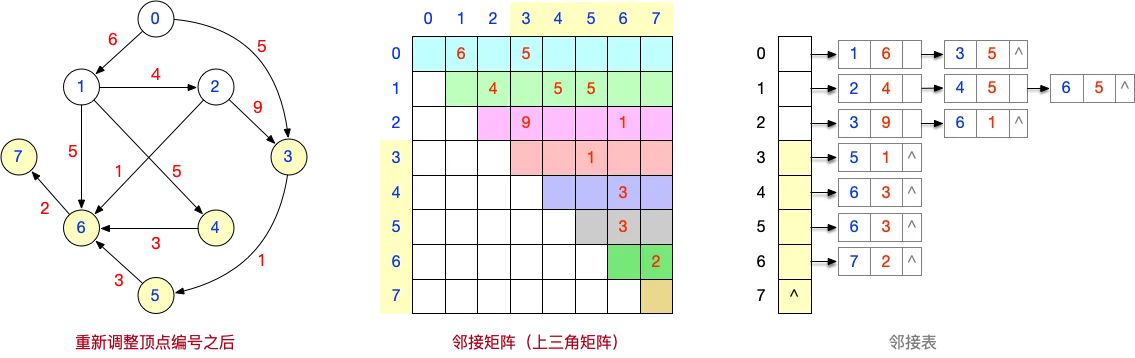
“上三角矩阵”可以按行优先压缩存储,如下所示:

4.5.3 文字描述:基于你压缩存储的数组,如何判断结点 i、j 之间是否有边?
行优先压缩存储上三角矩阵,元素 (i, j) 和一维数组间的对应关系为:
只需用上述公式将 i、j 转化为 k,再检查一维数组中下标为 k 的元素即可。
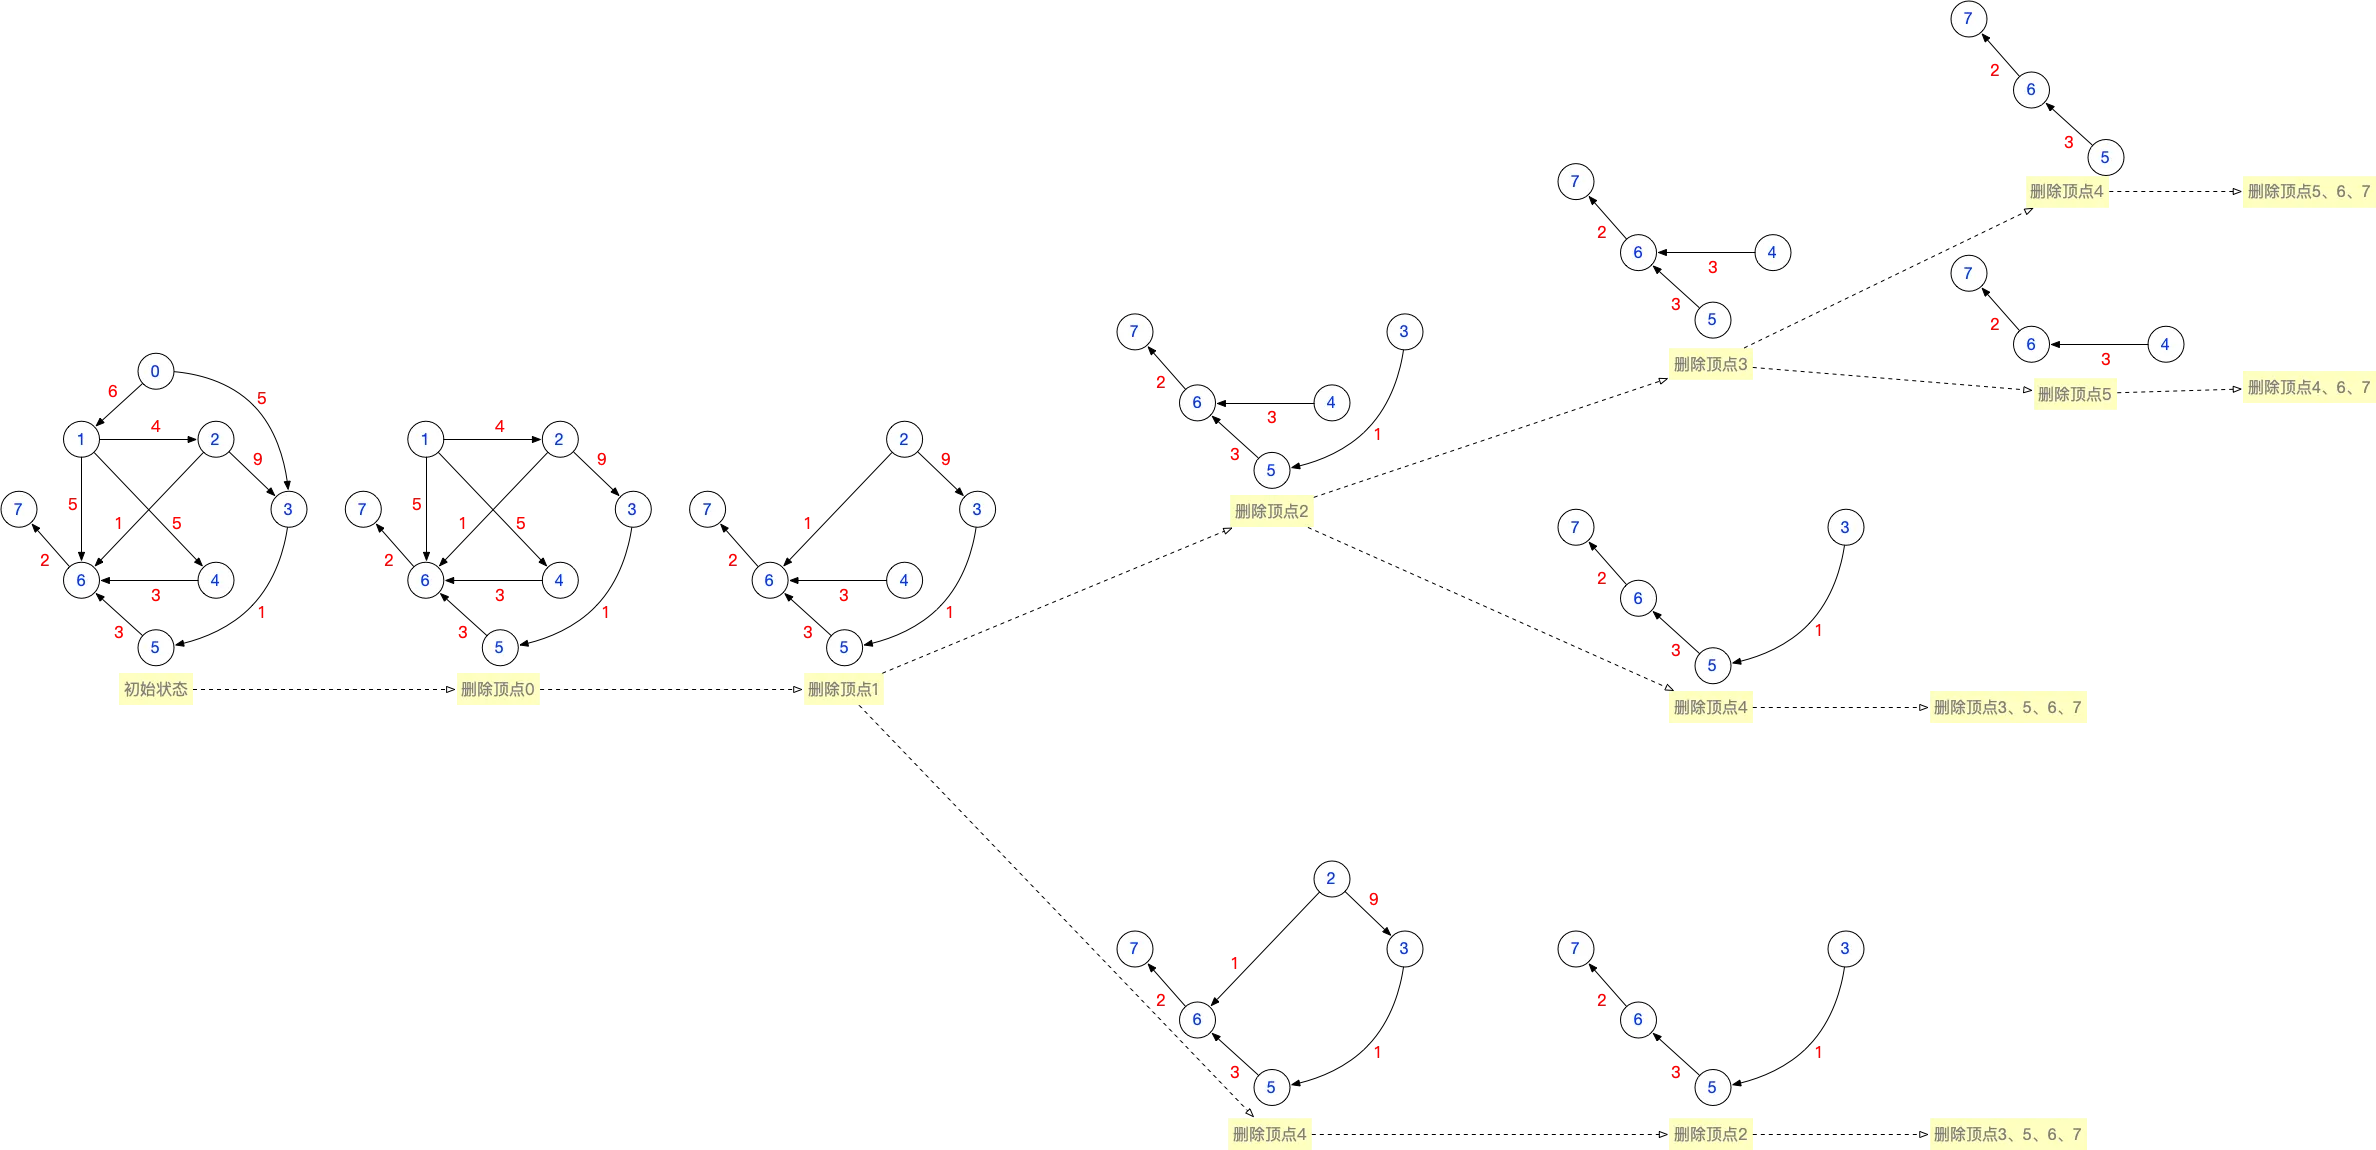
4.5.4 基于你设计的带权有向无环图,写出所有合法的拓扑排序序列
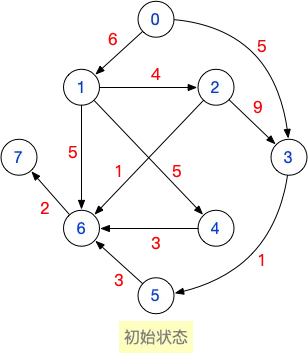
拓扑排序序列1:0,1,2,3,4,5,6,7
拓扑排序序列2:0,1,2,3,5,4,6,7
拓扑排序序列3:0,1,2,4,3,5,6,7
拓扑排序序列4:0,1,4,2,3,5,6,7
可参考下面这张图分析所有可能出现的拓扑排序序列:
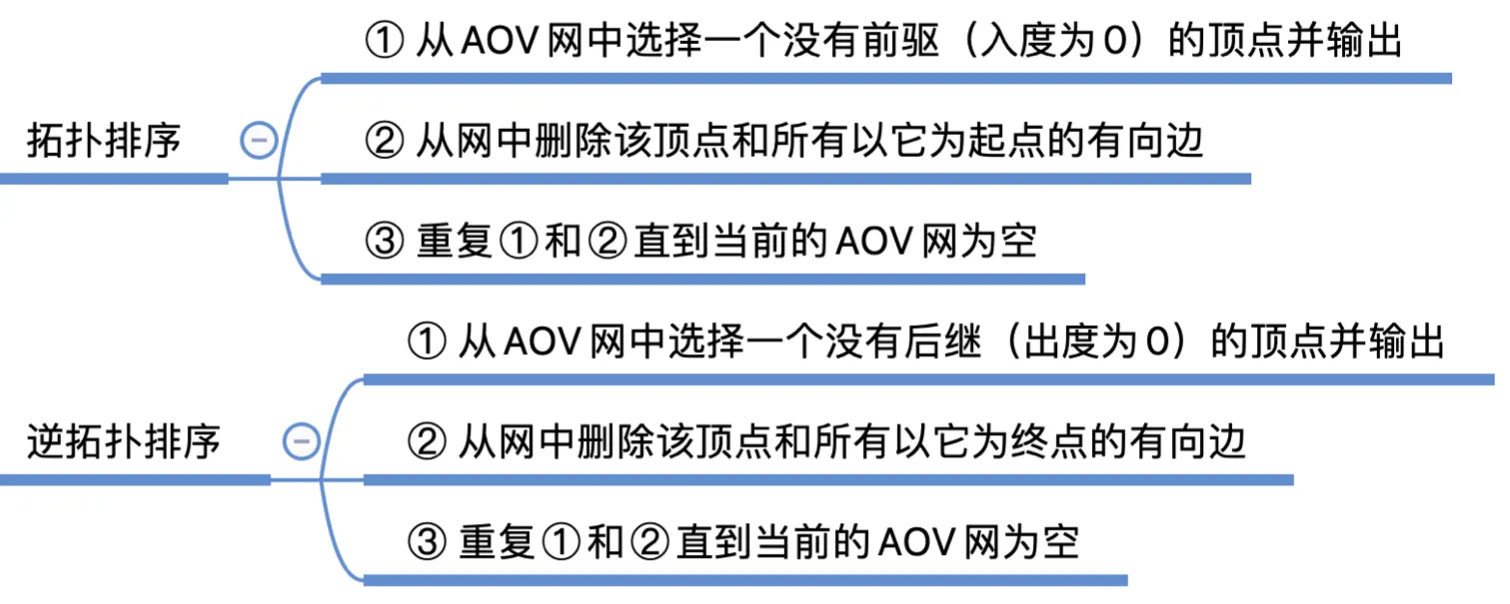
4.5.5 文字描述:拓扑排序的过程
4.6 图的应用:关键路径
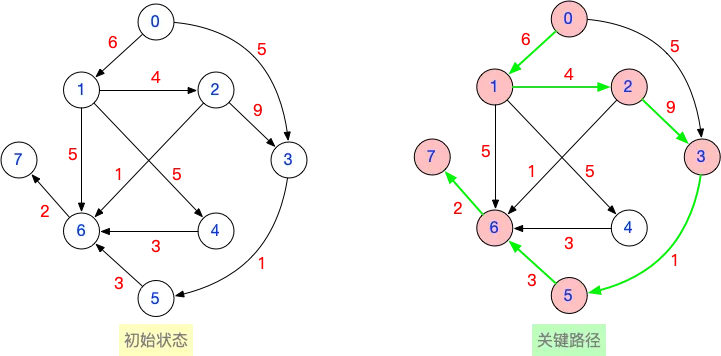
4.6.1 基于你设计的 带权有向无环图 ,写出所有合法的关键路径,并算出关键路径总长度
Warning
用手算的方式求关键路径,就是要找到从起点到终点的所有路径中最长的那条。
在上面这个图中,起点是0,终点是7,从0到7最长的路径是 0→1→2→3→5→6→7,关键路径总长度为 25
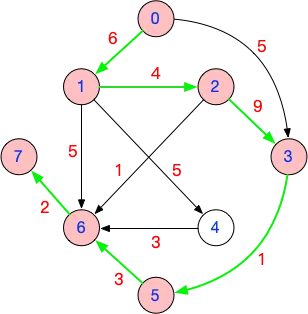
用手算的方式求关键路径,就是要找到从起点到终点的所有路径中最长的那条。
在上面这个图中,起点是0,终点是7,从0到7最长的路径是 0→1→2→3→5→6→7,关键路径总长度为 25
Ch5 查找算法的分析和应用
5.1 分块查找
5.1.1 自己设计一个分块查找的例子,不少于15个数据元素,并建立分块查找的索引
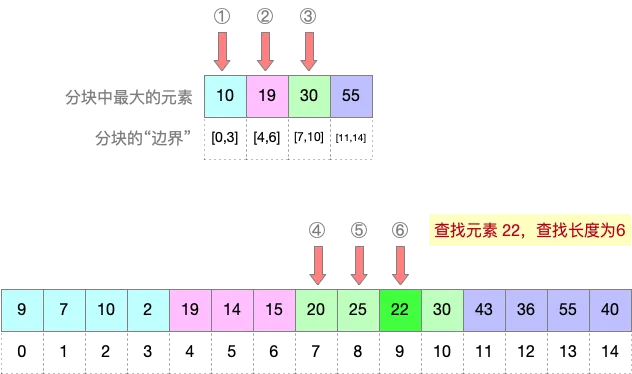
5.1.2 基于上述例子,计算查找成功的ASL、查找失败的ASL
注:对于分块查找算法,可能会让你分析查找成功的ASL。查找失败的ASL没有统一的计算方法,不可能考。
上图中,共有15个元素,计算查找成功时的平均查找长度ASL,每个元素被查找的概率相同,都是 1/15。每个元素的查找都需要先查分块索引,再顺序查找分块内各个元素。
查找元素9时,查找长度为 1+1
查找元素7时,查找长度为 1+2
查找元素10时,查找长度为 1+3
查找元素2时,查找长度为 1+4
查找元素19时,查找长度为 2+1
查找元素14时,查找长度为 2+2
查找元素15时,查找长度为 2+3
查找元素20时,查找长度为 3+1
查找元素25时,查找长度为 3+2
查找元素22时,查找长度为 3+3
查找元素30时,查找长度为 3+4
查找元素43时,查找长度为 4+1
查找元素36时,查找长度为 4+2
查找元素55时,查找长度为 4+3
查找元素40时,查找长度为 4+4
综上,查找成功的ASL=(2+3+4+5+3+4+5+4+5+6+7+5+6+7+8)×1/15=4.933
5.2 折半查找
注1:关于折半查找的算法效率分析,可参考基础课课件,重点复习“如何画查找分析树”、“如何计算查找成功、查找失败的ASL”
注2:关于折半查找的算法执行过程,可以去408快乐小网站玩一玩,传送门如下:https://www.cs.usfca.edu/~galles/visualization/Search.html
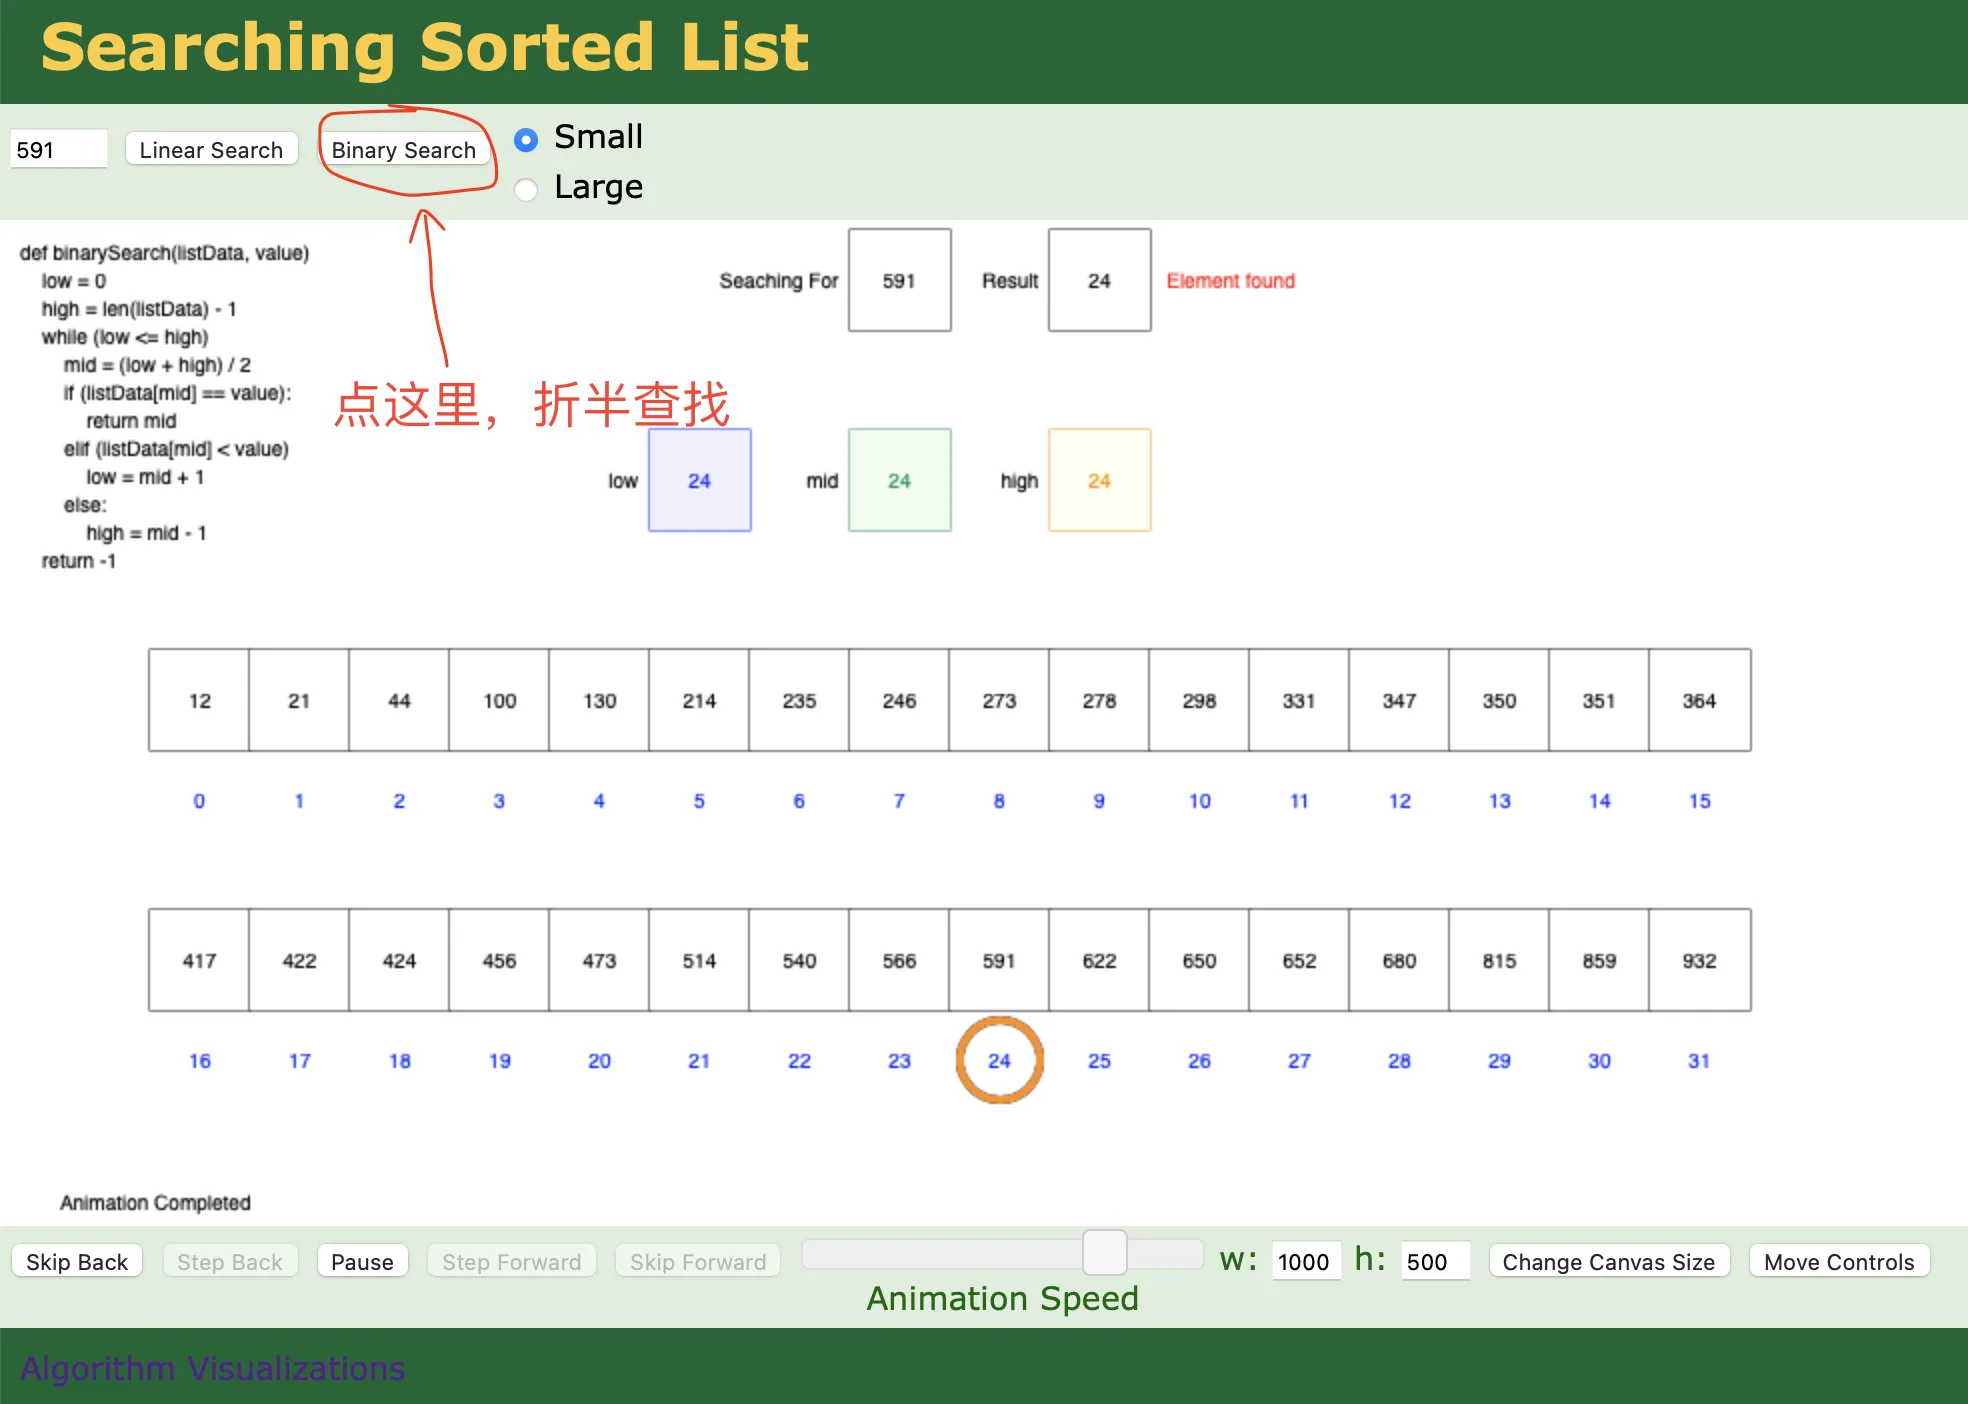
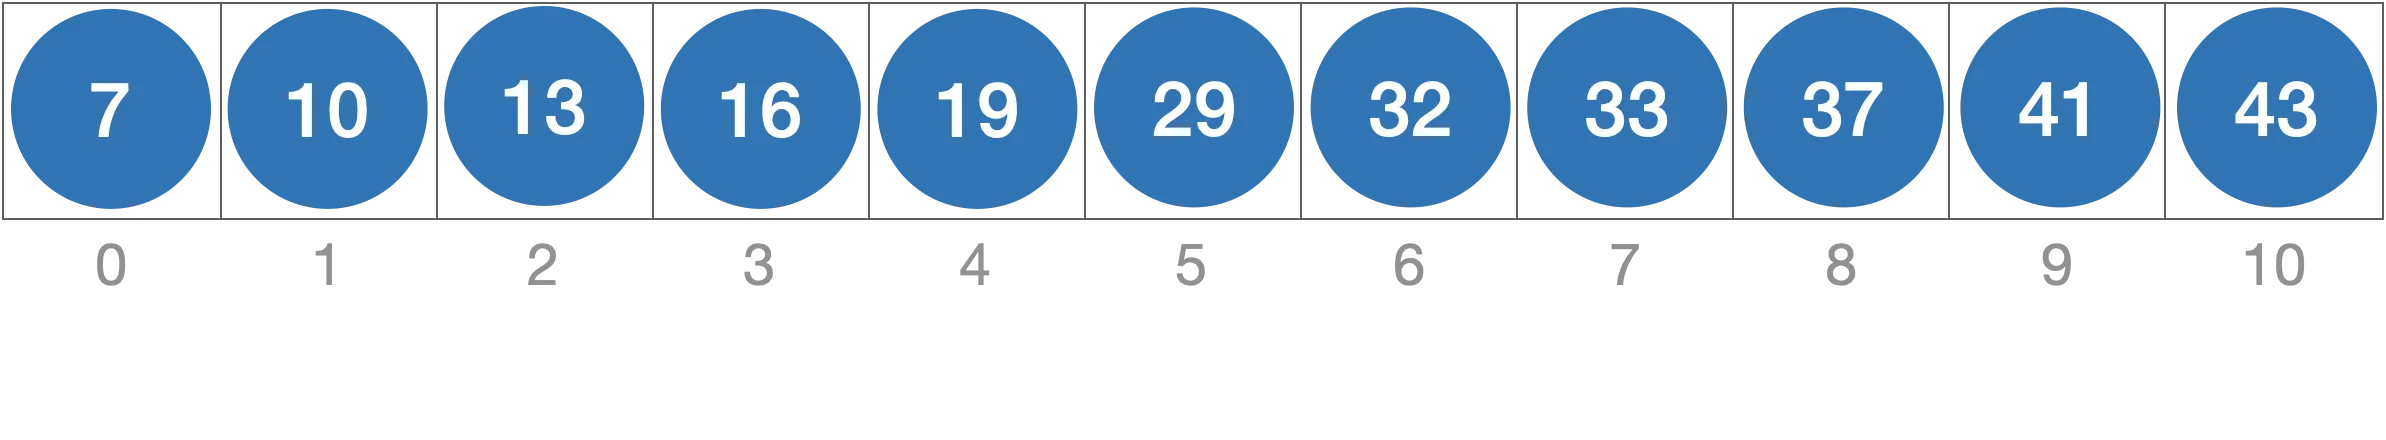
5.2.1 自己设计一个折半查找的例子,不少于10个数据元素,画出对应的查找分析树
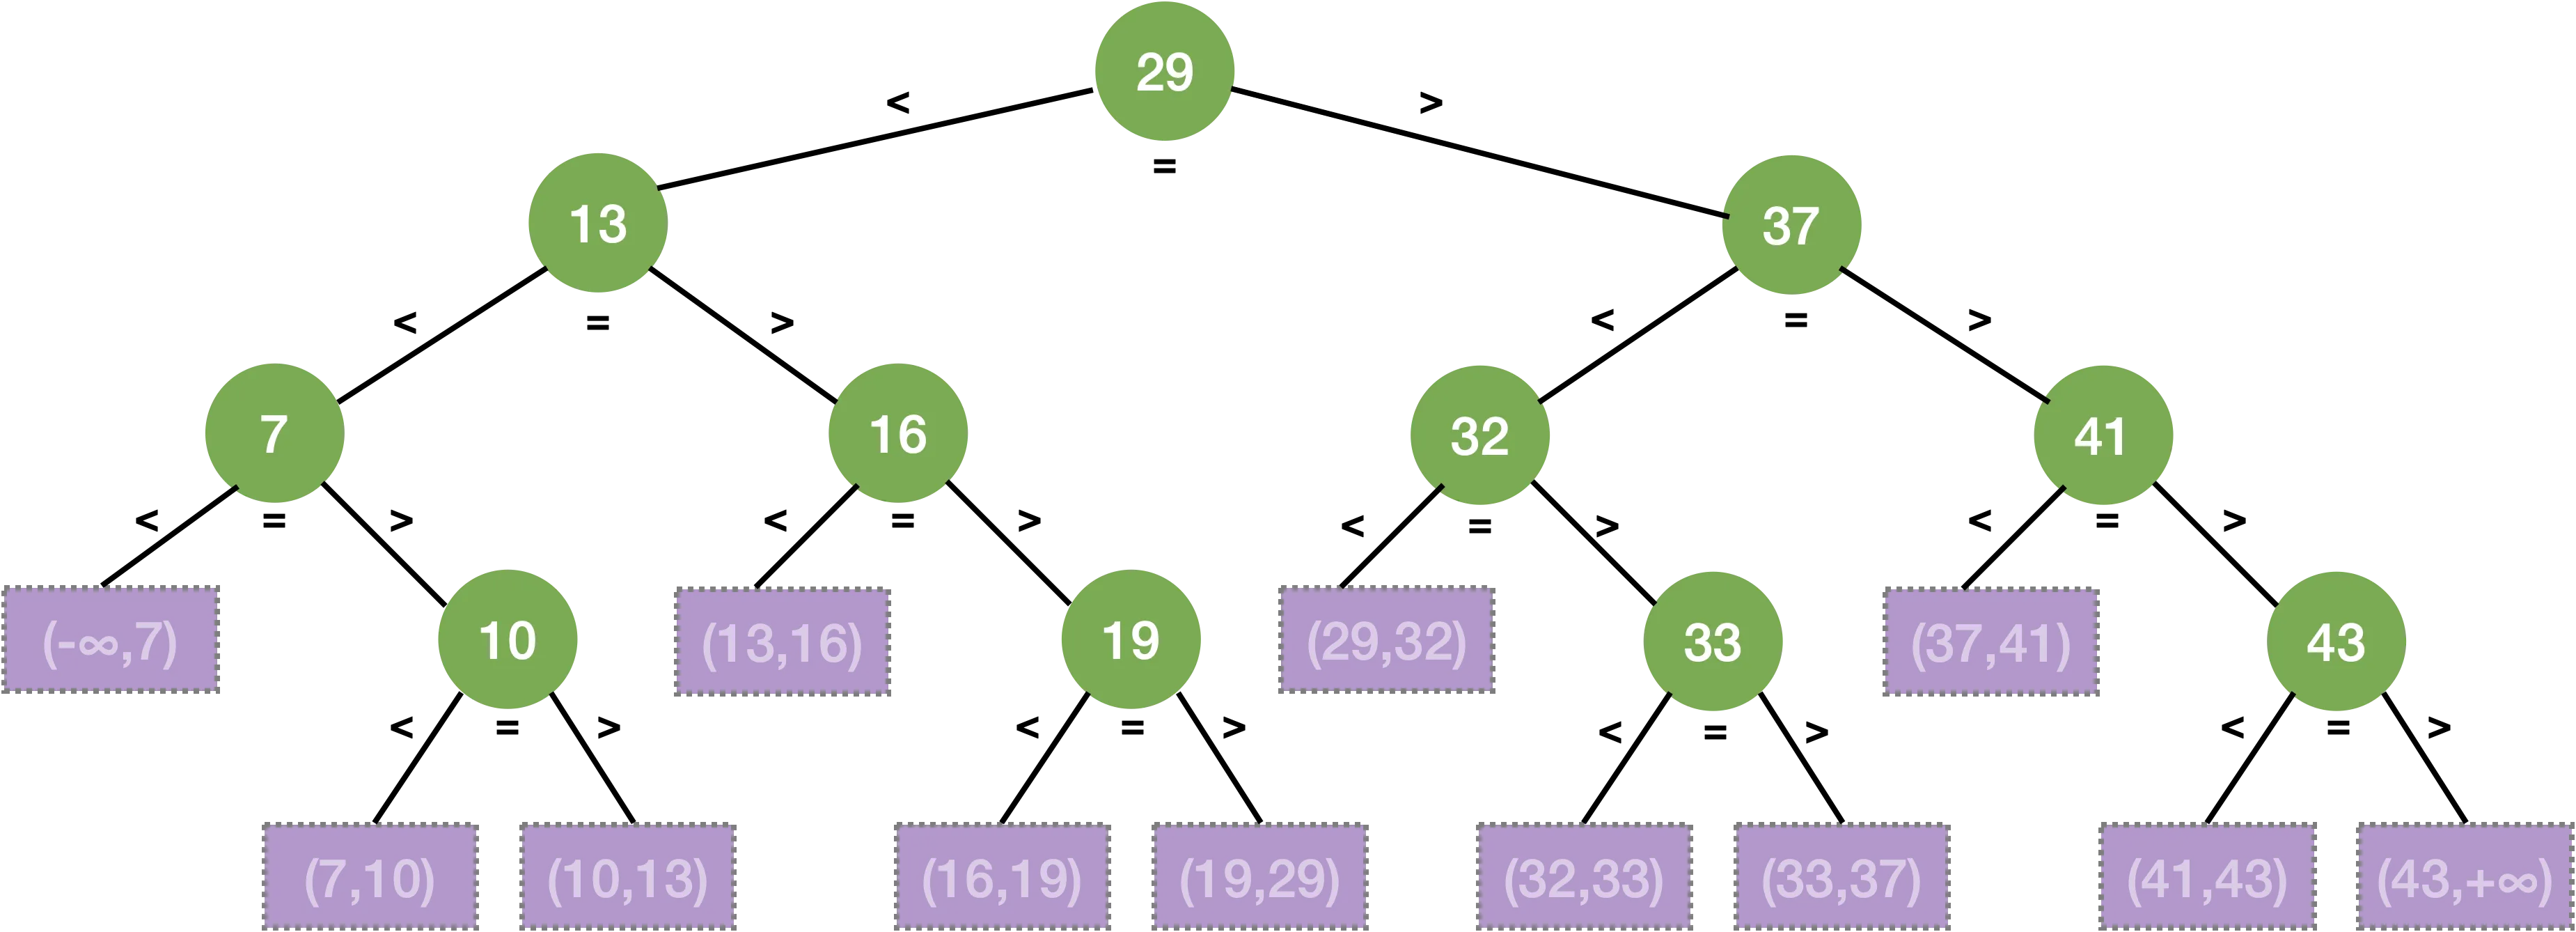
5.2.2 基于上述例子,计算查找成功的ASL、查找失败的ASL
5.3 散列查找
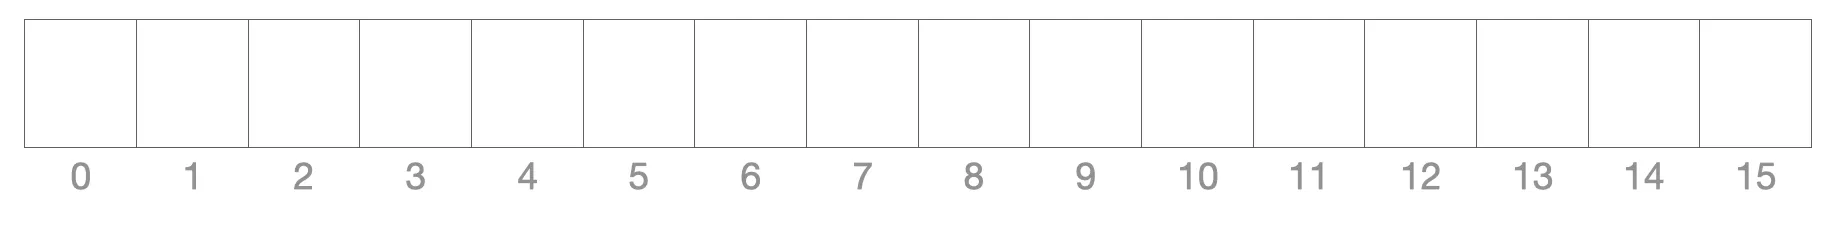
5.3.1 自己设计一个散列表,总长度由你决定,并设计一个合理的散列函数,使用线性探测法解决冲突
可参考基础课视频中的例子,设散列表长度为16,采用线性探测法解决冲突,从空表开始,依次插入关键字 {19, 14, 23, 1, 68, 20, 84, 27, 55, 11, 10, 79},散列函数 H(key)=key%13
注:散列表的长度可以比散列函数的映射范围更大,散列函数的映射范围是 0~12,散列表的后面几个位置 13~15 不可能被直接映射,但是在线性探测法处理冲突时,可能被使用到
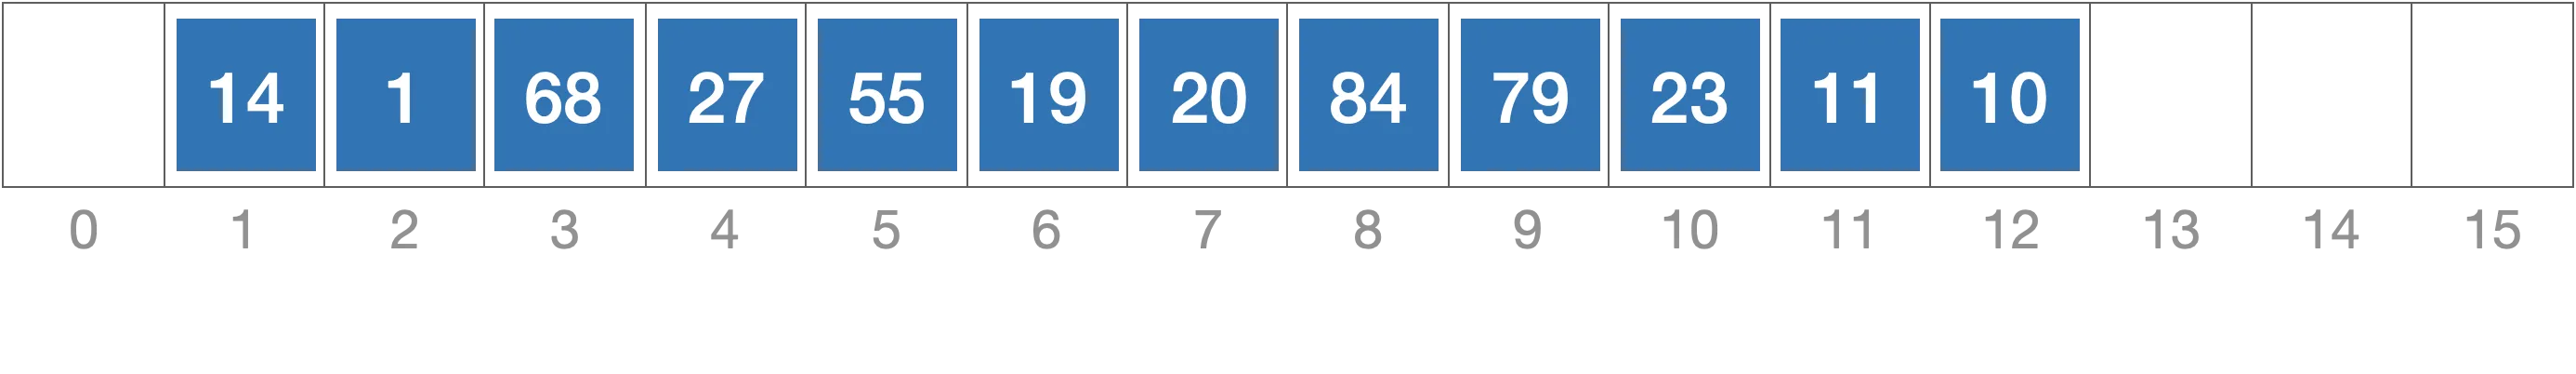
5.3.2 基于上述散列表,设计不少于10个元素的插入序列,依次插入散列表,画出散列表最终的样子(插入过程至少发生4次冲突)
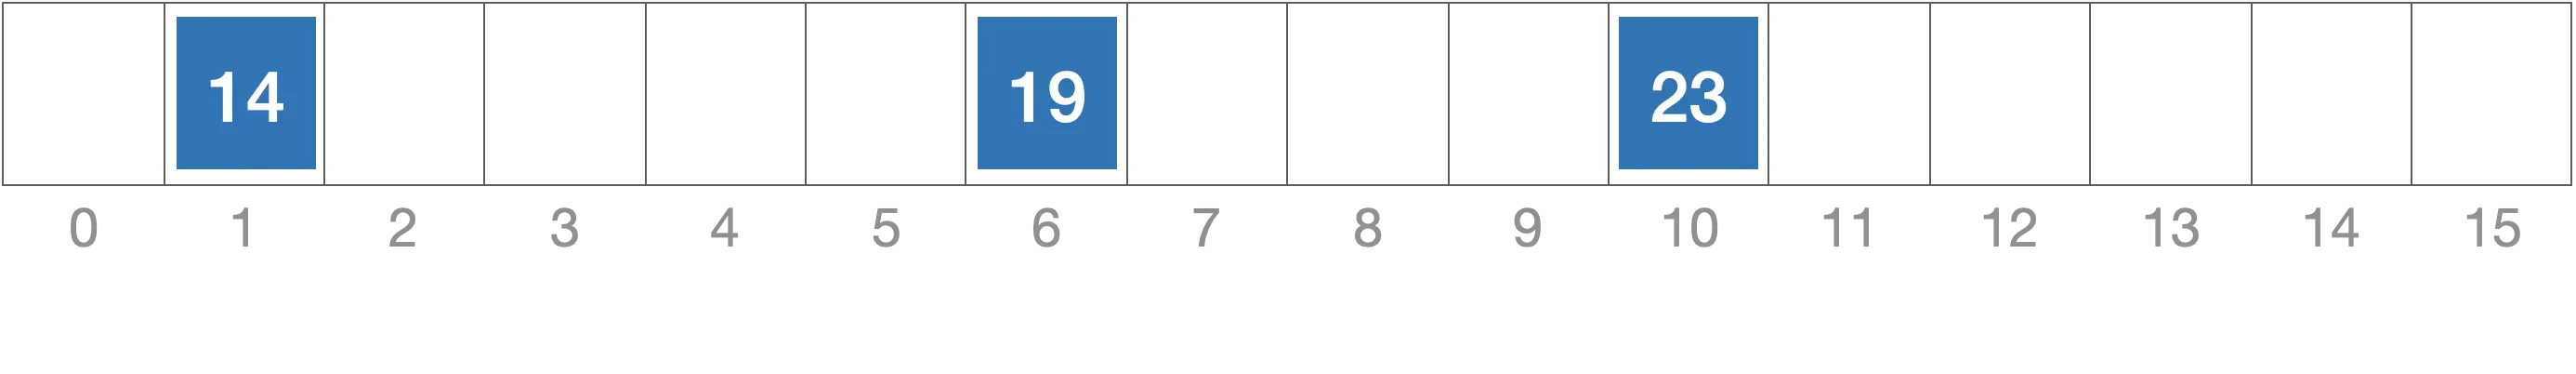
19%13=6,插入元素 19,未发生冲突
14%13=1,插入元素 14,未发生冲突
23%13=10,插入元素 23,未发生冲突
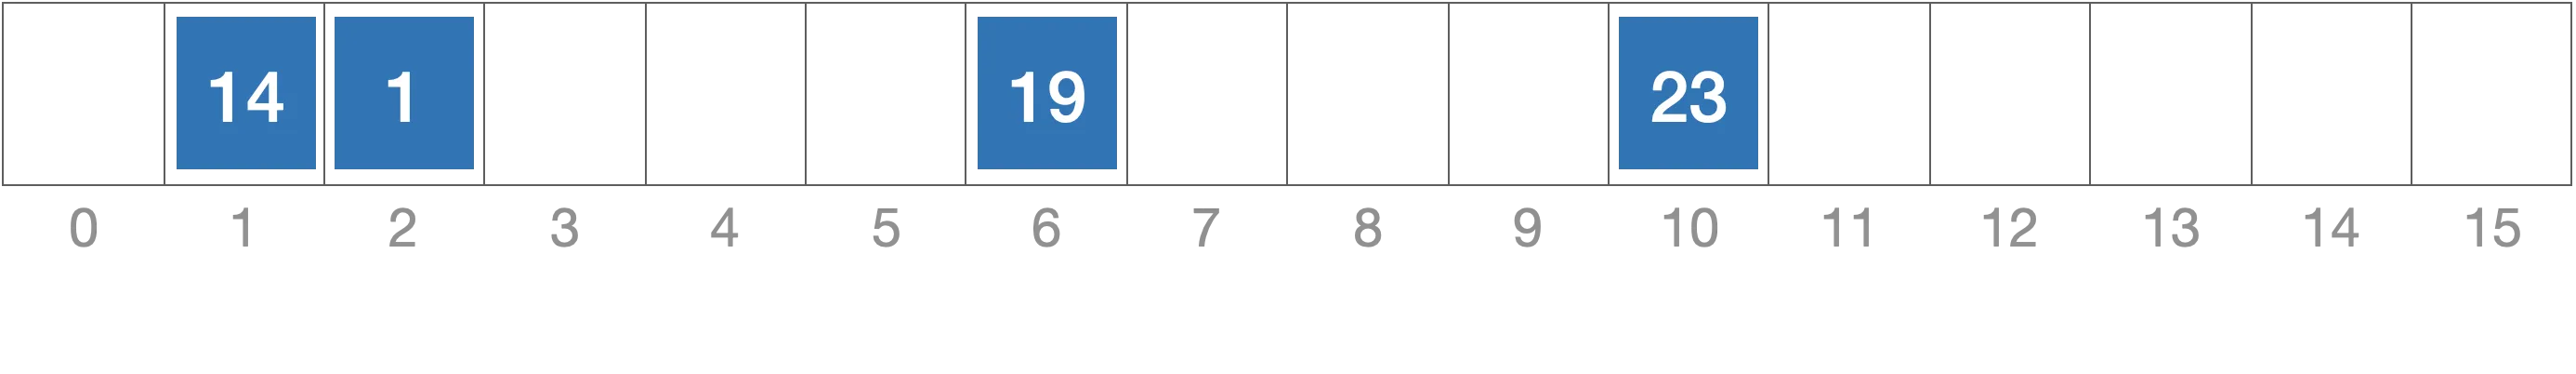
1%13=1,插入元素1,发生冲突,线性探测法解决冲突
68%13=3,插入元素 68,未发生冲突
20%13=7,插入元素 20,未发生冲突
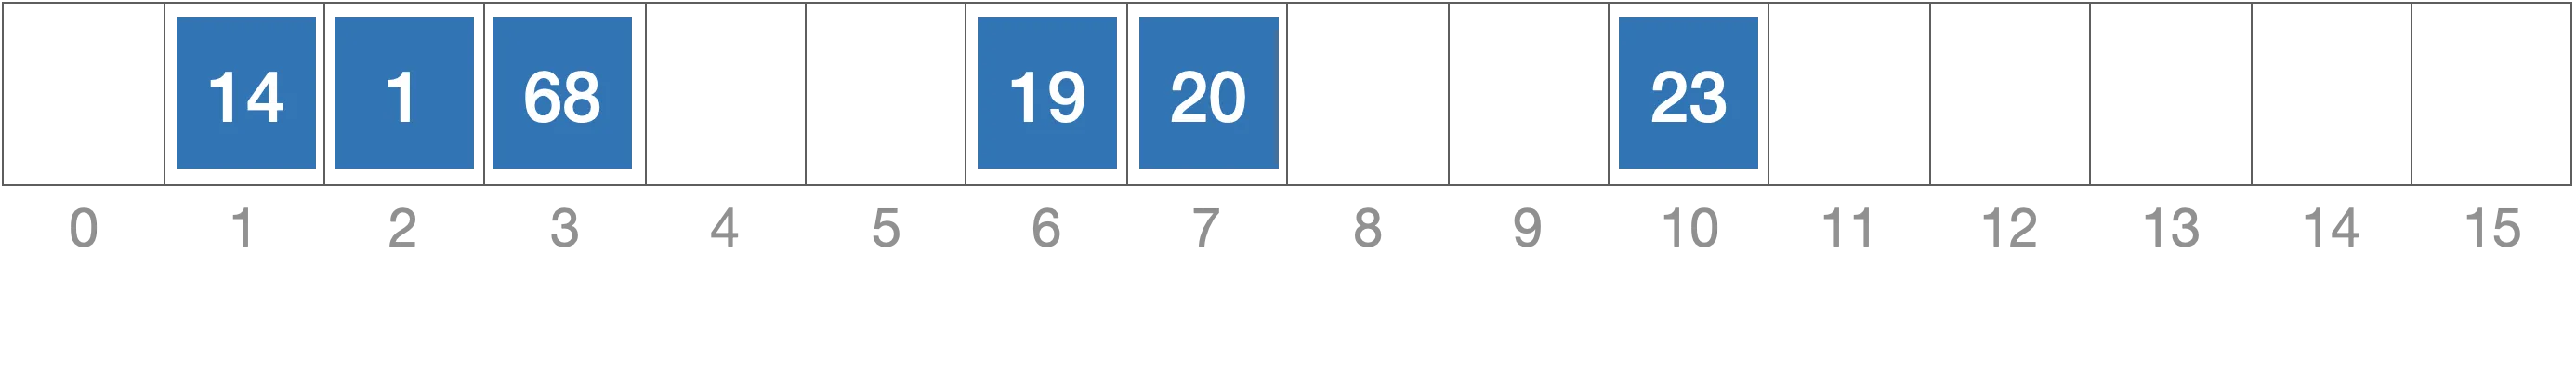 84%13=6,插入元素 84,发生冲突,线性探测法解决冲突
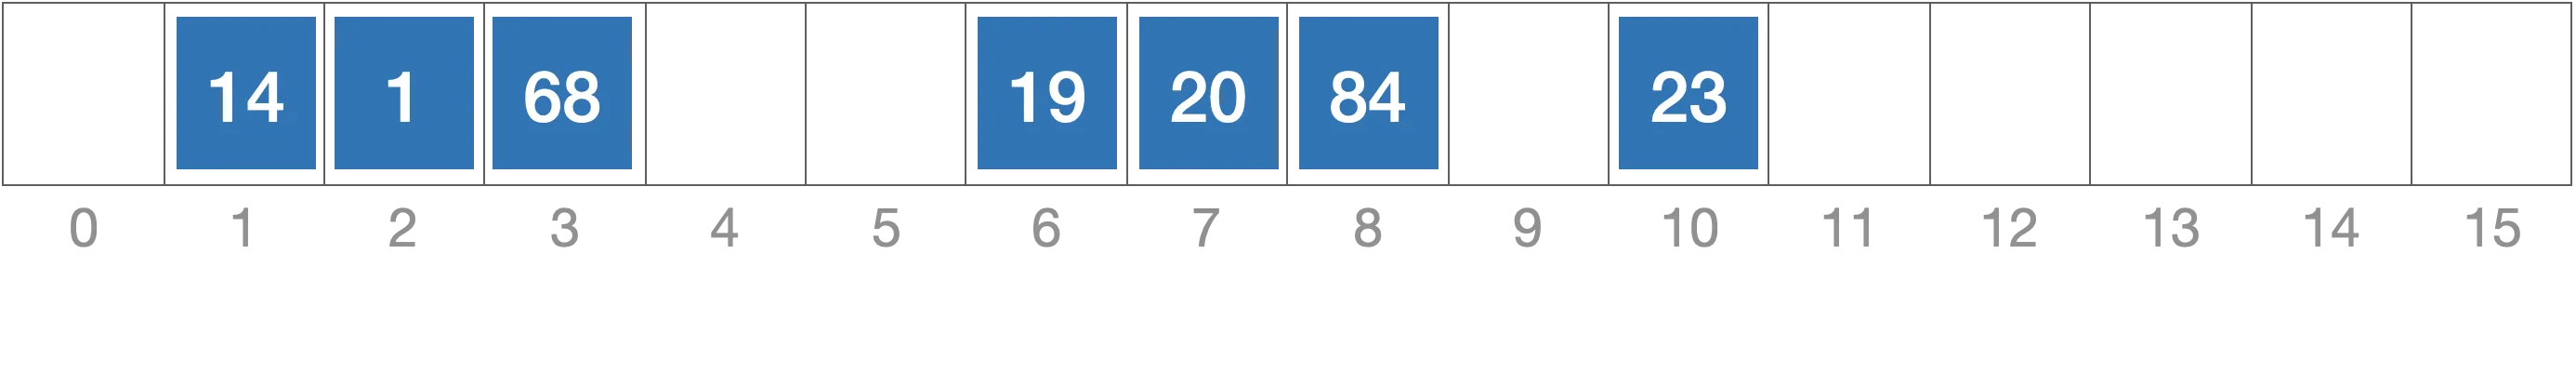 27%13=1,插入元素 27,发生冲突:
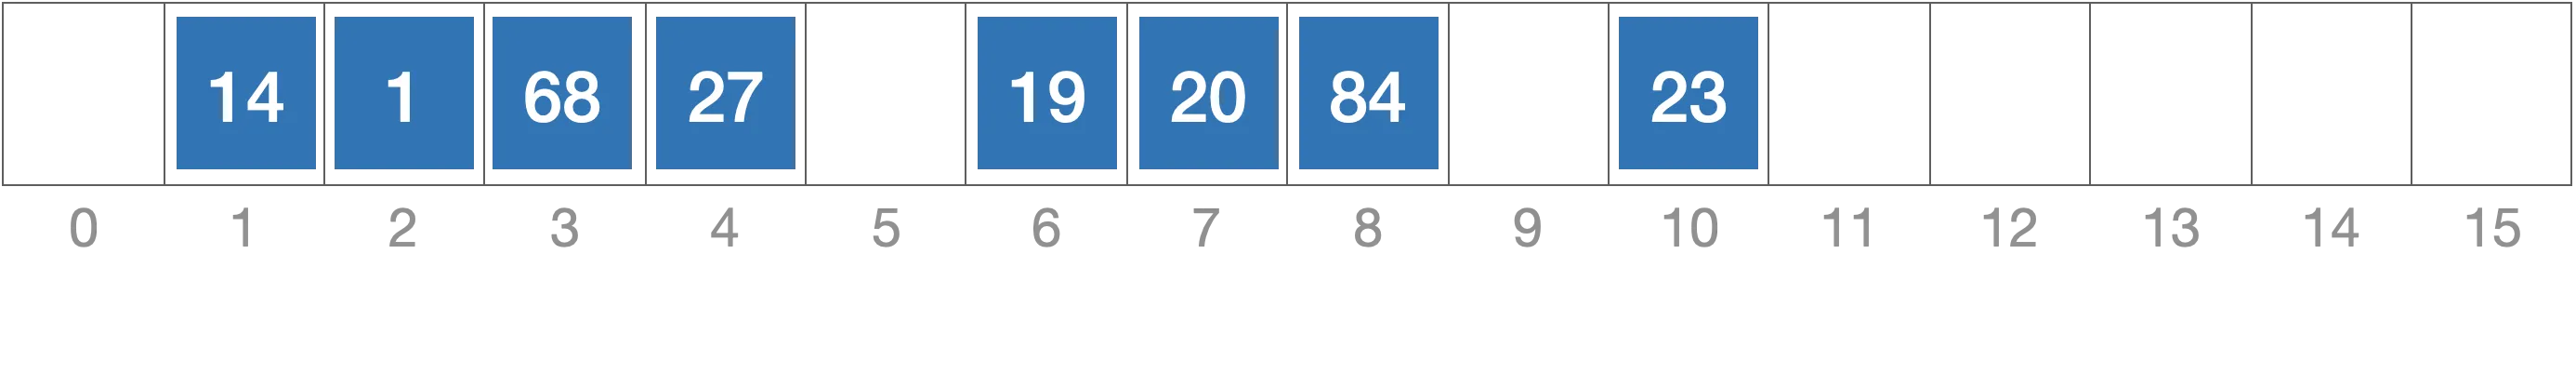 55%13=3,插入元素 55,发生冲突,线性探测法解决冲突
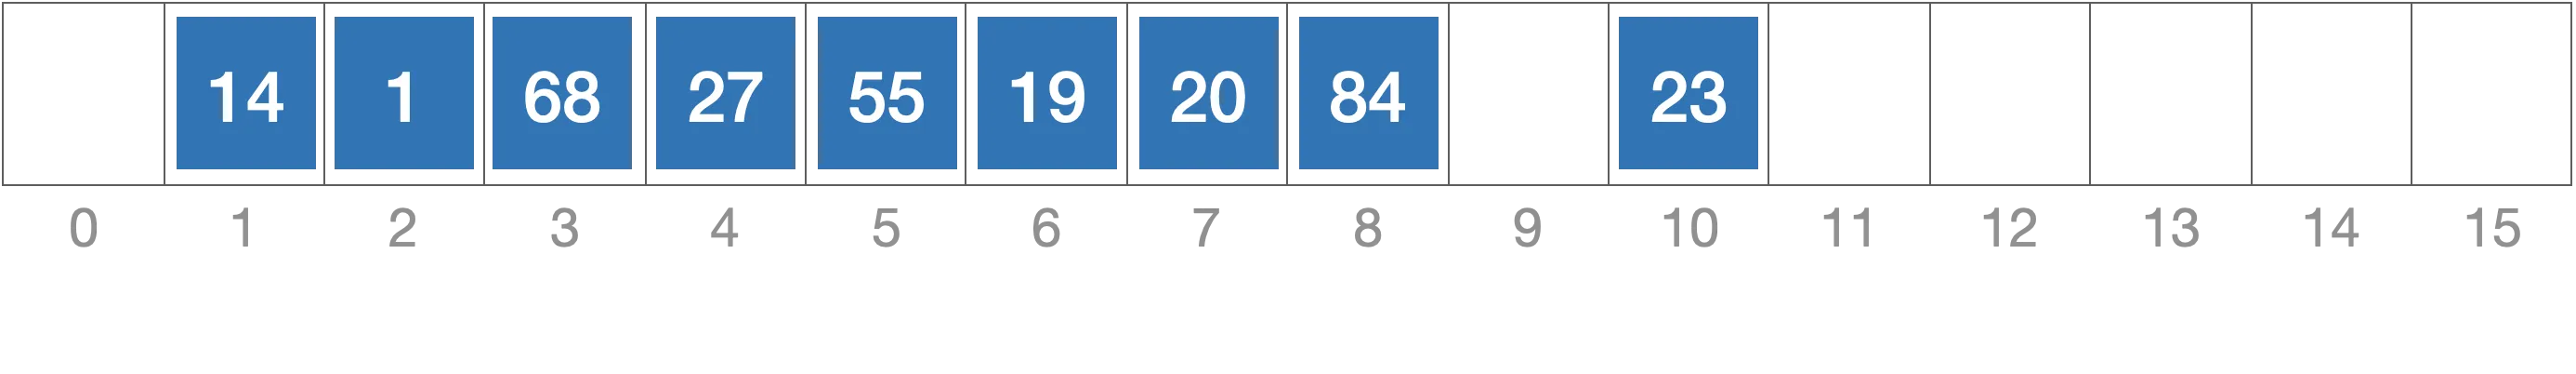 11%13=11,插入元素 11,未发生冲突
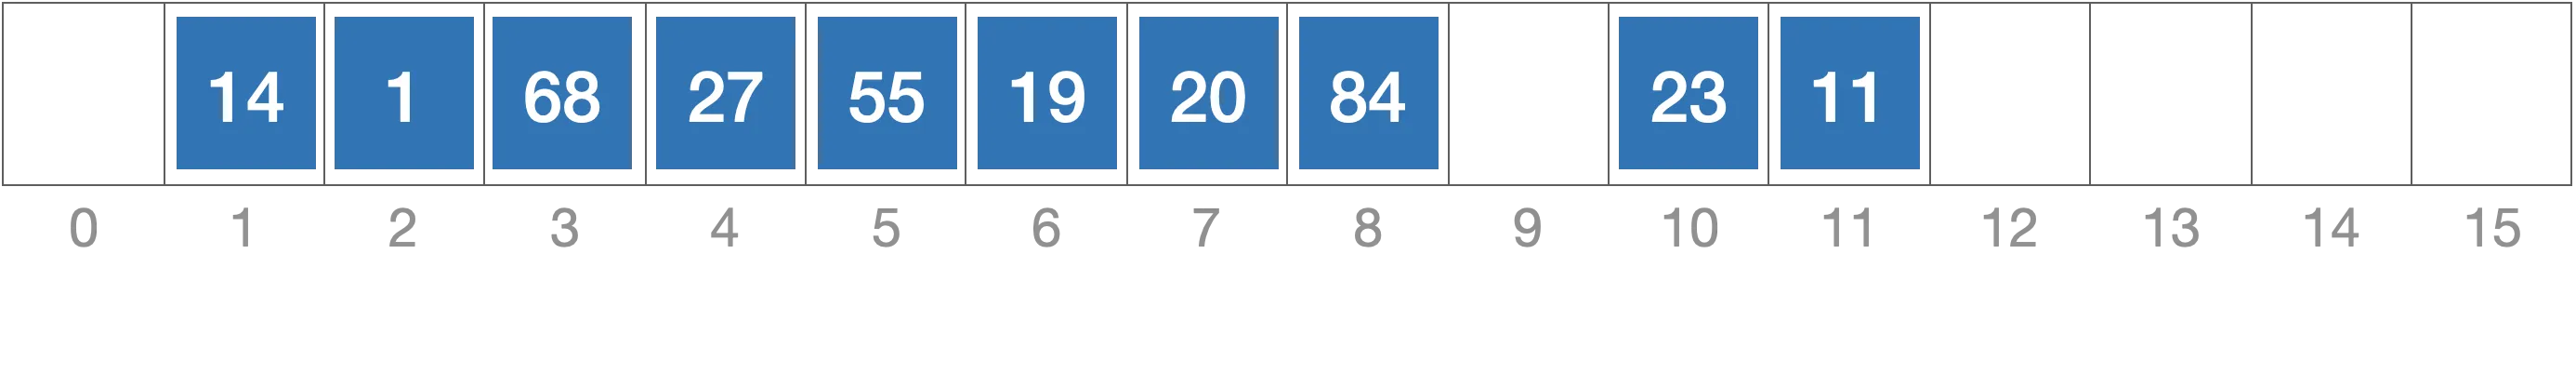 10%13=10,插入元素 10,发生冲突,线性探测法解决冲突
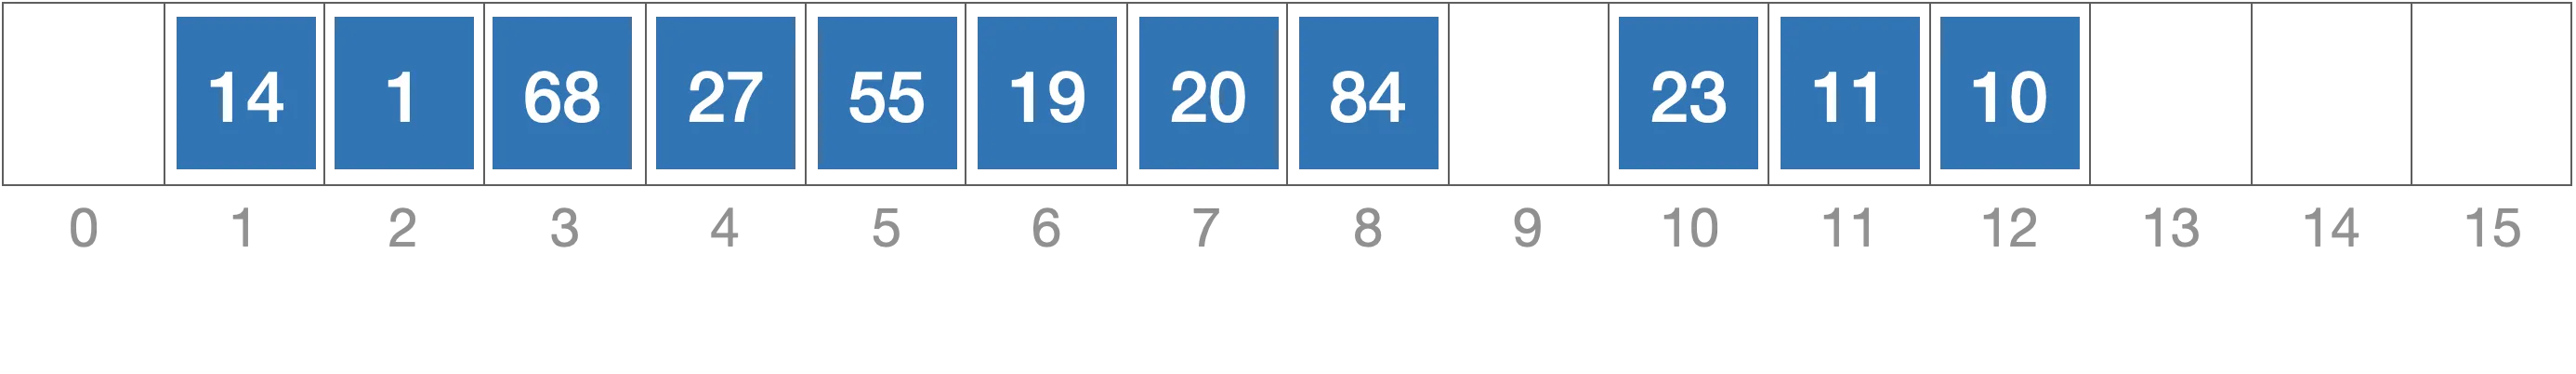 79%13=1,插入元素 79,发生冲突,线性探测法解决冲突
5.3.3 基于上述例子,计算查找成功的ASL、查找失败ASL
考虑查找成功的所有情况。各元素查找成功时的查找长度如下:
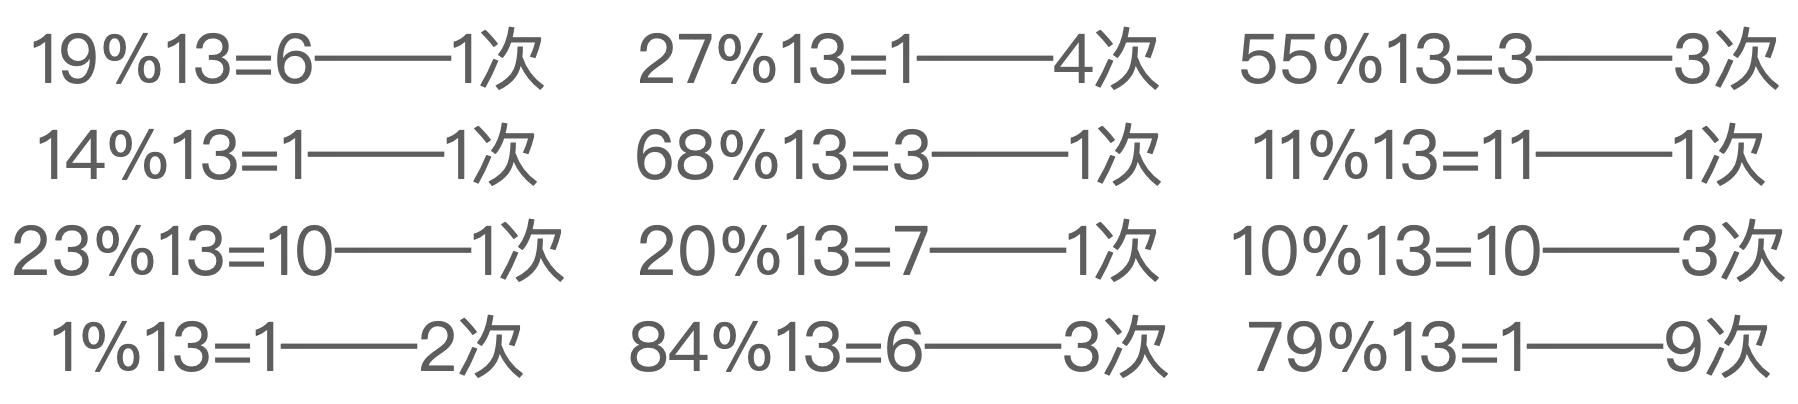
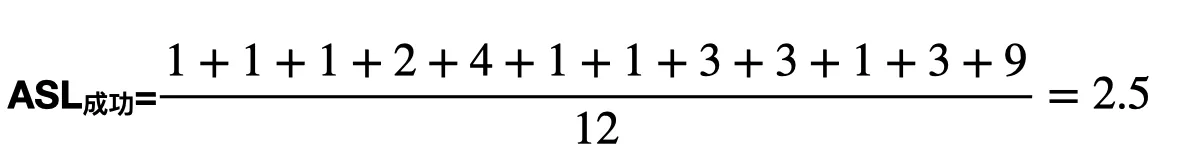
考虑查找失败的所有情况。若目标元素的散列值为0,则只需对比位置0的关键字即可确定查找失败,查找长度为1;若目标元素的散列值为1,采用线性探测法,需对比位置1~位置13,才能确定查找失败,查找长度是13;若目标元素的散列值为2,采用线性探测法,需对比位置2~位置13,才能确定查找失败,查找长度是12;其他散列值同理。
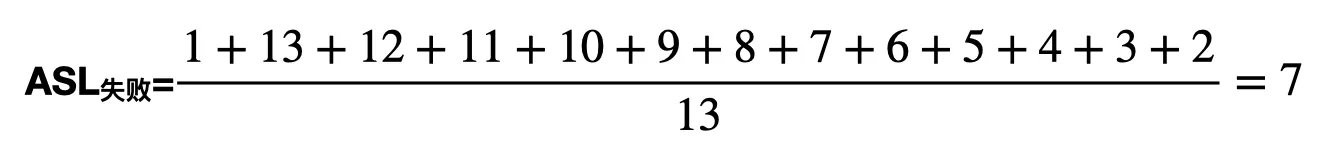
5.3.4 代码能力强的同学,尝试实现上述散列表的数据结构定义,并实现查找、插入、删除三个基本操作
略,有能力的同学自己实现
5.3.5 自己设计一个散列表,总长度由你决定,并设计一个合理的散列函数,使用拉链法解决冲突
可参考基础课视频中的例子,设散列表长度为13,采用拉链法解决冲突,从空表开始,依次插入关键字 {19, 14, 23, 1, 68, 20, 84, 27, 55, 11, 10, 79},散列函数 H(key)=key%13
注:如果采用拉链法处理冲突,则散列表的长度应该和散列函数的映射范围相同,散列函数的映射范围是 0~12。
5.3.6 基于上述散列表,设计不少于10个元素的插入序列,依次插入散列表,画出散列表最终的样子(插入过程至少发生4次冲突)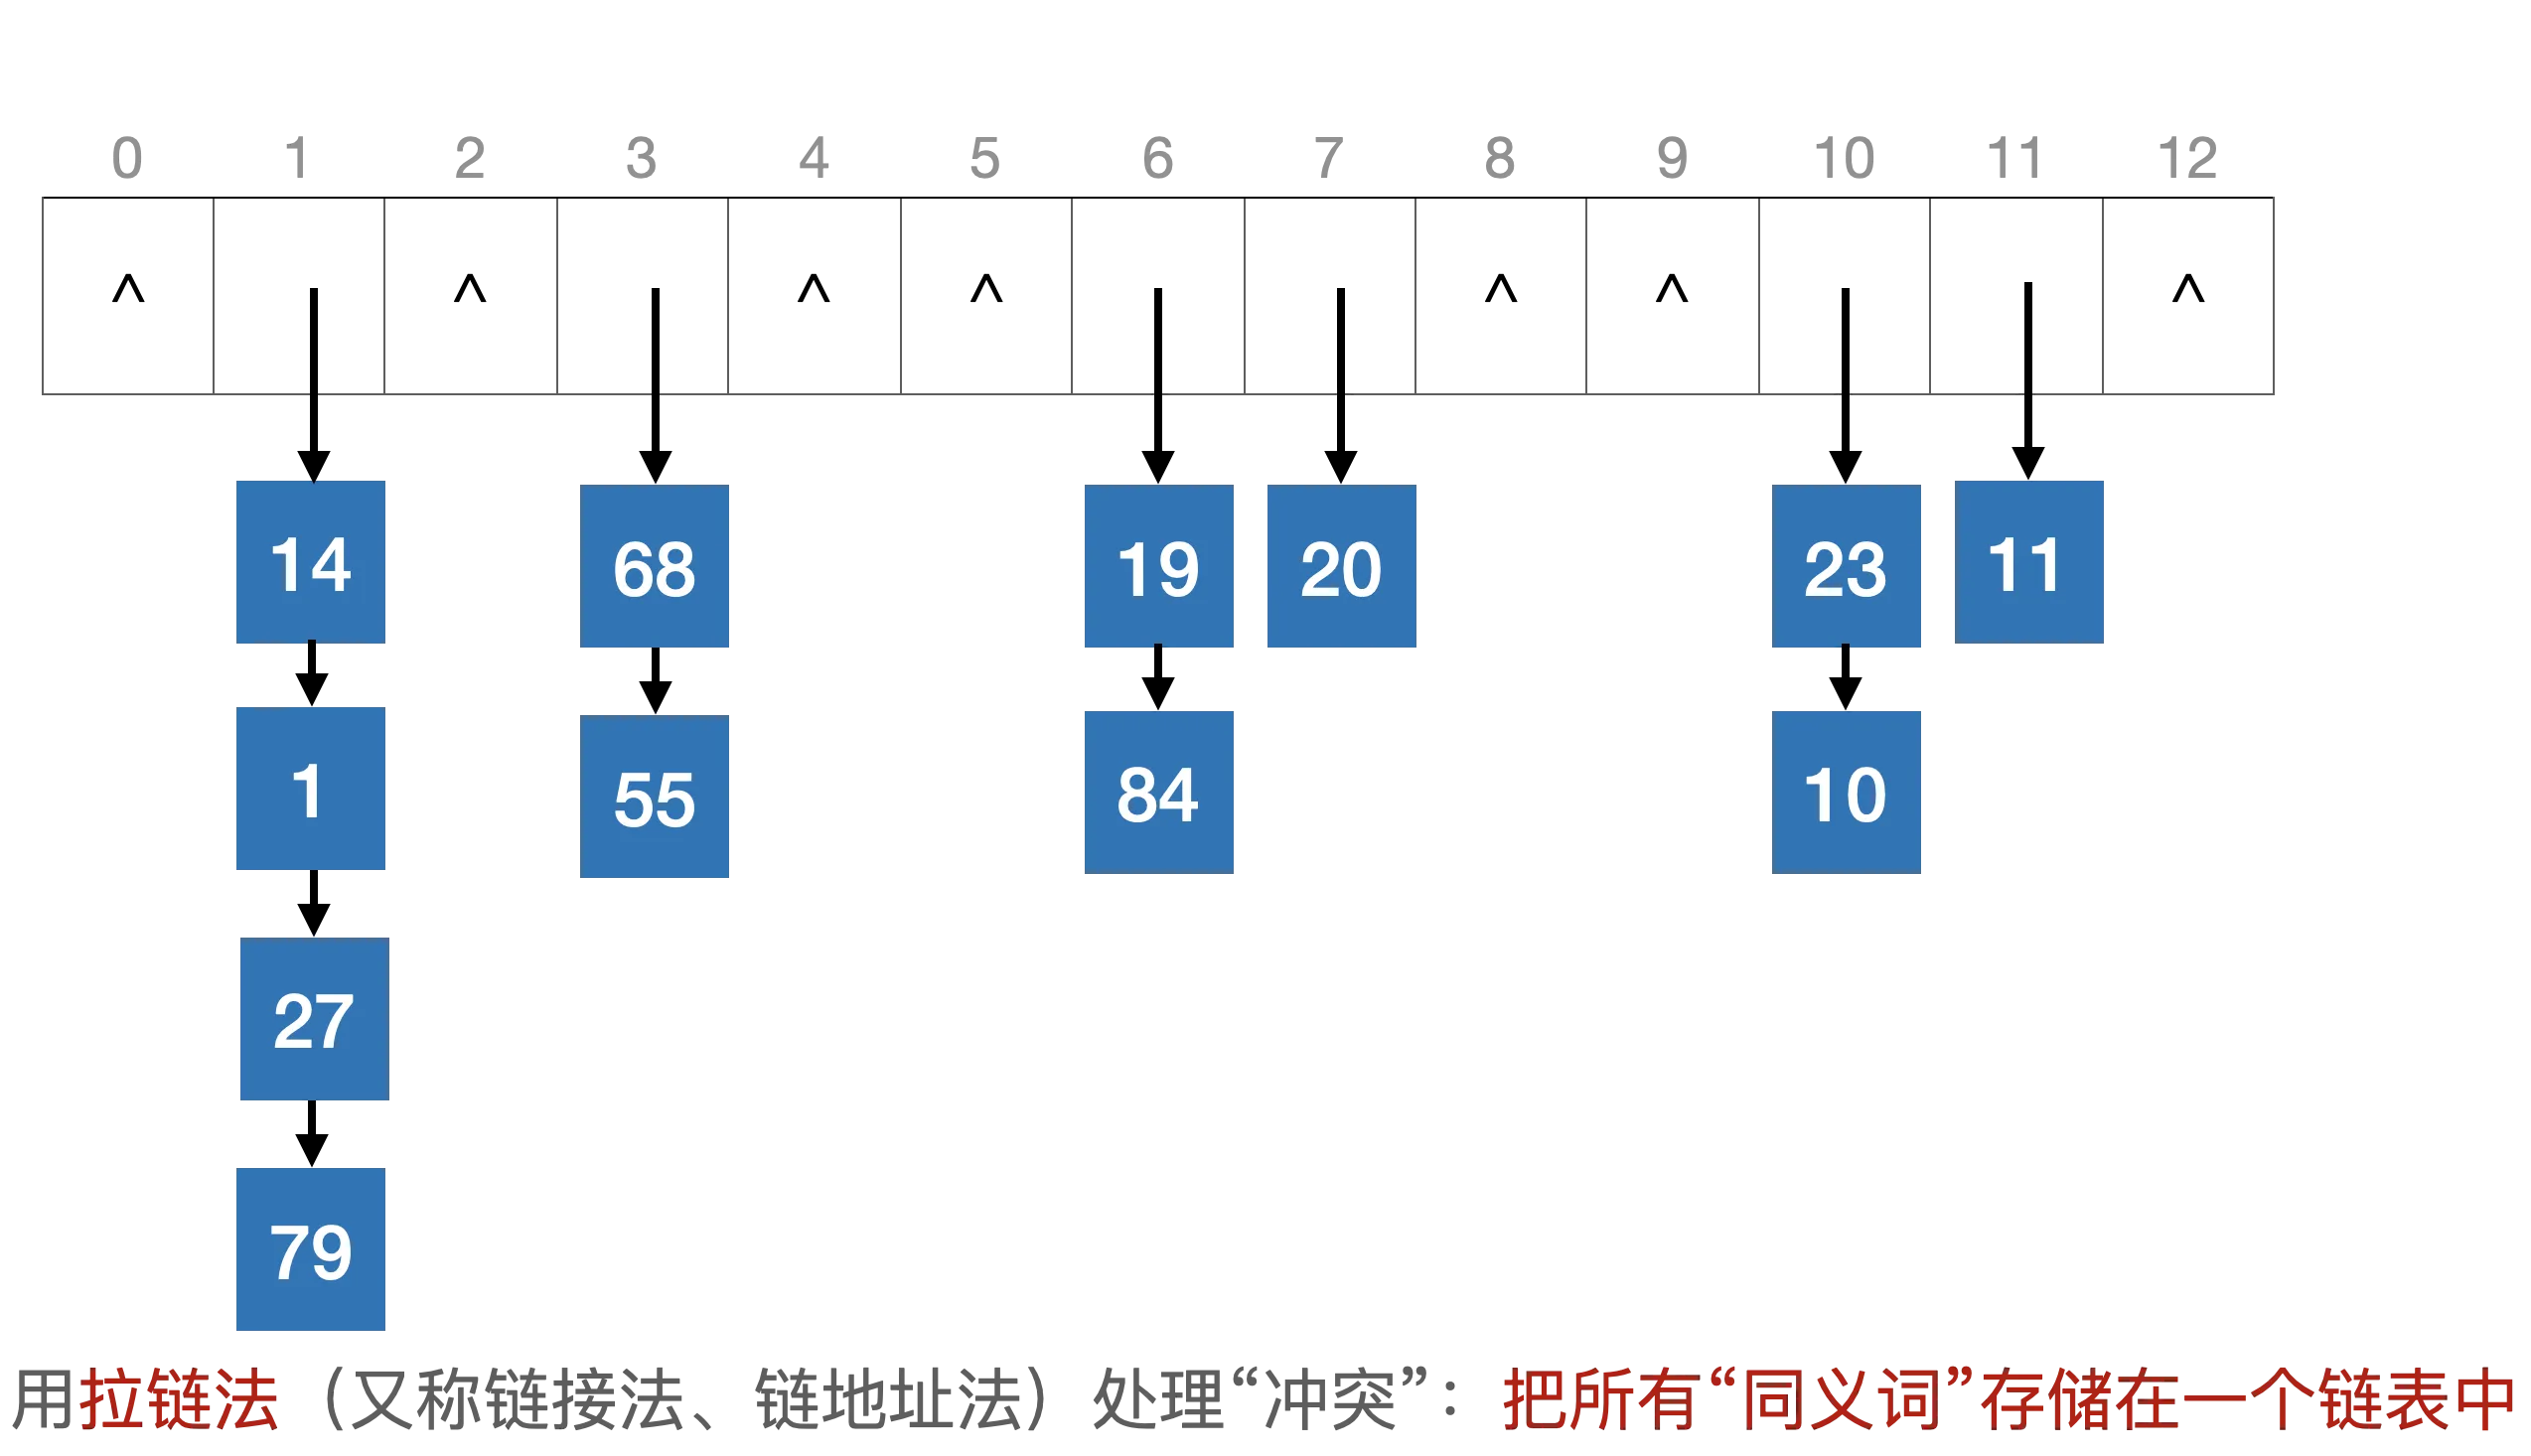 
5.3.7 基于上述例子,计算查找成功的ASL、查找失败的ASL
考虑查找成功的所有情况。元素 14、68、19、29、23、11 的查找长度为1;元素1、55、84、10 的查找长度为2;元素27的查找长度为3;元素79的查找长度为4,因此:
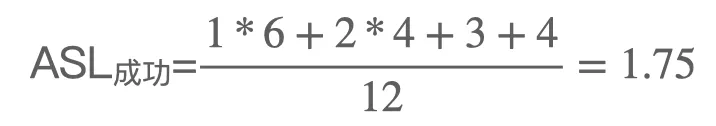
考虑查找失败的所有情况。若目标元素的散列值为0,则无需对比任何关键字即可确定查找失败,查找长度为0;若目标元素的散列值为1,则需要依次对比关键字14、1、27、79才能确定查找失败,查找长度为4;其他散列值同理。
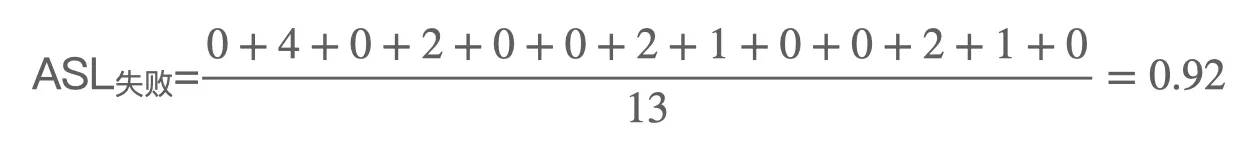
5.3.8 代码能力强的同学,尝试实现上述散列表的数据结构定义,并实现查找、插入、删除三个基本操作
略,有能力的同学自己实现,或参考强化课补充代码包。
Ch6 排序算法的分析和应用
6.1 希尔排序
6.1.1 自己设计一个长度不小于10的乱序数组,用希尔排序,自己设定希尔排序参数
6.1.2 画出每一轮希尔排序的状态
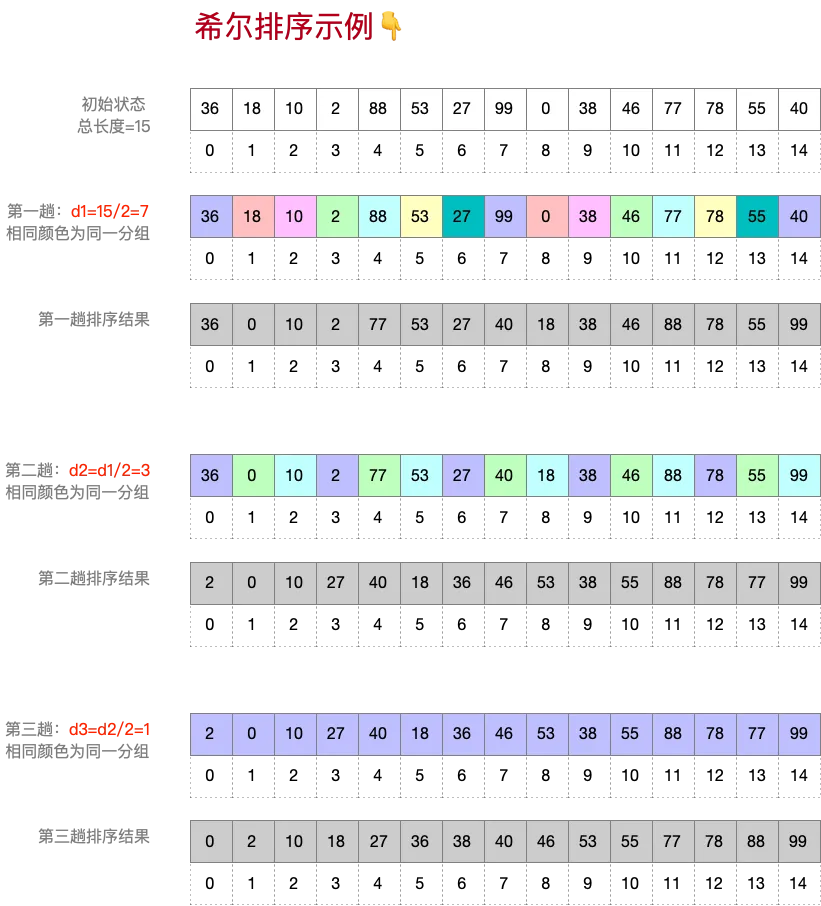
6.2 堆排序
6.2.1 自己设计一个长度不小于10的乱序数组,用堆排序,最终要 生成升序数组 ,画出建堆后的状态
假设乱序数组的初始状态如下,元素从0开始存储👇: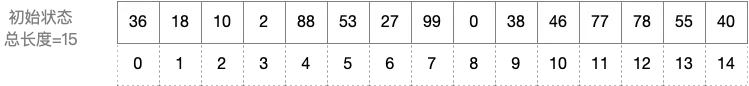
注:参考本文档 3.1.3~3.1.5
Warning
若顺序二叉树从数组下标1开始存储结点,则:
● 结点 i 的父结点编号为 i/2
● 结点 i 的左孩子编号为 i*2
● 结点 i 的右孩子编号为 i*2+1
若顺序二叉树从数组下标0开始存储结点,则:
● 结点 i 的父结点编号为 [(i+1)/2] - 1
● 结点 i 的左孩子编号为 [(i+1)2] - 1 = 2i + 1
● 结点 i 的右孩子编号为 [(i+1)2+1] - 1 = 2i + 2
在本例中,元素从数组下标0开始存储,因此,0号元素是根节点,1号元素是其左孩子,2号元素是其右孩子。其他元素间的关系如下:
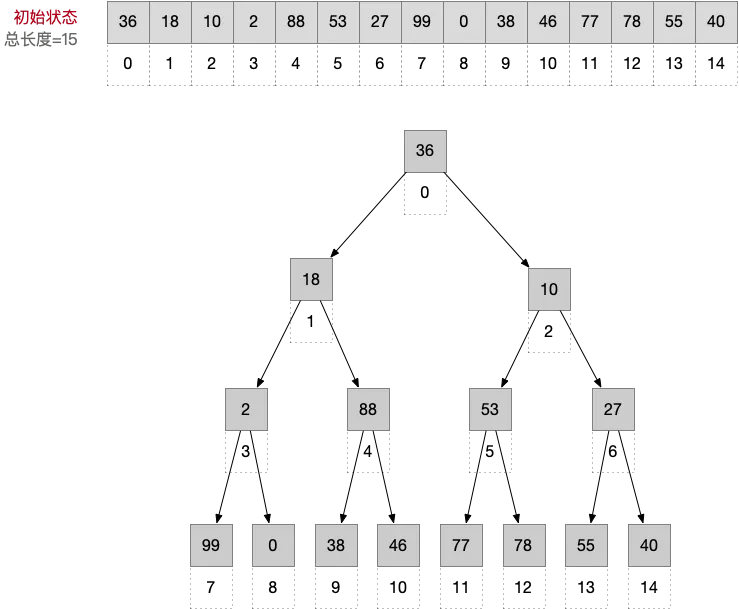
Warning
注:如果应用题让你画出一个乱序数组建堆后的样子,只需要画出数组形式的图示即可,不用画二叉树形态的图示。如下👇
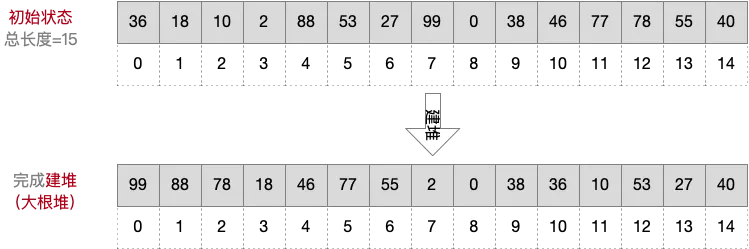
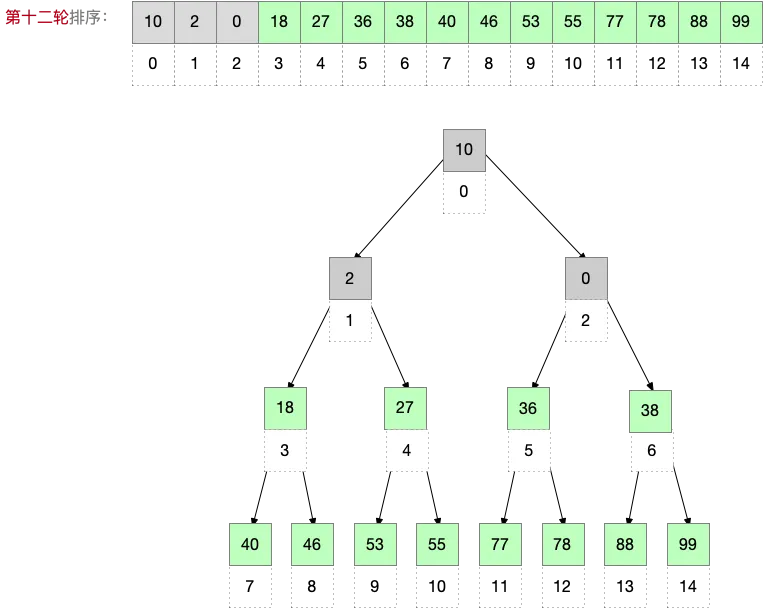
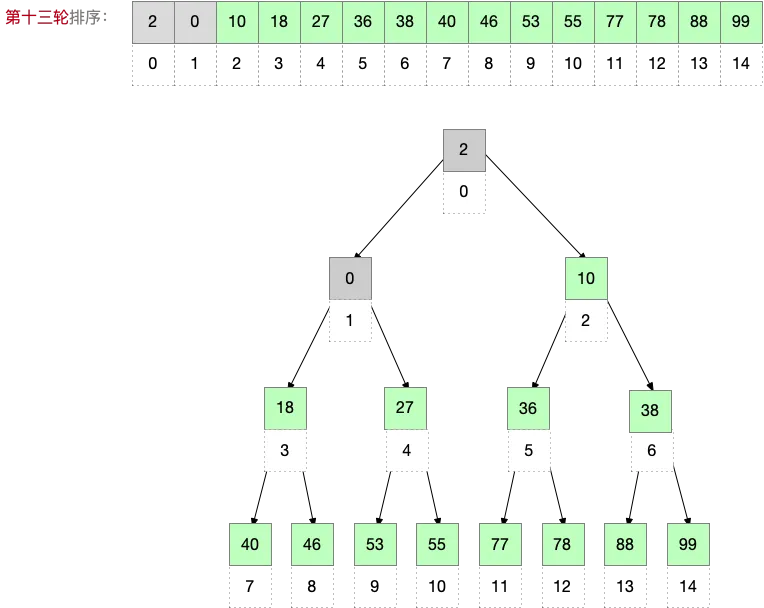
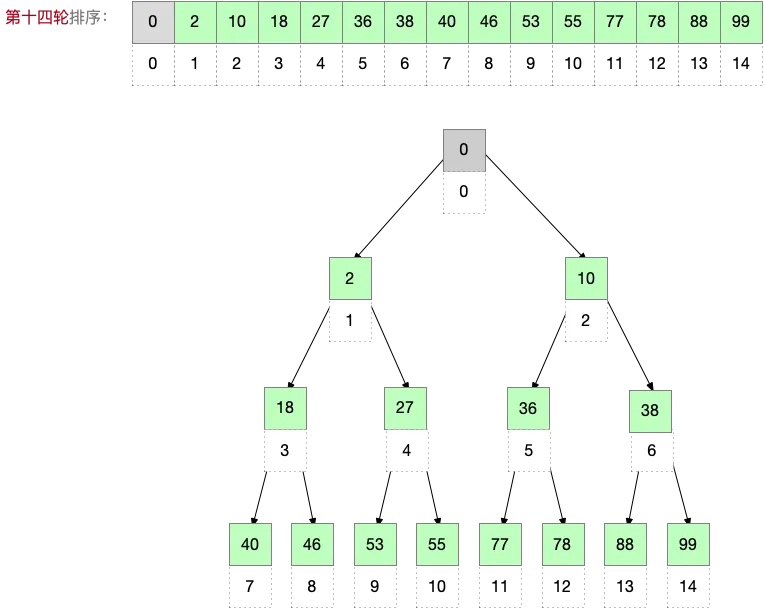
6.2.2 画出每一轮堆排序的状态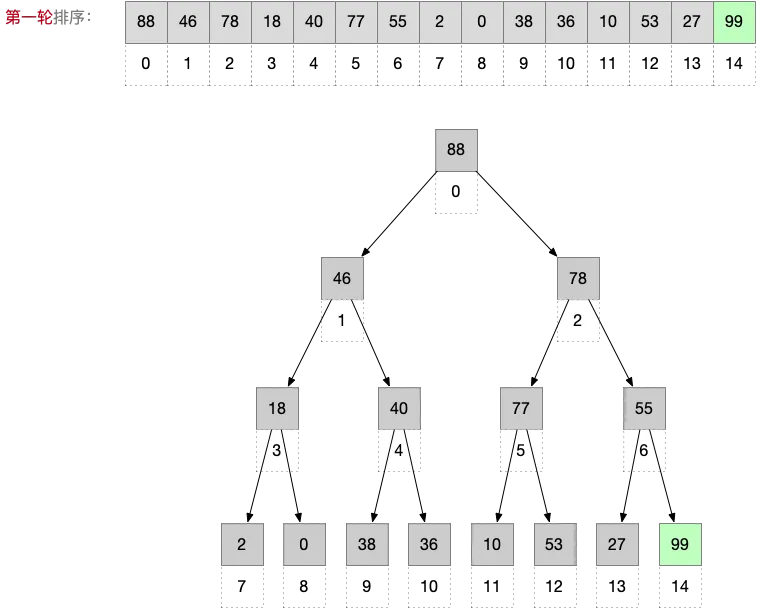 
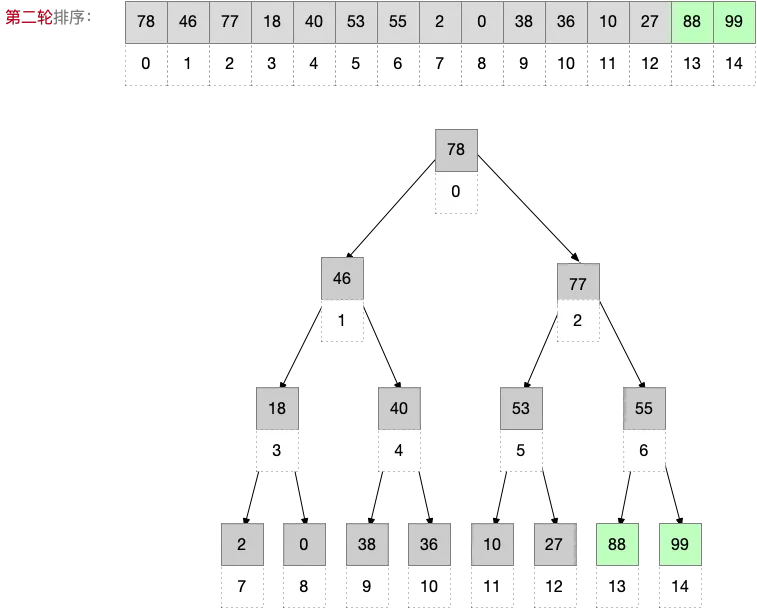
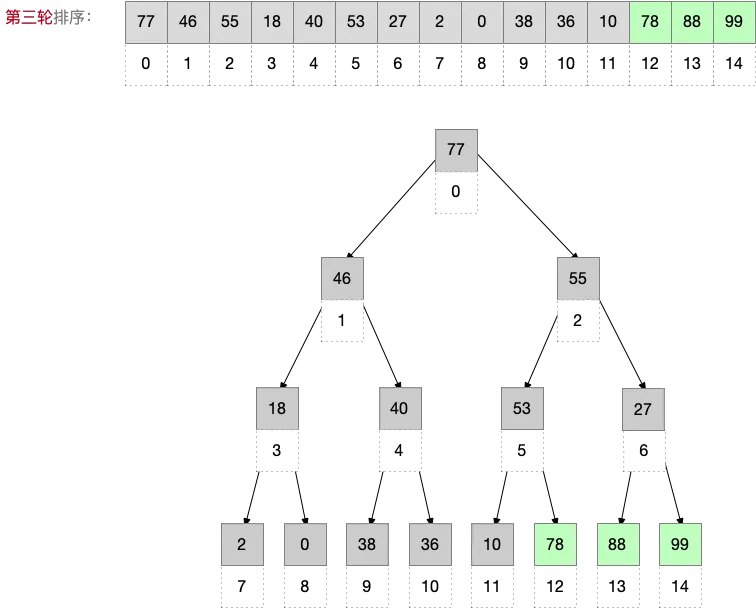
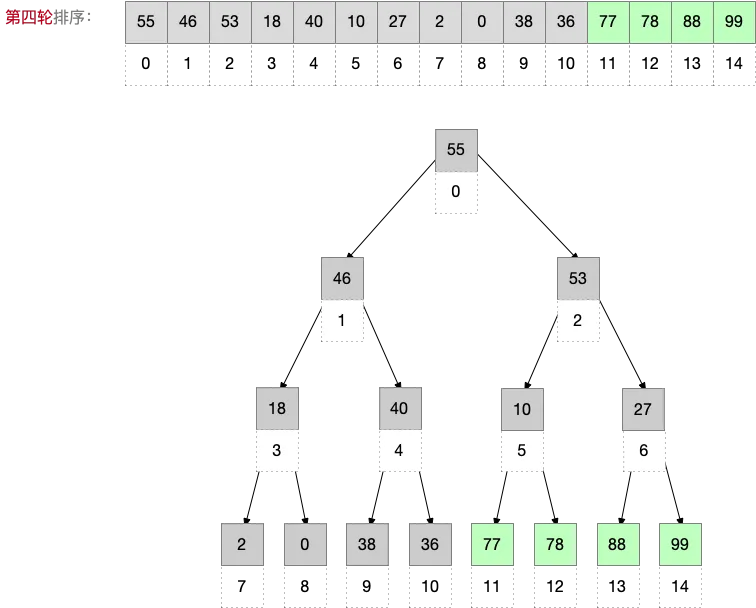
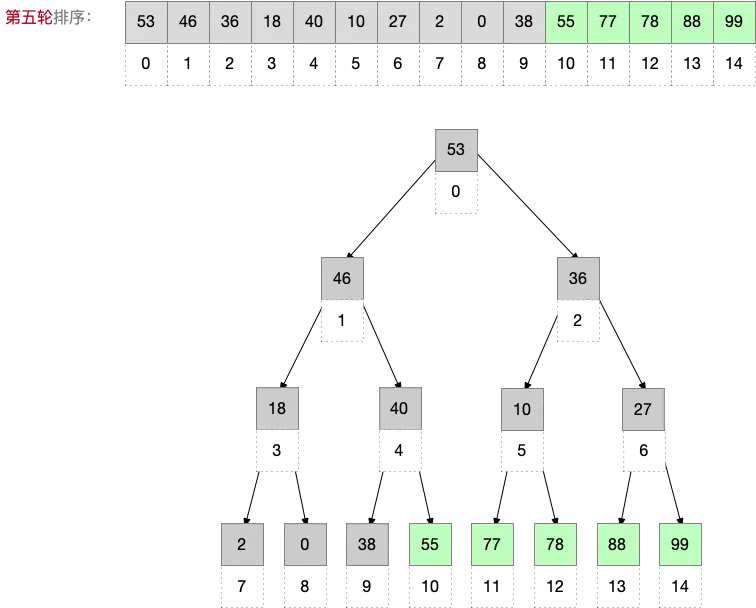
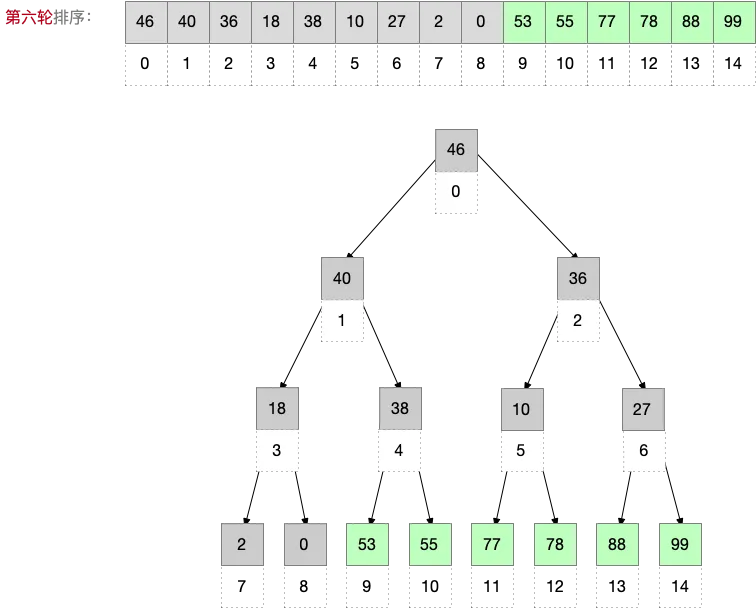
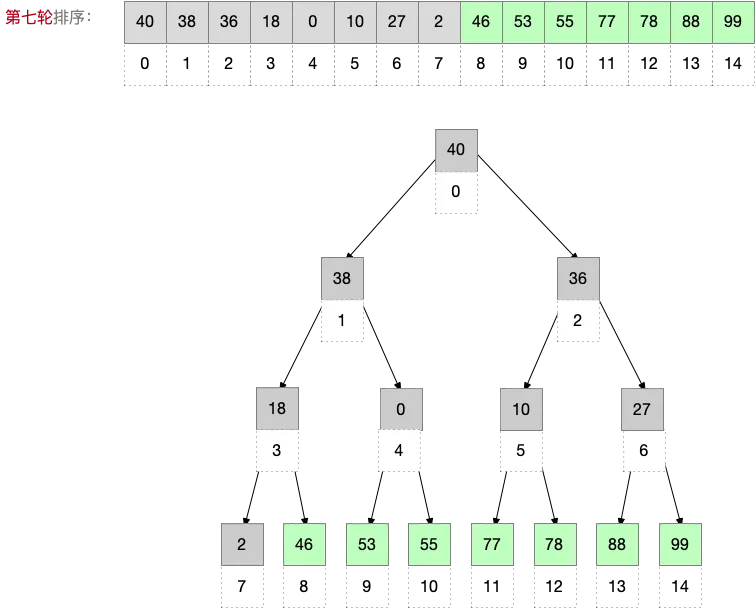
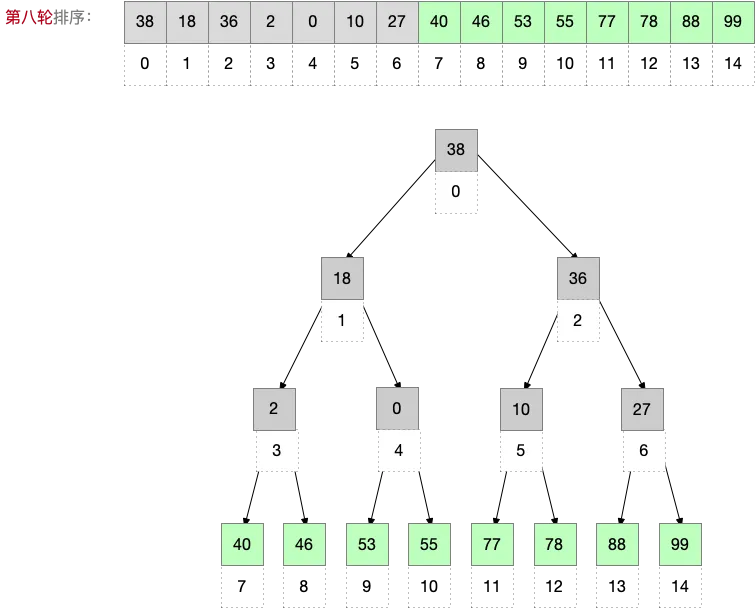
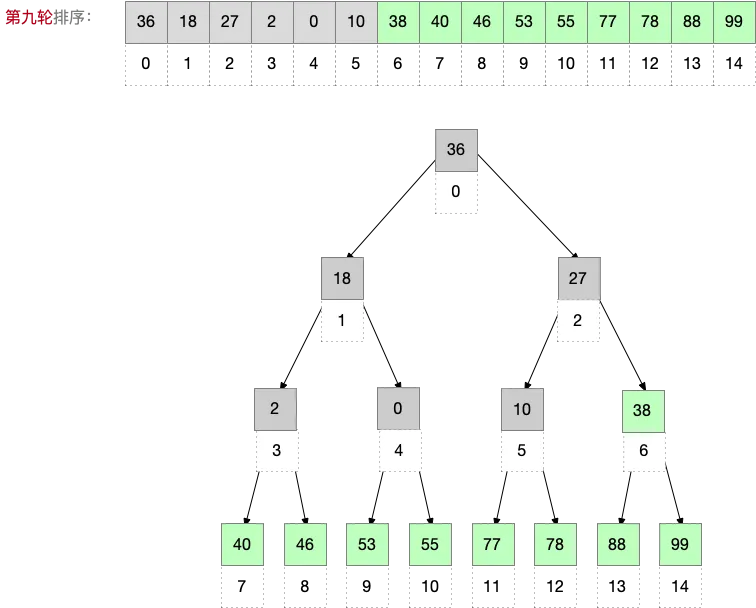
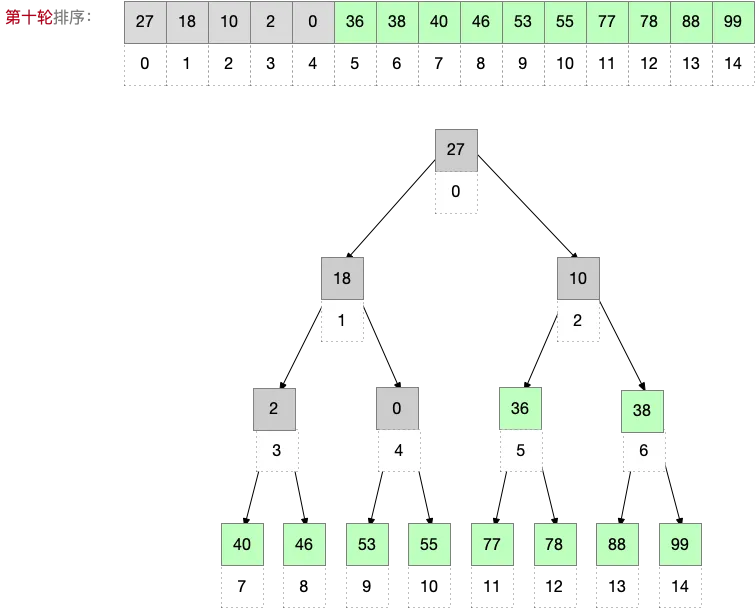
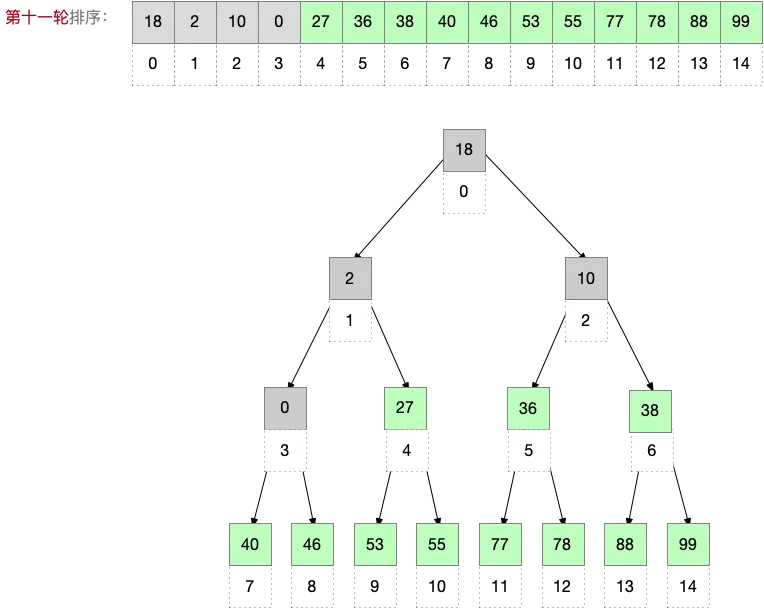
6.3 快速排序
6.3.1 自己设计一个长度不小于10的乱序数组,用快速排序,最终要生成升序数组
6.3.2 画出每一轮快速排序的状态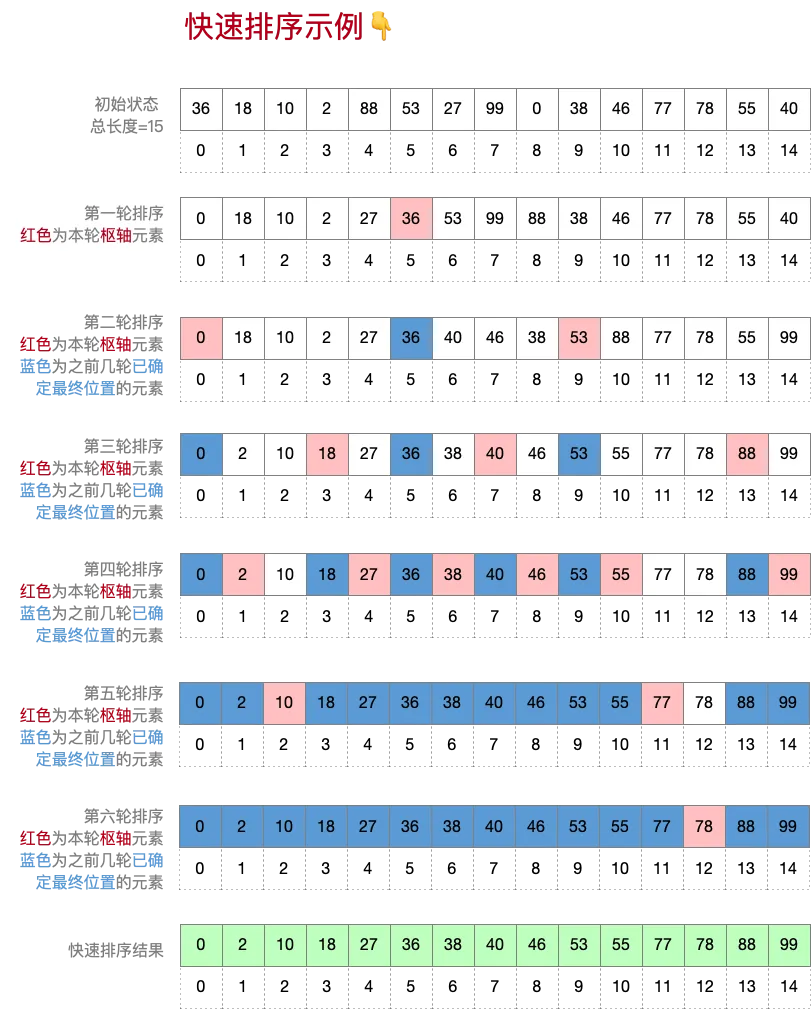 
6.4 基数排序
6.4.1 自己设计一个长度不小于15的乱序链表,每个数据元素取值范围0~99,用基数排序,最终要生成升序链表
6.4.2 画出每一轮基数排序的状态
6.4.3 代码能力强的同学,尝试实现上述基数排序的相关代码
略,有能力的同学自己实现,或参考数据结构强化课补充代码包
6.5 外部排序
“外部排序”在历年真题中的考频不算高,因此许多考生并不重视对该考点的复习。但是 2023 年应用题突然深入考察了“外部排序”,让广大考生感到被偷袭,猝不及防。因此,我们需要重 视这个考点。以下是历年真题中,涉及到“外部排序”的题目:
【2016 年真题 11 题】(选择题)考察了“外部排序的思想”
【2019 年真题 11 题】(选择题)考察了“最佳归并树”
【2023 年真题 42 题】(应用题)考察了“置换-选择排序”
接下来,我们将 2023 年真题进行改编,用于回顾外部排序的三个重要考点:①置换-选择排序, ②最佳归并树,③败者树
Warning
对含有 19 个记录的文件进行外部排序,其关键字依次是 51, 94, 37, 92, 14, 63, 15, 99, 48, 56, 23, 60, 31, 17, 43, 8, 90, 166, 100。假设每个文件记录刚好占一个磁盘块。请回答下列问题:
1)若采用置换-选择排序生成初始归并段,工作区中能保存 3 个记录,可生成几个初始归 并段?各是什么?请问置换-选择排序的过程中,读、写磁盘次数分别是几次?
2)若要对几个初始归并段进行 3 路归并,为实现最佳归并,需要补充的虚段个数是多少? 请画出最佳归并树的样子,并计算该归并树的 WPL。请问归并过程中,读、写磁盘次数分 别是多少次?磁盘 I/O 次数是多少次?
3)若要对几个初始归并段进行 4 路归并,为减少归并过程中关键字对比次数,需使用“败 者树”。请问构造初始败者树时,需要对比几次关键字?基于构造好的败者树,每次从 4 个 归并段中找到最小关键字所需的关键字对比次数是多少?
1)排序过程如下表所示:
| 输出文件 FO | 工作区 WA | 输入文件 FI |
|---|---|---|
| — | — | 51, 94, 37, 92, 14, 63, 15, 99, 48, 56, 23, 60, 31, 17, 43, 8, 90, 166, 100 |
| — | 51, 94, 37 | 92, 14, 63, 15, 99, 48, 56, 23, 60, 31, 17, 43, 8, 90, 166, 100 |
| 37 | 51, 94, 92 | 14, 63, 15, 99, 48, 56, 23, 60, 31, 17, 43, 8, 90, 166, 100 |
| 37, 51 | 14, 94, 92 | 63, 15, 99, 48, 56, 23, 60, 31, 17, 43, 8, 90, 166, 100 |
| 37, 51, 92 | 14, 94, 63 | 15, 99, 48, 56, 23, 60, 31, 17, 43, 8, 90, 166, 100 |
| 37, 51, 92, 94 | 14, 15, 63 | 99, 48, 56, 23, 60, 31, 17, 43, 8, 90, 166, 100 |
| 37, 51, 92, 94# | 14, 15, 63 | 99, 48, 56, 23, 60, 31, 17, 43, 8, 90, 166, 100 |
| 14 | 99, 15, 63 | 48, 56, 23, 60, 31, 17, 43, 8, 90, 166, 100 |
| 14, 15 | 99, 48, 63 | 56, 23, 60, 31, 17, 43, 8, 90, 166, 100 |
| 14, 15, 48 | 99, 56, 63 | 23, 60, 31, 17, 43, 8, 90, 166, 100 |
| 14, 15, 48, 56 | 99, 23, 63 | 60, 31, 17, 43, 8, 90, 166, 100 |
| 14, 15, 48, 56, 63 | 99, 23, 60 | 31, 17, 43, 8, 90, 166, 100 |
| 14, 15, 48, 56, 63, 99 | 31, 23, 60 | 17, 43, 8, 90, 166, 100 |
| 14, 15, 48, 56, 63, 99# | 31, 23, 60 | 17, 43, 8, 90, 166, 100 |
| 23 | 31, 17, 60 | 43, 8, 90, 166, 100 |
| 23, 31 | 43, 17, 60 | 8, 90, 166, 100 |
| 23, 31, 43 | 8, 17, 60 | 90, 166, 100 |
| 23, 31, 43, 60 | 8, 17, 90 | 166, 100 |
| 23, 31, 43, 60, 90 | 8, 17, 166 | 100 |
| 23, 31, 43, 60, 90, 166 | 8, 17, 100 | — |
| 23, 31, 43, 60, 90, 166# | 8, 17, 100 | — |
| 8 | 17, 100 | — |
| 8, 17 | 100 | — |
| 8, 17, 100 | — | — |
| 8, 17, 100# | — | — |
可生成 4 个归并段,分别是:
37, 51, 92, 94
14, 15, 48, 56, 63, 99
23, 31, 43, 60, 90, 166
8,17,100
置换-选择排序的过程中,需要读磁盘 19 次,写磁盘 19 次。因为 19 条文件记录(即上表所示 的“输入文件 FI”)初始时存储在磁盘,每条记录占一个磁盘块,进行置换-选择排序时,这 19 条记录需要依次读入内存中(即上表所示的“工作区 WA”),再逐一写回外存(即上表所示的 “输出文件 FO”)。因此,整个过程需要读磁盘 19 次,写磁盘 19 次。
2)回顾“最佳归并树”的构造方法:
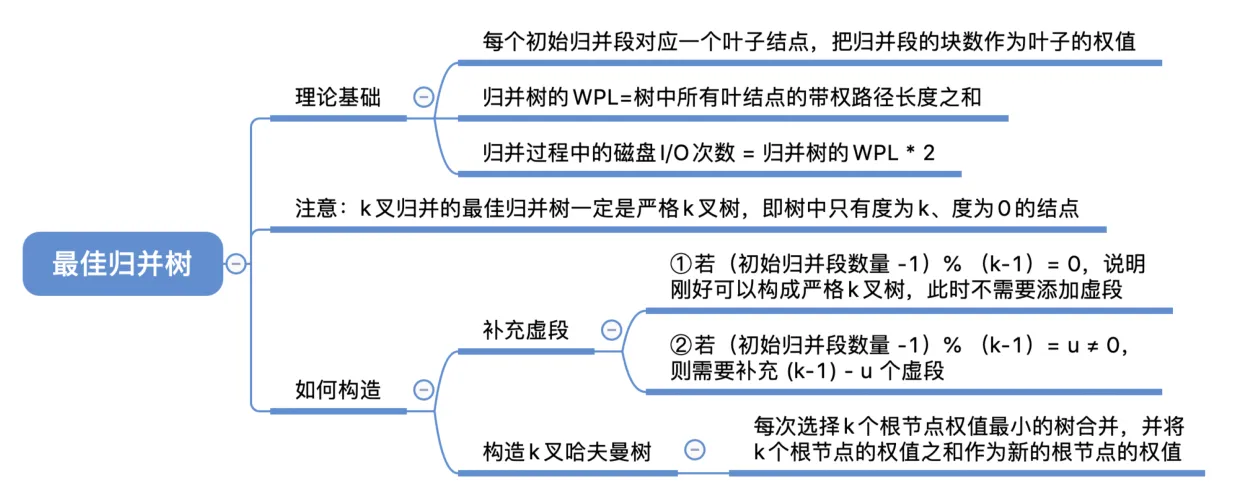
本题中,有 4 个初始归并段,进行 3 路归并,因此需要构造 3 叉最佳归并树。
(初始归并段数量-1) % (k-1) = (4-1)%(3-1)=1≠0,因此需要补充 (k-1)-u = (3-1)-1=1 个虚段。
补充 1 个虚段后,各初始归并段的长度为:
37, 51, 92, 94——归并段①长度为 4
14, 15, 48, 56, 63, 99——归并段②长度为 6
23, 31, 43, 60, 90, 166——归并段③长度为 6
8, 17, 100——归并段④长度为 3
NULL——归并段⑤为虚段,长度为 0
最佳归并树形态如下:
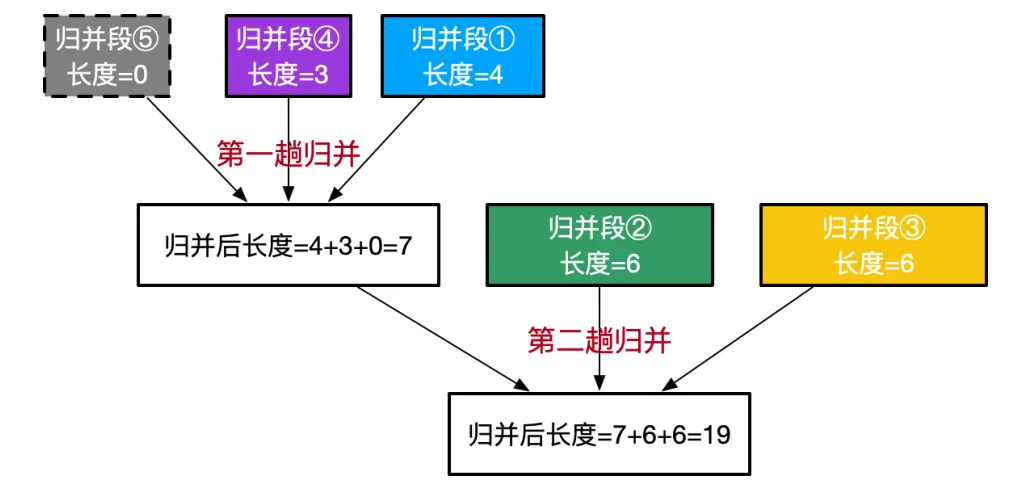
WPL = 树中所有叶节点的带全路径之和 = (0+3+4)2 + (6+6)1 = 26
注:最佳归并树形态不唯一,但 WPL 一定是 26
归并过程中,读磁盘次数=WPL=26 次
写磁盘次数=WPL=26 次
磁盘 I/O 总次数=WPL*2=52 次。
注:每个记录刚好占一个磁盘块,因此每读一个记录就需要一次读磁盘,每写一个记录就需要 一次写磁盘。在进行第一趟归并时,需要三个归并段中的记录依次读入磁盘、再按归并顺序依次写回磁盘。 因此第一趟归并带来了 0+3+4=7 次读磁盘、以及 7 次写磁盘。在进行第二趟归并时,需要将三个归并段中的记录依次读入磁盘、再按归并顺序依次写回磁盘, 因此第二趟归并带来了 7+6+6 = 19 次读、以及 19 次写。
综上,经过两趟归并,读磁盘次数 = 7+19=26 次,写磁盘次数=7+19=26 次。
3)本题要求构造 4 路归并的败者树,因此需要对比关键字 3 次。
注:三次关键字对比如图下所示
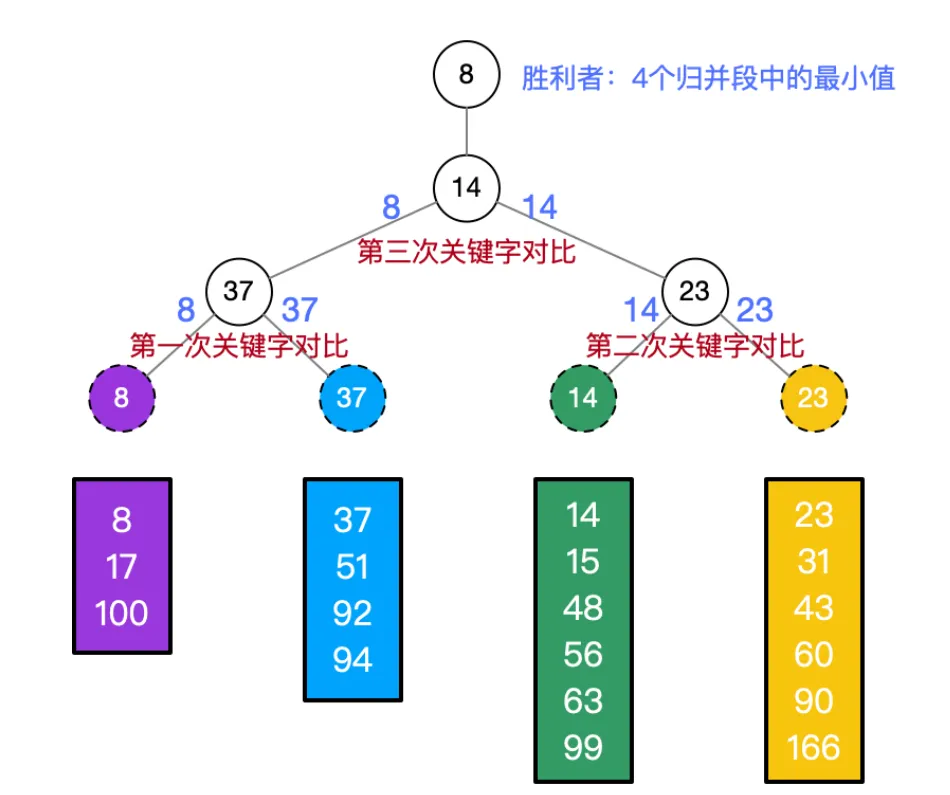
首先分别取出 4 个初始归并段中的最小值,用于构造初始败者树。
第一次关键字对比:将关键字 8、37 进行对比。37 更大,为“失败者”;8 更小,为“胜利者”, 晋级至下一轮对比。
第二次关键字对比:将关键字 14、23 进行对比。23 更大,为“失败者”;14 更小,为“胜利者”, 晋级至下一轮对比。
第三次关键字对比:将上一层的两个“胜利者”,即关键字 8、14 进行对比。14 更大,为“失败 者”;8 更小,为最终“胜利者”,也就找到了最小元素。
基于构造好的败者树,每次从 4 个归并段中找到最小关键字所需的关键字对比次数是 2 次。
举个例子,在初始败者树构造完成后,可知 4 个归并段中,最小元素为 8(来自于最左边一个 归并段)。接下来,基于已经构造好的败者树,要继续找到剩余元素中的最小关键字,仅需进行两次关键 字对比。
第一次关键字对比:将关键字 17、37 进行对比。37 更大,为“失败者”;17 更小,为“胜利者”, 晋级至下一轮对比。
第二次关键字对比:将关键字 14、17 进行对比。17 更大,为“失败者”;14 更小,为最终“胜利 者”,也就找到了最小元素。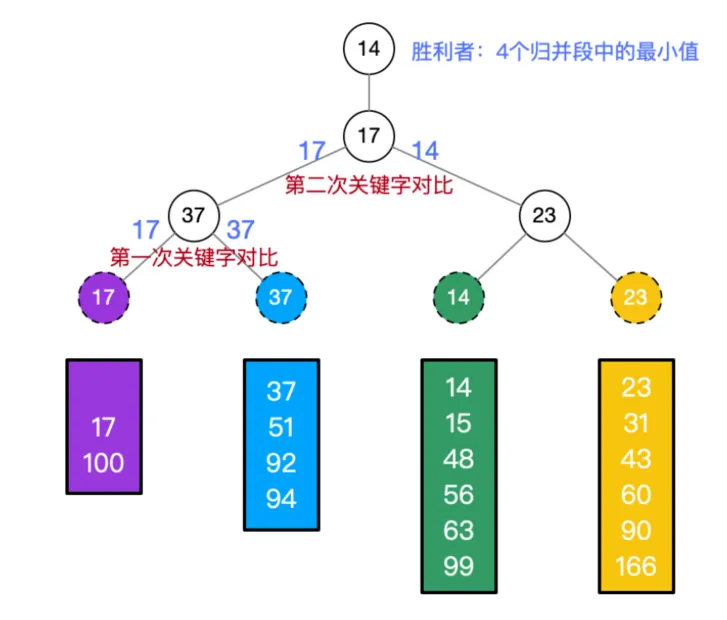
Warning
咸鱼认为,如果考题中考到败者树,最有可能的三个出题角度是:
①问你败者树的作用
②构造 k 路归并的败者树时,关键字对比次数是多少?
③基于构造好的败者树,每次从 k 个归并段中找到最小关键字,至多/至少需要对比关键字 多少次?
下面对着三个问题进行总结:
①败者树的作用是:在进行多路归并时,减少关键字对比次数。
②构造 k 路归并的败者树时,需要对比关键字 k-1 次。例如:构造 7 路归并的败者树时,需要对比关键字 6 次。
③基于构造好的败者树,每次从 k 个归并段中找到最小关键字所需的关键字对比次数,取 决于败者树的高度和形态。万一考到这类问题,可以先画出败者树的形态,再来分析。 k 路归并的败者树,形态上是一棵具有 k 个叶子结点的完全二叉树。
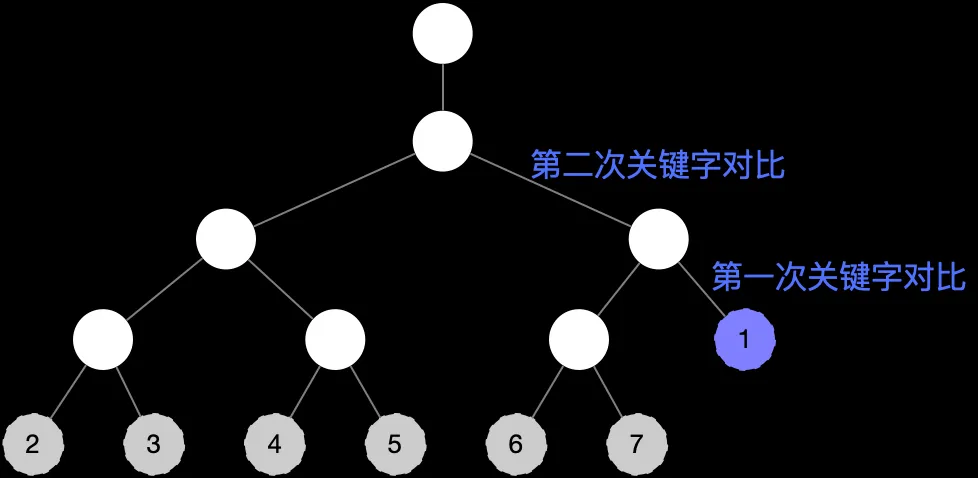
例如:7 路归并的败者树形态如下
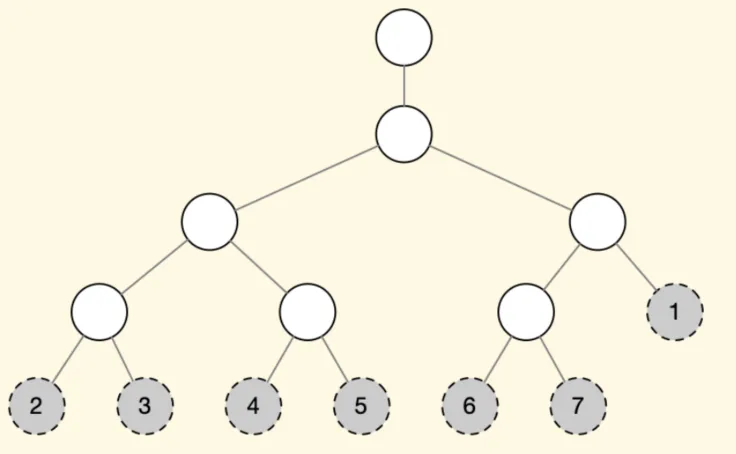
总共有 7 个叶子结点,每个叶子对应一个归并段。
基于这棵构造好的败者树,从 7 个归并段中找到最小关键字,最多需要 3 次关键字对比; 最少需要 2 次关键字对比。
如果本轮新关键字来自于归并段 1,则只需要 2 次关键字对比即可找到 7 个归并段中的最 小关键字。如下所示: