链表的相关算法题及解题模板
对比数组题,链表题可以说是简单不少,主要是花样少,无非考察以下几种:
1.单指针遍历
2.双指针
3.快慢指针:双指针的进化版,快指针每次走两步,慢指针每次走一步,可用于找链表中间节点,找环等。
4.反转链表:建议递归迭代头插法三种方法都掌握。
5.链表节点的删除和连接:牢记口诀,先连后,再连前,(如有删除)最后释放删除节点。
- 408历年考题都是带有头结点的链表,如果是不带头结点的链表就自己创建一个
dummy结点指向第一个结点,让dummy结点当作头结点之后再用一样的思路处理即可;当然也可以视情况另作处理,画个图就好做了。- 在做链表题时,要舍得用变量,千万别想着节省变量,否则极有可能把自己绕晕。
Info
【总结】
- 分隔链表(假设分隔值为x)可以定义两个链表,一个连接比x大的,一个连接剩下的,这种方式最后注意连接起来的时候,大的那个链表末尾要置空,防止头尾相连,小的连上大的,定义哑节点操作更方便。这个问题也可以通过定义两个数组来做,各自存放,最后在把小的先放入链表中,大的后放入。
- 合并有序链表通过递归来做,先对比两个表的表头,如果是从大到小排序,则只需要让表头值较小的链表的第二个节点开始与另一个链表进行递归。
- 两数相加链表逆序排列问题,定义一个进制即可,注意取余操作和进制的取整操作,并且在最后一位加完后,还要对进制进行一次判断,若大于1,需要再定义一个空间存放该值。
- 反转链表,旋转链表(可能多用到取余决定位置下标)问题,如果需要剪断的可以通过快慢指针或者对值比较或者其他方式找到剪断的位置,然后进行置空操作,进行翻转只要率先定义一个空节点和当前节点的next节点即可,最后在接回原来的链表中,注意指针的指向可能因为逆序发生了改变,画个图就好理解了。
- 两两交换链表,利用递归就好了,和合并链表同理。
- 删除倒数第k个直接快慢指针,快指针先运行k步。
- 将一个数组有序合并到另一个有序数组中,可以从最大值开始比较,将大的放入数组的末尾,这样既不会影响存储,也不会影响前面的值的比较。
- 寻找两个链表第一个公共节点时,先把较长的链表剪断到和两一个链表一样长,然后逐一比较他们的值,第一个相等的即是所求的。
- 对链表进行插入排序,只要定义两个指向头结点的指针,一个每次都指向当前要比较元素的位置,一个只想之前已经排序完的最后一个元素的位置,若当前的比排序完的最后一个节点的值大,继续往下即可,若小了,则需要在定义一个指针指向头节点,然后遍历找到比当前节点小的最大值,然后插入在她的后面。
- 重排链表,需要先利用快慢指针找到中间值,然后剪断,将后半部分在进行逆序,然后一次插入到前排,注意指针指向问题。
- 删除当前所在位置的节点,把后一个节点的值赋给当前节点,在直接让当前节点的指针指向下下个节点。
删除结点问题
Tip
删除结点只要找到待删除结点的直接前驱结点,然后用删除结点的基本操作将待删除结点删除即可;
这部分推荐看一下灵神的视频:删除链表重复节点【基础算法精讲 08】
删除结点问题如果算上倒数第\(n\)个结点的话,真题已经考察过2次,我觉得可以重点关注一下后面两道.
在带有头结点的链表中删除值为x的所有结点
【示例】: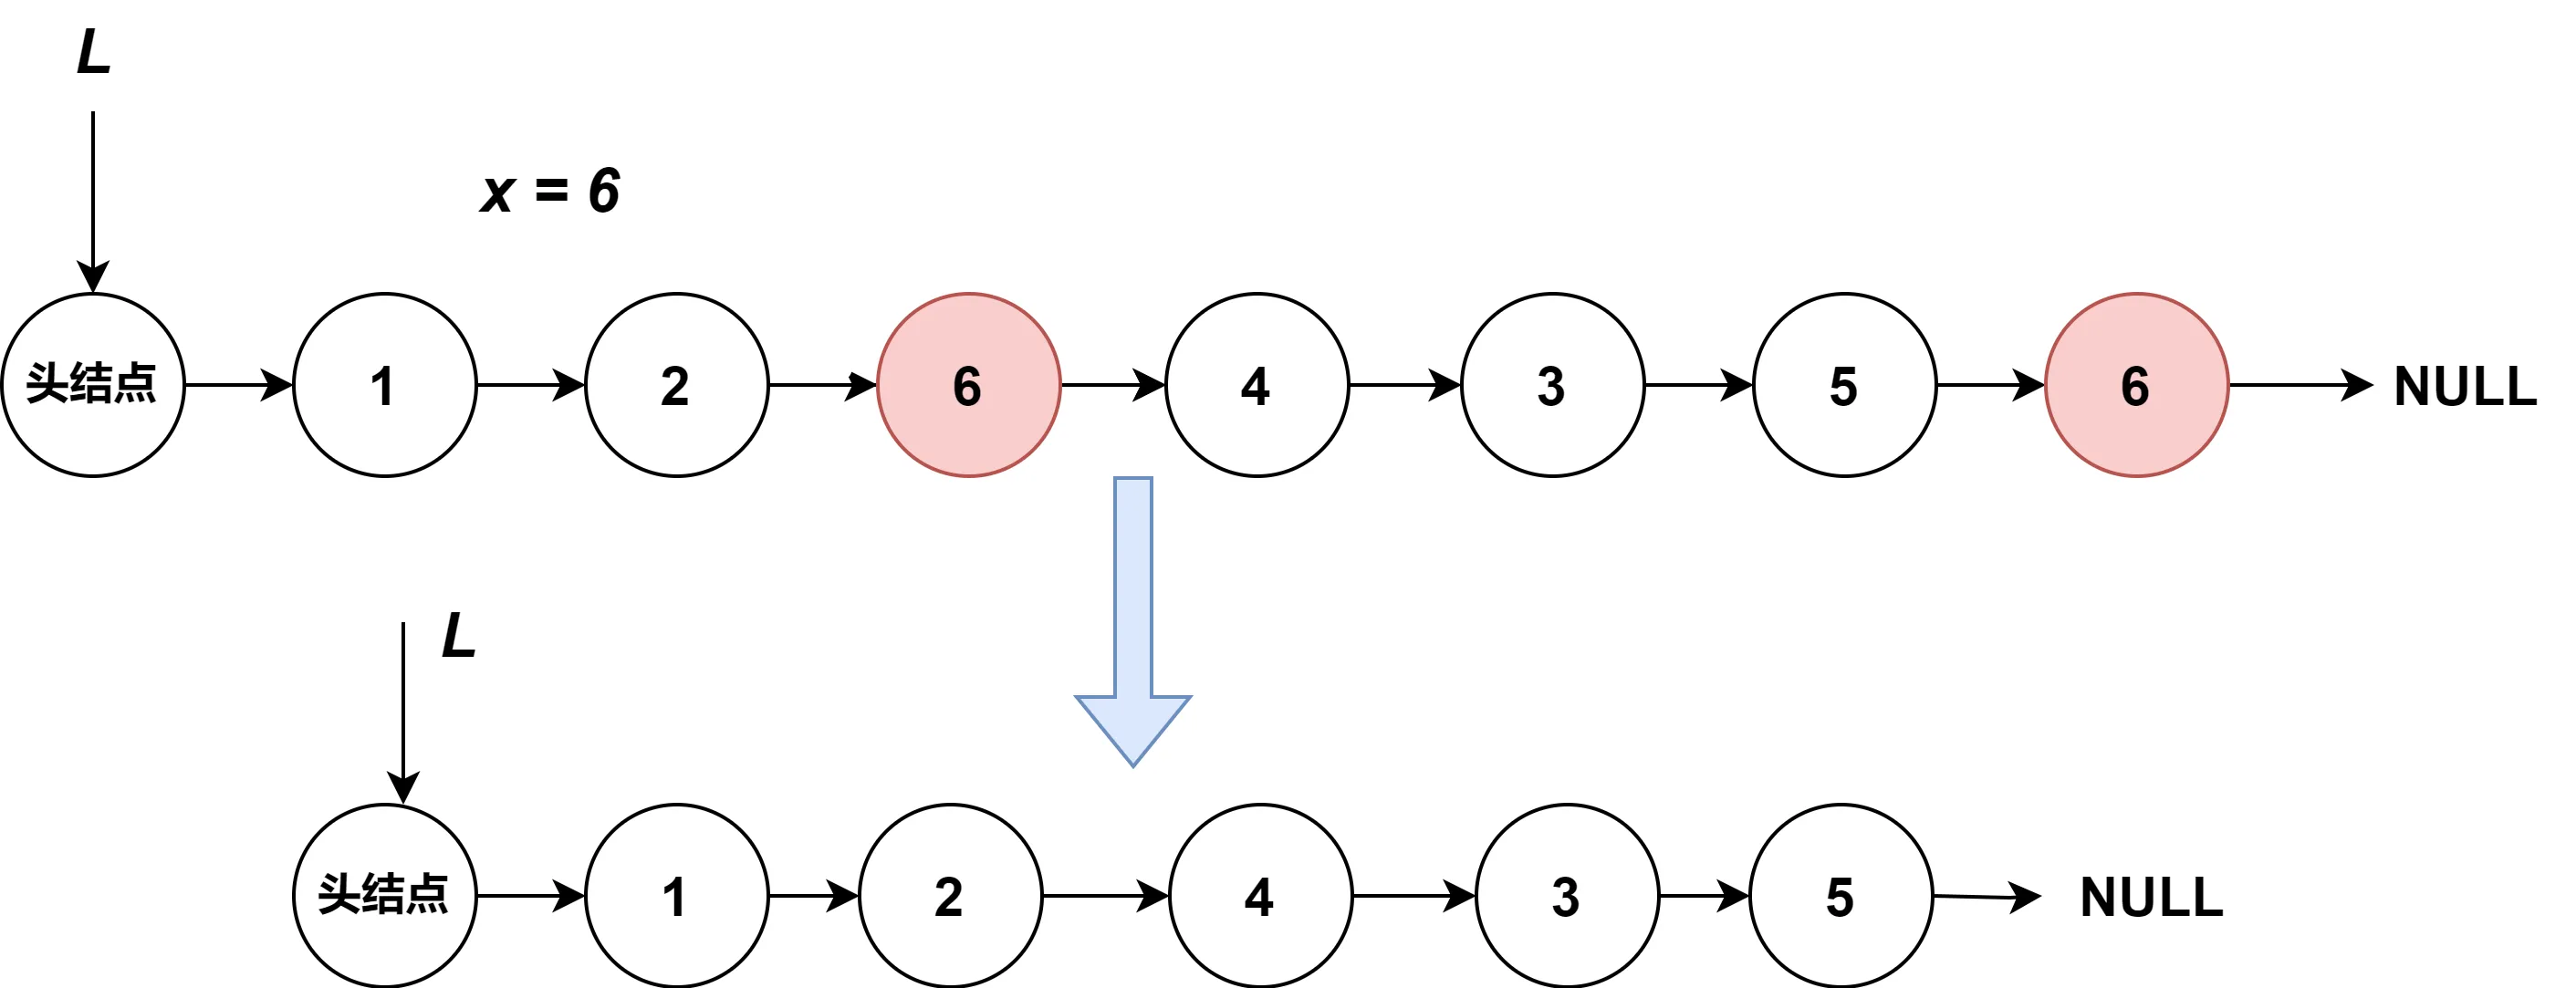
- 题源:203. 移除链表元素
- 示意代码:
// 法一:设置两个指针,一个用于遍历链表,另一个标记待删结点的前驱。
void delete_x_iterative(LNode *&L,int x) {
    LNode *pre = L, *p = L->next, *q;
    // 用pre记录当前结点的前驱,q用于保存待释放结点。
    while(p != NULL) {
        if(p -> data != x) {    //如果遍历到的当前结点值不为x;
            pre = p;         //更新pre指针;
            p = p -> next;     //更新p指针,然后继续遍历链表,注意顺序不可以颠倒哦
        }else{
            q = p;          //如果遍历到的当前结点值为x,用q指针标记待删除元素位置;
            pre -> next = p -> next;    //  删除当前结点;
            p = p -> next;   //更新p指针;
            free(q);    //释放掉删除结点所占用的空间;
        }
    }
}

// 法二:直接检查当前结点的后继。
void delete_x_next(LNode *&L,int x) {
    LNode *p = L, *q;
    while(p != NULL && p->next != NULL) {
        if(p -> next ->data == x) {
            q = p -> next;
            p -> next = q -> next;
            free(q);
        }else{
            p = p -> next;
        }
    }
}

// 法三:递归写法(这里是不带头结点的链表)。
void delete_x_recursive(LNode *&L, int x) {
    LNode *p;
    if (L == NULL) return;
    if(L -> data == x) {
        p = L;
        L = L -> next;
        free(p);
        delete_x_recursive(L,x);
    }else{
        delete_x_recursive(L -> next,x);
    }
}
如果要删除的元素是值为位于某个区间的话,那么只要修改判断条件语句即可;
删除带头结点的链表中值为x的第一个结点;
【示例】: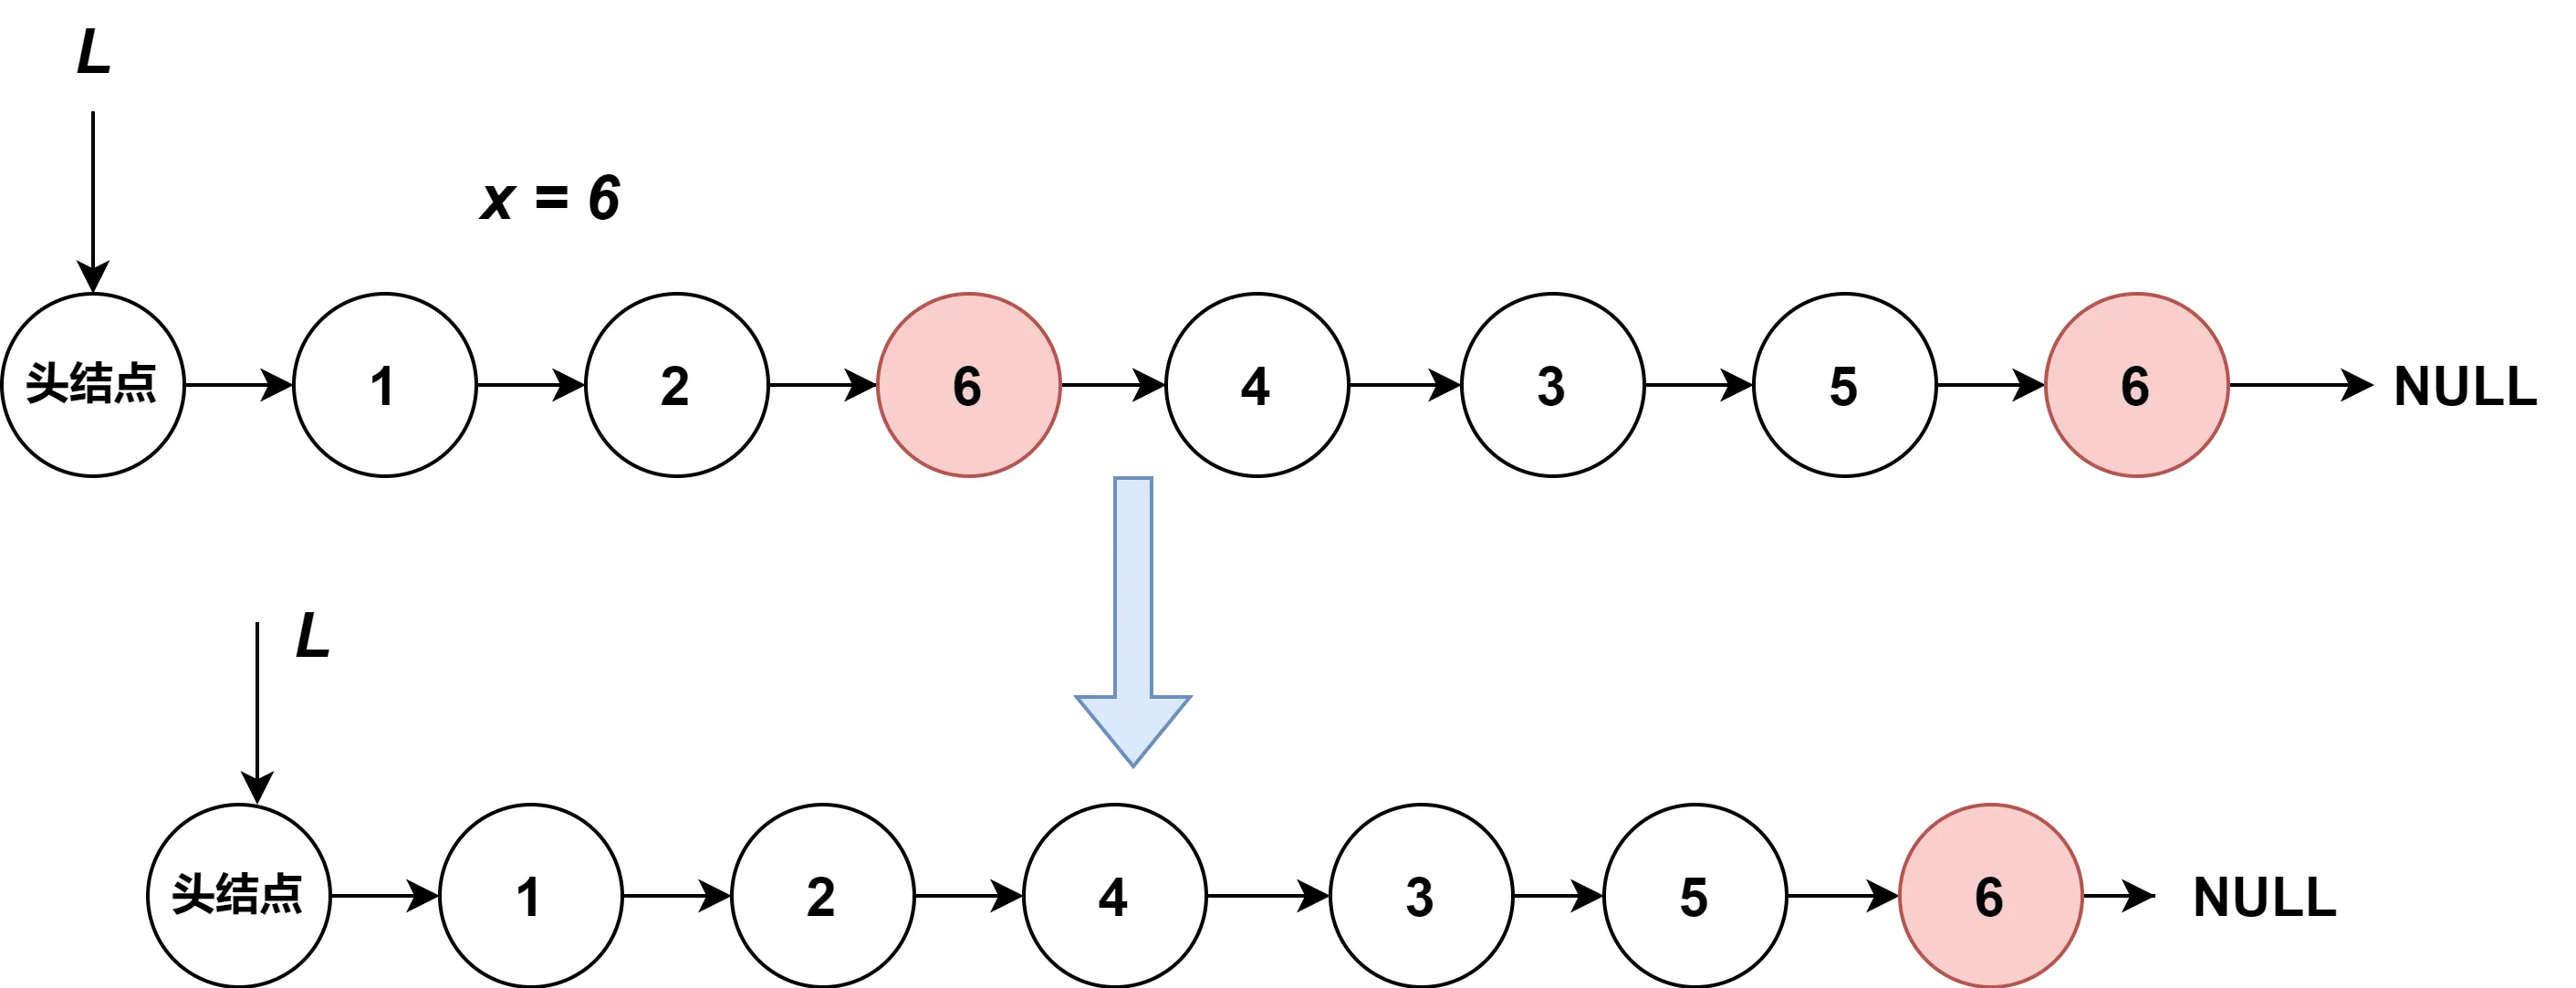
解题思路:由于本题只要删除值为x的第一个结点,因此如果找到了待删除结点的直接前驱或者已经遍历完整条链表也没有找到时,跳出循环即可;然后根据这两种情况执行相应操作即可;
示意代码:
bool delete_first_x(LNode *&L, int x) {
    LNode *p = L;
    while(p->next != NULL && p->next->data != x){
        p = p -> next;
    }
    //由判断条件可知,跳出while循环有两种情况;
    if(p-> next == NULL) {
        return  false;   //第一种情况,该链表中不含值为x的结点,返回false;
    }else{
        LNode *q = p -> next;
        p -> next = q -> next;
        free(q);
        return true;   //第二种情况,成功找到并删除,返回true;
    }
}
在带有头结点的链表中删除值最小的那个结点(假设这样的结点存在且唯一)
【示例】: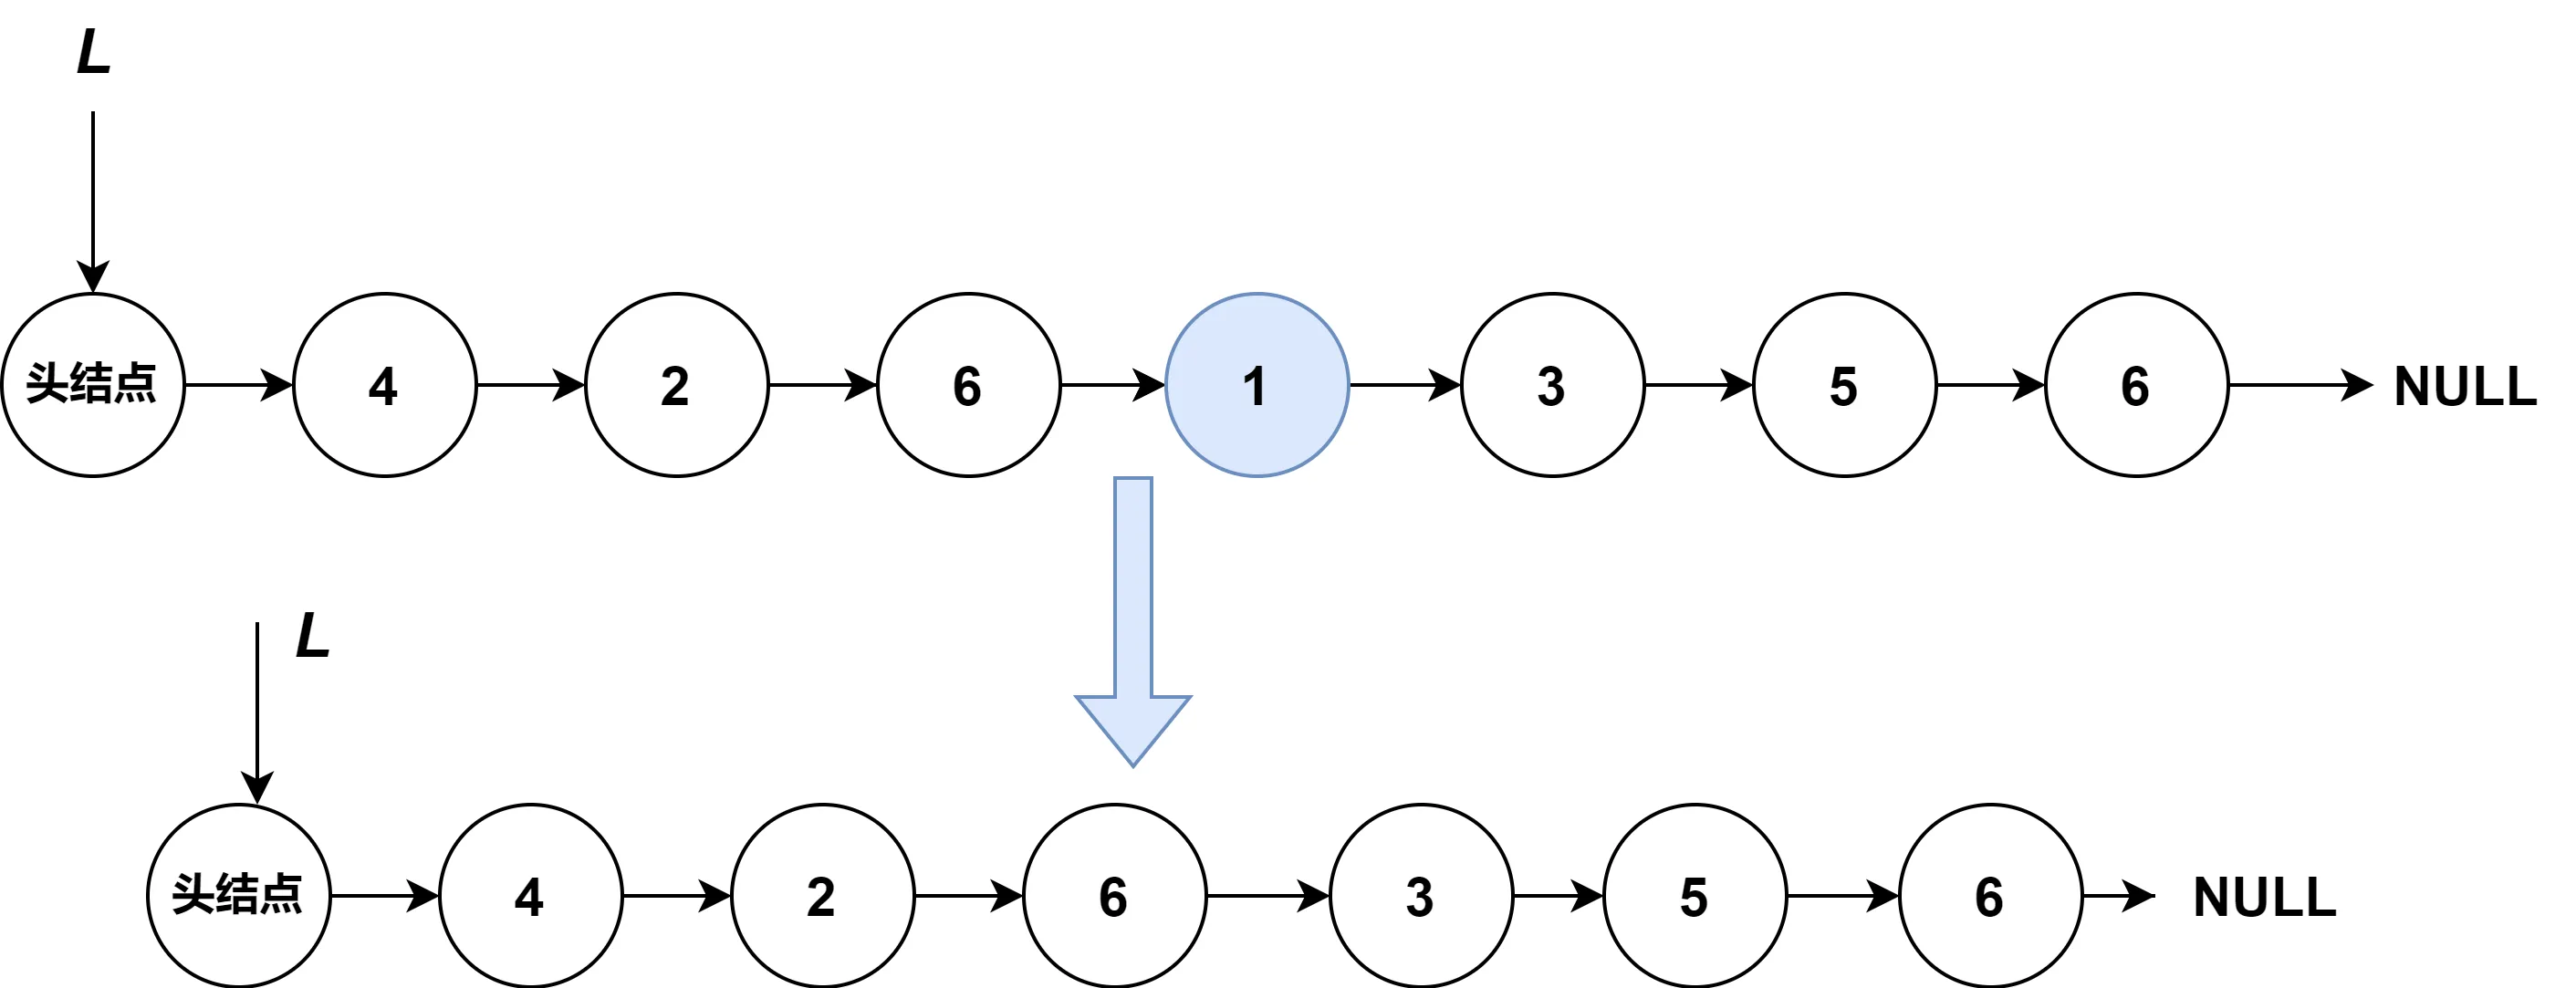
Tip
解题思路:设置两个指针p和minNode,p用于遍历链表,minNode用来寻找值最小的那个结点的直接前驱,如果p->next结点值比minNode->next值小,则更新minNode指针位置,让其移动到当前p指针所处位置,然后p指针继续向后遍历比较;如果p->next结点值比minNode->next值大的话,则p指针继续向后遍历,minNode指针不动;这样的话当p指针遍历结束时,minNode指针的直接后继就是值最小的那个结点,然后执行删除操作就可以啦!
示意代码:
void delete_min(LNode *&L) {
    if (L == NULL || L->next == NULL) return;
    LNode *minNode = L;
    for (LNode *p = L; p->next != NULL; p = p->next) {
        if (p->next->data < minNode->next->data) {
            minNode = p;
        }
    }
    LNode *q = minNode -> next;
    minNode -> next = q -> next;
    free(q);
}
Tip
若要删除值最大的那个结点,也可以这样用一个maxNode指向最大值结点的直接前驱结点;
如果题目要求按递增排序顺序输出单链表各节点的数据元素,并释放结点空间,可以考虑用该方法在外面再套一个while(L -> next)循环;每次输出值最小的一个并删除即可,因为有两层遍历,因此时间复杂度为\(O(n^2)\),空间复杂度为\(O(1)\);当然也可以将链表中的元素依次输入到数组中,再对数组排序输出,这样的话时间复杂度为\(O(nlogn)\),但是空间复杂度为\(O(n)\),因为用到了额外空间。
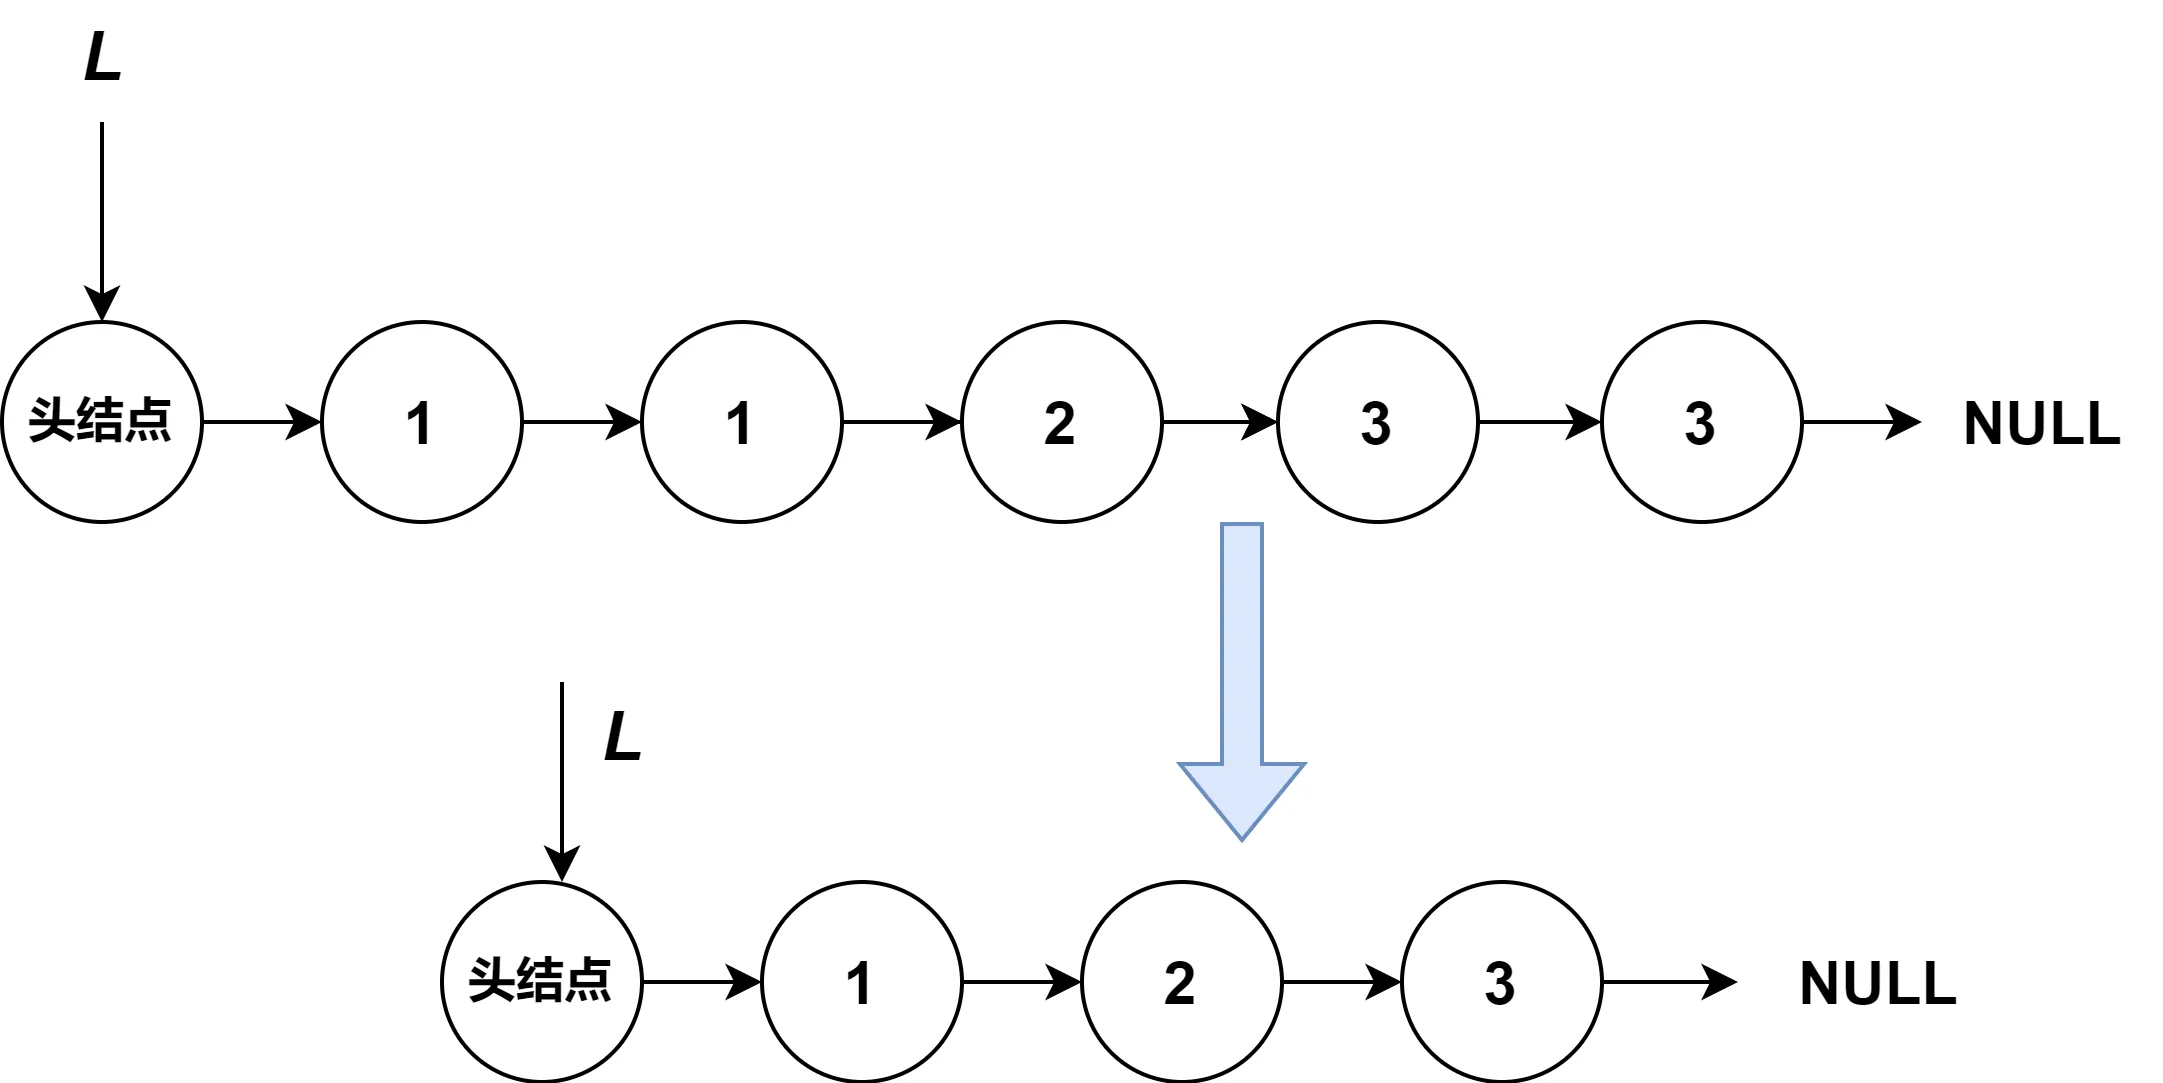
在有头节点的[有序](https://leetcode.cn/problems/remove-duplicates-from-sorted-list/)链表中删除重复元素;使每个重复元素只出现一次;(leetcode第83题)
- 示例:
- 解题思路:
示意代码:
void delete_same(LNode *&L) {
    LNode *p = L -> next, *q;   //初始化p指向链表第一个结点,q指针用来在后面指向p的直接后继结点;
    while(p != NULL && p->next != NULL) {
        q = p -> next;
        if(q -> data == p -> data) {   //发现重复元素
            p -> next = q -> next;    //执行删除操作;
            free(q);    //释放结点空间;
        }else{    //没有发现重复元素
            p = p -> next;  //遍历下一个节点;
        }
    }
}
删除排序链表的重复元素,注意是删除所有含有重复数字的结点,只保留下不同的数字。
- 【示例】:
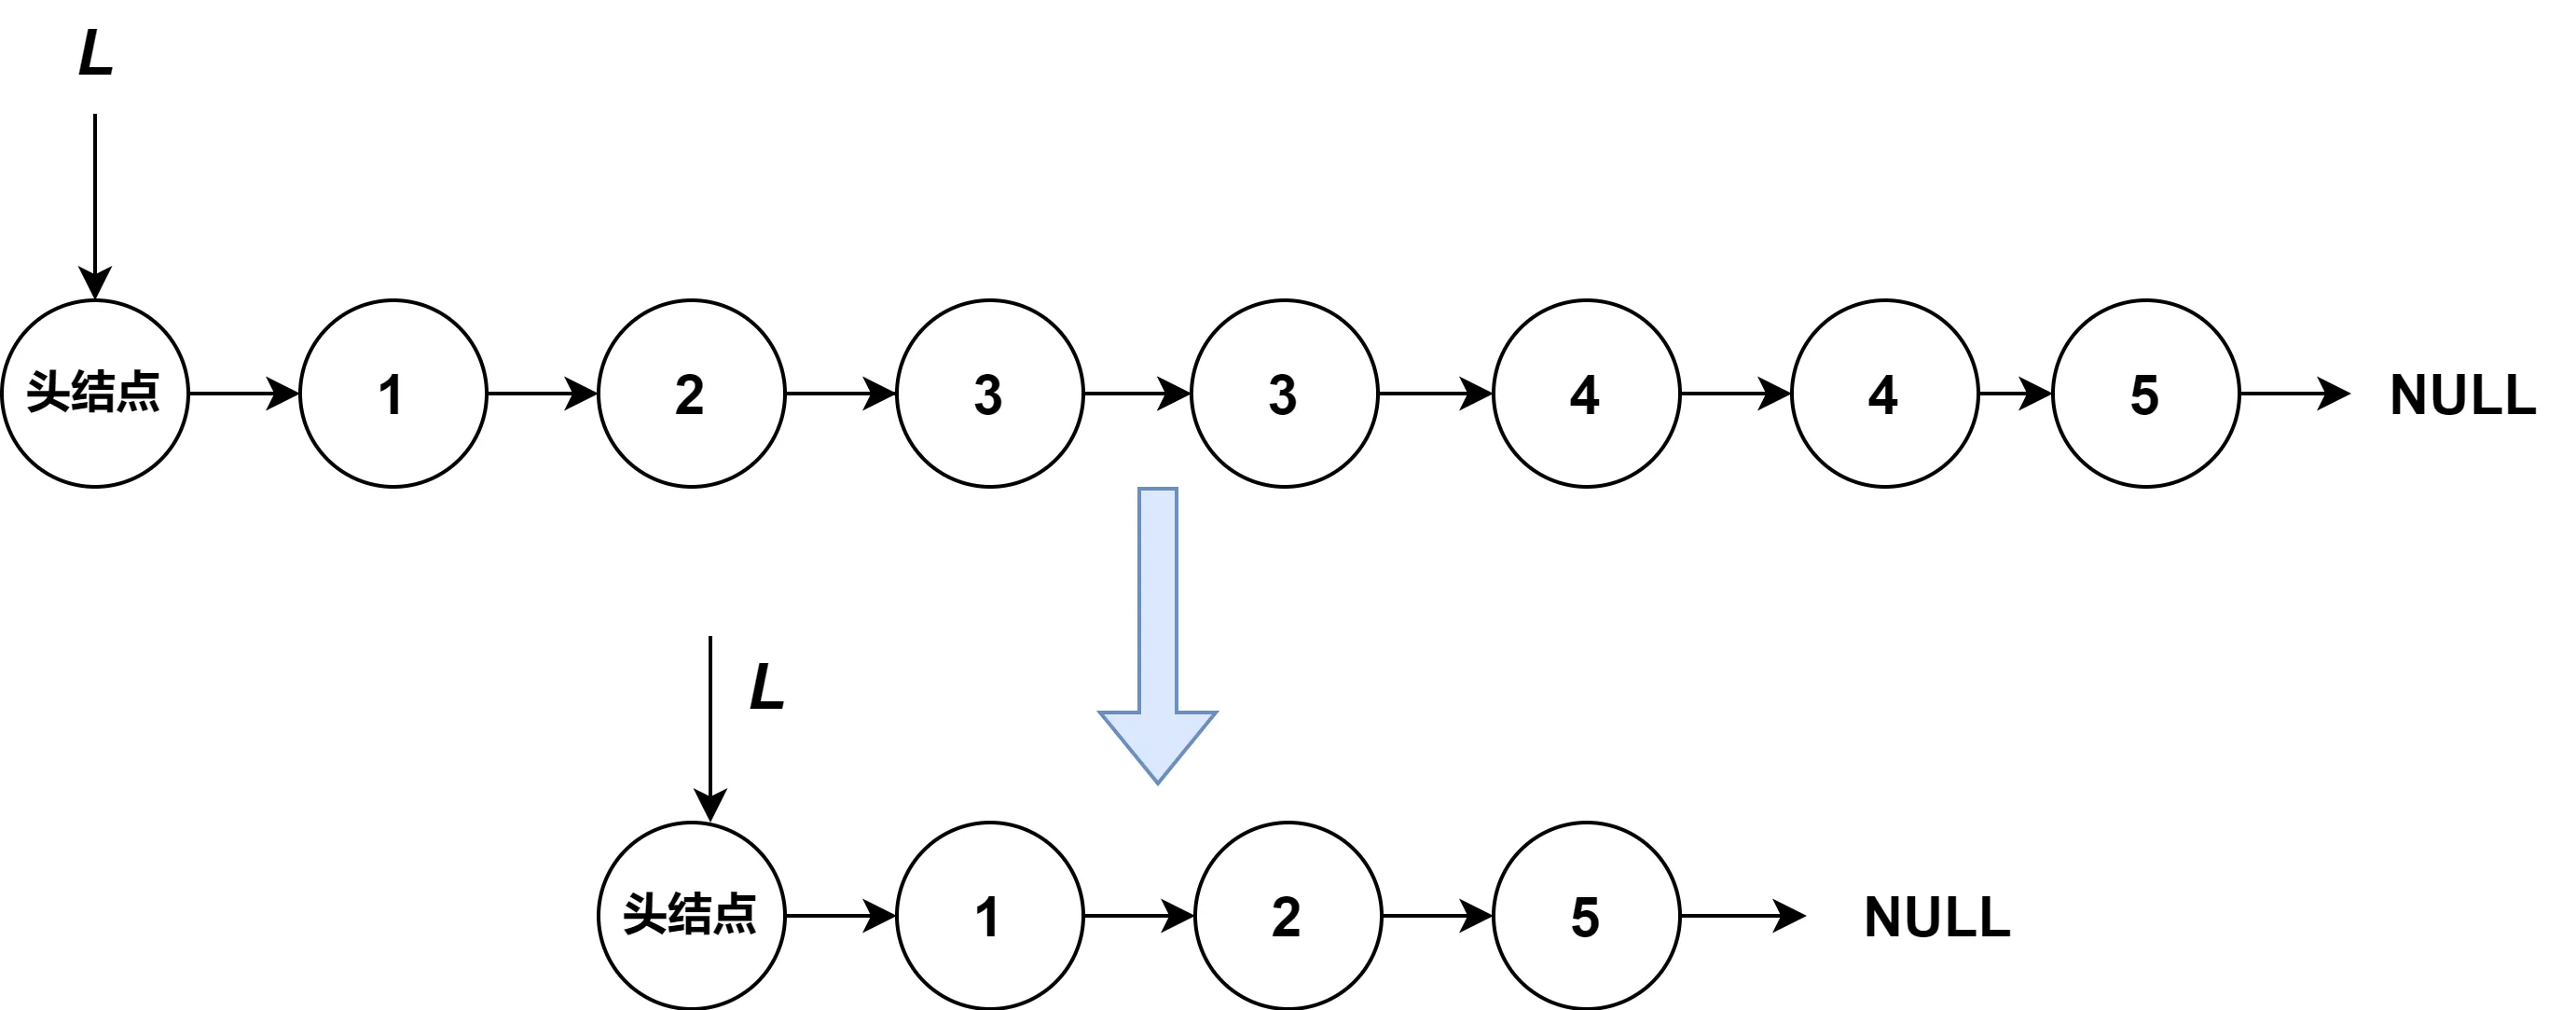
- 题源:82. 删除排序链表中的重复元素 II
- 解题思路:我们让指针\(cur\)指向链表的头结点,随后开始对链表进行遍历。如果当前\(cur.next\)与\(cur.next.next\)对应的元素相同,那么我们就需要将\(cur.next\)以及所有后面拥有相同元素值的链表节点全部删除。我们记下这个元素值\(x\),随后不断将\(cur.next\)从链表中移除,直到\(cur.next\)为空节点或者其元素值不等于\(x\)为止。此时,我们将链表中所有元素值为的\(X\)节点全部删除。
如果当前\(cur.next\)与\(cur.next.next\)对应的元素不相同,那么说明链表中只有一个元素值为\(cur.next\)的节点,那么我们就可以将\(cur\)指向\(cur.next\)。
当遍历完整个链表之后,我们返回链表的头结点即可。
需要注意\(cur.next\)以及\(cur.next.next\)可能为空节点,如果不加以判断,可能会产生运行错误。
- 示意代码:
//带有头结点的版本
LNode *deleteDuplicates(LNode *&L) {
    LNode *cur = L;
    //用于遍历链表,将其下下个结点值与其下个结点值比较,
    //这样如果相等的话执行删除操作,那么cur就是待删除结点的直接前驱结点,从而方便了后续的删除操作;
    while(cur -> next && cur -> next -> next) {
        int x = cur -> next -> data;    //先记录下一个节点的值
        if(cur -> next -> next -> data == x) {  //如果下下个结点的值和记录值相等时,则进入循环把与记录值相等的结点通通删除;
             while(cur -> next && cur -> next -> data == x) {   //只要cur->next值与记录值x相等,就一直循环执行删除操作;
                  LNode *q =  cur -> next;
                  cur -> next = q -> next;
                  free(q);
             }
        }else {     //如果下下个结点的值和下个结点的值不相等,则更新cur结点
            cur = cur -> next;
        }
    }
    return L;
}
虽然看起来函数内部有两重循环,但是注意每一次循环要么删除一个结点,要么cur向右移动一位,也相当于处理了一个结点,因此总的执行次数为\(O(n)\),因此时间复杂度是\(O(n)\)的,空间复杂度为\(O(1)\)
删除链表的倒数第\(n\)个结点
暴力方法,先遍历一遍链表记录链表长度,再遍历一次找到其前驱结点,执行删除操作;
最优解:双指针写法;前后指针
示意代码:
//不带头结点
ListNode* removeNthFromEndNoHead(ListNode* head, int n) {
        ListNode* dummy = new ListNode(0,head);
        ListNode *left = dummy, *right = dummy;
        while(n -- ) {
            right = right -> next;
        }
        while(right -> next) {
            left = left -> next;
            right = right -> next;
        }
        left -> next = left -> next -> next;
        return dummy -> next;
}

//带头结点:
ListNode* removeNthFromEndWithHead(ListNode* head, int n) {
        ListNode *left = head , *right = head;
        while(n -- ) {
            right = right -> next;
        }
        while(right -> next) {
            left = left -> next;
            right = right -> next;
        }
        left -> next = left -> next -> next;
        return head;
}
从链表中删去总和值为零的连续节点
给你一个链表的头节点 head,请你编写代码,反复删去链表中由 总和 值为 0 的连续节点组成的序列,直到不存在这样的序列为止。
删除完毕后,请你返回最终结果链表的头节点。
示例1:
示例2:
解答:
// 前缀和写法
ListNode* removeZeroSumSublists(ListNode* head) {
    ListNode dummy(0, head);
    unordered_map<int, ListNode*> last;
    int sum = 0;
    for (ListNode* p = &dummy; p != nullptr; p = p->next) {
        sum += p->val;
        last[sum] = p;
    }
    sum = 0;
    for (ListNode* p = &dummy; p != nullptr; p = p->next) {
        sum += p->val;
        p->next = last[sum]->next;
    }
    return dummy.next;
}
链表逆置问题(反转链表问题)
该部分参考了408之2023年算法题预测和力扣相关题解
Tip
解决这类问题,有三种方法,递归法、迭代法和头插法。头插法是教科书中创建链表的头插法在反转链表中的应用,但是需要依赖反转的第一个结点的前驱结点,如果该结点没有前驱结点,需要先创建一个dummy结点指向第一个结点,像是leetcode的风格中一般链表都没有头结点,但是408考试中链表都是带头结点的,因此这种方法必须掌握。而递归法和迭代法,均不需要dummy结点就可以进行反转链表,但是由于递归法的空间复杂度为 \(O(n)\) ,而迭代法的空间复杂度为 \(O(1)\) ,所以迭代法是反转链表的最优解法,大概率也是标准答案的解法,因此反转链表只需要掌握迭代法即可。
带有头结点的链表逆序(从尾到头)输出每个结点的值
- 法一:先反转链表再遍历打印结点;反转链表方法见下面的具体例题;
- 法二:递归法,空间复杂度为\(O(n)\)
//这是不带头结点的写法
void printListNoHead(LNode *L) {
    if (L == NULL) return;
    if(L -> next == NULL) {
        cout << L -> data << " ";     //递归出口
        return;
    }
    printListNoHead(L -> next);
}

//带头结点的写法
void print(LNode *L) {
    if (L == NULL) return;
    if(L -> next == NULL) {
        cout << L -> data << " ";     //递归出口
        return;
    }
    print(L -> next);
}

void printListWithHead(LNode *head) {
    if (head != NULL) print(head -> next);
}
- 法三:将链表中的结点值依次入栈,再出栈输出即可
void printList(LNode *L) {   //带头结点的情况
    stack<int> stk;
    LNode *p = L -> next;    //若为不带头结点的链表这一步可省略;
    while(p != NULL) {
        stk.push(p -> data);
        p = p -> next;
    }
    while(!stk.empty()){
        cout << stk.top() << " ";
        stk.pop();
    }
}
-
反转链表
不懂的可以看一下灵佬的视频讲解,十分透彻:反转链表【基础算法精讲 06】
也可以看一下代码随想录这一节的讲解:https://programmercarl.com/0206.翻转链表.html#思路 -
【示例】:
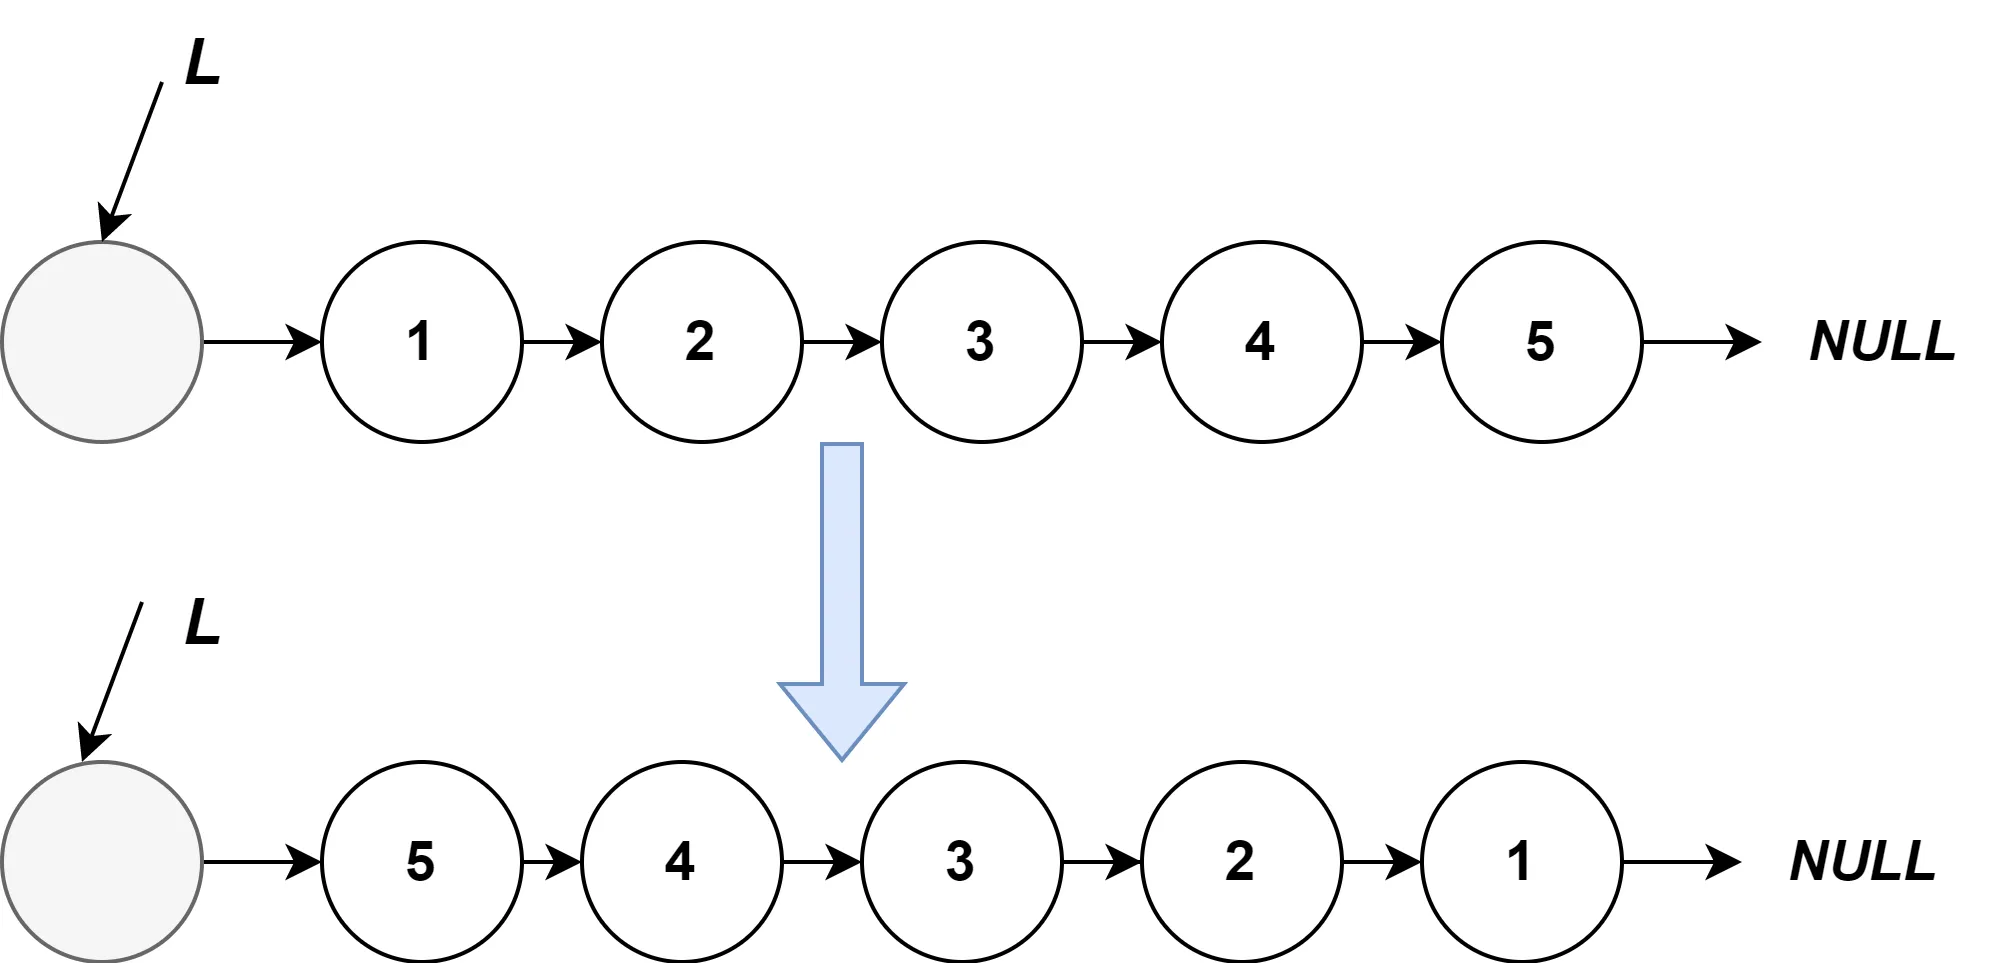
- 法一:头插法,该方法依赖于链表中第一个结点的直接前驱结点,如果是不带头结点的链表,可以设置一个
dummy结点指向它;
如图: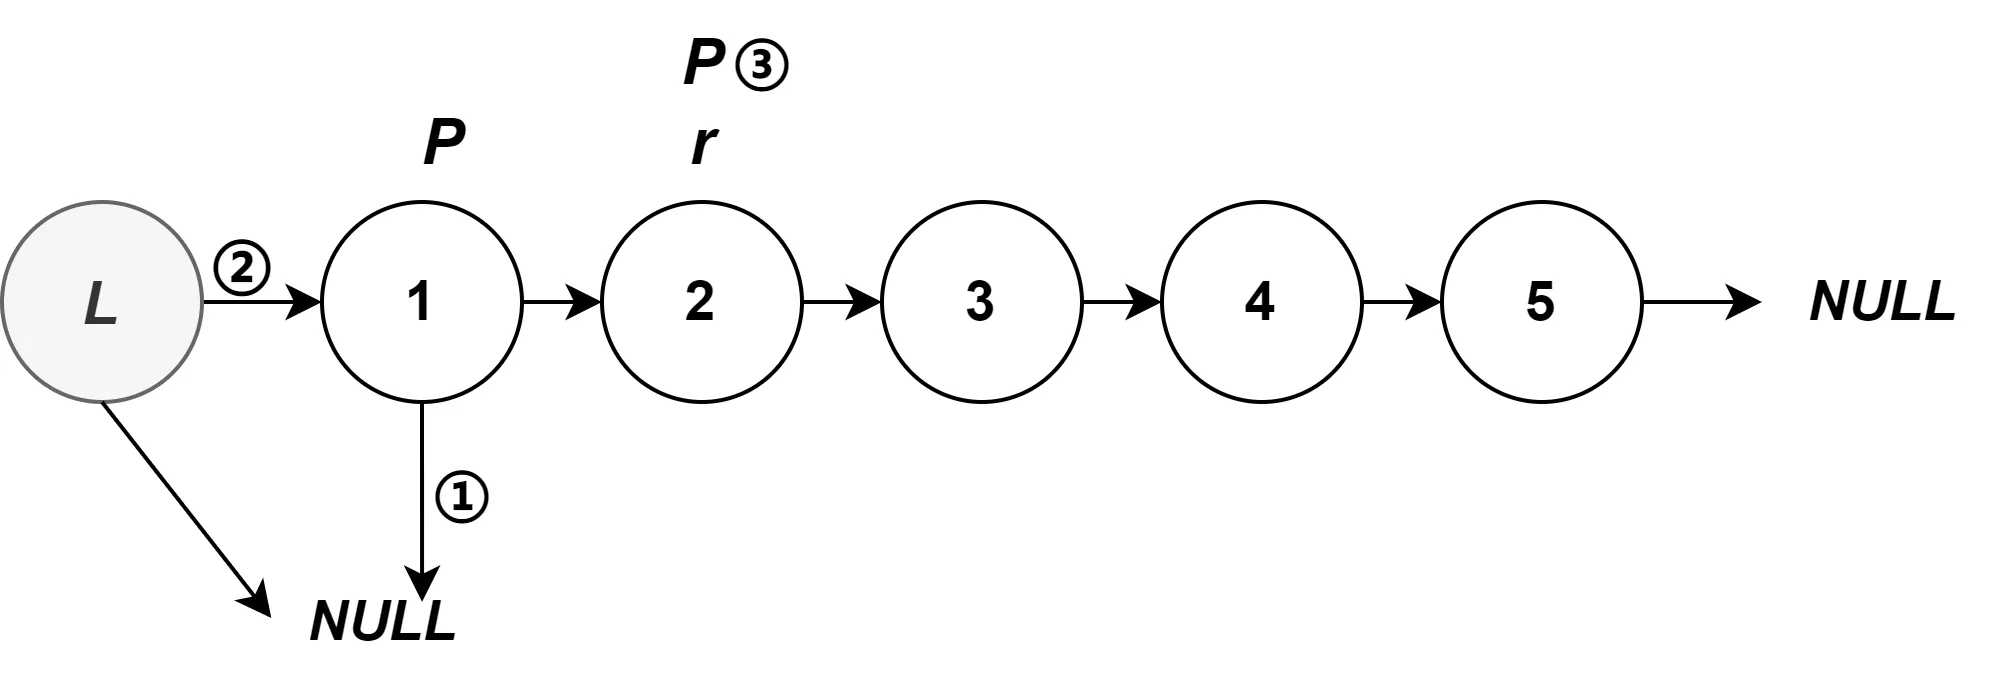
//带头结点写法
LNode *reverseList(LNode *&L) {
    LNode *p = L -> next, *r;
    L -> next = NULL;   //将头结点和原来的链表断连;
    while(p) {
        r = p -> next;    //保存一下后继结点为后面更新p结点做准备;
        p -> next = L -> next;
        L -> next = p;     //采用头插法将遍历到的结点依次插入L头结点新组成的链表中;
        p = r;      //更新p指针继续向后遍历;
    }
    return L;
}

//无头结点写法
LNode* reverseList(LNode* &head){
    LNode*dummy =(LNode*) malloc(sizeof(LNode));
    dummy->data = 0,dummy->next = NULL;
    LNode* p =head,*r;
    while(p){
        r = p->next;
        p->next=dummy->next;
        dummy->next=p;
        p=r;

    }
    LNode*ans=dummy->next;
    return ans;
}
时间复杂度:\(O(n)\),其中\(n\)是链表的长度,需要遍历链表一次。
空间复杂度:\(O(1)\)
- 法二:迭代法:(
 重要模板,需记住!!!不懂的看灵神视频即可)
解题思路:从前往后不断将未反转的结点加入到反转的链表中,可以将链表一分为二,左边是已反转的链表结点,右边是未反转的链表结点。初始时,已反转的链表部分为空,未反转的链表部分为整条链表。
结束时,已反转的链表部分为整条链表,未反转的链表部分为空。
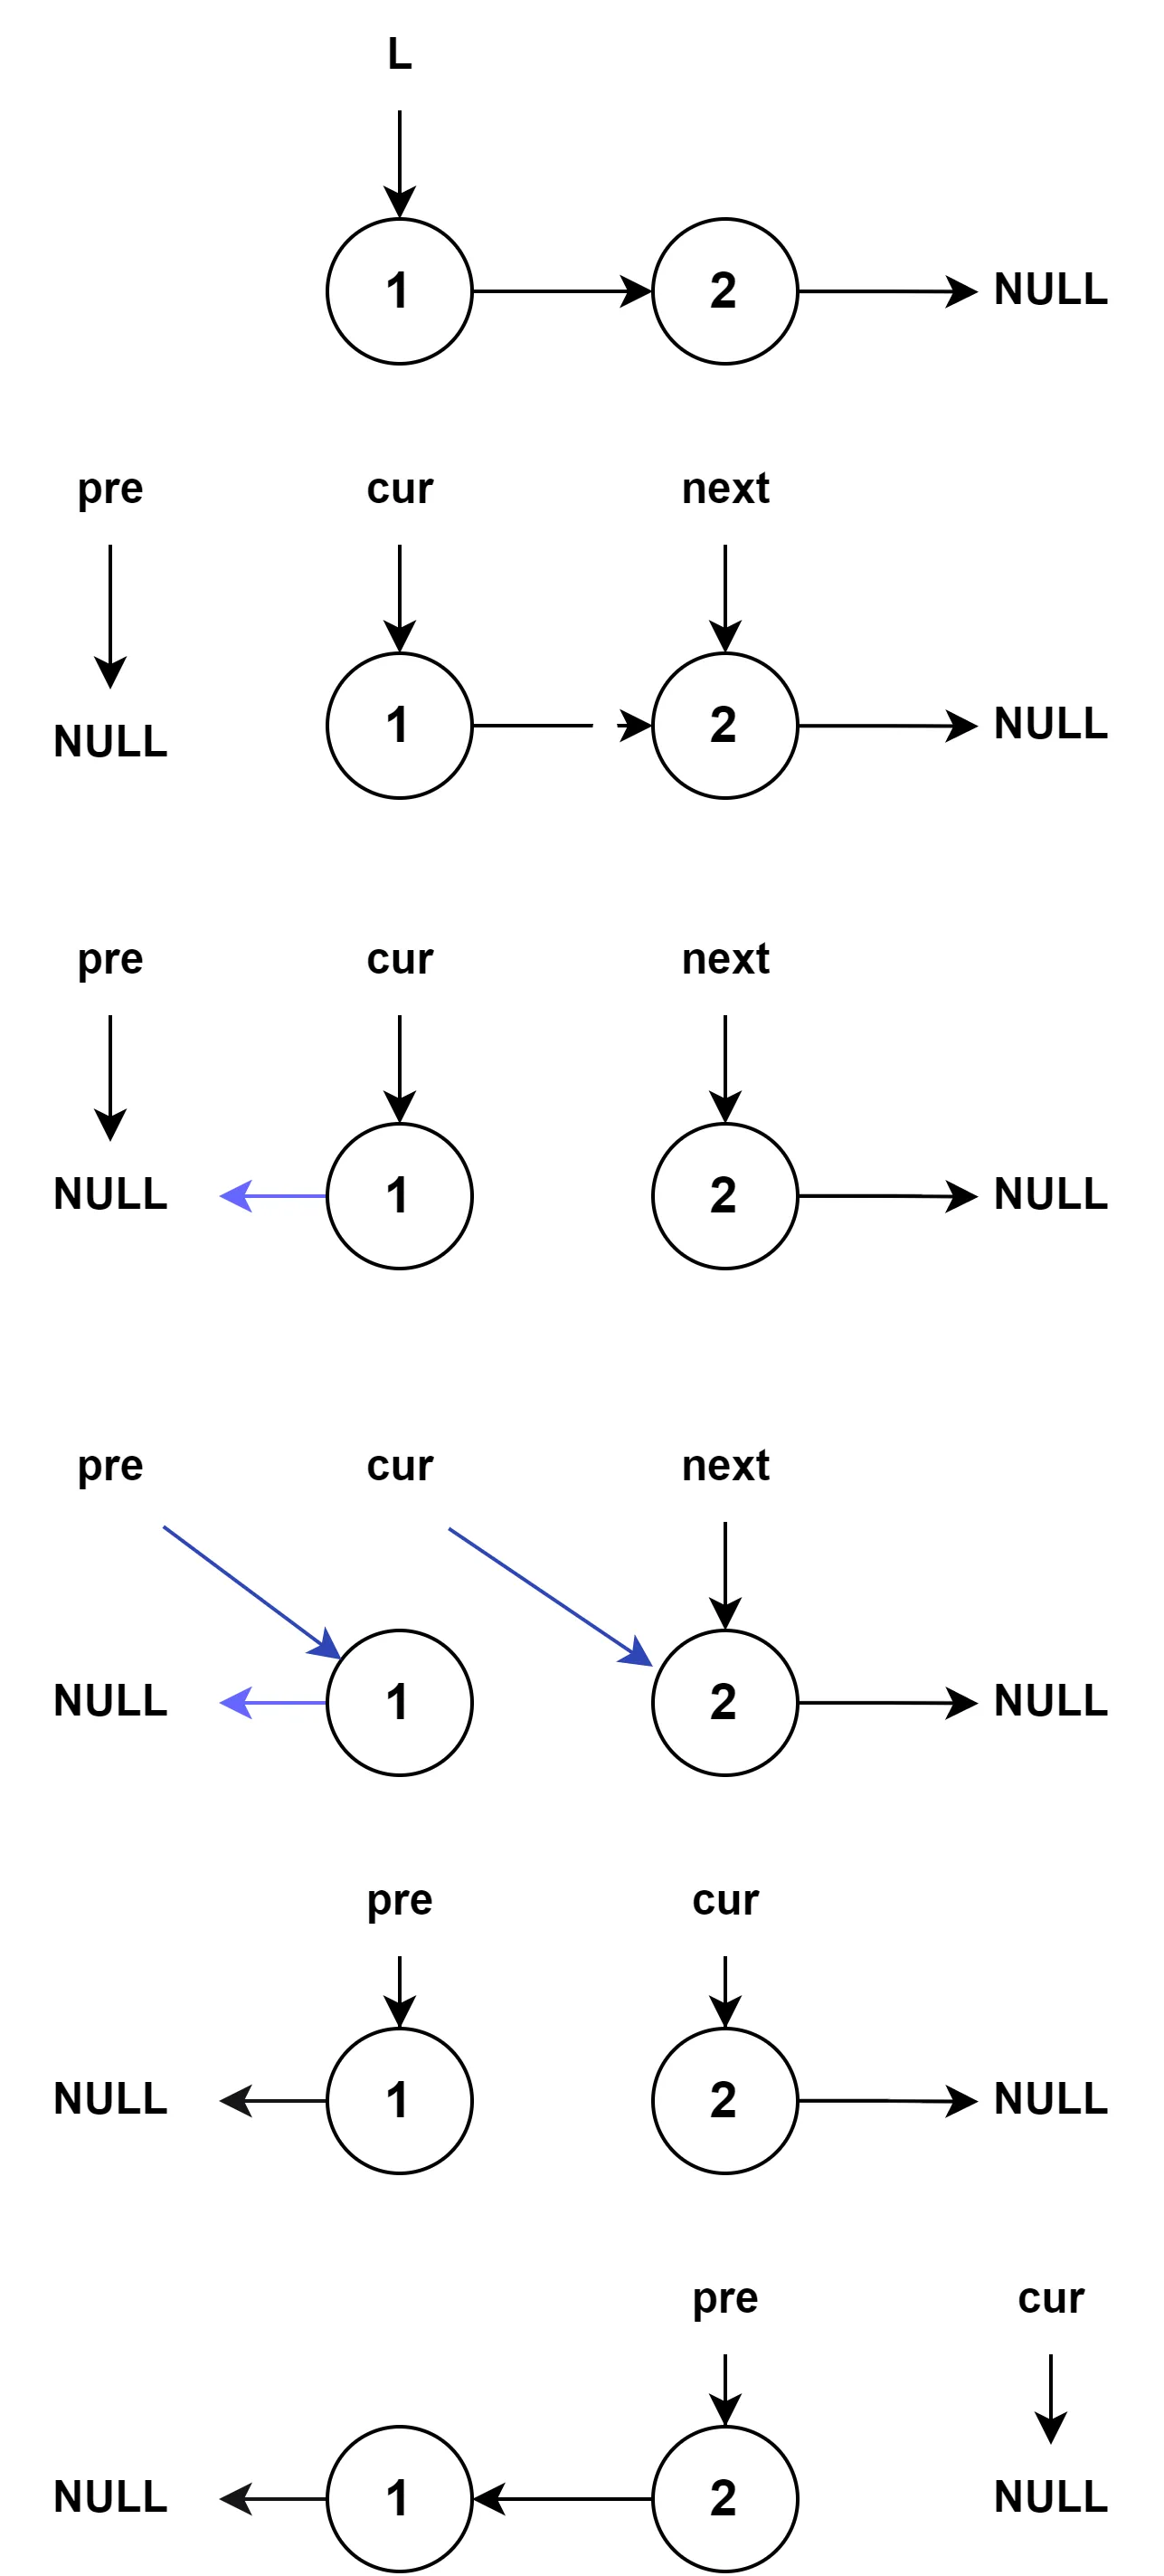
//不带头结点写法:这一部分可以就是反转链表的经典模板,必须掌握!!!输入待反转链表的第一个结点,可以返回反转后的链表
LNode* reverseListHelper(LNode *&L) {
    LNode* pre = NULL, * cur = L;
    while(cur) {     //只要cur不为空,就意味着还有结点没有反转;
        LNode * next = cur -> next;   //因为后面cur要重连,但是下一步要改变cur -> next, 所以得先保存一下它的直接后继结点;
        cur -> next = pre;   //逆置的关键,反转操作
        //更新两个指针;
        pre = cur;
        cur = next;
    }
    return pre;     //迭代结束后链表逆置成功,此时pre为新链表的第一个结点,cur指向空结点;
}

//带头结点写法,408风格
//调用前面的模板即可;
LNode *reverseList(LNode *&L) {
    L -> next = reverseListHelper(L -> next);
    return L;
}
【注意】:
pre指向反转这一段的最后一个结点,cur指向反转这一段后续的下一个结点,这个性质很重要,后面的问题经常需要用到!!!时间复杂度:\(O(n)\),其中\(n\)是链表的长度,需要遍历链表一次。
空间复杂度:\(O(1)\)
- 其他方法:递归法由于需要递归调用的栈空间,最多为\(n\)层,因此空间复杂度为\(O(n)\),而且处理不当可能会产生环从而陷入死循环;此外还可以用入栈出栈来实现逆置操作,但是不如上面的原地操作方法好,这里也不再介绍;
//递归法:不带头结点写法。
ListNode* reverseList(ListNode* head) {
        if(head == NULL || head -> next == NULL){
            return head;  //递归出口;
        }
        ListNode* newnode = reverseList(head -> next);
        //假设当前结点的后面部分都已经反转,现在要让当前结点的后面一个结点的后续指向当前结点,而当前结点应该指向NULL;
        head -> next -> next = head;
        head -> next = NULL;
        return newnode;
}
- 反转链表进阶版,即反转部分链表
给你带表头结点单链表的头指针head和两个整数left和right,其中 left小于或等于right。请你反转从链表中从第left个结点到第right个结点的链表段。
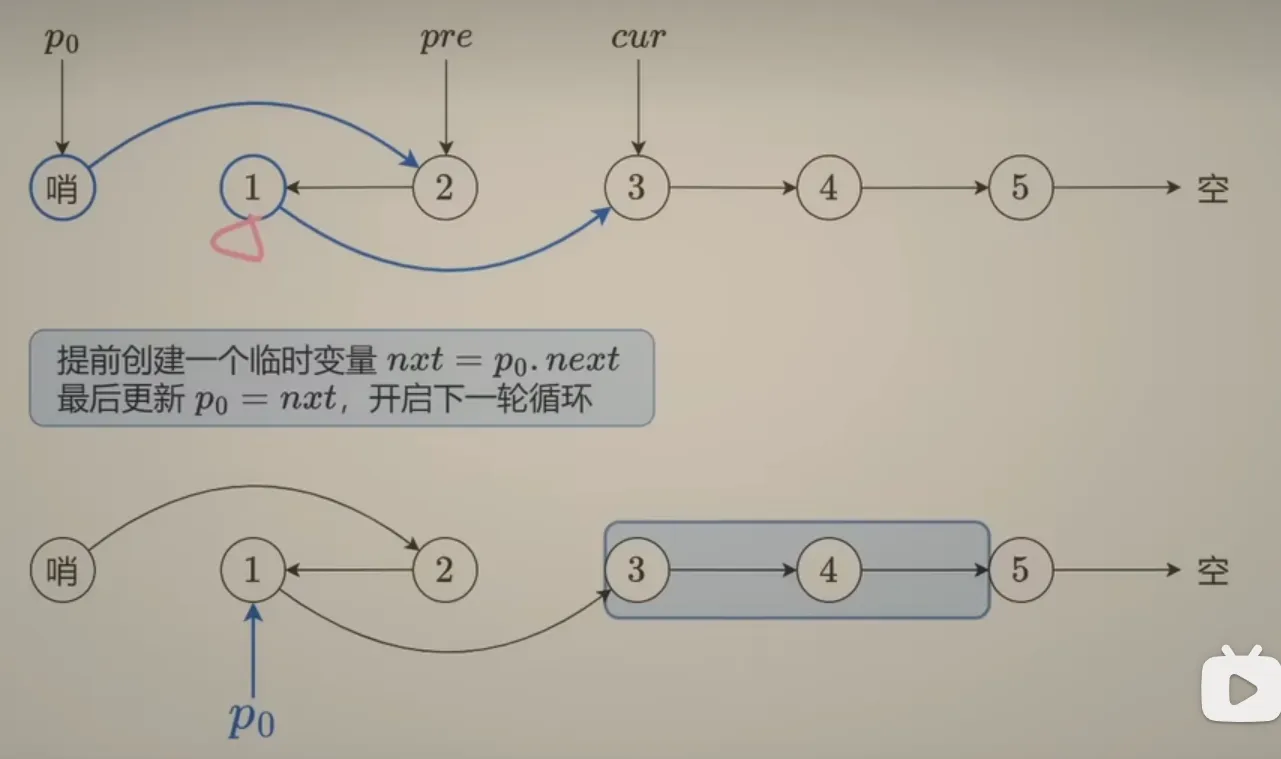
例如将链表 \(head→1→2→3→4→5\)中间的第2-4个结点反转为 \(head→1→4→3→2→5\) 。看上面链接的灵佬视频;
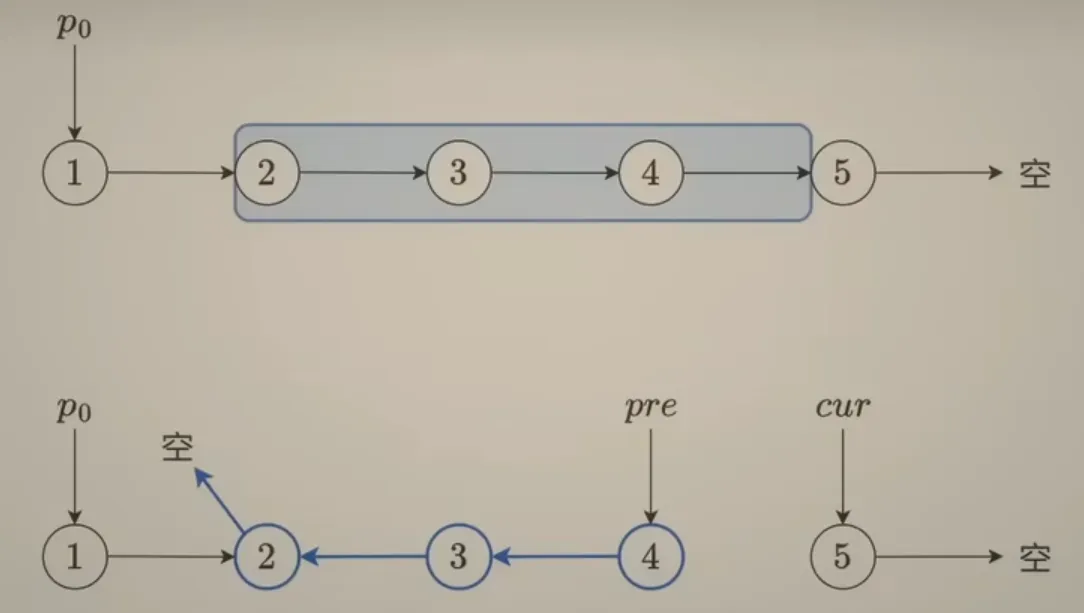
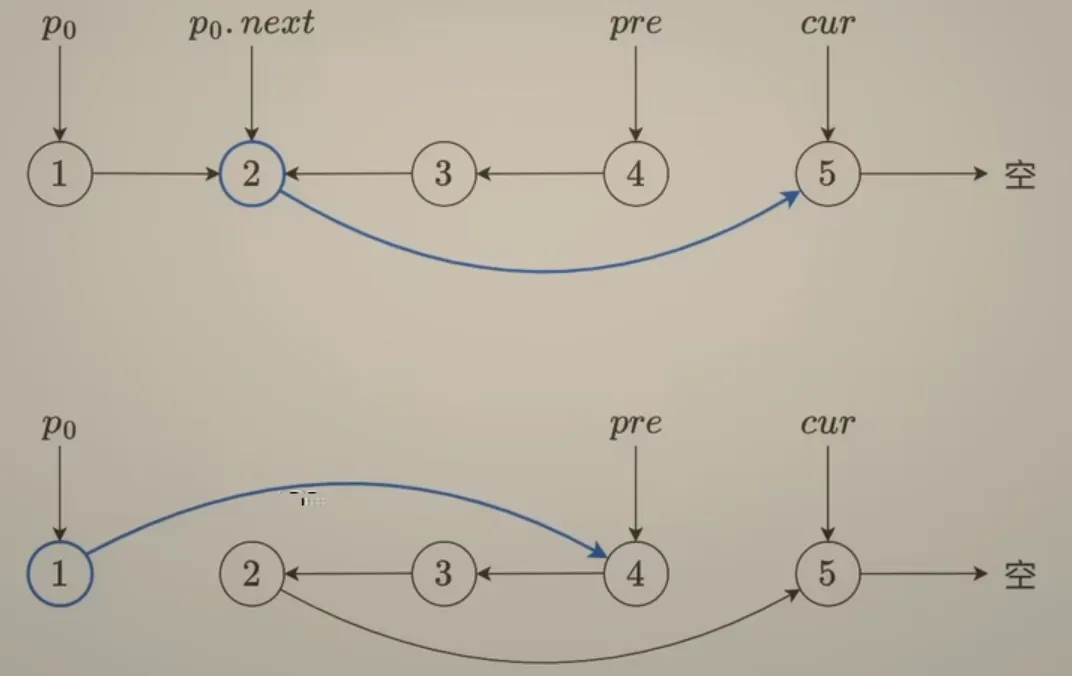
图示是不带头结点的做法,但是如果left等于1时,P0不好处理,因此可以设置一个dummy哨兵结点指向第一个结点,那样的话当left等于1时,P0结点就是dummy结点;
不过408考试中都是带头结点的链表,也就没有这个烦恼了;这里应用到了反转链表的重要性质:反转结束后,从原链表上看,pre指向反转这一段的最后一个结点,cur指向反转这一段后续的下一个结点。
//带头结点的链表
LNode* reverseList(LNode *&head, int left, int right) {
    LNode *p0 = head;
    for(int i = 0; i < left - 1; ++i) {
        p0 = p0 ->  next;       //先找到链表中待反转部分的前一个结点,将其标记为p0;
    }
    //接下来就像之前反转链表那样操作即可,只不过由于只是反转部分链表,因此更换判断条件即可;
    LNode *pre = NULL, *cur = p0 -> next;
    for(int i = 0; i < right - left  +1; ++i) {
        LNode *next = cur -> next;
        cur -> next = pre;
        pre = cur;
        cur = next;
    }
    //中间部分反转完毕,接下来将其与原链表段的左右两部分连接即可;下面就是用到之前提到的那个性质的时候;
    p0 -> next -> next = cur;  //中间部分反转完毕后cur指向中间部分的后一个结点;
    p0 -> next = pre;    //反转完毕后从原链表视角看,pre指向待反转链表段的最后一个结点;结合上图一起看;
    //注意上面两步顺序一定不能调换!
    return head;
}
时空复杂度和之前的一样.
-
题目描述:给你链表的头节点 head ,每 k 个节点一组进行翻转,请你返回修改后的链表。
k 是一个正整数,它的值小于或等于链表的长度。如果节点总数不是 k 的整数倍,那么请将最后剩余的节点保持原有顺序。
你不能只是单纯的改变节点内部的值,而是需要实际进行节点交换。 - 示例:
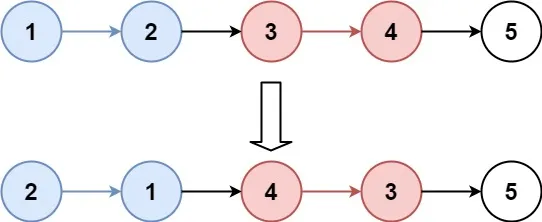
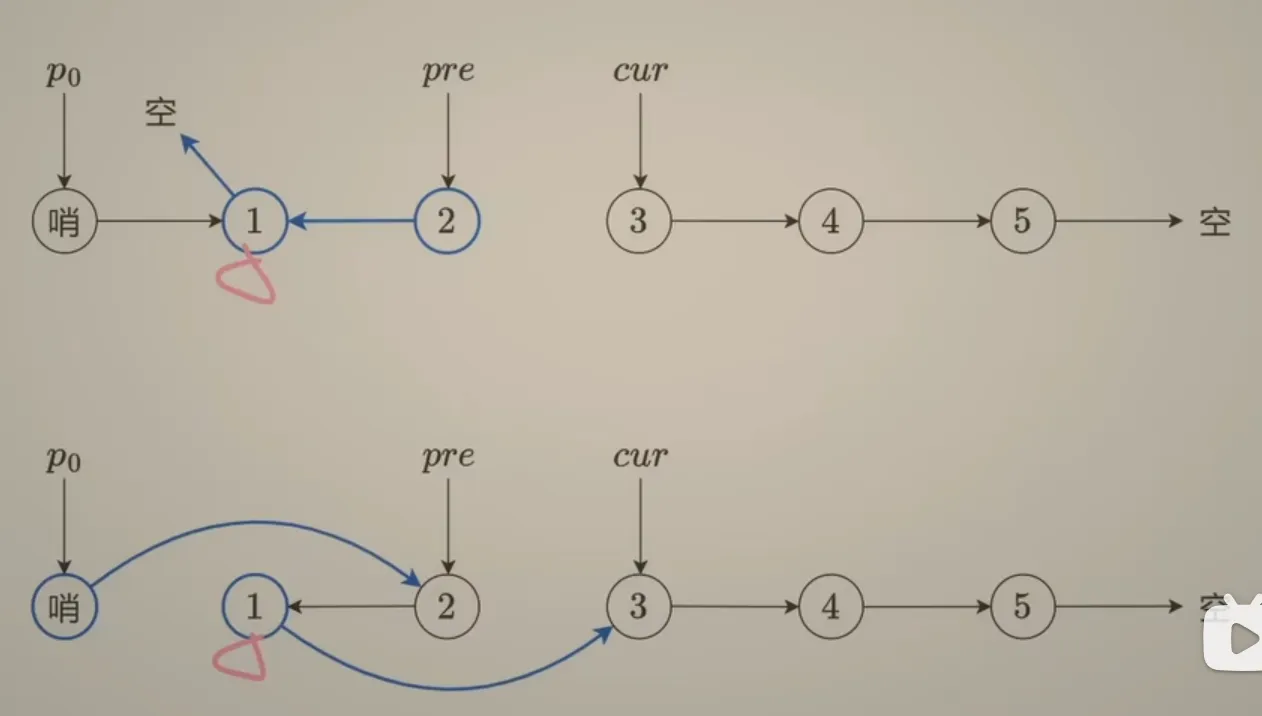
- 解题代码:
class Solution {
public:
    ListNode *reverseKGroup(ListNode *head, int k) {
        int n = 0;
        for (ListNode *cur = head; cur; cur = cur->next)
            ++n; // 统计节点个数

        ListNode *dummy = new ListNode(0, head), *p0 = dummy;
        ListNode *pre = nullptr, *cur = head;
        for (; n >= k; n -= k) {
            for (int i = 0; i < k; ++i) { // 下面的就是和之前一样的迭代法反转链表模板
                ListNode *nxt = cur->next;
                cur->next = pre; // 每次循环只修改一个 next,方便大家理解
                pre = cur;
                cur = nxt;
            }
            ListNode *nxt = p0->next;     //保存一下p0->next;
            p0->next->next = cur;
            p0->next = pre;
            p0 = nxt;     //始终让p0保持在待反转链表段的前一个结点处;
        }
        return dummy->next;
    }
};
- 时间复杂度:\(O(n)\),其中\(n\)为链表节点个数。
- 空间复杂度:\(O(1)\),仅用到若干额外变量。
2.7.3 快慢指针问题
无法高效获取长度,无法根据偏移快速访问元素,是链表的两个劣势。然而我们经常碰见诸如获取倒数第k个元素,获取中间位置的元素,判断链表是否存在环,判断环的长度等和长度与位置有关的问题。这些问题都可以通过灵活运用双指针来解决。
请见灵神该视频:环形链表II【基础算法精讲 07】
代码随想录:142.环形链表II
-
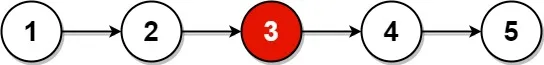
题目描述:给你单链表的头结点
head,请你找出并返回链表的中间结点。如果有两个中间结点,则返回第二个中间结点。 - 示例:
- 例题1:
- 例题1:
- 例题2:
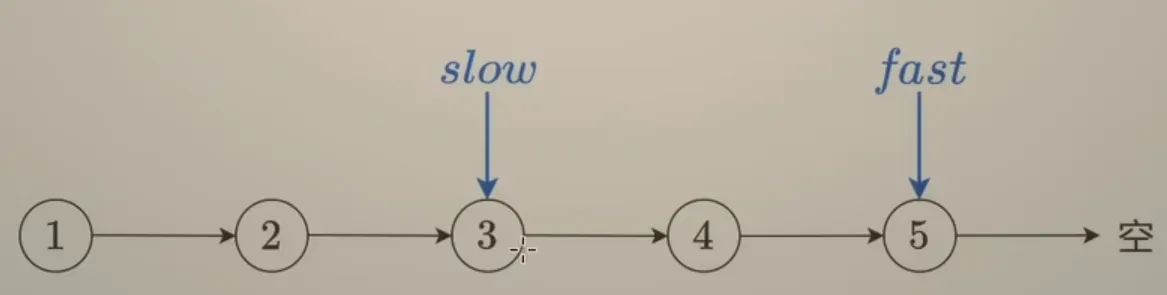
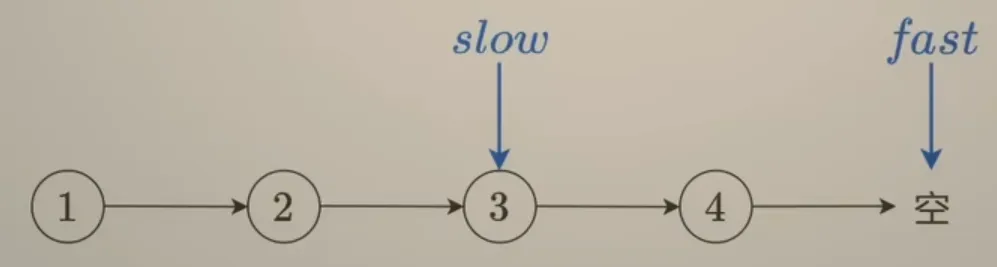
- 解题方法:快慢指针,定义一个快指针
fast每次执行走两步,定义一个慢指针slow每次走一步,当fast下一步为空或已经为空时,此时slow所指结点就是要找的中间结点. - 如图两种情况
- 代码:(重要模板)
//不带头结点的情况
LNode* middleNode(LNode *head) {
    LNode *fast = head, *slow = head;
    while(fast && fast -> next) {
        fast = fast -> next -> next;
        slow = slow -> next;
    }
    return slow;
}
//如果是带头结点的话将快慢指针修改为 fast = slow = head -> next即可;
- 时空复杂度:\(O(n)/O(1)\)
扩展题:如果题目要2095. 删除链表的中间节点,那么可以设置一个pre指针一直保持在slow指针的前面一位,找到后执行删除结点操作就可以啦,代码如下:
//不带头结点
ListNode* deleteMiddle(ListNode* head) {
        if(head -> next == NULL) return NULL;
        ListNode *fast = head, *slow = head, *pre = head;
        while(fast && fast -> next) {
            pre = slow;
            slow = slow -> next;
            fast = fast -> next -> next;
        }
        pre -> next = slow -> next;
        delete(slow);
        return head;
}
-
题目:给你一个链表的头节点 head ,判断链表中是否有环。
如果链表中存在环 ,则返回 true 。 否则,返回 false 。 - 解题思路:设置快慢指针;快慢指针的特性 —— 每轮移动之后两者的距离会加一。当一个链表有环时,快慢指针都会陷入环中进行无限次移动,然后变成了追及问题。想象一下在操场跑步的场景,只要一直跑下去,快的总会追上慢的。当两个指针都进入环后,每轮移动使得慢指针到快指针的距离增加一,同时快指针到慢指针的距离也减少一,只要一直移动下去,快指针总会追上慢指针。
bool hascycle(LNode *head) {
    LNode *fast = head, *slow = head;
    while(fast && fast -> next) {
        fast = fast -> next -> next;
        slow = slow -> next;
        if(fast == slow) {
            return true;
        }
    }
    return false;
}
-
题目:给定一个链表的头节点 head ,返回链表开始入环的第一个节点。 如果链表无环,则返回 null。不允许修改 链表。
- 解题思路:如下图,设置快慢指针,当二者相遇后,再让头结点指针和慢指针同步向后移动,当二者相遇时,此时第二个相遇点就是环的入口处;证明如下:
- 代码:
//不带头结点的版本:
LNode* detectCycle(LNode *head) {   //head即链表的第一个结点
    LNode *fast = head, *slow = head;
    while(fast && fast -> next) {
        fast = fast -> next -> next;
        slow = slow ->  next;
        if(fast == slow) {     //第一次快慢指针相遇点;
            while(head != slow) {      //如果头指针和慢指针相遇,说明此时二者都到了环的入口处;
                head = head -> next;
                slow = slow -> next;
            }
            return slow;
        }
    }
    return NULL;
}

//带头结点的版本;
LNode* detectCycle(LNode *head) {     //此时head指向链表的头结点,数据域为空
    LNode *fast = head -> next, *slow = head ->  next;
    while(fast && fast -> next) {
        fast = fast -> next -> next;
        slow = slow ->  next;
        if(fast == slow) {     //第一次快慢指针相遇点;
            LNode * p = head -> next;
            while(p != slow) {      //如果p指针和慢指针相遇,说明此时二者都到了环的入口处;
                p = p -> next;
                slow = slow -> next;
            }
            return slow;
        }
    }
    return NULL;
}
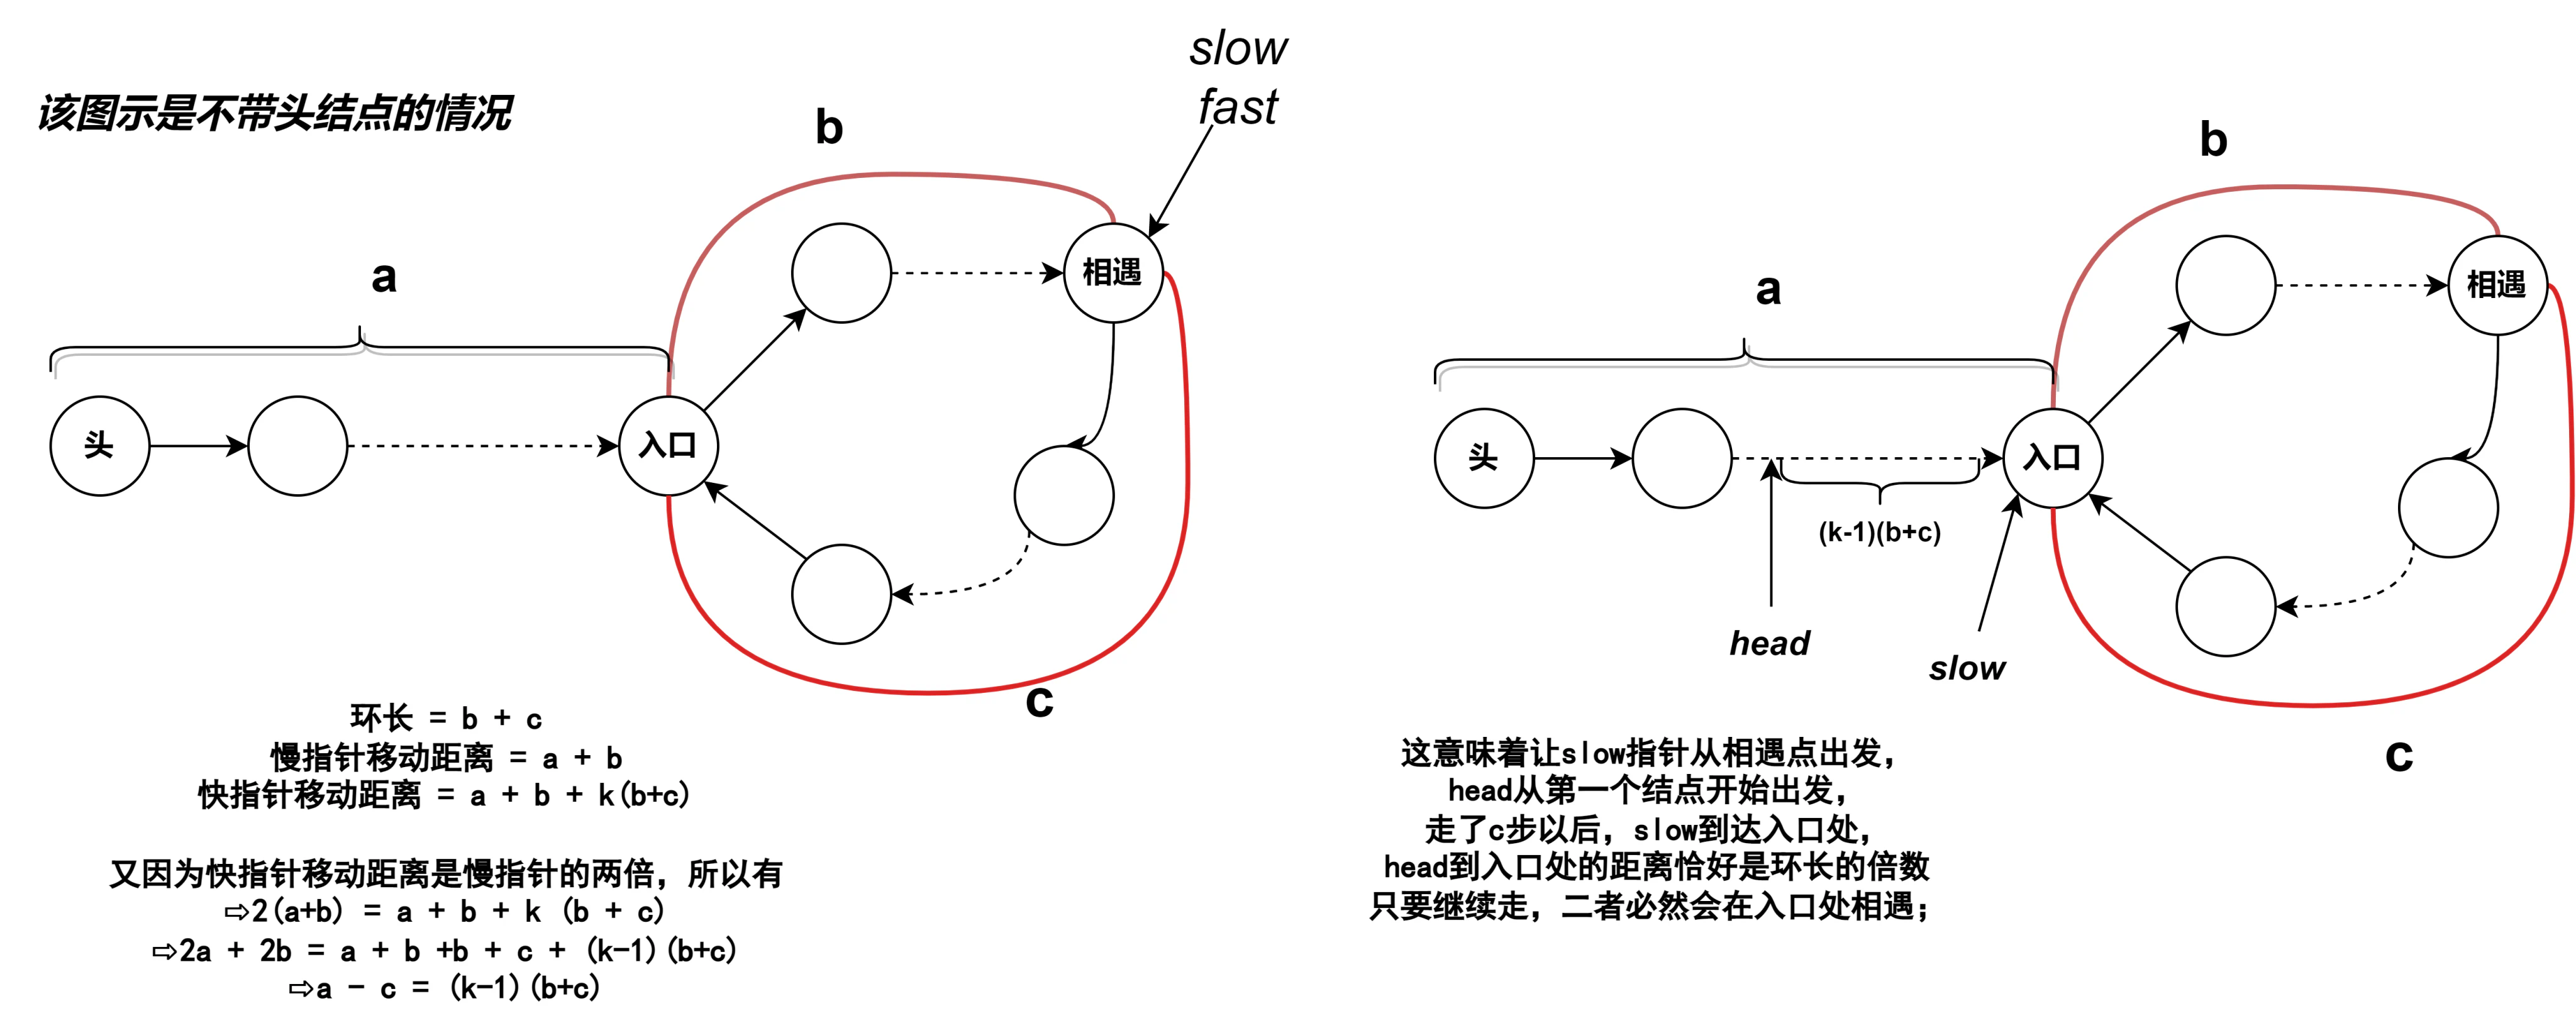
快慢指针相遇时,为什么慢指针的移动距离小于环长?:考虑最坏的情况,慢指针进入环时,快指针刚好在它前面一位,因为二者的相对速度差为1,因此快指针需要走(环长-1)次二者相遇,其他情况快指针需要走的次数都比这种情况需要走的少,即慢指针走的次数也一定比(环长-1)少,因此慢指针移动距离一定小于环长.
力扣评论区解释:为何慢指针第一圈走不完一定会和快指针相遇: 首先,第一步,快指针先进入环 第二步:当慢指针刚到达环的入口时,快指针此时在环中的某个位置(也可能此时相遇) 第三步:设此时快指针和慢指针距离为x,若在第二步相遇,则x = 0; 第四步:设环的周长为n,那么看成快指针追赶慢指针,需要追赶n-x; 第五步:快指针每次都追赶慢指针1个单位,设慢指针速度1/s,快指针2/s,那么追赶需要(n-x)s 第六步:在n-x秒内,慢指针走了n-x单位,因为x>=0,则慢指针走的路程小于等于n,即走不完一圈就和快指针相遇
-
环形链表扩展题,求解环的长度
-
解题思路:当快慢指针相遇时,继续移动,因为二者的相对速度差为1,因此到了第二次相遇时,两次相遇之间的移动次数就是环的长度;如果继续扩展的话,求整个链表的结点数的话,需要用上题的思路统计head指针移动到环的入口处移动的次数+环长即可(注意入环处的结点不要重复计数);
//不带头结点版本;
int  LengthCycle(LNode *head) {
    LNode *fast = head, *slow = head;
    while(fast && fast -> next) {
        fast = fast -> next -> next;
        slow = slow -> next;
        if(fast == slow) {       //第一次相遇
            int length = 1;
            LNode *p = slow -> next;
            while(p != slow) {
                p = p -> next;
                ++length;
            }
            return length;    //第二次相遇,跳出循环;
        }
    }
    return 0;
}
求解整个环形链表的结点数代码略,思路已给;
-
题目描述:给定一个单链表 L 的头节点 head ,单链表 L 表示为:
L0 → L1 → … → Ln - 1 → Ln
请将其重新排列后变为:
L0 → Ln → L1 → Ln - 1 → L2 → Ln - 2 → …
不能只是单纯的改变节点内部的值,而是需要实际的进行节点交换。 - 解题方法:本题考察了快慢指针找中间结点/链表的原地逆置(反转链表)/链表的交叉连接三个重要手法,题目不难但是代码量大,对基础要求高;
class Solution {
    ListNode *middleNode(ListNode *head) {    //求中间结点;
        ListNode* slow = head, *fast = head;
        while(fast && fast -> next) {
            fast = fast -> next -> next;
            slow = slow -> next;
        }
        return slow;
    }

    ListNode *reverseList(ListNode* head) {    //将链表的后半段原地逆置
        ListNode *pre = NULL, *cur = head;
        while(cur) {
            ListNode* next = cur -> next;
            cur -> next = pre;
            pre = cur;
            cur = next;
        }
        return pre;
    }


public:
    void reorderList(ListNode* head) {       //交叉链接
        ListNode *middle = middleNode(head);
        ListNode *head2 = reverseList(middle);
        while(head2 -> next) {
            ListNode * next = head -> next;     //保存后继结点,为了后面更新结点做准备
            ListNode *next2 = head2 -> next;   //保存后继结点
            head -> next = head2;
            head2 -> next =next;
            head = next;
            head2 = next2;
        }
    }
};
- 时间复杂度:\(O(n)\),其中\(n\)为链表节点个数。
- 空间复杂度:\(O(1)\),仅用到若干额外变量。
- 本题也有暴力解版本,把链表放进数组中,然后通过双指针法,一前一后,来遍历数组,构造链表。
class Solution {
public:
    void reorderList(ListNode* head) {
        vector<ListNode*> vec;
        ListNode* cur = head;
        if (cur == nullptr) return;
        while(cur != nullptr) {
            vec.push_back(cur);
            cur = cur->next;
        }
        cur = head;
        int i = 1;
        int j = vec.size() - 1;  // i j为之前前后的双指针
        int count = 0; // 计数,偶数去后面,奇数取前面
        while (i <= j) {
            if (count % 2 == 0) {
                cur->next = vec[j];
                j--;
            } else {
                cur->next = vec[i];
                i++;
            }
            cur = cur->next;
            count++;
        }
        if (vec.size() % 2 == 0) { // 如果是偶数,还要多处理中间的一个
            cur->next = vec[i];
            cur = cur->next;
        }
        cur->next = nullptr; // 注意结尾
    }
};
6. [<strong>回文链表</strong>](https://leetcode.cn/problems/palindrome-linked-list/)
- 题目描述:给你一个单链表的头节点 `head` ,请你判断该链表是否为回文链表。如果是,返回 `true` ;否则,返回 `false` 。
- 示例:,返回true;,返回`false`;
- 解题思路:跟上题一样,先用快慢指针找到中间结点,然后将后半段逆置,再设置一个指针指向第一个结点,让它和指向中间结点的指针同时同速向表尾方向移动,边移动边比较节点值是否相等,若不相等则跳出循环返回`false`,若一直遍历结束都没有跳出循环,说明该链表是回文链表.
- 注意后半段反转以后是这样的,也可以将链表断连一分为二,然后比较,但是只是单纯判断链表是否回文的话我觉得没有必要,我这样处理的话可以比较到中间结点结束即`p == middle`时结束,但是注意当链表为`[1,2]`这种情况的话会出错,即有特殊情况要处理,所以不妨直接比较到p为NULL时结束。 
class Solution {
    ListNode *middleNode(ListNode *head) {    //求中间结点模板;
        ListNode* slow = head, *fast = head;
        while(fast && fast -> next) {
            fast = fast -> next -> next;
            slow = slow -> next;
        }
        return slow;
    }

    ListNode *reverseList(ListNode* head) {    //反转链表模板
        ListNode *pre = NULL, *cur = head;
        while(cur) {
            ListNode* next = cur -> next;
            cur -> next = pre;
            pre = cur;
            cur = next;
        }
        return pre;
    }

public:
    bool isPalindrome(ListNode* head) {
        ListNode* middle = middleNode(head);   //求中间结点;
        ListNode* p =  reverseList(middle);    //将链表后半段逆置
        while(p){       //下面开始依次比较节点值是否相等;
            if(p -> val != head ->val ){
                return false;
            }
            p = p -> next;
            head = head -> next;
        }
        return true;
    }
};
时空复杂度:\(O(n)/O(1)\)
-  其他方法:
    1.  由于数组具有随机访问的性质,可以考虑复制链表结点数值到数组中,然后用双指针法判断是否为回文链表;
class Solution {
public:
    bool isPalindrome(ListNode* head) {
        vector<int> vals;
        while (head != NULL) {
            vals.push_back(head->val);
            head = head->next;
        }
        for (int i = 0, int j = vals.size() - 1; i < j; ++i, --j) {
            if (vals[i] != vals[j]) {
                return false;
            }
        }
        return true;
    }
};
2. 可以考虑用栈来做,将该链表所有结点值遍历输入到栈中,再依次弹出和链表元素比较;因为是回文所以链表反过来和正过来一模一样,用stack做很方便
class Solution {
    public boolean isPalindrome(ListNode head) {
        Stack<Integer> stack=new Stack<Integer>();
        ListNode cur=head;
        while(cur!=null){
            stack.push(cur.val);
            cur=cur.next;
        }
        while(head!=null){
            if(stack.pop()!=head.val)
                return false;
            head=head.next;
        }
        return true;
    }
}
//但是注意空间复杂度不符合O(1)的要求;
2.7.4 链表的排序问题
给你链表的头结点 head ,请将其按 升序 排列并返回 排序后的链表 。
- 暴力方法:将链表中的值全部存入数组,再将其排序,最后创建一个新链表按顺序将其用尾插法插入新链表即可;只不过这样的话空间复杂度为\(O(n)\),不是常数级别。
//带头结点版本
class Solution {
public:
    ListNode* sortList(ListNode* head) {
        vector<int> vec;    //创建一个数组待会将链表值装进去;
        ListNode *p = head -> next;
        while(p != NULL) {
            vec.push_back(p-> val);
            p = p -> next;    //装值进表
        }
        sort(vec.begin(),vec.end());    //对数组进行排序,408考试的话建议默写一个快排模板调用一下,这样会少扣点分;
        ListNode *tail = head;
        for(int i = 0; i < vec.size();++i) {
            tail -> next = new ListNode(vec[i]);    //将数组值创建结点并尾插入新链表;
            tail = tail -> next;
        }
        return head;
    }
};
时空复杂度为\(O(nlogn)/O(n)\),如果时间不够就用该方法,有能力的可以掌握一下归并排序的方法。
另外可以采用自顶向下的归并排序来解决这道题,这样的话这道题首先运用了
快慢指针找中间结点的模板,然后对左右两部分子链表分别归并排序,再将这两段排序后的链表运用合并两个有序链表的模板合并起来便得到最终结果。
class Solution {
public:
    ListNode* sortList(ListNode* head) {
        return mergeSort(head);

    }

    ListNode* mergeSort(ListNode* head) {     //运用了归并排序的思想
        if(head == NULL || head -> next == NULL) return head; //递归出口,没有结点或只有一个结点,无需排序,直接返回;
        ListNode *fast = head, *slow = head, *pre, *l, *r;
        while(fast && fast -> next) {    //快慢指针找中间结点模板,注意这里的pre是用来标记中间结点的直接前驱的指针,用于后面将链表从中间一分为二;
            pre = slow;
            slow = slow -> next;
            fast = fast -> next -> next;
        }
        r = mergeSort(slow);    //对右半部分进行归并排序;
        pre -> next = NULL;    //将链表从中间断开;
        l = mergeSort(head);  //对左半部分进行归并排序;
        return mergeTwoLists(l,r);   //调用合并两个有序链表的函数将左右两部分合并;
    }

    ListNode* mergeTwoLists(ListNode* list1, ListNode* list2) {        //合并两个有序链表的模板,具体见上面;
        ListNode* dummy = new ListNode(0,nullptr),*p = list1,*q = list2, *cur = dummy;
        while(p && q) {
            if(p -> val < q -> val) {
                cur -> next = p;
                cur = cur -> next;
                p = p -> next;
            }else {
                cur -> next = q;
                cur = cur -> next;
                q = q -> next;
            }
        }
        if(q == NULL) cur -> next = p;
        else{
            cur -> next = q;
        }
        return dummy -> next;
    }
};
时间复杂度:\(O(nlogn)\),其中\(n\)是链表的长度。
空间复杂度:\(O(logn)\),其中\(n\)是链表的长度。空间复杂度主要取决于递归调用的栈空间。
2.7.5 合并链表问题
-
将两个递增链表合并为一个递增链表(
[easy](https://leetcode.cn/problems/merge-two-sorted-lists/))【2013真题选择】 -
解题思路:
迭代法,分别在两条链表的第一个结点处设置一个指针(双指针)然后边比较边将较小的结点插入新链表,较小结点的那个指针向后移动,当跳出循环说明有一个链表已经遍历结束,此时将剩余未遍历完的链表加入新链表即可。
//带头结点的版本
    ListNode* mergeTwoLists(ListNode* list1, ListNode* list2) {
        if(list1 -> next == NULL) return list2;
        if(list2 -> next == NULL) return list1;
        ListNode * L = new ListNode(0,NULL);  //新链表的头结点;
        ListNode *p = list1 -> next , *q = list2 -> next;     //在两条链表的第一个结点处分别设置指针用于遍历当前链表;
        ListNode *tail = L;   //tail是新链表的表尾指针,用于尾插法,注意在插入节点后及时更新让其始终处于表尾位置;
        while(p && q) {
            if(p -> val < q -> val) {
                tail -> next = p;      //利用尾插法插入新结点;
                tail = p;       //更新表尾指针;也可以在"if-else"循环外写"tail = tail -> next";
                p = p -> next;    //更新用于遍历list1的指针
            }else {
                tail -> next = q;
                tail= q;
                q = q -> next;
            }
        }
       tail -> next = (p == NULL) ? q : p;    //二目运算符,如果跳出循环后list1为空,将list2剩余部分接到cur后面,否则接另一条的剩余部分;
       return L;
   }
时间复杂度:\(O(n+m)\),其中\(n\)和\(m\)分别为两个链表的长度。因为每次循环迭代中,
list1和list2只有一个元素会被放进合并链表中, 因此 while 循环的次数不会超过两个链表的长度之和。所有其他操作的时间复杂度都是常数级别的,因此总的时间复杂度为\(O(n+m)\)空间复杂度:\(O(1)\)。我们只需要常数的空间存放若干变量。
- 当然,本题也可以用递归来解决,这里给出代码具体原理不再赘述
//不带头结点的版本
class Solution {
public:
    ListNode* mergeTwoLists(ListNode* l1, ListNode* l2) {
        if (l1 == nullptr) {
            return l2;
        } else if (l2 == nullptr) {
            return l1;
        } else if (l1->val < l2->val) {
            l1->next = mergeTwoLists(l1->next, l2);
            return l1;
        } else {
            l2->next = mergeTwoLists(l1, l2->next);
            return l2;
        }
    }
};
时间复杂度:\(O(n+m)\),其中\(n\)和\(m\)分别为两个链表的长度。因为每次调用递归都会去掉 l1 或者 l2 的头节点(直到至少有一个链表为空),函数
mergeTwoList至多只会递归调用每个节点一次。因此,时间复杂度取决于合并后的链表长度,即\(O(n+m)\)。空间复杂度:\(O(n+m)\),其中\(n\)和\(m\)分别为两个链表的长度。递归调用
mergeTwoLists函数时需要消耗栈空间,栈空间的大小取决于递归调用的深度。结束递归调用时mergeTwoLists函数最多调用\(n+m\) 次,因此空间复杂度为\(O(n+m)\).由于递归空间复杂度大,考试时一般采用迭代法。
-
进阶版:23. 合并 K 个升序链表
-
给你一个链表数组,每个链表都已经按升序排列。请你将所有链表合并到一个升序链表中,返回合并后的链表。
- 暴力做法:顺序合并,用一个变量\(ans\)来维护以及合并的链表,第\(i\)次循环把第\(i\)个链表和\(ans\)合并,答案保存到\(ans\)中。
ListNode* mergeKLists(vector<ListNode*>& lists) {
        ListNode* ans = NULL;
        int n = lists.size();
        for(int i = 0; i < n; ++i) {
            ans = mergeTwoLists(ans,lists[i]);      //调用上面那个合并两条递增链表的函数;
        }
        return ans;
}
时间复杂度:假设每个链表的最长长度是\(n\)。在第一次合并后,\(ans\)的长度为\(n\);第二次合并后,\(ans\)的长度为\(2×n\),第\(i\)次合并后,\(ans\)的长度为\(i×n\)。第\(i\)次合并的时间代价是\(O(n+(i−1)×n)=O(i×n)\),那么总的时间代价为
\( \sum_{i = 1}^{k}(i*n)= n\sum_{i = 1}^{k}i = n(1+2+\cdots+k) = n*\frac{k(k+1)}{2}=O(k^2n) \)
其中k为链表条数,n为链表最长长度;
空间复杂度:没有用到与\(k和n\)规模相关的辅助空间,故渐进空间复杂度为\(O(1)\)。
- 也可以使用多路归并+优先队列等方法,可以看力扣题解区,俺不会;
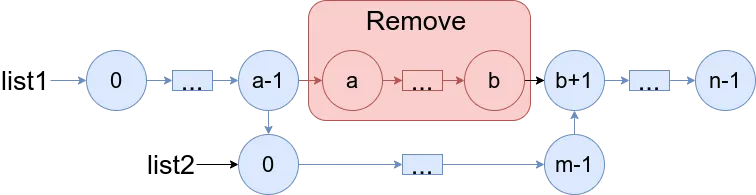
给你两个链表 list1 和 list2 ,它们包含的元素分别为 n 个和 m 个。
请你将 list1 中下标从 a 到 b 的全部节点都删除,并将list2 接在被删除节点的位置。
下图中蓝色边和节点展示了操作后的结果,请你返回结果链表的头指针。
-
class Solution {
public:
    ListNode* mergeInBetween(ListNode* list1, int a, int b, ListNode* list2) {
        ListNode* p = list1;
        for(int i = 0; i < a -1; ++i){   //找到第a-1个节点
            p = p -> next;
        }
        ListNode* q= p;
        int c = b - a + 2;    //找到第b+1个结点;
        while(c--) {
            q = q -> next;
        }
        p -> next = list2;
        ListNode *r = list2;   //找list2的最后一个节点;
        while(r -> next) {
            r = r -> next;
        }
        r -> next = q;
        return list1;
    }
};
时空复杂度:\(O(n+m),O(1)\)
-
两个递增链表合并为一个递减链表
-
解题思路:本题和上面那题思路差不多,设置两个指针比较大小,只不过上面那题可以采用尾插法,而本题必须采用头插法,将比较得出的较小结点插入新链表,(因为如果采用尾插的话比较当前结点得出的较大结点不是所有节点中的最大结点,因此不可行),在跳出循环后不能直接将剩余链表接在其后面,依然需要一个一个用头插法插回新链表。
//带头结点版本
ListNode* mergeTwoLists(ListNode* list1, ListNode* list2) {
        ListNode* L = new ListNode(0,NULL);  //新链表的头结点;
        ListNode*p = list1 -> next ,*q = list2 -> next;     //在两条链表的第一个结点处分别设置指针
        while(p && q) {
            if(p -> val <= q -> val) {
                ListNode *next = p -> next;     //由于后续要用到p-> next,但是下一步就更新了,所以先保存一下该指针
                p -> next = L -> next;    //头插法经典操作;
                L -> next = p;
                p = next;         //更新p指针
            }else {
                ListNode *next = q -> next;
                q -> next = L -> next;       //头插操作
                L -> next = q;
                q = next;
            }
        }
     while(p) {    //如果跳出循环后,list1还没有完全加入新链表,则继续将其用头插法插入到新链表中;
         ListNode *next = p -> next;
         p -> next = L -> next;      //头插法
         L -> next = p;
         p = next;
     }
    while(q) {
         ListNode *next = q -> next;
         q -> next = L -> next;     //头插法
         L -> next = q;
         q = next;
    }
    return L;
}
2.7.6 拆分链表问题
-
将一个带头结点的单链表分解成两个带头结点的单链表A和B,使A中含奇数位置元素,B中含偶数位置元素,且相对位置不变,返回链表B。
题源:328. 奇偶链表 -
本题需要用尾插法将链表处于奇、偶位置的结点插入相应位置,所以需要分别设置两条链表的表尾指针用于后插元素;
ListNode* splitOddEven(ListNode* A) {
        ListNode* B = new ListNode(0,NULL);   //创建B链表的头结点,并且指向空;
        ListNode *tail1 = A, *tail2 = B, *p = A-> next;      //分别设置两条链表的表尾指针,再用一个p指针用来遍历原链表;
        A -> next = NULL;   //将A结点与原链表断连;
        while(p != NULL) {
            tail1 -> next = p;    //将当前处于奇数位置的链表结点插入A链表的表尾处;
            tail1 = p;      //更新链表A的表尾指针;
            p = p -> next;    //更新p指针,向后移动遍历原链表;
            if(p) {      //当前还存在偶数位置结点
                tail2 -> next = p;
                tail2 = p;
                p = p -> next;
            }
        }
        tail1 -> next = NULL;    //将A链表表尾断连;
        tail2 -> next = NULL;
        return B;
}
如果题目是:给定单链表的头节点 head ,将所有索引为奇数的节点和索引为偶数的节点分别组合在一起,然后返回重新排序的列表。第一个节点的索引被认为是 奇数 , 第二个节点的索引为 偶数 ,以此类推。请注意,偶数组和奇数组内部的相对顺序应该与输入时保持一致。你必须在 O(1) 的额外空间复杂度和 O(n) 的时间复杂度下解决这个问题。
解题思路:按照上面的套路将链表一分为二,然后将链表B插入链表A后面就可以完成该题;
ListNode* oddEvenList(ListNode* A) {
        ListNode* B = new ListNode(0,NULL);
        ListNode *tail1 = A, *tail2 = B, *p = A-> next;
        A -> next = NULL;
        while(p != NULL) {
            tail1 -> next = p;
            tail1 = p;
            p = p -> next;
            if(p) {
                tail2 -> next = p;
                tail2 = p;
                p = p -> next;
            }
        }
        tail2 -> next = NULL;
        tail1 -> next = B-> next;     //将A链表的表尾指针指向B链表的第一个结点就可以完成题目要求;
        return A;     //返回插入后的A链表;
}
- 奇偶链表变体题:
设 \(C ={[a1, b1, a2, b2, a3, b3,\cdots]}\)为线性表,采用带头结点的单链表存放,设计一个就地算法,将其拆分为两个线性表,使得 \(A = {[a1, a2, ···, an}], B = {[bn,···,b2, b1}]\),并返回B链表。
- 解题思路:与上一题大致思路相等,只是不同的是,奇数位置按尾插法插入链表表尾,偶数位置采用头插法插到B链表中。
ListNode* splitOddEvenReverseEven(ListNode* A) {
        ListNode* B = new ListNode(0,NULL);   //创建B链表的头结点,并且指向空;
        ListNode *tail1= A, *p = A-> next, *q;      //设置A链表的表尾指针,再用一个p指针用来遍历原链表;
        A -> next = NULL;   //将A结点与原链表断连;
        while(p != NULL) {
            tail1 -> next = p;    //将当前处于奇数位置的链表结点利用尾插法插入A链表的表尾处;
            tail1 = p;      //更新链表A的表尾指针;
            p = p -> next;    //更新p指针,向后移动遍历原链表;
            if(p) {
                q = p;    //由于处于偶数位置的结点需要头插回B链表,所以其后继指针会变动,因此提前保存一下;
                p = p -> next;
                q -> next = B -> next;    //将偶数位置结点插入B链表;
                B -> next = q;
            }

        }
        tail1 -> next = NULL;    //将A链表表尾断连;
        return B;
}
当然本题也可以变成返回将这两条链表合体后的链表,只不过结尾多了一句
tail1 -> next = B -> next, return A即可。这里再赘述一遍,上面的是带有头结点的版本,如果去leetcode上写的话都是没有头结点的版本,只需要自己设置一个新的
dummy结点指向头结点便与此题一样了!
- 分隔链表
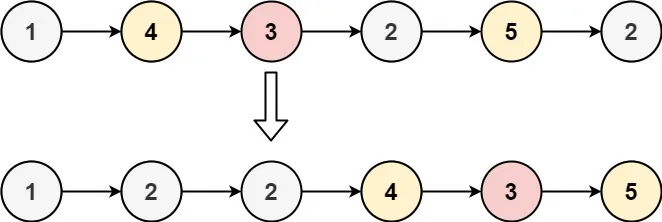
- 题目描述:给你一个链表的头节点 head 和一个特定值 x ,请你对链表进行分隔,使得所有
小于 x的节点都出现在 大于或等于x的节点之前;
你应当 保留 两个分区中每个节点的初始相对位置。 - 示例:
1.
- 解题思路:和第一题奇偶链表思路差不多,设置两条新链表,再用一个指针p来遍历链表,比x小的用尾插法放入第一条链表,比x大的用尾插法加入第二条链表,最后将两条链表链接起来返回即可;
用尾插法可以保证两个分区中的每个结点的相对位置不变,这也是尾插法的重要性质。
//不带头结点版本
class Solution {
public:
    ListNode* partition(ListNode* head, int x) {
        ListNode *dummy1 = new ListNode(0,NULL), *dummy2 = new ListNode(0,NULL);    //设置两条新链表的头结点;
        ListNode *tail1 = dummy1, *tail2 = dummy2, *p = head;    //两条链表的表尾指针,p指针用来遍历链表;
        while(p) {
            if(p -> val < x) {
                tail1 -> next = p;    //利用尾插法插入第一条链表表尾;
                tail1 = p;
            }else{
                tail2 -> next = p;      ////利用尾插法插入第二条链表表尾;
                tail2 = p;
            }
            p = p -> next;    //p结点向后移动遍历;
        }
        tail1 -> next = dummy2 -> next;   //将第二条链表接在第一条链表后面;
        tail2 -> next = NULL;     //注意释放临时结点的next指针以免超出内存限制;否则有可能成环;
        return dummy1 -> next;
    }
};
2.7.7 其他链表问题
- 相交链表2012年真题
给你两个单链表的头节点 headA 和 headB ,请你找出并返回两个单链表相交的起始节点。如果两个链表不存在相交节点,返回 null 。
图示两个链表在节点 c1 开始相交:题目数据 保证 整个链式结构中不存在环。注意,函数返回结果后,链表必须 保持其原始结构 。
如图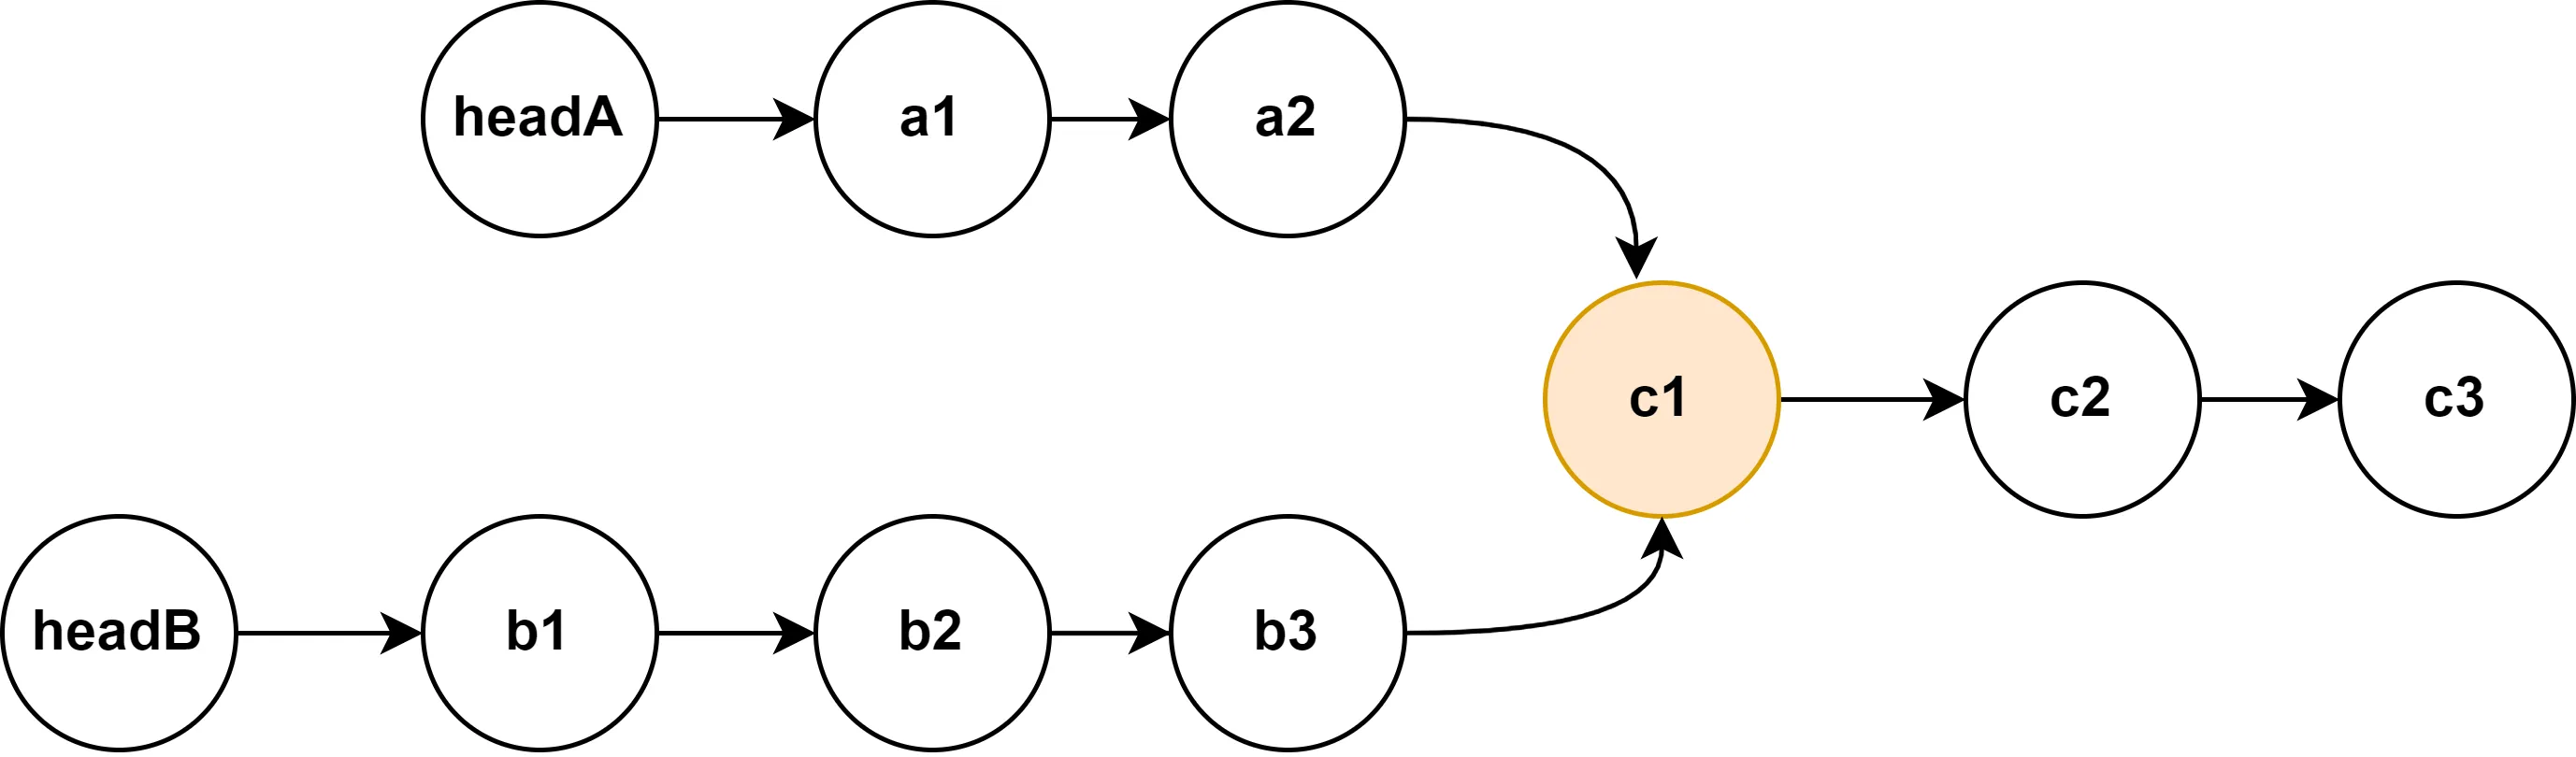
- 暴力解:先分别遍历两条链表求得其长度,然后设置两个指针分别指向表头,先让位于较长链表的那个指针先往后移动长度差距离,然后两个指针同时向后遍历,如果在遍历过程中发现相等则返回该结点,否则继续遍历,如果走到链尾也没有发现元素相等,则说明没有相交,返回NULL,这种方法需要遍历两次链表;不过该种方法空间复杂度也是\(O(1)\),也算不错。
ListNode *getIntersectionNode(ListNode *headA, ListNode *headB) {
        ListNode *p = headA -> next,  *q = headB-> next, *p1 = p, *q1 = q;
        int n1 = 0, n2 = 0;
        while(p){
            n1 ++;
            p = p -> next;
        }
        while(q) {
            n2++;
            q = q -> next;
        }
        if(n1 < n2) {
            for(int i = 0; i < n2 - n1; ++i) {
                q1  = q1  -> next;
            }
            while(p1){
                if(p1 == q1 ) {
                    return p1;
                }else{
                    p1 = p1 -> next;
                    q1 = q1  -> next;
                }
            }
            return NULL;
        }else{
            for(int i = 0; i < n1 - n2; ++i) {
                p1 = p1 -> next;
            }
            while(p1){
                if(p1 == q1) {
                    return p1;
                }else{
                    p1 = p1 -> next;
                    q1 = q1-> next;
                }
            }
            return NULL;
        }
    }
最优解:本题的难点在于由于两条链表的长度可能不同,两条链表之间的结点无法对应;这时我们可以分别在两条链表的第一个结点处设置一个指针,然后其中一条链表的指针走到结束时回到另一条链表的第一个结点处继续往后走,由于两个指针走过的距离一样长,因此如果两条链表相交的话,那么一定会相遇;否则则两个指针一直走到结束,其走过的路程为两条链表长度和的2倍;
// 设A的长度为a+c,B的长度为b+c;其中c为A、B的公共部分;
// 拼接AB、BA:A+B=a+c+b+c B+A=b+c+a+c;由于a+c+b=b+c+a,因此二者必定在c的起始点处相遇
//带头结点做法
ListNode *getIntersectionNode(ListNode *headA, ListNode *headB) {
 ListNode *curA=headA -> next,*curB=headB -> next;
   while(curA!=curB){
   // 每次判断当前点是否为空的好处是:避免A B无公共部分,再走完A+B和B+A后,会在null处相遇
       curA = curA ? curA->next : headB -> next;
       curB = curB ? curB->next : headA -> next;
   }
   return curA;   //只要是对的人,就算开始错过了,最终还是会再次相遇在一起的。
}

//不带头结点做法
ListNode *getIntersectionNode(ListNode *headA, ListNode *headB) {
 ListNode *curA=headA,*curB=headB;
   while(curA!=curB){
   // 每次判断当前点是否为空的好处是:避免A B无公共部分,再走完A+B和B+A后,会在null处相遇
       curA=curA?curA->next:headB;
       curB=curB?curB->next:headA;
   }
   return curA;
}